
Dans le champ contemporain de l’analyse quantitative et de la science des données, la restitution visuelle de dynamiques longitudinales constitue un vecteur fondamental de découverte empirique et de communication scientifique. Qu’il s’agisse d’évaluer la coévolution d’indicateurs macroéconomiques, de pister l’interaction entre deux biomarqueurs au cours d’un essai clinique, ou d’analyser les réponses comportementales différentielles de deux cohortes expérimentales, la représentation conjointe de trajectoires temporelles s’impose comme un prérequis analytique. Le langage de programmation statistique R, enrichi par son écosystème méthodologique Tidyverse, offre à travers le paquet ggplot2 une infrastructure computationnelle d’une rigueur et d’une expressivité sans équivalent pour formaliser ces représentations.
Toutefois, la transition d’un ensemble de données brutes vers une figure graphique rigoureuse, publiable et exempte de biais perceptifs exige une compréhension intime des principes formels qui sous-tendent la sémiologie graphique et l’architecture logicielle de R. La simple juxtaposition de deux courbes sur un même plan cartésien soulève des problématiques structurelles déterminantes : comment organiser les données pour respecter le modèle computationnel sous-jacent ? Quels compromis cognitifs accepter face aux disparités d’échelles de mesure ? Comment garantir une lisibilité optimale sans induire le lecteur en erreur par des artefacts de tracé ou des associations illusoires ? Tracer deux lignes ne se réduit pas à une commande syntaxique banale ; il s’agit d’un acte de modélisation visuelle qui articule théorie de la mesure, sémiotique graphique et programmation déclarative.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes théoriques, techniques et esthétiques permettant de tracer, personnaliser et interpréter deux courbes au sein de l’environnement ggplot2. À travers une démarche progressive débutant par les fondements de la grammaire des graphiques de Leland Wilkinson, en passant par les transformations de structures de données via tidyr, jusqu’aux raffinements typographiques et à la modélisation formelle de l’incertitude, cette monographie fournit aux chercheurs, analystes et praticiens les compétences requises pour produire des visualisations bivariées d’une irréprochable rigueur scientifique.
1. 1. Introduction à la visualisation de séries temporelles multiples avec ggplot2
1.1 1.1 Importance de la comparaison bivariée dans l’analyse quantitative
L’inférence visuelle constitue une composante indissociable de l’analyse exploratoire et confirmatoire des données. Dès lors que l’analyste cherche à appréhender la nature des relations dynamiques entre deux grandeurs continues, la superposition graphique de leurs trajectoires sur une échelle temporelle commune devient un instrument de discernement heuristique. Contrairement à l’examen de coefficients statistiques statiques, tels que la corrélation linéaire de Pearson ou le coefficient de détermination, l’observation conjointe de deux courbes permet d’identifier immédiatement des phénomènes d’hystérésis, des ruptures de tendance, des inversions de polarité locale, ou encore des régimes transitoires de désynchronisation. Cette capacité d’inspection granulaire protège l’expérimentateur contre le piège des agrégats trompeurs et favorise une contextualisation écologique des données observées.
Dans les disciplines des sciences comportementales, de la psychophysiologie et de l’épidémiologie, la comparaison bivariée répond à des impératifs méthodologiques cruciaux. Elle permet notamment de mesurer la covariation entre une variable indépendante manipulée et une réponse biologique dans le temps, ou d’observer la divergence développementale entre un groupe témoin et une cohorte clinique. Cependant, la mise en relation visuelle de deux trajectoires impose le respect strict des limites cognitives humaines. Le système visuel humain, bien qu’exceptionnellement performant pour détecter des continuités et des symétries, s’avère particulièrement vulnérable aux illusions de pente causées par le ratio d’aspect cartésien, ainsi qu’à la saturation de la mémoire de travail lorsque les stimuli graphiques manquent de différenciation nette. La lisibilité scientifique requiert donc une économie de moyens, une hiérarchisation sans ambiguïté des éléments figuratifs et une maîtrise absolue de la géométrie de l’information.
1.2 1.2 L’écosystème du Tidyverse et la philosophie sous-jacente de ggplot2
Pour dépasser l’approche purement impérative des tracés graphiques traditionnels, Hadley Wickham a formalisé dans le paquet ggplot2 une incarnation computationnelle de l’ouvrage fondateur de Leland Wilkinson, The Grammar of Graphics. Cette conceptualisation repose sur le principe fondamental qu’un graphique statistique n’est pas un dessin monolithique constitué de primitives isolées, mais une composition structurée associant des données tabulaires à des propriétés visuelles au travers d’un système formel de coordonnées et de transformations géométriques. L’intégration de ggplot2 au sein du méta-paquet Tidyverse consacre une synergie fonctionnelle profonde où la manipulation de données avec dplyr et la restructuration matricielle avec tidyr préparent organiquement le flux d’informations à sa traduction graphique.
Cette approche se distingue radicalement du système graphique de base fourni par R historique. Dans le système de base, une figure se construit par une séquence d’appels de bas niveau sur un dispositif d’affichage passif : la fonction standard initialise un canevas rigide et tout ajout ultérieur via des routines périphériques nécessite un recalcul explicite et manuel des emprises spatiales et des correspondances de couleurs. À l’inverse, ggplot2 procède par instanciation déclarative d’un arbre d’objets graphiques où les calques successifs conservent une conscience algorithmique réciproque. Cette modularité permet de dissocier totalement la définition logique des correspondances de données de leur rendu esthétique final, offrant une standardisation, une flexibilité architecturale et une reproductibilité incomparablement supérieures aux approches purement procédurales.
1.3 1.3 Objectifs méthodologiques et structure du guide
L’ambition première de ce traité méthodologique est de désambiguïser les mécanismes conduisant au tracé conjoint de deux courbes dans ggplot2, en exposant de manière symétrique et critique les deux grands paradigmes d’implémentation : la méthode directe fondée sur l’accumulation de calques géométriques à partir d’un format tabulaire large, et la méthode canonique reposant sur la normalisation ordonnée des données en format long combinée à l’assignation esthétique catégorielle. Chacune de ces voies techniques recèle des compromis spécifiques en termes de charge cognitive de développement, d’évolutivité algorithmique et de conformité aux standards de reproductibilité computationnelle.
La trajectoire pédagogique adoptée progresse de façon rigoureuse depuis les concepts théoriques fondamentaux jusqu’aux raffinements typographiques et paramétriques indispensables à la publication académique. Après l’établissement des bases formelles de l’association esthétique et de la structure tabulaire, nous aborderons la préparation des matrices de données, le décorticage syntaxique des deux approches de traçage, la personnalisation avancée des attributs vectoriels, la maîtrise des échelles cartésiennes, l’intégration de la métrologie de l’incertitude statistique, et enfin le diagnostic rigoureux des anomalies de rendu les plus courantes. Ce parcours vise à doter le chercheur d’un cadre décisionnel complet pour transformer une collection de mesures chronologiques en un message visuel univoque, robuste et élégant.
2. 2. Fondements théoriques de la grammaire des graphiques appliquée aux courbes multiples
2.1 2.1 Le mécanisme d’association esthétique (Aesthetic Mapping)
Au cœur de la machinerie de ggplot2 réside la fonction fondamentale d’association esthétique, notée de manière synthétique par l’opérateur fonctionnel aes(). Cette passerelle logicielle assure la correspondance univoque entre l’espace abstrait des variables contenues dans la structure tabulaire et l’espace perceptif des coordonnées géométriques, des tonalités chromatiques, des degrés de saturation, des épaisseurs ou des typologies de ligne. Une incompréhension courante chez les utilisateurs novices consiste à confondre l’association esthétique dynamique et l’assignation paramétrique statique. Lorsqu’un attribut est défini au sein de l’environnement fonctionnel esthétique, il est automatiquement pris en charge par le moteur de projection de ggplot2, qui segmente les données, attribue des valeurs perceptives distinctes selon les modalités observées et génère de manière intrinsèque une légende interprétative.
À l’inverse, lorsqu’une constante est transmise directement en argument à l’objet géométrique en dehors de l’appel d’association esthétique, elle s’applique uniformément à la totalité de la couche visuelle sans générer d’échelle ni de guide dans la légende. Cette dichotomie gouverne le tracé bivarié : l’attribution d’une couleur fixe à une courbe constitue une directive de dessin locale, tandis que la cartographie d’une variable de partitionnement sur l’esthétique de teinte informe le moteur graphique de l’existence de deux populations de mesures distinctes devant être vectorialisées indépendamment. La portée de ces associations peut en outre être décrétée globalement au niveau de l’initialisation du graphique ou localement à l’intérieur de chaque objet géométrique, une granularité essentielle lors de la composition de tracés composites complexes.
2.2 2.2 L’objet géométrique geom_line() et la continuité des données
L’instanciation visuelle d’une trajectoire continue s’effectue principalement par l’entremise de l’objet géométrique geom_line(). D’un point de vue topologique, cet opérateur calcule une interpolation linéaire continue entre des points discrets, sous l’hypothèse explicite d’une progression strictement ordonnée selon l’axe horizontal des abscisses. Il convient de distinguer formellement la primitive geom_line() de son pendant structurel geom_path(). Alors que la première commence par réordonner imperceptiblement les tuples de données selon la valeur croissante de leur abscisse avant de tracer les segments reliant les observations consécutives, la seconde respecte scrupuleusement l’ordre séquentiel natif d’apparition des lignes dans la table de données d’origine, permettant ainsi de représenter des trajectoires spatiales ou des diagrammes de phase en boucle fermée.
Un enjeu critique dans la manipulation de geom_line() réside dans l’utilisation correcte de l’esthétique structurelle group. Par défaut, lorsque des variables catégorielles sont assignées à des attributs perceptifs discrets comme la couleur ou le motif de pointillé, ggplot2 infère implicitement que chaque niveau de la variable constitue une série de données isolée et autonome, assignant un groupe de liaison unique à chaque sous-ensemble. En revanche, si l’analyste omet d’associer la variation de ligne à une esthétique discriminante ou force une coloration uniforme globale sans expliciter la structure sous-jacente de partitionnement, l’algorithme d’interpolation tentera de raccorder l’ensemble des points en une seule ligne zigzaguante erratique. La maîtrise explicite de l’argument de regroupement constitue ainsi le garde-fou primordial contre la corruption de la continuité sérielle.
2.3 2.3 Le paradigme Tidy Data versus structure tabulaire classique
La manipulation de données dans l’univers de R moderne est régie par la théorie des « données ordonnées » ou tidy data, formalisée par Hadley Wickham. Dans une matrice tabulaire au format large traditionnel, chaque colonne correspond souvent à une variable mesurée ou au résultat d’un indicateur particulier pour un temps d’observation donné. Ainsi, une étude comparant deux métriques chronologiques aura tendance à stocker l’indice temporel dans une première colonne, la première métrique dans une seconde, et la seconde métrique dans une troisième colonne distincte. Bien que cette disposition matricielle soit naturelle pour la saisie manuelle dans un tableur ou pour le calcul matriciel direct en algèbre linéaire, elle s’oppose frontalement au principe d’orthogonalité conceptuelle propre à la grammaire des graphiques.
Le paradigme tidy postule qu’un jeu de données est convenablement ordonné lorsque trois axiomes sont simultanément vérifiés : chaque variable constitue une colonne exclusive, chaque observation représente une ligne unique, et chaque type d’unité d’observation forme une table dédiée. Appliqué à notre problématique bivariée, le format long impose de restructurer le tableau de telle sorte qu’une colonne identifie l’axe temporel partagé, une colonne catégorielle nomme la métrique considérée (par exemple sous forme de facteur identifiant la série), et une unique colonne numérique héberge les valeurs mesurées correspondantes. Cette structuration supprime l’ambiguïté sémantique : la présence de deux courbes n’est plus la somme accidentelle de deux géométries manuelles hétérogènes, mais la projection unifiée d’une seule et même géométrie vectorielle stratifiée selon les modalités d’une variable factorielle.
3. 3. Préparation et structuration des jeux de données dans R
3.1 3.1 Création et inspection d’un jeu de données synthétique
Afin de garantir une reproductibilité computationnelle intégrale sans dépendre de flux de données externes volatils, construisons un scénario synthétique représentatif d’une étude d’activité organisationnelle ou comportementale. Considérons un système d’enregistrement longitudinal mesurant simultanément, sur une période d’échantillonnage de dix journées consécutives, un flux de transactions commerciales et un volume d’affluence d’usagers ou de clients. L’instanciation de ce jeu de données sous la forme d’un tableau d’origine permet d’établir une assise de manipulation claire pour éprouver nos différentes stratégies graphiques.
Dans ce cadre expérimental, la structure de données primaire contient un vecteur d’indices séquentiels journaliers allant de un à dix, un vecteur d’indicateurs de vente présentant une dynamique globale ascendante assortie de fluctuations stochastiques, et un vecteur d’affluence de clientèle caractérisé par une amplitude numérique distincte mais une trajectoire dynamique corrélée. Dès la création de cet objet, une vérification minutieuse de l’intégrité des types de données sous-jacents à l’aide des fonctions standards d’inspection structurelle s’impose. L’exécution de diagnostics structurels permet de confirmer que la variable ordinale temporelle est bien codée sous une forme numérique ou d’indexation continue, tandis que les métriques d’observation répondent aux contraintes scalaires exigées par les calculs géométriques continus.
3.2 3.2 Transformation du format large au format long avec tidyr::pivot_longer()
Bien qu’il soit techniquement envisageable d’opérer directement sur la forme large, la transition vers le format long constitue l’étape centrale de la normalisation analytique. Le paquet tidyr met à disposition la fonction de référence pivot_longer(), conçue pour résoudre précisément ce problème de transformation structurelle sans altérer le contenu informationnel de la table de départ. Cette fonction prend en entrée les colonnes cibles destinées à être condensées, et les convertit en une paire de colonnes clés-valeurs réorganisées orthogonalement.
Le paramétrage formel de pivot_longer() requiert de spécifier avec une extrême précision l’argument vectoriel identifiant les colonnes sources à transposer, généralement les variables désignant nos deux indicateurs continus. Conjointement, l’argument textuel déclarant le nom de la nouvelle colonne de regroupement accueille l’étiquette sémantique des séries, tandis que l’argument recevant les données quantitatives agrégées concentre l’ensemble des mesures dans un espace unidimensionnel continu. À l’issue de ce pivotement, le volume de lignes du tableau résultant est rigoureusement doublé par rapport à la structure originale, tandis que la largeur du tableau se contracte pour adopter une signature universelle : une variable d’index horizontal, une variable de partitionnement catégoriel et une variable de réponse scalaire. Cette conformation standardisée déverrouille l’intégralité du potentiel expressif des algorithmes vectoriels de ggplot2.
3.3 3.3 Nettoyage préalable et gestion des index temporels
L’exploitation de vecteurs chronologiques réels nécessite une rigueur supérieure à celle requise par de simples indices discrets ou séquentiels. Dans une application concrète, l’axe horizontal représente le plus souvent un flux de dates calendaires ou d’horodatages continus. L’intégration de classes temporelles standardisées, notamment par l’entremise des classes natives de dates ou de vecteurs d’horodatage universel, est un impératif technique fondamental. L’utilisation des routines du paquet lubridate ou de la fonction système d’instanciation de date garantit que les écarts d’intervalles soient mathématiquement proportionnels à la durée physique écoulée, neutralisant les artéfacts introduits par des saisies textuelles hétérogènes.
Parallèlement, la phase de prétraitement doit valider l’absence stricte de doublons temporels non contrôlés pour une même unité d’observation. Si le jeu de données présente plusieurs mesures divergentes associées à un même instant d’observation sans qu’une variable de réplication ou de groupe ne permette de les discriminer, l’algorithme d’interpolation linéaire générera un segment de liaison vertical aberrant, annihilant la valeur fonctionnelle de la courbe. De surcroît, le filtrage préventif des valeurs manquantes ou leur imputation selon un protocole explicite doit être tranché en amont de toute manipulation visuelle, afin d’éviter que des interruptions inopinées de collecte ne se traduisent par des extrapolations graphiques silencieuses non déclarées.
4. 4. Méthode élémentaire : Tracé direct de deux lignes à partir d’un format large
4.1 4.1 Implémentation de couches geom_line() successives
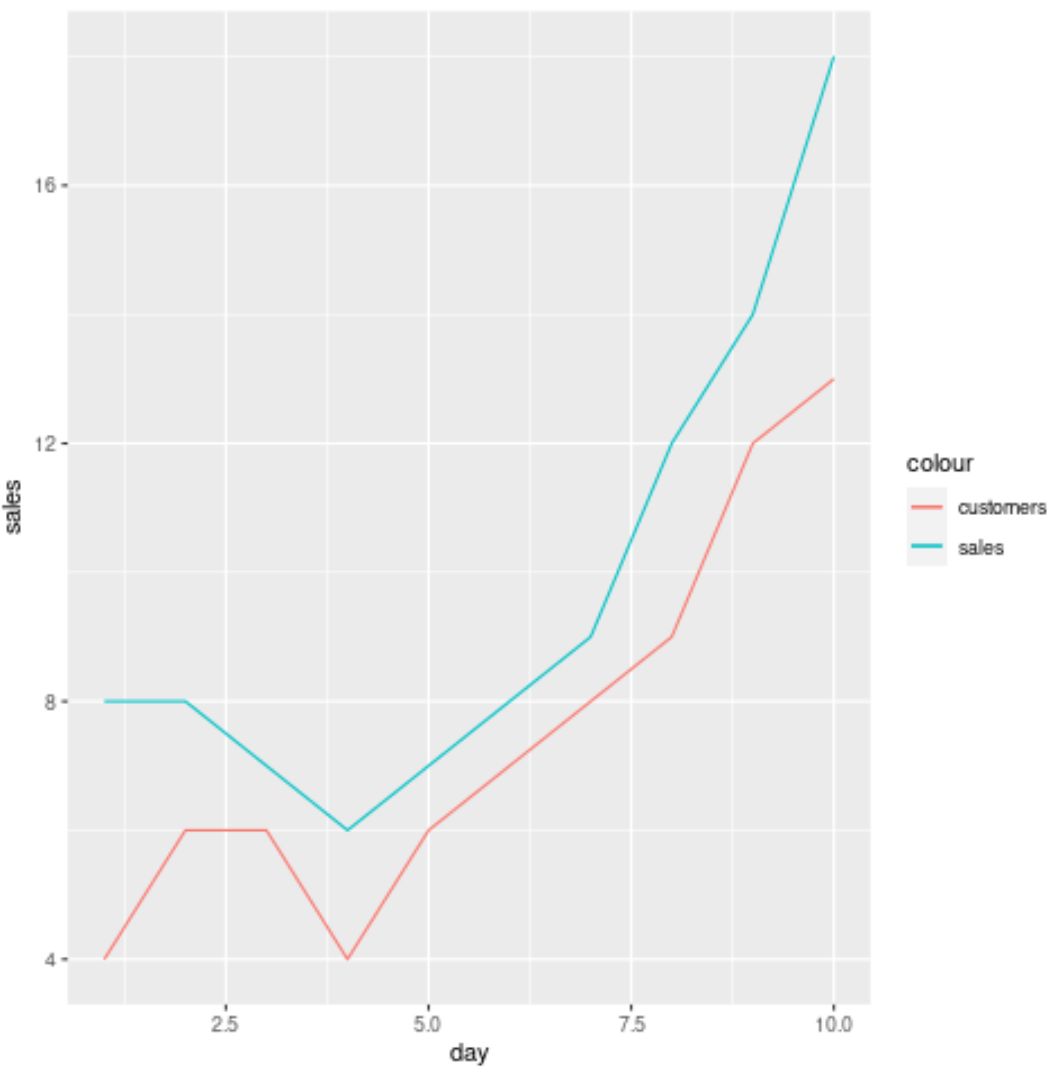
Pour les praticiens désireux de visualiser rapidement des indicateurs sans modifier la topologie structurelle de leur table de données d’origine, ggplot2 autorise la superposition séquentielle d’objets géométriques indépendants opérant sur des colonnes distinctes d’un même format large. Dans cette configuration élémentaire, l’appel initial à la fonction constructrice initialise l’environnement cartésien global en associant de manière exclusive la variable temporelle à l’axe des abscisses. La déclaration des ordonnées n’est pas effectuée de manière générale au sein de cet appel primaire, mais déléguée localement à chaque couche géométrique successive.
La première courbe est ainsi matérialisée par l’adjonction d’un premier calque géométrique geom_line(), au sein duquel l’association esthétique lie la première variable numérique à l’axe vertical. Immédiatement après, un second calque geom_line() est greffé par l’opérateur d’accumulation arithmétique standard de ggplot2, associant quant à lui la seconde variable numérique à l’ordonnée. Afin de forcer le moteur graphique à générer une légende différentielle sans passer par une variable factorielle préexistante, une technique répandue consiste à associer l’esthétique de couleur, non pas à une variable de colonne, mais à une chaîne de caractères littérale constante au sein de la fonction d’association esthétique locale de chaque calque. Ce mécanisme force ggplot2 à créer un facteur synthétique d’échelle et à composer automatiquement un guide visuel à deux entrées.
4.2 4.2 Avantages pratiques et compromis architecturaux
Cette méthodologie directe présente un avantage heuristique indéniable dans les contextes d’exploration rapide et ad hoc. Elle permet au chercheur ou au biostatisticien d’interroger visuellement deux indicateurs bruts directement après leur extraction, sans exiger l’écriture de pipelines de transformation préalables impliquant des modules de restructuration tabulaire. Lorsqu’un tableau de bord de supervision ne comportera jamais plus de deux séries fixes et que l’urgence analytique prime sur l’élégance architecturale, cette méthode se révèle opérationnelle et économe en lignes de code préliminaires.
Cependant, cet opportunisme syntaxique engendre de lourds compromis structurels. Dès que l’analyse exige d’étendre la comparaison à trois, cinq ou dix séries chronologiques concurrentes, le script subit une inflation linéaire intenable nécessitant la duplication manuelle de chaque bloc de code géométrique. Ce mode de développement impératif et itératif multiplie de façon critique le risque d’erreurs de copier-coller, nuit à la lisibilité générale du flux de traitement et rend tout ajustement cosmétique global laborieux, dans la mesure où chaque couche héberge ses propres directives locales. L’approche viole de manière explicite le principe de développement logiciel stipulant qu’une source de vérité ne doit pas être démultipliée artificiellement.
4.3 4.3 Résolution des problèmes courants liés aux chaînes de caractères littérales
L’implémentation du tracé sur format large par injection de constantes textuelles soulève fréquemment des difficultés d’interprétation pour les développeurs non chevronnés. L’erreur la plus récurrente survient lorsqu’un utilisateur déclare une chaîne de caractères désignant une couleur directement à l’intérieur de l’association esthétique, en espérant que le moteur interprète cette mention comme une consigne directe de teinte. Au lieu d’appliquer la couleur demandée, ggplot2 traite la mention littérale comme un niveau catégoriel d’une variable fictive et applique par défaut la teinte standard de sa palette discrète native, générant incompréhension et frustration chez l’analyste.
Un autre désagrément récurrent réside dans le contrôle de l’ordre d’apparition et du titrage des séries au sein de la légende contextuelle. Les chaînes littérales évaluées dans chaque couche géométrique sont triées par défaut selon l’ordre alphanumérique standard de l’environnement d’exécution R, ce qui peut intervertir la hiérarchie logique ou empirique souhaitée entre les deux phénomènes observés. Pour corriger ces désalignements sans altérer l’intégrité du code, il devient obligatoire d’ajouter manuellement des déclarations correctives sur l’échelle des couleurs afin d’harmoniser les étiquettes et de redéfinir explicitement les noms des séries, alourdissant encore la charge de maintenance de cette approche élémentaire.
5. 5. Méthode canonique : L’approche par pivotement et esthétique de groupe
5.1 5.1 Pipeline analytique intégrée avec dplyr et ggplot2
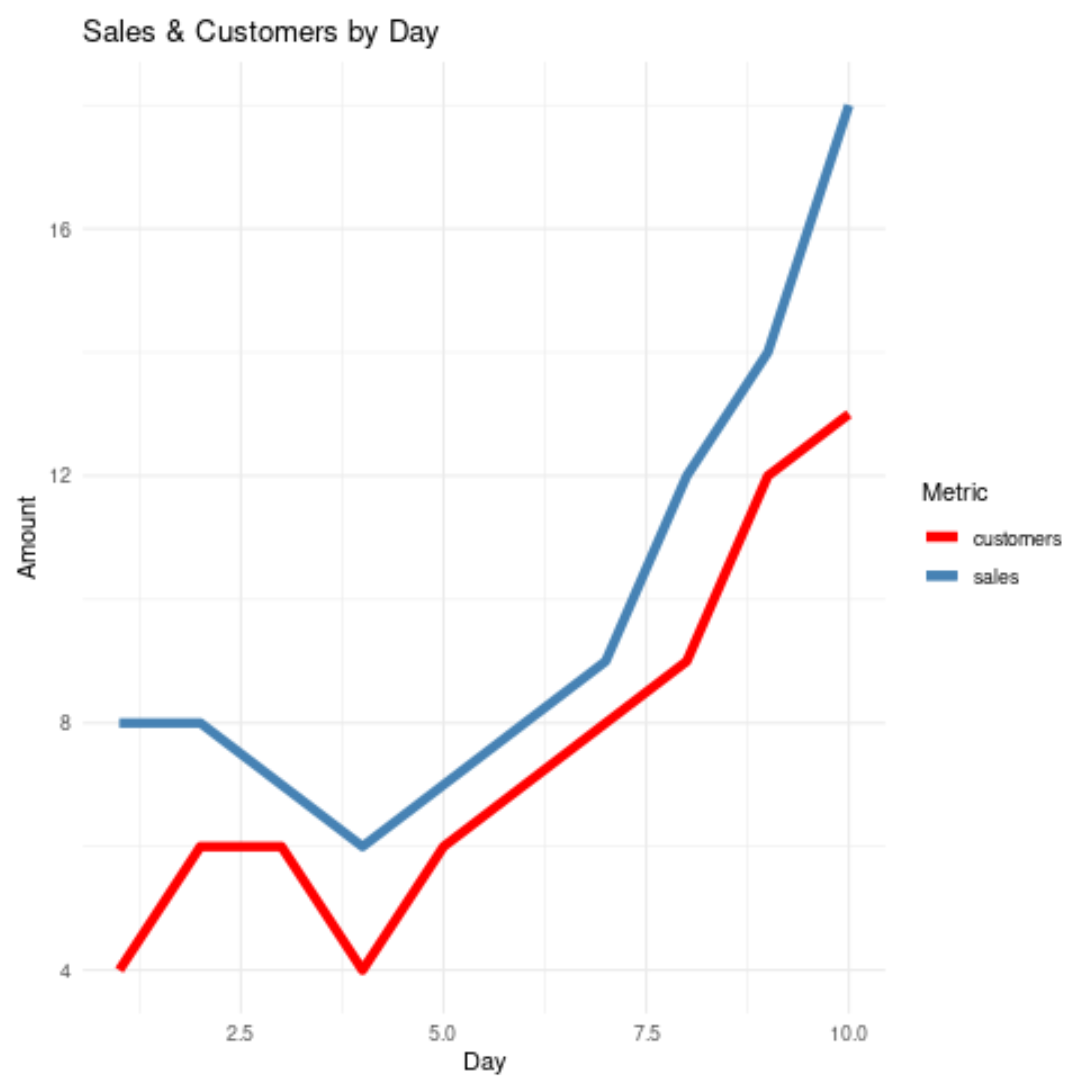
La démarche standard recommandée sans réserve par la communauté scientifique et les concepteurs du Tidyverse consiste à composer une chaîne de traitement fluide reliant organiquement la transformation des structures de données et leur projection géométrique. En exploitant l’opérateur de chaînage natif ou l’opérateur pipe historique de manipulation fonctionnelle, la table de données d’origine subit un remodelage dynamique en temps réel avant d’être transmise directement au constructeur graphique, sans nécessiter d’assignation intermédiaire dans l’environnement global de travail.
Dans ce pipeline unifié, l’opération de pivotement restructure les métriques sélectionnées en un tuple sémantique unifié comprenant un nom d’indicateur et une valeur scalaire associée. À la sortie immédiate de cette opération, la fonction de construction graphique hérite d’une table normalisée et déclare de manière globale et transparente l’association spatiale : l’axe des abscisses reçoit l’index temporel, l’axe des ordonnées accueille la colonne des valeurs numériques unifiées, et l’esthétique différentielle de couleur est cartographiée directement sur la colonne catégorielle identifiant l’indicateur d’origine. Dès lors, une seule et unique déclaration de l’objet géométrique geom_line() suffit à générer l’ensemble des trajectoires d’une manière parfaitement vectorisée et intrinsèquement liée à la structure formelle de la table.
5.2 5.2 Modularité et passage à l’échelle supérieure
Le saut qualitatif opéré par cette architecture unifiée s’exprime avec un éclat particulier lors du passage à l’échelle supérieure des volumes et dimensions de l’analyse. Alors que la méthode fondée sur le format large exige une reconstruction laborieuse de chaque instruction géométrique pour tout nouvel élément comparatif, l’architecture sur format long présente une évolutivité immédiate : si le chercheur décide d’intégrer une troisième, une quatrième ou une énième série à sa comparaison, aucune modification de la syntaxe graphique n’est requise. Le système vectoriel ajuste dynamiquement la palette chromatique, calibre de manière autonome les bornes cartésiennes des ordonnées et met à jour les entrées de la légende sans aucune intervention humaine additionnelle.
Cette modularité paradigmatique confère également une compatibilité absolue avec les fonctions avancées de segmentation spatiale par facettage, telles que facet_wrap() ou facet_grid(). Si les deux courbes présentent des caractéristiques rendant leur superposition directe confuse ou inopérante, une simple directive conditionnelle permet de dissocier instantanément les deux trajectoires dans des panneaux coordonnés adjacents tout en conservant une harmonie d’échelle rigoureuse. L’application de filtres analytiques préalables par des instructions conditionnelles devient également triviale, permettant d’exclure ou d’isoler des segments d’observation sans jamais déstructurer l’assise géométrique de la figure finale.
5.3 5.3 Comparaison critique des deux méthodes d’implémentation
L’analyse comparative des deux démarches révèle des divergences profondes qui transcendent la simple préférence stylistique pour toucher à la rigueur de l’ingénierie logicielle appliquée à la science ouverte. D’un point de vue purement computationnel, la manipulation de tables au format long dans l’environnement vectoriel de R optimise l’exploitation des structures mémoire internes et garantit des temps d’exécution minimaux lors du traitement d’échantillons massifs comprenant plusieurs dizaines de milliers d’enregistrements chronologiques.
Sur le plan de la maintenance logicielle et de l’auditabilité par les pairs, la méthode canonique s’impose sans contestation comme le standard industriel incontournable. Elle garantit qu’aucune valeur de label ni aucun paramètre esthétique fondamental n’est injecté de manière empirique ou dissimulée au cœur de déclarations géométriques isolées. La séparation nette entre les données brutes, leur préparation formelle et leur instanciation graphique favorise une traçabilité intégrale, prévient l’introduction d’erreurs de transcription manuelle et assure une reproductibilité parfaite des figures à travers le temps et les plateformes logicielles.
6. 6. Personnalisation esthétique avancée des deux courbes
6.1 6.1 Typologie, épaisseur et transparence des tracés
L’élévation d’un graphique brut au rang de document académique publiable exige une maîtrise pointue des attributs vectoriels qui définissent la sémiologie des tracés géométriques. L’épaisseur des segments linéaires, historiquement contrôlée par un paramètre générique, est désormais formellement gouvernée par l’argument spécialisé linewidth au sein de ggplot2. Cet ajustement permet de définir une hiérarchisation perceptuelle : attribuer un trait d’épaisseur modérée à une série témoin tout en accentuant la ligne représentant une cohorte d’intervention expérimentale guide instantanément l’attention visuelle du lecteur vers le foyer de l’analyse sans pour autant masquer le contexte de comparaison.
La diversification des motifs structurels de tracés par l’entremise de l’esthétique linetype constitue une exigence fondamentale de l’accessibilité scientifique. En attribuant à une courbe un tracé continu classique et à la seconde un motif discontinu tel qu’un pointillé ou un tiretement régulier, l’analyste garantit une désambiguïsation intégrale des séries, même lorsque la figure est reproduite en niveaux de gris lors d’une impression physique ou visualisée par un lecteur atteint de déficiences de la vision des couleurs. Conjointement, la modulation de la transparence par l’indice alpha autorise une atténuation mesurée des chevauchements intempestifs, préservant la distinction des dynamiques locales même aux points de croisement géométrique les plus denses.
6.2 6.2 Palettes de couleurs scientifiques et harmonisation visuelle
Le choix des teintes chromatiques ne doit en aucun cas répondre à des considérations purement ornementales, mais se conformer rigoureusement aux principes de l’accessibilité visuelle et de l’uniformité perceptive. La substitution des couleurs par défaut de ggplot2 par des échelles scientifiquement calibrées s’opère couramment via la fonction de paramétrage manuel des couleurs scale_color_manual(), ou par l’intégration directe de bibliothèques éprouvées comme viridis, ColorBrewer ou MetBrewer. Les palettes de la famille viridis se distinguent par une propriété géométrique remarquable : leur luminance progresse de manière strictement monotone, garantissant une préservation parfaite du contraste visuel et de la hiérarchie informative quelle que soit la modalité d’affichage.
Il importe également de veiller scrupuleusement au respect des directives internationales d’accessibilité du contenu visuel, en maintenant un ratio de contraste chromatique minimal entre chacune des courbes et la teinte du fond de canevas cartésien. Enfin, une attention méthodologique soutenue doit être accordée à la valence affective et culturelle des couleurs sélectionnées : associer arbitrairement des teintes connotées positivement ou négativement à des séries descriptives peut introduire des biais cognitifs inconscients lors de l’évaluation des résultats par un comité de lecture ou un collège d’experts, faussant la neutralité requise par la communication scientifique.
6.3 6.3 Ajout de marqueurs discrets avec geom_point()
Lorsque la série chronologique ne dérive pas d’un enregistrement continu automatisé mais procède d’un échantillonnage à pas de temps discrets, relier les observations par une interpolation linéaire continue peut induire l’illusion trompeuse d’une mesure ininterrompue. Pour conjurer ce biais perceptif, la superposition explicite de marqueurs d’échantillonnage discrets par le truchement de l’objet géométrique geom_point() constitue une pratique de restitution recommandée. Ces points matérialisent avec exactitude les coordonnées temporelles réelles où une collecte de données a effectivement eu lieu, la ligne ne jouant plus alors qu’un rôle de connecteur relationnel facilitant l’appréhension de la tendance générale.
Le paramétrage esthétique conjoint de ces symboles autorise l’utilisation de typologies géométriques creuses ou pleines, régulées par les variables de forme, de remplissage intérieur et de bordure périphérique. Une telle configuration permet par exemple de tracer des disques colorés dotés d’un contour sombre distinct, renforçant considérablement le détachement optique des points individuels par rapport au réseau de lignes sous-jacent. L’analyste veillera cependant à ne pas encombrer le canevas d’une surcharge de symboles si la densité temporelle est excessive, réservant cette approche aux séries présentant un volume de points modéré propice à une discrimination granulaire.
7. 7. Gestion des échelles, des axes et des unités de mesure
7.1 7.1 Contrôle fin des axes continus et des graduations
La crédibilité empirique d’un graphique bivarié repose pour une large part sur la rigueur géométrique avec laquelle ses axes cartésiens sont bornés et calibrés. Les fonctions de contrôle des échelles d’abscisse et d’ordonnée continues, scale_x_continuous() et scale_y_continuous(), confèrent à l’expérimentateur un contrôle exhaustif sur les intervalles d’expansion spatiale, les bornes d’ancrage et la disposition des graduations numériques majeures et secondaires. L’ancrage de l’axe des ordonnées à zéro, bien que non obligatoire dans tous les contextes d’analyse relative, doit faire l’objet d’une décision méthodologique consciente afin d’éviter d’exagérer artificiellement des variations infinitésimales entre les deux trajectoires.
L’articulation de ces fonctions avec le paquet compagnon scales optimise l’intégration des formats numériques professionnels. Il devient ainsi possible d’imposer des délimiteurs de milliers conformes aux normes typographiques internationales, de contraindre l’affichage de pourcentages explicites ou de formater les données monétaires sans avoir à altérer manuellement le type de variable numérique dans le jeu de données source. De surcroît, lorsqu’il devient impératif d’isoler une fenêtre d’observation spécifique sans induire d’effets secondaires délétères sur les calculs statistiques sous-jacents, l’emploi de la fonction de zoom cartésien pur coord_cartesian() doit impérativement être privilégié par rapport à la restriction brutale des bornes dans l’échelle, cette dernière méthode ayant pour défaut d’exclure silencieusement les points situés hors champ et de rompre les interpolations linéaires en périphérie.
7.2 7.2 Traitement des données à échelles temporelles réelles
L’affichage de séries chronologiques réelles exige le recours à la fonction spécialisée scale_x_date() ou à son pendant d’horodatage haute précision. Ces opérateurs sont spécifiquement conçus pour interpréter les intervalles temporels selon une logique calendaire naturelle, permettant de spécifier directement des pas de graduation fondés sur des unités de durée humaine comme les jours, les semaines, les mois civils ou les semestres d’activité. Cette souplesse prévient les fractionnements arithmétiques aberrants qui surviennent inévitablement lorsqu’un index temporel calendaire est traité comme une simple variable numérique continue ordinaire.
Le paramétrage des chaînes de formatage temporel permet de localiser avec précision les étiquettes textuelles générées, autorisant l’affichage de noms de jours ou de mois en français conformément aux exigences éditoriales régionales. Lorsque la densité des pas temporels risque de provoquer un chevauchement illisible des mentions de dates le long de l’axe horizontal, l’orientation angulaire des étiquettes peut être modifiée par les arguments de contrôle thématique d’inclinaison textuelle. Cependant, une rotation excessive doit être maniée avec circonspection : orienter les textes à 45 degrés avec un ajustement d’ancrage précis représente souvent le compromis idéal entre optimisation de l’espace disponible et confort ergonomique de lecture.
7.3 7.3 La controverse du double axe des ordonnées (Secondary Y-Axis)
Une tentation récurrente lors de la comparaison de deux métriques ne partageant pas la même unité de mesure ou le même ordre de grandeur consiste à adjoindre un second axe vertical d’ordonnées sur la bordure droite du graphique. Bien que ggplot2 autorise techniquement cette configuration au moyen de l’argument sec_axis(), son concepteur Hadley Wickham ainsi que les théoriciens les plus éminents de la visualisation quantitative, à l’instar d’Edward Tufte, déconseillent formellement cette approche en raison de son potentiel élevé d’induction en erreur et de distorsion perceptuelle.
Le double axe vertical souffre en effet d’une vulnérabilité fondamentale : le choix du facteur de cadrage, de décalage d’origine et de ratio multiplicatif entre les deux échelles est laissé à l’arbitraire complet du concepteur. En manipulant ces paramètres d’échelle secondaire, l’analyste peut à dessein ou par inadvertance forcer la convergence visuelle, l’intersection graphique ou l’écartement de deux séries qui, dans la réalité de leurs unités respectives, ne partagent aucune similitude dynamique objective. Deux alternatives méthodologiquement irréprochables doivent lui être systématiquement préférées : la conversion préalable des deux séries sous une forme standardisée adimensionnelle (telle que le calcul des scores centrés-réduits ou la base 100), ou la dissociation des deux phénomènes en deux panneaux verticaux coordonnés via un facettage à échelles indépendantes garantissant une comparaison de tendance sans contamination métrologique.
8. 8. Typographie, légendes et annotations contextuelles
8.1 8.1 Conception et positionnement stratégique de la légende
La légende constitue le pont sémantique entre les codages visuels abstraits et leur signification substantielle. Par défaut, ggplot2 implémente cette table de correspondance sur la frange latérale droite du canevas cartésien. Bien que fonctionnelle, cette disposition automatique comprime souvent inutilement la largeur dévolue à l’affichage des séries temporelles, ce qui peut nuire à la perception des micro-variations de pente lorsque le graphique est inséré dans une colonne de manuscrit étroite. L’ajustement thématique du positionnement de la légende, que ce soit par une relocalisation au sommet, à la base du graphique ou au sein même de la zone de tracé sous forme d’encadré flottant, offre un levier efficace d’optimisation spatiale.
Une alternative graphique de premier plan, largement plébiscitée par les directives éditoriales de publications de référence comme le Financial Times ou The Economist, consiste à éliminer totalement la légende déportée au profit d’un étiquetage direct des courbes en bout de tracé. En positionnant le nom de chaque série immédiatement à proximité de la terminaison terminale de sa ligne respective sur l’axe des abscisses, l’analyste réduit considérablement la charge cognitive imposée au lecteur, qui n’est plus contraint d’effectuer d’incessants allers-retours oculaires entre la courbe observée et un encart explicatif périphérique distant.
8.2 8.2 Rédaction des titres, sous-titres et légendes académiques
L’enrichissement textuel d’une visualisation de données bivariée s’articule formellement autour de la fonction de métadonnées labs(). Dans un contexte académique rigoureux, la titraille ne doit pas se confiner à une redite tautologique décrivant bêtement les variables cartographiées, mais expliciter de manière synthétique la conclusion substantielle ou l’observation majeure qui se dégage du comportement comparé des deux séries. Le sous-titre sert quant à lui d’espace de contextualisation méthodologique, précisant par exemple l’échelle temporelle globale, l’unité de mesure principale ou la fréquence d’échantillonnage adoptée lors du protocole expérimental.
La documentation des fondations empiriques du graphique est consolidée par l’usage rigoureux du paramètre de légende de bas d’image (caption). Cet espace technique accueille traditionnellement la mention précise des sources institutionnelles de données, le rappel des effectifs d’échantillonnage sous-jacents, l’indication des éventuelles transformations mathématiques appliquées en amont, ainsi que le seuil de signification des procédures d’ajustement. Lorsque des notations mathématiques formelles ou des symboles grecs s’avèrent nécessaires pour désigner les grandeurs physiques mesurées, le recours aux expressions mathématiques natives ou au paquet latex2exp permet d’insérer des formules typographiquement irréprochables directement au cœur des étiquettes d’axes.
8.3 8.3 Enrichissement sémantique par annotations ponctuelles et géométries de référence
Un graphique brut associant deux courbes demeure souvent incomplet s’il n’offre pas les repères contextuels indispensables à l’interprétation des phénomènes causaux. L’introduction de géométries de référence fixes constitue la première modalité d’enrichissement analytique : les fonctions geom_hline() et geom_vline() permettent d’ancrer respectivement des seuils critiques constants (comme une valeur limite de toxicité ou un objectif organisationnel) ou des ruptures temporelles historiques majeures (comme l’amorce d’une intervention thérapeutique ou un choc macroéconomique externe).
Pour mettre en exergue des épisodes complexes ou des périodes d’intérêt particulier s’étendant sur plusieurs pas temporels consécutifs, l’utilisation de rectangles d’ombrage translucides via geom_rect() fournit une contextualisation spatiale remarquable sans occulter les trajectoires sous-jacentes. Enfin, l’adjonction de commentaires explicatifs ciblés à l’aide de l’opérateur universel annotate(), combinant un fragment textuel et un vecteur indicateur fléché pointant vers une divergence critique entre les deux lignes, transforme une simple figure descriptive en une démonstration analytique hautement percutante et pédagogique.
9. 9. Représentation de l’incertitude et des intervalles de confiance
9.1 9.1 Superposition de bandes d’erreur avec geom_ribbon()
Dans la recherche empirique moderne, la représentation conjointe de deux courbes de tendance centrale ne saurait s’abstraire de la quantification explicite de l’incertitude statistique. Tracer de simples trajectoires moyennes sans matérialiser la variance ou l’erreur standard associée expose l’analyste à un risque sévère d’illusion d’inférence, en suggérant des divergences catégoriques entre deux cohortes là où les distributions probabilistes se chevauchent en réalité largement. La réponse géométrique idoine dans ggplot2 réside dans l’intégration de rubans de confiance continus matérialisés par l’opérateur geom_ribbon().
Le paramétrage d’un ruban d’incertitude requiert l’association explicite de deux bornes verticales délimitant la variabilité de la mesure : une frontière inférieure et une frontière supérieure, calculées préalablement au moyen d’indicateurs de dispersion comme l’intervalle de confiance à 95% ou l’écart interquartile. Pour garantir une lisibilité sans faille des deux séries comparées, l’attribut de translucidité alpha du ruban doit impérativement être calibré sur des valeurs faibles, de l’ordre de dix à vingt pour cent. Cette précaution assure que les deux bandes d’erreur puissent s’entrecroiser sans masquer les lignes de tendance centrales, tout en conservant une perception immédiate des zones de chevauchement stochastique où la nullité de la différence entre les deux dynamiques ne peut être rejetée.
9.2 9.2 Utilisation des barres d’erreur discrètes avec geom_errorbar()
Lorsque la structure des données ne relève pas d’une fonction continue mais d’une série d’évaluations temporelles discrètes réparties sur des pas de temps bien individualisés, le recours aux barres d’erreur ponctuelles via geom_errorbar() ou geom_pointrange() est méthodologiquement plus approprié que l’usage d’un ruban continu lissé. Toutefois, la superposition de deux séries temporelles dotées de barres d’erreur sur un même axe vertical induit quasi inévitablement un encombrement visuel destructeur : les segments d’incertitude se superposent exactement sur les mêmes coordonnées d’abscisse, devenant totalement indéchiffrables pour le lecteur.
La résolution élégante de cet antagonisme topologique s’obtient par l’application stricte d’un ajustement de positionnement latéral via la fonction position_dodge(). En appliquant un décalage horizontal minime et symétrique aux deux calques de points et de barres d’erreur, les deux structures verticales se déploient parallèlement côte à côte sans se masquer mutuellement. Il convient alors de réduire la largeur horizontale des chapeaux de barres d’erreur afin de ne pas saturer l’espace visuel, maintenant un équilibre géométrique optimal entre précision métrologique et pureté de restitution formelle.
9.3 9.3 Traitement rigoureux des observations manquantes (NA)
La présence de lacunes ou de valeurs manquantes au sein d’une ou des deux séries chronologiques soulève des enjeux d’intégrité graphique capitaux. Par défaut, lorsqu’un vecteur quantitatif transmis à geom_line() contient une ou plusieurs données manquantes, le moteur de calcul de ggplot2 interrompt immédiatement le tracé linéaire au niveau de la lacune et reprend l’interpolation dès la valeur valide suivante. Ce comportement produit des ruptures visuelles marquées au sein de la ligne observée, qui ont le mérite d’informer sincèrement l’observateur d’un défaut ponctuel de recueil d’information.
Dans un code de production standardisé, ces interruptions génèrent systématiquement des avertissements d’exécution dans la console R. Bien qu’inoffensifs pour l’intégrité de la figure, ces messages d’alerte doivent être neutralisés de manière explicite et concertée en renseignant l’argument de suppression délibérée des valeurs manquantes directement au niveau de l’objet géométrique. Si le protocole expérimental impose de masquer ces interruptions pour privilégier la continuité visuelle, l’analyste se doit de mettre en place une stratégie d’imputation algorithmique préalable rigoureuse, en déclarant formellement la méthode de reconstruction statistique employée au sein des métadonnées du graphique afin de prévenir tout reproche de maquillage empirique.
10. 10. Cas pratiques et applications expérimentales
10.1 10.1 Étude longitudinale : Groupe contrôle versus Groupe expérimental
Pour ancrer ces concepts dans la pratique concrète de la recherche, considérons un protocole d’évaluation clinique ou comportementale longitudinale mesurant l’évolution d’un score d’adaptation cognitive au sein de deux cohortes de participants suivies sur une durée de douze semaines. Le premier groupe constitue la cohorte témoin soumise aux conditions environnementales ordinaires, tandis que le second groupe fait l’objet d’une intervention ciblée débutant précisément au terme de la quatrième semaine de suivi. Cette situation bivariée illustre typiquement la puissance de la visualisation de séries multiples pour révéler la dynamique temporelle différentielle d’un effet expérimental.
La visualisation complète de ce protocole requiert d’ordonner préalablement la structure de données au format long, de calculer pour chaque groupe et chaque semaine la moyenne empirique du score ainsi que l’erreur type de mesure, puis de projeter les deux trajectoires au travers d’une association esthétique différentielle liant le groupe expérimental à la couleur et à la typologie de pointillé. L’adjonction d’une ligne verticale pointillée sur l’abscisse correspondant à la quatrième semaine délimite sans équivoque la phase de référence préalable de la phase d’intervention effective. L’observation simultanée de la superposition des courbes durant la phase préliminaire confirme visuellement l’équivalence initiale des cohortes, tandis que leur divergence progressive et soutenue après l’amorce du traitement valide la réactivité fonctionnelle induite par l’intervention.
10.2 10.2 Analyse conjointe de deux processus psychophysiologiques
Un défi analytique récurrent dans les sciences de la santé et les neurosciences cognitives concerne l’exploration simultanée de deux processus biologiques dotés d’échelles physiques incomparables, à l’instar des variations toniques de la conductance électrodermale mesurée en microsiemens et de la fréquence cardiaque exprimée en battements par minute au cours d’un paradigme de stress aigu. Dans une telle configuration, tenter de tracer les valeurs absolues brutes sur un même axe d’ordonnées conduirait à l’aplatissement graphique complet de la conductance cutanée sur la ligne de base, écrasée par la magnitude numérique supérieure du rythme cardiaque.
La solution méthodologique canonique consiste à soumettre les deux vecteurs chronologiques à une procédure de standardisation centrée-réduite préalablement à la structuration au format long. En retranchant à chaque signal sa moyenne empirique respective et en le divisant par son écart type d’échantillonnage, les deux grandeurs biologiques sont converties en scores adimensionnels comparables exprimés en unités d’écart à la moyenne. Le tracé conjoint de ces deux dynamiques standardisées, potentiellement enrichi d’un lissage polynomial local de type loess, permet d’identifier immédiatement le découplage physiologique, les phénomènes de latence temporelle où la réponse cardiaque précède l’activation sudorale, ainsi que la cinétique asymétrique de récupération homéostatique au décours de la stimulation.
10.3 10.3 Suivi d’indicateurs de performance organisationnelle
Revenons au scénario organisationnel exposé lors de la création de notre matrice synthétique, associant les variations quotidiennes du volume des ventes et l’affluence du trafic d’usagers sur une période de dix jours ouvrés. Dans ce contexte managérial et analytique, le tracé de deux courbes s’avère précieux pour déceler des altérations systémiques du taux de conversion opérationnel. Alors qu’une inspection isolée des volumes de transactions pourrait suggérer une croissance d’activité réjouissante, leur confrontation directe avec le flux d’entrée d’utilisateurs est susceptible de révéler une érosion pernicieuse de l’efficacité unitaire du système si le volume de fréquentation progresse à un rythme substantiellement plus soutenu que les transactions réelles.
En matérialisant ces deux séries temporelles au moyen d’un tracé bivarié épuré, soutenu par des marqueurs discrets à chaque point d’inflexion quotidien et complété par un formatage typographique soigné, l’analyste façonne un tableau de bord à haute densité d’information. La mise en évidence par des annotations textuelles des journées atypiques caractérisées par une divergence brutale des deux signaux permet de concentrer l’effort d’audit sur les anomalies fonctionnelles réelles, fournissant à la gouvernance un instrument d’aide à la décision immédiatement actionnable et étayé par une modélisation visuelle robuste.
11. 11. Optimisation esthétique globale et exportation pour publication
11.1 11.1 Thémage complet et dépouillement selon les standards académiques
L’apparence visuelle brute issue des configurations par défaut de ggplot2, notamment son célèbre fond de canevas gris quadrillé de lignes blanches, ne correspond généralement pas aux critères formels de sobriété exigés par les revues scientifiques à comité de lecture. Le système modulaire de theming de ggplot2 offre une collection de gabarits préconfigurés remarquables, au rang desquels figurent theme_minimal(), theme_light() et particulièrement theme_classic(). Ce dernier émule les standards éditoriaux traditionnels en éliminant intégralement les quadrillages internes pour ne conserver que les deux axes cartésiens orthogonaux de référence, conférant au graphique une épure conforme aux recommandations sémiologiques d’Edward Tufte et aux normes de l’American Psychological Association (APA).
Au-delà de l’application de gabarits prédéfinis, l’analyste avisé construit ses propres spécifications thématiques en intervenant sur les composants structurels par l’entremise de la fonction régulatrice theme(). Cette granularité autorise la suppression sélective des lignes de quadrillage mineures souvent inutiles, le recalibrage des marges externes du canevas pour éviter toute sensation de confinement géométrique, l’uniformisation des familles typographiques et le contrôle rigoureux du ratio de contraste des bordures d’axes. La formalisation de ces directives dans une fonction de thème personnalisée réutilisable au sein du laboratoire garantit une cohérence visuelle parfaite à travers l’ensemble des figures d’un mémoire doctoral ou d’une campagne de publication internationale.
11.2 11.2 Paramètres d’exportation vectorielle et matricielle haute résolution
La production d’un graphique scientifiquement irréprochable perd toute efficacité si son exportation vers le système de fichiers physique n’est pas maîtrisée. L’environnement graphique de RStudio propose des routines interactives de capture d’écran, mais ces mécanismes manuels doivent être rigoureusement proscrits au profit de l’opérateur d’exportation programmatique ggsave(). Cet opérateur garantit une reproductibilité mathématique intégrale en figeant de manière déterministe les dimensions physiques de l’image de sortie, exprimées explicitement en centimètres ou en pouces selon les préconisations du périodique scientifique ciblé.
Le choix du format de fichier engage directement la fidélité de restitution des tracés linéaires bivariés. Pour l’insertion dans des manuscrits destinés à la composition typographique, les formats vectoriels comme le PDF ou le SVG constituent le choix d’excellence absolue : ils conservent les courbes sous forme de primitives mathématiques vectorielles indépendantes de la résolution d’écran, autorisant un agrandissement infini sans la moindre dégradation ni pixellisation des segments de ligne ou des symboles. Si les exigences de l’éditeur imposent un format matriciel de type TIFF ou PNG, il est impératif de contraindre la densité d’échantillonnage de sortie à un seuil minimal de 300 à 600 points par pouce (DPI), prévenant toute pixellisation floue susceptible de compromettre la lisibilité des détails fins lors de l’impression sur presse papier.
11.3 11.3 Reproductibilité logicielle et contrôle des versions graphiques
Dans le contexte actuel de crise de la reproductibilité en science empirique, une visualisation graphique doit être considérée comme le produit dérivé d’un artefact computationnel auditable. La traçabilité intégrale du pipeline ayant conduit à la génération du tracé bivarié suppose l’archivage rigoureux de l’état environnemental de la session R. L’enregistrement systématique des versions logicielles des paquets mobilisés, accessible via la fonction sessionInfo() ou géré par des infrastructures d’isolation de dépendances comme renv, prévient les régressions visuelles provoquées par des évolutions futures de l’architecture logicielle de ggplot2.
L’intégration de ce code dans des documents computationnels unifiés de type R Markdown ou Quarto parachève cette exigence d’intégrité scientifique. En articulant au sein d’un même fichier source le texte narratif de l’article, les instructions d’extraction de données, les transformations matricielles et les paramètres géométriques de traçage, le chercheur offre à la communauté scientifique les moyens d’exécuter à l’identique l’intégralité du protocole graphique. Cette transparence totale garantit la pérennité des résultats visuels, facilite les révisions par les pairs et rehausse le niveau de confiance accordé aux conclusions quantitatives présentées.
12. 12. Diagnostic des erreurs fréquentes et solutions méthodologiques
12.1 12.1 Résolution des tracés en dents de scie et désordres d’abscisse
L’un des dysfonctionnements les plus déconcertants auxquels se heurte l’utilisateur lors du tracé de deux lignes dans ggplot2 se manifeste par l’apparition d’une figure chaotique où les segments de droite semblent effectuer d’incessants retours en arrière horizontaux, générant une structure discontinue en dents de scie illisible. Dans l’immense majorité des cas, ce phénomène ne traduit aucun bogue algorithmique de ggplot2, mais résulte d’une erreur d’importation de la variable d’axe des abscisses, malencontreusement stockée sous la forme d’un vecteur de chaînes de caractères plutôt que d’un index numérique ou d’une date formelle.
Lorsque l’abscisse est typée sous forme textuelle, R classe par défaut les observations selon l’ordre alphanumérique de leur désignation textuelle plutôt que selon leur continuité chronologique intrinsèque. Ainsi, un jour noté chronologiquement dix sera intercalé arbitrairement entre le premier et le second jour du mois, brisant totalement la trajectoire linéaire ordonnée. La remédiation consiste à appliquer une conversion explicite et typée à la colonne d’abscisse avant le tracé. Une vigilance symétrique s’impose pour traquer d’éventuels doublons stricts non ségrégués sur l’axe temporel, dont la présence contraint le moteur graphique à tracer des segments verticaux spontanés entre les mesures conflictuelles associées à un même instant d’observation.
12.2 12.2 Problèmes de superposition indifférenciée (lignes connectées à tort)
Une autre anomalie visuelle classique survient lors de la migration d’une table de données vers le format long : au lieu d’obtenir deux courbes nettement distinctes et individualisées par leur teinte respective, l’utilisateur découvre avec stupeur une ligne continue unique et erratique, qui relie alternativement et de manière chaotique chaque point de la première métrique au point homologue de la seconde métrique pour chaque pas temporel successif. Cette corruption graphique découle de l’omission structurelle de l’instruction de partitionnement au sein de l’association esthétique.
Lorsque la variable de distinction catégorielle est assignée à une esthétique purement locale ou lorsque l’analyste omet d’informer le moteur graphique de l’existence de deux populations d’échantillons distinctes, ggplot2 infère que l’ensemble des tuples de la colonne numérique appartient à un continuum d’observation unique. L’algorithme d’interpolation linéaire ordonne alors les données par abscisse croissante et relie aveuglément les points des deux métriques qui partagent le même temps d’échantillonnage. La résolution définitive de cette pathologie syntaxique impose soit de déclarer explicitement l’argument de partitionnement structurel aes(group = indicateur), soit de mapper directement la variable discriminante sur une esthétique globale différentielle comme la couleur ou le type de tracé.
12.3 12.3 Discordances d’échelles et masquage visuel d’une série
Le dernier piège méthodologique majeur concerne la discordance d’amplitude numérique entre les deux phénomènes investigués. Si la première variable s’exprime dans des grandeurs de l’ordre du millier d’unités tandis que la seconde évolue dans un registre unitaire décimal, la projection directe des deux séries sur un axe cartésien standard produit un écrasement visuel complet de la seconde métrique : confinée sur la bordure horizontale zéro, cette courbe secondaire apparaît comme une ligne parfaitement plate et dépourvue de relief, masquant entièrement ses dynamiques relatives internes et conduisant l’observateur non averti à conclure erronément à une absence de variabilité.
Face à ce défi métrologique, l’analyste doit impérativement récuser l’illusion d’une solution miraculeuse par le double axe vertical non transformé, et engager un arbitrage méthodologique lucide fondé sur les propriétés de ses données. Trois stratégies formelles s’offrent à lui : l’application préalable d’une transformation logarithmique stricte si les deux séries présentent des dynamiques exponentielles et des grandeurs strictement positives, la standardisation normalisée des variables sous forme de scores réduits afin d’examiner la corrélation temporelle des fluctuations relatives, ou le recours au facettage en deux panneaux verticaux empilés dotés d’échelles verticales libres par l’entremise de l’argument facet_wrap(~ indicateur, scales = 'free_y'). Cette dernière modalité préserve l’intégrité métrologique native de chaque indicateur tout en offrant un alignement temporel parfait sur l’axe horizontal, conciliant avec une élégance absolue les exigences de rigueur quantitative et de lisibilité scientifique universelle.
Références
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2e éd.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science (2e éd.). O’Reilly Media.
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer Science & Business Media. https://doi.org/10.1007/0-387-28695-0