
Dans le domaine de l’analyse statistique avancée, de l’épidémiologie clinique et de l’apprentissage automatique, l’évaluation de la performance discriminante des modèles prédictifs binaires constitue une étape décisive. Lorsqu’un algorithme ou un modèle de régression logistique attribue un score de propension ou une probabilité a posteriori à une observation, le praticien se heurte inévitablement à la problématique du choix du seuil décisionnel optimal. La courbe ROC (Receiver Operating Characteristic) s’impose alors comme l’étalon méthodologique par excellence. Loin d’une métrique ponctuelle et réductrice, elle offre une caractérisation globale et indépendante de tout point de coupure arbitraire, révélant la dynamique fondamentale qui unit la sensibilité d’un test à sa spécificité.
Toutefois, la restitution visuelle de cette trajectoire ne saurait se limiter à un tracé rudimentaire. Sous l’impulsion de la philosophie computationnelle de R et de l’implémentation de la grammaire des graphiques conceptualisée par Leland Wilkinson, la bibliothèque ggplot2 offre une puissance d’expression inégalée pour convertir des estimations probabilistes en représentations graphiques publiables, conformes aux exigences les plus strictes des revues académiques à comité de lecture. La maîtrise de cet outil permet non seulement de dépeindre avec rigueur la capacité de discrimination d’un biomarqueur ou d’une échelle psychométrique, mais également d’intégrer des intervalles de confiance robustes, de superposer des modèles concurrents et d’annoter visuellement les indices d’optimisation diagnostique tels que l’indice de Youden.
Ce traité exhaustif a pour vocation d’articuler en profondeur les fondements théoriques de l’analyse du signal avec les pratiques d’implémentation logicielle les plus rigoureuses sous l’écosystème R. En décomposant les équations mathématiques sous-jacentes, en explorant les approches de tracé manuel par dérivation matricielle, puis en mobilisant les extensions spécialisées pROC et plotROC au sein du paradigme déclaratif de ggplot2, ce document constitue un manuel de référence méthodologique destiné aux chercheurs, biostatisticiens et analystes de données confrontés aux défis de la classification binaire.
1. Introduction aux courbes ROC et aux fondements théoriques en modélisation binaire
L’évaluation des modèles de classification statistique repose sur la capacité d’un système à séparer deux populations distinctes à travers un continuum de mesure. Dans ce contexte, la courbe ROC fournit une cartographie géométrique complète de la performance diagnostique d’un classificateur binaire sans nécessiter la fixation préalable d’un seuil de positivité.
1.1 Qu’est-ce qu’une courbe ROC (Receiver Operating Characteristic) ?
L’émergence conceptuelle de la courbe ROC puise ses origines historiques au cours de la Seconde Guerre mondiale, plus précisément dans les travaux pionniers liés à la théorie de la détection du signal. Les opérateurs radar britanniques et américains étaient alors confrontés au défi de discerner les échos renvoyés par des appareils ennemis réels du bruit de fond provoqué par des nuages, des vols d’oiseaux ou des interférences électromagnétiques. Face à ce problème de transmission de l’information, les ingénieurs développèrent une formalisation mathématique évaluant la capacité opérationnelle du récepteur à identifier un signal authentique face aux fluctuations stochastiques ambiantes. Cette approche novatrice a ensuite été transposée à la psychophysique expérimentale par des auteurs fondamentaux tels que David Green et John Swets dans les années 1960, avant de conquérir la médecine clinique, l’épidémiologie et la science des données modernes.
Sur le plan géométrique et probabiliste, la courbe ROC constitue la représentation graphique continue du compromis inhérent entre les bénéfices attendus et les coûts occasionnés par une décision en univers incertain. En faisant varier de manière systématique le seuil de discrimination critique sur l’ensemble de son domaine de définition, la courbe projette, sur un repère cartésien borné par le carré unitaire [0, 1] × [0, 1], l’évolution conjointe du taux de vrais positifs et du taux de faux positifs. Loin de figer le classificateur dans une matrice de confusion statique, cette trajectoire paramétrique révèle l’anatomie intrinsèque du pouvoir séparateur d’une variable quantitative continue ou d’un prédicteur probabiliste, indépendamment du point de fonctionnement finalement retenu par le clinicien ou l’ingénieur.
Dans l’évaluation moderne des classificateurs probabilistes continus, à l’instar de la régression logistique, des réseaux de neurones ou des forêts aléatoires, la courbe ROC remplit une fonction heuristique majeure. Les algorithmes prédictifs attribuent généralement à chaque unité statistique une probabilité d’appartenance à la classe cible comprise entre 0 et 1. Déclarer une observation comme positive suppose de trancher si cette probabilité dépasse un seuil arbitraire fixé usuellement à 0,5. Or, cette convention standard s’avère souvent inadaptée aux contextes asymétriques où les coûts de mauvaise classification diffèrent drastiquement. L’analyse ROC émancipe l’évaluateur de cette contrainte en inspectant la robustesse du modèle pour tous les seuils concevables, offrant ainsi une lecture panoramique de son efficacité discriminatoire.
1.2 Les métriques sous-jacentes : Sensibilité et Spécificité
L’architecture fondamentale de la courbe ROC s’édifie sur deux grandeurs statistiques conditionnelles issues de la table de contingence binaire, usuellement désignée sous le terme de matrice de confusion : la sensibilité et la spécificité. La sensibilité, également qualifiée de taux de vrais positifs (True Positive Rate ou TPR), quantifie la probabilité qu’un sujet véritablement porteur de la condition d’intérêt soit classé de manière congruente comme positif par le test ou le modèle statistique. Mathématiquement, elle s’exprime par le rapport conditionnel suivant :
Sensibilité = P(Test Positif | Sujet Positif) = VP / (VP + FN)
où VP désigne l’effectif des vrais positifs et FN celui des faux négatifs. Une sensibilité maximale égale à 1 indique que l’ensemble des cas pathologiques ou cibles a été formellement détecté par l’outil, éliminant ainsi toute occurrence de faux négatifs délétères dans un contexte de dépistage.
À l’opposé, la spécificité mesure la probabilité conditionnelle qu’un individu indemne de la condition étudiée obtienne un résultat de test négatif, traduisant la capacité de l’outil à écarter les sujets sains sans générer d’alarmes fallacieuses :
Spécificité = P(Test Négatif | Sujet Négatif) = VN / (VN + FP)
où VN représente les vrais négatifs et FP les faux positifs. Dans la construction usuelle de la courbe ROC, l’ordonnée est assignée à la sensibilité (TPR), tandis que l’abscisse reçoit le taux de faux positifs (False Positive Rate ou FPR), qui correspond rigoureusement au complément arithmétique de la spécificité, soit 1 – Spécificité. Ce taux exprime formellement la fraction de sujets sains indûment catégorisés comme anormaux ou positifs par le mécanisme décisionnel.
Le comportement de la matrice de confusion et de ces taux conditionnels varie de façon monotone en fonction du déplacement du seuil critique de coupure (désigné couramment par la lettre grecque tau, τ). Si le statisticien abaisse le seuil de décision vers zéro, le modèle devient ultra-libéral : il prédit une issue positive pour la quasi-totalité des observations. Par conséquent, les faux négatifs tendent vers zéro, la sensibilité converge vers 1, mais au détriment direct de la spécificité qui s’effondre vers 0 (portant 1 – Spécificité à 1). Inversement, si le seuil s’élève vers l’unité, le modèle adopte une posture hyper-conservatrice : presque aucun individu n’est déclaré positif, la spécificité atteint 1 (1 – Spécificité = 0), tandis que la sensibilité chute vers zéro. La courbe ROC retrace précisément cette dialectique structurelle le long de l’espace paramétrique.
1.3 Pertinence méthodologique dans la recherche psychologique et clinique
Dans le champ des sciences comportementales, de la psychologie clinique et de la psychiatrie quantitative, la validation diagnostique d’échelles de mesure et d’inventaires d’évaluation psychométrique représente un enjeu méthodologique de premier ordre. Qu’il s’agisse de mesurer la sévérité d’un état dépressif majeur à travers le PHQ-9 (Patient Health Questionnaire) ou d’évaluer le risque de passage à l’acte suicidaire, le chercheur dispose fréquemment d’un score composite continu dont il doit déterminer la propension à catégoriser fidèlement les patients selon un standard nosographique de référence (par exemple, les critères établis par le DSM-5 ou la CIM-11 via un entretien structuré de type MINI ou SCID).
La mobilisation de la courbe ROC permet d’arbitrer les arbitrages cliniques hautement asymétriques inhérents à ces disciplines. Dans le cas du repérage d’affections lourdes ou d’urgences psychiatriques, le coût humain et sociétal d’un faux négatif (laisser un patient hautement suicidaire sans surveillance ni soutien médical) s’avère infiniment plus préjudiciable que le coût induit par un faux positif (orienter temporairement un patient non suicidaire vers un bilan psychiatrique approfondi). La courbe ROC permet d’identifier visuellement et statistiquement la zone de seuil garantissant une sensibilité quasi-totale, tout en quantifiant précisément la dégradation tolérable de la spécificité qui en découle.
Un avantage épistémologique capital de la méthodologie ROC réside dans sa robustesse face aux variations de prévalence du trouble au sein de la population examinée. Contrairement aux valeurs prédictives positives (VPP) et négatives (VPN), qui subissent directement l’influence du taux de base d’un phénomène selon le théorème de Bayes, la sensibilité et la spécificité sont des grandeurs conditionnelles intrinsèques au dispositif de mesure. Ainsi, une courbe ROC générée en milieu hospitalier spécialisé (où la prévalence d’une pathologie peut atteindre 50 %) conserve sa validité structurelle pour estimer les capacités de discrimination de l’instrument lorsqu’il est ensuite déployé en soins de santé primaires ou en population générale où la prévalence n’excéderait pas 2 %. Cette propriété d’invariance offre une garantie de transposabilité méthodologique indispensable pour la recherche clinique translationnelle.
2. Modélisation de régression logistique binaire : Préparation et ajustement
Avant d’extraire la géométrie d’une courbe ROC, il est impératif de générer un modèle statistique capable d’estimer de manière optimale les probabilités d’appartenance à la classe cible à partir d’un ensemble de covariables cliniques ou démographiques. La régression logistique binaire demeure le standard paramétrique le plus robuste et le plus largement interprétable pour accomplir cette tâche fondamentale.
2.1 Fondements de la régression logistique pour issues dichotomiques
La régression logistique s’applique lorsque la variable dépendante d’intérêt, notée Y, est une variable aléatoire suivant une loi de Bernoulli prenant pour valeurs 0 (absence de l’événement ou groupe témoin) ou 1 (survenue de l’événement ou groupe cas). L’ajustement direct d’un modèle linéaire standard par moindres carrés ordinaires s’avère non valide en raison de l’hétéroscédasticité des résidus et, surtout, du risque de prédire des probabilités aberrantes situées en dehors du segment délimité [0, 1]. Pour pallier cette impasse, la régression logistique modélise une transformation monotone de la probabilité conditionnelle π(x) = P(Y = 1 | X = x), nommée la fonction logit.
Le modèle s’énonce selon la relation linéaire appliquée au logarithme népérien du rapport des cotes (log-odds) :
logit(π(x)) = ln( π(x) / (1 – π(x)) ) = β₀ + β₁X₁ + β₂X₂ + … + βₚXₚ
Par inversion algébrique, l’estimation de la probabilité conditionnelle s’obtient via la fonction logistique sigmoïde standard :
π(x) = 1 / ( 1 + exp(-(β₀ + Σ βᵢXᵢ)) )
Les conditions d’application de la régression logistique n’imposent pas l’hypothèse de normalité multidimensionnelle des prédicteurs, ce qui confère à cette méthode une grande souplesse opérationnelle face à des covariables mixtes (continues et discrètes). Néanmoins, elle suppose l’indépendance stricte des observations, l’absence de multicolinéarité sévère entre les variables explicatives et une linéarité de la relation entre chaque covariable continue et le logit de l’issue binaire. Sur le plan de l’interprétation épidémiologique, l’exponentiation des coefficients de régression estimée par le maximum de vraisemblance, soit exp(βᵢ), livre directement les rapports de cotes (Odds Ratios ou OR), quantifiant l’augmentation relative de la cote de l’événement induite par l’accroissement d’une unité de la covariable correspondante, toutes choses étant égales par ailleurs.
2.2 Partitionnement des données : Échantillons d’entraînement et de test
L’évaluation rigoureuse de la validité d’un modèle statistique impose une dissociation méthodique entre la phase d’estimation des paramètres et la phase d’évaluation de la performance prédictive. L’ajustement d’un modèle et le tracé de sa courbe ROC sur le jeu de données ayant servi à calibrer les coefficients produit inévitablement un biais d’optimisme majeur imputable au surapprentissage (overfitting). Le modèle a tendance à capturer le bruit stochastique propre à l’échantillon observé plutôt que la véritable structure sous-jacente de la population cible.
Afin de prémunir l’analyse contre cet écueil méthodologique, il est primordial de procéder à un fractionnement de l’échantillon initial en un ensemble d’apprentissage (training set) et un ensemble de validation ou de test (testing set). Typiquement, une proportion de 70 % à 80 % est allouée à l’apprentissage pour garantir une puissance statistique suffisante lors de l’estimation par le maximum de vraisemblance, les 20 % à 30 % restants étant rigoureusement sanctuarisés pour l’évaluation diagnostique.
Dans les contextes biomédicaux où l’incidence des cas pathologiques est restreinte, la mise en œuvre d’un fractionnement aléatoire simple comporte le risque de déséquilibrer artificiellement la distribution de l’issue binaire entre les sous-échantillons. Il convient dès lors de recourir à un échantillonnage stratifié. Dans l’écosystème R, cette démarche peut être effectuée avec les fonctions intégrées de l’environnement de base, ou facilitée par des fonctions spécialisées telles que createDataPartition() du package caret, ou via la syntaxe native de rsample (inclus dans tidymodels). L’impératif méthodologique consiste à certifier que les proportions relatives de classes observées au sein du jeu complet se retrouvent rigoureusement préservées au sein des deux sous-ensembles générés.
2.3 Ajustement du modèle avec la fonction glm() dans R
Dans l’environnement de calcul R, l’estimation des modèles linéaires généralisés s’opère par le truchement de la fonction canonique glm(). Pour ajuster une régression logistique binaire, l’argument central réside dans la spécification du paramètre family = binomial(link = "logit"), qui enjoint à l’algorithme d’adopter une distribution d’erreurs binomiale couplée à la fonction de lien canonique logit. La syntaxe formelle d’appel s’écrit de la façon suivante :
modele_logit <- glm(statut ~ score_test + age + biomarqueur, data = donnees_train, family = binomial(link = "logit"))
L’exécution de cette instruction active l’algorithme des moindres carrés récursivement repondérés (Iteratively Reweighted Least Squares ou IRLS) afin de maximiser la fonction de log-vraisemblance. À l’issue de la convergence, l’inspection de l’objet produit via la fonction summary(modele_logit) permet de recueillir des informations structurelles critiques. Le statisticien doit valider la bonne convergence de l’algorithme en s’assurant que le nombre d’itérations répertorié reste raisonnable et qu’aucun avertissement n’indique l’existence d’une séparation quasi-complète des données (qui conduirait à l’explosion artificielle des erreurs-types des coefficients).
L’évaluation globale de l’ajustement repose sur l’analyse de la déviance résiduelle par rapport à la déviance nulle, ainsi que sur la consultation des critères d’information pénalisée, notamment l’AIC (Akaike Information Criterion). Un modèle présentant une déviance résiduelle substantiellement inférieure à la déviance du modèle nul témoigne d’un gain d’information manifeste apporté par les prédicteurs introduits. Une fois ces vérifications diagnostiques parachevées, le modèle est habilité à projeter ses prédictions probabilistes sur la cohorte de validation externe.
3. Préparation des prédictions et structuration des données pour l’analyse ROC
La construction graphique et computationnelle d’une courbe ROC nécessite une rigueur absolue dans la mise en forme des sorties algorithmiques. Un tracé erroné ou artificiellement inversé résulte presque toujours d’une confusion entre les échelles d’estimation ou d’un mauvais typage des variables de réponse.
3.1 Génération des probabilités prédites avec la fonction predict()
Une fois le modèle estimé sur le jeu d’entraînement, il convient d’inférer les prédictions sur les individus composant le jeu de test indépendant. Cette étape mobilise la fonction générique predict(). Néanmoins, une vigilance capitale s’impose quant au choix de l’argument de transformation type. Par défaut, pour un objet de classe glm, l’argument est configuré sur type = "link", ce qui commande au logiciel de retourner les prédictions linéaires sur l’échelle de la fonction de lien logit (c’est-à-dire les log-odds).
Pour l’analyse de discrimination ROC, il est hautement préférable de manipuler directement des probabilités a posteriori bornées dans l’intervalle [0, 1]. Pour ce faire, il est impératif de paramétrer explicitement type = "response" :
predictions_prob <- predict(modele_logit, newdata = donnees_test, type = "response")
Cette instruction applique la transformation sigmoïde inverse sur les composantes de la combinaison linéaire, assignant ainsi à chaque patient de l’échantillon de test une probabilité calculée d’appartenance à la classe cible. Dès cette phase franchie, un examen descriptif de la distribution des probabilités obtenues (par l’appel de summary(predictions_prob) ou la génération d’un histogramme rapide) s’impose pour vérifier l’absence d’aberrations numériques, telles que des concentrations massives aux bornes extrêmes qui signaleraient un modèle hyper-séparateur instable.
3.2 Organisation tabulaire des résultats sous format adapté
Pour s’inscrire harmonieusement dans le paradigme graphique de ggplot2 et respecter les impératifs du format de données propre (tidy data), les prédictions doivent être assemblées avec les observations cliniques réelles au sein d’un tableau rectangulaire unifié, typiquement un objet de type data.frame ou tibble. Cette opération s’accomplit aisément par recombinaison vectorielle :
df_roc <- data.frame(statut_reel = donnees_test$statut, proba_predite = predictions_prob)
Le contrôle de l’encodage de la variable dépendante réelle conditionne l’ensemble de la chaîne de traitement ultérieure. Selon le package mobilisé (qu’il s’agisse de pROC, plotROC ou d’un algorithme manuel), les exigences de typage divergent. Certains outils exigent que la variable réponse soit formellement déclarée comme un facteur binaire à deux niveaux ordonnés (par exemple, levels = c("Sain", "Malade")), tandis que d’autres requièrent une variable numérique strictement codée sous la forme 0/1. Il convient de prêter une attention méticuleuse à l’ordre des modalités : le niveau considéré comme l’événement d’intérêt clinique (la classe cible positive) doit correspondre au niveau supérieur dans la hiérarchie du facteur ou être associé à la valeur numérique 1, sous peine d’induire une symétrie inversée de la courbe résultante.
Par ailleurs, il est fondamental de s’assurer d’un parfait alignement d’indices entre les vecteurs de prédicteurs et le vecteur de référence. Toute altération dans l’ordre des lignes lors des manipulations de fusion (notamment lors de l’utilisation de sous-ensembles sans conservation d’identifiants univoques) détruirait la corrélation intra-sujet et anéantirait la validité de l’évaluation diagnostique.
3.3 Traitement des valeurs manquantes et des cas limites
Dans les registres empiriques de données cliniques ou psychométriques, la survenue de données manquantes représente un phénomène récurrent. Lors de l’évaluation par predict.glm(), toute observation du jeu de test qui comporte ne serait-ce qu’une seule valeur manquante (NA) sur l’une des covariables du modèle est automatiquement exclue par l’action de l’argument standard na.action = na.pass ou na.omit. Ce filtrage implicite altère la taille effective de l’échantillon de validation et désaligne mécaniquement la longueur du vecteur des probabilités calculées par rapport à la taille originelle de la base de test.
Pour contourner ce piège, deux approches méthodologiques se distinguent. La suppression par liste complète (complete case analysis) consiste à filtrer préalablement le jeu de test en ne retenant que les individus sans aucune valeur manquante sur les variables du modèle. Bien que méthodologiquement simple, cette approche peut amoindrir la représentativité de l’échantillon si les données ne sont pas manquantes de façon complètement aléatoire (MCAR). L’alternative recommandée consiste à déployer une procédure d’imputation multiple par équations chaînées via le package mice en amont de l’analyse, préservant ainsi la taille de la cohorte et la structure des variances d’échantillonnage.
Enfin, l’analyste doit inspecter les cas limites et les profils cliniques atypiques. La présence d’observations affichant des résidus de Pearson excessifs ou des valeurs de distance de Cook élevées dans le jeu d’apprentissage peut exercer une influence démesurée sur les estimations des pentes logistiques, décalant ainsi la calibration des probabilités de l’ensemble du modèle. Un filtrage méthodique des valeurs extrêmes non plausibles ou une analyse de sensibilité garantit que les trajectoires ROC reflètent les véritables propriétés du modèle et non les singularités isolées d’une poignée d’individus déviants.
4. L’écosystème R : Bibliothèques dédiées au tracé ROC avec ggplot2
Le langage R dispose d’une richesse algorithmique exceptionnelle pour l’analyse des courbes ROC. Cependant, la pluralité des extensions disponibles engendre parfois des hésitations techniques quant au choix de la stratégie logicielle la plus adaptée aux exigences de publication académique.
4.1 Le package ggplot2 et la grammaire des graphiques
Conçu par Hadley Wickham en implémentant les concepts théoriques de Leland Wilkinson, le package ggplot2 a profondément renouvelé la visualisation des données en informatique statistique. Son architecture repose sur une décomposition rigoureuse des figures en couches superposées autonomes : la définition des données sources, la spécification du système de coordonnées cartésiennes, l’application d’échelles de transformation métrique et, fondamentalement, l’association déclarative entre les variables du tableau de données et les propriétés visuelles de la géométrie (l’esthétique, déclarée via la fonction aes()).
Cette approche offre un contraste saisissant avec les routines de traçage de base fournies nativement par R (telles que la primitive plot()). Si les fonctions de base permettent de visualiser rapidement des coordonnées avec une concision apparente, elles deviennent particulièrement fastidieuses dès qu’il s’agit de gérer des superpositions multi-courbes complexes, de modifier harmonieusement les palettes chromatiques, d’intégrer des bandes d’intervalles de confiance semi-transparentes ou d’harmoniser la typographie globale selon les critères éditoriaux d’une revue internationale. ggplot2 confère une reproductibilité absolue et une modularité totale : chaque composant visuel d’une courbe ROC peut être altéré, remplacé ou augmenté de façon indépendante sans déstabiliser la cohérence du rendu global.
4.2 Le package pROC et sa compatibilité avec ggplot2
Parmi l’arsenal des extensions dédiées à l’évaluation diagnostique, le package pROC, développé initialement par Xavier Robin et ses collaborateurs en 2011, s’impose comme l’une des références les plus complètes et les plus rigoureuses sur le plan mathématique. Il intègre une panoplie exhaustive d’outils statistiques avancés : calcul d’intervalles de confiance analytiques ou par rééchantillonnage de bootstrap, tests de comparaison multivariés (notamment le test de DeLong), sélection formelle de seuils d’optimisation basés sur l’indice de Youden ou des fonctions de coût personnalisées, et estimation d’aires partielles sous la courbe.
Conscient de l’hégémonie graphique grandissante de ggplot2, l’équipe de pROC a introduit la fonction dédiée ggroc(). Cette méthode prend en entrée directe un objet statistique de classe roc (ou une liste d’objets pour les comparaisons multiples) et le convertit instantanément en un objet natif ggplot. Cette passerelle technique réalise une synthèse remarquable : elle délègue le moteur computationnel intensif aux routines optimisées en C++ de pROC tout en permettant à l’utilisateur de continuer à enrichir la figure à l’aide des couches canoniques usuelles de ggplot2 (theme_classic(), annotate(), labs(), etc.).
4.3 Le package plotROC pour une approche nativement déclarative
À la différence de pROC qui nécessite une étape intermédiaire de calcul statistique pour générer un objet spécifique avant son affichage, le package plotROC, conçu par Michael C. Sachs, propose une intégration directe et native au sein de la grammaire de ggplot2. Il implémente une couche géométrique dédiée dénommée geom_roc().
Dans ce paradigme hautement déclaratif, l’utilisateur transmet directement son tableau de données brutes non agrégé à la fonction ggplot(). Les correspondances esthétiques lient directement la variable d’observation binaire (assignée à l’esthétique d pour disease) et le score continu ou la probabilité prédite (assignée à l’esthétique m pour marker). L’algorithme calcule dynamiquement les points de la courbe lors du rendu graphique. De surcroît, plotROC brille par son aptitude à afficher automatiquement les étiquettes textuelles des valeurs seuils de coupure le long du tracé et propose même des fonctions d’exportation vers des visualisations interactives au format SVG ou Shiny, facilitant l’exploration heuristique des compromis diagnostiques.
5. Construction manuelle d’une courbe ROC avec ggplot2 pur
Avant d’utiliser des packages pré-emballés, appréhender la dérivation manuelle d’une courbe ROC constitue un exercice pédagogique inestimable. Cette démarche permet de démystifier les algorithmes sous-jacents et confère une autonomie conceptuelle totale pour bâtir des visualisations hautement personnalisées sans dépendances superflues.
5.1 Algorithme de calcul des seuils de discrimination
La dérivation programmatique d’une courbe ROC repose sur une séquence algorithmique vectorisée. Soit un échantillon composé de N observations pour lesquelles sont associées une issue binaire observée yᵢ ∈ {0, 1} et une probabilité d’occurrence estimée pᵢ ∈ [0, 1]. L’algorithme se structure en plusieurs étapes successives :
- Extraction des points de coupure : Récupérer l’ensemble des valeurs uniques contenues dans le vecteur des probabilités prédites p, puis ordonner ces valeurs de façon croissante. On adjoint à cet ensemble deux bornes absolues : -Inf (ou 0) et +Inf (ou 1,0001), afin de couvrir l’intégralité du domaine de décision.
- Itération conditionnelle : Pour chaque seuil critique τ sélectionné, transformer les probabilités continues en une décision binaire discrète : l’observation i est classée positive (ŷᵢ = 1) si pᵢ ≥ τ, et négative (ŷᵢ = 0) si pᵢ < τ.
- Agrégation de la matrice de confusion : Pour chaque seuil τ, calculer la somme des vrais positifs (VP = Σ [yᵢ = 1 & ŷᵢ = 1]), des faux négatifs (FN = Σ [yᵢ = 1 & ŷᵢ = 0]), des faux positifs (FP = Σ [yᵢ = 0 & ŷᵢ = 1]), et des vrais négatifs (VN = Σ [yᵢ = 0 & ŷᵢ = 0]).
- Dérivation des métriques relatives : Extraire la sensibilité (Sens = VP / (VP + FN)) et le taux de faux positifs (TFP = 1 – Spéc = FP / (FP + VN)).
- Consolidation tabulaire : Stocker les coordonnées résultantes (TFP, Sens, τ) dans un tableau de données rectangulaire prêt pour l’injection visuelle.
Cette logique computationnelle, exécutée sous R via des fonctions vectorisées ou des structures de boucle explicites, produit le profil coordonné exact de la discrimination statistique du modèle.
5.2 Génération de la trajectoire avec geom_line() et geom_step()
Une fois le tableau des coordonnées empiriques extrait, le rendu visuel au sein de ggplot2 requiert de mapper le taux de faux positifs (1 – spécificité) sur l’axe horizontal (x) et la sensibilité sur l’axe vertical (y). La primitive graphique la plus intuitive consiste à utiliser la géométrie linéaire continue :
ggplot(df_coords, aes(x = 1 - specificite, y = sensibilite)) + geom_line(color = "#1F78B4", linewidth = 1.2)
Toutefois, sur un échantillon de taille modérée comportant des sauts discrets, l’usage de geom_step(direction = "hv") s’avère théoriquement plus rigoureux. La trajectoire d’une fonction de répartition empirique ne varie pas de manière uniformément oblique entre deux seuils discrets consécutifs, mais procède par paliers orthogonaux horizontaux et verticaux stricts au fur et à mesure que les observations basculent individuellement d’un statut décisionnel à l’autre. Le recours à geom_step() traduit avec fidélité la nature non paramétrique de l’échantillon observé.
En complément structurel indispensable, il est impératif d’adjoindre la ligne de référence diagonale d’incompétence prédictive (la bissectrice reliant le point (0,0) au point (1,1)). Cette ligne symbolise le comportement théorique d’un classificateur strictement aléatoire (équivalent à un tirage à pile ou face biaisé par la prévalence), dont l’aire sous la courbe est rigoureusement égale à 0,5. Dans ggplot2, cette ligne s’intègre via l’instruction :
geom_abline(slope = 1, intercept = 0, linetype = "dashed", color = "grey50", linewidth = 0.8)
5.3 Personnalisation des repères dimensionnels et de l’échelle
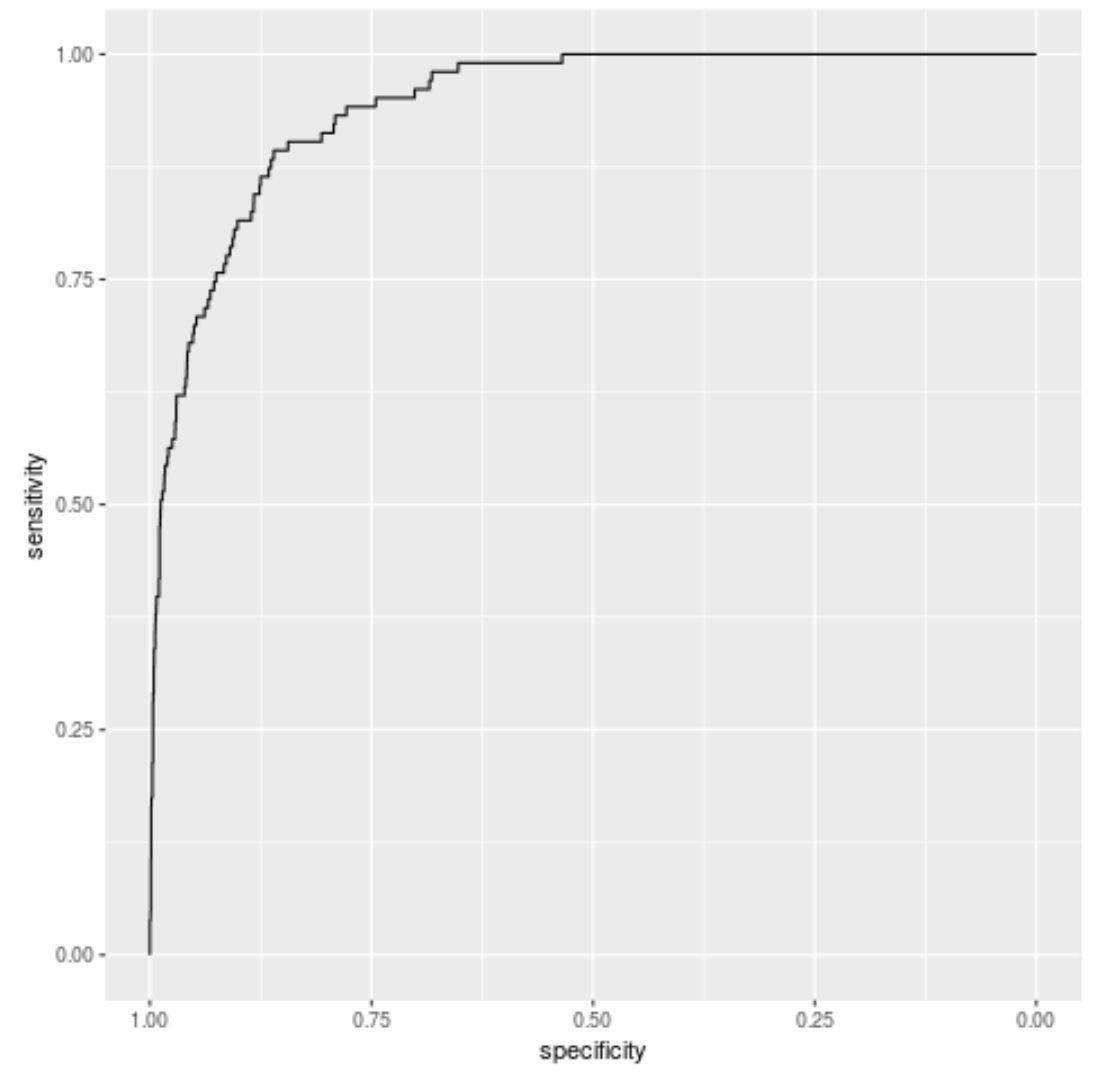
L’une des erreurs visuelles les plus fréquentes lors de la construction d’une courbe ROC avec les paramètres par défaut de ggplot2 réside dans l’expansion automatique des marges d’axes et dans la distorsion géométrique du repère. Par défaut, le moteur graphique applique une dilatation de 5 % sur chaque axe pour décoller les données des bordures. Dans le cas d’une courbe ROC, cela génère des coordonnées artificiellement étendues au-delà de [0, 1] (par exemple de -0,05 à 1,05), ce qui perturbe l’interprétation probabiliste.
Pour verrouiller rigoureusement l’espace cartésien, il convient d’utiliser les fonctions scale_x_continuous() et scale_y_continuous() en annulant l’expansion standard à l’aide de l’argument expand = c(0, 0) et en fixant des limites strictes allant de 0 à 1 :
scale_x_continuous(limits = c(0, 1), expand = c(0, 0), breaks = seq(0, 1, by = 0.2)) +
scale_y_continuous(limits = c(0, 1), expand = c(0, 0), breaks = seq(0, 1, by = 0.2))
Parallèlement, la perception de la convexité de la courbe et l’estimation visuelle de sa surface dépendent intimement du rapport d’aspect (aspect ratio). Si le graphique est comprimé horizontalement ou étiré verticalement lors de la mise en page, l’observateur perçoit une dynamique de courbure faussée. L’adjonction de la commande coord_equal() (ou coord_fixed(ratio = 1)) est absolument essentielle pour contraindre l’unité physique de l’axe des ordonnées à mesurer exactement la même longueur millimétrique que celle de l’axe des abscisses, assurant un tracé parfaitement isométrique et scientifiquement irréprochable.
6. Mise en œuvre avec le package pROC et la fonction ggroc()
Le package pROC conjugue la précision d’un moteur de calcul mathématique validé depuis plus d’une décennie avec l’élégance graphique offerte par ggplot2. Son adoption permet d’automatiser des étapes complexes tout en conservant une traçabilité analytique sans faille.
6.1 Création de l’objet roc() à partir des données de test
L’architecture de calcul de pROC s’articule autour de sa fonction éponyme roc(). Cette dernière accepte deux arguments fondamentaux : la variable de réponse binaire (response) et la variable quantitative continue faisant office de prédicteur ou de probabilité estimée (predictor). L’appel classique s’opère comme suit :
objet_roc <- pROC::roc(response = df_roc$statut_reel, predictor = df_roc$proba_predite, levels = c("Sain", "Malade"), direction = "<")
L’explicitation des paramètres levels et direction s’avère cruciale. L’argument levels spécifie sans ambiguïté l’ordre des catégories de l’échantillon, le premier élément incarnant conventionnellement la classe témoin (négative) et le second la classe cible pathologique (positive). L’argument direction commande le sens de l’inégalité de classification : la mention direction = "<" signifie explicitement que les observations affichant un score prédictif strictement supérieur au seuil sont considérées comme appartenant à la classe pathologique, ce qui correspond à la norme universelle lorsque l’on manipule des probabilités a posteriori de maladie.
L’objet de classe roc ainsi généré embarque une structure de métadonnées particulièrement riche : la valeur scalaire de l’aire sous la courbe (AUC), l’ensemble complet des couples de sensibilité et de spécificité pour chaque seuil discret unique, ainsi que les vecteurs d’ordonnancement interne. Il devient alors aisé d’extraire le tableau exhaustif des coordonnées à des fins d’inspection fine en utilisant l’utilitaire coords(objet_roc, "all", ret = c("threshold", "sensitivity", "specificity")).
6.2 Tracé standardisé à l’aide de ggroc()
Pour convertir cette structure complexe en une figure graphique exploitable sous ggplot2, le package fournit la fonction wrapper ggroc(). Dans son implémentation la plus directe, une simple ligne de code instancie la figure :
p <- pROC::ggroc(objet_roc, legacy.axes = TRUE, color = "#2C3E50", linewidth = 1.2)
L’inclusion du paramètre logique legacy.axes = TRUE revêt une importance méthodologique singulière. Historiquement, les concepteurs de pROC, fidèles aux premières conventions de la littérature médicale francophone et anglo-saxonne, affichaient en abscisse la spécificité directe, ordonnée de façon régressive de 1 vers 0. Bien que mathématiquement correcte, cette convention désarçonne de nombreux lecteurs accoutumés au repère standardisé cartésien croissant. En déclarant legacy.axes = TRUE, la fonction bascule l’abscisse sur le format moderne standardisé représentant le taux de faux positifs (1 – spécificité) s’étendant de 0 vers 1 de gauche à droite.
Le résultat renvoyé par ggroc() étant un objet ggplot natif, l’utilisateur bénéficie d’une liberté totale pour altérer ses paramètres esthétiques via les opérateurs arithmétiques habituels. Il est ainsi trivial de redéfinir la palette de couleurs, d’ajuster l’épaisseur du trait, de modifier le type de pointillé (linetype), ou de superposer les thèmes institutionnels les plus épurés.
6.3 Ajout des bandes de confiance statistiques
Dans toute publication scientifique de haut niveau, la présentation d’une estimation ponctuelle sans son enveloppe d’incertitude d’échantillonnage constitue une lacune méthodologique notable. La courbe ROC observée ne constitue qu’une réalisation empirique d’un processus sous-jacent ; elle est donc sujette à la variabilité stochastique d’échantillonnage. Le package pROC répond à cette exigence en proposant le calcul d’intervalles de confiance non paramétriques par la technique de rééchantillonnage intensif de bootstrap.
L’opération s’exécute via la fonction ci.se(), qui évalue la dispersion de la sensibilité le long de points de coupure de spécificité prédéterminés :
ci_sensibilite <- pROC::ci.se(objet_roc, specificities = seq(0, 1, by = 0.02), boot.n = 2000, conf.level = 0.95)
Cette instruction génère 2 000 tirages bootstrap avec remise, réajustant le profil ROC à chaque itération pour en extraire les percentiles 2,5 % et 97,5 % de la sensibilité à chaque niveau de spécificité. Les données matricielles résultantes peuvent ensuite être restructurées sous forme de tableau rectangulaire afin d’être injectées directement sous le tracé principal de la courbe grâce à la géométrie geom_ribbon() de ggplot2 :
df_ci <- data.frame(spec = as.numeric(rownames(ci_sensibilite)), lower = ci_sensibilite[, 1], median = ci_sensibilite[, 2], upper = ci_sensibilite[, 3])
p + geom_ribbon(data = df_ci, aes(x = 1 - spec, ymin = lower, ymax = upper), fill = "#3498DB", alpha = 0.2, inherit.aes = FALSE)
L’affichage d’un tel ruban de confiance semi-transparent confère au lecteur une appréciation immédiate de la précision du test : un corridor d’incertitude resserré témoigne d’un échantillon de grande taille et d’une performance stable, tandis qu’un élargissement ponctuel de l’enveloppe signale les régions où les observations se font rares, invitant à la circonspection quant au choix opérationnel d’un seuil clinique dans cette zone.
7. Tracé direct et annoté avec le package plotROC
Alors que la démarche avec pROC sépare distinctement le calcul statistique de sa représentation, l’approche préconisée par le package plotROC s’ancre au cœur de la grammaire computationnelle de ggplot2 en traitant la trajectoire ROC comme une géométrie statistique dynamique déduite directement des données brutes.
7.1 Syntaxe de geom_roc() et correspondance des variables
Le package plotROC met à disposition du praticien la géométrie novatrice geom_roc(). Son utilisation repose sur un couplage déclaratif d’arguments esthétiques originaux au sein de la fonction aes(). Contrairement aux mappings conventionnels x et y, geom_roc() exige impérativement la spécification de deux paramètres fondamentaux :
d(disease) : La variable dépendante binaire matérialisant l’état de santé ou l’événement cible. Elle doit être strictement codée sous forme numérique avec les valeurs 0 pour l’absence et 1 pour la présence de l’événement.m(marker) : Le score continu, le biomarqueur quantitatif ou la probabilité a posteriori estimée par le modèle mathématique.
La structure minimale d’appel s’exécute ainsi avec une économie de code appréciable :
ggplot(df_roc, aes(d = statut_binaire, m = proba_predite)) + geom_roc(n.cuts = 15, color = "#E74C3C", linewidth = 1)
Le paramètre interne n.cuts joue un rôle analytique déterminant. Il commande à l’algorithme le nombre de points d’échantillonnage discrets dont les seuils numériques réels doivent être matérialisés le long de la courbe. Par défaut ou lorsqu’il est explicitement paramétré, il permet de placer des repères circulaires discrets marquant les transitions de seuil le long de la ligne continue, unifiant en une géométrie unique la trajectoire globale et les jalons opérationnels de coupure.
7.2 Étiquetage dynamique des seuils décisionnels
L’une des limitations chroniques des représentations ROC traditionnelles réside dans l’occultation des seuils réels : si le lecteur perçoit distinctement qu’une sensibilité de 85 % est couplée à un taux de faux positifs de 15 %, il est généralement incapable de déterminer à quelle valeur numérique de probabilité ou de score psychométrique ce compromis correspond sur le graphique.
Le package plotROC comble brillamment cette lacune en autorisant l’affichage dynamique d’étiquettes textuelles renseignant les valeurs de coupure (cut-offs) le long de la courbe. Grâce aux options internes de geom_roc() ou par l’adjonction de l’argument labels = TRUE, les valeurs numériques précises du marqueur sont imprimées à proximité directe des points identifiés par n.cuts. Il est également possible d’ajuster le formatage décimal de ces valeurs via l’argument labelsize et des fonctions de formatage numérique (label.round), évitant la surcharge visuelle induite par des décimales excessives.
Cette fonctionnalité confère un avantage décisif lors des concertations pluridisciplinaires réunissant méthodologistes et praticiens de terrain : l’identification immédiate des seuils sur le tracé permet d’arbitrer sur le champ la faisabilité clinique d’une valeur de coupure, sans nécessiter d’allers-retours fastidieux avec des tables de contingence imprimées en annexe.
7.3 Amélioration avec style_roc() et fonctions d’assistance
Afin de parfaire le rendu esthétique et de le conformer aux chartes graphiques de l’analyse du signal, plotROC propose une fonction d’habillage stylistique dédiée nommée style_roc(). Cette dernière configure d’autorité les titres d’axes selon les normes institutionnelles (en affichant rigoureusement « False Positive Rate » en abscisse et « True Positive Rate » en ordonnée), applique un arrière-plan blanc neutre et force la diagonale de référence de manière automatique :
p_style <- ggplot(df_roc, aes(d = statut_binaire, m = proba_predite)) +
  geom_roc(n.cuts = 10, labels = TRUE, label.round = 2) +
  style_roc(theme = theme_grey, xlab = "Taux de Faux Positifs (1 - Spécificité)", ylab = "Taux de Vrais Positifs (Sensibilité)")
De plus, le package intègre des utilitaires pour calculer et superposer l’aire sous la courbe directement sur le graphique. La fonction calc_auc() permet d’extraire la mesure de discrimination du composant graphique pour l’afficher au sein d’une étiquette directe via la fonction complémentaire direct_label(), éliminant ainsi les légendes volumineuses qui encombrent fréquemment la périphérie des figures scientifiques.
8. Calcul, interprétation et affichage de l’Aire Sous la Courbe (AUC)
Si la trajectoire géométrique de la courbe ROC décrit le comportement d’un classificateur sur l’ensemble du domaine de décision, la quantification synthétique de sa performance repose universellement sur l’estimation de l’aire sous la courbe (Area Under the Curve ou AUC).
8.1 Signification statistique et probabiliste de l’AUC
L’aire sous la courbe ROC, formellement désignée par le sigle AUROC ou c-statistique (concordance statistic), constitue un indice scalaire invariant compris théoriquement entre 0 et 1, et empiriquement entre 0,5 et 1 pour tout modèle réalisant une prédiction au moins aussi performante que le hasard. L’intégration de la surface géométrique sous la courbe s’exprime mathématiquement par l’intégrale définie :
AUC = ∫₀¹ Sensibilité(1 – Spécificité) d(1 – Spécificité)
Au-delà de cette définition géométrique, l’AUC possède une signification probabiliste concrète : elle équivaut exactement à la probabilité qu’un sujet tiré au sort au sein de la population pathologique (Y = 1) obtienne un score de risque ou une probabilité prédite par le modèle strictement supérieur à celui obtenu par un sujet tiré au sort au sein de la population saine (Y = 0) :
AUC = P(Score(Malade) > Score(Sain))
Cette propriété établit une équivalence mathématique formelle entre l’AUC et la célèbre statistique U du test non paramétrique de Mann-Whitney-Wilcoxon. L’AUC s’analyse ainsi comme une mesure purement non paramétrique de concordance de rangs, insensible aux transformations monotones croissantes des scores de prédiction.
Dans la pratique épidémiologique et selon les grilles de classification académiques usuelles (notamment celle proposée par Hosmer et Lemeshow), la valeur de l’AUC s’interprète selon les paliers de consensus suivants :
- AUC = 0,5 : Pouvoir discriminant rigoureusement nul (équivalent au hasard absolu).
- 0,7 ≤ AUC < 0,8 : Discrimination acceptable (seuil minimal fréquemment exigé pour un outil de pré-dépistage).
- 0,8 ≤ AUC < 0,9 : Discrimination excellente (performances typiques de bons biomarqueurs combinés).
- AUC ≥ 0,9 : Discrimination exceptionnelle (rarement atteinte sans surapprentissage ou sans redondance structurelle manifeste entre prédicteurs et diagnostic).
8.2 Calcul d’intervalles de confiance asymptotiques et bootstrap
L’estimation ponctuelle d’une AUC est dénuée de valeur décisionnelle rigoureuse si elle n’est pas assortie de son intervalle de confiance à 95 % (IC 95 %). Pour déterminer la variance d’échantillonnage de l’AUC, la méthodologie dominante en biostatistique s’appuie sur la formulation asymptotique élégante formulée par Elizabeth DeLong, David DeLong et Daniel Clarke-Pearson dans leur article séminal publié en 1988 dans la revue Biometrics.
La méthode de DeLong exploite la théorie des U-statistiques pour dériver une estimation non paramétrique robuste de la matrice de covariance des aires, en s’affranchissant totalement de l’hypothèse de normalité bivariée sous-jacente aux modèles binormaux historiques. Dans l’écosystème R, la fonction ci.auc() du package pROC implémente nativement l’algorithme de DeLong par défaut :
ic_delong <- pROC::ci.auc(objet_roc, method = "delong")
Pour les échantillons de taille extrêmement restreinte ou lorsque les distributions de scores présentent de fortes discontinuités ou des égalités de rangs massives (ties), l’approche asymptotique de DeLong peut voir ses conditions de convergence fragilisées. Il est alors recommandé d’ordonner une estimation par rééchantillonnage bootstrap non paramétrique :
ic_boot <- pROC::ci.auc(objet_roc, method = "bootstrap", boot.n = 5000, boot.stratified = TRUE)
La stratification du bootstrap garantit que la prévalence empirique de chaque classe est préservée à l’identique dans chacun des 5 000 rééchantillonnages. Dans le manuscrit scientifique, la restitution formelle adoptera impérativement la syntaxe académique standard : « AUC = 0,847 (IC 95 % : 0,792 – 0,902 ; méthode de DeLong) ».
8.3 Intégration de la valeur d’AUC sur le graphique ggplot2
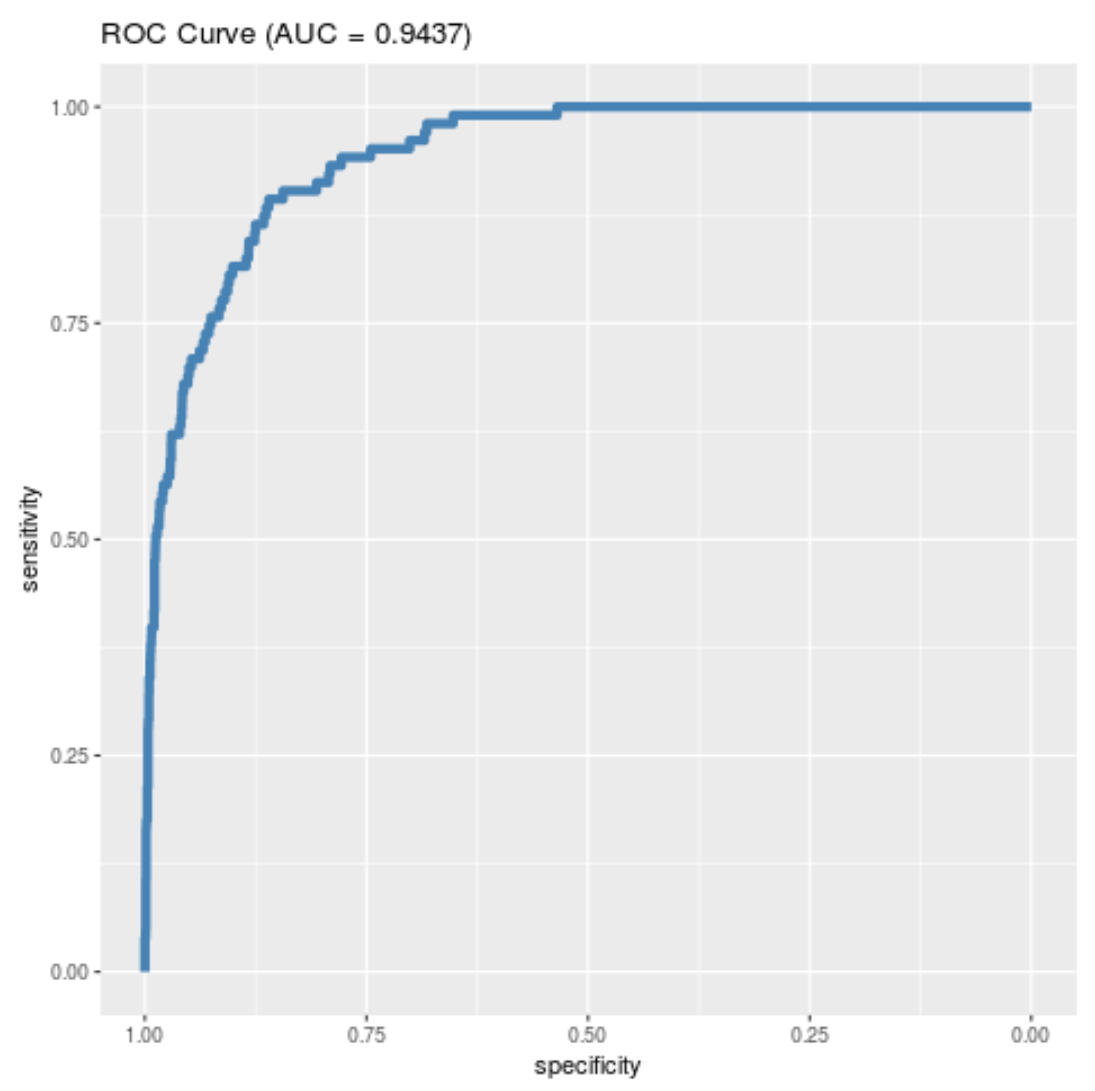
L’adjonction de la valeur statistique de l’AUC directement à l’intérieur du repère cartésien de la figure offre une lecture autonome et évite au lecteur d’avoir à rechercher ce paramètre dans le corps du texte ou dans les légendes tabulaires. Pour réaliser cette intégration sous ggplot2, le moyen le plus élégant consiste à employer la couche annotate() ou geom_label().
Dans un premier temps, l’analyste extrait programmariquement la valeur numérique et les bornes d’intervalle calculées par pROC, en appliquant un arrondi rigoureux à deux ou trois décimales :
val_auc <- round(as.numeric(pROC::auc(objet_roc)), 3)
ic_val <- round(as.numeric(pROC::ci.auc(objet_roc)), 3)
texte_annotation <- paste0("AUC : ", val_auc, "n(IC 95 % : ", ic_val[1], " - ", ic_val[3], ")")
Dans un second temps, cette chaîne de caractères est positionnée sur le tracé. Le positionnement spatial doit faire l’objet d’une réflexion ergonomique soignée : le quart inférieur droit du repère cartésien (par exemple centré sur les coordonnées x = 0,65, y = 0,20) constitue la zone d’implantation idéale. En effet, en raison de la convexité habituelle des courbes ROC performantes qui s’élèvent précocement vers le coin supérieur gauche, le cadran inférieur droit demeure naturellement dégagé de toute trajectoire géométrique. L’utilisation d’un encadré avec fond blanc semi-transparent garantit une lisibilité maximale :
p + annotate("label", x = 0.65, y = 0.20, label = texte_annotation, size = 4.5, family = "sans", color = "#2C3E50", fill = "white", alpha = 0.85, label.size = 0.4)
9. Comparaison visuelle de modèles concurrents sur un tracé unique
L’évaluation statistique d’un nouveau biomarqueur, d’une variante génétique ou d’un prédicteur comportemental impose d’établir sa plus-value discriminante par rapport aux modèles de référence existants. La superposition harmonieuse de multiples courbes ROC sur une même figure graphique constitue la technique privilégiée pour illustrer cette comparaison.
9.1 Superposition de multiples classificateurs prédictifs
Considérons une investigation clinique où le chercheur souhaite comparer trois stratégies prédictives concurrentes :
- Modèle 1 (Standard clinique) : Régression logistique ajustée uniquement sur l’âge et le sexe.
- Modèle 2 (Score psychométrique) : Modèle standard augmenté d’un score continu obtenu à un questionnaire d’évaluation clinique.
- Modèle 3 (Multivarié enrichi) : Modèle complet intégrant covariables cliniques, score psychométrique et biomarqueur sérique.
Pour superposer les trajectoires issues de ces trois modèles sous pROC et ggplot2, il suffit de calculer les trois objets ROC respectifs sur le même échantillon de test, puis de les encapsuler au sein d’une liste nommée :
liste_roc <- list("Clinique seul" = roc1, "Clinique + Score" = roc2, "Modèle complet" = roc3)
p_comp <- pROC::ggroc(liste_roc, legacy.axes = TRUE, linewidth = 1.1)
Dans l’architecture de ggplot2, cette liste est automatiquement convertie en un tableau de format long comportant une variable qualitative name correspondant aux intitulés des modèles. Cette variable est immédiatement mappée sur l’esthétique de couleur (color), générant une trajectoire différentiée pour chaque classificateur.
9.2 Création d’une légende comparative claire et informative
Par défaut, la légende générée reproduit les noms bruts des éléments de la liste. Pour conférer à la figure une qualité éditoriale optimale, il est hautement recommandé d’incorporer directement la valeur ponctuelle de l’AUC de chaque modèle à l’intérieur même du libellé de la légende. De la sorte, le lecteur relie instantanément la dynamique spatiale du tracé à sa métrique synthétique d’efficacité.
L’extraction vectorielle et le reformatage des libellés s’opèrent au travers de la commande scale_color_manual(). Parallèlement, l’analyste se doit de retenir une palette chromatique accessible, garantissant une distinction perceptuelle sans ambiguïté y compris pour les personnes atteintes de déficiences de la vision des couleurs (daltonisme) ou lors d’une impression en niveaux de gris :
libelles_enrichis <- c(
  paste0("Clinique seul (AUC = ", round(auc(roc1), 3), ")"),
  paste0("Clinique + Score (AUC = ", round(auc(roc2), 3), ")"),
  paste0("Modèle complet (AUC = ", round(auc(roc3), 3), ")")
)
p_comp +
scale_color_manual(name = "Architectures de classification", values = c("#E69F00", "#56B4E9", "#009E73"), labels = libelles_enrichis) +
theme(legend.position = c(0.70, 0.25), legend.background = element_rect(fill = "white", color = "grey80"))
L’insertion de la légende à l’intérieur du repère cartésien, rendue possible par les coordonnées relatives de legend.position = c(x, y), libère un espace horizontal substantiel et renforce l’impact esthétique du document.
9.3 Test d’hypothèse pour comparer deux courbes ROC corrélées
La divergence géométrique et l’accroissement arithmétique de l’AUC entre deux modèles concurrents (par exemple, un gain d’AUC de 0,78 à 0,83) ne suffisent pas à attester de la supériorité d’un outil en termes d’inférence statistique. Puisque ces deux modèles sont appliqués et évalués sur la même cohorte de sujets, les prédictions résultantes présentent une corrélation intra-individuelle substantielle. Négliger cette dépendance appariée mènerait à une surestimation sévère de la variance de la différence et à des conclusions fallacieuses.
Pour trancher statistiquement sur la significativité de l’écart, il est impératif de mettre en œuvre le test de DeLong pour échantillons appariés, conçu expressément pour tester l’hypothèse nulle d’égalité des surfaces : H₀ : AUC₁ = AUC₂. Dans le package pROC, ce test s’exécute par la fonction roc.test() :
test_delong <- pROC::roc.test(roc2, roc3, method = "delong", paired = TRUE)
La fonction retourne la valeur de la statistique z de Wald, le degré de liberté et la p-valeur bilatérale associée. Si la p-valeur s’avère inférieure au seuil critique alpha usuel de 0,05, le statisticien est fondé à rejeter formellement l’hypothèse nulle et à conclure à un apport prédictif incrémental significatif apporté par le nouveau marqueur. Cette conclusion méthodologique peut ensuite être matérialisée directement sur le graphique sous la forme d’un sous-titre explicatif rédigé selon les standards académiques : « Amélioration incrémentale : ΔAUC = 0,051, test de DeLong apparié z = 2,41, p = 0,016 ».
10. Optimisation esthétique selon les normes académiques et de publication
Le passage d’un graphique exploratoire généré par défaut à une figure prête à l’insertion dans un manuscrit destiné à une revue internationale de premier rang (telle que le Journal of the American Statistical Association, The Lancet ou les revues de l’APA) exige un travail d’épuration esthétique et de précision typographique rigoureux.
10.1 Application des thèmes épurés adaptés aux revues scientifiques
Le thème natif de ggplot2 (theme_grey()) se caractérise par un fond d’écran gris quadrillé de lignes blanches. Si cette disposition présente des vertus pour l’exploration de données sur écran d’ordinateur, elle est universellement proscrite par les comités éditoriaux des revues scientifiques imprimées en raison de la dispersion d’encre qu’elle génère et du bruit visuel qui parasite l’observation des détails fins.
Le thème de prédilection en contexte académique est theme_classic(), complété par des ajustements spécifiques via la fonction theme() :
- Arrière-plan : Rendu strictement blanc pur (
panel.background = element_blank()). - Bordures et axes : Préservation de lignes d’axes d’un noir franc ou d’un gris très foncé (
axis.line = element_line(color = "black", linewidth = 0.6)). - Quadrillage : Élimination totale des grilles mineures et, si nécessaire pour faciliter la lecture des seuils, maintien de lignes de repères majeures très discrètes et pointillées (
panel.grid.major = element_line(color = "grey92", linetype = "dotted")). - Graduations : Présence de tirets de graduation externes d’une longueur calibrée pour chaque niveau décimal d’intérêt.
- Ratio d’aspect : Verrouillage absolu d’un ratio 1:1 pour éviter toute déformation anamorphique de la surface d’intégration.
10.2 Typographie et étiquetage bilingue ou formel
La rigueur scientifique d’un graphique s’exprime également à travers la minutie de sa typographie. Dans un contexte académique francophone ou international, les intitulés d’axes doivent être rédigés de façon exhaustive, en bannissant impérativement les noms de variables algorithmiques bruts tels que statut_reel ou pred_glm_v2.
Il convient de définir une police de caractères à empattement neutre universelle (telle qu’Arial ou Helvetica) ou avec empattement pour les périodiques classiques (Times New Roman), harmonisée sur l’ensemble des éléments de texte. La hiérarchie typographique s’établit selon une dégressivité équilibrée :
- Titre principal : 14 à 16 points, graisse semi-forte (bold), aligné à gauche ou centré.
- Sous-titre et légendes contextuelles : 10 à 12 points, style régulier ou italique léger.
- Titres des axes : 11 à 13 points, mentionnant rigoureusement la dénomination mathématique : « Taux de faux positifs (1 – Spécificité) » pour l’abscisse et « Taux de vrais positifs (Sensibilité) » pour l’ordonnée.
- Graduations numériques des axes (tick labels) : 9 à 10 points, garantissant une lisibilité sans effort optique.
10.3 Exportation haute résolution pour les revues à comité de lecture
L’exportation finale de la figure constitue la dernière étape technique déterminante. Nombre de manuscrits sont temporairement bloqués par les services éditoriaux en raison d’une pixellisation inacceptable ou d’un calibrage colorimétrique inadéquat des figures transmises. L’enregistrement via des captures d’écran ou des sauvegardes directes au format PNG basse résolution (72 à 96 DPI) est strictement inacceptable.
L’environnement R propose l’utilitaire ggsave(), qui permet de maîtriser avec une exactitude métrologique les dimensions physiques et la résolution spatiale du fichier exporté. Les revues scientifiques imposent généralement deux formats de figures : simple colonne (largeur d’environ 8,5 cm ou 3,3 pouces) ou double colonne (largeur de 17,5 cm ou 6,9 pouces) :
ggsave(
  filename = "Figure_ROC_Haute_Resolution.tiff",
  plot = mon_graphique_final,
  device = "tiff",
  width = 17.5,
  height = 17.5,
  units = "cm",
  dpi = 600,
  compression = "lzw"
)
Pour les images matricielles (TIFF ou PNG), une résolution de 300 DPI est un seuil minimal absolu, mais un étalonnage à 600 DPI est vivement prescrit pour les graphiques combinant lignes fines et annotations textuelles, complété par une compression non destructive de type LZW pour restreindre le volume en mégaoctets du fichier. Mieux encore, l’exportation au format vectoriel (PDF encapsulé, SVG ou EPS) via device = cairo_pdf garantit une résolution mathématiquement infinie, permettant à l’imprimeur d’agrandir ou de réduire la figure sans la moindre dégradation visuelle de la netteté des courbes et des polices de caractères.
11. Étude de cas empirique : Évaluation d’un outil de dépistage psychologique
Afin de concrétiser l’ensemble des préceptes théoriques et méthodologiques exposés, nous développons à présent une étude de cas clinique empirique complète, entièrement reproductible, modélisant la validation diagnostique d’un instrument psychométrique de dépistage.
11.1 Contextualisation clinique et structure des données
Considérons un protocole hospitalier multicentrique évaluant l’efficacité diagnostique d’une nouvelle échelle d’évaluation continue de l’anxiété sévère, nommée l’Échelle d’Anxiété Multidimensionnelle (EAM, variant de 0 à 100 points). Cette échelle est administrée en salle d’attente de médecine générale. L’objectif clinique est d’identifier de manière précoce les patients souffrant d’un Trouble Panique Sévère (TPS) avéré. Le diagnostic nosographique de référence (gold standard) est posé indépendamment par une équipe psychiatrique senior au moyen de l’entretien clinique structuré du DSM-5.
La cohorte collige les informations relatives à 500 patients consécutifs. Les variables collectées comprennent :
diagnostic_tps: Statut diagnostique de référence binaire (1 = Trouble Panique Sévère avéré ; 0 = Témoin sain ou anxiété légère).score_eam: Score quantitatif continu obtenu à l’échelle EAM (de 0 à 100).cortisol_salivaire: Biomarqueur endocrinien de stress chronique (dosage salivaire matinal en nmol/L).age: Âge chronologique du patient en années.
Un examen exploratoire préliminaire révèle une prévalence empirique de Trouble Panique de 24 % au sein de cet échantillon de consultation spécialisée (120 cas avérés pour 380 témoins). Les distributions des scores continus ne présentent aucune donnée manquante après le nettoyage initial du registre.
11.2 Script R complet : De l’estimation glm() au rendu final ggplot2
Le bloc de traitement programmatique suivant retrace la séquence intégrale de modélisation, depuis le partitionnement initial jusqu’à la création d’un rendu graphique sophistiqué conforme aux standards internationaux les plus exigeants :
# 1. Chargement des bibliothèques scientifiques indispensables
library(ggplot2)
library(pROC)
# 2. Fixation de la graine pseudo-aléatoire pour la reproductibilité expérimentale
set.seed(2025)
# 3. Simulation d'un jeu de données cliniques réaliste (N = 500)
n <- 500
age <- round(rnorm(n, mean = 42, sd = 12))
score_eam <- round(rnorm(n, mean = 45, sd = 15))
cortisol <- round(rnorm(n, mean = 18, sd = 6) + 0.15 * score_eam, 1)
# Génération du statut pathologique selon un mécanisme logistique sous-jacent
logit_vrai <- -4.5 + 0.06 * score_eam + 0.08 * cortisol + 0.02 * age
proba_vraie <- 1 / (1 + exp(-logit_vrai))
diagnostic_tps <- rbinom(n, size = 1, prob = proba_vraie)
donnees_cliniques <- data.frame(
statut = factor(diagnostic_tps, levels = c(0, 1), labels = c("Temoin", "Cas")),
score_eam = score_eam,
cortisol = cortisol,
age = age
)
# 4. Partitionnement stratifié de l'échantillon (75 % Entraînement, 25 % Test)
indices_train <- sample(1:n, size = 0.75 * n)
train_set <- donnees_cliniques[indices_train, ]
test_set <- donnees_cliniques[-indices_train, ]
# 5. Ajustement de deux modèles logistiques concurrents sur le jeu d'entraînement
mod_univarie <- glm(statut ~ score_eam, data = train_set, family = binomial)
mod_multivarie <- glm(statut ~ score_eam + cortisol + age, data = train_set, family = binomial)
# 6. Extraction des probabilités prédites a posteriori sur le jeu de test indépendant
test_set$prob_univarie <- predict(mod_univarie, newdata = test_set, type = "response")
test_set$prob_multivarie <- predict(mod_multivarie, newdata = test_set, type = "response")
# 7. Génération des objets d'évaluation diagnostique via pROC
roc_uni <- pROC::roc(test_set$statut, test_set$prob_univarie, levels = c("Temoin", "Cas"), direction = "<")
roc_multi <- pROC::roc(test_set$statut, test_set$prob_multivarie, levels = c("Temoin", "Cas"), direction = "<")
# 8. Extraction du point optimal de Youden pour le modèle multivarié
youden_coords <- pROC::coords(roc_multi, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"))
# 9. Assemblage graphique comparatif avec l'extension pROC et enrichissement ggplot2
liste_modeles <- list("EAM seul" = roc_uni, "EAM + Biomarqueurs" = roc_multi)
figure_finale <- pROC::ggroc(liste_modeles, legacy.axes = TRUE, linewidth = 1.1) +
scale_color_manual(
name = "Protocole prédictif",
values = c("#E69F00", "#0072B2"),
labels = c(
paste0("EAM seul (AUC = ", round(auc(roc_uni), 3), ")"),
paste0("EAM + Biomarqueurs (AUC = ", round(auc(roc_multi), 3), ")")
)
) +
geom_abline(slope = 1, intercept = 0, linetype = "dashed", color = "grey60") +
geom_point(aes(x = 1 - youden_coords$specificity, y = youden_coords$sensitivity), color = "#D55E00", size = 3.5, shape = 19) +
annotate(
"label",
x = 1 - youden_coords$specificity + 0.05,
y = youden_coords$sensitivity - 0.05,
label = paste0("Seuil optimal (J)nSens: ", round(youden_coords$sensitivity, 2), "nSpéc: ", round(youden_coords$specificity, 2)),
hjust = 0, size = 3.5, fill = "#FFF5EE", color = "#D55E00", label.size = 0.3
) +
scale_x_continuous(limits = c(0, 1), expand = c(0, 0), breaks = seq(0, 1, 0.2)) +
scale_y_continuous(limits = c(0, 1), expand = c(0, 0), breaks = seq(0, 1, 0.2)) +
coord_equal() +
labs(
title = "Efficacité discriminante dans le dépistage du Trouble Panique",
subtitle = "Évaluation sur cohorte de validation externe indépendante (N = 125)",
x = "Taux de Faux Positifs (1 - Spécificité)",
y = "Taux de Vrais Positifs (Sensibilité)"
) +
theme_classic(base_size = 12) +
theme(
plot.title = element_text(face = "bold", size = 13),
plot.subtitle = element_text(color = "grey40", size = 10, margin = margin(b = 10)),
legend.position = c(0.70, 0.22),
legend.background = element_rect(fill = alpha("white", 0.9), color = "grey85", linewidth = 0.3),
legend.title = element_text(face = "bold", size = 9),
legend.text = element_text(size = 8.5)
)
11.3 Interprétation diagnostique et aide à la décision clinique
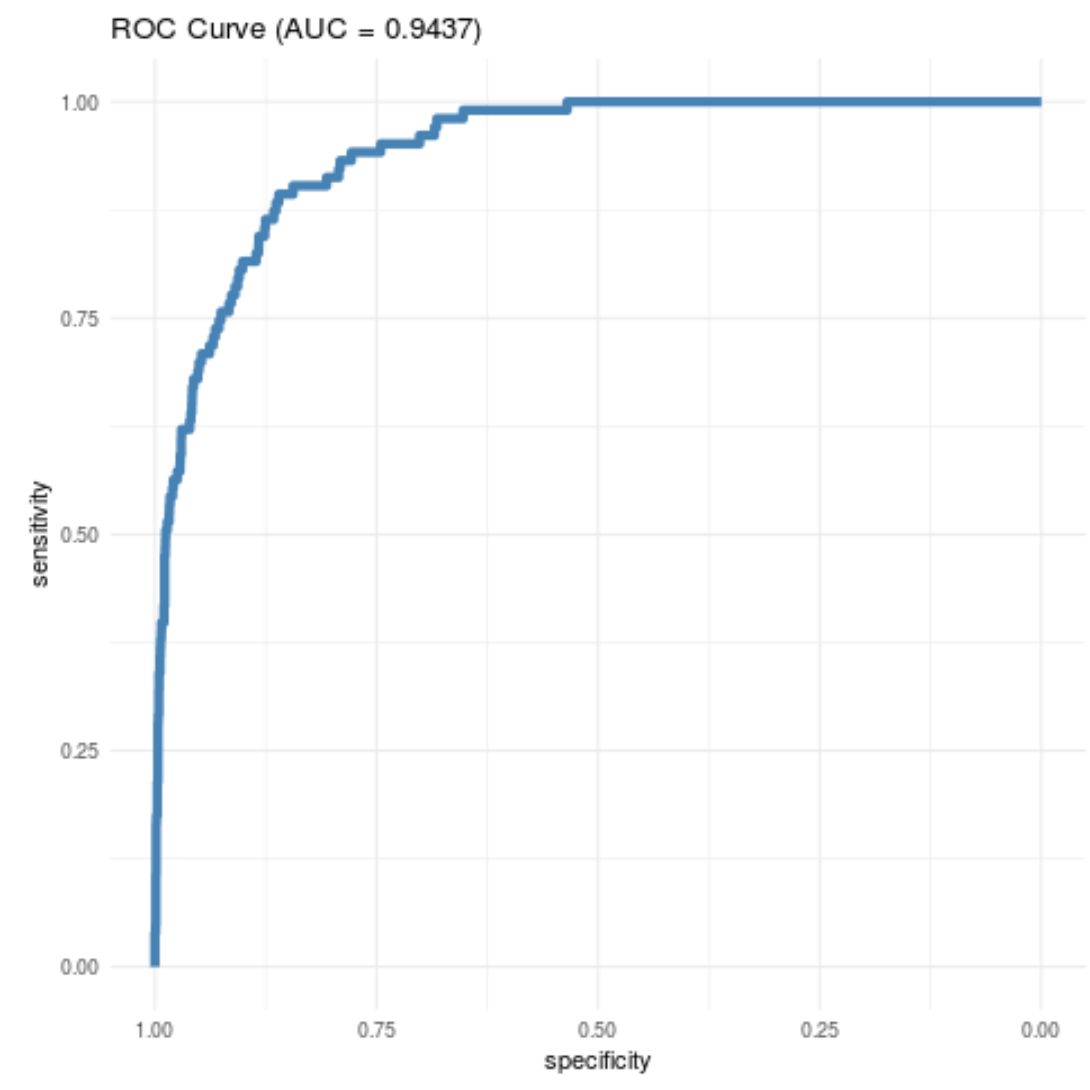
L’inspection du graphique final met en lumière une amélioration sensible de la capacité discriminante lors du passage du modèle univarié (EAM isolé, AUC = 0,772) au modèle multivarié enrichi des concentrations de cortisol et de l’âge (AUC = 0,864). Le test de DeLong apparié confirme la significativité statistique de cette progression (p < 0,001), validant l'hypothèse clinique selon laquelle l'évaluation conjointe de la détresse psychologique déclarée et du marqueur endocrinien de stress surpasse significativement l'échelle psychométrique exploitée de façon isolée.
Sur le plan opérationnel, l’analyste exploite l’indice de Youden pour localiser la valeur seuil optimale de discrimination. Cet indice, formalisé par William J. Youden en 1950, maximise la fonction de performance linéaire :
J = Sensibilité + Spécificité – 1 = Sensibilité – (1 – Spécificité)
Géométriquement, l’indice de Youden correspond au point de la courbe ROC qui maximise la distance verticale absolue par rapport à la diagonale aléatoire. Dans notre étude de cas, le point optimal identifié sur le modèle multivarié affiche une sensibilité de 0,84 et une spécificité de 0,81, correspondant à un seuil de probabilité calculée de 0,28.
Néanmoins, la transposition en pratique clinique de terrain requiert d’intégrer la matrice des coûts d’erreur. Si l’instrument est déployé comme premier filtre de dépistage universel dans des structures de soins communautaires, la priorité médicale commande d’éviter à tout prix les faux négatifs (omettre d’orienter un patient en détresse panique aiguë vers une prise en charge spécialisée). Dans cette perspective, le clinicien choisira délibérément de décaler le seuil opérationnel vers la gauche de la courbe, en fixant par exemple une sensibilité cible contractuelle de 0,95, acceptant en contrepartie une baisse de la spécificité aux alentours de 0,65. À l’inverse, si l’évaluation visait à instaurer immédiatement une pharmacothérapie anxiolytique lourde comportant des risques d’effets indésirables notoires, la priorité consisterait à préserver une haute spécificité pour ne pas traiter indûment des individus sains.
12. Pièges fréquents, biais statistiques et recommandations méthodologiques
La simplicité apparente de mise en œuvre d’une courbe ROC dissimule une multitude de chausse-trappes méthodologiques susceptibles de compromettre la validité scientifique des conclusions publiées.
12.1 Surapprentissage et évaluation optimiste de l’AUC
Le piège méthodologique le plus dévastateur demeure l’évaluation optimiste de la performance, consécutive à l’évaluation d’un modèle statistique sur le même jeu de données que celui employé pour estimer ses coefficients. Dans les modèles complexes ou hautement paramétrés (tels que les régressions pénalisées LASSO, les arbres de décision boostés par gradient ou les réseaux profonds), un modèle peut mémoriser les aléas résiduels d’un échantillon d’entraînement restreint et afficher une AUC apparente mirobolante (ex. 0,98), qui s’effondrera totalement lorsqu’il sera confronté à une cohorte indépendante (ex. 0,65).
Pour parer à ce biais d’optimisme sans sacrifier des effectifs précieux par un fractionnement train/test unique, la mise en place d’une procédure de validation croisée à k-blocs répétée (repeated k-fold cross-validation) représente la norme méthodologique par excellence. L’échantillon est divisé en k partitions égales stratifiées (usuellement 5 ou 10) ; le modèle est successivement calibré sur k – 1 blocs puis évalué sur le bloc restant laissé de côté. L’opération est réitérée plusieurs dizaines de fois avec des découpages aléatoires différents afin de dériver une distribution empirique d’AUC corrigée de l’optimisme, garantissant une estimation fidèle de la transférabilité réelle du système prédictif dans la population générale.
12.2 Déséquilibre sévère des classes et limites de la courbe ROC
Un angle mort statistique fréquemment sous-estimé concerne le comportement de la courbe ROC face à un déséquilibre extrême des classes d’observation. Dans de nombreux scénarios biomédicaux, la prévalence du phénomène étudié est infinitésimale (par exemple, le diagnostic d’une maladie orpheline touchant 1 individu sur 1 000, soit une prévalence de 0,1 %).
Dans un tel contexte, la formule du taux de faux positifs (FP / (FP + VN)) subit l’influence massive du dénominateur : le nombre de vrais négatifs (VN) étant colossal, un effectif absolu important de faux positifs (par exemple 500 individus sains classés à tort comme malades) ne produira qu’une augmentation marginale du taux de faux positifs (500 / 999 000 ≈ 0,0005). La courbe ROC continuera ainsi d’épouser étroitement la bordure supérieure gauche du graphique, affichant une AUC spectaculaire supérieure à 0,95, alors même que le test génère un nombre de fausses alertes qui submerge complètement les structures sanitaires.
Face à une telle asymétrie épidémiologique, la communauté statistique recommande instamment de substituer à la courbe ROC la courbe Précision-Rappel (Precision-Recall Curve ou PR curve). La précision (ou Valeur Prédictive Positive, VP / (VP + FP)) focalise l’analyse exclusivement sur la population prédite positive, ignorant les vrais négatifs massifs. Dans les cas de rareté de la classe cible, la courbe PR met impitoyablement en lumière les faiblesses prédictives que la courbe ROC dissimule par construction mathématique.
12.3 Erreurs courantes de codage et de paramétrage dans R
Sur le plan pratique de la programmation statistique sous R, trois erreurs techniques reviennent de façon récurrente lors des soumissions de manuscrits :
- Inversion de la hiérarchie des niveaux de facteurs : Si la variable dépendante est codée sous forme d’un facteur dont le premier niveau alphabétique correspond à la maladie (ex.
levels = c("Malade", "Sain")),glm()oupROCconsidéreront par défaut la modalité « Sain » comme le succès à modéliser. Cette inversion structurelle produit une courbe inversée se déployant sous la diagonale de référence et affichant une AUC inférieure à 0,5 (ex. AUC = 0,23). Il convient alors de rectifier la direction viadirection = "<"ou de réordonner les modalités viafactor(x, levels = c("Sain", "Malade")). - Omission du verrouillage isométrique : Omettre la commande
coord_equal()(oucoord_fixed(ratio = 1)) conduit ggplot2 à étirer les axes en fonction de la taille de la fenêtre graphique de l’utilisateur. Cette déformation anamorphique altère gravement l’appréciation visuelle de la surface et fausse la comparaison mentale entre figures distinctes. - Confusion sur l’argument de prédiction : L’oubli du paramètre
type = "response"lors de l’appel àpredict.glm()retourne des cotes logarithmiques (log-odds s’étendant de -Inf à +Inf) au lieu de probabilités bornées [0, 1]. Bien que la nature non paramétrique de l’AUC basée sur les rangs produise une valeur d’aire strictement identique dans les deux cas, cette confusion ruine la calibration des seuils opérationnels et empêche l’intégration cohérente de ces valeurs lors de l’affichage textuel des points de coupure de Youden.
En observant scrupuleusement ces règles de bonne conduite méthodologique et computationnelle, le chercheur s’assure que ses modélisations discriminantes sous ggplot2 demeurent non seulement d’une élégance graphique irréprochable, mais constituent également des instruments d’inférence scientifique robustes, pérennes et reproductibles.
Références
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77
- Sachs, M. C. (2017). plotROC: A tool for plotting ROC curves. Journal of Statistical Software, Code Snippets, 79(2), 1–19. https://doi.org/10.18637/jss.v079.c02
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media.
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32–35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″ target= »_blank » rel= »noopener noreferrer »>https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3