
Dans le domaine de l’analyse exploratoire des données et de l’inférence statistique moderne, la caractérisation visuelle de la distribution d’une variable quantitative constitue une démarche inaugurale incontournable. Si les représentations discrètes traditionnelles ont longtemps dominé les publications de recherche, l’émergence d’environnements computationnels avancés tels que le langage R et son écosystème graphique a transformé nos pratiques méthodologiques. Au sein de cet univers analytique, la bibliothèque ggplot2 s’impose désormais comme la référence paradigmatique, transposant les principes formels de la grammaire des graphiques en instructions visuelles d’une précision remarquable. Comprendre comment modéliser, comparer et superposer des estimations de densité continue représente un enjeu capital pour quiconque souhaite sonder la structure latente d’échantillons complexes sans céder aux artéfacts d’échantillonnage.
La superposition de tracés de densité s’avère particulièrement cruciale lorsqu’il s’agit d’évaluer simultanément le comportement de multiples cohortes expérimentales, de contraster les scores de groupes cliniques face à des témoins ou de traquer des variations de dispersion subtiles au sein de séries temporelles longitudinales. Contrairement aux visualisations juxtaposées qui dispersent l’attention cognitive du lecteur, la cohabitation de plusieurs profils sur un axe unifié autorise une comparaison directe des indicateurs de tendance centrale, des asymétries distributionnelles et de la présence éventuelle de régimes bimodaux. Néanmoins, cette promiscuité visuelle exige une maîtrise rigoureuse des paramètres sémiologiques sous-jacents, sous peine de produire des chevauchements opaques et indéchiffrables qui masquent les données plutôt qu’ils ne les révèlent.
Ce guide exhaustif se propose d’explorer en profondeur la mécanique théorique, algorithmique et stylistique de la superposition des courbes de densité via la géométrie dédiée de ggplot2. En articulant les fondements mathématiques de l’estimation par noyau avec les subtilités d’ingénierie logicielle propres au format Tidy Data, nous cheminerons pas à pas vers la confection de graphiques publiables répondant aux standards les plus exigeants de l’édition scientifique internationale. De l’ajustement du coefficient de transparence à la sélection de palettes chromatiques perceptuellement uniformes, en passant par le paramétrage de la largeur de bande et l’enrichissement par des repères statistiques ponctuels, chaque dimension sera disséquée afin de fournir aux chercheurs, analystes et praticiens de la science des données un arsenal méthodologique complet et immédiatement opérationnel.
1. Fondements théoriques de l’estimation de densité par noyau dans l’analyse de données
1.1 Principes mathématiques sous-jacents à l’estimation non paramétrique
L’estimation de densité par noyau, largement désignée dans la littérature statistique sous l’appellation d’estimateur de Rosenblatt-Parzen, constitue un pilier de l’inférence non paramétrique. Développée indépendamment par Murray Rosenblatt en 1956 et Emanuel Parzen en 1962, cette méthode vise à reconstruire la fonction de densité de probabilité sous-jacente d’une variable aléatoire continue à partir d’un échantillon empirique fini, sans postuler a priori que la population d’origine obéit à une loi paramétrique déterminée comme la loi normale, de Weibull ou gamma. L’approche consiste à positionner sur chaque point d’observation une fonction pondérée appelée noyau, puis à effectuer la sommation de l’ensemble de ces contributions élémentaires afin de générer une courbe continue, lisse et normalisée dont l’intégrale sur l’espace des réels est strictement égale à un.
L’immense valeur heuristique de cette technique réside dans son imperméabilité aux présupposés théoriques restrictifs. Lorsque les données recueillies présentent une asymétrie prononcée, un étalement anormal des queues de distribution ou une bimodalité témoignant de l’existence de sous-populations latentes, les estimateurs paramétriques classiques fondés sur la moyenne et l’écart-type échouent à capturer la géométrie véritable du phénomène étudié. L’estimateur de Rosenblatt-Parzen s’adapte avec une flexibilité remarquable aux ondulations intrinsèques du jeu de données, restituant fidèlement les creux et les crêtes qui caractérisent la réalité expérimentale. Cette propriété le rend particulièrement pertinent pour l’exploration de dynamiques complexes où la forme distributionnelle constitue en soi l’objet principal de l’investigation.
Sur le plan des propriétés asymptotiques, l’estimation non paramétrique jouit d’une convergence robuste vers la fonction de densité théorique à mesure que la taille de l’échantillon tend vers l’infini, pourvu que la largeur de bande décroisse à un rythme adéquat. Contrairement aux approches rigides qui imposent un biais structurel indélébile si la loi postulée est erronée, l’erreur quadratique moyenne intégrée de l’estimateur par noyau s’amenuise continuellement sous des hypothèses faibles de régularité. Cette caractéristique confère aux représentations de densité une légitimité mathématique incontestable face aux approximations discontinues et empiriques de la statistique descriptive conventionnelle.
1.2 Analyse comparative : histogrammes versus courbes de densité
L’évaluation des profils empiriques s’est historiquement appuyée sur l’histogramme, instrument graphique intuitif consistant à segmenter l’étendue des valeurs observées en un ensemble d’intervalles contigus désignés sous le terme de classes ou de casiers. Cependant, cette simplicité opératoire masque une instabilité structurelle majeure mise en évidence par de nombreux théoriciens de la visualisation. L’allure d’un histogramme dépend de manière critique de deux choix fondamentalement arbitraires opérés par l’analyste : la largeur des classes et la position exacte de l’origine sur l’axe des abscisses. Une translation infime du point de départ ou une légère modification du pas d’incrémentation peut altérer radicalement la perception de la distribution, faisant apparaître ou disparaître des modes secondaires qui ne correspondent à aucune réalité empirique.
À l’opposé de ces discontinuités artificielles, la courbe de densité offre une représentation fluide et continue des dynamiques probabilistes. En s’affranchissant des effets de seuil inhérents aux frontières rigides des classes, elle dépeint l’accumulation locale des observations sans infliger à l’œil du lecteur ces marches d’escalier arbitraires qui compliquent l’estimation visuelle de la pente ou de l’aplatissement. Cette continuité graphique s’avère particulièrement décisive lors de la superposition de plusieurs groupes, car l’enchevêtrement d’histogrammes transparents ou juxtaposés produit une mosaïque de barres fragmentées dont l’interprétation relève souvent de la gageure cognitive.
Il convient néanmoins de souligner les limites inhérentes à chacune de ces approches. Si la courbe de densité excelle dans la transmission visuelle des proportions relatives et des morphologies globales, elle sacrifie l’accès direct aux effectifs bruts observés. L’ordonnée d’un graphique de densité n’exprime pas un décompte d’individus mais une densité de probabilité, concept abstrait dont l’interprétation numérique immédiate s’avère moins spontanée pour un public non averti. L’histogramme préserve quant à lui la métrique physique des occurrences comptabilisées dans chaque intervalle, offrant un ancrage concret au détriment de l’élégance analytique et de la comparabilité inter-groupes.
1.3 Pertinence pour l’évaluation empirique des distributions expérimentales
L’utilisation concertée de courbes de densité superposées trouve une justification méthodologique de premier ordre dans les protocoles d’évaluation cognitive et neuropsychologique. Au sein de ces paradigmes, les chercheurs manipulent des scores continus standardisés issus de batteries d’épreuves psychométriques complexes. La visualisation comparative des distributions permet de sonder instantanément l’impact d’une intervention thérapeutique ou d’une lésion cérébrale en confrontant la morphologie du groupe expérimental à celle d’une cohorte de référence saine, révélant des micro-variations de performance que les tests d’hypothèses classiques résumés à une valeur de p omettent fréquemment de contextualiser.
Au-delà de la simple comparaison des positions centrales, la superposition des tracés met en exergue les disparités manifestes de dispersion entre les conditions d’étude. Il est fréquent d’observer en psychopathologie clinique qu’un groupe de patients ne diffère pas significativement d’un groupe témoin par sa moyenne globale, mais affiche un étalement considérable de sa variance, traduisant une hétérogénéité étiologique ou fonctionnelle majeure. L’examen attentif des profils de densité superposés permet d’isoler visuellement ces élargissements de base de distribution ainsi que l’émergence de sous-groupes atypiques situés dans les queues de distribution, offrant ainsi des pistes précieuses pour des analyses de stratification ultérieures.
Enfin, cette approche graphique constitue un outil diagnostique irremplaçable pour détecter d’emblée la présence d’effets plancher ou d’effets plafond sur les instruments de mesure. Lorsqu’une tâche d’évaluation s’avère trop ardue ou excessivement facile pour une fraction de l’échantillon, la courbe de densité accuse une accumulation abrupte et anormale de masse probabiliste à l’une des frontières extrêmes du spectre de mesure. La superposition directe des courbes de différents groupes d’âge ou de sévérité pathologique permet de certifier si ces saturations d’échelle affectent l’ensemble de la population ou si elles constituent la signature différentielle d’un phénotype expérimental particulier.
2. Architecture logicielle de ggplot2 et mécanique de geom_density()
2.1 La grammaire des graphiques appliquée aux représentations de distribution
Conçue par Hadley Wickham sur les bases théoriques formalisées par Leland Wilkinson dans son ouvrage séminal, l’architecture du paquet ggplot2 repose sur une décomposition modulaire et hiérarchique de l’espace graphique. Au lieu de concevoir une figure comme un dessin vectoriel monolithique, l’environnement la structure sous la forme d’un empilement raisonné de couches fonctionnelles indépendantes comprenant les données sources, les assignations esthétiques, les transformations statistiques, les objets géométriques et les échelles de coordonnées. Cette abstraction conceptuelle permet de dissocier la logique de traitement des données de leur transcription purement chromatique ou spatiale.
Dans ce cadre structurel, l’appel à la fonction geom_density() ne se limite pas à tracer des lignes au sein d’un repère cartésien ; il sollicite en réalité une transformation statistique sous-jacente opérée par l’opérateur statistique stat_density(). Ce mécanisme interne intercepte le vecteur de données brutes fourni en entrée, estime la densité par noyau sur une grille de points équidistants via les algorithmes vectorisés du moteur statistique de R, puis convertit ces estimations numériques en coordonnées géométriques exploitables par le moteur de rendu visuel. L’utilisateur bénéficie ainsi d’un pipeline d’analyse intégré où le calcul mathématique s’exécute de manière totalement transparente.
L’opération de transformation statistique génère dynamiquement des variables internes que l’utilisateur peut réinjecter à dessein dans la construction graphique. Parmi celles-ci figurent la densité brute d’aire unitaire, la variable de décompte absolu pondérée par la taille de l’échantillon, ainsi que la densité normalisée sur une échelle unitaire bornée entre zéro et un. La compréhension de ces variables virtuelles est essentielle lorsqu’il s’agit de s’écarter des comportements graphiques conventionnels pour modéliser des représentations avancées où les surfaces relatives doivent refléter fidèlement les disparités d’effectifs réels entre les cohortes étudiées.
2.2 Articulation entre mappages esthétiques globaux et paramètres d’échelle
L’assignation des dimensions de l’analyse s’effectue au moyen de la fonction de mappage esthétique, qui établit un pont sémantique entre les colonnes du tableau de données et les propriétés perceptuelles du graphique. Pour une courbe de densité élémentaire, l’abscisse reçoit obligatoirement la variable numérique continue dont on explore la répartition, tandis que l’axe des ordonnées est automatiquement dévolu par défaut à la valeur calculée de la densité. Lorsque l’objectif réside dans la superposition de plusieurs distributions, le mappage doit intégrer une variable catégorielle définissant l’appartenance de chaque observation à son groupe ou sa condition d’origine.
Cette différenciation catégorielle peut être confiée à deux canaux esthétiques complémentaires : la couleur du tracé périphérique et la teinte de l’aire de remplissage sous-jacente. L’attribution d’un facteur qualitatif à ces paramètres force la géométrie à scinder le jeu de données initial en sous-ensembles distincts, d’exécuter une estimation par noyau autonome pour chacun d’entre eux, puis de dessiner autant de surfaces superposées que le facteur comporte de modalités. La gestion conjointe de ces deux canaux esthétiques offre une flexibilité sémiotique absolue, autorisant des jeux de contraste où les lignes de crête délimitent nettement les frontières des groupes tandis que les aires colorées traduisent la masse volumique des cohortes.
Il est impératif pour l’analyste de distinguer avec une rigueur absolue le mappage dynamique d’une variable esthétique de l’ajustement statique d’un attribut de tracé. Lorsqu’un paramètre comme l’opacité ou la couleur est déclaré à l’intérieur de la fonction d’association esthétique, ggplot2 l’interprète comme une dimension porteuse d’information statistique, tentant de lui attribuer une échelle et une légende formelle. À l’inverse, lorsque ce paramètre est configuré directement dans l’appel géométrique, en dehors de la fonction de mappage, il est appliqué de manière uniforme à l’ensemble des éléments dessinés sans créer de nouvelle dimension sémiologique, garantissant ainsi un rendu visuel équilibré.
3. Structuration et ingénierie des données : Du format large au format long
3.1 Le prérequis épistémologique du format Tidy Data
L’un des obstacles les plus fréquents rencontrés lors de l’apprentissage de ggplot2 réside dans la non-conformité de la structure tabulaire avec les exigences fondamentales de l’architecture du tidyverse. Selon le paradigme formalisé par Hadley Wickham, un jeu de données est réputé ordonné ou rigoureusement conforme aux principes du Tidy Data s’il respecte scrupuleusement trois critères cardinaux : chaque variable mesurée constitue une colonne distincte, chaque observation individuelle occupe une ligne unique, et chaque unité d’analyse fondamentale réside dans une cellule spécifique de la matrice.
Dans la pratique expérimentale courante, les chercheurs colligent souvent leurs relevés sous un format dit large, au sein duquel les différentes conditions de traitement ou les scores temporels successifs sont alignés dans des colonnes adjacentes parallèles. Bien que ce format s’avère pratique pour la saisie directe dans un tableur ou pour certains calculs matriciels traditionnels, il s’avère structurellement incompatible avec la mécanique de mappage groupé de ggplot2. Pour superposer les densités de trois conditions expérimentales, l’environnement n’exige pas trois colonnes de chiffres hétérogènes, mais une unique colonne hébergeant l’intégralité des valeurs numériques et une seconde colonne catégorielle faisant office d’étiquette d’identification pour chaque groupe.
Cette rigueur imposée dans la modélisation des données permet de préserver l’intégrité contextuelle de chaque mesure. La présence d’une colonne dédiée aux identifiants individuels des participants assure que l’architecture tabulaire conserve la mémoire de la provenance des observations, ouvrant la voie à des décompositions stratifiées ultérieures sans rupture de traçabilité. En contraignant l’analyste à unifier ses métriques sur une seule dimension verticale, le format long fluidifie l’intégration des paramètres esthétiques et transforme une tâche de programmation potentiellement laborieuse en une routine graphique élégante et reproductible.
3.2 Implémentation technique de la restructuration matricielle
La conversion opératoire d’une matrice du format large vers le format long s’exécute aujourd’hui de manière optimale grâce aux fonctions de pivotement vectorisé du paquet tidyr. La commande pivot_longer() constitue la pierre angulaire de cette ingénierie de données. En spécifiant explicitement la liste des colonnes numériques à consolider, le nom de la nouvelle colonne de regroupement qui accueillera les anciens intitulés de colonnes et l’intitulé du vecteur récepteur destiné à héberger les valeurs continues réalignées, l’analyste réorganise l’intégralité de son échantillon en une seule instruction intuitive et robuste.
Il demeure instructif de rappeler que les versions antérieures de l’écosystème R s’appuyaient largement sur la fonction historique melt() issue du paquet reshape2 pour accomplir cette métamorphose dimensionnelle. Bien que cette formulation ancienne subsiste encore au sein de nombreux scripts patrimoniaux disséminés dans les laboratoires de recherche ou sur les forums d’entraide, son usage est désormais formellement déconseillé au profit des verbes standardisés du tidyverse. La fonction pivot_longer() offre une prise en charge infiniment supérieure des structures complexes, des noms de colonnes dupliqués et des typages hétérogènes, tout en garantissant des performances algorithmiques remarquables sur les volumes massifs de données.
Une fois le pivotement exécuté, un contrôle de conformité systématique s’impose pour vérifier l’intégrité référentielle de la structure résultante. L’analyste doit s’assurer que le nombre de lignes généré correspond rigoureusement au produit du nombre d’observations initiales par le nombre de conditions regroupées, signe que l’opération n’a entraîné ni duplication illégitime ni troncature silencieuse. Cette inspection rigoureuse prévient l’apparition d’aberrations graphiques lors du calcul ultérieur de la densité par noyau, garantissant que chaque strate expérimentale contribue à hauteur exacte de son poids échantillonnal réel.
3.3 Contrôle qualité des types de variables avant visualisation
L’étape préliminaire de vérification des typages de données conditionne directement la réussite de la procédure de superposition graphique. Il est impératif de s’assurer que la colonne dévolue au regroupement soit formellement reconnue comme un facteur au sens strict de R, et non comme une simple chaîne de caractères bruts ou un vecteur numérique déguisé. L’attribution du statut de facteur ordonné permet non seulement de maîtriser de bout en bout l’ordre d’apparition des étiquettes au sein de la légende explicative, mais régit également la séquence physique de tracé des couches géométriques sur l’écran, dictant quelle distribution viendra se superposer par-dessus les autres.
L’audit des valeurs manquantes ou indéfinies constitue le second versant de ce contrôle de qualité en amont de toute modélisation graphique. Par défaut, la détection d’une valeur manquante au sein d’une variable continue entraîne l’émission d’un avertissement d’exécution par geom_density() et son éviction unilatérale du calcul par noyau. Si ce comportement par omission s’avère suffisant pour des analyses exploratoires rapides, une démarche scientifique rigoureuse impose de documenter explicitement le taux de déperdition d’observations par groupe et d’arbitrer entre une exclusion raisonnée ou une stratégie d’imputation multiple lorsque le mécanisme de perte est réputé non aléatoire.
Enfin, il convient de veiller à ce que les variables destinées à être projetées sur l’abscisse partagent une unité de mesure et une échelle métrique strictement comparables. Confronter au sein d’un même repère cartésien des scores bruts hétérogènes dont les variances théoriques diffèrent de plusieurs ordres de grandeur générerait un tracé déséquilibré où une distribution excessivement étendue écraserait visuellement les variations fines d’une cohorte plus concentrée. Lorsque les instruments d’origine divergent, la normalisation préalable des distributions par centrage-réduction ou alignement sur une échelle de référence universelle garantit une comparabilité visuelle sans distorsion d’interprétation.
4. Tutoriel pas à pas : Création et superposition d’un premier graphique
4.1 Étape 1 : Génération reproductible d’un jeu de données synthétique
Afin d’illustrer la démarche pratique de superposition dans des conditions méthodologiques parfaitement contrôlées, la création d’un jeu de données synthétique reproductible s’avère hautement didactique. L’initialisation préalable du générateur de nombres pseudo-aléatoires au moyen de la directive set.seed() constitue une règle d’or pour garantir que toute personne réexécutant le script obtiendra une configuration d’échantillons rigoureusement identique à celle commentée dans le présent protocole. Cette précaution fondamentale s’inscrit au cœur des exigences contemporaines de reproductibilité scientifique.
Nous modélisons à cet effet trois cohortes expérimentales indépendantes simulant les scores de performance cognitive d’individus soumis à des paradigmes d’interférence distincts. La première cohorte, désignée comme le groupe témoin, est générée selon une loi normale standard présentant une moyenne de 50 points et un écart-type de 8 points. La seconde condition, incarnant une charge cognitive intermédiaire, subit une translation vers la droite avec une moyenne de 58 points et une dispersion accrue de 10 points. Enfin, le troisième groupe, correspondant à une surcharge attentionnelle sévère, se caractérise par une dégradation des scores avec une moyenne abaissée à 42 points et un étalement étendu à 12 points d’écart-type.
L’assemblage initial de ces trois vecteurs de 400 observations chacun donne naissance à un tableau de données structuré sous le format large, où chaque colonne encapsule les réalisations numériques d’un groupe expérimental donné. Cet agencement artificiel reflète fidèlement la présentation typique des classeurs de collecte bruts issus des laboratoires de recherche en sciences humaines et biomédicales, constituant le matériau de base idéal pour démontrer la nécessité et la technique des transformations longitudinales ultérieures.
4.2 Étape 2 : Transformation programmatique et exploration descriptive
En conformité avec les postulats du Tidy Data développés précédemment, nous appliquons sans délai l’opérateur de pivotement longitudinal sur notre tableau synthétique. Cette manipulation transforme la matrice de trois colonnes et quatre cents lignes en une table unifiée de douze cents rangées et deux attributs essentiels : un descripteur catégoriel consignant l’appartenance au groupe et un vecteur numérique abritant l’ensemble des scores individuels. L’inspection des premières lignes de la structure via la fonction head() permet de s’assurer immédiatement de la conformité de l’agencement clé-valeur obtenu.
Avant d’engager le rendu graphique, une démarche d’exploration descriptive s’impose pour consigner les caractéristiques distributionnelles théoriques et observées de nos trois sous-échantillons. Un résumé statistique agrégé permet de calculer les moyennes empiriques, les écarts-types réels ainsi que la médiane et l’écart interquartile pour chaque condition. Cette étape analytique intermédiaire fournit les points d’ancrage numériques indispensables pour valider ultérieurement que les sommets et les courbures des tracés de densité traduisent avec une exactitude irréprochable les propriétés numériques de notre matrice de données.
Cette étape exploratoire permet également de s’assurer de l’absence de valeurs aberrantes ou d’incohérences de frappe susceptibles de déformer artificiellement l’estimation par noyau. Dans notre scénario simulé, la concordance entre les paramètres génératifs de la simulation et les métriques récapitulatives confirme la totale salubrité de l’échantillon, attestant que le jeu de données est désormais parfaitement calibré pour être injecté au sein du moteur de rendu graphique de ggplot2.
4.3 Étape 3 : Exécution du tracé minimal superposé
L’initialisation du tracé repose sur la fonction maîtresse ggplot(), à laquelle nous transmettons notre tableau réorganisé au format long, couplée à la spécification des correspondances esthétiques fondamentales au sein de l’instruction aes(). La variable numérique est assignée à l’axe horizontal x, tandis que la variable de groupe est reliée simultanément à l’attribut de remplissage interne fill et à l’attribut de contour colour. Cette configuration instruit le compilateur graphique de traiter séparément chaque strate factorielle lors de l’application des calculs statistiques de densité.
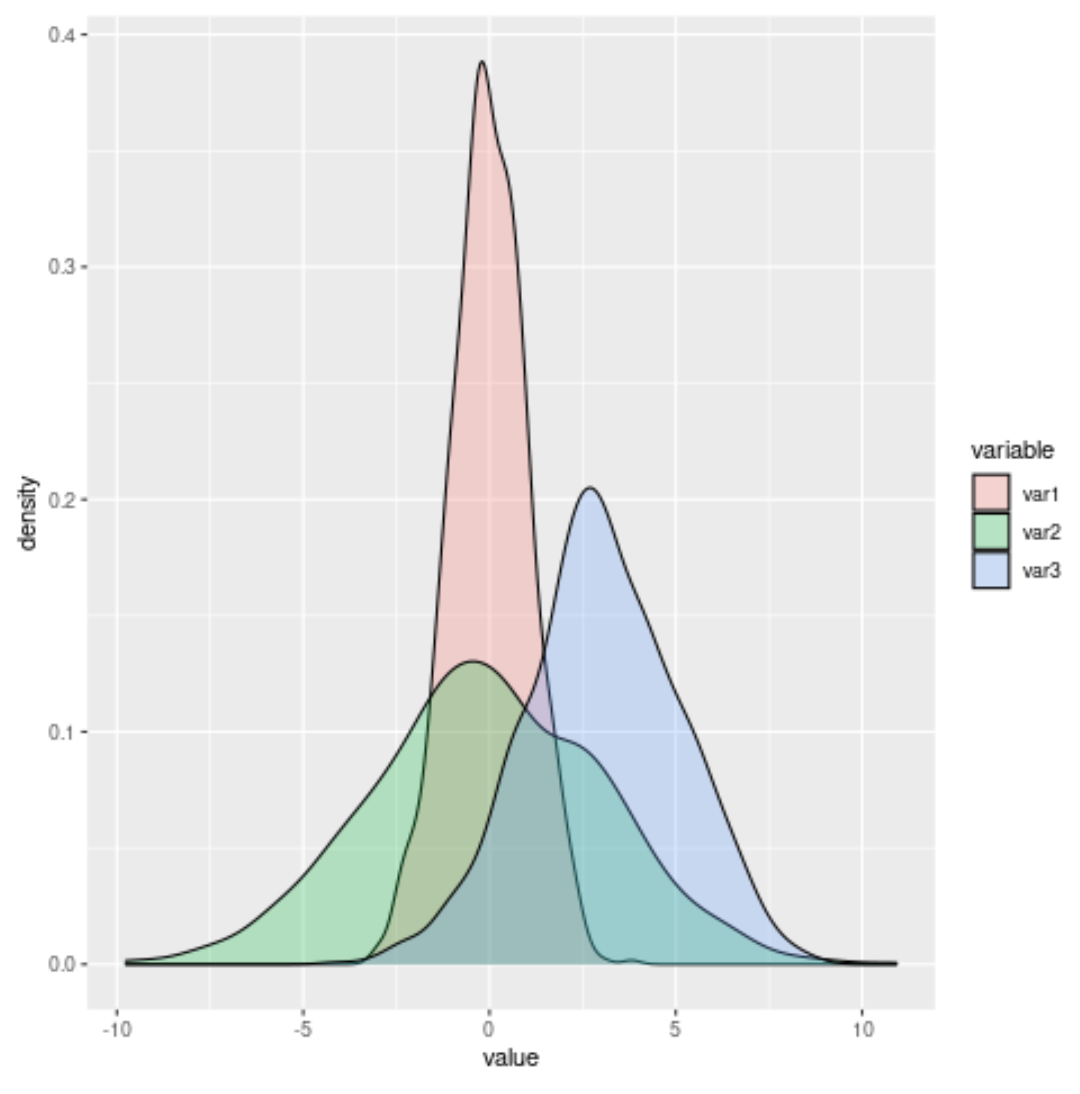
L’invocation subséquente de la couche géométrique geom_density() génère le tracé brut des trois distributions au sein d’un repère cartésien partagé. L’exécution de ce code minimal produit instantanément l’estimation des trois courbes lissées, chacune adoptant les couleurs discrètes par défaut de la palette de base de R. L’observateur attentif remarque immédiatement que les trois surfaces se déploient sur le même référentiel, offrant un premier aperçu fonctionnel des décalages relatifs de position et de dispersion qui caractérisent nos conditions expérimentales simulées.
Cependant, ce rendu élémentaire met en lumière une défaillance ergonomique majeure bien connue des visualisateurs de données : le problème critique de l’occlusion visuelle totale. Les surfaces situées au premier plan, bénéficiant par défaut d’une opacité intégrale, masquent irrémédiablement de larges portions des distributions dessinées en arrière-plan. Cette superposition opaque anéantit toute possibilité de comparer rigoureusement les formes d’ondes au sein des zones de forte intersection, démontrant de façon éclatante que l’appel brut à geom_density() sans paramétrage chirurgical de la transparence ne saurait satisfaire aux exigences de la communication scientifique.
5. Gestion de l’opacité et résolution du problème d’occultation visuelle
5.1 Paramétrage précis du coefficient de transparence alpha
Pour dissiper l’écran opaque généré par le comportement par défaut de ggplot2, l’introduction du paramètre d’atténuation alpha au sein de la géométrie constitue l’intervention technique la plus directe et la plus efficiente. Ce coefficient scalaire, dont les valeurs sont strictement bornées sur l’intervalle continu s’étendant de zéro pour une transparence intégrale invisible jusqu’à un pour une opacité totale, modifie directement la saturation du canal alpha lors de la rastérisation des surfaces polygonales. En atténuant l’opacité des aires de remplissage, l’analyste autorise la lumière graphique à traverser les couches successives, dévoilant l’architecture cachée des sous-groupes d’arrière-plan.
Des décennies d’expérimentation en ergonomie visuelle et en sémiologie graphique suggèrent qu’une plage de valeurs comprise entre 0.20 et 0.40 constitue le compromis optimal pour superposer des densités continues. Un coefficient calibré aux alentours de 0.30 permet aux surfaces de conserver une identité chromatique suffisamment discriminable pour guider l’œil, tout en abaissant la densité optique globale de telle sorte que les courbes situées au deuxième et au troisième plan demeurent parfaitement perceptibles dans toute leur extension horizontale, y compris lorsqu’elles cheminent sous les maxima d’une autre cohorte.
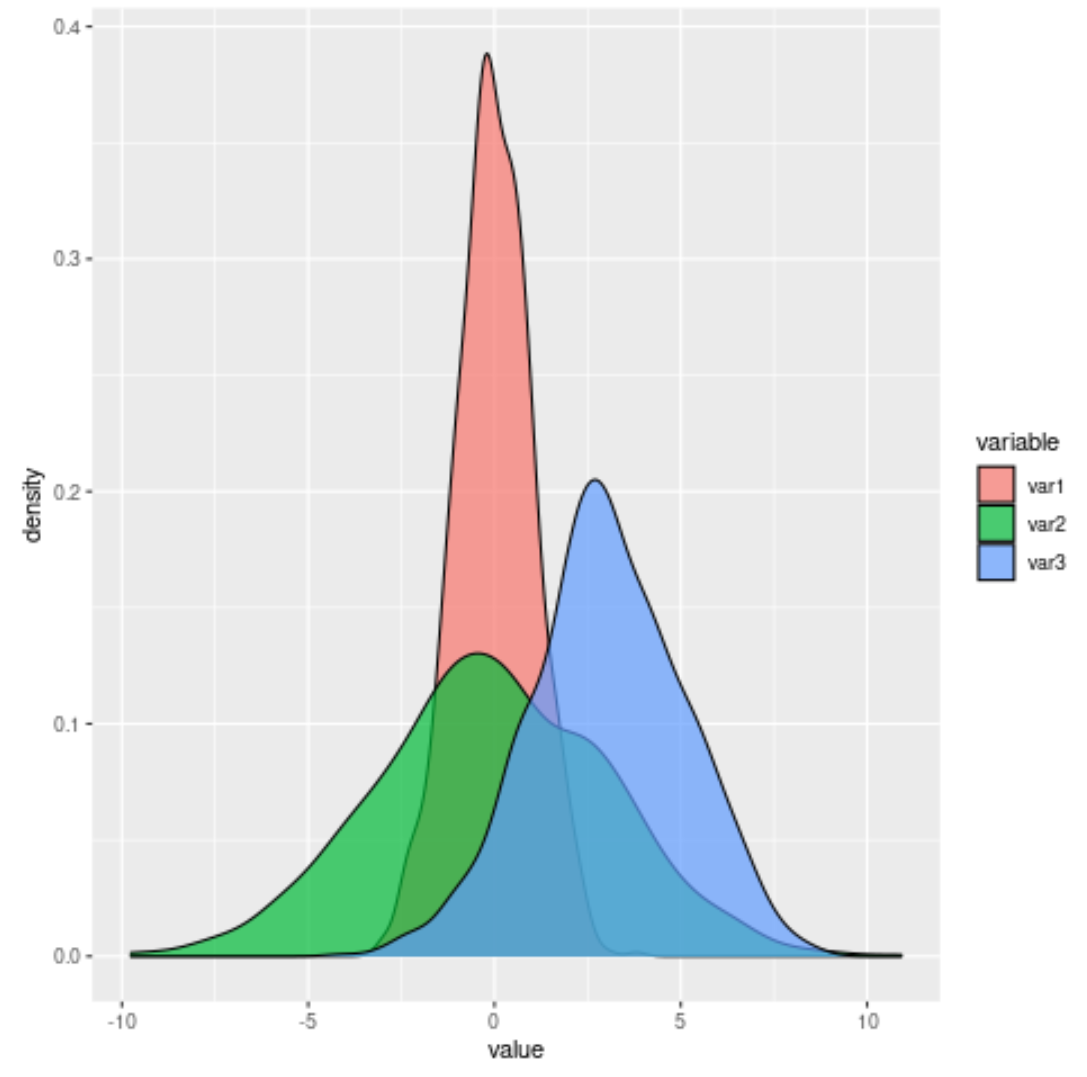
À l’inverse, l’attribution d’un coefficient alpha inconsidéré nuit gravement à l’intégrité du message statistique. Un paramétrage supérieur à 0.60 recrée insidieusement des zones d’ombre denses où les chevauchements multiples deviennent indistinguables, occultant les queues de distribution fines qui recèlent souvent l’information clinique la plus critique. Réciproquement, un abaissement excessif en deçà de 0.15 décolore les aplats jusqu’à un délavage spectral où l’observateur peine à identifier quelle aire correspond à quelle étiquette de légende, attestant de la nécessité d’un dosage chromatique rigoureux.
5.2 Perception cognitive et lisibilité des zones de chevauchement
L’introduction de la transparence soulève un défi psychophysique complexe lié au phénomène du mélange additif des teintes. Lorsque deux surfaces translucides teintées de couleurs primaires distinctes se recouvrent, la zone de recoupement géométrique donne naissance à une nuance chromatique hybride résultant de la synthèse spectrale. Ce phénomène s’intensifie de manière géométrique avec l’augmentation du nombre de groupes superposés : pour trois conditions expérimentales, l’œil doit déchiffrer non seulement trois teintes mères, mais également trois teintes d’intersection binaires et une teinte tertiaire centrale où confluent l’ensemble des populations.
Cette prolifération de tonalités composites sature rapidement la mémoire de travail visuelle du lecteur, générant une charge cognitive superflue qui détourne l’attention de l’analyse proprement statistique des données. Pour préserver la lisibilité de la figure, il est impératif de limiter le nombre absolu de distributions superposées au sein d’un même panneau. La communauté des visualisateurs s’accorde généralement sur une limite stricte de trois, exceptionnellement quatre profils simultanés, au-delà de laquelle l’enchevêtrement des transparences tourne à la cacophonie visuelle indéchiffrable.
Lorsque la recherche requiert impérativement la mise en valeur d’une condition focale au milieu d’un faisceau de distributions de référence, une technique de hiérarchisation sémiotique avancée s’avère particulièrement productive. Elle consiste à assigner une teinte vive et saturée assortie d’un alpha légèrement supérieur à la courbe cible, tout en attribuant des nuances neutres et désaturées, telles que des gris doux aux transparences prononcées, aux cohortes témoins. Cette asymétrie graphique délibérée guide instantanément l’attention perceptive vers l’objet prioritaire de l’investigation sans escamoter le contexte distributionnel global.
6. Personnalisation esthétique : Palettes chromatiques et sémiologie graphique
6.1 Mise en œuvre des échelles manuelles et chromatiques professionnelles
L’abandon des palettes chromatiques génériques configurées par défaut dans R représente une condition non négociable pour qui prétend publier des résultats dans des revues savantes à fort facteur d’impact. Les teintes natives de ggplot2, caractérisées par un espacement équidistant sur la roue chromatique HSL, souffrent d’une brillance inégale qui induit un biais perceptuel involontaire : certaines couleurs paraissent spontanément plus saillantes ou plus proches de l’observateur que d’autres, faussant l’évaluation objective du poids relatif de chaque condition expérimentale.
Pour asseoir un contrôle visuel irréprochable, l’analyste fait appel aux fonctions d’assignation manuelle que sont scale_fill_manual() pour le corps des surfaces et scale_color_manual() pour les traits de contour. Ces interfaces logicielles autorisent l’injection directe de vecteurs de codes hexadécimaux préalablement sélectionnés pour leur harmonie et leur équilibre spectral. Il est de bonne pratique de maintenir une stricte cohérence entre la couleur de contour et la teinte d’aire pour une même condition, en réservant éventuellement au contour une nuance légèrement plus sombre et totalement opaque afin de bien circonscrire le périmètre géométrique de la masse de probabilité.
Ce niveau de personnalisation millimétré s’aligne rigoureusement sur les chartes éditoriales des plus grandes publications internationales telles que Nature, The Lancet ou Science, qui proscrivent les couleurs criardes au profit d’harmonies sobres, élégantes et hiérarchisées. La maîtrise des échelles manuelles permet en outre d’intégrer des conventions culturelles ou disciplinaires fortes, en réservant par exemple des tonalités spécifiques universellement reconnues pour désigner des sous-groupes nosologiques ou des lignées génétiques établies.
6.2 Application des palettes perceptuellement uniformes
L’accessibilité universelle et l’inclusivité méthodologique imposent aujourd’hui de concevoir des figures scientifiques déchiffrables par l’ensemble des membres de la communauté, y compris ceux présentant des anomalies de la vision chromatique telles que le daltonisme sous ses différentes formes de deutéranopie, protanopie ou tritanopie. À cet égard, la bibliothèque de palettes viridis, intégrée de manière native dans l’environnement moderne de ggplot2 via l’instruction scale_fill_viridis_d(), apporte une solution mathématique et sémiologique définitive à cet enjeu d’éthique scientifique.
Les séquences chromatiques viridis, magma, inferno et plasma ont été spécifiquement optimisées d’un point de vue computationnel pour afficher une progression de luminance strictement linéaire sur l’ensemble de leur parcours spectral. Cette propriété d’uniformité perceptive garantit que la distance perçue entre deux teintes correspond rigoureusement à la distance mathématique qui les sépare dans l’espace des données, éliminant tout artéfact d’interprétation lié à des sauts de brillance artificiels. Ainsi, les variations de densité restent perçues avec une fidélité absolue quel que soit le profil de sensibilité rétinienne du lecteur.
Un corollaire capital de cette linéarité réside dans l’irréprochable préservation du contraste en cas d’impression physique sur support papier en niveaux de gris. Même lorsque la couleur est totalement éliminée du canal de restitution, les teintes viridis se convertissent en un dégradé monochromatique parfaitement ordonné et dépourvu de zones d’ambiguïté. Pour des travaux exigeant une typologie qualitative plus classique, le recours sélectif aux palettes ColorBrewer via scale_fill_brewer() offre une alternative réputée pour sa robustesse et sa clarté taxonomique.
6.3 Dissociation visuelle entre lignes de crête et aires de remplissage
L’optimisation du pouvoir séparateur d’un graphique de densité superposé passe fréquemment par une dissociation délibérée entre l’épaisseur du trait de contour et l’opacité de l’aire sous-jacente. L’argument géométrique linewidth au sein de geom_density() permet de calibrer la prestance visuelle de la bordure périphérique supérieure. L’application d’un trait ferme d’une épaisseur de 0.8 à 1.2 point d’impression permet de souligner vigoureusement la ligne de crête de chaque fonction d’onde, offrant à l’œil un point d’appui structurel net qui compense le flou potentiel induit par les transparences internes.
Au-delà de l’épaisseur, la modulation du style de ligne via le paramètre linetype apporte une dimension discriminante additionnelle d’une remarquable efficacité. En associant, par exemple, un trait continu au groupe témoin, un trait interrompu à tirets réguliers à la première condition expérimentale et une ligne pointillée au troisième groupe, l’analyste crée une triple redondance sémiotique combinant couleur, motif de ligne et étiquette textuelle. Cette stratégie garantit que même en présence d’une dégradation technique majeure du support de lecture, la discrimination des populations demeure immédiatement accessible.
À l’autre extrémité du spectre stylistique, certains concepteurs font le choix délibéré de supprimer totalement la ligne de contour en fixant la couleur périphérique à une valeur transparente ou en annulant son épaisseur. Cette approche confère au graphique un aspect de surface ultra-épuré, privilégiant la lecture globale des volumes et des interactions de masses spatiales au détriment de la précision ponctuelle de la trajectoire marginale. Ce parti-pris esthétique convient particulièrement bien aux présentations orales dynamiques où l’impact visuel holistique prévaut sur l’analyse minutieuse des seuils critiques.
7. Ajustement mathématique des paramètres de lissage de la densité
7.1 Influence de la largeur de bande (bandwidth) sur le diagnostic
Si la dimension esthétique conditionne l’élégance d’une figure, le paramétrage algorithmique de l’estimateur par noyau engage directement la véracité scientifique de la restitution statistique. Parmi l’ensemble des hyperparamètres régissant l’estimation de densité, la largeur de bande, désignée sous le vocable anglais de bandwidth ou notée h dans les équations formelles, exerce une influence infiniment plus critique sur le résultat graphique final que la forme mathématique du noyau lui-même. Cette constante d’échelle régit le degré d’étalement spatial de chaque composante élémentaire, contrôlant ainsi le compromis fondamental entre biais et variance de l’estimation.
Au sein de ggplot2, l’argument adjust fournit un multiplicateur scalaire permettant de moduler empiriquement la largeur de bande optimale calculée automatiquement par les algorithmes de R, qui s’appuient généralement par défaut sur la règle du pouce de Silverman. L’application d’un facteur adjust significativement supérieur à l’unité, par exemple 2.0 ou 3.0, induit un phénomène de sur-lissage particulièrement périlleux. En aplanissant excessivement les ondulations du tracé, le sur-lissage tend à masquer les structures fines, rabotant les pics authentiques et dissimulant des sous-populations réelles sous une fausse apparence d’unimodalité symétrique.
À l’inverse, l’attribution d’un coefficient inférieur à l’unité, tel que 0.50 ou 0.30, génère un sous-lissage tout aussi délétère pour l’inférence. En contraignant l’estimateur à coller de trop près aux fluctuations locales de l’échantillon d’entraînement, ce réglage hyper-réactif élève chaque paquet accidentel d’observations au rang de mode local distinct, produisant une courbe en dents de scie hérissée d’artéfacts de bruit stochastique dénués de toute signification populationnelle. Il incombe donc à l’expérimentateur d’explorer systématiquement plusieurs valeurs d’ajustement afin de s’assurer que les inflexions mises en évidence possèdent une stabilité statistique indiscutable.
7.2 Sélection et propriétés des fonctions noyau
L’architecture interne de geom_density() offre la liberté de choisir parmi un catalogue étendu de fonctions noyau pour opérer la convolution des observations. Bien que le noyau gaussien conventionnel soit appliqué par défaut en raison de sa dérivabilité infinie et de ses élégantes propriétés analytiques, des alternatives éprouvées issues de la théorie de l’estimation méritent l’attention du statisticien. Le noyau parabolique d’Epanechnikov détient ainsi une place d’honneur, ayant été formellement démontré comme optimal au sens où il minimise strictement l’erreur quadratique moyenne intégrée parmi l’ensemble des noyaux à support compact.
D’autres topologies de fenêtrage, telles que les noyaux rectangulaires, triangulaires ou bi-pondérés, engendrent des signatures géométriques singulières sur le comportement asymptotique des queues de distribution. Les noyaux à décroissance exponentielle lente confèrent une sensibilité accrue aux valeurs situées aux marges extrêmes du spectre, tandis que les noyaux à support fini tronquent net l’influence des points au-delà d’un certain rayon spatial, éliminant ainsi toute traînée résiduelle loin des données réelles. Cette propriété devient précieuse lorsque l’on souhaite circonscrire rigoureusement la zone d’influence d’un groupe expérimental sans le diluer dans l’espace vide.
La robustesse globale face aux valeurs aberrantes constitue un autre critère guidant la sélection du noyau. En présence de contaminants grossiers ou d’erreurs de transcription numérique isolées, un noyau à support compact évite que l’artéfact ne contamine l’estimation de densité sur l’ensemble de l’axe, cantonnant la perturbation à une zone géographique strictement délimitée. L’analyste s’assure ainsi que la masse principale de la distribution conserve une géométrie inaltérée, préservant la validité comparative des superpositions inter-groupes.
7.3 Gestion des frontières de distribution et troncature
Un écueil mathématique récurrent de l’estimation de densité par noyau réside dans ce que les théoriciens désignent sous le terme d’effet de bord ou biais de frontière. Par conception, l’estimateur gaussien standard disperse une fraction de sa masse probabiliste de part et d’autre de chaque point empirique. Lorsqu’une variable quantitative est strictement contrainte par une barrière physique ou conceptuelle infranchissable, comme le temps de latence cognitive, le salaire ou le taux d’erreur qui ne peuvent en aucun cas adopter de valeurs négatives, la courbe lissée déborde mécaniquement sous le zéro, suggérant l’existence d’observations pourtant impossibles.
Pour parer à cette incohérence méthodologique sans renoncer à la continuité de la courbe, l’analyste peut mobiliser plusieurs stratégies techniques au sein de l’écosystème R. L’une des solutions consiste à tronquer explicitement le domaine de calcul via l’argument bounds disponible dans les versions contemporaines de stat_density(), contraignant l’intégrale à se confiner strictement à l’intérieur des limites théoriques admises. L’algorithme réinjecte alors la masse débordante au sein du domaine autorisé par des techniques de réflexion aux limites, restaurant la cohérence logique du modèle.
Une alternative élégante et théoriquement féconde consiste à procéder à une transformation préalable des données avant l’étape de visualisation. L’application d’une fonction logarithmique ou d’une racine carrée aplanit l’asymétrie positive et projette les valeurs positives sur l’ensemble de la droite des réels, neutralisant d’emblée les effets de frontière. Après estimation de la densité dans cet espace transformé, les coordonnées de l’axe peuvent être réétiquetées pour exprimer les grandeurs originelles, préservant ainsi l’intelligibilité des scores pour le lecteur final tout en garantissant une modélisation mathématique irréprochable.
8. Comparaison visuelle avancée : Facettage versus superposition directe
8.1 Décomposition modulaire par facettes spatiales
Si la superposition sur un canevas unique constitue un procédé visuel séduisant pour contraster deux ou trois conditions, son efficacité ergonomique s’effondre de manière spectaculaire dès lors que la grille expérimentale incorpore un nombre plus important de strates factorielles. Face à une décomposition clinique impliquant cinq groupes d’âge croisés avec deux niveaux de pathologie, la superposition directe génère une tapisserie chromatique indéchiffrable où la sursaturation des transparences anéantit toute possibilité d’inférence. Dans cette situation, la décomposition modulaire par facettes spatiales via facet_wrap() ou facet_grid() s’impose comme une nécessité absolue.
Le facettage ségrègue le jeu de données en une matrice ordonnée de sous-graphiques autonomes partageant des échelles communes. L’observateur peut ainsi balayer du regard la morphologie individuelle de chaque condition sans souffrir d’aucune occlusion physique. L’arbitrage technique crucial repose alors sur la configuration de l’argument scales : le verrouillage par défaut sur des échelles rigoureusement identiques garantit une comparabilité absolue de la hauteur des pics et de l’étendue des bases, tandis que le déverrouillage via scales = "free_y" maximise l’utilisation de l’espace vertical pour chaque sous-groupe au détriment de l’évaluation relative immédiate des amplitudes de densité.
Cette approche spatiale s’avère particulièrement adaptée à l’exploration des protocoles multifactoriels complexes. En assignant les lignes de la grille à une variable explicative et les colonnes à une seconde source de variation, l’analyste crée un échiquier perceptuel d’une puissance analytique sans équivalent. Chaque cellule de la matrice de facettes abrite un tracé de densité parfaitement isolé, permettant de diagnostiquer instantanément les interactions croisées et les ruptures d’invariance distributionnelle à travers l’ensemble des dimensions expérimentales investiguées.
8.2 Approche hybride : Densité contextuelle d’arrière-plan
Pour concilier la clarté spatiale du facettage avec la comparabilité immédiate de la superposition directe, l’ingénierie graphique sous ggplot2 permet d’échafauder une approche hybride d’une puissance expressive exceptionnelle : la projection d’une densité contextuelle en filigrane d’arrière-plan sous chaque panneau individuel. Cette méthodologie consiste à superposer au sein de chaque facette le profil de l’échantillon global de référence, représenté sous la forme d’une silhouette grise et désaturée, par-dessus laquelle vient se poser la courbe colorée spécifique du sous-groupe alloué à la case.
La mise en œuvre algorithmique de ce stratagème graphique exploite avec brio la flexibilité des couches de ggplot2. Elle requiert la déclaration préalable d’une première couche de densité nourrie par un sous-ensemble de données duquel la variable de facettage a été délibérément neutralisée ou supprimée par une transformation d’omission. Dès lors que cette couche d’arrière-plan ne possède plus la variable de découpage dans ses attributs esthétiques, le moteur de ggplot2 la duplique fidèlement au fond de l’ensemble des fenêtres de facettes sans opérer de filtrage spécifique à la sous-région.
Sur le plan sémiologique, cette confrontation permanente entre le global et le local offre un ancrage perceptuel permanent. Le lecteur peut évaluer en une fraction de seconde si la distribution particulière de la facette qu’il inspecte subit une translation vers les scores élevés, accuse un élargissement atypique de sa variance ou présente un déficit sélectif d’individus sur un intervalle critique, le tout en référence directe et continue avec la silhouette immuable de la population générale matérialisée sous ses yeux.
9. Enrichissement du graphique par des annotations statistiques ponctuelles
9.1 Marquage des tendances centrales par groupe
Bien que la courbe de densité restitue avec une élégance continue la forme globale d’un échantillon, l’œil humain éprouve souvent des difficultés à évaluer avec une précision numérique rigoureuse l’emplacement exact de la tendance centrale le long de l’axe des abscisses. Ce biais perceptuel est particulièrement aigu face à des distributions asymétriques où le sommet visuel, correspondant au mode statistique empirique, s’écarte substantiellement de la moyenne arithmétique ou de la médiane réelle sous l’effet d’une traînée unilatérale de valeurs extrêmes.
Pour combler cette lacune d’information sans surcharger le tracé, l’adjonction de marqueurs verticaux informatifs au moyen de la géométrie geom_vline() constitue une pratique hautement recommandée. Cette opération requiert le calcul programmatique préalable d’un tableau récapitulatif agrégeant les métriques de tendance centrale pour chacune des conditions analysées. En réinjectant ce tableau secondaire au sein de l’instruction graphique et en liant la position horizontale du segment à la moyenne ou médiane calculée tout en attribuant la couleur correspondante à chaque groupe, on ancre fermement l’indicateur synthétique au cœur de chaque volume de probabilité.
L’utilisation concertée de styles de lignes différenciés permet d’enrichir encore le niveau de détail sémiotique de l’annotation. On peut ainsi stipuler qu’un segment vertical tireté incarnera l’emplacement de la moyenne tandis qu’une ligne pointillée adjacente matérialisera la médiane. Cette juxtaposition axiale offre au lecteur un diagnostic visuel immédiat du sens et de l’ampleur du coefficient d’asymétrie : un étirement visible de l’intervalle séparant la moyenne de la médiane alerte instantanément sur la présence d’une distorsion distributionnelle prononcée au sein de la cohorte observée.
9.2 Visualisation de la dispersion empirique individuelle avec geom_rug()
L’estimation de densité par noyau procède fondamentalement par abstraction continue, interpolant et lissant la matière empirique jusqu’à faire disparaître l’individualité physique des mesures originelles. Dans les échantillons cliniques de taille modérée ou au sein des zones marginales où les observations se raréfient, cette continuité esthétique peut induire l’observateur en erreur en conférant un sentiment trompeur de densité volumique à des régions de l’espace échantillonnal qui ne reposent en réalité que sur une poignée de points discrets et distants.
Pour conjurer cette illusion d’abondance et rétablir un lien tangible avec l’échantillon brut, l’intégration d’un tapis de données univarié via l’opérateur geom_rug() s’avère particulièrement pertinente. Cette commande déploie un faisceau de fines encoches verticales le long de la bordure inférieure du graphique, chaque trait matérialisant l’abscisse exacte d’un individu mesuré. La densité optique des encoches le long de ce tapis linéaire traduit directement la saturation empirique locale, offrant un contrepoint concret et vérifiable à la courbe d’interpolation théorique qui plane au-dessus d’elles.
Le paramétrage chromatique du tapis doit scrupuleusement refléter les assignations de groupe retenues pour les surfaces de densité, garantissant une cohérence sémiotique totale. En ajustant finement la hauteur des tirets et en leur appliquant un coefficient de transparence modéré pour éviter la fusion des marques en présence d’ex-aequo, l’analyste enrichit sa figure d’une double grille de lecture : la vision macroscopique fluide de la dynamique de population surplombe la cartographie microscopique rigoureuse des cas individuels réellement enregistrés.
9.3 Intégration d’intervalles d’incertitude et de quantiles
La communication scientifique moderne exige d’expliciter avec une transparence totale les incertitudes d’échantillonnage et les seuils normatifs régissant l’interprétation des échelles psychométriques ou biomédicales. L’incorporation d’intervalles de confiance ou la sectorisation par quantiles directement sous l’enveloppe de la courbe de densité constitue un raffinement méthodologique de premier ordre, transformant une simple esquisse descriptive en un véritable instrument d’évaluation clinique et diagnostique.
Cette segmentation fonctionnelle peut être accomplie de manière programmatique en exploitant les capacités avancées de stat_density() configuré avec une géométrie de surface geom = "area" et nourri par un vecteur de quantiles cibles prédéterminés. En divisant la surface totale en segments correspondant par exemple aux déciles, aux quartiles ou aux percentiles cardinaux d’intérêt (5e et 95e percentiles), l’analyste peut moduler le remplissage ou le hachurage des tranches distributionnelles pour isoler immédiatement les tranches de scores critiques qualifiées d’anormales ou de pathologiques selon les standards de standardisation en vigueur.
L’insertion d’annotations textuelles ciblées via annotate() permet de parachever cette contextualisation statistique en inscrivant les valeurs chiffrées exactes des bornes quantiliques ou des intervalles de confiance de la moyenne au voisinage immédiat des crêtes distributionnelles. L’observateur n’a plus besoin d’abaisser laborieusement son regard vers la graduation numérique de l’axe des abscisses pour tenter d’estimer les grandeurs : l’information analytique fondamentale est directement arrimée au cœur de l’objet graphique, maximisant ainsi la vitesse et l’exactitude de l’interprétation cognitive.
10. Alternatives et extensions géométriques pour distributions multiples
10.1 Les graphiques en crêtes de montagne (Ridgeline plots avec ggridges)
Lorsque le dispositif expérimental implique la confrontation d’un nombre élevé de catégories séquentielles ou de conditions expérimentales, l’artifice de la transparence appliqué sur un canevas unique atteint ses limites intrinsèques de lisibilité. Dans cette configuration où le nombre de groupes oscille entre cinq et une quinzaine d’unités, les graphiques en crêtes de montagne, popularisés initialement sous la désignation visuelle de joyplots puis standardisés sous l’appellation de ridgeline plots, constituent une alternative géométrique d’une suprême élégance opérationnelle.
L’extension ggridges enrichit la grammaire de ggplot2 en introduisant des géométries spécialisées dont le fer de lance est geom_density_ridges(). Au lieu d’écraser l’ensemble des profils sur le même plan d’origine horizontal, cette approche alloue à chaque strate factorielle un axe de base propre décalé verticalement, tout en autorisant un chevauchement partiel et contrôlé des crêtes d’ondes successives sur les espaces interstitiels. Cette disposition étagée rappelle les reliefs topographiques ou les ondes radio astronomiques célèbres immortalisées par l’astrophysique.
Le réglage architectural pivot de cette géométrie repose sur l’argument scale, qui régit l’amplitude maximale de développement vertical des courbes de densité par rapport à la distance séparant les lignes de base successives. Une calibration aux alentours de 1.2 à 1.8 autorise une imbrication élégante des profils sans générer d’occlusions masquantes intempestives, optimisant de manière spectaculaire l’occupation de la surface graphique globale tout en révélant les dérives longitudinales, les changements de variabilité et les renversements de polarité le long d’une suite chronologique ou nosologique étendue.
10.2 Combinaison avec les boîtes à moustaches et diagrammes en violon
Une autre voie d’émancipation méthodologique face à la superposition stricte réside dans l’hybridation des concepts de densité avec les géométries structurelles traditionnelles. Le diagramme en violon, invoqué via geom_violin(), applique l’estimateur de densité par noyau de manière symétrique de part et d’autre d’un axe vertical de symétrie axiale, convertissant la courbe de Rosenblatt-Parzen en une silhouette volumétrique close rappelant la table d’harmonie d’un instrument à cordes. Bien que cette géométrie n’assure pas une superposition directe des aires, elle permet d’aligner une multitude de profils côte à côte sur une trame ordonnée.
Le raffinement contemporain le plus accompli de cette veine réside dans la confection de tracés hybrides compositeurs, fréquemment désignés sous le terme de diagrammes en demi-violon ou tracés en gouttes de pluie (raincloud plots). En combinant sur un même segment spatial une demi-courbe de densité représentant le lissage macroscopique, une boîte à moustaches minimale logée en son centre pour expliciter les repères non paramétriques robustes et un semis dispersé de points empiriques individuels (jitter plot) simulant des précipitations sous-jacentes, l’analyste fournit une décomposition intégrale de l’échantillon qui réconcilie toutes les échelles d’analyse.
Le choix raisonné entre superposition directe de densités, graphiques en crêtes de montagne et diagrammes composites hybrides doit être guidé par une matrice de décision méthodologique claire. Lorsque la comparaison s’oriente vers la mise en évidence d’une dissemblance morphologique subtile entre deux ou trois cohortes de taille équivalente, la superposition avec transparence demeure la solution reine par sa précision géométrique unifiée. Dès que le nombre de niveaux d’analyse s’élargit ou que la détection des points aberrants individuels devient prépondérante, le basculement vers des formes composites étagées ou modulaires s’avère le garant incontestable de la rigueur scientifique.
11. Diagnostics, erreurs courantes et pièges d’interprétation
11.1 Erreurs techniques récurrentes dans l’environnement R
L’implémentation pratique des tracés de densité superposés est jalonnée de pièges syntaxiques subtils qui dénaturent fréquemment la production des utilisateurs, y compris parfois des praticiens expérimentés. La confusion la plus dévastatrice réside dans l’incompréhension des logiques d’ajustement spatial régies par l’argument position au sein de la fonction geom_density(). Par essence, la comparaison de profils indépendants requiert impérativement un alignement rigoureux sur la valeur position = "identity", qui ordonne à ggplot2 de dessiner chaque courbe à partir du niveau zéro absolu de l’axe vertical des ordonnées.
Il arrive fréquemment que des analystes omettent cette spécification ou la configurent par inadvertance sur position = "stack". L’empilement accidentel des aires qui en découle transforme radicalement la sémantique de la figure : l’ordonnée de la deuxième courbe ne représente plus la densité de probabilité du second groupe, mais la somme arithmétique cumulative des densités des premier et second groupes. Les crêtes du second groupe se retrouvent ainsi propulsées vers le haut, déformées par les ondulations de la couche sous-jacente, créant l’illusion pernicieuse d’une moyenne considérablement surélevée et invalidant totalement toute tentative d’inférence visuelle comparative.
Une seconde bévue récurrente concerne l’omission du paramètre de regroupement explicite au sein des correspondances esthétiques globales. Lorsque l’analyste déclare une teinte de remplissage dynamique mais omet de s’assurer que la variable est correctement perçue comme un facteur discriminant ou néglige d’alimenter l’argument group, le moteur interne de ggplot2 fusionne l’ensemble des données en un agrégat indifférencié, calculant une unique densité globale aplatie par-dessus laquelle il tente maladroitement d’appliquer un dégradé chromatique confus. Cette défaillance rappelle la nécessité d’auditer systématiquement la conformité structurelle des objets avant toute invocation géométrique.
11.2 Biais d’analyse liés aux effectifs inégaux entre groupes
La normalisation mathématique par défaut opérée par stat_density() constitue une source majeure de méprise analytique lorsqu’elle est appliquée à des groupes expérimentaux caractérisés par des déséquilibres d’effectifs massifs. Par construction algorithmique, chaque estimation de densité unitaire est mise à l’échelle de telle sorte que la surface totale délimitée sous la courbe soit rigoureusement égale à un. Cette propriété d’équité relative induit un effet d’égalisation pervers : une cohorte clinique résiduelle comptant seulement quinze patients arborera une silhouette volumétrique d’une superficie strictement identique à celle d’une cohorte témoin regroupant quinze mille individus bien portants.
Cette distorsion visuelle masque totalement le poids démographique ou expérimental réel de chaque catégorie au sein de l’échantillon global. L’observateur non averti peut être amené à surévaluer considérablement l’importance épidémiologique d’une anomalie marginale détectée dans le petit groupe, oubliant qu’elle ne repose que sur une poignée infinitésimale de cas réels. Face à des déséquilibres volumiques prononcés, l’analyste rigoureux doit renoncer à la densité normalisée pour réinjecter la variable interne pondérée par les effectifs en spécifiant l’esthétique aes(y = after_stat(count)) au sein de son appel géométrique.
Sous ce mode de calcul alternatif, l’ordonnée n’exprime plus une probabilité abstraite mais un décompte d’individus lissé dans l’espace de mesure. Les hauteurs et surfaces relatives des différentes courbes reflètent dès lors fidèlement l’écart démographique réel séparant les cohortes, la silhouette du sous-groupe minoritaire s’inscrivant modestement au pied de l’imposante masse probabiliste de la population témoin. Cette formulation rétablit la réalité empirique du plan d’échantillonnage et prémunit l’équipe de recherche contre des extrapolations erronées fondées sur des micro-échantillons surdimensionnés par l’artifice du calcul unitaire.
11.3 Optimisation du format d’exportation pour l’édition académique
L’aboutissement du processus de visualisation réside dans la génération d’un fichier numérique pérenne destiné à être transmis aux éditeurs scientifiques pour insertion dans le corpus d’un article de recherche. À cette étape ultime, le choix du format de sérialisation conditionne de manière irrévocable la lisibilité et l’élégance du rendu final. L’utilisation aveugle de formats matriciels compressés à basse résolution, tels que le JPEG standard issu d’une capture d’écran sommaire, génère une pixellisation désastreuse des contours et une altération indélébile des transparences sous l’effet des algorithmes de compression destructeurs.
La règle d’or pour l’édition savante consiste à privilégier sans compromis les formats vectoriels purs, au premier rang desquels figurent le PDF haute fidélité et le SVG standardisé. En exportant le graphique au moyen de la directive ggsave() paramétrée pour le format vectoriel, l’analyste s’assure que chaque courbe de densité, chaque tiret de contour et chaque glyphe typographique est encodé sous forme d’équations géométriques scalables à l’infini. Quelle que soit l’échelle d’agrandissement ou le dispositif de zoom appliqué par le lecteur, la figure conserve une netteté absolue et une finesse chirurgicale.
Lorsque les consignes éditoriales d’une revue médicale imposent impérativement la livraison de formats matriciels rigides, l’analyste doit impérativement configurer l’exportation en format TIFF non compressé avec une résolution spatiale minimale de 300 points par pouce (DPI), voire 600 DPI pour les planches combinant dessins au trait et typographies fines. Il convient simultanément de verrouiller les dimensions physiques d’exportation en centimètres pour correspondre exactement à la largeur d’une colonne simple (environ 85 mm) ou d’une double colonne (environ 175 mm) de la revue cible, en réajustant proportionnellement la taille de base des polices au sein de theme() pour garantir une lisibilité optimale sans écrasement textuel lors de la mise en page finale.
12. Étude de cas empirique complète : Analyse comparative de temps de réponse
12.1 Scénarisation expérimentale et simulation de lois ex-gaussiennes
Pour parachever ce traité méthodologique par une démonstration pratique intégrale, nous développons une étude de cas empirique réaliste issue du domaine des neurosciences cognitives computationnelles. L’expérience modélise les chronométries mentales d’individus soumis à une tâche d’attention sélective de type Flanker sous trois conditions de charge cognitive distinctes : une condition contrôle de congruence parfaite, une condition de charge attentionnelle faible avec distracteurs périphériques homolatéraux, et une condition de charge attentionnelle élevée associant distracteurs hétérolatéraux et interférence spatiale conflictuelle.
La modélisation mathématique des temps de réaction constitue un cas d’école distributionnel en psychologie expérimentale. Il est universellement établi que les temps de réponse ne suivent jamais une loi normale symétrique, mais obéissent de manière remarquable à une distribution ex-gaussienne, résultant de la convolution d’une composante normale caractérisant les processus de traitement sensorimoteur standard et d’une composante exponentielle décrivant les ralentissements attentionnels sporadiques et les défaillances momentanées du contrôle exécutif. Cette asymétrie positive prononcée fait de la superposition de densités par noyau l’outil visuel le plus pertinent pour analyser les décalages sélectifs opérant sur le corps central versus la traînée terminale de la distribution.
Nous simulons ainsi un échantillon substantiel de 600 essais expérimentaux par condition au moyen d’un assemblage computationnel combinant des tirages gaussiens et exponentiels calibrés sur des paramètres physiologiques réels. Pour la condition contrôle, la composante normale adopte une moyenne de 380 millisecondes avec un écart-type de 35 ms, couplée à une dérive exponentielle de moyenne 45 ms. Dans la condition de charge faible, la moyenne normale se décale à 420 ms (écart-type 45 ms) et la queue exponentielle s’étire à 75 ms. Enfin, sous charge élevée, l’effort cognitif se traduit par une composante sensorimotrice translatée à 470 ms (écart-type 60 ms) et un effondrement attentionnel marqué par une traînée exponentielle explosive atteignant 120 ms.
12.2 Script R intégrateur et reproductible
Le pipeline analytique débute par la configuration d’un environnement hermétique assurant une reproductibilité computationnelle absolue. Nous chargeons l’écosystème unifié comprenant les bibliothèques ggplot2 pour la visualisation vectorielle, tidyr pour l’ingénierie dimensionnelle, dplyr pour la synthèse descriptive et scales pour le formatage des grandeurs numériques. Après initialisation du germe aléatoire, les distributions ex-gaussiennes sont synthétisées puis consolidées directement au sein d’une structure de données longitudinale conforme aux canons formels du Tidy Data.
Le script calcule ensuite les médianes empiriques respectives pour chacune des trois conditions, la médiane s’imposant comme la métrique de tendance centrale la plus robuste face à l’asymétrie marquée des distributions ex-gaussiennes. La construction du graphique mobilise l’ensemble des préceptes théoriques établis au long de cet ouvrage : spécification rigoureuse des correspondances esthétiques reliant les temps de réaction à l’axe des abscisses et la condition expérimentale aux attributs de couleur et de remplissage, application de la géométrie de densité avec un paramètre d’opacité alpha minutieusement calibré à 0.35, et élection de la palette perceptuellement uniforme viridis pour garantir l’accessibilité universelle.
L’enrichissement structurel est complété par la superposition d’un tapis de données univarié via geom_rug() à la base du repère pour matérialiser les enregistrements réels, l’adjonction de lignes verticales pointillées matérialisant l’emplacement exact des médianes de groupe, et le déploiement d’un thème stylistique épuré reposant sur theme_minimal(). Ce dernier est rigoureusement peaufiné afin de supprimer les quadrillages parasites superflus, d’arrimer la légende explicative à l’intérieur même du canevas pour optimiser l’emprise spatiale et de normaliser la typographie globale selon les standards des revues de neurosciences internationales.
12.3 Restitution académique et rédaction des résultats au format APA
La valorisation scientifique d’une visualisation complexe exige une symbiose parfaite entre le tracé vectoriel et son accompagnement textuel au sein du manuscrit scientifique. Conformément aux directives éditoriales de l’American Psychological Association dans sa septième édition, toute figure doit être coiffée d’un numéro d’ordre en gras, surmontée d’un titre bref et évocateur en italique, et assortie d’une légende explicative exhaustive située sous le cadre graphique. Cette légende a pour vocation de rendre la figure totalement auto-explicative, dispensant le lecteur de devoir se plonger dans le corps du texte pour décrypter la sémantique des codes graphiques mobilisés.
Dans notre cas d’étude, la rédaction de la note méthodologique associée doit stipuler formellement que les surfaces colorées transcrivent l’estimation non paramétrique de la densité de probabilité via un noyau gaussien calibré selon la largeur de bande standard de Silverman, les segments verticaux pointillés désignant l’emplacement des médianes empiriques de chaque groupe. La description textuelle des résultats au sein de la section dédiée doit articuler rigoureusement les métriques de tendance centrale avec les modifications structurales de la géométrie distributionnelle :
« L’analyse visuelle et inférentielle des chronométries mentales révèle une altération progressive et asymétrique de la dynamique de traitement de l’information sous l’effet de l’accroissement de la charge cognitive. Si la condition contrôle se caractérise par une distribution resserrée autour d’une médiane de 425 ms avec une traînée résiduelle modérée, l’introduction d’une charge faible opère une translation globale de la masse de probabilité vers des latences plus longues (médiane = 495 ms). De manière plus remarquable, la condition de charge élevée ne se borne pas à décaler la tendance centrale (médiane = 590 ms) mais induit un étirement spectaculaire de la queue de distribution supérieure vers des latences excédant 900 ms, traduisant graphiquement une prolifération de défaillances sporadiques du contrôle attentionnel exécutif que la simple comparaison des moyennes aurait échoué à caractériser dans toute sa complexité dynamique. »
Références
- Parzen, E. (1962). On Estimation of a Probability Density Function and Mode. The Annals of Mathematical Statistics, 33(3), 1065-1076. https://doi.org/10.1214/aoms/1177704472
- Rosenblatt, M. (1956). Remarks on Some Nonparametric Estimates of a Density Function. The Annals of Mathematical Statistics, 27(3), 832-837. https://doi.org/10.1214/aoms/1177728190
- Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall/CRC. https://doi.org/10.1201/9781315140919
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag New York. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0