
Dans le domaine de l’analyse statistique contemporaine et des sciences empiriques, l’interprétation rigoureuse des structures de données discrètes constitue l’un des piliers méthodologiques les plus fondamentaux. Si les variables quantitatives continues bénéficient traditionnellement d’une attention méthodologique soutenue en raison de leur flexibilité mathématique et de leur adéquation immédiate aux modèles linéaires gaussiens, les données qualitatives et catégorielles recèlent une complexité sémiotique et probabiliste singulière. Qu’il s’agisse d’évaluer des réponses à des échelles psychométriques, des catégorisations diagnostiques nosographiques, des appartenances sociodémographiques ou des trajectoires longitudinales de rémission clinique, la restitution graphique de ces informations discrètes exige une maîtrise conceptuelle approfondie. La représentation visuelle ne se limite pas à une simple transposition esthétique ; elle constitue une opération cognitive de synthèse destinée à révéler des structures d’association latentes, des asymétries de répartition et des effets d’interaction qui échappent fréquemment à la simple lecture tabulaire.
L’environnement statistique R s’est imposé au fil des décennies comme l’écosystème computationnel de référence pour l’analyse et la modélisation graphique des données scientifiques. Grâce à l’avènement du Tidyverse et à la consécration de la grammaire des graphiques théorisée par Leland Wilkinson, les chercheurs disposent aujourd’hui d’un ensemble d’outils expressifs et orthogonaux permettant de déconstruire chaque composante visuelle en couches fonctionnelles indépendantes. Néanmoins, l’application de ces outils aux variables catégorielles confronte fréquemment l’analyste à des écueils perceptifs majeurs : distorsion des proportions marginales, surreprésentation visuelle des effectifs absolus au détriment des fréquences relatives, ou encore perte de la hiérarchie intrinsèque propre aux échelles ordinales. L’objectif de cet article est d’exposer de manière exhaustive les fondements théoriques, les mécanismes de préparation structurelle et les implémentations graphiques avancées nécessaires à la restitution fidèle des données catégorielles dans R.
À travers un parcours analytique débutant par les distinctions ontologiques entre échelles de mesure et s’étendant jusqu’à la composition de figures composites pour la publication internationale, cette étude offre un guide complet d’ingénierie visuelle. En mobilisant conjointement les fonctions fondamentales de R, les raffinements typologiques apportés par la bibliothèque forcats et la puissance expressive de ggplot2 et de ses extensions spécialisées, nous démontrerons comment transformer des matrices de contingence complexes en récits graphiques élégants, fidèles et épistémologiquement irréprochables.
1. Introduction théorique aux variables catégorielles et fondements de leur visualisation dans R
1.1 Distinction fondamentale entre variables nominales, ordinales et binaires
L’analyse rigoureuse des données discrètes repose sur une typologie épistémologique stricte, dont les contours ont été formellement établis par Stanley Smith Stevens dans sa théorie fondatrice des échelles de mesure publiée en 1946. Selon cette classification, les variables qualitatives se scindent principalement en échelles nominales et ordinales, auxquelles s’ajoute le cas particulier des structures binaires ou dichotomiques. Une variable nominale pure caractérise des modalités qualitatives mutuellement exclusives qui ne possèdent aucun ordre mathématique sous-jacent ni hiérarchie naturelle. Les entités catégorisées au sein d’une échelle nominale, à l’instar des classifications nosologiques psychiatriques du Manuel diagnostique et statistique des troubles mentaux (DSM-5), de l’appartenance géographique ou du groupe sanguin, ne peuvent être comparées qu’en termes d’égalité ou de différence. Les seules opérations mathématiques valides demeurent l’estimation du mode, le dénombrement des fréquences et le calcul des proportions relatives.
À l’opposé, les échelles ordinales introduisent une relation d’ordre strict entre les niveaux de la variable, tout en demeurant privées de la propriété d’équidistance propre aux échelles d’intervalle. Dans une structure ordinale, comme les stades de sévérité d’une pathologie (léger, modéré, sévère) ou les degrés d’adhésion d’une échelle de Likert, l’assertion selon laquelle une modalité supérieure surpasse une modalité inférieure est sémantiquement légitime, mais la distance métrique séparant deux échelons successifs demeure inconnue et fondamentalement non quantifiable. Cette caractéristique interdit l’usage direct de la moyenne arithmétique et de la variance standard, imposant le recours aux médianes, aux quantiles et aux rangs statistiques.
Les variables binaires ou dichotomiques représentent un cas limite où le support ne comporte que deux états mutuellement exclusifs, conventionnellement codés en probabilités d’occurrence. Les implications de ces distinctions sur le choix de la géométrie de visualisation graphique sont considérables. Alors qu’une échelle nominale autorise une réorganisation arbitraire de l’ordre d’affichage des axes afin d’optimiser la saillance perceptive, une échelle ordonné exige le respect scrupuleux de sa trajectoire séquentielle pour préserver l’intégrité cognitive du message scientifique.
1.2 Importance de la visualisation catégorielle en psychologie et sciences du comportement
Dans les sciences du comportement, en psychologie clinique et en neurosciences cognitives, les protocoles expérimentaux et observationnels génèrent une quantité prépondérante de variables discrètes. La stratification sociodémographique, les sous-types de personnalités, les profils d’attachement développementaux ou les diagnostics différentiels constituent autant d’objets d’étude catégoriels nécessitant une ségrégation visuelle transparente. La restitution visuelle de ces distributions soulève des défis perceptifs considérables, documentés par la psychologie cognitive et la théorie du traitement de l’information visuelle initiée par Jacques Bertin dans sa Sémiologie graphique. L’œil humain est intrinsèquement sensible aux contrastes de surface, aux longueurs relatives et aux saturations chromatiques, mais il s’avère particulièrement vulnérable aux illusions d’optique lorsqu’il s’agit d’estimer des proportions empiriques à travers des angles ou des aires géométriques irrégulières.
De plus, l’analyste en sciences humaines est fréquemment confronté au phénomène de surinterprétation des effectifs marginaux. Lorsqu’une catégorie minoritaire présente une prévalence clinique critique, son faible poids démographique au sein d’un échantillon général risque de masquer son impact statistique si la géométrie graphique choisie privilégie uniquement l’effectif brut. À l’inverse, une standardisation excessive en pourcentages relatifs peut conférer une importance visuelle démesurée à des variations accidentelles observées sur de très petits effectifs. La visualisation exploratoire joue ainsi un rôle d’arbitrage fondamental : elle permet d’inspecter l’homogénéité des cohortes, de déceler la présence de catégories sous-représentées susceptibles de biaiser les modèles de régression logistique, et de formuler des hypothèses d’interaction comportementale avant toute modélisation confirmatoire.
1.3 Panorama des moteurs graphiques dans l’environnement R
L’écosystème R se caractérise par une dualité historique entre son moteur de dessin natif, couramment désigné sous le terme de base R graphics, et les environnements modulaires déclaratifs modernes incarnés par ggplot2. Le système graphique originel repose sur un paradigme impératif hérité du langage S, où le tracé s’effectue par l’accumulation séquentielle de couches graphiques sur un canevas prédéfini via des fonctions procédurales telles que barplot(), plot() ou pie(). Si ce moteur natif se distingue par une exécution computationnelle extrêmement rapide et une absence de dépendances logicielles externes, il impose une gestion manuelle fastidieuse des espacements, de l’alignement des légendes et de la palette chromatique, ce qui limite considérablement sa reproductibilité et sa modularité dans des contextes analytiques complexes.
La publication par Hadley Wickham de la bibliothèque ggplot2 a opéré une véritable rupture paradigmatique en transcrivant informatiquement les concepts de la Grammar of Graphics de Leland Wilkinson. Dans ce système, un graphique n’est plus une suite d’instructions de dessin au trait, mais une association formelle entre des données tabulaires, des projections géométriques, des transformations statistiques sous-jacentes et des systèmes de coordonnées spatiales. Pour les données catégorielles, ce paradigme offre une flexibilité sans équivalent grâce à la dissociation nette entre la manipulation des facteurs et leur encodage esthétique.
Autour de ce noyau central s’est développé un réseau dense d’extensions spécialisées destinées à combler les exigences analytiques de pointe. Le package vcd (Visualizing Categorical Data) fournit des outils rigoureux pour l’exploration multivariée des tables de contingence via des représentations géométriques proportionnelles. Parallèlement, des bibliothèques telles que ggalluvial permettent de modéliser visuellement les flux et transitions qualitatives, tandis que ggstatsplot intègre automatiquement les tests d’inférence non paramétriques et les indicateurs d’association directement sur le rendu visuel.
2. Préparation et manipulation experte des facteurs avec R base et forcats
2.1 Structuration et typage des vecteurs avec factor() et ordered()
L’une des étapes les plus déterminantes dans la réussite d’une visualisation graphique sous R réside dans l’intégrité de la structure interne des vecteurs manipulés. Contrairement aux chaînes de caractères brutes de type caractère, qui ne véhiculent aucune information relative à la hiérarchie ou aux modalités potentielles absentes de l’échantillon, les objets de classe factor encapsulent une variable discrète sous la forme d’un vecteur d’entiers pointant vers une table de correspondance textuelle dénommée levels. La fonction fondamentale factor() permet de transformer une séquence de données brutes en une structure factorielle rigoureuse, en définissant explicitement l’ensemble des modalités admises via l’argument levels et leurs étiquettes d’affichage correspondantes via l’argument labels.
Cette distinction s’avère encore plus cruciale lorsque la variable sous-jacente possède une dimension hiérarchique intrinsèque. L’appel à la fonction ordered() ou l’adjonction du paramètre ordered = TRUE confère au facteur une classe double spécifique, autorisant le moteur graphique à interpréter la séquence des modalités comme un continuum ordonné. Lors de cette opération, la cohérence de l’encodage doit être systématiquement contrôlée au moyen de la fonction str(), qui révèle la distribution sous-jacente des entiers, et de la fonction levels(), qui assure la traçabilité de l’ordre canonique des modalités. Une omission dans la déclaration des niveaux engendre inévitablement l’apparition de valeurs manquantes artificielles ou un positionnement erratique des axes lors du rendu final sous ggplot2.
2.2 Réordonnancement dynamique des modalités à l’aide de forcats
Par défaut, l’environnement de base R classe les niveaux d’un facteur selon l’ordre alphabétique standard de leurs étiquettes textuelles. Ce comportement déterministe s’avère particulièrement contre-productif dans le cadre d’une communication graphique rigoureuse, car il détruit la saillance de l’information et impose à l’observateur un effort cognitif superflu de déchiffrage. Le package forcats, intégré à l’écosystème Tidyverse, met à disposition une suite de fonctions spécialisées destinées au réordonnancement probabiliste et fonctionnel des facteurs.
La fonction fct_relevel() offre un contrôle déclaratif absolu en permettant de repositionner manuellement une ou plusieurs modalités stratégiques au début ou à la fin de la séquence vectorielle. Cette manipulation s’avère indispensable dans les plans expérimentaux contrôlés où un groupe placebo ou une cohorte de référence doit impérativement occuper la première position sur l’axe visuel d’abscisse. Lorsqu’il s’agit d’analyser des distributions nominales univariées, la fonction fct_infreq() permet de réordonner les niveaux par ordre décroissant de leurs effectifs d’apparition empiriques, guidant instantanément le regard de l’audience vers les catégories dominantes. L’association conjointe avec fct_rev() autorise une inversion instantanée de cette trajectoire pour répondre aux exigences d’un affichage horizontal inversé.
Par ailleurs, la fonction fct_reorder() constitue un instrument analytique de premier plan pour croiser des variables catégorielles avec une métrique quantitative. Elle réorganise automatiquement les modalités du facteur en fonction d’un indicateur central (médiane ou moyenne) calculé sur une variable continue associée. Cette approche élimine toute disposition hasardeuse sur le graphique et convertit une juxtaposition de données éparses en un profil ordonné d’une clarté démonstrative irréprochable.
2.3 Gestion des catégories peu fréquentes et des données manquantes
L’exploration de vastes ensembles de données sociologiques ou cliniques se heurte régulièrement à la présence d’une multiplicité de catégories marginales ne regroupant que d’infimes fractions de l’échantillon. L’inclusion brute de ces dizaines de micro-niveaux sur un graphique génère une saturation visuelle délétère, comprime les barres principales et rend les étiquettes textuelles parfaitement illisibles. La boîte à outils de forcats répond à cette contrainte par le biais des fonctions d’agrégation conditionnelle fct_lump_n() et fct_lump_prop().
La fonction fct_lump_n() préserve rigoureusement les n catégories les plus volumineuses de la cohorte tout en fusionnant l’ensemble des modalités résiduelles sous une étiquette synthétique générique, communément intitulée « Autre ». De manière analogue, fct_lump_prop() procède à cette réduction dimensionnelle en se basant sur un seuil proportionnel minimal, par exemple en agrégeant systématiquement toute modalité dont la fréquence empirique s’avère inférieure à cinq pour cent de l’échantillon global. Par ailleurs, la question des données manquantes (NA) requiert un traitement graphique délibéré. Dans R, les valeurs non renseignées sont par défaut omises des visualisations géométriques, ce qui peut masquer des mécanismes d’attrition expérimentale ou des refus de réponse cliniquement signifiants. L’emploi de fct_explicit_na(), remplacé dans les versions récentes par fct_na_value_to_level(), transforme l’absence d’information en une modalité d’analyse à part entière, rendant ainsi le biais d’incomplétude immédiatement constatable par le lecteur.
Enfin, lorsqu’un filtre ou un sous-échantillonnage est appliqué à un ensemble de données, les modalités exclues demeurent virtuellement enregistrées dans les métadonnées du facteur, ce qui conduit ggplot2 à réserver des espaces vides sur les axes. L’application de la fonction droplevels() permet d’assainir la structure vectorielle en purgeant définitivement les niveaux inoccupés avant l’étape de rendu graphique.
3. Diagrammes en barres simples univariés avec ggplot2
3.1 Représentation des effectifs bruts à l’aide de geom_bar()
Le diagramme en barres univarié constitue la forme graphique canonique pour illustrer la distribution des fréquences au sein d’une variable qualitative unique. Au sein du formalisme de ggplot2, l’implémentation de cette visualisation repose sur la géométrie geom_bar(), dont l’architecture interne s’appuie par défaut sur la transformation statistique stat_count(). Contrairement aux approches procédurales qui requièrent un tableau récapitulatif préalablement calculé, geom_bar() accepte directement un tableau de données brutes contenant une ligne par observation individuelle. Le moteur statistique dénombre de manière autonome les occurrences de chaque modalité assignée à l’esthétique d’abscisse et projette sur l’axe des ordonnées la hauteur de la barre correspondante.
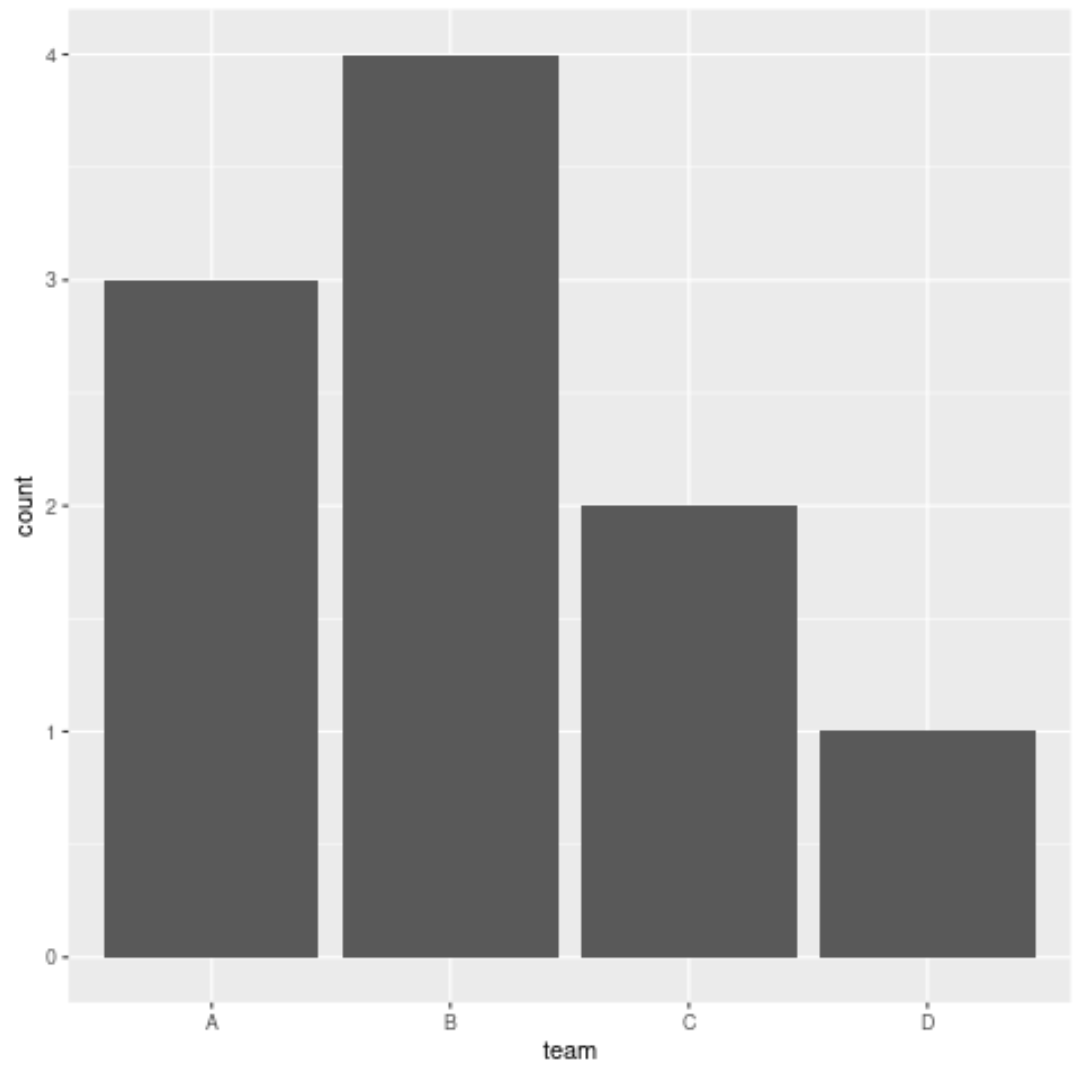
La configuration esthétique d’un tel diagramme impose une distinction rigoureuse entre les paramètres de contour et les attributs de remplissage volumétrique. Alors que l’argument color détermine la teinte de la bordure entourant le rectangle géométrique, l’argument fill régit la pigmentation de la surface interne de la barre. Pour des variables purement nominales sans hiérarchie préétablie, l’analyste veillera à utiliser des teintes sobres et uniformes, évitant ainsi d’assigner une palette multicolore arbitraire qui introduirait une saillance visuelle injustifiée sur certaines modalités. Par ailleurs, le contrôle de la largeur des barres, modulable via l’argument width, participe directement à l’équilibre visuel du panneau d’affichage, un espacement trop réduit provoquant une sensation d’encombrement graphique tandis qu’un espacement excessif fragilise la perception de continuité entre les niveaux.
3.2 Tracé à partir de tableaux récapitulatifs avec geom_col()
Si la souplesse de geom_bar() s’avère précieuse lors de l’exploration interactive de données individuelles, de nombreuses situations de recherche imposent de travailler sur des structures de données pré-agrégées, issues d’extractions de bases relationnelles ou d’enquêtes psychométriques consolidées. Dans cette configuration, les données se présentent sous la forme d’un tableau à deux colonnes associant à chaque niveau catégoriel une valeur numérique correspondant à son effectif dénombré ou à son poids statistique. L’utilisation directe de geom_bar() engendre alors une erreur de modélisation, à moins de spécifier manuellement l’argument stat = « identity » afin de neutraliser le décompte automatique.
Pour répondre avec élégance à ce besoin récurrent sans surcharger la syntaxe, ggplot2 met à disposition la fonction dédiée geom_col(). Cette dernière assume d’emblée une transformation d’identité statistique et cartographie sans ambiguïté les valeurs numériques de la colonne désignée sur l’axe de hauteur. Cette approche présente un gain d’efficacité computationnelle significatif lors du traitement de très volumineux échantillons comprenant plusieurs centaines de milliers d’individus. Au lieu de contraindre le processeur graphique à itérer sur chaque ligne du jeu de données brut pour exécuter la transformation stat_count(), l’analyste procède préalablement à l’agrégation via la fonction count() du package dplyr, puis transmet le tableau condensé à geom_col(), assurant ainsi une reproductibilité instantanée du pipeline visuel.
3.3 Conversion des effectifs en proportions et pourcentages relatifs
L’affichage des effectifs bruts présente des limites méthodologiques sévères dès lors qu’il s’agit d’interpréter le poids relatif d’une modalité au sein de sa population d’origine ou d’anticiper la comparabilité avec d’autres études menées sur des tailles d’échantillons différentes. La conversion de l’axe vertical en proportions normalisées ou en pourcentages constitue alors un impératif analytique. Au sein de geom_bar(), cette opération s’effectue sans modifier la structure des données sous-jacentes grâce à la syntaxe moderne des variables calculées par les étapes statistiques, encapsulée par la fonction after_stat().
En assignant à l’ordonnée l’expression after_stat(prop), le chercheur instruit le moteur de calcul d’extraire la proportion relative calculée par stat_count() plutôt que le décompte absolu. Cependant, en raison du partitionnement interne des données par groupe, ggplot2 tend à calculer la proportion relative au sein de chaque niveau individuel pris isolément, ce qui aboutit à une série de barres de hauteur égale à 100 %. Pour contourner cet écueil et forcer la normalisation par rapport à l’ensemble du corpus, il est indispensable de spécifier explicitement l’esthétique group = 1 dans l’environnement aes(). Afin de garantir une lisibilité éditoriale optimale conforme aux standards de diffusion scientifique, l’axe d’ordonnée ainsi obtenu est ensuite habillé via la fonction scale_y_continuous() combinée au formateur d’étiquettes scales::percent, convertissant des décimales abstraites en pourcentages explicites et immédiatement assimilables.
4. Diagrammes en barres bivariés et multivariés : groupement et empilement
4.1 Barres empilées et répartition cumulée (position = ‘stack’)
L’introduction d’une seconde variable catégorielle dans un diagramme en barres permet d’étudier la distribution conjointe et d’identifier d’éventuels schémas de covariation ou de dépendance structurelle. La configuration par défaut de ggplot2 lorsqu’une seconde variable qualitative est associée à l’attribut de remplissage fill est le diagramme en barres empilées, régi par le paramètre position = « stack ». Dans cette géométrie, les effectifs des différentes sous-catégories sont accumulés verticalement le long d’une colonne unique pour chaque modalité de la variable principale située en abscisse. Cette représentation permet d’appréhender d’un seul regard à la fois le volume total agrégé de chaque groupe principal et la composition interne fragmentée de ce volume.
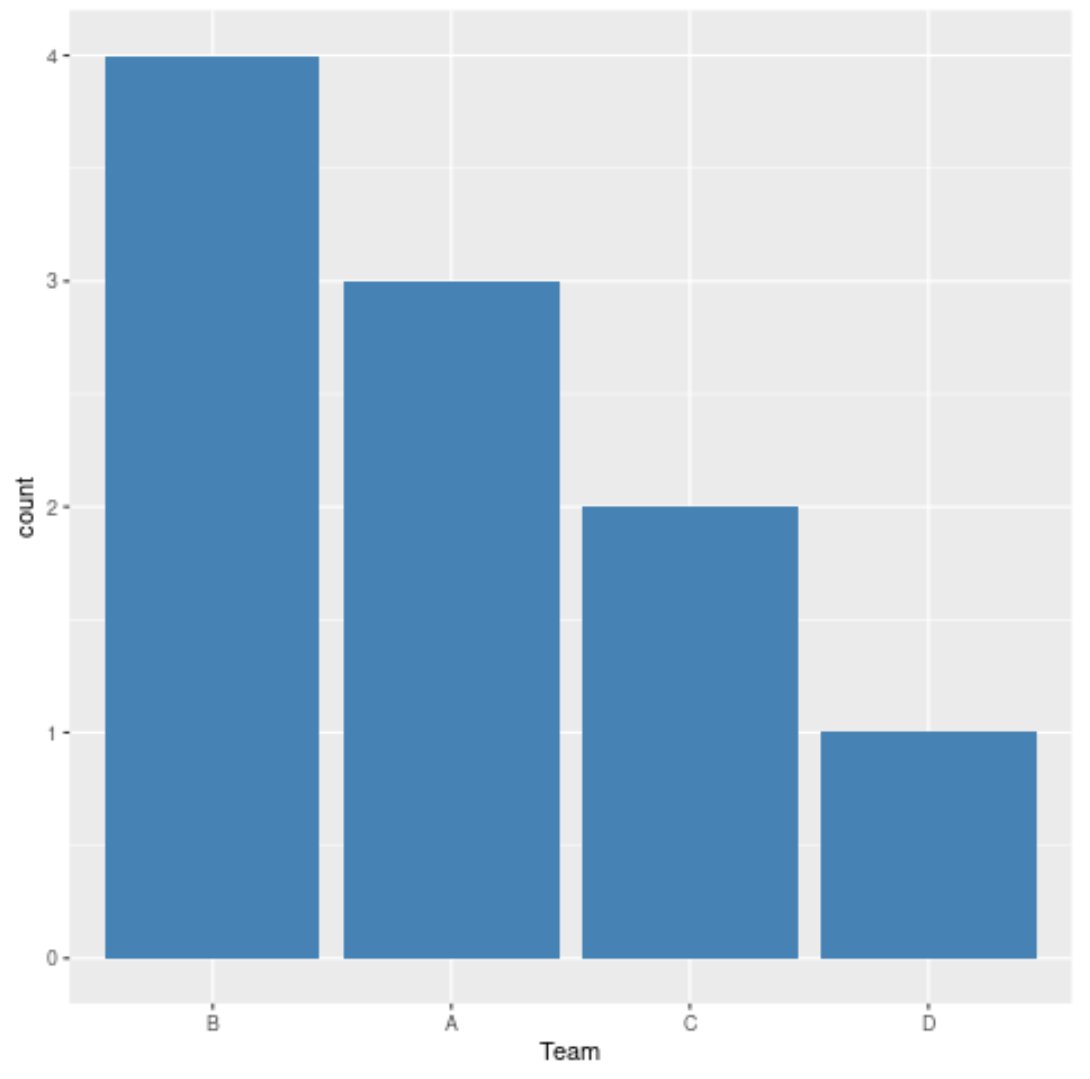
Néanmoins, la psychologie de la perception visuelle souligne les limites cognitives sévères inhérentes aux barres empilées. Si la sous-catégorie située à la base de la pile partage une ligne d’ancrage horizontale commune permettant des comparaisons d’amplitudes précises entre les groupes, les segments intermédiaires et supérieurs reposent sur des lignes de départ flottantes qui fluctuent en fonction de la taille des segments sous-jacents. Cette absence d’alignement systématique dégrade considérablement l’exactitude des jugements d’estimation portés par le lecteur. L’utilisation de cette géométrie doit par conséquent être réservée aux contextes où la somme globale cumulée présente un intérêt clinique ou théorique supérieur à la comparaison bilatérale fine des segments internes, tout en veillant à stabiliser la disposition hiérarchique des facteurs pour maintenir la cohérence de l’empilement.
4.2 Barres standardisées à 100 % (position = ‘fill’)
Lorsque la finalité de l’enquête statistique réside exclusivement dans la comparaison des distributions conditionnelles relatives sans que les écarts d’effectifs globaux entre les groupes principaux ne constituent le point focal, le positionnement standardisé à 100 %, configuré par position = « fill », représente l’alternative géométrique optimale. Dans cette modalité de tracé, chaque barre globale est uniformément étirée sur l’intégralité de l’axe vertical pour atteindre une valeur unitaire de un (ou cent pour cent), et les segments internes traduisent fidèlement les proportions conditionnelles de la variable secondaire au sein de chaque groupe primaire.
Cette standardisation visuelle opère une neutralisation complète de l’effet de taille de cohorte, facilitant une comparaison immédiate de la structure compositionnelle des cohortes indépendantes. Cette propriété s’avère particulièrement démonstrative pour révéler des asymétries de répartition d’un trouble psychopathologique à travers différentes strates d’âge présentant des tailles d’échantillon très disparates. Pour parfaire la rigueur éditoriale de ce type de visualisation, l’axe d’ordonnée doit être impérativement annoté sous la forme de pourcentages relatifs standardisés via scale_y_continuous(labels = scales::percent). De surcroît, l’adjonction discrète de lignes horizontales de guidage permet de projeter mentalement les frontières de démarcation d’une colonne à l’autre et d’identifier avec certitude les ruptures d’équilibre distributionnel.
4.3 Barres juxtaposées côte à côte (position = ‘dodge’)
Afin de pallier l’impossibilité de comparer rigoureusement des segments non alignés propres aux diagrammes empilés, la méthode de juxtaposition côte à côte, activée via l’argument position = « dodge », constitue une solution graphique de référence. En décalant latéralement les sous-groupes le long de l’axe des abscisses, cette disposition rétablit une ligne de base horizontale commune pour l’ensemble des éléments géométriques, permettant ainsi une évaluation comparative directe des longueurs absolues ou des proportions selon l’étalonnage choisi.
Toutefois, la mise en œuvre pratique de la juxtaposition dans ggplot2 peut se heurter à des distorsions géométriques lorsque certaines combinaisons factorielles ne comportent aucune observation. Par défaut, la fonction position_dodge() recalcule la largeur des barres restantes au sein du groupe incomplet, générant ainsi des colonnes anormalement larges qui faussent l’esthétique et la perception d’équivalence entre modalités. Pour juguler cette anomalie, l’analyste doit employer la commande formalisée position = position_dodge(preserve = « single »), laquelle garantit une largeur strictement identique pour l’ensemble des barres du graphique, quel que soit le dénombrement interne du sous-groupe. Sur le plan sémiotique, il est primordial de ne pas excéder un seuil de quatre à cinq sous-catégories juxtaposées par modalité principale, sous peine de saturer la mémoire de travail visuelle et de dégrader la lisibilité globale de la figure.
5. Visualisation des tableaux de contingence et associations via les diagrammes en mosaïque
5.1 Principes mathématiques et géométriques du graphique en mosaïque
Si les diagrammes en barres bivariés permettent d’appréhender les relations qualitatives simples, ils échouent à matérialiser fidèlement l’intégralité de la structure d’une table de contingence multivariée, notamment les variations simultanées des probabilités marginales et conjointes. Développé initialement par Hartigan et Kleiner en 1981, le diagramme en mosaïque (ou mosaic plot) répond à cette exigence en procédant à un partitionnement récursif de l’espace graphique bidimensionnel au prorata des fréquences observées. Contrairement aux diagrammes classiques dont l’une des dimensions spatiales est arbitrairement fixée à une largeur constante, la mosaïque module conjointement la largeur et la hauteur des tuiles rectangulaires composant l’espace visuel.
Le principe mathématique repose sur la factorisation géométrique de la probabilité conjointe : la surface totale unitaire du graphique est d’abord scindée verticalement en segments dont les largeurs sont rigoureusement proportionnelles aux probabilités marginales de la première variable. Puis, chacun de ces segments verticaux est subdivisé horizontalement selon les probabilités conditionnelles de la seconde variable sachant la première. Par conséquent, l’aire géométrique de chaque tuile élémentaire correspond exactement à la probabilité conjointe observée au sein de la cellule correspondante de la table de contingence. Cette propriété d’isomorphisme surfacique confère à la mosaïque un lien conceptuel direct avec le modèle probabiliste d’indépendance statistique évalué par le test du Chi-deux de Pearson. En situation d’indépendance parfaite, les découpes horizontales s’alignent de manière continue d’une colonne à l’autre, formant des bandes ininterrompues.
5.2 Implémentation complète avec le package spécialisé vcd
Bien que des implémentations dérivées existent au sein de l’environnement ggplot2 (notamment via le package tiers ggmosaic), la référence méthodologique pour le tracé de mosaïques demeure la bibliothèque spécialisée vcd (Visualizing Categorical Data), développée par David Meyer, Achim Zeileis et Michael Friendly. L’utilisation de cette infrastructure exige la conversion préalable des structures de données brutes ou des tibbles en objets de classe formelle table ou xtabs, encapsulant explicitement la matrice de contingence dimensionnelle.
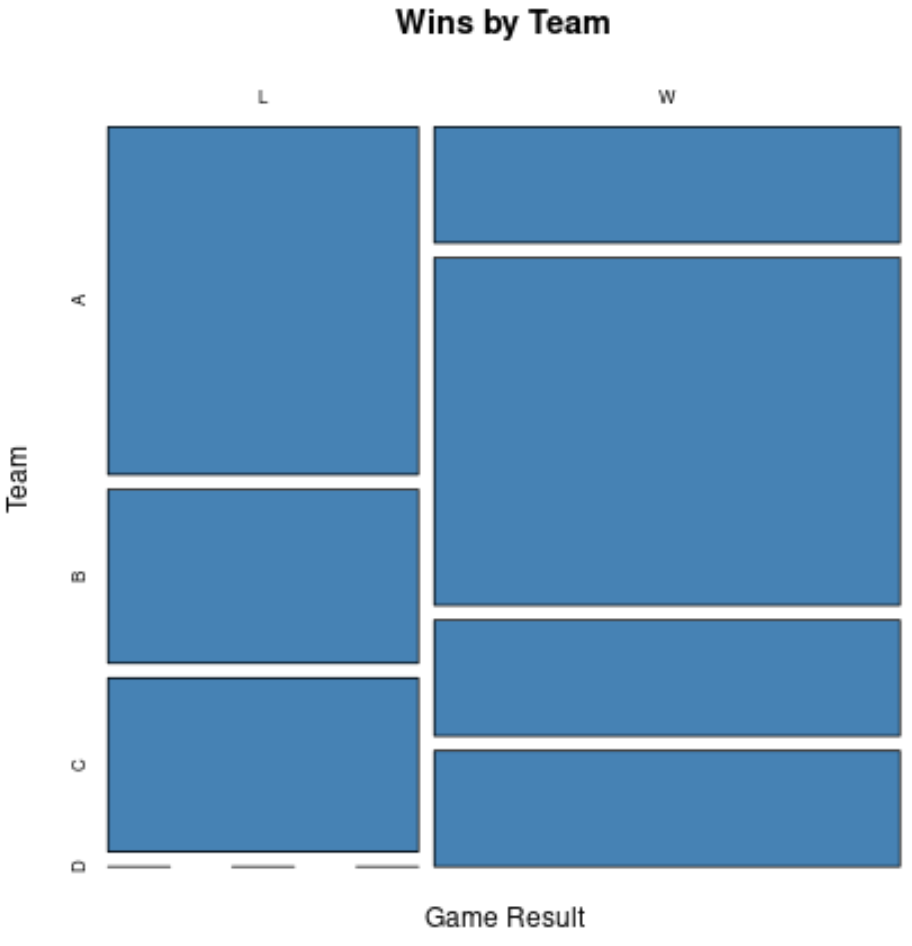
La fonction maîtresse mosaic() de vcd offre une paramétrisation exhaustive du processus de découpe et d’espacement. L’argument direction permet de spécifier l’axe d’orientation de chaque scission successive (par exemple une alternance verticale puis horizontale), tandis que le paramètre spacing introduit des espacements métriques contrôlés entre les blocs rectangulaires afin de souligner visuellement la structure hiérarchique des facteurs imbriqués. Cette granularité paramétrique autorise l’exploration visuelle de tables de contingence d’ordre supérieur à deux, offrant ainsi un moyen intuitif de disséquer des modèles de régression log-linéaire en représentant les interactions d’ordre trois ou quatre sans jamais rompre l’intégrité topologique des données discrètes.
5.3 Coloration diagnostique par les résidus de Pearson standardisés
L’innovation sémiotique majeure apportée par Michael Friendly dans le cadre des graphiques en mosaïque réside dans l’intégration d’un modèle d’ombrage diagnostique fondé sur les résidus statistiques du modèle d’indépendance. Dans une mosaïque non colorée, l’évaluation visuelle des écarts à l’indépendance impose d’estimer mentalement des décalages d’alignement entre tuiles, une tâche cognitive sujette à de fortes imprécisions. En intégrant l’argument shading = shading_Friendly ou shading = shading_max au sein de la fonction mosaic(), l’analyste superpose une dimension chromatique rigoureuse issue du calcul des résidus de Pearson standardisés.
Les résidus de Pearson représentent l’écart normalisé entre les effectifs empiriquement observés dans chaque cellule et les effectifs théoriques attendus sous l’hypothèse nulle d’indépendance stochastique. Le modèle d’ombrage de Friendly applique une échelle bipolaire conventionnelle : les cellules présentant une surreprésentation significative d’observations (résidus positifs excédant les valeurs critiques de deux et quatre en valeur absolue) sont saturées d’une teinte bleue de plus en plus dense, tandis que les cellules révélant un déficit significatif d’observations (résidus négatifs inférieurs à moins deux et moins quatre) sont habillées de nuances pourpres ou rouges. Les cellules dont les effectifs ne divergent pas significativement de l’attente théorique au seuil alpha conventionnel de 0.05 demeurent blanches ou gris neutre. Cette cartographie visuelle permet de localiser instantanément les sources spécifiques de rejet de l’hypothèse nulle au sein d’une table complexe, fournissant un outil de diagnostic étiologique précieux en psychopathologie pour détecter des patterns de comorbidités non aléatoires.
6. Croisement de variables quantitatives et qualitatives : les boîtes à moustaches (Boxplots)
6.1 Anatomie statistique de geom_boxplot()
L’intersection empirique entre des cohortes catégorielles et des métriques continues constitue le cœur opérationnel de la majorité des protocoles de recherche expérimentale. Pour visualiser ces distributions croisées sans présumer arbitrairement de la normalité des distributions sous-jacentes, la boîte à moustaches, formalisée par John Tukey en 1977 au sein de son ouvrage fondateur sur l’analyse exploratoire des données, demeure l’instrument graphique standardisé par excellence. Dans l’écosystème ggplot2, l’implémentation de cette géométrie s’opère par l’appel à la fonction geom_boxplot(), dont les conventions mathématiques traduisent fidèlement les estimateurs d’ordre non paramétriques robustes.
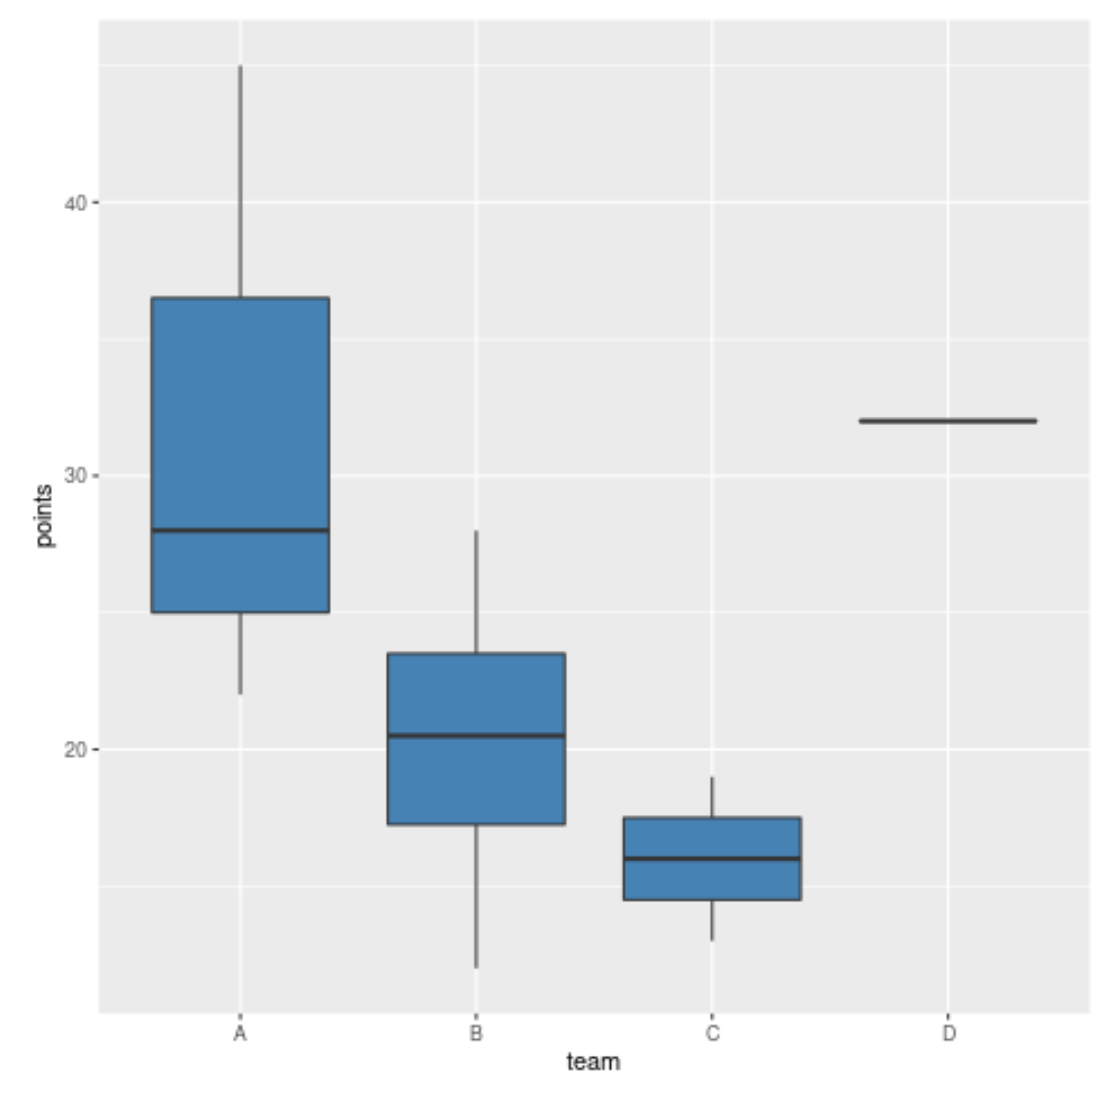
Le corps central de la boîte délimite l’écart interquartile (IQR), s’étendant du premier quartile (25e centile) au troisième quartile (75e centile), englobant ainsi les cinquante pour cent médians de la distribution. Une ligne transversale épaisse scinde la boîte au niveau de la médiane statistique (50e centile), offrant un indicateur de tendance centrale insensible aux asymétries distributionnelles. Les segments linéaires désignés sous le terme de moustaches s’étendent de part et d’autre de la boîte jusqu’à l’observation la plus extrême comprise dans une limite conventionnelle équivalente à 1.5 fois l’IQR calculée à partir des charnières. Tout point de mesure situé au-delà de cette frontière de Tukey est formellement identifié comme une valeur atypique (outlier) et restitué individuellement sous la forme d’un point isolé. Cette anatomie confère au boxplot une supériorité épistémologique absolue sur les traditionnels diagrammes en barres d’erreurs (souvent désignés sous le terme critique de « dynamite plots »), lesquels dissimulent la variance réelle et masquent les asymétries sévères derrière une moyenne arithmétique potentiellement trompeuse.
6.2 Stratification multifactorielle et interaction de groupes
L’analyse des plans factoriels expérimentaux en psychologie et en épidémiologie implique couramment l’évaluation simultanée de deux variables catégorielles indépendantes interagissant sur un score quantitatif continu, à l’image d’un protocole évaluant l’effet d’un traitement thérapeutique (groupe actif versus groupe contrôle) stratifié selon le sexe biologique ou le statut socio-économique. Au sein de ggplot2, cette stratification multifactorielle s’exécute de façon fluide en assignant la variable de classification principale à l’axe des abscisses x, et le facteur modérateur secondaire à l’esthétique de remplissage fill.
Dans cette configuration, ggplot2 active automatiquement un décalage horizontal des boîtes via son mécanisme interne de dodge, regroupant visuellement les sous-groupes par niveau du facteur d’abscisse. L’analyste doit néanmoins exercer un contrôle rigoureux sur l’espacement relatif en calibrant précisément l’argument position = position_dodge(width = 0.8) pour éviter tout chevauchement des boîtes adjacentes. Cette décomposition spatiale permet d’évaluer visuellement la présence d’effets d’interaction statistique : si l’écart médian séparant le traitement du contrôle demeure rigoureusement parallèle à travers les niveaux de la seconde variable, l’absence d’interaction se traduit graphiquement par des profils de dispersion stables ; à l’inverse, toute divergence d’amplitude ou inversion de pente entre les sous-groupes signale une modulation de l’effet thérapeutique par le facteur de stratification.
6.3 Enrichissement sémantique et ajout d’indicateurs paramétriques
Bien que la boîte à moustaches soit intrinsèquement conçue comme un outil d’exploration non paramétrique, les exigences éditoriales académiques imposent fréquemment de confronter les indicateurs de rangs aux paramètres gaussiens classiques. L’un des enrichissements graphiques les plus utiles consiste à superposer la moyenne arithmétique au sein du tracé médian. Cette intégration s’effectue au moyen de la fonction générique stat_summary(), en spécifiant l’argument fun = « mean » et en assignant une géométrie ponctuelle différenciée (par exemple un losange coloré ou une croix d’une teinte contrastante via geom = « point »). L’écart visuel entre le trait de la médiane et le point de la moyenne fournit un diagnostic instantané sur le degré d’asymétrie (skewness) de la distribution clinique.
De surcroît, la fonction geom_boxplot() dispose d’un paramètre analytique sophistiqué via l’argument notch = TRUE. L’activation des encoches génère un rétrécissement bilatéral de la boîte autour de la médiane, calculé selon une approximation asymptotique proportionnelle à l’écart interquartile divisé par la racine carrée de la taille d’échantillon. Deux groupes dont les encoches ne se chevauchent pas présentent, avec un niveau de confiance approchant grossièrement 95 %, une différence statistiquement significative entre leurs médianes respectives. Enfin, pour dissiper toute ambiguïté quant à la puissance statistique sous-jacente, il est hautement recommandé d’annoter le sommet de chaque boîte par la taille effective de la cohorte d’échantillonnage (l’effectif n), calculable dynamiquement via stat_summary(fun.data = fun_length, geom = « text »), garantissant ainsi une transparence méthodologique absolue.
7. Graphiques de densité catégorielle : diagrammes en violon et représentations hybrides
7.1 Modélisation de la densité de distribution avec geom_violin()
Malgré leurs qualités de synthèse indéniables, les boîtes à moustaches souffrent d’une incapacité structurelle à révéler les singularités morphologiques internes des distributions continues, telles que la multimodalité ou les creux de densité locaux. Un échantillon strictement bimodal peut en effet présenter des quartiles et des moustaches parfaitement identiques à ceux d’une distribution unimodale asymétrique. Pour s’affranchir de cet angle mort, le diagramme en violon, introduit par Hintze et Nelson en 1998 et implémenté sous ggplot2 via geom_violin(), combine l’architecture factorielle du boxplot avec l’estimation de densité par noyau (Kernel Density Estimation, KDE).
Pour chaque modalité de la variable catégorielle assignée à l’axe des abscisses, geom_violin() calcule de manière indépendante une courbe de densité continue le long de l’axe quantitatif, puis projette cette courbe de manière bilatérale et symétrique autour d’un axe central virtuel. La largeur du profil en chaque point de l’ordonnée est ainsi directement proportionnelle à la probabilité d’observer des sujets à ce niveau de mesure précis. Lors du déploiement de cette géométrie, l’analyste doit porter une attention méticuleuse au paramètre de largeur de bande (l’argument bw ou adjust). Une valeur de lissage trop faible induit un sur-ajustement graphique révélant des artéfacts d’échantillonnage dénués de sens théorique, tandis qu’un lissage excessif écrase les structures bimodales réelles sous une enveloppe unifiée. Le diagramme en violon s’impose ainsi comme l’outil privilégié pour déceler des sous-populations latentes au sein d’une catégorie clinique apparemment homogène.
7.2 Superposition des données individuelles brutes via geom_jitter()
L’abstraction géométrique offerte par les violons ou les boîtes à moustaches conserve un inconvénient fondamental : elle dissimule la granularité des points d’observation unitaires, ce qui peut induire le lecteur en erreur lorsque la densité apparente repose en réalité sur un échantillon d’effectif extrêmement restreint. La restitution de la transparence scientifique moderne exige de plus en plus fréquemment la visualisation directe des observations individuelles. Cependant, la projection naïve de points bruts le long d’un axe discret engendre un chevauchement massif (overplotting), rendant tout dénombrement visuel impossible.
La solution technique réside dans l’adjonction de la fonction geom_jitter(), qui applique une perturbation aléatoire contrôlée aux coordonnées spatiales de chaque observation. La maîtrise de cette dispersion exige de calibrer rigoureusement les arguments width (dispersion latérale le long de la catégorie discrète) et height (dispersion verticale le long de l’axe métrique, qui doit impérativement être fixée à zéro afin de ne pas fausser la lecture des scores quantitatifs réels). Par ailleurs, l’ajustement du coefficient de transparence via le paramètre alpha permet de moduler la saturation visuelle : les régions à forte concentration de points apparaissent plus denses et sombres, traduisant fidèlement l’accumulation des données empiriques. Enfin, pour garantir la reproductibilité absolue de la disposition des points lors de la régénération du graphique ou de l’exportation finale du manuscrit, il est impératif d’initialiser préalablement le générateur de nombres pseudo-aléatoires au moyen de la commande de base set.seed().
7.3 Construction de diagrammes en nuage de pluie (Raincloud plots)
Afin de synthétiser au sein d’une unique figure l’intégralité des informations distributionnelles sans compromis perceptif, Allen et ses collaborateurs ont formalisé en 2019 le concept de « diagramme en nuage de pluie » (Raincloud plot). Cette représentation hybride de pointe juxtapose de manière asymétrique et non redondante trois couches d’informations complémentaires : un demi-violon modélisant la densité continue (figurant le « nuage »), une boîte à moustaches ultra-compacte résumant les paramètres de dispersion de Tukey, et un nuage de points individuels étalés horizontalement sous la boîte (figurant les « gouttes de pluie »).
La réalisation d’un raincloud plot sous R repose sur l’utilisation de bibliothèques spécialisées telles que ggdist ou gghalves. La fonction stat_halfeye() de ggdist permet de tracer avec une précision chirurgicale la moitié supérieure de la distribution de densité par noyau, libérant ainsi l’espace spatial inférieur pour accueillir les autres composantes. En dessous de ce demi-violon, une géométrie de type geom_boxplot(width = 0.15, outlier.shape = NA) fournit un ancrage robuste pour la médiane et l’écart interquartile, tandis que geom_jitter() ou stat_dots() tapisse la base du tracé par les points unitaires de l’échantillon. Cette structure tripartite élimine toute symétrie superflue, maximise le ratio encre-données cher à Edward Tufte et répond aux standards contemporains les plus rigoureux de la science ouverte en matière de divulgation transparente des données empiriques.
8. Diagrammes de Cleveland et graphiques en sucette (Lollipop plots)
8.1 Supériorité perceptuelle du diagramme en points de Cleveland
Le diagramme en points de Cleveland, conçu par William S. Cleveland au début des années 1980 dans le cadre de ses recherches fondamentales sur la perception graphique aux laboratoires Bell, représente une alternative méthodologiquement supérieure au diagramme en barres pour la comparaison de listes étendues de modalités qualitatives. L’argumentaire épistémologique développé par Cleveland, puis repris par des théoriciens du design informationnel tels qu’Edward Tufte, repose sur le principe d’optimisation du ratio encre-données (data-ink ratio). Dans un diagramme en barres classique, l’immense majorité de l’encre imprimée ou des pixels affichés est mobilisée pour remplir des rectangles massifs dont seule la position de l’arête sommitale code l’information quantitative réelle.
Le graphique de Cleveland substitue à ces colonnes imposantes un simple point géométrique positionné avec exactitude le long d’une échelle graduée. Cette économie de moyens visuels allège drastiquement la charge cognitive imposée à l’observateur et libère l’espace graphique pour autoriser l’affichage simultané de plusieurs dizaines de catégories nominales sans provoquer de sentiment de saturation visuelle. De surcroît, le codage par la position le long d’une échelle commune constitue, selon les hiérarchies perceptives expérimentales établies par Cleveland et McGill, la tâche d’estimation visuelle la plus performante chez l’être humain, surpassant très largement l’évaluation des surfaces, des angles ou des saturations d’intensité. Sous ggplot2, cette géométrie s’implémente simplement via la fonction geom_point() appliquée à une variable factorielle préalablement ordonnée selon sa métrique de référence.
8.2 Construction d’un graphique en sucette avec geom_segment()
Bien que le tracé de Cleveland offre une pureté sémiotique exemplaire, il peut s’avérer parfois déstabilisant pour un public non initié en raison de l’absence de lien visuel matériel reliant le point de mesure à son niveau catégoriel d’abscisse ou d’ordonnée. Le graphique en sucette (lollipop plot) apporte une solution intermédiaire particulièrement esthétique et lisible en associant au point focal un fin segment rectiligne ancré sur la ligne de base d’origine.
L’implémentation de cette géométrie sous ggplot2 repose sur la combinaison articulée de deux couches fonctionnelles : la fonction geom_segment() et la fonction geom_point(). Pour une disposition horizontale (généralement préconisée pour faciliter la lecture des libellés textuels longs sans inclinaison typographique), l’esthétique de geom_segment() requiert la déclaration explicite de quatre coordonnées fondamentales : y = factor_var, yend = factor_var, x = 0, et xend = numeric_var. Par-dessus ce segment effilé, un appel à geom_point(aes(x = numeric_var, y = factor_var), size = 3) dépose la pastille sommitale marquant l’amplitude exacte du score. Cette double structure autorise des raffinements de mise en forme sophistiqués, tels que la modulation de l’épaisseur du trait pour préserver la discrétion de l’ancrage et la coloration dynamique du point terminal en fonction d’un seuil critique ou d’une troisième variable de regroupement.
8.3 Visualisation divergente autour d’une valeur de référence ou d’un seuil neutre
L’un des contextes d’application les plus puissants du graphique en sucette réside dans l’analyse de données divergentes, où l’enjeu statistique ne réside pas dans l’évaluation d’un total cumulé positif, mais dans l’estimation de déviations relatives par rapport à une valeur de référence étalonnée, telle qu’une moyenne théorique, un score normatif ou le point d’indifférence neutre d’une échelle psychométrique bipolaire (par exemple le score zéro ou le point médian d’une échelle de Likert). Dans cette perspective, la ligne d’ancrage des segments n’est plus positionnée sur l’origine absolue mais alignée sur le seuil normatif choisi via l’argument x = seuil_neutre.
Cette géométrie s’accompagne d’un encodage chromatique bivalent particulièrement expressif : les scores surpassant la valeur critique s’étirent vers la droite et sont habillés d’une couleur associée à la valence positive (par exemple un ton sarcelle ou bleu profond), tandis que les valeurs inférieures régressent vers la gauche sous une pigmentation contrastée (comme un ton terracotta ou corail). L’insertion d’une ligne verticale de référence tracée par geom_vline(xintercept = seuil_neutre, linetype = « dashed », color = « grey50 ») complète l’architecture du panneau. Ce dispositif visuel permet d’isoler instantanément les catégories présentant des comportements d’adhésion ou de rejet marqués, offrant ainsi une grille de lecture percutante pour l’analyse des profils de satisfaction ou des déséquilibres de traits de tempérament.
9. Diagrammes alluviaux et suivi longitudinal des transitions catégorielles
9.1 Concepts fondamentaux des flux catégoriels et diagrammes alluviaux
L’évaluation des dynamiques temporelles et des études de suivi longitudinal pose un problème récurrent de représentation visuelle dès lors que les variables d’intérêt sont de nature catégorielle. Si l’évolution d’une métrique quantitative se modélise aisément au moyen de trajectoires de lignes individuelles ou de splines de régression lissées, le passage discontinu d’individus d’un état qualitatif discret à un autre au fil du temps défie les géométries standard. Les diagrammes alluviaux (dérivés des diagrammes de Sankey appliqués aux flux physiques d’énergie) apportent une réponse mathématique et graphique élégante à ce défi méthodologique.
Dans un diagramme alluvial, l’axe horizontal représente la succession chronologique des temps de mesure expérimentaux (par exemple : pré-traitement, post-traitement immédiat, et suivi à six mois). À chaque point temporel, les états catégoriels sont matérialisés par des blocs verticaux désignés sous le terme de strates (strata), dont la hauteur cumulée reflète l’effectif total d’observations réparties entre les niveaux de la variable. Entre ces strates successives serpentent des bandes de flux continues et curvilignes, nommées alluvions (alluvia) ou lodes, dont l’épaisseur locale est strictement proportionnelle au nombre de sujets partageant la même trajectoire de transition spécifique. Cette visualisation permet d’appréhender d’un seul coup d’œil la stabilité nosologique des diagnostics, les dynamiques d’échappement thérapeutique, les taux de rémission partielle ou totale, ainsi que les schémas de rechute clinique au sein d’une cohorte.
9.2 Implémentation technique via le package ggalluvial
L’intégration des diagrammes alluviaux dans le formalisme de la grammaire des graphiques sous R a été rendue possible par le développement du package ggalluvial, conçu par Jason Cory Brunson. L’utilisation efficiente de cette bibliothèque exige au préalable une mise en forme structurelle rigoureuse des tables de données. Les protocoles longitudinaux sont conventionnellement stockés sous la forme d’un tableau large (wide format), où chaque point temporel constitue une colonne distincte. Pour être exploité par ggalluvial, le jeu de données doit être restructuré dans un format long spécialisé, désigné sous le terme technique de format par lodes (lodes form), via la fonction to_lodes_form(), qui transforme les mesures répétées en trois vecteurs fondamentaux : l’axe temporel (x), la strate catégorielle occupée (stratum), et l’identifiant invariant de la trajectoire du sujet (alluvium).
Le squelette géométrique du tracé sous ggplot2 s’articule autour de deux fonctions maîtresses complémentaires : geom_alluvium() et geom_stratum(). La fonction geom_stratum() dessine les blocs rectangulaires délimitant les catégories à chaque instant de mesure, tandis que geom_alluvium() calcule les splines cubiques assurant la liaison fluide entre les strates successives. La transparence chromatique (paramètre alpha) des bandes d’alluvions constitue un paramètre d’ajustement crucial : une opacité intermédiaire comprise entre 0.4 et 0.6 permet d’observer les chevauchements et les bifurcations de flux sans occulter les trajectoires minoritaires qui traversent l’espace d’analyse.
9.3 Personnalisation des strates et étiquetage textuel informatif
Pour qu’un diagramme alluvial atteigne une valeur démonstrative maximale, l’identification des strates ne doit pas contraindre l’observateur à des allers-retours incessants vers une légende annexe déportée. L’insertion d’étiquettes textuelles directement incrustées à l’intérieur ou à la périphérie immédiate des blocs de strates représente la solution ergonomique recommandée. Cette opération s’effectue via la fonction geom_text() combinée à l’argument analytique stat = « stratum », assignant dynamiquement le nom des modalités catégorielles au centre de gravité spatial de chaque bloc.
La mise en œuvre de cette annotation nécessite une gestion fine de l’encombrement typographique. Lorsque certaines strates correspondent à des effectifs extrêmement réduits, l’étiquette textuelle risque de déborder des frontières géométriques du rectangle. L’adjonction de l’argument de contrôle min.y au sein de la fonction d’annotation permet de supprimer sélectivement les libellés des strates marginales pour préserver la netteté du graphique, tout en renvoyant leur interprétation détaillée vers la légende générale ou vers le corps du texte académique. Enfin, le paramétrage des couleurs de remplissage via scale_fill_manual() doit impérativement être asservi à la variable catégorielle de départ ou d’arrivée, conférant une cohérence sémantique unifiée au suivi des trajectoires à travers les différentes étapes temporelles du protocole expérimental.
10. Techniques avancées : facettage, échelles chromatiques et personnalisation éditoriale
10.1 Décomposition en sous-graphiques avec facet_wrap() et facet_grid()
Lorsque la structure expérimentale d’une étude implique trois variables qualitatives ou davantage, l’accumulation d’encodages esthétiques concurrents (tels que la couleur, la forme et le regroupement spatial) au sein d’un panneau graphique unique aboutit rapidement à une surcharge cognitive préjudiciable à la compréhension. La technique du facettage (ou production de petits multiples conditionnels, small multiples) théorisée par Bertin et Tufte offre une issue méthodologique élégante en décomposant l’espace visuel en une matrice coordonnée de sous-graphiques autonomes partageant des échelles harmonisées.
L’environnement ggplot2 propose deux fonctions complémentaires pour implémenter cette modularité spatiale : facet_wrap() et facet_grid(). La fonction facet_wrap() prend en charge une variable de conditionnement unique et enroule séquentiellement les panneaux résultants selon un nombre défini de lignes (nrow) ou de colonnes (ncol), ce qui en fait l’outil idéal pour explorer des facteurs comportant un nombre élevé de modalités. À l’inverse, facet_grid() organise l’espace selon une grille bidimensionnelle stricte régie par la formule facteur_lignes ~ facteur_colonnes, permettant de croiser simultanément deux variables modératrices indépendantes.
Le choix de configuration des échelles constitue le point d’arbitrage le plus sensible du facettage. Par défaut, l’argument scales = « fixed » verrouille des limites d’axes rigoureusement identiques pour l’ensemble des panneaux. Cette contrainte garantit une comparabilité visuelle absolue des amplitudes entre les facettes, interdisant toute distorsion d’interprétation. Dans de rares cas où les effectifs marginaux de certains sous-groupes sont extrêmement faibles au point de disparaître visuellement, l’analyste peut recourir à scales = « free_y » ou scales = « free_x », tout en explicitant expressément cette rupture métrique dans la légende afin d’éviter d’induire le lecteur en erreur lors de la comparaison inter-facettes.
10.2 Sélection rigoureuse de palettes chromatiques accessibles et universelles
L’attribution des couleurs dans la visualisation de données catégorielles ne saurait être guidée par des considérations purement ornementales ; elle engage la validité scientifique et l’accessibilité universelle de l’information produite. Une proportion significative de la population mondiale (estimée à environ 8 % des hommes et 0.5 % des femmes) présente une anomalie de la vision des couleurs, principalement sous la forme d’une deutéranopie ou d’une protanopie. L’emploi de palettes non calibrées (telles que le dégradé classique arc-en-ciel « rainbow » ou l’opposition naïve vert-rouge) engendre des zones de confusion perceptive totale où des modalités distinctes deviennent indiscernables pour ces lecteurs.
Pour parer à ce risque, la communauté statistique préconise l’utilisation de palettes perceptuellement uniformes et testées pour le daltonisme, au premier rang desquelles figurent les palettes de la bibliothèque viridis (incluant les variantes Viridis, Magma, Plasma et Cividis) et les ensembles discrets standardisés de ColorBrewer (développés par Cynthia Brewer). Pour les variables qualitatives nominales sans ordre hiérarchique, les palettes qualitatives de ColorBrewer (accessibles sous ggplot2 via scale_fill_brewer(palette = « Set2 ») ou palette = « Dark2 ») fournissent des contrastes de teinte bien équilibrés sans induire de fausse hiérarchie de luminance. Pour les variables ordinales, les dégradés séquentiels de viridis (invoqués via scale_fill_viridis_d()) imposent une progression monotone stricte de la luminosité, garantissant que l’ordonnancement mathématique demeure parfaitement lisible, y compris lors d’une impression monochrome en niveaux de gris.
10.3 Mise en conformité graphique avec les normes académiques (style APA 7e édition)
La diffusion de résultats empiriques au sein de revues scientifiques internationales à comité de lecture, particulièrement dans le champ de la psychologie et de la médecine comportementale, exige une standardisation esthétique conforme aux préconisations typographiques formelles, à l’image des normes établies par l’American Psychological Association (APA 7e édition). Ces standards éditoriaux proscrivent expressément les artifices ornementaux, les bordures de panneaux massives, les effets tridimensionnels dénués de sens et les quadrillages de fond d’intensité excessive.
Sous ggplot2, la conversion d’un tracé vers une esthétique de publication académique s’amorce par l’adoption d’un thème structurel épuré, tel que theme_classic() ou theme_bw(), complété par la neutralisation du quadrillage d’arrière-plan via theme(panel.grid.major = element_blank(), panel.grid.minor = element_blank()). La typographie doit être uniformisée à l’aide de polices proportionnelles standards (Arial, Times New Roman), en calibrant la taille des étiquettes d’axes (au moins 10 à 12 points) pour garantir une réduction homothétique sans perte de lisibilité lors de l’intégration dans la maquette finale de la revue. De surcroît, les légendes doivent être épurées, leurs titres formulés sans abréviations cryptiques, et leur positionnement spatial relégué soit au sommet du panneau, soit inséré dans les espaces vierges du tracé, évitant ainsi de comprimer l’axe de restitution principale des données catégorielles.
11. Écueils méthodologiques, biais visuels et pièges d’interprétation
11.1 Le rejet scientifique des diagrammes circulaires (Pie Charts)
S’il existe un consensus méthodologique solidement établi au sein de la communauté des statisticiens et des spécialistes de la visualisation des données, c’est bien celui du rejet formel des diagrammes circulaires (pie charts) et de leurs dérivés toroïdaux (donut charts) pour la communication de résultats scientifiques. Les fondements de ce rejet ne relèvent pas d’un dogmatisme esthétique arbitraire, mais s’appuient sur un corpus abondant de recherches expérimentales en psychophysique de la perception, inauguré par les travaux séminales de Cleveland et McGill en 1984.
L’appareil cognitif visuel humain démontre une incompétence systématique lorsqu’il s’agit d’estimer avec précision des angles et des surfaces curvilignes relatives. Dans un diagramme circulaire, l’observateur tente instinctivement de déduire l’information soit à partir de l’angle central sous-tendu par la part, soit à partir de la surface du secteur, deux métriques perceptives affectées d’une marge d’erreur considérablement plus élevée que l’évaluation d’une longueur rectiligne alignée sur un axe commun. Cette lacune devient critique lorsque des catégories adjacentes présentent des proportions proches : distinguer visuellement un secteur de 22 % d’un secteur de 28 % s’avère particulièrement difficile sans l’adjonction redondante d’étiquettes textuelles chiffrées, ce qui vide la représentation géométrique de sa valeur propre. Le diagramme en barres ordonné ou le graphique de Cleveland surpasse systématiquement le diagramme circulaire en termes d’exactitude de restitution, d’encombrement spatial et de vitesse de décodage cognitif.
11.2 Distorsions d’échelles et manipulations de l’axe des ordonnées
L’un des biais les plus insidieux dans la représentation des effectifs ou des proportions catégorielles concerne la manipulation délibérée ou accidentelle de l’origine de l’axe vertical des ordonnées. Dans un diagramme en barres, la hauteur géométrique totale du rectangle constitue le véhicule physique du message quantitatif ; le cerveau humain encode intuitivement l’amplitude de la catégorie en mesurant la distance séparant la ligne de base du sommet de la colonne. Par conséquent, toute troncature de l’axe des ordonnées omettant le zéro absolu fausse irrémédiablement le rapport de proportionnalité visuelle.
Une troncature d’axe faisant débuter l’échelle à un seuil artificiel de quarante pour cent pour comparer deux prévalences de 45 % et 55 % produira un artéfact visuel saisissant : la seconde barre apparaîtra trois fois plus imposante que la première, induisant chez l’observateur non averti la perception fallacieuse d’une démultiplication massive du phénomène étudié, alors que l’écart réel ne relève que d’une variation modeste de dix points de pourcentage. Alors que le zoom sur l’axe d’ordonnée est scientifiquement recevable pour les diagrammes en points ou les boîtes à moustaches (qui codent des positions locales et non des aires cumulées), le maintien du zéro absolu demeure une règle d’or non négociable pour tout diagramme en barres. De même, l’adjonction d’un double axe d’ordonnées aux échelles asymétriques pour croiser des effectifs catégoriels et des indices continus doit être formellement bannie en raison des corrélations illusoires qu’elle suscite inévitablement.
11.3 Détection visuelle du paradoxe de Simpson dans l’agrégation catégorielle
Le traitement des données catégorielles agrégées expose l’analyste au risque permanent d’une interprétation fallacieuse induite par le paradoxe de Simpson. Ce phénomène probabiliste remarquable désigne une configuration mathématique dans laquelle une corrélation ou une tendance d’association observée au niveau global d’une cohorte s’inverse totalement ou disparaît lorsque l’échantillon est ventilé selon les sous-groupes d’une variable de confusion catégorielle sous-jacente.
Un exemple historique paradigmatique demeure l’analyse des admissions académiques de l’Université de Berkeley en 1973 : le décompte global des admissions suggérait une discrimination statistique défavorable aux candidates féminines, mais la désagrégation visuelle par département mit en évidence que les femmes postulaient majoritairement dans des filières présentant des taux de sélection extrêmement drastiques, tandis que les hommes candidataient préférentiellement dans des départements acceptant une large proportion de candidats. Au sein de la quasi-totalité des départements pris isolément, le taux d’admission des femmes s’avérait en réalité égal ou supérieur à celui des hommes. Sur le plan de la visualisation des données, cet écueil impose une prudence absolue : tout graphique catégoriel univarié ou bivarié agrégé doit impérativement être confronté à une décomposition facettée intégrant les variables modératrices potentielles afin d’attester que la distribution présentée ne constitue pas un artefact d’agrégation masquant des réalités structurelles opposées.
12. Étude de cas empirique pas-à-pas : analyse complète d’une cohorte psychologique
12.1 Importation, exploration initiale et assainissement des facteurs
Pour opérationnaliser l’ensemble des concepts théoriques exposés dans cet article, nous déployons une étude de cas empirique exhaustive portant sur une cohorte clinique simulée en psychologie de la santé. L’échantillon comprend 1 200 patients admis au sein d’un protocole d’évaluation des troubles anxiodépressifs, documentés par cinq variables fondamentales : l’identifiant individuel, le groupe nosologique primaire (Trouble Panique, Anxiété Généralisée, Dépression Majeure, Phobie Sociale), le niveau de sévérité ordonné évalué par le clinicien (Léger, Modéré, Sévère), le statut d’adhésion au protocole (Observant versus Non-observant), et le score quantitatif obtenu à une échelle validée de résilience psychologique (score continu allant de zéro à cent).
La première phase computationnelle consiste en une inspection préliminaire des vecteurs importés. À l’aide des fonctions glimpse() et table(), l’analyste identifie les incohérences de saisie, les chaînes textuelles redondantes dues à des variations typographiques, et les cellules non renseignées. Les variables qualitatives sont converties formellement en facteurs à l’aide des fonctions de forcats. La variable de sévérité clinique est structurée comme un facteur ordonné via factor(sevérité, levels = c(« Léger », « Modéré », « Sévère »), ordered = TRUE), garantissant que les axes visuels respecteront la progression nosologique. Les modalités marginales du diagnostic primaire représentant moins de 5 % des admissions sont consolidées au sein d’une catégorie générique via fct_lump_prop(diagnostic, prop = 0.05). Enfin, les données manquantes sur le statut d’observance sont explicitées via fct_na_value_to_level(observance, level = « Inconnu »), garantissant une intégrité totale du corpus avant l’amorce des modélisations graphiques.
12.2 Construction d’une figure composite prête pour la soumission académique
La phase de conception visuelle vise à bâtir une figure composite multi-panneaux standardisée, répondant aux exigences formelles d’un manuscrit soumis pour publication dans une revue internationale de psychiatrie computationnelle. Cette architecture combine trois visualisations coordonnées : le panneau A présente les proportions relatives standardisées des diagnostics primaires selon le statut d’adhésion thérapeutique (diagramme en barres avec position = « fill »), le panneau B déploie une mosaïque diagnostique mettant en évidence les résidus d’indépendance de Pearson pour déceler les associations spécifiques entre sous-type clinique et sévérité, et le panneau C offre un diagramme en nuage de pluie (Raincloud plot) comparant la distribution fine des scores de résilience à travers les strates de sévérité ordonnées.
L’assemblage des panneaux indépendants s’opère sans discontinuité grâce au package patchwork. Cette infrastructure permet d’additionner les objets graphiques au moyen d’opérateurs mathématiques intuitifs, par exemple (panel_A | panel_B) / panel_C, tout en coordonnant automatiquement l’alignement des bordures de tracés et la consolidation des légendes partagées via plot_layout(guides = « collect »). L’adjonction de l’instruction plot_annotation(tag_levels = « A ») incruste automatiquement les étiquettes alphabétiques normatives dans les coins supérieurs gauches de chaque panneau. Enfin, des annotations textuelles intégrées informent le lecteur sur les indices d’inférence statistique (la taille d’effet V de Cramér et la p-valeur du Chi-deux d’indépendance), assurant une interface transparente entre l’analyse confirmatoire et l’exploration descriptive visuelle.
12.3 Exportation vectorielle haute résolution et reproductibilité totale
L’aboutissement du pipeline d’ingénierie graphique réside dans l’exportation du résultat selon des paramètres techniques garantissant une fidélité géométrique et typographique inaltérable lors des processus d’impression ou de diffusion numérique. Les formats d’images matriciels classiques (tels que JPEG ou PNG) doivent être manipulés avec la plus grande réserve : lorsqu’ils sont redimensionnés par les éditeurs de presse, ils subissent une pixellisation destructive qui floute les contours des tracés et rend les étiquettes textuelles indéchiffrables.
La référence absolue repose sur l’utilisation de formats vectoriels conteneurisés, au premier rang desquels figure le format PDF vectoriel ou le format SVG (Scalable Vector Graphics). L’exportation s’effectue via la commande maîtresse ggsave(), en déclarant explicitement le moteur de rendu Cairo (via l’argument device = cairo_pdf) pour garantir la gestion parfaite de la transparence chromatique (canaux alpha) et l’incorporation sans distorsion des glyphes typographiques universels. Les dimensions spatiales doivent être paramétrées en unités physiques réelles (pouces ou centimètres) en se conformant strictement aux spécifications des guides aux auteurs des revues ciblées (par exemple une largeur calibrée sur la largeur standard d’une colonne de texte de 85 millimètres ou d’une double colonne pleine page de 180 millimètres). Pour les situations où l’éditeur impose impérativement un format matriciel (généralement le format TIFF non compressé), la fonction ggsave() sera assortie d’un argument d’échantillonnage imposant une résolution spatiale minimale de 300 points par pouce (dpi = 300), complétant ainsi un protocole d’analyse et de visualisation entièrement reproductible, pérenne et scientifiquement irréprochable.
Références
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: a multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions de l’École des Hautes Études en Sciences Sociales.
- Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975). Sex Bias in Graduate Admissions: Data from Berkeley. Science, 187(4175), 398–404. https://doi.org/10.1126/science.187.4175.398
- Brewer, C. A. (2005). Designing Better Maps: A Guide for GIS Users. ESRI Press.
- Brunson, J. C. (2020). ggalluvial: Layered Grammar for Alluvial Plots. Journal of Open Source Software, 5(49), 2017. https://doi.org/10.21105/joss.02017
- Cleveland, W. S., & McGill, R. (1984). Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Friendly, M. (1994). Mosaic Displays for Multi-Way Contingency Tables. Journal of the American Statistical Association, 89(425), 190–200. https://doi.org/10.1080/01621459.1994.10476460
- Hartigan, J. A., & Kleiner, B. (1981). Mosaics for investigating contingency tables. Proceedings of the 13th Symposium on the Interface, 268–273.
- Hintze, J. L., & Nelson, R. D. (1998). Violin Plots: A Box Plot-Density Trace Synergism. The American Statistician, 52(2), 181–184. https://doi.org/10.1080/00031305.1998.10480559
- Meyer, D., Zeileis, A., & Hornik, K. (2006). The Strucplot Framework: Visualizing Multiway Contingency Tables with vcd. Journal of Statistical Software, 17(3), 1–48. https://doi.org/10.18637/jss.v017.i03
- Stevens, S. S. (1946). On the Theory of Scales of Measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2e éd.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2e éd.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0