
Dans le paysage contemporain de la science des données et de l’analyse statistique, l’environnement logiciel R s’est imposé comme un standard de référence au sein des milieux universitaires, biomédicaux et industriels. Sa force réside en grande partie dans sa gestion native et rigoureuse des structures de données complexes, parmi lesquelles les variables qualitatives occupent une position centrale. Contrairement aux simples chaînes de caractères, les facteurs constituent une structure sophistiquée qui encapsule à la fois des valeurs discrètes et des métadonnées sémantiques indispensables aux moteurs d’inférence. Cependant, l’un des écueils les plus récurrents rencontrés par les chercheurs et analystes réside dans la manipulation de l’ordre interne des modalités de ces facteurs. Un ordonnancement inadéquat ne se limite pas à dégrader l’esthétique d’une représentation graphique : il peut altérer substantiellement la lisibilité d’un modèle économétrique, compliquer l’évaluation des contrastes cliniques ou induire des biais cognitifs majeurs lors de l’interprétation des résultats empiriques.
Le contrôle de l’ordre des niveaux de facteurs (communément appelés levels) représente ainsi une compétence méthodologique indispensable pour quiconque aspire à produire des analyses reproductibles et rigoureuses. Qu’il s’agisse d’établir une condition témoin dans un essai randomisé contrôlé, de hiérarchiser les échelons d’une échelle de Likert en psychométrie, ou d’optimiser l’ordre d’affichage des catégories au sein d’une visualisation complexe générée via le package ggplot2, la maîtrise des fonctions dédiées du langage R de base ainsi que des extensions modernes du Tidyverse conditionne l’efficacité communicationnelle et analytique des projets quantitatifs. Cette problématique technique touche directement au paradigme de la communication scientifique, où la transparence du codage des données garantit la validité externe des conclusions formulées.
Cet article propose une exploration encyclopédique, théorique et appliquée des techniques permettant de réordonner les niveaux de facteurs dans le langage R. De l’architecture binaire sous-jacente des objets de classe S3 aux extensions fonctionnelles du package forcats, nous analyserons l’ensemble des mécanismes algorithmiques, statistiques et syntaxiques régissant la manipulation des modalités qualitatives. À travers des cas d’usage contextualisés, des démonstrations méthodologiques exhaustives et une étude approfondie des pièges computationnels classiques, ce guide ambitionne de fournir aux praticiens les fondements conceptuels et opérationnels nécessaires à une maîtrise sans faille des variables catégorielles.
1. Introduction aux variables qualitatives et aux facteurs dans R
1.1 Définition et nature des facteurs en programmation R
Au cœur de l’architecture du langage R, le type de données factor représente les variables qualitatives ou catégorielles avec une optimisation structurelle remarquable. D’un point de vue ontologique, un facteur n’est pas un simple conteneur de texte, mais un vecteur d’entiers atomiques dissimulé sous une couche d’abstraction. Chaque modalité textuelle unique est consignée dans un dictionnaire interne d’étiquettes, appelé attribut levels. Les observations individuelles de la série sont stockées en mémoire sous forme d’indices entiers pointant directement vers cette table de correspondance. Cette dualité confère aux facteurs une nature hybride : ils se comportent extérieurement comme des chaînes de caractères perceptibles par l’utilisateur, tout en conservant intérieurement l’efficacité computationnelle des entiers natifs.
Cette distinction entre le vecteur textuel classique de type character et le facteur de classe S3 est fondamentale pour comprendre l’écosystème R. Un vecteur de caractères stocke chaque chaîne de manière indépendante, ce qui entraîne une duplication massive de l’information textuelle en mémoire vive dès lors que des modalités se répètent sur des centaines de milliers de lignes. À l’inverse, le facteur restreint l’empreinte textuelle aux seules modalités distinctes, réduisant drastiquement la charge allouée à la mémoire vive (RAM) et optimisant la vitesse des opérations vectorielles lors des regroupements, tris et calculs matriciels. Les métadonnées associées aux facteurs — définies principalement par les attributs class et levels — signalent aux fonctions génériques de R la marche à suivre pour le traitement statistique adéquat, empêchant l’application involontaire d’opérations purement arithmétiques comme la moyenne ou le produit vectoriel sur des données qualitatives non quantifiables.
Dans le cadre de projets exploitant des bases de données massives (Big Data), cette optimisation structurelle s’avère déterminante. Lorsque des millions d’enregistrements partagent une poignée d’étiquettes catégorielles — telles que des régions géographiques, des affiliations institutionnelles ou des codes nosologiques —, l’usage rigoureux des facteurs permet de diviser la consommation de mémoire par un facteur substantiel, tout en accélérant de manière mesurable le temps d’exécution des algorithmes de partitionnement et des routines de modélisation mathématique intégrées au moteur R de base.
1.2 L’importance méthodologique de l’ordre des niveaux en recherche quantitative
L’organisation séquentielle des modalités d’une variable qualitative ne relève pas d’une simple coquetterie typographique ou cosmétique ; elle constitue un impératif méthodologique de premier ordre au sein de la démarche empirique. Dans toute communication scientifique, les représentations tabulaires (tableaux croisés, statistiques descriptives univariées) et les représentations graphiques constituent le point d’entrée cognitif des évaluateurs et des pairs. Un agencement chaotique ou arbitraire des catégories sur un axe visuel augmente la charge cognitive du lecteur, dilue le signal statistique au profit du bruit informationnel, et peut masquer des tendances longitudinales, hiérarchiques ou monotones pourtant déterminantes dans le phénomène étudié.
Sur le plan de l’inférence statistique et de l’économétrie, le positionnement de la première modalité au sein de l’attribut levels revêt une importance analytique capitale. Dans la majorité des modèles paramétriques — qu’il s’agisse de modèles linéaires généraux ou de régressions logistiques —, la première modalité est automatiquement capturée par l’algorithme pour servir de catégorie de référence (ou baseline). L’ordonnée à l’origine (intercept) du modèle représente alors l’espérance mathématique de la variable dépendante conditionnellement à cette catégorie de base. Tous les coefficients de régression associés aux autres modalités s’interprètent mathématiquement comme des écarts relatifs ou des rapports de cotes (odds ratios) mesurés exclusivement par rapport à ce point d’ancrage. Un choix erroné ou aléatoire de la modalité de référence complique dramatiquement l’interprétation substantielle des estimateurs et peut conduire à des erreurs d’inférence lors de la lecture des p-valeurs associées aux tests de Wald.
En outre, la rigueur appliquée au classement des niveaux de facteurs répond aux exigences déontologiques de la recherche reproductible. Un pipeline analytique robuste doit impérativement déclarer de manière programmatique et déterministe l’ordre de ses catégories. Laisser un script s’exécuter sous le contrôle de l’ordre par défaut attribué automatiquement par le système expose l’analyste à des incohérences méthodologiques sévères, notamment lors du déploiement du code sur des machines fonctionnant avec des environnements linguistiques ou des systèmes d’exploitation hétérogènes.
1.3 Facteurs nominaux versus facteurs ordinaux
La typologie des variables en statistique inférentielle impose une distinction stricte entre les échelles purement nominales et les échelles ordinales, une séparation que le langage R implémente nativement via la gestion de deux classes distinctes : les facteurs simples (factor) et les facteurs ordonnés (ordered factor). Les échelles nominales caractérisent des variables dont les catégories ne possèdent intrinsèquement aucune relation mathématique d’ordre, de supériorité ou de hiérarchie séquentielle. Le groupe sanguin, le statut marital, la nationalité ou l’affectation à un groupe de traitement randomisé constituent des exemples archétypaux où tout ordonnancement n’est qu’une commodité de présentation sans portée métrique.
À l’opposé, les échelles ordinales s’appliquent à des concepts théoriques impliquant une progression directionnelle stricte, bien que l’écart métrique exact entre deux modalités adjacentes demeure inconnu ou non quantifiable. Dans ce contexte, l’utilisation de l’argument ordered = TRUE au sein du constructeur de base factor() — ou l’invocation directe de la fonction dédiée ordered() — confère à l’objet la double classe ordered et factor. Cette formalisation indique sans ambiguïté au moteur d’analyse que la séquence déclarée dans le vecteur des niveaux doit être interprétée comme une chaîne d’inégalités strictes, autorisant ainsi l’emploi d’opérateurs relationnels élémentaires tels que les comparateurs d’infériorité ou de supériorité mathématique.
Au-delà de la sémantique de programmation, la déclaration explicite d’un facteur comme étant ordinal modifie fondamentalement le traitement algébrique réservé à la variable dans les fonctions d’ajustement de modèles telles que lm() ou glm(). Par défaut, R applique alors un système de contrastes polynomiaux orthogonaux (linéaire, quadratique, cubique, etc.) au lieu des contrastes de traitement usuels (codage dummy). Cette distinction opérationnelle est critique dans les protocoles biomédicaux lors de l’évaluation de la toxicité par paliers de dose, de la classification par stades tumoraux (stades TNM I à IV) ou dans l’exploitation des scores nosologiques standardisés en épidémiologie psychiatrique.
2. Anatomie structurelle des niveaux de facteurs
2.1 Attribution par défaut de l’ordre alphabétique par le moteur R
Lorsque des données brutes issues de fichiers de texte délimité (CSV, TSV) ou de requêtes SQL sont transformées en facteurs via la fonction as.factor() sans spécification préalable de l’utilisateur, l’interpréteur R applique un algorithme déterministe standardisé : le tri alphabétique lexicographique des chaînes de caractères uniques. Ce mécanisme s’appuie sur la fonction interne de tri de bas niveau du moteur C sous-jacent, laquelle analyse les codes de points de la table de caractères courante pour indexer séquentiellement chaque modalité rencontrée.
Ce comportement par défaut introduit une vulnérabilité majeure : la dépendance structurelle aux paramètres régionaux (locale) configurés sur le système d’exploitation de la machine exécutant le code. Selon que l’environnement R fonctionne sous une locale anglaise (POSIX/C), française ou scandinave, l’ordre de tri des caractères diacrités, des majuscules et des symboles typographiques peut fluctuer de manière imprévisible. Il en résulte un risque d’altération de la reproductibilité computationnelle du code lors d’une transition d’un serveur Linux distant vers une station de travail locale sous Windows ou macOS, modifiant insidieusement la modalité positionnée en référence sans qu’aucun message d’avertissement ne soit émis par l’interpréteur.
Par ailleurs, l’ordre alphabétique coïncide rarement avec la rationalité scientifique ou l’ordonnancement logique des phénomènes observables. Considérons l’exemple paradigmatique d’une variable qualitative mesurant une intensité subjective ou une charge clinique déclinée sous les modalités « Faible », « Moyen » et « Élevé ». L’attribution alphabétique par défaut produira invariablement la séquence : « Élevé », « Faible », puis « Moyen » (ou « Faible », « Moyen », « Élevé » selon la gestion des accents). Cette organisation contre-intuitive perturbe immédiatement l’analyse, en plaçant le niveau intermédiaire en queue de distribution et en introduisant une rupture cognitive manifeste dans toute production graphique ou inférentielle.
2.2 Inspection et diagnostic des niveaux avec levels() et nlevels()
Face à ces risques structurels, le diagnostic précoce de l’état des facteurs constitue une étape obligatoire de toute phase d’ingénierie des caractéristiques (feature engineering). Le langage R met à la disposition des praticiens deux fonctions de diagnostic fondamentales intégrées au package de base : levels() et nlevels(). L’exécution de levels(x) permet d’extraire le vecteur de caractères sous-jacent contenant l’intégralité des étiquettes associées à l’objet x, strictement ordonnées de l’indice 1 à l’indice k. Ce vecteur reflète fidèlement la topologie interne de la variable telle qu’elle sera exploitée par les algorithmes en aval.
La fonction nlevels(x), quant à elle, renvoie un entier scalaire correspondant au cardinal de l’ensemble des modalités déclarées. Elle s’avère particulièrement utile pour vérifier rapidement l’absence de prolifération indésirable de modalités due à des anomalies de saisie, telles que la coexistence de libellés identiques différant uniquement par un espace superflu en fin de chaîne, une casse variable ou une omission d’accent. Une telle inspection permet de détecter ce que la littérature appelle fréquemment les « niveaux fantômes » (ghost levels ou empty levels) : des modalités officiellement déclarées dans l’attribut levels du facteur mais ne comptant aucune occurrence empirique parmi les observations du jeu de données courant.
Ces niveaux non peuplés surviennent généralement à la suite d’opérations de filtrage ou de partitionnement de données (par exemple via la fonction subset() ou le verbe filter() de dplyr). Bien que les observations correspondantes aient été purgées du tableau de données, le vecteur levels conserve par défaut la mémoire structurelle de l’ensemble du vocabulaire initial. Sans une purge explicite exécutée par la fonction droplevels(), ces modalités orphelines persistent dans les tables de contingence sous forme de colonnes de zéros et continuent d’apparaître sur les axes graphiques ou d’engendrer des singularités numériques dans les matrices de variance-covariance des modèles d’ajustement statistique.
2.3 Conséquences empiriques d’un mauvais agencement des modalités
L’inattention portée à l’agencement des modalités d’un facteur engendre des répercussions négatives en cascade tout au long de la chaîne analytique. Sur le plan visuel, l’absence de hiérarchisation structurée transforme les diagrammes en boîte (boxplots) et les diagrammes en barres en représentations désordonnées qui entravent la lecture immédiate des patrons de distribution. Dans le cadre d’un diagramme d’interaction modélisant les effets croisés de deux facteurs sur une variable continue, un ordre anarchique des niveaux sur l’axe des abscisses produit des tracés en dents de scie illisibles, empêchant l’identification intuitive d’effets synergiques, additifs ou antagonistes.
Sur le plan de l’économétrie et de la biométrie, les conséquences sont encore plus critiques. Lorsque la modalité de référence d’un facteur est choisie par défaut alphabétique plutôt qu’en vertu d’une justification théorique rigoureuse, l’interprétation substantielle des sorties logicielles devient fastidieuse. Dans un essai pharmacologique évaluant trois molécules innovantes face à un groupe témoin (Placebo), si l’ordre alphabétique attribue arbitrairement le rôle de référence à la première molécule active, les coefficients de régression n’indiqueront plus l’efficacité absolue de chaque traitement par rapport à l’absence de traitement, mais documenteront l’écart différentiel entre les molécules thérapeutiques, nécessitant des recombinaisons linéaires a posteriori (via des tests de Wald ou la fonction linearHypothesis()) pour répondre aux questions cliniques primaires.
Enfin, dans l’analyse de la variance (ANOVA) reposant sur des contrastes polynomiaux, inverser ou perturber la séquence ordonnée d’un facteur quantitatif discrétisé (comme des classes d’âge ou des échelons de revenu) fausse mathématiquement l’estimation des composantes linéaire et quadratique. L’analyste risque alors de conclure faussement à une relation non linéaire ou à l’absence d’effet tendanciel, illustrant comment une simple négligence structurelle au niveau du pré-traitement des facteurs peut invalider la rigueur épistémique de l’ensemble d’un protocole de recherche empirique.
3. Méthode fondamentale : Réordonnancement manuel avec la fonction factor()
3.1 Syntaxe de base et manipulation explicite de l’argument levels
La méthode la plus fondamentale et la plus exhaustive pour contrôler l’organisation des modalités d’un facteur consiste à réinstancier l’objet à l’aide de la fonction native factor(), issue du socle historique de R. Cette approche programmatique repose sur la déclaration explicite d’un vecteur de chaînes de caractères fourni à l’argument nommé levels. La signature canonique de cette opération s’articule comme suit : df$variable <- factor(df$variable, levels = c("Modalite_1", "Modalite_2", "Modalite_3")). Dans cette formulation, la séquence exacte d’apparition des éléments au sein du vecteur détermine de manière irrévocable l’ordre des indices entiers sous-jacents qui structureront l’objet S3 résultant.
Il convient de maintenir une vigilance conceptuelle absolue entre le paramètre levels et le paramètre labels, dont la confusion figure parmi les sources d’erreurs les plus dommageables en programmation R. L’argument levels spécifie l’ordre et l’ensemble exhaustif des modalités préexistantes dans les données brutes qui doivent être capturées lors de la conversion. À l’inverse, l’argument labels permet d’attribuer de nouvelles étiquettes textuelles de substitution pour renommer ces niveaux. Fournir à levels des chaînes qui ne correspondent pas exactement à la morphologie textuelle des données d’origine n’opère pas un renommage, mais supprime purement et simplement le signal informationnel sous-jacent en remplaçant les valeurs non appariées par des données manquantes.
Cette méthode présente l’avantage d’une immutabilité prévisible : en réécrivant proprement l’objet avec une définition stricte de ses niveaux, l’analyste fige définitivement la hiérarchie catégorielle au sein de l’environnement de travail. Cette standardisation garantit que l’ensemble des packages graphiques, des moteurs de modélisation inférentielle et des fonctions tabulaires interagiront de manière univoque avec la variable, quel que soit le contexte algorithmique dans lequel elle sera appelée ultérieurement.
3.2 Exemple reproductible pas à pas avec données synthétiques
Afin de concrétiser cette mécanique fondamentale, concevons un protocole expérimental synthétique simulant une cohorte clinique mesurant le niveau de récupération fonctionnelle chez des patients soumis à trois protocoles de rééducation : « Soins_Standards », « Protocole_Intensif » et « Controle_Attente ». Générons un jeu de données contenant ces catégories assignées de manière aléatoire, accompagnées d’un score continu de récupération motrice.
Lors de l’ingestion brute des données, l’interpréteur R configure la variable sous forme textuelle ou applique un classement alphabétique automatique lors de l’appel à as.factor(). Une inspection via levels(donnees$Groupe) révèle immédiatement la séquence : « Controle_Attente », « Protocole_Intensif », « Soins_Standards ». Si cette hiérarchie par défaut place incidemment le groupe témoin en première position, elle juxtapose de manière discordante le protocole intensif avant les soins conventionnels, rompant la graduation naturelle de l’effort thérapeutique.
Pour rétablir une séquence cohérente avec la logique du protocole expérimental — à savoir progresser du témoin neutre vers le soin standard, pour aboutir à l’intervention expérimentale maximale —, l’analyste applique l’assignation explicite : donnees$Groupe <- factor(donnees$Groupe, levels = c("Controle_Attente", "Soins_Standards", "Protocole_Intensif")). L’exécution subséquente de la fonction de contrôle levels(donnees$Groupe) confirme la mutation topologique de l’objet. Les représentations graphiques subséquentes et les comparaisons de moyennes respecteront scrupuleusement ce continuum thérapeutique, améliorant instantanément l’intelligibilité des synthèses empiriques produites.
3.3 Piège classique : Omission involontaire de niveaux et génération de valeurs NA
L’utilisation de la fonction factor() avec l’argument levels comporte un piège redoutable inhérent à la rigueur de son implémentation en C : le mécanisme de coercition silencieuse en valeurs manquantes (NA). Dès lors qu’une modalité présente dans le vecteur d’origine est omise lors de la rédaction de la liste des niveaux au sein de l’argument levels, le moteur R considère cette catégorie comme exclue du domaine de définition de la variable. En conséquence directe, toutes les observations appartenant à cette modalité ignorée sont impitoyablement converties en <NA>, sans que le système n’émette d’erreur bloquante ou d’avertissement immédiat.
Cette caractéristique algorithmique sépare nettement l’opération de réordonnancement de celle de filtrage : tenter de réordonner les modalités en oubliant involontairement une chaîne de caractères (par exemple en raison d’une faute de frappe, d’une majuscule mal positionnée ou de l’omission d’un espace insécable) entraîne une perte sèche d’observations empiriques. Si l’analyste écrase sa variable originale dans le tableau de données principal (data.frame), cette altération des données s’avère irréversible sans rechargement de la source brute.
Pour prémunir les scripts contre ces destructions accidentelles de données, il est recommandé d’adopter des stratégies défensives de comparaison d’ensembles. L’usage de la fonction setdiff() permet d’identifier préventivement toute discordance entre les modalités observées et les modalités attendues : setdiff(unique(df$variable), nouveaux_niveaux). Si le résultat de cette instruction n’est pas un ensemble vide (character(0)), l’analyste dispose d’une preuve programmatique qu’au moins une catégorie est menacée de transformation en NA. De même, l’intégration de clauses d’assertion dans les chaînes de traitement automatisées (via des bibliothèques telles que stopifnot ou assertthat) garantit l’intégrité volumétrique du jeu de données post-transformation.
4. Définition d’un nouveau groupe de référence avec relevel()
4.1 Principe et algorithme de la fonction stats::relevel()
Dans de nombreuses configurations analytiques, le praticien ne cherche pas à restructurer manuellement l’intégralité de la séquence des modalités, mais souhaite uniquement isoler une catégorie singulière pour lui assigner le statut de premier niveau (indice 1), tout en laissant les autres modalités dans leur disposition relative antérieure. C’est précisément l’objectif algorithmique de la fonction spécialisée relevel(), intégrée dans le package fondamental stats de R. Son architecture est conçue pour optimiser la manipulation des facteurs nominaux sans requérir la déclaration fastidieuse de l’ensemble des étiquettes existantes.
Le fonctionnement interne de relevel() est d’une grande élégance fonctionnelle : la fonction extrait le niveau spécifié par le paramètre ref, supprime temporairement cette occurrence de la liste ordonnée des niveaux, puis l’insère en tête de liste avant de réindexer l’ensemble des modalités résiduelles. Ainsi, si une variable présente initialement les modalités ordonnées alphabétiquement (A, B, C, D, E) et que l’utilisateur applique l’instruction relevel(x, ref = "D"), le nouvel arrangement vectoriel devient rigoureusement (D, A, B, C, E). L’ordre relatif des catégories non ciblées est scrupuleusement préservé, éliminant tout risque d’altération collatérale au sein des niveaux secondaires.
La syntaxe de cette fonction brille par sa concision : df$variable <- relevel(df$variable, ref = "NomDeLaModalite"). Contrairement à la fonction factor(), relevel() refuse catégoriquement d’opérer sur des vecteurs qui ne sont pas préalablement typés en tant que facteurs ; toute tentative d’application directe sur une variable de type character déclenchera immédiatement une erreur d’exécution explicite. De surcroît, elle est intrinsèquement limitée au déplacement d’un niveau unique à la fois, interdisant la spécification d’un vecteur de plusieurs références au sein d’un appel scalaire simple.
4.2 Application ciblée aux contrastes statistiques et groupes de contrôle
L’application privilégiée de la fonction relevel() réside dans la configuration des modèles statistiques linéaires et généralisés (fonctions lm() et glm()). Dans ces contextes modélisateurs, le choix de la modalité de référence (la baseline) détermine la structure mathématique de la matrice d’expérience (model matrix). Par convention, le premier niveau du facteur est absorbé par le terme constant du modèle (l’ordonnée à l’origine ou $\beta_0$). L’ensemble des coefficients estimés associés aux autres niveaux quantifient alors l’écart paramétrique entre chaque condition et cette référence fondamentale.
Considérons une étude épidémiologique observant l’incidence d’une pathologie selon le statut tabagique, segmenté en : « Fumeur_Regulier », « Non_Fumeur », « Fumeur_Occasionnel » et « Ancien_Fumeur ». Si l’analyste ajuste un modèle logistique sans intervention préalable, l’ordre alphabétique désignera automatiquement « Ancien_Fumeur » comme condition de référence. Les rapports de cotes (odds ratios) calculés compareront alors les fumeurs réguliers et les non-fumeurs à des individus ayant un historique d’exposition tabagique passée. Cette formulation, bien que mathématiquement valide, s’avère sous-optimale et contre-intuitive sur le plan biomédical. En appliquant l’instruction df$Statut <- relevel(df$Statut, ref = "Non_Fumeur"), le modèle prend immédiatement pour référence le groupe le plus sain. Les exponentielles des coefficients de régression se transforment directement en risques relatifs transposables sans manipulation algébrique supplémentaire, standardisant l’interprétation clinique selon les canons méthodologiques internationaux.
Ce basculement paramétrique ne modifie en rien la qualité globale de l’ajustement du modèle (le coefficient de détermination $R^2$, l’écart résiduel ou deviance, ainsi que le critère d’information d’Akaike [AIC] demeurent rigoureusement invariants). Seule la décomposition des contrastes locaux et les tests d’hypothèses univariés de Student ou de Wald portant sur les coefficients individuels sont réorientés, offrant à l’analyste un alignement précis entre la question scientifique posée et le formatage de la sortie logicielle.
4.3 Comparaison fonctionnelle entre factor() exhaustif et relevel() ciblé
Le choix programmatique entre la réinstanciation globale via factor() et le déplacement ciblé par relevel() répond à un arbitrage entre exhaustivité granulaire et sécurité d’exécution. La fonction factor() confère à l’analyste un pouvoir démiurgique sur la totalité de la variable : elle permet de redistribuer arbitrairement chaque position, de réassigner l’ensemble de l’architecture catégorielle et d’éliminer simultanément d’éventuels niveaux superflus. Toutefois, cette puissance s’accompagne d’un risque élevé d’erreurs typographiques, d’une grande vulnérabilité à la génération accidentelle de valeurs manquantes (NA) et d’une lourdeur d’écriture notable lorsque la variable comporte plusieurs dizaines de modalités distinctes.
À l’inverse, relevel() privilégie le principe de moindre surprise et l’économie syntaxique. En limitant la modification au seul ancrage de la condition de base, elle garantit l’impossibilité physique de supprimer involontairement des catégories résiduelles. Le risque de corruption des données est ainsi nul. Si l’analyste commet une coquille orthographique dans la désignation de l’argument ref, la fonction interrompt immédiatement son exécution en renvoyant une erreur informative explicite signalant que le niveau spécifié n’existe pas dans le facteur, protégeant ainsi l’intégrité structurelle de l’objet en mémoire.
Dans le cadre de projets d’analyse de données collaboratifs et de scripts de production industriels, la concision de relevel() améliore grandement la maintenabilité du code source. Un lecteur extérieur saisit instantanément l’intention de l’auteur : isoler la modalité témoin pour les besoins de l’analyse inférentielle. Dès lors, la recommandation méthodologique préconise l’usage systématique de relevel() pour les tâches de recentrage de référence, réservant la lourde syntaxe de factor() aux situations nécessitant une reconfiguration intégrale et non triviale de l’ordre interne des modalités.
5. Réordonnancement dynamique selon une variable numérique avec reorder()
5.1 Fonctionnement mathématique et syntaxe de base de stats::reorder()
Au-delà de la réorganisation manuelle ou de la désignation d’un point d’ancrage arbitraire, il est fréquemment nécessaire d’ordonner les modalités d’une variable qualitative en fonction des propriétés quantitatives d’une seconde variable continue. Cette approche dite dynamique permet de classer les catégories non plus selon des critères nominaux subjectifs, mais sur la base empirique du signal mesuré. Pour accomplir cette tâche, le package de base fournit la fonction stats::reorder(), un outil d’une remarquable puissance analytique.
La signature formelle de cette fonction s’articule autour de quatre arguments cardinaux : reorder(x, X, FUN = mean, ..., order = is.ordered(x)). L’argument x représente le facteur dont les niveaux doivent être réorganisés. L’argument X (en majuscule) désigne le vecteur numérique continu servant de critère métrique de tri. Le paramètre FUN spécifie la fonction statistique d’agrégation qui sera calculée sur les sous-ensembles de X partitionnés par chaque modalité de x. Enfin, les points de suspension ... permettent de transmettre des paramètres additionnels cruciaux à la fonction d’agrégation, au premier rang desquels figure le traitement des données manquantes via l’argument na.rm = TRUE.
Mathématiquement, reorder() segmente le jeu de données selon les $k$ niveaux du facteur $x$, calcule pour chaque sous-groupe $j in {1, dots, k}$ la valeur scalaire $\theta_j = \text{FUN}(X_j)$, puis ordonne de manière croissante (par défaut) les modalités de $x$ selon le rang des valeurs $\theta_j$ obtenues. La structure vectorielle de base est ensuite réécrite en attribuant les nouveaux indices entiers correspondants, automatisant un processus qui nécessiterait sans cela une longue séquence d’agrégations, de tris et de réaffectations manuelles.
5.2 Choix de la métrique d’agrégation : moyenne, médiane ou fonctions sur mesure
La robustesse méthodologique du réordonnancement dynamique dépend intrinsèquement du choix de la fonction d’agrégation statistique appliquée via l’argument FUN. Par défaut, la moyenne arithmétique (mean) est classiquement sollicitée. Cependant, la moyenne présente une forte sensibilité aux valeurs atypiques (outliers) et aux distributions fortement asymétriques. Dans les jeux de données réels caractérisés par des queues de distribution épaisses (tels que des données de rémunérations, de temps de séjour hospitalier ou de consommation de ressources), ordonner les facteurs selon la moyenne arithmétique peut positionner une modalité au sommet de la hiérarchie sous l’influence exclusive d’une seule observation extrême.
Pour immuniser le tri contre ces distorsions de représentativité, la médiane statistique (median) s’impose comme une alternative robuste largement supérieure. La médiane capture la tendance centrale de la distribution sans subir l’influence déstabilisatrice des valeurs extrêmes, garantissant que l’agencement des modalités reflète le centre de gravité empirique de la majorité des observations. Dans d’autres contextes d’investigation, l’analyste peut souhaiter trier les catégories selon des métriques de dispersion, en utilisant par exemple l’écart-type (sd) ou l’écart interquartile (IQR), dans l’optique d’ordonner des groupes expérimentaux du plus homogène au plus hétérogène.
De surcroît, reorder() autorise la transmission de fonctions anonymes ou de fonctions personnalisées complexes afin de répondre à des exigences analytiques pointues. On peut ainsi classer des segments d’utilisateurs selon un ratio spécifique, un quantile déterminé (par exemple le 90e percentile via FUN = function(y) quantile(y, 0.90, na.rm = TRUE)) ou un coefficient de variation standardisé. Cette flexibilité algorithmique transforme reorder() en un instrument d’exploration multidimensionnelle capable de révéler des structures statistiques latentes dans les données catégorielles.
5.3 Étude de cas : Organisation des scores continus à travers des groupes indépendants
Illustrons la mise en œuvre de reorder() à travers une étude de cas appliquée à la psychométrie clinique. Considérons un échantillon de plusieurs centaines de patients ventilés au sein de six catégories diagnostiques distinctes (par exemple : Troubles Anxieux Généralisés, Épisode Dépressif Majeur, Trouble Obsessionnel Compulsif, Phobie Sociale, Trouble Panique et Témoins Sains). Chaque participant est évalué sur une échelle psychométrique standardisée mesurant l’intensité des symptômes d’anxiété somatique.
Si l’analyste projette ces données dans un graphique ou un tableau récapitulatif sans manipulation préalable, les six pathologies apparaissent dans l’ordre alphabétique usuel. Cette configuration désordonnée empêche la visualisation directe d’un gradient de sévérité clinique. Pour structurer les diagnostics de manière intelligible, l’analyste applique l’instruction : donnees$Diagnostic <- reorder(donnees$Diagnostic, donnees$Score_Anxiete, FUN = median, na.rm = TRUE).
Le traitement algorithmique réorganise instantanément les niveaux de la variable Diagnostic, plaçant à l’indice 1 la pathologie affichant la médiane d’anxiété la plus basse (naturellement les Témoins Sains), suivie séquentiellement des autres entités cliniques jusqu’au groupe présentant l’expression symptomatique la plus sévère. Un diagramme en boîte consécutif généré sur cette variable transformée affichera une progression parfaitement monotone de gauche à droite ou de bas en haut. Cette rationalisation spatiale élimine toute ambiguïté interprétative, permettant aux praticiens d’identifier d’un simple coup d’œil les frontières phénotypiques et l’amplitude des contrastes intergroupes.
6. L’approche moderne du Tidyverse : La fonction fct_relevel() de forcats
6.1 L’écosystème forcats et sa philosophie centrée sur les facteurs
Bien que le système R de base propose tous les outils nécessaires à la manipulation des variables catégorielles, leur syntaxe s’avère souvent hétérogène, parfois verbeuse et sujette à des écueils structurels chronophages. C’est pour remédier à ces frictions ergonomiques que Hadley Wickham et l’équipe de développement de RStudio ont conçu le package forcats (anagramme transparente de factors), composant officiel du méta-package moderne forcats sur le CRAN. La philosophie de cet écosystème repose sur un principe cardinal : offrir un ensemble homogène de fonctions rigoureusement préfixées par fct_, garantissant une cohérence syntaxique totale, une intégration native au pipeline d’analyse via les opérateurs de liaison (pipe classique %>% ou natif |>) et une sécurité renforcée contre les altérations involontaires de données.
Contrairement aux fonctions historiques qui acceptent des comportements d’évaluation implicites ou des coercitions silencieuses potentiellement destructrices, les primitives de forcats adoptent une approche de programmation défensive. Toute opération exécutée au sein de cette bibliothèque préserve scrupuleusement la nature du facteur sous-jacent et interdit formellement la transformation fortuite de modalités non référencées en valeurs manquantes. De surcroît, forcats harmonise l’ordre et le typage des arguments : le premier argument est invariablement le facteur .f, autorisant un enchaînement fluide des opérations de nettoyage de données au sein des verbes de manipulation tabulaire fournis par le package dplyr.
Dans un contexte d’ingénierie logicielle et d’analyse statistique industrielle, l’adoption de l’écosystème forcats favorise la standardisation des bases de code. Les scripts gagnent en lisibilité, facilitant l’évaluation par les pairs (peer review) et la maintenance à long terme des algorithmes d’analyse dans les institutions de recherche et les entreprises de biotechnologie.
6.2 Positionnement flexible des modalités : début, fin et index arbitraire
Au sein de cette boîte à outils moderne, la fonction fct_relevel() constitue la réinterprétation contemporaine de la réorganisation manuelle des niveaux. Dépassant les contraintes rigides de son ancêtre stats::relevel(), fct_relevel() permet de déplacer une ou plusieurs modalités vers n’importe quel emplacement de la hiérarchie vectorielle, sans jamais exiger la redéclaration de la totalité des niveaux existants. Sa signature autorise la spécification d’un nombre arbitraire de modalités à repositionner, transmises sous forme d’arguments successifs ou d’un vecteur de chaînes de caractères.
L’argument formel after confère à cette fonction une polyvalence structurelle inégalée. Par défaut, la valeur de cet argument est initialisée à after = 0L, ce qui signifie que les modalités déclarées sont propulsées en tête de peloton (positions 1, 2, etc.), reprenant le rôle classique d’ancrage de référence. Cependant, l’analyste peut spécifier un index numérique positif arbitraire pour insérer les catégories ciblées précisément après une position donnée. Par exemple, l’instruction fct_relevel(f, "Modalite_X", after = 2) placera « Modalite_X » en troisième position, glissant harmonieusement entre les niveaux résiduels sans modifier l’ordonnancement préalable des autres éléments.
De plus, forcats offre une fonctionnalité remarquable pour la relégation des catégories secondaires en autorisant la valeur after = Inf. Cette propriété syntaxique résout un problème ergonomique récurrent : envoyer des modalités telles que « Autre », « Non précisé », « Refus de répondre » ou « Données manquantes » directement à la fin du facteur, sans devoir calculer préalablement le nombre total de modalités de la variable. L’instruction fct_relevel(df$Secteur, "Autre", after = Inf) garantit que l’étiquette « Autre » occupera systématiquement le dernier rang vectoriel, préservant la clarté séquentielle des catégories substantielles.
6.3 Tolérance aux erreurs et robustesse en production analytique
La conception de fct_relevel() intègre des mécanismes d’alerte et de tolérance aux erreurs qui sécurisent son exécution au sein de pipelines automatisés de production de données. Si un développeur ou un statisticien fournit accidentellement le nom d’une modalité qui ne figure pas dans le facteur source (par exemple à la suite d’un changement imprévu dans la structure d’un fichier entrant ou d’une faute d’orthographe), la fonction n’échoue pas silencieusement. Elle émet immédiatement un message d’avertissement explicite (warning) indiquant précisément quelle étiquette est absente des niveaux réels, évitant ainsi le masquage de dysfonctionnements dans la chaîne de traitement.
Parallèlement, la fonction fait preuve d’une bienveillance algorithmique salutaire en conservant intacts tous les niveaux non mentionnés dans l’appel. Alors qu’une telle omission sous la fonction factor() de R base aurait anéanti une partie des observations en les transformant en valeurs NA, fct_relevel() prend en charge les niveaux spécifiés, les déplace à l’endroit désigné, et maintient l’ordre relatif exact de toutes les autres modalités existantes. Les données sous-jacentes ne subissent aucune dégradation matérielle.
Cette résilience rend l’usage de fct_relevel() particulièrement adapté aux opérations de mutation conditionnelle exécutées sous dplyr::mutate(), y compris au sein de données partitionnées via group_by(). Le code demeure concis, expressif et résistant aux variations volumétriques des échantillons traités, satisfaisant aux standards les plus exigeants de la programmation défensive.
7. Fonctions avancées de forcats pour le tri automatisé
7.1 Tri basé sur les fréquences d’occurrence avec fct_infreq() et fct_rev()
Dans l’exploration descriptive de variables catégorielles à haute cardinalité (comme des professions, des codes postaux ou des motifs d’admission clinique), la hiérarchie théorique s’efface souvent devant la distribution empirique des occurrences. Pour répondre à cet impératif descriptif, le package forcats met à disposition la fonction fct_infreq(), qui réordonne automatiquement les modalités d’un facteur selon leur fréquence d’apparition dans le jeu de données, de la plus récurrente à la plus rare.
Le fonctionnement de fct_infreq() est déterministe : l’algorithme calcule le tri à plat des effectifs marginaux de chaque catégorie, puis indexe l’attribut levels dans un ordre strictement décroissant d’abondance empirique. Cette transformation est particulièrement précieuse en analyse exploratoire préliminaire : elle permet d’identifier instantanément les modalités majoritaires sans nécessiter d’étape intermédiaire de calcul tabulaire via la fonction table(). En cas d’égalité d’effectifs (ex æquo), la fonction préserve l’ordre relatif d’apparition initial des niveaux pour lever l’ambiguïté.
Dans de nombreuses circonstances graphiques — notamment lors de la conception de diagrammes en barres horizontaux —, il est visuellement souhaitable de présenter les catégories de la plus modeste à la plus dominante pour guider naturellement le regard vers le sommet du graphique. La bibliothèque propose alors la fonction fct_rev(), dont l’unique mandat algorithmique consiste à inverser mathématiquement l’intégralité du vecteur des niveaux (le premier devenant le dernier, et réciproquement). En composant fonctionnellement ces deux instructions au sein d’un pipeline fluide : fct_rev(fct_infreq(df$Variable)), le praticien obtient une hiérarchie par fréquences croissantes d’une élégance absolue, le tout en une seule ligne de code lisible et auto-documentée.
7.2 Tri basé sur d’autres variables avec fct_reorder() et fct_reorder2()
Reprenant les fondements de la fonction stats::reorder() de R base, l’implémentation moderne fct_reorder() en sublime l’usage au sein du Tidyverse en proposant une interface fluide et prévisible. Sa signature formelle s’écrit : fct_reorder(.f, .x, .fun = median, ..., .desc = FALSE). Le premier argument désigne le facteur cible, le second la variable numérique d’évaluation, le troisième la fonction d’agrégation désirée, tandis que l’argument booléen explicite .desc permet d’ordonner directement les niveaux en sens décroissant sans exiger un appel subséquent à une fonction d’inversion.
La puissance expressive de fct_reorder() éclate particulièrement lorsqu’elle est combinée aux verbes de visualisation spatiale. Elle permet de réordonner dynamiquement une variable directement au sein de l’instruction esthétique d’un graphique (par exemple aes(x = fct_reorder(Pays, Esperance_Vie, .fun = mean))), évitant ainsi la création permanente de colonnes intermédiaires dans le tableau de données maître tout en garantissant un tracé impeccablement aligné sur la distribution du signal mesuré.
Pour les contextes analytiques impliquant des séries temporelles ou des plans d’expérience longitudinaux, forcats offre une innovation méthodologique majeure : la fonction fct_reorder2(). Cette primitive prend en charge deux variables prédictives — généralement une variable continue sur l’axe des abscisses (comme le temps) et une variable de réponse continue sur l’axe des ordonnées — pour ordonner un facteur de regroupement (comme des cohortes ou des pays). fct_reorder2() classe les modalités de sorte que leur ordre dans la légende graphique coïncide rigoureusement avec la position verticale des courbes à l’extrémité droite du graphique (valeurs maximales de l’abscisse). Cette prouesse élimine la gymnastique cognitive traditionnellement requise pour associer mentalement la couleur d’une courbe dans la légende aux lignes tracées dans le corps de la figure.
7.3 Préservation de l’ordre d’apparition originel avec fct_inorder()
Un problème pernicieux lors de l’ingestion de données structurées réside dans la perte systématique de l’ordonnancement séquentiel initial au moment de la conversion en facteurs. Par exemple, lorsqu’un tableau recense des relevés mensuels (« Janvier », « Février », « Mars », …), des étapes de fabrication industrielle ou des enregistrements chronologiques pré-triés dans le fichier plat source, l’application naïve de la fonction as.factor() brise cet agencement chronologique pour lui substituer l’inévitable ordre alphabétique (« Août », « Avril », « Décembre », …), anéantissant la cohérence temporelle sous-jacente.
La fonction fct_inorder() répond spécifiquement à cette anomalie en fixant les niveaux du facteur selon leur premier ordre d’apparition dans le flux séquentiel des données brutes. L’algorithme parcourt le vecteur de haut en bas : la première chaîne unique rencontrée devient le niveau 1, la deuxième chaîne distincte devient le niveau 2, et ainsi de suite jusqu’à épuisement du vecteur. Aucune réorganisation alphabétique n’intervient.
Cette approche s’articule idéalement avec les packages d’importation de données modernes tels que readr ou readxl. En encapsulant la colonne dès sa lecture via fct_inorder(df$Mois), l’analyste préserve l’intégrité de la structure séquentielle originale sans devoir renseigner manuellement un vecteur exhaustif des douze mois de l’année. Cette technique confère un gain d’efficience substantiel lors de l’automatisation de rapports périodiques où les fichiers d’entrée respectent une chronologie rigoureuse en amont.
8. Visualisation avancée avec ggplot2 : Tirer parti des niveaux réordonnés
8.1 Amélioration des diagrammes en barres avec geom_bar() et geom_col()
La restitution graphique des variables catégorielles via la grammaire des graphiques formalisée par le package ggplot2 dépend de manière symbiotique de l’architecture des facteurs sous-jacents. Dans un tracé généré par les couches geom_bar() (comptage automatique d’occurrences) ou geom_col() (représentation de grandeurs numériques explicites), ggplot2 projette invariablement les modalités sur les axes dimensionnels en suivant à la lettre l’indexation de l’attribut levels. Un facteur non réordonné engendre des barres oscillant chaotiquement en hauteur, ce qui oblige le cortex visuel du lecteur à effectuer des va-et-vient fastidieux pour comparer les grandeurs.
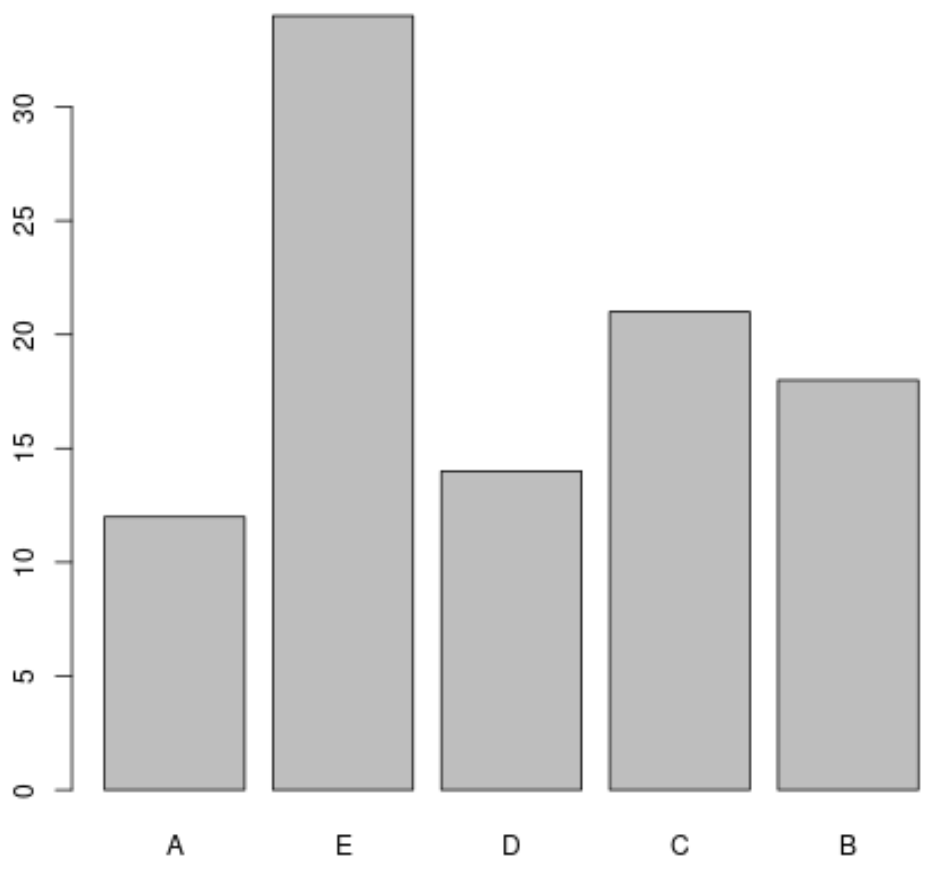
En orchestrant un réordonnancement préalable des catégories via fct_reorder() ou fct_infreq(), le diagramme en barres acquiert une lisibilité immédiate. Les barres se déploient selon une trajectoire ascendante ou descendante harmonieuse, facilitant l’identification instantanée des extrêmes, des médianes et de la courbure de la distribution globale. Dans le cas particulier des barres empilées (stacked bar charts), le contrôle précis de l’ordre des niveaux du facteur assigné à l’esthétique de remplissage (fill) est tout aussi fondamental : il dicte l’agencement vertical des segments à l’intérieur de chaque colonne ainsi que l’ordre des pastilles dans la légende associée. Une désynchronisation entre ces éléments visuels engendre des risques de confusion lors de l’interprétation des pourcentages cumulés.
Par ailleurs, l’exploitation de la fonction fct_rev() appliquée à l’axe des ordonnées au sein d’une configuration utilisant coord_flip() permet de positionner la catégorie dominante au sommet du graphique, s’accordant avec le sens de lecture occidental conventionnel (de haut en bas). Cette rigueur de disposition réduit la charge cognitive de l’observateur et maximise l’impact persuasif des synthèses graphiques lors de communications académiques ou de restitutions décisionnelles.
8.2 Organisation visuelle des diagrammes en boîte (geom_boxplot)
Le diagramme en boîte (boxplot) constitue un instrument analytique de référence pour disséquer la distribution conjointe d’une variable numérique continue à travers les différentes modalités d’un facteur. Trop souvent cependant, les boîtes sont juxtaposées sur l’axe horizontal selon l’ordre alphabétique fortuit de leurs libellés, ce qui complique l’évaluation des décalages de distribution et des écarts de variance entre populations.
L’intégration de l’ordonnancement dynamique au sein de l’instruction graphique transforme radicalement l’utilité du diagramme. En formulant la projection sous la forme ggplot(df, aes(x = fct_reorder(Groupe, Mesure, .fun = median), y = Mesure)) + geom_boxplot(), l’analyste contraint l’axe des abscisses à structurer les distributions selon un gradient monotone de leurs médianes respectives. Dès lors, toute tendance générale, toute rupture d’homosラックcédasticité (hétérogénéité des variances visualisée par l’étalement relatif des boîtes) ou tout comportement bimodal émerge avec une acuité visuelle remarquable.
Lorsque les étiquettes textuelles des catégories présentent une longueur typographique importante, leur accumulation sur l’axe horizontal induit des chevauchements disgracieux ou contraint l’analyste à incliner le texte à 45 ou 90 degrés, ce qui pénalise fortement la lisibilité. La parade méthodologique canonique consiste à permuter les axes via la spécification directe de la variable catégorielle sur l’axe $Y$ (ou l’emploi de coord_flip()), tout en veillant à ce que le niveau le plus élevé apparaisse en haut de l’axe vertical grâce à l’application judicieuse de fct_reorder(…, .desc = FALSE). Le diagramme qui en résulte se conforme aux exigences graphiques les plus rigoureuses des publications internationales à fort facteur d’impact.
8.3 Synchronisation rigoureuse entre facettes, légendes et axes graphiques
Dans les architectures graphiques sophistiquées mobilisant la segmentation en panneaux multiples (faceting via facet_wrap() ou facet_grid()), l’ordre d’affichage des sous-graphiques est une fois encore asservi à la topologie des niveaux du facteur de partitionnement. Laisser le moteur de facettage trier les panneaux par défaut alphabétique disperse fréquemment les groupes d’intérêt ou dissocie des étapes logiques qui devraient être contiguës (tels que des stades de développement biologique ou des trimestres calendaires).
En réordonnant délibérément le facteur assigné au facettage en amont de la construction graphique, le chercheur s’assure que les panneaux se succéderont de gauche à droite et de haut en bas selon une progression théoriquement cohérente. Cette synchronisation narrative permet au lecteur de suivre l’évolution d’un phénomène de manière naturelle sans devoir reconstruire mentalement l’agencement temporel ou typologique des panneaux d’affichage.
Un défi similaire concerne la concordance absolue entre les axes spatiaux et les légendes explicatives de couleurs ou de textures. Rien n’est plus préjudiciable à la communication scientifique qu’un graphique où une série de courbes s’étage de haut en bas dans l’ordre (A, B, C) tandis que la légende adjacente répertorie les catégories dans l’ordre alphabétique inversé (C, B, A). L’emploi conjoint de fct_reorder2() pour les séries tracées via geom_line() ou l’ajustement explicite des limites discrètes dans l’échelle graphique via scale_color_discrete(limits = levels(df$Facteur)) garantit une harmonie visuelle intégrale, supprimant toute discordance entre la représentation géométrique des données et son appareil sémiotique d’accompagnement.
9. Impact du réordonnancement sur la modélisation statistique
9.1 Définition de la référence dans les modèles linéaires généraux (lm)
L’estimation des paramètres d’un modèle linéaire général via la fonction lm() repose sur la transformation d’un facteur qualitatif à $k$ modalités en un ensemble de $k-1$ variables indicatrices binaires (souvent appelées variables muettes ou dummy variables). Par défaut, R applique le système de contrastes de traitement (contr.treatment). Dans ce schéma algébrique, la modalité occupant le premier rang de l’attribut levels est omise de la matrice d’expérience pour éviter la colinéarité stricte (piège de la variable indicatrice) et fusionne directement dans le terme constant $\beta_0$ (l’intercept).
Dès lors, l’ordonnée à l’origine capture l’espérance mathématique de la réponse conditionnelle lorsque toutes les variables explicatives continues sont nulles et que le facteur se situe à sa modalité de référence : $\mathbb{E}[Y | X = \text{Reference}] = \beta_0$. Chaque coefficient partiel $\beta_j$ associé à une modalité $j in {2, dots, k}$ mesure l’écart absolu entre la moyenne du groupe $j$ et celle du groupe de référence : $\beta_j = \mathbb{E}[Y | X = j] – \mathbb{E}[Y | X = \text{Reference}]$. En conséquence, la statistique $t$ de Student et la valeur $p$ associée à ce coefficient évaluent exclusivement l’hypothèse nulle d’égalité entre le niveau $j$ et le niveau de base ($H_0 : \mu_j = \mu_{\text{Ref}}$), et non une différence globale ou une comparaison face à la moyenne générale de l’échantillon.
Si l’analyste réordonne les niveaux du facteur à l’aide de relevel() ou factor(), l’ordonnée à l’origine et l’ensemble des coefficients $\beta_j$ sont recalculés pour refléter les nouveaux contrastes avec le nouvel ancrage choisi. Cependant, il est essentiel de souligner une propriété mathématique fondamentale : le réordonnancement des niveaux d’un facteur n’altère absolument pas les propriétés omnibus du modèle. Le coefficient de détermination global $R^2$, la statistique $F$ de Fisher-Snedecor, l’estimation de la variance de l’erreur résiduelle $\hat{\sigma}^2$ ainsi que les valeurs prédites $\hat{Y}_i$ demeurent rigoureusement identiques au bit près. Seule change la perspective interprétative locale des coefficients marginaux.
9.2 Interprétation des rapports de cotes dans les modèles logistiques (glm)
Dans le domaine des modèles linéaires généralisés (GLM), et plus spécifiquement lors de l’ajustement d’une régression logistique binaire via glm(family = binomial), la mécanique des contrastes catégoriels prend une dimension épidémiologique déterminante. Les coefficients de régression $\beta_j$ s’expriment en unités d’échelle logarithmique des cotes (log-odds). L’application de la fonction exponentielle à ces paramètres fournit les célèbres rapports de cotes ou odds ratios (OR) : $\text{OR}_j = \exp(\beta_j)$.
Le rapport de cotes s’interprète strictement comme la cote de survenue de l’événement d’intérêt dans la catégorie $j$ rapportée à la cote de ce même événement dans la catégorie de référence :
$$\text{OR}_j = \frac{\text{Cote}(Y=1 mid X=j)}{\text{Cote}(Y=1 mid X=\text{Reference})}$$
Si la modalité de référence est mal positionnée, l’orientation sémiotique du risque se trouve inversée. Par exemple, si l’on étudie l’impact de classes thérapeutiques sur la mortalité et que la classe de référence choisie par défaut alphabétique s’avère être la thérapie la plus toxique, l’ensemble des autres traitements affichera des rapports de cotes inférieurs à 1 (effet protecteur apparent face à la référence). Si, en revanche, le traitement conventionnel ou le groupe contrôle est établi en référence grâce à relevel(), les coefficients quantifieront intuitivement l’éventuel surcroît ou déficit d’efficacité de chaque thérapie innovante par rapport au standard de soins usuel.
Cette distinction est d’autant plus critique lors de la synthèse des résultats empiriques au sein de méta-analyses ou de publications médicales normées. Une inversion accidentelle de la baseline due à un classement alphabétique non maîtrisé peut conduire des lecteurs non avertis à commettre des contresens sur la direction protectrice ou délétère d’une exposition environnementale ou thérapeutique, illustrant le rôle de garde-fou méthodologique dévolu au codage explicite des facteurs.
9.3 Influence sur l’analyse de variance univariée et multivariée (ANOVA / MANOVA)
Les interactions entre l’ordre des modalités de facteurs et l’analyse de variance (ANOVA) révèlent des subtilités d’algèbre matricielle qui échappent fréquemment aux praticiens. En analyse univariée standard reposant sur un plan expérimental équilibré (effectifs rigoureusement égaux dans toutes les cellules), l’ordre des niveaux d’un facteur n’exerce aucune influence sur le calcul de la somme des carrés intergroupes (Sum of Squares) ni sur les p-valeurs globales associées au test $F$.
Toutefois, la situation diverge drastiquement dans les plans d’expérience déséquilibrés (unbalanced designs) dès lors que l’on applique la décomposition de la somme des carrés de Type I (sommes des carrés séquentielles ou hiérarchiques), qui constitue la méthode par défaut implémentée dans la fonction anova() de base sous R. Dans ce cadre de Type I, l’effet de chaque terme est évalué conditionnellement aux termes introduits préalablement dans la formule. Si un facteur nominal est associé à des contrastes spécifiques non orthogonaux, ou si un facteur ordinal est évalué via des contrastes polynomiaux, la séquence ordonnée des niveaux dictera la construction successive des polynômes orthogonaux (degrés linéaire, quadratique, cubique).
Modifier la hiérarchie interne d’un facteur ordonné transforme intégralement l’estimation de ces composantes tendancielles. Si un facteur ordinal reflète une progression logique de doses de principe actif (0 mg, 10 mg, 50 mg, 100 mg), le contraste linéaire testera la présence d’une relation proportionnelle entre la dose et la réponse physiologique. Inverser l’ordre des niveaux 10 mg et 50 mg par erreur mathématiserait une fonction polynomiale absurde, anéantissant la validité du test de linéarité. En revanche, pour les décompositions de sommes des carrés de Type II et de Type III (accessibles via le package car avec car::Anova()), l’orthogonalité par rapport aux effets d’ordre marginal assure l’invariance des résultats omnibus, sous réserve d’avoir configuré les contrastes adéquats (typiquement contr.sum pour le Type III).
10. Gestion spécifique des échelles psychométriques et de type Likert
10.1 Structuration logique des gradients d’accord et de fréquence
Dans les sciences comportementales, la psychométrie, les sciences de l’éducation et le marketing quantitatif, le recueil de données s’effectue massivement au moyen d’échelles de cotation subjectives, au premier rang desquelles figure l’échelle de Rensis Likert. Ces instruments soumettent aux répondants une série d’affirmations associées à des modalités d’accord échelonnées, traditionnellement en cinq ou sept points : de « Pas du tout d’accord » à « Tout à fait d’accord », en passant par une position d’indécision centrale (« Ni en accord ni en désaccord »).
L’importation de ces questionnaires sous R aboutit presque inévitablement à une dispersion anarchique des libellés due au tri alphabétique. La modalité « Tout à fait d’accord » se retrouve fréquemment juxtaposée à « Pas du tout d’accord », tandis que le niveau neutre dérive arbitrairement au gré des lettres initiales. Pour restaurer la fidélité psychométrique de l’échelle, il est impératif d’assigner une séquence rigoureusement ordonnée qui préserve la valence directionnelle du construit psychologique sous-jacent, progressant de la polarité la plus négative vers la polarité la plus positive :
vecteur_accord <- c("Pas du tout d'accord", "Pas d'accord", "Neutre", "D'accord", "Tout à fait d'accord")
donnees$Item1 <- factor(donnees$Item1, levels = vecteur_accord, ordered = TRUE)
Ce formatage prépare également le jeu de données pour les outils de visualisation spécialisés dans les données d’attitudes, tels que le package HH ou le package likert. Ces extensions logicielles requièrent impérativement un alignement ordonné strict pour tracer des diagrammes en barres divergentes centrés sur le point de neutralité, offrant une lisibilité immédiate des consensus d’opinion au sein de la population interrogée.
10.2 Inversion d’items scorés négativement et cohérence interne
Un principe méthodologique classique dans la conception de tests psychométriques consiste à inclure des « items inversés » (reverse-coded items) au sein d’une batterie de questions afin de contrer le biais d’acquiescement (la propension de certains répondants à cocher systématiquement les modalités d’accord sans examiner attentivement le texte). Par exemple, dans une échelle évaluant l’anxiété, la majorité des questions exploreront des manifestations de détresse psychologique, tandis qu’un item formulé positivement (« Je me sens parfaitement détendu ») mesurera l’absence du trouble.
Avant de procéder à l’agrégation de ces items dans un score factoriel global ou d’évaluer la fidélité de l’instrument via le calcul du coefficient alpha de Cronbach ou de l’oméga de McDonald, l’analyste doit impérativement aligner la polarité sémantique de tous les items. Conserver l’orientation initiale de l’item inversé introduirait une corrélation négative artificielle avec les autres composantes de l’échelle, dégradant artificiellement les indices de cohérence interne.
La bibliothèque forcats apporte une réponse computationnelle rapide et sécurisée à cette exigence grâce à sa fonction fct_rev(). En appliquant simplement donnees$Item_Inversé <- fct_rev(donnees$Item_Inversé), l’ensemble des niveaux d’accord est retourné sur son axe : le premier niveau devient le dernier, transformant « Tout à fait d’accord » en l’équivalent structurel de « Pas du tout d’accord ». Une fois cette inversion opérée, l’extraction de la matrice numérique sous-jacente via as.numeric() permet de sommer directement les scores individuels en toute conformité avec le modèle théorique sous-jacent.
10.3 Regroupement et consolidation des modalités rares ou bruitées
Les données d’enquêtes réelles comportent fréquemment des modalités marginales affichant des effectifs extrêmement réduits (par exemple moins de 1 à 2 % de l’échantillon global sur des catégories comme « Fortement opposé » ou « Ne sait pas »). Cette rareté statistique engendre des instabilités numériques majeures lors de l’estimation de modèles multivariés, se traduisant par une inflation disproportionnée des erreurs-types associées aux coefficients et par l’apparition d’intervalles de confiance anormalement larges, voire non calculables (phénomène de quasi-séparation en régression logistique).
Face à ce bruit observationnel, le praticien doit consolider les catégories sous-représentées en fusionnant intelligemment les modalités contiguës. Le package forcats offre pour ce faire deux fonctions remarquables : fct_collapse() et fct_lump_*(). La fonction fct_collapse() permet de redéfinir manuellement les frontières catégorielles en fédérant plusieurs niveaux historiques au sein de nouvelles super-catégories clairement étiquetées :
df$Echelle_Reduite <- fct_collapse(df$Echelle_Originale,
"Desaccord" = c("Pas du tout d'accord", "Pas d'accord"),
"Neutre" = "Neutre",
"Accord" = c("D'accord", "Tout à fait d'accord"))
Après cette fusion, l’ordre résultant des super-catégories est immédiatement conservé selon l’apparition des blocs déclarés dans la fonction. Parallèlement, pour les variables nominatives complexes présentant une myriade d’étiquettes résiduelles (telles que des spécialités médicales ou des pays mineurs), fct_lump_min() ou fct_lump_prop() automatise le regroupement de toutes les modalités sous un seuil d’effectif prédéterminé sous l’étiquette générique « Autre ». L’application conjointe d’un appel ultérieur à fct_relevel(…, « Autre », after = Inf) garantit une consolidation empirique doublée d’un agencement visuel parfait pour la modélisation en aval.
11. Erreurs courantes, débogage et bonnes pratiques de programmation
11.1 Confusion fréquente entre réordonner les niveaux et renommer les étiquettes
Parmi les anomalies de code les plus destructrices identifiées dans les scripts R rédigés par des analystes débutants ou intermédiaires, la manipulation directe de la fonction levels() à la gauche d’un opérateur d’assignation représente le piège paroxystique :
# ALERTE : ERREUR GRAVE DE MÉTHODOLOGIE
levels(df$Variable) <- c("Niveau_B", "Niveau_A", "Niveau_C")
Cette formulation semble intuitivement indiquer à R que l’utilisateur désire modifier l’ordre des catégories pour placer « Niveau_B » en première position. En réalité, cette syntaxe altère directement la table des étiquettes textuelles sans redistribuer les indices entiers stockés en mémoire sous forme vectorielle. L’indice entier 1, qui correspondait historiquement à « Niveau_A », conserve sa valeur 1 mais se voit attribuer la nouvelle étiquette « Niveau_B ». En exécutant cette instruction, l’analyste ne réordonne pas les données : il renomme silencieusement ses observations et attribue faussement la valeur de B à l’ensemble des individus qui étaient initialement A, corrompant de façon irréversible le signal empirique du jeu de données.
Pour réordonner sans modifier la correspondance textuelle originale sous R de base, il faut impérativement passer par la réinstanciation complète : df$Variable <- factor(df$Variable, levels = c("Niveau_B", "Niveau_A", "Niveau_C")). Pour renommer des modalités de manière sécurisée sans perturber l’ordonnancement structurel, il est recommandé d’abandonner l’assignation par levels<- au profit explicite de fonctions dévolues comme forcats::fct_recode(), qui vérifie explicitement les appariements avant d’opérer la moindre mutation en mémoire.
11.2 Préservation des attributs de facteurs dans les pipelines dplyr
L’intégration des facteurs au sein de chaînes de traitement reposant sur le package dplyr soulève des considérations architecturales spécifiques. Lors de l’usage des verbes de filtrage (filter), de découpage conditionnel (case_when) ou de fusion de tables (left_join), l’analyste doit surveiller attentivement la persistance des attributs de classe.
Un comportement classique lors de l’application de filter() réside dans la persistance obstinée des niveaux exclus au sein de l’attribut levels. Si une sous-population est éliminée de l’échantillon pour un sous-groupe d’analyse, ces modalités n’ayant plus aucune occurrence subsistent néanmoins sous forme de niveaux vides. Pour éviter que ces fantômes n’encombrent les graphiques futurs ou ne provoquent des singularités dans les matrices de régression, il convient de purger systématiquement le jeu de données épuré à l’aide de l’instruction df_filtre <- droplevels(df_filtre) ou de son homologue Tidyverse forcats::fct_drop().
De plus, l’utilisation de case_when() au sein d’une mutation (mutate) requiert une rigueur absolue de typage. case_when() est une fonction à typage strict : elle exige que l’ensemble des résultats retournés par les différentes branches conditionnelles partagent un type strictement identique. Tenter de mélanger des retours de type facteur et des retours de type chaîne déclenchera une interruption immédiate du pipeline avec une erreur de type vctrs::typed_error. La bonne pratique consiste à manipuler des chaînes de caractères pures au sein des instructions conditionnelles de case_when(), pour ne convertir la variable résultante en facteur qu’à la sortie ultime du pipeline, une fois la structure stabilisée.
11.3 Règles d’or pour un code robuste, documenté et reproductible
Afin de garantir la robustesse des chaînes de traitement dans les contextes de recherche académique et d’analyse institutionnelle, l’adoption de normes de codage formalisées s’avère indispensable. La première règle méthodologique prescrit de centraliser la configuration des facteurs dès l’étape initiale d’ingestion des données brutes. L’analyste doit éviter de disséminer des appels à factor() ou relevel() de manière opportuniste au milieu de scripts de modélisation ou de visualisation : les types et les hiérarchies doivent être fixés et validés dans un script de nettoyage préliminaire dédié.
La deuxième règle impose la documentation explicite de la rationalité scientifique ayant guidé chaque ordonnancement. Pourquoi une modalité spécifique a-t-elle été choisie en référence ? Pourquoi avoir adopté une hiérarchisation par médiane plutôt que par moyenne ? Ces choix théoriques doivent être consignés sous forme de commentaires clairs dans le code ou intégrés aux métadonnées des dictionnaires de variables (codebooks). Cette transparence protège le projet contre la perte de mémoire méthodologique lors des phases de révision par les pairs ou de passation de projet.
Enfin, l’usage d’assertions programmatiques garantit l’intégrité volumétrique du traitement. L’insertion de tests unitaires simples vérifiant après chaque transformation catégorielle que le nombre total de valeurs manquantes (sum(is.na(df$variable))) n’a pas augmenté accidentellement et que le cardinal des niveaux (nlevels(df$variable)) correspond exactement aux prévisions théoriques constitue un rempart infaillible contre les dégradations silencieuses de bases de données.
12. Synthèse comparative des méthodes et arbre décisionnel
12.1 Matrice comparative : Base R (factor, relevel, reorder) versus forcats
Pour guider le praticien dans le choix des instruments logiciels les plus pertinents pour son travail, il convient de dresser un bilan comparatif rigoureux opposant les fonctions historiques de R de base aux extensions fonctionnelles de la bibliothèque forcats. Les fonctions de R base (factor, relevel, reorder) présentent un avantage décisif : l’absence absolue de dépendances externes. Elles fonctionnent nativement dans n’importe quel environnement R minimaliste, sur des serveurs hautement sécurisés privés d’accès internet, et garantissent une stabilité rétrocompatible totale sur des décennies de code source.
Cependant, R de base souffre d’une dispersion syntaxique notable : les noms de paramètres oscillent entre majuscules et minuscules (l’argument X dans reorder contre x dans factor), la gestion des erreurs est permissive (génération silencieuse de valeurs NA lors d’omissions), et la manipulation combinatoire s’avère complexe sans emboîter de multiples parenthèses peu lisibles. En outre, la fonction relevel() reste confinée au déplacement d’une seule modalité vers la première position, sans aucune flexibilité pour les relégations en fin de distribution.
En contrepoint, l’écosystème forcats offre une interface moderne, hautement expressive et optimisée pour la composition via des tubes (pipes). La régularité des fonctions préfixées par fct_ simplifie l’apprentissage et l’auto-complétion au sein des environnements de développement intégrés (IDE tels que RStudio ou VS Code). Les messages d’erreur et d’avertissement sont riches, précis, et conçus pour interdire toute corruption accidentelle de données. Si son utilisation introduit une dépendance externe légère envers le métapackage Tidyverse, cette concession technique est aujourd’hui largement amortie par les gains spectaculaires apportés en termes de clarté du code, de sécurité logicielle et de vélocité de développement.
12.2 Arbre décisionnel pour sélectionner la fonction optimale selon le contexte
Le choix de la fonction idoine pour réordonner un facteur peut être systématisé à travers un processus logique formalisé selon l’objectif analytique immédiat de l’analyste :
- Objectif 1 : Établir une modalité de contrôle spécifique pour un modèle de régression univarié ou multivarié.
- Si l’environnement interdit les dépendances externes : utiliser
stats::relevel(x, ref = "Modalite_Temoin"). - Si l’environnement intègre le Tidyverse : employer
forcats::fct_relevel(x, "Modalite_Temoin").
- Si l’environnement interdit les dépendances externes : utiliser
- Objectif 2 : Réordonner la totalité des niveaux selon une logique théorique fixe (ex. échelle de Likert, stades cliniques).
- Si l’on opère sous R de base : utiliser
factor(x, levels = c("Stade_1", "Stade_2", "Stade_3"), ordered = TRUE/FALSE)en validant l’exhaustivité parsetdiff(). - Si l’on opère sous forcats : privilégier
forcats::fct_relevel(x, c("Stade_1", "Stade_2", "Stade_3"))pour sa résilience face aux omissions partielles.
- Si l’on opère sous R de base : utiliser
- Objectif 3 : Hiérarchiser visuellement des catégories selon une grandeur continue (diagrammes en barres ou boîtes à moustaches).
- Si l’on souhaite ordonner par la médiane ou la moyenne dans un flux ggplot2 : employer
forcats::fct_reorder(.f = Categorie, .x = Valeur, .fun = median, .desc = FALSE). - Pour aligner l’ordre des légendes sur la hauteur finale de tracés temporels : solliciter
forcats::fct_reorder2(Facteur, Temps, Reponse).
- Si l’on souhaite ordonner par la médiane ou la moyenne dans un flux ggplot2 : employer
- Objectif 4 : Structurer des données de comptage ou des catégories nominatives à forte dispersion.
- Pour classer selon l’abondance empirique : recourir à
forcats::fct_infreq(x)(décroissant) ou combiné avecforcats::fct_rev(fct_infreq(x))(croissant). - Pour refouler une modalité d’indécision ou résiduelle vers l’extrémité : utiliser
forcats::fct_relevel(x, "Autre", after = Inf).
- Pour classer selon l’abondance empirique : recourir à
- Objectif 5 : Préserver la séquence chronologique naturelle d’un tableau de données délimité.
- Appliquer immédiatement
forcats::fct_inorder(x)dès l’ingestion brute du fichier.
- Appliquer immédiatement
12.3 Recommandations méthodologiques finales pour la recherche en sciences empiriques
Au terme de cette analyse approfondie, il ressort que le traitement des variables catégorielles ne doit jamais être relégué à un ajustement cosmétique marginal exécuté en fin de chaîne analytique. Les niveaux des facteurs structurent la manière dont les modèles statistiques interprètent la réalité expérimentale et conditionnent l’efficacité narrative des visualisations scientifiques transmises aux pairs et aux décideurs.
Pour consolider la validité écologique et la reproductibilité des travaux quantitatifs, nous recommandons aux équipes de recherche d’adopter des protocoles stricts de standardisation : déclarer systématiquement l’intégralité des hiérarchies qualitatives dans des scripts de préparation des données isolés ; bannir rigoureusement l’assignation directe destructrice de type levels(x) <- ; et conserver les scripts de recodage complets au sein d’archives pérennes en accès ouvert (telles que l’Open Science Framework ou des dépôts GitHub versionnés et adossés à des identifiants DOI via Zenodo).
En appliquant avec discernement les méthodes fondamentales de R base et la boîte à outils moderne fournie par l’écosystème forcats, les analystes et chercheurs s’assurent une maîtrise technique irréprochable sur l’un des aspects les plus déterminants de l’ingénierie des données qualitatives, garantissant des inférences rigoureuses, des représentations visuelles irréprochables et une intégrité computationnelle conforme aux normes scientifiques les plus exigeantes.
Références
- Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer. https://doi.org/10.1007/978-0-387-75936-4
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science: Import, tidy, transform, visualize, and model data (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
- Wickham, H., & forcats development team. (2023). forcats: Tools for working with categorical variables (factors) (Version 1.0.0). CRAN. https://cran.r-project.org/package=forcats