
La visualisation de données contemporaine ne se résume plus à l’agencement rudimentaire de points discrets ou au tracé de trajectoires unidimensionnelles sur un plan cartésien. Dans les publications académiques, les rapports d’ingénierie avancée et la recherche fondamentale, la communication visuelle exige une transmission instantanée, dense et dépourvue d’ambiguïté des structures mathématiques sous-jacentes. L’espace bidimensionnel offert par un graphique constitue un champ sémiotique où les zones délimitées par des frontières fonctionnelles portent une charge informative capitale, révélant des topologies d’erreur, des densités de probabilité, des flux énergétiques ou des différentiels d’amplitude qui échappent souvent à la simple observation de courbes filiformes superposées.
Au sein de l’écosystème scientifique de Python, la bibliothèque Matplotlib s’est imposée comme le standard de référence pour la production de figures vectorielles de qualité éditoriale. Conçue à l’origine pour reproduire la syntaxe interactive des environnements de calcul matriciel, elle s’est métamorphosée en un moteur de rendu graphique modulaire d’une sophistication extrême, reposant sur une hiérarchie d’objets rigoureusement articulée. La maîtrise des mécanismes de remplissage géométrique au sein de cette bibliothèque ne relève pas d’un simple souci décoratif ; elle constitue une compétence méthodologique essentielle pour quiconque souhaite expliciter la variabilité statistique, isoler des domaines d’intégration ou matérialiser les frontières de décision dans des espaces de paramètres complexes.
Ce traité exhaustif a pour vocation d’explorer l’intégralité des aspects théoriques, algorithmiques, esthétiques et computationnels liés au remplissage des surfaces entre courbes dans Matplotlib. En disséquant les fonctions fondamentales que sont fill_between et fill_betweenx, nous mettrons en lumière les mécanismes internes de discrétisation polygonale, l’algèbre booléenne appliquée aux masques d’interpolation, l’optimisation du pipeline de rastérisation pour les volumes massifs de données, ainsi que les règles ergonomiques qui garantissent une interprétation scientifique irréprochable et accessible. L’objectif est d’offrir au chercheur et à l’ingénieur un manuel de référence définitif, alliant profondeur théorique et rigueur d’implémentation.
1. Introduction aux fonctions de remplissage dans la bibliothèque Matplotlib
L’acte d’ombrer une région sur une surface graphique engage une transformation cognitive majeure dans la lecture d’un document scientifique. Alors qu’une ligne continue guide le regard le long d’une trajectoire déterministe ou séquentielle, une surface fermée et colorée mobilise immédiatement les mécanismes de perception pré-attentive du système visuel humain, incitant l’esprit à appréhender une quantité globale, une étendue ou une incertitude systémique.
1.1 Rôle sémiotique et visuel des aires ombrées dans l’analyse de données
D’un point de vue sémiotique, la mise en valeur des espaces continus situés entre deux estimateurs statistiques remplit une fonction heuristique irremplaçable. Dans l’exploration de données empiriques, la courbe moyenne ou médiane ne représente qu’une réduction drastique de la réalité dimensionnelle d’un phénomène. L’adjonction d’une surface ombrée enveloppant cette trajectoire permet de réintroduire visuellement la variance, l’intervalle de confiance ou l’erreur type, conférant ainsi au lecteur une perception synoptique de la fiabilité du signal observé. Cette contextualisation continue évite les conclusions hâtives qui pourraient découler de la seule lecture d’une ligne centrale oscillante.
Sur le plan de l’ergonomie cognitive, le recours aux aires colorées allège considérablement la charge mentale requise pour décoder les graphiques denses. Alors que la multiplication de barres d’erreur ponctuelles segmente l’attention en une infinité de jugements discrets et crée un encombrement visuel néfaste à l’identification des tendances globales, une bande ombrée continue synthétise l’enveloppe de dispersion en une forme géométrique unifiée. Les théories de la psychologie de la forme (Gestalt) démontrent que l’œil perçoit une région connexe délimitée comme un objet unitaire avant même d’analyser ses frontières individuelles, facilitant ainsi la détection instantanée des zones de forte divergence ou de stabilité remarquable.
En comparaison directe avec d’autres paradigmes visuels, tels que les diagrammes en bandes disjointes ou les séries de boîtes à moustaches séquentielles, le remplissage surfacique continu excelle dans la représentation des processus stochastiques à évolution temporelle ou spatiale. Il préserve la notion de contiguïté infinitésimale inhérente aux phénomènes physiques sous-jacents. Enfin, dans le cadre des publications académiques à fort impact, la précision du rendu vectoriel de ces surfaces s’avère déterminante : un crénelage maladroit, une gestion défaillante de l’opacité ou un lissage arbitraire peuvent non seulement dégrader l’élégance formelle d’un manuscrit, mais également induire en erreur les pairs évaluateurs quant à la rigueur métrologique des données présentées.
1.2 Présentation des primitives graphiques : fill_between et fill_betweenx
Au cœur de l’architecture logicielle de Matplotlib se trouvent deux primitives fondamentales dédiées au remplissage surfacique bidimensionnel : la fonction fill_between et son pendant orthogonal fill_betweenx. La distinction opératoire entre ces deux méthodes repose sur l’axe directeur du balayage géométrique. La fonction fill_between opère selon une projection verticale le long de l’axe des abscisses, interpolant les hauteurs entre deux ordonnées fonctionnelles pour chaque valeur de x. À l’inverse, la primitive fill_betweenx adopte un balayage horizontal le long de l’axe des ordonnées, reliant les écarts d’abscisses pour chaque valeur de y. Cette dualité permet de traiter indifféremment des fonctions univoques selon l’un ou l’autre des repères cartésiens usuels.
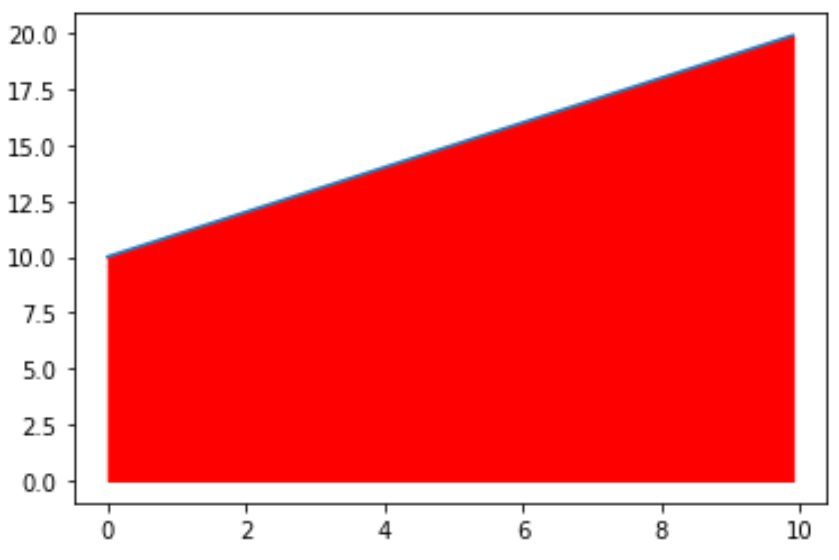
Sous le capot du moteur graphique, l’appel à ces primitives ne génère pas une simple collection de lignes juxtaposées, mais instancie un objet hautement optimisé appartenant à la classe matplotlib.collections.PolyCollection. Cet objet encapsule la description topologique d’un ou plusieurs polygones fermés à deux dimensions, composés d’une suite ordonnée de sommets reliant les trajectoires supérieures et inférieures, fermés hermétiquement à leurs extrémités. Cette approche vectorielle garantit que le rendu demeure mathématiquement exact, quelle que soit la résolution finale du dispositif d’affichage ou l’échelle de zoom appliquée au canevas.
Ces primitives bénéficient d’une compatibilité native et profonde avec les structures de données fondamentales de l’écosystème Python scientifique, notamment les tableaux multidimensionnels issus de NumPy, les séries et DataFrames de Pandas, ainsi que les fonctions d’interpolation de SciPy. Contrairement à l’instanciation manuelle de polygones génériques via la classe de base matplotlib.patches.Polygon, qui requiert de l’utilisateur un calcul fastidieux de la séquence ordonnée des sommets et de la boucle de fermeture géométrique, fill_between et fill_betweenx automatisent l’ordonnancement cyclique des coordonnées, la gestion des croisements de signaux et l’exclusion des valeurs non définies, déchargeant ainsi le programmeur des complexités inhérentes à la géométrie algorithmique élémentaire.
1.3 Configuration rigoureuse de l’environnement de développement Python
La génération de graphiques scientifiques d’une fidélité irréprochable nécessite l’établissement préalable d’un environnement de travail configuré de manière déterministe. L’importation conventionnelle des bibliothèques fondamentales s’articule autour de l’espace de noms standardisé de Python, associant le calcul vectoriel de NumPy sous l’alias np et le module de traçage procédural de Matplotlib sous l’alias plt. Cette convention universelle garantit non seulement l’interopérabilité des scripts entre différentes équipes de recherche, mais assure également la clarté conceptuelle lors de la lecture des protocoles de calcul.
Au-delà des simples déclarations d’importation, la configuration minutieuse des feuilles de style globales via le dictionnaire de configuration interne de Matplotlib (plt.rcParams) conditionne la réussite typographique et géométrique de la figure finale. Le recours à des styles prédéfinis optimisés pour l’édition scientifique, tels que les profils dérivés de seaborn ou des bibliothèques spécialisées comme scienceplots, permet d’harmoniser instantanément l’épaisseur des axes, le dimensionnement des polices de caractères, la texture des grilles cartésiennes et la balance des blancs. Ces paramètres évitent les discordances esthétiques courantes où des polices bitmap côtoient des tracés vectoriels à haute résolution.
Enfin, la reproductibilité computationnelle impose une définition explicite de la résolution spatiale du canevas, mesurée en points par pouce ou DPI (dots per inch). Alors qu’une résolution standard de cent DPI convient aux phases exploratoires sur écran, l’exportation destinée aux revues internationales à comité de lecture exige impérativement un calibrage minimal à trois cents DPI pour les formats matriciels, voire l’usage exclusif de formats vectoriels scalables tels que le PDF ou l’EPS. La maîtrise de ces paramètres initiaux garantit que les transparences, les hachures et les frontières différentielles générées par les primitives de remplissage conserveront leur intégrité géométrique absolue lors des processus industriels d’impression et de diffusion numérique.
2. Fondements théoriques et syntaxe fondamentale de plt.fill_between()
La compréhension rigoureuse du fonctionnement de plt.fill_between() exige une dissection minutieuse de sa signature syntaxique, de ses mécanismes de projection et de son comportement face à la diversité des formats d’entrée. L’outil repose sur des principes géométriques immuables qui dictent la manière dont le plan continu est segmenté en facettes polygonales discrètes.
2.1 Anatomie de la signature de la fonction fill_between
La signature standard de la fonction fill_between au sein du sous-module pyplot se déploie selon une structure formelle rigoureusement hiérarchisée. Les trois premiers arguments positionnels constituent le socle topologique de l’opération : le vecteur x, qui définit l’axe invariant des abscisses le long duquel s’effectue le balayage d’échantillonnage, suivi des bornes d’ordonnées y1 et y2. Dans le cas le plus général, x représente une séquence strictement ordonnée de coordonnées réelles, tandis que y1 et y2 représentent respectivement la première et la seconde fonction frontière délimitant l’espace vertical à ombrer.
Une caractéristique fondamentale du comportement par défaut de la fonction réside dans le caractère optionnel du troisième argument y2. Lorsque ce dernier est omis lors de l’appel, Matplotlib applique un comportement conventionnel strict en assignant implicitement la valeur scalaire zéro à l’ensemble du vecteur inférieur. Dans cette configuration, l’opération revient à matérialiser géométriquement l’aire comprise entre la courbe décrite par y1 et l’axe horizontal neutre d’ordonnée zéro. Si cette convention s’avère commode pour l’intégration de fonctions d’ondes ou de densités centrées, elle nécessite une vigilance constante lorsqu’il s’agit de traiter des données évoluant exclusivement dans des plages d’amplitudes strictement positives et éloignées de l’origine.
Concernant les structures de données admissibles, fill_between accepte une grande variété de collections itérables : les listes natives Python, les tableaux multidimensionnels ndarray de NumPy ainsi que les objets de type Series issus de la bibliothèque Pandas. Néanmoins, l’intégrité de l’algorithme repose sur le respect scrupuleux des lois de diffusion de formes dimensionnelles (broadcasting). Le vecteur x et les vecteurs fonctionnels y1 et y2 doivent obligatoirement posséder des dimensions compatibles le long de leur axe de projection. Toute incohérence dans le nombre d’éléments discrets se traduit immédiatement par une exception de dimensionnement, soulignant la nécessité d’un alignement préalable des index lors de la manipulation de séries temporelles asynchrones.
2.2 Remplissage géométrique entre deux droites horizontales statiques
Le cas d’école le plus élémentaire pour appréhender la mécanique spatiale de fill_between consiste à projeter une surface entre deux limites horizontales constantes sur un intervalle d’abscisses régulier. La génération du support spatial discret fait généralement intervenir les fonctions vectorielles numpy.arange ou numpy.linspace, lesquelles génèrent un maillage dense et équidistant de coordonnées réelles. Ce vecteur x constitue l’ossature numérique sur laquelle les bornes constantes seront projetées.
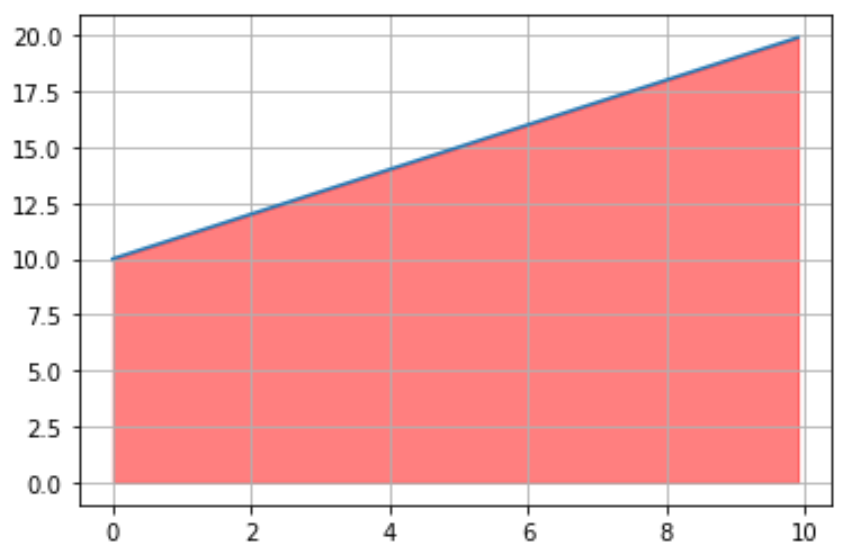
Lorsqu’on cherche à représenter graphiquement un corridor de tolérance ou un intervalle de spécification industrielle borné par deux valeurs scalaires fixes, disons une limite inférieure alpha et une limite supérieure bêta, il n’est pas nécessaire de construire manuellement des tableaux de coordonnées répétées pour y1 et y2. Le moteur interne de diffusion de NumPy et de Matplotlib prend en charge l’extension automatique d’une constante scalaire à l’ensemble de la dimension couverte par le vecteur x. Il suffit alors de fournir les scalaires respectifs aux arguments y1 et y2 pour voir émerger un parallélogramme parfait épousant les limites du domaine.
Dans la pratique de la mise en page scientifique, cette opération est quasi systématiquement conjointe à l’utilisation de plt.plot() pour tracer de façon nette et acérée les lignes frontières supérieures et inférieures. Cette démarcation structurelle renforce la lisibilité de la figure en conférant aux bornes une clarté optique que la seule transition de couleur entre la zone ombrée et le fond blanc ne saurait apporter avec une acuité suffisante. Par ailleurs, l’insertion judicieuse de la grille cartésienne au moyen de plt.grid() exige une vigilance accrue : la surface remplie risque, si l’ordre des plans n’est pas scrupuleusement maîtrisé, d’occulter les lignes de repère indispensables à l’estimation quantitative des valeurs.
2.3 Gestion de la transparence et lisibilité des données sous-jacentes
L’introduction d’un polygone coloré dans un espace graphique bidimensionnel pose immédiatement le problème de l’occlusion visuelle. Par défaut, les primitives de dessin appliquent une opacité totale sur les surfaces qu’elles engendrent, ce qui a pour effet pervers de masquer irrémédiablement tout élément graphique préexistant situé dans le même volume plan, qu’il s’agisse de courbes secondaires, de marqueurs de dispersion ou de la grille de lecture. La modulation de ce phénomène s’opère par le biais de l’argument scalaire alpha, dont la valeur est rigoureusement bornée entre 0.0 (transparence intégrale, rendant l’objet parfaitement invisible) et 1.0 (opacité absolue bloquant l’ensemble des rayons lumineux virtuels).
Le choix judicieux du coefficient d’opacité relève d’un compromis perceptif délicat. Dans la plupart des visualisations scientifiques, une valeur d’alpha comprise entre 0.15 et 0.35 est hautement recommandée. Cet intervalle permet de teinter l’espace d’une présence chromatique suffisamment discriminante pour identifier la frontière de la région sans jamais noyer les lignes de graduation sous-jacentes ni altérer la lisibilité des points de données individuels. Un coefficient trop faible dissout l’information dans la luminosité du fond, tandis qu’un coefficient trop fort crée une masse visuelle imposante qui déséquilibre l’harmonie pondérale de la figure.
Il importe en outre d’analyser l’interaction colorimétrique qui s’établit inévitablement entre la teinte sélectionnée pour le remplissage et la couleur de fond du canevas. Selon le modèle de composition alpha standard (synthèse soustractive ou additive numérique), l’application d’une couleur semi-transparente sur un fond blanc induit une désaturation perceptuelle : une teinte bleue pure appliquée avec un alpha de 0.2 apparaîtra visuellement comme un bleu pastel très clair. Si le fond du graphique n’est pas rigoureusement neutre (par exemple dans le cas de thèmes sombres ou sépia), la superposition chromatique génère des teintes intermédiaires imprévues qui peuvent altérer la signification sémiotique originelle de la palette.
3. Remplissage sous une courbe continue unique
L’application la plus fréquente des primitives de remplissage réside dans la matérialisation de l’aire située sous une trajectoire fonctionnelle continue unique. Ce motif graphique constitue la traduction visuelle directe de concepts mathématiques fondamentaux tels que l’intégration au sens de Riemann, le cumul probabiliste ou la réponse impulsionnelle globale d’un système dynamique.
3.1 Intégration visuelle de l’aire sous la courbe (AUC)
Dans des disciplines variées telles que la pharmacocinétique, la théorie de la détection de signaux ou l’apprentissage automatique (notamment à travers l’évaluation des courbes ROC), la métrique d’aire sous la courbe (AUC, pour Area Under the Curve) incarne l’indicateur synthétique de performance par excellence. Modéliser graphiquement cette grandeur requiert la projection d’une fonction mathématique continue non linéaire, qu’elle soit issue d’une distribution gaussienne, d’une cinétique de décroissance exponentielle ou d’oscillations harmoniques amorties.
Pour assurer une retranscription graphique exempte d’artefacts polygonaux bruts, la discrétisation spatiale de l’axe support doit être calibrée avec une extrême précision. L’œil humain possède une acuité remarquable pour déceler les discontinuités angulaires sur les contours que le cerveau sait devoir être curvilignes. Si le vecteur x comporte un nombre insuffisant d’échantillons, la surface polygonale générée par fill_between révélera une succession de segments sécants et d’arêtes rectilignes qui ruineront l’illusion de continuité différentiable. L’emploi d’un maillage dense, comprenant typiquement entre cinq cents et deux mille points d’évaluation sur l’intervalle d’intérêt, garantit une fluidité visuelle parfaite sans induire de surcharge computationnelle pénalisante.
La surface ainsi générée offre une incarnation matérielle de l’intégrale définie de la fonction sur le domaine considéré. Elle transforme une abstraction analytique — la somme des rectangles infinitésimaux de hauteur f(x) et de largeur dx — en une entité visuelle mesurable, dont l’impact psychologique sur le lecteur surpasse largement la simple mention numérique d’un scalaire d’intégration au sein d’une légende ou d’un paragraphe textuel.
3.2 Délimitation d’un sous-ensemble spatial précis de l’abscisse
Il est fréquent que l’analyse statistique ou physique n’exige pas le remplissage de la totalité du domaine de définition, mais se concentre exclusivement sur un sous-ensemble spatial critique, correspondant par exemple à un intervalle de rejet d’hypothèse, à un centile extrême ou à une bande spectrale d’absorption spécifique. Dans ce contexte, l’application aveugle de fill_between sur l’intégralité du vecteur x s’avère contre-productive.
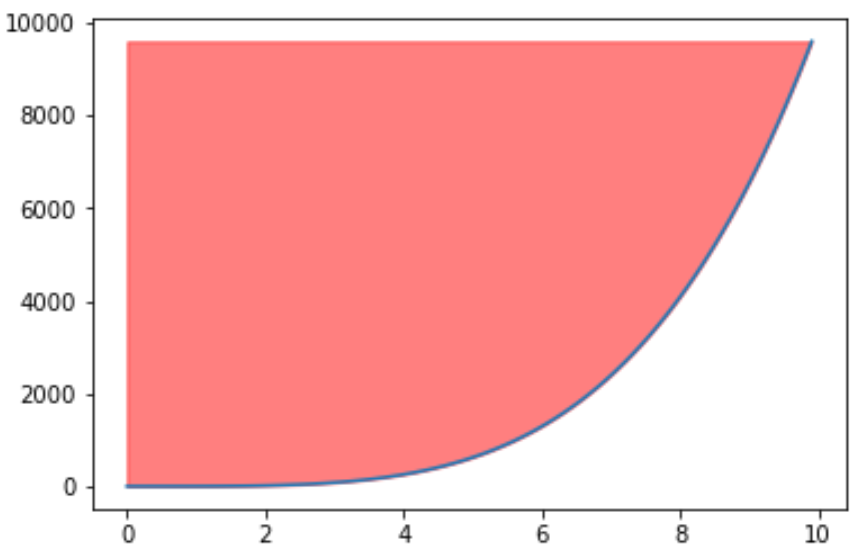
La méthodologie standard pour contraindre géométriquement la zone d’intégration consiste à exploiter la puissance des masques booléens vectorisés offerts par NumPy. En formulant une double condition logique sur le vecteur x — par exemple en isolant les coordonnées comprises strictement entre une borne inférieure a et une borne supérieure b —, on extrait un sous-ensemble de points coordonnés cohérents. Le passage de ce sous-ensemble tronqué d’abscisses et de son image fonctionnelle correspondante aux arguments de fill_between borne hermétiquement l’aire colorée à la région d’intérêt théorique.
L’écueil géométrique classique lors de cette opération réside dans la jonction aux frontières de troncature. Si l’échantillonnage ne coïncide pas exactement avec les valeurs scalaires a et b, une distorsion marginale du polygone peut apparaître, matérialisée par un décalage vertical oblique au lieu d’une démarcation strictement orthogonale à l’axe des abscisses. Pour résoudre cette imperfection dans les contextes de haute précision métrologique, il convient d’insérer artificiellement les valeurs limites exactes au sein du vecteur d’abscisses sous-échantillonné et de recalculer leurs ordonnées exactes avant de procéder à la génération polygonale.
3.3 Ajustement de la ligne de base de référence (y2 non nul)
Associer de manière immuable le remplissage d’une aire à l’axe neutre y=0 constitue un biais conceptuel limitant. Dans de nombreux protocoles expérimentaux, les signaux physiques fluctuent autour d’un état d’équilibre dynamique stationnaire non nul, d’une ligne de flottaison empirique ou d’une moyenne de bruit de fond instrumentale. L’ancrage rigide sur l’origine absolue fausse la perception des déviations en forçant le regard à intégrer une surface massive et non pertinente située entre l’axe zéro et la ligne basale réelle.
L’ajustement de la baseline s’effectue avec une remarquable simplicité conceptuelle en assignant à l’argument y2 la valeur scalaire ou vectorielle de référence choisie. Dès lors que y2 est configuré pour correspondre à cette valeur basale, la primitive géométrique projette l’ombre polygonale exclusivement entre le signal oscillant et cette ligne d’état stable. L’aire résultante met immédiatement en exergue l’amplitude et la durée des excursions positives ou négatives par rapport au niveau d’équilibre.
Cette approche s’avère fondamentale en électrophysiologie lors de l’étude des potentiels d’action cardiaque ou neuronale, où le potentiel de repos membranaire se situe classiquement autour de moins soixante-dix millivolts. Elle est tout aussi prépondérante en climatologie pour illustrer les anomalies thermiques annuelles par rapport à la moyenne séculaire de référence : l’élévation des températures se lit alors comme une dilatation volumique dressée au-dessus de la ligne basale historique, conférant à la visualisation une force probante instantanée.
4. Remplissage différentiel entre deux courbes arbitraires
La comparaison dynamique de deux systèmes évoluant simultanément constitue l’un des piliers de l’analyse empirique contemporaine. Lorsque deux séries de données continues se déploient sur un axe commun, la quantification visuelle de leur écart instantané transcende la simple observation de leurs profils respectifs : elle exige la matérialisation physique de l’interstice spatial qui les sépare.
4.1 Modélisation de deux signaux continus simultanés
Considérons deux trajectoires fonctionnelles distinctes, notées formellement y1(x) et y2(x), définies sur un domaine spatial ou temporel partagé. Ces trajectoires peuvent incarner la cinétique comparée de deux réactions chimiques concurrentes, l’évolution temporelle des dépenses budgétaires face aux recettes fiscales, ou encore les réponses fréquentielles de deux architectures de filtres électroniques. Pour rendre compte de l’écartement global de ces métriques longitudinales, la primitive fill_between est invoquée en lui assignant conjointement les vecteurs y1 et y2.
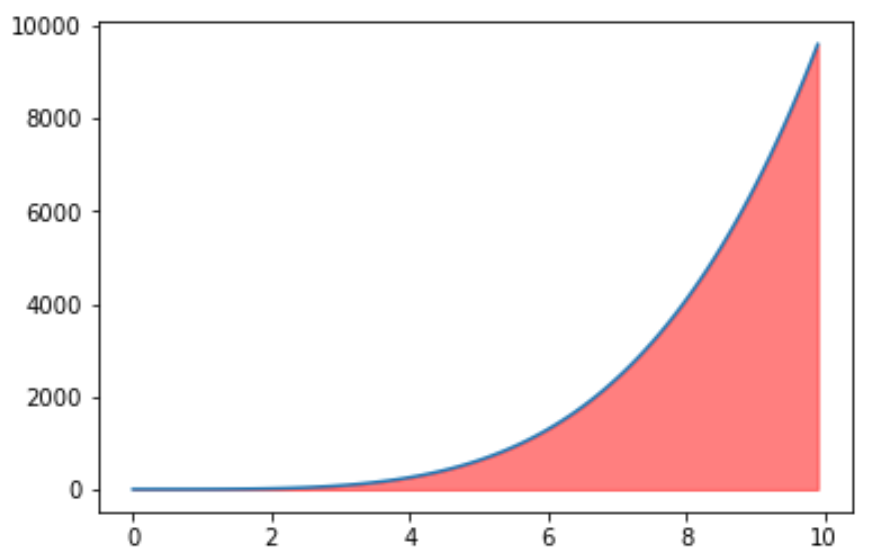
Le moteur de Matplotlib procède alors à un appariement point à point des ordonnées correspondantes pour chaque abscisse discrète. Le polygone résultant tisse une enveloppe continue reliant le premier vecteur fonctionnel au second. Dans un premier temps, si l’une des trajectoires domine rigoureusement l’autre sur l’intégralité du domaine sans jamais la croiser, la surface ombrée conserve une cohérence topologique parfaite : elle dépeint l’intégrale de la différence absolue des fonctions sans la moindre ambiguïté structurelle.
Cette coloration continue de l’interstice transforme un écart abstrait en une grandeur surfacique géométriquement quantifiable. Le volume de couleur injecté entre les signaux agit sur le cortex visuel comme un intégrateur analogique, permettant à l’observateur d’évaluer intuitivement la masse cumulée du différentiel sans avoir à effectuer mentalement la soustraction des ordonnées point par point le long de l’axe de progression.
4.2 Gestion des intersections multiples entre séries
La situation géométrique se complexifie drastiquement dès lors que les deux trajectoires fonctionnelles cessent de respecter une relation d’ordre monotone stricte et se croisent en un ou plusieurs points du domaine. En ces points singuliers, communément désignés sous le terme de nœuds topologiques, la quantité y1(x) – y2(x) change de signe algébrique, passant continûment d’une valeur positive à une valeur négative, ou inversement.
Si l’on applique l’instruction fill_between(x, y1, y2) de manière naïve sans spécification conditionnelle sur de tels signaux entrelacés, Matplotlib relie aveuglément les points homologues en générant une collection polygonale continue qui se contorsionne au niveau des nœuds de croisement. À ces points exacts de passage à zéro de la différence, la largeur du polygone s’annule, formant une configuration en sablier ou en papillon. Bien que mathématiquement exacte du point de vue de la fermeture des coordonnées discrètes, cette approche présente un défaut conceptuel majeur : elle applique la même identité chromatique indistinctement aux phases de dominance de la première courbe et aux phases de dominance de la seconde.
Ce traitement unicolore et indifférencié crée une confusion cognitive profonde chez le lecteur, incapable de discerner en un coup d’œil quel système prend le pas sur l’autre dans les différents segments du domaine d’observation. De surcroît, à l’approche immédiate du nœud de croisement, la discrétisation vectorielle brute peut engendrer des micro-artefacts d’auto-intersection polygonale lors de la rastérisation sous certains backends graphiques, dégradant la netteté vectorielle de l’intersection.
4.3 Différenciation chromatique des trajectoires et de leur zone commune
Pour résoudre le déficit d’intelligibilité inhérent aux intersections multiples, la pratique exemplaire de conception graphique scientifique impose une séparation rigoureuse des identités visuelles. Les lignes maîtresses représentant les fonctions y1 et y2 doivent recevoir des signatures stylistiques contrastées mais harmonieuses, combinant des teintes nettement discriminables et des épaisseurs de trait suffisantes pour émerger avec autorité au-dessus de la surface ombrée commune.
L’harmonisation de la palette chromatique doit impérativement s’inscrire dans le respect des directives internationales d’accessibilité visuelle, telles que les normes WCAG (Web Content Accessibility Guidelines) et les principes de conception adaptés aux déficiences de la vision des couleurs (daltonisme). L’association ancestrale et souvent irréfléchie du rouge et du vert pour désigner des états opposés doit être proscrite au profit de couples perceptuellement équilibrés et universellement lisibles, tels que le bleu cobalt et l’orange vermillon, ou la palette optimisée Viridis.
Illustrons cette nécessité par un cas concret d’évaluation biomédicale : la comparaison longitudinale d’un biomarqueur entre un groupe soumis à un principe actif expérimental et un groupe sous placebo. La trajectoire du groupe témoin sera tracée sous la forme d’une courbe continue grise anthracite, tandis que celle du groupe expérimental arborera un bleu profond. L’espace d’écartement bénéficiera d’une teinte d’accompagnement lumineuse, conférant à la divergence temporelle entre les cohortes une présence visuelle immédiate, immédiatement saisissable par les membres d’un comité scientifique ou de lecture médicale.
5. Remplissage conditionnel à l’aide de l’argument where
Pour transcender les limitations du remplissage indifférencié lors du croisement de séries, Matplotlib met à disposition des concepteurs un mécanisme algorithmique d’une élégance absolue : le paramètre conditionnel where. Ce paramètre autorise un partitionnement dynamique, logique et spatial de l’espace de dessin en fonction d’expressions booléennes vectorisées arbitrairement complexes.
5.1 Logique booléenne appliquée aux tableaux NumPy
L’argument where attend intrinsèquement une structure séquentielle de valeurs booléennes (vrai ou faux) de dimension strictement identique à celle du vecteur de projection x. La syntaxe expressive de NumPy permet d’engendrer ces masques logiques de manière déclarative et instantanée au moyen d’opérateurs relationnels appliqués directement aux tableaux de données. Par exemple, l’expression y1 > y2 produit instantanément un tableau d’indicateurs binaires identifiant chaque abscisse où le premier signal surpasse strictement le second.
La puissance du dispositif se déploie pleinement lors de la manipulation de critères décisionnels multifactoriels. Grâce aux opérateurs logiques bit à bit de Python appliqués aux tableaux NumPy — l’opérateur esperluette (&) pour la conjonction logique ET, la barre verticale (|) pour la disjonction inclusive OU, et le tilde (~) pour la négation unaire NON —, il devient trivial d’isoler des niches topologiques ultra-spécifiques. On peut ainsi instruire la fonction de ne remplir la surface que si le signal dépasse une valeur seuil critique tout en restant confiné sous une frontière de sécurité supérieure.
Chaque appel successif à la primitive fill_between peut être doté de son propre argument where indépendant, ouvrant la voie à une segmentation analytique totale du plan cartésien. Le canevas cesse d’être une simple toile passive pour devenir le réceptacle d’une segmentation programmatique de l’espace des données.
5.2 Le paramètre critique interpolate=True
L’utilisation de masques conditionnels vectorisés soulève un défi d’ordre géométrique fondamental : le phénomène de quantification spatiale discrète. Considérons deux courbes qui se croisent en une abscisse x* située rigoureusement entre deux points consécutifs d’évaluation du tableau x. Le tableau booléen assignera la valeur VRAI au point discret précédant l’intersection et la valeur FAUX au point discret suivant immédiatement celle-ci.
Si le paramètre booléen interpolate demeure positionné sur sa valeur par défaut False, l’algorithme de Matplotlib interrompt brutalement le polygone de remplissage à l’abscisse du dernier point discret validé par le masque. Il en résulte une discontinuité visuelle aberrante : la zone colorée s’arrête net avant d’atteindre le point physique réel de croisement des courbes, laissant un espace vide triangulaire tout à fait disgracieux et mathématiquement infondé. Ce défaut d’interpolation confère aux graphiques un aspect crénelé amateur indigne des standards d’édition scientifique de haut rang.
L’activation explicite de l’argument interpolate=True ordonne au moteur de Matplotlib d’exécuter un calcul d’interpolation linéaire barycentrique au voisinage immédiat des transitions booléennes. L’algorithme calcule les coordonnées exactes du point d’intersection géométrique entre les segments linéaires reliant les points d’échantillonnage de y1 et y2, et prolonge automatiquement le polygone de remplissage jusqu’à ce point singulier nodal. L’application de ce paramètre résout instantanément toute lacune spatiale et garantit que les surfaces complémentaires se rejoignent avec une perfection chirurgicale au point de bascule mathématique.
5.3 Double ombrage asymétrique pour les gains et déficits
L’alliance conjointe de l’argument conditionnel where et du commutateur d’interpolation linéaire permet de déployer l’un des schémas graphiques les plus expressifs de l’économétrie et des sciences du comportement : le double ombrage asymétrique. Ce paradigme consiste à colorer distinctement les régimes de sur-performance et les régimes de sous-performance au sein d’une seule et même figure intégrée.
L’implémentation repose sur l’exécution consécutive de deux blocs d’instructions fill_between partageant rigoureusement les mêmes vecteurs de coordonnées x, y1 et y2, mais régis par des conditions logiques strictement symétriques. Le premier bloc appliquera la condition y1 >= y2 couplée à une teinte évoquant traditionnellement la croissance, le surplus ou l’activation (comme un vert émeraude ou un bleu saphir feutré), tandis que le second bloc exploitera la condition inverse y1 <= y2 associée à une teinte symbolisant la contraction, le déficit ou l’inhibition (tel qu’un vermillon assourdi ou un pourpre texturé).
Ce patron de conception graphique trouve une application féconde dans l’analyse des signaux physiologiques différentiels, comme les potentiels évoqués en neurosciences cognitives. Lorsque l’amplitude de l’onde cérébrale enregistrée sous une condition expérimentale d’attention sélective outrepasse la condition de repos passif, la surface s’illumine d’un halo positif ; dès que la courbe plonge sous le témoin lors de la phase de réfraction neuronale, l’inversion chromatique matérialise instantanément l’inhibition synaptique sans qu’aucune gymnastique intellectuelle ne soit requise de la part du chercheur évaluateur.
6. Remplissage vertical le long de l’axe des ordonnées avec plt.fill_betweenx()
Si la projection orthogonale descendante le long de l’axe des abscisses répond à la majorité écrasante des besoins en visualisation, elle s’avère conceptuellement inadaptée lorsque la variable indépendante régissant le système physique est portée par l’axe des ordonnées. Dans ces configurations spécifiques, le recours à la primitive sœur fill_betweenx s’impose de manière impérative.
6.1 Translation conceptuelle du balayage : de l’axe X vers l’axe Y
La fonction fill_betweenx opère une rotation mentale de quatre-vingt-dix degrés de la logique opératoire de tracé. Dans ce cadre cartésien inversé, le vecteur régulier et invariant n’est plus l’abscisse x, mais l’ordonnée y. Le balayage spatial s’exécute de manière ascendante le long du bord vertical du repère, et les deux fonctions d’enveloppe délimitant la surface, notées symboliquement x1 et x2, décrivent les variations horizontales des coordonnées en réponse aux variations d’ordonnée.
Ce changement de paradigme trouve son élection naturelle dans plusieurs disciplines hautement spécialisées. C’est notamment le cas en océanographie physique et en géophysique des forages profonds, où l’ordonnée représente traditionnellement la profondeur sous le niveau de la mer ou sous la surface du sol, croissant conventionnellement vers le bas de la figure. Les signaux mesurés — qu’il s’agisse de gradients thermiques, de salinité de la colonne d’eau ou de profils de conductivité électrique de la roche sédimentaire — constituent des fonctions univoques de la profondeur. Tenter d’utiliser fill_between dans ce contexte nécessiterait une inversion artificielle des axes préjudiciable à la clarté algorithmique du code.
La structure géométrique de l’objet généré demeure un PolyCollection rigoureusement identique dans ses propriétés internes à celui produit par un balayage d’abscisses, mais l’ordonnancement séquentiel des couples de coordonnées spatiales au sein de la boucle polygonale fermée est permuté pour respecter l’orientation des arêtes le long de l’axe vertical.
6.2 Application du paramètre where dans le repère vertical
À l’instar de son pendant horizontal, fill_betweenx intègre nativement le paramètre de filtrage logique where. Toutefois, une rigueur absolue doit être observée lors de l’instanciation du masque booléen. Le vecteur d’évaluation servant de socle à la condition doit impérativement s’aligner sur la dimension spatiale du vecteur d’ordonnées y, et non sur une dimension d’abscisse.
L’évaluation relationnelle vectorielle porte donc typiquement sur la comparaison des bornes horizontales x1 et x2 pour chaque tranche altimétrique ou bathymétrique donnée, sous la forme d’expressions telles que x1 > x2 ou x1 > seuil_critique. L’activation de la compensation par interpolation (interpolate=True) conserve ici toute son acuité : elle assure que la convergence des frontières horizontales se raccorde de façon continue au micron près au niveau de la tranche d’ordonnée exacte où la bascule logique intervient.
Cette méthodologie ouvre des perspectives particulièrement élégantes pour la construction de nuages de points bivariés accompagnés de profils marginaux de densité ou de bandes de calibrage instrumentales. On peut ainsi délimiter avec une pureté visuelle absolue les zones d’hystérésis magnétique ou thermique où le cheminement ascendant d’une propriété physique diverge du cheminement descendant le long de l’axe vertical de commande d’excitation.
6.3 Tracé de bandes de tolérance verticales
Dans de multiples paradigmes chronométriques, tels que l’analyse des temps de réaction en psychologie expérimentale ou le dépouillement des signaux biomécaniques de la marche, certaines fenêtres temporelles critiques sont positionnées de manière invariante en ordonnée tandis que l’amplitude cinétique est projetée en abscisse. Bien que moins classique que la projection temporelle en abscisse, cette disposition permet d’empiler verticalement des essais cliniques répliqués.
L’utilisation conjointe de fill_betweenx et des primitives de guidage axé comme plt.axhline() permet de bâtir des bandes d’exclusion ou de tolérance spatiale d’une netteté exemplaire. On définit un intervalle continu d’ordonnées [y_min, y_max], et l’on déploie une zone ombrée transversale qui balaie tout ou partie de la largeur horizontale du repère. Cette surface agit comme un stabilisateur perceptif, isolant instantanément l’époque temporelle où le phénomène physiologique est réputé statistiquement valide.
Il est primordial de s’assurer d’un alignement géométrique parfait des bornes x1 et x2 avec les limites effectives de l’axe visualisé définies par plt.xlim(). Tout débordement involontaire au-delà des graduations cartésiennes peut contraindre Matplotlib à recalculer dynamiquement la boîte englobante (bounding box) de la figure, entraînant un écrasement visuel inattendu des autres séries tracées sur le même système d’axes.
7. Esthétique avancée : palettes chromatiques, textures et contours
L’art de la visualisation scientifique ne s’arrête pas à la simple transcription topologique exacte des grandeurs numériques ; il s’incarne dans la mise en scène graphique rigoureuse de ces formes. La lisibilité d’une figure sous différentes conditions de reproduction imprimée ou numérique dépend directement du contrôle subtil des textures, du rendu des bordures et de la continuité spectrale des teintes.
7.1 Application de motifs hachurés (argument hatch)
L’utilisation exclusive de couches de couleur semi-transparentes montre ses limites intrinsèques lorsque la figure scientifique est destinée à être reproduite au sein d’actes de colloques imprimés en noir et blanc, ou lorsqu’elle doit satisfaire aux exigences drastiques d’organismes éditoriaux prescrivant l’emploi exclusif d’encres monochromes. Dans ces conditions sévères, les nuances de gris semi-transparentes perdent tout pouvoir séparateur et tendent à fusionner en une masse sombre indistincte. C’est ici qu’intervient l’arsenal des textures hachurées, piloté par l’argument hatch.
Matplotlib met à la disposition de l’expérimentateur un ensemble diversifié de motifs de hachures géométriques, encodés sous la forme de caractères textuels spécifiques : la barre oblique classique (‘/’), la barre oblique inversée ( »), la ligne verticale (‘|’), le tiret horizontal (‘-‘), le croisillon symétrique (‘+’), la croix de saint André (‘x’), ainsi qu’une variété de semis de points, d’étoiles ou de petits cercles discrets (‘o’, ‘O’, ‘.’, ‘*’). Ces motifs sont dessinés sous forme vectorielle pure par-dessus la surface du polygone délimité.
Une caractéristique stylistique fondamentale réside dans la modulation de la densité spatiale du motif textural. Cette densité s’ajuste par la répétition séquentielle du caractère typographique assigné à la propriété. Par exemple, la chaîne ‘//’ produira un réseau de hachures obliques deux fois plus dense que la simple barre ‘/’, tandis que la combinaison complexe ‘x/o’ superposera un maillage de croix, de rayures et de ponctuations circulaires. Cette richesse combinatoire autorise la différenciation sans ambiguïté d’une douzaine de strates fonctionnelles sur un support strictement monochrome, garantissant ainsi l’intégrité intégrale du message scientifique lors des impressions industrielles dégradées.
7.2 Personnalisation des contours de bordure de l’aire remplie
Par défaut, l’appel à la fonction fill_between génère un polygone dont la couleur du corps surfacique (désignée par la propriété facecolor) est identique à celle de la bordure périphérique (nommée edgecolor). Cette continuité chromatique totale tend à flouter la perception des limites extrêmes de l’enveloppe, particulièrement lorsque des coefficients d’opacité réduits sont mobilisés. L’émancipation de ces deux composantes géométriques s’avère indispensable pour conférer au tracé une finition de standard éditorial supérieur.
En dissociant formellement l’assignation de facecolor et de edgecolor, le concepteur gagne un degré de liberté décisif. On peut, par illustration, opter pour un corps de polygone teinté d’un bleu céruléen très éthéré (alpha=0.15) et l’encadrer d’une bordure fine et soutenue de couleur bleu marine profond. Cette architecture visuelle délimite sans équivoque la boîte géométrique contenant l’incertitude tout en maintenant la neutralité diaphane de la surface intérieure.
Cette personnalisation s’étend au contrôle strict de l’épaisseur du trait périphérique au moyen de l’argument linewidth (qui peut être réduit à zéro absolu pour supprimer tout liseré parasite lors de juxtapositions contiguës) ainsi qu’au réglage du style de ligne via linestyle. L’application d’un contour périphérique en tireté fin ou en pointillés microscopiques sur une surface translucide constitue une convention graphique universellement reconnue pour indiquer le caractère estimé, conjectural ou non déterministe d’une enveloppe de prédiction statistique.
7.3 Remplissages dégradés et transitions spectrales continues
Les primitives élémentaires fill_between et fill_betweenx partagent une limitation structurelle inhérente à leur nature d’objet PolyCollection classique : elles ne permettent pas d’assigner nativement un dégradé de couleur continu (gradient spectral) au sein de la masse polygonale unique. Un polygone se voit attribuer une couleur scalaire de remplissage uniforme sur l’ensemble de son étendue bidimensionnelle.
Pour contourner cette contrainte et matérialiser visuellement un gradient d’intensité thermique ou un champ de densité probabiliste continue entre deux courbes, il convient de recourir à des stratagèmes computationnels plus subtils. La technique de référence consiste à discrétiser l’espace horizontal en une infinité de micro-segments trapézoïdaux verticaux accolés les uns aux autres. À chacun de ces micro-segments est attribuée une couleur ponctuelle échantillonnée le long d’une table de couleurs continue (colormap) perceptuellement uniforme, telle que Viridis, Plasma ou Cividis.
Une alternative encore plus performante sur le plan du rendu consiste à générer une image matricielle sous-jacente au moyen de la méthode plt.imshow(), étalonnée précisément sur le domaine spatial d’intérêt, puis à appliquer un masque de découpe géométrique vectoriel (clipping path) issu de la géométrie générée par fill_between. Cette hybridation vectorielle-matricielle permet d’obtenir des transitions spectrales somptueuses, où l’opacité et la chromaticité s’évanouissent de manière parfaitement fluide au fur et à mesure que l’on s’écarte de la ligne de régression centrale, sans jamais trahir la précision vectorielle chirurgicale des contours extérieurs.
8. Visualisation de l’incertitude statistique et des intervalles de confiance
L’estimation rigoureuse et la communication transparente de l’incertitude forment la pierre angulaire de la méthode scientifique. Une mesure expérimentale privée de son intervalle d’erreur n’a pas de valeur épistémologique. Au sein de ce paradigme, la mise en œuvre de bandes d’incertitude surfaciques autour des estimateurs de tendance constitue la manifestation visuelle la plus robuste et la plus immédiatement quantifiable de la solidité des données.
8.1 Modélisation de l’erreur type et des écarts types autour d’une moyenne
La représentation conjointe de la tendance centrale d’un processus et de sa dispersion stochastique mobilise une chaîne de calcul vectoriel bien rodée. À partir d’un ensemble de trajectoires expérimentales répliquées, on procède à l’extraction de la moyenne d’échantillon ponctuelle pour chaque instant du protocole, ainsi qu’au calcul de l’écart type empirique correspondant ou de l’erreur type de la moyenne (SEM, pour Standard Error of the Mean).
Le protocole de traçage commence par la projection de la ligne maîtresse figurant la moyenne centrale à l’aide de plt.plot(). Immédiatement après, l’appel à fill_between est orchestré en définissant la borne supérieure y1 comme la somme vectorielle de la moyenne et d’un multiple unitaire de l’écart type, et la borne inférieure y2 comme la soustraction symétrique de cette même quantité de dispersion. Ce procédé crée une bande de fluctuation enveloppante qui suit fidèlement chaque oscillation locale du signal.
Pour enrichir la granularité de l’interprétation statistique, il est particulièrement élégant de superposer de manière concentrique plusieurs strates de déviations standardisées, selon le principe des bandes de variabilité emboîtées (1-sigma, 2-sigma et 3-sigma). En attribuant un coefficient d’opacité dégressif à mesure que l’on s’éloigne du cœur de la distribution (par exemple alpha=0.4 pour la zone centrale 1-sigma, alpha=0.2 pour l’enveloppe 2-sigma, et alpha=0.1 pour les frontières extrêmes 3-sigma), on reconstitue visuellement la morphologie d’une cloche gaussienne projetée de façon longitudinale, traduisant graphiquement la chute rapide de la densité de probabilité aux marges de l’échantillon.
8.2 Représentation empirique des intervalles de confiance par bootstrap
Dans la recherche contemporaine, la distribution sous-jacente des erreurs s’écarte fréquemment de la normalité paramétrique idéale, manifestant de fortes asymétries, des queues épaisses ou des bruits multimodaux non linéaires. Dans ces conditions, l’usage naïf de l’écart type symétrique introduit une modélisation inexacte de la réalité physique. La méthode d’inférence non paramétrique par rééchantillonnage de Monte-Carlo, universellement connue sous le nom de bootstrap, fournit une parade mathématique d’une remarquable puissance.
L’application du bootstrap algorithmique génère, pour chaque abscisse d’évaluation, une distribution empirique de milliers d’estimations virtuelles de la moyenne. L’extraction des centiles empiriques appropriés — classiquement le centile 2.5% pour la borne inférieure et le centile 97.5% pour la borne supérieure — permet de déterminer un intervalle de confiance à 95% affranchi de tout postulat de symétrie. La trajectoire de la limite supérieure peut ainsi s’évaser amplement dans les régions de forte instabilité tandis que la limite inférieure demeure comprimée près de la médiane.
Le passage de ces séries de centiles non paramétriques asymétriques aux arguments y1 et y2 de fill_between engendre une enveloppe de confiance qui reflète scrupuleusement la vérité statistique des données expérimentales. L’adjonction d’une échelle d’opacité graduée permet de matérialiser la densité de probabilité a posteriori bayésienne, offrant ainsi une transparence méthodologique totale lors de la présentation d’analyses cliniques ou épidémiologiques soumises à un haut degré de variabilité biologique interindividuelle.
8.3 Comparaison de cohortes expérimentales multiples avec incertitude partagée
L’un des défis les plus redoutables de la sémiologie graphique intervient lorsqu’il s’agit de faire cohabiter au sein d’un même repère cartésien les trajectoires moyennes et les bandes de confiance de trois ou quatre cohortes expérimentales concurrentes. Dans ce scénario critique, le risque de saturation perceptive et de confusion visuelle atteint son paroxysme : les surfaces ombrées se chevauchent de manière anarchique, formant des zones d’interférence optique où les teintes se mélangent en nuances boueuses indéchiffrables.
Pour maintenir une discernabilité absolue des cohortes en conflit, une discipline stylistique inflexible s’impose. En premier lieu, le coefficient d’opacité alpha de chaque couche de remplissage doit être drastiquement restreint, généralement entre 0.10 et 0.18, de façon à ce que la triple superposition de surfaces ne masque en aucun cas les axes et n’assombrisse pas excessivement l’espace de lecture. En second lieu, les teintes affectées aux cohortes doivent occuper des positions spectrales diamétralement opposées sur la roue chromatique, excluant tout rapprochement entre tons voisins (comme le bleu et le turquoise).
Lorsque la densité de croisement devient trop extrême, il convient de substituer à l’opacité surfacique continue l’usage de hachures ultra-fines d’orientations orthogonales pour chaque groupe (par exemple, rayures à 45 degrés pour la cohorte témoin, rayures à 135 degrés pour la cohorte traitée), ou d’abandonner le remplissage intégral au profit de lignes limites fines dessinées en tiretés d’épaisseurs distinctes. Cette rigueur garantit que les zones d’indécision statistique — où les bandes de confiance des différents groupes se superposent, attestant d’une absence d’écart statistiquement significatif à ce stade de l’expérience — demeurent immédiatement identifiables par le regard critique de l’analyste.
9. Application aux données temporelles et séries chronologiques complexes
Le traitement des données longitudinales indexées par le temps calendaire introduit des problématiques spécifiques liées à la non-linéarité des échelles de dates, à la présence de ruptures calendaires et à la discontinuité intrinsèque des systèmes d’acquisition automatisés. La manipulation adéquate de ces structures de données au sein du moteur de Matplotlib conditionne la validité des visualisations de séries chronologiques.
9.1 Gestion des index temporels datetime avec Pandas et Matplotlib
Dans l’écosystème Python moderne, l’analyse temporelle transite quasi exclusivement par les objets structurés de la bibliothèque Pandas, notamment les séries et DataFrames indexés par des instances de DatetimeIndex. Ces objets encapsulent une temporalité calendaire réelle, tenant compte des années bissextiles, des décalages horaires et des conventions de microsecondes. Toutefois, le moteur sous-jacent de Matplotlib requiert formellement, pour exécuter ses algorithmes d’interpolation polygonale, des valeurs d’abscisses scalaires réelles homogènes.
Heureusement, Matplotlib intègre un convertisseur d’unités chronologiques automatique particulièrement performant au sein de son sous-module matplotlib.dates. Lorsque des objets de type datetime natifs ou des Timestamp de Pandas sont transmis directement à l’argument x de fill_between, le moteur les transmute en nombres réels à virgule flottante représentant le nombre de jours écoulés depuis une époque historique de référence (classiquement le premier janvier de l’an 0001). Cette conversion transparente permet d’étaler des bandes de remplissage sur des horizons temporels pluriannuels sans risquer la moindre désynchronisation géométrique avec les tracés ponctuels préexistants.
Une vigilance particulière doit néanmoins être accordée au traitement des discontinuités de calendrier régulières, telles que la fermeture des marchés boursiers durant les fins de semaine ou les périodes d’arrêt technique d’un télescope d’observation. Si l’on trace une surface continue sur un index calendaire strict sans neutraliser ces périodes creuses, Matplotlib interpolera géométriquement les surfaces à travers les samedis et dimanches, matérialisant des tendances linéaires fantômes qui n’ont aucune existence opérationnelle dans les faits enregistrés.
9.2 Mise en évidence visuelle de phases temporelles ou d’événements discrets
L’exploration des séries temporelles ne se borne pas à encadrer une trajectoire continue ; elle nécessite fréquemment d’isoler des époques contextuelles spécifiques afin d’en évaluer l’impact sur le comportement d’un système. Ces phases peuvent correspondre à la durée d’application d’un stimulus électrophysiologique, à des fenêtres de récession macroéconomique certifiées, ou à des phases de confinement sanitaire lors d’une vague pandémique.
Pour ombrer intégralement la hauteur d’une figure sur une tranche temporelle discrète s’étendant d’une date de début t_debut à une date de fin t_fin, on combine astucieusement les primitives. Si l’on souhaite saturer la totalité de l’espace vertical sans se préoccuper des ordonnées de données, la fonction dédiée plt.axvspan() s’avère extrêmement expéditive. Néanmoins, lorsque la zone d’ombrage contextuelle doit être modulée en hauteur pour ne couvrir qu’un sous-système de mesures ou pour s’interrompre au contact d’un seuil d’alerte, la fonction fill_between reprend ses droits absolus.
L’impact pédagogique de ces zones d’ombrage événementielles est démultiplié lorsqu’elles sont associées à des annotations textuelles ciblées déployées via la méthode plt.annotate(). L’automatisation du marquage des périodes d’intervention par l’intermédiaire de métadonnées expérimentales stockées dans un journal de laboratoire informatisé permet d’injecter automatiquement sur la figure finale les cartouches explicatifs d’un protocole, matérialisant visuellement les corrélations causales entre le début d’une phase de traitement et la rupture de pente du signal observé.
9.3 Gestion des données manquantes (NaN) dans les séries temporelles
Dans tout dispositif d’acquisition empirique déployé en conditions réelles — qu’il s’agisse de réseaux de capteurs environnementaux connectés ou de protocoles de télémétrie satellitaire —, la perte ponctuelle de paquets de données et les pannes temporaires d’échantillonnage constituent une fatalité inéluctable. Ces lacunes se traduisent numériquement par la présence d’éléments non définis (NaN, pour Not a Number) au sein des tableaux vectoriels de mesures.
Le comportement par défaut de la primitive fill_between face à des valeurs NaN introduites dans les vecteurs d’ordonnées y1 ou y2 est d’une rigueur absolue : l’algorithme interrompt immédiatement le polygone à l’approche de la valeur indéfinie et ne le reprend qu’au premier point suivant doté de coordonnées réelles complètes. Cette interruption se traduit sur le canevas par une brèche topologique nette dans la surface de remplissage, matérialisant sans équivoque la perte de signal auprès du lecteur attentif.
Il est impératif d’éviter l’écueil consistant à procéder à une interpolation aveugle ou à une imputation linéaire préalable des valeurs manquantes sans avertir graphiquement l’observateur. Bâtir une surface d’incertitude continue sur des segments où aucune donnée n’a été empiriquement collectée relève de la faute méthodologique grave. Si une stratégie d’imputation doit être adoptée à des fins de calcul de modèle, la zone interpolée doit obligatoirement arborer une texture différenciée — par exemple un hachurage croisé très diaphane — pour avertir le lecteur de la nature purement synthétique des valeurs qui y sont dépeintes.
10. Superposition multicouche et contrôle précis de la hiérarchie zorder
Un repère cartésien bidimensionnel dans Matplotlib dissimule sous sa planéité apparente une troisième dimension déterminante : la profondeur stérique de composition graphique. La disposition ordonnée des différents éléments picturaux sur l’axe virtuel perpendiculaire à l’écran régit l’intelligibilité globale de la figure et prévient les télescopages visuels désastreux.
10.1 Compréhension de la pile de rendu graphique (stacking order)
Lorsque le moteur graphique de Matplotlib rastérise les différentes couches d’une figure sur le tampon de pixels matriciel ou dans le flux d’instructions vectorielles, il procède selon un algorithme classique de peinture (painter’s algorithm). Les éléments invoqués en premier sont dessinés sur le fond du canevas, et chaque instruction ultérieure dépose une nouvelle couche de peinture numérique venant recouvrir partiellement ou totalement les éléments tracés précédemment.
Pour harmoniser le rendu sans contraindre l’utilisateur à une rigueur maniaque dans l’ordre séquentiel de ses lignes de code, Matplotlib implémente une hiérarchie par défaut de priorité de rendu régie par la propriété scalaire zorder. Par convention interne, le fond du canevas reçoit la valeur la plus basse, suivi immédiatement par les lignes de la grille cartésienne (zorder=0.5), puis par les objets polygonaux de type PolyCollection générés par les fonctions de remplissage (qui héritent classiquement d’un zorder=1), tandis que les lignes continues tracées par plot() reçoivent la valeur zorder=2, et les marqueurs discrets de nuages de points se hissent à zorder=3.
Cependant, des modifications contextuelles ou l’appel à des modules d’extension tiers peuvent dérégler cet équilibre par défaut. Il n’est pas rare de voir une surface issue d’un appel à fill_between se positionner inopportunément au-dessus d’une ligne directrice maîtresse ou d’un faisceau de graduations d’axes, détruisant instantanément l’autorité visuelle de la figure en reléguant le signal principal à l’état de fantôme sous-jacent.
10.2 Organisation hiérarchique idéale pour les figures scientifiques
L’obtention d’une figure scientifique à la lisibilité exemplaire requiert un contrôle explicite, systématique et rigoureux de l’attribut zorder pour chaque entité projetée sur le plan. Une architecture de stratification graphique optimale se déploie selon une distribution de profondeurs standardisée :
- Étage de référence (zorder = 1) : La grille cartésienne structurelle. Positionnée au niveau le plus profond, elle offre des repères kilométriques indispensables à la quantification mentale des grandeurs sans jamais segmenter la continuité des données.
- Étage des surfaces d’incertitude (zorder = 2) : Les polygones d’ombrage générés par fill_between et fill_betweenx. Situés immédiatement au-dessus de la grille, ils teintent l’espace sans masquer le réseau de coordonnées et s’effacent respectueusement sous les signaux déterministes.
- Étage des signaux continus et moyennes (zorder = 3) : Les courbes fonctionnelles maîtresses tracées à l’aide de plt.plot(). Leurs traits denses et nets doivent trancher sans la moindre occlusion au-dessus des nappes d’incertitude qui les accompagnent.
- Étage des événements discrets et mesures individuelles (zorder = 4) : Les marqueurs de dispersion empiriques (scatter) et les barres d’erreur ponctuelles. Ces éléments requièrent une isolation visuelle maximale pour préserver la détection des points aberrants ou singuliers.
- Étage supérieur des métadonnées (zorder = 5 et supérieur) : Les flèches d’annotation directionnelles, les boîtes de texte descriptives et le cadre de la légende officielle, qui ne doivent en aucun cas être interceptés ou brouillés par les composantes picturales inférieures.
L’application délibérée de cette grille de priorités garantit que chaque composant graphique remplit son office sémiotique à son niveau exact d’importance cognitive, délivrant une figure d’une limpidité visuelle instantanément appréciée par les comités de lecture les plus exigeants.
10.3 Intégration d’éléments de remplissage dans la légende officielle
Un défaut classique et pourtant récurrent des graphiques incorporant des surfaces ombrées réside dans l’oubli de leur déclaration explicite au sein de la légende générale du tracé. Trop souvent, la légende se borne à répertorier la ligne centrale continue, laissant le lecteur dans l’expectative quant à la signification métrologique exacte de l’enveloppe translucide qui l’entoure (s’agit-il d’un écart type, d’une erreur type de la moyenne, d’un intervalle de confiance à 95% ou des limites absolues min-max de l’échantillon ?).
La méthode la plus immédiate pour réconcilier l’objet de remplissage avec la légende consiste à lui adjoindre directement l’argument textuel label lors de l’appel initial à fill_between. L’objet PolyCollection généré s’enregistrera de façon autonome auprès du collecteur de légende de Matplotlib, produisant dans le cartouche final une vignette rectangulaire arborant rigoureusement la même texture, la même couleur de fond et le même degré d’opacité que la surface déployée sur les axes.
Toutefois, dans les agencements visuels complexes où une surface d’incertitude et sa courbe centrale moyenne forment une seule et même entité sémantique indissociable, la multiplication de lignes d’explication distinctes dans la légende encombre inutilement l’espace. Dans cette hypothèse hautement professionnelle, il est préférable de créer un mandataire d’artiste personnalisé (proxy artist) en exploitant la classe matplotlib.patches.Patch. On fabrique ainsi manuellement une entrée synthétique dans la légende combinant la ligne maîtresse et son halo d’incertitude sous un intitulé unique et univoque tel que « Moyenne ± 1 écart-type », épurant drastiquement le cartouche informatif.
11. Optimisation des performances computationnelles pour les jeux de données massifs
À l’ère des mégadonnées (Big Data) et des réseaux de capteurs haute fréquence capturant des flux continus à plusieurs kilohertz, les vecteurs de coordonnées ne se comptent plus en dizaines de points mais en millions d’enregistrements. Dans ces conditions extrêmes, l’usage candide des fonctions de tracé vectoriel peut saturer la mémoire vive de l’ordinateur hôte, figer le moteur de rendu et générer des fichiers graphiques d’une lourdeur rédhibitoire pour la diffusion scientifique.
11.1 Complexité algorithmique du tracé de polygones denses
Pour appréhender l’effondrement des performances lors du traitement de jeux de données massifs, il convient d’analyser la mécanique sous-jacente de la classe PolyCollection. Contrairement à une ligne simple dessinée par plt.plot(), qui se résume pour le rasterizer à une liste linéaire de segments, un polygone fermé généré par fill_between sur un vecteur de N éléments impose la création et la gestion topologique d’un anneau de 2N+1 sommets ordonnés pour sceller le contour géométrique.
Lorsque la cardinalité N franchit le seuil des centaines de milliers de points, la construction de cette arborescence de coordonnées requiert une allocation mémoire substantielle dans l’interpréteur Python. Mais le goulet d’étranglement le plus sévère survient lors de l’étape de rastérisation vectorielle ou de compilation du document final. Si l’on ordonne l’exportation de la figure vers un format vectoriel pur tel que le PDF, l’EPS ou le SVG, le moteur de Matplotlib tente de consigner scrupuleusement la totalité des millions de coordonnées polygonales au sein du fichier de sortie.
Le document ainsi produit peut facilement atteindre des tailles pharaoniques de plusieurs centaines de mégaoctets. Non seulement son ouverture provoquera le blocage quasi systématique des logiciels de lecture de documents PDF standard, mais son impression industrielle saturera la mémoire de travail des imprimantes professionnelles de photocomposition. Cette boulimie vectorielle constitue un contresens technique absolu, dans la mesure où la résolution spatiale intrinsèque des dispositifs de restitution physique (écrans rétina ou papier couché) est infiniment inférieure à la densité microscopique des sommets vectoriels ainsi codés.
11.2 Techniques de sous-échantillonnage et de décimation géométrique
La parade algorithmique fondamentale face à l’inflation des données réside dans l’application de techniques de décimation et de simplification géométrique préalablement à l’appel des fonctions graphiques. La méthode la plus intuitive consiste en un sous-échantillonnage par tranche régulière (slicing) utilisant les opérateurs de découpe vectorielle de NumPy (par exemple en ne conservant qu’un point tous les cinquante ou cent pas d’acquisition : x[::50]). Si cette approche présente l’avantage d’une exécution instantanée en complexité O(1), elle comporte le risque redoutable de masquer des pointes de résonance transitoires ou d’introduire des artefacts d’échantillonnage de type aliasing stochastique.
Une approche infiniment plus rigoureuse sur le plan métrologique consiste à mettre en œuvre des algorithmes de décimation géométrique conservatrice, au premier rang desquels figure le célèbre algorithme de Ramer-Douglas-Peucker (RDP) ou l’algorithme LTTB (Largest-Triangle-Three-Buckets) spécifiquement conçu pour les séries temporelles. Ces méthodes réduisent drastiquement le nombre de sommets d’une poly-ligne en ne préservant que les points d’inflexion critiques qui garantissent que la morphologie perceptuelle de la courbe et son enveloppe d’incertitude demeurent strictement fidèles à l’original dans la limite d’une tolérance d’erreur epsilon contrôlée.
Matplotlib incorpore d’ailleurs nativement un moteur interne de simplification polygonale, activable et paramétrable via les directives globales path.simplify et path.simplify_threshold au sein de plt.rcParams. Lorsqu’il est correctement calibré, ce moteur analyse les coordonnées à la volée lors de l’exportation et fusionne automatiquement les sommets consécutifs dont la séparation spatiale s’avère inférieure à la fraction d’un pixel d’affichage, éliminant ainsi les redondances invisibles sans nécessiter de prétraitement manuel de la part du chercheur.
11.3 Rastérisation sélective de la couche polygonale
Il existe une stratégie d’ingénierie logicielle d’une efficacité redoutable pour concilier l’infinie netteté typographique du format vectoriel et la légèreté de traitement des nuages de données massifs : la rastérisation sélective de sous-composants graphiques. Cette approche hybride permet de convertir une couche spécifique de la figure en un motif matriciel de pixels haute résolution tout en préservant la nature vectorielle intégrale de l’ossature globale du graphique.
Le déploiement de cette technique s’opère avec une simplicité déconcertante grâce à l’argument booléen rasterized=True, disponible directement au sein de la signature de la primitive fill_between :
En assignant rasterized=True à la surface d’incertitude dense tout en maintenant les options conventionnelles sur les autres appels de dessin, le moteur graphique effectue une scission lors de la compilation du fichier PDF ou EPS. L’enveloppe complexe d’un million de sommets est instantanément projetée et figée sous la forme d’un canevas matriciel optimisé à la résolution nominale spécifiée (par exemple 300 ou 600 DPI), tandis que les axes cartésiens, les graduations chiffrées, la grille, les annotations textuelles et les lignes maîtresses de régression demeurent encodés sous forme vectorielle purement géométrique.
Le fichier résultant voit son poids volumétrique s’effondrer de plusieurs centaines de mégaoctets à une poignée de kilooctets légers, garantissant une ouverture instantanée sur n’importe quelle plateforme numérique de consultation, une fluidité absolue lors du défilement des pages d’un article savant, et une netteté microscopique totale des éléments typographiques majeurs lors des agrandissements à l’échelle.
12. Résolution des anomalies récurrentes et bonnes pratiques de publication
Même le programmeur scientifique le plus chevronné se heurte régulièrement à des comportements graphiques inattendus, des distorsions polygonales inexplicables ou des imperfections de mise en page lors de l’utilisation intensive des primitives de remplissage. Cette section finale synthétise l’étiologie des pannes visuelles courantes, édicte les préceptes ergonomiques contemporains et propose une architecture logicielle standardisée pour les laboratoires.
12.1 Diagnostic et correction des artefacts topologiques courants
Le dysfonctionnement le plus fréquent et le plus spectaculaire observé lors de l’utilisation de fill_between se matérialise par l’apparition d’un maillage chaotique de facettes triangulaires sombres se superposant de manière anarchique sur l’ensemble de la figure, évoquant une toile d’araignée fracturée. L’origine de cette anomalie topologique réside quasi invariablement dans l’absence de tri monotone strict du vecteur d’abscisses x.
L’algorithme de fill_between présuppose axiomatiquement que le vecteur x progresse de manière ordonnée et strictement croissante le long du domaine de tracé. Si le tableau de coordonnées transmis contient des données désordonnées, issues par exemple d’une concaténation de fichiers mal purgée ou d’un mélange de sous-populations expérimentales, le moteur relie les sommets en effectuant des allers-retours spatiaux erratiques, cousant littéralement le polygone sur lui-même en une géométrie auto-intersectante désastreuse. La résolution de ce travers impose une phase de tri vectoriel préalable impérative au moyen de la fonction np.argsort() appliquée aux coordonnées de base.
Un autre écueil récurrent réside dans le débordement intempestif des surfaces au-delà des limites fixées manuellement pour les axes au moyen de plt.xlim() ou plt.ylim(). Par défaut, Matplotlib applique un masque de découpe strict (clipping) aux dimensions de la boîte englobante des axes cartésiens. Toutefois, si l’on manipule des projections d’axes non linéaires (logarithmiques, symétriques logarithmiques ou polaires) ou si le paramètre interne clip_on de la collection d’artistes est malencontreusement désactivé, les polygones s’épanchent à travers les marges de la figure, écrasant les graduations textuelles et débordant sur les titres adjacents. Le rétablissement forcé de la directive set_clip_on(True) sur l’objet PolyCollection restitue immédiatement l’étanchéité géométrique requise.
12.2 Bonnes pratiques ergonomiques et éthiques dans la présentation visuelle
La restitution visuelle des données scientifiques engage la responsabilité éthique du chercheur face à la communauté internationale et au grand public. L’un des pièges déontologiques majeurs réside dans la dramatisation outrancière ou l’atténuation manipulatoire de la variance statistique au moyen d’artifices de mise en page trompeurs.
L’emploi de couleurs hautement saturées et opaques pour ombrer des zones d’erreur tend à dramatiser inconsciemment l’incertitude auprès de l’observateur, transformant une fluctuation expérimentale banale en un signal de danger visuel alarmant. À l’inverse, l’effacement de l’intervalle d’incertitude derrière un coefficient d’opacité homéopathique (alpha inférieur à 0.05) dissimule la fragilité des preuves sous-jacentes pour donner une fausse impression de certitude déterministe absolue à un modèle purement conjectural. La neutralité scientifique impose l’emploi d’opacités modérées, équilibrées et constantes à travers l’ensemble des figures comparées au sein d’un même article.
De même, le respect scrupuleux des ratios d’aspect géométriques du cadre cartésien prévient toute distorsion de la perception des pentes et des taux de variation. L’écrasement délibéré de l’axe des ordonnées pour aplatir une zone de dispersion ou, au contraire, son étirement démesuré pour amplifier visuellement une divergence marginale entre deux traitements constitue un biais cognitif inacceptable. Enfin, la cohérence stylistique globale du manuscrit impose d’adopter une police vectorielle unique, un calibrage uniforme des épaisseurs de contours et une palette chromatique unifiée, évitant que chaque figure ne paraisse issue d’un laboratoire différent.
12.3 Standardisation d’une fonction réutilisable pour protocoles de laboratoire
Afin de pérenniser les investissements méthodologiques développés tout au long de ce guide et de garantir une reproductibilité industrielle au sein d’une équipe de recherche, il est vivement conseillé d’encapsuler la séquence d’instructions de traçage au sein d’une fonction Python modulaire, robuste et universellement documentée.
Cette fonction recevra idéalement en arguments d’entrée le conteneur d’axes cible (matplotlib.axes.Axes), les séries de données longitudinales brutes, le niveau désiré pour l’intervalle de confiance (par exemple 95%), ainsi qu’un ensemble d’options stylistiques optionnelles régissant les couleurs et l’activation éventuelle de la rastérisation sélective. En son cœur, la fonction orchestre le calcul vectoriel des estimateurs non biaisés, génère l’enveloppe de dispersion, active scrupuleusement le paramètre interpolate=True pour prévenir tout artefact nodal, configure un zorder irréprochable et insère de façon automatisée le mandataire d’artiste dans la légende.
Pour parachever ce protocole expérimental automatisé, la procédure se conclura systématiquement par l’exportation conjointe et automatisée de la figure sous deux déclinaisons industrielles complémentaires : d’une part un fichier vectoriel non compressé au format PDF destiné à l’intégration directe au sein du flux de compilation LaTeX pour soumission à l’éditeur académique, et d’autre part une image matricielle au format PNG calibrée à 300 DPI destinée à l’archivage rapide, aux présentations orales sur écran dynamique et à la diffusion électronique instantanée sur les portails de prépublication scientifique.
Références
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Matplotlib Development Team. (2023). matplotlib.pyplot.fill_between documentation. Matplotlib v3.8.0 Manual. https://matplotlib.org/stable/api/_as_gen/matplotlib.pyplot.fill_between.html
- Matplotlib Development Team. (2023). matplotlib.pyplot.fill_betweenx documentation. Matplotlib v3.8.0 Manual. https://matplotlib.org/stable/api/_as_gen/matplotlib.pyplot.fill_betweenx.html
- Rougier, N. P. (2021). Scientific Visualization: Python + Matplotlib. Nicolas P. Rougier via Open Book Publishers. https://hal.inria.fr/hal-03427195
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media. https://clauswilke.com/dataviz/