
L’analyse empirique des séries chronologiques s’est imposée comme l’un des piliers méthodologiques fondamentaux de la science des données moderne, irriguant des disciplines aussi diverses que l’économétrie financière, la biomécanique, la climatologie et la psychologie quantitative. Qu’il s’agisse d’enregistrements continus issus de capteurs physiologiques, de flux transactionnels à haute fréquence ou de données longitudinales recueillies par évaluation écologique momentanée, les praticiens sont invariablement confrontés à une problématique centrale : l’inadéquation entre l’échelle temporelle intrinsèque de la collecte des données et la granularité requise pour l’inférence statistique ou l’apprentissage automatique. Cette discordance dimensionnelle impose le recours à des protocoles de transformation rigoureux, communément désignés sous le terme générique de rééchantillonnage temporel.
Le rééchantillonnage temporel ne saurait être réduit à une simple manipulation technique ou à un artifice d’ingénierie logicielle. Il constitue une opération mathématique profonde qui altère substantiellement la structure stochastique, la distribution des fréquences spectrales, la variance conditionnelle et l’autocorrélation des processus sous-jacents. Une modification non maîtrisée de la cadence d’échantillonnage peut induire des artefacts d’analyse dévastateurs, tels que le repliement spectral, l’atténuation artificielle des extrema ou, pire encore, des contaminations causales rétrospectives communément appelées biais d’anticipation. Dès lors, la standardisation, l’agrégation et l’interpolation temporelles exigent une compréhension théorique sans faille adossée à une maîtrise algorithmique pointue.
Dans l’écosystème Python, la bibliothèque Pandas s’est érigée en référence universelle pour le traitement de ces structures dynamiques, notamment grâce à son interface dédiée implémentée au sein de la méthode resample(). Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes théoriques et pratiques du rééchantillonnage temporel. À travers une exploration méticuleuse de ses fondements mathématiques, de sa taxonomie fonctionnelle, de ses pièges statistiques et de ses architectures d’optimisation computationnelle, nous fournirons un cadre conceptuel et applicatif robuste pour aborder sereinement le prétraitement des séries temporelles les plus complexes.
1. Fondements théoriques et conceptuels du rééchantillonnage temporel
1.1 Définition formelle et taxonomie du rééchantillonnage
Sur le plan mathématique, une série temporelle continue peut être conceptualisée comme une réalisation d’un processus stochastique indexé sur un espace continu. La discrétisation temporelle constitue l’opération initiale par laquelle ce processus continu est capturé à des intervalles discrets pour former une suite de variables aléatoires ordonnées. Le rééchantillonnage temporel intervient en aval de cette étape : il s’agit d’un opérateur de transformation discret-à-discret modifiant la métrique d’espacement temporel d’une suite déjà numérisée. Cette transformation se distingue ontologiquement de la simple agrégation spatiale ou vectorielle par la préservation impérative de la relation d’ordre partiel strict induite par la flèche du temps.
La taxonomie canonique du rééchantillonnage repose sur une dichotomie fondamentale : le sous-échantillonnage (ou downsampling) et le sur-échantillonnage (ou upsampling). Le sous-échantillonnage correspond à une transition vers une fréquence temporelle inférieure, impliquant une réduction dimensionnelle via des opérateurs d’agrégation stochastique tels que la somme, la moyenne arithmétique ou des mesures de dispersion. À l’inverse, le sur-échantillonnage projette la série sur une grille temporelle de résolution plus dense, ce qui engendre une indétermination structurelle comblée par des méthodes d’interpolation déterministe ou d’imputation stochastique. Chacune de ces voies altère de manière singulière les propriétés de stationnarité au sens large, modifiant la structure des autocovariances.
L’effet le plus direct du changement de fréquence réside dans la modulation du rapport signal-bruit (SNR). Lors d’un sous-échantillonnage intégrant une fonction moyenne, les composantes de bruit blanc non corrélé à haute fréquence subissent une annulation destructive progressive en vertu de la loi des grands nombres, révélant ainsi la tendance macroscopique sous-jacente. Réciproquement, un sur-échantillonnage mal maîtrisé peut artificiellement compresser la variance résiduelle sans enrichir le signal d’une information substantielle réelle, introduisant une multicolinéarité temporelle prononcée qui fragilise la validité des modèles d’inférence ultérieurs.
1.2 Objectifs analytiques et nécessités méthodologiques
Dans les protocoles expérimentaux contemporains, l’hétérogénéité des fréquences de capture constitue la norme plutôt que l’exception. Un protocole biomédical standard peut intégrer simultanément des données électrocardiographiques mesurées à plusieurs centaines de Hertz, des variations hormonales échantillonnées quotidiennement et des auto-évaluations psychométriques ponctuelles. Pour procéder à une modélisation conjointe via des architectures multivariées, l’harmonisation de ces échelles divergentes sur une grille temporelle partagée devient un prérequis mathématique absolu. L’alignement temporel permet ainsi la synchronisation cohérente des vecteurs d’états.
Au-delà de la simple réconciliation dimensionnelle, le rééchantillonnage répond à des impératifs d’optimisation computationnelle. L’entraînement de réseaux neuronaux récurrents ou de modèles statistiques paramétriques sur des séries brutes contenant plusieurs millions de pas de temps s’avère prohibitivement coûteux en cycles processeur et en mémoire vive. Un sous-échantillonnage judicieux permet d’opérer une réduction dimensionnelle ciblée, préservant la dynamique informationnelle d’intérêt tout en éliminant les micro-variations sans valeur prédictive. Cette condensation de l’information facilite la convergence algorithmique et diminue les risques de surapprentissage liés au bruit d’échantillonnage.
Enfin, la mise en conformité avec les postulats des modèles classiques d’analyse des séries temporelles (tels que les processus ARIMA ou les régressions à erreurs dynamiques) impose fréquemment des observations équidistantes dans le temps. Les séries observées dans le monde réel comportant inévitablement des dérives d’horloge, des retards de transmission ou des interruptions de mesure, le rééchantillonnage fait office de filtre régulateur garantissant la stricte périodicité du pas d’incrémentation temporel, condition sine qua non à la décomposition rigoureuse des composantes saisonnières et tendancielles.
1.3 Le théorème d’échantillonnage et ses implications algorithmiques
Toute réflexion approfondie sur la manipulation temporelle discrète s’ancre dans le théorème de Nyquist-Shannon, énoncé fondamental de la théorie du traitement du signal. Ce théorème stipule qu’un signal continu de bande passante limitée ne contenant aucune composante fréquentielle supérieure ou égale à une fréquence critique $f_{\max}$ peut être parfaitement reconstitué à partir d’échantillons discrets si la fréquence d’échantillonnage $f_s$ satisfait la condition stricte $f_s > 2 f_{\max}$. Transposée au rééchantillonnage numérique de séries temporelles statistiques, cette règle impose des contraintes sévères sur la réduction de fréquence.
Lorsque l’on procède à un sous-échantillonnage sans précaution algorithmique, toute oscillation haute fréquence présente dans la série originale et dépassant la nouvelle limite de Nyquist ($f_{s,\text{nouveau}} / 2$) n’est pas simplement supprimée : elle se replie sur les basses fréquences. Ce phénomène de repliement spectral (ou aliasing) corrompt irrémédiablement le signal en injectant des tendances et des cycles artificiels qui ne possèdent aucune réalité empirique. En pratique, l’agrégation par fenêtre glissante (sommation ou moyenne) fait office de filtre anti-repliement rudimentaire, atténuant les fréquences élevées avant l’échantillonnage effectif.
La conséquence empirique d’une perte d’information haute fréquence doit faire l’objet d’un arbitrage minutieux. Si l’objectif analytique consiste à identifier des cycles circadiens ou des évolutions structurelles annuelles, l’élimination des fluctuations intra-journalières s’avère bénéfique. En revanche, si la détection d’événements critiques rares et brefs (tels que des chocs de volatilité financière ou des arythmies cardiaques paroxystiques) conditionne la validité de l’étude, une décimation temporelle excessive gommera irrémédiablement ces signatures singulières, détruisant la dynamique non-linéaire du système observé.
2. Configuration de l’environnement Python et préparation rigoureuse de l’index temporel
2.1 Architecture logicielle et bibliothèques requises
L’implémentation opérationnelle du rééchantillonnage sous Python repose sur un empilement logiciel cohérent, centré sur la triade scientifique Pandas, NumPy et SciPy, complétée par Matplotlib pour le diagnostic visuel. Pandas fournit la structure de données structurante qu’est le DataFrame temporel et encapsulate le moteur C d’agrégation, tandis que NumPy sous-tend les opérations vectorielles fondamentales. SciPy intervient spécifiquement lors des interpolations avancées requérant des algorithmes d’approximation fonctionnelle tels que les splines cubiques régularisées.
Pour garantir la stricte reproductibilité des transformations numériques, l’isolation des dépendances au sein d’un environnement virtuel géré via conda ou venv est formellement requise. Les disparités de versions mineures dans le code source de Pandas peuvent en effet introduire des modifications subtiles dans le traitement des bornes temporelles fermées ou dans la convention de dénomination des alias de fréquence. Il convient d’adopter des configurations explicites de précision numérique (par exemple en forçant le format 64 bits à virgule flottante pour l’accumulation des flux) afin de prévenir les erreurs d’arrondi lors des sommations massives.
Au cœur de cette architecture se trouvent les structures fondamentales dédiées au temps : l’objet scalaire Timestamp (équivalent optimisé du standard datetime.datetime de Python), la structure vectorielle ordonnée DatetimeIndex, et le concept connexe de PeriodIndex qui formalise la notion d’intervalle continu plutôt que d’instant ponctuel. La maîtrise de la transition entre l’instant infinitésimal et la période d’observation finie constitue le fondement technique de toute manipulation ultérieure de la granularité temporelle.
2.2 Instanciation et validation du DatetimeIndex
L’activation des méthodes de rééchantillonnage dans un DataFrame Pandas nécessite obligatoirement la présence d’un DatetimeIndex valide. Les données temporelles brutes se présentant quasi-systématiquement sous la forme de chaînes de caractères au sein de fichiers plats, la conversion via pd.to_datetime constitue l’étape liminaire incontournable. Cette transformation gagne à être explicitement paramétrée en spécifiant la chaîne de format (standard ISO 8601 ou format propriétaire) afin d’éviter le coût prohibitif de l’inférence heuristique automatique et de désambiguïser les notations jour/mois.
La rigueur méthodologique impose la gestion explicite des fuseaux horaires. L’omission de cette étape expose l’analyste à des anomalies majeures lors des transitions entre heures standard et heures d’été (disparition ou duplication artificielle d’intervalles horaires). La standardisation systématique en Temps Universel Coordonné (UTC) via tz_localize('UTC') ou tz_convert('UTC') neutralise ces distorsions calendaires. Dès cet instant, l’index temporel est rattaché à une échelle physique absolue et invariante, garantissant la parfaite consistance des agrégations subséquentes.
Avant d’engager toute opération de rééchantillonnage, une phase de validation d’intégrité structurelle s’impose. Elle requiert la vérification de la monotonicité stricte de l’index temporel à l’aide de la propriété index.is_monotonic_increasing. Une séquence temporelle non ordonnée engendre des comportements indéterminés ou des échecs critiques lors du découpage par fenêtres. De surcroît, la détection des doublons temporels via index.duplicated() doit déclencher l’application immédiate d’une stratégie de déduplication déterministe (élimination, moyenne contextuelle ou arbitrage par métadonnées), faute de quoi l’unicité de la clé temporelle se trouve rompue.
2.3 Création d’un jeu de données synthétique pour validation empirique
Afin de valider les concepts méthodologiques sur une référence contrôlée, la construction d’un jeu de données synthétique complexe s’avère indispensable. Ce jeu de données doit incorporer une grille temporelle continue, générée par exemple via pd.date_range avec un pas horaire (‘h’), s’étendant sur plusieurs semaines. L’attribution délibérée d’une graine de reproductibilité pseudo-aléatoire (via np.random.seed) garantit la réplication exacte des trajectoires stochastiques simulées d’un environnement d’exécution à l’autre.
Le DataFrame de travail gagne à structurer des processus stochastiques aux caractéristiques distributionnelles orthogonales : d’une part, une marche aléatoire gaussienne simulant un cours financier ou une température corporelle (variable d’état continue), et d’autre part, un processus de comptage de Poisson modélisant des occurrences d’événements discrets tels que des clics d’utilisateurs ou des précipitations atmosphériques (variable de flux cumulatif). L’adjonction intentionnelle de composantes déterministes (sinusoïde circadienne) enrichit le réalisme empirique de la modélisation.
Une visualisation diagnostique initiale de cette distribution brute non transformée permet d’en cartographier la dynamique de base. L’examen des résidus, de l’autocorrélogramme empirique et de l’amplitude maximale des oscillations fournit la base comparative indispensable par rapport à laquelle les déformations introduites par les opérations ultérieures de sous-échantillonnage et de sur-échantillonnage pourront être rigoureusement quantifiées et évaluées.
3. Syntaxe fondamentale et fonctionnement de la méthode resample() sous Pandas
3.1 Anatomie de l’objet Resampler
L’invocation de la méthode resample() sur un objet Series ou DataFrame n’exécute pas immédiatement le calcul arithmétique de transformation. À l’instar de la méthode groupby(), elle instancie un objet intermédiaire spécialisé appartenant à la classe pandas.core.resample.Resampler. Ce mécanisme repose sur le paradigme fondamental de l’ingénierie logicielle Split-Apply-Combine : fractionner la série en segments temporels disjoints, appliquer une opération de réduction ou d’interpolation sur chaque segment, puis combiner les résultats au sein d’une structure de données unifiée.
Cette architecture s’inscrit dans une logique d’évaluation paresseuse (ou lazy evaluation). L’objet Resampler stocke l’ensemble des instructions de paramétrage (la fréquence cible, le décalage, la convention de fermeture des intervalles, l’attribution du libellé) sans matérialiser les tableaux numériques sous-jacents en mémoire. L’exécution concrète de la transformation n’est déclenchée que lors de l’appel ultérieur d’une méthode terminale d’agrégation (comme .mean() ou .sum()) ou d’interpolation (comme .interpolate()).
L’inspection des attributs internes du Resampler révèle une mécanique sophistiquée reposant sur l’objet TimeGrouper. Cet objet calcule les bornes exactes des compartiments (ou bins) en fonction de l’horodatage initial et des lois calendaires spécifiques associées à l’alias de fréquence choisi. La compréhension de cette séparation entre la définition géométrique des intervalles et l’opération de calcul effectif est essentielle pour appréhender les performances computationnelles et la flexibilité de Pandas.
3.2 Répertoire des alias de fréquence standard
La définition de la granularité temporelle cible au sein de resample() s’effectue par l’intermédiaire de chaînes de caractères codifiées appelées alias de fréquence (frequency strings). Ces alias couvrent l’intégralité du spectre temporel standardisé. Pour les régimes sous-horaires, les symboles normalisés comprennent la seconde (‘s’), la minute (‘min’) et la microseconde (‘us’). La précision nanoseconde, inhérente aux horodatages 64 bits, permet de modéliser des cinétiques physiques extrêmement rapides sans dérive d’arrondi.
À l’échelle intermédiaire, la distinction entre le jour calendaire (‘D’) et le jour ouvré (‘B’ pour business day) illustre l’intégration des logiques organisationnelles humaines. Le passage aux échelles macroscopiques implique des alias périodiques sensibles aux irrégularités du calendrier grégorien : la fin de mois calendaire (‘ME’ dans les versions contemporaines de Pandas, succédant à l’historique ‘M’), le début de mois (‘MS’), les trimestres civils (‘QE’ ou ‘QS’) et les cycles annuels (‘YE’ ou ‘YS’). L’emploi des versions explicites terminées par ‘E’ (End) ou ‘S’ (Start) élimine toute ambiguïté sur l’instant d’ancrage effectif.
La puissance expressive de ce système réside dans la composition modulaire de ces fréquences par l’adjonction de multiplicateurs scalaires entiers. L’expression ’15min’ définit ainsi un compartimentage par quarts d’heure, tandis que ‘2h30min’ génère une grille bihoraire augmentée de trente minutes. Cette flexibilité permet d’épouser très précisément les contraintes des protocoles de recherche sans exiger de reconfiguration manuelle des structures d’indexation chronologique.
3.3 Premier cycle complet : transformation pas-à-pas
Afin d’illustrer la mécanique séquentielle de cette transformation, considérons une série temporelle synthétique enregistrée au pas horaire continu couvrant une période d’un mois civil, et soumise à un sous-échantillonnage journalier standardisé via l’alias ‘D’. L’appel initial de df.resample('D') prépare la partition de l’espace temporel en segments de vingt-quatre heures. À ce stade, la mémoire n’alloue aucun nouvel espace matriciel pour les résultats finaux.
L’application d’une fonction de réduction univariée simple, telle que la sommation cumulative via .sum() ou l’espérance empirique via .mean(), déclenche la phase d’exécution vectorisée. Pour chaque journée, les vingt-quatre valeurs scalaires associées aux pas horaires correspondants sont extraites, soumises à l’opérateur arithmétique, et réduites à une valeur scalaire unique associée à l’horodatage journalier représentatif. L’objet retourné est un nouveau DataFrame dont l’index temporel a vu sa cardinalité divisée par un facteur vingt-quatre.
L’examen comparatif des structures tabulaires avant et après l’opération démontre la transformation structurelle opérée. La dimension des vecteurs est contractée, la variance totale de la série résultante est amoindrie du fait de la neutralisation des fluctuations intrajournalières, et les propriétés de non-stationnarité locale s’en trouvent substantiellement modifiées. Cette transition synthétise la puissance du paradigme tout en matérialisant la responsabilité méthodologique inhérente à toute décision de changement d’échelle temporelle.
4. Méthodologie approfondie du sous-échantillonnage (Downsampling)
4.1 Opérations d’agrégation univariée standard
Le choix de l’opérateur d’agrégation statistique lors d’un sous-échantillonnage est indissociable de la nature phénoménologique de la variable observée. Pour les variables dites de flux (telles que le volume des transactions financières, la consommation énergétique en kilowattheures ou le débit pluviométrique), l’agrégation sommative via .sum() s’impose naturellement. Elle préserve l’intégrale numérique de la quantité sur la période considérée, assurant la conservation massique du phénomène physique ou économique à travers les différentes échelles d’observation.
Pour les grandeurs d’état ou variables intensives (telles que la pression atmosphérique, le taux de saturation en oxygène ou le rendement instantané d’un actif financier), la moyenne arithmétique via .mean() constitue l’estimateur standard du niveau central stable sur l’intervalle. Toutefois, en présence de distributions asymétriques ou contaminées par des valeurs aberrantes sporadiques, la médiane empirique (.median()) offre une robustesse accrue. Elle minimise l’influence des déviations extrêmes de mesure, garantissant une meilleure représentativité de l’état typique du système.
L’analyse ne saurait se limiter aux seules mesures de tendance centrale. L’évaluation de la variabilité intrapériode nécessite l’extraction systématique des moments statistiques d’ordre supérieur à travers la variance (.var()) ou l’écart-type échantillonnal (.std()). Concomitamment, l’isolement des bornes de fluctuations critiques par les opérateurs .min() et .max() permet de surveiller les excursions dynamiques extrêmes survenues au cours de chaque fenêtre, informations qui se trouveraient irrémédiablement masquées par un simple calcul de moyenne lissante.
4.2 Agrégations financières et techniques : le format OHLC
Dans l’analyse des signaux hautement volatils, en particulier dans le domaine financier ou dans l’étude des contraintes mécaniques vibratoires, la réduction d’une période temporelle à un unique scalaire (moyenne ou somme) entraîne une perte critique d’information sur la structure séquentielle intra-fenêtre. Pour pallier cette lacune sans conserver l’intégralité du volume de données brut, l’industrie financière a formalisé l’agrégation dite Open-High-Low-Close (OHLC).
Sous Pandas, cette transformation multidimensionnelle s’exécute de manière native et hautement optimisée via l’instruction .ohlc() appliquée directement sur l’objet Resampler. Cette méthode synthétise instantanément chaque compartiment temporel selon quatre coordonnées critiques : la première valeur chronologique enregistrée dans l’intervalle (Open), la valeur maximale absolue atteinte (High), la valeur minimale observée (Low), et la dernière observation clôturant la fenêtre (Close). Le résultat généré structure un DataFrame à colonnes dédiées pour chaque variable agrégée.
Ce format condensé offre un compromis optimal entre compression de données et fidélité cinématique. Il permet notamment de détecter si une baisse de valeur s’est produite en début ou en fin d’intervalle et mesure l’amplitude maximale de l’excursion de volatilité. Sur le plan sémiotique et analytique, les séries rééchantillonnées en OHLC constituent le substrat indispensable pour la génération de visualisations graphiques avancées, telles que les diagrammes en chandeliers japonais, offrant une lecture immédiate du rapport de force entre les dynamiques d’expansion et de contraction au sein du système.
4.3 Contrôle des intervalles temporels : paramètres closed et label
L’un des pièges les plus subtils et méthodologiquement dommageables du rééchantillonnage réside dans la mauvaise configuration des frontières d’intervalles, régie par les paramètres closed et label de la fonction resample(). Mathématiquement, un compartiment temporel d’une durée $T$ débutant à $t_0$ et se terminant à $t_1$ ne peut être simultanément ouvert ou fermé à ses deux extrémités sans créer soit une omission, soit une duplication des observations situées précisément sur les frontières. Il doit être défini soit comme un intervalle semi-ouvert à gauche $[t_0, t_1[$, soit semi-ouvert à droite $]t_0, t_1]$.
Le paramètre closed dicte cette appartenance topologique : la valeur 'left' stipule que la borne inférieure est incluse dans l’agrégation tandis que la borne supérieure en est exclue, alors que la valeur 'right' inverse cette relation. Par défaut, Pandas applique conventionnellement closed='left' pour les fréquences sous-journalières, mais bascule sur closed='right' pour les fréquences journalières et macroscopiques (‘D’, ‘ME’, ‘YE’). Cette asymétrie de conception par défaut peut introduire des décalages massifs et silencieux dans les agrégations si l’analyste n’en maîtrise pas les implications formelles.
Le paramètre label détermine quant à lui quel horodatage servira d’identifiant à la série résultante. Si label='left' est configuré, l’intervalle allant de 10:00:00 à 11:00:00 portera le sceau temporel ’10:00:00′. Si label='right' est retenu, il portera la marque ’11:00:00′. L’utilisation inconsidérée de label='left' pour nommer une période dont les données sont collectées jusqu’à 11:00:00 induit un risque critique de contamination temporelle : un algorithme prédictif consultant cette valeur à 10:05:00 intégrera des informations qui ne se sont en réalité produites qu’à 10:59:00, générant une forme insidieuse de biais d’anticipation (look-ahead bias).
5. Agrégations avancées et personnalisées de séries temporelles
5.1 Utilisation de la méthode agg() pour calculs composites
Dans le cadre d’analyses exploratoires poussées ou de protocoles empiriques rigoureux, l’application d’un opérateur statistique univarié unique sur l’ensemble d’un DataFrame s’avère rapidement limitante. La méthode agg() (ou aggregate()), interfacée avec l’objet Resampler, lève cette contrainte en permettant l’exécution simultanée d’architectures de calculs composites extrêmement élaborées. Elle autorise le passage de listes de fonctions ou de dictionnaires structurés associant à chaque variable physique un ensemble sur mesure de métriques statistiques descriptives.
Cette approche permet, au cours d’une unique passe de calcul optimisée, de quantifier simultanément la tendance centrale et la forme de la distribution d’une variable continue. À titre d’exemple, on peut assigner à une série de températures l’évaluation conjointe de sa moyenne arithmétique, de son écart-type et de ses percentiles extrêmes, tout en contraignant une variable de précipitations conjointe à une stricte sommation cumulative. Cette différenciation fonctionnelle garantit le respect scrupuleux des dimensions physiques propres à chaque canal de mesure au sein de jeux de données multivariés complexes.
L’application d’opérateurs multiples sur des colonnes génère structurellement un objet DataFrame indexé par un MultiIndex au niveau des colonnes (index hiérarchique à plusieurs niveaux). Pour préserver l’interopérabilité du tableau au sein de pipelines de production automatisés, une étape de post-traitement systématique s’impose : l’aplatissement de la hiérarchie colonnaire. Cette formalisation s’opère par la concaténation programmatique des descripteurs (par exemple via une compréhension de liste combinant le nom de la variable d’origine et le nom de la fonction appliquée, produisant des intitulés transparents du type temperature_mean ou flux_sum).
5.2 Définition et injection de fonctions d’agrégation sur mesure
Bien que la bibliothèque standard Pandas dispose d’un vaste répertoire de méthodes d’agrégation compilées en langage C via Cython, certaines métriques théoriques ou indicateurs probabilistes spécifiques nécessitent l’implémentation d’algorithmes personnalisés. La méthode agg() accepte sans restriction des fonctions Python standard ou des expressions anonymes lambda, conférant une flexibilité analytique intégrale à l’opérateur de rééchantillonnage.
Cette extensibilité permet d’injecter des estimateurs robustes issus de la statistique non-paramétrique, particulièrement résilients face aux contaminations leptokurtiques des distributions réelles. On peut ainsi implémenter l’écart interquartile normalisé ($IQR = Q_{75} – Q_{25}$), la médiane des écarts absolus par rapport à la médiane (MAD), ou des moyennes tronquées (trimmed means) éliminant un pourcentage arbitraire des valeurs extrêmes de chaque fenêtre. L’accès direct aux sous-séries temporelles au sein de la fonction utilisateur permet également l’évaluation de quantiles dynamiques conditionnels spécifiques à chaque intervalle rééchantillonné.
Il importe toutefois de souligner l’impact computationnel de ces fonctions sur mesure. Contrairement aux méthodes natives qui court-circuitent l’interpréteur Python pour exécuter des boucles vectorisées à bas niveau, les fonctions injectées manuellement subissent le coût de l’appel itératif de l’interpréteur sur chaque sous-segment temporel. De surcroît, ces fonctions doivent impérativement intégrer une gestion explicite des cas limites, notamment le traitement des fenêtres temporelles totalement dépourvues d’observations ou composées exclusivement de valeurs manquantes (NaN), sous peine de lever des exceptions d’exécution interrompant le pipeline d’analyse.
5.3 Fenêtres mobiles rééchantillonnées et interactions statistiques
Une confusion méthodologique récurrente consiste à assimiler le rééchantillonnage temporel pur au calcul de moyennes mobiles sur fenêtres glissantes (rolling windows). Bien que ces deux familles d’opérateurs temporels poursuivent des objectifs partagés d’atténuation du bruit haute fréquence, leurs architectures mathématiques sont radicalement divergentes. Le rééchantillonnage opère une partition stricte et disjointe de l’espace temporel en réduisant structurellement la fréquence de la grille d’indexation, tandis que la fenêtre mobile préserve la fréquence d’échantillonnage d’origine tout en introduisant un recouvrement continu des sous-ensembles d’évaluation.
La sophistication analytique maximale s’atteint par la combinaison séquentielle de ces deux paradigmes. Il est courant et hautement rigoureux de procéder d’abord à un rééchantillonnage standardisé pour corriger les asynchronismes et projeter la série sur une grille temporelle uniforme, puis d’appliquer sur cette nouvelle base équidistante une fenêtre glissante via la méthode .rolling() ou un lissage exponentiel via .ewm(). Cette composition permet de lisser la dynamique macroscopique sans subir les biais induits par les irrégularités de la grille temporelle brute.
Dans ce type de chaînage algorithmique, la préservation de la chronologie causale stricte demeure l’impératif suprême. L’application d’une fenêtre mobile centrée (center=True) sur une série rééchantillonnée entraîne une fuite systématique d’information future dans l’évaluation du point présent, ruinant toute perspective d’évaluation prédictive valide. L’ancrage causal unilatéral fermé à droite (center=False) constitue la seule configuration scientifiquement recevable pour garantir que l’état estimé au temps $t$ ne dépend que de l’historique observable strict antérieur ou contemporain à ce repère temporel.
6. Maîtrise du sur-échantillonnage (Upsampling) et techniques d’interpolation
6.1 Problématique théorique de l’expansion temporelle
Le sur-échantillonnage (upsampling) correspond au passage d’une résolution temporelle grossière à une fréquence d’observation substantiellement plus fine (par exemple, la transition d’un pas journalier à une grille horaire ou minute). Contrairement au sous-échantillonnage qui synthétise et compresse une information existante, l’expansion temporelle se heurte à une indétermination mathématique fondamentale : la création structurelle de vides distributionnels. La cardinalité de l’index temporel augmentant, la vaste majorité des nouveaux pas temporels générés ne possèdent aucune mesure empirique correspondante.
Cette expansion introduit instantanément une matrice clairsemée dominée par des valeurs indéterminées (NaN). Dès lors, le chercheur se trouve confronté à un écueil épistémologique majeur : le risque de fabriquer de l’information factice dépourvue de tout fondement observationnel. L’imputation de valeurs au sein de ces intervalles d’ignorance ne constitue jamais une mesure neutre, mais l’affirmation implicite d’une hypothèse modélisatrice forte sur la continuité spatio-temporelle ou la cinétique différentielle du phénomène étudié.
La sélection d’une méthode de remplissage doit donc s’ancrer dans la réalité phénoménologique sous-jacente. Si le processus sous-jacent opère par sauts d’états discrets et invariants (par exemple un taux d’intérêt directeur fixé par une banque centrale ou un statut de traitement pharmacologique), les méthodes de propagation par paliers constants constituent la seule représentation logique recevable. En revanche, si la variable matérialise une dynamique physique fondamentalement continue mais échantillonnée de manière parcimonieuse (comme la température de l’eau d’un lac), les approches par interpolation continue différentiable s’imposent théoriquement.
6.2 Techniques de propagation constante des valeurs
La méthode la plus immédiate et computationnellement la plus frugale pour saturer les valeurs manquantes issues d’un sur-échantillonnage consiste en la propagation vers l’avant, opération désignée sous le terme de forward-fill ou padding, accessible via .ffill() (ou historiquement .pad()). Cette technique propage la dernière valeur valide observée dans le passé sur l’ensemble des nouveaux pas temporels subséquents jusqu’à ce qu’une nouvelle observation empirique soit enregistrée. Elle postule l’invariance temporelle locale de l’état du système en l’absence de mise à jour observationnelle.
À l’opposé de cette cinétique causale se trouve la propagation rétrospective, ou backward-fill, déclenchée par .bfill(). Cette méthode prend la valeur empirique de la future observation et la rétro-propage sur les instants passés antérieurs. Si cette technique peut posséder des justifications théoriques restreintes dans des protocoles rétrospectifs étanches fermés (par exemple l’imputation d’une caractéristique individuelle stable mesurée en fin d’étude), son utilisation dans des séries temporelles dynamiques constitue une violation caractérisée du principe de causalité et doit être formellement proscrite dans tout cadre prédictif ou inférentiel en ligne.
L’utilisation de ces imputations constantes génère toutefois des artefacts statistiques identifiables, caractérisés par l’apparition de plateaux artificiellement plats et dépourvus de toute variance locale. Cette création de paliers constants induit une autocorrélation sérielle positive artificielle extrêmement élevée à court terme et une sous-estimation systématique de la variance locale du processus. De surcroît, l’application naïve d’une constante arbitraire globale via .fillna(valeur) brise brutalement la structure d’autocovariance intrinsèque et ne saurait être tolérée qu’en cas d’absence structurelle absolue d’événement (par exemple un comptage nul d’impulsions).
6.3 Méthodes d’interpolation continue et polynomiale
Lorsque la phénoménologie du processus exige une transition progressive et lisse entre les points d’observation espacés, le recours à la méthode .interpolate() adossée à l’objet issu du sur-échantillonnage devient nécessaire. Le mode d’interpolation le plus répandu demeure l’interpolation linéaire (method='linear'), qui relie les observations adjacentes par des segments de droite euclidiens continus. Si cette approche garantit la continuité spatiale d’ordre $C^0$, elle introduit des discontinuités brutales de la dérivée première au passage de chaque nœud empirique, générant des angles vifs peu conformes aux cinétiques physiques inertielles.
Pour assurer la continuité des dérivées premières et secondes (régularité d’ordre $C^2$), les approximations polynomiales supérieures et les méthodes par splines cubiques (method='spline', order=3) offrent une élégance mathématique supérieure. En ajustant des polynômes par morceaux dont la courbure est minimisée au niveau des nœuds de transition, les splines reproduisent avec un grand réalisme les dynamiques oscillatoires continues. Pandas permet en outre l’interpolation pondérée par le temps effectif via method='time', qui prend en compte les espacements temporels calendaires réels de l’index plutôt que de supposer un espacement géométrique théoriquement équidistant.
Néanmoins, l’analyste doit impérativement se prémunir contre les écueils mathématiques de l’interpolation polynomiale d’ordre élevé, au premier rang desquels figure le phénomène de Runge. Lorsque le degré du polynôme d’interpolation est augmenté ou que les nœuds d’observation présentent des configurations locales asymétriques, l’approximation subit des oscillations marginales divergentes catastrophiques, générant des valeurs aberrantes massives aux abords des extrémités de l’intervalle. Une validation visuelle et un examen des résidus s’avèrent indispensables pour certifier que la courbe interpolée ne s’affranchit pas des bornes physiques plausibles du phénomène modélisé.
7. Gestion des décalages, cycles saisonniers et alignements d’ancrage
7.1 Ancrage personnalisé des fréquences périodiques
Les calendriers civils et économiques ne constituent pas des grilles temporelles homogènes et isotropes. Ils sont régis par des conventions institutionnelles, des jours chômés, des périodicités fiscales singulières et des cycles sociétaux hebdomadaires. La méthode resample() intègre ces contraintes anthropiques complexes au moyen de modificateurs d’ancrage syntaxiques greffés sur les alias de fréquence fondamentaux, permettant de contrôler avec précision la position relative des frontières d’échantillonnage.
Dans le domaine des rééchantillonnages hebdomadaires, l’utilisation de l’alias générique ‘W’ agrège par défaut les observations sur des fenêtres se clôturant le dimanche soir. Or, l’analyse des marchés obligataires ou des flux de transport routier exige fréquemment un ancrage sur le cycle des jours ouvrables. La spécification explicite d’un ancrage hebdomadaire, tel que ‘W-MON’ pour une clôture le lundi ou ‘W-FRI’ pour une clôture le vendredi ouvré, permet d’aligner la partition des compartiments sur le rythme fonctionnel effectif du domaine d’application.
Cette granularité parametrée s’étend aux découpages mensuels et trimestriels. L’arbitrage structurel entre un ancrage en clôture de mois (‘ME’, Month End) et un ancrage en ouverture (‘MS’, Month Start) modifie fondamentalement l’attribution des étiquettes et le regroupement des observations liminaires. De surcroît, les calendriers fiscaux spécifiques des organisations (dont le premier trimestre budgétaire peut débuter arbitrairement en novembre ou en avril) sont fidèlement pris en charge par des alias spécialisés tels que ‘Q-NOV’ ou ‘YS-OCT’, éliminant le besoin de retraitements manuels fastidieux et sources d’erreurs.
7.2 Application du paramètre origin et gestion des déphasages
Par défaut, l’algorithme sous-jacent de découpage de Pandas ancre les compartiments temporels sur des origines conventionnelles préétablies (telles que le début de l’époque Unix, le 1er janvier 1970 à 00:00:00 UTC). Lorsque l’on procède à un rééchantillonnage selon une fréquence qui ne divise pas parfaitement une journée entière (par exemple des blocs temporels de 7 heures ou de 45 minutes), cet ancrage historique implicite peut induire des frontières d’intervalles arbitraires qui ne coïncident avec aucun événement signifiant de la série observée.
L’introduction du paramètre origin résout formellement cette contrainte en permettant de redéfinir le point zéro géométrique de la segmentation temporelle. La configuration origin='start' ancre le premier compartiment exactement sur le premier horodatage présent dans l’index de la série étudiée, garantissant que chaque intervalle se déploie de manière strictement relative à l’amorce de l’enregistrement empirique. L’argument accepte également des chaînes temporelles absolues arbitraires (par exemple origin='2024-01-01 08:30:00'), synchronisant ainsi le maillage sur une référence externe explicite.
Conjointement, le paramètre offset permet d’introduire un vecteur de translation temporelle systématique constant (exprimable via une chaîne de fréquence ou un objet pd.Timedelta). Cet outil se révèle inestimable pour corriger les dérives de phase chroniques affectant certains capteurs asynchrones ou pour réaligner des séries présentant un retard de transmission déterministe connu. La manipulation conjointe de origin et offset confère à l’analyste un contrôle absolu sur la phase spatio-temporelle de la grille de rééchantillonnage.
7.3 Alignement de séries temporelles asynchrones
L’un des défis empiriques les plus complexes en science des données réside dans l’intégration multivariée de flux observationnels asynchrones. Considérons deux capteurs autonomes enregistrant des événements physiques intermittents : leurs horodatages respectifs ne coïncident pratiquement jamais sur une échelle nanoseconde. Tenter une jointure relationnelle classique par clé d’index produit une structure matricielle quasi-nulle, où chaque observation d’une variable s’associe à un NaN pour la variable concurrente.
La résolution de cette hétérogénéité impose une stratégie de rééchantillonnage conjoint articulée autour de la standardisation de grille. Le protocole méthodologique optimal consiste à projeter préalablement les deux séries asynchrones sur une grille commune de référence via resample() en retenant une fréquence compatible avec la dynamique physique d’intérêt, puis d’appliquer les opérateurs d’agrégation ou d’interpolation adéquats. Alternativement, la méthode .reindex() conjuguée à des techniques d’appariement tolérant au plus proche voisin temporel (method='nearest' avec un argument tolerance rigoureusement borné) permet de restaurer la comparabilité des flux.
L’enjeu critique de cet alignement réside dans la minimisation de la distorsion de synchronisation. Une grille de rééchantillonnage trop lâche masque les interactions causales rapides entre les variables, tandis qu’une grille excessivement dense multiplie artificiellement les imputations par interpolation. Ce compromis conditionne directement la validité des analyses de covariance croisée et des estimations de causalité au sens de Granger, lesquelles sont notoirement vulnérables aux déphasages artificiels induits par les protocoles d’alignement numérique.
8. Rééchantillonnage de séries chronologiques multivariées complexes
8.1 Traitement simultané de variables aux propriétés statistiques distinctes
Dans les architectures de données massives, les structures tabulaires DataFrame unifient fréquemment des grappes de variables hétéroclites dont les natures physiques et statistiques s’avèrent mutuellement incompatibles. Un jeu de données issu de la télématique industrielle peut agréger simultanément des compteurs cumulatifs d’énergie (variables extensives de flux), des relevés instantanés de contraintes thermiques (variables intensives d’état) et des indices de statut opérationnel (variables discrètes ou catégorielles).
Le traitement simultané de ces entités au moyen d’un opérateur d’agrégation monolithique uniforme constitue une faute méthodologique majeure. L’application indiscriminée d’une sommation sur des variables intensives n’a aucun sens thermodynamique, tandis que l’évaluation de la moyenne d’un compteur incrémental détruit la métrique de consommation énergétique globale. La méthodologie rigoureuse impose la structuration d’un dictionnaire d’agrégation sophistiqué, transmis comme argument à .agg(), qui cartographie précisément chaque colonne vers son opérateur mathématique canonique (sommation pour les flux, moyenne et percentiles pour les états continus, mode pour les variables discrètes).
L’attention de l’analyste doit également se porter sur la dégradation potentielle de la structure de covariance multivariée consécutive au changement d’échelle temporelle. Le sous-échantillonnage a tendance à amplifier artificiellement les coefficients de corrélation linéaire entre des séries présentant des tendances de fond similaires, phénomène bien documenté sous l’appellation de régression fallacieuse de Yule. La mesure de la corrélation intra-classe et l’évaluation systématique de la matrice des covariances pré- et post-rééchantillonnage permettent de surveiller cette altération des relations inter-variables.
8.2 Gestion des attributs qualitatifs et catégoriels
Le traitement des séries chronologiques incorporant des dimensions qualitatives (telles que le mode opératoire d’une machine, le type de météo observée ou l’état affectif auto-déclaré) pose un défi singulier lors des opérations de rééchantillonnage temporel. Les opérations arithmétiques standards (somme, moyenne) étant formellement indéfinies sur les types de données object ou category, le repliement de ces attributs au sein d’une fenêtre temporelle plus large exige des arbitrages heuristiques rigoureux.
La première voie, conservative mais réductrice, consiste à extraire la valeur la plus fréquente sur l’intervalle au moyen de la statistique du mode (souvent formulée via une fonction personnalisée encapsulant Series.mode()), ou en retenant l’ultime statut observé via l’opérateur .last(). Si cette approche garantit la préservation du type catégoriel d’origine, elle occulte totalement la dynamique de transition interne qui a pu se déployer au sein de la fenêtre de rééchantillonnage.
Une alternative méthodologique largement supérieure réside dans la vectorisation préalable des descripteurs qualitatifs via un encodage disjonctif complet (one-hot encoding via pd.get_dummies). Une fois chaque modalité catégorielle projetée sous la forme d’un vecteur binaire d’activation indicatrice, le rééchantillonnage temporel de ces colonnes virtuelles par un opérateur de moyenne arithmétique convertit directement la présence catégorielle en une densité de probabilité temporelle empirique ou proportion de temps passée dans chaque état au cours de l’intervalle. Cette transformation enrichit la modélisation ultérieure en préservant l’information relative à l’hétérogénéité des états internes.
8.3 Rééchantillonnage hiérarchique avec MultiIndex spatial ou individuel
L’analyse empirique contemporaine manipule de plus en plus fréquemment des structures de données dites de panel ou longitudinales, au sein desquelles les séries temporelles sont dupliquées pour une multitude d’unités d’observation indépendantes (patients au sein d’une cohorte clinique, capteurs disséminés sur un réseau géographique ou actifs financiers négociés simultanément). Ces architectures sont structurellement formalisées sous Pandas au moyen d’index hiérarchiques (MultiIndex) combinant un identifiant individuel ou spatial et la dimension temporelle.
Exécuter une opération de rééchantillonnage sur un MultiIndex impose d’isoler hermétiquement la dynamique temporelle propre à chaque entité pour bannir tout risque d’interpénétration ou de contamination statistique entre des unités d’observation étanches. L’articulation technique s’opère par l’intermédiaire de l’association de groupby() et de l’objet pd.Grouper, en précisant explicitement le niveau de l’index sur lequel s’applique la partition temporelle : df.groupby(['identifiant_sujet', pd.Grouper(freq='1D', level='timestamp')]).agg(...).
Cette syntaxe avancée préserve l’intégrité de la hiérarchie tout en garantissant que les opérations de sous-échantillonnage ou d’interpolation sont exécutées de manière strictement locale et unitaire pour chaque individu du panel. La validation algorithmique de cette étanchéité constitue une étape indispensable du contrôle qualité, permettant de certifier qu’aucune interpolation rétrospective ou propagation de valeur n’a franchi la frontière délimitant deux unités observationnelles distinctes.
9. Diagnostic, valeurs manquantes et contrôle qualité post-rééchantillonnage
9.1 Évaluation systématique des lacunes induites (sparsity check)
L’exécution d’un rééchantillonnage sur une série chronologique réelle modifie inévitablement la structure de complétude de la matrice de données. L’application d’une nouvelle grille temporelle peut engendrer une forme pernicieuse de clairsemance (sparsity), caractérisée par l’apparition d’intervalles totalement dépourvus de données brutes d’origine. Cette situation se traduit immédiatement par l’injection de valeurs NaN lors de l’évaluation de fonctions de réduction comme la moyenne.
Un contrôle qualité rigoureux impose de quantifier précisément ce taux d’incomplétude induit dès la finalisation du rééchantillonnage. Ce diagnostic s’appuie sur la cartographie systématique des valeurs manquantes et l’examen de leur profil de distribution à l’aide de matrices d’incomplétude ou de profils de densité. L’évaluation du ratio de pas de temps incomplets par rapport à la taille théorique de la série conditionne la validité des analyses ultérieures.
Sur le plan statistique, il est impératif d’opérer une distinction formelle entre une absence réelle d’événement (par exemple un comptage nul d’achats sur une période de fermeture d’un commerce) et une lacune d’enregistrement imputable à une panne de capture. Dans le premier cas, la valeur indéterminée doit être explicitement convertie en zéro arithmétique (.fillna(0)), tandis que dans le second cas, l’assimilation à un zéro constitue une dénaturation de la distribution sous-jacente, exigeant soit une censure explicite de l’intervalle, soit le recours à des stratégies d’imputation formelles.
9.2 Traitements avancés des discontinuités structurelles
Lorsque le diagnostic de clairsemance révèle des interruptions significatives mais limitées dans la continuité de la série rééchantillonnée, des protocoles de réparation de signal doivent être mis en œuvre. La règle d’or consiste à borner rigoureusement toute tentative d’interpolation au moyen du paramètre limit disponible dans les méthodes d’imputation de Pandas. La spécification de limit=3 garantit par exemple qu’un trou observationnel supérieur à trois pas temporels consécutifs ne sera pas artificiellement masqué par une interpolation aveugle, préservant ainsi la visibilité des pannes instrumentales majeures.
Pour les discontinuités structurelles plus profondes, les techniques d’interpolation déterministes locales s’avèrent insuffisantes. Il convient alors de mobiliser des approches d’imputation assistées par décomposition saisonnière-tendancielle (à l’instar des algorithmes STL pour Seasonal and Trend decomposition using Loess). Ces modèles permettent d’isoler la composante cyclique régulière et la tendance séculaire de fond de la série pour estimer des valeurs de remplacement en harmonie avec la structure globale du signal historique.
De surcroît, les séries rééchantillonnées doivent être soumises à un filtrage non-linéaire visant à éradiquer les aberrations induites par les agrégations marginales. L’application de filtres gaussiens ou de filtres à médiane mobile sur le signal rééchantillonné permet d’atténuer les pointes transitoires artificielles sans dégrader la dynamique de transition. Chaque intervention de cette nature doit être scrupuleusement journalisée au sein du protocole expérimental pour garantir l’entière reproductibilité de la recherche.
9.3 Validation de l’intégrité énergétique et distributionnelle
L’étape ultime du protocole de rééchantillonnage réside dans la validation formelle de l’intégrité énergétique et distributionnelle de la série transformée. Toute modification de granularité temporelle altère nécessairement les propriétés statistiques de surface ; l’enjeu méthodologique consiste à démontrer que les invariants physiques ou stochastiques fondamentaux ont été rigoureusement respectés au cours de la manipulation numérique.
Pour les grandeurs cumulatives extensives, la vérification s’opère par le contrôle du bilan massique global : la somme intégrale de la série brute originale doit coïncider, à une tolérance numérique infinitésimale près, avec l’intégrale de la série rééchantillonnée. Tout écart caractérisé signale une fuite d’information liée à une mauvaise configuration des bornes fermées (closed) ou à une exclusion non documentée d’intervalles marginaux.
Pour les variables intensives continues, il convient d’exécuter un test statistique d’adéquation, tel que le test non paramétrique de Kolmogorov-Smirnov à deux échantillons, afin de comparer la distribution empirique initiale à celle issue de la transformation temporelle. Enfin, pour les signaux à forte composante spectrale, la comparaison des densités spectrales de puissance (PSD) avant et après traitement permet d’attester l’absence de repliement spectral parasite ou d’harmoniques résiduelles induites par une périodisation imparfaite de la grille d’interpolation.
10. Études de cas empiriques : application aux dynamiques comportementales et psychologiques
10.1 Agrégation de données d’évaluation écologique momentanée (EMA)
L’évaluation écologique momentanée (Ecological Momentary Assessment, ou EMA) s’est imposée comme une méthodologie d’avant-garde en psychiatrie computationnelle et en psychologie de la santé. Elle implique la sollicitation répétée des participants au sein de leur environnement quotidien par l’émission de notifications pseudo-aléatoires sur ordiphone, invitant ces derniers à évaluer leur niveau d’affect négatif, de stress perçu ou de désir compulsif. Par conception, les données ainsi recueillies présentent un asynchronisme temporel extrême, avec des espacements inter-mesures éminemment fluctuants et une absence totale d’enregistrements durant les phases de sommeil.
Pour étudier les dynamiques d’interaction entre ces états affectifs et des facteurs environnementaux réguliers, la standardisation sur une grille journalière uniforme constitue un impératif analytique. Cette transformation s’implémente sous Python par une procédure de sous-échantillonnage journalier intégrant une censure rigoureuse des fenêtres nocturnes. L’arbitrage méthodologique entre une agrégation par moyenne arithmétique ou par médiane empirique possède ici des conséquences cliniques substantielles : la moyenne tend à surpondérer les épisodes de crise affective aiguë sporadiques, tandis que la médiane reflète fidèlement le tonus émotionnel de base du sujet.
La normalisation intra-individuelle (centrage et réduction des scores par les moments statistiques propres à chaque participant) doit impérativement intervenir après le rééchantillonnage pour éviter que les variations de complétude temporelle entre sujets ne biaisent les scores z globaux. L’harmonisation sur une échelle commune permet ensuite la mise en œuvre de modèles vectoriels autorégressifs en panel pour explorer les trajectoires d’inertie psychologique et prédire les basculements dépressifs.
10.2 Synchronisation de biomarqueurs physiologiques continus et d’auto-évaluations
L’avènement des technologies portables (wearables) permet désormais de collecter en continu des signaux photopléthysmographiques (PPG) haute résolution mesurés à des fréquences typiquement comprises entre 50 Hz et 100 Hz, tout en confrontant ces métriques à des auto-évaluations cognitives discrètes ponctuelles collectées plusieurs fois par jour. L’analyste se trouve confronté à un abîme dimensionnel : plusieurs millions d’échantillons physiologiques haute fréquence doivent être synchronisés avec une poignée d’événements discrets psychologiques.
Le protocole de traitement s’articule autour d’une double décimation séquentielle. Dans un premier temps, le signal PPG brut subit un sous-échantillonnage vers une fréquence intermédiaire de 1 Hz au moyen d’un filtre décimateur anti-repliement (implémenté via scipy.signal.decimate) afin d’isoler la variabilité inter-battements (intervalles R-R). Dans un second temps, Pandas entre en jeu pour opérer un rééchantillonnage par fenêtres de dix minutes centrées rétrospectivement sur les moments exacts de validation des auto-évaluations subjectives, permettant l’extraction robuste d’indicateurs temporels de variabilité de la fréquence cardiaque (comme la métrique standardisée RMSSD).
L’alignement temporel causal strict s’avère ici décisif : la fenêtre d’agrégation des biomarqueurs physiologiques doit impérativement être fermée à droite à la seconde précise où le participant débute son questionnaire d’auto-évaluation. Tout débordement temporel ultérieur entraînerait l’incorporation de signaux physiologiques induits par la lecture même des questions, corrompant la mesure de l’état émotionnel antérieur et invalidant la thèse de causalité biologique sous-jacente.
10.3 Suivi longitudinal des métriques d’activité et de sédentarité
Dans l’évaluation épidémiologique de l’activité physique, les accéléromètres triaxiaux portés au poignet enregistrent des accélérations physiques brutes à des fréquences sub-secondaires. Ces gigaoctets de données brutes doivent être convertis en métriques d’activité sédentaire, modérée ou vigoureuse agrégées à des échelles décisionnelles cliniquement interprétables, telles que le bloc hebdomadaire standardisé.
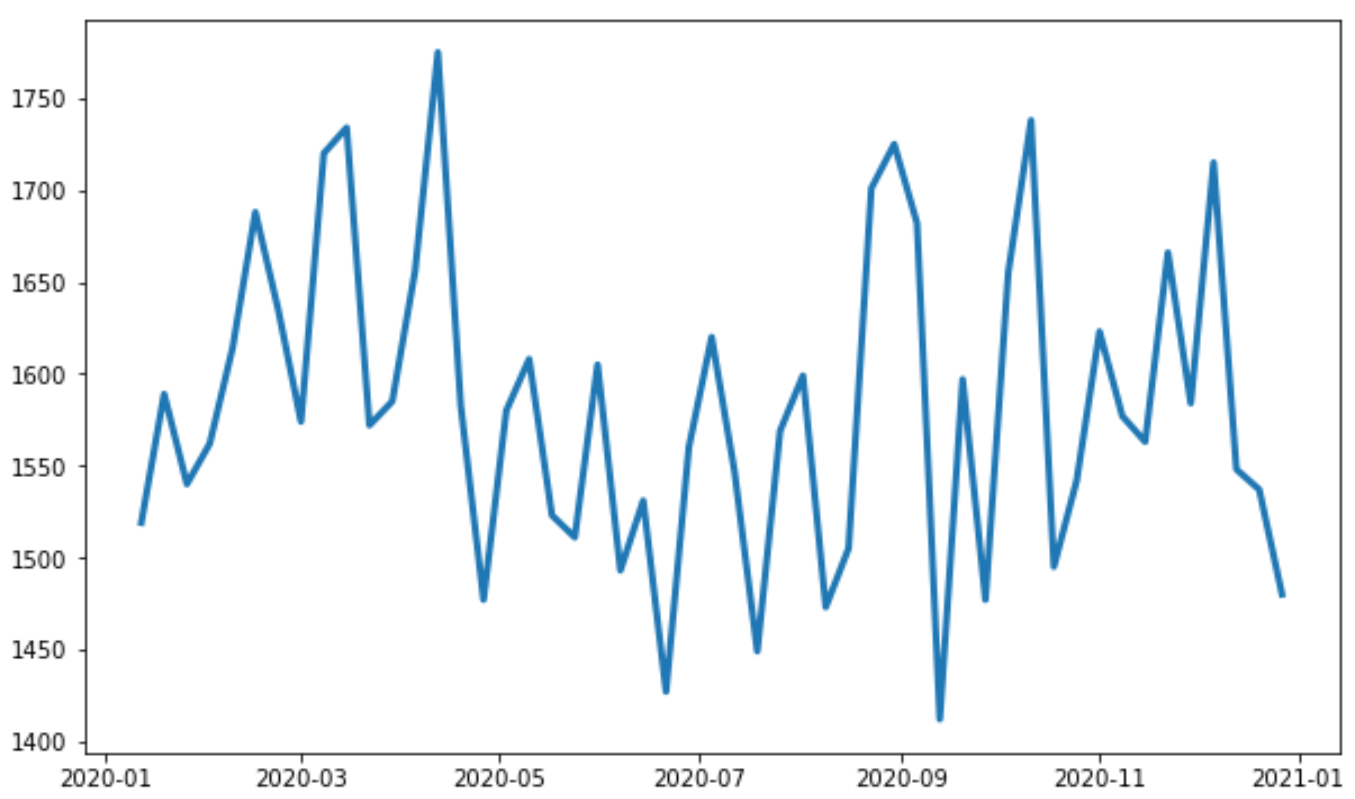
La chaîne computationnelle débute par l’agrégation des accélérations brutes en magnitude vectorielle euclidienne (ENMO) rééchantillonnée à une minute (‘1min’) par sommation intégrale. Cette série de premier niveau est ensuite filtrée pour classifier chaque minute selon des seuils standardisés d’intensité métabolique. Enfin, un second cycle de rééchantillonnage via .resample('W-MON') opère l’intégration cumulative hebdomadaire des volumes d’activité vigoureuse, garantissant la parfaite comparabilité des semaines d’observation entre les différentes cohortes épidémiologiques.
Ce niveau d’agrégation macroscopique permet d’identifier sans ambiguïté les ruptures de trajectoire comportementale consécutives à des interventions thérapeutiques ou des événements environnementaux perturbateurs. Par l’analyse combinée des moyennes hebdomadaires et des déviations standard mobiles sur ces séries stabilisées, l’analyste dégage des marqueurs prédictifs robustes du maintien ou de l’abandon progressif des habitudes de vie favorables à la santé.
11. Optimisation algorithmique et passage à l’échelle sur volumétries massives
11.1 Efficacité mémoire et vectorisation native
Le traitement des séries chronologiques industrielles ou financières massives s’étend fréquemment sur des dizaines de millions de lignes, saturant rapidement la mémoire vive disponible si aucune discipline de typage n’est appliquée. Par défaut, l’interpréteur Python et Pandas instancient les valeurs à virgule flottante au format standard float64 (huit octets par scalaire) et les index en précision 64 bits. Un premier niveau d’optimisation structurelle réside dans la conversion raisonnée (downcasting) des types primitifs : transformer des colonnes numériques en float32 permet de réduire de 50 % l’empreinte mémoire brute avant tout rééchantillonnage.
Sur le plan algorithmique, l’analyste doit formellement proscrire l’implémentation de boucles itératives manuelles en Python (telles que les compréhensions de listes ou l’itération via iterrows()). L’ensemble des routines de la méthode resample() et de ses fonctions d’agrégation terminales est nativement implémenté et vectorisé en langage C et Cython au sein du code source de Pandas. Toute boucle personnalisée introduit un surcoût d’indirection massif qui dégrade les temps d’exécution de plusieurs ordres de grandeur.
Pour surveiller et auditer rigoureusement ces consommations matérielles, l’instrumentation du code via des bibliothèques de profilage de mémoire vive (telles que memory_profiler ou l’infrastructure native tracemalloc) s’avère indispensable. Face à des volumétries excédant la capacité de la mémoire vive physique, la mise en œuvre de techniques de découpage par partitionnement temporel (chunking via read_csv(chunksize=...) ou le traitement par blocs temporels étanches) permet d’exécuter des rééchantillonnages continus sans jamais provoquer d’erreurs de saturation mémoire (Out-of-Memory).
11.2 Accélération parallèle et alternatives modernes
Bien que Pandas demeure la référence canonique pour les travaux d’analyse exploratoire et les séries chronologiques de taille modérée, son modèle d’exécution monothread limite son efficacité sur des jeux de données d’échelle supérieure. Des architectures logicielles modernes ont émergé pour pallier cette contrainte, au premier rang desquelles figurent Polars, Dask et DuckDB.
Polars, conçu en langage Rust, réinvente la manipulation des séries temporelles au moyen du parallélisme multi-cœur natif et d’une vectorisation avancée exploitant les instructions SIMD du processeur. Sa méthode group_by_dynamic() permet d’exécuter des rééchantillonnages temporels équivalents à ceux de Pandas avec des accélérations de vitesse atteignant fréquemment un facteur dix à trente, tout en réduisant drastiquement l’empreinte mémoire vive grâce au format standardisé Apache Arrow. Pour les séries temporelles gigantesques distribuées sur des grappes de calcul, Dask DataFrame offre une abstraction mimant l’API de Pandas tout en distribuant le calcul d’agrégation temporelle sur une multiplicité de nœuds physiques.
Concomitamment, le moteur SQL embarqué DuckDB s’affirme comme une solution d’une efficacité redoutable pour exécuter des agrégations temporelles massives directement sur des fichiers de stockage persistants sans passage intermédiaire par des structures en mémoire vive. DuckDB traite nativement les fenêtres temporelles au travers de ses fonctions time_bucket(), permettant d’exécuter des sous-échantillonnages complexes à des vitesses défiant les pipelines d’ingénierie les plus sophistiqués.
11.3 Optimisation des pipelines d’entrées/sorties (I/O)
L’efficience globale d’une chaîne de traitement de séries chronologiques ne dépend pas uniquement de la vitesse des algorithmes d’agrégation ; elle est tributaire de manière critique des performances de lecture et d’écriture sur disque physique. La persistance systématique de séries volumineuses sous la forme de fichiers texte délimités (CSV) constitue un goulot d’étranglement majeur : la sérialisation et la désérialisation de dates sous format textuel mobilisent une charge processeur considérable et consomment un espace de stockage démesuré.
Il est impératif d’adopter des formats de stockage colonnaires optimisés pour les séries chronologiques, tels qu’Apache Parquet ou Feather. Ces formats binaires préservent nativement le typage précis des horodatages sous forme d’entiers 64 bits, éradiquant tout surcoût de réencodage de texte lors du chargement. De plus, ils intègrent des algorithmes de compression hautement performants (Snappy, Zstandard) et organisent les données en groupes de lignes (row groups) indexés par des métadonnées temporelles de bornes minimales et maximales, autorisant l’élagage prédictif (predicate pushdown) qui évite de lire les blocs de données hors du champ temporel ciblé.
Enfin, pour les architectures de traitement de flux quasi-temps réel, la mise en cache méthodique des résultats de rééchantillonnage intermédiaire au moyen de bases de données temporelles spécialisées (telles que TimescaleDB ou InfluxDB) prévient la réévaluation redondante de fenêtres historiques stables et non modifiées. L’application combinée d’un stockage colonnaire binaire et d’une stratégie de mise en cache différentielle permet d’atteindre une fluidité computationnelle optimale sur des architectures de production pérennes.
12. Pièges méthodologiques, biais d’inférence et recommandations de clôture
12.1 Biais d’anticipation et contamination causale (Look-ahead bias)
Le biais d’anticipation (communément désigné sous le vocable anglo-saxon de look-ahead bias) représente l’écueil méthodologique le plus destructeur en modélisation temporelle. Il se matérialise dès lors qu’un algorithme d’apprentissage automatique, un modèle économétrique ou un protocole inférentiel exploite, pour formuler une estimation à l’instant $t$, des informations qui n’étaient pas empiriquement observables à ce point chronologique précis. Dans le contexte du rééchantillonnage temporel sous Pandas, ce biais s’infiltre insidieusement par une mauvaise maîtrise des paramètres d’intervalles closed et label.
Illustrons empiriquement ce phénomène : supposons qu’une série horaire soit rééchantillonnée sur une base journalière (‘D’). Si l’analyste configure la fonction avec label='left', l’agrégation de toutes les mesures relevées entre 00:00:00 et 23:59:59 le 1er janvier portera l’étiquette temporelle 2024-01-01 00:00:00. Tout modèle prédictif évaluant une décision le 1er janvier à l’aube incorporera ainsi, à son insu, des valeurs de cours, de température ou d’accidents qui ne surviendront que dans l’après-midi ou la soirée. Les métriques d’évaluation hors-échantillon (comme le coefficient de détermination $R^2$ ou la précision de classification) atteindront des niveaux mirobolants lors de la validation rétrospective, mais le modèle s’effondrera instantanément lors de son déploiement prospectif en production réelle.
Pour immuniser les protocoles expérimentaux contre cette contamination temporelle, une discipline stricte s’impose : toute fenêtre d’agrégation rétrospective doit impérativement porter le libellé de sa clôture temporelle effective (label='right'). De plus, l’analyste gagne à concevoir des tests de causalité formels au sein de sa chaîne d’intégration continue, consistant à injecter des perturbations aléatoires sur les données futures d’une série pour s’assurer qu’elles ne modifient en rien les prédictions générées aux pas chronologiques passés.
12.2 L’illusion de complétude et l’erreur d’imputation naïve
L’utilisation indiscriminée des techniques de sur-échantillonnage (upsampling) et d’interpolation expose les chercheurs à ce qu’il convient d’appeler l’illusion de complétude observationnelle. En passant d’une fréquence mensuelle à une grille journalière par interpolation spline, un jeu de données de 12 points empiriques se trouve artificiellement démultiplié en 365 lignes tabulaires continues et parfaitement régulières. Cette inflation numérique superficielle dissimule une vulnérabilité épistémologique fondamentale.
L’erreur méthodologique majeure consiste à injecter ces 365 observations au sein de tests statistiques inférentiels classiques (comme le test t de Student ou des régressions de Pearson) en traitant chaque ligne interpolée comme un degré de liberté observationnel authentique. Cette naïveté méthodologique entraîne un effondrement artificiel des erreurs standards, comprimant drastiquement les valeurs de $p$ et induisant des erreurs de type I massives (rejet à tort d’une hypothèse nulle d’absence d’effet). L’augmentation artificielle du nombre de points d’évaluation ne crée aucune information informationnelle réelle supplémentaire sur le plan statistique.
Lorsque des séries sur-échantillonnées doivent impérativement faire l’objet de modélisations statistiques, des corrections rigoureuses des degrés de liberté s’imposent. Les techniques d’estimation à variance corrigée (estimateurs de Newey-West) ou le recours systématique à des modèles de pondération statistique accordant un poids fractionnaire aux valeurs imputées par rapport aux nœuds empiriques réels permettent de restaurer la validité des intervalles de confiance et de prévenir les conclusions scientifiques erronées.
12.3 Synthèse procédurale et protocole de contrôle qualité
Afin de prémunir les projets d’ingénierie et de recherche contre ces multiples écueils, l’exécution de toute opération de rééchantillonnage temporel sous Python gagne à s’adosser à un protocole standardisé en cinq phases, matérialisant un arbre décisionnel rigoureux :
- Phase 1 : Audit et normalisation de l’index d’origine : Vérification de la monotonicité temporelle stricte, élimination ou arbitrage univoque des doublons chronologiques, et projection impérative sur un référentiel horaire universel (UTC) sans ambiguïté de fuseau.
- Phase 2 : Adéquation théorique du régime de rééchantillonnage : Arbitrage entre sous-échantillonnage (filtration spectrale, réduction dimensionnelle) et sur-échantillonnage (interpolation causale) en fonction de la nature phénoménologique des variables (flux extensifs versus grandeurs d’état intensives).
- Phase 3 : Configuration paramétrique stricte : Neutralisation systématique des biais d’anticipation par la fixation explicite des paramètres
closedetlabelen accord avec la causalité chronologique de l’expérience, complétée par la gestion précise des déphasages viaoriginetoffset. - Phase 4 : Diagnostic distributionnel post-transformation : Cartographie systématique de la clairsemance générée, contrôle des bilans massiques pour les grandeurs cumulatives, et validation de la préservation des moments statistiques clés par des tests d’adéquation non paramétriques.
- Phase 5 : Documentation et persistance optimisée : Enregistrement transparent des hypothèses d’interpolation au sein des métadonnées du protocole expérimental, et sérialisation de la série standardisée sous un format binaire colonnaire haute performance (Parquet).
Le respect scrupuleux de cette discipline procédurale transforme le rééchantillonnage temporel d’une manipulation algorithmique opaque en un instrument d’une précision méthodologique absolue. Il garantit la robustesse computationnelle des chaînes de traitement de données et assure l’intégrité scientifique des inférences et découvertes émergeant de l’exploration des séries temporelles complexes.
Références
- Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118619193
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
- Shannon, C. E. (1949). Communication in the presence of noise. Proceedings of the IRE, 37(1), 10–21. https://doi.org/10.1109/JRPROC.1949.232969
- Shiffman, S., Stone, A. A., & Hufford, M. R. (2008). Ecological momentary assessment. Annual Review of Clinical Psychology, 4, 1–32. https://doi.org/10.1146/annurev.clinpsy.3.022806.091415
- The Pandas Development Team. (2024). pandas-dev/pandas: Pandas (Version 2.2.0). Zenodo. https://doi.org/10.5281/zenodo.3509134
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2