
Dans le champ de la psychologie scientifique et des neurosciences cognitives et comportementales, la modélisation des processus mentaux requiert presque invariablement l’analyse simultanée de multiples déterminants. Les comportements humains, loin d’obéir à des mécanismes causaux univariés et isolés, émergent de l’entrelacement complexe de prédispositions individuelles, de contextes situationnels et d’interventions thérapeutiques ou expérimentales. L’analyse de variance à deux facteurs, communément désignée sous l’acronyme d’ANOVA factorielle à deux voies, constitue à cet égard le socle analytique fondamental permettant d’appréhender empiriquement cette complexité. En autorisant l’examen concomitant de deux variables indépendantes catégorielles sur une variable dépendante quantitative continue, cette méthode statistique transcende les comparaisons bivariées élémentaires pour révéler la dynamique des systèmes psychologiques sous-jacents.
L’environnement de programmation et de calcul statistique R s’est imposé au fil des deux dernières décennies comme le standard méthodologique dominant au sein des laboratoires universitaires et des centres de recherche internationaux. Sa flexibilité algorithmique, son ancrage au sein du paradigme de la science ouverte et la puissance de son écosystème modulaire permettent de déployer des modélisations linéaires d’une rigueur absolue. Néanmoins, l’exécution d’une ANOVA à deux facteurs au sein de cet environnement ne saurait se résumer à une simple séquence de commandes algorithmiques ou à la sollicitation machinale de scripts préétablis. Elle exige une compréhension intime des hypothèses distributionnelles, de l’algèbre linéaire gouvernant la décomposition des sommes des carrés, ainsi qu’une vigilance constante quant aux structures de données déséquilibrées, fréquemment rencontrées dans les protocoles cliniques et quasi-expérimentaux.
Ce guide exhaustif et méthodique a été conçu pour accompagner le chercheur, l’enseignant-chercheur, le statisticien ou l’étudiant doctoral à travers l’ensemble des étapes requises pour concevoir, exécuter, interpréter et publier une ANOVA à deux facteurs dans le logiciel R selon les standards académiques les plus rigoureux. De la formalisation théorique du modèle linéaire général aux ajustements post-hoc via les moyennes marginales estimées, en passant par les diagnostics résiduels approfondis et le traitement des violations de postulats, chaque étape est disséquée tant sur le plan conceptuel que sur le plan de sa programmation effective. En adoptant les préceptes de la 7e édition du manuel de publication de l’American Psychological Association, cet article offre une feuille de route complète pour transformer des données brutes en inférences scientifiques irréprochables et reproductibles.
1. Fondements théoriques de l’ANOVA à deux facteurs en psychologie
1.1 Définition et formalisation mathématique du plan factoriel
L’analyse de variance à deux facteurs repose sur l’extension directe du modèle linéaire généralisé appliqué à des données expérimentales discrètes réparties selon deux dimensions de classification. Dans ce cadre, la variation totale observée au sein d’un ensemble d’observations quantitatives continues est mathématiquement décomposée en composantes additives orthogonales ou quasi-orthogonales. Sur le plan fondamental, la somme totale des carrés des écarts à la moyenne générale est partitionnée en deux variations fondamentales : la variance intergroupes, attribuable aux effets systématiques des facteurs expérimentaux manipulés et de leur combinaison, et la variance résiduelle intra-groupe, qui reflète la variabilité stochastique, les différences interindividuelles inhérentes à l’échantillon et l’erreur de mesure non contrôlée.
Dans un plan factoriel à deux variables indépendantes, conventionnellement notées A et B, chaque facteur comprend un nombre fini de modalités mutuellement exclusives, désignées respectivement par les indices i (allant de 1 à p) et j (allant de 1 à q). L’intersection de chaque niveau du facteur A avec chaque niveau du facteur B définit une cellule expérimentale élémentaire contenant un groupe de sujets observés. Le modèle linéaire sous-jacent s’exprime formellement par l’équation structurelle suivante pour chaque observation individuelle k (allant de 1 à n au sein de chaque cellule) :
Yijk = μ + αi + βj + (αβ)ij + εijk
Dans cette formulation paramétrique, Yijk représente le score brut obtenu par le k-ième individu exposé à la modalité i du facteur A et à la modalité j du facteur B. La constante μ désigne la moyenne théorique globale de la population parente non subdivisée. Le paramètre αi quantifie l’effet propre de la modalité i du facteur A sous la contrainte d’identifiabilité habituelle imposant que la somme pondérée de ces effets soit nulle. De manière symétrique, βj symbolise l’effet différentiel associé à la modalité j du facteur B. L’élément central (αβ)ij représente la composante d’interaction non additive spécifique à l’association des deux modalités considérées. Enfin, εijk désigne le terme d’erreur résiduelle non expliquée, modélisé comme une variable aléatoire indépendante et identiquement distribuée suivant une distribution normale d’espérance nulle et de variance homogène σ2.
L’hypothèse nulle globale soumise à l’épreuve statistique n’est pas unique dans un plan factoriel ; elle se scinde en trois épreuves d’hypothèses distinctes et formellement indépendantes en présence de plans équilibrés. La première hypothèse nulle postule l’absence de tout effet principal du facteur A (tous les αi sont simultanément nuls). La deuxième postule l’absence d’effet principal du facteur B (tous les βj sont nuls). La troisième hypothèse nulle, souvent la plus cruciale sur le plan théorique, soutient la stricte additivité des effets, c’est-à-dire l’inexistence d’une interaction entre les deux facteurs (tous les termes (αβ)ij sont rigoureusement nuls).
Il est impératif de distinguer sur le plan formel les plans factoriels croisés des plans hiérarchisés ou emboîtés. Dans un plan factoriel croisé standard, chaque modalité du facteur A est croisée avec l’intégralité des modalités du facteur B, permettant une estimation complète et symétrique de tous les effets principaux et des termes d’interaction croisée. En revanche, dans un plan hiérarchisé, les niveaux d’un facteur donné ne prennent sens qu’au sein d’un niveau particulier du facteur englobant, interdisant le calcul d’un effet d’interaction conventionnel et requérant une paramétrisation spécifique des carrés moyens résiduels.
1.2 Distinction entre effets principaux et effets d’interaction
L’effet principal d’une variable indépendante reflète la modulation de la variable dépendante sous l’influence unique de ce facteur, calculée en agrégeant les données à travers l’ensemble des modalités du second facteur. Autrement dit, l’effet principal du facteur A évalue si les moyennes marginales des différents niveaux i diffèrent significativement entre elles lorsque l’on neutralise mathématiquement l’influence du facteur B. Cette approche marginale offre une perspective synthétique globale mais peut masquer des disparités structurales substantielles si le comportement des individus varie de façon asymétrique selon les contextes expérimentaux.
L’effet d’interaction mathématique caractérise quant à lui une rupture de l’additivité des effets simples. Sur le plan conceptuel, il y a interaction lorsque l’ampleur, la trajectoire ou la direction de l’effet d’un premier facteur dépend directement du niveau spécifique assigné au second facteur. Si, par exemple, un protocole de remédiation cognitive n’améliore la mémoire de travail que chez des participants présentant un niveau initial d’anxiété faible, mais s’avère totalement inefficace, voire délétère, chez des sujets hautement anxieux, la moyenne globale de l’intervention dissimule la réalité du phénomène. Les deux facteurs n’agissent pas comme des forces indépendantes dont les effets s’additionnent de façon arithmétique, mais s’articulent dans une interdépendance fonctionnelle.
Sur le plan épistémologique et clinique dans l’étude des comportements humains, l’effet d’interaction constitue fréquemment l’objet de recherche premier. L’interaction incarne la contextualisation des lois psychologiques, confirmant le postulat lewinien classique selon lequel le comportement résulte de l’interaction constante entre les caractéristiques structurales de la personne et les propriétés objectives de l’environnement. Dans les recherches sur l’efficacité des psychothérapies, l’identification d’une interaction traitement-par-patient constitue la condition statistique sine qua non pour valider la personnalisation des trajectoires de soins et dépasser les approches universelles indifférenciées.
Cette primauté théorique de l’interaction impose une règle méthodologique immuable dans la hiérarchisation analytique de l’ANOVA factorielle : l’inspection et le test de l’interaction doivent impérativement précéder toute tentative d’interprétation des effets principaux. En présence d’une interaction statistiquement significative et d’ampleur substantielle, la notion même d’effet principal perd la majeure partie de sa validité écologique et explicative. L’analyse des effets simples conditionnels s’impose alors pour expliciter la nature précise des mécanismes à l’œuvre.
1.3 Pertinence méthodologique dans la recherche expérimentale en psychologie
Le recours aux plans factoriels à deux facteurs offre des avantages méthodologiques considérables qui surpassent très largement la conduite d’expérimentations univariées disjointes. En premier lieu, ce paradigme expérimental permet l’étude conjointe de facteurs dispositionnels, intrinsèques au sujet (comme le tempérament, le profil neuropsychologique ou le genre biologique), et de facteurs situationnels, manipulés directement par l’expérimentateur (tels que le type de tâche, l’exposition à un stresseur aigu ou la charge cognitive imposée). Cette conjonction optimise la validité externe et écologique des protocoles de laboratoire en intégrant la variabilité humaine au lieu de la traiter exclusivement comme un bruit résiduel.
En second lieu, l’ANOVA factorielle permet une optimisation spectaculaire de la puissance statistique globale sans nécessiter une inflation de la taille globale de l’échantillon. Lorsqu’un chercheur teste deux facteurs de manière isolée au sein de deux protocoles indépendants, il doit recruter deux cohortes expérimentales complètes. Dans un plan factoriel croisé, chaque sujet contribue simultanément à l’estimation de l’effet du facteur A, à l’estimation de l’effet du facteur B et à la modélisation de leur interaction. De surcroît, l’inclusion d’une seconde variable explicative pertinente dans le modèle linéaire permet d’isoler une part substantielle de la variance totale qui aurait autrement été amalgamée dans la somme des carrés résiduelle intra-groupe, réduisant ainsi le dénominateur des ratios F et augmentant la sensibilité statistique de l’ensemble du dispositif.
Enfin, l’ANOVA factorielle garantit un contrôle mathématique strict de l’erreur de premier type globale (taux d’erreur α de l’expérience). La multiplication irréfléchie de tests t de Student univariés pour examiner les sous-groupes expose inévitablement l’expérimentateur au problème classique de l’inflation de l’erreur par famille de comparaisons, selon la fonction exponentielle standardisée 1 – (1 – α)c, où c représente le nombre total de contrastes évalués. En formalisant l’analyse à l’intérieur d’un cadre paramétrique unifié via le ratio de Fisher-Snedecor, l’ANOVA garantit que le risque de déclarer à tort un effet inexistant dans la population demeure cantonné au seuil nominal préétabli, usuellement fixé à 0,05.
2. Hypothèses statistiques et prérequis fondamentaux
2.1 Indépendance des observations et structure de l’échantillonnage
Le postulat d’indépendance des observations représente la condition mathématique la plus impérative et la moins robuste de l’analyse de variance factorielle. Cette hypothèse stipule formellement que l’erreur résiduelle associée à n’importe quelle observation εijk n’entretient aucune relation de corrélation ou de dépendance stochastique avec l’erreur résiduelle d’une quelconque autre observation εi’j’k’. Dans le contexte des protocoles expérimentaux inter-sujets (between-subjects designs), chaque participant ne doit être assigné qu’à une et une seule cellule expérimentale définie par l’intersection des modalités des facteurs, et la passation de l’épreuve doit être conduite de manière à exclure toute interaction communicative ou imitation comportementale entre les participants.
Le non-respect de l’indépendance survient couramment lors de biais d’échantillonnage insidieux, tels que le recrutement en grappes non contrôlées (par exemple, des élèves partageant une même classe scolaire, des patients traités par le même thérapeute ou des mesures collectées par vagues successives soumises à des fluctuations d’environnement). Lorsque des observations sont corrélées positivement en raison d’une structure groupée sous-jacente, la variance d’échantillonnage empirique est systématiquement sous-estimée. Cette distorsion engendre une inflation spectaculaire des statistiques F observées et augmente massivement le taux d’erreur de première espèce effectif, qui peut atteindre des valeurs excédant 0,30 pour un seuil nominal théorique fixé à 0,05.
Il est dès lors primordial d’opérer une distinction conceptuelle sans équivoque entre un plan factoriel inter-sujets authentique et un plan mixte ou à mesures répétées (within-subjects design). Si l’un des deux facteurs manipulés implique des évaluations répétées d’une même cohorte d’individus à travers le temps ou sous différentes conditions perceptives, la covariance naturelle intra-sujet invalide l’application de l’ANOVA factorielle standard et nécessite impérativement le recours à l’ANOVA pour mesures répétées avec correction de sphéricité ou, préférentiellement, l’emploi de modèles linéaires mixtes à effets aléatoires.
2.2 Normalité de la distribution des résidus
Une confusion récurrente parmi les praticiens de l’analyse quantitative consiste à exiger la normalité de la distribution globale de la variable dépendante brute avant toute tentative de modélisation. Cette exigence est scientifiquement erronée. Le postulat théorique de l’ANOVA ne porte en aucun cas sur la distribution marginale inconditionnelle de la variable réponse Y, mais concerne exclusivement la distribution conditionnelle des erreurs résiduelles du modèle, c’est-à-dire les déviations des observations individuelles par rapport à la moyenne estimée de leur propre cellule d’appartenance.
Formellement, les erreurs ε doivent suivre une distribution gaussienne d’espérance nulle :
εijk ~ N(0, σ2)
Lorsque la distribution des résidus s’éloigne notablement de cette forme en cloche, présentant une asymétrie marquée (skewness) ou un aplatissement excessif (kurtosis leptokurtique ou platykurtique), la forme mathématique théorique de la statistique de test ne correspond plus exactement à la loi continue de Fisher-Snedecor sous l’hypothèse nulle. Néanmoins, en vertu du théorème central limite appliqué aux formes linéaires, l’ANOVA démontre une robustesse statistique remarquable face aux déviations modérées de la normalité, à condition impérative que les effectifs par cellule soient équilibrés et suffisamment conséquents (usuellement n ≥ 20 à 30 par sous-groupe).
Cette tolérance asymptotique s’amenuise toutefois drastiquement lorsque les échantillons sont réduits ou que les distributions résiduelles sont fortement multimodales ou tronquées en raison d’effets de plancher ou de plafond dans les instruments de mesure psychométriques. Dans de telles situations, la probabilité associée au test F perd sa calibration exacte, imposant des vérifications formelles et, le cas échéant, des transformations de variables ou des rééchantillonnages non paramétriques.
2.3 Homoscédasticité et égalité des variances intergroupes
L’hypothèse d’homoscédasticité, ou d’homogénéité des variances, exige que la variance de l’erreur résiduelle demeure constante et uniforme à travers toutes les p × q cellules expérimentales constitutives du plan d’échantillonnage. En d’autres termes, l’écart-type de la variable dépendante mesuré au sein du groupe exposé aux conditions (i, j) doit être théoriquement équivalent à celui mesuré au sein de n’importe quel autre groupe expérimental. Cette hypothèse conditionne la légitimité du calcul d’un carré moyen résiduel unique, utilisé comme dénominateur universel pour évaluer la significativité de l’ensemble des sources de variation intergroupes.
L’impact de la violation de l’homoscédasticité dépend de manière critique de l’équilibre des effectifs entre les cellules. Lorsque le plan d’expérience est rigoureusement équilibré, c’est-à-dire lorsque chaque cellule contient rigoureusement le même nombre de participants, le test F d’ANOVA demeure extrêmement robuste à des écarts d’hétéroscédasticité modérés à substantiels. La statistique F conserve alors une distribution d’échantillonnage très proche de sa valeur nominale.
En revanche, la conjonction d’une hétéroscédasticité marquée et d’un plan expérimental déséquilibré (unbalanced design) induit des altérations gravissimes du comportement statistique du modèle. Si les groupes possédant les plus petits effectifs présentent les variances résiduelles les plus volumineuses, l’erreur type globale est lourdement sous-estimée, conduisant à un test excessivement libéral dont le taux d’erreur de type I réel est dramatiquement gonflé. Inversement, si les groupes d’effectifs les plus massifs affichent les variances les plus dispersées, le test F devient ultraconservateur, entraînant une chute drastique de la puissance statistique (erreur de type II). En règle empirique, les méthodologistes recommandent que le ratio entre la variance empirique maximale observée et la variance minimale observée au sein des cellules ne dépasse pas un facteur de 3 à 4 pour tolérer l’application de l’ANOVA sans correction spécifique.
3. Configuration de l’environnement de travail et préparation des données dans R
3.1 Installation et chargement des extensions spécialisées
Pour assurer la rigueur du traitement statistique et l’intégrité de l’analyse, l’environnement de base fourni par l’installation standard de R doit être enrichi par un ensemble de modules spécialisés issus du dépôt officiel CRAN. L’écosystème moderne de la science des données dans R repose sur une architecture combinant des outils de manipulation tabulaire, des modules d’ajustement de modèles linéaires complexes et des utilitaires d’extraction des tailles d’effet standardisées.
Le méta-package tidyverse forme le socle fondamental pour l’ingestion, le nettoyage et la manipulation des structures de données via des syntaxes hautement lisibles centrées sur les verbes d’action du package dplyr et la grammaire graphique de ggplot2. Pour les calculs statistiques avancés, le package car, développé par John Fox et Sanford Weisberg, est indispensable pour calculer les sommes des carrés ajustées selon les principes du Type II et du Type III face aux plans déséquilibrés. Le package rstatix propose des implémentations de tests d’hypothèses totalement intégrables dans des chaînes d’instructions chaînées, tandis que le package effectsize permet l’extraction immédiate des indices d’amplitude d’effet tels que l’éta-carré partiel et l’oméga-carré accompagnés de leurs intervalles de confiance exacts.
L’installation s’opère via la fonction canonique install.packages(), suivie de leur activation au début de la session de travail grâce à la fonction library(). De surcroît, afin d’assurer la reproductibilité intégrale des simulations de données et des diagnostics d’échantillonnage, la fixation d’une graine aléatoire explicite via la commande set.seed() constitue une règle d’or déontologique dans toute analyse quantitative.
3.2 Création et structuration du jeu de données expérimental
Afin d’illustrer la démarche de manière concrète et opérationnelle, considérons un protocole expérimental conduit en psychologie cognitive de la santé. L’étude examine l’influence conjointe de deux facteurs : le facteur Genre biologique (à deux modalités : Féminin vs Masculin) et le facteur Intensité_Exercice physique aérobie (à trois modalités ordonnées : Faible, Modérée, Élevée) sur les performances à un test standardisé d’attention sélective (mesurée par un score continu allant théoriquement de 50 à 120 points).
Un jeu de données représentatif de ce design factoriel 2 × 3 peut être généré ou importé directement sous la forme d’un tableau rectangulaire (data frame ou tibble). Chaque ligne de ce tableau doit impérativement représenter une unité observationnelle distincte (un participant unique), tandis que les colonnes matérialisent les deux variables indépendantes de groupement et la variable dépendante continue. Cette structuration correspond rigoureusement au format long ou normalisé exigé par l’intégralité des algorithmes de modélisation dans R.
Après l’instanciation de l’objet de données, deux vérifications préliminaires s’imposent : l’examen systématique de la morphologie tabulaire au moyen des fonctions str() et head(), qui confirme le bon nombre d’enregistrements et les intitulés des variables, et l’évaluation de la contingence des effectifs via la commande table(). Cette dernière opération permet de constater immédiatement si le plan expérimental est strictement équilibré (nombres identiques d’observations dans chacune des 6 cellules du plan) ou s’il comporte des cellules déséquilibrées résultant d’abandons expérimentaux (attrition).
3.3 Typage rigoureux et encodage des facteurs
L’une des causes les plus courantes d’erreurs gravissimes dans l’exécution d’une ANOVA dans R provient du typage défaillant des variables catégorielles. Par défaut, lors de l’importation de fichiers textes, de feuilles de calcul Excel ou de bases de données relationnelles, les colonnes textuelles sont fréquemment importées sous le format de chaînes de caractères brutes (type character), ou pire, sous la forme d’entiers numériques arbitraires (par exemple 1 pour Faible, 2 pour Modérée, 3 pour Élevée) si les modalités ont été préalablement codées sous forme chiffrée.
Si un analyste transmet une variable codée en entiers numériques à la fonction d’ajustement du modèle sans conversion factorielle préalable, le moteur mathématique de R traitera cette variable comme un prédicteur continu dans le cadre d’une régression linéaire simple ou polynomiale. Au lieu d’estimer les écarts moyens entre les niveaux qualitatifs et de consommer deux degrés de liberté pour un facteur à trois modalités, le logiciel n’ajustera qu’une seule pente linéaire continue, dénaturant ainsi complètement l’analyse de variance factorielle.
Pour immuniser l’analyse contre cet écueil méthodologique, il est obligatoire d’appliquer la fonction factor() ou la fonction de coercition as.factor() aux colonnes explicatives. Cette procédure permet de déclarer explicitement les étiquettes textuelles ainsi que l’ordre des niveaux sous-jacents. La vérification peut être exécutée instantanément à l’aide de la commande is.factor(), garantissant que le moteur linéaire instanciera correctement les variables indicatrices muettes (dummy variables) indispensables à la paramétrisation matricielle du plan d’expérience.
4. Analyse exploratoire et visualisation descriptive préliminaire
4.1 Agrégation des statistiques descriptives conditionnelles
L’estimation globale des paramètres centraux à l’échelle de la cohorte entière ne présente qu’une utilité marginale dans un plan factoriel. Le statisticien doit impérativement ventiler l’exploration descriptive selon les cellules spécifiques définies par le croisement des deux variables indépendantes. Cette étape fondamentale permet de cartographier la structure des réponses, d’anticiper la présence potentielle d’un effet d’interaction et de vérifier la cohérence des ordres de grandeur mesurés.
L’exploitation de la syntaxe chaînée avec le package dplyr permet d’articuler consécutivement les opérations de partitionnement et d’agrégation. En appliquant la fonction group_by(Genre, Intensite_Exercice) suivie de la fonction summarise(), on extrait pour chaque combinaison factorielle la moyenne empirique (M), l’écart-type d’échantillon (SD), la médiane, l’écart interquartile (IQR) ainsi que l’erreur type de la moyenne (SEM), calculée par le ratio de l’écart-type sur la racine carrée de l’effectif local :
SEM = SD / √n
L’inspection comparée de la moyenne et de la médiane au sein de chaque cellule offre un premier indicateur robuste de la symétrie locale des distributions. Si ces deux indices de tendance centrale divergent notablement au sein d’une ou plusieurs cellules, une déviation par rapport à la loi normale ou la présence d’observations extrêmes asymétriques doit être suspectée. De même, l’observation des écarts-types cellule par cellule permet d’établir un diagnostic visuel préliminaire quant au respect ou à la dégradation de l’homoscédasticité.
4.2 Visualisation descriptive par boîtes à moustaches avec ggplot2
Bien que les tableaux synthétiques fournissent des repères numériques incontournables, la représentation graphique de la distribution empirique est indispensable pour appréhender l’architecture complète des données. La boîte à moustaches (boxplot), enrichie d’une superposition des données individuelles réelles, constitue le paradigme de référence pour les revues scientifiques de haut niveau.
En mobilisant la bibliothèque ggplot2, la structure visuelle s’articule en assignant le facteur Intensite_Exercice à l’axe horizontal d’abscisse et le score continu d’attention à l’axe vertical d’ordonnée. Le second facteur, Genre, est mappé à l’attribut chromatique de remplissage (fill). Cette disposition produit des paires juxtaposées de boîtes à moustaches qui matérialisent instantanément la médiane, les charnières délimitant les premier et troisième quartiles, ainsi que les limites des valeurs adjacentes selon la convention de John Tukey.
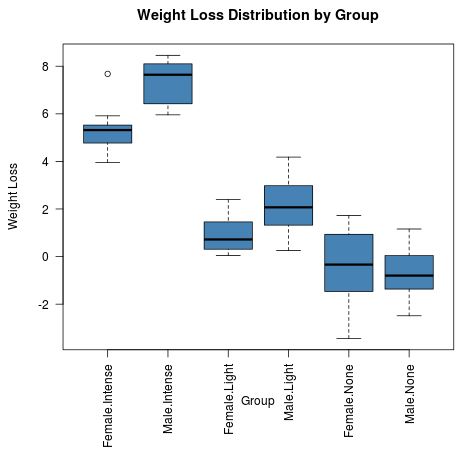
L’adjonction d’une couche géométrique de points dispersés à l’aide de geom_jitter() avec une faible transparence (alpha) et une largeur de dispersion contrôlée permet d’observer la granularité fine de l’échantillon tout en neutralisant le masquage des observations superposées. Cette stratification permet de repérer immédiatement la présence d’observations aberrantes isolées se situant au-delà des limites des moustaches, tout en évaluant l’homogénéité visuelle de l’étalement des distributions intra-groupes à travers l’ensemble des six conditions du dispositif expérimental.
4.3 Tracé préliminaire des profils de moyennes
Le tracé des profils de moyennes, ou graphique d’interaction préliminaire, est l’outil diagnostique de référence pour prévisualiser la dynamique relationnelle entre les facteurs. Historiquement généré par la fonction interaction.plot() de l’environnement de base de R, il relie par des segments rectilignes les moyennes calculées de la variable dépendante à travers les modalités du facteur d’abscisse, en traçant des lignes distinctes pour chaque niveau du second facteur catégoriel.
L’analyse visuelle de la configuration géométrique des tracés fournit une indication clinique immédiate quant à l’existence ou à l’absence d’une composante d’interaction. Lorsque les segments reliant les moyennes sont rigoureusement parallèles, l’effet du premier facteur s’exerce de manière strictement uniforme quel que soit le niveau du second facteur. Cette configuration signale la validité d’un modèle purement additif sans interaction significative.
À l’inverse, l’observation de lignes non parallèles constitue l’empreinte graphique d’une interaction. Deux typologies structurelles se distinguent : les interactions ordinales, dans lesquelles les pentes des segments divergent sans jamais se croiser (indiquant que l’ampleur de l’effet varie selon les modalités mais que la hiérarchie relative des groupes demeure constante), et les interactions disjonctives ou croisées (cross-over interactions), où les segments se coupent formellement dans l’espace factoriel. Ce dernier cas illustre une inversion directionnelle de l’effet, situation dans laquelle une condition expérimentale s’avère hautement bénéfique dans un contexte mais délétère dans l’autre.
5. Vérification empirique des postulats sous R
5.1 Évaluation de la normalité des résidus
L’évaluation rigoureuse du postulat de normalité nécessite d’extraire formellement les résidus après l’ajustement du modèle factoriel complet. Dans l’environnement R, cette opération s’effectue directement sur l’objet modèle instancié via la fonction residuals() ou rstandard() pour obtenir les résidus standardisés (réduits par l’estimation de leur écart-type résiduel). Cette démarche conditionnelle permet d’agréger l’ensemble des écarts individuels nets pour évaluer globalement le comportement distributionnel du processus générateur de données.
Le test d’adéquation statistique le plus rigoureux pour de petits à moyens échantillons est le test de Shapiro-Wilk, sollicité au moyen de la fonction shapiro.test() appliquée au vecteur des résidus du modèle. L’hypothèse nulle du test pose que les résidus proviennent d’une population gaussienne. Dès lors, l’obtention d’une p-valeur supérieure au seuil critique conventionnel de 0,05 conduit à ne pas rejeter l’hypothèse de normalité, attestant que les fluctuations observées sont compatibles avec les prérequis de l’inférence par le test F.
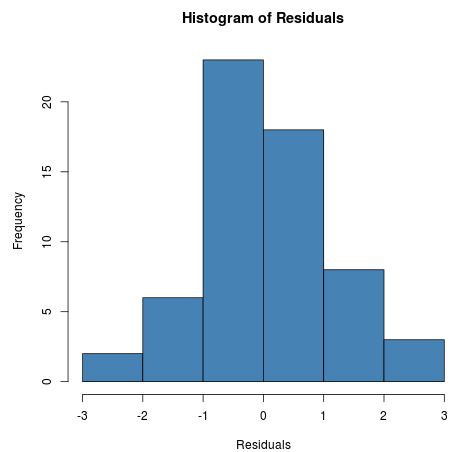
Toutefois, l’usage aveugle du test de Shapiro-Wilk comporte des limites méthodologiques majeures bien documentées. Sur des échantillons de très grande taille (plusieurs centaines d’individus), le test acquiert une puissance statistique excessive et devient sensible à des déviations triviales n’ayant aucun impact pratique sur la robustesse du ratio F. Inversement, sur de très faibles échantillons, il manque cruellement de puissance pour déceler des asymétries problématiques. C’est pourquoi l’analyse quantitative doit obligatoirement être corroborée par l’inspection visuelle du diagramme quantile-quantile (Q-Q plot), où les quantiles empiriques des résidus standardisés sont projetés contre les quantiles théoriques d’une loi normale standard. Un alignement régulier des points le long de la bissectrice d’égalité confirme l’adéquation distributionnelle, tandis que des courbures en S ou des décrochages distaux dénoncent respectivement des distributions asymétriques ou à queues épaisses.
5.2 Test de l’homoscédasticité des variances
Pour vérifier le respect de l’hypothèse d’homogénéité des variances à travers les cellules du plan factoriel, le test d’homoscédasticité de référence est le test de Levene. Contrairement au test historique de Bartlett qui souffre d’une hypersensibilité rédhibitoire à la moindre entorse de la normalité des données, le test de Levene, en particulier dans sa version modifiée par Brown et Forsythe, utilise des écarts calculés par rapport à la médiane de chaque groupe au lieu de la moyenne.
Sous R, l’implémentation la plus fiable est assurée par la fonction leveneTest() accessible via le package car. La syntaxe prend formellement en entrée la formule factorielle croisée :
leveneTest(Score ~ Genre * Intensite_Exercice, data = donnees, center = median)
Dans ce cadre décisionnel, l’hypothèse nulle pose l’égalité absolue des variances de la variable réponse à travers l’ensemble des p × q groupes formés par le croisement factoriel. L’obtention d’une statistique F non significative associée à une probabilité supérieure à 0,05 confirme que la variabilité résiduelle intra-groupe peut être assimilée à une valeur homogène commune σ2. L’analyste est dès lors fondé à exploiter le carré moyen de l’erreur calculé globalement sans craindre de biais systématique sur le taux d’erreur de première espèce.
5.3 Diagnostic des observations atypiques et points d’influence
L’estimation des moindres carrés ordinaires qui structure l’ANOVA est intrinsèquement vulnérable à l’influence disproportionnée exercée par un nombre restreint d’observations extrêmes ou atypiques (outliers). Une seule mesure aberrante résultant d’une erreur de saisie, d’un défaut d’attention passager du sujet ou d’un artefact technique peut gonfler artificiellement la variance résiduelle et déformer les estimations des moyennes de cellules.
Le diagnostic moderne combine l’examen des résidus standardisés et l’estimation de la distance de Cook. Un résidu standardisé dont la valeur absolue excède le seuil de 3 unités d’écart-type est unanimement qualifié d’observation atypique sévère. La fonction identify_outliers() du package rstatix permet de scanner automatiquement l’ensemble des résidus du modèle pour isoler les points extrêmes. Parallèlement, la distance de Cook quantifie l’amplitude du déplacement global des coefficients de régression et des estimations du modèle en cas d’omission d’une observation spécifique. Une observation associée à une distance de Cook excédant le seuil empirique de 4 / (N – k – 1), où N est la taille totale de l’échantillon et k le nombre de paramètres estimés, doit faire l’objet d’une analyse clinique approfondie.
La doctrine méthodologique contemporaine récuse la suppression systématique et aveugle des valeurs atypiques dans l’unique but d’améliorer l’ajustement du modèle. L’exclusion d’une donnée ne peut être motivée que par la découverte avérée d’une erreur matérielle non corrigible ou par un manquement documenté aux critères stricts du protocole de passation. Lorsque l’atypicité reflète une facette légitime de la variabilité humaine, le chercheur doit maintenir l’observation au sein de la cohorte et envisager le recours à des modélisations linéaires robustes ou rapporter l’analyse avec et sans les données en cause dans une démarche de transparence méthodologique.
6. Spécification et ajustement du modèle avec aov()
6.1 Syntaxe de modélisation dans le langage R
L’ajustement formel de l’analyse de variance à deux facteurs s’effectue canoniquement dans l’environnement R au moyen de la fonction aov(), qui constitue une interface spécialisée encapsulant le moteur général de modélisation linéaire lm(). La formalisation de la relation d’interdépendance repose sur l’usage rigoureux d’opérateurs syntaxiques spécifiques au sein de la formule de régression.
L’opérateur multiplicatif astérisque (*) est au cœur de la spécification d’un plan factoriel complet. Lorsque l’analyste écrit la formule symbolique :
modele_complet <- aov(Score ~ Genre * Intensite_Exercice, data = donnees)
l’interpréteur de R déploie automatiquement l’expression selon le principe de décomposition hiérarchique classique. Cette formulation est l’équivalent strict et exhaustif de l’écriture explicite :
modele_complet <- aov(Score ~ Genre + Intensite_Exercice + Genre:Intensite_Exercice, data = donnees)
L’opérateur deux-points (:) isole mathématiquement le terme d’interaction bidirectionnelle en excluant les composantes principales, tandis que l’opérateur d’addition (+) spécifie un modèle purement additif sans interaction (Score ~ Genre + Intensite_Exercice). L’assignation du résultat de la fonction aov() à un objet dédié stocke l’intégralité des matrices de projection, des résidus, des valeurs ajustées et des degrés de liberté, permettant des interrogations en aval.
6.2 Lecture et décomposition de la table de variance
L’interrogation de l’objet modèle résultant s’opère usuellement via l’application de la fonction générique summary(). Cette commande génère l’affichage normalisé de la table de décomposition de la variance d’ANOVA, structurée selon une séquence rigoureuse de colonnes analytiques.
La première colonne rapporte les degrés de liberté (Df) associés à chaque terme expérimental. Pour un facteur A à p niveaux, le nombre de degrés de liberté est égal à p – 1. Pour un facteur B à q niveaux, il est égal à q – 1. Les degrés de liberté dévolus au terme d’interaction correspondent au produit algébrique des degrés de liberté de ses composantes parentes, soit (p – 1)(q – 1). Enfin, les degrés de liberté résiduels intra-groupe correspondent à la différence entre le nombre total de sujets N et le nombre total de cellules factorielles pq, soit N – pq.
La colonne suivante présente la somme des carrés (Sum Sq), mesurant la dispersion quadratique brute expliquée par chaque source de variation. La division de la somme des carrés par son degré de liberté respectif fournit la colonne des carrés moyens (Mean Sq), qui représentent des variances non biaisées :
MS = SS / Df
Le ratio de Fisher-Snedecor (F value) est ensuite calculé en divisant le carré moyen de l’effet considéré par le carré moyen résiduel de l’erreur :
F = MSEffet / MSRésiduel
La dernière colonne (Pr(>F)) rapporte la probabilité asymptotique critique (la valeur p) d’obtenir une statistique F au moins aussi extrême que celle observée sous l’hypothèse nulle. Si cette probabilité s’avère inférieure au seuil conventionnel de significativité α = 0,05, l’expérimentateur rejette l’hypothèse nulle et conclut à l’existence d’une différence systématique statistiquement significative.
6.3 Validation de l’ajustement global
Au-delà de la lecture directe des probabilités marginales, l’évaluation critique d’un modèle d’ANOVA requiert la validation de la consistance de son ajustement global. L’inspection des degrés de liberté résiduels constitue une vérification élémentaire indispensable : une discordance entre la valeur attendue par le plan expérimental théorique et la valeur affichée dans la table d’ANOVA signale immédiatement la survenue de données manquantes non identifiées (valeurs NA) ayant entraîné l’exclusion automatique de participants lors de l’estimation.
Par ailleurs, l’extraction des coefficients de régression sous-jacents au moyen de la fonction coef(modele_complet) permet de lever le voile sur la paramétrisation matricielle mise en œuvre par R. Par défaut, R emploie un codage par traitement (treatment contrasts) dans lequel la première modalité alphabétique de chaque facteur est arbitrairement érigée en condition de référence (interception). Bien que cette méthode soit rigoureusement équivalente sur le plan de la variance globale expliquée (R2 global), elle requiert une grande vigilance dès lors que l’on manipule des plans déséquilibrés.
Enfin, la proportion globale de variance expliquée par l’ensemble du dispositif factoriel face au modèle nul dépourvu de prédicteur se déduit en effectuant le ratio entre la somme totale des carrés du modèle (la somme des SS des facteurs et de l’interaction) et la somme des carrés totale de l’expérience (somme des carrés du modèle majorée de la somme des carrés résiduelle). Cette valeur fournit une appréciation immédiate du pouvoir explicatif du protocole de recherche.
7. Gestion des plans non équilibrés et sommes des carrés (Types I, II et III)
7.1 Fondements de l’orthogonalité et typologie des sommes des carrés
Dans un plan d’expérience factoriel rigoureusement équilibré (où chaque sous-groupe expérimental présente un effectif n strictement identique), les facteurs sont mutuellement orthogonaux au sens géométrique de l’algèbre linéaire. Cette propriété fondamentale garantit que l’effet attribué au facteur A est totalement indépendant de celui attribué au facteur B et de leur terme d’interaction. Les sommes des carrés des différents effets s’additionnent alors de façon rigoureusement univoque pour reconstituer la somme des carrés totale expliquée.
Cependant, dès lors que les effectifs cellulaires deviennent inégaux, l’orthogonalité du design s’effondre. Une corrélation d’échantillonnage s’établit entre les variables explicatives catégorielles, induisant un chevauchement partiel des sommes des carrés. Dès lors, la variance attribuable à une source donnée peut varier drastiquement selon la méthode choisie pour partitionner cette aire partagée. Trois typologies majeures de décomposition de variance coexistent dans la littérature statistique :
- Sommes des carrés de Type I (approche séquentielle) : La fonction native
aov()et la commande génériqueanova()de R calculent par défaut des sommes des carrés dites séquentielles. Dans cette approche, le premier terme saisi dans la formule (par exemple A) reçoit l’intégralité de la variance qui lui est associée. Le second terme (B) ne reçoit ensuite que la variance additionnelle qu’il explique une fois l’effet de A neutralisé. Enfin, l’interaction A:B ne reçoit que la variance subséquente non expliquée par A et B réunis. Cette propriété séquentielle engendre une vulnérabilité méthodologique majeure : l’inversion de l’ordre d’écriture des termes dans la formule (écrireScore ~ B * Aau lieu deScore ~ A * B) modifie arbitrairement les sommes des carrés des effets principaux ainsi que leurs statistiques F respectives dans les plans non équilibrés. - Sommes des carrés de Type II (approche hiérarchique ou marginale pure) : Cette méthode calcule l’effet de chaque facteur principal en contrôlant pour l’autre effet principal, mais en ignorant délibérément le terme d’interaction d’ordre supérieur. Elle s’avère particulièrement puissante et pleinement justifiée sur le plan théorique lorsqu’il est préalablement établi que l’effet d’interaction est statistiquement négligeable ou inexistant.
- Sommes des carrés de Type III (approche de régression standard ou ajustement simultané total) : Dans la décomposition de Type III, introduite historiquement par Frank Yates, chaque terme du modèle est évalué marginalement par rapport à l’ensemble de tous les autres termes, y compris les termes d’interaction d’ordre supérieur. Ainsi, l’effet principal de A est testé après élimination complète de l’influence de B et de l’interaction A:B.
7.2 Mise en œuvre du Type III via le package car
Dans les sciences comportementales et biomédicales, les comités de lecture exigent très largement l’application des sommes des carrés de Type III en présence de plans d’expériences déséquilibrés, précisément afin de neutraliser les effets de l’asymétrie d’échantillonnage tout en maintenant l’évaluation formelle des interactions.
La mise en œuvre correcte de ce calcul dans R nécessite une démarche spécifique en deux étapes. La première étape, souvent omise par inadvertance, consiste à redéfinir la politique globale des contrastes appliqués par le système. Par défaut, R emploie le codage contr.treatment, qui n’est pas orthogonal. Si un utilisateur applique des sommes des carrés de Type III sur un modèle paramétré avec des contrastes par traitement, les résultats d’ANOVA générés pour les effets principaux seront mathématiquement invalides, testant des hypothèses dénuées de sens biologique ou psychologique.
Pour restaurer l’orthogonalité indispensable au calcul de Type III, l’analyste doit impérativement exécuter au préalable l’instruction suivante :
options(contrasts = c("contr.sum", "contr.poly"))
Cette commande impose à R d’utiliser les contrastes de somme (sum-to-zero contrasts) pour les facteurs nominaux non ordonnés et les contrastes polynomiaux pour les facteurs ordonnés. Une fois cette précaution paramétrique verrouillée, le modèle linéaire standardisé peut être réestimé avec lm() ou aov(), puis soumis à la fonction Anova() (remarquez la majuscule obligatoire) du package car avec l’argument explicite type = 3 :
modele_car <- lm(Score ~ Genre * Intensite_Exercice, data = donnees)
table_type3 <- car::Anova(modele_car, type = 3)
7.3 Comparaison raisonnée des sorties statistiques selon le type retenu
L’impact comparé des différentes options de décomposition met en lumière la nécessité d’une décision méthodologique consciente. Dans un plan factoriel présentant des cellules inégales (par exemple avec des effectifs oscillant entre 15 et 30 sujets par cellule), l’exécution conjointe des méthodes de Type I, Type II et Type III révèle des décalages concrets sur les valeurs de sommes des carrés et, par conséquent, sur les probabilités p.
Dans un Type I séquentiel, le facteur positionné en tête de script s’accapare l’ensemble de la variance d’intersection, pouvant artificiellement apparaître significatif au détriment du second facteur. Dans le cadre d’un modèle sans interaction significative, le Type II offre la puissance statistique maximale pour détecter les effets principaux, car il ne dissipe pas de degrés de liberté résiduels à partialiser une interaction inexistante. En revanche, dès lors qu’une interaction substantielle émerge, le Type II devient biaisé car ses hypothèses d’invariance marginale sont théoriquement rompues.
L’arbre décisionnel contemporain en psychologie quantitative préconise par conséquent l’algorithme suivant : débuter par l’inspection de l’interaction à l’aide d’un calcul de Type III ; si l’interaction s’avère indiscutablement négligeable (p > 0,20 et taille d’effet microscopique), le modèle peut être ré-estimé sans terme d’interaction via des sommes des carrés de Type II pour maximiser la sensibilité sur les effets principaux ; si l’interaction est significative, le cadre de Type III doit être rigoureusement maintenu pour encadrer la décomposition consécutive des effets simples conditionnels.
8. Calcul et interprétation de la taille d’effet
8.1 Mesures basées sur l’éta-carré
La seule déclaration d’une significativité statistique basée sur une probabilité p inférieure à un seuil arbitraire constitue une pratique scientifique aujourd’hui jugée insuffisante dans les standards internationaux. La p-valeur informe sur la probabilité d’observer de telles données sous l’hypothèse nulle, mais demeure captive de la taille de l’échantillon : un effet trivial peut devenir statistiquement significatif au sein d’une cohorte colossale, tandis qu’un effet clinique majeur peut échouer à franchir le seuil fatidique en contexte de faible effectif. Dès lors, la quantification standardisée de la magnitude de l’effet s’impose de façon incontournable.
La première métrique historique est l’éta-carré global (η2), défini par le ratio arithmétique de la somme des carrés de l’effet considéré sur la somme des carrés totale du modèle :
η2 = SSEffet / SSTotal
Bien qu’intuitive car représentant le pourcentage absolu de la variance totale du phénomène imputable au facteur étudié, cette mesure présente l’inconvénient structurel majeur de dépendre étroitement du nombre de variables explicatives injectées dans l’expérience. Plus un protocole intègre de facteurs indépendants, plus la somme des carrés totale s’accroît, comprimant mécaniquement l’estimation de l’η2 de chaque terme individuel.
Pour contourner ce biais comparatif, la communauté scientifique a privilégié l’usage de l’éta-carré partiel (ηp2). L’éta-carré partiel neutralise la variance absorbée par les autres facteurs expérimentaux pour n’évaluer le pouvoir explicatif d’un terme qu’en relation directe avec la variance résiduelle inexpliquée :
ηp2 = SSEffet / (SSEffet + SSRésiduel)
Sur le plan interprétatif, Jacob Cohen a défini des balises conventionnelles pour appréhender l’amplitude de l’éta-carré partiel au sein des disciplines comportementales : une valeur proche de 0,01 caractérise un effet de petite taille ; un indice atteignant 0,06 signale un effet d’ampleur moyenne ; enfin, un score égal ou supérieur à 0,14 traduit un effet de grande amplitude, dénotant un impact substantiel du protocole expérimental sur le plan psychologique.
8.2 Estimations non biaisées avec l’oméga-carré
Bien que l’éta-carré partiel demeure la métrique la plus fréquemment publiée dans les revues académiques de psychologie, les statisticiens méthodologistes ont démontré qu’il souffre d’une surestimation systématique de la taille d’effet réelle au sein de la population parente. L’indice ηp2 constitue une métrique purement descriptive issue de l’échantillon observé, qui a tendance à capturer une fraction de la fluctuation stochastique locale, particulièrement lorsque la taille des groupes demeure modeste (n < 30).
Pour obtenir une estimation populationnelle non biaisée, l’indice d’oméga-carré partiel (ωp2) constitue une alternative psychométrique nettement supérieure. L’oméga-carré partiel intègre formellement le carré moyen de l’erreur résiduelle dans son numérateur pour pénaliser la variance empirique échantillonnale et ajuster l’estimation en fonction des degrés de liberté réels :
ωp2 = (SSEffet – DfEffet × MSRésiduel) / (SSEffet + (N – DfEffet) × MSRésiduel)
Lorsque la statistique F observée est inférieure ou proche de 1, le numérateur devient négatif ; par convention mathématique, l’ωp2 est alors théoriquement assigné à zéro. L’indice d’oméga-carré partiel reflète ainsi avec une intégrité supérieure la part réelle de variance généralisable hors du laboratoire.
8.3 Calcul informatique automatisé dans l’écosystème R
L’estimation manuelle de ces métriques est source d’erreurs récurrentes, notamment lors de l’application aux sorties de plans non équilibrés. Le package effectsize résout cette difficulté en fournissant des fonctions optimisées opérant directement sur les objets d’ANOVA produits tant par aov() que par car::Anova().
Pour calculer l’ensemble des grandeurs d’éta-carré partiel, la syntaxe s’exprime immédiatement par :
effectsize::eta_squared(modele_complet, partial = TRUE)
De façon strictement symétrique, l’extraction des indices non biaisés s’opère par :
effectsize::omega_squared(modele_complet, partial = TRUE)
L’atout méthodologique majeur du package effectsize réside dans le calcul automatique par défaut des intervalles de confiance exacts à 95 % entourant chaque taille d’effet, déterminé via l’inversion de la distribution de F non centrale. La mention explicite de cet intervalle de confiance dans les publications permet d’apprécier la précision métrologique de l’estimation, répondant ainsi pleinement aux exigences contemporaines de reproductibilité scientifique.
9. Analyses post-hoc et comparaisons multiples
9.1 Comparaisons post-hoc des effets principaux avec Tukey HSD
Lorsqu’un effet principal portant sur une variable indépendante comprenant au moins trois modalités (comme le facteur Intensite_Exercice) s’avère statistiquement significatif et que le terme d’interaction bidirectionnelle est rigoureusement non significatif, l’analyste se trouve confronté à une limitation inhérente au test F global : l’ANOVA indique que les moyennes des trois groupes ne sont pas toutes égales, mais elle est incapable de désigner quelles paires de modalités diffèrent spécifiquement l’une de l’autre.
Pour lever cette indétermination sans compromettre le seuil d’erreur de première espèce, le recours à la procédure des différences honnêtement significatives de Tukey (Tukey HSD – Honestly Significant Difference) constitue la démarche de référence. Cette méthode ajuste rigoureusement la distribution de référence en exploitant la loi de l’amplitude standardisée (studentized range distribution), assurant que le taux d’erreur par famille de comparaisons (FWER) n’excède sous aucun prétexte le seuil α = 0,05, quel que soit le nombre de paires comparées.
Dans R de base, la commande s’exécute directement sur l’objet modèle via :
TukeyHSD(modele_complet, which = "Intensite_Exercice")
L’affichage tabulaire qui en résulte rapporte pour chaque comparaison par paire (par exemple Modérée vs Faible, Élevée vs Faible, Élevée vs Modérée) la différence estimée entre les moyennes, les bornes inférieure et supérieure de l’intervalle de confiance ajusté à 95 % ainsi que la probabilité p corrigée (p adj). Si l’intervalle de confiance n’englobe pas la valeur zéro, la comparaison unilatérale est formellement déclarée statistiquement significative au niveau choisi.
9.2 Décomposition des effets simples en présence d’une interaction significative
L’interprétation directe des effets principaux est strictement proscrite sur le plan méthodologique dès lors qu’un effet d’interaction significatif a été établi. Proclamer qu’il existe un « effet général » de l’intensité d’exercice indépendamment du genre n’a aucun sens théorique si la réponse attentionnelle varie de manière opposée selon que le participant est une femme ou un homme. L’analyse globale doit alors céder la place à l’évaluation méthodique des effets simples conditionnels (simple effects).
L’analyse des effets simples consiste à fractionner le plan factoriel bidimensionnel pour tester l’impact d’un premier facteur à chaque modalité fixée du second facteur. Deux familles d’effets simples peuvent être investiguées :
- L’effet de l’intensité d’exercice ségrégé séparément chez les participantes féminines, puis chez les participants masculins.
- L’effet du genre analysé séparément au sein de la modalité d’exercice faible, puis au sein de la modalité modérée, puis au sein de la modalité élevée.
Le package emmeans (Estimated Marginal Means), développé par Russell Lenth, est le standard algorithmique contemporain pour exécuter cette décomposition avec une rigueur absolue. L’appel séquentiel à la fonction emmeans() couplée à la fonction joint_tests() permet d’interroger la significativité globale des tranches conditionnelles du modèle :
library(emmeans)
marges_interaction <- emmeans(modele_complet, ~ Intensite_Exercice | Genre)
effets_simples_F <- joint_tests(modele_complet, by = "Genre")
Cette commande génère un test F dédié pour chaque strate, utilisant le carré moyen résiduel mutualisé de l’ANOVA globale pour conserver une puissance optimale tout en évaluant séparément les dynamiques propres à chaque genre.
9.3 Ajustement de la significativité statistique pour comparaisons multiples
Une fois les effets simples globaux évalués par tranche factorielle, la comparaison méthodique des paires de sous-groupes (contrastes post-hoc d’effets simples) déclenche une prolifération de tests statistiques distincts. Pour neutraliser l’inflation de l’erreur α qui en découle inéluctablement, un protocole d’ajustement mathématique doit être explicitement configuré.
La correction conservative historique de Bonferroni divise simplement le seuil nominal α par le nombre total k de tests exécutés. Bien qu’extrêmement robuste, elle s’avère souvent excessivement punitive et détériore dramatiquement la puissance statistique lorsque le nombre de contrastes s’accroît. La méthode de Holm-Bonferroni (procédure séquentielle par étapes) s’avère uniformément supérieure à la correction de Bonferroni classique, offrant un contrôle strict du FWER tout en libérant une sensibilité statistique substantiellement plus forte.
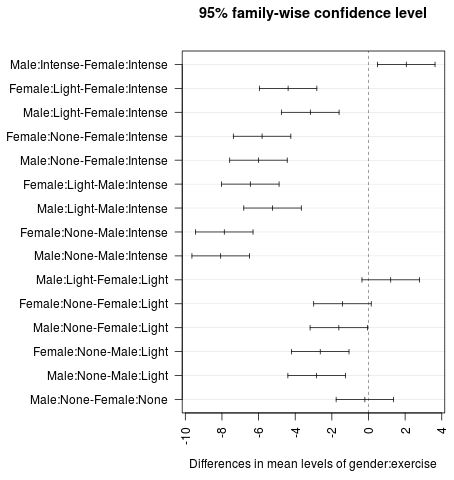
Dans les contextes de criblage expérimental étendu où de multiples comparaisons conditionnelles sont conduites, l’ajustement selon le taux de faux positifs (False Discovery Rate – FDR de Benjamini-Hochberg) constitue une stratégie alternative pragmatique reconnue. Au sein du package emmeans, l’application de ces ajustements se configure directement lors de l’appel à la fonction pairs() via l’argument adjust :
comparaisons_conditionnelles <- pairs(marges_interaction, adjust = "holm")
Cette instruction recalibre instantanément l’ensemble des probabilités et permet d’isoler précisément quelles cellules conditionnelles diffèrent de leurs homologues avec un contrôle d’erreur irréprochable.
10. Visualisation avancée de l’interaction pour la publication scientifique
10.1 Représentation graphique des moyennes marginales estimées
Pour communiquer efficacement la dynamique d’une interaction au sein d’une revue scientifique à comité de lecture, le chercheur doit privilégier la modélisation graphique des moyennes marginales estimées (least-squares means) issues directement du modèle linéaire ajusté, plutôt que les simples moyennes arithmétiques descriptives de l’échantillon brut. Cette distinction méthodologique garantit que la figure reflète exactement la décomposition paramétrique testée, notamment en compensant l’asymétrie éventuelle des effectifs cellulaires.
L’extraction de ces estimations pour la visualisation s’effectue avec le package emmeans converti sous forme d’un tableau de données exploitable par ggplot2 :
df_emmeans <- as.data.frame(emmeans(modele_complet, ~ Intensite_Exercice * Genre))
Ce tableau structure les coordonnées exactes des points centraux (emmean), des erreurs types (SE) ainsi que les bornes inférieures et supérieures des intervalles de confiance à 95 % ajustés (lower.CL et upper.CL). En intégrant ces estimations dans un pipeline ggplot2 articulant geom_line() et geom_point(), on obtient une trajectoire factorielle rigoureuse, complétée par l’adjonction de barres d’erreur explicites au moyen de geom_errorbar().
10.2 Personnalisation esthétique respectant les standards académiques
L’esthétique visuelle par défaut des graphiques de R de base ou du thème standardisé de ggplot2 (notamment le fond gris quadrillé) est inadaptée aux exigences éditoriales des revues académiques. Selon les préceptes formels de l’American Psychological Association (normes APA), une figure scientifique doit arborer une clarté typographique totale, exempte de fioritures ornementales ou de surcharge d’encre inutile (chartjunk).
L’application du thème theme_classic() constitue la base de cette mise en conformité en supprimant intégralement les quadrillages parasites et en instanciant des axes orthogonaux noirs nets. Les choix chromatiques doivent obligatoirement être compatibles avec les contraintes d’impression en niveaux de gris et demeurer parfaitement lisibles pour les personnes présentant des déficiences de la vision des couleurs (daltonisme). L’utilisation de la palette scale_color_viridis_d(option = "D") ou de déclinaisons de gris contrastées associées à des formes de points différenciées (cercles pleins versus triangles pleins via shape = Genre) assure cette universalité perceptive.
De surcroît, les intitulés d’axes ne doivent en aucun cas comporter les noms de variables bruts du code informatique, mais afficher des formulations textuelles explicites enrichies des unités de mesure physiques ou psychométriques (par exemple : « Performance attentionnelle (Score standardisé de 50 à 120) » et « Intensité de l’exercice physique »).
10.3 Exportation haute résolution pour les revues à comité de lecture
L’exportation finale de la figure depuis la session R vers l’environnement éditorial constitue l’ultime maillon technique du dispositif. Les éditeurs scientifiques imposent des spécifications extrêmement rigoureuses quant à la résolution matricielle et aux formats vectoriels des illustrations scientifiques. Une image pixélisée ou floue constitue un motif fréquent de renvoi lors du processus de révision.
La commande universelle ggsave() du package ggplot2 offre un contrôle total de ces paramètres d’exportation. Il est recommandé de privilégier les formats vectoriels purs tels que le PDF ou le format SVG pour les revues supportant ces standards, car ils garantissent une netteté absolue quelle que soit l’échelle d’agrandissement typographique :
ggsave("Figure1_Interaction_Attention.pdf", width = 16, height = 11, units = "cm")
Pour les éditeurs requérant exclusivement des fichiers matriciels non compressés (tels que les formats TIFF ou PNG haute définition), l’argument dpi (dots per inch) doit impérativement être configuré à un seuil minimal de 300 DPI pour les photographies en demi-teintes et de 600 à 1200 DPI pour les graphiques au trait et figures statistiques :
ggsave("Figure1_Interaction_Attention.tiff", dpi = 600, width = 16, height = 11, units = "cm", compression = "lzw")
La définition métrique précise de la largeur et de la hauteur en centimètres assure que la taille des polices de caractères demeurera parfaitement proportionnée à la mise en page finale de l’article sur une colonne ou deux colonnes.
11. Solutions méthodologiques face à la violation des postulats
11.1 Transformations mathématiques de la variable dépendante
Lorsque les diagnostics résiduels révèlent des violations substantielles des postulats de normalité ou d’homogénéité des variances, l’application directe de l’ANOVA factorielle standard sur les scores bruts devient intenable. La première stratégie correctrice, historiquement préconisée, consiste à appliquer une transformation mathématique non linéaire à la variable dépendante continue afin de symétriser les distributions et de stabiliser la variance locale.
En présence d’une asymétrie positive prononcée (distribution étirée vers la droite avec une longue queue), fréquente dans l’évaluation des temps de réaction ou des concentrations de biomarqueurs salivaires de stress (cortisol), la transformation logarithmique népérienne ou décimale (log(Y) ou log10(Y)) constitue le traitement de référence. Si les données comportent des scores nuls, l’adjonction d’une constante minimale unitaire (log(Y + 1)) est requise. Pour des données de comptage psychologique discret ou des taux d’erreurs limités, la transformation par racine carrée (sqrt(Y)) ou la transformation arcosinus de la racine de la proportion démontrent une efficacité reconnue.
Une approche paramétrique unifiée plus avancée consiste à déterminer empiriquement le paramètre optimal λ de la famille des transformations de Box-Cox via la fonction boxcox() du package MASS. La valeur λ maximisant la vraisemblance du modèle linéaire guide le choix de la transformation la plus rigoureuse (par exemple λ = 0 pour le log, λ = 0.5 pour la racine carrée, λ = -1 pour la transformation inverse). Toutefois, les transformations mathématiques introduisent une lourde contrainte épistémologique : les inférences statistiques et les comparaisons de moyennes sont établies sur une échelle transformée artificielle, ce qui complique substantiellement l’interprétation clinique directe et impose des rétro-conversions métriques délicates lors de la rédaction des résultats.
11.2 Approches non paramétriques factorielles et tests sur rangs alignés
Face à des données quantitatives qui résistent aux transformations mathématiques ou qui se présentent sous une forme ordinale manifeste, les analystes cherchent souvent des alternatives non paramétriques. Il existe toutefois une méconception répandue consistant à tenter d’appliquer le test de Kruskal-Wallis. Ce dernier est un test univarié à une dimension incapable de modéliser un plan croisé et formellement inapte à tester une interaction factorielle.
Pour conduire une analyse factorielle non paramétrique authentique sous R, la méthode de transformation par rangs alignés (Aligned Rank Transform – ART), développée par Wobbrock et ses collaborateurs, constitue la solution méthodologique optimale. Contrairement à une simple conversion des scores globaux en rangs (qui fausse l’estimation des interactions dans les plans factoriels), l’algorithme ART procède à un alignement préalable des données en soustrayant à chaque observation les estimations des effets marginaux avant d’assigner les rangs. Cette opération isole mathématiquement l’effet spécifique d’intérêt avant la phase de classement.
Cette approche se déploie dans R grâce au package spécialisé ARTool. La syntaxe opérationnelle s’articule comme suit :
library(ARTool)
modele_art <- art(Score ~ Genre * Intensite_Exercice, data = donnees)
table_art <- anova(modele_art)
L’objet résultant produit une table d’ANOVA non paramétrique robuste fournissant des statistiques F valides tant pour l’ensemble des effets principaux que pour le terme d’interaction bidirectionnelle, sans exiger aucune hypothèse distributionnelle quant à la normalité des résidus.
11.3 Modélisation linéaire robuste et techniques de rééchantillonnage
L’armement méthodologique contemporain offre des voies de modélisation plus flexibles et directes que la transformation de variables ou la conversion en rangs : les modèles linéaires robustes et le bootstrap non paramétrique.
La modélisation linéaire robuste substitue à la fonction de perte quadratique standard des estimateurs M ou MM qui atténuent considérablement le poids des observations périphériques et résistent à l’hétéroscédasticité locale. Sous R, la fonction rlm() du package MASS ou, de manière encore plus performante, le package robustbase avec la commande lmrob() permettent d’ajuster des plans factoriels complexes dont les coefficients et les matrices de covariance résistent aux déformations structurales de l’échantillonnage.
Parallèlement, les techniques de rééchantillonnage bootstrap permettent d’engendrer empiriquement la distribution d’échantillonnage de la statistique F ou des différences de moyennes sans formuler le moindre postulat paramétrique théorique. En tirant plusieurs milliers de sous-échantillons aléatoires avec remise au sein des données d’origine via le package boot, le statisticien dérive des intervalles de confiance percentiles ou BCa (bias-corrected and accelerated) d’une fiabilité absolue.
Enfin, lorsque la variable dépendante obéit à une distribution mathématique spécifique non gaussienne mais connue (par exemple une distribution binomiale pour des choix binaires, une distribution de Poisson ou binomiale négative pour des comptages d’événements discrets, ou une loi Gamma pour des durées strictement positives), l’ajustement direct d’un Modèle Linéaire Généralisé (GLM) via la fonction glm() constitue la démarche statistique la plus rigoureuse et la plus élégante du point de vue théorique.
12. Rédaction et diffusion académique des résultats selon les normes APA (7e édition)
12.1 Directives typographiques pour l’expression des statistiques d’ANOVA
La formalisation textuelle des inférences quantitatives au sein des publications universitaires est strictement régie par les conventions éditoriales du manuel de l’APA (7e édition). Tout rapport statistique d’un test d’ANOVA factorielle doit obligatoirement encapsuler un ensemble complet et standardisé de métriques pour permettre au lecteur d’évaluer la portée de la preuve empirique.
La statistique du test doit être symbolisée par la lettre majuscule F, rigoureusement imprimée en caractères italiques. Elle doit être immédiatement suivie, entre parenthèses, des degrés de liberté intergroupes de l’effet considéré et des degrés de liberté résiduels intra-groupe, séparés par une virgule (par exemple : F(2, 84)). La valeur exacte du ratio F calculé doit être rapportée avec un arrondi strict à deux décimales.
Concernant la valeur de probabilité associée (valeur p), la lettre p minuscule doit être en italique. Si la probabilité est égale ou supérieure à 0,001, elle doit être explicitée avec sa valeur exacte arrondie à trois décimales (par exemple : p = .023 ou p = .418), sans omettre de supprimer le zéro initial précédant la virgule ou le point décimal selon les usages anglo-saxons repris en psychométrie internationale. Si la probabilité est inférieure au seuil millième, elle est déclarée sous la forme de l’inégalité stricte : p < .001. Enfin, toute statistique inférentielle doit être accompagnée de son indice de taille d’effet standardisé, conventionnellement l’éta-carré partiel (ηp2) ou l’oméga-carré partiel (ωp2), arrondi à deux ou trois décimales.
12.2 Exemples de formulations textuelles de synthèses expérimentales
Pour concrétiser ces préceptes rédactionnels, examinons deux gabarits de synthèse textuelle répondant parfaitement aux standards d’évaluation par les pairs.
Cas 1 : Modèle avec interaction non significative
« Une analyse de variance factorielle à deux facteurs (2 × 3) inter-sujets a été conduite pour évaluer l’impact du genre (féminin vs masculin) et de l’intensité de l’exercice physique (faible, modérée, élevée) sur les performances attentionnelles. Les analyses préliminaires ont confirmé la normalité des résidus (test de Shapiro-Wilk, W = 0.989, p = .682) ainsi que l’homoscédasticité des variances entre les groupes (test de Levene centré sur la médiane, F(5, 114) = 1.12, p = .354). L’effet d’interaction entre le genre et l’intensité d’exercice ne s’est pas avéré statistiquement significatif, F(2, 114) = 0.84, p = .434, ηp2 = .01, ωp2 < .001, justifiant l’interprétation directe des effets principaux. L’effet principal du genre n’a révélé aucune différence significative entre les femmes (M = 78.45, SD = 10.12) et les hommes (M = 77.89, SD = 10.45), F(1, 114) = 0.18, p = .672, ηp2 = .002. En revanche, un effet principal statistiquement significatif et d’ampleur substantielle a été mis en évidence pour l’intensité de l’exercice, F(2, 114) = 14.62, p < .001, ηp2 = .20, ωp2 = .18. Des comparaisons post-hoc ajustées par la méthode de Tukey ont indiqué que l’exercice d’intensité modérée induisait des scores d’attention significativement supérieurs (M = 85.12, SD = 8.76) par rapport à l’exercice de faible intensité (M = 72.34, SD = 9.45, p < .001, d = 1.40) et à l’exercice d’intensité élevée (M = 76.95, SD = 9.12, p = .002, d = 0.91). »
Cas 2 : Modèle avec interaction significative
« L’analyse de variance à deux facteurs a révélé une interaction bidirectionnelle hautement significative entre le genre des participants et l’intensité de l’exercice physique sur les scores attentionnels, F(2, 114) = 8.95, p < .001, ηp2 = .14, ωp2 = .12. Compte tenu de cette dépendance structurelle, les effets principaux n’ont pas été interprétés globalement et une décomposition en effets simples conditionnels a été réalisée à l’aide de moyennes marginales estimées avec un contrôle du FWER par la méthode de Holm-Bonferroni. Chez les femmes, l’effet simple de l’intensité d’exercice s’est avéré significatif, F(2, 114) = 18.41, p < .001, ηp2 = .24, les contrastes post-hoc révélant une supériorité marquée de l’intensité modérée (M = 91.20, SE = 1.82) face à l’intensité faible (M = 70.15, SE = 1.82, p < .001). À l’inverse, chez les hommes, l’effet simple de l’intensité d’exercice n’a pas atteint le seuil de significativité conventionnel, F(2, 114) = 1.23, p = .296, ηp2 = .02, les performances demeurant stables à travers l’ensemble des conditions. »
12.3 Conception d’un tableau synthétique d’ANOVA normé APA
L’intégration d’une table synthétique récapitulative est souvent requise pour consigner l’intégralité des termes du modèle linéaire général. Les normes de l’APA imposent une géométrie éditoriale épurée : l’usage des lignes verticales est formellement interdit, et seules trois lignes de séparation horizontales principales doivent structurer le tableau (délimitant l’en-tête supérieure, la séparation des libellés de colonnes et la clôture inférieure du corps de table).
| Source de variation | SS | dl | MS | F | p | ηp2 | 95% IC [ηp2] |
|---|---|---|---|---|---|---|---|
| Genre | 16.42 | 1 | 16.42 | 0.18 | .672 | .002 | [.000, .045] |
| Intensité exercice | 2648.75 | 2 | 1324.38 | 14.62 | < .001 | .204 | [.089, .318] |
| Genre × Intensité | 1621.50 | 2 | 810.75 | 8.95 | < .001 | .136 | [.037, .242] |
| Résidus (Erreur) | 10325.33 | 114 | 90.57 |
Dans l’écosystème R contemporain, la production automatisée de ces tableaux normés s’effectue avantageusement au moyen du package papaja (conçu spécifiquement pour la compilation de manuscrits scientifiques reproductibles via R Markdown ou Quarto) à travers la commande apa_print(), ou via les fonctions spécialisées du package sjPlot (telles que tab_model()) et gtsummary. Ces outils permettent d’exporter instantanément des tableaux statistiques irréprochables directement éditables sous Microsoft Word ou intégrables dans des flux de composition LaTeX, éliminant ainsi définitivement les risques d’erreurs de retranscription manuelle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Kassambara, A. (2023). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.2). Comprehensive R Archive Network. https://CRAN.R-project.org/package=rstatix
- Lenth, R. V. (2023). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.5). Comprehensive R Archive Network. https://CRAN.R-project.org/package=emmeans
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
- Wobbrock, J. O., Findlater, L., Gergle, D., & Higgins, J. J. (2011). The aligned rank transform for nonparametric factorial analyses using only ANOVA procedures. Proceedings of the ACM Conference on Human Factors in Computing Systems (CHI 2011), 143–146. https://doi.org/10.1145/1978942.1978963