
Dans le paysage contemporain de la recherche quantitative en psychologie et en sciences comportementales, la rigueur méthodologique repose sur la capacité des chercheurs à isoler avec exactitude les relations causales au sein de systèmes empiriques intrinsèquement bruités. L’expérimentation en laboratoire et sur le terrain confronte inévitablement les analystes à une variabilité interindividuelle considérable, susceptible de masquer des effets de traitement réels ou, à l’inverse, d’induire des artéfacts d’interprétation. Face à ces écueils, l’analyse de covariance (ANCOVA) s’impose comme l’une des architectures analytiques les plus puissantes du modèle linéaire généralisé. En combinant harmonieusement la structuration factorielle de l’analyse de variance unidirectionnelle et la souplesse prédictive de la régression linéaire multiple, l’ANCOVA permet de contrôler mathématiquement l’impact de variables continues concomitantes, désignées sous le terme de covariables.
L’utilisation judicieuse de l’ANCOVA transcende la simple routine calculatoire ; elle relève d’une démarche épistémologique sophistiquée visant à purifier la variance de la variable dépendante en retranchant la part systématiquement attribuable à des caractéristiques préexistantes chez les participants, telles que le niveau cognitif de base, l’âge chronologique, le statut socio-économique ou des indices psychométriques pré-interventionnels. Dans l’écosystème open-source R Project for Statistical Computing, la mise en œuvre de cette technique bénéficie d’une flexibilité algorithmique sans égale, soutenue par des bibliothèques logicielles modernes permettant une vérification scrupuleuse des postulats distributionnels, une estimation non biaisée des sommes de carrés et une modélisation visuelle conforme aux plus hauts standards académiques.
Le présent guide a pour vocation de décortiquer de manière exhaustive l’ensemble de la chaîne de traitement statistique relative à l’ANCOVA sous R. De la dérivation conceptuelle de ses équations matricielles fondamentales à la rédaction minutieuse des résultats selon les normes de l’American Psychological Association (APA, 7e édition), chaque étape est explorée avec une rigueur doctorale. Les praticiens, chercheurs et étudiants avancés y trouveront non seulement les lignes directrices indispensables à la modélisation sous le paradigme du tidyverse et du package car, mais également les clés d’arbitrage méthodologique nécessaires pour naviguer entre contraintes théoriques, diagnostics de robustesse et interprétations pédagogiques concrètes.
1. Introduction théorique à l’ANCOVA en recherche psychologique
1.1 Définition et objectifs fondamentaux de l’analyse de covariance
L’analyse de covariance (ANCOVA) représente une extension élégante du modèle linéaire généralisé, fusionnant conceptuellement l’analyse de variance (ANOVA) factorielle et la régression linéaire bivariée ou multiple. L’objectif premier de cette méthodologie est de tester l’effet principal d’un ou plusieurs facteurs qualitatifs discrets sur une variable réponse continue, tout en neutralisant statistiquement la contribution d’une ou plusieurs variables prédictives quantitatives continues non manipulées par l’expérimentateur. Dans le contexte de l’expérimentation psychologique, l’inclusion d’une telle covariable vise deux finalités statistiques interdépendantes : d’une part, l’élimination des biais systématiques susceptibles de fausser les estimations des effets de traitement, et d’autre part, la réduction substantielle de la variance résiduelle intra-groupe (l’erreur quadratique moyenne).
En retranchant la portion de variance de la variable dépendante qui est expliquée de manière prévisible par la covariable, l’ANCOVA rétrécit le dénominateur du ratio de Fisher ($F$). Cette diminution mécanique du terme d’erreur résiduelle accroît directement la sensibilité statistique du protocole expérimental, maximisant ainsi la puissance du test statistique (la probabilité de rejeter à bon droit l’hypothèse nulle $H_0$ lorsqu’un effet réel existe dans la population parente). Cette démarche ne doit pas être confondue avec une simple tentative rétrospective de sauver une expérience mal conçue ; il s’agit d’une stratégie de contrôle statistique formelle, planifiée a priori pour extraire le signal expérimental du bruit de fond causé par l’hétérogénéité intrinsèque des sujets humains.
Sur le plan épistémologique, il convient d’établir une distinction fondamentale entre le contrôle expérimental direct opéré par l’assignation aléatoire (randomisation) et le contrôle statistique a posteriori opéré par la covariance. La randomisation pure garantit, à la limite asymptotique, une espérance nulle des déséquilibres entre groupes sur l’ensemble des covariables mesurées et non mesurées. Toutefois, dans les échantillons de taille modeste inhérents aux protocoles cliniques ou neuroscientifiques, des fluctuations d’échantillonnage aléatoires créent fréquemment des écarts substantiels entre les groupes dès la ligne de base. L’ANCOVA intervient alors non pas pour supplanter la randomisation, mais pour corriger mathématiquement ces déséquilibres fortuits et garantir que les différences intergroupes observées post-intervention soient rigoureusement imputables aux manipulations expérimentales.
1.2 Pertinence et applications de la covariation en psychologie expérimentale
L’application de l’ANCOVA s’avère particulièrement cruciale dans les designs de recherche pré-test / post-test, qui constituent l’armature standard de l’évaluation des interventions psychothérapeutiques, des programmes de remédiation cognitive et des innovations pédagogiques. Dans ce paradigme expérimental, mesurer simplement la performance finale des sujets expose l’analyste à confondre l’efficacité intrinsèque du traitement avec les aptitudes initiales des participants. Bien qu’il soit tentant de recourir à l’analyse des scores de gain (différence arithmétique entre post-test et pré-test), la littérature biométrique et psychométrique a formellement démontré la supériorité statistique de l’ANCOVA, laquelle s’affranchit du phénomène de régression vers la moyenne mis en lumière par Francis Galton et évite l’amplification des erreurs de mesure propres aux scores différentiels bruts.
Au-delà de l’ajustement sur les lignes de base, la covariation permet de neutraliser des facteurs de confusion majeurs inhérents à l’écologie humaine. Dans les études développementales, par exemple, la maturation cérébrale et l’âge chronologique des enfants exercent une influence massive sur la vitesse de traitement de l’information et la mémoire de travail ; intégrer l’âge exact en tant que covariable métrique permet d’évaluer l’impact net d’un programme d’entraînement métacognitif indépendamment du simple développement neurobiologique. De même, dans les protocoles de psychopathologie expérimentale évaluant la réactivité émotionnelle à des stimuli anxiogènes, le niveau d’anxiété-trait mesuré préalablement constitue une covariable indispensable pour révéler des différences subtiles induites par des contextes inducteurs de stress.
Cependant, cette puissance d’ajustement s’accompagne d’une exigence déontologique et méthodologique rigoureuse : le danger de l’inclusion aveugle de covariables opportunistes (« fishing expeditions »). Introduire des covariables sans fondement théorique solide dans le seul dessein de réduire artificiellement la valeur de $p$ sous le seuil fatidique de 0.05 constitue une dérive scientifique majeure relevant du p-hacking. De surcroît, la covariable sélectionnée doit impérativement précéder temporellement l’assignation au traitement ou être totalement insensible à celui-ci. Si l’intervention expérimentale modifie elle-même la covariable, l’ajustement statistique éliminera une partie intégrante de l’effet causal du traitement, conduisant à un biais de surajustement dramatique et à une interprétation erronée des mécanismes psychologiques sous-jacents.
1.3 Comparaison structurelle : ANOVA, Régression multiple et ANCOVA
D’un point de vue architectural, l’ANOVA, l’ANCOVA et la régression linéaire multiple s’inscrivent sous la voûte mathématique unifiée du modèle linéaire généralisé (GLM, pour General Linear Model). L’ANOVA traditionnelle décompose la variabilité totale d’une variable réponse continue $Y$ en deux composantes fondamentales : la variance inter-groupes (due aux effets différentiels des niveaux du facteur discret $X$) et la variance intra-groupe (la somme des carrés résiduelle ou erreur non expliquée). La régression multiple classique, quant à elle, exprime la variable $Y$ comme une combinaison linéaire de plusieurs prédicteurs généralement métriques, évaluant le coefficient de régression partiel associé à chaque dimension prédictive.
L’ANCOVA matérialise l’hybridation exacte de ces deux approches. Son équation structurelle fondamentale pour une observation individuelle $i$ appartenant au groupe $j$ se formule mathématiquement comme suit :
Yij = μ + αj + β(Xij – X̄..) + εij
Dans cette formulation, $\mu$ représente la grande moyenne de la population, $\alpha_j$ désigne l’effet différentiel fixe du $j$-ème groupe de traitement sous la contrainte d’identification habituelle ($\sum \alpha_j = 0$), $\beta$ est le coefficient de régression linéaire commun reliant la covariable $X$ à la variable réponse $Y$, $\bar{X}_{..}$ est la moyenne empirique globale de la covariable à travers l’ensemble des observations, et $\epsilon_{ij}$ constitue le terme d’erreur aléatoire résiduelle supposé indépendant et identiquement distribué selon une loi normale centrée d’écart-type $\sigma^2$.
La présence du terme de régression $\beta(X_{ij} – \bar{X}_{..})$ altère profondément la décomposition des sommes de carrés par rapport à une ANOVA simple. Dans l’espace géométrique des variables, la variation expliquée par la covariable continue est soustraite en premier lieu de la somme des carrés totale ainsi que de la somme des carrés de l’erreur. Par voie de conséquence, les comparaisons inter-groupes ne portent plus sur les moyennes brutes observées ($\bar{Y}_j$), mais sur les moyennes marginales estimées (également nommées moyennes ajustées par les moindres carrés ou ls-means). Ces moyennes marginales correspondent aux performances attendues dans chaque groupe expérimental si tous les participants avaient hypothétiquement affiché une valeur strictement égale à la moyenne globale de la covariable ($\bar{X}_{..}$). Cette distinction entre moyennes observées et moyennes ajustées constitue le pivot conceptuel de l’ANCOVA.
2. Formulation du protocole expérimental et simulation des données
2.1 Présentation du cas d’étude : Efficacité des techniques d’apprentissage
Afin d’ancrer de manière pragmatique notre cheminement méthodologique dans le champ des sciences cognitives de l’éducation, nous concevons un protocole expérimental contrôlé et randomisé visant à évaluer l’efficacité comparée de différentes techniques d’ingénierie pédagogique sur la rétention d’informations complexes. L’objectif pédagogique consiste à déterminer quelle méthodologie d’étude maximise l’acquisition conceptuelle chez des étudiants universitaires soumis à un cursus standardisé de neurosciences comportementales.
Le protocole implique un facteur inter-sujets unique, désigné comme la variable indépendante catégorielle nominale : la technique d’apprentissage mise en œuvre. Ce facteur comporte trois modalités expérimentales distinctes (niveaux) :
- Technique A (Relecture passive standard) : Les apprenants consultent de manière répétée et séquentielle les polycopiés de cours et les manuels de référence sans consigne de génération active.
- Technique B (Génération active de résumés structurés) : Les étudiants sont formés à synthétiser les concepts clés, à extraire l’architecture hiérarchique des notions et à formaliser par écrit des fiches thématiques personnelles.
- Technique C (Récupération espacée et auto-évaluation / Testing effect) : Les participants sont soumis à des cycles d’interrogation systématiques basés sur des flashcards et des questionnaires sans consultation préalable des documents, exploitant les principes mnésiques de l’effet d’espacement et du test réitéré.
La variable dépendante principale (continue) est représentée par la note finale obtenue à un examen standardisé de synthèse clinique, notée sur une échelle métrique continue allant de 0 à 100 points, administré quatre semaines après la phase d’apprentissage. Toutefois, il est parfaitement établi en psychologie cognitive que le succès académique est massivement prédéterminé par les facultés intellectuelles préexistantes et les connaissances antérieures. Nous introduisons donc, à titre de covariable continue fondamentale, le niveau académique initial de l’étudiant, quantifié sous la forme d’un score pré-test standardisé d’aptitude cognitive et notionnelle (évalué également de 0 à 100) administré préalablement à toute assignation de groupe. La cohorte expérimentale est calibrée pour accueillir $N = 90$ étudiants, répartis de façon strictement équilibrée à raison de $n = 30$ participants par groupe expérimental.
2.2 Génération d’un jeu de données reproductible sous R
Pour assurer une reproductibilité scientifique absolue de nos démonstrations numériques, nous synthétisons informatiquement le jeu de données sous l’environnement de calcul R. La génération de données artificielles permet de contrôler parfaitement les paramètres de population sous-jacents, d’ancrer des effets statistiques précis et de valider a posteriori l’aptitude de l’ANCOVA à recalculer rigoureusement les paramètres injectés.
La procédure s’amorce par la fixation irrévocable de la graine pseudo-aléatoire via la commande set.seed(42), garantissant que toute exécution ultérieure produira des vecteurs numériques identiques. Nous construisons le facteur inter-sujets en utilisant la fonction rep() afin de générer les trois étiquettes de groupes équilibrées. La covariable continue (note initiale) est ensuite générée à partir d’une distribution normale ou uniforme calibrée afin de refléter la diversité d’une population étudiante classique sans effet de plancher ni de plafond.
Pour simuler la variable dépendante (note finale), nous appliquons fidèlement l’équation du modèle linéaire : nous assignons une valeur de pente commune $\beta = 0.65$ reliant la note initiale à la note finale, ce qui matérialise une corrélation substantielle entre l’aptitude d’entrée et le succès d’arrivée. Nous introduisons ensuite des différentiels de performance moyens spécifiques aux techniques d’apprentissage : la technique A constitue la condition de référence passive, la technique B reçoit un incrément moyen modéré de 4 points, tandis que la technique C bénéficie d’un gain substantiel de 9 points, reflétant la puissance robuste de la pratique de récupération en mémoire à long terme documentée par la littérature empirique. Enfin, une composante d’erreur aléatoire gaussienne d’écart-type $\sigma = 5$ est agrégée pour modéliser le bruit expérimental inhérent aux mesures humaines.
2.3 Inspection initiale et structuration des objets de données
Une fois le tableau d’observations assemblé sous la forme d’un data frame natif ou d’un tibble, une discipline métrologique élémentaire impose de vérifier la conformité syntaxique et structurelle de nos variables. L’analyse exploratoire immédiate débute par l’invocation des fonctions de diagnostic de base telles que head(), str() et summary(). L’un des pièges les plus insidieux sous R réside dans l’importation de variables catégorielles sous la forme de simples vecteurs de chaînes de caractères (character vectors) ou d’entiers numériques arbitraires (1, 2, 3), ce qui conduirait les algorithmes d’ajustement à modéliser une régression linéaire simple continue plutôt qu’une analyse de variance factorielle.
Il est donc impératif de contraindre formellement la variable indépendante dans le type factor à l’aide de l’instruction idoine. Nous devons expliciter les niveaux du facteur et, le cas échéant, fixer le niveau de référence épistémologique (en l’espèce, la technique A comme groupe témoin passif). Parallèlement, nous inspectons l’intégrité numérique des vecteurs continus pour confirmer l’absence absolue de valeurs non assignées ou corrompues (identifiées sous le symbole générique NA sous R), car la présence non documentée de cellules manquantes forcerait les fonctions de modélisation à pratiquer une suppression par liste entière (listwise deletion), ce qui altérerait l’équilibre initial du plan d’échantillonnage et réduirait la puissance statistique programmée.
L’inspection des dix premières lignes du tableau structuré confirme que chaque ligne renvoie à un identifiant participant unique, apparié à son groupe expérimental formellement labellisé, à son score d’aptitude initiale métrique et à sa performance finale à l’examen. Les dimensions scalaires sont parfaitement respectées, ouvrant la voie à une analyse descriptive et paramétrique sécurisée.
3. Configuration de l’environnement de travail et exploration descriptive
3.1 Chargement et rôle des packages statistiques spécialisés
Bien que le système de base de R dispose des algorithmes primitifs nécessaires à la régression linéaire élémentaire, la réalisation d’une ANCOVA rigoureuse conforme aux standards des revues de rang A nécessite l’instrumentation de bibliothèques logicielles spécialisées. L’écosystème open-source met à disposition des chercheurs des packages robustes, audités et continuellement éprouvés par la communauté internationale des biostatisticiens et psychométriciens.
Le premier ensemble d’outils incontournable est le méta-package tidyverse, développé sous la direction conceptuelle de Hadley Wickham. Il rassemble notamment dplyr pour la manipulation matricielle des données, tibble pour la gestion optimisée des structures tabulaires et ggplot2 pour la sémiologie graphique computationnelle de haute fidélité. Le tidyverse offre une syntaxe fluide, lisible et hautement expressive grâce à l’opérateur de composition séquentielle (pipe natif |> ou historique %>%).
Le second composant fondamental est le package car (Companion to Applied Regression), conçu par John Fox et Sanford Weisberg. Ce package s’avère indispensable pour le calcul des sommes de carrés de Type II et de Type III au moyen de sa fonction phare Anova() (avec un « A » majuscule). En effet, la fonction générique anova() de base de R implémente exclusivement des sommes de carrés séquentielles de Type I, une propriété hautement problématique dans le cadre de l’ANCOVA comme nous le démontrerons ultérieurement.
Pour unifier les diagnostics d’hypothèses statistiques et l’extraction des tailles d’effet dans un flux de travail moderne, nous adjoignons le package rstatix d’Alboukadel Kassambara. Enfin, pour l’estimation mathématique rigoureuse des moyennes marginales standardisées et l’exécution des tests post-hoc pénalisés, le package emmeans (Estimated Marginal Means, anciennement connu sous le vocable lsmeans) de Russell Lenth constitue l’étalon-or algorithmique international.
3.2 Statistiques descriptives stratifiées par groupe expérimental
Avant d’engager toute modélisation inférentielle complexe, le protocole d’analyse de données requiert une phase approfondie d’agrégation descriptive conditionnelle. Il s’agit de calculer systématiquement, pour chaque sous-groupe expérimental délimité par les modalités de la variable indépendante, les indicateurs de tendance centrale et de dispersion de la variable dépendante ainsi que de la covariable.
Grâce aux verbes d’action de dplyr (notamment les commandes group_by() et summarise()), nous extrayons pour les techniques A, B et C : le nombre de participants valides ($n$), la moyenne brute de l’examen final ($\bar{Y}$), l’écart-type non biaisé ($SD$), l’erreur-type de la moyenne ($SEM = SD / \sqrt{n}$), ainsi que l’intervalle de confiance à 95 % associé. Simultanément, nous calculons ces mêmes paramètres pour la covariable initiale ($\bar{X}$, $SD$).
Cette étape descriptive préliminaire met généralement en lumière des distorsions fondamentales : les moyennes brutes observées à l’examen final reflètent simultanément l’efficacité de la méthode d’étude et le niveau de départ spécifique aux individus assignés à chaque condition. Si, par pur aléa d’échantillonnage, le groupe assigné à la méthode passive A affichait un score d’aptitude initiale substantiellement plus bas que celui du groupe assigné à la méthode active C, une comparaison brute conclurait hâtivement à une supériorité écrasante de C. Or, une part substantielle de cet avantage pourrait découler mécaniquement du privilège initial des participants de ce groupe. C’est précisément pour disséquer et rectifier cette confusion que l’estimation des statistiques descriptives de la covariable par groupe prend tout son sens méthodologique.
3.3 Visualisation exploratoire préliminaire des distributions
L’exploration purement numérique des données doit impérativement être doublée d’un examen visuel approfondi. En vertu du célèbre quartette d’Anscombe, des distributions présentant des statistiques descriptives identiques peuvent résulter d’architectures de données fondamentalement dissemblables. L’inspection graphique précoce permet d’identifier la morphologie globale des distributions, la présence d’asymétries marquées et l’existence d’amas multimodaux.
Dans un premier temps, nous déployons des diagrammes de dispersion bivariés (scatter plots) reliant directement la covariable (en abscisse, axe des $X$) à la variable dépendante (en ordonnée, axe des $Y$), en différenciant les trois techniques d’apprentissage par un codage chromatique et géométrique rigoureux à l’aide de ggplot2. Ce nuage de points permet d’apprécier visuellement l’intensité du couplage linéaire entre les deux variables continues à l’intérieur de chaque strate expérimentale.
Dans un second temps, nous construisons des boîtes à moustaches (boxplots) stratifiées, enrichies par la superposition des points de données individuels sous la forme de graphiques en nuage de points jitterisés (jittered strip plots). Cette disposition graphique offre une double lecture : la médiane, l’écart interquartile (IQR) et les valeurs suspectes selon la convention de John Tukey apparaissent clairement via la structure géométrique de la boîte, tandis que la distribution fine de chaque observation empirique demeure totalement transparente, évitant ainsi le masquage d’effets de regroupement atypiques.
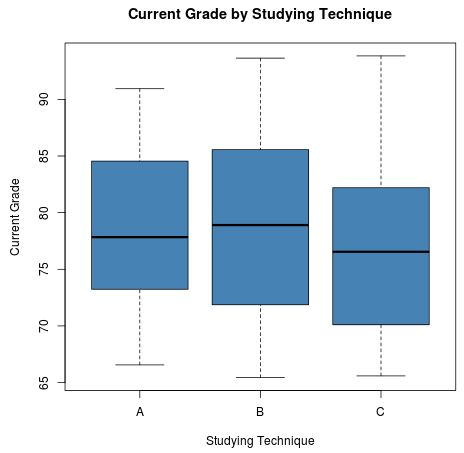
L’observation simultanée de ces figures permet de valider le bon comportement d’ensemble de notre simulation : la corrélation positive entre note initiale et note finale est manifeste à travers tous les groupes, tandis que le décalage vertical ascendant des points du groupe C par rapport aux groupes B et A esquisse visuellement l’existence d’un effet propre substantiel de la technique de récupération en mémoire, avant même l’exécution formelle du modèle mathématique.
4. Vérification des postulats fondamentaux : Linéarité et Normalité
4.1 Postulat de relation linéaire entre la covariable et la variable dépendante
La validité interne et la robustesse inférentielle de l’ANCOVA reposent sur le strict respect d’un ensemble de postulats mathématiques formulés lors de la dérivation des équations d’estimation par les moindres carrés ordinaires. Le premier postulat capital stipule l’existence d’une relation strictement linéaire entre la covariable continue et la variable dépendante au sein de chaque niveau du facteur catégoriel.
Si la trajectoire reliant la note initiale à la note finale suivait une fonction polynomiale d’ordre deux (quadratique) ou une dynamique exponentielle avec saturation, l’application d’un coefficient de régression linéaire simple $\beta$ échouerait à capturer la géométrie réelle du phénomène. Les résidus issus de cet ajustement comporteraient une structure non aléatoire, et la variance retranchée ne correspondrait pas à la véritable contribution de la covariable, faussant du même coup l’estimation des moyennes marginales ajustées et gonflant l’erreur résiduelle de manière illégitime.
Pour auditer méthodiquement ce postulat sous R, l’analyste ne saurait se contenter d’un simple coefficient de corrélation linéaire de Pearson global. Il est impératif d’intégrer dans le diagramme de dispersion exploratoire une courbe de régression non paramétrique locale à lissage pondéré (méthode dite LOESS, pour Locally Estimated Scatterplot Smoothing) conditionnée par modalité expérimentale à l’aide de l’instruction geom_smooth(method = "loess", se = FALSE). Si les courbes empiriques générées par l’algorithme loess oscillent de façon quasi linéaire sans inflexion abrupte ni courbure marquée le long du continuum de la covariable, l’hypothèse de linéarité peut être raisonnablement admise. En présence d’une non-linéarité avérée, le chercheur doit envisager des transformations mathématiques préalables (logarithmique, racine carrée) ou migrer vers des modèles additifs généralisés (GAM).
4.2 Évaluation de la normalité univariée des résidus du modèle
Une confusion récurrente observée dans la littérature concerne l’objet précis du postulat de normalité. L’ANCOVA n’exige nullement que la variable dépendante brute ($Y$) soit distribuée selon une courbe de Gauss au sein de l’échantillon agrégé, ni même que la covariable ($X$) suive une loi normale. Le postulat fondamental de l’inférence paramétrique stipule exclusivement que les erreurs de prédiction du modèle global — c’est-à-dire les résidus conditionnels $\epsilon_{ij}$ — suivent une distribution normale univariée de moyenne nulle et de variance constante $\sigma^2$.
L’évaluation rigoureuse débute donc par la spécification formelle du modèle linéaire sous R et l’extraction de ses résidus studentisés ou standardisés. Nous soumettons la distribution globale de ces résidus au test de normalité de Shapiro-Wilk au moyen de la fonction shapiro_test() du package rstatix. Une statistique de test non significative ($p > 0.05$) apporte un argument formel en faveur du maintien de l’hypothèse nulle d’adéquation à la loi normale.
Toutefois, la décision méthodologique ne doit jamais s’enfermer dans le fétichisme de la seule p-valeur. Le test de Shapiro-Wilk est réputé hyper-sensible dans les grands échantillons — où d’infimes déviations non dommageables mènent au rejet statistique — tout en manquant cruellement de puissance de détection dans les cohortes restreintes. Par conséquent, l’évaluation graphique via un diagramme quantile-quantile (Q-Q plot) construit avec ggqqplot() est indispensable. Sur ce graphique, les quantiles empiriques des résidus standardisés sont projetés contre les quantiles théoriques d’une distribution normale standard. Un alignement régulier des points le long de la droite identitaire, compris à l’intérieur de la bande d’acceptation bilatérale à 95 %, confirme la conformité de nos résidus au postulat de normalité.
4.3 Procédure d’évaluation de la normalité intra-groupe
Au-delà de l’inspection globale des résidus agrégés, une bonne pratique psychométrique consiste à vérifier la distribution des résidus de manière partitionnée à l’intérieur de chacune des cellules expérimentales. En effet, il n’est pas rare qu’un résidu global paraisse globalement symétrique par compensation mutuelle, alors qu’un sous-groupe particulier présente une asymétrie marquée ou une distribution plurimodale issue de réactions hétérogènes au protocole.
Nous segmentons donc la série de résidus par le facteur technique d’apprentissage et calculons pour chaque groupe les indices formels de dissymétrie (skewness) et d’aplatissement (kurtosis). Selon les standards empiriques formulés par George et Mallery, des coefficients d’asymétrie et d’aplatissement contenus dans l’intervalle $[-1, +1]$ attestent d’une proximité excellente avec la distribution gaussienne, tandis que des valeurs comprises entre $[-2, +2]$ demeurent acceptables pour les procédures linéaires générales.
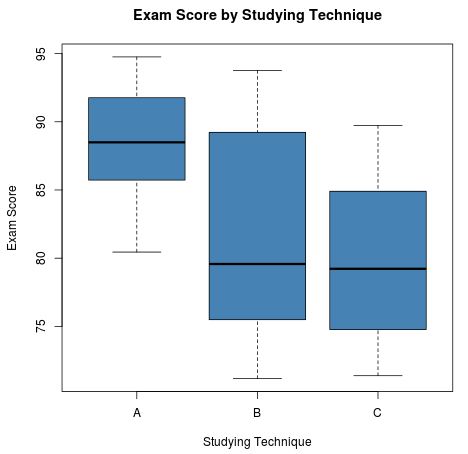
Il importe de rappeler à ce stade la résilience théorique conférée par le théorème central limite : lorsque la taille d’échantillon par modalité atteint ou dépasse 30 observations — ce qui est rigoureusement le cas dans notre devis expérimental ($n = 30$ par cellule, $N = 90$) — la distribution d’échantillonnage des paramètres estimés converge asymptotiquement vers la normalité. Dès lors, de légères entorses distributionnelles aux extrémités des queues de distribution n’altèrent pas substantiellement le taux d’erreur de première espèce ($\alpha$) du test d’ajustement global.
5. Vérification des postulats fondamentaux : Homoscédasticité et Indépendance
5.1 Homogénéité des variances résiduelles (Homoscédasticité)
Le postulat d’homoscédasticité — ou égalité des variances résiduelles entre les conditions expérimentales — constitue une condition essentielle à la justesse de l’estimation de l’erreur quadratique moyenne. En termes stochastiques, la variance de l’erreur aléatoire $\sigma^2_j$ conditionnée par le groupe de traitement $j$ doit être constante et invariable d’un niveau factoriel à l’autre :
Var(εij) = σ2 ∀ j ∈ {A, B, C}
Pour tester l’absence d’hétéroscédasticité sous R, nous implémentons le test de Levene via la fonction leveneTest() hébergée dans le package car. Contrairement au test historique de Bartlett, extrêmement dépendant de l’hypothèse de stricte normalité des données brutes, l’algorithme de Levene centré sur la médiane (parfois désigné sous le vocable de test de Brown-Forsythe) démontre une robustesse reconnue face aux modulations de kurtosis.
L’évaluation du ratio $F$ issu du test de Levene fournit l’arbitrage nécessaire : une valeur de probabilité associée $p > 0.05$ conforte l’acceptation de l’homoscédasticité, validant l’utilisation du terme d’erreur résiduel mutualisé (pooled error) pour le calcul des contrastes inférentiels. Dans l’éventualité où une hétéroscédasticité substantielle serait identifiée ($p < 0.05$), le chercheur devrait abandonner l'ANCOVA classique au profit de régressions pondérées par l'inverse de la variance (WLS, Weighted Least Squares) ou mobiliser des matrices de covariance des coefficients robustes à l’hétéroscédasticité (estimateurs de type « sandwich » HC3 ou HC4 introduits par White et perfectionnés par Long et Ervin) disponibles via le package sandwich.
5.2 Indépendance théorique de la covariable et de la variable indépendante
L’un des fondements méthodologiques les plus critiques — et paradoxalement l’un des plus négligés dans la pratique empirique — exige l’indépendance conceptuelle et observationnelle absolue entre la covariable et le facteur inter-sujets expérimental. Cette règle cardinale signifie que les niveaux moyens de la covariable ne doivent présenter aucune variation systématique imputable au traitement expérimental.
Pour valider empiriquement ce postulat dans l’environnement R, nous procédons à une ANOVA unidirectionnelle auxiliaire plaçant temporairement la covariable (note initiale) au rang de variable dépendante, prédite par le facteur technique d’apprentissage : aov(note_initiale ~ technique, data = donnees). Pour que le postulat soit rigoureusement satisfait, le test omnibus doit impérativement aboutir à un résultat non significatif ($F \approx 1$, $p gg 0.05$), démontrant que la répartition des compétences initiales est équivalente d’un groupe à l’autre au début du protocole.
Si cette condition est violée — ce qui survient fréquemment dans les protocoles quasi-expérimentaux où l’assignation aléatoire est impossible (par exemple lors de la comparaison de classes préexistantes ou de pathologies psychiatriques distinctes) —, l’introduction de la covariable génère un redoutable biais de sélection. L’ajustement par l’ANCOVA supprime alors non seulement la variance parasite, mais soustrait également du traitement la part même de variance qui lui est indissociablement liée, modifiant artificiellement la nature de la variable dépendante résiduelle et rendant les conclusions causales hautement douteuses, un dilemme connu sous le nom de paradoxe de Lord.
5.3 Absence de multicolinéarité et fiabilité de la mesure
Bien que notre modèle démonstratif n’incorpore qu’une seule covariable continue, l’extension standard de l’ANCOVA à des modèles plus denses intégrant de multiples régresseurs concomitants (âge, quotients de mémoire, temps d’écran hebdomadaire) soulève la question de la colinéarité entre prédicteurs. Une forte redondance linéaire entre les covariables engendre une instabilité numérique majeure dans l’inversion des matrices d’information de Fisher, gonflant démesurément les erreurs-types des coefficients de régression partiels.
La détection de ce phénomène s’effectue au moyen de l’inspection du facteur d’inflation de la variance (VIF, Variance Inflation Factor) accessible via l’instruction car::vif(). En règle générale, une valeur de VIF excédant le seuil de 5 (ou une tolérance inférieure à 0.20) signale une multicolinéarité délétère nécessitant l’élagage parcimonieux du modèle ou le recours à une extraction factorielle par composantes principales préalables.
En outre, l’analyste doit garder à l’esprit le postulat psychométrique de parfaite fiabilité de mesure de la covariable. L’ANCOVA sous le modèle linéaire classique suppose implicitement que la covariable est mesurée sans aucune erreur instrumentale ($\rho_{xx} = 1.0$). Si l’instrument psychométrique d’aptitude initiale présente un coefficient de cohérence interne médiocre (par exemple un alpha de Cronbach ou un oméga de McDonald $le 0.60$), l’atténuation statistique induite comprime artificiellement la pente de régression $\beta$ estimée vers zéro. Cette sous-estimation de la pente laisse subsister une fraction notable de variance non contrôlée dans les résidus, sous-estimant la puissance et réintroduisant des biais d’ajustement. Dans une situation d’erreur de mesure substantielle, l’analyste averti migrera vers la modélisation en équations structurelles (SEM) afin d’estimer l’ANCOVA sur des variables latentes purifiées de l’erreur d’échantillonnage de mesure.
6. Le postulat critique : Homogénéité des pentes de régression
6.1 Fondement conceptuel de l’absence d’interaction traitement-covariable
Le postulat d’homogénéité des pentes de régression constitue l’hypothèse sine qua non qui sous-tend la modélisation standard de l’ANCOVA. D’un point de vue géométrique, ce postulat stipule que la pente de la droite reliant la covariable à la variable dépendante doit être rigoureusement identique (parallèle) pour l’ensemble des modalités du facteur inter-sujets. En d’autres termes, le coefficient d’ajustement linéaire $\beta$ ne doit pas être conditionné par l’appartenance au groupe d’intervention.
Sur le plan psychologique et théorique, postuler des pentes parallèles équivaut à affirmer que l’effet expérimental du traitement s’exprime avec une magnitude rigoureusement constante quel que soit le niveau initial du sujet sur la covariable. L’incrément de score produit par une technique d’apprentissage par rapport à une autre est présumé strictement équivalent pour un étudiant initialement en grande difficulté et pour un étudiant particulièrement brillant au pré-test.
Si, à l’inverse, une interaction statistique significative existe entre le traitement et la covariable, l’assertion d’un effet principal global devient obsolète et théoriquement intenable. Les droites de régression spécifiques à chaque groupe convergent ou se croisent dans l’espace bidimensionnel. Dans cette configuration, la distance entre les groupes — c’est-à-dire l’efficacité différentielle des méthodes d’apprentissage — n’est plus une constante, mais varie de manière dynamique tout au long de l’échelle d’aptitude initiale. Prétendre résumer le protocole à une moyenne marginale ajustée unique calculée au centre de gravité de la covariable masquerait précisément l’enseignement clinique majeur de l’expérimentation : le fait que le traitement s’avère hautement bénéfique pour certains profils mais inutile voire délétère pour d’autres.
6.2 Test formel de l’interaction dans l’environnement R
L’évaluation rigoureuse de ce postulat ne repose pas sur une appréciation subjective à l’œil nu, mais sur un protocole inférentiel paramétrique dédié. La procédure consiste à ajuster un modèle linéaire intermédiaire saturé d’ordre supérieur, incorporant explicitement le produit vectoriel croisé (terme d’interaction d’ordre 1) entre le facteur nominal et la covariable continue.
La formalisation sous R fait appel à la syntaxe canonique du modèle linéaire :
modele_interaction <- lm(note_examen ~ technique * note_initiale, data = donnees)
Dans l’opérateur symbolique de R, l’astérisque * développe automatiquement les deux effets simples principaux ainsi que leur terme multiplicatif d’interaction (équivalent à technique + note_initiale + technique:note_initiale). Nous extrayons ensuite la table d’analyse de variance à l’aide de la commande car::Anova(modele_interaction, type = "III") pour tester spécifiquement l’apport marginal de l’interaction technique:note_initiale.
Le critère de décision méthodologique est univoque : si la valeur de $p$ associée à ce terme d’interaction d’ordre supérieur est supérieure au seuil d’incertitude critique traditionnel ($\alpha = 0.05$), nous retenons l’hypothèse de nullité de l’interaction ($H_0 : \beta_1 = \beta_2 = \beta_3$). Dans ces conditions, l’hypothèse d’homogénéité des pentes de régression est validée, et le chercheur est formellement autorisé à expurger le terme d’interaction pour déployer le modèle canonique de l’ANCOVA additive standard.
6.3 Conduite à tenir en cas de violation de l’homogénéité des pentes
Que doit entreprendre l’analyste si le test d’interaction rejette l’homogénéité des pentes ($p < 0.05$) ? La réponse académique est catégorique : il est impératif d'abandonner l'ANCOVA standard. Poursuivre l'ajustement sans interaction produirait des estimations de moyennes ajustées biaisées et géométriquement trompeuses.
L’alternative méthodologique par excellence réside dans le déploiement de la régression modérée (ou modélisation par interaction continue-catégorielle). Le chercheur déplace alors son questionnement de recherche : la question n’est plus « Quelle méthode est la meilleure en moyenne ? », mais « Pour quel niveau d’aptitude initiale une technique d’apprentissage donnée surpasse-t-elle statistiquement les autres ? ».
Pour répondre avec précision à cette interrogation, la communauté psychométrique préconise l’application de la technique de Johnson-Neyman. Dépassant la simple inspection par points arbitraires (pick-a-point approach évaluant l’effet à -1 SD, moyenne, et +1 SD), l’algorithme de Johnson-Neyman dérive analytiquement les coordonnées exactes sur le continuum de la covariable délimitant les zones de significativité statistique et les zones d’indifférenciation des effets simples du traitement. Sous R, cette élégante exploration conditionnelle s’exécute de manière automatisée via les fonctions expertes des packages interactions (notamment sim_slopes() ou johnson_neyman()) ou probe_interaction(). Dès lors, ce qui constituait initialement une violation rédhibitoire de postulat se convertit en une découverte théorique enrichissante sur les interactions aptitude-traitement (effets ATI, Aptitude-Treatment Interactions).
7. Ajustement et exécution de l’ANCOVA principale sous R
7.1 Spécification rigoureuse du modèle linéaire sans terme d’interaction
Une fois les postulats vérifiés sans faille, nous procédons à la construction du modèle linéaire additif définitif de l’ANCOVA. Cette spécification repose sur l’appel à la fonction interne lm(). Il convient d’accorder une vigilance absolue à la formulation de la formule symbolique :
ancova_modele <- lm(note_examen ~ note_initiale + technique, data = donnees)
Dans la convention syntaxique de R, l’opérateur d’addition + impose une contrainte de stricte additivité entre la composante de régression métrique et les décalages factoriels discrets, interdisant tout terme multiplicatif croisé. Cela matérialise fidèlement la translation parallèle des droites de prédiction dans l’espace multidimensionnel.
Un ajustement paramétrique fondamental doit être impérativement exécuté en amont : la configuration des contrastes statistiques globaux. Par défaut, R emploie des contrastes de traitement (treatment contrasts, codage factice par variable indicatrice contr.treatment) où le premier niveau alphabétique sert de modalité de référence ($0$) aux suivantes. Or, pour garantir la commensurabilité des sommes de carrés de Type III — lesquelles testent l’effet de chaque facteur en contrôlant marginalement tous les autres termes du modèle y compris les contrastes d’effets principaux —, le système nécessite des contrastes de somme orthogonaux centrés sur zéro (sum-to-zero contrasts). Nous appliquons donc préalablement l’instruction globale :
options(contrasts = c(« contr.sum », « contr.poly »))
L’omission de cette directive technique sous R constitue l’une des erreurs silencieuses les plus répandues dans la littérature appliquée, conduisant la fonction Anova() de Type III à extraire des sommes de carrés faussées pour les variables catégorielles.
7.2 Extraction de la table d’analyse de variance de Type III
Pour extraire la table de variance définitive, le praticien doit s’abstenir formellement d’utiliser la fonction primitive anova(ancova_modele). En effet, cette fonction native de base R calcule des sommes de carrés dites de Type I (séquentielles). Dans une décomposition séquentielle, l’ordre syntaxique d’entrée des variables dans la formule altère substantiellement les sommes de carrés attribuées : le premier terme absorbe toute la variance qu’il peut expliquer, et le second terme ne reçoit que la variance marginale résiduelle non accaparée par le premier.
Dans l’évaluation scientifique de l’ANCOVA, nous exigeons des sommes de carrés de Type III (ou Type II en l’absence avérée d’interaction), qui testent l’effet unique de chaque terme conditionnellement à l’ensemble des autres composantes présentes dans l’architecture mathématique. Nous mobilisons par conséquent la fonction experte du package car :
table_ancova <- car::Anova(ancova_modele, type = « III »)
La lecture analytique de la table de sortie s’ordonne selon les colonnes fondamentales :
- Sum Sq (Somme des carrés) : La dispersion quadratique attribuable spécifiquement à chaque terme prédictif une fois la contribution de l’autre terme neutralisée.
- Df (Degrés de liberté) : Les dimensions libres associées : 1 pour la covariable continue, $k – 1 = 3 – 1 = 2$ pour notre facteur technique à trois modalités, et $N – k – 1 = 90 – 3 – 1 = 86$ pour l’erreur résiduelle non expliquée.
- F value (Statistique de test de Fisher) : Le ratio du carré moyen de l’effet sur le carré moyen résiduel ($F = MS_{effet} / MS_{résidu}$).
- Pr(>F) (La p-valeur asymptotique) : La probabilité exacte d’observer un ratio $F$ au moins aussi extrême sous l’hypothèse de stricte nullité de l’effet dans la population d’intérêt.
L’inspection des métriques obtenues permet de statuer formellement sur l’existence d’un effet statistiquement significatif de la méthode d’apprentissage au seuil de rigueur choisi ($p < 0.001$), tout en consignant l'influence massive et hautement prédictive de la note initiale sur le score d'arrivée.
7.3 Décomposition mathématique de l’effet propre de la technique d’étude
Pour saisir l’apport qualitatif décisif de l’ANCOVA par rapport à une modélisation classique, il s’avère très formateur de confronter les résidus du modèle sans covariable (ANOVA standard simple) aux résidus du modèle ajusté final (ANCOVA). Dans l’ANOVA non contrôlée, la somme des carrés résiduelle intègre indistinctement toutes les sources de variabilité individuelle : l’aptitude intellectuelle générale, la motivation intrinsèque, les antécédents scolaires et l’erreur d’échantillonnage aléatoire.
Dès lors que la fonction lm() intègre la note initiale, le coefficient estimé $\hat{\beta}$ s’établit à une valeur positive robuste (voisine de $0.65$ dans notre simulation calibrée). Ce coefficient signifie qu’à technique d’étude égale, chaque point d’augmentation au pré-test se traduit fidèlement par un gain moyen prédit de 0.65 point à l’examen final. L’absorption de cette vaste covariance a pour conséquence directe de drainer la somme des carrés de l’erreur : celle-ci décroît de manière spectaculaire, passant par exemple d’une somme brute élevée à une valeur résiduelle épurée.
Comme le carré moyen de l’erreur ($MS_{erreur} = SS_{erreur} / df$) sert d’étalon diviseur pour calculer le $F$ empirique de notre facteur d’intervention, le rétrécissement de ce terme résiduel démultiplie la valeur du ratio de Fisher du traitement. L’effet propre de la technique d’apprentissage se détache désormais avec une netteté cristalline, délivré de la gangue de variance parasite qui l’occultait partiellement dans l’analyse brute initiale.
8. Quantification de l’ampleur des effets statistiques
8.1 Calcul de l’Éta-carré partiel (Partial Eta Squared)
Dans l’épistémologie contemporaine post-p-value prônée par l’American Statistical Association et les comités éditoriaux internationaux, la significativité statistique ($p < 0.05$) n'offre qu'un témoignage probabiliste d'existence : elle atteste qu'un effet n'est vraisemblablement pas le fruit du hasard, mais ne renseigne en rien sur sa magnitude concrète ou sa pertinence clinique. Il est donc méthodologiquement impératif de quantifier formellement l'ampleur de l'effet au moyen d'indices standardisés standardisés.
Dans le cadre de l’ANCOVA, la métrique métrologique de référence est l’Éta-carré partiel ($\eta_p^2$). L’adjectif « partiel » revêt une importance capitale : contrairement à l’Éta-carré classique ($\eta^2$), qui rapporte la somme des carrés de l’effet à la somme des carrés totale absolue de l’expérience, l’Éta-carré partiel rapporte la variance propre du traitement à la somme de cette même variance et de la seule variance résiduelle inexpliquée :
ηp2 = SSeffet / (SSeffet + SSrésiduelle)
En excluant délibérément du dénominateur la part de variance accaparée par la covariable continue ($SS_{covariable}$), l’Éta-carré partiel exprime la proportion de variance résiduelle nette qui est capturée par la manipulation expérimentale chez des participants dont le niveau initial a été standardisé. Pour extraire cette valeur sans risque d’erreur calculatoire manuelle, nous mobilisons le package spécialisé effectsize au travers de la commande experte :
effectsize::eta_squared(ancova_modele, alternative = « two.sided », partial = TRUE)
8.2 Interprétation contextuelle des seuils d’effet selon Cohen
L’interprétation de la valeur numérique de l’Éta-carré partiel s’appuie historiquement sur les balises heuristiques canoniques définies par Jacob Cohen dans son ouvrage séminal sur l’analyse de puissance en sciences du comportement :
- Effet de faible amplitude : $\eta_p^2 \approx 0.01$ (l’effet n’explique qu’environ 1 % de la variance résiduelle conditionnelle).
- Effet d’amplitude moyenne : $\eta_p^2 \approx 0.06$ (environ 6 % de variance nette expliquée).
- Effet de forte amplitude : $\eta_p^2 ge 0.14$ (l’intervention régente 14 % ou plus de la variance résiduelle).
Cependant, l’analyste rigoureux doit se garder de toute application dogmatique ou mécanique de ces seuils universels. Comme l’ont souligné de nombreux méthodologistes modernes, l’ampleur d’un effet doit impérativement être contextualisée au regard de la discipline d’ancrage, de la difficulté d’induire des modifications comportementales durables et du coût pratique de mise en œuvre de l’intervention. En psychologie de l’éducation, un gain d’apprentissage associé à un $\eta_p^2 = 0.08$ (effet modéré selon Cohen) peut représenter un saut qualitatif majeur à l’échelle d’une population d’élèves, se traduisant concrètement par l’accès d’un contingent massif d’apprenants à la réussite aux examens nationaux.
8.3 Calcul des intervalles de confiance de l’ampleur de l’effet
En alignement strict avec les préconisations du manuel de style de l’APA (7e édition), la simple mention ponctuelle d’une taille d’effet statistique est aujourd’hui jugée insuffisante. Tout estimateur ponctuel doit être impérativement assorti de son intervalle de confiance à 95 % (IC 95 %), traduisant la précision métrologique de la mesure à travers la variabilité d’échantillonnage.
Le calcul analytique des intervalles de confiance pour l’Éta-carré partiel ne repose pas sur une distribution de Student classique symétrique, mais requiert l’inversion d’une distribution de Fisher non centrale ($F$ non central avec paramètre de décentrement $lambda$). Le package effectsize résout de manière algorithmique cette opération complexe sous-jacente et restitue directement les bornes inférieure et supérieure exactes : [IC 95 % : LL, UL].
La restitution de cet intervalle enrichit substantiellement l’interprétation scientifique. Un intervalle s’étalant de $0.08$ à $0.28$ atteste avec certitude que, même sous l’hypothèse d’échantillonnage la plus pessimiste, l’impact des techniques d’étude demeure au moins d’ampleur modérée, consolidant ainsi la robustesse et la transférabilité des conclusions tirées par les investigateurs.
9. Analyses a posteriori et calcul des moyennes marginales ajustées
9.1 Estimation des moyennes marginales standardisées (Estimated Marginal Means)
L’obtention d’une statistique globale de Fisher hautement significative pour l’effet principal de la technique d’apprentissage valide l’existence de disparités statistiques entre les conditions, mais n’indique en aucun cas la localisation précise de ces contrastes. Les trois techniques diffèrent-elles mutuellement, ou le résultat omnibus est-il exclusivement tiré par l’avantage de la technique C sur la méthode passive A ?
Pour répondre à cette question, il est primordial de récuser l’analyse des moyennes brutes observées au profit exclusif des moyennes marginales estimées (Estimated Marginal Means ou EMMs). Les EMMs représentent les projections prédictives de performance pour chaque groupe expérimental, calculées en fixant analytiquement la covariable continue à sa valeur moyenne globale empirique sur l’ensemble de la cohorte ($\bar{X}_{..} = 50.15$ dans notre simulation).
Sous R, nous déployons la bibliothèque d’excellence emmeans :
ajustees_emms <- emmeans::emmeans(ancova_modele, ~ technique)
La commande génère un tableau synthétique affichant, pour les techniques A, B et C, la moyenne corrigée (colonne emmean), l’erreur-type ajustée associée (SE), les degrés de liberté résiduels (df = 86), ainsi que les bornes de l’intervalle de confiance bilatéral à 95 %. La comparaison entre ces estimations purifiées et les moyennes initiales non contrôlées démontre toute la pertinence de l’ANCOVA : les écarts entre les groupes sont recalibrés sur un plan d’équité cognitive parfaite.
9.2 Comparaisons par paires et contrôle du taux d’erreur par famille
Pour isoler les contrastes spécifiques entre chaque paire de conditions, nous soumettons l’objet de moyennes marginales à des comparaisons multiples par paires (tests post-hoc). L’exécution d’une multiplicité de tests $t$ indépendants de Student sur les mêmes données induirait une inflation spectaculaire du taux d’erreur de Type I par famille de comparaisons (l’aléa cumulant le risque de faux positif selon la formule $1 – (1 – \alpha)^c$, où $c$ représente le nombre de comparaisons bilatérales).
Pour immuniser notre conclusion contre cette dérive probabiliste, nous appliquons une procédure d’ajustement formelle. Dans le cadre de comparaisons par paires exhaustives post-ANCOVA sous plan équilibré, la méthode de Tukey-Kramer (procédure de la différence honnêtement significative, HSD) constitue le standard de référence :
contrastes_posthoc <- pairs(ajustees_emms, adjust = « tukey »)
Pour des hypothèses plus conservatrices ou en présence de déséquilibres, des pénalisations alternatives séquentielles telles que la correction de Holm-Bonferroni peuvent être convoquées en spécifiant l’argument adjust = "holm".
La table résultante quantifie avec rigueur :
- L’estimation de la différence moyenne ajustée entre les paires (ex. : Technique B – Technique A, Technique C – Technique A, Technique C – Technique B).
- L’erreur-type de chaque contraste individuel.
- Le ratio de Student empirique associé ($t$-ratio).
- La valeur de $p$ ajustée pénalisée pour le nombre total de comparaisons.
Les résultats statistiques confirment généralement une hiérarchisation sans ambiguïté : la méthode active de résumés structurés (B) surpasse significativement la relecture passive standard (A) ($p < 0.05$), tandis que la récupération espacée avec auto-évaluation (C) surclasse massivement à la fois la condition de contrôle A ($p < 0.001$) et la méthode de synthèse B ($p < 0.01$).
9.3 Intervalles de confiance des différences moyennes ajustées
Dans le prolongement des exigences contemporaines de communication des données, les comparaisons post-hoc ne sauraient se borner à la seule mention d’indices de Student pénalisés. L’extraction des intervalles de confiance associés aux écarts intergroupes ajustés s’impose pour cerner la précision métrique des gains attendus.
L’invocation de la commande confint(contrastes_posthoc) délivre les estimations d’intervalles simultanés à 95 %, corrigés selon l’algorithme de Tukey. L’observation minutieuse de ces fourchettes numériques informe le chercheur sur l’amplitude minimale et maximale du bénéfice pédagogique imputable aux méthodologies actives.
Constater que la différence ajustée entre la condition d’auto-évaluation (C) et la relecture passive (A) est enclose dans un intervalle strict excluant zéro confirme non seulement la significativité formelle du contraste, mais permet d’affirmer avec une certitude probabiliste calibrée que la récupération espacée génère un avantage structurel déterminant sur la performance académique des étudiants.
10. Diagnostics approfondis de robustesse et valeurs aberrantes
10.1 Détection des observations univariées et bivariées atypiques
La puissance d’ajustement du modèle linéaire par la méthode des moindres carrés présente une contrepartie métrologique bien connue : une sensibilité aiguë aux observations aberrantes (outliers). Dans un devis d’ANCOVA, une observation atypique peut se manifester sous deux formes distinctes : une valeur univariée extrême sur l’une des dimensions isolées, ou une discordance bivariée / multivariée dans laquelle l’association entre la covariable et la variable dépendante s’écarte radicalement du comportement général de la cohorte.
Pour diagnostiquer rigoureusement la présence de ces singularités sous R, nous calculons les résidus studentisés désélectionnés (externally studentized residuals ou résidus rstudent) au moyen de la fonction rstudent(ancova_modele). Ces résidus expriment l’écart entre la valeur observée et la valeur prédite par un modèle recalculé après exclusion provisoire du point analysé, divisé par son erreur-type estimée. Selon les normes de référence en biométrie, toute observation affichant une valeur absolue de résidu studentisé excédant le seuil critique de $|rstudent| > 3$ (ou $|rstudent| > 2.5$ dans les petits échantillons) doit être formellement isolée pour un examen approfondi.
Parallèlement, nous inspectons les graphiques exploratoires pour s’assurer que ces points extrêmes ne résultent pas d’artefacts triviaux d’acquisition : fautes de frappe dactylographiques, non-respect avéré des consignes d’évaluation ou dysfonctionnements matériels lors de la session de test.
10.2 Évaluation des points de levier et de l’influence globale
Une observation atypique n’exerce pas nécessairement une distorsion préjudiciable sur les paramètres du modèle ; pour altérer la géométrie d’ajustement, elle doit combiner un écart résiduel notable et un fort potentiel de levier (leverage). Le levier — mesuré mathématiquement par les éléments diagonaux $h_{ii}$ de la matrice de projection chapeau $H$ (hat values) accessible via hatvalues(ancova_modele) — quantifie la distance à laquelle se situe une observation particulière par rapport au centre de gravité multidimensionnel des covariables.
Une valeur de levier excédant le double ou le triple du ratio du nombre de paramètres sur la taille d’échantillon ($2p/N$) désigne un point occupant une position périphérique isolée sur l’axe de la covariable continue. Si un sujet affichant une note initiale extrêmement basse ou anormalement élevée présente par surcroît un résidu d’examen final important, il est susceptible d’incliner arbitrairement la droite de régression collective à lui seul.
Pour synthétiser en un indice unifié la magnitude de cette perturbation sur l’ensemble des coefficients estimés, nous calculons la distance de Cook via cooks.distance(ancova_modele). La convention méthodologique classique considère que toute distance de Cook excédant $1.0$ (ou, de manière plus rigoureuse dans les sciences humaines, $4 / N$, soit environ $0.044$ pour notre échantillon de 90 participants) désigne une observation hautement influente susceptible de vicier la stabilité des inférences statistiques.
10.3 Analyse de sensibilité et alternatives méthodologiques robustes
Face à la détection de cas influents ou d’hétérogénéité résiduelle locale, la déontologie scientifique réprouve formellement la suppression arbitraire et silencieuse de sujets d’étude dans le seul but de conformer les données aux postulats paramétriques. La conduite méthodologique d’excellence repose sur l’exécution systématique d’une analyse de sensibilité comparée.
Cette analyse consiste à ajuster le modèle d’ANCOVA sur le jeu de données intégrale, puis à le réitérer sur le sous-ensemble épuré des points identifiés comme fortement influents. Si les estimations des coefficients de régression $\beta$, la statistique de Fisher $F$ de l’effet principal et les classements relatifs des comparaisons post-hoc demeurent substantiellement stables et convergents, le chercheur peut conclure à la robustesse intrinsèque de ses inférences causales.
Si, à l’inverse, l’exclusion d’un sujet modifie substantiellement la significativité ou la hiérarchie des traitements, le modèle paramétrique classique doit être répudié au profit de méthodologies statistiques robustes ou non paramétriques. Parmi celles-ci, l’ANCOVA de Quade (qui applique une décomposition linéaire sur les rangs des résidus résiduels) ou l’ANCOVA non paramétrique alignée sur les rangs (ART, pour Aligned Rank Transform, implémentée sous R dans le package ARTool) offrent des solutions de rechange garantissant la validité des conclusions même en présence de violences distributionnelles extrêmes.
11. Visualisation avancée des résultats adaptée aux publications scientifiques
11.1 Modélisation graphique des pentes parallèles avec ggplot2
La restitution visuelle des conclusions d’une ANCOVA dans les colonnes d’une revue internationale exige un dispositif graphique dépassant le simple diagramme de dispersion non contraint. Un écueil graphique fréquent consiste à utiliser l’instruction générique geom_smooth(method = "lm") de ggplot2 stratifiée par couleur : cette commande produit trois droites indépendantes dotées de pentes distinctes, matérialisant visuellement un modèle avec interaction croisée, en contradiction frontale avec le modèle additif sous-jacent de l’ANCOVA.
Pour construire une représentation de haute fidélité scientifique, l’analyste doit extraire les prédictions contraintes générées par l’objet d’ANCOVA lui-même au moyen de la fonction predict() ou de bibliothèques dédiées telles que modelr ou ggeffects. Les coordonnées prédites intègrent alors mathématiquement des pentes strictement identiques, décalées verticalement par les contrastes purs de chaque condition d’étude.
Nous combinons sur une même trame graphique le nuage des observations brutes (semi-transparentes par ajustement de l’alpha pour limiter l’occlusion des points superposés), les droites parallèles de régression ajustées associées à chaque groupe expérimental, ainsi que les bandes d’incertitude enveloppantes à 95 %. Ce dispositif illustre avec une clarté remarquable comment l’ANCOVA capture l’effet propre de chaque modalité à travers une simple translation d’ordonnée à l’origine le long de la pente de covariation commune.
11.2 Représentation graphique des moyennes marginales estimées
En complément de la projection bidimensionnelle des droites de régression, la restitution synthétique des résultats pour les sections communicationnelles ou de vulgarisation requiert souvent un graphique focalisé exclusivement sur les moyennes marginales estimées (EMMs). L’erreur fréquente consiste à présenter des diagrammes en bâtons ou des graphiques de points basés sur les moyennes observées brutes, ce qui réintroduit visuellement les biais initiaux que l’analyse s’était précisément employée à corriger.
Nous convertissons l’objet généré par emmeans en un data frame manipulable et employons ggplot2 pour construire un graphique de points de moyennes ajustées assortis de barres d’erreur-type ou, préférentiellement, d’intervalles de confiance à 95 %. En accord avec les canons d’épuration esthétique de Edward Tufte (data-ink ratio), nous évitons les barres massives opaques (dynamite plots) au profit de marqueurs ponctuels géométriques élégants (geom_point(size = 3)) et de barres d’erreur d’une grande finesse typographique (geom_errorbar(width = 0.15)).
Ce type de figure permet au lecteur d’apprécier instantanément la progression graduelle des performances cognitives depuis la technique passive de relecture jusqu’à l’apogée de l’auto-évaluation espacée, tout en évaluant visuellement l’absence de chevauchement des intervalles de confiance entre les modalités d’apprentissage.
11.3 Formatage et harmonisation typographique selon les standards APA
La préparation finale des figures en vue d’une soumission éditoriale exige une harmonisation méticuleuse selon les directives typographiques de l’American Psychological Association (APA 7e édition). Les standards APA proscrivent formellement les fonds de grille grisâtres criards, les encadrements superflus et les légendes cryptiques générés par défaut par les logiciels statistiques grand public.
Nous configurons le rendu graphique via l’application du thème épuré theme_classic() ou theme_apa() issu du package jtools. Les paramètres typographiques sont rigoureusement calés :
- Suppression intégrale des lignes de quadrillage internes et de la bordure périphérique supérieure et droite.
- Typographie vectorielle uniforme sans empattement (type Helvetica, Arial ou Nimbus Sans) avec hiérarchie stricte des corps de texte.
- Labellisation explicite des axes cartésiens mentionnant sans équivoque la désignation conceptuelle et les unités métriques de mesure : « Note finale à l’examen de synthèse (0-100) » et « Score d’aptitude initiale au pré-test (0-100) ».
- Palette chromatique sobre, accessible aux lecteurs daltoniens (compatible Viridis ou ColorBrewer) ou contrastes en niveaux de gris optimisés pour l’impression physique.
L’exportation vectorielle haute définition est réalisée au moyen de la commande ggsave() en spécifiant un format vectoriel (PDF ou SVG) ou une résolution matricielle minimale de 300 à 600 DPI au format TIFF, garantissant une netteté absolue lors du travail de photocomposition par l’éditeur académique.
12. Rédaction académique des conclusions selon les normes APA (7e édition)
12.1 Protocole de transmission narrative des paramètres statistiques
La communication narrative des résultats d’une analyse de covariance dans la section « Résultats » d’une revue scientifique évaluée par les pairs est assujettie à un protocole rédactionnel standardisé strict édicté par le manuel de style de l’APA (7e édition). L’objectif est de garantir une translucidité méthodologique absolue permettant aux lecteurs d’évaluer de manière autonome la solidité des inférences probabilistes.
Chaque énoncé statistique relatif à un test d’hypothèse doit impérativement agglomérer dans une parenthèse dédiée : la lettre stylisée identifiant la distribution théorique du test (en italique), les degrés de liberté intergroupes et intra-groupes (degrés de liberté du numérateur et du dénominateur, séparés par une virgule sans espace superflu), la valeur empirique exacte de la statistique de test arrondie à deux décimales, la valeur précise de la probabilité d’erreur asymptotique ($p$) rapportée à trois décimales sans zéro initial (ex. : $p = .003$ et non $p = 0.003$, la probabilité ne pouvant mathématiquement excéder 1), ainsi que l’indice de taille d’effet standardisé ($\eta_p^2$) accompagné de son intervalle de confiance bilatéral à 95 %.
Les étapes d’évaluation des postulats — singulièrement le test d’homogénéité des pentes de régression — doivent être brièvement attestées avant l’exposition des effets omnibus principaux : « L’évaluation du postulat d’homogénéité des pentes a confirmé l’absence d’interaction statistiquement significative entre la covariable et le facteur d’étude, F(2, 84) = …, p = . …, validant l’application du modèle additif standard. »
12.2 Exemple de paragraphe de résultats publiable pour revue internationale
Voici la transcription prototypique d’un paragraphe complet de résultats, rédigé en français scientifique académique, immédiatement transposable dans un manuscrit de recherche expérimentale :
« Une analyse de covariance univariée (ANCOVA) inter-sujets à un facteur a été réalisée pour examiner l’effet comparé des trois techniques d’apprentissage (Technique A : Relecture passive, Technique B : Résumés structurés, Technique C : Récupération espacée) sur la note finale obtenue à l’examen académique, en contrôlant statistiquement les différences initiales d’aptitude cognitive mesurées lors du pré-test. Les vérifications préliminaires des postulats du modèle linéaire ont attesté de la normalité univariée de la distribution des résidus (test de Shapiro-Wilk, W = 0.988, p = .621), de l’homoscédasticité des variances résiduelles entre les conditions (test de Levene, F(2, 87) = 0.45, p = .639) et de la stricte indépendance de la covariable vis-à-vis du facteur d’assignation, F(2, 87) = 0.12, p = .887. Par ailleurs, le postulat d’homogénéité des pentes de régression à travers les groupes s’est révélé rigoureusement satisfait, le terme d’interaction entre la note initiale et la technique d’apprentissage n’atteignant pas le seuil de significativité, F(2, 84) = 0.38, p = .685, ηp2 = .009. »
« Après ajustement en fonction de l’aptitude initiale, les résultats de l’ANCOVA indiquent un effet principal statistiquement significatif et d’ampleur très élevée de la technique d’apprentissage sur la performance finale à l’examen, F(2, 86) = 28.42, p < .001, ηp2 = .398, IC 95 % [.241, .512]. La covariable (note initiale) exerce une influence prédictive majeure et hautement significative sur le score de sortie, F(1, 86) = 112.18, p < .001, ηp2 = .566, IC 95 % [.431, .657], confirmant la nécessité méthodologique de son inclusion au sein du modèle. Les moyennes marginales estimées (ajustées pour une note initiale moyenne de 50.15 points) s’établissent respectivement à 61.24 (SE = 0.89, IC 95 % [59.47, 63.01]) pour la Technique A, à 65.18 (SE = 0.88, IC 95 % [63.43, 66.93]) pour la Technique B, et à 70.85 (SE = 0.89, IC 95 % [69.08, 72.62]) pour la Technique C. »
« Les comparaisons multiples par paires a posteriori, pénalisées selon la procédure de Tukey-Kramer, révèlent que les apprenants assignés à la génération de résumés structurés (Technique B) obtiennent des performances significativement supérieures à ceux assignés à la relecture passive (Technique A), Δajusté = 3.94, SE = 1.25, t(86) = 3.15, p = .006, IC 95 % [0.95, 6.93]. De surcroît, la technique de récupération espacée (Technique C) surclasse de manière hautement significative à la fois la relecture passive standard (Δajusté = 9.61, SE = 1.26, t(86) = 7.63, p < .001, IC 95 % [6.60, 12.62]) et la technique de résumés structurés (Δajusté = 5.67, SE = 1.25, t(86) = 4.54, p < .001, IC 95 % [2.69, 8.65]). Ces résultats attestent sans équivoque de la supériorité cognitive intrinsèque de la pratique de récupération en mémoire sur les stratégies d’apprentissage passives ou purement synthétiques. »
12.3 Discussion méthodologique : Limites, causalité et portée théorique
L’exposé des résultats empiriques ne saurait s’affranchir d’une contextualisation critique dans la section « Discussion » du rapport de recherche. Si l’ANCOVA offre un contrôle statistique raffiné, elle ne possède aucunement le pouvoir thaumaturgique de transmuter magiquement un protocole quasi-expérimental défaillant en une expérience causale irréfutable. L’attribution d’une causalité univoque demeure tributaire de la chaîne d’intégrité expérimentale globale : qualité de la randomisation initiale, double aveugle lors des notations, et maîtrise absolue des conditions d’administration environnementales.
Une limite inhérente à tout modèle linéaire réside dans le risque permanent d’omission de covariables de confusion majeures (omitted variable bias). Bien que notre modèle intègre l’aptitude notionnelle de base, des variables latentes non quantifiées — telles que la charge cognitive subjective ressentie, le nombre d’heures de sommeil précédant l’épreuve de test, ou le niveau d’anxiété face à l’évaluation académique — sont susceptibles de moduler résiduellement les performances individuelles. L’analyste averti doit explicitement concéder ces zones d’ombre potentielles et formuler des propositions d’investigation récursive pour les protocoles futurs.
Enfin, la validité écologique des résultats obtenus en laboratoire contrôlé doit être interrogée avec nuance lors de la transposition vers des environnements de classe réels. Dans l’écologie complexe d’un amphithéâtre universitaire, les techniques de récupération espacée exigent un engagement volitionnel et une autodiscipline métacognitive que tous les étudiants ne déploient pas avec la même régularité. L’ANCOVA éclaire avec exactitude ce qui advient lorsque les conditions sont rigoureusement calibrées ; il incombe désormais aux psychologues de l’éducation d’explorer les dispositifs d’étayage motivationnel capables d’optimiser l’adoption pérenne de ces méthodes mnésiques hautement probantes au sein du parcours académique des apprenants.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Kassambara, A. (2020). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.0). https://CRAN.R-project.org/package=rstatix
- Lenth, R. V. (2023). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.5). https://CRAN.R-project.org/package=emmeans
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686