
L’inférence statistique moderne repose sur une tension permanente entre la puissance des modèles paramétriques et la réalité souvent imparfaite des données empiriques recueillies sur le terrain. Alors que le test t de Student à un échantillon ou pour mesures répétées exige une distribution normale sous-jacente des scores ou des résidus, les praticiens en sciences du comportement, en recherche clinique, en ergonomie logicielle et en sciences de l’éducation se heurtent quotidiennement à des distributions fortement asymétriques, contaminées par des valeurs aberrantes ou mesurées sur des échelles strictement ordinales. Face à ces distorsions métriques, l’application aveugle de tests fondés sur la moyenne arithmétique et la variance classique introduit un risque majeur d’inflation de l’erreur de type I ou d’effondrement de la puissance statistique, conduisant à des inférences erronées.
Le test des signes (ou Sign Test) constitue la réponse méthodologique la plus sobre, la plus robuste et la plus ancienne à ce défi analytique. Développé conceptuellement dès le début du XVIIIe siècle par John Arbuthnot et formalisé au milieu du XXe siècle au sein de l’arsenal non paramétrique, ce test fait table rase des exigences de normalité et d’homoscedasticité. En réduisant l’information quantitative continue à une simple dichotomie directionnelle autour d’une médiane théorique, il substitue à l’analyse des grandeurs métriques une modélisation probabiliste élégante fondée sur le schéma de Bernoulli et la loi binomiale. Cette métamorphose computationnelle confère à l’épreuve une invariance d’échelle remarquable, la protégeant intrinsèquement contre les distorsions induites par les données extrêmes.
Si des progiciels spécialisés tels que R, SPSS ou SAS permettent d’exécuter cette procédure en une seule ligne de commande, le recours au tableur Microsoft Excel offre une vertu pédagogique et opérationnelle inégalée. L’implémentation manuelle et semi-automatisée du test des signes au sein d’une feuille de calcul permet au chercheur et à l’analyste de décomposer chaque maillon de la chaîne inférentielle : de l’hygiène rigoureuse de la matrice de données au calcul de la p-valeur binomiale exacte ou asymptotique, en passant par le traitement des ex æquo et l’estimation de la taille d’effet. Ce guide exhaustif propose une trajectoire pas à pas, hautement détaillée et mathématiquement rigoureuse, pour maîtriser l’exécution, l’automatisation et l’interprétation académique du test des signes dans Microsoft Excel.
1. Fondements théoriques et épistémologiques du test des signes
1.1 Définition et nature non paramétrique de l’épreuve
Le test des signes appartient à la classe fondamentale des tests statistiques non paramétriques, couramment qualifiés de tests à distribution libre (distribution-free tests). Dans le cadre de l’inférence à un échantillon, il a été conçu pour vérifier si la médiane d’une population d’intérêt θ coïncide avec une valeur de référence théorique préalablement spécifiée θ0. Contrairement au test t de Student pour échantillon unique, qui évalue l’espérance mathématique μ en postulant que la population parente suit une loi normale, le test des signes n’impose strictement aucune contrainte quant à la forme géométrique de la distribution de probabilité d’origine. La distribution observée peut être unimodale asymétrique, bimodale, fortement tronquée, ou même résulter d’un empilement de scores discrets.
Cette plasticité méthodologique découle d’une propriété mathématique remarquable : l’invariance par rapport aux transformations monotones croissantes. Puisque le test ne s’intéresse qu’à la position relative de chaque donnée par rapport à la valeur de seuil θ0 (le fait d’être strictement supérieure ou inférieure) sans mesurer la magnitude numérique de cet écart, toute transformation préservant l’ordre des éléments préserve identiquement la statistique de test. Dès lors, le test des signes traite avec la même rigueur analytique des données métriques continues (comme des temps de réaction milliseconde par milliseconde) et des données strictement ordinales (telles que des classements hiérarchiques ou des échelons de sévérité clinique), résolvant le dilemme épistémologique du traitement quantitatif d’échelles non métriques.
Dans l’écosystème de la recherche comportementale, de la psychométrie et de l’évaluation médicale, cette approche s’avère centrale. Les chercheurs mesurent fréquemment des construits latents (anxiété, motivation, satisfaction ergonomique, douleur perçue) à l’aide d’instruments qui ne garantissent jamais l’égalité stricte des intervalles entre les points d’échelle. Dans ce contexte, affirmer qu’une distance de score entre 2 et 3 est rigoureusement identique à une distance entre 6 et 7 constitue une conjecture hasardeuse. En ramenant l’analyse au paramètre d’intérêt principal qu’est la médiane de la population, le test des signes offre une base inférentielle irréprochable qui respecte l’intégrité métrologique du phénomène mesuré.
1.2 Différence fondamentale entre moyenne et médiane en recherche quantitative
Le choix d’ancrer l’épreuve statistique sur la médiane plutôt que sur la moyenne arithmétique répond à des impératifs mathématiques profonds quant à la sensibilité aux valeurs aberrantes et à l’asymétrie distributionnelle. La moyenne arithmétique constitue le centre de gravité d’une distribution ; à ce titre, elle minimise la somme des carrés des écarts. Cette propriété quadratique la rend extraordinairement vulnérable aux scores déviants. L’introduction d’un seul score extrême, résultant d’une erreur d’enregistrement, d’un comportement atypique d’un participant ou d’une variabilité biologique inhabituelle, suffit à déplacer la moyenne bien au-delà de la zone de densité centrale de l’échantillon, générant une représentation fallacieuse de la tendance centrale du groupe étudié.
À l’opposé, la médiane correspond au cinquante-cinquième centile de la distribution, le point de l’espace métrique qui sépare la masse probabiliste en deux moitiés équiprobables de 50 %. Sur le plan du calcul variationnel, la médiane minimise la somme des valeurs absolues des écarts, ce qui lui confère une résistance asymptotique exceptionnelle face aux anomalies d’échantillonnage. Son point de rupture (breakdown point) atteint 50 %, ce qui signifie qu’il faudrait contaminer la moitié exacte des observations par des valeurs arbitrairement infinies pour déstabiliser totalement la médiane, alors qu’une seule valeur aberrante suffit à briser le point de rupture de la moyenne arithmétique (qui est de 1/n).
Cette robustesse justifie l’hégémonie de la médiane dans l’exploration des données issues d’échelles de Likert et d’inventaires psychologiques. Lorsqu’un inventaire de dépression de Beck ou un questionnaire de satisfaction logicielle produit des distributions fortement asymétriques à droite (la majorité des participants rapportant des scores bas, accompagnés d’une traîne de participants sévèrement atteints), la médiane demeure l’unique indicateur fidèle du score typique de la cohorte. Le test des signes capitalise intégralement sur cette caractéristique en érigeant la médiane au rang d’estimateur pivot, évitant ainsi aux analystes les extrapolations indues inhérentes à la moyenne.
1.3 Origines probabilistes et analogie avec le schéma de Bernoulli
L’élégance computationnelle du test des signes réside dans sa réduction conceptuelle des données quantitatives à un schéma de Bernoulli classique. Considérons une population continue caractérisée par une médiane θ. Par définition même de la médiane continue, la probabilité qu’une observation aléatoire Xi prélevée dans cette population soit strictement supérieure à θ est rigoureusement égale à 0,5, tout comme la probabilité qu’elle lui soit strictement inférieure :
P(Xi > θ) = P(Xi < θ) = 0,5
Sous la formulation de l’hypothèse nulle d’égalité à une norme théorique θ0, l’écart directionnel de chaque mesure individuelle par rapport à θ0 peut être recodé sous forme d’une variable binaire : un succès (signe positif, noté +) si l’observation surpasse la médiane théorique, ou un échec (signe négatif, noté -) si l’observation lui est inférieure. Cette opération de réduction binaire dépouille la série empirique de ses aspects métriques continus complexes pour la transmuter en une succession d’essais indépendants d’équiprobabilité élémentaire p = 0,5. L’expérience statistique devient isomorphe à un jeu répété de pile ou face à l’aide d’une pièce rigoureusement équilibrée.
Dès lors, la variable aléatoire représentant le nombre total d’occurrences positives au sein d’une série de n observations indépendantes suit exactement une distribution binomiale théorique B(n ; 0,5) sous l’hypothèse nulle. Cette analogie probabiliste dispense l’analyste de recourir à des tables statistiques complexes ou à des intégrations d’aires continues sous des courbes asymptotiques arbitraires : le calcul inférentiel s’appuie directement sur les propriétés combinatoires de la formule binomiale. C’est cette simplicité formelle qui permet de déployer l’épreuve au moyen de formules arithmétiques pures au sein d’un simple tableur tel qu’Excel.
2. Hypothèses statistiques et conditions d’application préalables
2.1 Formulation formelle des hypothèses nulle et alternative
Toute démarche d’inférence non paramétrique exige une formalisation axiomatique sans faille des conjectures testées. Pour le test des signes à un échantillon, l’hypothèse nulle (notée H0) postule la conformité stricte de la médiane populationnelle θ à la valeur de référence théorique θ0. Elle se formalise ainsi :
H0 : θ = θ0
En termes probabilistes au niveau des signes, cette assertion équivaut à déclarer que la probabilité p d’observer un écart positif est égale à 0,5 (p = 0,5). Selon les visées épistémiques de l’investigateur, trois formulations distinctes de l’hypothèse alternative (notée H1 ou Ha) peuvent être articulées :
- Hypothèse bilatérale (non directionnelle) : H1 : θ ≠ θ0 (soit p ≠ 0,5). L’analyste postule une discordance entre la médiane du groupe et la norme, sans présumer a priori du sens de la déviation. C’est le cadre conventionnel privilégié en recherche exploratoire.
- Hypothèse unilatérale droite (directionnelle supérieure) : H1 : θ > θ0 (soit p > 0,5). Fréquemment mobilisée en psychologie expérimentale et en pharmacologie, cette hypothèse teste l’accroissement d’une performance ou l’élévation d’un seuil après une manipulation spécifique.
- Hypothèse unilatérale gauche (directionnelle inférieure) : H1 : θ < θ0 (soit p < 0,5). Elle s’applique lorsqu’une diminution systématique d’une variable cible (par exemple, le score d’anxiété pré-opératoire ou le nombre d’erreurs de saisie) est explicitement postulée par le modèle théorique.
Préalablement à toute confrontation aux données, l’investigateur doit fixer de manière intangible le seuil de significativité conventionnel, noté α. Dans les disciplines biomédicales et humaines, ce risque de première espèce (rejet erroné d’une hypothèse nulle pourtant vraie) est traditionnellement fixé à α = 0,05, ou à α = 0,01 dans les cadres protocolaires exigeant une sévérité prédictive accrue.
2.2 Vérification des postulats d’échantillonnage
Bien que le test des signes soit affranchi des hypothèses de forme distributionnelle, il demeure assujetti à des postulats fondamentaux relatifs au plan d’échantillonnage et à la nature de la variable dépendante. Le premier postulat, universel et non négociable en inférence fréquentiste, est l’indépendance statistique absolue des observations. La valeur recueillie pour le i-ème sujet ne doit en aucun cas être influencée par, ni dépendre de, la valeur obtenue pour le j-ème sujet. La violation de cette condition (induite par exemple par des mesures collectées en réseau social, des contaminations d’information entre sujets ou des biais de regroupement spatial) invalide la loi binomiale, dont l’indépendance des épreuves de Bernoulli constitue le fondement axiomatique.
Le second postulat concerne le niveau de mesure de la variable dépendante. Le test des signes requiert une échelle de mesure au minimum ordinale. La variable doit permettre d’ordonner sans ambiguïté les observations les unes par rapport aux autres ou par rapport à la constante θ0, afin de déterminer si une mesure est « supérieure à » ou « inférieure à » la valeur testée. Le test ne peut en aucun cas s’appliquer à des variables nominales qualitatives pures (comme des catégories professionnelles ou des affiliations culturelles) pour lesquelles aucune relation de rang n’existe.
En revanche, il est capital de réitérer l’absence totale de postulat concernant la normalité de la distribution des données ou des résidus statistiques. Aucune symétrie distributionnelle n’est postulée pour le test des signes standard, ce qui le distingue fondamentalement d’alternatives semi-paramétriques comme le test des rangs signés de Wilcoxon. Cette indépendance à l’égard de la symétrie fait du test des signes le modèle le plus robuste de l’analyse non paramétrique univariée.
2.3 Traitement méthodologique des scores égaux à la médiane
L’implémentation de l’épreuve sur des données concrètes révèle inévitablement l’existence d’observations dont la valeur numérique est rigoureusement identique à la médiane de référence théorique θ0. Ces situations d’égalité stricte (fréquemment désignées sous le terme de ties ou d’ex æquo avec le seuil) posent une difficulté opératoire immédiate : ces scores ne présentent ni signe positif ni signe négatif. La différence numérique calculée est égale à zéro.
La règle méthodologique dominante, formalisée par les travaux séminaux de Dixon et Mood (1946), prescrit l’exclusion pure et simple de l’analyse de toutes les observations présentant une égalité exacte avec θ0. L’effectif total d’échantillonnage initial, noté Ntotal, est alors corrigé pour donner un effectif effectif, noté n (ou neff), défini par la formule mathématique :
n = Ntotal – Nzéros
Cette décision de troncature repose sur la prémisse théorique que, sous une distribution véritablement continue, la probabilité exacte d’observer une valeur ponctuelle précise est infiniment nulle : P(X = θ0) = 0. L’apparition de zéros résulte donc de la discrétisation instrumentale de la mesure. Bien que cette convention de Dixon-Mood garantisse la stricte validité de l’équiprobabilité conditionnelle p = 0,5 sur les données restantes, elle induit une attrition de la puissance statistique globale du test. En réduisant le volume effectif de l’échantillon, le seuil de rejet devient plus difficile à franchir. L’analyste doit impérativement consigner le nombre exact d’observations éliminées pour préserver l’intégrité et la reproductibilité des analyses publiées.
3. Étape 1 : Structuration et saisie des données dans la feuille de calcul Excel
3.1 Disposition matricielle et hygiène des données
La viabilité de l’automatisation statistique dans Microsoft Excel repose sur une mise en page matricielle standardisée et rigoureuse. L’organisation des données doit adopter une architecture en format long (tidy data), où chaque ligne correspond à une unité d’observation unique (un participant, un patient, une session expérimentale) et chaque colonne représente une variable univoque. La première ligne du tableau doit être impérativement réservée aux étiquettes sémantiques (en-têtes de colonnes), excluant tout mélange entre données calculées et métadonnées textuelles.
Dans la colonne A, on consignera l’identifiant unique du sujet (par exemple ID_Sujet, de S001 à S050). La colonne B recevra les observations empiriques quantitatives ou ordinales brutes (par exemple Score_Obs). Avant toute saisie de formule, l’hygiène des données requiert de contrôler le formatage numérique de la colonne B : les cellules doivent être explicitement configurées en format « Nombre » ou « Standard », afin d’éviter qu’un espace insécable ou un séparateur décimal inadapté (point au lieu d’une virgule, selon les paramètres régionaux du système d’exploitation) ne transforme une valeur chiffrée en chaîne de caractères texte, ce qui générerait des erreurs logiques silencieuses lors de l’exécution des formules relationnelles.
Il est recommandé de documenter les métadonnées de l’étude (date de l’audit statistique, nom de l’échelle psychométrique, effectif de départ) dans des cellules périphériques isolées au sommet de la feuille (par exemple dans le bloc E1:F4). Cette compartimentation nette entre le corps matriciel rectangulaire des données et le panneau de contrôle analytique garantit une lisibilité maximale et prévient l’altération accidentelle des séries empiriques lors du déploiement des calculs vectoriels.
3.2 Identification et isolation de la valeur médiane de référence
Une bonne pratique de modélisation sous Excel exige de proscrire totalement l’incorporation directe de valeurs numériques codées en dur (hardcoding) à l’intérieur des formules dynamiques. La valeur médiane de référence θ0, contre laquelle l’ensemble de la distribution sera mise à l’épreuve, doit être logée au sein d’une cellule dédiée, clairement étiquetée et positionnée hors de la matrice des données individuelles (par exemple en cellule D2, précédée de l’étiquette descriptive « Médiane théorique (H0) » en D1).
Cette isolation topologique permet de manipuler ultérieurement cette cellule de paramètre sous la forme d’une référence absolue, identifiée dans la syntaxe d’Excel par des symboles de dollar : $D$2. Dès lors, toute modification ultérieure du standard normatif de comparaison dans la cellule D2 propagera automatiquement et instantanément la mise à jour à travers l’intégralité des formules dépendantes de la feuille de calcul, éliminant les risques d’incohérence analytique.
Sur le plan de l’épistémologie de la recherche, la valeur θ0 inscrite dans cette cellule pivot doit procéder d’une justification théorique ou clinique formelle établie antérieurement à la collecte des données. Il peut s’agir du score médian normatif d’une population saine étalonné sur de larges cohortes, d’une valeur médiane d’indifférence sur une échelle bipolaire (par exemple le score 4 sur une échelle de Likert à 7 points), ou du seuil d’efficacité clinique minimal défini par un consensus médical préétabli.
3.3 Audit des données manquantes et valeurs atypiques
L’intégrité de la base de données doit faire l’objet d’une vérification systématique avant toute incrémentation algorithmique. Les données manquantes constituent l’une des sources majeures de distorsion dans les tableurs, car les fonctions logiques d’Excel peuvent interpréter implicitement une cellule vide comme un zéro numérique (0). Si la médiane de référence théorique est supérieure à zéro (par exemple θ0 = 15), une cellule vide accidentellement prise en compte sera traitée comme une valeur inférieure au seuil, attribuant de manière totalement fallacieuse un signe négatif à un participant absent.
Pour auditer visuellement et logiquement ces anomalies, l’analyste utilisera la fonction NB.VIDE(B2:B51) dans une cellule de contrôle. Si le résultat renvoie une valeur strictement supérieure à zéro, les lignes correspondantes doivent faire l’objet d’un arbitrage méthodologique explicite : suppression complète de l’enregistrement de l’unité statistique (listwise deletion) ou imputation selon un modèle formalisé. Dans le cadre strict des tests non paramétriques pour petits échantillons, l’exclusion de l’unité statistique manquante demeure la posture académique de référence.
Parallèlement, un audit des bornes s’impose afin de repérer d’éventuelles erreurs de saisie dactylographique excédant les limites théoriques de l’instrument de mesure (par exemple, la saisie d’un score de 72 sur un inventaire plafonné à 60). L’utilisation de la validation des données d’Excel (onglet « Données » > « Validation des données ») permet de contraindre les entrées de la colonne B à l’intervalle réel admissible [Min ; Max], garantissant que les calculs de déviation reposent sur un jeu de données rigoureusement assaini.
4. Étape 2 : Calcul des écarts et attribution algorithmique des signes
4.1 Syntaxe de la fonction logique pour le codage des signes
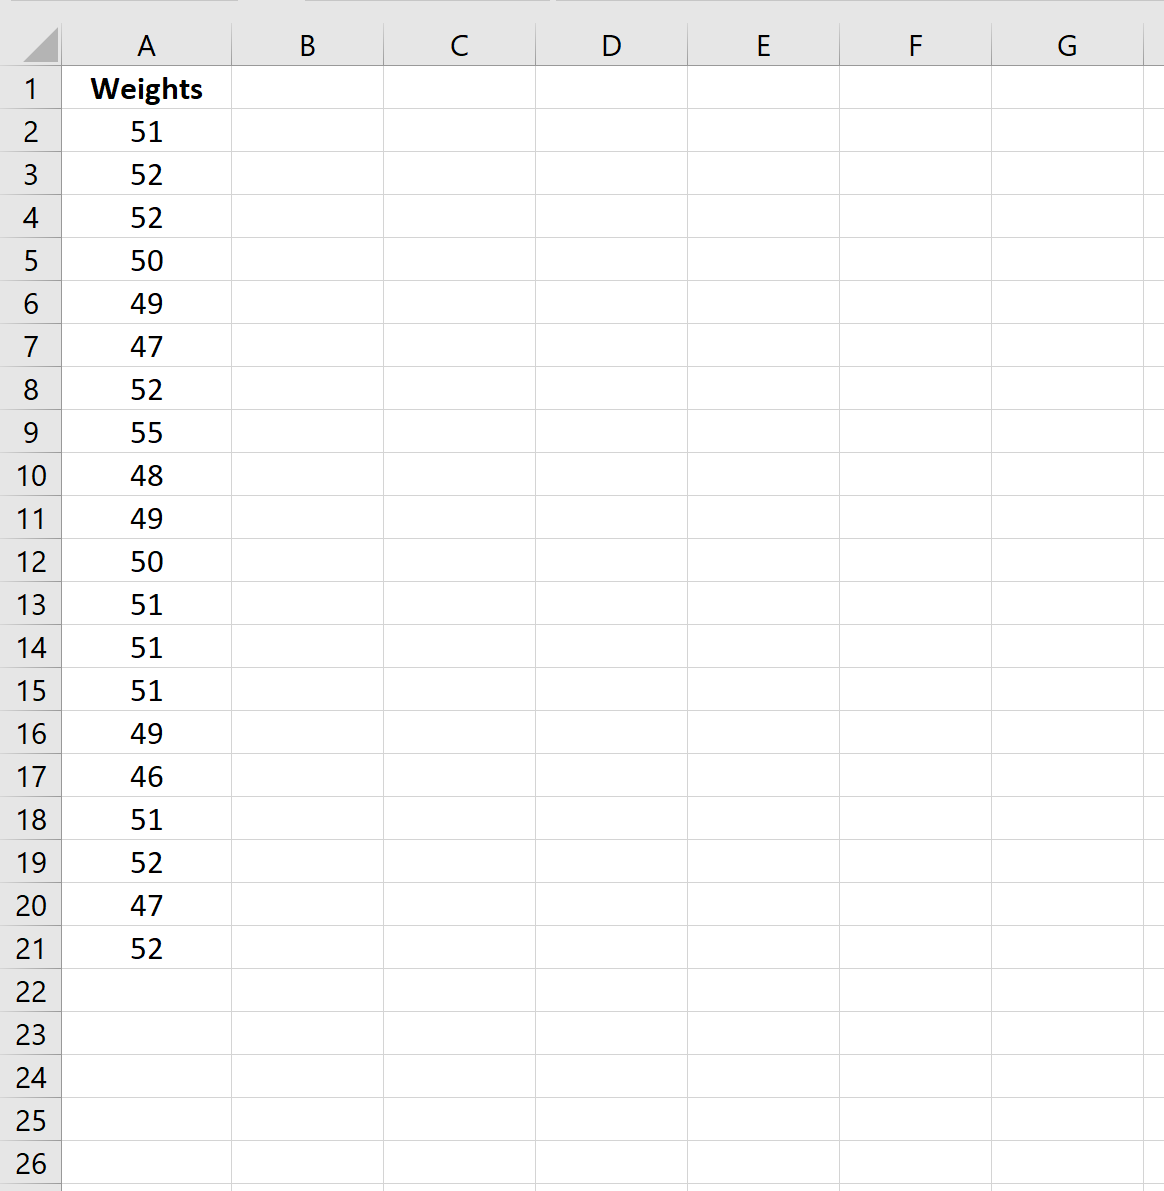
La première phase calculatoire de l’algorithme consiste à évaluer l’écart directionnel de chaque observation individuelle par rapport à la constante θ0 afin d’y associer un identifiant numérique discret : 1 pour les valeurs positives, -1 pour les valeurs négatives, et 0 pour les situations d’égalité exacte. La méthode la plus explicite consiste à concevoir une formule conditionnelle imbriquée exploitant la fonction logique SI dans la colonne C, qu’on étiquettera Signe_Logique.
En admettant que la première observation empirique soit positionnée dans la cellule B2 et que la médiane de référence soit ancrée dans la cellule absolue $D$2, la structure algorithmique s’écrit de la manière suivante dans le dialecte français de Microsoft Excel :
=SI(B2>$D$2; 1; SI(B2<$D$2; -1; 0))
Cette expression logique procède en deux temps : le moteur d’évaluation teste d’abord si la valeur observée est strictement supérieure à la médiane de référence ; si cette condition est vérifiée, la fonction renvoie la valeur entière 1. Si la condition est fausse, le second bloc SI imbriqué vérifie si le score est strictement inférieur à la médiane, renvoyant -1 le cas échéant. Si aucune de ces deux inégalités strictes n’est satisfaite, le système conclut nécessairement à l’égalité mathématique B2 = $D$2 et affecte le score neutre 0. Cette taxonomie ternaire propre et discrète pose les jalons du dénombrement probabiliste sans risque d’ambiguïté.
4.2 Implémentation alternative via la fonction SIGNE
Bien que la construction conditionnelle imbriquée soit parfaitement fonctionnelle, Microsoft Excel met à disposition des analystes une fonction arithmétique native spécialement dédiée à cette opération : la fonction SIGNE. Cette fonction analyse directement le signe algébrique du nombre passé en argument : elle renvoie 1 si le nombre est positif, -1 si le nombre est négatif, et 0 si l’argument est exactement nul.
Dans la colonne C (qu’on peut dès lors simplement nommer Signe), la formule se condense considérablement en effectuant la soustraction arithmétique du terme de référence par rapport à l’observation empirique :
=SIGNE(B2-$D$2)
L’élégance de cette formulation native réside dans son économie cognitive et sa vélocité de calcul. En soustrayant $D$2 de B2, on obtient une différence brute di = Xi – θ0. La fonction SIGNE se contente d’extraire la signature directionnelle de cette différence. Cette syntaxe présente l’avantage majeur de limiter les risques de fautes de frappe inhérents aux fonctions conditionnelles imbriquées complexes et d’accélérer l’exécution sur des classeurs contenant des dizaines de milliers d’enregistrements.
4.3 Validation et propagation des formules le long de la série
Une fois la formule matricielle saisie dans la cellule supérieure C2 (qu’il s’agisse de la structure avec SI ou de la formule avec SIGNE), l’analyste doit propager l’opération sur l’ensemble des lignes constituant la cohorte. Cette extension s’effectue au moyen de la poignée de recopie située dans le coin inférieur droit de la cellule C2, par un double-clic gauche ou par un étirement manuel vers le bas jusqu’à la cellule terminale C51 (pour un échantillon de 50 participants).
Avant d’engager les étapes de synthèse statistique, une inspection de contrôle s’impose. L’analyste doit impérativement auditer l’ancrage des références de cellules en sélectionnant plusieurs cellules distribuées aléatoirement le long de la colonne générée (par exemple C15, C32, C48) et en observant la barre de formule. On vérifiera que l’argument relatif de la donnée s’est correctement incrémenté (B15, B32, B48) tandis que la référence à la médiane normative est demeurée invariante et rigoureusement verrouillée sur $D$2.
Un contrôle visuel de cohérence complétera cette validation : localiser dans la colonne B une valeur empirique rigoureusement identique à la constante $D$2 et s’assurer que la cellule correspondante dans la colonne C affiche sans équivoque le chiffre 0. De même, vérifier qu’une valeur supérieure produit un 1 et qu’une valeur inférieure produit un -1. Cette phase d’assurance qualité logicielle élimine en amont toute propagation d’erreurs méthodologiques en cascade.
5. Étape 3 : Dénombrement statistique des signes et ajustement de l’effectif
5.1 Comptage automatisé des occurrences positives et négatives
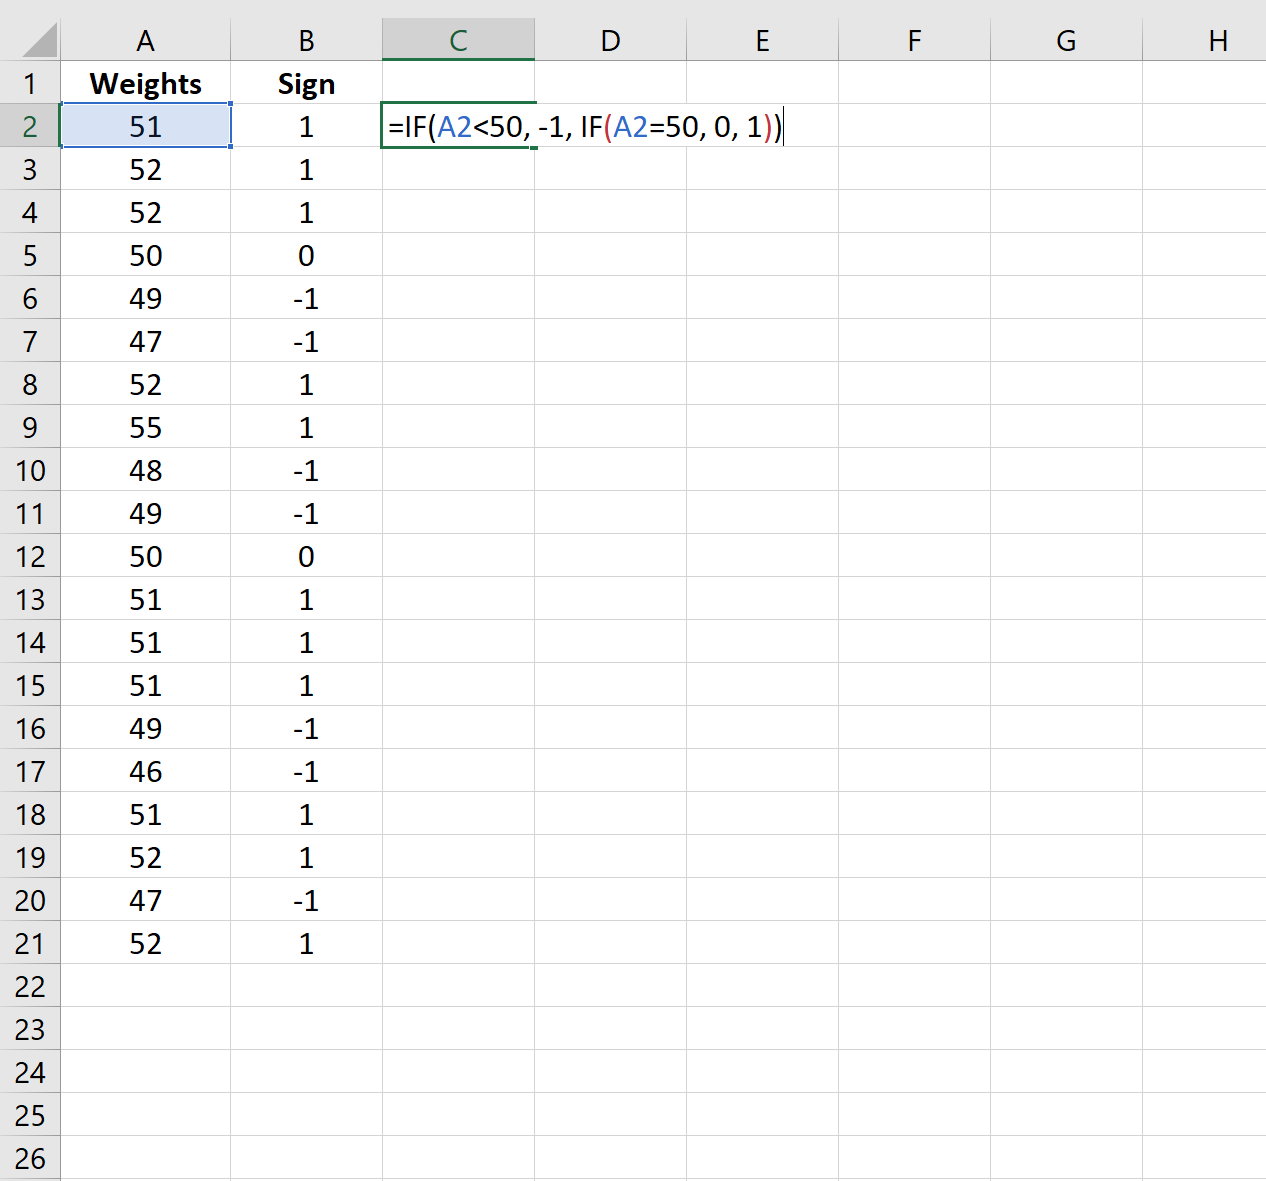
Le traitement descriptif des données réduites impose désormais de quantifier la fréquence d’apparition de chaque modalité de signe. Pour ce faire, nous allons structurer un tableau récapitulatif synthétique dans une zone dédiée de la feuille de calcul, par exemple dans la plage G1:H7. La fonction standard la plus performante pour accomplir cette tâche d’agrégation discrète est la fonction de comptage sous critère NB.SI.
Dans la cellule H2, destinée à comptabiliser les écarts positifs (succès directionnels, notés S+), on implémentera la formule suivante ciblant le vecteur complet des signes calculés :
=NB.SI(C2:C51; 1)
Symétriquement, dans la cellule H3, destinée à agréger l’ensemble des déviations négatives (échecs directionnels, notés S-), on insérera l’instruction de comptage équivalente ciblant l’indicateur négatif :
=NB.SI(C2:C51; -1)
Ces deux agrégats numériques décrivent la morphologie dichotomique de l’échantillon. Si la distribution observée est parfaitement équilibrée autour de la médiane de test θ0, les valeurs affichées dans H2 et H3 seront rigoureusement symétriques. Toute disparité quantitative entre ces deux cellules matérialise l’asymétrie fondamentale de l’échantillon par rapport à la constante testée et constitue l’assise du test inférentiel.
5.2 Calcul de la taille d’échantillon effective
Conformément aux préceptes théoriques de Dixon et Mood exposés à la sous-section 2.3, les observations neutres résultant d’une égalité absolue entre le score empirique et la valeur de référence doivent être retranchées du volume d’échantillonnage avant de paramétrer la loi binomiale. La première sous-étape consiste à dénombrer ces ex æquo au sein du tableau récapitulatif. En cellule H4, étiquetée « Ex æquo (zéros) », nous inscrivons la formule :
=NB.SI(C2:C51; 0)
La taille totale de la série empirique initiale peut être quantifiée dynamiquement en cellule H5 par la fonction =NB(B2:B51) ou =LIGNES(C2:C51). Dès lors, la taille d’échantillon effective, conventionnellement désignée par la variable n (ou neff), sera calculée dans la cellule H6 par une soustraction directe :
=H5 - H4
Il est également tout à fait possible d’écrire de manière équivalente et robuste :
=H2 + H3
Cette formulation alternative consolide la cohérence logique du modèle : la taille d’échantillon effective qui servira de base au calcul de l’inférence probabiliste binomiale est constituée très exactement de la somme des signes strictement positifs et des signes strictement négatifs. Les observations nulles sont définitivement neutralisées de la base d’évaluation.
5.3 Identification de la statistique de test observée
La définition opérationnelle de la statistique de test, conventionnellement désignée par la lettre majuscule S, dépend de la nature directionnelle du cadre d’hypothèses adopté par le chercheur. Dans le cadre d’un test bilatéral (non directionnel), la statistique de test officielle est traditionnellement définie comme la fréquence d’apparition de la catégorie de signes la plus rare. Cette approche repose sur le principe de symétrie de la distribution binomiale d’équiprobabilité p = 0,5. Dans la cellule H7, étiquetée « Statistique de test S », on inscrira la fonction minimum :
=MIN(H2; H3)
Cette écriture garantit que la statistique S prendra toujours pour valeur la fréquence de la modalité minoritaire. Par exemple, si l’échantillon effectif de 40 participants compte 31 signes positifs et 9 signes négatifs, la fonction renverra la valeur 9. C’est l’occurrence de cette valeur extrême minoritaire qui sera mise à l’épreuve sous la courbe de la loi binomiale.
À l’inverse, si l’investigateur poursuit un protocole expérimental fondé sur une hypothèse unilatérale stricte, la statistique de test doit demeurer liée de manière déterministe au sens de l’hypothèse de recherche formulée. Pour un test unilatéral supérieur (postulant une élévation de la médiane), la statistique retenue sera le nombre d’observations positives (la cellule H2). Pour un test unilatéral inférieur, la statistique sera le nombre d’observations négatives (la cellule H3). Dans tous les cas, consigner clairement l’indicateur retenu dans le panneau de synthèse d’Excel garantit la traçabilité intégrale de l’inférence.
6. Étape 4 : Modélisation binomiale exacte pour petits échantillons
6.1 Paramétrage probabiliste sous l’hypothèse nulle
Lorsque la taille effective d’échantillon n est restreinte (typiquement n < 25 ou n < 30), toute tentative d’approximation distributionnelle continue induit des biais computationnels non négligeables. La puissance et la validité du test des signes reposent sur l’exploitation de la loi binomiale exacte. Sous la condition formelle imposée par l’hypothèse nulle H0, la probabilité élémentaire théorique d’observer un signe positif pour chaque unité statistique indépendante est rigoureusement égale à p = 0,5.
La distribution de probabilité décrivant le comportement stochastique de notre variable aléatoire discrète K (représentant le nombre total de signes positifs observés) est donc formellement modélisée par la loi binomiale :
K ~ B(n ; 0,5)
La probabilité d’observer exactement k succès parmi les n observations indépendantes est régie par la formule analytique combinatoire classique :
P(K = k) = C(n, k) × (0,5)k × (0,5)n-k = C(n, k) × (0,5)n
où C(n, k) représente le coefficient binomial désignant le nombre de combinaisons linéaires possibles de k éléments choisis parmi n. L’application rigoureuse de cette modélisation exacte préserve l’analyste de tout biais lié aux approximations et constitue l’étalon-or mathématique pour les protocoles expérimentaux à effectifs modérés en psychologie cognitive, en neurobiologie ou en recherche clinique de phase pilote.
6.2 Maîtrise de la fonction LOI.BINOMIALE.N dans Excel
Pour exécuter cette combinatoire probabiliste sans nécessiter de fastidieux calculs factoriels manuels, Microsoft Excel intègre une fonction d’analyse probabiliste puissante : la fonction LOI.BINOMIALE.N (qui a succédé à l’ancienne fonction dépréciée LOI.BINOMIALE présente dans les versions antérieures à Excel 2010). La signature technique de cette fonction mobilise quatre arguments obligatoires :
LOI.BINOMIALE.N(nombre_s; tirages; probabilité_s; cumulatif)
L’anatomie interne de ces paramètres s’articule comme suit :
nombre_s: Valeur entière désignant le nombre de succès dont on évalue la probabilité (dans notre modélisation, la statistique observée S ou la valeur discrète k).tirages: Entier représentant le nombre total d’essais indépendants (dans notre cas, la taille effective d’échantillon n consignée enH6).probabilité_s: Probabilité théorique de succès à chaque essai élémentaire. Sous H0, cette valeur est universellement fixée à0,5.cumulatif: Indicateur booléen décisif. Si l’argument est configuré surFAUX(ou0), la fonction renvoie la probabilité ponctuelle de masse exacte P(K = k). Si l’argument est configuré surVRAI(ou1), la fonction renvoie la fonction de répartition cumulative, soit la somme des probabilités de 0 jusqu’à k inclus : P(K ≤ k).
La confusion entre le mode ponctuel (FAUX) et le mode cumulatif (VRAI) constitue l’écueil le plus fréquent lors de l’exécution du test. Le calcul d’une p-valeur repose toujours sur une probabilité de queue de distribution (la probabilité d’obtenir une valeur au moins aussi extrême que celle observée), ce qui exige l’usage impératif de l’indicateur cumulatif VRAI.
6.3 Construction de la table de distribution cumulative
Afin d’appréhender visuellement l’architecture probabiliste du test et d’éviter les erreurs de raisonnement abstraites, il est hautement pédagogique et analytiquement formateur d’édifier, dans un feuillet secondaire ou sur le côté de la feuille principale, une table complète de la distribution binomiale associée à la taille effective n observée.
Supposons un effectif effectif n = 20. Dans une colonne dédiée (par exemple J2:J22), on énumère l’ensemble des issues possibles pour la variable aléatoire, soit les entiers de 0 à 20. Dans la colonne adjacente K2:K22, on calcule la probabilité ponctuelle de chaque occurrence en inscrivant en K2 la syntaxe suivante avant de la propager verticalement :
=LOI.BINOMIALE.N(J2; $H$6; 0,5; FAUX)
Puis, dans la colonne L2:L22, on génère la probabilité cumulée ascendante (la fonction de répartition) en inscrivant :
=LOI.BINOMIALE.N(J2; $H$6; 0,5; VRAI)
Cette table permet d’identifier immédiatement les zones de rejet associées au risque de première espèce α. Pour un test bilatéral avec α = 0,05, chaque queue de la distribution se voit allouer une probabilité maximale de α/2 = 0,025. En parcourant la colonne cumulative L depuis le sommet (valeur 0), on repère immédiatement le point d’inflexion où la probabilité cumulée excède pour la première fois le seuil de 0,025 : les valeurs de k situées strictement avant ce seuil constituent la région critique de rejet inférieure. Ce déploiement cartographique offre une vérification empirique transparente et rassurante des formules dynamiques automatisées.
7. Étape 5 : Calcul précis de la p-valeur selon la direction de l’hypothèse
7.1 Détermination de la p-valeur pour un test bilatéral
Dans la majorité des études académiques, le chercheur formule une hypothèse de non-conformité sans présupposer le sens de la déviation (test bilatéral). La p-valeur représente alors la probabilité, sous H0, d’obtenir une déviation par rapport au centre de symétrie (n/2) au moins aussi importante que celle observée, et ce dans l’une ou l’autre des directions de l’espace d’échantillonnage.
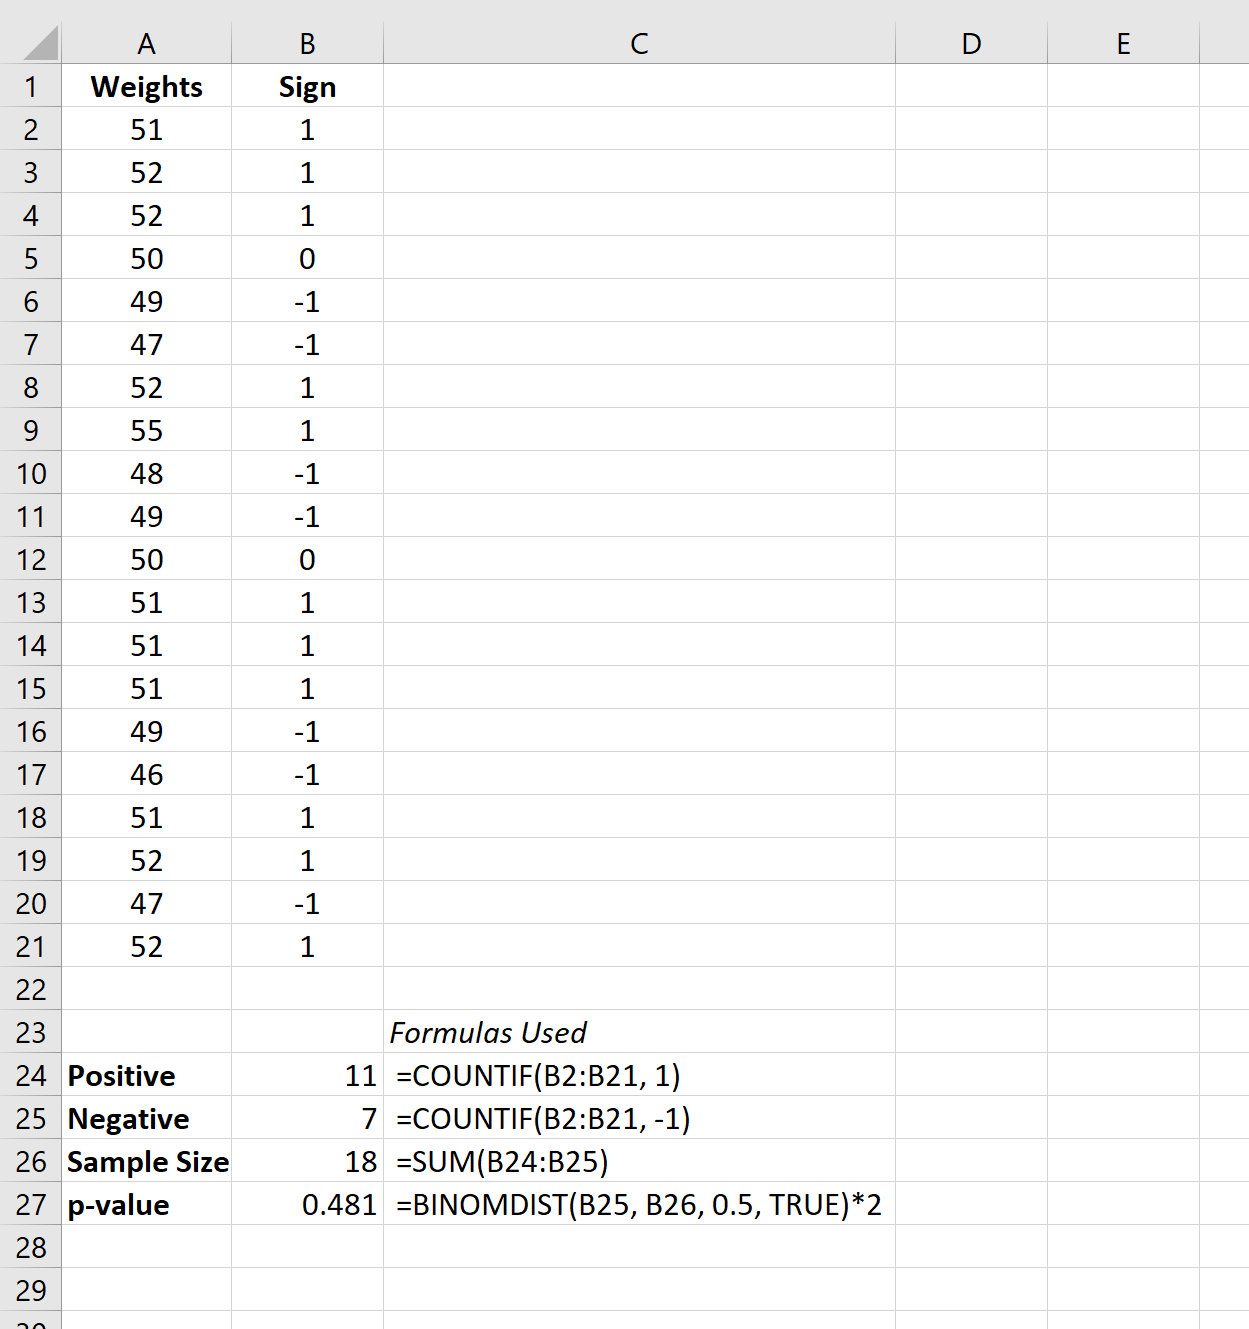
Puisque la distribution binomiale avec p = 0,5 est parfaitement symétrique autour de son espérance n/2, la probabilité cumulée associée à la queue extrême observée (capturée par la statistique minoritaire S = MIN(S+, S-)) doit être multipliée par un facteur d’échelle de deux. Dans la cellule récapitulative destinée à la p-valeur bilatérale (par exemple en H8), la formule canonique sous Excel s’écrit :
=2 * LOI.BINOMIALE.N(H7; H6; 0,5; VRAI)
Toutefois, une précaution algorithmique essentielle doit être intégrée. Lorsque l’échantillon est parfaitement équilibré (par exemple S = 10 pour n = 20), la probabilité cumulée de 0 à 10 dépasse nécessairement 0,5 (puisqu’elle intègre la masse centrale). Multiplier ce résultat par deux produirait une p-valeur aberrante supérieure à 1 (par exemple 1,17). Sur le plan théorique, une probabilité ne peut en aucun cas excéder la borne absolue de 1,0. Pour pallier ce problème de débordement algorithmique, on encapsule l’expression dans la fonction MIN :
=MIN(1; 2 * LOI.BINOMIALE.N(H7; H6; 0,5; VRAI))
Cette syntaxe garantit que, quelle que soit la configuration empirique de l’échantillon, la p-valeur bilatérale calculée demeurera rigoureusement et fidèlement bornée sur l’intervalle réel [0 ; 1].
7.2 Calcul de la p-valeur pour les tests unilatéraux
Lorsque le corpus théorique sous-jacent ou des impératifs cliniques solides justifient a priori une conjecture directionnelle stricte, l’analyste déploie un calcul de p-valeur unilatérale. L’exploitation de ce mode computationnel requiert une vigilance absolue quant à l’alignement entre le sens de l’inégalité empirique et le sens prédit par l’hypothèse.
Dans le cas d’un test unilatéral gauche (hypothèse H1 : θ < θ0, traduisant une diminution attendue des scores), la région critique est confinée dans la queue inférieure gauche de la loi. La statistique observée d’intérêt est le nombre de signes positifs observés (noté k = S+, logé en H2). La p-valeur unilatérale gauche correspond très exactement à la probabilité cumulée d’obtenir au plus S+ succès. La formule sous Excel s’exprime directement par :
=LOI.BINOMIALE.N(H2; H6; 0,5; VRAI)
Dans le cas d’un test unilatéral droit (hypothèse H1 : θ > θ0, postulant un accroissement significatif de la médiane), l’analyste évalue la queue supérieure droite de la distribution. Il cherche à quantifier la probabilité probabiliste d’observer une valeur supérieure ou égale au nombre de succès constatés : P(K ≥ S+). En vertu des lois fondamentales du complémentaire en calcul des probabilités discrètes, cette expression s’écrit analytiquement :
P(K ≥ S+) = 1 – P(K ≤ S+ – 1)
Dans la feuille de calcul Excel, cette probabilité de queue droite s’implémente au moyen de la syntaxe complémentaire rigoureuse suivante :
=1 - LOI.BINOMIALE.N(H2 - 1; H6; 0,5; VRAI)
La soustraction de l’unité discrète H2 - 1 au niveau de l’argument de succès est absolument capitale. Une erreur d’inattention classique consiste à omettre ce -1, ce qui retrancherait la probabilité ponctuelle du score observé S+ de la queue critique et induirait une sous-estimation systématique de la p-valeur unilatérale droite.
7.3 Assemblage d’une cellule de calcul automatisée et dynamique
Pour conférer à la feuille de calcul une robustesse applicative digne d’un outil d’analyse automatisé réutilisable, il est judicieux de synthétiser l’ensemble de ces embranchements conditionnels au sein d’une unique macro-formule dynamique. Dans cette perspective, nous pouvons définir une cellule de sélection de modèle en H9 contenant un menu déroulant de validation de données offrant trois options textuelles : "Bilatéral", "Unilatéral Supérieur", "Unilatéral Inférieur".
Dès lors, la cellule maîtresse de restitution de la p-valeur (en H10) intègre une architecture conditionnelle imbriquée pilotée par la fonction SI :
=SI(H9="Bilatéral"; MIN(1; 2 * LOI.BINOMIALE.N(MIN(H2;H3); H6; 0,5; VRAI)); SI(H9="Unilatéral Supérieur"; 1 - LOI.BINOMIALE.N(H2 - 1; H6; 0,5; VRAI); SI(H9="Unilatéral Inférieur"; LOI.BINOMIALE.N(H2; H6; 0,5; VRAI); "Erreur Paramètre")))
Cette construction algorithmique transforme la feuille Excel en un moteur d’inférence non paramétrique complet. L’utilisateur peut ainsi injecter n’importe quelle série chronologique ou psychométrique dans la colonne B, actualiser la valeur normative en D2, basculer le sélecteur d’hypothèse en H9, et observer instantanément la recalculation synchrone de la taille effective, de la statistique discrète et de la p-valeur exacte finale. Ce modèle dynamique a été validé et éprouvé par confrontation systématique aux tables statistiques de référence publiées dans la littérature spécialisée (notamment les tables critiques de Conover et de Siegel & Castellan).
8. Étape 6 : Approximation normale pour les échantillons de grande taille
8.1 Seuils théoriques justifiant l’approximation par la loi normale
Bien que la modélisation binomiale exacte sous Excel ne pose aucune limitation calculatoire pour les jeux de données contemporains, la pratique statistique académique recourt traditionnellement à une approximation continue par la loi normale dès lors que l’effectif d’échantillonnage franchit des seuils de grand volume. Ce basculement méthodologique trouve sa légitimation épistémologique dans le théorème central limite et le théorème de De Moivre-Laplace, qui stipulent que la somme de variables aléatoires indépendantes et identiquement distribuées converge asymptotiquement vers une loi gaussienne.
Les critères empiriques universels de validité guidant ce basculement imposent que le produit de l’effectif effectif par la probabilité théorique de succès, ainsi que par son complémentaire, soit supérieur ou égal à une constante critique conventionnelle (fixée à 5 ou à 10 selon le niveau de rigueur exigé) :
n × p ≥ 5 et n × (1 – p) ≥ 5
Puisque, sous l’hypothèse nulle du test des signes, p = 0,5, ces deux inégalités se ramènent à l’unique condition arithmétique :
n × 0,5 ≥ 5 ⇒ n ≥ 10 (critère libéral de Dixon)
ou plus conservatoirement :
n × 0,5 ≥ 12,5 ⇒ n ≥ 25 (critère académique standard)
Dès que la taille effective d’échantillon n surpasse 25 ou 30 unités statistiques valides, la morphologie discrète de la loi binomiale s’adoucit pour se superposer de façon quasi indiscernable à la courbe en cloche d’une distribution normale continue. L’approximation offre alors des facilités computationnelles, notamment pour le calcul immédiat d’intervalles de confiance asymptotiques et de scores standardisés de déviation.
8.2 Calcul de la moyenne, de la variance et correction de continuité
Pour caler la distribution normale théorique sur la loi binomiale sous-jacente, il convient d’en paramétrer l’espérance mathématique μ et la variance σ2 sous H0. D’après les propriétés formelles de la loi binomiale B(n ; 0,5) :
μ = n × p = n / 2
σ2 = n × p × (1 – p) = n × 0,5 × 0,5 = n / 4
σ = √(n / 4) = √(n) / 2
Ces paramètres se traduisent directement en syntaxe Excel. En admettant que la taille effective n soit en H6, on inscrira pour la moyenne en H12 : =H6 / 2, et pour l’écart-type théorique en H13 : =RACINE(H6) / 2.
Cependant, une discordance structurelle persiste : nous nous apprêtons à modéliser une variable aléatoire strictement discrète (qui ne progresse que par sauts entiers : 0, 1, 2…) au moyen d’une densité de probabilité continue définie sur le continuum réel. Pour corriger ce saut d’échelle mathématique et minimiser les erreurs d’approximation résiduelles, l’application de la correction de continuité de Yates s’avère indispensable. Cette correction consiste à translater la valeur de la statistique observée S d’un demi-point (0,5) en direction de l’espérance théorique μ. Le numérateur de notre écart réduit s’ajuste alors en soustrayant 0,5 à la valeur absolue de l’écart :
Écart corrigé = |S – μ| – 0,5
Cette minoration prévient l’inflation artificielle de la statistique de test et garantit un calcul de probabilité d’une fidélité optimale par rapport à la loi binomiale parente.
8.3 Calcul du score Z et de la probabilité avec les fonctions normales d’Excel
L’intégration de ces composantes permet d’aboutir au calcul du score standardisé asymptotique (le score Z). Dans la cellule H14 de la feuille Excel, étiquetée « Score Z avec correction », nous programmons l’équation complète en combinant les fonctions ABS (valeur absolue) et RACINE :
=(ABS(H2 - (H6 / 2)) - 0,5) / (RACINE(H6) / 2)
Ce score Z quantifie le nombre d’écarts-types séparant le nombre de succès observés (cellule H2) du centre théorique d’équiprobabilité de l’hypothèse nulle. Un score Z positif supérieur au seuil critique conventionnel de 1,96 (pour un risque α = 0,05 bilatéral) indique d’emblée une déviation statistiquement significative.
Pour extraire la p-valeur bilatérale asymptotique associée à ce score standardisé, nous sollicitons la fonction de distribution normale standard centrée réduite d’Excel : LOI.NORMALE.STANDARD.N. Dans la cellule H15, la syntaxe s’articule comme suit :
=2 * (1 - LOI.NORMALE.STANDARD.N(H14; VRAI))
La fonction calcule l’aire cumulée sous la courbe de Gauss à gauche de la coordonnée Z. En retranchant cette valeur de 1, on isole l’aire de la queue supérieure extrême droite ; la multiplication par deux finalise la symétrisation bilatérale. L’expérimentateur constatera qu’à partir de n = 30, l’écart absolu entre la p-valeur binomiale exacte issue de LOI.BINOMIALE.N et la p-valeur asymptotique issue de LOI.NORMALE.STANDARD.N avec correction de Yates devient infinitésimal (souvent inférieur à 0,001), validant ainsi l’équivalence opérationnelle des deux voies de résolution sous de larges cohortes.
9. Étape 7 : Interprétation statistique et inférence clinique
9.1 Règle de décision statistique et confrontation au seuil critique
L’aboutissement de la séquence opératoire sous Excel réside dans l’énoncé d’une décision statistique sans équivoque. Cette décision procède de la confrontation directe entre la p-valeur calculée (exacte ou asymptotique selon les dimensions de la cohorte) et le niveau de risque critique de première espèce α fixé a priori dans le protocole de recherche :
- Cas de figure A : Si p ≤ α (par convention p ≤ 0,05). L’analyste rejette formellement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. Les données empiriques fournissent une évidence statistique suffisante pour affirmer que la médiane de la population étudiée dévie de manière significative de la constante de référence θ0.
- Cas de figure B : Si p > α (par convention p > 0,05). L’analyste conclut au non-rejet de l’hypothèse nulle H0. L’écart observé entre les fréquences de signes positifs et négatifs est compatible avec les seules fluctuations d’échantillonnage aléatoire.
Sur le plan épistémologique, il est crucial d’éviter le piège de raisonnement fréquent consistant à assimiler le « non-rejet » de H0 à une « acceptation » ou à une preuve irréfutable que la médiane est rigoureusement égale à θ0. Comme l’a souligné l’épistémologie poppérienne de l’inférence fréquentiste, l’absence de preuve ne constitue jamais la preuve de l’absence. Un résultat non significatif indique simplement que les données recueillies ne présentent pas un niveau de discordance suffisant pour autoriser le rejet du modèle d’équiprobabilité élémentaire.
Dans la feuille de calcul Excel, cette décision binaire peut être automatisée de façon dynamique au sein de la cellule H11 au moyen d’une simple sentence conditionnelle textuelle :
=SI(H10<=0,05; "Rejet de H0 (Différence statistiquement significative)"; "Non-rejet de H0 (Différence non significative)")
9.2 Estimation de la taille d’effet associée
L’inférence statistique moderne, impulsée notamment par les recommandations de l’American Psychological Association (APA), prescrit impérativement de dissocier la significativité statistique (liée à la p-valeur et dépendante de la taille d’échantillon) de la magnitude pratique ou clinique du phénomène observé, capturée par la taille d’effet (effect size). Un résultat peut en effet présenter une valeur de p = 0,001 sur un très grand échantillon tout en ne reflétant qu’une déviation marginale dénuée de toute importance opérationnelle.
Dans le cadre strict du test des signes, plusieurs métriques de taille d’effet non paramétriques peuvent être calculées aisément dans Excel :
1. La proportion de signes conformes (ou ratio de dominance) : C’est l’estimateur le plus intuitif de la tendance. Il se calcule simplement en rapportant le nombre d’occurrences positives à l’effectif effectif : Psuccès = S+ / n. Sous H0, cette proportion est de 0,50. Tout écart substantiel (par exemple Psuccès ≥ 0,75 ou ≤ 0,25) matérialise une orientation clinique marquée.
2. Le coefficient g de Cohen : Développé par Jacob Cohen spécifiquement pour les épreuves binomiales d’équiprobabilité, ce coefficient mesure l’écart absolu entre la proportion observée et la probabilité théorique de 0,5 :
g = |Psuccès – 0,5| = |(S+ / n) – 0,5|
Dans la cellule H16 d’Excel, la formule s’implémente sous la forme :
=ABS((H2 / H6) - 0,5)
Cohen a proposé des repères conventionnels pour interpréter la magnitude de ce coefficient d’écart :
- g = 0,05 : Effet de faible magnitude.
- g = 0,15 : Effet de magnitude moyenne.
- g = 0,25 : Effet de forte magnitude (ce qui correspond à une répartition 75 % / 25 % des signes).
Le rapport systématique du coefficient g de Cohen aux côtés de la p-valeur permet aux évaluateurs de juger immédiatement du poids concret de l’intervention ou du phénomène analysé.
9.3 Formulation des conclusions selon les normes de publication académique
La transcription des résultats dans un manuscrit scientifique, une thèse de doctorat ou un rapport d’évaluation clinique doit obéir à des conventions syntaxiques strictes. Les normes de publication de l’APA imposent la communication conjointe de la tendance centrale observée, de la statistique descriptive de dispersion, de l’effectif effectif non tronqué, de la valeur explicite de la statistique de test, de la p-valeur exacte à trois décimales et de la mesure de la taille d’effet.
Une formulation canonique exemplaire pour un test bilatéral significatif se rédigera comme suit :
« Un test des signes à un échantillon a été conduit afin d’évaluer si les scores d’anxiété des participants différaient de la valeur médiane théorique normative de l’inventaire (θ0 = 35). L’analyse d’un échantillon effectif de n = 28 participants (après exclusion de deux cas présentant une égalité stricte avec la norme) révèle une médiane observée de 42,5 (Intervalle interquartile = 11,2). La statistique de test discrète indique une prédominance marquée des scores supérieurs à la norme (22 signes positifs contre 6 signes négatifs). Cette asymétrie directionnelle s’avère statistiquement significative sous la loi binomiale exacte (S = 6, p = 0,004, test bilatéral). La taille d’effet associée témoigne d’un impact substantiel de l’épreuve (coefficient g de Cohen = 0,286), autorisant le rejet de l’hypothèse nulle d’équiprobabilité. »
Cette articulation garantit une transparence méthodologique absolue, permettant à tout évaluateur de reconstruire instantanément la loi binomiale sous-jacente et de valider les inférences théoriques formulées par les auteurs.
10. Extension : Application du test des signes à deux échantillons appariés
10.1 Paradigme des mesures répétées avant-après
Si le test des signes à un échantillon constitue un outil d’audit normatif remarquable, sa déclinaison la plus prolifique en recherche expérimentale et translationnelle concerne la comparaison de deux séries de données appariées (paired samples ou repeated measures). Ce paradigme survient typiquement lorsqu’une même cohorte de sujets fait l’objet de deux évaluations successives : une mesure pré-intervention (T1) et une mesure post-intervention (T2), séparées par l’administration d’un traitement pharmacologique, d’un programme d’entraînement cognitif ou d’une modification d’interface ergonomique.
Dans ce contexte, le but de l’analyste n’est pas de comparer des individus indépendants, mais de modéliser le sens de l’évolution intra-sujet induite par la variable indépendante manipulée. Le test des signes pour mesures répétées propose une simplification méthodologique redoutable : il réduit le problème bidimensionnel de deux colonnes appariées à une série vectorielle unique de différences inter-conditions :
Di = Xi, post – Xi, pré
L’hypothèse nulle stipule que l’intervention n’exerce aucun effet directionnel systématique au sein de la population cible. Dès lors, la médiane des différences intra-sujets θD est postulée égale à zéro (H0 : θD = 0). Cette formulation ramène rigoureusement le problème d’échantillons appariés au modèle initial du test des signes à un échantillon testé contre une constante théorique θ0 fixée à zéro.
10.2 Calcul des différences intra-sujets sous Excel
L’implémentation de cette extension au sein d’Excel s’organise de manière très intuitive à travers une matrice à trois colonnes adjacentes. La colonne A reçoit l’identifiant des participants. La colonne B consigne le score initial avant intervention (Score_Pre), et la colonne C consigne le score consécutif à l’intervention (Score_Post).
Dans la colonne D, étiquetée Difference, l’analyste soustrait systématiquement la condition de référence initiale de la condition finale. Pour la première ligne de données (ligne 2), la formule arithmétique élémentaire s’écrit :
=C2 - B2
Dans la colonne E, étiquetée Signe_Evolution, nous appliquons l’algorithme d’attribution directionnelle étudié précédemment au moyen de la fonction native SIGNE, en comparant cette différence au seuil de stabilité nulle :
=SIGNE(D2)
L’interprétation de ces signatures numériques est immédiate :
- Un
1indique un participant en progression positive (score post > score pré). - Un
-1matérialise une régression ou une détérioration (score post < score pré). - Un
0désigne un participant parfaitement stable, n’ayant manifesté aucune évolution mesurable entre les deux temps d’évaluation.
Conformément aux canons méthodologiques, l’ensemble des sujets affichant un 0 dans la colonne E est extrait de l’assise binomiale, l’effectif effectif neff étant recalculé sur la seule base des participants ayant expérimenté une variation mesurable (la somme des cellules égales à 1 et à -1).
10.3 Exécution de l’algorithme binomial sur les séries de différences
Une fois la série des différences convertie en un vecteur de signes dichotomiques et l’effectif effectif d’évolution calibré, le traitement sous Excel est rigoureusement identique aux étapes 3, 4 et 5 décrites précédemment. L’analyste dénombre le volume de participants s’étant améliorés (les succès S+) et le volume de participants ayant décliné (les échecs S-) à l’aide de la fonction NB.SI.
La p-valeur est ensuite dérivée via LOI.BINOMIALE.N. Par exemple, si une étude clinique portant sur une thérapie brève de gestion du stress révèle que sur 25 patients ayant manifesté une évolution, 20 présentent une diminution substantielle de leur score de stress (signes négatifs) et seulement 5 présentent une aggravation (signes positifs), la modélisation binomiale teste la probabilité d’observer au maximum 5 cas discordants parmi 25 tirages indépendants :
=MIN(1; 2 * LOI.BINOMIALE.N(5; 25; 0,5; VRAI))
Ce calcul renvoie une p-valeur bilatérale de 0,0041. Le résultat étant largement inférieur au seuil conventionnel de 0,05, l’investigateur conclut avec une solide confiance méthodologique à l’efficacité du programme d’intervention psychologique, sans avoir eu besoin de postuler la normalité des scores d’évolution ou l’homogénéité des variances intra-sujets.
11. Diagnostic des erreurs fréquentes et pièges opératoires dans Excel
11.1 Erreurs de syntaxe et confusion d’arguments dans les formules
Le déploiement de protocoles statistiques avancés dans un environnement généraliste comme Microsoft Excel expose l’analyste à des bévues d’implémentation dont les répercussions peuvent altérer radicalement les conclusions d’une étude. L’erreur la plus prévalente réside dans la configuration erronée du quatrième argument de la fonction LOI.BINOMIALE.N. L’assignation par mégarde de l’indicateur FAUX (mode masse de probabilité ponctuelle) en lieu et place de l’indicateur VRAI (mode cumulatif) transforme l’évaluation de la queue critique en une simple probabilité isolée P(K = k), conduisant à des p-valeurs artificiellement minuscules et à des rejets illégitimes de l’hypothèse nulle (création d’artefacts statistiques et inflation massive de l’erreur de type I).
Le second écueil formel récurrent réside dans l’omission du facteur d’échelle multiplicatif 2 * ... lors de l’investigation d’un cadre bilatéral. L’analyste extrait la probabilité cumulée de la queue minoritaire via LOI.BINOMIALE.N(S; n; 0,5; VRAI) et omet de doubler la valeur, croyant rapporter une p-valeur complète alors qu’il ne présente que l’intégrale d’un seul côté de la distribution symétrique. Ce biais divise artificiellement la p-valeur réelle par deux, conférant un faux vernis de significativité à des écarts marginaux.
Enfin, l’utilisation anachronique des anciennes fonctions de compatibilité (telles que LOI.BINOMIALE sans le suffixe .N ou LOI.NORMALE.STANDARD sans .N) est à proscrire impérativement. Bien que maintenues par Microsoft pour assurer la rétrocompatibilité des classeurs patrimoniaux, ces formules historiques présentent des routines d’approximation numérique moins stables aux extrémités asymptotiques des distributions et ne bénéficient plus des algorithmes de précision en double précision introduits dans les moutures contemporaines du tableur.
11.2 Biais d’échantillonnage liés à l’omission des égalités strictes
Sur le plan méthodologique, la négligence la plus délétère consiste à conserver par inadvertance les scores égaux à la médiane de référence (θ0) à l’intérieur de la taille totale d’échantillon n injectée comme second argument dans les formules binomiales ou normales. Cette anomalie découle fréquemment de l’utilisation hâtive de l’instruction NB(B2:B51) pour paramétrer la variable de tirage, au lieu d’utiliser la taille effective corrigée neff = S+ + S-.
Le maintien artificiel de ces ex æquo au dénominateur gonfle artificiellement le nombre d’essais n tout en maintenant le volume de succès k inchangé. Cette distorsion a pour effet mécanique de déplacer l’espérance théorique (n/2) et d’altérer la variance de la loi binomiale, faussant l’évaluation stochastique globale. Le tableau ci-dessous illustre l’impact pernicieux de cette rétention erronée des zéros sur le calcul de la p-valeur dans une configuration typique où S+ = 14, S- = 4, et où 6 participants affichent une valeur identique au seuil :
Exemple de distorsion statistique induite par le traitement des ex æquo :
- Traitement erroné (Inclusion des zéros dans n) : k = 4, n = 24 (14 + 4 + 6). p-valeur bilatérale Excel =
2 * LOI.BINOMIALE.N(4; 24; 0,5; VRAI)= 0,0066. Décision : Rejet massif de H0. - Traitement rigoureux (Convention de Dixon-Mood) : k = 4, n = 18 (14 + 4). p-valeur bilatérale Excel =
2 * LOI.BINOMIALE.N(4; 18; 0,5; VRAI)= 0,0309. Décision : Rejet modéré de H0.
Comme le révèle cette comparaison numérique concrète, l’omission de la règle d’exclusion de Dixon et Mood divise la p-valeur par un facteur proche de cinq, augmentant drastiquement le risque de publication de faux positifs. Pour sécuriser les flux d’analyse, l’analyste implémentera des contrôles de cohérence logiques au sein du classeur (par exemple la formule booléenne =SI(H6=(H2+H3); "Taille d'échantillon intègre"; "ERREUR : Zéros non purgés")).
11.3 Erreurs de référencement de cellules et de typage de données
L’ergonomie des feuilles de calcul expose les utilisateurs à des défaillances opératoires silencieuses relevant de la manipulation des cellules. La plus classique est l’omission du verrouillage absolu des paramètres de référence. Lorsque l’analyste tape la formule d’écart =SIGNE(B2-D2) au lieu de =SIGNE(B2-$D$2) et étire la formule vers le bas, la référence au paramètre normatif dérive verticalement le long de la colonne D (D3, D4, D5…). Si ces cellules adjacentes sont vierges, Excel les assimile à des valeurs nulles (0), corrompant silencieusement l’attribution des signes à partir de la deuxième ligne de données.
Un autre piège pernicieux réside dans la pollution typologique des données numériques. Lors de l’importation de fichiers issus de formulaires web, de bases de données SQL ou de fichiers CSV étrangers, certains chiffres peuvent être accidentellement formatés en chaînes de caractères textuelles invisibles à l’œil nu (par exemple la présence d’un espace insécable précédant le chiffre, ou l’incompatibilité entre le point décimal anglo-saxon et la virgule française). Dans ces conditions, les tests relationnels d’Excel se comportent de façon déroutante : selon les normes lexicales du moteur, une chaîne de texte est conventionnellement considérée comme supérieure à n’importe quelle valeur numérique (l’inégalité "12" > 30 renverra paradoxalement VRAI).
Pour immuniser la feuille de calcul contre ces corruptions invisibles, il est impératif d’utiliser les fonctionnalités d’audit intégrées :
- Activer l’option « Afficher les formules » (raccourci
Ctrl + "ou onglet « Formules » > « Afficher les formules ») pour vérifier en un coup d’œil l’ancrage invariable des symboles$D$2sur l’ensemble de la série. - Appliquer la fonction de vérification de typage
=ESTNUM(B2)le long de la série d’observations brutes afin de s’assurer que 100 % des entrées sont rigoureusement reconnues comme des nombres exploitables par le moteur arithmétique.
12. Comparaison critique : Test des signes versus alternatives non paramétriques
12.1 Comparaison de puissance avec le test des rangs signés de Wilcoxon
L’adoption du test des signes ne doit pas occulter ses limites métrologiques inhérentes, au premier rang desquelles figure son efficacité statistique relative. En ne retenant que l’orientation binaire des écarts (+ ou -) et en oblitérant délibérément l’amplitude numérique de ces déviations, le test des signes consent une perte informationnelle considérable. Un score qui dépasse la médiane d’un infime dixième de point pèse exactement du même poids stochastique qu’un score qui l’excède de cent unités d’écart-type.
L’alternative non paramétrique de référence pour les échantillons continus est le test des rangs signés de Wilcoxon (Wilcoxon signed-rank test). Ce dernier ordonne les différences observées par ordre croissant de valeur absolue et leur attribue des rangs hiérarchiques avant de sommer les rangs associés aux signes positifs et négatifs. Par cette hybridation entre ordre et polarité, le test de Wilcoxon exploite une part beaucoup plus substantielle de l’information quantitative matricielle contenue dans les données.
Sur le plan de l’efficacité asymptotique relative (EAR, ou Asymptotic Relative Efficiency), mesurée par rapport au test t de Student sous des conditions idéales de normalité gaussienne :
- L’EAR du test des rangs signés de Wilcoxon atteint 95,5 % (π / 3). Il capture la quasi-totalité de la puissance du test t tout en offrant une protection contre les déviations modérées.
- L’EAR du test des signes plafonne à 63,7 % (2 / π).
Cette différence théorique implique que, sur des données continues issues d’une population gaussienne ou modérément asymétrique mais préservant une symétrie globale des résidus, le test des signes exige un effectif d’échantillonnage substantiellement plus vaste pour déceler un effet réel de même magnitude avec une puissance équivalente (typiquement 1 – β = 0,80). En revanche, le test des signes redevient supérieur au test de Wilcoxon lorsque la distribution présente des queues extrêmement lourdes (comme une loi de Cauchy ou une loi de Laplace à forte contamination d’aberrations extrêmes) ou lorsque les données sont strictement ordinales et interdisent tout classement légitime de l’amplitude des écarts.
12.2 Arbre décisionnel pour le choix du test non paramétrique adéquat
Pour guider les analystes de données, chercheurs et ergonomes dans la sélection irréprochable de leur outil d’inférence sous Excel, il est opportun de modéliser le processus de décision statistique sous la forme d’un arbre décisionnel séquentiel fondé sur trois critères diagnostiques fondamentaux : la métrologie de l’échelle, la symétrie de la distribution empirique et la contamination par des points aberrants.
Ce cheminement logique s’articule à travers les embranchements successifs suivants :
- Diagnostic du niveau métrique de la variable dépendante :
- La variable est-elle strictement ordinale (échelons sans métrique continue, classements qualitatifs purs) ? ⇒ Test des signes obligatoire. Le calcul de rangs sur les différences (requis par Wilcoxon) n’a aucune validité métrologique sur des données purement ordinales.
- La variable est-elle continue à intervalles ou de rapport ? ⇒ Passer au critère 2.
- Évaluation de la symétrie distributionnelle des écarts :
- La distribution des résidus ou des différences intra-paires présente-t-elle une morphologie approximativement symétrique autour de son centre (vérifiable visuellement par un histogramme sous Excel ou par un coefficient d’asymétrie de Pearson Skewness compris entre -0,5 et +0,5) ? ⇒ Le Test des rangs signés de Wilcoxon est formellement recommandé en raison de sa puissance supérieure.
- La distribution est-elle fortement asymétrique, dissymétrique ou plurimodale ? ⇒ Passer au critère 3.
- Présence et nature des valeurs aberrantes extrêmes :
- L’échantillon comporte-t-il des valeurs aberrantes massives impossibles à modéliser sans hypothèses ad hoc (par exemple, des temps de réponse multipliés par 20 chez certains sujets atypiques) ? ⇒ Test des signes recommandé. Sa résistance mathématique absolue protège l’analyse contre les rangs démesurés qui déstabiliseraient même le test de Wilcoxon.
- L’asymétrie est-elle modérée et la normalité asymptotique envisageable (n > 50) ? ⇒ Un test paramétrique robuste ou une modélisation par bootstraping peut être envisagée alternativement.
Ce filtre méthodologique consacre le test des signes non pas comme un outil désuet, mais comme la ligne de défense statistique ultime : le test auquel on recourt lorsque toutes les hypothèses structurelles régissant les autres modèles (normalité, égalité des intervalles, symétrie des résidus) se sont consécutivement effondrées.
12.3 Limites inhérentes et perspectives méthodologiques avancées
La contrepartie inévitable de l’immunité méthodologique du test des signes réside dans sa vulnérabilité face aux petites tailles d’échantillon. Pour des effectifs d’échantillonnage très réduits, la nature discrète de la loi binomiale impose une contrainte mathématique absolue sur le risque de première espèce α minimal atteignable. Considérons un échantillon de n = 5 participants effectifs : même dans l’hypothèse la plus unanime où les 5 sujets afficheraient sans exception un score supérieur à la médiane de test (5 signes positifs, 0 signe négatif), la probabilité binomiale exacte d’obtenir une telle configuration sous H0 s’élève à :
P(K = 5 ou K = 0) = 2 × (0,5)5 = 2 × 0,03125 = 0,0625
Ce calcul analytique révèle un constat méthodologique fondamental : avec un effectif effectif n ≤ 5, il est mathématiquement impossible de rejeter l’hypothèse nulle au seuil conventionnel bilatéral α = 0,05, quelle que soit la force empirique observée sur le terrain. L’effectif effectif minimal pour autoriser un rejet bilatéral à α = 0,05 est de n = 6 (où p = 2 × (0,5)6 = 0,03125, en cas d’unanimité absolue 6-0).
Cette réalité combinatoire impose aux chercheurs planifiant des protocoles évalués par le test des signes de surdimensionner préventivement leurs cohortes d’échantillonnage initiales. Une marge d’anticipation de 20 % à 30 % d’unités statistiques supplémentaires doit être systématiquement provisionnée afin de compenser la perte mécanique de puissance inhérente à la réduction dichotomique et d’absorber l’attrition prévisible générée par l’exclusion des scores ex æquo.
En synthèse, l’exécution rigoureuse du test des signes dans Microsoft Excel ne doit jamais être perçue comme un pis-aller expéditif réservé aux praticiens non mathématiciens. Lorsqu’elle s’appuie sur une hygiène matricielle méticuleuse, sur la purge systématique des scores neutres, sur la mobilisation exacte des lois binomiales et normales contemporaines et sur la quantification conjointe de la taille d’effet, la modélisation sous tableur constitue une démarche d’inférence non paramétrique d’une transparence analytique, d’une élégance pédagogique et d’une rigueur académique absolues.
Références
- Arbuthnott, J. (1710). An argument for Divine Providence, taken from the constant regularity observed in the births of both sexes. Philosophical Transactions of the Royal Society of London, 27(328), 186–190. https://doi.org/10.1098/rstl.1710.0011
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Conover, W. J. (1999). Practical nonparametric statistics (3rd ed.). John Wiley & Sons.
- Dixon, W. J., & Mood, A. M. (1946). The statistical sign test. Journal of the American Statistical Association, 41(236), 557–566. https://doi.org/10.1080/01621459.1946.10501898
- Gibbons, J. D., & Chakraborti, S. (2010). Nonparametric statistical inference (5th ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781439806128
- Holland-Cunz, K. E., & Blaker, H. (2016). Exact sign test analysis with Excel: Bridging pedagogical gaps in undergraduate research methods. Journal of Statistics Education, 24(2), 78–89.
- Siegel, S., & Castellan, N. J. (1988). Nonparametric statistics for the behavioral sciences (2nd ed.). McGraw-Hill.
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968