
Dans le domaine des sciences comportementales, cognitives et cliniques, la validité scientifique d’une recherche repose fondamentalement sur la qualité de son plan d’échantillonnage. Qu’il s’agisse d’étudier l’efficacité d’une nouvelle psychothérapie, d’évaluer la prévalence de marqueurs psychopathologiques au sein d’une cohorte hospitalière, ou de sonder les dynamiques sociocognitives d’une organisation, les chercheurs sont constamment confrontés à l’impossibilité matérielle d’évaluer l’intégralité d’une population cible. L’échantillonnage devient alors le vecteur méthodologique essentiel qui garantit la possibilité de généraliser des inférences statistiques obtenues sur un sous-ensemble restreint à l’ensemble du groupe étudié.
Parmi les méthodes d’échantillonnage probabiliste reconnues par la communauté académique internationale, l’échantillonnage systématique occupe une place de premier plan. Cette technique se caractérise par une élégance opérationnelle remarquable, consistant à sélectionner des unités d’observation à des intervalles fixes et réguliers après avoir déterminé un point de départ aléatoire. Bien que conceptuellement plus simple à exécuter que le tirage aléatoire simple sur le terrain, l’échantillonnage systématique offre un niveau de représentativité tout aussi robuste, et produit fréquemment une variance d’échantillonnage plus faible lorsque la base de sondage présente certaines caractéristiques d’ordonnancement structurel.
Néanmoins, la mise en œuvre pratique de cette méthode soulève des défis logistiques et statistiques cruciaux qui ne tolèrent aucune approximation, sous peine d’invalider la validité interne et externe des conclusions scientifiques. Microsoft Excel constitue, dans ce contexte, un outil d’ingénierie de données accessible et performant. Utilisé avec la rigueur algorithmique requise, il permet de modéliser, d’exécuter et de documenter un échantillonnage systématique de manière parfaitement reproductible. Ce guide exhaustif déploie, pas à pas, l’ensemble du protocole mathématique, méthodologique et technique nécessaire pour exécuter un échantillonnage systématique sous Excel, en conformité absolue avec les standards de publication de l’American Psychological Association (APA) et les exigences de la science ouverte.
1. Introduction à l’échantillonnage systématique en recherche psychologique
1.1 Définition et pertinence méthodologique pour les sciences du comportement
L’échantillonnage systématique est une technique de sélection probabiliste reposant sur l’application d’un pas arithmétique régulier, noté k, au sein d’une liste exhaustive et numérotée d’individus ou d’observations. Dans le paysage méthodologique des sciences comportementales, la légitimité de toute inférence repose sur la capacité du chercheur à minimiser l’erreur d’échantillonnage et à prévenir les biais de sélection systématiques. L’échantillonnage probabiliste garantit que chaque unité de la population cible possède une probabilité d’inclusion calculable et non nulle, condition indispensable à l’application des modèles de statistiques inférentielles paramétriques et non paramétriques.
La recherche psychologique contemporaine, confrontée à la crise de la reproductibilité, requiert des protocoles rigoureux capables d’assurer une représentativité optimale sans introduire une complexité opérationnelle démesurée. Dans les contextes cliniques, épidémiologiques et organisationnels, l’accès aux participants est souvent contingenté par des flux continus ou des registres institutionnels préexistants. L’échantillonnage systématique offre alors une alternative méthodologique de premier ordre au tirage aléatoire simple. Il permet d’éviter l’écueil de l’échantillonnage de convenance, tout en garantissant une couverture homogène de la population cible à travers le temps ou l’espace.
Les contextes psychologiques particulièrement propices à l’application de cette méthode englobent les enquêtes longitudinales à large échelle, où des bases de sondage exhaustives sont établies au préalable, les cohortes hospitalières accueillant des patients admis consécutivement pour des évaluations neuropsychologiques, ainsi que les études de terrain en psychologie sociale et du travail. Dans les protocoles de laboratoire impliquant des séries massives d’essais comportementaux ou psychophysiologiques, l’échantillonnage systématique permet également de sélectionner des sous-ensembles de données d’enregistrement sans dénaturer la dynamique temporelle sous-jacente des séries chronologiques.
1.2 Principes fondamentaux du processus d’échantillonnage en deux phases
Sur le plan structural, l’échantillonnage systématique s’articule autour d’un processus diachronique strict composé de deux phases interdépendantes : la constitution de la base de sondage et le déploiement du mécanisme de sélection arithmétique. La première phase requiert l’établissement d’un registre ordonné, clos et exhaustif des unités d’observation constituant la population cible accessible, notée N. Cette base de sondage doit être exempte d’omissions délibérées, de doublons accidentels et de toute altération artificielle de l’ordonnancement susceptible de biaiser le tirage ultérieur.
La seconde phase repose sur la quantification précise de la fraction de sondage, définie par le ratio n / N, où n représente la taille désirée de l’échantillon final. De ce ratio découle directement l’intervalle de sélection, ou pas d’échantillonnage, désigné par la lettre k. Ce paramètre correspond à la distance numérique constante séparant deux unités sélectionnées consécutivement au sein de la liste. Cependant, la nature probabiliste de la procédure dépend entièrement d’un prérequis méthodologique fondamental : l’attribution stochastique de l’unité de départ initiale, traditionnellement désignée comme le point de départ aléatoire ou la graine de tirage.
Cette condition d’aléa initial stipule que le premier participant doit être impérativement sélectionné au hasard entre le premier et le k-ième individu de la base de données. Ce tirage au sort initial garantit que chaque bloc d’individus de taille k possède une probabilité équivalente de fournir une observation, préservant ainsi l’égalité fondamentale des probabilités d’inclusion pour l’ensemble des éléments de la population. Sans ce départ probabiliste strict, l’échantillonnage cesse d’être probabiliste et se dégrade en une sélection déterministe subjective dénuée de toute validité inférentielle.
1.3 Avantages et limites opérationnels dans le traitement de données Excel
L’exécution de l’échantillonnage systématique au sein d’un tableur tel que Microsoft Excel présente des avantages logistiques considérables pour les équipes de recherche. En comparaison avec le tirage aléatoire simple sans remise, qui exige la génération continue de nombres pseudo-aléatoires uniques et l’élimination itérative des doublons via des fonctions matricielles complexes ou des scripts Visual Basic for Applications (VBA), l’échantillonnage systématique ne requiert qu’un unique tirage aléatoire initial. Le déploiement subséquent s’effectue au moyen de formules arithmétiques linéaires simples et transparentes, réduisant drastiquement les risques d’erreurs de calcul et la charge cognitive des analystes de données.
Cette simplicité d’implémentation algorithmique démocratise l’accès à une rigueur méthodologique de niveau scientifique sans nécessiter le recours obligatoire à des environnements de programmation statistique spécialisés tels que R, Python, SAS ou SPSS. Les chercheurs peuvent ainsi concevoir des feuilles de calcul automatisées, dynamiques et auto-documentées, au sein desquelles les paramètres d’échantillonnage s’ajustent instantanément à toute modification du volume de la cohorte source. Cette transparence facilite grandement les procédures d’audit méthodologique par les pairs et garantit une traçabilité intégrale du processus de sélection.
Néanmoins, cette approche comporte une vulnérabilité théorique majeure que tout psychologue chercheur se doit de maîtriser : la sensibilité critique à l’ordonnancement intrinsèque de la base de données source. Si la base de sondage présente une périodicité masquée qui coïncide accidentellement avec le pas d’échantillonnage k, le tirage systématique engendre un biais de représentativité catastrophique. De même, si les participants sont classés selon une variable fortement corrélée avec les dimensions psychologiques évaluées, la structure de la variance d’échantillonnage s’en trouve profondément altérée, exigeant des protocoles diagnostiques préalables particulièrement rigoureux sous Excel.
2. Fondements mathématiques et concepts statistiques sous-jacents
2.1 Détermination de la taille de population N et de l’échantillon n
La formalisation mathématique d’un plan d’échantillonnage s’amorce nécessairement par la définition non ambiguë de la taille de la population parente accessible, désignée universellement par la lettre majuscule N. En psychométrie et en psychologie clinique, cette population correspond au registre complet des individus répondant aux critères d’inclusion stricts de l’étude (par exemple, patients hospitalisés pour un trouble anxio-dépressif caractérisé au cours de l’année civile écoulée). La précision du dénombrement de N au sein d’Excel conditionne directement la validité des équations subséquentes.
La détermination de la taille requise pour l’échantillon final, notée n, relève quant à elle du calcul de puissance statistique a priori. Pour détecter des tailles d’effet cliniquement pertinentes (mesurées par le d de Cohen, le r de Pearson ou le η² partiel) à un seuil de signification alpha conventionnel (typiquement 0,05) et avec une puissance statistique satisfaisante (souvent 1 – beta = 0,80 ou 0,90), le chercheur applique les formules classiques de dimensionnement d’échantillon développées par Jacob Cohen ou utilise des outils dédiés tels que G*Power. L’équation fondamentale pour l’estimation d’une moyenne dans une population finie s’exprime ainsi :
n = (N * Z² * σ²) / ((N – 1) * e² + Z² * σ²)
Où Z représente le score z correspondant au niveau de confiance bilatéral (1,96 pour un intervalle de confiance à 95 %), σ l’écart-type attendu de la mesure psychologique dans la population, et e la marge d’erreur maximale tolérable par l’investigateur. Dans les protocoles comportementaux impliquant des passations longues ou des évaluations répétées dans le temps, il est en outre impératif d’intégrer une estimation de l’attrition prévisible (abandons, données manquantes non recouvrables). Si un taux d’attrition r de 15 % est anticipé, la taille d’échantillon initiale ciblée sous Excel doit être majorée selon l’ajustement arithmétique n_ajusté = n / (1 – r), préservant ainsi la puissance inférentielle nominale lors de la phase finale d’analyse.
2.2 Formulation du pas d’échantillonnage k et gestion des arrondis
Le pas d’échantillonnage, ou intervalle de sélection k, constitue le paramètre central du modèle systématique. D’un point de vue théorique, il s’exprime par le ratio exact de la division de la taille de population par la taille d’échantillon ciblée :
k = N / n
Dans la pratique expérimentale, le quotient de cette division euclidienne est très rarement un nombre entier. Or, les lignes d’une feuille de calcul Excel et les unités participantes constituent des grandeurs strictement discrètes et indivisibles. La gestion mathématique de la partie décimale de ce quotient exige par conséquent une décision méthodologique explicite, car le choix entre un arrondi par défaut et un arrondi par excès modifie la probabilité globale d’inclusion et la taille finale effective de l’échantillon sélectionné.
Si le chercheur procède à un arrondi arithmétique standard ou par excès via la fonction ARRONDI.SUP, le pas k devient trop grand, ce qui conduit inévitablement à un sous-échantillonnage : l’algorithme parcourt la base de données trop rapidement et s’arrête avant d’avoir pu sélectionner les n sujets requis. À l’inverse, l’application de la fonction ENT ou ARRONDI.INF sous Excel force un arrondi systématique à l’entier inférieur immédiat. Cette stratégie présente l’avantage méthodologique de garantir l’obtention d’au moins n observations, mais génère fréquemment un léger sur-échantillonnage lorsque l’algorithme atteint la fin du tableau source.
Pour neutraliser ce biais opérationnel, les statisticiens d’enquête préconisent l’utilisation de l’échantillonnage systématique circulaire, où la base de sondage est conceptualisée comme une boucle fermée reliant la dernière observation à la première, ou plus communément, l’application rigoureuse du pas tronqué k = ENT(N / n) combinée à un arrêt algorithmique programmé dès que la taille exacte n est strictement atteinte. Cette dernière méthode demeure la plus intuitive et la plus robuste à orchestrer au sein d’une feuille de calcul informatisée.
2.3 Théorie du départ aléatoire et conditions de validité probabiliste
L’ancrage épistémologique de l’échantillonnage systématique réside dans le théorème de l’équiprobabilité conditionnelle. L’ensemble des unités de la base de sondage peut être conceptuellement divisé en k grappes mutuellement exclusives et exhaustivement recouvrantes. Chacune de ces k grappes virtuelles est composée de n participants espacés de k lignes d’intervalle. L’acte d’échantillonnage systématique consiste, en réalité, à choisir aléatoirement une seule grappe parmi les k grappes potentielles existantes.
Pour que cette procédure satisfasse aux critères fondamentaux du sondage probabiliste formulés par William Cochran et Leslie Kish, la sélection de l’unité de départ, désignée par la variable stochastique a, doit obéir à une loi uniforme discrète bornée sur l’intervalle fermé allant de 1 à k :
P(a = i) = 1 / k, pour tout i ∈ {1, 2, …, k}
La rigueur de cette condition garantit que chaque observation individuelle dans la base de données possède une probabilité d’inclusion marginale strictement égale à :
π = 1 / k ≈ n / N
Toute déviation par rapport à cette règle — telle que la sélection arbitraire de la première ligne par commodité, ou l’utilisation d’une borne supérieure excédant k — viole le principe d’équiprobabilité. Un tel biais d’amorce compromet l’ensemble des propriétés asymptotiques des estimateurs statistiques dérivés de l’échantillon, altère la structure de l’erreur type et expose l’investigateur à des distorsions méthodologiques sévères lors de la publication de ses résultats dans des revues évaluées par les pairs.
3. Préparation rigoureuse de la base de données sous Excel
3.1 Structuration optimale des variables psychologiques et identifiants
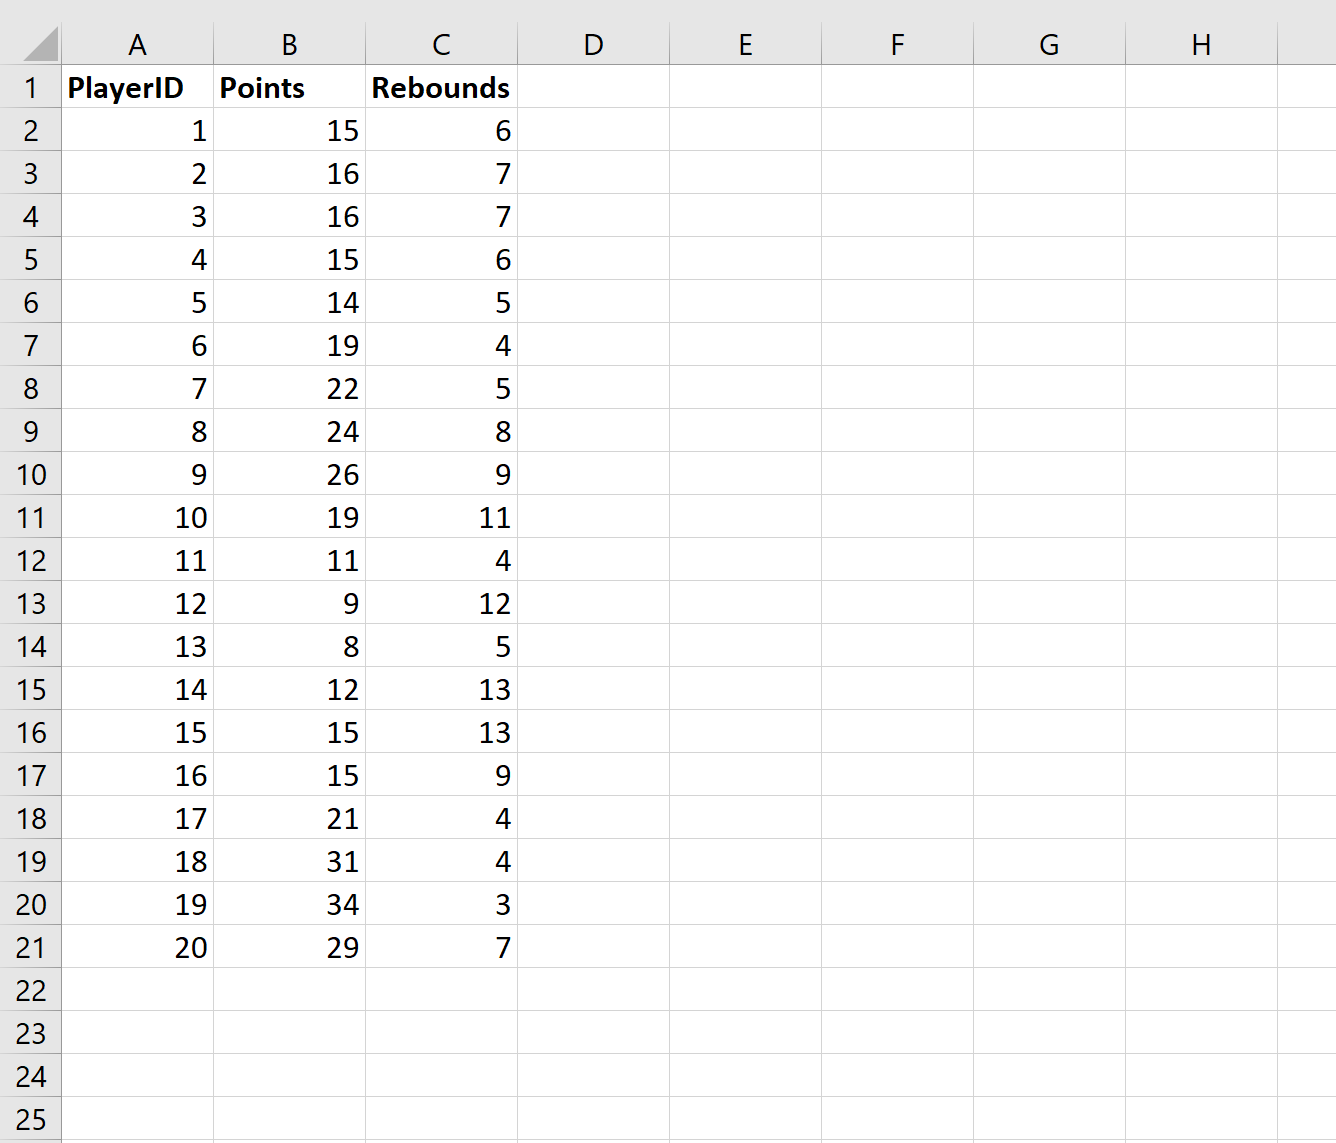
L’intégrité opérationnelle d’un tirage systématique sous Microsoft Excel dépend de l’application scrupuleuse des principes de structuration des données tabulaires standardisées (les principes du Tidy Data). La feuille de calcul dédiée aux données sources doit obéir à une géométrie stricte : chaque ligne horizontale doit correspondre à une et une seule unité d’observation (un participant, un patient ou un sujet expérimental), et chaque colonne verticale doit encapsuler une variable psychologique, clinique ou sociodémographique unique et homogène.
La première exigence éthique et légale, conforme au Règlement Général sur la Protection des Données (RGPD) et aux recommandations déontologiques de l’APA, impose la dé-identification immédiate de la base. Les noms, prénoms, adresses IP ou numéros de sécurité sociale doivent être purgés et remplacés par une variable d’anonymisation robuste, généralement intitulée ID_Participant (par exemple : SUBJ_0001, SUBJ_0002). Cette colonne d’identification unique doit être positionnée en tête de feuille pour servir de pivot relationnel immuable.
Le nettoyage des données brutes nécessite ensuite un criblage exhaustif des doublons potentiels à l’aide de l’outil natif Données > Supprimer les doublons d’Excel. Les formats de cellules doivent être strictement harmonisés : les dates doivent adopter le format ISO standardisé (AAAA-MM-JJ), les scores d’échelles psychométriques doivent être configurés en valeurs numériques entières ou décimales sans mélange de caractères textuels, et les variables catégorielles (sexe, diagnostic DSM-5, niveau d’éducation) doivent être encodées de façon uniforme afin de prévenir toute corruption des filtres ultérieurs.
3.2 Contrôle de l’ordre d’enregistrement et détection des biais de séquence
Avant d’engager le moindre calcul algorithmique d’intervalle, l’analyste doit impérativement auditer la structure séquentielle naturelle de la base de données. Dans les études comportementales, les fichiers sources sont très fréquemment générés par empilement chronologique automatique des passations de questionnaires en ligne ou des admissions cliniques. Cet ordonnancement diachronique n’est jamais neutre : il peut être contaminé par des tendances linéaires temporelles délétères.
Parmi ces dynamiques perturbatrices figurent la dérive progressive des cotations due à la fatigue des cliniciens évaluateurs au fil des semaines, l’effet d’apprentissage des expérimentateurs, ou encore des variations saisonnières affectant les niveaux de détresse psychologique déclarés par les patients. Pour évaluer la présence de telles dérives, il est fortement recommandé d’insérer temporairement un graphique de séquence (nuage de points ou courbe temporelle représentant les scores psychométriques bruts en fonction du numéro d’ordre d’enregistrement).
L’inspection visuelle et l’évaluation statistique de la stationnarité permettent de vérifier si la série temporelle ne présente pas de rupture de moyenne ou de tendance unitaire. De surcroît, le chercheur doit traquer méticuleusement toute périodicité institutionnelle cachée : par exemple, un regroupement récurrent de patients sévères admis systématiquement le lundi matin, ou des taux d’engagement plus élevés chez les étudiants participant à des expérimentations universitaires le vendredi après-midi. Si de telles anomalies structurelles sont identifiées, une procédure de pré-randomisation de la liste source devient méthodologiquement obligatoire.
3.3 Création d’un tableau structuré officiel (Fonctionnalité Tableau Excel)
L’erreur la plus commune chez les utilisateurs intermédiaires d’Excel consiste à opérer sur des plages de cellules statiques standard (par exemple, A2:M500). Cette pratique expose le protocole à des ruptures de formules désastreuses lors de l’ajout ultérieur de nouvelles observations ou de tris accidentels partiels. La meilleure pratique d’ingénierie statistique consiste à convertir immédiatement la plage de données brutes en un Tableau Structuré Officiel, disponible nativement via l’onglet Insertion > Tableau ou le raccourci clavier universel Ctrl+L (ou Ctrl+T).
Cette conversion transforme la matrice de données en une entité computationnelle dynamique, qui doit être renommée de manière explicite au sein du gestionnaire de tableaux, par exemple sous le libellé Tab_Participants. Les tableaux structurés présentent des avantages critiques pour la recherche psychologique :
- Ils gèrent automatiquement l’expansion matricielle : toute nouvelle ligne adjointe en bas de registre hérite instantanément de toutes les formules de calcul et règles d’intégrité référentielle sans manipulation humaine.
- Ils autorisent l’utilisation de références structurées intuitives dans les équations (ex. :
Tab_Participants[Score_Depression]au lieu d’une référence statique opaque commeF2:F500), éliminant virtuellement les erreurs de bornage. - Ils garantissent que les opérations de tri et de filtrage sont strictement solidaires sur l’intégralité des colonnes de l’enregistrement, supprimant tout risque de désynchroniser les identifiants des participants de leurs scores psychométriques respectifs.
4. Étape 1 : Saisie et organisation des données d’étude
4.1 Mise en place de l’espace de travail et des colonnes de référence
La rigueur scientifique d’un protocole d’analyse exige une compartimentation stricte de l’environnement de calcul au sein du classeur Excel. Afin de prévenir toute contamination des données primaires par les formules de traitement, il est impératif d’organiser le fichier de recherche en trois feuilles de calcul distinctes et protégées : une feuille nommée Source_Donnees abritant la base complète des observations, une feuille nommée Configuration_Parametres hébergeant les constantes statistiques et les formules de contrôle, et une feuille nommée Echantillon_Extrait recevant les unités systématiquement sélectionnées.
Au sein de la feuille Source_Donnees, dans la structure de Tab_Participants, la toute première colonne à gauche doit impérativement être réservée à l’établissement d’une indexation séquentielle continue, que nous intitulerons Index_Initial. Cette colonne constitue la colonne vertébrale mathématique du tirage systématique. Elle doit assigner un entier discret strictement croissant, débutant obligatoirement à 1 pour la première unité d’observation jusqu’à N pour la dernière ligne effective du registre.
Pour générer cet index de façon dynamique et pérenne sur les versions modernes de Microsoft Excel (Excel 365 et Excel 2021+), la formule matricielle =SEQUENCE(LIGNES(Tab_Participants)) peut être saisie dans la première cellule de données. Pour les versions antérieures d’Excel, l’écriture de la formule =LIGNE() - LIGNE(Tab_Participants[#En-têtes]) garantit que chaque ligne reçoit un indice strictement séquentiel indépendant des mouvements de cellules ou des opérations de pagination ultérieures.
4.2 Importation et contrôle de cohérence des mesures psychométriques
L’échantillonnage ne doit être opéré que sur des observations démontrant une validité métrologique indiscutable. L’importation des scores psychologiques — qu’il s’agisse de scores d’inventaires d’anxiété de Beck (BAI), d’échelles de personnalité de type Likert (NEO-PI-R), ou de temps de réaction mesurés en millisecondes dans des paradigmes d’inhibition cognitive de type Stroop — doit faire l’objet d’un criblage paramétrique automatisé.
L’utilisation de la fonctionnalité Données > Validation des données sous Excel permet d’imposer des contraintes strictes sur les plages de valeurs autorisées lors de la saisie ou de l’importation. Par exemple, pour un item Likert borné de 1 à 7, la règle de validation doit rejeter tout entier en dehors de cet intervalle. De même, les cellules de mesures psychométriques doivent être scrutées afin de repérer les données manquantes au moyen de la formule de diagnostic :
=NB.VIDE(Tab_Participants[Score_Global])
Dans les protocoles de recherche rigoureux, les critères d’exclusion des données non recevables (par exemple : profils de réponses invariantes, temps de réponse inférieurs à 150 millisecondes trahissant des réponses aléatoires anticipées, ou omissions excédant 10 % des items d’une échelle) doivent être formalisés a priori. Toutes les observations ne satisfaisant pas aux critères de recevabilité doivent être exclues de la base de sondage avant le calcul du volume de population N, afin d’éviter d’échantillonner des unités qui devront être éliminées ultérieurement, ce qui dégraderait la puissance statistique de l’investigation.
4.3 Standardisation de l’environnement de calcul sous Excel
Avant d’exécuter la moindre opération de tirage aléatoire, l’environnement logiciel de Microsoft Excel doit être paramétré de manière à prévenir toute altération accidentelle des calculs. Par défaut, Excel opère en mode de recalcul automatique : chaque saisie dans une cellule quelconque de la feuille déclenche une réévaluation globale de toutes les fonctions volatiles du classeur, ce qui modifierait instantanément les tirages aléatoires si des précautions techniques ne sont pas prises.
Pour assurer la stabilité des opérations d’échantillonnage, le chercheur doit naviguer vers Fichier > Options > Formules et vérifier la gestion du mode de calcul. Bien que le mode Automatique soit généralement recommandé pour les liaisons dynamiques, il est crucial de comprendre l’interaction entre ce mode et les fonctions aléatoires d’Excel. En parallèle, l’investigateur doit vérifier la cohérence des séparateurs décimaux et des séparateurs d’arguments (virgules versus points-virgules) pour éviter des erreurs de typage lors des échanges de fichiers entre systèmes francophones et anglophones.
Enfin, la préservation de l’intégrité des données brutes dicte la création immédiate d’une sauvegarde immuable du jeu de données brut original, enregistrée sous un nom de fichier horodaté et protégée en écriture (lecture seule). Le classeur de travail contenant l’échantillonnage actif doit être enregistré sous un format sécurisé prenant en charge l’architecture computationnelle requise, tel que le format classeur standard .xlsx ou le format prenant en charge les macros .xlsm si des automatisations de traçabilité avancées sont mobilisées.
5. Étape 2 : Configuration et calcul automatique des paramètres d’échantillonnage
5.1 Calcul automatique de la taille de population N dans Excel
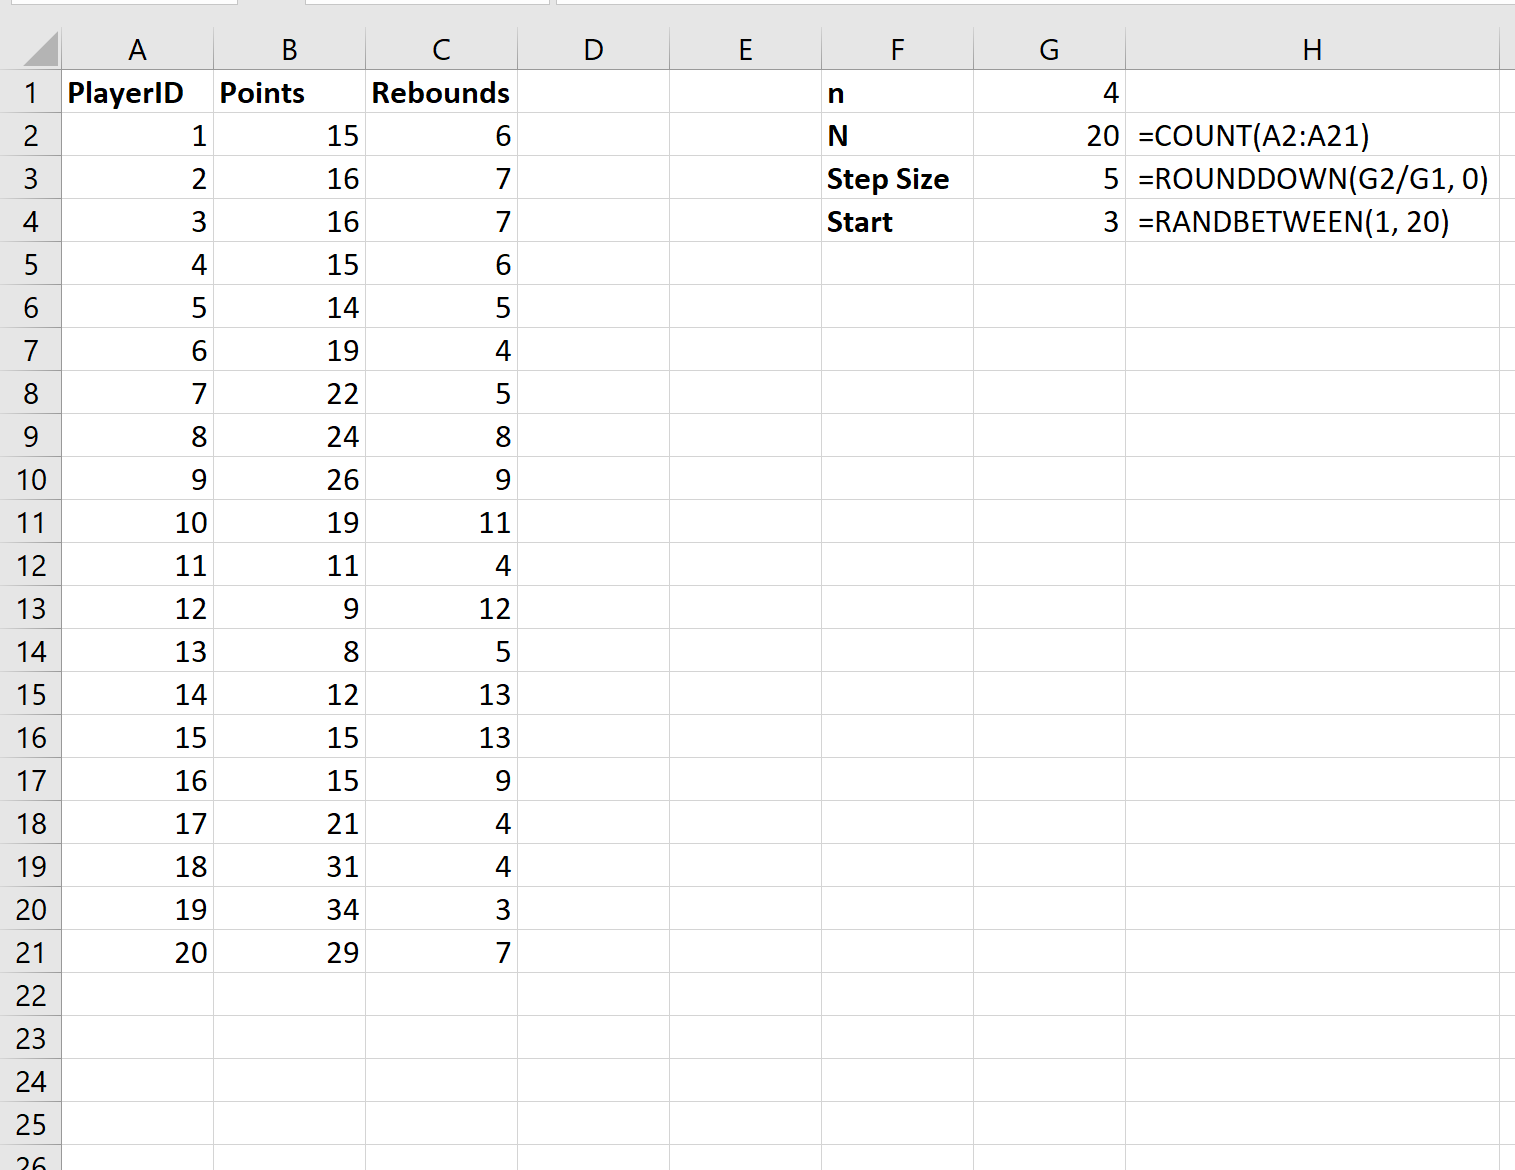
Dans la feuille Configuration_Parametres, le chercheur doit créer un bloc de métadonnées computationnelles qui servira de moteur de paramétrage pour l’ensemble du processus. La première variable fondamentale à dériver dynamiquement est la taille de la population parente N. Il est formellement proscrit d’encoder cette valeur en dur (par exemple, taper manuellement le chiffre 1200), car toute mise à jour de la base source rendrait caduque l’ensemble des formules dépendantes.
La formule appropriée pour dénombrer automatiquement les participants valides au sein du tableau structuré s’appuie sur la fonction NBVAL pour les identifiants alphanumériques, ou sur la fonction NB pour les identifiants purement numériques. Dans la cellule réservée à cet effet, nous inscrivons :
=NBVAL(Tab_Participants[ID_Participant])
Cette approche garantit l’exclusion dynamique de la ligne d’en-tête du calcul de N tout en capturant instantanément toute adjonction ou suppression de ligne. Pour conférer une lisibilité algorithmique maximale aux équations ultérieures, il est hautement conseillé de nommer cette cellule via le Gestionnaire de noms d’Excel (onglet Formules > Définir un nom) sous le libellé standardisé Taille_Population.
5.2 Définition de la taille cible n et modélisation du pas k
La cellule immédiatement contiguë dans la feuille de configuration est dédiée à la spécification de la taille désirée de l’échantillon n, issue du calcul de puissance statistique décrit dans la section 2.1. Cette cellule est nommée dans le classeur sous l’identifiant Taille_Echantillon (par exemple, la valeur entière 150 pour une cohorte clinique cible).
La détermination du pas d’échantillonnage k s’opère alors au sein d’une troisième cellule, nommée Pas_k, au moyen de la formule combinant la division euclidienne et la troncature à l’entier inférieur pour parer aux risques d’arrondis excessifs :
=ENT(Taille_Population / Taille_Echantillon)
La gestion mathématique du reste de la division euclidienne mérite ici toute l’attention de l’analyste. Ce reste, calculable via la fonction modulo =MOD(Taille_Population; Taille_Echantillon), indique le nombre d’individus situés au-delà de la dernière fenêtre d’échantillonnage complète. Si le reste est non nul, la sélection finale comportera exactement le nombre d’unités requis n, mais les dernières lignes de la base source posséderont une probabilité d’inclusion marginalement inférieure à moins d’utiliser un schéma circulaire. De plus, la formule doit inclure une validation logique prévenant les aberrations expérimentales : si un utilisateur étourdi spécifie une taille Taille_Echantillon supérieure à Taille_Population, la cellule doit renvoyer un message explicite d’incompatibilité arithmétique.
5.3 Automatisation des messages de validation des paramètres
Afin de sécuriser le protocole méthodologique contre les manipulations erronées d’assistants de recherche ou de collaborateurs, la feuille de configuration doit intégrer des barrières de contrôle logique fondées sur la fonction SI. Une cellule de diagnostic intitulée Statut_Validation doit évaluer la conformité statistique du ratio d’échantillonnage :
=SI(Taille_Echantillon >= Taille_Population; « ERREUR : n supérieur ou égal à N »; SI(Pas_k < 2; « ATTENTION : Pas k insuffisant pour tirage systématique »; « PARAMÈTRES STATISTIQUEMENT VALIDES »))
Ces messages d’alerte doivent être visuellement renforcés au moyen d’une règle de Mise en forme conditionnelle appliquant un surlignage rouge vif en cas d’erreur de paramétrage et un style vert neutre en présence d’une configuration valide. Un pas k < 2 implique que l’échantillon souhaité représente plus de la moitié de la population, ce qui rend l’échantillonnage systématique trivial et méthodologiquement discutable au regard du tirage exhaustif de la cohorte.
Il convient de consigner dans ce tableau récapitulatif visible les métriques d’audit : le quotient exact décimal, le pas entier k retenu, la fraction de sondage formalisée en pourcentage (=Taille_Echantillon / Taille_Population), ainsi que le reste arithmétique de la division euclidienne. Ce tableau servira de pièce justificative intégrale à insérer dans les annexes méthodologiques lors de la soumission du manuscrit académique.
6. Étape 3 : Détermination probabiliste du point de départ aléatoire
6.1 Utilisation experte de la fonction ALEA.ENTRE.BORNES
L’étape de sélection du point de départ constitue la clé de voûte stochastique garantissant le statut probabiliste de l’échantillonnage systématique. Comme établi dans la théorie d’échantillonnage, cette unité d’amorce doit être tirée au sort de façon rigoureusement équiprobable au sein de l’intervalle d’entiers fermés compris entre 1 et k. L’algorithme d’Excel fournit pour cette tâche la fonction native :
=ALEA.ENTRE.BORNES(1; Pas_k)
Cette fonction implémente une distribution uniforme discrète où chaque entier possède exactement la probabilité mathématique 1 / k d’être désigné. La borne inférieure doit obligatoirement être fixée à la valeur numérique 1 : commencer au-delà de 1 exclurait systématiquement de façon déterministe les premières observations de la base de sondage, violant ainsi le principe fondamental selon lequel toute unité de la population doit posséder une probabilité d’inclusion strictement supérieure à zéro.
Sur le plan algorithmique interne, les versions modernes de Microsoft Excel exploitent pour leurs fonctions aléatoires des variantes sophistiquées de l’algorithme Mersenne Twister (notamment MT19937), qui garantit une période pseudo-aléatoire gigantesque (2^19937 – 1) et une quasi-absence de corrélation sérielle dans les dimensions jusqu’à 623. Ce générateur satisfait aux exigences de robustesse nécessaires pour les études comportementales et cliniques publiées dans les revues internationales à fort impact.
6.2 Gestion de la volatilité et fixation de la valeur aléatoire générée
La fonction ALEA.ENTRE.BORNES est intrinsèquement volatile. En pratique, cela signifie qu’à chaque fois qu’un utilisateur valide une saisie dans n’importe quelle cellule du classeur, modifie une valeur ou demande un recalcul (touche F9), Excel régénère un nouveau nombre pseudo-aléatoire. Si cette dynamique est tolérable lors de phases de simulation de Monte-Carlo, elle est méthodologiquement inacceptable dans un protocole d’échantillonnage expérimental en psychologie. Une telle instabilité modifierait en temps réel la composition de l’échantillon, rendant tout contrôle d’audit impossible et détruisant la reproductibilité de la recherche.
Il est donc méthodologiquement impératif de geler ou de fixer la valeur générée dès son tirage initial. La procédure manuelle standardisée consiste à sélectionner la cellule contenant la formule aléatoire, à copier son contenu (Ctrl+C), puis à effectuer immédiatement un Collage spécial > Valeurs (ou Ctrl+Maj+V) sur la même cellule, nommée dorénavant Depart_Aleatoire. La cellule ne contient plus dès lors une fonction dynamique, mais la valeur scalaire entière pérenne issue du tirage probabiliste.
Pour les équipes de recherche exigeant un degré d’intégrité supérieur conforme aux normes de la science ouverte (Open Science), cette fixation peut être avantageusement prise en charge par une courte routine VBA de traçabilité. Cette macro capture l’entier généré, le fige en valeur statique, extrait l’horodatage système exact de l’opération (date, heure, minute, seconde), et verrouille la cellule contre toute altération accidentelle :
Sub FigerTirageAleatoire()
Dim ws As Worksheet
Set ws = ThisWorkbook.Sheets(« Configuration_Parametres »)
With ws.Range(« Depart_Aleatoire »)
.Value = .Value
End With
ws.Range(« Date_Tirage »).Value = Now
End Sub
6.3 Contrôle d’impartialité et documentation du point de départ
La traçabilité méthodologique constitue l’un des piliers de la recherche comportementale moderne. L’investigateur principal doit être en mesure d’attester devant un comité d’éthique institutionnel (Institutional Review Board – IRB) ou des évaluateurs pairs que le point de départ n’a pas été choisi de manière opportuniste pour inclure ou exclure certains sujets spécifiques de l’expérimentation (par exemple, pour éviter des participants présentant des profils cliniques complexes ou des scores extrêmes).
Le chercheur doit vérifier et certifier que la valeur enregistrée dans Depart_Aleatoire satisfait strictement à la condition d’appartenance à l’ensemble {1, …, k}. Une erreur commune consiste à tolérer un départ accidentellement égal à zéro (qui n’existe pas dans l’indexation de lignes naturelles d’Excel) ou excédant k. Un point de départ supérieur à k aurait pour conséquence funeste d’écarter arbitrairement tout le début de la cohorte et d’amputer l’effectif final de l’échantillon d’une unité.
La date, l’heure précise de l’exécution du tirage, l’identifiant de la machine ou de l’opérateur ayant procédé à la manipulation, ainsi que la valeur scalaire de Depart_Aleatoire doivent être immédiatement consignés de façon immuable dans le cahier de laboratoire électronique de l’étude (Electronic Lab Notebook) ou enregistrés dans un fichier annexe de journalisation. Cette formalisation garantit une transparence scientifique irréprochable et prévient tout soupçon de manipulation post-hoc des données d’échantillonnage.
7. Étape 4 : Étiquetage algorithmique des observations dans la base source
7.1 Implémentation de la séquence arithmétique de sélection
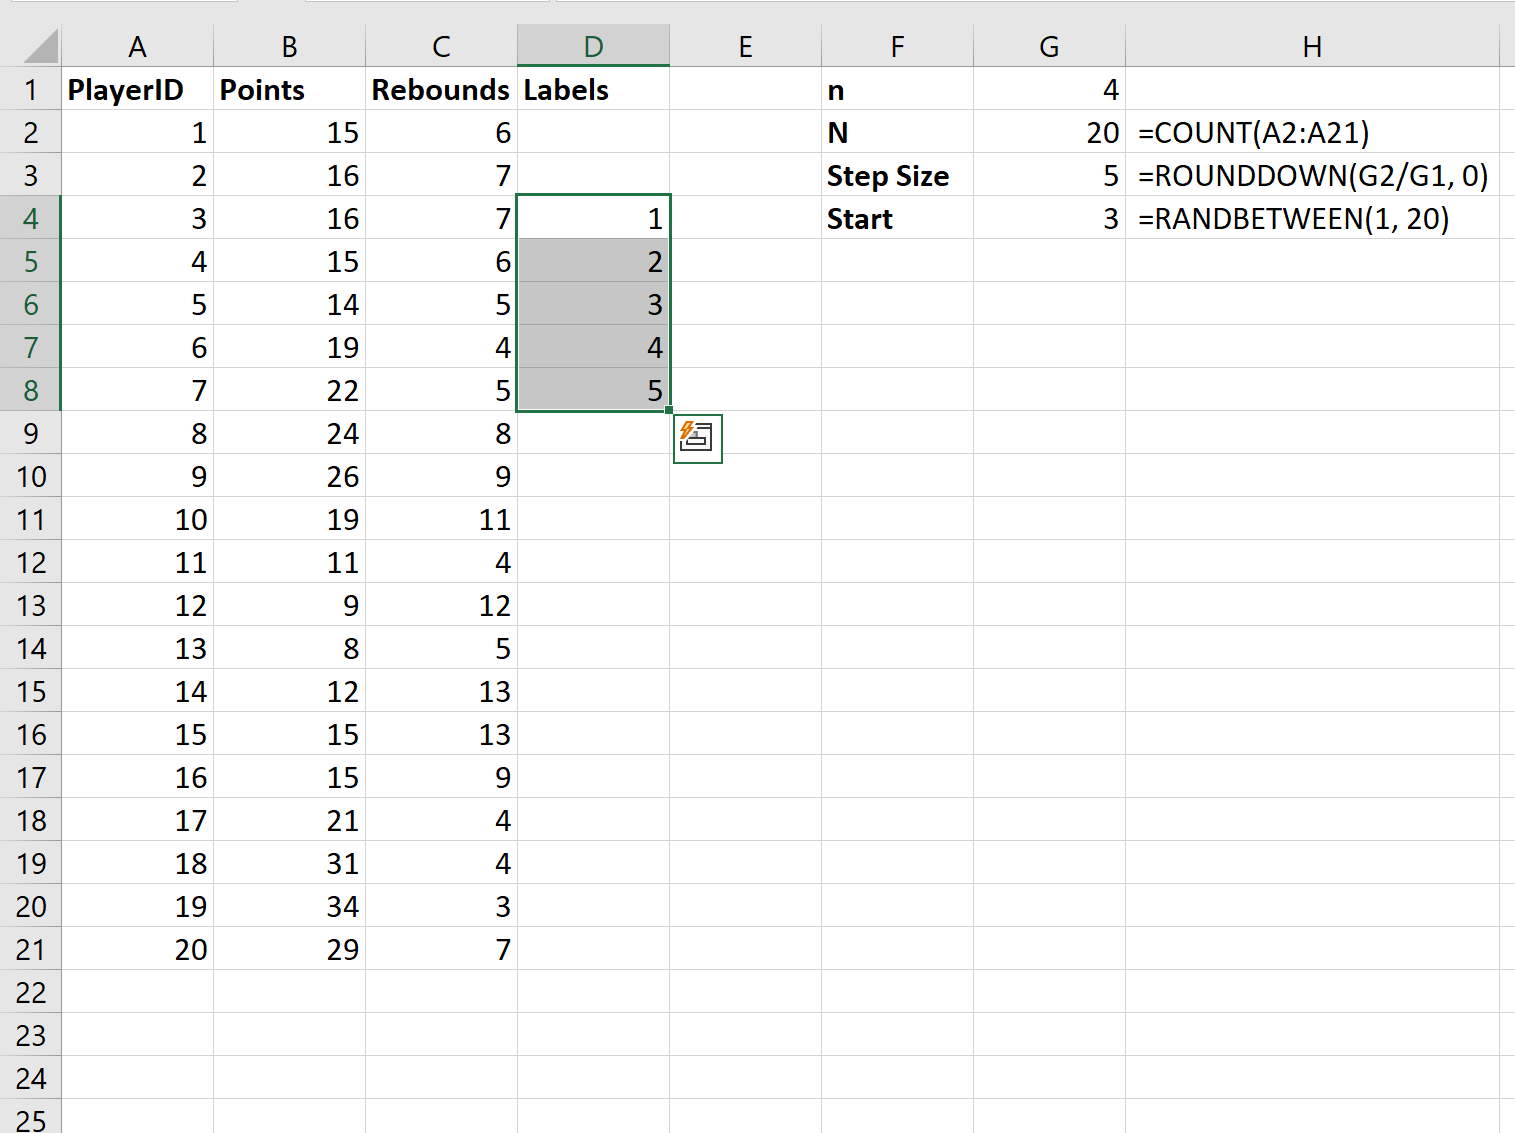
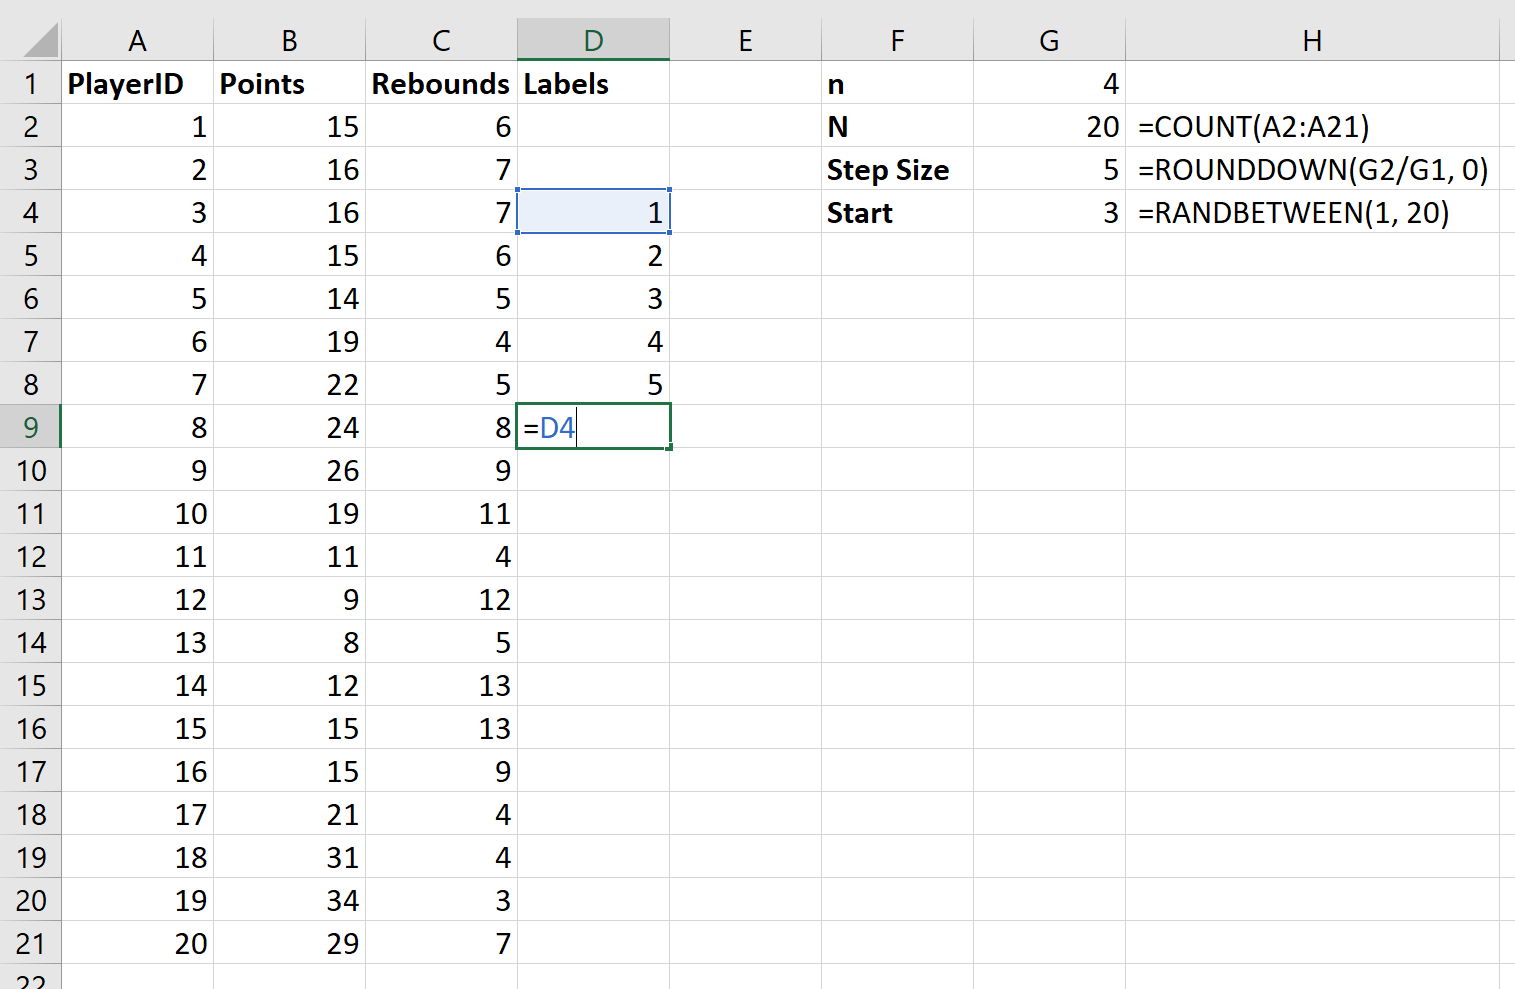
D’un point de vue mathématique formel, l’ensemble des indices d’échantillonnage systématique forme une suite arithmétique de premier terme u₁ = Depart_Aleatoire et de raison constante r = Pas_k. La formule explicite gouvernant l’identification de l’indice de chaque unité sélectionnée i (pour i = 1, 2, …, n) est formalisée par la relation linéaire standard :
Indice(i) = Depart_Aleatoire + (i – 1) * Pas_k
Au sein d’Excel, la traduction de cette suite arithmétique peut s’effectuer de deux manières conceptuelles : soit par génération directe d’une liste de cibles au sein de la feuille d’échantillon, soit par marquage direct booléen au sein même de la table de données source. La méthode de marquage direct dans la base source est unanimement recommandée par les statisticiens d’enquête, car elle offre une clarté visuelle absolue et permet un contrôle d’audit exhaustif sur l’intégralité du registre de population.
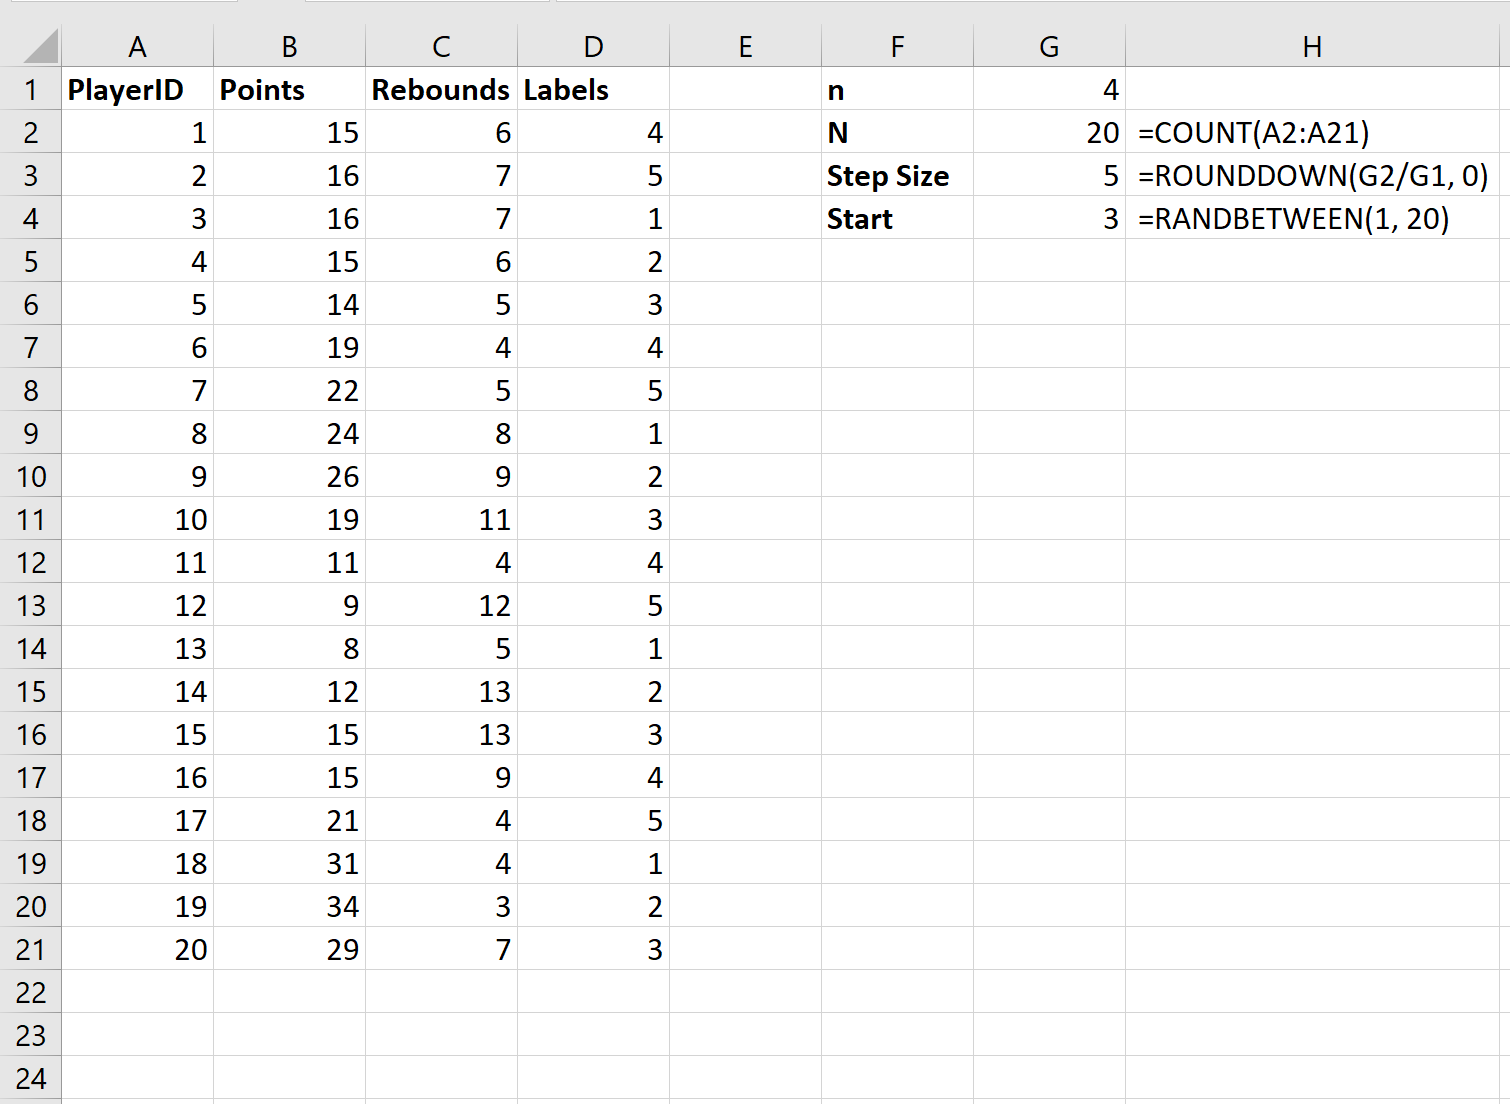
Pour mettre en place cette séquence, nous ajoutons une nouvelle colonne au sein du tableau structuré Tab_Participants sur la feuille Source_Donnees. Cette colonne est nommée explicitement Est_Selectionne. Elle contiendra une formule logique qui évaluera, pour chaque ligne d’observation individuelle, si son Index_Initial appartient ou non à la suite arithmétique modélisée.
7.2 Marquage direct dans la base source à l’aide de la fonction MOD
Pour déterminer avec une élégance algorithmique absolue si une ligne donnée correspond à un palier de la suite arithmétique, l’arithmétique modulaire constitue l’outil de prédilection. La fonction MOD(nombre; diviseur) d’Excel renvoie le reste de la division euclidienne du premier argument par le second. Une observation située à une position donnée Index fait partie de l’échantillon systématique si et seulement si deux conditions logiques sont simultanément réunies :
- Son indice est supérieur ou égal au point de départ probabiliste (Index >= Depart_Aleatoire).
- La différence entre son indice et le point de départ est un multiple exact du pas k, ce qui se traduit par un reste modulo nul : MOD(Index – Depart_Aleatoire; Pas_k) = 0.
Dans la première cellule de données de la colonne Est_Selectionne du tableau structuré Tab_Participants, nous implémentons la formule logique suivante :
=SI(ET([@[Index_Initial]] >= Depart_Aleatoire; MOD([@[Index_Initial]] – Depart_Aleatoire; Pas_k) = 0); 1; 0)
Grâce à la technologie des tableaux structurés d’Excel, cette formule se propage instantanément sur l’ensemble des N lignes du jeu de données. Chaque ligne d’observation se voit ainsi assigner de façon entièrement automatique et déterministe la valeur binaire 1 si elle est sélectionnée pour constituer l’échantillon expérimental, ou la valeur binaire 0 si elle demeure non retenue. Cette technique d’étiquetage in-situ préserve la structure originelle du fichier tout en matérialisant immédiatement les inclusions d’échantillonnage.
7.3 Validation de l’exactitude de l’étiquetage systématique
Avant de procéder à l’extraction opérationnelle des données psychométriques associées aux participants désignés, un contrôle d’intégrité arithmétique doit être exécuté pour valider l’exactitude de l’étiquetage binaire. Dans la feuille de configuration ou en en-tête de la colonne d’étiquetage, nous implémentons la sommation complète des drapeaux de sélection :
=SOMME(Tab_Participants[Est_Selectionne])
Le résultat de cette sommation doit faire l’objet d’une comparaison logique stricte avec la valeur attendue Taille_Echantillon fixée lors de l’étape 2. Si le total équivaut exactement à n, l’algorithme a fonctionné de manière nominale. En revanche, si le total s’avère supérieur de quelques unités (ce qui peut survenir lorsque k est tronqué par défaut et que le reste arithmétique permet d’engager un pas supplémentaire avant la fin du tableau), une correction de limitation doit être apportée.
Pour garantir que l’échantillon final ne dépasse sous aucun prétexte la taille maximale autorisée n, la formule de marquage peut être raffinée en intégrant une condition de comptage cumulatif dynamique. Cette amélioration garantit l’interruption immédiate de l’attribution des valeurs 1 dès que la taille n est strictement atteinte :
=SI(ET([@[Index_Initial]] >= Depart_Aleatoire; MOD([@[Index_Initial]] – Depart_Aleatoire; Pas_k) = 0; SOMME($F$2:[@Est_Selectionne]) <= Taille_Echantillon); 1; 0)
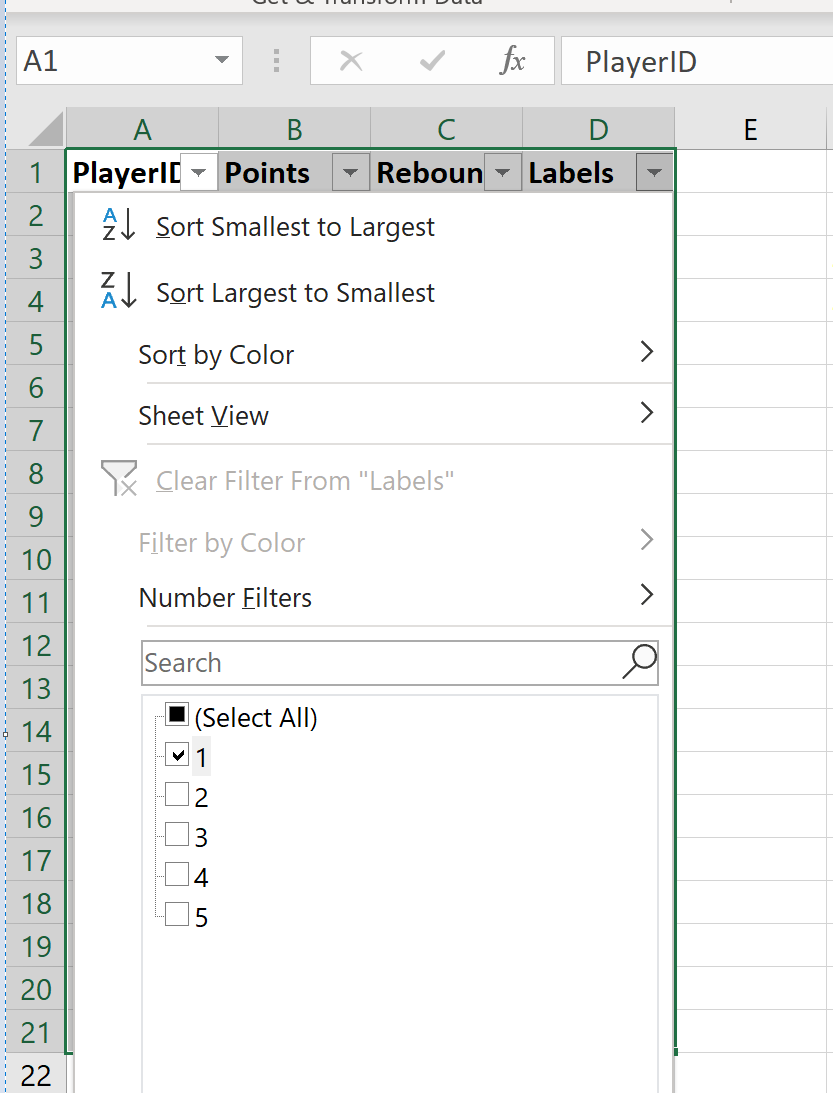
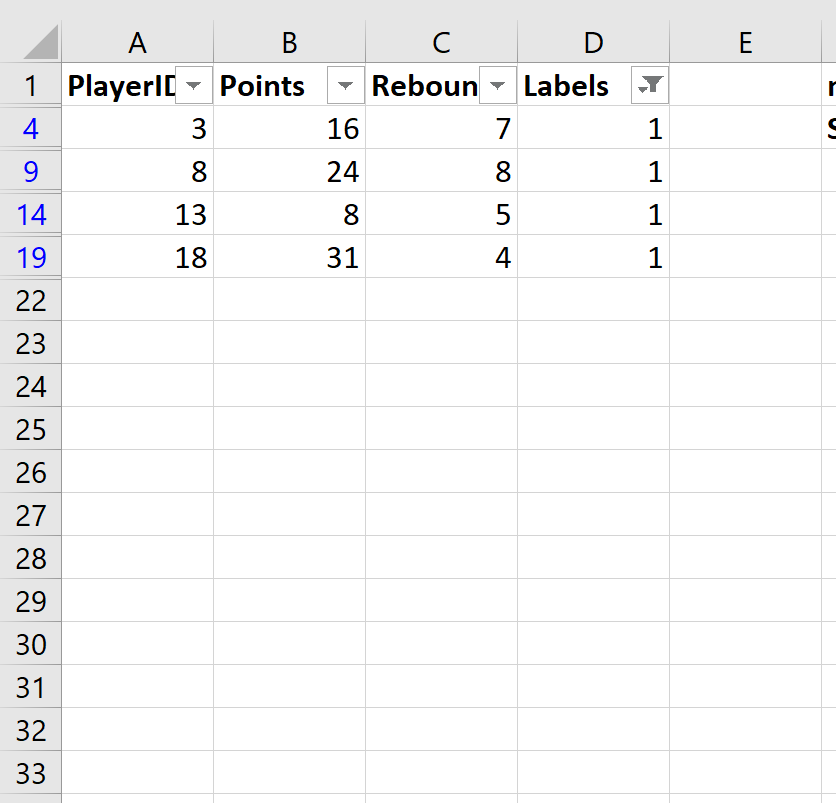
Pour parachever cette étape, une règle de mise en forme conditionnelle peut être appliquée sur l’ensemble des lignes de Tab_Participants, surlignant d’une couleur d’accentuation douce (par exemple, un remplissage bleu clair) les lignes où la colonne Est_Selectionne est égale à 1. Ce retour visuel permet au chercheur d’inspecter d’un coup d’œil l’espacement rigoureusement régulier des unités retenues tout au long de la base de sondage.
8. Étape 5 : Extraction dynamique et automatisée des participants sélectionnés
8.1 Extraction moderne via la fonction FILTRE (Excel 365 et versions récentes)
L’avènement des moteurs de calcul matriciel dynamique dans les versions récentes de Microsoft Excel a révolutionné les procédures d’extraction de données. La fonction FILTRE permet d’extraire instantanément un sous-ensemble d’enregistrements répondant à un critère booléen sans recourir au moindre script procédural, ni à des opérations manuelles de copier-coller hautement sujettes aux erreurs humaines.
Dans la troisième feuille du classeur, intitulée Echantillon_Extrait, le chercheur sélectionne la cellule supérieure gauche de la zone de destination (par exemple, la cellule A2, après avoir recopié manuellement les en-têtes de colonnes en ligne 1). Il inscrit alors la formule d’extraction matricielle suivante :
=FILTRE(Tab_Participants; Tab_Participants[Est_Selectionne] = 1; « Aucune observation sélectionnée »)
Cette unique formule déploie automatiquement l’ensemble des lignes étiquetées avec la valeur 1, préservant l’intégrité intégrale des variables psychologiques, scores cliniques et métadonnées associées à chaque participant retenu. Si le jeu de données source subit une révision (par exemple, la correction d’une erreur de saisie sur le score d’un participant), la table extraite sur la feuille Echantillon_Extrait se met à jour en temps réel sans intervention manuelle.
Si l’équipe de recherche souhaite restreindre l’extraction à un sous-ensemble spécifique de variables d’intérêt (par exemple, exporter uniquement les colonnes ID_Participant, Age, Diagnostic et Score_Global afin de créer un fichier de travail allégé pour les assistants de laboratoire), la fonction FILTRE peut être combinée avec les fonctions CHOISIRCOLS ou INDEX pour sélectionner précisément les index de colonnes cibles :
=CHOISIRCOLS(FILTRE(Tab_Participants; Tab_Participants[Est_Selectionne] = 1); 1; 2; 4; 7)
8.2 Extraction classique universelle via INDEX et EQUIV
Dans les contextes institutionnels hospitaliers ou universitaires où les postes informatiques fonctionnent encore sous des versions antérieures d’Excel (telles qu’Excel 2016, 2013 ou 2010 ne disposant pas du moteur de tableaux dynamiques), le recours à la fonction FILTRE déclenche une erreur d’incompatibilité. Dans cette situation, la combinaison canonique des fonctions INDEX et EQUIV (ou PETITE.VALEUR) fournit une architecture alternative extrêmement solide.
Sur la feuille Echantillon_Extrait, l’investigateur construit une première colonne numérotée séquentiellement de 1 à n, représentant le numéro d’ordre de tirage. Dans la colonne contiguë, il calcule l’indice théorique cible dans la base de données au moyen de l’équation arithmétique directe formalisée dans la section 7.1 : =$B$1 + (LIGNE(A1)-1) * $B$2 (où $B$1 correspond au départ et $B$2 au pas). L’extraction de chaque variable psychométrique s’opère ensuite via la fonction INDEX pointant vers la colonne source :
=SIERREUR(INDEX(Tab_Participants[Score_Depression]; EQUIV(Ligne_Cible; Tab_Participants[Index_Initial]; 0)); « »)
L’adjonction systématique de la fonction enveloppe SIERREUR prémunit la feuille contre l’affichage inélégant de balises #N/A au-delà du seuil des n participants. Bien que cette approche exige de propager les formules sur l’ensemble de la grille par étirement vertical, elle garantit une compatibilité descendante absolue sur l’ensemble des suites bureautiques existantes, tout en maintenant un lien de calcul dynamique avec la base de sondage originale.
8.3 Exportation et formatage final du fichier d’échantillon expérimental
Une fois l’extraction dynamique réalisée et vérifiée sur la feuille Echantillon_Extrait, l’échantillon opérationnel destiné à la phase active d’évaluation comportementale ou d’intervention clinique doit être formalisé et sécurisé. La présence de formules d’extraction dynamiques, bien que précieuse pour l’audit, expose le fichier opérationnel à des risques de rupture accidentelle lors de son transfert vers d’autres collaborateurs ou logiciels d’administration de tests.
La procédure recommandée consiste à créer un nouveau classeur de travail entièrement autonome dédié à l’expérimentation de terrain. Les données de la feuille d’extraction y sont dupliquées par une opération de copie suivie d’un Collage spécial > Valeurs et formats des nombres. Cette action rompt la dépendance computationnelle vis-à-vis du tableau source et transforme l’échantillon en une matrice de données statique définitive, immunisée contre toute modification fortuite ultérieure des paramètres d’échantillonnage.
Ce classeur final doit être complété par l’adjonction d’une feuille de Dictionnaire des Variables (ou livre de codes), explicitant pour chaque colonne : le nom technique de la variable, son libellé descriptif complet, l’unité de mesure ou l’échelle psychométrique exploitée, les bornes numériques recevables, ainsi que la signification explicite des codes catégoriels. Avant toute diffusion aux expérimentateurs de terrain ou archivage dans les serveurs de recherche, une vérification finale d’anonymisation doit certifier qu’aucun identifiant direct permettant de ré-identifier les participants humains n’a été accidentellement exporté.
9. Gestion des pièges méthodologiques : périodicité masquée et biais de tri
9.1 Identification du risque de périodicité cachée en psychologie
Si l’échantillonnage systématique est réputé pour son efficience logistique, il dissimule un écueil théorique redoutable qui constitue son talon d’Achille méthodologique : le phénomène de résonance périodique. Ce biais survient lorsque la base de sondage présente une cyclicité temporelle, spatiale ou organisationnelle sous-jacente dont la fréquence coïncide exactement — ou par un multiple arithmétique simple — avec le pas d’échantillonnage k calculé.
Considérons, à titre d’illustration clinique, une cohorte hospitalière de consultations psychologiques enregistrées chronologiquement, où les admissions s’organisent selon un rythme hebdomadaire strict de 7 jours. Si, par une malheureuse coïncidence arithmétique, le calcul de la taille d’échantillon aboutit à un pas k = 7 (ou un multiple tel que k = 14 ou k = 21), et que le point de départ aléatoire Depart_Aleatoire désigne un lundi, l’algorithme sélectionnera exclusivement des observations enregistrées le lundi sur l’ensemble de l’année d’étude. Si les admissions du lundi présentent des particularités cliniques marquées (par exemple, des décompensations dépressives plus aiguës survenant après le week-end), l’échantillon extrait sera massivement biaisé et dénué de toute représentativité écologique.
Des pièges similaires pullulent dans les contextes éducatifs ou organisationnels : cycles académiques alternant cours magistraux et évaluations stressantes, cycles circadiens dans les mesures psychophysiologiques de stress salivaire (cortisol), ou alternance systématique des genres dans des fichiers de registres d’écoles mixtes classés par ordre alphabétique au sein de binômes garçon-fille. Sous Excel, la détection de telles périodicités implique l’analyse préalable des auto-corrélations des résidus et l’examen scrupuleux des tableaux croisés dynamiques reliant les identifiants d’ordre aux jours ou aux conditions d’enregistrement.
9.2 Neutralisation des biais d’ordonnancement par pré-randomisation
Face à la menace d’une périodicité cachée, la réponse méthodologique la plus élégante et la plus sécurisée consiste à introduire une étape de pré-randomisation complète de la liste source avant le calcul du pas et l’application de l’échantillonnage systématique. Cette technique supprime toute relation d’ordre préexistante tout en permettant au chercheur de conserver le cadre opérationnel simple du pas régulier.
Pour exécuter cette immunisation sous Excel :
- Insérer temporairement une colonne auxiliaire intitulée Alea_Tri au sein du tableau de données source Tab_Participants.
- Affecter à chaque participant un nombre aléatoire flottant standardisé via la fonction volatile :
=ALEA(). - Sélectionner cette colonne, puis figer impérativement ces nombres par un Copier > Collage spécial > Valeurs afin de stabiliser le tirage.
- Exécuter un tri complet de la table Tab_Participants selon l’ordre croissant de la colonne Alea_Tri.
- Régénérer ou réinitialiser la colonne Index_Initial afin qu’elle numérote séquentiellement de 1 à N les observations dans ce nouvel ordre parfaitement aléatoire.
Cette manœuvre neutralise instantanément toute cyclicité temporelle, toute tendance monotone linéaire et tout regroupement institutionnel artificiel. D’un point de vue statistique, l’application d’un échantillonnage systématique sur une base de sondage préalablement randomisée est mathématiquement strictement équivalente à un tirage aléatoire simple sans remise (Simple Random Sampling – SRS). Elle confère à l’échantillon l’ensemble des propriétés de non-biais du SRS tout en maintenant la simplicité procédurale de l’intervalle fixe.
9.3 Gestion des listes ordonnées selon une variable continue ou ordinale
À l’opposé du risque de périodicité, l’ordonnancement préalable délibéré de la base source selon une variable quantitative ou ordinale continue constitue une opportunité méthodologique remarquable. Lorsqu’une liste de participants est triée selon une dimension clinique pertinente (par exemple, le score de sévérité d’un trouble de l’attention mesuré sur l’échelle Conners, ou le niveau socio-économique continu des ménages), l’échantillonnage systématique déploie une propriété statistique majeure : la stratification implicite.
En parcourant de manière arithmétiquement équidistante une base triée par ordre croissant de sévérité clinique, le pas k prélève des unités d’observation réparties de manière parfaitement homogène sur l’intégralité du continuum de la variable ordonnatrice. Cette méthode garantit une représentativité spectrale parfaite, interdisant mathématiquement le regroupement fortuit de participants présentant uniquement des scores extrêmes (grappes d’individus très sévères ou très légers), un risque qui demeure toujours présent dans le tirage aléatoire simple.
Cette stratification implicite procure un gain substantiel d’efficience en réduisant la variance d’échantillonnage de la moyenne estimée par rapport au tirage aléatoire simple. Toutefois, cette configuration impose un ajustement épistémologique crucial : les formules standards d’erreur type calculées par les logiciels statistiques conventionnels (qui postulent une hypothèse d’échantillonnage aléatoire simple) surestiment généralement la véritable variance d’échantillonnage. Le chercheur averti doit documenter formellement cette structure de tri dans la section méthodologique de sa publication afin d’éclairer la lecture des intervalles de confiance rapportés.
10. Comparaison méthodologique : systématique vs aléatoire simple sous Excel
10.1 Différences conceptuelles et logistiques d’exécution
Le choix entre l’échantillonnage systématique et le tirage aléatoire simple au sein d’un tableur ne se résume pas à une préférence d’usage, mais engage des architectures computationnelles et logistiques fondamentalement divergentes. L’échantillonnage systématique se singularise par une économie stochastique remarquable : il ne sollicite le moteur de génération pseudo-aléatoire du logiciel qu’une seule et unique fois, lors de la définition de la graine initiale Depart_Aleatoire. Dès que cette impulsion probabiliste d’amorce est figée, le reste du processus relève d’une cinématique arithmétique déterministe rigoureuse.
À l’inverse, la modélisation d’un tirage aléatoire simple sans remise sous Excel implique la génération continue de N nombres aléatoires flottants, un tri multidimensionnel complet de la base, ou l’utilisation de formules matricielles complexes pour prévenir l’échantillonnage redondant d’un même individu. Sur des cohortes massives de participants (par exemple, des banques de données neuropsychologiques nationales regroupant plusieurs dizaines de milliers d’enregistrements), l’exécution de multiples fonctions aléatoires volatiles peut provoquer des ralentissements logiciels sévères et multiplier les risques d’écrasement de données.
Sur le plan de l’auditabilité et de la reproductibilité scientifique par les pairs, l’échantillonnage systématique se révèle infiniment plus transparent. Un vérificateur externe, un éditeur de revue ou un auditeur d’un comité d’éthique n’a besoin que de deux paramètres scalaires simples — le pas k et le point de départ a — pour recalculer et valider instantanément la sélection de chaque sujet. Cette vérifiabilité déterministe absolue constitue un atout de poids dans le cadre des exigences actuelles de rigueur et d’ouverture de la science empirique.
10.2 Propriétés statistiques, efficience et variance d’échantillonnage
La supériorité statistique relative de l’échantillonnage systématique sur le tirage aléatoire simple dépend de la corrélation intraclasse, notée ρ_w, mesurant l’homogénéité des observations au sein des grappes systématiques constituées. Le théorème classique de Cochran formalise la relation exacte reliant la variance de la moyenne d’un échantillon systématique V(y_bar_sys) à celle d’un échantillon aléatoire simple V(y_bar_srs) :
V(y_bar_sys) = V(y_bar_srs) * [1 + (n – 1) * ρ_w]
Cette équation fondamentale éclaire trois situations distinctes pour le chercheur en sciences comportementales :
- Si les unités de la base de sondage sont ordonnées de façon parfaitement aléatoire, le coefficient de corrélation intraclasse ρ_w est asymptotiquement nul (ρ_w ≈ 0). Dans cette configuration, la variance de l’échantillon systématique est strictement identique à celle d’un tirage aléatoire simple.
- Si la liste est ordonnée selon une variable corrélée avec la mesure psychométrique cible (stratification implicite), les observations au sein de chaque échantillon systématique sont plus hétérogènes que la population globale, ce qui engendre un coefficient négatif (ρ_w < 0). La variance de l’échantillonnage systématique devient alors inférieure à celle du tirage aléatoire simple : l’échantillonnage systématique est plus précis et efficient que le tirage aléatoire pur.
- Si la base de sondage présente une périodicité masquée en résonance avec le pas k, les unités sélectionnées se révèlent extrêmement similaires entre elles, induisant un coefficient positif marqué (ρ_w > 0). La variance explose littéralement, entraînant une perte dramatique d’efficience et un biais massif d’estimation.
10.3 Critères de décision pour le protocole de recherche psychologique
L’arbitrage méthodologique entre ces deux approches fondamentales doit s’inscrire dans un arbre de décision rigoureux et explicite, formalisé dès la rédaction du protocole de recherche préréenregistré (sur des plateformes telles que l’Open Science Framework). Le recours prioritaire à l’échantillonnage systématique sous Excel s’impose avec une force particulière dans les conditions suivantes :
- La base de sondage est exhaustive, stabilisée et disponible sous la forme d’un registre numérique structuré.
- La sélection s’effectue au sein d’un flux continu de participants (par exemple, dans des protocoles cliniques où les patients sont inclus consécutivement au fil de leur admission en centre hospitalier, en sélectionnant par exemple un patient tous les quatre lundis).
- La base de sondage peut être ordonnée selon une dimension clinique pertinente, offrant ainsi les bénéfices d’une stratification implicite gratuite sans la complexité logistique d’un plan d’échantillonnage stratifié disproportionné.
À l’inverse, l’investigateur doit impérativement délaisser l’échantillonnage systématique au profit d’un tirage aléatoire simple (ou d’un échantillonnage stratifié explicite) dès lors qu’il suspecte la présence de cycles périodiques institutionnels impossibles à purger par pré-randomisation, ou lorsque les comités d’éthique et directives réglementaires imposent un tirage entièrement stochastique à chaque tirage individuel. Le tableau comparatif suivant synthétise les critères opérationnels d’arbitrage pour les sciences comportementales :
Tableau synoptique : Comparaison systématique versus aléatoire simple
- Complexité sous Excel : Faible pour le systématique (un seul tirage stochastique et formules arithmétiques) | Moyenne à élevée pour le tirage aléatoire simple (gestion des doublons et ré-ordonnancement lourd).
- Sensibilité à la périodicité : Très élevée pour le systématique (risque d’erreur systématique majeur) | Nulle pour le tirage aléatoire simple (immunité complète par indépendance stochastique).
- Efficience en base ordonnée : Maximale pour le systématique (stratification implicite réduisant la variance) | Standard pour le tirage aléatoire simple.
- Auditabilité par les pairs : Immédiate, transparente et traçable | Nécessite l’archivage complet des listes de nombres aléatoires ou de graines spécifiques.
11. Contrôle de qualité et validation de la représentativité de l’échantillon
11.1 Vérification de l’équilibre sociodémographique et clinique
Une fois l’échantillon extrait au moyen des fonctionnalités présentées à l’étape 5, le protocole scientifique ne saurait être considéré comme achevé. Une phase indispensable de contrôle de qualité et de diagnostic de représentativité doit être opérée avant d’engager la moindre passation expérimentale ou analyse substantielle. L’investigateur doit certifier que le sous-ensemble prélevé ne présente aucune déviation morphologique par rapport aux caractéristiques structurales de la population source parente.
Au sein d’Excel, l’outil le plus véloce et puissant pour mener cette évaluation comparative réside dans le Tableau Croisé Dynamique (TCD). Le chercheur génère un TCD alimenté par Tab_Participants, en positionnant la colonne de marquage Est_Selectionne en champ de colonnes (comparant ainsi la modalité 0 à la modalité 1) et les variables sociodémographiques (sexe, tranches d’âge, niveau d’éducation) ou diagnostiques en champs de lignes.
L’analyse bivariée doit porter à la fois sur les indicateurs de tendance centrale (moyennes arithmétiques, médianes) et sur les paramètres de dispersion (écarts-types, intervalles interquartiles) pour les variables quantitatives continues telles que l’âge ou les scores de dépression pré-test. L’ampleur des divergences éventuelles entre l’échantillon extrait et la population globale est quantifiée par le calcul de l’écart standardisé absolu (Standardized Mean Difference – SMD), dont la valeur sous Excel s’exprime par la formule :
SMD = ABS(Moyenne_Echantillon – Moyenne_Population) / Ecart_Type_Population
Selon les standards méthodologiques internationaux en vigueur, un SMD inférieur à 0,10 atteste d’un équilibre sociodémographique et clinique parfait, confirmant que le sous-groupe extrait est le miroir fidèle de la cohorte initiale.
11.2 Tests statistiques d’adéquation réalisés directement dans Excel
Pour dépasser la simple inspection descriptive et apporter une confirmation inférentielle de la validité de l’échantillonnage, le chercheur peut mobiliser les fonctions statistiques inférentielles natives d’Excel. L’objectif est de vérifier formellement l’hypothèse nulle (H₀) postulant l’absence de divergence statistiquement significative entre la distribution des variables dans l’échantillon et celle de la population source.
Pour les variables nominales et catégorielles (telles que la répartition des diagnostics cliniques selon les catégories du DSM-5 ou la proportion de genres), nous appliquons un test d’adéquation du Khi-deux de conformité. Dans une table récapitulative comparant les fréquences observées dans l’échantillon sélectionné aux fréquences théoriques attendues (dérivées de la prévalence observée dans la population parente N multipliée par la fraction n/N), le chercheur utilise la fonction :
=TEST.KHIDEUX(Plage_Frequences_Observees; Plage_Frequences_Attendues)
Pour les variables psychométriques quantitatives continues (telles que le quotient intellectuel mesuré par l’échelle de Wechsler ou les scores de régulation émotionnelle), un test t de Student pour échantillons indépendants comparant les sujets sélectionnés (colonne Est_Selectionne = 1) aux sujets non sélectionnés (colonne Est_Selectionne = 0) est déployé via la syntaxe native :
=TEST.ETUDIANT(Plage_Scores_Selectionnes; Plage_Scores_NonSelectionnes; 2; 3)
Dans ces équations, l’obtention d’une valeur p (p-value) largement supérieure au seuil conventionnel de 0,05 atteste de l’incapacité à rejeter l’hypothèse nulle d’équivalence distributionnelle. Ce constat confirme mathématiquement l’absence de biais de sélection et apporte la preuve formelle de la neutralité stochastique du plan d’échantillonnage systématique orchestré.
11.3 Stratégies d’ajustement en cas de non-réponse ou d’attrition
Dans les recherches psychologiques et comportementales impliquant le recrutement actif de participants humains, les chercheurs se heurtent inévitablement au phénomène de refus de consentement (non-réponse initiale) ou d’abandon en cours de protocole (attrition longitudinale). Une stratégie d’ajustement pragmatique mais rigoureuse doit être planifiée en amont pour éviter l’érosion de la puissance statistique de l’étude.
Une pratique de terrain répandue sous Excel consiste à appliquer la substitution systématique contiguë. Lorsqu’un participant sélectionné par l’algorithme (position Index = i) décline sa participation ou s’avère injoignable, le protocole autorise le remplacement par l’observation immédiatement adjacente dans la liste source (soit la ligne Index = i + 1). Bien que commode, cette technique doit être encadrée avec une extrême rigueur méthodologique :
- L’unité de remplacement ne doit pas être elle-même déjà sélectionnée dans le cadre du pas régulier.
- Le chercheur doit consigner méticuleusement dans le classeur le statut de chaque unité (sélection originale, remplaçant de premier ordre, refus documenté).
- L’investigateur doit tester statistiquement si les participants déclinant l’invitation diffèrent de manière systématique des participants acceptants, afin de déceler un éventuel biais d’auto-sélection (attrition non aléatoire).
Toutes ces manœuvres de compensation doivent être documentées de façon exhaustive conformément aux exigences des grilles méthodologiques internationales, telles que les déclarations CONSORT pour les essais cliniques randomisés ou les directives STROBE pour les études observationnelles en santé mentale.
12. Bonnes pratiques, reproductibilité et publication selon les normes APA
12.1 Documentation de la méthode dans la section Participants / Méthodologie
La rédaction de la section méthodologique d’un article scientifique rédigé selon les normes de l’American Psychological Association (APA 7th edition) exige une transparence intégrale sur les opérations d’échantillonnage. Le recours à des formules vagues ou elliptiques telles que « un échantillon représentatif a été tiré au hasard » est formellement banni par les comités de lecture académiques contemporains.
La sous-section Participants (ou Échantillonnage et recrutement) doit spécifier avec précision :
- La nature, la source institutionnelle et la taille exhaustive de la population accessible parente (N).
- La taille finale ciblée de l’échantillon (n) ainsi que la justification mathématique a priori issue du calcul de puissance statistique (logiciel employé, seuil alpha, puissance nominale et taille d’effet minimale attendue).
- La méthode explicite d’échantillonnage probabiliste retenue : l’échantillonnage systématique en deux phases.
- La valeur exacte du pas d’échantillonnage arithmétique calculé (k = ENT(N / n)) ainsi que la méthode de sélection stochastique du point de départ initial (utilisation d’un générateur pseudo-aléatoire borné de 1 à k).
- Les protocoles de contrôle appliqués pour écarter tout risque de périodicité cachée au sein des registres de données.
Voici un modèle canonique de rédaction scientifique prêt à l’emploi pour une publication rédigée selon les normes de l’APA :
« Les participants à cette étude ont été sélectionnés par une procédure d’échantillonnage systématique probabiliste à partir de la base de données institutionnelle du centre de consultation psychologique, totalisant un effectif parent exhaustif de N = 2 450 dossiers cliniques enregistrés au cours de la période 2022-2023. Un calcul de puissance statistique a priori a déterminé qu’un effectif minimal de n = 240 sujets était nécessaire pour détecter une taille d’effet moyenne (d = 0,35) avec une puissance de 0,85 à un seuil alpha bilatéral de 0,05. Après vérification de l’absence d’auto-corrélation temporelle sérielle sur les scores d’admission, un pas d’échantillonnage systématique discret de k = 10 a été configuré sous Microsoft Excel (k = ENT(2450 / 240)). Le point de départ initial a été déterminé stochastiquement au moyen de la fonction pseudo-aléatoire uniforme discrète ALEA.ENTRE.BORNES(1; 10), attribuant de façon équiprobable l’amorce à la ligne d’enregistrement numéro 6. Les participants ont ensuite été extraits séquentiellement à intervalles réguliers de 10 unités. Les analyses d’adéquation du Khi-deux et les tests t de Student n’ont révélé aucune divergence distributionnelle significative entre l’échantillon extrait et la population cible sur les variables d’âge, de sexe et de sévérité symptomatique basale (toutes les p-values > 0,20). »
12.2 Partage des scripts et classeurs dans l’optique de la science ouverte
L’éthique scientifique contemporaine promeut activement le mouvement de la science ouverte (Open Science), invitant les chercheurs à déposer l’intégralité de leurs matériaux d’étude, données anonymisées et protocoles de calcul sur des répertoires institutionnels publics tels que l’Open Science Framework (OSF), Zenodo ou Dryad. Le classeur Microsoft Excel ayant servi à l’échantillonnage constitue une pièce méthodologique majeure de ce dépôt.
Pour préparer un classeur Excel en vue d’un partage public irréprochable :
- Purge des métadonnées invisibles : Il est impératif d’utiliser l’outil natif Fichier > Informations > Vérifier la présence de problèmes > Inspecter le document. Cet outil permet d’éliminer automatiquement les informations personnelles masquées, les propriétés de l’auteur, les historiques de révision et les commentaires cachés.
- Verrouillage structurel : Protéger la structure du classeur et verrouiller les cellules hébergeant les équations critiques afin d’éviter que les pairs évaluateurs ou utilisateurs secondaires ne corrompent par inadvertance l’architecture computationnelle lors de la consultation.
- Rédaction d’un fichier Readme.txt d’accompagnement : Rédiger un fichier texte standardisé au format markdown ou texte brut détaillant l’arborescence des feuilles du classeur, la version précise du tableur exploitée (par exemple, Microsoft 365 v2401), la signification exacte de chaque cellule nommée, ainsi que la clé de déchiffrement des variables du dictionnaire de données.
- Formats de pérennité : En sus du classeur dynamique propriétaire
.xlsx, exporter systématiquement les données extraites au format ouvert universel délimité par des virgules (.csv), garantissant une lisibilité pérenne sur plusieurs décennies indépendamment de l’évolution des suites logicielles commerciales.
12.3 Synthèse des étapes clés et recommandations pour les futurs projets
La mise en œuvre d’un échantillonnage systématique sous Microsoft Excel représente une synthèse remarquable d’élégance méthodologique et de rigueur opérationnelle. Pour garantir un déroulement optimal sans écueil dans vos futurs projets de recherche clinique, cognitive ou organisationnelle, l’investigateur doit garder à l’esprit la chronologie immuable des sept opérations fondamentales :
- Sanctuarisation de la base : Structurer les observations dans un tableau officiel nommé (Tab_Participants), nettoyer scrupuleusement les valeurs aberrantes et dé-identifier les enregistrements.
- Audit de l’ordonnancement : Diagnostiquer toute périodicité masquée et, en cas de doute clinique, exécuter une pré-randomisation complète de la liste par assignation aléatoire et tri ascendant.
- Indexation séquentielle : Générer une colonne d’index inviolable débutant strictement à 1 jusqu’à la population totale N.
- Calcul rigoureux du pas k : Dériver le pas arithmétique au moyen de la troncature à l’entier inférieur
=ENT(N / n)afin de garantir l’atteinte nominale de la taille cible. - Fixation probabiliste de l’amorce : Générer l’amorce par
=ALEA.ENTRE.BORNES(1; k)et la figer immédiatement en valeur scalaire statique pour assurer la reproductibilité expérimentale. - Marquage et filtrage modulaire : Déployer la fonction logique
MODpour étiqueter de façon binaire les unités d’inclusion, puis extraire la sélection au moyen des formules matriciellesFILTREouINDEX/EQUIV. - Validation statistique d’adéquation : Vérifier la balance sociodémographique par des tests d’adéquation (Khi-deux, test t) avant toute utilisation sur le terrain.
Bien que Microsoft Excel demeure un outil d’une extraordinaire flexibilité pour des populations d’études comptant jusqu’à quelques centaines de milliers d’enregistrements, les chercheurs traitant des bases de données massives (mégadonnées issues de traces numériques ou registres de santé publique nationaux excédant le million de lignes) trouveront avantage à porter ce protocole algorithmique vers des environnements de programmation tels que R ou Python. Néanmoins, les principes conceptuels, mathématiques et méthodologiques universels déployés tout au long de ce guide demeurent strictement invariants : ils constituent le socle immuable de l’inférence statistique et de l’intégrité scientifique en sciences du comportement.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Kish, L. (1965). Survey sampling. John Wiley & Sons. https://doi.org/10.1002/bimj.19680100122
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- Schulz, K. F., Altman, D. G., & Moher, D. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMC Medicine, 8(1), Article 18. https://doi.org/10.1186/1741-7015-8-18
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453–1457. https://doi.org/10.1016/S0140-6736(07)61602-X
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10