
Dans le domaine de l’analyse exploratoire et de la communication scientifique des données, la restitution visuelle constitue le vecteur privilégié de transmission de l’information empirique. L’écosystème Python, porté par la puissance conjointe de la bibliothèque de bas niveau Matplotlib et de la surcouche statistique de haut niveau Seaborn, s’est imposé comme la référence incontournable pour la modélisation graphique des distributions multivariées. Toutefois, l’automatisation esthétique offerte par Seaborn se heurte fréquemment à un obstacle ergonomique majeur : la gestion spatiale des métadonnées explicatives, et plus spécifiquement le positionnement de la légende. Par défaut, les algorithmes heuristiques logent ces annotations à l’intérieur même du canevas de traçage, créant des interférences directes avec les structures graphiques indispensables à la compréhension analytique.
L’encombrement visuel résultant de l’occultation de points critiques, de courbes de régression ou d’intervalles de confiance altère profondément la lisibilité des représentations et induit une charge cognitive superflue chez le lecteur. Déporter la boîte de légende à l’extérieur des limites cartésiennes de la figure s’avère alors être une exigence méthodologique essentielle pour quiconque souhaite élaborer des visualisations rigoureuses, conformes aux standards éditoriaux des revues scientifiques internationales. Cette opération, bien que conceptuellement élémentaire, exige une compréhension approfondie de la hiérarchie des objets graphiques, des systèmes de coordonnées projectives et des mécanismes d’ancrage sous-jacents qui lient Matplotlib et Seaborn.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les mécanismes géométriques et les techniques programmatiques permettant d’externaliser avec précision la légende d’un graphique Seaborn. En explorant l’articulation subtile entre le système de coordonnées normalisées de la boîte englobante (la fameuse bounding box), le comportement différentiel des fonctions opérant au niveau des axes par rapport à celles opérant au niveau de la figure, ainsi que les stratégies d’exportation sans troncature, nous fournirons au lecteur les clés d’une maîtrise absolue de l’espace graphique en Python.
1. Fondements théoriques de la visualisation graphique et surcharge cognitive liée aux légendes
1.1 Le principe de clarté perceptive et la théorie de la charge cognitive appliquée aux figures
La théorie de la charge cognitive, formulée initialement par John Sweller à la fin des années 1980, établit une distinction épistémologique fondamentale entre la charge cognitive intrinsèque, inhérente à la complexité conceptuelle des données observées, et la charge cognitive extrinsèque, générée par la manière dont l’information est structurée et présentée au récepteur. Lorsqu’un chercheur ou un analyste examine une figure scientifique complexe impliquant plusieurs dimensions — telles que des variables continues corrélées et stratifiées par des facteurs catégoriels —, la mémoire de travail est fortement sollicitée pour synthétiser les motifs morphologiques et spatiaux. Si la boîte de légende est insérée au cœur de l’espace de données, elle introduit un bruit visuel perturbateur qui alourdit inutilement la charge extrinsèque.
L’impact de cette superposition visuelle des métadonnées sur l’interprétation des données expérimentales est dévastateur. En occultant des points aberrants, des queues de distribution ou des bifurcations de trajectoires temporelles, la légende crée des zones d’ombre artificielles qui faussent l’appréciation des grandeurs statistiques. La sémiotique graphique, telle que théorisée par Jacques Bertin dans sa Sémiologie Graphique, postule que chaque variable visuelle (position, taille, valeur, couleur) doit pouvoir être lue de manière univoque sans qu’un plan textuel parasite ne vienne rompre la continuité du plan géométrique des données. L’externalisation systématique de la boîte de légende en dehors de la grille de coordonnées répond directement à ce principe de clarté perceptive. En dissociant physiquement l’espace de mesure de l’espace d’indexation symbolique, on permet au système visuel humain de basculer de manière fluide entre l’exploration structurelle des données et la consultation référentielle des clés de décodage chromatique.
1.2 Les contraintes inhérentes au positionnement automatique interne dans Seaborn
Seaborn délègue historiquement le positionnement de la légende au moteur sous-jacent de Matplotlib, lequel emploie par défaut une heuristique automatisée paramétrée sur la valeur symbolique loc=’best’. Ce mécanisme algorithmique procède à un maillage spatial discret de la surface de tracé afin d’évaluer la densité locale des éléments graphiques (segments, marqueurs, polygones ombrés) et tente de localiser la boîte englobante dans la région présentant le moins de recouvrement statistique. Malgré l’ingéniosité théorique de cette approche computationnelle, elle s’avère notoirement défaillante dès lors que la dispersion spatiale des données occupe de manière homogène le plan cartésien, ce qui est le propre des jeux de données denses modernes.
Dans la pratique empirique, l’heuristique loc=’best’ échoue fréquemment à anticiper l’étendue volumétrique des barres d’erreur, l’étalement asymptotique des courbes d’estimation de densité par noyau ou encore la dispersion clairsemée mais cruciale des valeurs extrêmes. Il en résulte des collisions graphiques systématiques où des nuages entiers de points de données se trouvent masqués par le cadre opaque de la légende. Par ailleurs, ce placement probabiliste introduit une variabilité indésirable dans les chaînes de traitement automatisées : une simple modification de la graine du générateur pseudo-aléatoire ou l’ajout de quelques observations peut déplacer brutalement la légende d’un coin à l’autre de la figure. Dans le contexte de la recherche empirique reproductible, ce comportement non déterministe est inacceptable, imposant le recours à une configuration manuelle, géométriquement verrouillée et systématiquement déportée.
1.3 L’articulation architecturale entre Seaborn et Matplotlib
Pour maîtriser le déportement de la légende, il est indispensable de comprendre avec rigueur l’articulation logicielle unissant Seaborn à l’architecture orientée objet de Matplotlib. Seaborn ne constitue pas un moteur de rendu graphique autonome ; il s’agit d’une interface de programmation de haut niveau, conçue pour transformer des structures de données tabulaires (principalement des objets DataFrame issus de Pandas) en représentations statistiques sophistiquées, en manipulant en coulisses les primitives graphiques fournies par Matplotlib. Chaque figure générée par Seaborn s’inscrit donc dans la hiérarchie classique de Matplotlib, articulée autour de deux classes fondamentales : l’objet Figure, qui matérialise le canevas global, la toile vierge sur laquelle tous les éléments reposent, et l’objet Axes, qui représente la région rectangulaire spécifique dotée d’un système de coordonnées propre et dans laquelle les données sont projetées.
La légende elle-même est une instance de la classe matplotlib.legend.Legend, associée de manière préférentielle soit à un objet Axes unique, soit directement à l’objet Figure englobant. Lorsque l’utilisateur invoque une fonction Seaborn de niveau axe (telle que sns.scatterplot ou sns.lineplot), celle-ci instancie et configure automatiquement un objet Legend selon des paramètres prédéterminés. Dès lors, le positionnement externe de la légende ne nécessite pas l’apprentissage d’un nouveau paradigme propre à Seaborn, mais repose sur l’exploitation des méthodes de la classe Legend héritée de Matplotlib. Cette passerelle technique permet au programmeur de surcharger, de reconfigurer ou d’extraire l’objet de légende généré par Seaborn pour lui appliquer les transformations spatiales de translation cartésienne les plus strictes.
2. Anatomie technique de la méthode plt.legend() et du paramètre bbox_to_anchor
2.1 Décomposition géométrique du système de coordonnées normalisées de la Bounding Box
L’externalisation déterministe d’une légende repose sur l’utilisation conjointe de la méthode de configuration de la légende et du paramètre géométrique fondamental nommé bbox_to_anchor (abréviation de bounding box to anchor). Une boîte englobante (Bbox) est une entité mathématique rectangulaire définie par ses coordonnées spatiales minimales et maximales. Dans le paradigme de Matplotlib, les transformations spatiales reposent sur plusieurs espaces de coordonnées distincts : les coordonnées de données (déterminées par l’échelle des variables physiques tracées sur les axes), les coordonnées de la figure (normalisées entre 0 et 1 sur l’ensemble de la fenêtre graphique), et les coordonnées des axes. C’est précisément ce dernier système de coordonnées normalisées de l’objet Axes qui régit par défaut le comportement du paramètre bbox_to_anchor.
Dans ce repère d’axes normalisé, le coin inférieur gauche de la zone de traçage correspond rigoureusement à l’origine vectorielle (0, 0), tandis que le coin supérieur droit correspond au vecteur unitaire (1, 1). L’espace intérieur du tracé est donc strictement confiné dans l’intervalle bidimensionnel [0, 1] × [0, 1]. Par conséquent, toute valeur scalaire affectée à bbox_to_anchor qui excède l’unité désigne un emplacement physique situé en dehors des limites immédiates du repère des données. Spécifier une abscisse supérieure à 1.0 projette immédiatement le point de référence vers la droite de l’axe des ordonnées secondaire, tandis qu’une ordonnée inférieure à 0.0 projette le point sous l’axe des abscisses. La compréhension de cette géométrie projective est indispensable pour appréhender les transformations affines qui régissent le placement des composants graphiques.
2.2 Le rôle du paramètre loc comme point d’ancrage cardinal
Le paramètre bbox_to_anchor ne peut fonctionner de manière isolée et cohérente sans l’intervention structurante du paramètre loc (abréviation de location). Tandis que bbox_to_anchor définit une coordonnée cible précise dans l’espace de projection des axes (un point d’amarrage fixe), l’argument loc spécifie quel point d’ancrage spécifique de la boîte de légende elle-même viendra coïncider avec cette coordonnée cible. Le paramètre loc accepte une chaîne de caractères correspondant aux neuf positions cardinales et ordinales standards : ‘upper left’, ‘upper right’, ‘lower left’, ‘lower right’, ‘upper center’, ‘lower center’, ‘center left’, ‘center right’ et ‘center’.
L’interaction mécanique entre ces deux paramètres est souvent source de confusion chez les praticiens. Par exemple, si l’on assigne le vecteur bbox_to_anchor=(1.05, 1) tout en déclarant loc=’upper left’, l’instruction ne signifie pas que la légende doit être placée dans le coin supérieur gauche du graphique, mais bien que le coin supérieur gauche du rectangle de la légende doit être verrouillé au point spatial de coordonnées (1.05, 1) exprimé dans le référentiel de l’axe. En conséquence, l’ensemble du volume de la légende va s’étendre vers la droite et vers le bas à partir de ce pivot, garantissant que la totalité de la surface de la boîte se développe en dehors de l’aire de données. Une mauvaise attribution de ce point cardinal engendre immanquablement un chevauchement partiel ou une projection de la boîte dans une direction spatiale non désirée.
2.3 Calibration précise de l’espacement avec borderaxespad
Au-delà de la définition brute des coordonnées par le vecteur d’ancrage, la finition typographique d’une figure de qualité professionnelle requiert la maîtrise d’un micro-paramètre essentiel : borderaxespad. Ce paramètre flottant contrôle l’espacement ou le dégagement résiduel entre la bordure de l’objet Axes et le rectangle enveloppant la légende. Contrairement aux coordonnées d’ancrage qui sont normalisées par rapport à la taille de l’axe, la valeur de borderaxespad est dimensionnée comme une fraction relative de la taille de la police de caractères courante (exprimée en points typographiques pt).
Par défaut, Matplotlib assigne à borderaxespad une valeur standard de 0.5. Lorsque l’on réalise un déportement manuel via bbox_to_anchor, cette marge supplémentaire s’additionne aux décalages scalaires explicitement formulés dans les coordonnées cartésiennes. Une calibration pointue de borderaxespad permet d’ajuster avec une précision chirurgicale l’écartement de la légende pour l’harmoniser avec l’épaisseur des lignes d’axes, la saillie des tirets de graduation (ticks) et la marge d’impression exigée par les gabarits éditoriaux stricts. Réduire ou annuler borderaxespad (en lui assignant la valeur 0) permet d’obtenir un comportement strictement géométrique où les coordonnées scalaires de la boîte englobante dictent l’intégralité du décalage métrique.
3. Initialisation de l’environnement expérimental et modélisation des données
3.1 Configuration des bibliothèques Python et paramétrage stylistique
Afin d’illustrer de manière concrète et reproductible les techniques de déportement de légende, il convient d’établir un environnement expérimental rigoureux. Dans un script Python moderne ou au sein d’un environnement interactif tel que JupyterLab, l’importation canonique mobilise trois bibliothèques fondamentales de la science des données : Pandas pour la structuration relationnelle, Seaborn pour la formulation statistique de haut niveau, et l’interface Pyplot de Matplotlib pour le contrôle granulaire des primitives graphiques. Cette triade logicielle constitue le socle opérationnel de la quasi-totalité des flux d’analyses scientifiques en Python.
L’initialisation stylistique doit être formalisée dès le préambule au moyen de l’appel à la fonction sns.set_theme(). L’adoption d’un style épuré, tel que style=’whitegrid’, permet de matérialiser clairement les frontières cartésiennes de la zone de traçage grâce à une grille d’arrière-plan discrète. Simultanément, la configuration de la résolution d’affichage via le paramètre dpi (points par pouce) dans les dictionnaires d’exécution globale de Matplotlib (mpl.rcParams[‘figure.dpi’] = 300) est impérative. Une résolution élevée prévient les phénomènes de pixellisation lors du calcul des boîtes de rendu vectoriel et garantit que les délimitations physiques de la légende externe seront évaluées avec une précision sub-pixelique.
3.2 Création d’un jeu de données synthétique stratifié
L’évaluation rigoureuse du positionnement de la légende requiert un jeu de données possédant une complexité structurelle suffisante pour saturer naturellement l’espace graphique. À cet effet, nous générons par voie programmatique un DataFrame Pandas stratifié simulant un protocole expérimental biomédical multivarié. Ce jeu de données synthétique intègre un millier d’observations réparties entre plusieurs cohortes de traitement, caractérisées par des biomarqueurs continus corrélés et une variable catégorielle ordonnée représentant les stades d’évolution d’une pathologie.
L’utilisation de distributions gaussiennes tronquées et de modélisations non linéaires permet de disperser les points de manière extensive sur l’intégralité de la plage de valeurs des axes X et Y. L’adjonction intentionnelle de bruit hétéroscédastique assure que des points de mesure viennent occuper les périphéries extrêmes du plan cartésien, précisément là où une légende interne par défaut viendrait créer un phénomène d’occultation dommageable. La validation préalable des types de colonnes (typologie numérique en virgule flottante pour les abscisses et ordonnées, typologie catégorielle factorielle pour les modalités d’indexation) garantit une assimilation sémantique optimale par les fonctions de traçage de Seaborn.
3.3 Génération de la figure de référence avec Seaborn
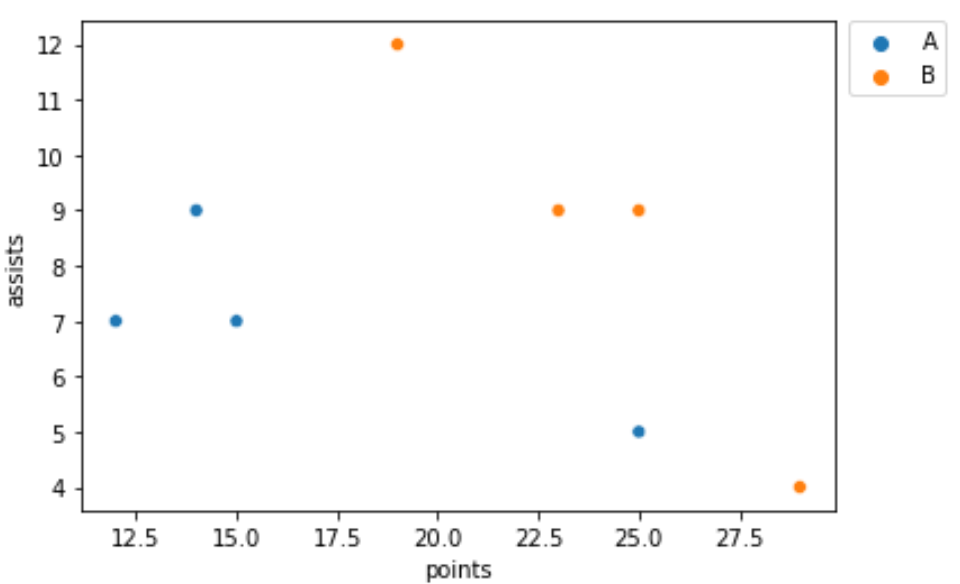
La matérialisation du problème intervient lors de l’instanciation de la figure de référence. En invoquant la fonction sns.scatterplot(), nous lions les coordonnées cartésiennes aux deux biomarqueurs continus, tandis que le paramètre sémantique hue est alloué à la variable catégorielle comprenant cinq sous-groupes expérimentaux distincts. Seaborn procède alors à une analyse d’échelle automatique : il attribue une palette chromatique contrastée aux modalités et génère immédiatement une légende au sein de l’objet Axes actif pour expliciter la correspondance entre couleurs et cohortes.
Le résultat produit illustre sans ambiguïté les limites du comportement par défaut. L’algorithme d’optimisation interne de Matplotlib positionne automatiquement la légende dans l’un des coins du graphique (le plus souvent en haut à droite ou en haut à gauche, selon la densité apparente). Ce faisant, le rectangle de légende masque un sous-ensemble critique du nuage de dispersion, rendant impossible l’évaluation visuelle de la corrélation locale et dissimulant d’éventuels groupements morphologiques cruciaux. Ce constat empirique immédiat démontre la nécessité impérieuse de déporter manuellement cet élément informatif au-delà du cadre cartésien.
4. Positionnement de la légende en dehors du graphique dans le coin supérieur droit
4.1 Implémentation canonique avec bbox_to_anchor=(1.05, 1) et loc=’upper left’
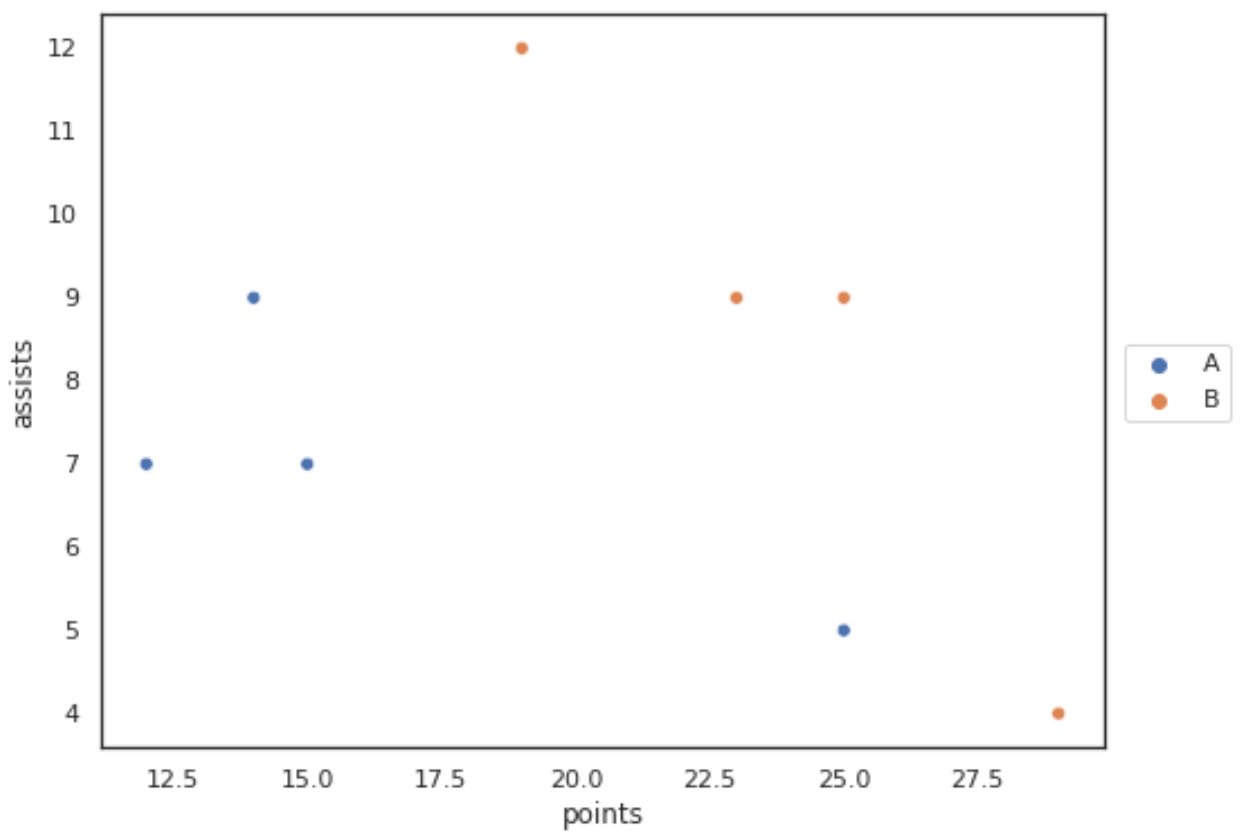
La configuration géométrique la plus répandue et la plus naturelle sur le plan perceptif consiste à translater la légende à l’extérieur immédiat de la frontière droite de la figure, avec un alignement vertical calé sur le sommet de l’axe des ordonnées. Sur le plan programmatique, cette opération s’exécute avec une remarquable concision en invoquant la méthode plt.legend() sur l’axe courant (ou via la méthode membre ax.legend()), en lui passant le tuple bbox_to_anchor=(1.05, 1) et la chaîne d’alignement loc=’upper left’.
La décomposition analytique de cette commande éclaire sa mécanique : l’abscisse normalisée 1.05 projette le point d’attache à 5 % de la largeur totale de l’axe vers la droite, franchissant ainsi nettement la bordure verticale droite. L’ordonnée normalisée 1.0 positionne ce même point d’attache à la hauteur exacte de l’arête supérieure de l’axe. En déclarant simultanément loc=’upper left’, nous ordonnons au moteur de rendu de faire coïncider le coin supérieur gauche du bloc de légende avec ce point extérieur d’ancrage. En conséquence, la boîte de métadonnées se déploie harmonieusement vers le bas et vers la droite, sans empiéter d’un seul pixel sur le domaine cartésien interne, libérant ainsi l’intégralité de la surface de mesure pour l’interprétation des données empiriques.
4.2 Ajustement fin du décalage horizontal (X-offset)
Le choix de la valeur scalaire affectée à l’abscisse d’ancrage ne doit pas résulter d’une approximation aléatoire, mais d’une calibration raisonnée prenant en compte les éléments périphériques de l’axe. Bien que la valeur 1.05 constitue un point de départ ergonomique satisfaisant dans les cas simples, l’analyste doit ajuster ce décalage horizontal selon une plage empirique comprise généralement entre 1.01 et 1.15. Un décalage trop faible (par exemple 1.01) présente le risque majeur d’entraîner une collision typographique avec les étiquettes de graduation (tick labels) de l’axe Y si celui-ci comporte des graduations secondaires à droite, ou avec le libellé de l’axe secondaire dans le cas d’une figure à deux échelles (twinx).
À l’inverse, un décalage horizontal excessif (supérieur à 1.15) introduit une discontinuité perceptive dommageable : la distance spatiale entre les points colorés et leur clé de lecture chromatique devient trop importante, imposant des mouvements saccadiques de l’œil qui fatiguent l’observateur et ralentissent le décodage sémiotique. De plus, un espace blanc disproportionné entre l’axe et la légende compromet l’équilibre esthétique global de la composition graphique. Il convient donc de moduler ce vecteur scalaire en fonction de la présence ou de l’absence de bordures d’axes visibles (les spines) et de l’encombrement typographique des valeurs numériques périphériques.
4.3 Traitement du problème de clipping et débordement d’affichage
L’application brute de la transformation bbox_to_anchor vers l’extérieur engendre un effet secondaire technique bien connu des praticiens : le phénomène de rognage ou de troncature visuelle (souvent désigné sous le terme de clipping). Par défaut, le canevas de rendu de Matplotlib alloue une surface géométrique fixe déterminée par la taille de la figure déclarée (via plt.figure(figsize=(largeur, hauteur))). L’espace situé en dehors des marges par défaut n’est pas anticipé par le moteur d’affichage initial ; par conséquent, projeter la légende au-delà de l’abscisse 1.0 a pour conséquence fréquente de faire sortir la moitié droite de la légende du cadre physique de l’image, rendant le texte illisible ou invisible.
La résolution de ce débordement impose d’ajuster l’enveloppe globale de la composition. Dans un calepin interactif de type Jupyter Notebook, ce phénomène se manifeste par une bordure d’image tronquée à droite lors du rendu inline. Pour pallier cette anomalie sans déformer les ratios cartésiens, il convient soit d’ordonner au moteur graphique de recalculer les limites globales de la figure avant le tracé définitif, soit de réserver explicitement une marge droite via les fonctions de gestion du layout. Cette prise en compte des limites physiques du canevas constitue la condition sine qua non pour obtenir un document graphique publiable et parfaitement intègre.
5. Positionnement de la légende au centre droit à l’extérieur du canevas
5.1 Configuration mathématique de l’ancrage médian vertical
Si l’alignement sur le coin supérieur droit répond à une convention visuelle classique, il peut induire un déséquilibre esthétique notable lorsque la figure présente une extension verticale importante ou lorsque la légende ne comporte que deux ou trois modalités brèves. Dans cette configuration, le coin supérieur droit apparaît surchargé tandis que la portion latérale médiane demeure vide. L’alternative ergonomique réside alors dans le centrage vertical parfait de la boîte de métadonnées le long de la bordure droite du graphique.
La formulation mathématique de cet agencement repose sur une modification précise des coordonnées projectives au sein du paramètre bbox_to_anchor, couplée à une réorientation de l’ancre cardinale : on spécifie rigoureusement bbox_to_anchor=(1.02, 0.5) en assignant au paramètre loc la valeur ‘center left’. Le vecteur (1.02, 0.5) cible un point situé immédiatement à l’extérieur de la paroi droite de l’axe (à 2 % de décalage horizontal) et à mi-hauteur exacte du segment vertical délimitant l’axe des ordonnées (l’ordonnée 0.5 matérialisant le centre barycentrique de l’axe Y). L’instruction loc=’center left’ désigne le point médian de la bordure gauche du rectangle de la légende comme le point de contact qui doit être arrimé à cette cible. L’ensemble de la légende s’étend ainsi vers la droite tout en se distribuant de manière parfaitement symétrique au-dessus et en dessous de la médiane horizontale.
5.2 Application concrète sur des distributions denses et étendues
Cette disposition centrée à droite s’avère particulièrement pertinente lors du traitement de nuages de points denses issus de plans d’expériences factoriels complexes ou lors de la visualisation de cartes thermiques (heatmaps) stratifiées. Dans le cadre de figures allongées verticalement, où le rapport d’aspect (aspect ratio) privilégie la hauteur par rapport à la largeur, aligner la légende en haut crée une sensation de pesanteur visuelle asymétrique. En revanche, l’ancrage médian confère une stabilité morphologique remarquable à l’ensemble du canevas, ce qui facilite considérablement son intégration au sein des colonnes de texte étroites des revues scientifiques imprimées sur deux colonnes.
L’implémentation opérationnelle sur un tracé de régression multivarié montre que le regard de l’évaluateur se déplace avec une efficacité accrue entre le centre géométrique de la distribution des données et la légende explicative. L’effort d’accommodation visuelle est minimisé, car la distance euclidienne moyenne reliant n’importe quel point du nuage cartésien à la boîte de légende est structurellement réduite par rapport à un positionnement calé sur les coins supérieurs ou inférieurs extrêmes. Cette symétrie spatiale optimise ainsi le flux d’extraction de l’information statistique.
5.3 Gestion des légendes volumineuses à multiples modalités
Un défi de mise en page récurrent survient lorsque la variable catégorielle assignée au paramètre sémantique hue (ou style) comprend un nombre substantiel de classes — par exemple, une typologie génétique ou géographique comportant dix à quinze modalités. Si l’on applique un ancrage médian vertical standard, la hauteur physique cumulée de la boîte de légende peut excéder la hauteur totale de l’axe cartésien lui-même, provoquant un débordement à la fois par le haut et par le bas au-delà des limites du tracé.
Pour juguler cette prolifération verticale, l’analyste doit combiner le centrage externe avec une réduction contrôlée de l’échelle typographique et de l’espacement inter-lignes de la légende. Matplotlib et Seaborn offrent des leviers paramétriques fins tels que fontsize pour calibrer la taille des étiquettes textuelles, labelspacing pour contracter l’espace vertical séparant les symboles successifs, et handletextpad pour réduire la distance entre le marqueur graphique et son étiquette textuelle associée. La compression maîtrisée de ces micro-espacements permet de loger des légendes denses au centre droit sans jamais rompre l’alignement architectural de la figure principale.
6. Positionnement horizontal de la légende sous la figure
6.1 Configuration cartésienne pour un placement inférieur
Dans de nombreuses configurations éditoriales, notamment pour les rapports au format paysage ou les figures destinées à occuper la largeur totale d’une page académique (format dit full-width sur deux colonnes), le déportement latéral à droite n’est pas optimal car il réduit l’espace horizontal alloué à l’axe des données. La solution méthodologique consiste alors à déporter la boîte de légende sous le tracé principal, dans une disposition horizontale étendue.
La translation géométrique vers le bas s’effectue en projetant les coordonnées de la boîte englobante dans la région des ordonnées négatives au sein de l’espace normalisé de l’axe. L’implémentation standard s’articule autour de la signature bbox_to_anchor=(0.5, -0.15) couplée à la constante cardinale loc=’upper center’. L’abscisse 0.5 localise le point de pivotement au centre exact de la largeur de l’axe X. L’ordonnée -0.15 translate ce point sous la bordure inférieure de l’axe, à une distance équivalente à 15 % de la hauteur du tracé. En spécifiant loc=’upper center’, le sommet médian de la boîte de légende est arrimé à cette coordonnée, contraignant la légende à se déployer vers le bas, à bonne distance des données cartésiennes.
6.2 Transformation de la légende en agencement horizontal multicolonne
Une erreur ergonomique critique consisterait à déporter la légende sous le graphique tout en conservant une disposition verticale par défaut à colonne unique. Une telle décision entraînerait une extension démesurée de la hauteur globale du canevas et laisserait d’immenses espaces vides à gauche et à droite de la boîte de métadonnées. L’externalisation inférieure impose de transformer structurellement l’agencement interne des éléments de la légende pour les distribuer sur plusieurs colonnes horizontales.
Cette métamorphose s’opère au moyen du paramètre fondamental ncol (ou ncols dans les versions récentes de Matplotlib). En introduisant par exemple ncol=3 ou ncol=5 dans l’appel de configuration de la légende, les symboles et leurs étiquettes ne sont plus empilés verticalement, mais ordonnés de manière matricielle sur une ou deux rangées horizontales s’étirant harmonieusement le long de l’axe des abscisses. Cette disposition en bandeau offre une lecture séquentielle transversale particulièrement adaptée à la comparaison immédiate de cohortes expérimentales ordonnées, tout en respectant l’équilibre proportionnel de la mise en page scientifique.
6.3 Optimisation du dégagement vertical inférieur
Le principal écueil technique rencontré lors du placement inférieur réside dans la présence physique des composants typographiques propres à l’axe horizontal : les valeurs chiffrées des graduations (tick labels) et, surtout, l’intitulé de l’axe (xlabel). Si la coordonnée verticale négative dans bbox_to_anchor est sous-évaluée (par exemple fixée trop timidement à -0.08), la bordure supérieure de la légende viendra directement chevaucher le libellé de l’axe X, rendant les deux blocs textuels absolument illisibles.
L’optimisation de ce dégagement vertical requiert une analyse dimensionnelle minutieuse. Si l’axe X comporte des étiquettes longues orientées obliquement (par exemple des dates au format ISO pivotées à 45 degrés), l’emprise spatiale sous l’axe s’accroît considérablement. Dans ce contexte, l’ordonnée d’ancrage doit être descendue à des valeurs plus profondes, telles que -0.25 voire -0.35. L’ajustement dynamique de ce décalage garantit une séparation visuelle franche entre les métadonnées de mesure (l’axe) et les métadonnées catégorielles (la légende), assurant ainsi une isolation typographique sans faille.
7. Gestion des figures au niveau de la figure : FacetGrid, relplot et catplot
7.1 Divergence d’architecture : Axes-level versus Figure-level dans Seaborn
L’un des pièges les plus déroutants pour les développeurs réside dans la dualité architecturale de l’API de Seaborn, qui scinde les méthodes de traçage en deux grandes catégories conceptuelles : les fonctions opérant au niveau de l’axe (Axes-level functions) et les fonctions opérant au niveau de la figure globale (Figure-level functions). Les fonctions de niveau axe (telles que scatterplot, lineplot, histplot) acceptent un argument ax optionnel, s’exécutent directement sur une instance de matplotlib.axes.Axes et retournent cet objet. Sur ces graphiques, les invocations traditionnelles de plt.legend() ou ax.legend() s’appliquent immédiatement sans rupture logique.
À l’opposé, les fonctions de niveau figure — au premier rang desquelles figurent sns.relplot(), sns.catplot(), sns.displot() et sns.lmplot() — sont des méta-constructeurs qui instancient et pilotent un objet gestionnaire complexe nommé FacetGrid. Ces fonctions ne renvoient pas un objet Axes, mais une grille composite orchestrant potentiellement une matrice de sous-graphiques. Les fonctions Figure-level interceptent et gèrent la légende de manière centralisée au niveau de la figure entière. Toute tentative d’invoquer naïvement plt.legend() après l’exécution d’un relplot se solde généralement par un échec cuisant : soit l’instruction ne produit aucun effet sur la légende globale, soit elle instancie une seconde légende parasite et redondante à l’intérieur du dernier sous-axe actif de la grille.
7.2 Utilisation native de la fonction moderne sns.move_legend()
Conscients de la complexité historique liée au repositionnement des légendes sur les objets composites, les développeurs de Seaborn ont introduit à partir de la version 0.11.2 une fonction de haut niveau élégante et puissante : sns.move_legend(). Cette méthode a été spécifiquement conçue pour combler le fossé syntaxique entre les structures Axes et les gestionnaires de grille FacetGrid, en offrant une interface unifiée pour réassigner les coordonnées d’une légende déjà matérialisée sans devoir reconstruire manuellement ses descripteurs graphiques.
L’application de sns.move_legend() s’illustre par une clarté remarquable. Il suffit de transmettre l’instance cible (qu’il s’agisse d’un objet Axes individuel ou du wrapper FacetGrid issu d’un appel à relplot), suivie des nouveaux paramètres d’implantation spatiale. La signature typique prend la forme suivante :
sns.move_legend(obj, loc=’upper left’, bbox_to_anchor=(1.02, 1), ncol=1, title=’Cohortes’, frameon=True)
Cette commande moderne extrait l’objet Legend existant, préserve l’intégralité des correspondances complexes de formes, de couleurs et de marqueurs définies par Seaborn, calcule les nouvelles matrices de transformation spatiale, et redéploie le bloc englobant aux coordonnées externes spécifiées, le tout sans risque de duplication ni de perte d’information sémantique.
7.3 Désactivation et extraction manuelle des légendes pour architectures complexes
Bien que sns.move_legend() résolve l’immense majorité des cas standards, certaines architectures de tableaux de bord ou de figures multi-panneaux hautement personnalisées exigent une dissociation complète des mécanismes automatisés. Dans ce cadre de conception avancée, la première étape consiste à neutraliser explicitement la génération de la légende native de Seaborn en intégrant le paramètre legend=False directement dans l’appel initial de la fonction de tracé statistique.
Une fois l’espace de données tracé sans métadonnées résiduelles, l’analyste extrait manuellement les identifiants graphiques (les handles) et les descriptions textuelles (les labels) associés aux couches géométriques au moyen de la méthode fondamentale ax.get_legend_handles_labels(). Ces descripteurs vectoriels peuvent ensuite être agrégés, triés ou combinés avec des éléments issus d’autres sous-graphiques, avant d’être réinjectés au niveau racine de la figure via l’appel direct fig.legend(handles, labels, loc=’outside upper center’, bbox_to_anchor=…). Cette dérivation manuelle confère un contrôle absolu sur la topologie de l’espace graphique, permettant la composition de légendes globales uniques régissant des matrices denses de facettes scientifiques.
8. Résolution définitive du problème de rognage lors de l’exportation
8.1 Mécanisme de troncature lors de l’appel à plt.savefig()
L’un des traumatismes techniques les plus récurrents pour les chercheurs réside dans le décalage brutal constaté entre le rendu visuel au sein d’une interface de développement interactive et le fichier graphique final produit sur disque lors de l’invocation de plt.savefig(). Alors que la fenêtre interactive d’affichage peut sembler présenter une légende externe convenablement dégagée, le fichier vectoriel (PDF, SVG) ou matriciel (PNG, TIFF) résultant apparaît fréquemment amputé : la boîte de légende déportée est impitoyablement découpée par la marge droite ou inférieure, laissant un fragment textuel illisible.
La raison fondamentale de ce dysfonctionnement réside dans le mode opératoire du moteur de rasterisation et de découpage de Matplotlib. Par défaut, la méthode plt.savefig() évalue le rectangle d’impression en se basant sur les dimensions statiques assignées à l’objet Figure lors de son instanciation (les paramètres de figsize). Lors de la phase de composition géométrique finale, le canevas n’élargit pas spontanément ses frontières physiques pour englober les artistes graphiques (les Artists) situés au-delà des limites nominales des axes. Tout élément projeté par bbox_to_anchor en dehors du domaine de figure prédéfini est tout simplement exclu du champ de vision final de la caméra de rendu virtuel.
8.2 La solution universelle : bbox_inches=’tight’
Le moyen le plus simple, universel et éprouvé pour remédier à ce découpage consiste à adjoindre systématiquement le paramètre bbox_inches=’tight’ au sein de la commande d’enregistrement plt.savefig(‘figure.png’, bbox_inches=’tight’). Ce commutateur modifie profondément la séquence de calcul exécutée par le moteur de rendu graphique avant l’écriture des flux d’octets sur le système de fichiers.
Lorsque le paramètre bbox_inches=’tight’ est activé, Matplotlib suspend la restitution brute aux dimensions fixes et exécute un balayage spatial complet de tous les éléments graphiques constitutifs du document (titres, étiquettes, tracés de données, graduations et boîtes de légende externes). L’algorithme calcule l’enveloppe convexe minimale englobant l’intégralité de ces composants vectoriels et réajuste dynamiquement les dimensions physiques de la figure sauvegardée pour inclure chaque pixel d’annotation. Toutefois, une mise en garde méthodologique s’impose : cette solution modifie légèrement la taille finale de l’image exportée par rapport au figsize initialement formulé, ce qui peut poser des contraintes d’ajustement si l’analyste est contraint de respecter un gabarit de largeur de colonne rigoureusement figé imposé par un éditeur typographique.
8.3 Contrôle prédictif avec plt.subplots_adjust() et bbox_extra_artists
Pour les environnements de production rigides où la taille de l’image de sortie doit demeurer strictement immuable (par exemple pour s’insérer au millimètre près dans une maquette InDesign ou un document compilé via pdfLaTeX), le recours à un dimensionnement élastique automatique peut s’avérer indésirable. L’approche prédictive consiste alors à réserver explicitement un couloir d’accueil spatial pour la légende externe en amont de la phase de restitution, au moyen de la fonction plt.subplots_adjust().
En formulant par exemple plt.subplots_adjust(right=0.75), l’analyste contraint l’axe cartésien des données à ne pas occuper l’intégralité de la largeur de la figure, mais à s’interrompre à 75 % de celle-ci, ménageant ainsi une bande vierge de 25 % sur le flanc droit du canevas. La légende déportée via bbox_to_anchor=(1.05, 1) vient alors se loger avec une perfection millimétrique au sein de cet espace préalablement réservé. Pour garantir une sécurité absolue lors de l’exportation, il est d’usage de déclarer formellement l’instance de légende dans la liste des artistes supplémentaires lors de l’appel de sauvegarde en utilisant l’argument bbox_extra_artists=(legende,). Cette double disposition garantit une reproductibilité dimensionnelle déterministe et une intégrité visuelle sans faille.
9. Personnalisation stylistique avancée de la légende déportée
9.1 Modification typographique et hiérarchie textuelle
L’externalisation de la légende transforme son statut visuel : d’élément intrusif superposé aux données, elle devient un composant architectural à part entière de la planche graphique. Ce changement de statut exige un calibrage typographique soigné pour instaurer une hiérarchie visuelle claire. L’assignation d’un titre explicite au moyen du paramètre title est la première étape de cette structuration. Plutôt que de conserver le nom brut de la colonne du DataFrame (souvent technique ou condensé), il convient de fournir un intitulé sémantiquement transparent, enrichi le cas échéant des unités de mesure applicables.
Le contrôle de la typographie s’effectue au travers d’un ensemble de paramètres dédiés. La taille du titre de légende est modulée par title_fontsize, qui doit adopter un poids supérieur ou égal à celui des étiquettes individuelles (réglées via fontsize). Matplotlib autorise également l’injection d’un dictionnaire d’attributs de police (prop={‘family’: ‘sans-serif’, ‘weight’: ‘medium’}) permettant de synchroniser l’identité typographique de la légende avec les polices de corps de texte de l’article scientifique de destination. Enfin, l’alignement textuel au sein de la boîte peut être ajusté via le paramètre alignment pour assurer un ordonnancement rigoureux à gauche ou centré des intitulés descriptifs.
9.2 Esthétique du cadre de légende : contours, remplissage et transparence
La matérialité de la boîte enveloppante participe activement à la lisibilité générale de la composition. Le paramètre booléen frameon dicte l’existence même du rectangle conteneur. Dans une démarche minimaliste inspirée des principes de design d’Edward Tufte — préconisant la maximisation du ratio données/encre (data-ink ratio) —, désactiver le cadre via frameon=False permet d’alléger la composition en éliminant les lignes de contour inutiles, la légende flottant alors sur le fond immaculé de la marge externe.
Si la conservation du cadre est jugée nécessaire pour regrouper visuellement des catégories complexes, sa finition plastique doit être calibrée pour ne pas concurrencer l’axe cartésien. Il est recommandé de modifier la couleur de remplissage (facecolor=’whitesmoke’ ou ‘white’) et la couleur de délimitation (edgecolor) en optant pour un gris neutre d’une épaisseur modérée (linewidth=0.8). La gestion de la transparence via le paramètre framealpha (échelonné entre 0.0 pour une transparence totale et 1.0 pour une opacité absolue) s’avère moins critique lorsque la légende est externalisée que lorsqu’elle est interne, mais confère un fini velouté hautement professionnel. L’usage d’effets d’ombrage (shadow=True) doit quant à lui être strictement proscrit dans les contextes académiques en raison de son caractère anachronique et décoratif non fonctionnel.
9.3 Filtrage et réordonnancement programmatique des éléments de légende
Les routines automatisées de Seaborn tendent à incorporer exhaustivement l’intégralité des niveaux de facteurs dans la légende, incluant parfois des modalités superflues ou générant des séquences qui ne respectent pas la logique analytique du chercheur. Il est fréquemment nécessaire de modifier l’ordre d’apparition des séries ou d’élaguer les marqueurs redondants pour aligner la légende sur la narration scientifique des résultats.
Cette opération s’articule par l’interception programmatique des collections d’objets graphiques et textuels. En récupérant le couple de listes via handles, labels = ax.get_legend_handles_labels(), l’analyste peut manipuler ces éléments au moyen des structures natives de Python. L’application d’un tri personnalisé sur les chaînes de caractères de labels, ou l’utilisation d’une compréhension de liste pour ne conserver qu’un sous-ensemble d’indices choisis, permet de réordonner les modalités selon une hiérarchie thématique précise. La réinjection de ces listes filtrées dans l’appel plt.legend(handles_filtres, labels_filtres, bbox_to_anchor=…) assure que la légende externe ne présente que l’information strictement signifiante, débarrassée de tout artéfact algorithmique involontaire.
10. Applications pratiques sur divers types de visualisations Seaborn
10.1 Application aux séries temporelles complexes avec sns.lineplot()
L’analyse longitudinale de données temporelles via la fonction sns.lineplot() génère fréquemment des structures sémantiques combinatoires de haute complexité. Lorsque l’on alloue simultanément une variable de regroupement au paramètre chromatique hue et une variable de condition expérimentale au paramètre de texture style (pointillés, tirets, traits pleins), Seaborn génère une légende composite à sections multiples. Cette volumétrie verticale importante est absolument incompatible avec un positionnement interne, sous peine de masquer des segments entiers de trajectoires temporelles critiques.
L’externalisation de cette double hiérarchie s’effectue avec un succès remarquable en combinant un ancrage externe latéral supérieur droit avec une structuration typographique ordonnée. En configurant l’ancre à bbox_to_anchor=(1.04, 1.0) et en utilisant des tailles de police calibrées pour les en-têtes de sous-sections, on offre à l’observateur un tableau de bord analytique clair. Les variations subtiles de styles de tirets et de nuances chromatiques sont examinées côte à côte, en dehors de la dynamique cinématique des courbes de séries temporelles, préservant ainsi la continuité cognitive indispensable à la détection des tendances, des périodicités ou des ruptures de pente.
10.2 Application aux diagrammes à barres groupées avec sns.barplot()
Les diagrammes à barres groupées, couramment déployés pour comparer des agrégats statistiques et des moyennes factorielles au moyen de sns.barplot(), présentent une contrainte spatiale unique : la présence verticale de barres d’erreur matérialisant les intervalles de confiance ou les écarts-types empiriques. Lorsque les barres de données s’étendent vers le sommet du graphique, le positionnement automatique interne de la légende se traduit inévitablement par une collision frontale avec les moustaches d’erreur supérieures.
La déportation de la légende sur le flanc droit (ou sous l’axe X dans une disposition multicolonne via ncol) permet de préserver l’intégrité de la lecture quantitative. L’espace surplombant les colonnes d’estimation reste totalement dégagé, autorisant l’insertion éventuelle d’annotations d’hypothèses statistiques (telles que des étoiles de significativité de tests de Student ou d’ANOVA). La standardisation de ce placement externe pour les représentations factorielles garantit une comparabilité visuelle immédiate entre différentes planches de résultats au sein d’un même article de recherche.
10.3 Application aux tracés d’estimation de densité par noyau avec sns.kdeplot()
Les tracés d’estimation de densité par noyau non paramétrique, matérialisés par la fonction sns.kdeplot(), illustrent avec une acuité particulière la nécessité de désengorger l’espace graphique. Dans ces représentations continues, les zones de recouvrement probabiliste sont souvent enrichies par des remplissages de couleur en transparence (paramètre fill=True). Une boîte de légende interne opaque brise la perception visuelle continue de ces surfaces de probabilité, tandis qu’une boîte transparente engendre des interférences graphiques illisibles où les courbes sous-jacentes strient le texte explicatif.
En projetant délibérément la légende hors du domaine cartésien, l’observateur peut contempler la topologie intégrale des distributions probabilistes, apprécier sans distorsion l’asymétrie des densités et scruter le comportement des queues de distribution asymptotiques. Les gradients de transparence et les croisements subtils des densités de probabilité demeurent purs de toute interférence typographique, ce qui constitue le garant fondamental d’une transmission fidèle de la structure sous-jacente des variables aléatoires modélisées.
11. Diagnostic et résolution des anomalies courantes
11.1 Élimination des doublons de légende non désirés
Un désagrément récurrent rencontré lors de la manipulation combinée de Seaborn et Matplotlib est l’apparition intempestive de deux légendes concurrentes sur la même figure : une légende fantôme logée à l’intérieur du tracé et une seconde légende positionnée à l’extérieur. Cette anomalie découle de la séquence d’exécution des méthodes graphiques. Seaborn, lors de l’exécution de fonctions de niveau axe, instancie d’autorité sa propre légende interne. Si le développeur invoque ultérieurement plt.legend(…) en lui fournissant de nouveaux handles sans neutraliser l’objet précédent, Matplotlib superpose une nouvelle instance de Legend sans détruire celle instanciée par Seaborn.
Pour éradiquer définitivement ce dédoublement, deux stratégies s’offrent au programmeur. La méthode la plus rigoureuse consiste à supprimer explicitement l’instance générée par Seaborn avant d’en créer une nouvelle, en utilisant l’instruction ax.get_legend().remove(). Alternativement, la méthode contemporaine consiste à ne pas recréer d’objet de zéro, mais à modifier directement la position de l’instance existante en exploitant la méthode sns.move_legend(), neutralisant ainsi à la racine tout risque de prolifération redondante sur le canevas de dessin.
11.2 Correction des disparitions totales de légendes dues aux coordonnées erronées
Il arrive que l’application de coordonnées d’ancrage personnalisées conduise à la disparition pure et simple de la boîte de légende de l’espace visible, laissant l’analyste perplexe face à une figure privée de toute clé d’interprétation. Ce phénomène traduit presque toujours une erreur d’échelle dans les vecteurs fournis à bbox_to_anchor. Une confusion conceptuelle fréquente consiste à renseigner des coordonnées exprimées dans l’espace des données physiques (par exemple des milliers d’unités de chiffre d’affaires ou des années calendaires) au lieu de manipuler l’espace normalisé de l’axe compris entre 0 et 1.
Si l’on assigne par inadvertance une coordonnée brute de données telle que bbox_to_anchor=(2024, 100), le moteur de rendu projette l’objet de légende à des milliers d’unités graphiques au-delà du canevas visible, la rendant définitivement inaccessible à la vue. Pour diagnostiquer cette anomalie, l’analyste doit vérifier l’espace de transformation assigné via le paramètre bbox_transform. Si aucune matrice de transformation spécifique n’est déclarée, le système interprète les coordonnées dans le repère ax.transAxes. Les valeurs fournies doivent donc impérativement osciller autour de l’unité (par exemple 1.05 pour une translation latérale modérée et non 10.5 ou 105).
11.3 Gestion des disparités entre versions de Seaborn et Matplotlib
La maintenance à long terme des scripts d’analyse de données expose inévitablement les équipes de recherche aux ruptures de compatibilité ascendante entre les versions logicielles. L’écosystème graphique a connu des évolutions structurelles significatives entre les versions 0.11 et 0.13 de Seaborn, parallèlement aux modernisations internes apportées à Matplotlib 3.5 et supérieur. Des méthodes historiquement tolérées ont été dépréciées (déclenchant des messages d’alerte de type DeprecationWarning), tandis que de nouvelles syntaxes plus robustes ont été institutionnalisées.
Dans un contexte de production industrielle ou de publication de code pérenne, il est impératif d’écrire des structures d’ancrage rétrocompatibles. L’utilisation de sns.move_legend() doit être privilégiée dès lors que l’on opère sur des versions modernes (>= 0.11.2), tout en encapsulant le code dans des blocs conditionnels capables de basculer vers les interfaces canoniques de Matplotlib si le script est exécuté sur des clusters de calcul institutionnels disposant de versions historiques figées. Cette vigilance technique prévient les échecs d’exécution silencieux et garantit la reproductibilité computationnelle des visualisations à travers le temps.
12. Synthèse méthodologique et gabarit de production pour revues scientifiques
12.1 Matrice décisionnelle pour le choix de l’emplacement optimal de la légende
Le choix architectural de l’emplacement de la légende déportée ne relève pas d’une préférence cosmétique arbitraire, mais doit découler d’un arbitrage rationnel articulant les contraintes morphologiques des données et le gabarit typographique final du document de diffusion. La matrice de décision méthodologique suivante formalise les orientations de conception recommandées :
- Déportement Supérieur Droit (bbox_to_anchor=(1.05, 1), loc=’upper left’) : Idéal pour les tracés carrés ou au format paysage comportant un nombre modéré de modalités (entre 3 et 8). Cette option offre la continuité de lecture la plus naturelle pour les cultures occidentales lisant de gauche à droite.
- Déportement Médian Droit (bbox_to_anchor=(1.02, 0.5), loc=’center left’) : Hautement recommandé pour les figures au format portrait allongé, les tracés de corrélations ou les dendrogrammes, assurant un centrage de gravité visuel symétrique.
- Déportement Inférieur Multicolonne (bbox_to_anchor=(0.5, -0.15), loc=’upper center’, ncol=K) : Indispensable pour les figures occupant la pleine largeur d’une page sur deux colonnes, ou pour les jeux de données factoriels étendus où la largeur disponible sous l’axe X permet un affichage panoramique sans empiéter sur l’espace d’analyse latéral.
12.2 Gabarit Python réutilisable pour figure scientifique publiable
Pour synthétiser l’ensemble des préceptes techniques développés au long de ce traité, nous fournissons ci-après une structure algorithmique exemplaire prête pour la production scientifique. Ce gabarit illustre l’instanciation maîtrisée d’une figure complexe, le traçage statistique via Seaborn, le déportement géométrique de la légende avec calibration de marge, et la sauvegarde vectorielle haute fidélité immunisée contre tout rognage :
Dans la pratique, la structuration s’opère par l’initialisation explicite d’une figure et d’un axe via fig, ax = plt.subplots(figsize=(8, 6), dpi=300). Le traçage statistique s’exécute ensuite via Seaborn, par exemple par un appel de type sns.scatterplot(data=df, x=’Biomarqueur_Alpha’, y=’Biomarqueur_Beta’, hue=’Cohorte_Clinique’, style=’Cohorte_Clinique’, s=80, alpha=0.85, ax=ax). Une fois le tracé complété, l’externalisation de la légende est formalisée au moyen de l’instruction sns.move_legend(ax, loc=’upper left’, bbox_to_anchor=(1.03, 1.0), title=’Cohortes Expérimentales’, title_fontsize=’11’, fontsize=’10’, frameon=True, framealpha=0.9, edgecolor=’#cccccc’, borderaxespad=0).
La finalisation de la planche graphique intègre le nettoyage des contours via sns.despine(ax=ax, top=True, right=True), la déclaration explicite des libellés scientifiques d’axes munis de leurs métriques, et enfin l’exportation conjointe aux formats matriciel et vectoriel : plt.savefig(‘figure_publication.png’, dpi=300, bbox_inches=’tight’) ainsi que plt.savefig(‘figure_publication.pdf’, format=’pdf’, bbox_inches=’tight’). Ce canevas garantit une conformité absolue aux protocoles graphiques des éditeurs les plus stricts de la littérature internationale.
12.3 Check-list de contrôle qualité avant soumission de manuscrit
Préalablement à l’intégration définitive d’une figure vectorielle au sein d’un manuscrit soumis pour examen par les pairs, une vérification systématique de conformité graphique doit être opérée. Cette procédure de contrôle qualité s’articule autour de cinq points cardinaux incontournables :
- Absence totale d’occultation : Vérifier qu’aucun point de donnée, extrémité de barre d’erreur ou étiquette de graduation n’est intercepté par l’enveloppe de la légende déportée.
- Intégrité du fichier exporté : Ouvrir le fichier PDF ou PNG généré indépendamment de l’IDE pour s’assurer que les bordures de la boîte de légende ne sont pas tronquées par le cadre physique de la page.
- Accessibilité visuelle et chromatique : Confirmer que la palette de couleurs sélectionnée au niveau du paramètre hue est conforme aux normes de contraste pour les déficiences de la vision chromatique (utilisation de palettes telles que ‘viridis’, ‘cividis’ ou ‘colorblind’).
- Harmonie des échelles typographiques : S’assurer que la taille de police des étiquettes de légende (fontsize) ne diverge pas de plus de deux points typographiques par rapport aux annotations d’axes et au corps de texte principal du manuscrit.
- Stabilité de la résolution : Valider que les figures matricielles conservent une netteté cristalline à un facteur de grossissement de 200 %, attestant du respect des 300 DPI minimaux requis pour l’impression scientifique de prestige.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media.