
La représentation graphique des données empiriques constitue l’un des piliers fondamentaux de la démarche scientifique contemporaine. Dans l’écosystème du langage de programmation statistique R, la visualisation ne se résume pas à une simple projection illustrative ; elle représente une véritable modalité de raisonnement analytique, d’inférence visuelle et de vérification d’hypothèses. La manière dont les données brutes sont projetées sur les axes orthogonaux d’un repère cartésien conditionne de façon décisive la perception des grandeurs, l’identification des régularités sous-jacentes et la détection d’anomalies distributionnelles. Un mauvais calibrage d’échelle ne produit pas seulement une figure esthétiquement déficiente : il engendre des artefacts cognitifs susceptibles de fausser l’interprétation théorique de résultats expérimentaux majeurs.
Au fil des décennies, l’environnement logiciel R s’est enrichi de multiples paradigmes graphiques. Alors que le moteur graphique traditionnel, communément désigné sous le vocable de « Base R », propose une approche impérative issue des principes du système S originel, le méta-paquetage contemporain développé autour de la « Grammaire des graphiques » (implémenté au sein de la bibliothèque logicielle ggplot2) a instauré une démarche déclarative et hautement structurée. Chacun de ces écosystèmes mobilise des conventions spécifiques pour régir la transformation des coordonnées, le positionnement des encoches métriques, l’étendue des intervalles représentés et le traitement des valeurs extrêmes. La maîtrise technique de ces mécanismes s’avère indispensable pour quiconque souhaite produire des visualisations rigoureuses, conformes aux exigences des revues académiques internationales les plus rigoureuses.
Le présent traité méthodologique explore de manière exhaustive les mécanismes de paramétrage, d’ajustement et de transformation des échelles d’axes dans l’environnement R. En explorant successivement les fondements algorithmiques du moteur standard et l’élégance formelle de la syntaxe de ggplot2, ce guide détaille les stratégies de délimitation continue, de modification directionnelle, de transposition logarithmique, de gestion catégorielle et de contrôle typographique fin. Chaque section propose une déconstruction analytique des processus computationnels, assortie de démonstrations reproductibles et de recommandations épistémologiques destinées aux chercheurs, analystes de données et praticiens de la statistique appliquée.
1. Introduction à l’ajustement des échelles d’axes dans la visualisation de données avec R
1.1 Rôle épistémologique des échelles d’axes dans la recherche quantitative
L’acte de calibrer les axes d’un graphique constitue un choix méthodologique de premier ordre, dont la neutralité n’est qu’apparente. Selon les travaux pionniers de William S. Cleveland et Robert McGill dans le domaine de la sémiologie graphique et de la perception visuelle, l’œil humain évalue les variations quantitatives principalement à travers le décodage de positions alignées le long d’échelles communes. Dès lors, l’amplitude attribuée à un intervalle cartésien modifie directement la pente perçue d’une trajectoire, la dispersion apparente d’un nuage de points et l’amplitude perçue des contrastes expérimentaux. Une échelle d’ordonnées excessivement dilatée minimise visuellement l’importance d’un effet statistique réel, tandis qu’un axe exagérément resserré tend à survaloriser des fluctuations aléatoires d’échantillonnage, induisant le lecteur en erreur quant à la signification pratique des observations.
Au-delà de la perception immédiate, le choix des échelles prévient activement les distorsions cognitives et les biais de confirmation qui menacent la recherche quantitative. Les principes fondamentaux formalisés par Edward Tufte rappellent que le facteur de distorsion visuelle, défini comme le rapport entre la variation constatée graphiquement et la variation réelle mesurée dans les données, doit idéalement tendre vers l’unité. Lorsqu’une échelle tronque arbitrairement l’origine sans avertissement contextuel clair, ou lorsque des unités dissemblables sont juxtaposées de manière asymétrique, le chercheur court le risque de formuler des conclusions fallacieuses. La fidélité de représentation s’érige ainsi en garant incontournable de la reproductibilité scientifique, garantissant que tout observateur indépendant parviendra à des inférences similaires à partir de la même configuration géométrique.
Dans le contexte exploratoire de données empiriques hétérogènes, l’ajustement dynamique des axes permet d’adapter l’optique analytique aux particularités distributionnelles des variables à l’étude. Face à des phénomènes caractérisés par des asymétries prononcées, des lois de puissance ou des dynamiques exponentielles, le maintien d’une échelle arithmétique linéaire standard oblitère les variations locales situées dans les basses valeurs au profit exclusif de quelques observations extrêmes. L’intervention explicite sur la géométrie des axes permet donc de révéler la morphologie interne des phénomènes sans altérer la rigueur numérique des mesures sous-jacentes.
1.2 Aperçu des architectures graphiques dans l’environnement R
L’architecture graphique du logiciel R se caractérise par la coexistence de deux grands paradigmes conceptuels : le système graphique de base (Base R) et le système unifié fondé sur la grammaire des graphiques incarné par l’extension ggplot2. Le moteur graphique traditionnel, intégré nativement au cœur du système R, repose sur un modèle séquentiel de dessin sur canevas. Dans cette approche impérative, l’utilisateur trace une première figure fondamentale via des instructions primitives, puis superpose successivement des couches supplémentaires (points, lignes, axes, légendes) par mutation d’état de la fenêtre graphique courante. Les paramètres régissant les dimensions géométriques sont alors gérés par une combinaison d’arguments passés à la fonction de haut niveau et d’états internes administrés par la fonction globale de contrôle de l’environnement graphique.
À l’opposé, le paradigme développé au sein de ggplot2 s’inspire formellement des théories exposées par Leland Wilkinson dans son ouvrage canonique The Grammar of Graphics. Dans cette vision déclarative, un graphique n’est pas conçu comme une série d’opérations d’encrage successives sur un support vierge, mais comme une composition structurelle stricte associant des jeux de données structurés, des transformations statistiques, des objets géométriques et des composants d’échelle autonomes désignés sous le vocable de scales. Cette dissociation conceptuelle fondamentale implique que la modification d’un axe ne s’opère pas en redessinant un élément isolé, mais en reconfigurant la fonction mathématique de mise en correspondance bijective reliant l’espace abstrait des données empiriques à l’espace physique de restitution visuelle.
L’objectif méthodologique du présent guide consiste à doter le chercheur d’une compréhension transversale de ces deux architectures. Il s’agit d’exposer avec une précision chirurgicale les correspondances fonctionnelles, les singularités comportementales et les écueils algorithmiques inhérents à chaque système. Que l’analyste privilégie la vélocité d’exécution et l’absence de dépendances externes propres à Base R, ou qu’il recherche la modularité, la cohérence sémiotique et la puissance typographique de ggplot2, il trouvera dans les sections suivantes les clés techniques indispensables à une manipulation experte des coordonnées cartésiennes.
2. Fondements techniques : le système graphique standard de R (Base R)
2.1 Comportement par défaut de la fonction plot()
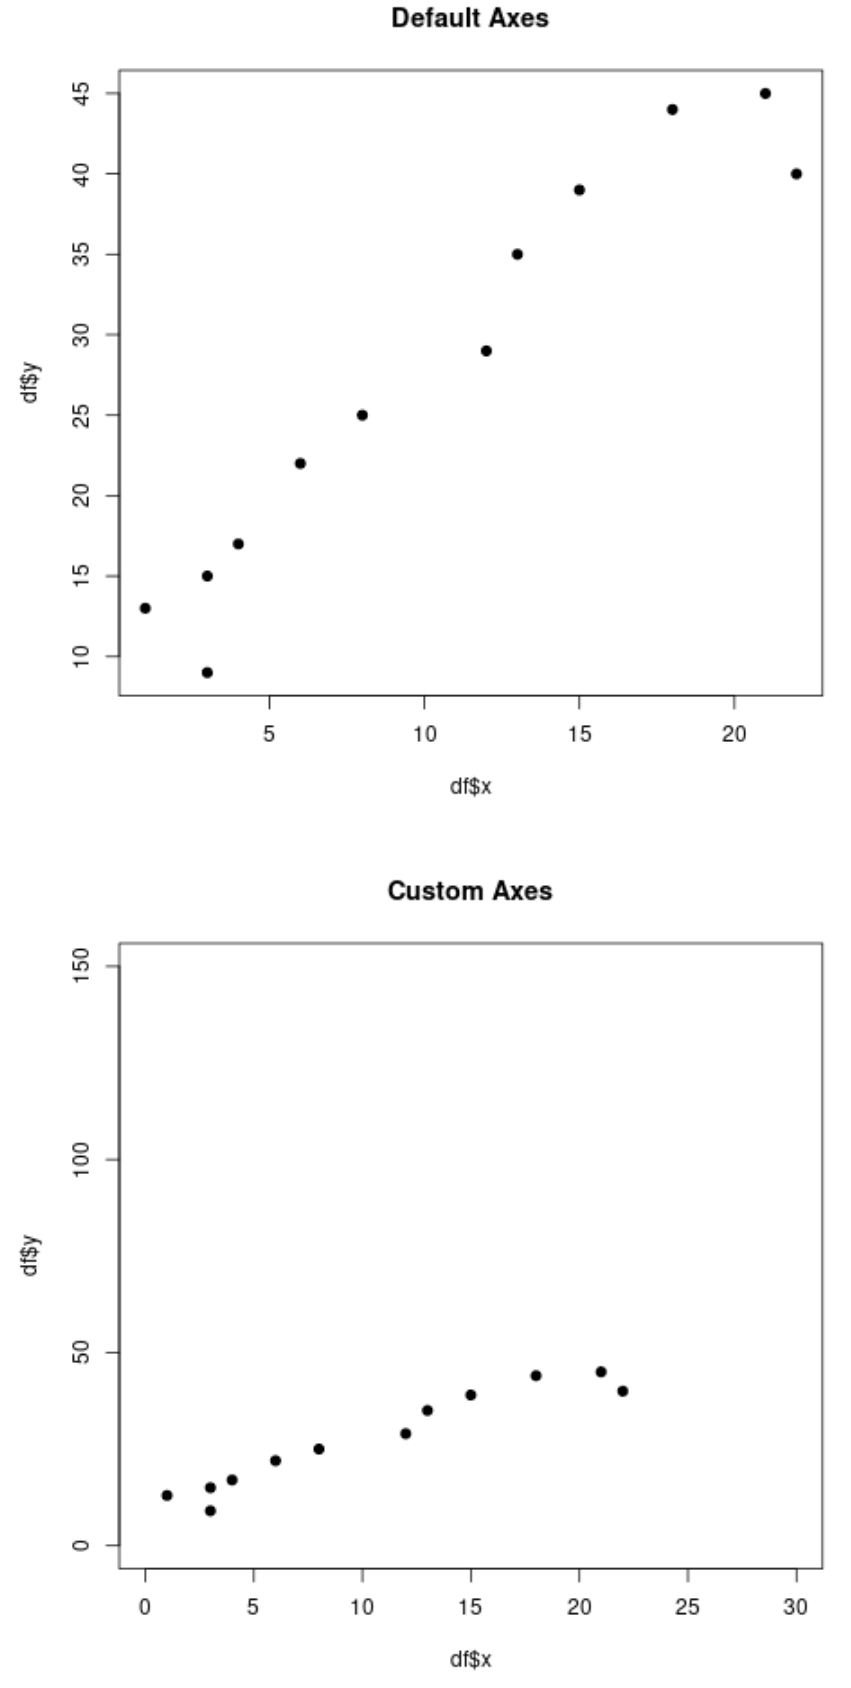
Dans le système standard de R, la génération d’un graphique bidimensionnel s’appuie principalement sur la commande générique de projection cartésienne. Lorsque l’analyste transmet deux vecteurs quantitatifs à cette fonction sans spécifier explicitement les dimensions spatiales, le moteur graphique exécute un algorithme déterministe d’évaluation des limites. Dans un premier temps, le système calcule les valeurs minimales et maximales absolues de chaque vecteur via l’évaluation interne de leur étendue statistique. Cependant, la boîte englobante ainsi obtenue n’est pas directement appliquée aux bords extrêmes de la zone d’affichage. Pour éviter que les symboles graphiques situés aux bornes mathématiques de la série ne soient tronqués ou superposés exactement sur les segments délimitant le cadre de la figure, le moteur introduit systématiquement une marge résiduelle de dilatation.
Cette expansion automatique est gouvernée par les paramètres internes de style d’axe, identifiés dans la nomenclature du système par les symboles techniques régissant l’expansion cartésienne. Par défaut, ces contrôleurs adoptent une configuration désignée par le mode régulier, laquelle applique une majoration symétrique de quatre pour cent de part et d’autre de l’intervalle empirique total. Ainsi, pour une variable continue s’étendant théoriquement de 0 à 100 unités, la commande standard n’ancrera pas l’origine visuelle sur le zéro strict, mais projettera le système de coordonnées sur un segment effectif compris approximativement entre -4 et 104. Cette dilatation implicite, bien que bénéfique pour la lisibilité immédiate des marqueurs géométriques, peut s’avérer problématique lorsque l’analyste cherche à superposer des courbes analytiques précises ou à garantir qu’un seuil absolu coïncide rigoureusement avec la bordure du tracé.
Pour observer rigoureusement cette dynamique, considérons la génération d’un jeu de données synthétique suivant une distribution asymétrique :
Dans un contexte où les données empiriques présentent une forte dispersion ou une queue de distribution étirée, l’algorithme sous-jacent de discrétisation métrique (souvent délégué à des fonctions internes d’optimisation d’intervalles réguliers) tend à produire des graduations disjointes qui ne reflètent pas adéquatement la concentration locale de l’échantillon. L’automatisation aveugle montre ici ses limites intrinsèques, imposant à l’expérimentateur de prendre le contrôle direct des paramètres régissant l’espace géométrique d’affichage.
2.2 Structure des paramètres graphiques liés aux dimensions
Le contrôle dimensionnel dans le moteur traditionnel repose sur une hiérarchie d’arguments passés soit directement au sein de l’instruction de tracé principale, soit en amont via l’interface de gestion de l’environnement graphique global. La fonction de configuration des paramètres d’affichage permet de définir l’agencement spatial global de la session active. Les dimensions effectives de la zone de données résultent d’une soustraction arithmétique continue : la taille globale du dispositif graphique est amputée des marges extérieures, puis des marges de la figure elle-même, définies en lignes de texte ou en pouces métriques.
Lorsque des arguments de restriction d’échelle sont passés directement lors de l’appel d’une fonction de haut niveau, ils surchargent temporairement les évaluations automatiques calculées par le moteur. Cette surcharge opère à un niveau très bas de la chaîne de rendu : elle redéfinit les coefficients de transformation matricielle qui convertissent les unités utilisateur en coordonnées physiques de rendu sur le périphérique de sortie. Si l’utilisateur manipule ces paramètres sans harmoniser les marges globales via l’appel d’environnement correspondant, des incohérences géométriques peuvent émerger, telles que l’écrasement des étiquettes ou une discordance entre le ratio d’aspect visuel et le rapport théorique des grandeurs mesurées.
L’interaction entre ces spécifications locales et les variables de contrôle global exige une rigueur méthodologique constante. Une modification non réinitialisée au sein de l’état persistant du périphérique graphique continuera d’affecter tous les tracés ultérieurs exécutés durant la même session de travail R. Il est dès lors fondamental d’appréhender le fonctionnement intime des arguments vectoriels qui délimitent formellement les axes cartésiens.
3. Définition des limites d’axes avec xlim et ylim en Base R
3.1 Implémentation technique des vecteurs de délimitation
L’intervention la plus directe et la plus classique pour contraindre l’étendue visuelle d’un graphique en Base R réside dans l’emploi des arguments dédiés aux limites vectorielles horizontales et verticales. Ces deux paramètres attendent rigoureusement un vecteur numérique composé de deux éléments ordonnés, définissant respectivement la borne inférieure et la borne supérieure du système de projection cartésienne. La syntaxe standard s’exprime sous la forme conventionnelle assignant une paire de coordonnées numériques aux arguments correspondants lors de l’exécution de la fonction graphique.
L’un des cas d’usage les plus fréquents de cette spécification manuelle réside dans l’expansion artificielle de la zone de tracé afin d’intégrer un point d’ancrage conceptuellement critique, tel que le zéro théorique. Dans de nombreuses études expérimentales, des valeurs empiriques fluctuant par exemple entre 75 et 90 unités masquent l’ampleur relative réelle du phénomène si l’axe ne débute pas à l’origine absolue. En forçant la limite inférieure à zéro via un vecteur adapté, le chercheur rétablit une perspective proportionnelle équilibrée, évitant ainsi le piège de la surinterprétation des écarts relatifs.
Inversement, ces mêmes arguments permettent d’opérer une troncature intentionnelle afin de concentrer le regard analytique sur un sous-ensemble particulier de l’espace échantillonnal. Lorsqu’une telle troncature est mise en œuvre, il convient de maîtriser parfaitement la manière dont le moteur de Base R gère les données marginalisées : contrairement aux procédures de filtrage de bases de données, les observations situées au-delà des bornes assignées ne sont pas effacées de la structure mémoire sous-jacente. Le moteur graphique se contente d’appliquer une règle de découpage visuel rigoureuse : tout point, segment ou symbole géométrique dont les coordonnées cartésiennes se situent hors du périmètre délimité est simplement omis lors de l’encrage sur le canevas, sans impacter la validité computationnelle des objets R manipulés.
3.2 Inversion d’échelle et manipulation directionnelle
La flexibilité des arguments vectoriels de délimitation se manifeste également dans leur capacité à inverser la directionnalité de lecture spatiale d’une variable. Par défaut, la géométrie cartésienne classique oriente les valeurs croissantes de la gauche vers la droite pour l’axe horizontal, et du bas vers le haut pour l’axe vertical. Toutefois, de multiples paradigmes scientifiques imposent une inversion conventionnelle de ces polarités. En psychologie cognitive et en neurosciences comportementales, la mesure des temps de réaction est régulièrement illustrée de manière inversée : des latences plus courtes, traduisant une célérité cognitive supérieure, sont souvent projetées vers le haut de l’espace visuel pour correspondre intuitivement à une performance plus élevée.
Pour opérer cette inversion en Base R, il suffit d’inverser l’ordre des éléments constitutifs du vecteur de limitation, en transmettant la valeur maximale en premier élément et la valeur minimale en second élément. Dès lors que le premier terme est strictement supérieur au second, le moteur graphique déploie une matrice de transformation symétrique inverse. L’axe conserve l’ensemble de ses propriétés métriques fondamentales : l’intervalle quantitatif demeure rigoureusement respecté et le positionnement des tirets indicateurs s’ajuste sans générer d’aberration géométrique.
Cette technique trouve également une application systématique dans l’analyse de classements ordinaux, d’indices de dégradation écologique ou de profondeurs bathymétriques en océanographie. Dans ce dernier cas, un axe vertical inversé permet de représenter le niveau zéro de la surface de la mer à la crête du graphique, tandis que les profondeurs négatives progressent géographiquement vers la partie inférieure du document, respectant ainsi l’analogie spatiale inhérente à l’observation physique du milieu marin.
3.3 Ajustement strict des bordures avec les paramètres xaxs et yaxs
Même après avoir assigné des bornes explicites via les vecteurs de limitation dimensionnelle, le moteur graphique standard continue d’appliquer, par défaut, la marge d’expansion périphérique de quatre pour cent mentionnée précédemment. Si l’on spécifie des bornes comprises strictement entre 0 et 10, le tracé générera une fenêtre d’affichage s’étendant en réalité de -0,4 à 10,4 unités. Cette caractéristique algorithmique soulève des difficultés majeures dès lors que l’on cherche à aligner des représentations adjacentes ou à assurer le contact strict d’une courbe avec les contours géométriques de la boîte englobante.
Pour neutraliser cette expansion automatique et forcer les bornes visuelles à correspondre exactement aux valeurs stipulées, l’analyste doit modifier les paramètres de style d’ajustement des axes. Ces paramètres acceptent une valeur littérale définissant le mode de calcul d’emprise. Alors que le mode régulier (‘r’) pérennise l’extension d’espacement standard, le mode interne, désigné par la lettre simple ‘i’, contraint le moteur graphique à caler le canevas de manière stricte et indéformable sur les limites exactes stipulées par l’utilisateur.
L’application simultanée de ces deux directives stylistiques au niveau des axes horizontal et vertical transforme radicalement la précision géométrique de la scène graphique. Elle est absolument indispensable pour la superposition de modèles de densités de probabilité théoriques, l’affichage de diagrammes de phase en dynamique des systèmes non linéaires, ou la construction de mosaïques cartésiennes où la moindre discontinuité spatiale entre des panneaux juxtaposés altérerait la continuité de lecture de surfaces bidimensionnelles.
4. Transformations logarithmiques directes dans les graphiques de base
4.1 Syntaxe de l’argument log dans les fonctions graphiques de base
L’analyse de séries quantitatives caractérisées par des dynamiques de croissance exponentielle, des cinétiques biochimiques ou des distributions de richesses asymétriques requiert fréquemment l’abandon du repère arithmétique linéaire en faveur d’une métrique logarithmique. Dans le système graphique standard de R, cette opération ne nécessite pas obligatoirement la modification préalable des structures de données numériques au sein du tableau de variables. La fonction graphique principale intègre nativement un argument dédié à cette conversion spatiale, formulé sous une syntaxe textuelle concise.
En assignant la chaîne de caractères correspondante à l’argument de transformation logarithmique, l’analyste instruit le moteur de modifier l’espacement visuel sans recalculer manuellement les données sources. Les options valides permettent de cibler exclusivement l’axe horizontal, l’axe vertical, ou d’appliquer simultanément la transformation aux deux dimensions pour produire un tracé bilogarithmique. La distinction conceptuelle entre transformer la donnée en amont et transformer l’axe de projection est primordiale : dans le premier cas, les valeurs affichées sur les graduations deviennent les logarithmes des données réelles, ce qui complexifie la restitution visuelle des grandeurs empiriques ; dans le second cas, le système conserve les valeurs originales des mesures tout en espaçant géométriquement les repères selon les puissances de la base mathématique.
Sur le plan computationnel, l’usage de cette transformation impose une vigilance absolue quant au domaine de définition mathématique des variables projetées. Le logarithme n’étant défini que sur le corps des réels strictement positifs, toute tentative d’application de cette fonction sur un ensemble comprenant des valeurs nulles ou strictement négatives déclenche une interruption d’affichage ou l’émission d’avertissements explicites signalant que les observations incompatibles ont été écartées du processus de rendu visuel.
4.2 Étude de cas : modélisation de distributions de puissance
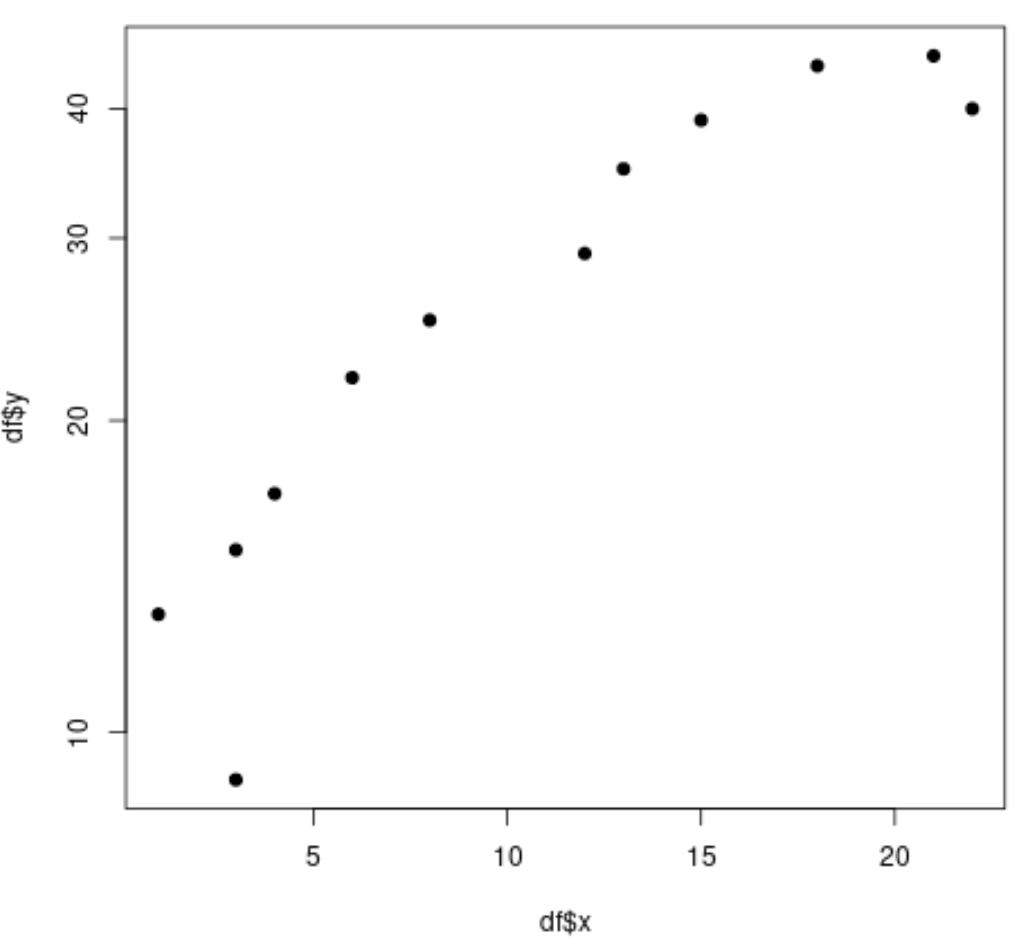
Pour illustrer la portée analytique de cette transformation au sein du moteur de base, examinons le comportement d’un phénomène gouverné par une loi de puissance, fréquent en écologie des communautés ou en traitement automatique des corpus linguistiques. Projetées sur un plan arithmétique linéaire, les observations de ce type s’agglutinent de manière indéchiffrable contre l’axe vertical, tandis que la décroissance rapide rend invisible toute distinction fine entre les rangs intermédiaires et terminaux.
Dès lors que l’on applique une échelle logarithmique à l’axe des ordonnées, la morphologie du phénomène se modifie substantiellement à l’écran : la dynamique exponentielle décroissante se redresse en une trajectoire visuellement linéaire, dont la pente géométrique correspond directement au coefficient d’échelle du modèle mathématique sous-jacent. Cette linéarisation optique facilite l’évaluation diagnostique immédiate de la qualité d’ajustement du modèle par le chercheur, bien avant la mise en œuvre de régressions formelles.
Un aspect technique remarquable du moteur de Base R réside dans sa manière de composer automatiquement les graduations lors d’une transition logarithmique. Au lieu de proposer des tirets uniformément distribués, le système génère des faisceaux d’encoches compressées caractéristiques des cycles décimaux exponentiels. Ces repères visuels offrent un retour immédiat sur la nature non linéaire de l’espace métrique sous-jacent, guidant le regard critique de l’observateur à travers les différents ordres de grandeur du phénomène empirique investigué.
5. Contrôle précis des graduations et étiquettes avec la fonction axis() en Base R
5.1 Désactivation des axes automatiques
Bien que les routines automatiques de positionnement des graduations fournies par Base R se révèlent satisfaisantes pour une exploration préliminaire, elles s’avèrent limitées dès lors qu’une publication académique requiert un contrôle typographique strict, des intervalles spécifiques ou des notations spécialisées. L’approche experte en Base R consiste à débrayer entièrement la machinerie d’annotation par défaut pour concevoir manuellement chaque composant métrique de la figure.
Cette inhibition sélective s’opère au moyen d’arguments dédiés au contrôle des marques d’axes intégrés à la commande de tracé initial. En transmettant la valeur textuelle négative ‘n’ à l’argument d’axe horizontal ou vertical, l’utilisateur ordonne au processeur graphique de dessiner les symboles de données et le cadre englobant tout en omettant délibérément les segments de tirets et les chaînes numériques associées. Si l’on souhaite épurer totalement le canevas, il est également possible de supprimer le cadre délimitant rectangulaire au moyen de l’argument de style de boîte, ouvrant un espace vierge dédié à une composition entièrement individualisée.
Cette démarche en deux temps (dessin primitif des données sans annotations, suivi de l’adjonction séquentielle de repères métriques sur mesure) constitue le patron de conception canonique pour produire des graphiques d’une précision irréprochable au sein de l’environnement standard de R.
5.2 Paramétrage exhaustif de la fonction axis()
L’adjonction programmatique de graduations contrôlées repose exclusivement sur l’utilisation de la fonction spécialisée de gestion des axes. Cette commande impérative accepte une collection rigoureuse de paramètres permettant d’agir sur chaque pixel du composant dimensionnel. Le premier argument obligatoire, d’ordre positionnel, définit le côté du repère cartésien sur lequel l’axe doit être matérialisé. Selon une convention d’orientation horaire immuable, la valeur 1 cible la bordure inférieure, la valeur 2 correspond à la bordure gauche, la valeur 3 désigne le bord supérieur et la valeur 4 active la bordure latérale droite.
Le positionnement numérique exact des encoches métriques est dicté par l’argument d’ancrage, auquel l’analyste transmet un vecteur quantitatif contenant les coordonnées précises où chaque graduation doit s’implanter. Corrélativement, l’argument d’étiquetage permet d’assigner un vecteur de chaînes de caractères qui viendront s’aligner rigoureusement en face de chaque marqueur. Si cet argument est omis, le système projette automatiquement la conversion textuelle des valeurs numériques fournies pour les points d’ancrage. Cette dissociation autorise l’introduction d’unités de mesure complexes, de notations scientifiques ou d’abréviations catégorielles personnalisées sans corrompre la métrique de position.
Un autre levier technique crucial réside dans le contrôle de l’orientation spatiale du texte des étiquettes, formalisé par le paramètre de style d’alignement. Prenant des valeurs entières comprises entre 0 et 3, ce paramètre régit la posture géométrique des caractères par rapport à la bordure du graphique :
- La valeur 0 force une orientation toujours parallèle à l’axe concerné ;
- La valeur 1 impose un alignement strictement horizontal quel que soit l’axe ciblé, optimisant la lisibilité immédiate en évitant les contorsions cervicales de lecture pour l’axe des ordonnées ;
- La valeur 2 configure une orientation perpendiculaire au segment d’ancrage ;
- La valeur 3 maintient un alignement uniformément vertical pour l’ensemble des textes d’annotations.
5.3 Génération de graduations mineures et échelles composées
Dans les disciplines relevant des sciences de l’ingénieur, de la physique expérimentale ou de la biométrie avancée, la distinction hiérarchique entre graduations majeures et graduations mineures est indispensable pour faciliter l’interpolation visuelle précise de mesures continues. Le moteur de Base R ne disposant pas d’un argument automatisé direct pour générer des subdivisions intermédiaires au sein d’une seule instruction, l’analyste doit mobiliser une stratégie algorithmique élégante articulée autour d’appels successifs à la commande d’axe.
La méthodologie consiste à superposer un premier passage dédié aux repères majeurs, dotés de leurs étiquettes alphanumériques et de tirets de longueur conventionnelle, puis d’exécuter un second passage ciblant une séquence numérique plus dense mais en assignant une valeur logique fausse à l’argument d’étiquetage. Parallèlement, la longueur relative des segments indicateurs est modulée finement grâce aux paramètres d’échelle de tiret. L’argument de taille relative des marques permet de réduire l’extension des tirets mineurs, créant une hiérarchie optique limpide entre les seuils décimaux et leurs subdivisions internes.
Cette approche modulaire autorise également la synchronisation métrique entre axes opposés. Il est ainsi trivialement reproductible d’insérer sur la bordure supérieure (côté 3) ou latérale droite (côté 4) des encoches en miroir parfait de celles tracées sur les bordures principales, répondant aux standards esthétiques les plus sévères de l’édition scientifique internationale.
6. Transition méthodologique vers ggplot2 : la grammaire des graphiques
6.1 Architecture conceptuelle des échelles dans ggplot2
L’abandon de l’approche impérative de Base R au profit du paradigme structuré incarné par la bibliothèque ggplot2 représente une mutation épistémologique profonde dans la formalisation des graphiques statistiques. Dans cette architecture conceptuelle, l’échelle cesse d’être un ensemble de segments et de marques typographiques dessinés sur commande pour devenir un opérateur mathématique abstrait. L’échelle est définie formellement comme une application bijective chargée de transformer un espace d’entrée (le domaine des données empiriques) en un espace de sortie (l’intervalle esthétique de rendu, qu’il s’agisse de coordonnées spatiales x et y, de teintes de couleur, de tailles de glyphes ou de motifs de remplissage).
Toute intervention sur une dimension visuelle s’exprime à travers une nomenclature standardisée extrêmement rigoureuse obéissant au schéma lexical scale_esthétique_type(). Pour les dimensions spatiales cartésiennes, les fonctions opérationnelles se déclinent sous les formes scale_x_continuous(), scale_y_continuous(), scale_x_discrete() ou scale_y_log10(). L’intérêt méthodologique fondamental de cette grammaire déclarative réside dans la séparation étanche des préoccupations : la définition des données et des représentations géométriques élémentaires est découplée de la mécanique de mise à l’échelle, permettant d’altérer la métrique sous-jacente sans jamais devoir réécrire les instructions géométriques sous-jacentes.
Cette rigueur architecturale garantit une reproductibilité sans faille dans le cadre de protocoles d’analyse complexes. Lorsqu’un jeu de données subit des variations d’échantillonnage ou des stratifications factorielles, l’échelle grammaticale recalcule dynamiquement l’intégralité des paramètres géométriques associés sans risque de dérive spatiale ou de télescopage d’éléments visuels.
6.2 Initialisation du modèle de données de démonstration pour ggplot2
Afin de concrétiser les manipulations syntaxiques avancées qui suivent, il est opportun de définir une structure de données empirique représentative. Considérons un cadre expérimental standard modélisant la réponse physiologique d’organismes vivants soumis à des concentrations croissantes d’un principe actif, intégrant à la fois des réponses continues fortement non linéaires, des classifications qualitatives par groupes et des dynamiques longitudinales datées.
La génération d’un tracé élémentaire au sein de ggplot2 s’initie par l’évaluation conjointe de la source de données tabulaire et de la cartographie des paramètres esthétiques au sein de l’instruction de base. Par défaut, la bibliothèque inspecte les colonnes référencées, applique une heuristique interne pour identifier si les variables sont quantitatives continues ou qualitatives catégorielles, puis instancie automatiquement les échelles d’axe correspondantes. L’espace cartésien ainsi tracé inclut une légère expansion spatiale visant à préserver l’intégrité des points périphériques, tout en instaurant des graduations harmonisées sur les chiffres ronds calculés par un algorithme d’espacement sophistiqué dérivé des travaux de Justin Talbot.
C’est à partir de cette toile de base que l’analyste peut déployer une vaste panoplie de modifications structurales visant à ajuster, tronquer, inverser ou reformater la métrique spatiale avec un niveau d’expressivité logicielle sans équivalent.
7. Ajustement des limites continues dans ggplot2
7.1 Utilisation des fonctions raccourcies xlim() et ylim()
Pour restreindre ou étendre rapidement le champ cartésien d’une visualisation sous ggplot2, le système propose des fonctions d’assistance syntaxique particulièrement concises désignées sous les noms explicites xlim() et ylim(). Conçues pour offrir une ergonomie similaire aux arguments de Base R, ces instructions s’intègrent directement au pipeline graphique via l’opérateur d’addition unaire standard. L’utilisateur leur transmet soit deux scalaires ordonnés distincts, soit un vecteur numérique unique définissant les bornes minimale et maximale souhaitées.
Cependant, l’utilisation de ces raccourcis masque un mécanisme interne essentiel que tout analyste quantitatif doit impérativement appréhender : le processus de censure algorithmique des données. Contrairement à une simple loupe optique, les fonctions xlim() et ylim() opèrent en réalité comme un filtre destructif en amont du rendu géométrique. Toute observation empirique dont la coordonnée spatiale se situe en deçà de la limite minimale ou au-delà de la limite maximale assignée est purement et simplement convertie en valeur manquante (NA) pour la phase de tracé.
Cette élimination silencieuse des données marginalisées est systématiquement signalée par la bibliothèque via l’émission d’un message d’avertissement avertissant l’utilisateur du nombre précis de lignes de données écartées de la composition géométrique. Si cette coupure n’affecte que des points isolés dans un diagramme de dispersion, elle peut induire des altérations catastrophiques dès lors que la figure intègre des couches d’inférence statistique dépendantes de la totalité de la distribution échantillonnale.
7.2 Maîtrise complète avec scale_x_continuous() et scale_y_continuous()
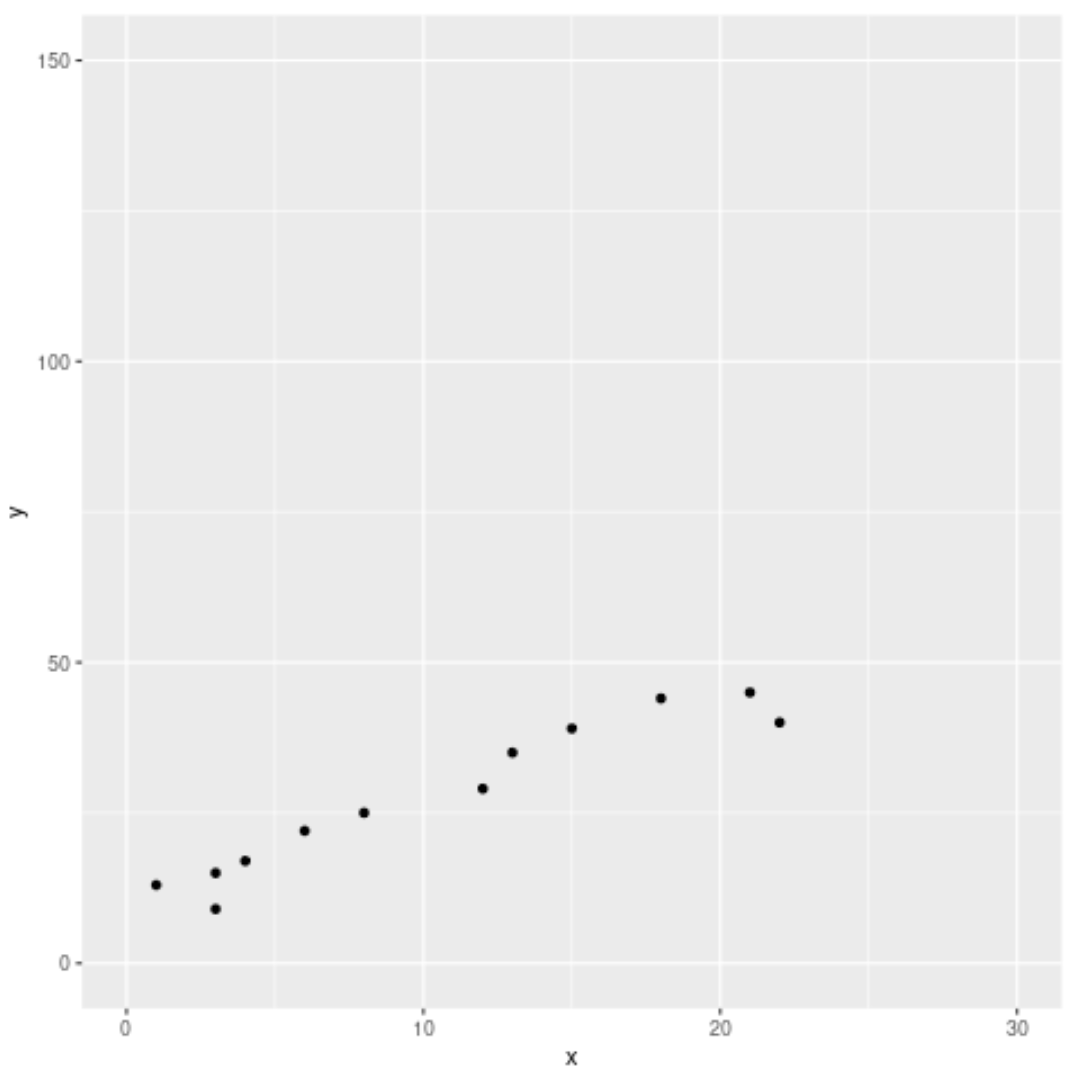
L’approche la plus robuste, explicite et flexible pour moduler les coordonnées continues au sein de l’environnement ggplot2 repose sur la déclaration explicite des couches de spécification d’échelle. Les fonctions scale_x_continuous() et scale_y_continuous() exposent une interface paramétrique complète autorisant un paramétrage millimétrique de chaque aspect de l’axe quantitatif.
Le contrôle de l’étendue s’effectue via l’argument des limites, lequel accepte un vecteur de deux réels. Une caractéristique syntaxique majeure de cette interface réside dans la possibilité d’assigner la valeur spéciale NA à l’une des bornes : cette souplesse ordonne à ggplot2 de maintenir le calcul automatique pour l’extrémité spécifiée par NA tout en imposant un seuil arbitraire strict sur l’autre borne. Par exemple, assigner un vecteur débutant à zéro et se terminant par une valeur manquante garantit que l’origine absolue sera toujours visible sur l’axe, tout en laissant le moteur adapter dynamiquement la borne supérieure à la valeur maximale observée dans les données brutes.
Au-delà des frontières spatiales, ces fonctions régissent la périodicité des encoches d’étalonnage via l’argument d’ancrage des coupures. L’utilisateur peut transmettre une séquence arithmétique rigoureuse stipulant exactement où les tirets majeurs doivent être implantés. De surcroît, l’argument dédié aux coupures secondaires permet d’insérer des repères mineurs non étiquetés pour guider visuellement la lecture fine entre les seuils structurants. Enfin, l’argument d’étiquetage permet de substituer aux valeurs numériques par défaut un vecteur d’expressions textuelles, d’unités symboliques ou de fonctions de conversion dynamique.
7.3 Contrôle de l’expansion résiduelle des axes avec expand
À l’instar du système classique, ggplot2 introduit nativement un rembourrage spatial périphérique le long des échelles continues, visant à désenclaver les symboles géométriques extrêmes. Ce comportement par défaut alloue une expansion multiplicative de cinq pour cent de part et d’autre de l’intervalle continu total. Dans des contextes graphiques particuliers, tels que l’élaboration de diagrammes en barres débutant rigoureusement à l’origine ou de cartes thermiques matricielles, cet espace interstitiel perturbe la justesse géométrique du dessin en créant un flottement artificiel entre le socle des barres et le segment horizontal de base.
Le paramétrage de ce comportement s’opère au moyen de l’argument d’expansion intégré à l’échelle continue, en mobilisant la fonction auxiliaire expansion(). Cet opérateur offre une distinction rigoureuse entre deux modalités d’élargissement spatial : une composante multiplicative, qui applique un ratio proportionnel à la longueur globale de l’intervalle cartésien, et une composante additive, qui ajoute une quantité fixe exprimée directement dans les unités métriques de la variable visualisée.
Pour annuler intégralement tout espacement périphérique et arrimer de manière hermétique la zone de données aux bordures cartésiennes, l’analyste transmet une directive d’annulation absolue fixant les facteurs multiplicatifs et additifs à zéro. Cette manipulation est cruciale pour maximiser l’efficacité de l’espace d’affichage et garantir un calage parfait lors de la combinaison de panneaux multiples.
8. Différenciation critique : zoom cartésien versus filtrage des données
8.1 Mécanisme de filtrage dans scale_*_continuous() et xlim()
L’un des pièges méthodologiques les plus insidieux et les plus fréquents rencontrés par les praticiens de ggplot2 réside dans la confusion fondamentale entre le zoom cartésien optique et la réduction de l’étendue par filtrage d’échelle. Comme évoqué précédemment, contraindre les bornes d’un graphique via les arguments de limites dans les fonctions d’échelle standard ou au moyen des raccourcis vectoriels modifie directement la structure du tableau de données transmis au sous-système de calcul statistique.
Pour comprendre la gravité de cette distinction, il convient d’analyser le cycle de vie interne d’une figure au sein du moteur ggplot2. La construction graphique s’articule selon une séquence sérialisée précise :
- Dans un premier temps, les données brutes sont filtrées selon les limites stipulées au sein des couches d’échelle ;
- Dans un second temps, les transformations statistiques associées aux représentations géométriques (telles que le calcul des droites de régression moindres carrés, l’estimation des densités par noyau ou le calcul des quantiles structurant les boîtes à moustaches) sont exécutées sur l’échantillon tronqué subsistant ;
- Dans un troisième temps seulement, les éléments géométriques sont dessinés sur le canevas.
Si un analyste resserre l’échelle verticale pour focaliser l’attention sur le cœur d’un nuage de points, toutes les valeurs marginales supérieures et inférieures sont expulsées de la mémoire de travail avant l’ajustement du modèle statistique. Par conséquent, la droite de régression linéaire recalculée sur cet ensemble censuré verra sa pente et son ordonnée à l’origine modifiées de manière substantielle et erronée. Ce phénomène produit un artefact statistique trompeur d’une extrême gravité scientifique : la ligne affichée ne représente plus la relation empirique globale entre les deux grandeurs, mais un ajustement local biaisé par l’exclusion arbitraire des valeurs extrêmes.
8.2 Zoom optique préservateur avec coord_cartesian()
Lorsque l’objectif visé par le chercheur consiste exclusivement à réaliser un agrandissement visuel sur une sous-région spatiale d’intérêt sans altérer en aucune façon la validité des modèles statistiques sous-jacents, l’unique approche méthodologiquement recevable réside dans l’emploi explicite de la couche de coordonnées cartésiennes. La fonction coord_cartesian() gouverne le repère géométrique bidimensionnel indépendamment du flux de traitement des échelles.
En assignant des limites numériques aux arguments horizontaux et verticaux au sein de cette commande de repère, le système opère à la manière d’une lentille grossissante optique. La totalité des observations empiriques est préservée durant l’intégralité du cycle de calcul computationnel : les modèles de régression lissent l’ensemble des données brutes, les distributions de densité intègrent l’intégralité des queues d’échantillonnage, et les boîtes à moustaches conservent leurs valeurs médianes et leurs écarts interquartiles authentiques. Ce n’est qu’au moment ultime du rendu sur l’écran que le moteur graphique applique un masque de détourage visuel sur la fenêtre cartésienne restreinte.
La règle de décision pratique s’énonce de façon catégorique : si l’analyste cherche à purifier le jeu de données pour en exclure des valeurs aberrantes préalablement identifiées comme non pertinentes, le filtrage via l’échelle ou le sous-ensemblement amont constitue l’opération requise. En revanche, pour toute démarche de cadrage esthétique, d’exploration locale ou d’agrandissement d’une zone dense au sein d’une modélisation globale, le recours exclusif à la manipulation des coordonnées cartésiennes s’impose comme une exigence scientifique non négociable.
9. Transformations mathématiques d’axes dans ggplot2
9.1 Échelles logarithmiques intégrées : scale_x_log10() et scale_y_log10()
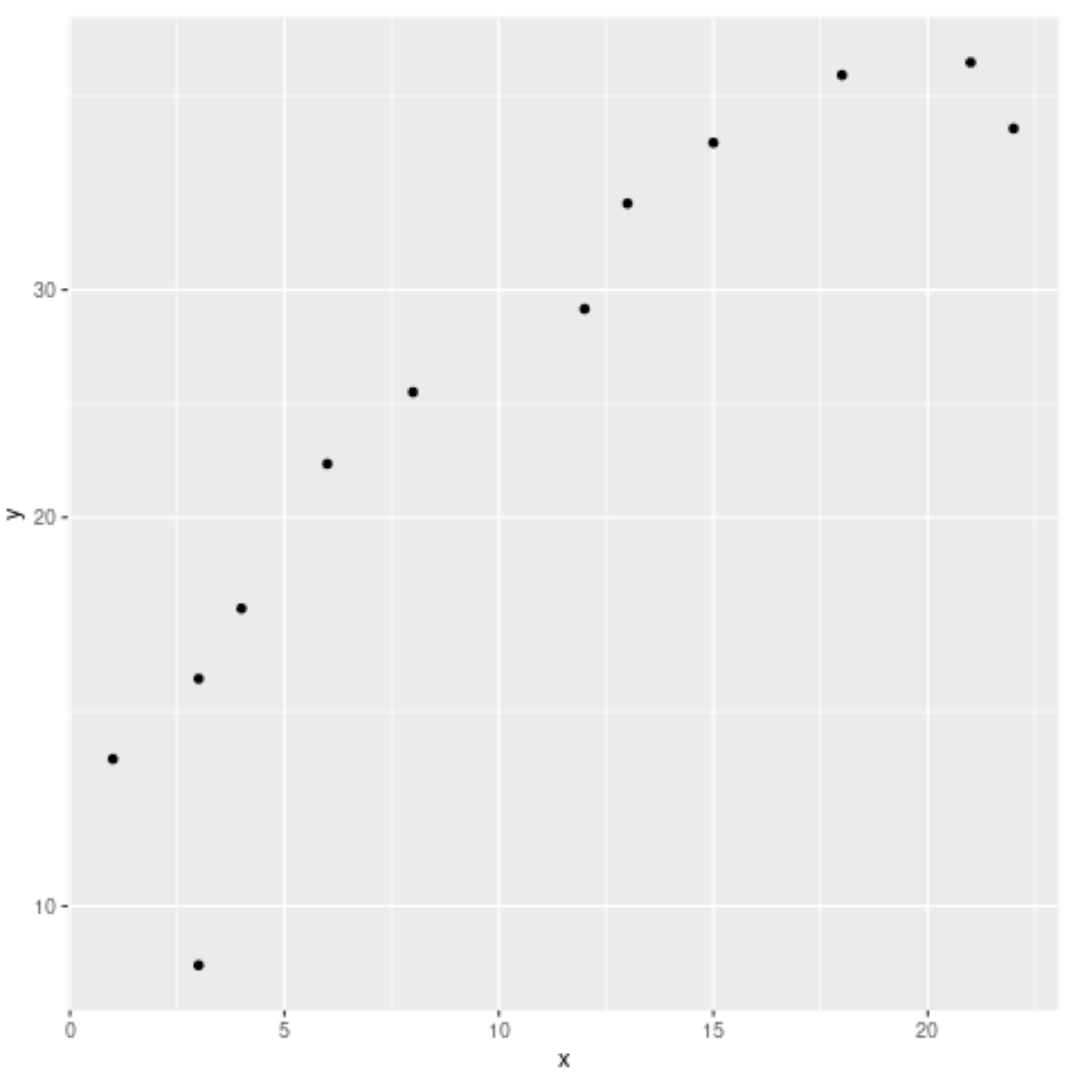
L’application d’une anamorphose logarithmique sous ggplot2 s’avère particulièrement élégante grâce à la mise à disposition d’échelles spécialisées clés en main. Les instructions scale_x_log10() et scale_y_log10() fournissent une interface dédiée pour projeter les grandeurs selon une métrique décimale sans nécessiter de conversion préalable des variables au sein de la table de données d’origine.
L’avantage épistémologique majeur de cette intégration réside dans la préservation des unités de mesure originelles sur les graduations de l’axe. Lorsqu’un analyste applique une transformation manuelle en calculant le logarithme d’une variable avant d’en confier le tracé à ggplot2, les axes matérialisent des valeurs abstraites correspondant aux exposants mathématiques, rendant la lecture intuitive ardue pour les évaluateurs. À l’inverse, l’échelle logarithmique intégrée calcule la disposition spatiale non linéaire tout en maintenant l’annotation des valeurs empiriques réelles sur les encoches de référence, facilitant la contextualisation immédiate des résultats par le lecteur.
De surcroît, ces composants d’échelle spécialisés dialoguent harmonieusement avec les bibliothèques d’extension typographique, garantissant que les graduations soient positionnées sur des puissances de dix clairement identifiables et accompagnées, le cas échéant, de subdivisions secondaires condensées traduisant visuellement la dynamique logarithmique de l’espace cartésien.
9.2 Transformations avancées avec l’argument trans ou transform
Au-delà des échelles logarithmiques décimales conventionnelles, ggplot2 intègre un moteur puissant de transformation continue généralisée. Historiquement administré par l’argument trans, et renommé transform dans les itérations logicielles récentes pour une cohérence accrue avec la grammaire contemporaine de R, ce paramètre accepte aussi bien des chaînes désignant des transformateurs précompilés que des objets formels construits sur mesure via le paquetage spécialisé scales.
La panoplie des transformations natives comprend une vaste diversité d’opérateurs mathématiques adaptés aux problématiques expérimentales spécialisées :
- La transformation inverse, qui produit un retournement directionnel instantané tout en préservant la nature continue de l’échelle ;
- La transformation racine carrée, régulièrement employée dans l’analyse de données de comptage poissonniennes ou de surfaces pour stabiliser la variance résiduelle des distributions ;
- La transformation réciproque, mobilisée dans l’étude des taux de cinétique chimique et des durées d’attente ;
- La transformation probit ou logistique, particulièrement pertinente dans l’analyse des doses létales et des courbes d’efficacité pharmacologique.
L’analyste dispose en outre de la liberté de concevoir des fonctions de transformation totalement personnalisées. Cette capacité s’avère providentielle lorsqu’il s’agit de représenter des grandeurs astrophysiques complexes ou des indices de biodiversité nécessitant des combinaisons d’ajustements hyperboliques et linéaires selon les segments d’observation.
9.3 Gestion des doubles axes avec sec_axis()
La question de la coexistence de deux axes verticaux distincts au sein d’une même représentation graphique constitue un sujet de controverse récurrent en visualisation de données. De nombreux concepteurs exploitent abusivement les doubles axes pour corréler artificiellement des séries temporelles sans rapport, en calibrant les échelles de manière à faire coïncider des fluctuations purement fortuites. Face à ce péril cognitif documenté par les spécialistes de l’intégrité visuelle, les auteurs de ggplot2 ont instauré une politique de conception restrictive particulièrement salutaire.
Il est techniquement impossible, au sein de l’architecture native de ggplot2, de générer un axe secondaire totalement indépendant portant des unités sans lien déterministe avec l’axe principal. L’adjonction d’une dimension latérale droite, articulée via la fonction sec_axis(), requiert impérativement une fonction mathématique univoque et inversible dérivant strictement de l’axe primaire. L’argument de transformation attend ainsi une formule mathématique explicite définissant la relation affine liant les deux représentations métriques.
Cette approche trouve sa pleine légitimité dans la conversion simultanée de systèmes d’unités complémentaires. Par exemple, une figure illustrant une température expérimentale peut matérialiser les degrés Celsius sur l’axe vertical gauche tout en exposant leur conversion directe en degrés Fahrenheit ou en kelvins sur l’axe secondaire droit. De même, dans les protocoles de biochimie, un axe exprimant des masses brutes peut être doublé d’une graduation en concentrations molaires calculées par division par la masse moléculaire du réactif, enrichissant la communication scientifique sans introduire de distorsion cognitive.
10. Gestion des échelles discrètes, qualitatives et catégorielles
10.1 Paramétrage des axes catégoriels avec scale_x_discrete()
Toutes les visualisations quantitatives ne reposent pas sur des dimensions physiques continues. Une part prépondérante de la recherche empirique traite de facteurs catégoriels, de groupes expérimentaux, de typologies morphologiques ou de cohortes longitudinales discrètes. Lorsque de telles variables qualitatives sont assignées aux paramètres esthétiques de position, ggplot2 mobilise l’opérateur scale_x_discrete() ou son pendant vertical.
Le contrôle le plus fondamental exercé sur une échelle catégorielle réside dans l’ordonnancement structurel des modalités. Par défaut, le moteur applique un tri alphabétique lexicographique standard aux chaînes textuelles composant le facteur, ce qui conduit fréquemment à des configurations sous-optimales où l’ordre de lecture visuel ne respecte aucune logique métier ni hiérarchie d’amplitude statistique. En transmettant un vecteur exhaustif ordonné à l’argument des limites de l’échelle discrète, le chercheur impose la séquence spatiale exacte de présentation des catégories sur l’axe, permettant de classer immédiatement les groupes selon leur niveau de performance, leur chronologie ou leur distribution médiane.
Parallèlement, cet argument autorise le masquage ciblé de certaines modalités expérimentales : toute modalité présente dans le jeu de données mais absente du vecteur fourni est instantanément exclue du tracé cartésien. Enfin, l’argument d’étiquetage permet de substituer aux identifiants informatiques internes des libellés typographiés complets, intégrant des retours à la ligne ou des désignations bilingues, sans nécessiter de mutation préalable des facteurs au sein de la base de données brute.
10.2 Tronquage et saut de catégories
Face à des jeux de données denses caractérisés par un nombre élevé de catégories sur l’axe horizontal, la lisibilité se détériore rapidement en raison de la collision physique des chaînes de caractères d’identification. Dans certaines situations exploratoires, l’analyste souhaite délibérément tronquer la présentation spatiale pour se concentrer sur les dix premières modalités d’un classement de prévalence tout en préservant l’intégrité computationnelle de l’échantillon global.
Pour résoudre l’encombrement sans élaguer agressivement le jeu de données, des stratégies syntaxiques permettent de moduler la densité d’affichage des étiquettes textuelles. En manipulant l’argument d’ancrage avec une fonction de sélection conditionnelle ou en injectant des valeurs manquantes (NA) aux positions non prioritaires au sein du vecteur d’étiquettes, le système trace l’intégralité des géométries associées à chaque groupe discret tout en n’inscrivant les chaînes descriptives que sous un sous-ensemble stratégique d’encoches de référence.
Cette méthode permet d’éviter l’écueil classique des textes noirs superposés et indéchiffrables le long de la frange inférieure du graphique, assurant une esthétique épurée et immédiatement interprétable par les comités de lecture académiques.
10.3 Échelles de dates et de temps avec scale_x_date()
L’enregistrement longitudinal d’observations empiriques nécessite une gestion spécifique des structures temporelles, lesquelles oscillent entre la régularité mathématique du continu et les périodicités calendaires conventionnelles du discret. Pour les colonnes dûment instanciées au format Date ou POSIXct, ggplot2 fournit une suite de fonctions spécialisées incarnées par scale_x_date() et scale_x_datetime().
Ces interfaces se distinguent par l’intégration d’arguments acceptant des spécifications calendaires en langage naturel pour la détermination des coupures métriques. Au lieu de devoir formuler des séquences arithmétiques complexes de millisecondes ou de jours juliens, l’utilisateur indique la fréquence souhaitée sous la forme de directives textuelles telles que « 1 month », « 2 weeks » ou « 5 years ». Le moteur graphique calcule alors l’implantation temporelle exacte de chaque encoche en tenant compte automatiquement de la longueur variable des mois et des ruptures d’années bissextiles.
Le formatage visuel des annotations calendaires bénéficie quant à lui de la puissance des conventions de formatage universelles POSIX. Grâce à l’argument d’étiquetage temporel, le chercheur injecte des codes de formatage standardisant la transcription des mois abrégés, des millésimes complets ou des jours ordinaux. Cette modularité permet de conformer instantanément la typographie des axes aux exigences linguistiques et stylistiques de la revue de destination, qu’il s’agisse de formats anglo-saxons ou de standards typographiques francophones.
11. Formatage typographique et numérique avancé avec l’extension scales
11.1 Intégration du package scales dans les arguments de labels
Bien que ggplot2 intègre des fonctionnalités natives considérables, son articulation avec le paquetage compagnon scales élève la personnalisation typographique et numérique à un degré d’excellence professionnelle rarement égalé dans les logiciels statistiques. Cette bibliothèque fournit un catalogue exhaustif de générateurs de formatage qui s’injectent directement en tant que fonctions d’ordre supérieur au sein de l’argument d’étiquetage des échelles continues ou discrètes.
L’utilisation de ces assistants dynamiques métamorphose la lisibilité des axes quantitatifs. Parmi les opérateurs les plus indispensables à la communication scientifique, mentionnons :
- label_percent(), qui applique une multiplication décimale par cent et adjoint harmonieusement le symbole de pourcentage avec un contrôle strict de la précision décimale ;
- label_scientific(), qui substitue aux notations exponentielles informatiques brutes (comme 1e+06) une écriture scientifique rigoureuse adaptée aux manuscrits de chimie et de physique théorique ;
- label_log(), spécialement conçu pour formater les graduations sous forme de bases assorties de leurs exposants mathématiques typographiquement rehaussés ;
- label_number(), qui offre un contrôle exhaustif des délimiteurs de grands nombres, autorisant la configuration immédiate des normes typographiques francophones en insérant des espaces insécables en séparateurs de milliers et des virgules strictes en lieu et place des points décimaux anglo-saxons.
11.2 Rotation et évitement du chevauchement d’étiquettes
L’un des défis récurrents lors de la composition finale d’une figure réside dans le chevauchement physique des chaînes d’étiquetage d’axes lorsque la densité des graduations est élevée ou que les libellés catégoriels s’avèrent volumineux. Historiquement, les utilisateurs de ggplot2 contournaient cet obstacle en intervenant manuellement sur les composantes de thème via l’argument d’orientation angulaire des éléments textuels de l’axe horizontal, nécessitant des ajustements trigonométriques fastidieux de justification spatiale pour assurer que l’extrémité du mot pointe précisément sur l’encoche correspondante.
Depuis les évolutions structurelles récentes de la bibliothèque, une solution architecturale considérablement plus robuste et élégante s’exprime à travers l’emploi des guides d’axe personnalisés via la commande guide_axis(). Ce modificateur s’intègre directement à l’échelle via l’argument de guide ou au sein d’une couche autonome. Il autorise l’activation de deux mécanismes hautement efficaces :
- L’échelonnement vertical en quinconce, configuré par l’attribution d’une valeur de décalage étagé (n.dodge = 2), lequel dispose alternativement les étiquettes sur deux niveaux de hauteur distincts, doublant instantanément l’espace linéaire disponible sans altérer l’horizontalité naturelle de lecture ;
- La rotation angulaire intégrée (angle = 45), qui applique l’inclinaison souhaitée tout en calculant automatiquement les décalages de justification géométrique optimaux pour préserver un alignement parfait entre l’étiquette et le marqueur physique cartésien.
Cette modernisation évite la manipulation fastidieuse des paramètres de bas niveau du bloc de thème, garantissant une esthétique standardisée et exempte d’artefacts d’alignement sur l’ensemble des figures du manuscrit scientifique.
12. Synthèse comparative, recommandations pratiques et erreurs fréquentes
12.1 Tableau comparatif des méthodes : Base R vs ggplot2
Pour consolider la maîtrise opérationnelle de l’analyste, il est opportun de formaliser la stricte correspondance entre les commandes exécutées dans le moteur traditionnel et leurs équivalents déclaratifs au sein de la grammaire contemporaine. Le choix entre ces deux environnements ne relève pas d’une querelle doctrinale, mais d’une adéquation instrumentale aux contraintes spécifiques du projet d’analyse :
| Fonctionnalité recherchée | Approche Base R | Approche ggplot2 | Implication computationnelle |
|---|---|---|---|
| Bornage strict sans filtrage | xlim = c(a, b), ylim = c(c, d) | coord_cartesian(xlim = c(a, b)) | Zoom optique pur ; l’intégralité des données est préservée pour les statistiques. |
| Filtrage amont des observations | Sous-ensemblement explicite du vecteur/tableau | scale_x_continuous(limits = c(a, b)) | Les points externes sont convertis en NA avant le calcul des régressions et densités. |
| Suppression de la marge de 4% | xaxs = « i », yaxs = « i » | scale_x_continuous(expand = c(0, 0)) | L’origine des tracés s’arrime strictement aux bordures physiques de la fenêtre. |
| Échelle logarithmique décimale | log = « x », log = « y », log = « xy » | scale_x_log10(), scale_y_log10() | Les unités originales sont conservées visuellement avec espacement exponentiel. |
| Inversion du sens de lecture | xlim = c(max, min) | scale_x_reverse() | Inverse les polarités spatiales sans modifier les signes mathématiques réels. |
| Personnalisation des repères | axis(side, at = …, labels = …) | scale_*_continuous(breaks, labels) | Dissocie les coordonnées des repères et leur transcription textuelle ou symbolique. |
Sur le strict plan de la performance computationnelle, le moteur graphique de Base R surpasse largement ggplot2 lors de la restitution de très volumineux ensembles de données comprenant plusieurs millions de points. L’absence de couche d’abstraction grammaticale et la manipulation directe du pilote de périphérique graphique garantissent une vélocité d’exécution critique pour l’exploration en temps réel de flux de données massifs. En contrepartie, dès lors que la complexité sémiotique de la figure croît (stratifications multifactorielles, panneaux multiples en treillis, intégration rigoureuse d’axes secondaires univoques), la grammaire de ggplot2 élimine les centaines de lignes de calcul géométrique manuel requises par Base R, assurant une maintenabilité et une reproductibilité infiniment supérieures du code source.
12.2 Diagnostics des erreurs et comportements inattendus
L’ajustement des dimensions d’axes s’accompagne régulièrement de comportements inattendus qui déconcertent les utilisateurs les plus avertis. Le premier dysfonctionnement classique concerne l’utilisation conjointe des facettes multiples et du verrouillage des limites continues. Lorsqu’un analyste applique la fonction facet_wrap() pour subdiviser un graphique selon les modalités d’un groupe, tout en assignant manuellement des bornes strictes au sein de scale_x_continuous(), le moteur applique ces mêmes frontières invariables à l’ensemble des panneaux. Si les sous-groupes présentent des étendues distributionnelles très hétérogènes, les sous-graphiques à faible variance apparaissent complètement écrasés. La résolution exige alors de libérer l’indépendance dimensionnelle des facettes en stipulant l’argument d’échelles libres (scales = « free » ou scales = « free_x »), permettant au processeur de calculer des limites contextuelles autonomes pour chaque facette.
Le second écueil méthodologique fréquent survient lors de la transition logarithmique appliquée à des séries de données empiriques comportant des valeurs nulles. Face à des dénombrements microbiologiques ou des mesures pluviométriques où le zéro traduit une absence effective, l’appel à scale_y_log10() engendre l’exclusion pure et simple de tous les zéros avec un avertissement de valeurs non définies. Si le chercheur applique une translation artificielle arbitraire (en ajoutant couramment une unité à l’ensemble de la série avant transformation), il introduit un artefact qui déforme la structure des faibles valeurs. La solution rigoureuse consiste à mobiliser la transformation pseudo-logarithmique fournie par l’extension scales via transform = « pseudo_log », laquelle assure une continuité différentiable en se comportant comme une échelle arithmétique linéaire autour de zéro avant de basculer progressivement vers une dynamique logarithmique au-delà d’un seuil critique spécifié.
Enfin, le télescopage entre spécifications de limites contradictoires au sein d’un même pipeline ggplot2 engendre souvent des écrasements silencieux. Si un utilisateur définit des bornes au sein d’une échelle continue puis ajoute ultérieurement une commande d’agrandissement cartésien coord_cartesian(), ce dernier bloc prime hiérarchiquement sur la fenêtre d’affichage, mais les données auront tout de même subi la censure de l’échelle si celle-ci était plus restrictive. Une inspection rigoureuse de la hiérarchie des couches s’avère donc impérative lors de tout débogage graphique.
12.3 Bonnes pratiques de communication scientifique des résultats
La finalité ultime de la maîtrise des échelles d’axes réside dans la transmission transparente et non équivoque du savoir scientifique. À cette fin, un ensemble de principes déontologiques et méthodologiques doit guider la composition de tout manuscrit soumis à l’évaluation par les pairs.
Le premier impératif concerne l’honnêteté intellectuelle relative à l’inclusion du zéro absolu. Si l’interruption de l’axe vertical se justifie pleinement dans les diagrammes de dispersion ou les tracés de séries temporelles visant à mettre en évidence des micro-variations de processus homéostatiques régulés, elle est formellement proscrite dans les diagrammes en barres ou les représentations de surfaces d’aires. Dans ces configurations géométriques, l’œil humain interprète la masse encrée comme la mesure directe de la quantité sous-jacente ; tronquer la base revient à fabriquer une distorsion optique artificielle délibérée. Lorsqu’une coupure d’axe s’avère absolument inévitable, elle doit être explicitement matérialisée par des symboles de discontinuité normalisés et documentée sans ambiguïté au sein de la légende explicative.
Le second principe réside dans la standardisation vectorielle haute résolution. L’ajustement géométrique des axes doit systématiquement être conçu en prévision de la méthode d’exportation définitive. Les formats matriciels compressés à basse résolution (tels que le format standard matriciel non vectoriel) introduisent des effets de crénelage qui brouillent les tirets fins et empâtent les typographies soignées. L’analyste rigoureux privilégiera toujours l’exportation vectorielle native via des moteurs de rendu de précision (tels que CairoPDF ou les fichiers vectoriels scalables SVG), en calibrant rigoureusement le rapport d’aspect géométrique global. Une attention particulière sera portée à la fixité des proportions dimensionnelles : la commande coord_fixed() garantira par exemple qu’une unité le long de l’abscisse mesure exactement le même nombre de millimètres physiques qu’une unité le long de l’ordonnée, préservant ainsi l’intégrité géométrique irréprochable des projections spatiales et des analyses en composantes principales.
Références
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Murrell, P. (2018). R Graphics (3e éd.). CRC Press. https://doi.org/10.1201/9780429490231
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Talbot, J., Lin, S., & Hanrahan, P. (2010). An extension of Wilkinson’s algorithm for positioning tick labels on axes. IEEE Transactions on Visualization and Computer Graphics, 16(6), 1036-1043. https://doi.org/10.1109/TVCG.2010.130
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2e éd.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., & Seidel, D. (2022). scales: Scale Functions for Visualization (Version 1.2.1). CRAN. https://CRAN.R-project.org/package=scales
- Wilkinson, L. (2005). The Grammar of Graphics (2e éd.). Springer Science & Business Media. https://doi.org/10.1007/0-387-28695-0