
L’analyse computationnelle moderne repose sur la manipulation efficiente, rigoureuse et reproductible de corpus de données hétérogènes. Parmi l’éventail des formats textuels plats structurés, le format TSV (Tab-Separated Values) occupe une place singulière, particulièrement prégnante au sein des sciences quantitatives, de la bio-informatique génomique, de l’astrophysique computationnelle et de la psychométrie expérimentale. Alors que le format CSV conventionnel subit fréquemment des ambiguïtés syntaxiques inhérentes à l’usage de virgules au sein des champs littéraires ou des notations décimales régionales, le fichier TSV offre une séparation canonique fondée sur la tabulation horizontale. Cette caractéristique technique en fait un standard privilégié pour l’archivage pérenne et la transmission de matrices d’observations scientifiques volumineuses.
Dans l’écosystème du langage de programmation Python, la bibliothèque Pandas s’est imposée comme le standard de facto pour l’ingestion, la transformation et l’interrogation de ces structures tabulaires. Grâce à son objet central, le DataFrame, Pandas conjugue l’expressivité conceptuelle de l’algèbre relationnelle et la vélocité algorithmique de structures compilées en langage C ou adossées au framework Apache Arrow. Néanmoins, l’ingestion sans heurts d’un fichier TSV exige une compréhension fine des mécanismes d’inférence lexicale, des protocoles d’encodage de caractères, de la gestion de la mémoire vive et de la coercition de types scalaire. Une mauvaise configuration des parseurs peut engendrer des altérations insidieuses de la typologie des variables, des fuites de mémoire substantielles ou des corruptions irréversibles de séries temporelles.
Ce guide exhaustif a pour dessein d’explorer de manière systématique l’ensemble des dimensions méthodologiques et logicielles gouvernant la lecture de fichiers TSV avec la bibliothèque Pandas. De la syntaxe fondamentale de la fonction read_csv appliquée aux séparateurs tabulaires jusqu’aux stratégies avancées de streaming par lots (chunking), d’optimisation d’empreinte mémoire pour les données massives et de bascule vers des moteurs vectorisés modernes, chaque section articulera fondements théoriques, décorticage des mécanismes internes et implémentations exemplaires. L’ambition de ce traité est d’offrir aux chercheurs, ingénieurs de données et analystes quantitatifs le cadre analytique nécessaire à une ingestion irréprochable et optimisée de leurs corpus empiriques.
1. Introduction aux fichiers TSV et à leur utilisation avec Pandas
L’interopérabilité des jeux de données constitue le socle de la science des données contemporaine. Le choix d’un format de sérialisation textuelle conditionne non seulement la pérennité de l’information brute, mais également le coût computationnel nécessaire à son exploitation ultérieure. Le format TSV s’inscrit dans cette exigence de robustesse en éliminant structurellement de nombreuses pathologies syntaxiques propres aux formats concurrents.
1.1 Définition et spécificités du format TSV (Tab-Separated Values)
Le format TSV (Tab-Separated Values) est une spécification formelle de stockage tabulaire en texte brut appartenant à la famille des formats délimités. Formellement défini par l’Internet Assigned Numbers Authority (IANA) sous le type MIME text/tab-separated-values, le TSV organise les enregistrements matriciels selon une structure bidimensionnelle stricte. Dans ce format, chaque ligne textuelle correspond à une observation empirique ou une entité vectorielle, tandis que chaque champ ou variable au sein d’une ligne est rigoureusement séparé de ses voisins par un caractère de tabulation horizontale. Sur le plan de la codification binaire, ce délimiteur correspond au point de code décimal 9 de la table ASCII standard, couramment représenté en notation hexadécimale par 0x09 et dans la plupart des grammaires de programmation par la séquence d’échappement t.
L’avantage cardinal du format TSV par rapport au CSV conventionnel réside dans l’intégrité contextuelle des données textuelles libres. Dans de multiples protocoles expérimentaux, qu’il s’agisse de transcriptions d’entretiens psychométriques, d’annotations génomiques complexes ou de journaux d’erreurs informatiques, le texte brut contient fréquemment des virgules grammaticales, des points-virgules ou des doubles guillemets. Dans un fichier CSV, la présence de ces caractères impose l’usage systématique de mécanismes d’échappement complexes et de délimiteurs de chaînes (tels que les guillemets anglais doubles), ce qui complexifie l’analyseur syntaxique (parser) et multiplie les risques de scission de colonnes involontaire. À l’inverse, l’usage de la tabulation horizontale dans un corpus discursif non formaté est statistiquement rarissime, conférant au TSV une immunité structurelle remarquable face aux corruptions syntaxiques de segmentation.
En matière d’encodage, les fichiers TSV contemporains adoptent universellement la norme internationale UTF-8, permettant une prise en charge intégrale des alphabets polytoniques, des caractères diacritiques romans et des logogrammes d’Asie orientale. Toutefois, certains corpus historiques d’origine gouvernementale ou universitaire demeurent encodés sous d’anciennes pages de code régionales comme ISO-8859-1 (Latin-1) ou Windows-1252. La représentation des retours à la ligne répond quant à elle aux conventions canoniques des systèmes sous-jacents, opposant le saut de ligne Unix (LF, n, 0x0A) au saut de ligne combiné Windows (CRLF, rn, 0x0D0A), une dualité que les parseurs robustes se doivent de neutraliser automatiquement.
1.2 Comparaison structurelle entre TSV, CSV et autres délimiteurs
Une analyse comparative rigoureuse des délimiteurs tabulaires met en exergue des divergences fondamentales touchant à l’ambiguïté morphologique et à l’efficience de traitement. La virgule (,), pivot du format CSV, souffre d’une surcharge sémantique majeure à l’échelle internationale. Dans le monde anglo-saxon, elle sépare les champs de données ou isole les milliers dans les grands nombres, tandis que dans la quasi-totalité des pays d’Europe continentale et d’Amérique latine, elle fait office de séparateur décimal mathématique. L’ingestion d’un CSV non standardisé généré par un tableur configuré en environnement francophone provoque immanquablement la désintégration de variables continues en fragments lexicaux erronés, à moins d’adapter manuellement le délimiteur vers le point-virgule (;).
La tabulation horizontale transcende intégralement cette problématique de localisation culturelle. Étant sémantiquement neutre au regard de la ponctuation grammaticale et des notations numériques numériques universelles, elle permet une segmentation binaire instantanée. Sur le plan algorithmique, la détection du caractère 0x09 dans un flux d’octets permet au moteur d’ingestion de découper les jetons (tokens) sans avoir à scruter récursivement si le délimiteur rencontré est enchâssé à l’intérieur d’un bloc textuel encapsulé par des guillemets doubles. Cette propriété simplifie considérablement l’automate à états finis régissant l’analyse lexicale, diminuant le nombre de cycles CPU requis pour segmenter chaque ligne de données.
En outre, l’interopérabilité offerte par le TSV au sein de l’écosystème scientifique est optimale. Les outils d’analyse statistique en ligne de commande, tels que les utilitaires GNU (awk, cut, sed, sort), considèrent par défaut la tabulation comme délimiteur intrinsèque des flux de données. Les tableurs de référence, comme Microsoft Excel, LibreOffice Calc ou Apple Numbers, interprètent instantanément les flux TSV déposés dans le presse-papier sans exiger le recours à des assistants de conversion textuelle. Dès lors qu’un corpus textuel volumineux doit transiter entre des logiciels spécialisés de modélisation bayésienne ou des environnements de calcul distribué sans déperdition de structure, le TSV s’affirme comme le dénominateur commun le plus efficient.
1.3 Rôle de la bibliothèque Pandas dans l’écosystème Python
Dans l’univers du calcul scientifique articulé autour du langage Python, la bibliothèque Pandas joue le rôle d’interface structurante pour les flux d’information tabulaire. Conçue initialement par Wes McKinney pour répondre aux impératifs d’analyse quantitative en finance, Pandas repose sur une abstraction mathématique fondamentale : le DataFrame. Il s’agit d’une structure de données bidimensionnelle, hétérogène et mutable en taille, pourvue d’axes étiquetés désignant formellement les lignes (l’index) et les colonnes. Cette abstraction transcende les limitations des simples matrices multidimensionnelles numériques en permettant la cohabitation rigoureuse de séries chronologiques, d’indicateurs qualitatifs discrets, de chaînes textuelles arbitraires et de mesures en virgule flottante.
Pandas ne fonctionne pas en vase clos ; elle constitue l’épine dorsale d’un écosystème hautement intégré. Elle s’appuie directement sur NumPy pour l’allocation contiguë de vecteurs en mémoire et le calcul matriciel sous-jacent, tout en servant de passerelle immédiate vers les modules de modélisation statistique avancée comme SciPy, statsmodels et scikit-learn. Lorsqu’un analyste sollicite l’ingestion d’un fichier TSV, Pandas mobilise des algorithmes d’entrée/sortie (I/O) optimisés capables de convertir un flux d’octets brut séquentiel en structures de mémoire vive prêtes pour la vectorisation mathématique.
L’apport de Pandas à la recherche scientifique reproductible est inestimable. En encapsulant les variations de syntaxe, les exceptions d’encodage et les anomalies morphologiques au sein d’une API programmatique cohérente, elle garantit que le pipeline de chargement des données demeure rigoureusement traçable et scripté de bout en bout. L’absence de manipulations manuelles via des interfaces graphiques écarte les risques d’altération silencieuse des données empiriques, assurant ainsi une auditabilité totale du cycle de vie des jeux de données, depuis leur lecture sur support persistant jusqu’aux restitutions inférentielles finales.
2. Syntaxe fondamentale de pd.read_csv() pour les fichiers TSV
L’ingestion d’un fichier délimité par des tabulations s’opère dans Pandas par l’intermédiaire d’une fonction polymorphe d’une extrême richesse : la méthode pandas.read_csv(). Bien qu’historiquement nommée en référence au format à virgules, cette fonction constitue en réalité un parseur universel de fichiers plats délimités, dont le comportement est orchestré par un ensemble précis de paramètres d’ingestion.
2.1 Le paramètre clé sep=’t’ et l’alternative delimiter
Le point d’ancrage fondamental pour contraindre pd.read_csv() à traiter un fichier TSV réside dans la manipulation du paramètre sep. Par défaut, ce dernier est initialisé avec la valeur de chaîne ','. Pour ordonner au moteur de segmentation d’isoler les champs sur la base des tabulations horizontales, il convient d’assigner rigoureusement à ce paramètre la chaîne d’échappement 't'. L’interpréteur Python traduit cette séquence de deux caractères en l’unique point de code ASCII 0x09, lequel est ensuite transmis directement au cœur de l’analyseur lexical compilé.
Il importe de souligner que la signature de la fonction pd.read_csv() propose également un argument nommé delimiter. Sur le plan strictement fonctionnel, les deux paramètres sont de parfaits synonymes : l’argument delimiter a été introduit à des fins de compatibilité syntaxique avec le module standard csv de Python ainsi qu’avec d’autres bibliothèques tierces. Cependant, dans les standards stylistiques de Pandas et les conventions de codage professionnelles, l’usage de sep est unanimement privilégié pour préserver la concision et la lisibilité du code source. Si un développeur transmet simultanément les arguments sep et delimiter avec des valeurs contradictoires, Pandas lèvera systématiquement une exception ou générera un comportement indéfini, raison pour laquelle l’utilisation exclusive de sep='t' s’impose comme une bonne pratique fondamentale.
En outre, le paramètre sep accepte des expressions régulières lorsque le moteur d’analyse sous-jacent est spécifié en mode Python pur (engine='python'). Cela permet, le cas échéant, de segmenter des fichiers présentant des tabulations multiples consécutives traitées comme une frontière unique via l’expression régulière sep='t+'. Néanmoins, pour les fichiers TSV canoniques respectant scrupuleusement la spécification de l’IANA où chaque tabulation isole un champ vide potentiel, le recours à la chaîne littérale standard sep='t' est impératif afin de préserver la correspondance structurelle de la matrice sans court-circuiter l’évaluation des valeurs manquantes.
2.2 Chargement basique d’un fichier TSV local
L’exécution pratique de l’importation requiert une clarification méthodologique quant à la désignation du chemin d’accès au fichier cible sur le support de stockage physique. Pandas prend en charge nativement les chemins absolus (ancrés à la racine du système de fichiers de la machine hôte) et les chemins relatifs (calculés à partir du répertoire de travail courant depuis lequel le script ou le carnet interactif est exécuté). Pour prémunir le code contre les incompatibilités structurelles entre systèmes d’exploitation — notamment la divergence historique entre les barres obliques de Linux/macOS (/) et les barres obliques inversées de Windows () —, il est fortement recommandé d’utiliser des objets issus du module standard pathlib.
Considérons l’instruction canonique d’importation dans un environnement Python : l’import préalable de la bibliothèque via l’alias universel conventionnel import pandas as pd permet d’appeler l’instruction df = pd.read_csv('donnees_experimentales.tsv', sep='t'). Dans cette expression élémentaire, le parseur ouvre le flux binaire associé au fichier désigné, lit les premiers blocs d’octets pour initialiser ses mémoires tampons, scinde les flux en fonction des tabulations et des sauts de ligne, puis instancie un DataFrame complet en mémoire vive sans exiger le paramétrage explicite des dizaines d’autres arguments optionnels pris en charge par l’algorithme.
Une vérification immédiate du succès de l’opération consiste à contrôler que la variable retournée référence bel et bien un pointeur d’objet valide. Si le chemin d’accès est erroné ou que le fichier s’avère inaccessible pour des raisons de permissions d’accès au système de fichiers, l’interpréteur interrompt le flux d’exécution et soulève l’exception standard FileNotFoundError ou PermissionError. L’utilisation d’une encapsulation par blocs de capture d’exceptions try...except constitue dès lors une précaution élémentaire lors de l’intégration de cette instruction au sein de pipelines de production automatisés.
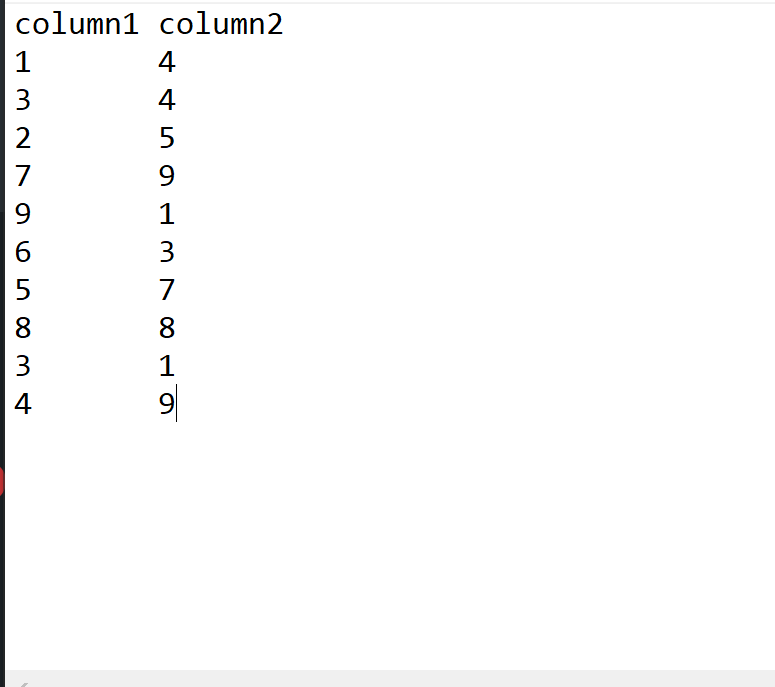
2.3 Vérification de la structure : exploration initiale du DataFrame
Une fois l’opération d’ingestion menée à son terme, il est indispensable de procéder à un audit structurel immédiat de l’objet nouvellement matérialisé. Cet audit vise à certifier que le séparateur d’origine a été interprété avec exactitude et que le fichier n’a pas été agglutiné en une unique colonne textuelle monstrueuse, anomalie classique survenant lorsqu’un fichier TSV est malencontreusement lu avec le séparateur par défaut à virgule.
La première instruction d’inspection consiste à solliciter la fonction native type(df), dont le retour doit rigoureusement correspondre à la classe pandas.core.frame.DataFrame. Immédiatement après, l’évaluation de la dimensionalité s’effectue au travers de la propriété matricielle df.shape. Cet attribut renvoie un tuple d’entiers de la forme (N, P), où N correspond au nombre total d’observations (lignes) indexées et P au nombre de variables (colonnes) identifiées. La concordance entre la valeur P observée et le nombre théorique de champs tabulés attendus constitue la première preuve formelle de la validité du parsing.
L’étape exploratoire suivante mobilise la méthode df.head(n=5), laquelle restitue un sous-ensemble projeté des cinq premiers enregistrements du tableau sous une mise en forme lisible. Cette restitution permet de vérifier visuellement l’alignement des données, la séparation correcte des textes vis-à-vis des valeurs chiffrées et la conformité des noms de colonnes. Parallèlement, l’inspection de l’index d’axe s’effectue en interrogeant la propriété df.columns, qui fournit la liste ordonnée des étiquettes dimensionnelles, et l’attribut df.index, qui décrit la nature de la séquence d’indexation des observations, généralement configurée par défaut sous la forme d’un objet RangeIndex débutant à l’entier zéro.
3. Lecture d’un fichier TSV doté d’une ligne d’en-tête (Header)
Dans la typologie usuelle des fichiers TSV scientifiques, la toute première ligne textuelle est quasi systématiquement allouée à la désignation descriptive des dimensions de mesure. Cette convention morphologique fondamentale, communément désignée sous le terme d’en-tête ou header, simplifie l’assignation immédiate de clés sémantiques aux séries numériques contenues dans le corps du document.
3.1 Comportement par défaut avec le paramètre header=’infer’
La fonction pd.read_csv() intègre nativement un mécanisme d’inférence sémantique sophistiqué gouverné par la valeur implicite de son paramètre : header='infer'. Dans la configuration courante où aucune spécification manuelle n’est fournie, ce mécanisme analyse le premier enregistrement non vide rencontré au sein du fichier plat. S’il constate que cette première ligne est constituée de chaînes de caractères disjointes séparées par des tabulations, il l’isole structurellement de la masse des données empiriques et promeut ses différents termes au rang de métadonnées d’identification pour les colonnes du DataFrame.
Ce procédé d’inférence automatique s’avère particulièrement efficient dans la majorité des cas d’usage réguliers, mais il induit des conséquences directes sur la chaîne de typage des valeurs sous-jacentes. En interceptant la ligne d’en-tête, le moteur d’ingestion soustrait les étiquettes textuelles de la procédure d’inférence des types numériques. Les colonnes numériques situées sous ces étiquettes peuvent ainsi être directement identifiées et converties en types scalaires natifs de haute performance (tels que int64 ou float64), sans risque de voir toute la série contaminée et déclassée vers le type générique object en raison de la présence d’une chaîne textuelle en position initiale.
Néanmoins, les limites de cette heuristique se révèlent dès lors que le fichier TSV intègre un préambule documentaire informel, comme des mentions de licence de données, des lignes d’horodatage expérimental ou des descriptions textuelles d’appareillages de mesure précédant le tableau réel. Dans ces configurations, l’inférence automatique assimilera à tort la première ligne de métadonnées brutes aux noms des variables analytiques, engendrant un décalage structurel sévère. Une formalisation explicite des paramètres de lecture devient alors indispensable pour guider l’analyseur lexical vers la ligne d’en-tête effective.
3.2 Exemple pratique : Importation et affichage des données tabulées
Pour illustrer la mécanique opératoire d’ingestion d’un fichier tabulé régulier, formalisons un exemple pratique d’architecture de données textuelles. Supposons l’existence d’un fichier stocké sous l’identifiant mesures_laboratoire.tsv, dont le contenu textuel brut répond à la disposition syntaxique suivante :
identifiant_sujetttemps_reaction_msttaux_erreurtcondition_test
S01t245.8t0.02tControle
S02t312.4t0.08tStress_Thermique
S03t198.1t0.00tControle
S04t405.6t0.15tPrivation_Sommeil
L’exécution de la commande de lecture standardisée s’articule comme suit dans un script d’analyse :
import pandas as pd

chemin_fichier = "mesures_laboratoire.tsv"

df_mesures = pd.read_csv(chemin_fichier, sep='t', header='infer')
Lors de l’évaluation de cette expression, le parseur lit la première ligne, isole les quatre étiquettes sémantiques identifiant_sujet, temps_reaction_ms, taux_erreur et condition_test, puis procède à l’alignement univoque de chaque enregistrement ultérieur sur ces quatre repères dimensionnels. L’affichage du résultat via l’instruction standard print(df_mesures) permet de constater une restitution géométrique sans faille au sein du terminal d’exécution, chaque valeur empirique venant s’ordonner dans le vecteur de sa variable respective sans le moindre glissement ordinal.
3.3 Inspection des métadonnées et validation de la structure
Après chargement de ce tableau expérimental régulier, le protocole méthodologique impose une vérification rigoureuse des propriétés structurelles des objets générés. La première métadonnée d’importance réside dans l’objet d’indexation accessible via la commande df_mesures.columns. Ce vecteur d’index renvoie un objet spécialisé Index(['identifiant_sujet', 'temps_reaction_ms', 'taux_erreur', 'condition_test'], dtype='object'), certifiant l’incorporation formelle des labels.
L’étape subséquente exige une inspection systématique des types élémentaires déduits par l’environnement logiciel au moyen de l’attribut df_mesures.dtypes. Pour le jeu de données susmentionné, l’analyste constate que Pandas a automatiquement et adéquatement assigné le type object (dédié aux chaînes de caractères en mémoire Python) aux variables nominales identifiant_sujet et condition_test, tout en promouvant les métriques continues temps_reaction_ms et taux_erreur au standard de précision en virgule flottante float64.
Pour parachever cette vérification liminaire, la méthode synthétique df_mesures.info() offre une vue synoptique exhaustive. Elle récapitule non seulement la classe de la structure, le nombre total d’enregistrements (ici 4 entrées étiquetées de 0 à 3) et le dénombrement des valeurs non nulles par attribut, mais délivre également une estimation précise de l’empreinte en mémoire vive consommée par le DataFrame. Cette procédure de diagnostic précoce prévient l’exécution de modélisations mathématiques invalides sur des colonnes dont le format interne aurait été mal interprété lors de l’ingestion initiale.
4. Gestion des fichiers TSV dépourvus d’en-tête
Tous les jeux de données tabulés ne répondent pas aux standards documentaires idéaux. Dans de nombreux contextes de calcul haute performance ou d’acquisition automatisée par des capteurs embarqués à microcontrôleurs, les lignes d’en-tête textuelles sont délibérément omises afin de limiter l’entropie des flux binaires et de maximiser la compacité des fichiers enregistrés sur disque.
4.1 Utilisation explicite de header=None
L’ingestion d’un fichier TSV dépourvu de métadonnées d’en-tête représente un piège analytique majeur lorsque le paramètre par défaut header='infer' demeure actif. En l’absence de directive contraire, le moteur lexical intercepte la première ligne d’observations factuelles et l’impose indûment comme étiquette des colonnes. Dès lors, cette observation initiale est irrémédiablement retranchée de la population statistique du jeu de données, introduisant une distorsion expérimentale silencieuse et faussant l’intégralité des calculs d’agrégation ultérieurs (moyennes, écarts-types, distributions marginales).
Pour neutraliser rigoureusement ce comportement et contraindre le parseur à considérer l’intégralité du fichier comme un flux ininterrompu d’observations factuelles, il est indispensable de spécifier le paramètre booléen nul header=None dans la signature de chargement. Cette instruction a pour effet immédiat de désactiver l’algorithme d’inférence d’en-tête, garantissant la préservation intégrale des lignes de données au sein de la matrice opérationnelle.
Sur le plan computationnel, l’usage de header=None modifie également le traitement du typage dès la ligne d’ouverture. Aucune chaîne textuelle arbitraire n’étant promue artificiellement au titre de descripteur d’axe, l’évaluation des types par blocs vectoriels s’applique de manière uniforme de la première à la dernière ligne physique du fichier TSV, garantissant une estimation statistique strictement intègre de la taille de l’échantillon d’observation.
4.2 Attribution d’index numériques séquentiels aux colonnes
Lorsqu’un fichier TSV est ingéré sous la directive header=None, Pandas résout le problème de l’étiquetage des colonnes en attribuant une séquence arithmétique d’entiers naturels continus. L’axe dimensionnel des variables se voit dès lors indexé selon l’intervalle [0, 1, 2, ..., P-1], où P représente le nombre total de variables segmentées par les tabulations horizontales.
Ce mécanisme repose en interne sur la génération d’un objet spécialisé nommé RangeIndex appliqué aux colonnes. L’accès aux séries statistiques ne s’effectue plus via des désignations nominales descriptives, mais au travers d’indices positionnels stricts, tels que df[0] pour solliciter le premier vecteur tabulé ou df.iloc[:, 1] pour projeter le second champ d’observations. Bien que cette structure garantisse une manipulation fonctionnelle immédiate du tableau matriciel, elle introduit un risque d’obscurcissement cognitif et d’erreurs méthodologiques au sein de scripts d’analyse étendus, l’analyste devant mémoriser arbitrairement la signification sous-jacente de chaque entier de position.
Par conséquent, si la configuration de colonnes indexées par des entiers s’avère parfaitement tolérable lors de phases de prototypage rapide ou de calculs matriciels abstraits, elle constitue une vulnérabilité critique pour la pérennité et la maintenabilité des chaînes de traitement de données documentées. Une formalisation lexicale des colonnes doit impérativement intervenir lors du chargement.
4.3 Définition de noms de colonnes personnalisés via le paramètre names
Pour concilier l’absence d’en-tête au sein du fichier source physique et l’exigence de clarté documentaire au sein du code applicatif, la bibliothèque Pandas met à disposition le paramètre fondamental names. Cet argument accepte une séquence ordonnée (le plus couramment une liste de chaînes de caractères en Python) dont les éléments sont directement mappés sur les champs délimités par les tabulations, de gauche à droite.
L’utilisation combinée des paramètres s’articule formellement ainsi :
labels_colonnes = ['identifiant_patient', 'pression_systolique', 'pression_diastolique', 'frequence_cardiaque']

df_physio = pd.read_csv('mesures_brutes.tsv', sep='t', header=None, names=labels_colonnes)
Dans cette architecture déclarative, la présence conjointe de header=None et de names=labels_colonnes ordonne explicitement au parseur de conserver l’intégralité des lignes textuelles dans le corps du DataFrame, tout en superposant instantanément la nomenclature fournie sur les axes verticaux. Si un analyste omettait header=None en spécifiant uniquement names sur un fichier possédant originellement un en-tête, Pandas écraserait la première ligne de métadonnées en la remplaçant par les nouveaux labels, mais si le fichier n’en possédait pas, l’omission de header=None conduirait à l’écrasement irrémédiable de la première ligne empirique du fichier source.
Il importe en outre de veiller à ce que la cardinalité de la liste transmise à names coïncide rigoureusement avec le nombre réel de champs isolés par les tabulations au sein du fichier TSV. Si la liste de noms comporte moins d’éléments que de colonnes physiques détectées, Pandas interprétera par défaut les premières colonnes de données comme constituant un index hiérarchique de lignes, bouleversant dramatiquement la géométrie du tableau produit.
5. Gestion avancée de l’indexation et sélection des colonnes
La volumétrie et la complexité des fichiers TSV exploités dans les infrastructures scientifiques exigent fréquemment des stratégies de chargement sélectives. Charger l’intégralité d’un corpus matriciel lorsque seules quelques dimensions analytiques s’avèrent nécessaires constitue une aberration en termes d’allocation de ressources computationnelles.
5.1 Définition d’une variable comme index via index_col
Par défaut, lors de l’ingestion d’un flux tabulé, Pandas adjoint au DataFrame résultant un index séquentiel arbitraire (RangeIndex) numéroté de 0 à N-1. Toutefois, dans une immense majorité de situations expérimentales ou administratives, le jeu de données intègre d’emblée une variable de clé primaire naturelle : un identifiant univoque de transaction, un code échantillon de laboratoire, une immatriculation génomique ou un numéro de sécurité sociale anonymisé.
Le paramètre index_col permet de désigner expressément la ou les colonnes devant être immédiatement promues au rang d’index d’axe des lignes lors de la phase de segmentation textuelle. Cet argument peut être instancié de deux manières distinctes : soit par l’entremise d’une référence ordinale entière (par exemple index_col=0 pour convertir la première colonne délimitée en index de ligne), soit par l’intermédiaire de l’étiquette textuelle de la colonne concernée lorsque le fichier dispose d’un en-tête valide (par exemple index_col='identifiant_patient').
Cette approche apporte un gain substantiel en matière d’architecture computationnelle. La conversion immédiate d’une variable unique en index permet à Pandas de structurer en interne les clés sous forme de tables de hachage hautement véloces, conférant aux futures opérations de projection, de sélection par clé via l’opérateur .loc[] et d’alignement inter-tables une complexité algorithmique en temps constant O(1), là où une recherche séquentielle conventionnelle sur une série non indexée opérerait en temps linéaire O(N).
5.2 Sélection ciblée d’un sous-ensemble de variables avec usecols
Dans de nombreuses disciplines quantitatives, les fichiers TSV générés par des instruments automatisés d’observation peuvent contenir des dizaines, voire des centaines de colonnes contextuelles inutiles pour l’hypothèse de recherche étudiée. Le paramètre usecols intervient alors comme un filtre d’ingestion à la source, interdisant au moteur de lecture d’allouer de la mémoire vive pour les colonnes non sollicitées.
Le paramètre usecols fait preuve d’une souplesse d’utilisation exemplaire. Il accepte en premier lieu une liste explicite d’identifiants de colonnes (au format chaînes de caractères correspondant aux étiquettes d’en-tête, ou au format indices entiers positionnels). Par exemple, la directive pd.read_csv('sequence.tsv', sep='t', usecols=['identifiant', 'valeur_signal']) ordonne au parseur de segmenter l’ensemble de la ligne mais d’abandonner immédiatement les colonnes surnuméraires sans les matérialiser en objets Python persistants.
En second lieu, usecols accepte des fonctions personnalisées sous la forme de callables ou d’expressions lambda. Cette disposition avancée permet de formaliser des sélections dimensionnelles dynamiques sans avoir à connaître l’inventaire complet des colonnes à l’avance. L’instruction suivante illustre ce principe avec élégance :
df_filtre = pd.read_csv('donnees_capteurs.tsv', sep='t', usecols=lambda col: col.startswith('mesure_') or col == 'timestamp')
Cette commande filtre à la volée toutes les colonnes dont le libellé débute par le préfixe spécifié ou correspond rigoureusement à l’horodatage, éliminant ainsi les données techniques parasites et réduisant drastiquement la sollicitation du bus mémoire du système lors du traitement de fichiers textuels gigantesques.
5.3 Saut de métadonnées et de lignes superflues (skiprows, skipfooter)
Une pathologie récurrente des fichiers de données scientifiques réside dans l’adjonction de blocs documentaires informels disposés au sommet ou à la base du document textuel. Les logiciels d’acquisition physique inscrivent couramment des mentions de configuration instrumentale au sommet du fichier, tandis que des statistiques récapitulatives de clôture ou des signatures cryptographiques viennent ponctuer la terminaison du document.
Le paramètre skiprows offre une réponse directe à la présence de ces blocs liminaires parasites. Configuré avec un entier simple skiprows=K, il contraint le pointeur de fichier à ignorer purement et simplement les K premières lignes physiques du fichier avant d’initier la procédure de parsing et d’identification de l’en-tête. En outre, skiprows peut se voir assigner une liste d’entiers explicites pour écarter des lignes discontinues, ou une fonction callable retournant un booléen pour écarter par exemple toute ligne textuelle débutant par un symbole de commentaire conventionnel tel que le dièse (#), bien que le paramètre dédié comment='#' puisse également être employé à cette fin.
À l’autre extrémité du spectre structurel, le paramètre skipfooter permet d’interdire la lecture des M dernières lignes du fichier source, prévenant ainsi l’intégration accidentelle de résumés statistiques ou de totaux de contrôle au sein des vecteurs de données brutes. Néanmoins, l’analyste doit impérativement garder à l’esprit une contrainte technique fondamentale : l’utilisation du paramètre skipfooter est strictement incompatible avec le moteur d’analyse C haute vélocité de Pandas. Son invocation force mécaniquement l’activation du moteur en langage Python pur (engine='python'), induisant une baisse sensible des débits d’ingestion sur les fichiers volumineux, le calcul du nombre de lignes de fin imposant une analyse intégrale préalable du fichier sur disque.
6. Spécification rigoureuse et coercition des types de données
L’une des fonctionnalités les plus séduisantes, mais également les plus potentiellement pernicieuses de la bibliothèque Pandas réside dans son moteur d’inférence automatique de types de données. Laissé à lui-même, ce système heuristique peut commettre des erreurs d’interprétation lourdes de conséquences scientifiques et compromettre l’efficience de calcul du système hôte.
6.1 Inférence automatique des types par Pandas et ses limites
Pour chaque colonne d’un fichier TSV, le parseur standard inspecte un sous-ensemble séquentiel d’enregistrements initiaux afin de déterminer le type de données scalaire le plus approprié. Si une colonne ne contient que des séquences de chiffres, elle sera typée en entier (int64) ; si elle intègre des séparateurs décimaux, elle migrera vers les réels à double précision (float64) ; enfin, dès qu’une chaîne non numérique apparaît, l’intégralité du vecteur est coercée vers le type générique object, correspondant en interne à des pointeurs d’adresses d’objets Python hétérogènes.
Cette approche présente de sévères limitations dans les contextes industriels et de recherche. Le premier écueil concerne la surconsommation mémoire : Pandas tend à attribuer systématiquement le conteneur float64 ou int64 (pesant 8 octets par valeur unitaire), y compris pour des variables n’exigeant structurellement qu’un entier signé sur 8 bits (comme une variable booléenne ou une réponse à une échelle de Likert bornée de 1 à 7). Le second écueil, bien plus critique encore, concerne l’altération sémantique des identifiants alphanumériques. Des codes postaux régionaux, des numéros d’échantillons ou des codes d’inventaire débutant par des zéros non significatifs (par exemple 004521) sont fréquemment interprétés par l’inférence comme des nombres entiers, provoquant la suppression immédiate et silencieuse des zéros de tête (devenant 4521), ce qui corrompt irrémédiablement la clé d’identification.
En outre, lorsque le fichier TSV est d’une grande profondeur temporelle et comporte plusieurs centaines de milliers de lignes, le comportement du parseur peut déclencher l’alerte d’exécution DtypeWarning. Cet avertissement survient lorsque le moteur C découvre, au-delà du bloc initial échantillonné, des types hétérogènes contredisant ses suppositions de départ, l’obligeant à un reclassement d’urgence en mémoire vive au détriment dramatique des performances d’exécution.
6.2 Attribution explicite des types au moyen du paramètre dtype
Pour ériger un pipeline de traitement robuste, déterministe et économe en ressources de calcul, la bonne pratique fondamentale consiste à désactiver l’inférence arbitraire en imposant une typologie explicite dès la phase d’ingestion. Cette coercition contrôlée s’opère au moyen du paramètre dtype, lequel reçoit usuellement un dictionnaire associant chaque nom de variable à un type NumPy ou une extension typée native de Pandas.
Considérons la configuration programmatique suivante appliquée à un protocole de données médicales :
types_structures = {

    'code_dossier': str,

    'age_patient': 'uint8',

    'score_depression': 'float32',

    'groupe_sanguin': 'category'

}

df_clinique = pd.read_csv('cohorte.tsv', sep='t', dtype=types_structures)
Dans ce modèle d’ingestion, le champ code_dossier est expressément verrouillé en chaîne textuelle (str), sanctuarisant la conservation inaltérée d’éventuels zéros initiaux ou caractères d’échappement. L’assignation du type entier non signé sur huit bits uint8 pour l’âge limite l’allocation à 1 unique octet par individu au lieu des 8 octets traditionnels, divisant par huit l’empreinte de ce vecteur. L’emploi de réels sur 32 bits (float32) divise par deux le volume de la variable de score continu tout en conservant une précision amplement suffisante pour la psychométrie.
Enfin, l’assignation du type category sur la variable nominale groupe_sanguin métamorphose radicalement la gestion interne des chaînes redondantes. Au lieu d’allouer des milliers d’instances d’objets chaînes identiques dispersées dans la mémoire vive, Pandas crée une table d’encodage d’entiers compacts couplée à un glossaire unique de modalités. Sur des tables contenant des millions d’enregistrements comportant des variables qualitatives répétitives, ce paramétrage réduit couramment l’empreinte globale du DataFrame de 80 à 90 % dès l’instant de son franchissement de la mémoire de disque vers la mémoire vive.
6.3 Conversion et interprétation des horodatages avec parse_dates
La dimension temporelle constitue l’un des piliers de l’analyse empirique moderne, qu’il s’agisse de relever des dynamiques climatiques, des cours boursiers ou des séries chronologiques d’essais comportementaux. Or, dans un fichier TSV standard, les horodatages ne sont rien d’autre que des chaînes de caractères brutes (par exemple "2023-10-15 14:32:01.452") dépourvues de toute intelligence temporelle native.
Le paramètre parse_dates informe l’analyseur syntaxique qu’il doit convertir ces représentations textuelles en objets temporels unifiés de classe datetime64[ns]. Cet argument accepte des structures variées : une liste simple de noms de colonnes ou d’indices positionnels pour convertir des variables isolées, ou encore une liste de listes (par exemple parse_dates=[['annee', 'mois', 'jour']]) ordonnant à Pandas de combiner plusieurs champs distincts en un unique vecteur chronologique consolidé.
Dans les versions contemporaines de Pandas, l’accélération de ce processus d’interprétation chronologique peut être optimisée grâce au paramètre complémentaire date_format. Lorsque le schéma des horodatages du fichier TSV est strictement unifié (par exemple selon la norme internationale ISO 8601 "%Y-%m-%d %H:%M:%S"), spécifier ce format explicite permet au parseur d’éviter de tester itérativement de multiples heuristiques de détection de date sur chaque ligne du fichier. Ce choix d’ingestion confère un gain de vitesse pouvant atteindre un ordre de grandeur sur des millions de jalons temporels, tout en assurant une conformité parfaite vis-à-vis des fuseaux horaires (UTC).
7. Traitement des valeurs manquantes et des valeurs non conformes
La complétude parfaite d’un jeu de données empiriques relève de la pure utopie expérimentale. Défaillances instrumentales, refus d’obtempérer des participants lors d’enquêtes ou pannes de capteurs télémétriques génèrent inévitablement des lacunes structurelles que le moteur d’ingestion doit identifier, classifier et isoler avec une rigueur absolue pour éviter toute distorsion mathématique.
7.1 Identification des sentinelles de données nulles avec na_values
Par défaut, la fonction pd.read_csv() intègre un dictionnaire interne exhaustif de sentinelles textuelles considérées nativement comme traduisant l’absence de donnée : des mentions telles que '' (chaîne vide), '#N/A', '#N/A N/A', '#NA', '-1.#IND', '-1.#QNAN', '-NaN', '-nan', '1.#IND', '1.#QNAN', '', 'N/A', 'NA', 'NULL', 'NaN', 'None', 'n/a', 'nan' et 'null' sont automatiquement interceptées et remplacées par la sentinelle à virgule flottante IEEE standard numpy.nan (ou l’objet indicateur pd.NA pour les extensions typées de Pandas).
Cependant, dans de nombreuses disciplines académiques et industrielles, les concepteurs de systèmes d’acquisition emploient des conventions de codage spécifiques pour désigner l’absence de réponse, le dysfonctionnement d’un transducteur ou la non-applicabilité d’une mesure. Des valeurs sentinelles comme -999, 9999, "NON_DISPONIBLE", "REFUS" ou encore un simple point isolé "." (courant dans les anciens exports statistiques SAS ou SPSS) ne sont pas reconnues nativement par Pandas et demeurent intégrées comme des valeurs empiriques réelles, corrompant les calculs de moyennes qui intègrent alors d’aberrants scores de -999.
Le paramètre na_values résout cette pathologie en permettant de déclarer des motifs de nullité sur mesure. Il peut recevoir une simple liste de valeurs sentinelles ou, de manière encore plus robuste et ciblée, un dictionnaire spécifiant des règles de nullité distinctes selon les colonnes étudiées :
sentinelles_nulles = {

    'vitesse_vent': [-999.0, 999.9],

    'reponse_questionnaire': ['REFUS', 'INAPPLICABLE', '99'],

    'identifiant_sujet': []

}

df_meteo = pd.read_csv('stations.tsv', sep='t', na_values=sentinelles_nulles)
Cette approche granulaire garantit que le nombre 99 ne sera converti en NaN que dans le champ des questionnaires, évitant ainsi d’effacer une observation authentique de vitesse de vent s’élevant fortuitement à 99 km/h.
7.2 Gestion des lignes vides et filtrage via keep_default_na
Une interaction subtile s’opère entre les sentinelles personnalisées et la liste prédéfinie de Pandas. Par défaut, le paramètre booléen keep_default_na est assigné à True, ce qui signifie que vos valeurs transmises à na_values s’ajoutent à la liste des sentinelles internes. Or, dans certaines architectures lexicales, cette fusion automatique engendre de graves altérations contextuelles. Le cas d’école le plus célèbre concerne les codes de pays définis selon la norme ISO 3166-1 alpha-2 : le code territorial de la Namibie étant NA, Pandas le convertit d’office en valeur manquante NaN si keep_default_na n’est pas explicitement basculé à False.
En assignant keep_default_na=False, l’analyste désactive intégralement le catalogue d’inférence par défaut et impose à Pandas de ne considérer comme valeurs manquantes exclusivement et strictement que les chaînes répertoriées dans le dictionnaire ou la liste fournis via na_values. Cette rigueur déclarative s’impose comme une nécessité absolue dans le traitement de données internationales comportant des acronymes administratifs.
Parallèlement, la prise en charge des interruptions matérielles de flux textuels est régulée par l’argument skip_blank_lines. Activé par défaut (True), ce paramètre instruit le parseur de franchir les lignes physiques entièrement vides (c’est-à-dire ne contenant que des séquences de saut de ligne immédiates) sans instancier des rangées entières de valeurs NaN. Si, dans un schéma matriciel strict, une ligne entièrement vide revêt une signification séquentielle (comme la démarcation formelle de deux blocs expérimentaux), la bascule de cet argument à False préserve ces discontinuités au sein de l’index de lignes résultant.
7.3 Stratégies d’évaluation immédiate de la complétude
Dès l’achèvement de l’étape de parsing, l’analyste se doit d’auditer la distribution spatiale des cellules manquantes afin de valider l’intégrité globale de l’ingestion du TSV. La métrique de contrôle immédiate s’obtient par l’assemblage matriciel d’opérateurs booléens :
rapport_manquants = df.isna().sum()

taux_attrition = (df.isna().mean() * 100).round(2)
Cette double évaluation quantifie le décompte absolu et la proportion relative de données lacunaires variable par variable. Une prolifération inattendue de valeurs manquantes sur une colonne théoriquement continue constitue le signal d’alarme archétypal d’une faille dans le séparateur sep='t', souvent causée par l’intrusion d’espaces insécables ou de tabulations superflues ayant décalé les champs lexicaux vers la droite.
Si la stratégie de traitement impose un élagage préliminaire dès le franchissement du disque, certaines options permettent d’exclure les enregistrements incomplets. Cependant, la déontologie statistique commande généralement de réaliser cette sélection de façon maîtrisée en post-traitement au moyen de la méthode matricielle df.dropna(), afin de conserver une traçabilité totale sur les volumes d’observations retranchées et d’éviter les biais d’échantillonnage induits par des suppressions aveugles à l’entrée.
8. Gestion des encodages de caractères et des formats textuels
La sérialisation d’informations structurées dans un format textuel impose un pont entre le monde abstrait des glyphes alphabétiques et la réalité physique des agencements d’octets. Dès lors qu’un fichier TSV transite entre différentes architectures de systèmes d’exploitation, des conflits d’encodage peuvent provoquer des échecs d’ingestion critiques ou l’apparition de caractères corrompus (mojibake).
8.1 Prise en charge des encodages non standards (UTF-8, Latin-1, CP1252)
La bibliothèque Pandas utilise par défaut le système d’encodage universel UTF-8 pour décoder les flux d’octets d’un fichier TSV. Ce choix reflète les standards contemporains de l’Internet et de la recherche ouverte. Toutefois, lorsqu’un analyste est confronté à des extractions issues de vieux systèmes d’information hospitaliers, de bases de données patrimoniales ou de tableurs fonctionnant sur d’anciens postes Windows configurés pour le marché francophone, le fichier TSV peut être codé selon la norme ISO-8859-1 (Latin-1) ou l’encodage propriétaire Windows-1252 (CP1252).
Tenter de lire un fichier encodé en Latin-1 avec les paramètres par défaut d’UTF-8 conduit inévitablement à l’interruption du processus de lecture, le parseur C soulevant l’exception fatale :
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xe9 in position...: invalid continuation byte
L’octet 0xE9 correspond au caractère « é » en Latin-1, une séquence binaire jugée structurellement invalide au regard des règles d’assemblage multi-octets d’UTF-8.
Pour résoudre cette incompatibilité d’entrée, il est impératif de déclarer explicitement le schéma binaire approprié au moyen du paramètre encoding :
df_patrimoine = pd.read_csv('archives_1998.tsv', sep='t', encoding='latin1')
Le terme 'latin1' (ou son alias 'iso-8859-1') possède la particularité structurelle de faire correspondre chacun des 256 octets possibles à un caractère défini, ce qui supprime toute possibilité de blocage par UnicodeDecodeError, bien qu’un encodage inapproprié puisse alors résulter en un affichage aberrant des caractères spéciaux. Lorsque l’encodage source d’un fichier TSV volumineux demeure rigoureusement inconnu, il est possible de mobiliser des bibliothèques externes d’analyse probabiliste d’octets comme chardet ou charset_normalizer sur un bloc d’octets restreint afin d’estimer avec une haute probabilité le format avant de solliciter Pandas.
8.2 Gestion des guillemets et caractères d’échappement (quoting, escapechar)
Même au sein de la syntaxe propre au TSV, des chaînes de caractères complexes peuvent contenir de manière exceptionnelle des tabulations internes (par exemple une citation textuelle transcrite) ou des retours de chariot. Pour éviter que le parseur ne découpe ces éléments textuels en segments dimensionnels erronés, ces champs sont conventionnellement encadrés de guillemets doubles. La gestion de ces délimitations d’isolation est orchestrée par le paramètre quoting et ses arguments conjoints.
Le paramètre quoting s’alimente directement des constantes définies au sein du module standard csv de Python :
• csv.QUOTE_MINIMAL (valeur par défaut) : seuls les champs intégrant explicitement le délimiteur (t) ou des sauts de ligne sont encadrés.
• csv.QUOTE_ALL : ordonne au parseur de traiter l’intégralité des champs textuels comme étant encapsulés par des guillemets.
• csv.QUOTE_NONE : interdit absolument la reconnaissance des guillemets comme caractères de délimitation, traitant chaque guillemet comme un simple glyphe littéral.
Si un fichier TSV utilise un caractère spécifique pour neutraliser la sémantique de la tabulation ou des guillemets — le cas le plus classique étant l’usage de la barre oblique inversée d’échappement —, il est indispensable de renseigner l’argument escapechar=''. Cette configuration avertit le moteur que la présence d’une séquence telle que t à l’intérieur d’un bloc textuel ne doit pas être traitée comme une frontière de colonne, mais absorbée comme une simple tabulation littérale faisant partie intégrante du corps de la chaîne de données.
8.3 Régulation des anomalies de ligne avec on_bad_lines
Dans les corpus de grande envergure collectés sur des flux non contrôlés du web ou issus de concaténations massives de journaux d’événements, certaines lignes physiques peuvent se révéler corrompues, comportant accidentellement sept tabulations là où le schéma strict d’en-tête n’en attendait que quatre. Historiquement, une telle discordance provoquait la levée immédiate d’une exception fatale de type pandas.errors.ParserError, paralysant l’ensemble de la chaîne de traitement batch.
Les versions récentes de Pandas ont unifié et standardisé la résolution de ces pathologies morphologiques au travers du paramètre on_bad_lines, lequel propose trois attitudes computationnelles distinctes :
1. on_bad_lines='error' (comportement par défaut) : interrompt immédiatement l’exécution et soulève l’exception ParserError à la première irrégularité rencontrée, garantissant l’orthodoxie intégrale du jeu de données mais bloquant les processus automatisés continus.
2. on_bad_lines='warn' : intercepte l’irrégularité, écarte purement et simplement la ligne corrompue du DataFrame résultant, mais émet une alerte explicite (warning) dans les journaux système d’exécution indiquant le numéro d’ordre de la ligne physique rejetée.
3. on_bad_lines='skip' : élimine silencieusement et immédiatement les enregistrements non conformes, permettant le chargement fluide de millions d’enregistrements sans aucune pollution du flux de sortie standard.
En outre, les ingénieurs de données ont la faculté de transmettre à on_bad_lines une fonction callable personnalisée. Cette technique de haut niveau offre la possibilité d’intercepter la liste brute de jetons de la ligne défaillante, d’en consigner le contenu dans un fichier d’audit forensique distinct à des fins de correction ultérieure, ou de corriger dynamiquement le vecteur de chaînes avant de le restituer à l’analyseur lexical de Pandas.
9. Lecture de fichiers TSV volumineux et optimisation de la mémoire
La manipulation de fichiers scientifiques TSV dont la volumétrie dépasse plusieurs gigaoctets sur disque constitue un défi d’ingénierie majeur pour l’analyste. Le chargement monolithique naïf d’un tel fichier risque de saturer instantanément la mémoire vive (RAM) de la machine hôte, provoquant le déclenchement violent du mécanisme de purge de l’environnement ou l’apparition de l’erreur système fatale MemoryError.
9.1 Chargement itératif par morceaux avec le paramètre chunksize
Pour s’affranchir de la contrainte physique imposée par la capacité de la mémoire vive, Pandas met à disposition un patron de conception algorithmique d’une remarquable efficacité : le chargement par morceaux (chunking). Ce mécanisme s’active dès que l’analyste renseigne le paramètre chunksize=K au sein de la fonction pd.read_csv(), où K représente le nombre entier d’enregistrements (lignes) devant composer chaque lot successif.
Sous cette configuration, l’appel à la fonction ne renvoie plus un objet DataFrame unique consolidé, mais un itérateur spécialisé de classe pandas.io.parsers.TextFileReader. Cet objet maintient un pointeur ouvert sur le fichier TSV sous-jacent et permet de parcourir séquentiellement le jeu de données par l’entremise d’une simple boucle for Python :
accumulateur_statistique = 0

taille_lot = 50000

for lot_df in pd.read_csv('corpus_gigantesque.tsv', sep='t', chunksize=taille_lot):

    lot_filtre = lot_df[lot_df['valeur_mesure'] > 0]

    accumulateur_statistique += lot_filtre['valeur_mesure'].sum()
Dans ce paradigme de programmation par flux séquentiel, la mémoire vive consommée à un instant t ne dépend plus de la taille absolue du fichier stocké sur le disque dur (fût-il de cinquante gigaoctets), mais uniquement de la mémoire requise pour allouer le bloc circonscrit de 50 000 lignes. À la fin de chaque itération, le DataFrame temporaire lot_df est libéré par le ramasse-miettes (garbage collector) de Python dès que la boucle passe au bloc suivant, ouvrant la voie au traitement direct de corpus massifs sur de modestes stations de travail locales.
9.2 Optimisation des types pour réduire l’empreinte mémoire
Lorsqu’un traitement analytique exige néanmoins la présence simultanée de l’intégralité du jeu de données en mémoire pour des modélisations globales (comme l’entraînement d’un modèle d’apprentissage automatique), la réduction de l’empreinte physique des données via l’optimisation des types scalaires s’avère indispensable. Par défaut, Pandas adopte une politique d’allocation sécuritaire mais dispendieuse en instanciant systématiquement des conteneurs 64 bits.
L’optimisation passe par une réingestion ciblée où chaque colonne se voit assigner le type le plus ajusté à son domaine mathématique strict :
• Remplacement des flottants float64 (8 octets par élément) par des flottants float32 (4 octets), réduisant de moitié la charge mémoire sans préjudice notable pour la grande majorité des mesures expérimentales empiriques.
• Substitution des types entiers int64 par des formats réduits signés ou non signés, tels que int16 (valeurs comprises entre -32 768 et 32 767) ou uint8 (entiers positifs compris entre 0 et 255), divisant le coût de stockage unitaire par quatre ou par huit.
• Conversion des colonnes textuelles à forte répétitivité sémantique en types catégoriels (category), ce qui remplace le stockage d’adresses d’objets chaînes complets par de minuscules entiers servant d’index à un glossaire lexical unique.
De surcroît, les types d’entiers à gestion native des valeurs manquantes introduits récemment par Pandas (comme Int32 ou Int16 avec une majuscule distinctive) permettent d’éviter l’écueil historique qui imposait de convertir toute colonne d’entiers contenant une unique valeur manquante en float64 simplement pour supporter la constante NaN. La mise en application conjointe de ces règles dès la ligne de commande de pd.read_csv() via l’argument dtype permet couramment d’ingérer un volume de données 5 à 10 fois plus grand au sein d’une enveloppe de mémoire vive strictement identique.
9.3 Évaluation et suivi de l’empreinte mémoire
La conduite d’une politique rigoureuse d’optimisation mémoire impose une métrologie objective des structures instanciées. L’appel standard à la méthode df.info() délivre une indication d’utilisation de la mémoire vive, mais cette estimation superficielle s’avère trompeuse en présence de colonnes génériques de type object. En effet, dans sa configuration par défaut, Pandas ne comptabilise que la taille des pointeurs de références vectorielles contigus, sans sonder la taille réelle des blocs de mémoire occupés par les chaînes de caractères dispersées dans le tas (heap) de CPython.
Pour obtenir une cartographie exacte et absolue des ressources physiques monopolisées, il est indispensable de requérir une analyse structurelle approfondie via l’instruction :
df.info(memory_usage='deep')
Cette commande instruit le moteur de suivre chaque référence de pointeur pour mesurer la masse octale effective de l’ensemble des chaînes de caractères stockées en mémoire. Parallèlement, pour isoler les variables constituant les goulots d’étranglement de l’architecture, l’analyste peut interroger la méthode analytique df.memory_usage(deep=True), qui restitue le décompte exact d’octets absorbés par chaque colonne individuelle. Cette surveillance granulaire permet d’identifier précisément les variables prioritaires à convertir en types catégoriels ou à compresser pour fluidifier les calculs subséquents.
10. Importation de fichiers TSV distants et compressés
Dans un monde scientifique interconnecté et dominé par les paradigmes de la science ouverte (Open Science), les jeux de données tabulés ne résident plus uniquement sur les disques durs magnétiques ou les disques SSD des postes locaux, mais sont hébergés sur des serveurs distants, des plateformes collaboratives d’archivage pérenne ou des infrastructures de stockage en nuage (cloud storage).
10.1 Lecture directe depuis une URL ou une infrastructure réseau
L’un des atouts architecturaux les plus remarquables de la fonction pd.read_csv() réside dans sa capacité à traiter de manière totalement transparente les identifiants de ressources uniformes (URL). Au lieu de transmettre un simple chemin de fichier relatif à l’arborescence locale, l’analyste a la faculté de renseigner directement une adresse réseau s’appuyant sur les protocoles standard http://, https:// ou ftp://.
Considérons l’instruction canonique suivante visant l’ingestion d’un jeu de données institutionnel :
url_depot = "https://raw.githubusercontent.com/datasets/gdp/master/data/gdp.tsv"

df_distant = pd.read_csv(url_depot, sep='t')
Lors de l’évaluation de cette requête, Pandas mobilise en sous-main les modules de communication réseau standards de Python pour négocier la connexion avec le serveur distant, émettre une requête HTTP de type GET, transférer les paquets de données sous forme de flux mémoire tamponné (sans nécessiter de copie physique explicite sur le disque dur local), puis acheminer immédiatement ce flux binaire vers son analyseur lexical C. Cette méthodologie garantit une reproductibilité scientifique absolue : le script d’analyse peut être exécuté sur n’importe quel poste distant ou conteneur d’intégration sans exiger de protocoles manuels préalables de téléchargement ou de décompression de fichiers.
Il convient néanmoins de veiller à ce que l’URL fournie pointe directement vers le flux textuel brut (raw data) et non vers une page web applicative encapsulant le fichier au sein d’une interface graphique interactive en langage HTML. De plus, la prise en compte des délais d’attente réseau (timeouts) et la validation des certificats cryptographiques TLS/SSL doivent être rigoureusement observées lors de l’intégration au sein de serveurs institutionnels sécurisés.
10.2 Décompression automatique des archives de données
En raison de leur nature purement textuelle, les fichiers TSV présentent un taux d’entropie informationnelle qui se prête admirablement bien aux algorithmes de compression de données sans perte. Pour réduire les coûts de bande passante réseau et optimiser l’occupation des serveurs de stockage, la quasi-totalité des bases de données internationales mettent à disposition leurs fichiers sous la forme d’archives compressées portant des extensions composées telles que .tsv.gz, .tsv.bz2, .tsv.zip ou .tsv.xz.
La bibliothèque Pandas fait preuve en la matière d’une intelligence d’ingestion native : elle analyse l’extension du nom de domaine du fichier cible pour inférer dynamiquement l’algorithme de décompression à mobiliser. L’instruction suivante décompresse et ingère un fichier sans exiger la moindre étape manuelle intermédiaire :
df_archive = pd.read_csv('donnees_satellitaires.tsv.gz', sep='t')
Pour parer aux cas atypiques où l’archive ne porterait pas une extension standard, la fonction expose le paramètre explicite compression, lequel accepte les chaînes 'gzip', 'bz2', 'zip', 'xz' ou 'zstd'. Sur le plan architectural, Pandas instancie un décompresseur de flux à la volée, de sorte que les blocs d’octets sont décompressés en mémoire vive au fur et à mesure de l’avancée du pointeur lexical, limitant considérablement les écritures intermédiaires coûteuses sur disque. Bien que la décompression mobilise une fraction mesurable de cycles du processeur hôte (CPU), ce surcoût est très largement compensé par l’économie drastique réalisée sur les temps de transfert d’entrée/sortie (I/O), faisant de la lecture compressée un standard d’excellence pour le traitement de données massives.
10.3 Gestion des en-têtes d’authentification et protocoles sécurisés
L’ingestion de fichiers TSV hébergés sur des plateformes d’entreprise ou des conteneurs de stockage sécurisés (tels que les compartiments Amazon Web Services S3, Microsoft Azure Blob Storage ou Google Cloud Storage) impose l’intégration de jetons d’authentification cryptographiques et de clés de sécurité d’accès.
Pandas délègue cette couche de transport sécurisée à la bibliothèque spécialisée fsspec. Grâce à cette intégration transparente, il est possible de lire directement un fichier TSV situé sur un conteneur sécurisé en renseignant un protocole dédié et un dictionnaire de configurations contextuelles transmises au paramètre storage_options :
options_connexion = {

    'key': 'VOTRE_CLE_ACCES_AWS',

    'secret': 'VOTRE_SECRET_CRYPTOGRAPHIQUE_AWS'

}

df_cloud = pd.read_csv('s3://mon-entrepot-donnees/experience.tsv', sep='t', storage_options=options_connexion)
Dans cette architecture sécurisée, aucune donnée sensible d’authentification n’est encodée de manière irréversible dans les flux textuels. De plus, lors de l’accès à des API gouvernementales ou universitaires sécurisées exigeant des en-têtes HTTP personnalisés (comme l’adjonction d’un jeton d’autorisation de type Bearer Token), l’analyste a la possibilité d’utiliser la bibliothèque requests pour négocier la transaction sécurisée, avant de transmettre le flux brut encapsulé dans un objet mémoire standard io.StringIO directement à la fonction pd.read_csv().
11. Comparaison des moteurs d’analyse (Engines : C, Python, PyArrow)
Le traitement des flux de données textuels au sein de Pandas ne repose pas sur une architecture monolithique figée. La bibliothèque intègre en réalité sous son capot plusieurs moteurs d’analyse syntaxique aux propriétés algorithmiques radicalement divergentes, gouvernés par le paramètre fondamental engine.
11.1 Le moteur standard en langage C : rapidité et contraintes
Le moteur d’analyse configuré par défaut au sein de Pandas est le moteur C (engine='c'). Développé spécifiquement sous forme d’extension compilée de bas niveau, ce parseur a été conçu dans un impératif d’efficience computationnelle absolue. Il s’affranchit des mécanismes dynamiques de l’interpréteur Python pour opérer au plus près du silicium, manipulant directement des pointeurs d’octets et assurant une allocation mémoire contiguë pour les tableaux NumPy sous-jacents.
La supériorité cinétique du moteur C sur les fichiers tabulaires standards est indiscutable : il présente des vitesses d’ingestion supérieures d’un ordre de grandeur à celles du moteur Python pur. Cependant, cette vélocité s’accompagne d’une relative rigidité structurelle. Le moteur C n’est capable de gérer que des délimiteurs de champs formés d’un unique caractère scalaire (comme t). Il est totalement incapable de traiter des expressions régulières pour segmenter des colonnes, et refuse systématiquement certaines commandes complexes de saut sélectif d’enregistrements terminaux, telles que l’argument skipfooter.
Dès lors qu’un fichier TSV respecte scrupuleusement la nomenclature de l’IANA sans altérations de syntaxe et que les manipulations requises demeurent standards, le moteur C s’impose incontestablement comme l’outil privilégié de l’analyste pour maximiser le débit de calcul.
11.2 Le moteur Python : flexibilité et gestion des délimiteurs complexes
À l’opposé du moteur C, Pandas propose un parseur intégralement rédigé en langage Python pur (engine='python'). Conçu comme une solution de repli adaptative face aux situations structurelles les plus inextricables, ce moteur s’appuie sur le module standard csv tout en y adjoignant des fonctionnalités algorithmiques d’une immense flexibilité.
Le moteur Python accepte notamment des expressions régulières complexes au sein de son paramètre sep, autorisant par exemple la segmentation simultanée sur des tabulations combinées à des espaces variables via l’expression syntaxique sep=r't+|s+'. C’est également ce moteur qui permet l’utilisation du paramètre skipfooter pour élaguer dynamiquement la terminaison d’un document sans en connaître préalablement le nombre absolu de lignes. De surcroît, le moteur Python offre des rapports d’erreurs d’une finesse incomparable lorsque surviennent des corruptions de guillemets imbriqués ou des collisions de séquences d’échappement.
Néanmoins, cette malléabilité a un coût : la vitesse d’exécution. Tributaire de la machine virtuelle CPython et du verrou global de l’interpréteur (GIL), le moteur Python peut se révéler de 5 à 15 fois plus lent que son homologue compilé en C sur des volumes de données substantiels. Son usage doit par conséquent être strictement circonscrit aux étapes de nettoyage de corpus très irréguliers ou au traitement de fichiers d’une complexité morphologique atypique.
11.3 Le moteur PyArrow : performances contemporaines multi-cœurs
Depuis les versions récentes de Pandas, une révolution d’ingénierie s’est matérialisée avec l’intégration du moteur basé sur la bibliothèque Apache Arrow, activable par la directive explicite engine='pyarrow'. Ce composant logiciel moderne déplace le paradigme du traitement séquentiel classique vers des architectures d’ingestion hautement vectorisées, nativement multi-cœurs et orientées colonnes.
Le parseur PyArrow tire parti des capacités d’accélération matérielle des microprocesseurs modernes (notamment les jeux d’instructions vectorielles SIMD). Lors de l’ingestion d’un fichier TSV volumineux, PyArrow scinde le flux textuel en sous-tâches parallèles réparties sur l’intégralité des cœurs de calcul du processeur, offrant des accélérations stupéfiantes pouvant surpasser le moteur C historique d’un facteur 2 à 5 sur des machines multicœurs modernes. De plus, il instaure une gestion rigoureuse et unifiée des types de données, garantissant une représentation stricte des valeurs manquantes et éliminant les corruptions de types scalaires.
Pour exploiter pleinement ce moteur de nouvelle génération, l’instruction s’articule comme suit :
df_moderne = pd.read_csv('donnees_massives.tsv', sep='t', engine='pyarrow')
L’utilisation conjointe de PyArrow et du paramètre d’arrière-plan dtype_backend='pyarrow' permet en outre de matérialiser directement des colonnes au format Arrow, contournant intégralement les surcharges d’allocation mémoire historiques associées à NumPy. Cette architecture représente l’état de l’art technologique pour quiconque doit ingérer quotidiennement des dizaines de gigaoctets de données expérimentales structurées au format TSV.
12. Cas pratiques appliqués et résolution des erreurs courantes
La mise en pratique rigoureuse des concepts d’ingestion tabulaire requiert une immersion dans des cas d’usage réels ainsi qu’une maîtrise aiguisée des méthodologies de diagnostic et de résolution des anomalies lexicales les plus fréquemment rencontrées dans les flux de production.
12.1 Étude de cas : Traitement de journaux expérimentaux et données comportementales
Considérons une situation expérimentale en neurosciences cognitives où un banc de tests automatisé génère pour chaque participant un fichier journal TSV nommé selon la convention sujet_[ID].tsv. Ces fichiers consignent les temps de réaction à des stimuli perceptifs, mais présentent de nombreuses imperfections structurelles : des commentaires précédés du symbole # en tête de fichier, des horodatages textuels non unifiés, des valeurs sentinelles -99.0 pour les essais où le participant a failli répondre dans le temps imparti, et une variable nominale de condition d’essai hautement répétitive.
Le script d’industrialisation suivant illustre un pipeline robuste capable d’ingérer et d’assainir unitairement ces corpus au moyen des paramètres explorés précédemment :
import pandas as pd

from pathlib import Path
repertoire_donnees = Path('./donnees_cognitives')
registre_global = []
colonnes_cibles = ['timestamp', 'id_essai', 'temps_reponse', 'condition']
types_colonnes = {'id_essai': 'uint16', 'temps_reponse': 'float32', 'condition': 'category'}
for chemin_fichier in repertoire_donnees.glob('sujet_*.tsv'):
df_participant = pd.read_csv(
chemin_fichier,
sep='t',
comment='#',
usecols=colonnes_cibles,
dtype=types_colonnes,
parse_dates=['timestamp'],
na_values={'temps_reponse': [-99.0]}
)
df_participant['identifiant_participant'] = chemin_fichier.stem
registre_global.append(df_participant)
df_consolide = pd.concat(registre_global, ignore_index=True)
Cette routine d’ingestion illustre une chaîne de traitement complète : isolation sélective des variables signifiantes, optimisation drastique de la consommation mémoire par coercition de types en 32 bits et catégories, neutralisation déclarative des fausses valeurs de temps de réaction au moyen de na_values, exclusion des en-têtes documentaires via comment, et concaténation matricielle finale sans aucune distorsion structurelle.
12.2 Diagnostic et correction des exceptions récurrentes de parsing
Lors de la manipulation de fichiers TSV aux provenances hétérogènes, l’analyste fait face à trois familles récurrentes d’exceptions logicielles nécessitant un diagnostic méthodique :
La première est l’exception pandas.errors.ParserError: Error tokenizing data. Cette erreur indique sans équivoque qu’à une ligne physique précise du fichier TSV, le parseur a comptabilisé davantage de tabulations que le nombre établi lors de la lecture de la ligne d’en-tête. La résolution immédiate consiste à inspecter la ligne incriminée au moyen d’un utilitaire shell tel que sed -n 'ligne_numero p' fichier.tsv | cat -A pour visualiser les caractères non imprimables, puis de réguler le comportement global du parseur en intégrant l’argument on_bad_lines='skip' ou on_bad_lines='warn' si la ligne s’avère manifestement corrompue.
La seconde anomalie classique est l’erreur pandas.errors.EmptyDataError: No columns to parse from file. Elle survient lorsque le script tente de lire un fichier TSV totalement vide (taille 0 octet sur disque) ou dont l’intégralité des lignes a été ignorée suite à une mauvaise spécification des paramètres skiprows ou comment. L’architecture de chargement doit par conséquent intégrer une vérification liminaire de la taille physique du fichier via la commande os.path.getsize() avant de lancer la fonction de lecture.
Enfin, l’exception UnicodeDecodeError signale une rupture de congruence entre la table d’encodage binaire du fichier et les conventions de décodage par défaut de Pandas. Le diagnostic s’opère en modifiant l’argument encoding vers des normes régionales ('latin1', 'cp1252') ou en convertissant en amont le fichier source vers l’encodage canonique UTF-8 universel à l’aide de l’outil en ligne de commande iconv.
12.3 Bonnes pratiques de standardisation et validation post-chargement
L’achèvement réussi de l’appel à la fonction pd.read_csv() ne marque pas le terme du contrôle qualité de la donnée. Un ensemble de vérifications de conformité doit être exécuté immédiatement pour certifier la navigabilité et l’orthodoxie mathématique du DataFrame généré.
La première règle de standardisation consiste à épurer les étiquettes de colonnes. Les fichiers TSV générés par des tableurs tiers contiennent fréquemment des espaces résiduels invisibles nichés avant ou après le délimiteur de tabulation (par exemple "temps_reponset condition t"). Pour prévenir des échecs d’indexation nominative ultérieurs, il est salutaire d’exécuter l’instruction d’assainissement systématique suivante :
df.columns = df.columns.str.strip().str.lower().str.replace(' ', '_')
Cette directive supprime les espaces périphériques, homogénéise les libellés en minuscules typographiques et substitue les espaces internes par des traits de soulignement, instaurant une nomenclature d’accès parfaitement prévisible.
La seconde validation post-chargement réside dans le contrôle de l’unicité de la clé primaire et la validation formelle des contraintes d’intégrité référentielle :
assert df['identifiant_cle'].is_unique, "Violation d'unicité détectée sur l'index de clé primaire !"

assert df['temps_reponse'].notna().all(), "Présence anormale de valeurs nulles dans un vecteur obligatoire !"
La formalisation de ces assertions logiques dès la sortie du parseur garantit que le pipeline de modélisation inférentielle recevra des structures tabulaires parfaitement conformes aux axiomes théoriques des analyses statistiques projetées, assurant une étanchéité méthodologique intégrale à l’ensemble du cycle de recherche.
Références
- Apache Software Foundation. (2023). Apache Arrow documentation. https://arrow.apache.org/docs/
- Internet Assigned Numbers Authority (IANA). (1993). The text/tab-separated-values Media Type (RFC 2046). https://www.iana.org/assignments/media-types/text/tab-separated-values
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-00a
- McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
- NumPy Developers. (2023). NumPy user guide. https://numpy.org/doc/stable/user/
- Pandas Development Team. (2023). pandas.read_csv API reference documentation. https://pandas.pydata.org/docs/reference/api/pandas.read_csv.html
- Python Software Foundation. (2023). The Python standard library: csv — CSV File Reading and Writing. https://docs.python.org/3/library/csv.html
- Shafranovich, Y. (2005). Common Format and MIME Type for Comma-Separated Values (CSV) Files (RFC 4180). Internet Engineering Task Force (IETF). https://datatracker.ietf.org/doc/html/rfc4180
- Unicode Consortium. (2023). The Unicode Standard, Version 15.0. https://www.unicode.org/versions/Unicode15.0.0/
- Van Rossum, G., & Drake, F. L. (2009). Python 3 reference manual. CreateSpace.