
L’ingestion de flux textuels au sein d’environnements computationnels contemporains constitue l’une des étapes cardinales de la science des données et de l’ingénierie logicielle appliquée. Bien que les formats sérialisés binaires et les bases de données relationnelles ou distribuées dominent les architectures de production à large échelle, le fichier texte brut — qu’il se décline sous la forme de documents délimités par des virgules, des tabulations, des points-virgules ou selon des largeurs de colonnes fixes — demeure le vecteur universel d’échange d’informations hétérogènes. Cette omniprésence s’explique par son interopérabilité absolue entre plateformes disparates, sa lisibilité immédiate par l’opérateur humain et son indépendance vis-à-vis des écosystèmes logiciels propriétaires. Néanmoins, transformer une séquence brute d’octets textuels non structurés en une structure tabulaire exploitable exige une rigueur conceptuelle et méthodologique substantielle.
Au cœur de l’écosystème scientifique Python, la bibliothèque Pandas s’est imposée comme le paradigme standard pour l’orchestration, le nettoyage et l’analyse exploratoire des données matricielles. Conçue initialement par Wes McKinney pour répondre aux exigences de modélisation quantitative des marchés financiers, cette suite logicielle intègre des analyseurs lexicaux d’une sophistication remarquable. Ces mécanismes permettent d’abstraire la complexité inhérente aux opérations d’entrée-sortie (I/O) tout en offrant des performances computationnelles proches des langages compilés de bas niveau. L’objectif fondamental de cet article est d’examiner de manière exhaustive les fondements théoriques, les mécanismes algorithmiques et les protocoles pratiques régissant la lecture des fichiers texte à l’aide de Pandas, afin de garantir une ingestion optimale, robuste et reproductible de vos corpus d’information.
À travers ce traité, le chercheur ou l’ingénieur sera guidé à travers les méandres de l’analyse lexicale, depuis la gestion des encodages de caractères jusqu’aux stratégies avancées de partitionnement séquentiel en mémoire vive. En explorant méthodiquement chaque paramètre critique, les subtilités d’inférence de types, ainsi que les écueils liés aux délimitations complexes et aux valeurs sentinelles, ce manuel vise à établir un cadre de référence pérenne. L’analyse détaillée des comportements internes du moteur d’analyse, conjuguée à des scénarios empiriques concrets, fournira les clés nécessaires pour maîtriser le chargement de données textuelles, qu’il s’agisse de journaux système massifs, de relevés d’instrumentation scientifique ou de jeux de données d’enquêtes psychosociales hautement bruités.
1. Fondements théoriques de l’ingestion de fichiers texte dans l’écosystème Pandas
1.1 Architecture sous-jacente de l’objet DataFrame et traitement tabulaire
L’architecture matricielle bidimensionnelle incarnée par l’objet DataFrame dans Pandas repose sur une abstraction rigoureuse de la théorie tabulaire. Contrairement à un fichier texte plat, qui n’est au niveau physique qu’une succession linéaire d’octets entrecoupée de délimiteurs de retour à la ligne, le DataFrame conceptualise les données sous une forme rectangulaire rigide. Cette matrice est organisée selon deux axes orthogonaux : l’axe vertical (index des observations ou lignes) et l’axe horizontal (séries de variables ou colonnes). Chaque colonne d’un DataFrame est matérialisée par un objet de type Series, lui-même encapsulé au sein d’une structure interne nommée BlockManager. Ce gestionnaire de blocs regroupe en mémoire contiguë les séries partageant des types primitifs identiques, maximisant ainsi l’efficacité d’adressage et le débit du processeur via la mise en cache de niveau un et deux (L1/L2).
Les avantages computationnels de cette abstraction tabulaire sont considérables comparativement au traitement séquentiel de fichiers plats. Dans un fichier texte standard, la recherche d’une cellule spécifique nécessite un balayage linéaire avec une complexité temporelle proportionnelle à la taille du document, soit un comportement d’ordre O(N). À l’inverse, l’ingestion préalable dans un DataFrame charge les adresses mémoires au sein de vecteurs typés, autorisant des accès indexés à temps constant O(1) et des opérations de calcul vectoriel exploitant les instructions de vectorisation Single Instruction, Multiple Data (SIMD) offertes par les architectures de processeurs modernes.
Cette supériorité algorithmique dépend intrinsèquement des bibliothèques C sous-jacentes qui propulsent l’analyseur lexical de Pandas. Le parseur natif est rédigé en langage C hautement optimisé, tirant parti d’allocations mémoires directes et d’arbres de dérivation syntaxique minimisant les copies superflues d’objets en mémoire. Cette intégration bas niveau assure une conversion rapide du flux d’octets issu du disque magnétique ou de l’unité SSD vers les structures mémoires de la bibliothèque NumPy, servant de socle physique aux colonnes du DataFrame sans subir la surcharge temporelle inhérente à la machine virtuelle Python.
1.2 Analyse comparative de l’IO textuelle : Pandas face aux primitives Python
L’exploitation des primitives intégrées de Python, telle que la fonction native open() associée aux méthodes read() ou readlines(), montre rapidement ses limites lorsqu’elle est confrontée à des exigences d’analyse multidimensionnelle. Lorsqu’un fichier est manipulé par ces fonctions élémentaires, le programmeur doit concevoir manuellement les boucles d’itération, la séparation des champs lexicaux par la méthode split(), l’élimination des caractères d’échappement et la conversion explicite de chaque fragment textuel vers des entiers, des flottants ou des booléens. Cette approche artisanale génère une dette technique majeure, démultiplie le risque d’erreurs logiques silencieuses et provoque une dégradation catastrophique des performances d’exécution due au ramasse-miettes (garbage collector) de Python, qui doit instancier des millions de micro-objets indépendants.
Pandas résout ces limitations structurelles en intégrant un système hautement sophistiqué d’inférence heuristique des types de données. Dès la lecture des premiers octets du flux, le parseur évalue simultanément la topologie du fichier et la nature sémantique des données contenues dans chaque segment colonnaire. Si une séquence de caractères ne contient que des chiffres ordonnés, l’algorithme alloue directement un tableau d’entiers signés 64 bits de type NumPy ; si des séparateurs décimaux sont détectés, une promotion vers des nombres à virgule flottante est automatiquement déclenchée. Cette automatisation évite à l’analyste d’écrire des vérifications conditionnelles redondantes et coûteuses en temps machine.
En outre, l’ingestion textuelle via Pandas offre une gestion unifiée et standardisée des métadonnées contextuelles. Alors qu’une lecture via open() ignore la notion même d’en-tête de variable — obligeant l’utilisateur à extraire et stocker manuellement la première ligne sous forme de liste de chaînes dissociée —, Pandas fusionne la définition structurelle des axes avec les données sous-jacentes. Les libellés de colonnes deviennent des clés d’accès directes, et les identifiants de lignes permettent d’établir des relations d’alignement automatiques lors de jointures ultérieures, garantissant l’intégrité référentielle des données tout au long du cycle de calcul.
1.3 Typologie des fichiers texte en analyse computationnelle
Dans l’univers du calcul scientifique et de la gestion de données, les fichiers texte se divisent principalement en deux grandes catégories morphologiques : les formats à délimitation explicite et les formats à largeur fixe. Les fichiers à séparateurs explicites, dont le format standardisé CSV (Comma-Separated Values) et sa déclinaison TSV (Tab-Separated Values) sont les archétypes les plus prégnants, utilisent des caractères réservés pour matérialiser la frontière séparant deux attributs consécutifs. À l’opposé, les formats à délimitation fixe (Fixed-Width Formats ou FWF) n’emploient aucun séparateur intérieur ; l’identité d’un champ est strictement définie par un intervalle invariant de colonnes typographiques sur chaque ligne, une convention héritée de l’ère des cartes perforées et encore courante dans les systèmes bancaires traditionnels ou les modélisations météorologiques anciennes.
L’évaluation des contraintes d’encodage constitue un autre vecteur de complexité dans cette typologie. Un fichier texte ne possède pas de sens en dehors de la table de correspondance qui attribue un glyphe à une configuration d’octets spécifique. La divergence entre les formats normalisés modernes, dominés par l’encodage universel UTF-8, et les normes régionales historiques telles que l’ASCII étendu, l’ISO-8859-1 (Latin-1) ou le codage propriétaire Windows-1252, représente une source prolifique d’anomalies d’ingestion. La présence d’octets invalides dans un flux binaire interrompt l’analyse syntaxique ou produit des corruptions sémantiques pernicieuses, altérant les analyses quantitatives ultérieures.
Enfin, la propreté structurelle d’un corpus textuel brut doit être jugée à l’aune de critères stricts d’uniformité et de cohérence dimensionnelle. Un fichier parfaitement formé présente une orthogonalité absolue, où chaque enregistrement physique contient un nombre rigoureusement invariant de délimiteurs, des terminaisons de lignes uniformisées (CRLF pour les environnements Microsoft Windows ou LF pour les environnements conformes à POSIX), et un échappement rigoureux des caractères réservés lorsqu’ils se trouvent imbriqués dans des chaînes littérales. L’analyse computationnelle moderne doit composer avec la réalité de données bruitées, ce qui nécessite des parseurs tolérants capables de diagnostiquer et de redresser les asymétries de flux à l’exécution.
2. Syntaxe fondamentale et fonctionnement du parseur read_csv
2.1 Paramètres cardinaux de la fonction read_csv
La porte d’entrée universelle pour l’ingestion textuelle dans la bibliothèque Pandas est la fonction pandas.read_csv. Bien que son appellation suggère un usage restreint aux fichiers délimités par des virgules, il s’agit en réalité d’un moteur d’analyse polyvalent capable de déstructurer pratiquement n’importe quel flux de texte tabulaire. Le paramètre fondamental de cette fonction est filepath_or_buffer. Cet argument accepte non seulement une chaîne littérale représentant un chemin absolu ou relatif sur le système de fichiers local, mais également un descripteur de fichier ouvert, un flux mémoire en octets (comme les objets io.StringIO) ou même une URL pointant directement vers un serveur HTTP, HTTPS ou un système de stockage objet de type Amazon S3.
Le paramètre sep (ou son alias delimiter) est l’opérateur de scission contextuelle. Par défaut, sa valeur est configurée sur la virgule standard. Toutefois, dans le contexte de la lecture de fichiers portant l’extension générique .txt, il est fréquent que les champs soient séparés par des espaces, des tabulations ou des points-virgules. Une configuration explicite de cet argument est donc indispensable pour éviter que le parseur ne considère chaque ligne comme un unique bloc textuel indivisible, ce qui produirait un DataFrame dégénéré à colonne unique.
Un autre arbitrage déterminant réside dans la sélection de l’argument engine, qui autorise le choix explicite entre le moteur standard écrit en C (‘c’) et le moteur d’interprétation écrit en Python (‘python’). Le moteur C offre une exécution foudroyante grâce à sa gestion optimisée des pointeurs bas niveau, constituant le choix préférentiel pour les fichiers massifs. Néanmoins, le moteur Python présente une souplesse syntaxique accrue : il est le seul à accepter des expressions régulières complexes comme séparateurs de champs et propose une gestion plus compréhensive des exceptions de parsing, bien qu’au détriment de la vitesse de traitement global.
2.2 Mécanique d’instanciation et contrôle du flux d’entrée
L’exécution de la méthode d’ingestion repose sur une séquence de décodage, de découpage lexical (tokenization) et d’instanciation d’objets. Considérons le cas d’un fichier textuel élémentaire nommé data.txt hébergé sur le système de fichiers local. Lorsque l’instruction d’ingestion est soumise au runtime Python via la commande pandas.read_csv(‘data.txt’, sep=’t’), le sous-système d’E/S ouvre immédiatement un descripteur de lecture et achemine le flux d’octets bruts vers l’analyseur lexical configuré.
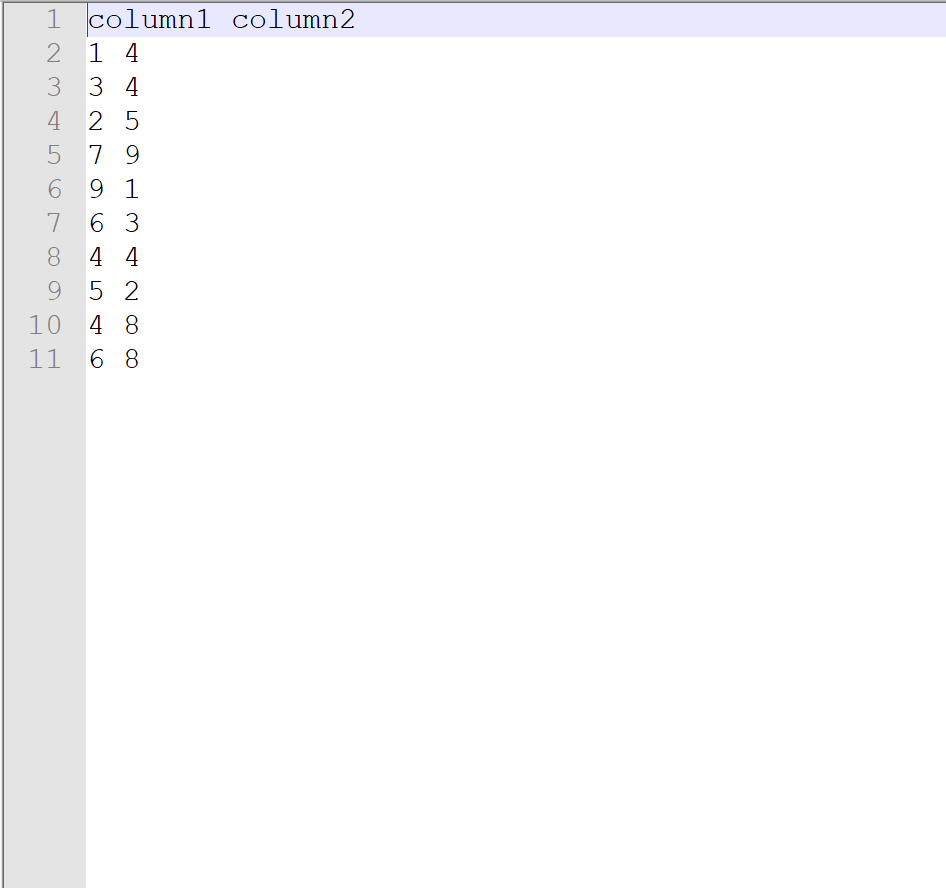
L’évaluation du statut de retour de cette opération confirme la création atomique d’un nouvel objet DataFrame résident en mémoire vive. Pandas n’altère en aucun cas le fichier source textuel d’origine, garantissant un principe strict d’immuabilité des sources sur le disque. Le résultat renvoyé est une référence vers la structure tabulaire qui vient d’être projetée dans l’espace d’adressage virtuel du processus en cours.
En inspectant les structures internes allouées, on observe la matérialisation immédiate de structures matricielles sous-jacentes. Le gestionnaire de blocs mémoire cartographie les colonnes selon leurs propriétés déduites, isolant par exemple les colonnes numériques au sein de blocs contigus optimisés, tandis que les colonnes de texte libre sont stockées sous forme de vecteurs de pointeurs vers des objets chaînes Python ou des blocs de mémoire tampon fléchés, préparant ainsi le terrain aux opérations d’algèbre relationnelle ultérieures.
2.3 Vérification dimensionnelle et validation structurelle
Dès l’achèvement de l’opération de lecture, la première directive méthodologique consiste à soumettre le DataFrame résultant à une vérification dimensionnelle rigoureuse. L’attribut shape de l’objet permet d’obtenir immédiatement un tuple d’entiers quantifiant l’envergure de la matrice chargée, sous la forme générale (nombre_de_lignes, nombre_de_colonnes). Cette information synthétique permet de valider sur-le-champ si le délimiteur sélectionné a correctement opéré : un nombre inattendu de colonnes — en particulier une dimension colonnaire égale à un — trahit invariablement une anomalie d’interprétation du séparateur de champs.
Parallèlement, la validation structurelle requiert l’examen minutieux de l’attribution des index de lignes et des étiquettes de colonnes. Les attributs index et columns fournissent une description directe de ces métadonnées d’alignement. Par défaut, si aucune colonne d’identification n’a été spécifiée lors de l’appel, Pandas alloue un RangeIndex séquentiel débutant à 0 et s’étendant jusqu’à N-1, où N correspond au total des observations validées par le parseur.
Enfin, l’interrogation de la classe de l’objet au moyen de la fonction native type(df) permet de confirmer qu’aucun pipeline asynchrone ou générateur d’itérateurs partiels n’a été conservé par mégarde. L’objet doit être expressément reconnu comme une instance de pandas.core.frame.DataFrame. La méthode info() peut être appelée dans la foulée pour fournir une synthèse télégraphique comprenant le décompte des valeurs non nulles par attribut et l’empreinte globale estimée en octets au sein de la mémoire vive.
3. Lecture méthodologique de fichiers texte comportant des en-têtes
3.1 Inférence implicite des métadonnées d’en-tête
L’immense majorité des jeux de données textuels structurés incorpore dès la première ligne une série d’identifiants textuels destinés à qualifier la sémantique de chaque variable. Par conception par défaut, la fonction read_csv applique une inférence implicite en posant le paramètre header=’infer’, ce qui équivaut fonctionnellement à affecter la valeur header=0. Dès lors, le parseur lexical isole la première séquence d’éléments délimités par le séparateur déclaré et les affecte directement comme étiquettes d’identification du vecteur columns.
Illustrons cette dynamique à l’aide d’un corpus empirique comportant deux variables distinctes : une variable alphanumérique qualifiant un patronyme et une variable numérique mesurant un indicateur métrologique. Si le fichier texte présente en amorce la chaîne NomtScore suivie des observations substantielles, le parseur reconnaît ces chaînes initiales comme des métadonnées descriptives. Les données quantitatives subséquentes ne sont pas polluées par la présence de texte dans les lignes de tête, autorisant le typage immédiat de la seconde colonne en tant qu’entier ou flottant.
La vérification des index de colonnes générés automatiquement permet d’observer la création d’un conteneur Index composé des chaînes de caractères littérales isolées. Cette structuration immédiate simplifie l’adressage programmatique ultérieur, l’analyste pouvant désormais requérir l’extraction d’une série par sa clé sémantique explicite sans avoir à cartographier manuellement la position ordinale de la variable dans la grille sous-jacente.
3.2 Configuration explicite du paramètre header
L’organisation typographique des fichiers textes générés par des environnements industriels ou des plateformes scientifiques s’éloigne fréquemment du schéma idéal d’une table débutant immédiatement à la ligne zéro. Il est très commun que les premières lignes d’un document brut contiennent des métadonnées contextuelles non tabulaires : horodatage de l’extraction, paramètres de l’opérateur, informations de versionnage logiciel ou mentions légales. Si ces lignes parasites sont ingérées sans précaution, le comportement d’inférence implicite échoue dramatiquement, tentant de convertir des phrases narratives entières en en-têtes de colonnes.
Le recours au paramètre header sous forme d’une indication numérique explicite résout cette difficulté avec élégance. En spécifiant header=k (où k est un entier positif fondé sur un indexation à base zéro), l’ingénieur commande au parseur d’ignorer fonctionnellement l’intégralité des lignes antérieures à k en tant que définitions d’axes, et de fixer rigoureusement la ligne d’indice k comme le registre des libellés de colonnes. Les lignes situées au-dessus sont ignorées du schéma d’en-tête, tandis que les lignes immédiatement postérieures sont assimilées au corpus des observations de données.
En outre, Pandas excelle dans l’ingestion de structures tabulaires complexes présentant des en-têtes hiérarchiques à plusieurs niveaux (MultiIndex). Si un tableau textuel sépare ses données par des catégories englobantes sur la ligne zéro, puis par des sous-variables descriptives sur la ligne un, il suffit d’assigner une liste d’entiers ordonnés au paramètre, sous la forme header=[0, 1]. Le parseur synthétise alors un objet MultiIndex sur l’axe colonnaire, conservant la généalogie dimensionnelle du document source et évitant des opérations laborieuses de fusion ou de découpage manuel de chaînes textuelles après importation.
3.3 Résolution des ambiguïtés typographiques dans les libellés
Même lorsque la ligne d’en-tête est clairement délimitée, les corpus textuels souffrent chroniquement d’approximations typographiques commises par les systèmes émetteurs ou les opérateurs de saisie. Le problème le plus insidieux réside dans la prolifération d’espaces blancs périphériques parasites encadrant les noms des variables (par exemple, » Nom « au lieu de « Nom »). Lorsqu’un tel phénomène survient lors de la lecture d’un fichier texte, Pandas préserve scrupuleusement ces caractères non visibles au sein des chaînes de l’index des colonnes. Il s’ensuit des erreurs d’indexation déroutantes de type KeyError lorsque l’analyste tente ultérieurement d’accéder à la colonne par son libellé théorique dépourvu d’espaces superflus.
Pour neutraliser ce désagrément, deux voies méthodologiques sont envisageables. La première consiste à appliquer des expressions d’assainissement programmatique immédiatement après l’ingestion en redéfinissant l’attribut des colonnes via une compréhension de liste combinée à la primitive d’élagage des chaînes textuelles : df.columns = df.columns.str.strip(). Cette instruction balaie exhaustivement chaque libellé, éradiquant les espaces blancs en tête et en queue ainsi que les tabulations résiduelles. Il est également recommandé d’appliquer une uniformisation syntaxique supplémentaire en forçant les caractères en minuscules et en remplaçant les espaces internes résiduels par des tirets bas pour faciliter la manipulation programmatique.
Un autre défi typographique concerne la survenue d’en-têtes dupliqués au sein du document d’origine. Si un fichier texte présente deux colonnes dotées rigoureusement de la même appellation nominative, Pandas déploie un algorithme de résolution automatique d’homonymie pour préserver l’unicité des clés de hachage. Il modifie de manière déterministe les étiquettes consécutives en leur adjoignant un suffixe incrémental numérique précédé d’un point (par exemple Valeur, Valeur.1, Valeur.2). Bien que cette mutation préserve l’intégrité de la structure matricielle sans provoquer d’interruption du processus, l’ingénieur doit impérativement documenter ces occurrences afin d’éviter toute confusion sémantique lors de l’application de calculs vectoriels subséquents.
4. Ingestion et structuration de fichiers texte dépourvus d’en-tête
4.1 Neutralisation de l’inférence via header=None
Une anomalie fréquente dans le traitement de fichiers texte automatisés réside dans l’absence totale de métadonnées de colonnes. Les extracteurs de données bas niveau, les flux télémétriques et les systèmes de journalisation sérialisent fréquemment les enregistrements sous forme de rangées brutes de données pures, omettant toute désignation littérale. Si l’on applique le parseur read_csv par défaut sur un tel fichier, l’algorithme d’inférence implicite va inéluctablement interpréter le tout premier enregistrement d’observation substantielle comme s’il s’agissait du registre d’en-tête du tableau.
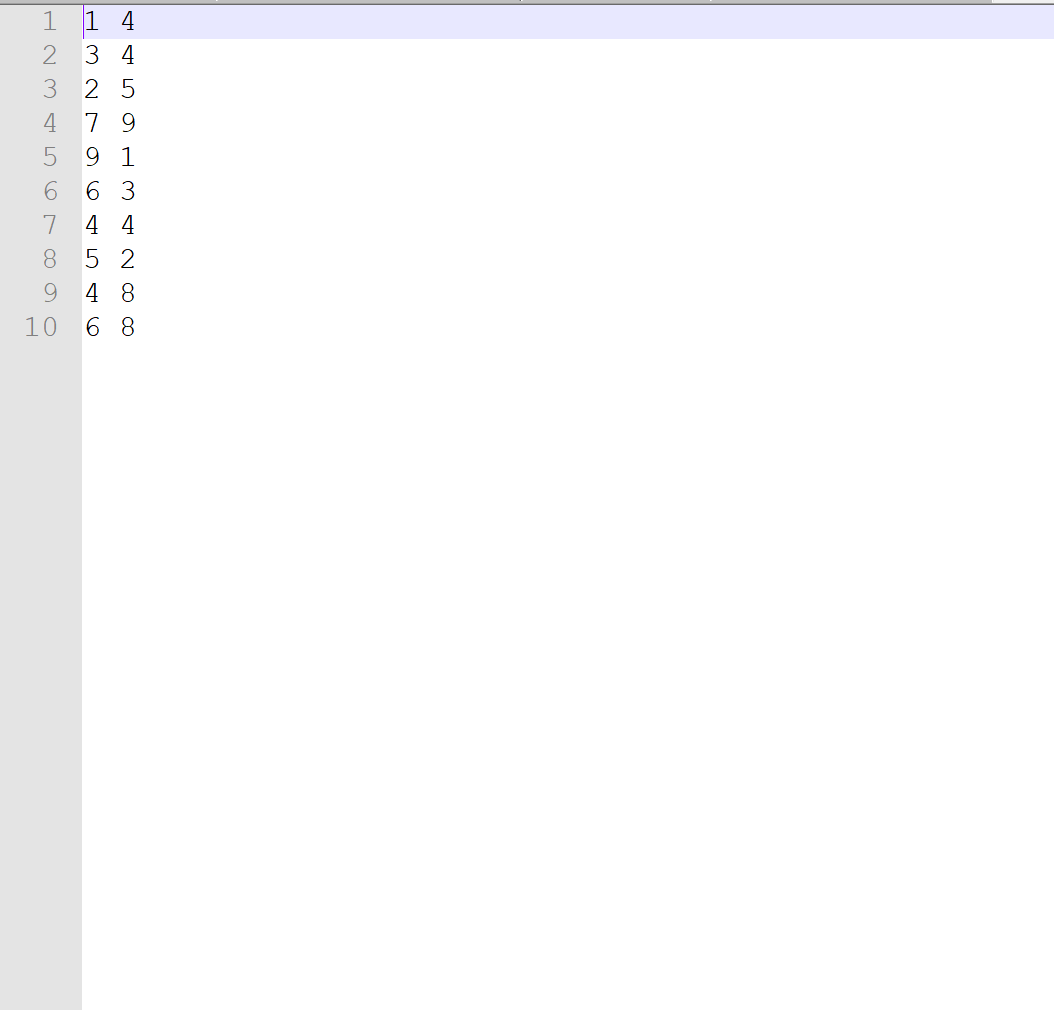
Cette absorption erronée altère immédiatement l’intégrité scientifique du corpus de données. La première ligne d’observation est définitivement soustraite du volume de données analysables, conduisant à une sous-estimation du nombre d’échantillons. Pis encore, si les valeurs de cette première observation sont des grandeurs numériques, les libellés des colonnes deviendront des représentations textuelles de ces nombres spécifiques (tels que ‘12.4’, ‘108’, ‘0.003’), perturbant toute la sémantique de l’espace tabulaire.
La neutralisation impérative de cette inférence repose sur la configuration explicite du paramètre header=None. En déclarant cette option, le parseur reçoit l’instruction formelle d’amorcer l’ingestion des enregistrements dès la ligne physique zéro, sans en extraire d’étiquettes de variables. Pour combler l’absence de noms de colonnes, Pandas génère dynamiquement un RangeIndex colonnaire composé d’entiers séquentiels consécutifs débutant à 0 (0, 1, 2, …, K-1). La matrice préserve ainsi son exhaustivité quantitative absolue sans distorsion structurelle.
4.2 Attribution taxonomique manuelle via le paramètre names
Bien que l’indexation numérique anonyme des colonnes préserve l’intégralité des observations, elle s’avère hautement préjudiciable à la lisibilité du code et à l’expressivité de l’analyse analytique. Manipuler des colonnes désignées par les entiers 0, 1 ou 2 multiplie le risque d’inversion conceptuelle d’attributs et complique la maintenance logicielle. Pour pallier cette faiblesse, Pandas autorise l’injection d’un dictionnaire taxonomique explicite directement lors de la phase de scission lexicale au moyen de l’argument names.
Le paramètre names attend la transmission d’une séquence itérable — le plus souvent une liste ordonnée de chaînes de caractères — dont les éléments correspondent fidèlement à la sémantique de chaque variable projetée. Un couplage syntaxique parfait exige alors de coordonner soigneusement names et header. Lorsque le fichier source est totalement dépourvu de ligne d’en-tête, l’usage conjoint de header=None et de names=[‘Variable_A’, ‘Variable_B’, ‘Variable_C’] garantit que la totalité des lignes textuelles sera incorporée comme données, tout en couronnant immédiatement le DataFrame résultant des libellés fournis par l’utilisateur.
Il importe de souligner les conséquences fonctionnelles déstabilisantes qui surgissent en cas de discordance entre la granularité vectorielle de la liste fournie et le nombre effectif de champs délimités dans le flux textuel. Si la liste transmise au paramètre names comporte moins d’éléments que le fichier texte ne compte de colonnes, les versions récentes de Pandas déclenchent des avertissements ou procèdent à des réalignements arbitraires qui décalent l’indexation. Inversement, si la liste est plus longue que la dimension colonnaire observée, Pandas peut considérer les variables excédentaires comme des colonnes peuplées exclusivement de valeurs manquantes (NaN). Une validation préalable de la largeur du document est donc une exigence méthodologique incompressible.
4.3 Validation de la topologie des données brutes injectées
L’ingestion d’un fichier textuel dénué d’en-tête transfère l’entière responsabilité de la cohérence géométrique à la phase de contrôle post-lecture. L’analyste doit impérativement s’assurer que chaque enregistrement a été projeté dans la colonne adéquate sans le moindre décalage horizontal. Dans les documents textuels non normalisés, la présence accidentelle d’un délimiteur surnuméraire — par exemple un espace double dans un fichier délimité par des espaces — peut décaler l’ensemble des valeurs d’une ligne vers la droite, corrompant la distribution des données sous-jacentes.
L’absence d’en-tête affecte également le typage inductif opéré par le moteur d’ingestion. Lorsque les en-têtes sont présents, la frontière entre le texte des étiquettes et les données numériques est franche. Dans les fichiers sans en-tête, le moteur scanne la première ligne pour tenter d’en déterminer le type sans le biais de métadonnées narratives. Si une valeur textuelle corrompue s’est glissée sur la ligne initiale d’une colonne qui devrait être numérique, le moteur peut contraindre l’intégralité de la colonne vers le type générique object, dégradant massivement les performances computationnelles.
D’un point de vue documentaire et méthodologique, il est impératif d’intégrer dans le pipeline de traitement un schéma de données (Data Schema) formel. Documenter systématiquement la correspondance entre les index ordinaux d’origine et la nomenclature fonctionnelle assignée via names au sein d’un dictionnaire de métadonnées immuable (par exemple au format JSON ou YAML) garantit que les transformations ultérieures demeureront traçables et auditables par d’autres équipes d’ingénierie.
5. Maîtrise avancée des délimiteurs et analyse par expressions régulières
5.1 Gestion des espaces blancs et tabulations récurrentes
Dans la taxonomie des fichiers textuels, la famille des séparateurs invisibles — communément désignée sous le vocable d’espaces blancs — représente une source constante de complexité d’analyse syntaxique. Il convient d’opérer une distinction rigoureuse entre un espace simple (code ASCII 32), une tabulation horizontale conventionnelle notée t (code ASCII 9) et les éventuelles séquences combinées d’espaces insécables ou de retours chariot résiduels. Un fichier texte dont l’extension est nominalement .txt recourt massivement à la tabulation comme délimiteur canonique, formant ce que l’on qualifie techniquement de structure TSV.
L’instruction de scission lexicale pour de tels corpus requiert l’affectation explicite du caractère d’échappement idoine au paramètre de séparation : sep=’t’. Si cette déclaration est omise ou substituée par inadvertance par un espace simple, le parseur traitera les tabulations comme des caractères d’espacement standard ou échouera à segmenter la matrice, aboutissant à une agglomération toxique de champs adjacents au sein d’une unique variable textuelle amorphe.
Les conséquences structurelles d’une déclaration erronée du délimiteur s’étendent au-delà de la topologie immédiate. Elles génèrent des perturbations critiques dans la détection des types primitifs, conduisent à l’inclusion de caractères d’échappement invisibles à l’intérieur des chaînes littérales ingérées, et faussent les mécanismes d’alignement mémoire, invalidant ainsi toute possibilité d’appliquer des filtres de prédicats efficaces sans assainissement préalable lourd.
5.2 Résolution des espacements variables au moyen d’expressions régulières
L’un des obstacles les plus redoutables rencontrés lors de l’ingestion de sorties machines non standardisées — telles que les rapports générés par des terminaux mainframe, des progiciels anciens ou des séries chronologiques d’instruments scientifiques patrimoniaux — réside dans l’utilisation d’espacements à géométrie variable. Dans ces fichiers, les valeurs successives ne sont pas séparées par une tabulation unique ou une virgule stricte, mais par une quantité arbitraire d’espaces blancs consécutifs destinés à aligner visuellement le texte pour un observateur humain consultant un écran cathodique.
Pour déconstruire ces structures instables, l’assignation d’un délimiteur statique unicaractère s’avère inopérante. Il devient nécessaire de mobiliser la puissance des expressions régulières (Regex) en définissant un motif de découpage dynamique. La configuration standard pour capturer un ou plusieurs espaces blancs consécutifs s’écrit sous la forme sep=r’s+’. L’expression s cible universellement tout caractère d’espacement (espaces standards, tabulations, sauts de page), tandis que le quantificateur unaire + force le regroupement gourmand de toutes les occurrences adjacentes au sein d’un délimiteur logique unique.
Cependant, l’introduction d’un délimiteur sous forme d’expression régulière entraîne une conséquence algorithmique majeure : elle force automatiquement la bascule du moteur d’exécution vers l’interpréteur Python (engine=’python’). Le moteur C, optimisé pour les délimiteurs invariants à un seul octet, est structurellement incapable d’exécuter des moteurs d’automates finis non déterministes inhérents aux expressions régulières complexes. L’utilisateur doit être pleinement conscient que cette bascule induit une dégradation sensible des performances de lecture, pouvant multiplier par un facteur de trois à dix le temps nécessaire au traitement de fichiers volumineux.
5.3 Alternative computationnelle avec la fonction read_fwf
Face à des documents textuels où l’espacement visuel reflète une grille spatiale rigoureusement constante, le recours aux expressions régulières représente une surcharge computationnelle superflue. La bibliothèque Pandas propose une alternative dédiée spécifiquement conçue pour ces architectures : la fonction pandas.read_fwf (Fixed-Width Formatted lines). Ce parseur n’interroge pas la présence de séparateurs explicites ; il découpe le flux textuel selon des fenêtres spatiales strictes définies par leurs coordonnées de colonnes typographiques.
Le paramétrage de read_fwf s’opère principalement au travers de l’argument colspecs, qui accepte une liste de tuples définissant les coordonnées semi-ouvertes (indice_début, indice_fin) de chaque champ sur une ligne donnée. Par exemple, une spécification colspecs=[(0, 10), (10, 25), (25, 30)] découpera chirurgicalement chaque enregistrement en trois segments immuables, quelles que soient les chaînes textuelles ou les blancs intérieurs présents dans ces intervalles. Si le fichier présente une régularité parfaite avec des marges d’alignement explicites sur l’en-tête, le paramètre peut être omis ou fixé à colspecs=’infer’, laissant la fonction deviner la démarcation des colonnes sur un échantillon préliminaire de lignes.
L’arbitrage de robustesse entre read_csv configuré avec un séparateur régulier et read_fwf tourne résolument à l’avantage de cette dernière dès lors que les données textuelles internes comportent des espaces signifiants — tels que des descriptions nominatives ou des adresses physiques — qui seraient déchiquetés à tort par un motif regex de type s+. De surcroît, read_fwf garantit une stabilité géométrique supérieure face aux valeurs manquantes non matérialisées, évitant le glissement des colonnes subséquentes vers la gauche de la matrice.
6. Système de types et stratégies de conversion dynamique
6.1 Mécanisme d’inférence heuristique des types de données
L’un des composants les plus élaborés du parseur C de Pandas réside dans son moteur d’inférence heuristique de types de données. À mesure que les fragments textuels sont isolés par l’analyseur lexical, ils transitent par une série de tests logiques successifs en cascade ordonnée. Le moteur tente d’abord de convertir la chaîne en un entier 64 bits signé ; en cas d’échec — par exemple si un point décimal ou une notation exponentielle est décelée —, il tente une conversion vers un nombre à virgule flottante double précision (float64). Si cette tentative échoue à son tour, il vérifie si la séquence correspond à un booléen standard avant de se résoudre, en dernier recours, à assigner le type générique object (représentant des pointeurs vers des chaînes de caractères en mémoire Python).
Bien que cette heuristique offre un confort d’utilisation indéniable pour l’analyse exploratoire interactive, elle génère des risques d’instabilité structurelle considérables lorsqu’elle traite des corpus massifs ou hétérogènes. Par défaut, le moteur n’analyse pas l’intégralité du fichier pour déterminer le type d’une colonne : il scrute un échantillon initial de lignes consécutives. Si un attribut est composé de valeurs purement entières sur les dix mille premières lignes, mais contient accidentellement une valeur textuelle ou un identifiant alphanumérique à la dix millième et unième ligne, le parseur se voit contraint de lever un avertissement de type DtypeWarning et de rétrograder l’ensemble de la colonne vers le type object, ce qui entraîne une fragmentation mémoire immédiate.
L’identification méthodique des colonnes affectées par des types mal interprétés s’opère par l’interrogation systématique de l’attribut dtypes consécutivement au chargement. La présence inattendue du type object pour une colonne supposée porter des mesures quantitatives signale immanquablement la présence de données polluées dans le fichier source, exigeant la mise en place d’une politique de typage rigide en amont du processus de lecture.
6.2 Affectation stricte des types via le paramètre dtype
Pour garantir une reproductibilité computationnelle absolue et optimiser radicalement l’allocation des ressources matérielles, la bonne pratique absolue consiste à désactiver l’inférence heuristique au profit d’une déclaration déterministe au moyen du paramètre dtype. Cet argument attend un dictionnaire associant nominativement chaque variable identifiée à son type primitif Pandas ou NumPy cible, tel que dtype={‘identifiant’: ‘int32’, ‘mesure’: ‘float32’, ‘code_statut’: ‘string’}.
Cette approche s’avère indispensable pour préserver la fidélité sémantique de données critiques hautement vulnérables aux conversions numériques automatiques. Le cas d’école emblématique concerne les codes postaux, les identifiants nationaux de sécurité sociale ou les numéros de téléphone. Si un code postal tel que « 01340 » est ingéré sans typage explicite, l’heuristique de Pandas l’assimile à un entier arithmétique et élimine impitoyablement le zéro initial, transformant la chaîne en l’entier 1340, ce qui constitue une corruption irrémédiable de l’information. Forcer le type en dtype={‘code_postal’: str} ou vers le type standardisé string neutralise tout risque d’élagage préjudiciable.
Au-delà de la préservation de l’intégrité de surface, le typage strict constitue le levier le plus puissant d’optimisation de la mémoire vive. Par défaut, l’inférence alloue quasi-systématiquement des types 64 bits (int64 ou float64), même pour des grandeurs n’excédant jamais la valeur 100. En forçant l’allocation vers des types signés plus compacts comme int8, int16 ou float32, la charge mémoire occupée par les vecteurs tabulaires peut être divisée par deux, voire par huit, permettant ainsi d’ingérer des corpus textuels considérablement plus massifs sur une machine aux capacités matérielles modestes.
6.3 Traitement des valeurs temporelles et dates textuelles
Le traitement des séries chronologiques constitue un domaine où l’ingestion textuelle rencontre des obstacles majeurs liés à la diversité des conventions de notation calendaire internationales. Par défaut, une date sérialisée sous forme textuelle (par exemple « 2023-10-24 14:30:00 » ou « 24/10/2023 ») est purement et simplement ingérée comme une chaîne de caractères de type object, interdisant toute opération ultérieure de rééchantillonnage temporel, de fenêtrage glissant ou de calcul de deltas de durée.
Pour forcer l’analyse lexicale des chronomètres dès l’ingestion, Pandas fournit le paramètre parse_dates. En assignant à cet argument la liste des noms ou des index positionnels des colonnes temporelles (par exemple parse_dates=[‘Horodatage’]), le parseur délègue la transformation des segments textuels correspondants vers des objets de type datetime64[ns]. Si la date se trouve fragmentée sur plusieurs champs textuels contigus — tels qu’une colonne distincte pour l’année, le mois et le jour —, parse_dates accepte également une syntaxe de dictionnaires permettant de fusionner ces colonnes distinctes en une série temporelle unique et cohérente.
Face à des notations calendaires exotiques ou complexes qui échouent face aux algorithmes génériques, il devient impératif de personnaliser la fonction de décodage via l’argument date_format ou, pour les versions plus anciennes, date_parser. L’utilisation de spécificateurs standardisés conformes à la norme POSIX strftime (tels que date_format=’%d-%m-%Y %H:%M:%S’) neutralise toute ambiguïté d’interprétation — comme la confusion classique entre le format américain mois/jour/année et le format européen jour/mois/année — tout en accélérant substantiellement la vitesse de conversion en évitant au parseur d’explorer inutilement une multiplicité de formats candidats.
7. Traitement des valeurs manquantes et artefacts textuels
7.1 Identification et paramétrage des valeurs sentinelles
Dans la composition des fichiers textuels réels, l’absence de mesure ou l’inapplicabilité d’un attribut s’exprime rarement par une absence physique d’octets. Les systèmes émetteurs déploient une panoplie de conventions sémantiques arbitraires, intégrant des valeurs sentinelles textuelles telles que « N/A », « NA », « NULL », « None », « -999 », « 9999 », « Missing » ou simplement une séquence de tirets courts (« –« ). Si ces artéfacts textuels ne sont pas neutralisés lors de l’ingestion, ils demeurent sous forme de chaînes littérales, polluant irrémédiablement les colonnes numériques qui se retrouvent converties de force en type object.
Pandas intègre par défaut une collection prédéfinie d’expressions sentinelles qu’il convertit automatiquement en la constante mathématique standardisée numpy.nan (Not a Number) pour les structures flottantes ou en l’objet sentinelle pd.NA pour les extensions typées modernes. Toutefois, pour capturer les singularités spécifiques à un système d’information donné, il est essentiel d’enrichir cette liste au moyen du paramètre na_values. Cet argument accepte soit une liste globale de chaînes sentinelles à rechercher dans toutes les colonnes, soit un dictionnaire granulaire précisant les sentinelles propres à chaque colonne (par exemple na_values={‘Age’: [‘-1’, ‘999’], ‘Statut’: [‘Inconnu’, ‘VIDE’]}).
Dans certains contextes analytiques stricts, la détection par défaut des valeurs sentinelles peut provoquer des effets secondaires destructeurs. L’exemple le plus flagrant concerne les données codées selon les normes de l’Organisation internationale de normalisation (ISO), notamment les codes de pays ISO 3166-1 alpha-2. Le code officiel représentant la République de Namibie est la chaîne littérale « NA ». Par défaut, Pandas interprète cette chaîne comme le raccourci d’un marqueur d’absence (Not Available) et écrase le pays par une valeur manquante. Pour désactiver ce comportement aveugle, il convient de fixer keep_default_na=False, forçant ainsi le parseur à ne considérer strictement comme manquantes que les valeurs explicitement déclarées dans l’argument na_values.
7.2 Gestion des cellules corrompues et des lignes discordantes
L’asymétrie structurelle des enregistrements constitue un poison redoutable pour les parseurs tabulaires déterministes. Il n’est pas rare qu’un fichier texte brut contienne des lignes discordantes résultant d’erreurs d’écriture matérielle, d’interruptions brutales de flux réseau ou de concaténations maladroites de sources dissemblables. Ces lignes se manifestent le plus souvent par un nombre excédentaire ou déficitaire de délimiteurs de champs comparativement au schéma défini par l’en-tête du document.
Face à une telle anomalie, le moteur C de Pandas interrompt immédiatement l’exécution en soulevant une exception fatale de type pandas.errors.ParserError signalant qu’une ligne spécifique contient, par exemple, sept champs là où quatre étaient attendus. Pour conférer une résilience maximale aux chaînes de traitement automatisées qui ne peuvent se permettre un crash brutal face à des corpus volumineux imparfaits, Pandas offre le paramètre de contrôle on_bad_lines. Ce paramètre remplace les anciens drapeaux dépréciés error_bad_lines et warn_bad_lines.
Le paramètre on_bad_lines autorise trois postures méthodologiques distinctes :
- ‘error’ : Posture par défaut qui interrompt le traitement et soulève une exception à la moindre divergence géométrique.
- ‘skip’ : Élimine silencieusement les enregistrements défectueux du flux d’ingestion, préservant la stabilité du pipeline tout en garantissant la complétude des lignes retenues.
- ‘warn’ : Élimine les enregistrements corrompus tout en émettant un avertissement explicite dans le flux de journalisation standard (stderr), indiquant précisément les numéros de lignes exclues pour faciliter le diagnostic et l’audit a posteriori.
7.3 Distinction sémantique entre vide textuel et absence de valeur
D’un point de vue de la modélisation formelle des bases de données et de la théorie de l’information, une distinction ontologique profonde sépare la chaîne de caractères vide (concrétisée par deux délimiteurs consécutifs sans contenu intermédiaire : « ») de l’absence totale de valeur conceptuelle (le concept de NULL en algèbre relationnelle). Une chaîne de caractères vide peut légitimement représenter une réponse positivement nulle — par exemple un champ de commentaire libre délibérément laissé sans texte par un répondant —, tandis qu’une valeur nulle indique que la mesure n’a pu être collectée ou que l’information est inconnue.
La configuration par défaut du parseur de Pandas a tendance à aplatir cette nuance sémantique en amalgamant les délimiteurs consécutifs sans matière avec la notion de valeur sentinelle, projetant ces deux états vers la représentation commune NaN. Si le protocole de recherche exige impérativement la préservation de la chaîne vide en tant qu’information signifiante distincte du néant métrologique, l’utilisation concertée des paramètres keep_default_na=False et na_values devient incontournable. En évitant d’inclure la chaîne vide dans le registre des expressions nulles, la cellule sera fidèlement allouée en mémoire comme une chaîne de longueur zéro de type textuel.
L’impact de cet arbitrage sur les calculs statistiques subséquents est massif. Dans Pandas, les opérations de réduction telles que count() ignorent systématiquement les valeurs manquantes réelles (NaN), mais comptabilisent les chaînes de caractères vides comme des observations valides. Ainsi, le calcul des fréquences relatives, les opérations de regroupement hiérarchique via groupby() et les modèles d’apprentissage automatique subséquents produiront des inférences diamétralement opposées selon la manière dont cette dichotomie entre vacuité textuelle et absence métrique aura été arbitrée dès la ligne d’ingestion.
8. Encodage des caractères et internationalisation des données
8.1 Théorie des encodages de caractères en informatique documentaire
L’illusion selon laquelle un fichier texte ne contiendrait que des « lettres » s’effondre dès lors que l’on étudie la physique logicielle des systèmes de fichiers. Un support de stockage ne conserve exclusivement que des arrangements binaires structurés en octets (valeurs de 0 à 255). L’encodage de caractères est la convention mathématique et algorithmique qui attribue un point de code abstrait à un glyphe typographique spécifique. Historiquement, le standard américain ASCII a verrouillé l’informatique sur 7 bits, ne proposant que 128 caractères fondamentaux couvrant l’alphabet latin non accentué et les symboles de commande élémentaires.
Pour répondre à la diversité des systèmes linguistiques mondiaux, une myriade d’encodages régionaux incompatibles a émergé. Le standard ISO-8859-1 (souvent désigné sous l’appellation Latin-1) a tenté d’adresser les idiomes ouest-européens sur un octet complet (8 bits), étendant la table à 256 caractères pour y inclure les caractères diacritiques français. Parallèlement, l’écosystème Microsoft développait le standard propriétaire Windows-1252 (ANSI), qui enrichissait la plage réservée de l’ISO-8859-1 avec des glyphes spécifiques comme le symbole de l’euro ou les guillemets courbes. La résolution universelle de cette fragmentation est incarnée par le standard Unicode et son implémentation de compression séquentielle UTF-8, qui encode les glyphes mondiaux sur une longueur variable d’un à quatre octets.
La célèbre exception UnicodeDecodeError: ‘utf-8’ codec can’t decode byte in position… se déclenche inexorablement lorsque l’analyseur lexical de Pandas — configuré par défaut selon le paradigme UTF-8 contemporain — se heurte à un octet non conforme aux règles combinatoires strictes d’Unicode. Cette rupture physique empêche toute interprétation textuelle et bloque l’exécution du processus d’ingestion dès le premier octet fautif rencontré.
8.2 Configuration explicite de l’encodage lors du chargement
Pour restaurer l’intégrité de la lecture face à des fichiers forgés sous d’anciens environnements ou des systèmes d’exploitation hétérogènes, la solution programmatique immédiate consiste à renseigner l’argument encoding de la fonction read_csv. Si le fichier source provient d’un système bureautique francophone Windows historique, l’assignation de encoding=’cp1252′ ou de son homologue normalisé encoding=’latin1′ (alias d’ISO-8859-1) permet de rétablir immédiatement la fidélité des accents, des cédilles et des symboles typographiques particuliers sans générer d’exception de bas niveau.
Lorsque la provenance du fichier texte est totalement obscure et que l’encodage initial n’a pas été documenté par l’émetteur de la donnée, l’ingénieur ne doit pas procéder par essais et erreurs aléatoires. La méthodologie rigoureuse consiste à mobiliser des bibliothèques externes d’analyse statistique de distribution d’octets, telles que chardet ou charset-normalizer. En injectant un fragment brut d’octets dans ces outils d’inspection heuristique en amont de la lecture Pandas, il est possible d’extraire une estimation prédictive hautement probable de l’encodage réel accompagnée d’un indice de confiance mathématique.
Dans les cas désespérés où le corpus textuel présente des corruptions locales irréparables — par exemple des séquences d’octets invalides issues d’un transfert réseau incomplet —, il est envisageable de paramétrer le gestionnaire d’erreurs de décodage via l’argument encoding_errors disponible dans les versions contemporaines de Pandas. L’assignation de la valeur encoding_errors=’replace’ commande au décodeur d’insérer le glyphe de substitution standardisé Unicode (le caractère losange pointé d’interrogation U+FFFD) à l’emplacement exact des octets fautifs, tandis que encoding_errors=’ignore’ les élimine purement et simplement, autorisant la finalisation du chargement au prix d’une perte locale et circonscrite de données.
8.3 Traitement des spécificités linguistiques et typographiques
L’internationalisation d’un processus d’ingestion ne se cantonne pas au décodage binaire des glyphes alphabétiques ; elle englobe également la gestion des conventions numériques régionales. Dans l’écosystème anglo-saxon standard, le point est le séparateur décimal conventionnel, tandis que la virgule sert d’isolateur de milliers (ex: 1,250,000.50). Dans la francophonie et la majeure partie de l’Europe continentale, cette typographie est inversée : la virgule marque la frontière décimale, tandis que l’espace insécable ou le point matérialise les milliers (ex: 1.250.000,50).
Si un fichier texte comportant des grandeurs numériques formatées selon les normes européennes est ingéré avec les paramètres anglo-saxons par défaut, les nombres contenant une virgule seront universellement convertis en chaînes de caractères de type object, neutralisant toute possibilité de calcul mathématique ultérieur. Pour régir cette divergence de manière élégante sans devoir exécuter des opérations de remplacement de chaînes a posteriori, Pandas propose les paramètres conjoints decimal et thousands.
En déclarant formellement decimal=’,’ et thousands=’.’ au sein de la fonction d’ingestion, le moteur C applique la transformation arithmétique directement au cours de la phase de scission lexicale. Les séquences textuelles de chiffres intégrant des séparateurs de milliers européens sont nettoyées de leurs points isolateurs et les virgules sont directement projetées vers la représentation interne standardisée des nombres flottants. Cette rigueur garantit une uniformité métrologique parfaite pour les colonnes monétaires, scientifiques ou financières dès leur entrée en mémoire vive.
9. Filtrage structural et partitionnement sélectif à l’ingestion
9.1 Projection colonnaire ciblée au moyen de usecols
L’ingestion aveugle de la totalité des données contenues dans un document textuel constitue une pratique inefficace qui épuise inutilement les ressources matérielles de la station de calcul. Dans de nombreux scénarios d’ingénierie, un fichier texte peut comporter plusieurs dizaines ou centaines de colonnes contextuelles, alors que la question scientifique ou le modèle prédictif n’en requiert qu’un sous-ensemble restreint. Pour restreindre la lecture aux seules dimensions pertinentes, Pandas expose le paramètre de projection colonnaire usecols.
L’argument usecols accepte une grande diversité de formes syntaxiques. Il peut s’agir d’une liste ordonnée d’indices positionnels numériques (par exemple usecols=[0, 3, 5]), d’une liste exhaustive de libellés textuels correspondant exactement aux noms déclarés dans l’en-tête (par exemple usecols=[‘Date’, ‘Volume’, ‘Prix’]), ou même d’un prédicat fonctionnel sous la forme d’une fonction lambda. Cette dernière approche offre une souplesse exceptionnelle : une expression telle que usecols=lambda col: col.startswith(‘Mesure_’) projettera dynamiquement toutes les variables respectant ce motif nominatif sans exiger la saisie fastidieuse de leur liste exhaustive.
L’impact algorithmique de cette restriction est spectaculaire. En éliminant les colonnes superflues dès l’analyse lexicale, le parseur économise les allocations mémoires associées aux blocs vectoriels NumPy correspondants, réduit les opérations de conversion de types et allège substantiellement la pression exercée sur le bus de données de la mémoire vive. Le débit de traitement global s’en trouve démultiplié, autorisant l’accès à des fichiers volumineux qui auraient autrement provoqué un épuisement de la mémoire système (Out-Of-Memory error).
9.2 Omission délibérée de segments textuels via skiprows et skipfooter
Les fichiers d’exportation de données — générés par des instruments de laboratoire, des capteurs environnementaux ou des passerelles de paiement — intègrent quasi-systématiquement des segments parasites en préambule et en conclusion de fichier. Le préambule compile traditionnellement des blocs descriptifs libres (identifiant du capteur, version du microprogramme, conditions ambiantes), tandis que la conclusion héberge des lignes de synthèse telles que la somme des colonnes, la moyenne globale ou la signature numérique du fichier.
Pour contourner ces artefacts non tabulaires, Pandas met à disposition les paramètres de filtrage vertical skiprows et skipfooter. Le paramètre skiprows s’illustre sous deux déclinaisons fondamentales :
- Une valeur scalaire entière skiprows=n, qui commande au parseur de faire progresser le pointeur de lecture au-delà des n premières lignes physiques avant d’amorcer le parsing de l’en-tête ou des données.
- Une liste d’entiers ou une fonction d’évaluation logique — telle que skiprows=[0, 2, 5] ou skiprows=lambda x: x % 2 != 0 —, autorisant l’omission arbitraire de lignes spécifiques ou l’échantillonnage de motifs réguliers au sein du corpus.
Inversement, le paramètre skipfooter=m commande l’exclusion des m dernières lignes physiques du fichier texte. Cependant, il convient de souligner une contrainte technique fondamentale : l’utilisation de skipfooter interdit formellement l’usage du moteur C standard. Le moteur de bas niveau étant incapable d’anticiper la terminaison d’un fichier sans le parcourir intégralement via des pointeurs, l’utilisation conjointe de cet argument impose systématiquement la déclaration explicite de engine=’python’. L’analyste doit arbitrer entre la commodité d’une omission automatisée de bas de page et le coût temporel inhérent à l’exécution du moteur interprété.
9.3 Échantillonnage exploratoire via le contrôle nrows
Lorsqu’un ingénieur aborde un corpus textuel massif dont le volume se compte en dizaines de gigaoctets, tenter une ingestion intégrale immédiate constitue une imprudence méthodologique majeure. La phase d’exploration préliminaire vise à valider la conformité du schéma conceptuel, l’exactitude des séparateurs, l’absence d’ambiguïté dans les encodages et la justesse de l’inférence des types. Pour mener ces vérifications sans immobiliser la station de travail, le paramètre nrows s’impose comme l’outil d’échantillonnage cardinal.
En déclarant nrows=100 ou nrows=1000, le parseur interrompt impérativement l’analyse dès que le quota spécifié d’observations valides a été ingéré et converti dans le DataFrame. Cette opération ne requiert qu’une fraction infinitésimale de seconde, fournissant immédiatement à l’analyste un objet représentatif de l’architecture globale des données. Sur cet échantillon réduit, il devient possible d’exécuter des diagnostics poussés sur les types de colonnes, d’affiner le dictionnaire dtype, d’isoler les valeurs sentinelles au moyen de na_values et de valider les règles de conversion de dates.
Ce protocole d’échantillonnage préliminaire accélère de manière exponentielle le cycle de développement et de débogage interactif. Une fois que l’intégralité du pipeline d’ingestion a été syntonisé, validé et éprouvé sur cet échantillon restreint, il suffit d’élaguer le paramètre nrows du script d’exécution pour déployer l’ingestion massive sur l’intégralité du corpus en toute sérénité, en éliminant les risques de plantage après des dizaines de minutes d’attente stérile.
10. Stratégies d’optimisation mémoire pour corpus textuels massifs
10.1 Fragmentation séquentielle à l’aide du paramètre chunksize
L’ingestion d’un fichier textuel monolithique dont la taille excède la capacité nominale de la mémoire vive physique (RAM) constitue une impasse architecturale classique. Tenter de charger un fichier de quarante gigaoctets sur une machine ne disposant que de seize gigaoctets déclenche inévitablement un swapping agressif sur disque virtuel, suivi de la résiliation brutale du processus par le gestionnaire d’allocation mémoire du système d’exploitation (le redouté signal SIGKILL de l’OOM Killer sous les environnements GNU/Linux). Pour transcender cette limitation physique, Pandas implémente le modèle de partitionnement séquentiel via l’argument chunksize.
L’affectation d’une valeur scalaire entière au paramètre chunksize — par exemple chunksize=50000 — altère profondément le comportement d’instanciation de la fonction read_csv. Au lieu de renvoyer directement un objet unitaire DataFrame, la fonction retourne un itérateur de flux séquentiel appartenant à la classe générique pandas.io.parsers.TextFileReader. Cet itérateur agit comme un curseur paresseux (lazy evaluator) qui conserve ouvert le descripteur de fichier et produit, à chaque itération, un DataFrame autonome dimensionné strictement au volume spécifié d’observations.
Le patron d’architecture associé consiste à concevoir une boucle itérative procédant à des agrégations partielles. Chaque fragment de cinquante mille lignes est ingéré, filtré, réduit par des opérations matricielles (telles que le calcul de sommes ou de décomptes locaux), puis immédiatement purgé de l’espace d’adressage pour permettre la réallocation de la mémoire vive au bloc suivant. À l’issue du balayage exhaustif du document textuel, l’analyste combine les résultats partiels pour synthétiser les indicateurs globaux finaux. Cette méthodologie garantit une stabilité absolue de l’empreinte mémoire, permettant le traitement de fichiers de centaines de gigaoctets avec une consommation mémoire résidente invariante et minimale.
10.2 Réduction de l’empreinte mémoire par conversion catégorielle
Dans un très grand nombre de corpus textuels, les colonnes alphanumériques ne contiennent pas un texte libre infini, mais un ensemble fini et restreint de modalités sémantiques mutuellement exclusives — par exemple des dénominations de pays, des catégories socioprofessionnelles, des codes d’états d’un protocole ou des libellés de genres. Lorsqu’une telle variable est ingérée selon le paradigme standard object, Pandas stocke chaque entrée sous forme d’un pointeur mémoire vers une chaîne Python unique, multipliant la consommation d’octets et dispersant l’adressage mémoire.
La substitution du type object par le type catégoriel natif de Pandas (category) constitue un vecteur de compression mémoire colossal. Le modèle catégoriel repose sur le principe de l’encodage par dictionnaire : la liste des modalités distinctes n’est stockée qu’une seule fois dans une table de symboles d’indexation, tandis que la colonne physique sous-jacente est remplacée par un vecteur très compact d’entiers pointant vers les identifiants de ce dictionnaire (généralement des entiers non signés sur 8 bits de type uint8 si le nombre de catégories n’excède pas 256).
L’arbitrage entre l’usage du type objet et du type catégoriel dépend strictement de la cardinalité de la variable concernée (c’est-à-dire le rapport entre le nombre de modalités uniques et le nombre total d’observations). Si la cardinalité est faible — par exemple moins de mille modalités pour un fichier de dix millions d’enregistrements —, l’assignation directe du type catégoriel dès l’ingestion via le dictionnaire de correspondances dtype={‘Region’: ‘category’} permet d’observer une compression de l’empreinte mémoire de la colonne avoisinant fréquemment les quatre-vingt-dix pour cent (90%), tout en décuplant la vélocité des opérations ultérieures de tri et de partitionnement groupé.
10.3 Exploitation des moteurs modernes à haut rendement
L’écosystème du calcul scientifique a connu une rupture technologique majeure avec l’émergence du projet open source Apache Arrow, qui définit une spécification standardisée pour la représentation de structures tabulaires contiguës en mémoire colonnaire. Depuis ses versions 2.0+, Pandas intègre nativement une passerelle d’interopérabilité directe avec le moteur de calcul haute performance PyArrow, autorisant son invocation explicite comme moteur de scission lexicale pour les fichiers textes via l’assignation engine=’pyarrow’.
Les gains de latence procurés par l’ingénierie logicielle de PyArrow sont absolument majeurs. Alors que l’historique moteur C de Pandas opère essentiellement de manière séquentielle sur un seul fil d’exécution processeur (single-thread), le moteur PyArrow est conçu pour exploiter nativement le parallélisme massif des processeurs multi-cœurs modernes. Le fichier textuel source est fragmenté logiquement à la volée et confié à un ensemble de threads d’exécution concurrents qui procèdent à l’analyse syntaxique, au typage direct et au compactage vectoriel en parallèle, réduisant les temps d’ingestion par un facteur pouvant atteindre cinq à dix sur les architectures contemporaines.
Néanmoins, l’adoption de ce moteur ultra-rapide exige la prise en considération de certaines limitations fonctionnelles actuelles. Le parseur PyArrow ne propose pas encore la granularité chirurgicale absolue du moteur C historique pour la manipulation de certains paramètres ésotériques (tels que des motifs regex sophistiqués ou certaines formes de sauts de lignes dynamiques non standards). Dès lors que le fichier texte présente une morphologie tabulaire stricte et hautement normalisée, le recours à engine=’pyarrow’ représente néanmoins l’état de l’art technologique pour optimiser le débit d’ingestion documentaire.
11. Protocoles méthodologiques appliqués : Études de cas empiriques
11.1 Étude empirique 1 : Journal d’événements système non standardisé
Pour illustrer la mise en œuvre pratique de ces concepts théoriques, considérons l’analyse d’un fichier de journalisation d’infrastructure serveur nommé system_logs.txt. Ce type de document textuel se caractérise par des lignes d’événements horodatées, séparées par des espaces d’alignement arbitraires, intégrant des codes de criticité (INFO, WARN, CRITICAL) suivis de messages textuels contenant eux-mêmes des espaces internes. L’objectif consiste à ingérer les quatre premiers champs structurels — Date, Heure, Niveau et Code_Erreur — tout en ignorant les alertes mineures de test insérées par les techniciens de maintenance.
Le protocole de parsing nécessite le déploiement d’une stratégie articulée. Puisque les délimiteurs sont des séquences d’espaces à largeur non constante, nous configurons le séparateur sous la forme d’une expression régulière sep=r’s+’, imposant la bascule vers engine=’python’. La projection colonnaire est immédiatement verrouillée via usecols=[0, 1, 2, 3] pour exclure le message narratif variable qui violerait autrement la dimensionnalité matricielle. Pour neutraliser les cinq lignes préliminaires d’initialisation du daemon système, nous spécifions skiprows=5.
La robustesse du pipeline face aux enregistrements corrompus est garantie par l’adjonction de la directive on_bad_lines=’warn’, consignant les anomalies d’écriture réseau sans faire dérailler le chargement des millions d’autres lignes. Les champs de date et d’heure sont conjointement fusionnés et interprétés en déclarant parse_dates={‘Horodatage’: [0, 1]}, convertissant immédiatement deux colonnes textuelles disparates en un axe temporel unifié prêt à alimenter des visualisations de séries temporelles opérationnelles.
11.2 Étude empirique 2 : Exportation brute d’instrumentation de recherche
Le second scénario d’application empirique se concentre sur un fichier issu d’un spectromètre de masse de laboratoire, sérialisé sous l’intitulé spectro_mesures.txt. Ce document incarne l’archétype des données scientifiques européennes : les vingt premières lignes décrivent les conditions de calibration thermique et la configuration matérielle ; les données effectives sont délimitées par des points-virgules ; les grandeurs décimales emploient la virgule française conventionnelle ; et les défaillances de capteurs sont matérialisées par l’inscription textuelle « ERR_SENSOR » ou « -999.0 ».
L’ingestion méthodologique exige l’élimination absolue de toute inférence hasardeuse par une configuration chirurgicale de read_csv :
- skiprows=20 : Ignore le cartouche des métadonnées de calibration pour faire coïncider le pointeur de début avec la ligne des noms de canaux de mesure.
- sep=’;’ : Assignation du séparateur point-virgule, isolant convenablement chaque dimension d’observation.
- decimal=’,’ : Conversion dynamique des décimales européennes vers le standard flottant binaire sans nécessiter d’assainissement textuel a posteriori.
- na_values=[‘ERR_SENSOR’, ‘-999.0’] : Capture et transformation immédiate des valeurs aberrantes en sentinelles NaN, préservant l’homogénéité physique des séries.
- dtype={‘Canal_A’: ‘float32’, ‘Canal_B’: ‘float32’} : Typage strict allouant des nombres à virgule flottante simple précision, diminuant par deux l’allocation de mémoire vive comparé au standard 64 bits.
L’application rigoureuse de ces paramètres génère un objet DataFrame immédiatement consommable pour les bibliothèques d’analyse statistique inférentielle telles que SciPy ou Statsmodels, sans exiger une seule ligne d’assainissement manuel supplémentaire.
11.3 Étude empirique 3 : Fichier d’enquête psychosociale sans étiquettes
La troisième étude de cas modélise le traitement d’une base de données d’enquête psychométrique hébergée dans un document nommé enquete_psychosociale.txt. Ce fichier textuel brut rassemble les réponses quantitatives de dix mille sujets à une batterie de questions ordonnées selon des échelles de Likert (valeurs discrètes de 1 à 5). Les données sont sérialisées sous forme de chaînes de chiffres compactes séparées par de simples espaces, sans aucune mention d’en-tête de variable, et certaines omissions de réponse sont codées sous la chaîne « 99 ».
Le protocole d’ingestion commence par la neutralisation absolue de la première ligne au moyen de header=None, interdisant à la première observation participante d’être engloutie sous forme d’étiquettes d’axes. Simultanément, nous transmettons un vecteur taxonomique préétabli issu du dictionnaire de l’enquête au paramètre names=[‘Sujet_ID’, ‘Extraversion_1’, ‘Extraversion_2’, ‘Nevrosisme_1’, ‘Nevrosisme_2’], conférant instantanément une structure sémantique claire au tableau.
Les spécificités métrologiques sont adressées en couplant na_values=’99’ avec un dictionnaire de typage strict déclarant les réponses aux échelles sous forme d’entiers optimisés : dtype={var: ‘Int8’ for var in [‘Extraversion_1’, ‘Extraversion_2’, ‘Nevrosisme_1’, ‘Nevrosisme_2’]}. Notons l’utilisation du type nullable capitalisé ‘Int8’ de Pandas, qui autorise la coexistence d’entiers très compacts sur un octet avec des valeurs manquantes réelles (ce que le type primitif int8 de NumPy ne permet pas). Le résultat est une matrice psychométrique d’une légèreté et d’une rigueur formelle idéales pour les calculs de cohérence interne (alpha de Cronbach) ou les analyses factorielles exploratoires.
12. Bonnes pratiques, robustesse logicielle et gestion des exceptions
12.1 Interception rigoureuse des exceptions d’ingestion textuelle
Dans un contexte de déploiement logiciel professionnel — tel qu’un microservice d’ingestion ou un pipeline de données orchestré par Airflow —, la commande de lecture ne doit jamais être exécutée dans un vide structurel. Les entrées-sorties sur le système de fichiers sont par nature hautement faillibles et vulnérables aux contingences de l’environnement matériel. L’ingénieur rigoureux doit encapsuler systématiquement l’appel à read_csv au sein d’un bloc de gestion des exceptions d’une granularité chirurgicale.
La première exception physique à intercepter est l’erreur native FileNotFoundError, qui se déclenche lorsque le chemin résolu ne pointe vers aucune ressource accessible — problème typique lié à des divergences de chemins d’accès relatifs entre environnements de développement et de conteneurisation Docker. Dans la foulée, il est impératif d’intercepter les exceptions spécialisées émises par la bibliothèque elle-même, notamment pandas.errors.EmptyDataError, qui se produit lorsque le fichier cible est physiquement présent sur le disque mais ne contient aucun octet exploitable, ou lorsque toutes ses lignes ont été exclues par des directives de filtrage préambulaires.
Enfin, la capture de l’exception pandas.errors.ParserError permet de neutraliser de manière élégante les ruptures critiques de géométrie tabulaire qui n’auraient pas été adressées par des règles d’exclusion d’enregistrements. En isolant ces blocs au sein d’une structure conditionnelle try…except, l’application peut consigner l’anomalie dans un journal d’audit formel, déclencher des procédures de notification aux équipes d’infrastructure et basculer sur un protocole de repli sécurisé, évitant ainsi l’effondrement silencieux de l’ensemble de la chaîne d’analyse de données.
12.2 Documentation, traçabilité et reproductibilité scientifique
L’intégrité de la démarche scientifique et la maintenabilité des infrastructures logicielles exigent une traçabilité intégrale des conditions d’ingestion documentaire. Consigner en dur (hardcoding) des paramètres complexes au sein du corps fonctionnel des scripts de calcul constitue une dérive méthodologique préjudiciable à la reproductibilité. La bonne pratique industrielle préconise la déportation de l’ensemble des métadonnées de parsing — encodage des caractères, délimiteur logique, délimiteur décimal, dictionnaires de types, listes de valeurs manquantes — au sein d’un fichier de configuration immuable au format YAML, JSON ou TOML.
De surcroît, la documentation explicite des dépendances matérielles et logicielles doit être systématiquement annexée au code source. Les comportements subtils d’inférence de types ou la gestion de certains formats temporels peuvent varier d’une version mineure à l’autre de Pandas ou de ses dépendances sous-jacentes (notamment NumPy et PyArrow). Spécifier formellement ces exigences d’exécution au travers d’environnements virtualisés reproductibles garantit que l’ingestion textuelle exécutée aujourd’hui produira une matrice rigoureusement identique dans cinq ans sur une infrastructure matérielle distincte.
Enfin, il convient de réitérer le principe cardinal d’immuabilité de la source primaire textuelle : le fichier source ne doit sous aucun prétexte faire l’objet de modifications directes ou destructives sur le disque d’origine par des scripts d’assainissement préliminaires. Toutes les transformations d’élagage d’espaces, de typage, de normalisation d’en-têtes et de substitution de sentinelles doivent être orchestrées en flux par Pandas dans l’espace d’adressage mémoire, préservant ainsi l’intégrité de l’enregistrement original comme trace d’audit primaire inviolable.
12.3 Synthèse procédurale et arbre de décision pour l’ingestion textuelle
Pour formaliser la démarche intellectuelle de l’ingénieur face à un fichier texte inconnu, il est hautement profitable d’adopter une heuristique de décision séquentielle. Cette arborescence procédurale oriente rationnellement le choix des arguments de la fonction read_csv afin de garantir une ingestion optimale dès la première itération.
La démarche se structure selon la séquence diagnostique suivante :
- Étape 1 : Diagnostic de l’encodage binaire. Le fichier est-il un document UTF-8 standard ? Si non, identifier l’encodage source (ex: cp1252, latin1) et renseigner encoding.
- Étape 2 : Morphologie des séparateurs. Les colonnes sont-elles régies par un délimiteur unique invariant (virgule, tabulation, point-virgule) ? Si oui, configurer sep. S’agit-il d’espacements variables ? Recourir à sep=r’s+’. S’agit-il de coordonnées de colonnes géométriquement immuables ? Déployer read_fwf.
- Étape 3 : Cartographie des axes et en-têtes. Le document possède-t-il des étiquettes de variables sur sa première ligne utile ? Si oui, ajuster header pour sauter les éventuelles lignes narratives initiales. Si non, spécifier impérativement header=None et injecter un dictionnaire de libellés via names.
- Étape 4 : Règles typographiques et métrologiques. Le document emploie-t-il des conventions décimales européennes ? Si oui, spécifier decimal=’,’ et thousands=’.’. Existe-t-il des sentinelles arbitraires ? Les référencer rigoureusement via na_values.
- Étape 5 : Dimensionnement et optimisation mémoire. Le volume textuel excède-t-il la capacité de la mémoire vive disponible ? Si oui, implémenter un partitionnement séquentiel via chunksize ou adopter le moteur parallèle engine=’pyarrow’ couplé à une projection colonnaire restrictive usecols.
En observant scrupuleusement cette discipline méthodologique, l’analyste transforme l’ingestion textuelle — souvent perçue comme une corvée aléatoire et fragile — en une procédure d’ingénierie formelle, prédictible et résiliente, capable de dompter les flux de données les plus chaotiques pour les insérer harmonieusement au cœur des architectures d’analyse computationnelle contemporaines.
Références
Apache Arrow Development Team. (2023). Apache Arrow Python bindings (PyArrow): Cross-language development platform for in-memory data. Apache Software Foundation. https://arrow.apache.org/docs/python/
Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & K. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). SciPy. https://doi.org/10.25080/Majora-92bf1924-009
McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
The pandas development team. (2024). pandas-dev/pandas: Pandas documentation (Version 2.2). Zenodo. https://pandas.pydata.org/docs/
Unicode Consortium. (2023). The Unicode Standard, Version 15.1.0. Unicode Consortium. https://www.unicode.org/versions/Unicode15.1.0/