
L’analyse de régression linéaire par les moindres carrés ordinaires constitue l’un des piliers méthodologiques les plus largement mobilisés dans les sciences quantitatives contemporaines, qu’il s’agisse de la psychologie différentielle, de l’économétrie, de l’épidémiologie ou des sciences des données. Toutefois, la validité interne des inférences statistiques issues d’un modèle linéaire repose fondamentalement sur le respect scrupuleux d’un ensemble de postulats théoriques régissant le comportement des termes d’erreur. Dans la pratique empirique, l’estimation d’un modèle et l’examen direct des coefficients de régression et de leurs valeurs de significativité p s’avèrent dangereusement illusoires si ces conditions fondamentales ne sont pas préalablement et rigoureusement inspectées.
Le recours exclusif à des tests d’hypothèse formels pour évaluer la conformité des données aux exigences de modélisation présente des angles morts statistiques considérables. La dépendance mécanique de la puissance statistique vis-à-vis de la taille d’échantillon conduit fréquemment soit à une surdétection d’écarts négligeables dans les volumétries massives, soit à une cécité dramatique face à des violations structurelles critiques dans les échantillons de taille restreinte. Face à ces limites épistémologiques, l’analyse graphique des résidus s’impose non pas comme une simple commodité visuelle subsidiaire, mais bien comme l’outil diagnostique cardinal permettant au chercheur de saisir la nature qualitative, la localisation spatiale et l’impact dynamique des anomalies sous-jacentes à la distribution des données.
Dans l’écosystème du logiciel statistique open-source The R Project for Statistical Computing, l’évaluation diagnostique bénéficie d’une architecture native d’une élégance et d’une puissance remarquables. Par le simple appel de fonctions graphiques génériques appliquées aux objets de modélisation, le praticien dispose instantanément d’une suite de représentations visuelles spécifiquement paramétrées pour isoler la non-linéarité, la non-normalité distributionnelle, l’hétéroscédasticité et la présence délétère d’observations influentes ou d’effets de levier excessifs. Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes mathématiques, l’interprétation substantielle et les implications inférentielles de ces tracés diagnostiques sous R, tout en fournissant les repères méthodologiques et les stratégies correctives indispensables à la conduite d’une recherche empirique irréprochable.
1. Introduction aux postulats de la régression linéaire et rôle des graphiques de diagnostic
L’architecture de l’inférence statistique dans le cadre du modèle linéaire ne saurait être dissociée de ses assises probabilistes fondamentales. Trop souvent, l’apprentissage de la modélisation statistique réduit la régression à un algorithme d’optimisation numérique visant à minimiser la somme des carrés des écarts. Cette perspective purement calculatoire occulte la réalité stochastique sous-jacente : les coefficients estimés ne possèdent de propriétés optimales que sous la condition expresse que le processus générateur de données sous-jacent satisfasse aux hypothèses postulées lors de l’établissement des théorèmes fondamentaux de l’estimation linéaire.
1.1 Fondements théoriques du modèle linéaire général
La formalisation mathématique de l’équation de régression linéaire multiple s’articule traditionnellement sous la forme matricielle Y = Xβ + ε, où Y désigne le vecteur colonne des n observations relatives à la variable dépendante, X représente la matrice de dimension n × (p + 1) contenant le vecteur unitaire dédié à la constante ainsi que les n observations pour chacun des p prédicteurs continus ou catégoriels, β correspond au vecteur colonne des (p + 1) paramètres de régression inconnus de la population à estimer, et ε incarne le vecteur stochastique des n perturbations ou erreurs théoriques non observables. L’estimation par les moindres carrés ordinaires vise à déterminer le vecteur d’estimation b qui minimise la fonction de coût quadratique définie par la somme des carrés des erreurs théoriques projetées, aboutissant à la solution algébrique classique b = (X’X)⁻¹X’Y.
L’édifice inférentiel de cette méthode repose sur le respect des célèbres hypothèses formulées dans le cadre du théorème de Gauss-Markov. Ce théorème démontre mathématiquement que, sous réserve que l’espérance mathématique conditionnelle des erreurs sachant X soit strictement nulle, E(ε|X) = 0, que la variance conditionnelle des erreurs soit constante sur l’ensemble du domaine de prédiction, Var(ε|X) = σ²I (hypothèse d’homoscédasticité et d’absence d’autocorrélation), et que les variables explicatives soient exogènes et dénuées de colinéarité exacte, l’estimateur des moindres carrés ordinaires constitue le meilleur estimateur linéaire non biaisé (connu sous l’acronyme anglophone BLUE : Best Linear Unbiased Estimator). Lorsque l’on y adjoint l’hypothèse de normalité multidimensionnelle des erreurs, ε ~ N(0, σ²I), l’estimateur coïncide rigoureusement avec celui du maximum de vraisemblance, autorisant le déploiement des tests paramétriques de Student sur les coefficients individuels et de Fisher-Snedecor sur la décomposition globale de la variance.
Il est impératif pour l’analyste de maintenir une distinction conceptuelle et épistémologique intransigeante entre les erreurs théoriques ε et les résidus empiriques e. Les perturbations stochastiques ε représentent une entité théorique abstraite, intrinsèquement non mesurable, qui sépare la variable dépendante de la véritable fonction de régression populationnelle déterministe. À l’inverse, les résidus empiriques e, formalisés par le vecteur e = Y – Ŷ = (I – H)Y où H représente la matrice de projection orthogonale H = X(X’X)⁻¹X’, constituent des réalisations calculées à partir de l’échantillon observé. Cette distinction est cruciale : même si les erreurs théoriques ε sont indépendantes et de variance rigoureusement identique, les résidus observés e sont mathématiquement contraints par les données d’échantillonnage, induisant une dépendance linéaire mutuelle et des variances hétérogènes dépendant de la géométrie de la matrice des variables indépendantes.
1.2 Nécessité de l’inspection visuelle par rapport aux tests formels
La pratique empirique contemporaine souffre fréquemment d’un travers scientiste consistant à déléguer l’évaluation de la conformité des modèles à des tests d’hypothèse formels automatisés, tels que le test de Shapiro-Wilk pour la normalité, le test de Breusch-Pagan pour l’hétéroscédasticité, ou encore le test de Durbin-Watson pour l’autocorrélation sérielle. Si ces instruments conservent une utilité indicatrice indéniable, leur confiance aveugle et exclusive expose le chercheur à des écueils d’interprétation majeurs, principalement gouvernés par la dépendance asymptotique de la puissance statistique vis-à-vis de l’effectif total N de l’échantillon considéré.
Dans le cadre d’échantillons de grande taille, couramment rencontrés dans les registres épidémiologiques ou les bases de données issues du traçage numérique, le phénomène de surpuissance statistique conduit inévitablement au rejet catégorique de l’hypothèse nulle à des seuils de p-value infinitésimaux (p < 0.001), même lorsque l’écart distributionnel ou la variation de variance est infinitésimale et dénuée de tout impact pratique sur la précision des estimations ou l’erreur de type I. Inversement, dans le contexte d’échantillons réduits propres aux protocoles de recherche en neuro-imagerie ou aux études cliniques ciblées, la sous-puissance statistique structurelle des tests d’adéquation empêche quasi systématiquement le rejet de l’hypothèse nulle, conférant une fallacieuse sensation de sécurité méthodologique à des modèles pourtant altérés par des violations substantielles et invalidantes.
C’est précisément ici que s’illustre la complémentarité épistémologique indispensable entre les approches paramétriques inférentielles et l’inspection visuelle rigoureuse. L’analyse graphique ne se contente pas d’émettre un verdict binaire d’acceptation ou de rejet ; elle possède la capacité unique d’exposer la structure spatiale, la morphologie continue et l’étiologie des anomalies sous-jacentes. Un graphique de résidus révèle instantanément si un écart à la linéarité découle d’un effet de seuil non modélisé, d’une trajectoire quadratique ou d’un regroupement en grappes non anticipé, guidant de manière intelligente et contextualisée les choix de spécification du chercheur là où une valeur p muette ne propose aucun diagnostic constructif.
1.3 Présentation des quatre graphiques canoniques de la fonction plot()
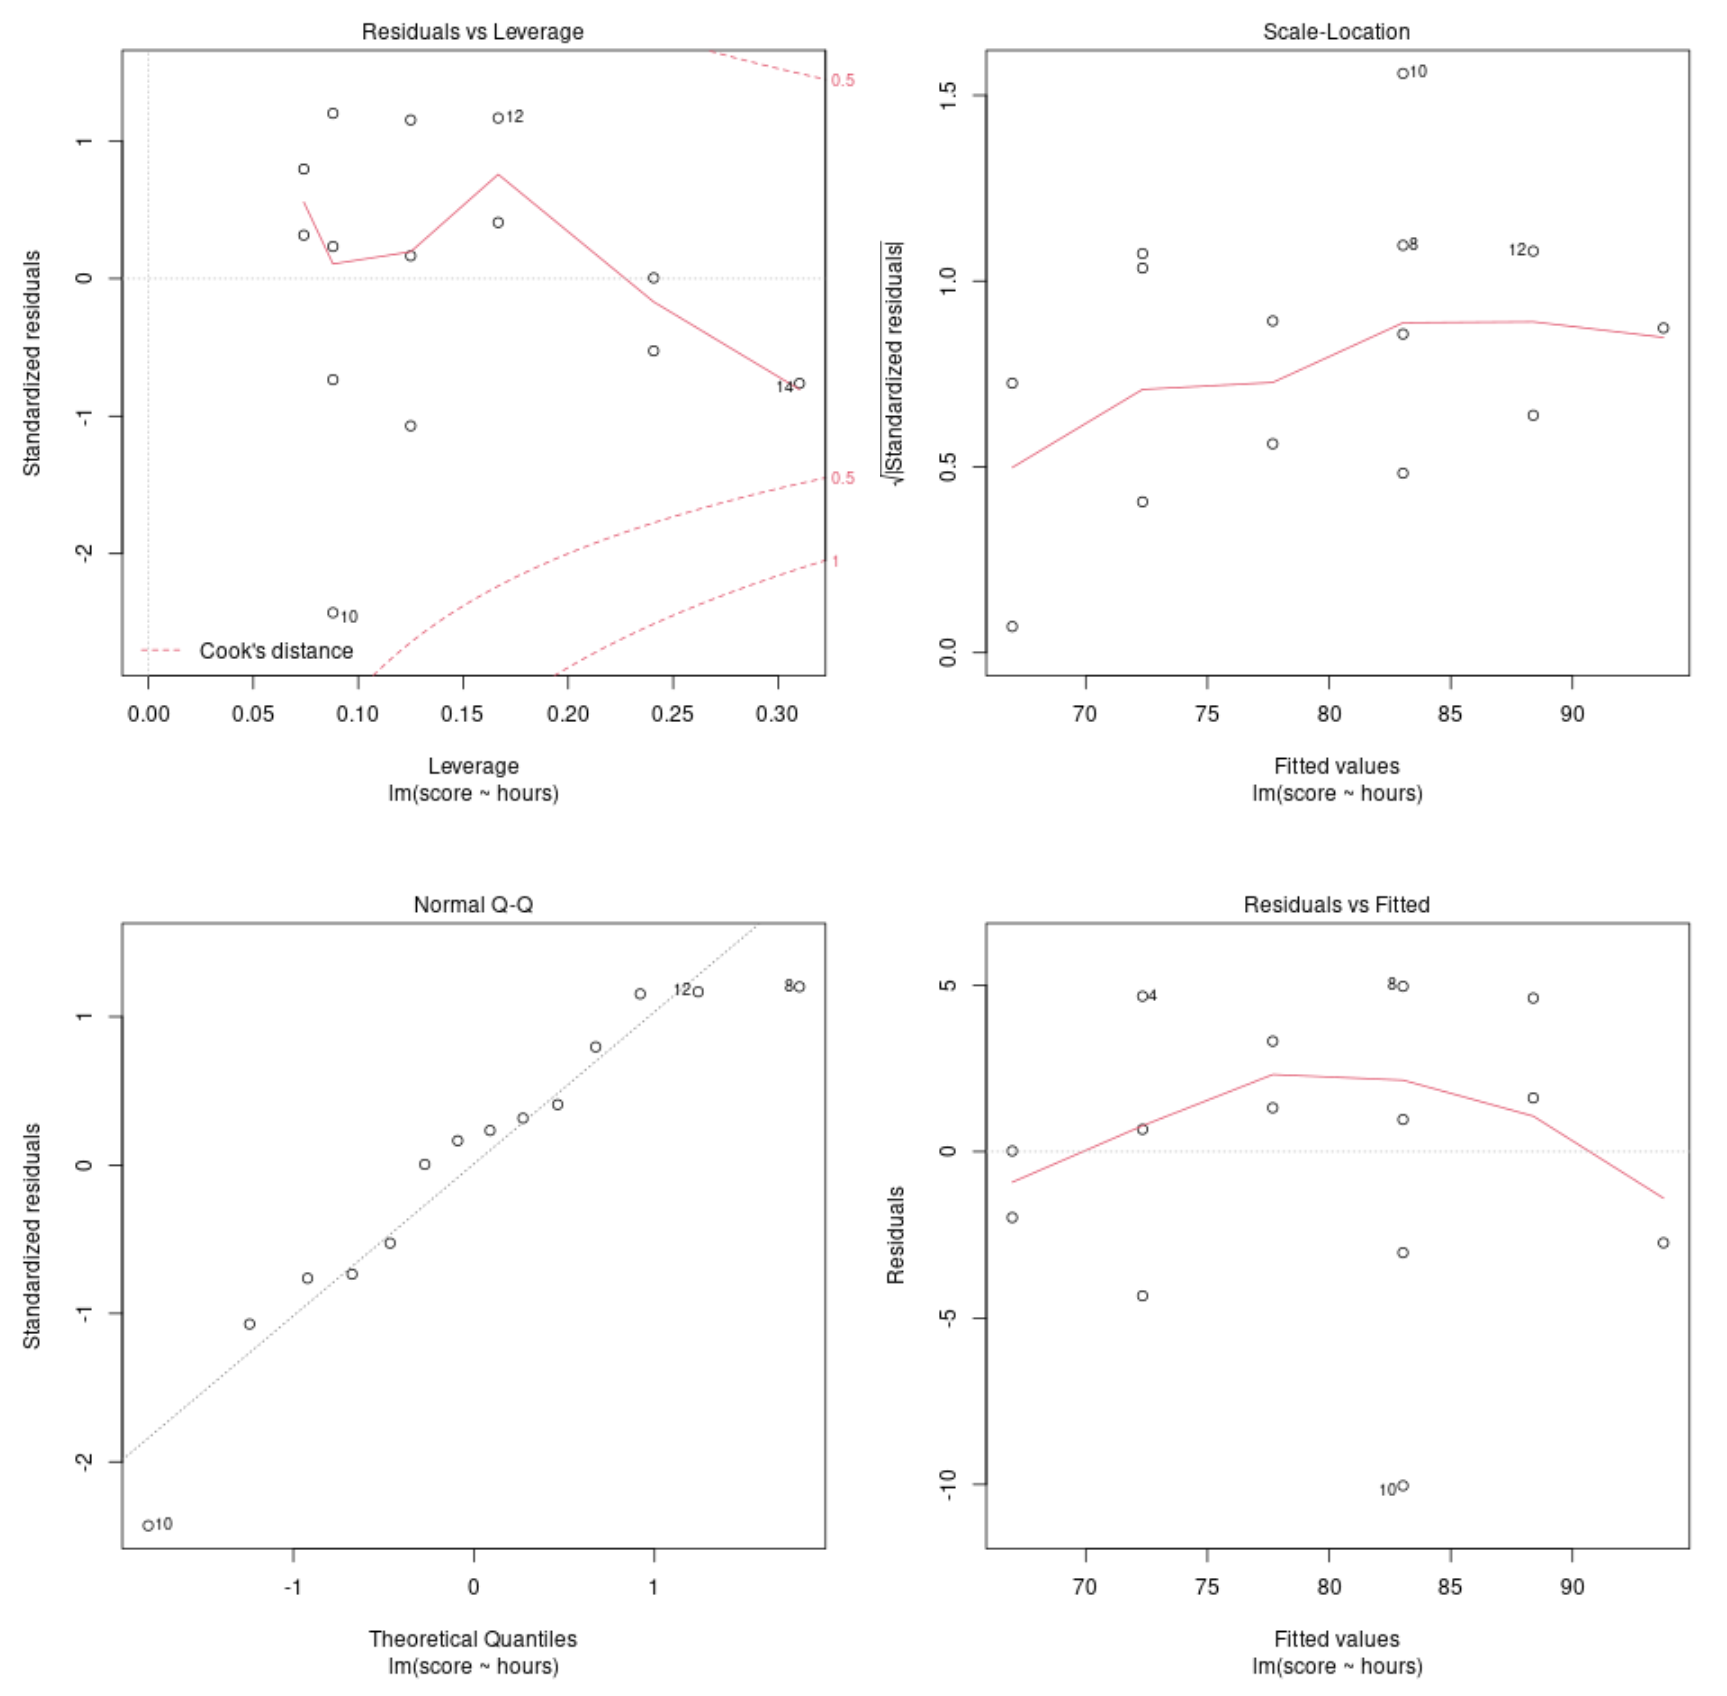
Dans l’environnement R, le concepteur du langage a intégré nativement un dispositif diagnostique standardisé d’une efficacité remarquable. Lorsqu’un objet de modélisation issu de la fonction d’ajustement linéaire standard est passé en argument à la fonction générique d’affichage, le moteur interne dispatche l’instruction vers la méthode spécifique dédiée aux régressions linéaires. Cette routine calcule de manière automatisée une suite standardisée de quatre tracés graphiques canoniques, conçus pour offrir une radiographie exhaustive des hypothèses fondamentales du modèle.
La cartographie fonctionnelle de ce quartet diagnostique s’organise selon une logique d’investigation séquentielle et ciblée :
- Le graphique des résidus versus les valeurs ajustées (Residuals vs Fitted) : dédié à l’évaluation de la linéarité intrinsèque de la fonction d’espérance conditionnelle et à l’examen préliminaire de l’homogénéité de dispersion des erreurs.
- Le diagramme quantile-quantile normal (Normal Q-Q Plot) : dévolu à l’évaluation de la normalité de la distribution stochastique des résidus standardisés via la comparaison géométrique des quantiles observés aux quantiles théoriques.
- Le tracé d’échelle-localisation (Scale-Location Plot) : calibré pour le diagnostic rigoureux de l’homoscédasticité par la standardisation et la transformation des résidus sous forme d’amplitude de dispersion absolue.
- Le graphique des résidus versus l’effet de levier (Residuals vs Leverage) : structuré pour identifier les observations exerçant une influence démesurée sur la configuration vectorielle des coefficients par la conjonction du levier mathématique et de l’amplitude résiduelle.
Afin de procéder à une analyse séquentielle efficace sans nécessiter une validation interactive manuelle à chaque affichage, il est universellement recommandé dans la communauté scientifique de configurer au préalable le périphérique graphique via l’instruction d’organisation matricielle adéquate. La définition d’une grille bilatérale à deux lignes et deux colonnes constitue le standard ergonomique incontournable pour apprécier d’un seul regard les interactions croisées entre ces différentes dimensions de diagnostic statistique.
2. Mise en œuvre technique et génération des tracés sous R
L’application rigoureuse des procédures d’évaluation diagnostique nécessite une parfaite maîtrise de l’interaction logicielle entre les fonctions d’ajustement statistique, l’extraction des structures matricielles internes et le contrôle fin des paramètres graphiques natifs de l’interpréteur R. L’environnement R repose sur une philosophie orientée objet au sein de laquelle l’exécution d’une régression ne génère pas un simple tableau récapitulatif textuel, mais une structure de données complexe encapsulant l’ensemble des coordonnées nécessaires aux vérifications empiriques.
2.1 Construction du jeu de données et ajustement du modèle avec lm()
Pour illustrer de manière pédagogique et reproductible l’ensemble des concepts développés, la démarche empirique s’articule autour de la génération programmatique de structures de données simulées intégrant volontairement des propriétés de distribution contrôlées, ou l’utilisation de collections de données de référence. Dans le paradigme syntaxique standard, l’ajustement du modèle de régression par les moindres carrés est confié à la fonction fondamentale *lm()*, qui procède à la résolution analytique du système d’équations normales sous-jacent.
Lorsqu’un modèle est instancié par l’assignation d’une formule symbolique spécifiant la variable dépendante en fonction des régresseurs, l’interpréteur compile les données dans une structure d’environnement dédiée. La fonction *summary()* extrait alors les paramètres de variance résiduelle, le coefficient de détermination R² et la table de significativité des coefficients basée sur la loi de Student. Cependant, l’objet retourné par l’ajustement contient une arborescence de listes bien plus riche, comprenant notamment les vecteurs d’observations ajustées calculées par le produit matriciel des prédicteurs et des coefficients estimés, ainsi que les écarts résiduels bruts obtenus par soustraction de ces prédictions aux données observées.
La compréhension de ces objets internes est indispensable pour l’analyste, car ils constituent le matériau computationnel direct exploité par les sous-routines de visualisation. La consultation attentive des éléments internes d’un modèle ajusté permet d’appréhender concrètement la distinction entre les éléments scalaires du modèle global et les vecteurs dimensionnés à la taille N de l’échantillon empirique qui serviront de base à l’évaluation point par point des postulats statistiques.
2.2 Paramétrage graphique natif et syntaxe d’exécution
L’affichage simultané des quatre représentations canoniques requiert une manipulation préliminaire des paramètres d’affichage du périphérique graphique standard. Par défaut, l’instruction graphique appliquée à un objet de régression génère les figures de manière séquentielle, invitant l’utilisateur à frapper la touche Entrée pour naviguer d’un panneau à l’autre. Pour contourner cette contrainte et obtenir une vue d’ensemble holistique indispensable à une interprétation croisée, il convient de modifier le paramètre global de partition de la fenêtre graphique via l’instruction *par(mfrow = c(2, 2))*.
Au-delà de cette disposition quadripartite, la fonction graphique propose un contrôle chirurgical de l’affichage grâce à son argument *which*. Cet argument vectoriel entier accepte des valeurs comprises entre 1 et 6, permettant au modélisateur d’isoler exclusivement la figure présentant un intérêt diagnostique particulier pour ses investigations ou la rédaction de son rapport. Ainsi, l’exécution ciblée de la fonction avec la spécification *which = 1* concentrera l’affichage sur la seule dynamique de courbure des résidus, garantissant une résolution visuelle maximale pour la détection de violations ténues de la linéarité.
Pour les besoins d’une communication académique de haut niveau, il est fréquent d’adjoindre à ces commandes de base des arguments de personnalisation esthétique et analytique. La modification des intitulés d’axes par *xlab* et *ylab*, l’adjonction de titres explicites via *main*, ainsi que l’ajustement de la palette chromatique des points et des lignes de tendance permettent d’adapter les tracés aux chartes éditoriales les plus rigoureuses. Enfin, la sauvegarde de ces rendus diagnostiques pour publication doit impérativement privilégier des formats vectoriels indépendants de la résolution tels que les extensions SVG ou PDF, ou des formats matriciels à haute densité d’échantillonnage comme les fichiers TIFF configurés au minimum à 300 points par pouce (DPI).
2.3 Extraction programmée des valeurs résiduelles
Bien que les graphiques automatisés constituent l’interface visuelle première, la rigueur analytique impose fréquemment de procéder à l’extraction numérique directe des différentes métriques de déviance afin de mener des vérifications programmées ou de construire des visualisations personnalisées hautement spécifiques. R offre une suite de fonctions dédiées permettant de naviguer à travers les différentes strates mathématiques de standardisation des écarts.
La fonction *residuals()* extrait les résidus bruts empiriques, c’est-à-dire la simple différence scalaire entre la trajectoire mesurée et la prédiction du modèle. Cependant, en raison des contraintes géométriques imposées par la matrice de projection H, la variance des résidus bruts n’est pas constante à travers les observations, mais équivaut à la quantité σ²(1 – h_ii), où h_ii représente l’effet de levier propre à la i-ème observation. Pour corriger cette distorsion structurelle et rendre les résidus comparables entre eux à l’échelle d’une variance unitaire théorique, la commande *rstandard()* calcule les résidus standardisés, également appelés résidus studentisés internes, en divisant chaque résidu brut par son écart-type individuel estimé sur la base de la variance résiduelle globale du modèle.
À un niveau d’isolation supérieur, la fonction *rstudent()* calcule les résidus studentisés externes. Dans ce schéma computationnel sophistiqué, l’estimation de la variance résiduelle sous-jacente au dénominateur est recalculée pour chaque observation après avoir exclu l’observation cible du processus d’estimation. Ce processus garantit qu’une valeur aberrante particulièrement extrême ne vienne pas artificiellement gonfler la variance globale de l’erreur, ce qui masquerait en partie sa propre déviance standardisée. Les résidus externes suivent rigoureusement une distribution t de Student à (n – p – 2) degrés de liberté, autorisant le chercheur à déployer des seuils d’alerte stochastiques d’une précision absolue pour isoler les observations en rupture avec le modèle central.
3. Graphique 1 : Résidus vs Valeurs ajustées (Residuals vs Fitted)
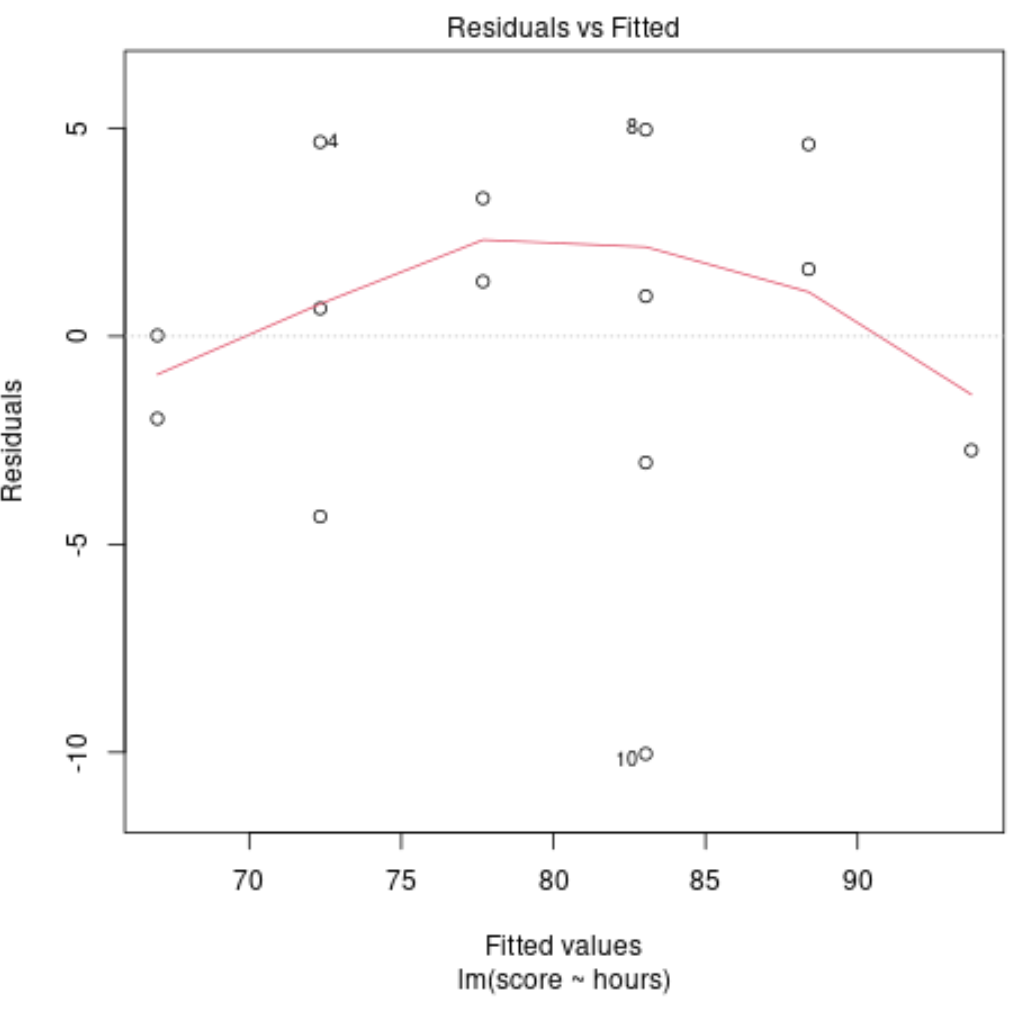
Le premier graphique généré par la routine diagnostique native de R constitue l’instrument d’investigation primordial de la régression linéaire. En plaçant sur l’axe horizontal les valeurs prédites par l’équation d’ajustement et sur l’axe vertical les résidus bruts empiriques observés, ce système de coordonnées confronte directement l’ampleur de la réponse estimée aux défaillances locales de modélisation.
3.1 Détection de la non-linéarité et courbure structurelle
Le postulat de linéarité stipule que la relation liant l’espérance conditionnelle de la variable dépendante aux prédicteurs est de nature strictement additive et linéaire sur le plan des coefficients vectoriels. Sur le plan visuel, la validation de cette condition exige que le nuage de points s’articule de manière parfaitement symétrique autour de l’axe horizontal passant par le point zéro, formant une bande de dispersion homogène et informe sans orientation privilégiée ni motif identifiable.
Afin d’assister l’œil humain dans l’identification des tendances émergentes qui échapperaient à une perception globale du nuage, R trace automatiquement sur ce graphique une ligne de tendance rouge continue. Cette trajectoire n’est pas issue d’un ajustement paramétrique classique, mais relève d’une procédure non paramétrique d’ajustement polynomial local par régression pondérée, connue sous le nom de lissage LOESS (Locally Estimated Scatterplot Smoothing). Sous l’hypothèse de linéarité parfaite, cette courbe de lissage doit se superposer quasi parfaitement à la droite horizontale en pointillés gris marquant le résidu zéro sur l’intégralité du domaine de prédiction.
Toute inflexion systématique, déviation en cloche, profil en U ou trajectoire en forme de S adoptée par cette ligne rouge traduit une violation du postulat de linéarité. Un motif parabolique convexe ou concave indique l’omission d’un terme quadratique régissant la dynamique entre l’un des prédicteurs majeurs et la variable réponse. L’impact statistique d’une telle violation est dramatique : lorsque le postulat de linéarité est transgressé, les estimateurs des moindres carrés cessent d’être non biaisés. Les estimations des paramètres β s’en trouvent fondamentalement distordues, entraînant des déductions substantiellement erronées sur la magnitude réelle et la direction des effets observés au sein du phénomène modélisé.
3.2 Diagnostic visuel de l’hétéroscédasticité naissante
Bien que le troisième graphique canonique soit spécifiquement optimisé pour l’étude de l’hétéroscédasticité, le tracé des résidus contre les valeurs ajustées offre un signalement préliminaire indispensable des distorsions affectant la constance de la variance stochastique. L’évaluation repose ici sur l’observation attentive de la dispersion verticale du nuage de résidus à mesure que l’on progresse de la gauche vers la droite de l’axe des abscisses.
La manifestation visuelle la plus typique de l’hétéroscédasticité sur ce plan est la configuration dite en « entonnoir » ou en éventail (funnel shape). Dans cette configuration fréquente, les points résiduels demeurent étroitement groupés autour de la valeur zéro pour les estimations de faible magnitude, puis voient leur variabilité verticale s’élargir de façon spectaculaire à mesure que les valeurs prédites s’élèvent le long de l’abscisse. Ce phénomène survient classiquement dans l’analyse de grandeurs économiques ou psychométriques (revenus, temps de latence cognitive, consommation de ressources) où la variance absolue des écarts individuels augmente proportionnellement à l’intensité de la réponse.
La survenue d’un tel patron indique que la variance des termes d’erreur dépend fonctionnellement du niveau de la réponse modélisée, en infraction directe avec l’hypothèse Var(ε|X) = σ². La conséquence méthodologique directe réside dans une estimation erronée de la variance d’échantillonnage des coefficients de régression. Le plus souvent, l’hétéroscédasticité induit une sous-estimation systématique des erreurs-types standards calculées par la formule classique des moindres carrés, ce qui gonfle artificiellement les statistiques de test t de Student et génère un taux inacceptable de faux positifs (erreurs de type I) au moment des décisions d’inférence statistique.
3.3 Identification des résidus aberrants isolés
Le graphique des résidus versus valeurs ajustées sert également de dispositif sentinelle pour repérer les déviances univariées extrêmes au niveau de l’espace résiduel. En présence d’un échantillon important, quelques observations individuelles peuvent s’écarter de manière spectaculaire du regroupement probabiliste central, traduisant soit des erreurs de mesure expérimentale, des anomalies de saisie, soit des singularités comportementales au sein de la cohorte d’étude.
Le moteur graphique interne de R intègre un algorithme d’annotation automatique conçu pour faciliter l’identification immédiate de ces anomalies. Par défaut, le tracé annote systématiquement les indices numériques des trois observations présentant les déviances résiduelles les plus considérables en valeur absolue dans le jeu de données sous-jacent. Ces numéros de ligne, apposés directement à côté des points concernés, permettent au chercheur de remonter instantanément à l’observation source au sein de son tableau de données sans nécessiter d’opération de filtrage algorithmique manuelle préalable.
L’évaluation critique de ces observations annotées exige de déterminer si l’amplitude de l’écart constitue une fluctuation stochastique attendue dans le cadre d’un échantillonnage gaussien ou si elle relève d’une rupture pathologique du modèle. Une déviance dépassant deux à trois fois l’écart-type résiduel global doit systématiquement inciter l’analyste à une inspection minutieuse du dossier clinique ou de la fiche expérimentale associée à l’identifiant marqué, afin de vérifier l’intégrité absolue de la mesure avant de décider d’une éventuelle mesure de remédiation méthodologique.
4. Graphique 2 : Graphique quantile-quantile normal (Normal Q-Q Plot)
L’inférence statistique paramétrique repose sur l’hypothèse que la population sous-jacente des erreurs résiduelles se conforme à une loi de distribution gaussienne univariée à moyenne nulle. Le deuxième graphique diagnostique natif de R opérationnalise la confrontation de cette hypothèse théorique aux réalités distributionnelles observées par le biais d’un diagramme quantile-quantile d’une rigueur géométrique absolue.
4.1 Principes géométriques du diagramme quantile-quantile
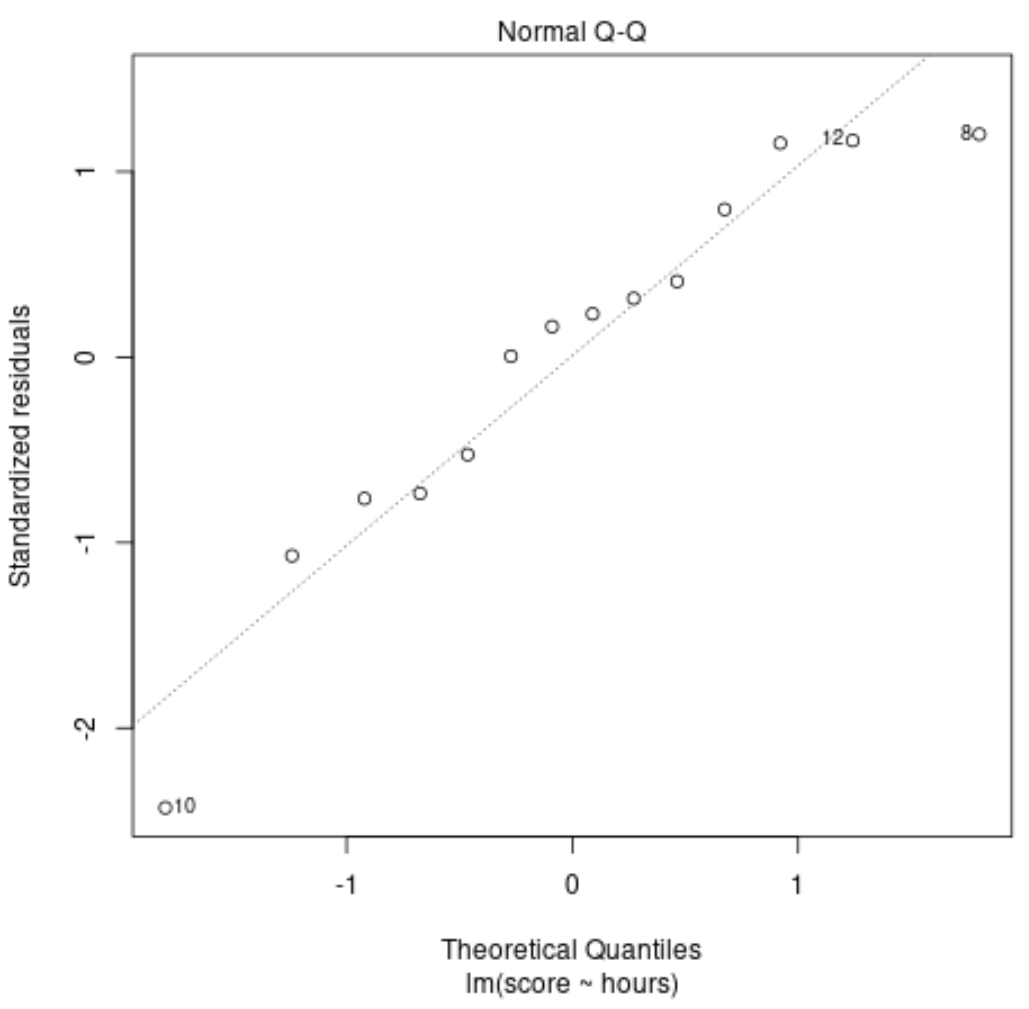
La construction mathématique du diagramme quantile-quantile repose sur la projection bilatérale ordonnée des distributions statistiques. Sur l’axe horizontal sont positionnés les quantiles théoriques attendus issus d’une distribution normale standard N(0, 1). Ces valeurs représentent les scores z théoriques qui découpent la fonction de densité gaussienne en tranches de probabilité cumulative équivalentes en fonction du nombre total n d’observations composant l’échantillon. Sur l’axe vertical sont projetés les quantiles empiriques correspondants, calculés à partir de la distribution triée des résidus standardisés extraits du modèle linéaire ajusté.
En présence d’un alignement distributionnel rigoureusement conforme au postulat de normalité gaussienne, la confrontation des coordonnées empiriques et théoriques donne lieu à une trajectoire géométrique rectiligne. Pour fournir un repère visuel objectif, R surimpose sur ce nuage une droite de référence pointillée. Cette droite passe précisément par le premier et le troisième quartile de la distribution (soit le 25e et le 75e centile théorique et empirique), matérialisant la pente théorique à 45 degrés que devrait rigoureusement épouser le tracé si le processus générateur des erreurs ne présentait aucune contamination distributionnelle.
Dans l’interprétation courante d’un Q-Q plot empirique, une tolérance méthodologique est naturellement accordée aux menues fluctuations stochastiques observées aux extrémités de la distribution. Du fait de la raréfaction probabiliste des données dans les zones distales, la variance d’échantillonnage des quantiles extrêmes est intrinsèquement supérieure à celle des quantiles médians. Ainsi, de légers détachements vis-à-vis de la droite théorique portant sur les quelques observations terminales ne constituent pas nécessairement une preuve de violation invalidante de la normalité, à condition que le segment interquartile médian demeure étroitement solidaire du vecteur de référence.
4.2 Diagnostic des asymétries et queues de distribution
Les violations substantielles de la normalité se traduisent par des déformations géométriques spécifiques de la trajectoire des points résiduels le long de la droite de référence, permettant une identification immédiate de la nature du moment distributionnel affecté (asymétrie ou aplatissement).
L’asymétrie distributionnelle (skewness) se caractérise par une déformation unilatérale de courbure globale du graphique. Une asymétrie positive (distribution étirée vers les valeurs positives élevées) engendre une courbure concave où les deux extrémités du nuage de points s’infléchissent vers le haut par rapport à la droite de référence : les quantiles empiriques faibles sont moins négatifs qu’attendu tandis que les quantiles empiriques élevés sont nettement plus grands que les valeurs théoriques. À l’opposé, une asymétrie négative se matérialise par une morphologie globalement convexe, où la courbe plonge sous la droite de référence sur l’ensemble de son parcours, trahissant un étirement anormal de la queue de distribution vers les valeurs résiduelles négatives.
L’analyse de l’aplatissement (kurtosis) repose sur l’observation de la dynamique d’écartement simultanée aux deux extrémités opposées du graphique. La violation la plus critique en modélisation empirique est celle induite par les distributions leptokurtiques, dites à « queues lourdes » (heavy tails). Ce phénomène se manifeste sous la forme d’un profil sigmoïde inversé en « S » : les quantiles empiriques négatifs s’effondrent bien plus bas que les quantiles théoriques correspondants dans la région gauche, tandis que les quantiles positifs s’envolent bien au-dessus de la droite dans la région droite. Cette configuration atteste que le modèle génère des valeurs extrêmes avec une fréquence infiniment supérieure à ce que prédirait la théorie gaussienne, invalidant les probabilités de dépassement associées aux tests paramétriques.
4.3 Robustesse inférentielle et théorème central limite
Face à la détection d’une déviation de la normalité sur le Normal Q-Q plot, l’analyste rigoureux doit pondérer son jugement à l’aune des enseignements du théorème central limite et de la théorie asymptotique moderne. L’hypothèse de normalité des erreurs est souvent mal comprise : elle n’est requise de façon stricte que pour garantir l’exactitude des tests inférentiels t et F dans le cadre d’échantillons de taille modeste.
Dès lors que la taille d’échantillon N franchit un seuil substantiel (généralement situé par convention au-delà d’une cinquantaine ou d’une centaine d’observations par prédicteur), les distributions d’échantillonnage des coefficients de régression b convergent de manière asymptotique vers une loi normale multidimensionnelle, quand bien même la distribution sous-jacente des erreurs individuelles présenterait des écarts modérés à la gaussianité. Dans ces conditions de grand échantillon, la modélisation par les moindres carrés fait preuve d’une résilience remarquable face aux violations de normalité relatives à l’asymétrie, assurant une préservation satisfaisante des taux nominaux d’erreur de première espèce sans exiger de mesures correctives drastiques.
Cependant, cette robustesse asymptotique s’effondre en présence d’échantillons de taille réduite ou de distributions résiduelles frappées d’une leptokurticité dramatique causée par des contaminations extrêmes ou des bruits à variance non bornée. Lorsque des queues de distribution excessivement lourdes se conjuguent à un effectif restreint, la variance d’échantillonnage des estimateurs b explose de manière incontrôlée, anéantissant l’efficacité des estimations et rendant caduque toute tentative d’extrapolation scientifique basée sur les tables de Student ou de Fisher standardisées.
5. Graphique 3 : Graphique d’échelle-localisation (Scale-Location Plot)
Le troisième graphique diagnostique nativement proposé par R, également baptisé tracé d’étalement-localisation (Spread-Location Plot), affine l’investigation du postulat d’homoscédasticité en déployant une transformation mathématique des coordonnées résiduelles optimisée pour la détection des fluctuations de variabilité d’erreur à travers l’éventail des prédictions.
5.1 Transformation mathématique des résidus
La limite inhérente à l’inspection de l’homoscédasticité sur le premier graphique (Résidus vs Valeurs ajustées) réside dans la présence simultanée des composantes de signe (positives et négatives) et de courbure structurelle au sein du nuage de points, brouillant la perception sensorielle de l’amplitude absolue des dispersions. Pour surmonter cet obstacle psychophysique, le graphique d’échelle-localisation applique une double transformation mathématique sur le vecteur des résidus.
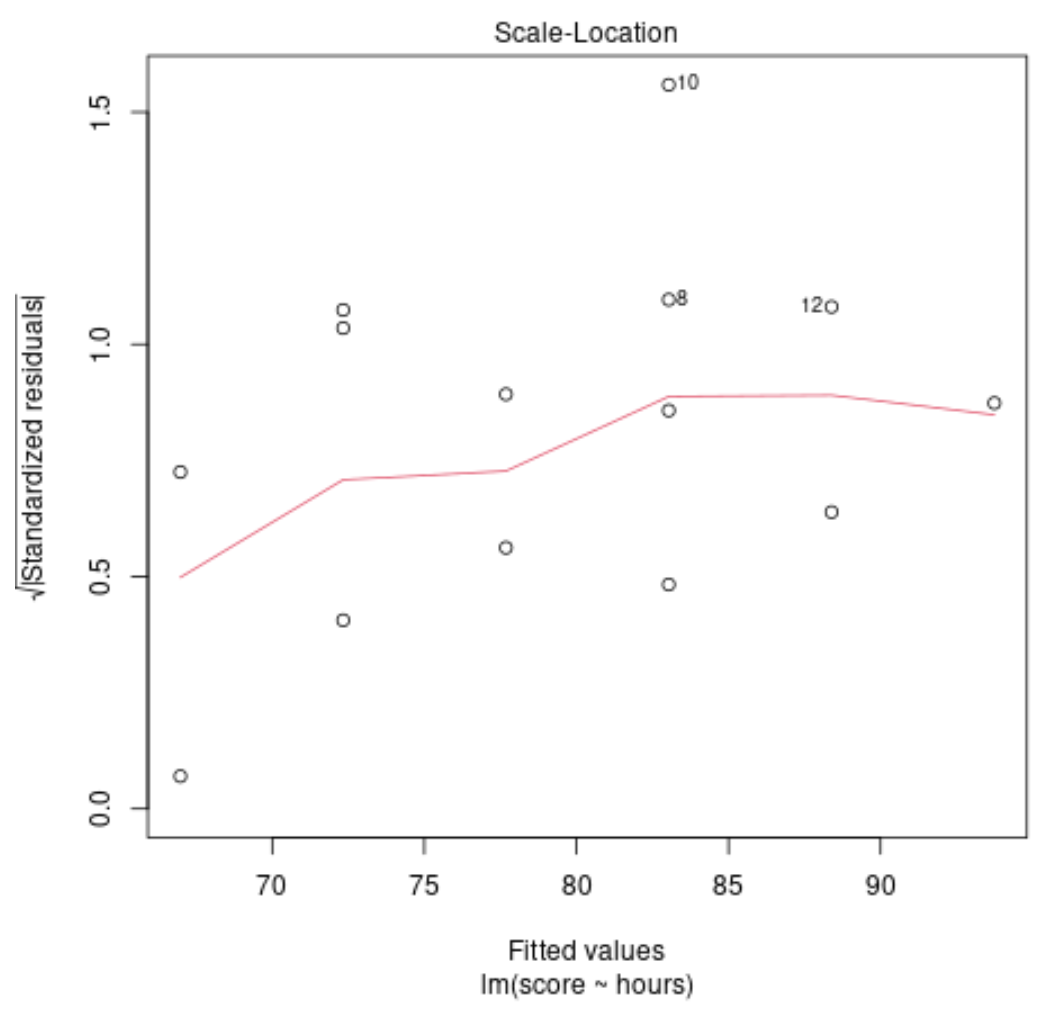
Dans un premier temps, les résidus standardisés sont extraits en valeur absolue, éliminant ainsi toute considération d’orientation pour ne conserver que l’amplitude univariée de la déviance par rapport à l’espérance conditionnelle. Dans un second temps, R applique une transformation stabilisatrice consistant à extraire la racine carrée de ces résidus standardisés absolus, positionnant ainsi sur l’axe des ordonnées la quantité mathématique √(|résidus standardisés|). L’axe horizontal conserve, pour sa part, la projection des valeurs ajustées du modèle.
Cette transformation par la racine carrée de la norme résiduelle n’est pas arbitraire : sous l’hypothèse nulle de normalité et d’homoscédasticité parfaite, la distribution de la racine carrée des valeurs absolues d’une variable gaussienne standardisée présente une asymétrie considérablement réduite par rapport à la distribution de variance brute (qui suit une loi du khi-deux à un degré de liberté). Cette régularisation géométrique contracte l’étalement des valeurs extrêmes et permet à l’œil d’examiner l’uniformité de la variance d’erreur avec une sensibilité et une résolution sans précédent sur l’intégralité du continuum des prédictions.
5.2 Critères d’homoscédasticité parfaite
La grille de lecture du graphique d’échelle-localisation repose sur deux critères visuels complémentaires que l’analyste doit inspecter conjointement : l’horizontalité de la courbe de lissage non paramétrique et l’homogénéité de la largeur de dispersion du semis de points.
À l’instar du premier panneau diagnostique, R projette une ligne rouge continue issue d’un algorithme de lissage LOESS calculé cette fois sur les résidus transformés en racine carrée d’amplitude. Dans une situation idéale de conformité absolue à l’hypothèse d’homoscédasticité de Gauss-Markov, cette ligne rouge doit se déployer de manière parfaitement rectiligne et horizontale sur toute la largeur de l’espace de prédiction. Une trajectoire plane atteste que l’espérance de l’amplitude des erreurs ne varie aucunement en fonction du niveau attendu de la variable dépendante, confirmant la constance universelle du paramètre de variance résiduelle σ².
Parallèlement à la linéarité de cette courbe, l’analyste doit observer une répartition homogène, aléatoire et uniforme des points au-dessus et en dessous de cette référence sur l’ensemble de l’abscisse. Si la largeur verticale de la bande de dispersion demeure invariable depuis les prédictions les plus faibles jusqu’aux extrapolations les plus élevées, l’homoscédasticité est pleinement attestée. À l’inverse, toute inclinaison ascendante ou descendante de la ligne rouge, ou tout renflement localisé de l’épaisseur du nuage de points, constitue la signature visuelle sans équivoque d’une violation hétéroscédastique caractérisée.
5.3 Implications de l’hétéroscédasticité confirmée
La mise en évidence d’une hétéroscédasticité flagrante sur le tracé d’échelle-localisation emporte des répercussions sévères sur la validité interne des conclusions statistiques issues de la modélisation linéaire par moindres carrés.
Sur le plan théorique, la présence d’une variance résiduelle non constante invalide le théorème de Gauss-Markov. Bien que les coefficients estimés b demeurent techniquement non biaisés (leur espérance mathématique continue de coïncider avec la vraie valeur des paramètres de la population sous réserve du maintien de l’exogénéité stricte), ils cessent définitivement d’être de variance minimale. L’estimateur MCO perd sa propriété fondamentale d’efficacité statistique optimale au profit d’autres familles d’estimateurs pondérés capables d’intégrer la structure matricielle de la variance.
Sur le plan opérationnel de l’inférence, la conséquence est plus critique encore : les formules standardisées exploitées par R pour dériver la matrice de covariance des paramètres reposent sur l’hypothèse que la matrice d’erreur se résume à σ²I. En présence d’hétéroscédasticité, cette simplification s’avère mathématiquement erronée, ce qui déforme systématiquement le calcul des erreurs-types des coefficients. Ces erreurs-types étant biaisées, les intervalles de confiance construits à 95 % deviennent trompeurs (sous-couvrant généralement la zone réelle de variabilité), et les statistiques de test t de Student associées perdent leur étalonnage, conduisant à des inférences substantiellement fallacieuses qui ne sauraient être tolérées dans une démarche de recherche rigoureuse.
6. Graphique 4 : Résidus vs Effet de levier (Residuals vs Leverage)
Le quatrième graphique canonique constitue sans conteste l’outil diagnostique le plus sophistiqué et le plus puissant de la panoplie native de R. Délaissant les seules considérations d’ajustement global, ce tracé opère la synthèse cruciale entre l’écart résiduel univarié et la configuration spatiale multidimensionnelle des prédicteurs, permettant d’isoler avec une précision chirurgicale les observations isolées capables de distordre unilatéralement l’intégralité du modèle estimé.
6.1 Définition et calcul du levier statistique (hat-values)
Pour comprendre les soubassements de ce tracé, il convient de définir formellement la notion de levier statistique, traditionnellement désigné dans la littérature sous le vocable de valeurs chapeau (hat-values). Sur le plan algébrique, le levier d’une observation correspond à l’élément diagonal h_ii issu de la matrice de projection orthogonale H = X(X’X)⁻¹X’. Cette matrice est qualifiée de matrice chapeau car elle opère la transformation projetant le vecteur des valeurs observées Y directement sur le vecteur des valeurs prédites ajustées Ŷ (Y chapeau).
La valeur diagonale h_ii mesure la distance multidimensionnelle qui sépare le profil des prédicteurs de la i-ème observation du centre de gravité (barycentre) formé par l’ensemble des prédicteurs de l’échantillon dans l’espace euclidien à p dimensions. Une observation présentant une valeur h_ii élevée possède des scores extrêmes ou une combinaison totalement atypique de variables explicatives par rapport au reste de la cohorte d’étude. La trace de la matrice H étant égale au rang de la matrice, c’est-à-dire au nombre de paramètres estimés p’ = (p + 1) incluant la constante, la valeur moyenne théorique du levier au sein d’un échantillon s’établit mécaniquement à h_moyen = (p + 1) / n.
Dans la pratique diagnostique, il est universellement convenu d’appliquer des seuils d’alerte méthodologiques proportionnels à cette moyenne structurelle. Une observation est considérée comme présentant un levier suspect dès lors que sa valeur h_ii franchit le double de la valeur moyenne, soit 2(p + 1) / n, et comme manifestant un levier hautement critique au-delà du seuil triple, soit 3(p + 1) / n. L’axe horizontal du quatrième graphique diagnostique projette précisément ces valeurs de levier, bornées théoriquement entre 1/n et la valeur limite 1.
6.2 Interprétation des contours de la distance de Cook
Un levier élevé ne suffit pas à lui seul pour déformer les résultats d’un modèle : encore faut-il que cette position atypique dans l’espace des prédicteurs s’accompagne d’une déviance sur la variable dépendante. Pour quantifier cette influence globale combinée, le statisticien Dennis Cook a formalisé la métrique devenue canonique de la distance de Cook (D_i). Mathématiquement, la distance de Cook synthétise l’effet conjoint du levier h_ii et du résidu standardisé r_i selon l’élégante formulation :
D_i = [ r_i² / (p + 1) ] × [ h_ii / (1 – h_ii) ]
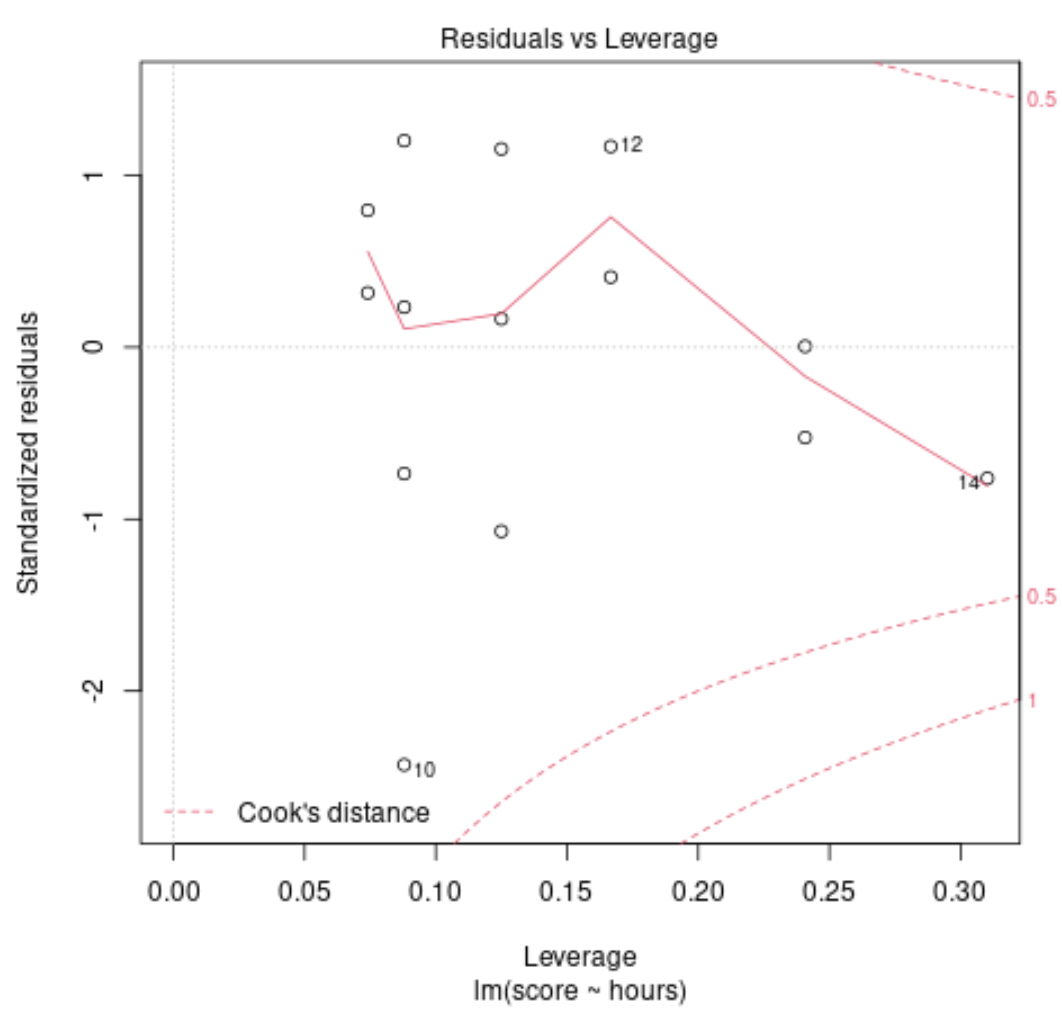
Cette métrique calcule géométriquement la distance euclidienne multidimensionnelle qui sépare le vecteur des paramètres de régression estimés sur l’échantillon complet b, du vecteur des paramètres b_(-i) qui résulterait de l’ajustement du même modèle après exclusion pure et simple de la i-ème observation. Sur le quatrième graphique diagnostique, R surimpose sous la forme de lignes pointillées rouges des courbes de niveau isolignes représentant les seuils critiques de la distance de Cook, traditionnellement calibrés à des valeurs de 0.5 et de 1.0.
Toute observation venant se positionner au-delà de ces lignes d’isocontour pointillées de Cook exerce une influence considérable sur le modèle. Une distance de Cook excédant le seuil de 1.0 indique que l’omission de cette seule observation déplacerait l’estimation des coefficients de régression vers une région située en dehors d’un intervalle de confiance à 50 % centré sur les estimations initiales, altérant potentiellement de manière spectaculaire la significativité ou le signe même des coefficients directeurs du modèle.
6.3 Typologie des observations problématiques
L’exploitation conjointe des résidus standardisés sur l’axe vertical et des valeurs de levier sur l’axe horizontal permet à l’analyste de classifier les observations de son échantillon selon une typologie comportementale quadripartite particulièrement éclairante pour la décision méthodologique :
- Le cas du bon point de levier : caractérisé par une valeur de levier h_ii très élevée, mais un résidu standardisé proche de zéro. Cette observation possède une combinaison de prédicteurs totalement atypique, mais sa valeur observée sur la variable dépendante se situe précisément dans le prolongement de la trajectoire définie par les autres observations. Loin de déformer le modèle, ce type d’observation consolide l’estimation en stabilisant la pente et en réduisant la variance d’échantillonnage globale.
- Le cas de la valeur aberrante à faible levier : caractérisée par un résidu standardisé d’amplitude spectaculaire (dépassant 3 ou 4 écarts-types), mais associée à une valeur h_ii très proche de la moyenne. L’observation dévie massivement de la réponse attendue, mais se situe au cœur du barycentre des prédicteurs. Elle gonfle l’estimation de la variance résiduelle σ², affaiblissant la puissance globale des tests paramétriques, mais n’exerce qu’une distorsion minime sur la pente vectorielle des coefficients b.
- Le cas critique du point d’influence destructeur : caractérisé par la convergence malheureuse d’un fort levier et d’un résidu standardisé d’amplitude substantielle, projetant le point dans le coin supérieur ou inférieur droit du graphique, au-delà des courbes d’isocontour de Cook. Une telle observation tire littéralement la droite ou l’hyperplan de régression vers elle par un effet de bras de levier disproportionné, masquant artificiellement sa propre aberration tout en faussant intégralement l’estimation pour l’ensemble du reste de la cohorte.
7. Métriques diagnostiques quantitatives complémentaires sous R
Si la sémiologie graphique des quatre tracés canoniques de la fonction standard fournit une vision globale et intuitive des dynamiques d’ajustement, l’investigation rigoureuse d’un modèle statistique gagne immensément à être adossée à des métriques quantitatives d’influence isolant les contributions singulières de chaque unité d’observation. L’architecture computationnelle de R intègre une batterie complète d’indicateurs de diagnostic par suppression unitaire.
7.1 Calcul et visualisation directe de la distance de Cook
En complément de sa représentation sous forme d’isocontours sur le tracé résidus-levier, la distance de Cook peut faire l’objet d’une extraction vectorielle numérique directe et d’une visualisation spécifique sous forme de diagramme en bâtons d’une clarté exemplaire. L’appel à la fonction native *cooks.distance()*, prenant en argument l’objet de régression, retourne instantanément le vecteur des N métriques D_i associées à chaque ligne de la matrice des données.
Sur le plan graphique, l’utilisateur peut solliciter le quatrième tracé optionnel du moteur de diagnostic en spécifiant l’argument *plot(model, which = 4)*. Cette commande génère un graphique dédié où chaque observation est représentée par une tige verticale dont la hauteur est proportionnelle à sa distance de Cook, facilitant le repérage immédiat des singularités par émergence visuelle au-dessus de la ligne d’horizon des données communes.
Au-delà du seuil conventionnel absolu de 1.0 (souvent jugé excessivement conservateur dans les contextes de modélisation en sciences humaines), la littérature méthodologique moderne préconise l’usage de seuils d’alerte relatifs ajustés à la taille de l’échantillon N et au nombre de paramètres p’. Le critère le plus largement validé fixe le seuil de vigilance à D_seuil = 4 / (n – p – 1) ou 4 / n. Dès lors qu’une unité empirique dépasse cette limite relative, elle doit être extraite algorithmiquement du jeu de données pour faire l’objet d’une analyse de sensibilité approfondie visant à vérifier si la conclusion scientifique de l’étude ne repose pas indûment sur sa seule présence stochastique.
7.2 Diagnostics d’influence par suppression : DFBETAS et DFFITS
La distance de Cook résume l’influence globale exercée sur l’ensemble du vecteur des prédictions, mais elle demeure incapable d’indiquer quel paramètre spécifique de la régression subit la distorsion la plus sévère. C’est précisément l’objet des métriques diagnostiques par suppression différentielle DFBETAS et DFFITS.
La métrique des DFBETAS mesure, pour chaque observation individuelle i et pour chaque prédicteur j du modèle, la variation standardisée du coefficient de régression β_j induite par l’exclusion de cette i-ème observation. Accessible sous R par la fonction native *dfbetas()*, cette procédure génère une matrice de dimension n × (p + 1). Une valeur de DFBETAS positive indique que la présence de l’observation tire le coefficient vers le haut, tandis qu’une valeur négative signale une traction vers le bas. Le seuil critique conventionnel au-delà duquel une observation est réputée exercer une influence abusive sur un coefficient donné est défini par la valeur normalisée 2 / √n pour les échantillons d’envergure, ou 1.0 pour les effectifs restreints.
Parallèlement, la statistique DFFITS, extraite par la fonction native *dffits()*, quantifie le nombre d’écarts-types dont la valeur ajustée de la i-ème observation se déplace lorsque cette dernière est retirée de l’estimation de l’équation de régression. Cette mesure combine de manière élégante le résidu studentisé externe et le levier individuel, constituant une variante d’échelle de la distance de Cook. Le seuil de vigilance standard généralement appliqué pour isoler les observations déstabilisatrices sur le plan prédictif est formalisé par la quantité 2 × √((p + 1) / n).
7.3 Synthèse exhaustive avec influence.measures()
Face à la multiplicité de ces indices diagnostiques univariés et multivariés, l’analyste peut éprouver des difficultés à compiler manuellement les différents vecteurs de métriques. Pour pallier cette dispersion procédurale, R intègre une fonction d’agrégation diagnostique globale d’une puissance computationnelle remarquable : la commande *influence.measures()*.
Lorsqu’elle est appliquée à un modèle ajusté, cette routine calcule de manière simultanée pour chaque unité d’observation l’ensemble exhaustif des indicateurs de déviance et d’influence : la matrice complète des DFBETAS pour chaque variable, les scores DFFITS, les ratios de covariance déterminantale (covratio), la distance de Cook ainsi que les valeurs de levier h_ii. Mais la force distinctive de cette commande réside dans l’application automatisée des règles de décision théoriques standardisées. Dans la sortie textuelle générée par l’instruction *summary(influence.measures(model))*, l’interpréteur R filtre et affiche exclusivement les observations pour lesquelles au moins l’un des indicateurs dépasse les seuils critiques mathématiques conventionnels.
Dans ce tableau de synthèse opérationnel, chaque franchissement de seuil théorique est mis en exergue par l’adjonction d’un astérisque typographique placé en regard de la métrique transgressée. L’analyste dispose ainsi instantanément d’une liste condensée des identifiants d’observations suspectes, autorisant un filtrage algorithmique immédiat et systématique via des scripts R automatisés pour documenter avec une transparence méthodologique totale l’anatomie distributionnelle des données analysées.
8. Diagnostics graphiques avancés avec les extensions R modernes
Si la panoplie des graphiques canoniques natifs de base répond admirablement aux exigences de l’inspection diagnostique conventionnelle, le dynamisme de l’écosystème open-source R a donné naissance à des extensions modernes qui enrichissent considérablement les capacités de visualisation, l’ergonomie sémiotique et la puissance d’analyse statistique à disposition du chercheur contemporain.
8.1 Visualisation enrichie avec la librairie car
La librairie car (Companion to Applied Regression), développée sous la direction méthodologique de John Fox et Sanford Weisberg, constitue l’extension de référence universelle pour le diagnostic avancé des modèles linéaires. Ce package fournit une collection d’outils analytiques d’une sophistication remarquable, comblant les quelques limites perceptuelles des tracés de base.
Parmi ces enrichissements figure la fonction *residualPlots()*. Contrairement au tracé standard qui projette les résidus uniquement contre la prédiction globale agrégée, cette fonction génère une matrice de graphiques projetant les résidus de manière distincte contre chaque prédicteur individuel intégré dans le modèle. Pour chaque sous-graphique, la fonction ajuste une courbure de lissage et exécute simultanément un test de courbure polynomiale (test de Tukey pour l’interaction non modélisée), fournissant une valeur p formelle indiquant spécifiquement quel prédicteur est à l’origine d’une non-linéarité structurelle au sein de l’équation globale.
Parallèlement, la fonction *influenceIndexPlot()* du package car révolutionne l’inspection visuelle des valeurs aberrantes en projetant sur quatre panneaux verticaux alignés par index séquentiel d’observation : les résidus studentisés externes (avec enveloppe de Bonferroni pour le contrôle des tests multiples), les valeurs de levier hat, les statistiques de distance de Cook et les probabilités d’influence. Enfin, la librairie permet d’évaluer de manière conjointe la colinéarité multivariée à l’aide de la fonction *vif()*, complétée par des représentations visuelles des facteurs d’inflation de la variance qui alertent sur l’instabilité géométrique de l’inversion matricielle X’X.
8.2 Intégration dans le tidyverse via ggfortify et ggplot2
L’essor considérable du paradigme Tidyverse et du moteur graphique standardisé ggplot2, fondé sur la grammaire des graphiques de Leland Wilkinson, a transformé les pratiques de visualisation scientifique. La librairie d’interfaçage *ggfortify* permet de jeter un pont élégant et immédiat entre les objets d’estimation statistique linéaire standard et l’univers graphique vectoriel de ggplot2.
Grâce à la commande générique *autoplot()*, l’analyste peut générer instantanément l’intégralité du quartet diagnostique canonique sous une forme esthétique moderne et raffinée, surpassant les rendus rustiques du moteur graphique de base. L’instruction syntaxique standard s’intègre harmonieusement dans les chaînes de traitement par pipes, produisant des figures à la résolution vectorielle irréprochable intégrant des palettes de couleurs adaptées aux personnes daltoniennes, des thèmes typographiques d’une grande sobriété académique et des étiquetages automatisés par le moteur intelligent de positionnement d’étiquettes ggrepel.
Cette intégration au sein de l’écosystème ggplot2 confère au chercheur une flexibilité éditoriale totale. Chaque panneau diagnostique généré via *autoplot()* constitue un calque graphique entièrement modifiable auquel peuvent être superposées des primitives géométriques additionnelles, des annotations textuelles contextuelles ou des facettages catégoriels complexes. Cette standardisation graphique s’avère particulièrement précieuse lors de la compilation automatisée de rapports scientifiques reproductibles rédigés sous R Markdown ou Quarto, garantissant une cohérence visuelle parfaite entre les modèles statistiques et les illustrations insérées dans le manuscrit final.
8.3 Le package performance : l’approche check_model()
Au sein de la constellation d’outils méthodologiques modernes, l’écosystème *easystats* a introduit une petite révolution dans les pratiques de laboratoire avec son extension dédiée performance. Cette librairie a été expressément conçue pour démocratiser l’évaluation diagnostique exhaustive tout en élevant les standards de rigueur méthodologique grâce à la fonction unifiée *check_model()*.
L’exécution de la simple commande *check_model(model)* compile automatiquement un tableau de bord diagnostique holistique composé de six panneaux d’une lisibilité exceptionnelle. Au-delà des vérifications traditionnelles, ce tableau de bord enrichit l’analyse visuelle par l’adjonction systématique d’intervalles de confiance graphiques sous forme de zones d’incertitude ombrées et de bandes de tolérance probabilistes calculées par rééchantillonnage ou par dérivation théorique. L’analyste n’est plus laissé seul face à l’appréciation subjective d’une déviation : les graphiques indiquent explicitement, par des plages de normalité colorées en vert ou en bleu, les limites stochastiques à l’intérieur desquelles le nuage de points peut fluctuer sans violer le postulat sous-jacent.
Ce tableau de bord intègre une vérification visuelle de la colinéarité par barres d’amplitude colorimétriques, une évaluation de la normalité par comparaison de densités prédictives a posteriori (posterior predictive checks), et un tracé de linéarité assisté par des seuils de confiance non paramétriques. Cette approche visuelle intégrée réduit considérablement les risques d’erreur d’interprétation chez les jeunes chercheurs ou les praticiens non statisticiens, tout en fournissant des illustrations diagnostiques d’une qualité didactique et esthétique prête pour les revues scientifiques internationales à comité de lecture.
9. Interprétation des diagnostics dans la recherche en psychologie
L’interprétation des graphiques diagnostiques sous R ne saurait se réduire à une lecture mécanique de théorèmes mathématiques désincarnés. Dans les disciplines confrontées à la complexité des comportements humains, à l’instar de la psychologie empirique, des neurosciences cognitives et des sciences de l’éducation, les singularités distributionnelles observées sur les tracés résiduels constituent l’empreinte directe des contraintes de mesure et de l’hétérogénéité biopsychosociale inhérente aux cohortes étudiées.
9.1 Particularités des données psychométriques et comportementales
Les protocoles de recherche en psychologie exploitent massivement des instruments psychométriques standardisés sous forme d’échelles de Likert ordinales discrètes, ou des paradigmes chronométriques enregistrant des temps de réaction motrice milliseconde par milliseconde. Ces modalités de recueil de données imposent des contraintes géométriques sévères qui se répercutent de manière caractéristique sur l’anatomie des graphiques diagnostiques de régression.
L’un des artefacts les plus omniprésents réside dans les effets de plancher et les effets de plafond propres aux inventaires cliniques évaluant la psychopathologie (comme les inventaires d’anxiété ou de dépression administrés à des populations non cliniques). Sur le premier graphique diagnostique (Résidus vs Valeurs ajustées), ces effets se traduisent visuellement par des alignements rectilignes de points disposés en diagonales parallèles rigides. Cette compartimentation géométrique ne découle pas d’une hétérogénéité des sujets, mais reflète simplement la troncature mathématique de l’échelle d’évaluation, dont la borne inférieure ou supérieure heurte les limites physiques du système de notation. Ignorer cette structure en l’attribuant à du bruit stochastique fausse l’évaluation de la linéarité et masque l’existence d’une censure à gauche ou à droite qui nécessiterait des modèles spécifiques de type Tobit.
De surcroît, la présence structurelle d’hétérogénéité non observée dans les échantillons psychologiques (variations de sous-groupes d’âge, traits de personnalité latents, niveaux d’engagement attentionnel) génère fréquemment des motifs d’hétéroscédasticité spontanés. La variance résiduelle s’élargit souvent dans les zones extrêmes de performance en raison de l’intervention de mécanismes de compensation cognitive différentielle, tandis que l’erreur de mesure inhérente aux construits latents non observables induit une atténuation artificielle de la pente des coefficients de régression, phénomène connu sous le concept de biais d’atténuation lié à l’erreur de mesure sur les prédicteurs.
9.2 Dilemme éthique et méthodologique de l’exclusion des valeurs aberrantes
La découverte d’observations isolées se détachant massivement du nuage résiduel ou franchissant les courbes d’isocontour de la distance de Cook place invariablement le chercheur face à un dilemme déontologique et méthodologique redoutable : faut-il ou non supprimer ces points influents du jeu de données final destiné à l’évaluation des hypothèses ?
Dans la conduite de la recherche, il est impératif d’établir une taxonomie rigoureuse des causes sous-jacentes à l’aberration statistique avant d’envisager toute action corrective :
- Les erreurs de saisie matérielle ou défaillances techniques : un temps de réaction enregistré à zéro milliseconde par suite d’un dysfonctionnement de l’interface informatique, ou un score d’âge codé à 999 relèvent de la corruption de données manifeste. Leur élimination est non seulement légitime, mais impérative pour préserver l’intégrité de l’échantillon.
- Les participants inattentifs ou non conformes : dans les passations d’enquêtes en ligne, des participants répondent parfois de manière aléatoire ou stéréotypée (phénomène de straightlining). Dès lors que des indices objectifs (vérificateurs d’attention ou temps de passation aberrant) attestent de l’invalidation du protocole, l’exclusion est méthodologiquement fondée.
- Les variations phénotypiques extrêmes mais authentiques : un individu présentant un profil d’anxiété exceptionnellement élevé consécutif à un traumatisme documenté fait pleinement partie de la population cible étudiée. Supprimer cette observation sous le seul prétexte qu’elle déstabilise l’alignement sur le Normal Q-Q plot ou qu’elle tire la ligne de lissage de Cook constitue une faute scientifique lourde, assimilable à une altération frauduleuse des résultats.
L’élimination opportuniste et non documentée de points influents afin d’abaisser artificiellement une p-value en deçà du seuil fatidique de significativité de 0.05 s’inscrit au cœur des dérives méthodologiques regroupées sous le terme de « p-hacking ». Ces pratiques ont contribué de manière décisive à la crise contemporaine de la reproductibilité en psychologie. L’éthique de la recherche moderne impose désormais une transparence totale : les règles d’exclusion doivent impérativement être pré-enregistrées de manière formelle sur des plateformes dédiées (telles que l’Open Science Framework) avant le début de la collecte des données, interdisant toute manipulation de tri post-hoc dictée par la contemplation des graphiques de résidus.
9.3 Analyses de sensibilité obligatoires
Lorsque le protocole de recherche n’a pas fait l’objet d’un pré-enregistrement verrouillant la gestion des données extrêmes, ou lorsque le statut authentique ou erroné d’une observation influente demeure empiriquement indécidable, la règle d’or méthodologique réside dans la conduite et la publication systématiques d’analyses de sensibilité multiscénarios.
Cette approche consiste à ajuster le modèle linéaire selon deux configurations analytiques parallèles : une première estimation intégrant l’intégralité des observations collectées sans aucune censure, et une seconde estimation excluant les unités d’échantillonnage formellement identifiées comme problématiques sur le graphique résidus-levier ou dépassant les seuils de distance de Cook. Le chercheur compare ensuite minutieusement les deux tableaux de résultats, documentant de façon exhaustive l’ampleur des variations observées sur les coefficients directeurs non standardisés, sur les tailles d’effet standardisées et sur les niveaux de significativité statistique associés.
Si les conclusions substantielles et le sens des associations demeurent invariants à travers ces deux conditions d’estimation, le chercheur peut légitimement affirmer que son modèle fait preuve d’une robustesse satisfaisante face aux perturbations d’échantillonnage individuelles. Si, en revanche, l’exclusion de deux ou trois participants atypiques suffit à anéantir un effet expérimental majeur ou à inverser la direction d’une relation prédictive, le devoir de probité académique impose de rapporter explicitement cette fragilité structurelle dans le corps du texte. Les résultats doivent alors être présentés comme conditionnels et préliminaires, prévenant la communauté scientifique contre toute généralisation hâtive bâtie sur l’illusion d’une régularité statistique artificielle.
10. Stratégies de remédiation face aux violations des postulats identifiées
La découverte d’une violation substantielle des postulats de Gauss-Markov lors de l’inspection des tracés diagnostiques sous R ne sonne pas le glas de la recherche empirique. Elle marque, bien au contraire, le point de départ d’une démarche d’ingénierie statistique corrective visant à restaurer la validité inférentielle du modèle par le déploiement de stratégies de remédiation adaptées à la nature de la pathologie distributionnelle identifiée.
10.1 Transformations de variables et linéarisation
Lorsque le tracé des résidus contre les valeurs ajustées révèle une courbure structurelle non ambiguë ou que le graphique d’échelle-localisation démontre une configuration hétéroscédastique en entonnoir proportionnelle à la magnitude des valeurs prédites, la stratégie corrective de première intention repose sur la transformation mathématique non linéaire de l’espace des variables.
Pour les grandeurs positives asymétriques à variance croissante (telles que le revenu, les temps de réaction ou les concentrations hormonales), l’application d’une transformation logarithmique standard *log(Y)* ou *log(X)* opère fréquemment un double miracle méthodologique : elle compresse les échelles expansives, linéarisant les dynamiques de croissance exponentielle tout en stabilisant de manière spectaculaire la variance résiduelle sur l’ensemble du domaine de prédiction. Pour les distributions d’asymétrie modérée, la transformation par la racine carrée *sqrt(Y)* constitue une alternative élégante, particulièrement adaptée aux données de comptage d’événements à variance proportionnelle à l’espérance mathématique (propriété de Poisson). Pour les déformations plus sévères, la transformation inverse *1/Y* permet de contracter violemment les queues de distribution étirées vers l’infini positif.
Afin de s’émanciper des choix empiriques arbitraires, le modélisateur sous R peut mobiliser l’algorithme d’optimisation de puissance développé par George Box et David Cox. Accessible au sein de la librairie *MASS* via la fonction *boxcox()*, cette méthode calcule par maximisation du profil de vraisemblance le paramètre optimal lambda (λ) définissant la transformation de puissance Y^(λ) la plus rigoureusement apte à normaliser les résidus et homogénéiser leur variance. Cependant, le chercheur ne doit jamais perdre de vue le coût interprétatif d’une telle remédiation : transformer une variable altère son unité de mesure originelle, rendant l’interprétation substantielle des coefficients β infiniment plus complexe et exigeant souvent un calcul de re-transformation non trivial pour communiquer les résultats dans l’espace métrique initial du phénomène étudié.
10.2 Modélisation robuste face aux points d’influence
Lorsque les graphiques diagnostiques révèlent que les perturbations du modèle sont imputables à des queues de distribution leptokurtiques incontrôlables ou à la présence incontournable d’observations influentes à fort effet de levier qu’il serait méthodologiquement injustifiable d’éliminer manuellement, le recours à la modélisation statistique robuste s’impose comme l’alternative d’excellence aux moindres carrés conventionnels.
La première voie de modélisation robuste consiste à substituer au critère d’optimisation quadratique standard des moindres carrés ordinaires une fonction de perte moins sensible aux écarts démesurés, démarche connue sous le nom de régression par M-estimateurs. Sous R, la fonction *rlm()* issue du package d’autorité MASS ajuste un modèle linéaire en déployant des schémas de pondération itératifs (tels que la fonction de coût de Huber ou la fonction bi-carrée de Tukey). Dans ce cadre computationnel sophistiqué, les observations associées à des résidus substantiels voient leur pondération statistique décroître de manière continue dans la fonction d’optimisation, annihilant l’impact perturbateur des valeurs aberrantes sans nécessiter leur amputation binaire du tableau de données.
La seconde voie, hautement préconisée en présence d’hétéroscédasticité pure ne découlant pas de valeurs aberrantes isolées mais d’un processus de variance hétérogène diffus, consiste à conserver les estimations ponctuelles b des moindres carrés tout en recalculant la matrice de covariance asymptotique à l’aide d’estimateurs de variance robustes à l’hétéroscédasticité (famille des estimateurs dits sandwich ou HC : Heteroscedasticity-Consistent). Par le couplage des packages sandwich et *lmtest*, le modélisateur extrait par la fonction *coeftest(model, vcov = vcovHC(model, type = « HC3 »))* des erreurs-types corrigées et des p-values rigoureusement asymptotiquement exactes, neutralisant intégralement le risque de faux positifs imputable à l’hétéroscédasticité observée sur les tracés d’échelle-localisation.
10.3 Transition vers des cadres statistiques non linéaires ou généralisés
Il est des configurations méthodologiques où les violations visualisées sur les graphiques diagnostiques ne constituent pas de simples accrocs réparables par transformation ou robustesse, mais signent l’inadéquation fondamentale du cadre de la régression linéaire générale face à la nature intrinsèque des données empiriques recueillies.
Lorsque la variable dépendante est intrinsèquement bornée (proportions binaires, choix catégoriels discrets), les résidus ne sauraient en aucun cas satisfaire aux hypothèses d’homoscédasticité et de normalité, contraignant le modélisateur à migrer vers le cadre théorique unifié des Modèles Linéaires Généralisés (GLM). En mobilisant sous R la fonction fondamentale *glm()*, l’analyste spécifie la famille de distribution stochastique réelle du processus générateur (famille binomiale avec fonction de lien logit pour des probabilités, famille de Poisson ou quasi-Poisson avec fonction de lien logarithmique pour des dénombrements d’occurrences comportementales), éliminant de facto les distorsions diagnostiques par l’adoption d’hypothèses probabilistes enfin conformes à la réalité physique du recueil empirique.
Lorsque le tracé résidus-valeurs ajustées dévoile des courbures sinueuses complexes ou multimodales qui défient toute paramétrisation polynomiale simple, l’analyste doit opérer une transition méthodologique vers les Modèles Additifs Généralisés (GAM), implémentés de façon magistrale sous R via la librairie standard mgcv. Par l’ajustement de fonctions de lissage spline non paramétriques pénalisées via l’instruction *gam(Y ~ s(X))*, le chercheur s’affranchit de l’exigence de linéarité stricte pour laisser la structure mathématique interne des données guider la découverte de la trajectoire fonctionnelle réelle reliant les variables.
Enfin, lorsque le diagnostic d’indépendance révèle des groupements résiduels par grappes (clusters) ou des autocorrélations temporelles ou hiérarchiques (mesures répétées au sein des mêmes sujets individuels ou emboîtement d’élèves au sein d’établissements scolaires distincts), la modélisation doit impérativement intégrer des effets aléatoires par l’intermédiaire des modèles mixtes linéaires (LMM) déployés avec la célèbre librairie lme4, permettant de modéliser explicitement la structure de covariance des résidus intra-groupes.
11. Étude de cas empirique : Analyse diagnostique complète pas à pas sous R
Afin de concrétiser l’ensemble de ces préceptes théoriques et méthodologiques au sein d’une séquence de traitement réaliste et immédiatement reproductible, cette section déploie un cas d’étude empirique complet modélisant une problématique fondamentale en psychologie organisationnelle et en santé au travail.
11.1 Présentation du cas : Prédiction du stress par la charge de travail
L’étude modélise empiriquement l’impact de la charge d’activité professionnelle hebdomadaire sur le niveau d’épuisement psychologique ressenti par des salariés du secteur tertiaire. Le jeu de données se compose d’un échantillon expérimental de n = 150 cadres d’entreprise ayant complété une évaluation standardisée mesurant leur score d’épuisement perçu (variable dépendante continue notée *Epuisement*, théoriquement bornée sur une échelle de 0 à 100) en regard de leur volume moyen d’heures d’activité hebdomadaires effectives (prédicteur quantitatif continu noté *HeuresHebdo*).
Sur le plan computationnel, le chercheur instancie son analyse sous R par la formulation d’un modèle de régression linéaire univariée classique en exécutant l’instruction :
*modele_stress <- lm(Epuisement ~ HeuresHebdo, data = donnees_stress)*
L’affichage préliminaire délivré par la fonction standard *summary(modele_stress)* met en évidence un coefficient de régression hautement significatif pour la variable explicative (b = 1.42, t(148) = 8.76, p < 0.001) associé à un coefficient de détermination apparent R² de 0.341, suggérant à l’analyste inexpérimenté que chaque heure hebdomadaire de labeur supplémentaire accroît mécaniquement le score d’épuisement perçu de près d’un point et demi. Cependant, une telle conclusion demeure scientifiquement irrecevable tant que l’ensemble des postulats sous-jacents aux perturbations résiduelles n’a pas été rigoureusement confronté au verdict des tracés diagnostiques.
11.2 Analyse séquentielle commentée des quatre graphiques
L’exécution de la configuration d’affichage *par(mfrow = c(2, 2))* immédiatement suivie de l’appel graphique *plot(modele_stress)* déclenche la projection du quartet diagnostique fondamental. L’analyste entreprend alors un examen séquentiel minutieux :
Premier graphique (Residuals vs Fitted) : L’observation du premier panneau révèle une altération manifeste de la linéarité. Loin d’évoluer de manière rectiligne le long de la référence horizontale nulle, la courbe de lissage rouge LOESS décrit une parabole concave prononcée, plongeant dans les valeurs résiduelles négatives pour les prédictions intermédiaires (entre 35 et 55) avant de se redresser vivement vers les déviances positives aux deux extrémités de l’échelle. Ce motif parabolique expose indubitablement que la dynamique reliant la charge horaire à l’épuisement psychologique n’est pas linéaire mais suit un schéma exponentiel ou polynomial : l’impact d’une heure additionnelle est minime chez un travailleur à temps partiel, mais devient exponentiellement destructeur au-delà d’un certain seuil d’heures de travail hebdomadaires.
Deuxième graphique (Normal Q-Q Plot) : L’inspection du diagramme quantile-quantile normal témoigne d’une violation sévère de la normalité distributionnelle des résidus standardisés. Si le centre de la distribution (les quantiles compris entre -1 et +1) s’ajuste passablement à la droite de référence à 45 degrés, l’extrémité supérieure droite s’arrache de manière spectaculaire vers le haut à partir du deuxième écart-type théorique. Les résidus standardisés associés aux quantiles théoriques élevés s’envolent bien au-delà de la droite pointillée, signant une asymétrie positive marquée couplée à une queue de distribution lourdement chargée. Trois observations spécifiques sont d’ailleurs étiquetées numériquement par R (les indices 42, 118 et 147), attestant de réactions d’épuisement aigu totalement disproportionnées par rapport au modèle gaussien postulatif.
Troisième graphique (Scale-Location Plot) : L’examen du panneau d’échelle-localisation corrobore sans ambiguïté la suspicion d’hétéroscédasticité naissante. La ligne de tendance LOESS rouge accuse une inclinaison ascendante continue et monotone d’une grande netteté sur l’axe des valeurs ajustées. Concomitamment, le semis des résidus transformés en racine carrée d’amplitude absolue, étroitement serré pour les faibles valeurs de prédiction d’épuisement, s’épanouit en un éventail spectaculaire à mesure que l’on progresse vers les prédictions d’épuisement élevé. La variabilité des réponses s’avère infiniment plus volatile chez les salariés soumis à une surcharge de travail que chez les collaborateurs préservés, invalidant formellement l’hypothèse d’une variance résiduelle constante σ².
Quatrième graphique (Residuals vs Leverage) : L’analyse du tracé d’influence met en exergue l’existence de deux profils d’observations singulièrement déstabilisateurs. L’observation numéro 118 se distingue par une valeur de levier hat h_ii considérable (h_118 = 0.082, soit plus de quatre fois le levier moyen de l’échantillon fixé à 2/150 = 0.013), matérialisant un salarié déclarant un volume extravagant de plus de 75 heures d’activité hebdomadaire. Heureusement, son résidu standardisé demeure modéré, traduisant un profil de levier relativement bien aligné. En revanche, l’observation numéro 42 conjugue un levier substantiel à un résidu studentisé excédant +3.4 écarts-types, franchissant de manière agressive l’isocontour pointillé rouge délimitant la distance de Cook au seuil critique de 0.5. Cette observation tire unilatéralement la pente de régression vers elle, confirmant son statut d’observation influente perturbatrice.
11.3 Mise en œuvre de la correction et réévaluation comparative
Face à la convergence de ces violations (non-linéarité parabolique, hétéroscédasticité expansive et présence d’un point d’influence critique), l’analyste décide de réviser sa stratégie de modélisation par l’application d’une transformation mathématique stabilisatrice conjuguée à la prise en compte de la non-linéarité de la trajectoire.
Une optimisation de puissance par la méthode de Box-Cox via l’instruction *boxcox(modele_stress)* suggère une valeur de paramètre λ proche de zéro, prescrivant l’application rigoureuse d’une transformation logarithmique de la variable dépendante. Parallèlement, l’introduction d’un terme quadratique orthogonal sur le régresseur continu est testée pour capturer l’emballement asymptotique du phénomène. Le chercheur ajuste par conséquent son nouveau modèle révisé :
*modele_stress_corrige <- lm(log(Epuisement) ~ poly(HeuresHebdo, 2), data = donnees_stress)*
La réexécution de la partition graphique diagnostique *plot(modele_stress_corrige)* permet de constater une métamorphose spectaculaire des propriétés résiduelles :
- Sur le premier graphique, la ligne de tendance LOESS s’aplatit de façon remarquable, se confondant désormais presque rigoureusement avec l’axe horizontal passant par zéro sur la quasi-totalité de l’intervalle de prédiction, confirmant le rétablissement plein et entier de la linéarité fonctionnelle.
- Sur le Normal Q-Q plot, les quantiles empiriques s’agglutinent désormais avec une régularité exemplaire le long de la droite théorique à 45 degrés, les anciens écarts extrêmes ayant été résorbés par la compression logarithmique des grandes valeurs.
- Sur le tracé d’échelle-localisation, la ligne rouge de lissage adopte une posture parfaitement horizontale et la largeur de dispersion du nuage de points demeure invariable de gauche à droite, attestant de la pleine restauration de l’homoscédasticité.
- Sur le graphique de levier enfin, l’observation 42 voit sa distance de Cook s’effondrer bien en deçà des seuils d’alerte méthodologiques, n’exerçant plus aucune influence destructrice sur l’estimation finale.
Le chercheur dispose désormais d’un modèle non seulement mathématiquement valide et inférentiellement irréprochable, mais dont les conclusions statistiques reflètent enfin avec exactitude la dynamique réelle reliant la contrainte temporelle au syndrome d’épuisement au sein de la cohorte analysée.
12. Bonnes pratiques de reporting académique et écueils d’interprétation
L’excellence méthodologique dans l’exploitation des graphiques diagnostiques sous R ne s’arrête pas aux frontières de l’interpréteur de commandes : elle engage la responsabilité éthique et la clarté rédactionnelle du chercheur au moment de communiquer ses analyses à la communauté scientifique internationale. La documentation rigoureuse des vérifications diagnostiques constitue une exigence fondamentale de transparence dans les protocoles de recherche contemporains.
12.1 Standards de publication selon les normes APA (7e édition)
Les recommandations éditoriales de l’American Psychological Association (APA 7th edition) imposent que tout manuscrit empirique mobilisant des procédures de modélisation linéaire intègre une attestation explicite et détaillée de la vérification de l’ensemble des postulats sous-jacents aux modèles estimés.
Dans la section « Analyses statistiques » du manuscrit, le chercheur doit consacrer un paragraphe spécifique décrivant la méthodologie diagnostique déployée. Il convient de formuler explicitement le recours conjoint aux inspections graphiques natives sous R (examen de la linéarité sur le graphique des résidus versus prédictions, de la normalité via le diagramme quantile-quantile, de l’homoscédasticité par le tracé d’échelle-localisation et de l’influence via la distance de Cook) et, le cas échéant, aux métriques quantitatives associées. Les seuils de décision appliqués pour isoler les observations aberrantes ou influentes doivent être rigoureusement documentés et cités par leurs références méthodologiques d’origine.
Il est vivement encouragé d’annexer l’intégralité du quartet de graphiques diagnostiques sous la forme de matériel supplémentaire accessible en ligne sur des dépôts de science ouverte institutionnels (Dataverse, OSF). Si des transformations de variables ou des suppressions chirurgicales d’observations ont été opérées, le texte académique doit systématiquement faire état d’un tableau comparatif reportant les coefficients de régression, les erreurs-types standards et les indices d’ajustement global avant et après modification, permettant aux pairs évaluateurs et aux lecteurs d’apprécier en toute indépendance la robustesse et la stabilité des assertions inférentielles formulées.
12.2 Erreurs méthodologiques et pièges fréquents
La pratique courante de l’évaluation diagnostique demeure entachée d’une série de confusions théoriques tenaces que tout chercheur averti se doit de repérer et de proscrire au sein de son laboratoire :
- La confusion tragique entre normalité des variables et normalité des résidus : Il s’agit sans conteste de l’écueil le plus répandu dans la littérature empirique. De nombreux praticiens procèdent à des tests de normalité de Shapiro-Wilk directement sur la variable dépendante brute Y ou sur les prédicteurs X, s’alarmant de leur non-gaussianité. Le modèle linéaire n’exige absolument pas que les variables brutes suivent une loi normale ; il postule exclusivement que les résidus conditionnels de l’erreur ε se distribuent normalement à prédiction fixée. Une variable dépendante peut présenter une distribution bimodale brute très accusée sans violer le moindre postulat, pourvu que cette bimodalité soit parfaitement capturée par un prédicteur dichotomique présent dans le modèle.
- La sur-réaction face aux déviations mineures en grand échantillon : Comme évoqué précédemment, contempler un diagramme Q-Q plot portant sur un échantillon de plusieurs milliers d’individus et s’inquiéter de micro-détachements aux extrémités distales traduit une méconnaissance de la puissance asymptotique. En présence d’un volume de données massif, le chercheur doit résister à la tentation de transformer inutilement ses échelles sous prétexte que le test de Shapiro-Wilk rejette l’hypothèse nulle à p < 0.001.
- L’amputation injustifiée d’observations conformes : Éliminer systématiquement toute observation présentant une distance de Cook légèrement supérieure à la moyenne constitue une altération méthodologique inadmissible. Les observations extrêmes sont souvent les plus informatives sur le comportement réel des systèmes étudiés. Une observation ne doit être neutralisée que si la preuve formelle d’un artefact expérimental est établie, ou dans le cadre rigoureusement circonscrit d’une analyse de sensibilité comparée.
12.3 Protocole de synthèse pour le chercheur
Afin de guider de manière ordonnée le processus d’investigation diagnostique au fil des analyses de données sous R, le praticien peut s’appuyer sur l’arbre décisionnel séquentiel synthétisé dans la grille de vérification méthodologique suivante :
- Étape 1 : Inspection de la Linéarité (which = 1). La ligne de tendance LOESS s’écarte-t-elle substantiellement de l’axe horizontal ? Si oui, envisager une transformation polynomiale des prédicteurs, une transformation non linéaire de la réponse (log, racine), ou une transition vers un modèle additif généralisé (GAM).
- Étape 2 : Inspection de l’Homoscédasticité (which = 3). La ligne d’échelle-localisation présente-t-elle une trajectoire ascendante ou une dispersion en entonnoir marquée ? Si oui, appliquer une transformation stabilisatrice de variance (Box-Cox), mobiliser des erreurs-types robustes sandwich (HC3), ou opter pour une modélisation par moindres carrés pondérés (WLS).
- Étape 3 : Inspection de la Normalité (which = 2). Les quantiles des résidus standardisés s’écartent-ils massivement de la droite théorique au-delà des fluctuations stochastiques d’échantillonnage ? Si N est restreint et que les queues sont excessivement lourdes, recourir à la régression robuste par M-estimateurs (*rlm*) ou au rééchantillonnage par bootstrap non paramétrique.
- Étape 4 : Inspection de l’Influence et du Levier (which = 4 ou 5). Des observations franchissent-elles les courbes de niveau de la distance de Cook (0.5 ou 1.0) ? Si oui, identifier impérativement les observations correspondantes, vérifier leur validité substantielle, et exécuter obligatoirement une analyse de sensibilité comparant les modèles avec et sans ces unités d’échantillonnage.
- Étape 5 : Reproductibilité intégrale par script. Assurer que l’ensemble du protocole diagnostique, depuis l’ajustement initial jusqu’aux graphiques finaux et calculs de sensibilité, soit consigné dans un script R impeccablement annoté, prêt pour l’archivage et l’audit scientifique dans un souci permanent de transparence et de reproductibilité empirique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman & Hall.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
Horikoshi, M., & Tang, Y. (2018). ggfortify: Data visualization tools for statistical analysis results. CRAN. https://cran.r-project.org/package=ggfortify
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), Article 3139. https://doi.org/10.21105/joss.03139
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471852333
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org/
Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781315370279
Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10