
L’analyse quantitative moderne repose sur un postulat fondamental que la réalité empirique contredit quasi systématiquement : l’exhaustivité des données collectées. Dans la pratique de la science des données, de l’économétrie et de l’apprentissage automatique, les praticiens sont continuellement confrontés à des matrices observationnelles mitées par des valeurs manquantes. Ces lacunes informationnelles ne constituent pas de simples désagréments cosmétiques ; elles introduisent des distorsions potentielles sévères dans l’estimation des paramètres, affaiblissent la robustesse des inférences et peuvent invalider l’application d’algorithmes mathématiques conçus pour opérer sur des espaces vectoriels continus et complets. Face à cet écueil universel, la bibliothèque logicielle Pandas s’est imposée comme l’environnement computationnel de référence en Python pour ausculter, structurer et réhabiliter les ensembles de données lacunaires.
La remédiation à l’incomplétude des données ne saurait toutefois se réduire à l’exécution mécanique d’une instruction informatique. Elle relève d’une démarche méthodologique rigoureuse qui exige de comprendre les mécanismes probabilistes ayant présidé à la disparition de l’information, d’évaluer la distribution sous-jacente des variables et de mesurer avec exactitude les répercussions statistiques de chaque modalité de substitution. Remplacer une cellule vide par un indicateur de tendance centrale ou par une valeur interpolée le long d’une trajectoire temporelle modifie la variance, la covariance et la structure d’autocorrélation de la série étudiée. Dès lors, le choix d’un protocole d’imputation requiert un équilibre délicat entre réalisme mathématique, parcimonie computationnelle et fidélité empirique.
Ce traité exhaustif a pour vocation d’explorer l’intégralité du cycle de vie du traitement des données manquantes au sein de l’écosystème Pandas. Des fondements de la théorie de Rubin aux architectures d’interpolation algorithmique les plus avancées, en passant par l’interopérabilité avec les modules d’apprentissage statistique de Scikit-Learn, ce guide offre une grille d’analyse théorique et pratique approfondie. À travers des formulations détaillées, des analyses comparatives d’impact distributionnel et des études de cas pas à pas, le praticien acquerra la maîtrise indispensable pour transformer des jeux de données altérés en bases de connaissances fiables, prêtes pour la modélisation prédictive ou la recherche académique de haut niveau.
1. 1. Introduction théorique et méthodologique à l’incomplétude des données avec Pandas
1.1 La problématique des données manquantes en analyse quantitative
Dans le domaine de l’inférence statistique et de la modélisation prédictive, la complétude des matrices de conception constitue un prérequis formel pour l’application des théorèmes asymptotiques usuels. Lorsque des observations sont omises, la première conséquence immédiate réside dans la réduction drastique de la taille effective de l’échantillon, ce qui induit une diminution corollaire de la puissance statistique des tests d’hypothèses. Cette perte de puissance accroît la probabilité de commettre une erreur de type II, consistant à échouer à rejeter une hypothèse nulle pourtant fausse. Cependant, le péril le plus insidieux ne réside pas dans la simple perte de précision volumétrique, mais bien dans l’altération de la validité interne des estimations. Si le processus ayant généré les lacunes d’observation est corrélé avec les variables à l’étude, l’échantillon résiduel cesse d’être représentatif de la population cible, introduisant un biais de sélection structurel irréversible.
Face à des vecteurs de données incomplets, la réponse historiquement intuitive a consisté en l’application de la suppression par liste, communément désignée sous le terme anglophone de listwise deletion ou suppression complète des observations. Cette approche, bien que triviale à implémenter puisqu’elle revient à éliminer toute ligne contenant au moins un champ non renseigné, s’avère méthodologiquement destructrice. Dans des jeux de données multidimensionnels comprenant des dizaines ou des centaines de variables explicatives, une telle politique conduit fréquemment à l’éviction de plus de la moitié des unités statistiques observées, anéantissant l’effort de collecte initial. À l’opposé, la préservation de la structure des données par le biais de techniques d’imputation méthodique permet de retenir l’information résiduelle présente sur les variables non altérées de chaque observation, maintenant ainsi la géométrie globale de l’espace des descripteurs.
L’arbitrage entre l’omission pure et l’imputation repose sur la modélisation statistique du mécanisme générateur de l’absence. Alors que l’omission suppose implicitement une absence totalement aléatoire sans distorsion de profil, l’imputation cherche à reconstruire la valeur contrefactuelle la plus plausible sous certaines hypothèses de régularité mathématique. L’enjeu méthodologique consiste dès lors à imputer sans injecter de variance artificielle ni contraindre de manière fallacieuse l’erreur standard des estimateurs finaux, un défi conceptuel qui sous-tend toute la littérature moderne de l’ingénierie des données tabulaires.
1.2 L’écosystème Pandas face aux valeurs manquantes
L’émergence de la bibliothèque Pandas dans le paysage du calcul scientifique en langage Python a profondément révolutionné la manipulation des données hétérogènes. Historiquement, le traitement des tableaux numériques reposait exclusivement sur la bibliothèque NumPy, laquelle, bien qu’exceptionnellement performante pour l’algèbre linéaire vectorisée, souffrait d’une rigidité conceptuelle face aux tableaux de bord intégrant simultanément des variables qualitatives, discrètes et continues parsemées de données non disponibles. La création des structures de données Series et DataFrame par Wes McKinney a permis de superposer une couche d’abstraction sémantique aux tableaux multidimensionnels contigus en mémoire, conférant aux praticiens un contrôle analytique sans précédent sur les métadonnées et la topologie des absences.
La flexibilité architecturale de Pandas permet de gérer avec une grande fluidité les discontinuités au sein de jeux de données massifs. Les DataFrames intègrent nativement des mécanismes d’alignement automatique d’index, de propagation d’états d’absence et d’opérations fenêtrées résilientes aux valeurs non définies. Cette robustesse opérationnelle permet d’intégrer le traitement de l’incomplétude au sein d’un flux continu d’ingénierie des données. Plutôt que de concevoir le nettoyage des données comme une phase isolée et manuelle, Pandas autorise la formalisation de pipelines de transformation déterministes, auditables et hautement scalables, aptes à absorber les flux de données réels caractérisés par leur volatilité et leurs défauts structurels.
Toutefois, cette souplesse impose l’adoption d’un protocole d’ingénierie standardisé préalablement à toute entreprise de modélisation statistique ou d’apprentissage automatique. Les algorithmes sous-jacents, tels que les régressions régularisées, les réseaux de neurones ou les machines à vecteurs de support, ne tolèrent structurellement aucune valeur absente dans leurs tenseurs d’entrée. L’environnement Pandas constitue ainsi le sas méthodologique impératif où les données brutes sont scannées, catégorisées selon leur profil de complétude, puis transformées de manière à ce que les espaces vectoriels résultants respectent l’intégrité distributionnelle requise par les estimateurs d’inférence.
1.3 Typologie des marqueurs d’absence dans Pandas
La représentation interne du néant informationnel au sein de Pandas est le résultat d’un compromis technique entre l’héritage de la norme IEEE 754 régissant le calcul en virgule flottante et le modèle objet dynamique de Python. Le marqueur historique et le plus répandu demeure np.nan (Not a Number), une sentinelle numérique issue de la bibliothèque NumPy. Sur le plan matériel, np.nan est un motif binaire spécifique défini par la norme de virgule flottante double précision. Cette nature flottante engendre une conséquence architecturale majeure : toute colonne d’entiers ou de booléens hébergeant une seule valeur manquante se voit automatiquement promue en type flottant (float64) afin de pouvoir accueillir ce marqueur, ce qui modifie l’empreinte mémoire et peut altérer l’arithmétique exacte sur les identifiants discrets.
Parallèlement, Python fournit l’objet singleton natif None, utilisé conventionnellement pour signaler l’absence de valeur ou la nullité dans les structures de données génériques. Lorsque None est injecté au sein d’une série numérique Pandas, le moteur interne procède généralement à sa conversion coercitive vers np.nan afin de préserver les performances de calcul vectorisé exécutées en langage C sous le capot. En revanche, au sein de colonnes de type objet hébergeant des chaînes de caractères ou des structures hétérogènes, None et np.nan peuvent coexister, engendrant des comportements asymétriques lors des comparaisons logiques directes, puisque l’égalité stricte np.nan == np.nan s’évalue par définition à faux selon les spécifications IEEE.
Pour résoudre cette ambiguïté historique et pallier les effets de bord de la promotion de type indésirable, l’équipe de développement de Pandas a introduit un type unifié et extensible : l’objet pd.NA, adossé à un système de types dits « nullables » (tels que Int64, Float64 ou boolean). Contrairement à np.nan, pd.NA applique une logique trivalente de Kleene, dans laquelle les opérations booléennes impliquant une absence retournent une incertitude formelle plutôt qu’une falsification arbitraire. Cette avancée fondamentale garantit que des séries d’entiers ou de valeurs logiques puissent conserver leur typage strict tout en encapsulant des absences informationnelles, harmonisant ainsi le traitement algorithmique au sein des architectures logicielles modernes.
2. 2. Taxonomie et mécanismes générateurs des données manquantes
2.1 Données manquantes complètement au hasard (MCAR)
L’évaluation rigoureuse de l’incomplétude nécessite de formaliser la relation probabiliste liant la propension à l’absence aux données observées et inobservées, un paradigme établi par Donald Rubin en 1976. Le premier régime théorique, désigné sous le vocable de données manquantes complètement au hasard (Missing Completely at Random, ou MCAR), postule que la probabilité qu’une observation soit manquante est strictement indépendante tant des valeurs observées sur l’ensemble des covariables que des valeurs hypothétiques qui auraient dû être mesurées sur la variable lacunaire elle-même. Formellement, si l’on note Y_obs la matrice des données collectées, Y_mis la composante manquante et M la matrice binaire indicatrice d’absence, le mécanisme MCAR impose que la probabilité conditionnelle P(M | Y_obs, Y_mis) soit rigoureusement égale à la probabilité marginale P(M).
Sous l’hypothèse MCAR, l’échantillon des observations complètes peut être assimilé à un sous-échantillon aléatoire simple de la population parente d’origine. Les statistiques d’échantillonnage calculées exclusivement sur les cas renseignés, telles que la moyenne empirique ou la matrice de variance-covariance, demeurent des estimateurs non biaisés des paramètres populationnels. Bien que séduisante par sa simplicité conceptuelle, l’hypothèse MCAR est rarement vérifiée dans les conditions expérimentales ou observationnelles réelles, où la perte de données découle fréquemment de contingences matérielles ou contextuelles corrélées à l’environnement d’enregistrement.
La validation empirique de l’hypothèse MCAR fait appel à des protocoles de diagnostic statistique spécifiques, parmi lesquels le test omnibus de Little s’avère le plus prééminent. Ce test paramétrique évalue l’homogénéité des moyennes multivariées à travers les différents sous-groupes d’observations définis par leurs motifs d’incomplétude. Sous l’hypothèse nulle d’un mécanisme purement MCAR, la statistique du test suit asymptotiquement une distribution du Chi-deux avec un nombre de degrés de liberté dépendant du nombre de patterns d’absence et de variables. Le rejet de cette hypothèse nulle contraint le statisticien à abandonner l’omission simple et impose le recours à des approches d’imputation conditionnelle plus sophistiquées.
2.2 Données manquantes au hasard (MAR)
Le second régime probabiliste, nettement plus fréquent dans les applications empiriques, est celui des données manquantes au hasard (Missing at Random, ou MAR). Contrairement à ce que sa dénomination vernaculaire pourrait suggérer de manière trompeuse, ce mécanisme n’implique nullement une absence chaotique ou imprévisible. Dans le formalisme de Rubin, l’hypothèse MAR stipule que la probabilité de défaillance observationnelle sur une variable donnée dépend exclusivement des valeurs prises par d’autres caractéristiques observées et mesurées au sein du même jeu de données, mais demeure conditionnellement indépendante de la valeur sous-jacente non observée elle-même. Mathématiquement, cette condition s’exprime par l’égalité P(M | Y_obs, Y_mis) = P(M | Y_obs).
Un exemple paradigmatique de mécanisme MAR se rencontre fréquemment dans les enquêtes épidémiologiques ou sociodémographiques. Considérons la mesure de la pression artérielle ou du revenu personnel : si la probabilité qu’un individu refuse de déclarer son revenu varie substantiellement en fonction de son âge, de son niveau de diplôme et de sa catégorie socio-professionnelle, mais que, pour toute strate d’âge et de profession fixée, le taux de non-réponse ne dépend pas du montant absolu du revenu caché, le mécanisme est formellement MAR. L’information nécessaire et suffisante pour expliquer et prédire l’absence est intégralement encapsulée dans le sous-espace des données observées.
Cette distinction conceptuelle possède des implications immédiates quant aux stratégies de remédiation algorithmique dans Pandas. Face à un régime MAR, la suppression unilatérale des lignes incomplètes engendre des estimateurs gravement biaisés, car les classes de population surreprésentées parmi les données absentes voient leur poids artificiellement minoré. En revanche, ce régime autorise l’usage légitime d’algorithmes d’imputation conditionnelle. Dès lors que l’analyste conditionne l’imputation sur les variables explicatives corrélées (au moyen de modèles régressifs, de plus proches voisins ou de techniques stochastiques multivariées), il est mathématiquement possible de restaurer l’impartialité des estimations distributionnelles finales.
2.3 Données manquantes non au hasard (MNAR)
Le troisième scénario, représentant le cas le plus complexe en modélisation statistique, concerne les données manquantes non au hasard (Missing Not at Random, ou MNAR), également désignées sous le terme d’incomplétude non-ignorable. Dans cette configuration, la probabilité d’absence est directement fonction de la valeur de la variable omise elle-même, même après conditionnement sur la totalité des autres variables explicatives observables. Formellement, la probabilité P(M | Y_obs, Y_mis) ne peut être simplifiée et demeure irréductiblement dépendante de la valeur latente Y_mis. Aucune manipulation matricielle passive des prédicteurs disponibles ne permet d’annihiler la corrélation entre l’événement d’absence et la grandeur physique mesurée.
Les illustrations concrètes du phénomène MNAR abondent dans les domaines d’évaluation psychologique, économique et industrielle. Dans un protocole de test évaluant la dépression clinique, les patients éprouvant les symptômes les plus sévères présentent une propension significativement plus élevée à abandonner l’étude avant la collecte des scores longitudinaux ultimes. De manière analogue, dans le secteur bancaire, les ménages confrontés à un surendettement critique tendent à dissimuler sciemment le volume de leurs dettes non consolidées. Dans ces contextes, la distribution des valeurs tronquées ou censurées diffère radicalement de celle des valeurs observables, introduisant un biais d’attrition ou de censure à gauche ou à droite particulièrement sévère.
Face à un processus générateur MNAR, l’ensemble des méthodes d’interpolation standard, qu’elles soient univariées (comme la moyenne ou la spline) ou multivariées simples, échouent structurellement à corriger le biais de sélection. Ces algorithmes projettent en effet la structure d’espérance des données observées sur les cellules vacantes, amplifiant la distorsion paramétrique. Le traitement des données MNAR requiert impérativement des architectures de modélisation conjointe sophistiquées, telles que le modèle de sélection d’Heckman, des modèles à variables latentes ou des analyses de sensibilité poussées. Le praticien utilisant Pandas doit donc faire preuve d’une extrême prudence épistémologique lorsqu’il suspecte la présence de dynamiques MNAR au sein de son jeu de données empirique.
3. 3. Diagnostic systématique et détection des valeurs manquantes dans un DataFrame
3.1 Fonctions d’inspection fondamentale
L’exploration méthodique de l’intégrité d’un DataFrame sous Pandas débute invariablement par la mobilisation des primitives d’inspection binaire destinées à isoler les coordonnées des lacunes informationnelles. Les méthodes fondamentales isna() et son alias historique strict isnull() constituent la pierre angulaire de ce diagnostic préliminaire. Lorsqu’elles sont appliquées à une structure tabulaire, ces méthodes génèrent une matrice booléenne homothétique au DataFrame d’origine, au sein de laquelle chaque cellule est évaluée à la valeur logique vraie (True) si elle héberge un marqueur d’absence (tel que np.nan, None ou pd.NA), et à faux (False) dans le cas contraire. L’utilisation interchangeable de ces deux syntaxes relève d’une redondance sémantique délibérément préservée par les concepteurs de la bibliothèque pour offrir une cohérence conceptuelle tant aux usagers habitués au vocabulaire SQL qu’à ceux issus de l’écosystème R.
En miroir dialectique, la méthode notna() (ou son équivalent notnull()) produit l’inverse logique strict du masque de nullité, attribuant la valeur vraie aux composantes validement renseignées. Cette fonction s’avère particulièrement précieuse lors des phases de filtrage conditionnel et d’indexation booléenne vectorisée. Elle permet d’extraire instantanément des sous-ensembles d’observations pour calibrer un modèle sans recourir à des copies mémoire coûteuses. Par exemple, l’expression df[df[‘feature’].notna()] permet d’isoler l’échantillon complet support avec une efficacité de calcul optimale garantie par l’exécution vectorisée au niveau du noyau C de Pandas.
Sur le plan des performances computationnelles, ces fonctions d’évaluation binaire sont hautement optimisées grâce à des balayages séquentiels contigus en mémoire qui tirent profit des instructions SIMD (Single Instruction, Multiple Data) des microprocesseurs contemporains. Néanmoins, lorsque les jeux de données atteignent des dimensions critiques de plusieurs millions de lignes associées à des colonnes hétérogènes de type objet, l’évaluation de isna() peut induire une surcharge non négligeable due au déréférencement individuel des pointeurs Python sous-jacents. L’analyste veillera donc, dans le cadre de pipelines de production haute performance, à privilégier des typages stricts (numériques ou catégoriels optimisés) afin de maximiser la vitesse d’exécution de ces masques d’inspection primaires.
3.2 Agrégation et cartographie descriptive des manques
Une fois la cartographie booléenne élémentaire établie, l’étape analytique subséquente réside dans la condensation descriptive de cette information atomique au moyen d’opérations d’agrégation multidimensionnelle. L’idiome paradigmatique de l’écosystème Pandas s’articule autour de l’instruction en chaîne df.isna().sum(). Cette syntaxe exploite élégamment la coercition arithmétique implicite du langage Python, selon laquelle le booléen True s’évalue numériquement à 1 et False à 0. L’agrégation verticale s’exécutant par défaut le long de l’axe vertical (axis=0), cette opération retourne une Série décrivant le décompte absolu des valeurs manquantes pour chaque attribut du tableau analysé.
Toutefois, la simple lecture de métriques absolues est notoirement insuffisante pour apprécier la criticité relative de l’incomplétude au sein d’échantillons asymétriques. L’analyste rigoureux adjoint systématiquement à cette mesure le calcul des ratios relatifs, obtenu par l’expression df.isna().mean() * 100. Cette formulation vectorisée fournit instantanément la proportion de non-réponse exprimée en pourcentage par variable. La comparaison de ces taux permet de ségréguer immédiatement les colonnes dont l’incomplétude est marginale (inférieure à 1 % ou 5 %, se prêtant à une vaste palette de remédiations) de celles souffrant d’une dégradation structurelle majeure (dépassant 40 % ou 50 %, imposant la suppression pure et simple de la variable ou la mise en œuvre de modèles prédictifs complexes dédiés).
Pour parfaire ce tableau de bord descriptif, il est indispensable de dépasser l’analyse univariée marginale pour appréhender les profils multivariés de co-occurrence de l’absence. L’agrégation croisée des motifs permet de déterminer si plusieurs variables subissent des extinctions informatives simultanées, suggérant un arrêt technique d’un instrument de mesure ou un saut de section au sein d’un questionnaire d’enquête. L’application d’opérations groupées telles que df.isna().value_counts() sur un sous-ensemble de descripteurs clés génère un inventaire exhaustif des configurations matricielles de sparsité, révélant la combinatoire intime des manques qui orientera le choix final entre imputation univariée conditionnelle ou modélisation conjointe multivariée.
3.3 Visualisation diagnostique des structures d’absence
La caractérisation diagnostique de la sparsité matricielle franchit un palier qualitatif déterminant lorsque l’inspection numérique est couplée à des méthodes de visualisation spatiale et chronologique. L’examen graphique permet de révéler des structures d’incomplétude imperceptibles à la simple lecture d’indicateurs scalaires agrégés. Dans les séries temporelles et les jeux de données longitudinaux, la génération d’un tracé graphique élémentaire mettant en relief les discontinuités de mesure le long de l’index temporel constitue un préalable incontournable. Un tel tracé expose sans ambiguïté la présence d’éventuels black-outs périodiques, de ruptures soudaines de télémétrie ou d’accroissements graduels de la fréquence de non-réponse induits par l’obsolescence d’un capteur physique.
Au-delà des tracés standards offerts par le module matplotlib adossé à Pandas, l’utilisation de bibliothèques spécialisées dans la méta-analyse d’incomplétude, au premier rang desquelles figure missingno, confère une acuité visuelle exceptionnelle à l’investigation. La matrice de sparsité (missingno.matrix) offre une cartographie globale de la trame de données, où chaque cellule manquante se traduit par une strie immaculée au sein d’un bloc de pixels sombres. Cette projection synoptique facilite la détection immédiate de corrélations de non-réponse entre colonnes contiguës et met en évidence la nature monotone ou fracturée des patrons d’absence à travers les différentes strates de l’échantillon.
L’interprétation de ces motifs graphiques guide de façon décisive la validation ou la réfutation des hypothèses théoriques sous-jacentes. Une répartition uniforme et granuleuse des absences à travers l’ensemble des coordonnées du graphique étaye empiriquement la plausibilité d’un mécanisme MCAR. Inversement, l’apparition de bandes de vide informationnel alignées horizontalement sur des sous-populations spécifiques d’observations corrobore l’existence d’une dynamique MAR dépendante d’une variable de segmentation. L’analyse des dendrogrammes de similarité d’absence calculés par regroupement hiérarchique permet enfin de quantifier formellement la distance statistique séparant les profils d’omission des différentes variables, ancrant ainsi la prise de décision méthodologique sur un substrat empirique incontestable.
4. 4. Méthodes d’imputation univariée simple par indicateurs de tendance centrale
4.1 Imputation par la moyenne arithmétique
L’imputation par la moyenne arithmétique représente sans doute la technique d’ingénierie compensatoire la plus élémentaire et la plus couramment mobilisée dans les premiers cycles de traitement de données quantitatives continues. Sa mise en œuvre au sein de la bibliothèque Pandas s’opère avec une grande concision syntaxique via l’instruction df[‘colonne’] = df[‘colonne’].fillna(df[‘colonne’].mean()). Dans cette commande, la méthode interne mean() calcule l’espérance arithmétique empirique sur le sous-ensemble strict des valeurs valides résiduelles, puis la méthode fillna() substitue scalairement cette valeur d’équilibre à chaque case hébergeant un marqueur de nullité au sein de la série ciblée.
Sur le plan des propriétés statistiques fondamentales, cette méthode présente l’avantage formel de préserver rigoureusement l’espérance mathématique de la variable analysée. En vertu de la linéarité de l’opérateur d’espérance, l’introduction de valeurs strictement égales à la moyenne de l’échantillon ne modifie en rien la moyenne globale de la série imputée résultante. Cette caractéristique s’avère rassurante pour les analyses descriptives sommatives de premier niveau, où la masse totale ou le barycentre de la distribution doit demeurer invariant après assainissement de la table de données.
Néanmoins, les contreparties méthodologiques de l’imputation par la moyenne sont sévères et largement documentées dans la théorie statistique. Le premier écueil réside dans la réduction artificielle et mécanique de la variance de la variable. En concentrant arbitrairement une fraction potentiellement substantielle de la masse de probabilité exactement sur un point unique de la droite des réels, l’analyste tronque la dispersion naturelle des données. Plus formellement, si une proportion p de valeurs est manquante et imputée par la moyenne, la variance de l’échantillon complété se trouve minorée d’un facteur approximatif (1 – p) par rapport à la variance intrinsèque de la population. Ce tassement distributionnel entraîne une sous-estimation systématique des erreurs-types, générant par voie de conséquence des intervalles de confiance indûment étroits et une inflation fallacieuse des significativités statistiques (valeurs p artificiellement basses) lors des tests de Student ou des régressions ultérieures.
4.2 Imputation par la médiane pour distributions asymétriques
Lorsque les distributions empiriques s’écartent sensiblement de la symétrie gaussienne pour présenter une asymétrie marquée (présence d’un étalement substantiel à droite ou à gauche) ou hébergent une contamination par des valeurs extrêmes ou aberrantes (outliers), l’imputation par la moyenne arithmétique devient méthodologiquement proscrite. L’estimateur de la moyenne est notoirement non robuste, possédant un point de rupture statistique de zéro, signifiant qu’une unique valeur aberrante infinitésimale suffit à dévier arbitrairement son estimation. Dans ce contexte, l’imputation par la médiane s’impose comme une alternative univariée supérieure, formalisée sous Pandas par l’expression df[‘colonne’] = df[‘colonne’].fillna(df[‘colonne’].median()).
La médiane, en tant que valeur partageant l’échantillon ordonné en deux effectifs rigoureusement identiques, bénéficie d’une insensibilité empirique totale face à l’amplitude des observations situées aux extrémités de la distribution. En termes mathématiques, la médiane constitue le minimiseur de la fonction de perte basée sur la norme L1 (valeur absolue des écarts), là où la moyenne minimise la perte quadratique L2. Son recours est particulièrement indiqué pour les variables économiques et financières telles que le revenu des ménages, la valorisation d’actifs immobiliers ou le montant des transactions bancaires, distributions dont l’asymétrie positive prononcée fausserait irrémédiablement tout calcul basé sur l’espérance quadratique.
Afin de maximiser la granularité contextuelle de cette approche sans basculer dans la complexité des modèles multivariés, l’analyste peut procéder à une imputation par médiane conditionnelle au moyen d’un partitionnement par groupes. L’idiome Pandas df[‘colonne’] = df.groupby(‘categorie’)[‘colonne’].transform(lambda x: x.fillna(x.median())) permet de calculer la médiane spécifique à chaque strate sociodémographique ou technique avant de l’injecter au sein des cellules vacantes respectives. Si la comparaison des densités empiriques avant et après imputation par médiane révèle une bien meilleure préservation de la forme globale que celle offerte par la moyenne, elle n’élude pas totalement le risque de création d’une discontinuité artificielle (un pic de Dirac discret) au point médian de la fonction de répartition empirique.
4.3 Imputation par le mode pour variables catégorielles et discrètes
Le traitement des colonnes non numériques, hébergeant des attributs nominaux ou ordinaux (tels que la catégorie de produit, le pays de résidence ou le statut matrimonial), prohibe formellement le recours aux moyennes ou médianes, les opérations arithmétiques sous-jacentes étant dépourvues de sens logique sur des ensembles qualitatifs discrets. L’équivalent fonctionnel en tendance centrale réside dans l’imputation par le mode statistique, représentant la modalité présentant la fréquence d’occurrence empirique maximale au sein de la série. La transcription technique de ce principe sous Pandas requiert une attention particulière quant à la structure de retour de la primitive analytique, matérialisée par la syntaxe df[‘colonne’] = df[‘colonne’].fillna(df[‘colonne’].mode()[0]).
La méthode mode() appliquée à une Série Pandas ne retourne pas un scalaire isolé, mais une nouvelle Série ordonnée contenant l’ensemble des valeurs modales identifiées. Cette construction algorithmique découle de la possibilité inhérente qu’une distribution soit multimodale (présence de plusieurs modalités ex æquo affichant la même fréquence absolue maximale). L’indexation explicite via [0] garantit l’extraction du premier élément modal invariant, permettant son utilisation scalaire immédiate en argument de la fonction fillna() afin de préserver l’intégrité de la typologie qualitative sous-jacente.
Toutefois, cette modalité d’imputation univariée souffre d’effets pervers analogues à ceux décrits pour les variables continues, voire exacerbés par la nature discrète de l’espace d’état. L’injection récurrente de la modalité majoritaire tend à surreprésenter mécaniquement la classe dominante, écrasant d’autant la prévalence relative des catégories minoritaires au sein de l’échantillon. Cette amplification unilatérale réduit l’entropie informationnelle de la variable et distord les tableaux de contingence croisés avec d’autres facteurs qualitatifs, augmentant artificiellement le degré d’association perçu (mesuré par le V de Cramér ou le test d’indépendance du Chi-deux). Le recours au mode doit donc être circonscrit aux variables dont le taux d’incomplétude est infinitésimal, ou relayé par des approches probabilistes tirant aléatoirement des modalités selon la distribution multinomiale observée.
5. 5. Fondements mathématiques et syntaxiques de l’interpolation dans Pandas
5.1 Principe analytique de l’interpolation linéaire
Lorsque les données observées s’inscrivent dans un continuum temporel, spatial ou séquentiel ordonné, l’imputation par agrégats de tendance centrale devient méthodologiquement inadaptée, car elle ignore totalement l’agencement topologique des mesures adjacentes. Dans ce cas de figure, l’interpolation mathématique offre une approche de reconstruction structurelle infiniment supérieure. L’interpolation linéaire simple repose sur l’hypothèse de régularité et de continuité locale du phénomène physique ou économique mesuré le long de la coordonnée de progression. Elle postule qu’entre deux points de mesure disjoints mais chronologiquement ou spatialement rapprochés, la trajectoire de la grandeur étudiée peut être fidèlement approchée par un segment de droite affine.
Sur le plan géométrique et analytique, considérons deux observations complètes délimitant un intervalle d’incomplétude : le point initial (x_0, y_0) et le point final (x_1, y_1), où x représente l’index de positionnement (fréquemment le temps discret) et y la grandeur scalaire observée. Pour toute coordonnée intermédiaire x comprise strictement entre x_0 et x_1 pour laquelle la mesure y fait défaut, la formulation de l’interpolation linéaire s’établit par l’équation affine classique : y = y_0 + (x – x_0) * [(y_1 – y_0) / (x_1 – x_0)]. Le coefficient directeur de cette droite modélise le taux de variation moyen instantané du phénomène sur l’intervalle considéré, projetant une progression arithmétique uniforme sur les valeurs manquantes intercalaires.
Cette formalisation mathématique s’avère particulièrement optimale lorsque les données sont échantillonnées à intervalles temporels ou spatiaux réguliers et équidistants. En supposant que le processus stochastique ne subit pas de chocs exogènes discontinus majeurs durant la phase de panne d’enregistrement, l’interpolation linéaire reconstitue une transition déterministe minimale qui minimise l’erreur quadratique sous condition de courbure nulle. Elle préserve ainsi la dynamique directionnelle locale du système physique sans injecter la dispersion artificielle propre aux tirages aléatoires.
5.2 Syntaxe canonique de la méthode .interpolate()
L’opérationnalisation de ce principe d’approximation géométrique au sein de l’écosystème Pandas est orchestrée par une méthode dédiée extrêmement puissante : interpolate(). L’instruction canonique fondamentale pour assainir une colonne spécifique s’écrit formellement sous la forme : df[‘nom_colonne’] = df[‘nom_colonne’].interpolate(). Par défaut, lorsqu’aucun paramètre spécifique n’est instancié, la méthode déploie un algorithme d’interpolation linéaire pure appliqué le long de l’axe vertical des index (correspondant à l’argument par défaut axis=0). La Série résultante conserve sa structure dimensionnelle exacte tout en voyant ses lacunes internes comblées par les projections linéaires dérivées de leurs ancrages supérieur et inférieur.
Une distinction logicielle primordiale concerne les modalités d’affectation en mémoire de l’opération d’interpolation. Historiquement, de nombreuses fonctions Pandas intégraient un paramètre inplace=True, permettant d’altérer la structure de données directement à son adresse mémoire sans requérir d’assignation explicite. Toutefois, la doctrine contemporaine de développement de Pandas déconseille formellement l’usage du mode inplace, celui-ci étant voué à la dépréciation en raison de comportements sous-jacents incohérents liés à la gestion des vues (views) et des copies (copies) dans le gestionnaire de mémoire C (BlockManager). La pratique d’ingénierie canonique et robuste exige l’assignation explicite de l’objet transformé, garantissant la traçabilité des mutations et prévenant l’apparition des avertissements SettingWithCopyWarning.
Il est par ailleurs fondamental de noter que la méthode interpolate() traite les données de façon vectorisée en allouant des segments continus d’exécution, conférant au processus une vélocité comparable aux routines d’algèbre sous-jacentes écrites en Fortran ou C. Le comportement par défaut assume une progression unitaire basée sur les entiers d’indexation implicites (0, 1, 2, …, N), ce qui convient parfaitement aux DataFrames pourvus d’un RangeIndex standard. Lorsque l’axe de projection obéit à une métrique non uniforme, l’analyste devra toutefois paramétrer explicitement le schéma d’alignement de la méthode, ainsi que nous l’exposerons dans les sections dédiées aux extensions spécialisées.
5.3 Paramètres cardinaux de contrôle de l’interpolation
L’implémentation industrielle de l’interpolation ne saurait s’affranchir de contraintes de garde-fous destinées à régir le comportement de l’algorithme face aux cas limites. Le premier paramètre cardinal de contrôle réside dans l’argument limit, lequel accepte un entier positif définissant le nombre maximal de cellules manquantes consécutives autorisées à recevoir une valeur interpolée. Si une panne de capteur engendre un vide informationnel continu de cinquante pas de temps, il peut être méthodologiquement inconsidéré de tracer une ligne droite artificielle sur une durée aussi longue, la vraisemblance de l’hypothèse de continuité s’effondrant avec l’éloignement des bornes. En spécifiant par exemple limit=3, l’algorithme n’imputera que les trois premiers pas de temps suivant la dernière observation valide, laissant les cellules ultérieures vacantes pour un traitement alternatif.
Le contrôle directionnel de ce comblement est gouverné de façon synergique par le paramètre limit_direction, qui admet trois modalités fondamentales : ‘forward’ (orientation par défaut, où l’imputation se propage chronologiquement de haut en bas depuis l’ancrage passé), ‘backward’ (orientation rétrograde, où le remplissage s’opère de bas en haut depuis l’observation future vers le passé), et ‘both’ (propagation bidirectionnelle convergent vers le centre de la lacune). Cette granularité directionnelle devient particulièrement opérante lorsque l’argument limit est actif, dictant avec précision l’ancrage spatial ou temporel sur lequel la reconstruction mathématique doit s’adosser.
Enfin, une limitation structurelle intrinsèque de l’interpolation linéaire réside dans son incapacité formelle à résoudre les valeurs manquantes situées en bordure extérieure du DataFrame, c’est-à-dire les lacunes initiales (leading NaNs) ou terminales (trailing NaNs). L’interpolation exigeant par définition deux bornes d’encadrement pour évaluer le coefficient directeur de la droite sécante, toute cellule vide positionnée avant la toute première observation valide ou après la dernière mesure enregistrée demeurera rigoureusement inchangée après exécution de l’algorithme standard. Pour circonscrire cette contingence, le praticien doit faire appel à l’argument limit_area (qui permet de restreindre l’action exclusivement aux manques internes via la modalité ‘inside’ ou aux bornes via ‘outside’) ou concevoir une stratégie hybride combinant interpolation pour le cœur de série et propagation séquentielle pour ses extrémités.
6. 6. Étude de cas empirique pas à pas : Imputation d’une série chronologique de ventes
6.1 Instanciation du jeu de données expérimental
Afin d’illustrer de façon rigoureuse et reproductible l’impact opérationnel de l’interpolation au sein de Pandas, concevons un protocole expérimental basé sur une série chronologique journalière modélisant le chiffre d’affaires d’une entreprise commerciale. Considérons une fenêtre d’observation de 15 jours consécutifs s’étendant du premier au quinze janvier. Dans des conditions normales d’exploitation, le processus sous-jacent est caractérisé par une tendance haussière déterministe couplée à une oscillation stochastique résiduelle. Pour formaliser ce jeu d’essai, instancions un DataFrame Pandas indexé par des dates régulières, générées via la primitive pd.date_range, et doté d’une colonne vectorielle nommée ‘sales’.
Pour reproduire le phénomène critique de panne d’acquisition de données, nous injectons délibérément une séquence continue de quatre valeurs d’absence np.nan situées précisément entre le 8 et le 11 janvier inclus. Cette fenêtre d’incomplétude de quatre jours consécutifs représente un défi typique dans l’analyse de séries temporelles : un intervalle trop vaste pour une simple omission sans perturber le cycle hebdomadaire, mais suffisamment restreint pour qu’une trajectoire interpolée conserve un haut degré de vraisemblance physique. Les sept premiers jours d’observation affichent une ascension graduelle passant de 100 à environ 170 unités de vente, tandis que la reprise d’enregistrement du 12 au 15 janvier atteste d’un niveau d’activité culminant aux alentours de 220 à 250 unités.
L’inspection matricielle préliminaire du DataFrame ainsi généré met en lumière la nature discontinue de l’échantillon. L’application immédiate de df.info() confirme que la colonne des ventes ne dénombre que 11 observations non nulles sur les 15 attendues, le typage de la variable s’établissant strictement en flottant 64 bits sous l’effet de la présence des sentinelles np.nan. La table de données se trouve ainsi dans une configuration idéale pour tester empiriquement la chaîne de traitement diagnostique, graphique et reconstructive.
6.2 Visualisation de la discontinuité par analyse graphique
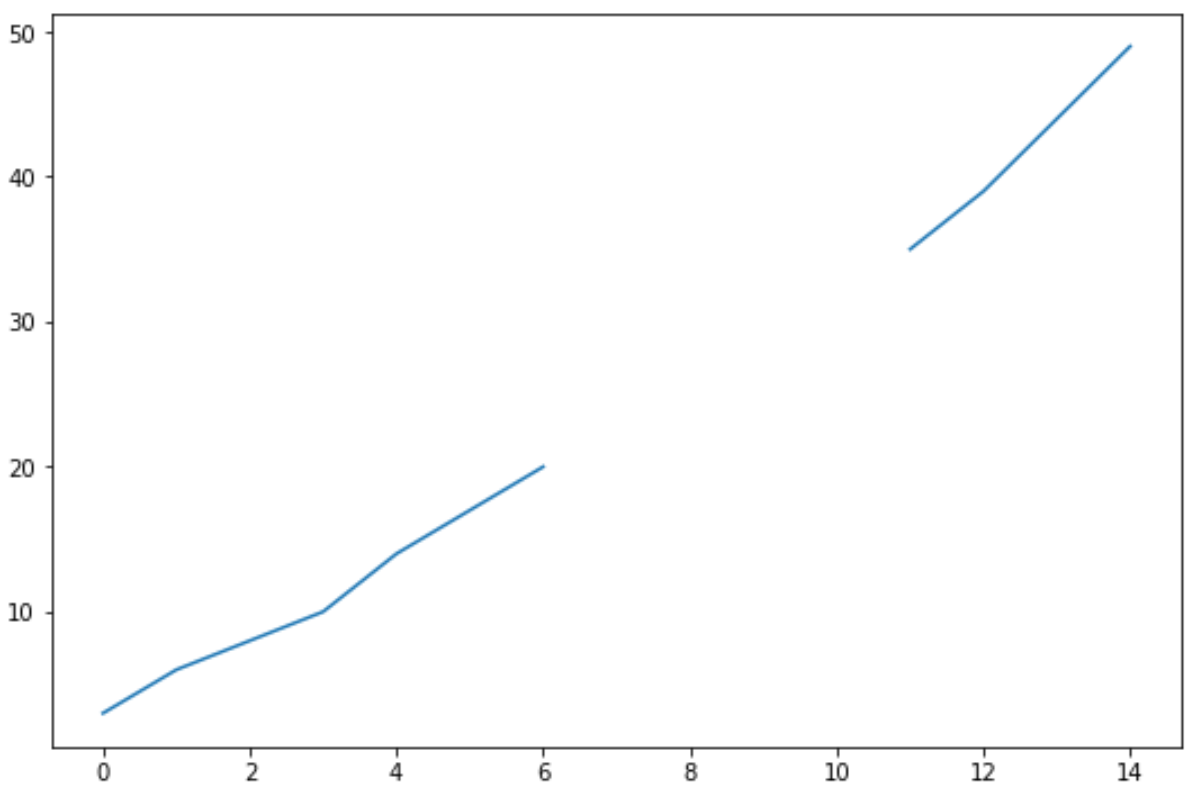
Préalablement à toute modification destructive des données, l’exploration visuelle de la série brute s’avère indispensable pour apprécier la forme générale de la fonction génératrice sous-jacente. L’invocation directe de la méthode intégrée df[‘sales’].plot(marker=’o’) via l’interface graphique de Matplotlib produit une courbe continue interrompue brutalement au cours de la deuxième semaine de mesure. Le moteur de rendu graphique de Pandas, se conformant aux standards analytiques, refuse de joindre artificiellement par un trait les points encadrant un vide d’observation, matérialisant ainsi un espace blanc révélateur entre le point du 7 janvier et celui du 12 janvier.
L’analyse visuelle de cette rupture de pente expose avec acuité le vide informationnel béant au cœur de la chronologie. En observant attentivement les segments de droite encadrant la discontinuité, l’analyste décèle immédiatement une dynamique directionnelle monotone croissante : la trajectoire précédant le jour 8 converge vers le haut, et la trajectoire émergeant le jour 12 poursuit une ascension amorcée à un niveau d’ordonnée substantiellement supérieur. Cette disposition graphique plaide sans équivoque contre l’emploi d’une imputation univariée par la moyenne globale. Injecter la moyenne globale de l’échantillon (située autour de 160 unités) sur les jours 8 à 11 créerait un artefact graphique en forme de cuvette ou de décrochage, entrant en contradiction flagrante avec la tendance générale sous-jacente.
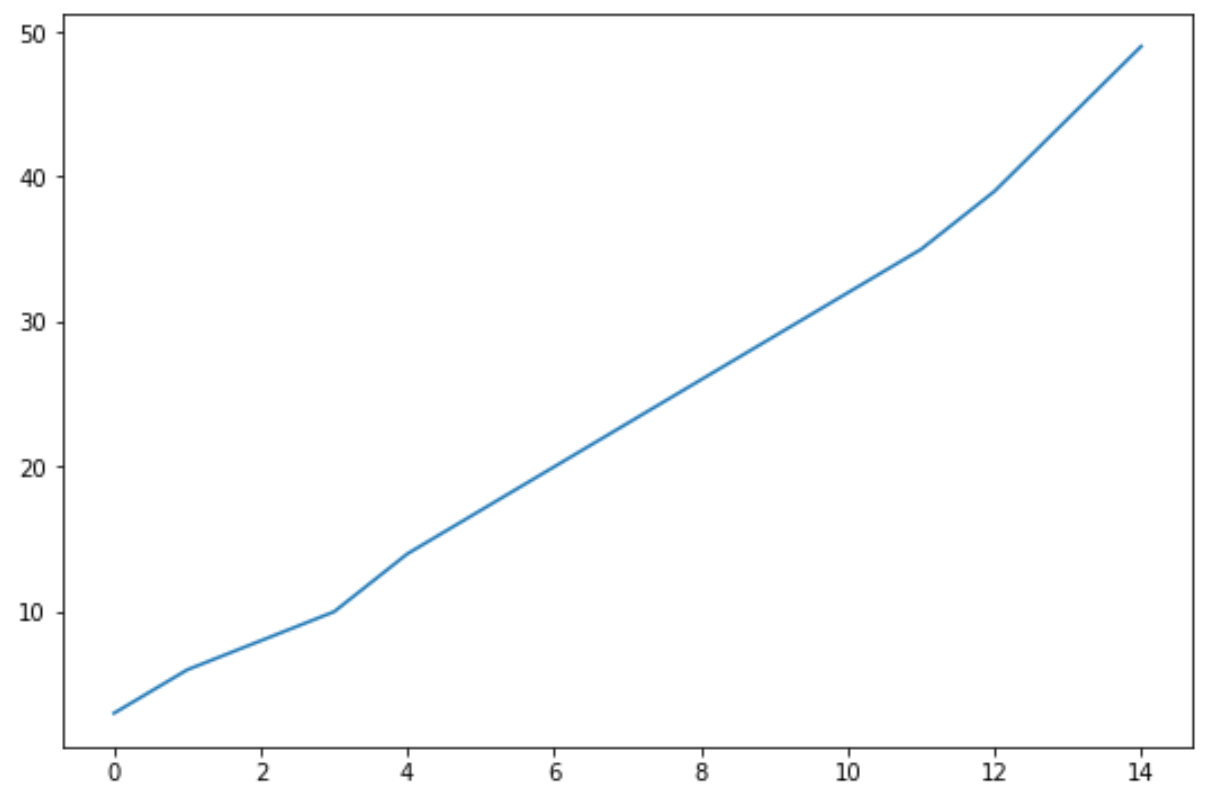
Le diagnostic visuel confirme dès lors l’adéquation conceptuelle de l’interpolation linéaire pour cette typologie de problème. Le tracé linéaire suggère que le taux de variation moyen entre le 7 janvier (dont la valeur observée est de 170) et le 12 janvier (dont la valeur enregistrée s’établit à 220) capture de façon optimale le sentier de croissance le plus probable qu’a traversé l’activité commerciale durant l’intervalle d’invisibilité opérationnelle.
6.3 Exécution de l’interpolation et vérification des résultats
L’étape de réhabilitation informationnelle se concrétise par l’application de la méthode canonique df[‘sales_interpolated’] = df[‘sales’].interpolate(method=’linear’). L’exécution de cette instruction déclenche la résolution instantanée de l’équation sécante liant les coordonnées du 7 janvier (x=7, y=170) à celles du 12 janvier (x=12, y=220). L’amplitude totale de l’écart vertical équivaut à 50 unités de ventes, distribuée uniformément sur une durée différentielle de 5 pas journaliers, ce qui définit une pente incrémentale arithmétique rigoureusement égale à 10 unités par jour d’observation.
L’inspection détaillée des valeurs générées algorithmiquement par Pandas pour les cellules jadis vacantes confirme la perfection arithmétique du mécanisme d’interpolation : le 8 janvier se voit attribuer la valeur 180, le 9 janvier la valeur 190, le 10 janvier la valeur 200, et le 11 janvier la valeur 210. Chaque point calculé s’insère sans rupture de gradient au sein de la chronologie. La vérification post-exécution au moyen de df[‘sales_interpolated’].isna().sum() confirme l’élimination intégrale des marqueurs de nullité, le compte d’incomplétude tombant formellement à zéro.
Pour achever cette étude de cas, la génération d’un tracé graphique post-imputation superposant la série originale et les valeurs imputées permet de constater le rétablissement complet de la continuité géométrique du signal de vente. La courbe résultante trace désormais une trajectoire ascendante fluide, exempte de décrochages ou de singularités artificielles. Cette réhabilitation permet non seulement de calculer des statistiques descriptives fiables (telles que des moyennes mobiles hebdomadaires sans effets de bord), mais fournit également une série structurellement conforme pour alimenter des modèles de prévision économétrique avancés de type ARIMA ou des réseaux récurrents LSTM.
7. 7. Méthodes d’interpolation non-linéaires et spécialisées dans Pandas
7.1 Interpolation polynomiale et par splines
Si l’interpolation linéaire offre une solution robuste et parcimonieuse pour des évolutions purement affines, elle se révèle incapable de modéliser fidèlement des dynamiques physiques ou biologiques caractérisées par des accélérations, des courbures harmoniques ou des transitions douces sans cassures différentielles. Pour transcender cette limite, Pandas intègre des mécanismes d’interpolation non-linéaire avancés en s’adossant directement aux routines d’approximation numérique de la bibliothèque SciPy. Les options method=’polynomial’ et method=’spline’ permettent d’ajuster des fonctions polynomiales par morceaux garantissant non seulement la continuité de la fonction interpolée, mais également celle de ses dérivées première et seconde.
L’activation de ces méthodes requiert la spécification formelle du paramètre order, désignant le degré du polynôme d’ajustement. Par exemple, l’instruction df[‘colonne’].interpolate(method=’spline’, order=3) mobilise une spline cubique, le standard absolu pour générer des courbes lisses traversant une série de points de contrôle. La spline cubique ajuste des polynômes de degré 3 entre chaque paire de nœuds d’observation, en contraignant mathématiquement l’égalité des courbures aux frontières de chaque intervalle. Cette formulation est particulièrement plébiscitée dans l’analyse de données cinématiques, de signaux biomédicaux (électrocardiogrammes) ou de trajectoires thermodynamiques où les discontinuités de pente n’ont aucune réalité physique.
Cependant, l’utilisation d’interpolations polynomiales d’ordre élevé comporte un risque théorique et empirique redoutable connu sous le nom de phénomène de Runge. Lorsque le degré polynomial augmente, ou lorsque les nœuds d’interpolation sont espacés de façon sous-optimale, le polynôme global a tendance à développer des oscillations d’amplitude divergente à l’approche des extrémités de l’intervalle d’interpolation. Ce comportement peut engendrer des valeurs imputées totalement extravagantes, plongeant dans des valeurs négatives impossibles ou explosant vers des grandeurs infinies. Le praticien veillera donc à restreindre rigoureusement l’ordre des splines à des degrés modestes (typiquement d’ordre 2 ou 3) et à vérifier scrupuleusement la cohérence des bornes extrêmes générées.
7.2 Interpolation temporelle sensible aux écarts irréguliers
Une lacune conceptuelle majeure de l’interpolation linéaire standard basée sur les index numériques entiers réside dans son incapacité native à prendre en compte la distorsion temporelle réelle lorsque les données sont collectées à des fréquences d’échantillonnage irrégulières. Dans le domaine de la finance de marché à haute fréquence ou de la télémétrie de réseaux de capteurs IoT, les observations ne surviennent pas selon un métronome parfait : un capteur peut émettre des trames à 10 secondes d’intervalle, puis subir une latence réseau de trois heures, avant de reprendre à un rythme effréné. Dans ce contexte, traiter l’index comme une succession d’entiers uniformes aboutirait à une erreur d’approximation grossière.
Pour surmonter cette contrainte, Pandas propose la méthode d’interpolation temporelle, accessible via l’argument method=’time’. Cette approche exige expressément que l’index du DataFrame soit un objet de type DatetimeIndex. L’algorithme calcule dès lors la pente de progression en pondérant mathématiquement l’écart d’ordonnée par la distance chronologique absolue séparant les horodatages réels (exprimée en nanosecondes sous le capot). Si deux observations distantes d’une journée présentent un saut scalaire identique à deux observations distantes de cinq minutes, la formule d’interpolation temporelle modulera le coefficient directeur avec une stricte proportionnalité temporelle.
L’intérêt empirique de cette méthode est prépondérant dans l’analyse de séries financières discontinues, où la survenue de week-ends, de jours fériés ou de suspensions de cotation altère l’espacement chronologique réel des prix d’actifs. En mobilisant l’interpolation temporelle, la reconstruction des cours de clôture manquants s’aligne fidèlement sur la dynamique de l’écoulement réel du temps plutôt que sur la structure artificielle de la trame de données, garantissant ainsi le calcul ultérieur de rendements logarithmiques ou d’indicateurs de volatilité dépourvus de biais d’échantillonnage.
7.3 Méthodes basées sur l’indexation et les plus proches voisins
Pandas déploie également un ensemble d’options d’interpolation dont la logique géométrique s’adosse directement aux grandeurs physiques représentées par l’index, qu’il soit continu, numérique ou spatial. La méthode method=’index’ (ou son équivalent method=’values’) ordonne à l’algorithme d’utiliser la valeur intrinsèque de l’index lui-même comme variable explicative indépendante pour évaluer la distance séparant les observations. Cela s’avère particulièrement utile lorsque l’index modélise une grandeur physique telle qu’une coordonnée spatiale (kilométrage sur un tracé ferroviaire, altitude le long d’un profil topographique ou profondeur dans un forage géologique), assurant que l’interpolation reflète la métrique spatiale réelle du phénomène sous-jacent.
Par ailleurs, pour des phénomènes caractérisés par des dynamiques en escalier ou des états stationnaires par morceaux, Pandas propose des méthodes d’approximation par palier telles que method=’nearest’, ‘zero’ ou ‘slinear’. La variante ‘nearest’ opère une projection géométrique simplifiée en attribuant à chaque cellule manquante la valeur de l’observation la plus proche selon la métrique de l’index, produisant un partitionnement analogue à un diagramme de Voronoï unidimensionnel. La méthode ‘zero’ applique quant à elle une fonction spline d’ordre zéro, maintenant la valeur constante jusqu’au point de bascule suivant.
Le choix raisonné entre ces formalismes d’approximation repose sur une compréhension approfondie de la nature du système étudié. Dans le cas d’une grandeur thermodynamique évoluant continûment sous l’effet de lois de diffusion, une spline cubique ou une interpolation linéaire continue constitue le choix méthodologique optimal. À l’inverse, si l’attribut modélise une consigne d’état discrète d’une vanne industrielle régulée par un automate programmable, toute interpolation curviligne constituerait une hérésie physique, l’approche par plus proche voisin ou maintien d’état constant représentant le seul formalisme en adéquation avec la cinématique réelle de l’équipement.
8. 8. Techniques de propagation séquentielle : Forward Fill et Backward Fill
8.1 La méthode ffill : Principe et limites empiriques
Au sein de la panoplie des techniques d’ingénierie des données séquentielles, la propagation vers l’avant, universellement désignée sous l’acronyme ffill (pour forward fill) ou sous sa formalisation académique LOCF (Last Observation Carried Forward), occupe une place prépondérante. Son principe algorithmique est d’une grande simplicité : dès qu’une valeur manquante est rencontrée dans la progression séquentielle d’une Série, l’algorithme réplique à l’identique la dernière observation valide immédiatement antérieure pour combler la cellule vide. Sous Pandas, cette opération est exécutable soit via l’instruction dédiée df.ffill(), soit via son alias historique df.fillna(method=’ffill’) ou encore à travers l’interpolation df.interpolate(method=’pad’).
La légitimité opérationnelle du ffill repose sur le postulat d’inertie temporelle ou d’état stationnaire persistant. Cette hypothèse est particulièrement fondée pour des variables de configuration industrielle, des données de prix administrés, des taux directeurs de banques centrales ou des inventaires de stocks qui conservent rigoureusement leur valeur d’assignation jusqu’à l’enregistrement délibéré d’une mise à jour événementielle. Dans ces architectures, une cellule non renseignée ne dénote pas une omission aléatoire ou une mesure continue inconnue, mais traduit simplement l’absence d’événement de changement d’état (traitement par flux d’événements).
Néanmoins, la transposition inconsidérée du mécanisme LOCF à des processus stochastiques dynamiques, continus ou volatils (tels que la valorisation d’actifs boursiers ou la surveillance de constantes physiologiques) engendre de sévères pathologies statistiques. Le risque majeur réside dans la création artificielle de faux plateaux de stabilité parfaite au sein de données intrinsèquement fluctuantes. En maintenant une grandeur inchangée sur des dizaines de pas d’observation, le ffill détruit artificiellement la variance locale, fausse les corrélations croisées avec d’autres variables réactives et injecte une auto-corrélation d’ordre 1 fallacieusement élevée, susceptible de biaiser lourdement les modèles de détection d’anomalies ou d’estimation de volatilité.
8.2 La méthode bfill : Rétro-propagation directionnelle
Symétrique exacte de la démarche précédente, la rétro-propagation directionnelle, désignée par l’instruction bfill (pour backward fill) ou le vocable académique NOCB (Next Observation Carried Backward), opère une substitution rétrograde. L’algorithme scanne la Série en sens inverse ou recherche pour toute coordonnée manquante la première valeur valide survenant chronologiquement dans le futur pour la projeter en amont. Cette fonctionnalité est accessible via les syntaxes df.bfill() ou df.fillna(method=’bfill’).
Dans l’ingénierie des données statiques transversales ou pour le traitement spécifique des cellules initiales vacantes d’un tableau d’observation (où aucun passé n’est disponible pour alimenter un ffill), le bfill remplit un rôle pragmatique évident d’égalisation structurelle. Il permet de stabiliser les données de cadrage historique préalable au démarrage officiel d’une campagne de mesures, garantissant que l’échantillon ne subit pas d’amputation prématurée de ses premières lignes.
Cependant, dans tout contexte impliquant l’apprentissage statistique supervisé ou l’analyse économétrique causale de séries temporelles, l’usage du bfill introduit un péril méthodologique rédhibitoire : la fuite d’information prospective (connue sous le terme anglophone de look-ahead bias ou violation de la causalité temporelle). En affectant à un instant t une grandeur qui ne sera observée et mesurée qu’à l’instant t + k, l’analyste confère au modèle prédictif une prescience artificielle des événements futurs. Un algorithme de trading algorithmique entraîné sur des données imputées par bfill apprendra à réagir à des mouvements de marché avant même que ceux-ci ne surviennent dans la réalité empirique, conduisant à des performances rétrospectives mirifiques en laboratoire, mais à des pertes financières catastrophiques dès le déploiement en conditions réelles d’exploitation.
8.3 Combinaison séquentielle et contraintes de seuillage
Pour surmonter les défaillances respectives des approches unilatérales, la pratique d’ingénierie avancée sous Pandas privilégie des stratégies composites articulant interpolation centrale et propagation séquentielle régulée aux bornes. Une séquence analytique standard et particulièrement robuste consiste à appliquer en premier lieu une interpolation linéaire destinée à résoudre l’ensemble des lacunes internes à la série, suivie séquentiellement d’un ffill pour combler les éventuelles extinctions terminales, puis d’un bfill résiduel pour saturer les absences initiales de début de série : df[‘colonne’] = df[‘colonne’].interpolate().ffill().bfill().
Cependant, une telle cascade de transformations ne saurait être laissée sans contrainte d’arrêt algorithmique, sous peine de diffuser des valeurs obsolètes sur des segments disproportionnés de l’échantillon. L’adjonction systématique du paramètre de seuillage limit constitue le garde-fou impératif de tout pipeline de production. En formulant par exemple df.ffill(limit=2), l’ingénieur s’assure qu’une observation ne pourra être maintenue que sur un maximum de deux pas de temps consécutifs. Au-delà de ce seuil de tolérance, le silence informationnel demeure ouvertement explicité par des valeurs NaN, prévenant l’accumulation pernicieuse de faux plateaux d’invariance.
Cette rigueur méthodologique permet de préserver l’intégrité de la structure dynamique des données sans sacrifier la complétude nécessaire à la modélisation. En bornant la portée de la propagation séquentielle, l’analyste contraint l’algorithme à n’opérer que sur des micro-discontinuités transitoires, tout en forçant l’architecture logicielle à router les pannes prolongées d’acquisition vers des mécanismes d’imputation multivariée plus sophistiqués, aptes à reconstruire la dynamique latente du système sans violer les lois de probabilité gouvernant la série.
9. 9. Approches multivariées et algorithmiques : Extension vers Scikit-Learn
9.1 Imputation par les k-plus proches voisins (KNNImputer)
Lorsque les interdépendances entre les différentes caractéristiques d’un jeu de données sont substantielles, les techniques univariées s’avèrent structurellement insuffisantes puisqu’elles négligent les covariances croisées. Pour franchir le cap de l’imputation multivariée, l’intégration de Pandas avec les modules spécialisés de Scikit-Learn s’avère incontournable. La première grande approche algorithmique multivariée repose sur l’estimateur des k-plus proches voisins, implémenté au sein de la classe sklearn.impute.KNNImputer. Cette méthode substitue à l’absence d’une cellule la moyenne pondérée ou arithmétique des valeurs prises par les observations les plus similaires au sein de l’espace multidimensionnel des descripteurs.
Sur le plan mathématique, le KNNImputer adapte le calcul de la distance euclidienne standard afin de pouvoir évaluer la proximité entre vecteurs comportant eux-mêmes des lacunes d’observation, en utilisant la métrique de distance de Gower ou la formulation euclidienne normalisée par les coordonnées partagées (Nan-Euclidean distance). Pour deux vecteurs u et v, la distance est calculée exclusivement sur le sous-ensemble des coordonnées où les deux entités sont simultanément renseignées, avec un facteur de mise à l’échelle compensant la dimensionnalité réduite : d(u, v) = sqrt( (nombre_total_features / nombre_features_communes) * somme((u_i – v_i)^2) ). Une fois les k voisins les plus proches identifiés dans ce sous-espace, la valeur imputée est synthétisée à partir de leurs observations respectives.
L’optimisation de l’hyperparamètre k constitue un arbitrage classique entre biais et variance : un k excessivement faible (par exemple k=1) rend l’imputation hypersensible au bruit de mesure local et aux valeurs aberrantes, tandis qu’un k trop large (tendant vers la taille de l’échantillon) dilue la spécificité locale pour converger vers la moyenne globale univariée. De surcroît, cette méthode impose un prérequis d’ingénierie strict : toutes les variables explicatives continues doivent être scrupuleusement standardisées ou normalisées (via StandardScaler ou MinMaxScaler) préalablement à l’imputation, faute de quoi les descripteurs présentant les plus grands ordres de grandeur domineraient arbitrairement le calcul métrique de proximité.
9.2 Imputation itérative multivariée par équations chaînées (MICE)
Le standard méthodologique le plus abouti en matière d’imputation multivariée conditionnelle réside dans l’approche itérative par équations chaînées, formalisée dans la littérature sous l’acronyme MICE (Multivariate Imputation by Chained Equations) et accessible dans Scikit-Learn via le module expérimental IterativeImputer. Cette approche modélise chaque variable présentant des valeurs manquantes comme une fonction récursive et paramétrique de l’ensemble des autres attributs composant la matrice de conception. Elle transcende les limites des modèles fermés en traitant l’incomplétude au moyen d’un processus de régression séquentiel à passages multiples.
Le mécanisme computationnel s’articule selon un cycle algorithmique rigoureux. Dans une phase d’initialisation, toutes les cellules manquantes du DataFrame reçoivent une imputation univariée sommaire (généralement la moyenne). Puis, de manière séquentielle, chaque variable cible est à son tour « dé-imputée » pour restaurer ses absences initiales, et un modèle de régression (par défaut une régression bayésienne de type BayesianRidge, mais pouvant être paramétré avec des forêts aléatoires ou du gradient boosting) est ajusté sur les observations où cette cible est valide, en utilisant toutes les autres variables comme prédicteurs. Le modèle prédictif ainsi calibré génère une prédiction d’imputation pour les cellules manquantes de la variable cible. Ce balayage en boucle (round-robin) est répété à travers l’ensemble des variables pour achever un cycle d’itération.
L’opération est ensuite réitérée sur plusieurs cycles (typiquement de 10 à 20 itérations) jusqu’à ce que les paramètres estimés atteignent un seuil de convergence déterministe. La supériorité épistémologique de l’imputation itérative réside dans son aptitude exceptionnelle à préserver avec une fidélité mathématique remarquable l’intégralité de la matrice de variance-covariance et les structures de dépendances non-linéaires complexes existant entre les descripteurs. Contrairement aux approches simplistes, MICE maintient les corrélations naturelles entre variables, évitant la dénaturation de l’espace multidimensionnel qui vicierait toute inférence statistique ou modélisation ultérieure.
9.3 Réintégration et harmonisation avec le DataFrame d’origine
L’utilisation des transformateurs d’imputation de Scikit-Learn génère une rupture technique qu’il convient de gérer avec minutie au sein des pipelines Python. Par construction architecturale, les méthodes fit_transform() de Scikit-Learn acceptent des DataFrames Pandas en entrée, mais expulsent en sortie des tableaux matriciels NumPy purs (numpy.ndarray). Cette transformation sous-jacente entraîne la perte immédiate des métadonnées essentielles du DataFrame : les index d’échantillonnage (qu’ils soient temporels ou textuels), les dénominations textuelles des colonnes ainsi que le typage strict des données (dtypes) sont intégralement éradiqués au profit d’une matrice uniforme de flottants.
Le praticien doit donc opérer une réintégration structurelle et une harmonisation post-imputation rigoureuse afin de restituer l’intégrité de l’objet Pandas d’origine. Cette réassignation s’opère canoniquement par l’instanciation explicite d’un nouveau DataFrame encapsulant la matrice NumPy imputée, tout en lui réinjectant formellement l’index original et les colonnes préservées : df_imputed = pd.DataFrame(data=imputer.fit_transform(df), index=df.index, columns=df.columns). Cette précaution garantit l’alignement dimensionnel parfait des matrices et prévient toute désynchronisation lors d’éventuelles jointures ou concaténations subséquentes.
Enfin, une vérification scrupuleuse des types de données s’impose à l’issue de cette réintégration. Des variables catégorielles ou discrètes jadis encodées en entiers ou en chaînes de caractères, temporairement converties en flottants continus pour satisfaire aux exigences computationnelles des équations matricielles de l’imputeur, doivent faire l’objet d’un transtypage de restitution (casting). L’application de méthodes telles que df_imputed[‘identifiant’] = df_imputed[‘identifiant’].round().astype(‘Int64’) permet de rétablir les formats adéquats, évitant l’introduction de valeurs décimales fantaisistes au sein de descripteurs à cardinalité finie et garantissant la conformité stricte du jeu de données pour les phases aval de l’ingénierie logicielle.
10. 10. Analyse d’impact statistique et validation des données imputées
10.1 Évaluation de la préservation de la distribution originale
La complétion intégrale d’un jeu de données ne marque nullement l’achèvement du protocole d’ingénierie ; elle inaugure la phase critique de contrôle de validité statistique. Tout acte d’imputation constituant une manipulation artificielle du substrat empirique, il est méthodologiquement impératif d’évaluer dans quelle mesure l’intervention a déformé la distribution de probabilité des variables traitées. Cette auscultation débute par la comparaison minutieuse des quatre premiers moments statistiques fondamentaux calculés avant et après traitement : l’espérance mathématique (moyenne), la dispersion (variance ou écart-type), l’asymétrie (skewness) et l’aplatissement (kurtosis).
Une altération substantielle de ces indicateurs d’ordre supérieur signale l’introduction de distorsions méthodologiques sévères. Si l’écart-type post-imputation s’affaisse de manière disproportionnée par rapport à l’échantillon brut, ou si le kurtosis explose (témoignant d’une concentration anormale au voisinage de la valeur d’imputation), l’analyste doit immédiatement remettre en question la méthode mise en œuvre. Au-delà des métriques descriptives scalaires, la réalisation formelle de tests d’adéquation de distribution non paramétriques, au premier rang desquels le test de Kolmogorov-Smirnov à deux échantillons, permet de quantifier rigoureusement la distance suprémum existant entre la fonction de répartition empirique originelle et celle issue de l’imputation.
Cette validation paramétrique gagne à être systématiquement adossée à une inspection visuelle par superposition des fonctions de densité de probabilité (estimées par la méthode du noyau ou KDE). Le tracé comparatif conjoint de la courbe de densité des données observées valides et de celle de la série imputée finale permet de démasquer instantanément les pathologies d’ingénierie : formation de singularités artificielles, distorsion des queues de distribution ou déplacement pernicieux des modes statistiques. Une imputation méthodologiquement irréprochable doit idéalement se fondre dans la topologie distributionnelle native sans générer d’artefacts morphologiques discordants.
10.2 Conservation de la matrice de corrélation
L’impact d’une imputation ne saurait être évalué sous l’angle exclusif de chaque variable considérée isolément ; il doit obligatoirement intégrer l’analyse des interactions multivariées. L’un des risques les plus pernicieux des approches univariées simples (moyenne, médiane, interpolation élémentaire décorrélée) réside dans l’atténuation drastique de la force des liaisons statistiques inter-variables. En remplaçant des valeurs manquantes par des scalaires constants ou des trajectoires affines unidimensionnelles, l’analyste injecte une indépendance artificielle qui dilue mécaniquement la covariance empirique liant la variable imputée à l’ensemble des autres prédicteurs du modèle.
Pour mesurer cette dégradation, l’analyste procède au calcul comparatif des matrices de corrélation linéaire de Pearson et de corrélation de rang de Spearman avant et après la chaîne de traitement, via la primitive df.corr(). Le calcul différentiel matérialisé par matrice_delta = df_impute.corr() – df_original.corr() génère une matrice des écarts qui met en exergue les affaiblissements ou, à l’inverse, les amplifications artificielles de liaisons statistiques induites par la remédiation. Des déviations excédant un seuil empirique de 0.05 ou 0.10 sur les coefficients de corrélation majeurs doivent être interprétées comme une alerte méthodologique critique.
Les répercussions pratiques de cette dénaturation de la covariance se manifestent violemment lors de l’estimation de modèles économétriques ou d’apprentissage supervisé. Dans une régression linéaire multiple, l’atténuation de la corrélation entre un régresseur majeur et la variable cible biaise systématiquement le coefficient de régression associé vers zéro (phénomène de biais d’atténuation). Réciproquement, si une méthode d’imputation mal conditionnée amplifie la colinéarité entre deux prédicteurs indépendants, elle peut déclencher des instabilités numériques majeures, gonfler l’inflation de la variance (VIF – Variance Inflation Factor) et rendre erratique l’interprétabilité des coefficients de décision du modèle final.
10.3 Validation croisée et évaluation sur valeurs masquées
Pour s’affranchir des conjectures subjectives et départager de manière objective plusieurs stratégies d’imputation concurrentes (par exemple, arbitrer entre une spline cubique, un KNNImputer ou un IterativeImputer), la démarche scientifique prescrit le déploiement d’un protocole expérimental de validation croisée sur valeurs masquées artificiellement. Ce paradigme d’évaluation empirique repose sur la création d’un banc d’essai contrôlé au sein duquel la « vérité terrain » (ground truth) est rigoureusement connue et documentée.
Le protocole opératoire s’articule selon une séquence déterministe. L’analyste extrait en premier lieu le sous-ensemble des observations rigoureusement complètes du DataFrame d’origine. Au sein de cette matrice témoin saine, il injecte de façon synthétique un patron de valeurs manquantes (généralement calibré à hauteur de 10 % à 20 % des cellules) selon un mécanisme probabiliste contrôlé (MCAR ou MAR). Les différentes méthodes d’imputation candidates sont ensuite déployées sur ce jeu de données artificiellement amputé pour reconstruire les cellules ciblées.
L’évaluation comparative s’effectue dès lors par le calcul de métriques d’erreur déterministes confrontant directement les grandeurs réelles originelles aux valeurs estimées par chaque algorithme d’imputation. Les critères d’arbitrage usuels mobilisent l’erreur absolue moyenne (MAE – Mean Absolute Error), la racine carrée de l’erreur quadratique moyenne (RMSE – Root Mean Squared Error) ou l’erreur absolue moyenne en pourcentage (MAPE). La méthode d’imputation minimisant de façon statistiquement significative ces métriques d’écart sur les données masquées sera dès lors désignée comme l’architecture de remédiation optimale à déployer sur les véritables données lacunaires du projet.
11. 11. Risques méthodologiques, fuites de données et reproductibilité scientifique
11.1 La fuite d’information (Data Leakage) lors du prétraitement
Dans l’ingénierie contemporaine de l’apprentissage automatique, la fuite d’information préalable à l’apprentissage (couramment désignée sous le terme anglophone de data leakage) représente l’un des pièges méthodologiques les plus destructeurs et les plus répandus. Cette pathologie survient dès lors que des informations statistiques issues du jeu de test ou de validation contaminent indûment le processus d’entraînement du modèle algorithmique. L’imputation mal conduite constitue l’un des principaux vecteurs de cette compromission épistémologique lorsque l’analyste exécute le nettoyage des données globalement sur l’ensemble de la table avant de procéder au partitionnement d’échantillonnage (train-test split).
Illustrons formellement ce mécanisme : si un praticien calcule la moyenne, la médiane ou ajuste un modèle régressif multivarié MICE sur l’intégralité du DataFrame avant de séparer ses ensembles d’entraînement et de test, les paramètres statistiques d’imputation injectés dans les données d’entraînement encapsulent déjà la distribution, la variance et les extrema des données de test. En conséquence, les métriques d’évaluation de la performance prédictive calculées ultérieurement sur le jeu de test seront artificiellement optimistes, masquant une incapacité structurelle du modèle à généraliser ses inférences face à des données réelles totalement inédites. L’interdiction formelle d’interpoler ou d’imputer un jeu de données global sans ségrégation préalable constitue un dogme méthodologique inaliénable.
La remédiation rigoureuse à cet écueil exige l’encapsulation de l’ensemble du protocole d’imputation au sein d’objets logiciels de type Pipeline (fournis par Scikit-Learn ou des architectures logicielles équivalentes). Dans cette structure, l’imputeur est calibré exclusivement sur le sous-ensemble d’entraînement via la méthode fit(), extrayant uniquement de cette fraction les indicateurs d’ancrage (moyennes, coefficients régressifs ou graphes de voisins). La méthode transform() applique ensuite de manière strictement passive ces règles préétablies sur le jeu d’entraînement puis sur le jeu de test indépendant, sanctuarisant ainsi l’étanchéité informationnelle absolue nécessaire à la validité scientifique des expérimentations.
11.2 L’illusion de complétude et la sous-estimation de l’incertitude
L’un des biais cognitifs et statistiques les plus insidieux induits par l’usage intensif de Pandas réside dans ce que les théoriciens de la statistique nomment « l’illusion de complétude ». Lorsqu’une instruction telle que df.interpolate() ou df.fillna() a été exécutée avec succès, le DataFrame ne renvoie plus aucun marqueur NaN, conférant à la matrice un aspect visuel et computationnel de perfection achevée. L’analyste est dès lors enclin à manipuler ces données reconstruites comme s’il s’agissait de mesures certaines et parfaitement observables, oubliant que chaque cellule imputée n’est en réalité qu’une conjecture probabiliste entachée d’une erreur d’estimation latente.
Cette cécité méthodologique engendre une pathologie paramétrique documentée : la sous-estimation systématique de l’incertitude. Tout processus d’imputation simple (dite imputation déterministe ou unique) substitue un point scalaire unique à une distribution d’incertitude conditionnelle. En traitant cette valeur prédite comme une observation fixe exempte d’aléa, les modèles statistiques avals calculent des résidus artificiellement resserrés, ce qui majore fallacieusement la précision des paramètres estimés. Les matrices de covariance des estimateurs s’en trouvent artificiellement comprimées, les intervalles de confiance deviennent trop étroits et les taux de fausses découvertes (erreurs de type I) explosent au détriment de la réplicabilité scientifique des résultats.
Pour contrecarrer cette défaillance inhérente à l’imputation déterministe unique, Donald Rubin a formalisé le paradigme de l’imputation multiple. Ce cadre théorique ne génère pas un jeu de données complété unique, mais un ensemble de m jeux de données distincts (généralement m compris entre 5 et 20), au sein desquels chaque cellule manquante reçoit une valeur issue d’un tirage stochastique tiré de la distribution prédictive postérieure d’imputation. L’analyse statistique d’intérêt est ensuite exécutée indépendamment sur chacun des m jeux complets, et les résultats finaux sont combinés via les célèbres « règles de Rubin » (Rubin’s rules). Cette approche permet de décomposer la variance totale de l’estimation en deux termes orthogonaux : la variance intra-imputation (reflétant l’aléa d’échantillonnage standard) et la variance inter-imputations (capturant formellement l’incertitude additionnelle directement attribuable à l’incomplétude des données initiales).
11.3 Auditabilité et traçabilité du pipeline d’ingénierie
Dans un contexte réglementaire et scientifique de plus en plus exigeant quant à la gouvernance, à l’explicabilité et à la reproductibilité des modèles algorithmiques (à l’instar des réglementations bancaires de Bâle ou des directives européennes sur l’intelligence artificielle), altérer silencieusement des données brutes au sein d’un DataFrame constitue une pratique prohibée. L’ingénieur doit garantir une auditabilité intégrale de la trajectoire subie par chaque cellule d’observation. Cela implique qu’à tout instant du cycle de vie des données, un auditeur ou un système de contrôle doive être en mesure de discriminer sans équivoque une mesure originelle d’une donnée reconstruite artificiellement par un algorithme d’interpolation.
La formalisation technique de cette traçabilité sous Pandas s’articule autour de la génération explicite de variables indicatrices de substitution, fréquemment implémentées via la classe MissingIndicator de Scikit-Learn ou par l’assignation vectorisée de colonnes booléennes miroirs : df[‘colonne_was_missing’] = df[‘colonne’].isna(). La préservation de ces métadonnées d’absence offre un double bénéfice méthodologique. D’une part, elle permet de documenter précisément l’historique d’assainissement de la base. D’autre part, elle fournit aux algorithmes de modélisation supervisée une information prédictive explicite : le fait même qu’une donnée ait été manquante constitue fréquemment en soi un descripteur informatif puissant quant à l’état du système (signalant une vulnérabilité d’un capteur ou une réticence révélatrice d’un utilisateur).
Enfin, la gouvernance du pipeline requiert la documentation formelle et le versionnement strict de l’ensemble des hyperparamètres mobilisés pour l’imputation. Les constantes scalaires retenues (valeurs des moyennes, médianes d’entraînement, ordres des polynômes d’interpolation, nombre de voisins k) doivent être sérialisées sous forme de métadonnées associées au modèle de production. L’emploi d’outils de traçabilité d’expériences logicielles (tels que MLflow ou DVC – Data Version Control) garantit que tout déploiement ultérieur d’un script d’imputation s’exécutera dans des conditions déterministes rigoureusement identiques, condition sine qua non de la reproductibilité scientifique et de la conformité industrielle.
12. 12. Guide décisionnel et protocole standardisé d’imputation sous Pandas
12.1 Arbre de décision pour le choix de la méthode idoine
Afin de synthétiser les arbitrages théoriques et pratiques exposés tout au long de ce traité, la sélection d’une méthode d’imputation au sein de l’écosystème Pandas doit être adossée à un arbre de décision rigoureux, structuré par la nature mathématique des descripteurs, l’agencement topologique des observations et le mécanisme probabiliste d’absence sous-jacent. Le premier embranchement discriminant réside dans la structure séquentielle de l’échantillon. Si les données s’inscrivent dans une série chronologique ou longitudinale continue indexée à intervalles constants ou mesurables :
- Pour des micro-lacunes transitoires (de 1 à 3 pas d’échantillonnage) au sein d’une variable physique continue : privilégier l’interpolation linéaire (interpolate(method=’linear’)) ou temporelle (method=’time’ si l’espacement chronologique est irrégulier).
- Pour des dynamiques harmoniques, ondulatoires ou fluides documentées par les lois du domaine : mobiliser une interpolation par spline cubique d’ordre restreint (method=’spline’, order=3), en contrôlant scrupuleusement les oscillations aux frontières.
- Pour des variables d’état discret, de configuration événementielle ou de paliers administratifs : appliquer la propagation séquentielle régulée vers l’avant (ffill(limit=K)), complétée par un comblement rétrograde résiduel pour les bornes initiales.
Si les données sont de nature transversale pure (coupes instantanées d’observations indépendantes) :
- Pour des variables quantitatives continues sous mécanisme MCAR avec un taux d’incomplétude marginal (inférieur à 3 %) : l’imputation univariée par la moyenne (si distribution gaussienne symétrique) ou par la médiane robuste (si présence d’asymétrie ou d’outliers) offre une solution parcimonieuse acceptable.
- Pour des variables qualitatives nominales ou ordinales à très faible taux de manque : retenir le mode statistique univarié (mode()[0]) ou conditionnel groupé via groupby().
- Pour des ensembles de données complexes présentant un taux d’incomplétude intermédiaire (de 5 % à 30 %) sous mécanisme MAR avec de fortes corrélations structurelles : déployer impérativement des méthodes algorithmiques multivariées, en arbitrant entre KNNImputer (idéal pour les espaces métriques continus standardisés de taille modérée) et IterativeImputer / MICE (optimal pour préserver la structure globale de covariance et les dépendances paramétriques complexes).
- Pour des variables présentant une incomplétude structurelle excédant 40 % à 50 % : envisager formellement l’abandon pur et simple de l’attribut (suppression de colonne), l’imputation dans ces volumes d’absence injectant davantage de bruit méthodologique que d’information exploitable.
12.2 Modèle d’implémentation fonctionnelle standardisée
Pour transposer ces préceptes au sein des architectures logicielles de production, il est recommandé de modulariser le protocole d’ingénierie sous la forme d’un pipeline fonctionnel réutilisable et auditable. Ce composant logiciel standardisé doit encapsuler successivement le diagnostic d’incomplétude, la validation des préconditions dimensionnelles, l’exécution contrôlée de l’algorithme retenu et la génération d’un rapport de synthèse des mutations opérées. Une telle fonction prévient les dérives de codage manuel récurrentes et garantit l’homogénéité du traitement des données au sein des équipes de science des données.
L’architecture logique d’une telle fonction d’imputation industrielle peut être formalisée conceptuellement à travers les étapes procédurales suivantes :
- Phase d’audit préliminaire : Analyse des types de colonnes (numériques versus catégorielles), mesure des taux d’incomplétude respectifs, détection de la nature temporelle ou arbitraire de l’index et génération d’une copie isolée du DataFrame pour prévenir les effets de bord de mémoire partagée.
- Contrôle des préconditions : Vérification de l’absence de colonnes intégralement vides (qui feraient échouer les algorithmes d’interpolation ou d’estimation régressive) et notification explicite des avertissements si certaines variables dépassent les seuils critiques de tolérance d’absence.
- Création des indicateurs d’absence : Génération automatisée de colonnes booléennes d’audit (_missing_flag) documentant formellement les coordonnées spatiales de chaque imputation pour assurer la traçabilité complète du pipeline.
- Exécution conditionnelle de l’algorithme : Application de l’interpolation séquentielle (avec limitation de propagation via limit) sur les séries temporelles déclarées, ou instanciation d’un estimateur Scikit-Learn (tel que IterativeImputer) pour les matrices transversales, avec reconversion automatique des types en sortie d’algorithme.
- Validation distributionnelle post-traitement : Calcul différentiel des moments statistiques (moyennes, écarts-types) entre les données d’entrée et de sortie, puis émission d’un rapport de logs confirmant le rétablissement de la complétude intégrale (absence résiduelle égale à zéro) sans distorsion anormale de la variance.
Cette approche fonctionnelle garantit une résilience logicielle optimale, permettant d’intégrer le traitement de l’incomplétude au sein de flux de travail orchestrés (tels qu’Airflow, Prefect ou des pipelines Kubeflow) avec un niveau de robustesse technique et de traçabilité statistique répondant aux exigences des environnements industriels critiques.
12.3 Perspectives et synthèses des pratiques exemplaires
Au terme de cette analyse exhaustive du traitement de l’incomplétude des données au moyen de la bibliothèque Pandas, il convient de souligner que l’imputation statistique ne constitue jamais un acte neutre. Remplacer une valeur absente consiste fondamentalement à injecter une hypothèse théorique au cœur d’un tableau d’observations empiriques. Si la syntaxe de Pandas rend ces opérations d’une remarquable simplicité computationnelle (qu’il s’agisse de l’appel d’un fillna(), d’un ffill() ou de l’instruction interpolate()), la responsabilité méthodologique finale incombe intégralement au praticien, qui doit constamment confronter l’élégance du code aux réalités probabilistes du phénomène physique ou social sous-jacent.
Dans la restitution académique ou industrielle des résultats modélisés, l’intégrité scientifique exige une transparence totale sur les protocoles d’ingénierie déployés. Toute publication de modèle de recherche ou tout rapport d’évaluation décisionnelle devrait obligatoirement comporter un paragraphe méthodologique détaillant la proportion initiale de données manquantes, les arguments fondant l’hypothèse de mécanisme d’absence (MCAR, MAR ou MNAR), la justification formelle du choix de l’algorithme d’imputation retenu et l’évaluation de son impact sur la variance et la colinéarité des prédicteurs finaux.
Enfin, le champ de la réhabilitation des données continue d’évoluer rapidement au-delà des méthodes déterministes classiques. Les frontières actuelles de la recherche explorent avec succès l’apport des modèles génératifs profonds, tels que les réseaux antagonistes génératifs dédiés à l’imputation (GAIN – Generative Adversarial Imputation Networks) ou les auto-encodeurs variationnels (VAE). Ces architectures neuronales avancées apprennent la distribution conjointe complexe de matrices hautement dimensionnelles pour échantillonner des imputations non-linéaires d’un réalisme stupéfiant, ouvrant de nouvelles perspectives fascinantes pour la science des données de demain. Face à ces révolutions algorithmiques à venir, la maîtrise rigoureuse des structures matricielles de Pandas et des fondements de la théorie de l’incomplétude demeurera, pour tout ingénieur et chercheur quantitatif, le socle de compétences indispensable pour transformer l’incertitude des données en certitude d’analyse.
Références
- Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Buuren, S. van. (2018). Flexible Imputation of Missing Data (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429492259
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153-161. https://doi.org/10.2307/1912352
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198-1202. https://doi.org/10.1080/01621459.1988.10478722
- Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). Austin, TX. https://doi.org/10.25080/Majora-92bf1922-00a
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-592. https://doi.org/10.1093/biomet/63.3.581
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. John Wiley & Sons. https://doi.org/10.1002/9780470316696
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Yoon, J., Jordon, J., & Schaar, M. (2018). GAIN: Missing data imputation using generative adversarial nets. In International Conference on Machine Learning (pp. 5689-5698). PMLR. https://proceedings.mlr.press/v80/yoon18a.html