
La modélisation des phénomènes stochastiques constitue le socle méthodologique sur lequel repose l’ensemble des sciences contemporaines, qu’il s’agisse de la physique statistique, de l’économétrie, de l’épidémiologie ou des sciences du comportement. Au centre de cet édifice probabiliste se dresse la distribution normale, communément qualifiée de courbe en cloche ou de courbe de Gauss. Découverte initialement par Abraham de Moivre au début du dix-huitième siècle dans le cadre de l’approximation des probabilités binomiales, puis approfondie par Carl Friedrich Gauss et Pierre-Simon de Laplace pour la formalisation des erreurs d’observation astronomiques, cette fonction mathématique singulière transcende les frontières disciplinaires grâce à ses propriétés d’invariance et de convergence universelle.
Dans la recherche empirique moderne et en particulier en psychométrie, la courbe en cloche n’est pas un simple artefact géométrique : elle matérialise l’hypothèse fondamentale selon laquelle les variations individuelles observées autour d’une tendance centrale résultent de l’agrégation d’une myriade de micro-facteurs indépendants et non corrélés. Qu’il s’agisse de mesurer des aptitudes cognitives, des traits de personnalité latents ou des temps de réaction neuromoteurs, la distribution gaussienne sert d’étalon universel pour convertir des scores bruts hétérogènes en grandeurs standardisées, interprétables et comparables à l’échelle de populations entières.
Avec l’essor de la science des données et de l’informatique scientifique, la maîtrise des outils computationnels permettant de modéliser, de manipuler et de restituer graphiquement la courbe en cloche est devenue une compétence cardinale. L’écosystème du langage Python, propulsé par des bibliothèques hautement optimisées telles que NumPy, SciPy et Matplotlib, offre aux chercheurs un environnement d’une puissance sans précédent pour automatiser la visualisation de distributions théoriques et empiriques. Ce guide exhaustif explore de manière rigoureuse les fondements mathématiques, les implications psychométriques et les protocoles algorithmiques permettant de générer, d’annoter et d’exporter des courbes en cloche de standard publication.
1. Fondements mathématiques et pertinence de la courbe en cloche
1.1 Définition analytique de la distribution normale
Sur le plan purement analytique, la distribution normale univariée est définie par une fonction de densité de probabilité continue, notée traditionnellement f(x), dont le domaine de définition s’étend sur l’ensemble de la droite des nombres réels. La formulation mathématique exacte de cette fonction fait intervenir la constante d’Euler ainsi que le nombre pi dans une relation exponentielle quadratique. Pour une variable aléatoire continue X caractérisée par une espérance mathématique notée μ et une variance σ², la densité de probabilité s’énonce selon l’équation canonique où l’inverse du produit de l’écart-type par la racine carrée de deux fois pi sert de constante de normalisation, garantissant que l’intégrale impropre de la fonction sur l’intervalle infini converge strictement vers l’unité.
Les deux paramètres fondamentaux, μ (paramètre de localisation ou d’espérance) et σ (paramètre d’échelle ou d’écart-type), gouvernent intégralement l’architecture géométrique de la courbe. L’espérance μ détermine l’axe de symétrie bilatérale parfait : pour tout écart delta positif, la valeur de la fonction en μ moins delta équivaut exactement à sa valeur en μ plus delta. Cette symétrie parfaite implique la coïncidence géométrique absolue de la moyenne arithmétique, de la médiane et du mode au point d’abscisse central. Parallèlement, l’écart-type σ, qui quantifie la dispersion des valeurs autour de la moyenne, régit la hauteur du sommet central ainsi que la courbure générale du tracé. Plus σ est réduit, plus le pic central s’élève pour préserver une surface unitaire sous la courbe.
L’analyse différentielle de la fonction de densité met en lumière des caractéristiques structurelles cruciales. La dérivée première s’annule précisément en x = μ, marquant l’unique extremum global de la fonction, qui est son sommet modal. La dérivée seconde, quant à elle, s’annule aux points d’abscisses situés exactement à une distance d’un écart-type de l’espérance, c’est-à-dire en x = μ – σ et en x = μ + σ. Ces coordonnées correspondent aux points d’inflexion géométriques de la courbe, où le tracé passe d’une concavité orientée vers le bas à une convexité orientée vers le haut. De surcroît, les queues de distribution décroissent exponentiellement vers zéro sans jamais toucher l’axe horizontal, manifestant un comportement asymptotique bilatéral d’ordre quadratique.
La prééminence statistique de la courbe en cloche puise sa légitimité théorique suprême dans le théorème central limite. Ce théorème fondamental stipule que la somme, ou par extension la moyenne arithmétique, d’un nombre suffisamment élevé de variables aléatoires indépendantes et identiquement distribuées tend asymptotiquement vers une distribution gaussienne, indépendamment de la loi de probabilité originelle des variables sous-jacentes, sous réserve d’une variance finie. En métrologie et dans l’observation des grandeurs physiques et comportementales, cette loi limite explique pourquoi les erreurs de mesure non systématiques et les scores composites présentent spontanément une morphologie en cloche.
1.2 Applications de la loi normale en sciences psychologiques
Dans l’univers des sciences psychologiques, de la psychométrie et de la recherche comportementale, la distribution gaussienne constitue l’armature conceptuelle de la théorie classique des tests. La modélisation des traits latents repose en grande partie sur l’hypothèse que les capacités cognitives ou les dimensions structurales de la personnalité sont distribuées de manière continue au sein de la population générale. L’archétype le plus notoire de cette formalisation demeure l’étalonnage du quotient intellectuel standardisé issu des échelles de Wechsler, où la distribution théorique est paramétrée artificiellement avec une espérance μ égale à 100 et un écart-type σ fixé à 15 points.
Cette standardisation métrique permet aux cliniciens et aux chercheurs d’opérer une distinction rigoureuse entre la variabilité aléatoire inhérente à l’échantillonnage et les véritables variations interindividuelles relatives au construit psychologique ciblé. Sans cette distribution de référence, un score brut obtenu à un questionnaire d’évaluation de l’anxiété ou à une tâche d’attention soutenue serait dépourvu de signification universelle. En projetant les scores bruts sur la distribution normale par le biais de la transformation en notes centrées réduites ou scores Z, les psychologues peuvent situer un individu par rapport à un percentile précis, quantifiant ainsi la rareté clinique d’un profil cognitif ou émotionnel.
Au-delà de l’étalonnage psychométrique, l’hypothèse de normalité univariée et multivariée conditionne l’application de la quasi-totalité des méthodes d’inférence statistique paramétrique. Qu’il s’agisse de conduire une analyse de variance, d’estimer un modèle de régression linéaire multiple ou d’ajuster des modèles d’équations structurelles, la validité des tests statistiques de Student et de Fisher repose sur l’hypothèse que les résidus du modèle se distribuent selon une loi gaussienne. Dès lors, la capacité d’examiner visuellement et empiriquement l’adéquation d’un échantillon expérimental avec une courbe en cloche théorique devient un prérequis méthodologique absolu pour tout chercheur en sciences humaines.
1.3 Objectifs computationnels de la visualisation en Python
La transposition de la formulation analytique abstraite de la courbe de Gauss vers un graphique exploitable requiert une chaîne computationnelle éprouvée. Dans le contexte de la recherche académique contemporaine, la crise de la reproductibilité a mis en exergue les failles inhérentes aux logiciels propriétaires fonctionnant par interfaces graphiques interactives opaques. À l’inverse, l’élaboration de scripts en langage Python offre une traçabilité totale, permettant à la communauté scientifique de relire, d’exécuter et de répliquer à l’identique chaque étape de la génération graphique, depuis le calcul infinitésimal des ordonnées jusqu’au rendu stylistique final.
Le deuxième objectif computationnel concerne la précision du rendu géométrique et typographique. La communication scientifique de haut niveau exige des figures vectorielles dépourvues de tout artefact de pixelisation, respectant fidèlement les proportions mathématiques de la densité de probabilité. Les bibliothèques graphiques de l’écosystème Python permettent de contrôler au pixel près la résolution spatiale, les marges de délimitation, l’intégration des équations en syntaxe LaTeX et la cohérence des formats d’exportation requis par les comités éditoriaux des revues internationales de premier rang.
Enfin, le recours à Python établit un pont continu entre l’analyse descriptive préliminaire, l’ajustement de modèles statistiques complexes et la visualisation terminale. Au lieu de dissocier l’étape du calcul analytique de celle de la représentation graphique au moyen d’outils disparates, le chercheur intègre l’ensemble de sa démarche dans un unique pipeline programmatique. Cette synergie optimise non seulement le flux de travail mais diminue drastiquement le risque d’erreurs manuelles lors du transfert de jeux de données psychométriques volumineux.
2. Configuration de l’écosystème Python et gestion des dépendances
2.1 Installation et importation des bibliothèques clés
L’exécution fluide et professionnelle de visualisations statistiques en Python nécessite l’édification d’un environnement d’exécution sain, découplé de l’installation système globale. L’emploi d’environnements virtuels standardisés, créés au moyen de l’utilitaire natif venv ou du gestionnaire de paquets spécialisé Conda, prévient les conflits de versions entre les dépendances et garantit une étanchéité logicielle optimale. Pour un projet axé sur la statistique mathématique et le tracé graphique, trois bibliothèques fondamentales forment le socle incontournable : NumPy, SciPy et Matplotlib.
Le module NumPy représente la pierre angulaire du calcul numérique en Python. Grâce à sa structure de tableau multidimensionnel compilée en langage C, NumPy effectue des opérations vectorielles avec une rapidité d’exécution incomparable, éliminant les lenteurs associées aux boucles itératives natives de Python. Dans notre contexte, il interviendra principalement pour générer des grilles continues d’abscisses et pour calculer les statistiques descriptives fondamentales sur les scores expérimentaux.
La bibliothèque SciPy, et plus particulièrement son sous-module stats, héberge l’ensemble des distributions de probabilité continues et discrètes nécessaires à la recherche quantitative. Contrairement à une réimplémentation manuelle de l’équation gaussienne susceptible de comporter des instabilités numériques ou des erreurs d’arrondi, scipy.stats.norm encapsule des routines de calcul hautement optimisées et testées unitairement pour évaluer la densité, la fonction de répartition cumulative et les quantiles théoriques.
Enfin, Matplotlib, complété éventuellement par Seaborn, agit comme le moteur de rendu graphique vectoriel par excellence. Son interface orientée objet confère au programmeur une autorité totale sur l’arborescence des figures, depuis la granularité des repères sur les axes jusqu’à la transparence des calques d’ombrage. L’importation conventionnelle de ces modules dans un script Python s’effectue traditionnellement sous leurs alias consacrés : import numpy as np, from scipy import stats et import matplotlib.pyplot as plt.
2.2 Gestion des versions et reproductibilité des calculs
La pérennité d’un protocole d’analyse de données exige une gestion scrupuleuse des versions des modules mobilisés. L’évolution continue des bibliothèques scientifiques entraîne parfois des dépréciations d’arguments ou des modifications subtiles dans le moteur de rendu typographique. L’archivage formel de la configuration au sein d’un fichier requirements.txt ou d’un fichier d’environnement Conda au format YAML permet à n’importe quel chercheur tiers de réinstancier l’écosystème technique exact ayant servi à l’élaboration des figures publiées.
Au-delà de la stratification logicielle, la reproductibilité des calculs stochastiques implique l’initialisation déterministe des générateurs de nombres pseudo-aléatoires. Lorsqu’un tracé graphique inclut une distribution empirique simulée pour émuler une cohorte de sujets en psychologie cognitive, l’absence de fixation de la graine aléatoire aboutit à des figures légèrement discordantes à chaque réexécution du code. L’appel à la fonction np.random.seed(), ou l’instanciation moderne d’un générateur via np.random.default_rng(seed), sanctuarise les tirages aléatoires et assure une fidélité visuelle immuable.
De plus, l’adoption des conventions stylistiques préconisées par la proposition d’amélioration PEP 8 constitue un impératif déontologique. La lisibilité d’un script scientifique conditionne son auditabilité par les pairs : respect des espacements normés autour des opérateurs arithmétiques, nomenclature explicite des variables (évitant les lettres isolées polysémiques au profit de termes tels que moyenne_theorique ou vecteur_abscisses), et segmentation du code en sections logiques indépendantes améliorent considérablement la robustesse logicielle globale.
3. Génération de l’abscisse et calcul analytique de la densité
3.1 Création du vecteur des abscisses avec NumPy
L’obtention d’une courbe en cloche visuellement lisse et mathématiquement fidèle requiert la discrétisation ordonnée d’un segment fini de la droite réelle. Bien que la loi normale s’étende théoriquement jusqu’aux infinis négatif et positif, l’amplitude de la densité devient numériquement négligeable dès que l’on s’écarte de plus de quatre à cinq écarts-types de la moyenne. Pour calibrer le domaine d’observation graphique, il est donc coutumier de définir des bornes d’échantillonnage circonscrites entre μ – 4σ et μ + 4σ, cet intervalle englobant plus de 99,99 % de la masse de probabilité totale.
NumPy met à la disposition du programmeur deux fonctions principales pour orchestrer cette discrétisation : np.arange et np.linspace. Bien que np.arange permette de spécifier explicitement un pas d’incrémentation fixe entre les coordonnées successives, cette méthode peut occasionner de légères dérives d’arrondi en virgule flottante sur les bornes d’arrêt. C’est pourquoi la fonction np.linspace lui est universellement préférée dans les environnements de publication scientifique. En précisant la valeur initiale, la valeur finale et le nombre total d’intervalles discrets souhaités, np.linspace garantit une inclusion rigoureuse des frontières du domaine.
Le choix de la cardinalité du vecteur d’abscisses représente un compromis d’ingénierie entre l’élégance du rendu géométrique et la charge mémoire allouée au processeur graphique. Un échantillonnage trop succinct, par exemple cinquante points, engendre une courbe polygonale rugueuse où les ruptures de pente sont décelables au sommet central et aux points d’inflexion. À l’opposé, allouer un million d’abscisses sature inutilement la mémoire tampon sans aucun gain perceptif sur un écran standard ou sur une planche d’impression. Une allocation comprise entre cinq cents et mille points assure un lissage infinitésimal parfait tout en conservant une empreinte computationnelle quasi instantanée.
3.2 Évaluation de la densité de probabilité avec SciPy
Une fois le vecteur unidimensionnel des abscisses convenablement instancié, l’évaluation des ordonnées s’effectue via l’invocation de la méthode pdf (acronyme de probability density function) rattachée à l’objet scipy.stats.norm. Cette fonction vectorisée reçoit en premier argument le tableau NumPy des abscisses générées, complété impérativement par les paramètres loc et scale, qui correspondent respectivement à la moyenne théorique (μ) et à l’écart-type théorique (σ) de la distribution ciblée.
Il est fondamental de rappeler la distinction opérée par les mathématiciens entre une probabilité discrète et une densité de probabilité continue. La valeur f(x) renvoyée par la méthode norm.pdf ne représente aucunement la probabilité ponctuelle que la variable aléatoire prenne exactement la valeur x, cette probabilité étant strictement nulle dans tout ensemble continu non dénombrable. L’ordonnée traduit le taux relatif de concentration de la probabilité au voisinage infinitésimal de l’abscisse considérée. Pour les lois normales dont l’écart-type est inférieur à l’inverse de la racine de deux pi (approximativement 0,3989), la densité au sommet central peut parfaitement dépasser la valeur 1 sans que cela ne viole les axiomes de Kolmogorov.
Pour s’assurer de l’exactitude des calculs avant tout tracé visuel, il s’avère instructif de vérifier numériquement la normalisation de l’aire sous la courbe. En appliquant la méthode des trapèzes via la fonction np.trapz sur les vecteurs d’ordonnées et d’abscisses nouvellement créés, le résultat doit égaler 1 avec une précision infinitésimale de l’ordre de dix décimales lorsque l’intervalle est suffisamment large. Par ailleurs, l’examen asymptotique des valeurs terminales atteste que les ordonnées décroissent harmonieusement vers zéro, interdisant toute troncature brutale qui fausserait la perception de la dispersion psychométrique.
4. Tracé fondamental de la courbe en cloche avec Matplotlib
4.1 Initialisation de la figure et du système d’axes
Dans l’architecture de conception logicielle de Matplotlib, il coexiste deux modes d’interaction fondamentaux : l’approche séquentielle inspirée de l’environnement historique MATLAB, reposant sur l’état global du sous-module pyplot, et l’approche orientée objet explicite. Pour toute application d’envergure scientifique, la syntaxe orientée objet est non seulement recommandée, mais indispensable. Elle garantit une isolation absolue des éléments graphiques et prévient les effets de bord indésirables lors de l’agencement de visualisations multifactorielles complexes.
Cette initialisation s’orchestre typiquement à l’aide de l’instruction fig, ax = plt.subplots(). Cette commande unitaire génère simultanément deux entités hierarchisées : l’objet Figure, qui matérialise l’espace canevas global incluant le papier virtuel, les légendes externes et les métadonnées du document, et l’objet Axes, qui délimite la zone de coordonnées cartésiennes où se déploient les tracés de données, les étiquettes et les graduations. La maîtrise de ces deux instances constitue la clef de voûte d’un contrôle typographique absolu.
Dès cette phase liminaire d’instanciation, le calibrage des dimensions physiques via le paramètre figsize prend une importance déterminante. Les directives de soumission des manuscrits éditées par l’American Psychological Association (APA) exigent des proportions d’affichage harmonieuses, privilégiant fréquemment des ratios de largeur à hauteur oscillant entre 1,3 et 1,6. Par exemple, assigner un couple de dimensions de 8 pouces de largeur par 5 pouces de hauteur assure un équilibre visuel optimal tant sur une page imprimée en simple colonne que sur un écran numérique haute définition, particulièrement lorsqu’on anticipe une résolution d’au moins 300 points par pouce (DPI).
4.2 Exécution du tracé de la fonction de densité
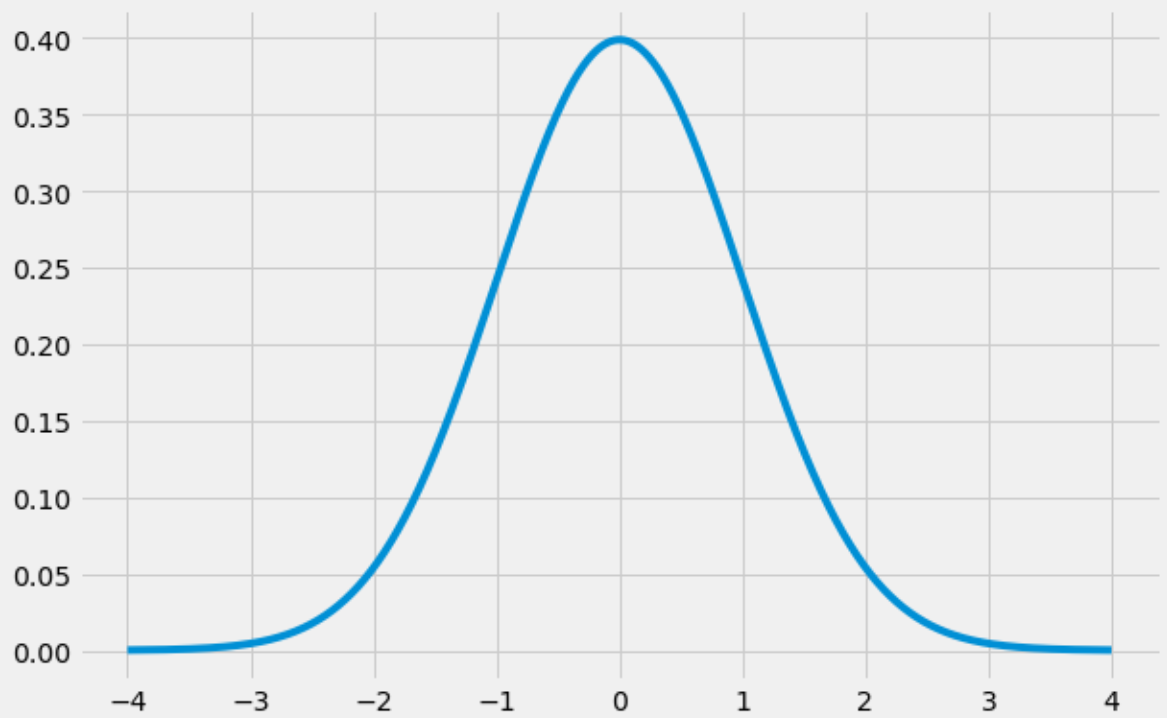
L’opération de dessin proprement dite se concrétise en sollicitant la méthode ax.plot(), en lui transmettant le vecteur d’abscisses et le vecteur de densité préalablement générés. Cette fonction calcule l’interpolation linéaire entre chacun des points contigus. Comme la discrétisation établie précédemment comporte un nombre élevé d’intervalles (par exemple 1000 points), le tracé résultant offre au regard l’illusion parfaite d’une trajectoire continue, dépourvue de toute angularité fracturée.
La personnalisation stylistique de ce tracé inaugural s’accomplit par l’adjonction de paramètres de contrôle au sein de l’appel de fonction. L’épaisseur du trait, régie par l’argument linewidth, doit être calibrée avec soin : un trait trop ténu disparaît lors des réductions d’échelle dans les articles de synthèse, tandis qu’un trait excessivement épais émousse la précision visuelle des coordonnées d’inflexion et du sommet. Une valeur nominale comprise entre 2 et 2,5 points représente généralement le standard de lisibilité dans les publications de référence. De même, le choix de la couleur primaire, contrôlé par l’argument color, gagne à être défini via des palettes chromatiques harmonieuses ou des codes hexadécimaux professionnels plutôt que des dénominations basiques.
L’inspection du graphique généré, rendue possible en environnement de développement local par l’appel de plt.show(), permet de valider empiriquement la conformité géométrique de la cloche. Le sommet de la voûte doit s’aligner rigoureusement sur la moyenne théorique décrétée, tandis que la descente des deux flancs latéraux doit manifester une symétrie axiale irréprochable. Cette étape fondamentale forme l’ossature nue sur laquelle s’échafauderont successivement les couches d’ombrage probabiliste, les annotations typographiques et les repères de dispersion.
5. Coloration et ombrage des aires sous la courbe
5.1 Principe d’intégration visuelle par ax.fill_between
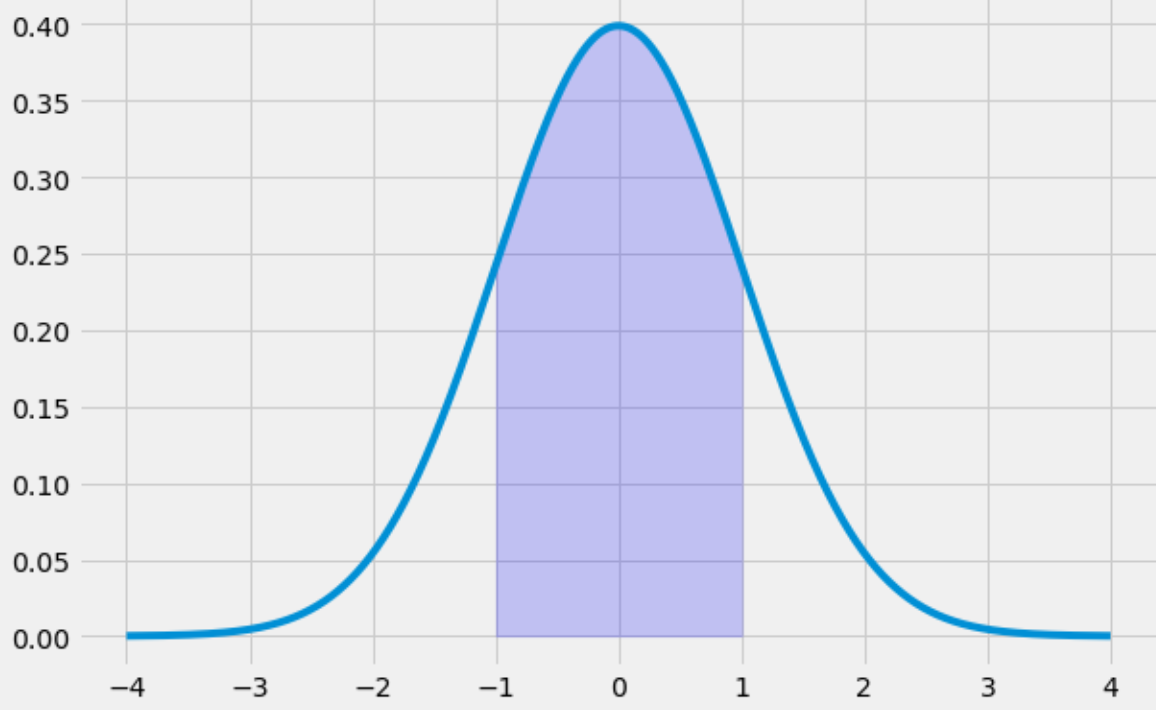
En théorie des probabilités appliquées, la valeur géométrique la plus informative d’une courbe de densité n’est pas tant la trajectoire de sa frontière supérieure que la superficie totale délimitée par celle-ci au-dessus de l’axe des abscisses. L’intégration visuelle d’un segment de l’axe horizontal matérialise directement la probabilité cumulée que la variable aléatoire s’inscrive dans l’intervalle correspondant. Dans Matplotlib, cette restitution volumique s’effectue avec maestria grâce à la méthode ax.fill_between().
Pour cibler une région probabiliste spécifique sans corrompre le reste de la figure, il convient de procéder à un masquage booléen du vecteur des abscisses. À l’aide des opérateurs vectoriels de NumPy, on crée un sous-ensemble d’abscisses vérifiant une condition logique bivalente (par exemple, les points supérieurs ou égaux à une borne inférieure tout en étant inférieurs ou égaux à une borne supérieure). La méthode fill_between prend alors comme arguments ce sous-vecteur délimité, le sous-vecteur d’ordonnées correspondant, et la ligne de base d’ordonnée nulle vers laquelle s’opère le remplissage.
La réussite esthétique de cette stratification dépend de la gestion rigoureuse de la transparence chromatique, gouvernée par le paramètre scalaire alpha compris entre 0 (invisibilité absolue) et 1 (opacité totale). Une opacité excessive occulte le quadrillage sous-jacent et alourdit considérablement le document scientifique. Une valeur d’alpha calibrée aux alentours de 0,25 à 0,35 confère une coloration diaphane et élégante, permettant de distinguer distinctement la ligne de crête tracée par ax.plot tout en faisant ressortir clairement la masse probabiliste intégrée.
5.2 Illustration de la règle empirique des écarts-types (68-95-99.7)
L’une des vertus didactiques majeures de la courbe en cloche réside dans l’illustration de la célèbre règle empirique dite des 68-95-99.7, pierre angulaire de l’interprétation des données psychologiques. D’après les propriétés d’intégration de la loi normale centrée réduite, la probabilité cumulée comprise dans un rayon d’un écart-type autour de l’espérance mathématique (μ ± 1σ) s’élève exactement à environ 68,27 %. Si l’on élargit la fenêtre d’observation à deux écarts-types (μ ± 2σ), l’aire sous-tendue capte 95,45 % des observations, tandis qu’à trois écarts-types (μ ± 3σ), ce ratio atteint 99,73 %.
Pour illustrer ce concept sur un graphique pédagogique d’étalonnage, il est particulièrement judicieux de superposer plusieurs calques d’ombrage successifs présentant des intensités de transparence ou des nuances chromatiques dégradées. La première strate, englobant la zone centrale ±1σ, peut arborer une teinte soutenue pour souligner la forte concentration de la population médiane. Une seconde strate s’étirant jusqu’à ±2σ se parera d’une déclinaison plus lumineuse, et la troisième strate couvrant les intervalles extrêmes jusqu’à ±3σ complétera l’éventail de manière subtile.
Dans la pratique clinique et neuropsychologique, la visualisation immédiate de ces strates possède une portée diagnostique capitale. Les scores franchissant la frontière des deux écarts-types au-dessus ou en dessous de la moyenne normative (c’est-à-dire les centiles inférieurs à 2,3 % ou supérieurs à 97,7 %) délimitent traditionnellement les zones d’atypicité statistique majeure. Qu’il s’agisse de détecter un haut potentiel cognitif ou de diagnostiquer une détérioration mnésique pathologique, l’ombrage différentiel sur la courbe en cloche matérialise sans ambiguïté la transition entre la variabilité normative ordinaire et la marginalité clinique.
6. Annotation rigoureuse et typographie scientifique du tracé
6.1 Structuration des étiquettes et des titres
Un graphique scientifique dépourvu d’une armature sémantique détaillée demeure inexploitable pour la communauté académique. La structuration des axes et des titres doit répondre aux normes strictes de la communication par les pairs, où l’exhaustivité de l’information côtoie la sobriété formelle. Le titre de la figure ne doit pas se borner à énoncer platement le tracé géométrique réalisé, mais contextualiser la variable observée, la population ciblée et, le cas échéant, les paramètres d’échantillonnage associés.
L’étiquetage de l’axe horizontal requiert une exactitude conceptuelle rigoureuse. Selon la nature de la représentation, l’axe traduira soit des scores centrés réduits universels notés z (sans unité métrique), soit des scores bruts contextualisés munis de leur dimension physique ou psychométrique explicite, tels que des points de Quotient Intellectuel, des indices d’anxiété sur l’échelle de Spielberger, ou des millisecondes d’attention. L’axe vertical, pour sa part, doit porter sans équivoque la mention de « Densité de probabilité », interdisant toute confusion avec un décompte d’occurrences absolues ou un pourcentage direct de fréquence.
Matplotlib se distingue par son intégration native du moteur de composition mathématique LaTeX, activable en enchâssant les syntaxes formelles entre deux symboles de dollar au sein des chaînes littérales de Python. Cette capacité permet de formater avec une élégance typographique incomparable les caractères grecs indispensables comme μ et σ, les indices numériques, les symboles d’intégrales ou les équations d’intervalles statistiques. L’application d’une taille de police hiérarchisée (par exemple 14 points pour le titre principal, 12 points pour les titres d’axes et 10 points pour les graduations) garantit une lisibilité irréprochable lors de l’intégration du tracé dans un document éditorial.
6.2 Ajout de repères verticaux et d’annotations textuelles
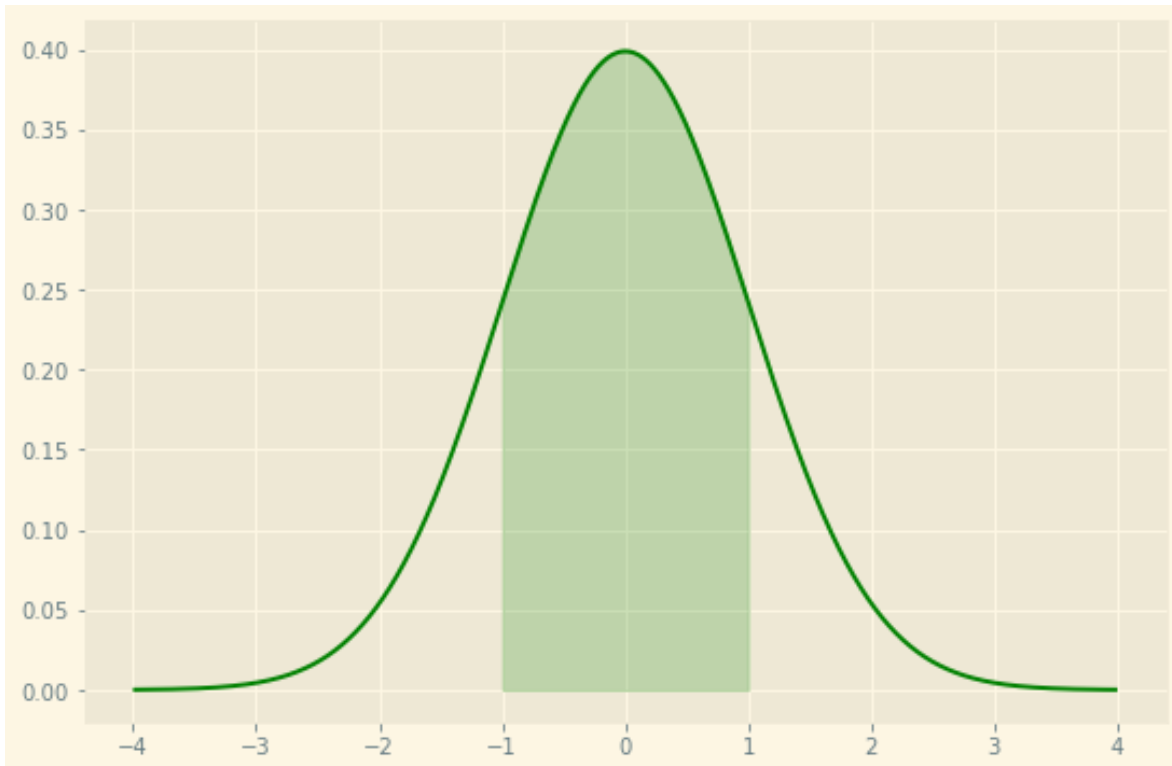
L’enrichissement analytique d’une courbe en cloche suppose l’adjonction de lignes de repérage spatial signalant les seuils directeurs de la distribution. La méthode ax.axvline() permet de projeter des droites verticales s’étendant d’un bout à l’autre de la zone graphique sur n’importe quelle abscisse déterminée. Une ligne pleine érigée en x = μ ancre visuellement la position du centre de gravité de la population, tandis qu’une série de lignes tracées en tiretés ou en pointillés aux abscisses ±1σ, ±2σ et ±3σ découpe la distribution en compartiments de dispersion réguliers.
Pour commenter des singularités méthodologiques ou des seuils psychométriques cruciaux, l’adjonction de texte explicatif contextualisé s’effectue de manière ciblée avec la commande ax.annotate(). Cette méthode sophistiquée surpasse un simple placement textuel brut en autorisant l’intégration d’une flèche directionnelle reliant un libellé textuel positionné dans un espace vierge du canevas vers une coordonnée précise de la courbe, telle que le sommet modal ou un point d’inflexion périphérique. Les propriétés géométriques de la flèche, son rayon de courbure et sa coloration peuvent être finement modalisés pour préserver l’harmonie esthétique de la figure.
Enfin, la présence d’une légende synthétique, déployée via ax.legend(), parachève la formalisation du graphique. Grâce à l’argument d’optimisation d’agencement loc=’best’, Matplotlib explore algorithmiquement la matrice de pixels du tracé pour déterminer la localisation spatiale occasionnant le moins de recouvrement possible avec les courbes et les zones ombragées. Chaque ligne ou aire sous la courbe recevant une étiquette explicite lors de son instanciation initiale (paramètre label), la légende délivre aux lecteurs un décodage immédiat et autonome des dimensions visualisées.
7. Application de styles visuels standardisés et publication
7.1 Exploitation des feuilles de style Matplotlib
L’apparence visuelle d’une représentation graphique conditionne la réceptivité du lectorat et le professionnalisme perçu du chercheur. Matplotlib intègre un ensemble très riche de feuilles de style prédéfinies, activables instantanément via la directive plt.style.use(). Pour une publication à caractère éditorial ou journalistique, le style fivethirtyeight propose un rendu dynamique avec un fond légèrement teinté et des typographies robustes. Cependant, pour la recherche académique formelle, les déclinaisons issues de l’écosystème Seaborn, telles que seaborn-v0_8-whitegrid ou un tracé dépouillé sans fond, répondent idéalement aux critères de sobriété requis.
Pour un contrôle encore plus minutieux et reproductible, l’ajustement dynamique du dictionnaire matplotlib.rcParams permet de redéfinir globalement les paramètres par défaut du moteur de rendu. On peut ainsi fixer uniformément la famille de polices de caractères sur une fonte à empattement comme Times New Roman pour correspondre aux normes des revues psychologiques internationales, imposer des épaisseurs d’axes standardisées, et réguler la disposition des graduations mineures et majeures.
Une préoccupation méthodologique fondamentale réside dans l’accessibilité visuelle des figures produites, conformément aux recommandations contemporaines sur le daltonisme et les déficiences de la vision chromatique. L’usage exclusif de contrastes rouge-vert pour discriminer deux distributions sous-jacentes doit être proscrit. Le recours à des palettes perceptuellement uniformes et universelles, telles que viridis, plasma ou les palettes de type ColorBrewer conçues pour être discriminables par les personnes atteintes de deutéranopie ou de protanopie, garantit que la transmission des données scientifiques demeure inclusive et sans ambiguïté.
7.2 Exportation vectorielle et matricielle haute définition
L’aboutissement de la chaîne de production graphique est l’exportation du canevas vers un fichier autonome destiné à être intégré dans un système de composition typographique comme LaTeX ou un logiciel de traitement de texte académique. La méthode fig.savefig() constitue l’instruction cardinale assurant cette sauvegarde. Une erreur commune réside dans l’utilisation de captures d’écran ou l’exportation matricielle basse résolution, qui détériorent dramatiquement la lisibilité des axes lors des tirages sur presse ou de l’affichage sur écrans haute densité.
Pour les schémas analytiques de courbes en cloche, les formats vectoriels comme le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics) doivent systématiquement être privilégiés. Dans ces formats, les tracés ne sont pas encodés sous la forme d’un quadrillage de pixels figés mais sous celle d’équations géométriques d’inversion mathématique. Il en résulte que le lecteur peut agrandir la courbe à l’infini sans subir la moindre altération de netteté ni flou d’interpolation, conférant aux lignes et aux équations LaTeX une pureté géométrique absolue.
Lorsqu’un éditeur impose expressément la remise d’un fichier matriciel non vectorisé, le format PNG (Portable Network Graphics) compressé sans perte représente la norme de référence. Il convient alors de spécifier impérativement le paramètre dpi=300, voire dpi=600, pour garantir une résolution minimale conforme aux standards de l’édition scientifique. Conjointement, l’adjonction systématique de l’argument bbox_inches=’tight’ ordonne à Matplotlib de recalculer la boîte englobante de la figure au plus juste, éliminant les marges blanches superflues et prévenant le rognage inopportun des étiquettes d’axes positionnées en périphérie extrême du canevas.
8. Tracé d’une courbe en cloche ajustée sur des données empiriques
8.1 Échantillonnage et ajustement paramétrique
Dans la recherche empirique, la courbe en cloche n’est que rarement tracée isolément dans un vide abstrait ; elle sert le plus souvent de modèle théorique confronté à une série d’observations réelles. Imaginons le recueil d’un échantillon de scores psychométriques mesurant la vitesse de traitement de l’information chez un groupe de 500 participants adultes. Les scores bruts obtenus présentent une dispersion propre, conditionnée par le hasard de l’échantillonnage et les singularités individuelles de la cohorte.
Pour évaluer dans quelle mesure cette distribution empirique se conforme à une architecture gaussienne, il est nécessaire d’en estimer les paramètres optimaux. Si la moyenne empirique et la déviation standard de l’échantillon constituent des estimateurs naturels sans biais de l’espérance et de l’écart-type de la population sous-jacente, la méthode stats.norm.fit(donnees) offre une procédure d’estimation par le maximum de vraisemblance. Cette fonction hautement performante calcule de manière automatisée le couple de paramètres μ et σ minimisant l’entropie croisée entre la distribution théorique continue et l’échantillon observé.
Cette étape d’estimation paramétrique permet au statisticien de quantifier l’écart éventuel entre les propriétés postulées a priori et la réalité empirique du terrain. Si un test standardisé est censé calibrer une moyenne exacte de 100 et un écart-type de 15, l’observation dans un échantillon clinique d’une moyenne ajustée à 93 avec un écart-type de 18 trahit immédiatement un décalage structurel de la population examinée, qu’il convient de rendre visuellement explicite dans le protocole de restitution graphique.
8.2 Superposition de l’histogramme normalisé et de la courbe théorique
L’association visuelle la plus robuste pour juger de l’adéquation d’un échantillon à la normalité consiste à superposer l’histogramme de fréquences des données observées et la fonction de densité gaussienne ajustée par maximum de vraisemblance. Pour que cette superposition soit mathématiquement valide et signifiante, une contrainte dimensionnelle impérative s’impose : l’histogramme doit être normalisé en surface unitaire afin de partager rigoureusement la même échelle verticale que la densité de probabilité continue.
Cette mise en conformité dimensionnelle s’opère dans Matplotlib en activant l’argument density=True lors de l’appel à la fonction ax.hist(). Sous ce régime, l’aire cumulée de l’ensemble des rectangles formant l’histogramme s’ajuste strictement à 1, l’ordonnée de chaque barre représentant le quotient de la fréquence relative par la largeur de la classe correspondante. Parallèlement, le choix du découpage en classes (ou bins) revêt une importance critique : un nombre insuffisant de classes occulte la forme véritable de la distribution, tandis qu’un excès de classes engendre un bruit graphique discontinu.
L’application d’heuristiques scientifiques formalisées comme la règle de Freedman-Diaconis, qui calcule la largeur de classe idéale en fonction de l’intervalle interquartile et de la taille de l’échantillon (proportionnelle à la racine cubique inverse de N), surpasse largement le choix arbitraire par défaut. Une fois l’histogramme normalisé dressé avec un niveau d’opacité modéré pour en adoucir l’impact visuel, la projection de la courbe théorique de densité continue norm.pdf dotée des paramètres estimés met instantanément en lumière les zones de concordance, les éventuels excès de fréquence centrale ou les asymétries latérales de l’échantillon étudié.
9. Superposition et comparaison de plusieurs distributions normales
9.1 Visualisation de contrastes inter-groupes
L’investigation scientifique en psychologie et en neurosciences cognitives s’articule quasi systématiquement autour de designs expérimentaux comparant au moins deux sous-groupes d’individus : une condition expérimentale recevant une intervention thérapeutique face à un groupe témoin recevant un placebo, ou un groupe de patients cérébrolésés confronté à un groupe de sujets sains appariés. La modélisation conjointe de plusieurs courbes en cloche sur un unique système d’axes cartésiens offre une lisibilité incomparable pour expliciter les contrastes de performance.
Sur le plan programmatique, cette démarche s’articule par l’exécution séquentielle de plusieurs appels à ax.plot et ax.fill_between au sein du même bloc de tracé. Chaque sous-groupe est alors caractérisé par ses paramètres propres : une moyenne expérimentale décalée le long de l’axe des abscisses traduira l’effet substantiel du traitement, tandis que les écarts-types quantifieront la variance intra-groupe respective. L’harmonisation chromatique doit s’appuyer sur des teintes distinctes et contrastées, associées à des niveaux de transparence calibrés pour que le chevauchement des masses probabilistes demeure parfaitement déchiffrable.
Cette visualisation constitue le support géométrique par excellence pour conceptualiser la notion fondamentale de taille d’effet, illustrée de manière canonique par le d de Cohen. La simple affirmation d’une significativité statistique déduite d’une p-valeur issue d’un test de Student omet la magnitude clinique réelle de l’effet. En contemplant l’espace d’intersection des deux cloches superposées, le clinicien appréhende intuitivement le pourcentage de non-chevauchement des deux populations, évaluant si le déplacement moyen induit par la thérapie se démarque nettement de la variabilité naturelle du groupe de référence.
9.2 Variation concomitante de l’écart-type et aplatissement
La morphologie de la courbe en cloche ne varie pas uniquement par translation le long de l’axe horizontal ; elle subit de profondes métamorphoses structurelles lorsque l’on modifie son paramètre d’échelle σ, tout en conservant une espérance μ rigoureusement stationnaire. La comparaison de distributions partageant une même tendance centrale mais des dispersions hétérogènes constitue un exercice didactique d’une grande portée pour la compréhension des dynamiques de variance en psychométrie.
Lorsque la déviation standard est restreinte, la courbe adopte une allure aiguë et resserrée qualifiée de leptokurtique, manifestant une forte concentration des individus autour du score modal. À mesure que l’écart-type croît, la cloche s’affaisse en son sommet et élargit ses flancs pour adopter un profil mésokurtique standard puis platykurtique aplati. Sur un graphique comparatif réunissant trois ou quatre courbes d’écarts-types divergents (par exemple σ = 5, 10, 15 et 20), l’observateur perçoit immédiatement comment la contrainte de normalisation d’aire unitaire force l’ordonnée maximale à s’abaisser mécaniquement pour compenser l’étalement horizontal des queues de distribution.
L’interprétation théorique de ces variations de profil renvoie directement à la notion d’hétérogénéité d’un échantillon psychologique. Dans une cohorte scolaire hautement standardisée et sélectionnée, les performances cognitives présenteront un tracé leptokurtique caractérisé par une dispersion minime. En revanche, au sein d’un groupe clinique souffrant de troubles neurodéveloppementaux aux étiologies variées, l’hétérogénéité des scores bruts se manifestera par une courbe considérablement étalée, avertissant le praticien que la tendance centrale dissimule un spectre d’expressions comportementales extrêmement diffus.
10. Méthodes alternatives avec la bibliothèque Seaborn
10.1 Estimation de la densité par noyau avec kdeplot
Si la bibliothèque Matplotlib procure un contrôle total de bas niveau sur l’ensemble des éléments géométriques de la figure, l’extension spécialisée Seaborn offre une couche d’abstraction statistique de haut niveau particulièrement séduisante pour la recherche rapide. Parmi ses fonctionnalités phares figure l’estimation de la densité par noyau (couramment désignée sous l’acronyme KDE pour Kernel Density Estimation), implémentée au moyen de la méthode unifiée sns.kdeplot.
Contrairement à la distribution gaussienne analytique pure qui impose une formulation théorique rigide caractérisée uniquement par μ et σ, le KDE est une approche non paramétrique. Son algorithme consiste à déposer une fonction noyau continue (généralement gaussienne) sur chaque point de données empirique de l’échantillon, puis à sommer l’ensemble de ces micro-fonctions locales pour dégager une estimation globale continue de la densité. Cette méthode permet de tracer directement une courbe en cloche lissée à partir d’une série d’observations brutes sans formuler d’hypothèse préalable contraignante sur la loi mère.
Le paramètre critique qui gouverne l’architecture du tracé KDE est la largeur de fenêtre ou paramètre de lissage, contrôlé via l’argument bw_adjust dans Seaborn. Une largeur excessive engendre un sous-ajustement lissant artificiellement des particularités bimodales réelles de l’échantillon, tandis qu’une largeur excessivement étroite produit un sur-ajustement générant des oscillations parasitaires au sommet de la cloche. En combinant l’argument fill=True et un réglage optimal de la bande passante, sns.kdeplot trace en une seule ligne de code une courbe en cloche empirique d’un raffinement visuel exceptionnel.
10.2 Visualisation combinée via displot et histplot
Dans les versions contemporaines de Seaborn, les fonctions sns.histplot et sns.displot représentent l’état de l’art de l’analyse exploratoire univariée et multivariée. Alors que histplot opère directement au sein d’un objet Axes préalablement instancié dans Matplotlib, displot constitue une fonction de niveau figure gérant automatiquement la création de grilles de sous-graphiques multi-facettes en fonction de variables qualitatives catégorielles.
L’atout majeur de sns.histplot réside dans son aptitude à unifier en une formulation synthétique la construction de l’histogramme empirique discret et le tracé continu de la densité de probabilité via l’argument booléen kde=True. De surcroît, son interconnexion native avec la bibliothèque de manipulation de données Pandas permet d’alimenter directement la fonction avec des structures de type DataFrame, en spécifiant simplement le libellé de la colonne ciblée pour l’abscisse et une colonne de segmentation pour la couleur via le paramètre hue.
Cette intégration prend toute sa dimension méthodologique lors du traitement de cohortes psychométriques stratifiées par des facteurs socio-démographiques ou cliniques. En assignant par exemple une variable de diagnostic binaire au paramètre de teinte, Seaborn déploie instantanément deux histogrammes et deux courbes en cloche lissées en vis-à-vis, ajustant automatiquement les palettes contrastées, la légende explicative et la normalisation des ordonnées. Cette puissance expressive accélère substantiellement le cycle d’investigation statistique du chercheur sans jamais sacrifier la rigueur esthétique.
11. Validation diagnostique et tests de conformité à la courbe en cloche
11.1 Construction et interprétation du diagramme quantile-quantile (Q-Q plot)
Bien que la superposition d’une courbe en cloche sur un histogramme offre une première évaluation intuitive, le jugement visuel de la normalité à travers une fonction de densité est sujet à d’importants biais perceptifs humains, particulièrement au niveau des queues de distribution où l’épaisseur infinitésimale de la courbe masque souvent de graves anomalies distributionnelles. Pour surmonter cette limitation géométrique, les statisticiens recourent à un outil de diagnostic graphique supérieur : le diagramme quantile-quantile ou Q-Q plot.
Dans l’écosystème Python, la fonction scipy.stats.probplot constitue l’outil de référence pour générer ce diagramme diagnostique. Le principe algorithmique du Q-Q plot consiste à ordonner les scores empiriques de l’échantillon par ordre croissant, puis à confronter chacun de ces quantiles observés au quantile correspondant qu’aurait produit une distribution normale théorique pure de même effectif. Si l’échantillon est issu d’une population rigoureusement gaussienne, les points de coordonnées résultants s’alignent parfaitement le long d’une droite diagonale de référence reliant le premier et le troisième quartile.
L’analyse visuelle des déviations par rapport à cette droite de référence livre un diagnostic clinique d’une précision chirurgicale sur la morphologie des données comportementales. Si les points situés aux extrémités s’écartent vers le haut ou vers le bas en dessinant une ondulation en forme de « S », cela atteste la présence de queues lourdes ou légères, signalant un aplatissement non conforme de la cloche (kurtosis pathologique). Si les points fléchissent systématiquement d’un seul côté de la ligne, cela trahit une asymétrie marquée (skewness positive ou négative), alertant le chercheur sur l’invalidité fondamentale de l’hypothèse de symétrie bilatérale.
11.2 Vérification inférentielle de la normalité
L’évaluation diagnostique ne saurait être exclusivement graphique ; elle doit s’appuyer sur des procédures d’inférence statistique formalisées permettant de statuer avec rigueur sur l’hypothèse nulle d’adéquation à la loi normale. La bibliothèque scipy.stats intègre un arsenal de tests d’hypothèse dédiés, au premier rang desquels figure le test de Shapiro-Wilk, accessible par la fonction stats.shapiro(donnees).
Considéré par le consensus méthodologique comme le test le plus puissant pour détecter des déviations à la normalité sur des échantillons d’effectifs restreints à modérés (généralement inférieurs à deux mille observations), le test de Shapiro-Wilk calcule une statistique W reposant sur la corrélation linéaire entre les quantiles de l’échantillon et les scores gaussiens théoriques attendus. Une valeur de W proche de 1 témoigne d’une excellente concordance, tandis qu’une p-valeur inférieure au seuil alpha conventionnel de 0,05 conduit au rejet formel de l’hypothèse de normalité.
Pour des jeux de données volumineux, fréquents dans les études épidémiologiques ou les bases de données psychométriques nationales, le test omnidirectionnel de D’Agostino-Pearson (via stats.normaltest) représente une alternative hautement recommandée, combinant les déviations d’asymétrie et d’aplatissement dans une statistique globale de khi-carré. Néanmoins, le chercheur doit se prémunir contre le paradoxe des grands échantillons : à mesure que N croît, la puissance statistique devient si démesurée que des déviations minimes et sans portée clinique réelle entraînent inévitablement une p-valeur hautement significative. La décision méthodologique de maintenir l’approximation gaussienne doit donc toujours procéder d’une synthèse équilibrée entre les tests inférentiels et l’inspection minutieuse des figures produites.
12. Encapsulation dans une fonction réutilisable et bonnes pratiques
12.1 Développement d’une fonction Python modulaire
L’industrialisation des visualisations scientifiques au sein d’un laboratoire ou d’un département de recherche implique d’abandonner l’écriture linéaire de scripts séquentiels à usage unique au profit d’une approche d’ingénierie logicielle modulaire. L’encapsulation de l’ensemble de la logique computationnelle et typographique au sein d’une fonction Python paramétrable et réutilisable garantit une homogénéité stylistique absolue à travers l’ensemble des livrables de recherche d’une équipe.
La signature d’une telle fonction d’élite doit être conçue pour concilier rigueur mathématique et souplesse d’utilisation. Elle recevra obligatoirement les grandeurs paramétriques fondamentales que sont la moyenne et l’écart-type de la distribution à représenter, ainsi qu’un argument optionnel désignant un objet Axes cible de Matplotlib sur lequel opérer le dessin. Si cet objet d’axes n’est pas fourni par l’utilisateur, la fonction se charge de l’instancier dynamiquement. D’autres arguments optionnels viendront piloter l’activation de l’ombrage des écarts-types, le choix des palettes chromatiques, l’amplitude des bornes d’échantillonnage et les étiquettes textuelles des axes.
La documentation de la fonction constitue un impératif de bonne pratique logicielle. L’incorporation d’une chaîne de documentation formelle (ou docstring) conforme au standard NumPy ou Google détaille exhaustivement la nature des arguments d’entrée, les types de retour, les exceptions potentielles levées et des exemples minimaux d’invocation. L’adjonction d’annotations de typage statique (type hints introduits dans le module typing de Python) sécurise l’exécution du code en facilitant l’analyse statique et l’auto-complétion au sein des environnements de développement intégrés modernes.
12.2 Automatisation et inclusion dans un pipeline de recherche
L’étape ultime de la méthodologie computationnelle consiste à intégrer cette fonction vectorisée dans un pipeline automatisé de traitement des données. Lors de l’administration d’une batterie complexe de tests psychométriques (par exemple dix épreuves cognitives distinctes passées par une cohorte de sujets), la génération manuelle et répétitive de dix graphiques indépendants s’avère non seulement fastidieuse mais hautement vulnérable aux erreurs de manipulation humaine.
L’automatisation repose sur l’itération programmatique à travers un dictionnaire ou un fichier de configuration répertoriant les caractéristiques normatives de chacune des sous-épreuves du protocole. Une simple boucle itérative ou l’emploi de fonctions de cartographie vectorielle appelle la fonction de tracé maîtresse pour chaque variable, générant successivement les figures, adaptant les plages d’abscisses aux échelles de scores spécifiques, et exportant automatiquement les fichiers vectoriels correspondants dans une arborescence de répertoires rigoureusement hiérarchisée.
Cette approche d’ingénierie logicielle garantit une traçabilité intégrale, conforme aux standards ouverts de la science reproductible. Si un réétalonnage de l’échantillon ou une correction post-expérimentale d’une sous-échelle survient au cours de la révision par les pairs d’un article de recherche, une seule exécution du script racine recalcule instantanément l’intégralité des représentations de la courbe en cloche de l’étude avec une exactitude mathématique et visuelle inaltérable. C’est à ce confluent précis entre rigueur théorique, métrologie psychologique et sophistication algorithmique que Python s’affirme comme le langage indispensable de la visualisation statistique moderne.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- De Moivre, A. (1738). The Doctrine of Chances (2nd ed.). H. Woodfall.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Laplace, P. S. (1812). Théorie analytique des probabilités. Courcier.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., Carey, C. J., … SciPy 1.0 Contributors (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021