
L’analyse empirique contemporaine repose massivement sur l’intégrité, la granularité et la précision du traitement des données alphanumériques brutes. Au sein des environnements computationnels contemporains, Google Sheets s’est imposé comme un outil fondamental pour les chercheurs, analystes décisionnels et ingénieurs de données désireux de manipuler des corpus textuels hétérogènes sans recourir systématiquement à une infrastructure logicielle lourde. Néanmoins, les données textuelles collectées à partir de formulaires, de bases de données relationnelles ou d’interfaces de programmation applicatives (API) se présentent rarement sous une forme immédiatement exploitable. Elles se caractérisent au contraire par des formats agrégés, composites ou sémi-structurés exigeant une phase critique de déconstruction syntaxique.
Le traitement des chaînes de caractères, et plus particulièrement l’opération d’extraction de sous-chaînes (ou substring extraction), constitue l’un des piliers méthodologiques fondamentaux de la préparation des données (le data wrangling). Qu’il s’agisse d’isoler une métrique temporelle dissimulée dans une estampille temporelle complexe, de segmenter un numéro de nomenclature industrielle pour en révéler les composantes intrinsèques ou d’extraire des identifiants au sein d’adresses électroniques, l’opérateur doit disposer d’une maîtrise sans faille des mécanismes d’indexation, des calculs de décalage et des algorithmes de localisation lexicale. Une mauvaise appréciation d’un décalage d’un seul octet ou d’un caractère peut induire un biais systématique compromettant la validité interne d’une étude statistique complète.
L’objectif de cette étude exhaustive est de modéliser, d’analyser et de formaliser l’ensemble des protocoles algorithmiques permettant d’extraire des sous-chaînes dans Google Sheets. En progressant des architectures déterministes et positionnelles les plus directes jusqu’aux techniques d’inférence lexicale probabilistes assistées par les expressions régulières et l’optimisation matricielle vectorisée, ce traité fournit le cadre théorique et appliqué indispensable à l’industrialisation de vos pipelines d’ingénierie textuelle. Chaque section détaille les principes mathématiques sous-jacents, les syntaxes formelles ainsi que les garde-fous nécessaires pour garantir la reproductibilité et la résilience computationnelle de vos feuilles de calcul.
1. Introduction aux fondements de l’extraction textuelle dans Google Sheets
1.1 Définition théorique et typologie des chaînes de caractères
Sur le plan de la théorie computationnelle, une chaîne de caractères (désignée par le terme string en informatique théorique) se définit formellement comme une suite finie et ordonnée d’éléments discrets issus d’un ensemble fini dénommé alphabet. Dans le paradigme d’une feuille de calcul telle que Google Sheets, cette suite linéaire constitue une dimension scalaire fondamentale, distincte des données numériques pures, temporelles ou booléennes. Il convient de distinguer avec une grande rigueur méthodologique les données atomiques des données composites. Une donnée atomique représente une entité sémantique irréductible dans le domaine d’étude considéré, comme un chiffre d’affaires brut ou une modalité binaire d’accord. En revanche, une donnée composite agrège plusieurs signifiants au sein d’une seule enveloppe textuelle, à l’instar d’un code alphanumérique combinant une année fiscale, un identifiant d’entrepôt et une nomenclature de produit.
L’indexation et la manipulation de ces entités textuelles dépendent directement de l’encodage sous-jacent, historiquement standardisé par les spécifications Unicode et plus particulièrement la transformation UTF-8. Dans ce système de représentation, chaque glyphe visible ou invisible est associé à un point de code précis. Une source majeure de dysfonctionnement dans l’analyse de données réside dans la présence de caractères invisibles possédant des signatures d’encodage distinctes. C’est le cas emblématique de l’espace insécable (codé U+00A0 en hexadécimal, souvent issu d’extractions web ou de logiciels de traitement de texte) face à l’espace standard ASCII (U+0020). Pour le moteur textuel de Google Sheets, ces deux entités constituent des entités physiques distinctes, ce qui altère profondément les fonctions métriques et de recherche de sous-chaînes.
La modularisation textuelle, c’est-à-dire le processus algorithmique consistant à fracturer une donnée composite en variables atomiques discrètes, représente une étape préalable non négociable en statistique inférentielle. Sans cette atomisation, l’application de filtres de tri, de régressions ou de groupements catégoriels demeure impossible. La qualité d’une analyse empirique repose donc sur la capacité du chercheur à délimiter formellement la frontière séparant chaque composant d’un agrégat textuel.
1.2 Principes directeurs de l’adressage et de l’indexation positionnelle
Le traitement des flux de caractères au sein de Google Sheets obéit aux règles strictes de l’indexation positionnelle basée sur l’unité (indexation dite 1-based). Contrairement aux langages de bas ou moyen niveau tels que le C, Python ou Java qui adoptent une indexation basée sur zéro (où le premier élément occupe l’indice 0), Google Sheets assigne invariablement l’indice scalaire 1 au caractère initial de toute séquence textuelle. Cette convention d’ingénierie simplifie considérablement l’intuition arithmétique pour l’analyste profane mais nécessite une vigilance accrue lors de la transposition d’algorithmes conçus dans des environnements de programmation classiques.
Dans ce cadre géométrique linéaire, il est impératif de conceptualiser la différence fondamentale entre la longueur physique et la longueur logique d’une chaîne. La longueur logique correspond au nombre exact de glyphes ou de symboles sémantiques perceptibles par l’opérateur. La longueur physique, quant à elle, comptabilise la totalité des points de code constitutifs, y compris les caractères d’espacement périphériques, les tabulations, les retours à la ligne masqués et les marques diacritiques combinées. Une fonction calculant un découpage textuel s’exécute toujours au niveau physique des points de code séquentiels.
La précision chirurgicale de tout découpage repose sur la maîtrise conjointe de deux grandeurs arithmétiques : l’indice de départ (ou offset absolu) et l’amplitude de coupe (la longueur relative du segment ciblé). Une erreur d’évaluation sur l’indice de départ décale l’intégralité du prélèvement vers l’avant ou vers l’arrière, provoquant une corruption immédiate du sens lexical. De même, une mauvaise appréciation de l’amplitude relative génère soit une troncature dommageable des données finales, soit l’agrégation parasite de délimiteurs adjacents.
1.3 Cartographie des fonctions natives d’extraction textuelle
Pour répondre aux impératifs d’extraction de données, Google Sheets propose une taxonomie hautement hiérarchisée de fonctions natives intégrées. Le socle élémentaire d’extraction positionnelle directe se compose de trois fonctions maîtresses : GAUCHE (ou LEFT selon la locale logicielle active), conçue pour le prélèvement de préfixes depuis la marge orientale de la cellule ; STXT (ou MID), optimisée pour l’isolation de segments intercalaires situés en milieu de structure ; et DROITE (ou RIGHT), dédiée à la capture de suffixes ancrés à la terminaison terminale de la chaîne.
Ces trois opérateurs fondamentaux ne peuvent toutefois fonctionner de manière résiliente sans l’adjonction de fonctions métriques quantitatives. La plus importante d’entre elles est la fonction NBCAR (ou LEN), dont l’unique mandat algorithmique consiste à évaluer et retourner la longueur physique totale d’une séquence de caractères donnée sous forme d’un nombre entier naturel. Cette mesure de l’amplitude globale sert de point d’ancrage absolu pour tous les calculs de décalage dynamique et de fenêtrage glissant.
Enfin, la strate de localisation dynamique est complétée par le tandem fonctionnel constitué de CHERCHE (ou SEARCH) et TROUVE (ou FIND). Ces fonctions agissent comme des scanners lexicaux explorant séquentiellement la chaîne source afin de repérer les occurrences de séparateurs prédéterminés. Elles convertissent une recherche textuelle en une coordonnée spatiale entière (l’indice de position), laquelle est immédiatement transmise aux fonctions d’extraction pour automatiser le partitionnement adaptatif des données.
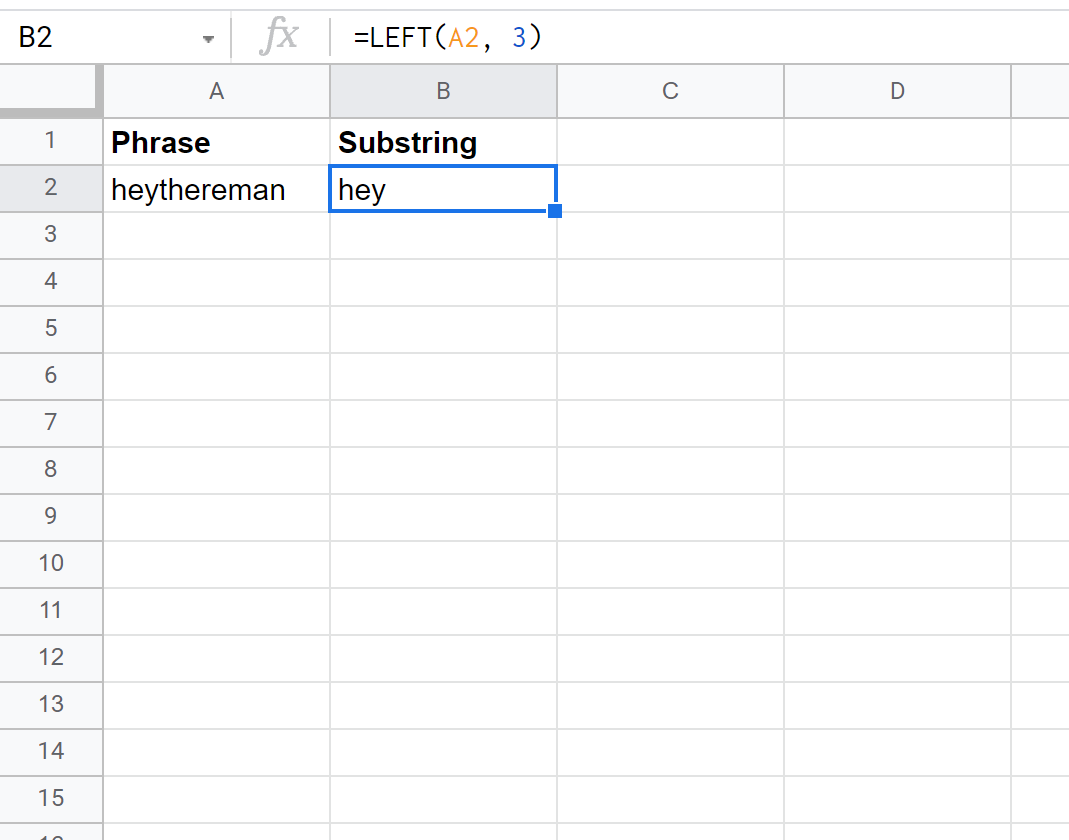
2. Méthode 1 : Extraction positionnelle initiale via la fonction GAUCHE (LEFT)
2.1 Syntaxe formelle et mécanique opératoire de GAUCHE
La fonction GAUCHE répond à une logique déterministe simple : extraire un contingent prédéterminé de caractères à compter de la bordure initiale gauche d’une cellule cible. La signature syntaxique formelle de cette fonction s’énonce comme suit : GAUCHE(texte; [nombre_caractères]). Le premier argument, texte, est obligatoire et désigne la chaîne source ou la référence matricielle pointant vers la cellule contenant la matière textuelle brute à analyser. Le second paramètre, nombre_caractères, est facultatif sur le plan purement syntaxique mais constitue le régulateur principal de l’amplitude de coupe.
En cas d’omission explicite du paramètre nombre_caractères, le processeur de calcul applique un comportement par défaut strict fondé sur une constante scalaire : il extrait précisément un unique caractère, soit l’élément situé à l’indice positionnel 1. Sur le plan de la gestion des cas limites, l’assignation de la valeur zéro (0) à cet argument contraint la fonction à retourner une chaîne vide (représentée informatiquement par ""), sans toutefois déclencher d’erreur d’exécution. À l’inverse, l’injection d’un nombre négatif (par exemple -3) est jugée mathématiquement invalide et engendre l’apparition immédiate de l’erreur système #VALEUR!.
Dans l’éventualité où la valeur de nombre_caractères excède strictement la longueur totale réelle de la chaîne source (telle que renvoyée par NBCAR(texte)), la fonction fait preuve de tolérance structurelle : elle s’exécute sans interruption logicielle et restitue l’intégralité du contenu textuel de la cellule cible, sans ajouter d’espaces de remplissage artificiels.
2.2 Cas d’usage empiriques et protocoles d’application
L’extraction standardisée au moyen de la fonction GAUCHE s’avère particulièrement pertinente lors du traitement d’architectures textuelles rigidement normalisées par des protocoles industriels ou scientifiques. Un cas canonique concerne l’isolation des codes de pays standardisés selon la norme internationale ISO 3166-1 alpha-2 au sein de registres logistiques internationaux. Considérons une chaîne composite telle que "FR-LYO-2023-0092" stockée dans la cellule A2. L’extraction du code d’identification nationale s’opère par l’application de la formule suivante :
=GAUCHE(A2; 2)
Cette commande isole avec une précision absolue les deux premiers octets de la chaîne, produisant en sortie la valeur textuelle "FR". Un autre domaine d’application empirique majeur concerne l’extraction des indicatifs téléphoniques régionaux fixes au sein de cohortes d’études épidémiologiques. Dans un registre de participants français où les coordonnées téléphoniques sont uniformément enregistrées au format national compact sans espaces (par exemple "0472110022" en A3), l’isolement du périmètre géographique régional s’effectue via l’expression :
=GAUCHE(A3; 2)
Ce protocole isole le préfixe territorial "04", permettant ultérieurement des analyses de stratification spatiale. De la même manière, dans les cas où des estampilles temporelles sont sérialisées sous le format strict de la norme ISO 8601 (par exemple "2023-11-14T08:30:00"), la capture de l’année civile s’accomplit sans calcul complexe grâce à la formule =GAUCHE(cellule; 4), extrayant directement les quatre chiffres du millésime.
2.3 Limitations inhérentes aux découpages statiques de préfixes
Bien que la fonction GAUCHE brille par sa vitesse d’exécution algorithmique et sa simplicité d’implémentation, son usage comporte une vulnérabilité critique dès lors que l’on quitte le domaine des données rigoureusement calibrées pour aborder des flux textuels hétérogènes ou semi-structurés. La fragilité inhérente d’un partitionnement statique provient de son incapacité absolue à s’adapter aux variations morphologiques de la source. Si une série d’identifiants mélange aléatoirement des codes à deux lettres et des codes à trois lettres (comme "DE-900" et "USA-900"), une extraction statique paramétrée sur deux caractères produira la valeur tronquée et inintelligible "US" pour l’entité américaine.
Pour prévenir l’introduction silencieuse de ces données corrompues au sein de l’environnement analytique, l’analyste doit instaurer des protocoles stricts de validation en amont. Cette validation peut s’effectuer via des fonctions conditionnelles vérifiant que la structure globale respecte le schéma attendu, par exemple en combinant SI et NBCAR pour rejeter les anomalies structurelles :
=SI(NBCAR(A2)=15; GAUCHE(A2; 3); "FORMAT_INVALID")
L’absence de telles mesures prophylactiques entraîne des répercussions désastreuses : les indexages erronés échappent généralement aux mécanismes de détection automatique d’erreurs, contaminant insidieusement les tables de contingence, faussant les jointures relationnelles ultérieures et détériorant la reproductibilité des résultats quantitatifs finaux.
3. Méthode 2 : Extraction centrale segmentée par la fonction STXT (MID)
3.1 Décomposition structurelle des paramètres de STXT
L’extraction de matière textuelle localisée au sein d’une chaîne, encadrée par d’autres segments significatifs, nécessite le déploiement de la fonction d’extraction intermédiaire STXT (correspondant au mot-clé anglophone MID). Sa signature formelle impose obligatoirement la transmission de trois arguments distincts : STXT(texte; position_départ; nombre_caractères). À la différence de GAUCHE ou de DROITE, aucun paramètre ne présente ici de caractère optionnel, ce qui reflète la complexité géométrique de l’échantillonnage interstitiel.
Le paramètre position_départ est une coordonnée arithmétique scalaire qui définit l’ancrage du premier caractère à intégrer dans le segment extrait. Conformément à la logique d’indexation base 1 de Google Sheets, cette coordonnée doit être rigoureusement supérieure ou égale à 1. L’injection d’une valeur inférieure à l’unité entraîne la génération immédiate d’une anomalie computationnelle sous forme d’erreur #VALEUR!. Le troisième argument, nombre_caractères, quantifie l’amplitude vectorielle du balayage, stipulant le volume exact de caractères consécutifs à capturer à partir de l’ancrage.
Sur le plan du traitement des limites algorithmiques, il convient d’analyser le comportement de STXT face aux valeurs hors limites. Si position_départ est strictement supérieure à la longueur métrique totale de la chaîne cible (autrement dit, si position_départ > NBCAR(texte)), la fonction ne génère pas de crash logiciel mais retourne une chaîne de caractères vide (""). En revanche, si la position de départ se situe à l’intérieur de la chaîne mais que la somme de position_départ + nombre_caractères dépasse l’extrémité physique terminale de celle-ci, la fonction extrait tous les caractères résiduels jusqu’au dernier élément sans générer d’artefacts d’espacement.
3.2 Implémentation pratique sur des formats normalisés
L’utilité analytique de la fonction STXT s’exprime pleinement dans le traitement des chaînes composites structurées par blocs contigus de taille invariante. Un exemple archétypique réside dans l’exploitation des numéros d’identification nationale de sécurité sociale en France (codes NIR), lesquels répondent à une typologie structurelle mathématiquement figée sur quinze chiffres. Considérons l’enregistrement d’un matricule dans la cellule A2 : "185127510804255". Au sein de cette architecture, le code départemental de naissance est universellement situé aux positions d’index 6 et 7.
Le prélèvement de cette variable géographique s’effectue sans aucune ambiguïté grâce à l’articulation méthodique suivante :
=STXT(A2; 6; 2)
L’indice 6 ordonne au moteur computationnel d’ancrer son opération sur le sixième caractère de la chaîne (ici le chiffre "7"), tandis que le quantum 2 impose la capture séquentielle de deux éléments, renvoyant impeccablement la sous-chaîne départementale "75".
De même, dans les systèmes d’information logistique où les références d’inventaire agrègent des codes sectoriels rigides, comme le matricule "PRD-ELEC-4099-B" stocké en A3, l’isolation de la catégorie centrale (ici le segment "ELEC") nécessite d’initier le découpage à l’indice positionnel 5 sur une amplitude de quatre caractères consécutifs :
=STXT(A3; 5; 4)
Cette approche standardisée garantit la reproductibilité des classifications typologiques au sein de vastes entrepôts de données.
3.3 Diagnostic des décalages d’indices et remédiations
L’écueil méthodologique le plus prévalent lors de l’implémentation de la fonction STXT réside dans le phénomène bien connu en science informatique sous le nom d’« erreur du décalage d’un » (ou off-by-one error). Cette dérive systématique se produit lorsque l’analyste confond la position ordinale d’un caractère avec la distance de décalage séparant ce caractère de l’origine de la chaîne. Par exemple, si l’on souhaite extraire une séquence débutant immédiatement après un tiret situé à l’indice 4, l’indice de départ doit être formellement fixé à 5 (4 + 1) et non à 4. L’omission de cette incrémentation mathématique élémentaire provoque l’inclusion indésirable du séparateur au sein du résultat extrait (renvoyant "-ELE" au lieu de "ELEC").
Pour immuniser les formules contre ces distorsions, il est recommandé de mettre en place un calibrage empirique préalable au moyen de chaînes tests témoins. Une séquence témoin standardisée telle que "1234567890ABCDEF" permet de visualiser instantanément les positions cibles et de vérifier la congruence de l’algorithme d’indexation.
Par ailleurs, un nettoyage de surface préalable s’avère indispensable : l’existence de variations typographiques invisibles (espaces doubles au sein de la chaîne) déplace mécaniquement l’ensemble des indices subséquents vers la droite. Par conséquent, l’harmonisation structurelle de la chaîne source à l’aide de fonctions de normalisation en amont constitue une exigence d’hygiène logicielle absolue avant tout recours à STXT.
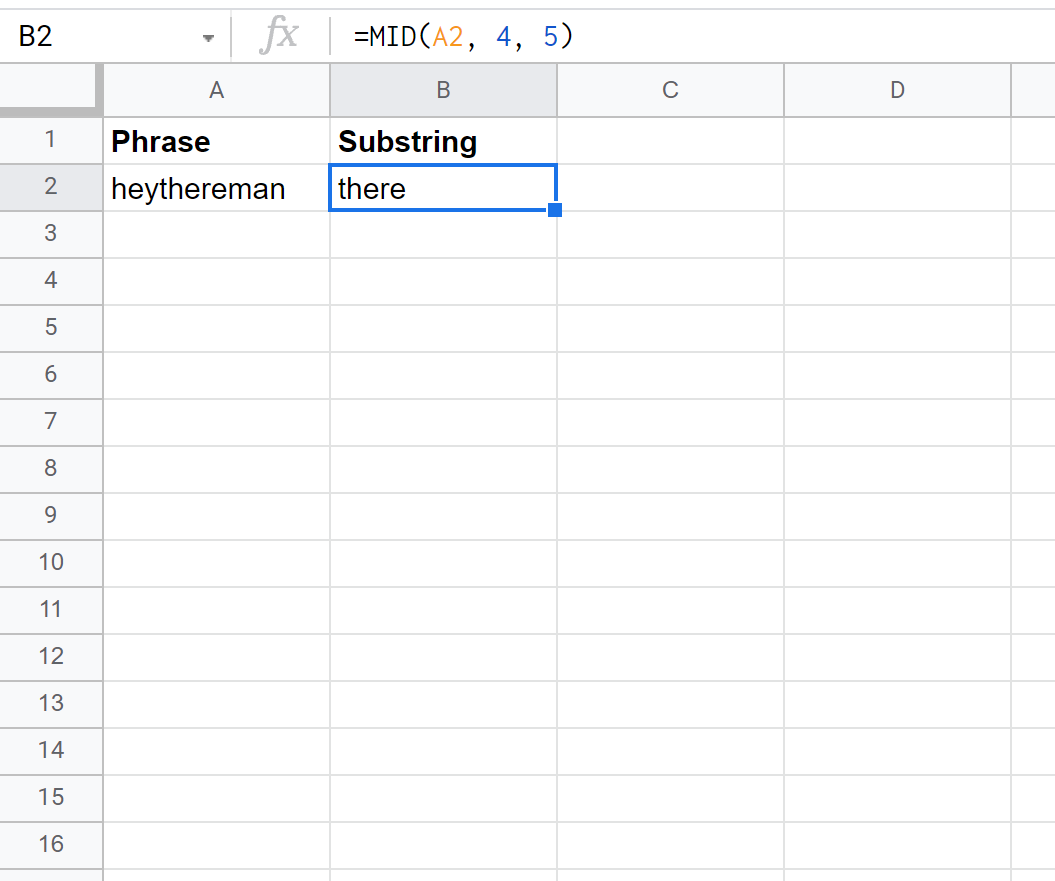
4. Méthode 3 : Extraction terminale rétrospective avec la fonction DROITE (RIGHT)
4.1 Fondements mathématiques et syntaxe de la fonction DROITE
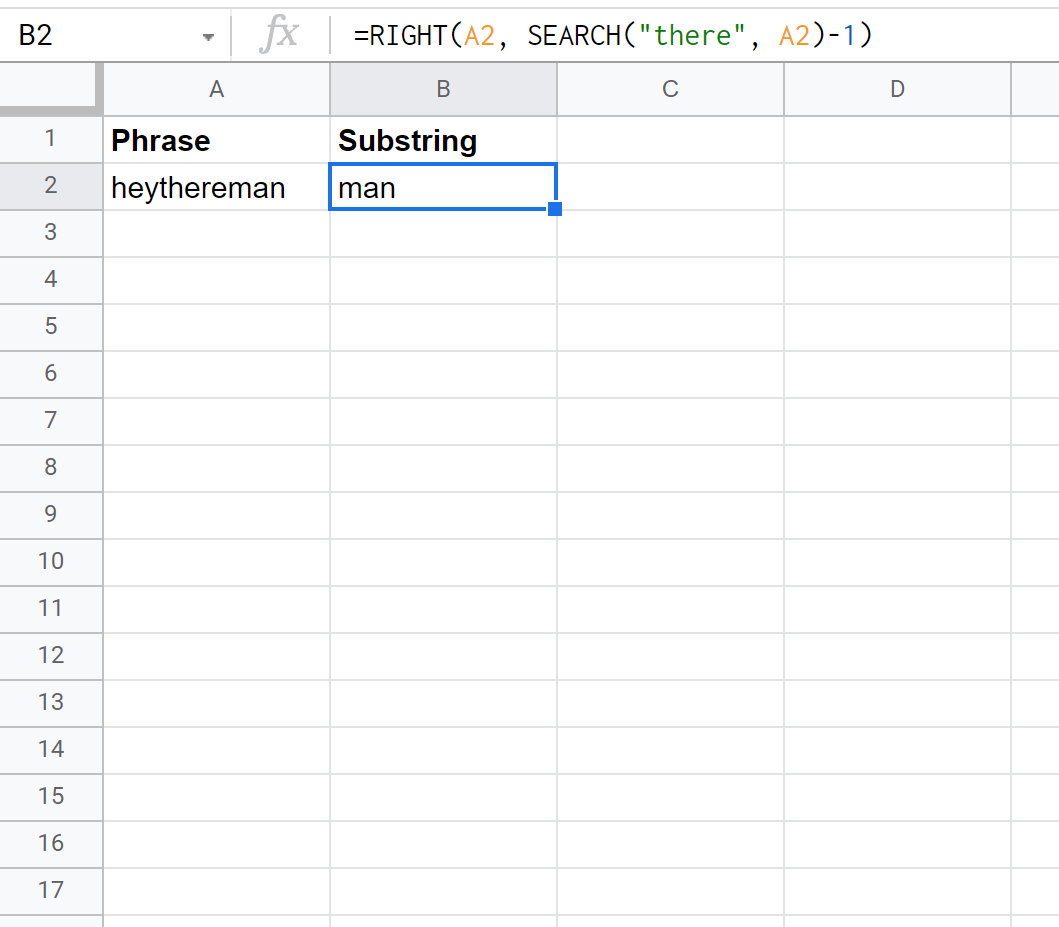
La fonction DROITE opère le symétrique spéculaire exact de la fonction GAUCHE : elle procède à un partitionnement rétrograde en sélectionnant un segment d’une amplitude donnée en partant de l’extrémité droite (le terminus ultime) de la chaîne de caractères. Sa structure syntaxique canonique s’articule comme suit : DROITE(texte; [nombre_caractères]). De manière analogue à sa contrepartie orientale, le second paramètre régulant le volume d’extraction demeure formellement optionnel et se voit affecter la valeur par défaut d’une unité scalaire (1) s’il n’est pas explicitement renseigné dans la formule.
Sur le plan mécanique, l’indexation rétrograde de DROITE peut être modélisée en termes mathématiques comme une fonction dérivée de la longueur totale de la chaîne. Extraire $k$ caractères avec la fonction DROITE(texte; k) équivaut sur le plan fonctionnel strict à invoquer l’opération centrale STXT(texte; (NBCAR(texte) - k) + 1; k). L’indice de départ est donc implicitement recalculé de manière dynamique en fonction de la taille absolue de la chaîne cible.
Cette interdépendance structurelle avec la longueur globale implique que tout facteur externe venant corrompre la métrique de l’entité textuelle modifiera par ricochet l’indice de départ calculé pour l’opération rétrograde. La fonction applique les mêmes tolérances limites que ses homologues : un paramètre de longueur supérieur à la longueur totale physique retournera la totalité du contenu textuel de la cellule sans déclencher de message d’alerte ou d’exception d’interruption.
4.2 Protocoles de prélèvement de suffixes et terminaisons
L’extraction terminale répond à des besoins critiques au sein de pipelines de traitement documentaire, particulièrement dans la gestion de bases de données multimédias et de registres d’archivage numérique. La récupération des extensions de fichiers représente l’un des archétypes d’application de cette méthode. Supposons une colonne de métadonnées documentaires au sein de laquelle des fichiers standardisés partagent tous une extension à trois lettres précédée d’un point (par exemple "rapport_financier_annuel.pdf" en A2, ou "synthese_protocole_clinique.csv" en A3). L’extraction systématique du type de document s’opère par l’instruction :
=DROITE(A2; 3)
Le traitement renvoie avec une fidélité parfaite les chaînes "pdf" et "csv", facilitant l’instauration ultérieure de segmentations conditionnelles ou de filtres d’inventaire par typologie de ressource.
Un autre cas d’usage régulier dans les secteurs de la bancassurance et de la recherche comportementale biométrique concerne l’isolement des composantes d’anonymisation terminales. Dans le cadre de la vérification de transactions sécurisées, la rétention des quatre derniers chiffres d’une séquence de carte de paiement ou d’un identifiant de compte (par exemple "FR76-3000-4000-5000-8910" en A4) constitue une modalité d’audit universelle :
=DROITE(A4; 4)
Cette commande dégage immédiatement le bloc terminal "8910", permettant une identification confirmée du sujet tout en garantissant la non-divulgation des données sensibles situées en amont dans la séquence alphanumérique.
4.3 Facteurs de distorsion et erreurs de troncature
L’opération rétrograde assurée par DROITE présente une sensibilité extrême aux contaminations spatiales de fin de chaîne. Dans un tableau de données, il est fréquent que des opérations de saisie manuelle ou des exportations de données mal optimisées introduisent subrepticeusement un ou plusieurs caractères d’espacement (espaces simples ou tabulations) à la clôture de la chaîne. Pour l’œil humain, la cellule contenant "rapport.pdf " semble identique à une cellule propre. Or, pour l’algorithme de DROITE, l’espace terminal est un élément physique d’indice valide. L’instruction =DROITE(cellule; 3) extraira dès lors la séquence "df " (deux lettres suivies d’une espace vide), produisant une extension tronquée et totalement inexploitable pour des analyses de regroupement.
Une autre source d’invalidité systémique provient de la présomption erronée d’homogénéité des longueurs de suffixes. Si l’on applique aveuglément l’argument scalaire 3 sur des extensions comprenant quatre caractères (à l’instar des formats modernes .docx, .xlsx ou .html), l’extraction produira respectivement "ocx", "lsx" et "tml", faussant irrémédiablement la taxonomie du catalogue.
La neutralisation méthodique de ces facteurs d’échec impose l’application systématique d’une passe de nettoyage structurel préalable au moyen de la fonction SUPPRESPACE (détaillée ultérieurement dans cet ouvrage), seule capable d’éradiquer les résidus terminaux avant que le découpage rétrograde ne soit opéré :
=DROITE(SUPPRESPACE(A2); 3)
5. Méthode 4 : Extraction dynamique en amont d’un délimiteur arbitraire
5.1 Articulation synergique entre GAUCHE et CHERCHE
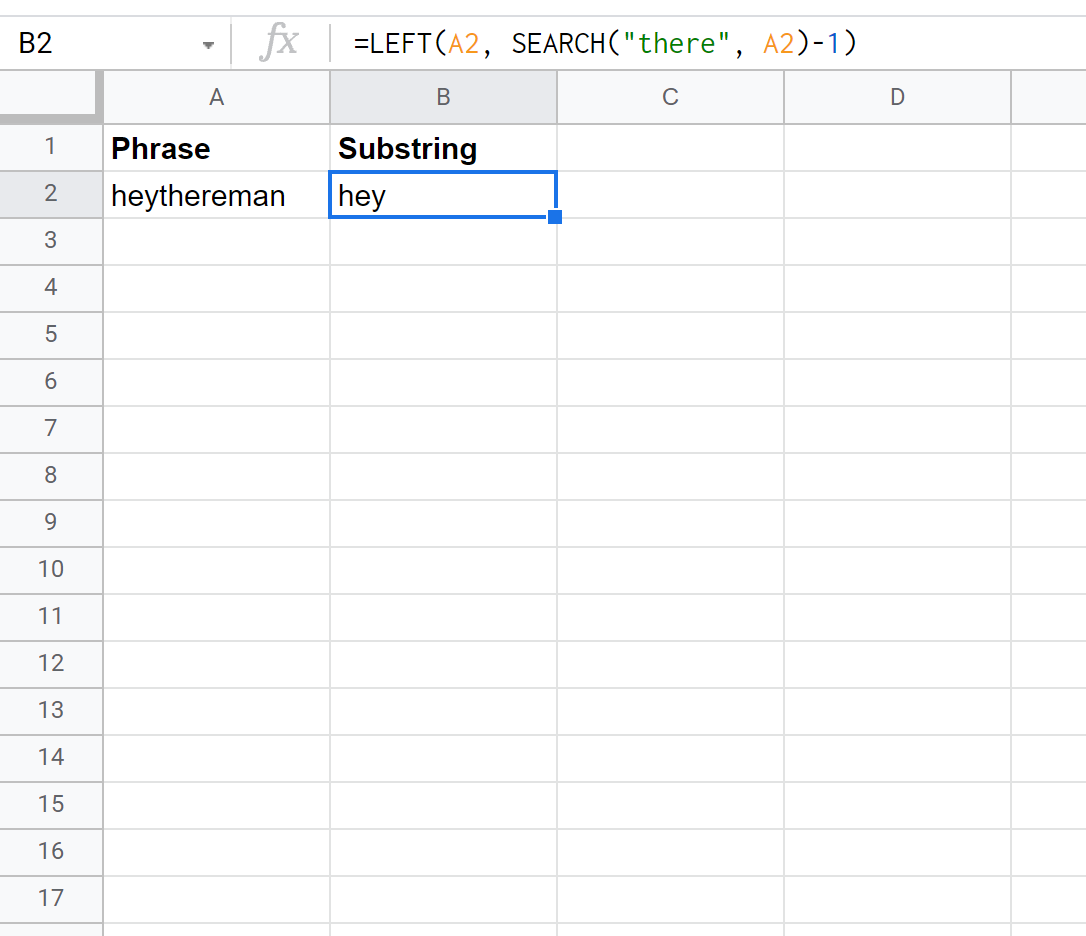
L’extraction statique par indexation constante atteint ses limites dès que les données présentent une variabilité morphologique, situation prédominante dans le monde réel. Pour extraire un préfixe dont la taille varie de façon imprévisible selon les enregistrements, il est nécessaire de substituer à l’argument constant de la fonction GAUCHE une équation dynamique basée sur la localisation spatiale d’un séparateur ou d’une balise contextuelle. Cette synergie algorithmique s’incarne magistralement dans la composition matricielle imbriquant GAUCHE et la fonction CHERCHE (nommée SEARCH en anglais).
La fonction CHERCHE(chaine_recherchée; texte_à_analyser; [position_départ]) procède à une analyse linéaire de gauche à droite afin d’identifier la première occurrence d’un métacaractère ou d’un séparateur donné, et retourne sous forme d’entier naturel son indice de positionnement scalaire exact. La caractéristique architecturale majeure de CHERCHE réside dans son insensibilité totale à la casse typographique (elle ne différencie pas minuscules et majuscules).
Dans la mesure où la position renvoyée par CHERCHE désigne précisément l’emplacement physique du séparateur lui-même, il est indispensable, dans le cadre d’une extraction propre d’un préfixe, d’opérer un ajustement arithmétique unitaire par décrémentation. En retranchant l’unité entière (-1) à la coordonnée renvoyée, on borne l’extraction strictement à l’élément précédant immédiatement la rupture textuelle. La formule paradigmatique s’énonce ainsi :
=GAUCHE(A2; CHERCHE("délimiteur"; A2) - 1)
5.2 Application méthodologique à l’extraction de prénoms et identifiants
L’exploitation de cette composition dynamique constitue le standard de référence pour la déconstruction des états civils combinés dans des listes de participants de recherche quantitative. Considérons une série de noms d’individus agrégés sous la forme conventionnelle "Prénom Nom" dans la colonne A (par exemple "Alexandre Dumas" en A2 et "Émile Zola" en A3). Les longueurs des prénoms respectifs sont éminemment variables (9 caractères pour Alexandre, 5 pour Émile), ce qui condamne toute approche par indexage statique. L’algorithme dynamique de partitionnement s’écrit de la façon suivante :
=GAUCHE(A2; CHERCHE(" "; A2) - 1)
Le traitement computationnel s’exécute séquentiellement : pour la cellule A2, CHERCHE(" "; A2) identifie le caractère d’espacement à l’indice positionnel 10. La soustraction unitaire fixe le paramètre de longueur de GAUCHE à 9 (10 – 1), capturant avec une exactitude clinique la chaîne "Alexandre", exempte de tout espace résiduel périphérique.
Cette méthodologie déploie une efficacité analogue lors de l’isolation du nom d’utilisateur (le local-part) au sein d’une adresse de courrier électronique standardisée. Considérons le courriel "[email protected]" stocké dans la cellule A4. L’extraction de l’identifiant opérant en amont du séparateur arobase ("@") s’effectue par la transposition rigoureuse du même principe formel :
=GAUCHE(A4; CHERCHE("@"; A4) - 1)
Cette expression isole instantanément le sous-composant "marie.curie", quelle que soit sa longueur réelle.
5.3 Variantes avec TROUVE (FIND) et délimiteurs alternatifs
Bien que la fonction CHERCHE convienne à la majorité des situations en raison de sa permissivité morphologique, il existe des configurations d’ingénierie textuelle où la sensibilité stricte à la casse devient une condition sine qua non de succès. Dans ces scénarios avancés, on substitue la fonction TROUVE (ou FIND en anglais) à la fonction CHERCHE. La syntaxe formelle demeure structurellement analogue, mais TROUVE discrimine méticuleusement les minuscules et les majuscules. Cette distinction s’avère indispensable pour découper des nomenclatures encodées selon la convention typographique CamelCase (par exemple "sujetAlphaTest"), où la transition typographique constitue le séparateur logique implicite.
Une complexité supérieure survient lorsque la chaîne source contient plusieurs instances du délimiteur cible. La fonction CHERCHE classique borne son exploration à la survenue de la toute première occurrence depuis la gauche. Si une chaîne contient la séquence "division-region-secteur" et que l’on vise le découpage au premier tiret, la formule précédente s’exécute impeccablement pour isoler "division". En revanche, si la chaîne est dépourvue du séparateur ciblé, l’évaluation déclenche inéluctablement une erreur de type #VALEUR!.
Pour conférer une résilience industrielle à l’architecture de calcul et prévenir les plantages en cascade dans les tableaux de bord décisionnels, il est impératif d’encapsuler la formule dynamique au sein d’une structure conditionnelle préventive utilisant la fonction SI.NON.DISP ou SIERREUR :
=SIERREUR(GAUCHE(A2; CHERCHE(" "; A2) - 1); A2)
Grâce à ce blindage formel, l’absence du délimiteur n’interrompt pas le calcul : la formule se contente de restituer la chaîne originelle intégrale comme valeur de repli logique par défaut.
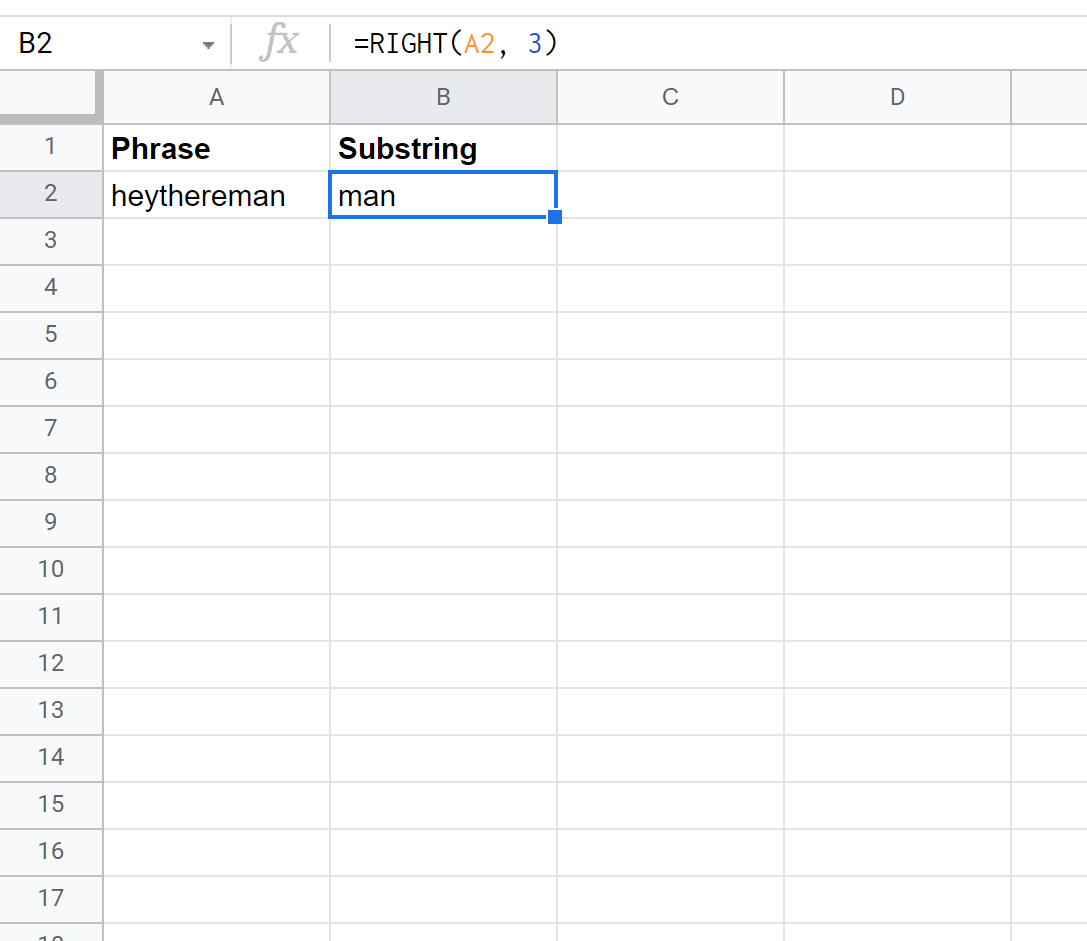
6. Méthode 5 : Extraction dynamique en aval d’un délimiteur contextuel
6.1 Formulation algébrique : Combinaison de DROITE, NBCAR et CHERCHE
L’extraction dynamique d’un suffixe d’amplitude variable situé en aval d’un délimiteur contextuel impose une gymnastique algébrique plus élaborée. Dans la mesure où la fonction DROITE effectue son décompte spatial depuis la terminaison orientale de la chaîne, et que la fonction CHERCHE localise le séparateur en mesurant une distance depuis l’origine occidentale (la marge gauche), il existe une asymétrie vectorielle qu’il convient de résorber par un calcul d’offset relatif.
Pour déterminer le volume exact de caractères résidant à droite du délimiteur, la solution algébrique universelle consiste à soustraire l’indice positionnel absolu du délimiteur (fourni par CHERCHE) de la longueur physique globale de la chaîne (déterminée par la fonction NBCAR). L’équation différentielle s’énonce simplement :
Amplitude_Suffixe = NBCAR(chaîne) - CHERCHE(délimiteur; chaîne)
En intégrant cette équation de décalage comme paramètre de dimensionnement au sein de la fonction d’extraction rétrograde DROITE, on obtient une formule robuste permettant de capter l’intégralité du contenu terminal, sans inclure le séparateur contextuel lui-même :
=DROITE(A2; NBCAR(A2) - CHERCHE("délimiteur"; A2))
Cette construction garantit que quelle que soit l’oscillation morphologique de la chaîne ou la position variable du séparateur, la fenêtre glissante de découpage s’ajustera au millimètre près sur la partie aval ciblée.
6.2 Alternative élégante reposant sur STXT et CHERCHE
Bien que la combinaison DROITE-NBCAR-CHERCHE soit historiquement plébiscitée par les utilisateurs de feuilles de calcul, il existe une formulation alternative nettement plus élégante et économique sur le plan cognitif, reposant sur l’association des fonctions STXT et CHERCHE. La fonction STXT réclame une coordonnée de départ et une amplitude d’extraction. En positionnant l’indice de départ immédiatement après le marqueur identifié (soit CHERCHE(délimiteur; A2) + 1), on s’ancre exactement sur le premier caractère utile de la terminaison.
L’astuce d’ingénierie algorithmique réside dans le calibrage de l’argument d’amplitude (nombre_caractères). Au lieu de calculer méticuleusement la longueur exacte du segment restant par une soustraction intermédiaire, l’analyste peut simplement assigner comme valeur d’amplitude la longueur totale de la chaîne originelle, soit NBCAR(A2). Comme nous l’avons établi dans la section consacrée aux spécifications de STXT, si l’amplitude sollicitée excède la longueur disponible au-delà du point d’ancrage, le moteur de Google Sheets extrait simplement tous les caractères jusqu’à l’extrémité finale de la cellule sans générer d’anomalie.
La syntaxe opérationnelle s’en trouve allégée et gagne en clarté sémantique :
=STXT(A2; CHERCHE("délimiteur"; A2) + 1; NBCAR(A2))
Cette approche réduit la charge de calcul en évitant une double imbrication et prévient les erreurs de parenthèses récurrentes lors de la rédaction de formules analytiques complexes.
6.3 Applications pratiques : Domaines de messagerie et noms de famille
L’intérêt empirique de ces protocoles d’extraction aval se manifeste immédiatement lors de la désagrégation de données nominatives et télématiques. En reprenant l’exemple d’un état civil combiné du type "Claude Shannon" stocké dans la cellule A2, la capture du patronyme (le nom de famille) localisé après le caractère d’espacement médian s’exécute de manière optimale via l’implémentation de la syntaxe STXT :
=STXT(A2; CHERCHE(" "; A2) + 1; NBCAR(A2))
Le moteur identifie l’espace à l’indice 7, bascule son ancrage d’extraction à l’indice 8 (7 + 1), et collecte tous les éléments subséquents pour retourner fidèlement la sous-chaîne "Shannon".
Dans le domaine de l’ingénierie des télécommunications et de l’audit informatique, l’extraction systématique des noms de domaine de serveurs de messagerie électronique répond au même protocole rigoureux. Considérons l’enregistrement "[email protected]" consigné dans la cellule A3. L’isolation de la structure d’hébergement DNS située à la droite de l’arobase s’opère par :
=STXT(A3; CHERCHE("@"; A3) + 1; NBCAR(A3))
Cette commande renvoie immédiatement la chaîne "bletchley.ac.uk". Cette donnée épurée peut dès lors être immédiatement soumise à des analyses de segmentation organisationnelle, d’authentification de nom de domaine ou de contrôle de validité des adresses.
7. Extraction avancée de sous-chaînes délimitées par deux marqueurs distincts
7.1 Mécanique du double ancrage positionnel
L’un des défis les plus sophistiqués de l’ingénierie textuelle élémentaire réside dans l’extraction d’une sous-chaîne nichée au sein d’un corps de texte complexe, enserrée entre deux marqueurs syntaxiques distincts et dissemblables. Cette architecture réclame la mise en œuvre d’un double ancrage positionnel pour déterminer de façon dynamique à la fois la borne inférieure d’ouverture et la borne supérieure de clôture du segment visé.
L’infrastructure technique repose exclusivement sur la fonction STXT, dont les deux paramètres variables doivent être asservis aux résultats de deux recherches lexicales coordonnées. La position de départ correspond naturellement à l’emplacement du marqueur initial d’ouverture, auquel on additionne la longueur physique de ce marqueur pour commencer la capture au premier caractère textuel utile. La détermination de l’amplitude constitue l’étape la plus critique : elle est mathématiquement égale à la distance différentielle séparant le marqueur de fin du marqueur de départ, minorée de la longueur du marqueur initial.
Pour garantir que la recherche du marqueur de clôture ne se méprenne pas en sélectionnant une occurrence située en amont du marqueur d’ouverture, il est formellement requis d’exploiter le troisième argument optionnel de la fonction CHERCHE, à savoir la position de départ de la scrutation. La formulation matricielle d’un double ancrage prend dès lors la configuration paramétrique suivante :
=STXT(A2; CHERCHE("["; A2) + 1; CHERCHE("]"; A2; CHERCHE("["; A2)) - CHERCHE("["; A2) - 1)
7.2 Cas d’école : Données entre parenthèses, crochets ou balises
L’exploitation de ces équations différentielles prend tout son sens lors du dépouillement de données psychométriques ou de registres cliniques où des annotations explicatives ou des scores quantitatifs sont enchâssés entre des signes de ponctuation au sein d’une observation textuelle libre. Supposons la consignation suivante en cellule A2 : "Sujet clinique (Score_BDI: 24) Réponse positive". Pour isoler la mesure diagnostique logée entre les parenthèses d’ouverture et de fermeture, le protocole s’articule comme suit :
=STXT(A2; CHERCHE("("; A2) + 1; CHERCHE(")"; A2) - CHERCHE("("; A2) - 1)
L’évaluation isole rigoureusement l’expression "Score_BDI: 24" sans altérer le flux textuel environnant.
Cette technique s’applique avec une efficacité redoutable au nettoyage de micro-balises de balisage textuel au format XML ou HTML simplifié, typiquement rencontrées lors de l’extraction de corpus web par moissonnage automatisé (web scraping). Soit une cellule contenant le fragment "<identifiant>ID_98821</identifiant>". Pour prélever le noyau sémantique sans recourir à un analyseur syntaxique externe, la formule calcule l’amplitude exacte comprise entre le chevron fermant ">" et le chevron d’ouverture terminal "</" :
=STXT(A2; CHERCHE(">"; A2) + 1; CHERCHE("</"; A2) - CHERCHE(">"; A2) - 1)
Le résultat extrait, soit la chaîne "ID_98821", se trouve immédiatement débarrassé de tout résidu de balisage structurel.
7.3 Résilience face aux délimiteurs asymétriques et imbriqués
L’implémentation de formules d’extraction à double ancrage rencontre des obstacles majeurs face à des données asymétriques ou caractérisées par des imbrications multiples du même délimiteur (par exemple des parenthèses imbriquées de type "Donnée (niveau 1 (niveau 2))"). Dans ce contexte précis, la fonction CHERCHE conventionnelle s’arrête systématiquement dès la première parenthèse fermante rencontrée, ce qui tronque la sous-chaîne et capture une fraction illégitime de la structure interne ("niveau 1 (niveau 2"), générant une rupture de symétrie lexicale.
Par ailleurs, si les délimiteurs d’ouverture et de fermeture sont des caractères identiques (comme deux guillemets standards """" ou deux barres obliques "/"), l’utilisation d’une syntaxe statique élémentaire échoue systématiquement car la deuxième fonction CHERCHE repérera exactement le même délimiteur que la première si son paramètre de position de départ n’est pas rigoureusement incrémenté.
Pour contrer cet écueil algorithmique lors de l’utilisation de séparateurs identiques, l’analyste doit impérativement paramétrer la seconde fonction CHERCHE pour qu’elle initie sa recherche vectorielle strictement après l’indice du premier séparateur repéré :
=STXT(A2; CHERCHE("/"; A2) + 1; CHERCHE("/"; A2; CHERCHE("/"; A2) + 1) - CHERCHE("/"; A2) - 1)
Ce protocole assure la robustesse du ciblage en obligeant le pointeur de recherche à sauter la première occurrence afin de localiser de manière fiable la frontière terminale de l’intervalle.
8. Exploitation de la puissance des expressions régulières avec REGEXEXTRACT
8.1 Introduction aux métacaractères et à la syntaxe RE2 dans Google Sheets
Lorsque la structure textuelle à traiter s’affranchit de toute régularité géométrique et que les délimiteurs sont variables, incertains ou multiples, les fonctions textuelles arithmétiques classiques atteignent un seuil de complexité ingérable. Google Sheets résout cette limitation par l’intégration d’un moteur d’expressions régulières accessible via la fonction maîtresse REGEXEXTRACT. Le processeur interne de Google Sheets applique rigoureusement les standards syntaxiques de la bibliothèque logicielle libre RE2, développée par Google pour garantir des performances d’exécution linéaires et prévenir les vulnérabilités liées aux retours sur trace exponentiels (catastrophic backtracking).
La syntaxe de base de l’opérateur s’énonce simplement : REGEXEXTRACT(texte; expression_régulière). Le premier argument spécifie la cellule cible, tandis que le second transmet un motif textuel combinant des caractères littéraux et des métacaractères computationnels. Parmi les classes de caractères fondamentales de la syntaxe RE2, citons notamment d (représentant tout chiffre décimal de 0 à 9), w (ciblant tout caractère alphanumérique ou trait de soulignement) et s (identifiant toute forme d’espace blanc, saut de ligne ou tabulation).
Ces classes sont complétées par des quantificateurs arithmétiques régissant la cardinalité du motif, tels que + (une ou plusieurs occurrences de l’entité précédente), * (zéro, une ou plusieurs occurrences) et ? (zéro ou une occurrence unique). Enfin, l’introduction de parenthèses de capture () permet de circonscrire précisément le segment textuel à renvoyer en sortie, ce qui confère à REGEXEXTRACT une puissance d’isolement analytique inégalée.
8.2 Motifs fondamentaux pour l’extraction de motifs hétérogènes
La supériorité opérationnelle de REGEXEXTRACT s’illustre de façon éclatante dans l’extraction sélective d’adresses de courrier électronique perdues au sein d’un paragraphe descriptif non standardisé. Imaginons que la cellule A2 contienne le compte-rendu textuel suivant : "L'investigateur principal a validé le protocole (contact: [email protected]) le mois dernier.". Pour capter directement l’adresse sans se soucier des parenthèses ou des espaces périphériques, on emploie le motif structurel suivant :
=REGEXEXTRACT(A2; "[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}")
Le moteur balaie la chaîne, ignore le texte narratif non pertinent et extrait avec une précision absolue la séquence conforme au schéma d’adressage électronique standard.
Un autre cas d’école empirique réside dans l’extraction de codes postaux ou de numéros d’identification normalisés au sein d’adresses physiques hétérogènes. Considérons une colonne où des adresses postales françaises mélangent typologies de voies et mentions complémentaires : "24 boulevard des Capucines, 75009 Paris". Pour isoler sans faille le code postal à cinq chiffres, il suffit de formuler une expression ciblant une rupture de mot suivie de cinq entités numériques contiguës :
=REGEXEXTRACT(A2; "bd{5}b")
Cette formule localise la sous-chaîne "75009", abstraction faite de la longueur globale de la phrase, du nom de la rue ou des annotations terminales.
8.3 Comparaison critique entre fonctions textuelles classiques et REGEXEXTRACT
L’arbitrage entre l’usage des fonctions textuelles conventionnelles (GAUCHE, STXT, CHERCHE) et l’arsenal des expressions régulières via REGEXEXTRACT repose sur un compromis entre flexibilité heuristique, lisibilité conceptuelle et charge computationnelle. Sur le plan de la compacité algorithmique, REGEXEXTRACT surpasse systématiquement ses concurrentes en réduisant des formules complexes et imbriquées de trois lignes à un motif synthétique de quelques caractères.
Néanmoins, cette flexibilité expressive a un coût matériel non négligeable. Le moteur de traitement RE2 nécessite l’instanciation d’un automate fini déterministe (DFA) pour chaque évaluation de motif. Sur de très vastes volumes de données (plusieurs dizaines ou centaines de milliers de lignes), l’invocation massive de formules REGEXEXTRACT induit une consommation significative de mémoire vive et un ralentissement perceptible du rendu de la feuille de calcul. À l’inverse, les fonctions déterministes primitives comme GAUCHE ou STXT s’exécutent en temps constant quasi-instantané, ne réclamant qu’une simple lecture d’adresses mémoires contiguës.
Sur le plan de la maintenance applicative, les formules fondées sur les expressions régulières souffrent d’une barrière d’accessibilité cognitive : un collaborateur profane sera souvent incapable de déboguer ou de modifier un motif RE2 complexe. Le tableau méthodologique ci-après résume les critères d’orientation opérationnelle :
| Dimension d’Évaluation | Méthodes Classiques (GAUCHE, STXT, DROITE) | Expression Régulière (REGEXEXTRACT) |
|---|---|---|
| Régularité structurelle requise | Très stricte à modérée (séparateurs fixes indispensables) | Hétérogène et bruitée (tolérance morphologique totale) |
| Consommation computationnelle | Extrêmement faible (temps de calcul quasi nul) | Modérée à lourde sur les très grands volumes |
| Accessibilité pour les tiers | Élevée (intuition arithmétique accessible) | Technique (nécessite une expertise en syntaxe RE2) |
| Robustesse face aux anomalies | Vulnérable aux absences inattendues de délimiteurs | Très haute résilience par filtrage de motifs |
9. Automatisation matricielle : Traitement en volume avec ARRAYFORMULA
9.1 Principes du calcul vectoriel appliqué aux flux de sous-chaînes
Dans le paradigme standard des feuilles de calcul, une formule d’extraction textuelle possède un comportement scalaire unitaire : elle est rédigée dans une cellule donnée, traite un enregistrement source unique, et doit être reproduite mécaniquement sur l’ensemble de la colonne par étirement manuel ou duplication logicielle. Cette approche archaïque présente des inconvénients majeurs en matière de maintenance industrielle, d’intégrité référentielle et de performance. Google Sheets permet de transcender cette contrainte grâce au calcul vectoriel orchestré par la fonction ARRAYFORMULA.
L’encapsulation d’un algorithme d’extraction au sein d’une structure ARRAYFORMULA métamorphose le moteur de calcul en un processeur vectoriel unifié. Au lieu d’accepter une coordonnée unitaire (comme A2), la fonction accepte désormais une plage matricielle vectorielle continue (telle que A2:A). Le système itère alors automatiquement sur chaque vecteur de la colonne, projetant instantanément le résultat sur l’intégralité de la plage de sortie sans qu’aucune formule ne soit inscrite dans les cellules sous-jacentes.
À titre d’illustration, la vectorisation d’une extraction de préfixe basée sur GAUCHE combinée à une détection par CHERCHE se déploie depuis l’en-tête de colonne (cellule B2) de la manière suivante :
=ARRAYFORMULA(GAUCHE(A2:A; CHERCHE(" "; A2:A) - 1))
Une modification unique apportée à la cellule matricielle maîtresse modifie instantanément la logique d’extraction pour l’ensemble des milliers de lignes de l’expérience, garantissant une reproductibilité opérationnelle absolue.
9.2 Optimisation des plages ouvertes et préservation des performances
L’implémentation de plages matricielles ouvertes (du type A2:A) sans précautions de filtrage algorithmique engendre une détérioration critique des performances computationnelles. En l’absence de garde-fous explicites, le moteur ARRAYFORMULA traite indifféremment chaque ligne de la grille spatiale, y compris les cellules vierges s’étendant jusqu’aux confins structurels de la feuille (la limite par défaut étant fréquemment fixée à 50 000 lignes ou plus). Cette itération dans le vide déclenche des milliers de calculs inutiles, saturant la mémoire tampon et provoquant l’apparition massive d’erreurs #VALEUR! sur les lignes vides.
Pour éliminer radicalement cette surcharge computationnelle, il est impératif d’intégrer un filtre conditionnel d’interruption basé sur la détection de vacuité textuelle via la fonction ESTVIDE (ou son équivalent arithmétique A2:A=""). L’algorithme vectoriel optimisé s’articule formellement ainsi :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); ""; STXT(A2:A; CHERCHE("-"; A2:A) + 1; NBCAR(A2:A))))
Dans les versions contemporaines de Google Sheets, l’analyste peut également mobiliser les fonctions itératives avancées de type MAP associées aux fonctions LAMBDA, offrant une alternative modulaire puissante pour segmenter le traitement matriciel élément par élément :
=MAP(A2:A; LAMBDA(chaine; SI(chaine=""; ""; GAUCHE(chaine; 3))))
9.3 Industrialisation du prétraitement pour la recherche quantitative
L’application systématique des méthodes vectorielles à grande échelle transforme radicalement la conduite des protocoles de préparation de données (data wrangling) en recherche quantitative. Dans le cadre d’essais cliniques multicentriques, d’études écologiques par capteurs distribués ou d’expérimentations en psychologie cognitive, les données brutes sont régulièrement collectées par des flux automatisés qui incrémentent les feuilles de calcul de manière asynchrone.
En déployant en amont des architectures matricielles en colonnes dédiées, les variables dérivées (identifiants de groupes, dates d’intervention isolées, codes de validation) sont calculées en temps réel dès l’instant où un nouvel enregistrement pénètre la feuille. Ce traitement automatisé élimine définitivement les risques d’erreur humaine inhérents au copier-glisser manuel de formules, où des omissions d’application sur des segments de lignes introduisent des discontinuités invisibles.
De plus, cette standardisation vectorielle simplifie considérablement la documentation des protocoles analytiques. Au lieu de décrire une myriade d’interventions disparates, le chercheur consigne dans son plan de gestion de données une unique fonction d’extraction vectorielle déclarative, rendant l’étape de prétraitement totalement transparente, vérifiable et reproductible pour l’ensemble de la communauté scientifique.
10. Normalisation préliminaire et assainissement des données textuelles
10.1 Éradication des pollutions d’espacements par SUPPRESPACE et EPURAGE
Toute tentative d’extraction de sous-chaîne appliquée sur un corpus de données textuelles brutes non assaini est condamnée à une instabilité structurelle majeure. Les pollutions lexicales les plus insidieuses prennent invariablement la forme d’anomalies d’espacement et de caractères de contrôle résiduels non imprimables. Les espaces excédentaires positionnés en tête d’enregistrement faussent l’indexation de départ de la fonction GAUCHE, tandis que les espaces terminaux perturbent le calcul rétrograde de la fonction DROITE.
Pour neutraliser ces corruptions en amont de toute manipulation morphologique, l’arsenal méthodologique repose en premier lieu sur la fonction SUPPRESPACE (dénommée TRIM en environnement anglophone). Cette commande opère un triple mandat d’assainissement : elle purge l’intégralité des espaces situés au début de la chaîne, éradique sans condition tous les espaces terminaux, et réduit systématiquement toute succession d’espaces multiples internes à un unique intervalle standardisé.
Néanmoins, SUPPRESPACE demeure inopérante face aux caractères de contrôle invisibles du standard ASCII (points de code décimaux 0 à 31), tels que les tabulations horizontales (caractère 9), les sauts de ligne (caractères 10 et 13) ou les retours chariot générés par des interfaces logicielles hétérogènes. C’est ici qu’intervient la fonction complémentaire EPURAGE (nommée CLEAN). La fusion synergique de ces deux outils produit une formule d’assainissement total qu’il convient d’appliquer systématiquement à la source avant extraction :
=SUPPRESPACE(EPURAGE(A2))
10.2 Conversion typologique post-extraction : Le passage du texte au nombre
Une règle fondamentale régissant le moteur interne de Google Sheets stipule que toute sous-chaîne générée par l’invocation des fonctions d’extraction natives (GAUCHE, STXT, DROITE ou REGEXEXTRACT) se voit invariablement assigner le typage scalaire de texte (ou chaîne alphanumérique). Cette assignation persiste sans exception, même si la sous-chaîne résultante n’est constituée que d’une succession exclusive de symboles numériques décimaux (comme "125").
Cette classification typologique engendre des blocages mathématiques immédiats si cette valeur extraite est ensuite soumise à des fonctions de calcul quantitatif telles que SOMME, MOYENNE ou des opérateurs logiques de comparaison. Une valeur textuelle "125" sera ignorée par la plupart des fonctions d’agrégation numérique standard ou induira des erreurs d’incompatibilité logique.
Pour rétablir le statut arithmétique authentique d’une sous-chaîne numérique extraite, l’analyste dispose de deux méthodes canoniques éprouvées. La première consiste à encapsuler l’extraction au sein de la fonction dédiée CNUM (nommée VALUE en anglais) :
=CNUM(STXT(A2; 5; 3))
La seconde technique, empruntée à l’ingénierie financière avancée pour son économie syntaxique, repose sur l’application de l’opérateur arithmétique unaire double (le double signe négatif --). Cet opérateur contraint le processeur à exécuter une double négation numérique implicite, ce qui convertit instantanément le type de la valeur sans en altérer la grandeur scalaire :
=--STXT(A2; 5; 3)
10.3 Gestion de la casse et standardisation morphologique
L’efficacité des algorithmes de recherche lexicale dynamique (notamment TROUVE) dépend directement de la standardisation de la casse typographique des données analysées. Dès lors que l’on traite des volumes massifs générés par des opérateurs multiples ou des formulaires ouverts, la disparité typographique (mélange aléatoire de majuscules, de minuscules ou de capitalisations partielles) constitue une cause prévalente de rupture computationnelle.
Pour harmoniser un registre textuel avant d’engager des calculs d’indexation complexes, Google Sheets propose trois fonctions fondamentales de modification morphologique : MAJUSCULE (ou UPPER), qui convertit la totalité des caractères alphabétiques en capitales ; MINUSCULE (ou LOWER), qui applique une transposition intégrale vers le bas de casse ; et NOMPROPRE (ou PROPER), qui assigne une capitale au caractère initial de chaque mot tout en réduisant les suivants.
L’incorporation de ces normalisateurs morphologiques au cœur des comparateurs dynamiques permet de construire des motifs invariants. Par exemple, si l’on recherche le marqueur "ref" dans une cellule A2 dont la capitalisation est imprévisible, l’unification morphologique garantit le succès systématique de l’évaluation :
=CHERCHE("REF"; MAJUSCULE(A2))
Ce protocole assure la préservation de la sémantique originelle tout en éliminant les aléas liés aux variations typographiques lors des transferts de données entre plateformes logicielles hétérogènes.
11. Résolution méthodique des erreurs et diagnostic algorithmique
11.1 Typologie et étiologie des anomalies récurrentes
Le développement d’architectures d’extraction textuelle complexes s’accompagne inévitablement de manifestations d’erreurs computationnelles que le chercheur doit être capable de diagnostiquer et de résoudre avec méthode. L’anomalie la plus omniprésente dans l’ingénierie des sous-chaînes est l’erreur #VALEUR! (ou #VALUE!). Son étiologie renvoie presque exclusivement à un échec d’évaluation au sein des fonctions de recherche (CHERCHE ou TROUVE) lorsqu’un motif ou délimiteur spécifié demeure introuvable dans la cible, ou à l’injection d’une coordonnée géométrique négative ou nulle au sein des arguments de position ou d’amplitude.
Une seconde typologie d’anomalie majeure est matérialisée par l’erreur #REF!. Dans le contexte de l’extraction textuelle, cette rupture structurelle survient principalement lors du déploiement de formules matricielles vectorisées (ARRAYFORMULA). Si la plage de sortie requise pour projeter les résultats du calcul vectoriel est partiellement occupée ou obstruée par une donnée préexistante, le moteur refuse d’écraser la donnée et suspend l’exécution en générant un conflit d’extension spatiale (spill error).
Enfin, il convient de souligner l’erreur pernicieuse résultant de longueurs calculées négatives. Lorsque la formule soustrait la position d’un marqueur A de celle d’un marqueur B, et que le marqueur B apparaît en réalité avant le marqueur A dans la chaîne, la différence arithmétique résultante génère une amplitude négative. Injectée dans STXT ou GAUCHE, cette valeur non naturelle provoque l’arrêt immédiat du calcul et l’affichage d’une erreur #VALEUR!.
11.2 Techniques de blindage logique et tolérance aux pannes
Pour assurer la pérennité opérationnelle des modèles de données face à des corpus volumineux et imparfaits, l’intégration de mécanismes défensifs est impérative. La technique fondamentale consiste à encapsuler les segments de formules vulnérables au sein de fonctions d’interception conditionnelle d’erreurs. L’opérateur le plus puissant est la fonction SIERREUR (nommée IFERROR), laquelle évalue une expression primaire et, en cas de survenue d’une anomalie quelconque, bascule vers une valeur de substitution prédéfinie :
=SIERREUR(GAUCHE(A2; CHERCHE("-"; A2) - 1); "NON_DEFINI")
Bien que particulièrement efficace, SIERREUR présente l’inconvénient de masquer indistinctement toutes les typologies d’erreurs, y compris des fautes de syntaxe interne ou des erreurs de références circulaires qui mériteraient une intervention technique. Il est donc souvent plus rigoureux sur le plan méthodologique de restreindre l’interception aux seuls échecs de localisation en recourant à la fonction SI.NON.DISP (ou IFNA).
Une bonne pratique d’ingénierie logicielle appliquée aux feuilles de calcul consiste à instaurer des « valeurs sentinelles » explicites (comme des codes d’anomalie documentés : "ERR_SANS_SEPARATEUR", "VALEUR_MANQUANTE") plutôt que de retourner une simple cellule vide. Ce protocole facilite l’audit ultérieur des données en permettant de dénombrer et d’isoler rapidement les lignes nécessitant une révision humaine ou un nettoyage ciblé.
11.3 Protocole de débogage pas à pas d’une formule imbriquée
Face à une formule d’extraction complexe hautement imbriquée qui génère un résultat aberrant ou un message d’erreur persistant, l’analyste ne doit pas tenter de réécrire l’algorithme d’un bloc. Il convient d’appliquer un protocole d’isolation séquentielle modulaire, décomposant la formule en ses briques élémentaires pour tester individuellement chaque palier computationnel.
Le protocole standardisé de débogage se structure en trois étapes successives :
- Étape 1 : Diagnostic des coordonnées de localisation. Isolez les fonctions
CHERCHEouTROUVEdans des colonnes de test temporaires et visualisez les entiers scalaires renvoyés. Vérifiez scrupuleusement que les positions identifiées correspondent physiquement aux délimiteurs attendus, en tenant compte d’éventuels espaces masqués. - Étape 2 : Vérification arithmétique de l’amplitude. Calculez la métrique différentielle (la distance séparant les marqueurs ou l’offset résiduel) dans une cellule indépendante. Confirmez formellement que cette valeur est un entier strictement positif ($>0$) et qu’elle concorde avec la dimension réelle de la sous-chaîne ciblée.
- Étape 3 : Injection dans la fonction d’extraction d’accueil. Réintégrez progressivement les arguments validés au sein de la fonction maîtresse (
STXT,GAUCHEouDROITE). Cette approche par décomposition isole instantanément l’opérateur responsable de l’anomalie et permet une correction ciblée sans ambiguïté.
12. Études de cas intégrées et protocoles d’ingénierie des données
12.1 Cas 1 : Désagrégation d’une clé d’anonymisation de sujet d’étude
Pour illustrer la mise en œuvre pratique de ces préceptes au sein d’un protocole d’ingénierie des données scientifiques, examinons le cas de la déconstruction d’une clé d’anonymisation multicomposants au sein d’une cohorte clinique internationale. Considérons une table où chaque sujet se voit attribuer un identifiant alphanumérique normalisé stocké dans la colonne A, configuré sous le schéma standard suivant : "2023-PAR-EXP04-V2". Cette structure agrège successivement l’année d’inclusion (4 caractères), l’identifiant du centre hospitalier investigateur (3 caractères), la désignation du protocole expérimental (5 caractères) et le statut de révision de version (2 caractères).
La décomposition systématique et synchrone de cette structure en variables atomiques discrètes prêtes pour l’analyse statistique s’opère par le déploiement d’un panel coordonné de formules spécialisées réparties sur les colonnes adjacentes :
- Extraction de l’Année (Colonne B) : Découpage initial de préfixe direct :
=GAUCHE(A2; 4)
Cette formule retourne la chaîne"2023". - Extraction du Centre Hospitalier (Colonne C) : Découpage interstitiel fixe :
=STXT(A2; 6; 3)
L’extraction s’ancre au 6e caractère et capture le segment"PAR". - Extraction du Protocole Expérimental (Colonne D) : Découpage interstitiel central :
=STXT(A2; 10; 5)
Elle isole fidèlement le code d’affectation"EXP04". - Extraction de la Version (Colonne E) : Extraction terminale rétrograde :
=DROITE(A2; 2)
Cette commande dégage le marqueur suffixe"V2".
Grâce à ce partitionnement rigoureux, la feuille de calcul transforme une matière textuelle opaque en une matrice d’analyse factorielle multidimensionnelle parfaitement normalisée.
12.2 Cas 2 : Parsing de journaux d’horodatage et métadonnées d’interaction
Le second scénario d’ingénierie analytique concerne le traitement de traces d’interaction numérique (fichiers journaux de serveurs d’expérimentation en ligne) collectant des flux d’événements comportementaux d’utilisateurs. Les données brutes issues de l’infrastructure logicielle se présentent sous forme d’une chaîne concaténée brute enregistrée en cellule A2 : "LOG_SERVER [2023-10-25 14:02:11.842] IP:192.168.1.45 LATENCY:124ms SUCCESS".
La mission d’ingénierie consiste à extraire deux variables fondamentales pour l’analyse chronométrique : d’une part, l’estampille temporelle complète isolée de ses marqueurs, et d’autre part, la mesure de latence en millisecondes convertie au format numérique.
L’isolement de l’estampille temporelle encadrée par des crochets s’exécute à l’aide de l’algorithme à double délimiteur asymétrique :
=STXT(A2; CHERCHE("["; A2) + 1; CHERCHE("]"; A2) - CHERCHE("["; A2) - 1)
Cette expression isole la chaîne chronologique "2023-10-25 14:02:11.842".
Pour capturer la métrique de latence sans subir les fluctuations de l’adresse IP située en amont, on déploie une expression régulière avec REGEXEXTRACT, capable de cibler directement le motif d’étiquetage contextuel et d’en extraire la composante chiffrée :
=CNUM(REGEXEXTRACT(A2; "LATENCY:(d+)ms"))
Le groupe de capture délimité par les parenthèses (d+) prélève uniquement la séquence de chiffres décimaux consécutifs suivant immédiatement l’étiquette "LATENCY:", tandis que la fonction CNUM réactive la polarité numérique de la donnée en sortant la valeur entière 124, immédiatement exploitable pour des régressions statistiques ou des calculs de dispersion chronométrique.
12.3 Synthèse architecturale et matrice décisionnelle
L’ingénierie du prétraitement textuel dans Google Sheets requiert une sélection raisonnée de la méthode la plus appropriée à chaque contexte technique. Choisir une méthode inadaptée peut alourdir inutilement les calculs ou rendre le classeur excessivement fragile face aux imprévus de saisie. Le tableau synoptique décisionnel ci-après synthétise les propriétés structurelles, les coûts algorithmiques et les cas d’application optimaux associés à chacune des méthodes explorées au long de cet ouvrage :
| Méthode Computationnelle | Formule Type de Référence | Niveau de Complexité | Scénario d’Usage Recommandé |
|---|---|---|---|
| Extraction Préfixe Fixe | =GAUCHE(texte; n) |
Faible | Codes standardisés d’amplitude invariable (ISO, pays, années). |
| Extraction Médiane Fixe | =STXT(texte; départ; n) |
Faible | Structures de codes strictes (NIR, immatriculations, nomenclatures). |
| Extraction Suffixe Fixe | =DROITE(texte; n) |
Faible | Extensions documentaires régulières, 4 derniers chiffres de cartes. |
| Amont Délimiteur Dynamique | =GAUCHE(texte; CHERCHE(d; texte)-1) |
Moyen | Prénoms dans un état civil, identifiants avant séparateur. |
| Aval Délimiteur Dynamique | =STXT(texte; CHERCHE(d; texte)+1; NBCAR(texte)) |
Moyen | Noms de domaine de courriels, patronymes en fin de libellé. |
| Double Balisage Linéaire | =STXT(texte; CHERCHE(d1; texte)+1; CHERCHE(d2; texte)-...) |
Élevé | Données encapsulées dans des parenthèses, crochets ou balises XML. |
| Extraction par Motif RE2 | =REGEXEXTRACT(texte; motif) |
Avancé | Extraction heuristique sur flux désorganisés ou motifs complexes. |
| Vectorisation Matricielle | =ARRAYFORMULA(...) ou =MAP(...) |
Avancé | Industrialisation de colonnes complètes sans étirement manuel. |
En adoptant ces méthodologies rigoureuses et en intégrant systématiquement des phases de normalisation en amont ainsi que des garde-fous contre les erreurs de décalage d’indices, les analystes de données s’assurent d’ériger des architectures d’analyse textuelle fiables, évolutives et parfaitement reproductibles au sein de l’environnement de calcul de Google Sheets.
Références
- Google. (2023). Google Sheets function list. Google Docs Editors Help. https://support.google.com/docs/answer/3093281
- Google. (2023). REGEXEXTRACT function. Google Docs Editors Help. https://support.google.com/docs/answer/3098244
- Google. (2023). ARRAYFORMULA function. Google Docs Editors Help. https://support.google.com/docs/answer/3093275
- Google. (2022). RE2 syntax reference. GitHub Repository. https://github.com/google/re2/wiki/Syntax
- International Organization for Standardization. (2020). Codes for the representation of names of countries and their subdivisions (ISO Standard No. 3166). https://www.iso.org/iso-3166-country-codes.html
- Unicode Consortium. (2022). The Unicode Standard, Version 15.0. Unicode Consortium. https://www.unicode.org/versions/Unicode15.0.0/
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10