
Dans le paysage contemporain des sciences computationnelles, de la bio-informatique, de l’économétrie et de l’ingénierie des données, la bibliothèque Pandas développée pour le langage Python s’est imposée comme le standard empirique pour la manipulation, le nettoyage et l’analyse exploratoire de jeux de données structurés. Grâce à son objet fondamental, le DataFrame, Pandas offre un cadre d’abstraction matricielle d’une souplesse inégalée, permettant de formaliser des opérations vectorisées complexes sur des séries temporelles, des matrices de covariance ou de vastes cohortes observationnelles. Néanmoins, l’écosystème de la recherche scientifique et de l’aide à la décision industrielle ne fonctionne pas en vase clos à l’intérieur d’environnements d’exécution interactifs tels que Jupyter ou de pipelines d’intégration continue. Le transfert de données vers des formats ubiquitaires et interactifs demeure une nécessité opérationnelle absolue afin d’assurer la diffusion des résultats empiriques auprès de comités de lecture, d’analystes métier ou d’instances de régulation.
Parmi ces vecteurs de communication, le classeur tableur, incarné historiquement et universellement par l’application Microsoft Excel et ses spécifications de format associées, occupe une position paradoxale mais incontournable. Bien que les informaticiens et les statisticiens pointent fréquemment du doigt les risques méthodologiques liés aux artefacts d’interprétation automatique des cellules ou aux contraintes volumétriques des tableurs, le format Office Open XML SpreadsheetML (.xlsx) constitue le dénominateur commun de l’échange documentaire institutionnel. La capacité d’extraire des matrices numériques épurées depuis la mémoire vive d’un interpréteur Python pour les matérialiser fidèlement sous la forme de classeurs structurés, annotés, multi-onglets et stylisés représente une compétence technique charnière pour quiconque aspire à conjuguer rigueur algorithmique et pragmatisme communicationnel.
Le présent traité méthodologique se propose d’explorer de manière exhaustive, approfondie et systématique l’ensemble des mécanismes régissant l’exportation de données depuis un DataFrame Pandas vers les formats de classeurs compatibles avec Microsoft Excel. Loin de se limiter à la simple récitation syntaxique d’une fonction élémentaire, cette monographie analyse les sous-jacents logiciels, les interactions avec les moteurs d’écriture tiers tels qu’openpyxl et XlsxWriter, la préservation scrupuleuse de la typologie des données, l’optimisation des flux d’entrées-sorties face à des volumes massifs, ainsi que les protocoles de validation indispensables à la conformité scientifique. En établissant une passerelle robuste entre la rigueur conceptuelle de Python et la flexibilité ergonomique du tableur, ce guide constitue un manuel de référence pour l’élaboration de pipelines de restitution de données reproductibles, sécurisés et pérennes.
1. Introduction aux enjeux méthodologiques de l’exportation de données Pandas vers Excel
1.1 Rôle du format tableur dans la communication des résultats de recherche
L’intégration croissante des langages de script scientifique au sein des laboratoires universitaires et des services de recherche et développement a profondément redéfini les standards de reproductibilité analytique. Cependant, la communication des résultats intermédiaires ou définitifs se heurte régulièrement à une fracture technologique notable entre les concepteurs de modèles algorithmiques et les parties prenantes institutionnelles. Dans ce contexte, le format tableur agit comme une interface sociotechnique fondamentale. Alors que la manipulation d’objets en mémoire via des terminaux textuels ou des calepins numériques requiert des compétences affirmées en programmation, le fichier Excel offre une affordance immédiate, permettant à tout évaluateur d’appréhender tactilement la distribution spatiale des observations, de déployer des filtres dynamiques ad hoc ou de vérifier des sous-totaux par des formules locales.
Cette accessibilité démocratique ne doit pas être interprétée comme une concession à la rigueur, mais plutôt comme un impératif de transparence épistémique. Les collaborateurs non programmeurs, qu’il s’agisse de cliniciens supervisant un essai randomisé, d’auditeurs financiers validant un modèle de risque ou de décideurs politiques évaluant des projections macroéconomiques, exigent des artefacts documentaires autonomes, manipulables sans dépendance logicielle lourde. Le transfert de données quantitatives depuis un DataFrame vers un classeur Excel permet de décentraliser l’examen critique des résultats. Il autorise une vérification sensorielle directe des valeurs extrêmes, des anomalies d’échantillonnage et des distributions marginales que des résumés statistiques statiques sous forme de graphiques matriciels ne sauraient pleinement retranscrire.
Néanmoins, la transition du code vers le tableur implique la responsabilité impérieuse de préserver l’intégrité des structures relationnelles. Une extraction mal maîtrisée risque de détruire l’ordonnancement dimensionnel des données, de corrompre les typologies fines ou de masquer des métadonnées contextuelles cruciales. La sérialisation tabulaire doit donc être pensée non pas comme un simple déversement de caractères typographiques, mais comme un acte de traduction méthodologique rigoureux, visant à transposer la sémantique computationnelle de l’environnement Python vers une sémiologie visuelle standardisée et directement exploitable au sein des suites bureautiques modernes.
1.2 Comparaison structurelle entre objets Pandas et classeurs Excel
Comprendre en profondeur le processus d’exportation exige une analyse comparative des paradigmes sous-tendant respectivement la bibliothèque Pandas et le logiciel Microsoft Excel. Un DataFrame Pandas est conceptuellement une matrice bidimensionnelle hétérogène dotée d’axes étiquetés. Chaque colonne, modélisée sous la forme d’un objet Series, est gouvernée par un type de données homogène unique et immuable en mémoire, adossé aux représentations de bas niveau de la bibliothèque NumPy ou aux architectures de colonnes d’Apache Arrow. Cette typologie stricte garantit la cohérence des calculs vectorisés et prévient les dérives sémantiques. De surcroît, le DataFrame intègre un index de lignes sophistiqué, capable de supporter des hiérarchies multiniveaux, des structures temporelles à haute fréquence ou des clés composites abstraites.
À l’opposé, la feuille de calcul Excel repose sur un modèle matriciel spatialisé non typé a priori au niveau de la colonne. Dans la grille d’un classeur, chaque cellule individuelle constitue une entité indépendante, possédant son propre format d’affichage, sa valeur sous-jacente et ses règles de calcul. Rien n’interdit théoriquement à une cellule Excel de contenir un entier, tandis que la cellule immédiatement inférieure héberge une chaîne de texte libre ou une formule récursive non résolue. Cette plasticité extrême, bien qu’ergonomique pour l’utilisateur manuel, représente un défi considérable lors de la sérialisation automatisée. Le compilateur de formats d’Excel tend à appliquer des règles d’inférence heuristique lors de la lecture des cellules, transformant par exemple arbitrairement des identifiants génétiques ou des codes postaux alphanumériques en valeurs numériques tronquées ou en notations scientifiques exponentielles non désirées.
La gestion des métadonnées axiales constitue une autre divergence fondamentale. Alors que l’index de Pandas est une dimension structurelle explicite, indispensable au réalignement relationnel et aux jointures internes, Excel ne dispose d’aucun concept natif équivalent en dehors de son système d’adressage cartésien immuable composé de lettres alphabétiques pour les colonnes et de nombres entiers pour les lignes. Exporter un DataFrame vers Excel impose dès lors un choix architectural : faut-il matérialiser l’index comme une colonne conventionnelle au risque de fausser les calculs d’agrégation ultérieurs dans le tableur, ou convient-il de le supprimer au profit d’une matrice purement positionnelle ? De même, la hiérarchie dimensionnelle des objets MultiIndex doit subir un aplatissement ou une fusion de cellules contiguës, opération visuellement élégante mais susceptible de compliquer la désérialisation ultérieure par d’autres logiciels statistiques.
1.3 Objectifs pédagogiques et cadre d’application du tutoriel
Ce document a pour vocation d’armer les chercheurs, ingénieurs et analystes d’une méthodologie systématique et reproductible pour orchestrer la sérialisation de données complexes. Le premier objectif réside dans la maîtrise opératoire absolue de la fonction d’exportation standardisée offerte par l’écosystème Pandas, en disséquant l’ensemble de ses arguments formels afin de neutraliser tout comportement implicite potentiellement destructeur pour l’intégrité scientifique des données. Nous examinerons avec précision comment chaque paramètre module le flux de bits généré, depuis la neutralisation des index superflus jusqu’à la restitution fidèle des chronodatations temporelles selon les normes internationales en vigueur.
Le second objectif pédagogique concerne le traitement rigoureux des cas particuliers inhérents aux protocoles expérimentaux avancés. Les environnements de laboratoire génèrent couramment des matrices creuses, des structures d’échantillonnage factorielles imbriquées, ainsi que des jeux de données pollués par des absences de réponse ou des pannes d’instrumentation. Nous aborderons de manière détaillée les stratégies d’encodage des valeurs nulles, la gestion des jeux de caractères multilingues complexes via l’Unicode, et les techniques de préservation de la précision numérique en virgule flottante, en prévenant les dégradations d’arrondi fréquemment introduites lors de la conversion entre bases binaires et décimales.
Enfin, ce tutoriel ambitionne de définir un cadre de travail pérenne s’inscrivant dans les principes contemporains de la science ouverte et de l’ingénierie logicielle défendue par la communauté scientifique internationale. À travers l’étude approfondie du gestionnaire de contexte d’écriture et l’interfaçage programmatique direct avec les moteurs de manipulation de classeurs, le lecteur apprendra à automatiser la production de rapports multi-onglets hautement documentés, enrichis de dictionnaires de variables et conformes aux chartes graphiques académiques les plus strictes. L’objectif ultime est d’abolir l’intervention manuelle post-exportation, source majeure d’erreurs humaines non traçables, au profit d’un flux de traitement intégralement automatisé et auditable de bout en bout.
2. Prérequis techniques et configuration de l’environnement Python
2.1 Installation et rôle critique du moteur openpyxl
La bibliothèque Pandas ne dispose pas, au sein de sa base de code source native, de modules bas niveau dédiés au décodage et à la compilation des spécifications binaires et XML régissant les fichiers de la suite bureautique Microsoft Office. Historiquement découplée des dépendances applicatives lourdes, Pandas délègue l’ensemble des opérations d’encodage physique à des moteurs d’écriture spécialisés tiers. Pour manipuler les classeurs modernes répondant à la norme ECMA-376 et adoptant l’extension .xlsx, la bibliothèque openpyxl s’impose actuellement comme la référence hégémonique et le moteur d’écriture désigné par défaut au sein des versions récentes de Pandas.
L’architecture d’openpyxl est conçue pour matérialiser l’intégralité de l’arborescence XML encapsulée à l’intérieur de l’archive compressée au format Zip qui constitue un fichier .xlsx. Lorsqu’un DataFrame est sérialisé, Pandas convertit ses structures vectorielles en séquences d’appels d’API adressées à openpyxl, qui se charge d’instancier les éléments de schéma XML correspondants, tels que les feuilles de travail, les chaînes partagées, les styles de formatage et les définitions de tables relationnelles. L’installation de cette dépendance critique s’effectue usuellement au sein d’un environnement virtuel isolé au moyen du gestionnaire de paquets standard de Python. L’exécution de la commande d’installation système permet de déployer openpyxl ainsi que ses propres dépendances mathématiques et de traitement d’images si des fonctionnalités graphiques avancées sont requises :
pip install openpyxl
Il est impératif, dans le cadre d’un protocole de recherche rigoureux, de valider programmatiquement la présence et la compatibilité de version de ce moteur avant d’initier un pipeline de traitement de données volumineux. Une omission d’installation se solderait, au moment de l’appel d’exportation, par une exception d’exécution bloquante de type ImportError, interrompant prématurément le flux de calcul. L’interaction sous-jacente entre l’abstraction conceptuelle de haut niveau de Pandas et les objets Worksheet d’openpyxl repose sur un protocole de communication synchrone où chaque cellule fait l’objet d’une instanciation typée, assurant ainsi que les métadonnées déclarées sous Python sont scrupuleusement traduites dans le schéma descriptif du document final.
2.2 Panorama comparatif des moteurs secondaires d’exportation
Bien qu’openpyxl constitue la solution standard pour la majorité des cas d’usage généraux, l’écosystème Python offre des alternatives spécialisées dont le choix raisonné dépend directement des contraintes de performance, de volumétrie et d’enrichissement graphique du projet de recherche. Parmi ces moteurs secondaires, la bibliothèque XlsxWriter se distingue par ses performances supérieures et son éventail fonctionnel extrêmement riche pour la génération ex nihilo de classeurs au format .xlsx. Contrairement à openpyxl, XlsxWriter est un moteur conçu exclusivement pour l’écriture séquentielle; il ne permet pas de relire ou de modifier un document préexistant, mais cette spécialisation unidirectionnelle lui confère une vitesse d’exécution accrue et une consommation de mémoire vive hautement optimisée lors de la création de très volumineuses tables de données.
XlsxWriter brille particulièrement lorsqu’il s’agit d’intégrer des fonctionnalités avancées d’Excel directement depuis Python, telles que la génération programmatique de diagrammes vectoriels complexes, l’application de filtres automatiques natifs élaborés, la validation de données par listes déroulantes ou l’insertion de règles de formatage conditionnel sophistiquées. À l’autre extrémité du spectre historique, la bibliothèque xlwt assure la maintenance du support pour l’ancien format binaire propriétaire .xls, caractéristique de Microsoft Excel 97 à 2003. L’usage de ce moteur patrimonial doit aujourd’hui être strictement circonscrit aux impératifs d’interopérabilité avec des systèmes informatiques embarqués anciens, des équipements de laboratoire obsolètes ou des bases de données institutionnelles non modernisées, en raison de ses limitations structurelles insurmontables, notamment le plafonnement strict à 65 536 lignes par feuille.
Le tableau conceptuel ci-dessous permet de synthétiser les critères d’arbitrage méthodologique présidant à la sélection du moteur d’exportation :
- openpyxl : Moteur universel par défaut. Supporte l’écriture, la lecture et l’édition de classeurs .xlsx existants. Idéal pour l’enrichissement de gabarits préconfigurés et les flux de travail standards. Vitesse modérée sur les très grands volumes.
- XlsxWriter : Moteur d’écriture pure haute performance pour formats .xlsx. Recommandé pour la production de rapports hautement stylisés, l’intégration de graphiques natifs Excel et les opérations exigeant une optimisation rigoureuse des temps d’encodage. Incompatible avec la relecture de fichiers.
- xlwt : Moteur d’archivage historique dédié à l’extension binaire .xls. À réserver impérativement aux contextes de rétrocompatibilité logicielle avec des architectures informatiques patrimoniales.
2.3 Initialisation du jeu de données expérimental de référence
Afin de fonder les démonstrations techniques de ce manuel sur une base empirique concrète et reproductible, nous concevons un jeu de données expérimental simulé représentant un protocole de recherche biométrique et psychométrique longitudinal. Ce DataFrame de référence intègre délibérément une diversité de types de données scalaires : des identifiants catégoriels alphanumériques, des variables continues à virgule flottante nécessitant un contrôle précis de la précision décimale, des variables discrètes temporelles standardisées selon le format ISO, ainsi que des vecteurs contenant des valeurs manquantes non aléatoires simulant des défaillances de capteurs ou des abandons de sujets au cours de l’étude.
La structuration de cette matrice d’étude s’effectue via l’instanciation programmatique d’un DataFrame exploitant les structures fondamentales de Pandas. Nous définissons une cohorte de sujets identifiés par un code alphanumérique unique, soumis à des mesures répétées de biomarqueurs sanguins, d’indices de réactivité cognitive et de statuts cliniques qualitatifs. Avant d’engager toute procédure de sérialisation sur le disque dur, une inspection rigoureuse de la structure s’impose à travers l’interrogation systématique des métadonnées de l’objet. L’analyse des dimensions de la matrice, obtenue par la propriété de forme bidimensionnelle, permet de vérifier le décompte exact des lignes et des colonnes constitutives.
De même, l’examen scrupuleux des types internes via l’attribut de typage des séries s’avère indispensable pour s’assurer que les variables n’ont pas fait l’objet d’un transtypage implicite pernicieux. Par exemple, les horodatages doivent être formellement encapsulés dans des types temporels explicites et non pas sous la forme d’objets textuels génériques, sous peine de voir le moteur d’exportation échouer dans la transmission des métadonnées de chronodatation au logiciel tableur. Cette étape préparatoire garantit la cohérence interne du corpus d’évaluation et prévient les erreurs de diagnostic qui pourraient survenir ultérieurement lors de la validation physique des classeurs générés sur le support de stockage persistant.
3. Syntaxe fondamentale et fonctionnement interne de la méthode to_excel()
3.1 Analyse de la signature canonique de DataFrame.to_excel()
La méthode d’instance to_excel() de la classe DataFrame représente le point d’entrée universel pour la conversion des structures tabulaires en classeurs bureautiques. D’un point de vue programmatique, sa signature présente un éventail exhaustif de paramètres formels permettant d’exercer un contrôle granulaire sur chaque dimension de la sérialisation physique. L’appel de cette méthode déclenche une routine synchrone complexe qui orchestre la translation séquentielle de la topologie mémoire du DataFrame vers le modèle objet du moteur d’écriture sélectionné.
Au cœur de cette signature se trouvent des arguments stratégiques : l’argument de destination qui accepte une chaîne de caractères représentant le chemin d’accès au fichier ou un gestionnaire de flux d’octets en mémoire tampon; le paramètre désignant la feuille de calcul cible; le commutateur booléen de gestion de l’index matriciel; ainsi que les spécificateurs de formatage des cellules vides et des chaînes temporelles. L’exécution de cette méthode mobilise des ressources d’entrées-sorties substantielles : la mémoire de l’interpréteur Python est temporairement sollicitée pour construire l’arbre structurel des cellules avant que ce dernier ne soit compressé selon les spécifications des archives Zip contenant les fichiers XML constitutifs du document final.
Il convient de souligner que l’appel standard de la méthode bloque l’interpréteur jusqu’à ce que la totalité des flux de bits ait été transférée et scellée sur le sous-système de stockage persistant. Cette nature bloquante garantit que l’intégrité transactionnelle du document est préservée avant que les lignes de code subséquentes ne tentent d’accéder au fichier généré pour des vérifications post-opératoires. La maîtrise des valeurs affectées par défaut à ces paramètres constitue la première ligne de défense contre les altérations involontaires de données lors de la publication automatique de rapports statistiques.
3.2 Procédure d’exportation basique vers un chemin d’accès défini
L’opération d’écriture la plus élémentaire consiste à transmettre au premier paramètre de la méthode une chaîne de caractères formalisant le chemin absolu ou relatif menant au fichier de sortie envisagé. Dans les environnements multiplateformes contemporains, la manipulation des chemins d’accès au système de fichiers requiert une vigilance particulière afin de prévenir les erreurs syntaxiques découlant des divergences entre les conventions de séparateurs de répertoires sous les systèmes d’exploitation Unix et Microsoft Windows. Sous ce dernier, l’emploi du séparateur barre oblique inversée peut être interprété par l’analyseur lexical de Python comme un caractère d’échappement, provoquant des erreurs de syntaxe particulièrement insidieuses.
Il est dès lors recommandé d’adopter systématiquement les classes de manipulation de chemins de haut niveau fournies par la bibliothèque standard pathlib de Python, ou, à défaut, d’encapsuler les chemins de fichiers Windows au sein de chaînes brutes en préfixant la séquence de caractères du littéral approprié. L’instruction d’écriture basique se formule alors en spécifiant explicitement le nom du fichier assorti de l’extension .xlsx. Dès l’exécution de la commande, Pandas instancie en arrière-plan le moteur openpyxl, initialise un classeur virtuel, transcode l’ensemble des données scalaires et génère le fichier cible sur le support physique.
À l’issue de cette opération élémentaire, un contrôle de conformité immédiat doit être opéré au niveau du système d’exploitation. Ce contrôle implique la vérification de l’existence physique du fichier au chemin spécifié, l’inspection de sa taille volumétrique en octets pour écarter l’éventualité d’un fichier vide généré suite à une exception silencieuse, et le cas échéant, le contrôle des privilèges d’accès en écriture accordés au processus Python sur le répertoire parent. Cette démarche minimale assure que le pont entre l’espace d’adressage virtuel de l’interpréteur et la mémoire de masse de la machine hôte a fonctionné sans rupture matérielle ou logique.
3.3 Comportement par défaut lors de la conversion des types
Lorsque la méthode est invoquée avec sa configuration par défaut, Pandas applique un protocole d’inférence et de conversion automatique visant à faire correspondre les types de données de ses séries internes aux formats primitifs supportés nativement par le standard de classeur électronique. Les colonnes typées comme des entiers ou des flottants sont immédiatement traduites en valeurs numériques pures au sein des cellules XML correspondantes. Cette conversion garantit que, dès l’ouverture du classeur sous l’application bureautique, ces champs sont immédiatement exploitables par le moteur de calcul mathématique d’Excel, permettant la sommation, le calcul de moyennes ou l’application de formules matricielles sans qu’aucune conversion textuelle préalable ne soit requise de la part de l’opérateur.
De même, les objets de type chaîne de caractères ou les catégories textuelles sont transcrits dans la table des chaînes partagées du classeur, préservant scrupuleusement la typographie d’origine. Les valeurs booléennes issues de masques logiques reçoivent quant à elles le typage logique natif d’Excel, s’affichant sous la forme standardisée VRAI ou FAUX selon la localisation linguistique de la suite bureautique de l’utilisateur final. Toutefois, deux comportements structurels majeurs appliqués par défaut méritent une attention analytique rigoureuse : l’insertion systématique de l’index et la génération de la ligne d’en-tête.
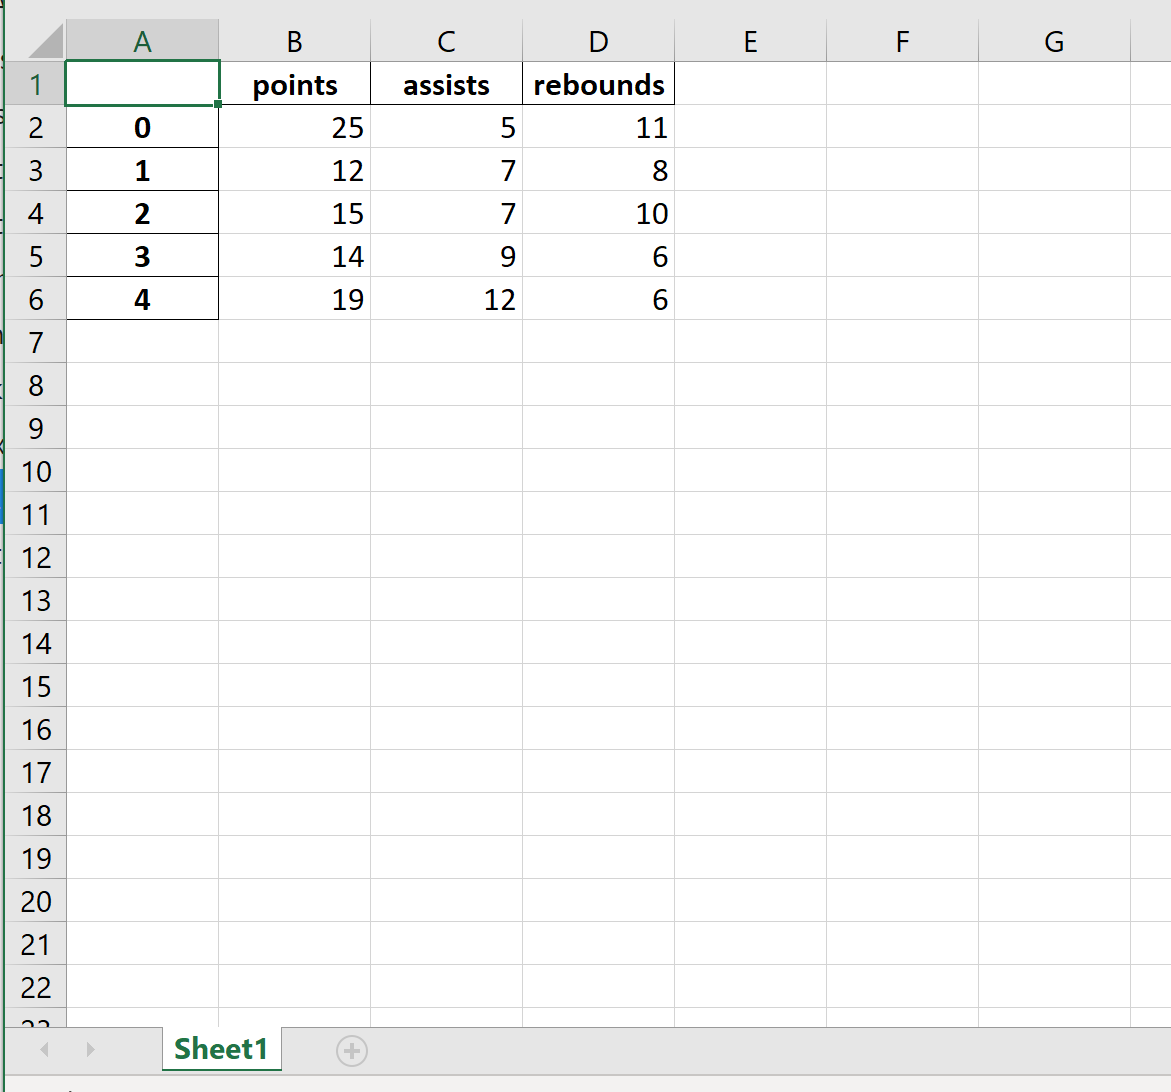
Par défaut, Pandas alloue l’entièreté de la première colonne physique de la feuille de calcul (la colonne A dans la nomenclature du tableur) à la sérialisation de l’index de lignes du DataFrame. Si l’utilisateur n’a pas explicitement défini d’index sémantique particulier au cours de son analyse statistique, cette colonne initiale accueille l’index de plage implicite, matérialisé par une suite incrémentale d’entiers débutant à zéro. Simultanément, la première ligne physique de la grille (la ligne 1) est automatiquement réservée aux étiquettes des colonnes. Bien que ce schéma garantisse l’exhaustivité théorique de la structure de données, il introduit fréquemment une redondance visuelle indésirable et peut interférer avec les logiciels de traitement aval qui s’attendent à ce que la première colonne corresponde immédiatement à la première variable empirique du protocole d’étude.
4. Gestion des index et des étiquettes de colonnes lors du transfert
4.1 Suppression de la colonne d’index numérique arbitraire
L’inclusion automatique de l’index de lignes de Pandas constitue l’une des sources de confusion les plus récurrentes lors du partage de résultats statistiques avec des collaborateurs externes. Dans la majorité des cas de figure analytiques, l’index par défaut généré par Pandas n’est qu’un artifice informatique positionnel, dépourvu de valeur informative intrinsèque pour le lecteur final. Présente dans la première colonne de la feuille de calcul sous un libellé souvent vide ou anonyme, cette suite d’entiers perturbe l’ergonomie visuelle, fausse les graphiques automatiques générés sous tableur et oblige souvent les destinataires à supprimer manuellement cette colonne parasite pour intégrer le tableau dans leurs propres synthèses documentaires.
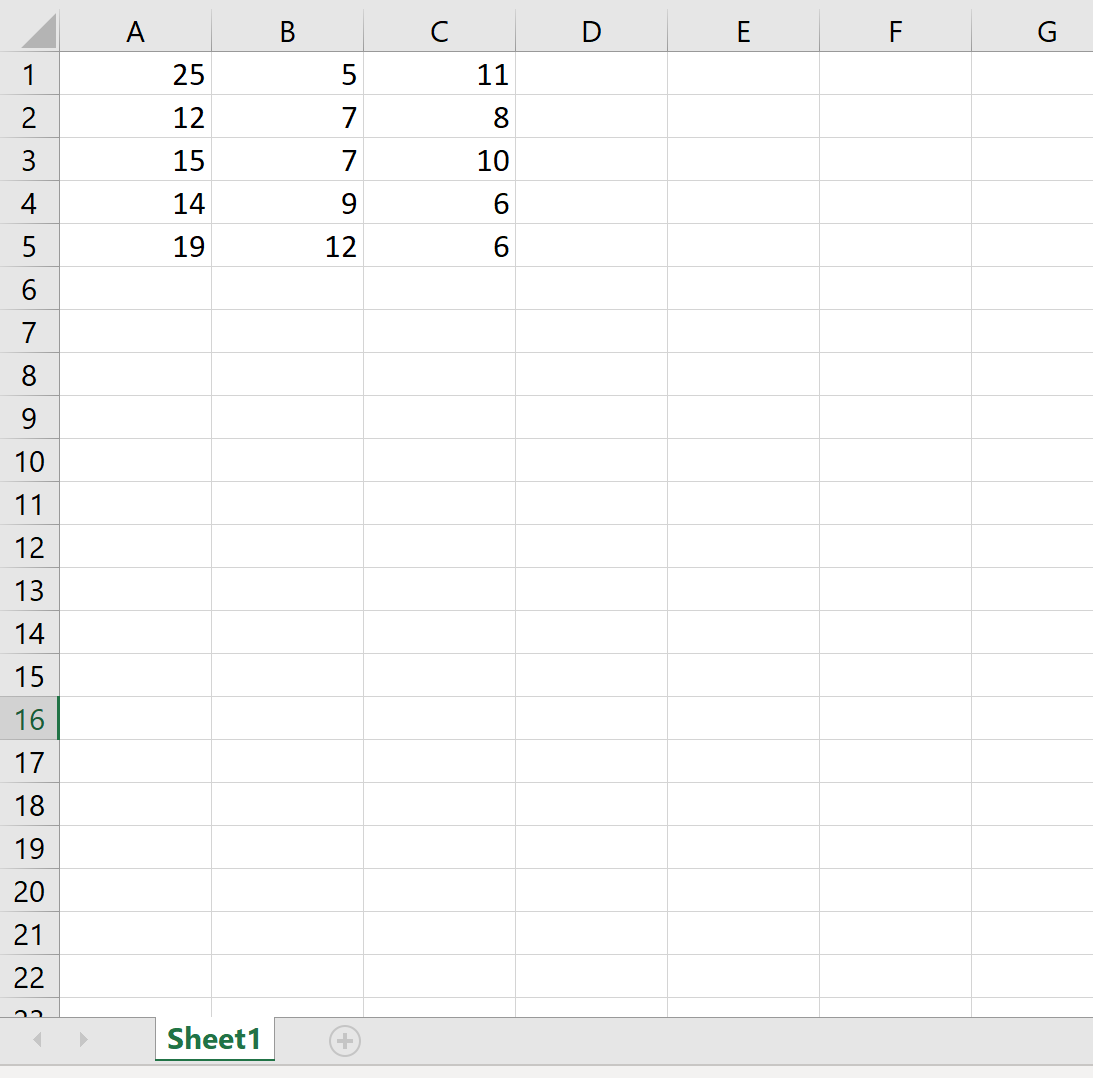
Pour remédier à cet écueil ergonomique et méthodologique, la méthode offre un levier d’action direct à travers l’argument booléen index. En affectant formellement la valeur booléenne False à ce paramètre lors de l’appel d’exportation, l’utilisateur intime au moteur d’écriture l’ordre strict de ne pas sérialiser l’axe d’indexation des lignes. Le flux de données commence alors immédiatement par la première variable empirique déclarée au sein des colonnes du DataFrame, occupant naturellement la colonne A de la grille Excel.
Cette pratique d’élagage délibéré s’avère hautement vertueuse dans tous les protocoles où les entités observationnelles disposent déjà de leurs propres identifiants explicites intégrés sous forme de variables dédiées dans le corps de la table. La lisibilité globale s’en trouve instantanément rehaussée : la table se présente sous une forme matricielle pure et compacte, facilitant son ingestion sans retraitement préalable par des logiciels d’analyse tiers ou des outils de modélisation relationnelle qui assimileraient à tort l’index incrémental à une variable prédictive ou à une mesure quantitative du phénomène étudié.
4.2 Masquage ou personnalisation des étiquettes d’en-tête
De manière analogue à la gestion des index de lignes, le traitement de l’en-tête de colonnes peut faire l’objet d’adaptations substantielles au moyen du paramètre header. Par défaut, ce dernier est positionné sur la valeur booléenne True, ce qui instruit le moteur d’insérer les étiquettes de colonnes sur la ligne initiale de la grille. Dans certaines architectures méthodologiques spécifiques, notamment lors de la constitution de bases de données brutes destinées à alimenter des macro-commandes industrielles ou des matrices mathématiques pures, il est impératif d’omettre totalement cette ligne de métadonnées textuelles. L’assignation de la valeur booléenne False à l’argument permet alors de neutraliser la génération des libellés et d’initier le remplissage des cellules dès la première coordonnée par les valeurs de données brutes.
Au-delà de cette neutralisation binaire, le paramètre offre une flexibilité de substitution particulièrement élégante : il autorise le passage d’une liste explicite de chaînes de caractères. Cette fonctionnalité permet de renommer à la volée l’ensemble des colonnes lors de la phase d’exportation physique sans altérer la dénomination interne des variables au sein de l’environnement Python en cours d’exécution. Les ingénieurs de données exploitent couramment cette possibilité pour transformer des identifiants de variables programmatiques courts, condensés ou standardisés en snake_case en libellés verbeux, descriptifs, accentués et formatés conformément aux exigences de clarté rédactionnelle des revues scientifiques ou des rapports institutionnels.
Il convient néanmoins d’exercer une rigueur mathématique stricte lors de l’utilisation de cette substitution : la collection de chaînes transmise au paramètre doit obligatoirement présenter une cardinalité strictement identique au nombre de colonnes constitutives du DataFrame exporté. Toute disparité dimensionnelle entre la longueur de la liste de substitution et la largeur de la matrice sous-jacente déclenche une exception de validation immédiate de la part de Pandas, prévenant ainsi tout risque de décalage spatial involontaire entre les intitulés de colonnes et les séries de mesures empiriques sous-jacentes.
4.3 Exportation avancée de structures d’index hiérarchiques (MultiIndex)
L’un des atouts conceptuels majeurs de Pandas réside dans sa capacité à manipuler des espaces dimensionnels complexes par l’intermédiaire de structures hiérarchiques d’indexation, couramment désignées sous le vocable technique de MultiIndex. Ces structures se révèlent fondamentales lors de l’exécution de groupements statistiques multifactoriels ou de la manipulation de données de panel combinant des dimensions temporelles, géographiques et expérimentales imbriquées. Lorsque la méthode est confrontée à un DataFrame pourvu d’un MultiIndex au niveau des lignes ou des colonnes, son comportement d’encodage par défaut s’adapte de façon spectaculaire.
Le moteur d’écriture traduit automatiquement la hiérarchie dimensionnelle en un ensemble ordonné de colonnes ou de lignes adjacentes au sein de la feuille de calcul. De surcroît, le paramètre booléen merge_cells, activé par défaut sur la valeur True, instruit le moteur de procéder à la fusion visuelle automatique des cellules contiguës partageant des valeurs d’étiquettes identiques aux niveaux hiérarchiques supérieurs. Cette fusion offre un rendu visuel d’une grande sophistication académique, rappelant les tables de contingence canoniques publiées dans les revues d’épidémiologie ou de psychométrie, où les catégories macroscopiques englobent visuellement les sous-facteurs d’échantillonnage sans redondance textuelle superflue.
Toutefois, cette élégance visuelle induite par la fusion de cellules pose un problème méthodologique majeur si le fichier généré est destiné à une réutilisation ultérieure par des pipelines d’ingestion automatisée. Dans le modèle sous-jacent d’Excel, une cellule fusionnée ne conserve sa valeur textuelle que dans la cellule d’ancrage supérieure gauche; l’ensemble des cellules subordonnées englobées dans la zone fusionnée contiennent en réalité des valeurs nulles. Si un utilisateur ultérieur tente de filtrer ou de trier la table sans précaution, des ruptures d’intégrité relationnelle apparaissent immédiatement. En conséquence, lorsque la finalité du classeur est l’interopérabilité computationnelle plutôt que la simple lecture humaine, il est formellement recommandé de désactiver cette fusion en configurant le paramètre sur False, garantissant ainsi que chaque ligne conserve l’intégralité de ses clés hiérarchiques explicites.
5. Personnalisation avancée de la structure du classeur : onglets et feuilles
5.1 Attribution explicite du nom de la feuille de calcul
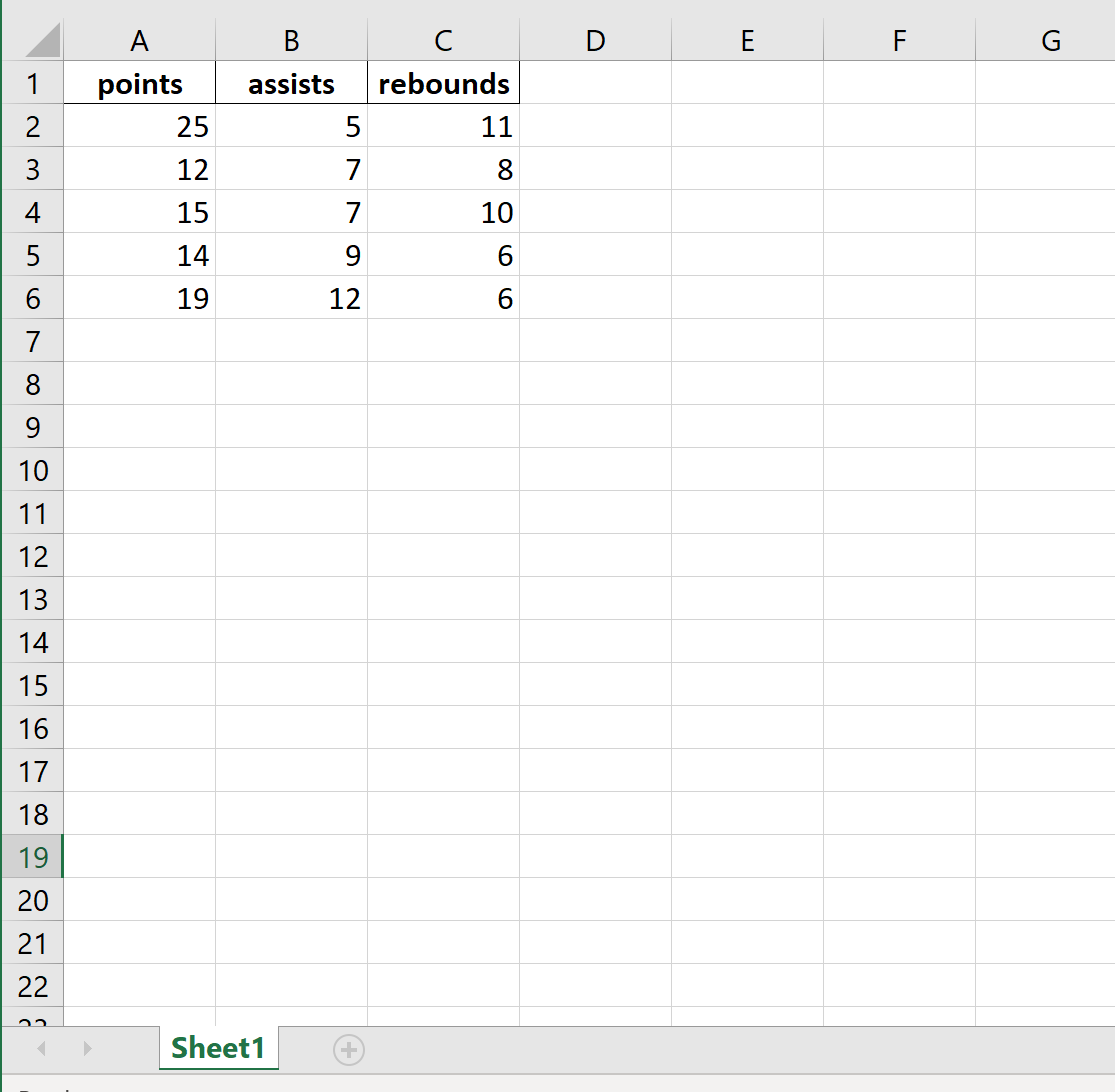
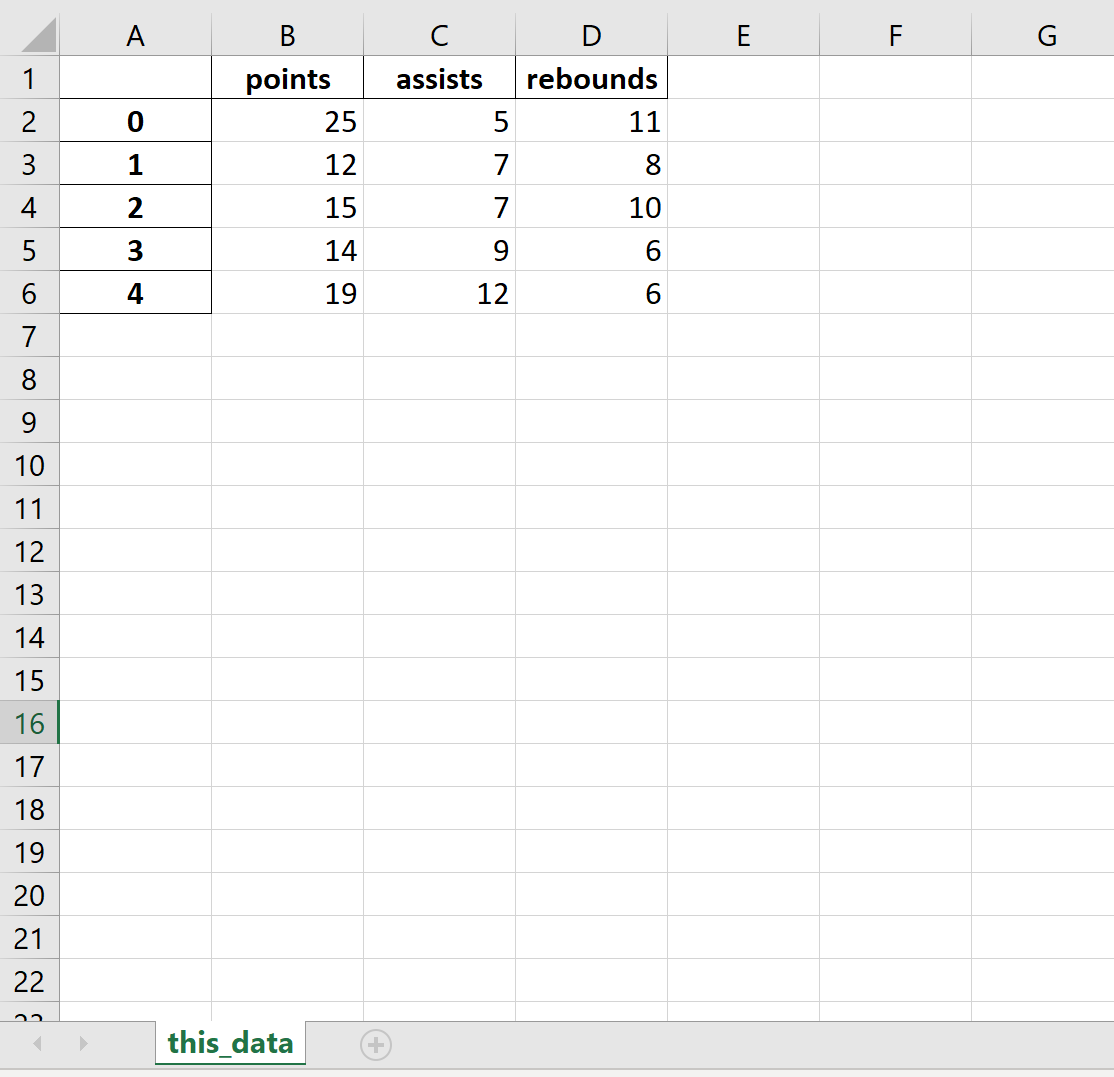
Au sein de l’environnement applicatif d’Excel, un document est modélisé sous la forme d’un classeur regroupant une ou plusieurs feuilles de calcul indépendantes ou interconnectées, matérialisées dans l’interface graphique par des onglets de navigation inférieurs. Par défaut, la méthode de Pandas sérialise les données dans un onglet unique désigné par le libellé générique prédéfini Sheet1. L’abandon de cette dénomination arbitraire au profit d’une désignation sémantiquement signifiante constitue le premier pas vers l’élaboration d’un rapport de données professionnel et auto-descriptif. L’attribution de ce libellé s’opère directement par l’intermédiaire du paramètre textuel sheet_name.
L’assignation d’un nom d’onglet impose le respect strict des contraintes techniques et lexicales dictées par les spécifications formelles de Microsoft Excel. L’architecture du format de classeur interdit formellement que le nom d’une feuille excède une longueur limite de trente-et-un caractères typographiques. De surcroît, un ensemble de caractères réservés est strictement prohibé par le validateur syntaxique du tableur; il s’agit notamment des symboles de deux-points, de barres obliques directes et inversées, de points d’interrogation, d’astérisques, ainsi que de crochets d’ouverture et de fermeture. Toute tentative de sérialisation d’un nom d’onglet contenant ces glyphes interdits ou excédant la longueur autorisée se solde par une levée d’erreur fatale émise par le moteur sous-jacent.
Dans le cadre de chaînes de traitement automatisées générant des dizaines de rapports longitudinaux, il est hautement recommandé d’implémenter des mécanismes de troncature et d’assainissement programmatiques des chaînes destinées à ce paramètre. L’établissement d’une nomenclature normalisée — intégrant par exemple la date du protocole au format compact, le code d’identification de la cohorte et la nature des métriques statistiques calculées — confère aux classeurs finaux une navigabilité immédiate et une intégration transparente au sein des dépôts documentaires institutionnels.
5.2 Positionnement spatial de la table dans la grille de calcul
L’ancrage standardisé de la table de données aux coordonnées absolues de la cellule supérieure gauche de la feuille de calcul (la coordonnée A1) correspond rarement aux exigences éditoriales d’un rapport de synthèse destiné à une direction scientifique ou à des évaluateurs externes. Très souvent, la mise en page d’un document professionnel exige de ménager des marges supérieures et latérales afin d’insérer des pavés contextuels de métadonnées, des avertissements méthodologiques, des dates d’extraction de bases de données ou des résumés exécutifs en langage naturel avant l’apparition effective de la matrice numérique brute.
Pandas offre une maîtrise spatiale complète de cette implantation cartésienne grâce aux arguments numériques entiers startrow et startcol. Le système d’adressage employé par ces deux paramètres repose sur une convention d’indexation à base zéro, identique aux standards internes de Python : l’indice 0 correspond ainsi à la première ligne ou colonne physique de la grille Excel. Par conséquent, l’instruction d’un décalage vertical par l’attribution de la valeur 4 au paramètre d’ancrage vertical instruit le moteur de réserver les quatre premières lignes de la grille (lignes 1 à 4 dans Excel) à d’autres usages documentaires et de débuter l’écriture de la matrice de données rigoureusement à la cinquième ligne physique.
Cette capacité d’espacement spatial permet de concevoir de véritables architectures visuelles composites au sein d’une seule et même feuille de calcul. Les ingénieurs de données peuvent ainsi tirer parti de cet espacement pour allouer les coordonnées A1 à D3 à des blocs d’information textuels ou à des paramètres d’exécution d’algorithmes, créant une séparation nette entre l’appareil contextuel narratif et les données quantitatives sérialisées. Cette approche structurée valorise considérablement le travail d’analyse en offrant aux relecteurs une mise en contexte immédiate sans les contraindre à déchiffrer une table dépourvue de documentation liminaire.
5.3 Gestion de la politique d’écrasement de fichiers préexistants
L’exécution répétée de scripts d’exportation dans le cadre de cycles itératifs de développement statistique soulève d’importantes problématiques d’intégrité logicielle liées aux politiques d’accès concurrentiel et d’écrasement de fichiers. Par conception native, lorsque la méthode est invoquée en lui transmettant un chemin pointant vers un fichier déjà existant sur le disque local, le comportement par défaut de l’interpréteur consiste à détruire purement et simplement le fichier préexistant pour le remplacer par le nouveau classeur généré. Cette opération d’écrasement est irréversible, le système d’exploitation ne conservant aucun historique automatique des versions détruites au niveau de ses primitives d’écriture standard.
Ce comportement agressif présente des risques méthodologiques évidents, particulièrement dans les contextes où plusieurs analystes partagent des volumes réseau distribués, ou lorsque le classeur ciblé contient d’autres feuilles de calcul préalablement consolidées par des intervenants tiers. Pour prémunir les flux de travail contre ces destructions accidentelles, il s’avère indispensable d’intégrer des routines préventives de vérification de l’arborescence avant tout déclenchement de la sérialisation. L’interrogation programmatique des modules du système de fichiers de Python permet de déterminer si le document cible est déjà présent sur le support persistant et d’adopter des logiques de contournement adaptées, comme l’émission d’une alerte d’interruption ou la génération dynamique d’un suffixe d’horodatage pour archiver l’itération sans écraser la précédente.
De surcroît, une situation critique fréquente en environnement de bureau concerne les cas où le fichier de destination se trouve être déjà ouvert et verrouillé par un processus tiers, typiquement par l’application Microsoft Excel elle-même exécutée sur le poste de travail de l’utilisateur. Dans ces circonstances, toute tentative d’écrasement direct est bloquée par le verrou exclusif du système d’exploitation, déclenchant une interruption d’exécution pour violation de permissions. L’anticipation de ces conflits d’accès structurels, par des blocs de capture d’exceptions adéquats, constitue une marque de maturité technique essentielle dans le déploiement d’outils analytiques résilients.
6. Exportation sélective de sous-ensembles de données et traitement des valeurs manquantes
6.1 Filtrage et restriction des colonnes exportées
Dans les architectures d’analyse de données expérimentales, les DataFrames hébergent couramment une pléthore de variables instrumentales, de colonnes d’indexation temporaires, de compteurs d’itérations algorithmiques ou de caractéristiques sensibles anonymisées qui n’ont pas vocation à être divulguées dans le livrable final transmis aux parties prenantes. Procéder au nettoyage de ces variables en amont par des suppressions destructives au sein de la mémoire vive peut s’avérer néfaste pour la poursuite de l’analyse interactive dans le même environnement de calcul. Pandas résout cette tension méthodologique en offrant le paramètre columns au sein même de la signature d’exportation.
Cet argument attend une collection de chaînes de caractères correspondant aux étiquettes des variables que l’utilisateur souhaite explicitement intégrer dans le document physique. Lors de l’écriture, le moteur opère une projection sélective : seules les séries identifiées dans la liste transmise sont sérialisées, dans l’ordre rigoureux prescrit par l’agencement de cette collection, tandis que l’ensemble des autres variables présentes dans le DataFrame en mémoire sont intégralement ignorées lors de l’opération d’encodage. L’ordre d’affichage dans la feuille de calcul finale découle directement de l’ordonnancement de la collection déclarée, ce qui offre également une opportunité immédiate de réorganisation esthétique des colonnes sans surcharge de calcul en mémoire.
Sur le plan éthique et légal, cette sélectivité s’avère particulièrement cruciale dans les domaines régis par des contraintes de confidentialité strictes, tels que la recherche clinique ou la psychométrie appliquée soumise aux directives du Règlement Général sur la Protection des Données (RGPD). Elle permet de s’assurer de façon déterministe que des variables identifiantes directes ou indirectes demeurent confinées au sein de l’environnement Python sécurisé et ne s’échappent jamais vers des classeurs bureautiques diffusables hors du périmètre de confinement de la recherche.
6.2 Normalisation de la représentation des valeurs nulles
La présence de valeurs manquantes, qu’elles résultent d’abandons expérimentaux, de pannes de capteurs électroniques ou d’omissions volontaires dans des questionnaires psychométriques, constitue une réalité omniprésente de l’analyse de données réelles. Au sein d’un DataFrame Pandas, ces absences sont typiquement modélisées par des sentinelles numériques spécifiques telles que les valeurs NaN (Not a Number) de la bibliothèque NumPy ou les objets d’absence typés plus récents intégrés à Pandas. Lors de la phase de sérialisation vers un tableur, la question de la transcription de ces absences revêt une importance analytique capitale.
Par défaut, la méthode traduit ces sentinelles par des chaînes vides, ce qui se matérialise sous Excel par des cellules intégralement vierges de toute valeur ou caractère. Si cette approche offre une lisibilité visuelle épurée, elle introduit une ambiguïté sémiologique majeure pour les statisticiens : une cellule vierge traduit-elle une véritable donnée manquante documentée par le protocole expérimental, ou reflète-t-elle une anomalie technique survenue lors de l’écriture du fichier ? De plus, certains logiciels d’analyse économétrique réimportant des fichiers Excel interprètent différemment une cellule vide et une valeur manquante explicite.
Pour dissiper toute incertitude interprétative, le paramètre na_rep permet de définir une chaîne de caractères substitutive qui sera inscrite systématiquement dans chaque cellule correspondant à une valeur nulle. Dans la littérature scientifique, il est d’usage d’affecter à ce paramètre des mentions conventionnelles standardisées telles que « NA », « NaN » ou « Non Renseigné ». Cette explicitation garantit l’intégrité sémiologique du rapport de recherche. Il convient néanmoins de garder à l’esprit que l’insertion d’une chaîne textuelle comme « NA » force le tableur à traiter la cellule comme du texte brut, ce qui peut inhiber l’exécution de certaines fonctions mathématiques locales nécessitant une distinction stricte entre zéros arithmétiques et données non observées.
6.3 Formatage et préservation des variables temporelles
La gestion des séries temporelles, des dates d’échantillonnage et des horodatages à haute résolution constitue historiquement l’une des sources majeures de corruption de données lors des transferts vers les tableurs bureautiques. Les logiciels de la suite Microsoft Excel stockent de manière interne les dates sous la forme d’un nombre flottant séquentiel représentant le nombre de jours écoulés depuis une date pivot conventionnelle (généralement le 1er janvier 1900 sous le système de datation par défaut de Windows). Lorsque des chronodatations sont exportées sans spécification explicite de masque d’affichage, le logiciel récepteur peut appliquer des conventions régionales discordantes, inversant par exemple le jour et le mois selon que le système hôte est configuré selon les standards anglo-saxons ou européens continentaux.
Pour conjurer ces risques majeurs de dérive temporelle, la fonction intègre l’argument date_format, qui autorise la déclaration explicite d’un masque de formatage chronologique conforme aux directives de la convention internationale ISO 8601. En spécifiant une chaîne de mise en forme normalisée telle que l’agencement « YYYY-MM-DD » pour les dates civiles ou « YYYY-MM-DD HH:MM:SS » pour les horodatages intégrant les dimensions horaires, l’analyste contraint le moteur d’écriture à intégrer les métadonnées de style appropriées directement au sein de la définition XML des cellules concernées.
Cette standardisation rigoureuse offre une double garantie méthodologique. D’une part, elle assure que la présentation visuelle des variables chronologiques demeure immuable, quel que soit le contexte linguistique ou géographique du poste informatique sur lequel le classeur sera ultérieurement examiné. D’autre part, elle préserve la nature temporelle sous-jacente des données au sein d’Excel, permettant aux évaluateurs d’exécuter des tris chronologiques valides ou des calculs de durées par soustraction d’intervalles sans nécessiter de fastidieuses opérations manuelles de conversion de formats de texte en objets temporels natifs.
7. Mise en page, formatage conditionnel et intégration du moteur OpenPyXL
7.1 Accès programmatique au classeur via l’interface OpenPyXL
Bien que l’abstraction fournie par Pandas couvre l’intégralité des besoins fonctionnels de transfert de données pures, elle n’a pas été conçue pour offrir des outils avancés de stylisation typographique, d’agencement visuel complexe ou de conception d’interfaces graphiques sous tableur. Pour satisfaire aux standards esthétiques et éditoriaux des publications académiques de premier rang, il s’avère nécessaire de dépasser le niveau d’abstraction de Pandas pour interagir directement avec le modèle objet de bas niveau mis à disposition par la bibliothèque openpyxl. Cette synergie s’opère de manière fluide en interceptant l’instance du moteur d’écriture générée lors de l’exportation.
En accédant à l’objet racine du classeur (la classe Workbook) ainsi qu’aux objets représentant les feuilles de calcul individuelles (Worksheet), le développeur Python acquiert un contrôle total et chirurgical sur chaque atome de la grille de calcul. Dès lors, il n’est plus contraint par les limitations de l’interface tabulaire standard et peut parcourir les cellules de manière itérative, injecter des métadonnées contextuelles, reconfigurer les largeurs géométriques des colonnes ou redéfinir les paramètres d’impression du document.
Cette passerelle programmatique garantit une continuité méthodologique exemplaire : la phase de calcul vectorisé, de transformation statistique et d’agrégation matricielle demeure fermement adossée à la puissance computationnelle de Pandas, tandis que la phase finale d’embellissement éditorial et de mise en conformité visuelle bénéficie de l’expressivité de l’API d’openpyxl. Ce découplage fonctionnel permet de concevoir des chaînes de production de rapports où la forme et le fond sont traités avec un niveau d’excellence technique rigoureusement équivalent.
7.2 Ajustement automatique de la largeur des colonnes et alignement
L’un des défauts visuels les plus frustrants lors de l’ouverture d’un classeur généré de manière purement programmatique réside dans l’inadéquation structurelle entre la largeur par défaut des colonnes d’Excel (fixée conventionnellement à un peu plus de huit caractères standard) et la longueur réelle des chaînes de caractères ou des intitulés de variables scientifiques qui y sont inscrits. Ce décalage dimensionnel conduit fréquemment à la troncature inélégante des libellés textuels ou, pire encore, au masquage complet des valeurs numériques continues par des suites de symboles dièse, phénomène se produisant dès lors qu’un nombre excède l’espace physique visible de sa cellule hôte.
Pour pallier ce désagrément sans exiger de manipulation manuelle de la part du destinataire, il est possible de déployer un algorithme Python élégant exploitant l’interface d’openpyxl afin de calculer dynamiquement la dimension géométrique optimale de chaque colonne. La méthode consiste à itérer sur l’ensemble des colonnes de la feuille de calcul active, à déterminer la longueur maximale de la chaîne de caractères présente au sein de chaque vecteur (en comparant systématiquement l’étiquette d’en-tête et l’intégralité des cellules de données sous-jacentes), puis à réassigner cette valeur majorée d’une marge de sécurité typographique appropriée à la propriété de dimensionnement de la colonne correspondante.
Simultanément à ce recalibrage géométrique, il convient de normaliser l’alignement spatial des contenus afin d’adhérer aux conventions typographiques internationales de publication scientifique. L’orthodoxie éditoriale prescrit en effet que les variables textuelles qualitatives soient rigoureusement alignées sur la marge gauche des cellules pour en faciliter la scansion visuelle, tandis que l’ensemble des valeurs numériques, discrètes ou continues, doivent impérativement être alignées sur la marge droite afin d’assurer l’alignement vertical des unités, des virgules décimales et des ordres de grandeur mathématiques.
7.3 Implémentation de styles typographiques et de bordures
L’aspect brut d’une grille Excel non stylisée nuit considérablement à la transmission efficace des hiérarchies conceptuelles d’une étude scientifique. L’attribution raisonnée de styles typographiques distincts, de bordures structurelles et de palettes de couleurs discrètes permet de transformer un déversement de données aride en un instrument de communication analytique percutant. Via les modules de stylisation d’openpyxl, le chercheur dispose d’une panoplie complète pour orchestrer cette mise en scène visuelle conforme aux chartes graphiques académiques les plus exigeantes.
La ligne d’en-tête fait traditionnellement l’objet d’un traitement visuel prioritaire. L’application d’une graisse typographique affirmée, conjuguée à une couleur de fond sobre (telle qu’un gris neutre ou un bleu institutionnel discret) et à un texte contrasté, établit une césure immédiate entre l’appareil identificatoire des variables et le corps des observations empiriques. Il est également recommandé d’appliquer une politique de bordures géométriques minimale mais signifiante, directement inspirée des standards de mise en page des tables d’articles scientifiques (standards popularisés notamment par les directives éditoriales de l’American Psychological Association).
Ce formalisme visuel préconise l’usage de bordures horizontales pleines pour délimiter l’en-tête supérieur et la ligne terminale du tableau, tout en proscrivant formellement l’utilisation anarchique de bordures verticales continues entre chaque colonne, pratique considérée comme polluante pour la lisibilité de l’œil. L’application programmatique de ces règles de style via openpyxl garantit que chaque itération de la recherche produit des documents harmonisés, éliminant tout écart cosmétique accidentel entre les différents livrables d’un même consortium de recherche.
7.4 Déploiement de règles de formatage conditionnel
Le formatage conditionnel constitue l’une des fonctionnalités interactives les plus analytiquement fécondes offertes par les logiciels de tableur. Il permet de moduler dynamiquement l’apparence des cellules (couleur de fond, police, bordure) en fonction de la valeur quantitative ou qualitative qu’elles hébergent, appliquant ainsi un filtre cognitif instantané pour l’œil humain. L’injection programmatique de règles de formatage conditionnel via l’API d’openpyxl permet d’automatiser le pré-diagnostic des anomalies, la détection des valeurs aberrantes ou l’évaluation de seuils de significativité statistique avant même toute consultation humaine détaillée.
Deux grands scénarios d’application se distinguent particulièrement dans le cadre de l’exploitation de résultats empiriques. Le premier concerne l’application d’échelles de couleurs continues (communément désignées sous le terme de cartes de chaleur thermiques ou heatmaps). Cette technique est particulièrement efficace lorsqu’elle est déployée sur des matrices de corrélation, des coefficients de covariance ou des indices psychométriques continus : le moteur colore graduellement les cellules depuis des teintes froides pour les valeurs négatives ou faibles jusqu’à des teintes chaudes pour les associations intenses, rendant la structure factorielle des données visible d’un simple coup d’œil d’ensemble.
Le second champ d’intervention méthodologique réside dans la mise en exergue discrète mais systématique des points d’inflexion critiques ou des valeurs aberrantes univariées. L’intégration de règles conditionnelles identifiant automatiquement les cellules dont la valeur s’écarte de plus de trois écarts-types de la moyenne de leur colonne respective, ou dont les probabilités associées à des tests d’hypothèses tombent sous le seuil alpha conventionnel de 5%, alerte immédiatement les relecteurs du classeur sur des signaux statistiques faibles ou d’éventuelles corruptions expérimentales, consolidant ainsi la robustesse globale du protocole d’audit des données.
8. Utilisation de la classe ExcelWriter pour les exportations multi-DataFrames
8.1 Principes fondamentaux du gestionnaire de contexte ExcelWriter
Lorsque le protocole de publication exige la consolidation de plusieurs DataFrames distincts au sein d’un document de synthèse unique, l’appel successif et direct de la méthode d’exportation standardisée révèle son inadaptation structurelle. En effet, chaque invocation unitaire de base tente de réinitialiser le document cible, conduisant inéluctablement à l’écrasement de la feuille précédente par la nouvelle table générée. Pour orchestrer la convergence de multiples sources de données matricielles vers un même classeur persistant, Pandas propose une abstraction de contrôle dédiée de premier ordre : la classe ExcelWriter.
La classe ExcelWriter opère conceptuellement comme un gestionnaire de contexte de flux de fichiers, conçu pour être instancié de manière canonique par le truchement de l’instruction with de Python. Cette architecture sémantique garantit la gestion optimale du cycle de vie des ressources système mobilisées. À l’ouverture du bloc contextuel, le moteur d’écriture sélectionné est initialisé en mémoire vive et prépare l’arborescence du document; tout au long de l’exécution du bloc, différentes méthodes de sérialisation peuvent être appliquées pour injecter des tables de données successives sur différentes coordonnées ou onglets.
L’atout méthodologique déterminant de cette approche réside dans l’automatisation sécurisée de la phase de clôture du fichier. Lorsque le flux d’exécution franchit la ligne terminale du bloc d’instruction contextuel, la méthode de finalisation est invoquée de manière implicite et déterministe par l’interpréteur. Cette fermeture automatique assure le scellement définitif de l’archive XML sur le support de stockage et libère immédiatement l’ensemble des descripteurs de fichiers système et de la mémoire vive allouée, neutralisant tout risque de corruption de données ou de fuite de mémoire même en cas de levée inopinée d’une exception d’exécution en cours de transfert.
8.2 Consolidation de multiples DataFrames sur des onglets distincts
Le cas d’usage le plus emblématique de la classe ExcelWriter réside dans la sérialisation séquentielle de plusieurs cohortes, conditions expérimentales ou niveaux d’agrégation statistique au sein d’onglets distincts abrités sous le toit d’un même classeur unifié. Dans le cadre d’un protocole expérimental longitudinal, un laboratoire peut souhaiter regrouper au sein d’un document pérenne la table des mesures démographiques initiales, la matrice des réponses psychométriques intermédiaires et le tableau récapitulatif des paramètres d’analyse multivariée finaux.
Pour matérialiser cette architecture documentaire, il suffit d’instancier un objet ExcelWriter en lui spécifiant le chemin du document de destination ainsi que le moteur d’encodage retenu, puis d’exécuter successivement la méthode to_excel() sur chacun des DataFrames impliqués en leur passant en premier argument l’instance active du gestionnaire de contexte. Chaque appel doit alors obligatoirement spécifier une valeur unique et distinctive pour le paramètre désignant le nom de la feuille de calcul (sheet_name), prévenant ainsi toute collision d’onglets au sein de la structure du classeur.
Cette pratique d’organisation modulaire présente des vertus analytiques inestimables. Elle permet de structurer de vastes ensembles d’investigation en unités documentaires thématiques étanches tout en maintenant leur affiliation à une base de données unifiée. L’intégrité globale du classeur final est mathématiquement garantie : chaque feuille dispose de ses propres dimensions, de son typage autonome et de ses index spécifiques sans qu’aucune interférence croisée ne vienne déformer les matrices de données adjacentes.
8.3 Disposition conjointe de plusieurs tables sur une même feuille de calcul
Au-delà de la distribution des données sur plusieurs onglets isolés, les impératifs de restitution visuelle exigent fréquemment de faire cohabiter plusieurs tableaux statistiques sur une seule et unique feuille de calcul physique. Un tableau de bord de pilotage scientifique gagne par exemple à exposer sur la même grille une table descriptive primaire de grande dimension et, immédiatement à ses côtés ou sur ses lignes inférieures, des sous-tables synthétiques résumant des tests d’ajustement, des indicateurs de normalité ou des décomptes d’effectifs marginaux.
La matérialisation de cette cohabitation matricielle s’effectue en manipulant avec une rigueur géométrique absolue les coordonnées spatiales d’ancrage offertes par les paramètres startrow et startcol au sein du gestionnaire de contexte ExcelWriter. L’analyste doit conceptualiser sa feuille de calcul comme une grille d’adressage cartésien en deux dimensions et calculer méthodologiquement les décalages nécessaires pour éviter tout chevauchement destructeur de cellules. Par exemple, pour superposer verticalement deux tables statistiques séparées d’un espacement de sécurité, il convient de mesurer la longueur exacte de la première matrice (incluant l’éventuelle ligne d’en-tête), d’y adjoindre un intervalle de quelques lignes vierges, et d’affecter la somme obtenue au paramètre d’ancrage vertical de la seconde méthode d’écriture.
Le déploiement méthodique de ces calculs géométriques permet d’élaborer de véritables interfaces de reporting statistique hautement élaborées. En combinant judicieusement des décalages verticaux et latéraux, il devient aisé de composer des synthèses analytiques multipolaires où les données brutes, les analyses de variance et les paramètres de régression sont présentés de concert, offrant ainsi aux comités d’audit scientifique une vision panoramique et simultanée de l’ensemble des ramifications d’un protocole d’expérimentation complexe.
9. Exportation vers des formats alternatifs et rétrocompatibilité
9.1 Spécificités techniques de l’exportation vers l’ancien format binaire .xls
Bien que la norme internationale actuelle pour la sérialisation des classeurs repose sur le format ouvert et zippé Office Open XML (.xlsx), les réalités industrielles et institutionnelles confrontent régulièrement les scientifiques de données à des impératifs d’interopérabilité avec des infrastructures informatiques patrimoniales. Dans de nombreux hôpitaux, observatoires astronomiques ou réseaux industriels sensibles, les systèmes d’exploitation résidents ou les équipements de laboratoire automatisés ne disposent pas des couches logicielles requises pour parser les architectures XML modernes et exigent formellement l’ingestion de fichiers encodés dans l’ancien format binaire propriétaire Microsoft Excel 97-2003 (.xls).
La génération de ce format binaire ancien ne peut pas être assurée par le moteur openpyxl; elle nécessite le recours obligatoire au moteur tiers xlwt. Lors de l’initialisation de l’exportation, l’utilisateur doit spécifier l’extension appropriée et notifier formellement à Pandas la sélection de ce moteur via le paramètre engine=’xlwt’. Cette transition vers un paradigme binaire implique l’acceptation immédiate d’une série de contraintes physiques drastiques inhérentes à l’architecture historique d’Excel :
- Limite de volumétrie stricte : Une feuille de calcul au format .xls est bridée de façon indépassable à une capacité maximale de 65 536 lignes et 256 colonnes. Tout dépassement matriciel déclenche un crash d’encodage irréversible.
- Capacité mémoire des chaînes : La gestion des chaînes de caractères complexes est restreinte par des tables de codage d’octets limitées, augmentant les risques de corruption de symboles typographiques rares.
- Absence de fonctionnalités modernes : Impossibilité structurelle de bénéficier de styles étendus, de palettes chromatiques riches ou de formats conditionnels multiniveaux introduits à partir de 2007.
L’usage de cette filière d’exportation doit ainsi être strictement limité aux seuls protocoles de rétrocompatibilité certifiés, sous peine de brider artificiellement le potentiel expressif et volumétrique des pipelines d’analyse statistique contemporains.
9.2 Gestion des fichiers prenant en charge les macros (.xlsm)
Dans de multiples contextes d’ingénierie appliquée, les classeurs Excel ne servent pas uniquement de récipients pour des données inertes; ils intègrent des routines d’automatisation complexes programmées en Visual Basic for Applications (VBA), conçues pour offrir des interfaces utilisateur interactives, piloter des bancs de test ou actualiser des formulaires de saisie. Les fichiers hébergeant ces séquences d’instructions exécutables adoptent la spécification formelle de classeurs prenant en charge les macros, désignée par l’extension .xlsm.
L’ouverture, l’injection de données et la sauvegarde d’un fichier .xlsm au moyen d’un script Python constituent une opération particulièrement délicate. Si l’environnement de calcul n’est pas instruit avec une rigueur absolue, le moteur d’écriture standard traitera le document comme une archive XML conventionnelle et supprimera purement et simplement l’ensemble des conteneurs de binaires hébergeant le code des modules VBA lors de la phase de réencodage. Pour neutraliser ce risque majeur de destruction logicielle, il est indispensable de faire appel à la configuration spécialisée d’openpyxl en initialisant le chargement du document modèle avec l’instruction explicite keep_vba=True.
Cette configuration avancée contraint le parseur à préserver l’intégralité du module de macros préexistant au sein de l’archive physique tout en autorisant Pandas à injecter ses nouvelles matrices d’observations sur les plages de cellules désignées. Les données quantitatives produites par la modélisation statistique avancée sous Python peuvent ainsi être transmises en continu à des outils bureautiques enrichis d’automatisations fonctionnelles antérieures, sans rupture de compatibilité logicielle et sans nécessiter de réécriture complexe des macros d’entreprise sous-jacentes.
9.3 Considérations sur le format binaire haute performance .xlsb
Face aux volumétries de données massives rencontrées dans l’analyse financière à haute fréquence, la génomique ou l’analyse des réseaux de capteurs, le format textuel XML compressé (.xlsx) peut manifester des goulets d’étranglement sévères en termes de vitesse de décompression et d’empreinte spatiale sur disque dur. Pour pallier ces limites sans renoncer à l’écosystème Excel, Microsoft a développé la spécification de classeur binaire non XML, identifiée par l’extension .xlsb. Contrairement aux formats standards, le format .xlsb encapsule l’ensemble des enregistrements de cellules au sein de séquences binaires optimisées, court-circuitant la lourdeur d’évaluation syntaxique des balises XML.
L’adoption du format binaire haute performance confère des gains d’efficience considérables lors de la manipulation de jeux de données approchant les limites dimensionnelles du tableur. La vitesse de sérialisation et de réouverture d’un fichier .xlsb peut être jusqu’à deux à trois fois plus rapide que son équivalent XML conventionnel, tandis que la taille finale de l’archive sur le disque dur connaît typiquement une compression volumétrique de l’ordre de 20 à 50%. Cette compacité accélère considérablement les transferts de fichiers volumineux sur les réseaux distribués inter-laboratoires.
Cependant, l’intégration de ce format haute performance au sein de l’écosystème Python exige le déploiement d’extensions spécialisées telles que la bibliothèque pyxlsb pour les opérations de lecture et des configurations spécifiques pour les écritures binaires. Il importe également de peser le compromis méthodologique inhérent à cette sélection : si le format .xlsb brille par sa vélocité, il sacrifie la nature auto-documentée et universelle du schéma XML ouvert, rendant son inspection directe par des utilitaires de diagnostic en ligne de commande ou des gestionnaires de version textuels beaucoup plus complexe.
10. Optimisation des performances et gestion des jeux de données volumineux
10.1 Limites intrinsèques du format Excel et gestion des dépassements
Tout chercheur ou praticien de la donnée engagé dans l’exportation de matrices d’envergure doit impérativement garder à l’esprit les contraintes dimensionnelles absolues imposées par l’architecture du standard de feuille de calcul Microsoft Excel moderne. Depuis la révision formelle de la norme en 2007, une feuille de calcul est strictement limitée à un plafond infranchissable de 1 048 576 lignes et 16 384 colonnes physiques. Toute tentative d’écriture d’un DataFrame dont les dimensions géométriques outrepassent ne serait-ce que d’une unité l’un de ces seuils structurels déclenche une levée d’exception fatale de la part du moteur de sérialisation, interrompant instantanément le processus.
Lorsque le volume empirique d’un jeu de données s’approche ou excède cette barrière architecturale, plusieurs stratégies méthodologiques d’urgence s’offrent à l’analyste. La première consiste à concevoir une routine de scission horizontale programmatique du DataFrame : les données sont morcelées par tranches successives n’excédant pas un million de lignes, et chaque segment est orienté vers un onglet spécifique au sein d’un même classeur via un objet ExcelWriter. Bien que cette approche permette de contourner l’interruption logicielle, elle dégrade significativement la maniabilité analytique du document pour les évaluateurs finaux.
Dès lors que les cohortes atteignent de telles échelles volumétriques, il convient de poser un diagnostic critique sur la pertinence méthodologique du format tableur lui-même. Excel n’a jamais été conçu pour opérer comme un entrepôt de mégadonnées ou une base de données de stockage analytique massif. Lorsque les données dépassent de façon récurrente ces ordres de grandeur, l’impératif scientifique dicte d’opérer un basculement technologique vers des formats de stockage orientés colonnes ou des schémas d’archivage binaire universels optimisés, tels que le standard Apache Parquet, les fichiers Feather ou des bases de données relationnelles SQL conteneurisées, réservant Excel à la seule diffusion d’échantillons stratifiés ou d’indicateurs statistiques agrégés.
10.2 Minimisation de la consommation de mémoire vive durant l’exportation
L’exportation de volumineuses structures de données via le moteur openpyxl sous sa configuration conventionnelle s’avère particulièrement gourmande en ressources de mémoire vive (RAM). Dans son mode opérationnel par défaut, openpyxl instancie un arbre complet d’objets Python en mémoire pour représenter chaque cellule individuelle avant de compiler l’archive finale. Pour un DataFrame regroupant des centaines de milliers de lignes et des dizaines de colonnes, cette empreinte mémoire peut subir une inflation exponentielle, représentant jusqu’à cinquante à cent fois la taille volumétrique du fichier binaire final, provoquant fréquemment des saturations critiques de mémoire vive conduisant au crash pur et simple de l’interpréteur Python par manque de ressources.
Pour neutraliser ce goulet d’étranglement mémoire majeur, openpyxl propose une architecture de streaming optimisée dédiée à l’écriture pure, désignée par le mode write_only. Lorsqu’il est configuré dans ce mode haute performance, le moteur ne conserve pas en mémoire l’arbre topologique global du document; il compile et compresse les lignes de cellules au fil de l’eau dans des flux d’octets temporaires sur le disque dur, libérant immédiatement la mémoire vive correspondante après l’écriture de chaque enregistrement horizontal.
En parallèle à cette configuration du moteur d’écriture, l’analyste se doit d’optimiser l’empreinte mémoire intrinsèque de son DataFrame Pandas avant même le déclenchement de la phase d’exportation. Cette optimisation s’opère par des techniques rigoureuses d’abaissement de typage (downcasting), consistant à convertir les flottants 64 bits standards en représentations 32 bits lorsque la précision empirique le tolère, à convertir les entiers larges en sous-types adaptés, et à transtyper les vecteurs de chaînes de caractères répétitives en types catégoriels optimisés. Cette hygiène d’ingénierie des données réduit drastiquement la charge de travail des allocateurs de mémoire de Python et accélère de manière spectaculaire l’ensemble de la chaîne de sérialisation bureautique.
10.3 Techniques de traitement par blocs (chunking)
Dans les scénarios extrêmes d’extraction de données où la matrice source ne peut même pas être chargée intégralement au sein de la mémoire vive de la machine de calcul (par exemple lors de l’interrogation continue d’un entrepôt de données institutionnel ou de flux de télémesure continue), l’emploi des techniques de traitement par blocs (dites de chunking) s’impose comme une nécessité absolue. Cette méthode consiste à fragmenter le pipeline de lecture et d’exportation en une série séquentielle d’itérations portant chacune sur une fraction volumétrique modérée du jeu de données.
Sous Pandas, cette stratégie se déploie en exploitant l’argument dimensionnel de fragmentation des curseurs de données, permettant d’ingérer séquentiellement des blocs de quelques milliers de lignes. Une fois le premier bloc chargé, il est injecté dans la feuille de calcul via un gestionnaire d’écriture; pour les blocs subséquents, l’indice d’ancrage vertical startrow est calculé dynamiquement de manière à inscrire chaque nouvelle vague de données immédiatement sous la ligne terminale de la vague précédente, tout en neutralisant rigoureusement la génération des en-têtes et des index pour l’ensemble des blocs postérieurs au premier.
Cette approche séquentielle garantit que la charge de travail du processeur et la consommation de mémoire vive demeurent remarquablement stables et confinées tout au long du processus d’exportation, indépendamment de la taille globale du jeu de données sérialisé. Il convient néanmoins de rappeler que, si cette méthode permet de repousser considérablement les frontières d’ingénierie sur des machines dotées de ressources modestes, l’écriture concurrente ou hautement parallélisée sur un classeur Excel demeure formellement impossible en raison de la nature monolithique de l’archive de compression Zip centrale, limitant de facto l’accélération du processus aux optimisations séquentielles de traitement par lots.
11. Traitement des erreurs courantes et intégrité des données scientifiques
11.1 Résolution des conflits d’accès et verrouillages de fichiers
L’une des anomalies d’exécution les plus récurrentes et prévisibles lors du déploiement de scripts de recherche en environnement applicatif réside dans l’apparition brutale de l’exception PermissionError. Ce blocage système survient invariablement lorsqu’un script Python tente de réécrire ou de modifier un fichier Excel alors que ce dernier est simultanément ouvert dans une session active du logiciel Microsoft Excel sur le même poste de travail ou sur un lecteur réseau partagé. Le système d’exploitation Windows, appliquant un verrou exclusif sur tout fichier ouvert par la suite bureautique pour prévenir les incohérences d’édition manuelle, refuse catégoriquement l’accès en écriture au processus d’arrière-plan de Python.
Pour conférer à un pipeline de recherche une résilience industrielle, il est inconcevable de laisser une telle exception interrompre brutalement des heures de calculs statistiques en amont. L’architecture du script d’exportation doit impérativement encapsuler l’opération d’écriture au sein d’un bloc de capture d’exceptions défensif. Dès lors que l’erreur de verrouillage est interceptée, le script peut déclencher des stratégies de secours automatisées : avertir immédiatement l’utilisateur par une notification visuelle ou sonore explicite l’invitant à fermer le tableur, suspendre temporairement l’exécution pendant quelques secondes au moyen d’une boucle d’attente active vérifiant la libération du verrou, ou dérouter dynamiquement l’écriture vers un nouveau fichier doté d’un suffixe d’urgence dérivé de l’horodatage courant.
Cette gestion défensive des flux d’entrées-sorties protège les résultats empiriques contre les pertes accidentelles et améliore l’expérience utilisateur dans les environnements de laboratoire partagés. L’implémentation de ces routines de tolérance aux pannes évite aux chercheurs d’avoir à relancer fastidieusement l’ensemble de leurs modèles de régression ou de simulation de Monte-Carlo pour un simple conflit de consultation bureautique au moment de la restitution finale.
11.2 Préservation de l’encodage des caractères spéciaux et données textuelles
La mondialisation de la recherche scientifique et la montée en puissance des méthodes d’analyse qualitative textuelle impliquent que les DataFrames hébergent couramment des corpus intégrant des caractères diacritiques complexes, des symboles phonétiques de l’alphabet international, des idéogrammes asiatiques ou des caractères spéciaux de nomenclature biochimique. L’intégrité de ces chaînes textuelles constitue une condition sine qua non de la validité de l’étude. Historiquement, l’exportation de données vers des formats délimités comme le CSV provoquait fréquemment des corruptions d’encodage (phénomène connu sous le terme de mojibake), résultant de désalignements entre les normes UTF-8 et Windows-1252.
Le format Office Open XML (.xlsx) exploité par openpyxl présente l’avantage structurel majeur d’imposer nativement l’encodage universel UTF-8 au sein de ses schémas de chaînes partagées, réduisant drastiquement les risques de corruption de caractères lors du transfert direct. Toutefois, des altérations insidieuses peuvent persister lorsque des données textuelles issues de formulaires en ligne ou de questionnaires ouverts comportent des caractères de contrôle invisibles de bas niveau (tels que les octets nuls ou les sauts de ligne non standardisés). L’injection de ces glyphes illicites au sein des balises XML peut corrompre l’intégrité globale du fichier, poussant Excel à afficher un message d’erreur alarmant déclarant le document corrompu lors de sa tentative d’ouverture.
Pour garantir une préservation absolue des données qualitatives, le protocole d’ingénierie doit intégrer une phase systématique d’assainissement lexical des séries d’objets textuels avant l’exportation. Cette purification consiste à expurger ou remplacer les caractères de contrôle non imprimables au moyen d’expressions régulières normalisées, à unifier les séquences de retour à la ligne sous le standard conventionnel et à vérifier l’intégrité des caractères Unicode étendus. Cette vigilance méthodologique assure que le classeur généré s’ouvrira de manière fluide sur n’importe quel système d’exploitation mondial sans susciter d’incompréhension textuelle ni déclencher d’alertes de sécurité anxiogènes de la part du tableur.
11.3 Validation automatisée de la conformité post-exportation
Dans les protocoles de recherche soumis à des exigences réglementaires rigoureuses, telles que les Bonnes Pratiques de Laboratoire (BPL) ou les directives de la Food and Drug Administration (FDA) relatives aux enregistrements électroniques, il est inadmissible de postuler que le fichier généré sur disque correspond en tout point à la structure résidente en mémoire sur la simple foi de l’absence de message d’erreur lors de l’exécution du script. Une validation programmatique systématique de la conformité post-exportation s’impose comme une étape charnière de l’assurance qualité scientifique.
Cette validation s’articule autour d’une routine de relecture programmatique immédiate du classeur fraîchement matérialisé sur le disque, suivie d’un audit de parité statistique exhaustif comparant la nouvelle matrice relue avec le DataFrame d’origine. Les critères fondamentaux de conformité devant être validés par cette procédure automatisée regroupent les dimensions suivantes :
- Parité dimensionnelle : Vérification stricte de l’égalité du décompte des lignes et des colonnes entre l’objet source et l’objet réimporté.
- Invariance des sommes de contrôle : Calcul et comparaison des sommes de contrôle arithmétiques, des moyennes marginales et des sommes de hachage cryptographique sur les variables continues pour attester de l’absence de dérive numérique ou de troncature décimale.
- Conservation de la distribution des absences : Recensement du décompte exact des cellules vides ou codifiées NA pour confirmer qu’aucune valeur valide n’a été indûment convertie en valeur manquante au cours du transfert.
- Stabilité typologique : Contrôle de l’adéquation des types réimportés afin de détecter toute conversion implicite destructrice de variables textuelles numériques en entiers ou de dates en chaînes statiques.
L’intégration de ces vérifications d’intégrité au sein d’une suite de tests unitaires automatisés scelle l’inviolabilité de la chaîne de transmission des données et confère aux conclusions scientifiques publiées une assise empirique irréfutable.
12. Bonnes pratiques de reproductibilité et automatisation des flux de recherche
12.1 Structuration modulaire des fonctions d’exportation réutilisables
L’éparpillement d’instructions d’exportation ad hoc au sein de multiples calepins d’analyse statistique représente une dette technique lourde, propice à la prolifération d’erreurs méthodologiques et à la rupture des standards de reproductibilité institutionnels. La professionnalisation des flux de travail scientifiques exige la centralisation des logiques de transfert de données au sein de modules Python dédiés, regroupant des fonctions standardisées, documentées et réutilisables par l’ensemble des collaborateurs d’une équipe de recherche.
Une fonction d’exportation bien conçue doit agir comme une enveloppe logicielle de haut niveau (wrapper) encapsulant l’ensemble des garde-fous identifiés dans ce manuel : validation dimensionnelle préalable, gestion préventive des permissions d’accès, assainissement automatique des caractères textuels, application systématique des chartes typographiques et exécution immédiate de la suite de contrôle de parité post-exportation. De plus, cette fonction modulaire doit être dotée d’un système de journalisation d’événements (logging) rigoureux, enregistrant de manière traçable l’identité de l’opérateur, l’horodatage exact de l’opération, les dimensions des matrices traitées ainsi que les sommes de contrôle cryptographiques du document généré.
La séparation conceptuelle stricte entre les étapes d’exploration statistique, de modélisation mathématique et de sérialisation finale constitue le fondement d’une architecture de code maintenable. En déléguant l’intégralité des contingences physiques d’encodage bureautique à un composant logiciel unifié et rigoureusement audité, les statisticiens peuvent concentrer toute leur énergie cognitive sur la modélisation des phénomènes empiriques, assurés que la matérialisation documentaire de leurs résultats bénéficiera d’une fiabilité technique sans faille.
12.2 Enrichissement du classeur par l’adjonction de métadonnées scientifiques
Un jeu de données dénué de son appareil contextuel de métadonnées est un jeu de données voué à une obsolescence rapide ou à de funestes contresens interprétatifs. Dans l’esprit des standards internationaux de documentation scientifique, tout classeur de données destiné à être partagé ou archivé doit fonctionner comme une unité documentaire autonome et auto-suffisante. L’automatisation de l’exportation sous Pandas offre une opportunité remarquable pour enrichir systématiquement les classeurs finaux d’onglets contextuels dédiés à la préservation de la sémantique de l’étude.
La bonne pratique cardinale réside dans la génération programmatique d’un onglet réservé au dictionnaire des variables (couramment désigné sous le terme de codebook). Ce dictionnaire, sérialisé sous la forme d’une table secondaire accompagnant la matrice des données empiriques, explicite de manière granulaire la définition opérationnelle de chaque variable, les unités de mesure physiques associées, les échelles psychométriques exploitées, ainsi que la signification exacte des codifications attribuées aux valeurs qualitatives ou manquantes. L’évaluateur ne se trouve ainsi jamais confronté à des acronymes hermétiques ou des unités de mesure implicites.
En complément de ce dictionnaire, il est vivement recommandé d’intégrer un onglet d’audit traçant l’historique informatique complet du cycle de génération des données : identifiants de version du code source issu du gestionnaire de versions, numéros de révision des bibliothèques logicielles mobilisées (notamment les versions exactes de Python, Pandas et du moteur d’écriture), paramètres de graines aléatoires appliqués lors des simulations de Monte-Carlo et identifiants des bases de données institutionnelles interrogées. Cette contextualisation exhaustive transforme un simple tableur en une archive scientifique de référence, hautement citable et pleinement intelligible pour les générations futures de chercheurs.
12.3 Intégration dans des architectures de recherche ouverte et traçable
L’ultime frontière méthodologique de l’exportation de données s’inscrit dans le mouvement mondial en faveur de la science ouverte et de la transparence de la recherche publique. La publication de jeux de données tabulaires doit aujourd’hui satisfaire aux principes directeurs FAIR, stipulant que les données scientifiques doivent être Faciles à trouver, Accessibles, Interopérables et Réutilisables. Bien qu’historiquement critiqué pour sa nature partiellement propriétaire, le classeur Excel structuré selon le standard ouvert ISO/IEC 29500 (Office Open XML) s’avère parfaitement compatible avec ces impératifs dès lors qu’il est produit au terme de pipelines programmatiques entièrement auditables.
L’automatisation complète de la chaîne de sérialisation exclut toute intervention manuelle humaine entre la fin du calcul statistique et l’enregistrement du document définitif. Cette herméticité technique garantit l’alignement parfait du fichier avec les versions du code hébergées sur des plateformes de contrôle de versions distribuées telles que GitHub ou GitLab. Les classeurs ainsi générés peuvent être automatiquement poussés vers des dépôts d’archivage scientifique pérennes dotés d’identifiants d’objets numériques pérennes (DOI), tels que Zenodo, Figshare ou les entrepôts de données institutionnels des universités de rattachement.
En couplant la puissance exploratoire et vectorielle de Pandas avec les capacités universelles d’intermédiation du tableur, l’analyste contemporain ne se contente pas d’accomplir une tâche technique subalterne d’extraction bureautique. Il érige une passerelle rigoureuse, transparente et démocratique entre l’abstraction computationnelle de la recherche algorithmique et la matérialité tangible de la décision humaine, concourant ainsi à l’élévation des standards de qualité, de diffusion et de reproductibilité de l’ensemble de la communauté scientifique internationale.
Références
- Kluyver, T., Ragan-Kelley, B., Pérez, F., Granger, B., Bussonnier, M., Frederic, J., Kelley, K., Hamrick, J., Grout, J., Corlay, S., Ivanov, P., Avila, D., Abdalla, S., & Willing, C. (2016). Positioning Jupyter notebooks as a tool for open scientific research. In F. Loizides & B. Schmidt (Eds.), Positioning and Power in Academic Publishing: Players, Agents and Agendas (pp. 87–90). IOS Press. https://doi.org/10.3233/978-1-61499-649-1-87
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). SciPy. https://doi.org/10.25080/Majora-92bf1924-00a
- McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
- Openpyxl Development Team. (2023). openpyxl: A Python library to read/write Excel 2010 xlsx/xlsm files (Version 3.1.2) [Computer software]. https://openpyxl.readthedocs.io/
- Pandas Development Team. (2024). pandas: Powerful Python data analysis toolkit (Version 2.2.0) [Computer software]. Zenodo. https://doi.org/10.5281/zenodo.3509134
- Perez-Riverol, Y., Gatto, L., Wang, R., Sachsenberg, T., Uszkoreit, J., Leprevost, F. D. V., Sanchez, A., De Franceschi, S., Delanghe, B., Krishnan, J. A. P., Pfeuffer, J., Walzer, M., Zhou, S., Ondracek, J., Labadi, P., Perez, C., Neely, B. A., & Vizcaíno, J. A. (2016). Ten simple rules for taking advantage of Git and GitHub. PLOS Computational Biology, 12(7), Article e1004947. https://doi.org/10.1371/journal.pcbi.1004947
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., … Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3, Article 160018. https://doi.org/10.1038/sdata.2016.18
- XlsxWriter Development Team. (2024). XlsxWriter: A Python module for creating Excel XLSX files (Version 3.2.0) [Computer software]. https://xlsxwriter.readthedocs.io/
- Ziemann, M., Eren, Y., & El-Osta, A. (2016). Gene name errors are still widespread in the scientific literature. Genome Biology, 17, Article 177. https://doi.org/10.1186/s13059-016-1044-7