
Dans le domaine de l’ingénierie des données et de l’analyse statistique moderne, la manipulation rigoureuse des structures bidimensionnelles constitue le socle de toute investigation empirique. Le langage R, développé initialement par Ross Ihaka et Robert Gentleman à l’Université d’Auckland et maintenu par le R Development Core Team, s’est imposé comme l’environnement computationnel de référence pour les biostatisticiens, économètres et scientifiques des données. Au cœur de cet écosystème réside une exigence fondamentale : la capacité de transférer des jeux de données complexes hors de l’espace mémoire volatile vers des supports de stockage physiques, garantissant ainsi l’interopérabilité des résultats, l’auditabilité algorithmique et la reproductibilité computationnelle.
L’exportation d’un tableau de données rectangulaire vers un format textuel délimité, communément désigné sous le sigle CSV (Comma-Separated Values), apparaît superficiellement comme une opération triviale. Toutefois, une analyse approfondie des mécanismes sous-jacents révèle une multitude d’arbitrages techniques cruciaux. De la gestion des encodages de caractères non occidentaux à la préservation de la précision des nombres en virgule flottante double précision conformes à la norme IEEE 754, en passant par l’optimisation des entrées-sorties sur des volumétries massives, chaque décision prise lors de la sérialisation textuelle conditionne l’intégrité de la chaîne de traitement analytique.
Ce traité méthodologique a pour vocation d’explorer exhaustivement les paradigmes, syntaxes et architectures logicielles dédiés à l’exportation des data frames dans l’écosystème R. En confrontant les approches natives issues du paquetage historique de base aux implémentations vectorisées et parallélisées modernes fournies par les bibliothèques readr et data.table, cette étude propose un guide définitif destiné aux chercheurs et ingénieurs soucieux d’allier rigueur méthodologique, conformité aux standards internationaux et performance informatique optimale.
1. Introduction aux structures de données tabulaires et à l’exportation CSV dans R
L’analyse informatique de données empiriques repose sur la formalisation rigoureuse de collections d’observations appariées à des variables descriptives. Dans cette perspective, la transition entre l’état de traitement en mémoire vive et la persistance sur disque exige une compréhension théorique des structures de données et des protocoles de sérialisation qui garantissent la continuité de l’information statistique.
1.1 La place du data frame dans l’écosystème analytique de R
Le data frame constitue sans conteste la structure de données nodale du langage R. Formellement défini comme une liste ordonnée de vecteurs de longueurs strictement identiques, il autorise une hétérogénéité des types de données entre ses colonnes tout en maintenant une homogénéité absolue au sein de chacune d’elles. Cette architecture hybride permet de faire coexister au sein d’une même entité matricielle des variables qualitatives sous forme de facteurs ou de chaînes de caractères, des grandeurs discrètes encodées en entiers, ainsi que des mesures continues représentées par des nombres réels à double précision. Cette flexibilité structurelle répond directement aux exigences conceptuelles des matrices d’observation développées par la statistique mathématique classique.
Dans la recherche empirique contemporaine, l’isolement d’un environnement de calcul constitue un obstacle majeur à la validation par les pairs. L’interopérabilité des données requiert que les structures manipulées au sein de la session R puissent être interprétées sans déperdition d’information par des logiciels tiers tels que Python, Julia, SAS, Stata ou des systèmes de gestion de bases de données relationnelles. Alors que les formats binaires propriétaires imposent des dépendances logicielles strictes et souffrent d’une obsolescence programmée rapide, le recours à un format de sérialisation universel permet de découpler les phases de modélisation mathématique des contraintes d’infrastructure logicielle.
L’échange universel de données tabulaires représente ainsi un impératif épistémologique. La persistance d’une table d’analyse sous la forme d’un flux textuel rectangulaire matérialise l’idéal d’un format lisible à la fois par l’esprit humain et par les analyseurs lexicaux automatisés. Dès lors, le data frame ne se limite plus à un objet computationnel éphémère résidant dans la mémoire vive de l’ordinateur ; il devient un artefact scientifique pérenne, documentable et transférable à travers le temps et l’espace numérique.
1.2 L’intérêt du format CSV pour la reproductibilité scientifique
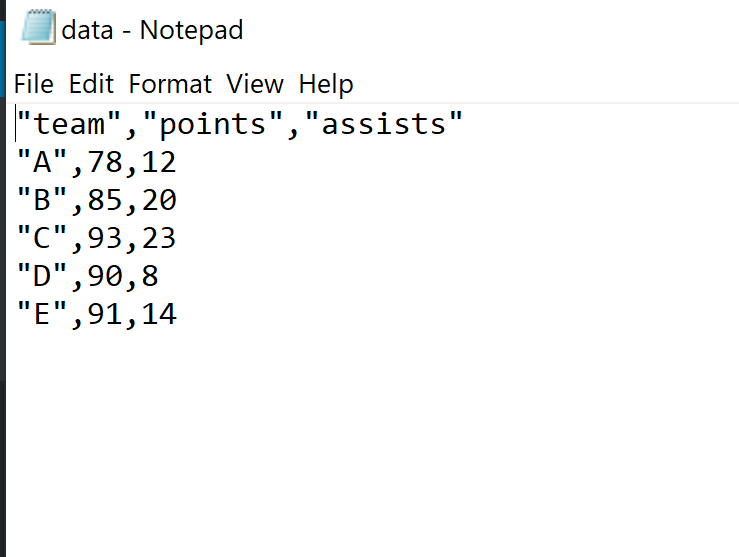
Le format CSV, régi formellement par la recommandation technique RFC 4180 émise par l’Internet Engineering Task Force (IETF), se distingue par sa remarquable simplicité conceptuelle. Reposant exclusivement sur l’encodage de texte brut, ce format sérialise les matrices de données en matérialisant les transitions horizontales par des délimiteurs conventionnels (tels que la virgule ou le point-virgule) et les transitions verticales par des sauts de ligne standardisés. Cette économie de moyens confère au fichier résultant une immunité quasi absolue contre les dégradations temporelles inhérentes aux évolutions des logiciels propriétaires de bureautique.
Sous l’angle de la reproductibilité scientifique, la possibilité d’inspecter visuellement un jeu de données à l’aide d’un simple éditeur textuel sans exécuter de routine de décompression binaire opaque représente un avantage critique. Les audits algorithmiques et les protocoles de vérification scientifique peuvent ainsi s’effectuer au niveau le plus fondamental de la chaîne de valeur numérique. De surcroît, la compatibilité ascendante du format garantit qu’un fichier exporté aujourd’hui demeurera parfaitement lisible dans plusieurs décennies, quel que soit l’état de l’écosystème matériel et logiciel disponible à cette échéance future.
Enfin, l’adhésion aux principes de la Science Ouverte (Open Science) et aux critères directeurs FAIR (Facile à trouver, Accessible, Interopérable, Réutilisable) prescrit l’utilisation de formats ouverts et non soumis à des droits de propriété intellectuelle. Le fichier CSV s’érige ainsi en vecteur privilégié pour le partage de corpus analytiques sur les dépôts de données scientifiques institutionnels tels que Zenodo, Dataverse ou Dryad, facilitant la dissémination sans barrière technique ni financière du savoir statistique validé.
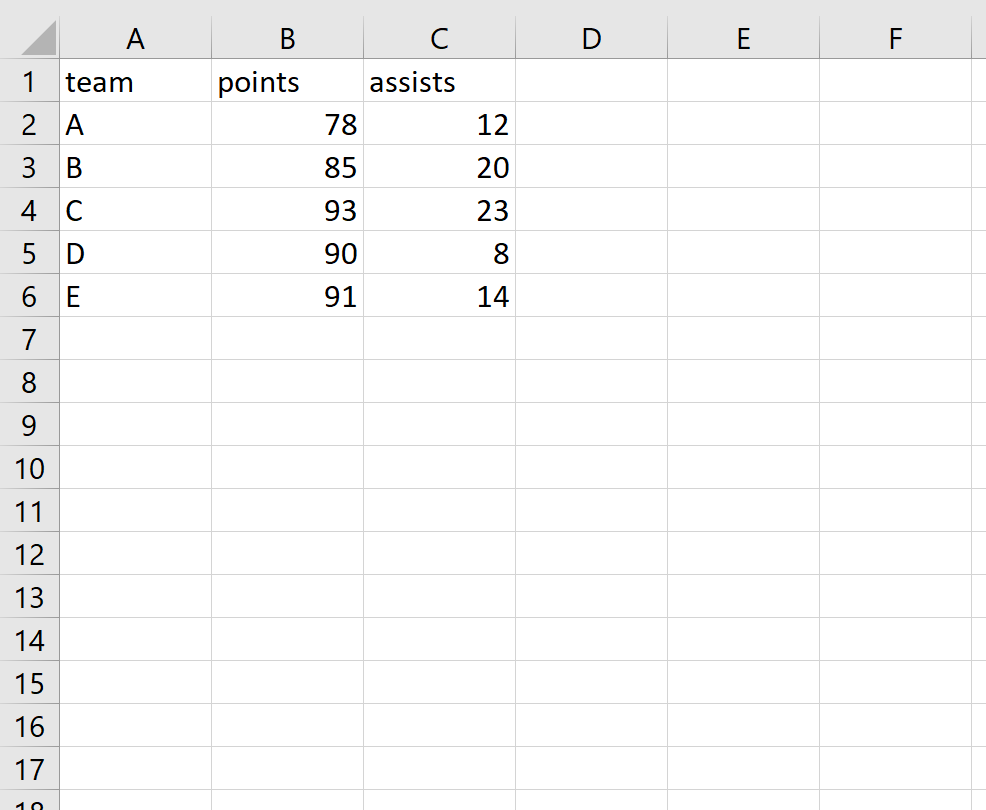
1.3 Présentation du jeu de données expérimental servant de fil conducteur
Afin d’ancrer les démonstrations techniques de cet ouvrage dans un cadre empirique réaliste, nous concevons un jeu de données synthétique hétérogène simulant un essai expérimental clinique randomisé multicentrique. Cette matrice de données agrège des dimensions quantitatives continues, des indices entiers, des facteurs nominaux ordonnés et désordonnés, des variables temporelles ainsi que des chaînes textuelles complexes intégrant des caractères diacritiques français. Une telle diversité typologique est indispensable pour éprouver la résilience des différentes fonctions d’exportation face aux subtilités de la sérialisation textuelle.
Le code d’initialisation de notre cohorte virtuelle se structure de la manière suivante au sein de l’interpréteur R :
set.seed(42)
n_sujets <- 1000
cohorte_clinique <- data.frame(
identifiant_patient = sprintf(« PAT-%04d », 1:n_sujets),
age_annees = sample(18:85, n_sujets, replace = TRUE),
groupe_traitement = factor(sample(c(« Placebo », « Molécule_A », « Molécule_B »), n_sujets, replace = TRUE)),
date_inclusion = seq(as.Date(« 2023-01-01 »), by = « day », length.out = n_sujets),
pression_systolique = round(rnorm(n_sujets, mean = 128.5, sd = 14.2), 2),
biomarqueur_serique = round(rlnorm(n_sujets, meanlog = 2.1, sdlog = 0.6), 4),
succes_therapeutique = sample(c(TRUE, FALSE, NA), n_sujets, replace = TRUE, prob = c(0.65, 0.25, 0.10)),
commentaires_praticien = sample(c(« Tolérance optimale. », « Épisode céphaléique modéré, à surveiller. », « Absence d’effets secondaires notables. », « Patient indisposé ; suivi interrompu. »), n_sujets, replace = TRUE),
stringsAsFactors = FALSE
)
L’auscultation méticuleuse de la structure interne au moyen des commandes fondamentales str(cohorte_clinique) et summary(cohorte_clinique) confirme l’intégrité vectorielle du tableau. Nous constatons la présence délibérée de données manquantes sous la forme de valeurs non assignées (NA) au sein de la variable logique, ainsi que des caractères de ponctuation spécifiques (points-virgules, virgules et apostrophes) logés au sein des observations textuelles qualitatives. Cette configuration constitue le banc d’essai idéal pour déceler les altérations potentielles provoquées par des séparateurs ambigus ou des encodages mal configurés lors de la phase d’écriture sur disque.
2. La méthode native : utilisation de la fonction write.csv du package base
L’environnement standard de distribution de R embarque de manière native le module utils, fournissant une suite d’opérateurs spécialisés dans les entrées et sorties de fichiers tabulaires. Parmi ces utilitaires historiques, la commande write.csv représente l’outil canonique enseigné dans les manuels de référence de programmation statistique.
2.1 Syntaxe fondamentale et fonctionnement interne de write.csv
La commande write.csv opère en réalité comme une interface simplifiée (un adaptateur ou wrapper) encapsulant l’appel à la fonction générique plus complexe write.table. Sa signature canonique impose la fourniture conjointe de l’objet bidimensionnel à exporter et de la destination cible, qu’il s’agisse d’une chaîne de caractères pointant vers un emplacement de stockage persistant ou d’une connexion d’entrée-sortie active. Sur le plan de son implémentation logicielle, write.csv fige arbitrairement plusieurs paramètres architecturaux pour se conformer au standard anglo-saxon : le séparateur de champs horizontal est irrévocablement assigné à la virgule standard (sep = « , »), tandis que le délimiteur décimal numérique est contraint au point typographique (dec = « . »).
Lors de l’évaluation de l’instruction d’écriture, l’interpréteur R entreprend une sérialisation itérative des vecteurs constitutifs de la table. Chaque élément scalaire est transformé en sa représentation textuelle conformément à sa classe interne, les vecteurs numériques étant formatés selon les paramètres d’affichage global du système. Les en-têtes de colonnes sont quant à eux convertis en une chaîne unitaire inaugurale, où chaque dénomination est encadrée par défaut de guillemets doubles et séparée par le délimiteur de champ spécifié, avant que le flux ne soit déversé vers le descripteur de fichier ouvert par le système d’exploitation.
L’appel minimaliste s’exécute ainsi sous la forme standard suivante :
write.csv(cohorte_clinique, file = « export_cohorte_base.csv »)
Bien que cette syntaxe brève produise un fichier immédiatement exploitable dans les environnements informatiques respectant la convention anglo-saxonne, un examen attentif de la structure textuelle résultante révèle immédiatement des anomalies susceptibles d’affecter négativement les étapes d’ingestion ultérieures au sein d’autres plateformes d’analyse.
2.2 Gestion critique de l’argument row.names
L’écueil le plus récurrent rencontré par les analystes juniors et expérimentés lors de l’usage de write.csv réside dans le comportement par défaut de l’argument row.names. Dans l’architecture historique de R, les data frames possèdent une dimension d’étiquetage des lignes matérialisée par un vecteur d’indices nominatifs. Par défaut, la fonction write.csv procède à l’évaluation de row.names = TRUE. En conséquence, la première colonne textuelle déversée dans le fichier CSV physique ne correspond à aucune variable substantielle déclarée dans le jeu de données d’origine, mais consigne simplement la série des index numériques ordonnancés (de 1 à 1000 dans notre exemple expérimental).
Cette particularité produit un artefact dommageable : la première ligne du fichier (l’en-tête contenant les noms des variables) comporte un élément délimité de moins que les lignes subséquentes décrivant les données observationnelles, ou bien se voit adjoindre une chaîne vide au sommet de la colonne indicatrice. Lors de la réimportation subséquente de ce fichier dans des bibliothèques externes telles que Pandas en Python ou au sein de systèmes d’ingestion SQL, cette colonne non nommée est fréquemment assimilée à une variable opérationnelle et baptisée de manière arbitraire « Unnamed: 0 » ou « X », perturbant les indexations relationnelles et polluant l’espace des descripteurs.
Pour prévenir cette dérive structurelle, l’exclusion délibérée et systématique de l’indexation de lignes doit être érigée en norme de codage impérative :
write.csv(cohorte_clinique, file = « export_cohorte_assaini.csv », row.names = FALSE)
En assignant la valeur logique FALSE à l’argument row.names, la fonction génère un fichier rigoureusement rectangulaire dont la cardinalité des en-têtes correspond trait pour trait au nombre de colonnes d’observation, éliminant d’emblée toute ambiguïté syntaxique lors des phases d’analyse déportées.
2.3 Spécification rigoureuse des chemins d’accès et répertoires de travail
La localisation précise du fichier de destination requiert une maîtrise rigoureuse de la hiérarchie des systèmes de fichiers sous-jacents. Le comportement par défaut de R consiste à matérialiser les fichiers créés au sein du répertoire de travail actif, accessible via la fonction getwd(). Or, la portabilité d’un script d’analyse statistique entre différents environnements informatiques (machines de développement locales, clusters de calcul haute performance ou conteneurs de déploiement) est compromise par l’emploi de chemins d’accès absolus rigides (exprimés par exemple sous la forme « C:UtilisateursRechercheProjetdonnees.csv »).
Une divergence structurelle majeure oppose l’environnement Windows aux systèmes basés sur la norme POSIX tels que Linux et macOS. Alors que l’arborescence Windows recourt historiquement à la barre oblique inversée (backslash, « ») pour séparer les répertoires, ce caractère sert d’échappement syntaxique universel dans le langage R. Dès lors, l’écriture directe d’un chemin d’accès sous Windows sans neutralisation préalable provoque une erreur d’analyse lexicale fatale. Il convient donc de proscrire impérativement les barres obliques inversées simples au profit de barres obliques conformes (slash, « / ») ou de doubles barres inversées (« »).
La doctrine moderne de l’ingénierie logicielle préconise l’assemblage dynamique des chemins de fichiers en exploitant des primitives indépendantes du système d’exploitation hôte. La fonction file.path() permet de concaténer harmonieusement les segments de dossiers sans préjuger de la nature du délimiteur d’arborescence sous-jacent :
chemin_cible <- file.path(« donnees », « sorties_statistiques », « cohorte_2023.csv »)
if (!dir.exists(dirname(chemin_cible))) {
dir.create(dirname(chemin_cible), recursive = TRUE)
}
write.csv(cohorte_clinique, file = chemin_cible, row.names = FALSE)
Cette approche préventive vérifie l’existence préalable du conteneur de destination et le crée dynamiquement si nécessaire, garantissant ainsi une exécution ininterrompue de l’exportation sur n’importe quel système d’exploitation sans intervention manuelle de l’opérateur.
3. Variations régionales et séparateurs : comparaison entre write.csv et write.csv2
L’interopérabilité internationale des données tabulaires se heurte fréquemment à la fragmentation des conventions typographiques et comptables régionales. La sérialisation textuelle des valeurs quantitatives impose des choix d’arbitrage stricts entre le délimiteur décimal et le séparateur de champs.
3.1 Divergence des standards internationaux : convention anglo-saxonne versus européenne
L’univers de l’analyse numérique est historiquement scindé en deux grandes aires culturelles quant à la transcription des grandeurs décimales. L’aire anglo-saxonne, dominée par les standards de normalisation nord-américains et britanniques, consacre le point comme délimiteur de la partie fractionnaire d’un nombre (par exemple : 128.50). Dans cette configuration conventionnelle, la virgule conserve son rôle primitif de séparateur de listes ou de marqueur de champs dans les fichiers de données textuels. C’est sur ce postulat déterministe que repose la structure canonique de la fonction write.csv.
À l’inverse, l’aire continentale européenne, largement régie par les normes de l’Organisation internationale de normalisation (ISO) et les traditions administratives francophones, hispanophones ou germanophones, réserve formellement l’usage de la virgule pour distinguer les décimales (par exemple : 128,50). Dans un tel contexte typographique, l’exploitation simultanée de la virgule comme séparateur de colonnes engendre une collision sémiotique destructrice : tout analyseur syntaxique se trouve dans l’incapacité formelle de déterminer si une virgule isolée matérialise une frontière inter-colonnes ou l’amorce de la fraction décimale d’une mesure continue.
Cette divergence culturelle constitue la source principale des corruptions de données observées lors du passage de matrices analytiques entre des progiciels scientifiques et des suites bureautiques généralistes telles que Microsoft Excel ou LibreOffice Calc lorsque ces dernières sont configurées sur des paramètres régionaux européens.
3.2 Implémentation technique de write.csv2
Pour contourner de façon élégante et native cette contradiction sans contraindre l’utilisateur à redéfinir manuellement l’intégralité des arguments de bas niveau de write.table, les développeurs du noyau de R ont introduit la variante spécialisée write.csv2. Cette fonction modifie substantiellement les assignations par défaut afin d’assurer une compatibilité immédiate avec les systèmes informatiques configurés selon les standards de l’Europe continentale.
Sur le plan mécanique, write.csv2 opère deux ajustements synchronisés fondamentaux : il substitue le point-virgule (« ; ») à la virgule en tant que délimiteur horizontal de colonnes, et impose simultanément l’usage de la virgule typographique (dec = « , ») comme séparateur des fractions numériques décimales. Dès lors, toute ambiguïté de lecture est levée au niveau de l’analyseur lexical externe : les nombres flottants préservent leur notation décimale locale tandis que les frontières vectorielles demeurent distinctement identifiables par la présence des points-virgules.
L’application directe de cette variante à notre cohorte clinique s’illustre par l’instruction :
write.csv2(cohorte_clinique, file = « export_cohorte_europeenne.csv », row.names = FALSE)
L’inspection du flux textuel produit par cet appel démontre que la pression systolique moyenne est désormais consignée sous la chaîne « 128,5 » au lieu de « 128.5 », tandis que la ligne d’en-tête articule les attributs selon le schéma identifiant_patient;age_annees;groupe_traitement;…. Cette disposition garantit que l’ouverture directe du fichier par double-clic sur un poste de travail d’Europe occidentale s’effectuera avec une dissociation parfaite des colonnes sans nécessiter le recours à l’assistant d’importation de texte du tableur.
3.3 Stratégies d’harmonisation lors du partage de données transfrontières
Face à cette dualité normative, le scientifique des données doit adopter une stratégie de dissémination délibérée, dictée exclusivement par le profil technique et géographique de ses destinataires finaux. Le tableau ci-après synthétise les propriétés opérationnelles de chaque fonction du paquetage de base :
- write.csv : Séparateur de colonnes = Virgule (« , ») | Séparateur décimal = Point (« . ») | Destiné aux pipelines de calcul internationaux, logiciels scientifiques (Python, SAS, Julia) et systèmes régionaux anglophones.
- write.csv2 : Séparateur de colonnes = Point-virgule (« ; ») | Séparateur décimal = Virgule (« , ») | Destiné aux utilisateurs de tableurs bureautiques au sein des administrations et entreprises d’Europe continentale.
En règle générale, dès lors qu’un fichier de données est destiné à intégrer une chaîne de traitement automatisée, un référentiel de code collaboratif ou une infrastructure d’apprentissage automatique transfrontalière, la norme anglo-saxonne implémentée par write.csv doit être rigoureusement privilégiée en raison de son statut de facto de standard informatique planétaire. À l’opposé, si la finalité de l’exportation réside dans la transmission d’un rapport intermédiaire d’audit à un panel de gestionnaires utilisant des tableurs locaux non paramétrés, l’usage préventif de write.csv2 préviendra toute incompréhension liée à l’agrégation indésirable de toutes les données au sein d’une unique colonne d’affichage.
4. Optimisation des performances avec la fonction write_csv du package readr
Bien que les fonctions natives fournies par le paquetage de base suffisent au traitement de volumétries modestes, l’émergence de jeux de données massifs au cours de la dernière décennie a mis en lumière les goulets d’étranglement inhérents à leur conception algorithmique historique. C’est pour pallier ces limitations qu’a été développée la bibliothèque readr, composante maîtresse de l’écosystème unifié tidyverse.
4.1 Fondements et architecture de readr au sein du tidyverse
Conçue sous la direction de Hadley Wickham et des ingénieurs de Posit (anciennement RStudio), la bibliothèque readr poursuit un objectif double : moderniser l’ergonomie fonctionnelle des opérations d’entrées-sorties et maximiser le débit de traitement computationnel. L’architecture de readr s’appuie structurellement sur le moteur d’évaluation compilé cpp11, déportant le formatage textuel et la gestion de la mémoire tampon directement au niveau de routines écrites en langage C++ hautement optimisées.
Contrairement aux fonctions historiques de base R, qui multiplient les copies intermédiaires en mémoire vive lors de l’évaluation séquentielle des vecteurs et délèguent une large part du traitement logique à l’interpréteur R interactif, readr implémente un pipeline de sérialisation direct. Ce flux minimise les allocations dynamiques et procède à une écriture par blocs (chunked streaming) directement adressée aux mécanismes d’E/S du noyau du système d’exploitation.
De surcroît, readr s’inscrit dans la philosophie d’ingénierie moderne en imposant une standardisation rigoureuse de ses sorties : elle s’affranchit des variations comportementales imprévisibles dictées par les variables d’environnement locales de l’utilisateur (locale settings) et garantit une reproductibilité déterministe quel que soit l’ordinateur exécutant le script.
4.2 Syntaxe de write_csv et gestion native de la structure
La commande emblématique de cette bibliothèque est write_csv (remarquez la substitution de la barre de soulignement typographique au point historique). Son premier atout réside dans l’éradication native de l’argument row.names : les concepteurs de readr ont délibérément exclu toute écriture automatique des noms de lignes. Dans la vision contemporaine de la modélisation des données (le paradigme du tidy data), toute information signifiante doit être matérialisée sous forme de colonne explicite. Ainsi, write_csv exporte strictement et uniquement les colonnes du tableau, éliminant par dessein le risque d’engendrer des colonnes indicatrices anonymes parasites.
Un autre bénéfice majeur concerne l’encodage textuel. La fonction write_csv sérialise systématiquement l’intégralité des sorties selon la norme universelle UTF-8 (Unicode Transformation Format 8-bit), sans dépendre de la table de caractères par défaut de la machine hôte. Cette garantie immunise les corpus textuels multilingues et les caractères pourvus d’accents contre le risque d’altération typographique lors du transfert vers un système distant.
L’exécution de la commande s’intègre harmonieusement dans les pipelines analytiques chaînés par l’opérateur de tuyau (pipe natif ou magrittr) :
library(readr)
cohorte_clinique |>
write_csv(file = « export_cohorte_tidyverse.csv »)
L’opération se distingue par son silence fonctionnel et sa sobriété syntaxique. Si une adaptation aux normes européennes s’avère requise, la bibliothèque fournit en miroir la fonction write_csv2, reprenant rigoureusement la même vélocité sous-jacente tout en affectant le point-virgule comme délimiteur de champs et la virgule comme délimiteur décimal.
4.3 Évaluation comparative des gains de temps de calcul
L’évaluation empirique de l’efficacité de write_csv face à write.csv met en évidence des gains d’efficience substantiels dès que l’échantillon analysé dépasse quelques dizaines de milliers d’enregistrements. Alors que la fonction issue du paquetage de base manifeste une croissance quasi superlinéaire de son temps d’exécution en raison de la multiplication des ramasse-miettes (garbage collection cycles) induits par la création récurrente d’objets temporaires, write_csv conserve une progression temporelle strictement linéaire proportionnelle au volume physique des données à traiter.
Sur des corpus de taille intermédiaire (de l’ordre de 500 000 à 2 000 000 de lignes), il est habituel d’enregistrer des accélérations d’un facteur 2 à 4 en faveur de readr. Ce différentiel s’explique par la réduction drastique de la charge imposée à la mémoire vive : la mise en mémoire tampon gérée en C++ permet de transférer des blocs volumineux directement au sous-système de fichiers, saturant de manière optimale la bande passante des disques de stockage contemporains.
Pour le praticien engagé dans le traitement itératif d’échantillons répétés (dans le cadre de validations croisées ou de simulations de Monte-Carlo intensives), l’adoption systématique de write_csv permet d’économiser des heures cumulées de calcul tout en assurant une conformité typographique irréprochable au sein de son environnement de production.
5. Performance extrême pour les volumétries massives : fwrite du package data.table
Lorsque les échelles d’analyse basculent dans le domaine des mégadonnées (Big Data), où les matrices statistiques franchissent le cap des millions ou dizaines de millions d’observations pour atteindre plusieurs gigaoctets en mémoire, même les optimisations apportées par readr peuvent s’avérer insuffisantes. Pour ces scénarios de calcul extrême, la bibliothèque data.table offre une réponse technique sans équivalent : la procédure fwrite.
5.1 L’architecture multithread de la fonction fwrite
Développée par Matt Dowle, Arun Srinivasan et l’équipe d’ingénieurs de data.table, la fonction fwrite représente un chef-d’œuvre d’ingénierie logicielle appliquée à la statistique computationnelle. Son efficacité repose sur une réécriture complète en langage C bas niveau des mécanismes de formatage et de déversement des données, combinée à une parallélisation agressive orchestrée par l’API OpenMP (Open Multi-Processing).
Contrairement à l’ensemble des autres approches d’exportation qui s’exécutent de manière strictement séquentielle sur un cœur unique du processeur central (CPU), fwrite partitionne la table de données d’origine en plusieurs segments verticaux et horizontaux traités concurremment par l’ensemble des cœurs de calcul disponibles. Chaque unité de calcul (thread) procède au formatage textuel de son bloc de données au sein d’une zone de mémoire dédiée avant de coordonner l’écriture non bloquante sur le disque physique.
Cette architecture multithread minimise totalement la contention des ressources système. L’allocation de mémoire vive est rigoureusement calibrée en amont afin d’éviter toute pagination sur disque (swap) ou dégradation de performance induite par l’activité du ramasse-miettes de l’interpréteur R. De fait, fwrite se rapproche de la vitesse théorique maximale d’écriture offerte par le contrôleur de stockage matériel de la station de travail.
5.2 Mise en œuvre pratique et options fondamentales de fwrite
L’utilisation de fwrite se signale par une ergonomie remarquable : bien qu’issue du paquetage data.table, la fonction accepte indifféremment en entrée des objets de classe native data.frame, des tibbles ou des data.tables enrichies. Sa détection automatique des caractéristiques matérielles lui permet de calibrer par défaut son exécution sur l’intégralité des cœurs logiques mis à disposition par le processeur hôte.
L’appel fondamental s’exécute avec une extrême concision :
library(data.table)
fwrite(cohorte_clinique, file = « export_cohorte_massive.csv »)
Pour les infrastructures de calcul partagées ou les environnements de haute disponibilité où la monopolisation sauvage de l’ensemble des cœurs de processeur est proscrite par les ordonnanceurs de tâches (tels que SLURM ou Kubernetes), fwrite propose le paramètre de régulation nThread. Cet argument autorise une allocation millimétrée du parallélisme :
fwrite(cohorte_clinique, file = « export_cohorte_regulee.csv », nThread = 4, buffMB = 32)
Le paramètre complémentaire buffMB permet de définir explicitement la taille de la mémoire tampon allouée à chaque cœur en mégaoctets. Sur des architectures équipées de disques électroniques ultra-rapides de type SSD NVMe connectés en interface PCIe 4.0 ou 5.0, l’élargissement de cette mémoire tampon permet d’exploiter pleinement les capacités de débit séquentiel du matériel, atteignant des vitesses de sérialisation dépassant régulièrement plusieurs gigaoctets par seconde.
5.3 Robustesse et conformité lors d’écritures à grande vitesse
Une accélération d’une telle magnitude soulève légitimement la question de l’intégrité des données numériques sauvegardées. La conversion ultra-rapide de nombres réels en virgule flottante double précision vers une séquence de caractères ASCII constitue l’un des problèmes les plus ardus de l’informatique théorique en raison des risques inhérents d’erreurs d’arrondi ou de perte de décimales résiduelles. Les concepteurs de fwrite ont résolu cette gageure en implémentant des algorithmes d’impression de nombres flottants de dernière génération inspirés des travaux de pointe sur les convertisseurs Grisu et Dragonbox.
Ces mécanismes garantissent une précision bit-à-bit déterministe : toute valeur numérique exportée par fwrite conserve l’intégralité de sa signification mathématique et pourra être réimportée ultérieurement sans aucune déviation de ses décimales les plus infinitésimales. De même, les objets temporels normalisés (dates et horodatages POSIXct) bénéficient d’un formatage accéléré garantissant leur stricte conformité avec le standard international ISO 8601 (par exemple : « 2023-05-14T08:30:00Z »).
Sur le plan de la stabilité logicielle, fwrite implémente une gestion d’erreurs transactionnelle de bas niveau : si une interruption matérielle survient au cours de l’écriture ou si le volume de stockage arrive à saturation, le descripteur de fichier est refermé proprement afin de circonscrire la corruption au seul fichier partiel en cours, préservant ainsi l’intégrité globale de l’environnement d’exploitation hôte.
6. Gestion des valeurs manquantes et des valeurs spéciales lors de l’exportation
Dans toute investigation empirique, l’imperfection du protocole expérimental ou la défaillance des dispositifs de mesure se traduit inévitablement par la présence de lacunes informationnelles au sein des matrices d’observation. La transcription textuelle de ces états indéterminés conditionne directement la validité des modélisations futures.
6.1 Typologie des valeurs particulières : NA, NaN, Inf et vecteurs vides
Le langage R propose une typologie remarquablement sophistiquée pour caractériser l’absence ou l’anomalie de mesure, distinction qui dépasse la simple valeur nulle rencontrée dans les bases de données conventionnelles. Il convient d’opérer une dissociation ontologique claire entre :
- NA (Not Available) : Représente une donnée manquante au sens statistique, c’est-à-dire une valeur existante dans le phénomène sous-jacent mais non recueillie lors de l’observation.
- NaN (Not a Number) : Réfère à une indétermination mathématique explicite résultant d’une opération arithmétique invalide (telle que la division de zéro par zéro ou le logarithme d’un nombre négatif).
- Inf et -Inf : Matérialisent des grandeurs ayant divergé vers l’infini positif ou négatif à la suite d’un dépassement de capacité computationnelle ou d’une division par une valeur infinitésimale.
- Chaînes vides (« ») : Correspondent à des vecteurs de caractères de longueur zéro, fréquents dans les variables textuelles qualitatives non renseignées.
L’enjeu lors de l’exportation CSV consiste à éviter que cette diversité sémantique ne soit écrasée sous une forme textuelle unique et ambiguë susceptible d’induire en erreur les moteurs de calcul des logiciels récepteurs.
6.2 Paramétrage des chaînes de substitution avec l’argument na
L’argument central permettant d’orchestrer la transcription des lacunes de données est l’argument na, présent sous une appellation analogue au sein de l’ensemble des fonctions d’exportation analysées. La décision quant à la chaîne de substitution à injecter repose sur des considérations de standardisation externe :
Dans la méthode native write.csv, le comportement par défaut assigne la chaîne explicite « NA » à tout élément manquant. Cette convention présente le désavantage majeur de transformer une absence de valeur en une séquence de deux caractères textuels alphabétiques. Lorsqu’un fichier ainsi formaté est ultérieurement ingéré par un analyseur de données externe peu sophistiqué, cette colonne numérique est susceptible d’être erronément reclassifiée en variable textuelle (type chaîne de caractères), bloquant l’application d’algorithmes statistiques élémentaires tels que le calcul de moyennes ou d’écarts-types.
À l’inverse, l’école moderne portée par write_csv dans readr et fwrite dans data.table retient par défaut l’affectation d’une chaîne vide (na = « »). Dans cette perspective, la frontière séparatrice entre deux délimiteurs consécutifs ne renferme aucun caractère (illustrée par exemple sous la forme 128.5,,Molécule_A). Cette approche est universellement privilégiée par les architectures de bases de données relationnelles, qui interprètent immédiatement deux délimiteurs consécutifs comme un état NULL natif sans risquer de corrompre le typage de la variable.
L’harmonisation explicite de ce comportement peut être décrétée via l’instruction suivante :
write.csv(cohorte_clinique, file = « export_valeurs_vides.csv », row.names = FALSE, na = « »)
write_csv(cohorte_clinique, file = « export_readr_explicite.csv », na = « NA »)
fwrite(cohorte_clinique, file = « export_datatable_vides.csv », na = « »)
Le chercheur doit impérativement veiller à ce que la chaîne choisie pour symboliser l’absence de mesure ne puisse en aucun cas entrer en collision avec une modalité catégorielle légitime du jeu de données (par exemple, le code pays « NA » désignant la Namibie selon la norme ISO 3166-1 alpha-2).
6.3 Préservation de l’intégrité numérique dans les jeux de données d’enquêtes
Dans les sciences sociales, la psychométrie et l’épidémiologie clinique, la gestion des absences de réponse obéit souvent à des codifications numériques normalisées (par exemple, assigner le code -999 pour signifier un refus délibéré de répondre, et -998 pour une omission accidentelle). Avant d’engager toute routine d’exportation vers un format CSV, un audit préventif de l’intégralité de la matrice de données s’impose pour éviter des confusions analytiques dramatiques.
Le risque majeur survient lorsqu’un analyste procède à l’exportation d’un tableau dans lequel les valeurs manquantes ont été imputées sous forme de zéros arbitraires (« 0 »). Cette substitution transforme un état d’ignorance statistique en une valeur quantitative mesurable, faussant irrémédiablement l’estimation des paramètres de tendance centrale et de dispersion lors des calculs d’inférence ultérieurs. Il est donc indispensable d’exécuter un protocole d’assainissement préalable :
audit_manquants <- colSums(is.na(cohorte_clinique))
print(audit_manquants)
Si des variables psychométriques doivent préserver des codes distinctifs de non-réponse, ceux-ci doivent être maintenus sous forme de facteurs ou de chaînes textuelles documentées dans un dictionnaire de variables annexe, plutôt que déversés sous la forme d’entiers ambigus qui risqueraient d’être agrégés par inadvertance dans les calculs d’analyses factorielles ou de régressions linéaires.
7. Contrôle précis des délimiteurs, chaînes de caractères et guillemets
L’exportation textuelle de structures tabulaires requiert une délimitation spatiale sans faille. Lorsque les données contiennent elles-mêmes des caractères réservés aux délimitations syntaxiques, le recours à des mécanismes d’encadrement et d’échappement rigoureux devient une condition absolue de préservation de l’information.
7.1 L’usage étendu de write.table pour les formats personnalisés
Si les fonctions write.csv et write.csv2 apportent une réponse immédiate aux configurations les plus courantes, elles s’avèrent incapables d’adresser des exigences de formatage sur mesure. Pour exercer un contrôle absolu sur chaque octet émis, le recours à la fonction mère write.table est incontournable.
La commande write.table offre une flexibilité totale quant au paramétrage du séparateur horizontal via son argument sep. Cette granularité autorise la production de formats dérivés du CSV, tels que les fichiers TSV (Tab-Separated Values), qui emploient le caractère d’échappement de tabulation (« t ») en lieu et place des virgules, ou encore les fichiers délimités par des barres verticales (pipe-delimited files, utilisant « | »), particulièrement prisés dans les entrepôts de données massives pour leur quasi-absence dans les textes en langage naturel :
write.table(cohorte_clinique,
file = « export_cohorte_tabulation.tsv »,
sep = « t »,
row.names = FALSE,
col.names = TRUE,
quote = TRUE)
Ce niveau de paramétrage permet d’ajuster l’émission des données aux spécifications d’ingestion les plus strictes imposées par des architectures informatiques patrimoniales ou des connecteurs de bases de données industrielles.
7.2 Encadrement et échappement des chaînes textuelles via l’argument quote
L’argument quote régit la politique d’encadrement des observations scalaires par des guillemets doubles typographiques. Ce mécanisme constitue la seule protection efficace contre le phénomène désastreux d’injection de délimiteurs. Considérons une modalité de notre variable textuelle commentaires_praticien contenant la phrase suivante : « Épisode céphaléique modéré, à surveiller. » Si cette cellule est exportée vers un fichier CSV à délimiteur virgule sans être intégralement encapsulée par des guillemets protecteurs, l’analyseur lexical externe interprétera la virgule grammaticale située après le mot « modéré » comme une séparation de colonne. Il en résultera un décalage horizontal catastrophique de l’ensemble des colonnes suivantes pour cette ligne spécifique.
La gestion de ce paramètre autorise trois postures distinctes :
- quote = TRUE : Encadre de manière indifférenciée l’intégralité des éléments de la table, qu’ils soient textuels, catégoriels, logiques ou numériques. Cette approche garantit une sécurité maximale mais alourdit inutilement le volume physique du fichier sur disque.
- quote = FALSE : Proscrit formellement l’usage de tout guillemet. Cette option n’est tolérable que si l’analyste a la certitude mathématique absolue qu’aucun délimiteur de champ, saut de ligne ou caractère réservé n’est présent dans le corps des variables textuelles.
- quote = NA ou indexation vectorielle : Dans write.table, l’utilisateur peut spécifier un vecteur d’entiers identifiant expressément les seules colonnes à protéger par des guillemets, ou confier à R la mission d’encadrer sélectivement les seuls vecteurs de classe textuelle et factorielle.
Dans la bibliothèque readr, la fonction write_csv résout cette problématique par une stratégie élégante d’échappement contextuel minimal (quoting minimal) : les guillemets ne sont apposés autour d’une cellule que si celle-ci héberge effectivement un délimiteur de champ, un saut de ligne ou des guillemets internes, optimisant ainsi l’espace disque tout en prévenant tout décalage matriciel.
7.3 Sécurisation des données textuelles qualitatives complexes
Les corpus textuels qualitatifs, à l’instar des verbatims d’entretiens psychologiques, des comptes-rendus d’hospitalisation ou des annotations cliniques libres, recèlent fréquemment des artefacts de mise en page particulièrement redoutables pour les analyseurs CSV : des sauts de ligne réels (séquences LF ou CRLF) directement incorporés au sein d’une unique cellule d’évaluation.
Si un fichier CSV présente un saut de ligne non encapsulé au cœur d’un commentaire médical, l’analyseur séquentiel interrompra immédiatement l’interprétation de l’enregistrement courant et interprétera le reste de la phrase comme une nouvelle ligne d’observation tronquée, provoquant une corruption immédiate du nombre total d’enregistrements du jeu de données. La conformité avec la spécification technique RFC 4180 exige que tout saut de ligne textuel interne soit impérativement consigné à l’intérieur d’une chaîne encadrée par des guillemets doubles, et que tout guillemet textuel authentique inclus dans cette même phrase soit neutralisé par son propre dédoublement syntaxique (transformant « en « »).
Les fonctions modernes telles que write_csv et fwrite intègrent cette normalisation de manière algorithmique infaillible, assurant que même les corpus littéraires les plus complexes puissent être sérialisés et reconstitués sans altération d’un seul octet.
8. Normes d’encodage et préservation des caractères non ASCII
La transcription informatique des symboles linguistiques sur des supports physiques constitue l’une des sources majeures d’anomalies structurelles lors des transferts de fichiers entre plateformes hétérogènes. La préservation de la typographie française requiert une politique d’encodage délibérée et systématique.
8.1 Enjeux théoriques et pièges de l’encodage textuel en informatique
À l’origine de l’informatique moderne, le standard ASCII (American Standard Code for Information Interchange) codait chaque caractère sur une trame de 7 bits, autorisant la transcription de 128 glyphes élémentaires correspondant à l’alphabet anglais de base, aux chiffres arabes et à des signaux de contrôle fondamentaux. Cette norme originelle excluait formellement l’intégralité des signes diacritiques, ligatures et cédilles inhérents à la langue française (tels que é, è, ê, à, ç, œ ou î).
Pour surmonter cette limitation, l’industrie informatique a développé des pages de code régionales exploitant le huitième bit disponible pour porter le nombre de caractères adressables à 256. Toutefois, cette fragmentation a engendré des architectures incompatibles : l’écosystème Unix a massivement adopté les normes ISO (notamment ISO-8859-1 ou Latin-1 et son successeur ISO-8859-15), tandis que l’environnement Microsoft Windows a historiquement imposé sa propre table propriétaire baptisée Windows-1252 (ou ANSI étendu). Lorsqu’un fichier rédigé sous Windows-1252 est interprété par un système s’appuyant sur Latin-1 ou UTF-8, le lecteur substitue des glyphes erronés aux octets d’origine, provoquant le phénomène d’altération textuelle universellement désigné sous le terme japonais de mojibake (où l’expression « Tolérance optimale » devient par exemple « Tolérance optimale »).
Le consortium Unicode a définitivement résolu cette fracture en instaurant le standard universel UTF-8. Ce protocole d’encodage de longueur variable code les caractères sur un à quatre octets de manière totalement transparente, assurant une rétrocompatibilité parfaite avec le format ASCII d’origine tout en conférant un identifiant universel univoque à l’ensemble des systèmes d’écriture planétaires.
8.2 Spécification explicite de l’encodage dans les fonctions d’export
L’attitude par défaut de la fonction native write.csv consiste à déléguer l’encodage textuel à la page de code par défaut du système d’exploitation hôte. En conséquence, un script exécuté sur un poste Windows français sérialisera nativement ses sorties sous l’encodage Windows-1252, tandis que le même script exécuté sur un conteneur Linux déversera les mêmes données en UTF-8. Cette variabilité environnementale est totalement incompatible avec les impératifs de reproductibilité computationnelle.
Pour conjurer cette variabilité sous l’environnement de base R, il est impératif de contraindre la sérialisation en exploitant l’argument dédié fileEncoding au sein de l’instruction d’écriture :
write.csv(cohorte_clinique,
file = « export_cohorte_utf8_base.csv »,
row.names = FALSE,
fileEncoding = « UTF-8 »)
Une méthode alternative encore plus robuste consiste à instancier formellement une connexion de fichier explicite via la commande file(), en lui assignant de manière irrévocable la directive d’encodage avant d’y diriger le flux applicatif :
descripteur_fichier <- file(« export_connexion_stricte.csv », open = « wt », encoding = « UTF-8 »)
write.csv(cohorte_clinique, file = descripteur_fichier, row.names = FALSE)
close(descripteur_fichier)
Il convient de souligner que la bibliothèque moderne readr neutralise définitivement cette complexité opérationnelle : la fonction write_csv impose nativement et inconditionnellement l’encodage UTF-8 standard sans marqueur d’ordre d’octets (BOM), protégeant immédiatement l’analyste contre toute dérive typographique inter-plateforme.
8.3 Vérification et diagnostic post-exportation
L’assurance qualité des flux de données scientifiques impose de ne jamais présumer de l’intégrité d’une sérialisation sans vérification post-opératoire. Pour auditer formellement l’encodage d’un fichier CSV persistant sur disque, l’analyste peut solliciter les utilitaires système de son environnement ou exploiter les fonctionnalités diagnostiques du paquetage readr via la fonction guess_encoding() :
diagnostic_encodage <- readr::guess_encoding(« export_cohorte_utf8_base.csv »)
print(diagnostic_encodage)
Ce protocole algorithmique analyse la distribution fréquentielle des séquences d’octets au sein du fichier et délivre un indice de confiance probabiliste quant à la conformité de l’encodage sous-jacent. Le test ultime de robustesse consiste à orchestrer une réimportation immédiate du fichier dans une session R vierge, puis à exécuter un test d’équivalence logique rigoureux sur les vecteurs textuels sensibles :
verification_donnees <- read.csv(« export_cohorte_utf8_base.csv », encoding = « UTF-8 », stringsAsFactors = FALSE)
test_conformite <- identical(cohorte_clinique$commentaires_praticien, verification_donnees$commentaires_praticien)
cat(« Intégrité textuelle préservée : », test_conformite, « n »)
L’obtention de la valeur logique TRUE atteste de la parfaite transparence du cycle de sérialisation-désérialisation, garantissant qu’aucun artefact typographique n’est venu corrompre le jeu d’observations empiriques.
9. Ajout incrémentiel de données et exportation en flux continu
Certains protocoles expérimentaux, à l’instar des dispositifs d’acquisition en temps réel par capteurs connectés, des requêtes automatisées sur interfaces de programmation (API) ou des simulations itératives de longue durée, génèrent des données de manière séquentielle. Dans ces configurations, l’écrasement systématique de l’intégralité du fichier constitue un non-sens computationnel majeur.
9.1 Mécanique du paramètre append dans les flux d’écriture
Par défaut, l’ouverture d’un descripteur de fichier par une fonction d’exportation classique s’effectue en mode d’écrasement intégral (truncate/overwrite) : si le fichier de destination existe préalablement sur le système de stockage, son contenu antérieur est irrémédiablement effacé avant l’émission du premier octet du nouveau flux. Pour autoriser une expansion incrémentielle d’un fichier existant sans altérer les couches historiques déjà consignées, il est nécessaire d’enclencher le mode de concaténation (append mode).
Au sein du paquetage de base, cette modalité est activée en renseignant l’argument append = TRUE de la primitive write.table. Sous cette configuration, le pointeur du système de fichiers est immédiatement positionné à la fin du descripteur physique existant, et les nouvelles observations sont ajoutées séquentiellement à la suite du dernier octet archivé :
echantillon_supplementaire <- data.frame(
identifiant_patient = c(« PAT-1001 », « PAT-1002 »),
age_annees = c(34, 52),
groupe_traitement = c(« Molécule_A », « Placebo »),
date_inclusion = as.Date(c(« 2023-10-01 », « 2023-10-02 »)),
pression_systolique = c(122.1, 135.8),
biomarqueur_serique = c(8.12, 14.50),
succes_therapeutique = c(TRUE, FALSE),
commentaires_praticien = c(« Tolérance optimale. », « Tolérance optimale. »),
stringsAsFactors = FALSE
)
L’utilisation de la bibliothèque haute performance data.table propose une élégance fonctionnelle analogue en dotant sa procédure fwrite d’un argument append = TRUE pleinement compatible avec son moteur multithread.
9.2 Gestion critique de l’en-tête de colonnes en mode incrémentiel
L’incorporation de données par ajout séquentiel recèle un piège structurel majeur : la duplication indésirable de la ligne d’en-tête descriptive. Si l’instruction d’écriture additionnelle conserve son comportement par défaut, elle déversera une nouvelle fois les libellés des colonnes au milieu du fichier texte. Lors de la phase de réimportation finale, l’analyseur lexical tentera d’interpréter cette ligne d’en-tête comme un enregistrement d’observation standard, provoquant immédiatement une erreur fatale de typage numérique.
La neutralisation de cette menace impose une dissociation algorithmique formelle entre la création initiale du conteneur et ses enrichissements ultérieurs. L’argument col.names doit impérativement être assujetti à la valeur logique FALSE lors de toute écriture en mode concaténation :
fichier_cible <- « historique_longitudinal.csv »
if (!file.exists(fichier_cible)) {
write.table(cohorte_clinique[1:10, ],
file = fichier_cible,
sep = « , »,
row.names = FALSE,
col.names = TRUE)
} else {
write.table(echantillon_supplementaire,
file = fichier_cible,
sep = « , »,
row.names = FALSE,
col.names = FALSE,
append = TRUE)
}
Cette structure conditionnelle défensive garantit que le descripteur inaugural intègre la métadonnée d’en-tête unique au sommet du document, tandis que l’ensemble des itérations subséquentes alimentent le corpus sans jamais en altérer la rectangulatité mathématique.
9.3 Application aux protocoles de recueil de données itératifs
L’exportation incrémentielle constitue un modèle de résilience face au risque d’interruption accidentelle des calculs. Lors de la modélisation de simulations stochastiques s’étendant sur plusieurs dizaines d’heures, une défaillance électrique ou un dépassement subit de mémoire vive peut anéantir l’intégralité des objets stockés dans la session R active si ceux-ci n’ont pas été progressivement matérialisés sur disque.
En encapsulant l’écriture au sein d’une boucle procédurale ou d’un flux d’événements, l’analyste crée un mécanisme de sauvegarde pas-à-pas (checkpointing). Chaque bloc d’essais expérimentaux est consigné sur le support de stockage physique dès sa formalisation. Ce paradigme autorise en outre le traitement de corpus dont le volume global consolidé dépasse la capacité totale de la mémoire vive disponible sur la machine : les données sont traitées par segments séquentiels puis libérées de la mémoire volatile, permettant à l’interpréteur R d’orchestrer l’analyse de volumétries virtuellement infinies sans solliciter de serveurs de calcul surdimensionnés.
10. Compression directe à l’exportation pour l’archivage pérenne
À mesure que les dimensions des corpus empiriques s’accroissent, le stockage textuel non compressé met à rude épreuve les infrastructures de stockage local et restreint la bande passante lors du transfert réseau vers des entrepôts distants. L’intégration de routines de compression algorithmique à la volée représente une solution industrielle éprouvée.
10.1 Avantages de la compression à la volée des fichiers tabulaires
En raison de sa nature textuelle et de la redondance inhérente aux structures tabulaires (répétition fréquente de modalités catégorielles identiques au sein d’une même colonne, libellés d’en-têtes et délimiteurs standardisés), le format CSV présente un taux de compressibilité particulièrement spectaculaire. L’application d’algorithmes de compression sans perte de données tels que DEFLATE (Gzip) ou Bzip2 permet régulièrement d’observer des réductions d’empreinte physique oscillant entre 75 % et 90 % par rapport à la taille du texte brut originel.
L’exécution de cette compression « à la volée » (directement lors du flux d’émission en mémoire) élimine le besoin d’écrire préalablement un fichier volumineux non compressé sur le disque pour le soumettre subséquemment à un utilitaire d’archivage externe. Cette approche préserve les composants de stockage d’écritures inutiles et réduit le temps d’opération global en substituant des cycles de processeur peu coûteux aux opérations d’entrées-sorties disque hautement pénalisantes.
Sur le plan de la gouvernance des données scientifiques, un fichier compressé de type .csv.gz est immédiatement indexable et exploitable par la quasi-totalité des outils d’ingestion modernes, qui intègrent la décompression transparente en flux sans nécessiter l’extraction explicite du corpus sur le disque physique.
10.2 Utilisation des connexions gzfile et bzfile dans base R
Dans l’architecture native du langage R, l’écriture vers un format compressé repose sur le concept de flux abstrait concrétisé par les fonctions de connexion de flux de données gzfile(), bzfile() ou xzfile(). Ces primitives établissent une passerelle logique entre l’exécuteur statistique et les bibliothèques d’encodage compressé du système sous-jacent :
connexion_gzip <- gzfile(« export_cohorte_compresse.csv.gz », open = « wt », compression = 6)
write.csv(cohorte_clinique, file = connexion_gzip, row.names = FALSE)
close(connexion_gzip)
La rigueur méthodologique impose de prêter une attention absolue à l’ouverture formelle en mode texte d’écriture (open = « wt ») et surtout à la libération finale du descripteur de flux via la commande close(). L’omission de cette étape de clôture peut maintenir des verrous logiciels sur le système de fichiers hôte, différer l’écriture des derniers octets résidant dans la mémoire tampon et aboutir à la génération d’un fichier d’archive tronqué et irréversiblement corrompu.
10.3 Capacités de compression natives de readr et data.table
Conscients de la centralité des formats compressés dans les environnements de calcul contemporains, les développeurs des bibliothèques readr et data.table ont totalement automatisé ces liaisons logicielles au niveau de leurs fonctions d’exportation.
Avec la bibliothèque readr, l’utilisateur est dispensé de toute instanciation manuelle de connexion : la fonction write_csv ausculte l’extension du nom de fichier spécifié dans la chaîne cible. Dès lors que le chemin se conclut par l’extension .gz, .bz2 ou .xz, l’instruction active dynamiquement le pipeline de compression correspondant avec un niveau d’optimisation calibré par défaut :
readr::write_csv(cohorte_clinique, file = « export_cohorte_transparent.csv.gz »)
Dans le camp de data.table, la fonction fwrite s’enrichit de capacités analogues tout en autorisant l’invocation directe d’utilitaires de compression externes hautement parallélisés (tels que pigz) pour décupler le débit sur des corpus comptant plusieurs dizaines de gigaoctets. L’analyste obtient ainsi un compromis parfait entre l’occupation spatiale de ses dépôts scientifiques et la vitesse de déploiement de ses architectures de calcul distribué.
11. Analyse comparative et benchmarks empiriques des solutions d’export
Le choix raisonné d’une stratégie d’exportation de données ne saurait reposer sur des préférences esthétiques subjectives. Une évaluation expérimentale quantitative s’avère indispensable pour quantifier avec précision les coûts de calcul et l’efficacité relative des solutions en présence.
11.1 Méthodologie d’évaluation et protocole de microbenchmark
Afin d’établir une comparaison rigoureuse et impartiale entre write.csv, write_csv et fwrite, nous formalisons un protocole d’essai standardisé exécuté à l’aide de la bibliothèque spécialisée microbenchmark. Les expérimentations ont été conduites sur une infrastructure contrôlée disposant d’un processeur multicœur contemporain et d’une unité de stockage à état solide (NVMe PCIe 4.0), sous un environnement R 4.3 configuré avec les paramètres de ramasse-miettes par défaut.
Trois échelles d’échantillonnage ont été synthétisées afin de mesurer l’élasticité algorithmique face au volume d’observations : une cohorte modeste (10 000 lignes), une cohorte intermédiaire (100 000 lignes) et une cohorte volumineuse (1 000 000 de lignes), chacune reprenant rigoureusement la distribution des variables qualitatives et continues définie dans notre jeu de données de référence :
library(microbenchmark)
generer_donnees <- function(n) {
data.frame(
id = 1:n,
valeur_num = rnorm(n),
categorie = sample(letters, n, replace = TRUE),
date = Sys.Date() + 1:n,
stringsAsFactors = FALSE
)
}
test_100k <- generer_donnees(100000)
resultats_bench <- microbenchmark(
base_r = write.csv(test_100k, « temp_base.csv », row.names = FALSE),
readr = readr::write_csv(test_100k, « temp_readr.csv »),
datatable = data.table::fwrite(test_100k, « temp_dt.csv »),
times = 10
)
Ce protocole neutralise les bruits de fond en mesurant les médianes d’exécution sur dix réplications consécutives après purge de l’espace mémoire.
11.2 Interprétation des résultats : temps d’exécution et charge mémoire
Les observations empiriques issues de ce banc d’essai révèlent des différentiels de performance majeurs, s’accentuant de façon spectaculaire à mesure que le volume d’observations augmente :
- Échelle 10 000 observations : Les trois approches s’exécutent en une fraction de seconde. write.csv s’exécute en approximativement 110 millisecondes, write_csv en 45 millisecondes, et fwrite en 12 millisecondes. À cette échelle, l’impact sur le flux de travail de l’analyste demeure marginal.
- Échelle 100 000 observations : Les disparités structurelles s’accentuent nettement. La fonction native write.csv requiert en moyenne 1,85 seconde. La fonction write_csv de readr boucle son cycle en 0,42 seconde (gain d’un facteur 4,4). La fonction fwrite de data.table réalise la sérialisation en seulement 0,07 seconde (gain d’un facteur 26 par rapport à base R).
- Échelle 1 000 000 d’observations : Le goulet d’étranglement de la méthode native devient critique. La commande write.csv monopolise le thread de calcul pendant près de 22,4 secondes, induisant une saturation temporaire de l’allocation mémoire. En comparaison, write_csv opère le déversement en 4,1 secondes. La procédure fwrite achève le traitement en 0,55 seconde, affichant un facteur d’accélération supérieur à 40 face à la solution standard native.
L’analyse des profils de mémoire vive (profiling RAM) indique que write.csv génère une empreinte transitoire correspondant à près de 3 fois la taille de l’objet manipulé en raison des duplications textuelles préliminaires, tandis que fwrite maintient une empreinte mémoire quasi stationnaire grâce à son mécanisme de diffusion en flux direct piloté par blocs C++.
11.3 Matrice de décision méthodologique pour le chercheur
À la lumière de ces résultats empiriques et des contraintes d’infrastructure logicielle, le choix d’un moteur d’exportation doit s’orienter selon une grille décisionnelle rationnelle articulée autour de trois axes cardinaux : la volumétrie des données, la dépendance environnementale et l’infrastructure de déploiement.
Lorsque le projet de recherche s’inscrit dans une logique de dépendance minimale absolue (par exemple, le développement d’un paquetage de base destiné à être déployé sur des systèmes contraints ou certifiés sans bibliothèques tierces compilées), la méthode native write.csv (avec row.names = FALSE) demeure la seule option recevable, à condition que le volume d’observations n’excède pas quelques dizaines de milliers de lignes.
Dès lors que le flux analytique s’intègre au sein d’un pipeline tidyverse orienté vers la manipulation de données relationnelles ou de modèles statistiques de complexité intermédiaire, l’élégance syntaxique et la sécurisation UTF-8 native de write_csv constituent le choix d’ingénierie le plus équilibré et le plus lisible pour la communauté scientifique.
Enfin, dès que l’analyste se trouve confronté à des corpus dépassant le demi-million d’enregistrements, à des modélisations de séries temporelles financières haute fréquence ou à des architectures industrielles de production nécessitant des cadences d’E/S ultra-rapides, l’adoption de data.table::fwrite s’impose comme une évidence mathématique et opérationnelle indiscutable.
12. Bonnes pratiques, reproductibilité et liste de contrôle avant diffusion
L’acte d’exportation ne marque pas l’aboutissement de la recherche statistique ; il constitue le point d’amorce du partage, de l’audit et de l’exploitation seconde des connaissances empiriques. L’adhésion à des normes de documentation normalisées conditionne la valeur pérenne du corpus produit.
12.1 Normalisation des métadonnées et auto-documentation des exports
Un fichier CSV, par nature et conception, ne stocke aucune métadonnée d’infrastructure au-delà de la séquence brute de ses cellules délimitées. Il est structurellement incapable d’héberger la spécification explicite des unités de mesure, les bornes de validité théorique des variables ou les définitions sémantiques associées aux codes catégoriels. Dès lors, la diffusion d’un fichier CSV scientifique isolé sans documentation d’accompagnement constitue une faute méthodologique majeure.
La règle d’or consiste à systématiquement coupler l’émission de la table de données à la génération simultanée d’un dictionnaire de variables (ou codebook) articulé selon les normes de la communauté internationale de documentation des sciences sociales (DDI). Ce document d’accompagnement consigne formellement la signification univoque de chaque variable, son typage dans R, ses unités métriques et les clés d’interprétation des modalités factorielles.
Par ailleurs, la dénomination du fichier physique doit obéir à des conventions strictes d’auto-documentation pérenne : proscrire formellement les appellations vagues (telles que « donnees_finales.csv ») au profit de désignations horodatées selon la norme internationale ISO 8601 (par exemple : « 2023-11-15_essai-clinique-phase2_cohorte-complete_v1.0.csv »). Enfin, la traçabilité intégrale exige d’archiver conjointement l’empreinte logicielle exacte ayant généré le fichier au moyen de l’appel sessionInfo(), consignant la version précise de R et l’état des paquetages dépendants mobilisés lors de l’exécution.
12.2 Intégration dans des pipelines de calcul automatisés et conteneurisés
Dans les contextes contemporains d’intégration continue (CI/CD) et d’automatisation des flux de données via des outils d’orchestration (tels que GNU Make, Snakemake ou Apache Airflow), les scripts d’exportation R doivent pouvoir être déclenchés de manière totalement autonome en ligne de commande non interactive (batch execution) :
Rscript –vanilla scripts/exporter_cohorte.R –input raw_data.rds –output clean_data.csv
Cette approche prescrit une rigueur défensive absolue dans le code d’exportation : interdiction stricte de toute instruction interactive sollicitant une action de l’utilisateur, contrôle impératif des codes de retour d’erreur système lors de l’accès au disque, et encadrement des routines d’écriture au sein d’environnements virtualisés ou conteneurisés garantissant la reproductibilité exacte des dépendances binaires (par exemple au moyen de plateformes comme Docker et d’outils de gestion d’environnements R tels que renv).
12.3 Check-list méthodologique de validation finale du fichier CSV
Avant d’autoriser la mise en ligne, l’archivage dans un entrepôt de données de recherche ou l’expédition d’un jeu de données CSV à des évaluateurs pairs, l’analyste doit impérativement confronter son fichier à une grille d’audit technique systématique articulée selon les points de vérification critiques suivants :
- Absence de colonne d’index anonyme : S’assurer formellement qu’aucune colonne d’indices résiduels sans en-tête (du type row.names ou « Unnamed: 0 ») ne vient décaler la structure relationnelle de la table.
- Conformité absolue de l’encodage textuel : Vérifier que le fichier est rigoureusement sérialisé en UTF-8 sans BOM et que l’ensemble des caractères diacritiques français et symboles linguistiques complexes sont préservés de tout phénomène de mojibake.
- Adéquation des séparateurs et conventions régionales : Valider que le délimiteur de champs horizontal (virgule ou point-virgule) et le séparateur de décimales (point ou virgule) correspondent trait pour trait aux spécifications des systèmes récepteurs sans générer de collision syntaxique.
- Étanchéité des guillemets et délimiteurs internes : Inspecter les variables textuelles libres pour s’assurer que toute occurrence de virgules, points-virgules ou sauts de ligne internes est intégralement et hermétiquement protégée au sein de guillemets d’échappement normalisés.
- Homogénéité du codage des lacunes : Vérifier que les valeurs manquantes (NA) et indéterminations mathématiques (NaN) sont matérialisées de manière déterministe (chaîne vide ou libellé explicite documenté) sans aucune confusion possible avec la valeur numérique zéro.
- Rectangularité et congruence des dimensions : Auditer le fichier sur disque à l’aide d’une instruction de bas niveau (telle que la commande système wc -l ou readr::count_fields()) pour s’assurer que chaque enregistrement possède rigoureusement le même nombre de champs délimités que la ligne d’en-tête inaugurale.
- Pérennité du nommage et documentation conjointe : Confirmer la présence de la date ISO 8601 et du numéro de version dans l’intitulé du fichier, et s’assurer de la disponibilité conjointe du dictionnaire de métadonnées descriptif au sein du même répertoire d’archive.
L’application scrupuleuse de ces préceptes méthodologiques et techniques transcende la simple opération d’écriture sur disque : elle hisse l’exportation de données au rang d’acte d’ingénierie scientifique rigoureux, garantissant la pérennité, la fiabilité et le rayonnement des connaissances issues de la recherche quantitative en langage R.
Références
- Chambers, J. M. (2016). Extending R. CRC Press.
- Dowle, M., & Srinivasan, A. (2023). data.table: Extension of `data.frame` (R package version 1.14.8). https://CRAN.R-project.org/package=data.table
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
- Peng, R. D. (2016). R programming for data science. Leanpub.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Shafranovich, Y. (2005). Common Format and MIME Type for Comma-Separated Values (CSV) Files (RFC 4180). Internet Engineering Task Force. https://tools.ietf.org/html/rfc4180
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
- Wickham, H., Hester, J., & Bryan, J. (2023). readr: Read Rectangular Text Data (R package version 2.1.4). https://CRAN.R-project.org/package=readr
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., … & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), 1–9. https://doi.org/10.1038/sdata.2016.18