
Dans le champ de l’économétrie appliquée, de la biométrie et de la psychologie quantitative, l’analyse des données empiriques se heurte de manière récurrente à une divergence fondamentale entre la réalité observationnelle et les postulats des modèles statistiques classiques. Les méthodes d’inférence linéaire, au premier rang desquelles figurent la régression par les moindres carrés ordinaires et l’analyse de variance, reposent en effet sur l’hypothèse canonique selon laquelle les résidus d’un modèle suivent une distribution normale de variance constante. Pourtant, les mesures expérimentales issues des sciences comportementales et physiologiques, telles que les temps de réaction, les taux d’erreur ou les concentrations sériques, exhibent presque universellement une asymétrie positive prononcée couplée à une hétéroscédasticité structurelle où la variabilité croît en proportion directe de la moyenne.
Pour restaurer la validité des tests paramétriques sans abandonner le cadre interprétatif de l’analyse linéaire, les statisticiens ont développé des démarches correctives visant à remodeler l’espace métrique des variables observées. Si les transformations historiques simples, telles que le passage au logarithme népérien ou à la racine carrée, fournissaient des solutions heuristiques ponctuelles, elles demeuraient rigides et dépendaient d’un choix subjectif de l’analyste. C’est pour remédier à cette limitation qu’a été conçue la transformation de Box-Cox, une approche paramétrique continue d’une redoutable élégance mathématique, permettant d’identifier de façon optimale, par le critère du maximum de vraisemblance, la puissance exacte nécessaire pour normaliser les données et stabiliser leur variance.
L’essor de l’écosystème scientifique du langage Python, structuré autour de bibliothèques de référence telles que NumPy, SciPy, Pandas et Scikit-Learn, a démocratisé l’usage de cette méthode tout en facilitant son intégration dans des chaînes de traitement automatisées. Cependant, l’application computationnelle de la transformation de Box-Cox ne saurait se réduire à un simple appel procédural de fonction. Elle exige une compréhension approfondie de ses fondements analytiques, de ses contraintes mathématiques strictes (notamment la stricte positivité du support), ainsi que de ses conséquences sur l’interprétabilité métrique des résultats modélisés. Ce traité exhaustif explore l’ensemble du cycle théorique et pratique de la transformation de Box-Cox en environnement Python, depuis les équations fondamentales jusqu’aux architectures modernes de validation croisée.
1. Introduction aux fondements théoriques de la transformation de Box-Cox
L’édifice de la statistique paramétrique moderne repose largement sur l’algèbre linéaire et la géométrie euclidienne des espaces vectoriels gaussiens. Lorsque les distributions empiriques violent les postulats de normalité et d’homoscédasticité, la structure géométrique sous-jacente des estimateurs se dégrade, entraînant une perte d’efficacité statistique et une distorsion des probabilités critiques associées aux tests d’hypothèses. La transformation paramétrique de Box-Cox constitue l’une des réponses méthodologiques les plus influentes apportées à ce défi au cours du XXe siècle.
1.1 Origines historiques et postulat méthodologique de George Box et David Cox
C’est en 1964 que les statisticiens britanniques George E. P. Box et David R. Cox publièrent dans le Journal of the Royal Statistical Society leur article séminal intitulé An Analysis of Transformations. À cette époque, la statistique appliquée était confrontée à un problème d’arbitrage permanent : les chercheurs devaient soit adopter des transformations manuelles et ad hoc de leurs variables de réponse pour satisfaire aux exigences des modèles linéaires, soit renoncer aux tests classiques au profit de méthodes non paramétriques embryonnaires ou d’analyses computationnellement prohibitives pour les calculateurs de l’époque.
Le coup de génie méthodologique de Box et Cox résida dans l’unification des transformations de puissances dispersées au sein d’une unique famille paramétrique continue régie par un paramètre scalaire, traditionnellement désigné par la lettre grecque lambda (λ). Plutôt que de postuler arbitrairement si une variable devait subir une conversion logarithmique, une inversion ou une extraction de racine carrée, les auteurs proposèrent d’estimer simultanément les paramètres du modèle linéaire et la valeur optimale de ce paramètre de puissance à partir des données elles-mêmes, en s’appuyant sur la théorie du maximum de vraisemblance.
Cette approche a profondément transformé les sciences comportementales et biomédicales. Dès les années 1970, l’analyse des temps de réponse et des indicateurs psychométriques s’est emparée de cette formulation afin de corriger les biais distributionnels inhérents aux limitations physiologiques humaines. La transformation de Box-Cox est ainsi passée du statut de curiosité mathématique à celui de standard méthodologique incontournable pour l’harmonisation des mesures expérimentales continues.
1.2 Importance de la normalité des résidus dans la recherche expérimentale et psychologique
Dans la recherche expérimentale moderne, la confusion entre la normalité marginale des variables observées et la normalité conditionnelle des résidus demeure fréquente. Les théorèmes fondamentaux de la régression linéaire et de l’analyse de variance n’imposent nullement que la variable dépendante brute suive une loi normale ; ils requièrent en revanche que les erreurs stochastiques résiduelles, conditionnellement aux variables explicatives, soient distribuées de façon normale, indépendante et identiquement distribuée avec une variance homogène.
Lorsque cette condition résiduelle est violée de manière substantielle, notamment en présence d’asymétries prononcées typiques des chronométries mentales (où les distributions de temps de réaction présentent une longue traîne vers les valeurs élevées), les propriétés d’optimalité du théorème de Gauss-Markov cessent de s’appliquer. Les estimateurs des moindres carrés ordinaires conservent théoriquement leur non-biais, mais ils perdent leur efficacité minimale, ce qui signifie que leur variance d’échantillonnage n’est plus la plus faible possible parmi la classe des estimateurs linéaires sans biais.
Plus grave encore pour la recherche expérimentale, la sensibilité des distributions d’échantillonnage des statistiques F de Fisher et t de Student aux asymétries sévères entraîne une altération du taux d’erreur de première espèce (α). Les valeurs p calculées deviennent fallacieuses, conduisant soit à des rejets abusifs de l’hypothèse nulle, soit, à l’inverse, à un effondrement dramatique de la puissance statistique face aux distributions fortement leptokurtiques. La transformation de Box-Cox permet de restaurer la symétrie distributionnelle et de réaligner les propriétés d’échantillonnage sur les modèles théoriques nécessaires à une inférence robuste.
1.3 Principe fondamental de stabilisation de la variance et correction de l’hétéroscédasticité
L’un des apports les plus cruciaux de la transformation de Box-Cox réside dans sa capacité intrinsèque à corriger l’hétéroscédasticité. Dans une multitude de phénomènes biologiques et psychophysiologiques, la variance des observations n’est pas indépendante du niveau moyen de la réponse ; il existe une relation fonctionnelle directe où l’écart-type empirique augmente linéairement ou exponentiellement avec l’espérance mathématique du groupe ou de la condition expérimentale considérée.
Cette interdépendance viole directement le postulat d’homoscédasticité, entraînant une invalidation des erreurs-types standards et un gonflement artificiel des statistiques de test dans les régions à forte variance. D’un point de vue géométrique, la transformation de Box-Cox opère une déformation non linéaire de l’espace métrique dans lequel les observations sont projetées. En comprimant de manière différentielle les zones d’échelle où la densité est dispersée et en étirant les zones de forte concentration, elle découple l’espérance de la dispersion résiduelle.
Comparée aux approches empiriques traditionnelles, telles que l’application mécanique du logarithme ou de la racine carrée, la formulation paramétrique continue de Box-Cox ne contraint pas les données à adopter une correction prédéterminée. Alors que le logarithme présuppose rigoureusement une relation de proportionnalité stricte entre la moyenne et l’écart-type (coefficient de variation constant), Box-Cox estime le degré exact de courbure nécessaire pour atteindre la neutralité de la variance, offrant ainsi un ajustement infiniment plus fin et mathématiquement justifié.
2. Formulation mathématique et propriétés du paramètre lambda
La puissance opérationnelle de la méthode conçue par George Box et David Cox repose sur une définition analytique unifiée capable de balayer un spectre continu de modifications morphologiques tout en évitant les discontinuités mathématiques qui interdiraient l’optimisation différentielle.
2.1 Équations fondamentales selon les valeurs du paramètre lambda
Soit un vecteur d’observations positives y = (y1, y2, …, yn) où chaque élément satisfait à la condition yi > 0. La transformation de Box-Cox, paramétrée par le scalaire λ, est définie par l’équation par morceaux suivante :
Pour toute valeur de λ strictement différente de zéro, la transformation prend la forme algébrique : y(λ) = (yλ – 1) / λ. Cette écriture se distingue de la simple puissance yλ par la présence de la soustraction de l’unité au numérateur et de la division par le paramètre au dénominateur. Ces termes d’ajustement sont indispensables pour préserver l’ordre de grandeur des données transformées et garantir que la dérivée par rapport à y au point y = 1 demeure égale à l’unité quelle que soit la valeur de λ.
Lorsque le paramètre λ est rigoureusement nul, l’évaluation directe de l’expression précédente conduit à une indétermination mathématique du type 0/0. Cependant, en appliquant la règle de L’Hôpital et en dérivant le numérateur et le dénominateur par rapport à λ, la limite analytique se déploie sans ambiguïté. La dérivée du numérateur par rapport à λ donne d(yλ – 1)/dλ = yλ ln(y). En évaluant cette dérivée en λ = 0, on obtient y0 ln(y) = ln(y). La dérivée du dénominateur par rapport à λ étant égale à 1, la limite lorsque λ tend vers zéro est exactement égale au logarithme naturel : y(0) = ln(y). Cette continuité mathématique est le pilier central qui permet de traverser sans rupture l’espace des paramètres lors de l’estimation numérique.
2.2 Typologie et interprétation des valeurs courantes de lambda
L’espace continu des valeurs possibles de λ interpole une typologie bien connue de transformations statistiques classiques. L’interprétation de la valeur estimée fournit à l’analyste une indication précieuse sur la nature de la non-linéarité et de l’asymétrie présentes dans la distribution originelle.
Lorsque λ = 1, la formule devient (y1 – 1) / 1 = y – 1. Cette relation n’est qu’une simple translation linéaire unitaire qui ne modifie aucunement la courbure de la distribution, la variance relative, ni les coefficients d’asymétrie et d’aplatissement. Une estimation convergeant vers λ = 1 indique formellement que la variable dépendante sous sa forme brute ne requiert aucune déformation pour satisfaire aux critères de normalité du modèle linéaire.
Pour les valeurs intermédiaires et inverses fréquemment rencontrées en pratique :
- λ = 2 : Transformation quadratique, indiquée lorsque la queue de distribution s’étire vers les valeurs négatives ou présente une compression dans les valeurs élevées.
- λ = 0.5 : Transformation racine carrée modifiée, très utile pour stabiliser la variance de variables de comptage ou de processus poissoniens à forte intensité.
- λ = 0 : Transformation logarithmique pure, optimale pour corriger les distributions présentant une asymétrie positive marquée et une dispersion proportionnelle à la moyenne.
- λ = -0.5 : Transformation racine carrée inverse (1 / √y), adaptée aux asymétries positives extrêmement sévères.
- λ = -1 : Transformation inverse pure ((1/y) – 1)/(-1), qui rétablit les relations harmoniques, fréquemment observée dans les mesures de temps de transport ou d’impédance physique.
2.3 Méthode d’estimation par le maximum de vraisemblance (MLE)
L’identification de la valeur optimale de λ ne procède pas d’une recherche par essais et erreurs mais repose sur l’optimisation formelle d’une fonction de vraisemblance profilée. L’hypothèse fondamentale est qu’il existe une valeur de λ pour laquelle les données transformées y(λ) suivent une loi normale univariée de moyenne μ et de variance σ2.
La difficulté théorique majeure réside dans le fait que la transformation modifie l’échelle de mesure. On ne peut pas simplement maximiser la vraisemblance de y(λ) comme s’il s’agissait d’une variable indépendante fixe, car la densité de probabilité de la variable d’origine y dépend du jacobien de la transformation. Ce jacobien s’exprime par le produit des dérivées de chaque observation transformée par rapport à son observation brute d’origine : J = ∏ |dyi(λ) / dyi| = ∏ yiλ – 1.
En intégrant ce terme jacobien dans la densité conjointe gaussienne, la fonction de log-vraisemblance profilée (en concentrant les paramètres μ et σ2 par leurs estimateurs du maximum de vraisemblance conditionnels à λ) s’écrit sous la forme suivante :
L(λ) = -(n / 2) ln(2π) – (n / 2) ln(σ̂2(λ)) – (n / 2) + (λ – 1) ∑ ln(yi), où σ̂2(λ) représente la variance d’échantillonnage résiduelle calculée sur les données transformées : σ̂2(λ) = (1 / n) ∑ (yi(λ) – ȳ(λ))2.
Cette formulation permet d’établir un intervalle de confiance asymptotique rigoureux pour λ en exploitant le test du rapport de vraisemblance. L’ensemble des valeurs de λ vérifiant la condition L(λ̂) – L(λ) ≤ (1/2) χ2(1, 1 – α) définit la région de confiance à 100(1 – α)%. Si la valeur λ = 1 est contenue dans cet intervalle, l’analyste peut légitimement conclure à l’absence de nécessité statistique d’une transformation.
3. Conditions préalables et contraintes d’application de la méthode
Bien que la transformation de Box-Cox offre une élégance conceptuelle indéniable, son cadre d’applicabilité est strictement borné par des contraintes analytiques fondamentales. L’ignorance de ces prérequis mathématiques conduit immanquablement à des erreurs de calcul fatales ou à des distorsions distributionnelles incontrôlées.
3.1 L’exigence de positivité stricte des données observées
La contrainte la plus impérative et la plus immédiatement visible de la formulation canonique de Box-Cox réside dans l’obligation pour chaque élément du vecteur observé d’être strictement supérieur à zéro : yi > 0 ∀ i. Cette exigence découle directement des propriétés de l’analyse réelle : pour des valeurs réelles non entières de λ, l’expression yλ n’admet de solution réelle unique que si la base y est strictement positive. Dès lors qu’une observation est nulle ou négative, la fonction de puissance engendre soit une division par zéro, soit des solutions imaginaires pures incompatibles avec l’analyse de données réelles.
Dans la recherche psychologique et psychométrique, de nombreuses métriques présentent des effets de plancher, des scores d’erreur nuls ou des variations relatives négatives (par exemple, des indices de gain d’apprentissage calculés par différence de scores). Tenter d’appliquer mécaniquement la fonction de Box-Cox sur de telles structures sans vérification préalable du support déclenche inévitablement des exceptions d’exécution dans les environnements computationnels ou produit des valeurs indéterminées qui corrompent l’intégrité de la chaîne de traitement.
Il est donc impératif de réaliser un audit préliminaire des bornes du domaine des variables cibles avant d’envisager la moindre optimisation algorithmique. Toute présence d’une valeur minimale inférieure ou égale à zéro interdit l’usage de la formulation standard et impose l’adoption de stratégies compensatoires formelles.
3.2 Stratégies d’ajustement par translation par une constante
Face à des séries quantitatives contenant des zéros ou des réels négatifs modérés, la pratique historique a vu émerger une solution d’ajustement pragmatique consistant à introduire un paramètre de translation additif c (parfois noté λ2). La transformation devient alors : y(λ) = ((y + c)λ – 1) / λ, où la constante scalaire c est choisie de telle sorte que yi + c > 0 pour l’ensemble des observations.
Cependant, cette approche recèle des pièges théoriques considérables que la littérature statistique contemporaine a largement mis en lumière. Le choix de la constante c n’est en rien neutre : la valeur finale estimée pour le paramètre de puissance λ est extrêmement sensible à la magnitude relative de c par rapport à l’étendue interquartile des données. Ajouter une constante infime (comme 0.001) ou une constante plus généreuse (comme 1.0 ou la valeur absolue du minimum plus une marge) modifie substantiellement la courbure de la log-vraisemblance et peut déplacer l’optimum de λ de plusieurs fractions d’unité.
Cette instabilité fragilise la reproductibilité scientifique et peut introduire des artefacts distributionnels majeurs, notamment une séparation artificielle entre le point zéro translaté et le continuum des valeurs positives. Pour ces raisons, si une constante arbitraire doit être injectée, elle doit être explicitement documentée, ou mieux, le paramètre c doit être co-estimé avec λ par maximisation conjointe de la vraisemblance, comme le prévoit la variante à deux paramètres.
3.3 Sensibilité aux valeurs aberrantes et aux données extrêmes
Un postulat erroné très répandu consiste à envisager la transformation de Box-Cox comme un substitut universel aux procédures de détection et de traitement des valeurs aberrantes (outliers). En réalité, la fonction de log-vraisemblance profilée est exceptionnellement vulnérable aux observations extrêmes situées dans les queues de distribution.
Puisque la log-vraisemblance dépend de la variance d’échantillonnage σ̂2(λ) et de la somme des logarithmes des observations brutes, un unique point aberrant situé très loin de la masse distributionnelle principale peut exercer un effet de levier considérable sur le processus d’optimisation. L’algorithme sera contraint de choisir une valeur extrême de λ non pas pour conférer une allure gaussienne à la majorité des données, mais pour comprimer artificiellement ce point isolé afin de minimiser son impact sur la somme des carrés résiduels.
Il est par conséquent crucial de distinguer méthodologiquement l’asymétrie structurelle continue (qui est une propriété intrinsèque de la population source, telle que la distribution log-normale des temps de réponse sensoriels) de la contamination par des points aberrants imputables à des décrochages attentionnels des participants ou à des erreurs d’instrumentation. Un protocole rigoureux exige que le nettoyage et la détection d’anomalies soient exécutés en amont de toute tentative de normalisation par Box-Cox.
4. Configuration de l’environnement Python et des dépendances scientifiques
L’exécution computationnelle des transformations statistiques avancées nécessite une assise logicielle stable et performante. L’écosystème Python propose une infrastructure unifiée où les tableaux multidimensionnels, les routines d’optimisation numérique et les grammaires de visualisation graphique s’articulent harmonieusement.
4.1 Installation et configuration des bibliothèques fondamentales
Le traitement complet d’une transformation de Box-Cox repose sur un quintette canonique de bibliothèques scientifiques open source. Chacun de ces paquets remplit un rôle algorithmique spécialisé au sein du pipeline de traitement analytique :
- NumPy : Fournit la structure fondamentale de tableau multidimensionnel homogène (ndarray) et vectorise l’application des opérateurs mathématiques élémentaires au niveau de performance du langage C.
- SciPy : Héberge dans son sous-module scipy.stats l’implémentation algorithmique de référence pour l’estimation de Box-Cox, les tests de normalité d’hypothèses et les fonctions spéciales de calcul d’inversion.
- Pandas : Assure la manipulation tabulaire, la gestion des séries temporelles, le nettoyage des structures de données manquantes et le partitionnement par groupes expérimentaux.
- Matplotlib & Seaborn : Constituent le moteur graphique permettant de tracer les densités à noyau, les fonctions de vraisemblance profilée et les diagrammes d’adéquation quantile-quantile.
La gestion stricte des dépendances est indispensable pour garantir l’immuabilité des résultats de recherche. Des variations subtiles dans les solveurs d’optimisation sous-jacents (tels que l’algorithme de Nelder-Mead ou de Brent exploités par SciPy) selon les versions peuvent induire des dérives marginales sur les décimales des paramètres λ estimés. Il est donc recommandé de figer les versions de bibliothèques au sein de fichiers de spécification d’environnement.
4.2 Structuration d’un environnement expérimental reproductible
La reproductibilité numérique constitue la pierre angulaire de la science moderne. Lorsque des simulations stochastiques ou des estimations non linéaires sont exécutées, la variabilité des états internes des générateurs pseudo-aléatoires peut générer des divergences d’analyse trompeuses d’une session à l’autre.
L’organisation du flux de travail statistique sous Python doit impérativement débuter par l’initialisation explicite des graines pseudo-aléatoires au niveau du noyau de calcul. Avec NumPy, l’usage des générateurs modernes basés sur l’algorithme PCG64 (via la méthode default_rng) prévaut désormais sur l’ancien module d’aléatoire global, garantissant des propriétés cryptographiques et statistiques optimales pour les tirages d’échantillons synthétiques.
De surcroît, la modularisation du code sous la forme de pipelines exécutables et traçables — que ce soit au sein de carnets Jupyter documentés ou de modules Python autonomes — permet de ségréguer rigoureusement les étapes de préparation des données, de calcul d’adéquation distributionnelle, d’inférence des paramètres et de restitution des métriques d’évaluation.
5. Simulation et exploration de données asymétriques en Python
Pour appréhender la mécanique intime de la transformation de Box-Cox sans dépendre des bruits parasites inhérents aux séries d’observation bruitées, la modélisation et la génération de données de synthèse aux propriétés morphologiques parfaitement contrôlées constituent une démarche didactique indispensable.
5.1 Génération de jeux de données empiriques synthétiques
Dans les paradigmes expérimentaux de temps de réaction (tels que les tâches d’inhibition de type Stroop ou de détection visuelle simple), les distributions empiriques sont traditionnellement modélisées par des lois exponentielles, des lois d’ex-Gaussienne ou des distributions log-normales. Ces lois présentent la particularité formelle de posséder un plancher physiologique non compressible (le temps minimal de conduction nerveuse) et une longue traîne asymétrique positive induite par les fluctuations attentionnelles.
À l’aide des fonctions de tirage stochastique offertes par NumPy, il est aisé d’engendrer un vecteur synthétique de latences cognitives simulant, par exemple, un échantillon de 1000 participants soumis à une tâche d’attention soutenue. Une distribution exponentielle combinée à un décalage scalaire, ou une loi log-normale de paramètres d’échelle et de position soigneusement étalonnés, fournit un substrat expérimental parfait exhibant une asymétrie marquée vers la droite et un étalement de variance dépendant directement du niveau de performance moyen.
Cette simulation contrôlée permet de mesurer avec une précision absolue la capacité de l’algorithme d’optimisation à converger vers le paramètre de puissance théorique connu d’avance (par exemple, λ = 0 dans le cas d’une pure variable log-normale transformée canoniquement).
5.2 Diagnostic exploratoire de l’asymétrie et de l’aplatissement
Préalablement à toute modification géométrique des observations, une cartographie quantitative des moments d’ordre supérieur de la distribution est obligatoire. Deux métriques fondamentales dominent cette phase exploratoire : le coefficient d’asymétrie empirique (skewness) et le coefficient d’aplatissement (kurtosis).
Le coefficient d’asymétrie, calculé sous Python via la fonction skew du module scipy.stats, évalue le troisième moment centré normalisé de la variable. Pour une loi normale parfaite, cette métrique est strictement égale à zéro. Une valeur positivement décalée indique un étirement prononcé de la distribution vers les valeurs élevées, configuration où Box-Cox déploie son efficacité maximale. Inversement, une asymétrie négative traduit une accumulation de données vers la droite avec une traîne vers les valeurs faibles.
Le coefficient d’aplatissement, quantifié par la fonction kurtosis de SciPy (généralement formulé en kurtosis de Fisher avec correction de soustraction de la valeur 3 de la gaussienne), renseigne sur l’épaisseur des queues de distribution par rapport au centre. Les lois leptokurtiques (kurtosis positif supérieur à zéro) abritent une proportion substantielle de données dans leurs extrémités, ce qui complique la normalisation et doit immédiatement alerter le statisticien sur la présence potentielle de sous-populations ou de processus générateurs composites.
6. Implémentation pratique avec scipy.stats.boxcox
L’implémentation de référence dans l’écosystème Python réside au cœur de la bibliothèque SciPy. La fonction scipy.stats.boxcox encapsule l’ensemble de la complexité mathématique relative à l’estimation par le maximum de vraisemblance profilée et renvoie des structures optimisées prêtes à l’analyse.
6.1 Syntaxe, arguments et valeurs de retour de la fonction
La signature standard de la fonction est d’une grande sobriété opérationnelle : boxcox(x, lmbda=None, alpha=None, optimizer=None). Le premier paramètre positionnel x représente le vecteur de données sous forme de tableau unidimensionnel, lequel doit satisfaire impérativement à la condition de stricte positivité numérique.
Le comportement de la fonction est gouverné par l’état du paramètre optionnel lmbda :
- Lorsque lmbda est laissé à sa valeur par défaut None, la fonction exécute une recherche numérique d’optimisation afin d’identifier la valeur exacte de λ qui maximise la log-vraisemblance profilée gaussienne. Elle retourne alors un tuple contenant deux éléments : d’une part, le tableau NumPy des données transformées conformément à ce paramètre optimal, et d’autre part, la valeur scalaire flottante de ce λ estimé.
- Si l’argument alpha est renseigné (par exemple alpha=0.05), la fonction élargit son tuple de retour en adjoignant un intervalle de confiance à 100(1 – α)% pour le paramètre λ, calculé directement à partir du profil de rapport de vraisemblance.
- Si, en revanche, un scalaire numérique est explicitement fourni à l’argument lmbda, l’algorithme d’optimisation est désactivé. La fonction applique alors purement et simplement la transformation déterministe avec ce paramètre prescrit et renvoie uniquement le tableau des données transformées.
6.2 Application pas à pas sur le vecteur de données synthétiques
L’application concrète sur notre échantillon asymétrique synthétisé s’opère en injectant le vecteur de mesures continues dans la routine d’estimation. Lors de l’exécution, SciPy déploie en arrière-plan un algorithme d’optimisation univarié (généralement la méthode de Brent bornée) pour naviguer sur la surface de log-vraisemblance profilée jusqu’à convergence vers l’extrémum global.
Dès la récupération des résultats, l’analyste extrait la valeur optimale de λ et procède à une analyse comparative immédiate des propriétés statistiques avant et après transformation. L’inspection des statistiques d’échantillonnage révèle typiquement un recentrage spectaculaire : le coefficient d’asymétrie, initialement positionné à des valeurs positives sévères (par exemple entre 1.5 et 3.0 sur des données log-normales), subit une résorption drastique pour s’établir dans une plage quasi-nulle, fréquemment comprise entre -0.05 et 0.05.
Cette neutralisation de l’asymétrie s’accompagne d’un rééquilibrage de l’aplatissement, témoignant du fait que la distribution a été morphologiquement remodelée pour épouser au plus près la courbure caractéristique d’une fonction de densité gaussienne.
6.3 Transformation d’une nouvelle série avec un paramètre fixé
Une erreur méthodologique dévastatrice consiste à estimer de manière indépendante un paramètre λ distinct pour chaque groupe, chaque condition expérimentale, ou entre un échantillon d’entraînement et un échantillon de test. Une telle pratique brise l’équivalence d’échelle métrique : comparer deux groupes de participants dont les scores ont été déformés par deux puissances différentes équivaut à comparer des mètres avec des litres.
Pour assurer la cohérence expérimentale, le paramètre λ doit être estimé sur une base de référence consolidée (par exemple l’ensemble de l’échantillon de contrôle ou le jeu de données d’apprentissage d’un modèle prédictif), puis conservé sous forme de constante scalaire immuable. Cette valeur scalaire est ensuite injectée directement dans l’appel de scipy.stats.boxcox via son argument lmbda lors du traitement des nouvelles cohortes ou des données ultérieures de test.
Cette approche garantit que la fonction de déformation appliquée est strictement identique pour l’ensemble des unités d’observation, préservant ainsi l’homogénéité du modèle d’échelle indispensable à toute inférence différentielle ultérieure valide.
7. Évaluation graphique et diagnostique de la normalisation
L’évaluation de la qualité d’une transformation statistique ne saurait s’en remettre aveuglément à des valeurs scalaires résumées. L’inspection visuelle et géométrique des distributions constitue une composante indissociable de la validation diagnostique.
7.1 Comparaison visuelle des courbes de densité de probabilité
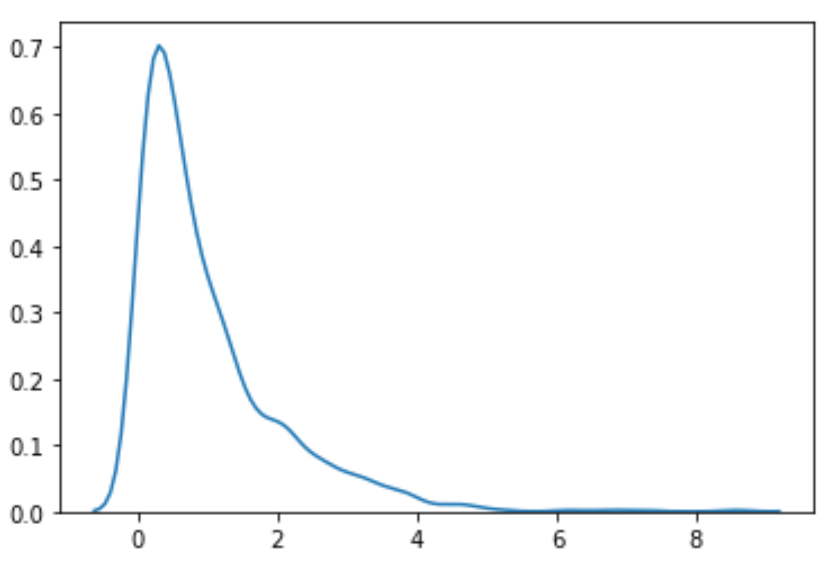
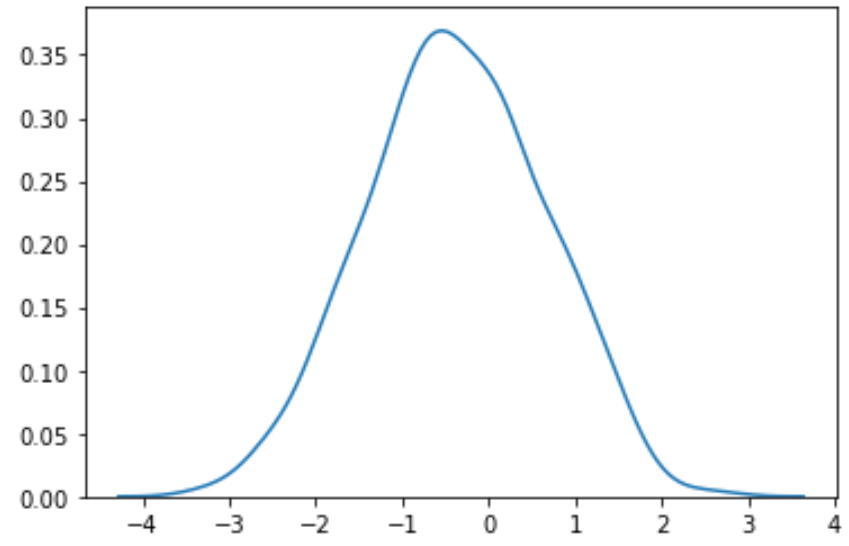
L’approche graphique primordiale consiste à superposer ou à juxtaposer, par le truchement des fonctions d’estimation de densité par noyau (Kernel Density Estimation ou KDE) fournies par Seaborn et Matplotlib, la morphologie de la variable avant et après traitement. Cette visualisation permet d’appréhender instantanément la déformation spatiale opérée par la puissance de Box-Cox.
Sur le panneau initial, l’asymétrie positive se matérialise par un pic modal aigu et décentré vers la gauche, suivi d’une longue traîne asymptotique étirée vers la droite. Sur le panneau transformé, la distribution exhibe une symétrie centrale remarquable où la moyenne empirique, la médiane et le mode convergent approximativement vers un point d’inflexion unique.
La visualisation de la courbe de densité permet en outre de déceler visuellement d’éventuels effets pervers de la transformation, tels que la création artificielle d’artefacts d’aplatissement ou l’exagération de la densité dans des zones frontières, que les métriques synthétiques de skewness pourraient occulter.
7.2 Construction et analyse critique des diagrammes quantile-quantile (Q-Q plots)
Le diagramme quantile-quantile (Q-Q plot), généré en environnement Python à l’aide de la fonction scipy.stats.probplot, représente le test graphique d’ajustement distributionnel le plus puissant et le plus rigoureux à disposition du statisticien. Il met en relation les quantiles observés d’une série de données avec les quantiles théoriques attendus d’une loi normale univariée standardisée.
Si la variable étudiée suit parfaitement une loi normale, l’ensemble des points d’observation vient se superposer de façon continue le long d’une droite de référence à quarante-cinq degrés représentant l’isomorphisme parfait. Avant transformation, la trajectoire des quantiles asymétriques prend la forme d’une courbe en cloche ou d’un arc fortement concave s’écartant radicalement de la ligne d’identité théorique.
L’inspection du Q-Q plot post-transformation permet d’évaluer la qualité de la normalisation au centre de la distribution mais surtout dans les queues. Un alignement parfait des points centraux couplé à des déviations persistantes aux deux extrémités distales (queues lourdes ou légères) signale à l’analyste que si l’asymétrie globale a bien été neutralisée, la distribution résiduelle conserve un aplatissement non gaussien nécessitant d’éventuelles corrections d’erreur-type.
7.3 Visualisation de la courbe de log-vraisemblance profilée
Pour appréhender la précision et la stabilité de l’estimation du paramètre λ, il est hautement instructif de tracer la trajectoire de la fonction de log-vraisemblance profilée en fonction des variations continues de λ sur un intervalle d’intérêt (par exemple de -2 à +2). La fonction scipy.stats.boxcox_llf permet de calculer analytiquement cette quantité pour n’importe quel scalaire de puissance candidat.
Le graphique résultant prend la forme d’une parabole inversée ou d’une courbe concave unimodale dont l’apex correspond très exactement à la solution optimale identifiée par l’algorithme de maximisation de SciPy. La courbure de cette fonction fournit une information géométrique directe sur l’erreur-type d’estimation : une concavité très abrupte et resserrée dénote une estimation hautement précise avec des intervalles de confiance très étroits.
À l’inverse, une fonction très aplatie et évasée révèle que les données sont compatibles avec un large spectre de transformations alternatives, suggérant que le gain statistique d’une puissance spécifique par rapport à une autre est ténu. Tracer une ligne horizontale de troncature à la hauteur L(λ̂) – 0.5 χ2(1, 0.95) permet de lire visuellement sur l’axe des abscisses les bornes de l’intervalle de confiance à 95% de la transformation.
8. Validation inférentielle par tests d’hypothèses statistiques
Si l’exploration graphique guide le jugement intuitif, la validation formelle de l’adéquation distributionnelle doit s’appuyer sur un corpus d’inférence statistique structuré. Plusieurs tests d’adéquation paramétrique permettent de corroborer formellement l’hypothèse de normalité.
8.1 Application du test de normalité de Shapiro-Wilk
Le test de Shapiro-Wilk, invoqué via la routine scipy.stats.shapiro, est reconnu dans la littérature statistique comme l’un des tests d’adéquation à la loi normale les plus puissants pour les échantillons de taille petite à modérée (n < 2000). Il repose sur le calcul d’une statistique W obtenue par la régression des quantiles d’échantillonnage ordonnés sur les espérances des statistiques d’ordre d’une distribution normale standard.
L’hypothèse nulle (H0) du test stipule que l’échantillon est issu d’une population normalement distribuée. Par conséquent, l’observation d’une valeur p (p-value) strictement inférieure au seuil de significativité conventionnel (α = 0.05) contraint au rejet de l’hypothèse nulle et atteste d’une non-normalité statistiquement significative. L’application du test de Shapiro-Wilk sur des données de temps de réaction brutes se solde invariablement par une statistique W médiocre et une valeur p infinitésimale.
Après l’application de la transformation de Box-Cox, la remontée de la statistique W vers des valeurs très proches de l’unité (par exemple 0.995) et le retour de la valeur p au-dessus de la ligne de démarcation de 0.05 confirment la réussite statistique du processus de normalisation sur le critère de Shapiro-Wilk.
8.2 Utilisation complémentaire des tests de D’Agostino-Pearson et d’Anderson-Darling
Malgré sa popularité, le test de Shapiro-Wilk souffre d’une hypersensibilité notoire sur les très grands échantillons où la moindre déviation microscopique par rapport à la normalité entraîne un rejet systématique de l’hypothèse nulle. Pour pallier cette faiblesse, l’arsenal méthodologique doit s’enrichir de tests complémentaires aux propriétés asymptotiques ciblées.
Le test combiné de D’Agostino-Pearson, exécuté en Python par scipy.stats.normaltest, agrège explicitement les statistiques standardisées d’asymétrie et de kurtosis au sein d’une métrique omnibus suivant asymptotiquement une loi du χ2 à deux degrés de liberté. Ce test présente l’avantage analytique de disséquer la source exacte de violation de normalité en permettant d’identifier si l’écart résiduel relève d’une asymétrie non corrigée ou d’une leptokurtose persistante.
Parallèlement, le test d’Anderson-Darling, implémenté dans scipy.stats.anderson avec l’argument dist=’norm’, constitue une amélioration sophistiquée du test de Kolmogorov-Smirnov. Sa spécificité réside dans l’application d’une fonction de pondération quadratique sur les queues de la distribution cumulative empirique, conférant au test une sensibilité accrue à la présence d’observations extrêmes susceptibles de compromettre les propriétés des tests d’inférence linéaire ultérieurs.
8.3 Arbre de décision inférentiel pour valider l’adéquation de la transformation
L’évaluation des résultats issus de ces multiples batteries de tests confronte fréquemment le chercheur à des conclusions contradictoires, particulièrement en présence de jeux de données massifs. Il devient dès lors crucial d’établir un arbre de décision inférentiel structuré évitant les décisions arbitraires :
- Cas 1 : Concomitance de la normalité inférentielle et graphique. La valeur p des tests d’hypothèses dépasse 0.05 et le Q-Q plot affiche un alignement rectiligne parfait. La transformation est pleinement validée et les modèles linéaires classiques peuvent être ajustés en toute rigueur.
- Cas 2 : Quasi-normalité sur grand échantillon. Pour n > 5000, les tests d’hypothèses rejettent H0 avec p < 0.01, mais l’asymétrie absolue est inférieure à 0.1, le kurtosis est proche de zéro et le Q-Q plot est visuellement rectiligne sur plus de 98% des données. La normalité asymptotique pratique est validée en vertu du théorème central limite et de la robustesse intrinsèque des estimateurs des moindres carrés.
- Cas 3 : Échec structurel de normalisation. La valeur p demeure infinitésimale et le Q-Q plot révèle une courbure en S persistante ou des décrochages sévères aux extrémités. La transformation de puissance est déclarée inopérante, imposant un changement de paradigme vers les modèles linéaires généralisés ou des approches de rééchantillonnage par bootstrap.
9. Gestion des valeurs nulles et négatives : alternatives et extensions
L’incapacité mathématique fondamentale de la formule originale de Box-Cox à traiter des valeurs inférieures ou égales à zéro a stimulé le développement d’extensions paramétriques formelles et de fonctions généralisées plus polyvalentes.
9.1 La transformation de Box-Cox à deux paramètres
Pour formaliser rigoureusement le recours à un paramètre de translation plutôt que de s’en remettre à une constante ad hoc fixée au jugé, George Box et David Cox ont proposé dans leur travail initial une version bivariée de leur transformation, traditionnellement qualifiée de transformation de Box-Cox à deux paramètres.
Dans cette modélisation, le vecteur transformé s’écrit : y(λ1, λ2) = ((y + λ2)λ1 – 1) / λ1 si λ1 ≠ 0, et ln(y + λ2) si λ1 = 0, sous la condition de stricte positivité conjointe yi + λ2 > 0 pour tout i. Le paramètre λ1 continue de régir la puissance de courbure, tandis que le paramètre λ2 modélise de façon endogène le décalage spatial optimal.
L’estimation des deux paramètres s’effectue par maximisation conjointe de la log-vraisemblance sur une surface bidimensionnelle. Si cette approche résout l’arbitraire du choix de la constante, elle soulève des difficultés computationnelles notables : la surface de vraisemblance peut présenter des crêtes étroites et instables où l’algorithme d’optimisation peine à converger, augmentant considérablement le risque de surajustement (overfitting) statistique par rapport à une formulation univariée.
9.2 La transformation de Yeo-Johnson comme généralisation universelle
Conçue par In-Kwon Yeo et Richard A. Johnson en 2000, la transformation de Yeo-Johnson constitue l’extension la plus aboutie et la plus rigoureuse de la famille des transformations de puissance paramétriques, s’affranchissant définitivement de toute contrainte de positivité sur les données d’entrée.
La transformation de Yeo-Johnson est définie par une fonction par morceaux continue sur l’intégralité du corps des réels, modulant son comportement selon le signe de chaque observation individuelle :
- Pour y ≥ 0 et λ ≠ 0 : y(λ) = ((y + 1)λ – 1) / λ
- Pour y ≥ 0 et λ = 0 : y(λ) = ln(y + 1)
- Pour y < 0 et λ ≠ 2 : y(λ) = -((-y + 1)2 – λ – 1) / (2 – λ)
- Pour y < 0 et λ = 2 : y(λ) = -ln(-y + 1)
Cette formulation remarquable assure la continuité analytique de la fonction ainsi que de sa dérivée première par rapport à y sur l’ensemble du domaine réel, y compris au passage critique du point d’inflexion zéro. En environnement Python, cette méthode est nativement disponible et optimisée au sein du module SciPy via la fonction scipy.stats.yeojohnson.
9.3 Critères de choix entre Box-Cox translaté et Yeo-Johnson
Le choix méthodologique entre une transformation de Box-Cox avec translation et la transformation de Yeo-Johnson ne doit pas être guidé par la simple commodité algorithmique, mais par la nature structurelle de la variable étudiée.
Lorsque la variable mesurée possède un zéro absolu naturel et ne peut physiquement pas descendre sous ce seuil (par exemple des scores d’erreurs d’inattention ou des comptages d’événements discrets), l’application de Yeo-Johnson est théoriquement supérieure car elle évite d’introduire un décalage arbitraire et gère le point zéro de façon continue. De même, si le jeu de données contient des réels négatifs représentant des variations réelles (comme des pourcentages de dépréciation ou des deltas de température corporelle), Yeo-Johnson s’impose comme la solution universelle de référence.
En revanche, lorsque les observations sont strictement et rigoureusement positives par nature ontologique (comme les latences chronométriques pures ou les salaires), la transformation de Box-Cox standard demeure préférable. Elle jouit d’une littérature d’étalonnage infiniment plus dense et offre une interprétation théorique plus directe des puissances canoniques dans les sciences appliquées.
10. Intégration de la transformation dans les pipelines Scikit-Learn
Dans les contextes d’apprentissage automatique (Machine Learning) et de modélisation prédictive supervisée, l’application isolée des transformations statistiques est proscrite au profit d’architectures de pipelines hermétiques garantissant l’intégrité de la validation.
10.1 Utilisation de la classe PowerTransformer
Le module de prétraitement de Scikit-Learn intègre une classe dédiée de haut niveau, sklearn.preprocessing.PowerTransformer, conçue pour unifier l’estimation et le déploiement des transformations de puissance au sein de flux de modélisation standardisés.
L’instanciation de cette classe permet de sélectionner explicitement le moteur paramétrique via l’argument method=’box-cox’ ou method=’yeo-johnson’. Par défaut, la classe intègre un argument booléen standardize=True, lequel applique automatiquement un centrage-réduction (moyenne zéro et variance unitaire) immédiatement après l’exécution de la transformation de puissance.
Cette standardisation intégrée constitue une différence ergonomique cruciale par rapport aux fonctions natives de scipy.stats, qui renvoient les données transformées dans l’échelle d’origine déformée par la puissance λ. L’activation de la standardisation est particulièrement bénéfique pour les algorithmes sensibles à l’amplitude des échelles de variables, tels que les régressions pénalisées (Ridge, Lasso) ou les réseaux de neurones.
10.2 Prévention de la fuite d’information (data leakage) par validation croisée
La règle d’or de l’ingénierie des caractéristiques stipule qu’aucune information statistique issue de l’ensemble de validation ou de test ne doit infiltrer la phase d’apprentissage d’un modèle prédictif. L’estimation du paramètre λ de Box-Cox sur la totalité d’un jeu de données préalablement au partitionnement en sous-ensembles d’entraînement et d’évaluation constitue une forme pernicieuse de fuite d’information (data leakage).
Puisque le calcul de λ exploite la variance globale et la structure distributionnelle intégrale du jeu de données, ajuster ce paramètre en amont du partitionnement contamine le modèle d’entraînement avec des propriétés géométriques intrinsèques aux données de test. Pour immuniser le protocole d’évaluation contre ce biais méthodologique, l’objet PowerTransformer doit être encapsulé au sein d’une structure de Pipeline Scikit-Learn conjointe avec l’estimateur statistique final.
Lors de l’exécution d’une validation croisée (cross-validation) par tranches k-fold, la méthode fit du pipeline n’est exécutée que sur la fraction d’entraînement de chaque pli, garantissant que le paramètre λ est estimé à l’aveugle sans aucune porosité avec les observations d’évaluation réservées pour le calcul des scores de généralisation.
10.3 Application pratique sur un jeu de données psychométriques multivarié
Dans les enquêtes expérimentales complexes, les jeux de données tabulaires comportent typiquement une matrice de plusieurs dizaines de variables continues présentant des degrés hétérogènes d’asymétrie. Traiter manuellement chaque colonne de manière procédurale devient une source d’erreurs et alourdit considérablement le code.
La classe PowerTransformer de Scikit-Learn vectorise nativement ce traitement multivarié : appliquée à une matrice bidimensionnelle ou à un DataFrame Pandas complet, elle estime indépendamment et de façon concurrente un paramètre λ optimal distinct pour chaque colonne numérique. Les vecteurs de paramètres identifiés sont ensuite conservés dans l’attribut d’instance lambdas_ du transformateur ajusté.
Cette approche systématique garantit que les variables affichant une forte asymétrie positive recevront une correction logarithmique ou racine adaptée, tandis que les variables déjà proches de la normalité verront leur paramètre λ converger vers 1, préservant ainsi l’orthogonalité et la cohérence de l’espace dimensionnel pour les algorithmes ultérieurs d’analyse factorielle ou de classification supervisée.
11. Interprétation des résultats et transformation inverse des données
La normalisation des données par modification d’échelle résout avec élégance les blocages computationnels et inférentiels, mais elle introduit un défi méthodologique corollaire majeur : l’obscurcissement de la signification métrique originale des observations.
11.1 Le défi de l’interprétabilité psychologique des échelles transformées
Dans la recherche expérimentale et clinique, l’unité de mesure possède une valeur sémantique propre. Un clinicien comprend intuitivement la signification d’un écart de 150 millisecondes sur un temps de réaction attentionnel ou d’une chute de 5 points sur une échelle d’évaluation de la dépression. Dès lors que la variable a été transformée via une puissance non entière de Box-Cox (par exemple, λ = -0.37), les scores modélisés sont projetés dans un espace abstrait dépourvu de matérialité empirique immédiate.
Communiquer des coefficients de régression ou des tailles d’effet sous forme de millisecondes à la puissance moins 0.37 est inopérant auprès des pairs non spécialistes et des décideurs publics. Cette barrière conceptuelle a historiquement suscité des réticences méthodologiques quant à l’adoption généralisée des transformations paramétriques.
Les normes de publication académique, à l’image des recommandations méthodologiques de l’American Psychological Association (APA), préconisent par conséquent de réaliser l’ensemble des modélisations statistiques et des calculs d’intervalles de confiance dans l’espace mathématique transformé, tout en restituant systématiquement les grandeurs descriptives finales et les estimations d’effets dans l’échelle métrique naturelle d’origine au moyen de fonctions inverses adaptées.
11.2 Calcul de la transformation inverse pour la restitution des prédictions
La restitution des valeurs modélisées ou prédites vers leur espace d’expression original nécessite le calcul formel de la fonction réciproque de la transformation de Box-Cox. Sur le plan algébrique, la formule inverse s’obtient par inversion directe de l’équation constitutive :
Pour tout λ ≠ 0 : y = (λ y(λ) + 1)1 / λ, et pour λ = 0 : y = exp(y(0)). En environnement Python, cette fonction réciproque est optimisée de manière hautement performante dans le module des fonctions spéciales de SciPy via la routine scipy.special.inv_boxcox.
Cependant, une mise en garde théorique fondamentale s’impose lors de la réversion des espérances mathématiques. En vertu de l’inégalité de Jensen, pour toute fonction non linéaire convexe ou concave f, l’espérance de la fonction n’est pas égale à la fonction de l’espérance : E[f(Y)] ≠ f(E[Y]). Par conséquent, appliquer purement et simplement la transformation inverse sur la moyenne estimée d’une variable transformée ne reconstitue pas la moyenne arithmétique originale mais fournit une estimation de la médiane géométrique conditionnelle de la distribution naturelle.
Lorsque la restitution fidèle de l’espérance arithmétique dans l’échelle d’origine est impérative, une correction de biais de Taylor au second ordre, intégrant la variance résiduelle de la régression, doit être appliquée lors du rétro-calcul.
11.3 Rapport et vulgarisation des métriques transformées dans les rapports de recherche
La rédaction de la section méthodologique et des résultats d’un article scientifique exploitant Box-Cox requiert une rigueur formelle absolue afin d’assurer la transparence et la réplicabilité du protocole d’analyse.
Le chercheur doit impérativement documenter : la justification préalable de la transformation (coefficients d’asymétrie initiaux et résultats des tests de violation d’adéquation), le logiciel et la bibliothèque computationnelle utilisés (SciPy ou Scikit-Learn avec leurs versions exactes), la valeur ponctuelle du paramètre λ estimé accompagnée de son intervalle de confiance à 95%, et la preuve diagnostique que la transformation a restauré la normalité résiduelle.
Dans la présentation des synthèses descriptives tabulaires ou graphiques, la pratique exemplaire consiste à convertir les bornes des intervalles de confiance calculés sur l’échelle transformée vers l’échelle originale au moyen de la fonction inverse. De surcroît, la présentation conjointe des médianes et des écarts interquartiles bruts fournit un repère robuste et non déformé permettant au lecteur de contextualiser la dynamique des résultats indépendamment des artifices computationnels de la modélisation.
12. Erreurs courantes, limites méthodologiques et alternatives non paramétriques
L’utilisation de la transformation de Box-Cox ne saurait constituer une panacée universelle applicable de manière indiscriminée à tous les problèmes d’asymétrie distributionnelle. L’analyste critique doit en connaître les frontières méthodologiques et savoir identifier les situations où d’autres architectures de modélisation s’avèrent impératives.
12.1 Mauvaises pratiques fréquentes lors de l’application de Box-Cox
Parmi les dérives méthodologiques les plus couramment relevées dans la littérature appliquée figure la tentative de forcer la normalisation de distributions multimodales. La transformation de Box-Cox est une déformation purement monotone de l’espace métrique : elle est mathématiquement incapable de fusionner des modes multiples distincts. Tenter de normaliser un mélange de deux populations gaussiennes aux moyennes distantes ne fera que déplacer et asymétriser les bosses respectives sans jamais converger vers une distribution univariée homogène.
Une seconde erreur majeure réside dans la confusion entre normalité marginale brute et normalité résiduelle conditionnelle. Transformer la variable dépendante Y brute pour la rendre normale sans tenir compte des prédicteurs catégoriels ou continus d’un modèle d’analyse linéaire détruit la relation fonctionnelle sous-jacente. L’objectif canonique de la transformation de Box-Cox est d’assurer la normalité et l’homoscédasticité des résidus de modélisation e = y – ŷ, et non de forcer la variable brute à une normalité artificielle décontextualisée.
Enfin, l’application de Box-Cox sur des données discrètes de faible cardinalité (telles que des échelles de Likert ordonnées à 5 points ou des comptages à faible taux d’occurrence) viole l’hypothèse de continuité sous-jacente au support gaussien et engendre des distributions transformées en peigne particulièrement pathologiques pour l’inférence.
12.2 Limites de la méthode face aux distributions à queues épaisses ou asymétries complexes
La transformation de Box-Cox opère principalement sur l’asymétrie (troisième moment centré). Sa marge d’action sur le coefficient d’aplatissement (quatrième moment centré) demeure indirecte et mécaniquement contrainte. Dans les contextes où les données empiriques proviennent de processus générateurs à queues particulièrement épaisses (lois de Cauchy, lois de Pareto ou distributions de Lévy), la transformation de puissance s’avère incapable d’absorber l’excès de dispersion extrême.
Même lorsque la valeur estimée de λ ramène avec succès le skewness d’échantillonnage à une valeur voisine de zéro, la distribution résultante conserve fréquemment une leptokurtose structurelle majeure se traduisant par un décrochage sévère aux deux extrémités du diagramme quantile-quantile. Poursuivre l’analyse linéaire classique sous l’illusion que le problème distributionnel est résolu expose le chercheur à des erreurs d’inférence substantielles sur la variance d’échantillonnage des coefficients.
Par ailleurs, la transformation induit une distorsion agressive des distances métriques entre les individus situés aux bornes de l’échantillon : une modification infinitésimale sur une observation extrême peut se traduire par une variation colossale sur l’échelle transformée lorsque le paramètre λ est fortement négatif, accroissant la vulnérabilité du modèle global aux artefacts locaux.
12.3 Alternatives modernes : modèles linéaires généralisés (GLM) et statistiques robustes
Face aux apories méthodologiques induites par la déformation des variables d’observation, la statistique contemporaine a largement basculé vers un paradigme alternatif puissant : les Modèles Linéaires Généralisés (GLM), complétés par les approches de régression robuste et de rééchantillonnage stochastique.
Plutôt que de contraindre la variable observée Y à se conformer artificiellement à une distribution gaussienne par une transformation mathématique potentiellement déstabilisante, les modèles linéaires généralisés conservent la variable de réponse dans son échelle métrique d’origine non modifiée. Le modèle spécifie explicitement une loi d’appartenance issue de la famille exponentielle naturelle (telle que la loi Gamma pour les latences continues asymétriques ou la loi de Poisson/Quasi-Poisson pour les comptages) et relie la moyenne conditionnelle aux régresseurs par l’intermédiaire d’une fonction de lien analytique (par exemple la fonction de lien logarithmique ou inverse).
En parallèle, l’avènement de puissances de calcul massives rend particulièrement attractives les méthodes d’inférence robuste par rééchantillonnage (bootstrap non paramétrique). Ces techniques permettent de calculer des intervalles de confiance et d’exécuter des tests d’hypothèses sur les coefficients de modèles linéaires standards sans formuler le moindre postulat paramétrique quant à la distribution exacte des résidus.
L’arsenal statistique moderne n’oppose donc pas Box-Cox aux modèles linéaires généralisés dans une querelle stérile : le praticien avisé considère la transformation de Box-Cox en Python comme un outil géométrique d’ajustement rapide et efficace au sein de pipelines prédictifs linéaires, tout en sachant mobiliser les GLM dès lors que la fidélité de l’échelle d’observation et l’élégance théorique de l’inférence priment sur les considérations de standardisation numérique.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- D’Agostino, R. B., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of b2 and √b1. Biometrika, 60(3), 613–622. https://doi.org/10.1093/biomet/60.3.613
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Sakia, R. M. (1992). The Box-Cox transformation technique: A review. The Statistician, 41(2), 169–178. https://doi.org/10.2307/2348250
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Yeo, I. K., & Johnson, R. A. (2000). A new family of power transformations to improve normality or symmetry. Biometrika, 87(4), 954–959. https://doi.org/10.1093/biomet/87.4.954