
L’analyse statistique constitue le socle fondamental sur lequel repose la validité des conclusions scientifiques dans l’ensemble des disciplines empiriques contemporaines, qu’il s’agisse des sciences comportementales, de la recherche biomédicale, de l’éducation ou de l’économie expérimentale. Au cœur de cette démarche d’inférence inductive, la comparaison de moyennes observées au sein de différents groupes expérimentaux ou observationnels représente l’une des démarches les plus fréquemment mobilisées par les chercheurs. Lorsqu’une expérimentation implique d’évaluer l’impact d’une variable indépendante catégorielle se déclinant en trois modalités ou davantage sur une variable dépendante quantitative continue, le recours à une procédure analytique globale devient indispensable. C’est précisément cette fonction centrale que remplit l’analyse de variance à un facteur, universellement désignée sous le terme d’ANOVA unidirectionnelle (ou One-Way ANOVA).
Bien que des progiciels statistiques spécialisés tels qu’IBM SPSS Statistics, R, SAS ou JASP soient traditionnellement privilégiés dans les laboratoires universitaires de pointe, le logiciel Microsoft Excel demeure un outil incontournable, accessible et remarquablement puissant pour réaliser des analyses quantitatives rigoureuses. Souvent sous-estimé dans sa dimension inférentielle en raison de sa vocation initiale de tableur bureautique, Excel dispose pourtant, à travers son module complémentaire nommé l’Utilitaire d’analyse (Analysis ToolPak), d’algorithmes informatiques parfaitement fiables et conformes aux standards métrologiques internationaux. Maîtriser l’exécution d’une ANOVA à un facteur dans l’environnement d’Excel confère aux étudiants, cliniciens, enseignants-chercheurs et analystes de données une flexibilité opérationnelle majeure, leur permettant de passer instantanément de la saisie brute des observations empiriques au test d’hypothèses formel, sans nécessiter l’apprentissage fastidieux de langages de programmation complexes.
Le présent guide a été conçu pour offrir un examen approfondi, didactique et méthodologiquement irréprochable de la conduite d’une analyse de variance à un facteur au sein de Microsoft Excel. Loin de se limiter à une succession mécanique de manipulations logicielles, cet ouvrage détaille minutieusement les fondements mathématiques sous-jacents, l’évaluation préalable des postulats paramétriques, la restructuration optimale des matrices de données, le décryptage pointilleux des sorties d’analyse, l’estimation des indices de taille d’effet, la réalisation des tests post-hoc et la formalisation des résultats selon les normes éditoriales de l’American Psychological Association (APA). Que vous soyez engagé dans la rédaction d’un mémoire de recherche empirique, d’une thèse de doctorat ou dans l’évaluation d’interventions professionnelles sur le terrain, ce traité vous fournira l’ensemble des clés théoriques et pratiques nécessaires à une interprétation statistique sans faille.
1. Introduction théorique et fondements de l’ANOVA à un facteur
1.1 Définition et principes directeurs de l’analyse de variance
L’analyse de variance univariée à un facteur a été conceptualisée et formalisée dans les années 1920 par le statisticien et généticien britannique Sir Ronald Aylmer Fisher. Confronté à des problématiques agronomiques complexes nécessitant de comparer la productivité de multiples parcelles traitées avec différents types de fertilisants, Fisher comprit rapidement les limites structurelles inhérentes aux méthodes bivariées traditionnelles. Le principe fondamental de l’ANOVA repose sur une intuition mathématique brillante : plutôt que d’examiner isolément des différences directes entre moyennes arithmétiques, la procédure évalue la dispersion relative des données en décomposant la variabilité totale observée dans l’échantillon en composantes indépendantes attribuables à des sources de variation distinctes et identifiables.
Cette approche permet d’accomplir une comparaison simultanée des moyennes de trois groupes indépendants ou plus, sans induire le phénomène délétère d’inflation du risque d’erreur de première espèce (le risque alpha). Si un chercheur dispose de quatre groupes expérimentaux distincts (par exemple, A, B, C et D) et souhaite vérifier s’ils diffèrent significativement, l’emploi exclusif du classique test t de Student pour échantillons indépendants nécessiterait de procéder à six comparaisons binaires exhaustives (A contre B, A contre C, A contre D, B contre C, B contre D, et C contre D). En fixant le seuil de signification alpha nominal standard à 0,05 pour chaque test individuel, la probabilité cumulée de commettre au moins une erreur de type I (rejeter à tort une hypothèse nulle qui est pourtant vraie) au cours de cette série d’évaluations successives n’est plus de 5 %, mais atteint une valeur critique donnée par la formule d’erreur par famille :
$$\alpha_{global} = 1 – (1 – \alpha)^c = 1 – (1 – 0{,}05)^6 \approx 0{,}2649$$
Soit plus de 26 % de risque de déclarer à tort un effet expérimental inexistant dans la population parente. L’analyse de variance résout magistralement cette aporie méthodologique en soumettant l’intégralité des conditions expérimentales à un test statistique unique et unifié. Pour parvenir à ce résultat, Fisher a démontré que la variance totale de l’ensemble des données observées peut être rigoureusement partitionnée en deux éléments orthogonaux : la variance intergroupe (ou variance factorielle, désignée par Between-group variance) et la variance intragroupe (ou variance résiduelle, désignée par Within-group variance).
La variance intergroupe quantifie la mesure dans laquelle les moyennes de chaque condition expérimentale s’écartent de la grande moyenne générale calculée sur la totalité des participants de l’étude. Cette dispersion reflète conjointement deux phénomènes : l’effet réel de la variable indépendante manipulée par le chercheur (le traitement expérimental) et les fluctuations d’échantillonnage aléatoires inévitables. À l’inverse, la variance intragroupe évalue l’ampleur des écarts individuels existant entre chaque participant et la moyenne spécifique du sous-groupe auquel il a été assigné. Dans la mesure où tous les individus d’un même groupe sont soumis à un protocole strictement identique, ces variations internes ne peuvent en aucun cas résulter du traitement ; elles matérialisent purement l’erreur résiduelle non contrôlée, procédant de la variabilité biologique intrinsèque des sujets, des différences psychologiques individuelles et des erreurs de mesure instrumentales. L’ANOVA consiste précisément à comparer ces deux estimations de variance par l’intermédiaire d’un quotient que nous expliciterons ultérieurement.
1.2 Formulation des hypothèses statistiques nulle et alternative
L’édifice inférentiel de l’ANOVA repose sur la mise en concurrence dialectique de deux postulats théoriques mutuellement exclusifs, désignés sous les vocables d’hypothèse nulle (notée H0) et d’hypothèse alternative (notée H1). La formalisation mathématique de l’hypothèse nulle postule une stricte égalité des paramètres centraux des k populations sous-jacentes dont sont extraits les échantillons observés. Si l’on désigne par la lettre grecque $\mu$ la moyenne théorique d’une population parente, l’hypothèse nulle s’écrit formellement comme suit :
$$H_0 : \mu_1 = \mu_2 = \mu_3 = dots = \mu_k$$
Sous la validité formelle de H0, la variable indépendante n’exerce absolument aucun impact systématique sur la variable dépendante mesurée. Les disparités numériques constatées entre les moyennes arithmétiques empiriques ($\bar{X}_1, \bar{X}_2, dots, \bar{X}_k$) calculées dans les sous-échantillons d’Excel sont alors interprétées comme de simples fluctuations stochastiques d’échantillonnage dénuées de portée substantielle.
En contrepoint direct, l’hypothèse alternative (H1) ne postule pas, contrairement à une méprise conceptuelle récurrente chez les chercheurs néophytes, que l’intégralité des moyennes de population doivent être mutuellement distinctes les unes des autres. L’énoncé rigoureux de H1 affirme simplement l’existence d’au moins une divergence significative au sein du système de paramètres étudiés. Mathématiquement, elle se formalise sous la forme suivante :
$$H_1 : \exists , (i, j) \quad \text{tel que} \quad \mu_i \neq \mu_j \quad \text{a\vec} \quad i \neq j$$
Ou, formulé en langage propositionnel académique : « Il existe au moins une paire de groupes pour laquelle la différence entre les moyennes de population est non nulle. » Cette particularité confère à l’ANOVA la nature fondamentale d’un test statistique omnibus (global). En tant que test omnibus, l’analyse de variance n’apporte aucune information directionnelle sur la localisation précise des divergences : elle ne permet pas d’établir, à ce stade préliminaire, si le groupe 1 surpasse le groupe 2, si le groupe 3 s’effondre face aux autres modalités, ou si seuls les extrêmes s’écartent significativement. Rejeter l’hypothèse nulle constitue une validation empirique robuste certifiant que la variation intergroupe observée dépasse trop largement ce que le simple hasard de l’échantillonnage aléatoire permettrait d’expliquer, légitimant ainsi la poursuite de l’investigation par des tests de comparaison multiple complémentaires.
1.3 Applications empiriques de l’ANOVA en recherche psychologique
L’analyse de variance à un facteur constitue l’épine dorsale méthodologique de nombreuses disciplines scientifiques empiriques, et trouve un terrain d’application privilégié dans la recherche psychologique, psychiatrique et en neurosciences cognitives. Dans ces domaines caractérisés par une forte hétérogénéité interindividuelle, l’expérimentateur s’efforce de déterminer avec précision si des interventions ciblées produisent des modifications mesurables du comportement ou des structures psychiques.
À titre d’illustration clinique, considérons l’évaluation de l’efficacité de plusieurs protocoles thérapeutiques distincts dans la réduction de la symptomatologie dépressive majeure. Un chercheur en psychologie clinique pourrait concevoir une étude longitudinale assignant aléatoirement des patients diagnostiqués à l’une des trois conditions suivantes : un groupe bénéficiant d’une thérapie cognitivo-comportementale (TCC standardisée), un groupe recevant un protocole de réduction du stress basé sur la pleine conscience (MBSR), et un groupe témoin placé sur liste d’attente (recevant une prise en charge médicale habituelle sans psychothérapie active). À l’issue d’une période de douze semaines, les scores d’intensité dépressive sont colligés au moyen de l’inventaire de dépression de Beck (BDI-II). Dans ce dispositif expérimental, la variable indépendante à un facteur correspond au type d’intervention psychologique (comportant trois modalités), tandis que la variable dépendante quantitative continue est représentée par le score résiduel au BDI-II. L’ANOVA à un facteur exécutée sous Excel permet ici d’attester scientifiquement si les différentes approches thérapeutiques se démarquent globalement du groupe témoin et entre elles.
Dans le domaine de la psychologie cognitive et expérimentale, l’ANOVA est couramment déployée pour examiner les performances de mémoire de travail ou la vitesse de traitement de l’information sous diverses conditions environnementales contrôlées. Une équipe de recherche pourrait tester les temps de réaction de sujets soumis à une tâche d’attention soutenue de type psychomotor vigilance task (PVT) sous quatre niveaux de privation de sommeil (0 heure, 12 heures, 24 heures et 36 heures d’éveil continu). L’analyse permettra de valider statistiquement la détérioration non linéaire des ressources attentionnelles au fur et à mesure de l’élévation de la pression homéostatique de sommeil.
Enfin, en psychologie sociale et organisationnelle, l’outil sert fréquemment à évaluer le niveau d’épuisement professionnel (burnout) mesuré sur l’échelle de Maslach selon divers styles de leadership managérial (leadership transformationnel, transactionnel ou laisser-faire). Dans tous ces cas d’application, la robustesse inférentielle de l’ANOVA est tributaire de l’étanchéité du protocole de recueil des données et du contrôle rigoureux des variables parasites (âge, sexe, comorbidités, niveau d’instruction) susceptibles de biaiser la partition de variance effectuée par l’algorithme d’Excel.
2. Les postulats statistiques préalables à l’ANOVA à un facteur
2.1 Indépendance des observations et de l’échantillonnage
L’analyse de variance paramétrique repose sur un socle d’hypothèses distributionnelles et méthodologiques strictes dont le respect conditionne la validité des conclusions inférentielles tirées de la statistique F. Le premier de ces postulats, et de loin le plus intransigeant, concerne l’indépendance mutuelle des observations. Ce postulat exige que la mesure collectée auprès d’un participant donné ne soit aucunement conditionnée, influencée ou corrélée avec la mesure obtenue auprès d’un quelconque autre participant, que ces individus appartiennent à la même condition expérimentale ou à des groupes de traitement distincts.
D’un point de vue méthodologique, l’indépendance ne peut être vérifiée rétrospectivement par un test statistique ou une formule mathématique dans Excel ; elle découle exclusivement de la qualité du devis expérimental mis en œuvre durant la phase de collecte des données. Elle implique une assignation aléatoire stricte (randomisation) des unités expérimentales aux différentes modalités du facteur étudié. Les violations de ce postulat surviennent fréquemment dans les contextes de recherche où les participants interagissent collectivement, par exemple lorsque des élèves sont testés au sein de classes scolaires constituées, où l’effet d’entraînement, l’ambiance pédagogique ou les interactions directes génèrent une corrélation intra-classe non négligeable.
Les conséquences d’une entorse au postulat d’indépendance sont méthodologiquement dévastatrices. L’existence d’une dépendance sérielle ou spatiale positive entre les sujets a pour effet pervers de sous-estimer dramatiquement la variance résiduelle au sein des groupes ($MS_{Intra}$). En conséquence directe, le dénominateur de la statistique de test F est artificiellement contracté, ce qui gonfle de manière erronée la valeur calculée de F et effondre la p-valeur associée. Le taux réel d’erreur de première espèce ($\alpha$) peut ainsi grimper de façon vertigineuse, atteignant parfois 30 % ou 40 % au lieu des 5 % théoriques prévus, conduisant le chercheur à déclarer une découverte illusoire. Lorsque l’indépendance des observations ne peut être garantie, l’ANOVA classique doit être impérativement abandonnée au profit de modélisations linéaires mixtes hiérarchiques (modèles multiniveaux).
2.2 Normalité de la distribution de la variable dépendante
Le second postulat gouvernant l’ANOVA univariée stipule que la variable dépendante doit suivre une distribution normale (ou gaussienne) au sein de chaque population parente représentée par les groupes expérimentaux. Sur le plan algébrique, cela équivaut à exiger que le terme d’erreur résiduelle stochastique ($\epsilon_{ij}$) soit distribué de manière normale, indépendante et identiquement distribuée avec une espérance nulle et une variance constante : $\epsilon_{ij} \sim \mathcal{N}(0, \sigma^2)$.
Fort heureusement pour les praticiens, l’analyse de variance démontre un degré de robustesse remarquable face aux déviations modérées vis-à-vis de la normalité idéale, en particulier lorsque le protocole expérimental repose sur un plan factoriel équilibré comportant des effectifs égaux (ou substantiellement similaires) au sein de chaque cellule ($n_1 = n_2 = dots = n_k$). Cette propriété dérive directement du théorème central limite (TCL), stipulant que la distribution d’échantillonnage des moyennes converge asymptotiquement vers une loi normale lorsque la taille des échantillons croît, quand bien même la population sous-jacente s’écarte de la symétrie parfaite.
En pratique empirique, des échantillons affichant un effectif supérieur ou égal à 25 ou 30 observations par groupe permettent généralement de s’affranchir d’une légère non-normalité sans distorsion notable de l’erreur alpha. Les recommandations psychométriques actuelles considèrent que des valeurs d’asymétrie (skewness) comprises dans l’intervalle $[-1{,}0 ; +1{,}0]$ et des indices d’aplatissement (kurtosis) oscillant entre $[-1{,}5 ; +1{,}5]$ n’altèrent pas substantiellement la fiabilité de l’ANOVA. En revanche, en présence de micro-échantillons ($n < 15$ par modalité) combinés à une asymétrie marquée (distributions fortement étalées à droite, typiques des temps de latence ou des biomarqueurs salivaires), le risque d’erreur de type I et la puissance statistique sont sévèrement compromis, nécessitant une normalisation préalable des données ou l’orientation vers des tests non paramétriques.
2.3 Homogénéité des variances ou homoscédasticité
Le troisième postulat fondamental de l’analyse de variance à un facteur est l’exigence d’homoscédasticité, désignant l’égalité formelle des variances de la variable dépendante à travers tous les niveaux de traitement considérés. Formellement, ce critère implique que les dispersions des populations mères satisfassent l’égalité stricte :
$$\sigma_1^2 = \sigma_2^2 = \sigma_3^2 = dots = \sigma_k^2 = \sigma^2$$
L’homogénéité des variances constitue une condition opératoire cruciale dans la mesure où l’algorithme d’Excel mutualise (ou pool) l’ensemble des variances internes de chaque sous-groupe afin de calculer une mesure unique et consolidée de l’erreur résiduelle, formalisée par le carré moyen résiduel ($MS_{Intra}$). Si les variances réelles des sous-groupes divergent substantiellement, cette mutualisation perd toute signification statistique légitime.
L’impact de la violation de l’homoscédasticité sur la validité de l’ANOVA dépend intimement du caractère équilibré ou déséquilibré des effectifs du protocole expérimental :
- En plan expérimental équilibré ($n_1 = n_2 = dots = n_k$) : La statistique F de Fisher conserve une robustesse tout à fait appréciable. Des simulations statistiques exhaustives démontrent que des ratios de variance ($s^2_{\max} / s^2_{\min}$) n’excédant pas 3 à 4 n’affectent que de façon marginale le taux nominal d’erreur alpha.
- En plan expérimental déséquilibré ($n$ inégaux) : L’hétéroscédasticité devient particulièrement délétère. Si les échantillons les plus petits présentent les variances les plus volumineuses, la statistique F globale est artificiellement gonflée, provoquant une hausse dramatique du taux d’erreur de première espèce (rejet abusif de l’hypothèse nulle). Inversement, si les groupes hébergeant les plus grands effectifs affichent les variances les plus étendues, la statistique F est indûment comprimée, ce qui dégrade massivement la puissance statistique du test et débouche sur des erreurs de type II répétées (non-détection d’effets réels).
3. Préparation et structuration rigoureuse des données dans Excel
3.1 Format tabulaire adapté à l’Utilitaire d’analyse statistique
L’obtention de résultats inférentiels exempts de distorsions computationnelles dans Microsoft Excel repose sur la disposition adéquate des données brutes au sein de la feuille de calcul. Contrairement aux progiciels d’analyse matricielle modernes tels que R (via les packages tidyverse) ou SPSS, qui privilégient de manière presque exclusive le format dit « long » (où chaque ligne unique correspond à une observation individuelle et où une colonne code le facteur de regroupement catégoriel), l’Utilitaire d’analyse d’Excel exige structurellement un agencement au format « large ».
Dans cette configuration tabulaire optimale, chaque modalité ou niveau de la variable indépendante doit être consigné dans une colonne adjacente dédiée et continue. La toute première cellule de chaque colonne (ligne 1 du tableau de données) doit être réservée à un libellé textuel explicite identifiant sans ambiguïté la condition expérimentale correspondante (par exemple, Groupe_Controle, Therapie_TCC, Therapie_MBSR). L’ensemble des cellules sous-jacentes d’une même colonne accueillera exclusivement les valeurs numériques quantitatives de la variable dépendante recueillie pour les participants assignés à cette condition spécifique. Il convient de veiller scrupuleusement à ce qu’aucune ligne vide, aucune sous-somme intermédiaire ni aucune note explicative textuelle ne vienne s’intercaler dans le corps de la matrice de données numériques.
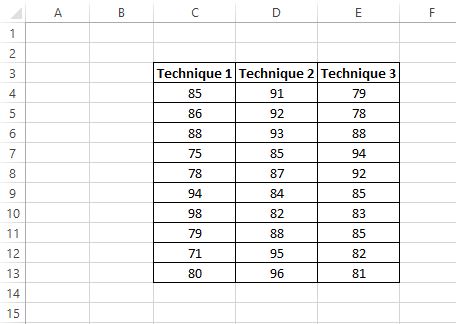
Bien que le module d’analyse d’Excel offre la possibilité technique de traiter des variables structurées en lignes horizontales (les conditions étant alors étalées sur les lignes 1, 2, 3…), l’organisation verticale par colonnes constitue la norme internationale établie, minimisant les risques de fausses manœuvres lors de la délimitation de la matrice d’entrée dans les boîtes de dialogue logicielles.
3.2 Nettoyage des données et gestion des valeurs aberrantes
L’intégrité de l’analyse de variance dépend dramatiquement de la propreté métrologique de la base de données. En raison de sa structure mathématique fondée sur la minimisation des écarts quadratiques, la moyenne arithmétique — et par conséquent les sommes des carrés calculées par l’ANOVA — manifeste une vulnérabilité extrême face aux données aberrantes ou discordantes (outliers). Une unique valeur numérique erronée ou hors norme peut fausser de façon spectaculaire la moyenne de son groupe, tout en décuplant la variance résiduelle interne, occultant ainsi des effets expérimentaux pourtant majeurs.
Préalablement à l’activation du module d’ANOVA, une inspection systématique des données doit être entreprise dans Excel. Plusieurs méthodes quantitatives complémentaires peuvent être mobilisées à même la feuille de calcul :
- Le calcul des scores Z : En utilisant la combinaison des fonctions statistiques
MOYENNEetECARTYPE.STANDARD, le chercheur peut standardiser les scores de chaque condition. Toute observation générant un score centré-réduit $|Z| > 3{,}0$ (ou $|Z| > 2{,}5$ pour les petits échantillons) doit être qualifiée de valeur extrême potentielle. - La méthode de Tukey basée sur l’écart interquartile : En mobilisant les fonctions
QUARTILE.EXCLUREouQUARTILE.INCLURE, on délimite les bornes extérieures de la distribution selon la formule classique des boîtes à moustaches :
$$\text{Borne supérieure} = Q_3 + 1{,}5 \times (Q_3 – Q_1)$$
$$\text{Borne inférieure} = Q_1 – 1{,}5 \times (Q_3 – Q_1)$$
Toute valeur débordant de ces limites d’exclusion fait l’objet d’un examen minutieux.
Lorsqu’une observation atypique est isolée, le chercheur doit en déterminer la source étiologique : s’il s’agit d’une coquille de saisie évidente (par exemple, un score de 77 encodé sur une échelle psychométrique bornée de 1 à 7), la rectification immédiate s’impose. S’il s’agit d’une observation valide mais physiologiquement extrême, une réflexion méthodologique doit arbitrer entre le maintien de la donnée, son élimination justifiée dans le rapport scientifique, ou la mise en œuvre d’une transformation d’échelle stabilisatrice.
3.3 Gestion des plans expérimentaux déséquilibrés
Dans la recherche empirique idéale, les protocoles expérimentaux visent une égalité parfaite des effectifs au sein de chaque condition d’observation ($n_1 = n_2 = n_3$). Néanmoins, les contingences de terrain — abandons de participants en cours d’étude (attrition), défaillances techniques lors de l’enregistrement de biomarqueurs ou données inexploitables — aboutissent fréquemment à des designs factoriels non orthogonaux dits à effectifs inégaux ou déséquilibrés.
Il est fondamental de noter que le module de l’ANOVA à un seul facteur d’Excel est parfaitement capable de gérer des plages de données rectangulaires intégrant des colonnes de longueurs différentes. Lorsqu’un groupe comporte 20 sujets tandis qu’un groupe adjacent n’en dénombre que 14, il suffit d’aligner les observations à partir du haut de la colonne sans insérer d’espace fictif ; Excel interprète les cellules vides situées au bas de la matrice comme l’absence légitime d’observations supplémentaires pour cette modalité précise et ajuste dynamiquement les degrés de liberté résiduels. L’algorithme d’Excel exécute automatiquement dans ce cas de figure ce que la littérature statistique formalise sous le terme d’ANOVA non pondérée à effectifs inégaux.
Toutefois, une vigilance méthodologique extrême s’impose au chercheur. Comme souligné précédemment dans la section consacrée aux postulats, l’asymétrie des effectifs fragilise grandement la tolérance de la statistique F vis-à-vis des entorses à l’homoscédasticité. Lorsque les effectifs sont substantiellement inégaux, il est impératif de s’assurer que les variances de groupe demeurent très proches les unes des autres afin de préserver l’exactitude du niveau de risque alpha nominal.
4. Activation et configuration de l’Utilitaire d’analyse statistique
4.1 Procédure d’installation sur le système d’exploitation Windows
L’Utilitaire d’analyse (Analysis ToolPak) est une macro complémentaire préinstallée dans l’architecture native du logiciel Microsoft Excel pour l’ensemble des versions modernes (Office 365, Office 2021, 2019 et 2016). Toutefois, dans le cadre de la configuration standard par défaut du logiciel, ce module statistique avancé n’est pas déployé d’emblée sur l’interface graphique de l’utilisateur afin d’alléger la mémoire d’exécution du tableur. Son activation initiale requiert un paramétrage élémentaire mais incontournable.
Pour activer l’Utilitaire d’analyse sous un environnement Windows, la démarche opératoire séquentielle se formalise comme suit :
- Lancez l’application Microsoft Excel et accédez à l’onglet supérieur gauche étiqueté Fichier, situé dans le bandeau supérieur de navigation.
- Faites défiler le menu vertical gauche vers le bas jusqu’à la section finale et cliquez sur Options (si votre fenêtre est réduite, cette commande peut être logée dans le sous-menu « Plus… »).
- Au sein de la boîte de dialogue contextuelle intitulée Options d’Excel, parcourez la liste des rubriques du volet latéral gauche et sélectionnez formellement Compléments.
- Portez votre attention sur la partie inférieure de cette fenêtre d’administration : repérez le menu déroulant intitulé Gérer :, assurez-vous qu’il affiche précisément Compléments Excel, puis cliquez sur le bouton de validation Atteindre… situé immédiatement à droite.
- Une boîte de dialogue compacte intitulée Macros complémentaires apparaît alors à l’écran. Dans la liste à cocher présentée, cochez sans ambiguïté la case adossée à la mention Utilitaire d’analyse. Notez qu’il n’est pas requis d’activer la version « Utilitaire d’analyse – VBA » à moins que vous ne prévoyiez d’automatiser vos tests au moyen de scripts programmés en code Visual Basic.
- Validez définitivement l’opération en cliquant sur OK. Excel procède instantanément à l’injection des bibliothèques de calcul statistique dans la mémoire vive de l’application.
4.2 Procédure d’activation sur l’environnement macOS
Pour les chercheurs et analystes évoluant sur le système d’exploitation Apple macOS, le déploiement de l’Utilitaire d’analyse s’effectue selon une cinématique structurellement distincte de la version Windows, en raison de l’intégration spécifique de la suite Microsoft Office dans le framework d’Apple.
La séquence d’activation sous macOS s’établit selon le protocole suivant :
- Ouvrez votre classeur Excel de travail sur macOS.
- Déplacez le curseur de votre souris vers la barre de menus universelle d’Apple située au sommet physique de votre écran (et non dans la fenêtre de l’application elle-même).
- Cliquez sur le menu déroulant intitulé Outils (Tools dans les environnements anglophones).
- Parcourez les commandes jusqu’au sous-menu nommé Compléments Excel… (Excel Add-ins…) et cliquez dessus pour ouvrir la fenêtre modale de configuration.
- Dans le panneau qui s’affiche, repérez l’élément Analysis ToolPak (ou Utilitaire d’analyse selon la langue de compilation de votre pack linguistique localisé) et cochez la case associée.
- Cliquez sur le bouton OK pour enregistrer la modification. L’intégration logicielle est immédiate et ne nécessite aucun redémarrage du système ni de l’application.
4.3 Vérification fonctionnelle au sein du ruban Données
Quelle que soit la plateforme d’exploitation déployée au sein du laboratoire (Windows ou macOS), il est indispensable de procéder à une validation visuelle et fonctionnelle de l’ancrage définitif du module d’analyse avant d’entamer les procédures de calcul.
Pour attester du déploiement opérationnel du module :
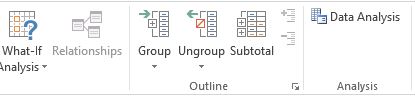
- Cliquez sur l’onglet Données logé au cœur du ruban supérieur d’Excel.
- Portez votre regard vers l’extrême droite du bandeau : un nouveau groupe d’icônes désigné sous l’intitulé Analyse doit désormais être visible.
- Ce groupe doit héberger le bouton d’action nommé Utilitaire d’analyse (ou Analyse de données selon les révisions incrémentielles du logiciel).
Si ce bouton d’accès rapide demeure introuvable après l’exécution scrupuleuse des étapes d’activation, deux diagnostics de panne prédominent : une restriction de sécurité imposée par les chartes informatiques d’entreprise ou d’université (nécessitant l’intervention d’un administrateur système pour débloquer les composants COM/Add-ins), ou l’utilisation d’une version allégée du tableur basée sur le web (Excel pour le Web via navigateur), laquelle ne supporte pas nativement l’Utilitaire d’analyse classique et exige l’installation d’un complément cloud alternatif certifié depuis le Microsoft Office Store.
5. Procédure pas-à-pas pour exécuter l’ANOVA à un facteur
5.1 Sélection de la procédure analytique adéquate
Une fois le module d’analyse opérationnel et les séries quantitatives rigoureusement vérifiées sur la feuille de calcul active, l’exécution computationnelle du test inférentiel peut débuter. Cliquez fermement sur l’icône Utilitaire d’analyse (ou Analyse de données) présente dans le ruban Données.
Une boîte de dialogue contextuelle s’ouvre, dressant l’inventaire exhaustif des routines statistiques intégrées au cœur de l’application (incluant des analyses de corrélation, de régression linéaire, de covariance et diverses déclinaisons de tests t). Tout en haut de cette liste alphabétique figurent trois procédures distinctes consacrées à l’analyse de variance :
- ANOVA : un seul facteur
- ANOVA : deux facteurs avec reproduction
- ANOVA : deux facteurs sans reproduction
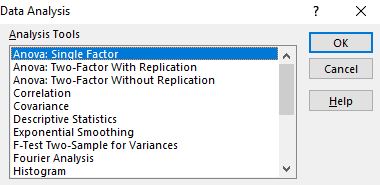
Pour le cas de figure faisant l’objet de cette étude — à savoir la comparaison des moyennes de plusieurs groupes indépendants régis par une unique variable indépendante catégorielle — vous devez impérativement sélectionner la première occurrence : ANOVA : un seul facteur. Cliquez ensuite sur le bouton OK pour afficher le formulaire de paramétrage de l’algorithme mathématique.
5.2 Paramétrage méticuleux des plages d’entrée
L’interface de configuration de l’ANOVA univariée requiert la spécification rigoureuse de plusieurs champs opératoires capitaux pour éviter toute défaillance d’exécution :
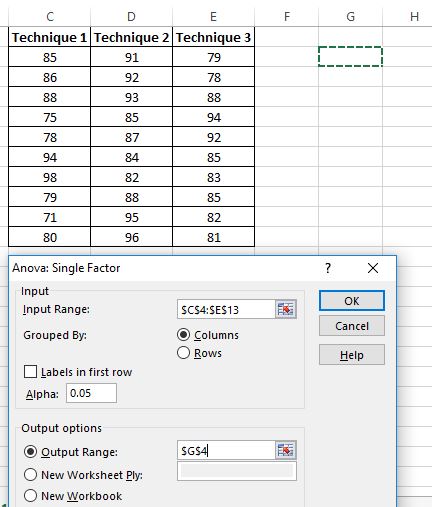
- Plage d’entrée : Cliquez dans le champ de saisie correspondant, puis sélectionnez à l’aide du curseur de votre souris l’intégralité du rectangle matriciel abritant vos données expérimentales. Il est vivement conseillé d’englober la toute première ligne contenant le libellé textuel de chaque condition expérimentale. Si, par exemple, vos scores d’observation occupent les colonnes A, B et C de la première ligne à la vingt-et-unième ligne, la syntaxe de sélection absolue doit afficher
$A$1:$C$21. - Groupé par : Deux cases d’option s’offrent à votre sélection : Colonnes ou Lignes. Si vous avez respecté le format de structuration tabulaire recommandé dans la section 3.1, assurez-vous que l’option Colonnes est activée par défaut.
- Intitulés en première ligne : Ce paramètre est d’une importance cruciale. Si vous avez inclus les cellules textuelles de tête de colonne au sein de votre plage d’entrée, cochez obligatoirement cette case. Cet avertissement signale à l’algorithme d’Excel qu’il ne doit pas tenter de convertir les étiquettes textuelles en valeurs quantitatives d’observation (ce qui déclencherait un message d’erreur d’incompatibilité de type) et qu’il doit réutiliser ces libellés pour structurer élégamment les tableaux de résultats de sortie.
5.3 Définition du seuil de signification et options de sortie
La section inférieure de la fenêtre de paramétrage permet de calibrer les constantes théoriques du test d’hypothèse et de choisir la destination d’affichage des résultats compilés :
- Alpha : Ce champ définit le risque d’erreur de première espèce toléré par l’expérimentateur. Par consensus scientifique dans la recherche quantitative académique, la valeur de $\alpha$ est conventionnellement préétablie à 0,05 (soit 5 %). Si votre protocole exige un conservatisme statistique plus drastique (par exemple dans le cadre d’essais cliniques pharmacologiques de phase III), vous pouvez manuellement abaisser ce paramètre à 0,01 ou 0,001. Cette valeur gouverne le calcul de la valeur critique de F fournie en fin d’analyse.
- Options de sortie : Vous disposez de trois modes de restitution cartographique pour vos tableaux finaux :
- Plage de sortie : Permet de sélectionner une cellule cible spécifique (par exemple
$E$2) sur la feuille de calcul en cours de consultation, afin d’afficher les résultats à proximité immédiate des séries brutes. Veillez à sélectionner une zone libre suffisamment vaste pour éviter d’écraser des calculs préexistants. - Nouvelle feuille de calcul : Option préconisée pour une lisibilité ergonomique optimale. Excel génère instantanément un nouvel onglet vierge dans votre classeur et y loge les matrices inférentielles générées.
- Nouveau classeur : Exportation intégrale des résultats de sortie dans un fichier Excel totalement distinct.
- Plage de sortie : Permet de sélectionner une cellule cible spécifique (par exemple
Une fois l’ensemble de ces paramètres méticuleusement renseignés et vérifiés, validez l’exécution du calcul par un clic sur le bouton OK. En une fraction de seconde, l’algorithme procède aux sommations d’écarts quadratiques et restitue deux tableaux statistiques complets.
6. Compréhension et décryptage des tableaux de sortie
6.1 Analyse du tableau descriptif préliminaire
Le module de sortie d’Excel génère en premier lieu un tableau synthétique intitulé RECAPITULATIF. Cette matrice constitue le point d’ancrage fondamental de l’exploration descriptive univariée, offrant un condensé des métriques d’échantillon pour chacune des conditions expérimentales intégrées à l’analyse.
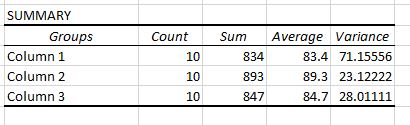
Pour chaque modalité factorielle répertoriée dans la première colonne (reprenant vos intitulés de variables d’origine), quatre indicateurs statistiques de base sont minutieusement compilés :
- Nombre : Représente l’effectif valide ($n_j$) recensé au sein de chaque groupe. La consultation immédiate de cette colonne permet de s’assurer de l’exhaustivité des participants pris en compte et de vérifier l’absence d’omissions accidentelles de cellules numériques.
- Somme : Indique le cumul mathématique brut ($\sum X$) des scores enregistrés pour chaque condition. Bien que cet indicateur n’ait pas de portée interprétative clinique directe, il constitue l’étape arithmétique intermédiaire requise pour le calcul de la moyenne et sert à la dérivation des sommes de carrés globales.
- Moyenne : Fournit la moyenne arithmétique empirique ($\bar{X}_j$) observée dans le groupe concerné :
$$\bar{X}_j = \frac{\sum_{i=1}^{n_j} X_{ij}}{n_j}$$
Cet indicateur synthétise la tendance centrale de chaque niveau expérimental et offre un premier aperçu visuel brut de la direction des écarts entre traitements. - Variance : Présente la variance d’échantillon corrigée ($s_j^2$) calculée avec $n_j – 1$ degrés de liberté au dénominateur :
$$s_j^2 = \frac{\sum_{i=1}^{n_j} (X_{ij} – \bar{X}_j)^2}{n_j – 1}$$
L’inspection critique de cette dernière colonne offre une appréciation visuelle rapide du respect du postulat d’homoscédasticité : une variance d’échantillon qui s’avérerait décuplée par rapport à celle d’un groupe voisin doit immédiatement alerter le chercheur sur un risque d’hétéroscédasticité problématique.
6.2 Décomposition des sommes des carrés et degrés de liberté
Immédiatement sous le bloc récapitulatif descriptif s’articule le tableau inférentiel pivot, universellement intitulé ANOVA. Ce tableau structure la décomposition formelle de la dispersion globale conformément aux postulats d’additivité de Sir Ronald Fisher.
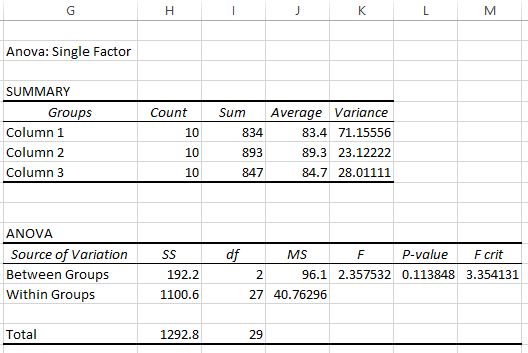
Le tableau se divise en trois lignes analytiques délimitant les composantes de la variance totale, ainsi que plusieurs colonnes d’estimation inférentielle :
- Somme des carrés (notée SS pour Sum of Squares) :
- Entre groupes ($SS_{Entre}$ ou $SS_{Factorielle}$) : Cette valeur évalue la somme des carrés pondérés des écarts existant entre la moyenne arithmétique spécifique de chaque groupe ($\bar{X}_j$) et la grande moyenne générale ($\bar{X}_{bullet}$) calculée sur l’ensemble des participants. Elle mesure l’effet pur attribuable au traitement expérimental combiné aux fluctuations aléatoires du plan d’échantillonnage :
$$SS_{Entre} = \sum_{j=1}^k n_j (\bar{X}_j – \bar{X}_{bullet})^2$$ - À l’intérieur des groupes ($SS_{Intra}$ ou $SS_{Résiduelle}$) : Cette somme chiffre l’accumulation des déviations quadratiques individuelles de chaque sujet par rapport à la moyenne de son propre sous-groupe d’appartenance. Elle capture la part de variabilité résiduelle inexpliquée, agissant comme le bruit de fond d’erreur de mesure du système expérimental :
$$SS_{Intra} = \sum_{j=1}^k \sum_{i=1}^{n_j} (X_{ij} – \bar{X}_j)^2$$ - Total ($SS_{Total}$) : Représente la dispersion agrégée absolue de l’ensemble des scores par rapport à la moyenne générale unifiée :
$$SS_{Total} = SS_{Entre} + SS_{Intra} = \sum_{j=1}^k \sum_{i=1}^{n_j} (X_{ij} – \bar{X}_{bullet})^2$$
- Entre groupes ($SS_{Entre}$ ou $SS_{Factorielle}$) : Cette valeur évalue la somme des carrés pondérés des écarts existant entre la moyenne arithmétique spécifique de chaque groupe ($\bar{X}_j$) et la grande moyenne générale ($\bar{X}_{bullet}$) calculée sur l’ensemble des participants. Elle mesure l’effet pur attribuable au traitement expérimental combiné aux fluctuations aléatoires du plan d’échantillonnage :
- Degrés de liberté (notés Degré de liberté ou df) :
- Pour la ligne Entre groupes : Les degrés de liberté valent rigoureusement le nombre de conditions expérimentales distinctes minoré d’une unité, soit $k – 1$ (si l’on compare 3 groupes, $df = 3 – 1 = 2$).
- Pour la ligne À l’intérieur des groupes : Les degrés de liberté résiduels correspondent au nombre total de participants inclus dans l’étude ($N$) minoré du nombre de groupes ($k$), soit $N – k$.
- Pour la ligne Total : Les degrés de liberté globaux s’élèvent au volume total d’observations moins un, soit $N – 1$. L’additivité des degrés de liberté se vérifie parfaitement : $(k – 1) + (N – k) = N – 1$.
6.3 Composantes inférentielles fondamentales : Moyennes des carrés et ratio F
Les sommes des carrés étant des grandeurs cumulatives sensibles au nombre d’observations, elles ne peuvent être directement confrontées pour évaluer la significativité du traitement. Pour les convertir en véritables variances comparables, il est nécessaire de calculer leurs valeurs moyennes par unité de liberté, désignées sous le vocable de Moyenne des carrés (notées MS pour Mean Squares ou Carrés Moyens).
Dans la colonne intitulée Moyenne des carrés du tableau d’Excel, les valeurs sont calculées par division élémentaire :
- Le carré moyen intergroupe ($MS_{Entre}$) : Dérivé par le quotient du $SS_{Entre}$ par son degré de liberté correspondant :
$$MS_{Entre} = \frac{SS_{Entre}}{k – 1}$$ - Le carré moyen résiduel intragroupe ($MS_{Intra}$) : Obtenu par la division de la somme des carrés résiduelle par ses degrés de liberté résiduels :
$$MS_{Intra} = \frac{SS_{Intra}}{N – k}$$
L’aboutissement ultime de l’analyse réside dans la dérivation de la statistique de test paramétrique univariée, matérialisée dans la colonne intitulée formellement F. Cette statistique d’inférence de Fisher-Snedecor correspond au quotient strict de la variance factorielle sur la variance d’erreur résiduelle :
$$F = \frac{MS_{Entre}}{MS_{Intra}}$$
Sur le plan conceptuel et pédagogique, la valeur F doit être comprise comme un ratio signal-sur-bruit. Le numérateur ($MS_{Entre}$) matérialise le « signal », c’est-à-dire l’amplitude des variations structurelles impulsées par le traitement expérimental, tandis que le dénominateur ($MS_{Intra}$) incarne le « bruit », soit le niveau de fluctuation aléatoire et incontrôlable inhérent aux sujets. Si la variable indépendante n’exerce aucune influence systématique sur les mesures (hypothèse nulle vérifiée), la variance intergroupe sera uniquement alimentée par le bruit stochastique, et le ratio F oscillera au voisinage de 1. À l’inverse, si l’intervention produit un effet tangible, la dispersion entre les groupes surpassera largement l’aléa résiduel, propulsant le ratio F bien au-delà de l’unité.
7. Interprétation statistique et prise de décision expérimentale
7.1 Comparaison entre la statistique F observée et la valeur critique
Pour arbitrer scientifiquement le rejet ou le maintien de l’hypothèse nulle d’égalité des moyennes, deux paradigmes inférentiels complémentaires sont mis à disposition par le tableau de calcul d’Excel. Le premier d’entre eux repose sur l’approche classique de Neyman et Pearson consistant à comparer directement la valeur de la statistique observée ($F_{obs}$) vis-à-vis d’un seuil critique théorique ($F_{crit}$).
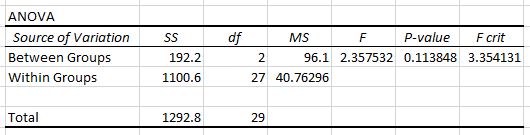
Dans le tableau de sortie d’Excel, repérez la colonne intitulée Valeur critique pour F (logée à l’extrême droite du tableau de l’ANOVA). Cette borne d’acceptation mathématique correspond au quantile de la distribution de probabilité continue de Snedecor-Fisher pour les degrés de liberté considérés ($df_1 = k – 1$ au numérateur et $df_2 = N – k$ au dénominateur) associé au niveau de confiance bilatéral $1 – \alpha$ préalablement spécifié dans les options d’entrée. Dans les faits, Excel calcule cette valeur en invoquant en coulisse la fonction intégrée équivalente à :
=LOI.F.INVERSE.N(1 - Alpha; df_Entre; df_Intra)
La règle formelle de décision statistique s’énonce comme suit :
- Si $F_{obs} > F_{crit}$ : La statistique empirique franchit le seuil de rejet. L’amplitude des divergences observées entre les moyennes expérimentales possède une probabilité d’occurrence sous l’hypothèse nulle inférieure au seuil alpha toléré. L’expérimentateur décide formellement de rejeter l’hypothèse nulle ($H_0$) et d’embrasser l’hypothèse alternative ($H_1$). La différence globale entre les groupes est déclarée statistiquement significative.
- Si $F_{obs} le F_{crit}$ : La statistique de test s’inscrit dans la zone de non-rejet de la distribution. Les disparités de moyennes sont pleinement compatibles avec les fluctuations d’échantillonnage aléatoire normales. L’expérimentateur échoue à rejeter l’hypothèse nulle ($H_0$). Il est méthodologiquement incorrect d’affirmer que les moyennes sont « prouvées rigoureusement égales » ; on formule simplement qu’aucune divergence statistiquement significative n’a pu être mise en lumière par le protocole expérimental.
7.2 Évaluation probabiliste par la p-valeur
Le second paradigme de décision — universellement privilégié par les comités de lecture des revues scientifiques à comité de pairs — exploite la valeur probabiliste calculée, désignée dans le tableau de sortie d’Excel sous le libellé Probabilité (qui traduit le terme universel de p-value ou p-valeur).
La p-valeur quantifie la probabilité exacte d’observer une valeur de la statistique F au moins aussi extrême que celle effectivement obtenue dans l’échantillon d’étude, dans l’hypothèse où l’hypothèse nulle ($H_0$) d’absence totale d’effet serait rigoureusement vraie dans la population mère. Dans l’architecture algorithmique d’Excel, cette probabilité est dérivée de l’intégrale de queue de distribution de la loi de Fisher :
=LOI.F.DROITE(F_obs; df_Entre; df_Intra)
L’interprétation de la p-valeur s’effectue par confrontation directe avec le niveau d’erreur alpha consenti par l’expérimentateur (généralement $\alpha = 0{,}05$) :
- Si $p le 0{,}05$ : Le résultat est dit statistiquement significatif au seuil standard. Il existe moins de 5 % de risques que les variations de moyennes observées soient dues au simple hasard d’échantillonnage sous l’hypothèse d’une absence d’effet.
- Si $p le 0{,}01$ : Le résultat est hautement significatif (moins de 1 % de chances de survenue fortuite).
- Si $p le 0{,}001$ : Le résultat est qualifié de très hautement significatif (souvent consigné sous la notation normalisée $p < 0{,}001$). Notez que si la p-valeur affichée par Excel prend une allure scientifique inhabituelle telle que
3,42E-05, cela signifie simplement $3{,}42 \times 10^{-5}$, soit $0{,}0000342$, attestant d’une significativité extrême. - Si $p > 0{,}05$ : Le résultat n’atteint pas le seuil conventionnel de significativité statistique. L’hypothèse nulle est conservée.
Il est impératif d’éviter deux écueils interprétatifs récurrents : d’une part, la p-valeur ne reflète aucunement la probabilité que l’hypothèse nulle soit vraie (une telle inférence nécessiterait une approche bayésienne computationnelle distincte) ; d’autre part, une faible p-valeur n’atteste en rien de la portée pratique ou de la grandeur clinique d’un effet thérapeutique, d’où la nécessité absolue de quantifier systématiquement la taille de l’effet.
7.3 Formulation formelle de la conclusion scientifique
L’aboutissement de la démarche inférentielle consiste à rédiger une synthèse conclusive traduisant les sorties mathématiques brutes en un énoncé scientifique rigoureux, sans jamais sur-interpréter les attributions causales au-delà des limites du protocole.
Le chercheur doit formuler clairement si la manipulation de la variable indépendante catégorielle a induit des altérations significatives sur la variable dépendante continue au sein de la population cible. Cependant, il convient de réitérer avec force la limite structurelle intrinsèque du test omnibus : attester d’une analyse de variance globale significative indique formellement qu’au moins une condition expérimentale diverge des autres, mais n’autorise en aucun cas à affirmer unilatéralement la supériorité d’un groupe spécifique sur un autre sans avoir préalablement exécuté des procédures statistiques de comparaisons multiples orthogonales ou post-hoc.
De surcroît, la généralisation écologique des conclusions tirées des sorties d’Excel ne peut être validée qu’à la condition que le chercheur ait vérifié l’absence de biais majeurs d’échantillonnage, le respect satisfaisant des postulats paramétriques préalables et le contrôle approprié des facteurs de confusion environnementaux lors de l’expérimentation.
8. Calcul de la taille de l’effet à partir des sorties Excel
8.1 Estimation de l’Eta-carré au moyen de formules dédiées
Une limitation méthodologique fondamentale du tableau de sortie natif de l’ANOVA généré par l’Utilitaire d’analyse d’Excel réside dans l’omission regrettable de tout indice standardisé de magnitude ou de taille d’effet (effect size). Or, depuis plusieurs décennies, les instances méthodologiques internationales telles que l’American Psychological Association exigent formellement que toute annonce d’un test de significativité statistique soit assortie d’une mesure quantitative de la taille de l’effet constaté, afin de distinguer la simple significativité probabiliste (largement conditionnée par la taille de l’échantillon) de la pertinence empirique réelle.
L’indicateur de taille d’effet le plus couramment calculé dans le cadre de l’ANOVA à un facteur est l’Éta-carré ($\eta^2$). L’Éta-carré représente le pourcentage de variance de la variable dépendante directement expliqué ou imputable à l’action de la variable indépendante factorielle. Sa définition mathématique est remarquablement simple :
$$\eta^2 = \frac{SS_{Entre}}{SS_{Total}}$$
Pour calculer facilement cette valeur métrique dans votre feuille de calcul Excel à partir du tableau de sortie de l’ANOVA, positionnez-vous dans une cellule libre adjacente et construisez la formule en pointant vers les cellules dynamiques correspondantes de la colonne Somme des carrés. Par exemple, si votre cellule $SS_{Entre}$ est logée en B13 et que la cellule $SS_{Total}$ réside en B15, inscrivez la syntaxe suivante :
=B13/B15
Pour interpréter de façon contextualisée l’indice d’Éta-carré obtenu, le chercheur s’appuie sur les conventions empiriques formulées par le statisticien Jacob Cohen dans ses ouvrages de référence sur la puissance statistique :
- $\eta^2 \approx 0{,}01$ (soit 1 % de variance expliquée) : Taille d’effet modeste ou faible.
- $\eta^2 \approx 0{,}06$ (soit 6 % de variance expliquée) : Taille d’effet moyenne (fréquemment rencontrée dans les interventions comportementales complexes).
- $\eta^2 ge 0{,}14$ (soit 14 % ou plus de variance expliquée) : Taille d’effet volumineuse ou forte, signalant un impact déterminant du traitement sur la variable mesurée.
8.2 Correction du biais d’échantillon par l’Omega-carré
Bien que l’Éta-carré soit massivement diffusé dans la littérature scientifique en raison de sa simplicité computationnelle intuitive, il présente une tare théorique bien connue des biométriciens : il constitue un estimateur purement descriptif et systématiquement biaisé vers le haut (optimiste) de la variance expliquée. En d’autres termes, l’Éta-carré tend à surestimer l’impact réel du traitement au sein de la population générale, un biais de distorsion qui s’amplifie dangereusement lorsque les effectifs d’échantillonnage sont restreints ($n < 20$ par modalité).
Pour remédier à cette anomalie d’échantillonnage, la littérature contemporaine recommande d’estimer un paramètre corrigé non biaisé : l’Oméga-carré ($\omega^2$). Cet indicateur intègre explicitement les carrés moyens résiduels pour ajuster l’estimation en tenant compte du nombre de conditions et de participants. Sa formule algébrique s’établit comme suit :
$$\omega^2 = \frac{SS_{Entre} – (k – 1) \times MS_{Intra}}{SS_{Total} + MS_{Intra}}$$
Pour intégrer l’Oméga-carré dans votre rapport de recherche à l’aide d’Excel, vous pouvez automatiser son extraction numérique en encodant une formule adressant directement les coordonnées matricielles du tableau d’ANOVA. Si nous reprenons un agencement d’output standard où :
- $SS_{Entre}$ réside en
B13 - Le degré de liberté factoriel ($k – 1$) réside en
C13 - Le carré moyen résiduel ($MS_{Intra}$) réside en
D14 - $SS_{Total}$ réside en
B15
La syntaxe opératoire à intégrer dans la cellule cible d’Excel sera rédigée sous la forme :
=(B13 - (C13 * D14)) / (B15 + D14)
Il convient de noter que si l’effet mesuré s’avère particulièrement ténu ou inexistant et que la statistique F s’affaisse en deçà de 1, la formule peut générer une valeur mathématique négative : dans cette conjoncture spécifique, l’Oméga-carré est conventionnellement borné et rapporté à la valeur nulle ($\omega^2 = 0{,}00$). Les seuils d’interprétation heuristiques de Cohen s’appliquent identiquement à l’Oméga-carré (0,01 pour un petit effet ; 0,06 pour un effet moyen ; 0,14 pour un grand effet).
8.3 L’importance de la taille d’effet pour la reproductibilité scientifique
L’incorporation systématique des indicateurs de taille d’effet dépasse largement le simple formalisme stylistique académique imposé par les manuels de rédaction. Dans le contexte actuel de la crise de la reproductibilité scientifique qui traverse les sciences biomédicales et humaines, l’analyse d’effet joue un rôle primordial dans l’accumulation cumulative du savoir.
En premier lieu, les coefficients tels que l’Éta-carré ou l’Oméga-carré constituent les briques de données indispensables à la réalisation future de synthèses quantitatives et de méta-analyses. Un test de significativité isolé dépendant étroitement du volume $N$ de l’étude (un micro-effet dénué de pertinence concrète pouvant devenir hautement significatif dès lors que l’on examine des milliers de sujets), la taille d’effet standardisée demeure la seule mesure objective permettant d’agréger et de comparer rigoureusement les résultats d’expérimentations conduites par différents laboratoires à travers le monde.
En second lieu, l’évaluation rétrospective précise de la taille d’effet obtenue dans une expérimentation menée sur Excel permet d’exécuter des analyses de puissance statistique a priori lors de la conception des protocoles d’investigation ultérieurs (notamment via des outils spécialisés tels que G*Power). Connaître la magnitude attendue d’un effet thérapeutique permet d’ajuster scientifiquement la taille minimale de cohorte requise pour détecter cet effet avec une puissance acceptable ($1 – \beta ge 0{,}80$), évitant ainsi le gaspillage éthique et financier consistant à mener des études sous-alimentées statistiquement.
9. Analyses post-hoc et comparaisons multiples suite à une ANOVA
9.1 Pourquoi le test omnibus demeure insuffisant
Comme nous l’avons théorisé dans la section 1.2, l’ANOVA à un facteur constitue fondamentalement un test omnibus. Une issue globale significative ($p le 0{,}05$ assorti d’un $F$ supérieur au seuil critique) certifie formellement que l’hypothèse nulle d’égalité conjointe des moyennes de populations doit être rejetée. Cela informe l’expérimentateur de la présence indiscutable de disparités significatives dans le système expérimental, mais laisse en suspens une question scientifique décisive : quelles paires de conditions spécifiques diffèrent réellement les unes des autres ?
L’expérimentateur pourrait être tenté de conduire naïvement une série de tests t de Student bivariés classiques entre toutes les combinaisons possibles de groupes en mobilisant l’outil Test t pour deux échantillons de l’Utilitaire d’analyse d’Excel. Une telle démarche intuitive est méthodologiquement erronée et scientifiquement inacceptable : sans ajustement correcteur, l’inflation multiplicative du taux d’erreur globale par famille (illustrée précédemment par l’équation de l’erreur cumulative) exposerait l’étude à un risque critique d’inventions de faux positifs.
L’Utilitaire d’analyse de base d’Excel souffrant d’une lacune fonctionnelle notable — à savoir l’absence totale de module d’ajustement automatisé pour les analyses de comparaisons multiples post-hoc (contrairement à des logiciels dédiés intégrant en un clic les corrections de Tukey, Scheffé ou Dunnett) —, il incombe au chercheur de mettre en œuvre manuellement ces corrections indispensables à même sa feuille de calcul.
9.2 Implémentation pratique de la correction de Bonferroni dans Excel
Parmi l’arsenal des procédures correctrices permettant de juguler la prolifération de l’erreur de première espèce lors de tests d’hypothèses multiples, la méthode développée par le mathématicien italien Carlo Emilio Bonferroni est de loin la plus aisée à matérialiser directement dans l’interface d’Excel.
Le principe fondamental de la correction de Bonferroni consiste à diviser le seuil de risque d’erreur alpha nominal initial (habituellement $\alpha = 0{,}05$) par le nombre total combinatoire de comparaisons binaires distinctes menées au sein de l’expérience ($c$). Le nombre de paires comparables issues de $k$ groupes s’obtient par la formule des combinaisons simples :
$$c = \frac{k(k – 1)}{2}$$
Ainsi, pour un protocole expérimental intégrant 4 conditions distinctes, le nombre total de comparaisons binaires s’élève à :
$$c = \frac{4(4 – 1)}{2} = \frac{12}{2} = 6 \text{ comparaisons}$$
Le seuil de significativité corrigé ajusté (désigné par $\alpha_{ajustacute{e}}$ ou $alpha’$) à appliquer individuellement à chacune des six comparaisons binaires sera recalculé de la manière suivante :
$$\alpha_{ajustacute{e}} = \frac{\alpha_{initial}}{c} = \frac{0{,}05}{6} \approx 0{,}00833$$
La mise en application concrète sous Excel se structure alors selon la démarche séquentielle suivante :
- Activez l’Utilitaire d’analyse et sélectionnez l’outil Test t : deux échantillons en supposant des variances égales (en tirant parti du fait que l’ANOVA omnibus préalable a validé l’homogénéité des variances).
- Conduisez successivement le test t pour chaque dyade de groupes d’intérêt (par exemple, Groupe A contre B, puis A contre C, A contre D, etc.).
- Consignez minutieusement les p-valeurs bilatérales (désignées par P(T<=t) bi-directionnel) restituées par Excel dans les tableaux de sortie correspondants.
- Confrontez chaque p-valeur individuelle non plus au seuil historique de 0,05, mais au seuil d’exclusion recalculé plus sévère ($alpha’ = 0{,}0083$). Seules les paires de moyennes pour lesquelles $p le 0{,}0083$ seront déclarées authentiquement et significativement différentes au terme du processus.
Bien que d’une remarquable simplicité opératoire, la méthode de Bonferroni présente l’inconvénient méthodologique d’être extrêmement conservatrice : en bridant drastiquement le risque d’erreur de première espèce, elle majore corrélativement le risque d’erreur de type II ($\beta$), augmentant la probabilité d’ignorer de réelles différences entre moyennes lorsque le nombre de comparaisons devient volumineux ($c > 10$).
9.3 Méthode de la plus petite différence significative et test de Tukey
Pour contourner le conservatisme excessif de Bonferroni, la procédure de la Différence Significative Honnête de Tukey (notée HSD pour Honestly Significant Difference) représente le standard méthodologique absolu pour procéder à l’exploration exhaustive de toutes les comparaisons par paires consécutives à une ANOVA à plan équilibré ($n_1 = n_2 = dots = n_k$).
Le test de Tukey repose sur le calcul d’une amplitude critique unique de divergence de moyennes, désignée par la valeur seuil HSD. Toute paire de conditions dont la différence de moyennes arithmétiques absolue $|\bar{X}_i – \bar{X}_j|$ s’avère supérieure ou égale à cette borne seuil HSD est formellement déclarée statistiquement significative au niveau alpha global de 0,05. L’équation fondamentale du Tukey HSD est la suivante :
$$HSD = q_{\alpha, , k, , df_{Intra}} \times \sqrt{\frac{MS_{Intra}}{n}}$$
Où :
- $q_{\alpha, , k, , df_{Intra}}$ représente la valeur critique issue de la loi d’étendue studentisée (Studentized Range Distribution) pour un niveau de risque $\alpha$, un nombre total de groupes $k$, et les degrés de liberté résiduels de l’ANOVA ($df_{Intra} = N – k$).
- $MS_{Intra}$ est le carré moyen intragroupe (résiduel) extrait directement du tableau d’ANOVA généré par Excel.
- $n$ correspond à l’effectif standard par condition (ou à la moyenne harmonique des effectifs $n_h$ en cas de légères divergences d’échantillonnage).
Pour mettre en place cette procédure sous Excel :
- Localisez et notez les valeurs de $MS_{Intra}$ et de ses degrés de liberté dans votre sortie d’ANOVA.
- Extrayez le coefficient $q$ en consultant une table statistique standard de la distribution d’étendue studentisée (disponible dans les manuels de référence de biostatistique ou via des formulaires en ligne spécialisés).
- Dans une cellule d’Excel, appliquez la formule arithmétique :
=q_valeur * RACINE(Cellule_MS_Intra / Effectif_n)
Vous obtenez la valeur seuil HSD en unités réelles de votre échelle de mesure. - Construisez un tableau matriciel bivarié croisant vos différentes conditions et calculez les différences absolues entre moyennes :
=ABS(Moyenne_GroupeA - Moyenne_GroupeB) - Confrontez chaque écart obtenu à votre seuil HSD calculé : dès lors que
Différence >= HSD, la divergence est déclarée formellement significative.
Pour synthétiser visuellement ces résultats dans un rapport d’expertise, les chercheurs ont coutume d’utiliser le système de classification par lettres partagées (compact letter display) : deux moyennes assignées d’une lettre commune dans le compte-rendu descriptif ne diffèrent pas significativement au seuil de Tukey.
10. Vérification empirique des postulats directement dans Excel
10.1 Évaluation de la normalité par les coefficients d’asymétrie et d’aplatissement
Conformément aux préceptes de la démarche inférentielle rigoureuse, les conclusions issues du test F de l’ANOVA ne possèdent de validité qu’autant que les postulats distributionnels fondamentaux sont empiriquement soutenus. Avant d’entériner les résultats de votre tableau de sortie, il est de bonne pratique de mobiliser les fonctions mathématiques natives d’Excel pour tester la normalité de la distribution au sein de chaque niveau factoriel.
Les deux métriques centrales permettant de quantifier la fidélité gaussienne d’une série continue d’observations sont le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis) :
- Le coefficient d’asymétrie : Évalue le degré de symétrie de la courbe de densité par rapport à la moyenne. Dans Excel, cette valeur s’obtient en mobilisant la formule :
=COEFFICIENT.ASYMETRIE(Plage_de_données_du_groupe)
Une distribution parfaitement normale présente un coefficient nul ($G_1 = 0$). Une valeur positive indique un étalement de la queue de distribution vers la droite (scores élevés rares), tandis qu’une valeur négative signale un étirement asymétrique vers la gauche. Un intervalle standard compris entre $[-1{,}0 ; +1{,}0]$ est généralement toléré comme garantissant une normalité acceptable pour l’ANOVA. - Le coefficient d’aplatissement : Évalue la lourdeur des queues de distribution et la proéminence du pic central (caractère leptokurtique ou platykurtique). Dans Excel, on mobilise la fonction native :
=COEFFICIENT.APLATISSEMENT(Plage_de_données_du_groupe)
Cette fonction calcule l’excès de kurtosis (par rapport à la normale de référence qui vaut 0). Des valeurs comprises dans l’intervalle $[-1{,}5 ; +1{,}5]$ indiquent une dispersion convenable ne remettant pas en cause la robustesse du modèle linéaire d’Excel.
En complément de ces indicateurs paramétriques, les chercheurs avancés peuvent esquisser un graphique quantile-quantile d’approximation (Q-Q plot) sous Excel en confrontant les rangs percentiles observés aux quantiles théoriques issus de la distribution normale inversée calculée par la fonction =LOI.NORMALE.STANDARD.INVERSE(Probabilite), pour s’assurer graphiquement de l’alignement des points le long de la bissectrice orthogonale.
10.2 Vérification de l’homoscédasticité par le test de Hartley ou le test F
L’évaluation rigoureuse de l’homogénéité des variances au sein des différents groupes expérimentaux peut être menée à bien dans Excel au travers d’indices de dispersion issus directement du premier tableau récapitulatif fourni par l’Utilitaire d’analyse.
La première stratégie, particulièrement adaptée aux plans factoriels équilibrés ($n_1 = n_2 = dots = n_k$), repose sur le test $F_{\max}$ de Hartley. Cette méthode consiste à établir le ratio arithmétique simple entre la variance d’échantillon empirique la plus élevée recensée parmi les groupes et la variance la plus faible observée :
$$F_{\max} = \frac{s^2_{maximale}}{s^2_{minimale}}$$
Pour mettre en œuvre ce test, repérez dans la colonne Variance du tableau RECAPITULATIF d’Excel la valeur la plus volumineuse et divisez-la par la valeur la plus basse. La valeur calculée est ensuite confrontée aux tables de valeurs critiques du test de Hartley en fonction du nombre de groupes $k$ et des degrés de liberté individuels ($n – 1$). À titre de règle empirique générale (rule of thumb), si les effectifs de groupe sont équilibrés, un ratio $F_{\max}$ inférieur à 3 (ou 4 pour de grands effectifs) indique que le postulat d’homogénéité des variances est raisonnablement respecté et que l’ANOVA peut être interprétée en toute quiétude.
Dans l’hypothèse où le chercheur souhaiterait procéder à une confrontation formelle bilatérale des variances entre deux groupes précis, il est possible de mobiliser l’algorithme dédié présent dans le panneau de l’Utilitaire d’analyse : Test F pour deux échantillons : analyses de variance. Cet outil génère la statistique $F$ de confrontation des variances et restitue la p-valeur exacte correspondante. Si cette probabilité s’avère nettement supérieure au seuil critique de 0,05, l’égalité des variances des deux échantillons considérés ne peut être réfutée.
10.3 Stratégies de remédiation en cas de violation avérée des postulats
Lorsque les tests préliminaires de normalité révèlent une asymétrie intolérable ou que le test d’homoscédasticité sanctionne une divergence majeure des dispersions au sein d’un plan expérimental à effectifs inégaux, l’interprétation brute du tableau d’ANOVA généré par Excel devient scientifiquement hasardeuse.
L’expérimentateur dispose alors de plusieurs trajectoires méthodologiques curatives, dont la plus classique consiste à appliquer une transformation mathématique stabilisatrice directement sur la matrice de données d’origine dans la feuille Excel, avant de relancer l’algorithme d’ANOVA sur les données transformées :
- La transformation logarithmique ($\log_{10}(X)$ ou $ln(X)$) : Idéale pour corriger les distributions étalées vers la droite (asymétrie positive prononcée) et pour stabiliser les variances lorsque l’écart-type croît proportionnellement à la moyenne. Dans Excel, on utilise la formule
=LN(Cellule)ou=LOG10(Cellule)(si la variable comporte des valeurs nulles, on applique la variante $log(X + 1)$ via=LN(Cellule + 1)). - La transformation par racine carrée ($\sqrt{X}$) : Préconisée pour les données de comptage (nombres d’erreurs commises, fréquences d’événements discrets) suivant approximativement une loi de Poisson. Syntaxe Excel :
=RACINE(Cellule). - La transformation inverse ou réciproque ($1 / X$) : Recommandée pour normaliser les variables temporelles d’attente ou de latence (les temps de réaction se transformant ainsi en vitesse de traitement). Syntaxe Excel :
=1/Cellule.
Une fois les scores d’origine convertis par la fonction mathématique adéquate, l’Utilitaire d’analyse est réexécuté sur la nouvelle plage de calcul. Il convient ensuite de vérifier si la transformation a effectivement rétabli l’homoscédasticité et la normalité des résidus.
Si, en dépit de ces efforts d’ingénierie mathématique, les violations subsistent de façon critique, le cadre paramétrique linéaire de Fisher atteint ses limites structurelles dans l’environnement standard d’Excel. La déontologie scientifique impose alors de renoncer à l’ANOVA à un facteur pour migrer vers l’alternative non paramétrique de rang : le test de Kruskal-Wallis. Bien que le test de Kruskal-Wallis ne soit pas préprogrammé sous forme d’option automatique dans l’Utilitaire d’analyse d’Excel, il peut être intégralement calculé de façon manuelle dans la feuille de calcul via la fonction d’assignation de rangs =RANG.MOYENNE, ou exécuté par exportation des matrices de données vers des logiciels dédiés tels que R ou Jamovi.
11. Représentation graphique et visualisation académique sous Excel
11.1 Construction d’un diagramme en barres standard avec barres d’erreur
Dans la communication des résultats de la recherche empirique, la restitution brute de tableaux numériques ne saurait se substituer à une visualisation graphique explicite et rigoureuse de la tendance centrale et de la dispersion des conditions analysées. Le diagramme en barres (ou histogramme groupé de moyennes) assorti de barres d’erreur constitue le modèle iconographique classique requis dans les publications scientifiques.
Pour construire ce graphique de façon méthodologiquement irréprochable sous Microsoft Excel, il convient d’éviter formellement l’écueil fréquent consistant à tracer un graphique directement depuis les données brutes ; il est impératif de s’appuyer sur le tableau descriptif RECAPITULATIF issu de la sortie d’ANOVA :
- Dans le tableau RECAPITULATIF, sélectionnez conjointement la colonne répertoriant le nom de vos groupes et la colonne hébergeant les valeurs de leurs Moyennes respectives.
- Accédez au ruban supérieur Insertion, localisez le groupe Graphiques et sélectionnez l’icône Insérer un histogramme ou un graphique à barres, puis choisissez Histogramme 2D groupé.
- Une fois le graphique déployé sur votre écran, il est impératif d’intégrer des barres d’erreur basées sur l’erreur standard de la moyenne (SEM), et non sur un pourcentage arbitraire proposé par le logiciel. Pour calculer la SEM de chaque condition dans une cellule adjacente de votre feuille de calcul, appliquez la formule standard :
$$SEM = \frac{s}{\sqrt{n}} = \frac{\sqrt{\text{Variance}}}{\sqrt{\text{Nombre}}}$$
Dans Excel, cela s’exprime sous la forme :=RACINE(Cellule_Variance)/RACINE(Cellule_Nombre). - Cliquez sur les barres verticales de votre graphique pour les activer, puis cliquez sur le pictogramme + situé à l’angle supérieur droit du tracé (ou accédez à l’onglet Création de graphique > Ajouter un élément de graphique).
- Cochez la section Barres d’erreur, puis cliquez sur le petit triangle latéral et sélectionnez Autres options de barres d’erreur…
- Dans le volet latéral de mise en forme qui s’affiche à droite de votre espace de travail, descendez tout en bas dans la rubrique Marge d’erreur, activez la case d’option Personnalisée, puis cliquez sur le bouton Spécifier une valeur.
- Dans la petite boîte de dialogue contextuelle, pointez simultanément pour la Valeur d’erreur positive et pour la Valeur d’erreur négative vers la plage de cellules hébergeant vos valeurs de SEM préalablement calculées. Validez en cliquant sur OK.
Vos colonnes sont désormais coiffées de barres d’erreur statistiquement valides illustrant avec exactitude la précision de l’estimation de la moyenne de chaque population.
11.2 Alternative visuelle : Construction de boîtes à moustaches
Bien que le diagramme en barres demeure populaire, la communauté académique contemporaine lui préfère de plus en plus la boîte à moustaches (ou Boxplot). Contrairement au diagramme en colonnes qui dissimule la morphologie interne des données sous un agrégat unique, la boîte à moustaches offre une transparence visuelle totale en illustrant simultanément la médiane, les quartiles (écart interquartile représenté par le corps de la boîte), l’étendue globale des scores et la présence d’éventuelles valeurs atypiques isolées.
Depuis ses déclinaisons 2016 et Office 365, Excel propose un type de graphique natif dédié aux boîtes à moustaches :
- Sélectionnez l’intégralité de vos colonnes de données brutes d’origine (en englobant la ligne d’en-tête contenant les noms des groupes).
- Rendez-vous dans l’onglet Insertion, repérez le bloc des graphiques statistiques (arborant l’icône d’un histogramme bleu stylisé) et cliquez sur l’option Boîte et moustaches.
- Excel dresse instantanément une série de boîtes juxtaposées élégantes, chaque colonne représentant l’une des modalités de votre variable indépendante.
- Par défaut, l’algorithme calcule les charnières de quartiles et trace de petits points distincts à l’extérieur des moustaches pour signaler les observations divergentes répondant aux critères d’exclusion de Tukey ($> 1{,}5 \times IQR$). De surcroît, une petite croix interne ($\times$) vient localiser la position de la moyenne arithmétique au sein de la distribution.
La boîte à moustaches constitue l’outil heuristique par excellence pour illustrer visuellement auprès d’un lectorat scientifique la qualité de vos données, tout en corroborant empiriquement la symétrie des distributions et l’homogénéité visuelle de l’étalement des variances.
11.3 Conception graphique conforme aux exigences des publications scientifiques
Les chartes graphiques imposées par les périodiques scientifiques à comité d’évaluation (tels que ceux publiés par l’APA, Elsevier ou Springer) proscrivent sévèrement les fioritures esthétiques générées par défaut par les logiciels bureautiques grand public.
Pour conférer à votre graphique Excel un standard de finition digne d’une publication savante de rang A, appliquez scrupuleusement les règles de mise en forme suivantes :
- Épuration intégrale : Supprimez sans ménagement toutes les lignes de quadrillage horizontales ou verticales d’arrière-plan (gridlines) qui encombrent l’espace visuel. Éliminez tout effet de relief tridimensionnel (3D), d’ombre portée ou de dégradé de couleur. L’arrière-plan du graphique doit être parfaitement blanc et le contour extérieur transparent (aucun cadre de délimitation).
- Optimisation chromatique : Si votre article est destiné à une publication papier ou à une impression monochrome, substituez aux couleurs vives par défaut une palette sobre déclinée en nuances de gris contrastées ou en aplats noirs bordés de contours nets.
- Sobriété typographique : Uniformisez la police de caractères sur l’ensemble du graphique (adoptez des polices standard universelles telles qu’Arial, Calibri ou Times New Roman) en veillant à ce que la taille de police demeure parfaitement lisible (généralement entre 10 et 12 points pour les graduations d’axes, 12 points en gras pour les titres des axes).
- Graduation rigoureuse des axes : Cliquez avec le bouton droit de la souris sur l’axe vertical des ordonnées (axe Y), choisissez Mise en forme de l’axe, et assurez-vous d’imposer un trait de ligne plein noir muni de petits tirets de graduation extérieurs. Veillez scrupuleusement à ne pas tronquer arbitrairement la base de l’axe numérique sans justification méthodologique explicite, afin de ne pas distordre visuellement la magnitude perçue des disparités réelles.
- Légende et identification : Les normes éditoriales exigent qu’un graphique académique ne comporte aucun titre textuel en gros caractères au-dessus de son tracé. Le descriptif de la figure doit figurer exclusivement dans la légende textuelle autonome qui sera rédigée sous l’image dans le corps final du manuscrit (ex : Figure 1. Scores moyens de dépression (BDI-II) en fonction du protocole thérapeutique assigné. Les barres d’erreur représentent l’erreur standard de la moyenne ($\pm 1$ SEM).).
12. Rédaction des résultats de l’ANOVA selon les normes de l’APA
12.1 Structure formelle du paragraphe de résultats en psychologie
La communication scientifique des analyses quantitatives est codifiée de façon universelle par le manuel de publication de l’American Psychological Association (actuellement dans sa 7e édition). Un compte-rendu d’analyse de variance à un facteur doit s’articuler selon une architecture discursive canonique en trois temps distincts, excluant toute ambiguïté interprétative :
- L’exposé descriptif préliminaire : Présentation contextuelle des conditions expérimentales évaluées, accompagnée impérativement des statistiques descriptives fondamentales pour chaque groupe — nommément la moyenne arithmétique ($M$) et l’écart-type d’échantillon ($SD$ pour Standard Deviation, obtenu en calculant la racine carrée de la variance restituée par Excel via la fonction
=RACINE()). - L’énoncé du résultat inférentiel omnibus : Formulation explicite du résultat du test F, intégrant rigoureusement au sein d’une parenthèse normalisée la statistique calculée, les deux degrés de liberté associés (intergroupe et intragroupe), la p-valeur exacte et la taille d’effet mesurée ($\eta^2$ ou $\omega^2$).
- L’exposé détaillé des contrastes post-hoc : Présentation des comparaisons multiples par paires menées pour localiser les divergences, en mentionnant explicitement la méthode de correction déployée (Bonferroni ou Tukey) et les niveaux de significativité locaux atteints.
12.2 Typographie et notation académique rigoureuse des paramètres
L’application des normes APA requiert le respect pointilleux de conventions de mise en page typographique hautement spécialisées :
- La mise en italique formelle : Tous les symboles statistiques désignés par des lettres latines conventionnelles doivent être rigoureusement typographiés en italique : F, p, M, SD, t, n, N. À l’inverse, les lettres grecques quantifiant des paramètres de population ou des tailles d’effet ($\eta^2$, $\omega^2$, $\alpha$, $\beta$) ainsi que les indices de positionnement s’écrivent obligatoirement en caractères romains droits (non italiques).
- La règle d’omission du zéro initial : Conformément aux règles de l’APA, il est strictement interdit d’insérer un zéro devant une virgule ou un point décimal lorsque le chiffre concerné ne peut mathématiquement jamais excéder l’unité. C’est le cas par excellence de la p-valeur (p) ainsi que des indices de corrélation ou de taille d’effet basés sur des proportions ($\eta^2$). On écrira ainsi correctement p = .023 ou $\eta^2 = .18$, et jamais p = 0.023. En revanche, dans la mesure où la statistique F ou la moyenne M peuvent dépasser la valeur 1, elles requièrent la présence du zéro initial si elles sont inférieures à l’unité (ex : F(2, 42) = 0.85).
- Le calibrage des décimales : Les statistiques générales (M, SD, F) s’arrondissent systématiquement à deux décimales après la virgule. La p-valeur (p) s’arrondit à trois décimales, à moins qu’elle ne s’avère inférieure à .001, auquel cas elle se consigne sous la formule invariante : p < .001.
Voici un modèle rédactionnel exhaustif d’un paragraphe complet, rédigé dans les règles de l’art académique et prêt à être inséré dans la section « Résultats » d’une thèse de doctorat ou d’un mémoire de recherche empirique :
« Une analyse de variance univariée à un facteur entièrement inter-sujets (ANOVA) a été conduite afin d’évaluer l’impact du type d’intervention thérapeutique sur le niveau d’anxiété résiduelle mesuré à l’aide de l’inventaire STAI-Y. Les participants étaient distribués entre le groupe thérapie cognitivo-comportementale (n = 20, M = 34.20, SD = 6.15), le groupe intervention basée sur la pleine conscience (n = 20, M = 38.50, SD = 5.82) et le groupe témoin sur liste d’attente (n = 20, M = 46.80, SD = 7.04). Les analyses révèlent un effet principal significatif du protocole de traitement, F(2, 57) = 21.34, p < .001, $\eta^2 = .43$, indiquant une taille d’effet très volumineuse selon les conventions de Cohen. Les comparaisons post-hoc conduites avec l’ajustement conservateur de Bonferroni ($alpha’ = .017$) démontrent que les patients du groupe TCC ainsi que ceux du groupe pleine conscience présentent des niveaux d’anxiété significativement inférieurs à ceux des sujets du groupe témoin (respectivement p < .001 et p = .002). En revanche, la différence observée entre le protocole TCC et l’approche par pleine conscience n’atteint pas le seuil critique de significativité corrigé (p = .084). »
12.3 Erreurs fréquentes de rédaction et écueils à éviter
L’évaluation des manuscrits scientifiques révèle la persistance de fautes de style et de conceptualisation récurrentes lors de l’exposition des sorties de l’analyse de variance :
- La fallacieuse « quasi-significativité » : Lorsqu’une p-valeur s’établit légèrement au-delà du seuil conventionnel (par exemple p = .063), de nombreux rédacteurs affirment l’existence d’une « tendance marginalement significative » ou d’un « effet quasi-significatif ». Cette formulation est formellement rejetée par les comités de lecture modernes. Dans le cadre de l’inférence décisionnelle bivalente de Neyman-Pearson, un résultat est soit statistiquement significatif au seuil préalablement défini, soit non significatif. Échouer à rejeter l’hypothèse nulle à p = .06 ne permet pas de revendiquer un effet naissant.
- L’omission des degrés de liberté du modèle et de l’erreur : La statistique F ne doit jamais être formulée isolément. L’omission des deux degrés de liberté dans la parenthèse normalisée — F($df_{Entre}$, $df_{Intra}$) — prive le lecteur de la capacité de reconstituer le dimensionnement d’échantillonnage de l’expérimentation et invalide la rigueur du manuscrit.
- La confusion terminologique entre écart-type et erreur standard : Indiquer qu’un groupe présente un score de « 45.2 $\pm$ 3.1 » sans préciser s’il s’agit de l’écart-type d’échantillon ($SD$) ou de l’erreur standard de la moyenne ($SEM$) induit une confusion grave. L’écart-type décrit la variabilité intrinsèque des sujets au sein de l’échantillon, tandis que l’erreur standard quantifie la précision d’estimation de la moyenne sous-jacente. L’APA recommande de stipuler explicitement M = 45.20, SD = 3.10.
- L’extrapolation causale abusive en plans quasi-expérimentaux : Utiliser des verbes traduisant une causalité mécanique stricte (« le traitement a causé la diminution de l’anxiété ») n’est scientifiquement toléré que si l’étude repose sur une assignation véritablement aléatoire en double-aveugle et un contrôle strict des facteurs environnementaux. Si les groupes étaient formés de façon quasi-expérimentale sur la base de caractéristiques préexistantes (par exemple, des comparaisons selon des tranches d’âge ou des catégories professionnelles), le chercheur doit strictement modérer son vocabulaire en évoquant des « différences associées » ou des « variations observées », sous peine de commettre un sophisme méthodologique de causalité illusoire.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Snedecor, G. W., & Cochran, W. G. (1989). Statistical methods (8th ed.). Iowa State University Press.
Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913