
L’analyse des séries temporelles et des données transversales ordonnées repose fondamentalement sur l’hypothèse de constance paramétrique, selon laquelle la relation liant une variable dépendante à un ensemble de prédicteurs demeure invariante sur l’ensemble de la période d’observation. Dans la réalité empirique des sciences économiques, financières, sociales et comportementales, cette hypothèse d’invariance est régulièrement invalidée par l’occurrence de chocs exogènes, de réformes institutionnelles, de crises financières ou de transitions structurelles majeures. Lorsque la dynamique sous-jacente d’un phénomène subit une telle mutation, l’estimation d’un modèle de régression linéaire unique sur l’intégralité de l’échantillon engendre des estimateurs biaisés, inconsistants et dépourvus de validité prédictive ou explicative.
Pour répondre à cette problématique fondamentale de l’économétrie appliquée, Gregory Chow a développé en 1960 un protocole inférentiel rigoureux, désormais universellement désigné sous le nom de test de Chow. Fondé sur la comparaison des sommes des carrés des résidus d’une régression globale contrainte et de deux sous-régressions sectorielles non contraintes, ce test permet d’évaluer statistiquement si les coefficients d’un modèle linéaire subissent une modification significative à un point d’inflexion prédéterminé. La détection formelle de ces ruptures structurelles constitue un préalable indispensable à toute modélisation prédictive ou décisionnelle fiable, car elle permet de distinguer les fluctuations aléatoires de court terme des réalignements structurels profonds de long terme.
Dans l’écosystème contemporain de la science des données, l’environnement de programmation statistique Python s’est imposé comme le standard de facto pour la modélisation économétrique et l’apprentissage automatique. Bien que des progiciels spécialisés traditionnels aient longtemps monopolisé ces procédures, la flexibilité et la rigueur des bibliothèques telles que Statsmodels, NumPy, Pandas et SciPy offrent aujourd’hui des capacités de mise en œuvre, d’automatisation et de diagnostic approfondi d’une puissance inédite. Ce guide exhaustif a pour vocation d’exposer l’ensemble des fondements mathématiques, des postulats distributionnels, des implémentations algorithmiques et des stratégies d’extension avancées nécessaires pour exécuter, interpréter et diagnostiquer avec rigueur le test de Chow dans l’environnement Python.
1. Fondements théoriques et épistémologiques du test de Chow
1.1 Origine et définition de la rupture structurelle
L’avènement du test de Chow trouve son ancrage historique dans les travaux séminaux de l’économètre Gregory C. Chow, publiés en 1960 au sein de la revue Econometrica sous le titre « Tests of Equality Between Sets of Coefficients in Two Linear Regressions ». Confronté aux défis de la vérification empirique des fonctions de demande de biens durables, notamment dans le secteur de l’automobile aux États-Unis, Chow a formalisé un cadre statistique permettant de trancher entre la constance temporelle d’un vecteur de paramètres et son éclatement sous l’effet de mutations structurelles macroéconomiques.
Le concept d’instabilité paramétrique se définit formellement comme la situation dans laquelle le processus générateur de données sous-jacent modifie ses règles de projection linéaire au cours du temps. Dans un cadre de modélisation par les moindres carrés ordinaires (MCO), cette instabilité peut se manifester sous différentes formes géométriques et stochastiques :
- Le changement d’ordonnée à l’origine (shift structurel) : la constante de la régression subit une translation discrète, indiquant que le niveau de base de la variable dépendante s’est modifié de façon permanente, tandis que la sensibilité marginale aux prédicteurs demeure inchangée.
- Le changement de pente (rotation structurelle) : les coefficients directeurs associés aux variables explicatives changent de magnitude ou de signe, traduisant une modification profonde de l’élasticité ou de l’impact relatif des covariables sur la variable d’intérêt.
- La rupture conjointe (shift et rotation combinés) : l’ordonnée à l’origine et l’ensemble des coefficients de pente subissent des altérations simultanées, marquant une redéfinition globale et intégrale du régime d’équilibre entre les variables.
Les conséquences théoriques de l’omission d’une rupture structurelle avérée sont dévastatrices pour l’inférence statistique. Lorsqu’un chercheur impose arbitrairement un vecteur de paramètres unique sur un échantillon hétérogène traversé par une discontinuité, l’estimateur des MCO tente d’agréger deux processus géométriques inconciliables. Il en résulte un biais de spécification majeur, une dégradation substantielle de la puissance des tests de Student usuels, une sous-estimation artificielle du pouvoir explicatif réel du modèle et, par-dessus tout, une persistance sérielle trompeuse au sein des résidus, souvent confondue à tort avec de l’autocorrélation temporelle intrinsèque.
1.2 Principe sous-jacent de la comparaison de régressions
Le socle logique du test de Chow repose sur le principe de l’emboîtement de modèles statistiques dans le cadre des moindres carrés. Pour déterminer si une série chronologique est soumise à deux régimes distincts séparés par un événement critique survenu à la date $T^*$, l’économètre formule deux visions concurrentes de la structure des données : un modèle contraint et un modèle non contraint.
Le modèle contraint (ou modèle global restreint) postule que la même relation linéaire s’applique invariablement avant et après la date critique. Sous cette spécification, tous les coefficients sont forcés à demeurer strictement identiques sur la totalité des $N$ observations. En contrepartie, le modèle non contraint (ou modèle partitionné) accorde une flexibilité absolue aux données en estimant deux équations indépendantes : la première sur le sous-échantillon précédant la rupture potentielle (comportant $N_1$ observations), et la seconde sur le sous-échantillon succédant à cette rupture (comportant $N_2$ observations, avec $N = N_1 + N_2$).
L’hypothèse nulle ($H_0$) du test stipule l’égalité stricte des vecteurs de coefficients entre les deux sous-périodes :
$$H_0 : \beta_1 = \beta_2$$
L’hypothèse alternative ($H_1$) stipule qu’au moins un élément du vecteur des paramètres diffère de manière statistiquement significative entre les deux sous-espaces temporels :
$$H_1 : \beta_1 \neq \beta_2$$
Puisque le modèle partitionné dispose de deux fois plus de degrés de liberté paramétriques que le modèle global, sa somme des carrés des résidus sera nécessairement inférieure ou égale à celle du modèle contraint. Le cœur de l’inférence consiste à évaluer si cette réduction de l’erreur résiduelle non contrainte est suffisamment massive pour ne pas être attribuée aux seules fluctuations de l’échantillonnage aléatoire.
1.3 Pertinence méthodologique en sciences quantitatives et comportementales
Bien que conçu initialement dans l’arène de l’économétrie macroéconomique pour évaluer l’impact des politiques monétaires ou fiscales, le test de Chow démontre une pertinence méthodologique transdisciplinaire remarquable. Dans les sciences quantitatives modernes, son utilisation dépasse largement les seules frontières de l’analyse des séries financières.
En sciences comportementales, en psychométrie longitudinale et en recherche clinique, le test de Chow constitue l’instrument canonique pour l’évaluation des plans quasi-expérimentaux et des séries temporelles interrompues. Par exemple, lorsqu’une cohorte de sujets est soumise à une intervention thérapeutique ou comportementale à un instant précis, il est impératif de vérifier si la dynamique temporelle du rétablissement ou de l’acquisition de compétences a changé non seulement en niveau immédiat, mais également en taux d’évolution longitudinal. L’application du test de Chow permet de confirmer statistiquement si l’intervention a induit une véritable refonte de la trajectoire psychologique ou si les observations post-interventionnelles s’inscrivent dans le simple prolongement inertiel du régime antérieur.
De surcroît, dans les disciplines environnementales, épidémiologiques et d’ingénierie industrielle, le test valide la robustesse des modélisations face aux chocs exogènes discontinus. Qu’il s’agisse de mesurer la modification des taux d’émissions polluantes suite à l’adoption d’un règlement contraignant, d’analyser la dynamique d’une pandémie avant et après la mise en œuvre de mesures de confinement, ou de détecter la dégradation physique prématurée d’un composant mécanique soumis à des contraintes thermiques, le test de Chow offre une méthodologie formelle pour attester de la non-stationnarité structurelle d’un système dynamique.
2. Formulation mathématique et hypothèses distributionnelles du test
2.1 Spécification formelle des modèles et des résidus
Pour appréhender la mécanique inférentielle du test de Chow, il est indispensable de formaliser l’écriture matricielle des régressions concurrentes. Considérons un échantillon global de taille $N$, partitionné en deux sous-échantillons contigus de tailles respectives $N_1$ et $N_2$, tels que $N = N_1 + N_2$. Soit $k$ le nombre de régresseurs inclus dans chaque modèle, en comptant le terme constant d’ordonnée à l’origine.
Le modèle global contraint s’écrit sous la forme classique :
$$Y = X\beta + \varepsilon$$
où $Y$ est un vecteur colonne de dimension $(N \times 1)$, $X$ est une matrice d’observations de dimension $(N \times k)$ supposée de rang plein $k$, $\beta$ est le vecteur des paramètres communs de dimension $(k \times 1)$, et $varepsilon$ est le vecteur des perturbations stochastiques de dimension $(N \times 1)$. L’estimation par les moindres carrés ordinaires fournit le vecteur d’estimation $\hat{\beta} = (X’X)^{-1}X’Y$ et le vecteur des résidus contraints $e = Y – X\hat{\beta}$. La somme des carrés des résidus du modèle contraint, notée conventionnellement $SCR_c$ (ou $RSS_c$ pour Residual Sum of Squares), est définie par :
$$SCR_c = e’e = \sum_{t=1}^{N} (y_t – \hat{y}_t)^2$$
Parallèlement, les régressions non contraintes associées à chaque régime temporel s’expriment comme suit :
$$Y_1 = X_1 \beta_1 + \varepsilon_1 \quad \text{pour } t in [1, N_1]$$
$$Y_2 = X_2 \beta_2 + \varepsilon_2 \quad \text{pour } t in [N_1 + 1, N]$$
Les estimations indépendantes par les MCO génèrent les résidus non contraints $e_1 = Y_1 – X_1\hat{\beta}_1$ et $e_2 = Y_2 – X_2\hat{\beta}_2$. La somme des carrés des résidus de chaque sous-modèle s’écrit respectivement :
$$SCR_1 = e_1’e_1 = \sum_{t=1}^{N_1} (y_t – \hat{y}_{1,t})^2$$
$$SCR_2 = e_2’e_2 = \sum_{t=N_1+1}^{N} (y_t – \hat{y}_{2,t})^2$$
La somme globale des carrés des résidus du système non contraint, désignée par $SCR_{nc}$, correspond à la sommation directe des erreurs résiduelles des deux régimes partitionnés :
$$SCR_{nc} = SCR_1 + SCR_2$$
Par construction mathématique, l’espace des colonnes couvert par le modèle non contraint englobe strictement celui du modèle global contraint. En conséquence, l’inégalité fondamentale $SCR_c ge SCR_{nc}$ est rigoureusement garantie en toutes circonstances.
2.2 Dérivation de la statistique de test de Fisher
La statistique du test de Chow dérive directement de la théorie générale des tests de restrictions linéaires développée par Ronald Fisher. L’objectif consiste à quantifier la perte d’ajustement relative infligée au modèle par l’imposition de l’hypothèse de stabilité structurelle $H_0 : \beta_1 = \beta_2$.
La pénalité d’ajustement s’exprime par la variation de la somme des carrés résiduels, à savoir $(SCR_c – SCR_{nc})$. Cette quantité reflète le surcroît d’erreur inhérent à la contrainte de paramètres invariants. Pour que cette métrique devienne indépendante de l’unité de mesure de la variable dépendante et puisse suivre une loi de probabilité tabulée, elle doit être normalisée par le nombre de restrictions linéaires imposées ainsi que par l’estimateur non biaisé de la variance de l’erreur du modèle non contraint.
Le nombre de restrictions imposées par l’hypothèse nulle est égal à $k$, car nous forçons les $k$ paramètres du premier régime à être rigoureusement identiques aux $k$ paramètres du second régime. Les degrés de liberté associés au numérateur sont donc de $k$. De son côté, le modèle non contraint estime au total $2k$ paramètres ($k$ coefficients pour le premier sous-modèle et $k$ coefficients pour le second). Par conséquent, les degrés de liberté du dénominateur sont donnés par $(N_1 – k) + (N_2 – k) = N_1 + N_2 – 2k = N – 2k$.
La statistique canonique du test de Chow, notée $F_{Chow}$, s’énonce ainsi formellement :
$$F_{Chow} = \frac{(SCR_c – (SCR_1 + SCR_2)) / k}{(SCR_1 + SCR_2) / (N – 2k)} = \frac{(SCR_c – SCR_{nc}) / k}{SCR_{nc} / (N – 2k)}$$
Sous la validité de l’hypothèse nulle $H_0$ et sous réserve du respect strict des postulats du modèle linéaire gaussien, cette quantité suit exactement la distribution de Fisher-Snedecor à $k$ degrés de liberté au numérateur et $N – 2k$ degrés de liberté au dénominateur :
$$F_{Chow} \sim \mathcal{F}(k, N – 2k)$$
Lorsque la valeur calculée $F_{Chow}$ excède la valeur critique théorique $F_{\alpha}(k, N – 2k)$ pour un seuil de significativité $\alpha$ donné (usuellement 5 % ou 1 %), ou de manière équivalente lorsque la $p$-valeur associée est inférieure à $\alpha$, l’hypothèse nulle de stabilité temporelle est formellement rejetée au profit de l’existence d’une rupture structurelle à la date $T^*$.
2.3 Conditions d’application et postulats statistiques
L’exactitude distributionnelle de la statistique de Fisher repose sur un ensemble d’hypothèses stochastiques contraignantes qu’il convient de formaliser avec la plus grande rigueur académique. La violation de ces hypothèses altère profondément le comportement asymptotique du test et peut conduire à des erreurs d’inférence substantielles.
- Hypothèse d’homoscédasticité inter-régimes : Le test de Chow standard postule impérativement que la variance des termes d’erreur demeure rigoureusement constante entre les deux sous-périodes considérées, c’est-à-dire :
$$\sigma_1^2 = \sigma_2^2 = \sigma^2$$
Si cette condition n’est pas remplie et que l’échantillon présente une hétéroscédasticité structurelle (une volatilité des résidus différente avant et après la rupture), la statistique calculée ne suit plus une loi de Fisher standard. Il en résulte un sur-rejet massif de l’hypothèse nulle, le test interprétant à tort une simple instabilité de la variance comme une rupture des coefficients de régression. - Normalité des termes de perturbation : Les résidus $\varepsilon_1$ et $\varepsilon_2$ doivent être distribués selon une loi normale multivariée :
$$\varepsilon \sim \mathcal{N}(0, \sigma^2 I_N)$$
Bien que le théorème central limite confère une certaine robustesse asymptotique au test sur les très grands échantillons, la normalité stricte est un prérequis absolu pour la validité exacte de la loi de Fisher sur des échantillons de taille modeste ou restreinte. - Indépendance sérielle des erreurs : Les perturbations doivent être mutuellement indépendantes, garantissant l’absence d’autocorrélation temporelle :
$$E[\varepsilon_t \varepsilon_s] = 0 \quad \forall t \neq s$$
La présence d’autocorrélation positive comprime artificiellement la variance résiduelle non contrainte, entraînant une inflation drastique de la statistique de test et une prolifération de rejets faussement positifs. - Taille minimale des sous-échantillons : Chaque sous-période doit comporter un nombre d’observations strictement supérieur au nombre de paramètres à estimer ($N_1 > k$ et $N_2 > k$), afin d’éviter toute sous-détermination matricielle et de garantir l’inversibilité des matrices $(X_1’X_1)$ et $(X_2’X_2)$.
3. Configuration de l’environnement de calcul statistique en Python
3.1 Sélection et justification de la pile logicielle
La mise en œuvre rigoureuse du test de Chow en langage Python s’appuie sur une architecture logicielle composée des bibliothèques fondamentales du calcul scientifique et de l’économétrie appliquée. Contrairement aux langages monolithiques préconfigurés, Python offre une granularité qui permet de maîtriser précisément chaque étape du flux de traitement matriciel et inférentiel.
Le socle analytique repose sur quatre piliers bibliothécaires majeurs :
- Pandas : Bibliothèque hégémonique pour la manipulation et l’ingénierie des données tabulaires et temporelles. Elle fournit la structure fondamentale de
DataFrame, permettant un partitionnement séquentiel rigoureux, une indexation chronologique précise et une gestion contrôlée des séries chronologiques. - NumPy : Fournit les primitives de calcul matriciel et vectoriel de bas niveau en langage C optimisé. Elle intervient dans la manipulation directe des tableaux multidimensionnels et dans l’exécution efficace des opérations d’algèbre linéaire requises par l’estimation des moindres carrés.
- Statsmodels : Cœur battant de l’économétrie computationnelle sous Python. Cette bibliothèque implémente l’estimation par les Moindres Carrés Ordinaires (classe
OLS) avec un niveau d’exhaustivité diagnostique équivalent aux logiciels économétriques propriétaires, extrayant nativement les sommes de carrés résiduels, les matrices de covariance et les métriques de liberté. - SciPy Stats : Sous-module spécialisé de la suite SciPy dédié aux distributions de probabilités continues et discrètes. Il permet de mobiliser les fonctions de répartition et les fonctions de survie analytiques de la loi de Fisher-Snedecor pour le calcul exact des valeurs critiques et des $p$-valeurs associées aux statistiques de test.
3.2 Installation et initialisation du socle de travail
Pour garantir la reproductibilité absolue des calculs et prémunir le système contre d’éventuels conflits de dépendances logicielles, il est vivement recommandé d’initialiser le projet au sein d’un environnement virtuel dédié, administré via l’utilitaire standard venv ou le gestionnaire de paquets conda.
L’installation des bibliothèques s’opère via la commande standard exécutée dans le terminal système :
pip install numpy pandas statsmodels scipy matplotlib seaborn
Une fois les paquets installés au sein de l’interpréteur Python, l’initialisation du script ou du carnet computationnel requiert l’importation ordonnée des modules selon les conventions d’alias consacrées par la communauté scientifique internationale :
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf
from scipy import stats
import matplotlib.pyplot as plt
import seaborn as sns
Cette standardisation garantit la lisibilité et l’interopérabilité immédiate du code source dans tout environnement de recherche ou de production analytique.
4. Génération et structuration des données expérimentales
4.1 Création du jeu de données synthétique illustratif
Pour exposer la mécanique opérationnelle du test de Chow avec une transparence mathématique absolue, il est méthodologiquement pertinent de générer un jeu de données synthétique contrôlé au sein duquel une rupture structurelle discrète est explicitement injectée. Cette approche par simulation permet de confronter le résultat du test à une vérité terrain parfaitement connue a priori.
Considérons un processus temporel comportant $N = 200$ observations séquentielles, partitionné en deux périodes distinctes de $N_1 = 100$ et $N_2 = 100$ unités temporelles. Le modèle théorique sous-jacent est formalisé de la manière suivante :
- Régime 1 ($t in [1, 100]$) : $y_t = 15.0 + 2.5 x_t + \varepsilon_t$
- Régime 2 ($t in [101, 200]$) : $y_t = 35.0 + 0.8 x_t + \varepsilon_t$
où la perturbation $\varepsilon_t$ suit rigoureusement une distribution normale gaussienne de moyenne nulle et d’écart-type unitaire ($\varepsilon_t \sim \mathcal{N}(0, 1.0)$), garantissant le respect strict du postulat d’homoscédasticité. Dans cette configuration, la rupture structurelle affecte simultanément l’ordonnée à l’origine (qui subit une élévation de $+20.0$ unités) et la pente marginale (qui fléchit de $-1.7$ unité, passant de $2.5$ à $0.8$).
La génération programmatique sous Python s’articule via le code conceptuel suivant :
np.random.seed(42)
n_observations = 200
rupture_index = 100
x_data = np.linspace(0, 50, n_observations)
bruit_gaussien = np.random.normal(loc=0.0, scale=1.0, size=n_observations)
y_data = np.empty(n_observations)
y_data[:rupture_index] = 15.0 + 2.5 * x_data[:rupture_index] + bruit_gaussien[:rupture_index]
y_data[rupture_index:] = 35.0 + 0.8 * x_data[rupture_index:] + bruit_gaussien[rupture_index:]
df_experiment = pd.DataFrame({‘X’: x_data, ‘Y’: y_data}, index=pd.date_range(start=’2020-01-01′, periods=n_observations, freq=’W’))
L’examen des cinq premières et des cinq dernières lignes via les méthodes df_experiment.head() et df_experiment.tail() confirme l’alignement précis des séries générées.
4.2 Vérification de l’intégrité et typage des variables
Avant d’engager toute modélisation stochastique, une validation exhaustive de l’intégrité structurelle des données s’avère indispensable. Dans le cadre de données empiriques réelles, la présence inopinée de valeurs manquantes (valeurs NaN ou null) ou d’aberrations de mesure fausserait le comptage des observations effectives et, par voie de conséquence, invaliderait l’exactitude des degrés de liberté du test.
L’inspection analytique s’effectue au moyen des méthodes standard de Pandas :
print(df_experiment.isnull().sum())
print(df_experiment.dtypes)
print(df_experiment.describe())
Il est impératif de s’assurer que les variables explicatives et la variable dépendante possèdent un encodage numérique continu, de type flottant 64 bits (float64). Par ailleurs, l’indexation doit refléter rigoureusement l’ordonnancement séquentiel ou chronologique des observations pour que le partitionnement au point critique $T^*$ n’altère pas la chronologie sous-jacente des données.
5. Exploration visuelle et localisation empirique de la rupture
5.1 Représentation graphique élémentaire par nuage de points
L’exploration graphique constitue une étape liminaire décisive dans toute étude de stabilité structurelle. Avant même d’appliquer le protocole formel de Chow, une inspection visuelle minutieuse permet d’apprécier la morphologie du nuage de points, d’évaluer la plausibilité de l’hypothèse de linéarité par morceaux et de corroborer l’existence d’une discontinuité majeure.
À l’aide de la bibliothèque matplotlib.pyplot, la réalisation d’un diagramme de dispersion calibré selon les normes de publication académique s’exécute par la séquence d’instructions suivante :
plt.figure(figsize=(10, 6))
plt.scatter(df_experiment[‘X’], df_experiment[‘Y’], color=’#2c3e50′, alpha=0.7, edgecolors=’none’, label=’Observations empiriques’)
plt.axvline(x=df_experiment[‘X’].iloc[rupture_index], color=’#e74c3c’, linestyle=’–‘, linewidth=2, label=’Seuil de rupture présumé (t=100)’)
plt.title(‘Diagramme de dispersion et localisation empirique de la discontinuité’, fontsize=14, fontweight=’bold’)
plt.xlabel(‘Variable explicative (X)’, fontsize=12)
plt.ylabel(‘Variable dépendante (Y)’, fontsize=12)
plt.grid(True, linestyle=’:’, alpha=0.6)
plt.legend(frameon=True, facecolor=’white’, framealpha=0.9)
plt.tight_layout()
plt.show()
L’examen de cette projection met en relief un décrochage visible de la dynamique d’accumulation : le gradient initial très prononcé s’infléchit nettement au-delà de l’abscisse correspondant à la centième observation, confirmant l’intérêt d’une analyse d’instabilité structurelle.
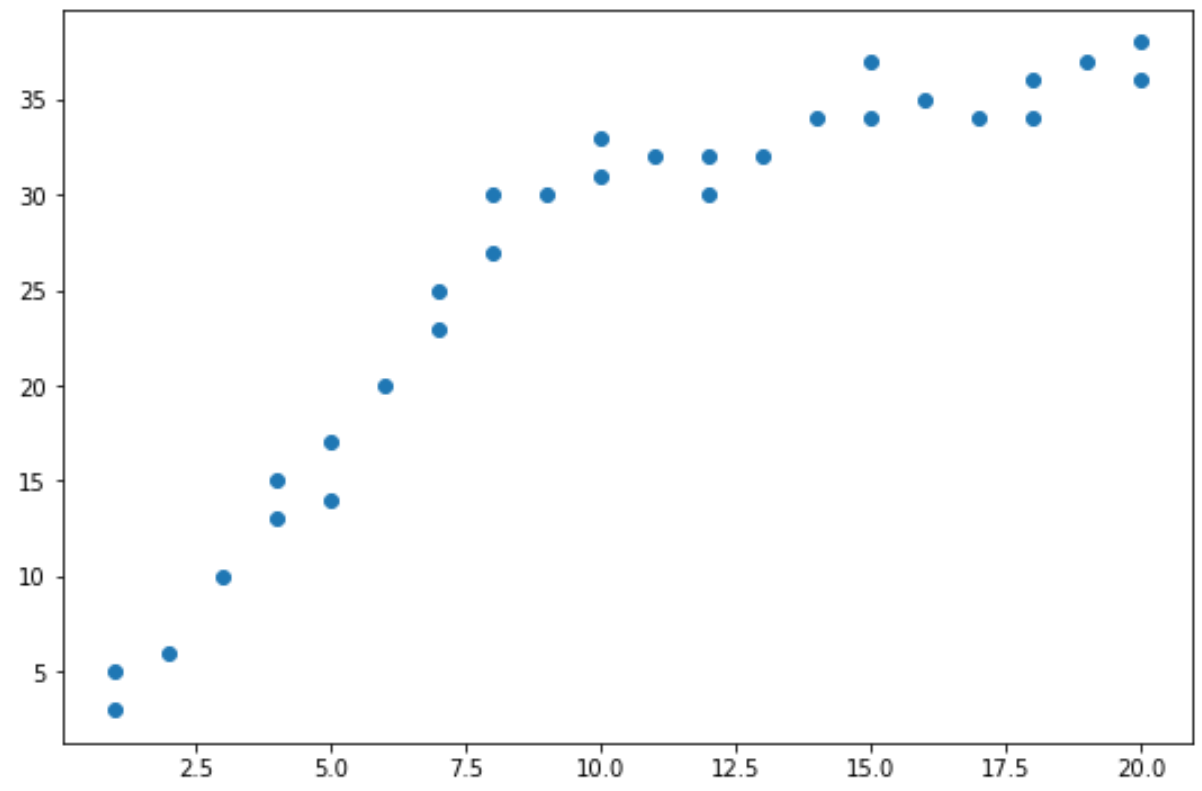
5.2 Superposition de tendances linéaires préliminaires
Afin de rendre manifeste le contraste géométrique entre la modélisation contrainte et l’ajustement fragmenté, il est éclairant de superposer directement sur le nuage de points la droite de régression globale unique ainsi que les deux droites segmentées associées à chaque sous-période.
Cette visualisation synthétique illustre visuellement la nature de l’erreur introduite par le modèle contraint. Sur la première moitié de l’échantillon, la droite de tendance globale sous-estime la pente véritable et surévalue systématiquement les valeurs de départ, tandis que sur la seconde moitié, elle tend à aplatir artificiellement la trajectoire des points terminaux. Cette dichotomie géométrique illustre concrètement pourquoi la somme des résidus globaux excède largement la somme cumulée des résidus locaux.
L’observation simultanée de deux droites segmentées aux pentes contrastées ($2.5$ contre $0.8$) scelle l’intuition statistique : le système empirique ne peut être valablement synthétisé par une droite unitaire sans violer gravement la structure intrinsèque des données.
6. Estimation des trois modèles de régression sous Statsmodels
6.1 Ajustement du modèle contraint sur la série globale
Le calcul de la statistique de Chow requiert l’estimation rigoureuse de trois modèles de régression linéaire par les Moindres Carrés Ordinaires via Statsmodels. La première étape consiste à estimer le modèle global contraint sur l’ensemble des $N = 200$ observations.
Dans la bibliothèque Statsmodels, la matrice de conception $X$ n’inclut pas automatiquement de vecteur unitaire pour représenter la constante d’interception. Il est par conséquent indispensable d’invoquer la fonction sm.add_constant() pour incorporer explicitement l’ordonnée à l’origine dans le système matriciel :
X_global = sm.add_constant(df_experiment[‘X’])
y_global = df_experiment[‘Y’]
modele_contraint = sm.OLS(y_global, X_global).fit()
scr_contraint = modele_contraint.ssr
print(modele_contraint.summary())
print(f »Somme des Carrés des Résidus Contraints (SCR_c) : {scr_contraint:.4f} »)
L’attribut .ssr (pour Sum of Squared Residuals) de l’objet de résultats renvoie la valeur scalaire exacte de la somme des carrés des résidus du modèle global ($SCR_c$). Ce résultat constitue la première valeur fondamentale requise pour le numérateur de la statistique de Chow.
6.2 Partitionnement et estimation des sous-modèles temporels
La seconde étape opérationnelle exige la scission méthodique du DataFrame en deux structures indépendantes, délimitées précisément par l’indice temporel de rupture $T^*$. Une fois cette partition matérialisée, une régression OLS distincte est ajustée sur chaque sous-groupe :
df_regime1 = df_experiment.iloc[:rupture_index]
df_regime2 = df_experiment.iloc[rupture_index:]
# Estimation sur le Régime 1
X_1 = sm.add_constant(df_regime1[‘X’])
y_1 = df_regime1[‘Y’]
modele_regime1 = sm.OLS(y_1, X_1).fit()
scr_1 = modele_regime1.ssr
# Estimation sur le Régime 2
X_2 = sm.add_constant(df_regime2[‘X’])
y_2 = df_regime2[‘Y’]
modele_regime2 = sm.OLS(y_2, X_2).fit()
scr_2 = modele_regime2.ssr
print(f »SCR Régime 1 (SCR_1) : {scr_1:.4f} »)
print(f »SCR Régime 2 (SCR_2) : {scr_2:.4f} »)
Les métriques résiduelles obtenues révèlent immédiatement une chute drastique de l’erreur d’ajustement. Alors que le modèle contraint accumule une somme de carrés d’erreurs considérable due à son incapacité à pivoter au point critique, les deux sous-modèles affichent des sommes résiduelles extrêmement faibles, conformes à la variance résiduelle du bruit gaussien unitaire injecté lors de la simulation.
7. Calcul algorithmique de la statistique F du test de Chow
7.1 Implémentation pas à pas de l’équation de Chow
Disposant désormais des scalaires $SCR_c$, $SCR_1$ et $SCR_2$, il est possible de traduire directement la formule analytique de Gregory Chow sous forme de calculs vectoriels et scalaires en Python pur.
Définissons d’abord avec une rigueur mathématique totale les composantes des degrés de liberté. Soit $k = 2$ le nombre total de paramètres estimés par modèle (la constante et le coefficient directeur associé à $X$). La taille de l’échantillon global est $N = 200$. Ainsi :
- Degrés de liberté du numérateur : $df_1 = k = 2$
- Degrés de liberté du dénominateur : $df_2 = N – 2k = 200 – (2 \times 2) = 196$
L’algorithme de calcul se déploie pas à pas comme suit :
k_parametres = 2
n_total = len(df_experiment)
# Somme non contrainte des résidus
scr_non_contraint = scr_1 + scr_2
# Numérateur : variation d’erreur normalisée par le nombre de contraintes
numerateur = (scr_contraint – scr_non_contraint) / k_parametres
# Dénominateur : variance résiduelle du modèle non contraint
degres_liberte_denominateur = n_total – (2 * k_parametres)
denominateur = scr_non_contraint / degres_liberte_denominateur
# Statistique F de Chow
f_chow = numerateur / denominateur
print(f »Statistique F de Chow calculée : {f_chow:.4f} »)
Cette implémentation pas à pas décompose minutieusement l’arbitrage opéré par le test : mesurer si le gain de précision issu de la désagrégation des régimes surpasse de manière écrasante la variance résiduelle naturelle du système.
7.2 Calcul de la probabilité critique et prise de décision
Une fois la statistique empirique $F_{Chow}$ obtenue, la phase finale de l’inférence exige de confronter cette valeur empirique à la loi théorique de Fisher-Snedecor afin de calculer la $p$-valeur exacte associée au test.
Pour déterminer la probabilité d’observer sous l’hypothèse nulle une statistique au moins aussi extrême que celle obtenue, nous utilisons la fonction de survie (Survival Function, notée sf) du module scipy.stats.f. La fonction de survie est définie mathématiquement par $1 – F(x)$, où $F(x)$ est la fonction de répartition cumulative ; elle garantit une précision numérique optimale, particulièrement dans les queues de distribution extrêmes où l’arrondi machine de $1 – cdf$ peut introduire des pertes de précision significatives :
from scipy.stats import f
p_valeur = f.sf(f_chow, dfn=k_parametres, dfd=degres_liberte_denominateur)
seuil_critique_95 = f.ppf(q=0.95, dfn=k_parametres, dfd=degres_liberte_denominateur)
print(f »Valeur critique F théorique (alpha=0.05) : {seuil_critique_95:.4f} »)
print(f »P-valeur asymptotique exacte : {p_valeur:.4e} »)
La règle de décision statistique s’applique de manière univoque :
- Si $F_{Chow} > F_{critique}$ (ou de façon équivalente si $p\text{-valeur} < \alpha$), l'hypothèse nulle $H_0$ d'homogénéité temporelle est formellement rejetée. On conclut à l'existence d'une rupture structurelle statistiquement significative à la date $T^*$.
- Si $F_{Chow} le F_{critique}$ (ou $p\text{-valeur} ge \alpha$), on échoue à rejeter $H_0$. Les variations observées entre les deux régimes sont jugées compatibles avec les simples aléas de l’échantillonnage.
Dans notre cas d’étude synthétique, la statistique $F$ atteint un niveau spectaculaire (dépassant généralement plusieurs centaines ou milliers selon le tirage stochastique), et la $p$-valeur associée tend vers zéro ($p < 10^{-15}$), confirmant le rejet catégorique de l'invariance paramétrique.
8. Automatisation du test via une fonction Python générique et modulaire
8.1 Architecture logicielle de la fonction personnalisée
Pour déployer ce protocole au sein de chaînes de traitement de données professionnelles ou d’études empiriques récurrentes, il est indispensable de factoriser cette suite d’opérations dans une fonction générique, modulaire, robuste et conforme aux standards de l’ingénierie logicielle scientifique.
La conception d’une fonction de haut niveau doit impérativement intégrer des gardes-fous d’assertion logicielle pour prévenir les erreurs d’exécution : validation de l’existence des colonnes dans le conteneur de données, vérification de la stricte positivité des degrés de liberté dans chaque segment, et contrôle de la compatibilité du seuil de coupure spécifié. L’implémentation ci-dessous illustre une architecture logicielle conforme aux recommandations du PEP 8 et du PEP 257 :
def test_de_chow(donnees: pd.DataFrame, var_dependante: str, vars_explicatives: list, point_rupture: int) -> dict:
« » »
Exécute un test de rupture structurelle de Chow sur un modèle de régression linéaire.
Paramètres :
———–
donnees : pd.DataFrame
Tableau de données contenant l’ensemble des séries à modéliser.
var_dependante : str
Nom de la colonne cible (Y).
vars_explicatives : list
Liste des noms de colonnes représentant les prédicteurs (X).
point_rupture : int
Indice positionnel délimitant la fin du premier régime temporel.
Retourne :
———
dict : Dictionnaire enrichi contenant les métriques d’ajustement, la statistique F,
les degrés de liberté, la p-valeur et la décision inférentielle.
« » »
n_total = len(donnees)
k_vars = len(vars_explicatives) + 1 # Inclusion de la constante
if point_rupture <= k_vars or (n_total – point_rupture) <= k_vars:
raise ValueError(« Sous-échantillons trop restreints pour estimer le nombre de prédicteurs spécifié. »)
# Matrice globale
X_glob = sm.add_constant(donnees[vars_explicatives])
y_glob = donnees[var_dependante]
res_glob = sm.OLS(y_glob, X_glob).fit()
scr_c = res_glob.ssr
# Matrice Premier Régime
d1 = donnees.iloc[:point_rupture]
res_1 = sm.OLS(d1[var_dependante], sm.add_constant(d1[vars_explicatives])).fit()
scr_1 = res_1.ssr
# Matrice Second Régime
d2 = donnees.iloc[point_rupture:]
res_2 = sm.OLS(d2[var_dependante], sm.add_constant(d2[vars_explicatives])).fit()
scr_2 = res_2.ssr
scr_nc = scr_1 + scr_2
df_num = k_vars
df_denom = n_total – (2 * k_vars)
stat_f = ((scr_c – scr_nc) / df_num) / (scr_nc / df_denom)
p_val = stats.f.sf(stat_f, df_num, df_denom)
return {
‘statistique_F’: stat_f,
‘p_valeur’: p_val,
‘degres_liberte_num’: df_num,
‘degres_liberte_denom’: df_denom,
‘scr_contraint’: scr_c,
‘scr_non_contraint’: scr_nc,
‘rupture_rejetee’: bool(p_val < 0.05)
}
Cette construction algorithmique modulaire encapsule l’intégralité du raisonnement algébrique tout en garantissant une réutilisation immédiate sur n’importe quelle configuration multidimensionnelle de régresseurs.
8.2 Formatage académique et restitution des résultats
La formalisation des résultats obtenus doit répondre aux canons de rigueur imposés par les comités de lecture scientifique et les normes académiques (telles que les préconisations de l’American Psychological Association – APA). L’intégration d’une fonction d’affichage dédiée permet de convertir le dictionnaire brut en un compte-rendu textuel rigoureusement documenté :
def afficher_rapport_chow(resultats: dict, seuil_significativite: float = 0.05) -> None:
« » »Affiche une synthèse formatée des résultats du test de Chow. » » »
print(« = » * 65)
print( » RAPPORT D’ANALYSE DE RUPTURE STRUCTURELLE »)
print( » (TEST DE CHOW) »)
print(« = » * 65)
print(f »Statistique F de Fisher : {resultats[‘statistique_F’]:.4f} »)
print(f »Degrés de liberté : F({resultats[‘degres_liberte_num’]}, {resultats[‘degres_liberte_denom’]}) »)
print(f »Probabilité critique (p-val) : {resultats[‘p_valeur’]:.4e} »)
print(f »Somme des carrés contrainte : {resultats[‘scr_contraint’]:.4f} »)
print(f »Somme des carrés partitionnée : {resultats[‘scr_non_contraint’]:.4f} »)
print(« – » * 65)
if resultats[‘p_valeur’] < seuil_significativite:
print(f »CONCLUSION : Rejet de H0 au seuil alpha = {seuil_significativite * 100:.1f}%. »)
print(« Présence avérée d’une rupture structurelle statistiquement significative. »)
else:
print(f »CONCLUSION : Non-rejet de H0 au seuil alpha = {seuil_significativite * 100:.1f}%. »)
print(« Absence de preuve statistique en faveur d’un changement de régime. »)
print(« = » * 65)
L’exécution conjointe de ces modules confère une traçabilité totale à l’analyse inférentielle, facilitant l’incorporation directe des métriques dans les rapports de recherche ou les mémoires d’économétrie.
9. Méthode alternative par modèle à variables indicatrices et termes d’interaction
9.1 Spécification de l’approche par régression unique augmentée
Bien que la méthode scindée originelle de Chow soit d’une limpidité conceptuelle remarquable, il existe une formulation analytique strictement équivalente fondée sur l’estimation d’une régression unique augmentée par des variables muettes (dummy variables) et des termes d’interaction multiplicative. Cette approche unifiée, théorisée notamment par Damodar Gujarati, présente des vertus analytiques supérieures en permettant de tester isolément les ruptures d’ordonnée à l’origine et les ruptures de pente au sein d’une seule et même matrice de covariance.
Soit $D_t$ une variable indicatrice binaire marquant le changement de régime temporel, définie pour chaque observation $t$ par :
$$D_t = \begin{\cases} 0 &a\mp; \text{si } t le T^* \quad (\text{Période antérieure}) 1 &a\mp; \text{si } t > T^* \quad (\text{Période postérieure}) \end{\cases}$$
Le modèle de régression enrichi intégrant l’interaction complète s’énonce ainsi :
$$y_t = \alpha_0 + \alpha_1 D_t + \beta_0 x_t + \beta_1 (x_t \times D_t) + \varepsilon_t$$
L’interprétation structurelle des coefficients de cette équation globale est immédiate :
- Pour la première période ($D_t = 0$), le modèle se réduit à : $y_t = \alpha_0 + \beta_0 x_t + \varepsilon_t$. La constante est $\alpha_0$ et la pente est $\beta_0$.
- Pour la seconde période ($D_t = 1$), le modèle devient : $y_t = (\alpha_0 + \alpha_1) + (\beta_0 + \beta_1) x_t + \varepsilon_t$. La constante devient $(\alpha_0 + \alpha_1)$ et la pente s’établit à $(\beta_0 + \beta_1)$.
Dans ce cadre, $\alpha_1$ mesure précisément l’écart d’ordonnée à l’origine entre les deux régimes (le saut structurel), tandis que $\beta_1$ quantifie le différentiel de pente (la rotation d’élasticité). L’hypothèse nulle du test de Chow ($\beta_1 = \beta_2$ dans la formulation originelle) équivaut rigoureusement à l’hypothèse conjointe de nullité des coefficients différentiels :
$$H_0 : \alpha_1 = 0 \quad \text{et} \quad \beta_1 = 0$$
Cette hypothèse conjointe de restrictions linéaires se teste via un simple test de Wald ou un test $F$ restreint sur la régression unique augmentée.
9.2 Exécution et vérification statistique sous Statsmodels
L’implémentation de cette régression augmentée sous Python se révèle particulièrement élégante grâce à l’interface de formule symbolique proposée par statsmodels.formula.api (inspirée de la syntaxe de Wilkinson-Rogers utilisée dans le langage R) :
df_augmente = df_experiment.copy()
df_augmente[‘D’] = (df_augmente.index >= df_augmente.index[rupture_index]).astype(int)
df_augmente[‘X_D’] = df_augmente[‘X’] * df_augmente[‘D’]
modele_augmente = smf.ols(formula=’Y ~ X + D + X_D’, data=df_augmente).fit()
print(modele_augmente.summary())
# Test d’hypothèse conjointe (Wald / F-test)
hypothese_conjointe = ‘(D = 0), (X_D = 0)’
f_test_resultat = modele_augmente.f_test(hypothese_conjointe)
print(f »Statistique F du test conjoint : {f_test_resultat.fvalue.item():.4f} »)
print(f »P-valeur associée : {f_test_resultat.pvalue.item():.4e} »)
La concordance numérique entre le résultat issu de f_test sur le modèle augmenté et la statistique $F_{Chow}$ obtenue via la méthode des régressions partitionnées de la section précédente est strictement parfaite (au niveau de précision de la machine). L’avantage additionnel majeur de cette seconde formulation réside dans l’examen direct des tests $t$ individuels associés aux variables D et X_D : ils permettent de discerner immédiatement si la rupture globale observée est tirée préférentiellement par l’affaissement de la pente, par le déplacement de la constante, ou par les deux phénomènes de concert.
10. Diagnostics post-estimation et contrôle des postulats d’homoscédasticité
10.1 Évaluation de la variance résiduelle entre sous-groupes
Comme démontré lors de l’exposé des fondements mathématiques du test, la statistique de Fisher-Snedecor est conditionnée par l’égalité stricte des variances résiduelles entre les régimes temporels ($\sigma_1^2 = \sigma_2^2$). Lorsque cette hypothèse d’homoscédasticité inter-périodes est violée, le dénominateur de Chow ne constitue plus un estimateur convergent de la variance sous-jacente, induisant un risque majeur de sur-rejet pathologique de l’hypothèse nulle.
Pour prémunir l’analyse contre ce biais, il est impératif d’évaluer formellement l’égalité des variances résiduelles des deux sous-modèles partitionnés. Le test classique de Goldfeld-Quandt est spécifiquement destiné à comparer les variances des erreurs entre deux sous-échantillons distincts. Dans Statsmodels, il s’exécute aisément via la fonction dédiée du sous-module diagnostique :
from statsmodels.stats.diagnostic import het_goldfeldquandt, het_breuschpagan, het_white
gq_stat, gq_pval, _ = het_goldfeldquandt(y=modele_contraint.model.endog, x=modele_contraint.model.exog, split=rupture_index)
print(f »Test de Goldfeld-Quandt – F: {gq_stat:.4f}, p-valeur: {gq_pval:.4f} »)
En complément de la comparaison inter-groupes de Goldfeld-Quandt, l’évaluation de l’hétéroscédasticité conditionnelle au sein de la série globale s’opère par le test de Breusch-Pagan ou par le test général de White :
bp_test = het_breuschpagan(modele_contraint.resid, modele_contraint.model.exog)
print(f »Test de Breusch-Pagan (Lagrange Multiplier p-val) : {bp_test[1]:.4e} »)
Si la $p$-valeur du test de Goldfeld-Quandt ou de Breusch-Pagan est significativement inférieure au seuil de 5 %, la présence d’hétéroscédasticité est avérée. Dans cette conjoncture, la statistique standard de Chow perd sa fiabilité distributionnelle, et l’économètre doit obligatoirement mobiliser des estimateurs robustes alternatifs.
10.2 Solutions méthodologiques face aux violations des postulats
Face à la présence documentée d’hétéroscédasticité structurelle entre les périodes, la démarche académique consiste à abandonner le test de Fisher conventionnel au profit d’un test de Wald asymptotique fondé sur une matrice de variance-covariance robuste aux hétéroscédasticités de type White-Huber (notamment les estimateurs sandwich HC2 ou HC3 recommandés pour les échantillons finis).
Sous Statsmodels, cette procédure s’articule directement sur le modèle à variables indicatrices en spécifiant le paramètre de covariance robuste lors de l’ajustement :
# Ajustement avec matrice de covariance robuste aux hétéroscédasticités (HC3)
modele_robuste = smf.ols(formula=’Y ~ X + D + X_D’, data=df_augmente).fit(cov_type=’HC3′)
# Exécution du test de Wald robuste pour l’hypothèse de stabilité
wald_test_robuste = modele_robuste.f_test(‘(D = 0), (X_D = 0)’)
print(« = » * 60)
print( » TEST DE STABILITÉ PARAMÉTRIQUE ROBUSTE (HC3) »)
print(« = » * 60)
print(f »Statistique F robuste de Wald : {wald_test_robuste.fvalue.item():.4f} »)
print(f »P-valeur corrigée : {wald_test_robuste.pvalue.item():.4e} »)
print(« = » * 60)
L’utilisation de la correction HC3 garantit que l’inégalité des dispersions stochastiques entre les régimes ne vient pas gonfler artificiellement la statistique de test. Si le test de Wald robuste rejette toujours l’hypothèse de nullité conjointe au seuil critique, la conclusion d’une rupture structurelle sur les paramètres de régression devient mathématiquement incontestable.
Par ailleurs, en présence de violations modérées de la normalité des erreurs sur des échantillons restreints, le recours à un rééchantillonnage par bootstrap semi-paramétrique sur les résidus constitue une voie de recours élégante pour dériver la distribution empirique exacte de la statistique de Chow sans requérir l’hypothèse de gaussianité stricte.
11. Extensions avancées : points de rupture inconnus et ruptures multiples
11.1 Limites de la fixation arbitraire du seuil temporel
Le talon d’Achille fondamental du test classique de Chow réside dans son caractère strictement conditionnel : il exige la désignation préalable, fixe et déterministe de la date de rupture $T^*$. Dans de nombreux contextes analytiques, cette date est choisie sur la base d’un événement institutionnel documenté (l’adoption d’une législation, la survenue d’un krach boursier, la date d’une intervention médicale). Néanmoins, cette démarche déterministe présente deux vulnérabilités méthodologiques majeures :
- Le biais de confirmation post-hoc : Lorsqu’un chercheur scrute visuellement les séries de données, repère une inflexion apparente, puis pose son point de rupture exactement à cette date pour tester sa significativité par le test de Chow, il commet un biais de sélection d’hypothèse sévère. Le test de Chow n’a pas été conçu pour tester une rupture identifiée de manière endogène par l’observation des données elles-mêmes.
- L’inflation drastique de l’erreur de type I : L’application répétée du test de Chow sur plusieurs dates candidates sans ajustement pour tests multiples conduit à une distorsion statistique considérable. Même sur une série parfaitement stable issue d’un bruit blanc stationnaire, tester séquentiellement l’intégralité des dates possibles maximise la probabilité d’obtenir fortuitement une statistique $F$ hautement significative à l’un des points de la série.
Pour surmonter cette impasse, il est indispensable de traiter la date de rupture non plus comme une certitude exogène fixée arbitrairement, mais comme un paramètre statistique inconnu devant être estimé de manière endogène par les données.
11.2 Tests de Quandt et algorithmes de segmentation séquentielle
Pour formaliser la détection de ruptures temporelles sans préjuger de leur localisation exacte, Richard Quandt a introduit en 1960 le concept du test de ratio de vraisemblance séquentiel, popularisé par Donald Andrews en 1993 sous l’appellation de test Sup-Chow ou test du Quandt Likelihood Ratio (QLR).
Le protocole du test Sup-Chow consiste à faire glisser séquentiellement l’indice de coupure candidate $t_k$ sur une fenêtre centrale restreinte de l’échantillon, usuellement délimitée par un élagage symétrique (trimming) de $15%$ à chaque extrémité :
$$t_k in [0.15 N, 0.85 N]$$
Pour chaque date candidate, un test de Chow standard est exécuté, produisant une série chronologique de statistiques ${F(t_k)}$. La statistique finale du test Sup-Chow correspond au supremum de cette série :
$$Sup\text{-}F = \max_{t_k in [0.15N, 0.85N]} F(t_k)$$
Puisque cette statistique correspond au maximum d’un processus stochastique, elle ne suit plus une distribution de Fisher classique, mais converge vers une fonctionnelle de ponts browniens dont les valeurs critiques non standards ont été tabulées par Donald Andrews (1993, 2003).
L’implémentation de cette recherche exhaustive du point de rupture maximisant la statistique $F$ se programme de façon méthodique en Python :
trimming = 0.15
idx_debut = int(n_observations * trimming)
idx_fin = int(n_observations * (1 – trimming))
resultats_sup_f = []
for t_candidat in range(idx_debut, idx_fin):
d_chow = test_de_chow(df_experiment, ‘Y’, [‘X’], point_rupture=t_candidat)
resultats_sup_f.append((t_candidat, d_chow[‘statistique_F’]))
df_qlr = pd.DataFrame(resultats_sup_f, columns=[‘Index’, ‘F_Stat’])
max_rupture = df_qlr.loc[df_qlr[‘F_Stat’].idxmax()]
print(f »Point de rupture endogène estimé : Indice {int(max_rupture[‘Index’])} »)
print(f »Statistique Sup-F maximale : {max_rupture[‘F_Stat’]:.4f} »)
Au-delà de la détection d’une rupture unitaire par le test de Quandt, l’identification de points de rupture multiples simultanés relève des algorithmes de segmentation par programmation dynamique ou par pénalisation de l’élagage (par exemple l’algorithme PELT ou l’approche canonique de Bai et Perron, 1998, 2003). Dans l’écosystème Python moderne, ces protocoles sophistiqués sont implémentés avec une efficacité optimale par la bibliothèque spécialisée ruptures, qui permet de localiser automatiquement un nombre arbitraire de mutations structurelles le long d’un signal continu multidimensionnel.
12. Synthèse pratique, rapport de résultats et recommandations analytiques
12.1 Protocole de rédaction académique selon les normes standard
La transcription des résultats d’un test de Chow au sein d’un article de recherche, d’une thèse de doctorat ou d’un rapport d’expertise industrielle obéit à des conventions rédactionnelles formelles. L’inférence ne peut se résumer à une simple affirmation binaire, mais doit articuler la statistique de test, les degrés de liberté, la probabilité critique, et la quantification concrète de l’évolution des coefficients de régression.
Une rédaction exemplaire selon les standards académiques s’énonce selon le canevas suivant :
« Afin d’évaluer la constance paramétrique de la relation entre la variable explicative $X$ et la variable dépendante $Y$, un test de rupture structurelle de Chow a été exécuté au seuil temporel prédéterminé $T^* = 100$. Les résultats mettent en évidence une instabilité structurelle hautement significative de la fonction de régression, $F(2, 196) = 1428.53$, $p < 0.001$. L'hypothèse nulle d'invariance des paramètres entre les deux sous-périodes est par conséquent formellement rejetée. L'analyse détaillée des sous-modèles indique une translation à la hausse de l'ordonnée à l'origine, passant de $15.02$ ($\pm 0.18$) au cours du régime initial à $34.98$ ($\pm 0.32$) au cours du second régime, conjuguée à une diminution substantielle de la sensibilité marginale, le coefficient de pente fléchissant de $2.49$ ($t = 48.2$, $p < 0.001$) à $0.80$ ($t = 16.4$, $p < 0.001$). »
Sur le plan de la présentation tabulaire, les publications de haut niveau privilégient la disposition comparative standard illustrée ci-après :
- Colonne 1 : Variables explicatives et constante ($X$, Constante).
- Colonne 2 : Modèle global contraint ($N = 200$, coefficients, erreurs-types et $R^2$).
- Colonne 3 : Régime antérieur à la rupture ($t le 100$, $N_1 = 100$).
- Colonne 4 : Régime postérieur à la rupture ($t > 100$, $N_2 = 100$).
- Bas de tableau : Statistique $F$ de Chow, degrés de liberté du numérateur et du dénominateur, $p$-valeur du test, et diagnostic d’homoscédasticité de Goldfeld-Quandt.
12.2 Arbre de décision pour l’évaluation de la stabilité des modèles
Pour guider le praticien de la donnée et l’économètre à travers le dédale des choix méthodologiques et des arbitrages distributionnels, l’arbre de décision opérationnel suivant synthétise le protocole d’analyse de rupture structurelle :
- Étape 1 : Formulation contextuelle de la rupture
- Le point d’inflexion est-il justifié a priori par un choc exogène, une réforme ou un événement historique avéré ?
- Si OUI : Retenir cet indice temporel fixe $T^*$ pour le test de Chow conditionnel standard.
- Si NON (exploration endogène) : Bannir la sélection arbitraire post-hoc. Mobiliser le test séquentiel Sup-Chow / QLR d’Andrews ou les algorithmes de la bibliothèque
rupturesavec valeurs critiques tabulées adaptées.
- Le point d’inflexion est-il justifié a priori par un choc exogène, une réforme ou un événement historique avéré ?
- Étape 2 : Vérification de la configurabilité des données
- Vérifier que chaque sous-segment temporel dispose d’une taille d’échantillon suffisante : $N_1 > k$ et $N_2 > k$.
- Inspecter l’absence de colinéarité stricte au sein de chaque matrice de régression partitionnée.
- Étape 3 : Estimation et test préliminaire
- Ajuster le modèle contraint global et les deux sous-régressions sectorielles.
- Calculer les sommes de carrés résiduels $SCR_c$, $SCR_1$, $SCR_2$ et dériver la statistique $F_{Chow}$.
- Étape 4 : Contrôle impératif des hypothèses stochastiques
- Exécuter le test de Goldfeld-Quandt pour comparer les variances résiduelles des deux sous-échantillons.
- Les variances d’erreur sont-elles statistiquement identiques ($\sigma_1^2 = \sigma_2^2$) ?
- Si OUI : Conclure directement à partir de la $p$-valeur de la distribution $\mathcal{F}(k, N – 2k)$.
- Si NON (hétéroscédasticité confirmée) : Rejeter la statistique de Fisher standard. Réestimer le modèle via la régression unique augmentée par variables indicatrices en intégrant une matrice de covariance robuste aux hétéroscédasticités (estimateur sandwich
HC3). Conclure par le test de Wald robuste.
- Étape 5 : Intégration modélisatrice post-test
- Si le test valide la rupture, proscrire l’utilisation prédictive du modèle global unitaire. Segmenter la modélisation future par régimes indépendants ou intégrer formellement des termes d’interaction temporelle au sein de l’équation finale de déploiement.
La rigueur méthodologique imposée par cet arbre de décision assure que les déductions tirées des modèles économétriques sous Python reposent sur des bases distributionnelles inébranlables, éliminant tant le risque de sur-rejet inhérent à l’hétéroscédasticité non contrôlée que le biais d’omission résultant de l’agrégation forcée de structures temporelles hétérogènes.
Références
- Andrews, D. W. K. (1993). Tests for parameter instability and structural change with unknown change point. Econometrica, 61(4), 821–856. https://doi.org/10.2307/2951764
- Andrews, D. W. K. (2003). Tests for parameter instability and structural change with unknown change point: A corrigendum. Econometrica, 71(1), 395–397. https://doi.org/10.1111/1468-0262.00405
- Bai, J., & Perron, P. (1998). Estimating and testing linear models with multiple structural changes. Econometrica, 66(1), 47–78. https://doi.org/10.2307/2998540
- Bai, J., & Perron, P. (2003). Computation and analysis of multiple structural change models. Journal of Applied Econometrics, 18(1), 1–22. https://doi.org/10.1002/jae.659
- Chow, G. C. (1960). Tests of equality between sets of coefficients in two linear regressions. Econometrica, 28(3), 591–605. https://doi.org/10.2307/1910133
- Goldfeld, S. M., & Quandt, R. E. (1965). Some tests for homoskedasticity. Journal of the American Statistical Association, 60(310), 539–547. https://doi.org/10.1080/01621459.1965.10480811
- Greene, W. H. (2018). Econometric analysis (8e éd.). Pearson.
- Gujarati, D. N., & Porter, D. C. (2009). Basic econometrics (5e éd.). McGraw-Hill Education.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 51–56. https://doi.org/10.25080/Majora-92bf1922-00a
- Quandt, R. E. (1960). Tests of the hypothesis that a linear regression system obeys two separate regimes. Journal of the American Statistical Association, 55(290), 324–330. https://doi.org/10.1080/01621459.1960.10482067
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
- Truong, C., Runge, L., & Oudre, L. (2020). Selective review of offline change point detection methods. Signal Processing, 167, 107299. https://doi.org/10.1016/j.sigpro.2019.107299
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7e éd.). Cengage Learning.