
L’évaluation quantitative des protocoles expérimentaux au sein des sciences contemporaines, et tout particulièrement en psychologie cognitive, en neuropsychologie clinique et en biomédecine, repose sur une modélisation rigoureuse des variations observées au sein des cohortes étudiées. Lorsqu’un chercheur manipule une variable indépendante comprenant plus de deux modalités distinctes — qu’il s’agisse de comparer l’efficacité de plusieurs psychothérapies, de mesurer les répercussions cognitives de différents dosages pharmacologiques ou d’évaluer le déclin mnésique à travers plusieurs tranches d’âge —, l’analyse de variance à un facteur (communément désignée sous l’acronyme d’ANOVA unidirectionnelle) constitue le point d’ancrage traditionnel de l’inférence statistique. Toutefois, le test omnibus de l’ANOVA ne fournit qu’une vision globale et indifférenciée de la structure des données : il atteste de l’existence d’une hétérogénéité significative entre les moyennes du système expérimental, sans pour autant expliciter quelles paires de groupes divergent réellement.
Cette indétermination intrinsèque du test F de Fisher impose le recours à des analyses dites post-hoc, dont la finalité méthodologique consiste à sonder rétrospectivement la matrice des contrastes empiriques. Au cœur de cet arsenal inférentiel, le test de Tukey — formellement désigné sous l’appellation de test de la différence honnêtement significative ou Honestly Significant Difference (HSD) — s’est imposé comme l’étalon-or des comparaisons multiples par paires. Conçu spécifiquement pour juguler le phénomène délétère de l’inflation de l’erreur de type I tout en préservant une puissance statistique optimale, ce test mobilise la distribution de l’étendue studentisée pour garantir un contrôle strict du taux d’erreur par famille d’hypothèses.
Le logiciel statistique open-source R s’avère être un environnement d’une puissance et d’une souplesse exceptionnelles pour mener à bien ces démarches de modélisation linéaire et de comparaisons multiples. Grâce à des fonctions natives robustes ainsi qu’à un écosystème florissant de packages spécialisés dans la modélisation marginale et la visualisation de données, R permet aux chercheurs et aux analystes d’exécuter des tests post-hoc avec une précision algorithmique remarquable. Cet article propose une exploration exhaustive, théorique et opérationnelle, de la mise en œuvre du test de Tukey dans R, depuis la vérification scrupuleuse des postulats gaussiens jusqu’à la rédaction académique des conclusions selon les exigences formelles des normes de l’American Psychological Association (APA).
1. Introduction aux analyses post-hoc et aux fondements théoriques du test de Tukey (HSD)
1.1 Origine et définition de la différence honnêtement significative (HSD)
L’histoire de la statistique inférentielle moderne a été profondément marquée par les travaux pionniers du statisticien américain John Wilder Tukey. En 1949, confronté à l’absence de méthodologie standardisée et équilibrée pour discriminer les moyennes expérimentales à la suite d’une analyse de variance globale, Tukey introduisit la procédure formelle de la différence honnêtement significative (HSD). L’objectif fondamental de Tukey était de concevoir un cadre mathématique capable d’évaluer l’ensemble exhaustif des comparaisons par paires possibles au sein d’un plan factoriel, sans encourir le risque inhérent aux tests t de Student itératifs non corrigés, tout en évitant la sévérité excessive de l’inégalité de Bonferroni. Cette innovation méthodologique a permis de combler un vide analytique majeur dans les sciences expérimentales du milieu du vingtième siècle.
Sur le plan mathématique, le test de Tukey repose sur les propriétés fondamentales de la distribution de l’étendue studentisée, communément notée par la statistique q. Contrairement à la statistique t conventionnelle, qui quantifie l’écart normalisé entre deux moyennes isolées, la variable aléatoire q correspond au rapport entre l’étendue maximale d’un ensemble d’échantillons indépendants issus d’une même population gaussienne et l’estimation combinée de l’écart-type résiduel. En considérant un ensemble de moyennes ordonnées, la statistique q est calculée en divisant la différence absolue entre la moyenne la plus élevée et la moyenne la plus faible par l’erreur standard de la moyenne. L’intégrale de probabilité sous-jacente à la loi de q permet d’établir des seuils critiques rigoureux en fonction du nombre total de groupes en compétition et des degrés de liberté de la variance résiduelle du modèle linéaire.
Il convient de distinguer d’emblée, sur le plan épistémologique et méthodologique, les contrastes dits a priori des tests post-hoc a posteriori. Les contrastes a priori procèdent directement d’hypothèses théoriques déductives, formalisées par le chercheur avant toute collecte empirique des données ; ils ciblent des comparaisons spécifiques, souvent orthogonales, et ne requièrent pas l’exploration exhaustive de la matrice relationnelle. À l’inverse, le test HSD de Tukey relève de la logique a posteriori : il est mobilisé en l’absence d’hypothèses directionnelles exclusives portant sur des sous-ensembles réduits, autorisant une exploration non biaisée de toutes les divergences intergroupes observables. Cette méthode garantit que la valeur critique retenue pour déclarer deux conditions statistiquement distinctes prend en considération le volume global des permutations calculées au sein du dispositif expérimental.
1.2 La problématique de l’inflation de l’erreur de type I en psychologie expérimentale
Dans le domaine des sciences du comportement, de la psychiatrie biologique et des neurosciences, la rigueur inférentielle se heurte continuellement au problème de la multiplicité des tests statistiques. Lorsqu’un expérimentateur choisit de comparer plusieurs conditions empiriques en répétant des tests d’hypothèse sans correction d’aucune sorte, il s’expose au phénomène d’inflation de l’erreur de première espèce, communément désignée sous le terme d’erreur de type I. Cette erreur correspond au rejet erroné d’une hypothèse nulle pourtant véridique dans la population générale, conduisant à affirmer l’existence d’un effet thérapeutique ou d’une dissociation cognitive qui ne relève en réalité que de fluctuations d’échantillonnage aléatoires.
Le mécanisme probabiliste sous-jacent à cette accumulation d’erreurs s’explique par la loi de probabilité conjointe des événements indépendants. Si l’on fixe le seuil de signification alpha à la valeur conventionnelle de 0,05 pour chaque test individuel, la probabilité de ne commettre aucune erreur de type I au cours d’une comparaison unique s’élève à 1 – alpha, soit 0,95. Dès lors qu’un protocole expérimental implique k groupes indépendants, le nombre total de comparaisons par paires possibles est donné par la formule combinatoire k(k – 1) / 2. Si l’on applique des tests indépendants à chacune de ces paires, la probabilité globale de commettre au moins une erreur de type I sur l’ensemble de la famille de tests — définie comme le family-wise error rate (FWER) — augmente de manière exponentielle selon l’expression 1 – (1 – alpha)^c, où c représente le nombre de comparaisons. Ainsi, pour une expérimentation comportant seulement quatre groupes d’individus, six comparaisons par paires sont envisageables, ce qui propulse le risque réel de fausse découverte à environ 26,5 %. Pour un protocole à six groupes, soit quinze comparaisons potentielles, le FWER franchit le cap alarmant des 53,6 %.
Dans la littérature en psychologie expérimentale, l’omission d’un contrôle adéquat de ce taux d’erreur a historiquement contribué à la crise de la reproductibilité, en favorisant la publication d’effets artéfactuels issus de démarches d’exploration opportuniste des données. L’intérêt capital de la méthode HSD de Tukey réside précisément dans sa capacité à fixer le FWER exactement au seuil nominal choisi par le chercheur (habituellement 5 %), indépendamment du nombre de paires analysées, dès lors que les données respectent les hypothèses de normalité et d’homogénéité des variances. Comparée à l’application naïve de tests t non corrigés, la méthode de Tukey offre un rempart méthodologique irremplaçable tout en évitant les pénalisations excessives sur la puissance statistique induites par des approches plus rudimentaires.
1.3 Champ d’application clinique et expérimental
Les protocoles cliniques et expérimentaux modernes constituent le terrain d’élection par excellence pour l’application du test de Tukey. Dans la recherche en psychothérapie empiriquement fondée, les investigateurs comparent fréquemment l’efficacité respective de plusieurs modalités d’intervention actives en les confrontant à des conditions de contrôle standardisées. Considérons un essai contrôlé randomisé conçu pour atténuer la symptomatologie dépressive chez des patients adultes : un tel dispositif peut comporter une thérapie cognitivo-comportementale (TCC), une psychothérapie interpersonnelle, une approche basée sur la pleine conscience, un traitement médical conventionnel et un groupe placé sur liste d’attente. L’analyse post-hoc de Tukey permet d’établir une hiérarchie précise entre ces différentes stratégies d’intervention en isolant les paires qui manifestent des contrastes cliniques réels, évitant ainsi d’inférer à tort la supériorité d’une modalité sur une autre en raison du seul bruit d’échantillonnage.
Dans les domaines connexes de la psychopharmacologie et de la neuropsychiatrie, la détermination de la courbe dose-réponse d’une nouvelle molécule psychotrope exige une discrétisation fine de multiples niveaux d’administration (par exemple : placebo, 5 mg, 10 mg, 25 mg et 50 mg). Les mesures d’anxiété ou de connectivité neuronale fonctionnelle recueillies auprès de ces sous-populations doivent faire l’objet de comparaisons systématiques afin de déterminer le seuil d’efficacité minimale ainsi que le plateau au-delà duquel aucune amélioration clinique mesurable n’est constatée. L’application du test de Tukey offre ici l’assurance de déceler les paliers posologiques pertinents tout en prévenant les décisions erronées relatives à la tolérance ou à l’efficacité du produit.
Enfin, la psychologie du développement et la psychologie cognitive du vieillissement exploitent largement ce cadre méthodologique pour cartographier l’évolution des fonctions exécutives ou de la mémoire de travail à travers diverses tranches d’âge indépendantes. L’analyse de cohortes réparties en jeunes adultes, adultes d’âge moyen, personnes âgées jeunes et personnes âgées très avancées requiert une analyse post-hoc approfondie pour circonscrire les phases exactes de bascule ou de déclin significatif au cours de la trajectoire de vie, affirmant ainsi le statut fondamental du test HSD comme outil d’élucidation théorique en sciences humaines et biomédicales.
2. Le contexte méthodologique : De l’ANOVA unidirectionnelle aux comparaisons multiples
2.1 Rôle et limites du test F global de Fisher
La mise en œuvre raisonnée du test de Tukey ne peut s’affranchir d’une compréhension limpide de la logique sous-jacente au test F de Fisher dans le cadre de l’analyse de variance à un facteur. L’ANOVA repose sur la formalisation d’une hypothèse nulle globale (H0) postulant l’égalité parfaite des paramètres de moyenne au sein des différentes sous-populations étudiées, soit mathématiquement : mu_1 = mu_2 = … = mu_k. L’hypothèse alternative (H1) affirme quant à elle la négation de cette proposition, ce qui implique qu’au moins l’une des moyennes diffère de manière non triviale d’au moins une autre, sans formuler la moindre précision quant à la configuration interne de ces disparités.
L’estimation statistique opérée par Fisher repose sur une décomposition élégante de la variance totale observée dans le jeu de données empiriques. Cette variance totale est scindée en deux composantes fondamentales : la variance intergroupe (ou variance expliquée par le modèle factoriel) et la variance intragroupe (communément appelée variance résiduelle ou erreur aléatoire). Le ratio de ces deux estimateurs, normalisés par leurs degrés de liberté respectifs, fournit la statistique de test F. Lorsque la dispersion observée entre les centres de gravité des différents groupes expérimentaux excède substantiellement les variations aléatoires observées au sein de chaque modalité, la valeur calculée de F croît et franchit le seuil critique défini par la distribution de Snedecor, conduisant au rejet formel de l’hypothèse nulle globale.
Néanmoins, la limite méthodologique majeure du test F réside dans son caractère strictement omnibus et non directionnel. Un résultat statistiquement significatif au niveau de l’ANOVA indique avec certitude que le jeu de données ne présente pas une configuration homogène, mais demeure totalement muet sur les déterminants locaux de cette hétérogénéité. La signification globale peut résulter de la déviation d’une unique condition isolée par rapport à toutes les autres, d’une divergence polarisée entre deux sous-groupes opposés, ou encore d’une gradation continue et diffuse le long d’un continuum expérimental. Par conséquent, pour localiser avec précision les ruptures significatives et convertir un résultat global en savoir scientifique exploitable, le recours aux analyses post-hoc devient une nécessité absolue.
2.2 La transition rigoureuse entre ANOVA significative et analyse post-hoc
Sur le plan de la déontologie méthodologique, l’engagement d’une série de comparaisons post-hoc au moyen du test de Tukey requiert impérativement la satisfaction d’une condition préalable : l’obtention d’un seuil p inférieur au risque alpha conventionnel (généralement 0,05) lors de l’estimation de l’ANOVA omnibus. L’examen direct des comparaisons par paires en faisant l’économie de cette étape de validation globale constitue une dérive expérimentale préjudiciable, souvent assimilée aux pratiques de fouille de données opportuniste ou de data fishing (voire de p-hacking). Cette démarche illégitime tend à altérer l’intégrité du protocole en guidant les conclusions analytiques à partir de fluctuations secondaires non représentatives de l’architecture générale des variables.
Cependant, une nuance théorique fondamentale développée par John Tukey mérite d’être soulignée : sur le plan purement mathématique, la distribution de l’étendue studentisée possède ses propres mécanismes intrinsèques de contrôle du taux d’erreur par famille d’hypothèses, ce qui a conduit certains théoriciens à affirmer que le test de Tukey conserve sa validité même en cas de non-signification du test F global. Malgré cette particularité mathématique, la coutume scientifique établie en psychologie cognitive et en biomédecine impose rigoureusement la séquence séquentielle descendante : la significativité omnibus demeure le filtre protecteur préliminaire autorisant l’investigateur à déployer l’appareil de Tukey.
Par ailleurs, l’évaluation de la pertinence de la transition vers les comparaisons multiples nécessite la prise en compte de la taille d’effet omnibus du modèle linéaire. Le calcul de l’êta-carré partiel (ou de l’oméga-carré, réputé pour limiter les biais d’estimation sur les petits échantillons) permet de quantifier la proportion de variance de la variable dépendante directement imputable à l’intervention expérimentale. Un test F statistiquement significatif associé à une taille d’effet microscopique sur un effectif massif met en garde le chercheur contre les artefacts de surpuissance : les contrastes par paires qui résulteront de l’analyse de Tukey risquent d’exhiber des p-valeurs formellement significatives pour des différences réelles dénuées de toute pertinence pratique ou clinique.
3. Les postulats statistiques préalables à l’application du test de Tukey
3.1 Normalité de la distribution des résidus
Le test de Tukey, en tant que dérivé direct du modèle linéaire général, repose sur l’hypothèse primordiale selon laquelle les résidus expérimentaux — c’est-à-dire l’écart individuel entre chaque observation empirique et la moyenne de son groupe de rattachement — proviennent d’une population parente distribuée selon une courbe de Gauss. Il est capital de rappeler une confusion méthodologique récurrente : la condition de normalité ne cible pas la distribution globale de la variable dépendante agrégée sur l’ensemble de l’échantillon, mais bien la distribution des résidus du modèle, ce qui équivaut rigoureusement à l’exigence de distributions normales intra-groupes pour chaque niveau du facteur étudié.
L’évaluation diagnostique de ce postulat privilégie traditionnellement une approche graphique combinée à des démarches d’inférence statistique formelle. Sur le plan visuel, l’examen des diagrammes quantile-quantile (Q-Q plots) appliqués aux résidus standardisés s’avère particulièrement informatif. Si les résidus se conforment à l’idéal théorique gaussien, les points empiriques s’alignent de façon étroite le long de la ligne diagonale de référence bissectrice ; toute déviation substantielle en forme de « S » ou d’incurvation prononcée aux extrémités traduit la présence d’asymétries (skewness) ou de distributions leptokurtiques ou platykurtiques (kurtosis). Ces inspections peuvent être complétées par les tests d’adéquation que sont le test de Shapiro-Wilk, largement plébiscité pour sa sensibilité optimale sur des effectifs modérés, et le test de Kolmogorov-Smirnov (adapté via la correction de Lilliefors).
Bien que le test HSD de Tukey manifeste une certaine robustesse face à des écarts mineurs à la normalité en vertu des théorèmes centraux limites appliqués aux moyennes, l’apparition d’asymétries sévères ou de queues de distribution particulièrement épaisses biaise les probabilités réelles de la distribution de l’étendue studentisée. Dans un tel contexte, les estimations d’erreur standard sont dégradées, ce qui compromet l’exactitude des intervalles de confiance et affaiblit le pouvoir de discrimination du test post-hoc.
3.2 Homogénéité des variances (homoscédasticité)
Le deuxième pilier fondamental conditionnant la validité du test classique de Tukey réside dans l’homoscédasticité, qui requiert que l’ensemble des sous-populations associées aux différentes modalités du facteur présentent une variance résiduelle identique. L’estimation de l’erreur standard mobilisée dans le dénominateur de la statistique q de Tukey repose sur le carré moyen des résidus issu de l’ANOVA globale, qui n’est autre qu’une moyenne pondérée des variances empiriques des différents groupes. Dès lors que cette égalité fondamentale est violée, ce paramètre combiné cesse d’être représentatif de la variabilité interne propre à chaque condition expérimentale prise isolément.
Sur le plan du diagnostic statistique au sein de l’environnement R, la vérification de l’homoscédasticité est communément dévolue au test de Levene, qui présente l’avantage considérable d’être robuste aux écarts modérés vis-à-vis de la normalité lorsqu’il est calculé autour de la médiane des groupes (procédure de Brown-Forsythe). Le test de Bartlett peut également être mis en œuvre, mais sa sensibilité excessive à la non-normalité tend à produire des taux de faux positifs élevés pour la détection de l’hétéroscédasticité dès que les données s’écartent de la stricte symétrie gaussienne. Un examen graphique des résidus en fonction des valeurs ajustées constitue une aide décisionnelle indispensable : la visualisation d’un étalement en entonnoir signale immédiatement une dispersion hétérogène des variances conditionnelles.
Les conséquences d’une rupture d’homoscédasticité sur le test de Tukey standard sont particulièrement sévères, tout particulièrement lorsque les effectifs au sein des différents groupes ne sont pas strictement équilibrés. Lorsque les groupes présentant les effectifs les plus réduits affichent les variances les plus massives, le taux réel d’erreur de type I s’envole bien au-delà du seuil nominal de 5 %, exposant l’investigateur à des conclusions triomphalistes trompeuses. Inversement, si les groupes volumineux concentrent la plus forte variabilité, le test devient excessivement conservateur, étouffant la puissance statistique du protocole. Face à cette défaillance de l’homogénéité des variances, l’utilisation de variantes adaptées comme la méthode de Tukey-Kramer ou le test de Games-Howell devient incontournable.
3.3 Indépendance stricte des observations
Le postulat d’indépendance statistique des observations représente la contrainte la plus impérieuse et la moins négociable lors de l’application du test de Tukey. Dans le cadre d’un modèle d’ANOVA unidirectionnelle inter-sujets (between-subjects design), chaque unité expérimentale — qu’il s’agisse d’un patient clinique, d’un sujet volontaire ou d’un animal de laboratoire — doit être assignée à une seule modalité factorielle, et la réponse fournie par un participant ne doit en aucun cas être corrélée ou influencée par la mesure d’un autre participant au sein du dispositif.
Dans les recherches menées en psychologie clinique, sociale ou organisationnelle, la violation de ce postulat survient fréquemment de manière insidieuse par le biais de structures de données groupées ou hiérarchiques non prises en compte. Par exemple, si l’efficacité d’un protocole éducatif est mesurée sur des cohortes d’étudiants répartis au sein de différentes salles de classe, les interactions psychosociales au sein d’un même groupe d’apprentissage génèrent un biais de corrélation intraclasse. De même, les mesures répétées dans le temps appliquées à un même échantillon (designs intra-sujets) introduisent une autocorrélation systématique entre les scores successifs qui rend le test standard de Tukey totalement caduc.
Contrairement aux entorses à la normalité ou à l’homoscédasticité, pour lesquelles des ajustements mathématiques compensatoires existent au sein du modèle univarié, aucune gymnastique statistique post-hoc ne peut corriger la violation de l’indépendance d’échantillonnage dans le cadre de l’ANOVA classique. Lorsque les observations s’avèrent interdépendantes, l’estimation des degrés de liberté de l’erreur est artificiellement surévaluée, conduisant à une sous-estimation dramatique de l’erreur standard et à une prolifération massive de faux positifs. De telles situations méthodologiques exigent l’abandon de l’ANOVA classique au profit des modèles linéaires mixtes (GLMM) ou de l’analyse de variance à mesures répétées assortie de corrections de sphéricité adaptées.
4. Préparation de l’environnement de travail et structuration des données sous R
4.1 Configuration des bibliothèques R requises
Pour assurer la fluidité des opérations, la transparence analytique et la rigueur de la chaîne de traitement statistique sous R, l’installation et le chargement préalable d’une suite logicielle spécifique s’avèrent nécessaires. Si l’environnement de base de R intègre nativement des commandes performantes pour l’ajustement de l’ANOVA et l’exécution du test de Tukey, l’écosystème moderne offre des outils d’une lisibilité et d’une puissance graphique supérieures, indispensables pour la production de rapports académiques de premier plan.
Le socle fondamental de manipulation de données s’appuie sur le méta-package Tidyverse. Au sein de cet ensemble cohérent, les packages dplyr et tidyr permettent d’orchestrer la structuration, le filtrage et l’agrégation des matrices d’observations avec une grande élégance syntaxique, tandis que le package ggplot2 s’affirme comme le standard absolu pour l’élaboration de visualisations complexes et esthétiques conformes aux attentes éditoriales internationales. Pour la phase d’évaluation diagnostique des postulats du modèle, le chargement du package car (Companion to Applied Regression), développé sous la direction de John Fox, est fortement préconisé en raison de sa fonction dédiée au test d’homoscédasticité de Levene. De manière complémentaire, le package rstatix permet d’exécuter des pipelines d’analyses descriptives et inférentielles totalement compatibles avec les principes du formalisme fonctionnel moderne.
Enfin, afin de garantir une reproductibilité computationnelle intégrale des simulations et des procédures d’échantillonnage présentées dans le cadre de ce protocole, la fixation d’une graine pseudo-aléatoire au moyen de la fonction set.seed() constitue une précaution technique incontournable. Cette instruction verrouille le générateur aléatoire interne de la machine, assurant ainsi qu’un lecteur réexécutant le script obtiendra une copie rigoureusement identique des données simulées et des métriques statistiques associées.
4.2 Génération et nettoyage d’un jeu de données psychologiques simulé
Dans l’optique d’ancrer les développements méthodologiques dans une perspective clinique concrète, nous simulons ci-après un essai clinique contrôlé évaluant l’évolution de la symptomatologie dépressive mesurée au moyen de l’Inventaire de Dépression de Beck (BDI-II). Notre protocole met en scène une cohorte de 90 patients diagnostiqués avec un trouble dépressif caractérisé d’intensité modérée à sévère, assignés de manière strictement aléatoire à trois conditions thérapeutiques distinctes (N = 30 patients par groupe) : un groupe bénéficiant d’une thérapie cognitivo-comportementale formalisée (TCC), un second groupe engagé dans un protocole d’intervention basé sur la pleine conscience (Mindfulness), et un troisième groupe maintenu sur liste d’attente avec suivi de soutien non directif (Controle).
La formalisation du code sous R nécessite l’attribution d’une graine aléatoire, suivie de l’échantillonnage de vecteurs gaussiens présentant des paramètres de moyenne et d’écart-type représentatifs de la littérature clinique. Pour le groupe Controle, le niveau moyen résiduel de dépression post-intervention est fixé à une valeur élevée de 28 points (écart-type de 5,5). Le groupe TCC, dont l’efficacité thérapeutique a été historiquement documentée, est calibré avec un score moyen post-thérapie de 16 points (écart-type de 4,8). Enfin, le groupe Mindfulness est modélisé avec une moyenne intermédiaire de 21 points (écart-type de 5,2). Ces séries numériques sont ensuite assemblées dans une structure de données rectangulaire (data.frame ou tibble) sous l’identifiant « depression_data ».
L’étape technique cruciale du nettoyage consiste à convertir impérativement la variable indépendante modélisant les conditions de traitement en facteur catégoriel au moyen de l’instruction factor() ou as.factor(). Si cette conversion est négligée et que les modalités de traitement demeurent enregistrées sous forme de chaînes textuelles ou d’indices numériques bruts, les fonctions d’estimation de R refuseront d’exécuter l’analyse de variance factorielle ou traiteront la variable explicative comme un régresseur continu linéaire. L’inspection de l’architecture interne du tableau s’effectue au travers des commandes str() et summary(), qui permettent de vérifier l’absence d’aberrations numériques, de valeurs manquantes (NA) ou d’asymétries empiriques flagrantes.
4.3 Analyse descriptive préliminaire des cohortes
Avant d’engager toute modélisation inférentielle lourde, une immersion dans la structure empirique des données s’impose afin d’en saisir la distribution et les tendances centrales. Cette phase exploratoire préliminaire conditionne la bonne appréhension de la dispersion et prévient les erreurs d’interprétation subséquentes. Au moyen des verbes de syntaxe dplyr (notamment group_by() et summarise()), l’analyste synthétise pour chaque condition thérapeutique la taille d’échantillon effective, la moyenne arithmétique, l’écart-type, la médiane ainsi que l’intervalle de confiance standardisé calculé à 95 %.
L’exploration visuelle constitue le pendant indispensable de ces métriques numériques. L’implémentation graphique d’un diagramme en boîte de Tukey (boxplot) enrichi des points d’observations individuels superposés (jittering) via ggplot2 permet d’évaluer d’un coup d’œil l’étalement des données, la symétrie des quartiles et la présence éventuelle d’observations aberrantes ou extrêmes situées au-delà des clôtures d’exclusion (1,5 fois l’espace interquartile). L’inspection de ces graphiques exploratoires offre une première confirmation intuitive de la dissociation clinique entre les groupes : la boîte à moustaches du groupe TCC apparaît nettement décalée vers les scores inférieurs de dépression comparativement au groupe témoin, le groupe Mindfulness occupant un statut médian.
Cette étape descriptive renseigne également l’investigateur sur l’homogénéité visuelle de l’étalement des dispersions. Si les longueurs des moustaches et les surfaces des boîtes interquartiles se révèlent remarquablement similaires entre les trois colonnes graphiques, l’intuition d’une conformité satisfaisante à l’hypothèse d’homoscédasticité s’en trouve provisoirement étayée, pavant la voie vers la formalisation du modèle d’analyse de variance paramétrique.
5. Étape 1 : Ajustement du modèle d’analyse de variance (ANOVA) dans R
5.1 Syntaxe et exécution de la fonction aov()
L’environnement R standard met à la disposition du statisticien deux fonctions primordiales pour estimer un modèle d’analyse de variance : la fonction lm(), dédiée à l’ajustement des modèles linéaires généraux par la méthode des moindres carrés ordinaires, et la fonction dédiée aov(), qui agit comme une enveloppe spécialisée conçue pour faciliter le traitement des plans expérimentaux factoriels. Bien que l’objet résultant de la commande aov() hérite directement de la structure de base des modèles de type lm, sa classe spécifique conditionne le comportement des fonctions d’analyse post-hoc natives, et tout particulièrement de la commande TukeyHSD(). Il est donc impératif de formuler l’analyse initiale au moyen de la fonction aov().
La syntaxe canonique requiert la définition d’une formule symbolique liant la variable dépendante quantitative continue aux variables explicatives catégorielles. Dans le cadre de notre essai clinique sur la dépression, la syntaxe s’énonce selon le schéma : modele_dep <- aov(Score_BDI ~ Groupe_Therapie, data = depression_data). Le symbole tilde (~) sépare la réponse mesurée (le score résiduel au BDI-II) du facteur d’assignation expérimentale. Lors de l’exécution, R procède à l’estimation des paramètres de position et calcule de façon itérative la décomposition des sommes de carrés selon l’algorithme des projections orthogonales.
L’attribution du résultat de cette fonction à un objet structuré dans l’espace de travail global (ici dénommé « modele_dep ») est une condition préalable indispensable. Cet objet ne se résume pas à une simple matrice de valeurs textuelles ; il contient l’ensemble des métadonnées du modèle, notamment les résidus individuels non standardisés, les coefficients d’ajustement, les valeurs prédites par les moyennes de groupe, ainsi que la structure complète de la matrice de covariance indispensable aux calculs ultérieurs de l’étendue studentisée.
5.2 Lecture et analyse critique du tableau d’ANOVA
L’extraction des résultats d’ajustement s’effectue par l’invocation de la commande générique summary() appliquée à l’objet de modélisation préalablement stocké. L’exécution de cette directive génère un tableau d’ANOVA classique respectant scrupuleusement la tradition biométrique de Ronald Fisher. L’analyste se doit de procéder à un examen méthodique de chaque colonne pour valider la robustesse de l’estimation globale.
La première colonne détaille les degrés de liberté (Df), fixés ici à 2 pour le terme factoriel intergroupe (soit k – 1, où k correspond aux 3 groupes cliniques) et à 87 pour la ligne des résidus d’erreur (soit N – k, correspondant aux 90 patients déduction faite des 3 degrés de liberté consommés par l’estimation des moyennes). La colonne suivante récapitule les sommes des carrés (Sum Sq), attestant de l’amplitude absolue des écarts de variance attribuables respectivement au facteur thérapeutique et aux variations individuelles incontrôlées. La division de ces sommes de carrés par leurs degrés de liberté respectifs produit les carrés moyens (Mean Sq), dont le rapport direct constitue la valeur empirique de la statistique F de Fisher.
L’indicateur cardinal de validation reste la probabilité critique asymptotique rapportée dans la colonne « Pr(>F) ». Dans notre simulation, l’ampleur des écarts induits par les protocoles psychothérapeutiques engendre une valeur de F substantielle, associée à une p-valeur très largement inférieure au seuil critique conventionnel de 0,001 (souvent annotée de trois astérisques sous R). Cette découverte permet de rejeter sans équivoque l’hypothèse nulle d’égalité globale des moyennes des populations traitées. Le test omnibus confirmant formellement l’existence d’une divergence structurée au sein du système expérimental, le chercheur dispose de la légitimité méthodologique absolue pour engager la seconde phase de l’investigation : la localisation de ces effets au moyen du test post-hoc de Tukey.
6. Étape 2 : Exécution de la fonction TukeyHSD() dans l’environnement R
6.1 Paramétrage fondamental de la fonction native TukeyHSD()
L’exécution de la procédure de la différence honnêtement significative au sein du système R de base repose sur l’appel direct de la fonction interne TukeyHSD(). Cette fonction algorithmique hautement optimisée requiert comme argument principal obligatoire un objet ayant été préalablement modélisé et structuré par la commande aov(). Si l’analyste tente d’appliquer directement TukeyHSD() à un objet dérivé exclusivement de la fonction lm(), l’interpréteur R renverra un message d’erreur d’incompatibilité de classe, soulignant ainsi la dépendance formelle du test vis-à-vis des métadonnées de l’ANOVA factorielle.
La fonction dispose de plusieurs arguments optionnels permettant d’affiner son comportement selon la configuration du plan d’expérience. L’argument « which » offre la possibilité de cibler sélectivement une variable indépendante particulière au sein des modèles comportant plusieurs facteurs de classification, évitant ainsi le calcul superflu de contrastes sur des variables de contrôle secondaires. Si cet argument est omis, la fonction applique par défaut l’algorithme à l’ensemble des facteurs catégoriels identifiés dans l’architecture du modèle. L’argument « conf.level » régit le seuil de probabilité bilatéral encadrant l’estimation des intervalles de confiance ; fixé par défaut à 0.95 (correspondant à un risque d’erreur alpha de 5 %), il peut être ajusté à 0.99 pour répondre aux exigences conservatrices de certains protocoles cliniques ou à 0.90 dans le cadre d’études exploratoires pilotes.
L’assignation de la syntaxe standard « tukey_result <- TukeyHSD(modele_dep, which = ‘Groupe_Therapie’, conf.level = 0.95) » génère dans l’environnement un objet complexe de classe « TukeyHSD ». Cet objet encapsule une liste de tableaux d’inférence multidimensionnels regroupant les statistiques calculées pour chaque paire de conditions confrontée.
6.2 Décomposition détaillée de la matrice de sortie
L’affichage terminal généré par l’inspection de l’objet issu de TukeyHSD() se présente sous la forme d’un tableau à quatre colonnes d’une grande clarté conceptuelle. Chaque ligne du tableau correspond à une comparaison par paire spécifique, désignée de manière explicite par les étiquettes textuelles des deux groupes mis en contraste (par exemple : « Mindfulness-Controle », « TCC-Controle » et « TCC-Mindfulness »).
La première colonne, libellée « diff », consigne la différence arithmétique brute calculée entre les moyennes empiriques des deux cohortes confrontées. Il convient de souligner que l’ordre de la soustraction procède de l’ordonnancement alphabétique ou factoriel des niveaux de la variable : une valeur négative signale que le premier groupe mentionné dans le libellé affiche un score moyen inférieur à celui du second. Dans le cadre de notre simulation sur la dépression, où un score BDI-II bas traduit une réduction des symptômes, la valeur négative substantielle observée pour la paire TCC-Controle reflète directement le gain thérapeutique majeur induit par l’approche cognitive.
Les deuxième et troisième colonnes, respectivement désignées par « lwr » (lower bound) et « upr » (upper bound), délimitent les bornes inférieure et supérieure de l’intervalle de confiance ajusté à 95 % pour la différence des moyennes. Ces bornes sont calculées en intégrant la valeur critique de la distribution de l’étendue studentisée q. La propriété géométrique cardinale de ces intervalles est la suivante : si l’intervalle de confiance ne contient pas la valeur zéro (c’est-à-dire si les deux bornes sont simultanément positives ou simultanément négatives), la divergence entre les deux moyennes est déclarée statistiquement significative au seuil alpha choisi. Enfin, la quatrième colonne, identifiée par le label « p adj », expose la p-valeur corrigée selon l’algorithme exact de Tukey. Cette métrique rend compte de la probabilité exacte d’observer un écart d’au moins cette magnitude sous l’hypothèse nulle, en prenant en compte l’ajustement requis par le FWER pour la totalité de la famille de tests.
6.3 Gestion des designs expérimentaux factoriels à plusieurs variables
Dans la recherche expérimentale avancée, les protocoles ne se limitent que rarement à un unique facteur univarié ; ils incorporent fréquemment des designs factoriels croisés à deux ou trois variables indépendantes (par exemple, un design 3×2 croisant le Type d’Intervention et le Genre des patients, ou le Type d’Intervention et la Sévérité Initiale du trouble). Dans un tel contexte factoriel complexe modélisé sous la forme « Score ~ FacteurA * FacteurB », l’interprétation des résultats issus du test de Tukey requiert une prudence méthodologique décuplée.
Lorsque la fonction TukeyHSD() est appliquée à un objet aov() factoriel complet, R génère automatiquement trois sous-matrices de contrastes : les comparaisons par paires associées aux effets principaux du premier facteur, celles relatives au second facteur, et enfin une matrice étendue explorant l’ensemble exhaustif des combinaisons d’interaction croisée. Il est impératif pour l’analyste d’inspecter en priorité la significativité statistique du terme d’interaction dans le tableau d’ANOVA omnibus avant de se pencher sur les résultats de Tukey. Si l’interaction s’avère hautement significative, l’interprétation des effets principaux globaux devient fallacieuse, car l’efficacité d’un traitement dépend intrinsèquement du sous-groupe considéré. L’attention doit alors se focaliser exclusivement sur les comparaisons par paires du terme d’interaction, qui isolent ce que la littérature nomme les effets simples conditionnels.
Néanmoins, la gestion de ces termes d’interaction confronte le chercheur à l’écueil de l’explosion combinatoire. Dans un plan comportant par exemple deux facteurs à quatre modalités chacun, le terme d’interaction totalise 16 cellules expérimentales distinctes, engendrant une matrice vertigineuse de 120 comparaisons multiples potentielles. Face à une telle prolifération d’hypothèses, la méthode de Tukey-Kramer atteint ses limites de puissance statistique et d’intelligibilité théorique, incitant les analystes chevronnés à restreindre manuellement le champ des comparaisons via des packages de modélisation plus flexibles.
7. Visualisation graphique avancée des intervalles de confiance de Tukey
7.1 Exploitation du tracé graphique de base dans R
La restitution visuelle des inférences statistiques constitue un levier déterminant pour faciliter la communication des résultats dans les publications scientifiques et les thèses de doctorat. Le système graphique natif de R propose une méthode immédiate et hautement fonctionnelle pour illustrer les résultats d’un test HSD, en surchargeant la fonction générique plot() dès lors qu’elle est appliquée à un objet produit par la commande TukeyHSD().
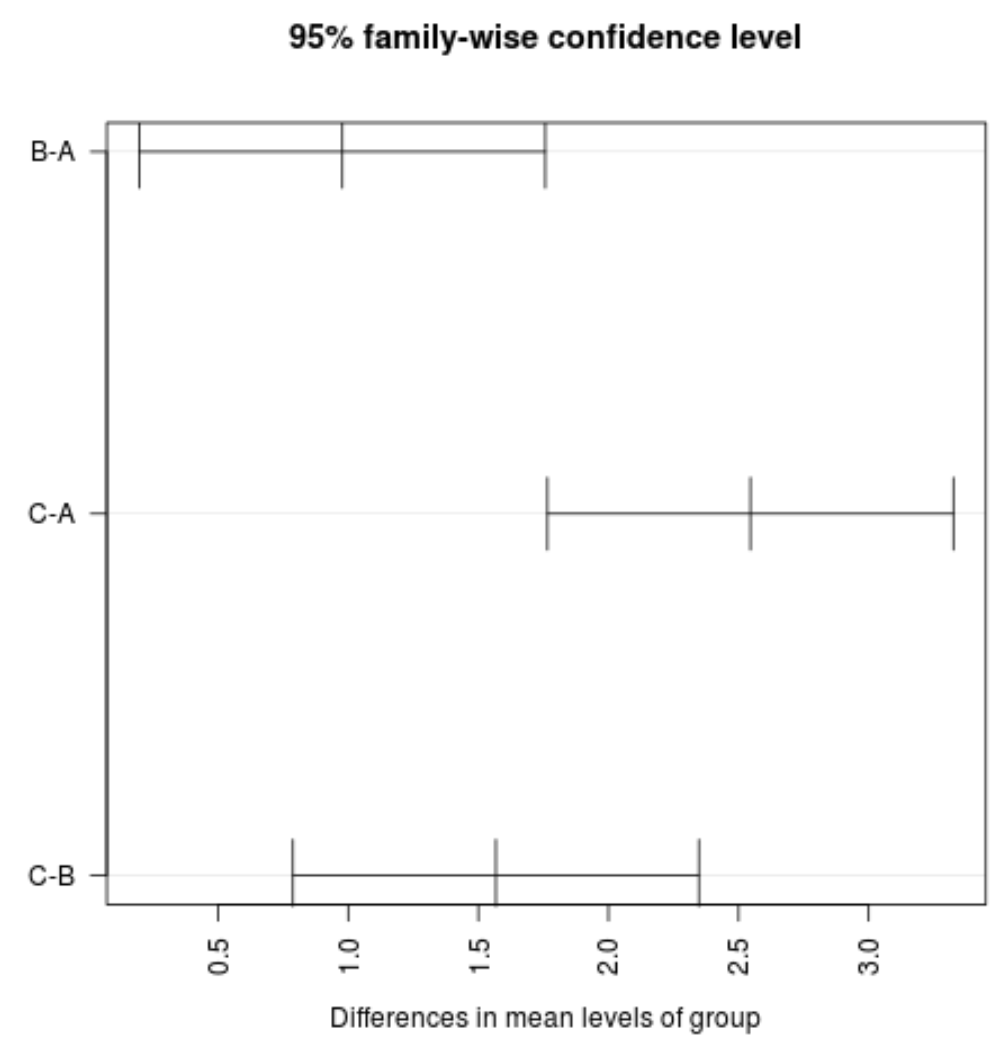
L’exécution de l’instruction « plot(tukey_result) » engendre un tracé horizontal représentant pour chaque contraste un point central (figurant la différence empirique moyenne calculée dans la colonne « diff ») encadré par un segment continu matérialisant l’intervalle de confiance ajusté à 95 %. L’élément sémiologique fondamental de ce graphique réside dans la ligne verticale en pointillés gris positionnée précisément sur l’abscisse zéro. Tout segment d’intervalle de confiance qui croise ou chevauche cette droite de référence neutre indique sans ambiguïté une absence de différence statistiquement significative entre les deux modalités confrontées (valeur de p adj supérieure à 0,05) ; à l’inverse, tout intervalle rejeté intégralement à gauche ou à droite de l’axe zéro valide l’existence d’une dissociation significative.
Pour optimiser la lisibilité du graphique dans le système de base, plusieurs ajustements de paramètres graphiques généraux au moyen de la fonction par() s’avèrent hautement recommandés. L’argument « las = 1 » force l’orientation strictement horizontale de l’ensemble des étiquettes textuelles situées sur l’axe des ordonnées, améliorant considérablement l’ergonomie visuelle. Parallèlement, l’élargissement des marges externes via l’argument vectoriel « mar = c(5, 10, 4, 2) » évite que les désignations textuelles complexes des paires expérimentales ne soient tronquées lors de l’exportation vectorielle de l’illustration.
7.2 Conception d’une visualisation de qualité publication avec ggplot2
Bien que le système de base de R demeure irremplaçable pour une inspection diagnostique rapide, la confection de figures de haute résolution destinées à des revues internationales de premier rang requiert le déploiement du moteur de rendu graphique ggplot2. Cette démarche implique une manipulation intermédiaire : l’objet de sortie généré par TukeyHSD() n’étant pas structuré nativement comme un tableau de données rectangulaire standard, il doit être extrait, transformé et converti en un objet de type data.frame au moyen de la syntaxe standard ou de fonctions d’extraction automatisées telles que tidy() issues du package broom.
Une fois le tableau restructuré — isolant dans des colonnes dédiées le nom du contraste, la différence arithmétique moyenne, les bornes inférieure et supérieure de l’intervalle, ainsi que la p-valeur ajustée —, l’analyste peut générer un pipeline de code graphique totalement modulable. La variable binaire de significativité statistique (fondée sur le critère p < 0,05) peut être injectée directement dans l’esthétique de couleur (« aes(color = Significatif) »), permettant de distinguer instantanément les contrastes opérants par une teinte chromatique vive (par exemple, un bleu saphir) tandis que les contrastes non concluants sont relégués dans une tonalité neutre (un gris ardoise discret).
L’application rigoureuse des géométries geom_hline() pour ancrer l’axe de référence neutre à zéro, geom_errorbar() pour figurer avec précision les barres d’erreurs ajustées, et geom_point() pour matérialiser les estimations ponctuelles confère à la visualisation une clarté analytique sans équivalent. L’application d’un habillage dépouillé tel que theme_minimal(), combinée à l’adjonction de titres d’axes rigoureusement calibrés et d’annotations typographiques soignées, produit une figure répondant sans réserve aux exigences formelles les plus strictes des maisons d’édition académiques.
8. Approche alternative : Utilisation des packages emmeans et multcomp
8.1 Mise en œuvre du package emmeans (Estimated Marginal Means)
Au cours de la dernière décennie, la modélisation statistique computationnelle sous R a connu une évolution majeure avec l’émergence du package emmeans, conçu et maintenu par Russell V. Lenth. Dans la pratique moderne des sciences comportementales et de la biomédecine, emmeans supplante désormais fréquemment les fonctions natives de Tukey grâce à son intégration harmonieuse au sein de modèles statistiques infiniment plus variés, allant des simples ANOVA univariées aux modèles linéaires à effets mixtes hiérarchiques et aux modèles linéaires généralisés (GLM).
Le concept fondateur d’emmeans repose sur l’estimation des moyennes marginales prédites par le modèle linéaire, plutôt que sur la simple agrégation descriptive des scores bruts observés. Cette distinction conceptuelle est fondamentale : dans les protocoles déséquilibrés ou comportant des covariables d’ajustement (ANCOVA), les moyennes brutes sont faussées par les disparités d’échantillonnage, alors que les moyennes marginales estimées neutralisent ces biais structurels en calculant les espérances mathématiques conditionnelles pour chaque modalité factorielle. L’exécution s’articule en deux temps : la commande « emmeans(modele_dep, ~ Groupe_Therapie) » isole tout d’abord les moyennes ajustées, puis l’application de la méthode pairs() ou contrast() déploie les comparaisons par paires.
La fonction pairs() prend nativement en charge la correction de Tukey grâce à la déclaration explicite de l’argument « adjust = ‘tukey' ». L’un des atouts analytiques majeurs de cette approche réside dans la clarté pédagogique de sa restitution : outre la différence de moyenne et l’intervalle de confiance, emmeans rapporte directement les erreurs standard d’estimation harmonisées, les degrés de liberté résiduels exacts, ainsi que la valeur d’un ratio t spécifique associé à chaque paire, facilitant ainsi grandement la compréhension mécanique de l’inférence.
8.2 Comparaisons multiples simultanées avec multcomp
Une seconde approche alternative majeure dans l’écosystème R s’incarne dans le package multcomp, développé par Torsten Hothorn et ses collaborateurs, qui implémente la théorie mathématique unifiée des tests d’hypothèses linéaires générales (General Linear Hypotheses). Au sein de ce package, la fonction centrale glht() (pour general linear hypothesis test) constitue un outil d’une extraordinaire robustesse pour modéliser des contrastes arbitraires ou standardisés.
La formulation syntaxique de cette méthode s’établit selon la structure : « glht_modele <- glht(modele_dep, linfct = mcp(Groupe_Therapie = ‘Tukey’)) ». L’opérateur mcp() — pour multiple comparisons — spécifie à la fonction la matrice de contraste désirée, activant l’algorithme exact de Tukey pour l’évaluation conjointe des paramètres. L’inspection des résultats via summary(glht_modele) fournit un contrôle simultané du taux d’erreur familial reposant sur des approximations asymptotiques de distributions multivariées normales ou de Student, adaptées même à des architectures de modélisation non standards.
Par ailleurs, le package multcomp s’illustre par sa capacité à générer un affichage par lettres compactes hautement intuitif grâce à la fonction cld() (Compact Letter Display). Cette méthode algorithmique regroupe les modalités factorielles au moyen d’un système lettré (par exemple : ‘a’, ‘b’, ‘ab’) : deux groupes partageant une même lettre typographique ne manifestent aucune divergence statistiquement significative, tandis que deux groupes associés à des lettres mutuellement exclusives diffèrent formellement au seuil alpha sélectionné. Cette technique d’annotation s’avère particulièrement utile pour condenser des tableaux de résultats massifs au sein d’articles scientifiques denses.
8.3 Avantages comparatifs des différentes syntaxes
La coexistence au sein de l’environnement R de trois méthodologies d’évaluation distinctes — la fonction native TukeyHSD(), le package d’analyse marginale emmeans et la bibliothèque de contrastes simultanés multcomp — amène légitimement le chercheur à s’interroger sur l’algorithme optimal à privilégier selon le design expérimental engagé.
La fonction native TukeyHSD() se distingue par son accessibilité immédiate et son absence totale de dépendances logicielles externes, ce qui en fait l’outil d’élection pour les étudiants, l’enseignement universitaire fondamental et l’analyse rapide de modèles d’ANOVA équilibrés standardisés à un ou deux facteurs fixes. Toutefois, elle souffre d’une rigidité architecturale rédhibitoire dès lors que l’on quitte le cadre strict des modèles moindres carrés ordinaires sans mesures répétées : elle se révèle totalement inopérante face à des modèles à intercept aléatoire modélisant des cohortes de patients ou des essais multicentriques.
C’est précisément dans ces situations de haute complexité méthodologique que s’imposent les packages emmeans et multcomp. Le framework emmeans offre sans doute la flexibilité conceptuelle la plus éclatante pour les sciences biomédicales et comportementales, grâce à sa gestion native et transparente des modèles mixtes ajustés avec lme4, des structures de variances hétérogènes résolues via nlme, et des variables de confusion continues introduites dans les ANCOVA. Sa syntaxe fluide s’intègre parfaitement au sein de pipelines de traitement modernes. Le package multcomp, quant à lui, brille par sa rigueur mathématique inflexible lors de l’application de contrastes non orthogonaux complexes et personnalisés, faisant de lui l’outil de référence pour les statisticiens méthodologistes confrontés à des modèles de survie ou des régressions logistiques multivariées.
9. Interprétation clinique et psychologique des résultats statistiques
9.1 Distinction entre pertinence statistique et significativité clinique
L’un des écueils les plus pernicieux guettant le praticien ou le chercheur dans le traitement de données empiriques consiste à assimiler béatement une significativité statistique hautement attestée (matérialisée par une p-valeur très inférieure à 0,001) à un effet clinique ou comportemental substantiel. La p-valeur ajustée produite par le test de Tukey n’informe l’investigateur que sur une seule dimension : la probabilité mathématique d’observer une différence de cette envergure sous l’hypothèse nulle d’identité parfaite. Elle demeure fondamentalement muette quant à la magnitude concrète, à la valeur d’usage et à la portée thérapeutique du phénomène étudié.
Pour contourner ce piège interprétatif, la quantification systématique de la taille d’effet standardisée pour chaque paire de moyennes s’avère absolument indispensable. Le d de Cohen par paire, calculé en divisant la différence brute moyenne par l’écart-type résiduel combiné issu de l’ANOVA, fournit une mesure adimensionnelle universelle de la séparation des distributions empiriques. Dans notre étude sur la dépression, l’observation d’un d de Cohen de 1,8 entre la condition TCC et la liste d’attente documente une dissociation massive excédant largement les seuils conventionnels de Jacob Cohen (qui définit un effet majeur à partir d’un seuil de 0,8), conférant à la p-valeur de Tukey une véritable assise théorique.
Dans la recherche médicale et psychothérapeutique appliquée, cette quantification statistique doit impérativement être confrontée au concept de Différence Minimale Cliniquement Importante ou Minimal Clinically Important Difference (MCID). Le MCID représente la plus petite variation numérique sur une échelle de mesure clinique qu’un patient ou un praticien perçoit comme une amélioration significative de sa qualité de vie ou de son bien-être. Dès lors qu’un protocole expérimental mobilise un effectif d’échantillonnage massif (plusieurs milliers de sujets), le test de Tukey peut aisément déclarer statistiquement significative une différence empirique de 1,5 point sur l’échelle de Beck ; or, si la littérature clinique s’accorde à fixer le seuil d’amélioration perceptible à un minimum de 4 ou 5 points de BDI-II, cette significativité statistique n’est qu’un artefact d’hypersensibilité mathématique dénué de la moindre valeur translationnelle sur le plan du soin.
9.2 Traduction conceptuelle des résultats pour les sciences cognitives
La restitution scientifique des analyses post-hoc ne saurait se borner à une récitation désincarnée de coefficients numériques et d’intervalles matriciels ; elle requiert une articulation narrative rigoureuse capable d’éclairer la théorie psychologique sous-jacente. L’analyse fine des résultats de Tukey permet d’ordonner hiérarchiquement les interventions testées et de trancher entre des modèles cognitifs concurrents.
Reprenons les résultats générés par notre modèle simulé sur les 90 patients dépressifs. L’analyse de Tukey révèle simultanément que : premièrement, le protocole TCC produit une réduction drastique de la symptomatologie significativement supérieure à celle observée au sein du groupe de contrôle sous liste d’attente ; deuxièmement, le protocole Mindfulness engendre également une décroissance significative de la dépression comparativement à cette même condition contrôle ; et troisièmement, la confrontation directe entre la TCC et la Pleine Conscience documente un avantage statistiquement significatif en faveur de la restructuration cognitive TCC. Sur le plan de la formalisation psychologique, cette constellation d’inférences permet d’affirmer non seulement que les deux approches actives constituent des stratégies d’intervention empiriquement validées, mais également que la restructuration active des schémas de pensée cognitifs manifeste une supériorité opérationnelle mesurable par rapport aux démarches d’acceptation méditative pure dans la phase aiguë du trouble.
Cette traduction conceptuelle doit s’accompagner d’une discussion honnête des implications écologiques et institutionnelles. La mise en évidence d’une efficacité thérapeutique différenciée oriente de manière rationnelle l’allocation des ressources de santé publique : elle fournit aux décideurs institutionnels les preuves empiriques requises pour prioriser le remboursement et la formation clinique aux interventions manifestant les tailles d’effets les plus prononcées au sein de la matrice de Tukey, ancrant résolument la biométrie quantitative au cœur de l’optimisation des prises en charge humaines.
10. Diagnostic des violations des postulats et alternatives robustes
10.1 Stratégies face à la violation de l’homoscédasticité
Lorsque les diagnostics préliminaires — qu’il s’agisse de l’inspection visuelle des nuages de dispersion résiduelle ou de la récusation formelle opérée par un test de Levene (p < 0,05) — confirment l’existence d’une hétérogénéité prononcée des variances intergroupes, l’application aveugle du test HSD de Tukey standard expose l’analyste à de graves distorsions de l’inférence. Le dénominateur de la statistique q de Tukey reposant sur la mutualisation uniforme de la variance résiduelle globale, le test devient incapable de modéliser avec fidélité les risques d’erreur réels en contexte d’hétéroscédasticité.
Face à cette rupture méthodologique, la stratégie analytique standardisée consiste à substituer au modèle ANOVA de Fisher la modélisation robuste de Welch. L’ANOVA de Welch s’affranchit du postulat d’égalité des variances en appliquant une correction mathématique directe aux degrés de liberté de l’erreur résiduelle, pondérée par la dispersion individuelle de chaque sous-échantillon. Dans l’environnement R, cette modélisation préalable s’exécute avec la plus grande simplicité au travers de l’instruction native oneway.test(Score ~ Groupe, var.equal = FALSE).
Sur le plan des comparaisons multiples post-hoc proprement dites, le relais théorique du test de Tukey en présence d’hétéroscédasticité est historiquement assuré par la procédure de Games-Howell. Dérivé des principes d’approximation de Welch-Satterthwaite, le test de Games-Howell calcule pour chaque paire une erreur standard indépendante fondée exclusivement sur les variances empiriques des deux modalités confrontées, tout en attribuant des degrés de liberté fractionnaires spécifiques à chaque contraste. Dans l’écosystème R moderne, le test de Games-Howell s’exécute de manière élégante au moyen du package rstatix via la fonction games_howell_test(), ou via la commande posthocTGH() du package userfriendlyscience, garantissant ainsi une protection irréprochable du taux d’erreur familial sans sacrifier la validité des conclusions.
10.2 Gestion des échantillons déséquilibrés : La procédure de Tukey-Kramer
La formulation originelle introduite par John Tukey en 1949 supposait rigoureusement l’égalité absolue de la taille des échantillons (n_1 = n_2 = … = n_k) au sein de l’ensemble des conditions expérimentales. Or, dans les investigations réelles en milieu clinique, la survenue de données manquantes non attribuables au protocole, de défections de patients (drop-out thérapeutique) ou de contraintes logistiques d’échantillonnage induit de manière quasi-systématique des designs expérimentaux déséquilibrés, caractérisés par des effectifs d’échantillon inégaux entre les cohortes.
Pour parer à cette asymétrie opérationnelle, Clyde Kramer publia en 1956 une extension mathématique fondamentale, connue sous le nom de procédure de Tukey-Kramer. Cette adaptation substitue à la taille d’échantillon uniforme un calcul de moyenne harmonique des effectifs propres aux deux groupes composant la paire analysée. L’erreur standard ajustée intervenant au dénominateur de la statistique de test prend alors la forme de la racine carrée du produit du carré moyen résiduel de l’ANOVA par la demi-somme des inverses des effectifs de la paire considérée : sqrt( (MS_res / 2) * ( (1 / n_i) + (1 / n_j) ) ). Des démonstrations mathématiques ultérieures ont prouvé que la méthode de Tukey-Kramer demeure strictement exacte lorsque les variances sont homogènes, maintenant le FWER à un niveau conservateur légèrement inférieur ou égal au seuil alpha nominal.
Il est extrêmement rassurant pour l’utilisateur de R de savoir que la fonction native TukeyHSD() intègre nativement et de manière entièrement automatisée l’algorithme de Tukey-Kramer. Dès lors que l’objet de classe aov() passé en argument met en jeu des groupes dont les effectifs diffèrent numériquement, R détecte instantanément l’asymétrie matricielle et bascule automatiquement sur la formulation harmonique de Tukey-Kramer pour recalculer les bornes des intervalles de confiance et les p-valeurs ajustées, sans nécessiter la moindre intervention syntaxique manuelle de la part de l’opérateur.
10.3 Solutions non paramétriques pour les distributions asymétriques
Lorsque la variable dépendante mesurée s’écarte radicalement de l’idéal théorique gaussien — par exemple en présence de distributions de survie exponentielles, de données de comptage fortement asymétriques ou d’échelles ordinales psychométriques à pas discrets — et qu’aucune transformation mathématique de normalisation (telle que la transformation logarithmique, la racine carrée ou la famille des transformations de Box-Cox) ne parvient à restaurer la symétrie des résidus, l’ensemble de l’édifice inférentiel de l’ANOVA et du test de Tukey s’effondre.
L’étape diagnostique impose alors le basculement vers l’équivalent non paramétrique classique de l’ANOVA : le test de Kruskal-Wallis. Cette procédure repose non plus sur l’analyse des grandeurs métriques absolues des observations, mais sur le traitement de leurs rangs relatifs après agrégation globale. Dans R, l’exécution s’opère via la commande native kruskal.test(Score ~ Groupe, data = donnees). Dès lors que le test de Kruskal-Wallis atteste d’une hétérogénéité statistiquement significative de la structure des rangs entre les groupes, l’investigateur doit mobiliser des comparaisons post-hoc adaptées aux distributions non gaussiennes.
L’analyse post-hoc canonique succédant au test de Kruskal-Wallis est le test de Dunn, qui évalue la séparation stochastique des sommes de rangs moyennes pour chaque paire de conditions. Dans l’écosystème R, cette démarche s’exécute couramment grâce à la fonction dunn_test() du package rstatix ou dunn.test() du package éponyme. Ces fonctions intègrent la possibilité d’ajuster les p-valeurs obtenues au moyen de multiples algorithmes de contrôle de l’erreur familiale, notamment la procédure séquentielle de Holm-Bonferroni (recommandée pour son équilibre de puissance) ou la régulation du taux de fausse découverte de Benjamini-Hochberg (FDR). Cette transition non paramétrique garantit une intégrité inférentielle totale face à des données profondément rebelles aux lois normales.
11. Comparaison critique : Quand privilégier le test de Dunnett ou de Bonferroni face à Tukey
11.1 Le test de Dunnett : Traitements expérimentaux contre groupe contrôle
Si la méthode HSD de Tukey s’impose comme l’instrument roi pour explorer sans a priori l’exhaustivité de la matrice des paires possibles, elle s’avère méthodologiquement sous-optimale dans une configuration expérimentale omniprésente en biomédecine : l’essai clinique avec condition contrôle de référence unique. Lorsqu’un protocole vise exclusivement à déterminer si différentes molécules actives ou thérapies innovantes manifestent une efficacité supérieure à un placebo ou au traitement standard (standard of care), le calcul de contrastes croisés entre les modalités actives s’avère scientifiquement superflu au regard de l’objectif central de l’investigation.
Dans ce contexte précis, le test de Dunnett représente la solution statistique idéale. Alors que le test de Tukey calcule k(k – 1) / 2 comparaisons, le dispositif de Dunnett ne calcule que k – 1 contrastes, confrontant chaque condition active exclusivement au groupe de référence désigné. Cette économie massive du volume d’hypothèses statistiques testées réduit considérablement la sévérité de la pénalisation d’ajustement : la distribution statistique multivariée propre à Dunnett autorise des valeurs critiques inférieures à celles de l’étendue studentisée de Tukey, conférant au test de Dunnett un gain spectaculaire de puissance statistique. En recourant à Dunnett plutôt qu’à Tukey dans un protocole à groupe contrôle, le chercheur diminue drastiquement le risque de commettre une erreur de type II (c’est-à-dire manquer une différence thérapeutique réelle).
La mise en pratique du test de Dunnett sous R s’exécute de façon remarquable via la fonction DunnettTest() issue du package DescTools, ou encore par l’intermédiaire du framework multcomp en spécifiant l’option mcp(Groupe = ‘Dunnett’). La seule exigence technique préalable consiste à déclarer rigoureusement la condition témoin comme le niveau de référence cardinal (baseline) du facteur catégoriel dans R au moyen de l’instruction relevel().
11.2 La correction conservatrice de Bonferroni
La correction de Bonferroni constitue sans conteste l’algorithme d’ajustement multiple le plus universellement répandu dans la littérature biomédicale, en grande partie en raison de son apparente simplicité mathématique. Fondée sur l’inégalité de Boole-Bonferroni, elle stipule que pour garantir un taux d’erreur familial maximal de alpha sur un ensemble de m tests statistiques indépendants ou dépendants, il suffit d’assigner à chaque test individuel un seuil de décision critique fixé à alpha divisé par m (ou, de manière strictement équivalente, de multiplier chaque p-valeur observée par m).
Toutefois, cette sévérité algorithmique sans compromis engendre des effets pervers majeurs dès lors que le nombre de comparaisons augmente. La correction de Bonferroni procède d’une hypothèse sous-jacente d’orthogonalité ou de déconnexion totale des événements ; or, dans une matrice de comparaisons par paires, les différentes paires sont intimement corrélées et mathématiquement interdépendantes (si la condition A diffère massivement de B, et que B est identique à C, le contraste entre A et C n’est plus aléatoirement indépendant). En ignorant cette covariance géométrique, Bonferroni applique une sur-pénalisation drastique qui étouffe la puissance statistique, multipliant de façon exponentielle les faux négatifs (erreurs de type II).
La confrontation théorique entre Tukey et Bonferroni délimite un champ d’arbitrage méthodologique sans équivoque : dès lors que l’expérimentateur entreprend de tester l’ensemble exhaustif des paires d’un design factoriel, le test de Tukey s’avère universellement plus puissant et plus précis que la correction de Bonferroni, car il modélise la corrélation mathématique intrinsèque de l’étendue des moyennes. En revanche, si l’investigateur restreint son analyse a priori à un nombre très restreint et théoriquement délimité de contrastes planifiés (par exemple deux ou trois paires soigneusement ciblées au sein d’un plan à six groupes), la pénalisation de Bonferroni calculée sur cette fraction réduite devient mathématiquement moins sévère que le seuil de Tukey calculé sur la matrice complète, faisant de Bonferroni ou de sa variante séquentielle de Holm l’option analytique la plus performante.
11.3 Critères d’aide à la décision pour le chercheur en psychologie
Afin de guider le chercheur dans le labyrinthe des procédures d’analyse post-hoc, l’élaboration d’un arbre décisionnel formel articulant postulats statistiques et objectifs de recherche s’avère d’une grande valeur pragmatique. La sélection de la méthode optimale ne doit jamais découler d’une habitude arbitraire ou de l’opportunisme de la p-valeur, mais d’une logique déductive rigoureuse.
La première bifurcation décisionnelle interroge le statut des hypothèses expérimentales : l’analyste cherche-t-il à explorer toutes les combinaisons possibles sans priorisation théorique (démarche post-hoc exploratoire complète) ou souhaite-t-il évaluer un sous-ensemble restreint de comparaisons motivées a priori par la littérature ? Dans ce dernier scénario, l’utilisation de contrastes planifiés orthogonaux ou de la correction de Holm-Bonferroni sur des tests ciblés constitue l’approche la plus robuste. Si la démarche s’avère exploratoire et exhaustive, la seconde question porte sur la présence d’un groupe contrôle de référence universel. Si le protocole oppose divers traitements à un placebo sans intérêt pour les comparaisons inter-traitements, le test de Dunnett s’impose catégoriquement pour maximiser la puissance statistique.
Dans l’hypothèse où l’ensemble des paires doit être analysé, l’arbre décisionnel examine les postulats de modélisation. Dès lors que la normalité des résidus et l’homogénéité des variances sont corroborées empiriquement, le test HSD de Tukey (ou Tukey-Kramer pour les effectifs asymétriques) constitue le standard méthodologique absolu. Si l’homoscédasticité est formellement violée, l’investigateur doit bifurquer immédiatement vers l’ANOVA de Welch assortie du test post-hoc de Games-Howell. Enfin, si les distributions empiriques défient toute modélisation gaussienne, le recours au test non paramétrique de Kruskal-Wallis prolongé par le test de rangs de Dunn avec ajustement de Benjamini-Hochberg ou de Holm finalise cet itinéraire décisionnel, assurant une conformité exemplaire entre la nature des données et le traitement biométrique engagé.
12. Bonnes pratiques de reporting selon les normes APA (7e édition) et reproductibilité
12.1 Rédaction formelle des résultats selon l’APA 7
La communication publique des résultats inférentiels au sein des revues savantes affiliées aux sciences psychologiques et cognitives est régie de manière stricte par les directives éditoriales de l’American Psychological Association, actuellement dans sa septième édition (APA 7). Le reporting textuel d’un test de Tukey ne doit pas être dilué dans des formulations approximatives ; il exige un ensemble rigoureusement standardisé de paramètres numériques associant moyennes de groupe, écarts-types, magnitude de la divergence observée, intervalles de confiance et p-valeurs ajustées.
Sur le plan de la typographie académique standardisée, toute désignation statistique abrégée représentée par une lettre latine unique doit impérativement être composée en italique (par exemple : M pour la moyenne, SD pour l’écart-type, F pour la statistique de Fisher, p pour la probabilité critique, et d pour la taille d’effet de Cohen). Les degrés de liberté du modèle omnibus doivent être indiqués entre parenthèses immédiatement après la statistique F, séparés par une virgule (ex. : F(2, 87) = 45,32). L’exposition des p-valeurs requiert une précision maximale à trois décimales (par exemple p = .023), en omettant le zéro précédant la virgule pour les probabilités bornées à l’unité, et en substituant la mention p < .001 à toute valeur infinitésimale affichée comme un zéro absolu par le logiciel informatique.
Un modèle de rédaction narrative exemplaire pour l’intégration au sein de la section ‘Résultats’ d’un manuscrit scientifique prend la forme suivante : « Une analyse de variance univariée à un facteur a mis en évidence un effet principal statistiquement significatif de la modalité thérapeutique sur les scores de dépression post-intervention, F(2, 87) = 42,18, p < .001, êta-carré partiel = .49. L’analyse post-hoc menée au moyen du test de la différence honnêtement significative de Tukey (HSD) a indiqué que les patients ayant suivi la TCC (M = 16,12, SD = 4,75) présentaient des scores de dépression significativement inférieurs à ceux du groupe de contrôle sur liste d’attente (M = 28,34, SD = 5,42), diff = -12,22, IC à 95 % [-15,10, -9,34], p < .001, d = 2,39. De manière similaire, le protocole de pleine conscience (M = 21,05, SD = 5,18) s’est traduit par une réduction significative des symptômes comparativement au groupe contrôle, diff = -7,29, IC à 95 % [-10,17, -4,41], p < .001, d = 1,37. Enfin, la comparaison directe entre les deux approches actives a documenté un avantage statistiquement significatif en faveur de la TCC par rapport à la pleine conscience, diff = -4,93, IC à 95 % [-7,81, -2,05], p = .002, d = 0,99. »
12.2 Génération de tableaux récapitulatifs automatisés
Lorsque le design factoriel incorpore un nombre substantiel de conditions expérimentales, l’exposition purement textuelle des résultats devient lourde et nuit à la lisibilité générale de l’article. La confection de tableaux synthétiques structurés conformes aux exigences esthétiques de l’APA constitue alors la meilleure pratique de communication scientifique. Les normes APA proscrivent catégoriquement l’emploi de bordures verticales dans les tableaux, n’autorisant que trois lignes horizontales dominantes : une ligne fermant le sommet du tableau, une séparant l’en-tête de colonnes du corps de texte, et une marquant la base terminale avant les notes de bas de page.
Au sein de l’environnement R, la conversion directe des objets matriciels générés par TukeyHSD() ou emmeans() en tableaux conformes aux normes de publication s’opère de manière totalement automatisée grâce aux bibliothèques knitr et kableExtra. En utilisant la fonction kable(), l’analyste formate les colonnes de contrastes, spécifie le nombre de décimales uniformisé au moyen de l’argument « digits = 2 », et intègre la mise en forme formelle via kable_classic() ou kable_styling(). L’adjonction de notes explicatives détaillant la nature de l’ajustement familial parachève l’intégration éditoriale du document.
Pour les utilisateurs évoluant dans des chaînes de production de documents dynamiques via Quarto ou R Markdown, ces tableaux générés dynamiquement présentent l’immense avantage d’éliminer toute erreur humaine de transcription typographique entre les résultats calculés par l’interpréteur R et le manuscrit finalisé, garantissant une cohérence documentaire irréprochable.
12.3 Reproductibilité computationnelle et science ouverte
L’essor contemporain du mouvement de la Science Ouverte (Open Science) impose désormais des exigences de transparence méthodologique et de reproductibilité computationnelle que tout chercheur se doit d’intégrer dans sa routine analytique. Le simple partage des coefficients numériques terminaux au sein d’une publication ne suffit plus : la communauté scientifique internationale attend la mise à disposition pleine et entière des protocoles de calcul, des scripts de nettoyage et des codes sources de modélisation ayant permis d’aboutir aux conclusions affirmées.
Pour garantir la pérennité et la réplicabilité intégrale d’une analyse post-hoc de Tukey sous R, la mise en place d’un environnement de travail isolé s’avère primordiale. L’usage du package renv permet de capturer l’état exact des versions de R et des différentes bibliothèques logicielles mobilisées au moment précis de l’analyse, préservant le script contre d’éventuelles rétro-incompatibilités introduites par des mises à jour futures des packages. L’intégration du code statistique, de ses sorties graphiques et des commentaires interprétatifs au sein d’un document computationnel unique structuré au format Quarto (.qmd) ou R Markdown (.Rmd) garantit une traçabilité intégrale du raisonnement scientifique, depuis l’importation du tableau de données brutes jusqu’au tracé des intervalles de confiance.
Enfin, le dépôt public de ces archives documentaires sur des plateformes institutionnelles ouvertes et pérennes, telles que l’Open Science Framework (OSF) ou Zenodo, enrichit la production intellectuelle d’un identifiant numérique d’objet (DOI) permanent. Cette démarche d’intégrité permet aux pairs et aux relecteurs académiques de vérifier immédiatement la conformité du modèle linéaire, d’auditer les hypothèses diagnostiques et de réexécuter l’intégralité du test de Tukey en un simple clic, érigeant la rigueur méthodologique en vertu cardinale de la recherche moderne.
Références
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001466
- Lenth, R. V. (2023). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.5). https://cran.r-project.org/package=emmeans
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.r-project.org/
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., Takahashi, K., Vaughan, D., Wilke, C., Woo, K., & Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686