
L’analyse de régression constitue depuis plus d’un siècle la pierre angulaire de l’inférence statistique appliquée aux sciences humaines, biomédicales et comportementales. Historiquement dominée par la méthode des moindres carrés ordinaires, la modélisation statistique s’est principalement focalisée sur l’espérance conditionnelle d’une variable dépendante sachant un ensemble de prédicteurs. Cette concentration quasi exclusive sur la moyenne arithmétique procède d’un postulat implicite : l’effet d’une variable explicative serait homogène sur l’ensemble des individus composant un échantillon, de telle sorte qu’un résumé central suffirait à synthétiser l’intégralité des dynamiques sous-jacentes du phénomène étudié. Or, dans les contextes empiriques complexes, les distributions réelles dérogent systématiquement à cette simplification outrancière en affichant de l’asymétrie, une variabilité non constante et des queues de distribution épaisses où se nichent précisément les phénomènes cliniques ou comportementaux les plus critiques.
Introduite par les travaux séminaux des économètres Roger Koenker et Gilbert Bassett Jr. en 1978, la régression quantile s’est imposée comme une révolution épistémologique et méthodologique majeure face à ce réductionnisme de la moyenne. En substituant à la minimisation des résidus quadratiques une minimisation pondérée d’écarts absolus, cette approche permet d’estimer non pas un unique paramètre central, mais une famille infinie de fonctions quantiles conditionnelles. Dès lors, le chercheur dispose d’un instrument d’investigation panoramique capable de révéler si l’impact d’une intervention, d’une variable cognitive ou d’une vulnérabilité environnementale demeure identique ou, au contraire, diverge radicalement selon que l’individu se situe dans les quantiles inférieurs, médians ou supérieurs de la distribution de la réponse.
Dans l’écosystème contemporain de la science des données et du calcul scientifique, le langage de programmation Python s’est affirmé comme l’un des vecteurs privilégiés pour le déploiement d’architectures analytiques rigoureuses. Grâce à des bibliothèques hautement optimisées telles que Statsmodels, NumPy et SciPy, l’implémentation de la régression quantile est désormais accessible avec un niveau de raffinement mathématique et algorithmique jadis réservé aux spécialistes de la programmation linéaire. Ce guide exhaustif a pour vocation de guider le chercheur, l’analyste quantitatif et l’étudiant avancé à travers les fondements formels, les procédures d’implémentation numérique, l’inférence non paramétrique robuste et l’interprétation critique de la régression quantile appliquée aux données empiriques.
1. Fondements théoriques de la régression quantile
Avant d’aborder les considérations algorithmiques et le développement de code sous Python, il est indispensable de formaliser les limites structurelles du paradigme linéaire classique et d’élucider les mécanismes mathématiques qui confèrent à l’estimation quantile son pouvoir d’élucidation distributionnelle.
1.1 Limites de la régression linéaire classique par moindres carrés ordinaires
La régression linéaire par les moindres carrés ordinaires repose sur le théorème de Gauss-Markov, lequel stipule que, sous des hypothèses strictes d’exogénéité stricte, d’absence de colinéarité, d’espérance conditionnelle nulle des erreurs et d’homoscédasticité, l’estimateur obtenu est le meilleur estimateur linéaire non biaisé. Néanmoins, dans la pratique de la recherche psychologique, psychiatrique et sociologique, la condition d’homoscédasticité — postulant que la variance de l’erreur conditionnelle demeure strictement invariante quel que soit le niveau des covariables — est quasi systématiquement violée. Dès lors que l’hétérogénéité de la variance s’installe, les erreurs types calculées par la méthode classique deviennent erronées, entraînant des distorsions sévères dans les tests d’hypothèses paramétriques usuels tels que le test de Student ou le test de Fisher.
Une seconde vulnérabilité majeure réside dans l’extrême sensibilité de la moyenne arithmétique aux observations aberrantes, atypiques ou issues de contaminations de mesure. Dans le cadre des moindres carrés, la fonction de coût quadratique élève au carré l’écart entre la valeur observée et la valeur prédite. Cette pénalisation exponentielle confère un bras de levier démesuré aux points extrêmes, tirant artificiellement l’hyperplan de régression vers les marges de l’échantillon. Le point de rupture de l’estimateur des moindres carrés ordinaires est infinitésimal : la modification arbitraire d’une unique observation au sein d’un échantillon arbitrairement grand suffit à corrompre totalement l’estimation des coefficients de pente et de constante.
Enfin, l’incapacité conceptuelle des moindres carrés ordinaires à caractériser la dynamique des queues de distribution constitue une entrave épistémologique déterminante. En modélisant exclusivement l’espérance conditionnelle, le chercheur formule l’hypothèse implicite que toute variation du prédicteur se traduit par une simple translation rigide de la distribution de la variable dépendante sans en affecter la forme, la dispersion ou l’asymétrie. Or, la plupart des hypothèses théoriques substantielles concernent les marges : les facteurs déterminant l’excellence scolaire, le décrochage académique sévère, la résilience extrême face au traumatisme ou l’intensité pathologique de l’anxiété n’agissent que rarement de façon identique sur les individus moyens et sur les individus situés aux confins de la population.
1.2 Principe mathématique et fonction de perte asymétrique
Pour dépasser l’estimation de l’espérance et accéder aux quantiles conditionnels, Roger Koenker et Gilbert Bassett Jr. ont proposé de redéfinir le problème d’estimation non plus comme le calcul d’un moment d’ordre supérieur, mais comme l’optimisation d’une fonction de perte asymétrique spécialement configurée. Soit une variable aléatoire réelle continue notée Y caractérisée par une fonction de répartition cumulative F(y). Pour toute probabilité tau appartenant à l’intervalle ouvert ]0, 1[, le tau-ième quantile de cette variable est défini formellement par la borne inférieure des valeurs de y pour lesquelles la fonction de répartition est supérieure ou égale à tau.
Dans le cas non conditionnel, le calcul de ce quantile équivaut à la minimisation, par rapport à un scalaire theta, de l’espérance d’une fonction de coût appelée fonction de perte quantile asymétrique, souvent désignée dans la littérature anglo-saxonne sous le terme de fonction en flèche ou « pinball loss ». Cette fonction attribue un poids asymétrique aux résidus selon leur signe arithmétique. Mathématiquement, pour un résidu défini par la différence entre la variable observée et la prédiction, la perte est égale au résidu multiplié par le facteur tau si le résidu est positif ou nul, et au résidu multiplié par le facteur tau moins un si le résidu est strictement négatif.
Lorsque tau est rigoureusement fixé à 0.50, cette fonction de perte devient symétrique et correspond à la moitié de la valeur absolue du résidu, ce qui engendre l’estimation de la médiane conditionnelle, traditionnellement formalisée sous le concept de régression des moindres déviations absolues ou régression L1. Pour toute autre valeur de tau, le coût d’une sous-estimation par rapport à une sur-estimation est pondéré de manière différentielle. Par exemple, au nonantième percentile (tau égal à 0.90), une sous-estimation est pénalisée neuf fois plus sévèrement qu’une surestimation de magnitude équivalente, contraignant la droite ou l’hyperplan de régression à laisser exactement quatre-vingt-dix pour cent des résidus sous sa surface.
Sur le plan computationnel, contrairement aux moindres carrés ordinaires qui admettent une solution analytique explicite sous forme matricielle fermée, la fonction de perte quantile présente une non-dérivabilité stricte à l’origine, là où le résidu s’annule. Par conséquent, les algorithmes de descente de gradient classiques fondés sur la matrice hessienne ne peuvent être employés directement sans régularisation. La minimisation s’effectue en reformulant l’équation d’optimisation sous la forme d’un problème canonique de programmation linéaire sous contraintes. Historiquement, l’algorithme du simplexe modifié de Barrodale et Roberts a constitué le standard d’ajustement, avant d’être supplanté, pour les jeux de données volumineux, par les méthodes de points intérieurs développées par Frisch et Newton.
1.3 Pertinence méthodologique en psychométrie et sciences quantitatives
L’adoption de la régression quantile au sein des sciences quantitatives, particulièrement en psychométrie, en neuropsychologie et en sciences comportementales, répond à des nécessités théoriques fondamentales. L’une des applications les plus prééminentes concerne la modélisation rigoureuse des seuils cliniques critiques chez les sujets présentant des profils cognitifs ou affectifs atypiques. Dans l’évaluation des déficits attentionnels ou du ralentissement psychomoteur consécutif à une lésion cérébrale, l’investigateur ne cherche pas à savoir si le temps de réaction moyen d’un patient dévie légèrement de la moyenne normative, mais si les quantiles les plus lents de ses réponses — reflétant des lapses attentionnels périodiques — s’étirent de manière disproportionnée par rapport aux quantiles médians ou rapides.
Par ailleurs, la régression quantile permet de modéliser avec précision l’impact différentiel d’une intervention thérapeutique, pédagogique ou pharmacologique en fonction du niveau de base initial du sujet. Dans les études d’efficacité éducative, par exemple, un programme d’entraînement cognitif intensif peut n’exercer aucun effet décelable sur les élèves les plus performants situés au quantile 0.90 (effet de plafond), tout en déployant un gain substantiel chez les élèves en situation de vulnérabilité scolaire situés au quantile 0.10. Une régression linéaire classique par moindres carrés agrègerait ces deux dynamiques divergentes au sein d’une moyenne édulcorée, concluant potentiellement à une efficacité globale modeste, voire insignifiante, masquant ainsi une réussite clinique majeure auprès du sous-groupe cible.
Enfin, cette approche préserve l’intégrité structurelle des données en évitant le recours aux transformations arbitraires et souvent délétères des variables dépendantes. Face à une distribution fortement asymétrique, la pratique courante consiste fréquemment à appliquer une transformation logarithmique ou une transformation de Box-Cox. Bien que ces manipulations puissent stabiliser la variance, elles altèrent fondamentalement l’échelle de mesure d’origine, complexifient considérablement l’interprétation concrète des coefficients estimés et introduisent des biais d’inégalité de Jensen lors du retour à l’échelle brute. La régression quantile est équivariante aux transformations monotones croissantes : si l’on applique une transformation monotone à la variable dépendante, les quantiles de la variable transformée sont rigoureusement égaux à la transformation des quantiles d’origine, une propriété dont ne jouit nullement l’espérance mathématique.
2. Configuration de l’environnement Python et bibliothèques requises
L’exécution rigoureuse d’une analyse par régression quantile nécessite la mise en place d’un écosystème logiciel stable, fondé sur les briques scientifiques les plus robustes de la communauté du calcul numérique en Python.
2.1 Présentation des dépendances scientifiques essentielles
La mise en œuvre pratique de la modélisation quantile fait intervenir une chaîne intégrée de bibliothèques spécialisées dans le calcul matriciel, la structuration relationnelle des données et la visualisation analytique. Au fondement de cette architecture se trouve la bibliothèque NumPy, laquelle assure l’allocation vectorisée des tableaux multidimensionnels et fournit les routines d’algèbre linéaire de bas niveau nécessaires au traitement rapide des opérations matricielles sous-jacentes.
Pour l’ingestion, la manipulation tabulaire et la préparation des données empiriques, la bibliothèque Pandas constitue l’outil central. Elle structure les jeux de données sous la forme d’objets DataFrame dotés d’un indexage explicite, gère de façon transparente les valeurs manquantes et permet d’appliquer des regroupements et des filtrages conditionnels préalables à la modélisation. Pandas s’interface sans aucune friction avec l’environnement de modélisation en garantissant que les étiquettes de colonnes et les typages de variables (continues, catégorielles, ordinales) soient fidèlement préservés.
Le cœur de l’estimation économétrique et statistique repose sur le module spécialisé de la bibliothèque Statsmodels. Contrairement aux bibliothèques de pur apprentissage automatique comme Scikit-Learn — qui privilégient les métriques de prédiction brute et la minimisation d’erreurs hors échantillon —, Statsmodels est délibérément orienté vers l’inférence statistique académique. Son sous-module formula api fournit une interface calquée sur le système de formules popularisé par le langage R, facilitant l’écriture intuitive d’équations statistiques complexes intégrant constantes, effets principaux, interactions d’ordre supérieur et contrastes qualitatifs.
Enfin, l’analyse distributionnelle et la restitution graphique des faisceaux quantiles requièrent le couplage de Matplotlib et Seaborn. Matplotlib offre un contrôle granulaire de l’ensemble des éléments typographiques, cartésiens et vectoriels nécessaires à la production de figures répondant aux normes de publication des revues scientifiques internationales. Seaborn superpose à cette base des primitives de haut niveau permettant de tracer des distributions conditionnelles élégantes et d’illustrer la trajectoire continue des coefficients à travers le spectre des quantiles.
2.2 Installation et configuration de l’espace de travail virtuel
La reproductibilité des calculs scientifiques requiert l’isolation absolue de l’environnement de développement afin de prémunir les scripts contre les ruptures de compatibilité ascendante entre les versions de paquets. Il est formellement recommandé d’instancier un environnement virtuel dédié au moyen du module standard venv ou du gestionnaire Conda. Une configuration rigoureuse s’articule autour de versions récentes et stables de l’interpréteur Python, idéalement une version égale ou supérieure à la révision 3.10, au sein de laquelle seront déployées les versions compatibles de SciPy, Statsmodels et Pandas.
La chaîne des dépendances s’installe typiquement via le gestionnaire de paquets officiel de Python en exécutant une commande consolidant les bibliothèques scientifiques maîtresses. Une fois l’environnement instancié, la première étape logique au sein d’un script ou d’un carnet interactif consiste à importer formellement les modules requis selon les conventions communautaires reconnues. Il convient d’importer NumPy sous l’alias np, Pandas sous l’alias pd, Matplotlib pyplot sous l’alias plt, Seaborn sous l’alias sns, et le module statsmodels.formula.api sous l’alias smf.
Au-delà des importations, il est d’usage de paramétrer immédiatement les options globales de formatage de l’affichage de la bibliothèque Pandas. La définition explicite du format des nombres à virgule flottante — par exemple en limitant l’affichage à quatre décimales — et l’élargissement du nombre maximal de colonnes affichables permettent d’inspecter avec clarté les tableaux récapitulatifs complexes d’estimation sans que des troncatures automatiques ne viennent dégrader la lisibilité des coefficients, des erreurs types asymptotiques et des seuils de significativité statistique.
3. Génération et structuration des données expérimentales
Afin de démontrer sans ambiguïté les vertus analytiques de la régression quantile par rapport aux moindres carrés ordinaires, il est particulièrement instructif de concevoir un protocole de simulation contrôlé dans lequel une forme manifeste d’hétéroscédasticité est mathématiquement injectée dans la structure des données.
3.1 Simulation d’un jeu de données avec hétéroscédasticité contrôlée
Pour assurer la reproductibilité intégrale de l’expérimentation numérique, la procédure débute par l’initialisation explicite du générateur de nombres pseudo-aléatoires de NumPy au moyen de la méthode de fixation de graine aléatoire. Ce protocole garantit que chaque séquence stochastique générée demeurera parfaitement reproductible d’une machine à l’autre. Nous fixons un effectif d’échantillon substantiel, comprenant par exemple mille observations, représentatif d’une grande cohorte psychologique ou éducationnelle.
Nous introduisons une variable indépendante continue modélisant le volume hebdomadaire d’heures d’apprentissage ou d’entraînement cognitif, distribuée uniformément sur un intervalle allant de deux à quarante heures. L’hypothèse sous-jacente est que l’exposition à la tâche induit une élévation globale du niveau de performance psychométrique. Toutefois, conformément aux observations de terrain, l’entraînement n’exerce pas un effet uniformément calibré sur tous les individus : chez certains apprenants, des facultés cognitives intrinsèques ou un engagement qualitatif exceptionnel amplifient considérablement les bénéfices du travail, tandis que d’autres progressent de façon plus modeste.
Cette divergence se formalise mathématiquement par la création d’un terme d’erreur hétéroscédastique dont la variance s’accroît linéairement avec le prédicteur. Le terme stochastique résiduel est défini comme le produit d’un bruit blanc gaussien standard (centré et réduit) par une fonction linéaire monotone croissante de la variable d’heures d’étude. La variable dépendante continue, simulant un score standardisé à une batterie d’évaluation cognitive, est ensuite construite en sommant une constante de base, une pente linéaire déterministe et ce terme d’erreur à variance multiplicative. Cette structure générative garantit que la dispersion conditionnelle s’évase au fur et à mesure que les heures augmentent, conférant au nuage de points la géométrie caractéristique d’un cône ou d’un éventail.
3.2 Exploration descriptive initiale du jeu de données
Une fois les vecteurs numériques compilés au sein d’un DataFrame Pandas structuré, la phase exploratoire initiale débute par l’inspection minutieuse de la structure tabulaire à l’aide de la méthode descriptive d’aperçu des premières lignes. Cette étape élémentaire confirme l’intégrité des types de données, la parfaite concordance des dimensions matricielles et l’absence fortuite de valeurs non numériques ou d’aberrations computationnelles introduites lors de la phase de vectorisation.
L’évaluation se poursuit par le calcul systématique des métriques transversales de tendance centrale et de dispersion via la méthode récapitulative descriptive globale de Pandas. Cette analyse fait ressortir la disparité fondamentale entre la moyenne et les différents percentiles de l’échantillon. L’évaluation de l’écart interquartile (distance séparant le soixante-quinzième du vingt-cinquième percentile) couplée aux coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) confirme l’existence d’écarts significatifs par rapport à la distribution normale multivariée idéale requise par les postulats classiques des moindres carrés.
Enfin, la modélisation graphique exploratoire préliminaire au moyen d’un nuage de points généré par Seaborn matérialise immédiatement l’architecture hétéroscédastique des données. Pour les faibles valeurs d’entraînement, la variance conditionnelle des scores demeure extrêmement étroite, les performances individuelles étant concentrées dans un corridor restreint. À l’inverse, pour les niveaux élevés d’heures d’étude, le spectre de dispersion s’élargit considérablement : certains sujets atteignent des scores d’excellence spectaculaires tandis que d’autres stagnent à des niveaux à peine supérieurs à la moyenne initiale. Ce constat visuel constitue l’indication diagnostique par excellence justifiant le déploiement immédiat de la régression quantile en lieu et place d’un modèle par moindres carrés ordinaires qui écraserait totalement cette richesse morphologique.
4. Implémentation d’un modèle univarié pour le quantile médian
Le point d’ancrage logique de la régression quantile réside dans l’estimation du cinquantième percentile, communément dénommé quantile médian. Cette étape intermédiaire établit le pont conceptuel entre les méthodes robustes de tendance centrale et l’exploration plus avancée du spectre distributionnel complet.
4.1 Définition du modèle avec l’interface de formule Statsmodels
Dans l’écosystème Statsmodels, l’instanciation d’un modèle de régression quantile s’effectue via la méthode quantreg accessible au sein de l’interface de formules de haut niveau. Cette approche s’inspire de la syntaxe de Wilkinson-Rogers, dans laquelle la relation fonctionnelle s’énonce au moyen d’une chaîne de caractères explicite reliant la variable dépendante aux covariables par un opérateur d’équivalence symbolisé par le tilde. Pour notre expérimentation univariée, l’expression stipule simplement que le score cognitif est régressé sur la variable représentative des heures d’apprentissage.
La spécification du modèle à ce stade ne calcule pas encore les estimateurs, mais prépare la matrice d’expérience en y intégrant automatiquement une colonne unitaire dédiée à l’estimation de l’ordonnée à l’origine, sauf instruction explicite contraire. C’est au moment de l’appel de la méthode d’ajustement que le chercheur déclare formellement la valeur du paramètre quantile tau d’intérêt. Pour modéliser la médiane, l’argument scalaire q se voit assigner la valeur stricte de 0.50.
Il importe de distinguer rigoureusement sur le plan théorique la régression médiane ainsi spécifiée de la régression L1 classique ou méthode des moindres déviations absolues. Si, pour tau égal à 0.50, les deux approches convergent conceptuellement vers la même droite d’ajustement minimisant la somme des valeurs absolues des résidus, l’implémentation au sein de Statsmodels traite la régression quantile sous un cadre d’inférence asymptotique plus large. Elle autorise le calcul direct de matrices de variance-covariance robustes adaptées à l’estimation de densités locales, permettant une quantification précise de l’incertitude d’échantillonnage que la simple optimisation L1 déterministe ne fournit pas d’emblée.
4.2 Ajustement et optimisation numérique du modèle
L’exécution de la méthode d’ajustement déclenche les algorithmes d’optimisation numérique sous-jacents. Dans Statsmodels, l’algorithme par défaut utilisé pour résoudre le programme linéaire de la régression quantile repose sur une implémentation sophistiquée de la méthode de points intérieurs développée par Portnoy et Koenker, couplée à des mécanismes de barrière logarithmique. Contrairement à l’algorithme classique du simplexe qui progresse de sommet en sommet le long des facettes du polyèdre des contraintes, les algorithmes de points intérieurs traversent directement l’intérieur du domaine réalisable, conférant un avantage d’accélération polynomial majeur lors du traitement d’échantillons volumineux.
Le chercheur vigilant doit s’assurer du succès formel de la convergence numérique du solveur. L’objet résultat retourné par la méthode d’ajustement encapsule une série de métriques internes relatives à l’état du processus itératif, notamment le nombre total d’itérations requises et les indicateurs booléens attestant que les critères de terminaison sur le gradient de la fonction de pénalité ont été scrupuleusement satisfaits. Si une quasi-colinéarité ou un mauvais conditionnement de la matrice des prédicteurs survient, le solveur peut émettre des alertes d’instabilité numérique qu’il convient d’inspecter avant toute interprétation substantielle.
L’objet de résultats d’ajustement ainsi obtenu agrège en mémoire la totalité des paramètres estimés, les résidus conditionnels asymétriques, les matrices d’information et les statistiques d’inférence associées. Cet objet constitue l’élément central à partir duquel seront extraites l’ensemble des métriques d’ajustement et déployées les visualisations subséquentes.
5. Interprétation académique des résultats statistiques
L’extraction de la synthèse textuelle d’un modèle quantile via la méthode récapitulative standard de Statsmodels produit un tableau détaillé dont l’interprétation exige une maîtrise rigoureuse des concepts d’estimation asymptotique.
5.1 Analyse du tableau récapitulatif des paramètres estimés
Le tableau de synthèse issu de la régression quantile structure ses résultats de manière analogue aux sorties économétriques traditionnelles, tout en modifiant fondamentalement la sémantique probabiliste des coefficients. L’ordonnée à l’origine estimée ne représente plus la moyenne attendue du score lorsque le prédicteur est nul, mais correspond précisément au cinquantième percentile (la médiane) de la distribution conditionnelle du score en l’absence d’heures d’apprentissage.
Le coefficient associé à la variable continue d’heures d’étude mesure la variation marginale du quantile médian induite par l’accroissement unitaire d’une heure d’apprentissage. Si ce coefficient présente une valeur de 1.85, l’interprétation académique exacte stipule que chaque heure d’étude additionnelle décale la médiane de la distribution conditionnelle des scores de 1.85 unité, toutes choses étant égales par ailleurs. Cette nuance est fondamentale : le coefficient n’indique pas que chaque sujet gagne individuellement 1.85 unité, mais informe sur la translation de la position médiane de la distribution sous-jacente.
L’évaluation de la signification statistique procède de l’analyse conjointe des erreurs standards asymptotiques, des ratios t de Student correspondants et des valeurs de probabilité associées. Sous l’hypothèse nulle postulant que la pente quantile est rigoureusement nulle, le ratio du coefficient divisé par son erreur type robuste converge asymptotiquement vers une loi normale centrée réduite. L’observation d’une p-valeur inférieure au seuil conventionnel de 0.05 autorise le rejet de l’hypothèse nulle d’absence d’effet. De surcroît, le tableau fournit les bornes inférieures et supérieures des intervalles de confiance à 95 pour cent, lesquels délimitent avec précision la marge d’incertitude liée à l’échantillonnage pour le percentile spécifié.
5.2 Indicateurs de qualité de l’ajustement quantile
Dans l’univers des moindres carrés ordinaires, le coefficient de détermination usuel R-carré quantifie la proportion de variance de la variable dépendante expliquée par l’hyperplan de régression. Ce coefficient reposant sur la somme des carrés des écarts à la moyenne arithmétique, il s’avère conceptuellement invalide dans le cadre de la régression quantile où l’objet d’intérêt n’est pas la variance mais une déviation absolue asymétrique. Pour combler cette lacune, Koenker et Machado ont formulé en 1999 une mesure analogue rigoureuse dénommée le pseudo R-carré quantile.
Cette statistique s’obtient en calculant le ratio entre la somme pondérée des pertes absolues asymétriques du modèle complet spécifié et la somme pondérée des pertes du modèle nul ne comportant qu’une unique ordonnée à l’origine pour le même quantile tau. En soustrayant ce ratio de l’unité, on obtient un indice standardisé oscillant entre zéro et un. Il quantifie le gain d’ajustement relatif apporté par l’introduction des covariables dans la modélisation du quantile conditionnel ciblé par rapport à une estimation quantile marginale brute.
Un diagnostic d’intégrité empirique incontournable consiste enfin à vérifier la proportion d’observations effectives du jeu de données qui se positionnent strictement en dessous de l’hyperplan ajusté. Pour un modèle estimé à un quantile tau égal à 0.50, l’algorithme d’optimisation doit mathématiquement converger vers un état où approximativement cinquante pour cent des résidus sont de signe négatif. Un écart systématique et massif entre la valeur nominale de tau et la fréquence empirique des observations inférieures indique des dysfonctionnements sévères dans la structure matricielle, une présence massive d’observations ex aequo (ties) ou des problèmes de convergence algorithmique non résolus.
6. Estimation multi-quantiles simultanée le long du spectre distributionnel
La véritable puissance analytique de la régression quantile se déploie lorsqu’elle abandonne l’analyse isolée d’un unique percentile pour embrasser simultanément l’intégralité de la distribution conditionnelle à travers l’estimation d’un faisceau de quantiles échelonnés.
6.1 Construction d’une boucle itérative d’estimation
Afin de cartographier la dynamique de la relation fonctionnelle sur l’ensemble du spectre, il convient de programmer une séquence itérative automatisée sous Python. Cette procédure débute par l’instanciation d’un vecteur numérique discret contenant une série ordonnée de percentiles d’intérêt, régulièrement distribués depuis la queue inférieure (par exemple tau égal à 0.05 ou 0.10) jusqu’à la queue supérieure (tau égal à 0.90 ou 0.95), par incréments de cinq ou dix centiles.
Une boucle de programmation itère sur chaque élément scalaire de cette grille de quantiles. À chaque itération, la méthode d’ajustement quantreg est sollicitée avec le paramètre q ajusté sur la valeur courante de tau. L’algorithme procède à l’optimisation du système linéaire spécifique à ce percentile et extrait immédiatement les résultats clés : le vecteur des coefficients estimés pour l’ordonnée à l’origine et la pente, les erreurs types asymptotiques associées, ainsi que les intervalles de confiance encadrant ces métriques.
Ces données d’estimation sont collectées séquentiellement au sein de listes ou de dictionnaires Python temporaires, avant d’être unifiées sous la forme d’un tableau relationnel global. Ce processus automatisé convertit une succession d’estimations atomiques en un ensemble cohérent d’informations structurelles sur la morphologie de la distribution étudiée.
6.2 Stockage structuré et synthèse tabulaire des trajectoires
La compilation des résultats d’estimation séquentielle dans un DataFrame Pandas de synthèse constitue une étape méthodologique fondamentale pour l’analyse avancée. Cette structure tabulaire répertorie, pour chaque quantile tau analysé, la valeur ponctuelle de la constante, l’amplitude de la pente, l’erreur standard robuste, la valeur p du test de significativité, ainsi que les bornes inférieure et supérieure de l’intervalle de confiance à 95 pour cent.
L’examen transversal de ce tableau met immédiatement en lumière l’hétérogénéité des effets induite par notre dispositif expérimental. Si la relation était rigoureusement homoscédastique, les pentes associées au prédicteur demeureraient rigoureusement constantes à travers tous les quantiles, oscillant uniquement au gré des fluctuations d’échantillonnage aléatoires. En revanche, en présence de l’hétéroscédasticité simulée, le tableau de synthèse montre une trajectoire de pentes continuellement ascendante : les coefficients sont modestes aux percentiles inférieurs et croissent substantiellement à mesure que tau progresse vers les déciles supérieurs.
Cette synthèse tabulaire sert également de filtre diagnostique pour détecter d’éventuelles anomalies d’ajustement, au premier rang desquelles figure le phénomène indésirable de croisement de quantiles. Dans le cadre de régressions quantiles ajustées indépendamment les unes des autres, il peut arriver, en particulier dans les régions de l’espace où les données sont rares ou bruitées, que la droite prédite pour un quantile supérieur vienne couper et passer sous la droite prédite pour un quantile inférieur, violant ainsi le principe mathématique fondamental selon lequel une fonction de répartition cumulative inverse doit être strictement non décroissante.
7. Visualisation avancée des résultats de régression quantile
L’interprétation des modèles distributionnels complexes atteint son plus haut degré d’efficience heuristique lorsqu’elle s’appuie sur des représentations graphiques vectorielles conformes aux canons des publications internationales.
7.1 Représentation du faisceau de droites sur le nuage de points
Le premier graphique de diagnostic consiste à superposer l’ensemble des droites quantiles conditionnelles estimées directement sur le nuage de points des données empiriques brutes. Cette composition visuelle permet de confronter directement l’ajustement distributionnel fin à la régression moyenne traditionnelle.
Sous Python, la construction s’effectue en générant un vecteur de coordonnées d’abscisses régulièrement espacées couvrant le domaine de variation du prédicteur. Pour chaque quantile tau préalablement estimé, la droite de prédiction est projetée sur ce domaine au moyen du produit scalaire des valeurs d’abscisses par les coefficients respectifs du modèle. La droite des moindres carrés ordinaires est ensuite superposée, typiquement représentée avec un trait discontinu distinctif de fort contraste visuel, afin de souligner le contraste avec les lignes quantiles.
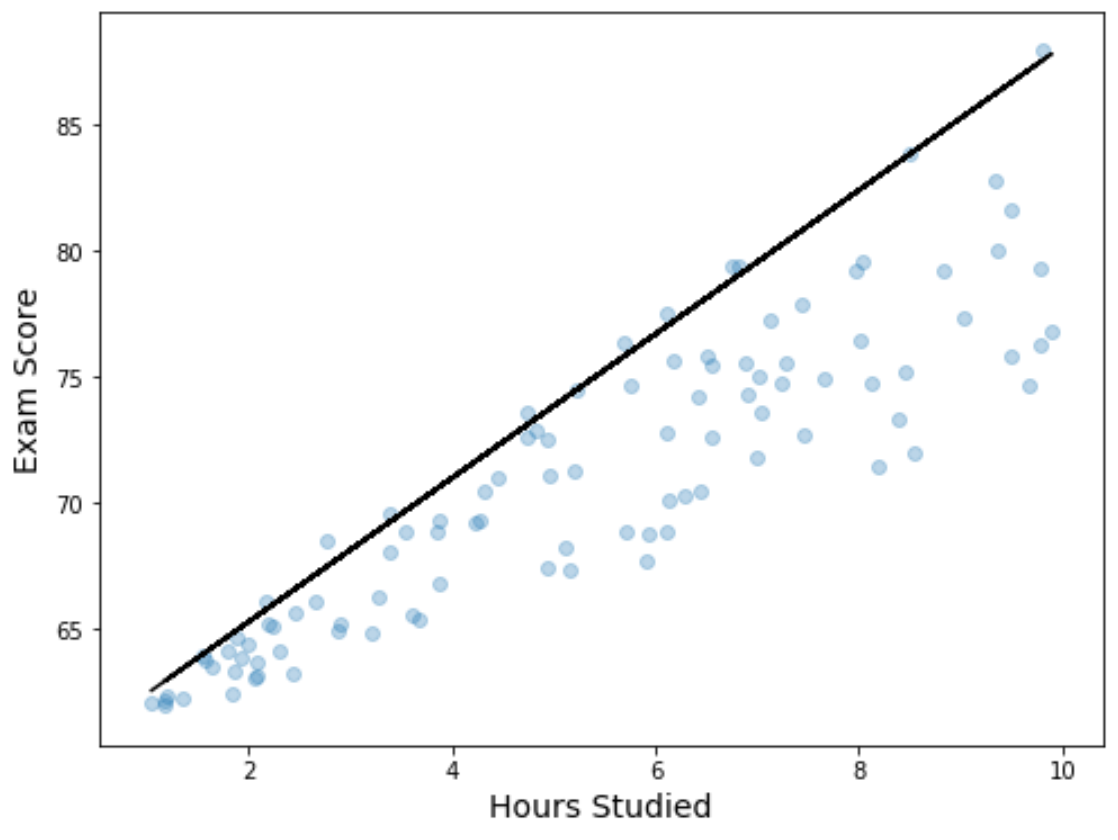
L’application de palettes chromatiques perceptuellement uniformes (issues des palettes modernes de Matplotlib telles que Viridis ou Plasma) permet de coder l’élévation du paramètre tau de manière progressive et intuitive. L’observateur visualise ainsi d’un coup d’œil l’évasement en éventail du faisceau de droites : les lignes quantiles inférieures présentent une inclinaison modérée, tandis que les lignes quantiles supérieures affichent une pente nettement plus abrupte, épousant fidèlement la dispersion conique des données sans subir la distorsion de quelques points marginaux.
7.2 Graphique de la dynamique des coefficients selon les quantiles
Si la superposition des droites sur le nuage de points est séduisante, la représentation canonique de la régression quantile — popularisée par Roger Koenker — est le graphique de la trajectoire des paramètres en fonction du quantile tau. Dans ce diagramme bidimensionnel, l’axe horizontal balaye l’intervalle continu des quantiles de 0 à 1, tandis que l’axe vertical indique la magnitude du coefficient de pente associé au prédicteur.
La trajectoire du coefficient quantile est tracée sous la forme d’une courbe continue reliant les estimations ponctuelles obtenues pour la grille de percentiles. Autour de cette courbe d’estimation, un ruban d’incertitude semi-transparent est généré à l’aide de la méthode de remplissage entre courbes de Matplotlib, représentant l’enveloppe de confiance à 95 pour cent calculée à partir des erreurs standards asymptotiques ou obtenues par rééchantillonnage.
À des fins de comparaison rigoureuse, la valeur ponctuelle du coefficient calculé par les moindres carrés ordinaires est projetée sur l’ensemble du graphique sous la forme d’une ligne horizontale invariante. De part et d’autre de cette ligne de moyenne, deux droites horizontales discontinues tracent les limites de l’intervalle de confiance à 95 pour cent du modèle classique. Cette disposition graphique permet une interprétation immédiate : dès lors que la courbe quantile et son enveloppe d’incertitude émergent en dehors du couloir délimité par l’intervalle des moindres carrés ordinaires (que ce soit dans les déciles inférieurs ou supérieurs), le chercheur apporte la preuve visuelle et inférentielle irréfutable que le modèle linéaire moyen est incapable de synthétiser la réalité distributionnelle du phénomène étudié.
8. Inférence statistique et diagnostics de robustesse
L’estimation ponctuelle des coefficients ne suffit pas à l’établissement de conclusions scientifiques définitives ; la modélisation doit être adossée à des procédures d’inférence statistique robustes tenant compte de la nature non classique des estimateurs quantiles.
8.1 Estimation robuste de la matrice de covariance des paramètres
L’évaluation de l’incertitude d’échantillonnage en régression quantile dépend de l’estimation précise de la fonction de densité de la variable dépendante conditionnellement aux covariables, évaluée précisément au niveau du quantile d’intérêt. L’inverse de cette quantité est connu dans la littérature statistique sous le terme de fonction de densité quantile ou « fonction de sparseté ». Lorsque la densité des données au voisinage immédiat du quantile considéré est faible, l’incertitude sur la localisation exacte de la droite de régression s’accroît mécaniquement, ce qui dilate l’erreur type du coefficient de pente.
Dans Statsmodels, plusieurs méthodologies asymptotiques sont disponibles via l’argument de spécification de la matrice de variance-covariance au sein de la méthode d’ajustement. L’approche standard repose sur l’estimation par noyau de la fonction de densité de l’erreur, telle que théorisée par Koenker. Cette méthode nécessite le calibrage d’une largeur de bande (bandwidth). Deux règles de sélection dominent la pratique académique : la règle de Hall-Sheather, qui optimise l’approximation pour la construction d’intervalles de confiance et de tests de Student, et la règle de Bofinger, davantage orientée vers la minimisation de l’erreur quadratique moyenne de l’estimateur de densité.
Lorsque le chercheur suspecte une hétéroscédasticité non linéaire complexe ou des formes irrégulières de dépendance au sein des erreurs résiduelles, l’option d’estimation robuste dite de sandwich (approche de Powell) est vivement recommandée. Cet estimateur asymptotique relaxe l’hypothèse d’indépendance et de distribution identique des résidus en intégrant des noyaux adaptatifs locaux qui protègent les erreurs types contre les spécifications erronées de la forme fonctionnelle de la variance conditionnelle.
8.2 Tests d’hypothèses sur l’égalité des pentes entre quantiles
Une question scientifique récurrente est de déterminer si les différences de pentes observées d’un quantile à un autre sont statistiquement significatives ou si elles relèvent simplement du bruit d’échantillonnage. En d’autres termes, le chercheur doit tester formellement l’hypothèse nulle d’homogénéité des effets à travers le spectre des quantiles : la pente au premier quartile (tau égal à 0.25) est-elle statistiquement identique à la pente au troisième quartile (tau égal à 0.75) ?
La validation formelle de cette hypothèse s’effectue par le déploiement d’un test de Wald conjoint inter-quantiles. Contrairement à la comparaison naïve de deux intervalles de confiance disjoints (qui constitue une erreur méthodologique classique car les estimateurs aux différents quantiles sont calculés sur le même échantillon et sont donc positivement corrélés), le test de Wald prend en compte la covariance non nulle entre les estimateurs issus des différents sous-modèles quantiles. Pour ce faire, les modèles quantiles d’intérêt doivent être formulés au sein d’un système d’équations empiriques jointes résolu par estimation simultanée.
Le rejet statistique de l’hypothèse nulle d’égalité des pentes, caractérisé par une p-valeur du test de Wald inférieure au seuil critique alpha de 0.05, apporte la preuve formelle que l’effet marginal du prédicteur n’est pas uniforme au sein de la population. En contexte clinique, ce rejet atteste de manière concluante que l’intervention étudiée déploie un impact asymétrique substantiel, justifiant l’abandon irréversible des moindres carrés ordinaires au profit d’une lecture stratifiée de l’action thérapeutique.
9. Techniques de rééchantillonnage par Bootstrap pour modèles quantiles
Bien que la théorie asymptotique de la régression quantile soit rigoureusement établie, les approximations en grand échantillon peuvent s’avérer défaillantes lorsque la taille de l’échantillon empirique est réduite ou lorsque l’analyste explore des quantiles extrêmes où la densité d’observations s’amenuise drastiquement.
9.1 Fondements du bootstrap pour l’inférence quantile non-paramétrique
Dans les échantillons psychologiques de taille modeste ou caractérisés par de fortes non-linéarités, les méthodes d’estimation asymptotique de la densité de sparseté peuvent introduire des biais non négligeables dans le calcul des erreurs types. L’inférence non paramétrique fondée sur le rééchantillonnage par bootstrap s’affirme alors comme une alternative méthodologique d’une supériorité reconnue. Le bootstrap ne postule aucune forme paramétrique a priori sur la loi de distribution de l’aléa résiduel et contourne l’obligation d’estimer explicitement la fonction de densité conditionnelle au voisinage du quantile.
Deux grandes taxonomies de rééchantillonnage s’offrent au chercheur : le bootstrap par paires (ou bootstrap d’observations) et le bootstrap résiduel. Le bootstrap par paires consiste à tirer de manière itérative, avec remise, des lignes entières de la matrice de données originale (associant la variable dépendante et ses régresseurs correspondants). Cette procédure préserve intégralement la structure d’hétéroscédasticité sous-jacente sans formuler d’hypothèse restrictive sur la liaison unissant les moments conditionnels de la réponse aux covariables. Le bootstrap résiduel, quant à lui, suppose une homoscédasticité structurelle et rééchantillonne uniquement les résidus centrés, une hypothèse en contradiction flagrante avec la vocation même de la régression quantile.
La méthode par paires s’impose donc comme le standard de rigueur pour l’inférence quantile. En réestimant le modèle quantile sur un millier ou dix mille pseudo-échantillons bootstrapés, l’analyste génère une distribution empirique d’échantillonnage pour chaque coefficient de pente et d’ordonnée à l’origine. Cette distribution empirique reflète fidèlement la véritable incertitude d’estimation, particulièrement dans les queues distributionnelles extrêmes (taux inférieurs à 0.10 ou supérieurs à 0.90) où les estimateurs asymptotiques conventionnels ont tendance à sous-estimer la variance réelle.
9.2 Mise en œuvre algorithmique du bootstrap en Python
L’implémentation d’un schéma d’inférence par bootstrap en Python peut s’effectuer au moyen de fonctions vectorisées exploitant la méthode de choix aléatoire avec remise de NumPy appliquée à l’indexation des DataFrames Pandas. La structure algorithmique générale s’articule autour de l’allocation préalable d’une matrice de stockage destinée à enregistrer les vecteurs de coefficients estimés au fil des itérations.
Une boucle itérative cadencée typiquement sur un minimum de mille répétitions tire un échantillon aléatoire de même taille N que le jeu de données initial, ajuste le modèle quantreg pour le quantile tau considéré, et stocke les coefficients résultants. À l’issue de cette phase de rééchantillonnage intensif, le chercheur dispose d’un ensemble de mille répliques pour chaque paramètre du modèle.
Le calcul des intervalles de confiance bootstrap s’opère préférentiellement via la méthode des percentiles empiriques. L’intervalle à 95 pour cent est délimité par le 2.5-ième et le 97.5-ième percentile de la distribution des coefficients bootstrapés, accessibles via la méthode percentile de NumPy. Pour une robustesse mathématique encore plus élevée en présence de distributions asymétriques des estimateurs, l’application de la méthode bootstrap corrigée du biais et accélérée (dénommée BCa) permet d’ajuster les seuils de percentiles en fonction du coefficient d’asymétrie de la distribution d’échantillonnage et d’un facteur d’accélération calculé par jackknife.
10. Extension aux modèles multivariés et spécifications non-linéaires
Les dynamiques comportementales et cliniques ne sauraient se réduire à des configurations univariées. L’adjonction de multiples variables prédictives, de contrôles démographiques et de termes non linéaires est indispensable pour capturer la complexité des systèmes réels.
10.1 Intégration de régresseurs multiples et de covariables catégorielles
La formulation de modèles multivariés s’effectue naturellement au travers de la syntaxe de formules de Statsmodels, laquelle mobilise la bibliothèque Patsy pour la génération automatique de la matrice de plan d’expérience. L’introduction de prédicteurs additionnels s’opère par l’adjonction de termes séparés par des signes d’addition au sein de la formule de régression.
Lors de l’incorporation de variables catégorielles (telles que l’appartenance à un groupe thérapeutique, le niveau d’éducation ou le genre biologique), l’interface gère automatiquement l’encodage sous forme de variables indicatrices muettes (dummy variables) par rapport à une modalité de référence arbitraire ou spécifiée par l’utilisateur. Dans ce cadre, le coefficient associé à une modalité catégorielle ne représente pas la différence de moyennes entre les groupes, mais l’écart existant entre les tau-ièmes quantiles conditionnels des groupes considérés, ajusté pour l’ensemble des autres covariables incluses dans le modèle.
De surcroît, la modélisation autorise l’évaluation fine d’interactions statistiques multivariées complexes, spécifiées au moyen du caractère deux-points ou de l’astérisque. Une interaction entre un prédicteur continu et une modalité qualitative permet d’examiner si la divergence de pente quantile entre les groupes s’amplifie ou s’atténue selon le rang percentile de la variable dépendante. L’analyste peut ainsi révéler que deux sous-populations affichent une trajectoire similaire au niveau de leur médiane, mais divergent radicalement au niveau de leur dixième ou quatre-vingt-dixième percentile sous l’action combinée des facteurs d’exposition.
10.2 Modélisation des relations non-linéaires par polynômes et splines
L’hypothèse d’une liaison strictement linéaire entre les prédicteurs continus et les quantiles de la variable de réponse est fréquemment infirmée dans les contextes empiriques. Des phénomènes physiologiques ou cognitifs d’épuisement, de saturation, de rendement décroissant ou d’effets de seuil imposent l’intégration de flexibilités fonctionnelles au sein du modèle quantile.
Une première approche élémentaire réside dans l’adjonction de termes polynomiaux d’ordre deux ou trois au sein de la formule analytique. Néanmoins, les polynômes globaux souffrent d’inconvénients majeurs, notamment leur propension à osciller de manière erratique aux extrémités du domaine des données (phénomène de Runge). Pour contourner cette limite, le recours aux splines de régression s’affirme comme la méthodologie de référence. En mobilisant la fonction spline intégrée dans Patsy, le chercheur peut décomposer la trajectoire du prédicteur en une série de fonctions polynomiales par morceaux reliées en douceur au niveau de nœuds internes prédéfinis.
Le couplage des B-splines avec la régression quantile permet d’estimer des surfaces de réponse quantile non linéaires extraordinairement souples. Pour chaque quantile tau investigué, le modèle ajuste une courbe spline indépendante épousant les inflexions locales de la relation conditionnelle. Cette souplesse permet par exemple de révéler qu’une augmentation du temps d’entraînement induit un gain cognitif logarithmiquement saturé chez les individus des quantiles supérieurs, alors qu’elle engendre une relation en cloche (en U inversé) chez les individus situés dans les quantiles de vulnérabilité clinique.
11. Application contextuelle à la recherche en sciences psychologiques
Pour illustrer la portée paradigmatique de la régression quantile, examinons son apport déterminant dans deux champs majeurs de la recherche comportementale contemporaine : la chronométrie cognitive et la psychopathologie quantitative.
11.1 Analyse des distributions de temps de réaction et de vigilance cognitive
Dans l’investigation des processus d’attention soutenue et de contrôle exécutif, l’analyse des temps de réaction (TR) se heurte structurellement à l’asymétrie positive prononcée de leurs distributions empiriques. Les données chronométriques individuelles présentent typiquement une masse dense de réponses véloces suivie d’une longue queue s’étirant vers les valeurs temporelles élevées, correspondant aux ralentissements transitoires et aux défaillances attentionnelles épisodiques.
La pratique traditionnelle consistant à calculer le temps de réaction moyen par sujet puis à appliquer un modèle de moindres carrés ordinaires détruit l’information distributionnelle la plus précieuse. Pire encore, les chercheurs procèdent fréquemment à l’élimination arbitraire des temps de réaction lents en les qualifiant de valeurs aberrantes, ou appliquent des transformations inverses ou logarithmiques qui dénaturent l’échelle chronométrique réelle en millisecondes.
La régression quantile s’affranchit totalement de ces expédients méthodologiques. En modélisant les données brutes à travers une famille de quantiles allant de tau égal à 0.10 à tau égal à 0.90, elle permet de dissocier formellement la vitesse d’exécution de base du sujet (capturée par les quantiles rapides 0.10 et 0.20) de la variabilité attentionnelle et de l’occurrence des « lapses » exécutifs (capturés par les quantiles lents 0.80 et 0.90). Lors de l’évaluation d’un médicament nootropique ou d’un protocole de remédiation cognitive, la régression quantile met régulièrement en lumière que la thérapie ne modifie aucunement la vitesse motrice pure des patients (stagnation des quantiles inférieurs), mais compresse massivement la queue des temps de réaction lents, réduisant significativement les épisodes de rupture de la vigilance. Une telle conclusion, cliniquement décisive, demeure totalement inaccessible à une analyse par moindres carrés ordinaires.
11.2 Étude des populations vulnérables et des seuils pathologiques
Un enjeu fondamental de la psychologie clinique et de la psychiatrie réside dans l’identification des prédicteurs environnementaux ou neurobiologiques qui pèsent sur l’émergence des pathologies mentales. La modélisation classique par moindres carrés ordinaires présume implicitement que les facteurs d’adversité sociale ou génétique agissent avec la même intensité sur la population générale saine que sur les individus manifestant une détresse psychologique extrême.
En déployant la régression quantile sur des échelles continues de dépression, d’anxiété ou de stress post-traumatique, les chercheurs ont pu démontrer que la sensibilité aux stress environnementaux augmente drastiquement chez les sujets situés dans les quantiles supérieurs de détresse (tau égal à 0.85 ou 0.95). Tandis qu’un facteur de stress chronique n’exerce qu’une influence négligeable sur le score d’anxiété d’individus résilients situés aux percentiles inférieurs, le même stresseur déclenche une hausse exponentielle des symptômes chez les individus prédisposés ancrés dans la queue supérieure de la distribution.
Cette approche permet en outre de dépasser définitivement la dichotomisation artificielle des scores cliniques continus en catégories nosologiques binaires (sain versus pathologique). La dichotomisation via des scores seuils arbitraires induit une perte colossale de puissance statistique, réduit la fiabilité des mesures et masque les hétérogénéités intra-classes. La régression quantile préserve l’intégralité de la métrique sous-jacente tout en focalisant spécifiquement la puissance du calcul statistique sur les zones distributionnelles où s’opère le basculement vers la pathologie caractérisée.
12. Synthèse méthodologique, écueils fréquents et recommandations pratiques
La mise en œuvre de la régression quantile en environnement de recherche exige une rigueur protocolaire méthodique afin de se prémunir contre des pièges analytiques récurrents et de garantir la conformité des rapports scientifiques aux standards académiques les plus élevés.
12.1 Identification et remédiation des écueils analytiques majeurs
Le premier écueil technique à surveiller est le problème structurel du croisement de quantiles. Lorsque des modèles quantiles sont estimés de manière séparée sur des échantillons de taille modeste ou en présence de fortes variations locales, les fonctions d’ajustement peuvent violer la contrainte de monotonicité de la fonction de répartition. Bien que ce phénomène soit rare au voisinage de la médiane sur des jeux de données denses, il se manifeste fréquemment aux confins de la distribution. Pour y remédier, des techniques avancées de réordonnancement a posteriori ou d’ajustement conjoint sous contraintes linéaires non négatives peuvent être programmées en Python via des solveurs d’optimisation quadratique ou semi-définie au sein de la bibliothèque SciPy.
Un deuxième écueil réside dans l’illusion de puissance statistique lors de l’exploration des percentiles extrêmes. Par définition, un échantillon de 200 individus ne contient structurellement qu’une dizaine d’observations au-delà du 95-ième percentile. Ajuster un modèle quantile comportant de multiples prédicteurs à tau égal à 0.95 sur un tel échantillon conduit inévitablement à une variance d’échantillonnage gigantesque, à des erreurs types instables et à un risque majeur d’erreur de type II. Les chercheurs doivent caler le choix de la grille de quantiles sur l’effectif effectif de leur échantillon, en réservant les déciles extrêmes (en dessous de 0.05 ou au-dessus de 0.95) aux grands échantillons de population comprenant plusieurs milliers d’unités statistiques.
Enfin, la tentation de surajustement (overfitting) lors de l’utilisation conjointe de régressions quantiles et de splines flexibles nécessite une vigilance constante. L’introduction d’un trop grand nombre de degrés de liberté via les nœuds de splines peut amener l’hyperplan quantile à épouser des fluctuations stochastiques aléatoires propres à un sous-échantillon localisé. La validation croisée k-fold adaptée à la fonction de perte quantile asymétrique doit systématiquement être mise en œuvre pour sélectionner le degré optimal de flexibilité non linéaire garantissant une capacité de généralisation hors échantillon optimale.
12.2 Protocole décisionnel et bonnes pratiques de publication académique
Pour guider le praticien dans sa démarche d’analyse distributionnelle, le tableau suivant synthétise les critères de décision formels permettant d’orienter le choix entre la modélisation classique par moindres carrés ordinaires, la régression pondérée et la régression quantile en fonction des propriétés structurelles des données et des objectifs théoriques poursuivis :
| Critère d’évaluation | Moindres Carrés Ordinaires (MCO) | Régression Pondérée (WLS) | Régression Quantile (QR) |
|---|---|---|---|
| Hypothèse sur la variance résiduelle | Homoscédasticité stricte requise sous peine de distorsion des tests. | Hétéroscédasticité autorisée si la structure de variance est connue a priori. | Hétérogénéité de la variance pleinement intégrée sans modélisation a priori. |
| Sensibilité aux valeurs extrêmes | Vulnérabilité maximale ; point de rupture infinitésimal. | Vulnérabilité élevée aux valeurs atypiques dans l’espace des covariables. | Résistance robuste (point de rupture élevé, particulièrement pour la médiane). |
| Cible probabiliste modélisée | Espérance mathématique conditionnelle uniquement. | Espérance mathématique conditionnelle pondérée. | Spectre infini de quantiles conditionnels le long de la distribution. |
| Robustesse aux formes asymétriques | Moyenne déformée en présence d’asymétrie sévère. | Moyenne affectée par l’asymétrie non modélisée. | Préservation rigoureuse de la structure asymétrique originale. |
| Complexité computationnelle | Résolution matricielle analytique fermée quasi instantanée. | Résolution analytique par moindres carrés généralisés. | Programmation linéaire itérative (méthodes de points intérieurs). |
| Interprétabilité théorique | Synthèse globale résumant l’effet moyen d’un traitement. | Effet moyen ajusté pour la précision des mesures. | Cartographie différentielle révélant les effets de plancher, plafond et seuils. |
Dans la perspective d’une soumission éditoriale conforme aux normes de l’American Psychological Association (normes APA 7e édition), la transparence méthodologique est primordiale. Le chercheur doit consigner explicitement dans la section méthodologique :
- La valeur numérique exacte de l’ensemble des quantiles tau explorés et la justification théorique ou clinique sous-tendant leur sélection (par exemple, analyse des quartiles 0.25, 0.50, 0.75 complétée par les déciles extrêmes 0.10 et 0.90 pour capturer les seuils d’alerte psychopathologique).
- L’algorithme d’optimisation numérique déployé (méthode de points intérieurs ou algorithme du simplexe modifié de Barrodale et Roberts).
- La procédure spécifique retenue pour le calcul des erreurs types asymptotiques (méthode d’estimation de la densité par noyau avec indication explicite de la largeur de bande choisie, telle que Hall-Sheather ou Bofinger) ou les paramètres de rééchantillonnage par bootstrap (nombre d’itérations bootstrap, typiquement B supérieur ou égal à 1000, et nature de l’intervalle de confiance calculé, par exemple percentile ou BCa).
- Le tableau récapitulatif complet des coefficients comprenant l’estimation ponctuelle, l’erreur type, la valeur p et l’intervalle de confiance à 95 pour cent pour chaque quantile, assorti des valeurs du pseudo R-carré de Koenker-Machado.
- La figure représentant la trajectoire continue des coefficients le long du spectre des quantiles avec leur ruban d’incertitude, confrontée à l’intervalle horizontal invariable des moindres carrés ordinaires.
Enfin, au regard des exigences modernes de la science ouverte et de la reproductibilité computationnelle, il est impératif que les scripts de programmation Python soient mis à disposition de la communauté académique au sein de dépôts institutionnels publics ou sur des plateformes dédiées telles que Zenodo ou le cadre Open Science Framework (OSF). Le code source doit être intégralement documenté, inclure la fixation formelle des graines aléatoires, et être accompagné d’un fichier décrivant avec rigueur l’environnement virtuel d’exécution (notamment via un fichier de spécification de dépendances figé) garantissant que les chercheurs pairs puissent reproduire à l’identique l’intégralité des convergences d’optimisation, des tableaux inférentiels et des compositions graphiques publiées.
Références
- Bassett, G., & Koenker, R. (1978). Asymptotic theory of least absolute error regression. Journal of the American Statistical Association, 73(363), 618–622. https://doi.org/10.1080/01621459.1978.10480065
- Cade, B. S., & Noon, B. R. (2003). A gentle introduction to quantile regression for ecologists. Frontiers in Ecology and the Environment, 1(8), 412–420. https://doi.org/10.1890/1540-9295(2003)001[0412:AGITQR]2.0.CO;2
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Koenker, R. (2005). Quantile regression (Econometric Society Monographs, No. 38). Cambridge University Press. https://doi.org/10.1017/CBO9780511754098
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Koenker, R., & Hallock, K. F. (2001). Quantile regression. Journal of Economic Perspectives, 15(4), 143–156. https://doi.org/10.1257/jep.15.4.143
- Koenker, R., & Machado, J. A. (1999). Goodness of fit and related inference processes for quantile regression. Journal of the American Statistical Association, 94(448), 1296–1310. https://doi.org/10.1080/01621459.1999.10473882
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1924-00a
- Portnoy, S., & Koenker, R. (1997). The Gaussian hare and the Laplacian tortoise: Computability of squared-error versus absolute-error estimators. Statistical Science, 12(4), 279–300. https://doi.org/10.1214/ss/1030037960
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (pp. 92–96). https://doi.org/10.25080/Majora-92bf1924-011
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021