
L’analyse de régression linéaire simple constitue la pierre angulaire de l’inférence statistique et de la modélisation prédictive dans les sciences contemporaines. Développée historiquement à travers les travaux fondateurs de Francis Galton et formalisée mathématiquement par Karl Pearson et Ronald Fisher, cette méthode offre un cadre rigoureux pour explorer, quantifier et modéliser la relation fonctionnelle univariée qui lie une variable dépendante continue à un prédicteur unique. En dépit de l’émergence d’algorithmes d’apprentissage automatique de plus en plus complexes, la régression linéaire préserve un statut épistémologique privilégié, tant en raison de son interprétabilité paramétrique absolue que de sa robustesse théorique adossée au théorème de Gauss-Markov.
Dans les sciences comportementales, cognitives, sociales et biomédicales, la démarche du chercheur dépasse la simple quête de performance prédictive pour s’ancrer dans l’explication des phénomènes. Comprendre comment une variation marginale d’une variable environnementale ou individuelle module un comportement ou un score psychométrique exige un instrument analytique transparent. Le langage de programmation Python s’est imposé comme l’environnement d’ingénierie et de recherche par excellence, articulant la flexibilité du calcul matriciel vectorisé avec des bibliothèques statistiques de premier ordre. Ce guide exhaustif a pour vocation de décomposer chaque dimension de la régression linéaire simple, depuis la modélisation mathématique fondamentale jusqu’à la restitution normalisée des résultats selon les standards académiques internationaux.
Adopter une démarche analytique rigoureuse requiert de ne jamais réduire l’ajustement statistique à l’exécution mécanique d’une ligne de code. Ce manuel méthodologique propose une progression systématique : clarification des hypothèses probabilistes sous-jacentes, diagnostic exploratoire des distributions, implémentation comparative via les écosystèmes Statsmodels et Scikit-Learn, vérification méticuleuse des postulats sur les résidus et détection raisonnée des points aberrants et influents. Chaque étape est adossée à une réflexion théorique approfondie, assurant ainsi une maîtrise complète du processus de modélisation pour la recherche empirique.
1. Fondements théoriques de la régression linéaire simple
1.1 Définition et modélisation mathématique du lien univarié
La modélisation de la régression linéaire simple repose sur l’hypothèse selon laquelle une variable quantitative continue, qualifiée de variable de réponse, dépendante ou expliquée, notée usuellement $Y$, entretient une relation structurelle de premier ordre avec une variable indépendante, explicative ou prédictive, notée $X$. La formalisation mathématique de cette relation au sein de la population générale s’énonce selon l’équation fondamentale :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
Dans cette formulation, l’indice $i$ désigne la $i$-ième observation individuelle au sein d’un échantillon de taille $n$. Le paramètre $\beta_0$ représente l’ordonnée à l’origine (ou intercept), c’est-à-dire la valeur mathématiquement attendue pour l’espérance conditionnelle de $Y$ lorsque le prédicteur $X$ est rigoureusement égal à zéro. Le paramètre $\beta_1$ constitue le coefficient de régression ou la pente ; il quantifie le taux de variation moyen de $Y$ consécutif à une augmentation unitaire de la variable $X$. L’entité $\varepsilon_i$ est le terme d’erreur stochastique, une variable aléatoire non observable traduisant à la fois la variabilité naturelle intrinsèque du phénomène étudié, les erreurs potentielles de mesurage et l’omission d’autres déterminants infinitésimaux non inclus dans le modèle univarié.
La distinction épistémologique entre relation déterministe et relation probabiliste constitue le socle de la modélisation statistique. Alors qu’une relation physique purement déterministe assigne à chaque valeur de $X$ une unique valeur exacte de $Y$ (à l’instar de la loi de Hooke ou de la gravitation newtonienne dans un vide parfait), la relation statistique modélisée en sciences empiriques est fondamentalement probabiliste. Le modèle ne prédit pas une trajectoire absolue pour un individu donné, mais stipule la moyenne conditionnelle d’une distribution de probabilités :
$$\mathbb{E}(Y | X = x) = \beta_0 + \beta_1 x$$
D’un point de vue distributionnel, le modèle linéaire standard postule que les erreurs stochastiques $\varepsilon_i$ sont indépendantes et identiquement distribuées selon une loi normale d’espérance nulle et de variance constante $\sigma^2$, une condition formellement résumée par l’expression $\varepsilon_i \overset{i.i.d.}{\sim} \mathcal{N}(0, \sigma^2)$. Ce postulat implique directement que, pour toute valeur fixée de $X$, la variable conditionnelle $Y|X$ suit elle-même une distribution gaussienne de moyenne $\beta_0 + \beta_1 X$ et de variance $\sigma^2$.
1.2 Principe de la méthode des moindres carrés ordinaires (MCO)
L’estimation empirique des paramètres inconnus de la population, à savoir $\beta_0$ et $\beta_1$, à partir des données d’un échantillon fini requiert un critère d’optimisation mathématique objectif. La méthode des moindres carrés ordinaires (MCO), conceptualisée de façon indépendante par Adrien-Marie Legendre et Carl Friedrich Gauss au début du XIXe siècle, consiste à identifier les estimateurs ponctuels, notés traditionnellement $\hat{\beta}_0$ (ou $b_0$) et $\hat{\beta}_1$ (ou $b_1$), qui minimisent la somme du carré des écarts verticaux entre les valeurs observées $y_i$ et les valeurs prédites par la droite de régression $\hat{y}_i$.
Cette fonction de coût, désignée sous le nom de somme des carrés des résidus (SCR ou Residual Sum of Squares, RSS), se formalise comme suit :
$$S(b_0, b_1) = \sum_{i=1}^{n} e_i^2 = \sum_{i=1}^{n} (y_i – \hat{y}_i)^2 = \sum_{i=1}^{n} (y_i – (b_0 + b_1 x_i))^2$$
La dérivation analytique de ces estimateurs s’opère en calculant les dérivées partielles de la fonction quadratique $S$ par rapport à $b_0$ et $b_1$, puis en annulant ces gradients pour trouver le minimum global, le système d’équations résultant étant qualifié d’équations normales :
$$\frac{\partial S}{\partial b_0} = -2 \sum_{i=1}^{n} (y_i – b_0 – b_1 x_i) = 0$$
$$\frac{\partial S}{\partial b_1} = -2 \sum_{i=1}^{n} x_i (y_i – b_0 – b_1 x_i) = 0$$
La résolution de ce système linéaire permet d’isoler les solutions uniques de façon explicite :
$$\hat{\beta}_1 = \frac{\sum_{i=1}^{n} (x_i – \bar{x})(y_i – \bar{y})}{\sum_{i=1}^{n} (x_i – \bar{x})^2} = \frac{\mathrm{Cov}(X, Y)}{\mathrm{Var}(X)}$$
$$\hat{\beta}_0 = \bar{y} – \hat{\beta}_1 \bar{x}$$
où $\bar{x}$ et $\bar{y}$ représentent respectivement les moyennes arithmétiques empiriques des variables $X$ et $Y$. Selon le célèbre théorème de Gauss-Markov, sous les postulats d’espérance nulle, d’homoscédasticité et d’absence d’autocorrélation des résidus, les estimateurs des MCO sont les meilleurs estimateurs linéaires sans biais (propriété dite BLUE : Best Linear Unbiased Estimator). Cela signifie qu’au sein de la classe de tous les estimateurs linéaires et non biaisés de $\beta_0$ et $\beta_1$, ceux obtenus par les MCO possèdent la variance d’échantillonnage minimale.
Néanmoins, en raison de la nature quadratique de la fonction de coût, qui amplifie de manière exponentielle les déviations de grande magnitude, les estimateurs MCO manifestent une extrême sensibilité aux valeurs extrêmes ou aberrantes. Un unique point empirique situé à une distance substantielle de la tendance générale peut infléchir drastiquement l’angle de la pente ou décaler l’ordonnée à l’origine, dégradant la représentativité générale du modèle.
1.3 Pertinence de la régression linéaire en sciences psychologiques et comportementales
L’application de la régression linéaire simple revêt une importance capitale dans les disciplines étudiant le comportement humain, la cognition et les dynamiques organisationnelles. Les données psychométriques issues de protocoles standardisés — telles que les mesures de temps de réaction, les quotients intellectuels, les indices d’anxiété ou les scores d’évaluation des compétences académiques — se prêtent naturellement à cette modélisation lorsqu’elles sont enregistrées sur des échelles d’intervalles ou de rapports. Par exemple, quantifier avec précision l’impact du nombre d’heures consacrées à l’apprentissage sur la performance cognitive lors d’une tâche d’évaluation permet de formaliser des lois d’apprentissage quantitatives et d’optimiser les stratégies pédagogiques.
Il demeure cependant primordial de souligner la distinction critique entre association statistique et inférence causale. Bien que le modèle de régression linéaire postule mathématiquement une asymétrie fonctionnelle — la variable $X$ prédisant la variable $Y$ —, cette directionnalité n’implique en aucun cas que $X$ soit la cause directe de $Y$. En psychologie empirique, des corrélations robustes peuvent être générées par des variables confondantes non observées (phénomène de causalité commune) ou par des relations de causalité inverse. L’affirmation d’une causalité véritable requiert impérativement un dispositif expérimental avec assignation aléatoire et manipulation systématique du prédicteur, conditions que le modèle mathématique ne peut suppléer à lui seul.
Sur le plan structurel, la régression linéaire simple ne doit pas être perçue comme un outil isolé, mais bien comme la brique élémentaire du vaste cadre des modèles linéaires généraux (GLM). Elle constitue le cas particulier le plus accessible d’un continuum statistique englobant la régression multiple, l’analyse de variance (ANOVA), l’analyse de covariance (ANCOVA) et, par extension aux distributions non gaussiennes via des fonctions de lien, les modèles linéaires généralisés (GLZ). Maîtriser les propriétés géométriques et probabilistes du cas univarié constitue le prérequis méthodologique indispensable pour aborder ces extensions multivariées complexes.
2. Configuration de l’environnement de développement Python
2.1 Mise en place de l’écosystème scientifique
L’exécution rigoureuse d’analyses statistiques complexes nécessite un environnement de calcul stable, isolé et parfaitement reproductible. Dans l’écosystème Python, la distribution intégrée Anaconda s’est largement imposée au sein de la communauté scientifique en raison de sa gestion native des dépendances binaires non-Python et de son gestionnaire de paquets optimisé conda. Alternativement, l’emploi de l’outil natif venv associé à l’installateur de paquets standard pip offre une solution extrêmement légère pour créer des environnements virtuels isolés, garantissant qu’aucune mise à niveau inopinée d’une bibliothèque système ne vienne altérer le fonctionnement des scripts d’analyse.
La traçabilité et la pérennité des résultats constituent des impératifs épistémologiques fondamentaux dans le cadre de la crise de la reproductibilité scientifique. Il est formellement recommandé de figer les versions précises des environnements logiciels (notamment la version majeure de Python, telle que Python 3.10 ou 3.11) et de consigner l’intégralité des dépendances au sein d’un fichier déclaratif de type requirements.txt ou environment.yml. Cette pratique standardisée permet à tout pair ou évaluateur de reconstruire à l’identique la pile logicielle employée lors de l’étude.
Au sein de cet écosystème, l’interface des carnets de calcul interactifs Jupyter Notebooks (ou JupyterLab) fournit un cadre de travail idéal pour l’analyse exploratoire et la modélisation statistique. En autorisant la juxtaposition fluide de cellules de code exécutables, de représentations graphiques haute définition rendues en ligne et de blocs explicatifs rédigés en syntaxe Markdown et LaTeX, Jupyter favorise une documentation transparente de la démarche intellectuelle, depuis l’ingestion brute des données jusqu’à l’interprétation inférentielle terminale.
2.2 Importation et rôle des bibliothèques fondamentales
Le traitement des données en Python s’articule autour d’un ensemble de bibliothèques tierces hautement spécialisées, développées en C et Fortran afin de pallier la lenteur inhérente au caractère interprété du langage de base. La manipulation tabulaire des ensembles empiriques s’effectue via Pandas. Cette bibliothèque introduit la structure fondamentale du DataFrame, un tableau bidimensionnel hétérogène doté d’axes indexés, capable d’aligner automatiquement des observations, de gérer des types de données diversifiés et d’exécuter des opérations d’agrégation, de filtrage et de transformation vectorisées indispensables lors de la phase de préparation méthodologique.
Sous-jacent à Pandas et à la quasi-totalité de l’informatique scientifique moderne, le module NumPy constitue le cœur névralgique du calcul numérique. Il implémente la classe d’objets ndarray, qui alloue des blocs de mémoire contigus pour stocker des tableaux multidimensionnels homogènes. NumPy propose un ensemble exhaustif de fonctions mathématiques optimisées, exécutant des calculs d’algèbre linéaire de bas niveau indispensables à la dérivation des estimateurs de régression, tels que le produit matriciel, l’inversion de matrice et la décomposition en valeurs singulières.
Complétant ce socle, la bibliothèque SciPy, et tout particulièrement son sous-module scipy.stats, met à disposition une vaste collection de distributions statistiques théoriques continues et discrètes. Elle permet le calcul exact des densités de probabilité, des fonctions de répartition cumulées, des percentiles et des probabilités critiques ($p$-valeurs), tout en fournissant une panoplie exhaustive de tests non paramétriques et d’outils d’optimisation indispensables pour évaluer formellement la conformité des données aux hypothèses sous-jacentes des modèles théoriques.
2.3 Outils spécialisés de modélisation et de rendu graphique
Pour la phase d’ajustement du modèle de régression linéaire, deux bibliothèques logiques aux finalités complémentaires coexistent dans l’écosystème Python : Statsmodels et Scikit-Learn. Statsmodels a été expressément conçu selon les paradigmes de la statistique inférentielle et de l’économétrie formelle. Il excelle dans la restitution exhaustive de tableaux d’analyse de variance, la fourniture des erreurs-types des paramètres, les intervalles de confiance et les tests de spécification sur la structure des résidus. À l’inverse, Scikit-Learn adopte la philosophie de l’apprentissage automatique (machine learning), orientée prioritairement vers la performance de généralisation, la validation croisée et le déploiement opérationnel au sein de pipelines de production.
Sur le versant de la visualisation des données et des diagnostics graphiques, la bibliothèque Matplotlib sert de moteur graphique de bas niveau. Elle offre un contrôle granulaire absolu sur l’ensemble des éléments de la figure : positionnement précis des axes, calibrage des échelles logarithmiques ou linéaires, personnalisation typographique fine et rendu vectoriel exportable dans des formats d’impression haute résolution (PDF, EPS, SVG) conformes aux exigences des revues académiques les plus strictes.
Bâtie directement au-dessus de Matplotlib, la bibliothèque Seaborn propose une couche d’abstraction de haut niveau orientée vers la visualisation statistique exploratoire. Seaborn s’intègre nativement avec les structures de données Pandas, automatisant l’agrégation statistique, l’application de palettes chromatiques scientifiquement calibrées et la génération conjointe d’ajustements de régression avec bandes d’incertitude bayésiennes ou bootstrapées. La combinaison synergique de ces deux outils graphiques assure une exploration esthétique et rigoureuse des données empiriques.
3. Étape 1 : Structuration et chargement des données d’étude
3.1 Création du jeu de données empirique
Afin d’ancrer notre démarche dans un protocole méthodologique concret, nous élaborons un jeu de données empirique issu du champ de la psychologie cognitive de l’éducation. L’objectif expérimental consiste à évaluer dans quelle mesure l’allocation du temps d’étude individuel, exprimé en heures cumulées au cours d’un semestre académique, constitue un prédicteur direct et linéaire de la performance obtenue lors d’une épreuve d’évaluation finale standardisée, mesurée par un score numérique continu gradué sur une échelle de zéro à cent points.
Dans un contexte réel, les observations sont généralement extraites de bases relationnelles ou importées depuis des fichiers plats délimités (fichiers au format CSV ou TSV). En Python, la formalisation de cette structure tabulaire s’effectue via l’instanciation directe d’un pd.DataFrame Pandas à partir d’un dictionnaire de vecteurs numériques. Cette méthode permet de contrôler précisément les valeurs associées à chaque unité statistique. Un échantillon typique de vingt étudiants ($n = 20$) est ainsi structuré, où la première colonne correspond au prédicteur $X$ (heures d’étude) et la seconde à la réponse $Y$ (note d’examen).
Dès l’instanciation de la structure de données, la première tâche de l’analyste consiste à inspecter rigoureusement la géométrie de la matrice au moyen de la propriété .shape, qui renvoie le tuple $(n, p)$ correspondant au nombre de lignes et de colonnes. Une visualisation directe des premiers enregistrements via la méthode .head() et des derniers via .tail() confirme l’intégrité de l’alignement indexiel et écarte les éventuelles anomalies de conversion immédiatement perceptibles lors du chargement initial.
3.2 Contrôle de l’intégrité et typage des variables
L’intégrité structurelle des données conditionne la validité des calculs algébriques subséquents. Une défaillance dans l’assignation des types de données sous-jacents peut silently corrompre les algorithmes d’estimation matricielle. Il est dès lors impératif de solliciter la méthode .dtypes et la méthode récapitulative .info() du DataFrame afin de s’assurer formellement que les variables d’intérêt sont encodées sous forme de nombres à virgule flottante (types float64 ou int64) et non sous forme de chaînes de caractères (type object), ce qui traduirait la présence accidentelle de caractères typographiques invisibles ou d’espaces insécables.
La détection des valeurs manquantes ou incomplètes (usuellement désignées par la valeur sentinelle NaN pour Not a Number) constitue une étape non négociable du protocole de validation. L’exécution de la commande chaînée df.isnull().sum() permet de quantifier précisément l’ampleur d’éventuelles omissions de collecte. Dans le cadre théorique strict des moindres carrés ordinaires, toute observation présentant une valeur indéterminée sur $X$ ou sur $Y$ est éliminée par les procédures d’estimation standard (suppression par liste ou listwise deletion), ce qui modifie la taille effective de l’échantillon et peut introduire des biais systématiques si ces disparitions ne sont pas complètement aléatoires (mécanisme MCAR).
Enfin, la vérification des bornes de validité computationnelle garantit l’absence d’incohérences matérielles évidentes, telles que des scores d’examen négatifs ou des temps d’étude excédant le nombre d’heures théoriquement disponibles au sein d’une période académique donnée. Toute anomalie identifiée à ce stade doit faire l’objet d’une traçabilité documentaire méticuleuse avant toute tentative de modélisation mathématique.
3.3 Documentation métrologique des variables
La rigueur académique impose que toute grandeur numérique soit adossée à une définition métrologique irréprochable. L’analyste doit impérativement expliciter les propriétés de mesure des variables étudiées. Dans notre dispositif d’illustration, la variable prédictive continue « Temps d’étude » ($X$) est quantifiée en unités horaires réelles ($h$), mesurées avec une précision décimale d’un dixième d’heure, reflétant le temps effectif passé par chaque apprenant en interaction active avec le matériel pédagogique (lectures, exercices, révisions dirigées), exclusion faite des temps de pause passive.
La variable de réponse « Score à l’examen » ($Y$) est formalisée sur une échelle continue théorique de $0$ à $100$ points. Bien que les notes d’examens soient parfois discrétisées par les processus de notation académique en nombres entiers ou demi-entiers, le continuum sous-jacent du construit cognitif évalué autorise son traitement légitime en tant que variable continue dans le cadre du modèle linéaire, sous réserve que l’échelle ne présente pas d’effets de plancher ou de plafond marqués qui tronqueraient artificiellement la distribution.
La traçabilité des données nécessite également la conservation des métadonnées associées : protocole d’enregistrement utilisé (relevés automatiques de temps de connexion sur plateforme pédagogique, journaux de bord auto-rapportés), conditions environnementales de passation de l’évaluation finale et anonymisation stricte des identifiants des participants. Cette documentation garantit la transparence scientifique et facilite d’éventuelles réanalyses secondaires par la communauté académique.
4. Étape 2 : Analyse exploratoire des données (EDA)
4.1 Statistiques descriptives univariées
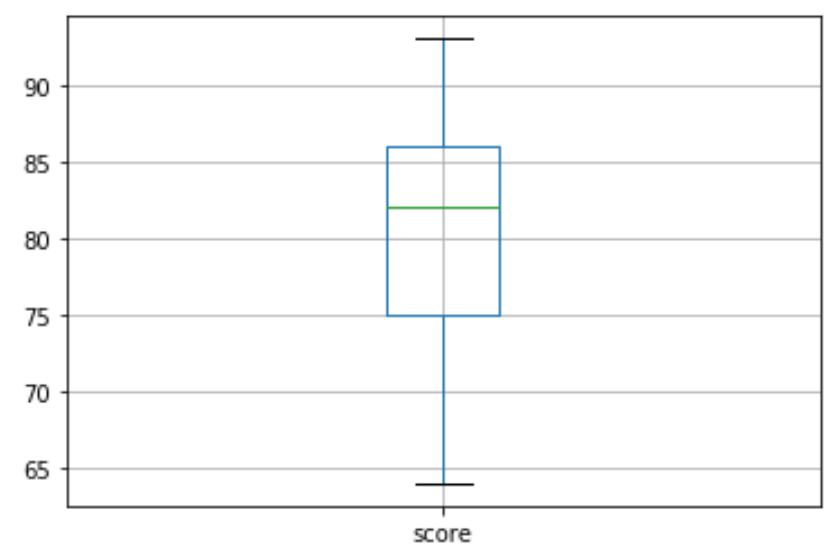
Préalablement à toute modélisation bivariée, l’exploration détaillée des distributions univariées individuelles constitue un prérequis incontournable de l’analyse exploratoire des données (Exploratory Data Analysis). La méthode df.describe() fournit une première synthèse tabulaire des propriétés de position et d’échelle de chaque variable. La tendance centrale est appréhendée conjointement par la moyenne arithmétique et par la médiane (50e percentile). Une divergence prononcée entre la moyenne et la médiane constitue le premier signal d’une asymétrie distributionnelle ou de l’influence potentielle d’observations atypiques logées dans les queues de distribution.
La dispersion des variables s’évalue au moyen de l’écart-type d’échantillon, noté $s$, dont le carré définit la variance non biaisée (divisée par $n – 1$ degrés de liberté). Pour compléter ces paramètres gaussiens traditionnels, l’intervalle interquartile ($IQR = Q_3 – Q_1$), calculé entre le premier et le troisième quartile, fournit une mesure d’étalement robuste et non paramétrique, insensible aux éventuelles valeurs déviantes situées aux extrêmes de la série.
Pour approfondir la caractérisation de la forme géométrique des lois empiriques, le calcul des coefficients de forme s’avère indispensable : le coefficient d’asymétrie de Fisher (skewness) et le coefficient d’aplatissement (kurtosis). Une asymétrie statistiquement nulle reflète une distribution symétrique de type gaussien, tandis qu’une valeur positive dénote un étalement de la queue de distribution vers la droite (valeurs élevées). Un coefficient d’aplatissement excédant la valeur de référence de la loi normale (kurtosis d’excès positif) signale une distribution leptokurtique, caractérisée par un pic central acéré et des queues épaisses sujettes à des événements extrêmes plus fréquents que sous l’hypothèse de normalité.
4.2 Visualisation préliminaire par nuage de points
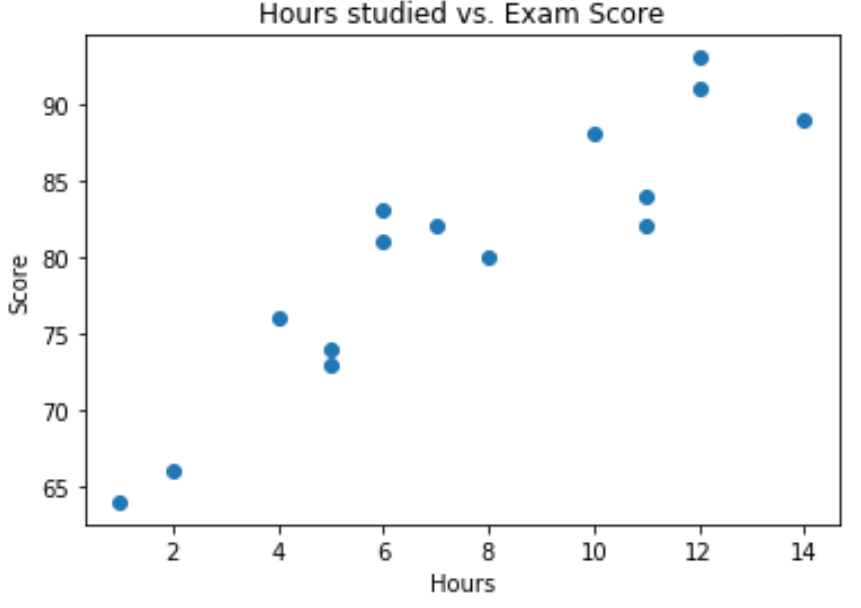
L’inspection graphique d’une distribution constitue l’un des garde-fous méthodologiques les plus puissants contre les erreurs d’interprétation purement arithmétiques, comme l’a magistralement démontré le statisticien Francis Anscombe avec son célèbre quatuor. Le diagramme de dispersion (ou scatter plot) représente l’espace bidimensionnel défini par les axes orthogonaux $(X, Y)$, sur lequel chaque couple d’observations empiriques $(x_i, y_i)$ est projeté sous la forme d’un point géométrique discret.
En mobilisant la fonction sns.scatterplot() de la bibliothèque Seaborn ou la fonction native plt.scatter() de Matplotlib, le chercheur procède à un examen morphologique attentif du nuage d’observations. L’objectif premier est de confirmer visuellement l’adéquation d’une trajectoire linéaire droite. Une disposition générale des points s’étirant le long d’une bande diagonale ascendante uniforme constitue le signal favorable indiquant qu’un modèle de régression du premier degré permettra de capturer fidèlement la structure dominante des données.
Ce diagnostic visuel permet également d’identifier immédiatement des anomalies de conformation spatiale qui échapperaient aux synthèses numériques globales. Il s’agit notamment de repérer d’éventuelles non-linéarités flagrantes (courbures logarithmiques, inflexions sigmoïdales ou trajectoires paraboliques en forme de U inversé), des concentrations asymétriques suggérant des effets de grappes ou de sous-groupes non identifiés au sein de l’échantillon, ainsi que des points isolés situés à une distance considérable du corps principal de la distribution.
4.3 Estimation de l’association linéaire bivariée
La quantification mathématique formelle du degré d’association linéaire univariée entre la variable explicative et la variable cible repose sur le coefficient de corrélation produit-moment de Pearson, usuellement désigné par le symbole $r$. Ce coefficient paramétrique s’obtient en divisant la covariance empirique des deux grandeurs par le produit de leurs écarts-types respectifs :
$$r = \frac{\sum_{i=1}^{n} (x_i – \bar{x})(y_i – \bar{y})}{\sqrt{\sum_{i=1}^{n} (x_i – \bar{x})^2} \sqrt{\sum_{i=1}^{n} (y_i – \bar{y})^2}}$$
Par construction mathématique, la valeur de $r$ est strictement bornée au sein de l’intervalle fermé $[-1, +1]$. Une valeur tendant vers $+1$ indique une corrélation linéaire positive parfaite, une valeur de $0$ caractérise l’absence absolue de corrélation linéaire, et une valeur tendant vers $-1$ matérialise une relation linéaire négative parfaite. Selon les conventions canoniques proposées par Jacob Cohen pour les sciences humaines et comportementales, une corrélation $|r| ge 0{,}10$ est qualifiée de faible, $|r| ge 0{,}30$ de modérée, et $|r| ge 0{,}50$ d’élevée.
L’estimation ponctuelle de ce coefficient doit impérativement s’accompagner d’un test d’hypothèse inférentiel visant à évaluer la significativité statistique de la liaison observée au sein de la population parente. L’hypothèse nulle formalise l’absence d’association linéaire : $H_0: \rho = 0$. La statistique de décision suit une loi de Student à $n – 2$ degrés de liberté :
$$t = \frac{r \sqrt{n – 2}}{\sqrt{1 – r^2}}$$
L’exécution de la fonction pearsonr du sous-module scipy.stats renvoie simultanément l’estimation ponctuelle de $r$ et la probabilité critique bilatérale ($p$-valeur) associée à cette statistique $t$. Si cette $p$-valeur est inférieure au seuil de signification conventionnel $\alpha = 0{,}05$, l’hypothèse nulle est rejetée, attestant que l’association observée ne peut raisonnablement être imputée au seul hasard de l’échantillonnage.
5. Étape 3 : Évaluation préliminaire des postulats théoriques
5.1 Postulat de linéarité de la relation
Le premier postulat fondamental du modèle de régression linéaire classique stipule que la forme fonctionnelle liant l’espérance conditionnelle de $Y$ à la valeur de $X$ est une fonction affine droite. Une erreur de spécification relative à cette linéarité théorique entraîne des conséquences désastreuses sur le plan mathématique : les estimateurs des MCO perdent leur propriété de non-biais, induisant des sous-estimations ou des surestimations systématiques des valeurs cibles sur différentes plages de l’espace des covariables.
Pour valider l’adéquation d’une modélisation linéaire sans imposer a priori une trajectoire paramétrique rigide, les statisticiens emploient des méthodes d’estimation non paramétrique locale, au premier rang desquelles figure le lissage polynomial local pondéré ou LOWESS (Locally Weighted Scatterplot Smoothing). Cette technique estime la tendance centrale en calculant des régressions polynomiales locales pondérées au voisinage de chaque observation, attribuant un poids inversement proportionnel à la distance géométrique des points voisins.
En superposant graphiquement la courbe issue du lissage LOWESS à la droite de régression linéaire paramétrique des MCO, le chercheur peut déceler visuellement d’éventuelles inflexions ou courbures progressives. Si la trajectoire non paramétrique oscille étroitement autour de la droite géométrique sans manifester de dérive systématique persistante, l’hypothèse de linéarité peut être jugée empiriquement acceptable. Dans le cas contraire, une transformation non linéaire des variables (transformation logarithmique, racine carrée ou modélisation polynomiale d’ordre supérieur) doit être envisagée avant de poursuivre.
5.2 Indépendance conceptuelle des observations
L’hypothèse selon laquelle chaque observation individuelle $(x_i, y_i)$ est stochastiquement indépendante de toutes les autres constitue un pilier théorique indispensable du modèle standard. L’absence d’indépendance structurelle survient fréquemment dans les protocoles comportant des mesures longitudinales répétées sur les mêmes sujets, des données hiérarchisées (tels que des élèves regroupés au sein de classes scolaires distinctes) ou des séries chronologiques caractérisées par une dépendance temporelle sérielle.
La violation du postulat d’indépendance ne biaise pas directement l’estimation ponctuelle des coefficients $\hat{\beta}_0$ et $\hat{\beta}_1$, mais affecte dramatiquement le calcul de leur matrice de variance-covariance empirique. Lorsque les résidus sont corrélés positivement entre eux, l’information redondante contenue dans l’échantillon est traitée par le modèle comme s’il s’agissait d’observations autonomes réelles. Il en résulte une sous-estimation systématique des erreurs-types asymptotiques des paramètres, ce qui gonfle artificiellement les statistiques $t$ de Student et produit une multiplication intolérable du taux d’erreur de première espèce ($\alpha$), conduisant à rejeter abusivement l’hypothèse nulle.
Il est fondamental de maintenir une distinction claire entre l’indépendance conceptuelle des variables brutes et l’indépendance des termes d’erreur résiduels. Alors que la première dépend intrinsèquement de l’architecture du plan d’échantillonnage expérimental, la seconde fait l’objet de vérifications empiriques quantitatives post-estimation. Dans notre cas d’étude, l’échantillonnage transversal aléatoire d’étudiants distincts n’ayant aucun lien de dépendance mutuelle permet de considérer le postulat d’indépendance du plan de collecte comme vérifié.
5.3 Échelle et absence d’erreur de mesure sur le régresseur
Le cadre classique de la régression par les moindres carrés ordinaires s’articule formellement autour de l’hypothèse selon laquelle la variable explicative $X$ est mesurée sans erreur stochastique ou, à tout le moins, avec une précision métrologique infiniment supérieure à celle de la variable de réponse $Y$. Dans la littérature statistique avancée, cette condition sépare les modèles de régression classiques des modèles d’erreurs sur les variables (Errors-in-Variables Models).
Lorsque le prédicteur $X$ est entaché d’une erreur de mesure aléatoire non négligeable — situation particulièrement prévalente en psychologie lorsque les variables indépendantes proviennent de questionnaires auto-rapportés ou d’instruments psychométriques à fidélité imparfaite —, un phénomène pernicieux dénommé biais d’atténuation (ou régression vers la moyenne) se produit. Ce biais mathématique comprime systématiquement l’estimation de la pente $\hat{\beta}_1$ vers zéro :
$$\text{p\lim} , \hat{\beta}_1 = \beta_1 \left( \frac{\sigma_X^2}{\sigma_X^2 + \sigma_u^2} \right)$$
où $\sigma_u^2$ représente la variance de l’erreur de mesure grevant la variable $X$. Le coefficient d’atténuation étant strictement inférieur à l’unité dès lors que $\sigma_u^2 > 0$, l’analyste sous-estime systématiquement la force de l’effet univarié réel du prédicteur sur la population. Il est par conséquent impératif de s’assurer en amont que les outils métrologiques servant à enregistrer le régresseur possèdent des indices de fidélité et de consistance interne (tels que l’alpha de Cronbach ou l’oméga de McDonald) d’un niveau particulièrement élevé avant d’intégrer leurs mesures dans un modèle MCO conventionnel.
6. Étape 4 : Ajustement du modèle de régression avec Statsmodels
6.1 Construction de la matrice de régression
La mise en œuvre computationnelle de l’ajustement linéaire via la bibliothèque Statsmodels requiert une compréhension précise de la structure de l’algèbre matricielle sous-jacente. Dans un système linéaire général, le modèle s’exprime sous la forme compacte $\mathbf{Y} = \mathbf{X}boldsymbol{\beta} + boldsymbol{\varepsilon}$, où $\mathbf{X}$ désigne la matrice de dessin (design matrix). Par défaut, pour des raisons de flexibilité algorithmique, Statsmodels ne présume pas de la présence obligatoire d’une ordonnée à l’origine dans la formulation mathématique.
Afin d’estimer le coefficient $\beta_0$, il est impératif de modifier le vecteur dimensionnel de la variable explicative en lui adjoignant une colonne de constantes unitaires (des valeurs scalaires égales à $1$). Cette opération matricielle s’effectue au moyen de la fonction sm.add_constant(), qui convertit la série uni-colonne de taille $(n, 1)$ en une matrice bidimensionnelle de dimensions $(n, 2)$, dont la première colonne est constituée de $1$ et la seconde des valeurs empiriques de la variable $X$.
L’omission de cette étape technique constitue un piège classique aux conséquences analytiques majeures : l’appel direct de la fonction de régression sans l’adjonction de cette colonne unitaire force artificiellement la droite à traverser l’origine géométrique des coordonnées $(0, 0)$. Cela contraint l’ordonnée à l’origine à être strictement nulle ($\hat{\beta}_0 = 0$), ce qui fausse radicalement l’estimation de la pente $\hat{\beta}_1$, altère le calcul de la somme des carrés et rend le coefficient de détermination $R^2$ mathématiquement incohérent et virtuellement inutilisable pour l’inférence.
6.2 Instanciation et résolution par les moindres carrés
Une fois les structures de données rigoureusement configurées, l’ajustement du modèle statistique s’opère par l’appel à la classe sm.OLS (pour Ordinary Least Squares). La signature formelle du constructeur impose de spécifier le vecteur cible de la variable dépendante $Y$ comme premier argument positionnel, suivi de la matrice de dessin $\mathbf{X}$ préalablement augmentée de sa constante :
modele = sm.OLS(y, X_const)
L’instanciation de cette classe ne déclenche pas immédiatement la résolution numérique, mais initialise un objet de modèle statistique formel. C’est l’exécution explicite de la méthode .fit() sur cette instance qui active les routines de calcul numérique sous-jacentes. En coulisses, Statsmodels n’exécute pas une inversion matricielle naïve de type $(\mathbf{X}^T\mathbf{X})^{-1}$, laquelle s’avérerait numériquement instable en présence de quasi-colinéarité ou de mauvais conditionnement numérique, mais s’appuie sur des algorithmes avancés de factorisation matricielle, tels que la décomposition QR ou la décomposition en valeurs singulières (SVD) implémentées dans la bibliothèque sous-jacente LAPACK.
La méthode .fit() retourne une instance spécialisée de la classe RegressionResultsWrapper. Cet objet central encapsule de manière exhaustive l’intégralité des sorties statistiques du modèle : estimations ponctuelles des paramètres, matrices de variance-covariance asymptotique, résidus du modèle, métriques globales de qualité d’ajustement et valeurs critiques associées aux tests d’hypothèses univariés et multivariés.
6.3 Décodage complet du tableau récapitulatif (Summary Table)
L’affichage structuré des résultats d’ajustement s’obtient via l’appel de la méthode resultats.summary(), qui génère un rapport textuel normalisé composé de trois blocs analytiques distincts. L’en-tête supérieur regroupe les informations contextuelles du protocole statistique : la variable dépendante modélisée, le modèle théorique exploité (OLS), la méthode d’optimisation (Least Squares), la date et l’horodatage d’exécution, le nombre d’observations effectives incluses ($n$), ainsi que les degrés de liberté du modèle (égaux à $1$ pour une régression simple) et des résidus (égaux à $n – 2$).
La section centrale du rapport est dévolue à la quantification des paramètres de la droite de régression :
- coef : l’estimation ponctuelle calculée par les moindres carrés pour la constante ($\hat{\beta}_0$) et la pente du prédicteur ($\hat{\beta}_1$).
- std err : l’erreur-type d’échantillonnage de chaque coefficient, quantifiant la déviation attendue de l’estimateur sous répétition hypothétique infinie de l’expérience d’échantillonnage.
- t : la valeur de la statistique de test de Student d’adéquation univariée ($t = \text{coef} / \text{std err}$).
- P>|t| : la probabilité critique bilatérale ($p$-valeur) associée à la statistique $t$ sous l’hypothèse nulle de nullité du paramètre.
- [0.025 – 0.975] : les bornes inférieure et supérieure de l’intervalle de confiance calculé au seuil de confiance standard de 95 %.
Enfin, le tableau inférieur fournit un ensemble de tests diagnostiques de spécification post-estimation : le test d’Omnibus et le test de Jarque-Bera évaluent la normalité distributionnelle des erreurs résiduelles ; la statistique de Durbin-Watson évalue l’indépendance temporelle sérielle des résidus ; et le nombre de conditionnement (Condition Number) mesure la sensibilité géométrique de la solution matricielle aux perturbations d’arrondi ou aux instabilités d’échelle.
7. Étape 5 : Interprétation académique des paramètres estimés
7.1 Interprétation substantielle de la constante et de la pente
L’exploitation légitime des résultats statistiques requiert de traduire la terminologie arithmétique en propositions conceptuelles substantielles dans le domaine d’étude considéré. Le paramètre estimé de l’ordonnée à l’origine, noté $\hat{\beta}_0$, correspond au score d’examen mathématiquement prédit pour un apprenant qui consacrerait un temps d’étude rigoureusement égal à zéro heure ($X = 0$). Dans de nombreux contextes empiriques, l’interprétation substantielle directe de cette constante s’avère sujette à caution : si l’intervalle de distribution empirique de $X$ ne contient pas la valeur zéro (par exemple si tous les étudiants ont révisé au minimum dix heures), l’intercept constitue une extrapolation en dehors de la plage d’observation, dépourvue de validité écologique directe, bien que mathématiquement indispensable pour ancrer la droite de régression.
À l’inverse, l’estimation ponctuelle de la pente, notée $\hat{\beta}_1$, constitue le paramètre d’intérêt substantiel majeur. Elle formalise l’ampleur moyenne du gain ou de la perte sur la variable dépendante par unité marginale d’incrément sur le prédicteur. Si, par exemple, la valeur de $\hat{\beta}_1$ ressort à $+2{,}45$, cela signifie rigoureusement que, selon notre modèle d’échantillon, chaque heure additionnelle investie dans l’apprentissage s’accompagne d’une progression linéaire moyenne de $2{,}45$ points sur la note d’évaluation finale.
L’analyste doit constamment contextualiser cette progression moyenne au regard de l’échelle globale de la mesure. Un incrément de deux points ne possède pas la même portée pratique si l’épreuve est calibrée sur une échelle de vingt points ou sur une échelle centésimale. L’évaluation de la signification pratique d’un effet nécessite impérativement de croiser la grandeur brute de la pente avec l’écart-type de la variable dépendante, permettant le calcul d’indices de taille d’effet standardisés assimilables au coefficient d’ajustement standardisé $\beta^*$.
7.2 Inférence statistique et tests de significativité
L’estimation des coefficients sur un échantillon empirique fini soulève inévitablement la question de la validité de ces estimations à l’échelle de la population parente globale. Pour déterminer si l’effet mesuré par la pente $\hat{\beta}_1$ traduit une véritable régularité substantielle ou s’il résulte de simples fluctuations d’échantillonnage aléatoire, l’inférence statistique met en œuvre le test $t$ de Student de non-nullité du coefficient. Les hypothèses statistiques formelles s’énoncent comme suit :
$$H_0 : \beta_1 = 0 \quad \text{versus} \quad H_1 : \beta_1 \neq 0$$
Sous l’hypothèse nulle $H_0$, la variable explicative ne contribue aucunement à la prédiction linéaire de la réponse. La statistique de test s’obtient en divisant la pente estimée par son erreur-type standardisée :
$$t = \frac{\hat{\beta}_1 – 0}{\mathrm{SE}(\hat{\beta}_1)}$$
où $\mathrm{SE}(\hat{\beta}_1) = \frac{\hat{\sigma}}{\sqrt{\sum (x_i – \bar{x})^2}}$ et $\hat{\sigma}$ désigne l’erreur-type des résidus. Cette statistique suit une loi de Student à $n – 2$ degrés de liberté. Si la valeur absolue du score $|t|$ dépasse la valeur critique tabulée pour le seuil $\alpha = 0{,}05$, ou de manière équivalente si la probabilité critique $p$-valeur associée est strictement inférieure à ce seuil conventionnel, l’hypothèse nulle est rejetée avec un risque contrôlé d’erreur de première espèce.
Au-delà de la décision binaire induite par les tests d’hypothèses conventionnels, la construction des intervalles de confiance à 95 % apporte une estimation enrichie de la précision paramétrique. Un intervalle de confiance bilatéral pour $\beta_1$ est délimité par les bornes mathématiques :
$$\hat{\beta}_1 \pm t_{1 – alpha/2, , n-2} \cdot \mathrm{SE}(\hat{\beta}_1)$$
Cet intervalle délimite la plage de valeurs plausibles compatibles avec les données observées. Si la valeur zéro n’est pas contenue à l’intérieur de ces bornes, le chercheur conclut à l’existence d’un effet non nul au seuil de confiance spécifié, tout en disposant d’une estimation quantifiée de l’incertitude entourant l’intensité de cet impact.
7.3 Quantification de la qualité d’ajustement globale
L’évaluation de la performance globale du modèle de régression nécessite de quantifier la part de la variabilité totale de la variable de réponse qui se trouve effectivement expliquée par la droite d’ajustement. Cette mesure est synthétisée par le coefficient de détermination, universellement désigné par le symbole $R^2$. L’analyse de décomposition de la variance postule l’orthogonalité géométrique et l’additivité stricte des sommes de carrés :
$$\mathrm{SCT} = \mathrm{SCE} + \mathrm{SCR}$$
où $\mathrm{SCT} = \sum (y_i – \bar{y})^2$ est la Somme des Carrés Totale, $\mathrm{SCE} = \sum (\hat{y}_i – \bar{y})^2$ est la Somme des Carrés Expliquée par le modèle, et $\mathrm{SCR} = \sum (y_i – \hat{y}_i)^2$ représente la Somme des Carrés Résiduelle. Le coefficient $R^2$ s’obtient alors par le ratio :
$$R^2 = \frac{\mathrm{SCE}}{\mathrm{SCT}} = 1 – \frac{\mathrm{SCR}}{\mathrm{SCT}}$$
Le $R^2$ varie continûment entre $0$ et $1$. Une valeur de $0{,}68$, par exemple, indique précisément que $68 %$ de la variance observée dans les scores d’examen des étudiants peut être mathématiquement expliquée par les disparités observées dans leurs temps de révision individuels. Dans le cas spécifique de la régression linéaire simple à prédicteur univarié, le coefficient de détermination correspond très exactement au carré arithmétique du coefficient de corrélation produit-moment de Pearson : $R^2 = r_{XY}^2$.
Néanmoins, le $R^2$ ne doit jamais être interprété isolément. L’analyste doit impérativement lui associer l’erreur-type de l’estimation ou l’erreur quadratique moyenne des résidus (RMSE pour Root Mean Squared Error), qui rétablit l’échelle de mesure originale de la variable dépendante :
$$\mathrm{RMSE} = \sqrt{\frac{\sum_{i=1}^{n} (y_i – \hat{y}_i)^2}{n}}$$
Tandis que le $R^2$ fournit un indice adimensionnel d’adéquation globale, la RMSE quantifie directement l’écart moyen concret entre les notes observées et les notes estimées, offrant ainsi un repère métrologique immédiatement compréhensible pour évaluer l’utilité prédictive effective du modèle.
8. Étape 6 : Implémentation alternative via la bibliothèque Scikit-Learn
8.1 Préparation dimensionnelle pour Scikit-Learn
Bien que Statsmodels constitue la bibliothèque de référence pour l’analyse inférentielle approfondie, la bibliothèque Scikit-Learn représente le standard industriel pour l’implémentation de modèles au sein d’architectures d’apprentissage automatique plus étendues. L’utilisation de Scikit-Learn impose toutefois une rigueur stricte quant au formatage dimensionnel des tenseurs de données d’entrée.
L’interface de programmation unifiée de Scikit-Learn exige que la matrice des caractéristiques (features), notée usuellement $X$, soit impérativement transmise sous la forme d’un tableau bidimensionnel (2D array) de morphologie $(n_samples, n_features)$, même lorsque l’analyse ne porte que sur une unique variable explicative ($n_features = 1$). Si l’analyste transmet une série Pandas univariée ou un vecteur NumPy unidimensionnel (1D) de taille $(n,)$, le module déclenchera une exception d’incompatibilité de forme (ValueError). La conversion s’opère usuellement par l’application de la méthode .reshape(-1, 1) sur le vecteur NumPy ou par l’extraction de la colonne sous la forme d’un sous-DataFrame Pandas : df[['Heures_Etude']].
Dans une perspective typique d’évaluation prédictive supervisée, le chercheur peut également choisir de scinder son jeu de données empirique en sous-ensembles d’apprentissage (training set) et d’évaluation (testing set) via la fonction train_test_split(). Cette partition permet d’ajuster les coefficients du modèle sur une fraction des sujets (par exemple 80 %) et d’évaluer la qualité de généralisation des prédictions sur la fraction résiduelle d’individus non observés lors de l’entraînement (20 %), limitant ainsi les risques de surajustement (overfitting).
8.2 Instanciation et entraînement de LinearRegression
L’implémentation opérationnelle s’effectue en important la classe LinearRegression depuis le sous-module sklearn.linear_model. Le constructeur accepte plusieurs hyperparamètres fonctionnels, le plus important étant fit_intercept, qui est configuré par défaut sur True. Contrairement à Statsmodels, Scikit-Learn prend automatiquement en charge l’adjonction interne de la constante mathématique, dispensant l’utilisateur de toute manipulation matricielle préalable pour ajouter une colonne unitaire.
L’exécution de la méthode d’entraînement .fit(X, y) déclenche la résolution algorithmique par moindres carrés. Une fois le processus de minimisation convergé, les valeurs estimées des paramètres sont conservées au sein d’attributs publics spécifiques de l’instance, reconnaissables à leur suffixe souligné (trailing underscore) conformément aux conventions de conception de la bibliothèque :
model.intercept_: valeur scalaire flottante correspondant à l’ordonnée à l’origine ($\hat{\beta}_0$).model.coef_: tableau unidimensionnel contenant la valeur estimée de la pente ($\hat{\beta}_1$).
Cette approche standardisée permet d’insérer aisément le modèle de régression au sein de pipelines de traitement plus complexes (sklearn.pipeline.Pipeline), combinant de manière transparente des opérations d’imputation de données manquantes, de normalisation ou de standardisation (StandardScaler) et de validation croisée systématique (cross_val_score).
8.3 Arbitrage méthodologique : Statsmodels versus Scikit-Learn
Le choix raisonné entre Statsmodels et Scikit-Learn ne relève pas d’une préférence stylistique superficielle, mais d’une adéquation épistémologique stricte aux objectifs poursuivis par le chercheur. Le tableau comparatif suivant synthétise les orientations conceptuelles distinctes qui régissent ces deux bibliothèques logicielles majeures :
Lorsque la recherche vise l’explication théorique, la démonstration de la significativité de variables expérimentales ou la publication académique au sein de revues spécialisées, Statsmodels constitue le choix impératif. Il génère nativement l’ensemble des diagnostics paramétriques, les erreurs-types corrigées pour l’hétéroscédasticité et les tests d’adéquation globale indispensables pour attester de la rigueur du modèle face aux évaluateurs scientifiques.
À l’inverse, lorsque l’objectif principal consiste à déployer une composante prédictive au sein d’une application industrielle, à optimiser des prédictions sur de nouveaux échantillons non observés ou à comparer la performance de la régression linéaire avec des algorithmes d’apprentissage automatique plus sophistiqués (comme les forêts aléatoires, le gradient boosting ou les réseaux de neurones profonds), Scikit-Learn s’avère infiniment mieux armé. Il convient toutefois de souligner l’équivalence numérique absolue entre les deux approches : dès lors que les données d’entrée sont identiques et qu’aucun terme de régularisation n’est appliqué, les coefficients $\hat{\beta}_0$ et $\hat{\beta}_1$ calculés par Statsmodels et Scikit-Learn coïncident rigoureusement jusqu’à la dernière décimale de précision machine.
9. Étape 7 : Génération de prédictions et visualisation de la droite d’ajustement
9.1 Calcul computationnel des valeurs ajustées
L’une des finalités fondamentales de l’ajustement d’un modèle de régression consiste à projeter des prédictions conditionnelles pour des valeurs cibles spécifiques du prédicteur. Dans l’écosystème de programmation, cette projection s’opère au moyen de la méthode universelle .predict(), disponible aussi bien sur les objets de résultat de Statsmodels que sur les régresseurs Scikit-Learn. Lorsque cette fonction est appliquée sur la matrice d’entraînement originelle, elle calcule le vecteur des valeurs ajustées ou fitted values, formellement désigné par $\hat{\mathbf{y}}$.
Sur le plan analytique, chaque prédiction individuelle pour une valeur donnée $x_{nouv}$ résulte de l’évaluation directe de l’équation arithmétique de la droite empirique :
$$\hat{y}_{nouv} = \hat{\beta}_0 + \hat{\beta}_1 x_{nouv}$$
Il est essentiel que le chercheur soit en mesure d’exécuter ce calcul manuellement afin de contrôler la cohérence de l’implémentation logicielle. Par exemple, si l’on cherche à déterminer la note théoriquement prévisible pour un étudiant ayant travaillé précisément 35 heures, l’injection de cette valeur scalaire dans l’équation paramétrique issue des moindres carrés fournit instantanément la note estimée correspondante.
D’un point de vue computationnel, l’analyste doit veiller à fournir des structures de données strictement conformes aux exigences d’entrée de la méthode prédictive. Avec Statsmodels, les nouvelles requêtes prédictives doivent être formalisées sous forme de tableaux ou DataFrames incorporant impérativement la colonne de constante unitaire (via sm.add_constant()), sous peine de voir la fonction appliquer le vecteur de coefficients sur des axes mal alignés et de renvoyer des estimations aberrantes.
9.2 Représentation graphique de la ligne de régression
La communication scientifique moderne exige une restitution visuelle claire de la relation modélisée. La superposition graphique de la droite de régression empirique au nuage originel de points permet d’apprécier d’un coup d’œil l’ajustement spatial global et l’étalement des résidus autour de la trajectoire estimée.
Avec Matplotlib, ce graphique s’élabore en combinant une instruction de tracé ponctuel (plt.scatter) avec une instruction de tracé continu (plt.plot) appliquant les valeurs prédites $\hat{\mathbf{y}}$. Pour satisfaire aux normes de publication scientifique les plus exigeantes, le chercheur veillera à enrichir la figure de labels textuels exhaustifs précisant le nom des variables et leurs unités de mesure respectives sur chacun des axes, d’un titre formel décrivant le modèle et d’une légende différenciant explicitement les données empiriques observées de la droite théorique estimée par les moindres carrés.
La bibliothèque Seaborn permet d’automatiser élégamment cette représentation grâce à sa fonction haut niveau sns.regplot(). Cette fonction prend en charge simultanément le tracé du nuage d’observations, l’ajustement computationnel de la droite de régression linéaire et l’affichage par défaut d’une enveloppe translucide matérialisant l’intervalle de confiance à 95 % autour de la trajectoire moyenne. Cet outil visuel facilite considérablement l’analyse exploratoire et l’évaluation préliminaire de la précision d’ajustement.
9.3 Intervalles de confiance versus intervalles de prédiction
Une confusion méthodologique extrêmement répandue au sein de la littérature scientifique consiste à assimiler l’intervalle de confiance associé à la droite de régression et l’intervalle de prédiction associé à une observation individuelle future. Ces deux concepts reposent sur des fondements théoriques distincts et quantifient des incertitudes de natures fondamentalement différentes :
- L’intervalle de confiance pour la réponse moyenne : Il mesure l’incertitude stochastique relative à la localisation de l’espérance conditionnelle $\mathbb{E}(Y | X = x_0)$. Sa variance dépend exclusivement de l’erreur d’échantillonnage des estimateurs $\hat{\beta}_0$ et $\hat{\beta}_1$. À mesure que la taille de l’échantillon $n$ tend vers l’infini, la précision de l’estimation de la moyenne conditionnelle augmente et la largeur de cet intervalle converge mathématiquement vers zéro.
- L’intervalle de prédiction pour une observation individuelle : Il cherche à borner la valeur réalisée $y_{nouv}$ d’un individu unique pour lequel la variable explicative est égale à $x_0$. Sa variance incorpore obligatoirement la variance d’estimation des paramètres du modèle additionnée de la variance propre de l’erreur stochastique individuelle inhérente au processus ($\sigma^2$). Par conséquent, même si la taille de l’échantillon $n$ devient infinie, l’intervalle de prédiction conserve une largeur incompressible égale à $\pm z_{1-alpha/2} \sigma$.
Dans Statsmodels, l’extraction de ces intervalles analytiques pour n’importe quelle coordonnée s’effectue au moyen de l’objet de prédiction étendu issu de la méthode get_prediction(), accessible via le tableau .summary_frame(alpha=0.05). Ce rapport explicite sépare rigoureusement la moyenne prédite (mean), ses bornes de confiance (mean_ci_lower, mean_ci_upper) et les bornes de prédiction individuelle beaucoup plus larges (obs_ci_lower, obs_ci_upper). La modélisation graphique de ces courbes révèle leur morphologie hyperbolique caractéristique : les intervalles sont au plus étroit au centre de gravité de l’échantillon $(\bar{x})$ et s’évasent progressivement à mesure que l’on s’éloigne vers les périphéries de la distribution.
10. Étape 8 : Diagnostic approfondi des résidus et vérification post-estimation
10.1 Extraction et analyse descriptive des erreurs résiduelles
L’estimation des coefficients par les moindres carrés ordinaires ne garantit aucunement en soi que le modèle est statistiquement valide. L’ensemble de l’appareil inférentiel (tests $t$, tests $F$, intervalles de confiance) repose sur des postulats distributionnels formulés sur les termes d’erreur théoriques non observables $\varepsilon_i$. L’analyste doit par conséquent étudier les résidus empiriques, notés $e_i$, qui constituent les substituts observables directs de ces erreurs latentes :
$$e_i = y_i – \hat{y}_i$$
Par construction algébrique directe de la méthode des MCO (dès lors qu’une ordonnée à l’origine est incluse dans le modèle), la somme vectorielle et la moyenne arithmétique des résidus bruts sont rigoureusement nulles : $\sum e_i = 0$ et $\bar{e} = 0$. Il convient de vérifier empiriquement cette égalité numérique au sein de l’environnement Python pour s’assurer de l’absence de toute distorsion de calcul.
Au-delà des résidus bruts, dont l’échelle dépend directement des unités de la variable $Y$, l’analyste fait appel aux résidus standardisés et aux résidus studentisés (externes). Ces derniers s’obtiennent en divisant chaque résidu par son écart-type d’estimation propre, lequel prend en compte le levier exercé par chaque observation. Cette transformation confère aux erreurs une variance unitaire standard, permettant d’identifier immédiatement des anomalies de distribution sans ambiguïté métrologique.
10.2 Évaluation de la normalité des résidus
L’hypothèse selon laquelle les erreurs résiduelles se distribuent conformément à une loi normale gaussienne conditionne rigoureusement l’exactitude des valeurs de probabilité critique des tests d’hypothèses univariés. Si le théorème central limite confère une robustesse asymptotique au modèle lorsque la taille de l’échantillon devient très importante ($n > 100$), les échantillons d’échelle modeste typiques des études comportementales ou expérimentales requièrent une conformité stricte à ce postulat.
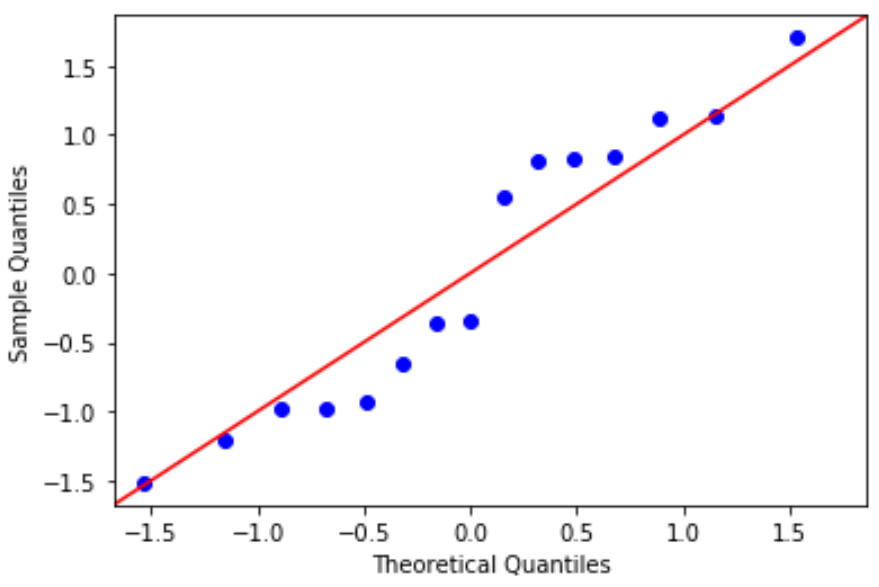
Le diagnostic de normalité s’articule prioritairement autour de la construction d’un diagramme quantile-quantile (ou Q-Q Plot). Cet outil graphique reporte les quantiles empiriques de la série des résidus en regard des quantiles théoriques issus d’une distribution normale standard de référence. La visualisation s’obtient via la fonction sm.qqplot(residus, line='45', fit=True). Si les erreurs se conforment au modèle gaussien, les points doivent s’agréger de façon étroite et rectiligne le long de la bissectrice diagonale. Des décrochages marqués aux extrémités de la ligne suggèrent des distributions leptokurtiques à queues lourdes ou des distorsions d’asymétrie structurelles.
Ce diagnostic visuel doit impérativement être complété par l’application de tests formels d’adéquation statistique. Le test de Shapiro-Wilk, implémenté au sein de scipy.stats.shapiro(), est reconnu comme l’un des plus puissants pour détecter les écarts à la normalité sur des échantillons finis. L’hypothèse nulle stipule la normalité de la distribution parentale ($H_0$). Une $p$-valeur associée supérieure au seuil usuel $\alpha = 0{,}05$ indique que l’hypothèse de normalité des résidus ne peut être rejetée. De son côté, le test de Jarque-Bera, systématiquement reporté dans la table récapitulative de Statsmodels, évalue simultanément si l’asymétrie et l’aplatissement empiriques concordent avec les moments théoriques gaussiens.
10.3 Diagnostic de l’homoscédasticité et linéarité résiduelle
Le postulat d’homoscédasticité stipule que la variance des termes d’erreur résiduels demeure constante sur l’intégralité du continuum de la variable explicative : $\mathrm{Var}(\varepsilon_i | X) = \sigma^2$. Lorsque cette condition n’est pas remplie, le modèle présente de l’hétéroscédasticité, une pathologie statistique qui se traduit par une variance conditionnelle fluctuante le long de la droite d’ajustement. L’évaluation de ce postulat s’opère au moyen du graphique des résidus en fonction des valeurs ajustées (Residuals vs Fitted plot).
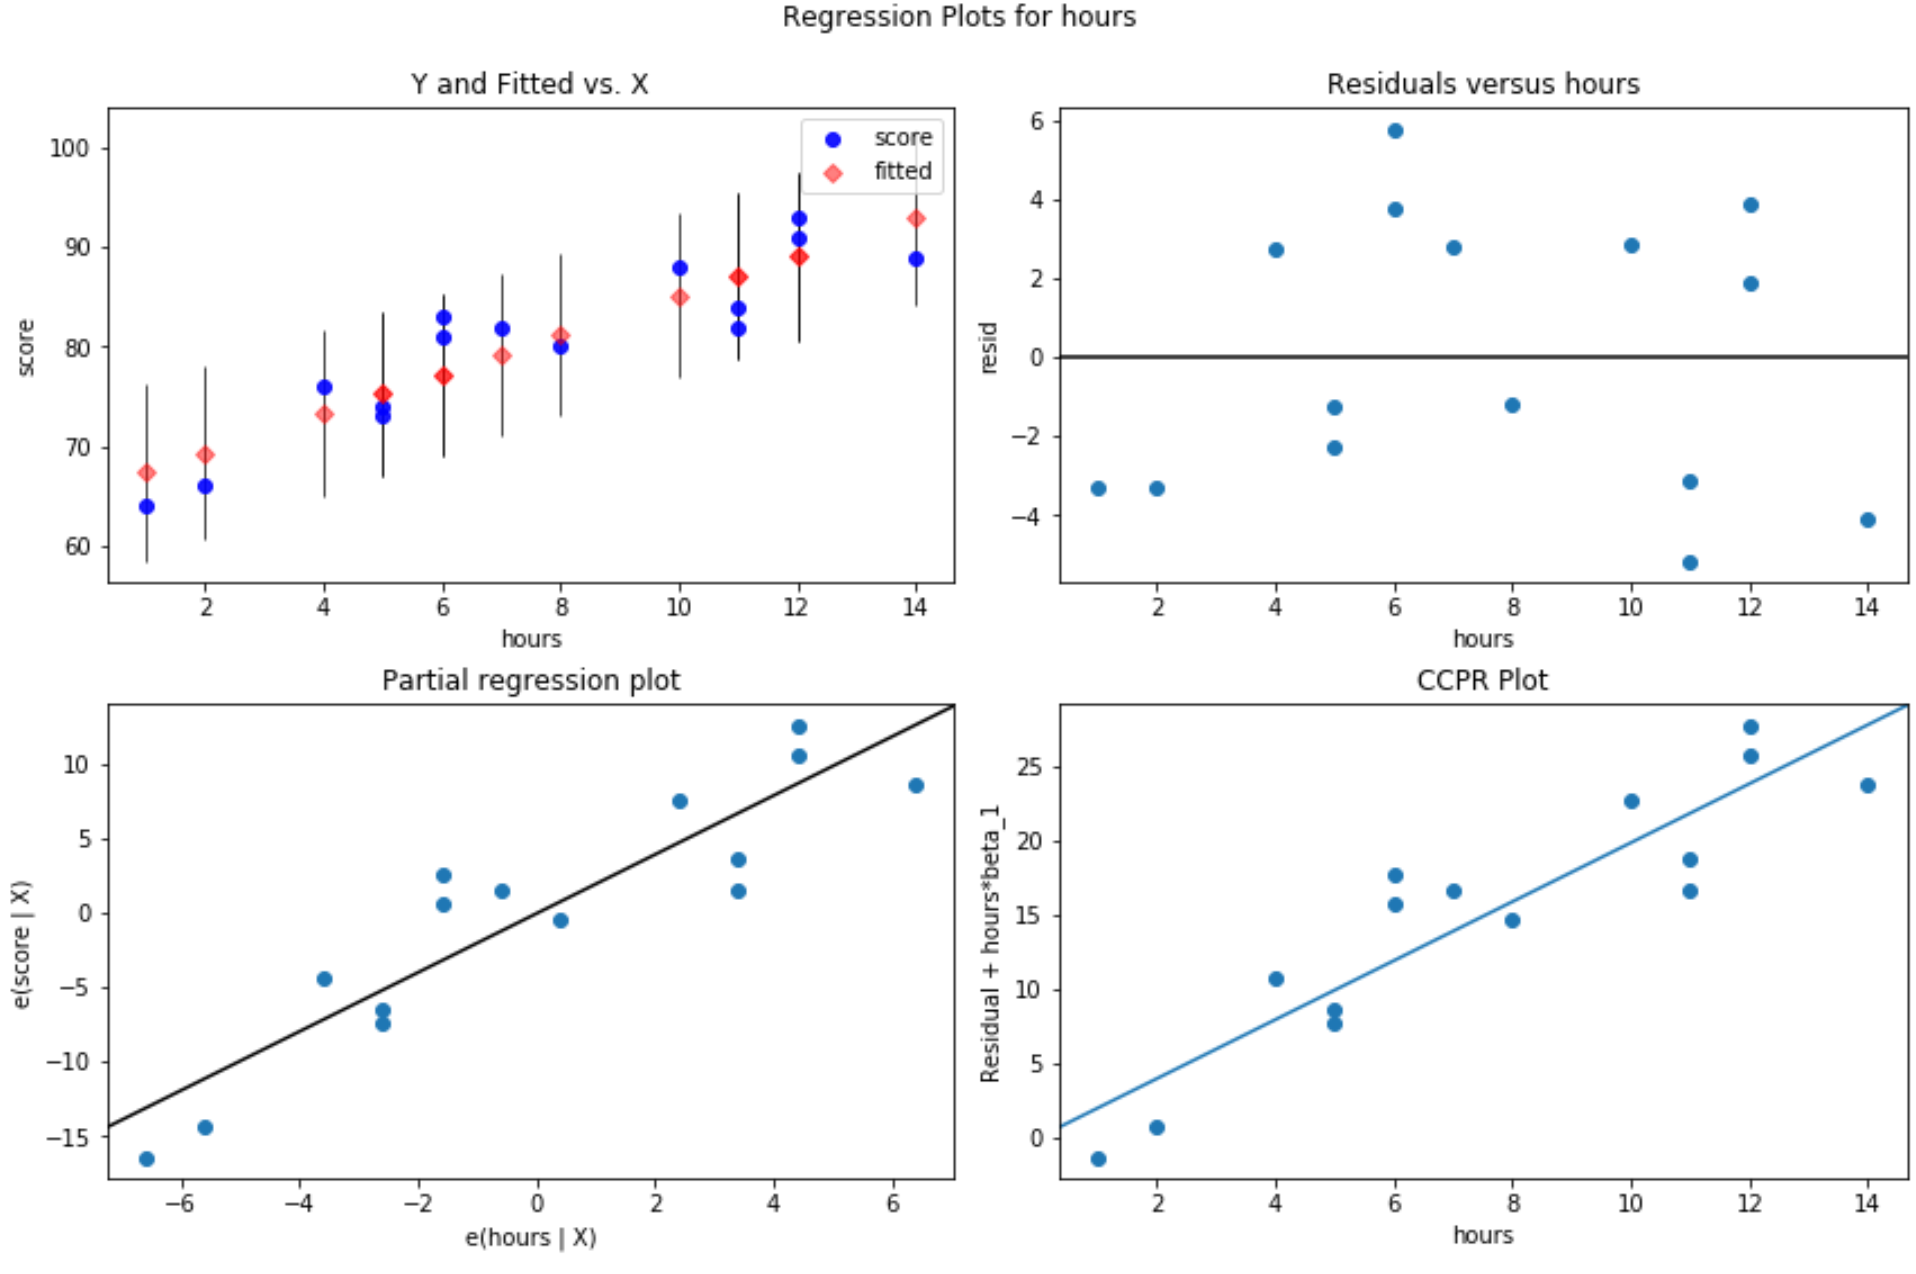
Sur ce diagramme, les résidus bruts ou studentisés sont projetés sur l’axe vertical des ordonnées, tandis que les valeurs théoriques prédites $\hat{y}_i$ occupent l’axe horizontal des abscisses. Un modèle convenablement spécifié génère un nuage de points sans structure apparente, réparti de manière aléatoire et uniforme au sein d’une bande horizontale symétrique centrée sur l’axe horizontal d’ordonnée zéro. La présence d’une forme d’entonnoir (funnel shape) — caractérisée par un étalement de plus en plus ample des résidus à mesure que les valeurs prédites progressent — constitue la signature visuelle incontestable d’une hétéroscédasticité prononcée.
Pour confirmer rigoureusement ce diagnostic au-delà de l’appréciation graphique, l’analyste met en œuvre des tests d’hypothèses formels tels que le test de Breusch-Pagan ou le test de White, disponibles au sein du sous-module statsmodels.stats.diagnostic via les fonctions het_breuschpagan et het_white. Ces tests régressent les carrés des résidus sur les prédicteurs ou leurs termes quadratiques pour vérifier si la dispersion d’erreur présente une dépendance fonctionnelle statistiquement significative. Si la probabilité critique $p$ est inférieure à $0{,}05$, l’homoscédasticité est rejetée, ce qui impose d’ajuster les erreurs-types du modèle au moyen d’estimateurs robustes de type sandwich d’Huber-White (options cov_type='HC3' sous Statsmodels).
11. Étape 9 : Détection des points influents et valeurs aberrantes
11.1 Identification des valeurs extrêmes (Outliers)
Dans tout ensemble d’observations empiriques, certaines données se situent à une distance remarquable du comportement prédominant de la cohorte. Il convient de distinguer avec précision les valeurs atypiques (outliers) relatives à la variable dépendante des points atypiques situés sur la variable prédictive. Une observation atypique se caractérise par une note observée $y_i$ particulièrement éloignée de la prédiction linéaire formulée par le modèle pour son niveau de régresseur $x_i$, générant un résidu empirique de magnitude anormale.
L’identification objective de ces déviances repose sur le calcul des résidus studentisés externes (ou supprimés), désignés par $t_i$. Ces résidus sont pondérés en réestimant l’écart-type d’erreur après avoir exclu tour à tour chaque observation de l’ajustement matriciel. Selon les conventions académiques en vigueur dans l’inférence des modèles linéaires :
- Une observation affichant $|t_i| > 2$ dans des échantillons de taille modeste doit être isolée comme suspecte et soumise à une inspection attentive.
- Une valeur excédant le seuil critique absolu $|t_i| > 3$ est conventionnellement qualifiée de valeur aberrante avérée.
En présence d’une valeur aberrante, l’erreur quadratique associée pèse de manière disproportionnée dans la fonction de coût des MCO. Cela force la droite à s’écarter de son orientation naturelle pour tenter de résorber cet écart substantiel, ce qui peut masquer la véritable tendance sous-jacente propre à l’écrasante majorité des participants.
11.2 Mesure du levier statistique et de la distance de Cook
Une observation peut présenter un résidu parfaitement nul tout en altérant profondément la stabilité du modèle de régression : c’est le cas des points à fort levier (high leverage points). Le levier, noté $h_{ii}$, correspond à l’élément diagonal de la matrice de projection orthogonale $\mathbf{H} = \mathbf{X}(\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T$, souvent désignée sous le terme de matrice chapeau (hat matrix). Il quantifie l’isolement géométrique d’un individu par rapport au barycentre des valeurs de la variable indépendante ($x_i – \bar{x}$). La somme des leviers équivaut au nombre de paramètres du modèle ($p = 2$ pour une régression simple) ; un individu est empiriquement considéré comme un point de levier critique lorsque son indice $h_{ii}$ excède le double ou le triple du levier moyen, soit le seuil critique $h_{ii} > \frac{2p}{n}$ ou $\frac{3p}{n}$.
Un point atypique ou isolé ne modifie cependant l’estimation des coefficients que s’il conjugue simultanément un levier élevé et un résidu substantiel : c’est ce que formalise la notion fondamentale d’influence. La mesure canonique de l’influence statistique globale d’une observation est synthétisée par la distance de Cook, notée $D_i$. Elle évalue le déplacement vectoriel induit sur l’ensemble des prédictions $\hat{\mathbf{y}}$ lorsque l’observation $i$ est totalement omise du processus d’estimation :
$$D_i = \frac{\sum_{j=1}^{n} (\hat{y}_j – \hat{y}_{j(i)})^2}{p \cdot \mathrm{MSE}} = \frac{e_{si}^2}{p} \left( \frac{h_{ii}}{1 – h_{ii}} \right)$$
où $e_{si}$ représente le résidu standardisé interne et $\mathrm{MSE}$ l’erreur quadratique moyenne. Selon les préconisations empiriques usuelles, toute observation dont la distance de Cook excède $D_i > \frac{4}{n}$ (ou de manière plus conservatrice $D_i > 1$) doit être considérée comme un point influent majeur capable de déstabiliser à lui seul l’estimation globale du modèle.
Statsmodels propose une interface graphique intégrée pour synthétiser simultanément ces dimensions diagnostiques au moyen de la méthode sm.graphics.influence_plot(resultats, criterion="cooks"). Cette visualisation reporte sur l’axe des abscisses le levier statistique de chaque point, sur l’axe des ordonnées leurs résidus studentisés respectifs, et matérialise la magnitude relative de la distance de Cook par l’intermédiaire du diamètre de chaque point, permettant une détection immédiate des cas influents majeurs.
11.3 Prise de décision méthodologique face aux points atypiques
La découverte d’une observation aberrante ou d’un point influent confronte le chercheur à un arbitrage méthodologique délicat. L’exclusion aveugle et automatisée d’une donnée sous le seul prétexte qu’elle s’écarte de la trajectoire idéale du modèle constitue une faute scientifique majeure, susceptible de générer un biais de confirmation artificiel et d’invalider la représentativité de l’étude empirique.
La démarche rigoureuse impose en premier lieu de remonter à la source de la collecte pour éliminer l’hypothèse d’une erreur matérielle de saisie, d’un dysfonctionnement d’instrumentation ou d’un non-respect patent du protocole expérimental par le sujet (par exemple, un participant ayant abandonné l’épreuve après quelques minutes seulement). En présence d’une erreur d’enregistrement indubitable et non corrigible, la suppression de l’observation est scientifiquement légitime et doit être explicitement documentée dans le rapport de recherche.
Lorsque la valeur aberrante relève de la variabilité naturelle et légitime du phénomène psychologique sous étude, la conduite d’une analyse de sensibilité s’avère indispensable. Cette approche consiste à ajuster le modèle à deux reprises — une première fois avec l’échantillon complet, puis une seconde fois après exclusion du point d’influence critique —, puis à juxtaposer rigoureusement les deux jeux d’estimations dans la publication finale. Si les conclusions substantielles et la significativité statistique de la pente demeurent invariantes face à cette exclusion, l’analyste atteste de la robustesse de ses conclusions. Dans le cas contraire, il convient de renoncer à l’optimisation par les moindres carrés ordinaires au profit de méthodes de régression robuste, telles que la régression de Huber ou les M-estimateurs implémentés au sein de la classe sm.RLM (Robust Linear Models) de Statsmodels.
12. Bonnes pratiques, pièges récurrents et rédaction académique
12.1 Le danger de l’extrapolation abusive
L’un des égarements analytiques les plus fréquents dans l’usage appliqué de la régression linéaire simple réside dans la propension à évaluer des prédictions en dehors du domaine de validité empirique des données disponibles. L’extrapolation consiste à projeter l’équation de régression calculée pour des valeurs de $X$ qui se situent bien au-delà des bornes inférieure ou supérieure observées lors de l’expérimentation ($x_{cible} \max(X)$).
Si la relation observée peut se révéler rigoureusement linéaire sur une plage de travail restreinte (par exemple entre 10 et 40 heures d’étude), rien ne garantit sur le plan biologique ou cognitif que cette linéarité se prolonge indéfiniment. Des mécanismes de saturation cognitive, des phénomènes d’épuisement mental ou des seuils de rendement décroissant induisent quasi-systématiquement des comportements asymptotiques non linéaires sur les plages extrêmes.
Projeter de manière irréfléchie qu’un temps de révision de 150 heures produirait une note théorique de 230 points sur une échelle graduée jusqu’à 100 met en lumière l’absurdité matérielle de l’extrapolation linéaire non bornée. La règle méthodologique d’or impose de restreindre formellement toute affirmation prédictive à l’enveloppe convexe délimitée par les données de l’échantillon d’ajustement initial.
12.2 Erreurs d’interprétation fréquentes en psychologie empirique
La littérature comportementale et psychologique présente de façon récurrente des maladresses d’interprétation conceptuelle qu’il convient de proscrire rigoureusement :
- La confusion entre association statistique et causalité substantielle : Ajuster une droite de régression linéaire simple ne démontre jamais, par sa seule vertu computationnelle, que la variable explicative constitue le moteur causal de la variable dépendante. En l’absence d’un plan d’expérience randomisé avec assignation aléatoire et neutralisation expérimentale des variables parasites, toute inférence causale tranchée demeure abusive.
- La surinterprétation du coefficient de détermination $R^2$ : Il est scientifiquement erroné d’ériger le $R^2$ en juge absolu de la validité d’une modélisation. Un $R^2$ modeste (de l’ordre de $0{,}15$ ou $0{,}20$) n’invalide nullement l’intérêt scientifique d’une régression en sciences humaines, où les comportements résultent de déterminants multifactoriels complexes. Réciproquement, un $R^2$ artificiellement élevé ($> 0{,}90$) peut résulter d’une modélisation tautologique où le prédicteur n’est qu’une reformulation sous un format alternatif de la variable réponse.
- L’omission de facteurs confondants majeurs : La régression simple possède par définition une vision parcellaire du monde. Si une tierce variable corrélée simultanément à $X$ et à $Y$ — telle que la motivation intrinsèque, les compétences cognitives préalables ou l’environnement socio-éducatif — est omise de l’analyse, l’effet apparent quantifié par la pente $\hat{\beta}_1$ se trouve biaisé et absorbe une part indue de l’impact de ces variables masquées. C’est tout l’enjeu du passage méthodologique vers la régression multiple.
12.3 Normes de rapportage selon le format académique (APA)
La communication des résultats statistiques au sein des publications internationales répond à des normes de formalisation standardisées très précises, définies notamment par le manuel de style de l’American Psychological Association (APA 7e édition). Ces préconisations régissent tant la rédaction du corps de texte que l’élaboration des tableaux de synthèse récapitulatifs.
Lors de la description textuelle des résultats d’une régression linéaire simple, le protocole impose de reporter systématiquement : le test d’adéquation globale du modèle avec ses degrés de liberté ($F$), le coefficient de détermination ($R^2$), l’estimation brute de la pente ($b$ ou $B$), son erreur-type standardisée ($SE$), le coefficient standardisé ($\beta$), ainsi que la valeur exacte de la statistique de Student ($t$) accompagnée de sa probabilité critique ($p$) et de l’intervalle de confiance à 95 % :
« Une régression linéaire simple a été conduite afin d’évaluer la capacité du temps d’étude (en heures) à prédire les scores obtenus à l’examen standardisé final. Le modèle s’avère statistiquement significatif et explique une part substantielle de la variance observée, $F(1, 18) = 38{,}24$, $p < 0{,}001$, $R^2 = 0{,}680$. Le nombre d'heures consacrées à l'apprentissage prédit positivement et significativement la note finale obtenue par les étudiants, $b = 2{,}45$, $SE = 0{,}40$, $\beta = 0{,}82$, $t(18) = 6{,}18$, $p < 0{,}001$, IC à 95 % $[1{,}61, 3{,}29]$. Ces résultats démontrent que chaque heure additionnelle d'étude est associée à un gain moyen d'environ 2,45 points sur l'épreuve finale. »
De surcroît, la présentation sous forme d’un tableau récapitulatif normalisé prêt pour la publication académique doit respecter la structure canonique suivante :
L’application rigoureuse de ces conventions de notation garantit une transparence méthodologique absolue, facilite la lecture critique par les pairs et autorise l’intégration sans ambiguïté des résultats paramétriques au sein de futures synthèses méta-analytiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/9780805822236
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications. https://us.sagepub.com/en-us/nam/applied-regression-analysis-and-generalized-linear-models/book237254
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b16018
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1920-00a
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Introduction+to+Linear+Regression+Analysis%2C+6th+Edition-p-9781119578727
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 61–66). https://doi.org/10.25080/Majora-92bf1920-011
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021