
Dans le champ foisonnant des sciences quantitatives contemporaines, la modélisation statistique constitue le socle méthodologique sur lequel reposent l’inférence scientifique, la validation empirique des hypothèses et la prise de décision éclairée. Qu’il s’agisse de disséquer les mécanismes sous-jacents aux dynamiques comportementales en psychologie, d’évaluer l’impact combiné de politiques publiques en économie ou de quantifier l’influence conjointe de biomarqueurs en santé publique, la nécessité de dépasser l’analyse bivariée élémentaire s’impose à tout chercheur soucieux d’appréhender la complexité du réel. La régression linéaire multiple s’affirme précisément comme l’un des instruments les plus robustes, polyvalents et universellement employés pour explorer et formaliser la relation fonctionnelle existant entre une variable continue d’intérêt et une constellation de prédicteurs covariants.
Pourtant, la mise en œuvre pratique de cette architecture analytique soulève fréquemment des défis opératoires non négligeables, en particulier lorsqu’elle doit être exécutée au sein d’environnements logiciels accessibles mais rigides. Si des progiciels spécialisés tels que le logiciel libre de statistiques computationnelles The R Project for Statistical Computing, IBM SPSS ou SAS dominent traditionnellement les cursus doctoraux et les laboratoires universitaires, Microsoft Excel demeure l’écosystème numérique le plus universellement déployé dans les organisations, les administrations et les centres de recherche appliquée. Doté de son module dédié, l’Utilitaire d’analyse, le tableur dispose d’une puissance algorithmique suffisante pour réaliser des estimations paramétriques rigoureuses par la méthode des moindres carrés ordinaires, à condition d’en maîtriser scrupuleusement la configuration technique, les hypothèses mathématiques sous-jacentes et les règles strictes de mise en forme des données.
Le présent traité propose une déconstruction exhaustive, théorique et opérationnelle de la régression linéaire multiple mise en œuvre dans Microsoft Excel. Conçu pour les chercheurs, analystes de données, psychométriciens et praticiens des sciences humaines et sociales, ce manuel examine en profondeur chaque maillon de la chaîne analytique : depuis l’assise épistémologique du modèle linéaire généralisé et la vérification impérative des postulats gaussiens, jusqu’à la dissection détaillée des tables d’analyse de variance, des coefficients de régression partielle et des métriques de diagnostic résiduel. En alliant précision conceptuelle, formalisation mathématique et pragmatisme procédural pas-à-pas, ce document vise à transformer une procédure logicielle parfois automatisée de manière aveugle en une démarche d’investigation scientifique hautement maîtrisée et conforme aux standards internationaux de publication académique.
1. Fondements conceptuels de la régression linéaire multiple en sciences du comportement
1.1 Définition théorique et modèle mathématique général
La régression linéaire multiple constitue une extension mathématique fondamentale du modèle linéaire simple. Elle permet de formaliser la relation stochastique unissant une variable dépendante continue, conventionnellement notée Y, à un ensemble constitué de k variables explicatives ou indépendantes, désignées par le vecteur (X1, X2, …, Xk). Sur le plan théorique de la population générale, le modèle s’articule autour d’une relation fonctionnelle linéaire pondérée par des paramètres structurels inconnus, à laquelle s’adjoint un terme d’aléa ou résidu stochastique. Ce modèle théorique s’écrit formellement sous l’expression :
Yi = β0 + β1X1i + β2X2i + … + βkXki + εi
Dans cette formulation canonique, l’indice i réfère à la i-ième unité statistique observée (par exemple un sujet, un groupe ou un instant temporel), β0 représente l’ordonnée à l’origine populationnelle, traduisant l’espérance mathématique conditionnelle de Y lorsque l’ensemble exhaustif des prédicteurs s’annule simultanément, et εi figure l’erreur stochastique non observée, capturant le bruit de mesure, les fluctuations individuelles imprévisibles et l’effet marginal de variables omises.
Les paramètres scalaires βj (avec j variant de 1 à k) incarnent conceptuellement les coefficients de régression partielle. Chacun de ces coefficients quantifie l’amplitude et le sens de la variation attendue de la variable réponse Y consécutive à une variation unitaire du prédicteur Xj correspondant, sous l’hypothèse stricte que l’ensemble des autres variables indépendantes incluses dans la spécification du modèle demeure parfaitement constant. Cette condition formelle, désignée sous l’expression latine classique ceteris paribus, confère à la régression multiple sa puissance analytique singulière en isolant l’apport spécifique de chaque covariable au-delà du simple chevauchement corrélationnel bivarié.
Il convient de préserver une différenciation épistémologique stricte entre les paramètres populationnels vrais et intangibles (notés en caractères grecs βj et εi) et les estimateurs statistiques dérivés d’un échantillon empirique fini de taille n (notés en caractères latins bj ou munis d’un accent circonflexe β̂j, accompagnés des résidus calculés ei). Selon les axiomes développés dans le cadre du théorème fondamental formulé par le mathématicien Carl Friedrich Gauss et le statisticien Andreï Markov, la méthode des moindres carrés ordinaires (MCO) vise à minimiser la somme quadratique des écarts verticaux entre les valeurs empiriquement observées Yi et les prédictions calculées Ŷi. Ce critère d’optimisation computationnelle garantit l’obtention des meilleurs estimateurs linéaires sans biais (BLUE, Best Linear Unbiased Estimator), conférant aux coefficients empiriques des propriétés asymptotiques de convergence, d’efficacité et de robustesse indispensables à la généralisation inférentielle.
1.2 Applications psychométriques et recherche quantitative
Au sein des sciences du comportement, de la psychologie cognitive et de la recherche translationnelle en santé mentale, la modélisation statistique est systématiquement confrontée à la nature diffuse, multivariée et latentielle des phénomènes observés. Contrairement aux sciences dures où les constantes physiques peuvent être mesurées avec une précision instrumentale quasi absolue, les construits psychologiques complexes — tels que l’estime de soi, l’épuisement professionnel (burnout), l’intelligence fluide ou la propension à l’inhibition motrice — sont invariablement influencés par une multitude intriquée de facteurs comportementaux, génétiques, psychologiques et environnementaux. La régression linéaire multiple offre un cadre unificateur rigoureux permettant de décomposer cette variance phénotypique composite et de tester des modèles théoriques intégrateurs formulés dans la littérature psychologique.
À titre d’illustration paradigmatique, considérons l’évaluation expérimentale de la performance cognitive générale mesurée lors d’une épreuve standardisée de raisonnement inductif. Un investigateur cherchant à prédire cette variable dépendante ne saurait se satisfaire d’une régression simple basée uniquement sur le volume d’heures consacrées à l’apprentissage ciblé. En effet, l’état d’activation émotionnelle du sujet, objectivé par exemple par un inventaire psychométrique d’anxiété-trait, exerce une interférence notable sur l’allocation des ressources exécutives en mémoire de travail, comme l’établit la théorie du traitement de l’efficacité cognitive documentée par l’American Psychological Association. En introduisant simultanément le temps d’étude formel et l’échelle d’anxiété au sein d’une équation multivariée, le modélisateur psychométricien parvient non seulement à quantifier la contribution relative de chacun de ces déterminants, mais également à examiner leur éventuel antagonisme fonctionnel ou leur complémentarité dans l’explication du rendement intellectuel global.
Au-delà de la pure prédiction comportementale, la régression linéaire multiple s’avère un instrument d’une indispensabilité absolue pour le contrôle statistique au sein des protocoles quasi-expérimentaux ou observationnels. Dans de nombreux contextes écologiques où l’assignation aléatoire des participants au sein de conditions expérimentales strictes s’avère matériellement impossible ou déontologiquement proscrite (par exemple lors de l’étude des conséquences de traumatismes psychologiques ou de trajectoires socio-éducatives défavorisées), des variables parasites ou confondantes viennent invariablement polluer les données. L’adjonction systématique de ces covariables au sein de la matrice de régression (telles que le niveau socio-économique parental, le quotient intellectuel prémorbide, ou la structure familiale) neutralise mathématiquement leur pouvoir explicatif résiduel, simulant ainsi un contrôle d’homogénéité équivalent a posteriori à une neutralisation par appariement expérimental.
1.3 Portée et limites de l’inférence causale par régression
L’utilisation intensive de la régression linéaire multiple requiert une vigilance épistémologique permanente quant à la nature des inférences qu’elle autorise. Il demeure crucial de réaffirmer avec force que la régression demeure, par construction algorithmique, une technique d’association statistique conditionnelle et ne constitue en aucune manière une démonstration de causalité ontologique univoque. L’obtention d’un coefficient de régression hautement significatif sur le plan paramétrique (p < 0,001) indique exclusivement l’existence d’une relation de covariation linéaire prédictive au sein de l’échantillon analysé, conditionnellement aux autres termes présents dans l’équation, mais s’avère incapable à elle seule de prouver que la manipulation délibérée de la variable Xj entraînera mécaniquement une modification de Y dans le monde réel.
Cette distinction conceptuelle prend tout son sens à la lumière des distorsions majeures induites par l’endogénéité et le biais d’omission de variables. Lorsqu’une variable explicative fondamentale, agissant conjointement sur le système étudié, est omise de la spécification de l’équation — soit par méconnaissance théorique, soit par impossibilité technique de collecte empirique —, les coefficients estimés pour les régresseurs inclus dans le modèle deviennent biaisés et incohérents. Ce phénomène, documenté sous l’appellation de biais de variable omise, implique que le coefficient calculé absorbe indûment la variance attribuable au facteur négligé. De surcroît, le problème de la causalité inverse — situation dans laquelle la variable dépendante présumée influe rétroactivement sur le prédicteur — ne peut en aucun cas être résolu par un ajustement linéaire classique sous Excel, réclamant des méthodologies économétriques plus sophistiquées comme l’estimation par variables instrumentales ou les équations structurelles longitudinales.
Enfin, la stabilité numérique, la puissance statistique et la réplicabilité des estimations par régression linéaire multiple demeurent intimement subordonnées à la taille de l’échantillon colligé. L’exploitation d’échantillons restreints face à un nombre pléthorique de prédicteurs induit une sur-optimisation contextuelle de l’ajustement (phénomène de surapprentissage ou overfitting), capturant des singularités idiosyncratiques ou du bruit de mesure au détriment de régularités populationnelles transposables. À l’inverse, l’analyse d’échantillons massifs présente le risque d’ériger des effets d’une petitesse négligeable au rang d’associations statistiquement significatives, sans que leur pertinence théorique ou clinique ne soit avérée. L’inférence légitime exige ainsi un équilibre méthodique entre puissance nominale du protocole, rigueur de l’échantillonnage probabiliste et parcimonie conceptuelle.
2. Distinction méthodologique entre régression linéaire simple et multiple
2.1 L’expansion géométrique de la droite au plan multidimensionnel
Sur le plan topologique et géométrique, le passage de la régression linéaire simple à la régression multiple marque une transition conceptuelle profonde dans la représentation spatiale des phénomènes empiriques. Dans une modélisation bivariée unitaire, l’espace d’analyse est un plan cartésien bidimensionnel défini par l’intersection orthogonale de l’axe des abscisses (prédicteur X) et de l’axe des ordonnées (réponse Y). L’ajustement par les moindres carrés ordinaires s’y matérialise visuellement sous la forme d’une unique droite de tendance, dont la pente représente l’unique taux de variation et l’ordonnée à l’origine fixe le point de convergence avec l’axe vertical.
Dès l’instant où un second prédicteur (X2) est introduit, l’espace d’observation bascule irréversiblement dans un repère euclidien tridimensionnel. L’équation de régression cesse alors de décrire une droite pour se matérialiser sous la forme d’un plan d’ajustement bidimensionnel flottant au sein d’un volume tridimensionnel. Lorsque le nombre de variables prédictives k excède deux, l’esprit humain ne peut plus visualiser géométriquement la configuration spatiale, qui se traduit mathématiquement par un hyperplan de régression de dimension k évoluant dans un espace continu à (k + 1) dimensions. L’optimisation algorithmique n’opère plus une minimisation des distances quadratiques par rapport à une droite, mais projette orthogonalement le vecteur d’observations sur le sous-espace vectoriel engendré par la matrice des régresseurs, minimisant ainsi la distance euclidienne globale entre le point vectoriel de réponse et l’hyperplan ajusté.
Cette extension multidimensionnelle modifie radicalement le comportement de la variance non expliquée. Dans l’espace bivarié, la variance résiduelle est simplement la part de dispersion de Y orthogonale à la droite de régression. Dans l’espace multivarié, l’introduction de dimensions supplémentaires tend invariablement à réduire la somme des carrés des erreurs résiduelles (ou, au minimum absolu, à la maintenir stable), car chaque nouveau vecteur de prédicteurs offre un degré de liberté supplémentaire pour absorber une portion résiduelle de variabilité. Il en résulte un rétrécissement progressif du bruit inexpliqué, au prix cependant d’une complexification géométrique croissante liée aux angles de covariance existant entre les différents axes de régression, rendant obsolète toute projection univariée simpliste.
2.2 Le rôle du contrôle statistique partiel
L’avantage méthodologique prééminent de la régression multiple sur la régression simple réside dans sa capacité opératoire à exercer un contrôle statistique partiel sur la structure de dépendance des données. Dans une régression linéaire simple reliant un prédicteur X1 à Y, le coefficient estimé capture sans discernement l’effet direct de X1 ainsi que la totalité des effets indirects transitant par toutes les autres variables qui se trouvent être corrélées à la fois avec X1 et avec Y. Cette agrégation aveugle de covariances peut conduire à des erreurs d’interprétation désastreuses, conférant un poids prédictif erroné à des indicateurs purement épiphénoménaux.
La régression multiple résout cette difficulté par un mécanisme analytique équivalent au calcul d’une corrélation partielle. Sur le plan algébrique, estimer le coefficient de régression partielle b1 de X1 en présence de X2 équivaut rigoureusement à une séquence en trois étapes : régresser préalablement Y sur X2 et en extraire les résidus eY|X2 (reflétant la variance de Y expurgée de l’influence de X2) ; régresser parallèlement X1 sur X2 et en extraire les résidus eX1|X2 (représentant la variance de X1 totalement indépendante de X2) ; puis, enfin, ajuster une régression linéaire simple passant par l’origine reliant ces deux séries résiduelles. Ainsi, le paramètre final n’exprime que la relation fonctionnelle épurée unissant X1 et Y une fois que toute la variance partagée avec les autres prédicteurs a été mathématiquement soustraite.
Cette capacité d’isolement analytique permet d’élucider des structures de causalité sous-jacentes complexes, particulièrement fréquentes en sciences sociales. Elle met en lumière les phénomènes de confusion, où une relation bivariée significative disparaît totalement après adjonction de la véritable variable explicative sous-jacente. Elle permet également d’identifier des effets de suppression statistique, situation fascinante où l’inclusion d’une variable tierce, initialement non corrélée avec la réponse Y, augmente drastiquement le pouvoir prédictif d’un autre régresseur en supprimant sa variance non pertinente (bruit résiduel). L’analyste se dote ainsi d’une grille de lecture infiniment plus fine que l’observation naïve des coefficients de corrélation linéaire de Pearson pris isolément.
2.3 Critères de décision pour sélectionner une approche multiple
La décision méthodologique d’abandonner le cadre sécurisant de la régression simple pour implémenter un modèle multiple ne doit jamais découler d’un automatisme algorithmique irréfléchi, mais reposer sur un faisceau d’arguments théoriques et empiriques solides. Le critère premier et inaliénable réside dans la plausibilité conceptuelle et l’exhaustivité théorique de l’explication avancée. Tout phénomène biologique, sociologique ou psychologique étant intrinsèquement multifactoriel, limiter son étude à un seul prédicteur constitue presque invariablement une sous-spécification du modèle, garantissant l’émergence de biais d’estimation. L’adjonction de covariables explicatives simultanées s’impose dès lors que la littérature scientifique suggère que plusieurs facteurs distincts exercent des influences conjointes, modératrices ou compensatoires sur la réponse.
Néanmoins, la quête d’exhaustivité se heurte immédiatement au principe épistémologique de parcimonie (connu sous le nom de rasoir d’Ockham). Un modèle excessivement lourd, englobant une multitude de prédicteurs secondaires faiblement articulés à la théorie, entraîne une dilapidation inutile de degrés de liberté, accroît l’instabilité numérique des algorithmes matriciels et complexifie à l’excès l’interprétation substantielle des résultats sans apporter de gain prédictif réel. L’analyste doit donc arbitrer minutieusement entre la richesse explicative empirique du modèle et sa simplicité structurale, en privilégiant l’inclusion ciblée de régresseurs dont l’impact fonctionnel est étayé par des hypothèses solides déduites a priori.
Pour prévenir le phénomène de surajustement statistique (overfitting) et garantir la validité de l’inférence paramétrique, des règles empiriques relatives au ratio entre le volume d’observations valides n et le nombre de prédicteurs k ont été largement théorisées dans la littérature méthodologique. Si les recommandations classiques d’experts comme Jacob Cohen suggèrent un seuil minimal absolu de 10 à 15 sujets par variable explicative pour une puissance modérée, les standards contemporains les plus rigoureux en psychométrie préconisent fréquemment un ratio de 20 à 30 observations par régresseur, voire un ratio de 50 pour 1 lorsque des effets de faible magnitude sont anticipés ou lorsque les prédicteurs présentent un certain degré d’intercorrélation naturelle. Tout non-respect caractérisé de ces proportions condamne le modèle à n’être qu’un artéfact computationnel non reproductible.
3. Postulats fondamentaux et conditions préalables d’application
3.1 Linéarité des relations et additivité du modèle
La validité statistique et l’interprétabilité des estimations issues d’une régression linéaire multiple reposent impérativement sur le respect scrupuleux d’un ensemble de postulats formels formulés par la théorie classique de Gauss-Markov. Le premier de ces axiomes fondamentaux stipule la stricte linéarité de la relation structurelle existant entre chaque variable prédictive et la réponse conditionnelle attendue. Cela implique mathématiquement que la fonction liant la moyenne de Y aux prédicteurs Xj est une combinaison linéaire de ces derniers, se traduisant par un taux de changement marginal constant quelle que soit la position occupée sur l’échelle de mesure du prédicteur considéré.
La violation de cette hypothèse de linéarité survient fréquemment dans les sciences humaines, où les processus dynamiques manifestent souvent des seuils de saturation, des lois de rendements décroissants ou des configurations en U inversé (telle que la célèbre loi de Yerkes-Dodson reliant l’éveil motivationnel à la performance cognitive). Si une telle courbure non linéaire sous-jacente est ignorée et contrainte de force dans un cadre linéaire strict, le modèle commettra des erreurs systématiques de prédiction, sous-estimant la réponse sur certains segments de l’échelle et la surestimant sur d’autres, tout en sous-évaluant grossièrement l’intensité de la véritable force de liaison empirique.
Concomitamment, le modèle postule l’additivité parfaite des effets prédictifs. L’additivité signifie que l’impact d’une modification unitaire de X1 sur Y est strictement identique, quel que soit le niveau quantitatif atteint par une autre variable X2 présente dans l’équation. En présence d’interactions statistiques réelles — c’est-à-dire de modérations où l’effet d’un facteur varie en intensité ou en direction selon la modalité d’un autre —, l’absence de modélisation explicite de termes multiplicatifs produit une rupture d’additivité. La détection de ces anomalies exige impérativement une inspection attentive des diagrammes de dispersion bivariés préliminaires croisant chaque prédicteur potentiel avec la variable dépendante avant toute soumission aveugle au moteur de calcul matriciel.
3.2 Indépendance et homoscédasticité des erreurs
Le second ensemble de conditions préalables indispensables concerne les propriétés stochastiques du terme d’erreur résiduelle non observable εi. La condition d’homoscédasticité postule l’homogénéité et la stricte constance de la variance des erreurs sur l’ensemble du continuum des valeurs prédites :
Var(εi | X) = σ2 ∀ i
En termes simples, la dispersion du bruit résiduel autour de l’hyperplan de régression doit demeurer stationnaire, que les valeurs estimées soient particulièrement faibles, médianes ou exceptionnellement élevées. Lorsque cette variance fluctue de manière systématique en fonction des régresseurs, le modèle sombre dans l’hétéroscédasticité.
Ce phénomène d’hétéroscédasticité est particulièrement récurrent lors de l’étude de données économiques ou de variables psychologiques liées à l’apprentissage ou au revenu, où les écarts de performance ont tendance à s’accroître considérablement à mesure que le niveau global s’élève. Bien que les estimateurs des coefficients des moindres carrés demeurent mathématiquement sans biais en présence d’hétéroscédasticité, ils perdent leur propriété d’efficacité maximale (ils ne sont plus BLUE). Plus grave encore, le calcul conventionnel des erreurs-types associées aux coefficients est totalement faussé, conduisant généralement à leur sous-estimation artificielle. Il en découle une inflation pernicieuse des statistiques de test, déclenchant des rejets injustifiés de l’hypothèse nulle (erreurs d’inférence de Type I).
Parallèlement, l’hypothèse d’indépendance mutuelle des résidus exige une absence absolue d’autocorrélation entre les erreurs de mesure :
Cov(εi, εj) = 0 ∀ i ≠ j
Cette condition est classiquement violée dans les plans d’échantillonnage longitudinaux ou temporels où des mesures répétées sont effectuées sur les mêmes sujets, générant une dépendance sérielle captée traditionnellement par des diagnostics d’autocorrélation comme le test statistique classique de Durbin et Watson disponible dans la littérature méthodologique formalisée sur des bases de données comme JSTOR. Elle l’est également dans les architectures de données hiérarchiques ou emboîtées (par exemple, des élèves échantillonnés au sein de mêmes classes scolaires), réclamant alors des modélisations mixtes ou multiniveaux plutôt qu’une régression standard par moindres carrés ordinaires.
3.3 Normalité distributionnelle des résidus
L’inférence paramétrique classique déployée dans le cadre de la régression linéaire multiple — comprenant l’établissement rigoureux des intervalles de confiance pour les coefficients et le calcul des probabilités critiques (valeurs p) adossées aux tests t de Student et F de Fisher — présuppose de façon cardinale que les résidus stochastiques du modèle suivent une distribution gaussienne dans la population parente :
εi ~ N(0, σ2)
Il est impératif de dissiper à cet égard une confusion théorique courante parmi les praticiens néophytes : le postulat de normalité ne s’applique aucunement aux distributions marginales des variables prédictives X, ni même à la distribution brute de la variable dépendante Y, mais s’applique de manière stricte et exclusive à la distribution des résidus conditionnels inexpliqués générés par le modèle.
Pour vérifier cette conformité distributionnelle, le chercheur doit recourir à des instruments diagnostiques tant quantitatifs que graphiques, au premier rang desquels figure le tracé de probabilité normale résiduelle ou diagramme quantile-quantile (Q-Q plot). Dans cette représentation, les quantiles empiriques des résidus standardisés sont projetés en regard des quantiles attendus sous une loi normale théorique. Tout alignement rigoureux des points sur la droite bissectrice diagonale atteste de la parfaite adéquation gaussienne du terme d’erreur. À l’inverse, l’observation de motifs récurrents en « S » ou de déviations abruptes aux extrémités traduit la présence d’asymétries (skewness) ou de queues de distribution épaisses à aplatissement excessif (kurtosis), signalant la présence fréquente de cas aberrants extrêmes.
Sur le plan asymptotique, l’invocation du théorème central limite garantit une relative résilience et robustesse des estimateurs des moindres carrés face aux écarts de normalité dès lors que l’échantillon analysé atteint une taille suffisante (généralement n > 100 ou 200 sujets selon le degré de distorsion). Dans ces configurations de grands échantillons, les distributions d’échantillonnage des coefficients tendent vers la normalité quelle que soit la loi empirique sous-jacente des erreurs. Néanmoins, pour les échantillons réduits fréquemment rencontrés dans les protocoles neuropsychologiques spécialisés, toute violation substantielle de ce postulat compromet sévèrement l’exactitude des seuils critiques nominaux, exigeant alors des procédures de rééchantillonnage (bootstrapping) ou des transformations préalables de variables.
3.4 Absence de multicolinéarité excessive
Le postulat d’absence de multicolinéarité parfaite constitue une condition mathématique sine qua non pour la solubilité même des algorithmes matriciels de la régression linéaire multiple. Sur le plan formel, la matrice d’inversion des prédicteurs (X’X) doit impérativement être de plein rang et régulière pour être inversible. Si deux prédicteurs présentent une corrélation linéaire bivariée absolue égale à 1 (ou si une variable explicative est une combinaison linéaire parfaitement exacte de deux ou plusieurs autres régresseurs), la multicolinéarité est dite parfaite, rendant l’opération d’inversion mathématiquement impossible et plongeant l’ordinateur dans une division algorithmique par zéro.
Dans la pratique empirique des sciences du comportement, la multicolinéarité parfaite est exceptionnelle (résultant le plus souvent d’une grossière erreur de manipulation, telle que l’inclusion simultanée de scores sous-dimensionnels et du score global qui en constitue la somme directe). En revanche, la multicolinéarité imparfaite mais sévère est un fléau omniprésent. Elle survient lorsque des variables indépendantes conceptuellement distinctes partagent des degrés de corrélation empirique extrêmement élevés (par exemple r > 0,80 ou 0,90), se chevauchant presque intégralement dans l’espace de variance de l’échantillon. Bien que le calcul matriciel demeure formellement exécutable sous ces conditions, les répercussions statistiques sont particulièrement insidieuses.
La conséquence prépondérante d’une forte multicolinéarité réside dans l’inflation démesurée des erreurs-types associées aux coefficients de régression partielle concernés. Cette inflation élargit considérablement les intervalles de confiance et affaisse artificiellement les statistiques t associées, conduisant fréquemment à des situations paradoxales où le modèle global présente un ajustement phénoménal (avec un R2 élevé et une statistique F immensément significative), tandis qu’aucun des prédicteurs individuels ne parvient à atteindre le seuil critique de significativité statistique. De surcroît, le système d’équations devient d’une instabilité numérique extrême : l’adjonction ou la suppression d’une seule observation au sein de la base de données peut provoquer des fluctuations titanesques de la magnitude, voire une inversion dramatique du signe algébrique des coefficients de régression.
4. Configuration et activation de l’Utilitaire d’analyse dans Microsoft Excel
4.1 Localisation et intégration du complément sous Windows
L’architecture native de Microsoft Excel sous l’environnement de bureau Windows intègre un moteur de calcul statistique avancé, mais ce dernier demeure par défaut désactivé lors de l’installation standard de la suite bureautique Microsoft 365 ou Office Pro. Pour pouvoir exploiter les fonctionnalités de régression linéaire multiple, l’analyste doit procéder à l’initialisation explicite du complément logiciel homologué dénommé « Utilitaire d’analyse » (ou Analysis ToolPak en nomenclature anglo-saxonne d’origine).
La procédure d’intégration s’opère selon un protocole séquentiel rigide au sein de l’interface graphique du système d’exploitation de Microsoft. Il convient d’accéder au menu principal en cliquant sur l’onglet Fichier situé dans le coin supérieur gauche du ruban de commande, puis de sélectionner la rubrique Options logée au bas du panneau de navigation latéral. Dans la boîte de dialogue contextuelle qui se déploie à l’écran, l’utilisateur doit orienter son attention vers le volet Compléments. Au bas de cette fenêtre d’administration technique figure une zone de paramétrage intitulée Gérer, configurée par défaut sur la sélection « Compléments Excel ». Il s’agit alors de cliquer sur le bouton Atteindre… situé immédiatement à droite.
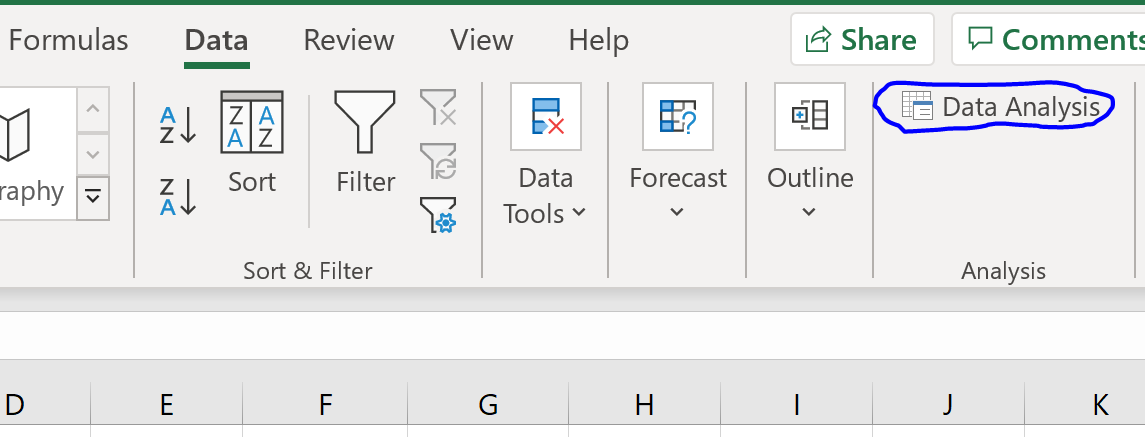
Une nouvelle interface restreinte apparaît, répertoriant les extensions internes développées pour le logiciel. Il est impératif de cocher la case relative à l’Utilitaire d’analyse (il est inutile d’activer l’utilitaire d’analyse VBA pour un usage standard sans programmation de macros automatisées). Après validation en cliquant sur le bouton OK, Excel procède au chargement dynamique de la bibliothèque de fonctions statistiques sans exiger le moindre redémarrage du programme. La confirmation définitive de cette activation s’opère en basculant sur l’onglet Données du ruban supérieur : à son extrémité droite absolue doit désormais trôner un nouveau groupe de commande labellisé Analyse, hébergeant l’icône interactive Utilitaire d’analyse.
4.2 Activation de l’Utilitaire d’analyse sur l’environnement macOS
L’implémentation de procédures quantitatives avancées au sein de l’écosystème Apple macOS requiert une démarche d’initialisation légèrement différenciée, tributaire de la philosophie ergonomique propre au système d’exploitation développé par la firme de Cupertino. Bien que les versions récentes d’Excel pour Mac intègrent une parité fonctionnelle complète concernant les algorithmes sous-jacents de la régression, l’accès structurel aux paramètres d’activation ne transite pas par un panneau des options global identique à celui de Windows.
Sur macOS, l’utilisateur doit porter son attention sur la barre de menus système positionnée tout en haut de l’écran physique. En déroulant le menu textuel Outils, il convient de repérer et de sélectionner la commande intitulée Compléments Excel…. Cette action déclenche l’ouverture instantanée d’une modale flottante centrée, présentant la liste des extensions disponibles pour le noyau Unix du logiciel. Comme sur l’environnement homologue, il est nécessaire de cocher avec précision la ligne intitulée Analysis ToolPak (ou Utilitaire d’analyse selon la langue de localisation système paramétrée), puis de confirmer l’opération par un clic d’approbation.
Les dysfonctionnements d’affichage sur Mac surviennent principalement lors de conflits de résolution d’affichage ou lorsque le ruban dynamique masque les onglets secondaires en mode plein écran. Si, à la suite du processus d’activation formelle, le bouton « Analyse de données » demeure invisible au sein de l’onglet Données, il est vivement conseillé de vérifier les préférences de personnalisation du ruban dans le menu Excel > Préférences > Ruban et barre d’outils, en s’assurant que le groupe « Analyse » est explicitement coché. Une fois cette validation opérée, l’environnement Mac offre une réactivité algorithmique strictement analogue à celle observée sur station de travail Windows.
4.3 Validation de l’intégrité de l’environnement de calcul
Avant d’engager toute soumission de matrices quantitatives massives au processeur de calcul d’Excel, une validation minutieuse de l’intégrité opérationnelle du classeur s’avère indispensable pour prémunir l’analyste contre l’émergence d’erreurs logiques silencieuses. La source la plus dévastatrice d’altération de calcul sous Excel réside historiquement dans la mauvaise gestion des paramètres régionaux, et tout particulièrement du séparateur décimal. Dans l’espace francophone international, la virgule (,) fait office de séparateur décimal standard conventionnel, tandis que les systèmes anglo-saxons mobilisent exclusivement le point (.).
Si des données quantitatives sont importées depuis des fichiers au format CSV générés par des plateformes d’expérimentation en ligne (telles que Qualtrics ou Gorilla) sans ajustement préalable, les chiffres comportant des points peuvent être automatiquement interprétés par Excel comme des chaînes de texte typographiques non numériques ou comme des formats de dates calendaires. L’Utilitaire d’analyse est totalement incapable de traiter des données textuelles et émettra un message d’erreur bloquant ou, pire, ignorera les lignes concernées. Il est donc fondamental de vérifier dans les options avancées d’Excel (Options > Options avancées > Utiliser les séparateurs système) la conformité du traitement des décimales, ou d’appliquer une substitution globale des points par des virgules.
De surcroît, le chercheur doit obligatoirement contrôler les options de calcul de son classeur en s’assurant que le mode de recalcul est impérativement configuré sur Automatique (accessible via Formules > Options de calcul). Enfin, il est vivement recommandé de désactiver ou de décharger temporairement les compléments logiciels tiers invasifs ou les macros d’automatisation non sollicitées. Certaines extensions de reporting d’entreprise injectent des liaisons dynamiques d’arrière-plan susceptibles d’interférer avec l’allocation de la mémoire volatile lors de l’exécution des calculs d’inversion matricielle de l’Utilitaire d’analyse, garantissant ainsi une parfaite étanchéité de l’expérimentation computationnelle.
5. Structuration et préparation rigoureuse de la matrice de données
5.1 Organisation spatiale des colonnes dans la feuille de calcul
La contrainte ergonomique la plus stricte imposée par l’algorithme de régression de l’Utilitaire d’analyse d’Excel concerne l’agencement topologique des données sur la grille de calcul. Contrairement à des environnements comme R où les formules de modélisation acceptent des variables disséminées arbitrairement via une syntaxe symbolique du type lm(Y ~ X1 + X2), l’outil d’Excel impose une contrainte structurelle incontournable : l’ensemble des variables indépendantes (X) doit être impérativement regroupé dans un bloc unique de colonnes rigoureusement adjacentes et contiguës.
Concrètement, la feuille de calcul doit être structurée avec une rigueur géométrique absolue. La première ligne (ligne 1) doit être réservée de manière exclusive à l’attribution d’intitulés de variables explicites, courts, concis et univoques, évitant absolument les espaces typographiques multiples ou les caractères spéciaux complexes (par exemple : Temps_Etude, Score_Anxiete, Niveau_SocioEco). La variable dépendante continue Y (par exemple, Performance_Cognitive) doit être logée dans une colonne unitaire dédiée, qu’il est méthodologiquement judicieux de positionner immédiatement à gauche ou immédiatement à droite de la matrice rectangulaire des prédicteurs pour des motifs de lisibilité.
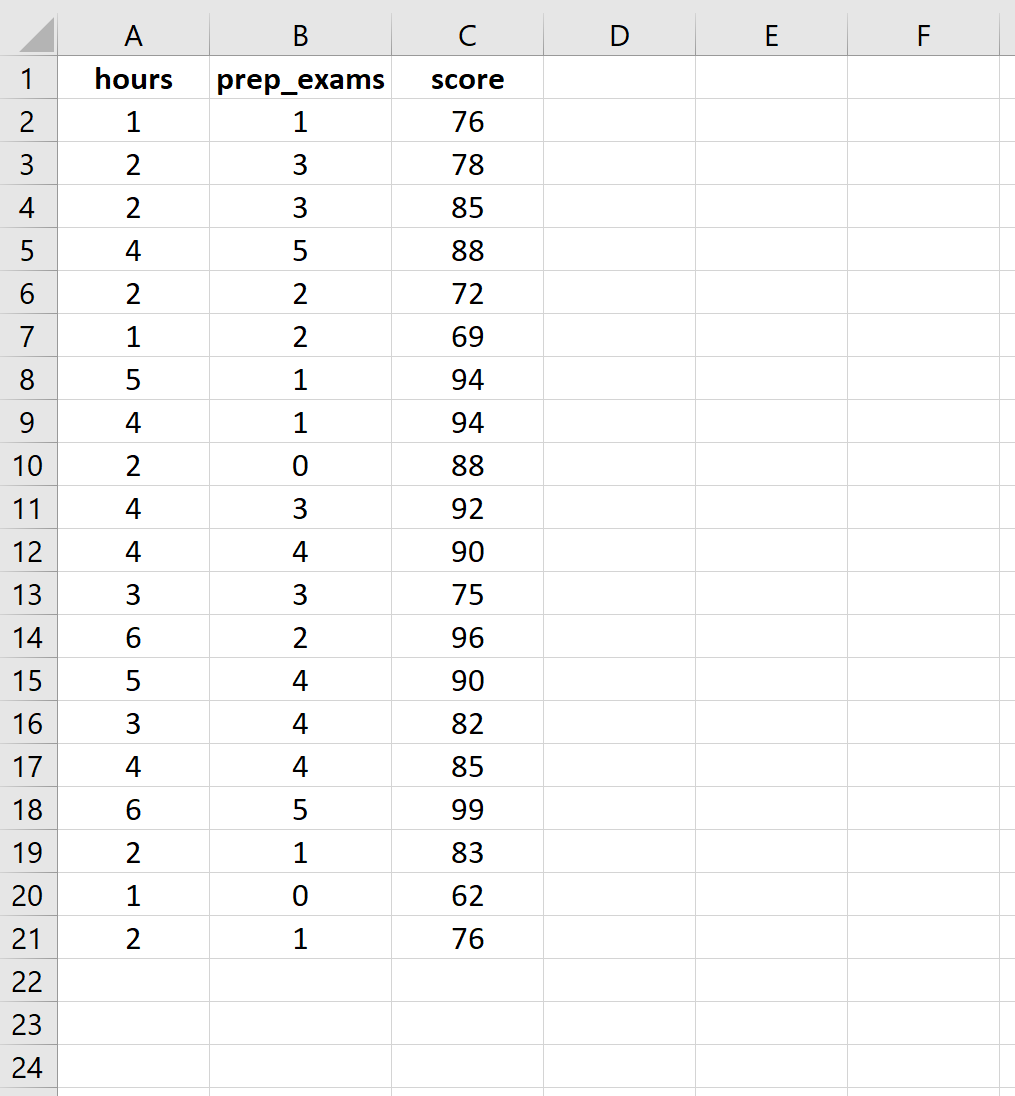
Toute discontinuité spatiale au sein du bloc des variables X — telle que l’intercalation accidentelle d’une colonne de calcul intermédiaire, d’un identifiant de sujet textuel ou d’une colonne de notes qualitatives — provoquera l’impossibilité technique de renseigner la plage d’entrée dans la boîte de dialogue de l’Utilitaire d’analyse. Celle-ci ne tolère qu’une seule plage matricielle continue pour l’argument X (par exemple $B$1:$D$150). Une restructuration physique préalable des colonnes par copier-coller s’avère donc impérative avant d’initialiser le traitement statistique.
5.2 Nettoyage et traitement des données manquantes
L’Utilitaire d’analyse d’Excel ne dispose d’aucun moteur algorithmique interne sophistiqué pour gérer dynamiquement les valeurs manquantes lors d’une régression multiple. Si une seule cellule au sein de la matrice sélectionnée est vide ou comporte un caractère alphanumérique erroné (un espace invisible, un tiret d’absence, ou une mention textuelle comme « N/A »), le module interrompt prématurément le calcul en affichant une boîte d’alerte laconique indiquant que les plages d’entrée doivent contenir des données exclusivement numériques. Un protocole rigoureux d’assainissement préliminaire de la matrice s’avère ainsi obligatoire.
Pour auditer l’intégrité de la base de données, l’analyste peut déployer les fonctionnalités de Mise en forme conditionnelle en programmant une règle de mise en surbrillance automatique des cellules vides sur l’ensemble de la plage opérationnelle, ou recourir à l’outil Atteindre les cellules… (raccourci Ctrl + Touche F5 sous Windows, puis sélection de l’option « Cellules vides »). Face aux observations incomplètes identifiées, le chercheur doit trancher entre deux orientations méthodologiques fondamentales :
- La suppression par liste complète (listwise deletion) : Elle consiste à éliminer purement et simplement la ligne entière correspondant au participant dès lors qu’une seule de ses valeurs (sur Y ou sur l’un des X) est absente. Cette méthode, la plus simple et la plus couramment déployée sous Excel, est statistiquement neutre uniquement sous l’hypothèse stricte que les données manquent de manière totalement aléatoire (mécanisme MCAR, Missing Completely At Random). En revanche, si la non-réponse est systématique (liée par exemple à une anxiété extrême empêchant de remplir l’inventaire), l’exclusion introduit un biais de sélection substantiel dans l’échantillon analysé.
- L’imputation de données : Pour les jeux de données complexes où la perte de puissance statistique consécutive à l’exclusion brute serait prohibitive, l’analyste peut procéder à des imputations calculées directement sous Excel. Si l’imputation par la moyenne globale de la variable est historiquement répandue, elle présente le grave défaut d’atténuer artificiellement la variance et de gonfler les corrélations. Des approches plus rigoureuses, telles que l’imputation par régression stochastique préalable ou l’interpolation linéaire, peuvent être préparées dans des colonnes de calcul annexes avant d’acheminer le tableau consolidé vers le module de régression.
5.3 Codage des variables catégorielles sous forme dichotomique
Une incompréhension récurrente chez les utilisateurs d’Excel réside dans la tentative d’injecter directement des variables qualitatives nominales au sein de la plage des variables explicatives X. L’algorithme des moindres carrés ordinaires requiert impérativement des opérandes arithmétiques numériques continus ou discrets. L’intégration de facteurs catégoriels (tels que le genre, le groupe d’appartenance clinique, ou le niveau de diplôme) nécessite obligatoirement le recours au codage par variables indicatrices binaires, universellement désigné sous le terme de codage fictif ou dummy coding.
Le principe mathématique du codage muet stipule que pour une variable nominale comportant C modalités distinctes, le modélisateur doit impérativement concevoir exactement (C – 1) colonnes binaires indicatrices indépendantes au sein de sa feuille Excel. Par exemple, si une variable clinique classe les individus en trois groupes mutuellement exclusifs : « Groupe Contrôle », « Groupe Thérapie Cognitive », et « Groupe Pharmacothérapie », le chercheur devra créer deux variables indicatrices distinctes (3 – 1 = 2 colonnes), valorisées exclusivement par les chiffres 0 ou 1 à l’aide de formules conditionnelles simples telles que :
=SI(A2="Thérapie Cognitive"; 1; 0)
La modalité omise (dans ce cas, le « Groupe Contrôle ») devient alors formellement la catégorie de référence conceptuelle du modèle. Chaque coefficient de régression associé aux variables indicatrices créées représentera alors l’écart paramétrique différentiel de la moyenne de Y par rapport à cette catégorie de référence fondamentale, les autres prédicteurs étant maintenus constants. L’omission de cette contrainte de soustraction (C – 1) — c’est-à-dire la création coupable de trois variables binaires pour les trois groupes — induirait une dépendance linéaire parfaite avec la colonne de l’ordonnée à l’origine (la somme des trois colonnes valant exactement 1 pour chaque ligne). Cette situation, documentée sous l’appellation classique de piège des variables muettes (dummy variable trap), rend la matrice mathématiquement singulière et conduit à un échec d’estimation algorithmique immédiat.
6. Procédure d’exécution de la régression multiple via l’interface Excel
6.1 Sélection et paramétrage des plages d’entrée
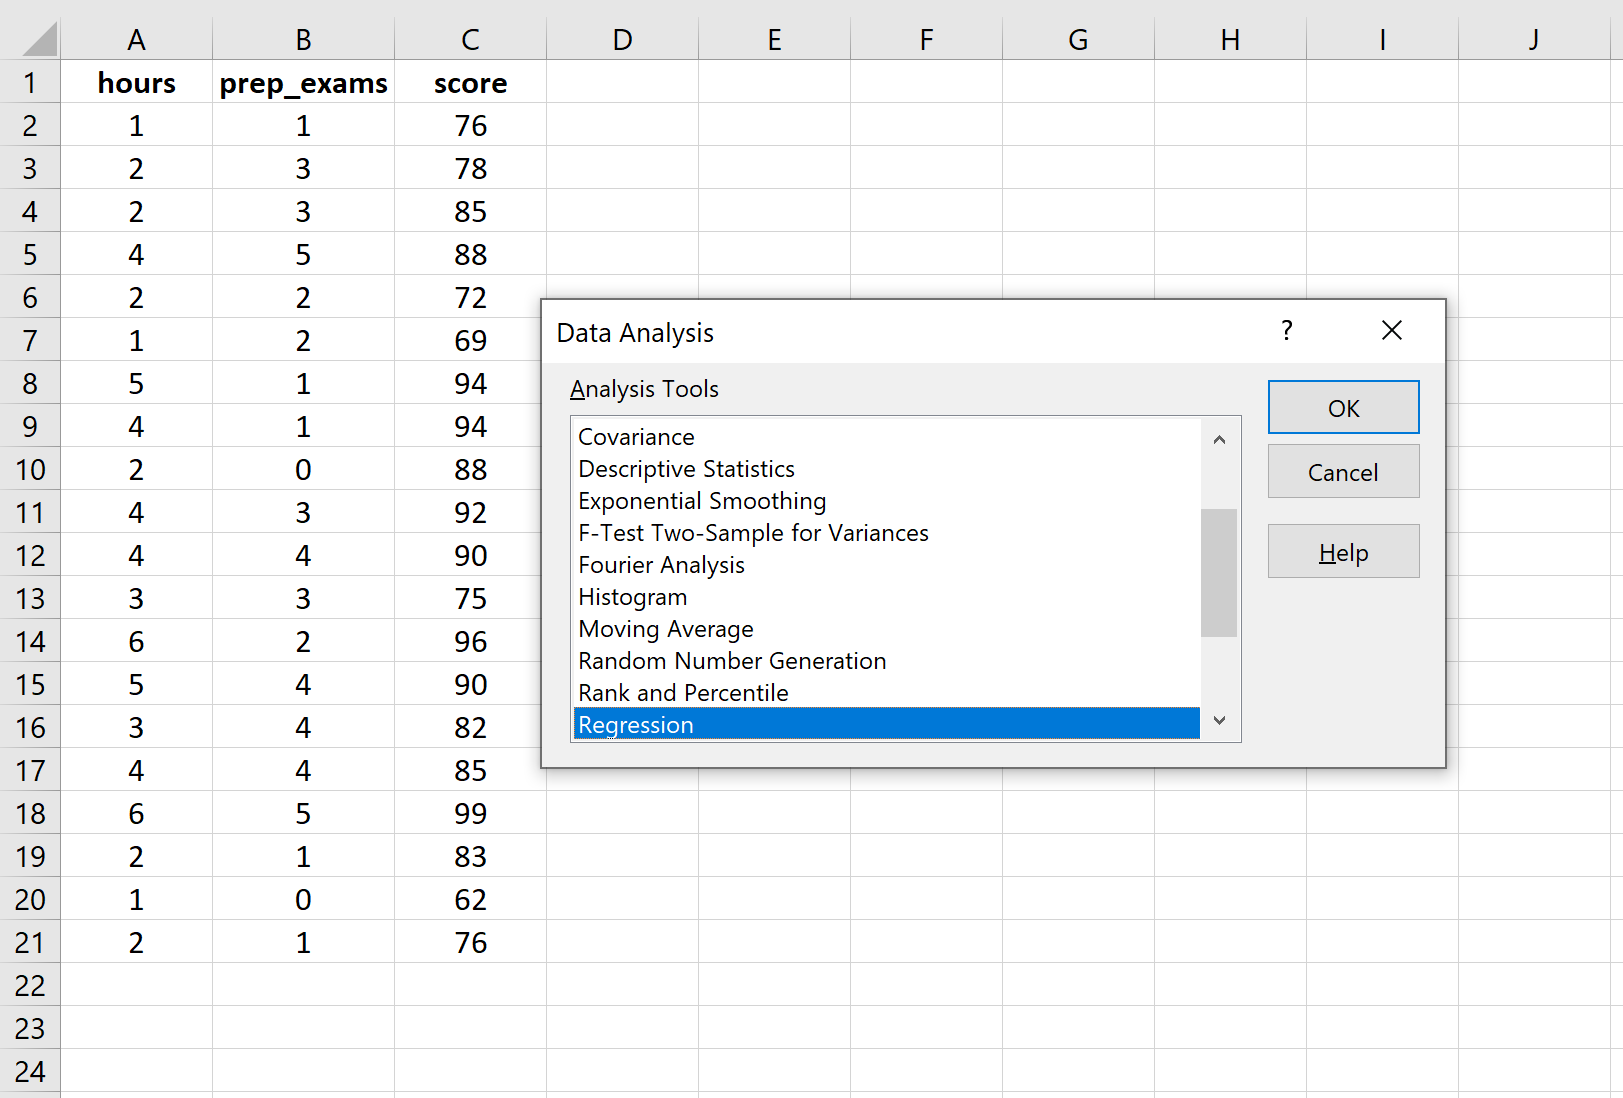
Une fois le tableau consolidé, assaini et convenablement agencé, l’exécution computationnelle de la modélisation s’effectue au travers d’une séquence rigoureuse au sein de l’interface graphique de l’Utilitaire d’analyse. Depuis l’onglet Données du ruban principal, l’analyste clique sur la commande Utilitaire d’analyse. Une fenêtre modale apparaît, listant par ordre alphabétique les différents modules statistiques disponibles. Il convient de faire défiler cette liste pour sélectionner le terme Régression, puis de confirmer l’ouverture de la boîte de dialogue principale par un clic sur OK.
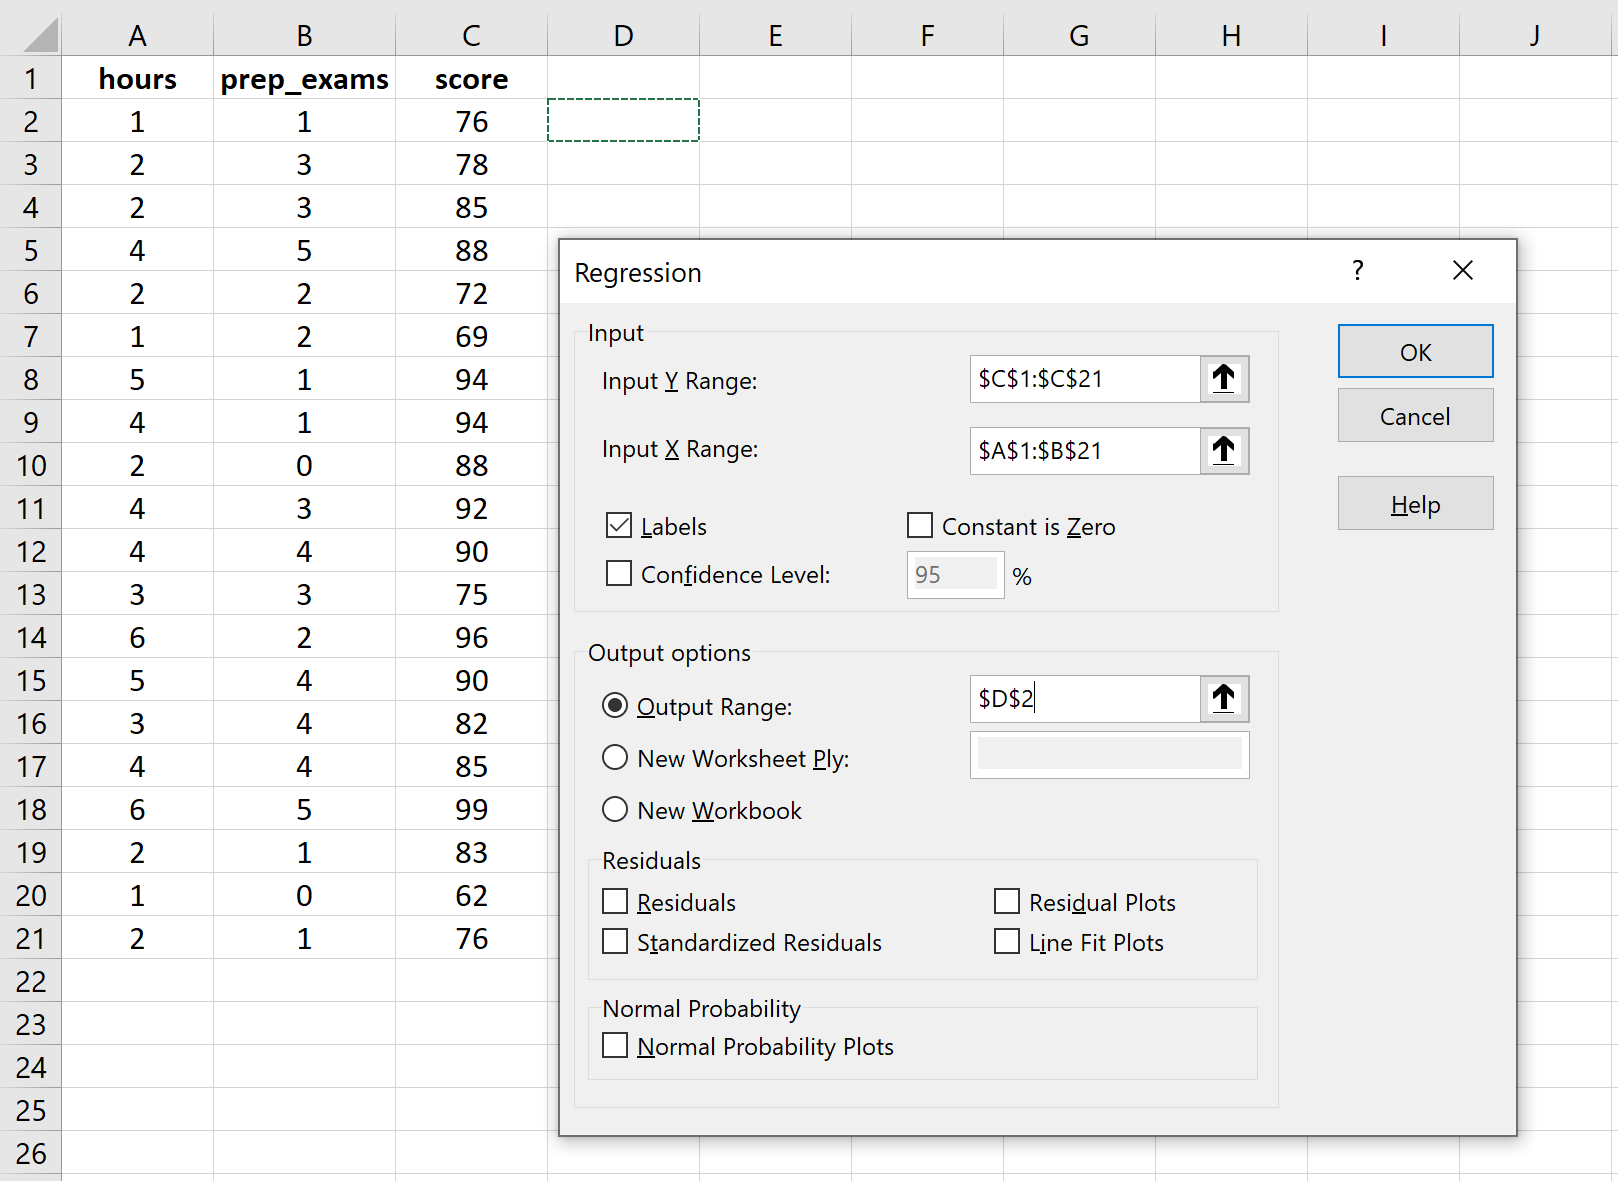
L’interface de configuration de la régression sollicite en premier lieu le renseignement de la Plage d’entrée Y. L’utilisateur doit y référencer l’intégralité du vecteur vertical de la variable dépendante continue, en incluant impérativement la première cellule supérieure contenant l’étiquette textuelle (par exemple $A$1:$A$151). Immédiatement en dessous, la zone Plage d’entrée X doit recevoir la matrice rectangulaire intégrale englobant toutes les colonnes contiguës des variables indépendantes sélectionnées, intégrant pareillement leur première ligne d’en-tête (par exemple $B$1:$E$151 pour un ensemble constitué de quatre prédicteurs covariants observés sur 150 participants).
L’élément d’administration crucial à ce stade consiste à cocher impérativement la case à cocher intitulée Intitulés (ou Labels). Cette action explicite notifie formellement au noyau d’analyse que la toute première ligne des plages sélectionnées ne comporte pas de grandeurs numériques, mais des descripteurs textuels. Cette précaution fondamentale remplit une double fonction : elle évite tout blocage computationnel lié à la présence de texte, et garantit que les tableaux statistiques générés ultérieurement identifieront chaque coefficient de manière parfaitement claire par son nom d’origine au lieu d’une numérotation opaque et anonyme du type « Variable X 1 ».
6.2 Options de confiance et contraintes du modèle
Dans la section intermédiaire de la boîte de paramétrage figurent deux options structurelles relatives aux contraintes mathématiques et à l’évaluation inférentielle du modèle. La première concerne le Niveau de confiance, paramétré par défaut à la valeur nominale de 95 % (correspondant au seuil d’erreur alpha conventionnel de 5 %, soit α = 0,05). Si les impératifs déontologiques ou méthodologiques du protocole expérimental imposent une sévérité accrue (par exemple lors d’essais cliniques pharmacologiques requérant un seuil α = 0,01), il convient de cocher la case dédiée et d’ajuster manuellement la valeur à 99 %. Cela ordonnera au logiciel d’adjoindre aux sorties numériques standard un second jeu d’intervalles de confiance calculé selon cette nouvelle amplitude critique.
La seconde option, libellée Constante nulle (ou Constant is Zero), requiert une vigilance méthodologique extrême de la part de l’investigateur. En cochant cette option, l’analyste contraint délibérément l’ordonnée à l’origine à s’annuler strictement (β0 = 0), forçant géométriquement l’hyperplan d’ajustement à traverser impérativement l’origine vectorielle (le point zéro de toutes les dimensions). Sauf justifications théoriques ou physiques exceptionnellement contraignantes — par exemple lors de l’étude de grandeurs physiques où une absence absolue de masse ou d’énergie implique logiquement et universellement une réponse nulle —, cette option ne doit absolument jamais être activée.
Imposer une constante nulle alors que le véritable processus empirique sous-jacent possède une ligne de base non nulle entraîne un biais sévère et destructeur sur l’ensemble des estimateurs des coefficients de régression partielle bj. De surcroît, cette contrainte artificielle fausse l’algèbre de décomposition des sommes de carrés de l’ANOVA, rendant le calcul du coefficient de détermination R2 non standard, voire capable de renvoyer des valeurs mathématiquement aberrantes ou négatives dans l’environnement Excel. Le maintien systématique de la constante libre demeure le garant de la validité de l’inférence statistique.
6.3 Configuration de l’emplacement et des formats de sortie
Le dernier panneau structurel de la boîte de dialogue de régression permet à l’utilisateur de dicter l’orientation spatiale des volumineux flux de résultats compilés par le logiciel. Trois options exclusives de routage typographique sont offertes :
- Plage de sortie : Cette option autorise l’affichage des tableaux directement au sein de la feuille de calcul active. L’analyste renseigne une référence cellulaire unique (par exemple
$G$2), qui constituera le coin supérieur gauche du bloc de résultats. Cette option présente le risque opérationnel majeur d’écraser irréversiblement des données préexistantes si la zone adjacente droite et inférieure n’est pas totalement dégagée sur plusieurs dizaines de lignes et de colonnes. - Nouvelle feuille de calcul : Représentant la recommandation ergonomique standard, ce choix ordonne à Excel d’insérer automatiquement un nouvel onglet vierge au sein du classeur courant et d’y déployer l’intégralité des tableaux et graphiques dès la finalisation du calcul. L’analyste peut attribuer un nom explicite à cet onglet dans le champ de saisie textuel adjacent (par exemple Sortie_Regression_Multiple).
- Nouveau classeur : Cette configuration génère un fichier Excel totalement autonome hébergeant exclusivement les résultats de la modélisation, une approche particulièrement adaptée lorsque les données brutes doivent être archivées séparément des analyses pour des motifs de confidentialité ou de gouvernance des données de laboratoire.
Avant d’appuyer sur l’ultime commande d’exécution, une vérification globale de cohérence s’impose : plages d’entrée correctement indexées en adressage absolu, intitulés effectivement validés, constante maintenue libre et destination de sortie judicieusement isolée. L’analyste peut alors procéder à la validation terminale.
7. Génération et exploitation des sorties graphiques des résidus
7.1 Sélection des options graphiques dans l’Utilitaire d’analyse
Au-delà de la production tabulaire de chiffres et d’indices paramétriques, l’Utilitaire d’analyse héberge un module graphique d’une utilité méthodologique majeure pour l’évaluation empirique des postulats du modèle. Dans la partie inférieure de la boîte de configuration, une série de quatre cases à cocher spécifiques commande la construction automatisée de représentations visuelles diagnostiques :
La première case, intitulée Résidus, génère un tableau numérique détaillé consignant, pour chaque unité statistique de l’échantillon, la valeur d’observation empirique de Y, la valeur prédite calculée par l’hyperplan d’ajustement (Ŷ), et la valeur brute du résidu d’estimation correspondant (ei = Yi – Ŷi). La sélection conjointe de l’option Résidus standardisés calcule et adjoint une colonne additionnelle dans laquelle chaque résidu est normalisé par division par l’écart-type des résidus, convertissant les écarts bruts en unités d’écart-type facilement interprétables (résidus z).
Les deux dernières options visuelles méritent une sélection systématique. La commande Graphiques des résidus instancie une suite de graphiques de dispersion orthogonaux croisant successivement les résidus calculés avec chacune des variables indépendantes Xj incluses dans le modèle. Enfin, l’option Tracé de probabilité normale génère le diagramme quantile théorique permettant de scruter la conformité gaussienne des erreurs. L’activation exhaustive de ces paramètres confère à la sortie logicielle une dimension diagnostique complète, indispensable à la validation académique du modèle.
7.2 Analyse visuelle du graphique de dispersion résidus versus valeurs prédites
Le diagnostic visuel prééminent en matière de régression linéaire multiple consiste à scruter la dispersion bidimensionnelle des résidus reportés sur l’axe des ordonnées en regard des valeurs prédites (estimations Ŷ) reportées sur l’axe des abscisses. Dans un modèle parfaitement valide respectant l’intégralité des postulats de Gauss-Markov, ce nuage de points doit présenter la configuration caractéristique d’une bande horizontale aléatoire homogène, évoquant un rectangle d’épaisseur constante dénué de toute structure ou dynamique discernable autour de la ligne horizontale centrale d’ordonnée zéro.
Deux déviations visuelles fondamentales doivent alerter immédiatement l’investigateur :
- La configuration en entonnoir ou en mégaphone : Si le nuage de points présente une dispersion étroite pour les faibles valeurs prédites puis s’évase progressivement de manière spectaculaire à mesure que l’on progresse vers les valeurs prédites élevées (ou vice-versa), l’hétéroscédasticité est formellement diagnostiquée. La variabilité résiduelle n’est plus stationnaire, trahissant une instabilité structurelle de l’estimation sur certaines plages de l’espace des données.
- La courbure parabolique ou sinusoïdale : Si les résidus adoptent un tracé systématique en forme de « U », de « U inversé » ou d’onde périodique, le modèle souffre d’un défaut flagrant de spécification de sa forme fonctionnelle. Cette configuration atteste que la relation sous-jacente entre les variables est en réalité curvilinéaire et que l’hyperplan linéaire force une approximation inadéquate, exigeant l’adjonction de termes polynomiaux ou d’approches semi-paramétriques.
7.3 Interprétation du graphique de probabilité normale
Le graphique de probabilité normale généré par le moteur d’Excel constitue l’équivalent direct du tracé P-P (Probability-Probability plot). Il cartographie le positionnement des observations ordonnées sur l’échelle des pourcentages cumulés empiriques face aux percentiles théoriques dérivés de la fonction de répartition de la loi normale centrée réduite. L’interprétation de ce support visuel exige une lecture critique minutieuse de la linéarité du tracé résultant.
Lorsque le postulat de normalité des résidus est rigoureusement respecté dans la population sous-jacente, l’ensemble des points d’observation s’agrège de manière harmonieuse le long de la droite de référence diagonale traversant le repère cartésien. Des déviations mineures et erratiques situées exclusivement dans la zone médiane du tracé ne constituent généralement pas un motif de rejet du modèle en présence d’échantillons de taille respectable.
En revanche, des bifurcations marquées observées aux extrémités supérieure et inférieure du graphique traduisent des anomalies distributionnelles majeures. Un décollement des points sous la ligne à l’extrémité gauche conjugué à un dépassement au-dessus de la droite à l’extrémité droite matérialise des « queues de distribution lourdes » (leptokurtose), indiquant que l’échantillon produit beaucoup plus d’observations hautement déviantes que ne le prédit l’idéal théorique de Gauss. Face à de telles déviations extrêmes, l’analyste ne peut maintenir son modèle en l’état sous peine d’invalider ses calculs de p-valeurs, et doit explorer des transformations non linéaires de la variable réponse (comme la transformation logarithmique ou la famille des transformations de Box-Cox).
8. Interprétation académique de la table des statistiques de la régression
8.1 Analyse du coefficient de corrélation multiple et du coefficient de détermination
Dès que le moteur computationnel finalise son itération matricielle, Excel déploie un ensemble structuré de trois tableaux académiques majeurs au sein de la zone de destination sélectionnée. Le tout premier tableau, universellement intitulé Statistiques de la régression, compile les indicateurs synthétiques globaux quantifiant la qualité de l’ajustement global du modèle aux données empiriques.
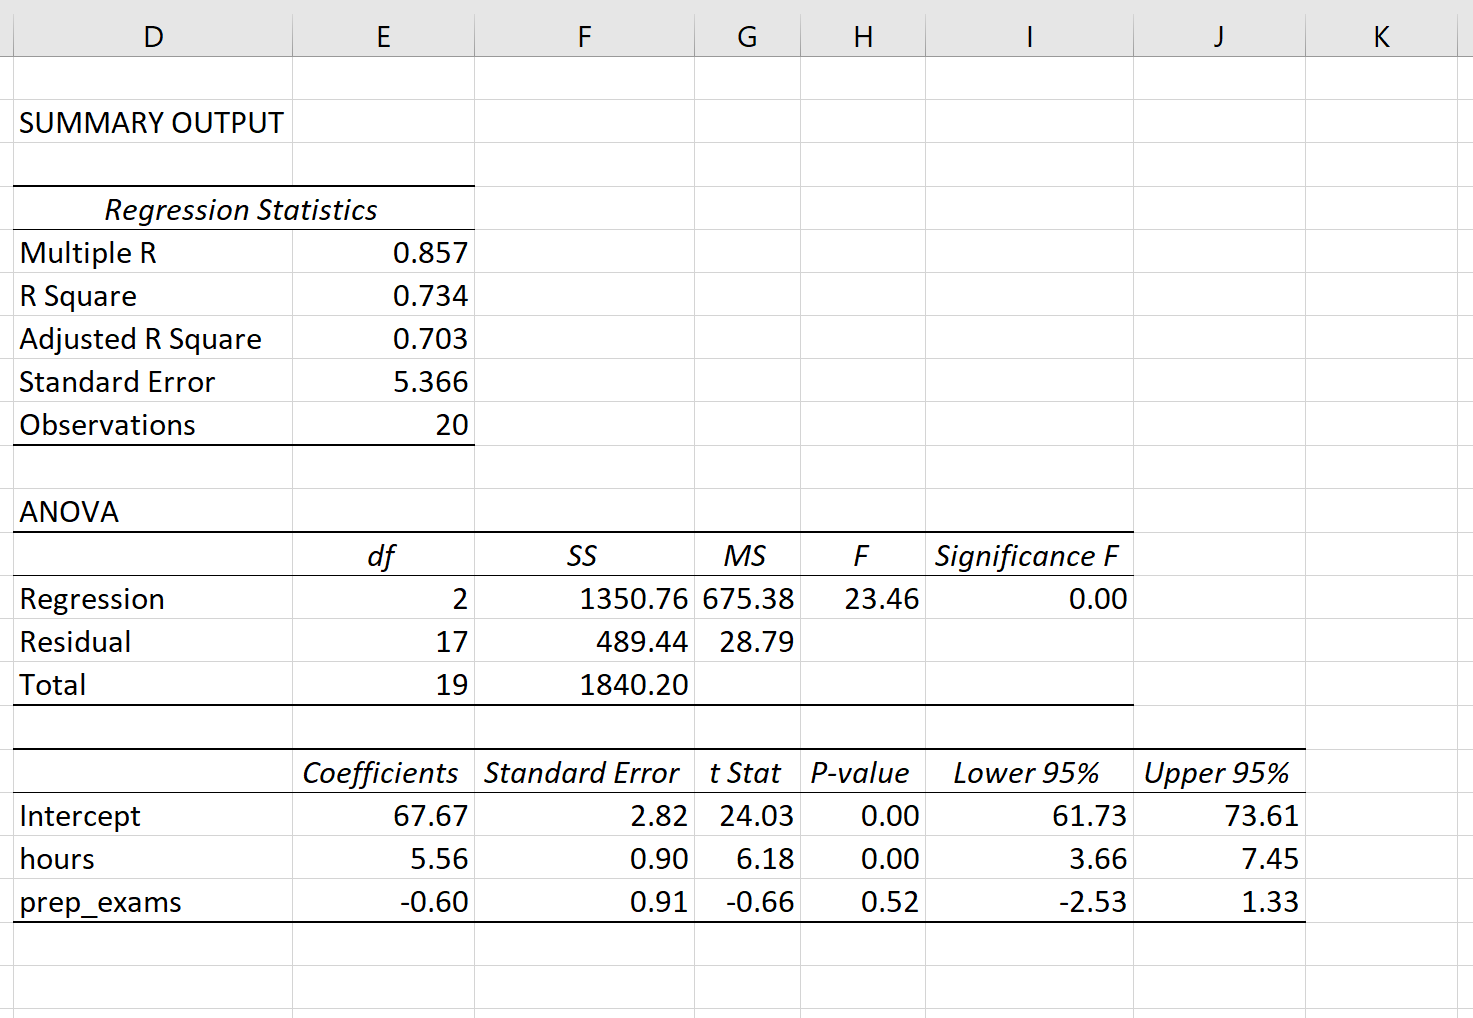
La première ligne de ce tableau affiche le Coefficient de corrélation multiple, conventionnellement désigné par la lettre majuscule R. Cette statistique scalaire représente l’intensité de la corrélation linéaire bivariée de Pearson existant entre le vecteur des observations réelles Y et le vecteur des prédictions estimées par le modèle composite Ŷ. Flottant impérativement dans un intervalle fermé borné entre 0 et 1 (contrairement au coefficient de corrélation de Pearson classique qui peut être négatif), le R multiple évalue la force brute de la synergie associative conjointe déployée par l’ensemble des prédicteurs réunis. Une valeur approchant de 1 traduit une capacité de prédiction globale particulièrement performante.
Immédiatement en dessous figure le paramètre le plus célèbre de la modélisation statistique : le Coefficient de détermination, noté universellement R-deux (ou R2). Dérivé mathématiquement par l’élévation au carré direct de la métrique précédente, le R2 traduit la proportion relative exacte de la variance de la variable dépendante Y qui est formellement expliquée, captée ou prédite par la combinaison linéaire des variables indépendantes introduites dans l’équation. Ainsi, un R2 chiffré à 0,428 indique sans ambiguïté que 42,8 % de la variance phénotypique totale du phénomène étudié au sein de l’échantillon est directement redevable à l’action conjointe des prédicteurs du modèle, les 57,2 % restants étant abandonnés au bruit résiduel stochastique ou à des facteurs non mesurés.
Cependant, le R2 brut présente une tare méthodologique rédhibitoire qu’aucun chercheur rigoureux ne saurait ignorer : il s’agit d’une fonction mathématique continuellement monotone et non décroissante par rapport au nombre de régresseurs. Cela signifie que l’adjonction systématique d’une nouvelle variable indépendante au sein de l’équation — quand bien même cette variable serait constituée d’une suite de chiffres aléatoires parfaitement dénuée de sens théorique — augmentera mécaniquement (ou, au pire absolu, maintiendra parfaitement constant) le niveau affiché du R2. Ce biais intrinsèque expose le chercheur naïf au piège du surajustement par empilement inconsidéré de variables explicatives.
8.2 Rôle déterminant du R-deux ajusté dans les modèles multiples
Pour contourner l’illusion statistique générée par l’inflation artificielle du coefficient de détermination brut, la table d’Excel fournit sur sa troisième ligne une statistique méthodologiquement supérieure : le R-deux ajusté (noté formellement R̅2). Théorisée par le statisticien Henri Theil, cette métrique sophistiquée applique une pénalité mathématique proportionnelle au nombre de prédicteurs k rapporté au nombre de degrés de liberté résiduels disponibles au sein de l’échantillon de taille n :
R̅2 = 1 – [(1 – R2) × (n – 1) / (n – k – 1)]
Grâce à ce mécanisme compensatoire de normalisation, le R2 ajusté ne progressera à la hausse lors de l’introduction d’un nouveau prédicteur que si et seulement si l’apport explicatif réel de cette variable additionnelle compense la perte mathématique d’un degré de liberté. Si la variable introduite n’apporte qu’un gain infinitésimal inférieur au coût du paramètre additionnel, le R2 ajusté diminuera de manière sanctionnatrice. Contrairement au R2 classique, l’indice ajusté peut théoriquement devenir négatif lorsque le pouvoir explicatif global du modèle s’avère plus faible que ce qui résulterait du simple hasard computationnel.
Le R2 ajusté constitue ainsi l’instrument de référence incontournable pour comparer la pertinence d’ajustement relative entre plusieurs modèles concurrents appliqués au même jeu de données. Dans le champ des sciences comportementales, de l’éducation et de la psychologie différentielle, où le bruit de mesure est intrinsèquement élevé, l’analyste ne doit pas s’attendre aux magnitudes d’explication rencontrées en sciences physiques. Des coefficients R̅2 oscillant entre 0,15 et 0,35 sont très fréquemment considérés comme des résultats remarquables et substantiels, documentant l’élucidation d’une fraction signifiante de dynamiques humaines profondément multifactorielles.
8.3 Évaluation de l’erreur-type de l’estimation
La quatrième métrique compilée au sein de ce premier tableau descriptif est l’Erreur-type de l’estimation (souvent désignée sous le symbole se ou RMSE pour Root Mean Square Error). Cette statistique cruciale est l’expression directe de l’écart-type de la distribution des résidus stochastiques autour de l’hyperplan de régression calculé. Elle est définie mathématiquement par la racine carrée du carré moyen de l’erreur (issu du tableau de l’ANOVA) :
se = √(SCErésiduelle / (n – k – 1))
L’avantage opérationnel fondamental de l’erreur-type réside dans sa dimension métrique : elle s’exprime rigoureusement dans la même unité de mesure physique ou psychométrique que la variable dépendante d’origine Y, ce qui confère à sa valeur une lisibilité concrète inaccessible aux indices standardisés sans dimension comme le R2. Elle quantifie l’amplitude moyenne de l’erreur de prédiction que commet le modèle lorsqu’il estime le score d’un individu particulier.
Pour apprécier la précision empirique du modèle, il est méthodologiquement recommandé de comparer l’erreur-type de l’estimation à l’écart-type brut non conditionnel de la variable dépendante initiale sY. Une régression efficace doit présenter une erreur-type résiduelle substantiellement inférieure à la dispersion brute de Y, confirmant ainsi que la connaissance conjointe des prédicteurs réduit concrètement l’incertitude entourant l’estimation individuelle. De plus, sous l’hypothèse de normalité des résidus, environ 68 % des observations de l’échantillon se trouveront comprises dans un intervalle de plus ou moins une erreur-type autour de leur valeur prédite, et 95 % dans une fourchette de deux erreurs-types, fournissant une jauge pragmatique pour évaluer l’exactitude opérationnelle du système prédictif.
9. Déconstruction critique du tableau d’analyse de la variance (ANOVA)
9.1 Partitionnement des sommes des carrés et degrés de liberté
Le second bloc numérique généré par l’Utilitaire d’analyse d’Excel est constitué par le Tableau d’analyse de variance (ANOVA). L’incorporation de l’ANOVA au cœur d’une procédure de régression linéaire multiple illustre l’unité conceptuelle du modèle linéaire généralisé théorisé par Ronald Fisher, dans lequel régression et analyse de variance ne constituent que des déclinaisons mathématiques siamoises d’une même algèbre de projection linéaire.
La logique fondamentale de ce tableau réside dans la décomposition arithmétique rigoureuse et additive de la variabilité globale de la variable réponse Y, conceptualisée sous la métrique de la Somme des Carrés Totale (SCT) :
SCT = SC_Régression + SC_Résiduelle
La Somme des Carrés Totale traduit la dispersion quadratique brute globale de toutes les observations individuelles Yi par rapport à la moyenne arithmétique générale Ȳ. La ligne labellisée Régression isole la fraction de cette somme des carrés directement attribuable à l’action conjointe de l’hyperplan d’ajustement (la somme des écarts quadratiques entre les valeurs prédites Ŷi et la moyenne générale). Enfin, la ligne labellisée Résidus (ou Erreur) capture la somme des déviations quadratiques inexpliquées séparant chaque point empirique Yi de sa prédiction mathématique Ŷi.
Chacune de ces composantes de dispersion est associée à un nombre précis de Degrés de Liberté (dl), reflétant le volume d’informations mathématiques indépendantes mobilisées lors du calcul. Pour la régression, les degrés de liberté correspondent strictement au nombre de prédicteurs inclus dans le modèle (k). Pour la composante résiduelle, les degrés de liberté s’établissent rigoureusement à (n – k – 1), où n figure le nombre total d’observations valides et 1 retranche le degré de liberté monopolisé par l’estimation de l’ordonnée à l’origine. En divisant chaque somme des carrés par son degré de liberté respectif, le logiciel calcule la colonne des Carrés Moyens (MS), représentant des variances non biaisées prêtes pour le test d’hypothèse globale.
9.2 Test global de validité statistique par la statistique F de Fisher
La finalité inférentielle ultime du tableau d’ANOVA consiste à trancher quant à la validité statistique globale de l’édifice prédictif au travers de la Statistique F de Fisher. Ce test omnibus s’articule autour de la confrontation rigoureuse de deux hypothèses statistiques mutuellement exclusives formulées sur les paramètres populationnels :
- Hypothèse Nulle (H0) : β1 = β2 = … = βk = 0. Cette hypothèse postule l’inutilité prédictive totale du modèle. Elle affirme que l’ensemble unanime des coefficients de régression partielle dans la population parente est rigoureusement nul, et qu’aucune des variables indépendantes introduites n’apporte la moindre information pour expliquer Y.
- Hypothèse Alternative (H1) : Au moins un des coefficients βj ≠ 0. Cette hypothèse affirme qu’au minimum un prédicteur (voire la totalité d’entre eux) entretient une liaison linéaire populationnelle réelle et non fortuite avec la réponse.
Pour trancher empiriquement ce dilemme, le logiciel calcule le ratio de variance F en divisant le Carré Moyen de la Régression par le Carré Moyen Résiduel :
F = CM_Régression / CM_Résiduels
Ce ratio évalue l’ampleur du signal explicatif apporté par le modèle structural rapporté au bruit stochastique d’échantillonnage. Si l’hypothèse nulle est vraie, ce ratio tend théoriquement vers une valeur proche de 1. Plus la variance captée par l’hyperplan excède le bruit résiduel, plus la valeur empirique de F progresse vers des valeurs élevées. L’investigateur consulte alors la cellule terminale du tableau intitulée F significatif, qui affiche la valeur p exacte associée à cette distribution de Fisher aux degrés de liberté (k ; n – k – 1).
9.3 Implications décisionnelles du rejet ou non-rejet de l’hypothèse nulle
L’interprétation de la valeur affichée dans la cellule F significatif commande la suite logique de l’investigation scientifique. Si cette probabilité critique s’avère inférieure au seuil de significativité nominal conventionnel fixé a priori (α = 0,05, ou 0,01 selon les standards disciplinaires), l’analyste rejette formellement l’hypothèse nulle globale. Il est dès lors scientifiquement légitime d’affirmer que le modèle de régression linéaire multiple est statistiquement significatif et qu’il capte une portion de variance phénotypique réelle ne pouvant raisonnablement être imputée aux seules fluctuations d’échantillonnage aléatoire.
À l’inverse, si la valeur p globale s’avère supérieure au seuil α (par exemple p = 0,142), l’hypothèse nulle ne peut être rejetée. Cette issue constitue un verdict d’invalidité méthodologique sans appel : elle indique que le modèle composite dans son ensemble ne parvient pas à prédire la variable dépendante avec une efficacité supérieure à celle offerte par la simple attribution de la moyenne générale Ȳ à chaque sujet. Dans ce scénario de non-rejet, il est déontologiquement prohibé de descendre dans l’analyse détaillée des prédicteurs individuels pour tenter d’extraire artificiellement une variable isolée qui semblerait significative, une telle manœuvre s’apparentant à de la pêche aux résultats (data dredging) invalidée par l’échec du test omnibus.
Enfin, même en présence d’un rejet hautement significatif du test F (p < 0,001), l’analyste doit préserver une distinction salutaire entre significativité statistique et pertinence pratique ou clinique. Dans les bases de données hébergeant des milliers de participants, un modèle doté d’un R2 infinitésimal de 0,02 produira presque systématiquement un test F étincelant sur le plan de la p-valeur. Pour autant, un tel modèle ne possédera qu’une portée prédictive concrète négligeable, soulignant la nécessité d’examiner de concert la significativité inférentielle et la taille d’effet brute de la variance expliquée.
10. Évaluation détaillée des coefficients partiels et inférence paramétrique
10.1 Interprétation sémantique des coefficients non standardisés
Le troisième tableau produit par l’Utilitaire d’analyse concentre l’attention opérationnelle de l’analyste en décortiquant les paramètres estimés pour chaque terme de l’équation linéaire. La première colonne de cette table livre les Coefficients non standardisés (estimations empiriques par les MCO, notées bj), débutant par la ligne fondamentale dédiée à la Constante (l’ordonnée à l’origine b0), suivie des lignes associées aux prédicteurs X1, X2, …, Xk.
La constante b0 possède une signification géométrique univoque : elle figure la valeur moyenne attendue de la variable réponse Y lorsque l’ensemble des régresseurs du modèle s’établit exactement à la valeur zéro. L’interprétation sémantique de cette constante requiert une précaution théorique élémentaire : si la valeur zéro est dénuée de sens physique ou empirique pour les prédicteurs étudiés (par exemple un quotient intellectuel de zéro, un âge de zéro ou une tension artérielle de zéro), la constante ne constitue qu’un point d’ancrage géométrique dénué de matérialité substantielle. Pour lui conférer une interprétation théorique directe, il est d’usage en psychométrie de procéder au centrage préalable des variables prédictives sur leur moyenne arithmétique respective avant la régression, ce qui transforme l’ordonnée à l’origine en espérance conditionnelle de Y pour un individu moyen de la cohorte.
Pour chaque prédicteur Xj, le coefficient partiel bj quantifie directement la pente multidimensionnelle associée. Il stipule avec exactitude qu’une augmentation d’une unité entière sur l’échelle métrique propre au prédicteur Xj est associée à une variation attendue moyenne de bj unités sur l’échelle de mesure de la variable dépendante Y, sous l’hypothèse stricte que tous les autres prédicteurs du modèle soient rigoureusement maintenus constants. Si le signe du coefficient est positif, la relation conditionnelle est proportionnelle ; s’il est négatif, la relation est inversement proportionnelle. Une mise en garde capitale concerne l’extrapolation : ces coefficients ne sont valides que sur l’espace d’observation délimité par les valeurs minimales et maximales observées dans l’échantillon empirique, toute projection au-delà constituant une conjecture non étayée.
10.2 Évaluation de la significativité individuelle via le test t de Student
Chaque coefficient de régression estimé est flanqué sur sa droite immédiate d’une estimation de son Erreur-type dédiée (SEb). Cette erreur-type quantifie l’écart-type de la distribution d’échantillonnage du coefficient, mesurant l’amplitude des fluctuations que ce paramètre subirait si l’on répétait l’expérimentation un nombre infini de fois sur des échantillons distincts issus de la même population parente. Plus la dispersion empirique du prédicteur est grande et plus la taille d’échantillon est vaste, plus cette erreur-type s’amenuise, conférant à l’estimation une précision accrue.
En divisant le coefficient estimé par son erreur-type respective, l’algorithme d’Excel calcule la statistique du t de Student affichée dans la colonne adjacente :
t = bj / SE(bj)
Ce ratio paramétrique permet de tester l’hypothèse nulle spécifique selon laquelle le coefficient partiel théorique vrai est rigoureusement nul dans la population (H0 : βj = 0). La colonne suivante, intitulée Probabilité (ou p-value), consigne la valeur p bilatérale associée à cette statistique t distribuée à (n – k – 1) degrés de liberté.
L’analyste examine attentivement cette probabilité critique en la confrontant au seuil de significativité conventionnel α = 0,05. Si p ≤ 0,05, le prédicteur apporte une contribution statistiquement significative à la prédiction de la réponse Y, au-delà et indépendamment de l’ensemble des autres prédicteurs déjà intégrés dans l’équation. Dans le cas contraire (p > 0,05), on ne peut rejeter l’hypothèse nulle : l’effet de ce facteur ne peut être distingué de manière statistiquement concluante d’un simple bruit de mesure stochastique, invitant à questionner son utilité au sein du modèle final.
10.3 Exploitation des intervalles de confiance à 95%
Bien que la consultation des valeurs p constitue la norme historique d’évaluation inférentielle, les recommandations contemporaines des méthodologistes et des comités éditoriaux internationaux — tels que l’American Psychological Association — prescrivent de subordonner la lecture des p-valeurs à l’examen méticuleux des Intervalles de confiance à 95 %. Les colonnes terminales du tableau d’Excel consignent précisément la Borne inférieure à 95 % et la Borne supérieure à 95 % associées à chaque paramètre estimé.
L’interprétation rigoureuse d’un intervalle de confiance à 95 % repose sur les lois de l’échantillonnage probabiliste : si l’investigateur réitérait indéfiniment le protocole de recherche en tirant des échantillons aléatoires de même taille et recalculait chaque fois l’intervalle selon le même algorithme, 95 % de ces intervalles construits recouvriraient la véritable valeur du paramètre populationnel inconnu βj. Sur le plan de la décision d’hypothèse, l’exclusion formelle de la valeur zéro de l’intervalle de confiance correspond rigoureusement au rejet de l’hypothèse nulle au seuil α = 0,05.
L’avantage épistémologique capital de l’intervalle de confiance sur le simple seuil de significativité binaire réside dans sa métrique de plausibilité et de précision. Un prédicteur affichant un coefficient ponctuel de b = 4,20 avec un intervalle de confiance extrêmement resserré compris entre [3,80 ; 4,60] démontre une précision d’estimation remarquable, autorisant des prédictions opérationnelles très fiables. En revanche, un même coefficient affichant un intervalle très étiré compris entre [0,05 ; 8,35], bien que formellement significatif au sens du test t (p < 0,05), révèle une immense imprécision empirique trahissant une instabilité structurelle de la mesure ou une taille d’échantillon insuffisante pour asseoir des conclusions robustes.
11. Diagnostics statistiques avancés et détection des violations sous Excel
11.1 Détection empirique de la multicolinéarité via la matrice de corrélation
Bien que Microsoft Excel ne calcule pas de manière automatisée des indices de multicolinéarité complexes tels que le Facteur d’Inflation de la Variance (VIF, Variance Inflation Factor) ou l’Indice de Condition au sein de son module standard de régression, le praticien dispose de méthodes alternatives fiables pour diagnostiquer l’interdépendance linéaire excessive entre ses régresseurs.
La première démarche exploratoire consiste à générer la Matrice de corrélation bivariée intégrale des prédicteurs. Pour ce faire, l’utilisateur active l’Utilitaire d’analyse, sélectionne la procédure Corrélation, et injecte en entrée l’ensemble contigu des colonnes abritant les variables X. L’examen attentif du tableau symétrique résultant permet de scruter les coefficients de corrélation linéaire de Pearson croisés. En règle générale, la présence d’un coefficient bivarié absolu supérieur à 0,70 ou 0,80 entre deux variables indépendantes constitue un signal d’alerte critique documentant une forte redondance empirique susceptible d’altérer gravement le calcul des erreurs-types du modèle multiple.
Pour raffiner cette détection et débusquer des colinéarités multivariées occultes (qui n’apparaissent pas nécessairement sous forme bivariée simple lorsqu’un régresseur est lié à la combinaison linéaire de plusieurs autres), l’analyste peut orchestrer manuellement le calcul du VIF sous Excel. La procédure implique d’exécuter une séquence de régressions intermédiaires : chaque prédicteur Xj est successivement érigé en variable dépendante temporaire et régressé sur l’ensemble des (k – 1) autres régresseurs. En extrayant le coefficient de détermination résultant (noté R2j), le Facteur d’Inflation de la Variance est alors calculé dans une cellule à l’aide de la formule formelle :
VIFj = 1 / (1 – R2j)
Selon les standards admis dans la littérature économétrique et psychométrique, un seuil de VIF supérieur à 5 signale une multicolinéarité problématique, tandis qu’une valeur franchissant le seuil critique de 10 indique une multicolinéarité sévère et intolérable exigeant une remédiation structurelle immédiate.
11.2 Identification des observations aberrantes et points de levier
La sensibilité de la méthode des moindres carrés ordinaires face aux valeurs aberrantes (outliers) et aux points de levier constitue l’une de ses faiblesses structurelles majeures. Une seule observation hautement déviante, issue par exemple d’une erreur de frappe numérique lors de la saisie ou d’un sujet présentant un comportement totalement atypique, peut exercer une traction gravitationnelle démesurée sur l’hyperplan d’ajustement, faussant l’orientation des pentes et générant des conclusions trompeuses.
L’exploitation de la colonne des Résidus standardisés générée par l’Utilitaire d’analyse d’Excel constitue le premier levier de dépistage. En triant cette colonne ou en y appliquant un filtre numérique conditionnel, l’analyste repère instantanément les observations dont le résidu normalisé excède en valeur absolue les seuils conventionnels critiques :
- Un résidu standardisé supérieur à |2| écarts-types concerne théoriquement moins de 5 % des cas sous loi gaussienne et doit faire l’objet d’un examen attentif.
- Un résidu standardisé supérieur à |3| écarts-types signale une anomalie statistique sévère (moins de 0,3 % de probabilité théorique), caractérisant formellement une observation aberrante résiduelle majeure.
Il importe de dissocier les aberrations résiduelles sur Y des points de levier (leverage points), qui désignent des sujets occupant des positions géométriques extrêmes et isolées au sein de l’espace multidimensionnel des prédicteurs X. Bien qu’Excel ne calcule pas nativement la distance de Mahalanobis ou la distance de Cook, l’analyste peut approcher l’influence de ces cas en procédant à une analyse de sensibilité rigoureuse : réexécuter l’intégralité de la régression en omettant délibérément le point suspecté. Si l’éviction de cette observation unique modifie substantiellement la magnitude ou la significativité des coefficients, la fragilité du modèle est avérée. L’éthique méthodologique impose de ne jamais supprimer aveuglément des données sans justification scientifique traçable et documentée dans le rapport d’analyse final.
11.3 Stratégies d’ajustement face aux violations d’hypothèses
Lorsque les diagnostics révèlent des entorses caractérisées aux postulats de Gauss-Markov, le chercheur ne doit pas abandonner sa démarche empirique, mais déployer des stratégies de remédiation analytique appropriées. Face à des violations de normalité ou à des relations manifestement curvilinéaires identifiées sur les graphiques de dispersion, l’application de transformations mathématiques non linéaires sur les variables d’origine représente la solution la plus accessible au sein du tableur Excel.
Si la variable réponse Y présente une forte asymétrie positive avec étalement vers la droite, l’application d’une transformation logarithmique naturelle par la fonction =LN(Cellule) permet fréquemment de comprimer les valeurs extrêmes, rétablissant simultanément la symétrie résiduelle et l’homoscédasticité. Pour des phénomènes modélisant des taux ou des dénombrements, des transformations par la racine carrée =RACINE(Cellule) ou par l’inverse =1/Cellule s’avèrent hautement performantes. Si la non-linéarité implique un prédicteur particulier, l’adjonction explicite d’un terme quadratique (création d’une nouvelle colonne élevant le prédicteur au carré : X2) convertit le modèle en régression polynomiale tout en préservant le cadre d’estimation linéaire des MCO.
En présence d’une multicolinéarité suffocante entre prédicteurs, plusieurs options s’offrent au praticien : éliminer le prédicteur le moins théoriquement pertinent parmi la paire redondante, fusionner les variables fortement corrélées en calculant un score composite moyen standardisé (réduction de dimensionnalité par création d’indice), ou augmenter substantiellement la taille de l’échantillon pour enrichir la variabilité informationnelle. Enfin, si une hétéroscédasticité persistante et incorrigible corrompt les données, l’analyste doit reconnaître les limites strictes du tableur : Excel ne disposant pas d’options automatisées pour calculer les erreurs-types robustes de White ou de Huber-White (estimations sandwich), la migration des données vers un logiciel de programmation statistique dédié devient un impératif méthodologique pour préserver la validité de l’inférence.
12. Synthèse académique, rédaction des résultats et comparaison logicielle
12.1 Normes de présentation des résultats selon le format APA
La finalité de toute modélisation quantitative réside dans sa communication scientifique normalisée auprès de la communauté des pairs. Les standards internationaux régis par l’American Psychological Association (APA 7e édition) prescrivent des règles typographiques et structurelles d’une rigueur absolue pour le rapportage tabulaire et narratif des régressions linéaires multiples, interdisant formellement l’insertion de captures d’écran brutes issues des sorties de tableurs.
Sur le plan rédactionnel narratif, la communication des résultats doit impérativement articuler l’indice de validité globale du modèle, sa taille d’effet et l’inférence des prédicteurs spécifiques. Un exemple de formulation académique standard s’établit selon la syntaxe suivante :
« Une régression linéaire multiple a été réalisée afin de prédire la performance cognitive générale à partir du temps d’étude hebdomadaire, du score d’anxiété-trait et du niveau socio-économique. Le modèle d’ajustement global s’avère hautement significatif, F(3, 146) = 14,82, p < 0,001, avec un coefficient de détermination R2 de 0,234 (R2 ajusté = 0,218). L’ensemble de ces facteurs explique 23,4 % de la variance phénotypique de la performance. L’analyse des coefficients individuels révèle que le temps d’étude prédit positivement et significativement le rendement intellectuel (b = 0,45, SE = 0,09, t(146) = 5,00, p < 0,001, IC à 95 % [0,27 ; 0,63]), tandis que le niveau d’anxiété exerce un effet inhibiteur significatif (b = -0,28, SE = 0,08, t(146) = -3,50, p < 0,001, IC à 95 % [-0,44 ; -0,12]). Le niveau socio-économique n’apporte en revanche pas de contribution significative indépendante (p = 0,342). »
Sur le plan tabulaire, l’analyste synthétise ces grandeurs au sein d’une table épurée respectant les canons APA : trois lignes horizontales principales délimitant l’en-tête et le bas de tableau, aucune ligne verticale de séparation, et un alignement méticuleux consignant pour chaque prédicteur le coefficient non standardisé (B), son erreur-type (SE B), le coefficient standardisé (β, s’il a été préalablement calculé par standardisation z sous Excel), la statistique t, la valeur p, et les bornes d’intervalles de confiance associées.
12.2 Avantages comparatifs et limites structurelles d’Excel
L’utilisation de Microsoft Excel pour la conduite de régressions multiples soulève un débat récurrent au sein de la communauté scientifique. Du côté des atouts incontestables figurent son universalité et son accessibilité universelle. Pratiquement tout étudiant, enseignant ou cadre d’organisation dispose d’une licence bureautique active. Sur le plan pédagogique, l’environnement visuel et matriciel transparent d’Excel démystifie la boîte noire statistique propre à d’autres logiciels : l’apprenant visualise physiquement l’organisation de ses colonnes, peut calculer manuellement ses sommes de carrés et ses résidus par formules directes, appréhendant ainsi l’architecture computationnelle intime du modèle linéaire.
Néanmoins, les limites structurelles du tableur pour la recherche professionnelle avancée sont substantielles :
- L’absence de dynamicité relationnelle : L’Utilitaire d’analyse génère des tables de résultats purement statiques. Si l’analyste rectifie une coquille typographique sur une donnée brute ou supprime une observation aberrante, les résultats ne s’actualisent absolument pas automatiquement, exigeant la réexécution manuelle exhaustive de l’ensemble de la procédure.
- L’incomplétude du catalogue diagnostique : Excel omet cruellement des métriques standard modernes : pas de calcul direct des coefficients standardisés bêta (β), absence d’indices d’influence avancés (distance de Cook, DFFITS, DFBETAS), et omission du calcul automatisé du VIF ou du test d’autocorrélation de Durbin-Watson.
- Le manque d’estimateurs robustes : L’impossibilité d’appliquer des corrections hétéroscédastiques robustes ou de modéliser des variables dépendantes non gaussiennes (régression logistique, modèles linéaires généralisés) relègue l’Utilitaire d’analyse au rang d’outil d’exploration préliminaire ou de formation initiale face aux progiciels scientifiques dédiés tels que Jamovi, JASP, SPSS ou l’écosystème R.
12.3 Recommandations méthodologiques pour la recherche computationnelle
Pour les chercheurs et praticiens faisant le choix opérationnel d’exploiter Microsoft Excel pour leurs travaux de modélisation quantitative, l’adoption d’un protocole de gouvernance des données rigoureux s’impose pour garantir la reproductibilité intégrale et l’intégrité de la chaîne computationnelle. La règle fondamentale absolue consiste à préserver scrupuleusement l’onglet hébergeant les données brutes initiales sous un format verrouillé et immuable, toute manipulation de recodage, d’imputation ou de nettoyage devant être opérée au sein de copies de travail transparentes et documentées.
Il est impératif d’archiver avec un soin méticuleux les feuilles de calcul sources, en assortissant chaque classeur d’un dictionnaire des variables (codebook) consignant la définition exacte de chaque indicateur, les transformations mathématiques éventuellement appliquées et la justification documentée de chaque exclusion d’observation aberrante. De surcroît, bien que les versions contemporaines d’Excel aient corrigé les faiblesses d’arrondis algorithmiques qui entachaient les versions antérieures à 2003 lors de calculs d’inversion matricielle hautement colinéaires, une vigilance systématique s’impose face aux micro-arrondis flottants lors du traitement de variables affichant des ordres de grandeur disparates.
Enfin, Excel doit être appréhendé comme une passerelle méthodologique fondamentale et non comme l’horizon indépassable de l’analyse empirique. La compréhension approfondie des mécanismes matriciels, des postulats de distribution et de l’anatomie de l’ANOVA acquise au travers du maniement du tableur constitue le socle cognitif le plus solide pour réussir, dans un second temps, une transition fluide et émancipatrice vers des environnements de recherche scriptés entièrement automatisés et reproductibles.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression: II. Biometrika, 38(1/2), 159-177. https://doi.org/10.2307/2332580
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). The Guilford Press.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Microsoft Corporation. (2024). Charger et activer l’Utilitaire d’analyse dans Excel. Support Microsoft. https://support.microsoft.com/fr-fr/office/charger-et-activer-l-utilitaire-d-analyse-dans-excel-64a3900a-79e4-4dd4-80ef-97d3f25c38d7
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.