
Dans le paysage contemporain du traitement quantitatif des données et des sciences computationnelles, la transition des logiciels de type tableur vers des environnements de programmation statistique constitue un tournant méthodologique décisif. Durant des décennies, la fonction RECHERCHEV (ou VLOOKUP dans sa déclinaison anglophone) de Microsoft Excel a incarné l’archétype universel de la réconciliation de données. Présente dans les cellules de millions d’analystes, de cliniciens et d’expérimentateurs à travers le monde, cette commande a permis de surmonter la fragmentation des tables en reliant des identifiants disparates à des métadonnées contextuelles. Néanmoins, l’essor contemporain des mégadonnées, la complexification exponentielle des protocoles expérimentaux et l’exigence impérative de reproductibilité scientifique imposent aujourd’hui une réévaluation critique des outils historiques de calcul matriciel.
Le recours exclusif aux tableurs traditionnels expose les chercheurs à des risques documentés de corruption silencieuse, de non-traçabilité des transformations et d’écrasement involontaire des données sources. Le langage statistique R propose une alternative fondamentale en substituant au paradigme de la manipulation visuelle de cellules celui de l’algèbre relationnelle rigoureuse et du calcul vectorisé. Loin d’être une simple transposition syntaxique, le passage de RECHERCHEV aux outils d’appariement de R implique une refonte conceptuelle majeure : l’analyste ne cherche plus une valeur isolée dans une plage de coordonnées rigides, mais fusionne des ensembles mathématiquement définis par des relations formelles d’adjacence et de correspondance.
Ce guide encyclopédique se propose d’explorer en profondeur la mécanique, les implications théoriques et les multiples déclinaisons pratiques de la correspondance de données au sein de l’écosystème R. Qu’il s’agisse de l’approche native via les fonctions fondamentales du système de base, de la syntaxe déclarative et expressive du Tidyverse, de l’indexation algorithmique ultra-performante par hachage ou de la puissance brute de data.table, chaque stratégie sera décortiquée à l’aune de cas d’usage réels issus des sciences comportementales et psychométriques. L’objectif est d’offrir au lecteur les repères méthodologiques indispensables pour dépasser définitivement les contraintes techniques du tableur et concevoir des pipelines analytiques entièrement pérennes, transparents et reproductibles.
1. Fondements conceptuels : Du modèle tabulaire d’Excel à l’algèbre relationnelle dans R
1.1 Analyse comparative du paradigme de RECHERCHEV et des opérations de jointure
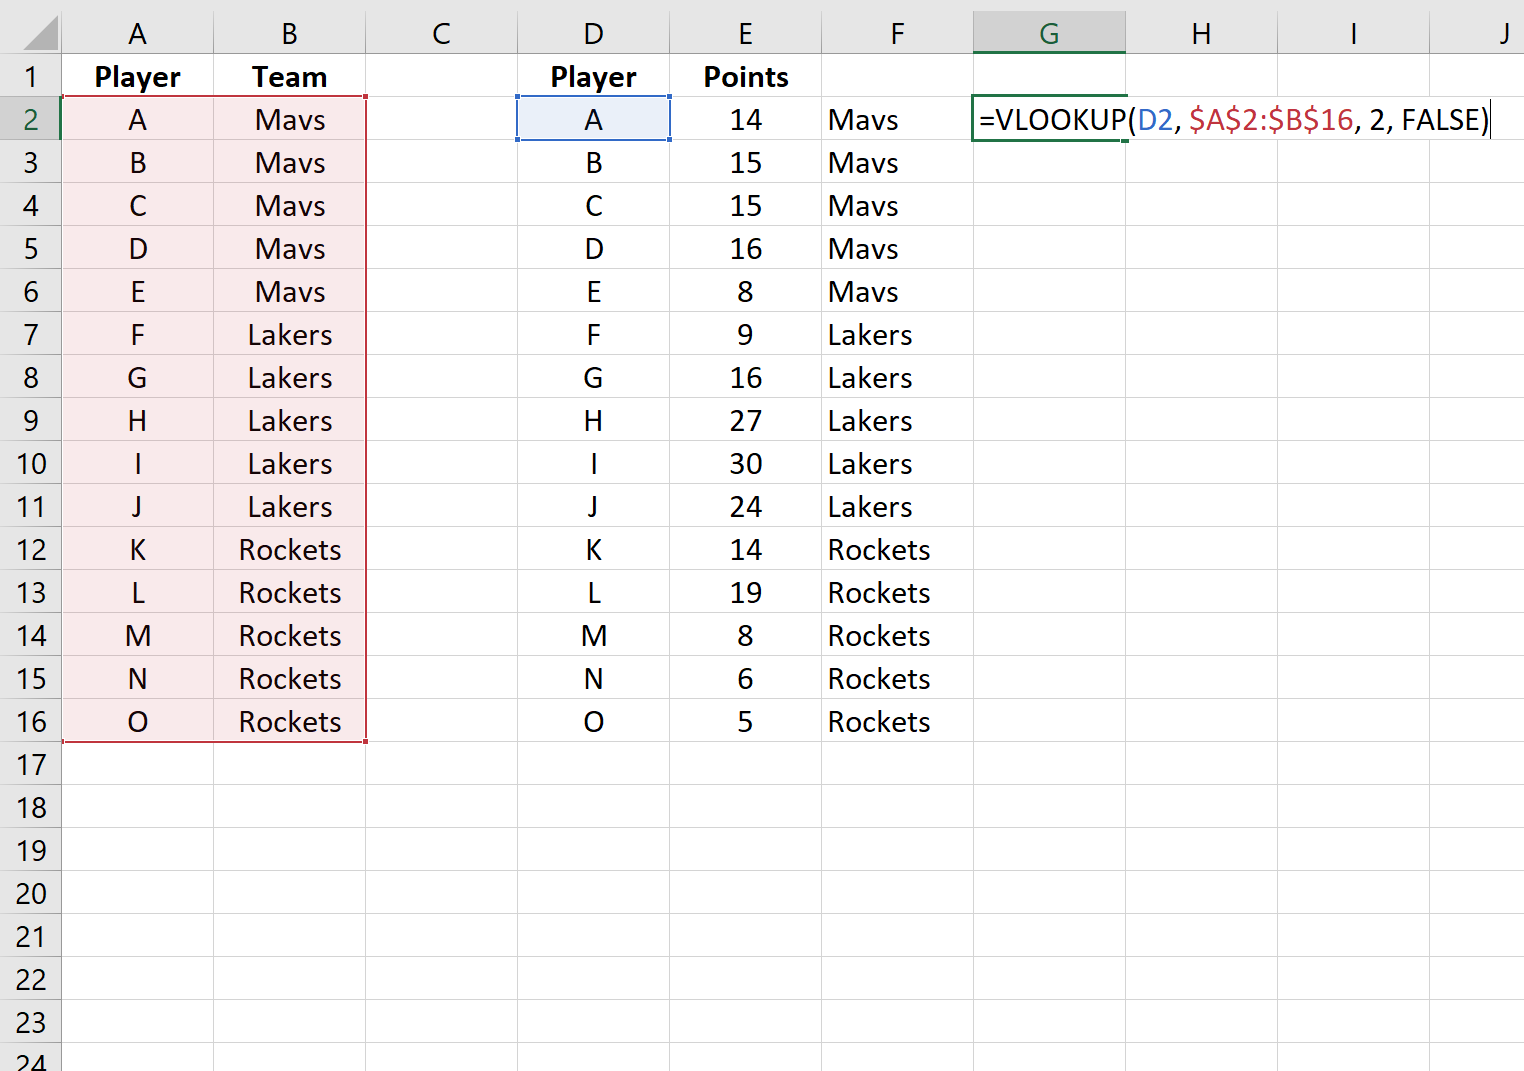
La fonction RECHERCHEV repose intrinsèquement sur un modèle spatial et topologique propre à la grille bidimensionnelle des tableurs. Lorsqu’un utilisateur formule une requête via cette instruction, il contraint le moteur de calcul à exécuter une exploration séquentielle unidirectionnelle : le programme parcourt la première colonne d’une plage sélectionnée, de haut en bas, jusqu’à ce qu’il identifie une correspondance textuelle ou numérique, pour ensuite décaler son regard horizontalement vers la droite selon un indice numérique fixe. Cette approche présente une faiblesse structurelle considérable. Elle impose une contrainte de contiguïté spatiale absolue où la variable clé de recherche doit impérativement se situer à l’extrême gauche de la matrice de référence, interdisant toute rétro-recherche directionnelle sans recourir à des formules alambiquées associant d’autres primitives de calcul.
À l’inverse, l’environnement logiciel R aborde la réconciliation de données sous l’angle de la théorie relationnelle énoncée par Edgar F. Codd. Dans ce cadre épistémologique, les jeux de données ne sont point envisagés comme des agrégats géométriques de cellules statiques, mais comme des relations formelles, désignées techniquement sous le vocable de data.frames ou de tables relationnelles. Dans R, l’opération de liaison n’est pas un balayage de curseur, mais une opération ensembliste d’intersection, d’union ou de projection. Cette perspective s’émancipe de toute contrainte spatiale : les colonnes portent un nom sémantique propre et invariable, et leur position physique dans l’objet informatique n’exerce aucune influence sur la validité logique de la fusion. L’ordre des colonnes devient un attribut secondaire d’affichage, garantissant une robustesse structurelle intégrale face aux modifications du schéma des données.
Par ailleurs, cette mutation de paradigme apporte des garanties indispensables en matière de traçabilité et de reproductibilité computationnelle. Dans un tableur propriétaire, l’application d’une formule sur une colonne entière implique le plus souvent un étirement vertical sensible à la manipulation humaine, créant des risques de discontinuité silencieuse si une formule vient à être écrasée accidentellement par une saisie brute. Dans R, le traitement est vectorisé et scripté : une unique instruction traite l’intégralité du vecteur d’observations de manière déterministe. Dans les protocoles de recherche expérimentale, notamment lors du croisement de biomarqueurs et d’évaluations psychologiques, cette imperméabilité aux manipulations fortuites constitue le rempart ultime contre les biais méthodologiques et l’invalidation a posteriori des cohortes cliniques.
1.2 Décomposition fonctionnelle des paramètres classiques du RECHERCHEV
Pour transposer efficacement les compétences acquises sur tableur vers l’environnement R, il convient de procéder à une rétro-ingénierie formelle des quatre arguments canoniques qui constituent l’architecture syntaxique de la commande RECHERCHEV(valeur_cherchée, table_matrice, no_index_col, [valeur_proche]). Le premier paramètre, la valeur_cherchée (ou lookup value), représente l’élément pivot autour duquel s’articule l’interrogation. Dans Excel, cette valeur est souvent définie par une référence relative pointant vers une cellule singulière au sein d’une ligne d’observation. Dans l’écosystème R, cette entité est conceptualisée comme une clé primaire ou un vecteur de clés qui transcende la cellule individuelle pour caractériser un ensemble distribué d’identifiants uniques rattachés à des unités statistiques indépendantes.
Le deuxième argument, désigné sous le terme de table_matrice (table_array), délimite la zone de prospection au sein du classeur. Cette référence géométrique rigide, fréquemment verrouillée à l’aide de symboles monétaires pour stabiliser les adresses absolues, trouve son équivalent sous R dans la notion de structure de données matricielle ou tabulaire, spécifiquement le data.frame ou le tibble. Dans R, la table de référence est un objet nommé, autonome, encapsulé en mémoire vive et pourvu de métadonnées intrinsèques. Cette autonomie fonctionnelle libère le programmeur du danger inhérent aux modifications accidentelles de bornes ou de coordonnées de feuilles de calcul, autorisant des opérations sur des ensembles de données partitionnés ou distribués sans perte de référence ontologique.
L’argument no_index_col (column index number) constitue l’un des maillons les plus vulnérables du système Excel, car il exige la saisie manuelle du rang ordinal de la colonne de restitution. Si un chercheur insère par inadvertance une nouvelle variable intermédiaire dans sa table d’origine, l’indice numérique pointe alors vers une grandeur erronée sans qu’aucun message d’erreur ne vienne signaler l’altération de l’analyse. R substitue systématiquement à ce repérage ordinal fragile une sélection nominale explicite des variables par leur appellation sémantique. Enfin, le quatrième paramètre booléen régissant la dichotomie entre correspondance exacte (déclarée par la constante FALSE ou 0) et correspondance approchée (TRUE ou 1) est géré dans R par des fonctions algorithmiques distinctes, dissociant nettement les jointures formelles d’équivalence des méthodes de segmentation par intervalles ou de recherche de plus proches voisins.
1.3 Préparation environnementale et structures de données psychométriques témoins
Afin d’ancrer les développements théoriques de cet exposé dans une réalité appliquée tangible, nous instancions un scénario méthodologique issu des sciences comportementales et de la psychométrie différentielle. Considérons un protocole de recherche expérimental au sein duquel des participants subissent une batterie d’évaluations cognitives informatisées complétées par une collecte hétérogène de données physiologiques et démographiques. La nécessité d’appariement naît de la séparation physique initiale des dispositifs de recueil : d’une part, une base de données principale consignant les identifiants des volontaires et leurs scores bruts d’anxiété état (mesurés via une échelle standardisée) ; d’autre part, une table secondaire administrée par un laboratoire tiers renfermant les indices de réserve cognitive et les diagnostics neurophysiologiques correspondants.
La préparation rigoureuse de cet environnement impose une formalisation sans faille des typologies de données sous R. L’une des anomalies les plus pernicieuses constatées lors du transfert de fichiers délimités (tels que les formats CSV ou TSV) réside dans l’altération subreptice de la nature des identifiants alphanumériques. Si des identifiants structurés débutent par des zéros non significatifs, un tableur conventionnel aura tendance à les convertir automatiquement en valeurs numériques entières, oblitérant irréversiblement les préfixes symboliques. Dans R, le typage strict des colonnes d’identification au sein d’une classe de caractères ou de facteurs contrôlés permet de verrouiller l’espace de nommage avant toute tentative de rapprochement inter-tables.
Préalablement à toute mise en œuvre d’algorithmes de liaison, la vérification des dimensions spatiales des objets s’avère indispensable. Dans une démarche de contrôle qualité scientifique, l’opérateur doit systématiquement caractériser le volume cardinal des cohortes en dénombrant rigoureusement le nombre de lignes et de variables avant et après la procédure d’appariement. Cette vérification matricielle permet de déceler immédiatement toute contraction anormale du volume d’observations ou, à l’inverse, toute expansion artéfactuelle traduisant la génération involontaire de produits cartésiens causés par la duplication non maîtrisée de clés d’identification.
2. L’approche fondamentale en Base R : Maîtriser la fonction merge()
2.1 Syntaxe formelle et mécanismes internes de merge()
Le socle natif du langage R intègre une fonction polyvalente et pérenne dénommée merge(), conçue pour opérer des fusions d’ensembles selon les règles formelles de l’algèbre relationnelle sans recourir à la moindre dépendance logicielle externe. L’architecture de cet algorithme repose sur la comparaison systématique des valeurs logées au sein de colonnes pivots spécifiées par l’opérateur ou déduites automatiquement par l’interpréteur par recoupement des dénominations communes. Par défaut, la signature canonique de la fonction s’articule autour des deux structures tabulaires principales, complétées par une constellation d’arguments directifs gouvernant le comportement mathématique de l’agrégation.
Lorsque la fonction merge() est invoquée dans sa configuration élémentaire, son comportement par défaut équivaut très exactement à une jointure interne, désignée sous le terme d’inner join dans la nomenclature des bases de données SQL. Ce mécanisme implique que seules les observations dont les identifiants existent simultanément et sans ambiguïté dans la table source et dans la table de destination sont préservées dans la structure résultante. Si un sujet expérimental dispose d’un enregistrement dans le premier tableau mais s’avère absent du second en raison d’une défection méthodologique, son profil entier est mécaniquement élidé du jeu de données synthétisé, ce qui constitue une différence comportementale radicale par rapport au RECHERCHEV d’Excel.
Sur le plan calculatoire, merge() procède en réordonnant les données ou en utilisant des algorithmes d’appariement interne basés sur le tri ou les tables de dispersion. Cette dynamique algorithmique a une conséquence directe sur la structure de sortie : l’ordre séquentiel originel des lignes n’est généralement pas maintenu. Les observations se trouvent réorganisées selon l’ordre croissant ou alphabétique des clés de liaison. Pour les chercheurs habitués à la linéarité absolue des grilles Excel, ce comportement peut sembler déstabilisant et nécessite la mise en place d’une colonne d’indexation artificielle si la chronologie originale des enregistrements doit être restaurée scrupuleusement au terme du traitement.
2.2 Reproduction exacte du comportement RECHERCHEV avec all.x = TRUE
Pour répliquer sans la moindre déviation la cinématique fonctionnelle du RECHERCHEV d’Excel à travers l’outillage fondamental de R, il est impératif de modifier le paramétrage par défaut de la fonction merge() en exploitant l’argument logique all.x = TRUE. En spécifiant cette instruction, l’analyste contraint le moteur relationnel à effectuer une jointure externe gauche, couramment désignée par la terminologie anglophone de left outer join. Dans cette configuration géométrique, la table déclarée en première position (le terme x) conserve l’intégralité inconditionnelle de ses rangées, indépendamment du fait qu’une clé d’appariement correspondante existe ou non au sein de la table secondaire (le terme y).
Cette distinction est fondamentale dans le cadre de l’exploitation de registres cliniques ou de protocoles expérimentaux d’envergure. Supposons qu’un protocole intègre une cohorte initiale de cinq cents sujets assignés à un protocole d’exposition cognitive. Si seulement trois cents d’entre eux ont validé un examen complémentaire d’imagerie par résonance magnétique consigné dans une base secondaire, l’adjonction de all.x = TRUE garantit que les cinq cents sujets initiaux figureront sans omission dans le fichier de travail final. Pour les deux cents participants dépourvus d’imagerie, les variables nouvellement adossées afficheront un marqueur formel de non-réponse, émulateur exact de l’anomalie #N/A familière aux usagers du tableur.
La gestion de la mémoire vive constitue un enjeu corollaire fondamental lors de l’exécution de fusions massives via cette fonction native. Comme l’interpréteur R procède à des allocations mémoires globales lors de l’instanciation de nouveaux objets data.frame, la fusion de cohortes biomédicales massives peut entraîner la duplication temporaire mais volumineuse des espaces vectoriels sous-jacents. L’analyste averti veillera donc à ne pas soumettre à la fonction des tables globales contenant des dizaines de colonnes parasites, mais à restreindre préalablement la table donneuse aux seules variables rigoureusement requises par les impératifs du modèle statistique, prévenant ainsi toute saturation de la pile mémoire.
2.3 Harmonisation des clés aux dénominations asymétriques
Dans la pratique de la recherche scientifique, il est exceptionnel que deux bases de données élaborées de manière autonome partagent une nomenclature rigoureusement identique pour nommer leurs clés de liaison. Une équipe hospitalière peut désigner l’identifiant d’un patient sous l’intitulé Patient_ID, tandis qu’un centre d’analyse génomique stocke la même information sous la désignation abrégée Num_Sujet. Sous Excel, cette disparité nominale demeure sans incidence puisque la formule de recherche s’applique manuellement sur une sélection géométrique aveugle aux en-têtes. Sous R, la réconciliation impose une déclaration déclarative explicite des termes concordants.
La fonction merge() résout cette asymétrie structurale grâce à la combinaison des arguments by.x et by.y. L’utilisateur assigne sous forme de chaînes de caractères le nom exact de la variable pivot dans la table d’origine au premier argument, et l’étiquette correspondante dans la table cible au second. Dès cet instant, le moteur relationnel applique l’opérateur d’égalité sur les domaines de valeurs respectifs sans exiger la modification préalable des fichiers sources, préservant ainsi l’intégrité originelle des systèmes de codification propres à chaque équipe de recherche.
Toutefois, une vigilance formelle doit être accordée à la conformité des modes de représentation interne de ces identifiants. Si la variable de gauche est encodée sous la forme d’un vecteur textuel standard tandis que son pendant dans la table de droite est modélisé sous la forme d’une structure factorielle pourvue de niveaux fixes, l’interpréteur natif est susceptible de lever un avertissement méthodologique ou de refuser d’exécuter la jointure. Le statisticien doit impérativement harmoniser le typage sous-jacent en amont par des conversions explicites. Enfin, l’opération post-fusion requiert fréquemment l’élimination des scories résiduelles : lorsque les clés portent des noms distincts, certaines routines natives conservent les deux déclinaisons nominales dans la table finale, imposant l’élagage délibéré de la colonne redondante afin de maintenir une clarté absolue au sein du schéma relationnel.
3. L’approche moderne et déclarative avec le package dplyr
3.1 La syntaxe fluide du Tidyverse appliquée aux données comportementales
L’avènement du méta-package Tidyverse et plus singulièrement de la bibliothèque dplyr a profondément remodelé l’écosystème de l’ingénierie des données sous R. Fondée sur une grammaire rigoureuse de la manipulation tabulaire, cette approche substitue aux appels de fonctions imbriquées une succession linéaire de verbes d’action expressifs. Dans cette syntaxe moderne, la réconciliation d’informations ne s’envisage plus à travers une fonction unique polymorphe, mais se décline en une famille harmonisée de jointures mutantes spécifiquement dévolues à chaque cas de figure relationnel : left_join(), inner_join(), right_join() et full_join().
L’un des apports majeurs de ce paradigme réside dans l’intégration native de l’opérateur de redirection séquentielle, couramment désigné sous le terme de pipe (qu’il prenne la forme historique %>% issue de magrittr ou la notation native intégrée |>). Cet opérateur permet d’agencer les traitements statistiques sous la forme de flux de transformation continus et limpides, mimant le cheminement intellectuel du chercheur. Une table de mesures psychométriques brutes peut ainsi être filtrée, débarrassée de ses artéfacts, fusionnée avec des variables sociodémographiques et agrégée en une série ininterrompue d’instructions parfaitement lisibles.
Cette lisibilité syntaxique transcende le simple confort ergonomique du programmeur : elle constitue un impératif méthodologique pour la science ouverte et la revue par les pairs. Lorsqu’un protocole d’analyse complexe repose sur une accumulation de formules RECHERCHEV disséminées au sein d’une grille Excel de plusieurs dizaines de milliers de cases, la vérification indépendante par un réviseur s’avère matériellement impossible sans procéder à un audit laborieux cellule par cellule. À l’opposé, un script structuré orchestré autour de verbes déclaratifs formalise sans ambiguïté les intentions analytiques de l’auteur, réduisant considérablement la charge cognitive requise pour auditer la validité de la chaîne d’assemblage des données.
3.2 Mise en œuvre concrète de left_join() comme alternative directe
Au sein de la gamme fonctionnelle proposée par dplyr, l’instruction left_join() s’impose comme l’émulateur le plus parfait, le plus robuste et le plus élégant du RECHERCHEV traditionnel d’Excel. Conçue pour prioriser systématiquement la structure de données maîtresse déclarée en amont, cette primitive garantit que chaque observation présente dans la table d’entrée subsistera au sein du produit final, tout en important de manière ciblée les attributs informatifs associés logés dans la table périphérique. La définition de la passerelle d’appariement s’effectue au moyen de l’argument explicite by, lequel reçoit un vecteur d’associations textuelles unissant sans ambiguïté les colonnes de correspondance.
Un avantage capital de left_join() par rapport à la méthode native merge() réside dans sa préservation rigoureuse et déterministe de l’ordonnancement originel des observations. Dans les paradigmes expérimentaux en psychologie cognitive où la séquence temporelle de présentation des stimuli ou l’ordre chronologique de passage des participants revêt une signification empirique majeure, la préservation intégrale de la disposition matricielle initiale épargne à l’analyste le recours à des opérations secondaires de ré-indexation. Le jeu de données enrichi conserve scrupuleusement la géométrie longitudinale de l’échantillon tout en accueillant de nouvelles dimensions descriptives.
De surcroît, left_join() déploie une stratégie sophistiquée pour résoudre les conflits d’homonymie entre les variables non discriminantes des deux tables. Si les deux structures partagent accidentellement des colonnes aux intitulés identiques qui n’ont pas été déclarées comme clés d’appariement (par exemple, une colonne commune documentant la date de passation), le système Tidyverse applique automatiquement des suffixes discriminants systématiques (tels que .x et .y). Ce dispositif préserve scrupuleusement l’intégrité de chaque source d’information sans risquer d’écraser silencieusement des données antérieures, écueil redoutable fréquemment rencontré lors de manipulations hâtives sur tableur.
3.3 Jointures conditionnelles et filtrantes : anti_join() et semi_join()
L’univers relationnel de dplyr enrichit l’arsenal de l’analyste de données d’une catégorie d’opérations totalement absente du répertoire natif d’Excel : les jointures filtrantes. Représentées principalement par les fonctions semi_join() et anti_join(), ces primitives algorithmiques n’ont point pour vocation d’annexer de nouvelles colonnes descriptives à la table maîtresse, mais exploitent la table secondaire comme un tamis relationnel sophistiqué pour réguler la sélection des lignes d’observation.
L’utilité méthodologique de l’instruction anti_join() s’avère considérable lors de la gestion du contrôle qualité dans les protocoles de recherche expérimentale. Cette fonction extrait exclusivement les enregistrements de la première table qui ne possèdent strictement aucune correspondance au sein de la table de comparaison. Dans le contexte d’une cohorte clinique longitudinale, elle permet d’isoler en une fraction de seconde l’ensemble exhaustif des participants non-répondeurs ou des volontaires ayant abandonné l’étude entre deux sessions de mesure, dispensant le biostatisticien de fastidieux tests logiques conditionnels imbriqués pour caractériser la nature des abandons.
Réciproquement, la fonction semi_join() opère une sélection positive rigoureuse : elle restreint la table d’analyse aux seules observations qui trouvent un écho au sein du registre d’évaluation secondaire, sans pour autant importer la moindre variable de ce dernier ni générer de duplication de lignes si la table cible comporte des entrées multiples. Cet outil constitue l’instrument idéal pour élaguer rapidement un fichier de données comportementales volumineux en le confrontant à une liste de validation clinique prédéfinie, garantissant l’inclusion stricte des seuls sujets répondant à l’ensemble des critères d’admissibilité préalablement à toute phase de modélisation inférentielle.
4. La méthode vectorielle haute performance : L’indexation par match()
4.1 Mécanique d’indexation positionnelle vectorisée
Au-delà des abstractions formelles de l’algèbre relationnelle implémentées dans merge() et left_join(), le langage R offre un mécanisme d’une pureté algorithmique remarquable : l’indexation positionnelle vectorisée par la fonction primitive match(). Alors que les méthodes de jointure globales traitent les tables comme des systèmes d’ensembles complets nécessitant des calculs d’intersections matricielles complexes, l’instruction match() opère au niveau vectoriel univarié le plus élémentaire, se rapprochant de façon saisissante du mécanisme intrinsèque d’adresses cellulaires exploité par le moteur d’Excel.
Le fonctionnement fondamental de match(x, table) repose sur la recherche d’éléments d’un vecteur source (le terme x) au sein d’un vecteur récepteur (la table). Loin de retourner directement les valeurs de contenu associées, la fonction renvoie un vecteur d’entiers de même dimension que la source, où chaque élément représente la position ordinale absolue (le rang d’indice débutant à un sous R) de la toute première occurrence trouvée dans le récepteur. Si aucun appariement n’est physiquement décelable, la fonction renvoie la constante conventionnelle NA. Ce vecteur d’indices sert ensuite de filtre de projection pour extraire directement n’importe quelle colonne dépendante.
Cette dissociation conceptuelle entre la localisation spatiale de l’information et son extraction effective octroie une flexibilité programmatique sans égale. L’analyste décompose le problème en deux temps : d’abord, établir la cartographie d’alignement positionnel entre les deux structures de données ; ensuite, solliciter sélectivement les seuls vecteurs de variables nécessaires par le biais de l’opérateur d’indexation matricielle entre crochets. Cette approche évite tout gonflement de l’environnement de calcul, ne créant aucune table temporaire volumineuse et préservant les performances de calcul même sur des machines aux ressources de calcul restreintes.
4.2 Simulation rigoureuse d’un RECHERCHEV univarié
L’application de la fonction match() offre la transposition la plus épurée et la plus économique d’un RECHERCHEV à visée univariée, c’est-à-dire lorsqu’un chercheur souhaite simplement greffer une unique mesure complémentaire au sein d’une table d’expérimentation préexistante. Illustrons cette mécanique : considérons une cohorte expérimentale pourvue d’une colonne d’identifiants anonymisés de participants, à laquelle on envisage d’adjoindre un indicateur diagnostique d’anxiété clinique stocké dans une table médicale indépendante.
En assignant les indices d’alignement générés par match() à une nouvelle variable dans la table de départ, l’extraction de la mesure cible s’accomplit par une affectation vectorielle directe : la nouvelle colonne reçoit la valeur de la table médicale ciblée indexée par le vecteur des rangs calculés. Les sujets ne possédant aucune entrée dans la base médicale héritent de manière entièrement déterministe de la mention NA, répliquant fidèlement la sémantique de non-réponse du tableur sans modifier d’un seul octet l’architecture spatiale du reste du jeu de données principal.
Sur le plan de l’allocation des ressources computationnelles, cette méthodologie surclasse largement les opérations de jointure exhaustives lorsque le volume de données s’accroît. Dans la mesure où elle n’opère aucun calcul de concordance sur les variables périphériques, ne tente pas de restructurer les tables et s’exécute entièrement dans le cœur compilé en langage C du noyau R, la fonction match() démontre une vélocité exceptionnelle. Elle constitue le choix préférentiel des biostatisticiens appelés à enrichir des bases de plusieurs millions d’enregistrements avec des constantes de calibration biologique univariées.
4.3 Limites critiques de l’indexation par match()
En dépit de sa fulgurance computationnelle et de sa séduisante simplicité syntaxique, la méthode d’indexation par match() comporte des limitations structurelles critiques dont l’ignorance peut s’avérer fatale pour la rigueur analytique. La contrainte la plus impérieuse réside dans sa rigidité algorithmique immuable : match() retourne exclusivement la position de la première occurrence satisfaisant la condition de correspondance au sein de la table de référence, ignorant superbement toutes les occurrences ultérieures potentielles.
Ce trait fonctionnel émule fidèlement l’une des failles les plus notoires du RECHERCHEV d’Excel, qui s’arrête dès la première ligne validée sans jamais avertir l’utilisateur de l’existence de doublons sous-jacents. Si la table de référence contient accidentellement des enregistrements multiples pour un même identifiant de sujet — par exemple, en raison de consultations médicales récurrentes ou de saisies administratives redondantes —, l’analyste capturera systématiquement la première entrée rencontrée, occultant les mesures subséquentes sans générer la moindre notification d’alerte dans la console R.
Par conséquent, l’usage de match() doit être formellement banni ou subordonné à des contrôles d’intégrité préalables stricts dans le cadre de protocoles impliquant des données répétées ou des cohortes longitudinales. Dès lors qu’une entité statistique peut être associée à de multiples états temporels, l’analyste doit impérativement délaisser l’indexation univariée positionnelle au profit de jointures relationnelles complètes capables de gérer les relations un-à-plusieurs ou plusieurs-à-plusieurs, préservant ainsi la multiplicité empirique des observations sans introduire de biais de sélection silencieux.
5. Traitement rigoureux des valeurs manquantes et anomalies #N/A
5.1 Équivalence sémiotique entre le code #N/A d’Excel et le NA de R
Dans l’univers fonctionnel de Microsoft Excel, l’apparition de l’erreur typographique #N/A (abréviation conventionnelle de Not Available) consécutive à l’évaluation d’un RECHERCHEV signale l’incapacité du système à localiser la valeur cible au sein de la plage de référence. Bien que traitée par le tableur comme une interruption d’évaluation de formule susceptible de contaminer les calculs en aval, cette notation est fréquemment appréhendée par les utilisateurs de manière pragmatique comme le signal d’une simple absence empirique, incitant à des contournements cosmétiques par la fonction SIERREUR().
Dans l’architecture conceptuelle de R, l’entité NA possède une profondeur sémantique et mathématique infiniment plus rigoureuse. Directement héritée de la logique tri-valuée formalisée par Stephen Cole Kleene, la constante NA ne constitue pas une simple erreur de calcul, mais représente explicitement une valeur réelle dont la magnitude demeure présentement inconnue ou non observée. Cette nuance épistémologique fondamentale dicte l’ensemble des règles de calcul de l’interpréteur : toute opération arithmétique ou logique impliquant une inconnue produit par définition une inconnue, de sorte que l’expression 5 + NA donne rigoureusement NA.
Lors d’une opération de fusion ou d’appariement de données dans R, l’apparition de NA doit faire l’objet d’un diagnostic étiologique différentiel rigoureux. Deux mécanismes de genèse distincts aboutissent en effet à la présence de cette valeur au sein de la matrice consolidée : d’une part, la non-concordance structurelle résultant d’une absence d’appariement de clé entre les deux tables (la ligne source ne trouve aucun écho dans le référentiel secondaire) ; d’autre part, l’existence d’une donnée manquante intrinsèque déjà logée au sein de la table donneuse (la clé concorde parfaitement, mais la valeur biologique mesurée était manquante à la source). Confondre ces deux phénomènes compromet l’interprétation des modèles statistiques ultérieurs.
5.2 Techniques d’imputation et de remplacement systématique
Pour réguler la présence des valeurs manquantes post-appariement sans altérer la cohérence des inférences statistiques, l’écosystème R propose une palette d’outils hautement spécialisés, évitant les imputations sauvages et opaques souvent pratiquées dans les environnements de tableurs non scriptés. La standardisation moderne passe notamment par l’usage des fonctions issues de l’extension tidyr, au premier rang desquelles figure replace_na(), qui autorise la substitution ciblée et typée de valeurs d’indétermination selon les contraintes propres à chaque variable.
Une alternative d’une élégance remarquable réside dans la fonction coalesce() du package dplyr, inspirée de la fonction homonyme standardisée en langage SQL. Cette commande inspecte séquentiellement plusieurs vecteurs de même longueur pour sélectionner la toute première valeur non manquante disponible pour chaque ligne d’observation. Dans les études longitudinales ou les protocoles intégrant des sources d’information concurrentes (par exemple, un score clinique issu d’un registre d’urgence confronté au score consolidé consigné dans un dossier hospitalier informatisé), coalesce() permet d’arbitrer rationnellement la fusion en comblant prioritairement les vides sans écraser les mesures de référence déjà validées.
Lorsque la substitution dépend d’une logique probabiliste ou de règles métier complexes propres au champ d’investigation psychométrique, le chercheur s’orientera vers des opérateurs conditionnels vectorisés tels que if_else() ou case_when(). Contrairement à la fonction native ifelse() de Base R, qui présente le risque de dégrader silencieusement les classes d’objets temporels ou les échelles qualitatives de type facteur, l’instruction dplyr::if_else() impose une stricte égalité de typage entre la valeur de substitution et le vecteur récepteur, érigeant une barrière de sécurité impérative contre les dérives d’encodage lors de la standardisation des scores d’évaluation.
5.3 Audit d’intégrité post-appariement
L’exécution d’une fusion de données dans un cadre scientifique ne saurait être considérée comme achevée sans la mise en œuvre d’un audit de conformité quantitatif et formel. Dans les études expérimentales publiées selon les normes de l’American Psychological Association (APA) ou les déclarations méthodologiques telles que CONSORT et STROBE, l’analyste a l’obligation déontologique de tracer avec une précision absolue les flux d’échantillonnage et de quantifier les pertes d’attrition générées par chaque étape de conciliation de bases de données.
Cet audit repose en premier lieu sur le calcul systématique des taux d’appariement effectifs, formalisé par le rapport entre le nombre d’identifiants sources ayant trouvé une correspondance intégrale et le volume global d’observations incluses dans la cohorte préliminaire. L’identification des lignes orphelines permet de déceler d’éventuels biais systématiques de non-réponse (par exemple, si les participants présentant les traits d’anxiété les plus sévères manifestent une défection systématique lors de la collecte biométrique secondaire), prévenant ainsi la publication d’analyses assises sur des échantillons tronqués et non représentatifs.
Pour sanctuariser cette démarche de contrôle qualité dans une optique d’automatisation des pipelines d’analyse, l’intégration de tests unitaires via des packages spécialisés tels que testthat ou des assertions logiques conditionnelles formelles est vivement préconisée. L’incorporation d’instructions explicites interrompant immédiatement l’exécution du script statistique si le taux de pertes excède un seuil préétabli garantit l’intégrité scientifique globale du processus analytique, prévenant la diffusion de résultats calculés sur des données incomplètes ou méthodologiquement compromises.
6. Appariements sur clés composites et critères multiples
6.1 Dépassement des limitations de conciliation univariée d’Excel
Dans la pratique courante d’Excel, l’utilisateur confronté à la nécessité de concilier des enregistrements en fonction de plusieurs critères simultanés — par exemple, croiser un identifiant de participant, un numéro de session expérimentale et une condition de passation — se heurte immédiatement aux limites de la fonction RECHERCHEV, laquelle est structurellement incapable d’ingérer plus d’une valeur de recherche à la fois. Pour contourner cette limitation logicielle, l’artifice empirique quasi universellement adopté consiste à créer manuellement, dans chaque feuille de travail, une colonne auxiliaire artificielle issue de la concaténation textuelle des différents champs d’intérêt (par exemple, la chaîne composite Sujet01_Session2_Placebo).
Cet artifice méthodologique s’avère particulièrement précaire et périlleux sur le plan de l’intégrité scientifique. D’une part, il altère irrémédiablement la pureté structurelle des matrices originelles en y injectant des colonnes d’artefacts redondantes qui gonflent inutilement la taille des fichiers. D’autre part, il expose l’analyste à des collisions d’appariement désastreuses causées par des ambiguïtés sémantiques lors de la concaténation de chaînes (par exemple, la fusion de l’identifiant 12 avec la session 34 produisant la même chaîne 1234 que l’identifiant 123 associé à la session 4, à moins d’intégrer des délimiteurs arbitraires eux-mêmes sujets à d’éventuelles corruptions de saisie).
L’environnement R émancipe totalement le chercheur de ces contraintes archaïques en intégrant nativement la notion mathématique de clé primaire composite multidimensionnelle. L’algèbre relationnelle sur laquelle repose le traitement des données dans R traite les tuples de variables comme des entités vectorielles coordonnées. L’appariement ne s’opère pas par fusion mécanique de chaînes de caractères, mais par l’évaluation conjointe et simultanée d’un vecteur logique d’équivalences strictes au sein de l’espace multidimensionnel défini par les colonnes de croisement, garantissant une stabilité mathématique absolue et une lisibilité parfaite des jeux de données.
6.2 Mise en œuvre technique via merge() et dplyr
La formalisation d’un appariement multi-critères s’avère particulièrement limpide et directe tant au sein des fonctions primitives de Base R que dans l’univers déclaratif de dplyr. Sous l’approche conventionnelle de merge(), la spécification d’une clé composite s’opère simplement en transmettant à l’argument by un vecteur contenant la liste nominative des variables conjointes qui caractérisent de façon univoque l’unité expérimentale. Si les colonnes présentent des intitulés discordants entre les deux bases, la concordance se résout par la déclaration coordonnée de vecteurs ordonnés assignés respectivement aux paramètres by.x et by.y.
Au sein de la syntaxe moderne de dplyr, l’opération s’exécute avec une clarté typographique encore plus affirmée. La fonction left_join() accueille dans son argument by un vecteur de chaînes où chaque dimension relationnelle est explicitée. L’instruction permet d’associer sans ambiguïté des colonnes aux dénominations hétérogènes sans requérir la moindre manipulation préalable de renommage, en adoptant une syntaxe d’association d’éléments vectoriels. Le compilateur évalue alors la concordance globale de l’ensemble des conditions logiques pour valider l’adjonction des métadonnées associées.
Cette approche est impérative pour gérer correctement les conflits de granularité temporelle inhérents aux protocoles de mesures répétées en neurosciences ou en psychologie comportementale. Lorsqu’un participant subit une série d’évaluations psychophysiologiques réparties sur plusieurs sessions distinctes, l’appariement croisé sur le couple de variables associant l’identifiant du volontaire et l’index de la session permet d’associer les données physiologiques au profil psychologique exact correspondant à ce créneau chronologique précis, sans risquer la contamination anachronique des mesures.
6.3 Conséquences empiriques d’une mauvaise spécification des clés
La mauvaise formulation ou la sous-spécification des clés de liaison constitue l’une des sources majeures d’aberration statistique dans les travaux quantitatifs informatisés. Le scénario pathologique le plus redoutable survient lorsqu’un chercheur tente de fusionner deux tables renfermant des mesures répétées en omettant d’inclure la dimension temporelle au sein de la clé de conciliation, réduisant l’association à l’unique identifiant du sujet alors que celui-ci apparaît sur de multiples lignes au sein de chacune des bases confrontées.
Sur le plan algorithmique, cette omission déclenche immédiatement la génération d’un produit cartésien involontaire, également désigné sous le terme de relation plusieurs-à-plusieurs (many-to-many relationship). Le moteur de calcul associe chaque occurrence de la première table à chaque occurrence correspondante de la seconde table. Si un participant possède quatre enregistrements de mesures dans le tableau A et quatre enregistrements dans le tableau B, le fichier résultant comportera seize lignes distinctes pour ce seul individu, multipliant artificiellement le volume de l’échantillon tout en introduisant des redondances de données massives et silencieuses.
Les répercussions statistiques d’une telle explosion combinatoire sont désastreuses. L’inflation artéfactuelle du nombre de degrés de liberté fausse intégralement les tests d’hypothèses inférentiels, comprimant de manière illusoire les erreurs types et augmentant drastiquement le risque de commettre une erreur statistique de type I (conclure à l’existence d’un effet significatif qui n’est que le reflet d’une duplication informatique). Pour parer à cette menace méthodologique, l’analyste doit instaurer des contrôles préalables d’unicité via des fonctions telles que dplyr::count() ou auditer scrupuleusement le différentiel de lignes avant et après l’opération de jointure.
7. Haute volée calculatoire : L’alternative ultra-rapide data.table
7.1 Architecture et paradigme de recherche binaire de data.table
Lorsque le volume des données dépasse les dimensions habituelles des cohortes de laboratoire pour atteindre des millions d’observations — une situation désormais courante lors du traitement de journaux comportementaux informatisés, de tracés d’eye-tracking à haute fréquence d’échantillonnage ou de données de neuro-imagerie fonctionnelle —, les méthodes standards de fusion de R peuvent accuser des latences perceptibles. Le package data.table offre une solution d’ingénierie logicielle d’une efficacité extrême, conçue pour minimiser la consommation de mémoire vive et accélérer considérablement les temps d’exécution.
L’avantage décisif de data.table repose sur son modèle d’indexation par recherche binaire (binary search) adossé au concept de clés physiques (keyed tables). Alors que les fonctions conventionnelles de Base R ou de Tidyverse recourent fréquemment à des algorithmes de balayage linéaire ou à des tables de hachage temporaires reconstruites à chaque exécution, l’instruction setkey() de data.table réordonne physiquement les données en mémoire selon les colonnes sélectionnées et crée un index persistant optimisé. Dès lors, la recherche d’une correspondance n’exige plus le parcours de l’ensemble de la structure, mais s’exécute en une complexité logarithmique O(log N), divisant par plusieurs ordres de grandeur la durée des requêtes.
La syntaxe de data.table se distingue par son extrême compacité et sa structure unifiée qui condense le filtrage, le calcul et la fusion au sein d’un formalisme matriciel élégant de type DT[i, j, by]. Dans cette géométrie conceptuelle, le premier argument i n’accueille pas simplement des filtres booléens de sélection de lignes, mais peut recevoir une autre table de données à part entière. Cette caractéristique transforme l’opération de recherche en un acte d’indexation direct, établissant une passerelle conceptuelle entre l’interrogation de bases de données distribuées et le calcul matriciel pur.
7.2 Réalisation du RECHERCHEV par jointure par la droite optimisée
L’émulation d’une démarche de type RECHERCHEV sous l’environnement data.table s’opère par une syntaxe concise qui peut, au premier abord, dérouter l’utilisateur accoutumé aux déclarations conventionnelles. La forme canonique prend la tournure TableReference[TablePrincipale, on = .(cle)]. Il est impératif de souligner l’inversion apparente des positions : c’est la table de référence qui accueille en son sein la table principale comme opérateur d’interrogation dans l’argument i, ce qui équivaut rigoureusement à une jointure externe droite optimisée sur le plan formel, tout en préservant l’exhaustivité des observations de la table maîtresse.
Cette formulation octroie une maîtrise absolue sur l’extraction des variables d’intérêt. Par le biais du second argument j, l’analyste peut spécifier à la volée la liste exacte des dimensions informatives à rapatrier, évitant ainsi l’importation superflue de dizaines de colonnes contextuelles non sollicitées. L’opération s’exécute sans générer de duplication d’objets intermédiaires dans l’environnement de calcul, grâce à l’implémentation exclusive de la modification par référence (l’opérateur :=), préservant ainsi l’empreinte mémoire du système informatique.
Les investigations comparatives de vitesse d’exécution (benchmarking) conduites via des bibliothèques d’évaluation temporelle de haute précision démontrent sans équivoque la suprématie de data.table face aux immenses volumes de données. Dans des contextes de traitement impliquant des tables de plusieurs gigaoctets, les opérations de liaison qui requièrent plusieurs dizaines de secondes via les approches traditionnelles s’exécutent sous data.table en une poignée de millisecondes, offrant un gain de temps inestimable pour les protocoles scientifiques requérant des ré-évaluations itératives ou des simulations intensives de type Monte-Carlo.
7.3 Jointures non-équi et correspondances d’intervalles
L’une des prouesses algorithmiques les plus sophistiquées offertes par data.table réside dans son aptitude native à opérer des jointures dites non-équi (non-equi joins). Alors que le RECHERCHEV traditionnel d’Excel et les jointures relationnelles classiques de base sont strictement conditionnés par un opérateur d’égalité stricte entre les clés (A = B), data.table autorise l’expression de conditions de liaison reposant sur des opérateurs d’inégalité relationnelle et de comparaison continue tels que <, <=, > et >=.
Cette fonctionnalité s’avère particulièrement puissante en psychométrie appliquée, notamment lors des procédures d’étalonnage et de standardisation de scores de tests cognitifs. Traditionnellement, l’attribution d’un rang centile ou d’une note standardisée en fonction d’un score brut continu exigeait soit de complexes imbrications de formules conditionnelles, soit l’application d’un RECHERCHEV approché contraignant. Grâce aux jointures non-équi, il devient possible d’apparier directement chaque performance brute à une grille normative en spécifiant que le score doit être compris entre la borne inférieure et la borne supérieure d’un intervalle diagnostique prédéterminé.
Ce mécanisme transcende également les architectures de boucles itératives lourdes fréquemment employées pour synchroniser des événements comportementaux asynchrones. Dans les protocoles d’évaluation cognitive en temps réel, l’analyste peut ainsi croiser un tracé d’enregistrement électrophysiologique continu avec un registre de stimuli événementiels discrets en établissant une fenêtre d’appariement temporelle flexible, consolidant des données massives en une instruction élégante, fluide et mathématiquement rigoureuse.
8. Reproduction de la correspondance approximative (RECHERCHEV avec TRUE)
8.1 Fondements de la recherche par intervalle de valeurs
Dans la configuration originale de la fonction RECHERCHEV d’Excel, la bascule de l’argument final sur la valeur logique VRAI (TRUE) déclenche le mode de correspondance approximative. Historiquement conçu pour pallier l’absence d’outils de discrétisation sophistiqués, ce mécanisme impose une exigence algorithmique stricte : la première colonne de la table de conversion doit impérativement faire l’objet d’un tri préalable par ordre strictement croissant. Dès lors, le tableur balaye la série jusqu’à identifier la valeur la plus élevée qui demeure inférieure ou égale à la cible recherchée, ce qui équivaut à une fonction de découpage par paliers.
Ce procédé algorithmique présente une fragilité intrinsèque manifeste dans le cadre d’un usage courant. Si l’opérateur omet de procéder au tri rigoureux de sa matrice de référence ou si des valeurs parasites viennent perturber la monotonie de la séquence, le système Excel ne génère aucun message d’anomalie explicite, mais restitue silencieusement une valeur erronée issue d’une rupture de son algorithme de recherche dichotomique. En outre, la délimitation floue des frontières d’intervalles — l’incertitude quant à la fermeture stricte à gauche ou à droite des seuils critiques — représente une source récurrente d’erreurs de classification dans l’interprétation des indices psychométriques.
Au sein de l’environnement de programmation R, la réplication de cette démarche ne s’effectue pas en tentant d’émuler maladroitement une recherche empirique hasardeuse, mais en formalisant rigoureusement l’acte de discrétisation continue au moyen de fonctions mathématiquement étanches. L’objectif est de projeter une variable quantitative continue sur une échelle ordinale ou catégorielle d’intervalles parfaitement documentés, garantissant une reproductibilité sans faille de l’attribution des étiquettes ou des coefficients normatifs associés.
8.2 Utilisation de base::findInterval() pour la conversion de scores
Pour transposer le comportement du RECHERCHEV approché avec un niveau de sécurité algorithmique maximal, la fonction findInterval() disponible dans le socle fondamental de Base R s’impose comme l’outil d’élection. Conçue pour opérer sur des structures purement vectorielles, cette primitive prend en argument le vecteur des valeurs continues à classifier ainsi qu’un vecteur ordonné définissant les bornes de découpage. Elle retourne pour chaque observation l’indice de l’intervalle dans lequel la valeur s’insère, en exécutant une recherche binaire rapide et robuste compilée au niveau natif.
Cette approche brille particulièrement lors de la segmentation d’échelles de sévérité clinique, à l’instar de l’inventaire de dépression de Beck ou des scores d’anxiété STAI. L’analyste formalise son référentiel de seuils sous la forme d’un vecteur numérique croissant (par exemple : 0, 10, 19, 30, 64) puis associe aux indices numériques générés par findInterval() un vecteur textuel de diagnostics qualitatifs (Minime, Léger, Modéré, Sévère). La classification s’exécute de manière instantanée, déterministe et totalement transparente quant à la définition des frontières mathématiques.
Un atout méthodologique déterminant de findInterval() réside dans sa gestion explicite de la fermeture des intervalles grâce à ses arguments logiques configurables (tels que rightmost.closed et left.open). Contrairement aux approximations opaques des grilles de tableur, le chercheur stipule expressément si une valeur frontière stricte (par exemple, un score exact de 10) bascule dans la catégorie inférieure ou dans la classe supérieure. Cette rigueur dans la définition des seuils d’inclusion est indispensable pour garantir la comparabilité internationale des classifications nosologiques.
8.3 Approches avancées : fuzzyjoin et jointures de chaînes textuelles
Il est des contextes méthodologiques où l’approximation ne relève point de la continuité numérique, mais procède de l’imperfection intrinsèque des données qualitatives textuelles : patronymes orthographiés avec des variations dialectales, identifiants cliniques pollués par des fautes de frappe dactylographiques ou dénominations médicamenteuses hétérogènes. Face à cette typologie de données corrompues, le RECHERCHEV d’Excel s’avère absolument inopérant, imposant des heures de nettoyages manuels à haut risque d’erreur.
L’écosystème R résout ce défi complexe par l’intermédiaire du package spécialisé fuzzyjoin, qui implémente des algorithmes de correspondance floue fondés sur la théorie de l’information. Notamment, la fonction stringdist_join() permet d’apparier deux tables de données non point sur une stricte égalité nominale de caractères, mais en évaluant la proximité métrique de leurs chaînes au moyen de distances mathématiques standardisées, telles que la distance de Levenshtein, de Damerau-Levenshtein ou de Jaro-Winkler.
L’analyste configure un seuil quantitatif de tolérance (max_dist) qui autorise la détection et la fusion de termes présentant un nombre maîtrisé de permutations, d’omissions ou d’insertions accidentelles de caractères. Cette stratégie permet de réconcilier de volumineux registres épidémiologiques historiques dont la numérisation a introduit des scories d’encodage, tout en conservant une traçabilité intégrale : le script consigne explicitement les distances calculées pour chaque paire identifiée, permettant d’auditer et de documenter la précision de l’appariement algorithmique au sein des publications de recherche.
9. L’inversion de direction : Répliquer RECHERCHEH et INDEX/EQUIV
9.1 Libération des contraintes spatiales du tableur
L’une des tares historiques les plus exaspérantes de la fonction RECHERCHEV réside dans son asymétrie spatiale fondamentale : l’algorithme est intrinsèquement aveugle à ce qui se situe à sa gauche. Si la clé de correspondance est positionnée dans la troisième colonne d’une feuille de calcul et que la grandeur quantitative à extraire se trouve consignée dans la première colonne, l’utilisateur d’Excel est contraint soit de modifier physiquement l’ordonnancement de son classeur — une manipulation éminemment périlleuse pour l’intégrité des autres formules préétablies —, soit d’abandonner RECHERCHEV au profit de la formule combinée INDEX/EQUIV.
Cette dualité de formules (complétée par RECHERCHEH pour les explorations horizontales) n’a strictement aucune raison d’exister au sein de l’environnement R. L’algèbre relationnelle ne possède aucune notion de polarité directionnelle gauche-droite ou haut-bas. Dans une jointure exécutée via left_join() ou merge(), la localisation physique des variables au sein de la disposition du tableau est strictement indifférente. La clé primaire peut occuper la dernière colonne de la table secondaire et l’attribut à extraire se situer en tête de fichier sans que cela n’exerce la moindre incidence sur la validité ou la syntaxe de l’opération.
Pour les analystes souhaitant émuler l’esprit d’indexation dynamique propre au duo INDEX/EQUIV d’Excel sans mobiliser d’infrastructures de jointure relationnelle lourdes, R propose une syntaxe d’indexation matricielle bidimensionnelle d’une compacité remarquable : Matrice[lignes, colonnes]. En couplant la fonction match() pour identifier la position ordinale de la ligne d’intérêt avec la désignation nominale de la colonne cible, on réalise en une ligne de code claire l’équivalent parfait d’une extraction bidirectionnelle, sans aucune contrainte de placement géométrique.
9.2 Transposition et recherche horizontale (RECHERCHEH)
La commande RECHERCHEH (HLOOKUP) a été introduite dans les tableurs pour opérer des recherches ligne par ligne au sein de structures tabulaires inversées, où les variables sont alignées verticalement en tête de rangées et les observations distribuées le long des colonnes horizontales. Si cette disposition en format dit « large » (wide format) flatte parfois la lecture visuelle humaine sur écran, elle constitue une hérésie sur le plan computationnel, contrevenant directement aux principes fondamentaux de la structure de données standardisée (tidy data).
Dans la philosophie de la science des données moderne sous R, formalisée par Hadley Wickham, un jeu de données valide obéit à trois règles intangibles : chaque variable forme une colonne distincte, chaque observation constitue une ligne univoque et chaque valeur réside dans une cellule indépendante. Dès lors, confronté à un fichier articulé à l’horizontale nécessitant une recherche de type RECHERCHEH, le biostatisticien ne cherche pas à adapter ses fonctions de recherche à cette géométrie incongrue ; il pivote structurellement la matrice pour la conformer aux standards internationaux.
Cette restructuration architecturale s’opère sans effort par le biais de la fonction pivot_longer() du package tidyr. L’instruction rabat l’éventail des colonnes horizontales en un couple normalisé de variables longitudinales caractérisant la mesure et sa magnitude. Une fois les données transmutées en ce format « long » (long format), le recours à des recherches horizontales spécifiques devient purement caduc. Toutes les fusions se déploient via les procédures standardisées de jointure verticale, garantissant l’interopérabilité immédiate des données avec l’ensemble des modules d’analyse statistique et de modélisation prédictive de l’écosystème R.
9.3 Recherche multidimensionnelle et dynamique
L’un des défis majeurs posés par l’ingénierie des données sur tableur réside dans l’incapacité d’extraire dynamiquement de multiples variables dépendantes sans dupliquer et adapter manuellement des séries d’instructions RECHERCHEV individuelles sur des dizaines de colonnes parallèles. Cette tâche répétitive engendre des risques élevés d’erreurs de pointage ordinal et transforme la maintenance des classeurs en un processus laborieux.
Sous R, l’extraction de métadonnées s’exécute de façon collective, structurelle et multidimensionnelle. Lorsqu’une jointure left_join() est instanciée, le moteur relationnel annexe simultanément l’ensemble exhaustif des variables portées par la table donneuse, sans exiger la moindre déclaration unitaire de la part de l’utilisateur. Si ce dernier souhaite restreindre l’importation à un sous-ensemble prédéfini d’attributs cliniques, la combinaison fluide des verbes select() et de l’appariement relationnel permet d’isoler à la volée les colonnes requises avec une concision exemplaire.
De plus, cette dynamique s’adapte sans faille aux contextes de modélisation mathématique matricielle avancée, tels que l’interpolation programmatique de valeurs au sein de matrices de corrélation, de tables de covariance ou de grilles de transition markovienne. Par le biais d’opérations d’indexation vectorielle coordonnée, le programmeur extrait instantanément les coefficients de variance associés à des paires de variables expérimentales distinctes, générant de manière automatisée des jeux de données d’étalonnage pour les analyses factorielles confirmatoires et la modélisation en équations structurelles.
10. Pièges fréquents, erreurs de typage et diagnostics analytiques
10.1 Incompatibilités silencieuses des types de données
La source la plus prévalente et insidieuse d’échec lors de l’exécution de rapprochements de données dans R provient des disparités silencieuses de typage atomique des variables pivots. Contrairement à Excel, dont le moteur procède à des conversions implicites floues — tentant d’assimiler sans avertissement un nombre stocké sous forme de texte à une magnitude numérique —, l’environnement R applique un principe de typage strict et inflexible. Si une variable clé est encodée sous la forme d’un nombre à virgule flottante ou d’un entier dans la première table et sous la forme d’un vecteur de chaînes de caractères dans la seconde, l’algorithme de jointure refusera catégoriquement d’opérer l’appariement.
Une complexité additionnelle émerge fréquemment de la gestion des objets de type factor, structure historique de R destinée à représenter les variables catégorielles à modalités fixes. Si deux colonnes de facteurs possèdent des identifiants nominaux identiques mais sont adossées à des dictionnaires de niveaux (levels) définis dans des ordres discordants ou comportant des modalités dissemblables, la fusion peut avorter ou générer des aberrations de codification. La bonne pratique méthodologique impose de convertir systématiquement les clés primaires en chaînes de caractères brutes (type character) préalablement à toute tentative de rapprochement relationnel.
Enfin, les scories invisibles d’encodage textuel et les espaces blancs résiduels constituent un piège redoutable lors de l’importation de fichiers issus de systèmes d’exploitation disparates. La présence accidentelle d’un espace non sécable en fin d’identifiant (par exemple "ID_104 " confronté à "ID_104") suffira à paralyser l’équivalence logique, se traduisant par une cascade inexplicable de valeurs NA. L’application préventive et systématique de fonctions de normalisation textuelle, telles que stringr::str_trim(), permet d’élaguer les espaces parasites et de fiabiliser intégralement la surface de contact textuelle des tables.
10.2 Multiplication non intentionnelle de lignes (Relation n-à-n)
L’une des déviances analytiques les plus pernicieuses générées par la transition d’un tableur vers R réside dans l’incapacité à anticiper le comportement des moteurs relationnels face à la duplication non maîtrisée des clés d’identification. Dans un classeur Excel, un RECHERCHEV mal configuré face à des doublons dans la table de référence présente le grave défaut d’ignorer les entrées secondaires, mais préserve néanmoins le nombre total de lignes de la grille maîtresse, maintenant l’illusion d’une géométrie stable pour l’utilisateur non averti.
Dans R, l’exécution d’une jointure left_join() ou merge() sur une base secondaire comportant des doublons non documentés au niveau de la clé pivot provoque une multiplication proportionnelle des rangées de la table maîtresse. Si un sujet expérimental dispose d’une unique ligne de mesures de temps de réaction dans la table d’entrée, mais que son identifiant apparaît sur trois lignes distinctes dans le registre clinique d’adjonction, la table finale générera trois lignes redondantes pour ce même individu, incorporant à l’identique les scores comportementaux originaux.
Cette altération insidieuse dénature la structure de l’échantillon expérimental et vicie la validité des modèles statistiques ultérieurs. La surgénération d’individus virtuels gonfle de façon factice la puissance statistique des tests, biaise l’estimation de la variance résiduelle et invalide les postulats d’indépendance des erreurs inhérents aux modèles linéaires généraux. Pour prémunir les protocoles de recherche contre cette menace, l’analyste doit impérativement instaurer un diagnostic préliminaire de duplicité en mobilisant des fonctions d’audit telles que janitor::get_dupes(), garantissant l’unicité stricte des identifiants au sein du référentiel donneur.
10.3 Gestion de la casse et sensibilité syntaxique
L’utilisateur initié sur les logiciels de la suite Microsoft Office est généralement conditionné par une absence totale de sensibilité à la casse typographique : dans Excel, l’expression "SUJET_01" est jugée rigoureusement équivalente à "sujet_01" ou à "Sujet_01" lors de l’exécution d’un RECHERCHEV standard. Cette permissivité induit de mauvaises habitudes de saisie chez les expérimentateurs, lesquels tolèrent fréquemment des alternances chaotiques de minuscules et de majuscules au gré des sessions de recueil de données cliniques.
Le langage R applique, à l’inverse, une sensibilité rigoureuse et absolue à la casse dans l’ensemble de ses structures lexicales et de ses évaluations de chaînes. Pour le compilateur, les entités "Participant" et "participant" constituent des réalités sémantiques distinctes sans le moindre recoupement possible. Dès lors, une jointure relationnelle exécutée sur des registres d’identifiants comportant des hétérogénéités de typographie échouera massivement, renvoyant une abondance indésirable de valeurs manquantes NA alors même que l’observateur humain perçoit la concordance conceptuelle des termes.
Pour immuniser les scripts d’analyse contre les aléas de la saisie humaine, l’établissement d’une étape de standardisation orthographique préalable s’avère impératif. L’application systématique de primitives d’harmonisation de casse telles que base::tolower() ou stringr::str_to_lower() sur l’ensemble des vecteurs de liaison garantit que toutes les clés sont nivelées sur un même registre typographique minuscule avant d’être soumises aux algorithmes d’appariement. Cette mesure d’hygiène numérique simple mais indispensable conditionne la pérennité et la reproductibilité absolue des chaînes d’assemblage de données scientifiques.
11. Applications pratiques : Cas d’études en psychologie et sciences comportementales
11.1 Scénario 1 : Fusion de données sociodémographiques et résultats d’inventaires de personnalité
Afin de concrétiser l’ensemble des fondements théoriques exposés précédemment, nous déployons une première étude de cas représentative des protocoles standard en psychologie différentielle. Considérons une recherche examinant l’interaction entre des variables démographiques fondamentales (âge, niveau d’éducation, statut socio-économique) et les cinq traits dimensionnels de la personnalité mesurés via le modèle standardisé du Big Five (Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme). Les données démographiques ont été colligées lors d’un questionnaire préliminaire sur support dématérialisé, tandis que les inventaires de personnalité ont été complétés deux mois plus tard sur une plateforme expérimentale indépendante.
Le flux méthodologique débute par la standardisation préalable des deux jeux de données au sein d’un pipeline Tidyverse rigoureux. Les identifiants alphanumériques font l’objet d’un élagage des espaces parasites et d’une uniformisation systématique de leur casse en minuscules. Les deux tables sont ensuite reliées au moyen de la primitive left_join(), en désignant la cohorte démographique comme structure référente maîtresse afin de tracer rigoureusement le statut d’adhésion de l’ensemble des participants initialement recrutés.
L’étape conclusive du pipeline intègre un audit automatisé des défections méthodologiques. L’application conjointe de verbes de filtrage et d’instructions d’imputation contrôlée permet de quantifier la proportion de questionnaires Big Five non complétés, d’isoler les participants ayant abandonné l’étude au moyen de anti_join() pour l’élaboration du diagramme de flux CONSORT, et d’extraire la sous-cohorte rigoureusement complète destinée à être soumise aux modélisations par régressions linéaires multiples ou modèles d’équations structurelles, matérialisant une démarche de recherche ouverte, reproductible et documentée de bout en bout.
11.2 Scénario 2 : Intégration de journaux d’événements informatisés et données physiologiques
Un deuxième cas d’application complexe concerne le croisement de flux de données comportementales hautement dynamiques avec des enregistrements de biomarqueurs physiologiques continus. Imaginons une tâche informatisée d’inhibition cognitive (de type paradigme de Stroop ou Go/No-Go) générant un journal textuel milliseconde par milliseconde des stimuli affichés et des temps de réaction enregistrés. Parallèlement, un système d’acquisition polygraphique mesure en continu la réponse électrodermale (conductance cutanée) des volontaires pour quantifier leur niveau d’activation sympathique face aux stimuli conflictuels.
La réconciliation de ces sources hétérogènes dépasse totalement le champ des compétences d’Excel. Les deux systèmes d’acquisition ne partagent aucune synchronisation d’horloge absolue parfaite et présentent des fréquences d’échantillonnage divergentes. Pour concilier ces enregistrements sans introduire de biais anachroniques, le recours à la bibliothèque data.table et à ses jointures d’intervalles glissants — couramment désignées sous le terme de rolling joins — s’avère indispensable. Grâce à l’argument syntaxique roll = "nearest", l’algorithme associe dynamiquement à chaque début d’essai expérimental la valeur de conductance cutanée la plus chronologiquement contiguë capturée dans une fenêtre temporelle tolérée.
Cette architecture calculatoire d’une extrême précision garantit l’alignement physiologique et comportemental indispensable à l’analyse fine des dynamiques d’inhibition cognitive. Le jeu de données final agrégé est immédiatement prêt pour l’intégration au sein de modèles linéaires mixtes à mesures répétées (via des packages spécialisés comme lme4), assurant aux chercheurs une maîtrise méthodologique absolue sur la granularité temporelle de leurs signaux sans recourir à des compromis d’interpolation hasardeux.
11.3 Scénario 3 : Harmonisation de données d’études longitudinales multi-vagues
Le troisième scénario d’étude illustre l’un des défis les plus redoutables de l’épidémiologie psychiatrique et de la psychologie du développement : la gestion d’études de panels prospectifs multi-vagues s’étendant sur plusieurs années d’observation. Dans ces protocoles d’envergure, une cohorte clinique initiale subit des ré-évaluations périodiques (par exemple, aux vagues T1, T2 et T3) comportant l’administration de bilans neuropsychologiques et d’échelles de sévérité symptomatique, le tout complété par des métadonnées statiques collectées uniquement lors de la vague d’inclusion basale.
L’harmonisation de ces bases temporelles fragmentées impose de dépasser les fusions plates pour concevoir des structures relationnelles hiérarchisées. La démarche méthodologique consiste d’abord à concilier les vagues successives d’évaluation au format long en utilisant des clés composites intégrant conjointement l’identifiant du patient et l’indicateur de vague temporelle. Cette opération permet de consolider l’ensemble des trajectoires individuelles au sein d’une matrice unique préservant l’hétérogénéité des intervalles de suivi effectifs.
Dans un second temps, les caractéristiques individuelles invariantes dans le temps — telles que le sexe biologique, le profil génétique ou le niveau socio-éducatif initial — consignées exclusivement dans la base d’inclusion sont diffusées vers l’ensemble des vagues subséquentes via une jointure left_join() univariée axée sur le seul identifiant primaire. Cette propagation automatique comble les absences d’informations contextuelles au sein des sessions ultérieures sans générer la moindre redondance matricielle superflue, garantissant l’intégrité intégrale de la cohorte préalablement à l’estimation des trajectoires développementales par modèles de croissance latente (Latent Growth Curve Models).
12. Arbre de décision méthodologique et recommandations pour la recherche reproductible
12.1 Critères de sélection de l’outil optimal : R natif, Tidyverse ou data.table
Face à la pluralité des instruments méthodologiques proposés par le langage R pour reproduire et dépasser la fonctionnalité RECHERCHEV d’Excel, l’analyste se trouve souvent confronté à un arbitrage programmatique complexe. Le choix de l’outil optimal ne procède pas d’une préférence esthétique subjective, mais doit être guidé par une évaluation rationnelle de trois dimensions fondamentales : le volume volumétrique du jeu de données, la lisibilité collaborative requise par le protocole et la contrainte d’indépendance environnementale du pipeline de traitement.
Pour les analyses conventionnelles portant sur des échantillons expérimentaux standards (inférieurs à quelques centaines de milliers de lignes), la syntaxe déclarative de dplyr au sein de l’écosystème Tidyverse constitue la recommandation préférentielle indiscutable. La lisibilité intuitive des verbes de jointure, la préservation systématique de l’ordonnancement originel et l’intégration transparente des opérateurs séquentiels de redirection (pipes) maximisent la clarté conceptuelle du code, réduisant drastiquement les risques d’erreurs humaines lors des revues par les pairs et facilitant la transmission des scripts au sein des équipes de recherche pluridisciplinaires.
À l’inverse, dès lors que le projet franchit le seuil des mégadonnées (plusieurs millions d’observations, fichiers de neuro-imagerie, logs d’interactions numériques massifs) ou que les algorithmes imposent des itérations massives d’appariement au sein de boucles de ré-échantillonnage de type bootstrap, l’adoption de data.table s’impose comme une nécessité technique absolue. Sa vitesse d’exécution décuplée et sa gestion de la mémoire par modification par référence préserveront le processeur de toute saturation. Enfin, pour les développeurs de packages autonomes ou les infrastructures cliniques institutionnelles ultra-régulées interdisant toute dépendance logicielle tierce, le recours rigoureux aux fonctions primitives du socle Base R (merge() et match()) garantira une pérennité décennale absolue exempte de toute dérive de compatibilité de bibliothèques externes.
12.2 Bonnes pratiques pour des scripts de traitement pérennes
L’élaboration d’un pipeline de traitement de données scientifiquement pérenne exige de rompre avec l’artisanat du script individuel éphémère pour embrasser les standards rigoureux du génie logiciel appliqué à la recherche. La première règle méthodologique commande d’encapsuler les opérations d’appariement complexes au sein de fonctions utilitaires dédiées, explicitement documentées au moyen de commentaires normalisés détaillant les pré-requis typologiques, les variables clés engagées et les structures de sortie générées.
La deuxième prescription incontournable concerne la journalisation systématique (logging) et formalisée de l’ensemble des opérations de rapprochement inter-tables. Tout script de recherche reproductible doit consigner, au sein d’un rapport textuel ou d’un tableau d’audit généré automatiquement à l’exécution, le dénombrement exact des lignes matricielles avant et après fusion, l’inventaire exhaustif des identifiants n’ayant pas trouvé de correspondance et les taux d’attrition résultants. Cette traçabilité constitue le fondement de la justification méthodologique exigée lors des soumissions d’articles au sein des revues scientifiques internationales à comité de lecture.
Enfin, la reproductibilité à long terme des analyses de fusion relationnelle impose la sanctuarisation de l’environnement informatique d’exécution. Les évolutions de versions de packages peuvent occasionnellement altérer le comportement par défaut de certaines fonctions ou modifier des structures d’avertissements. L’adoption d’un gestionnaire d’environnements virtuels hermétique, tel que le package renv, permet d’isoler et de verrouiller les versions exactes de R et de l’ensemble des bibliothèques employées, garantissant qu’un script d’appariement de données cliniques pourra être ré-exécuté à l’identique dix ans plus tard avec une fidélité computationnelle absolue.
12.3 Synthèse conclusive : L’émancipation analytique vis-à-vis des logiciels propriétaires
Au terme de cette exploration technique et épistémologique approfondie, il apparaît manifeste que la transposition de la démarche de RECHERCHEV sous l’environnement R ne se résume aucunement à une simple gymnastique syntaxique. Elle concrétise une rupture épistémologique majeure : l’émancipation définitive des contraintes spatiales, des fragilités structurelles et de l’opacité inhérentes au paradigme séculaire du tableur commercial, au profit de la rigueur mathématique universelle de l’algèbre relationnelle moderne.
En abandonnant les repères fragiles de cellules isolées et les formules d’extraction géométriques pour adopter la logique sémantique des ensembles de données vectorisés, le chercheur s’affranchit des erreurs silencieuses de propagation de formules, surmonte les barrières de volumétrie et s’ouvre l’accès à des dimensions analytiques inaccessibles aux tableurs conventionnels, à l’instar des jointures non-équi, des correspondances d’intervalles dynamiques ou de la synchronisation de séries temporelles asynchrones complexes.
Dans un contexte scientifique international justement préoccupé par la crise de la reproductibilité des résultats empiriques, la maîtrise des outils de réconciliation de données sous R élève substantiellement le niveau de rigueur méthodologique des équipes de recherche. En conférant aux opérations d’assemblage de données le statut d’algorithmes formels, totalement scriptés, audités et pérennes, le statisticien contribue directement à la transparence, à la robustesse et à l’intégrité de la science quantitative contemporaine.
Références
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377-387. https://doi.org/10.1145/362384.362685
- Dowle, M., & Srinivasan, A. (2023). data.table: Extension of ‘data.frame’ (R package version 1.14.8). https://CRAN.R-project.org/package=data.table
- Kleene, S. C. (1952). Introduction to Metamathematics. D. Van Nostrand Co.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Robinson, D. (2020). fuzzyjoin: Join tables together on inexact matching (R package version 0.1.6). https://CRAN.R-project.org/package=fuzzyjoin
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H., François, R., Henry, L., & Müller, K. (2023). dplyr: A grammar of data manipulation (R package version 1.1.2). https://CRAN.R-project.org/package=dplyr
- Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media.