
L’analyse numérique et le traitement moderne des données quantitatives reposent fondamentalement sur notre capacité à reconstruire une information continue à partir d’observations discrètes, bruitées ou lacunaires. Dans l’ensemble des disciplines scientifiques, qu’il s’agisse de la physique expérimentale, de la bio-informatique, de la modélisation économétrique ou de la psychométrie cognitive, les chercheurs et ingénieurs se heurtent de manière récurrente à une contrainte fondamentale : la finitude de l’échantillonnage temporel ou spatial. Face à un ensemble fini de couples d’observation liant une variable indépendante à une variable dépendante, l’estimation rigoureuse d’un état intermédiaire constitue une nécessité théorique et pratique. L’interpolation linéaire s’impose historiquement et méthodologiquement comme la réponse canonique, élémentaire mais remarquablement robuste, à cette problématique d’approximation fonctionnelle.
Le langage de programmation Python s’est solidement établi comme le standard technologique prééminent pour la recherche scientifique et l’ingénierie algorithmique. Son écosystème de calcul scientifique, articulé autour de bibliothèques fondamentales telles que NumPy, SciPy, Matplotlib et Pandas, offre une variété d’approches pour modéliser des interpolations linéaires. Du déploiement d’algorithmes matriciels vectorisés de bas niveau jusqu’à la manipulation d’opérateurs fonctionnels de haut niveau ou l’imputation de séries temporelles complexes, Python propose une panoplie d’outils dont l’efficacité dépend d’une compréhension intime des hypothèses mathématiques sous-jacentes. Trop souvent réduite à une simple boîte noire logicielle, l’interpolation requiert une vigilance méthodologique aiguë quant à ses postulats de continuité locale et à son comportement aux frontières du domaine mesuré.
Ce guide exhaustif a pour vocation de déconstruire, d’analyser et de maîtriser l’interpolation linéaire unidimensionnelle en environnement Python. Nous aborderons dans un premier temps les fondements formels et géométriques qui justifient l’approximation affine par morceaux, avant d’examiner ses champs d’application concrets en analyse quantitative. Nous poursuivrons par l’implémentation algorithmique directe en Python pur pour en éclairer les mécanismes internes, avant d’étudier en détail les interfaces spécialisées de l’écosystème scientifique standard, notamment les fonctions de SciPy et NumPy. À travers une étude de cas empirique complète, validée analytiquement et enrichie de visualisations graphiques avancées, nous détaillerons la gestion critique des bornes, les techniques d’extrapolation, le traitement des valeurs manquantes au sein de structures de données tabulaires et l’évaluation rigoureuse des bornes d’erreur théoriques.
1. Fondements théoriques et mathématiques de l’interpolation linéaire
1.1 Définition formelle de l’interpolation
L’interpolation mathématique désigne la procédure analytique consistant à construire une fonction continue issue d’une classe prédéfinie de modèles, dont la courbe représentative passe exactement par un ensemble donné de points discrets préalablement observés. Soit un ensemble ordonné de n paires de données réelles (x_i, y_i), où les abscisses forment une partition strictement croissante sur un intervalle compact de l’ensemble des réels. Le problème fondamental de l’interpolation consiste à déterminer une fonction f telle que f(x_i) soit rigoureusement égal à y_i pour chaque indice i de la séquence. Dans le cadre précis de l’interpolation linéaire, la fonction approchante choisie appartient à l’espace des fonctions affines par morceaux, ce qui implique que sur chaque sous-intervalle délimité par deux abscisses consécutives, l’approximation prend la forme d’un segment de droite.
Il est impératif d’opérer une distinction épistémologique et méthodologique stricte entre les concepts d’interpolation, d’extrapolation et de régression statistique. L’interpolation s’attache exclusivement à estimer une valeur inconnue située à l’intérieur strict de l’enveloppe convexe formée par les nœuds d’échantillonnage, c’est-à-dire entre la plus petite et la plus grande valeur d’abscisse observée. À l’inverse, l’extrapolation prétend projeter le comportement fonctionnel au-delà de ces frontières expérimentales, s’exposant ainsi à une instabilité prédictive majeure et à un risque d’erreur non borné. D’autre part, contrairement à la régression — linéaire ou polynomiale — qui cherche à minimiser un critère d’écart global comme la somme des carrés des résidus sans exiger que le modèle traverse précisément chaque mesure empirique en raison du bruit stochastique sous-jacent, l’interpolation contraint le modèle à une fidélité absolue envers les coordonnées des nœuds originels.
Cette démarche repose sur l’hypothèse fondamentale de la continuité locale du phénomène physique, biologique ou comportemental sous observation. L’interpolation linéaire postule que le taux de variation moyen mesuré entre deux bornes d’observation constitue la meilleure estimation a priori du comportement infinitésimal du système sur cet intervalle restreint. Ce postulat implique que l’échantillonnage expérimental a été réalisé à une fréquence spatiale ou temporelle suffisante pour capturer les dynamiques caractéristiques du système, conformément aux théorèmes fondamentaux de l’échantillonnage du signal. Si le système sous-jacent présente des singularités, des bifurcations ou des fréquences de résonance supérieures à la densité de la grille d’échantillonnage, l’hypothèse de continuité locale s’effondre et l’interpolation introduit un biais d’échantillonnage structurel.
1.2 Démonstration de l’équation de la droite d’interpolation
L’établissement de la formule de l’interpolation linéaire procède directement des axiomes fondamentaux de la géométrie euclidienne dans le plan cartésien, et plus particulièrement de la colinéarité des vecteurs reliant des points appartenant à une même droite. Considérons deux observations expérimentales distinctes désignées par les coordonnées cartésiennes P1(x1, y1) et P2(x2, y2), sous la condition d’existence impérative que x1 soit strictement différent de x2. Soit un point intermédiaire arbitraire P(x, y) dont l’abscisse x satisfait l’inégalité x1 < x < x2. Puisque les trois points P1, P et P2 sont supposés reposer sur le même segment rectiligne, le coefficient directeur de la droite reliant P1 à P doit être rigoureusement identique au taux de variation moyen calculé entre P1 et P2.
Cette égalité géométrique fondamentale des pentes s’exprime analytiquement par l’égalité des quotients différentiels : (y – y1) divisé par (x – x1) est égal à (y2 – y1) divisé par (x2 – x1). En multipliant chaque membre de cette équation par le terme (x – x1), qui est non nul par hypothèse, nous isolons l’écart en ordonnée : y – y1 = (x – x1) * (y2 – y1) / (x2 – x1). En transposant l’ordonnée de départ y1 dans le membre de droite de l’égalité, nous obtenons l’équation standard de l’interpolation linéaire unidimensionnelle : y = y1 + (x – x1) * (y2 – y1) / (x2 – x1). Cette formulation élégante décompose la valeur estimée y en la somme d’une condition initiale locale y1 et d’un incrément proportionnel à la distance relative parcourue sur l’axe des abscisses.
Cette formule canonique jouit de propriétés remarquables d’invariance d’échelle affine. Elle peut être reformulée sous la forme d’une combinaison linéaire convexe des ordonnées observées, en posant un paramètre adimensionnel t = (x – x1) / (x2 – x1), où t appartient nécessairement au segment unitaire [0, 1]. L’équation devient alors : y = (1 – t) * y1 + t * y2. Cette écriture barycentrique met en exergue le fait que l’ordonnée interpolée est une moyenne pondérée des bornes, dont les poids respectifs décroissent de manière parfaitement linéaire à mesure que la coordonnée x s’éloigne de chacune d’elles. Les conditions de validité de cette dérivation formelle sur le corps des réels reposent exclusivement sur l’absence de dégénérescence de l’intervalle spatial, excluant tout saut discontinu infini au sein du segment [x1, x2].
1.3 Propriétés mathématiques et comportement aux bornes
L’analyse des propriétés mathématiques de l’interpolation linéaire révèle à la fois son efficacité computationnelle et ses contraintes structurelles. La première propriété essentielle réside dans l’exactitude absolue de l’estimation aux nœuds d’interpolation. Lorsque l’abscisse cible x coïncide avec la borne inférieure x1, le ratio de progression (x – x1) / (x2 – x1) s’annule identiquement, ce qui réduit immédiatement l’équation à y = y1. Réciproquement, lorsque x converge vers la borne supérieure x2, le ratio devient égal à l’unité, conduisant à y = y1 + (y2 – y1) = y2. L’interpolateur linéaire respecte donc scrupuleusement les valeurs empiriques préalablement acquises, éliminant tout résidu numérique aux points de mesure.
Une seconde caractéristique analytique majeure concerne la monotonie locale et la préservation de la convexité immédiate. Si la séquence des ordonnées locales présente un comportement strictement croissant, c’est-à-dire si y2 est supérieur à y1, la dérivée première de la fonction interpolée est une constante positive donnée par la pente locale (y2 – y1) / (x2 – x1). Par conséquent, la fonction interpolée ne peut générer aucun extremum local parasite à l’intérieur de l’intervalle d’échantillonnage : elle ne présente ni oscillations adventices, ni dépassement de seuil, contrairement aux polynômes d’interpolation de degré élevé qui souffrent fréquemment d’instabilités de calcul sévères.
Néanmoins, la limite intrinsèque la plus notable de ce schéma réside dans la régularité différentielle de la fonction globale obtenue par recollement de segments. Si la fonction d’interpolation affine par morceaux appartient bien à l’espace des fonctions continues C0 sur l’ensemble du domaine d’observation, elle n’appartient généralement pas à l’espace des fonctions continûment dérivables C1. Au niveau de chaque nœud interne où deux segments de pentes distinctes se rejoignent, la dérivée à gauche est généralement différente de la dérivée à droite. Cette discontinuité de la dérivée première engendre des angles vifs géométriques, ce qui rend l’interpolation linéaire inadaptée aux contextes physiques exigeant la conservation de grandeurs dérivées comme la vitesse continue, l’accélération ou la courbure élastique.
2. Pertinence et cas d’usage en analyse de données quantitatives
2.1 Régularisation et rééchantillonnage de séries expérimentales
Dans la pratique expérimentale contemporaine, l’acquisition de flux de données numériques s’effectue couramment à l’aide de capteurs hétérogènes fonctionnant selon des fréquences d’horloge asynchrones ou instables. En télédétection, en imagerie médicale ou en instrumentation industrielle, il est fréquent qu’un capteur de température échantillonne le milieu à une fréquence nominale de dix hertz, tandis qu’un spectromètre optique adjacent délivre ses spectres à des intervalles irréguliers modulés par le temps d’exposition du détecteur. L’harmonisation de ces flux d’informations au sein d’une matrice d’analyse unifiée nécessite une procédure systématique de rééchantillonnage temporel sur une grille temporelle partagée, opération pour laquelle l’interpolation linéaire constitue la solution d’alignement computationnel la plus rapide et la plus stable.
La standardisation des intervalles d’observation représente un prérequis indispensable pour l’application des méthodologies statistiques conventionnelles, notamment l’analyse spectrale par transformation de Fourier discrète ou l’ajustement de modèles autorégressifs intégrés à moyenne mobile. La plupart des algorithmes d’analyse multivariée postulent implicitement une équidistance rigoureuse entre les pas temporels successifs. En projetant des séries temporelles irrégulièrement espacées sur un maillage synthétique rigoureusement uniforme, l’interpolation linéaire permet de restaurer la comparabilité des indices temporels sans altérer artificiellement les structures de corrélation à basse fréquence contenues dans le signal sous-jacent.
Enfin, la reconstruction de signaux continus à partir d’échantillons discrets joue un rôle déterminant lors de la phase de post-traitement des données. Dans les protocoles de commande numérique ou de simulation en boucle fermée, les actionneurs physiques requièrent souvent des consignes de pilotage délivrées à un taux de rafraîchissement considérablement plus dense que la cadence de génération des algorithmes d’optimisation de haut niveau. L’insertion de segments affines entre les points de contrôle permet d’assurer une transition fluide des variables d’état du système, évitant ainsi les chocs mécaniques ou les dépassements transitoires brutaux inhérents aux interpolations par paliers de type maintien d’ordre zéro.
2.2 Imputation méthodique de valeurs manquantes
L’altération de l’intégrité des jeux de données, causée par des pannes matérielles temporaires, des pertes de paquets lors de la transmission télémétrique ou des refus de réponse lors de protocoles longitudinaux, représente une entrave récurrente à l’analyse inférentielle. Le traitement méthodique de ces lacunes requiert des stratégies d’imputation capables de combler les vides d’information sans distordre la variance intrinsèque ni introduire de biais structurels au sein de l’échantillon. Pour des interruptions de brève durée au regard de la dynamique globale du phénomène, l’interpolation linéaire offre une solution locale objective qui reflète fidèlement la transition continue entre l’état précédant la défaillance et l’état observé lors du rétablissement de la mesure.
D’un point de vue épistémologique, l’imputation par interpolation linéaire se distingue nettement des méthodes d’imputation globale telles que l’attribution de la moyenne arithmétique ou de la médiane empirique de la cohorte. L’imputation par la moyenne globale détruit la structure d’autocorrélation temporelle d’une série continue en créant des ruptures soudaines vers le centre de gravité statistique de la distribution, réduisant artificiellement l’écart-type et affaiblissant les relations de covariance avec les variables concomitantes. L’interpolation linéaire, en revanche, exploite l’information contenue dans le voisinage chronologique immédiat de l’observation manquante, assurant une transition topologique cohérente qui préserve l’intégrité séquentielle de la trajectoire.
L’avantage opérationnel de cette approche se manifeste particulièrement dans le traitement des séries chronologiques non stationnaires caractérisées par des dérives tendancielles marquées ou des cycles saisonniers lents. En liant de façon rectiligne la dernière observation valide précédant le trou de mesure à la première observation valide le succédant, l’interpolateur s’adapte intrinsèquement au niveau local de la trajectoire sans exiger de spécification paramétrique préalable sur la nature de la tendance globale. Il importe toutefois de circonscrire cette technique à des intervalles de perte étroits : dès lors que la fenêtre de données manquantes s’élargit substantiellement, l’hypothèse de linéarité locale perd sa pertinence face aux fluctuations non observées du système stochastique.
2.3 Applications en sciences expérimentales et psychométrie
Dans le domaine des neurosciences cognitives et de la psychométrie quantitative, l’interpolation linéaire intervient de façon déterminante lors de la calibration des fonctions psychophysiques modélisant la relation empirique entre l’intensité d’une stimulation physique et la réponse perceptuelle du sujet. Les protocoles expérimentaux mesurent fréquemment les temps de réaction ou les taux de détection correcte en soumettant les participants à une série discrète et restreinte d’intensités stimulantes afin d’éviter la fatigue cognitive ou les phénomènes d’habituation. Dès lors, l’évaluation précise de seuils perceptifs différentiels ou absolus — définis conventionnellement comme l’intensité stimulant une probabilité de détection égale à cinquante pour cent — requiert une interpolation locale entre les deux intensités discrètes encadrant le seuil critique recherché.
Cette approche s’applique également à l’étalonnage et à la standardisation des métriques psychométriques sur des continuums théoriques standardisés. Lors de la construction d’échelles de mesure du tempérament, de l’anxiété ou des capacités cognitives, les scores bruts résultant de l’agrégation de questionnaires de type Likert constituent des variables discrètes réparties de façon inégale. Pour convertir ces scores empiriques bruts en quantiles théoriques, en notes standardisées ou en percentiles continus de la population de référence, les praticiens ont recours à l’interpolation linéaire par morceaux appliquée aux tables de conversion normatives, permettant d’attribuer une estimation continue à tout profil intermédiaire.
Enfin, en biomécanique du mouvement et en analyse cinématique du geste humain, les dispositifs de capture optoélectronique subissent fréquemment des occultations partielles de leurs marqueurs réfléchissants lors de rotations corporelles complexes. L’interpolation linéaire des coordonnées spatiales tridimensionnelles entre les trames visibles permet de reconstruire la continuité du mouvement articulaire sous réserve que l’intervalle d’occultation demeure infinitésimal par rapport aux constantes de temps d’accélération musculaire des segments anatomiques étudiés. Cette estimation constitue le socle indispensable au calcul ultérieur des forces articulaires et des moments de couple par dynamique inverse.
3. Configuration de l’écosystème Python pour le calcul numérique
3.1 Présentation des bibliothèques fondamentales
L’exécution efficace et vectorisée de calculs d’interpolation linéaire au sein de l’environnement Python s’appuie sur une hiérarchie logicielle éprouvée dont la pierre angulaire est la bibliothèque NumPy. Conçue pour pallier la lenteur inhérente aux boucles itératives du moteur d’exécution standard de Python, NumPy introduit la structure de données fondamentale d’arrangement multidimensionnel homogène désignée sous le type d’objet array. Cette structure alloue des blocs de mémoire contigus et implémente des opérations vectorisées écrites en langage C, permettant d’exécuter des calculs mathématiques massifs avec un débit d’instructions hautement optimisé au niveau matériel via les instructions SIMD des processeurs modernes.
Au-dessus de cette infrastructure de bas niveau s’articule la bibliothèque SciPy, dédiée aux algorithmes avancés pour l’ingénierie et la science. Au sein de son architecture modulaire, le sous-module spécialisé nommé scipy.interpolate propose une collection exhaustive d’opérateurs d’approximation allant de l’interpolation polynomiale classique aux surfaces de splines multidimensionnelles complexes. L’outil historique emblématique de ce sous-module pour les problèmes unidimensionnels demeure la classe interp1d, qui encapsule l’état géométrique de l’échantillonnage au sein d’un objet fonctionnel réutilisable capable de traiter aussi bien des scalaires que des tenseurs de requêtes.
Le triptyque du calcul scientifique est complété par la bibliothèque Matplotlib, et plus particulièrement son interface d’état state-machine matplotlib.pyplot. La validation empirique d’un modèle d’interpolation ne saurait se dispenser d’une inspection géométrique rigoureuse permettant de détecter immédiatement les artefacts d’échantillonnage, les dépassements de courbure ou les discontinuités angulaires aux nœuds d’évaluation. Matplotlib permet de générer des visualisations graphiques vectorielles d’une qualité conforme aux exigences de publication académique, rendant possible la superposition simultanée des nuages de points mesurés, des segments linéaires reconstruits et des intervalles de confiance associés.
3.2 Gestion de l’environnement de développement et versions
La pérennité et la reproductibilité des protocoles de traitement numérique imposent une gestion stricte des dépendances logicielles et l’isolation des environnements d’exécution. L’utilisation de gestionnaires d’environnements virtuels tels que venv ou le gestionnaire de paquets bivalents Conda s’impose comme une bonne pratique incontournable. Les incompatibilités entre versions binaires compilées de bibliothèques sous-jacentes, notamment les interfaces d’algèbre linéaire BLAS et LAPACK, peuvent introduire des divergences subtiles dans les calculs en virgule flottante d’une machine à l’autre. Une initialisation disciplinée consiste à figer les versions exactes des dépendances au sein d’un fichier de configuration standardisé.
Dans un terminal système standard, l’installation conjointe des dépendances indispensables au moyen du gestionnaire officiel de distribution pip s’articule via l’invocation de la commande suivante : pip install numpy scipy matplotlib pandas. Il est recommandé de s’assurer que la version majeure de SciPy est égale ou supérieure à 1.7.0, période à partir de laquelle les architectures d’interpolation ont bénéficié de rationalisations significatives de leurs interfaces de programmation. Par ailleurs, la compatibilité avec le typage statique moderne introduit par les spécifications PEP du langage Python autorise désormais l’adjonction d’annotations de type formelles, garantissant une meilleure robustesse du code de calcul.
Sur le plan de l’architecture matérielle et de la précision arithmétique, le choix du type de données primitif au sein des tableaux NumPy revêt une importance critique pour la précision et l’empreinte mémoire. Par défaut, sur les architectures modernes à soixante-quatre bits, les structures de données allouent des flottants à double précision selon le standard de la norme IEEE 754, soit le type float64. Cette précision garantit cinquante-trois bits de mantisse, conférant environ quinze à dix-sept chiffres décimaux significatifs, ce qui prémunit l’analyste contre l’accumulation pernicieuse d’erreurs d’arrondi lors du calcul itératif des pentes infinitésimales (y2 – y1) / (x2 – x1) pour des points d’échantillonnage spatialement très rapprochés.
4. Implémentation algorithmique manuelle en Python pur
4.1 Écriture d’une fonction d’interpolation native
Afin de démystifier complètement les processus computationnels régissant l’interpolation linéaire, il est hautement formateur d’implémenter l’algorithme sous sa forme élémentaire en Python pur, sans faire appel à des modules externes compilés. Cette approche permet de mesurer avec clarté les préconditions mathématiques requises et d’analyser la gestion des cas dégénérés. Considérons une fonction scalaire dont les paramètres d’entrée correspondent aux coordonnées de deux points de référence distincts, x1, y1, x2, et y2, ainsi qu’à la coordonnée cible x pour laquelle l’ordonnée correspondante doit être estimée de manière déterministe.
Le corps algorithmique de la fonction procède d’abord à la vérification impérative de l’écartement spatial des points de référence. Si la différence absolue entre x1 et x2 est inférieure à une tolérance numérique critique proche de la précision machine, l’algorithme doit obligatoirement interrompre son flux de contrôle en levant une exception explicite de type ZeroDivisionError ou ValueError. En l’absence d’une telle barrière défensive, l’évaluation du dénominateur (x2 – x1) déclencherait un plantage matériel ou générerait une valeur indéfinie non numérique (NaN), corrompant silencieusement l’ensemble de la chaîne de traitement située en aval.
Une fois cette validation d’intégrité franchie, le calcul s’opère par l’application rigoureuse de la formulation géométrique établie précédemment. L’expression associe l’ordonnée de base y1 au produit de la différence (x – x1) par le rapport de variation globale (y2 – y1) / (x2 – x1). En vertu des règles d’évaluation d’arité et de précédence des opérateurs arithmétiques du langage Python, les opérations de division et de multiplication sont évaluées prioritairement sur l’addition, garantissant l’évaluation conforme du polynôme d’ordre un. La valeur flottante finale résultante est alors immédiatement renvoyée à l’environnement appelant avec une complexité temporelle élémentaire constante O(1).
4.2 Généralisation à des collections itérables
L’étape algorithmique suivante consiste à étendre ce raisonnement élémentaire à une série expérimentale globale composée de séquences arbitraires d’abscisses et d’ordonnées ordonnées de taille N. Face à une valeur cible x_cible donnée, l’algorithme doit déterminer avec précision le sous-intervalle local [x_k, x_{k+1}] qui englobe la requête, de telle sorte que x_k soit inférieur ou égal à x_cible, et que x_cible soit strictement inférieur ou égal à x_{k+1}. Cette opération de localisation spatiale est la condition préliminaire incontournable avant l’application de la formule analytique locale.
Pour mener à bien cette recherche d’intervalle, une approche naïve consisterait à effectuer un parcours séquentiel itératif linéaire le long de la liste des abscisses au moyen d’une boucle for. Bien que conceptuellement triviale, cette stratégie présente une complexité temporelle dans le pire des cas de l’ordre de O(N), ce qui devient prohibitif lorsque le jeu de données comporte plusieurs dizaines de milliers de points de mesure. Une optimisation majeure consiste à exploiter le fait que la séquence des abscisses est obligatoirement ordonnée de façon strictement croissante, permettant l’emploi d’un algorithme de recherche dichotomique par bissection d’intervalle, tel que mis en œuvre par le module standard bisect de Python, abaissant ainsi la complexité de localisation à un ordre logarithmique O(log N).
Une fois l’indice k de la borne inférieure localisé avec certitude, la fonction extrait les quatre grandeurs scalaires scalaires correspondantes : x_k, y_k, x_{k+1} et y_{k+1}. L’algorithme applique ensuite l’équation linéaire fondamentale sur ce segment restreint. Lorsque la fonction doit traiter simultanément un conteneur itérable de multiples cibles indépendantes, elle réitère cette séquence d’opérations pour chaque élément au moyen d’une compréhension de liste ou d’un générateur itératif. Bien que cette implémentation en Python pur soit didactiquement transparente et d’une grande clarté conceptuelle, sa vitesse d’exécution reste intrinsèquement limitée par les coûts de surdébit associés à l’interprétation dynamique du bytecode de Python pour chaque élément évalué.
5. Interpolation standard avec scipy.interpolate.interp1d
5.1 Structure et syntaxe de la classe interp1d
Pour surmonter les limitations de performance des boucles natives de Python et bénéficier d’une ergonomie logicielle éprouvée, la communauté scientifique a historiquement standardisé ses calculs autour de la classe interp1d disponible au sein du sous-module scipy.interpolate. L’architecture logicielle de cette structure repose sur le paradigme orienté objet. Plutôt que d’exécuter immédiatement un calcul ponctuel et de détruire les variables intermédiaires, interp1d construit une instance d’objet d’interpolation pérenne en pré-compilant la structure des tableaux de données empiriques fournis lors de l’instanciation initiale.
La syntaxe d’instanciation de cette classe exige au minimum deux arguments positionnels : un premier tableau unidimensionnel contenant la séquence des abscisses observées, et un second tableau de dimension concordante contenant les ordonnées correspondantes. Un troisième paramètre nommé critique, désigné par kind, spécifie la nature formelle du modèle d’interpolation désiré. Par défaut, la valeur assignée à ce paramètre est la chaîne de caractères ‘linear’, contraignant explicitement la classe à déployer un modèle affine par morceaux. L’utilisateur peut également passer des tableaux multidimensionnels pour les ordonnées via le paramètre axis, permettant l’interpolation conjointe de multiples signaux parallèles partageant le même axe d’abscisse.
L’un des atouts conceptuels majeurs de la classe interp1d réside dans la nature fonctionnelle de l’objet produit. En effet, l’instance résultante surcharge la méthode spéciale __call__ du modèle d’objet Python. Par conséquent, l’objet créé se comporte syntaxiquement et sémantiquement comme une fonction mathématique continue ordinaire. L’utilisateur peut alors invoquer directement cet objet en lui passant en argument soit une valeur flottante scalaire unique, soit une liste Python standard, soit un tableau NumPy arbitraire de dimensions quelconques, l’interpolation étant automatiquement exécutée sur chaque élément cible de manière entièrement vectorisée.
5.2 Anatomie de l’objet résultant et signature d’appel
L’objet généré par scipy.interpolate.interp1d encapsule de manière transparente les mécanismes de bas niveau nécessaires à l’évaluation rapide des segments. Lors de sa construction, l’objet effectue une série de vérifications structurelles rigoureuses : il contrôle la stricte monotonie de la série des abscisses, s’assure de l’absence de valeurs infinies ou non numériques de type NaN, et vérifie la stricte concordance dimensionnelle entre l’axe des abscisses et les axes associés du tenseur des ordonnées. Cette validation en amont élimine tout risque d’incohérence mémoire lors des appels d’évaluation répétés ultérieurs.
En coulisses, interp1d s’appuie sur des routines hautement optimisées écrites en Fortran ou en langage C, s’interfaçant directement avec les allocations de mémoire sous-jacentes des tableaux NumPy d’origine sans duplication inutile de données. Lorsque l’objet est sollicité avec un vecteur de requêtes contenant plusieurs dizaines de milliers de points cibles, la recherche des intervalles encadrants s’effectue via des routines d’indexation compilées extrêmement rapides. Cette conception découple formellement la phase d’initialisation de l’interpolateur — qui analyse et structure la géométrie du problème — de la phase d’évaluation, maximisant ainsi l’efficacité computationnelle globale dans les scénarios où une même grille expérimentale sert à évaluer de nombreux sous-ensembles de requêtes successives.
La signature d’appel de l’instance d’interpolation offre également une flexibilité substantielle quant à la gestion des types de données de sortie. Si les coordonnées sources sont encodées selon une précision flottante à soixante-quatre bits (float64), le tableau renvoyé préserve rigoureusement cette fidélité arithmétique. Par ailleurs, bien que la classe interp1d soit désormais considérée comme une interface patrimoniale au sein des versions récentes de SciPy — qui favorisent parfois les fonctions plus modernes comme make_interp_spline pour des motifs d’uniformisation de l’API —, elle demeure le standard universellement documenté et massivement déployé dans l’écosystème de production pour les problèmes d’interpolation linéaire unidimensionnelle.
6. Étude de cas pas à pas : Exemple pratique d’interpolation
6.1 Définition du jeu de données de référence
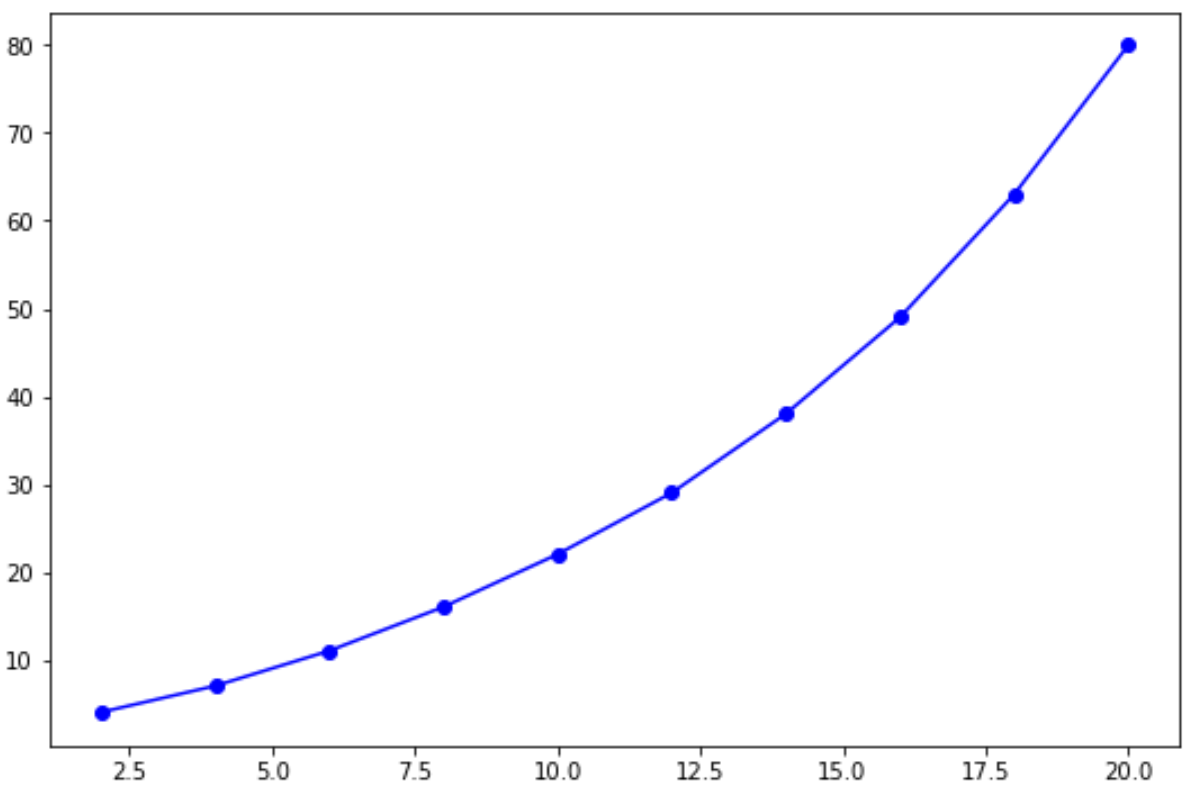
Afin d’illustrer de manière concrète et didactique la mise en œuvre pratique de ces concepts, concevons une étude de cas numérique représentative d’une observation expérimentale non linéaire. Considérons une série de dix mesures empiriques reliant une variable indépendante x — pouvant représenter un pas temporel en secondes ou un niveau de chargement mécanique — à une variable dépendante y traduisant la déformation mesurée d’un matériau composite ou la réponse neurophysiologique d’un capteur sensoriel. Le maillage des abscisses est délibérément initialisé selon une progression régulière couvrant le domaine allant de 2 à 20, avec un incrément constant fixé à 2 unités.
Le vecteur des abscisses x est donc formellement défini par la séquence des nombres entiers pairs suivants : 2, 4, 6, 8, 10, 12, 14, 16, 18 et 20. En vis-à-vis, attribuons à ces nœuds d’échantillonnage un vecteur d’ordonnées y présentant une dynamique non strictement linéaire afin de mettre en évidence la courbure globale du phénomène tout en conservant une monotonie croissante. Retenons la série d’observations expérimentales suivante pour les valeurs d’ordonnées associées : 3, 7, 11, 17, 21, 29, 38, 49, 58 et 67. Cette progression montre clairement une dérivée locale non constante : les écarts successifs d’ordonnées fluctuent, révélant une accélération de la réponse entre les abscisses 10 et 16.
Ce jeu de données constitue un banc d’essai idéal pour l’interpolation linéaire. Les points d’échantillonnage sont suffisamment espacés pour que la courbure intrinsèque de la fonction sous-jacente génère des écarts observables entre l’interpolation affine par morceaux et une éventuelle modélisation d’ordre supérieur, tout en restant suffisamment denses pour que l’approximation rectiligne locale conserve un sens physique pertinent et une erreur d’approximation mathématiquement bornée.
6.2 Exécution du calcul d’interpolation pour une nouvelle coordonnée
Supposons désormais que notre objectif expérimental consiste à estimer avec rigueur la valeur inconnue de l’ordonnée pour une coordonnée d’abscisse intermédiaire cible rigoureusement égale à x = 13. L’examen attentif du vecteur des abscisses disponibles permet de constater immédiatement que cette valeur cible 13 n’a jamais été observée directement lors de la phase d’acquisition instrumentale. Elle se situe néanmoins à l’intérieur du domaine expérimental global délimité par l’intervalle fermé [2, 20], et s’insère plus précisément entre les nœuds d’échantillonnage contigus situés à x = 12 et x = 14.
Pour réaliser cette estimation en Python au moyen de la bibliothèque spécialisée SciPy, nous commençons par importer le module d’interpolation via l’instruction conventionnelle : from scipy.interpolate import interp1d. Nous instancions ensuite notre objet fonctionnel d’interpolation en lui passant nos deux tableaux de données expérimentales sous la désignation explicite : interpolateur = interp1d(x, y, kind=’linear’). Cette opération construit le modèle linéaire par morceaux interne sans lever la moindre ambiguïté sur la nature de la méthode de raccordement.
L’évaluation numérique pour l’abscisse intermédiaire s’obtient alors de manière intuitive en invoquant l’objet interpolateur nouvellement configuré avec la cible requise : ordonnee_estimee = interpolateur(13). L’exécution de cette instruction déclenche la localisation automatique du sous-intervalle encadrant par le moteur compilé de SciPy, l’application de la formule affine et le retour de l’ordonnée prédite. L’affichage du résultat numérique produit une valeur scalaire flottante qui s’établit avec une exactitude parfaite à 33.5. Cette grandeur représente l’estimation affine de l’état du système à la coordonnée 13.
6.3 Validation manuelle du résultat obtenu
Dans toute démarche scientifique rigoureuse, la confiance accordée aux sorties d’une bibliothèque logicielle de calcul numérique doit être corroborée par une validation analytique manuelle directe. Procédons à la décomposition arithmétique pas à pas de l’estimation de notre point cible x = 13 en extrayant directement les valeurs des nœuds d’échantillonnage qui l’encadrent au sein de nos séries empiriques de référence. Les coordonnées des bornes inférieure et supérieure locales s’établissent respectivement à P1 = (12, 29) et P2 = (14, 38).
Commençons par calculer le coefficient directeur de la droite d’interpolation locale reliant ces deux nœuds d’observation, qui correspond à la pente du segment considéré. La différence d’ordonnée entre les deux bornes est donnée par y2 – y1 = 38 – 29 = 9. Parallèlement, l’écart sur l’axe des abscisses est égal à x2 – x1 = 14 – 12 = 2. Le taux de variation moyen sur cet intervalle restreint s’élève par conséquent à 9 divisé par 2, ce qui donne un coefficient angulaire exactement égal à 4.5 unités d’ordonnée par unité d’abscisse.
Appliquons désormais ce coefficient directeur à la distance relative séparant notre abscisse cible de la borne inférieure de référence : x – x1 = 13 – 12 = 1. L’accroissement d’ordonnée sur cette fraction d’intervalle est donc calculé par le produit 1 * 4.5 = 4.5. En additionnant cet incrément à l’ordonnée de départ y1 = 29, nous obtenons l’estimation manuelle finale : y = 29 + 4.5 = 33.5. La concordance entre cette résolution analytique manuelle et la valeur numérique retournée par la fonction d’interpolation de SciPy est totale et parfaite, validant empiriquement l’exactitude de l’implémentation et la conformité de l’algorithme avec les principes de la géométrie euclidienne élémentaire.
7. Visualisation graphique et analyse géométrique avec Matplotlib
7.1 Construction du tracé des observations empiriques
La représentation visuelle d’un jeu de données quantitatives constitue une étape méthodologique indispensable pour confirmer l’adéquation d’un modèle d’interpolation. Pour traduire graphiquement notre étude de cas, nous utilisons la bibliothèque Matplotlib afin de construire une figure bidimensionnelle détaillée. La première exigence graphique consiste à représenter les données brutes d’observation sans masquer leur nature intrinsèquement discrète. Si une courbe continue est directement tracée sans mettre en exergue les nœuds de mesure individuels, l’observateur peut être induit en erreur quant à la résolution réelle de l’échantillonnage initial.
Pour satisfaire aux exigences des publications académiques, les points de mesure expérimentaux doivent être visualisés au moyen de marqueurs géométriques explicites — par exemple des disques circulaires opaques ou des losanges de couleur contrastée — accompagnés d’un tracé discret reliant les nœuds consécutifs. Au niveau de la programmation en Python, l’appel à la fonction plt.plot(x, y, ‘o-‘, label=’Mesures expérimentales’, color=’#1f77b4′, linewidth=1.5, markersize=7) permet d’afficher simultanément la trajectoire linéaire par morceaux reliant les nœuds et la matérialisation physique des positions réelles acquises par les capteurs.
La scénarisation de l’environnement graphique implique également l’adjonction systématique d’une grille de fond orthogonale paramétrée avec une transparence atténuée au moyen de l’instruction plt.grid(True, linestyle=’–‘, alpha=0.6). Cette trame visuelle facilite la projection oculaire des coordonnées et l’évaluation quantitative directe des pentes. De surcroît, la labellisation explicite des axes par plt.xlabel(‘Variable Indépendante (x)’) et plt.ylabel(‘Réponse Mesurée (y)’), ainsi que l’insertion d’un titre de figure informatif, confèrent à la représentation graphique toute la rigueur méthodologique nécessaire à une transmission scientifique univoque.
7.2 Intégration du point interpolé sur la figure
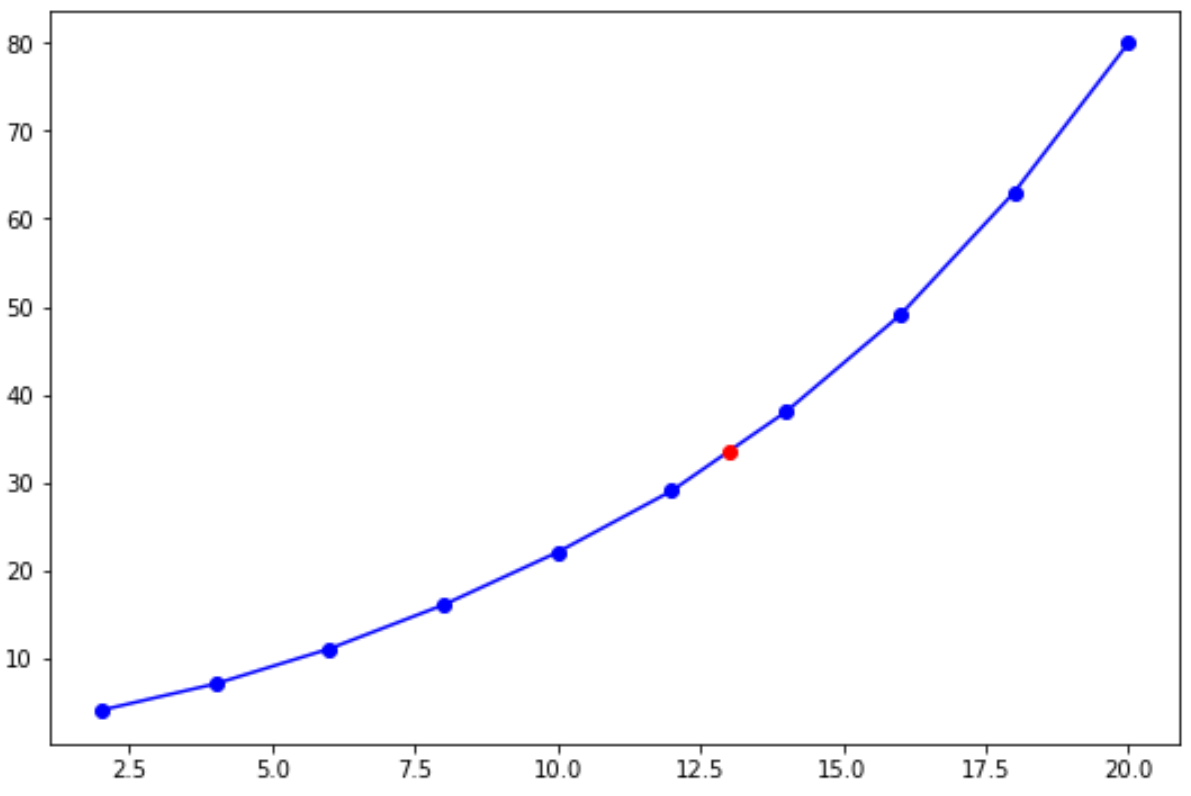
L’étape visuelle suivante consiste à mettre en valeur la coordonnée estimée (13, 33.5) au sein de la composition graphique afin d’illustrer la mécanique géométrique de l’interpolation locale. Pour distinguer sans ambiguïté cette valeur synthétique calculée des observations empiriques réelles du système, il convient d’adopter une sémiologie graphique différenciée : l’emploi d’une couleur vive tranchée, telle qu’un rouge carmin ou un orange cinabre, combiné à un marqueur géométrique distinctif comme une étoile ou un carré de dimension supérieure, s’avère particulièrement efficace.
L’affichage de ce point cible s’opère via une commande de dispersion dédiée : plt.plot(13, 33.5, marker=’*’, markersize=14, color=’#d62728′, label=’Point interpolé (13, 33.5)’). Pour souligner avec précision son intégration géométrique au sein du système de coordonnées cartésiennes, l’adjonction de lignes de projection orthogonales dirigées vers l’axe des abscisses et l’axe des ordonnées fournit une aide à la lecture substantielle. L’emploi de segments en pointillés fins tracés au moyen de plt.vlines(13, 0, 33.5, linestyles=’dotted’, colors=’#d62728′) et plt.hlines(33.5, 0, 13, linestyles=’dotted’, colors=’#d62728′) permet d’ancrer visuellement le point interpolé aux valeurs scalaires des repères d’axes.
Cette mise en scène graphique met en lumière le fait incontestable que le point nouvellement positionné repose rigoureusement sur le segment de droite reliant les nœuds de mesure situés à x = 12 et x = 14. L’alignement visuel parfait dissipe tout doute quant à la nature linéaire de l’ajustement local et démontre que le modèle ne génère aucune déviation curviligne artificielle, illustrant le postulat de conservation de la pente moyenne sur chaque sous-intervalle d’observation.
7.3 Génération d’une grille dense pour l’évaluation globale
Bien que l’évaluation ponctuelle d’une ordonnée unique pour une cible spécifique réponde à un besoin ciblé, la validation globale d’un opérateur d’interpolation impose de vérifier son comportement sur l’intégralité du continuum spatial défini par les bornes du domaine. Pour concrétiser cette exigence visuelle, il est d’usage de générer un maillage d’évaluation synthétique extrêmement dense composé de plusieurs centaines à plusieurs milliers de points régulièrement espacés, couvrant sans discontinuité l’intervalle s’étendant de la première à la dernière observation.
Au moyen de la primitive mathématique numpy.linspace(2, 20, num=500), nous synthétisons un vecteur de cinq cents valeurs d’abscisses équidistantes réparties sur l’intervalle [2, 20]. En soumettant ce vecteur dense à l’objet interpolateur préalablement instancié, interpolateur_dense = interpolateur(x_dense), le moteur de calcul vectorisé évalue de manière quasi-instantanée l’ensemble des segments affines composant le modèle global. Le tracé de cette série dense au sein de Matplotlib avec une ligne continue fluide permet de faire apparaître avec une netteté remarquable le profil géométrique complet de la fonction d’interpolation affine par morceaux.
L’analyse visuelle attentive de cette courbe continue met en exergue la signature morphologique indissociable du schéma linéaire : la présence d’angles vifs, ou points anguleux, exactement situés au droit de chaque nœud expérimental d’origine. Ces singularités visuelles correspondent géométriquement aux points de rupture de pente et matérialisent de manière éclatante la discontinuité de la dérivée première de la fonction d’approximation globale. Cette inspection visuelle achève la démonstration empirique de l’interpolation linéaire et fournit à l’analyste un retour graphique immédiat sur la nature affine de la solution implémentée.
8. L’alternative optimisée : Utilisation de numpy.interp
8.1 Syntaxe directe et signature fonctionnelle
Bien que l’approche orientée objet proposée par scipy.interpolate.interp1d offre un cadre élégant pour modéliser des flux d’évaluation réutilisables, l’écosystème Python propose une alternative directe, légère et substantiellement plus rapide par le biais de la fonction numpy.interp. Contrairement à la structure de SciPy qui nécessite la création formelle d’une instance intermédiaire en mémoire, numpy.interp adopte un paradigme purement fonctionnel de type sans état (stateless). L’estimation numérique s’effectue au moyen d’un appel unique passant l’ensemble des arguments requis directement à la fonction de calcul.
La signature fonctionnelle canonique de cette commande s’établit sous la forme : numpy.interp(x, xp, fp, left=None, right=None, period=None). Dans cette nomenclature, le premier paramètre désigné par x représente l’abscisse — ou le tableau d’abscisses — pour lesquelles l’interpolation doit être réalisée. Le deuxième paramètre, xp, reçoit le tableau ordonné des abscisses empiriques connues, tandis que le troisième argument, fp, correspond aux valeurs d’ordonnées observées associées. Les paramètres optionnels left et right offrent quant à eux un contrôle direct et intuitif sur le comportement de la fonction lorsque la cible x s’aventure au-delà des limites du domaine couvert par xp.
Cette fonction est implémentée nativement au cœur du code source C de la bibliothèque NumPy, sans aucun passage intermédiaire par des couches d’abstraction de haut niveau. Dès lors que les tableaux fournis en entrée sont des structures unidimensionnelles contiguës en mémoire et partagent le type flottant canonique float64, l’algorithme exécute une recherche dichotomique binaire d’une efficacité extrême, suivie immédiatement de l’évaluation arithmétique de la fraction affine. Pour la grande majorité des scripts d’analyse de données exigeant l’interpolation rapide d’une série temporelle ou spatiale 1D, l’usage de numpy.interp constitue la recommandation architecturale standard.
8.2 Comparatif des performances d’exécution
L’arbitrage technique entre l’approche fonctionnelle offerte par numpy.interp et l’architecture orientée objet de scipy.interpolate.interp1d s’articule principalement autour des performances de temps d’exécution et de l’empreinte mémoire induite. Lors de l’exécution de benchmarks de calcul intensif mesurant le temps requis pour interpoler des valeurs isolées ou des vecteurs de taille réduite, numpy.interp surpasse systématiquement interp1d d’un ordre de grandeur substantiel, affichant des durées d’exécution typiquement cinq à dix fois plus courtes en raison de l’absence totale de surcharge liée à la gestion de la classe Python.
Dans les contextes d’ingénierie impliquant le traitement de flux de données massifs en temps réel — par exemple lors de l’acquisition de signaux physiologiques à haute fréquence ou de la simulation d’écoulements fluides discrétisés —, le coût d’instanciation répété d’objets interp1d au sein de boucles itératives critiques peut entraîner une dégradation sévère du débit de traitement et solliciter de manière excessive le ramasse-miettes (garbage collector) de l’interpréteur Python. La fonction numpy.interp, par sa conception fonctionnelle sans état et son allocation mémoire prédictible, garantit une vitesse d’exécution optimale et une utilisation minimale de la mémoire vive.
Il convient toutefois de souligner que scipy.interpolate conserve une supériorité architecturale déterminante lorsque la complexité du problème s’accroît. Dès lors que l’analyste envisage de comparer de façon modulaire plusieurs schémas d’interpolation — en basculant en un unique paramètre de l’interpolation linéaire vers des splines cubiques de type kind=’cubic’ ou des polynômes de degré supérieur —, l’interface unifiée de SciPy s’impose sans équivoque. En résumé, les critères d’arbitrage sont clairs : pour l’interpolation linéaire unidimensionnelle pure où la vitesse brute et la compacité du code priment, numpy.interp est la solution privilégiée ; pour les architectures analytiques complexes exigeant une interchangeabilité aisée des modèles d’interpolation d’ordres variés, SciPy demeure le choix naturel.
9. Gestion des limites de domaine : Extrapolation et conditions aux bornes
9.1 Risques conceptuels de l’extrapolation linéaire
L’utilisation imprudente d’un modèle d’interpolation en dehors de son domaine de validité expérimentale constitue l’une des sources d’erreur prédictive les plus fréquentes en modélisation numérique. L’extrapolation linéaire postule que le taux de variation observé sur le dernier ou le premier sous-intervalle d’échantillonnage se maintient indéfiniment de façon rigoureusement constante au-delà des frontières de mesure. Cette hypothèse mathématique téméraire ne possède généralement aucun fondement physique, biologique ou économique réel et s’avère hautement vulnérable aux ruptures de régime non anticipées.
Dans les systèmes réels, la quasi-totalité des phénomènes d’amplification ou de croissance est soumise à des effets de saturation non linéaire, d’amortissement ou de rétroaction régulatrice. Projeter une droite au-delà du maximum observé x_max conduit invariablement à une divergence linéaire vers l’infini positif ou négatif, produisant rapidement des prédictions numériques absurdes telles que des probabilités négatives, des masses dénuées de sens physique ou des vitesses supraluminiques. De surcroît, la pente locale du segment terminal servant de base à l’extrapolation peut être fortement contaminée par le bruit stochastique de la dernière mesure, amplifiant de manière dramatique l’erreur d’estimation au fur et à mesure que la cible s’éloigne du domaine d’observation.
Pour l’ensemble de ces raisons, la communauté scientifique préconise la plus grande réserve méthodologique à l’égard de l’extrapolation. Si la prédiction hors des bornes d’échantillonnage s’avère absolument inévitable, elle doit être explicitement désignée comme une extrapolation hypothétique au sein des rapports de recherche, et ses résultats doivent être assortis d’une analyse d’incertitude rigoureuse reconnaissant la faillibilité intrinsèque du modèle affine au-delà de sa zone de corroboration empirique.
9.2 Paramétrage des erreurs dans interp1d
Conscients des dangers scientifiques inhérents à l’évaluation incontrôlée hors du domaine d’échantillonnage, les concepteurs de la bibliothèque SciPy ont intégré des mécanismes de sécurité rigides par défaut au sein de la classe scipy.interpolate.interp1d. Lorsqu’une instance est interrogée avec une valeur cible d’abscisse x strictement inférieure au minimum du tableau des nœuds ou strictement supérieure à son maximum, le système interrompt immédiatement l’exécution du programme en levant une exception explicite : ValueError: A value in x_new is above the interpolation range (ou below).
Cette barrière d’interruption logicielle, bien que salutaire pour prévenir la propagation silencieuse de prédictions erronées, peut entraver l’exécution de flux de traitement automatisés portant sur des millions d’enregistrements où quelques valeurs résiduelles dépassent marginalement le domaine nominal. Pour moduler ce comportement sans compromettre la stabilité de l’application, interp1d propose le paramètre booléen bounds_error. En spécifiant explicitement bounds_error=False lors de la phase d’instanciation, l’utilisateur désactive l’interruption par exception et autorise la classe à traiter gracieusement les requêtes situées hors domaine.
Parallèlement à la neutralisation de cette levée d’exception, l’utilisateur doit obligatoirement définir la politique de substitution de valeur au moyen du paramètre fill_value. Il est fréquent d’affecter à fill_value la constante numérique spéciale numpy.nan. Selon cette configuration, chaque requête positionnée en dehors des bornes d’observation se voit attribuer une ordonnée NaN (Not a Number), signalant de manière univoque aux fonctions statistiques subséquentes que l’information n’est pas interpolable, évitant ainsi toute pollution de l’analyse globale tout en garantissant la poursuite ininterrompue des calculs sur le reste du jeu de données.
9.3 Autorisation de l’extrapolation linéaire explicite
Lorsque la nature du problème scientifique justifie formellement le recours à une extrapolation linéaire délibérée — par exemple dans des calculs d’asymptotes géométriques ou des simulations cinématiques locales —, scipy.interpolate.interp1d autorise le déploiement explicite de cette modalité. Pour activer l’extension linéaire continue au-delà des bornes d’observation, il suffit de configurer conjointement deux paramètres : attribuer la valeur False à bounds_error et assigner la chaîne de caractères spécifique ‘extrapolate’ au paramètre fill_value.
Sous ce régime d’exécution particulier, lorsque l’interpolateur est sollicité pour une abscisse cible située en deçà de la borne inférieure x1, il calcule l’ordonnée en prolongeant rigoureusement la pente du tout premier segment défini par [x1, x2]. Réciproquement, pour toute coordonnée cible dépassant la frontière supérieure x_n, l’estimation est projetée en prolongeant indéfiniment la droite d’interpolation affine issue des deux derniers nœuds [x_{n-1}, x_n]. Cette cohérence de pente assure la continuité C0 de la fonction d’approximation étendue sur l’ensemble de l’axe réel.
Du côté de la fonction optimisée numpy.interp, l’approche retenue pour le traitement des frontières diffère substantiellement par défaut. Par construction, numpy.interp n’extrapole pas selon la pente terminale : elle applique par défaut un maintien d’ordre zéro aux limites. Toute requête inférieure à x_min se voit attribuer de façon constante l’ordonnée de la première mesure y1, et toute requête supérieure à x_max reçoit la dernière ordonnée y_n. Toutefois, la fonction permet de personnaliser ces valeurs de saturation grâce aux paramètres optionnels left et right, auxquels l’utilisateur peut assigner des scalaires de substitution arbitraires ou la valeur numpy.nan pour bloquer toute estimation hasardeuse hors du domaine d’observation.
10. Intégration au sein de structures de données Pandas
10.1 Interpolation directe sur des objets Series et DataFrame
Dans les pipelines modernes de science des données et d’ingénierie financière, les observations quantitatives sont massivement structurées au sein de tableaux de données hétérogènes manipulés via la bibliothèque standard Pandas. Les structures fondamentales que sont les Series unidimensionnelles et les DataFrames bidimensionnels intègrent de manière native des méthodes d’interpolation hautement sophistiquées, spécialement conçues pour interagir avec les marqueurs de valeurs manquantes désignés conventionnellement par numpy.nan ou l’objet sentinelle pd.NA.
La méthode fondamentale pour accomplir cette opération est DataFrame.interpolate(method=’linear’). Lorsqu’elle est appliquée à une colonne de données numériques comportant des lacunes d’observation éparses, la méthode identifie automatiquement la succession des valeurs valides encadrant chaque bloc de valeurs manquantes et leur applique l’équation de l’interpolation affine par morceaux. L’un des avantages conceptuels majeurs de l’implémentation de Pandas réside dans le fait que l’opération s’exécute directement sur l’objet sans nécessiter d’extraction matricielle explicite ou de conversion manuelle vers des structures NumPy.
Par ailleurs, l’interpolation sous Pandas peut être asservie à la nature sémantique de l’index de la structure de données. Par défaut, le paramètre method=’linear’ traite les données comme si elles étaient uniformément réparties selon un espacement d’entiers discrets consécutifs. Toutefois, si l’index du DataFrame est constitué de données horodatées de type DatetimeIndex ou de grandeurs réelles inégalement espacées, la spécification d’arguments alternatifs tels que method=’time’ ou method=’index’ ordonne au moteur de calcul de calculer les pentes réelles en exploitant les écarts d’intervalles effectifs mesurés sur l’axe des index. Cette capacité d’adaptation contextuelle garantit une fidélité d’interpolation temporelle rigoureuse dans les séries chronologiques présentant un échantillonnage asynchrone.
10.2 Contrôle des intervalles et limitations d’imputation
L’automatisation sans discernement de l’imputation par interpolation linéaire au sein de vastes jeux de données tabulaires présente un risque majeur de contamination statistique si de larges séquences continues d’enregistrements ont été perdues lors de la collecte. Pour prémunir l’analyste contre ce péril méthodologique, la méthode interpolate de Pandas propose un ensemble complet de paramètres régulateurs permettant de limiter précisément l’étendue des substitutions autorisées.
Le paramètre le plus déterminant à cet égard est le paramètre entier nommé limit. En spécifiant par exemple limit=3, l’utilisateur ordonne formellement à Pandas de n’imputer au maximum que trois valeurs manquantes consécutives. Si une séquence d’interruption instrumentale s’étend sur une durée supérieure — comportant par exemple dix valeurs NaN d’affilée —, seules les trois premières valeurs lacunaires adjacentes aux données observées seront interpolées, tandis que les sept positions suivantes demeureront inchangées à l’état de valeurs manquantes explicites. Cette retenue préserve la visibilité de la rupture expérimentale majeure au lieu de masquer artificiellement un effondrement du flux de données sous une ligne droite arbitraire.
De surcroît, la régulation fine du processus peut être complétée à l’aide des paramètres limit_direction et limit_area. Le paramètre limit_direction, acceptant les valeurs ‘forward’, ‘backward’ ou ‘both’, détermine si l’imputation doit se propager exclusivement dans le sens chronologique direct, en remontant l’axe temporel à partir de la valeur de reprise, ou de manière symétrique et bidirectionnelle. Parallèlement, le paramètre limit_area permet de restreindre l’action d’interpolation strictement à l’intérieur du domaine empirique délimité par les observations valides en spécifiant limit_area=’inside’, excluant systématiquement toute tentative d’imputation périphérique sur les segments initiaux ou terminaux du tableau de données.
11. Limites critiques, hypothèses et erreurs d’approximation
11.1 Évaluation de l’erreur d’interpolation linéaire
Bien que l’interpolation linéaire brille par sa simplicité conceptuelle et sa rapidité d’exécution numérique, son déploiement scientifique nécessite une compréhension rigoureuse de ses limites d’approximation analytique. En analyse numérique classique, l’écart d’interpolation entre une fonction théorique sous-jacente f(x) deux fois continûment dérivable et son approximation linéaire locale L(x) sur un intervalle compact [x1, x2] peut être quantifié formellement grâce au théorème des résidus de Taylor-Lagrange.
Pour tout point d’abscisse x appartenant au segment d’échantillonnage [x1, x2], l’erreur absolue résiduelle commise vérifie rigoureusement l’égalité formelle suivante : l’écart f(x) – L(x) est égal au produit de la dérivée seconde de f évaluée en un point inconnu xi appartenant à l’intervalle ouvert, divisée par la factorielle de deux, multipliée par le produit polynomial (x – x1) * (x – x2). Cette relation met immédiatement en évidence les deux déterminants fondamentaux de l’erreur d’approximation : la courbure intrinsèque du phénomène modélisé et l’écartement spatial des points d’échantillonnage.
En analysant les propriétés extrémales du produit parabolique (x – x1) * (x2 – x), dont le maximum absolu est atteint exactement au centre géométrique du sous-intervalle pour x = (x1 + x2) / 2 et vaut h^2 / 4 — où la grandeur h désigne le pas d’échantillonnage local (x2 – x1) —, nous établissons la borne supérieure universelle de l’erreur absolue locale : l’erreur maximale d’interpolation est bornée supérieurement par (M2 * h^2) / 8, où M2 représente la borne supérieure de la valeur absolue de la dérivée seconde de f sur l’intervalle considéré. Cette dérivation fondamentale démontre que l’erreur d’interpolation linéaire décroît quadratiquement avec le raffinement du pas d’échantillonnage h : diviser la distance entre les nœuds de mesure par deux a pour effet mécanique de réduire l’erreur théorique maximale d’un facteur quatre, ce qui confirme l’inadéquation de cette méthode sur des maillages d’échantillonnage trop lâches lorsque le système physique présente de fortes variations d’accélération.
11.2 Comparaison avec les méthodes d’ordre supérieur
Face aux contraintes inhérentes à la linéarité par morceaux, il est impératif de situer ce modèle par rapport aux méthodes d’approximation d’ordre supérieur, au premier rang desquelles figure l’interpolation par splines cubiques mise en œuvre par le module scipy.interpolate.CubicSpline. Les splines cubiques construisent une fonction d’approximation composée de polynômes de degré trois raccordés à chaque nœud d’observation de manière à garantir non seulement la continuité de la fonction elle-même (espace C0), mais également la stricte continuité de sa dérivée première (espace C1) et de sa dérivée seconde (espace C2). Cette régularité accrue élimine totalement les angles vifs caractéristiques de l’interpolation linéaire et confère à la courbe une courbure naturelle idéale pour modéliser des mouvements dynamiques lisses ou des surfaces aérodynamiques.
Toutefois, cette recherche de régularité différentielle élevée s’accompagne d’arbitrages méthodologiques critiques et de vulnérabilités spécifiques. D’une part, la résolution d’une spline cubique nécessite la résolution conjointe d’un système matriciel tridiagonal global couplant l’ensemble des nœuds de la série, ce qui induit une complexité de calcul plus élevée et interdit les évaluations purement locales et indépendantes permises par l’interpolation affine. D’autre part, dans les zones de transition brutale caractérisées par des gradients raides ou des discontinuités de mesure, les interpolateurs d’ordre supérieur ont tendance à produire des oscillations parasites sévères — connues sous le nom de phénomène d’overshoot ou phénomène de Gibbs discret —, générant des extrema locaux artificiels inexistants dans le phénomène physique réel.
Par ailleurs, l’interpolation linéaire présente l’avantage décisif d’échapper totalement au redoutable phénomène de Runge, qui décrit l’instabilité divergente catastrophique des polynômes d’interpolation de degré global élevé aux extrémités du domaine d’observation. En limitant rigoureusement le degré du polynôme d’ajustement à l’ordre un sur chaque sous-intervalle local fermé, l’interpolation affine par morceaux garantit une stabilité numérique inconditionnelle : l’enveloppe des valeurs interpolées demeure strictement confinée à l’intérieur de l’intervalle fermé délimité par les ordonnées minimales et maximales locales des nœuds encadrants, assurant une robustesse absolue face aux instabilités oscillatoires qui affectent fréquemment les modèles polynomiaux de degrés supérieurs.
12. Synthèse méthodologique et recommandations opérationnelles
12.1 Arbre décisionnel pour le choix des outils en Python
Pour naviguer avec efficacité parmi la multiplicité des options logicielles offertes par l’écosystème Python, les analystes de données et ingénieurs numériques doivent structurer leur choix technique selon un arbre décisionnel rationnel guidé par trois critères fondamentaux : la volumétrie des calculs, la structure typologique des données manipulées et la nécessité éventuelle d’extrapoler ou de faire évoluer le modèle vers des ordres supérieurs d’approximation.
Dans les scénarios d’analyse impliquant des données organisées sous forme de séries chronologiques ou de tableaux tabulaires hétérogènes structurés avec Pandas, il convient d’exploiter prioritairement la méthode native DataFrame.interpolate(). Ce choix architectural évite les opérations de transformation de types intermédiaires fastidieuses, préserve l’intégrité contextuelle des métadonnées associées aux colonnes et autorise un filtrage hautement paramétrable des lacunes d’observation au moyen des contrôles de limites temporelles et séquentielles intégrés à la méthode.
Dès lors que les données sont déjà converties sous la forme de tableaux matriciels NumPy homogènes, la distinction s’opère selon les objectifs de performance et d’extensibilité fonctionnelle. Si l’opération d’interpolation linéaire unidimensionnelle est intégrée au sein d’une boucle de simulation hautement intensive, d’un pipeline d’apprentissage automatique en flux continu ou d’un algorithme de rendu temps réel où chaque microseconde d’exécution est critique, l’emploi exclusif de numpy.interp s’impose comme la solution de référence absolue pour maximiser le débit computationnel. En revanche, si le projet s’inscrit dans un cadre exploratoire de recherche scientifique nécessitant la modularité de l’ordre d’interpolation, l’évaluation conjointe de multiples composantes tensorielles ou le déploiement d’une extrapolation linéaire rigoureusement balisée, l’interface orientée objet de scipy.interpolate s’impose par sa flexibilité et sa robustesse structurelle.
12.2 Protocole de validation et bonnes pratiques de code
L’industrialisation pérenne d’un code de calcul reposant sur l’interpolation linéaire exige l’adhésion rigoureuse à un protocole de bonnes pratiques de développement logiciel appliqué aux sciences numériques. La première règle méthodologique incontournable réside dans la validation systématique de l’ordonnancement strict des vecteurs d’abscisses de départ. Tout tableau de nœuds d’entrée doit faire l’objet d’un contrôle de monotonie au moyen de l’expression assert numpy.all(numpy.diff(x) > 0), garantissant que chaque abscisse est strictement supérieure à la précédente. L’introduction de doublons parfaits ou de segments désordonnés corrompt l’évaluation des dénominateurs locaux et provoque des comportements indéterminés au sein des algorithmes compilés.
La seconde exigence de qualité logicielle consiste à systématiser les tests unitaires couvrant l’ensemble des cas limites et singuliers de la fonction d’interpolation. Une suite de tests digne des standards de l’ingénierie moderne doit obligatoirement valider trois comportements cardinaux : la conformité absolue de l’estimation aux nœuds d’observation originels en vérifiant que le résidu f(x_i) – y_i est inférieur à la tolérance d’arrondi machine, la précision de l’interpolation au centre exact des intervalles d’échantillonnage, et le comportement parfaitement contrôlé de l’algorithme face aux requêtes formulées hors des frontières expérimentales, qu’il s’agisse de la levée déterministe d’une exception explicite ou de la génération rigoureuse de valeurs sentinelles NaN.
Enfin, sur le plan de la communication scientifique et de la gouvernance des données de recherche, il est primordial de documenter formellement la méthode d’interpolation adoptée ainsi que l’ensemble de ses paramètres de configuration au sein des carnets de calcul (Jupyter Notebooks) et des métadonnées associées aux résultats publiés. L’analyste doit expliciter en toute transparence les hypothèses physiques justifiant la simplification linéaire locale, mentionner la fréquence d’échantillonnage globale au regard des constantes de temps du phénomène étudié, et justifier le traitement réservé aux frontières et aux extrapolations. C’est à ce prix méthodologique que l’interpolation linéaire, outil élémentaire par essence, révèle toute sa puissance opératoire et concourt à la production de résultats scientifiques rigoureux, transparents et reproductibles.
Références
- Burden, R. L., Faires, J. D., & Burden, A. M. (2015). Numerical Analysis (10th ed.). Cengage Learning.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Press, W. H., Teukolsky, S. A., Vetterling, W. T., & Flannery, B. P. (2007). Numerical Recipes: The Art of Scientific Computing (3rd ed.). Cambridge University Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2