
Dans le paradigme contemporain de l’apprentissage automatique et de la modélisation statistique, la préparation des données brutes constitue une phase cardinale conditionnant directement la performance, la stabilité et l’interprétabilité des algorithmes. La majorité des modèles prédictifs, qu’il s’agisse de régressions linéaires pénalisées, de machines à vecteurs de support ou de réseaux de neurones profonds, opèrent exclusivement sur des espaces vectoriels réels continus. Or, les ensembles de données issus du monde réel intègrent massivement des attributs qualitatifs, caractérisés par des modalités discrètes telles que des statuts socio-économiques, des localisations géographiques ou des catégories de diagnostic médical. La transposition de ces variables symboliques en grandeurs numériques digestibles par les architectures computationnelles représente ainsi un défi méthodologique et théorique fondamental.
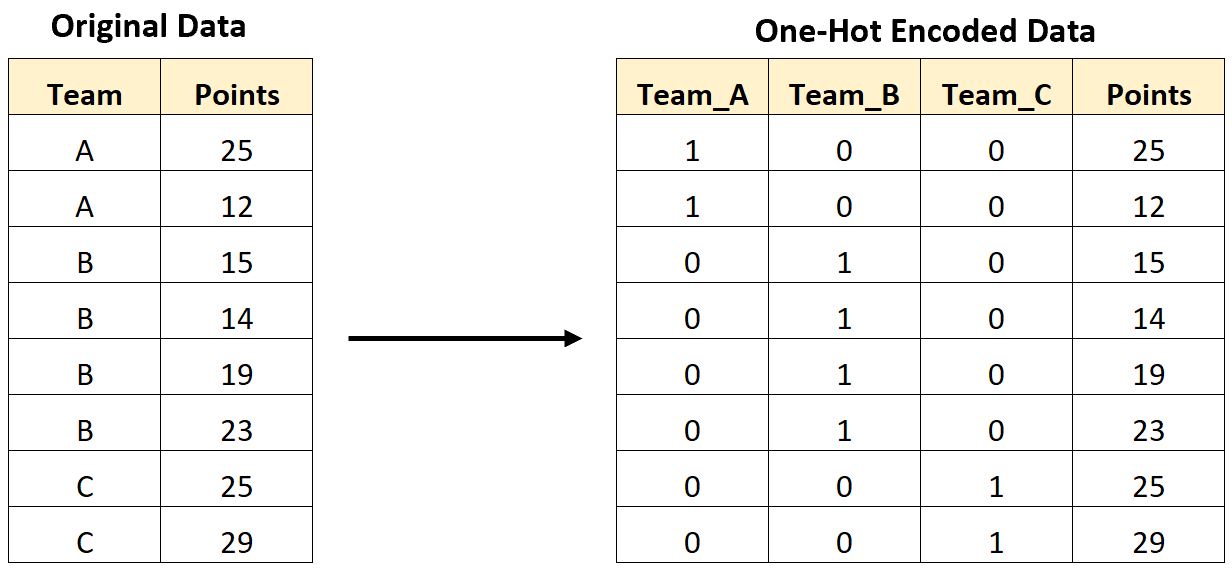
Parmi l’arsenal des techniques de prétraitement, l’encodage disjonctif complet, universellement désigné sous le terme d’encodage one-hot (ou one-hot encoding), s’impose comme l’approche canonique pour traiter les attributs qualitatifs dépourvus de relation d’ordre sous-jacente. Cette méthode consiste à transformer chaque modalité distincte d’une variable en un vecteur binaire exclusif au sein d’un nouvel espace vectoriel orthogonal. Si sa conception conceptuelle semble élémentaire, son implémentation rigoureuse en environnement de production logicielle sous Python soulève des problématiques complexes touchant à la dégénérescence de rang, à l’explosion dimensionnelle, à la gestion de la dérive de distribution et à l’optimisation de la mémoire vive.
Ce guide exhaustif a pour vocation d’analyser l’encodage one-hot sous toutes ses facettes, depuis ses assises géométriques et mathématiques jusqu’à son déploiement industriel via les bibliothèques scientifiques de pointe telles que Pandas et Scikit-Learn. En adoptant une perspective académique et pratique, nous examinerons les compromis structurants entre parcimonie et expressivité vectorielle, les pièges de multicolinéarité inhérents aux modèles linéaires, ainsi que les protocoles de validation croisée étanches garantissant l’absence totale de fuite d’information au sein des chaînes de traitement automatisées.
1. Fondements théoriques de l’encodage one-hot et représentation vectorielle
1.1 Définition mathématique et principe de l’encodage disjonctif complet
L’encodage one-hot repose sur la projection d’un ensemble discret non ordonné, noté formellement comme l’ensemble des modalités distinctes d’une variable qualitative, vers la base canonique d’un espace vectoriel euclidien de dimension équivalente au cardinal de cet ensemble. Considérons une variable qualitative prenant ses valeurs dans un ensemble fini de cardinalité K. L’encodage associe à chaque modalité un vecteur unitaire de l’espace vectoriel euclidien de dimension K, dont toutes les composantes sont rigoureusement nulles, à l’exception d’une coordonnée unique positionnée à la valeur unitaire un. Cette transformation garantit que la somme de toutes les composantes du vecteur résultant est invariablement égale à un, matérialisant ainsi une partition stricte de l’unité.
Le principe fondamental réside dans l’activation binaire exclusive. Deux modalités distinctes se voient attribuer deux vecteurs de base distincts, garantissant que leur produit scalaire euclidien standard est strictement nul. Cette orthogonalité parfaite confère à la représentation géométrique une propriété d’équidistance absolue : la distance euclidienne entre n’importe quelle paire de modalités différentes est invariablement égale à la racine carrée de deux. Cette métrique uniforme élimine de facto toute structure géométrique arbitraire qui résulterait d’un encodage ordinal naïf, où l’assignation d’entiers arbitraires induirait artificiellement des proximités ou des éloignements fallacieux entre les catégories sans fondement empirique.
D’un point de vue topologique, cette transformation dissocie une dimension scalaire hétérogène en un hypercube de dimension K, où chaque observation est contrainte de se situer exclusivement sur l’un des sommets dudit hypercube. Cette propriété préserve l’indépendance sémantique des catégories tout en fournissant une base opérationnelle stable pour les calculs différentiels propres aux optimiseurs statistiques modernes.
1.2 Origines conceptuelles et utilité dans l’apprentissage automatique
L’émergence de l’encodage one-hot trouve ses racines historiques dans la logique booléenne et les systèmes de commutation électromécaniques, où un état discret devait être matérialisé par l’activation d’une unique ligne physique parmi un ensemble de conducteurs disponibles. En analyse de données classique et en économétrie, cette technique est connue depuis plusieurs décennies sous la dénomination de création de variables indicatrices ou muettes (dummy variables), introduite pour permettre l’incorporation de facteurs qualitatifs au sein des modèles de régression multivariée.
Dans l’apprentissage automatique contemporain, la compatibilité structurelle avec le formalisme matriciel représente l’argument prépondérant en faveur de cette méthode. Les algorithmes d’apprentissage supervisé traitent les matrices d’observations où chaque colonne correspond à un axe de liberté mathématique. Pour les modèles linéaires, imposer une valeur scalaire continue sur une variable qualitative forcerait le modèle à estimer un unique coefficient de pente, imposant une relation de proportionnalité rigide et artificielle entre les modalités. L’encodage one-hot résout cette impasse en allouant un paramètre de poids distinct et indépendant à chaque modalité, permettant à la surface de régression de capturer librement l’effet marginal propre à chaque modalité.
En ce qui concerne les réseaux de neurones profonds, la différentiabilité des fonctions de perte par rapport aux poids synaptiques nécessite des entrées continues et bornées. L’encodage binaire prévient le phénomène de saturation prématurée des fonctions d’activation non linéaires, telles que la sigmoïde ou la tangente hyperbolique, qui surviendrait si de grands entiers ordinaux étaient injectés dans les couches d’entrée. De surcroît, le calcul du gradient stochastique bénéficie d’une stabilité numérique accrue lorsque les entrées sont strictement cantonnées à l’intervalle fermé zéro-un.
1.3 Limites inhérentes à la dimensionalité et explosion combinatoire
En dépit de son élégance conceptuelle et de sa neutralité géométrique, l’encodage disjonctif complet présente des vulnérabilités structurelles majeures lorsqu’il est confronté à des jeux de données massifs ou à des variables possédant un degré élevé d’éléments distincts. Ce phénomène s’inscrit directement dans le cadre théorique du fléau de la dimensionnalité, conceptualisé par Richard Bellman. Lorsque la cardinalité d’une variable qualitative s’élève à plusieurs centaines ou milliers d’entités, la projection one-hot induit une dilatation colossale de l’espace des caractéristiques, augmentant drastiquement le volume de l’hyperspace sans accroître proportionnellement la densité de l’échantillonnage empirique.
Cette prolifération dimensionnelle dégrade significativement le rapport signal-sur-bruit et amplifie la variance statistique des estimateurs. Les modèles paramétriques et non paramétriques deviennent particulièrement sujets au surapprentissage, dans la mesure où l’espace vectoriel devient extrêmement épars (sparse), la grande majorité des coordonnées étant constituée de zéros. Dans ce contexte géométrique, la notion même de proximité ou de voisinage euclidien perd sa pertinence différentielle, affectant gravement les algorithmes reposant sur des métriques de distance tels que les k-plus proches voisins ou les séparateurs à vaste marge.
Au niveau matériel, l’explosion combinatoire génère une pression insoutenable sur la mémoire vive lors de la manipulation de matrices de conception denses. Une variable textuelle comprenant dix mille modalités distinctes convertie sous forme dense pour un million d’observations requiert l’allocation instantanée de plusieurs dizaines de gigaoctets de mémoire, provoquant fréquemment des défaillances de saturation mémoire si des structures creuses optimisées ne sont pas rigoureusement mobilisées dès l’étape d’ingénierie des caractéristiques.
2. Typologie des variables catégorielles et cadre d’application
2.1 Distinction fondamentale entre variables nominales et ordinales
L’application rigoureuse de l’encodage one-hot présuppose une analyse typologique approfondie des attributs sous-jacents, gouvernée par la théorie des échelles de mesure initialement formulée par le psychophysicien Stanley Smith Stevens. Les variables qualitatives se subdivisent principalement en deux catégories mutuellement exclusives : les variables nominales et les variables ordinales. Les variables nominales pures désignent des classifications qualitatives dépourvues de toute relation d’ordre naturel, d’échelle de grandeur ou de transitivité intrinsèque. Le genre, l’état civil, le pays de résidence ou le type d’appareil de connexion constituent des archétypes de variables nominales.
Pour ces variables nominales, l’encodage one-hot s’avère non seulement légitime, mais théoriquement impératif, car il s’abstient d’injecter une hiérarchie fictive dans les données. En revanche, l’utilisation de l’encodage one-hot sur des variables ordinales constitue une erreur méthodologique fréquente dans la pratique statistique. Une variable ordinale, telle que le niveau de scolarité, une échelle d’évaluation de type Likert ou un niveau de risque de crédit, possède une relation d’ordre transitif claire et signifiante entre ses modalités.
Appliquer un encodage disjonctif complet sur un attribut ordinal détruit purement et simplement cette structure ordonnée. En imposant une orthogonalité parfaite et une équidistance artificielle entre tous les niveaux, le modélisateur prive l’algorithme d’apprentissage de l’information structurelle indiquant, par exemple, qu’un niveau d’études secondaires est plus proche d’un niveau primaire que d’un doctorat. Dans ce cadre précis, des techniques alternatives telles que l’encodage ordinal calibré ou l’encodage par rangs cumulés s’avèrent infiniment plus pertinentes pour préserver la monotonie de la relation fonctionnelle.
2.2 Analyse de la cardinalité des attributs qualitatifs
La cardinalité, définie comme le nombre absolu de modalités uniques contenues au sein d’une variable qualitative, constitue la métrique décisionnelle prépondérante lors de la conception des pipelines d’ingénierie des données. Une cardinalité faible, généralement comprise entre deux et une vingtaine de catégories, offre un cadre idéal pour l’application directe de l’encodage one-hot. La surcharge dimensionnelle induite reste modeste et parfaitement gérable pour les optimiseurs numériques standards sans dégradation notable de l’efficacité computationnelle.
Cependant, lorsque l’on observe un ratio élevé entre le nombre de modalités uniques et le volume total d’observations, l’encodage disjonctif complet devient contre-productif. Dans les jeux de données comportant des attributs à haute cardinalité, tels que les codes postaux, les identifiants d’utilisateurs ou les classifications professionnelles détaillées, l’apparition de modalités ultra-minoritaires ou observées une seule fois fausse la convergence des algorithmes. Ces catégories sporadiques agissent comme des anomalies statistiques qui encouragent la mémorisation du bruit plutôt que l’extraction de régularités sous-jacentes.
L’analyse exploratoire des données doit donc comporter une étude systématique de la distribution des fréquences empiriques. La pratique statistique recommandée consiste à établir un seuil critique de prévalence en deçà duquel les modalités rares sont pré-agglomérées au sein d’une méta-catégorie résiduelle unifiée. Des seuils empiriques fréquents fixent cette limite entre 1 % et 5 % du volume d’échantillonnage total, stabilisant ainsi la représentation vectorielle avant d’engager la transformation binaire disjonctive.
2.3 Contexte méthodologique dans le traitement de données comportementales
L’utilisation de l’encodage one-hot s’avère prépondérante dans l’analyse des données comportementales, de la psychométrie appliquée et des études d’opinion. Dans ces disciplines, les données d’entrée proviennent fréquemment de questionnaires standardisés intégrant des choix discrets multiples ou des scénarios d’arbitrage comportemental. La quantification de réponses catégorielles doit s’opérer avec une rigueur absolue afin de préserver l’objectivité statistique et de ne pas biaiser la restitution des profils individuels.
Lorsqu’un répondant sélectionne une option parmi plusieurs choix nominaux concurrents, par exemple le motif principal motivant la décision d’adhésion à un service public ou commercial, l’encodage one-hot garantit une neutralité herméneutique totale. Aucune pondération implicite n’est attribuée à une réponse par rapport à une autre. Cette propriété est fondamentale en modélisation économétrique du choix discret, notamment dans le cadre théorique des modèles logit multinomiaux développés par Daniel McFadden, où l’utilité perçue de chaque alternative est modélisée par des projections vectorielles découplées.
De surcroît, le traitement des variables démographiques exige une neutralité absolue pour satisfaire aux exigences éthiques et légales de justice algorithmique (algorithmic fairness). L’attribution de scalaires séquentiels à des appartenances ethniques, géographiques ou confessionnelles constituerait un non-sens statistique doublé d’une faute méthodologique grave. L’orthogonalité conférée par l’encodage one-hot assure que chaque profil est traité comme une direction indépendante dans l’espace vectoriel, évitant l’introduction de biais de classement non supervisés au cœur de l’analyse prédictive.
3. Préparation de l’environnement Python et manipulation préliminaire des données
3.1 Configuration de l’écosystème de calcul scientifique
L’implémentation robuste d’un pipeline de traitement de données sous Python requiert une structuration rigoureuse de l’environnement d’exécution. Les bibliothèques incontournables pour l’ingénierie des caractéristiques catégorielles comprennent NumPy pour les structures matricielles bas niveau, Pandas pour la manipulation tabulaire de haut niveau et Scikit-Learn pour l’intégration algorithmique au sein de chaînes de traitement étanches. L’isolation de l’espace de travail via des outils de virtualisation tels que venv ou Conda assure l’immuabilité et la reproductibilité des calculs scientifiques à long terme.
Le contrôle formel des versions logicielles installées constitue une bonne pratique impérative. Les interfaces de programmation et les comportements par défaut de fonctions critiques telles que l’encapsulation de matrices creuses ou la persistance des métadonnées catégorielles ont subi des évolutions structurelles substantielles entre les versions successives de Pandas et de Scikit-Learn. Il est indispensable de s’assurer de la conformité de l’environnement logiciel avant d’amorcer le chargement de volumes de données conséquents, en vérifiant particulièrement la compatibilité des liaisons C-API sous-jacentes qui gèrent l’accélération vectorielle.
Une configuration professionnelle implique également le paramétrage préventif des alertes logicielles et l’allocation des options d’affichage de Pandas. Spécifier les capacités maximales de colonnes et la précision des représentations numériques en mémoire évite les ralentissements graphiques lors de l’inspection de jeux de données dont la dimensionnalité est sur le point d’être substantiellement élargie par l’adjonction de multiples colonnes binaires générées dynamiquement.
3.2 Instanciation et inspection empirique d’un DataFrame de test
Afin de formaliser les protocoles de transformation, l’élaboration d’un ensemble de données hétérogène synthétique constitue une méthode pédagogique et empirique optimale. Un tel jeu de données doit incorporer une diversité de typologies structurelles : des variables numériques continues simulant des grandeurs physiologiques ou économiques, des variables ordinales clairement hiérarchisées et des variables nominales complexes présentant des fréquences de distribution dissymétriques.
L’inspection analytique de la structure de données instanciée s’opère par l’appel méthodique des propriétés de métadonnées de Pandas. L’examen des types de données permet de classifier immédiatement les colonnes d’objets génériques, qui stockent généralement les chaînes de caractères sous forme de pointeurs Python individuels particulièrement gourmands en ressources. L’évaluation du profilage mémoire initial offre un étalon de référence pour jauger l’impact dimensionnel ultérieur de l’encodage disjonctif.
Une étape d’optimisation préliminaire consiste à convertir explicitement les colonnes textuelles en types catégoriels natifs de Pandas. Cette conversion substitue le stockage redondant de chaînes de caractères par une table d’indexation interne composée de pointeurs entiers associés à un dictionnaire unique de modalités. Cette organisation interne allège considérablement l’empreinte mémoire initiale et prépare efficacement le terrain pour les étapes d’encodage algorithmique ultérieures en clarifiant la sémantique formelle de chaque variable.
3.3 Audit initial de la distribution et détection des valeurs manquantes
Préalablement à toute binarisation mécanique, un audit distributionnel rigoureux doit être mené pour sonder la morphologie statistique de chaque attribut catégoriel. Le calcul exhaustif des fréquences d’apparition relatives et absolues révèle immédiatement les disparités volumétriques entre les classes. L’identification d’une classe ultra-majoritaire englobant l’écrasante majorité de la distribution signale une variance informative potentiellement faible, qui nécessitera une attention particulière lors de la modélisation.
La détection et l’analyse de la typologie des valeurs manquantes représentent le second volet critique de cette phase préliminaire. En science des données, une absence d’information n’est que très rarement aléatoire. Il convient de distinguer les données manquantes complètement au hasard de celles dont la non-réponse découle d’un déterminisme latent, propre à un sous-groupe d’individus déterminé. La présence d’indicateurs sentinelles ou de chaînes de caractères vides non standardisées doit être interceptée et unifiée sous la valeur standard de non-disponibilité.
Face à des données qualitatives incomplètes, deux orientations méthodologiques fondamentales se dessinent. La première réside dans l’imputation probabiliste en amont, mobilisant par exemple la modalité modale ou un modèle d’imputation itérative multivarié. La seconde approche, particulièrement adaptée aux variables comportementales, consiste à considérer le statut manquant comme une modalité informationnelle à part entière. Dans cette perspective, la valeur manquante est explicitement conservée et se voit allouer sa propre colonne binaire dédiée lors de l’encodage one-hot, permettant au modèle statistique d’apprendre formellement l’effet prédictif induit par l’absence d’observation.
4. Implémentation pratique via la fonction get_dummies de Pandas
4.1 Utilisation élémentaire et mécanismes automatiques d’inférence
La bibliothèque Pandas met à disposition du praticien une fonction utilitaire native de haut niveau particulièrement accessible : get_dummies. Cette routine logicielle est conçue pour exécuter rapidement une binarisation disjonctive complète sur un tableau de données tabulaire. Lorsqu’elle est appliquée directement sur un DataFrame hétérogène sans paramétrage restrictif, la fonction inspecte automatiquement l’intégralité des colonnes et cible par défaut celles dont le type correspond à des objets textuels ou à des types catégoriels formels, laissant intactes les grandeurs numériques continues.
Ce mécanisme d’inférence implicite simplifie considérablement la phase d’analyse exploratoire préliminaire des données. La fonction extrait l’ensemble des modalités uniques présentes dans chaque colonne ciblée, génère autant de nouveaux vecteurs de zéros et de uns qu’il existe de classes distinctes, puis élimine les colonnes sources originelles pour leur substituer la matrice binaire résultante. L’ordonnancement interne des colonnes générées respecte généralement l’ordre alphabétique des modalités sous-jacentes ou l’ordre intrinsèque défini au sein de l’objet catégoriel formel de Pandas.
Pour garantir la clarté sémantique du DataFrame transformé et prévenir toute ambiguïté sur la provenance des caractéristiques, la fonction intègre un paramètre de préfixe. Cet argument permet d’adjoindre une chaîne textuelle explicite en tête des nouveaux intitulés de colonnes, typiquement le nom original de la variable qualitative suivi d’un séparateur configurable. Ainsi, une modalité descriptive issue d’une colonne régionale se trouve immédiatement indexée par un intitulé transparent et intelligible, facilitant les visualisations ultérieures et l’interprétation des pondérations statistiques.
4.2 Paramétrage fin : suppression de modalité et gestion des valeurs nulles
L’utilisation experte de la fonction get_dummies requiert un paramétrage ajusté afin de répondre précisément aux contraintes mathématiques du modèle statistique envisagé. L’un des arguments les plus structurants est le paramètre booléen drop_first. Lorsqu’il est activé, ce mécanisme supprime systématiquement la première colonne binaire générée pour chaque groupe de modalités. Cette opération élimine la redondance linéaire stricte qui affecte les matrices disjonctives complètes, neutralisant préventivement le piège classique des variables muettes lors de l’estimation de modèles linéaires standard à terme constant.
La gestion des valeurs manquantes bénéficie également d’un contrôle dédié via l’argument dummy_na. Par défaut, la fonction ignore les valeurs nulles, ce qui a pour conséquence géométrique d’attribuer un vecteur constitué exclusivement de zéros aux observations présentant une entrée non renseignée pour l’ensemble des colonnes associées à la variable. En assignant la valeur vrai à dummy_na, Pandas force l’instanciation d’une colonne indicatrice explicite quantifiant l’absence d’information. Cette fonctionnalité permet de modéliser directement les biais d’attrition ou les motifs d’omission systématique propres aux enquêtes comportementales complexes.
Enfin, le contrôle de l’empreinte mémoire s’opère par le biais de l’argument dtype. Historiquement, la fonction allouait fréquemment des entiers signés de 64 bits ou des valeurs flottantes pour stocker de simples indicateurs booléens, entraînant une surconsommation tragique d’espace mémoire. En spécifiant explicitement un type booléen ou un entier non signé de 8 bits (uint8), le volume alloué pour stocker la matrice binaire résultante est divisé par huit, un gain d’efficience fondamental lors de la manipulation de jeux de données comportant plusieurs dizaines de milliers de lignes.
4.3 Limites critiques de l’approche get_dummies en production
Malgré sa remarquable souplesse d’emploi dans le cadre d’analyses exploratoires interactives, la fonction get_dummies de Pandas présente des lacunes rédhibitoires qui la disqualifient formellement pour une utilisation dans des architectures industrielles de production ou des chaînes de déploiement continu d’apprentissage automatique. La déficience architecturale majeure de cette fonction réside dans son absence totale d’état persistant. Elle fonctionne selon un mode de calcul ponctuel purement fonctionnel, sans conserver en mémoire l’univers des catégories découvertes lors de son exécution.
Cette absence d’apprentissage persistant produit des incohérences dimensionnelles catastrophiques lors du passage de l’échantillon d’entraînement à l’échantillon de test ou lors de l’évaluation d’une nouvelle requête unitaire en ligne. Si l’échantillon de test contient une modalité qui n’était pas présente dans le jeu d’entraînement, get_dummies va générer une colonne supplémentaire inédite. Inversement, si une modalité rare observée à l’entraînement ne figure pas dans le sous-ensemble de test, la colonne correspondante sera tout simplement omise. La matrice de test ainsi construite présentera un nombre ou un agencement de colonnes non conforme à la matrice d’apprentissage, provoquant l’échec immédiat de la prédiction matricielle.
De surcroît, la fonction est incapable de s’insérer de manière native et découplée au sein des structures d’encapsulation séquentielle normalisées, telles que les pipelines de Scikit-Learn. Elle impose d’opérer globalement sur l’ensemble des données avant toute partition méthodologique, créant ainsi des risques substantiels de fuite d’information transversale (data leakage). Pour toutes ces raisons, l’usage de cette fonction doit être rigoureusement circonscrit aux étapes de prototypage rapide et de statistique descriptive ad hoc.
5. Mise en œuvre industrielle avec OneHotEncoder de Scikit-Learn
5.1 Architecture et paradigme fit / transform
Pour surmonter les limitations structurelles des fonctions purement descriptives, la bibliothèque Scikit-Learn a standardisé l’ingénierie des caractéristiques autour du paradigme programmatique fit et transform. La classe OneHotEncoder incarne l’aboutissement de cette rigueur méthodologique en dissociant formellement la phase d’apprentissage des métadonnées catégorielles de la phase de transformation effective des données vectorielles.
Lors de l’appel de la méthode fit, l’estimateur analyse méthodiquement la matrice ou le tableau d’entraînement qui lui est soumis. Il identifie et mémorise l’ensemble exhaustif des modalités distinctes observées pour chaque colonne sélectionnée, puis structure cet état interne sous la forme d’un attribut persistant désigné sous le nom de categories_. À ce stade, aucune modification n’est apportée aux données brutes. L’objet a simplement forgé son schéma de projection dimensionnelle, qui devient un invariant mathématique intangible pour toutes les opérations ultérieures.
C’est uniquement lors de l’exécution de la méthode transform que la projection matricielle disjonctive est exécutée. L’encodeur projette les données qui lui sont présentées en s’alignant scrupuleusement sur le référentiel appris lors de la phase d’ajustement initiale. Cette mécanique découplée offre une garantie mathématique absolue : quelles que soient les fluctuations de distribution ou les omissions observées au sein des données de validation, de test ou d’inférence en temps réel, l’espace vectoriel produit comportera invariablement la même dimension et le même agencement ordonné de colonnes que celui ayant servi à l’apprentissage du modèle prédictif.
5.2 Configuration détaillée de la classe OneHotEncoder
La classe OneHotEncoder dispose d’une panoplie étendue d’arguments d’initialisation permettant d’ajuster son comportement aux contraintes computationnelles les plus exigeantes. L’un des paramètres névralgiques concerne la nature de la matrice de sortie, contrôlée par l’argument sparse_output (anciennement sparse dans les versions antérieures de Scikit-Learn). Par défaut, cet argument est activé, ce qui conduit l’encodeur à retourner une matrice creuse optimisée basée sur le formalisme CSR (Compressed Sparse Row) de SciPy. Cette configuration protège l’environnement d’exécution contre toute saturation de mémoire vive face à des variables à forte cardinalité.
Le traitement des modalités inconnues représente un autre levier d’optimisation fondamental, articulé autour du paramètre handle_unknown. Dans un contexte de production industrielle, la rencontre d’une modalité inédite non observée durant l’entraînement constitue une certitude statistique à terme. En configurant cet argument sur la valeur ignore, l’estimateur neutralise silencieusement la nouvelle catégorie en lui assignant un vecteur de zéros complets, évitant la levée d’exceptions logicielles bloquantes tout en préservant l’intégrité de la structure matricielle globale.
Le paramètre drop permet quant à lui de piloter la suppression délibérée d’une colonne de référence pour chaque modalité afin de prévenir les pathologies de multicolinéarité. Contrairement à l’approche basique de Pandas, Scikit-Learn offre une granularité accrue : il est possible de supprimer la première catégorie par défaut, de fournir un tableau explicite des catégories spécifiques à écarter pour chaque variable, ou d’activer l’option if_binary, qui limite intelligemment la suppression aux seules variables strictement binaires, évitant ainsi d’altérer la structure des variables polymodales lorsque cela n’est pas strictement nécessaire.
5.3 Extraction des caractéristiques et réintégration dans Pandas
L’application de transformateurs Scikit-Learn se traduit historiquement par la génération de tableaux multidimensionnels NumPy ou de matrices creuses SciPy, formats qui évacuent par nature les métadonnées contextuelles telles que les étiquettes textuelles des colonnes d’origine. Cette perte d’information nominale complique considérablement les tâches d’audit ultérieures, l’inspection de l’importance des variables et l’explicabilité globale des modèles d’apprentissage automatique.
Pour combler cette lacune, l’estimateur met à disposition la méthode get_feature_names_out. Cette fonction interroge l’état interne de l’encodeur pour générer dynamiquement un tableau de chaînes de caractères représentant la combinaison syntaxique rigoureuse du nom originel de l’attribut et de la modalité binarisée correspondante. Grâce à cette nomenclature standardisée, le praticien dispose de la cartographie exacte de chaque axe dimensionnel créé au sein du nouvel espace vectoriel.
La reconstruction d’un DataFrame Pandas enrichi s’articule alors autour d’une opération matricielle propre. Le tableau issu de la méthode transform est réencapsulé au sein d’une structure DataFrame en lui assignant explicitement les noms de colonnes extraits ainsi que l’index original des observations pour préserver l’alignement des lignes. Cette matrice transformée peut ensuite être réassociée en toute sécurité aux variables quantitatives continues initiales par le biais d’une concaténation horizontale, rétablissant une vue analytique unifiée sans compromettre l’étanchéité des calculs vectoriels sous-jacents.
6. Gestion des modalités rares et des catégories inconnues en prédiction
6.1 Le défi de l’inférence face à la dérive catégorielle (Category Drift)
Le déploiement pérenne d’un modèle d’apprentissage automatique dans un environnement de production dynamique le confronte inévitablement au phénomène de dérive distributionnelle, et plus spécifiquement à la dérive catégorielle (category drift). Ce phénomène désigne la modification progressive ou brutale des fréquences d’apparition des modalités, ou encore l’émergence d’attributs nominaux totalement inédits au fil du temps. Dans des contextes applicatifs variés, tels que la détection de fraudes transactionnelles, le traitement du langage naturel ou la surveillance de parcours clients sur des plateformes web, l’apparition continue de nouvelles désignations qualitatives constitue la norme opérationnelle.
Lorsqu’un modèle d’inférence rencontre une modalité inconnue au sein du flux de données de production, une défaillance immédiate menace le système informatique si aucun protocole de résilience n’a été implémenté en amont. D’un point de vue matriciel, une modalité nouvelle correspond à une dimension vectorielle absente de la base d’apprentissage originale. Le modèle statistique, n’ayant jamais calibré de poids synaptique ou de coefficient de régression pour cette dimension, se trouve dans l’incapacité mathématique de calculer le produit scalaire correspondant.
L’impact psychométrique ou comportemental de ces nouvelles classes n’est pas négligeable : une catégorie marginale peut traduire une rupture sociologique émergente ou une modification des habitudes de consommation. Le diagnostic préventif de stabilité des modalités dans le temps, adossé au calcul d’indicateurs de divergence statistique tels que la divergence de Kullback-Leibler ou la distance de Wasserstein appliquée aux distributions qualitatives discrètes, représente ainsi un impératif de veille méthodologique pour tout ingénieur de données.
6.2 Stratégie d’encodage avec le paramètre handle_unknown=’ignore’
Au sein de la classe OneHotEncoder de Scikit-Learn, la réponse architecturale par défaut face à une modalité non observée durant l’entraînement consiste à lever une exception bloquante de type ValueError. Cette rigueur algorithmique est salutaire durant les phases de développement, car elle alerte immédiatement l’expérimentateur sur des anomalies structurelles ou des faiblesses d’échantillonnage. Néanmoins, dans un pipeline d’inférence en temps réel, l’interruption inopinée du service algorithmique est inacceptable.
La configuration de l’argument handle_unknown=’ignore’ modifie fondamentalement ce comportement. Lorsqu’une observation présente une modalité inédite, l’encodeur neutralise la non-conformité dimensionnelle en générant un vecteur ligne entièrement constitué de zéros pour l’ensemble des colonnes allouées à cette variable spécifique. D’un point de vue algébrique, cela équivaut à projeter l’observation sur l’origine du sous-espace vectoriel de la caractéristique considérée, annulant instantanément la contribution de cet attribut dans le calcul de la fonction de décision linéaire ou du score d’activation.
Bien que cette stratégie garantisse l’intégrité opérationnelle du système sans interruption d’exécution, elle induit des conséquences statistiques substantielles qu’il convient de mesurer avec lucidité. L’attribution d’un vecteur nul se traduit par une perte sèche d’information discriminante. Dans un modèle de régression linéaire à terme constant, l’observation inconnue se voit implicitement attribuer l’effet de base absorbé par l’ordonnée à l’origine, ce qui peut fausser la calibration des probabilités prédites si la nouvelle modalité présente des caractéristiques très éloignées de la moyenne de référence de la population d’entraînement.
6.3 Agrégation automatique des modalités sous-représentées via min_frequency
Pour endiguer la prolifération des dimensions éparses et immuniser le modèle contre la volatilité des classes marginales, les versions récentes de Scikit-Learn ont introduit des fonctionnalités d’agglomération statistique de pointe : les paramètres min_frequency et max_categories. Cette avancée technique majeure comble le fossé qui séparait historiquement le prétraitement ad hoc des pipelines de production rigoureusement reproductibles.
Le paramètre min_frequency permet de fixer un seuil minimal de prévalence, exprimé soit sous la forme d’un effectif absolu d’observations, soit sous celle d’une fraction décimale de la taille de l’échantillon d’entraînement. Durant la phase d’ajustement (fit), l’algorithme recense la distribution des modalités et identifie toutes les catégories dont la fréquence se situe en deçà de ce seuil critique. Plutôt que de consacrer une colonne binaire individuelle à chacune de ces micro-modalités, l’encodeur les fusionne automatiquement au sein d’une unique modalité synthétique consolidée, généralement étiquetée sous l’appellation générique d’infrequent.
Conjointement, le paramètre max_categories impose une borne supérieure stricte sur le nombre total de colonnes binaires générées pour une variable donnée, regroupant systématiquement les classes les moins représentées dès que ce plafond est atteint. Cette approche stabilise considérablement la variance des estimateurs en consolidant le support empirique de chaque variable encodée. Elle réduit drastiquement la dimensionnalité globale et l’éparsité matricielle tout en garantissant qu’aucune classe rarissime ne vienne déstabiliser l’apprentissage par des coefficients aberrants.
7. Le piège des variables muettes (Dummy Variable Trap) et la multicolinéarité
7.1 Démonstration de la colinéarité parfaite au sein des modèles linéaires
Le piège des variables muettes, formalisé dans la littérature économétrique anglo-saxonne sous le terme de Dummy Variable Trap, constitue une pathologie mathématique sévère affectant prioritairement les modèles paramétriques linéaires. Il découle directement de la violation de l’hypothèse de plein rang de la matrice de conception des données, condition préalable indispensable à l’existence et à l’unicité de la solution des moindres carrés ordinaires. Ce phénomène s’enracine dans la relation de dépendance linéaire exacte qui lie les vecteurs binaires issus d’un encodage disjonctif complet.
Considérons une variable qualitative subdivisée en K modalités distinctes. L’application d’un encodage one-hot exhaustif produit K vecteurs colonnes. Par construction arithmétique rigoureuse, pour chaque ligne de la matrice, l’une et une seule de ces coordonnées prend la valeur un, toutes les autres étant nulles. Il s’ensuit que la somme vectorielle de ces K colonnes binaires donne invariablement un vecteur dont toutes les composantes sont rigoureusement égales à un. Or, dans un modèle de régression linéaire standard intégrant une constante (l’ordonnée à l’origine ou intercept), la matrice de conception comprend déjà une colonne constante unitaire.
Cette configuration crée une situation de multicolinéarité parfaite : la colonne constante est rigoureusement égale à la somme des K colonnes générées. En conséquence, les colonnes de la matrice ne sont plus linéairement indépendantes, et la matrice de Gram (le produit de la transposée de la matrice par elle-même) n’est plus inversible, son déterminant s’annulant strictement. D’un point de vue computationnel, cela provoque l’échec des algorithmes d’inversion matricielle standard ou entraîne une instabilité numérique critique caractérisée par une explosion de la variance des coefficients estimés, rendant toute interprétation statistique nulle et non avenue.
7.2 Techniques de désactivation d’une colonne de référence
Pour désamorcer mathématiquement le piège des variables muettes, la solution canonique consiste à supprimer délibérément l’une des colonnes binaires résultant de l’encodage, ramenant ainsi le nombre de dimensions qualitatives à K – 1. En éliminant cette redondance vectorielle, la somme des colonnes restantes ne peut plus reproduire le vecteur unitaire constant de manière systématique, ce qui restaure immédiatement le rang plein de la matrice de conception et garantit l’inversibilité mathématique du système linéaire.
Sur le plan de l’interprétation statistique, la catégorie supprimée n’est aucunement évacuée du modèle ; elle est érigée au rang de modalité de référence, également appelée niveau de base comparatif. Au sein de l’équation de régression résultante, le terme constant absorbe intégralement l’effet marginal moyen associé à cette modalité de base. Les coefficients de régression estimés pour les K – 1 colonnes indicatrices résiduelles ne quantifient plus un effet absolu, mais expriment précisément l’écart marginal différentiel par rapport à la catégorie de référence.
La mise en œuvre de cette technique sous Scikit-Learn s’effectue aisément via le paramètre drop=’first’, qui écarte mécaniquement la première catégorie selon l’ordre lexicographique ou catégoriel. Néanmoins, dans des protocoles de recherche avancés, notamment en psychologie quantitative ou en épidémiologie, le choix de la modalité de référence ne doit pas être laissé au hasard de l’ordre alphabétique. Il est recommandé de sélectionner délibérément une modalité centrale, normative ou présentant un volume d’observations massif afin de minimiser l’erreur standard associée aux comparaisons relatives de tous les autres coefficients du modèle.
7.3 Insensibilité des modèles non linéaires et arbres de décision
Si la multicolinéarité parfaite constitue une menace existentielle pour les régressions linéaires, la régression logistique non pénalisée et les modèles de survie de Cox, il est primordial de souligner que les architectures d’apprentissage non linéaires, en particulier les modèles fondés sur des arbres de décision, y sont structurellement insensibles. Les forêts aléatoires (Random Forests) et les algorithmes de gradient boosting (tels que XGBoost ou LightGBM) n’opèrent aucun calcul d’inversion matricielle globale au cours de leur phase d’entraînement.
Le fonctionnement fondamental des arbres repose sur une optimisation séquentielle et locale de critères de partitionnement géométrique, tels que l’impureté de Gini ou l’entropie de Shannon. À chaque nœud de division, l’algorithme évalue indépendamment chaque caractéristique pour identifier le seuil de coupure maximisant le gain d’information. La colinéarité linéaire stricte liant un ensemble de variables binaires n’affecte en rien cette procédure de partitionnement univariée. La présence d’une modalité redondante n’altère pas la capacité intrinsèque d’un arbre à segmenter l’espace d’échantillonnage.
De surcroît, les modèles linéaires assortis de régularisations matricielles fortes, telles que la régression Ridge (pénalité L2) ou ElasticNet, tolèrent parfaitement la colinéarité complète sans nécessiter de suppression manuelle de colonne. La pénalisation L2 impose une contrainte quadratique sur la norme des poids qui force la matrice de Gram régularisée à devenir strictement définie positive, rendant son inversion parfaitement stable. Dans ce contexte, conserver l’intégralité des K colonnes sans suppression arbitraire présente l’avantage notable de préserver une stricte symétrie mathématique dans le traitement de l’ensemble des modalités.
8. Optimisation de l’empreinte mémoire et exploitation des matrices creuses
8.1 Structure et fonctionnement interne des matrices CSR et CSC
L’application massive de l’encodage disjonctif complet à des bases de données volumineuses engendre inévitablement une surreprésentation phénoménale de zéros au sein de la matrice de conception résultante. Une variable comptant cinquante catégories produit une matrice dont le taux d’occupation informationnelle réelle n’est que de deux pour cent, les quatre-vingt-dix-huit pour cent résiduels étant constitués d’éléments nuls sans valeur informative directe. Maintenir une telle structure sous la forme d’un tableau dense conventionnel représente un gaspillage massif et inefficace des registres de la mémoire vive.
Pour contourner ce goulet d’étranglement matériel, les bibliothèques de calcul scientifique recourent au formalisme des matrices creuses (sparse matrices), implémenté au cœur du module scipy.sparse. Le format CSR (Compressed Sparse Row) s’impose comme la structure de référence pour l’entraînement des modèles d’apprentissage automatique. Au lieu d’allouer de la mémoire pour chaque coordonnée matricielle, le formalisme CSR compresse les données en stockant exclusivement trois tableaux unidimensionnels condensés : un tableau contenant les valeurs non nulles réelles (constitué ici exclusivement de uns), un tableau indexant les numéros de colonnes de ces valeurs, et un tableau de pointeurs de lignes marquant l’emplacement du premier élément de chaque ligne au sein des tableaux précédents.
Cette représentation condensée réduit l’empreinte spatiale globale de plusieurs ordres de grandeur. L’économie d’échelle devient exponentielle à mesure que la cardinalité des variables s’élève. Parallèlement, les algorithmes de calcul matriciel exploitent directement cette topologie condensée pour accélérer les opérations algébriques d’algèbre linéaire, telles que les multiplications matrice-vecteur, en sautant systématiquement les étapes de sommation impliquant des termes nuls. Il convient toutefois de noter que certaines opérations complexes de manipulation tabulaire, comme les jointures d’index sous Pandas, s’accommodent mal des formats creux, imposant une gestion rigoureuse des interfaces de conversion.
8.2 Techniques de conversion de types de données scalaires
Lorsque des contraintes méthodologiques ou des impératifs d’interopérabilité logicielle imposent le maintien temporaire d’une matrice sous forme dense au sein de Pandas, la gestion méticuleuse de la précision des types scalaires constitue un levier d’optimisation majeur trop souvent négligé par les praticiens. Par défaut, de nombreux environnements scientifiques allouent des scalaires de type int64 ou float64 pour consigner des valeurs binaires. Dans ce schéma, chaque cellule matricielle consomme huit octets (64 bits) de mémoire pour représenter un état logique élémentaire ne nécessitant conceptuellement qu’un seul bit.
La substitution systématique de ces types surdimensionnés par des types entiers non signés ultra-compacts tels que uint8, ou par le type booléen natif, divise instantanément la consommation globale de mémoire vive par huit. Sur un jeu de données mobilisant plusieurs centaines de colonnes binarisées et plusieurs millions de lignes, cette simple requalification de type convertit une charge mémoire paralysante de seize gigaoctets en une structure maniable de deux gigaoctets seulement, maintenant l’exécution computationnelle dans les limites physiques de stations de travail standard.
Pandas intègre également une extension native dédiée, les tableaux creux (SparseArray), qui permet d’associer un type de données creux explicite (par exemple Sparse[int, 0]) directement au sein des colonnes d’un DataFrame classique. L’utilisation d’outils d’audit et de profilage mémoire approfondis, tels que memory_profiler, offre la possibilité de tracer les allocations transitoires au mégaoctet près au cours de la chaîne d’encodage, validant ainsi objectivement l’efficacité des protocoles de réduction scalaire déployés.
8.3 Calcul distribué et traitement de flux volumineux
Face à des jeux de données d’une volumétrie extrême qui outrepassent irrémédiablement la capacité physique de mémoire vive d’une machine isolée, les approches de traitement en mémoire unifiée deviennent caduques. Deux stratégies méthodologiques complémentaires s’offrent alors à l’ingénieur de données : le découpage par lots séquentiels (chunking) et l’orchestration de calculs distribués à mémoire partagée ou distribuée.
La technique du traitement par morceaux sous Pandas consiste à fractionner le flux de données entrant en blocs de taille maîtrisée au moyen du paramètre chunksize des fonctions de chargement. Chaque bloc est successivement chargé, filtré, projeté sous forme de matrice creuse via Scikit-Learn, puis persisté sur disque au format binaire compressé ou agrégé incrémentalement. Cette architecture garantit que l’empreinte mémoire instantanée ne dépasse jamais le plafond alloué à un lot unique, autorisant le traitement d’ensembles de données massifs sur des infrastructures matérielles modestes.
Pour les environnements de calcul massivement parallèle, l’intégration de bibliothèques distribuées telles que Dask devient impérative. Dask reproduit l’interface de programmation de Pandas et Scikit-Learn tout en segmentant les DataFrames en un graphe de tâches acyclique orienté (DAG). L’opération d’encodage one-hot distribuée est exécutée de manière coordonnée à travers un cluster de calcul, chaque nœud traitant une partition indépendante des données tout en maintenant une synchronisation centralisée du dictionnaire des modalités catégorielles, éliminant ainsi les goulets d’étranglement inhérents à la sérialisation des représentations denses.
9. Intégration robuste dans les pipelines Scikit-Learn avec ColumnTransformer
9.1 Architecture d’un préprocesseur hétérogène complet
Dans un contexte d’apprentissage automatique professionnel, un jeu de données réel ne se compose jamais exclusivement de variables qualitatives homogènes. Il associe structurellement des prédicteurs continus d’échelles variées, des mesures temporelles, des indicateurs binaires et des variables nominales ou ordinales complexes. Tenter d’appliquer des transformations isolées sur ces sous-espaces de données en dehors d’une architecture unifiée engendre un code fragile, propice aux erreurs de manipulation et impossible à certifier pour des environnements de production sécurisés.
La réponse architecturale canonique repose sur l’utilisation du module sklearn.compose.ColumnTransformer. Cet agrégateur de haut niveau permet de concevoir une architecture de prétraitement modulaire et compartimentée. Il autorise le ciblage sélectif des transformations appropriées en fonction des sous-ensembles de colonnes spécifiés : par exemple, en appliquant un standardiseur normalisateur (StandardScaler) sur les attributs quantitatifs continus, tout en déléguant le traitement des caractéristiques qualitatives à une instance dédiée de OneHotEncoder.
La configuration de l’argument remainder au sein de ColumnTransformer verrouille la gouvernance des attributs non explicitement mentionnés dans le dictionnaire des transformations. En positionnant cet argument sur drop, toutes les colonnes non sollicitées sont méthodiquement éliminées, garantissant que seuls les sous-espaces validés intègrent la matrice de modélisation finale. Inversement, l’assignation de la valeur passthrough autorise la traversée transparente et sans altération de caractéristiques préalablement encodées, offrant une flexibilité structurelle totale lors de l’assemblage de préprocesseurs sophistiqués.
9.2 Chaînage au sein d’un Pipeline de bout en bout
L’assemblage séquentiel de transformateurs multiples et d’un estimateur final s’opérationnalise par l’entremise de la classe Pipeline de Scikit-Learn. Le principe fondamental d’un pipeline est d’encapsuler l’intégralité du cycle de vie du traitement de la donnée — depuis l’imputation préliminaire des valeurs manquantes, en passant par la mise à l’échelle continue et l’encodage one-hot, jusqu’à l’ajustement du modèle prédictif final — au sein d’une entité programmatique unique exposant rigoureusement les méthodes fit, predict et score.
Cette encapsulation étanche résout de manière définitive le risque omniprésent de fuite d’information transversale (data leakage), l’un des écueils statistiques les plus insidieux en science des données. Une fuite d’information survient dès lors que des métadonnées issues de l’ensemble de validation ou de test s’infiltrent subrepticement dans l’étape d’entraînement. Si un encodage disjonctif complet est réalisé sur l’intégralité du jeu de données agrégé avant d’opérer la séparation d’échantillonnage, les catégories rares ou la structure distributionnelle de l’échantillon de test ont contaminé la matrice d’entraînement, induisant un biais d’optimisme artificiel dans l’évaluation empirique des performances du modèle.
En encapsulant le ColumnTransformer au sein d’un Pipeline, toute procédure de validation croisée (cross-validation) garantit l’étanchéité absolue de l’évaluation : pour chaque pli de partitionnement, les statistiques de standardisation et le dictionnaire des modalités de l’encodeur one-hot sont appris exclusivement sur les données du sous-ensemble d’entraînement courant, puis appliqués de manière aveugle au pli de validation préservé, simulant parfaitement les conditions réelles d’une inférence future en conditions inconnues.
9.3 Optimisation conjointe des hyperparamètres via GridSearchCV
L’intégration d’un encodeur one-hot au sein d’une structure de pipeline standardisée débloque une opportunité méthodologique déterminante : l’optimisation conjointe et simultanée des paramètres de transformation des données et des hyperparamètres de l’algorithme d’apprentissage statistique. Traditionnellement, le praticien ajuste de manière isolée le seuil de regroupement des modalités catégorielles, puis tente d’optimiser séparément le terme de pénalisation du modèle de classification ou de régression, passant à côté d’interactions structurelles complexes.
Grâce aux classes d’optimisation combinatoire telles que GridSearchCV ou RandomizedSearchCV, il devient possible d’explorer un espace de recherche conjoint en faisant varier systématiquement la nomenclature des préprocesseurs. L’opérateur peut évaluer formellement si l’introduction d’un seuil de fréquence minimale d’apparition des modalités (min_frequency) améliore la métrique d’évaluation finale par rapport à un encodage intégral pur, tout en modulant concomitamment la profondeur maximale d’un arbre ou la régularisation d’une régression logistique.
Une fois l’exploration combinatoire parachevée et la combinaison optimale validée au regard de la métrique d’intérêt sur les plis de validation croisée, l’ensemble de la chaîne de traitement est automatiquement réajusté sur l’intégralité des données disponibles. L’artefact résultant, consolidant harmonieusement les règles de transformation vectorielle et les coefficients prédictifs finaux, peut être exporté et sérialisé de manière atomique vers des formats standardisés via des outils de persistance logicielle comme joblib ou pickle, garantissant un déploiement sécurisé et sans friction en environnement opérationnel.
10. Analyse comparative : One-Hot versus alternatives d’encodage catégoriel
10.1 Encodage ordinal et binaire (Binary Encoding)
Si l’encodage one-hot demeure la référence pour les variables qualitatives nominales à cardinalité modérée, d’autres paradigmes de projection doivent être mobilisés lorsque la dimensionnalité devient prohibitive. L’encodage ordinal simple (ou Label Encoding) représente l’alternative la plus élémentaire, consistant à assigner un entier séquentiel distinct à chaque modalité. Bien que sa compacité dimensionnelle soit imbattable puisqu’il confine la variable à une dimension unique, cette méthode injecte une métrique d’ordre purement arbitraire dévastatrice pour les modèles paramétriques linéaires ou basés sur les distances.
Pour concilier la neutralité de l’orthogonalité et la compression spatiale, l’encodage binaire (Binary Encoding) offre un compromis algorithmique d’une remarquable élégance théorique. Cette technique commence par associer un identifiant entier séquentiel à chaque modalité, puis convertit cet entier dans sa représentation binaire en base deux. Les chiffres binaires individuels résultants sont ensuite répartis sur des colonnes distinctes. Par cette approche, une variable comportant mille modalités distinctes n’exige plus mille colonnes comme en encodage one-hot, mais seulement dix colonnes binaires (car deux puissance dix égale mille vingt-quatre).
Cette compression logarithmique de la dimensionnalité résout efficacement l’explosion combinatoire tout en atténuant le fléau de la dimensionnalité. En contrepartie, l’interprétabilité sémantique directe des colonnes individuelles est totalement rompue : une colonne binaire issue d’un tel encodage ne représente plus une modalité empirique tangible, mais un bit algorithmique abstrait dont la signification dépend étroitement de l’activation combinée des autres colonnes de la séquence binaire.
10.2 Encodage par la cible (Target / Mean Encoding) et risques de surapprentissage
L’encodage par la cible, couramment dénommé Target Encoding ou encodage par la moyenne, constitue une méthode supervisée particulièrement redoutable dans le cadre de compétitions d’apprentissage automatique et de modélisation prédictive sur des variables à très haute cardinalité. Le principe repose sur le remplacement direct de chaque modalité catégorielle par l’espérance conditionnelle de la variable cible calculée sur l’ensemble des observations associées à cette catégorie spécifique. Dans un problème de classification binaire, une modalité est ainsi substituée par la proportion empirique de cas positifs observés pour cette classe.
Cette approche condense instantanément une variable qualitative de cardinalité arbitrairement grande en une dimension scalaire continue unique, directement corrélée à l’objectif de prédiction. Toutefois, le talon d’Achille structurel de l’encodage par la cible réside dans sa propension aiguë au surapprentissage (overfitting), en particulier face à des modalités faiblement représentées. Si une catégorie n’apparaît qu’une seule fois dans le jeu d’entraînement et que la cible associée vaut un, lui attribuer un score de un induit un biais prédictif colossal non généralisable.
L’atténuation de ce surapprentissage sévère impose la mise en œuvre de techniques d’adoucissement bayésien (smoothing), qui pondèrent la moyenne conditionnelle locale par la moyenne globale de la cible en fonction de la taille de l’échantillon de la catégorie. De surcroît, le calcul des encodages doit s’opérer obligatoirement selon des schémas d’ajustement hors échantillon (out-of-fold target encoding) rigoureux afin de prévenir l’auto-mémorisation de la cible, une complexité de mise en œuvre nettement supérieure à celle, déterministe et non supervisée, de l’encodage one-hot.
10.3 Plongements vectoriels (Entity Embeddings) pour les très fortes cardinalités
Issus du paradigme connexionniste et popularisés par le traitement du langage naturel avec les modèles d’incorporation de mots tels que Word2Vec, les plongements vectoriels d’entités (Entity Embeddings) représentent l’état de l’art pour la modélisation des attributs qualitatifs à cardinalité massive. Cette méthodologie consiste à projeter chaque modalité discrète au sein d’un espace vectoriel continu et dense de dimension réduite, généralement calibrée entre dix et une centaine de dimensions.
Contrairement à l’encodage one-hot qui impose une orthogonalité figée et a priori entre toutes les catégories, les coordonnées des plongements vectoriels sont apprises de manière différentiable au cours de la rétropropagation du gradient au sein d’une architecture de réseau de neurones profonds. Au cours de l’apprentissage, les vecteurs représentatifs des catégories se déplacent dynamiquement dans l’espace latent, convergeant de telle sorte que les modalités partageant des comportements, des contextes ou des affinités fonctionnelles similaires se regroupent dans des voisinages topologiques étroits.
Cette expressivité sémantique continue surpasse largement l’encodage disjonctif complet pour capturer des non-linéarités complexes et des relations hiérarchiques implicites au sein de catalogues produits colossaux ou de graphes sociaux complexes. En revanche, le coût computationnel d’entraînement de telles représentations latentes, la nécessité de disposer d’échantillons massifs de données pour stabiliser la convergence et la relative opacité des représentations vectorielles obtenues constituent des barrières à l’entrée importantes comparativement à la simplicité mathématique et à l’immédiateté computationnelle de l’encodage one-hot.
11. Étude de cas complète : flux de traitement reproductible étape par étape
11.1 Formulation du problème et description des données brutes
Afin de synthétiser concrètement les principes exposés, développons une étude de cas appliquée portant sur la modélisation prédictive de l’adhésion à un programme de fidélisation bancaire d’un panel de clients. La problématique consiste à prédire une variable cible binaire désignant le consentement ou le refus du client face à une offre de services financiers. Le jeu de données brutes synthétique regroupe une typologie variée d’attributs individuels : l’âge du client (quantitatif continu), le score de solvabilité financière (quantitatif continu), le niveau d’éducation déclaré (ordinal hiérarchisé), la région administrative de résidence (nominale à cardinalité moyenne) et le canal préférentiel d’interaction bancaire (nominale pure).
Une inspection initiale de la matrice des données met en lumière des singularités distributionnelles : la variable régionale comporte des modalités territoriales à très forte fréquence associées à quelques départements ultra-minoritaires, tandis que le canal de communication intègre des valeurs manquantes résultant d’omissions de collecte lors de l’enregistrement en agence. Le niveau d’études s’échelonne quant à lui de manière ordonnée du cycle secondaire jusqu’au troisième cycle universitaire.
Le protocole expérimental impose une scission immédiate des données brutes en un sous-ensemble d’apprentissage (80 % du volume global) et un sous-ensemble de test préservé (20 % du volume global). Cette ségrégation initiale est opérée de manière stratifiée sur la variable cible, garantissant la préservation exacte de la prévalence d’adhésion au sein des deux partitions méthodologiques et interdisant formellement tout contact préalable entre le sous-ensemble de test et les estimateurs d’encodage.
11.2 Écriture du code d’ingénierie des caractéristiques
L’ingénierie des caractéristiques s’articule autour de l’instanciation de transformateurs distincts et hautement spécialisés. Pour les variables quantitatives continues (l’âge et le score de solvabilité), un pipeline dédié combine un imputeur univarié par la médiane suivi d’un transformateur de mise à l’échelle robuste (RobustScaler), assurant une neutralité face aux potentielles valeurs aberrantes extrêmes.
Pour les variables nominales (la région et le canal d’interaction), un second bloc de transformation est configuré. Il mobilise en premier lieu un imputeur catégoriel assignant une modalité textuelle sentinelle d’absence, puis orchestre un OneHotEncoder rigoureusement calibré. Afin de juguler l’éparsité dimensionnelle des micro-régions, le paramètre min_frequency=0.02 est activé pour fusionner automatiquement les entités marginales au sein d’un groupe résiduel. De surcroît, la directive handle_unknown=’ignore’ est engagée pour prémunir l’architecture logicielle contre l’apparition inopinée de localités territoriales non répertoriées lors des requêtes d’inférence futures.
Ces pipelines hétérogènes sont ensuite fusionnés au sein d’une instance maîtresse de ColumnTransformer, qui dispatche chirurgicalement chaque groupe de colonnes vers son transformateur assigné. Enfin, ce préprocesseur global est interconnecté en série avec un estimateur de régression logistique régularisée au sein d’un Pipeline unifié Scikit-Learn. L’intégralité de la chaîne d’apprentissage est exécutée au travers de l’unique méthode fit appelée exclusivement sur les données brutes d’entraînement, assurant l’étanchéité méthodologique absolue de l’ensemble des transformations vectorielles déployées.
11.3 Évaluation quantitative et inspection des coefficients
L’évaluation quantitative du modèle ainsi calibré s’opère en sollicitant la méthode predict du pipeline global sur l’échantillon de test préservé. L’analyse des performances mobilisant des métriques insensibles aux déséquilibres de classes, telles que l’aire sous la courbe ROC (ROC-AUC) et le score de précision moyenne (Average Precision), atteste d’une remarquable stabilité de généralisation prédictive, exempte de tout effondrement imputable à des incohérences dimensionnelles.
L’inspection analytique interne de la décision algorithmique devient possible grâce à la reconstitution vectorielle des étiquettes de caractéristiques. En invoquant get_feature_names_out sur le préprocesseur ajusté, l’expérimentateur extrait l’intitulé nominal précis de chaque coordonnée projetée, incluant les regroupements de modalités synthétiques. Ces dénominations sont immédiatement alignées avec les coefficients scalaires estimés par la régression logistique sous-jacente.
L’interprétation statistique des résultats met en évidence la puissance et la lisibilité du dispositif : chaque modalité binarisée se voit attribuer un coefficient logit indépendant dont l’exponentielle traduit fidèlement le rapport de cotes (odds ratio) associé au facteur comportemental spécifique. Le modélisateur peut ainsi affirmer avec certitude que l’interaction préférentielle par canal numérique multiplie significativement la cote d’adhésion par rapport aux interactions physiques en agence, validant à la fois la pertinence de l’encodage disjonctif complet et son apport irremplaçable à l’intelligibilité scientifique des modèles d’aide à la décision.
12. Bonnes pratiques, écueils statistiques et synthèse méthodologique
12.1 Écueils majeurs et protocoles d’atténuation
L’un des écueils méthodologiques les plus destructeurs et néanmoins ubiquitaires dans la pratique empirique réside dans l’application prématurée de fonctions d’encodage globales, telles que get_dummies, préalablement à la partition stricte entre données d’entraînement et données d’évaluation. Cette entorse épistémologique majeure induit une fuite d’information systémique en autorisant la distribution globale des modalités à déterminer la configuration dimensionnelle de la matrice d’apprentissage. Le protocole d’atténuation impératif exige l’utilisation exclusive de transformateurs à état persistant encapsulés au sein de pipelines étanches, où la phase d’ajustement est formellement ségréguée.
Un second écueil critique réside dans l’omission des diagnostics de multicolinéarité lors du déploiement de modèles linéaires explicatifs. Conserver l’intégralité des modalités issues d’un encodage disjonctif complet tout en intégrant une ordonnée à l’origine déstabilise irrémédiablement le conditionnement de la matrice de Gram, faussant les calculs de significativité statistique et invalidant les tests d’hypothèses de Student ou de Wald sur les coefficients individuels. Le praticien se doit d’activer systématiquement la désactivation d’une modalité pivot (drop=’first’) ou de recourir à des régularisations pénalisées de type Tikhonov (L2).
Enfin, le basculement aveugle vers des représentations matricielles denses lors de la manipulation de variables à très haute cardinalité représente un risque opérationnel immédiat d’épuisement mémoire (Out-Of-Memory crash). L’exploitation rigoureuse des sorties creuses natives de Scikit-Learn, couplée au profilage systématique des types scalaires en mémoire, doit s’imposer comme une exigence standard de contrôle qualité logiciel préalablement à tout transfert vers des grappes de serveurs de production.
12.2 Grille de décision systématique pour le praticien
Afin de guider rationnellement le praticien dans l’arbitrage des techniques d’encodage catégoriel, nous formalisons une grille de décision systématique s’appuyant sur trois critères discriminants : l’échelle de mesure de l’attribut, sa cardinalité empirique et la famille algorithmique exploitée pour la tâche prédictive.
Le premier filtre concerne la nature scalaire de la variable. Si l’attribut présente une hiérarchie intrinsèque manifeste et transitrice, l’encodage one-hot doit être formellement proscrit au profit d’un encodage ordinal étalonné. Pour les variables purement nominales sans relation d’ordre, l’arbitrage s’oriente alors en fonction du cardinal d’éléments uniques recensés.
Pour une cardinalité faible ou intermédiaire (inférieure à cinquante modalités) :
- Face à un modèle linéaire non régularisé (Régression Linéaire, GLM standard) : Utiliser rigoureusement OneHotEncoder avec le paramètre drop=’first’ pour éliminer la colinéarité exacte.
- Face à un modèle linéaire pénalisé (Ridge, Lasso, ElasticNet) : Utiliser OneHotEncoder avec l’intégralité des modalités conservées (drop=None) afin de préserver l’équipondération du rétrécissement bayésien.
- Face à un modèle arborescent (Random Forests, Gradient Boosting) : Utiliser OneHotEncoder sans suppression de modalité, ou privilégier l’encodage catégoriel natif optimisé proposé par des moteurs modernes tels que LightGBM ou CatBoost.
Pour une cardinalité élevée ou extrême (supérieure à cinquante ou cent modalités) :
- Si le maintien de l’interprétabilité directe est requis : Employer OneHotEncoder en conjonction stricte avec le paramètre min_frequency pour regrouper drastiquement les modalités résiduelles sous une classe unifiée.
- Si l’optimisation maximale de la précision prédictive prévaut sur l’explicabilité linéaire : S’orienter vers l’encodage par la cible adouci (Target Encoding with smoothing) ou mobiliser des plongements vectoriels neuronaux (Entity Embeddings).
12.3 Conclusions et perspectives scientifiques de la représentation de données
L’encodage one-hot demeure, plusieurs décennies après sa formalisation mathématique, l’une des colonnes du temple de l’ingénierie des caractéristiques et de la modélisation statistique. Sa puissance réside dans son élégance géométrique irréprochable : offrir une projection orthogonale équidistante garantissant la neutralité sémantique la plus pure pour le traitement computationnel des concepts nominaux humains. Loin d’être une simple recette de codage utilitaire, sa maîtrise engage des considérations fondamentales d’algèbre linéaire, de conditionnement matriciel et de théorie de l’échantillonnage statistique.
L’évolution contemporaine de la discipline ne vise pas à éradiquer cette transformation canonique, mais à l’intégrer au sein de processus toujours plus adaptatifs et automatisés. L’avènement des architectures d’apprentissage automatique automatisé (AutoML) intègre désormais des heuristiques dynamiques capables de moduler les seuils d’activation disjonctive, d’arbitrer automatiquement les stratégies de suppression de colinéarité et de basculer de manière transparente entre formats creux et denses en fonction des métriques de charge des processeurs graphiques et de la mémoire disponible.
Pour le chercheur comme pour l’ingénieur de données, la rigueur méthodologique imposée par la manipulation des variables qualitatives rappelle une vérité pérenne de la science des données : la sophistication intrinsèque d’un modèle algorithmique ne saurait jamais compenser les approximations ou les failles structurelles commises lors de la phase fondamentale de représentation mathématique du réel.
Références
Agresti, A. (2018). An introduction to categorical data analysis (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/An+Introduction+to+Categorical+Data+Analysis%2C+3rd+Edition-p-9781119405269
Bellman, R. (1957). Dynamic programming. Princeton University Press. https://press.princeton.edu/books/hardcover/9780691651873/dynamic-programming
Belsley, D. A., Kuh, E., & Welsch, R. E. (2005). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Guo, C., & Berkhahn, F. (2016). Entity embeddings of categorical variables. arXiv preprint arXiv:1604.06737. https://arxiv.org/abs/1604.06737
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). https://doi.org/10.25080/Majora-92bf1924-00a
Micci-Barreca, D. (2001). A preprocessing scheme for high-cardinality categorical attributes in classification and prediction problems. ACM SIGKDD Explorations Newsletter, 3(1), 27-32. https://doi.org/10.1145/507533.507538
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2