
L’exploration méthodique des données constitue le socle fondamental sur lequel repose l’ensemble de l’édifice de la science des données contemporaine, de la modélisation économétrique et de l’inférence statistique. Avant d’envisager le déploiement d’architectures d’apprentissage automatique sophistiquées, de réseaux neuronaux profonds ou de régressions multivariées complexes, le chercheur ou le praticien de la donnée doit impérativement s’astreindre à une auscultation minutieuse et individualisée de chaque dimension composant son univers d’analyse. Cette démarche d’investigation granulaire, désignée sous le terme d’analyse univariée, s’inscrit au cœur de la philosophie de l’analyse exploratoire des données (EDA) conceptualisée par John Tukey, qui préconisait une approche indiciaire et visuelle de la statistique, libérée des postulats probabilistes rigides préalables.
Au sein de l’écosystème open-source contemporain, le langage de programmation Python s’est imposé comme le standard de facto pour mener à bien ces investigations quantitatives et qualitatives. Grâce à une collection harmonieuse de bibliothèques scientifiques hautement optimisées — notamment Pandas, NumPy, SciPy, Statsmodels, Matplotlib et Seaborn —, Python offre une expressivité syntaxique exceptionnelle alliée à des performances de calcul vectorisé de premier ordre. Cet écosystème permet de décomposer chaque variable en ses composantes fondamentales : identifier sa position centrale, mesurer l’ampleur de sa variabilité, sonder la morphologie de sa distribution, détecter ses éléments atypiques et vérifier son adéquation aux distributions théoriques de référence.
Le présent traité constitue une monographie exhaustive dédiée à l’art et à la pratique de l’analyse univariée en Python. Conçu tant pour les chercheurs académiques exigeant une rigueur méthodologique sans faille que pour les ingénieurs en données confrontés à des environnements de production complexes, ce guide explore de manière systématique l’ensemble des concepts théoriques, des algorithmes computationnels et des conventions d’interprétation empirique. À travers des formulations mathématiques rigoureuses, des analyses critiques d’implémentation et des recommandations conformes aux standards de publication scientifique internationaux, cet ouvrage fournit les clés nécessaires pour transformer des séries de données brutes en connaissances analytiques solides et reproductibles.
1. 1. Introduction à l’analyse univariée et fondements méthodologiques
1.1 Définition et importance de l’analyse univariée
L’étymologie du terme « univarié » puise ses racines dans la juxtaposition du préfixe latin uni- (signifiant un seul) et de la notion de variable, désignant littéralement l’étude analytique d’une caractéristique observable unique au sein d’une population ou d’un échantillon déterminé. Contrairement aux démarches bivariées ou multivariées, qui s’attachent à décortiquer les relations de dépendance, les corrélations linéaires, les causalités ou les structures de covariance entre plusieurs dimensions simultanées, l’analyse univariée fait abstraction délibérée de toute interaction externe. Son objectif épistémologique exclusif consiste à décrire, synthétiser et comprendre la structure intrinsèque, la dispersion et les propriétés probabilistes de la variable étudiée, prise isolément dans son contexte empirique.
Dans le flux de travail de l’analyse exploratoire des données (EDA), l’analyse univariée occupe un rôle pivot et indéboulonnable. Elle constitue la première ligne de défense de l’analyste contre les illusions statistiques, les biais d’échantillonnage et les anomalies de mesure. Une modélisation prédictive prématurée, menée sans une compréhension univariée approfondie, expose inévitablement le chercheur au risque d’intégrer des prédicteurs viciés, caractérisés par une asymétrie extrême, une bimodalité insidieuse ou des valeurs aberrantes massives issues d’artefacts instrumentaux. L’investigation univariée permet ainsi d’établir la carte d’identité numérique de chaque colonne d’un tableau de données, validant la pertinence de son inclusion dans des étapes analytiques subséquentes.
Dans les sciences empiriques appliquées, telles que la psychométrie, l’épidémiologie comportementale ou la sociologie quantitative, l’analyse univariée représente souvent une fin en soi autant qu’un jalon méthodologique. Par exemple, lors de la standardisation d’une échelle de mesure psychométrique évaluant l’anxiété ou les fonctions cognitives, l’analyse univariée des scores d’items permet d’évaluer la fidélité, le pouvoir discriminant de chaque question et d’identifier de potentiels effets de plancher ou de plafond. Dans l’analyse des données comportementales en ligne (telles que le temps passé sur une interface ou la fréquence d’achats), elle met immédiatement en évidence la non-gaussienne quasi-systématique des conduites humaines, caractérisées par des distributions à queues lourdes régies par des lois de puissance.
1.2 Typologie des variables statistiques
L’édification de toute démarche analytique univariée requiert impérativement une classification taxinomique précise de la nature mathématique de la variable sous examen. Les variables statistiques se divisent fondamentalement en deux grandes familles ontologiques : les variables qualitatives (ou catégorielles) et les variables quantitatives (ou métriques), chacune se subdivisant en sous-catégories aux propriétés arithmétiques distinctes. Méconnaître cette hiérarchie conduit inéluctablement à des erreurs de catégorie désastreuses, telles que le calcul absurde de la moyenne arithmétique d’un code postal ou d’un statut marital.
Les variables qualitatives nominales regroupent des modalités mutuellement exclusives et exhaustivement énumérables, dépourvues de toute relation d’ordre naturelle ou mathématique. L’appartenance à une catégorie (telle que le genre, la nationalité, le groupe sanguin ou la typologie de panne machine) relève d’une simple désignation symbolique. Les variables qualitatives ordinales, en revanche, introduisent une relation d’ordre stricte ou faible entre les modalités, sans pour autant définir une distance métrique constante entre les échelons successifs. C’est le cas emblématique des échelles de Likert (allant de « pas du tout d’accord » à « tout à fait d’accord »), des niveaux de diplôme ou des stades cliniques d’une pathologie. Si l’on peut affirmer sans ambiguïté qu’un stade III est plus avancé qu’un stade II, il demeure mathématiquement proscrit de postuler que l’écart séparant ces deux stades équivaut à celui séparant les stades I et II.
Les variables quantitatives se caractérisent par le fait que leurs valeurs résultent d’un processus de comptage ou de mesure physique directe, autorisant les opérations d’addition et de soustraction. Les variables quantitatives discrètes prennent leurs valeurs dans un ensemble dénombrable, typiquement l’ensemble des entiers naturels, correspondant à des dénombrements d’événements (nombre d’enfants par foyer, nombre de réclamations clients, nombre de défaillances techniques). Les variables quantitatives continues, quant à elles, se déploient dans le continuum de l’ensemble des réels et découlent d’un processus de mesure continue (taille, pression artérielle, temps de réaction, masse financière). Dans l’univers computationnel de Python et de Pandas, la gestion rigoureuse de ces typologies impose l’assignation adéquate des types primitifs, transitant des types textuels ou objets vers le type category pour les données qualitatives, et vers les types int64 ou float64 pour les données quantitatives.
1.3 Les trois piliers méthodologiques de l’exploration univariée
L’architecture méthodologique d’une analyse univariée exhaustive repose invariablement sur une triangulation opérationnelle rigoureuse. Pour appréhender une variable dans toute sa complexité empirique, le chercheur doit conjuguer simultanément l’estimation des paramètres numériques synthétiques, la construction des structures tabulaires de distribution et le déploiement d’artéfacts visuels adaptés. Aucun de ces trois volets ne peut, à lui seul, résumer fidèlement la réalité de la distribution ; ils s’enrichissent et s’éclairent mutuellement dans une relation dialectique permanente.
Le premier pilier réside dans le calcul des statistiques descriptives résumées. Ces indicateurs de réduction dimensionnelle condensent une série volumineuse de données en un nombre restreint de scalaires hautement informatifs. Ce pilier s’articule autour de deux concepts complémentaires : les mesures de tendance centrale, qui visent à situer le point d’équilibre ou la valeur représentative de la distribution, et les mesures de dispersion, qui quantifient l’étalement, la variabilité ou l’incertitude entourant cette valeur centrale. L’examen isolé d’une mesure centrale sans son corollaire de dispersion constitue l’une des fautes méthodologiques les plus insidieuses en statistique appliquée.
Le deuxième pilier concerne l’élaboration des tables de distribution de fréquences. En organisant les données sous forme d’effectifs, de proportions, de pourcentages et de fréquences cumulées, ce procédé permet d’observer la manière dont la masse de probabilité empirique se répartit entre les différentes modalités ou intervalles de valeurs. Pour les variables continues, cette étape requiert une discrétisation raisonnée qui sert de passerelle entre les valeurs microscopiques individuelles et la structure macroscopique du phénomène. Enfin, le troisième pilier méthodologique réside dans la représentation graphique contextualisée. La visualisation traduit instantanément la géométrie sous-jacente des données — symétrie, aplatissement, multi-modalité et anomalies marginales — que de simples scalaires récapitulatifs échouent fréquemment à révéler pleinement, comme l’illustre de manière éclatante le célèbre quartette d’Anscombe.
2. 2. Configuration de l’environnement Python et préparation du jeu de données
2.1 Importation des bibliothèques scientifiques essentielles
Pour exécuter un protocole d’analyse univariée répondant aux exigences scientifiques contemporaines, il est indispensable de structurer un environnement d’exécution robuste s’appuyant sur les bibliothèques canoniques de l’écosystème Python. Chacune de ces bibliothèques joue un rôle fonctionnel spécialisé au sein de la chaîne de traitement, formant une suite analytique cohérente capable d’absorber des volumes de données substantiels tout en garantissant une précision numérique optimale.
Au centre de cette architecture se trouve la bibliothèque Pandas, indispensable pour la manipulation de structures tabulaires de haute performance nommées DataFrames et Series. Conçue sur une base computationnelle en C, Pandas fournit les primitives d’indexation, de découpage, d’agrégation et de calcul statistique vectorisé. Elle est complétée à bas niveau par NumPy, qui met à disposition des structures de tableaux multidimensionnels homogènes (ndarray) et des fonctions mathématiques opérant élément par élément avec une efficacité mémoire remarquable.
L’infrastructure graphique s’articule autour du couple indissociable formé par Matplotlib et Seaborn. Matplotlib, bibliothèque historique de traçage de bas niveau, assure un contrôle granulaire absolu sur la moindre composante topologique d’une figure (axes, graduations, typographies, projections). Seaborn se superpose harmonieusement à Matplotlib en fournissant des abstractions de haut niveau spécifiquement pensées pour la visualisation de modèles statistiques. Enfin, pour le calcul des moments statistiques d’ordre supérieur, la modélisation probabiliste et l’inférence formelle, l’adjonction des modules scipy.stats (issu de la suite SciPy) et de la bibliothèque Statsmodels s’avère incontournable afin d’exécuter des tests d’hypothèses et des tracés diagnostiques rigoureux.
2.2 Création et inspection du DataFrame d’étude
L’amorce de toute investigation commence par l’instanciation de la structure de données au sein de la mémoire vive, suivie immédiatement d’une série de vérifications structurelles visant à cartographier le cadre d’analyse. Qu’il s’agisse du chargement d’un fichier tabulaire distant ou de l’élaboration programmatique d’un jeu de données synthétique reflétant des métriques de performance athlétique ou comportementale, la structure doit être systématiquement auditée à l’aide des primitives de diagnostic de base fournies par Pandas.
L’appel successif des méthodes head() et tail() permet de visualiser les premiers et derniers enregistrements du jeu de données, fournissant une vérification empirique immédiate de la conformité du séparateur de colonnes, de l’alignement des index et de la présence visible de valeurs tronquées. Cette inspection superficielle doit être immédiatement approfondie par l’exécution de la méthode info(). Cette dernière délivre un bilan exhaustif de la santé structurelle de l’objet : le nombre total de lignes enregistrées, l’énumération nominative de chaque colonne, le décompte précis des cellules non nulles, ainsi que l’attribution de la mémoire vive consommée par la structure.
Une vigilance particulière doit être accordée à l’attribut dtypes, qui récapitule les types de données déduits par le moteur de Pandas. Il n’est point rare qu’une variable conceptuellement continue se retrouve cataloguée par inadvertance sous le type générique object (chaîne de caractères), généralement en raison de l’intrusion malencontreuse de caractères typographiques invisibles, de symboles monétaires ou de représentations hétérogènes de valeurs manquantes (comme le symbole du point d’interrogation ou les libellés « N/A »). L’identification précoce de ces dysharmonies typologiques est indispensable afin de convertir explicitement les vecteurs concernés à l’aide des fonctions pd.to_numeric() ou de la méthode astype() avant d’engager le moindre calcul statistique.
2.3 Nettoyage préliminaire et vérification des valeurs manquantes
L’intégrité inférentielle d’une analyse univariée dépend directement de la gestion des données manquantes. L’existence de lacunes observationnelles non contrôlées fausse les estimations de variance, réduit la puissance statistique des tests et peut introduire des biais systématiques majeurs si le mécanisme sous-jacent de ces disparitions n’est pas complètement aléatoire (Missing Completely at Random, MCAR).
La cartographie quantitative des absences s’effectue vectoriellement par la combinaison des méthodes isnull().sum() ou isna().mean(), cette dernière exprimant instantanément la proportion relative de valeurs défaillantes par variable. Si le taux d’attrition d’une variable s’avère marginal (par exemple inférieur à 1% ou 2%), une exclusion ponctuelle des lignes non renseignées lors du calcul des statistiques descriptives univariées peut être envisagée sans dénaturer gravement les propriétés de l’échantillon, en exploitant l’argument natif dropna=True des fonctions de Pandas.
En revanche, face à une attrition substantielle, l’analyste se trouve confronté au dilemme de l’imputation versus l’exclusion. Dans un cadre strictement univarié, les stratégies d’imputation déterministes consistent à substituer aux cellules vides une statistique représentative de la série, telle que la moyenne, la médiane ou le mode empirique. Néanmoins, une telle pratique réduit artificiellement la variance naturelle de la variable et amplifie de manière fallacieuse l’aplatissement de la distribution. Il importe donc, lors de cette phase préparatoire, de documenter scrupuleusement la proportion de valeurs manquantes et de justifier méthodologiquement le protocole de remédiation adopté, en privilégiant l’analyse de sensibilité lorsque les données manquantes excèdent les seuils de tolérance académiques usuels.
3. 3. Mesures de tendance centrale en Python
3.1 Calcul et interprétation de la moyenne arithmétique
La moyenne arithmétique représente sans conteste l’indicateur de tendance centrale le plus universellement déployé en statistique inférentielle et descriptive. Sur le plan mathématique formel, pour un échantillon composé de $n$ observations notées $x_1, x_2, dots, x_n$, la moyenne arithmétique empirique, traditionnellement désignée par la notation $\bar{x}$, correspond au barycentre des données et s’exprime selon l’équation suivante :
$$\bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_i$$
Au sein de la bibliothèque Pandas, l’extraction computationnelle de cette valeur s’effectue directement via l’application de la méthode mean() sur la série d’intérêt. D’un point de vue physique ou géométrique, la moyenne arithmétique s’interprète comme le point de pivotement où la somme des écarts algébriques des données individuelles par rapport à cette valeur s’annule rigoureusement : $\sum (x_i – \bar{x}) = 0$. Cette propriété fondamentale en fait le fondement mathématique de nombreuses théories de l’optimisation par moindres carrés.
Toutefois, la moyenne arithmétique souffre d’une faiblesse méthodologique critique : son absence totale de robustesse face aux asymétries prononcées et aux valeurs aberrantes. Dans la mesure où chaque observation participe au calcul avec une pondération uniforme égale à $1/n$, l’intrusion d’une unique valeur démesurément élevée ou anomalique suffit à déplacer substantiellement le centre de gravité de la variable vers la périphérie de l’échantillon. Pour pallier cette vulnérabilité intrinsèque sans renoncer aux propriétés algébriques de la moyenne, le recours à la moyenne tronquée (trimmed mean) s’avère particulièrement fécond. Implémentée dans le module scipy.stats.trim_mean(), cette fonction écarte délibérément une proportion symétrique prédéterminée des observations extrêmes (typiquement 5% ou 10% aux extrémités inférieure et supérieure) avant de procéder au calcul de la moyenne résiduelle, offrant ainsi un compromis judicieux entre efficacité statistique et insensibilité aux artefacts extrêmes.
3.2 Détermination de la médiane statistique
La médiane statistique, désignée conventionnellement par la notation $M$ ou $Med$, se définit sur le plan théorique comme la valeur centrale qui scinde une série ordonnée de données en deux sous-ensembles d’effectifs parfaitement identiques. Pour un jeu de données préalablement classé par ordre croissant, elle garantit qu’exactement 50% des observations présentent une magnitude inférieure ou égale à sa valeur, tandis que les 50% restants présentent une magnitude supérieure ou égale. Son obtention informatique s’opère instantanément via la méthode median() sous Pandas.
Sur le plan computationnel, si la taille de l’échantillon $n$ est impaire, la médiane correspond précisément à la valeur centrale située au rang $(n + 1) / 2$. Si la taille de l’échantillon est paire, la médiane s’obtient usuellement par l’interpolation arithmétique des deux observations centrales occupant les rangs $n / 2$ et $(n / 2) + 1$. La caractéristique épistémologique majeure de la médiane réside dans son insolente robustesse : son point de rupture (breakdown point) atteint 50%, ce qui signifie qu’il faudrait corrompre près de la moitié des observations d’un échantillon par des valeurs infinies pour amener la médiane à diverger vers l’infini, alors qu’une seule valeur aberrante suffit à corrompre la moyenne arithmétique.
Cette propriété de résilience confère à la médiane un statut de référence incontournable lors de l’étude de variables socio-économiques asymétriques, à l’instar des distributions de revenus, des patrimoines, des prix immobiliers ou des durées de survie clinique. L’écart directionnel observé entre la moyenne arithmétique et la médiane constitue par ailleurs un indicateur heuristique d’une utilité diagnostique remarquable : lorsque la moyenne dépasse sensiblement la médiane ($\bar{x} > Med$), cela témoigne de la présence d’une queue de distribution étirée vers la droite (asymétrie positive), tandis qu’une moyenne substantiellement inférieure à la médiane signale une queue orientée vers les valeurs négatives ou faibles (asymétrie négative).
3.3 Extraction du mode et analyse de la multi-modalité
Le mode statistique désigne la modalité, ou la valeur numérique discrète, qui enregistre la fréquence d’occurrence empirique la plus élevée au sein de la série sous observation. Mathématiquement, il correspond au maximum absolu de la fonction de masse empirique pour une variable discrète, ou au sommet de la fonction de densité de probabilité pour une variable continue sous-jacente. L’invocation de la méthode mode() sur une structure Pandas renvoie un objet de type Series, dans la mesure où un échantillon peut parfaitement ne comporter aucun mode saillant, présenter un pic unique (distribution unimodale), ou arborer plusieurs valeurs à égalité de fréquence maximale (distributions bimodales ou multimodales).
Le mode se singularise par son universalité taxinomique : il s’agit de l’unique mesure de tendance centrale théoriquement légitime et opérationnelle pour le traitement des variables qualitatives nominales pures. Lorsqu’il s’agit de caractériser le groupe sanguin prédominant au sein d’une cohorte ou le motif principal d’admission hospitalière, ni la moyenne arithmétique ni la médiane ne possèdent le moindre sens mathématique, conférant au mode l’exclusivité de la synthèse centrale.
Lors de l’analyse univariée de variables quantitatives continues, l’identification du mode empirique direct à partir des valeurs brutes se heurte fréquemment à des limites pratiques, car la probabilité que deux mesures physiques continues soient strictement identiques tend vers zéro. Dans ce contexte, l’analyse du mode requiert soit une discrétisation préalable de la variable en classes d’amplitudes définies, soit l’application d’un algorithme d’estimation de la densité par noyau pour localiser les extrema locaux de la fonction continue estimée. La découverte fortuite d’une multi-modalité au sein d’une variable quantitative constitue un signal d’alarme méthodologique de premier ordre : elle révèle presque systématiquement l’hétérogénéité sous-jacente de la population échantillonnée, traduisant la superposition silencieuse de plusieurs sous-populations distinctes (comme des distributions différentielles de tailles physiques selon le dimorphisme sexuel) qui nécessitent une stratification analytique disjointe.
4. 4. Mesures de dispersion et de variabilité statistique
4.1 Étendue et écart interquartile (IQR)
L’estimation des seules mesures de tendance centrale s’avère dramatiquement incomplète pour encapsuler la dynamique distributionnelle d’une variable. Deux distributions statistiques peuvent en effet exhiber une moyenne et une médiane rigoureusement identiques tout en affichant des structures de dispersion diamétralement divergentes. Les mesures de dispersion ont précisément pour vocation mathématique de quantifier l’amplitude de l’étalement des données autour de leur point focal.
La mesure de dispersion la plus élémentaire est l’étendue (range), définie comme le différentiel scalaire brut entre l’observation maximale et l’observation minimale d’un échantillon : $R = x_{\max} – x_{\min}$. Si son implémentation algorithmique sous Pandas s’exécute trivialement par l’expression df[‘variable’].max() – df[‘variable’].min(), sa pertinence analytique demeure extrêmement rudimentaire. L’étendue ne mobilise que deux points d’observation extrêmes et ignore superbement l’agencement interne des données, se trouvant de surcroît hyper-sensible aux valeurs aberrantes marginales et augmentant mécaniquement avec la taille de l’échantillon.
Pour contourner les apories de l’étendue, la statistique non paramétrique a forgé le concept d’écart interquartile (Interquartile Range ou IQR). Les quartiles correspondent aux trois points de coupure qui divisent la distribution ordonnée en quatre segments d’effectifs rigoureusement équivalents, soit 25% de la masse de probabilité par quart. Le premier quartile ($Q_1$ ou 25e percentile), obtenu sous Pandas via l’appel quantile(0.25), délimite le quart inférieur des données. Le troisième quartile ($Q_3$ ou 75e percentile), accessible via quantile(0.75), sépare les 75% de valeurs inférieures des 25% de valeurs supérieures. L’écart interquartile se formalise donc par la différence arithmétique suivante :
$$IQR = Q_3 – Q_1$$
L’IQR représente ainsi l’étendue occupée par les 50% centraux de l’échantillon. Insensible aux fluctuations aberrantes situées dans les queues de distribution, il affiche un point de rupture de 25%. Au-delà de sa puissance descriptive intrinsèque, l’IQR constitue le moteur algorithmique de la célèbre règle de détection des données aberrantes de John Tukey, employée universellement pour le tracé normé des boîtes à moustaches.
4.2 Variance et écart-type de l’échantillon
Les métriques de dispersion les plus vénérables de l’arsenal paramétrique demeurent la variance et son corollaire direct, l’écart-type. Sur le plan conceptuel, la variance mesure la moyenne des carrés des déviations de chaque observation individuelle par rapport à la moyenne arithmétique de l’échantillon. Toutefois, une distinction épistémologique cruciale sépare la variance d’une population finie exhaustive de la variance estimée à partir d’un échantillon représentatif.
Lorsqu’on travaille sur des données d’échantillonnage, la somme brute des carrés des écarts doit être divisée non pas par la taille globale de l’échantillon $n$, mais par ses degrés de liberté résiduels, à savoir $n – 1$. Cette correction, théorisée sous l’appellation de correction de Bessel, a pour fonction d’éliminer le biais systématique de sous-estimation de la variance populationnelle provoqué par l’utilisation de la moyenne empirique $\bar{x}$ à la place de la véritable moyenne populationnelle inaccessible $\mu$. L’estimateur non biaisé de la variance d’échantillon, noté $s^2$, répond à l’expression :
$$s^2 = \frac{1}{n – 1} \sum_{i=1}^{n} (x_i – \bar{x})^2$$
L’écart-type d’échantillon $s$ correspond simplement à l’extraction de la racine carrée positive de la variance d’échantillon : $s = \sqrt{s^2}$. Ce passage à la racine carrée rétablit l’homogénéité dimensionnelle de la métrique, réexprimant la variabilité dans l’unité de mesure d’origine de la variable (mètres, secondes, euros), ce qui en facilite l’interprétation concrète. Sous Pandas, l’appel de var() et std() intègre par défaut cette correction de Bessel via le paramètre interne ddof=1 (degrés de liberté d’écartement ajustés). En revanche, l’analyste doit veiller scrupuleusement au fait que les fonctions natives de NumPy, telles que numpy.std(), initialisent conventionnellement ddof=0, ce qui produit un estimateur de maximum de vraisemblance biaisé pour les petits échantillons.
4.3 Coefficient de variation et variabilité relative
L’interprétation clinique ou industrielle d’un écart-type absolu se heurte inévitablement à un obstacle heuristique dès lors que l’on cherche à confronter la variabilité de deux variables d’échelles disparates, ou d’une même variable mesurée au sein de deux populations dont les ordres de grandeur diffèrent radicalement. Un écart-type de 10 unités revêt une portée analytique vertigineuse s’il s’applique à un dosage médicamenteux dont la moyenne thérapeutique est de 5 unités, alors qu’il devient négligeable s’il caractérise le kilométrage de véhicules d’occasion affichant une moyenne de 150 000 kilomètres.
Pour s’affranchir de cet effet d’échelle et normaliser la dispersion, la statistique fait usage du coefficient de variation ($CV$). Il s’agit d’une métrique adimensionnelle, introduite par Karl Pearson, qui exprime l’écart-type sous la forme d’un ratio proportionnel de la moyenne arithmétique :
$$CV = \frac{s}{\bar{x}}$$
Fréquemment exprimé sous forme de pourcentage en multipliant le ratio obtenu par 100, le coefficient de variation s’avère exclusivement pertinent pour des variables quantitatives mesurées sur une échelle de rapports stricts, c’est-à-dire possédant un zéro absolu non arbitraire (comme une masse, un volume, un revenu ou une durée temporelle). Son application à des échelles d’intervalles relatives (telles que les températures en degrés Celsius ou Fahrenheit) relève d’une aberration méthodologique, le déplacement conventionnel du point zéro altérant mathématiquement la valeur du ratio.
L’implémentation en Python du coefficient de variation s’effectue aisément à l’aide d’une fonction personnalisée vectorisée ou en sollicitant directement la fonction dédiée scipy.stats.variation(). Un $CV$ inférieur à 10% ou 15% caractérise usuellement une distribution particulièrement homogène où les observations gravitent étroitement autour de la moyenne, tandis qu’un $CV$ excédant 30% à 40% traduit une hétérogénéité substantielle nécessitant une investigation approfondie des facteurs générateurs de variance.
5. 5. Analyse de la forme de la distribution : Asymétrie et aplatissement
5.1 Le coefficient d’asymétrie (Skewness)
L’investigation univariée avancée ne saurait cantonner son champ descriptif aux simples métriques de position et de dispersion. Deux variables dotées de moyennes et d’écarts-types identiques peuvent arborer des silhouettes distributionnelles fondamentalement asymétriques. L’exploration de la morphologie passe initialement par l’étude de l’asymétrie (ou skewness), mathématiquement indexée sur le troisième moment centré standardisé.
L’asymétrie quantifie le degré d’écart d’une distribution empirique par rapport à une morphologie parfaitement symétrique en forme de cloche, telle que celle prescrite par la loi normale théorique de Laplace-Gauss. Au niveau de la formulation computationnelle, la méthode skew() de Pandas implémente la formule du coefficient d’asymétrie ajusté de Fisher-Pearson, qui compense le biais d’échantillonnage selon l’expression :
$$G_1 = \frac{n}{(n – 1)(n – 2)} \sum_{i=1}^{n} \left(\frac{x_i – \bar{x}}{s}\right)^3$$
L’interprétation de ce coefficient s’articule autour du zéro. Une valeur de $G_1$ strictement nulle (ou statistiquement indiscernable de zéro) atteste d’une symétrie rigoureuse de la distribution, au sein de laquelle moyenne arithmétique et médiane coïncident. Un coefficient d’asymétrie positif significatif ($G_1 > 0$) révèle une distribution étirée à droite : la masse d’observations se concentre majoritairement vers les valeurs basses, tandis qu’une traînée de valeurs exceptionnellement élevées étire la queue droite de la courbe. À l’inverse, un coefficient négatif ($G_1 < 0$) indique une queue étirée vers la gauche. En règle empirique académique, une valeur comprise entre $-0.5$ et $+0.5$ dénote une asymétrie négligeable, alors qu'une valeur franchissant le seuil critique de $\pm 1.0$ signale une déviation morphologique majeure interdisant formellement l'usage aveugle de tests statistiques paramétriques standard fondés sur l'hypothèse de normalité.
5.2 Le coefficient d’aplatissement (Kurtosis)
Le second paramètre morphologique fondamental est le coefficient d’aplatissement (ou kurtosis), mathématiquement adossé au quatrième moment centré standardisé. Contrairement à une croyance tenace dans la culture statistique populaire assimilant le kurtosis à la seule acuité du sommet de la courbe (son caractère pointu), le kurtosis quantifie principalement l’épaisseur relative des queues de distribution, et par voie de conséquence directe, la propension de la variable à générer des événements extrêmes ou aberrants.
La bibliothèque Pandas, à travers sa méthode kurtosis() (ou son synonyme kurt()), calcule par convention l’excès de kurtosis de Fisher. Ce calcul soustrait la valeur de 3 au quatrième moment centré normalisé, de telle sorte qu’une distribution gaussienne de référence présente un excès de kurtosis rigoureusement égal à 0. L’équation de l’estimateur sans biais d’échantillon se formalise de la manière suivante :
$$G_2 = \frac{n(n + 1)}{(n – 1)(n – 2)(n – 3)} \sum_{i=1}^{n} \left(\frac{x_i – \bar{x}}{s}\right)^4 – \frac{3(n – 1)^2}{(n – 2)(n – 3)}$$
La typologie des profils morphologiques se décline en trois catégories. Une distribution mésokurtique affiche un excès de kurtosis voisin de 0, indiquant des queues d’épaisseur conforme au profil gaussien. Une distribution leptokurtique ($G_2 > 0$) présente un excès d’aplatissement positif : ses queues sont particulièrement épaisses et lourdes, ce qui signifie qu’elle génère bien plus d’observations extrêmes qu’une loi normale. Les données financières, telles que les rendements boursiers journaliers, sont typiquement leptokurtiques. Enfin, une distribution platykurtique ($G_2 < 0$) présente un excès de kurtosis négatif, traduisant des queues allégées, des observations uniformément dispersées et une quasi-absence d'extrema démesurés.
5.3 Utilisation de describe() pour une synthèse exhaustive
Dans la pratique courante de l’analyste sous Python, il s’avère peu rentable de calculer de manière isolée et séquentielle chacun de ces indicateurs. L’écosystème Pandas met à disposition un instrument d’une efficience remarquable pour automatiser la génération d’un tableau synthétique de descripteurs univariés : la méthode describe().
Appliquée sans argument sur un DataFrame comportant des colonnes numériques, la fonction df.describe() compile instantanément, pour chaque variable quantitative, une batterie d’indicateurs scalaires élémentaires : l’effectif non nul (count), la moyenne arithmétique (mean), l’écart-type d’échantillon corrigé (std), le minimum empirique (min), ainsi que les premier, deuxième (médiane) et troisième quartiles (25%, 50%, 75%), pour s’achever sur le maximum (max). Cette photographie panoramique permet de détecter d’un coup d’œil les incohérences métriques les plus flagrantes, comme des valeurs négatives pour des grandeurs physiques réputées strictement positives.
L’utilisation experte de describe() implique son paramétrage personnalisé. Par l’adjonction de l’argument percentiles=[0.01, 0.05, 0.10, 0.90, 0.95, 0.99], l’analyste peut disséquer avec une grande finesse le comportement des centiles extrêmes de la distribution. En outre, appliquée sur des colonnes catégorielles ou qualitatives via l’argument include=[‘O’, ‘category’], la méthode transmute entièrement son affichage pour fournir le nombre d’observations renseignées (count), le nombre de catégories distinctes uniques (unique), la modalité modale la plus fréquente (top) et la fréquence d’occurrence absolue de cette dernière (freq). La sortie tabulaire générée étant elle-même un DataFrame Pandas, ses valeurs peuvent être extraites programmatiquement pour être injectées dans des pipelines de vérification automatisée de la qualité des données.
6. 6. Construction et analyse des tableaux de fréquences
6.1 Fréquences absolues avec value_counts()
Pour les variables qualitatives (nominales comme ordinales) ainsi que pour les variables quantitatives discrètes à spectre restreint, l’estimation de moments numériques continus s’avère dénuée de pertinence. L’instrument analytique univarié par excellence réside alors dans l’élaboration du tableau de distribution des fréquences absolues. Cette structure énumère l’ensemble des modalités uniques observées et leur associe le décompte scrupuleux de leurs occurrences empiriques.
La bibliothèque Pandas fournit l’une des primitives computationnelles les plus rapides et intuitives pour exécuter ce dénombrement : la méthode value_counts() appliquée directement à une instance de Series. Algorithmiquement adossée à une table de hachage hautement optimisée, cette fonction parcourt le vecteur de données et compile les effectifs de chaque modalité, retournant un résultat trié par défaut dans un ordre d’occurrences strictement décroissant. Ce comportement par défaut s’avère idéal pour identifier immédiatement le mode empirique et déceler la longue traîne des catégories marginales.
Un enjeu méthodologique crucial dans l’utilisation de value_counts() concerne le traitement des lacunes d’observation. Par défaut, la méthode masque silencieusement les valeurs manquantes en configurant l’argument dropna=True. Cette omission dissimule une proportion potentiellement substantielle de l’échantillon, introduisant un biais majeur dans l’évaluation de la représentativité. L’analyste rigoureux veillera systématiquement à spécifier dropna=False lors de l’audit initial d’une variable catégorielle, afin d’élever la valeur NaN au rang de modalité à part entière et de quantifier la masse d’invalidation affectant le vecteur.
6.2 Fréquences relatives et proportions cumulées
Si la fréquence absolue renseigne utilement sur le volume d’occurrences au sein d’un échantillon déterminé, elle échoue à permettre des comparaisons rigoureuses entre échantillons de dimensions inégales. L’étape analytique subséquente consiste donc à convertir ces effectifs bruts en fréquences relatives (ou proportions), opération mathématique élémentaire consistant à diviser l’effectif d’une modalité $n_k$ par la taille totale de l’échantillon valide $n$.
Sous Pandas, cette transition s’effectue sans effort en renseignant le paramètre normalize=True au sein de la méthode value_counts(). Le résultat délivre une distribution empirique de probabilité discrète où la somme des proportions égale exactement 1 (soit 100% de la masse d’observations). Ce tableau de proportions relatives constitue le matériau brut privilégié pour la formalisation des résultats selon les normes de communication académique, où les pourcentages permettent une mise en perspective universelle.
Pour les variables ordinales et quantitatives discrètes, l’analyse gagne à être complétée par le calcul des fréquences relatives cumulées. En appliquant la méthode cumsum() sur la série des fréquences relatives préalablement triée selon l’ordre intrinsèque des modalités (obtenu via sort_index()), on construit la fonction de répartition empirique discrète. Cette approche permet de répondre immédiatement à des questions inférentielles de seuil : quelle est la proportion de patients affichant un stade de sévérité inférieur ou égal au stade 2 ? En regroupant fréquences absolues, pourcentages relatifs et pourcentages cumulés au sein d’un même DataFrame via la méthode pd.concat(), l’analyste confectionne un tableau de fréquences complet et exhaustif, prêt pour une intégration directe dans un manuscrit de recherche.
6.3 Discrétisation de variables continues (Binning)
L’application directe de tableaux de fréquences sur des variables quantitatives continues s’avère opérationnellement inopérante en raison de la dispersion quasi-infinie des réels, qui aboutit à une liste de fréquences unitaires de valeur 1. Pour soumettre une variable continue à l’analyse tabulaire de distribution, le chercheur doit recourir à un protocole de discrétisation artificielle, désigné sous le terme technique de binning ou découpage en classes d’intervalles.
Pandas offre deux fonctions complémentaires pour accomplir cette opération : pd.cut() et pd.qcut(), chacune incarnant une philosophie géométrique distincte. La fonction pd.cut() segmente le domaine de variation de la variable en intervalles d’égale amplitude spatiale. Par exemple, segmenter un vecteur de scores variant de 0 à 100 en 5 classes générera des segments de largeur uniforme de 20 unités ($[0-20], [20-40], dots$). Bien qu’intuitive, cette segmentation présente l’inconvénient majeur de pouvoir engendrer des classes presque désertes lorsque la distribution des données sous-jacente est fortement asymétrique.
À l’inverse, la fonction pd.qcut() opère une discrétisation basée sur les quantiles empiriques, générant des classes d’amplitudes variables mais garantissant des effectifs d’observations rigoureusement identiques au sein de chaque intervalle (découpage en déciles ou en quintiles). Ce partitionnement par effectifs constants neutralise l’impact des asymétries et facilite l’analyse comparative des segments extrêmes. Les séries discrétisées ainsi engendrées sont immédiatement traitables par la méthode value_counts() pour générer des tableaux de distribution de classes d’une clarté pédagogique irréprochable.
7. 7. Visualisation graphique des variables quantitatives continues
7.1 L’histogramme et l’estimation de la densité par noyau (KDE)
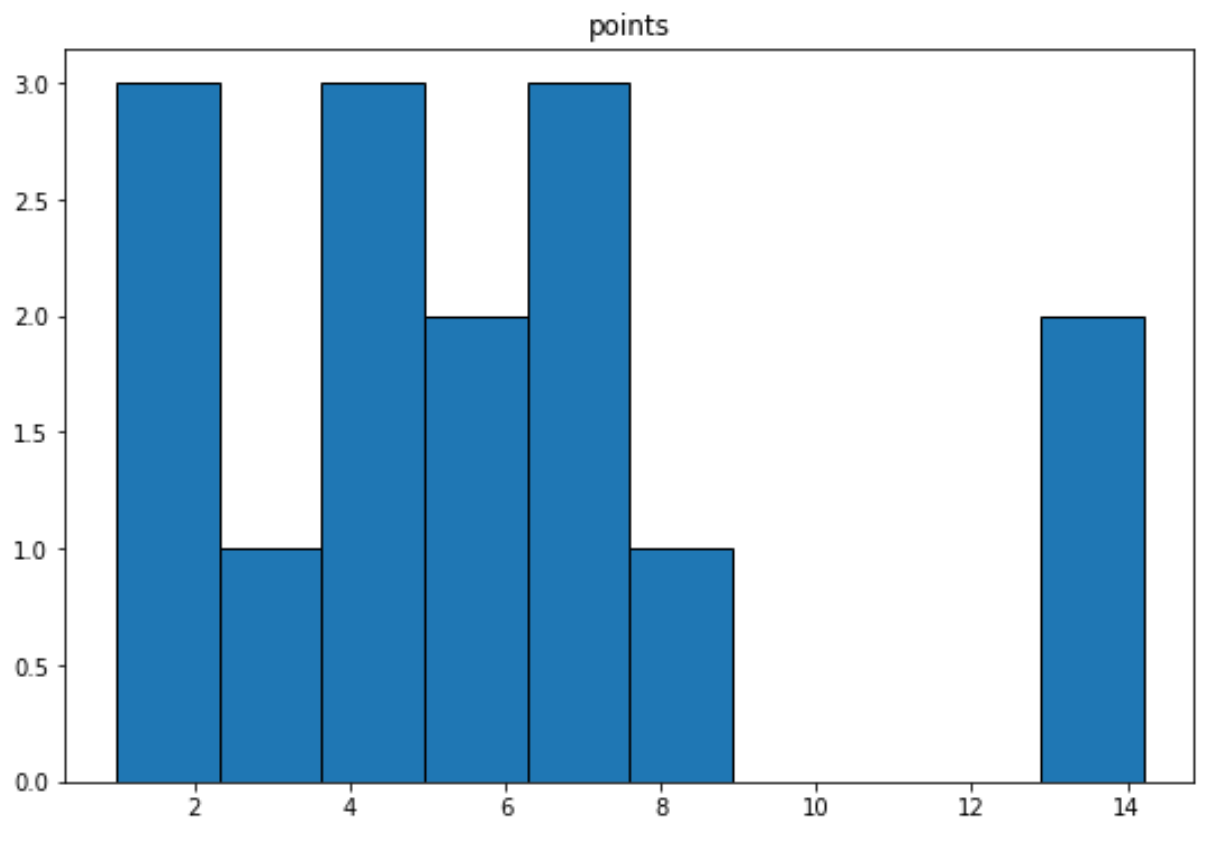
L’histogramme constitue l’artéfact graphique canonique pour appréhender la distribution spatiale d’une variable quantitative continue. Introduit à la fin du XIXe siècle par Karl Pearson, il partitionne l’axe des abscisses en une succession de rectangles adjacents représentant des intervalles de valeurs, dont l’aire totale — ou la hauteur en cas d’intervalles constants — est rigoureusement proportionnelle au nombre d’observations tombant dans chaque intervalle.
La bibliothèque Seaborn simplifie considérablement la génération d’histogrammes modernes grâce à sa fonction seaborn.histplot(). L’un des dilemmes méthodologiques centraux réside dans la sélection du nombre adéquat d’intervalles (bins). Un partitionnement trop grossier dissimule les singularités de la distribution, tandis qu’un découpage trop fin pulvérise l’information sous forme d’un bruit graphique illisible. La littérature statistique propose plusieurs règles computationnelles formalisées, notamment la règle de Sturges (adaptée aux distributions quasi-gaussiennes de taille modérée) et la règle de Freedman-Diaconis. Cette dernière, hautement recommandée pour les données bruitées ou asymétriques, détermine la largeur optimale des classes en fonction de l’écart interquartile :
$$\text{Largeur} = 2 \times IQR \times n^{-1/3}$$
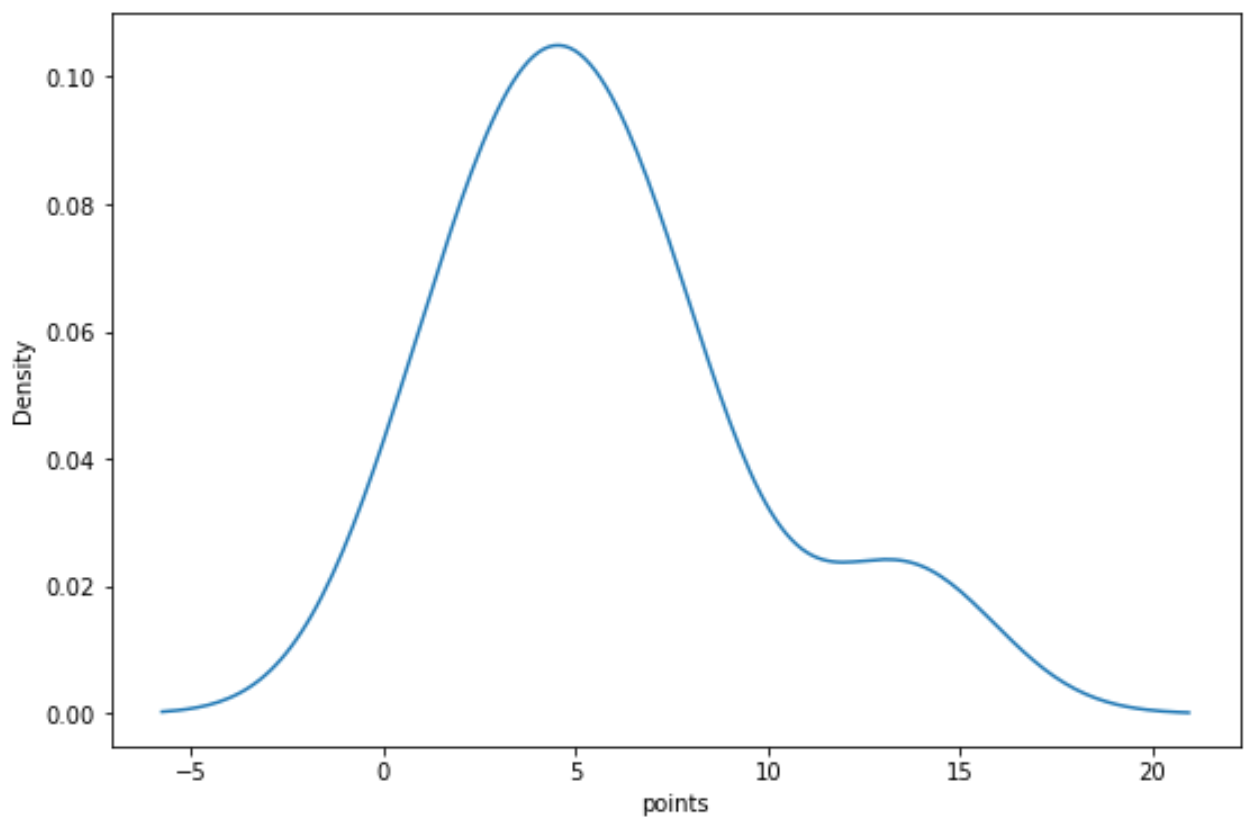
Pour dépasser le caractère discontinu de l’histogramme, l’estimation de la densité par noyau (Kernel Density Estimation ou KDE) fournit une approximation continue et différentiable de la fonction de densité de probabilité sous-jacente. En superposant sur chaque observation une fonction de noyau gaussienne lissée et en sommant l’ensemble de ces contributions locales, la courbe KDE, activée dans Seaborn par l’argument kde=True, dévoile la géométrie sous-jacente de la distribution sans subir les artefacts de frontières inhérents au choix des classes discrètes.
7.2 La boîte à moustaches (Boxplot)
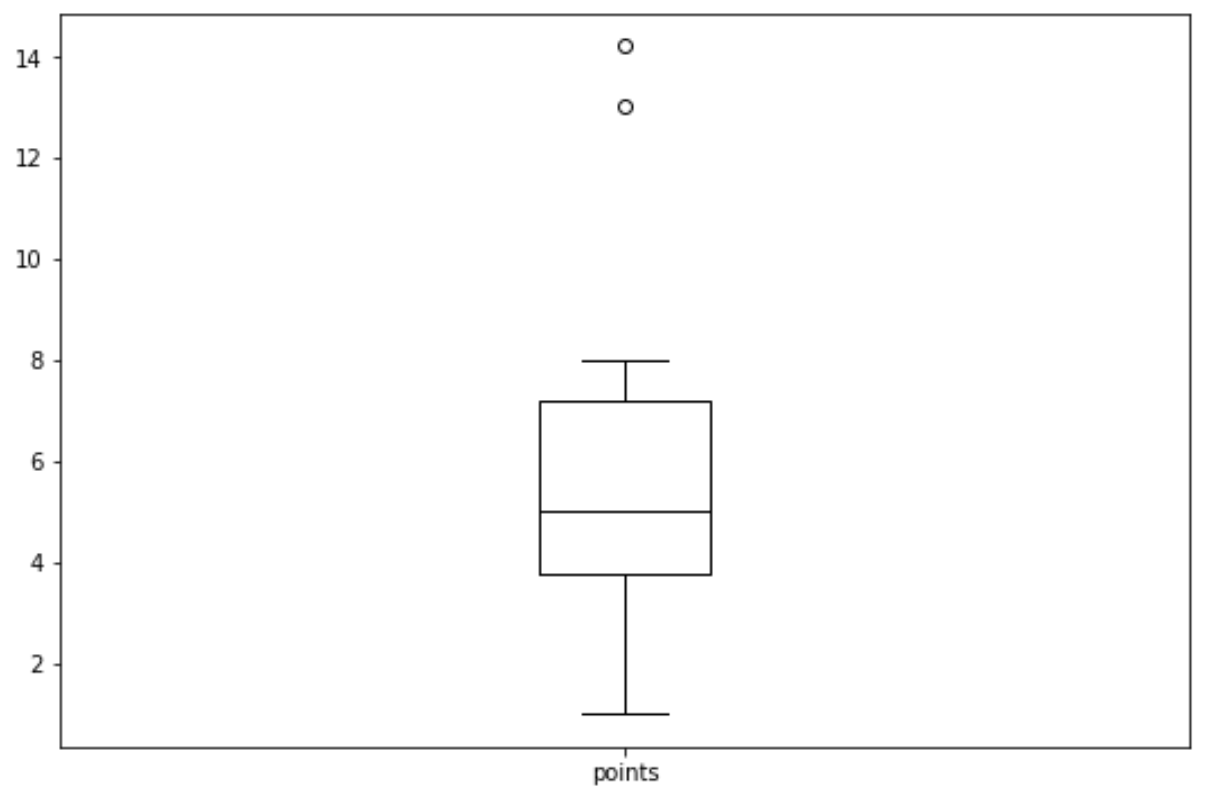
Conceptualisée par John Tukey dans le cadre de ses travaux fondateurs sur l’analyse exploratoire des données, la boîte à moustaches (boxplot) est un chef-d’œuvre de concision visuelle, condensant en une silhouette géométrique standardisée le résumé non paramétrique des cinq nombres : le minimum non atypique, le premier quartile ($Q_1$), la médiane statistique ($Q_2$), le troisième quartile ($Q_3$) et le maximum non atypique.
La construction graphique s’articule autour d’un rectangle central (la boîte) dont les charnières inférieure et supérieure coïncident avec $Q_1$ et $Q_3$, matérialisant ainsi visuellement l’écart interquartile (IQR). Une ligne continue interne scinde la boîte au niveau exact de la médiane. De chaque côté de la boîte s’étirent des segments linéaires, les moustaches (whiskers), dont l’extension est strictement encadrée par la convention de Tukey : la moustache supérieure s’étend jusqu’à l’observation la plus élevée contenue dans la limite théorique $Q_3 + 1.5 \times IQR$, tandis que la moustache inférieure s’arrête à la plus petite observation située au-dessus de la frontière $Q_1 – 1.5 \times IQR$.
Toute donnée se positionnant au-delà de ces frontières conventionnelles est considérée comme une valeur atypique potentielle et figure sous forme de points individualisés sur le graphique. Généré en Python au moyen de seaborn.boxplot(), le boxplot autorise un diagnostic instantané de la symétrie : si la médiane n’occupe pas le centre géométrique de la boîte et si les longueurs des deux moustaches sont asymétriques, l’hypothèse de symétrie gaussienne peut être écartée. Sa principale limite graphique réside toutefois dans son incapacité structurelle à révéler la bimodalité : une distribution unimodale symétrique et une distribution bimodale parfaitement équilibrée peuvent engendrer des diagrammes en boîte visuellement indiscernables.
7.3 Le diagramme en violon (Violin Plot)
Pour combler les carences descriptives de la boîte à moustaches face aux distributions complexes, Daniel Hintze et Ray Nelson ont conçu en 1998 le diagramme en violon (violin plot). Cet artéfact hybride réalise la fusion synérgique d’un boxplot conventionnel miniature inséré dans son axe central et d’une estimation de densité par noyau symétrisée en miroir de part et d’autre de cet axe.
Le tracé d’un diagramme en violon s’opère sous Python grâce à la fonction seaborn.violinplot(). La silhouette extérieure traduit immédiatement les variations de densité locale : les élargissements renflés du tracé signalent des concentrations massives de données (les modes), tandis que les rétrécissements allongés indiquent des zones de relative vacuité empirique. Cette morphologie évocatrice permet d’identifier au premier coup d’œil une multi-modalité insidieuse qu’un simple boxplot aurait masquée.
L’analyste dispose en outre d’arguments de configuration avancés, tels que inner=’quartile’ pour afficher explicitement les lignes de quantiles à l’intérieur du profil de densité, ou bw_adjust pour moduler le paramètre de lissage de la bande passante du noyau d’estimation. Dans les publications académiques contemporaines, le diagramme en violon se substitue de plus en plus au boxplot classique, fournissant aux lecteurs une lecture morphologique plus riche et non biaisée de la distribution de chaque variable continue explorée.
8. 8. Visualisation graphique des variables qualitatives et discrètes
8.1 Le diagramme en barres (Bar Chart)
L’exploration visuelle des variables catégorielles nominales et ordinales, de même que celle des variables quantitatives discrètes comportant un nombre modéré de valeurs entières, repose principalement sur le diagramme en barres (bar chart). Dans cette représentation, chaque catégorie discrète est matérialisée par une barre isolée sur un axe cartésien, la longueur ou la hauteur de la barre étant proportionnelle à la fréquence absolue ou relative de la modalité associée.
Sous l’environnement Python, l’outil le plus direct et élégant pour instancier cette figure est la fonction seaborn.countplot(). Contrairement à un histogramme, où les rectangles sont contigus pour refléter le continuum sous-jacent de l’espace de mesure des réels, les barres d’un diagramme catégoriel doivent impérativement être séparées par des espaces interstitiels francs. Cet agencement visuel rappelle qu’il n’existe aucune continuité mathématique entre les différentes modalités.
Pour optimiser la lisibilité du graphique, il est recommandé d’ordonner les barres de manière raisonnée. Pour une variable nominale, ordonner les catégories par effectifs décroissants via le paramètre order=df[‘variable’].value_counts().index améliore significativement la clarté visuelle. Pour une variable ordinale, les barres doivent impérativement respecter la hiérarchie intrinsèque des modalités. Enfin, l’adjonction textuelle précise des effectifs ou des pourcentages au sommet de chaque rectangle, réalisée à l’aide de la méthode ax.bar_label() introduite dans les versions récentes de Matplotlib, confère à la figure un niveau d’exhaustivité et de rigueur tout à fait conforme aux standards des revues scientifiques.
8.2 Le diagramme circulaire (Pie Chart) et ses limites critiques
Le diagramme circulaire (ou camembert) constitue historiquement l’une des figures les plus omniprésentes dans la communication médiatique et corporative pour illustrer la répartition proportionnelle d’une variable nominale. Généré sous Python via l’appel de matplotlib.pyplot.pie() avec l’argument autopct=’%1.1f%%’, ce graphique déploie un cercle partitionné en secteurs angulaires dont l’aire et l’angle au centre sont théoriquement proportionnels à la fréquence relative de chaque catégorie.
En dépit de sa popularité vernaculaire, le diagramme circulaire fait l’objet d’une réprobation quasi unanime au sein de la communauté statistique et graphique académique. Cette défaveur s’enracine dans les limites physiologiques de la perception visuelle humaine. De nombreuses recherches en psychologie cognitive démontrent avec constance que le cerveau humain est médiocre dans l’estimation comparative des angles et des surfaces curvilignes, alors qu’il excelle dans le jugement d’alignements linéaires sur une échelle graduée commune.
Dès lors qu’une variable nominale déploie plus de trois ou quatre modalités distinctes, ou que les proportions relatives des catégories sont proches, la discrimination visuelle des secteurs angulaires devient aléatoire et propice aux illusions perceptuelles. Cette vulnérabilité cognitive est encore aggravée lors de l’utilisation de projections tridimensionnelles (à proscrire rigoureusement), qui distorcent délibérément les angles situés au premier plan. Par conséquent, les directives graphiques académiques préconisent presque universellement de substituer au diagramme circulaire un diagramme en barres horizontales, sur lequel la comparaison visuelle des longueurs assure une interprétation non équivoque des proportions.
8.3 Le diagramme à points et distribution empirique cumulée (ECDF)
Pour visualiser une variable quantitative continue ou ordonnée sans encourir les pertes d’information inhérentes au découpage en classes de l’histogramme, le diagramme de la fonction de répartition empirique cumulée (Empirical Cumulative Distribution Function ou ECDF) représente la référence méthodologique absolue. L’ECDF associe à chaque valeur observée sur l’axe des abscisses la proportion exacte des données qui lui sont inférieures ou égales sur l’axe des ordonnées (variant strictement de 0 à 1).
L’implémentation graphique de cette méthode sous Python s’exécute nativement via la fonction seaborn.ecdfplot(). L’atout méthodologique majeur de l’ECDF réside dans son caractère non paramétrique complet : son tracé ne dépend d’aucun paramètre arbitraire de largeur de bande passante (comme le KDE) ni d’aucun choix du nombre de classes (comme l’histogramme). Chaque observation individuelle de l’échantillon est représentée par une marche d’escalier de hauteur $1/n$, fournissant une transcription fidèle de l’ensemble des données collectées.
Le tracé ECDF permet une lecture directe des percentiles : il suffit de tracer une ligne horizontale à l’ordonnée $0.5$ pour identifier instantanément la médiane sur l’axe des abscisses. De même, les pentes abruptes révèlent visuellement les zones de forte densité de probabilité, tandis que les paliers horizontaux signalent des intervalles de valeurs rares ou inexistantes. Enfin, la comparaison de l’ECDF d’un échantillon avec la fonction de répartition théorique d’une loi de probabilité permet de mesurer visuellement les déviations de distribution qui sous-tendent les tests d’adéquation formels de Kolmogorov-Smirnov.
9. 9. Détection et traitement univarié des valeurs aberrantes
9.1 Identification par la méthode du Z-score
Une étape déterminante de l’audit univarié concerne la détection des valeurs aberrantes (outliers), c’est-à-dire d’observations s’écartant si substantiellement du corps central de la distribution qu’elles éveillent la suspicion d’une erreur de saisie, d’une avarie instrumentale ou d’un comportement structurellement singulier au sein de la population génératrice. La technique paramétrique la plus traditionnelle repose sur le calcul de la cote standard, universellement désignée sous le vocable de Z-score.
Pour chaque observation $x_i$, le Z-score exprime la déviation de la valeur brute par rapport à la moyenne arithmétique de l’échantillon, étalonnée en unités d’écart-type :
$$z_i = \frac{x_i – \bar{x}}{s}$$
Sous Python, ce calcul vectorisé s’exécute aisément à l’aide de la fonction scipy.stats.zscore(). Conformément aux propriétés mathématiques de la loi normale centrée réduite $\mathcal{N}(0, 1)$, environ 99.73% des observations théoriques sont confinées dans un intervalle de plus ou moins trois écarts-types autour de la moyenne. En conséquence, la règle d’exclusion paramétrique classique retient le seuil critique absolu $|z_i| > 3$ pour étiqueter une observation comme valeur aberrante suspecte.
Néanmoins, l’analyste critique doit impérativement garder à l’esprit la fragilité méthodologique inhérente au Z-score classique. Ce dernier repose en effet sur la moyenne et l’écart-type, deux métriques hyper-sensibles à ces mêmes valeurs extrêmes. Ainsi, la présence d’aberrations massives tend à gonfler artificiellement l’écart-type de l’échantillon, ce qui resserre indûment les Z-scores des observations périphériques et engendre un effet délétère de masquage (masking effect). Dans ces contextes asymétriques, l’utilisation du Z-score modifié fondé sur la médiane et l’écart absolu médian (MAD) est nettement préférable.
9.2 Identification non paramétrique par l’intervalle interquartile
Face aux limites du Z-score en présence de distributions asymétriques ou fortement bruitées, l’approche non paramétrique élaborée par John Tukey s’impose comme le standard méthodologique de détection univariée le plus robuste. Cette approche ne postule aucune forme normale a priori et se fonde exclusivement sur la structure ordinale des quartiles empiriques et de l’écart interquartile (IQR).
La règle de détection de Tukey délimite deux barrières de coupure arithmétiques, établies à partir du premier et du troisième quartiles de la distribution :
$$\text{Borne inférieure} = Q_1 – 1.5 \times IQR$$
$$\text{Borne supérieure} = Q_3 + 1.5 \times IQR$$
Toute observation s’échouant au-delà de ces frontières conventionnelles est cataloguée comme valeur aberrante modérée. La taxinomie de Tukey affine en outre ce diagnostic en introduisant des barrières extérieures situées à $3 \times IQR$ des charnières ($Q_1 – 3 \times IQR$ et $Q_3 + 3 \times IQR$) : toute donnée franchissant ces seuils extrêmes est qualifiée d’aberrante sévère (far outlier), signalant une perturbation empirique majeure.
L’extraction informatique de ces sous-populations d’aberrations en Python s’exécute par un simple filtrage booléen vectorisé combinant les méthodes quantile() de Pandas. L’intérêt majeur de l’algorithme de Tukey réside dans son immunité aux effets de masquage : les quartiles et l’IQR étant insensibles à la dérive des valeurs extrêmes elles-mêmes, les frontières de décision conservent leur stabilité descriptive quelle que soit l’ampleur des déviations périphériques observées.
9.3 Protocoles de remédiation des valeurs atypiques
Une fois les observations atypiques localisées, l’analyste fait face au problème délicat de leur prise en charge méthodologique. La suppression aveugle et systématique des valeurs atypiques constitue une faute méthodologique grave. En effet, un point atypique peut parfaitement représenter non pas une anomalie expérimentale, mais l’observation la plus informative de tout l’échantillon (détection d’une fraude bancaire inédite, identification d’une mutation génétique rare, découverte d’une défaillance industrielle précoce). Trois voies de remédiation formelles sont généralement envisageables selon les objectifs analytiques visés.
La première technique est l’exclusion motivée (trimming). Elle consiste à purger l’échantillon des lignes suspectes, une option strictement réservée aux cas où l’anomalie découle d’une erreur de collecte ou de transcription documentée (comme un âge humain saisi à 999 ans). La deuxième alternative réside dans la winsorisation, une opération non paramétrique issue des travaux de Charles Winsor, implémentée en Python via la fonction scipy.stats.mstats.winsorize(). Ce procédé ne supprime point les observations extrêmes, mais réassigne leur amplitude à des seuils percentiles acceptables préalablement définis (par exemple, ramener l’ensemble des données situées au-delà du 99e percentile à la valeur exacte de ce percentile). Cette approche permet de conserver la puissance statistique de la taille de l’échantillon initial tout en étouffant l’impact déstabilisateur des valeurs périphériques sur le calcul des moments statistiques.
La troisième approche, particulièrement adaptée aux distributions étirées vers la droite, s’appuie sur des transformations mathématiques stabilisatrices de variance. L’application d’une transformation logarithmique via numpy.log1p(), ou d’une transformation racine carrée via numpy.sqrt(), compresse drastiquement les grands écarts sur l’axe des abscisses tout en préservant l’ordonnancement monotone des observations. Cette manipulation rapproche la distribution d’un profil gaussien symétrique, permettant ainsi de conserver l’ensemble des observations au sein des modélisations statistiques ultérieures.
10. 10. Tests statistiques univariés de normalité
10.1 Évaluation graphique via le diagramme quantile-quantile (Q-Q Plot)
Dans de nombreux contextes de recherche empirique, l’analyste est amené à vérifier si sa variable continue se conforme à une distribution normale, postulat fondamental garantissant la validité mathématique de nombreuses méthodes paramétriques (tests t de Student, analyse de variance ANOVA, régressions linéaires par moindres carrés). La première étape de ce diagnostic doit impérativement être visuelle, grâce au tracé du diagramme quantile-quantile (Q-Q plot).
Le principe théorique du diagramme Q-Q repose sur la projection cartésienne de deux séries de quantiles : en ordonnées figurent les quantiles empiriques extraits directement de l’échantillon ordonné, tandis qu’en abscisses sont alignés les quantiles théoriques attendus pour une distribution normale standard $\mathcal{N}(0, 1)$ de taille identique. Si l’échantillon empirique est issu d’une population gaussienne, les points doivent rigoureusement s’aligner sur une ligne de référence diagonale.
Sous Python, la confection d’un diagramme Q-Q s’exécute à l’aide des fonctions statsmodels.api.qqplot(line=’s’) ou scipy.stats.probplot(). L’interprétation sémiologique des déviations par rapport à la droite diagonale s’avère extrêmement informative : une courbure en forme de « S » inversé dénote des queues de distribution plus épaisses que prévu (caractère leptokurtique), les points s’écartant de la diagonale aux extrémités supérieure et inférieure. À l’inverse, une déviation incurvée globale en forme de parabole concave ou convexe révèle une asymétrie marquée (positive ou négative), orientant d’emblée l’analyste vers des ajustements non paramétriques.
10.2 Le test de Shapiro-Wilk
L’évaluation visuelle du diagramme Q-Q doit être corroborée par des tests d’hypothèses formels. Parmi l’éventail des tests de normalité disponibles dans la littérature biométrique, le test développé par Samuel Shapiro et Martin Wilk en 1965 s’impose empiriquement comme le test le plus puissant et le plus sensible pour détecter les déviations de normalité sur des échantillons de petite et moyenne envergure (typiquement pour $n < 50$ ou $n < 2000$).
La statistique du test, conventionnellement désignée par la lettre $W$, mesure le ratio entre l’estimateur de la pente issu de la régression linéaire des quantiles ordonnés et la variance d’échantillon classique. L’implémentation algorithmique en Python s’exécute par l’invocation directe de la fonction scipy.stats.shapiro(), laquelle retourne conjointement la statistique $W$ et la p-valeur (p-value) associée sous l’hypothèse nulle ($H_0$) postulant que l’échantillon est extrait d’une population distribuée selon une loi normale.
L’interprétation de la p-valeur s’effectue au regard d’un seuil de significativité $\alpha$, traditionnellement fixé à $0.05$. Si la p-valeur excède ce seuil ($p > 0.05$), on ne peut rejeter l’hypothèse nulle : la déviation observée est alors jugée compatible avec les fluctuations d’échantillonnage aléatoire. En revanche, si la p-valeur est inférieure au seuil critique ($p le 0.05$), l’hypothèse nulle est rejetée avec un risque contrôlé, confirmant que la distribution empirique s’écarte significativement du modèle gaussien. Il convient toutefois de souligner une limite méthodologique fondamentale du test de Shapiro-Wilk : sur de très volumineuses cohortes (par exemple $n > 5000$), le test devient hyper-sensible et rejette systématiquement la normalité pour des écarts morphologiques infimes et pratiquement insignifiants.
10.3 Tests de D’Agostino-Pearson et de Kolmogorov-Smirnov
Pour parer à la sensibilité excessive du test de Shapiro-Wilk face aux grands volumes de données et disposer de diagnostics complémentaires, d’autres tests inférentiels s’avèrent précieux. Le test omnibus de D’Agostino et Pearson réunit élégamment l’analyse de l’asymétrie et de l’aplatissement au sein d’une même statistique de test composite, distribuée asymptotiquement selon une loi du chi-deux ($\chi^2$) à deux degrés de liberté sous l’hypothèse nulle de normalité.
La bibliothèque SciPy met à disposition ce test via l’appel de scipy.stats.normaltest(). Ce test évalue si le coefficient d’asymétrie et le coefficient d’aplatissement de l’échantillon s’écartent conjointement des valeurs théoriques attendues pour une gaussienne ($0$ pour les deux métriques centrées). Cette approche présente l’avantage pédagogique majeur d’identifier explicitement la nature géométrique de la non-normalité constatée, selon que la défaillance statistique provienne principalement de l’asymétrie ou de l’épaisseur des queues de distribution.
Enfin, le test de Kolmogorov-Smirnov (accessible via scipy.stats.kstest()) opère sur un principe différent, en calculant la distance géométrique maximale $D$ séparant la fonction de répartition empirique (ECDF) de l’échantillon et la fonction de répartition théorique continue spécifiée. Lorsqu’il est appliqué à la normalité avec des paramètres de moyenne et d’écart-type estimés directement sur l’échantillon, ce test doit impérativement faire l’objet de la correction des tables de Lilliefors (accessible via le module statsmodels.stats.diagnostic.lilliefors()). Si cette convergence de tests formels et de visualisations graphiques conclut au rejet net de l’hypothèse de normalité, l’analyste dispose de justifications solides pour abandonner les indicateurs gaussiens au profit de statistiques non paramétriques (médiane, IQR) et de tests de rangs (Wilcoxon, Mann-Whitney).
11. 11. Automatisation de l’analyse univariée et rapports synthétiques
11.1 Création d’une fonction Python réutilisable d’analyse univariée
Face à des jeux de données d’entreprise ou des cohortes scientifiques comportant des dizaines, voire des centaines de variables hétérogènes, la réécriture itérative des scripts d’analyse univariée s’avère fastidieuse et propice aux erreurs de copié-collé. L’analyste moderne doit concevoir des fonctions d’encapsulation modulaires capables d’inspecter dynamiquement la typologie de chaque colonne et d’exécuter la batterie de tests appropriée.
Une fonction d’automatisation rigoureuse doit recevoir en paramètre une Series Pandas ou un couple (DataFrame, nom_de_colonne). Dans un premier temps, la fonction évalue la nature de la variable : si le type est identifié comme catégoriel, textuel ou booléen, l’algorithme génère les tableaux de fréquences absolues et relatives à l’aide de value_counts(), calcule le mode empirique et quantifie la proportion de valeurs manquantes. Si la variable s’avère numérique, la routine calcule les descripteurs de tendance centrale (moyenne, moyenne tronquée, médiane), les métriques de dispersion (étendue, écart interquartile, variance, écart-type corrigé, coefficient de variation), ainsi que les moments d’ordre supérieur (asymétrie de Fisher, excès de kurtosis).
Le point d’aboutissement fonctionnel de cet outil réside dans la structuration de la sortie sous la forme d’un nouveau DataFrame Pandas synthétique parfaitement mis en page. Cette structure tabulaire homogène facilite l’agrégation transversale de l’ensemble des colonnes d’une base de données, permettant de trier, filtrer et sérier les variables selon leur degré d’asymétrie ou leur volume de données manquantes dans le cadre d’un rapport de synthèse préalable à la modélisation.
11.2 Génération de visualisations combinées sur une figure unique
L’auscultation univariée gagne en efficacité lorsqu’elle rassemble sur un même panneau graphique multidimensionnel l’ensemble des visualisations diagnostiques complémentaires d’une variable quantitative. L’élaboration d’un tableau de bord visuel intégré évite de disperser les figures et permet de confronter simultanément les différentes représentations de la distribution.
La mise en œuvre de cette synergie graphique s’appuie sur la fonction matplotlib.pyplot.subplots(). En paramétrant une grille d’affichage composée d’une colonne et de trois lignes (ou une matrice $2 \times 2$), l’analyste peut agencer de manière harmonieuse :
- Une boîte à moustaches horizontale supérieure, configurée avec une faible épaisseur d’axe pour isoler visuellement la médiane et les valeurs aberrantes selon la règle de Tukey ;
- Un histogramme central avec superposition de la courbe d’estimation de la densité par noyau (KDE), partageant rigoureusement le même axe horizontal des abscisses que le boxplot grâce au paramètre sharex=True ;
- Un diagramme quantile-quantile (Q-Q plot) normalisé ou une courbe de distribution cumulative empirique (ECDF) occupant l’espace inférieur pour diagnostiquer les déviations de normalité.
Ce type de panneau multi-graphique, configuré avec des polices vectorielles soignées, des graduations clairement légendées et des annotations scalaires des paramètres clés ($\bar{x}, s, G_1$), constitue le standard par excellence pour l’élaboration d’annexes méthodologiques au sein de publications à comité de lecture ou de rapports techniques destinés à des comités d’audit.
11.3 Outils de profilage automatisé de données
L’essor de l’ingénierie des données a vu émerger une génération d’outils d’automatisation de haut niveau, couramment désignés sous le vocable de bibliothèques de profilage automatisé (data profiling). Des solutions logicielles open-source comme ydata-profiling (anciennement pandas-profiling) ou Sweetviz permettent, au moyen de quelques lignes d’instructions de haut niveau, de scanner l’intégralité d’un DataFrame et de compiler un rapport interactif complet au format HTML.
Ces outils automatisent la cartographie des variables : détection des types, calcul exhaustif des métriques paramétriques et robustes, traçage systématique des histogrammes de fréquences, identification des corrélations marginales et repérage automatique des valeurs manquantes ou des colonnes constantes. L’économie de temps offerte par ces suites logicielles lors de la phase initiale d’acculturation à un jeu de données massif est considérable, offrant une vision synoptique immédiate des pathologies structurelles du corpus étudié.
Néanmoins, une vigilance épistémologique s’impose face à l’usage exclusif et aveugle de ces rapports standardisés. L’automatisation intégrale tend à anesthésier le sens critique de l’analyste en générant une surcharge cognitive d’indicateurs décontextualisés. Ces outils appliquent des règles de décision standardisées qui peuvent se révéler inadaptées aux spécificités de domaines pointus (épidémiologie, physique des particules, actuariat), où le traitement d’une valeur limite ou d’une échelle ordinale requiert une expertise métier fine. L’automatisation du profilage doit donc être appréhendée comme un outil de débroussaillage initial rapide, qui ne saurait dispenser le chercheur d’une exploration méthodique manuelle approfondie de ses variables d’intérêt critiques.
12. 12. Étude de cas complète et interprétation des résultats empiriques
12.1 Déroulement exhaustif sur une variable continue
Afin de concrétiser l’articulation pratique de l’ensemble des concepts exposés, considérons une étude de cas appliquée à l’analyse univariée de la variable continue points, issue d’une base de données retraçant les performances athlétiques individuelles enregistrées au cours d’une saison sportive professionnelle. L’objectif consiste à documenter rigoureusement la distribution de cette variable pour orienter les modélisations prédictives ultérieures.
L’exécution de la méthode describe() révèle un effectif valide de $n = 500$ observations sans aucune valeur manquante. La moyenne arithmétique empirique s’élève à $\bar{x} = 24.8$ points, tandis que la médiane statistique s’établit à $Med = 22.0$ points. Cet écart directionnel positif où la moyenne excède la médiane suggère d’emblée une asymétrie vers les valeurs élevées. L’écart-type d’échantillon corrigé est quantifié à $s = 12.3$ points, adossé à un écart interquartile $IQR = 16.0$ points ($Q_1 = 15.0$, $Q_3 = 31.0$). Le coefficient de variation calculé atteint $CV = 49.6%$, signalant une dispersion relative substantielle au sein de la cohorte des joueurs.
L’approfondissement morphologique via les fonctions skew() et kurtosis() fournit des résultats sans ambiguïté : le coefficient d’asymétrie de Fisher-Pearson s’affiche à $G_1 = +1.18$, confirmant une distribution asymétrique positive prononcée, étirée vers la droite. L’excès de kurtosis ressort à $G_2 = +1.42$, traduisant une silhouette leptokurtique aux queues plus épaisses que celles d’une gaussienne. L’histogramme assorti de sa courbe KDE corrobore visuellement cette déviation, matérialisant une chute rapide de densité au-delà de 45 points, ponctuée de quelques performances d’élite marginales culminant à un maximum de 68 points. Le boxplot identifie plusieurs valeurs atypiques modérées au-delà de la barrière de Tukey ($31.0 + 1.5 \times 16.0 = 55.0$ points). Enfin, le test formel de normalité de Shapiro-Wilk renvoie une statistique $W = 0.912$ avec une p-valeur infinitésimale ($p < 0.001$), rejetant catégoriquement l'hypothèse de normalité à un seuil $\alpha = 0.05$. En conclusion, la variable points ne saurait être modélisée sous des hypothèses paramétriques gaussiennes sans une transformation logarithmique préalable ou le recours exclusif à des descripteurs non paramétriques robustes ($Med = 22.0$ ; $IQR = 16.0$).
12.2 Déroulement exhaustif sur une variable discrète
Poursuivons cette investigation empirique en soumettant à l’analyse univariée deux variables quantitatives discrètes du corpus sportif : la variable assists (passes décisives) et la variable rebounds (rebonds captés), représentant des dénombrements d’événements entiers finis.
L’inspection tabulaire de la variable assists débute par l’application de value_counts().sort_index(), qui met en évidence une concentration massive d’observations sur des valeurs basses : la fréquence modale absolue s’établit à $3$ passes décisives, représentant à elle seule $28.4%$ de l’échantillon global. Le décompte cumulé révèle que plus de $78%$ des athlètes enregistrent un total de passes décisives inférieur ou égal à 5. La distribution présente de nombreuses égalités (ties), typiques des variables de comptage en petits nombres entiers.
Sur le plan de la dispersion, la variable assists affiche une moyenne $\bar{x} = 4.2$ et une variance d’échantillon $s^2 = 8.6$. Cette situation, où la variance excède sensiblement la moyenne arithmétique, met en évidence le phénomène classique de surdispersion (overdispersion), ce qui exclut l’ajustement par une loi de Poisson théorique standard (qui postule l’égalité stricte de la moyenne et de la variance) au profit d’une modélisation univariée par une loi binomiale négative. Le diagramme en barres discrètes (barplot) illustre fidèlement cette décroissance exponentielle, à la différence de la variable rebounds qui, bien qu’entière, présente une dispersion plus symétrique centrée autour d’une moyenne $\bar{x} = 7.1$ et d’une médiane $Med = 7.0$ avec un coefficient d’asymétrie modéré ($G_1 = 0.22$), se prêtant ainsi davantage à des approximations linéaires conventionnelles.
12.3 Bonnes pratiques et directives pour la communication des résultats
La finalité ultime d’une analyse univariée réside dans la communication claire et rigoureuse de ses conclusions à la communauté scientifique ou aux décideurs stratégiques. Cette restitution obéit à des normes académiques internationales standardisées, dont les plus reconnues sont les directives rédactionnelles de l’American Psychological Association (style APA, 7e édition).
Une règle méthodologique essentielle régit la dualité de présentation des indicateurs de synthèse :
- Lorsque la variable étudiée satisfait raisonnablement aux postulats de symétrie et de normalité (validée par l’inspection conjointe du diagramme Q-Q et l’absence de significativité des tests de Shapiro-Wilk ou D’Agostino-Pearson), les résultats doivent impérativement être exprimés sous la forme du couple moyenne et écart-type, selon la typographie formelle : $M = 24.8$, $SD = 12.3$ (où $SD$ désigne la Standard Deviation).
- À l’inverse, dès lors que la variable présente une asymétrie caractérisée, une multi-modalité ou des valeurs atypiques massives, le chercheur doit substituer à ce duo paramétrique le couple non paramétrique médiane et écart interquartile : $Mdn = 22.0$, $IQR = 16.0$ (voire la mention de l’intervalle semi-interquartile ou des percentiles 25e et 75e). Rapporter la moyenne arithmétique d’une variable lourdement asymétrique sans mentionner la médiane constitue une distorsion informative majeure.
Enfin, les écueils usuels de restitution doivent être scrupuleusement évités. L’analyste s’abstiendra de surcharger ses tableaux de chiffres après la virgule : deux décimales s’avèrent amplement suffisantes pour la majorité des grandeurs continues, et une seule décimale pour les pourcentages relatifs. Les figures graphiques intégrées dans les manuscrits devront systématiquement comporter des barres d’erreurs explicitement identifiées en légende (écart-type ou intervalle de confiance à 95%), des axes commençant de manière non trompeuse (zéro d’ancrage obligatoire pour les diagrammes en barres) et des légendes auto-suffisantes permettant au lecteur d’appréhender la distribution de la variable sans devoir recourir à la lecture du corps de texte principal.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17-21. https://doi.org/10.1080/00031305.1973.10478966
- D’Agostino, R. B., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of $b_2$ and $\sqrt{b_1}$. Biometrika, 60(3), 613-622. https://doi.org/10.1093/biomet/60.3.613
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
- Hintze, J. L., & Nelson, R. D. (1998). Violin plots: A box plot-density trace synergism. The American Statistician, 52(2), 181-184. https://doi.org/10.1080/00031305.1998.10480559
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1920-00a
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343-414. https://doi.org/10.1098/rsta.1895.0010
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.1093/biomet/52.3-4.591
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021