
Dans le champ de l’ingénierie des données et de l’analyse quantitative contemporaine, l’écosystème Python s’est imposé comme une référence incontournable grâce à la puissance de manipulation matricielle offerte par la bibliothèque Pandas. Les chercheurs, analystes financiers et ingénieurs de données sont quotidiennement confrontés au défi de transformer des structures tabulaires complexes en livrables exploitables pour des tiers. Bien que le format de stockage brut demeure un élément central des chaînes de traitement automatisées, le format de classeur multi-feuilles conserve une place prépondérante dans la communication des résultats de recherche et la restitution de bilans stratégiques.
La sérialisation d’ensembles de données multidimensionnels pose toutefois une difficulté fondamentale lorsqu’il s’agit de structurer l’information de manière logique et cloisonnée sans multiplier les artéfacts de stockage. L’exportation de plusieurs tables de données vers un classeur unique doté d’onglets distincts constitue une réponse fonctionnelle majeure face à la prolifération de fichiers disparates. Cette pratique permet de centraliser des cohortes d’analyses, des partitions chronologiques ou des segmentations méthodologiques au sein d’une seule et même archive numérique cohérente et auditable.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, les mécanismes logiciels sous-jacents et les implémentations pratiques régissant l’écriture de multiples structures de données Pandas au sein de plusieurs feuilles d’un classeur Microsoft Excel. En explorant les interfaces de programmation, la gestion avancée des ressources matérielles, ainsi que les stratégies d’optimisation bas niveau offertes par les moteurs de rendu spécialisés, ce document fournit les compétences nécessaires pour bâtir des pipelines d’exportation de données rigoureux, pérennes et hautement reproductibles.
1. Introduction à l’exportation multidimensionnelle avec Pandas et Excel
1.1 Contexte de la gestion des données tabulaires en recherche
La recherche moderne, qu’elle s’exprime dans le domaine biomédical, en économétrie ou au sein des sciences des données appliquées, produit des volumes considérables d’informations caractérisées par leur forte hétérogénéité. Il est fréquent qu’un même protocole d’évaluation génère simultanément des données démographiques, des séries temporelles de mesures physiologiques, des scores statistiques intermédiaires et des synthèses descriptives globales. Face à cette pluralité de structures matricielles, le maintien d’une cohérence documentaire exige la centralisation de ces différentes strates au sein d’une structure de persistance unifiée capable de préserver la hiérarchie intrinsèque des corpus expérimentaux.
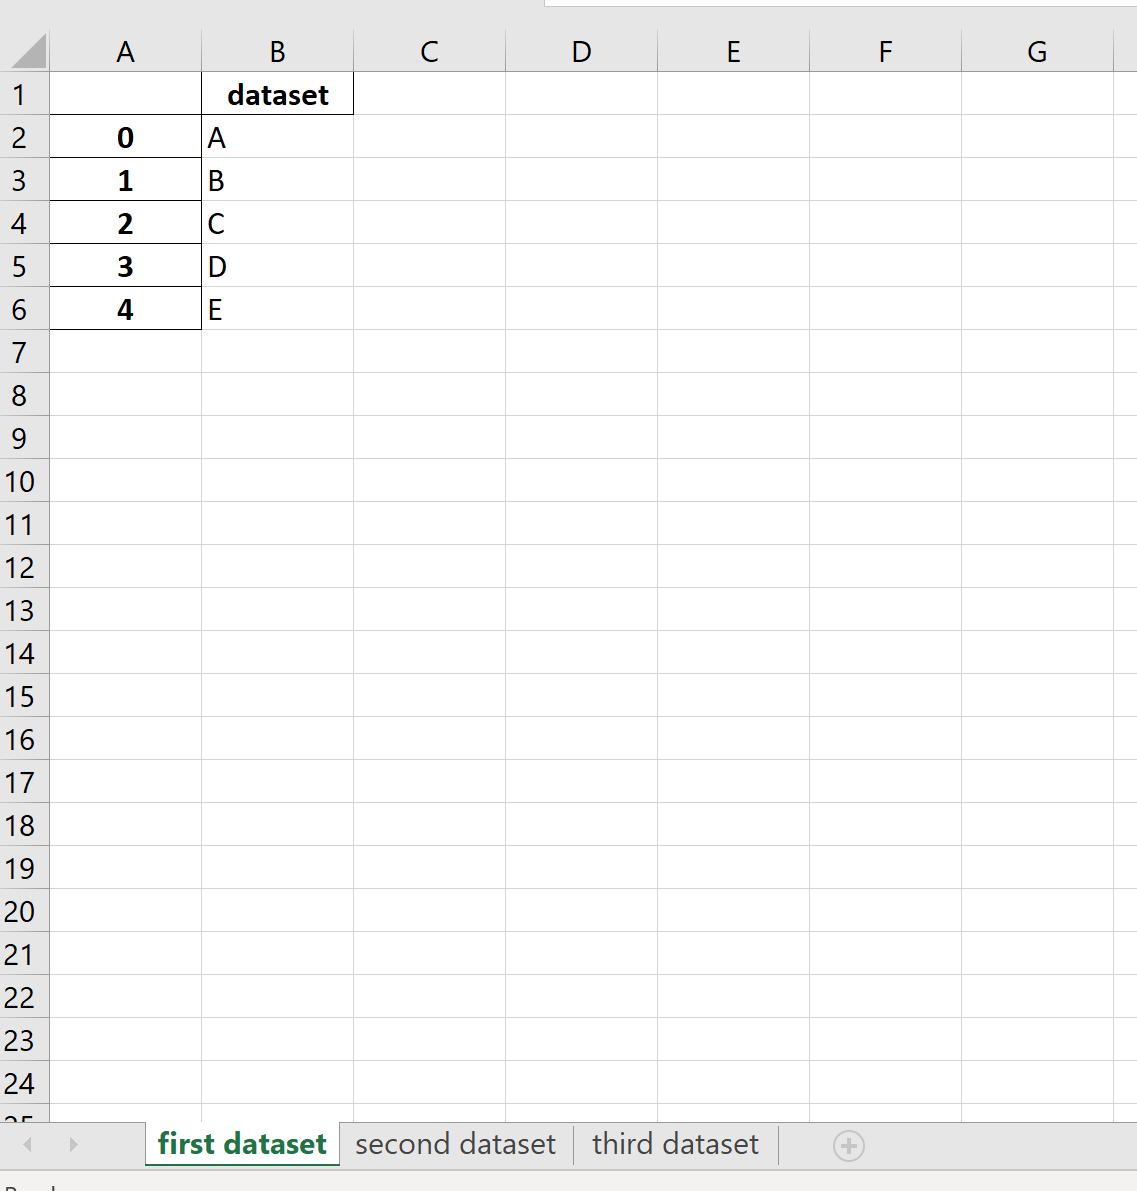
Dans ce cadre opératoire, l’exportation traditionnelle sous la forme de fichiers à valeurs séparées par des virgules (CSV) montre rapidement des défaillances structurelles critiques. Le format CSV est par essence un conteneur bidimensionnel plat, incapable de représenter nativement des hiérarchies de données complexes sans contraindre les chercheurs à disperser les observations dans une multiplicité de fichiers isolés. Cette fragmentation engendre des risques prononcés de désynchronisation de versions, complique l’archivage rigoureux des résultats et expose les équipes à des erreurs d’indexation lors du transfert manuel des livrables vers les instances de décision ou les comités d’évaluation par les pairs.
À l’inverse, l’adoption du format de classeur moderne (.xlsx), adossé aux spécifications ouvertes de l’ISO/IEC 29500 (OpenXML), propose un réceptacle particulièrement robuste pour la restitution synthétique et l’archivage pérenne des données. En encapsulant une multitude de tables dans des feuilles de calcul individualisées au sein d’une archive compressée unique, le classeur Excel agit comme un classeur analytique complet. Il offre aux collaborateurs la possibilité de naviguer intuitivement d’une cohorte expérimentale à une autre, tout en préservant l’intégrité contextuelle des données et en facilitant l’interaction directe avec des logiciels bureautiques sans recourir à des processus lourds de réimportation.
1.2 Problématique de la sérialisation multiple sous Python
Au sein de l’environnement Python, l’interface standard fournie par la structure fondamentale de données tabulaires dispose d’une méthode de haut niveau dédiée à l’exportation bureautique, à savoir la fonction DataFrame.to_excel(). Cependant, l’utilisation naïve et répétitive de cette méthode met en lumière une limitation technique majeure : chaque appel successif ciblant un même chemin de fichier réinitialise intégralement le descripteur de fichier sur le système d’exploitation hôte. Par défaut, la méthode tronque le fichier cible, créant une nouvelle archive binaire qui détruit irrémédiablement l’intégralité du contenu préalablement sérialisé lors des étapes antérieures de la chaîne de calcul.
Cette opération destructrice s’explique par l’absence, au niveau élémentaire de l’objet de données, de gestion de l’état persistant du flux d’entrée-sortie. L’opération d’écriture standard est conçue comme un acte unitaire atomique, dans lequel le fichier est ouvert en mode d’écrasement, rempli avec les données de la table courante, puis immédiatement refermé. Par conséquent, l’obtention d’un classeur contenant une constellation d’onglets requiert l’intervention d’un agent intermédiaire capable de maintenir un flux ouvert, d’orchestrer les ajouts successifs dans une mémoire tampon et de n’exécuter la phase de validation binaire définitive qu’une fois la totalité des structures matricielles injectées.
Cet intermédiaire architectural indispensable est matérialisé sous Python par la classe pd.ExcelWriter. Cet objet agit comme un pont de sérialisation entre les représentations matricielles en mémoire vive et les spécifications physiques des moteurs de rendu de feuilles de calcul. L’objectif méthodologique réside dans la maîtrise de cette passerelle afin de garantir une écriture séquentielle ou parallèle sans la moindre déperdition typologique ni tronquage d’enregistrements. Cela permet d’assurer une fidélité mathématique totale entre les structures de données générées en mémoire par l’interpréteur Python et les grilles tabulaires figées sur le disque magnétique ou l’espace de stockage flash.
2. Configuration de l’environnement technique et dépendances
2.1 Installation et gestion des bibliothèques requises
La manipulation programmatique des classeurs Excel par l’intermédiaire de Pandas ne s’effectue pas de manière autonome ; la bibliothèque délègue la sérialisation binaire bas niveau à des moteurs tiers spécialisés. Pour construire un environnement fonctionnel, il est impératif d’installer les bibliothèques adéquates par le biais de l’utilitaire pip ou des gestionnaires de paquets propres aux distributions scientifiques. La bibliothèque xlsxwriter représente l’une des solutions les plus répandues lorsqu’il s’agit de générer des classeurs vierges avec une grande vitesse d’exécution et un contrôle graphique étendu.
D’un point de vue historique, la manipulation des classeurs binaires reposait autrefois sur le module xlwt, conçu exclusivement pour la génération d’anciens formats Microsoft Excel 97-2003 (.xls). Aujourd’hui, xlwt est considéré comme obsolète par la communauté logicielle. Son utilisation est formellement déconseillée en raison de ses limitations intrinsèques, notamment l’impossibilité de dépasser la frontière stricte des 65 536 lignes par feuille et l’absence totale de compatibilité avec les architectures OpenXML contemporaines. L’infrastructure moderne repose désormais exclusivement sur des moteurs prenant en charge les schémas XML compressés.
Parallèlement à xlsxwriter, la bibliothèque tierce openpyxl constitue un maillon incontournable de l’écosystème de traitement de données. Alors que la première excelle dans la création rapide de fichiers neufs sans possibilité de relecture, openpyxl propose une modélisation bidirectionnelle exhaustive capable d’analyser, de charger et d’altérer des structures existantes. L’interopérabilité offerte par la combinaison conjointe de Pandas et de ces deux moteurs permet d’adapter l’outil aux exigences spécifiques du projet, qu’il s’agisse de performance pure à l’écriture ou de maintenance évolutive de classeurs patrimoniaux.
2.2 Vérification des versions logicielles et compatibilité
L’intégration harmonieuse de l’interface pd.ExcelWriter dépend directement de l’alignement des versions de l’interpréteur Python, de Pandas et des moteurs d’écriture sous-jacents. Depuis les jalons majeurs introduits par les versions 1.4 et ultérieurement 2.0 de Pandas, de substantielles refactorisations de l’infrastructure d’entrée-sortie ont été opérées. Il est crucial de s’assurer que l’environnement d’exécution dispose d’une version récente de la bibliothèque afin de bénéficier de la standardisation des interfaces de contextes et des correctifs de stabilité relatifs à l’intégration des types de données Apache Arrow et des types catégoriels natifs.
La gestion des dépendances au sein d’environnements virtuels isolés, qu’ils soient orchestrés via le gestionnaire venv standard ou par l’intermédiaire de conteneurs de paquets multi-plateformes comme Conda, prévient la survenue de conflits de bibliothèques C-dynamiques sous-jacentes. Des collisions surviennent fréquemment lorsque des versions divergentes de chargeurs XML ou de dépendances de sérialisation sont importées de manière asynchrone dans l’espace d’exécution global du système hôte. Le maintien d’un fichier de spécification rigoureusement versionné (de type requirements.txt ou environment.yml) constitue le gage indispensable d’un déploiement sans heurts.
Enfin, une étape de vérification automatisée de l’intégrité des modules doit être incorporée en amont de l’exécution des scripts de production. Cette étape consiste à tester par introspection l’importation de l’interface d’écriture et à interroger dynamiquement la variable pd.__version__ ainsi que les registres internes des moteurs. Un tel contrôle programmatique garantit que les fonctionnalités d’écriture binaire sont pleinement opérationnelles avant d’engager des calculs matriciels intensifs, évitant ainsi les interruptions préjudiciables de longs pipelines de traitement au stade ultime de la sérialisation sur disque.
3. Fondements théoriques de l’objet pd.ExcelWriter
3.1 Mécanisme interne de l’intermédiaire de flux
La classe pd.ExcelWriter fonctionne conceptuellement comme une couche d’abstraction matérielle s’interfaçant entre la structure de données interne de Pandas et les bibliothèques concrètes d’écriture binaire. Plutôt que de contraindre l’analyste à dialoguer directement avec les grammaires spécifiques de chaque moteur de rendu, cette classe unifie les mécanismes d’aiguillage des données sous une signature d’appel homogène. Elle agit comme une passerelle de flux qui intercepte les requêtes de sérialisation provenant des objets de données et les achemine vers une instance de classeur sous-jacente conservée en état de modification active.
Lorsqu’un écrivain de ce type est instancié, il initialise une structure de données arborescente représentant le futur fichier Excel, soit directement au sein de la mémoire vive du système, soit en s’appuyant sur un fichier temporaire déposé sur le disque. Tout au long du cycle de vie du processus, le pointeur de fichier est maintenu actif, et les opérations successives d’injection de feuilles de calcul n’effectuent pas d’écritures physiques directes et définitives vers le média de stockage final. Les données, les en-têtes et les définitions de métadonnées sont au contraire placés dans un tampon d’entrée-sortie qui accumule les transformations structurelles de manière asynchrone.
Il convient d’établir une distinction formelle entre l’instanciation de l’intermédiaire, l’écriture vectorielle des blocs de cellules et la phase d’engagement physique ou « commit ». La méthode d’exportation d’une table remplit uniquement les registres du classeur virtuel ; la consolidation des flux d’octets, la génération de l’architecture d’archives compressées (le conteneur ZIP formant l’essence des fichiers OpenXML) et la fermeture définitive des descripteurs de bas niveau ne sont déclenchées qu’au moment précis de la fermeture formelle de l’objet écrivain. Cette séparation temporelle garantit que le classeur produit n’est jamais exposé dans un état partiel ou corrompu en cas de suspension prématurée du processus.
3.2 Comparatif des moteurs de rendu disponibles
L’architecture ouverte de Pandas autorise la sélection explicite du moteur de restitution par le biais du paramètre engine lors de l’instanciation de l’intermédiaire d’écriture. Le moteur xlsxwriter a été spécifiquement conçu pour offrir un débit d’écriture maximal associé à une prise en charge exhaustive des fonctionnalités graphiques avancées d’Excel, telles que les tracés vectoriels, les mises en forme conditionnelles élaborées et la configuration millimétrée des propriétés d’impression. En raison de sa structure interne orientée flux sortant direct, il se révèle remarquablement véloce pour générer des classeurs complexes à partir de données calculées ex nihilo.
Toutefois, la rapidité d’exécution de xlsxwriter découle d’un compromis architectural strict : il est structurellement incapable de charger ou de modifier un document déjà présent sur le disque. Si le protocole expérimental requiert l’ouverture d’un classeur préexistant afin d’y adjoindre de nouvelles feuilles tout en conservant les données antérieures, le moteur openpyxl s’impose comme l’unique choix viable. Conçu autour d’un modèle d’objet de document (DOM) complet, openpyxl charge l’intégralité de l’arborescence XML du classeur en mémoire, ce qui autorise des manipulations chirurgicales des feuilles de calcul existantes au détriment d’une consommation de ressources mémoires nettement plus prononcée.
Le choix entre ces deux alternatives technologiques repose donc sur une analyse précise des contraintes opérationnelles de la chaîne de traitement. Lorsque le volume des matrices de données s’avère colossal et que l’infrastructure matérielle impose un plafond strict d’allocation de mémoire vive, xlsxwriter présente des garanties d’optimisation indispensables, notamment grâce à son mode d’écriture à consommation mémoire constante. À l’opposé, pour les processus d’intégration continue nécessitant l’enrichissement itératif de matrices de bord de route ou la mise à jour incrémentale de classeurs modèles renfermant des macros et des styles prédéfinis, openpyxl constitue la solution d’ingénierie par excellence.
4. Protocole fondamental d’écriture séquentielle
4.1 Initialisation des jeux de données expérimentaux
Avant d’engager le transfert des données vers les structures physiques de la feuille de calcul, une phase préparatoire rigoureuse est indispensable pour fiabiliser la typologie des variables manipulées. Considérons une situation expérimentale standard au sein de laquelle un pipeline d’analyse produit trois ensembles distincts : une table dédiée aux caractéristiques sociodémographiques d’une cohorte, une deuxième consignant les observations cinétiques longitudinales et une troisième compilant les résultats des inférences statistiques globales. Chacune de ces tables forme une entité matricielle autonome qu’il convient d’isoler dans sa propre feuille.
La validation de la typologie des données constitue une condition préalable fondamentale pour éviter la corruption insidieuse des enregistrements lors du passage au format bureautique. Les variables numériques doivent être rigoureusement castées en types primitifs standardisés, les variables temporelles doivent impérativement adopter le format datetime64 pour être reconnues nativement comme des dates par le tableur, et les chaînes textuelles doivent être purgées des caractères de contrôle non imprimables qui pourraient violer les spécifications XML de l’ISO. Un tel assainissement préalable prévient les coercitions de types indésirables, fréquentes lorsque le tableur interprète erronément des identifiants textuels comme des grandeurs numériques.
De surcroît, la configuration des axes d’indexation requiert une attention méthodologique particulière. Qu’il s’agisse d’un index numérique continu, d’un index temporel complexe ou d’un multi-index hiérarchique, l’analyste doit déterminer en amont si ces étiquettes d’alignement doivent figurer sur la feuille de calcul finale en tant que colonnes distinctes ou si elles doivent être rejetées au profit d’une structure purement relationnelle. Cette homogénéisation en amont garantit que les matrices transférées vers le moteur d’écriture ne généreront aucune anomalie de décalage spatial lors de la reconstitution du tableau au sein de la grille de calcul.
4.2 Instanciation de l’écrivain et affectation des onglets
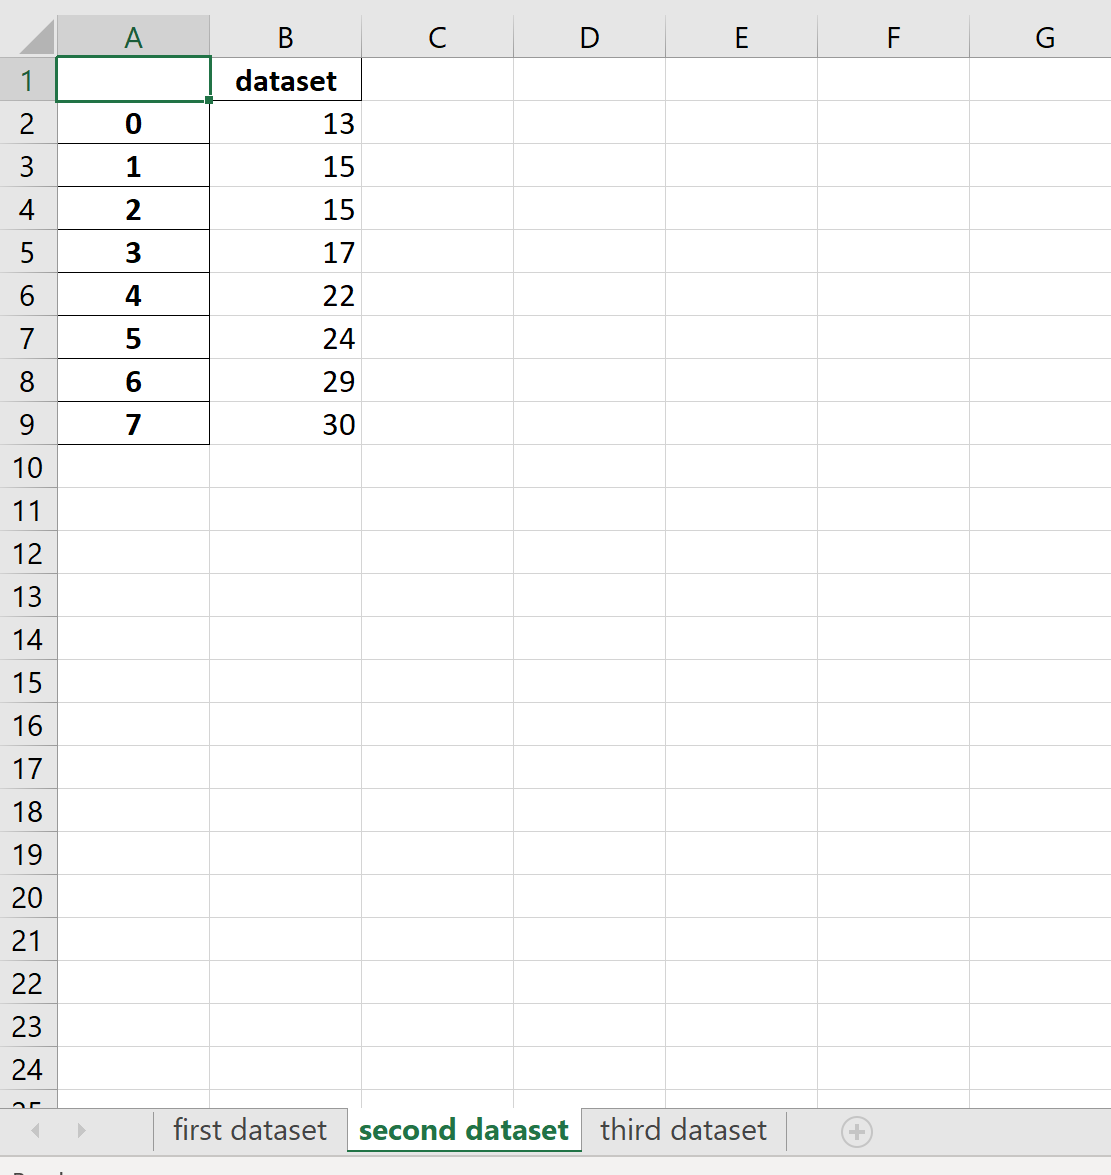
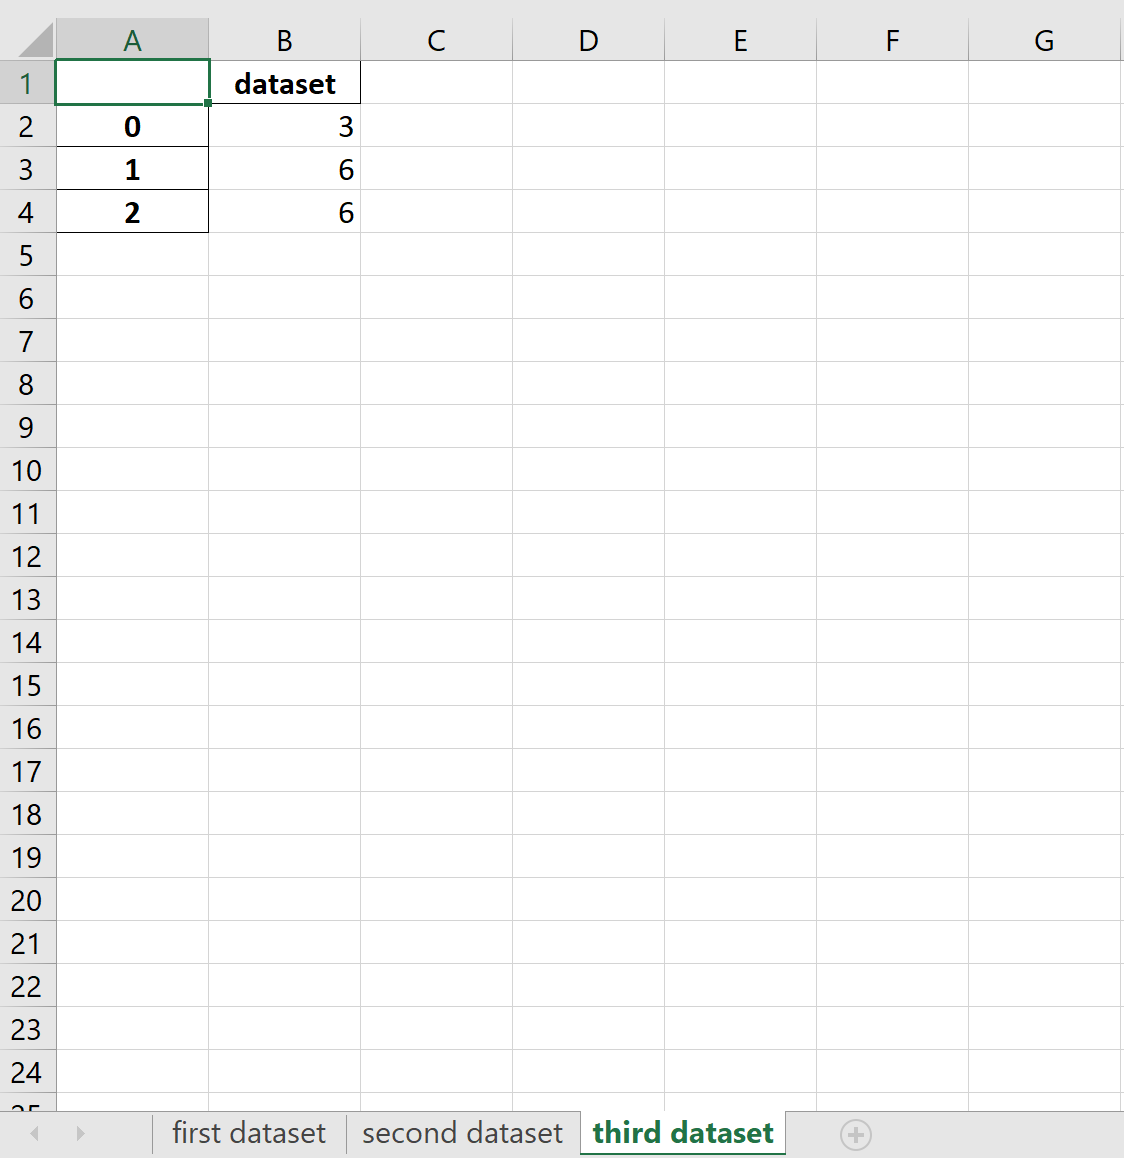
Le déploiement du protocole d’écriture séquentielle s’amorce par l’instanciation délibérée de l’objet pd.ExcelWriter, en renseignant explicitement le chemin absolu ou relatif du fichier de destination sur le système de fichiers, ainsi que le moteur sélectionné. Dès cette initialisation effectuée, l’intermédiaire de flux se positionne en attente d’instructions de transfert. Les différentes tables de données sont ensuite déversées de manière successive dans l’objet écrivain par le truchement direct de leur propre méthode to_excel(), en substituant le chemin d’accès usuel par l’instance de l’écrivain ainsi créé.
L’élément pivot de cette opération séquentielle réside dans la configuration de l’argument textuel sheet_name. Ce paramètre désigne de façon déterministe l’onglet de destination au sein duquel la matrice de données doit être matérialisée. Chaque appel de la fonction doit impérativement porter une chaîne d’identification distincte, sous peine de voir les données de l’appel précédent écrasées ou renommées arbitrairement par le moteur selon la configuration de secours choisie. L’attribution ordonnée de libellés sémantiques clairs facilite la traçabilité des analyses et l’exploration ergonomique ultérieure par les destinataires du document.
Dans l’éventualité où l’argument sheet_name serait négligé ou omis lors des invocations successives, la bibliothèque Pandas applique un mécanisme de nomenclature automatique standard, attribuant séquentiellement des désignations génériques telles que « Sheet1 » ou « Feuil1 ». Outre la dégradation de la lisibilité documentaire, cette omission peut engendrer des comportements erratiques selon le moteur utilisé, aboutissant parfois au remplacement masqué des données ou à l’émission d’avertissements de collision de métadonnées. L’explicitation rigoureuse des noms de feuilles doit être considérée comme une exigence non négociable de qualité logicielle.
4.3 Finalisation et libération des ressources système
Dans les versions historiques de la bibliothèque Pandas, le protocole classique de clôture de l’opération d’écriture exigeait l’exécution manuelle de la méthode save() sur l’instance de l’écrivain. Cette commande déclenchait la sérialisation effective des flux en mémoire, assemblait l’archive binaire et confirmait l’écriture physique sur le support persistant. Cependant, l’évolution continue des spécifications internes a conduit à la dépréciation formelle de cette méthode dans les moutures contemporaines de la bibliothèque, unifiant l’action de sauvegarde sous la seule invocation de la méthode close().
Cette transition vers l’appel exclusif de close() répond à des impératifs d’alignement avec les protocoles de gestion des entrées-sorties de l’interpréteur Python standard. L’exécution de close() assume la double responsabilité d’opérer le vidage exhaustif (« flush ») des mémoires tampons résiduelles vers le système de stockage et de détruire immédiatement le descripteur de fichier alloué au niveau du noyau du système d’exploitation. Cette action libère immédiatement les verrous d’accès matériels qui, s’ils étaient maintenus par inadvertance, bloqueraient l’accès au fichier pour d’autres processus ou interdiraient sa réouverture par le système d’exploitation hôte.
La validation de la terminaison effective des flux d’écriture revêt une importance critique au sein des environnements d’intégration continue ou des scripts exécutés en tâches d’arrière-plan. Si l’interpréteur Python est interrompu brusquement avant l’achèvement de la méthode de fermeture, le classeur résultant présente fréquemment un en-tête d’archive incomplet, rendant le document totalement illisible pour Microsoft Excel et les suites bureautiques dérivées. L’intégrité du livrable scientifique repose donc sur l’assurance inconditionnelle de cette étape de clôture opérationnelle.
5. Implémentation robuste via les gestionnaires de contexte
5.1 Syntaxe sécurisée avec l’instruction with
Bien que l’enchaînement séquentiel d’instanciation, d’appels successifs et de fermeture manuelle soit théoriquement fonctionnel, il présente une vulnérabilité logicielle majeure : la susceptibilité aux interruptions par exceptions inattendues. Si une anomalie matricielle, un défaut d’allocation de mémoire vive ou une erreur de typologie survient au cours de l’écriture d’une table intermédiaire, le script s’interrompt brutalement sans jamais atteindre l’instruction de clôture. Les descripteurs d’entrée-sortie demeurent alors béants au niveau du système d’exploitation, laissant le fichier sur disque dans un état instable, partiellement écrit et virtuellement irrécupérable.
Pour contourner ce risque systémique, le langage Python propose le paradigme du gestionnaire de contexte, formalisé syntaxiquement par l’instruction with. En encapsulant l’objet pd.ExcelWriter dans un bloc contextuel dédié, l’ingénieur délègue la gestion du cycle de vie de la ressource aux méthodes protocolaires internes __enter__ et __exit__ de l’objet. Ce mécanisme garantit, de manière totalement déterministe, que les ressources sous-jacentes seront scellées et libérées dès que l’exécution s’échappe de la portée délimitée par le bloc, que cette sortie s’opère de façon nominale ou qu’elle résulte de l’émergence d’une exception fatale non interceptée.
L’adoption systématique de cette structure syntaxique robuste immunise le pipeline contre la corruption silencieuse des fichiers de données. Elle uniformise en outre le code source en éliminant la nécessité d’implémenter de fastidieux blocs try...finally pour garantir la fermeture des descripteurs binaires. Dans les environnements scientifiques où la traçabilité et l’auditabilité du code constituent des critères fondamentaux d’acceptation, l’usage des gestionnaires de contexte représente la règle d’art universellement reconnue pour orchestrer les opérations d’entrée-sortie pérennes.
5.2 Schéma d’exécution pas à pas
L’orchestration d’une écriture sécurisée s’articule autour d’une architecture séquentielle rigide mais conceptuellement simple. L’ouverture contextuelle est initialisée en assignant l’objet écrivain à un alias symbolique, classiquement désigné sous le terme writer. Au sein de l’indentation régissant la portée de cette structure, chaque table de données exécute consécutivement sa propre directive de sérialisation. Le compilateur assure l’isolation séquentielle de chaque tâche, permettant le déversement ordonné des matrices analytiques sans interférence mutuelle entre les espaces mémoires alloués aux différentes cohortes de données.
Si, au cours de la sérialisation de la troisième feuille de calcul d’une série complexe, une erreur arithmétique de division par zéro ou une incohérence de schéma survient, le gestionnaire de contexte intercepte immédiatement le déroutement du programme. Avant de propager l’exception vers les couches supérieures du système de journalisation, il assure l’évacuation propre du pointeur de fichier et procède à la résiliation des verrous système. Cette intégrité transactionnelle prévient la persistance de processus orphelins susceptibles d’engorger la mémoire vive des serveurs de calcul haute performance ou de bloquer l’exécution de tâches planifiées concurrentes.
Le schéma fonctionnel ainsi instauré offre une clarté de lecture incomparable pour la révision de code par des pairs. L’ensemble des tables participant à la constitution du classeur cible se trouve géographiquement rassemblé au sein d’une indentation unique et explicite, attestant sans ambiguïté de leur destinée commune. Cette architecture préserve la modularité des applications logicielles tout en fournissant une structure extrêmement résistante aux pannes pour les architectures de traitement de flux continu de données volumineuses.
6. Paramétrage structural des feuilles de calcul générées
6.1 Gestion de l’indexation et des en-têtes
L’un des écueils les plus récurrents lors du déversement de structures de données Pandas vers un support bureautique réside dans la transcription mécanique de l’index interne de la structure. Par défaut, la bibliothèque assigne un index entier séquentiel démarrant à zéro pour ordonner les lignes matricielles. Si l’analyste n’intervient pas explicitement, cet identifiant arbitraire sans valeur sémantique pour le destinataire final se trouve coulé dans la première colonne de la grille Excel, altérant l’alignement naturel des variables et induisant en erreur les logiciels d’analyse statistique tiers qui réimporteraient le document.
Pour neutraliser ce comportement, il est impératif d’intégrer formellement l’argument booléen index=False au sein de l’appel de chaque méthode to_excel(). Cette directive ordonne au moteur de faire abstraction de l’axe vertical d’alignement pour n’écrire que les données réelles associées à leurs libellés de colonnes respectifs. Néanmoins, lorsque la structure matricielle repose sur un index porteur de sens scientifique fondamental — à l’instar d’un DatetimeIndex cadençant une chronologie d’observations boursières ou médicales —, la préservation de l’index est indispensable, et le paramètre peut alors être configuré pour conserver ou renommer explicitement l’en-tête de cette première colonne structurante.
La gestion des lignes d’en-tête exige une vigilance méthodologique équivalente. Grâce au paramètre header, l’opérateur dispose du pouvoir d’omettre sélectivement la transcription des noms de champs (en assignant la valeur False), ou d’injecter une liste explicite de chaînes textuelles pour substituer des désignations de colonnes internes au code par des libellés formalisés et audités pour la publication. Dans les cas avancés mettant en scène des multi-index hiérarchiques sur les colonnes, Pandas transpose fidèlement l’architecture arborescente sur plusieurs lignes superposées au sommet de la grille Excel, fournissant ainsi une structuration visuelle sophistiquée des agrégats dimensionnels.
6.2 Positionnement spatial des tables sur la grille Excel
L’agencement standard des feuilles de calcul générées par Pandas s’effectue systématiquement en ancrant l’origine du tableau matriciel à la cellule supérieure gauche de la grille, traditionnellement désignée par les coordonnées « A1 ». Cependant, les exigences de mise en page documentaire ou les besoins d’intégration de métadonnées contextuelles imposent fréquemment d’insérer des zones d’aération visuelle, d’introduire des titres institutionnels, des mentions de confidentialité ou des blocs de notes méthodologiques en amont de la table de données proprement dite.
Pour répondre à cette contrainte de conception, l’interface de transfert propose les arguments positionnels startrow et startcol. En déclarant une valeur entière non nulle pour startrow, l’opérateur repousse l’insertion de la première ligne du tableau du nombre correspondant de rangées vers le bas. De façon symétrique, l’ajustement de startcol opère une translation horizontale vers la droite. Cet adressage paramétrique offre une flexibilité de disposition remarquable, permettant de positionner précisément la table de données dans l’espace bidimensionnel de la feuille tout en sanctuarisant les marges nécessaires aux annotations de synthèse.
Cette caractéristique technique déverrouille une capacité fonctionnelle particulièrement avancée : la collocation ordonnée de plusieurs structures de données distinctes au sein d’un seul et même onglet. En calculant dynamiquement l’encombrement spatial (la longueur en lignes et la largeur en colonnes) d’une première table préliminaire, un ingénieur peut appliquer un décalage calculé pour implémenter un second tableau directement sous le premier, ou à sa droite immédiate, séparés par un intervalle de cellules vierges délibéré. Cette approche permet de synthétiser sur une vue synoptique unique un tableau de résultats détaillés flanqué de sa propre table de statistiques descriptives récapitulatives.
6.3 Traitement des valeurs manquantes et codage spécifique
L’intégrité des séries analytiques dépend substantiellement de la rigueur avec laquelle les enregistrements incomplets ou absents sont traités lors de la matérialisation physique sur la grille de calcul. Dans le formalisme Pandas, les absences d’observation sont représentées sous la forme de valeurs non définies (NaN, None, ou l’objet générique pd.NA). Par défaut, le moteur d’exportation retranscrit ces marqueurs matriciels sous forme de chaînes de caractères vides dans les cellules Excel correspondantes. Si cette approche visuelle allège la lecture, elle peut susciter des ambiguïtés critiques au sein des modèles d’audit en confondant une absence totale de saisie avec une valeur textuelle délibérément nulle.
Le recours à l’argument na_rep au sein de la fonction d’exportation autorise la substitution uniforme et déterministe de ces anomalies par un code documentaire normalisé. L’attribution explicite d’une chaîne telle que « ND » (Non Disponible), « NA » (Not Available) ou « NC » (Non Calculé) explicite sans équivoque la nature manquante de l’information pour tout lecteur ou système d’information aval. Cette précaution s’avère particulièrement déterminante dans les études cliniques ou les audits financiers hautement régulés, où l’indétermination doit être impérativement tracée et distinguée d’un champ vierge accidentel.
Il convient toutefois d’évaluer l’impact en chaîne de cette substitution sur le comportement subséquent du tableur. L’injection d’une chaîne de substitution textuelle dans une colonne par ailleurs exclusivement composée de données numériques réelles dégrade l’homogénéité typologique de la série sous Microsoft Excel. Cette conversion forcée interdit l’application immédiate de formules arithmétiques natives sur l’ensemble de la plage sans le recours à des filtres préliminaires. L’ingénieur doit donc arbitrer minutieusement entre l’intégrité d’affichage visuelle des valeurs manquantes et la préservation de la dynamicité fonctionnelle de calculs intégrés dans le document de sortie.
7. Automatisation itérative pour volumes de données multiples
7.1 Sérialisation de collections de DataFrames via des structures de contrôle
Lorsque la dimension des études expérimentales s’accroît, la sérialisation manuelle d’onglets individualisés par des appels séquentiels codés en dur devient une pratique intenable, source d’erreurs et contraire aux principes d’ingénierie logicielle élémentaires. Dans les cas d’usage industriels, il est classique de devoir ventiler des flux d’observations selon une variable de partitionnement catégorielle (par exemple, par zone géographique, par laboratoire d’analyse ou par millésime calendaire), générant de quelques dizaines à plusieurs centaines de sous-tables matricielles. L’automatisation itérative de l’exportation s’impose alors comme une nécessité absolue.
La stratégie architecturale la plus robuste consiste à consolider en mémoire vive les structures de données segmentées au sein d’une structure de collection ordonnée, telle qu’un dictionnaire natif Python où chaque clé représente l’identifiant nominal de l’onglet et chaque valeur correspond à l’objet DataFrame associé. L’écriture multiple se résume alors à une simple boucle itérative encapsulée dans le gestionnaire de contexte ExcelWriter. Ce modèle d’abstraction garantit une compacité algorithmique exemplaire et minimise drastiquement la dette technique ainsi que la redondance de code à travers le pipeline d’exportation.
Cette approche par boucle de balayage se prête admirablement à l’intégration d’instructions de filtrage et d’agrégation dynamiques. À chaque tour d’itération, la table peut subir une dernière passe de vérification d’intégrité ou un formatage ad hoc avant d’être expédiée vers l’intermédiaire de flux. La factorisation de cette logique au sein d’une structure itérative unifiée permet d’étendre sans aucune modification architecturale la génération de classeurs à des volumes de données croissants, réduisant ainsi les risques de régression fonctionnelle lors de l’adjonction de nouvelles cohortes analytiques.
7.2 Sanitisation automatique des identifiants d’onglets
Bien que l’automatisation itérative offre une puissance de traitement considérable, elle expose l’analyste aux règles strictes imposées par la norme technique de Microsoft Excel relative à la dénomination des feuilles de calcul. L’application bureautique applique une règle immuable : le nom d’un onglet ne peut excéder la limite rigoureuse de 31 caractères typographiques. Toute tentative d’injection programmatique d’un libellé outrepassant ce seuil via l’intermédiaire d’écriture déclenche une levée d’exception fatale au niveau du moteur sous-jacent, provoquant l’avortement immédiat et sans appel de l’ensemble du processus de sérialisation.
Outre cette contrainte dimensionnelle, une série de caractères d’échappement et de ponctuation est rigoureusement proscrite de la table d’allocation des noms d’onglets par la norme OpenXML. Les symboles tels que les deux-points (:), les barres obliques directes et inversées (/ et ), les points d’interrogation (?), les astérisques (*), ainsi que les crochets d’ouverture et de fermeture ([ et ]) sont interdits car ils entrent en conflit direct avec la syntaxe de référencement inter-classeurs interne du moteur de formules d’Excel. Si un identifiant extrait dynamiquement d’une base de données contient l’un de ces glyphes réservés, le processus d’écriture échouera invariablement.
Pour prémunir le système contre ces dysfonctionnements, il est impératif d’intégrer une routine algorithmique de « sanitisation » automatique en amont de l’affectation du paramètre sheet_name. Ce module d’épuration a pour rôle de tronquer préventivement les chaînes de caractères au-delà du 31e élément, de substituer les caractères interdits par un séparateur inoffensif (tel qu’un tiret de soulignement) et d’arbitrer les cas d’homonymie induits par la troncature au moyen d’une suffixation numérique incrémentielle. Ce niveau de blindage programmatique confère une résilience intégrale aux pipelines de reporting automatisés face à la variabilité des données d’entrée.
8. Modification et ajout d’onglets sur classeurs existants
8.1 Configuration du mode append avec le moteur openpyxl
Les besoins de gestion documentaire ne se résument pas à la création systématique de classeurs vierges à partir du néant ; ils exigent fréquemment la mise à jour incrémentale d’archives préexistantes. Ce scénario typique survient lorsque des calculs périodiques doivent enrichir un document de référence sans altérer les feuilles historiques stockées antérieurement. Or, l’initialisation standard de pd.ExcelWriter s’exécute par défaut en mode d’écriture destructeur (identifié par l’indicateur mode='w'), écrasant immédiatement le fichier cible s’il est détecté sur le support de stockage.
L’adjonction de nouvelles feuilles à un classeur existant sans destruction de son contenu requiert l’activation explicite du mode d’annexion, symbolisé par le paramètre mode='a' (pour « append ») lors de la construction de l’écrivain. Dans cette configuration, le moteur xlsxwriter devient totalement inopérant en raison de son incapacité structurelle à relire les flux binaires. L’ingénieur doit obligatoirement basculer sur le moteur openpyxl, capable de décoder la structure XML compressée du document sur disque, de charger les arbres d’éléments en mémoire vive et d’insérer les nouvelles ramifications sans altérer le reste de l’édifice documentaire.
Ce processus d’annexion binaire réalise une synthèse délicate. L’instance d’écriture lit l’architecture du conteneur, y insère les descripteurs associés aux nouvelles feuilles de calcul, réécrit les tables de relations (les fichiers .rels internes au format OpenXML) et recomprime l’ensemble du volume physique. Cette suite d’opérations garantit que les onglets historiques demeurent scrupuleusement intacts, préservant ainsi l’historique analytique tout en intégrant de façon fluide les cohortes de données nouvellement calculées.
8.2 Résolution des conflits d’onglets préexistants
L’opération d’annexion sur un document actif soulève inévitablement la question de la collision nominale. Que doit-il advenir si l’onglet que le pipeline s’apprête à injecter porte un nom strictement identique à une feuille déjà présente au sein du classeur hôte ? Pour encadrer ce comportement, l’interface de Pandas met à disposition le paramètre fondamental if_sheet_exists, dont la valeur dicte la doctrine de résolution arbitrée par le gestionnaire de flux lors de la survenue d’un doublon d’identifiant.
La directive par défaut, conventionnellement paramétrée sur la valeur error, ordonne au moteur de lever immédiatement une exception d’incompatibilité afin de protéger les données d’origine contre toute modification intempestive. À l’opposé, l’assignation de l’argument new neutralise la levée d’erreur et ordonne au système d’adjoindre automatiquement un suffixe de différenciation numérique (par exemple, transformant « Synthèse » en « Synthèse1 »), préservant simultanément l’ancienne version et la nouvelle mouture de la table de données au sein d’onglets distincts.
Dans les protocoles où la mise à jour chirurgicale d’un rapport est expressément recherchée, l’argument prend toute sa dimension avec l’option replace. Sous ce mode opérationnel, l’onglet préexistant est intégralement purgé de son contenu obsolète et immédiatement réécrit avec les nouvelles données matricielles injectées, sans que les autres feuilles du classeur ne subissent la moindre altération. Il convient toutefois de noter que ce processus de remplacement chirurgical requiert une extrême vigilance méthodologique, car il entraîne la destruction des formules et des graphiques natifs préalablement intégrés sur cette feuille précise s’ils n’ont pas été protégés en amont.
9. Stylisation et mise en forme programmatique des cellules
9.1 Accès aux objets bas niveau du moteur sous-jacent
Bien que la mission première de Pandas réside dans le calcul et l’ingestion de volumes matriciels, la diffusion de documents dans des sphères décisionnelles ou académiques requiert un niveau d’ergonomie visuelle que les paramètres standards de to_excel() ne peuvent fournir seuls. Pour pallier cette lacune, l’objet pd.ExcelWriter propose une architecture d’extensibilité remarquable, permettant aux développeurs d’outrepasser la couche d’abstraction pour accéder directement aux interfaces de bas niveau des moteurs de rendu sous-jacents.
Une fois la méthode d’écriture exécutée, il est possible d’extraire dynamiquement de l’instance d’écriture les objets centraux représentant le classeur physique et la feuille de travail individuelle. Par le biais des propriétés writer.book et writer.sheets[sheet_name], le programmeur récupère les descripteurs directs manipulables via l’API native de xlsxwriter ou les méthodes formelles d’openpyxl. Cette passerelle technique unifie en un script unique la puissance matricielle de Pandas et le raffinement typographique et cosmétique des bibliothèques bureautiques spécialisées.
Cette synchronisation étroite entre les structures de haut niveau et les descripteurs de présentation permet d’instaurer des routines de mise en page sophistiquées. Les données déversées à l’état brut par Pandas sont alors instantanément magnifiées par des directives de formatage ciblées, sans nécessiter de réouverture ultérieure du fichier par un processus d’édition tiers. L’intégrité visuelle du livrable s’en trouve automatisée, reproductible et totalement standardisée.
9.2 Application de formats numériques et typographiques
L’ergonomie d’un tableau scientifique repose en premier lieu sur la rigueur de sa notation numérique. Par défaut, les valeurs réelles à virgule flottante sont transcrites avec la précision brute issue des calculs de l’unité arithmétique et logique, affichant une multiplicité de décimales qui nuit considérablement à la lisibilité et donne une illusion de précision méthodologiquement contestable. Grâce à l’accès direct aux objets du moteur, il devient aisé de définir des gabarits de présentation stricts forçant l’affichage de deux ou trois décimales régulières, l’injection de séparateurs de milliers normalisés ou la notation de pourcentages et de devises conformes aux attentes sectorielles.
Un autre enjeu critique de la génération bureautique réside dans l’ajustement géométrique des dimensions des colonnes. Pandas ne calcule pas la largeur des cellules en fonction de leur contenu textuel, ce qui aboutit invariablement au redouté affichage de caractères de remplissage dièse (« ### ») lorsque la taille de la colonne est insuffisante pour afficher le nombre calculé. En appliquant un algorithme de balayage prédictif calculant la longueur maximale des chaînes de caractères composant chaque série, l’ingénieur peut instruire le moteur de recalculer dynamiquement la largeur de chaque colonne, assurant ainsi un confort de consultation immédiat dès l’ouverture du classeur.
La hiérarchisation typographique des en-têtes et des totaux complète ce dispositif de professionnalisation documentaire. Les polices de caractères génériques peuvent être substituées par des fontes institutionnelles, tandis que des fonds de couleur contrastés, des bordures d’alignement nettes et des alignements verticaux et horizontaux calibrés confèrent au document une clarté analytique irréprochable. Ces opérations de stylisation, loin d’être de simples coquetteries visuelles, réduisent substantiellement la charge cognitive des relecteurs et minimisent le risque d’interprétation erronée des grilles de données complexes.
9.3 Intégration de règles de mise en forme conditionnelle
Au-delà de la stylisation statique, la restitution de corpus de données massifs gagne en efficacité analytique grâce à l’intégration dynamique de règles de mise en forme conditionnelle. Les interfaces bas niveau de moteurs comme xlsxwriter permettent d’ancrer au cœur même de la grille des règles algorithmiques d’évaluation logique. Ces mécanismes d’inspection automatisée appliquent instantanément des modifications de couleur ou de police aux cellules dont les valeurs satisfont des seuils critiques prédéterminés.
Dans le cadre d’un rapport expérimental, cette capacité fonctionnelle s’avère déterminante pour mettre en exergue des anomalies statistiques ou des seuils de significativité. Il devient par exemple possible de surligner automatiquement en rouge toute cellule dont la valeur p (p-value) franchit un seuil de rejet fixé à 0.05, ou de teinter d’une nuance chromatique spécifique les grandeurs macroéconomiques s’écartant de plus de deux écarts-types de la moyenne empirique de l’échantillon. Cette sémiologie visuelle attire immédiatement le regard du chercheur sur les zones d’intérêt critique sans requérir de tri manuel préalable.
De surcroît, le déploiement d’échelles de couleurs continues (gradient chromatique ou cartes thermiques) transforme une simple matrice tabulaire en une cartographie visuelle dense et intuitive. En configurant des dégradés bicolores ou tricolores proportionnels aux percentiles observés sur une série, l’analyste insuffle une lisibilité spatiale immédiate aux données d’interaction complexes. L’exécution programmatique de ces mécanismes au moment de la génération garantit une totale reproductibilité empirique, éliminant tout biais d’évaluation lié à des manipulations manuelles ultérieures sur le tableur.
10. Optimisation de la mémoire et traitement de données volumineuses
10.1 Gestion des contraintes de mémoire vive
Le traitement de données massives (les flux dits de « Big Data » ou de volumétrie intermédiaire) se heurte inéluctablement aux limites matérielles de la mémoire vive lors de la sérialisation bureautique. Les formats basés sur l’arborescence OpenXML (.xlsx) sont par nature très voraces en mémoire : chaque cellule de la grille est matérialisée sous forme d’une arborescence d’objets XML complexes dotée de métadonnées d’encapsulation lourdes. Lorsque l’on accumule des dizaines de feuilles contenant chacune des centaines de milliers de lignes matricielles, le coût d’allocation RAM peut croître de manière exponentielle et provoquer l’arrêt brutal du système par manque de mémoire (le redouté « Out Of Memory killer » du noyau d’exploitation).
Pour pallier ce goulot d’étranglement structurel, le moteur xlsxwriter met à disposition une option de configuration architecturale fondamentale : l’activation du mode à mémoire constante, paramétré via l’instruction options={'constant_memory': True} lors de l’instanciation de l’intermédiaire d’écriture. Sous ce paradigme hautement performant, le moteur renonce à conserver l’arborescence intégrale du classeur en mémoire vive. Dès qu’une ligne de données est formatée et convertie en fragments XML, elle est immédiatement écrite sur le disque dans un fichier temporaire tamponné, puis définitivement purgée des registres de la mémoire vive.
Cette technique d’ingénierie d’optimisation permet de maintenir l’empreinte mémoire du processus Python à un niveau plat et invariant, quelle que soit la quantité d’enregistrements sérialisés. Elle s’associe idéalement aux stratégies de lecture par blocs fractionnés (le mécanisme de « chunking » proposé par Pandas lors de l’extraction de bases de données relationnelles massives). L’alliance d’un pipeline d’ingestion fragmenté et d’une écriture à mémoire constante repousse considérablement les frontières de traitement, permettant d’écrire des millions de cellules d’information sans risquer la saturation matérielle des postes de travail d’analyse.
10.2 Temps de calcul et efficacité de l’I/O disque
L’efficacité opérationnelle d’une infrastructure de données s’évalue non seulement à l’aune de sa consommation de mémoire vive, mais également par sa célérité à clore les transactions d’entrées-sorties sur disque. Le temps nécessaire à la complétion d’un classeur multi-feuilles est principalement dominé par deux facteurs : la vitesse de calcul sérialisé de l’interpréteur Python et la latence d’assemblage de l’archive ZIP finale. L’usage de benchmarks empiriques démontre des disparités d’ordre de grandeur notables entre les moteurs de calcul disponibles sur le marché logiciel.
D’une manière générale, l’implémentation algorithmique de xlsxwriter, rédigée dans une optique stricte d’optimisation des flux séquentiels, offre une réduction sensible des temps d’exécution (souvent de l’ordre de 30 à 60 % de latence en moins) comparativement au moteur openpyxl lorsqu’il s’agit de générer de nouveaux documents sans lecture préalable. Cette vélocité supérieure découle directement de l’absence de construction d’un graphe d’objets DOM complexe et de l’optimisation minutieuse des protocoles d’écriture binaire. En revanche, l’application massive de styles personnalisés cellule par cellule engendre un coût de traitement calculatoire non négligeable qui peut ralentir la cadence d’exportation de façon significative.
Afin de préserver la réactivité globale des chaînes de production de données, il est recommandé de privilégier des architectures d’application de formats globales et vectorisées plutôt que des manipulations atomiques itérées sur des millions de nœuds individuels. De même, le stockage temporaire des flux sur des disques électroniques à semi-conducteurs (SSD) à haut débit de transfert réduit mécaniquement les phases d’attente système (« I/O wait »), garantissant que la création de classeurs de données volumineux ne devienne pas le facteur limitant des cycles de calcul analytique.
11. Résolution méthodique des erreurs d’exportation
11.1 Diagnostic des exceptions courantes
L’exploitation des pipelines d’exportation en production confronte régulièrement l’ingénieur à des défaillances environnementales ou structurelles qu’il convient de diagnostiquer avec méthode. L’exception classique FileNotFoundError, souvent constatée lors du déploiement sur de nouveaux serveurs, trahit généralement l’inexistence des répertoires parents désignés dans le chemin d’accès au fichier de destination. Contrairement à certaines commandes utilitaires de bas niveau, Pandas n’engendre pas spontanément l’arborescence des dossiers manquants ; il appartient donc au développeur d’anticiper cette défaillance en créant préalablement les dossiers cibles à l’aide des fonctionnalités du module standard os ou de l’abstraction moderne pathlib.Path.
Une autre entrave récurrente, source de confusion fréquente dans les environnements de travail exécutés sous le système d’exploitation Microsoft Windows, se manifeste par la levée impromptue d’une exception de type PermissionError. Cette anomalie découle quasi systématiquement du mécanisme de verrouillage matériel exclusif imposé par l’application bureautique Excel lorsqu’un classeur est ouvert en cours de consultation par un utilisateur. Si le script Python tente d’ouvrir, d’écraser ou d’annexer des données sur ce fichier pendant qu’il est maintenu sous séquestre par le processus bureautique, le système hôte refuse net l’accès, entraînant l’échec brutal du pipeline de calcul.
Enfin, les discordances relatives aux encodages textuels et aux incompatibilités de types demeurent un foyer d’incidents notable. Bien que le format OpenXML repose nativement sur le codage universel Unicode (UTF-8), l’injection de chaînes de caractères brutes comportant des octets illisibles ou des caractères d’échappement invalides hérités de bases de données patrimoniales mal nettoyées peut altérer les arbres XML générés. Une inspection rigoureuse des logs d’erreurs émis par les moteurs de rendu permet d’isoler rapidement les lignes d’observations responsables de ces rejets techniques et de concevoir des filtres correctifs adaptés en amont.
11.2 Validation systématique post-génération
La clôture formelle du processus d’écriture ne marque pas nécessairement la fin de la responsabilité de la chaîne d’assurance qualité des données. Dans tout environnement d’audit rigoureux, la mise en œuvre d’une phase de validation systématique post-génération constitue une étape salutaire. Cette pratique consiste à recharger immédiatement en mémoire, par le truchement de la fonction complémentaire pd.read_excel(), les données fraîchement gravées sur le support persistant afin de vérifier qu’aucune altération subreptice ne s’est produite lors de la phase de sérialisation physique.
En tirant profit de la capacité de pd.read_excel(chemin, sheet_name=None) à importer l’intégralité des onglets d’un classeur sous la forme d’un dictionnaire de tables, le protocole peut alors procéder à des vérifications matricielles directes. La comparaison de parité exacte peut être formalisée au moyen de fonctions spécialisées telles que assert_frame_equal(), issue du module de test interne de Pandas. Cette assertion rigoureuse valide que la distribution des dimensions matricielles, l’homogénéité des index, la typologie des colonnes et la teneur arithmétique exacte des cellules sont demeurées absolument invariantes au terme de leur transition dans le classeur.
L’inclusion de ces assertions logiques au sein des suites de tests unitaires automatisés (orchestrées par des outils de validation comme pytest) scelle la fiabilité des systèmes de production de livrables. Si une discordance d’arrondi, une inversion accidentelle d’onglets ou une déformation des en-têtes venait à émerger consécutivement à une mise à jour d’un des paquets de la distribution, le pipeline d’intégration continue refuserait immédiatement de valider le livrable, empêchant la diffusion de documents de recherche non certifiés auprès des destinataires finaux.
12. Bonnes pratiques méthodologiques et synthèse opérationnelle
12.1 Standardisation du code pour la reproductibilité scientifique
L’intégration des techniques d’exportation vers des classeurs multi-onglets ne doit pas relever de routines improvisées, mais répondre à des standards d’architecture logicielle stricts assurant une reproductibilité totale des calculs scientifiques. L’encapsulation de l’ensemble de la logique de sérialisation au sein de modules fonctionnels clairement délimités, dotés d’une signature d’appel normalisée et de chaînes de documentation (« docstrings ») exhaustives, prévient la dissémination d’instructions non harmonisées à travers les scripts d’analyse. La fonction d’exportation doit être conçue comme un composant d’infrastructure autonome, agnostique vis-à-vis de la nature métier des données traitées.
La traçabilité documentaire constitue un corollaire indissociable de la rigueur scientifique. Lors de la génération d’un classeur multi-feuilles destiné à l’archivage ou à la publication, il est vivement recommandé d’intégrer systématiquement une feuille dédiée exclusivement aux métadonnées techniques du projet (communément intitulée « Métadonnées » ou « ReadMe »). Cet onglet doit récapituler formellement la version exacte de l’interpréteur Python, les numéros de version de Pandas et des moteurs de rendu, l’empreinte cryptographique de calcul (hachage SHA-256) des fichiers sources initiaux, ainsi que l’horodatage universel précis de la génération des données.
Cette hygiène méthodologique englobe également le verrouillage strict des environnements techniques de compilation. La publication de travaux empiriques intégrant des dépôts de code source devrait invariablement s’accompagner d’un fichier de verrouillage de dépendances (de type poetry.lock ou un environnement virtuel conteneurisé). Un tel verrouillage garantit que plusieurs années après la publication d’un rapport, un évaluateur indépendant sera en mesure de réexécuter l’intégralité du pipeline d’exportation sans craindre que les évolutions de syntaxe de Pandas ne viennent briser l’exécution de la chaîne de restitution.
12.2 Arbre décisionnel pour le choix des paramètres d’export
Pour aiguiller le praticien dans l’océan des alternatives architecturales abordées au sein de ce traité, la formalisation d’une grille de décision synthétique constitue un outil opérationnel inestimable. Face à un cahier des charges donné, l’analyste doit d’abord arbitrer la nature de l’opération physique : s’agit-il d’engendrer un classeur entièrement neuf ou d’enrichir une archive préexistante ? Si l’objectif vise à insérer de nouvelles feuilles ou à mettre à jour sélectivement des onglets dans un fichier historique sans altérer son écosystème, l’adoption du moteur openpyxl conjuguée à l’argument mode='a' constitue l’unique orientation technologique viable.
À l’inverse, dès lors qu’il s’agit d’une génération purement ex nihilo de classeurs à haute valeur ajoutée visuelle ou impliquant des volumes tabulaires imposants, le choix de xlsxwriter s’impose naturellement pour sa vélocité d’exécution et ses capacités étendues d’accès à l’API de stylisation. Dès que le volume des matrices dépasse les seuils d’aisance de la mémoire vive disponible, l’activation explicite du mode de consommation mémoire constante via le dictionnaire d’options doit être systématiquement engagée pour prévenir toute rupture de ressource matérielle au cours du processus.
En amont de la validation finale et de la diffusion institutionnelle des classeurs produits, une liste de contrôle méthodologique finale doit être méthodiquement passée en revue :
- Vérification inconditionnelle de l’emploi d’un gestionnaire de contexte
withafin d’écarter tout risque de descripteur de fichier orphelin ou de fichier corrompu en cas d’interruption. - Application formelle du paramètre
index=Falsesur chaque extraction dont l’index numérique séquentiel ne revêt aucune valeur contextuelle fondamentale. - Purge et sanitisation algorithmique systématique des chaînes d’identification d’onglets pour garantir le respect de la limite des 31 caractères et la neutralisation totale des caractères de ponctuation proscrits par la norme OpenXML.
- Configuration d’une politique explicite de substitution des valeurs absentes au moyen de l’argument
na_repafin d’éradiquer toute ambiguïté lors de l’audit ultérieur des données. - Validation de la lisibilité des cellules par le recalcul automatisé de la largeur des colonnes, assurant une expérience de lecture immédiate et sans artefact visuel de masquage de données.
En appliquant avec discernement cette architecture rigoureuse, les professionnels et chercheurs transforment une tâche de bureautique apparemment triviale en un processus d’ingénierie de données fiable, pérenne et parfaitement aligné sur les critères d’excellence de la science ouverte et de l’analyse industrielle moderne.
Références
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). Austin, TX. https://doi.org/10.25080/Majora-92bf1924-003
McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
Pandas Development Team. (2024). pandas.DataFrame.to_excel documentation (Version 2.2). PyData Organization. https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.to_excel.html
Gazoni, E., & Clark, C. (2024). openpyxl – A Python library to read/write Excel 2010 xlsx/xlsm files. OpenPyXL Documentation. https://openpyxl.readthedocs.io/
McNamara, J. (2024). XlsxWriter: A Python module for creating Excel XLSX files. XlsxWriter Documentation. https://xlsxwriter.readthedocs.io/
International Organization for Standardization. (2016). Information technology — Document description and processing languages — Office Open XML File Formats — Part 1: Fundamentals and Markup Language Reference (ISO/IEC Standard No. 29500-1:2016). https://www.iso.org/standard/71691.html
Van Rossum, G., Warsaw, B., & Coghlan, N. (2001). PEP 8: Style guide for Python code. Python Enhancement Proposals. Python Software Foundation. https://peps.python.org/pep-0008/