
La modélisation et la représentation visuelle des structures démographiques constituent depuis plus d’un siècle l’un des piliers méthodologiques des sciences sociales, de l’épidémiologie et de l’économie publique. Parmi l’ensemble des instruments sémiologiques développés pour appréhender la composition d’une population humaine à un instant précis ou au cours de son évolution diachronique, la pyramide des âges s’impose comme une référence fondamentale. Cet artefact graphique, conçu initialement pour condenser en une seule figure géométrique des millions d’observations d’état civil, ne se résume pas à un simple empilement de barres horizontales. Il matérialise l’histoire vivante d’une société, enregistrant avec une précision quasi géologique les traumatismes collectifs, les sursauts de fécondité, les mutations sanitaires et les redistributions migratoires.
À l’ère de la science des données contemporaine, la maîtrise des technologies informatiques dédiées à l’extraction, à l’analyse et à la visualisation de ces dynamiques de cohorte est devenue un prérequis pour les chercheurs, analystes décisionnels et praticiens de la santé publique. Le langage Python, fort de son écosystème scientifique éprouvé et particulièrement outillé grâce à des bibliothèques telles que Pandas, Matplotlib, Seaborn et Plotly, offre un environnement logiciel d’une flexibilité absolue pour concevoir des visualisations démographiques hautement personnalisées. Loin des modèles automatisés et souvent rigides des tableurs conventionnels, le recours à la programmation permet de contrôler rigoureusement chaque coordonnée géométrique, d’appliquer des transformations statistiques vectorisées et de garantir une reproductibilité computationnelle irréprochable.
Ce traité méthodologique approfondi propose une exploration exhaustive de la construction d’une pyramide des âges en Python. En associant une rigueur conceptuelle issue des sciences démographiques et comportementales à une mise en œuvre technique avancée, cet article détaille chaque étape du processus : de l’ingénierie des données brutes à la normalisation relative des cohortes, de l’architecture vectorielle dans Matplotlib aux approches interactives modernes, sans omettre l’interprétation clinique et sociologique des déformations morphologiques observées. L’objectif est d’outiller le chercheur pour qu’il produise non seulement des artefacts graphiques conformes aux standards universitaires de publication les plus stricts, mais également des analyses critiques aptes à éclairer les politiques publiques et les réalités psychosociales des populations étudiées.
1. Introduction conceptuelle et démographique à la pyramide des âges
1.1 Définition et morphologie d’une pyramide des âges
D’un point de vue topologique et sémiologique, une pyramide des âges se définit comme un double histogramme horizontal juxtaposé, disposé le long d’un axe vertical représentant les âges ou les cohortes de naissance successives, ordonnés de manière strictement croissante depuis la base (les âges les plus jeunes, commençant traditionnellement à la naissance ou cohorte zéro) jusqu’au sommet (les tranches d’âge les plus avancées, incluant une classe terminale ouverte telle que 85 ans et plus, ou 90 ans et plus). La convention graphique universellement adoptée au sein des instances statistiques internationales, telles que l’Institut de statistique des Nations Unies ou l’Insee, assigne la sous-population masculine à la partie gauche du graphique et la sous-population féminine à la partie droite. Cette organisation bilatérale crée un plan symétrique dont la ligne d’abscisse médiane correspond au zéro absolu pour les deux distributions.
L’observation morphologique globale d’une pyramide des âges permet de classifier instantanément le régime démographique d’une collectivité selon trois grands idéaux-types structurels théorisés par les démographes :
- La structure expansive : Caractérisée par une base très large et un rétrécissement rapide vers le sommet, évoquant une forme triangulaire classique. Ce profil traduit un régime démographique traditionnel ou en début de transition, dominé par une natalité très élevée et une mortalité précoce significative. L’âge médian de la population y est particulièrement bas, et chaque nouvelle cohorte s’avère numériquement supérieure à la précédente.
- La structure stationnaire : Présentant un profil quasi rectangulaire ou cylindrique sur les tranches d’âge jeunes et intermédiaires, ce modèle illustre un équilibre entre le taux brut de natalité et le taux de mortalité. Les effectifs des différentes cohortes demeurent relativement constants tout au long du parcours de vie, avant de décroître progressivement aux âges de sénescence avancée en raison du vieillissement naturel.
- La structure régressive ou constrictive : Se distinguant par une base resserrée, un renflement marqué aux âges médians ou matures et un sommet dilaté, ce profil traduit une fécondité durablement inférieure au seuil de renouvellement des générations (estimé en moyenne à 2,1 enfants par femme dans les pays développés). Cette configuration signale un vieillissement démographique accéléré et un futur déclin numérique de la population active.
Sur le plan méthodologique, la pyramide des âges offre un cadre d’observation privilégié pour l’analyse longitudinale et transversale des cohortes. Elle permet de dissocier les effets d’âge (processus physiologiques ou sociaux inhérents à l’avancement dans le cycle de vie), les effets de période (impacts d’événements contextuels majeurs survenant à une date donnée et touchant l’ensemble des tranches d’âge) et les effets de cohorte ou de génération (caractéristiques singulières marquant durablement un groupe d’individus nés durant la même période historique).
1.2 Importance analytique dans les sciences comportementales et sociales
L’intérêt de la pyramide des âges dépasse largement le cadre descriptif de la démographie formelle ; elle constitue une variable explicative déterminante dans l’étude des dynamiques psychosociales et sociétales. La configuration d’une structure par âge détermine en profondeur le système des relations intergénérationnelles, l’allocation des ressources collectives et le niveau d’anxiété sociale au sein d’une communauté. En psychologie sociale et en sociologie de la famille, le ratio de dépendance démographique — défini par le rapport entre les populations non actives (enfants de 0 à 14 ans et personnes âgées de 65 ans et plus) et la population en âge de travailler (15 à 64 ans) — constitue un indicateur direct de la charge normative et matérielle supportée par les générations intermédiaires.
Dans les sociétés à profil régressif, l’étirement du sommet de la pyramide engendre le phénomène psychosocial majeur désigné sous le terme de génération pivot ou « génération sandwich ». Ces cohortes, généralement situées entre 45 et 65 ans, se trouvent confrontées à une double charge de soins (caregiving) particulièrement éprouvante : soutenir leurs jeunes adultes encore dépendants dans un contexte d’insertion professionnelle différée, tout en accompagnant leurs parents très âgés subissant des pertes d’autonomie cognitives ou motrices. Ce fardeau objectif se traduit cliniquement par une prévalence accrue de l’épuisement psychologique, du stress chronique et de l’anxiété au sein de ces tranches d’âge, influençant directement les modèles de santé mentale communautaire.
Inversement, les déséquilibres structurels affectant le sex-ratio au sein de cohortes spécifiques peuvent déclencher des mutations psychosociales substantielles. Un déficit prolongé d’hommes jeunes — consécutif à un conflit armé dévastateur — ou un déficit artificiel de femmes consécutif à des politiques de contrôle des naissances associées à un avortement sélectif (comme observé historiquement dans certaines régions d’Asie de l’Est) modifie drastiquement le marché matrimonial. Ces asymétries numériques induisent des tensions relationnelles, augmentent le sentiment d’isolement ou de déclassement social chez les individus exclus des opportunités d’appariement, et peuvent favoriser des comportements de prise de risque ou d’agressivité au niveau macro-social. La pyramide des âges constitue ainsi une cartographie géométrique des vulnérabilités psychologiques d’une nation.
1.3 Écosystème Python dédié à la visualisation démographique
Pour traiter, manipuler et restituer visuellement les structures par âge et par genre, l’environnement scientifique du langage Python se distingue par sa modularité, sa robustesse algorithmique et son interopérabilité. Contrairement aux approches monolithiques logicielles, la chaîne de traitement démographique en Python s’articule autour de bibliothèques spécialisées agissant en synergie étroite :
- Pandas : Cette bibliothèque fournit les structures tabulaires fondamentales — notamment l’objet
DataFrame— permettant d’exécuter des agrégations, des filtres de cohortes et des réorganisations vectorielles complexes (opérations de pivotement, fusion de séries temporelles, gestion des types catégoriels ordonnés). Pandas assure l’intégrité numérique préalable au tracé graphique. - Matplotlib : Constituant le moteur de rendu fondamental du calcul scientifique en Python, Matplotlib offre un contrôle géométrique bas niveau absolu sur la scène graphique. Grâce à son paradigme orienté objet articulé autour des instances
FigureetAxes, il permet d’ajuster millimétriquement l’espacement des barres, l’inversion directionnelle des abscisses, le positionnement typographique des graduations et l’alignement des repères centraux, garantissant une conformité graphique sans compromis avec les règles de la sémiologie graphique classique. - Seaborn et Plotly : Seaborn surmonte Matplotlib en fournissant des abstractions statistiques de haut niveau pour l’exploration rapide et l’harmonisation esthétique immédiate. De son côté, Plotly introduit une dimension interactive native basée sur la technologie WebGL et le standard D3.js, permettant l’exploration dynamique au survol (infobulles), l’isolation instantanée de tranches d’âges spécifiques et l’intégration directe au sein d’applications web d’analyse décisionnelle.
2. Préparation de l’environnement de développement et structuration des données
2.1 Installation et importation des bibliothèques scientifiques
L’implémentation d’une chaîne de production de pyramides des âges exige la configuration d’un environnement Python rigoureusement maîtrisé. Il est fortement recommandé d’isoler les dépendances à l’intérieur d’un environnement virtuel dédié (via venv ou conda) afin d’éviter tout conflit de versions entre les bibliothèques d’analyse et les moteurs de rendu. Les composants fondamentaux requis incluent numpy pour les opérations vectorielles mathématiques, pandas pour l’ingénierie tabulaire, et matplotlib pour l’infrastructure visuelle fondamentale.
Au sein d’un calepin interactif (Jupyter Notebook ou JupyterLab), il est indispensable de spécifier dès l’entête le comportement du backend graphique afin d’assurer un rendu vectoriel irréprochable. L’utilisation de commandes magiques telles que %matplotlib inline couplée à la configuration de la résolution par défaut via l’instruction mpl.rcParams['figure.dpi'] = 300 permet d’obtenir un niveau de netteté textuelle et géométrique adapté aux exigences de l’édition scientifique. De plus, l’importation de modules spécialisés comme matplotlib.ticker s’avère indispensable pour piloter dynamiquement le formatage des valeurs numériques affichées le long des axes de coordonnées.
2.2 Construction manuelle et formatage du DataFrame de référence
Pour garantir la clarté pédagogique et la reproductibilité absolue de nos protocoles d’implémentation, nous établissons un jeu de données synthétique mais rigoureusement étalonné sur les profils démographiques des populations occidentales contemporaines vieillissantes. Les cohortes doivent être formalisées sous la forme de classes d’âges fermées d’amplitude constante (typiquement des tranches quinquennales ou décennales, comme ‘0-9′, ’10-19′, jusqu’à ’80-89′), complétées par une classe terminale ouverte (généralement notée ’90+’).
Le tableau de données doit initialement héberger trois vecteurs essentiels : la variable ordinale des cohortes d’âges, la série numérique des effectifs masculins exprimés en valeurs absolues positives, et la série correspondante des effectifs féminins. Une attention méthodologique méticuleuse doit être portée au typage des données : la variable des cohortes doit être instanciée de préférence sous la forme d’un type catégoriel ordonné (pd.CategoricalDtype). Cette précaution fondamentale empêche les algorithmes de tri de réordonner les tranches d’âges selon un ordre purement alphabétique non congru (qui placerait artificiellement ‘100+’ avant ’20-29′ ou ‘0-9’).
2.3 Transformation des données démographiques brutes
Les données démographiques issues des registres d’état civil, d’enquêtes rétrospectives ou d’instituts comme l’Insee et le Bureau du recensement des États-Unis se présentent généralement sous deux architectures tabulaires distinctes : le format long (longitudinal ou « tidy data ») et le format large (matriciel). Dans le format long, chaque enregistrement correspond à une combinaison unique [Cohorte, Genre, Effectif], ce qui s’avère idéal pour les analyses économétriques et les fonctions graphiques de haut niveau. En revanche, pour la construction paramétrique d’une pyramide symétrique sous Matplotlib, l’alignement bilatéral nécessite souvent une transition vers le format large via la méthode pivot_table ou pivot de Pandas.
Cette étape d’ingénierie de données doit impérativement résoudre le problème des valeurs manquantes ou des discordances de recensement dans les classes supérieures. Si une cohorte centenaire ne comporte aucun individu de sexe masculin dans un échantillon régional, l’imputation doit impérativement fixer la valeur à zéro (via fillna(0)) pour maintenir l’alignement vectoriel des tableaux. Par ailleurs, il est impératif de contrôler l’amplitude temporelle de chaque cohorte : juxtaposer des tranches d’âge de cinq ans (’20-24 ans’) avec des tranches de dix ans (’30-39 ans’) sans réajuster proportionnellement les effectifs induirait une illusion d’optique délétère, violant le principe d’équivalence entre l’aire des barres et la masse démographique observée.
3. Architecture graphique fondamentale avec Matplotlib
3.1 Principe de la double sous-figure symétrique
Sur le plan géométrique, la technique canonique pour implémenter une pyramide des âges sous Matplotlib repose sur l’instanciation conjointe de deux objets Axes disposés côte à côte au sein d’une même Figure, à l’aide de l’instruction plt.subplots(nrows=1, ncols=2, sharey=True). L’argument sharey=True revêt ici une fonction déterminante : il verrouille l’axe des ordonnées entre les deux sous-graphiques, garantissant que chaque tranche d’âge se trouve rigoureusement alignée à la même hauteur géométrique sur les panneaux masculin et féminin.
La figure globale est ainsi fractionnée en deux espaces cartésiens jumeaux : le panneau de gauche est alloué au tracé de la sous-population masculine, tandis que le panneau de droite est dévolu à la population féminine. L’écart physique entre ces deux sous-graphiques doit faire l’objet d’un paramétrage rigoureux via la fonction plt.subplots_adjust(wspace=0.0) ou l’objet gridspec. En réduisant l’interstice horizontal (wspace) à zéro ou à une valeur infime, on élimine la discontinuité visuelle entre les deux séries, fusionnant symboliquement les deux histogrammes en un profil anatomique unique et cohérent.
3.2 Mécanisme d’inversion directionnelle pour l’axe masculin
L’illusion d’une distribution bilatérale émanant d’un centre zéro partagé exige que le panneau masculin s’étende de droite à gauche, tandis que le panneau féminin progresse classiquement de gauche à droite. Pour obtenir cette disposition sans altérer la nature positive des données numériques enregistrées dans le DataFrame, la méthode la plus élégante consiste à inverser l’orientation spatiale de l’axe horizontal du premier graphique en appliquant l’instruction impérative ax_homme.invert_xaxis().
Cette approche orientée objet est conceptuellement supérieure à la technique rudimentaire consistant à multiplier les effectifs masculins par -1 pour les tracer sur un axe cartésien standardisé. En maintenant les effectifs en valeurs scalaires strictement positives et en inversant la direction de projection cartographique, on préserve l’intégrité sémantique des données. Dès lors, les zéros respectifs des deux axes horizontaux se retrouvent positionnés immédiatement en vis-à-vis au centre de la figure, créant le repère axial indispensable à la comparaison symétrique.
3.3 Attribution des axes et correspondance des étiquettes
Le positionnement mécanique des barres horizontales s’effectue le long de l’axe vertical à partir d’un ensemble de coordonnées numériques équidistantes, générées typiquement par la fonction numpy.arange(len(cohortes)). Les étiquettes textuelles désignant les tranches d’âges (‘0-9′, ’10-19’, etc.) sont ensuite assignées explicitement à ces coordonnées via la méthode set_yticks de l’objet Axes.
Pour assurer une parfaite lisibilité et éviter tout biais de confirmation perceptif, les limites extrêmes de l’axe des abscisses (abscissa limits) doivent impérativement être synchronisées sur les deux sous-graphiques. Si la cohorte féminine culmine à un effectif de 3,5 millions tandis que son homologue masculine ne dépasse pas 3,0 millions, les deux axes horizontaux doivent néanmoins être contraints à une amplitude identique (par exemple de 0 à 3,8 millions) via set_xlim(0, max_global). Le non-respect de cette équivalence dimensionnelle constitue une faute méthodologique grave, conduisant le lecteur à surestimer visuellement le poids numérique de la population masculine par rapport à son homologue féminine.
4. Implémentation pas à pas du tracé de base
4.1 Exécution du tracé horizontal (barh)
Le dessin effectif des éléments géométriques est orchestré par la méthode barh (bar horizontal) disponible sur chaque instance d’Axes. Cette primitive graphique requiert au minimum la position verticale des barres (le vecteur séquentiel des indices de tranches d’âge) et leur largeur horizontale (le vecteur des effectifs démographiques correspondants). Pour le graphique masculin situé à gauche, le tracé s’effectue sur le premier axe :
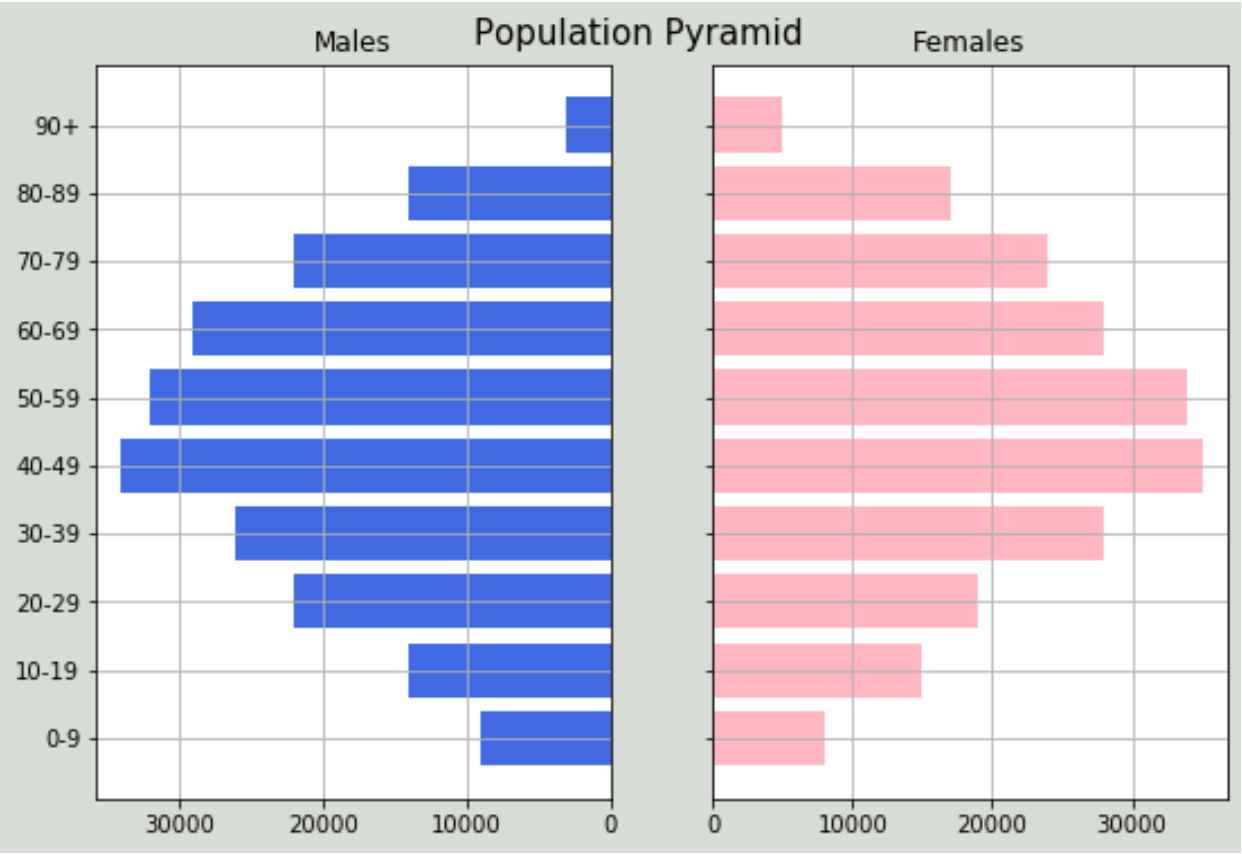
La commande applique une séquence horizontale dont la base se situe sur l’axe d’origine inversé. Simultanément, sur le second axe réservé aux données féminines, la même méthode est invoquée pour projeter les barres vers la droite conventionnelle. Il convient d’accorder une importance particulière au paramètre height de la méthode barh, qui définit la hauteur relative ou l’épaisseur verticale de chaque barre. Une valeur comprise entre 0.8 et 0.9 est généralement recommandée : elle permet de laisser un filet séparateur discret entre deux tranches consécutives, évitant ainsi un effet de masse compacte indéchiffrable tout en prévenant les discontinuités excessives qui rompraient l’évaluation visuelle du profil global.
4.2 Paramétrage des repères et ticks d’axes
Une fois les barres matérialisées, la configuration typographique des repères d’axes (ticks) et de leurs étiquettes associées (tick labels) doit être minutieusement paramétrée pour transformer le graphique brut en un instrument de lecture intelligible. En raison de l’option de partage de l’axe vertical (sharey=True), les étiquettes de cohortes d’âges s’affichent par défaut uniquement sur la bordure externe gauche du graphique masculin. Toutefois, dans les publications démographiques canoniques, il est fréquemment d’usage de reporter les labels de cohortes dans l’espace central compris entre les deux hémicycles, ou de masquer totalement les graduations internes de l’axe vertical féminin pour éviter les redondances graphiques superflues.
Sur l’axe horizontal, les graduations quantitatives relatives aux effectifs de population doivent être graduées avec un pas régulier et intelligible (par exemple tous les 500 000 individus ou chaque million). L’utilisation conjointe des méthodes set_xticks et set_xticklabels permet d’afficher des valeurs numériques abrégées et élégamment formatées (par exemple ‘1M’, ‘2M’, ‘3M’), ce qui allège considérablement la charge cognitive du lecteur tout en éliminant les séries fastidieuses de zéros qui encombrent inutilement le bas du graphique.
4.3 Affichage et revue critique du graphique initial
L’exécution finale des instructions graphiques produit un premier canevas fonctionnel mais qui révèle généralement plusieurs imperfections visuelles qu’il convient de corriger méthodiquement. La figure présente souvent des bordures périphériques (spines) trop prononcées, un manque de contraste entre le fond du tracé et les barres démographiques, et un désalignement potentiel des titres d’axes. Une inspection critique du tracé initial permet également de vérifier si l’orientation symétrique n’a pas introduit d’anomalies résiduelles dans le sens de lecture des étiquettes ou dans l’espacement inter-panneaux.
Cette étape de validation morphologique confirme que le profil correspond fidèlement à la typologie attendue du jeu de données. Elle permet d’identifier immédiatement si des classes d’âge particulières génèrent des ruptures inattendues — pouvant témoigner soit d’une anomalie dans le recodage des variables brutes, soit d’un événement démographique réel (creux de natalité, mortalité différentielle) qui exigera un traitement typographique et sémiotique spécifique lors des phases de raffinement esthétique.
5. Raffinage visuel et typographique pour publication académique
5.1 Harmonisation chromatique et accessibilité
La sélection de la palette de couleurs constitue un enjeu majeur d’intégrité sémiotique et d’accessibilité universelle. L’usage récurrent des stéréotypes binaires traditionnels — bleu pour les hommes, rose pour les femmes — doit être impérativement proscrit au profit de combinaisons chromatiques neutres, professionnelles et perceptuellement uniformes. Conformément aux directives internationales de visualisation scientifique des données, les nuances sélectionnées doivent présenter une lisibilité irréprochable pour les personnes atteintes de déficiences de la vision des couleurs (telles que le daltonisme, la deutéranopie ou la protanopie).
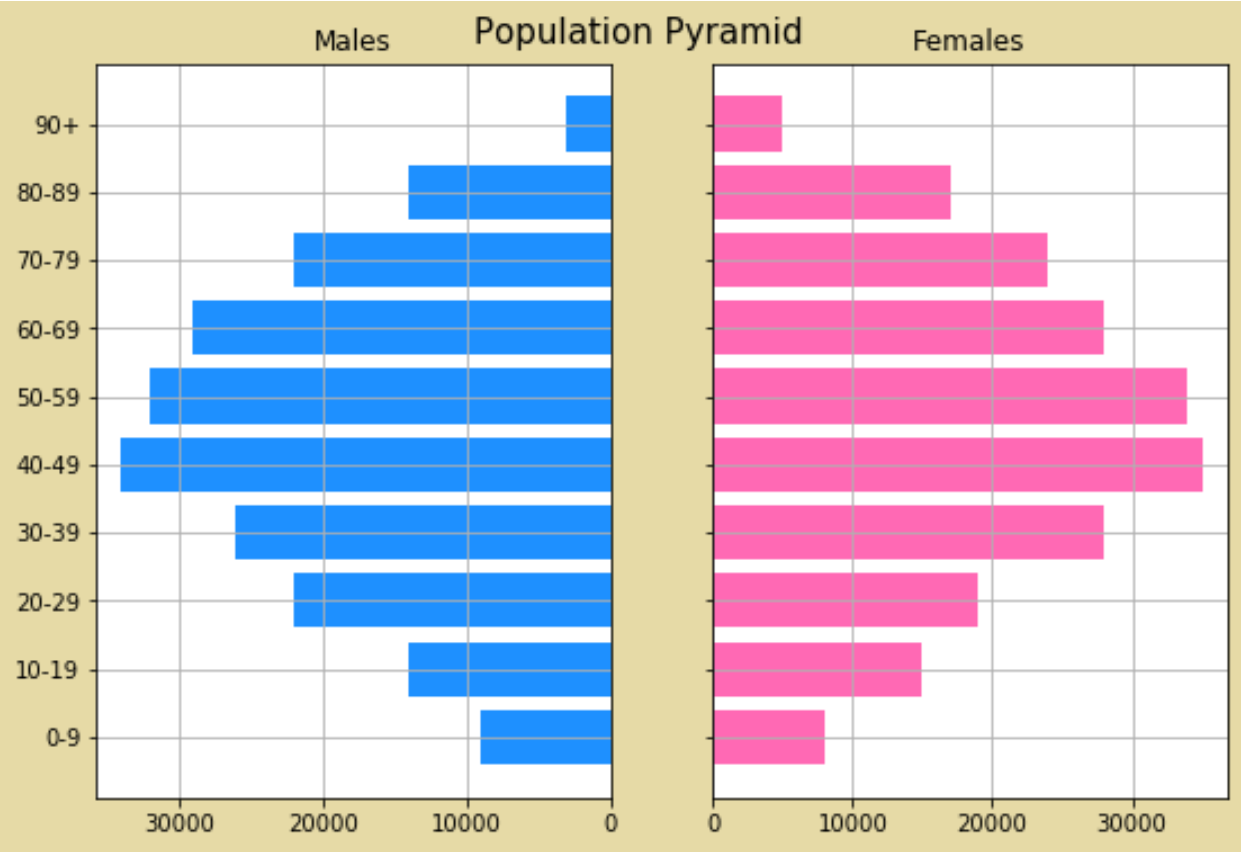
Le recours à des teintes complémentaires mais atténuées, issues par exemple des palettes ColorBrewer ou des palettes scientifiques éprouvées comme Viridis, Cividis ou Mako, garantit un contraste suffisant tout en conservant une tonalité sobre adaptée aux revues académiques à fort facteur d’impact. L’application d’un léger paramètre de transparence (alpha=0.85 à 0.95) combiné à un contour de barre extrêmement fin mais contrasté (via les arguments edgecolor='black' ou edgecolor='white' et linewidth=0.5) délimite parfaitement l’aire géométrique de chaque classe d’âge, évitant ainsi le flou perceptif qui survient lors de l’impression papier ou de la projection sur écrans à faible résolution.
5.2 Nettoyage des bordures (spines) et grille de lecture
L’amélioration de l’efficacité visuelle d’une pyramide des âges passe par la réduction systématique du « rapport encre-données » théorisé par Edward Tufte. Les bordures supérieures et latérales droites ou gauches de chaque panneau (désignées sous le nom de spines dans l’architecture Matplotlib) n’apportent aucune information statistique substantielle et constituent une pollution visuelle parasite. Elles doivent être désactivées méthodiquement à l’aide de la syntaxe ax.spines['top'].set_visible(False) et de ses variantes structurelles.
À l’inverse, l’intégration d’un quadrillage vertical très discret (grid le long de l’axe des abscisses) apporte un soutien cognitif inestimable en guidant le regard du lecteur depuis l’extrémité des barres jusqu’aux repères quantitatifs inférieurs. Ce quadrillage doit être paramétré avec une extrême subtilité : un trait discontinu (linestyle='--' ou linestyle=':'), d’une épaisseur réduite (linewidth=0.5) et d’une couleur grise très claire (color='#d3d3d3'), positionné sous les barres de données grâce au paramètre set_axisbelow(True). L’axe central vertical marquant l’origine (x = 0) doit quant à lui être conservé et souligné d’un trait continu franc, matérialisant avec fermeté la charnière de symétrie entre les deux populations.
5.3 Typographie rigoureuse et hiérarchisation textuelle
Le professionnalisme d’une figure repose pour une large part sur la qualité de son architecture typographique. Il est vivement conseillé d’uniformiser la police de caractères sur l’ensemble du canevas en privilégiant des familles de polices sans-serif modernes et hautement lisibles telles que Helvetica, Arial, Roboto ou Fira Sans. Pour les publications universitaires rédigées sous le système LaTeX, l’activation du rendu typographique natif via la commande mpl.rcParams['text.usetex'] = True permet d’aligner les polices des titres, des légendes et des nombres sur la typographie exacte du corps de l’article scientifique.
La hiérarchie des informations textuelles doit être rigoureusement ordonnée selon trois niveaux d’abstraction :
- Le titre principal : Placé au sommet de la figure, il doit formuler de manière claire et concise l’objet de la mesure, l’entité géopolitique observée et l’année calendaire exacte de référence (ex. « Structure démographique de la population française — Recensement au 1er janvier 2023 »).
- Les sous-titres et en-têtes de colonnes : Placés directement au-dessus de chaque demi-pyramide pour identifier sans équivoque les séries (« Hommes » / « Femmes ») accompagnées éventuellement du volume global de chaque sous-population.
- Les métadonnées et sources : Positionnées en bas de figure dans une taille de fonte réduite (8 à 9 points), elles documentent la source institutionnelle des microdonnées, la date d’extraction et les éventuels retraitements statistiques opérés par l’analyste.
6. Normalisation statistique : conversion des effectifs bruts en pourcentages
6.1 Limites interprétatives des effectifs bruts en analyse comparative
L’utilisation des effectifs démographiques bruts (exprimés en milliers ou en millions d’individus) présente une faille analytique majeure dès lors que le chercheur souhaite comparer deux populations de tailles dissemblables, ou examiner l’évolution diachronique d’un même pays à des époques distantes de plusieurs décennies. Si l’on confronte par exemple la structure par âge de la Suède (environ 10 millions d’habitants) à celle des États-Unis (plus de 330 millions d’habitants), l’amplitude absolue des barres américaines écrasera totalement la distribution suédoise, rendant toute superposition géométrique ou confrontation visuelle directe rigoureusement impossible sur une même échelle.
De surcroît, une augmentation brute du nombre de personnes âgées au fil du temps peut résulter d’un simple accroissement démographique global de l’ensemble du pays, sans nécessairement signifier une altération relative de l’équilibre des cohortes. La standardisation statistique s’impose donc comme un impératif méthodologique incontournable : elle consiste à convertir les valeurs absolues en proportions relatives, éliminant ainsi l’effet d’échelle démographique global pour se concentrer exclusivement sur la géométrie intrinsèque de la distribution des âges.
6.2 Calcul vectoriel des pourcentages par genre et globaux
Sur le plan de la formulation mathématique et de son implémentation sous Pandas, il existe deux paradigmes distincts de normalisation dont la signification sémiotique doit être comprise sans ambiguïté :
La première approche, universellement privilégiée par la division démographique des Nations Unies, consiste à rapporter l’effectif de chaque tranche d’âge et de chaque genre à la population totale combinée (somme agrégée des hommes et des femmes). Dans ce schéma, la somme cumulée de l’ensemble des pourcentages masculins et féminins sur l’ensemble des tranches d’âge égale rigoureusement 100 %. L’équation vectorielle exécutée dans Pandas s’écrit formellement :
Pourcentage_Homme = (Effectif_Homme / (Total_Hommes + Total_Femmes)) * 100
Cette approche présente le mérite exceptionnel de rendre compte simultanément de deux dimensions critiques : la proportion de chaque tranche d’âge au sein du corps social global, et le surcroît ou déficit relatif d’un sexe par rapport à l’autre à chaque étape de la vie.
La seconde approche calcule les pourcentages à l’intérieur de chaque genre de façon indépendante, de sorte que la somme des cohortes masculines atteigne 100 %, et celle des cohortes féminines également 100 %. Si cette seconde méthode permet de comparer l’allure morphologique intrinsèque du vieillissement masculin par rapport au vieillissement féminin, elle neutralise totalement le différentiel de masse globale entre les sexes (masquant par exemple la surreprésentation des femmes aux âges avancés). La première méthode doit donc être systématiquement privilégiée dans le cadre d’une publication démographique académique.
6.3 Tracé de la pyramide normalisée et reformatage des labels d’axes
Le tracé de la pyramide normalisée s’appuie sur le même canevas d’architecture Matplotlib que celui développé pour les effectifs bruts, à ceci près que les vecteurs passés à la méthode barh correspondent désormais aux séries relatives calculées. Les limites des axes horizontaux doivent être recalculées pour encadrer symétriquement la valeur maximale observée parmi l’ensemble des proportions masculines et féminines (par exemple de 0 % à 4,5 % de part de la population totale pour chaque classe).
Pour assurer une parfaite intelligibilité des valeurs d’abscisses, il est fortement conseillé de mobiliser la classe spécialisée matplotlib.ticker.PercentFormatter. En associant cette classe à l’axe via l’instruction ax.xaxis.set_major_formatter(PercentFormatter(xmax=100, decimals=1)), le système convertit automatiquement les nombres scalaires en chaînes de caractères typographiquement explicites affublées du symbole de pourcentage (par exemple ‘1.0 %’, ‘2.0 %’, ‘3.0 %’). Cette signalétique rigoureuse prévient tout malentendu de la part du lecteur quant à la nature statistique des données présentées.
7. Approche alternative avec Seaborn et architectures monoparcelles
7.1 Méthode des valeurs signées sur un axe unique
En marge de l’architecture à deux sous-graphiques jumeaux proposée sous Matplotlib, une méthode graphique alternative largement répandue en analyse exploratoire consiste à utiliser une parcelle cartésienne unique (un seul objet Axes) en appliquant une transformation de signe arithmétique aux données masculines. Dans ce modèle, l’ensemble des effectifs ou des pourcentages attribués aux hommes est multiplié par le scalaire -1, tandis que les métriques féminines demeurent strictement positives.
Lors de l’exécution graphique, les barres masculines se déploient ainsi naturellement vers la gauche de l’axe vertical (qui se trouve automatiquement positionné à x = 0), tandis que les barres féminines s’étendent vers la droite. Cette stratégie simplifie considérablement la synchronisation des ordonnées, puisqu’un seul axe vertical supporte l’ensemble des cohortes d’âges. Cependant, cette méthode génère un inconvénient sémiotique majeur : les graduations de l’axe des abscisses situées du côté masculin affichent par défaut des valeurs négatives incongrues (par exemple -3 %, -2 %). Il devient alors impératif d’intercepter ces graduations à l’aide d’un formateur personnalisé ou d’une fonction anonyme lambda pour restituer des valeurs absolues positives lors du rendu final.
7.2 Utilisation de Seaborn barplot pour une syntaxe concise
La bibliothèque Seaborn permet d’automatiser une grande partie de ce flux de travail grâce à sa fonction barplot et à sa prise en charge native du format tabulaire normalisé (tidy data). Pour préparer le terrain, le DataFrame initial doit être remodelé à l’aide de la fonction pandas.melt, de sorte à structurer les données en trois colonnes élémentaires : ‘Cohorte’, ‘Sexe’ et ‘Effectif_Signé’ (avec les valeurs masculines négatives).
Dès lors, l’appel à la fonction Seaborn s’effectue selon une syntaxe d’une concision remarquable :
- Assignation de la variable ‘Effectif_Signé’ sur l’axe x.
- Assignation de la variable ‘Cohorte’ sur l’axe y.
- Utilisation de la variable catégorielle ‘Sexe’ pour piloter l’argument
hue, ce qui segmente et colore automatiquement les barres selon le genre. - Désactivation de la barre d’erreur statistique si les données sont déjà agrégées (
estimator=Noneouci=Noneselon les versions de Seaborn).
Seaborn gère automatiquement la légende, la palette de couleurs thématique et l’espacement relatif des éléments graphiques, réduisant la verbosité du code source tout en produisant une figure préliminaire d’une remarquable élégance.
7.3 Comparatif technique : Seaborn monoparcelle vs Matplotlib double sous-figure
Le choix entre l’architecture monoparcelle (Seaborn/Matplotlib avec valeurs signées) et l’architecture biparcelle (double sous-figure Matplotlib) dépend étroitement des objectifs éditoriaux et de la phase du projet d’analyse de données. Le tableau conceptuel suivant éclaire leurs forces et faiblesses respectives :
L’approche Seaborn sur parcelle unique brille par sa vélocité de prototypage lors des phases de criblage exploratoire de grands jeux de données démographiques. Elle s’intègre avec une fluidité remarquable dans des pipelines analytiques automatisés où des dizaines de structures par âge doivent être inspectées sommairement. En revanche, elle présente une rigidité graphique certaine lorsqu’il s’agit d’insérer des étiquettes textuelles complexes au cœur de la figure, ou d’appliquer un traitement asymétrique particulier à l’un des deux genres.
À l’opposé, l’architecture Matplotlib à double panneau découplé constitue la référence incontournable pour la production de figures destinées à l’édition papier ou aux articles académiques de référence. Bien que plus exigeante en volume de code et nécessitant un pilotage fin des espacements géométriques, elle offre une souveraineté graphique totale : liberté d’aligner les libellés de cohortes dans une colonne centrale dédiée, indépendance absolue des axes d’échelles, et manipulation sans contrainte des annotations textuelles périphériques.
8. Création de pyramides interactives avec Plotly
8.1 Introduction à l’interactivité pour l’analyse démographique fine
Si les représentations graphiques statiques demeurent la norme incontournable des périodiques imprimés, la dissémination numérique contemporaine — via des plateformes d’information en ligne, des rapports scientifiques interactifs ou des tableaux de bord institutionnels — requiert des dispositifs visuels dynamiques. L’apport fondamental de l’interactivité réside dans la capacité à décharger visuellement la figure d’une multitude d’annotations secondaires tout en les maintenant accessibles à la demande.
Grâce aux technologies interactives telles que Plotly, le praticien peut survoler à l’aide du pointeur une barre spécifique pour dévoiler instantanément, au sein d’une infobulle contextuelle (tooltip), l’effectif exact au millième près, la proportion relative par rapport à la classe d’âge, le sex-ratio précis de la cohorte et l’impact d’événements historiques documentés. De plus, l’interactivité autorise le zoom dynamique, la sélection de sous-ensembles de générations et l’activation sélective des séries via le clic sur la légende, facilitant ainsi une exploration analytique d’une granularité sans précédent.
8.2 Construction d’une pyramide bidirectionnelle avec graph_objects
Pour concevoir une pyramide des âges interactive de haute précision sous Plotly, l’utilisation du module plotly.graph_objects est formellement recommandée par rapport à l’interface de haut niveau plotly.express, car elle accorde un contrôle direct sur les traces graphiques et le modèle d’agencement géométrique (layout). La construction repose sur l’instanciation de deux traces d’histogrammes horizontaux (go.Bar) configurées sur une orientation explicite (orientation='h').
La trace masculine reçoit la série des cohortes d’âges sur l’axe y et les valeurs numériques préalablement négativées sur l’axe x. La trace féminine est construite symétriquement avec les valeurs scalaires positives. Ces deux traces sont ensuite assemblées au sein d’une instance de go.Figure. Le paramétrage du dictionnaire layout constitue le cœur névralgique de cette architecture : il convient de définir le mode d’empilement des barres sur barmode='relative', ce qui positionne les valeurs négatives et positives de part et d’autre de l’axe d’origine vertical sans les chevaucher.
8.3 Personnalisation du template et export dynamique
La sophistication visuelle de la pyramide Plotly s’obtient par le paramétrage minutieux de l’argument hovertemplate pour chaque trace. Au lieu d’afficher la valeur négative artificielle de l’axe x, on configure une chaîne de formatage personnalisé exploitant des métadonnées additionnelles (via le paramètre customdata) : le survol d’une barre masculine affichera ainsi proprement « Hommes, 60-64 ans : 1 842 105 habitants (2,8 %) », garantissant une lecture irréprochable et pédagogique.
L’esthétique globale est affinée en sélectionnant des gabarits épurés comme template='plotly_white', en harmonisant la typographie selon les normes internationales et en personnalisant les graduations de l’axe des abscisses pour formater les valeurs en nombres absolus. L’exportation s’effectue ensuite soit sous la forme d’un composant HTML interactif entièrement autonome via fig.write_html("pyramide_interactive.html") (idéal pour l’intégration web sans serveur applicatif), soit sous forme d’actifs vectoriels statiques haute définition (PDF, SVG) par le biais du moteur de rastérisation kaleido.
9. Analyse démographique et interprétation psychologique des cohortes
9.1 Détection visuelle des accidents historiques et traumatismes collectifs
La morphologie d’une pyramide des âges ne constitue jamais une fonction mathématique lisse ; elle est accidentée, striée d’irrégularités qui traduisent la mémoire corporelle des sociétés. En démographie historique, ces accidents graphiques prennent la forme d’encoches ou d’indentations profondes (creux démographiques) qui entaillent horizontalement la structure. Ces encoches matérialisent les perturbations sévères du cycle vital : conflits armés majeurs, famines aiguës, crises sanitaires dévastatrices ou effondrements économiques brutaux.
Ces dépressions morphologiques s’expliquent par deux mécanismes conjoints : d’une part, la surmortalité directe touchant des classes d’âge spécifiques (par exemple, la surmortalité masculine massive chez les 20-35 ans lors des guerres conventionnelles) ; d’autre part, le déficit immédiat des conceptions et des naissances durant les périodes de crise aiguë. Ce déficit initial de fécondité engendre une cohorte creuse qui va inexorablement gravir les échelons de la pyramide des âges au fil des décennies. Plus fascinant encore sur le plan psychosocial, ce traumatisme s’avère transgénérationnel : lorsque cette cohorte numériquement affaiblie atteint l’âge adulte de la reproduction (25 à 30 ans plus tard), elle donne naissance, même à fécondité par femme constante, à un nombre de descendants réduit, générant ainsi un écho de l’encoche historique visible un demi-siècle après l’événement déclencheur originel.
9.2 Vieillissement démographique et implications sur la santé mentale publique
L’élargissement spectaculaire du sommet d’une pyramide des âges (le renflement des cohortes de 75 ans et plus) constitue la traduction visuelle directe du double phénomène démographique contemporain : l’allongement continu de l’espérance de vie aux âges avancés couplé à l’arrivée progressive des générations issues du baby-boom d’après-guerre aux âges de la sénescence. D’un point de vue épidémiologique et psychosocial, cette configuration pyramidale annonce une augmentation exponentielle des besoins en soins gériatriques et psychiatriques communautaires.
La prévalence des maladies neurodégénératives, au premier rang desquelles la maladie d’Alzheimer et les troubles apparentés, suit une progression fortement corrélée à l’âge. Dès lors, une pyramide à sommet dilaté révèle une transformation radicale du paysage de la santé publique : la charge morbide glisse des pathologies infectieuses aiguës vers des états chroniques de dépendance psychique et motrice prolongée. Cette évolution s’accompagne d’un risque élevé d’isolement relationnel et de détresse psychologique chez les aînés isolés, particulièrement chez les femmes âgées qui survivent souvent de longues années dans un état de veuvage en raison de l’écart d’espérance de vie masculine et féminine.
9.3 Transition démographique et bien-être des populations jeunes
À l’autre extrémité de la structure géométrique, la base de la pyramide des âges véhicule des implications majeures pour la santé mentale et le devenir psychosocial des jeunes générations. Dans les sociétés en phase préliminaire de transition démographique présentant une base fortement hypertrophiée (le « youth bulge » ou renflement de la jeunesse), une masse considérable d’adolescents et de jeunes adultes arrive simultanément sur le marché de l’emploi et de la vie publique. Lorsque les structures économiques institutionnelles sont incapables d’absorber ce flux démographique massif, il en résulte un sentiment collectif d’anomie, d’aliénation et de détresse psychologique accrue, susceptible de catalyser des mouvements d’instabilité sociale, des crises migratoires ou des révoltes collectives.
Inversement, dans les sociétés post-transitionnelles à base très étroite (hyper-vieillissement), les cohortes de jeunes enfants réduites se trouvent confrontées à une autre forme de pression psychosociale. Au sein de ces familles resserrées, les attentes parentales et sociétales pèsent de manière disproportionnée sur les épaules de quelques enfants uniques ou rares. Ce phénomène, documenté notamment dans les pays d’Asie orientale par le syndrome d’hyper-compétition scolaire et de stress anxio-dépressif précoce, démontre que la densité numérique relative d’une génération conditionne le climat psychologique au sein duquel grandissent et se construisent les individus.
10. Cas pratiques avancés : comparaisons temporelles et sous-groupes géographiques
10.1 Superposition de deux millésimes pour illustrer une dynamique évolutive
L’un des défis analytiques majeurs consiste à représenter graphiquement sur un support unique l’évolution temporelle de la structure démographique d’une nation sur un intervalle temporel significatif (par exemple comparer l’état d’une population en 1970 et en 2020). La simple juxtaposition de deux figures distinctes oblige l’œil du lecteur à un va-et-vient cognitif fastidieux qui nuit à l’évaluation instantanée des dynamiques de glissement.
La solution technique la plus rigoureuse sous Matplotlib consiste à superposer, sur le même jeu d’axes symétriques, les barres pleines représentant le millésime le plus récent et un tracé linéaire épuré (contour sans remplissage, désigné sous le terme de ligne de crête ou « step plot ») représentant le millésime historique de référence. Cette syntaxe s’exécute en combinant un premier appel classique à ax.barh pour l’année courante avec un appel coordonné à la méthode ax.plot ou ax.step pour le millésime passé. Cette technique met spectaculairement en lumière la translation ascendante des cohortes volumineuses du baby-boom, le rétrécissement progressif de la base des nouveau-nés et l’amplitude exacte de l’âge médian qui s’est décalé vers le haut au fil du demi-siècle écoulé.
10.2 Création de grilles comparatives (Faceting / Small Multiples)
Lorsque l’analyse démographique porte sur la disparité spatiale interne d’un territoire national (découpage par régions, départements ou entre zones métropolitaines et bassins ruraux), la méthode préconisée par la sémiologie graphique contemporaine est celle des « petits multiples » (small multiples). Cette approche consiste à construire une matrice ordonnée de micro-pyramides des âges partageant des échelles strictement identiques.
Sous Matplotlib, cette structure s’implémente via la création d’une grille de sous-figures articulée par plt.subplots(nrows, ncols, sharex=True, sharey=True) ou par l’utilisation de l’objet GridSpec. L’impératif catégorique réside ici dans la synchronisation absolue des limites d’axes horizontales et verticales pour l’ensemble des panneaux de la matrice. Une telle grille comparative met immédiatement en évidence les disparités sociodémographiques territoriales criantes :
- Les métropoles universitaires et tertiaires présentent une pyramide « en diabolo » ou en losange renflée artificiellement sur la tranche des 18-29 ans sous l’effet de l’attraction migratoire des étudiants et jeunes actifs.
- Les territoires ruraux ou littoraux affichent à l’inverse une forme de champignon inversé ou de cône tronqué, vidés de leurs jeunes adultes mais saturés de populations retraitées.
10.3 Animation temporelle avec Matplotlib FuncAnimation
Pour des fins pédagogiques ou de valorisation scientifique lors de conférences académiques, la restitution d’une transition démographique séculaire prend toute sa force sémiotique à travers l’animation dynamique continue. Le module matplotlib.animation.FuncAnimation offre le cadre computationnel adéquat pour animer séquentiellement l’évolution d’une pyramide des âges décennie après décennie.
L’implémentation exige la définition rigoureuse de deux fonctions maîtresses : une fonction d’initialisation init() qui dresse le canevas vierge, les axes et les repères stables de référence, et une fonction d’actualisation update(frame) qui, pour chaque pas de temps ou millésime annuel, recalcule la largeur vectorielle des barres horizontales masculines et féminines à l’aide de la méthode bar.set_width(). L’objet d’animation ainsi généré peut être optimisé et compilé dans des formats vidéo non compressés ou encodé sous forme de fichiers GIF haute fidélité, permettant d’observer de manière fluide les vagues successives des générations progresser à travers l’échelle des âges telle une onde démographique vivante.
11. Bonnes pratiques, erreurs fréquentes et pièges d’interprétation
11.1 Erreurs méthodologiques courantes dans la mise en forme des données
L’élaboration d’une pyramide des âges est jalonnée de pièges méthodologiques insidieux susceptibles de fausser gravement l’analyse statistique si l’opérateur ne fait pas preuve d’une vigilance épistémologique absolue. Le premier écueil réside dans l’agrégation non proportionnelle de cohortes d’amplitudes inégales. Il arrive fréquemment que les données brutes d’état civil présentent des classes annuelles ou quinquennales pour les âges actifs, puis regroupent brutalement les tranches supérieures en classes décennales ou plus vastes (’60-74 ans’, puis ’75 ans et plus’). Tracer ces effectifs bruts sur un histogramme d’épaisseur constante sans les normaliser par l’amplitude temporelle de la tranche constitue une erreur scientifique lourde : la barre décennale paraîtra artificiellement deux fois plus imposante qu’une tranche quinquennale à densité démographique identique.
Le second biais fréquent concerne le traitement de la classe terminale ouverte (généralement ’85+’, ’90+’ ou ’95+’). Cette classe regroupe par définition une somme cumulée d’âges multiples sans borne supérieure finie. Il est crucial d’avertir explicitement le lecteur par une mention typographique spécifique ou un style de hachure discret que cette dernière barre correspond à un reliquat d’accumulation statistique et non à une tranche d’âge régulière d’amplitude 5 ans. Enfin, une erreur triviale mais dévastatrice consiste en l’inversion par inadvertance des assignations conventionnelles des sexes (placer les femmes à gauche et les hommes à droite), rompant ainsi avec un siècle de convention cartographique internationale et induisant des erreurs d’interprétation réflexes chez les relecteurs pairs.
11.2 Écueils visuels et sélectivité perceptive
La perception humaine des surfaces et des proportions géométriques est hautement vulnérable aux distorsions de conception graphique. L’utilisation d’effets visuels tridimensionnels (pyramides des âges en pseudo-3D, barres extrudées, perspectives inclinées) — malheureusement encore proposés par certains logiciels bureautiques grand public — doit être rigoureusement bannie des publications scientifiques. La perspective 3D altère irréversiblement le parallélisme des barres et viole la loi fondamentale de correspondance linéaire entre la longueur graphique et la valeur numérique sous-jacente : les barres situées au premier plan apparaissent artificiellement hypertrophiées au détriment de celles reléguées en arrière-plan.
Un autre piège classique concerne l’asymétrie non déclarée des échelles horizontales d’abscisses. Si, pour des raisons d’adaptation automatique du logiciel, l’axe masculin est borné à 2 millions et l’axe féminin à 3 millions d’individus sans que le tracé global ne contraigne les deux panneaux à une échelle partagée maximale (max_global), la figure présentera une fausse impression de parité numérique absolue. Une telle négligence de programmation masque complètement le déséquilibre du sex-ratio, privant le chercheur d’un aperçu visuel crucial sur la surmortalité masculine différentielle.
11.3 Directives de rigueur pour la communication scientifique
Pour garantir la validité et la reproductibilité des visualisations démographiques publiées, la communauté scientifique impose le respect scrupuleux d’un ensemble de standards documentaires qui doivent impérativement figurer sur ou autour du canevas graphique :
- Le périmètre spatio-temporel exhaustif : Indiquer sans ambiguïté le territoire géographique observé (population nationale résidente, métropolitaine, ou sous-ensemble administratif) et la date calendaire exacte du recensement ou de l’estimation statistique.
- Le statut de la population : Spécifier si les données recensent la population de droit (résidents officiels habituels) ou la population de fait (individus physiquement présents lors de l’enquête), cette distinction modifiant profondément la composition des cohortes d’âges actifs dans les régions à forte mobilité saisonnière.
- L’unité d’analyse quantitative : Préciser expressément si l’abscisse mesure des effectifs bruts (en milliers/millions) ou des proportions relatives normalisées (pourcentage de la population globale cumulée).
- Les notes d’imputation méthodologique : Documenter dans la légende inférieure les ajustements statistiques apportés aux données manquantes, les méthodes de lissage éventuelles des déclarations d’âge (atténuation de l’attraction des chiffres ronds par indices de Whipple ou de Myers) et la référence bibliographique formelle du jeu de données source.
12. Modularisation du code et construction d’une fonction réutilisable
12.1 Conception d’une fonction robuste et paramétrable
Au sein d’un laboratoire de recherche ou d’un service d’études statistiques, la conception répétitive de visualisations graphiques à partir de scripts ad hoc disséminés représente une source majeure d’inefficience et d’erreurs d’implémentation. La professionnalisation de la démarche analytique exige la factorisation du code au sein d’une fonction Python paramétrable, robuste et autonome, capable d’ingérer indifféremment des structures de données variées tout en garantissant une uniformité esthétique irréprochable.
Une fonction de niveau industriel, par exemple dénommée tracer_pyramide_ages(), doit intégrer un système de typage strict (type hinting) et exposer des arguments permettant de piloter finement le comportement graphique :
data: Le DataFrame Pandas contenant les données nettoyées.col_age,col_hommes,col_femmes: Les chaînes identifiant les colonnes d’intérêt.normaliser: Un booléen activant ou non la conversion instantanée des effectifs bruts en pourcentages relatifs standardisés.palette: Un tuple de deux couleurs au format hexadécimal spécifiant les teintes masculine et féminine.titre,source: Les chaînes de métadonnées documentant la figure.
La fonction doit inclure des mécanismes de validation préventive (assertions) vérifiant que les vecteurs d’effectifs ne comportent aucune valeur négative initiale, que la somme des cohortes est strictement positive et que les dimensions vectorielles sont congruentes, levant des exceptions informatives si les prérequis statistiques ne sont pas satisfaits.
12.2 Documentation, annotations et conformité PEP 8
L’excellence logicielle en science des données requiert une documentation interne exhaustive et une conformité intégrale avec les directives du guide de style PEP 8. La fonction de tracé démographique doit obligatoirement être pourvue d’une docstring rédigée selon les standards reconnus par la communauté universitaire (format NumPy ou Google Docstring).
Cette documentation interne formalise la description analytique de chaque paramètre d’entrée, explicite les hypothèses sous-jacentes de structuration des données, et documente la nature exacte de l’objet renvoyé (en l’occurrence, un tuple structuré regroupant l’instance Figure et le tableau d’instances Axes de Matplotlib). En retournant systématiquement les objets graphiques sous-jacents au lieu d’exécuter un simple appel bloquant à plt.show(), la fonction préserve la modularité logicielle : l’utilisateur conserve ainsi la latitude d’ajouter ultérieurement des annotations analytiques ciblées, des lignes horizontales repères marquant un âge de départ en retraite ou des flèches indicatrices avant la sauvegarde finale.
12.3 Exemple d’exécution complète et reproductibilité
L’aboutissement de cette démarche d’ingénierie se concrétise par la mise en œuvre d’un pipeline complet et reproductible, partant de la définition synthétique des données jusqu’à l’exportation sur disque d’un document vectoriel prêt pour l’intégration typographique dans une revue savante. Une fois la fonction instanciée dans l’environnement de travail, un appel synthétique structuré permet d’exécuter l’ensemble de la chaîne graphique en une seule instruction cohérente :
L’exécution de la fonction opère le calcul vectoriel des proportions, initialise la double sous-figure symétrique, applique les inversions d’axes nécessaires, injecte les palettes de couleurs contrastées et accessibles, supprime la pollution visuelle des bordures externes, dresse le quadrillage millimétrique de lecture et applique le formateur d’abscisses en pourcentages. Enfin, la figure résultante est sauvegardée sur support de stockage pérenne à l’aide de l’instruction fig.savefig("pyramide_demographique_2023.pdf", format="pdf", dpi=300, bbox_inches="tight").
Le recours exclusif à des formats vectoriels encapsulés (PDF ou SVG) garantit que les tracés conserveront une précision géométrique mathématiquement infinie, sans aucun phénomène de pixellisation lors des agrandissements d’impression. Cette rigueur algorithmique, alliant maîtrise computationnelle de l’écosystème Python et profondeur conceptuelle de l’analyse sociodémographique, assure au chercheur une totale autonomie pour transformer des masses de données brutes d’état civil en artefacts scientifiques probants, élégants et pérennes.
Références
- Caldwell, J. C. (2006). Demographic Transition Theory. Springer. https://doi.org/10.1007/1-4020-4498-0
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Institut National de la Statistique et des Études Économiques (Insee). (2023). Bilan démographique 2022 : La fécondité baisse, la mortalité augmente. Insee Première, n° 1935. https://www.insee.fr/fr/statistiques/6687000
- Lotka, A. J. (1998). Analytical Theory of Biological Populations. Springer Science & Business Media. https://doi.org/10.1007/978-1-4757-9176-1
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1922-00a
- Omran, A. R. (1971). The epidemiologic transition: A theory of the epidemiology of population change. The Milbank Memorial Fund Quarterly, 49(4), 509–538. https://doi.org/10.2307/3349375
- Sauvy, A. (1952). Théorie générale de la population (Vol. 1). Presses Universitaires de France.
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- United Nations, Department of Economic and Social Affairs, Population Division. (2022). World Population Prospects 2022: Summary of Results (UN DESA/POP/2022/TR/NO. 3). United Nations. https://www.un.org/development/desa/pd/content/World-Population-Prospects-2022
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021