
L’analyse exploratoire des données multidimensionnelles constitue l’un des piliers méthodologiques fondamentaux de la recherche quantitative contemporaine, particulièrement au sein des sciences empiriques, du génie statistique et de la psychométrie. Lorsque les chercheurs et les scientifiques des données se trouvent confrontés à des jeux de données comportant de multiples covariables métriques, la première étape analytique consiste invariablement à sonder la morphologie des distributions individuelles ainsi que la nature des interconnexions linéaires et non linéaires qui s’établissent entre chaque paire d’indicateurs. Dans ce contexte épistémologique, la visualisation graphique transcende le simple statut d’illustration pour devenir un outil heuristique indispensable de découverte, de contrôle de validité des postulats statistiques et de détection des anomalies distributionnelles.
Au cœur de l’écosystème open-source Python, la bibliothèque Pandas s’est imposée comme la référence universelle pour la manipulation, la restructuration et l’interrogation de données tabulaires. Si Pandas est principalement réputée pour ses structures de données matricielles performantes que sont les séries et les DataFrames, elle intègre également un sous-module graphique d’une puissance sous-estimée, logé dans l’espace de noms pandas.plotting. Parmi les instruments visuels mis à disposition des analystes, la fonction scatter_matrix représente l’incarnation computationnelle de la matrice de diagrammes de dispersion bivariés, offrant une vue synoptique et exhaustive de toutes les combinaisons par paires d’un ensemble de variables quantitatives.
Le présent article propose une exploration académique, théorique et appliquée exhaustive de la matrice de dispersion au sein de l’environnement Python. À travers un décryptage rigoureux de ses fondements mathématiques, une mise en contexte appliquée aux protocoles expérimentaux et une manipulation minutieuse de ses paramètres graphiques et computationnels, nous examinerons comment configurer, affiner, interpréter et intégrer cette matrice au sein d’un pipeline d’analyse reproductible. Du choix fondamental entre histogrammes et densités par noyau à l’ajustement fin des interfaces de bas niveau pilotées par Matplotlib, ce guide dresse le panorama complet des techniques requises pour transformer des nuages de données brutes en diagnostics statistiques probants.
1. Introduction aux matrices de dispersion et à leur utilité en analyse exploratoire
1.1 Définition conceptuelle de la matrice de dispersion
La matrice de dispersion, communément désignée sous le vocable anglo-saxon de scatter matrix ou scatterplot matrix (SPLOM), se définit formellement comme un agencement géométrique bidimensionnel régulier composé de sous-graphiques juxtaposés sous forme de grille carrée de dimension p × p, où p représente le nombre total de variables quantitatives continues sélectionnées pour l’analyse. Chaque cellule de cette grille matricielle a pour vocation d’exposer la relation bivariée unissant deux variables spécifiques à travers un repère cartésien orthogonal, le plan horizontal correspondant à l’abscisse de la variable de colonne et le plan vertical traduisant l’ordonnée de la variable de ligne.
Dans le cadre strict de l’analyse exploratoire des données formalisée initialement par John Tukey, la matrice de dispersion remplit une double fonction analytique synchronisée. D’une part, elle matérialise visuellement les distributions marginales univariées de chacune des variables le long de sa diagonale principale, comblant ainsi le vide conceptuel laissé par l’auto-croisement d’une variable avec elle-même. D’autre part, elle déploie sur ses zones hors diagonale une cartographie détaillée des dépendances bivariées, permettant d’appréhender instantanément la morphologie des nuages de points, l’homogénéité de leur dispersion, ainsi que l’orientation directionnelle globale des associations statistiques observées.
D’un point de vue méthodologique, cet agencement graphique constitue un vecteur de diagnostic supérieur aux simples réductions scalaires telles que les matrices de coefficients de corrélation de Pearson. Alors qu’un coefficient numérique unitaire résume un lien sous l’hypothèse restrictive de linéarité stricte sans pouvoir déceler la présence de sous-groupes latents, la matrice de dispersion permet d’observer directement la convexité, la concavité, l’hétéroscédasticité ou encore les regroupements multimodaux au sein d’un espace multidimensionnel compact et standardisé.
1.2 Applications empiriques dans la recherche psychologique et comportementale
Dans le domaine des sciences psychologiques, comportementales et cognitives, les chercheurs manipulent quotidiennement des jeux de données composites réunissant des échelles de mesure psychométriques, des indices de temps de réaction, des scores factoriels latents et des paramètres psychophysiologiques issus de dispositifs de biofeedback ou d’imagerie. L’emploi d’une matrice de dispersion s’avère particulièrement fécond pour examiner la validité convergente et la validité discriminante lors de l’étalonnage d’un instrument de mesure psychologique standardisé.
À titre d’exemple, lorsqu’une batterie d’évaluations mesure simultanément des sous-échelles d’anxiété état-trait, des niveaux de dépression clinique et des indicateurs de résilience psychologique, la matrice de dispersion permet de vérifier si les sous-dimensions d’un même construit théorique présentent des covariations linéaires denses et positives, tout en s’assurant que les construits antagonistes démontrent les inversions directionnelles escomptées par les modèles théoriques. Elle garantit ainsi l’absence de saturation parasite ou d’effets de plancher susceptibles d’altérer la validité interne des protocoles d’évaluation clinique.
De surcroît, lors d’expérimentations portant sur la charge cognitive ou l’attention sélective, la conjonction des données de latence motrice et de scores d’erreurs génère souvent des distributions non gaussiennes complexes. L’examen des cellules bivariées de la matrice permet de détecter sans délai les compromis vitesse-précision (speed-accuracy trade-off), identifiant les sujets qui modifient leur profil de réponse sous contrainte temporelle, phénomène qui échapperait totalement à une analyse purement descriptive basée sur des moyennes marginales décontextualisées.
1.3 Avantages comparatifs face aux visualisations univariées isolées
L’utilisation de graphiques univariés isolés, tels qu’une série séquentielle d’histogrammes ou de diagrammes en boîte (boxplots), souffre d’un fractionnement cognitif majeur. L’analyste se trouve contraint de mémoriser les propriétés morphologiques d’une distribution avant de passer à l’observation d’une seconde variable, annihilant toute possibilité d’inférence immédiate sur la structure conjointe des données. La matrice de dispersion pallie ce problème d’ergonomie cognitive en condensant l’intégralité du système relationnel multivarié au sein d’un tableau d’ensemble visuellement unifié.
Un autre avantage comparatif déterminant réside dans l’identification précoce de la multicolinéarité avant l’ajustement de modèles statistiques avancés, tels que la régression linéaire multiple, la modélisation par équations structurelles ou l’analyse factorielle confirmatoire. La présence d’alignements linéaires quasi parfaits au sein de plusieurs cellules hors diagonale avertit immédiatement le chercheur du risque d’instabilité des estimateurs numériques, de l’inflation de la variance des erreurs-types et de l’indétermination potentielle de la matrice d’inversion sous-jacente.
Enfin, la condensation matricielle offre une sensibilité sans pareille pour détecter les ruptures de linéarité, les relations en forme de U inversé typiques des lois psychophysiologiques (comme la célèbre loi de Yerkes-Dodson reliant l’éveil cortical à la performance cognitive), et les effets de seuil. Ces motifs dynamiques, absolument indétectables par les statistiques descriptives univariées classiques, apparaissent instantanément lors de l’inspection optique des cellules bivariées juxtaposées.
2. Fondements théoriques de la matrice de dispersion (Scatter Matrix)
2.1 Topologie de la matrice : cellules hors diagonale et diagonale principale
L’architecture spatiale de la matrice de dispersion repose sur des propriétés topologiques d’une grande rigueur formelle. Soit un ensemble de données multidimensionnel comportant p variables aléatoires quantitatives continues notées X1, X2, …, Xp. La matrice résultante se structure sous la forme d’un tableau d’axes cartésiens ordonnés selon une grille carrée de dimension p × p, indexée par la ligne i et la colonne j, où les indices i et j varient de 1 à p.
Les cellules situées hors de la diagonale principale, définies par la condition d’inégalité des indices i ≠ j, affichent chacune le diagramme de dispersion bivarié opposant la variable Xj positionnée en abscisse à la variable Xi assignée en ordonnée. En vertu de cette convention topologique, la cellule symétrique (j, i) expose rigoureusement les mêmes paires d’observations mais selon une permutation orthogonale stricte des axes, où Xi devient l’abscisse et Xj l’ordonnée. Cette symétrie offre une double perspective analytique facilitant la lecture quel que soit le sens causal hypothétique envisagé par l’expérimentateur.
La diagonale principale de la matrice, caractérisée par l’égalité géométrique i = j, correspond théoriquement à la projection bivariée d’une variable sur elle-même. Si l’on appliquait un tracé de dispersion standard sur ces cellules diagonales, le résultat se limiterait à un segment linéaire parfait de pente unitaire, dénué de toute valeur informationnelle. Par conséquent, les concepteurs de bibliothèques statistiques comme Pandas exploitent ingénieusement ces emplacements stratégiques pour projeter l’estimateur de la densité univariée de la variable correspondante, transformant une redondance géométrique inutile en une synthèse distributionnelle fonctionnelle.
2.2 Principes statistiques sous-jacents : covariance et variance univariée
Sur le plan mathématique, la matrice de dispersion constitue la transposition graphique directe de la matrice de variance-covariance théorique et empirique caractérisant la population échantillonnée. Considérons le vecteur aléatoire X = [X1, X2, …, Xp]T. La matrice de variance-covariance empirique, notée S, est définie par l’équation matricielle classique :
S = (1 / (n – 1)) ∑k=1n (xk – x̄)(xk – x̄)T
où n désigne la taille de l’échantillon, xk représente le vecteur d’observation du k-ième individu statistique, et x̄ symbolise le vecteur des moyennes empiriques marginales. Les composantes diagonales sii de cette matrice numérique correspondent aux variances univariées empiriques de chaque variable, lesquelles sont reflétées par l’étalement horizontal et la largeur des courbes de densité ou des histogrammes tracés sur la diagonale principale du graphique.
À l’inverse, les composantes non diagonales sij quantifient la covariance empirique entre les variables Xi et Xj. Au sein de la scatter matrix, cette covariance se traduit par l’élongation, la directionnalité et la compacité du nuage de points. Si la covariance est nulle et les variables indépendantes, le nuage affectera une forme circulaire ou ovoïde parallèle aux axes cartésiens. En revanche, sous l’effet d’une forte covariance positive ou négative, les points se condenseront le long d’une trajectoire elliptique oblique dont l’orientation reflète directement le signe du coefficient de corrélation linéaire de Pearson.
2.3 Impact des données aberrantes et des distributions asymétriques
L’un des apports critiques de la matrice de dispersion réside dans sa réactivité visuelle immédiate face aux déviations par rapport aux postulats de normalité bivariée. Les valeurs aberrantes, qu’elles soient univariées (situées aux extrémités d’une seule distribution) ou multivariées (points isolés dans l’espace conjoint bien que compatibles avec les marges univariées), exercent une déformation spatiale substantielle sur le tracé. En imposant des limites d’axes englobant ces valeurs extrêmes, elles provoquent un tassement dramatique du corps principal des observations au centre de la cellule, réduisant la lisibilité des structures sous-jacentes.
De même, la présence d’une forte asymétrie distributionnelle, qu’elle soit positive (étalement vers la droite) ou négative (étalement vers la gauche), génère une forte densité de points agglomérés dans un coin du sous-graphique, accompagnée d’une traînée éparse sur le reste de la surface de tracé. Ce phénomène signale à l’expérimentateur que les estimations statistiques linéaires subséquentes risquent d’être biaisées par des violations fondamentales de la normalité.
Face à de telles manifestations morphologiques, la scatter matrix sert de baromètre décisionnel en incitant le statisticien à appliquer des transformations préliminaires sur les variables concernées. Des transformations logarithmiques, des racines carrées ou des transformations de la famille Box-Cox peuvent ainsi être sélectionnées, appliquées aux colonnes du DataFrame Pandas, puis validées par une réitération immédiate de la matrice de dispersion afin de constater le rétablissement de la symétrie et de l’homoscédasticité.
3. Préparation de l’environnement Python et configuration des dépendances
3.1 Écosystème logiciel : Pandas, NumPy et Matplotlib
La mise en œuvre pratique d’une matrice de dispersion en Python s’inscrit au confluent de trois bibliothèques fondamentales de l’écosystème scientifique : Pandas, NumPy et Matplotlib. Chacun de ces paquets logiciels assume un rôle opérationnel distinct et complémentaire au sein du pipeline d’exécution. Pandas fournit la structure tabulaire optimisée (le DataFrame) qui héberge les variables, gère les types de données, préserve les étiquettes de colonnes et encapsule les méthodes d’accès analytique.
NumPy intervient en amont comme moteur de calcul vectorisé et de manipulation matricielle de bas niveau. Dans le contexte de la modélisation ou de la simulation de données synthétiques, ses générateurs de nombres pseudo-aléatoires et ses structures de tableaux multidimensionnels (ndarray) constituent le substrat computationnel permettant de créer des distributions contrôlées aux propriétés statistiques vérifiées.
Matplotlib, quant à lui, constitue le moteur graphique fondamental sous-jacent. Bien que l’utilisateur n’invoque souvent qu’une seule fonction de haut niveau au sein de Pandas, c’est bien l’architecture d’objets de Matplotlib — articulée autour des figures (Figure) et des systèmes de coordonnées (Axes) — qui réalise le rendu graphique vectoriel ou matriciel. La fonction pd.plotting.scatter_matrix agit comme une interface d’abstraction élégante qui orchestre la création d’une grille complexe d’axes Matplotlib tout en appliquant les conventions de dessin requises pour chaque sous-graphique.
3.2 Configuration du cadre d’exécution pour la reproductibilité
Pour garantir la rigueur méthodologique et la reproductibilité absolue des analyses numériques et des visualisations présentées dans ce guide, il est impératif de configurer adéquatement le cadre d’exécution Python. Cela implique la fixation explicite de la graine aléatoire (seed) du générateur stochastique de NumPy afin d’assurer que toute simulation synthétique produise des résultats strictement identiques quel que soit l’environnement hôte.
Dans le cadre de l’utilisation d’environnements interactifs tels que les carnets de notes Jupyter ou les interfaces JupyterLab, il convient de déclarer la directive d’intégration graphique appropriée pour orchestrer l’affichage des figures dans le flux d’exécution du document de travail. De surcroît, la standardisation des paramètres de style graphique global via le module matplotlib.pyplot assure une cohérence éditoriale indispensable à la rédaction de manuscrits scientifiques conformes aux normes des revues internationales à comité de lecture.
Le bloc de code ci-dessous matérialise cette phase préparatoire indispensable. Il importe l’ensemble des modules logiciels nécessaires, assigne leurs alias conventionnels, initialise la graine stochastique pour neutraliser la dérive aléatoire et calibre les paramètres de rendu visuel par défaut afin d’optimiser le confort de lecture :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
# Fixation de la graine du générateur pseudo-aléatoire pour reproductibilité
np.random.seed(42)
# Paramétrage esthétique global de Matplotlib
plt.rcParams['font.sans-serif'] = 'DejaVu Sans'
plt.rcParams['axes.edgecolor'] = '#333333'
plt.rcParams['axes.linewidth'] = 0.8
4. Génération et structuration du jeu de données d’exemple
4.1 Création du DataFrame de référence
Afin d’illustrer la syntaxe, les capacités d’ajustement et les modalités d’interprétation d’une matrice de dispersion sans dépendre d’une source de données externe sujette à des ruptures de liens, nous procédons à la construction méthodique d’un jeu de données synthétique rigoureusement formalisé. Ce DataFrame modélisera les performances physiques et biométriques d’une cohorte d’athlètes professionnels au travers de trois variables quantitatives continues emblématiques : les points marqués (points), les passes décisives distribuées (assists) et les rebonds captés (rebounds).
Pour assurer un réalisme psychométrique et biométrique satisfaisant, ces variables sont générées au moyen de distributions normales multivariées contrôlées à l’aide de NumPy, simulant des niveaux de dispersion empiriques réalistes et standardisés. La structure tabulaire est ensuite matérialisée au moyen du constructeur standard pd.DataFrame, en affectant à chaque vecteur un nom explicite qui servira ultérieurement d’étiquetage automatique sur les axes de la visualisation.
L’implémentation algorithmique de cette étape d’instanciation s’articule comme suit :
# Définition de la taille de l'échantillon d'observations
n_observations = 250
# Génération de variables aléatoires continues avec propriétés distributionnelles définies
points = np.random.normal(loc=20.0, scale=5.5, size=n_observations)
assists = np.random.normal(loc=5.0, scale=2.2, size=n_observations)
rebounds = np.random.normal(loc=8.0, scale=3.1, size=n_observations)
# Encapsulation matricielle au sein d'une structure DataFrame Pandas
df = pd.DataFrame({
'points': points,
'assists': assists,
'rebounds': rebounds
})
4.2 Inspection préliminaire des données simulées
Avant d’engager toute procédure de restitution graphique multidimensionnelle, une démarche analytique rigoureuse exige une vérification scrupuleuse de la structure interne des données simulées. Il convient de s’assurer de l’adéquation des dimensions matricielles, de la conformité des types scalaires hébergés au sein de chaque vecteur (qui doivent impérativement appartenir au domaine numérique, sous peine d’induire des défaillances critiques lors du calcul des projections géométriques) et de l’absence totale de valeurs manquantes (NaN) ou de corruptions d’encodage.
Cette étape d’audit exploratoire s’exécute traditionnellement au travers des méthodes natives de Pandas telles que head(), qui extrait les premières observations du jeu de données pour une validation visuelle rapide de la topologie tabulaire, et describe(), qui synthétise les moments statistiques fondamentaux de chaque distribution continue, incluant la moyenne arithmétique, l’écart-type, les valeurs extrêmes minimale et maximale, ainsi que les quartiles empiriques.
Le code suivant permet de réaliser cette vérification préliminaire sur notre jeu de données :
# Examen des cinq premières lignes du DataFrame
print(df.head())
# Diagnostic synthétique des moments statistiques descriptifs
print(df.describe().round(2))
L’exécution de cette séquence permet de confirmer que les vecteurs de notre tableau comportent exactement 250 observations continues de type flottant 64 bits (float64), réparties selon des distributions aux moyennes empiriques proches des paramètres théoriques injectés dans le générateur stochastique, sans aucune rupture de continuité métrique.
5. Syntaxe fondamentale et premier exemple : la matrice de dispersion de base
5.1 Implémentation de pd.plotting.scatter_matrix
L’invocation de la matrice de dispersion au sein de l’écosystème Pandas bénéficie d’une ergonomie syntaxique remarquable. La fonction scatter_matrix réside directement dans le module pandas.plotting et peut être appelée en lui transmettant simplement le DataFrame cible comme argument principal obligatoire. Dans sa formulation la plus épurée, aucun paramétrage additionnel n’est strictement requis pour produire une visualisation fonctionnelle complète.
Lorsque cette fonction est exécutée sans modification de ses options par défaut, Pandas inspecte dynamiquement l’ensemble des colonnes composant le DataFrame, filtre automatiquement les attributs purement numériques en écartant les chaînes de caractères ou les types temporels incompatibles, calcule la dimension p de la grille résultante et alloue une collection de sous-graphiques interconnectés via Matplotlib.
L’instruction standard pour générer cette figure initiale se formule comme suit :
# Appel direct de la fonction scatter_matrix sur le DataFrame
pd.plotting.scatter_matrix(df)
plt.show()
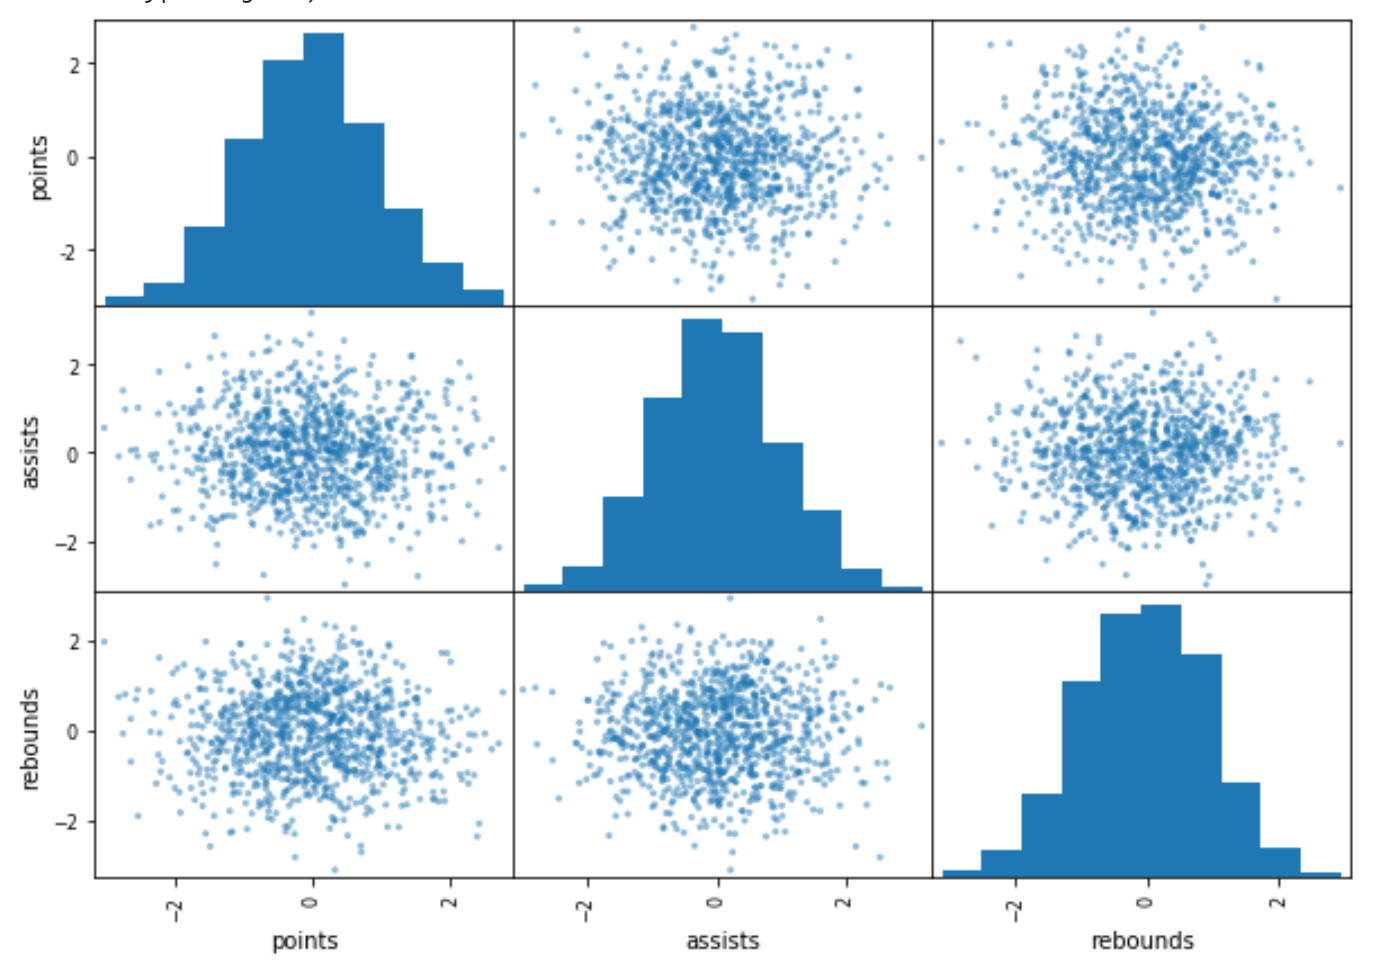
Ce bloc élémentaire déclenche l’exécution des routines de tracé vectoriel, calculant pour chaque combinaison de paires de colonnes le diagramme de dispersion correspondant et insérant sur chaque segment diagonal un histogramme de distribution discrétisé en dix classes par défaut.
5.2 Décomposition architecturale de la figure résultante
La figure générée par l’appel de base présente une topologie rigoureusement quadrillée de 3 × 3 sous-graphiques, correspondant fidèlement aux trois variables de notre jeu de données (points, assists, rebounds). Chacune des cellules est enchâssée dans un système d’axes cartésiens précisément coordonné, garantissant une cohérence géométrique sur l’ensemble de la figure.
Le système de désignation textuelle hérite directement des étiquettes attribuées aux colonnes du DataFrame : les noms de variables apparaissent en ordonnée le long de la colonne la plus à gauche de la grille et en abscisse à la base de la rangée inférieure. Cette disposition stratégique élimine la redondance textuelle qui résulterait de l’affichage systématique des étiquettes sur chacune des cellules individuelles, préservant ainsi la pureté visuelle globale.
Les six cellules situées en dehors de la diagonale principale exposent les diagrammes de dispersion bivariés standard, où chaque point bleu représente une observation individuelle projetée dans le plan bidimensionnel correspondant. Les trois cellules diagonales hébergent quant à elles des histogrammes discrets de fréquences absolues. Bien que cette configuration par défaut offre une première vision exploitable, elle révèle fréquemment des limites graphiques notables : les étiquettes d’axes peuvent se chevaucher en raison de la compacité de l’agencement, et le découpage automatique des histogrammes peut masquer des particularités de densité sous-jacentes.
5.3 Interprétation initiale des relations observées
L’observation attentive de la matrice de dispersion de base générée à partir de notre jeu de données synthétique autorise plusieurs inférences statistiques majeures. En premier lieu, l’examen des nuages de points dans les cellules hors diagonale montre une absence totale de directionalité linéaire marquée. Les observations se déploient de manière sphérique et isotrope autour du centre de gravité des coordonnées, ce qui atteste visuellement de l’indépendance statistique fondamentale des trois variables générées de façon stochastiquement disjointe.
En second lieu, l’inspection des histogrammes situés le long de la diagonale principale révèle des profils en cloche caractéristiques de la loi normale univariée. On note une concentration prépondérante des observations autour de la médiane et de la moyenne empirique de chaque variable, flanquée d’une décroissance symétrique progressive vers les queues de distribution à mesure que l’on s’écarte du centre de la distribution.
Enfin, cette première projection valide l’absence de colinéarité artificielle ou de perturbations méthodologiques induites par la simulation. Aucun regroupement discret (clustering), aucune discontinuité brutale ni aucune concentration marginale anormale ne vient troubler la régularité du schéma, fournissant ainsi une base neutre idéale avant d’entreprendre des opérations de sélection ciblée et de customisation esthétique poussée.
6. Sélection ciblée des sous-ensembles de variables via l’indexation
6.1 Utilisation de l’indexeur iloc pour l’extraction de variables spécifiques
Dans les contextes de recherche appliquée impliquant des bases de données volumineuses comportant des dizaines, voire des centaines d’indicateurs numériques, projeter l’intégralité du tableau dans une matrice de dispersion globale s’avère totalement contre-productif. L’analyste se trouve alors confronté à une micro-grille saturée d’axes illisibles. Il est par conséquent impératif de cibler l’analyse sur des sous-ensembles précis de variables au moyen des mécanismes d’indexation vectorielle de Pandas.
L’indexeur positionnel iloc constitue un instrument particulièrement robuste pour isoler des sous-matrices par découpage d’indices entiers (slicing). En spécifiant une plage de positions de colonnes, le chercheur extrait dynamiquement une vue réduite du DataFrame d’origine avant de la transmettre directement en argument à la fonction scatter_matrix. Cette méthode garantit une rapidité d’exécution optimale en évitant toute copie superflue de la structure en mémoire.
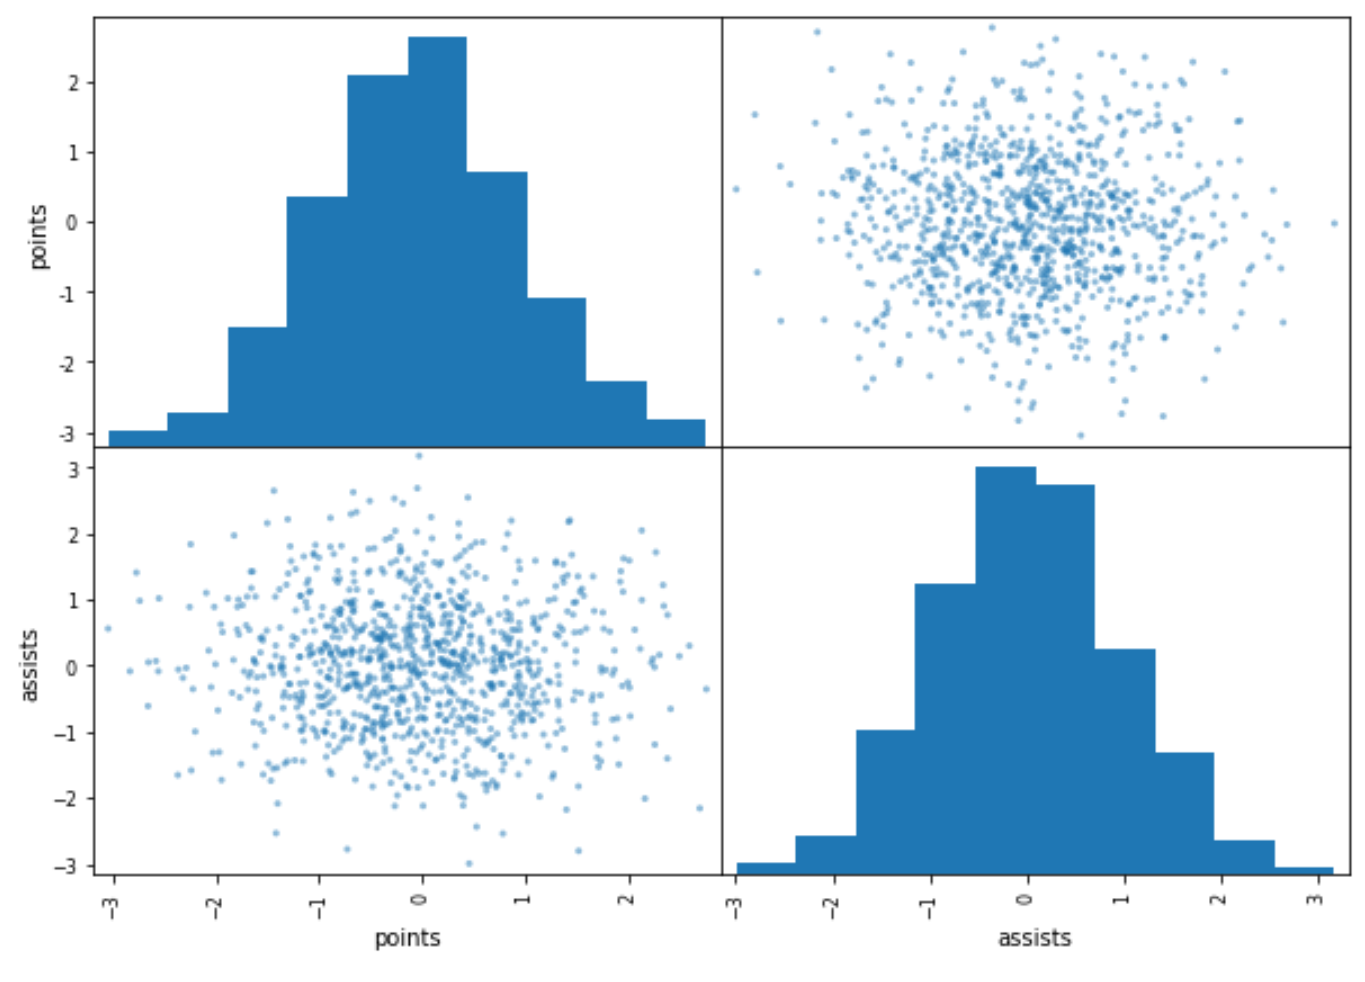
Le fragment de code ci-après démontre comment extraire strictement les deux premières variables du tableau (à savoir points et assists) au moyen de l’opérateur iloc afin de concentrer l’exploration bivariée sur un sous-espace vectoriel de dimension 2 × 2 :
# Extraction positionnelle des deux premières colonnes via iloc
sous_ensemble_positionnel = df.iloc[:, 0:2]
# Génération de la matrice de dispersion restreinte à 2x2 sous-graphiques
pd.plotting.scatter_matrix(sous_ensemble_positionnel)
plt.show()
Cette approche permet une inspection granulaire d’un binôme ou d’un trinôme de variables sans encombrer la mémoire de travail ni surcharger l’espace d’affichage de sous-graphiques non pertinents.
6.2 Sélection par étiquettes avec loc et listes de variables
Bien que l’indexation positionnelle via iloc soit fonctionnellement irréprochable, elle présente une vulnérabilité inhérente aux modifications structurelles ultérieures du jeu de données : si l’ordre des colonnes du DataFrame vient à être modifié lors d’une étape de prétraitement, le découpage positionnel risque de sélectionner des variables non souhaitées. Pour prévenir cette fragilité algorithmique et garantir la lisibilité du code, la sélection explicite par étiquettes textuelles via l’indexeur loc ou l’opérateur de sous-ensemble par liste de chaînes de caractères représente la bonne pratique reconnue.
Cette méthodologie d’extraction s’adapte idéalement à l’analyse de questionnaires psychométriques complexes comprenant de multiples échelles et sous-échelles factorielles, au sein desquels l’expérimentateur souhaite confronter des dimensions conceptuelles précisément nommées. La transmission explicite d’une liste d’identifiants de variables confère au script une parfaite clarté sémantique et une résilience totale aux réorganisations tabulaires.
Le code suivant illustre l’extraction de deux dimensions non adjacentes du DataFrame (points et rebounds) en utilisant la syntaxe d’accès direct par étiquettes :
# Définition formelle de la liste des variables d'intérêt clinique ou théorique
variables_cibles = ['points', 'rebounds']
# Sous-échantillonnage explicite par étiquettes et restitution matricielle
pd.plotting.scatter_matrix(df[variables_cibles])
plt.show()
6.3 Optimisation visuelle pour les jeux de données à haute dimension
Face à des jeux de données dits à haute dimension — caractéristiques des approches transcriptomiques en biologie, des enregistrements d’électroencéphalographie multicanaux ou des batteries d’évaluations cognitives massives — la construction d’une matrice de dispersion complète de dimension 20 × 20 ou supérieure induit une saturation cognitive absolue. Les cellules individuelles sont réduites à des dimensions physiques minuscules où les nuages de points se résument à des agrégats illisibles et où les graduations d’axes se télescopent inexorablement.
Pour contourner cet écueil ergonomique et statistique, la stratégie méthodologique préconisée consiste à partitionner l’espace global des variables en blocs conceptuels thématiques d’ordre hiérarchique. L’analyste peut ainsi concevoir des matrices modulaires indépendantes regroupant au maximum quatre à six indicateurs interconnectés par sous-système théorique.
Une démarche avancée complémentaire consiste à opérer une première sélection statistique guidée par une matrice de corrélation numérique préliminaire. En n’intégrant à la scatter matrix que les couples de variables affichant des coefficients de dépendance significatifs ou supérieurs à un seuil critique prédéterminé, l’analyste déploie l’effort de visualisation là où l’information structurale est la plus dense, allégeant significativement la charge computationnelle et cognitive globale.
7. Personnalisation esthétique : couleurs, marqueurs et dimensions de la figure
7.1 Gestion des paramètres de taille avec figsize
Le paramétrage dimensionnel global de la figure constitue le premier levier d’optimisation de la lisibilité d’une matrice de dispersion. Par défaut, Pandas dimensionne l’espace d’affichage selon les valeurs standard de Matplotlib (habituellement 6,4 × 4,8 pouces), ce qui engendre un écrasement considérable dès que le nombre de variables dépasse trois colonnes. Pour résoudre cette contrainte géométrique, le paramètre figsize accepte un tuple de deux valeurs numériques spécifiant respectivement la largeur et la hauteur totale du canevas en pouces.
L’attribution judicieuse de proportions carrées ou légèrement rectangulaires équilibrées (par exemple, figsize=(10, 10) ou figsize=(12, 12)) permet d’octroyer à chaque cellule un espace orthogonal suffisant pour que les points puissent se déployer sans tassement artificiel. Cette aération géométrique assure en outre la préservation de la visibilité des repères de graduation numérique (ticks) et évite le chevauchement des titres de variables sur les marges extérieures de la matrice.
Dans la perspective d’une publication dans une revue académique, le calibrage métrique de figsize doit s’ajuster aux spécifications techniques de mise en page des éditeurs scientifiques (format une colonne ou deux colonnes, généralement équivalent à une largeur physique comprise entre 8,5 et 17 centimètres), garantissant que la taille relative des polices de caractères et des éléments graphiques demeure parfaitement intelligible après réduction à l’échelle d’impression.
7.2 Attribution chromatique et personnalisation des points
L’apparence visuelle des points individuels au sein des cellules bivariées conditionne la finesse de l’analyse perceptive. La fonction scatter_matrix met à disposition trois paramètres graphiques majeurs pour piloter cette modélisation : color, marker et alpha.
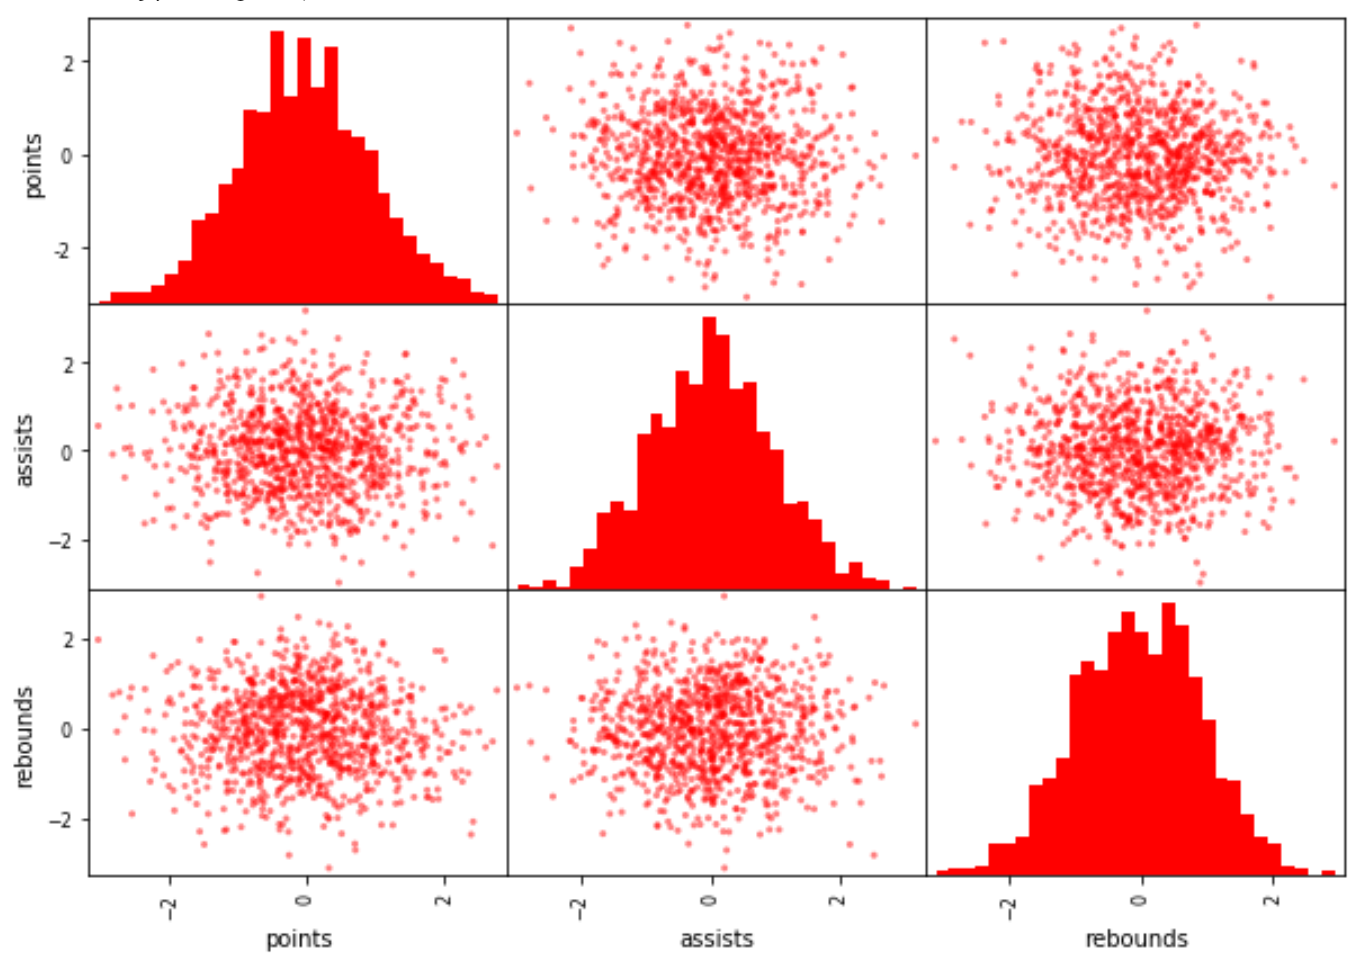
Le paramètre color permet de substituer à la couleur bleue par défaut des teintes conformes aux chartes graphiques de publications scientifiques ou aux échelles perceptuellement uniformes. Il accepte des codes hexadécimaux stricts (ex. '#2b5c8f') ou des identifiants nommés. Le paramètre marker autorise quant à lui le remplacement des cercles pleins standards par une grande variété de symboles géométriques issus de Matplotlib, tels que des croix ('x'), des carrés ('s') ou des triangles ('^'), ce qui peut s’avérer utile pour préserver la distinction visuelle lors de reproductions en niveaux de gris.
Le paramètre le plus critique pour l’analyse statistique demeure sans conteste alpha, qui module le coefficient d’opacité des marqueurs le long d’un intervalle continu s’étendant de 0 (transparence totale) à 1 (opacité absolue). En assignant une valeur intermédiaire (par exemple alpha=0.5 ou alpha=0.3), les points qui se chevauchent dans les zones de forte concentration spatiale intensifient proportionnellement leur teinte locale. Cela fait émerger de façon quasi topographique la densité probabiliste bivariée sous-jacente, éliminant l’illusion d’uniformité propre aux nuages de points saturés.
Le bloc de code ci-dessous matérialise l’intégration simultanée de ces options de personnalisation esthétique avancée :
# Génération d'une matrice hautement personnalisée
pd.plotting.scatter_matrix(
df,
figsize=(10, 10),
color='#2b5c8f',
marker='o',
alpha=0.4
)
plt.show()
7.3 Harmonisation typographique et gestion de la mise en page
Une visualisation scientifique n’atteint son plein potentiel de communication que si l’environnement typographique et l’agencement structural respectent les principes de base du design d’information. Par défaut, la scatter matrix de Pandas peut générer des sous-graphiques dont les textes d’axes périphériques empiètent sur les graduations voisines, compromettant la clarté du document final.
Pour remédier à ces interférences spatiales, l’analyste peut invoquer en amont les paramètres globaux de Matplotlib via plt.rc() ou plt.rcParams afin de calibrer uniformément la taille des polices de caractères pour les étiquettes de variables (axes.labelsize) et pour les repères de graduation (xtick.labelsize, ytick.labelsize). L’harmonisation typographique implique également l’usage de polices sans empattement hautement lisibles (comme DejaVu Sans, Helvetica ou Arial).
Par ailleurs, l’ajustement spatial des marges et des espacements inter-axes peut être affiné après l’appel de scatter_matrix au moyen de la méthode plt.tight_layout() ou, plus précisément encore, via la commande plt.subplots_adjust(). Cette dernière fonction permet de stipuler manuellement les espaces réservés horizontaux (wspace) et verticaux (hspace) séparant les cellules de la grille, instaurant une séparation nette entre chaque sous-graphique ou, au contraire, éliminant totalement les espaces pour concevoir une mosaïque continue de haute densité informationnelle.
8. Configuration des visualisations diagonales : histogrammes et densités par noyau
8.1 Paramétrage précis des histogrammes diagonaux via hist_kwds
Les représentations distributionnelles univariées déployées le long de la diagonale principale constituent une pièce maîtresse de l’interprétation diagnostique de la matrice. Par défaut, Pandas paramètre ces cellules avec des histogrammes discrets configurés avec un nombre standard de dix classes (bins). Cette discrétisation générique est rarement optimale : selon l’effectif total de l’échantillon, elle peut soit agréger excessivement l’information et dissimuler des asymétries locales, soit sur-segmenter la distribution et créer une variabilité d’échantillonnage purement artificielle.
Pour exercer un contrôle précis sur le comportement de ces histogrammes, la fonction scatter_matrix expose l’argument hist_kwds. Ce paramètre accepte un dictionnaire Python regroupant les arguments de bas niveau directement transmis à la fonction d’histogramme de Matplotlib (plt.hist). Grâce à ce canal de configuration, l’analyste peut ajuster dynamiquement le nombre d’intervalles ('bins'), spécifier les délimitations exactes des classes, modifier la couleur de remplissage ou appliquer une bordure contrastée sur chaque barre pour accentuer la netteté visuelle de la découpe.
La règle empirique de Sturges ou la formule plus robuste de Freedman-Diaconis basée sur l’écart interquartile peuvent ainsi être mises à profit pour déterminer le nombre optimal de classes à assigner dans le dictionnaire hist_kwds, comme illustré dans l’exemple technique suivant :
# Définition du dictionnaire d'ajustement avancé des histogrammes
parametres_hist = {
'bins': 20,
'color': '#4a7c59',
'edgecolor': '#ffffff',
'linewidth': 0.75
}
# Génération de la matrice avec histogrammes calibrés
pd.plotting.scatter_matrix(
df,
figsize=(10, 10),
diagonal='hist',
hist_kwds=parametres_hist
)
plt.show()
8.2 Substitution des histogrammes par l’estimation de densité par noyau (KDE)
Bien que les histogrammes apportent un rendu direct du comptage des fréquences empiriques, ils demeurent intrinsèquement tributaires de deux facteurs arbitraires : le nombre total de classes retenu et l’emplacement de l’origine de discrétisation. Pour s’affranchir de ces limites méthodologiques et accéder à une modélisation continue et lisse de la loi de probabilité sous-jacente, il est fortement recommandé de substituer aux histogrammes une estimation de la densité par noyau, conventionnellement désignée par l’acronyme KDE (Kernel Density Estimation).
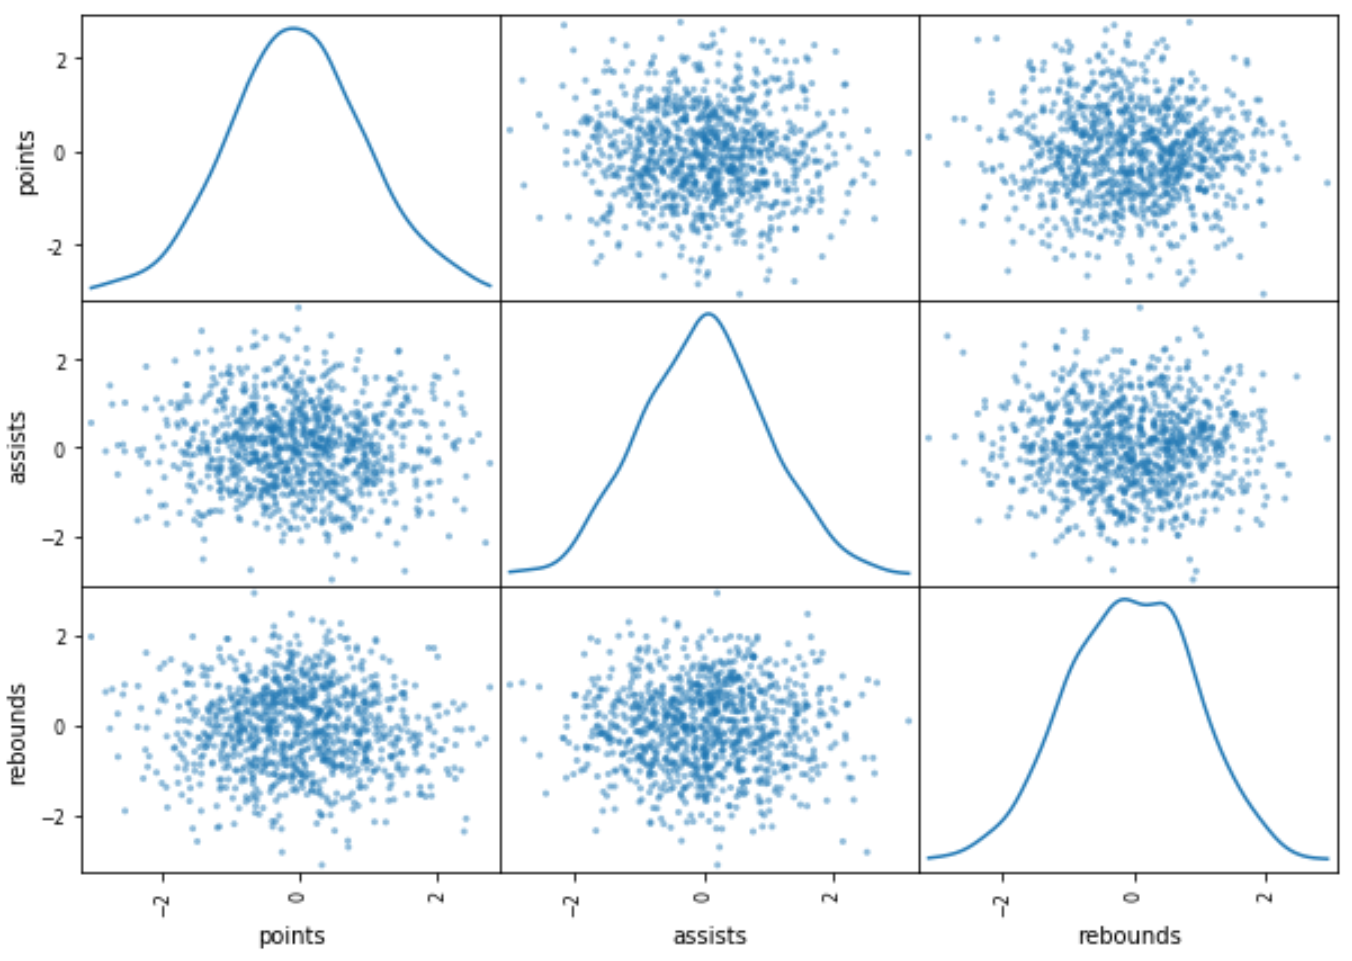
Dans la syntaxe de Pandas, cette transition s’opère instantanément en basculant l’argument diagonal de sa valeur par défaut 'hist' vers l’option 'kde' (ou son synonyme 'density'). Dès lors, le sous-système de calcul graphique applique un lissage statistique par convolution d’un noyau fonctionnel continu (le plus souvent un noyau gaussien standard) centré sur chaque observation individuelle de l’échantillon. L’expression mathématique de l’estimateur par noyau s’énonce classiquement :
f̂h(x) = (1 / (n h)) ∑k=1n K((x – xk) / h)
où K représente la fonction de noyau symétrique intégrant à un, n la taille d’échantillon, et h le paramètre de lissage essentiel désigné sous le terme de bande passante (bandwidth). Ce calcul, exécuté en arrière-plan via SciPy et intégré par Pandas, permet de restituer une courbe de densité différentiable continue révélant avec une grande pureté la morphologie globale, l’aplatissement et la symétrie de chaque variable.
8.3 Critères méthodologiques de choix entre histogramme et densité
Le choix délibéré entre histogrammes discrets et tracés de densité continus sur la diagonale principale ne relève pas d’une simple préférence esthétique, mais procède d’une réflexion méthodologique rigoureuse sur la nature de la distribution et les propriétés métriques des données étudiées. L’analyste doit évaluer les compromis statistiques inhérents à chaque option graphique.
L’histogramme s’impose comme le choix méthodologique le plus transparent lorsque les variables mesurées sont intrinsèquement discrètes (telles que des scores entiers sur une échelle de Likert, des dénombrements d’événements comportementaux ou des fréquences d’erreurs) ou lorsque l’échantillon comporte des discontinuités structurelles strictes (intervalles tronqués ou effets de seuil infranchissables). Dans ces conditions, le lissage continu d’une courbe KDE risquerait d’induire le lecteur en erreur en étalant de la probabilité hors des limites physiques réelles de la variable (par exemple, en suggérant des scores négatifs impossibles pour une échelle strictement bornée à zéro).
À l’inverse, l’estimation de densité par noyau révèle toute sa pertinence lorsque les variables sous-jacentes relèvent de continuums physiques ou latents théoriques (temps de réponse mesurés en millisecondes, concentrations biochimiques, scores factoriels composites standardisés) et que l’échantillon présente une taille intermédiaire à large (n > 100). Dans ce cadre, la courbe KDE filtre efficacement le bruit d’échantillonnage aléatoire haute fréquence et met en exergue la géométrie fondamentale de la distribution, facilitant la comparaison immédiate de la morphologie des différentes variables marginales.
9. Paramètres avancés et ajustement fin via les arguments de Matplotlib
9.1 Exploitation du dictionnaire density_kwds pour les courbes KDE
Tout comme hist_kwds gouverne le tracé des histogrammes, la fonction scatter_matrix fournit le paramètre density_kwds spécifiquement alloué au calibrage fin des courbes de densité par noyau lorsque l’option diagonal='kde' est activée. Ce conteneur dictionnaire permet d’ajuster l’épaisseur du trait vectoriel, son tracé géométrique (continu, tireté, pointillé) ou sa coloration spécifique afin de rehausser la distinction graphique par rapport aux nuages de points adjacents.
De plus, pour les analystes souhaitant enrichir le rendu de ces distributions continues, certains attributs graphiques complémentaires peuvent être injectés pour moduler l’aspect visuel de la courbe, garantissant ainsi une conformité stylistique absolue avec les exigences des maquettes de revues savantes.
Le script suivant illustre l’ajustement synchronisé des paramètres de dispersion bivariée et des options de modélisation continue univariée :
# Configuration du dictionnaire d'options pour l'estimation de densité
parametres_kde = {
'color': '#c0392b',
'linewidth': 2.2,
'linestyle': '-'
}
# Génération de la scatter matrix avec configuration univariée avancée
pd.plotting.scatter_matrix(
df,
figsize=(10, 10),
diagonal='kde',
density_kwds=parametres_kde,
color='#2c3e50',
alpha=0.5
)
plt.show()
9.2 Intégration d’éléments graphiques complémentaires
Une caractéristique architecturale essentielle de la fonction pd.plotting.scatter_matrix réside dans le fait qu’elle retourne explicitement un tableau NumPy bidimensionnel d’objets d’axes Matplotlib (numpy.ndarray contenant des instances de matplotlib.axes.Axes). Cette interface de programmation offre une flexibilité totale : l’analyste peut capturer cet objet au moment de l’appel pour itérer programmatiquement sur chaque cellule individuelle de la matrice et lui appliquer des modifications graphiques sur mesure.
Cette approche d’instrumentation fine autorise l’intégration de repères diagnostiques complémentaires non prévus nativement par Pandas. Par exemple, il est aisé d’ajouter des lignes de référence orthogonales matérialisant les moyennes empiriques (lignes horizontales et verticales au centre des distributions bivariées), d’insérer des segments diagonaux d’identité (x = y) pour vérifier des hypothèses de symétrie, ou encore de superposer une droite de tendance issue d’une régression linéaire empirique au moyen de la méthode ax.plot().
L’implémentation suivante démontre comment capturer le tableau d’axes généré et tracer une ligne de référence horizontale et verticale pointillée correspondant aux moyennes respectives de chaque couple de variables sur l’ensemble des cellules hors diagonale :
# Capture du tableau d'axes lors de la génération de la matrice
axes_matrix = pd.plotting.scatter_matrix(df, figsize=(10, 10), alpha=0.4)
# Calcul des moyennes empiriques marginales pour chaque colonne
moyennes = df.mean()
# Parcours itératif de l'ensemble des cellules de la grille
p = len(df.columns)
for i in range(p):
for j in range(p):
ax = axes_matrix[i, j]
if i != j:
# Ajout de lignes de référence passant par la moyenne
ax.axvline(moyennes.iloc[j], color='#7f8c8d', linestyle=':', linewidth=0.8)
ax.axhline(moyennes.iloc[i], color='#7f8c8d', linestyle=':', linewidth=0.8)
plt.show()
9.3 Exportation haute résolution pour manuscrits scientifiques
La production d’une figure multidimensionnelle de grande qualité ne s’arrête pas à son affichage dynamique à l’écran : elle doit pouvoir être exportée vers le système de fichiers dans des formats graphiques préservant son intégrité visuelle lors des processus d’édition savante. Les éditeurs académiques imposent systématiquement des standards rigoureux en matière de résolution, exigeant généralement une netteté minimale de 300 à 600 points par pouce (DPI, dots per inch) pour les figures matricielles.
L’enregistrement d’une scatter matrix s’opère via la fonction globale plt.savefig() de Matplotlib, invoquée impérativement avant l’appel d’affichage final plt.show() (qui réinitialise le canevas en mémoire). L’analyste doit choisir judicieusement entre formats vectoriels purs (tels que le PDF ou le SVG, garantissant un agrandissement infini sans pixelisation et préservant les textes comme des entités vectorielles éditables) et formats matriciels compressés sans perte (tels que le PNG à haut DPI).
L’exemple ci-dessous met en lumière la syntaxe d’exportation recommandée, en incluant l’argument bbox_inches='tight' qui assure le rognage automatique des marges blanches inutiles et empêche que les étiquettes textuelles situées en bordure de grille ne soient tronquées lors de l’encapsulation du fichier :
# Construction et exportation scientifique haute définition
pd.plotting.scatter_matrix(df, figsize=(11, 11), alpha=0.5, diagonal='kde')
# Exportation au format matriciel haute résolution (300 DPI)
plt.savefig('matrice_dispersion_publication.png', dpi=300, bbox_inches='tight')
# Exportation conjointe au format vectoriel pour édition typographique
plt.savefig('matrice_dispersion_vectorielle.pdf', format='pdf', bbox_inches='tight')
plt.close()
10. Interprétation statistique et psychométrique des visualisations multivariées
10.1 Détection des formes de distribution et des regroupements latents
L’exploitation analytique de la matrice de dispersion dépasse la simple contemplation esthétique pour s’ériger en instrument sémiotique de diagnostic statistique. L’inspection méticuleuse de la diagonale principale permet d’évaluer immédiatement la normalité univariée de chaque variable. La présence d’un aplatissement marqué (kurtosis négatif) ou d’une distribution pointue et leptokurtique avertit le statisticien d’éventuels risques d’instabilité des tests paramétriques standards (tels que l’analyse de variance ou les tests t de Student).
De surcroît, la détection d’une bimodalité ou d’une multimodalité sur la diagonale constitue une information substantielle majeure. Une telle morphologie trahit fréquemment l’existence de sous-populations hétérogènes non identifiées au sein de l’échantillon global (par exemple, des sous-groupes cliniques distincts, des différences liées au sexe biologique ou des variations de protocoles expérimentaux). Cette bimodalité univariée se prolonge visuellement dans les cellules hors diagonale sous forme d’amas ou d’îlots de dispersion nettement disjoints (clustering naturel).
Dans les sciences comportementales, l’identification précoce de ces regroupements latents évite l’écueil classique d’une interprétation monolithique des résultats. L’expérimentateur est immédiatement invité à introduire une variable catégorielle de stratification afin de partitionner les analyses et de prévenir les paradoxes statistiques d’agrégation, tels que le paradoxe de Simpson.
10.2 Diagnostic visuel de la colinéarité et de l’hétéroscédasticité
L’un des apports majeurs de la matrice de dispersion lors de la phase préparatoire d’une régression multiple réside dans sa capacité à révéler simultanément la multicolinéarité et l’hétéroscédasticité entre prédicteurs. La colinéarité entre deux variables se signale graphiquement par la compression extrême du nuage de points le long d’une droite ou d’une ellipse étroite. Plus le grand axe de l’ellipse est allongé et son petit axe aminci, plus la dépendance linéaire est critique, suggérant qu’une variable n’apporte que peu d’information incrémentielle par rapport à sa conjointe.
L’hétéroscédasticité — c’est-à-dire la non-constance de la variance conditionnelle d’une variable le long de l’axe de son corrélateur — se manifeste visuellement par des morphologies de dispersion en forme d’entonnoir, de pavillon de trompette ou d’éventail. Par exemple, si la variabilité des performances aux tests de mémoire (axe Y) s’accroît considérablement à mesure que le niveau d’anxiété (axe X) augmente, le nuage de points s’ouvrira progressivement de gauche à droite.
Ce diagnostic graphique avertit instantanément le modélisateur que l’hypothèse fondamentale d’homoscédasticité des résidus nécessaires aux moindres carrés ordinaires (MCO) sera vraisemblablement violée. Cette observation motive l’emploi de techniques d’inférence robustes, telles que l’utilisation d’estimateurs de covariance cohérents avec l’hétéroscédasticité (estimateurs de White ou de Huber-White) ou le recours à des modèles linéaires généralisés (GLM).
10.3 Identification et traitement des points d’influence
La scatter matrix offre une vision inégalée pour différencier avec précision deux types d’anomalies observationnelles souvent confondues dans les diagnostics sommaires : les valeurs aberrantes purement univariées et les points aberrants bivariés ou multivariés. Une valeur aberrante univariée se repère sans ambiguïté par son isolement extrême sur la marge d’une distribution diagonale, se situant bien au-delà de l’enveloppe générale de la courbe de densité ou de l’histogramme.
À l’inverse, une anomalie bivariée peut fort bien afficher des coordonnées parfaitement conformes aux marges univariées de chaque axe pris isolément, mais se trouver totalement désynchronisée de la loi de covariance conjointe. Dans une cellule hors diagonale, un tel point apparaîtra isolé, loin de la trajectoire elliptique principale du nuage d’observations. Dans un modèle de régression, ce point d’observation isolée est susceptible d’exercer un effet de levier considérable (high leverage point), faisant basculer la droite de régression et faussant dramatiquement l’estimation des coefficients de pente.
L’inspection visuelle de la matrice de dispersion permet d’identifier formellement les indices de ces observations influentes, incitant le chercheur à procéder à un examen qualitatif de leur genèse (erreur d’encodage matériel, perturbation du protocole d’acquisition) avant de décider méthodologiquement de leur exclusion, d’une troncature statistique (winsorisation) ou de l’application de méthodes de régression robuste fondées sur les M-estimateurs.
11. Pièges méthodologiques, limites computationnelles et résolution des anomalies
11.1 Gestion de la surcharge graphique par sur-traçage (Overplotting)
Lorsque la taille de l’échantillon analysé atteint des ordres de grandeur massifs (n supérieur à plusieurs milliers ou dizaines de milliers d’individus), la matrice de dispersion se heurte à une limitation graphique majeure désignée sous le terme de sur-traçage (overplotting). Les milliers de marqueurs cartésiens se superposent massivement les uns aux autres au centre des sous-graphiques, créant des aplats de couleur opaques et uniformes au sein desquels il devient strictement impossible de percevoir les variations locales de densité ou la structure interne du nuage.
Pour atténuer ce phénomène délétère sans abandonner l’usage de la scatter matrix, plusieurs ajustements stratégiques doivent être déployés simultanément. Le premier consiste à réduire de manière drastique la dimension géométrique des marqueurs (par exemple en assignant un symbole de pixel minimal via l’argument marker=',' ou en réduisant la taille des points) conjuguée à une diminution agressive du coefficient d’opacité (alpha=0.05 ou alpha=0.01).
Si la saturation demeure trop prononcée, une stratégie alternative robuste réside dans l’application d’un sous-échantillonnage aléatoire préliminaire rigoureusement contrôlé (random subsampling) via la méthode df.sample() de Pandas. En extrayant aléatoirement une fraction représentative de 5 à 10 % des données globales, on préserve fidèlement les propriétés probabilistes de la population tout en restituant la lisibilité graphique de l’espace multivarié.
11.2 Considérations algorithmiques et performances mémoire
L’architecture algorithmique sous-jacente à la fonction scatter_matrix repose sur une instanciation systématique d’objets graphiques régie par une complexité quadratique d’ordre O(p²), où p représente le nombre total de variables numériques transmises. Pour une sélection de 20 variables, le sous-système de tracé doit instancier, configurer et restituer exactement 400 systèmes d’axes interconnectés, chacun devant rendre n points ou calculer des convolutions de noyaux numériques.
Cette charge computationnelle engendre une explosion de la consommation de mémoire vive (RAM) et des temps de calcul CPU considérables, pouvant aboutir à des blocages purs et simples de l’interpréteur Python ou à des plantages de noyau dans les notebooks Jupyter. Il est donc fondamental de ne jamais appliquer brutalement pd.plotting.scatter_matrix sur un DataFrame sans avoir préalablement vérifié le nombre effectif de colonnes numériques au moyen de l’instruction df.select_dtypes(include=[np.number]).shape[1].
Pour optimiser les performances avant le tracé graphique, il convient de s’assurer que les colonnes numériques ne subissent pas de duplications mémoire inutiles et, le cas échéant, de convertir les types flottants 64 bits standards en flottants 32 bits (float32) lorsque la précision le permet, allégeant significativement l’empreinte mémoire vectorielle exploitée par les bibliothèques d’arrière-plan.
11.3 Divergence entre variables qualitatives et métriques continues
Un écueil méthodologique fréquent rencontré lors de l’analyse exploratoire réside dans l’inclusion involontaire de variables catégoriques discrètes préalablement encodées sous forme d’entiers numériques (comme des codes d’appartenance à un groupe notés 0, 1, 2 ou des échelles de type Likert ordinales très resserrées) au sein de la matrice de dispersion. Cette situation produit des motifs bivariés caractéristiques constitués de bandes de points parallèles rectilignes parfaitement rigides.
Ces alignements striés constituent une distorsion représentationnelle qui masque la véritable densité empirique des observations : des centaines de points identiques se retrouvent empilés exactement sur les mêmes coordonnées discrètes. D’un point de vue statistique, ces projections peuvent conduire l’analyste à des interprétations erronées concernant l’existence de supposées corrélations ou d’effets de seuil qui ne résultent en réalité que de la nature discrète de l’échelle d’évaluation.
La règle méthodologique fondamentale exige donc d’exclure formellement les facteurs nominaux et ordinaux purs de la scatter matrix continue. Si l’inclusion d’une échelle ordinale s’avère néanmoins inévitable, il est impératif d’appliquer une technique de micro-dispersion aléatoire artificielle désignée sous le terme de jittering. Cette méthode consiste à additionner à chaque modalité un bruit blanc gaussien infinitésimal centré sur zéro afin d’éclater l’agrégat ponctuel et de matérialiser visuellement le volume réel de répondants sur chaque palier de l’échelle.
12. Synthèse comparative et intégration dans un flux d’analyse de données
12.1 Comparaison entre scatter_matrix de Pandas et pairplot de Seaborn
Au sein de l’écosystème analytique Python, la fonction pd.plotting.scatter_matrix entre en concurrence directe avec une fonction hautement populaire proposée par la bibliothèque de haut niveau Seaborn : seaborn.pairplot. Bien que ces deux outils poursuivent le même objectif général de restitution visuelle matricielle par paires, ils présentent des compromis techniques et fonctionnels distincts qu’il importe de clarifier.
La fonction scatter_matrix de Pandas se distingue par sa légèreté computationnelle, son absence totale de dépendances logicielles additionnelles en dehors des fondations Matplotlib, et sa parfaite intégration native avec les structures de données DataFrame. Son exécution est généralement plus rapide et sa syntaxe plus prévisible lorsqu’on cherche à obtenir un diagnostic exploratoire rapide sans surcharge protocolaire.
En revanche, seaborn.pairplot offre des raffinements fonctionnels particulièrement avancés, au premier rang desquels figure le paramètre hue. Ce dernier permet de stratifier instantanément l’intégralité de la matrice selon une variable catégorielle (telle que le groupe expérimental ou le diagnostic clinique) en attribuant des codes couleurs différentiels aux points et en superposant des estimations de densité distinctes sur la diagonale principale. Seaborn propose également un paramètre corner=True permettant d’omettre le triangle supérieur de la matrice pour éliminer la redondance symétrique des cellules hors diagonale. Le choix entre ces deux instruments s’opère donc selon un arbitrage entre vélocité d’exploration directe (faveur à Pandas) et sophistication de stratification multivariée (faveur à Seaborn).
12.2 Positionnement au sein du pipeline d’analyse quantitative
Dans la conduite méthodique d’un projet de recherche quantitative ou de science des données appliquée, la matrice de dispersion ne doit jamais constituer un acte isolé d’illustration finale, mais doit s’ancrer de manière organique au cœur d’un pipeline d’analyse reproductible séquentiel. Elle intervient précisément à la jonction entre la phase de nettoyage et d’ingénierie des données tabulaires et la phase de modélisation statistique inférentielle ou prédictive.
En amont, la scatter matrix valide le succès des opérations d’imputation des valeurs manquantes, confirme l’absence de valeurs hors normes non corrigées et atteste de l’efficacité des transformations distributionnelles (stabilisation de la variance par transformation logarithmique). En aval, elle informe directement le modélisateur sur l’adéquation des hypothèses requises par les algorithmes statistiques envisagés, dictant le choix entre estimateurs paramétriques ou non paramétriques, signalant les risques de multicolinéarité avant une régression et orientant la composition factorielle d’un modèle structurel.
Enfin, dans le cadre de la science ouverte et de la traçabilité de la recherche, l’archivage des scripts de génération de matrices de dispersion hautement personnalisées — documentant explicitement les graines aléatoires, les paramètres de bandes passantes et les versions de bibliothèques utilisées — assure que tout chercheur tiers sera en mesure de reproduire fidèlement l’évaluation diagnostique visuelle initiale, scellant ainsi les principes de robustesse et de transparence inhérents à la démarche scientifique moderne.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1924-00a
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman & Hall/CRC. https://doi.org/10.1201/9781315140919
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098