
L’analyse exploratoire et la modélisation statistique de données quantitatives sont fréquemment confrontées à des phénomènes dont la dynamique sous-jacente défie la linéarité des représentations visuelles traditionnelles. Qu’il s’agisse de l’évaluation de la cinétique virale en épidémiologie, de l’étude de la distribution des richesses au sein des systèmes socio-économiques, de la caractérisation des flux d’expression génique par séquençage d’ARN à haut débit ou encore de la mesure des temps de latence au sein d’infrastructures informatiques distribuées, les distributions observées présentent couramment une asymétrie positive prononcée, caractérisée par une queue de distribution particulièrement étirée vers les valeurs extrêmes. Dans de telles configurations, une échelle arithmétique conventionnelle compresse l’immense majorité des observations dans une zone visuellement illisible proche de l’origine, tout en accordant un espace graphique disproportionné à une poignée d’observations atypiques ou aberrantes.
Au sein de l’écosystème de programmation statistique R, le package ggplot2, conçu par Hadley Wickham sur les bases théoriques de la grammaire des graphiques formulée par Leland Wilkinson, offre un ensemble d’outils particulièrement rigoureux pour restructurer la projection spatiale des données. L’introduction d’échelles logarithmiques ne constitue pas un simple artifice cosmétique d’ajustement visuel ; elle répond à des impératifs méthodologiques profonds, permettant de substituer à l’évaluation des écarts arithmétiques absolus une évaluation des variations relatives, proportionnelles ou exponentielles. La maîtrise des mécanismes d’échelonnage logarithmique sous ggplot2 s’avère ainsi indispensable pour tout chercheur ou praticien désireux de communiquer fidèlement la structure topologique et la signification mathématique de ses jeux de données.
Ce guide exhaustif propose une exploration approfondie de l’implémentation, de la personnalisation et de la théorisation des échelles logarithmiques au sein de ggplot2. À travers l’étude minutieuse des fonctions dédiées, la comparaison des paradigmes de transformation des échelles continues et des coordonnées, la gestion des singularités mathématiques relatives aux valeurs nulles et négatives, et l’intégration avancée de la typographie académique avec le package scales, cet article fournit l’ensemble des clés techniques et sémiologiques nécessaires à l’élaboration de figures publiables répondant aux standards les plus exigeants de la recherche internationale.
1. 1. Introduction théorique aux échelles logarithmiques dans ggplot2
1.1 1.1 Justification de la transformation logarithmique en analyse de données
La décision de soumettre une variable continue à une projection logarithmique découle d’une nécessité fondamentale liée à la distribution statistique sous-jacente des observations empiriques. Dans les distributions présentant une forte asymétrie positive (ou asymétrie à droite), la moyenne arithmétique est fortement tirée vers les valeurs supérieures par des occurrences rares mais massives, reléguant la médiane et le mode dans une zone de concentration extrême. Si l’on projette ces données sur un plan cartésien standard, le pouvoir de résolution graphique est presque intégralement confisqué par les valeurs maximales. La transformation logarithmique agit comme un opérateur de compression non linéaire des ordres de grandeur : chaque décade ou puissance multiplicative reçoit une allocation spatiale identique sur le support visuel, restaurant immédiatement la lisibilité des structures sous-jacentes dans les plages de valeurs inférieures et intermédiaires.
Par ailleurs, la transformation logarithmique modifie en profondeur la nature des comparaisons perceptives induites chez l’analyste. Sur un axe cartésien linéaire, une distance physique d’un centimètre correspond invariablement à une quantité absolue additionnelle fixée, par exemple dix unités, que l’on se situe entre dix et vingt ou entre dix mille et dix mille dix. À l’inverse, sur un axe logarithmique en base dix, un centimètre représentera systématiquement une multiplication par dix de la valeur observée, que l’on passe de un à dix ou de cent mille à un million. L’échelle met ainsi en évidence les taux de variation relative, les variations proportionnelles et les facteurs d’accroissement géométrique, ce qui s’avère particulièrement pertinent pour les processus stochastiques multiplicatifs où les variations s’expriment naturellement en pourcentages plutôt qu’en incréments d’unités constantes.
Cette propriété de rééchelonnage se traduit géométriquement par la linéarisation de fonctions mathématiques non linéaires complexes. Une trajectoire de croissance exponentielle, modélisée par une fonction où la variable dépendante croît de manière proportionnelle à son propre niveau, adopte la forme d’une droite affine lorsque l’ordonnée est assujettie au logarithme. De même, les lois de puissance, largement documentées en physique statistique et en sociologie quantitative sous des appellations telles que la loi de Zipf ou la loi de Pareto, se manifestent sous la forme de droites parfaitement rectilignes lorsque les deux axes dimensionnels font simultanément l’objet d’un échelonnage logarithmique. Enfin, dans les disciplines expérimentales telles que la psychophysique et les neurosciences cognitives, la réponse perceptive des organes sensoriels aux stimuli externes (intensité lumineuse, pression acoustique) suit des lois logarithmiques bien établies, conférant à cette transformation une validité ontologique directe pour la restitution de mesures chronométriques, comportementales ou physiologiques.
1.2 1.2 Architecture graphique de ggplot2 et logique de transformation
Pour appréhender correctement le fonctionnement des échelles logarithmiques dans ggplot2, il convient de comprendre la manière dont le package opérationnalise les concepts exposés par Leland Wilkinson dans son ouvrage fondateur sur la grammaire des graphiques. Dans cette architecture conceptuelle, un graphique n’est pas envisagé comme une image statique composite, mais comme un pipeline de composition formel reliant des données tabulaires brutes à des formes géométriques perceptibles. Les données traversent successivement des étapes d’extraction esthétique (mapping), de transformation statistique (stat), d’application d’échelles de mesure (scale), de projection dans un système d’axes (coord) et de composition au sein d’une armature thématique (theme).
Les échelles (scales) constituent précisément l’interface qui traduit les valeurs numériques appartenant à l’espace abstrait des données brutes en grandeurs appartenant à l’espace graphique (telles que des coordonnées physiques mesurées en millimètres ou en pixels, des teintes chromatiques ou des épaisseurs de trait). Lorsque l’on demande à ggplot2 d’appliquer une échelle logarithmique à un axe, cette opération est interceptée à un stade intermédiaire très spécifique du pipeline de rendu : les données brutes sont transmises au composant d’échelle qui effectue la transformation mathématique avant que les objets géométriques (geoms) ne procèdent à leurs calculs statistiques ou à leur positionnement final. Cette séquence assure une distinction conceptuelle capitale entre la transformation préalable d’un jeu de données au niveau du tableau de données (via une mutation manuelle dans le moteur R) et la transformation de l’échelle graphique elle-même.
Lorsqu’un utilisateur modifie préalablement son jeu de données en appliquant une fonction mathématique externe (par exemple en créant une nouvelle colonne contenant le logarithme de la variable), ggplot2 ne reçoit que des nombres transformés dont il ignore la genèse sémantique. Les graduations, les titres et les étiquettes de l’axe afficheront par conséquent les valeurs du logarithme lui-même (0, 1, 2, 3), forçant le lecteur à une gymnastique mentale de rétro-calcul exponentiel pour retrouver les unités réelles. À l’inverse, l’utilisation des mécanismes d’échelle internes à ggplot2 préserve rigoureusement l’intégrité des données brutes au sein des métadonnées du graphique. L’espace visuel est déformé de manière logarithmique, mais les repères numériques, les infobulles potentielles et les graduations continuent d’exprimer les valeurs originales du phénomène sous leur forme physique originelle (par exemple 1, 10, 100, 1000), garantissant ainsi une transparence analytique totale.
1.3 1.3 Vue d’ensemble des fonctions natives dédiées sous ggplot2
L’environnement de ggplot2 met à la disposition des utilisateurs plusieurs voies d’accès programmatiques pour instaurer un étalonnage logarithmique, chacune s’inscrivant à un niveau d’abstraction ou d’interaction différent au sein du moteur graphique. La première approche, la plus modulable et la plus fondamentale, repose sur les fonctions génériques d’échelle continue, à savoir scale_x_continuous() et scale_y_continuous(), associées à l’argument trans (ou son alias moderne transform introduit dans les versions récentes de ggplot2). Ce paramètre accepte des objets de transformation formalisés issus de la bibliothèque associée scales ou des chaînes de caractères prédéfinies identifiant des fonctions mathématiques standardisées.
La deuxième approche exploite le mécanisme des coordonnées déformées via la fonction coord_trans(). Contrairement à la modification des échelles continues de position qui intervient très tôt dans le calcul graphique, coord_trans() applique la transformation spatiale au tout dernier stade du pipeline, directement sur le plan géométrique cartésien lui-même. Cette nuance structurelle, qui sera disséquée dans les sections ultérieures de cet article, engendre des conséquences géométriques majeures, notamment sur le tracé des éléments de liaison, des barres de confiance et des ajustements statistiques prédictifs.
Enfin, ggplot2 intègre des fonctions d’aide condensées, couramment désignées sous le terme de fonctions raccourcies (« shortcuts »), à l’instar de scale_x_log10() et scale_y_log10(). Ces fonctions ont été conçues pour simplifier l’écriture syntaxique dans le cadre d’analyses exploratoires interactives. Elles encapsulent de manière transparente un appel prédéfini à scale_continuous() configuré spécifiquement pour la base décimale. Si leur compacité syntaxique est appréciée lors du prototypage rapide de graphiques, leur relative rigidité apparente nécessite souvent de repasser aux fonctions sous-jacentes dès lors que l’on exige un contrôle chirurgical de la typographie des exposants, du pas des graduations mineures ou de la gestion fine des seuils aux frontières de l’échantillon.
2. 2. Fondements mathématiques et perception cognitive des représentations logarithmiques
2.1 2.1 Principes psychophysiques de perception visuelle des échelles
L’efficacité d’un support graphique ne repose pas exclusivement sur sa conformité formelle aux règles de la syntaxe informatique ; elle dépend de la capacité du système cognitif humain à décoder les stimuli spatiaux qui lui sont soumis. Sur le plan de la psychophysique expérimentale, les travaux fondateurs d’Ernst Heinrich Weber et de Gustav Fechner ont formalisé la manière dont les êtres humains évaluent les variations d’intensité physique. La loi de Weber-Fechner postule que la sensation psychologique perçue est proportionnelle au logarithme de l’intensité du stimulus physique. Dans le domaine de la sémiologie graphique, cette observation implique que l’esprit humain traite intuitivement certains écarts géométriques sous une forme relative plutôt qu’arithmétique pure, en particulier lorsqu’il évalue des ordres de grandeur couvrant plusieurs puissances de dix.
Toutefois, la manipulation d’axes logarithmiques induit des biais cognitifs substantiels chez les lecteurs qui n’ont pas reçu de formation méthodologique avancée. Les études menées en cognition visuelle démontrent que la majorité des observateurs interprètent spontanément la distance spatiale séparant deux points sur un tracé comme un intervalle arithmétique constant. Face à une échelle logarithmique, cette heuristique par défaut engendre une sous-estimation systématique et sévère de l’amplitude des variations situées dans les régions supérieures de l’axe. Par exemple, sur un axe logarithmique gradué de un à un million, la distance physique séparant dix mille de cent mille est strictement égale à celle qui sépare un de dix. Un lecteur non averti aura tendance à percevoir ces deux sauts qualitatifs comme équivalents en volume absolu, oblitérant le fait que le second représente une différence numérique incomparablement plus massive que le premier.
Ce risque d’illusion perceptive impose une rigueur déontologique absolue dans la mise en page des visualisations de données. L’analyste doit impérativement fournir des repères visuels non ambigus pour signaler la non-linéarité de l’espace représenté. L’omission d’une signalétique graphique adéquate — telle que l’espacement resserré caractéristique des graduations mineures au sein de chaque décade ou une formulation textuelle explicite dans l’intitulé de l’axe — expose la communication scientifique à des accusations de manipulation visuelle, en masquant artificiellement la criticité d’une croissance exponentielle ou en aplanissant indûment des inégalités structurelles profondes au sein des populations étudiées.
2.2 2.2 Choix de la base logarithmique : log népérien, log10 et log2
Sur le plan strictement mathématique, les fonctions logarithmiques appartenant à différentes bases sont toutes proportionnelles entre elles, reliées par la formule du changement de base selon laquelle le logarithme en base b d’un nombre réel strictement positif x équivaut au rapport du logarithme naturel de x sur le logarithme naturel de b. Par conséquent, le choix de la base n’altère en rien la morphologie globale relative des distributions visualisées : un nuage de points projeté selon une base deux ou une base dix conservera rigoureusement les mêmes relations d’ordre et de proportionnalité géométrique interne. Néanmoins, d’un point de vue sémiotique et interprétatif, le choix de la base constitue une décision de premier plan qui doit être dictée par la nature du phénomène physique analysé et par les conventions disciplinaires en vigueur.
Le logarithme décimal, ou base dix, représente le standard prédominant pour les données couvrant des dynamiques d’ordres de grandeur massifs, s’étendant typiquement sur trois décades ou davantage. Il s’aligne harmonieusement avec notre système de numération de position à base dix, permettant une lecture instinctive des valeurs clés telles que cent, mille, dix mille ou un million. Il constitue le choix privilégié en géophysique (magnitude des séismes sur l’échelle de Richter), en acoustique (décibels), en chimie des solutions (potentiel hydrogène ou pH) et dans l’étude des distributions macroéconomiques transversales (produit intérieur brut par habitant, capitalisation boursière).
À l’opposé, le logarithme binaire, ou base deux, est l’outil d’élection pour l’analyse des phénomènes gouvernés par des mécanismes de dédoublement, de réplication binaire ou de facteurs de division. En bio-informatique génomique, notamment dans les études d’expression différentielle issues de puces à ADN ou de RNA-Seq, le concept de facteur de multiplication (« fold-change ») s’exprime conventionnellement en logarithme de base deux. Dans cette échelle, une unité graphique supplémentaire traduit un doublement net de l’expression génique, tandis qu’une baisse d’une unité signale une réduction de moitié, rendant l’interprétation biologique immédiate et intuitive. Enfin, le logarithme naturel (ou népérien, adoptant la constante d’Euler e comme base) demeure l’étalon des modèles mathématiques continus, des dérivations différentielles et de l’économétrie formelle. Bien que son interprétation directe des graduations d’axe soit moins intuitive pour le grand public en raison du caractère irrationnel de la constante fondamentale e, il demeure incontournable pour l’estimation de paramètres d’élasticité ou de taux instantanés de croissance au sein de modèles de régression log-linéaires.
2.3 2.3 Impact sur la géométrie des tracés et la densité des points
L’altération de la métrique spatiale via une projection logarithmique modifie substantiellement la densité apparente des éléments géométriques représentés. Dans une représentation arithmétique standard affectée par une forte asymétrie, les nuages de points souffrent généralement du phénomène de sur-traçage (« overplotting ») aigu au voisinage de l’origine : des milliers d’observations s’agglomèrent en une masse opaque et uniforme, interdisant toute distinction des structures locales de variance ou des regroupements sous-jacents, tandis que les régions éloignées de l’axe paraissent désespérément vides. La compression logarithmique étire l’espace physique alloué aux valeurs réduites et compresse celui dévolu aux valeurs considérables, ce qui a pour effet de décongestionner spectaculairement les zones denses de faible intensité et de révéler l’hétérogénéité structurelle interne de l’échantillon.
Cette transformation modifie également la perception visuelle de la corrélation et des relations fonctionnelles entre variables explicatives et dépendantes. Des trajectoires de données apparaissant sous la forme de courbes asymptotiques abruptes ou de paraboles fuyantes sur un plan linéaire se métamorphosent en structures géométriques rectilignes ou symétriques sur un plan logarithmique approprié. Ce changement morphologique simplifie l’évaluation visuelle de la qualité d’ajustement d’un modèle théorique, l’œil humain étant particulièrement réceptif à l’alignement colinéaire d’éléments graphiques.
De surcroît, la transformation logarithmique bi-axiale (tracé dit « log-log ») permet de discriminer visuellement des lois de puissance concurrentes. Si une relation empirique obéit à une loi de puissance où la variable dépendante est proportionnelle à la variable explicative élevée à une puissance donnée, la pente de la droite observée sur un graphique log-log correspond directement à l’exposant de cette puissance. Une pente unitaire indiquera une stricte proportionnalité géométrique, tandis qu’une pente supérieure à l’unité signalera des rendements croissants ou un phénomène d’allométrie positive, et une pente inférieure dénotera une sous-linéarité ou des économies d’échelle structurelles au sein du système modélisé.
3. 3. Première méthode : L’utilisation de scale_continuous avec trans=’log10′
3.1 3.1 Syntaxe fondamentale de scale_y_continuous(trans=’log10′)
L’approche canonique la plus robuste et la plus recommandée au sein de l’écosystème de ggplot2 pour projeter l’axe des ordonnées sur une trajectoire logarithmique repose sur l’appel explicite de la fonction d’échelle de position scale_y_continuous(), en lui assignant l’argument structurel trans = ‘log10’ (ou dans la nomenclature syntaxique actualisée, transform = ‘log10’). Cette syntaxe signale de manière formelle au moteur d’évaluation de ggplot2 que les coordonnées spatiales assignées à la dimension verticale doivent subir une bijection logarithmique décimale avant toute inscription géométrique sur le canevas.
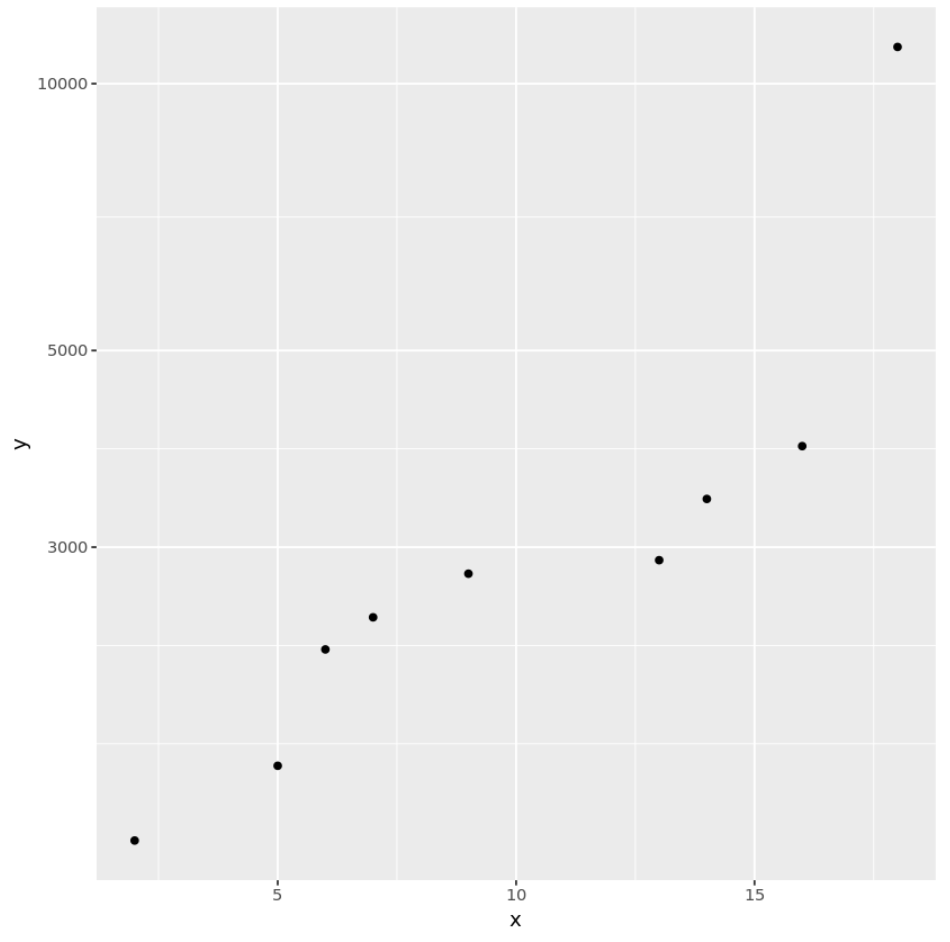
Sur le plan de l’architecture logicielle, lorsque ggplot2 interprète cette instruction, il interroge le gestionnaire de transformations intégré (développé au sein de la bibliothèque associée scales) pour récupérer l’objet de transformation correspondant à l’identifiant textuel fourni. Cet objet contient non seulement la fonction mathématique directe (le logarithme en base dix), mais également sa fonction réciproque (l’élévation de dix à la puissance y), la dérivée locale permettant le positionnement des graduations, ainsi que les algorithmes de calcul par défaut régissant l’implantation des coupures majeures et mineures. Le script fonctionnel minimal ci-après met en scène la génération d’un ensemble synthétique de données simulant une croissance bactérienne exponentielle sur plusieurs décades, suivi de son affichage sur une échelle logarithmique continue :
Pour construire ce graphique élémentaire, l’analyste charge les bibliothèques ggplot2 et dplyr, génère un vecteur temporel s’étendant de zéro à vingt-quatre heures, puis calcule une variable de biomasse cellulaire débutant à une unité et doublant toutes les deux heures. Lors de l’assemblage de l’objet graphique, l’appel de base associe le temps à l’axe horizontal et la biomasse à l’axe vertical au sein de ggplot(mapping = aes(x = temps, y = biomasse)). L’adjonction d’une couche géométrique linéaire via geom_line() suivie de la couche ponctuelle geom_point() matérialise l’observation. Enfin, l’instruction scale_y_continuous(trans = ‘log10’) est ajoutée à la chaîne d’instructions à l’aide de l’opérateur d’addition unaire caractéristique de ggplot2. Le tracé résultant redresse la trajectoire exponentielle en une droite parfaite tout en conservant des étiquettes numériques conformes aux unités réelles de biomasse sur l’axe vertical.
3.2 3.2 Application symétrique à l’axe des abscisses avec scale_x_continuous
Dans un nombre considérable de configurations analytiques, la non-linéarité et l’étirement des ordres de grandeur n’affectent pas uniquement la variable résultante mais gouvernent simultanément la variable explicative. C’est typiquement le cas lors de l’étude de phénomènes physiques ou économiques présentant des distributions à longue traîne sur les deux dimensions, comme l’évaluation des liens entre la superficie des territoires et leur densité démographique, ou l’analyse des courbes de dose-réponse en pharmacodynamie où les concentrations administrées progressent selon des progressions géométriques sur plusieurs puissances de dix. Dans ces contextes, l’instauration d’un graphique à double échelle logarithmique (« log-log plot ») devient une exigence technique incontournable.
L’implémentation de cette double échelle sous ggplot2 s’accomplit par l’adjonction symétrique de la fonction scale_x_continuous(trans = ‘log10’) en conjonction avec son homologue dédiée à l’axe vertical. Le système applique alors de façon totalement indépendante la transformation aux deux axes orthogonaux du plan cartésien. Cette symétrie d’application garantit une totale cohérence dimensionnelle lors de la restitution de lois d’échelle. Pour illustrer cette procédure, considérons un jeu de données simulant la célèbre relation masse-métabolisme de Kleiber en biologie comparée, reliant la masse corporelle d’organismes vivants (variant de quelques grammes chez les petits rongeurs à plusieurs dizaines de tonnes chez les cétacés) à leur consommation d’énergie métabolique basale.
Le tracé d’un tel nuage de points s’articule en déclarant les variables brutes de masse et de métabolisme dans la fonction aes(), en matérialisant les données à l’aide de geom_point(alpha = 0.6) pour mitiger les effets de recoupement, puis en enchaînant consécutivement scale_x_continuous(trans = ‘log10’) et scale_y_continuous(trans = ‘log10’). L’opération a pour effet de transformer un nuage curviligne difficilement exploitable en un ensemble colinéaire homogène. Les axes conservent une lisibilité absolue puisque les graduations horizontales indiquent les masses en grammes ou kilogrammes réels, tandis que les ordonnées indiquent les watts consommés réels, permettant une évaluation visuelle instantanée des rapports d’allométrie sur l’ensemble du règne animal représenté.
3.3 3.3 Interaction avec le moteur de calcul statistique sous-jacent
L’un des avantages structurels majeurs de la méthode scale_continuous(trans = ‘log10’) réside dans le calendrier précis de son exécution technique au sein du pipeline graphique de ggplot2. Dans la grammaire formelle, la transformation d’échelle de position intervient systématiquement avant que les modules de calcul statistique (les fonctions statistiques de type stat_* ou les calculs internes associés aux geom_*) ne procèdent à leurs opérations d’agrégation ou de modélisation mathématique. Cela signifie que lorsque vous demandez à ggplot2 d’ajuster une boîte à moustaches via geom_boxplot(), un estimateur de densité par noyau via geom_density(), ou un lissage statistique via geom_smooth(), ces algorithmes reçoivent des données préalablement projetées dans l’espace logarithmique.
Ce séquençage algorithmique garantit une stabilité numérique optimale et une cohérence théorique rigoureuse pour l’ensemble des représentations inférentielles. Prenons l’exemple critique des calculs d’intervalles de confiance ou de résumés statistiques non paramétriques. Si une boîte à moustaches est dessinée sur un axe soumis à scale_y_continuous(trans = ‘log10’), les quartiles (vingt-cinquième, cinquantième et soixante-quinzième centiles) sont calculés directement sur les valeurs logarithmiques ou sur les données d’origine de manière strictement ordinale, ce qui est mathématiquement invariant, mais les moustaches (déterminées par une fois et demie l’intervalle interquartile) sont projetées de manière parfaitement symétrique dans l’espace logarithmique, évitant ainsi le risque fréquent sur échelle linéaire de voir une moustache inférieure plonger dans des valeurs négatives impossibles pour des données strictement positives.
De manière analogue, la stabilité numérique des géométries vectorielles élémentaires (points, lignes continues, segments) est scrupuleusement préservée. Le moteur de rendu calcule les positions physiques exactes des coordonnées aux nœuds géométriques dans l’espace transformé, garantissant que les lignes reliant des points ne subissent aucun écrasement computationnel ni d’artefact de discrétisation grossière. Cette rigueur dans l’ordre d’évaluation fait de scale_continuous(trans = ‘log10’) l’outil de référence absolue pour toute démarche de modélisation visuelle adossée à une exigence d’exactitude statistique.
4. 4. Deuxième méthode : L’usage du système de coordonnées coord_trans()
4.1 4.1 Principe opérationnel de coord_trans(x=’log10′, y=’log10′)
La deuxième méthodologie offerte par ggplot2 pour instaurer une métrique logarithmique emprunte une logique conceptuelle fondamentalement différente : elle consiste à déléguer cette distorsion spatiale non pas aux échelles de variables, mais au système de coordonnées géométriques lui-même, au moyen de la fonction coord_trans(). Alors qu’un système de coordonnées standard tel que coord_cartesian() opère une projection euclidienne affine pure (où les distances métriques sur le canevas dépendent linéairement des valeurs numériques des données), coord_trans() applique une transformation mathématique non linéaire sur le canevas cartésien au terme de la construction du graphique.
Pour mettre en œuvre cette approche, la syntaxe requiert de spécifier les axes à déformer en fournissant le nom de la transformation souhaitée aux arguments correspondants, sous la forme coord_trans(y = ‘log10’) ou pour une transformation bi-axiale complète, coord_trans(x = ‘log10’, y = ‘log10’). Dans cette configuration, les couches d’échelles de position (scale_x_continuous() et scale_y_continuous()) demeurent techniquement des échelles linéaires par défaut. Les données sont initialement mappées selon une métrique linéaire standard, puis, au moment précis où le système graphique assemble les polygones, les lignes et les points pour les adresser au moteur de tracé sous-jacent (le système de rendu basé sur grid), les coordonnées spatiales bidimensionnelles de chaque vertex subissent l’opération mathématique logarithmique.
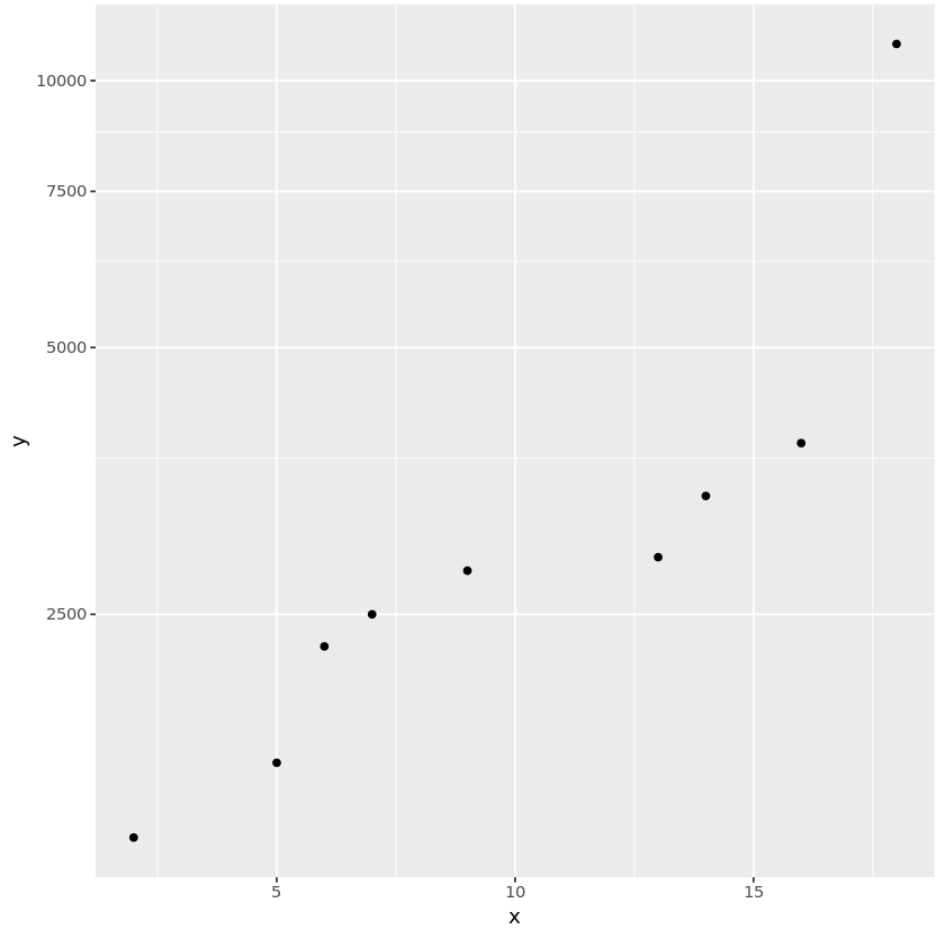
Sur un diagramme de dispersion canonique n’impliquant que de simples points isolés (geom_point()), le rendu visuel final obtenu via coord_trans(y = ‘log10’) apparaît quasiment identique à celui produit par scale_y_continuous(trans = ‘log10’). Les positions spatiales relatives des points individuels coïncident au pixel près. Cependant, dès lors que la visualisation intègre des primitives graphiques plus complexes reliant plusieurs points de données ou des surfaces fermées, des divergences structurelles majeures et parfois déconcertantes se manifestent, révélant la nature géométrique profonde de ce mode de rendu.
4.2 4.2 Comportement des représentations géométriques linéaires et polygonales
La distinction opératoire entre une échelle transformée et un système de coordonnées déformé devient flagrante lorsque l’on analyse le comportement des représentations géométriques linéaires et polygonales, telles que celles produites par geom_line(), geom_ribbon() ou geom_polygon(). Dans le cadre de l’utilisation conventionnelle de scale_y_continuous(trans = ‘log10’), toute ligne droite définie entre deux observations distinctes est interprétée comme un segment euclidien reliant deux coordonnées déjà transformées mathématiquement ; la ligne résultante tracée à l’écran demeure donc rigoureusement rectiligne d’un bout à l’autre de son parcours.
À l’inverse, au sein du système coord_trans(), le segment de droite est d’abord défini dans l’espace euclidien d’origine avant que le système de coordonnées ne vienne courber le plan dans son intégralité. Si une droite mathématique linéaire de type affine est tracée sur un tel repère, coord_trans() va déformer la trajectoire du trait pour refléter la courbure intrinsèque de la transformation appliquée au plan cartésien. Cela a pour conséquence visuelle remarquable de transformer des segments de droite en trajectoires courbes prononcées, ce qui est géométriquement exact du point de vue d’une variété déformée, mais peut dérouter l’observateur habitué aux tracés linéaires standards.
Ce phénomène affecte de manière spectaculaire les zones d’ombrage et les polygones de confiance. Si vous utilisez geom_ribbon() pour figurer un intervalle de prédiction ou une marge d’incertitude autour d’une série temporelle, coord_trans() déforme continûment les limites supérieures et inférieures de la bande le long du gradient d’ordonnée. Les surfaces ne sont plus simplement délimitées par des segments sécants brisés, mais par des arcs continus épousant fidèlement la déformation logarithmique globale du repère. Si cette propriété offre un intérêt indéniable pour visualiser fidèlement la déformation non linéaire d’un espace topologique continu, elle introduit des complexités calculatoires substantielles et peut altérer significativement la lisibilité de graphiques destinés à un public non averti.
4.3 4.3 Limitations techniques propres à coord_trans
En dépit de son élégance théorique sur le plan de la géométrie différentielle des tracés, coord_trans() souffre d’un certain nombre de limitations techniques sévères qui expliquent pourquoi la communauté des analystes de données sous R lui préfère généralement les transformations appliquées au niveau des échelles. La première limitation réside dans son incompatibilité chronique avec plusieurs extensions majeures de l’écosystème ggplot2. De nombreuses bibliothèques tierces conçues pour enrichir ggplot2 de fonctionnalités avancées (telles que ggrepel pour l’évitement des étiquettes textuelles, ggridges pour les distributions en crête, ou certains modules d’annotations spatiales de sf) calculent leurs algorithmes de positionnement spatial en supposant implicitement un repère cartésien standard rigide ; la présence de coord_trans() engendre fréquemment des comportements erratiques, des décalages d’ancrage visuel, voire des interruptions d’exécution fatales.
La deuxième restriction concerne le paramétrage fin des graduations et des libellés d’axes. Dans la mesure où les échelles sous-jacentes demeurent linéaires, la configuration manuelle des coupures majeures et mineures requiert une manipulation contre-intuitive. L’attribution automatique d’intervalles logarithmiques harmonieux (affichant des puissances régulières de dix ou des subdivisions mineures homogènes) est beaucoup plus laborieuse à paramétrer sous coord_trans() qu’avec scale_y_continuous(), car le module d’échelle ignore qu’il sera ultérieurement soumis à une distorsion par les coordonnées.
Enfin, coord_trans() engendre des anomalies notables sur l’épaisseur et le rendu stylistique des contours géométriques. Lors de la projection de formes vectorielles épaisses ou de symboles graphiques complexes, la déformation non linéaire du système de coordonnées peut provoquer des asymétries indésirables dans l’épaisseur des traits ou dans le rapport d’aspect de symboles censés demeurer isotropes, à moins que des précautions mathématiques complexes ne soient manuellement injectées par l’utilisateur lors de la configuration du canevas graphique.
5. 5. Analyse comparative approfondie : scale_continuous vs coord_trans
5.1 5.1 Différences fondamentales dans l’ordre d’évaluation des transformations
L’arbitrage technique entre l’emploi de scale_continuous(trans = ‘log10’) et celui de coord_trans(y = ‘log10’) exige une compréhension claire de l’ordre d’évaluation séquentiel au cœur du pipeline de ggplot2. Ce flux de traitement, strictement séquentiel, détermine à quel instant précis les données numériques brutes sont altérées par rapport aux calculs de modélisation statistique et à la matérialisation géométrique sur le périphérique de sortie. Le tableau ci-dessous explicite la bifurcation temporelle majeure séparant ces deux paradigmes méthodologiques :
Dans la modalité scale_continuous(), la transformation logarithmique se produit à l’Étape 2 du pipeline, immédiatement après la validation des esthétiques initiales. En conséquence immédiate, l’ensemble des transformations statistiques (Étape 3) reçoit les valeurs déjà logarithmiques. Lorsque ggplot2 procède au calcul d’un histogramme avec geom_histogram(), le partitionnement en classes (ou « binning ») opère sur les valeurs transformées : les intervalles de classe présentent ainsi des largeurs arithmétiques identiques dans l’espace logarithmique, ce qui correspond à des intervalles géométriques multiplicatifs dans l’espace des données brutes (par exemple de 1 à 10, de 10 à 100, de 100 à 1000). Il en résulte une distribution équilibrée et lisible, parfaitement conforme aux canons de l’analyse exploratoire pour variables asymétriques.
À l’opposé, lorsque l’on recourt à coord_trans(), la transformation est différée jusqu’à l’Étape 5 du pipeline graphique. Les calculs statistiques de l’Étape 3 s’effectuent donc dans l’espace linéaire des données d’origine. Si vous appliquez un histogramme dans cette configuration, le moteur va segmenter les classes selon des largeurs absolues constantes (par exemple des tranches régulières de 10 unités de 0 à 1000). Ce n’est qu’au moment ultime du tracé que ces rectangles de largeur uniforme vont être déformés de manière hétérogène par le système de coordonnées : les barres situées près de l’origine se verront démesurément étirées en largeur, tandis que les barres associées aux valeurs élevées seront compressées jusqu’à ne plus former que des traits filiformes d’épaisseur presque nulle. Cette distorsion visuelle aberrante illustre magistralement pourquoi l’ordre d’évaluation gouverne l’adéquation statistique d’une figure.
5.2 5.2 Influence directe sur les ajustements statistiques et géométries de lissage
L’impact de cet ordonnancement computationnel atteint son paroxysme lors de l’application de couches d’ajustement statistique prédictif ou de lissage non paramétrique, spécifiquement au travers de la fonction geom_smooth(). La confrontation empirique du comportement de geom_smooth(method = ‘lm’) (ajustement d’un modèle linéaire classique par la méthode des moindres carrés ordinaires) selon que l’on utilise une échelle transformée ou une coordonnée déformée met en lumière des divergences statistiques radicales qu’aucun chercheur ne peut ignorer.
Lorsque la régression linéaire geom_smooth(method = ‘lm’) est combinée avec scale_y_continuous(trans = ‘log10’), le moteur statistique ajuste le modèle linéaire sur la variable dépendante préalablement transformée, c’est-à-dire en modélisant log10(y) en fonction de x. Sur le plan économétrique et statistique, cela correspond à l’estimation d’un modèle semi-logarithmique standard. La droite d’ajustement résultante s’affiche sous la forme d’une ligne rigoureusement droite sur le graphique, et l’enveloppe de dispersion représentant l’intervalle de confiance à 95 % est calculée directement dans l’espace logarithmique, traduisant une variabilité relative proportionnelle constante.
Inversement, si l’on applique le modèle linéaire sous l’égide de coord_trans(y = ‘log10’), la régression est d’abord ajustée sur les données brutes non transformées (y en fonction de x), estimant ainsi une relation strictement arithmétique d’ordonnée à l’origine et de pente constante dans l’espace euclidien originel. Ce n’est qu’après ce calcul statistique que le segment de régression linéaire ainsi obtenu — de même que les bandes d’intervalles de confiance associées — est projeté dans le système de coordonnées déformé. La droite de régression linéaire classique apparaît alors sous la forme d’une courbe logarithmique infléchie vers le bas sur le graphique. Cette distinction est cruciale : dans le premier cas, on modélise et visualise une dynamique intrinsèquement exponentielle ; dans le second cas, on visualise la déformation visuelle d’un processus fondamentalement arithmétique au sein d’un espace non euclidien.
5.3 5.3 Critères de décision pour sélectionner l’approche optimale
Le choix raisonné entre l’échelle continue et le système de coordonnées déformées doit impérativement reposer sur des critères épistémologiques et sémiologiques explicites, guidés par la finalité démonstrative de la figure envisagée. Afin de guider le praticien dans cette décision structurante, les caractéristiques différentielles majeures sont synthétisées ci-dessous :
- scale_continuous(trans = ‘log10’) : Approche préconisée pour la quasi-totalité des applications scientifiques et analytiques. À retenir dès lors que la modélisation statistique (régressions, densités, boîtes à moustaches, violons) doit porter sur les grandeurs relatives ou multiplicatives. Indispensable pour la manipulation d’histogrammes et pour assurer une compatibilité totale avec l’écosystème d’extensions ggplot2 et la gestion des étiquettes académiques par le package scales.
- coord_trans(y = ‘log10’) : Approche réservée à des problématiques hautement spécialisées de visualisation cartésienne ou physique. À retenir exclusivement lorsque l’analyste désire préserver l’ajustement statistique d’un modèle défini dans l’espace métrique original (par exemple une cinétique linéaire stricte) tout en comprimant les dimensions géométriques du plan d’affichage pour révéler la déformation spatiale induite par un changement de repère topologique.
- Critère de robustesse géométrique : Les barres d’erreur expérimentales (geom_errorbar()) calculées en amont sous forme de moyennes et d’écarts-types bruts risquent de traverser le zéro dans coord_trans() et de provoquer des défaillances graphiques d’évaluation mathématique, alors qu’elles sont gérées avec une intégrité prévisible via les échelles de position continues associées à des fonctions statistiques dédiées.
6. 6. Fonctions raccourcies : scale_x_log10() et scale_y_log10()
6.1 6.1 Implémentation simplifiée et lisibilité du code R
Dans la perspective d’optimiser l’ergonomie de programmation et de faciliter les démarches itératives d’analyse exploratoire des données, les concepteurs de ggplot2 ont introduit des fonctions spécialisées à syntaxe condensée. Les commandes scale_x_log10() et scale_y_log10() représentent les incarnations les plus couramment exploitées de ces raccourcis logiciels. D’un point de vue programmatique, ces fonctions ne constituent pas des modules algorithmiques distincts ; elles opèrent comme de purs emballages fonctionnels (« wrappers ») qui appellent de manière totalement transparente les fonctions fondamentales scale_x_continuous(trans = ‘log10’) et scale_y_continuous(trans = ‘log10’).
L’attrait primordial de ces raccourcis syntaxiques réside dans le gain d’économie cognitive et de lisibilité qu’ils confèrent aux scripts R, tout particulièrement lors des phases préliminaires de découverte des données où la vitesse de codage prime sur le raffinement esthétique final. L’écriture d’une ligne telle que ggplot(gapminder, aes(gdpPercap, lifeExp)) + geom_point() + scale_x_log10() permet de transformer instantanément l’axe de la richesse par habitant sans avoir à charger explicitement de dépendances additionnelles ou à paramétrer des syntaxes imbriquées complexes. Pour tout analyste relisant le pipeline d’analyse, l’intention méthodologique est immédiate, limpide et sans équivoque.
Néanmoins, cette simplicité formelle ne doit pas occulter l’équivalence opérationnelle absolue qui lie ces raccourcis aux fonctions mères. Toutes les propriétés computationnelles détaillées précédemment — en particulier la transformation préalable des données avant le calcul des géométries statistiques, l’adaptation automatique des classes d’histogrammes et la préservation de la linéarité des segments reliant des observations contiguës — s’appliquent avec une rigueur identique lors de l’utilisation de scale_y_log10().
6.2 6.2 Variantes pour d’autres bases logarithmiques
Si la base décimale bénéficie d’un raccourci dédié sous la forme de scale_x_log10(), les analystes manipulant des dynamiques biologiques ou computationnelles requièrent fréquemment l’usage d’autres opérateurs mathématiques de compression, au premier rang desquels figurent le logarithme binaire (base deux) et la racine carrée. Pour cette dernière, ggplot2 intègre directement les raccourcis natifs scale_x_sqrt() et scale_y_sqrt(), fréquemment mobilisés pour stabiliser la variance de variables distribuées selon des processus de comptage de Poisson.
En revanche, il n’existe pas de fonction native directement nommée scale_x_log2() au sein du noyau standard de ggplot2 historique. Pour appliquer une échelle logarithmique en base deux, le praticien dispose de deux voies d’accès élégantes. La première méthode repose sur l’exploitation des fonctionnalités de transformation de base de la bibliothèque scales, en injectant l’objet formel via la syntaxe scale_x_continuous(trans = scales::log2_trans()) (ou simplement trans = ‘log2’, la chaîne de caractères étant reconnue en interne par les tables de résolution de noms de ggplot2). Cette approche applique rigoureusement les mêmes règles géométriques que pour la base dix, tout en configurant les espacements pour des progressions géométriques fondées sur les puissances de deux (1, 2, 4, 8, 16, 32…).
La seconde modalité, particulièrement précieuse dans le cadre de protocoles de modélisation mathématique hautement spécialisés, consiste à définir soi-même un objet de transformation personnalisé. Grâce à la fonction constructrice scales::trans_new(), un chercheur peut formaliser une échelle logarithmique adoptant une base arbitraire adaptée à son modèle expérimental (par exemple une base trois pour des études de ramification ternaire ou la constante e pour un logarithme naturel pur via trans = ‘log’), en stipulant explicitement la fonction directe, la fonction inverse et le générateur d’étiquettes associé.
6.3 6.3 Paramètres d’ajustement hérités de scale_continuous
Puisque scale_x_log10() et scale_y_log10() sont des extensions directes de la classe générale des échelles continues de position, elles héritent intégralement de la riche panoplie de paramètres de contrôle qui caractérisent scale_continuous(). L’un des plus déterminants est le paramètre limits, qui fixe les frontières inférieure et supérieure du domaine visible sur le graphique. Il importe de souligner avec force que lors de l’utilisation de ces raccourcis, les bornes spécifiées au sein du vecteur de limites doivent obligatoirement être fournies dans l’unité de mesure originale brute de la variable et non sous forme de logarithmes préalablement calculés. Ainsi, pour circonscrire l’axe des ordonnées entre dix et cent mille, on déclarera formellement limits = c(10, 100000).
Un autre argument hérité capital pour le contrôle du rendu esthétique final est le paramètre expand, qui pilote l’expansion automatique des marges spatiales entourant les données extrêmes. Par défaut, ggplot2 applique une marge de sécurité de 5 % de part et d’autre des valeurs limites pour éviter que les points périphériques ne soient tronqués par le cadre du panneau graphique (l’équivalent de expansion(mult = c(0.05, 0.05))). Sur une échelle logarithmique, cette expansion multiplicative est appliquée de manière géométrique dans l’espace transformé, garantissant que l’espacement visuel séparant la donnée maximale du bord supérieur du graphique est rigoureusement proportionné à la dynamique générale de l’axe.
Enfin, le paramètre position autorise la relocalisation physique de l’axe au sein de la composition graphique. Il permet de déporter l’axe horizontal vers le sommet du tracé via position = ‘top’, ou de basculer l’axe vertical vers le flanc droit de la figure à l’aide de l’option position = ‘right’. Cette flexibilité héritée garantit que l’usage de raccourcis syntaxiques ne se fait jamais au détriment de la précision de mise en page exigée par les standards typographiques des publications scientifiques de premier rang.
7. 7. Personnalisation avancée des graduations avec le package scales
7.1 7.1 Rôle de l’écosystème scales dans l’esthétique de ggplot2
L’excellence typographique et la lisibilité d’une figure sous ggplot2 sont intrinsèquement tributaires de l’infrastructure sous-jacente fournie par le package compagnon scales. Conçu au sein de la même mouvance méthodologique par le Tidyverse, ce package a été spécifiquement architecturé pour formaliser la machinerie arithmétique et algorithmique régissant la transformation des variables, le positionnement des coupures (breaks) et la transcription textuelle des libellés (labels). Le découplage délibéré entre le moteur de tracé géométrique de ggplot2 et la logique de calibration de scales confère à l’écosystème une modularité analytique exceptionnelle.
Dans la configuration par défaut de ggplot2, lorsqu’une échelle logarithmique élémentaire est déclarée, les algorithmes internes s’efforcent de sélectionner automatiquement un nombre restreint de points de rupture majeurs afin d’éviter la saturation de l’axe. Cependant, cette sélection automatisée produit fréquemment des résultats visuellement pauvres ou sous-optimaux, se limitant par exemple à afficher uniquement des décades très distantes (comme 1, 100, 10000) ou, à l’inverse, en implantant des graduations à intervalles arithmétiques incongrus qui perturbent l’appréciation intuitive de l’échelle logarithmique. L’installation et l’importation explicite de la bibliothèque scales au sommet des scripts de traitement statistique deviennent ainsi le prérequis incontournable de tout travail de mise en forme graphique abouti.
En mobilisant les fonctions spécialisées de scales au sein des arguments breaks, minor_breaks et labels de votre appel d’échelle sous ggplot2, vous reprenez le contrôle intégral sur le mécanisme d’échantillonnage de l’espace visuel. Ce niveau d’intervention permet d’harmoniser rigoureusement la chaîne de rendu graphique avec les directives de publication académique les plus contraignantes, en assurant que chaque division spatiale sur le papier correspond exactement à un seuil informatif pertinent pour l’observateur.
7.2 7.2 Définition précise des points de rupture avec breaks_log()
La fixation des points de rupture majeurs (les « breaks ») sur un axe logarithmique constitue le levier fondamental pour structurer la grille de lecture de la figure. La méthode la plus élégante et dynamique offerte par les versions récentes de scales réside dans la fonction breaks_log(). Contrairement à une séquence manuelle rigide codée en dur sous la forme d’un vecteur statique généré par une boucle ou une suite arithmétique, breaks_log() agit comme une fonction génératrice intelligente qui adapte dynamiquement la répartition des coupures en fonction de l’amplitude réelle des données observées et de la taille effective allouée à l’axe graphique.
La syntaxe fondamentale s’intègre au sein de l’échelle sous la forme scale_y_continuous(trans = ‘log10’, breaks = scales::breaks_log(n = 6)), où le paramètre n spécifie le nombre approximatif de divisions majeures désirées. L’algorithme interne de breaks_log() analyse l’empan des ordres de grandeur de la variable : si le jeu de données couvre de nombreuses décades (par exemple six ordres de grandeur), il sélectionnera rigoureusement chaque puissance de dix (1, 10, 100, 1000, 10000, 100000). Si la dynamique observée s’avère plus restreinte, ne couvrant qu’un ou deux ordres de grandeur, l’algorithme générera automatiquement des coupures majeures intermédiaires harmonieuses, positionnées généralement sur des facteurs multiplicatifs standards tels que 2, 5 et 10 (par exemple 1, 2, 5, 10, 20, 50, 100).
Pour les configurations d’affichage exigeant une stricte régularité décimale indépendamment du volume des données, les analystes s’appuient fréquemment sur la fonction historique trans_breaks(). En associant celle-ci à la fonction réciproque de la base retenue via l’instruction breaks = scales::trans_breaks(‘log10’, function(x) 10^x), le système garantit que seules les puissances pures de dix recevront une graduation majeure et une étiquette textuelle associée, écartant tout risque d’apparition inopinée de repères bâtards sur les axes de publication.
7.3 7.3 Intégration de graduations mineures informatives
L’un des marqueurs sémiologiques les plus distinctifs et les plus rigoureux du tracé logarithmique réside dans l’intégration explicite de graduations mineures informatives (« minor breaks »). Dans le papier millimétré semi-logarithmique traditionnel, chaque décade est subdivisée par neuf repères secondaires représentant les multiples entiers de la puissance de base (soit 2, 3, 4, 5, 6, 7, 8 et 9 pour la première décade ; 20, 30, 40… pour la seconde). L’espacement physique de ces graduations se resserre de manière continue à mesure que l’on s’approche de la borne supérieure de la décade, fournissant un indice visuel immédiat et non ambigu sur la nature logarithmique de l’axe.
Sous ggplot2, cette trame graphique essentielle est souvent absente par défaut ou configurée de manière simpliste avec une seule sous-division centrale équidistante. Pour restaurer la trame canonique du papier semi-logarithmique, il convient de programmer explicitement la génération des graduations mineures en combinant la fonction minor_breaks avec un générateur de séquences arithmétiques adapté. Une solution particulièrement robuste consiste à mobiliser une fonction anonyme exploitant la fonction de calcul des coupures logarithmiques, ou à définir explicitement le vecteur des multiples souhaités :
En configurant l’argument sous la forme minor_breaks = function(x) rep(1:9, times = length(x)) * rep(10^(seq(floor(log10(min(x))), ceiling(log10(max(x))), by = 1)), each = 9), le canevas de ggplot2 se structure avec l’ensemble des neuf sous-intervalles géométriques au sein de chaque cycle décimal. Cette densification visuelle renforce considérablement la précision d’estimation visuelle des points isolés par le lecteur. Il appartient toutefois à l’auteur de calibrer avec discernment ce niveau de granularité : sur des figures de petite dimension insérées dans des mises en page denses (articles en colonnes multiples, présentations diapositives), un réseau de graduations mineures trop serré peut saturer l’espace et nuire à la clarté d’ensemble, nécessitant d’alléger la grille via le paramétrage du thème graphique.
8. 8. Formatage typographique et notation exponentielle des étiquettes d’axe
8.1 8.1 Écriture scientifique versus notation en exposant mathématique
La transcription typographique des nombres le long des axes logarithmiques exerce une influence prépondérante sur la perception de la qualité scientifique d’un manuscrit de recherche. Par défaut, le moteur textuel de R bascule automatiquement vers la notation scientifique abrégée dès lors que les valeurs excèdent un certain seuil d’ordres de grandeur, générant des chaînes de caractères de type « 1e+03 », « 1e+04 » ou « 1e+05 ». Si cette nomenclature s’avère parfaitement fonctionnelle au sein d’une console de calcul de terminal informatique, son maintien au sein d’une figure destinée à une revue académique à comité de lecture est largement proscrit par les normes éditoriales internationales.
La notation exponentielle conventionnelle, formalisée sous la forme élégante 10³ ou 10⁵, offre une supériorité sémiotique et cognitive incontestable. D’une part, elle évite la lourdeur visuelle des zéros redondants des notations arithmétiques développées à rallonge (telles que 100000000), qui obligent le lecteur à un comptage fastidieux pour discerner les millions des milliards. D’autre part, elle élimine le caractère austère et mécaniste propre aux langages de bas niveau de la syntaxe informatique, restituant la nomenclature mathématique noble conforme aux standards de l’imprimerie savante et des publications typographiées en LaTeX.
Le respect de ces exigences d’édition requiert de maîtriser les mécanismes de passage de chaînes typographiques enrichies et d’expressions mathématiques au sein de la tuyauterie de rendu de ggplot2. Ce pont technique est rendu possible grâce au support des objets de type plotmath au sein des fonctions d’étiquetage du package scales.
8.2 8.2 Emploi de trans_format() et math_format()
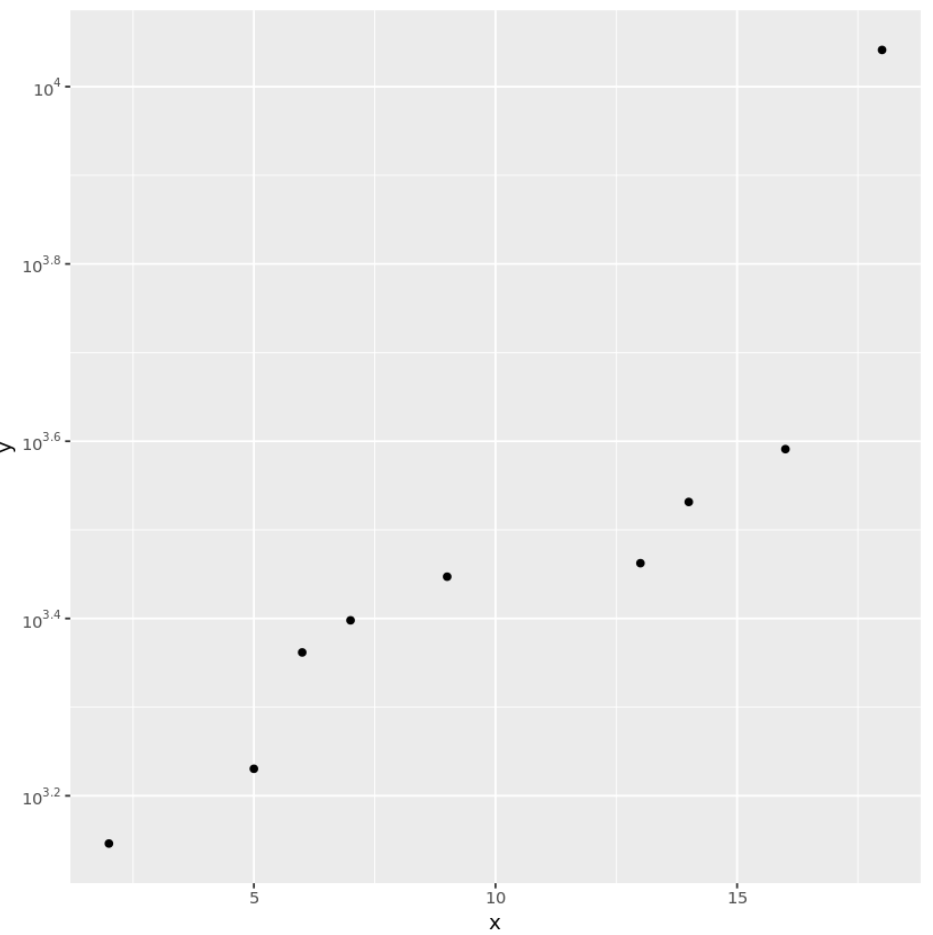
Pour substituer aux chaînes informatiques standard des expressions typographiques arborant de véritables exposants mathématiques, la méthode historique de référence associe les fonctions trans_format() et math_format() issues du package scales. Cette architecture procède à une encapsulation élégante : trans_format() intercepte les coordonnées numériques dans l’espace de la transformation logarithmique choisie, puis math_format() traduit ces valeurs en expressions vectorielles interprétables par le moteur plotmath natif de R.
La syntaxe opérationnelle s’implémente au sein de l’argument labels de la fonction d’échelle sous la configuration précise suivante : scale_y_continuous(trans = ‘log10’, breaks = scales::trans_breaks(‘log10’, function(x) 10^x), labels = scales::trans_format(‘log10’, scales::math_format(10^.x))). Dans cette écriture, le symbole .x représente le marqueur dynamique qui capture la puissance entière calculée par le générateur de rupture (par exemple 1, 2, 3, 4). Le module math_format formate alors chaque entrée sous la forme d’un objet de type expression mathématique de R équivalent à l’écriture 10^1, 10^2, 10^3, que le moteur de rendu graphique convertit sur le canevas en un chiffre 10 surmonté d’un exposant correctement aligné.
Lors de l’implémentation de cette séquence, les erreurs de syntaxe courantes proviennent généralement d’une mauvaise concordance entre l’opérateur de base et l’argument d’élévation. Si l’on applique une échelle logarithmique binaire, il conviendra d’adapter symétriquement l’expression en configurant trans_format(‘log2’, scales::math_format(2^.x)). Une attention méticuleuse portée à ces détails de codage prévient les erreurs de substitution d’arguments et garantit une restitution graphique d’une netteté irréprochable sur l’ensemble des sorties vectorielles en formats PDF ou SVG.
8.3 8.3 Combinaison avec label_scientific() et label_number()
Bien que la notation en exposant de puissances entières convienne idéalement aux données s’étendant sur de vastes horizons multi-décadaires, d’autres contextes empiriques exigent l’affichage d’unités de mesure réelles contextualisées (valeurs monétaires, masses biologiques précises, pourcentages d’évolution ou intervalles chronologiques). Pour répondre à ces exigences sans sacrifier la rigueur de l’échelle logarithmique, scales fournit des formateurs d’étiquettes de haute précision, parmi lesquels label_number() et label_scientific().
La fonction label_number() permet une flexibilité totale dans l’agencement des libellés numériques. Elle autorise notamment l’adjonction de préfixes et de suffixes sémantiques indispensables à la clarté de lecture, ainsi que le contrôle rigoureux du nombre de décimales affichées et des séparateurs de milliers. Dans les publications francophones, la règle typographique prescrit l’usage de la virgule comme séparateur décimal et de l’espace fine insécable pour les groupements de milliers. On configurera ainsi les étiquettes via : labels = scales::label_number(accuracy = 0.1, decimal.mark = ‘,’, big.mark = ‘ ‘). Ce paramétrage assure une parfaite conformité avec les règles de l’Imprimerie nationale et les réquisitions des périodiques scientifiques francophones.
Dans les configurations industrielles ou de métrologie physique où la notation scientifique demeure exigée mais où l’on désire un contrôle strict du nombre de chiffres significatifs, la fonction label_scientific() offre une alternative précieuse. Elle permet de standardiser le formatage selon des gabarits stricts (par exemple label_scientific(digits = 2) pour contraindre l’affichage à deux décimales significatives systématiques). En couplant ces utilitaires d’étiquetage avec les fonctions de positionnement de coupures vues précédemment, l’analyste dispose d’un attirail complet pour concevoir des axes logarithmiques alliant rigueur métrologique, élégance formelle et accessibilité immédiate.
9. 9. Gestion des valeurs nulles, négatives et transformations pseudo-logarithmiques
9.1 9.1 L’indéfinition mathématique du logarithme pour zéro et les réels négatifs
L’obstacle méthodologique le plus sévère rencontré lors de l’application pratique des échelles logarithmiques en science des données découle de la définition fondamentale de la fonction logarithme sur le corps des réels : le logarithme n’est défini de manière continue que sur l’intervalle ouvert des réels strictement positifs, c’est-à-dire l’ensemble des réels supérieurs à zéro. Dès lors qu’une variable contient des zéros stricts ou des grandeurs négatives, le moteur de calcul mathématique se heurte à une impossibilité algébrique : le logarithme de zéro tend vers l’infini négatif, tandis que le logarithme d’un nombre négatif produit une valeur indéterminée non réelle (NaN).
Face à cette contingence, le comportement par défaut de ggplot2 est d’une grande rigueur opérationnelle mais comporte des conséquences statistiques considérables. Lorsque des données nulles ou négatives sont soumises à une échelle logarithmique via scale_y_continuous(trans = ‘log10’), le moteur transforme ces observations en valeurs manquantes non attribuables (NA) ou en infinis négatifs. Ces points sont alors unilatéralement éliminés du rendu géométrique par le système graphique, qui émet un message d’avertissement caractéristique alertant l’utilisateur sur la suppression silencieuse de lignes de données (« Warning: Transformation introduced infinite values in continuous scale »).
D’un point de vue de l’intégrité de la démarche scientifique, cette troncature artificielle des échantillons pose un problème méthodologique majeur. L’élimination mécanique des valeurs nulles équivaut à un filtrage arbitraire susceptible d’introduire un biais de sélection destructeur dans l’analyse inférentielle. Dans les études d’expression génétique, la présence d’une valeur nulle n’indique pas une défaillance de mesure mais témoigne de l’extinction totale de la transcription d’un gène sous une condition expérimentale donnée ; en épidémiologie, un taux d’incidence nul signale l’éradication locale d’un pathogène. Exclure visuellement ces observations sans avertissement ni protocole de compensation déforme gravement la réalité phénoménologique observée.
9.2 9.2 L’artifice du décalage arithmétique : log(x + c)
Pour contourner l’indéfinition mathématique du zéro tout en conservant l’attrait de la compression logarithmique, une pratique heuristique largement répandue au sein de la communauté des praticiens consiste à appliquer un décalage arithmétique constant aux données, procédure conventionnellement désignée sous le vocable de transformation log(x + c) ou adjonction d’un « pseudo-compte ». Dans le cadre de dénombrements de comptages discrets (nombre d’infections, copies de transcrits d’ARN), la valeur de la constante c est traditionnellement fixée à l’unité (c = 1), ce qui présente l’attrait mathématique immédiat d’ancrer le zéro originel sur la coordonnée zéro de l’espace transformé, puisque le logarithme de 0 + 1 est rigoureusement nul.
Cependant, les travaux en statistique computationnelle et en visualisation méthodologique démontrent que cet artifice arbitraire introduit des biais d’interprétation et des distorsions géométriques considérables au voisinage immédiat de l’origine. L’ampleur de la distorsion est directement tributaire de l’amplitude relative de la constante c par rapport à la distribution effective des données observées. Si les données empiriques oscillent naturellement dans des ordres de grandeur inférieurs à l’unité (par exemple entre 0.001 et 0.1), l’ajout d’une constante égale à un va écraser totalement la variance locale de l’échantillon, transformant la projection en un artefact linéaire dépourvu de validité statistique.
De plus, l’adjonction d’une constante altère de façon non négligeable la pente locale et la dérivée des courbes de régression à proximité du seuil zéro. Des modèles théoriques prétendant identifier des lois de puissance ou des élasticités constantes se voient artificiellement incurvés dans les basses valeurs, compromettant les démarches d’inférence. Si l’artifice log(x + 1) peut être toléré dans des contextes exploratoires superficiels sur des données de comptages entiers volumineux, son emploi doit être rigoureusement documenté et justifié dans toute publication scientifique, et systématiquement proscrit lorsque des solutions mathématiques plus rigoureuses et continues sont disponibles.
9.3 9.3 Implémentation de la transformation pseudo-logarithmique (pseudo_log_trans)
Afin de surmonter de manière mathématiquement rigoureuse et élégante le problème des valeurs nulles et négatives, l’écosystème de ggplot2 intègre une solution algorithmique de premier plan : la transformation pseudo-logarithmique, accessible via la fonction pseudo_log_trans() du package scales. Cette approche repose sur une hybridation continue qui assure une transition fluide et dérivable entre une échelle linéaire au voisinage immédiat de zéro et une échelle logarithmique stricte lorsque l’on s’éloigne vers les valeurs positives ou négatives élevées.
Le principe mathématique sous-jacent est étroitement apparenté à la fonction inverse du sinus hyperbolique (asinh), fréquemment mobilisée en cytométrie de flux et en spectrométrie de masse pour linéariser les distributions asymétriques traversant le seuil zéro. La fonction pseudo-logarithmique garantit une continuité totale sans aucune discontinuité spatiale : pour les petites valeurs comprises à l’intérieur d’une zone de tolérance paramétrable, la fonction se comporte comme une transformation linéaire classique, préservant scrupuleusement le signe négatif et l’espacement arithmétique régulier des observations ; au-delà de ce seuil de basculement, elle adopte le comportement de compression asymptotique caractéristique du logarithme.
L’application pratique au sein de ggplot2 s’articule directement au niveau de l’échelle d’axe par l’instruction suivante : scale_y_continuous(trans = scales::pseudo_log_trans(base = 10, sigma = 1)). Le paramètre base permet de fixer la base logarithmique asymptotique désirée (généralement 10 ou 2), tandis que le paramètre sigma définit le rayon de la fenêtre centrale dans laquelle la dynamique demeure linéaire autour de zéro. Grâce à ce mécanisme puissant, l’ensemble des données de l’échantillon — y compris les observations nulles, les réductions d’activité relatives négatives et les valeurs positives géantes — sont projetées de manière cohérente, stable et sans aucune exclusion sur un unique plan visuel continu.
10. 10. Intégration d’éléments statistiques sur échelles logarithmiques
10.1 10.1 Ajustement de régressions linéaires et non linéaires avec geom_smooth()
L’adjonction de modèles de régression et de courbes de lissage via la couche geom_smooth() sur des données projetées selon une métrique logarithmique constitue une opération statistique particulièrement féconde, à condition d’en maîtriser parfaitement les implications analytiques. Dès lors que l’on applique l’approche recommandée scale_y_continuous(trans = ‘log10’) conjointement avec un ajustement linéaire geom_smooth(method = ‘lm’), le moteur algorithmique effectue l’estimation des paramètres de la régression directement sur les coordonnées transformées de la variable d’intérêt.
Sur le plan de l’interprétation économétrique et biométrique, cette modalité transforme la droite ajustée en un modèle exponentiel intrinsèque. L’équation estimée ne traduit plus une variation absolue additive, mais s’exprime sous la forme mathématique canonique du modèle log-linéaire. Le coefficient directeur (la pente) de la droite acquiert une signification directe en termes de taux de variation proportionnelle instantané : pour chaque augmentation d’une unité de la variable explicative x, la variable dépendante y se voit multipliée par dix élevé à la puissance de la pente. Si l’axe des abscisses est lui aussi assujetti à scale_x_continuous(trans = ‘log10’), le modèle résultant correspond à une régression log-log dont le coefficient directeur exprime l’élasticité directe reliant les deux phénomènes : une augmentation de 1 % de x entraîne une variation de k % de y, où k représente la pente de la droite visuelle.
De surcroît, le ruban de dispersion matérialisant l’erreur type et l’intervalle de confiance à 95 % entourant la droite de régression bénéficie d’un traitement mathématique irréprochable. Calculées dans l’espace logarithmique, les bornes de confiance demeurent rigoureusement parallèles et symétriques par rapport à la droite de prédiction sur le graphique affiché, traduisant une variabilité relative constante le long du gradient de prédiction. Si l’on souhaite à l’inverse ajuster des modèles non linéaires plus sophistiqués (tels que des modèles logistiques à quatre paramètres en bio-essais ou des lissages par splines pénalisées via method = ‘gam’), ggplot2 préserve l’intégrité des calculs d’optimisation en opérant directement sur l’échelle de projection définie.
10.2 10.2 Barres d’erreur et intervalles de dispersion asymétriques
L’affichage d’intervalles d’incertitude expérimentale à l’aide de la couche géométrique geom_errorbar() sur une échelle logarithmique confronte l’analyste à un piège méthodologique fréquemment rencontré dans la littérature biomédicale. Dans la pratique de laboratoire conventionnelle, les chercheurs synthétisent souvent leurs séries de mesures sous la forme d’une moyenne arithmétique encadrée d’une barre d’erreur définie par plus ou moins un écart-type ou une erreur type arithmétique. Projeter directement une telle structure arithmétique sur un axe logarithmique engendre une hérésie géométrique et statistique majeure.
D’une part, si l’écart-type est substantiel par rapport à la valeur de la moyenne, la borne inférieure de l’intervalle de confiance arithmétique risque de franchir la valeur zéro pour plonger dans le domaine négatif. Lorsque ggplot2 tente d’appliquer l’opérateur logarithmique à cette borne négative, il se heurte à l’indéfinition mathématique et supprime purement et simplement la borne inférieure, produisant des barres d’erreur tronquées ou décapitées qui décrédibilisent la rigueur du travail expérimental. D’autre part, même lorsque la borne inférieure demeure positive, l’intervalle arithmétique apparaît sur l’écran de manière asymétrique et difforme : la branche supérieure de la barre d’erreur semble artificiellement compressée par rapport à la branche inférieure, contredisant visuellement l’hypothèse de symétrie sous-jacente au modèle arithmétique.
Pour concevoir des barres d’erreur rigoureuses et exemptes d’artefacts sur un axe logarithmique, il est méthodologiquement impératif de calculer les résumés statistiques selon une logique multiplicative. Il convient de calculer la moyenne géométrique des observations (obtenue par l’exponentielle de la moyenne des logarithmes des mesures) ainsi que l’écart-type géométrique associé. Les bornes d’erreur doivent être modélisées sous forme de facteurs multiplicatifs et divisifs de la moyenne géométrique (en bornant par exemple l’intervalle entre la moyenne divisée par l’écart géométrique et la moyenne multipliée par ce même écart). Projetées sur un axe logarithmique continu, ces barres d’erreur retrouvent une symétrie visuelle parfaite d’une branche à l’autre, reflétant fidèlement la dispersion log-normale réelle de l’échantillon analysé.
10.3 10.3 Facettage de graphiques avec échelles logarithmiques libres
L’une des forces majeures de ggplot2 réside dans son architecture de mise en petits multiples via les fonctions de facettage facet_wrap() et facet_grid(), permettant de ventiler une visualisation complexe en sous-graphiques homogènes selon les modalités de variables catégorielles de partitionnement. L’association du facettage avec des échelles logarithmiques soulève des problématiques d’alignement et de calibrage d’axes particulièrement stimulantes.
Par défaut, ggplot2 applique une contrainte d’échelles fixes et strictement identiques (scales = ‘fixed’) à l’ensemble des panneaux générés par une opération de facettage. Si cette règle garantit une comparabilité visuelle absolue des amplitudes absolues entre sous-populations, elle devient hautement problématique si les différents groupes expérimentaux occupent des régimes de grandeurs totalement disjoints (par exemple si un groupe contrôle présente des mesures oscillant entre 10 et 100 unités, tandis qu’un groupe stimulé s’étend de 100 000 à 10 000 000 d’unités). Dans une telle conjoncture, le panneau du groupe contrôle se trouve écrasé au ras de l’axe inférieur, anéantissant l’apport de la transformation logarithmique.
Pour résoudre cette difficulté, le déverrouillage ciblé des échelles s’opère en configurant l’argument dédié au sein de la fonction de facettage : facet_wrap(~ condition, scales = ‘free_y’). Cette instruction confère à chaque sous-graphique la liberté d’ajuster automatiquement l’empan de ses limites logarithmiques d’ordonnées à la plage effective de ses propres données. Chaque panneau hérite néanmoins rigoureusement des spécifications de base, de pas de graduation et de formatage typographique déclarées au niveau central dans l’appel de scale_y_continuous(). L’analyste veillera toutefois à attirer l’attention du lecteur dans la légende du graphique sur le caractère dynamique et découplé des ordonnées, afin d’éviter toute comparaison inter-panneaux hâtive et erronée qui ignorerait le décalage des ordres de grandeur entre les facettes.
11. 11. Bonnes pratiques de conception graphique et sémiologie graphique
11.1 11.1 Clarté de la légende et étiquetage explicite des axes
La conception d’une figure incorporant des échelles logarithmiques ne saurait se limiter à la justesse de sa tuyauterie computationnelle ; elle doit obéir aux préceptes de la sémiologie graphique formulés par Jacques Bertin et modernisés par Edward Tufte. L’un des principes cardinaux de cette discipline est l’élimination absolue de toute ambiguïté sur la nature de la métrique spatiale employée. Il est déontologiquement inacceptable de présenter un axe logarithmique sous un intitulé laconique qui omettrait de mentionner formellement la transformation appliquée.
L’analyste doit formuler explicitement dans le titre de l’axe ou dans la légende accompagnant la figure la base logarithmique retenue ainsi que l’unité de mesure physique originale. Une formulation d’axe telle que « Concentration sérique (ng/mL) – Échelle logarithmique en base 10 » ou « Taux de réplication [log10] » prémunit immédiatement le lecteur contre le réflexe d’interprétation arithmétique linéaire. Si les étiquettes arborent des notations exponentielles directes (par exemple 10², 10³, 10⁴), l’intitulé de l’axe peut demeurer plus concis, la typographie elle-même servant d’avertisseur explicite.
Il importe également de distinguer rigoureusement la variable physique de sa transcription géométrique. Si l’échelle a été déformée via scale_y_continuous(trans = ‘log10’), les unités affichées le long des coupures sont bien des nanogrammes par millilitre réels, et le titre de l’axe doit continuer d’exprimer ces nanogrammes par millilitre. En revanche, si la transformation a été exécutée manuellement dans les données en amont via une fonction externe de type log10(x), les unités de l’axe deviennent des unités logarithmiques abstraites sans dimension physique directe, imposant un réétiquetage chirurgical pour éviter toute confusion néfaste sur la nature des grandeurs mesurées.
11.2 11.2 Réglage fin des grilles d’arrière-plan avec theme()
L’armature thématique régissant l’arrière-plan du graphique — spécifiquement le réseau de lignes de guidage constituant la grille majeure (panel.grid.major) et la grille mineure (panel.grid.minor) — joue un rôle déterminant dans l’appréhension spatiale des échelles logarithmiques. Dans un graphique arithmétique standard, les lignes de grille se croisent selon des maillages orthogonaux rigoureusement carrés et équidistants. Sur un graphique semi-logarithmique ou log-log, la disposition des lignes de guidage doit matérialiser visuellement la non-linéarité de l’espace pour guider l’œil sans l’encombrer.
Grâce à la flexibilité de la fonction theme() de ggplot2, l’analyste peut instaurer une hiérarchisation graphique subtile entre les décades maîtresses et les subdivisions secondaires. Une excellente pratique de conception consiste à assigner aux lignes de grille majeures (alignées sur les puissances entières de la base) une couleur neutre contrastée et une épaisseur mesurée via panel.grid.major = element_line(color = ‘grey80’, linewidth = 0.5), tandis que les lignes de grille mineures (alignées sur les multiples intermédiaires de deux à neuf) reçoivent une teinte beaucoup plus ténue et une épaisseur réduite via panel.grid.minor = element_line(color = ‘grey92’, linewidth = 0.25, linetype = ‘dotted’).
Cette différenciation stylistique confère à la figure une lisibilité architecturale remarquable : elle recrée numériquement l’ergonomie visuelle du papier millimétré de haute précision sans noyer les données sous un réseau de traits noirs agressifs. Le regard de l’observateur discrimine instantanément les changements de décades tout en conservant la capacité de situer avec une précision chirurgicale la magnitude des points de données isolés au sein de chaque intervalle logarithmique.
11.3 11.3 Accessibilité et transmissibilité des résultats scientifiques
L’aboutissement d’une démarche de visualisation réside dans sa transmissibilité sans faille auprès de l’ensemble de la communauté scientifique, ce qui exige de respecter les standards modernes d’accessibilité visuelle et d’intégrité de restitution. Le choix des palettes chromatiques pour encoder des sous-groupes ou des gradients d’intensité sur des graphiques logarithmiques doit privilégier des échelles perceptuellement uniformes et insensibles aux déficiences de la vision des couleurs (telles que le daltonisme sous ses formes deutéranope, protanope ou tritanope). L’emploi des palettes issues du package viridis ou de la famille ColorBrewer s’impose comme une précaution indispensable.
Un autre défi technique concerne la lisibilité des exposants mathématiques lors de l’impression physique ou de la réduction des figures pour les gabarits de revues. Les indices exponentiels générés par math_format() adoptent par construction une taille de police sensiblement inférieure à celle du corps principal du texte de l’axe. Si la taille globale des polices de la figure n’a pas été calibrée avec prévoyance via theme(axis.text = element_text(size = 10)), les exposants mathématiques risquent de devenir totalement illisibles une fois la figure réduite à la largeur standard d’une colonne de revue (environ 85 millimètres). L’exportation doit systématiquement être vérifiée à l’échelle finale d’impression.
Enfin, la transmission transparente des données impose d’éviter tout aplatissement cosmétique trompeur. L’usage d’échelles logarithmiques pour compresser artificiellement des écarts considérables et donner l’illusion d’une stabilité ou d’une maîtrise d’un phénomène volatile (comme la gestion d’une dette souveraine ou le suivi d’une épidémie naissante) relève de la faute déontologique. L’analyste doit veiller à ce que l’échelle serve exclusivement la révélation objective des structures mathématiques du réel, sans jamais masquer la criticité des variations d’échelle absolue auprès des décideurs ou du public.
12. 12. Résolution des erreurs courantes et optimisation du code
12.1 12.1 Diagnostic des messages d’avertissement récurrents
L’exploitation avancée des échelles logarithmiques sous ggplot2 s’accompagne régulièrement de messages d’avertissement émis par le moteur de rendu, dont l’interprétation diagnostique précise conditionne la stabilité du flux d’analyse. Le message le plus universellement rapporté stipule : « Warning: Transformation introduced infinite values in continuous scale ». Comme disséqué au sein de la section 9, cet avertissement signale formellement la présence de zéros stricts ou de valeurs numériques négatives au sein de la variable assignée à l’axe transformé. Ce message ne constitue pas une simple notification décorative ; il confirme que ggplot2 a converti ces points en valeurs non finies et les a irrémédiablement éliminés de la projection graphique.
Un second dysfonctionnement fréquent réside dans les conflits survenant lors de la spécification manuelle du paramètre limits au sein d’une échelle logarithmique continue. Si un utilisateur définit des limites incluant une valeur nulle ou négative (par exemple limits = c(0, 1000) sur scale_y_log10()), ggplot2 échouera à calculer la borne inférieure de la transformation et tronquera arbitrairement l’échelle ou générera un panneau graphique vide orné d’un avertissement d’impossibilité géométrique. La correction méthodique de cette anomalie exige de circonscrire explicitement la limite inférieure à une valeur strictement supérieure à zéro (par exemple limits = c(0.1, 1000) ou c(1, 1000) selon la dynamique des données).
Une troisième difficulté ergonomique découle des collisions d’étiquettes textuelles le long de l’axe lorsque les coupures sont programmées avec une densité excessive sur un intervalle spatial réduit. Si trop de subdivisions majeures sont sollicitées sur une figure de petite dimension, les libellés de puissances de dix finissent par se chevaucher horizontalement ou verticalement, rendant l’axe indéchiffrable. La résolution de ce problème passe par l’ajustement du paramètre de parcimonie dans breaks_log(n = …), par l’inclinaison des étiquettes d’axe au moyen de l’instruction theme(axis.text.x = element_text(angle = 45, hjust = 1)), ou par l’espacement stratégique des bornes de l’axe.
12.2 12.2 Incompatibilités entre transformations manuelles préalables et échelles
L’erreur conceptuelle la plus répandue chez les praticiens débutants ou intermédiaires consiste à opérer une transformation logarithmique manuelle préalable sur leur tableau de données tout en déclarant simultanément une échelle logarithmique au sein de l’instruction graphique ggplot2. Cette double manipulation engendre l’erreur dite du « double logarithme » (ou double transformation), aux conséquences désastreuses sur le plan de l’exactitude scientifique.
Concrètement, cette défaillance se manifeste lorsqu’un analyste écrit une instruction telle que ggplot(data, aes(x = x, y = log10(y))) + geom_point() + scale_y_log10(). Dans ce scénario, la variable y d’origine subit une première compression logarithmique décimale au moment de l’évaluation esthétique : une valeur de 10 000 est donc convertie en 4. Puis, lors de l’exécution de l’échelle, ggplot2 prend ce chiffre 4 et lui applique une seconde fois le logarithme décimal, projetant finalement le point à une coordonnée spatiale correspondant à log10(4) ≈ 0.602. Non seulement les distances géométriques deviennent totalement faussées par rapport à la théorie mathématique, mais les étiquettes de l’axe affichent des puissances de dix calculées sur les logarithmes des logarithmes, aboutissant à une distorsion absurde du phénomène visualisé.
Pour prévenir rigoureusement cette anomalie systémique, les équipes d’analyse de données doivent standardiser leurs protocoles de programmation au sein de leurs pipelines d’entreprise ou de laboratoire. La règle de standardisation optimale prescrit de préserver l’intégrité intégrale des données tabulaires brutes au sein des pipelines de préparation (avec dplyr), en s’interdisant toute transformation logarithmique destructrice des colonnes d’origine dans le flux de manipulation, et de déléguer l’intégralité du rééchelonnage mathématique et typographique aux fonctions d’échelles spécialisées de ggplot2 au moment de la restitution visuelle.
12.3 12.3 Modèle de code complet et réutilisable pour publication
Afin de capitaliser sur l’ensemble des notions théoriques, des choix sémiologiques et des solutions techniques exposés tout au long de cet article, nous proposons ci-après la structure d’un modèle complet, robuste et reproductible, spécialement calibré pour satisfaire aux exigences des revues académiques internationales de référence. Ce modèle synthétise la préparation rigoureuse d’un échantillon, l’application d’une échelle logarithmique continue, l’implantation d’une notation exponentielle noble, le réglage fin des grilles majeure et mineure, et l’exportation vectorielle haute définition.
Dans ce modèle de production, l’analyste débute par l’importation propre de l’environnement logiciel au travers du chargement de ggplot2, de scales et de dplyr. L’assemblage du graphique repose sur la composition structurée suivante : l’appel principal déclare le jeu de données et associe les variables brutes sans altération préalable dans aes(). La couche de points geom_point() est calibrée avec une légère transparence pour rendre visibles les zones denses d’accumulation de données. Une couche d’ajustement linéaire geom_smooth(method = ‘lm’, color = ‘#2C3E50’, fill = ‘#BDC3C7’) est adjointe pour matérialiser la tendance exponentielle sous forme rectiligne avec sa marge d’incertitude.
Le pilotage de l’axe vertical s’articule autour de l’instruction scale_y_continuous(), en configurant rigoureusement trans = ‘log10’, couplé à breaks = scales::trans_breaks(‘log10’, function(x) 10^x) et labels = scales::trans_format(‘log10’, scales::math_format(10^.x)) pour garantir une typographie en exposants de puissances pures de dix sans aucune notation machine de type « 1e+03 ». Les graduations mineures sont activées à l’aide de minor_breaks = scales::breaks_log(n = 9) pour matérialiser le réseau des sous-intervalles caractéristiques. L’intitulé de l’axe est précisé de manière non équivoque via la fonction labs(y = ‘Abondance moléculaire relative [10ⁿ]’, x = ‘Temps de réaction (minutes)’).
La finalisation esthétique mobilise le thème épuré theme_minimal(base_size = 12), ajusté minutieusement via theme() pour différencier le contraste et la texture des lignes de grille majeures et mineures, tout en s’assurant que la police des axes demeure d’une netteté parfaite. Enfin, la persistance physique de la figure s’accomplit au moyen de la commande ggsave(‘figure_publication_log.pdf’, width = 180, height = 120, units = ‘mm’, dpi = 600, device = cairo_pdf). L’emploi du moteur vectoriel Cairo assure la restitution irréprochable des symboles mathématiques et des exposants typographiques, offrant ainsi une figure directement insérable dans un article de recherche de premier rang.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions de l’École des Hautes Études en Sciences Sociales (EHESS). Gauthier-Villars.
- Cleveland, W. S. (1985). The Elements of Graphing Data. Wadsworth Publ. Co.
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., & Seidel, D. (2022). scales: Scale Functions for Visualization (Version 1.3.0) [R package]. CRAN. https://CRAN.R-project.org/package=scales
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Statistics and Computing. Springer. https://doi.org/10.1007/0-387-28695-0