
La surveillance, l’analyse et la régulation des processus constituent des impératifs méthodologiques transversaux qui unissent l’ingénierie industrielle de pointe, la gestion des systèmes d’information et la recherche expérimentale en sciences cognitives et comportementales. Face à la variabilité inhérente à tout système dynamique, l’analyste se trouve confronté à une énigme récurrente : comment distinguer avec certitude les fluctuations aléatoires normales d’une altération structurelle exigeant une intervention immédiate ? La réponse théorique et pratique à ce dilemme réside dans la méthodologie de la Maîtrise Statistique des Procédés (MSP), ou Statistical Process Control (SPC), un ensemble d’outils statistiques dont la carte de contrôle constitue l’instrument paradigmatique incontournable.
Conçue pour transformer des séries de données brutes en un système d’aide à la décision visuel et rigoureux, la carte de contrôle permet d’objectiver l’état d’un système sans recourir à des jugements intuitifs souvent biaisés. Si des progiciels spécialisés et particulièrement coûteux existent sur le marché de l’analyse décisionnelle, le tableur Microsoft Excel demeure l’environnement le plus accessible, le plus transparent et le plus versatile pour concevoir, personnaliser et déployer des cartes de contrôle robustes. Grâce à ses fonctions matricielles modernes, à la flexibilité de ses outils de visualisation et à ses capacités de modélisation mathématique, Excel permet d’échafauder des architectures de surveillance analytique parfaitement adaptées tant aux impératifs de la production qu’aux exigences des protocoles de recherche en laboratoire.
Le présent traité méthodologique propose une exploration exhaustive de la création, de l’optimisation et de l’interprétation d’une carte de contrôle statistique au sein d’Excel. En articulant une armature épistémologique exigeante avec des instructions opérationnelles pas à pas, ce guide détaille chaque étape du processus : depuis l’organisation matricielle des séries chronologiques et l’estimation rigoureuse de la dispersion jusqu’à la programmation d’algorithmes d’alerte automatisés et l’application avancée aux séries temporelles comportementales. L’objectif est d’offrir au chercheur, à l’ingénieur qualité et à l’analyste de données un manuel définitif pour maîtriser la variabilité systémique et garantir la reproductibilité de leurs observations empiriques.
1. Fondements théoriques de la maîtrise statistique des processus (MSP)
1.1 Origine historique et paradigme de Walter Shewhart
L’acte de naissance de la maîtrise statistique des processus remonte aux travaux séminaux menés par le physicien et statisticien Walter A. Shewhart au sein des laboratoires de la Bell Telephone Company au début des années 1920. Confronté aux défis d’uniformité et de fiabilité du matériel téléphonique émergent, Shewhart a compris que l’inspection systématique a posteriori des produits manufacturés constituait une hérésie économique et scientifique. Ce paradigme réactif laissait subsister le gaspillage et ne fournissait aucun éclairage sur la causalité génératrice des non-conformités. Shewhart a opéré une rupture épistémologique majeure en proposant de déplacer l’attention de l’analyste de l’objet produit vers le mécanisme générateur lui-même, c’est-à-dire le processus dynamique d’élaboration.
Cette transition de l’inspection finale vers la régulation préventive repose sur la distinction conceptuelle cruciale entre la conformité aux spécifications techniques et la stabilité statistique intrinsèque. Alors que les spécifications relèvent d’un désir normatif dicté par le cahier des charges ou les besoins de l’utilisateur, la stabilité statistique traduit la capacité endogène d’un processus à générer des résultats constants au fil du temps. Un processus peut générer des mesures situées temporairement à l’intérieur des tolérances prescrites tout en étant fondamentalement instable, annonçant une défaillance imminente et inéluctable. Inversement, un processus statistiquement stable peut voir ses limites naturelles déborder les exigences requises, indiquant que le mécanisme lui-même doit être reconfiguré plutôt que continuellement ajusté.
Le postulat central du paradigme de Shewhart énonce qu’un processus se trouve dans un état de contrôle statistique lorsque ses variations futures sont prédictibles à l’intérieur d’intervalles de probabilité déterminés. Cet état d’équilibre stationnaire n’implique nullement l’absence absolue de variabilité, car tout système physique ou biologique est soumis à des forces stochastiques permanentes. L’état sous contrôle signifie simplement que l’espace des états accessibles par le système demeure invariant au cours du temps, ce qui permet d’inférer légitimement les comportements futurs à partir de l’historique observationnel immédiat.
1.2 Taxonomie de la variabilité : causes communes et causes spéciales
Au cœur de la modélisation statistique élaborée par Shewhart et ultérieurement popularisée par W. Edwards Deming se trouve une classification rigoureuse des sources de dispersion au sein des systèmes dynamiques. La variabilité globale d’un phénomène est décomposée en deux catégories ontologiquement distinctes : la variabilité attribuable aux causes communes et celle issue des causes spéciales ou assignables. Les causes communes représentent le bruit de fond inhérent et omniprésent du système. Elles résultent de l’interaction cumulative d’une multitude de micro-facteurs indépendants, impossibles à isoler individuellement à un coût raisonnable (variations thermiques imperceptibles, micro-vibrations mécaniques, fluctuations attentionnelles spontanées). Ce bruit de fond est stable, aléatoire et caractérisé par une distribution probabiliste constante au cours du temps.
À l’opposé, les causes spéciales désignent des événements perturbateurs sporadiques, intermittents ou émergents qui n’appartiennent pas au fonctionnement permanent du système. Il peut s’agir de la dégradation soudaine d’un capteur, d’un lot défectueux de réactifs chimiques, de l’inattention aiguë d’un sujet expérimental ou d’une modification structurelle non documentée de la procédure de recueil. Alors que la variabilité commune relève de la structure même du système, la variabilité spéciale signale une altération de cette structure. Confondre ces deux régimes de dispersion engendre de graves dérives analytiques, théorisées par Deming à travers la célèbre expérience de l’entonnoir (Deming’s Funnel Experiment). Tenter de compenser une déviation imputable à des causes communes en ajustant manuellement les paramètres de pilotage équivaut à un surajustement (tampering), qui a pour effet mathématique certain d’accroître la variance globale du système et de précipiter son instabilité.
Pour prévenir cet écueil, la carte de contrôle institue un critère de démarcation mathématique opérationnel fondé sur des intervalles de dispersion standardisés. En définissant des bornes situées traditionnellement à trois écarts-types (3-sigma) de part et d’autre de l’espérance mathématique du processus, la carte formalise une règle de décision probabiliste : toute observation franchissant ces frontières possède une probabilité si infinitésimale de résulter du seul jeu des causes communes que l’hypothèse de stabilité doit être rejetée en faveur de l’existence d’une cause spéciale assignable qu’il convient d’isoler et de neutraliser.
1.3 Pertinence méthodologique en sciences comportementales et cognitives
Bien que formalisée originellement dans le contexte de l’industrie manufacturière, la méthodologie de la maîtrise statistique des processus possède une résonance épistémologique profonde avec les problématiques contemporaines des sciences comportementales, de la neuropsychologie et des neurosciences cognitives. L’étude du comportement humain et animal fait face à une hétérogénéité temporelle complexe où s’entremêlent des rythmes biologiques ultradiens, des phénomènes d’habituation, de l’apprentissage et des fluctuations endogènes de la vigilance. Appliquer une carte de contrôle à des séries temporelles comportementales individuelles permet de modéliser la stabilité des performances cognitives avec une acuité supérieure aux traditionnels tests d’hypothèse pré-post intervention.
La surveillance longitudinale de la variabilité intra-individuelle constitue l’un des champs d’application les plus fertiles de cette approche. Dans l’évaluation des temps de réaction psychomoteurs, de la mémoire de travail ou du contrôle inhibiteur, distinguer une fluctuation normale liée à la fatigue physiologique transitoire d’une dégradation cognitive pathologique ou induite par un stress environnemental majeur exige de quantifier précisément le bruit de fond propre à chaque sujet. La carte de contrôle fournit cette ligne de base dynamique personnalisée, évitant l’assimilation hâtive d’une baisse temporaire d’efficience à un trouble structurel.
Enfin, dans le domaine de la standardisation des protocoles expérimentaux récurrents au sein des plateformes de recherche partagées, la MSP s’avère indispensable pour garantir la consistance métrologique des instruments et des évaluateurs. Les dérives instrumentales, les biais d’observation inter-sessions ou les modifications non contrôlées de l’environnement de passation constituent autant de causes assignables que la carte de contrôle objective immédiatement. Elle assure ainsi la reproductibilité empirique indispensable à la validation des paradigmes en psychologie expérimentale et en neurosciences.
2. Typologie des cartes de contrôle et cadre décisionnel de sélection
2.1 Cartes pour mesures continues et sous-groupes rationnels
L’architecture d’une démarche de contrôle statistique dépend intimement de la nature des métriques collectées et de la stratégie d’échantillonnage mise en œuvre. Lorsque la variable d’intérêt est continue (temps, masse, concentration molaire, latence électrique) et qu’il est possible de regrouper les observations en sous-groupes rationnels homogènes, la structure classique repose sur le diptyque des cartes pour variables métriques. Le principe des sous-groupes rationnels, conceptualisé par Shewhart, stipule que les échantillons doivent être constitués de manière à ce que la probabilité de variation due à des causes assignables soit minimisée à l’intérieur d’un même sous-groupe, tout en étant maximisée entre les sous-groupes distincts.
Dans ce cadre, la carte de la moyenne et de l’étendue, universellement désignée sous l’appellation carte X-barre et R (ou $\bar{X}-R$), couple le suivi de la tendance centrale (la moyenne des sous-groupes $\bar{X}$) à celui de la dispersion locale estimée par l’étendue $R$, définie comme la différence arithmétique entre la valeur maximale et la valeur minimale au sein de chaque échantillon. Cette modalité s’avère particulièrement robuste et simple d’exploitation lorsque la taille des sous-groupes $n$ est modeste, typiquement comprise entre 2 et 8 observations. Pour cette taille d’échantillon restreinte, l’étendue constitue un estimateur remarquablement efficace et peu sensible à d’éventuels écarts modérés à la loi normale.
Dès lors que la taille du sous-groupe rationnel excède $n ge 9$ ou $n ge 10$, l’étendue perd de son efficacité statistique relative au profit de l’écart-type de l’échantillon $S$. La carte X-barre et S ($\bar{X}-S$) devient alors la référence mathématique absolue. En intégrant l’ensemble des écarts à la moyenne via la somme des carrés des déviations, l’écart-type offre une estimation non biaisée et de variance minimale de la dispersion interne du processus, stabilisant de manière optimale les limites de contrôle calculées pour des volumes d’échantillonnage plus substantiels.
2.2 Cartes de contrôle pour mesures individuelles (I-MR)
Dans de nombreuses configurations expérimentales, cliniques ou managériales, la constitution de sous-groupes rationnels est matériellement impossible ou conceptuellement inappropriée. C’est le cas lorsque la fréquence d’échantillonnage est particulièrement faible (relevé hebdomadaire d’un biomarqueur), lorsque le coût de mesure unitaire est exorbitant, ou lorsqu’on suit l’évolution longitudinale d’un sujet unique dans le cadre d’un protocole expérimental à cas unique (Single-Case Experimental Design ou protocoles N=1). Pour répondre à ces contraintes, la carte des valeurs individuelles et de l’étendue mobile, universellement désignée sous l’acronyme I-MR (pour Individual and Moving Range) ou carte X-MR, constitue la solution algorithmique prédominante.
La carte I-MR se déploie à travers deux graphiques synchronisés : le premier trace directement chaque observation unitaire successive $X_i$, tandis que le second trace l’étendue mobile (Moving Range, $MR$) calculée à partir de la différence absolue entre deux observations immédiatement consécutives, formalisée par :
$$MR_i = |X_i – X_{i-1}|$$
Cette dérivation séquentielle permet d’isoler la variabilité à court terme (le bruit local d’une transition à l’autre) et d’utiliser cette estimation de dispersion locale pour ériger les limites de contrôle de la carte des valeurs individuelles, immunisant ainsi l’analyse contre les distorsions induites par des tendances lourdes ou des oscillations de grande amplitude.
Il importe toutefois de souligner la vulnérabilité intrinsèque de la carte I-MR aux entorses à l’hypothèse de normalité de la distribution sous-jacente. Alors que les cartes à sous-groupes bénéficient de l’action lissante du Théorème Central Limite, qui garantit que la distribution des moyennes d’échantillons converge asymptotiquement vers une loi normale quelle que soit la loi mère (sous réserve d’un moment d’ordre deux fini), la carte individuelle confronte directement les données brutes aux seuils calculés. Toute asymétrie prononcée ou leptokurtose de la série empirique modifiera substantiellement le taux de fausses alertes théorique, imposant une vérification préalable minutieuse de la forme distributionnelle avant toute validation opérationnelle.
2.3 Cartes pour données discrètes et attributs qualitatifs
Lorsque le phénomène étudié ne se prête pas à une quantification continue mais se caractérise par des états discrets (conforme/non conforme, succès/échec, présence/absence d’une anomalie), l’analyste doit basculer vers les cartes de contrôle aux attributs. Ces dernières reposent sur des fondements probabilistes rigoureusement ancrés dans les lois discrètes classiques. On distingue deux grandes familles de cartes selon que l’on comptabilise des unités défectueuses ou que l’on dénombre des non-conformités ponctuelles au sein d’une unité de mesure.
Pour le suivi de la proportion d’unités présentant un défaut, la carte $p$ est mobilisée en se fondant sur les propriétés de la loi binomiale. Elle mesure le ratio entre le nombre d’événements observés et la taille globale de l’échantillon, autorisant des tailles d’échantillons variables d’une session à l’autre par un ajustement dynamique de la largeur des limites de contrôle. Si la taille de l’échantillon demeure rigoureusement constante à chaque prélèvement, on privilégie fréquemment la carte $np$, qui modélise directement le dénombrement absolu d’unités non conformes sans passer par le calcul fractionnaire, simplifiant ainsi l’interprétation par les équipes de terrain.
Lorsque l’objectif est de quantifier le nombre d’occurrences d’une anomalie au sein d’un continuum d’observation (par exemple, le nombre d’oublis ou d’erreurs commis lors d’une tâche complexe étalée sur une heure, ou le nombre de micro-éveils par cycle de sommeil), la modélisation fait appel à la loi de Poisson. La carte $c$ régit les situations où la zone d’opportunité d’apparition de l’événement est invariable, tandis que la carte $u$ standardise le taux d’occurrences par unité d’inspection lorsque l’étendue de l’observation fluctue. D’un point de vue de la puissance statistique, il convient de rappeler qu’à volume d’échantillonnage égal, une carte pour variables continues (comme la carte I-MR ou X-barre) possède une sensibilité aux dérives infiniment supérieure à celle d’une carte pour attributs, cette dernière exigeant des volumes massifs de données pour détecter des déplacements subtils du paramètre de forme.
3. Préparation rigoureuse et structuration des données dans Excel
3.1 Architecture du classeur et standardisation des colonnes
La robustesse mathématique et la maintenabilité d’une carte de contrôle élaborée sous Excel dépendent de l’architecture du classeur de calcul. L’erreur la plus fréquente des praticiens consiste à mélanger des blocs de saisie, des calculs intermédiaires dispersés et des graphiques sur un même plan désordonné. Pour ériger un système d’analyse pérenne, il est impératif d’adopter une structure tabulaire linéaire conforme aux principes de modélisation des données relationnelles (format tabulaire normalisé ou tidy data).
La première feuille de calcul doit être exclusivement dédiée au stockage structuré de la série temporelle. La colonne A reçoit l’identifiant univoque de l’observation ou l’horodatage séquentiel (numéro d’échantillon de 1 à $N$, date exacte ou numéro de session expérimentale). La colonne B est réservée à la variable quantitative continue mesurée ($X_i$). Les colonnes immédiatement adjacentes doivent être rigoureusement allouées aux paramètres constitutifs de la carte :
- Colonne C : Ligne Centrale ($\bar{X}$ ou Médiane) ;
- Colonne D : Limite Supérieure de Contrôle (LSC / UCL) ;
- Colonne E : Limite Inférieure de Contrôle (LIC / LCL) ;
- Colonnes subséquentes : calculs de dispersion auxiliaires (étendue mobile, résidus) et vecteurs d’alertes logiques.
Une séparation étanche doit être maintenue entre les données quantitatives pures destinées au calcul algorithmique et les métadonnées contextuelles (identifiant du sujet, nom de l’expérimentateur, température ambiante, version du matériel). Ces métadonnées peuvent être positionnées dans les colonnes situées à droite des bornes statistiques, garantissant ainsi que l’insertion ultérieure de fonctions matricielles ou de plages nommées ne sera pas parasitée par des valeurs alphanumériques non traitables par les opérateurs arithmétiques.
3.2 Nettoyage préliminaire et vérification des hypothèses distributionnelles
Avant d’engager le moindre calcul de bornes de contrôle, un audit distributionnel rigoureux s’impose. L’application mécanique du seuillage classique à trois écarts-types repose formellement sur l’hypothèse que les résidus du processus suivent une distribution gaussienne symétrique et mésokurtique. Dans Excel, cet audit préliminaire commence par l’évaluation des coefficients de forme via les fonctions COEFFICIENT.ASYMETRIE() (ou SKEW()) et KURTOSIS(). Un coefficient d’asymétrie s’écartant significativement de zéro ($|S| > 1$) ou un aplatissement s’éloignant de la référence normale ($|K| > 1,5$) signale que l’analyste ne peut pas appliquer aveuglément les limites standards sans risquer une distorsion critique des probabilités d’erreur de première espèce.
L’évaluation graphique de la normalité peut être conduite sous Excel par l’élaboration d’un diagramme quantile-quantile (Q-Q plot). Cette procédure consiste à classer les données de l’échantillon par ordre croissant, à associer à chaque rang une probabilité cumulée empirique via la formule $(i – 0,5) / N$, puis à convertir ces probabilités en quantiles théoriques normaux à l’aide de la fonction native LOI.NORMALE.STANDARD.INVERSE() (ou NORM.S.INV()). Le tracé de la variable observée en fonction du quantile théorique normal doit former une trajectoire rectiligne rigoureuse ; toute courbure en forme de « S » dénote des queues de distribution épaisses, tandis qu’une concavité générale révèle une asymétrie structurelle.
Le nettoyage préliminaire doit également adresser la question des données corrompues, des doublons d’enregistrement et des cellules vides. Dans Excel, une cellule vide ou une chaîne textuelle insérée par inadvertance au sein d’une série numérique altère le calcul matriciel des étendues ou engendre des décalages d’indices fatals lors des calculs d’étendues mobiles consécutives. Une passe systématique utilisant le filtre avancé ou la fonction logique ESTNUM() permet d’isoler et d’assainir ces anomalies sans tronquer la série temporelle de façon arbitraire.
3.3 Utilisation des tableaux structurés dynamiques d’Excel
L’intégration de la série de données dans un tableau structuré officiel d’Excel — accessible via la sélection de la plage puis l’instruction Ctrl + L ou Ctrl + T — constitue une bonne pratique pour tout modèle de contrôle statistique. Contrairement aux plages de cellules statiques délimitées par des coordonnées alphanumériques rigides ($A$2:$A$100), le tableau structuré confère une dynamique relationnelle au modèle : toute nouvelle observation insérée immédiatement sous la dernière ligne étend automatiquement la définition du tableau, incorporant instantanément le nouveau point dans le périmètre d’analyse.
L’avantage cardinal de cette architecture réside dans la propagation automatisée et déterministe des formules mathématiques. Lorsque vous saisissez une formule de calcul pour la ligne centrale ou les limites de contrôle sur la première ligne d’un tableau structuré, Excel propage cette formule sur l’intégralité de la colonne sans exiger le glissement manuel de la poignée de recopie. De plus, la nomenclature des références devient explicite via les étiquettes de colonnes (par exemple [@Observation] ou Tableau1[Mesure]), simplifiant drastiquement l’audit du modèle et réduisant à néant les risques de décalage accidentel de références lors des opérations de tri ou d’insertion de lignes intermédiaires.
Cette dynamicité s’avère décisive pour la mise à jour séquentielle en temps réel. Dans une configuration expérimentale ou opérationnelle où de nouvelles mesures sont intégrées quotidiennement, le tableau structuré alimente en continu le graphique de la carte de contrôle associé : le tracé vectoriel s’étire automatiquement vers la droite, recalculant au besoin les bornes ou projetant les nouvelles valeurs contre les limites initiales sans aucune intervention manuelle de reconfiguration logicielle.
4. Étape 1 : Saisie et organisation matricielle de la série temporelle
4.1 Saisie systématique de l’échantillon d’observation
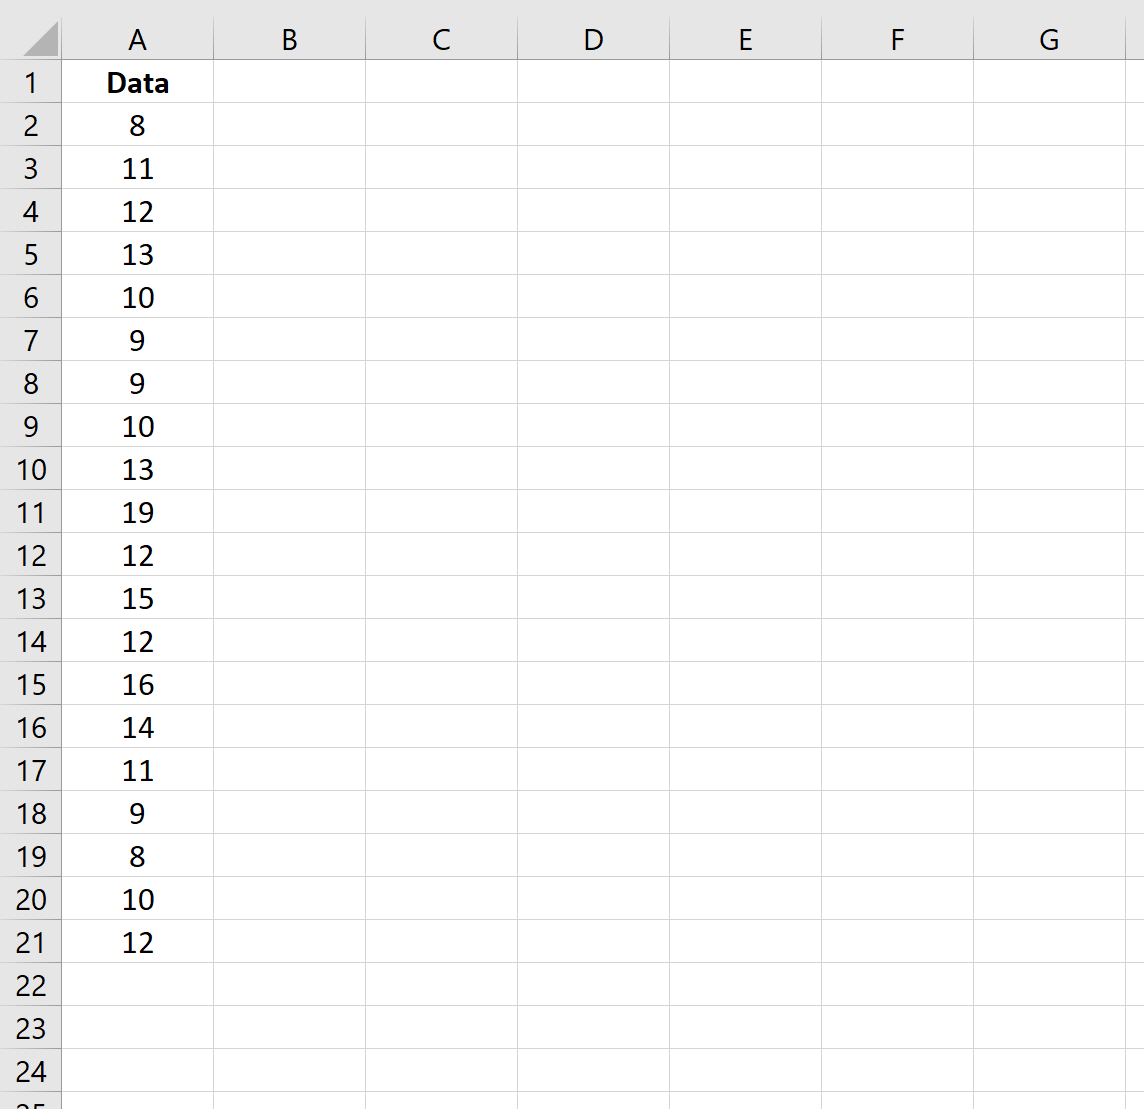
La première phase pratique d’implémentation de la carte de contrôle sous Excel requiert la consignation méthodique des observations au sein de la grille matricielle. L’analyste doit veiller à ce que l’ordre temporel des prélèvements soit scrupuleusement préservé. Dans la colonne A, initialisée à la cellule A2 (la ligne 1 étant consacrée aux étiquettes d’en-tête), on inscrit l’identifiant séquentiel incrémental de 1 à $N$. Pour garantir la pertinence de l’analyse séquentielle, l’espacement temporel entre les points d’échantillonnage doit être aussi régulier et isochrone que possible, l’analyse par carte de contrôle postulant une distribution temporelle stationnaire du prélèvement.
Dans la colonne B, on procède à la saisie rigoureuse de la valeur empirique mesurée. Une attention particulière doit être portée au format numérique de ces cellules : le séparateur décimal doit être strictement conforme aux paramètres régionaux du système (virgule ou point), sous peine de transformer la valeur numérique en chaîne textuelle que les algorithmes de calcul ignoreront silencieusement. De même, l’unité de quantification doit demeurer constante sur l’intégralité de la série : aucune variation dimensionnelle (par exemple, alterner des millisecondes et des secondes, ou des grammes et des kilogrammes) ne doit intervenir au sein de la même colonne.
Il est recommandé de constituer un historique de référence d’au moins 20 à 30 points d’échantillonnage consécutifs pour initialiser une carte de contrôle fiable. Un volume inférieur à 20 observations confère aux estimations de la moyenne et de la dispersion une instabilité statistique prononcée, élargissant de façon excessive les intervalles de confiance associés aux limites de contrôle et diminuant la sensibilité du dispositif face aux véritables causes spéciales d’altération.
4.2 Définition des plages de référence fixes et absolues
L’édification des formules de calcul dans Excel exige une maîtrise parfaite des modes d’adressage de cellules. Lorsque les calculs des paramètres globaux (moyenne, écart-type, étendue) sont établis hors du tableau ou au sein d’une formule destinée à être répliquée sur des centaines de lignes, le verrouillage des indices matriciels par l’opérateur dollar ($) s’avère obligatoire. L’expression $B$2:$B$21 indique à l’interpréteur de calcul d’Excel que la plage de référence demeure absolument invariante, quel que soit le déplacement de la cellule cible.
L’omission de cette fixation absolue représente l’un des pièges les plus fréquents chez les analystes débutants : en omettant les dollars (par exemple en écrivant B2:B21), le glissement vertical de la formule provoque un décalage séquentiel de la fenêtre de calcul (qui devient B3:B22 à la ligne suivante, puis B4:B23), transformant un calcul d’espérance globale en un calcul glissant non sollicité qui déforme complètement l’horizontalité requise pour les lignes de contrôle.
Pour immuniser définitivement le modèle contre ces erreurs d’adressage, la stratégie la plus élégante consiste à recourir au Gestionnaire de noms d’Excel (accessible via le ruban Formules > Définir un nom). En attribuant un nom de champ univoque à la plage d’étalonnage initiale — par exemple en désignant $B$2:$B$21 sous le label Série_Etalonnage —, les formules ultérieures gagnent en clarté sémantique et en sécurité : la formule de calcul de moyenne devient simplement =MOYENNE(Série_Etalonnage), éliminant tout risque d’altération syntaxique lors des manipulations ultérieures de la structure du classeur.
4.3 Documentation contextuelle des conditions opératoires
La puissance d’une carte de contrôle ne réside pas uniquement dans son abstraction mathématique, mais dans sa capacité à faire dialoguer les anomalies statistiques avec la réalité physique ou humaine du dispositif expérimental. À cette fin, il est fondamental de réserver les colonnes situées à droite de la matrice de calcul principale à la documentation méthodique des conditions environnementales et procédurales associées à chaque mesure unitaire.
Dans la colonne F ou G, l’analyste codifiera systématiquement les variables environnementales susceptibles d’induire une variabilité concomitante : température de la salle d’expérimentation, degré d’humidité, heure précise de passation (pour capter les effets de rythme circadien), ou encore numéro de version du logiciel d’acquisition. Toute modification d’un composant de mesure ou tout changement d’expérimentateur doit être rigoureusement indexé sous la forme d’un code catégoriel ou d’une note textuelle descriptive.
Cette rigueur de consignation contextuelle joue un rôle capital lors de la phase d’investigation rétrospective : lorsqu’un point de mesure franchira les limites de contrôle, la consultation immédiate de cette piste d’audit textuelle permettra de formuler des hypothèses explicatives immédiates (présence d’un bruit soudain durant l’évaluation, recalibrage défectueux du capteur) et d’isoler la cause spéciale sans devoir se livrer à des conjectures rétrospectives invérifiables.
5. Étape 2 : Calcul et propagation de la tendance centrale (Ligne centrale)
5.1 Implémentation algorithmique de la fonction MOYENNE
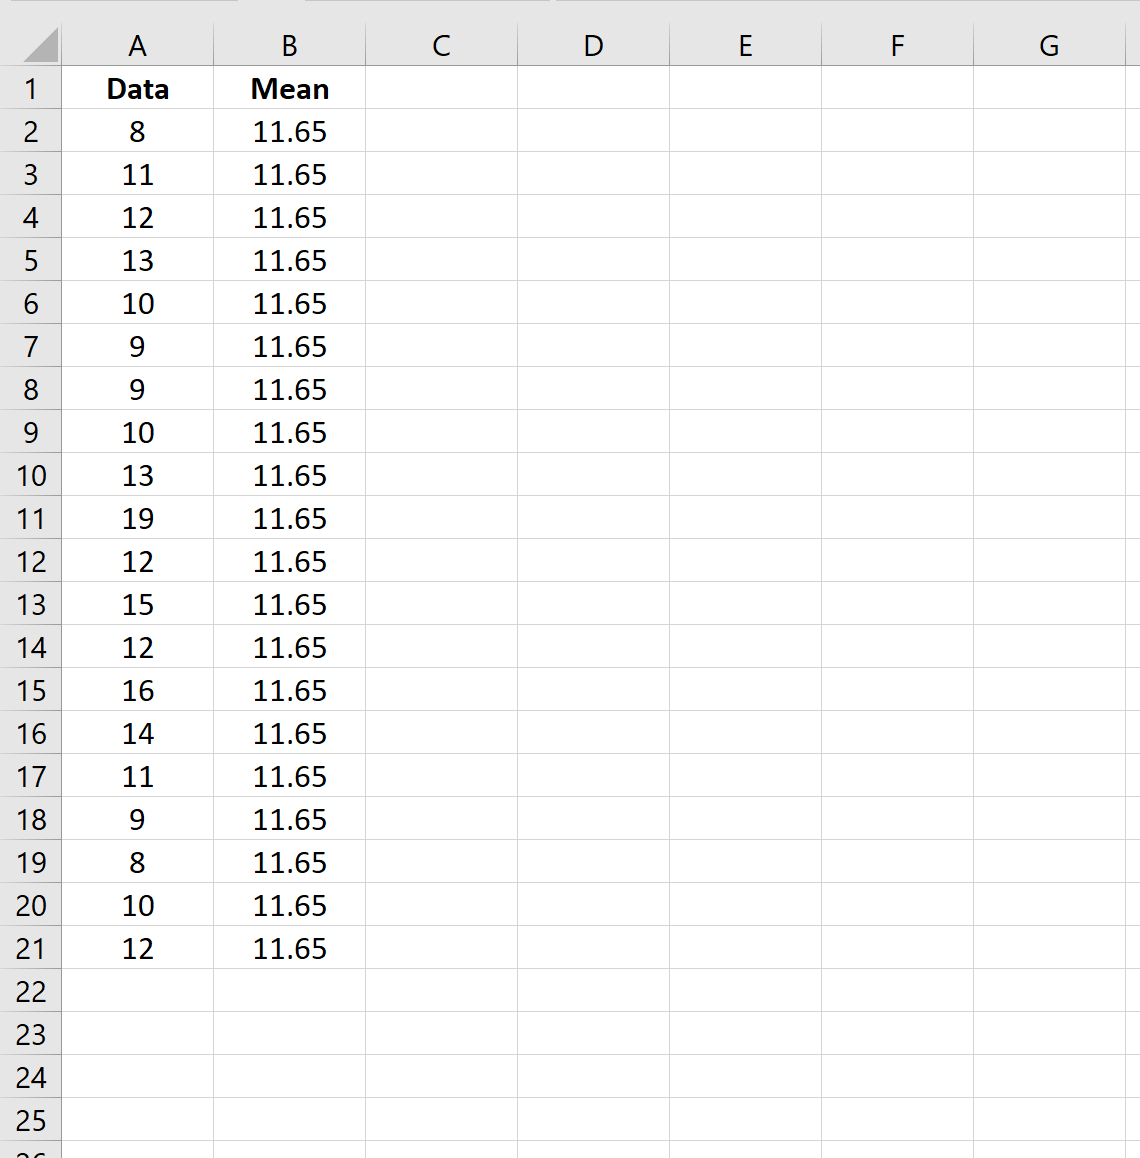
La Ligne Centrale (désignée conventionnellement sous l’acronyme LC ou CL pour Central Line) incarne l’ancre statistique fondamentale de la carte de contrôle. Elle représente la valeur de référence autour de laquelle le processus est supposé osciller librement sous l’unique juridiction des causes communes aléatoires. D’un point de vue probabiliste, elle constitue la meilleure estimation de l’espérance mathématique du système stationnaire ($\mu$).
Dans le cas d’une carte de mesures individuelles (I-MR) ou d’une carte de moyennes de sous-groupes ($\bar{X}$), la ligne centrale correspond à la moyenne arithmétique globale des observations de la phase de référence. Son implémentation dans Excel s’opère par la saisie de la fonction suivante dans la première cellule de la colonne dévolue à la ligne centrale (cellule C2) :
=MOYENNE($B$2:$B$21) (ou =AVERAGE($B$2:$B$21) dans la version anglaise du logiciel).
Pour que cette référence scalaire se matérialise sous la forme d’une ligne continue et parfaitement horizontale sur le graphique de dispersion, cette valeur moyenne doit impérativement être propagée de manière uniforme sur l’ensemble des cellules de la colonne C, jusqu’à la ligne $N$ correspondant à la dernière observation enregistrée. Cette recopie vers le bas génère une suite vectorielle de valeurs identiques, assurant ainsi la projection d’un vecteur rectiligne parallèle à l’axe des abscisses à travers l’ensemble du champ de contrôle visuel.
5.2 Distinction mathématique entre moyenne globale et médiane de processus
Bien que la moyenne arithmétique constitue le standard canonique pour la fixation de la ligne centrale, des considérations statistiques avancées peuvent inciter l’analyste à lui substituer la médiane du processus. La moyenne arithmétique possède en effet une propriété bien connue : sa vulnérabilité extrême aux observations déviantes de grande amplitude. Si, durant la phase d’initialisation du processus (les 20 premiers points servant à calibrer la carte), une cause spéciale est déjà à l’œuvre et engendre une valeur aberrante extrême, la moyenne sera décalée dans la direction de cette anomalie, faussant l’évaluation de la tendance centrale réelle.
Dans les contextes où l’on soupçonne la présence de valeurs extrêmes ou lorsque la distribution empirique présente une asymétrie modérée, le recours à la fonction =MEDIANE($B$2:$B$21) (ou =MEDIAN()) procure une robustesse accrue. La médiane, définie comme la valeur qui sépare la série ordonnée en deux sous-ensembles de cardinal égal, possède un point de rupture statistique de 50 %, ce qui signifie qu’elle ne bascule pas sous l’effet d’une perturbation unilatérale isolée.
Il convient néanmoins d’appliquer cette substitution avec discernement : l’usage de la médiane altère les propriétés probabilistes du seuillage standard à trois sigmas. En présence d’une distribution asymétrique où la médiane est adoptée comme ligne centrale, les probabilités de dépassement unilatéral des limites de contrôle ne sont plus symétriques. Dès lors, l’analyste devra vérifier si un tel centrage ne fausse pas l’équilibre entre les risques d’erreur de première espèce au-dessus et en-dessous de l’axe médian.
5.3 Mise à jour dynamique de la ligne centrale lors de fractionnements de phases
Une erreur critique consiste à maintenir une ligne centrale unique et immuable alors que le processus étudié a subi une intervention structurelle délibérée (mise en place d’un protocole d’amélioration, modification thérapeutique chez un patient, installation d’un nouvel équipement de mesure). Lorsqu’une action intentionnelle modifie le fonctionnement du système, le processus change de régime statistique : la moyenne historique n’a plus aucune pertinence pour évaluer les performances ultérieures.
Pour refléter cette discontinuité sans briser la continuité temporelle de la visualisation, la colonne de la ligne centrale doit être segmentée en phases distinctes (par exemple Phase A : ligne de base pré-interventionnelle, et Phase B : phase active d’intervention). Dans Excel, cette segmentation peut être automatisée en utilisant une fonction logique conditionnelle basée sur le numéro de l’observation ou sur un identifiant de phase inscrit dans une colonne auxiliaire. La formulation prend alors la forme suivante :
=SI(A2<=20; MOYENNE($B$2:$B$21); MOYENNE($B$22:$B$40))
Une telle écriture génère un saut de palier vertical au point de transition (entre l’observation 20 et l’observation 21), visualisant de manière spectaculaire le décalage de la moyenne généré par le nouveau protocole. Ce fractionnement de phase permet d’évaluer si la nouvelle politique a produit l’effet d’élévation ou d’abaissement escompté, tout en rétablissant de nouvelles limites de contrôle adaptées à la nouvelle variabilité du régime post-intervention.
6. Étape 3 : Estimation de la dispersion et de l’écart-type expérimental
6.1 Calcul de l’écart-type de l’échantillon avec ECARTYPE.STANDARD
La quantification de la dispersion est l’opération la plus sensible dans l’élaboration d’une carte de contrôle. De la précision de l’estimateur de l’écart-type ($\sigma$) découle directement la largeur de l’intervalle d’acceptabilité et, par voie de conséquence, la justesse du taux de détection des causes spéciales. Dans l’écosystème d’Excel, plusieurs fonctions d’écart-type coexistent, et leur distinction revêt une dimension statistique fondamentale qu’aucun analyste ne saurait ignorer.
La formulation conventionnelle immédiate repose sur l’écart-type de l’échantillon empirique, calculé à l’aide de la fonction :
=ECARTYPE.STANDARD($B$2:$B$21) (ou =STDEV.S($B$2:$B$21) sous la version anglaise).
Cette fonction applique rigoureusement la correction de Bessel au dénominateur en divisant la somme des carrés des écarts à la moyenne par $n – 1$ (les degrés de liberté) plutôt que par $n$, afin d’éliminer le biais d’estimation inhérent aux petits échantillons :
$$S = \sqrt{\frac{1}{n – 1}\sum_{i=1}^{n}(X_i – \bar{X})^2}$$
L’utilisation de la fonction alternative ECARTYPE.PEARSON() (ou STDEV.P()), qui divise la variance par $n$, doit être formellement proscrite. Elle suppose en effet que l’échantillon analysé constitue la totalité de la population statistique universelle, ce qui est conceptuellement faux dans une démarche de contrôle continu où l’échantillon présent n’est qu’une fraction temporelle d’un flux d’événements infini. Sous-estimer la dispersion en utilisant l’écart-type de population conduit à un rétrécissement artificiel des limites de contrôle et à une multiplication anarchique de fausses alertes.
6.2 Estimation alternative par l’étendue moyenne (Moving Range)
Bien que l’écart-type d’échantillon $S$ soit couramment usité, la théorie orthodoxe de Shewhart préconise une méthode d’estimation de la dispersion radicalement différente pour les cartes de mesures individuelles : l’utilisation de l’étendue mobile moyenne ($\overline{MR}$) divisée par le coefficient de débiaisement standardisé $d_2$. Cette approche présente l’avantage majeur d’isoler la dispersion locale à court terme sans la laisser contaminer par des dérives lentes ou des sauts de moyenne à long terme.
Pour mettre en œuvre cette méthode dans Excel, on crée en colonne E une série dédiée à l’étendue mobile d’ordre 2. La cellule E2 est laissée vide (car aucune observation ne précède la première), et l’on inscrit en cellule E3 la formule de différence absolue suivante :
=ABS(B3-B2)
Cette formule est ensuite étirée jusqu’au bas du tableau. On calcule ensuite la moyenne de ces étendues mobiles à l’aide de la formule :
=MOYENNE($E$3:$E$21)
Pour transformer cette étendue mobile moyenne en un estimateur non biaisé de l’écart-type $\sigma$, on applique la constante tabulée de Shewhart $d_2$, dont la valeur mathématique pour des sous-groupes consécutifs de taille $n = 2$ est rigoureusement égale à $1,128$ (démontrée par l’intégration de la distribution de l’étendue sous l’hypothèse de normalité). L’écart-type estimé du processus devient alors :
$$\hat{\sigma} = \frac{\overline{MR}}{d_2} = \frac{\overline{MR}}{1{,}128}$$
Ce calcul, formulé dans Excel sous la syntaxe =MOYENNE($E$3:$E$21)/1,128, offre une immunité remarquable : si une rupture brutale survient au milieu de la série, elle n’affectera qu’une seule valeur d’étendue mobile $MR$, alors qu’elle déformerait l’intégralité de la somme des carrés calculée par ECARTYPE.STANDARD.
6.3 Implications sur la robustesse du seuillage à trois sigmas
Le choix de l’estimateur de la dispersion n’a rien d’une querelle académique byzantine : il dicte la morphologie même de la zone de contrôle. Lorsque l’analyste utilise l’écart-type global ECARTYPE.STANDARD sur une série temporelle perturbée par une cause assignable de forte amplitude (par exemple un choc mécanique ou une distraction majeure lors d’une tâche de laboratoire), cette valeur anormale dilate l’écart-type calculé de manière disproportionnée en raison de l’élévation quadratique des écarts.
Cette dilatation artificielle engendre un phénomène pervers connu sous le nom de masquage statistique (masking effect) : les limites de contrôle, calculées sur la base d’un écart-type artificiellement gonflé, s’écartent excessivement de la ligne centrale. Dès lors, le système devient aveugle aux dérives modérées ultérieures, incapable de signaler des anomalies qui auraient dû pourtant être identifiées. La détection de la cause spéciale originelle a, par son influence sur le calcul, neutralisé la vigilance du dispositif pour les points subséquents.
C’est pourquoi la méthodologie rigoureuse impose un protocole d’épuration itératif lors de la phase de calibration : si une cause spéciale manifeste est identifiée et expliquée durant les 20 premières mesures, cette observation doit être retirée du calcul de l’écart-type (et de la moyenne), et les bornes doivent être recalculées à partir des observations restantes. Ce recalibrage à froid garantit que la dispersion de référence reflète fidèlement et exclusivement la variabilité intrinsèque aux causes communes.
7. Étape 4 : Dérivation mathématique des limites de contrôle supérieure et inférieure
7.1 Modélisation de la Limite Supérieure de Contrôle (LSC / UCL)
La Limite Supérieure de Contrôle, universellement désignée par le sigle LSC (ou UCL pour Upper Control Limit), matérialise le plafond statistique au-delà duquel toute observation empirique est jugée incompatible avec l’hypothèse de stabilité du processus sous le seul régime des causes communes aléatoires. L’établissement de cette frontière ne résulte pas d’un arbitrage empirique subjectif, mais de l’application stricte de la métrique 3-sigma établie par Shewhart.
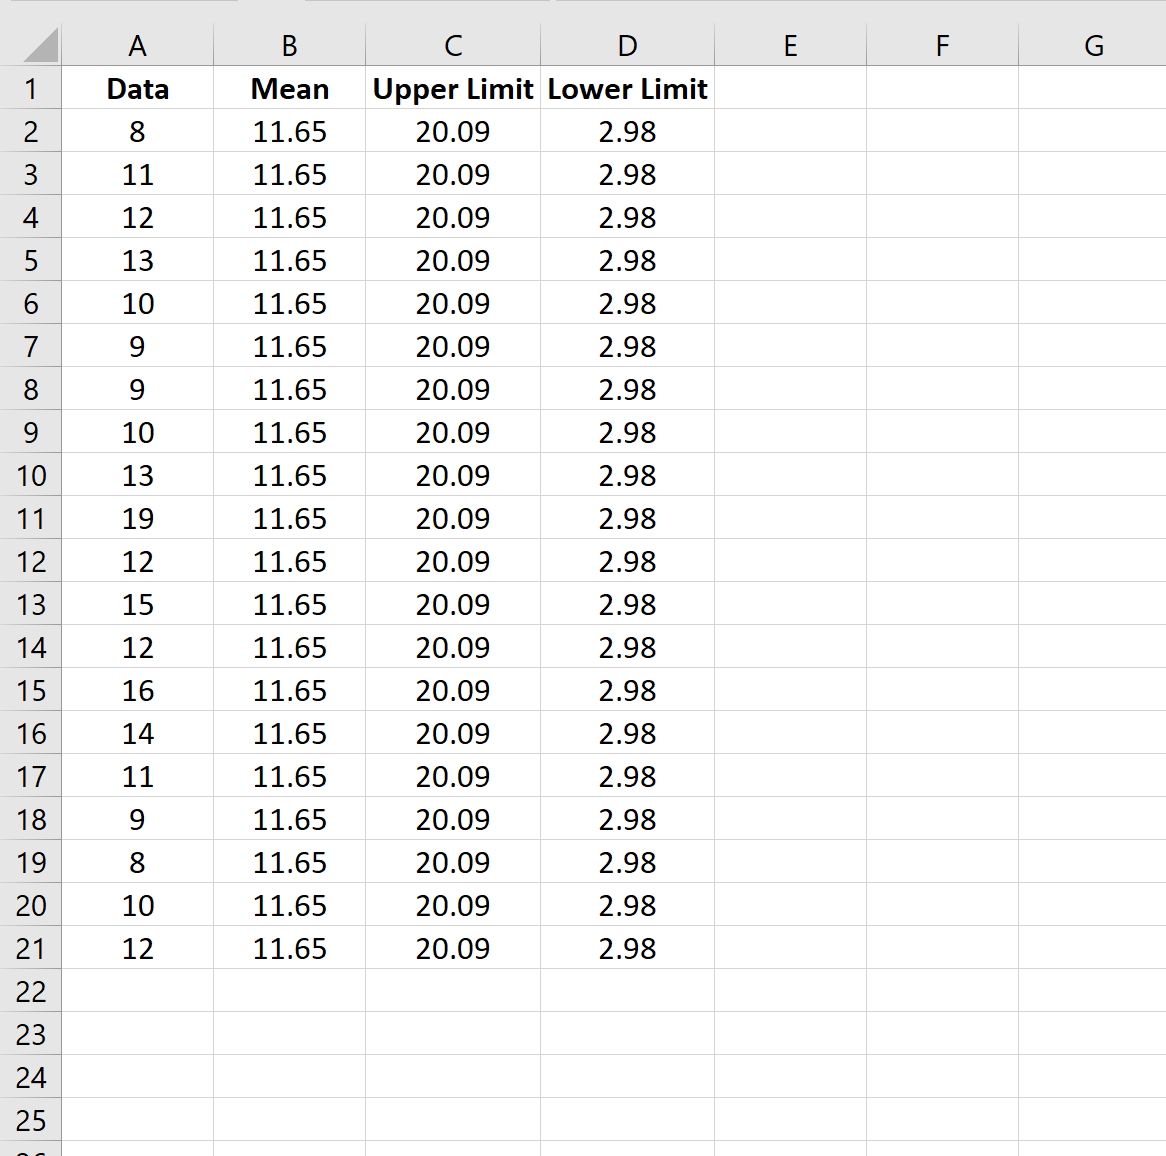
Dans l’environnement Excel, en adoptant l’estimation directe par l’écart-type d’échantillon, la modélisation de la LSC s’effectue en saisissant dans la cellule D2 de la colonne réservée la formulation algébrique suivante :
=$C$2 + 3 * ECARTYPE.STANDARD($B$2:$B$21)
Si l’on privilégie l’estimateur fondé sur l’étendue mobile moyenne explicité précédemment, la formule devient :
=$C$2 + 3 * (MOYENNE($E$3:$E$21) / 1,128) ou, sous sa forme pré-calculée simplifiée : =$C$2 + 2,66 * MOYENNE($E$3:$E$21) (le coefficient $3 / 1,128$ équivalant rigoureusement à $2,660$).
D’un point de vue probabiliste, sous l’hypothèse d’une distribution gaussienne des fluctuations aléatoires, l’intervalle bilatéral encadré par $\pm 3\sigma$ englobe exactement $99,73%$ de la masse de probabilité totale de la distribution. La probabilité résiduelle qu’une observation franchisse unilatéralement la LSC par le simple fait du hasard est infinitésimale, s’établissant à $p = (1 – 0,9973) / 2 = 0,00135$, soit approximativement 1,35 chance sur mille. Cette valeur doit ensuite être propagée verticalement jusqu’au terme du tableau afin de dessiner une trajectoire de seuil horizontale continue sur le graphique.
7.2 Modélisation de la Limite Inférieure de Contrôle (LIC / LCL)
Symétrique de la borne haute, la Limite Inférieure de Contrôle (désignée par le sigle LIC ou LCL pour Lower Control Limit) circonscrit le plancher opérationnel du système. Sa formulation algébrique standard se transcrit dans la cellule E2 d’Excel par l’expression soustractive directe :
=$C$2 - 3 * ECARTYPE.STANDARD($B$2:$B$21)
ou, via l’étendue mobile moyenne :
=$C$2 - 2,66 * MOYENNE($E$3:$E$21)
Toutefois, la modélisation de la LIC soulève une difficulté physique et logique majeure bien connue des métrologues : l’existence de limites naturelles physiques (natural physical boundaries). Dans une multitude d’applications pratiques — telles que le temps d’exécution d’une tâche, la latence de réponse motrice, le taux d’erreurs ou la concentration d’un contaminant biologique —, la grandeur mesurée est une variable strictement positive ($X in \mathbb{R}^+$) bornée à gauche par zéro. Lorsque la moyenne du processus est relativement basse et que la variance intrinsèque est substantielle, le calcul mathématique direct peut aboutir à une LIC négative, une aberration conceptuelle dépourvue de tout sens physique.
Pour résoudre cette incohérence dans le tableur sans fausser l’architecture du graphique, l’analyste doit encapsuler le calcul au sein d’une fonction de contrainte de positivité à l’aide de la fonction MAX(). La formule implémentée dans la cellule prend alors la forme péremptoire suivante :
=MAX(0; $C$2 - 3 * ECARTYPE.STANDARD($B$2:$B$21))
Cette troncature garantit que si la frontière théorique plonge en zone négative, la carte de contrôle affichera une LIC collée à l’axe d’origine zéro. Cette asymétrie fonctionnelle signale que le processus ne pourra déclencher d’alerte statistique sur la borne inférieure que si un saut qualitatif exceptionnel maintient durablement une séquence de zéros, adaptant ainsi le modèle à la réalité empirique du terrain.
7.3 Comparaison entre limites de contrôle statistique et spécifications techniques
L’une des confusions les plus dommageables en ingénierie de la qualité comme en recherche appliquée consiste à substituer les spécifications techniques (ou tolérances du cahier des charges) aux limites de contrôle statistique, ou à les tracer indifféremment sur le même graphique de surveillance. Cette confusion procède d’une incompréhension totale des niveaux épistémologiques régissant la variabilité.
Les limites de contrôle statistique (LSC et LIC) sont des entités purement endogènes. Elles sont calculées exclusivement à partir du comportement statistique observable du processus à un instant donné. Elles décrivent ce que le système est capable de réaliser concrètement dans son état actuel d’équilibre stochastique : elles incarnent la voix du processus (Voice of the Process). En aucun cas l’analyste ne peut décider unilatéralement d’élargir ou de resserrer ces limites par décret administratif ou convention de recherche.
À l’inverse, les limites de spécification — la Limite Supérieure de Spécification (LSS ou USL) et la Limite Inférieure de Spécification (LIS ou LSL) — sont des constructions exogènes. Elles expriment le niveau d’exigence imposé de l’extérieur par l’ingénieur, le médecin, le client ou le concepteur de l’expérience : elles traduisent la voix du client ou la norme théorique (Voice of the Customer). Un processus peut être parfaitement sous contrôle statistique (stable, prédictible, sans causes spéciales) mais se révéler totalement incapable de respecter les spécifications requises. Incorporer des spécifications sur une carte de contrôle de Shewhart pollue la lecture sémiologique et incite les opérateurs à ajuster indûment le processus tant que les points restent dans les tolérances, réintroduisant ainsi le phénomène dévastateur de surajustement (tampering).
8. Étape 5 : Génération et configuration graphique de la carte sous Excel
8.1 Insertion du graphique en courbes et sélection matricielle
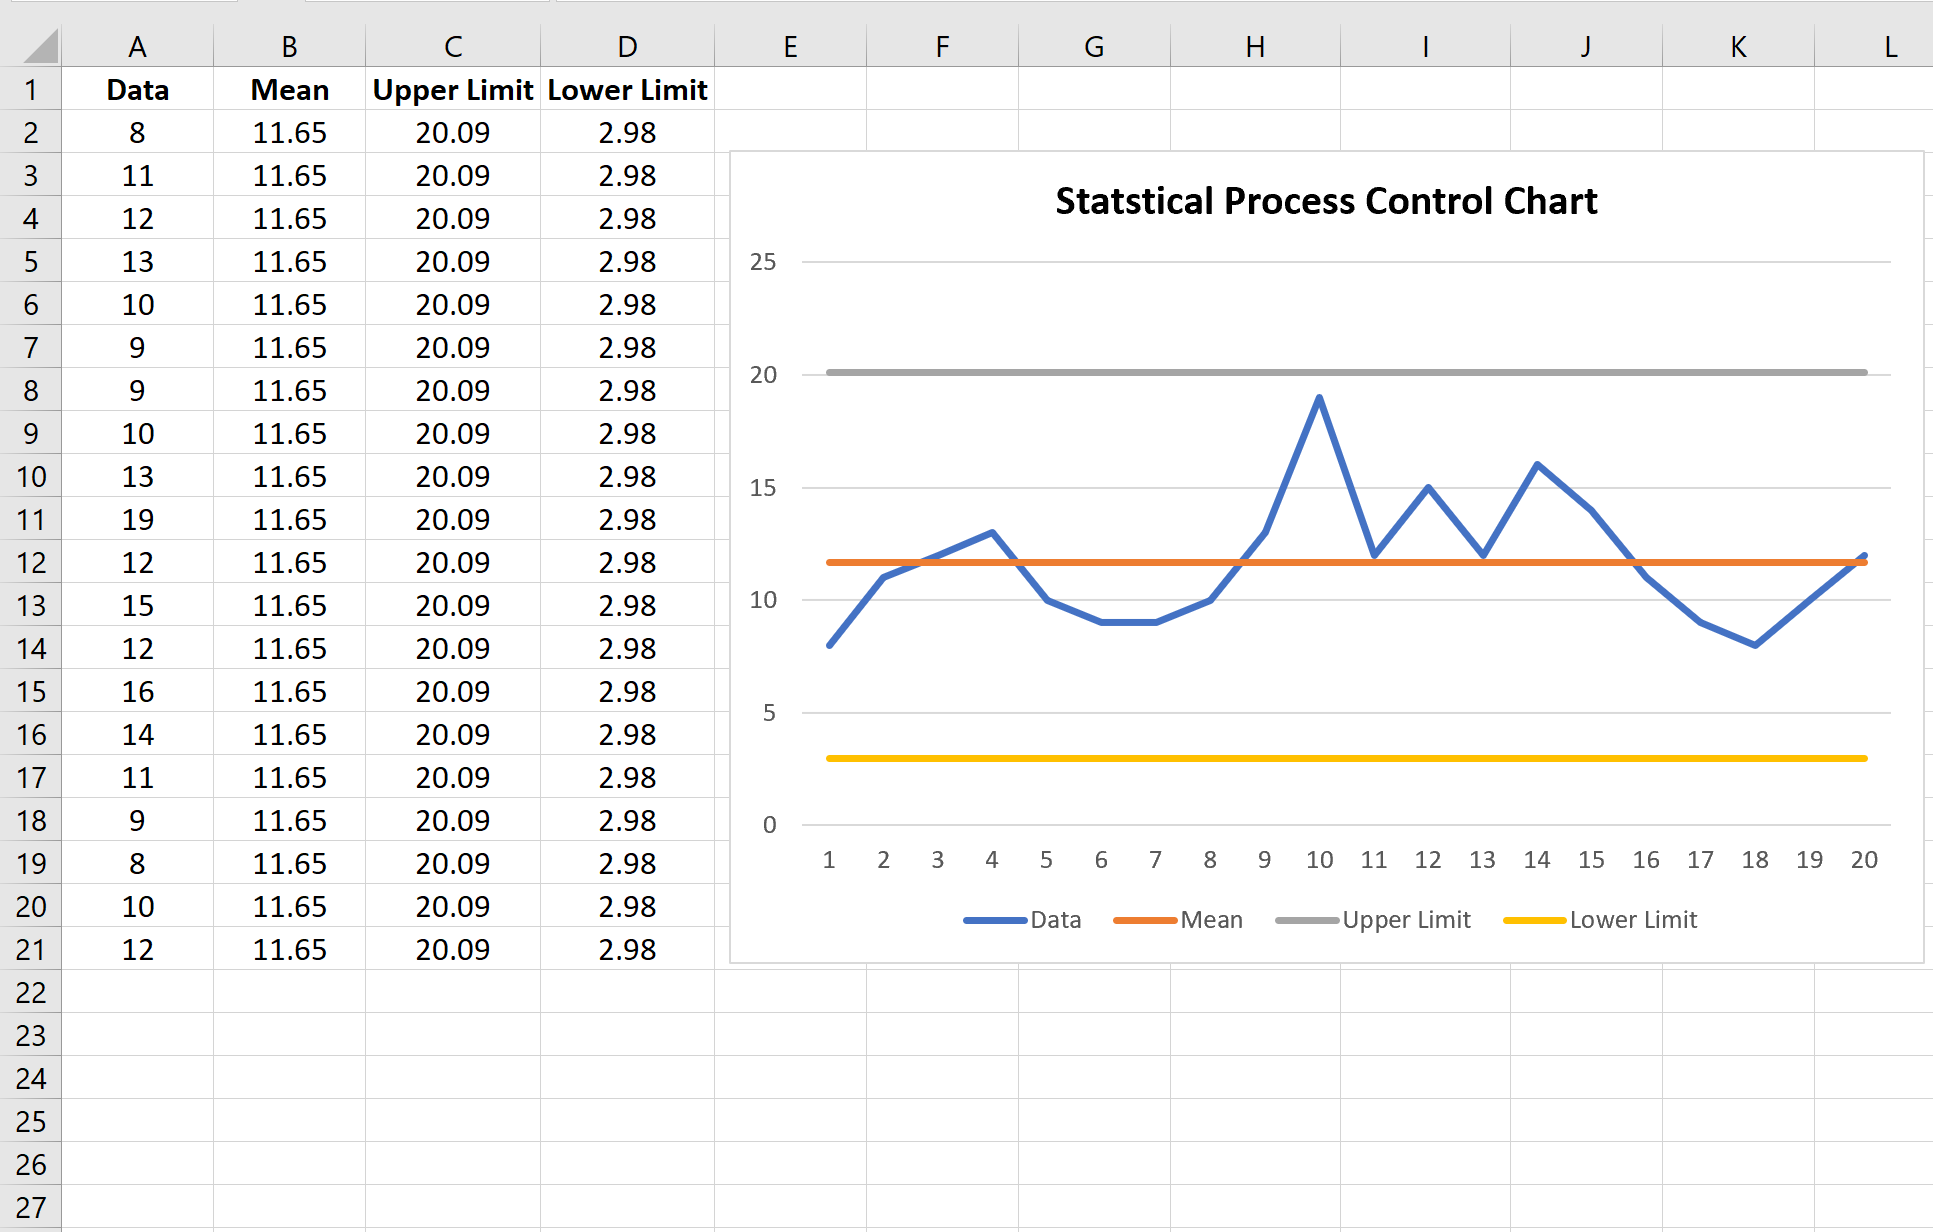
Une fois les calculs scalaires propagés sur l’ensemble des lignes du tableau, l’étape suivante consiste à convertir cette matrice de données en une représentation graphique sémiotiquement rigoureuse. La sélection de la plage doit englober exhaustivement les colonnes de l’identifiant séquentiel, de l’observation brute, de la ligne centrale, de la LSC et de la LIC, soit typiquement le bloc matriciel délimité par A1:E21 dans notre configuration de base.
Pour insérer le graphique sous Excel, l’utilisateur navigue vers le ruban Insertion, consulte la section Graphiques, puis clique sur l’icône Graphique en courbes. Il est impératif de sélectionner l’option spécifique Courbe 2D avec marqueurs pour la série de données empiriques. Cette typologie garantit que chaque observation unitaire est matérialisée par un glyphe distinct, tout en reliant chronologiquement les points par un segment rectiligne qui illustre le vecteur cinétique de variation.
Un écueil ergonomique majeur présent dans les versions contemporaines d’Excel doit être immédiatement neutralisé : l’activation accidentelle de l’option « Ligne lissée » dans la mise en forme des séries. Les courbes lissées par des algorithmes d’interpolation splines dessinent des ondulations douces d’une élégance trompeuse. En contrôle statistique, ce lissage est une faute méthodologique grave : il invente des extrema locaux inexistants entre deux pas de mesure et masque la rugosité discontinue de la réalité temporelle. Les tracés doivent demeurer strictement brisés, sous forme de segments linéaires reliant fidèlement les coordonnées matricielles brutes.
8.2 Harmonisation sémiologique et typologique des séries graphiques
La lisibilité cognitive d’une carte de contrôle conditionne la rapidité et la pertinence des décisions de pilotage. Une carte embrouillée, saturée de couleurs disparates ou dépourvue de hiérarchie visuelle, fatigue l’observateur et accroît le temps d’identification des signaux faibles. Il convient d’appliquer scrupuleusement les règles de la sémiologie graphique et le principe du ratio encre-données (Data-Ink Ratio) théorisé par Edward Tufte, qui prescrit d’éliminer toute fioriture ornementale ne véhiculant aucune information statistique.
L’harmonisation chromatique et typologique doit respecter les conventions internationales de la MSP :
- La série des données observées ($X_i$) : Elle doit occuper le premier plan perceptif. On lui attribue une ligne brisée fine de teinte sombre (noir d’encre, gris anthracite ou bleu marine soutenu) ponctuée de marqueurs circulaires pleins d’une taille modérée (taille 5 ou 6 points), permettant d’ancrer chaque mesure avec une précision sans équivoque.
- La Ligne Centrale (LC) : Elle doit être formatée sous la forme d’une ligne continue unie, d’épaisseur moyenne (1,5 point), arborant une couleur distinctive neutre et apaisante (un vert forêt profond ou un bleu roi), sans aucun marqueur sur ses nœuds de calcul.
- Les Limites de Contrôle (LSC et LIC) : Elles incarnent des barrières critiques d’interdiction. Elles doivent impérativement être configurées sous forme de lignes pointillées ou en tirets réguliers (dashed lines), d’une épaisseur de 1 à 1,5 point, arborant une teinte rouge brique normalisée. Ce traitement en pointillés rouges attire le regard tout en signalant visuellement leur nature de frontières probabilistes infranchissables.
8.3 Optimisation des échelles, axes et métadonnées graphiques
L’ajustement géométrique des axes de coordonnées sous Excel constitue le dernier verrou technique de la construction graphique. Par défaut, les algorithmes de cadrage automatique d’Excel ont tendance à dilater l’axe vertical pour l’ajuster au plus près des valeurs extrêmes observées, ou au contraire à forcer l’inclusion de l’origine zéro au détriment de l’amplitude apparente. Ce comportement machine peut écraser la variance perçue ou exagérer visuellement des micro-variations sans consistance.
L’analyste doit double-cliquer sur l’axe vertical (axe des ordonnées) pour accéder au panneau Mise en forme de l’axe et configurer manuellement les limites minimale et maximale. L’échelle doit être dimensionnée de manière à ce que l’intervalle entre la LIC et la LSC occupe approximativement 60 à 70 % de la hauteur totale du plan graphique, réservant un espace de respiration au-dessus de la LSC et en-dessous de la LIC pour accueillir visuellement les points en dérive sans qu’ils ne heurtent les bordures physiques du canevas.
L’axe horizontal (axe des abscisses) doit être verrouillé sur une numérotation discrète rigoureuse, faisant correspondre à chaque graduation le numéro exact de l’observation ou la séquence temporelle calendaire univoque. Enfin, le graphique doit être parachevé par l’insertion d’un titre académique descriptif indiquant avec précision l’identifiant du système, la variable métrique quantifiée et son unité dimensionnelle normalisée (par exemple : Carte de Contrôle I-MR – Latence d’Inhibition Motrice (ms) – Sujet 04), complété par une légende concise positionnée au bas ou à droite du tracé, débarrassée de tout encadrement superflu.
9. Interprétation analytique et détection des violations statistiques
9.1 Règle primordiale : Identification des points extrêmes hors limites
La règle canonique absolue de la maîtrise statistique des processus, qualifiée de règle de détection primaire de Shewhart, stipule que l’apparition d’un point unique en dehors des limites de contrôle (au-delà de la LSC ou en-deçà de la LIC) suffit à rejeter immédiatement l’hypothèse de stabilité statistique du système. Une telle occurrence constitue la preuve empirique flagrante de l’action d’une cause spéciale de variabilité.
La justification probabiliste de cette intransigeance analytique est implacable. Sous l’hypothèse nulle d’un processus stationnaire gouverné par une distribution normale, la probabilité cumulée qu’un point se situe au-delà de l’intervalle $[\mu – 3\sigma ; \mu + 3\sigma]$ est de :
$$\alpha = 1 – (\Phi(3) – \Phi(-3)) \approx 0{,}0027$$
soit seulement 0,27 % de faux positifs théoriques (ou environ 1 point sur 370 observations successives). L’argument consistant à relativiser un franchissement de limite en le qualifiant « d’anomalie passagère sans gravité » est méthodologiquement irrecevable : le risque de commettre une erreur de première espèce (déclarer une cause spéciale là où ne règne que le hasard) est si dérisoire que l’analyste a l’obligation épistémique de suspendre le processus pour diligenter une analyse causale approfondie.
Dès lors qu’un point sort des limites, l’investigation doit se focaliser immédiatement sur les métadonnées contextuelles associées à cette coordonnée temporelle exacte. L’analyste doit inspecter les journaux de bord, interroger les opérateurs de saisie, vérifier l’intégrité de la chaîne d’acquisition instrumentale et identifier la source d’énergie ou d’interférence exogène qui a brutalement propulsé le système hors de son bassin d’attraction stochastique naturel.
9.2 Application des règles de zones de Western Electric
Restreindre l’interprétation d’une carte de contrôle au seul constat des points hors limites priverait l’analyste d’une grande partie de la puissance diagnostique de la MSP. Un processus peut parfaitement dériver vers l’instabilité tout en maintenant l’ensemble de ses points à l’intérieur des frontières 3-sigma. Pour déceler précocement ces signaux d’alerte sous-jacents sans dégrader la robustesse du système, la société Western Electric Company a codifié en 1956 un ensemble de règles complémentaires fondées sur la partition probabiliste de l’espace de dispersion.
Cette partition s’opère en divisant la distance séparant la ligne centrale des limites de contrôle en trois zones concentriques d’une largeur exacte de 1 sigma chacune, de part et d’autre de l’axe :
- Zone C : Intervalle adjacent à la moyenne, s’étendant de $\mu$ à $\mu \pm 1\sigma$ (englobant environ 68,26 % des observations normales) ;
- Zone B : Intervalle intermédiaire, s’étendant de $\mu \pm 1\sigma$ à $\mu \pm 2\sigma$ (englobant environ 27,18 % des observations) ;
- Zone A : Intervalle périphérique extrême, situé entre $\mu \pm 2\sigma$ et $\mu \pm 3\sigma$ (représentant seulement 4,28 % des observations normales).
À partir de cette cartographie zonale, les célèbres règles de Western Electric formalisent des configurations de points dont la probabilité conjointe d’occurrence fortuite est quasi équivalente au franchissement direct du seuil de 3-sigma :
- Règle 2 : Deux points consécutifs sur une séquence de trois se positionnent en Zone A ou au-delà (détection précoce d’une translation modérée de l’espérance mathématique) ;
- Règle 3 : Quatre points consécutifs sur une séquence de cinq se situent en Zone B ou au-delà (signalement d’un glissement directionnel persistant) ;
- Règle 4 : Huit ou neuf points immédiatement consécutifs se localisent tous du même côté de la ligne centrale, sans aucune alternance (preuve statistique irréfutable d’un saut de moyenne, même minime).
9.3 Identification des motifs non aléatoires : dérives, cycles et mélanges
L’ultime degré d’expertise dans l’exploitation des cartes de contrôle réside dans la détection des motifs morphologiques non aléatoires au sein de la bande de dispersion. Un processus sous contrôle statistique rigoureux doit présenter une signature cinétique totalement erratique, où l’enchaînement des augmentations et des diminutions mime parfaitement un bruit blanc gaussien non corrélé. Toute émergence d’une géométrie ordonnée trahit la présence de forces déterministes sous-jacentes.
Le premier motif suspect est la dérive continue (trend), identifiée formellement par une suite ininterrompue de six ou sept points augmentant de manière monotone ($X_1 < X_2 < X_3 < dots < X_7$) ou diminuant rigoureusement. Cette trajectoire annonce l'usure mécanique progressive d'un outil, l'épuisement progressif d'un substrat chimique, ou l'accumulation graduelle d'une fatigue cognitive chez un sujet soumis à un effort d'attention prolongé.
Le second motif récurrent est la cyclicité ou périodicité sinusoïdale. Si le nuage de points dessine des vagues régulières alternant crêtes et creux avec une périodicité fixe, le processus est tributaire d’une variable périodique non contrôlée : variations nycthémérales de température dans le laboratoire, cycle de rotation des équipes de travail ou fluctuations hormonales cycliques.
Enfin, le phénomène de stratification représente une pathologie paradoxale particulièrement pernicieuse : les points se concentrent anormalement autour de la ligne centrale, sans jamais explorer la Zone B ou la Zone A (par exemple 15 points consécutifs restant confinés en Zone C). Cette absence anormale de variabilité ne traduit pas une perfection miraculeuse du procédé, mais une erreur d’échantillonnage majeure : le mélange artificiel au sein des données de deux populations distinctes dont les effets opposés s’annulent mathématiquement, ou une manipulation délibérée des données par un opérateur zélé cherchant à dissimuler la variabilité réelle.
10. Automatisation des alertes statistiques par mise en forme conditionnelle
10.1 Élaboration des formules logiques de surveillance dans la grille
L’inspection purement oculaire d’une carte de contrôle devient impraticable dès lors que les flux de données s’étendent sur des centaines d’observations longitudinales. Pour décharger l’analyste de cette vigilance chronophage et éliminer l’erreur d’inattention humaine, Excel offre un environnement propice à l’automatisation intégrale de la surveillance algorithmique via ses fonctions logiques combinatoires.
La première brique de cette automatisation consiste à implanter, au sein d’une colonne auxiliaire (par exemple la colonne F, intitulée Alerte_Shewhart), une formule logique évaluant le dépassement des limites 3-sigma. Dans la cellule F2, on insère la syntaxe suivante :
=SI(OU(B2>D2; B2<E2); "HORS CONTROLE"; "OK")
Cette expression renvoie instantanément un label explicite dès que la valeur observée en B2 franchit la LSC (colonne D) ou la LIC (colonne E). Pour prémunir le modèle contre d’éventuels bugs d’exécution lorsque des cellules du bas du tableau sont encore vides dans l’attente de mesures futures, on encapsule cette formulation au sein d’un test préliminaire de présence :
=SI(ESTVIDE(B2); ""; SI(OU(B2>D2; B2<E2); "ALERTE : Dépassement 3-Sigma"; "Stable"))
Pour surveiller la Règle 4 de Western Electric (la séquence de huit points consécutifs situés du même côté de la moyenne), l’algorithme fait appel aux fonctions statistiques unilatérales combinées à un décalage d’indices. L’analyse des résidus signés peut être encodée par une colonne vectorisant le signe de la différence $(B2 – C2)$. Une formule combinant les fonctions NB.SI() et des plages relatives ascendantes permet alors de dénombrer instantanément les séries unilatérales et de lever un drapeau textuel dès que le seuil de 8 unités identiques consécutives est franchi.
10.2 Paramétrage visuel des marqueurs critiques sur le graphique
La remontée d’une alerte textuelle dans une cellule du tableur est une excellente chose, mais son intégration directe et visuelle au sein même du tracé graphique décuple l’efficacité cognitive du tableau de bord. Excel ne permet pas nativement de colorer de façon conditionnelle un marqueur unique au sein d’une série de courbes standard. Il existe toutefois une astuce d’ingénierie logicielle particulièrement puissante : l’adjonction d’une série graphique secondaire fantôme dédiée exclusivement aux points en anomalie.
Pour matérialiser cette solution :
- On crée une colonne dédiée intitulée Points_Anomalies (colonne G).
- Dans la cellule G2, on intègre la formule conditionnelle suivante :
=SI(OU(B2>D2; B2<E2); B2; NA()) - L’élément fondamental de cette syntaxe réside dans l’utilisation de la fonction
NA()(qui génère la valeur d’erreur standard#N/A). Les moteurs graphiques d’Excel possèdent en effet une propriété remarquable : ils ignorent totalement les cellules contenant la valeur d’erreur#N/Alors du tracé vectoriel, ne traçant ni ligne ni marqueur pour ces coordonnées spécifiques. - On ajoute ensuite cette colonne G comme nouvelle série de données sur le graphique existant via le menu Sélectionner des données.
- On configure cette nouvelle série sous la forme d’un nuage de points sans ligne de liaison, en choisissant un marqueur circulaire large (taille 9 ou 10 points), rempli d’un rouge écarlate vif avec une bordure extérieure blanche contrastée.
Grâce à cette architecture élégante, la courbe normale continue de défiler en noir et bleu. Mais dès qu’une coordonnée viole l’une des limites, la formule conditionnelle bascule de #N/A vers la valeur réelle de l’observation : une pastille rouge proéminente apparaît alors instantanément sur le graphique, encerclant l’observation fautive d’une alerte visuelle percutante et entièrement automatisée.
10.3 Automatisation par fonctions dynamiques matricielles modernes
L’introduction récente dans le moteur de calcul de Microsoft 365 des fonctions matricielles dynamiques telles que LET(), LAMBDA(), FILTRE() et CHOISIRCOLS() permet de concevoir des architectures de cartes de contrôle d’une compacité algorithmique et d’une puissance logicielle jusqu’alors réservées aux environnements de programmation comme R ou Python.
La fonction LET() permet notamment de compacter le calcul matriciel des limites au sein d’une formule vectorielle globale auto-extensible, réduisant considérablement le nombre de colonnes de calcul intermédiaires et diminuant l’empreinte mémoire du classeur. Considérons la formulation moderne suivante déployée sur une seule cellule pour générer dynamiquement l’intégralité du statut diagnostique d’une série chronologique :
=LET(

  obs; FILTRE(Tableau1[Mesure]; NON(ESTVIDE(Tableau1[Mesure])));

  n; LIGNES(obs);

  moy; MOYENNE(obs);

  diffs; ABS(DECALER(obs; 1; 0; n-1; 1) - DECALER(obs; 0; 0; n-1; 1));

  sigma; MOYENNE(diffs) / 1,128;

  lsc; moy + 3 * sigma;

  lic; MAX(0; moy - 3 * sigma);

  statut; SI(obs > lsc; "ALERTE SUP"; SI(obs < lic; "ALERTE INF"; "STABLE"));

  statut

)
Dans ce bloc d’instructions condensé, la variable obs extrait dynamiquement les valeurs actives. La variable diffs calcule matriciellement l’ensemble du vecteur des étendues mobiles successives sans aucune formule glissée sur la feuille de calcul. L’écart-type non biaisé sigma est dérivé à la volée, suivi de la LSC et de la LIC. Enfin, le vecteur résultat statut se propage instantanément (phénomène de déversement matriciel ou spill) sur toute la hauteur de la colonne.
Cette approche vectorielle moderne élimine les risques d’altération accidentelle des formules par les utilisateurs finaux : la logique algorithmique est entièrement encapsulée dans la cellule de tête. En protégeant la structure de la feuille par un mot de passe d’audit tout en laissant la saisie libre sur la colonne des mesures brutes, le modélisateur met à disposition des équipes un outil de contrôle statistique d’une fiabilité absolue et parfaitement pérenne.
11. Applications pratiques dans les protocoles psychologiques et expérimentaux
11.1 Suivi longitudinal des latences de réponse et de l’attention soutenue
L’évaluation des fonctions exécutives humaines à travers des paradigmes informatisés — tels que la tâche de Stroop, la tâche de détection de signal ou le test de performance continue (CPT) — confronte systématiquement le neuropsychologue à une instabilité temporelle difficile à formaliser. La latence de réponse motrice, quantifiée en millisecondes, subit l’interférence permanente de facteurs non cognitifs qu’il s’avère capital de filtrer méthodologiquement pour accéder à la signature attentionnelle réelle du participant.
En transposant la tâche sur une carte de contrôle de type I-MR sous Excel, chaque essai unitaire successif ou chaque moyenne de micro-bloc d’essais est immédiatement projeté contre les limites 3-sigma du profil individuel du sujet. Cette projection permet de tracer une frontière rigoureuse entre deux dynamiques psychophysiologiques antagonistes :
- L’effet d’apprentissage ou d’automatisation motrice : Il se traduit graphiquement par une dérive descendante régulière et asymptotique de la moyenne des latences au cours des premiers blocs expérimentaux, s’accompagnant d’un resserrement progressif des étendues mobiles ($MR$).
- Le décrochage attentionnel ou lapsus de vigilance (mind-wandering) : Il se manifeste par l’émergence ponctuelle et explosive d’un temps de réaction franchissant la LSC. Ces points hors limites ne doivent pas être supprimés hâtivement en les assimilant à de simples scories expérimentales : ils constituent la quantification objective et mesurable de ruptures de l’inhibition motrice ou de l’attention soutenue.
De plus, cette méthode neutralise les artefacts liés aux fluctuations circadiennes lors des protocoles d’évaluation répétés s’étalant sur plusieurs journées consécutives. En suivant longitudinalement l’évolution de la Ligne Centrale calculée session par session, le chercheur objective si le niveau de performance de base est altéré par le manque de sommeil ou la dette de vigilance, tout en conservant une appréciation locale de la dispersion pour chaque heure de passation.
11.2 Analyse de séries temporelles interrompues en conception de cas unique (N=1)
La recherche clinique en psychothérapie comportementale, en remédiation cognitive et en ergothérapie recourt massivement aux protocoles de recherche à cas unique (Single-Case Experimental Designs ou SCED). Ces paradigmes, structurés sous la forme de séquences A-B, A-B-A ou B-A-B, analysent l’évolution d’un patient sous l’effet d’une intervention thérapeutique ciblée en utilisant le sujet comme son propre témoin statistique temporel.
L’analyse statistique de ces séries courtes interrompues a longtemps constitué une aporie méthodologique : l’application des tests d’hypothèse conventionnels (comme le test $t$ de Student ou l’ANOVA) y est formellement invalide en raison de la violation flagrante de l’indépendance des erreurs (présence d’autocorrélation sérielle substantielle) et de la faiblesse des effectifs d’échantillonnage. La carte de contrôle statistique résout cette difficulté avec une pertinence expérimentale remarquable :
- Durant la Phase A (ligne de base pré-interventionnelle), les comportements-cibles (par exemple le nombre de compulsions journalières ou le niveau d’anxiété auto-évalué) sont colligés sur une période de 15 à 20 jours.
- Les limites de contrôle (LC, LSC, LIC) sont calculées exclusivement à partir des données de cette Phase A, définissant le modèle stochastique du trouble à l’état stationnaire non traité.
- Dès l’engagement de la Phase B (phase active de traitement), les nouvelles mesures sont reportées chronologiquement sur la carte, mais les limites de référence antérieures de la Phase A sont projetées horizontalement sur cette nouvelle zone temporelle sans être recalculées.
Si la stratégie thérapeutique est cliniquement efficiente, les observations de la Phase B vont rapidement violer les lois de probabilité de la phase de référence : franchissement franc de la LIC (diminution spectaculaire du symptôme), dérive descendante continue de 6 points consécutifs, ou présence de 8 points consécutifs situés en dessous de la ligne centrale historique. L’analyste dispose ainsi d’une preuve probabiliste incontestable de l’efficacité du traitement sans dépendre de postulats distributionnels irréalistes.
11.3 Contrôle de l’accord inter-juges et de la consistance méthodologique
Dans les enquêtes épidémiologiques et les essais cliniques multicentriques, la collecte des critères d’évaluation principaux repose fréquemment sur la notation subjective d’évaluateurs humains (psychiatres, neuropsychologues, observateurs comportementaux) remplissant des échelles standardisées (comme l’échelle d’évaluation de la dépression de Hamilton ou l’inventaire d’autisme ADOS). La consistance interne du protocole dépend de la stabilité temporelle du calibrage évaluatif de ces juges.
L’implémentation d’une carte de contrôle de type X-barre et S sous Excel offre un outil de métrologie humaine pour surveiller la fidélité inter-observateurs. En consignant périodiquement les scores attribués par les différents juges à des cas cliniques standardisés enregistrés sur support vidéo (témoins méthodologiques aveugles), on calcule la moyenne d’évaluation et l’écart-type inter-juges ($S$) pour chaque session d’audit récurrente.
La carte $S$ permet de détecter immédiatement tout phénomène d’hétérogénéité émergente : une augmentation de la dispersion inter-juges au-delà de la limite supérieure de contrôle signale qu’une divergence doctrinale s’installe au sein de l’équipe, imposant une session de réalignement et d’étalonnage consensuel. Parallèlement, la carte de tendance centrale détecte les dérives d’évaluation systématiques : un évaluateur développant subrepticement un biais de sévérité ou d’indulgence verra ses scores s’isoler hors des zones d’acceptabilité, garantissant ainsi l’intégrité métrologique des données scientifiques publiées.
12. Écueils méthodologiques, limites d’application et indices de capabilité
12.1 Violations graves des postulats statistiques fondamentaux
L’apparente simplicité d’exécution technique d’une carte de contrôle au sein d’un tableur dissimule des contraintes théoriques que le praticien ne saurait ignorer sans compromettre la validité de ses déductions. La violation méthodologique la plus insidieuse concerne le postulat d’indépendance sérielle des résidus stochastiques. Les limites canoniques à $\pm 3\sigma$ supposent que chaque point de mesure $X_t$ est strictement indépendant du point précédent $X_{t-1}$, ce qui implique une autocorrélation nulle :
$$\rho_k = operatorname{Cov}(X_t, X_{t-k}) = 0 \quad (\forall k \neq 0)$$
Or, dans une multitude de séries temporelles physiques, chimiques ou psychologiques à haute fréquence, les mesures manifestent une inertie temporelle intrinsèque (autocorrélation positive d’ordre 1). Lorsqu’une autocorrélation positive affecte les données, la variance des différences consécutives diminue artificiellement : l’étendue mobile moyenne $\overline{MR}$ s’effondre, provoquant un rétrécissement indu des limites de contrôle. Le dispositif se met alors à émettre une avalanche de fausses alertes d’instabilité, confondant une inertie stochastique naturelle avec des causes assignables exogènes.
Face à des séries fortement autocorrélées, l’analyste doit d’abord tester la dépendance sérielle sous Excel à l’aide de la statistique de Durbin-Watson ou du tracé du corrélogramme des retards. Si l’autocorrélation est avérée, la méthodologie impose soit de sous-échantillonner la série en espaçant les prises de mesure dans le temps pour briser la mémoire du système, soit d’ajuster préalablement un modèle autorégressif de type ARIMA et de tracer la carte de contrôle non pas sur les données brutes, mais sur les résidus d’innovation du modèle.
Un autre écueil classique réside dans la présence de distributions résolument asymétriques ou multimodales (par exemple des mélanges de populations non identifiées). Face à une distribution fortement log-normale ou exponentielle (fréquente pour les durées d’attente ou les latences), l’application directe des formules standard génère une LIC tronquée à zéro et une LSC sous-dimensionnée. La bonne pratique méthodologique exige alors d’appliquer en amont une transformation mathématique de stabilisation de la variance — telle que la transformation logarithmique ou la transformation paramétrique de Box-Cox — avant d’engager le calcul des limites sur les valeurs transformées.
12.2 Calcul et interprétation des ratios de capabilité (Cp et Cpk) sous Excel
Dès lors qu’un processus a démontré sa parfaite stabilité statistique par l’absence prolongée de causes spéciales, se pose la question de son adéquation fonctionnelle : le système est-il capable de respecter les exigences opérationnelles ou les tolérances imposées par le cahier des charges ? Cette évaluation relève de l’analyse de capabilité, formalisée par des coefficients adimensionnels dont le calcul s’intègre au classeur Excel.
Le ratio de capabilité potentiel, noté $C_p$, met en perspective la dispersion totale admissible prescrite par les spécifications techniques (la largeur de l’intervalle $[LIS ; LSS]$) avec la dispersion intrinsèque réelle du processus sous contrôle ($6\sigma$). Sa formulation mathématique se traduit dans Excel par la cellule suivante :
=(LSS - LIS) / (6 * ECARTYPE.STANDARD($B$2:$B$21))
Un $C_p < 1,0$ indique que le processus est intrinsèquement incapable de tenir les spécifications, même s'il était parfaitement centré : sa dispersion naturelle excède la tolérance accordée. Un $C_p ge 1,33$ constitue le standard industriel minimal exigé pour garantir une marge de sécurité opérationnelle satisfaisante.
Toutefois, le $C_p$ présente la lacune d’ignorer totalement la position de la moyenne par rapport au centre des tolérances. Pour intégrer l’erreur de centrage, l’analyste dérive l’indicateur de capabilité effectif, désigné sous le sigle $C_{pk}$. Cet indice calcule la distance minimale normalisée séparant la moyenne empirique de chacune des deux bornes de spécification :
$$C_{pk} = \min\left( \frac{LSS – \bar{X}}{3\sigma}, \frac{\bar{X} – LIS}{3\sigma} \right)$$
Dans Excel, cette dérivation s’opère par la formule combinée :
=MIN((LSS - MOYENNE($B$2:$B$21)) / (3 * ECARTYPE.STANDARD($B$2:$B$21)); (MOYENNE($B$2:$B$21) - LIS) / (3 * ECARTYPE.STANDARD($B$2:$B$21)))
Si la moyenne dérive vers la borne supérieure de spécification, le numérateur $(LSS – \bar{X})$ se comprime, provoquant l’effondrement de la valeur du $C_{pk}$ en dépit d’une variance globale éventuellement très faible. Une mise en garde théorique absolue s’impose : le calcul des indices de capabilité $C_p$ et $C_{pk}$ est totalement dépourvu de sens mathématique si le processus n’est pas préalablement sous contrôle statistique. Calculer un ratio de capabilité sur une série chronologique instable parasitée par des causes spéciales équivaut à mesurer avec précision une distance à l’aide d’un mètre élastique dont la longueur se déforme continuellement.
12.3 Synthèse des bonnes pratiques pour la pérennité du système de contrôle
L’implantation pérenne d’une culture de la maîtrise statistique via l’outil informatique requiert une discipline méthodologique continue qui transcende la simple saisie de formules algorithmiques dans un tableur. Pour assurer la pérennité et la fécondité heuristique de ce dispositif, les équipes de recherche et de pilotage de la qualité doivent observer scrupuleusement un ensemble de bonnes pratiques organisationnelles :
- Le recalcul raisonné des limites : Les limites de contrôle ne doivent jamais être modifiées de manière arbitraire ou au gré de chaque nouvelle saisie de données. Les bornes historiques doivent rester strictement verrouillées tant que le processus n’a pas fait l’objet d’une intervention structurelle formellement documentée et validée. Tout recalibrage périodique des limites doit s’appuyer sur un audit d’au moins 25 à 30 nouvelles observations consécutives attestant de l’installation durable d’un nouveau régime de fonctionnement.
- L’archivage méthodique de la causalité : Chaque dérive, chaque point hors limites ou chaque alerte de Western Electric ayant déclenché une investigation de terrain doit faire l’objet d’une consignation systématique au sein d’un journal des causes assignables intégré au classeur (colonne de commentaires ou feuille d’audit associée). Cet archivage documente l’étiologie du phénomène et capitalise les solutions correctives apportées, constituant une mémoire organisationnelle précieuse.
- L’acculturation des équipes opérationnelles : La carte de contrôle doit être comprise par l’ensemble des acteurs impliqués dans la chaîne de recueil, du technicien de saisie au directeur de laboratoire. Chacun doit assimiler le message épistémologique fondamental : ne jamais intervenir sur un système qui fluctue à l’intérieur de ses limites sous le règne des causes communes, mais se mobiliser immédiatement dès qu’un signal assignable franchit les barrières statistiques.
Pour parachever cette démarche d’ingénierie analytique, la liste de contrôle suivante récapitule les étapes nécessaires pour vérifier la conformité d’un classeur de contrôle statistique élaboré sous Microsoft Excel avant son déploiement opérationnel :
- Les données de mesure sont disposées de manière linéaire et chronologique dans un tableau structuré officiel (raccourci
Ctrl + L) ; - L’audit distributionnel préalable confirme l’absence d’asymétrie extrême ou d’aplatissement pathologique non corrigé ;
- Les plages de référence matricielles sont rigoureusement figées par l’adressage absolu (
$) ou par des noms de champs univoques ; - L’écart-type expérimental est estimé sans biais, en évitant formellement l’emploi d’
ECARTYPE.PEARSONau profit d’ECARTYPE.STANDARDou du ratio$\overline{MR} / d_2$; - La contrainte de non-négativité logique est encapsulée via la fonction
MAX(0; ...)pour les grandeurs physiques bornées à zéro ; - Le graphique en courbes brisées 2D exclut formellement tout lissage par interpolation spline ;
- Les conventions sémiologiques (pointillés rouges pour les limites, trait plein neutre pour la ligne centrale, marqueurs distincts pour les points) sont scrupuleusement appliquées ;
- Un système d’alerte automatisé par formules logiques ou série d’anomalies sur base
#N/Asignale visuellement les signaux d’alarme ; - Aucune limite de spécification exogène n’est confondue avec les frontières de contrôle statistique endogènes sur le tracé de Shewhart.
En observant scrupuleusement ces principes méthodologiques et cette rigueur d’implémentation logicielle, l’analyste transforme un simple tableur bureautique en un puissant laboratoire de surveillance dynamique, capable de maîtriser le tumulte de la variabilité stochastique et de porter le pilotage des processus expérimentaux ou industriels à un degré de certitude scientifique inégalé.
Références
- American Society for Quality. (s. d.). What is statistical process control (SPC)? ASQ Quality Resources. https://www.asq.org/quality-resources/statistical-process-control
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Deming, W. E. (1986). Out of the crisis. Massachusetts Institute of Technology, Center for Advanced Engineering Study.
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332380
- International Organization for Standardization. (2011). Cartes de contrôle — Partie 1: Lignes directrices générales (Norme ISO 7870-1:2011). https://www.iso.org/fr/standard/50901.html
- International Organization for Standardization. (2013). Cartes de contrôle — Partie 2: Cartes de contrôle de Shewhart (Norme ISO 7870-2:2013). https://www.iso.org/fr/standard/50902.html
- Microsoft Support. (s. d.). Aide et apprentissage de Microsoft Excel. Microsoft Corporation. https://support.microsoft.com/fr-fr/excel
- Montgomery, D. C. (2019). Introduction to statistical quality control (8e éd.). John Wiley & Sons.
- National Institute of Standards and Technology. (2021). NIST/SEMATECH e-Handbook of statistical methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
- Pfadt, A., & Wheeler, D. J. (1995). Using statistical process control to evaluate the effects of social interventions in applied behavior analysis. Journal of Applied Behavior Analysis, 28(3), 349-366. https://doi.org/10.1901/jaba.1995.28-349
- Shewhart, W. A. (1931). Economic control of quality of manufactured product. D. Van Nostrand Company.
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Western Electric Company. (1956). Statistical quality control handbook. Western Electric Co., Inc.
- Wheeler, D. J., & Chambers, D. S. (1992). Understanding statistical process control (2e éd.). SPC Press.