
L’analyse de données multidimensionnelles constitue l’un des piliers méthodologiques fondamentaux des sciences contemporaines, s’étendant de la psychométrie quantitative à la bio-informatique, en passant par l’économétrie et l’apprentissage automatique. Face à l’accroissement exponentiel du volume et de la complexité des variables observées, les chercheurs et praticiens se heurtent de manière récurrente au fléau de la dimensionnalité, qui altère la puissance statistique, obscurcit la lisibilité des structures sous-jacentes et démultiplie le risque de colinéarité excessive. Dans ce contexte épistémologique, l’Analyse en Composantes Principales (ACP) s’impose comme une technique de réduction linéaire indispensable, visant à projeter un espace vectoriel de grande dimension vers un sous-espace de dimension inférieure tout en maximisant la préservation de la variance totale du système.
Cependant, la mise en œuvre rigoureuse d’une décomposition factorielle ou d’une ACP soulève inévitablement une interrogation décisionnelle critique : quelle est la quantité optimale de composantes ou de facteurs à retenir pour résumer l’information sans incorporer le bruit stochastique ? C’est précisément pour résoudre ce dilemme méthodologique que Raymond Cattell a introduit, au milieu des années soixante, le concept novateur du scree plot, ou graphique d’éboulis. En représentant visuellement la décroissance ordonnée des valeurs propres issues de la décomposition spectrale, cet outil graphique permet d’identifier empiriquement la frontière séparant les dimensions majeures porteuses de signal informatif des résidus aléatoires assimilables à de simples débris géologiques au pied d’une falaise.
L’écosystème open source Python, articulé autour de bibliothèques scientifiques hautement optimisées telles que NumPy, Pandas, Scikit-Learn et Matplotlib, offre un environnement d’une flexibilité et d’une puissance remarquables pour formaliser, calculer et visualiser cette procédure analytique. Le présent guide propose une exploration exhaustive, didactique et rigoureusement étayée de la construction pas à pas d’un scree plot académique en Python. En s’appuyant sur des fondements d’algèbre linéaire solide, sur une manipulation pas à pas du jeu de données empirique classique des statistiques criminelles américaines (USArrests) et sur une mise en perspective avec les critères de sélection factorielle les plus rigoureux, cet article vise à doter les analystes et chercheurs des compétences requises pour concevoir des visualisations diagnostiques conformes aux standards les plus exigeants de la publication scientifique.
1. Fondements conceptuels de l’Analyse en Composantes Principales (ACP) et du scree plot
L’exploration de vastes ensembles de données nécessite des cadres méthodologiques capables d’extraire la substantifique moelle de matrices complexes sans en dénaturer les relations internes. Avant d’aborder la programmation concrète d’une figure diagnostique en Python, il convient d’expliciter le socle théorique de la réduction de dimensionnalité, l’émergence historique du test de l’éboulis et le rôle fondamental de l’inspection visuelle dans la validation des modèles statistiques.
1.1 Définition et rôle de la réduction de dimensionnalité en psychologie quantitative
La psychométrie quantitative et les sciences comportementales sont historiquement confrontées à l’évaluation de construits latents non observables directement, tels que l’intelligence fluide, l’anxiété projective ou les traits de personnalité. L’approche empirique prédominante consiste à administrer des batteries de tests exhaustives composées de dizaines, voire de centaines d’items manifestes. Cette accumulation de mesures engendre quasi systématiquement une forte multicolinéarité au sein des données, rendant l’application directe des modèles linéaires classiques instable et redondante. La réduction de dimensionnalité intervient dès lors comme une nécessité opérationnelle, destinée à condenser ces multiples variables manifestes en un ensemble restreint de dimensions latentes, parfaitement orthogonales ou clairement délimitées, et immédiatement interprétables sur le plan théorique.
L’objectif fondamental de cette approche réside dans la préservation maximale de la variance totale du jeu de données multidimensionnel d’origine. En projetant les observations au sein d’un nouvel espace vectoriel dont les axes maximisent l’inertie du nuage de points, le praticien s’assure qu’une fraction substantielle de l’hétérogénéité individuelle est conservée dans les premières dimensions synthétiques. Ce processus garantit une compression informationnelle optimale tout en minimisant la perte d’information résiduelle, ce qui s’avère déterminant pour les modélisations prédictives ou explicatives ultérieures.
Il demeure néanmoins crucial de tracer une distinction épistémologique stricte entre l’Analyse en Composantes Principales (ACP) et l’Analyse Factorielle Exploratoire (AFE). Tandis que l’ACP constitue une méthode purement géométrique de réduction de variance totale ne distinguant pas la variance commune de la variance spécifique ou d’erreur, l’AFE postule un modèle réflexif sous-jacent où des variables latentes inobservées causent directement les corrélations constatées entre variables manifestes. Si les deux méthodologies exploitent couramment le scree plot pour guider le choix du nombre d’axes à extraire, leurs hypothèses d’identification statistique diffèrent radicalement : l’ACP opère sur la totalité de la diagonale unitaire d’une matrice de corrélation, alors que l’analyse factorielle procède à l’estimation préalable des communalités pour isoler la variance partagée du bruit de mesure.
1.2 Origine historique et principe méthodologique du scree plot de Cattell
C’est en 1966 que le psychologue et statisticien Raymond B. Cattell a formalisé le test de l’éboulis dans un article fondateur de la revue Multivariate Behavioral Research. Désireux de pallier le caractère arbitraire ou excessif des critères d’arrêt purement mathématiques disponibles à l’époque, Cattell a proposé un protocole heuristique reposant sur une analogie géologique particulièrement évocatrice. Dans la nature, l’érosion d’une falaise abrupte entraîne la chute de fragments de roches qui s’accumulent au pied de la paroi sous la forme d’un talus d’éboulis (désigné en anglais par le terme de scree ou scree slope). La morphologie de cette formation présente une déclivité spectaculaire au niveau du mur rocheux, suivie d’une rupture de pente nette menant à une traîne quasi horizontale de décombres géologiques.
Transposée au domaine de l’algèbre multidimensionnelle, cette métaphore structure la représentation graphique de la décroissance ordonnée des valeurs propres. Lorsque l’on extrait les valeurs propres associées aux axes principaux d’une matrice de dispersion et qu’on les ordonne de manière strictement décroissante en fonction de leur rang factoriel, la courbe qui en résulte reflète fidèlement la topographie d’une falaise. Les premières valeurs propres, d’une magnitude élevée, constituent la paroi verticale représentative du signal structural dominant. Dès lors que la dynamique de décroissance s’estompe pour former un palier continu et linéaire de faible magnitude, le praticien se trouve confronté aux débris résiduels assimilables à du bruit d’échantillonnage.
Le principe méthodologique du test de Cattell consiste ainsi à identifier graphiquement le seuil de coupure visuel, communément qualifié de point d’inflexion ou de coude (elbow point), qui sépare sans ambiguïté les composantes majeures explicatives des composantes mineures négligeables. L’analyste recherche le point géométrique précis où la pente s’adoucit brutalement pour adopter une course asymptotique, indiquant que chaque variable additionnelle n’apporte plus qu’une quantité résiduelle de variance, indiscernable des fluctuations stochastiques inhérentes à tout échantillon fini.
1.3 Importance de la visualisation graphique dans la décision de rétention factorielle
La sélection du nombre de dimensions factorielles représente une décision critique qui façonne l’ensemble des analyses subséquentes. S’en remettre de manière aveugle à des seuils numériques rigides et automatisés expose le chercheur à des écueils statistiques majeurs. Par exemple, l’application automatique d’une règle coupant strictement à une valeur numérique prédéterminée peut conduire à écarter un facteur explicatif potentiel dont la valeur propre se situerait à 0,999 ou, inversement, à inclure artificiellement une dimension n’apportant qu’une variance de 1,001 dépourvue de toute pertinence théorique. Les coupures automatisées décontextualisées occultent la configuration globale de la distribution de la variance.
L’inspection visuelle permise par le scree plot constitue un complément indispensable aux métriques formelles. En offrant une vue holistique de la structure spectrale des données, le graphique permet à l’analyste d’évaluer la netteté de la frontière entre le signal et le bruit. Un coude franc et saillant renforce considérablement la confiance du praticien dans la robustesse du modèle retenu, tandis qu’une décroissance monotone et continue sans rupture d’angle visible signale une structure factorielle floue ou une redondance diffuse entre variables, nécessitant une réévaluation prudente du cadre d’échantillonnage ou des hypothèses psychométriques.
L’impact du nombre de composantes retenues sur la validité de construit s’avère fondamental. La sous-extraction factorielle, qui consiste à éliminer trop précocement des composantes réelles, force l’agrégation de dimensions théoriques distinctes au sein d’un axe hybride artificiel, entraînant une perte de spécificité diagnostique et masquant des phénomènes psychologiques majeurs. À l’opposé, la sur-extraction fragmente des construits stables en composantes multiples d’une faible portée conceptuelle et tend à réifier des corrélations purement fortuites propres à l’échantillon analysé. La maîtrise de la visualisation graphique demeure ainsi le garant d’une modélisation parcimonieuse, stable et théoriquement justifiable.
2. Cadre mathématique : Valeurs propres, vecteurs propres et variance expliquée
L’interprétation et la génération programmatique d’un scree plot requièrent une compréhension rigoureuse de la machinerie d’algèbre linéaire qui sous-tend la décomposition factorielle. Cette section formalise les équations sous-jacentes à la décomposition spectrale, explicite le calcul des ratios de variance et souligne l’influence capitale du conditionnement d’échelle sur la validité des tracés factoriels.
2.1 Décomposition spectrale de la matrice de covariance ou de corrélation
Soit une matrice de données quantitatives notée X de dimensions N par p, où N représente le nombre d’observations indépendantes et p le nombre de variables manifestes mesurées. Préalablement à toute opération de réduction linéaire, les colonnes de cette matrice subissent une transformation de centrage-réduction de sorte que chaque variable présente une espérance empirique nulle et un écart-type unitaire. À partir de cette matrice standardisée Z, la matrice de corrélation empirique R (qui s’assimile à la matrice de covariance des données centrées-réduites) est dérivée de la manière suivante : R = (1 / (N – 1)) * (Z transposée multipliée par Z).
La décomposition spectrale repose sur le théorème spectral appliqué aux matrices symétriques réelles semi-définies positives. La matrice R peut être diagonalisée sous la forme canonique R = V * Lambda * V transposée, où Lambda est une matrice diagonale contenant les valeurs propres ordonnées lambda_1, lambda_2, …, lambda_p, et V représente la matrice orthogonale dont les colonnes correspondent aux vecteurs propres unitaires associés v_1, v_2, …, v_p. Le système matriciel fondamental s’exprime par l’équation aux valeurs propres : R * v_j = lambda_j * v_j, conditionnée par la contrainte d’orthogonalité stricte stipulant que le produit scalaire v_j transposé * v_k est égal à 1 si j = k, et égal à 0 si j est différent de k.
Chaque valeur propre lambda_j quantifie la variance absolue capturée par la j-ième composante principale le long de la direction spatiale définie par le vecteur propre unitaire v_j. L’orthogonalité des vecteurs propres garantit l’indépendance linéaire absolue des composantes principales nouvellement formées au sein de l’espace échantillonnal. Ainsi, les composantes successives se déploient selon des directions d’inertie maximale qui s’avèrent totalement décorrélées les unes des autres, chaque valeur propre mesurant précisément la contribution scalaire de son axe à la dispersion globale du système.
2.2 Ratio de variance expliquée et ratio cumulé
Pour conférer une portée interprétative immédiate aux résultats de la décomposition spectrale, les valeurs propres brutes sont généralement converties en grandeurs proportionnelles relatives. La trace de la matrice de dispersion R, notée tr(R), est égale à la somme de ses éléments diagonaux. Dans le cas d’une matrice de corrélation issue de p variables standardisées, la variance de chaque variable unitaire vaut exactement 1, ce qui implique rigoureusement que la trace est égale à la dimensionnalité p. Par propriété fondamentale du produit scalaire invariant, la somme de l’ensemble des valeurs propres est strictement équivalente à la trace de la matrice : la somme pour j variant de 1 à p des lambda_j est égale à la trace de R, qui vaut p.
Le ratio de variance individuelle expliquée par la composante j s’obtient alors en rapportant sa valeur propre respective à la variance totale du système, selon l’équation : Ratio_j = lambda_j / tr(R) = lambda_j / p. Cette grandeur scalaire adimensionnelle, couramment exprimée sous forme de pourcentage en la multipliant par 100, quantifie la fraction de l’information multidimensionnelle globale imputable exclusivement à ce sous-espace factoriel spécifique.
En agrégeant séquentiellement ces contributions individuelles, on définit la courbe de variance cumulative pour un ensemble de k composantes retenues (avec k inférieur ou égal à p) : Variance_cumulée_k = (somme de j=1 à k des lambda_j) / p. En sciences comportementales, sociales et psychologiques, où le bruit de mesure inhérent aux instruments psychométriques demeure substantiel, les critères conventionnels d’adéquation préconisent d’extraire un nombre suffisant de dimensions de manière à atteindre un seuil plancher de variance cumulative situé généralement entre 60 % et 80 %, seuil au-delà duquel la modélisation est jugée adéquatement représentative de la topologie originale des données.
2.3 Sensibilité mathématique à l’échelle des variables
L’algèbre linéaire démontre sans équivoque que la décomposition spectrale n’est pas invariante par changement d’échelle non uniforme. Si l’analyste procède à l’ACP sur la matrice de covariance brute d’un ensemble de variables exprimées dans des unités de mesure distinctes (par exemple des milligrammes, des années d’âge et des scores d’échelles de Likert), la variance empirique de chaque variable sera proportionnelle au carré de son unité d’étalonnage. Les variables affichant des amplitudes numériques élevées domineront artificiellement la décomposition spectrale, monopolisant les premières valeurs propres au détriment de variables à faible amplitude dont le pouvoir discriminant théorique pourrait pourtant s’avérer largement supérieur.
Sur le plan théorique, l’utilisation de la matrice de corrélation s’avère donc impérative lorsque les métriques originales diffèrent ou lorsqu’aucun postulat substantiel ne justifie de pondérer l’importance d’une dimension par son échelle brute. Opérer sur la matrice de corrélation équivaut strictement à réaliser une décomposition spectrale sur des variables préalablement centrées et réduites via leur score standardisé (z-score), garantissant que chaque variable contribue exactement pour une unité à la variance totale du système.
Un défaut d’harmonisation métrique entraîne des conséquences destructrices sur la topographie du scree plot. Les axes associés aux variables d’échelle disproportionnée créeront artificiellement une falaise abrupte factice, écrasant l’ensemble des autres dimensions dans un éboulis faussement uniformisé. Ce phénomène induit l’analyste en erreur en mimant un point de coude précoce purement artefactuel, issu non pas d’une structure factorielle réelle mais simplement de l’hétérogénéité des unités de mesure manipulées.
3. Configuration de l’environnement Python et préparation des bibliothèques
La mise en œuvre computationnelle rigoureuse de l’analyse en composantes principales et du scree plot repose sur la configuration d’un environnement Python scientifique stable, moderne et reproductible. Les bibliothèques sélectionnées couvrent l’intégralité du cycle de traitement, depuis la manipulation des tableaux de données jusqu’à l’ajustement vectoriel et au rendu graphique de haute résolution destiné aux publications savantes.
3.1 Sélection des bibliothèques d’analyse de données et d’algèbre linéaire
L’architecture logicielle de référence s’appuie sur le couple canonique formé par Pandas et NumPy. La bibliothèque Pandas fournit les structures de données fondamentales de type DataFrame, permettant une manipulation indicée, un étiquetage explicite des lignes et des colonnes, ainsi qu’une gestion native des métadonnées contextuelles indispensables pour documenter les analyses quantitatives. L’utilisation de DataFrames garantit la lisibilité immédiate des données tabulaires et simplifie considérablement les opérations d’extraction, de filtrage et d’agrégation statistique préliminaires.
En arrière-plan, la bibliothèque NumPy constitue le moteur d’algèbre linéaire haute performance de l’écosystème. Conçue autour de structures vectorielles contiguës en mémoire (ndarrays), elle optimise les opérations matricielles, les produits scalaires et les transformations tensorielles grâce à son interfaçage direct avec les routines optimisées de bas niveau écrites en C et Fortran, telles que BLAS et LAPACK. Elle permet en outre d’exécuter des calculs cumulatifs ou des fonctions vectorisées sans recourir à des boucles explicites lentes en Python pur.
Pour assurer la pérennité et la reproductibilité des protocoles expérimentaux, il est fortement recommandé d’isoler l’exécution du code au sein d’un environnement virtuel dédié, déployé via des outils standards tels que venv, pipenv ou Conda. Le verrouillage des versions logicielles de chaque composant via un fichier d’exigences explicite garantit que les algorithmes de décomposition et les fonctions de rendu graphique conserveront un comportement mathématique strictement identique au fil du temps et sur l’ensemble des architectures de calcul.
3.2 Modules d’apprentissage statistique et d’ingénierie des caractéristiques
Pour l’exécution des opérations factorielles, la bibliothèque Scikit-Learn représente le standard industriel et académique de référence. Le module spécifique sklearn.decomposition intègre la classe PCA, qui implémente de manière hautement optimisée la factorisation matricielle via des variantes sophistiquées de décomposition en valeurs singulières (SVD). Cette approche algorithmique assure une stabilité numérique substantiellement supérieure à la diagonalisation explicite directe de la matrice de corrélation, prévenant les erreurs d’arrondi sur les matrices mal conditionnées.
Parallèlement, le module sklearn.preprocessing met à disposition la classe StandardScaler, dédiée à l’opération de centrage et de réduction des variables. En appliquant une transformation déterministe qui soustrait la moyenne arithmétique et divise par l’écart-type empirique pour chaque descripteur, cette classe assure l’homogénéisation métrique rigoureuse indispensable à la validité de l’ACP.
Ces implémentations sont spécifiquement conçues pour conjuguer élégance syntaxique et efficacité algorithmique. Capables de traiter avec une latence minimale des échantillons empiriques volumineux comportant plusieurs dizaines de milliers d’observations, elles s’intègrent sans heurts au sein de pipelines analytiques standardisés où les étapes de prétraitement, d’ajustement statistique et de transformation s’enchaînent de manière fluide et transparente.
3.3 Outils de visualisation graphique pour publication académique
Le tracé du scree plot exige un contrôle typographique, spatial et géométrique absolu, qui est traditionnellement confié à la bibliothèque graphique historique Matplotlib, en particulier son interface déclarative pyplot. Cette infrastructure de bas niveau permet de manipuler avec une précision chirurgicale l’ensemble des primitives de la figure : positionnement individuel des axes, paramétrage de doubles ordonnées dépendantes, épaisseur des tracés vectoriels, formats d’annotations textuelles et configuration discrète des graduations numériques.
Afin de rehausser l’ergonomie visuelle globale et de satisfaire d’emblée aux exigences éditoriales académiques (telles que les normes formelles de l’American Psychological Association, ou normes APA), la bibliothèque Seaborn est couramment convoquée pour définir des palettes chromatiques harmonieuses, régler le contraste des fonds de canevas et optimiser la lisibilité des marqueurs. L’application d’un style typographique rigoureux prévient toute surcharge cognitive lors de la lecture des diagrammes.
Enfin, la production de figures scientifiques destinées aux revues à comité de lecture implique un paramétrage exigeant de la résolution d’exportation. La spécification explicite d’une densité de points par pouce (DPI pour dots per inch) supérieure ou égale à 300 DPI, combinée à l’emploi de formats d’exportation vectoriels tels que le SVG ou le PDF, garantit une netteté graphique irréprochable des lignes, symboles et étiquettes, éliminant tout artefact de pixellisation lors de l’impression physique ou de l’affichage sur écrans haute définition.
4. Étape 1 : Acquisition et inspection préliminaire des données
Toute entreprise de réduction dimensionnelle doit obligatoirement débuter par une étude scrupuleuse des données brutes afin de s’assurer de leur conformité structurelle et de leur pertinence statistique. Cette phase d’audit conditionne la validité des inférences subséquentes.
4.1 Chargement et structure du jeu de données USArrests
Pour illustrer de manière concrète et reproductible la création d’un scree plot en Python, nous exploitons le jeu de données empirique classique USArrests, fréquemment mobilisé dans la littérature statistique multivariée contemporaine. Ce jeu de données synthétise les statistiques criminologiques officielles collectées en 1973 à travers les 50 États américains, complétées par un indicateur démographique structurel. Il peut être acquis directement via les référentiels ouverts de données statistiques ou importé programmatique au format CSV à l’aide de l’instruction pandas.read_csv.
La dimensionnalité de la table comprend exactement 50 lignes, correspondant aux 50 entités étatiques américaines faisant office d’unités statistiques individuelles, et 4 colonnes quantitatives continues mesurant des comportements infractionnels distincts et le contexte démographique :
- Murder : Taux d’arrestations pour meurtre pour 100 000 habitants.
- Assault : Taux d’arrestations pour agression avec violence pour 100 000 habitants.
- UrbanPop : Pourcentage de la population totale de l’État résidant au sein de zones urbaines.
- Rape : Taux d’arrestations pour viol pour 100 000 habitants.
La pertinence de cette matrice réside dans son équilibre conceptuel : elle combine trois indicateurs de criminalité violente dont la corrélation mutuelle est attendue a priori avec une variable d’urbanisation dont l’impact sociologique sur la délinquance fait l’objet de vifs débats empiriques. La taille modérée de cet ensemble autorise une vérification arithmétique manuelle intuitive tout en offrant une structure factorielle non triviale propice au diagnostic visuel par scree plot.
4.2 Audit exploratoire et contrôle de qualité des données
L’audit préliminaire débute par la vérification de l’intégrité globale du DataFrame. L’invocation des méthodes standards info et isna().sum() permet d’attester l’absence stricte de valeurs manquantes (valeurs nulles ou NaN) sur l’ensemble des 50 observations. Cette exhaustivité est requise car les algorithmes standards d’ACP implémentés dans Scikit-Learn ne tolèrent aucune lacune d’enregistrement au sein de la matrice de covariance.
L’étape suivante consiste à examiner attentivement les statistiques descriptives univariées par l’intermédiaire de la méthode describe(). L’analyste scrute la disparité des moyennes arithmétiques et des dispersions empiriques. Dans le jeu USArrests, la variable Assault affiche une moyenne de 170,76 avec un écart-type considérable de 83,34, tandis que la variable Murder présente une moyenne de 7,79 pour un écart-type de 4,36. Cette divergence colossale d’ordre de grandeur confirme formellement l’hétérogénéité des échelles de dispersion nominales.
En complément, le calcul des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) permet de repérer d’éventuelles déviations majeures vis-à-vis d’une distribution normale multivariée. Bien que l’ACP linéaire ne requière pas théoriquement la stricte normalité des variables pour extraire la variance, la présence de distributions excessivement asymétriques ou fortement contaminées par des valeurs aberrantes univariées risquerait de déformer excessivement l’orientation des composantes orthogonales.
4.3 Évaluation de la factorisabilité de la matrice de données
La réduction factorielle n’a de sens sur le plan scientifique que si les variables observées partagent un niveau suffisant de variance commune. Procéder à une ACP sur des variables totalement orthogonales ou indépendantes reviendrait à extraire des facteurs factices capturant du bruit blanc. L’évaluation de la matrice de corrélation bivariée représente ainsi le premier test de conformité. L’examen des coefficients de Pearson révèle des corrélations linéaires substantielles, notamment entre Murder et Assault (r = 0,80), ainsi qu’entre Assault et Rape (r = 0,67).
Sur le plan psychométrique formel, la factorisabilité d’une matrice s’évalue traditionnellement au moyen de l’indice de Kaiser-Meyer-Olkin (KMO) et du test de sphéricité de Bartlett. L’indice KMO compare l’amplitude des coefficients de corrélation observés à celle des coefficients de corrélation partielle. Une valeur globale de KMO supérieure à 0,60 est traditionnellement considérée comme le plancher minimal justifiant l’application d’une méthode factorielle.
Conjointement, le test de sphéricité de Bartlett soumet à l’épreuve l’hypothèse nulle stipulant que la matrice de corrélation de la population équivaut à la matrice identité unitaire. Un rejet statistiquement significatif de cette hypothèse nulle confirme que les intercorrélations empiriques sont globalement trop élevées pour résulter du seul hasard d’échantillonnage, légitimant pleinement le recours à une synthèse multidimensionnelle par ACP.
5. Étape 2 : Prétraitement et standardisation rigoureuse des variables
Compte tenu des écarts d’amplitude mis en exergue par l’inspection descriptive univariée, l’opération de standardisation s’impose comme un préalable obligatoire à l’extraction des composantes principales. Cette étape garantit une pondération équitable et géométriquement neutre de chaque indicateur dans la décomposition factorielle finale.
5.1 Théorie du z-score appliqué aux dimensions comportementales
La normalisation standardisée repose sur la transformation linéaire canonique en z-score. Pour une valeur empirique brute x_ij associée à l’observation i sur la j-ième variable, le score centré-réduit z_ij est calculé selon la formulation mathématique : z_ij = (x_ij – mu_j) / sigma_j, où mu_j représente l’espérance arithmétique de la variable et sigma_j son écart-type empirique d’échantillon calculé avec un degré de liberté corrigé.
Cette transformation modifie l’origine et l’étalonnage de chaque vecteur de données. En soustrayant la moyenne locale, le centre de gravité du nuage de points spatial se trouve immédiatement translaté vers l’origine du système de coordonnées euclidien. En divisant ensuite chaque écart par l’écart-type correspondant, la variance de chaque variable est rigoureusement normalisée à une valeur unitaire exacte de 1,0.
Ce redressement neutralise de facto la domination mécanique qu’exerceraient des grandeurs quantitatives telles que le taux d’agressions (dont la magnitude brute s’étale de 45 à 337) par rapport au taux d’homicides (qui oscille entre 0,8 et 17,4). La standardisation assure une démocratie géométrique parfaite : à l’initialisation du processus de projection, chaque dimension manifeste contribue exactement à hauteur d’un quart (25 %) de la variance globale totale dans un système à quatre variables.
5.2 Mise en œuvre technique avec StandardScaler de Scikit-Learn
Dans l’écosystème Scikit-Learn, cette formalisation théorique s’exécute avec fluidité grâce à la classe StandardScaler. Le protocole programmatique débute par l’instanciation de l’objet transformateur sans paramétrage superflu, en veillant à préserver les arguments par défaut spécifiant un centrage à zéro et une variance unitaire.
La méthode conjointe fit_transform() est ensuite invoquée en lui fournissant comme argument la sélection explicite des quatre colonnes continues de notre DataFrame. Durant l’étape de calibrage (fit), le transformateur estime les paramètres empiriques (moyennes et écarts-types univariés) pour l’ensemble des colonnes. Durant l’étape de transformation (transform), il applique arithmétiquement la formule de normalisation vectorisée, renvoyant un tableau bidimensionnel NumPy de type ndarray hautement optimisé.
Afin de préserver la traçabilité des métadonnées analytiques et de faciliter les visualisations ultérieures, il est judicieux de reconvertir immédiatement cette matrice NumPy brute en un DataFrame Pandas documenté. Cette conversion réattribue explicitement les intitulés originaux des colonnes criminologiques et rétablit en guise d’index les noms textuels des cinquante États américains, garantissant ainsi une manipulation transparente lors des étapes interprétatives futures.
5.3 Vérification empirique post-transformation
Tout pipeline de science des données se doit d’intégrer des points de contrôle qualité permettant d’attester empiriquement du succès des transformations computationnelles appliquées. À la suite de la standardisation, il convient de vérifier numériquement les nouvelles propriétés distributionnelles du DataFrame reconstitué.
L’évaluation des moyennes des colonnes transformées via la méthode mean() doit renvoyer des valeurs numériques infinitésimales, généralement comprises entre 10^-15 et 10^-17, illustrant la convergence computationnelle vers une moyenne analytique strictement nulle sous réserve de la précision arithmétique en virgule flottante. De manière analogue, le calcul des écarts-types via std(ddof=0) doit confirmer une valeur unitaire rigoureuse de 1,0 sur chaque axe.
Cette vérification post-transformation offre également l’opportunité de dépister d’éventuelles valeurs aberrantes multivariées. En examinant les distances de Mahalanobis ou simplement les amplitudes extrêmes de z-scores excédant la valeur absolue critique de 3,0, l’analyste peut identifier d’emblée des États américains présentant des profils criminologiques ou démographiques exceptionnels (tels que l’Alaska pour ses taux spécifiques d’agressions ou la Floride) qui pourraient exercer une influence léviathanienne sur l’orientation des premiers axes factoriels.
6. Étape 3 : Ajustement du modèle ACP et extraction des métriques
Une fois les variables convenablement conditionnées et standardisées, le cœur du traitement statistique consiste à instancier le modèle d’analyse factorielle, à exécuter la factorisation matricielle et à en extraire les propriétés scalaires qui serviront de matière première au scree plot.
6.1 Paramétrage et ajustement de la classe PCA
L’exécution de la réduction dimensionnelle en Python mobilise la classe PCA disponible au sein du sous-module sklearn.decomposition. Une bonne pratique méthodologique lors de la phase exploratoire initiale consiste à initialiser l’objet sans imposer de contrainte réductrice sur le nombre de composantes via l’hyperparamètre n_components. En laissant cet argument à sa valeur par défaut, le modèle procède à l’extraction de la totalité des composantes mathématiquement disponibles, soit exactement quatre dimensions pour notre matrice à quatre descripteurs.
L’ajustement du modèle s’effectue via l’appel de la méthode fondamentale fit(), en lui transmettant le jeu de données préalablement standardisé. Sur le plan algorithmique interne, Scikit-Learn n’effectue pas une décomposition spectrale directe sur la matrice de corrélation carrée R, mais applique préférentiellement une Décomposition en Valeurs Singulières (SVD) sur la matrice des données centrées et réduites Z. La factorisation s’exprime selon Z = U * S * V transposée, où S représente les valeurs singulières scalaires.
Cette approche par SVD garantit une précision numérique et une stabilité de calcul supérieures, évitant le calcul intermédiaire explicite du produit matriciel (Z transposée * Z) susceptible d’engendrer une perte de précision en virgule flottante ou des instabilités lorsque les colonnes affichent des corrélations presque parfaites.
6.2 Extraction directe des ratios de variance expliquée
Une fois l’algorithme d’ajustement exécuté avec succès, l’objet PCA instancié encapsule les paramètres statistiques estimés sous forme d’attributs préfixés par un trait de soulignement final, conformément aux conventions logicielles établies de Scikit-Learn. L’attribut principal guidant l’évaluation de la performance d’extraction factorielle est désigné sous le nom de explained_variance_ratio_.
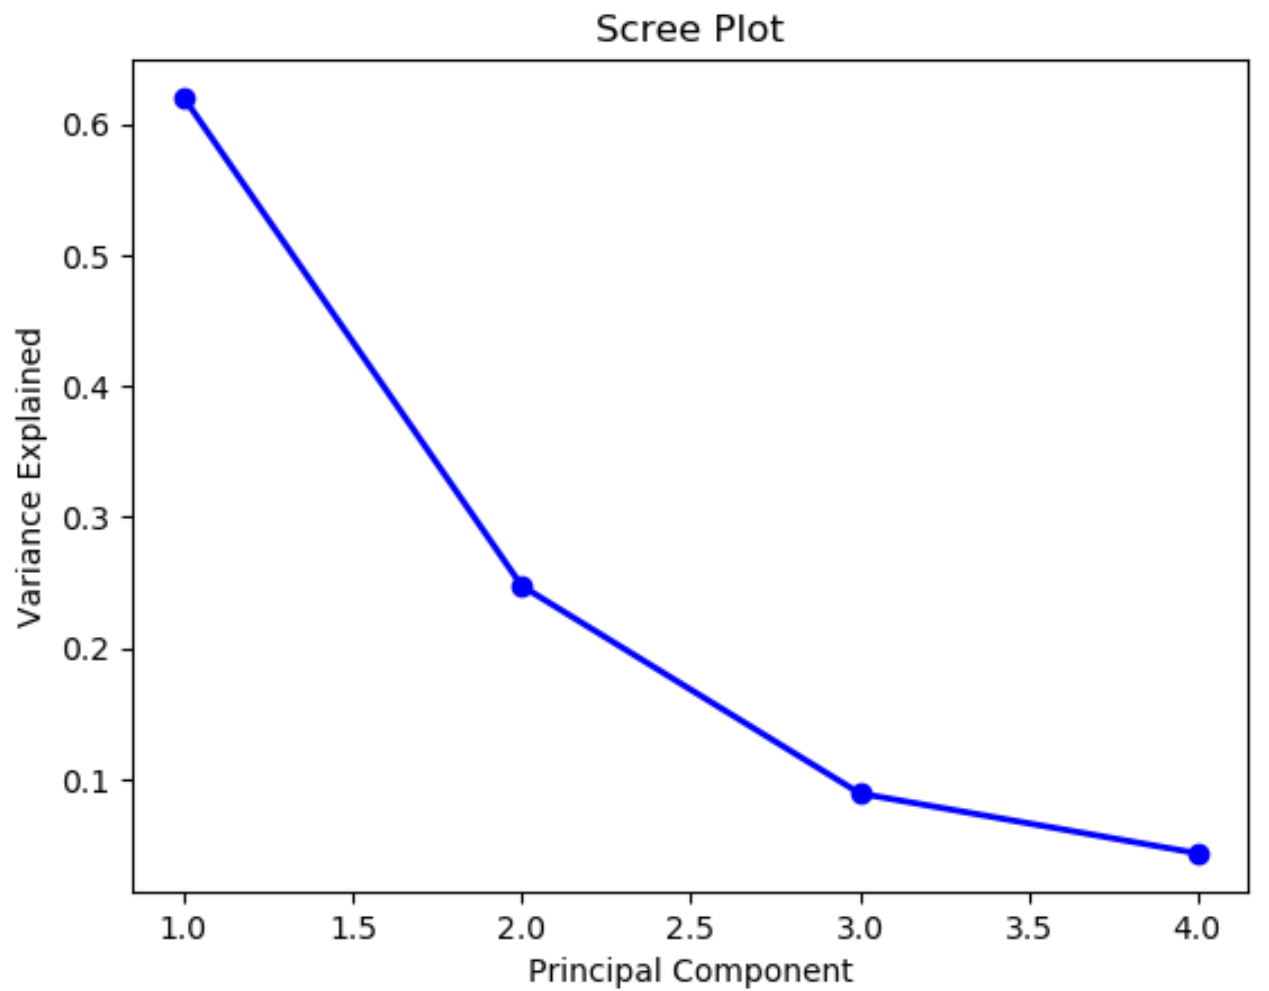
Cet attribut se présente sous la forme d’un vecteur NumPy unidimensionnel dont la taille correspond rigoureusement au nombre total de composantes calculées. Chaque élément flottant de ce tableau quantifie la fraction relative de variance expliquée attribuable à chaque axe factoriel respectif, les composantes étant ordonnées de façon strictement décroissante par construction algorithmique. Sur le jeu de données USArrests, la première composante capte à elle seule environ 62,01 % de la variance totale, la deuxième composante environ 24,74 %, la troisième composante 8,91 %, et la quatrième et dernière composante n’explique que 4,34 % de la dispersion globale.
L’intégrité arithmétique de la modélisation peut être confirmée en sommant l’ensemble des valeurs scalaires de ce vecteur à l’aide de l’instruction np.sum(pca.explained_variance_ratio_). Cette somme doit impérativement aboutir à une valeur rigoureusement égale à 1,0 (ou 100 %), confirmant qu’aucune particule de variance globale n’a été égarée ou altérée au cours du processus de décomposition orthogonale.
6.3 Dérivation mathématique des valeurs propres brutes
Bien que le ratio proportionnel relatif de variance constitue une métrique explicative d’une grande clarté pour l’interprétation vulgarisée, la théorie méthodologique du scree plot et l’application classique des règles de décision factorielle nécessitent de manipuler les valeurs propres brutes (les fameuses valeurs lambda). Dans Scikit-Learn, ces grandeurs scalaires directes sont rendues accessibles par l’intermédiaire de l’attribut explained_variance_.
L’attribut explained_variance_ stocke la variance empirique absolue de chaque composante principale projetée. Dans la mesure où les données initiales ont été rigoureusement centrées et réduites à une variance unitaire préalable, la variance totale s’avère numériquement égale au nombre total de colonnes p. Les valeurs propres brutes extraites sur USArrests correspondent respectivement à environ 2,48 pour le premier axe, 0,99 pour le deuxième axe, 0,36 pour le troisième axe, et 0,17 pour le quatrième axe.
Il existe une correspondance arithmétique rigoureuse entre ces valeurs propres brutes et la dimensionnalité globale de l’échantillon. La relation s’énonce simplement : lambda_j = Ratio_j * p. De surcroît, la somme arithmétique exacte des éléments du vecteur explained_variance_ équivaut avec exactitude à 4,0, validant de façon spectaculaire la cohérence du cadre d’algèbre matricielle sous-jacent.
7. Étape 4 : Structuration des résultats statistiques dans Pandas
Avant d’initialiser les fonctions de tracé graphique, il est d’une impérieuse rigueur méthodologique d’organiser l’ensemble des indicateurs scalaires extraits au sein d’une structure tabulaire structurée, documentée et facilement requêtable. Cette structuration préalable prévient les incohérences d’indexation lors de la création de la figure et autorise un export aisé des résultats vers les manuscrits scientifiques.
7.1 Construction d’un tableau récapitulatif des métriques factorielles
L’assemblage des métriques s’opère par la constitution d’un DataFrame Pandas dédié, couramment désigné sous le nom programmatique de scree_df ou de tableau de décomposition spectrale. La première démarche consiste à définir un index catégoriel explicite et homogène, assignant une nomenclature standardisée à chaque facteur, par exemple les étiquettes textuelles séquentielle ‘PC1’, ‘PC2’, ‘PC3’ et ‘PC4’ (pour Principal Component).
La première colonne du tableau récapitule les valeurs propres brutes issues de l’attribut explained_variance_. La deuxième colonne héberge les pourcentages individuels de variance expliquée, calculés en multipliant l’attribut explained_variance_ratio_ par cent. Cette disposition ordonnée offre un support immédiat pour les vérifications de cohérence analytique et constitue une source d’alimentation propre et infaillible pour l’ensemble des scripts de visualisation subséquents.
Ce tableau formalise la hiérarchie factorielle de manière limpide. Les analystes peuvent immédiatement juxtaposer la puissance explicative brute d’une composante (sa valeur propre) à son poids relatif au sein du système global, limitant drastiquement les risques de confusion d’échelle fréquemment observés lors de scripts de tracé rédigés à la volée.
7.2 Calcul vectoriel des pourcentages et cumuls de variance
Pour mesurer la déperdition globale d’information associée au choix d’un sous-espace dimensionnel réduit, l’intégration d’une métrique cumulative s’avère indispensable. L’analyste applique à la colonne des pourcentages individuels la fonction de sommation progressive cumsum() mise à disposition par Pandas ou NumPy.
L’opération vectorisée génère une séquence cumulative strictement croissante, plafonnant obligatoirement à un niveau terminal de 100,0 %. Sur les données de criminalité américaine, la trajectoire cumulative s’établit successivement à 62,01 % pour la première composante seule, bondit à 86,75 % dès l’adjonction de la deuxième composante, grimpe à 95,66 % avec la troisième composante, pour saturer enfin à 100 % sur la quatrième dimension résiduelle.
Afin de parachever la lisibilité typographique du tableau analytique, l’ensemble des vecteurs de données numériques flottantes subit une opération d’arrondi standardisé, généralement fixée à deux ou trois décimales significatives à l’aide de l’instruction round(). Cette normalisation esthétique prévient l’encombrement cognitif généré par les représentations par défaut en virgule flottante double précision.
7.3 Exportation des données analytiques vers des formats académiques
L’intégration des résultats quantitatifs dans des rapports scientifiques ou des articles soumis à des comités de lecture réclame des formats d’exportation standardisés et pérennes. La bibliothèque Pandas simplifie grandement cette passerelle académique en offrant des convertisseurs directs vers plusieurs langages de mise en page.
L’invocation de la méthode to_latex() permet de traduire instantanément la structure du tableau Pandas en code source LaTeX compilable, incluant l’alignement décimal, les séparateurs horizontaux conformes aux packages académiques tels que booktabs et les en-têtes d’index explicites. Ce flux direct élimine les risques critiques d’erreurs de recopie manuelle lors de la rédaction d’un manuscrit.
Conjointement, l’instruction to_csv() assure une sauvegarde physique de la table sous un format de texte délimité universellement interopérable. Cet enregistrement pérenne garantit l’archivage rigoureux des métriques du scree plot au sein des dépôts de science ouverte (tels que l’Open Science Framework ou Zenodo), favorisant la réplication computationnelle immédiate de l’étude par d’autres équipes de recherche.
8. Étape 5 : Construction du scree plot de base avec Matplotlib
L’élaboration du tracé graphique du scree plot commence par l’agencement géométrique du canevas sous Matplotlib. Cette version initiale vise à représenter fidèlement le principe d’éboulis tel que formulé historiquement par Raymond Cattell, en matérialisant la ligne de déclivité des valeurs propres.
8.1 Initialisation du canevas graphique et paramétrage des axes
La construction graphique s’amorce par l’instanciation conjointe de la figure englobante et de son conteneur d’axes cartésiens élémentaire via la fonction canonique matplotlib.pyplot.subplots(). Il convient de définir une géométrie spatiale équilibrée via l’argument figsize, par exemple une largeur de 10 pouces pour une hauteur de 6 pouces, offrant un ratio d’aspect rectangulaire idéal pour l’appréciation des pentes et des ruptures d’angles.
Le contrôle spatial des limites des axes horizontaux et verticaux prévient toute illusion d’optique délétère. Un resserrement abusif de l’axe vertical peut artificiellement aplatir un coude saillant, tandis qu’un étirement excessif risque d’exagérer visuellement une inflexion pourtant minime. Il est donc recommandé d’ancrer l’axe des ordonnées à une borne inférieure égale à zéro (ou légèrement sous zéro pour éviter que les marqueurs ne mordent sur l’axe horizontal) et de laisser une marge supérieure confortable au-dessus de la valeur propre maximale.
Cette rigueur géométrique s’accompagne de l’activation d’un carroyage discret de fond d’axe à l’aide de l’instruction ax.grid(True), configuré avec un niveau d’opacité modéré (alpha fixé à environ 0,3 ou 0,4) et un tracé pointillé. Ce quadrillage subtil guide l’œil du lecteur sans rivaliser visuellement avec les tracés statistiques de premier plan.
8.2 Tracé de la courbe d’éboulis avec marqueurs de données
Le tracé principal repose sur l’appel de la méthode plot() appliquée au conteneur d’axes. Les coordonnées horizontales reçoivent la séquence ordonnée des indices des composantes principales (de 1 à 4), tandis que l’axe vertical reçoit les valeurs propres brutes issues de notre tableau analytique.
Pour maximiser la lisibilité du profil géologique, la courbe continue matérialisant la trajectoire de décroissance factorielle est combinée à des marqueurs géométriques discrets positionnés à chaque coordonnée factorielle. L’emploi de marqueurs de forme circulaire (marker=’o’) ou de losanges, pourvus d’une taille visible (markersize=8) et d’une couleur de remplissage saturée, permet de distinguer nettement la continuité de la trajectoire globale de la valeur discrète propre à chaque dimension.
L’épaisseur du tracé linéaire (linewidth=2 ou 2.5) doit être calibrée pour s’imposer clairement au regard. La transition entre la falaise abrupte reliant la composante 1 à la composante 2 et le talus beaucoup plus plat s’étirant de la composante 2 aux composantes subséquentes devient alors immédiatement perceptible sur le plan sensoriel.
8.3 Typographie, étiquetage des axes et ajout des légendes
Une visualisation scientifique n’acquiert son autonomie sémantique que par un étiquetage textuel univoque. Le titre de la figure, configuré via set_title(), doit renseigner explicitement sur la nature du diagnostic, la méthode de calcul et la population étudiée, par exemple : « Test de l’éboulis de Cattell : Décomposition spectrale sur les données USArrests standardisées ».
L’étiquetage des axes cartésiens est régi par les méthodes set_xlabel() et set_ylabel(). L’axe horizontal doit porter sans ambiguïté la mention « Numéro de la composante principale » ou « Rang du facteur », tandis que l’axe des ordonnées doit stipuler formellement la grandeur mathématique représentée, à savoir « Valeur propre (Eigenvalue – Variance expliquée absolue) ».
Un écueil classique de programmation sous Python consiste à laisser Matplotlib générer des graduations horizontales décimales (telles que 1.5, 2.0, 2.5), ce qui constitue une aberration méthodologique majeure puisque le rang factoriel relève d’un ensemble discret strict d’entiers naturels. L’utilisation de l’instruction ax.set_xticks([1, 2, 3, 4]) permet de contraindre rigoureusement les graduations aux seuls entiers valides, parachevant ainsi la rigueur formelle de la présentation.
9. Étape 6 : Enrichissement graphique : Barres de variance et courbe cumulative
Si le scree plot rudimentaire à simple courbe de valeurs propres satisfait aux exigences du diagnostic historique de Cattell, les standards contemporains de la communication scientifique préconisent une synthèse visuelle enrichie. En combinant diagrammes en barres, doubles échelles ordonnées et tracés de seuils critiques, la figure concentre l’ensemble des critères décisionnels sur un canevas analytique unique.
9.1 Combinaison graphique de diagrammes en bâtons et de lignes brisées
L’une des représentations les plus expressives consiste à juxtaposer un diagramme en bâtons verticaux (représentant la variance individuelle expliquée par chaque composante) et une courbe brisée supérieure assurant la continuité visuelle de l’éboulis. Cette technique hybride exploite simultanément les fonctions ax.bar() et ax.plot() au sein du même espace de projection cartésien.
Les barres verticales s’érigent depuis la ligne de base zéro, offrant une appréciation intuitive immédiate de la masse d’information capturée par chaque dimension. Pour éviter toute confusion chromatique, il convient d’assigner aux bâtons une teinte sobre et modérément transparente (en paramétrant une opacité alpha de 0,5 à 0,7), tandis que la ligne brisée reliant les sommets adopte une couleur contrastée et saturée, dessinant avec éclat la silhouette de l’éboulis rocheux.
Cette combinaison graphique met instantanément en relief la prédominance monumentale de la première composante principale, dont le volume physique en barre dépasse visuellement de plus du double celui de la deuxième composante, laquelle surpasse à son tour très nettement l’étiage modeste des composantes 3 et 4.
9.2 Implémentation d’un second axe ordonné pour la variance cumulative
Pour intégrer la dynamique de saturation de l’information sans surcharger l’axe des ordonnées primaires dédié aux valeurs propres brutes, la création d’un système à double échelle verticale s’avère hautement judicieuse. Cette prouesse technique s’accomplit sous Matplotlib par l’invocation de la méthode ax.twinx(), qui génère un second conteneur d’axes superposé partageant rigoureusement le même axe horizontal mais disposant d’une ordonnée indépendante ancrée sur le bord droit de la figure.
Sur ce second axe Y, l’analyste projette la courbe d’évolution de la variance cumulative exprimée en pourcentages stricts. Pour matérialiser sa fonction diagnostique secondaire sans interférer avec la lisibilité du scree plot principal, cette courbe cumulative est traditionnellement tracée sous la forme d’une ligne pointillée ou tiretée (linestyle=’–‘), pourvue de ses propres marqueurs géométriques spécifiques (par exemple de petits carrés distincts).
L’axe vertical secondaire est alors calibré de manière déterministe entre 0 % et 105 % via set_ylim(), et son étiquette textuelle droite indique sans équivoque : « Pourcentage cumulé de variance expliquée (%) ». Cette disposition bifocale permet à l’observateur d’évaluer d’un seul coup d’œil la double contribution : l’apport marginal d’une composante donnée (lu sur l’axe de gauche) et l’exhaustivité du modèle factoriel tronqué résultant (lue sur l’axe de droite).
9.3 Inclusion de lignes de seuil critiques et annotations textuelles
Pour parfaire l’utilité diagnostique du graphique enrichi, des droites de repère horizontales matérialisant les critères méthodologiques formels doivent être superposées aux tracés empiriques. L’insertion du célèbre critère de Kaiser s’opère via la méthode ax.axhline(y=1.0, color=’crimson’, linestyle=’:’, linewidth=1.5), inscrivant une ligne pointillée rouge vif à la hauteur critique correspondant à une valeur propre unitaire exacte.
Simultanément, sur le second axe Y assigné à la variance cumulative, une ligne horizontale d’adéquation minimale peut être positionnée au niveau classique de 80 % (ax2.axhline(y=80, color=’darkgreen’, linestyle=’-.’, linewidth=1.5)). Cette démarcation verte signale instantanément au lecteur à partir de quel niveau de rétention factorielle le seuil conventionnel de représentativité globale est formellement atteint ou dépassé.
Enfin, l’adjonction d’annotations textuelles fléchées, programmées via la commande polyvalente ax.annotate(), permet de désigner explicitement le point d’inflexion majeur ou le coude de Cattell directement sur la courbe. En reliant une zone de texte explicative (« Coude identifié : Rétention optimale à 2 composantes ») au marqueur de la deuxième composante à l’aide d’une flèche stylisée élégante, l’analyste dissipe toute ambiguïté interprétative pour le lecteur ou le réviseur académique.
10. Critères méthodologiques d’interprétation pour la sélection factorielle
Disposer d’un tracé graphique de haute volée technique ne constitue qu’un prérequis instrumental. La valeur scientifique du protocole réside dans la rigueur méthodologique appliquée à l’interprétation des courbes et des seuils. Cette section examine de manière comparative les trois grandes règles décisionnelles qui prévalent dans la littérature psychométrique et statistique internationale.
10.1 Application rigoureuse du critère du coude (Elbow Rule)
L’application rigoureuse du critère du coude, ou règle géologique de Cattell, repose sur l’analyse de la dérivée discrète de la courbe formée par les valeurs propres. L’analyste scrute le graphique de gauche à droite à la recherche d’une cassure brutale dans la concavité de la fonction polygonale, matérialisant la fin de la falaise abrupte et le commencement du talus linéaire résiduel.
La règle décisionnelle formelle prescrit de retenir strictement toutes les composantes situées avant le point où s’amorce la pente linéaire des débris d’éboulis. Dans notre cas d’étude sur les statistiques criminelles américaines, la décroissance entre PC1 (2,48) et PC2 (0,99) dessine un pan de falaise spectaculaire. Entre PC2 et PC3 (0,36), la pente s’infléchit nettement mais demeure descendante, avant de s’aplatir très faiblement entre PC3 et PC4 (0,17). L’inflexion principale, marquant le commencement du plateau de décombres stables, se situe manifestement au niveau de la composante 2, guidant ainsi vers la conservation d’une solution parcimonieuse à deux dimensions.
Cependant, le critère du coude souffre de limites épistémologiques documentées, au premier rang desquelles figure sa part irréductible de subjectivité perceptuelle. Dans de nombreuses applications empiriques complexes, le praticien est confronté à des coudes multiples, étalés ou à une courbure parabolique continue sans angle saillant net. Cette ambiguïté visuelle a historiquement suscité d’âpres controverses méthodologiques, incitant les chercheurs à croiser systématiquement l’inspection de l’éboulis avec d’autres heuristiques numériques complémentaires.
10.2 Critère de Kaiser-Guttman et ses limites reconnues
Formulé par Louis Guttman et largement popularisé par Henry Kaiser dans les années 1960, le critère de Kaiser-Guttman (souvent désigné sous l’appellation de règle de Kaiser ou critère de la valeur propre supérieure à un) stipule qu’une composante principale ne doit être conservée que si sa valeur propre empirique excède rigoureusement le seuil scalaire de 1,0 (lambda > 1,0).
La justification théorique sous-jacente à ce critère s’avère particulièrement séduisante dans sa simplicité : dans la mesure où chaque variable initiale a été standardisée pour présenter une variance empirique unitaire exacte de 1,0, une dimension factorielle synthétique n’a de pertinence explicative que si elle parvient à capturer au moins autant de variance qu’une variable manifeste isolée unique. Extraire un facteur affichant une valeur propre inférieure à 1,0 reviendrait formellement à résumer plusieurs variables en une dimension synthétique dotée d’un pouvoir explicatif moindre que l’un quelconque des descripteurs initiaux pris isolément.
Néanmoins, la communauté statistique a largement mis en lumière les biais inhérents à cette règle mécanique. Des simulations de Monte-Carlo massives ont démontré que le critère de Kaiser tend de façon quasi systématique à une sur-extraction pathologique lorsque le nombre de variables p excède 20 ou 30, fragmentant artificiellement les dimensions réelles. Inversement, lorsque le nombre de variables est très restreint (comme dans notre échantillon où p = 4), le critère peut se révéler excessivement conservateur. Sur les données USArrests, la composante PC2 affiche une valeur propre de 0,99, échouant d’un cheveu arithmétique (0,01) devant le seuil de Kaiser, alors même qu’elle explique près d’un quart de la variance globale totale et conditionne la lisibilité sociologique complète de l’espace factoriel criminologique.
10.3 Introduction comparative à l’analyse parallèle de Horn
Face à la subjectivité inhérente à l’inspection du scree plot de Cattell et à la rigidité vulnérable de la règle de Kaiser, l’Analyse Parallèle introduite par John L. Horn en 1965 s’est progressivement imposée au sein de la psychométrie contemporaine comme le standard méthodologique de référence le plus robuste et le plus performant pour déterminer la dimensionnalité factorielle.
Le principe de l’analyse parallèle repose sur une simulation stochastique par rééchantillonnage de Monte-Carlo. Le protocole programmatique génère un nombre massif (couramment 500 ou 1000) de matrices de données aléatoires indépendantes, présentant une distribution gaussienne standardisée et partageant rigoureusement les mêmes dimensions N et p que la matrice empirique sous étude. Chaque matrice aléatoire est soumise à l’algorithme d’ACP standard, et les valeurs propres obtenues sur ces bruits blancs purs sont extraites puis moyennées, ou ordonnées pour en extraire le 95e centile empirique.
La règle décisionnelle de Horn est d’une grande rigueur : une composante empirique n’est conservée que si sa valeur propre observée est strictement supérieure au 95e centile de la distribution des valeurs propres générées aléatoirement sur des matrices de même taille. Graphiquement, cela se traduit par la superposition, sur le scree plot classique, d’une seconde courbe matérialisant le seuil critique simulé. Seules les valeurs propres réelles qui s’élèvent audacieusement au-dessus de la courbe de bruit aléatoire sont reconnues comme des dimensions structurales signifiantes, éradiquant ainsi le risque de sur-interpréter des composantes résiduelles issues de simples fluctuations stochastiques d’échantillonnage.
11. Interprétation substantive des composantes retenues sur les données USArrests
Une démarche de modélisation statistique ne saurait s’achever sur la production d’indices scalaires abstraits. La validation d’une réduction dimensionnelle s’éprouve ultimement dans la capacité des composantes retenues à éclairer les mécanismes substantiels et théoriques du domaine d’investigation considéré.
11.1 Analyse de la matrice des charges factorielles (loadings)
L’interprétation théorique de chaque axe factoriel retenu nécessite de calculer la matrice des charges factorielles, communément désignées sous l’anglicisme de loadings. En ACP, la charge factorielle d’une variable initiale sur une composante donnée représente le coefficient de corrélation linéaire de Pearson existant entre cette variable manifeste et le vecteur des scores de la composante projetée. Mathématiquement, pour la j-ième variable et la k-ième composante, le loading s’exprime par le produit du vecteur propre par la racine carrée de la valeur propre associée : Loading_jk = v_jk * sqrt(lambda_k).
L’inspection analytique de la matrice des charges factorielles calculée sur le jeu USArrests pour les deux premières composantes retenues met en exergue une structure extrêmement claire et contrastée :
- Sur la première composante (PC1), les variables criminologiques affichent des charges factorielles positives massives : Murder culmine à environ +0,84, Assault culmine à +0,92 et Rape atteint +0,77. En revanche, l’indicateur démographique UrbanPop présente une contribution marginale beaucoup plus modeste sur cet axe (+0,44).
- Sur la deuxième composante (PC2), la distribution des charges bascule de manière spectaculaire : la variable d’urbanisation UrbanPop domine outrageusement avec un coefficient de projection très élevé voisin de -0,87, alors que les variables criminologiques pures s’effondrent à des niveaux quasi négligeables (-0,18 pour Murder, -0,19 pour Assault, et +0,17 pour Rape).
Cette configuration de charges orthogonales révèle une partition sémantique presque idéale entre l’intensité de la criminalité violente d’une part, et le niveau d’urbanisation du territoire d’autre part.
11.2 Attribution de significations psychologiques et sociologiques aux dimensions
Sur le fondement de cette structure factorielle limpide, l’analyste est en mesure d’assigner des appellations théoriques signifiantes aux axes synthétiques extraits, ancrant l’analyse statistique au sein de la littérature sociologique et criminologique.
La première composante principale (PC1), qui monopolise 62,01 % de la variance totale du jeu de données, s’interprète sans équivoque comme un indice général de violence criminelle interpersonnelle. Elle capture la propension structurelle globale d’un État à être le théâtre d’infractions d’une gravité physique extrême (homicides, agressions armées, viols). Un score élevé sur cette dimension synthétique caractérise un territoire confronté à une délinquance violente systémique, indépendamment de sa configuration territoriale spécifique.
La deuxième composante principale (PC2), capturant 24,74 % de la variance, incarne pour sa part une dimension écologique d’urbanisation structurelle. Elle reflète le degré de concentration métropolitaine des populations au détriment des modes d’habitation ruraux traditionnels. Le fait que cette composante soit géométriquement orthogonale à la première prouve une propriété sociologique fondamentale : dans les États américains de cette époque, le degré d’urbanisation ne constitue pas un prédicteur direct et linéaire de l’intensité criminelle violente globale. Il existe des États hautement urbanisés affichant des niveaux de délinquance modérés, et des États ruraux marqués par des taux de criminalité violente alarmants. La validité de construit de cette modélisation bidimensionnelle s’avère donc exceptionnellement robuste, justifiant a posteriori la conservation de PC2 malgré sa valeur propre flirtant avec 0,99.
11.3 Visualisation conjointe via le biplot factoriel
Pour parachever l’exploration des deux dimensions retenues à l’issue de l’inspection du scree plot, la confection d’un biplot factoriel représente la modalité de restitution par excellence. Le biplot projette conjointement, au sein du même plan euclidien (défini en abscisse par PC1 et en ordonnée par PC2), les coordonnées individuelles des 50 États américains sous forme de points disséminés et les variables manifestes originales sous forme de flèches vectorielles rayonnant depuis l’origine.
La trigonométrie du biplot renseigne immédiatement sur les corrélations résiduelles. L’angle géométrique existant entre deux flèches de variables est proportionnel à leur niveau d’intercorrélation : des flèches pointant dans une direction quasi identique (comme Murder et Assault) traduisent un angle aigu marquant une corrélation positive très intense. Inversement, le vecteur représentant UrbanPop se déploie selon un angle avoisinant 90 degrés par rapport aux vecteurs d’infraction, attestant visuellement de son indépendance linéaire à l’échelle du plan factoriel.
Simultanément, la projection des scores des États permet de repérer instantanément des profils régionaux contrastés ou des anomalies multivariées saisissantes. Des États du Sud profond tels que le Mississippi, la Caroline du Nord ou la Caroline du Sud se projettent très loin vers la droite le long de PC1, témoignant de taux d’homicides et d’agressions particulièrement sombres. À l’opposé, des États à forte concentration urbaine mais à criminalité violente maîtrisée, tels que Rhode Island ou le Massachusetts, se positionnent dans le quadrant combinant un score PC1 négatif et une forte projection sur l’axe urbain. Le biplot transcende ainsi la réduction mathématique pour offrir une cartographie criminologique territoriale complète et immédiatement intelligible.
12. Bonnes pratiques, écueils fréquents et automatisation du code
La conduite d’une analyse factorielle en environnement computationnel exige une vigilance constante face aux pièges techniques et méthodologiques susceptibles de vicier les inférences. Cette dernière section dresse un inventaire des écueils récurrents et formalise une approche d’ingénierie logicielle modulaire et réutilisable.
12.1 Erreurs courantes lors de la conception du scree plot
L’observation des pratiques analytiques met en évidence trois catégories de méprises récurrentes lors de la conception et de l’exploitation d’un scree plot en Python. La première méprise, d’ordre théorique, réside dans la confusion fréquente entre la variance expliquée absolue (les valeurs propres) et le ratio de variance relative sur l’axe vertical du tracé. L’affichage de pourcentages relatifs en lieu et place des valeurs propres sans ajustement concomitant du seuil de Kaiser conduit à des aberrations décisionnelles monumentales, un chercheur inattentif pouvant chercher un seuil à 1 % au lieu de 1,0.
Le second écueil, de nature computationnelle, consiste en l’omission du centrage et de la réduction des variables préalablement au calcul factoriel. Dans un jeu de données aux échelles divergentes, cette négligence induit une ACP sur matrice de covariance non standardisée, ce qui fausse intégralement la topographie de l’éboulis en projetant une première valeur propre géante totalement artificielle. Le coude qui en découle ne reflète alors rien d’autre que l’écart d’étalonnage des instruments de mesure.
Enfin, le troisième écueil relève de la manipulation graphique et de la déformation perceptive : l’utilisation d’échelles ordonnées tronquées qui ne s’ancrent pas à une valeur zéro stable. En compressant l’axe Y ou en coupant sa base inférieure, l’analyste accentue artificiellement l’illusion d’une cassure abrupte sur des segments de pente pourtant très doux. Cette pratique est constitutive d’un biais visuel sévère, conduisant à des sous-extractions intempestives en faisant passer des fluctuations de bruit pour des coudes majeurs.
12.2 Écriture d’une fonction Python modulaire et réutilisable
Afin d’éradiquer ces risques de manipulation manuelle et d’ancrer le protocole dans les règles de l’art du développement logiciel académique, il est vivement conseillé de factoriser l’intégralité du pipeline au sein d’une fonction Python paramétrable et encapsulée. Cette fonction type reçoit en entrée un DataFrame brut, effectue la standardisation via StandardScaler, exécute l’ACP complète, assemble le tableau de décomposition spectrale et génère la figure double axe haute résolution.
L’architecture de cette fonction doit intégrer une gestion dynamique des paramètres éditoriaux : personnalisation des intitulés de titres, définition paramétrable du ratio de coupure de variance cumulative souhaité (par exemple 70 % ou 80 %), et possibilité d’activer ou de masquer le tracé de la ligne critique du seuil de Kaiser. En encapsulant ces instructions dans un bloc fonctionnel autonome, l’analyste s’assure qu’aucun artefact computationnel ne viendra polluer l’exécution répétée du script sur des sous-échantillons distincts.
La pérennité logicielle de cette fonction doit être garantie par la rédaction d’une documentation interne exhaustive (docstring) rédigée selon les standards académiques contemporains (tels que les formats de documentation Sphinx ou NumPy Doc). Cette documentation décrit formellement la nature et les types des structures d’entrée, explicite les hypothèses mathématiques sous-jacentes (normalisation unitaire implicite), et détaille la structure des objets renvoyés en sortie (figure Matplotlib prête à l’exportation et DataFrame Pandas des métriques factorielles), assurant ainsi une intégration transparente au sein de suites d’analyses quantitatives complexes.
12.3 Perspectives avancées : Analyse factorielle confirmatoire et rotations
L’Analyse en Composantes Principales couplée au scree plot représente une démarche essentiellement exploratoire et réductionniste. Dès lors que l’analyste dispose d’un modèle théorique a priori fort concernant l’architecture causale des construits latents mesurés, il convient d’envisager la transition méthodologique vers l’Analyse Factorielle Confirmatoire (AFC). Contrairement à l’ACP, l’AFC met à l’épreuve des structures de covariance contraintes et estime formellement la variance d’erreur résiduelle propre à chaque item manifeste, validant les hypothèses psychométriques par des indices d’adéquation globale rigoureux tels que le RMSEA, le CFI ou le TLI.
Dans les cadres exploratoires factoriels (AFE), le recours aux rotations d’axes représente une étape indispensable pour atteindre la structure simple postulée par Thurstone et maximiser l’interprétabilité des dimensions. Qu’il s’agisse de rotations orthogonales maintenant l’indépendance des facteurs (méthode Varimax) ou de rotations obliques autorisant une corrélation empirique entre dimensions latentes sous-jacentes (méthodes Promax ou Oblimin), la rotation redistribue l’inertie globale parmi les axes retenus afin de polariser les charges factorielles vers des valeurs très élevées ou voisines de zéro.
Il importe toutefois d’assimiler une distinction mathématique capitale fréquemment méconnue : le scree plot d’éboulis doit impérativement être tracé et interprété préalablement à toute opération de rotation factorielle. La rotation factorielle opère une réallocation de la variance extraite au sein du sous-espace multidimensionnel préalablement circonscrit. Elle modifie donc substantiellement les valeurs propres individuelles de chaque facteur post-rotation, anéantissant la hiérarchie spectrale strictement ordonnée d’origine. L’éboulis de Cattell est une propriété mathématique exclusive de la décomposition spectrale initiale d’une matrice complète, et c’est son examen rigoureux qui dicte le nombre exact de dimensions qui seront autorisées à pivoter lors des phases analytiques confirmatoires ultérieures.
Références
- Cattell, R. B. (1966). The scree test for the number of factors. Multivariate Behavioral Research, 1(2), 245-276. https://doi.org/10.1207/s15327906mbr0102_10
- Guttman, L. (1954). Some necessary conditions for common-factor analysis. Psychometrika, 19(2), 149-161. https://doi.org/10.1007/BF02289162
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179-185. https://doi.org/10.1007/BF02289447
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417-441. https://doi.org/10.1037/h0071325
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Jolliffe, I. T. (2002). Principal Component Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b98835
- Kaiser, H. F. (1960). The application of electronic computers to factor analysis. Educational and Psychological Measurement, 20(1), 141-151. https://doi.org/10.1177/001316446002000116
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84-99. https://doi.org/10.1037/1082-989X.4.1.84
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-003
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Zwick, W. R., & Velicer, W. F. (1986). Comparison of five rules for determining the number of components to retain. Psychological Bulletin, 99(3), 432-442. https://doi.org/10.1037/0033-2909.99.3.432