
L’analyse exploratoire des données contemporaines repose sur la capacité du praticien à appréhender immédiatement et fidèlement la structure probabiliste des variables quantitatives sous-jacentes. Dans le cadre des sciences des données appliquées et de l’économétrie empirique, la compréhension de la dispersion, de la tendance centrale et des singularités structurelles d’un jeu de données constitue le jalon préliminaire à toute démarche de modélisation inférentielle ou d’apprentissage statistique automatisé. Au sein de cet écosystème méthodologique, l’histogramme s’impose historiquement comme l’instrument fondamental d’estimation non paramétrique de la distribution empirique d’un phénomène mesurable, opérant une réduction dimensionnelle intuitive sans présupposer la forme analytique de la loi génératrice.
Le langage Python s’est imposé comme le standard de facto pour les sciences quantitatives, principalement grâce à la robustesse et à l’expressivité de sa bibliothèque de manipulation tabulaire, Pandas. Conçue initialement pour répondre aux impératifs d’analyse financière à haute fréquence, Pandas intègre au sein de ses structures de données cardinales — notamment l’objet bidimensionnel DataFrame et le vecteur unidimensionnel Series — des passerelles directes vers l’abstraction graphique. En encapsulant les primitives de bas niveau issues de Matplotlib, Pandas permet aux chercheurs et ingénieurs de générer des artéfacts visuels hautement informatifs au moyen d’instructions syntaxiques synthétiques et vectorisées.
Le présent article propose une exploration exhaustive, rigoureuse et didactique des méthodologies permettant d’ériger des histogrammes optimaux à partir de structures tabulaires Pandas. De l’assise mathématique de la discrétisation spatiale aux raffinements esthétiques et sémiotiques indispensables à la publication académique, en passant par le traitement des données aberrantes, la stratification multivariée et la convergence vers des densités continues par noyau, ce traité détaille l’intégralité du continuum analytique indispensable à la formalisation visuelle des distributions numériques.
1. Fondements théoriques de l’histogramme et représentation des distributions empiriques dans Pandas
1.1 Définition statistique et morphologie de l’histogramme
Introduit formellement par le statisticien britannique Karl Pearson à la fin du dix-neuvième siècle, l’histogramme est un estimateur non paramétrique de la fonction de densité de probabilité d’une variable aléatoire continue. D’un point de vue morphologique, il se présente sous la forme d’une juxtaposition de rectangles contigus érigés sur un axe cartésien continu. Le processus d’élaboration repose sur la discrétisation de l’intervalle de définition des données empiriques en une partition d’intervalles contigus et mutuellement disjoints, désignés sous le vocable scientifique de classes ou, selon l’emprunt lexical anglo-saxon usuel, de bins.
Une distinction conceptuelle absolue doit être maintenue entre l’histogramme et le diagramme en barres traditionnel. Alors que le diagramme en barres illustre la cardinalité d’entités appartenant à des catégories nominales discrètes — séparées arbitrairement par des espaces géométriques traduisant l’absence de continuité métrique —, l’histogramme projette une grandeur quantitative sur un support ordonné continu. Dès lors, l’espacement horizontal entre les barres d’un histogramme est nul par nature théorique, reflétant la compacité de l’espace métrique réel sur lequel s’évaluent les observations collectées.
Le principe fondamental gouvernant la mécanique de l’histogramme réside dans le fait que la fréquence relative d’une classe n’est pas proportionnelle à la hauteur géométrique de la barre correspondante, mais strictement à son aire. Dans le cas d’une discrétisation à pas constant, la hauteur s’avère certes proportionnelle au dénombrement empirique des observations encapsulées, mais dès que les classes présentent des largeurs hétérogènes, la hauteur doit impérativement correspondre à la densité de fréquence, afin que la somme cumulative de l’aire de tous les rectangles converge exactement vers l’unité dans une optique probabiliste ou vers l’effectif total dans un dénombrement absolu.
1.2 Rôle de la bibliothèque Pandas dans l’écosystème analytique Python
Dans l’architecture computationnelle de la science des données contemporaine, la bibliothèque Pandas agit en tant que métastructure d’unification. Bâtie au sommet de l’infrastructure vectorisée NumPy, elle confère aux tableaux multidimensionnels une sémantique tabulaire formelle à travers l’indexation explicite des lignes et le nommage rigoureux des colonnes. Cette abstraction allège considérablement la charge cognitive requise lors de l’exploration préliminaire, éliminant les manipulations matricielles manuelles qui prévalaient historiquement dans les routines d’analyse quantitative.
L’interface de visualisation embarquée au sein de Pandas repose sur une symbiose structurelle avec la bibliothèque Matplotlib. Plutôt que de contraindre le programmeur à instancier manuellement des conteneurs de figures, des systèmes d’axes cartésiens et des itérateurs de tracé, Pandas intercepte ces complexités architecturales à travers des wrappers méthodologiques de haut niveau. Les méthodes de visualisation attachées aux objets DataFrame et Series transforment automatiquement les séries numériques en structures exploitables par le moteur de rendu, assurant une intégration fluide entre le traitement de la donnée et sa restitution sémiotique.
Cette abstraction offre des gains computationnels substantiels. Les routines internes de Pandas sont optimisées en langage C et Cython, ce qui permet d’agréger, de catégoriser et de dénombrer les fréquences empiriques de cohortes comprenant des centaines de milliers de lignes en quelques millisecondes. Ainsi, l’analyste peut déployer une boucle itérative d’interrogation visuelle particulièrement rapide, validant ou réfutant des hypothèses distributionnelles sans subir de latence opérationnelle pénalisante.
1.3 Types de variables et conditions d’application
L’application rigoureuse d’un histogramme exige un examen scrupuleux de l’ontologie des variables soumises à l’analyse. Seules les variables quantitatives, qu’elles soient de nature strictement continue (comme le revenu, la masse volumique, le temps d’attente ou la pression artérielle) ou de nature discrète à support arithmétique étendu (comme le nombre d’occurrences d’un événement rare sur un temps long), constituent des candidats valides pour une restitution par tracé d’histogramme sans artifice mathématique préalable.
L’application directe de cette méthodologie à des variables qualitatives pures, qu’elles soient nominales (telles que le pays de résidence, la couleur des yeux ou le système d’exploitation) ou ordinales à échelle restreinte (comme les échelons d’une échelle de Likert à cinq niveaux), constitue une faute méthodologique grave. Projeter des catégories discrètes sur un axe métrique continu suggère fallacieusement l’existence d’une relation d’ordre géométrique et d’intervalles topologiques mesurables là où n’existent que des étiquettes symboliques. Ces attributs qualitatifs requièrent un recodage catégoriel préalable et doivent être représentés au moyen de diagrammes en barres ou de tables de contingence.
L’échelle de mesure retenue — d’intervalle ou de rapport — exerce également une influence déterminante sur l’interprétation. Les échelles de rapport, qui disposent d’un zéro absolu non arbitraire, autorisent l’interprétation multiplicative des classes, alors que les échelles d’intervalle imposent une réserve quant à la manipulation des limites de partitionnement. L’intégrité de la représentation repose entièrement sur le respect de ces axiomes de mesure fondamentale, condition sine qua non pour que la morphologie visuelle reflète sans distorsion le mécanisme stochastique générateur sous-jacent.
2. Configuration environnementale et préparation structurelle des données
2.1 Initialisation des dépendances logicielles
La mise en œuvre d’un protocole de visualisation analytique sous Python débute par l’orchestration concertée des dépendances fondamentales de l’écosystème scientifique. Au sommet de cet empilement logiciel figurent Pandas pour l’encapsulation relationnelle des données, NumPy pour les opérations d’algèbre vectorielle et de discrétisation numérique, ainsi que le module pyplot de la bibliothèque Matplotlib pour la gouvernance de la topologie graphique sous-jacente.
Dans un contexte d’analyse interactive, tel que celui offert par les carnets Jupyter ou les environnements de recherche intégrés, la configuration du moteur d’affichage (ou backend) conditionne la fidélité et la maniabilité des tracés. L’activation des moteurs de rendu vectoriel permet d’obtenir une netteté absolue des polices de caractères et des délimitations géométriques, surpassant les formats matriciels comprimés qui détériorent la précision de lecture sur les affichages haute résolution. La configuration explicite de ces paramètres assure une standardisation indispensable pour la recherche collaborative.
Il est par ailleurs impératif d’auditer la compatibilité des versions installées dans l’environnement virtuel d’exécution. Les ruptures d’API entre les versions majeures de Pandas et de Matplotlib peuvent modifier le comportement par défaut de l’ordonnancement des axes ou de l’application des feuilles de style. L’interrogation systématique des versions garantit l’invariance des comportements d’affichage et consolide la pérennité algorithmique des protocoles d’analyse déployés au fil du temps.
2.2 Création et validation du DataFrame d’échantillon
Afin de concrétiser les développements théoriques sans dépendre de flux d’ingestion externes sujets à des aléas d’infrastructure, l’élaboration programmatique d’un DataFrame de synthèse constitue la meilleure approche pédagogique et méthodologique. En générant des colonnes présentant des caractéristiques stochastiques délibérément hétérogènes — telles qu’une variable distribuée selon une loi gaussienne canonique, une série log-normale exhibant une asymétrie marquée à droite, et une distribution bimodale simulant la concaténation de deux sous-populations distinctes —, l’analyste se dote d’un banc d’essai complet.
Une fois la structure tabulaire matérialisée en mémoire centrale, une phase d’audit préliminaire doit être menée à bien. L’exécution de la méthode d’inspection structurelle permet d’apprécier la morphologie générale du tableau, de quantifier avec certitude le volume d’enregistrements pris en charge et de vérifier la cohérence des index assignés aux lignes. Cette observation immédiate permet d’identifier visuellement d’éventuelles incohérences d’encodage ou des décalages d’indices consécutifs à l’étape d’instanciation.
L’étape subséquente réside dans la validation catégorique des types de données sous-jacents, opération formalisée par l’examen de la typologie interne de chaque colonne. L’analyste doit s’assurer que les colonnes vouées à la modélisation sous forme d’histogramme sont bel et bien reconnues sous les types numériques flottants ou entiers standardisés. La présence fortuite d’un format générique non typé (tel que le type textuel générique) empêcherait l’application des algorithmes de discrétisation numérique, provoquant des erreurs bloquantes lors de l’appel aux modules de rendu graphique.
2.3 Diagnostic statistique initial des séries quantitatives
Préalablement à toute représentation graphique, l’analyste avisé procède à une quantification analytique des moments empiriques du jeu de données. La méthode d’agrégation descriptive native de Pandas synthétise les paramètres cardinaux de tendance centrale et de dispersion : l’effectif des valeurs valides, la moyenne arithmétique, l’écart-type, ainsi que la décomposition par quartiles incluant le minimum, la médiane et le maximum. Cette photographie numérique fournit les balises au sein desquelles s’inscrira la projection géométrique.
L’examen de ces métriques permet d’anticiper la structure morphologique du futur histogramme. La comparaison arithmétique entre la moyenne et la médiane constitue le premier indicateur d’asymétrie : une divergence marquée dénote une queue de distribution étirée, susceptible d’engendrer un étalement asymétrique des classes. De surcroît, le calcul du coefficient d’asymétrie (skewness) et du coefficient d’aplatissement (kurtosis) affine cette intuition, précisant respectivement la direction du biais distributionnel et la propension de la variable à générer des événements extrêmes au regard de la loi normale théorique.
Enfin, l’identification de l’étendue interquartile, couplée à la détection des bornes extrêmes via le critère conventionnel de John Tukey, permet d’établir les frontières théoriques de la distribution observable. Cette étape de cadrage mathématique prévient les mauvaises interprétations visuelles : elle avertit l’analyste de l’existence potentielle de données aberrantes qui comprimeraient les classes d’intérêt dans une portion infinitésimale de l’axe cartésien, compromettant la lisibilité structurelle de l’histogramme.
3. Syntaxe fondamentale et génération d’un histogramme univarié avec DataFrame.hist()
3.1 Exécution de base et sélection ciblée de variable
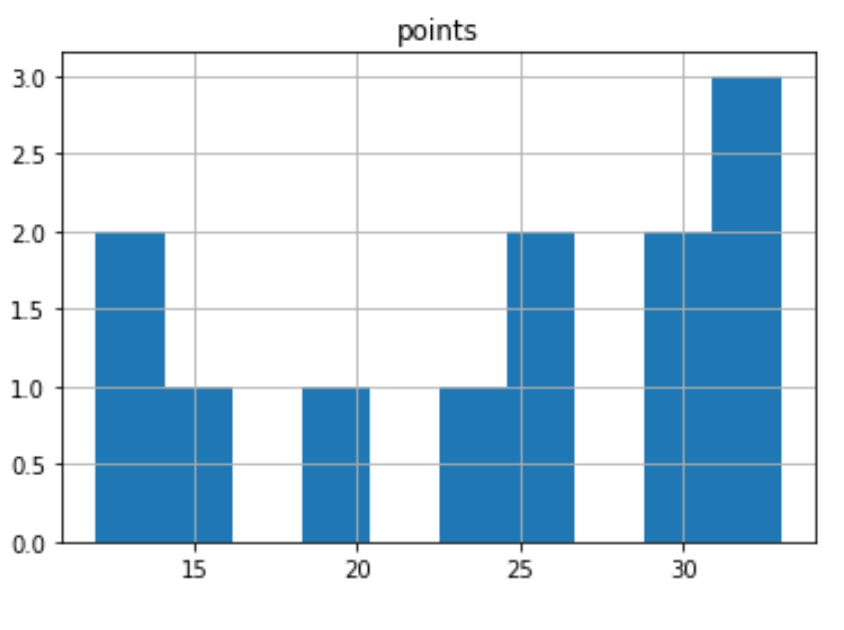
L’implémentation de référence pour la production d’un histogramme au sein de la bibliothèque Pandas s’articule autour de la méthode fondamentale d’objet désignée par l’instruction hist(). Appelée directement sur l’instance tabulaire, cette fonction déclenche en coulisse le calcul des fréquences d’intervalles et orchestre le tracé cartésien. Afin d’isoler une dimension analytique unique et d’éviter la génération indiscriminée d’un tableau d’axes exhaustif, l’argument dédié à la désignation de la colonne doit être expressément paramétré avec le label de la variable cible.
Le comportement algorithmique par défaut de la méthode applique une discrétisation canonique en dix segments d’amplitudes identiques, délimités automatiquement par les valeurs minimale et maximale de la série quantitative considérée. Cette automatisation dispense le chercheur de formaliser les bornes lors de la première itération exploratoire, produisant un panorama instantané de la forme distributionnelle sans nécessiter une volumétrie de code excessive.
Lors de son exécution dans une session interactive, l’appel à cette méthode produit deux effets simultanés : l’émission de commandes de rendu graphique envoyées au sous-système d’affichage actif et la restitution formelle d’une référence d’objet. Cette valeur de retour consiste généralement en un tableau unidimensionnel ou bidimensionnel d’objets d’axes Matplotlib. La capture explicite de cette référence scalaire permet d’enchaîner des instructions d’enrichissement graphique post-hoc, transformant une simple esquisse exploratoire en une figure rigoureusement annotée.
3.2 Différenciation de syntaxe entre DataFrame.hist() et Series.hist()
Une distinction syntaxique et fonctionnelle majeure réside dans le niveau d’instanciation auquel la méthode d’histogramme est invoquée. Lorsque l’instruction est déclenchée au niveau vectoriel d’une Series, la méthode s’exécute directement sur le flux unidimensionnel de données, sans nécessiter d’argument d’indexation de colonne. À l’inverse, l’appel opéré au niveau du DataFrame requiert la spécification formelle de la colonne ou procède par défaut à une itération exhaustive sur tous les attributs scalaires exploitables.
Cette divergence architecturale se répercute immédiatement sur la typologie de l’objet graphique retourné en fin de traitement. L’appel vectoriel via la structure Series retourne un objet d’axe cartésien singulier, prêt à être inséré au sein d’une composition graphique préexistante ou enrichi de tracés additifs. En contrepartie, la variante tabulaire instancie généralement une matrice d’axes, structurée dans un tableau NumPy, même si le filtrage n’a sélectionné qu’une unique variable d’intérêt.
Le choix entre ces deux approches relève d’un arbitrage méthodologique. Pour une exploration rapide et décontextualisée, l’approche tabulaire brille par son expressivité directe. Toutefois, dès lors que le projet implique l’insertion de l’histogramme au sein d’un tableau de bord analytique complexe composé de figures composites hétérogènes, l’approche vectorielle confère un contrôle granulaire supérieur, facilitant l’injection de l’axe au sein d’une grille cartésienne régie par les gestionnaires de disposition avancés.
3.3 Validation de la conformité du tracé univarié
L’obtention d’un rendu visuel ne dispense nullement le scientifique d’une validation critique de la conformité du graphique généré. Le premier contrôle consiste à vérifier la parfaite adéquation entre les fréquences observées et la sommation des hauteurs des rectangles affichés. Si l’histogramme est paramétré en fréquence absolue, l’altitude cumulée de chaque colonne doit refléter précisément le nombre d’enregistrements dont la valeur métrique s’inscrit dans les bornes semi-ouvertes de l’intervalle correspondant.
Il convient ensuite de s’assurer de l’absence de chevauchement artificiel ou de discontinuités illégitimes entre les rectangles. Dans la modélisation d’une variable quantitative continue, la contiguïté spatiale des classes doit être absolue : le bord droit d’une barre doit coïncider rigoureusement avec le bord gauche de la barre subséquente sur l’axe des abscisses. L’apparition de hiatus géométriques inexpliqués trahit fréquemment une discrétisation erronée ou la présence inattendue de valeurs manquantes corrompant la chaîne d’évaluation.
Enfin, l’évaluation de la lisibilité sémiotique immédiate impose un examen minutieux de la cohérence des axes. L’axe des abscisses doit présenter des graduations lisibles, exemptes de chevauchements textuels, réparties à intervalles réguliers et représentatives de l’unité physique ou économique de la variable étudiée. Quant à l’axe des ordonnées, il doit impérativement débuter à l’origine absolue de zéro pour les dénombrements de fréquences, tout décalage artificiel de la base tronquant la perception volumétrique de la distribution empirique.
4. Calibration statistique des classes d’intervalles (bins)
4.1 Impact du paramètre bins sur l’interprétation morphologique
Le paramètre gouvernant le nombre de classes de partitionnement constitue la décision méthodologique la plus déterminante lors de la conception d’un histogramme. L’adoption arbitraire de la valeur par défaut expose l’analyste à des distorsions interprétatives majeures, relevant des deux écueils symétriques de l’estimation distributionnelle : le sous-lissage et le sur-lissage de la série empirique.
Un nombre de classes structurellement insuffisant engendre un sous-lissage sévère. En agrégeant de vastes segments du support des données au sein de réceptacles macroscopiques, l’histogramme occulte la texture interne de la distribution. Les singularités locales, telles que des micro-modes secondaires, des asymétries subtiles ou des ruptures de pente, se retrouvent irrémédiablement écrasées au sein d’une barre unique, véhiculant l’illusion trompeuse d’une homogénéité spatiale inexistante.
À l’inverse, la sur-segmentation induite par une allocation disproportionnée de classes conduit au sur-lissage, matérialisé par une fragmentation excessive de la continuité visuelle. Dès lors que l’effectif moyen par classe devient trop réduit, la variance stochastique individuelle prend le pas sur la tendance structurelle. L’histogramme se dégrade en un peigne étiolé hérissé de pointes et de vides artificiels, imputables au seul aléa d’échantillonnage plutôt qu’aux propriétés sous-jacentes du phénomène modélisé. Le statisticien doit dès lors naviguer judicieusement au travers de ce compromis classique entre biais et variance.
4.2 Modèles mathématiques d’optimisation du nombre de classes
Pour s’affranchir de la subjectivité inhérente au calibrage empirique, la littérature statistique a formulé plusieurs règles déterministes d’optimisation mathématique du nombre de classes ou de leur largeur idéale. L’une des plus célèbres et des plus anciennes est la règle de Herbert Sturges, formulée en 1926. Fondée sur l’approximation binomiale de la loi normale, elle stipule que le nombre optimal de classes est égal à l’unité augmentée du logarithme en base deux de l’effectif de l’échantillon. Bien qu’efficace sur des échantillons modestes et strictement symétriques, cette règle tend à induire un sous-lissage marqué lorsque la taille d’échantillon devient substantielle ou en présence d’une forte asymétrie.
Pour pallier ces déficiences, le statisticien David Scott a théorisé en 1979 une approche minimisant l’erreur quadratique intégrée moyenne de l’estimateur de densité. La formule de Scott établit la largeur optimale de classe comme étant proportionnelle à l’écart-type de la variable, modulé par la racine cubique inverse de l’effectif. Cette formulation accorde une attention accrue à la dispersion globale, offrant une restitution bien plus robuste pour des distributions unimodales lisses.
La proposition la plus aboutie pour les distributions empiriques du monde réel demeure la règle de David Freedman et Persi Diaconis, formalisée en 1981. Conçue pour résister aux déformations induites par les valeurs aberrantes, elle substitue l’écart-type paramétrique par une métrique non paramétrique : l’écart interquartile. La largeur optimale de chaque classe s’établit selon la relation formulée ci-dessous :
- Largeur optimale de classe = 2 × (Écart Interquartile) × (Effectif Total)-1/3
- Le nombre de classes en découlant se calcule en divisant l’étendue totale des données par cette largeur optimale.
L’API de Pandas et de son moteur sous-jacent permet fort heureusement de déléguer ce calcul complexe en passant directement des chaînes de caractères descriptives au paramètre dédié, ordonnant à l’algorithme d’exécuter ces protocoles d’optimisation de manière totalement automatisée.
4.3 Définition de partitions explicites et asymétriques
Bien que l’équidistance des classes constitue la norme conventionnelle pour simplifier l’interprétation par lecture directe des hauteurs, certaines configurations empiriques requièrent impérativement une discrétisation asymétrique à pas variable. C’est notamment le cas dans l’étude des distributions de revenus, des patrimoines économiques ou des concentrations polluantes, où une infime minorité d’individus concentre des amplitudes numériques exponentielles par rapport au reste de la population.
Pandas autorise une flexibilité totale dans cette configuration grâce à l’injection d’une collection ordonnée de scalaires en lieu et place d’un entier unique pour le paramètre d’intervalles. En transmettant une liste explicite ou un tableau numérique définissant la suite strictement croissante des bornes d’intervalles, l’utilisateur dicte précisément la géométrie de chaque classe. Cela permet d’isoler des tranches fiscales spécifiques, des seuils de criticité médicale ou des barèmes réglementaires conformes aux nécessités d’un cadre métier contraignant.
Cependant, l’introduction de largeurs d’intervalles inégales implique un impératif méthodologique fondamental : l’histogramme ne peut plus être tracé en fréquence absolue sous peine de falsifier la réalité quantitative. Une classe deux fois plus large collectera mécaniquement un effectif double si la densité reste uniforme, produisant une barre géante trompeuse. Il devient impératif d’activer le paramètre de normalisation en densité probabiliste, afin que la hauteur de chaque rectangle corresponde rigoureusement à sa surface divisée par sa base, préservant la validité herméneutique de l’artéfact graphique.
5. Personnalisation graphique, esthétique et sémiotique visuelle
5.1 Gestion de l’espacement et du ratio géométrique des barres
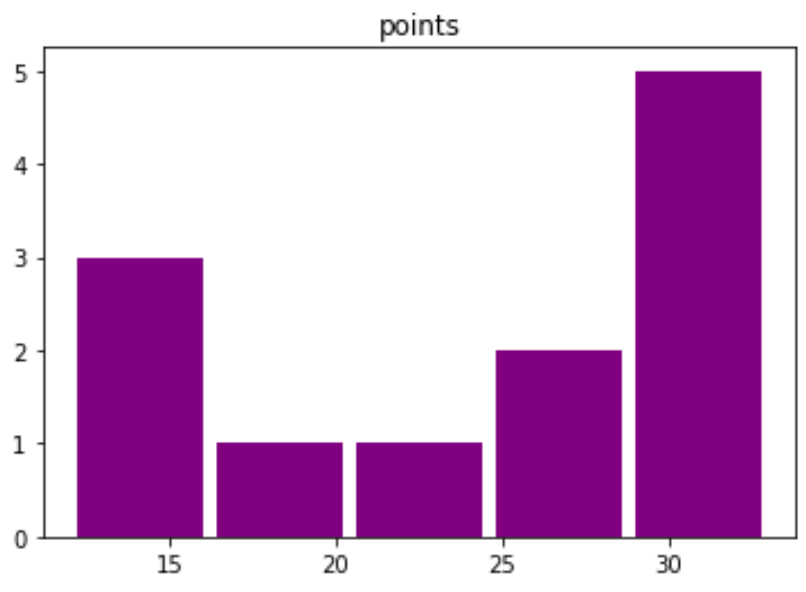
L’optimisation ergonomique d’un histogramme exige une manipulation mesurée de ses attributs dimensionnels. Par défaut, la méthode d’affichage trace des rectangles dont les bords se touchent parfaitement, concrétisant visuellement la continuité sous-jacente de la variable. Cependant, sur des graphiques matriciels à forte densité ou sur des supports imprimés de moyenne résolution, cette juxtaposition sans démarcation peut engendrer une masse chromatique indistincte pénalisant la lecture.
L’introduction d’un interstice infinitésimal entre les rectangles s’obtient au moyen de l’argument d’ajustement de la largeur relative, désigné sous le paramètre rwidth. En assignant à cet indicateur une valeur fractionnaire légèrement inférieure à l’unité (par exemple 0.90 ou 0.95), une marge géométrique imperceptible vient découper chaque classe sans rompre de manière rédhibitoire la perception de continuité, clarifiant ainsi l’individualité de chaque colonne.
Concomitamment, la gouvernance du quadrillage en arrière-plan doit être résolue avec sobriété. Bien que le paramètre booléen de grille (grid) soit activé par défaut dans certaines configurations historiques de Pandas, il est généralement préconisé par les chartes graphiques académiques de neutraliser cette trame de fond intrusive ou de la contraindre à l’axe vertical des ordonnées sous une opacité extrêmement atténuée. L’élimination du quadrillage horizontal parasite concourt à rehausser le ratio données-encre théorisé par Edward Tufte, maximisant l’efficience cognitive de la figure.
5.2 Harmonisation chromatique et accessibilité visuelle
Le choix de la palette chromatique ne saurait relever d’une simple complaisance décorative ; il obéit à des règles sémiotiques formelles de transmission d’information et d’accessibilité universelle. L’attribution d’une nuance chromatique s’opère directement par l’argument de couleur au sein de la signature d’appel de l’histogramme, acceptant aussi bien des identifiants littéraux que des encodages hexadécimaux stricts.
Afin de démarquer distinctement chaque intervalle sans nécessairement recourir au rétrécissement géométrique de la barre, il est hautement recommandé de délimiter le contour des rectangles au moyen de l’argument de bordure (edgecolor). L’application d’un liseré sombre contrastant avec un corps de barre plus clair garantit une dissociation visuelle irréprochable des classes, même lorsque celles-ci présentent des hauteurs comparables ou quasi identiques.
Les impératifs contemporains d’accessibilité imposent d’adopter des palettes insensibles aux déficiences de la vision chromatique (comme la deutéranopie ou la protanopie). L’usage de nuanciers perceptuellement uniformes — tels que les palettes Viridis, Cividis ou Plasma développées spécifiquement pour la communauté scientifique — garantit que les dégradés d’intensité lumineuse soient fidèlement interprétés par l’ensemble des lecteurs, tout en conservant une lisibilité optimale lors d’une reproduction photochimique en niveaux de gris.
5.3 Formalisation typographique et contextualisation des axes
Un tracé statistique dépourvu de labellisation univoque constitue une anomalie méthodologique. Bien que Pandas utilise automatiquement le libellé textuel de la colonne inspectée comme titre de base, la formalisation rigoureuse de la figure requiert une contextualisation typographique intégrale. La désignation de l’axe horizontal doit impérativement spécifier la nature du phénomène observé accompagnée scrupuleusement de son unité de mesure normalisée (par exemple : en milligrammes par litre, en euros constants ou en secondes écoulées).
L’axe des ordonnées doit faire l’objet de la même exactitude descriptive. Selon que la figure projette un décompte d’individus, une fréquence relative fractionnaire ou une densité probabiliste unitaire, le titre vertical doit refléter précisément la grandeur quantifiée. Omettre de préciser la mention de densité sur un graphique normalisé conduit fréquemment le lecteur non averti à interpréter à tort les valeurs infinitésimales des ordonnées comme des pourcentages directs, faussant radicalement l’inférence.
Enfin, la hiérarchisation des polices de caractères, régie par les modules de contextualisation de texte, parachève l’édifice esthétique. L’harmonisation des échelles typographiques entre le titre principal, les titres d’axes et les graduations chiffrées assure une lecture hiérarchique immédiate. Dans la perspective d’une publication dans une revue internationale à comité de lecture, l’intégration de chaînes de caractères formatées selon la syntaxe typographique scientifique garantit une inclusion élégante des symboles mathématiques et des alphabets grecs standardisés.
6. Génération simultanée et coordination d’histogrammes multivariés
6.1 Tracé matriciel global sans paramètre de filtrage
L’une des fonctionnalités les plus puissantes de l’abstraction offerte par Pandas réside dans sa capacité à orchestrer d’un trait l’audit distributionnel d’une table de données volumineuse. Lorsque la méthode hist() est invoquée directement sur l’objet tabulaire global, sans instanciation restrictive de l’argument de sélection univariée, l’interpréteur parcourt l’ensemble des attributs colonnaires hébergés en mémoire.
Durant ce balayage programmatique, un filtrage implicite s’exécute avec rigueur : seules les colonnes répondant aux contraintes du typage arithmétique (entiers et flottants de toute précision) sont retenues pour le calcul. Les variables encodées sous des formats textuels, catégoriels stricts ou temporels sont automatiquement écartées de la chaîne de projection, prévenant l’occurrence d’exceptions logicielles préjudiciables à l’automatisation du flux d’exploration.
Le résultat de cette opération consiste en une matrice ordonnée de sous-graphiques (ou subplots), logés au sein d’une toile cartésienne commune. Cette macro-visualisation panoramique offre à l’observateur une vision holistique simultanée de l’intégralité du profil statistique du jeu de données, facilitant la détection instantanée de variables dégénérées, d’asymétries généralisées ou de disparités d’échelles notables entre les différents attributs sous observation.
6.2 Harmonisation des échelles entre sous-graphiques
Si la production d’une matrice d’histogrammes indépendants s’avère féconde pour apprécier la forme univariée de chaque variable, elle recèle un piège méthodologique lorsqu’il s’agit de comparer ces attributs entre eux. Par défaut, Pandas recalibre dynamiquement et de manière autonome les échelles des abscisses et des ordonnées pour chaque sous-graphique, en fonction des extrema locaux propres à chaque série.
Pour forcer une comparabilité géométrique objective, la méthode expose deux paramètres de verrouillage dimensionnel : sharex et sharey. En assignant une valeur booléenne vraie à ces arguments, l’analyste contraint l’ensemble des sous-graphiques à partager rigoureusement la même étendue d’abscisses et le même plafond de fréquences. Cette configuration est indispensable lors de l’étude conjointe de batteries d’épreuves mesurées sur des échelles standardisées identiques (telles que des scores psychométriques ou des pourcentages normalisés).
Il importe néanmoins de manier ce verrouillage avec discernement. Dans un jeu de données rassemblant des variables aux amplitudes diamétralement disjointes — par exemple des taux d’intérêt exprimés en fractions centésimales et des valeurs de produit intérieur brut quantifiées en milliards d’unités monétaires —, l’harmonisation globale des axes provoquera inéluctablement l’écrasement cataclysmique des séries les plus modestes contre les marges cartésiennes, annihilant totalement leur lisibilité. La standardisation matricielle préalable s’avère alors obligatoire si l’alignement des axes demeure requis.
6.3 Contrôle géométrique de la disposition matricielle
L’ordonnancement géométrique automatique d’une matrice complexe d’histogrammes peut rapidement engendrer des compositions déséquilibrées si le nombre total de variables n’épouse pas un carré parfait. Pour structurer cet agencement spatial selon les nécessités d’un rapport technique, le paramètre d’organisation matricielle (layout) permet de spécifier un tuple fixant impérativement le nombre de lignes et de colonnes de la grille de restitution.
Conjointement à l’ordonnancement structurel, la maîtrise de l’encombrement spatial absolu repose sur le paramètre de dimensionnement global de la figure (figsize). Spécifié sous la forme d’un couple dimensionnel exprimé en pouces typographiques, il conditionne la superficie totale dévolue à l’affichage. Allouer un espace suffisant est une condition sine qua non pour empêcher l’écrasement vertical des barres et offrir un confort visuel optimal lors de l’examen de vastes collections d’attributs.
Un écueil récurrent lors du tracé de grilles étendues réside dans la superposition textuelle inesthétique entre les graduations chiffrées des lignes supérieures et les intitulés des sous-titres des lignes inférieures. Bien que Pandas tente d’équilibrer ces espacements, le recours programmatique aux routines d’espacement contraint de Matplotlib permet de recalculer dynamiquement les marges de délimitation, écartant tout risque d’empiétement typographique au sein du document final.
7. Stratification et décomposition conditionnelle via le paramètre by
7.1 Partitionnement par variable catégorielle
L’exploration approfondie d’un corpus de données exige fréquemment de décomposer la distribution globale d’un attribut quantitatif au travers des strates définies par une variable qualitative complémentaire. Plutôt que de contraindre l’analyste à rédiger des boucles d’itération programmatique complexes pour filtrer manuellement le DataFrame selon chaque modalité, Pandas intègre nativement le paramètre de stratification conditionnelle by.
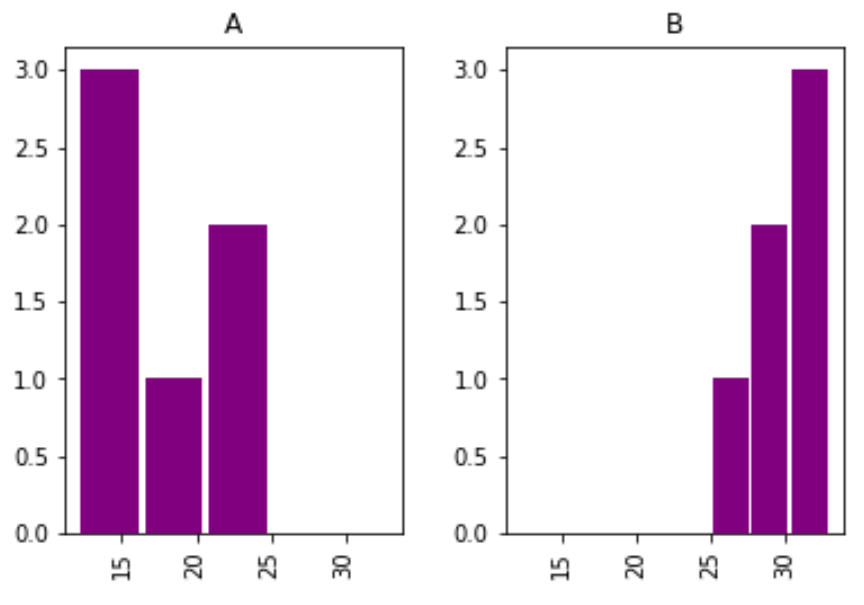
L’affectation du nom d’une variable catégorielle à ce paramètre instancie instantanément une décomposition sous forme de « petits multiples » (small multiples), un principe de conception graphique popularisé par l’école de la sémiologie graphique. Le jeu de données global est scindé en autant de sous-ensembles qu’il existe de modalités distinctes dans la variable de stratification, chaque groupe bénéficiant d’un sous-graphique d’histogramme dédié, généré sur une même ligne ou matrice visuelle.
Cette approche apporte une clarté analytique sans équivalent pour l’étude comparative des sous-populations. Qu’il s’agisse de comparer les distributions salariales selon le genre, la dispersion des mesures de pression sanguine selon les groupes d’âge clinique, ou le rendement de panneaux solaires selon la typologie géographique d’installation, la stratification par petits multiples permet d’isoler visuellement les glissements de tendances centrales et les déformations de variances intra-groupes sans interférence mutuelle.
7.2 Défis d’alignement et comparabilité des sous-populations
L’analyse comparative via la méthode de stratification impose une discipline rigoureuse concernant l’alignement des repères métriques. Si chaque cohorte de la partition est projetée avec son propre calibrage de classes et ses propres limites d’axes, le cerveau humain éprouve une difficulté considérable à estimer l’ampleur relative des décalages distributionnels, risquant de formuler des conclusions empiriques erronées.
Le premier défi concerne l’homogénéisation des intervalles de partitionnement. Il est impératif que les frontières de chaque classe coïncident rigoureusement d’une facette à l’autre. L’injection d’une séquence explicite de coupure commune passée en argument au sein de l’instruction de stratification garantit que les observations de chaque groupe soient soumises à la même grille géométrique, rendant l’examen des hauteurs relatives parfaitement valide.
Le second écueil méthodologique réside dans le déséquilibre potentiel des effectifs entre les strates étudiées. Si un sous-groupe rassemble dix mille observations tandis qu’une classe minoritaire n’en compte que quelques dizaines, le tracé en effectifs absolus rendra la distribution du groupe minoritaire invisible à l’œil nu, écrasée au niveau de l’axe des abscisses. La conversion obligatoire du tracé vers une échelle de densité probabiliste normalisée ou l’annotation textuelle rigoureuse de la taille d’échantillon propre à chaque facette s’impose alors pour restaurer l’équité sémiotique de la comparaison.
7.3 Alternatives analytiques à la superposition de distributions
Face à la nécessité de confronter des cohortes stratifiées, une alternative usuelle au facettage en petits multiples réside dans la superposition directe des histogrammes au sein d’un axe cartésien unique. Cette stratégie s’avère particulièrement séduisante lorsque le nombre de catégories demeure strictement restreint (deux ou trois groupes tout au plus) et que l’analyste désire mettre en exergue l’ampleur d’un recouvrement empirique ou d’une ségrégation bimodale.
La mise en œuvre d’une telle superposition impose de gouverner avec précision le coefficient d’opacité graphique des surfaces, matérialisé par le paramètre alpha. En assignant à chaque histogramme superposé un facteur de transparence fractionnaire compris généralement entre 0.4 et 0.6, les surfaces géométriques cessent de se masquer mutuellement. Les zones d’intersection distributionnelle apparaissent sous forme d’un mélange chromatique distinct, révélant la zone d’indifférenciation statistique entre les groupes.
Toutefois, cette méthodologie atteint rapidement ses limites cognitives dès lors que l’on excède trois catégories ou en présence de distributions très hachées. L’œil humain s’avère incapable de décomposer fidèlement les mélanges soustractifs de couleurs multiples, générant une confusion sémiotique importante. Dans ces situations de forte densité dimensionnelle, l’analyste doit impérativement délaisser la superposition directe au profit du facettage en sous-graphiques séparés ou recourir à des représentations alternatives telles que les diagrammes en violon ou les tracés de densités continues étagées.
8. Approche alternative : L’interface DataFrame.plot(kind=’hist’)
8.1 Divergences architecturales au sein de l’API Pandas
Au-delà de la méthode spécialisée native, la bibliothèque Pandas propose une porte d’entrée unifiée vers son écosystème de visualisation via la passerelle d’abstraction générique disponible sur chaque table de données. Cette interface s’invoque conventionnellement à travers la syntaxe de sélection paramétrique du type de tracé, formalisée par l’argument spécifiant la nature de l’histogramme, ou par l’accès direct aux accesseurs de méthodes graphiques dédiées.
Bien que les deux approches convergent vers le même moteur de rendu Matplotlib, elles se distinguent profondément par leur comportement architectural par défaut face aux jeux de données multivariés. Alors que la méthode spécialisée produit systématiquement un éclatement sous forme de grille de sous-graphiques isolés pour chaque variable quantitative, l’interface générique tente de projeter conjointement l’ensemble des colonnes numériques sélectionnées au sein d’un unique et même système d’axes cartésiens.
Cette divergence fondamentale redéfinit la flexibilité manipulationnelle post-opératoire. L’interface générique est conçue pour s’insérer au plus près des paradigmes de composition de Matplotlib, retournant par défaut une référence scalaire vers l’axe unique généré. Cela simplifie considérablement les flux de travail scripturaux où la figure doit être greffée au sein d’un canevas préétabli hautement personnalisé sans subir la fragmentation matricielle imposée par la méthode dédiée.
8.2 Paramétrage de la transparence et de l’empilement
Puisque l’approche par l’interface générique regroupe nativement les variables sur le même axe, elle expose des paramètres avancés d’ordonnancement volumétrique des classes. La gestion de la transparence par l’indice d’opacité demeure évidemment critique pour prévenir l’occultation des séries d’arrière-plan par celles positionnées au premier plan de la pile d’affichage.
Pour résoudre l’écueil du masquage sans recourir à la transparence, l’activation du paramètre d’empilement (stacked=True) permet d’ériger des histogrammes empilés. Dans cette configuration, la hauteur totale de chaque rectangle exprime la sommation cumulative des fréquences observées pour toutes les variables au sein de l’intervalle donné, chaque strate chromatique interne révélant la contribution proportionnelle de chaque série. Cette typologie de tracé s’avère féconde pour illustrer l’agrégation de sous-composantes économiques ou industrielles constituant une masse volumique globale.
Par ailleurs, l’interface permet d’activer avec une simplicité déconcertante le mode de calcul cumulatif par le truchement de l’argument booléen dédié (cumulative=True). Chaque classe successive accumule alors la somme de toutes les classes antérieures, traçant visuellement l’équivalent empirique de la fonction de répartition cumulative de la variable aléatoire. Cette fonction est essentielle pour évaluer visuellement des seuils de probabilité, déterminer graphiquement les fractiles ou exécuter des contrôles préliminaires d’adéquation non paramétrique.
8.3 Évaluation comparative des deux interfaces d’abstraction
Le tableau comparatif implicite gouvernant le choix entre ces deux interfaces dépend prioritairement des objectifs poursuivis dans le cycle d’ingénierie analytique. Pour le diagnostic rapide, la vérification d’intégrité de flux de données ou l’exploration préliminaire non supervisée, la méthode spécialisée s’avère indéniablement supérieure en matière de célérité d’écriture : une instruction unique et concise permet de balayer du regard l’intégralité d’une dizaine de variables sans nécessiter aucune orchestration de sous-graphiques.
En revanche, dès lors que la démarche requiert la construction de figures élaborées destinées à la publication scientifique, à l’élaboration de rapports exécutifs ou à l’intégration dans des chaînes de production de tableaux de bord automatisés, l’interface unifiée se révèle bien plus robuste. Elle permet de contrôler plus finement la légende, l’attribution séquentielle des étiquettes et l’articulation avec d’autres types de tracés sur un axe unique, évitant les effets de bord liés à la gestion automatique des grilles de sous-graphiques.
En matière de pérennité logicielle et de lisibilité de code pour des équipes de développement pluridisciplinaires, l’interface unifiée présente l’avantage d’harmoniser les conventions d’écriture : la syntaxe générale demeure identique qu’il s’agisse de tracer un histogramme, une estimation de densité, un diagramme de dispersion ou une série temporelle. Cette uniformité stylistique réduit la dette technique et simplifie grandement la relecture de code au sein des projets d’envergure industrielle.
9. Intégration avancée et personnalisation via l’API Matplotlib sous-jacente
9.1 Capture et manipulation directe des objets Axes et Figure
L’accès à l’excellence graphique impose de lever le voile sur les abstractions de haut niveau de Pandas pour dialoguer directement avec la hiérarchie d’objets fondamentale de la bibliothèque Matplotlib sous-jacente. La restitution graphique de toute méthode d’histogramme repose invariablement sur une hiérarchie bipartite : un canevas global désigné par la Figure, lequel héberge un ou plusieurs espaces cartésiens unifiés baptisés Axes.
En capturant explicitement la référence d’objet retournée lors de l’appel à la fonction d’histogramme, le chercheur s’affranchit des contraintes fonctionnelles préprogrammées de Pandas. Dans le cas d’une matrice multivariée, l’objet retourné prend la forme d’un tableau bidimensionnel de références d’axes. L’application d’une itération séquentielle programmatique — généralement via l’aplatissement unidimensionnel du tableau matriciel d’axes — permet d’accéder individuellement à chaque sous-graphique pour lui appliquer des transformations personnalisées d’une infinie précision.
Cette granularité opératoire permet par exemple d’invoquer les méthodes de contrôle fin des limites cartésiennes pour contraindre les bornes d’affichage sur des segments spécifiques, d’altérer la fréquence d’apparition des marques de graduation, ou encore de faire pivoter les étiquettes chiffrées afin de prévenir les chevauchements visuels. La maîtrise conjointe de ces deux couches logicielles confère à l’analyste une liberté totale dans la formalisation sémiotique de ses résultats empiriques.
9.2 Ajout de repères statistiques paramétriques et non paramétriques
Un histogramme acquiert une profondeur démonstrative incomparable lorsqu’il est enrichi de repères analytiques projetant la position relative des estimateurs fondamentaux de tendance centrale et de dispersion. L’adjonction de ces repères sur l’axe cartésien s’effectue au moyen de méthodes permettant d’ériger des lignes directrices verticales traversant la totalité de la hauteur de la figure.
Il est de rigueur académique de matérialiser la moyenne arithmétique de la distribution au moyen d’une ligne verticale discontinue, souvent signalée par une couleur vive contrastée (telle qu’un rouge cramoisi ou un bleu cobalt soutenu). Concomitamment, la projection de la médiane sous une autre texture de trait (par exemple un pointillé serré) offre une lecture immédiate du degré d’asymétrie empirique : la distance géométrique séparant ces deux traits verticaux constitue la matérialisation physique directe du biais de distribution de la variable analysée.
Cette instrumentation visuelle peut être étendue à la projection spatiale de l’intervalle interquartile ou des frontières correspondant aux écarts-types normalisés. Grâce aux routines d’annotation textuelle attachées à l’axe, le statisticien peut implémenter des boîtes de texte dynamiques affichant la valeur numérique exacte de ces estimateurs directement au-dessus des lignes indicatrices. Ce couplage entre géométrie et quantification chiffrée transforme un graphique exploratoire en un instrument d’inférence statistique parfaitement autonome.
9.3 Superposition conjointe d’une estimation par noyau (KDE)
L’une des synthèses visuelles les plus abouties dans l’analyse de distributions continues consiste à conjuguer la discrétisation empirique de l’histogramme avec la trajectoire fluide et non paramétrique d’une estimation de densité par la méthode du noyau (Kernel Density Estimation ou KDE). Cette modélisation continue lisse les variations stochastiques résiduelles pour esquisser la fonction de densité idéale qui gouverne l’échantillon fini.
La réalisation mathématique et visuelle de ce mariage impose une contrainte impérative : la mise à l’échelle absolue de l’histogramme doit obligatoirement être convertie en densité de probabilité unitaire via l’argument booléen dédié (density=True). Si cette opération n’est pas appliquée, l’histogramme exprimera des grandeurs en centaines ou milliers d’occurrences sur son axe vertical, tandis que la courbe d’estimation par noyau projettera des fractions décimales infinitésimales (dont l’intégrale totale égale l’unité), rendant la courbe mathématiquement invisible sur le tracé, comprimée à plat sur l’axe zéro.
Une fois les grandeurs harmonisées, la courbe du noyau peut être tracée directement sur l’axe receveur, venant draper l’histogramme d’une enveloppe continue d’une grande élégance. Cette superposition permet une vérification croisée particulièrement puissante : les rectangles empiriques apportent la preuve tangible des observations effectivement collectées dans chaque partition, tandis que l’enveloppe lissée fournit une vue dégagée des modes distributionnels sous-jacents, affranchie des artéfacts de discrétisation inhérents au choix des classes d’intervalles.
10. Traitement des anomalies statistiques, valeurs manquantes et valeurs extrêmes
10.1 Impact des données manquantes (NaN) sur la modélisation graphique
Dans la pratique analytique contemporaine, la présence de données lacunaires — matérialisées sous la sémantique formelle de valeurs NaN (Not a Number) — constitue une réalité quasi incontournable. Lors de l’exécution de la méthode d’histogramme, Pandas adopte un comportement algorithmique protecteur mais silencieux : toutes les entrées indéterminées sont automatiquement éliminées de la séquence numérique soumise au calcul avant que la partition en classes ne soit opérée.
Bien que cette exclusion prévienne l’effondrement fatal des routines d’algèbre vectorielle de NumPy, elle recèle des risques statistiques majeurs dont l’analyste doit rester pleinement conscient. Avant de procéder au tracé, il est indispensable de quantifier le taux d’attrition de la variable par un audit de complétude numérique. Si une colonne quantitative présente une proportion substantielle de valeurs manquantes (par exemple 20 ou 30 % du volume global), l’histogramme tracé ne représentera qu’une fraction arbitraire du phénomène réel.
Le péril méthodologique s’accentue dramatiquement si le mécanisme générateur des données manquantes n’est pas complètement aléatoire (processus non-MCAR). Si l’absence d’observation est conditionnée par la grandeur même de la variable (par exemple des répondants à très haut revenu refusant systématiquement de divulguer leurs avoirs financiers), l’exclusion aveugle de ces données produit une troncature artificielle de la distribution vers la droite. L’histogramme projeté induit alors une sous-estimation systématique de l’asymétrie réelle, propageant un biais analytique indétectable sur le seul fondement de la figure.
10.2 Gestion et détection des valeurs aberrantes (outliers)
Les valeurs aberrantes constituent l’ennemi juré de la fidélité morphologique des histogrammes. En présence d’une unique observation localisée à plusieurs ordres de grandeur au-delà de la cohorte normale (qu’elle découle d’un phénomène rarissime de type cygne noir ou d’une corruption de capteur de mesure), l’étendue totale des données se retrouve catapultée à une amplitude disproportionnée.
Ce phénomène altère dramatiquement la mécanique de discrétisation à classes régulières. Pour relier l’essentiel du nuage d’observations à l’aberration lointaine, l’algorithme génère des classes d’une largeur gigantesque. En conséquence, la quasi-totalité de l’échantillon se retrouve massée et compressée au sein d’une unique barre géante plaquée contre l’origine, flanquée d’un immense désert cartésien vide ne débouchant que sur une imperceptible barre d’un pixel à l’extrémité opposée de l’axe. Toute la richesse distributionnelle interne est instantanément anéantie.
Pour remédier à cette distorsion sans altérer l’intégrité de la base de données brute, deux approches sont préconisées. La première repose sur l’implémentation d’une transformation d’échelle logarithmique sur l’axe des abscisses ou des ordonnées, permettant de contracter les étendues exponentielles. La seconde relève de protocoles de troncature statistique (ou winsorisation), consistant à borner artificiellement l’intervalle d’affichage de l’histogramme entre des quantiles extrêmes rigoureux (par exemple entre le 1er et le 99e centile), neutralisant ainsi l’impact destructeur des valeurs atypiques sur la lisibilité générale de la distribution centrale.
10.3 Transformations mathématiques préalables au tracé
Lorsqu’une variable manifeste une asymétrie positive endémique et structurelle — caractérisée par une queue de distribution s’étirant sur plusieurs décades comme dans l’analyse des tailles de fichiers, de fréquences urbaines ou de concentrations chimiques —, la projection directe des valeurs scalaires brutes s’avère souvent inexploitable. Le recours à des opérateurs de redressement morphologique constitue alors une nécessité méthodologique incontournable.
La transformation la plus universelle repose sur l’application de l’opérateur logarithmique naturel ou népérien à l’ensemble de la série vectorielle préalablement à l’injection dans l’algorithme de tracé. Sous l’action du logarithme, les écarts exponentiels se muent en incréments additifs : les queues distributionnelles asymétriques se résorbent et la distribution empirique adopte fréquemment une allure quasi gaussienne standardisée, rendant l’application de classes régulières enfin performante et informative.
Dans des contextes statistiques plus formalisés, l’analyste peut déployer la famille des transformations paramétriques de Box-Cox ou la simple extraction de racine carrée pour stabiliser les variances hétéroscédastiques. Lors de la publication de telles figures, l’exigence de clarté sémiotique impose néanmoins de renseigner explicitement l’axe horizontal : l’intitulé doit impérativement préciser que la métrique projetée réside dans l’espace transformé, évitant toute méprise quant aux grandeurs physiques initiales de la variable mesurée.
11. Interprétation statistique rigoureuse des morphologies d’histogrammes
11.1 Identification des profils de distribution fondamentaux
L’histogramme constitue un révélateur universel de la typologie des lois de probabilité sous-jacentes. La morphologie la plus classique et recherchée est la cloche symétrique caractéristique de la distribution de Gauss ou loi normale. Sur le plan visuel, elle se distingue par un sommet d’intensité central unique coïncidant parfaitement avec la moyenne arithmétique et la médiane, bordé de deux pentes décroissantes à l’inflexion harmonieuse convergeant vers des queues asymptotiques sans étalement excessif.
Les déviations par rapport à cet étalon révèlent les caractéristiques stochastiques du système étudié. Une distribution asymétrique positive (vers la droite) présente un pic proéminent concentré vers les faibles valeurs, prolongé par une longue traînée de classes décroissantes s’étirant vers les valeurs positives élevées. Inversement, l’asymétrie négative (vers la gauche) positionne sa masse volumique sur les grandeurs élevées, exhibant une queue étirée vers les valeurs minimales. La détection de ces asymétries constitue un signal d’alerte quant à l’invalidité de certains tests paramétriques présupposant la normalité symétrique des résidus.
L’observation du profil d’aplatissement ou kurtosis affine ce diagnostic structurel. Une distribution leptokurtique projettera un pic central acéré associé à des queues épaisses révélant une probabilité accrue d’événements extrêmes, tandis qu’une distribution platykurtique présentera un profil aplati à la manière d’un plateau régulier. L’analyste attentif s’appuie sur ces signatures géométriques directes pour guider le choix de modèles probabilistes théoriques adaptés (tels que les lois de Student, de Pareto ou de Weibull).
11.2 Diagnostic de multimodalité et hétérogénéité des données
L’un des apports majeurs de l’histogramme dans le processus exploratoire réside dans son aptitude à dévoiler sans ambiguïté les structures de multimodalité. Alors que les métriques d’agrégation numérique scalaires (comme la moyenne et la variance) sont incapables de signaler l’existence de plusieurs pics de concentration et délivrent une synthèse aveuglante, l’histogramme expose instantanément la présence de deux ou plusieurs sommets disjoints séparés par des creux d’intensité prononcés.
L’apparition d’un profil bimodal au sein d’une série numérique constitue la signature caractéristique d’une hétérogénéité latente au sein de la cohorte analysée. Cette morphologie trahit quasi systématiquement la juxtaposition non maîtrisée de deux sous-populations distinctes régies par des mécanismes générateurs disjoints. À titre d’illustration, la mesure de la masse corporelle au sein d’un échantillon zoologique mixte de dimorphisme sexuel prononcé générera immanquablement deux modes distincts correspondant respectivement aux mâles et aux femelles.
Face à une telle constatation géométrique, le chercheur doit proscrire tout traitement global unifié sous peine d’émettre des inférences dénuées de sens physique (la moyenne empirique se situant souvent dans le creux séparateur, là où la probabilité réelle de trouver un individu est précisément minimale). La conduite appropriée consiste à remonter vers les attributs de stratification pour identifier la variable d’appartenance de groupe responsable de la scission, puis à segmenter formellement la modélisation à l’aide du partitionnement conditionnel abordé précédemment.
11.3 Limites inhérentes à la discrétisation spatiale
Malgré sa puissance évocatrice, l’histogramme souffre de limitations mathématiques structurelles inhérentes au processus même de discrétisation spatiale d’une variable continue. La principale vulnérabilité de cet outil réside dans sa dépendance aiguë non seulement au choix de la largeur des classes, mais également à la sélection de l’origine de coupure marquant le point de départ de la première classe sur l’axe des réels.
En décalant arbitrairement l’origine des intervalles d’une fraction minime de la largeur de classe — sans en modifier aucunement le nombre —, un analyste peut assister à des métamorphoses visuelles déconcertantes : un mode d’apparence robuste peut subitement se scinder en deux sommets contigus, ou une asymétrie nette peut paraître s’atténuer artificiellement. Ce phénomène d’instabilité, désigné sous le terme d’aléa de phasage, rappelle que l’histogramme n’est qu’une approximation discrète et discontinue d’une réalité mathématique continue sous-jacente.
Par conséquent, l’observation morphologique d’un histogramme ne saurait suffire à elle seule pour trancher définitivement des questions de validation d’hypothèses en milieu académique rigoureux. Elle doit impérativement être corroborée par des tests d’adéquation formels et standardisés — tels que le test de normalité de Shapiro-Wilk, le test de Kolmogorov-Smirnov ou le critère d’Anderson-Darling —, ainsi que par des tracés de quantiles théoriques contre quantiles empiriques (Q-Q plots), formant un arsenal d’inférence complet et robuste.
12. Bonnes pratiques académiques, optimisation computationnelle et reproductibilité
12.1 Optimisation des performances sur des ensembles de données massifs
À l’ère des mégadonnées et des entrepôts massifs, la taille des tables de données traitées par Pandas peut atteindre des dizaines de millions de lignes, saturant l’empreinte de la mémoire vive. Dans de telles conditions limites, invoquer naïvement la méthode d’histogramme directe peut entraîner des goulots d’étranglement sévères, voire déclencher un plantage par dépassement de mémoire lors de la phase d’instanciation des objets graphiques.
Pour optimiser drastiquement le débit computationnel, il est fortement recommandé de dissocier le calcul de l’agrégation statistique du processus de rendu visuel. Plutôt que de confier l’intégralité du traitement lourd au moteur graphique de Matplotlib, l’analyste peut déléguer le dénombrement des fréquences directement à la fonction de partitionnement hautement optimisée de NumPy. Cette routine vectorisée s’exécute en une fraction de seconde au niveau des structures d’algèbre bas niveau, retournant simplement deux vecteurs d’entiers et de flottants correspondant aux comptes et aux arêtes de coupure.
Ces vecteurs compacts peuvent ensuite être injectés directement au sein d’une méthode de dessin de barres primitives, réduisant la consommation de ressources à une fraction négligeable. Parallèlement, pour les phases exploratoires préliminaires sur des corpus colossaux, l’adoption d’un protocole d’échantillonnage aléatoire probabiliste sans remise (via la méthode d’échantillonnage interne de Pandas) permet de reconstituer une distribution empirique d’une fidélité mathématique indiscernable du jeu complet, pour un coût de calcul infiniment moindre.
12.2 Protocoles d’exportation pour l’édition scientifique
L’aboutissement d’un travail de visualisation réside dans son exportation en vue d’une inclusion dans un manuscrit scientifique, une thèse de doctorat ou un rapport technique d’entreprise. Pour satisfaire aux exigences drastiques des comités d’édition internationaux, le choix du format de fichier de sortie et de ses paramètres d’encodage géométrique est un enjeu de premier ordre.
La règle d’or consiste à privilégier prioritairement les formats vectoriels purs tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics). Contrairement aux formats matriciels constitués d’une grille immuable de pixels, les fichiers vectoriels conservent chaque rectangle de classe, chaque marque d’axe et chaque symbole textuel sous forme de primitives mathématiques géométriques. Il en résulte une figure infiniment zoomable, garantissant une netteté absolue lors de l’impression professionnelle, sans aucun phénomène d’artéfact ou de pixellisation floue.
Lorsque des contraintes éditoriales imposent formellement le recours à une image matricielle (généralement sous format PNG non destructif), il est impératif de configurer manuellement la résolution spatiale au moyen du paramètre de densité de points par pouce (dpi), en lui allouant une valeur minimale de 300 à 600 DPI. De plus, pour proscrire le rognage inopiné des légendes situées en périphérie immédiate du canevas, l’activation systématique du paramètre d’ajustement strict des marges extérieures garantit une coupe périphérique irréprochable du document exporté.
12.3 Standardisation du code et réplicabilité scientifique
La reproductibilité constitue le socle inviolable de la démarche scientifique moderne. Afin que les visualisations de distributions élaborées sous Pandas soient pleinement réplicables par d’autres équipes de recherche indépendantes, le code de génération graphique ne doit pas consister en une suite désorganisée d’instructions ad-hoc, mais s’articuler sous forme de pipelines d’exécution standardisés et déterministes.
L’analyste veillera à encapsuler ses protocoles de tracé au sein de fonctions logicielles documentées, prenant en entrée le DataFrame brut ainsi que des hyperparamètres de visualisation explicites. Toutes les décisions méthodologiques critiques — notamment la méthode exacte d’optimisation du nombre de classes retenue, les seuils de troncature des valeurs aberrantes et les règles de traitement des valeurs manquantes — doivent être consignées au sein des métadonnées de documentation ou dans le cartouche textuel accompagnant la figure finale.
Enfin, dès lors qu’un protocole d’échantillonnage aléatoire probabiliste ou qu’une méthode stochastique de calage de densité intervient dans le flux de traitement visuel, la fixation explicite de la graine du générateur de nombres pseudo-aléatoires (random seed) s’impose comme une exigence absolue. Ce verrouillage mathématique garantit qu’à code identique et données égales, le tracé morphologique obtenu sera rigoureusement superposable au pixel près, assurant une conformité sans faille aux standards de réplicabilité de la science ouverte contemporaine.
Références
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-003
Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
Van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098