
Dans le domaine de l’analyse exploratoire de données et de la communication scientifique, la représentation visuelle constitue le vecteur privilégié de transmission d’intuitions quantitatives complexes. Parmi les bibliothèques fondamentales de l’écosystème scientifique Python, Matplotlib s’impose depuis plus de deux décennies comme la référence incontournable pour la génération de graphiques publiables et hautement personnalisables. Toutefois, les praticiens de la science des données se heurtent régulièrement à un obstacle méthodologique et technique majeur : la nécessité de confronter, au sein d’un même espace visuel compact, deux grandeurs physiques ou économiques qui partagent une variable indépendante commune, telle que le temps, mais dont les échelles de mesure, les ordres de grandeur ou les dimensions fondamentales divergent de manière irréconciliable.
Le recours à un graphique comportant deux axes des ordonnées distincts, communément désigné sous le vocable de graphique à double axe Y, répond précisément à cette exigence analytique. En associant une ordonnance primaire à gauche du canevas et une ordonnance secondaire à sa droite, cette architecture graphique permet de superposer des dynamiques temporelles hétérogènes sans contraindre les données à subir des transformations normalisatrices qui pourraient masquer leurs unités intrinsèques. Néanmoins, la construction d’une telle figure ne se résume pas à un simple artifice esthétique ; elle engage des principes profonds de géométrie projective, d’architecture logicielle orientée objet, ainsi que des considérations sémiotiques et cognitives rigoureuses destinées à préserver la lisibilité de l’information sans induire le lecteur en erreur.
Le présent traité propose une déconstruction exhaustive, théorique et appliquée, de la mise en œuvre des graphiques à double axe Y sous Matplotlib. À travers une progression méthodique articulée autour de l’appel à la méthode fondamentale twinx(), nous explorerons les fondements de la hiérarchie interne du moteur graphique, les protocoles d’alignement structurel des données avec la bibliothèque Pandas, les stratégies d’harmonisation chromatique et typographique, ainsi que la résolution d’écueils récurrents tels que la fusion programmatique des légendes et la gestion du chevauchement des calques. Enfin, une mise en perspective critique évaluera la pertinence sémiologique de ce dispositif face aux biais cognitifs qu’il peut susciter, tout en fournissant des patrons d’architecture logicielle réutilisables pour les environnements de recherche et de production industrielle.
1. Fondements théoriques et architecture des graphiques à double axe Y dans Matplotlib
1.1 Problématique de la juxtaposition de grandeurs dimensionnelles hétérogènes
L’analyse comparative de séries quantitatives requiert fréquemment l’évaluation conjointe de deux phénomènes cooccurrents régis par une variable exogène partagée. Dans le cadre de l’expérimentation physique, de l’économétrie ou de l’analyse du comportement des utilisateurs sur des plateformes numériques, il est courant de vouloir corréler une mesure d’intensité ou de flux avec un indicateur d’état ou de ratio. À titre d’illustration, confronter un volume d’appels réseau exprimé en mégaoctets par seconde avec un taux d’erreur exprimé en pourcentage soulève une incompatibilité dimensionnelle absolue : ces deux grandeurs n’appartiennent pas au même espace vectoriel métrique et ne sauraient partager une graduation linéaire commune sans induire une aberration sémiotique.
Lorsque le chercheur tente de projeter ces variables dissemblables sur un axe vertical unique, deux dysfonctionnements analytiques majeurs émergent inévitablement. Si les ordres de grandeur des grandeurs en présence sont hautement asymétriques, par exemple des valeurs monétaires chiffrées en millions d’euros juxtaposées à des taux d’intérêt oscillant entre zéro et cinq pour cent, la série dont l’amplitude est la plus modeste se retrouve mécaniquement comprimée contre l’axe horizontal. Cette compression graphique annihile toute variation locale, masquant les micro-oscillations, les ruptures de tendance ou les instabilités périodiques pourtant cruciales pour le diagnostic statistique. À l’inverse, l’ajustement forcé de l’échelle par l’application d’un facteur d’échelle arbitraire modifie la pente apparente des courbes, créant un risque tangible d’interprétation fallacieuse.
D’un point de vue épistémologique, l’instauration d’un double repère cartésien vise à préserver l’intégrité nominale et métrologique de chaque signal observé. Chaque série préserve son échelle d’étalonnage originale, garantissant que les valeurs lues directement sur les graduations correspondent aux grandeurs brutes issues du protocole expérimental. Cette double échelle offre ainsi un compromis entre la contextualisation spatiale conjointe, nécessaire à l’appréhension intuitive des coïncidences temporelles, et le respect strict des dimensions physiques propres à chaque canal de mesure.
1.2 Structure hiérarchique de Matplotlib : Figure, Axes et Canvas
Pour maîtriser la manipulation avancée des coordonnées sous Matplotlib, il est impératif de s’extraire de l’interface procédurale simplifiée offerte par le module pyplot et d’appréhender le modèle objet sous-jacent. La bibliothèque structure ses représentations autour d’une hiérarchie rigide composée principalement de trois abstractions fondamentales : la classe Figure, la classe Axes et l’instance sous-jacente Canvas. La Figure incarne le conteneur englobant de plus haut niveau ; elle délimite l’espace physique ou virtuel de l’image, contrôle la résolution globale exprimée en points par pouce (dots per inch) et orchestre la disposition des sous-graphiques, des titres globaux et des éléments de légende partagés.
Au sein de cette enveloppe se déploie l’objet Axes, qui constitue l’espace de données à proprement parler. Un objet Axes définit une région bidimensionnelle (ou tridimensionnelle) bornée par des délimitations appelées Spines et munie de systèmes de projection transformant des coordonnées numériques abstraites en pixels d’affichage. C’est l’instance d’Axes qui détient la propriété des objets XAxis et YAxis, lesquels gouvernent les graduations, les marques de graduation et les étiquettes textuelles associées. L’instance de Canvas, généralement abstraite pour l’utilisateur final, gère quant à elle le moteur de rendu matériel de bas niveau, qu’il s’agisse de rasterisation via la bibliothèque Anti-Grain Geometry (AGG) ou de sérialisation vectorielle vers des formats tels que le PDF, le SVG ou le PostScript.
L’implémentation d’un double axe Y repose précisément sur la capacité de Matplotlib à instancier deux objets Axes distincts occupant exactement la même région géométrique au sein du conteneur Figure. Cette superposition spatiale ne constitue pas une simple duplication mécanique, mais une composition de calques interactifs où le second espace de coordonnées vient s’imbriquer au-dessus du premier tout en partageant une dépendance géométrique stricte sur l’abscisse horizontale, permettant ainsi la cohabitation harmonieuse de deux moteurs de rendu autonomes.
1.3 Rôle sémantique de l’axe secondaire dans la mise en évidence de corrélations
L’introduction d’un axe des ordonnées secondaire modifie fondamentalement la sémantique de la lecture graphique. Alors qu’un tracé standard invite à quantifier des valeurs absolues ou à évaluer des différences d’amplitudes directes, le tracé à double axe invite explicitement l’observateur à évaluer la synchronie, l’opposition de phase ou la covariance dynamique entre deux séries temporelles distinctes. Il permet de mettre en relation synchrone des flux continus, tels que la température atmosphérique mesurée en temps réel, et des processus discrets ou cumulatifs, comme la pluviométrie horaire ou la consommation électrique d’un bâtiment.
Ce procédé graphique préserve la dynamique temporelle commune sans requérir d’altération unitaire préalable. L’œil humain, particulièrement performant pour identifier des motifs géométriques et des points d’inflexion simultanés, peut ainsi confronter l’accélération d’une courbe avec la décélération d’une autre, isoler des décalages temporels (effets de latence ou lag) et identifier visuellement des régimes de fonctionnement corrélés. La contextualisation empirique s’en trouve grandement enrichie, puisque les événements exogènes marqués sur l’axe temporel horizontal impactent simultanément les deux métriques de référence.
Toutefois, cette mise en relation visuelle porte en elle une responsabilité scientifique de premier ordre. L’observateur a tendance à interpréter le croisement géométrique de deux courbes comme un point d’équilibre ou une égalité de performance, alors même que cette intersection n’est qu’un artefact visuel conditionné par le choix purement arbitraire des bornes inférieures et supérieures assignées à chaque axe vertical. La compréhension sémantique du double axe exige donc une rigueur interprétative accrue et une conception visuelle épurée qui guide le regard vers l’analyse des variations relatives plutôt que vers la confrontation spatiale naïve des ordonnées.
2. Analyse mécanique de la fonction twinx()
2.1 Principe de fonctionnement de la méthode Axes.twinx()
La création programmatique d’un second repère vertical sous Matplotlib s’opère canoniquement par l’invocation de la méthode twinx() accessible depuis n’importe quelle instance existante de la classe Axes. Lors de son exécution, cette fonction instancie un nouvel objet Axes dont les propriétés géométriques fondamentales sont intimement corrélées à l’axe parent. Ce couplage est réalisé au niveau structurel en assignant au nouvel axe la même boîte englobante (bounding box) que celle occupée par le premier, assurant ainsi une superposition géométrique parfaite au sein de la figure parente.
Le point saillant de l’opération réside dans le partage synchronisé du système de coordonnées de l’axe des abscisses. L’axe nouvellement créé hérite d’une référence directe vers l’axe X de l’objet originel, garantissant que toute translation, modification d’échelle ou ajustement des limites horizontales appliqué à l’un des axes se propage immédiatement et de manière bidirectionnelle à l’autre. En revanche, le système de transformation régissant l’axe vertical Y est entièrement découplé : le nouvel axe se voit doté de sa propre échelle, de ses propres graduations et de ses propres contraintes d’affichage, positionnées par convention sur le côté droit de la zone de traçage.
Ce mécanisme permet d’isoler hermétiquement l’application des transformations mathématiques propres à chaque variable. Que la variable de gauche soit linéaire et que celle de droite nécessite un traitement logarithmique, les moteurs de projection opèrent de façon indépendante sans créer d’interférences au sein de la matrice de calcul des coordonnées d’affichage.
2.2 Gestion des systèmes de projection et transformations mathématiques
Pour convertir des coordonnées d’espace de données (data coordinates) en coordonnées physiques d’affichage sur l’écran (display coordinates), Matplotlib emploie un pipeline sophistiqué de matrices de transformation géométrique et affine. Au cœur de ce système se trouvent les objets de transformation dérivés de la classe Transform, et plus particulièrement la transformation composite associant l’échelle des données à la boîte englobante de l’axe (BboxTransform). Lors de l’utilisation conjointe de deux axes jumeaux, deux pipelines de transformation distincts s’exécutent simultanément au sein de la même surface de projection.
Le maintien de l’isomorphisme horizontal constitue une condition critique du système. L’axe des abscisses partageant une transformation identique sur les deux couches d’Axes, le ratio de conversion entre une unité de temps et un nombre déterminé de pixels reste rigoureusement constant lors de toutes les opérations de redimensionnement de la fenêtre graphique ou du canevas vectoriel. Si l’utilisateur applique un zoom dynamique sur une portion temporelle spécifique de l’axe primaire, l’événement propage une mise à jour immédiate des limites de la matrice de transformation de l’axe secondaire, préservant l’alignement temporel des points observés.
Inversement, l’indépendance paramétrique des limites d’axes verticaux (les méthodes get_ylim et set_ylim opérant de façon autonome sur chaque objet) implique que les matrices de projection verticale ne partagent aucune variable d’état. L’axe primaire applique sa transformation linéaire ou affine basée sur ses propres extrêmes statistiques, tandis que l’axe secondaire calcule sa propre pente de projection d’ordonnées, permettant une flexibilité analytique maximale.
2.3 Comportement de l’arrière-plan et transparence des calques
L’un des défis d’ingénierie logicielle posés par la superposition de deux éléments graphiques volumineux réside dans la gestion de l’occlusion visuelle. Si le second objet Axes généré par twinx() était instancié avec les paramètres de remplissage par défaut d’un repère conventionnel, son arrière-plan opaque viendrait masquer intégralement le tracé, les grilles et les lignes de repère générés sur l’axe primaire sous-jacent. Pour pallier cette difficulté, la méthode twinx() applique une règle de configuration spécifique à la surface de traçage du nouvel objet.
Lors de son initialisation interne, l’attribut patch du second repère (qui représente le rectangle délimitant le fond de la zone graphique) voit sa propriété de visibilité désactivée par défaut, ou son canal alpha de couleur de fond assigné à une transparence totale. De ce fait, le canevas de l’axe secondaire se comporte comme une feuille transparente parfaitement superposée au calque primaire. Seuls les éléments tracés explicitement (lignes, marqueurs, étiquettes et ticks d’axe droit) sont rasterisés ou vectorisés au premier plan.
Cette hiérarchisation des événements graphiques lors du rendu itératif soulève néanmoins des questions d’ordre de superposition relative (le facteur z-order). Par construction, le calque supérieur étant celui de l’axe jumeau, les données tracées sur ce dernier se positionnent physiquement au-dessus de celles de l’axe d’origine. Si le concepteur du graphique n’y prend pas garde, des surfaces denses comme des histogrammes ou des diagrammes en aires tracés sur l’axe droit peuvent recouvrir et rendre invisibles les courbes fines tracées préalablement sur l’axe gauche, nécessitant un paramétrage explicite de l’ordre d’empilement.
3. Préparation et structuration des données avec Pandas
3.1 Alignement indexical des séries temporelles hétérogènes
L’intégrité sémiotique d’une visualisation à deux ordonnées repose intégralement sur l’hypothèse sous-jacente que les valeurs projetées le long de l’axe horizontal partagent un référentiel spatial ou chronologique d’une exactitude irréprochable. Lors du traitement de séries temporelles issues de bases de données distribuées ou d’équipements de captation distincts, l’un des pièges les plus insidieux réside dans la disparité des fréquences d’échantillonnage ou dans la présence de désynchronisations d’horloge. Une série financière peut par exemple être indexée sur les seuls jours ouvrés, tandis qu’un indicateur macroéconomique n’est publié qu’à fréquence mensuelle ou trimestrielle.
Avant d’engager toute procédure de restitution graphique avec Matplotlib, il est impératif de formaliser la structure de ces séries au sein de la bibliothèque Pandas. La première étape consiste à convertir explicitement les vecteurs temporels en structures de type DatetimeIndex standardisées via la fonction to_datetime(). Cette conversion garantit que la variable indépendante ne sera pas interprétée comme une simple séquence de chaînes catégorielles arbitraires, mais comme un continuum physique régulé par une métrique de temps sous-jacente.
Pour prévenir les décalages d’alignement au moment du tracé, l’analyste doit procéder à une harmonisation systématique des index à travers des opérations de rééchantillonnage (resample) ou d’interpolation contrôlée, ou bien recourir à une jointure externe complète (outer join) qui matérialisera formellement les valeurs manquantes (NaN). Matplotlib gère avec élégance les valeurs nulles en interrompant continûment les segments de courbe, évitant ainsi d’induire le lecteur en erreur par l’interpolation géométrique artificielle de données inexistantes.
3.2 Séparation modulaire des jeux de données d’analyse
Dans le cadre d’un pipeline de traitement reproductible, la structuration modulaire des vecteurs de données en amont du tracé constitue une garantie contre les erreurs de manipulation sémantique. Une architecture robuste privilégie l’agencement des variables au sein d’un DataFrame unifié mais strictement typé, ou la partition méthodique des flux au sein de structures distinctes clairement identifiées en mémoire. L’affectation de types numériques primitifs conformes (tels que float64 ou int64) s’avère indispensable pour garantir une exécution exempte d’avertissements de dépréciation au sein des couches d’optimisation numérique de Matplotlib.
Considérons un cas représentatif d’intelligence économique consistant à mettre en miroir le flux de génération de prospects qualifiés (mesuré sous forme de comptages discrets d’opportunités d’affaires par semaine) et la concrétisation de ce pipeline en chiffre d’affaires effectif (exprimé en devises monétaires volumineuses sur une échelle continue). L’index commun est défini par la séquence calendaire hebdomadaire, tandis que les deux colonnes cibles reflètent des natures d’objets profondément dissemblables : d’une part un signal transactionnel volatil sujet à de forts bruits statistiques, et d’autre part une fonction cumulative ou lissée soumise à une dynamique d’inertie temporelle.
La déclaration explicite et le découplage fonctionnel de ces deux séries sous forme de séries temporelles Pandas distinctes facilitent leur injection ultérieure dans les méthodes respectives des axes ax1 et ax2. Cette séparation hermétique garantit également qu’aucun traitement statistique préliminaire, tel qu’une imputation de moyenne ou un filtrage passe-bas, ne viendra contaminer accidentellement la série concurrente.
3.3 Considérations sur la normalisation préalable des données
Face à des séries aux échelles divergentes, une alternative conceptuelle fréquente au double axe vertical consiste à procéder à une normalisation mathématique préalable des signaux, par exemple via le calcul de scores centrés-réduits (z-score) ou une mise à l’échelle min-max sur l’intervalle unité zéro-un. Il convient toutefois de peser avec minutie l’arbitrage entre la rigueur mathématique de la standardisation et la lisibilité immédiate exigée par l’interprétation métier.
La normalisation transforme les données physiques en grandeurs sans dimension, ce qui a pour conséquence immédiate d’occulter la réalité quantitative brute des phénomènes observés. Pour un médecin observant la tension artérielle et la saturation en oxygène d’un patient, ou pour un gestionnaire de portefeuille évaluant des volumes de trésorerie et des taux de rendement obligataires, les valeurs absolues possèdent une charge sémantique autonome essentielle à la prise de décision. Déposséder le signal de son unité de mesure d’origine force l’opérateur à opérer une gymnastique mentale inverse complexe pour restituer l’ordre de grandeur réel.
Dès lors, l’emploi de deux axes Y distincts s’avère nettement supérieur à la normalisation préalable lorsqu’il s’agit de préserver l’accès direct aux unités physiques fondamentales. L’affichage en valeurs absolues sur des axes étalonnés de façon autonome permet une lecture non altérée des grandeurs tout en maintenant intacte la possibilité d’analyser visuellement leurs fluctuations synchrones.
4. Protocole d’implémentation standard pas-à-pas
4.1 Initialisation du canevas et du premier système de coordonnées
L’implémentation rigoureuse d’un graphique à double ordonnée commence par l’instanciation délibérée du conteneur de haut niveau et de son premier espace de projection par le biais de la fonction constructrice subplots() de Matplotlib. Cette approche orientée objet est formellement préférée aux mécanismes implicites de la machine à états de pyplot, car elle permet de conserver une référence programmatique directe et immuable vers chaque objet manipulation tout au long du cycle de vie du script.
Lors de cette phase d’initialisation, le paramétrage des dimensions physiques de l’image (via l’argument figsize) s’avère primordial pour offrir une emprise spatiale suffisante aux graduations doubles. Une fois l’objet ax1 généré, l’analyste procède à l’application de la première commande de tracé, traditionnellement via la méthode plot() pour les données continues. À cette étape, il est indispensable de définir avec précision les paramètres graphiques structurants : l’épaisseur du trait (linewidth), le style de jointure des segments, ainsi qu’une coloration chromatique exclusive qui servira de signature visuelle pour cette première dimension de données.
Il est également recommandé d’appliquer à ce stade les éventuels traitements de lissage ou de filtrage de signal souhaités pour l’axe primaire, afin que la complexité algorithmique soit circonscrite avant l’introduction du second système de projection.
4.2 Génération de l’axe jumeau et projection de la seconde variable
L’étape charnière de l’architecture logicielle réside dans la dérivation de l’axe primaire à l’aide de l’instruction ax2 = ax1.twinx(). Cette simple ligne de code instancie dynamiquement l’objet ax2, configure automatiquement le couplage des limites de l’axe X et déplace l’axe des ordonnées du nouveau calque vers le bord droit du canevas, tout en effaçant les graduations gauches redondantes.
Une fois le pointeur ax2 disponible dans le contexte d’exécution, la seconde variable peut y être projetée par le biais des méthodes graphiques appropriées (par exemple un second appel à plot() ou un tracé de dispersion scatter()). Il est fondamental de veiller à ce que toutes les opérations relatives à la seconde métrique soient adressées strictement à l’instance ax2 et non à ax1 ou aux commandes génériques du module plt.
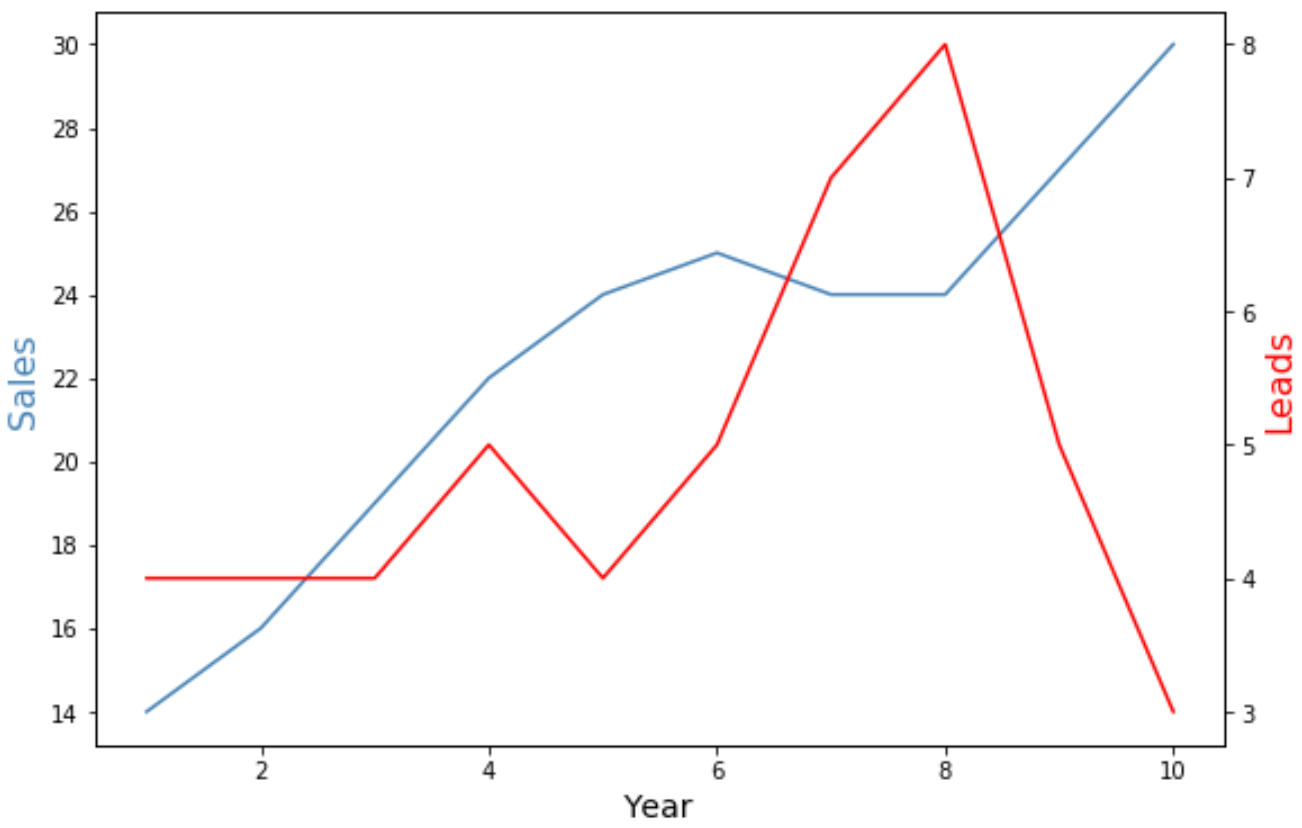
Cette distinction opérationnelle garantit que le moteur de tracé mettra à jour les limites automatiques (autoscale) du calque secondaire en se basant exclusivement sur le domaine de définition de la seconde série de données, sans modifier les bornes déjà calculées pour l’axe primaire sur le calque inférieur.
4.3 Étiquetage systématique et attribution chromatique différentielle
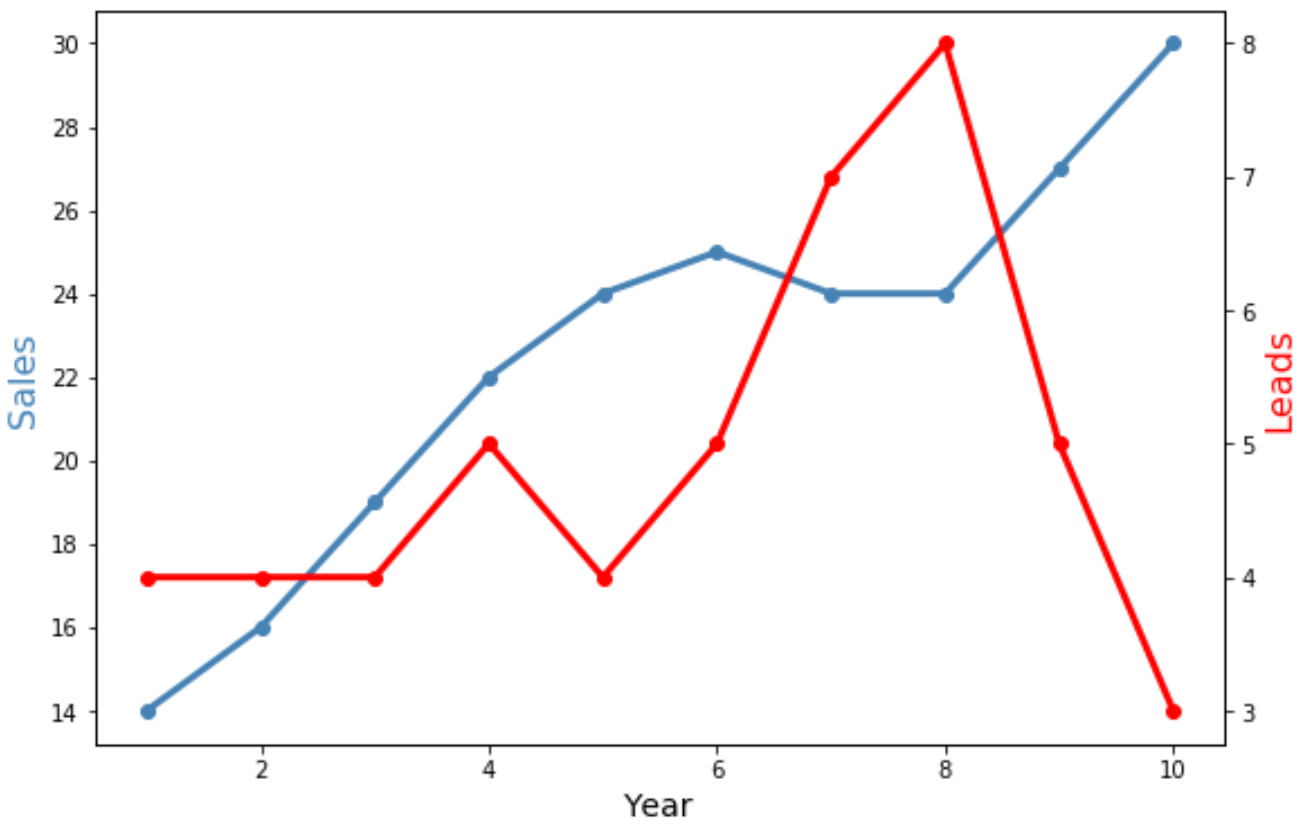
L’intelligibilité fonctionnelle d’un graphique à double axe repose entièrement sur l’absence d’ambiguïté dans l’attribution des échelles. Si les deux courbes partagent des couleurs similaires ou si les textes d’étiquetage n’explicitent pas clairement l’appartenance métrique, le lecteur est incapable de déterminer quelle série se rattache à l’axe gauche ou à l’axe droit. Le protocole d’implémentation doit par conséquent intégrer une stratégie stricte d’association chromatique différentielle.
Cette association s’opère par l’appel méthodique aux méthodes set_xlabel() sur l’axe primaire pour la variable indépendante, et set_ylabel() sur chacun des deux axes respectifs pour les variables dépendantes. Chaque libellé d’ordonnée doit comporter sans exception le nom de la variable ainsi que son unité de mesure formelle entre crochets ou parenthèses. De surcroît, la couleur de la police du libellé de l’axe gauche doit être configurée pour correspondre exactement à la teinte de la courbe de l’axe gauche, et inversement pour l’axe droit.
Le raffinement ultime consiste à appliquer ce même code couleur aux marques de graduation et aux valeurs numériques elles-mêmes par l’intermédiaire de la méthode tick_params(), établissant ainsi une continuité cognitive instantanée qui guide l’œil du lecteur vers le repère approprié sans effort d’interprétation contextuelle.
5. Harmonisation esthétique et différenciation sémiotique
5.1 Sélection de palettes chromatiques perceptuellement adaptées
L’efficacité d’un graphique scientifique ne saurait dépendre de choix chromatiques purement subjectifs ou décoratifs. En matière de visualisation à axes multiples, la palette sélectionnée doit répondre à deux impératifs sémiotiques majeurs : assurer une saillance visuelle équilibrée entre les deux phénomènes présentés et garantir une accessibilité universelle conforme aux directives d’accessibilité aux contenus web (WCAG) et aux contraintes liées aux déficiences de la vision des couleurs (daltonisme, deutéranopie, protanopie).
L’utilisation de teintes primaires saturées et antagonistes non calibrées, telles que l’association classique rouge pur et vert pur, doit être rigoureusement proscrite en raison de son illisibilité pour une fraction notable de la population masculine. On privilégiera l’emploi de palettes perceptuellement uniformes et divergentes, issues de référentiels reconnus comme ColorBrewer ou les cartes de couleurs natives de Matplotlib (telles que viridis, plasma, ou des paires contrastées bleu profond et ambre/orange brûlé).
Chaque teinte sélectionnée doit présenter un contraste de luminance suffisant par rapport au fond du canevas, garantissant que la lecture des labels et des graduations reste exempte de fatigue visuelle, même lors de reproductions en noir et blanc ou sous des conditions d’éclairage dégradées lors de présentations sur projecteur.
5.2 Stylisation des lignes et repères de trajectoire
Si la différenciation par la couleur constitue le premier niveau de catégorisation perceptive, elle s’avère insuffisante lorsqu’elle est employée de manière isolée. Pour conférer au graphique une résilience sémiotique absolue, il est hautement recommandé d’appliquer le principe de double encodage visuel en variant la texture et la morphologie des tracés géométriques.
L’analyste veillera à attribuer des styles de trait distincts aux différentes séries : une ligne continue solide pour la variable primaire sur l’axe gauche, et une ligne discontinue (telle qu’un motif à tirets longs ou un tracé mixte tiret-point) pour la variable secondaire sur l’axe droit. Cette rupture de continuité géométrique permet d’identifier immédiatement la trajectoire de chaque courbe, y compris lorsque celles-ci se superposent étroitement ou se croisent à des angles très aigus.
L’adjonction de marqueurs de points discrets (cercles, losanges, carrés) le long des segments fournit une couche d’information additionnelle précieuse. Ces marqueurs permettent d’identifier sans ambiguïté les instants exacts de mesure par rapport aux segments interpolés, tout en conservant une taille et une densité modérées afin d’éviter l’engorgement visuel de l’espace graphique.
5.3 Configuration des grilles sans interférence visuelle
La gestion du quadrillage d’arrière-plan (grid) représente l’un des écueils esthétiques les plus délicats lors de l’usage conjoint de deux axes verticaux. Si l’utilisateur active simultanément le quadrillage par défaut sur ax1 et sur ax2 via leurs méthodes grid(True) respectives, les deux ensembles de lignes horizontales vont se superposer selon des pas d’espacement différents, générant un réseau dense et anarchique de lignes sécantes connu sous le nom de motif de Moiré visuel. Ce phénomène détruit la lisibilité de la figure en détournant l’attention du lecteur vers des artefacts d’alignement non signifiants.
La règle empirique fondamentale consiste à restreindre l’affichage du quadrillage horizontal exclusivement à l’axe primaire ax1, tout en maintenant l’activation de la grille sur l’axe secondaire strictement éteinte. Ainsi, le lecteur bénéficie d’un réseau de repères stables pour situer la dynamique globale, sans que l’espace ne soit saturé par des lignes concurrentes.
Par ailleurs, la stylisation de cette grille unique doit obéir à une retenue visuelle stricte : une couleur gris clair neutre, une opacité atténuée via un coefficient alpha compris entre 0,25 et 0,40, et un style en pointillés fins suffisent amplement à guider l’œil sans interférer avec la clarté des tracés de données situés au premier plan.
6. Gestion fine des échelles et des graduations (Ticks)
6.1 Calibrage manuel des bornes d’ordonnées
Bien que Matplotlib intègre des algorithmes sophistiqués d’ajustement automatique d’échelle (autoscale), le contrôle délibéré des bornes d’ordonnées via la méthode set_ylim() s’avère indispensable pour garantir l’honnêteté intellectuelle et la précision analytique d’un graphique à double axe. L’ajustement automatique ajuste souvent les bornes au plus près des extrema observés dans le jeu de données, ce qui a pour effet de tronquer visuellement l’axe et de transformer des variations marginales en fluctuations d’apparence vertigineuse.
La décision d’inclure ou non le zéro absolu sur chaque axe vertical engage la responsabilité méthodologique du statisticien. Pour des grandeurs d’intensité physique (comme un niveau sonore en décibels ou une température corporelle), le zéro peut être dépourvu de sens direct ou hors de portée opérationnelle ; en revanche, pour des grandeurs de stock ou de flux (volumes de ventes, budgets, comptages de populations), forcer la borne inférieure à zéro prévient le risque d’amplification disproportionnée de la variance locale.
En outre, l’analyste averti calibrera manuellement les rapports d’échelles de manière à ce que les deux courbes ne se chevauchent pas de manière désordonnée dans la zone centrale du canevas si cela nuit à la distinction des signaux. L’ajustement symétrique des limites permet de cantonner visuellement une série dans la moitié supérieure du repère et l’autre dans la moitié inférieure, ou d’harmoniser les amplitudes perçues pour refléter fidèlement l’ampleur relative des fluctuations.
6.2 Formatage typographique des valeurs d’axes
L’affichage brut de valeurs à virgule flottante non formatées dégrade considérablement l’élégance et la clarté d’une figure scientifique. Le module spécialisé matplotlib.ticker met à disposition une infrastructure logicielle complète pour automatiser et personnaliser le positionnement des graduations (Locator) et leur rendu textuel (Formatter).
L’utilisation de classes telles que FuncFormatter ou StrMethodFormatter permet d’injecter des règles de mise en forme contextuelles : insertion de séparateurs de milliers, conversion de notations scientifiques complexes en représentations compactes, ou adjonction systématique de symboles monétaires ou de pourcentages. Par exemple, convertir une graduation de 1000000 en un label synthétique « 1,0 M€ » épure considérablement la colonne d’axe vertical et libère un espace horizontal critique.
Ce formatage s’applique également à l’aspect physique des graduations par l’intermédiaire de la méthode tick_params(). L’orientation des marques (orientées vers l’intérieur ou vers l’extérieur de la boîte de délimitation), leur longueur en points et leur épaisseur doivent être harmonisées entre l’axe de gauche et celui de droite afin de maintenir un équilibre architectural rigoureux sur l’ensemble de la figure.
6.3 Intégration d’échelles non-linéaires sur l’un des axes
La flexibilité structurelle de la méthode twinx() se manifeste pleinement lors de l’association de dynamiques mathématiques fondamentalement divergentes, telles qu’un processus à cinétique linéaire juxtaposé à un phénomène d’amplification exponentielle ou de dispersion en loi de puissance. Dans une telle configuration, l’application d’une échelle logarithmique sur l’un des axes représente la seule approche graphiquement viable.
Grâce à l’indépendance paramétrique des repères, il est trivial d’appliquer la commande ax2.set_yscale(‘log’) sur le second système de coordonnées tout en conservant l’échelle linéaire standard ax1.set_yscale(‘linear’) sur le premier. Le moteur de calcul de Matplotlib adapte instantanément la matrice de projection de ax2, transformant la dynamique exponentielle en une trajectoire rectiligne aisément quantifiable le long de décades régulières.
Cette hybridation impose toutefois un soin particulier dans la gestion des graduations mineures (minor ticks) de l’axe logarithmique. Il est nécessaire de vérifier que ces repères subsidiaires ne créent pas une asymétrie visuelle oppressante par rapport aux graduations plus espacées de l’axe linéaire primaire, ce qui peut être régulé en désactivant sélectivement les étiquettes mineures trop denses.
7. Résolution du défi de la légende unifiée
7.1 Diagnostic de la dispersion des poignées de tracé (handles)
L’un des désagréments techniques les plus fréquemment rapportés par les utilisateurs de twinx() réside dans l’incapacité native de Matplotlib à consolider spontanément les légendes des deux axes superposés. Ce comportement, souvent perçu comme un bogue logiciel par les praticiens novices, découle en réalité de manière rigoureusement logique de l’architecture objet de la bibliothèque.
Chaque instance de la classe Axes maintient en mémoire son propre registre interne d’objets graphiques, connus sous le nom d’identificateurs ou de « poignées de tracé » (handles), associés à leurs étiquettes descriptives respectives (labels). Lorsque le script exécute successivement ax1.legend() puis ax2.legend(), Matplotlib instancie deux conteneurs d’affichage distincts. Le premier ne référence que les courbes appartenant à ax1, tandis que le second n’intègre que celles issues de ax2.
Il en résulte une situation particulièrement inélégante : soit les deux boîtes de légendes viennent se superposer exactement au même emplacement physique (généralement le coin supérieur droit défini par défaut), rendant leurs textes mutuellement illisibles, soit l’analyste est contraint de les placer à des coins opposés du canevas, ce qui fragmente l’information contextuelle et oblige le lecteur à inspecter deux blocs distincts pour décoder une figure unique.
7.2 Extraction programmatique et agrégation des éléments graphiques
Pour surmonter cette limitation structurelle et composer un encart de légende parfaitement unifié, il est nécessaire de mettre en œuvre une procédure programmatique d’extraction et d’agrégation des poignées de tracé avant de déléguer la construction du bloc explicatif à un seul des deux axes.
La méthode canonique repose sur l’appel à la fonction get_legend_handles_labels(), disponible sur chaque instance d’Axes. Cette méthode interroge l’espace de données local et retourne un tuple contenant deux listes python : la première répertorie les instances géométriques des lignes ou marqueurs tracés, tandis que la seconde contient les chaînes de caractères affectées lors de l’appel aux arguments label des fonctions de tracé.
Le protocole technique consiste à récupérer ces tuples pour ax1 et pour ax2, puis à concaténer syntaxiquement les listes de poignées d’une part, et les listes d’étiquettes d’autre part, en utilisant les opérateurs standards de concaténation de listes. Enfin, cette collection fusionnée est injectée explicitement au sein d’un appel unique à la méthode legend() de l’un des axes, en fournissant les listes consolidées via les arguments nommés handles et labels.
7.3 Positionnement stratégique et finitions de l’encart explicatif
Une fois la légende consolidée au plan logiciel, son intégration spatiale exige un paramétrage géométrique soigné. L’argument loc de la méthode de légende permet d’indiquer l’ancrage spatial optimal au sein de la boîte englobante. Bien que la valeur dynamique loc=’best’ confie à un algorithme interne la tâche de trouver la zone présentant le moins d’intersections avec les courbes, il est souvent préférable, dans les rapports scientifiques formels, de fixer explicitement cet emplacement (par exemple loc=’upper left’ ou loc=’upper center’) pour stabiliser la composition visuelle d’une planche à l’autre.
Les propriétés matérielles de l’encart doivent également être ajustées pour préserver la lisibilité sans occulter les données qui passeraient éventuellement en arrière-plan. L’activation d’un cadre propre via frameon=True, combinée à une légère transparence de son fond via l’argument framealpha (typiquement calibré entre 0,85 et 0,95) et une couleur de bordure adoucie, garantit un détachement visuel net tout en maintenant une perception subtile de la continuité des tracés sous-jacents.
Enfin, l’agencement horizontal des entrées au sein de la légende par le truchement du paramètre ncol (permettant d’aligner les descriptions sur deux colonnes plutôt que sur une pile verticale étirée) contribue fréquemment à minimiser l’emprise en hauteur du bloc explicatif, libérant ainsi un espace vertical précieux pour l’observation des courbes de données.
8. Combinaison de typologies graphiques hétérogènes
8.1 Hybridation d’un diagramme en barres et d’une courbe continue
L’une des configurations visuelles les plus expressives et fonctionnelles permises par la double ordonnée consiste en l’hybridation d’une représentation discrète de volumes sous forme de diagramme en barres avec le tracé continu d’un indicateur de tendance ou d’efficacité. Cette morphologie graphique est abondamment exploitée en finance (confrontant le volume des transactions quotidiennes à l’évolution du cours de clôture) ainsi qu’en météorologie (associant l’histogramme des précipitations à la courbe des températures moyennes).
Dans ce scénario, la variable volumétrique discrète est tracée sur l’axe primaire via la méthode bar(). Il convient d’accorder une attention méticuleuse au paramètre de largeur des barres (width) et au calage de leur position horizontale afin de garantir qu’elles n’empiètent pas sur les intervalles temporels voisins. La variable continue est quant à elle projetée sur le calque secondaire ax2 via la méthode plot(), déployant son tracé linéaire au-dessus des rectangles verticaux.
Cette articulation résout élégamment le problème de la cohabitation entre des mesures d’accumulation (les barres exprimant des sommes sur un intervalle fini) et des mesures d’état instantané (la courbe reliant des points temporels précis), offrant une lecture multi-échelle fluide et immédiatement accessible.
8.2 Intégration d’un nuage de points avec régression et signal dense
Un autre cas d’usage avancé concerne la superposition d’un nuage de points empiriques hautement dispersé avec un signal déterministe ou une fonction de régression issue d’une modélisation mathématique. Cette approche permet de confronter directement les mesures d’observation individuelles (sujettes à la variance stochastique) avec une grandeur agrégée ou une cible théorique régie par une autre unité.
La méthode scatter() exécutée sur l’axe primaire ax1 génère la nébuleuse de données expérimentales. Pour éviter que la densité de points ne crée un bloc visuel opaque empêchant la lecture du fond, il est crucial d’ajuster le paramètre d’opacité alpha à une fraction modérée (entre 0,3 et 0,6) et de sélectionner des marqueurs d’échelle réduite. L’axe secondaire ax2 accueille alors la courbe d’estimation de densité, la moyenne mobile calculée ou la trajectoire d’une variable environnementale continue (telle qu’une pression ou une humidité ambiante).
Ce double encodage permet à l’observateur d’évaluer non seulement l’ajustement global de la tendance par rapport au nuage empirique, mais également de détecter d’éventuelles hétéroscédasticités ou déviations systématiques conditionnées par l’évolution de la variable secondaire associée.
8.3 Gestion stricte de l’ordre de superposition (z-order)
L’écueil fondamental guettant la combinaison de typologies graphiques hétérogènes réside dans les conflits d’empilement spatial, gouvernés en programmation graphique par le concept d’ordre Z (z-order). Par conception, tout élément tracé sur l’axe secondaire ax2 possède intrinsèquement un niveau d’élévation supérieur à celui des éléments positionnés sur l’axe primaire ax1, précisément parce que le calque d’ax2 est instancié chronologiquement après celui de son parent.
Ce comportement induit une contrainte sévère lorsqu’un diagramme en barres opaque est assigné à l’axe secondaire : les rectangles pleins du calque supérieur viennent masquer intégralement la courbe continue tracée sur l’axe primaire en arrière-plan. Même en modifiant l’argument zorder individuel des fonctions de tracé, la hiérarchie d’affichage interne entre les deux calques d’Axes distincts peut empêcher la ligne de passer au premier plan.
Pour contourner ce verrou structurel, deux stratégies complémentaires s’offrent au développeur. La première consiste à assigner systématiquement les typologies graphiques les plus volumineuses (surfaces remplies, histogrammes, barres larges) à l’axe primaire ax1, et à réserver l’axe secondaire ax2 aux tracés fins et filaires (lignes, marqueurs ouverts). La seconde méthode, plus interventionniste, impose de manipuler manuellement la propriété d’ordre Z de l’instance d’Axes elle-même en forçant ax1.set_zorder(ax2.get_zorder() + 1), tout en configurant explicitement le calque patch d’ax1 sur un état transparent pour empêcher l’occlusion inverse de l’arrière-plan de ax2.
9. Psychologie cognitive et ergonomie de la perception visuelle
9.1 Biais cognitifs induits par les doubles axes Y
Si la puissance technique de Matplotlib permet d’implémenter des doubles axes d’une sophistication visuelle exemplaire, le recours à ce dispositif fait l’objet de réserves appuyées au sein de la communauté des chercheurs en sémiologie graphique et en ergonomie cognitive, au premier rang desquels figurent les travaux séminales d’Edward Tufte. L’objection centrale réside dans la vulnérabilité extrême de l’observateur humain face aux manipulations involontaires ou intentionnelles des échelles d’ordonnées.
Le cerveau humain est biologiquement câblé pour extraire des relations causales à partir de proximités spatiales et d’alignements géométriques. Sur un graphique à double ordonnée, le point d’intersection où deux courbes se croisent physiquement est spontanément perçu comme un événement critique : un seuil de dépassement, une inversion de supériorité ou un point d’équilibre dynamique. Or, cette intersection est un artefact mathématique totalement artificiel. En modifiant arbitrairement la borne supérieure de l’un des axes ou en décalant sa ligne de base de quelques unités, le concepteur du graphique peut faire glisser ce point d’intersection vers la gauche, vers la droite, ou le faire disparaître totalement sans modifier en rien les données sous-jacentes.
Cette plasticité arbitraire génère ce que la littérature nomme l’illusion de corrélation : en étirant l’échelle d’une variable bruitée et en comprimant celle d’une variable stable, il devient aisé de faire coïncider visuellement leurs pentes respectives, suggérant au public non averti une interdépendance fonctionnelle étroite là où n’existe qu’une simple coïncidence stochastique.
9.2 Charge mentale et cheminement du regard
D’un point de vue psychophysique, la lecture d’un graphique comportant un double axe vertical impose une surcharge cognitive substantielle mesurable par l’analyse des mouvements oculaires (eye-tracking). Dans une visualisation standard à repère unique, le cheminement du regard s’opère selon une trajectoire fluide reliant les points de la courbe à l’axe vertical situé immédiatement à gauche.
Dans un dispositif à double axe, le parcours visuel est haché par des mouvements saccadiques continus et répétés. L’observateur doit inspecter une fluctuation locale, identifier la couleur ou la texture de la courbe correspondante, balayer horizontalement l’intégralité du graphique vers l’axe gauche ou droit selon le cas, mémoriser la valeur lue sur la graduation, puis renouveler l’opération pour la seconde courbe afin de tenter une synthèse mentale. Cette gymnastique oculomotrice augmente significativement le temps nécessaire à l’interprétation des données et accroît drastiquement le taux d’erreur de lecture sous contrainte temporelle.
Pour atténuer cette dégradation de l’ergonomie visuelle, l’analyste doit impérativement déployer des ancrages sémiotiques directs, tels que la labellisation directe des courbes à leurs extrémités finales plutôt que le recours exclusif à une légende déportée, ou l’utilisation d’étiquettes de données intégrées (direct labeling) qui dispensent le lecteur d’un va-et-vient perpétuel entre les courbes et les graduations d’ordonnées opposées.
9.3 Critères de validité pour la publication académique
Face à ces risques de distorsion cognitive, les comités de rédaction des revues scientifiques internationales de premier rang, ainsi que les manuels de style prescriptifs comme celui de l’American Psychological Association (APA), imposent des exigences rigoureuses quant à l’admissibilité des figures à axes jumeaux. L’analyste doit être en mesure de justifier que le double axe constitue la seule modalité technique permettant de répondre à l’interrogation scientifique posée.
Les situations où ce dispositif est scientifiquement recevable concernent principalement les cas où l’analyse porte sur la synchronisation fine d’événements de transition (par exemple, la corrélation temporelle exacte entre l’ouverture d’un canal ionique et la dépolarisation membranaire en neurobiologie), ou lorsqu’une variable constitue une fonction théorique directement liée à l’autre sans en être une transformation unitaire directe.
Dans toutes les occurrences de publication, il est impératif d’intégrer au sein de la légende textuelle accompagnant la figure (la caption) une explicitation méthodologique limpide. Le chercheur doit y détailler formellement les raisons du découplage d’échelles, expliciter clairement le codage chromatique assigné à chaque ordonnée et formuler une mise en garde explicite contre toute tentative d’interprétation naïve des points d’intersection physique des tracés.
10. Alternatives méthodologiques et comparatif architectural
10.1 Décomposition en sous-graphiques empilés verticalement
Lorsque la juxtaposition au sein d’un repère unique soulève des ambiguïtés interprétatives insolubles, la principale alternative méthodologique réside dans la décomposition de la visualisation sous la forme d’un panneau de sous-graphiques empilés verticalement (small multiples ou stacked subplots). Cette disposition architecturale sépare physiquement les deux grandeurs dans deux espaces géométriques distincts positionnés l’un au-dessus de l’autre, tout en conservant une synchronisation parfaite de leur axe horizontal.
Sous Matplotlib, cette structure s’implémente avec une grande élégance par le biais de l’instruction fig, (ax1, ax2) = plt.subplots(nrows=2, sharex=True). L’argument crucial sharex=True verrouille le partage du système de coordonnées de l’axe des abscisses entre les deux panneaux. Tout ajustement des limites horizontales ou toute opération de zoom dynamique effectuée sur le graphique supérieur se propage instantanément au graphique inférieur, maintenant un alignement temporel parfait.
Cette approche élimine radicalement l’écueil de l’intersection visuelle fallacieuse et permet d’activer un quadrillage d’arrière-plan propre à chaque métrique sans générer d’interférences de Moiré. En contrepartie, elle consomme une surface d’affichage verticale substantiellement plus importante au sein de la mise en page finale, ce qui peut constituer une contrainte limitante dans les articles de revues à format restreint ou sur des tableaux de bord pour terminaux mobiles.
10.2 Standardisation mathématique sur repère unifié
Une seconde approche alternative consiste à renoncer à l’affichage des unités physiques brutes au profit d’une standardisation mathématique préalable, autorisant la projection des deux signaux sur un repère orthonormé unifié doté d’un seul axe des ordonnées. Cette méthode est particulièrement prisée en économétrie quantitative et dans le traitement des signaux psychophysiologiques.
L’une des transformations les plus opérantes est la conversion en indices d’évolution en base 100. En divisant l’intégralité des termes de chaque série chronologique par sa valeur observée à un instant initial de référence, puis en multipliant le ratio par cent, les grandeurs hétérogènes se retrouvent converties en pourcentages d’évolution relative par rapport au point zéro commun. De même, la standardisation statistique par le calcul de scores Z (soustraction de la moyenne empirique et division par l’écart-type) projette les deux séries dans un espace commun où les amplitudes s’interprètent en multiples d’écarts-types.
Cette méthode présente l’immense avantage de restituer une comparabilité rigoureuse des volatilités relatives et des amplitudes de déviation, éliminant totalement l’artifice du double axe. Son usage doit néanmoins être réservé à des auditoires dotés d’une culture quantitative suffisante pour appréhender la notion de variable adimensionnelle sans regretter la disparition de l’échelle d’origine.
10.3 Matrice décisionnelle : choisir entre twinx() et les alternatives
Pour guider le praticien dans l’arbitrage architectural entre la fonction twinx() et ses stratégies concurrentes, il est utile de formaliser une grille de décision objective reposant sur les caractéristiques intrinsèques des données et les exigences du public cible.
Le recours à twinx() doit être privilégié lorsque l’objectif analytique premier réside dans l’identification de coïncidences temporelles locales hautement synchronisées, que les unités physiques d’origine doivent impérativement demeurer lisibles pour l’interprétation métier immédiate, et que l’espace éditorial vertical disponible est strictement contingenté. À l’inverse, dès lors que l’audience visée est hétérogène ou grand public (ce qui accroît la vulnérabilité aux illusions de corrélation), la décomposition en sous-graphiques empilés avec sharex=True doit s’imposer comme le standard de rigueur.
Enfin, si le cœur du propos scientifique porte sur la comparaison de l’élasticité, du taux de variation relatif ou de la volatilité normalisée de deux dynamiques dépendantes, l’analyste doit résolument écarter le double axe au profit d’une standardisation indicielle unifiée sur un axe vertical unique, garantissant ainsi une exactitude sémiotique inattaquable.
11. Résolution des écueils techniques et diagnostic d’anomalies
11.1 Gestion des chevauchements d’étiquettes et troncatures
L’ajout d’un second axe d’ordonnées sur le flanc droit du canevas graphique altère l’équilibre spatial standard géré par le moteur de mise en page de Matplotlib. Par défaut, la bibliothèque calibre ses marges extérieures en anticipant la présence exclusive de graduations et d’un libellé textuel sur le côté gauche. En conséquence, l’introduction d’un axe ax2 entraîne fréquemment la troncature pure et simple du libellé de l’axe droit lors de l’affichage ou de la sauvegarde de l’image, le texte se trouvant rejeté au-delà des limites géométriques du conteneur Figure.
Pour remédier à cette anomalie de manière robuste, il est indispensable de faire appel aux algorithmes d’ajustement dynamique de mise en page. L’invocation systématique de la méthode fig.tight_layout() ou l’activation de la mise en page contrainte via layout=’constrained’ lors de l’instanciation initiale de la Figure permet de forcer le moteur de calcul à recalculer les marges englobantes en tenant compte de l’ensemble des éléments textuels présents sur les quatre côtés du canevas.
Lors de la sérialisation finale du fichier sur le disque dur via l’instruction savefig(), il est vivement recommandé de spécifier l’argument bbox_inches=’tight’. Ce paramètre commande à Matplotlib de mesurer la boîte englobante exacte de tous les objets graphiques vectorisés et d’ajuster dynamiquement les frontières du document produit, éliminant tout risque de coupure inesthétique des légendes et étiquettes périphériques.
11.2 Conflits d’échelle lors de redimensionnements dynamiques
Dans les environnements d’analyse interactifs (tels que les blocs-notes Jupyter équipés de widgets ou les applications autonomes déployées sous GUI avec des backends interactifs comme Qt ou Tkinter), l’actualisation dynamique des flux de données en continu peut générer des comportements d’échelle asynchrones entre les deux repères d’ordonnées.
Lorsqu’un nouveau vecteur de mesures est injecté dans le tracé de l’axe primaire sans que l’axe secondaire ne soit formellement notifié, ou inversement, l’algorithme d’auto-étalonnage peut ne pas actualiser les matrices de projection de manière cohérente, provoquant un gel visuel des proportions relatives. Pour forcer une synchronisation déterministe lors d’une mise à jour programmatique, le développeur doit invoquer explicitement les méthodes relim() (pour recalculer les limites basées sur les nouvelles données géométriques) puis autoscale_view() successivement sur ax1 et sur ax2.
Ce protocole assure que les deux calques recalculent simultanément leurs domaines d’affichage respectifs avant que le moteur graphique ne déclenche l’événement d’invalidation et de redessinage complet du canevas via fig.canvas.draw_idle().
11.3 Anomalies lors de l’exportation vectorielle (PDF, SVG, EPS)
L’exportation de figures à double axe vers des formats vectoriels destinés à l’impression typographique professionnelle ou à l’intégration dans des documents de recherche complexes soulève des écueils particuliers liés à la gestion des calques transparents et des polices de caractères.
Certains moteurs de rendu PostScript (EPS) de génération ancienne ne gèrent pas nativement la transparence alpha introduite par la méthode twinx() pour le fond de l’axe secondaire. Lors de la compilation, cela peut se traduire par une rastérisation dégradée de l’ensemble de la figure (qui perd ses propriétés vectorielles au profit d’un maillage bitmap pixellisé) ou par la réapparition d’un fond opaque sur le calque supérieur venant masquer le tracé de l’axe inférieur. Pour pallier ce risque dans les filières de prépresse exigeantes, l’exportation en format PDF vectoriel conforme à la norme PDF/X ou en format vectoriel SVG moderne doit être formellement privilégiée.
De surcroît, il convient de s’assurer de la vectorisation intégrale des polices typographiques en configurant le paramètre global rcParams[‘pdf.fonttype’] = 42 (police TrueType incorporée) et rcParams[‘ps.fonttype’] = 42. Cette précaution technique garantit que les textes d’axes opposés et les valeurs numériques des graduations demeurent éditables sous forme de chaînes de caractères au sein de logiciels de publication assistée par ordinateur, sans subir de déformations vectorielles inattendues lors de l’impression définitive.
12. Cas d’usage appliqués et modélisation logicielle industrielle
12.1 Cas pratique d’affaires : corrélation entre prospection et chiffre d’affaires
Afin de matérialiser l’ensemble des concepts théoriques développés jusqu’ici, examinons un scénario empirique d’analyse de performance commerciale. Une organisation souhaite investiguer la dynamique temporelle reliant les efforts opérationnels de prospection (quantifiés par le nombre d’opportunités commerciales qualifiées ou leads générés chaque mois) et les résultats financiers tangibles (mesurés par le chiffre d’affaires effectivement comptabilisé, exprimé en dizaines de milliers d’euros).
Sur le plan structurel, le nombre de leads relève d’un processus discret soumis à de fortes variations aléatoires à court terme, tandis que le chiffre d’affaires répond à un cycle de conversion plus long, introduisant un décalage temporel structurel (lag) entre la cause opérationnelle et l’effet financier. Le script de visualisation commence par instancier l’axe primaire ax1, sur lequel les volumes d’opportunités sont projetés sous la forme d’un diagramme en barres fines ou d’un tracé teinté d’un bleu ardoise sobre. L’axe des ordonnées gauche est étalonné à partir de zéro et annoté avec le libellé formel « Opportunités d’affaires qualifiées [Unités] ».
Par l’intermédiaire de ax2 = ax1.twinx(), l’axe secondaire est généré pour accueillir la courbe de chiffre d’affaires, stylisée par un trait continu plus épais de couleur ambre chaleureux, enrichi de marqueurs discrets à chaque point mensuel. L’axe des ordonnées droit est alors paramétré via un FuncFormatter pour afficher des montants compacts munis du suffixe « k€ ». La légende consolidée est positionnée stratégiquement dans la partie supérieure de la zone de traçage. Ce graphique permet au comité de direction d’appréhender instantanément que les pics d’opportunités observés au premier trimestre trouvent leur concrétisation monétaire deux à trois mois plus tard, fournissant un outil prédictif précieux pour le pilotage budgétaire sans sacrifier les unités réelles de chaque métrique.
12.2 Cas d’application scientifique : suivi psychophysiologique multimodal
En neurosciences cognitives et en ergonomie clinique, l’analyse multimodale de l’état de stress chez un opérateur soumis à une tâche critique implique couramment l’enregistrement synchrone de biomarqueurs physiologiques autonomes. Les deux variables les plus emblématiques sont la fréquence cardiaque instantanée (exprimée en battements par minute, bpm) et la réponse électrodermale ou conductance cutanée (exprimée en micro-siemens, µS), marqueur électrophysiologique de l’activation du système nerveux sympathique.
Dans ce protocole, l’axe temporel horizontal commun représente la durée de l’expérimentation expérimentale chronométrée en secondes. L’axe primaire ax1 reçoit le signal de fréquence cardiaque, caractérisé par une dynamique oscillatoire rapide autour d’une ligne de base élevée (typiquement 60 à 130 bpm). L’axe secondaire ax2 accueille quant à lui la conductance cutanée, dont la morphologie se compose de variations lentes ponctuées de pics abrupts lors de l’occurrence d’événements de stress aigu (avec une amplitude variant entre 2 et 15 µS).
L’utilisation de deux ordonnées s’avère ici incontournable, toute mise à l’échelle commune étant dénuée de sens clinique. Le tracé de la fréquence cardiaque en bleu sombre sur l’axe gauche et de la conductance en cramoisi sur l’axe droit permet de mettre en évidence visuelle la latence physiologique exacte (de l’ordre de 1 à 3 secondes) séparant le choc cognitif de la décharge sudoripare sympathique. De plus, des bandes verticales semi-transparentes (axvspan) projetées sur le canevas unifié permettent d’annoter les périodes précises où les stimuli expérimentaux ont été appliqués, contextualisant instantanément la réaction physiologique conjointe sur les deux échelles d’ordonnées.
12.3 Industrialisation : encapsulation dans une fonction modulaire réutilisable
Pour dépasser le stade du script ad hoc et intégrer la génération de graphiques à double axe au sein d’une bibliothèque analytique d’entreprise réutilisable, il est primordial d’encapsuler la séquence procédurale au sein d’une fonction logicielle modulaire, hautement paramétrable et respectant les principes d’ingénierie logicielle propre (Clean Code).
Cette fonction industrielle, que l’on nommera conventionnellement creer_graphique_double_axe, doit accepter comme paramètres d’entrée les vecteurs de données sous forme de séries Pandas ou de tableaux NumPy, les étiquettes textuelles de chaque axe, les codes chromatiques souhaités, ainsi que des dictionnaires optionnels de configuration graphique avancée. L’architecture de la fonction doit impérativement comporter une section formelle d’assertion vérifiant la conformité dimensionnelle des index temporels pour interdire l’exécution si les longueurs ou les natures des vecteurs de données divergent.
La fonction prend en charge l’instanciation de la figure, l’appel à twinx(), l’application uniforme des styles de traits, la coloration symétrique des labels et des graduations, la désactivation chirurgicale de la grille sur le calque secondaire, l’extraction et la fusion programmatique des poignées de légende, et enfin l’ajustement dynamique de la mise en page via tight_layout(). La fonction retourne explicitement le tuple composé des objets (fig, ax1, ax2), conférant ainsi au développeur appelant la possibilité d’ajouter des couches d’annotations personnalisées avant d’ordonner la sauvegarde sur support persistant. Cette standardisation logicielle élimine la duplication de code au sein des équipes de science des données et assure une homogénéité graphique exemplaire sur l’ensemble des livrables de l’organisation.
Références
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Few, S. (2009). Now You See It: Simple Visualization Techniques for Quantitative Analysis. Analytics Press.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Matplotlib Development Team. (2023). Plots with different scales: twinx. Matplotlib Documentation. https://matplotlib.org/stable/gallery/subplots_axes_and_figures/two_scales.html
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 51–56. https://doi.org/10.25080/Majora-92bf1924-003
- Rost, L. C. (2018). Dual-Axis Charts: When to use them and why they are controversial. Datawrapper Blog. https://blog.datawrapper.de/dualaxis/
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- World Wide Web Consortium. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/