
Dans le domaine de l’analyse exploratoire de données, de la physique statistique, de l’économétrie et des sciences cognitives, la représentation visuelle constitue le premier jalon de l’inférence théorique. Lorsque les données couvrent plusieurs ordres de grandeur ou exhibent des relations non linéaires complexes, les systèmes de coordonnées cartésiennes linéaires traditionnels révèlent rapidement leurs limites intrinsèques. L’écrasement des valeurs proximales de l’origine et l’étirement excessif des valeurs extrêmes empêchent la détection de dynamiques structurelles sous-jacentes. C’est précisément dans ce cadre méthodologique que s’impose le graphique bilogarithmique, communément désigné sous le nom de graphique log-log.
Le tracé bilogarithmique n’est pas un simple artifice d’affichage cosmétique : il correspond à une transformation mathématique opérant une projection bijective des variables d’intérêt dans un espace d’échelles multiplicatives. En projetant le logarithme de la variable dépendante contre le logarithme de la variable indépendante, ce formalisme graphique convertit des lois de puissance réputées intraitables en droites affines directement mesurables et interprétables. La pente observée reflète alors fidèlement l’exposant d’échelle qui régit le phénomène physique ou comportemental étudié.
L’écosystème scientifique du langage Python, articulé autour de bibliothèques majeures telles que Matplotlib, NumPy, Pandas, SciPy et Seaborn, offre une panoplie d’outils d’une puissance algorithmique exceptionnelle pour construire, calibrer, modéliser et exporter des graphiques log-log conformes aux exigences les plus strictes de l’édition universitaire internationale. Ce guide exhaustif explore l’ensemble du spectre théorique, méthodologique, programmatique et diagnostique indispensable à la maîtrise absolue de cette technique de visualisation fondamentale.
1. 1. Introduction théorique au graphique log-log et fondements mathématiques
1.1 Définition et propriétés structurales des échelles logarithmiques
Le principe fondamental sous-tendant toute échelle logarithmique repose sur la substitution d’une métrique d’addition par une métrique de multiplication. Dans un repère cartésien linéaire conventionnel, un déplacement spatial constant le long d’un axe géométrique correspond invariablement à l’addition d’une quantité absolue fixe. À l’inverse, au sein d’une échelle logarithmique, ce même déplacement unitaire représente une multiplication par un facteur d’échelle constant, couramment qualifié de base ou d’ordre de grandeur. Cette propriété d’anamorphose géométrique permet de comprimer de manière logarithmique des intervalles d’observation gigantesques tout en préservant une résolution d’analyse locale parfaitement homogène au voisinage des valeurs de faible magnitude.
Il importe de distinguer formellement trois catégories distinctes de représentations spatiales. L’échelle linéaire conventionnelle cartographie les variables brutes sans altération métrique. L’échelle semi-logarithmique applique une déformation logarithmique à un seul des deux axes — typiquement l’axe des ordonnées dans les représentations temporelles ou biologiques —, ce qui a pour conséquence géométrique immédiate de linéariser les phénomènes de croissance ou de décroissance exponentielle régis par des équations du type y = a × ebx. Enfin, l’échelle bilogarithmique ou log-log soumet simultanément l’abscisse et l’ordonnée à une métrique logarithmique, transformant l’espace fonctionnel en un lieu géométrique où seules les relations proportionnelles multiplicatives et les fonctions de puissance émergent sous une forme rectiligne.
Sur le plan analytique, le comportement des fonctions de puissance sous transformation logarithmique réciproque illustre la symétrie remarquable de cette opération. Lorsque deux grandeurs physiques ou observables sont unies par une relation bijective monotone non linéaire, l’application conjointe d’un opérateur logarithmique découple l’amplitude globale du système de son élasticité relative. L’espace vectoriel résultant ne mesure plus des écarts absolus en unités arbitraires de mesure, mais des variations infinitésimales relatives, matérialisant ainsi la notion de dérivée logarithmique d(ln y) / d(ln x), invariant fondamental en mécanique des fluides et en microéconomie théorique.
1.2 Identification et modélisation des lois de puissance
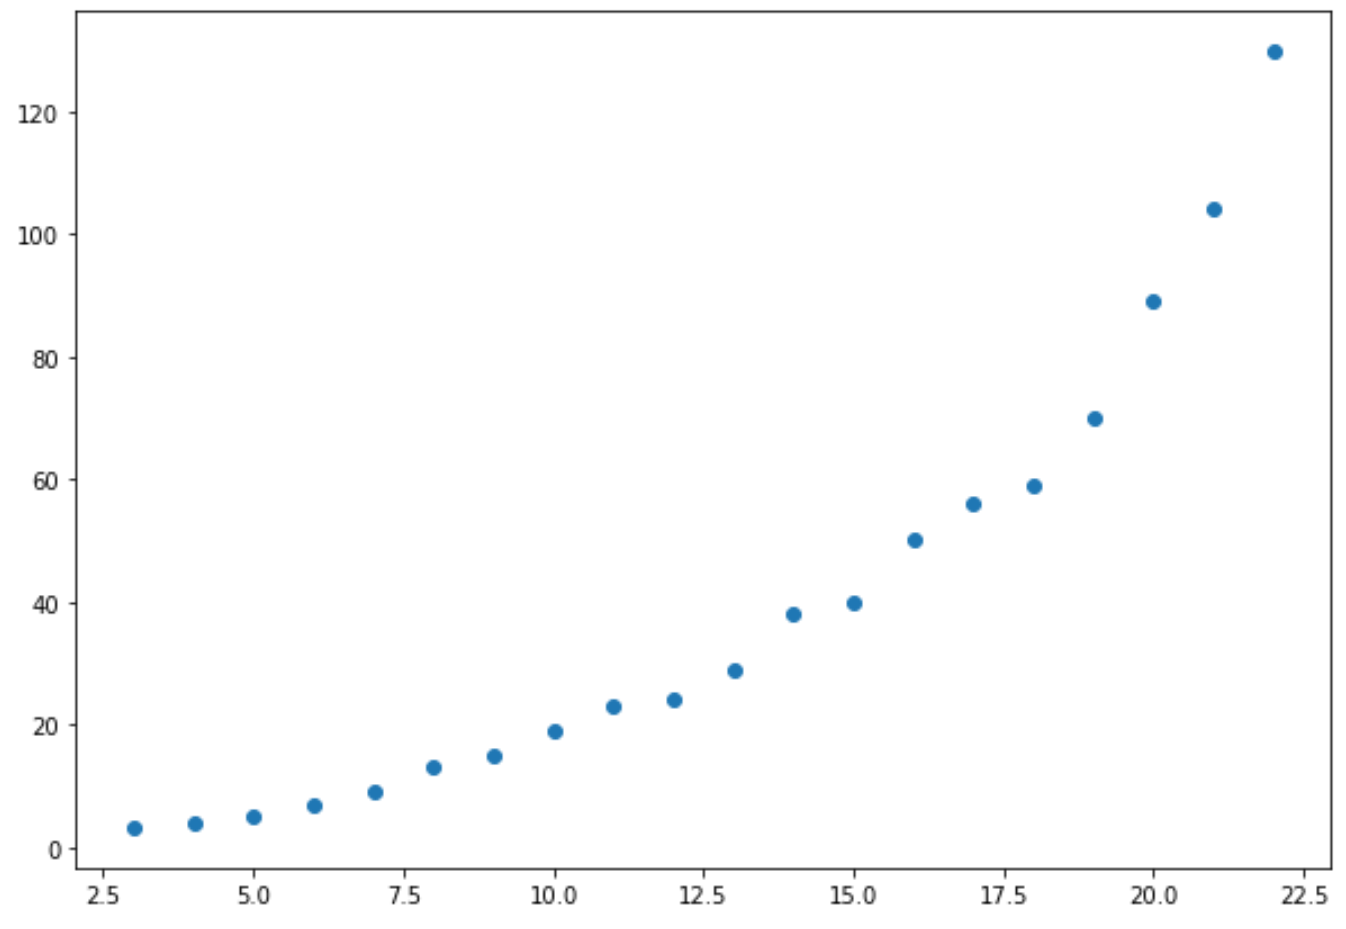
La formulation mathématique standard d’une loi de puissance exprime une relation déterministe ou stochastique unissant deux variables strictement positives selon l’équation canonique y = a × xk, où a représente une constante de proportionnalité multiplicative non nulle et k figure l’exposant d’échelle régissant l’intensité du couplage structural. L’application de la fonction logarithme népérien ou décimal aux deux membres de cette égalité conduit à la formulation linéarisée explicite : log(y) = log(a) + k × log(x). Cette manipulation algébrique élémentaire met en évidence une structure d’équation affine universelle où le terme log(a) constitue l’ordonnée à l’origine et le coefficient k correspond rigoureusement à la pente de la droite ainsi projetée.
L’interprétation épistémologique de la pente k s’avère capitale dans l’édifice scientifique expérimental : elle incarne l’exposant d’invariance d’échelle, traduisant le fait que le ratio relatif d’accroissement de y demeure strictement indépendant de l’échelle d’observation de x. Si la variable explicative subit une amplification par un facteur scalaire c, la variable résultante est modifiée d’un facteur ck, attestant l’absence d’échelle caractéristique intrinsèque dans le phénomène examiné. Cette universalité phénoménologique caractérise des domaines aussi disparates que les transitions de phase critiques en thermodynamique, les topologies de réseaux invariants d’échelle ou la distribution de la connectivité synaptique au sein du cortex cérébral.
Une distinction méthodologique critique doit être impérativement opérée entre les dynamiques d’allure exponentielle et les véritables lois de puissance. Une confusion récurrente dans la littérature préliminaire consiste à assimiler toute croissance visuellement explosive à une loi de puissance. Or, une dynamique exponentielle y = a × ekx possède une échelle caractéristique intrinsèque donnée par 1/k et se linéarise exclusivement en coordonnées semi-logarithmiques. Sur un graphique log-log, une fonction exponentielle présente une courbure systématiquement convexe vers le haut, divergeant brutalement de toute linéarité asymptotique, tandis que la loi de puissance y conserve une rectitude rigoureusement absolue d’un ordre de grandeur à l’autre.
1.3 Pertinence méthodologique dans la recherche empirique
Dans le cadre de l’investigation empirique moderne, la représentation bilogarithmique constitue l’instrument d’investigation privilégié pour la caractérisation des distributions statistiques dites à queue lourde ou à traîne épaisse, fréquemment désignées sous le concept de distributions parétiennes. Ces distributions statistiques se distinguent par l’occurrence non négligeable d’événements extrêmes que les modèles gaussiens classiques qualifient d’anomalies aberrantes impossibles. L’analyse log-log de la fonction de survie ou de la densité spectrale de probabilité permet d’identifier visuellement et sans ambiguïté le comportement asymptotique de ces phénomènes, confirmant l’absence de troncature exponentielle rapide.
Un autre bénéfice statistique majeur du graphique log-log réside dans son aptitude à tempérer et régulariser l’hétéroscédasticité des résidus d’observation. Dans une grande variété de systèmes expérimentaux, la variance du bruit de mesure croît proportionnellement à la magnitude moyenne du signal détecté, induisant une dispersion résiduelle en entonnoir sur les tracés linéaires classiques. La projection logarithmique stabilise cette variance relative, permettant ainsi de vérifier visuellement si l’homogénéité du processus d’erreur relatif est préservée sur toute la plage dynamique des instruments de mesure mis en œuvre.
La décision formelle de basculer vers une représentation bilogarithmique doit obéir à des critères méthodologiques rigoureux et standardisés. On privilégiera systématiquement cette approche lorsque les données empiriques embrassent au minimum deux ou trois décades (ordres de grandeur de dix) et que les hypothèses sous-jacentes postulent des relations multiplicatives ou des rétroactions positives en cascade. À l’inverse, l’emploi inconsidéré du graphique log-log sur des séries de données restreintes couvrant une demi-décade constitue un artifice trompeur, car presque toute fonction différentiable paraît visuellement linéaire sur un intervalle d’échantillonnage infinitésimal.
2. 2. Configuration de l’environnement Python et écosystème scientifique
2.1 Sélection et installation des bibliothèques fondamentales
L’édification d’un pipeline d’analyse et de visualisation bilogarithmique performant en Python exige l’orchestration concertée d’une suite logicielle éprouvée. Au cœur de cette architecture se trouve la bibliothèque Matplotlib, module de référence historique pour l’ensemble du calcul scientifique. Matplotlib offre un contrôle granulaire sans équivalent sur le moteur de rendu, permettant de générer aussi bien des représentations matricielles pour l’exploration rapide que des graphiques vectoriels publiables conformes aux normes typographiques les plus strictes des éditeurs académiques internationaux.
En amont du moteur graphique proprement dit, la manipulation computationnelle des flux de données numériques fait appel à NumPy et SciPy. NumPy procure les structures de données tensorielles denses vectorisées (ndarrays) indispensables pour appliquer des transformations mathématiques à cadence élevée sans recourir à des boucles interprétées en Python natif. SciPy complète cet ensemble fonctionnel en apportant les algorithmes d’optimisation non linéaire, d’estimation statistique et de régression robuste indispensables pour contraindre les paramètres des modèles analytiques superposés aux tracés graphiques.
Pour assurer la pérennité, la traçabilité et l’intégrité expérimentale des protocoles de calcul, il est impératif d’isoler l’environnement d’exécution à l’aide d’outils de gestion de dépendances tels que Conda ou Virtualenv via pip. Une installation propre garantit l’alignement des versions logicielles et prévient les conflits binaires entre bibliothèques mathématiques compilées sous-jacentes (BLAS, LAPACK). L’ingestion et la structuration tabulaire des jeux de données complexes seront quant à elles confiées à Pandas, dont l’interfaçage transparent avec Matplotlib garantit la fluidité du transfert des structures tabulaires vers les fonctions de rendu graphique.
2.2 Configuration des paramètres de style et reproductibilité
L’obtention systématique de figures répondant aux canons esthétiques de l’édition scientifique requiert la configuration fine du dictionnaire global des paramètres de style de Matplotlib, formalisé sous l’identifiant technique rcParams. Ce dictionnaire permet d’harmoniser en amont la résolution matricielle par défaut (dots per inch ou dpi), l’épaisseur des tracés de contour des axes (spines), la géométrie et la direction des graduations (ticks), ainsi que le dimensionnement proportionnel des étiquettes textuelles, évitant ainsi la redéfinition manuelle fastidieuse de ces attributs lors de chaque instanciation de figure.
Un soin particulier doit être apporté à l’infrastructure typographique des visualisations. Matplotlib propose un moteur d’interprétation LaTeX complet permettant de composer l’intégralité des annotations textuelles et des symboles mathématiques avec les polices de caractères standards du monde académique, telles que Computer Modern ou Times New Roman. En définissant les variables de configuration appropriées pour activer le rendu vectoriel des polices avec empattement (serif), le chercheur s’assure que les labels des axes logarithmiques s’intégreront avec une parfaite cohérence typographique au sein du manuscrit scientifique final rédigé en LaTeX.
La reproductibilité absolue des visualisations constitue un impératif méthodologique incontournable, particulièrement lorsque des simulations de Monte-Carlo ou des processus stochastiques synthétiques sont injectés pour illustrer des lois de puissance théoriques. Il est ainsi indispensable d’initialiser systématiquement le générateur de nombres pseudo-aléatoires de NumPy par l’entremise d’une graine déterministe (seed). Cette rigueur procédurale assure que la dispersion spatiale apparente des nuages de points, les résidus stochastiques observés et les intervalles d’estimation demeureront strictement identiques lors de chaque réexécution du code source.
3. 3. Préparation et structuration des données avec Pandas
3.1 Ingestion et nettoyage des ensembles de données
Le traitement des données empiriques destinées à une cartographie log-log débute par une phase critique d’ingestion et de typage strict au sein d’un DataFrame Pandas. La fonction de lecture standard read_csv doit être paramétrée pour identifier explicitement les séparateurs décimaux, les marqueurs de valeurs manquantes et contraindre le typage numérique en nombres à virgule flottante de double précision (float64). Une assignation erronée de colonnes numériques en chaînes de caractères (object) en raison de caractères parasites constitue une source d’échec fréquente lors des opérations ultérieures de conversion logarithmique.
La détection et l’élimination des valeurs nulles, négatives ou non finies forment l’étape de salubrité computationnelle la plus déterminante. La fonction logarithme, qu’elle soit népérienne ou de base dix, n’est mathématiquement définie que sur l’ensemble des réels strictement positifs ]0, +∞[. La présence d’une valeur zéro au sein d’une série numérique produit immédiatement une singularité asymptotique vers l’infini négatif, tandis que des valeurs négatives engendrent des indéterminations numériques non réelles (valeurs NaN ou erreurs de domaine d’exécution).
Une inspection rigoureuse de la complétude du jeu de données exige par conséquent l’exécution de masques booléens vectorisés visant à dénombrer et isoler toute coordonnée violant la stricte positivité. Contrairement aux visualisations linéaires où le zéro occupe une position nodale de référence cartésienne, le traçage log-log impose d’exclure formellement ou de ségréger méthodologiquement ces occurrences avant toute instanciation graphique, sous peine de déclencher des avertissements de calcul ou de corrompre l’auto-calibrage des limites des axes de projection.
3.2 Techniques de filtrage et imputation adaptées aux échelles log
Face à la contingence expérimentale de mesures nulles issues de limites de détection instrumentale ou d’intervalles de silence comportemental, deux approches méthodologiques s’opposent. La première, d’une rigueur absolue, consiste à appliquer un seuil de coupure minimal (cut-off). Ce seuil écarte systématiquement toutes les observations situées en deçà du seuil de sensibilité certifié des capteurs physiques. Les données restantes représentent dès lors un échantillon conditionnel non biaisé dont le régime fonctionnel s’inscrit sans équivoque dans le domaine des lois de puissance.
La seconde technique, fréquemment employée de manière pragmatique dans l’analyse de réseaux ou la génomique quantitative, consiste à adjoindre un pseudo-compte arbitraire c sous la forme d’une transformation modifiée log(x + c). Bien que cette pratique autorise le calcul du logarithme pour des valeurs nulles (puisque log(0 + c) = log(c)), elle introduit une distorsion géométrique et statistique pernicieuse. Si la constante c est du même ordre de grandeur que les mesures observées, la courbure induite détruit l’invariance d’échelle intrinsèque de la distribution et fausse dramatiquement l’estimation ultérieure de l’exposant de puissance.
Le chercheur doit donc évaluer avec un discernement critique les conséquences statistiques de l’imputation choisie. Si l’objectif exclusif consiste en la caractérisation sans faille de l’exposant structural d’une loi de puissance théorique, le filtrage strict des données strictement positives surpasse universellement toute tentative d’imputation artificielle par pseudo-constante, cette dernière altérant le comportement à queue lourde de la série en écrasant artificiellement la structure fractale de la distribution.
3.3 Structuration en DataFrames optimisés pour le traçage
Une fois les opérations de nettoyage menées à terme, l’organisation géométrique des données au sein de structures tabulaires Pandas doit être pensée pour maximiser la clarté et l’efficience computationnelle des pipelines de rendu graphique. L’utilisation d’une indexation hiérarchique (MultiIndex) permet de ségréger élégamment des cohortes expérimentales multiples, des répétitions de mesures ou des conditions pharmacologiques distinctes, facilitant l’extraction vectorielle instantanée de sous-ensembles cohérents pour la comparaison visuelle inter-groupes.
Il s’avère particulièrement judicieux d’adjoindre au DataFrame d’origine des colonnes précalculées encapsulant les indicateurs statistiques descriptifs essentiels, tels que les moyennes mobiles géométriques ou les médianes de dispersion interquartile par blocs logarithmiques. La distribution spatiale des points dans une loi de puissance étant exponentiellement clairsemée vers les valeurs élevées, un regroupement préalable (logarithmic binning) permet d’équilibrer la densité d’information entre les décades inférieures hyperdenses et les décades supérieures clairsemées.
Enfin, la dénomination des colonnes et l’intégration explicite des unités de mesure dans les métadonnées du DataFrame préviennent toute ambiguïté cognitive lors de la restitution finale. La structuration méticuleuse d’un DataFrame épuré garantit que l’injection séquentielle des variables d’abscisse et d’ordonnée dans les primitives de Matplotlib s’opérera de manière transparente, limitant les opérations de typage et de conversion au moment même de l’exécution graphique.
4. 4. Création élémentaire d’un graphique log-log par transformation explicite avec NumPy
4.1 Application de numpy.log() et nuances de bases logarithmiques
L’approche la plus élémentaire pour appréhender la genèse d’un graphique bilogarithmique consiste à opérer une transformation algébrique manuelle des données vectorielles au moyen des fonctions mathématiques vectorisées de la bibliothèque NumPy. Cette méthode sépare formellement l’étape de calcul arithmétique de l’étape de rendu géométrique sur l’écran. NumPy met à disposition trois fonctions transcendantes majeures : np.log pour le logarithme naturel ou népérien (base e), np.log10 pour le logarithme décimal (base 10), et np.log2 pour le logarithme binaire (base 2).
Le choix de la base logarithmique gouverne l’amplitude absolue des coordonnées calculées mais ne modifie aucunement la géométrie sous-jacente de la distribution normalisée. En vertu des propriétés fondamentales de changement de base des logarithmes, loga(x) = logb(x) / logb(a), le passage d’une base à une autre s’apparente à une simple homothétie scalaire. Dès lors, la linéarité d’une fonction de puissance demeure strictement préservée quelle que soit la base sélectionnée, la valeur absolue de la pente de régression étant invariante si la même base est appliquée uniformément sur l’abscisse et l’ordonnée.
Après l’exécution d’une transformation explicite via NumPy, une vérification systématique de l’intégrité numérique du vecteur résultant s’impose. L’utilisation conjointe des fonctions np.isfinite ou np.isnan permet de s’assurer qu’aucune valeur asymptotique infinie n’a été insidieusement générée par la présence résiduelle d’une valeur nulle non détectée en amont. Cette sécurité programmatique garantit que les matrices de coordonnées transférées aux moteurs de dessin de bas niveau demeurent strictement dans le domaine des grandeurs numériques réelles représentables.
4.2 Génération du nuage de points linéarisé
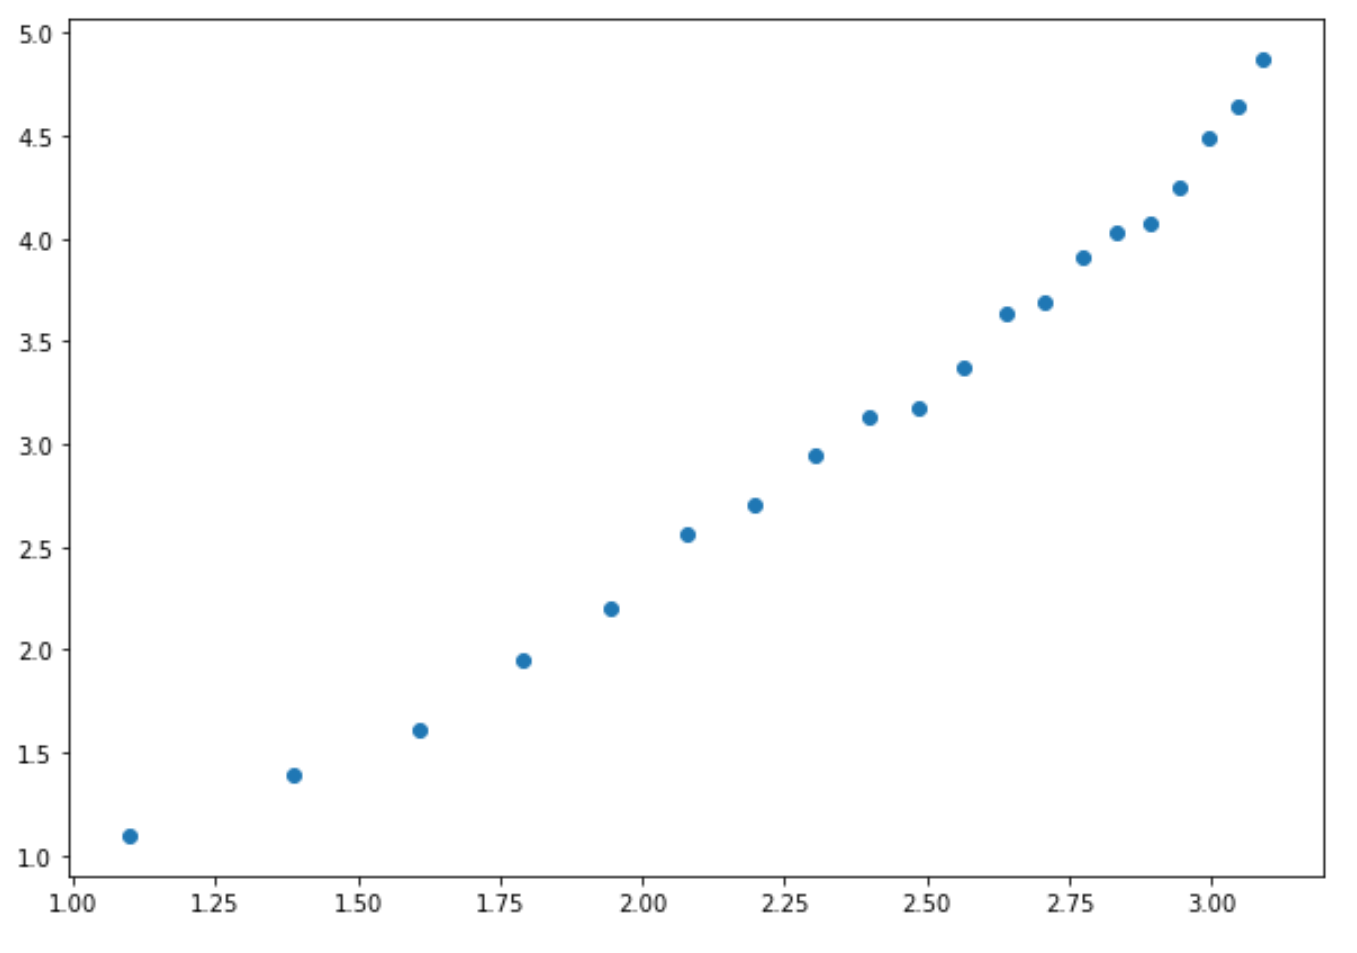
Une fois les coordonnées transformées sous forme logarithmique, la visualisation s’opère par le biais de la commande conventionnelle plt.scatter de Matplotlib, opérant dans un repère cartésien dont les échelles matérielles demeurent rigoureusement linéaires. Dans ce schéma technique, l’observateur contemple directement la projection affine de la loi de puissance : le nuage de points curviligne originel apparaît métamorphosé en une trajectoire rectiligne dont l’ordonnée et l’abscisse représentent les grandeurs transformées log(y) en fonction de log(x).
Cette méthode présente l’avantage pédagogique indéniable de démythifier la nature géométrique de la loi de puissance. L’alignement perceptible des points expérimentaux le long d’un axe directeur permet une évaluation immédiate de la validité de l’hypothèse de linéarité sous-jacente. L’homogénéité de la dispersion visuelle autour de la trajectoire médiane fournit un indicateur heuristique direct de la stabilité de la variance des fluctuations résiduelles du modèle empirique.
Cependant, cette approche manuelle par transformation vectorielle explicite souffre d’un défaut rédhibitoire dans le contexte de la communication scientifique et de la publication académique : la perte totale de la métrique originale sur les graduations des axes. L’observateur est contraint de déchiffrer des coordonnées exprimées en puissances logarithmiques abstraites (par exemple 0, 1, 2, 3 pour une échelle décimale) plutôt qu’en unités physiques réelles du phénomène étudié (1, 10, 100, 1000). Ce fardeau cognitif impose une charge de décodage mental inutile qui motive l’abandon de la transformation manuelle au profit des fonctionnalités natives de Matplotlib.
5. 5. Utilisation de la méthode native plt.loglog() de Matplotlib
5.1 Syntaxe fondamentale et conversion directe des axes
Pour concilier la rigueur d’une projection bilogarithmique et l’intelligibilité immédiate des unités physiques d’origine, Matplotlib propose la fonction procédurale native plt.loglog. Cette primitive de haut niveau encapsule en un appel unique l’ensemble des transformations spatiales nécessaires : elle applique simultanément une échelle logarithmique à l’abscisse et à l’ordonnée sans altérer les valeurs intrinsèques du jeu de données source. Les tableaux numériques bruts non transformés lui sont directement transmis, préservant ainsi la fidélité de l’information quantitative.
L’avantage opérationnel déterminant de plt.loglog réside dans la gestion automatisée et dynamique des ordres de grandeur. Le moteur graphique configure automatiquement les mécanismes internes de projection afin d’échelonner les graduations de manière géométrique plutôt qu’arithmétique. Les annotations positionnées le long des axes indiquent directement les magnitudes physiques réelles du système, matérialisées sous forme de puissances de dix clairement identifiables par le lecteur, ce qui abolit tout risque de méprise dans l’interprétation des seuils critiques.
En outre, la fonction plt.loglog hérite de l’intégralité de la flexibilité paramétrique de la primitive universelle plt.plot. Elle accepte sans distinction des directives de style combinant le traçage continu de lignes géométriques, l’affichage de marqueurs ponctuels discrets (scatter) ou la synthèse combinée des deux modalités. Cette polyvalence synthétique permet de représenter simultanément la dispersion expérimentale brute et la trajectoire analytique d’un modèle théorique continu au sein d’une syntaxe programmatique épurée et concise.
5.2 Configuration des bases logarithmiques de l’affichage
Bien que la base décimale (base 10) représente le standard prédominant dans l’écrasante majorité des disciplines scientifiques, certaines branches du savoir requièrent le paramétrage explicite de bases alternatives pour des raisons méthodologiques évidentes. Matplotlib répond à cette contingence par l’entremise des paramètres base, ou de façon différentielle par basex et basey (dont les appellations modernes au sein de l’API standardisée correspondent à base spécifiée dans les convertisseurs d’axes respectifs).
Dans les sciences naturelles, la biophysique et l’écologie évolutive, l’utilisation de la base dix ou de la base naturelle e prédomine en raison de la présence constante des constantes de Boltzmann ou d’Arrhenius régissant les mécanismes de thermorégulation et de cinétique moléculaire. L’affichage en puissances décimales confère une lisibilité immédiate aux amplitudes astronomiques, géophysiques ou épidémiologiques, permettant d’embrasser d’un seul coup d’œil des dynamiques s’étendant des échelles microscopiques aux échelles macroscopiques.
À l’inverse, dans les sciences de l’information, l’algorithmique théorique et l’analyse de la complexité computationnelle, le logarithme de base deux s’affirme comme le standard naturel indétrônable. La quantification de l’entropie de Shannon, les structures arborescentes binaires ou les lois de réduction de latence s’articulent intrinsèquement autour de doublements successifs. Paramétrer les axes logarithmiques de Matplotlib sur une base égale à deux permet d’aligner chaque graduation majeure sur un facteur multiplicatif de dédoublement, octroyant une signification physique immédiate à chaque subdivision graphique.
5.3 Comparaison fonctionnelle : semilogx, semilogy et loglog
La boîte à outils graphique de Matplotlib décline les projections logarithmiques en un triptyque fonctionnel précis : plt.semilogx, plt.semilogy et plt.loglog. Le choix judicieux de l’une de ces méthodes ne relève pas de la convenance arbitraire mais découle formellement de la classe mathématique de la relation fonctionnelle suspectée entre les variables. Sélectionner une projection inappropriée conduit inévitablement à masquer la structure réelle des données ou à induire l’observateur en erreur par une distorsion perceptive dommageable.
L’instruction semilogx restreint la compression logarithmique à l’axe des abscisses tout en maintenant l’axe des ordonnées sous une métrique strictement linéaire. Cette configuration constitue le canon méthodologique idéal pour linéariser les relations de type logarithmique pur, formalisées par l’équation y = a + b × log(x), fréquemment observées dans les processus de saturation progressive ou les réponses sensorielles de Weber-Fechner. Réciproquement, semilogy projette l’ordonnée en échelle log et conserve l’abscisse linéaire, offrant le cadre géométrique parfait pour l’analyse des cinétiques de décroissance radioactive ou d’emballement épidémique exponentiel y = a × ebx.
La confrontation directe d’un même jeu de données soumis successivement à ces trois modes de projection permet d’illustrer spectaculairement l’impact du repère spatial sur l’inférence visuelle. Une authentique loi de puissance, lorsqu’elle est projetée sur un axe semi-logarithmique, arbore une courbure concave prononcée qui pourrait suggérer à tort une saturation asymptotique imminente. Seul le graphique bilogarithmique loglog révèle la parfaite rectitude de la trajectoire, dissipant les artefacts de perspective et établissant sans ambiguïté la nature fractale ou invariante d’échelle du processus examiné.
6. 6. Configuration avancée des échelles logarithmiques via l’API orientée objet
6.1 Utilisation de ax.set_xscale(‘log’) et ax.set_yscale(‘log’)
Bien que l’interface procédurale issue du module pyplot offre une rapidité d’exécution appréciable pour les expérimentations préliminaires, la conception de figures complexes destinées aux revues internationales de premier rang requiert impérativement l’utilisation de l’API orientée objet de Matplotlib. Cette approche repose sur l’instanciation explicite d’un canevas structurel (l’objet Figure) et d’une ou plusieurs zones de traçage matricielles (les objets Axes), généralement générés par l’invocation de plt.subplots().
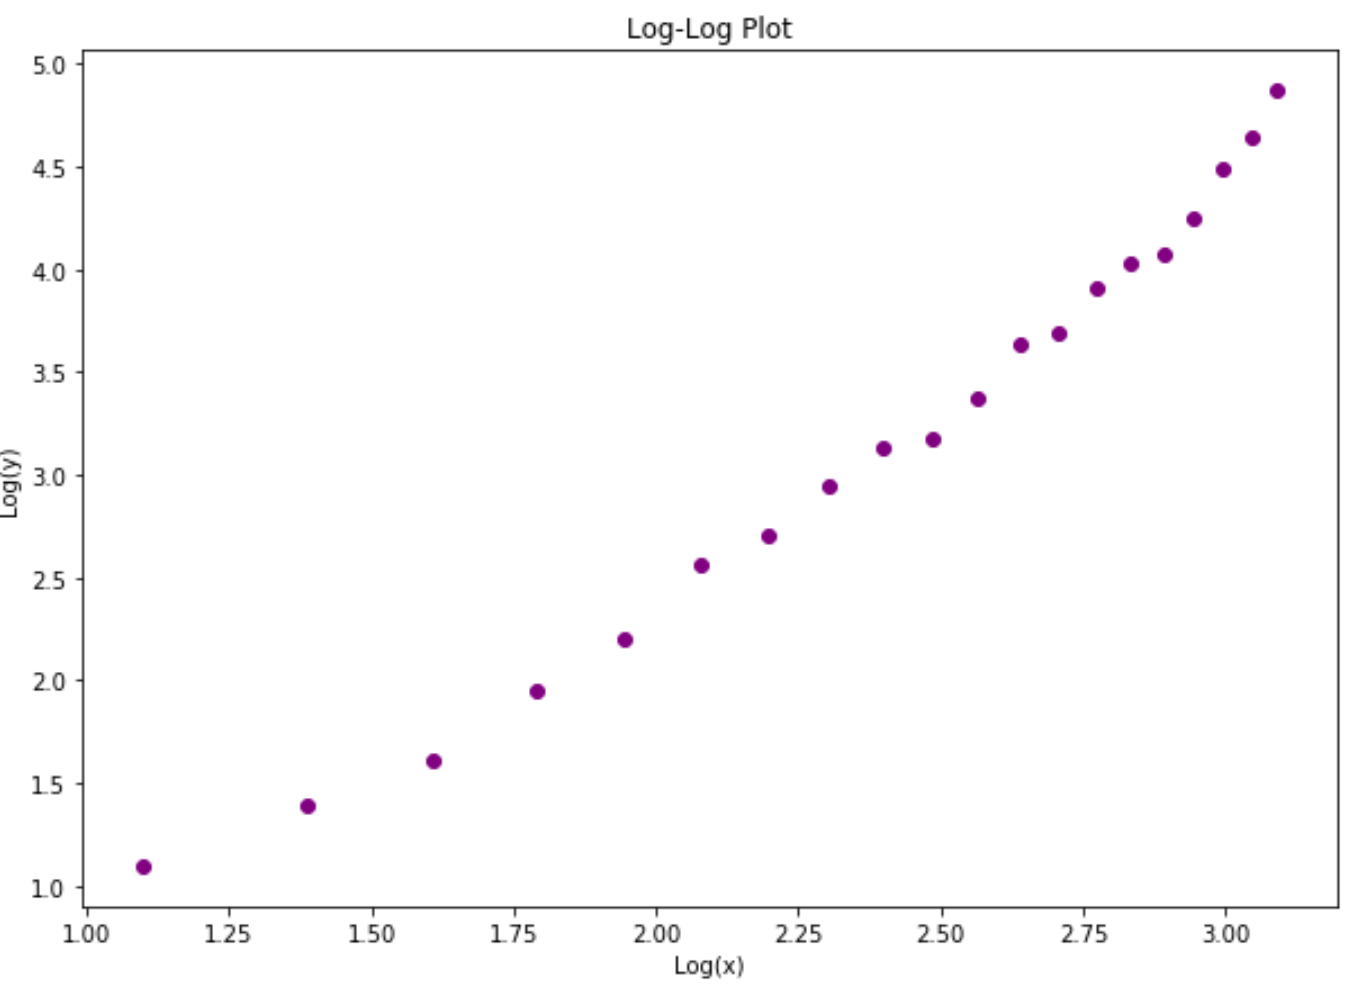
Dans ce paradigme orienté objet, la conversion bilogarithmique s’effectue via les méthodes dédiées ax.set_xscale(‘log’) et ax.set_yscale(‘log’). Cette décomposition confère une indépendance totale dans le calibrage métrique de chaque axe d’observation. L’architecte de la figure acquiert la latitude de combiner des échelles hétérogènes, d’ajuster les marges intérieures, et de synchroniser de manière programmatique des axes partagés au sein de visualisations composées multi-panneaux.
L’API orientée objet permet en outre de spécifier des échelles alternatives et sur-mesure répondant à des contraintes expérimentales singulières. Au-delà de l’échelle logarithmique standard, le moteur de Matplotlib prend en charge des configurations telles que ‘logit’ pour les probabilités cumulées ou ‘symlog’ pour la gestion des plages de données bipolaires, offrant un cadre d’extensibilité computationnelle indispensable au traitement de données scientifiques hautement spécialisées.
6.2 Maîtrise de l’échelle symétrique symlog
L’un des défis méthodologiques les plus épineux dans la visualisation log-log réside dans la présence sporadique de valeurs négatives ou de mesures rigoureusement nulles au sein d’un jeu de données par ailleurs distribué sur plusieurs ordres de grandeur. L’échelle logarithmique standard échoue face à cette configuration en raison de l’impossibilité de calculer le logarithme d’un nombre négatif ou nul. Pour contourner cette impasse sans tronquer les données, Matplotlib intègre l’échelle logarithmique symétrique, désignée par l’argument ‘symlog’.
Le fonctionnement de ‘symlog’ repose sur une hybridation géométrique ingénieuse. L’axe est segmenté en deux régimes opératoires distincts : au voisinage immédiat de l’origine zéro, l’échelle applique une projection strictement linéaire, assurant une transition continue et différentiable à travers zéro. Au-delà d’un seuil critique spécifié par l’utilisateur via le paramètre linthresh, le comportement de l’axe bascule automatiquement vers une échelle logarithmique conventionnelle, opérant la compression des ordres de grandeur tant dans le domaine positif que négatif.
La calibration du paramètre linthresh ainsi que du paramètre d’échelle linscale exige une extrême rigueur méthodologique. Si le seuil linéaire linthresh est défini de manière inappropriée, il peut induire des artefacts visuels trompeurs, notamment des ruptures de pente apparentes ou une distorsion de la continuité des trajectoires au franchissement de la frontière de transition. Le chercheur doit explicitement avertir le lecteur de l’existence de cette zone linéaire centrale afin de préserver l’intégrité de l’interprétation perceptive du graphique.
6.3 Gestion des limites d’axes avec ax.set_xlim() et ax.set_ylim()
Le cadrage spatial optimal d’un graphique log-log ne saurait être laissé aux algorithmes d’ajustement automatique par défaut de Matplotlib, qui tendent parfois à étendre excessivement les marges périphériques au détriment de la lisibilité du nuage de points. L’ajustement explicite des bornes s’opère par les méthodes ax.set_xlim() et ax.set_ylim(), dont la mise en œuvre doit respecter des règles formelles absolues inhérentes à la géométrie logarithmique.
La règle primordiale impose l’exclusion catégorique de la valeur zéro des arguments de bornage. Tenter d’assigner une borne minimale égale à zéro déclenche invariablement l’avertissement formel UserWarning: Attempted to set non-positive limits on a log-scaled axis, le système forçant arbitrairement la limite à une valeur infinitésimale non nulle susceptible de déformer profondément la disposition spatiale des données. Les bornes inférieure et supérieure doivent toujours être des grandeurs strictement positives, idéalement calées sur des puissances entières exactes de la base logarithmique employée.
Un cadrage judicieux consiste à focaliser l’attention perceptive sur le régime d’invariance d’échelle avéré, en éliminant les zones marginales de bruit expérimental situées aux extrêmes de la dynamique instrumentale. L’harmonisation des marges géométriques préserve la fidélité de lecture des pentes relatives : une distorsion disproportionnée de la boîte englobante de la figure altère la perception intuitive de l’angle visuel, compromettant l’estimation visuelle immédiate des coefficients d’échelle.
7. 7. Visualisation log-log avec Seaborn pour l’analyse exploratoire
7.1 Intégration des échelles log dans sns.scatterplot
La bibliothèque Seaborn, édifiée sur les fondations de Matplotlib et intimement articulée avec les structures de données de Pandas, élève l’analyse statistique exploratoire à un haut degré de concision sémantique. Dans le contexte de la modélisation bilogarithmique, Seaborn élimine les étapes manuelles fastidieuses grâce à l’introduction native du paramètre log_scale, directement accessible au sein de sa primitive universelle sns.scatterplot.
En assignant simplement un tuple booléen ou numérique à l’argument log_scale=(True, True), Seaborn configure automatiquement la double projection logarithmique de la figure tout en préservant le formatage mathématique optimal des étiquettes des axes. Cette fonctionnalité simplifie l’expérimentation rapide en autorisant l’introduction simultanée de dimensions catégorielles complexes par l’intermédiaire des arguments hue (différenciation chromatique) et style (différenciation des glyphes de marqueurs), sans perturber le comportement sous-jacent de l’échelle d’affichage.
En outre, Seaborn permet de corréler le diamètre géométrique des marqueurs à une troisième variable quantitative grâce à l’argument size. Au sein d’un espace bilogarithmique, cette cartographie multidimensionnelle autorise l’identification de structures d’invariance d’échelle conditionnelles, mettant en exergue des déviations locales systématiques de la loi de puissance en fonction de facteurs covariables biologiques, économiques ou sociologiques.
7.2 Exploitation de sns.lineplot et agrégation statistique
Lorsque le volume des observations empiriques devient pléthorique ou que des répétitions de mesures temporelles sont conduites pour chaque palier d’intensité, la lisibilité d’un simple nuage de points s’effondre sous l’effet de la saturation graphique. La fonction sns.lineplot apporte une réponse élégante en opérant une agrégation statistique automatisée des trajectoires et en superposant une enveloppe d’incertitude matérialisant l’intervalle de confiance (généralement calibré à 95%).
L’utilisation de cette méthode sur des données distribuées selon des lois de puissance requiert néanmoins une grande prudence méthodologique quant au choix du mode d’agrégation. Par défaut, Seaborn procède au calcul d’une moyenne arithmétique et d’un intervalle de confiance basé sur des hypothèses de distribution symétrique normale. Or, au sein d’un espace multiplicatif logarithmique, l’estimateur central pertinent est la moyenne géométrique (qui correspond rigoureusement à l’exponentielle de la moyenne des logarithmes des observations).
L’omission de cette distinction fondamentale peut conduire à des biais de représentation substantiels : l’agrégation arithmétique de données hétéroscédastiques tend à surévaluer le niveau central et à générer des bandes de confiance asymétriques déformées par les valeurs extrêmes de la distribution. Il est par conséquent recommandé de fournir à Seaborn des variables pré-agrégées selon la métrique géométrique ou de paramétrer explicitement des estimateurs robustes (tels que la médiane et les percentiles) pour garantir la pertinence de l’enveloppe d’incertitude affichée.
7.3 Création de grilles de sous-graphiques log-log avec FacetGrid
L’investigation de systèmes multivariés complexes exige fréquemment la décomposition d’un vaste jeu de données en une matrice ordonnée de sous-graphiques homogènes. La classe FacetGrid de Seaborn, ou sa transposition de haut niveau sns.relplot, répond à cet impératif d’architecture visuelle en autorisant le découpage factoriel instantané selon plusieurs dimensions qualitatives organisées en lignes et en colonnes.
L’intégration de la projection bilogarithmique au sein d’une grille FacetGrid s’exécute de manière élégante via l’instruction facet_kws={‘despine’: True} combinée à l’invocation de méthodes de mapping appliquant ax.set_xscale(‘log’) et ax.set_yscale(‘log’) sur l’ensemble des sous-axes instanciés. Ce mécanisme garantit l’harmonisation stricte des bornes d’échelles partagées (shared axes), condition sine qua non pour autoriser une comparaison cognitive directe et non biaisée des pentes de lois de puissance entre différentes strates expérimentales.
L’automatisation du positionnement des étiquettes d’axes et des légendes globales au sein de la grille Seaborn élimine les redondances graphiques susceptibles d’encombrer l’espace visuel. La figure résultante offre une vue d’ensemble compacte et d’une rigueur éditoriale irréprochable, permettant au chercheur d’évaluer en un coup d’œil si l’exposant d’échelle de la loi de puissance demeure universel ou s’il subit des modulations contingentes d’un sous-groupe expérimental à l’autre.
8. 8. Ajustement linéaire et estimation statistique des lois de puissance
8.1 Régression linéaire classique par moindres carrés ordinaires (MCO)
La pratique la plus répandue pour quantifier l’exposant d’échelle d’une loi de puissance consiste à appliquer l’algorithme de régression linéaire classique par les moindres carrés ordinaires (MCO) sur les données préalablement transformées par le logarithme. Au sein de l’écosystème Python, cette procédure s’implémente au moyen de la fonction scipy.stats.linregress, qui prend en arguments les vecteurs log(x) et log(y). L’algorithme retourne la pente k, l’ordonnée à l’origine log(a), l’écart-type de l’erreur d’estimation, la p-valeur du test de significativité de Student ainsi que le coefficient de détermination R2.
Bien que séduisante par sa simplicité algorithmique, cette démarche méthodologique dissimule d’importants pièges statistiques fondamentaux documentés par Clauset et al. (2009). L’application des MCO sur des données log-transformées postule implicitement que le terme d’erreur résiduelle stochastique est multiplicatif et suit une distribution log-normale homogène. Si le phénomène sous-jacent est entaché d’un bruit de mesure additif normal non corrélé, la transformation logarithmique déforme la structure des erreurs, accordant un poids statistique artificiellement excessif aux valeurs les plus faibles de l’échantillon au détriment de la précision d’estimation des valeurs élevées.
En outre, le coefficient de détermination R2 calculé dans l’espace logarithmique tend à être structurellement très élevé (dépassant fréquemment 0,95 ou 0,98) en raison de la forte compression géométrique opérée sur les ordres de grandeur. Cette amplitude élevée donne souvent au chercheur l’illusion trompeuse d’un ajustement parfait, alors même que le modèle peut dévier considérablement des données brutes en termes absolus ou échouer à capturer une courbure asymptotique révélatrice d’une dynamique non conforme à une loi de puissance pure.
8.2 Ajustement direct non linéaire par régression robuste
Afin de pallier les insuffisances théoriques de la régression linéaire sur données transformées, l’état de l’art méthodologique préconise le recours à l’ajustement direct non linéaire de la fonction de puissance y = a × xk sur les variables brutes non transformées. La bibliothèque SciPy offre pour cela la primitive scipy.optimize.curve_fit, qui implémente l’algorithme d’optimisation de Levenberg-Marquardt pour minimiser la somme quadratique des résidus non linéaires.
Pour prendre en compte l’hétéroscédasticité naturelle des fluctuations expérimentales, curve_fit permet d’intégrer un vecteur de pondération des résidus par l’intermédiaire de son paramètre sigma. En assignant des écarts-types proportionnels à la magnitude des valeurs observées, le chercheur s’assure que l’algorithme optimise la convergence du modèle en respectant la nature intrinsèquement multiplicative du système physique étudié. Cette approche préserve la structure originale des incertitudes de mesure sans introduire de biais d’asymétrie computationnelle.
L’exécution de curve_fit retourne non seulement le vecteur des paramètres optimisés (la constante multiplicative a et l’exposant d’échelle k), mais fournit également la matrice de covariance asymptotique complète associée aux estimateurs. L’extraction de la racine carrée des éléments diagonaux de cette matrice donne un accès direct aux incertitudes-types des paramètres estimés, permettant de renseigner les intervalles de confiance statistiques indispensables à toute validation hypothético-déductive dans un rapport de recherche formel.
8.3 Superposition de la droite d’ajustement sur le graphique bilogarithmique
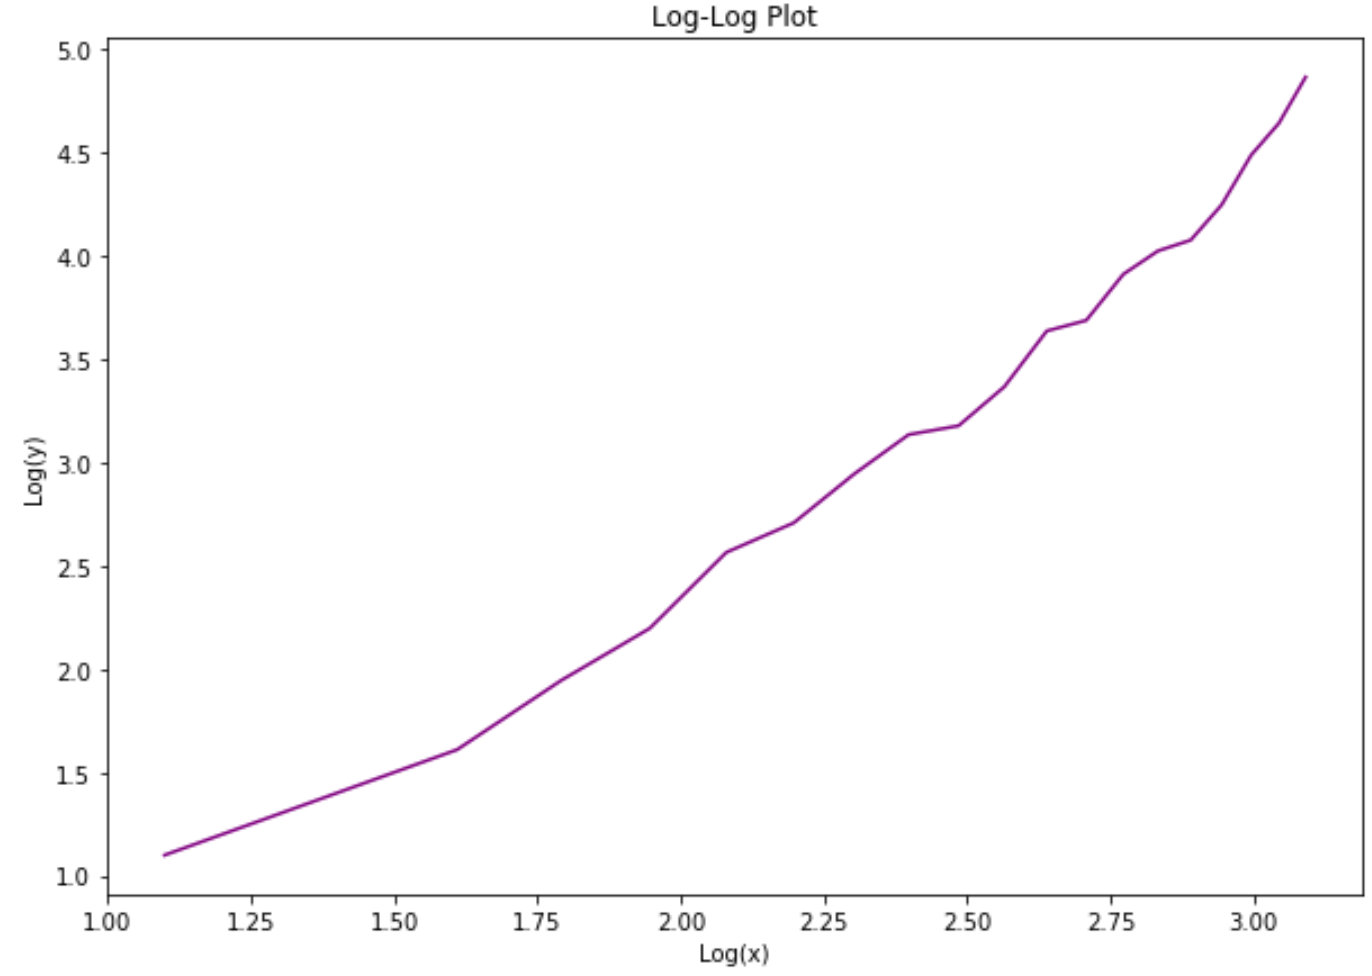
L’étape conclusive de la modélisation statistique consiste à superposer graphiquement la trajectoire analytique ajustée sur le nuage de points expérimentaux au sein de la figure bilogarithmique. Pour obtenir un tracé d’une fluidité visuelle parfaite, exempte de tout artefact de segmentation polygonale, il est impératif d’échantillonner la fonction d’ajustement sur un vecteur d’abscisses à haute densité numérique généré spécifiquement pour la visualisation.
Ce vecteur de prédiction synthétique doit être instancié au moyen de la fonction np.logspace, qui répartit les points d’évaluation de manière géométriquement équidistante dans l’espace des logarithmes, plutôt qu’avec np.linspace qui génère un espacement arithmétique linéaire. Un espacement arithmétique conduirait en effet à une concentration excessive des points calculés dans les décades supérieures et à une raréfaction dramatique dans les décades proximales de l’origine, produisant des segments brisés inacceptables lors du rendu de courbes non linéaires complexes.
La ligne de tendance théorique est ensuite matérialisée sur le canevas au moyen de la primitive ax.plot, en adoptant une couleur contrastante et un tracé continu ou tireté distinct des glyphes de mesure. La légende de la figure (ax.legend) doit être simultanément enrichie pour consigner de manière explicite les valeurs numériques de l’exposant d’échelle estimé, accompagnées de son erreur-type standardisée et de l’indicateur d’adéquation statistique retenu, offrant une synthèse analytique exhaustive au lecteur.
9. 9. Personnalisation esthétique et rigueur académique du tracé
9.1 Configuration des graduations majeures et mineures avec Ticker
L’excellence typographique d’une figure bilogarithmique repose largement sur la gestion rigoureuse de ses graduations principales (major ticks) et secondaires (minor ticks). Par défaut, Matplotlib peut générer des espacements de repères hétérogènes ou omettre les graduations intermédiaires en fonction de l’amplitude globale de la plage dynamique affichée. Pour dominer parfaitement ce rendu, il est nécessaire de mobiliser le sous-module spécialisé matplotlib.ticker.
Le positionnement spatial des graduations d’ordres de grandeur décimaux s’effectue au moyen de la classe LogLocator. On associera un premier localisateur aux graduations majeures (espacées de dix en dix) et un second localisateur aux graduations mineures (marquant les entiers intermédiaires de 2 à 9 à l’intérieur de chaque décade). Cette double articulation visuelle permet à l’observateur d’évaluer immédiatement la magnitude absolue et la position relative des points empiriques le long de la décade.
Le formatage sémantique des étiquettes numériques relève quant à lui de la classe LogFormatterMathtext. Ce module convertit les valeurs scalaires en expressions mathématiques élégantes, substituant des représentations décimales triviales ou la notation ingénieur abrégée (telle que ‘1e3’) par une typographie scientifique impeccable sous la forme de puissances de dix exactes (103). Il convient toutefois de veiller à ne pas saturer l’axe en n’affichant les labels textuels que sur les graduations majeures, les graduations mineures conservant un rôle de repère purement géométrique non étiqueté.
9.2 Grille de lecture et lisibilité de la figure
Dans un repère linéaire conventionnel, la présence d’une grille de fond peut parfois être considérée comme un encombrement visuel superflu. À l’inverse, au sein d’un graphique log-log, l’intégration d’une grille à double niveau constitue une exigence fonctionnelle absolue pour compenser l’anamorphose non linéaire des distances perçues et faciliter la lecture rapide des coordonnées.
L’activation de la grille s’effectue au moyen de l’instruction ax.grid(True, which=’both’), le mot-clé which=’both’ ordonnant le traçage simultané des lignes de rappel associées aux graduations majeures et mineures. Pour préserver la hiérarchie visuelle et éviter que le réseau géométrique n’occulte la distribution des données expérimentales, il est impératif d’ajuster finement les épaisseurs de trait et les niveaux de transparence (alpha). Les lignes directrices majeures seront typiquement rendues avec une opacité modérée (alpha de 0,5 à 0,7), tandis que les lignes mineures devront arborer un tracé estompé ou pointillé (alpha de 0,15 à 0,3).
Cette différenciation optique structure l’espace graphique en décades clairement délimitées tout en matérialisant l’écrasement progressif caractéristique de la métrique logarithmique interne à chaque décade. L’observateur dispose ainsi d’un canevas cartographique fiable permettant d’estimer instantanément l’amplitude de dispersion des résidus sans recourir à des instruments de mesure externes.
9.3 Typographie, labels d’axes et annotations d’équations
L’intelligibilité d’une figure scientifique est indissociable de la rigueur de son appareil textuel. Les étiquettes des axes (ax.set_xlabel et ax.set_ylabel) doivent indiquer sans la moindre ambiguïté le nom complet de la grandeur physique ou psychométrique mesurée, le symbole conventionnel associé et l’unité internationale de référence entre crochets. Il est formellement déconseillé d’indiquer simplement ‘log(Variable)’ si les graduations de l’axe sont déjà configurées sous une métrique logarithmique exprimée en unités brutes, sous peine d’induire une confusion conceptuelle sur l’état de transformation des coordonnées.
L’insertion des résultats de la modélisation mathématique s’exécute avec la méthode ax.annotate ou ax.text, en exploitant les capacités du moteur LaTeX de Matplotlib pour formater les expressions analytiques. L’écriture rigoureuse de l’équation fitted s’illustrera sous la forme d’un bloc de texte soigné renseignant explicitement l’exposant et ses limites d’erreur, à l’image de y = (2.41 ± 0.05) × x-1.28 ± 0.02. Ce formalisme garantit que l’intégralité du résultat statistique demeure auto-portée par la figure elle-même.
Le positionnement spatial de ce cartouche d’annotation doit faire l’objet d’un arbitrage minutieux afin d’éviter tout chevauchement avec le nuage de points ou les tracés de régression. L’utilisation d’un système de coordonnées normalisé relatif à l’espace de la boîte englobante (transform=ax.transAxes) permet de caler le texte d’annotation dans une zone vacante du graphique (par exemple dans le coin supérieur droit ou inférieur gauche), garantissant la stabilité spatiale du libellé indépendamment des ajustements ultérieurs apportés aux bornes des axes.
10. 10. Applications psychométriques et cognitives des graphiques log-log
10.1 Vérification expérimentale de la loi de puissance de Stevens en psychophysique
La psychophysique quantitative, inaugurée par Gustav Fechner et refondée de manière décisive par Stanley Smith Stevens au milieu du vingtième siècle, constitue l’un des théâtres d’application les plus remarquables des représentations bilogarithmiques. La loi de puissance de Stevens postule que la sensation psychologique perçue S est reliée à l’intensité physique du stimulus I par une fonction de puissance universelle de la forme S = k × Iβ, où l’exposant β caractérise la modalité sensorielle investiguée.
La validation empirique de cette loi repose sur des protocoles d’estimation de grandeur au cours desquels des sujets humains assignent des grandeurs numériques subjectives à des stimulations calibrées en laboratoire (luminance lumineuse, pression acoustique, intensité d’un courant électrique cutané ou concentration olfactive). L’injection de ces mesures au sein d’un tracé log-log en Python permet de vérifier instantanément si le système perceptif répond selon une règle d’invariance d’échelle globale.
L’interprétation neurophysiologique et clinique de la pente β extraite de la droite de régression log-log s’avère fascinante. Pour la perception de la brillance visuelle, β est typiquement inférieur à 1 (autour de 0,33), matérialisant une compression compressive protectrice permettant au système rétinien d’absorber des plages de photons considérables sans saturer. À l’inverse, pour l’estimation de la douleur induite par choc électrique, l’exposant β dépasse largement 3, dénotant une fonction expansive hautement adaptative qui amplifie exponentiellement l’alerte cognitive face à des agressions environnementales immédiatement délétères pour l’organisme.
10.2 Analyse du temps de réaction et loi de la pratique cognitive
Dans le domaine des neurosciences cognitives et de la psychologie de l’apprentissage moteur, la formalisation de l’acquisition des compétences s’appuie historiquement sur la « loi de puissance de la pratique » (Power Law of Practice), formalisée initialement par Newell et Rosenbloom (1981). Ce paradigme stipule que le temps de réaction T requis pour accomplir une tâche cognitive complexe ou une séquence motrice diminue en fonction du nombre d’essais cumulés N selon l’équation T = a × N-α, où α représente le taux d’apprentissage structural.
La projection des latences motrices en fonction de la répétition des sessions expérimentales sur un graphique log-log constitue l’outil analytique standard pour examiner la vitesse d’automatisation des processus cérébraux sous-jacents. L’alignement rectiligne des temps d’exécution sur plusieurs dizaines de milliers d’essais démontre que les mécanismes de plasticité synaptique et de réorganisation des réseaux corticaux opèrent sans échelle temporelle préférentielle, chaque doublement du volume de pratique réduisant le temps de traitement d’un pourcentage fixe.
Le tracé bilogarithmique s’avère en outre indispensable pour identifier la survenue d’un plateau cognitif ou d’une restructuration stratégique chez le sujet. L’observation d’une rupture de pente nette (elbow) sur le profil log-log trahit une bifurcation qualitative dans l’architecture cognitive mobilisée : par exemple, la transition d’un mode de résolution algorithmique séquentiel délibératif, lourdement dépendant de la mémoire de travail préfrontale, vers un mode de récupération associative directe automatisée au sein des structures sous-corticales et des ganglions de la base.
10.3 Étude des lois de fréquence lexicale (Loi de Zipf) en neuropsychologie
L’exploration de la désorganisation linguistique dans les pathologies neurodégénératives, à l’instar de la maladie d’Alzheimer, de la démence fronto-temporale ou des aphasies progressives primaires, mobilise fréquemment des indicateurs informatisés issus du traitement automatique du langage naturel. Au cœur de cette analyse se trouve la célèbre loi de Zipf, loi de puissance empirique établissant que la fréquence d’occurrence f d’un lemme dans un corpus verbal est inversement proportionnelle à son rang r dans la table des fréquences, soit f(r) ∝ r-γ, avec un exposant théorique γ ≈ 1 chez les locuteurs sains.
La mise en œuvre de protocoles de fluence verbale catégorielle ou de narration spontanée permet de recueillir des échantillons de discours dont les rangs et fréquences sont extraits puis cartographiés en coordonnées log-log avec Python. La comparaison des courbes bilogarithmiques entre des cohortes normatives appariées et des patients cérébrolésés révèle des modifications structurales profondes de la géométrie de distribution du stock lexical disponible.
Dans les tableaux d’altération mnésique ou sémantique sévère, le tracé log-log exhibe une troncature brutale aux rangs élevés associée à une amplification artificielle de la pente sur les rangs primaires. Cette signature graphique traduit l’écroulement de la diversité lexicale et la sur-sollicitation compensatoire d’un noyau restreint de mots passe-partout hyperfréquents. Le graphique bilogarithmique s’affirme ainsi comme un biomarqueur computationnel d’une grande valeur diagnostique et pronostique, autorisant le suivi longitudinal objectif de la détérioration cognitive au cours du temps.
11. 11. Diagnostic des erreurs fréquentes, valeurs nulles et artéfacts visuels
11.1 Gestion des zéros et des valeurs négatives dans l’entrée de données
L’une des défaillances logicielles les plus chroniques lors de l’exécution de scripts de visualisation bilogarithmique découle de la gestion maladroite des valeurs nulles ou négatives au sein des tenseurs de données d’entrée. Lorsque Matplotlib intercepte une valeur x ≤ 0 ou y ≤ 0 lors de la conversion interne par un convertisseur logarithmique standard, le moteur émet le message d’alerte classique UserWarning: Attempted to set non-positive limits on a log-scaled axis et procède unilatéralement au masquage arbitraire des points concernés ou à l’écrasement des limites d’affichage vers une valeur minimale prédéterminée arbitraire.
Ce traitement par défaut engendre souvent des effets secondaires désastreux : disparition silencieuse d’une partie non négligeable de l’échantillon, faussant l’évaluation statistique globale, ou distorsion visuelle sévère des marges avec compression anormale de la zone d’intérêt scientifique. Pour prémunir le pipeline de calcul contre ces avaries, il est impératif d’intégrer une phase défensive systématique reposant sur l’application de masques booléens étanches avant tout transfert vers les primitives graphiques.
Le développeur averti encapsulera systématiquement les instructions de filtrage à l’aide d’expressions vectorielles pures, isolant explicitement les couples (x, y) satisfaisant simultanément à la condition de stricte positivité. Si l’expérience impose de conserver l’information relative à des occurrences nulles, celles-ci devront faire l’objet d’une projection marginale dédiée sous forme de marques de tapis (rug plots) positionnées sur des axes secondaires linéaires adjoints, garantissant une intégrité d’analyse exempte de tout artifice géométrique tronqué.
11.2 Pièges de l’interprétation trompeuse de la linéarité
Un biais cognitif majeur, amplement dénoncé dans la littérature méthodologique contemporaine, réside dans l’effet d’illusion de linéarité engendré par l’échelle bilogarithmique. En raison de la compression logarithmique drastique qui atténue exponentiellement les distances géométriques absolues à mesure que l’on progresse le long de l’axe, des trajectoires issues de modèles mathématiques concurrents — tels que des distributions log-normales, des fonctions étirées de Kohlrausch ou des exponentielles tronquées — peuvent adopter une apparence trompeusement rectiligne sur une plage restreinte d’ordres de grandeur.
L’évaluation visuelle exclusive de l’alignement des points ne constitue donc en aucun cas une preuve suffisante pour attester de l’existence d’une loi de puissance authentique. Pour conjurer ce piège méthodologique, il est absolument indispensable d’associer systématiquement au graphique log-log principal un sous-graphique complémentaire dédié à l’analyse rigoureuse des résidus de régression. Dans cet espace diagnostique résiduel, les déviations par rapport au modèle sont représentées sans compression d’échelle, rendant instantanément perceptibles les éventuelles courbures systématiques ou dérives périodiques trahissant l’inadéquation du modèle retenu.
De surcroît, le protocole scientifique doit intégrer des tests statistiques formels de qualité d’adéquation (goodness-of-fit) et des comparaisons d’hypothèses basées sur le critère d’information d’Akaike (AIC) ou sur le test de rapport de vraisemblance de Vuong. Seule la conjonction d’une vraisemblance statistique validée et de l’absence de structure résiduelle résidant dans le diagnostic graphique permet d’asseoir définitivement la découverte d’un régime d’invariance d’échelle au sein des données empiriques.
11.3 Erreurs de redimensionnement d’aspect et distorsion géométrique
La perception humaine des coefficients d’inclinaison angulaire est tributaire du ratio géométrique dimensionnel unissant la hauteur physique et la largeur physique du cadre de dessin, concept formalisé sous l’expression d’aspect ratio. Dans un repère linéaire conventionnel, l’observateur perçoit une pente unitaire comme une ligne orientée à 45 degrés uniquement lorsque les échelles physiques des deux axes partagent une calibration isométrique unitaire.
Dans un graphique bilogarithmique, cette problématique de distorsion perceptive revêt une gravité accrue. Si la boîte englobante de la figure est étirée horizontalement ou écrasée verticalement par l’utilisateur ou par les mécanismes de redimensionnement automatique d’une interface graphique, l’angle visuel perçu de la droite s’écarte dramatiquement de la valeur théorique de l’exposant d’échelle k. Deux lois de puissance dotées d’exposants rigoureusement identiques paraîtront dotées de cinétiques radicalement disparates si elles sont présentées au sein de fenêtres graphiques affichant des formats d’image dissemblables.
Pour assurer la comparabilité absolue des figures à travers différentes conditions expérimentales ou séries de publications, il est impératif de contraindre formellement l’aspect ratio en sollicitant la méthode ax.set_aspect(‘equal’, adjustable=’box’) lorsque les étendues dynamiques des deux axes couvrent un nombre de décades rigoureusement équivalent. À défaut d’une égalité absolue de dimensionnement, le chercheur devra veiller à figer rigoureusement les proportions physiques de la figure (figsize) au moment de l’initialisation du canevas, garantissant la reproductibilité de l’expérience visuelle transmise au comité de lecture.
12. 12. Exportation vectorielle haute résolution et intégration éditoriale
12.1 Formats de sortie et résolution graphique pour revues académiques
L’ultime étape du processus d’ingénierie graphique consiste en l’encodage et l’exportation du graphique depuis la mémoire de calcul vers un support de stockage persistant, en vue de son intégration dans un article scientifique de calibre international. Cette opération ne saurait souffrir d’approximations techniques qui dégraderaient l’effort de modélisation déployé en amont. Deux grands paradigmes de fichiers graphiques s’offrent alors au chercheur : l’encodage vectoriel et l’encodage matriciel.
Les formats vectoriels, au premier rang desquels figurent le PDF (Portable Document Format) et le SVG (Scalable Vector Graphics), doivent être systématiquement privilégiés pour toute publication imprimée ou électronique. Ces formats ne figent pas l’image sous la forme d’une grille discrète de pixels, mais encodent chaque segment, chaque glyphe textuel et chaque marqueur sous forme d’instructions géométriques différentiables pures. Il en résulte une résolution virtuellement infinie, garantissant une netteté absolue des traits de graduation et des étiquettes mathématiques, quel que soit le niveau de zoom appliqué lors de la mise en page finale par l’éditeur.
Si des contraintes éditoriales spécifiques imposent l’usage de formats matriciels compressés sans perte, tels que le TIFF ou le PNG haute fidélité, il convient alors de verrouiller impérativement le paramètre de résolution d’échantillonnage de la primitive plt.savefig à un seuil minimal de dpi=300 pour des illustrations en quadrichromie et de dpi=600, voire dpi=1200, pour des tracés au trait monochromes. Enfin, l’adjonction systématique de l’argument bbox_inches=’tight’ s’avère indispensable pour neutraliser tout rognage accidentel des étiquettes marginales ou des formules LaTeX situées en périphérie de la boîte englobante de la figure.
12.2 Gestion de la colorimétrie et accessibilité visuelle
L’éthique et les exigences déontologiques de la recherche scientifique contemporaine prescrivent la conception de visualisations universellement intelligibles, indépendantes des facultés visuelles individuelles et adaptées aux multiples contingences de diffusion (y compris l’impression sur support physique monochrome en niveaux de gris). À ce titre, la sélection de la palette chromatique constitue une composante technique centrale de la confection graphique.
L’utilisation de palettes multicolores saturées non linéaires, à l’instar de l’historique carte de couleurs « Jet » ou « Rainbow », doit être bannie de manière irrévocable. Ces palettes souffrent d’aberrations perceptives majeures, introduisant des faux gradients d’intensité lumineuse là où les données sont homogènes et occultant des détails critiques au sein de transitions brutales. Le chercheur mobilisera exclusivement des palettes perceptuellement uniformes et séquentielles issues des standards modernes de Matplotlib, telles que Viridis, Cividis ou Plasma.
La palette Cividis, en particulier, a été mathématiquement optimisée pour garantir une lisibilité sans faille tant pour les observateurs dotés d’une vision trichromatique standard que pour les individus présentant des déficiences de perception des couleurs telles que la deutéranopie ou la protanopie. De surcroît, ces palettes garantissent que la conversion de la figure en échelle de gris préserve une progression tonale parfaitement monotone, assurant que le contraste visuel entre séries expérimentales superposées subsiste intact lors de la reprographie papier du document final.
12.3 Automatisation et encapsulation dans une fonction réutilisable
L’aboutissement méthodologique de l’ensemble des concepts théorisés et implémentés tout au long de cette étude réside dans leur encapsulation systématique au sein d’un composant logiciel réutilisable, robuste et modulaire. L’automatisation du processus de génération des graphiques log-log permet d’intégrer sans friction la visualisation au sein de pipelines de traitement par lots (batch processing) manipulés lors de l’exécution de simulations massives ou du dépouillement continu de banques de données cliniques.
Une fonction de haut niveau optimisée pour la recherche scientifique doit accepter en arguments les séries de données brutes, les libellés typographiques, la spécification des bases logarithmiques, ainsi que des commutateurs régissant l’exécution ou non d’un ajustement non linéaire robuste. La conformité avec les directives de style de développement PEP 257 impose la rédaction d’un bloc de documentation structuré (docstring) détaillant minutieusement les préconditions d’entrée, les exceptions computationnelles susceptibles d’être levées et le typage strict des arguments (type hinting) conformément aux standards modernes du langage Python.
En architecturant le code sous la forme d’un module autonome retournant les descripteurs de l’objet Figure et de l’objet Axes instanciés, le chercheur s’assure une totale liberté d’intervention a posteriori pour enrichir ponctuellement la mise en page avant l’enregistrement sur disque. Cette standardisation logicielle élimine la duplication de code source, prévient l’apparition d’erreurs de syntaxe récurrentes et garantit l’harmonisation esthétique et scientifique irréprochable de l’ensemble de la production graphique au sein des laboratoires de recherche.
Références
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661-703. https://doi.org/10.1137/070710111
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). https://doi.org/10.25080/Majora-92bf1924-003
- Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive Skills and Their Acquisition (pp. 1-55). Lawrence Erlbaum Associates.
- Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153-181. https://doi.org/10.1037/h0046162
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Zipf, G. K. (1949). Human Behavior and the Principle of Least Effort: An Introduction to Human Ecology. Addison-Wesley Press.