
Dans le paysage contemporain de l’analyse exploratoire des données et de la communication scientifique, la représentation graphique occupe une place épistémologique centrale. Loin d’être un simple artifice cosmétique destiné à agrémenter un rapport ou une communication de recherche, le choix d’un dispositif visuel conditionne directement la validité des inférences tirées par l’observateur. Au sein des sciences du comportement, de la biomédecine et des sciences sociales quantitatives, les chercheurs sont confrontés au défi récurrent de rendre compte de la variabilité empirique d’échantillons souvent restreints sans pour autant sacrifier l’intégrité granulaire de chaque observation individuelle. C’est précisément au confluent de cette double exigence de précision métrologique et de transparence méthodologique que se situe le graphique à points, communément désigné sous le terme anglo-saxon de dot plot.
Bien que le logiciel Microsoft Excel demeure l’environnement computationnel le plus largement diffusé dans les laboratoires, les administrations et les entreprises, il ne propose pas, dans ses configurations standard prêtes à l’emploi, de commande unitaire intitulée « Graphique à points de Wilkinson ». Cette absence apparente d’automatisation native a souvent conduit les analystes à se replier sur des visualisations sous-optimales, à l’instar des diagrammes en bâtons ou des histogrammes conventionnels dont les biais de discrétisation sont pourtant largement documentés dans la littérature statistique. La création d’un graphique à points rigoureux dans Excel requiert ainsi une compréhension approfondie de son moteur géométrique sous-jacent, reposant sur l’instrumentalisation méthodique des coordonnées cartésiennes d’un nuage de points combinée à des techniques d’empilement vertical algorithmique.
Ce guide exhaustif a pour vocation d’exposer de manière systématique, didactique et rigoureuse l’ensemble des fondements conceptuels, mathématiques et pratiques nécessaires à l’élaboration de graphiques à points hautement professionnels au sein de l’environnement Excel. En articulant les prescriptions sémiologiques issues des travaux fondateurs de la statistique visuelle avec des procédures pas à pas reproductibles, nous aborderons tant la restructuration matricielle des données que l’automatisation dynamique par formules avancées, l’intégration d’indicateurs de tendance centrale et la mise en conformité formelle avec les normes typographiques de l’American Psychological Association (APA 7e édition).
1. Introduction aux graphiques à points (Dot Plots) en méthodologie quantitative
1.1 Définition conceptuelle et origines statistiques du dot plot
L’émergence du graphique à points s’inscrit dans un mouvement intellectuel de rupture initié au cours de la seconde moitié du vingtième siècle, visant à libérer l’analyse des données de l’application aveugle de modèles paramétriques standardisés. Le pionnier de cette réorientation épistémologique, John W. Tukey, introduisit à travers son ouvrage séminal sur l’analyse exploratoire des données (Exploratory Data Analysis en 1977) une série d’outils graphiques minimalistes conçus pour révéler la morphologie intrinsèque des distributions sans imposer d’hypothèse distributionnelle a priori. Parmi ces innovations figurait l’ancêtre direct du dot plot contemporain, initialement formalisé comme une déclinaison visuelle du diagramme branche-et-feuille (stem-and-leaf display).
Toutefois, la taxonomie moderne des graphiques à points doit ses distinctions fondamentales aux travaux de William S. Cleveland et de Leland Wilkinson. William S. Cleveland développa au cours des années 1980 ce que la littérature nomme aujourd’hui le « dot plot de Cleveland ». Ce dernier se présente essentiellement comme une alternative supérieure au diagramme à barres horizontales pour représenter des variables quantitatives ventilées par catégories discrètes. En remplaçant les barres massives par des marqueurs circulaires positionnés sur un axe continu, Cleveland réduisit considérablement l’encombrement graphique superflu, maximisant ainsi ce que Edward Tufte qualifiera plus tard de « ratio encre-données » (data-ink ratio).
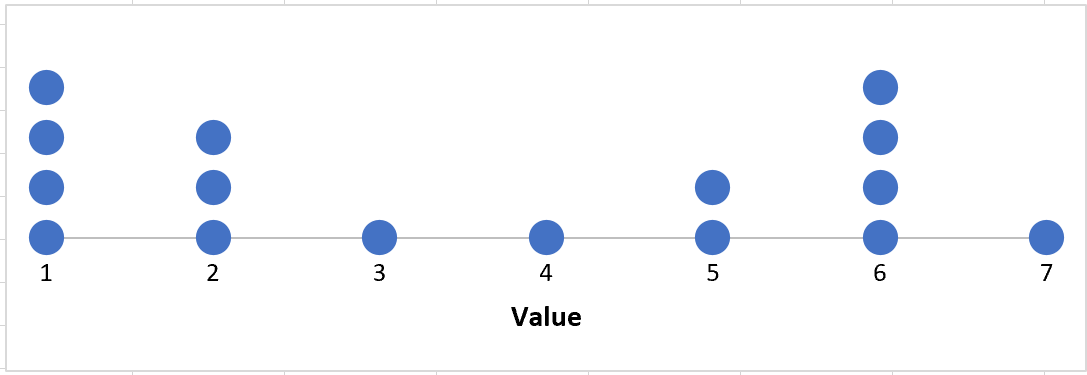
Quelques années plus tard, Leland Wilkinson formalisa dans sa grammaire des graphiques (The Grammar of Graphics) le dot plot de distribution univariée par empilement régulier. Contrairement à la variante de Cleveland qui associe une étiquette catégorielle unique à une coordonnée quantitative, le dot plot de Wilkinson discrétise une variable continue en micro-intervalles au sein desquels chaque observation individuelle est représentée par un symbole unique empilé verticalement. Cette approche garantit la préservation absolue de la taille de l’échantillon (N) : chaque entité empirique mesurée se voit assigner un point physique sur le canevas visuel, offrant une transparence analytique totale qu’aucun modèle synthétique ne peut égaler.
1.2 Pertinence et utilité du dot plot dans la recherche psychologique et comportementale
Dans le domaine des sciences comportementales, de la neuropsychologie clinique et des protocoles d’intervention thérapeutique, les chercheurs opèrent fréquemment sur des cohortes d’effectif modéré, typiquement comprises entre dix et quarante participants par bras expérimental. Dans ces configurations d’échantillonnage restreint, l’application machinale d’outils de visualisation globale tels que les histogrammes s’avère méthodologiquement trompeuse. Les histogrammes ont tendance à lisser artificiellement la variance ou, à l’inverse, à créer des ruptures de continuité purement artéfactuelles selon l’origine et l’amplitude des intervalles de classe sélectionnés.
Le graphique à points résout ce dilemme métrologique en fournissant une cartographie sans fard de la dispersion empirique. Il permet à l’investigateur de déceler instantanément l’existence de sous-groupes latents, de déviations sévères par rapport à la normalité théorique ou de plafonnements de scores (effets plancher et plafond), particulièrement fréquents dans les inventaires psychométriques et les épreuves de temps de réaction informatisées. La détection des valeurs aberrantes ou atypiques (outliers) ne s’effectue plus par une coupure statistique arbitraire, mais par une appréciation contextuelle immédiate de l’isolement spatial d’un marqueur sur l’axe des mesures.
Par ailleurs, sur le plan de la communication interprofessionnelle, le dot plot constitue un vecteur de médiation scientifique d’une rare efficacité. Alors que la lecture d’une boîte à moustaches requiert l’assimilation préalable de concepts statistiques abstraits tels que les quartiles, la médiane ou l’écart interquartile, le graphique à points fait appel à l’intuition perceptive primaire du dénombrement unitaire. Un clinicien, un décideur institutionnel ou un praticien de terrain non initié aux arcanes de la modélisation probabiliste appréhende immédiatement le fait que chaque point incarne la trajectoire d’un sujet clinique singulier, ce qui renforce l’adhésion aux conclusions tirées de l’expérimentation.
1.3 Comparaison critique : graphique à points versus histogramme et boîte à moustaches
L’évaluation comparative des dispositifs d’affichage univarié met en lumière des divergences structurales fondamentales. La boîte à moustaches de Tukey (boxplot), omniprésente dans les revues académiques, résume une distribution au travers d’un résumé à cinq nombres. Si cette compression informationnelle s’avère vertueuse face à des méga-données de plusieurs milliers d’enregistrements, elle constitue une boîte noire périlleuse pour les échantillons de taille petite à moyenne. Deux distributions diamétralement opposées, l’une unimodale symétrique et l’autre profondément bimodale (en sablier), peuvent engendrer des boîtes à moustaches rigoureusement identiques, dissimulant ainsi des phénomènes cliniques cruciaux tels que la présence d’une sous-population de non-répondeurs à une médication.
L’histogramme, quant à lui, est tributaire du paramétrage de ses classes (binning). Une variation infime dans la largeur de la classe ou dans le point de départ de l’axe des abscisses peut modifier radicalement la perception de la symétrie ou de l’asymétrie de la courbe observée. Ce phénomène de distorsion morphologique induit souvent les analystes en erreur lors de la phase d’évaluation visuelle de la normalité. Le graphique à points s’affranchit de ce biais majeur : chaque observation conservant son intégrité scalaire, la densité locale de la distribution émerge organiquement de la proximité et de la hauteur d’empilement des disques sans qu’aucune fonction de lissage arbitraire n’ait été imposée aux données brutes.
Le tableau comparatif suivant synthétise les propriétés métrologiques de ces trois instruments sémiologiques en fonction des contraintes de l’analyse expérimentale :
- Graphique à points (Dot Plot) : Résolution unitaire intégrale ; parfaitement adapté aux effectifs compris entre N = 5 et N = 100 ; mise en évidence sans équivoque de la multimodalité, des discontinuités et des scores singuliers ; accessibilité cognitive maximale pour tout public.
- Histogramme standard : Résolution agrégée par intervalles ; recommandé pour des effectifs supérieurs à N = 200 ; sensibilité excessive au choix de la largeur des intervalles ; risque d’occultation des cas cliniques extrêmes isolés.
- Boîte à moustaches (Boxplot) : Résolution non paramétrique synthétique ; idéale pour comparer un grand nombre de groupes lorsque N > 50 par groupe ; incapacité structurelle à diagnostiquer les mélanges de distributions normales ou les distributions en U.
2. Fondements mathématiques et structure des données dans Excel
2.1 Logique spatiale et système de coordonnées cartésiennes sous-jacent
Pour construire un graphique à points au sein d’un logiciel qui n’intègre pas cet objet graphique de manière native, il convient de conceptualiser l’opération comme la transposition d’une distribution de fréquences dans un espace vectoriel euclidien à deux dimensions (X, Y). L’axe horizontal des abscisses (X) incarne la variable empirique observée, qu’elle soit continue (par exemple, la latence de réponse en millisecondes), discrète (un score obtenu sur une échelle d’anxiété de 0 à 50) ou ordinale catégorisée.
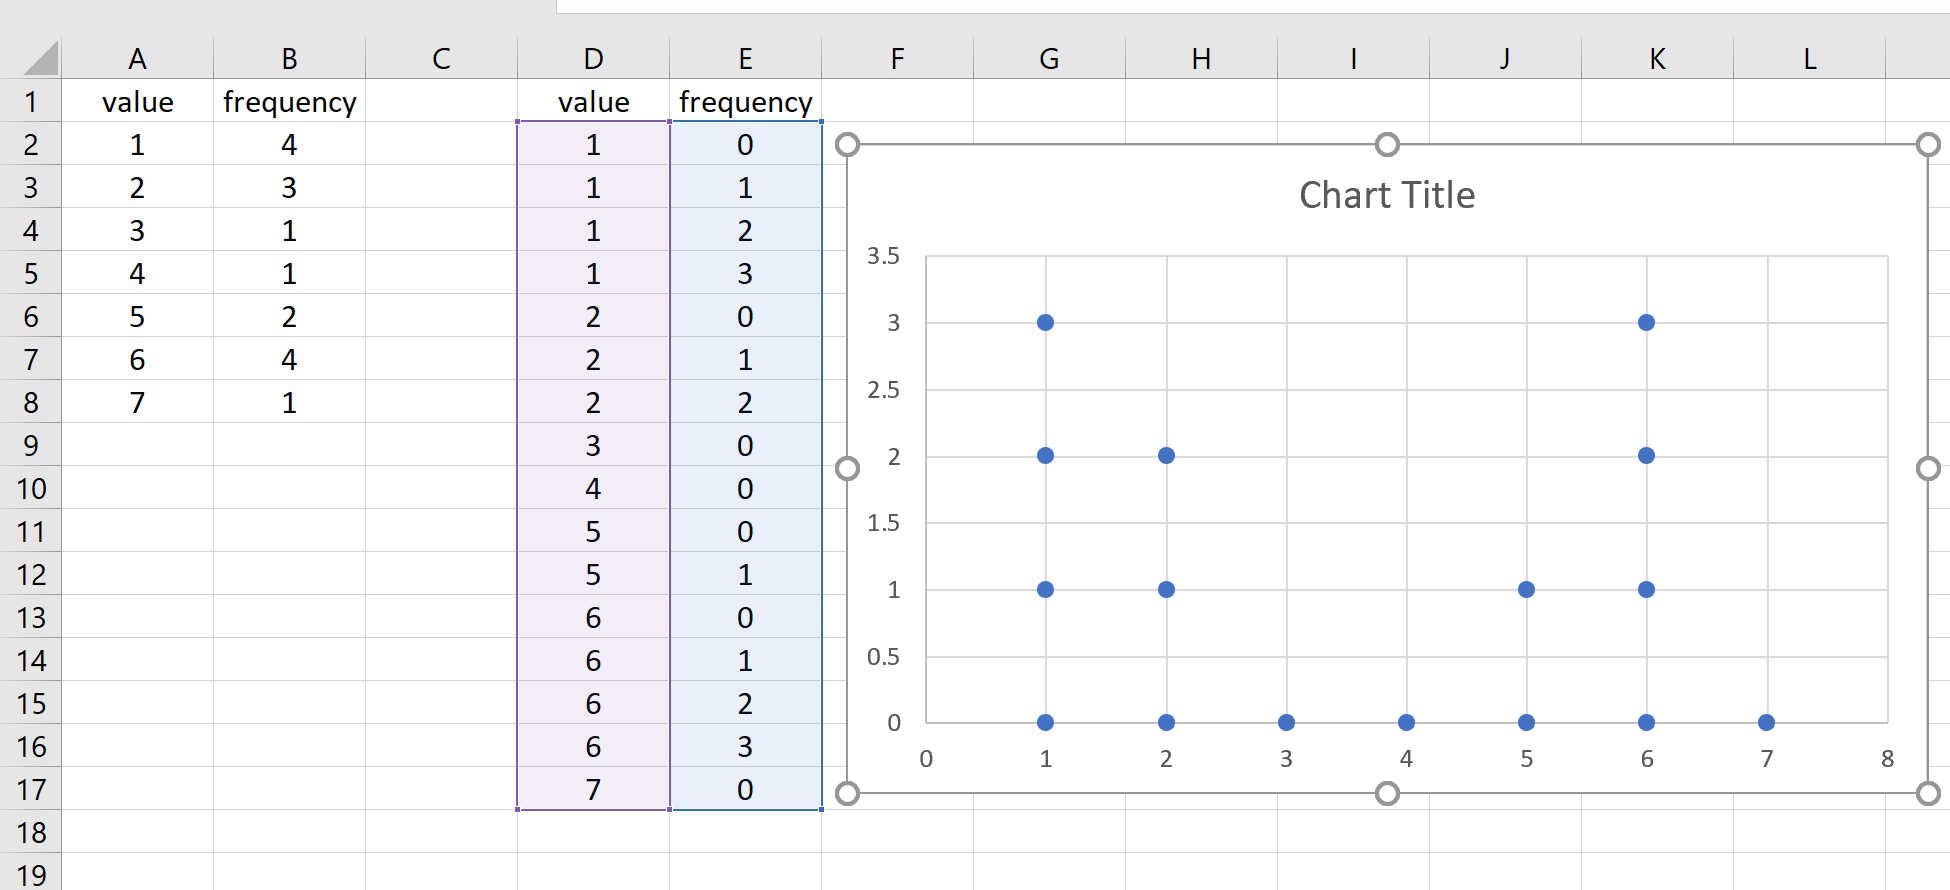
L’axe vertical des ordonnées (Y), en revanche, n’exprime pas une magnitude mesurée indépendante, mais une dimension artificielle d’empilement topologique représentant la fréquence d’occurrence cumulée locale. Si la valeur scalaire 14 apparaît à trois reprises au sein du jeu de données, ces trois observations doivent se voir attribuer la même abscisse spatiale X = 14, mais des ordonnées discrètes échelonnées selon une suite arithmétique unitaire : Y1 = 1, Y2 = 2 et Y3 = 3. Le moteur graphique interprète dès lors ces couples cartésiens (14, 1), (14, 2) et (14, 3) comme trois points distincts superposés sur une même verticale géométrique.
Ce mécanisme d’attribution matricielle impose une formalisation mathématique rigoureuse de l’empilement. La coordonnée ordonnée du k-ième individu partageant une valeur scalaire identique x est régie par la relation simple :
y_k = k, avec k ∈ {1, 2, …, f(x)}, où f(x) désigne la fréquence absolue observée de la valeur x dans l’échantillon d’étude. Tout l’enjeu méthodologique au sein d’Excel consistera donc à générer automatiquement cette composante vectorielle Y pour chaque élément de la série brute.
2.2 Structure tabulaire : passage du format large au format long
L’une des pierres d’achoppement les plus courantes dans la manipulation des données sous Excel réside dans la confusion récurrente entre le « format large » (wide format) et le « format long » (long format), formalisé dans le paradigme des données ordonnées (tidy data). Dans un format large conventionnel, l’analyste consigne souvent une table de contingence résumée : une colonne répertorie les scores uniques possibles, tandis qu’une colonne contiguë indique le décompte des effectifs associés. Bien que cette présentation soit commode pour la lecture humaine tabulaire, elle demeure totalement inopérante pour l’injection directe dans le moteur de nuage de points (scatter plot) d’Excel.
Le traceur de nuage de points cartésien exige que chaque marqueur physique affiché à l’écran corresponde à un enregistrement unitaire, c’est-à-dire à une ligne spécifique dans la feuille de calcul. Si l’échantillon comporte quarante sujets, la table finale alimentant le graphique doit impérativement comporter quarante lignes de données, indépendamment du nombre de valeurs distinctes observées. Le passage d’une table agrégée synthétique vers une table longue développée implique une opération d’expansion vectorielle où chaque valeur x est répliquée autant de fois que son effectif marginal, chaque répétition étant couplée à son incrément vertical d’empilement.
Il est par ailleurs impératif de veiller scrupuleusement au typage des cellules au sein du classeur. Excel possédant une propension bien connue à interpréter de manière erronée des valeurs numériques comme du texte lorsqu’elles proviennent de fichiers délimités (CSV) ou de saisies manuelles hétérogènes, toute valeur stockée en chaîne textuelle sur l’axe des X brisera l’équidistance géométrique continue du nuage de points, transformant la graduation métrique en une série d’étiquettes discrètes arbitraires dépourvues de proportionnalité spatiale.
3. Étape 1 : Préparation et restructuration rigoureuse des données dans Excel
3.1 Saisie de la table de contingence ou de fréquences de départ
La phase initiale de tout protocole d’affichage réside dans l’agencement méthodique des données primaires. Considérons une investigation psychologique portant sur l’évaluation des symptômes dépressifs résiduels via un questionnaire administré à un groupe de patients en post-thérapie. Les scores bruts observés s’échelonnent sur une échelle discrète comprise entre 10 et 25. La première étape consiste à consigner la distribution empirique dans une table de fréquences claire et structurée.
Dans la feuille de calcul, la colonne A sera dédiée à la désignation de la métrique observée, étiquetée conventionnellement Score_X, tandis que la colonne B recevra le dénombrement brut des occurrences, étiquetée Frequence. Il convient de vérifier avec la plus haute exigence méthodologique que la somme arithmétique de la colonne des fréquences soit rigoureusement égale à la taille effective de la cohorte expérimentale N. L’omission d’une fréquence nulle pour un score intermédiaire qui n’a été sélectionné par aucun participant doit être expressément évitée dans la table de référence : inscrire une fréquence de 0 garantit que l’échelle des abscisses ne subira pas de contraction spatiale masquant une discontinuité clinique importante.
L’utilisation de la nomenclature stricte sans caractères diacritiques complexes ou espaces parasites dans les en-têtes de colonnes prévient d’éventuelles erreurs de référence lors de l’intégration de formules matricielles ultérieures ou lors du transfert du classeur vers d’autres moteurs statistiques complémentaires tels que le langage R ou Python.
3.2 Expansion méthodique des observations au format long (méthode manuelle)
Pour des échantillons de taille modeste (typiquement N ≤ 40), la déconstruction manuelle de la table de fréquences vers la structure cartésienne longue constitue une méthode particulièrement pédagogique pour appréhender la spatialisation du graphique. Cette manipulation consiste à déployer verticalement deux nouvelles colonnes adjacentes, désignées respectivement par Axe_X et Axe_Y_Empilement.
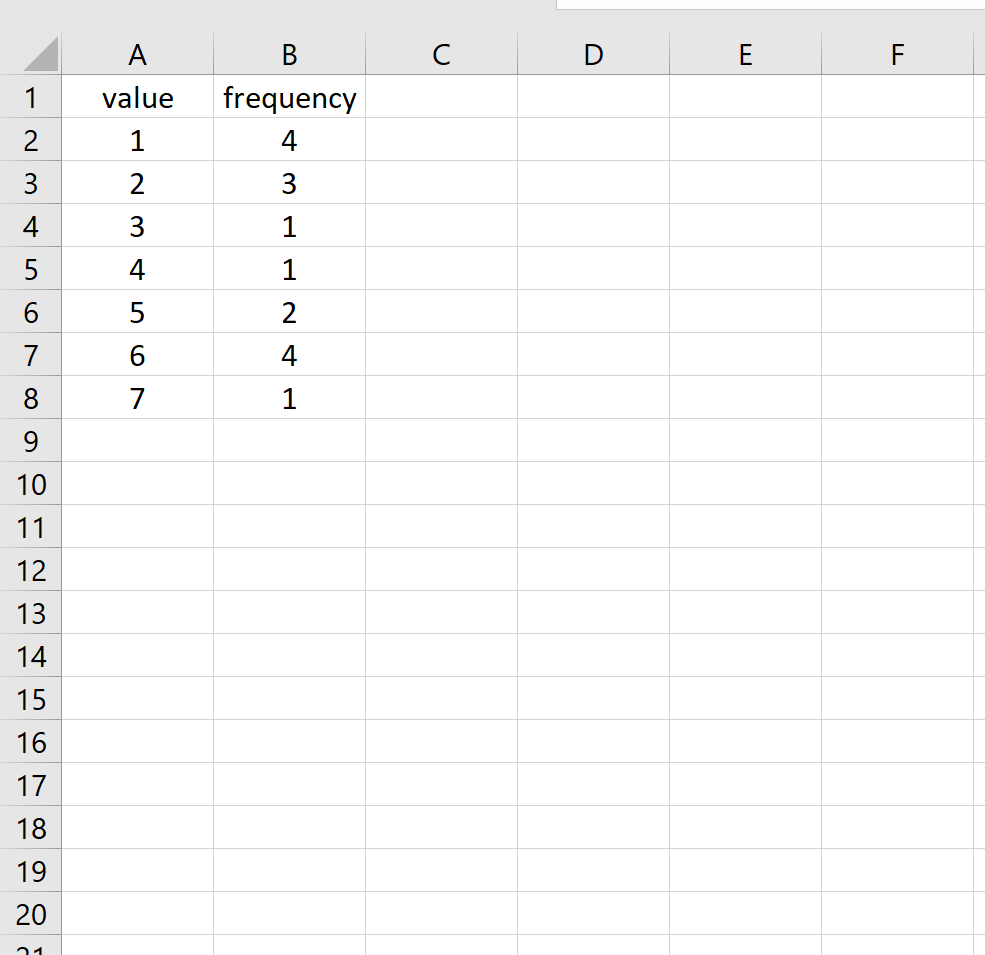
Si la modalité de score 12 présente une fréquence de 4 dans la table de départ, l’opérateur saisit la valeur 12 sur quatre lignes consécutives dans la colonne Axe_X (par exemple des cellules D2 à D5). Immédiatement en regard, dans la colonne Axe_Y_Empilement, l’opérateur affecte la suite d’entiers naturels croissants : 1 en E2, 2 en E3, 3 en E4 et 4 en E5. L’opération est réitérée méthodiquement pour chacune des modalités observées jusqu’à épuisement des données empiriques.
À l’issue de cette phase d’expansion, l’analyste procède à une double validation de cohérence : le nombre de lignes renseignées doit concorder point par point avec l’effectif global validé, et la valeur maximale enregistrée dans la colonne d’empilement vertical doit correspondre exactement au mode empirique de la distribution, c’est-à-dire à la fréquence de la modalité la plus représentée dans l’échantillon.
3.3 Traitement des données massives via Power Query pour automatiser la conversion
Dès lors que l’effectif expérimental dépasse la centaine d’observations ou que le protocole exige l’actualisation récurrente de tableaux de bord cliniques, la saisie manuelle de dédoublement devient prohibitive et source d’erreurs humaines. L’environnement Power Query, intégré nativement à Excel depuis les versions 2016, offre un pipeline de transformation automatisé et parfaitement reproductible.
Pour automatiser l’expansion des fréquences via Power Query, la procédure formelle s’établit comme suit :
- Sélectionner la table de contingence initiale (contenant
Score_XetFrequence) et naviguer vers l’onglet Données du ruban, puis cliquer sur À partir d’un tableau/d’une plage pour initialiser le moteur d’ingestion. - Dans l’éditeur Power Query, accéder à l’onglet Ajouter une colonne et sélectionner Colonne personnalisée.
- Dans la boîte de dialogue contextuelle, nommer la nouvelle colonne
Generateur_Listeet renseigner l’expression formelle en langage M :List.Numbers(1, [Frequence]). Cette instruction native ordonne au moteur de générer, pour chaque ligne du tableau, une séquence séquentielle d’entiers débutant à 1 et s’étendant sur une longueur égale à la valeur enregistrée dans le champ de fréquence. - Cliquer sur l’icône de double flèche d’expansion située dans l’en-tête de la colonne personnalisée nouvellement créée et sélectionner l’option Développer sur de nouvelles lignes. La table change instantanément de dimensionnalité : chaque ligne initiale est répliquée selon son coefficient d’occurrence, et la colonne développée affiche l’index unitaire d’empilement (1, 2, 3, etc.).
- Renommer la colonne d’expansion en
Coordonnee_Y, attribuer le type de données Nombre entier aux deux colonnes conservées, puis cliquer sur Fermer et charger dans afin de rapatrier la matrice résultante au format tabulaire propre au sein d’une nouvelle feuille de calcul.
4. Étape 2 : Création du graphique préliminaire via le nuage de points
4.1 Sélection des plages de données et insertion du scatterplot
Une fois la structure tabulaire au format long rigoureusement établie et vérifiée, la génération de la structure graphique s’effectue au moyen du moteur de nuage de points (scatter plot) d’Excel. Il s’agit du seul type de graphique conventionnel capable de distribuer des éléments visuels le long de deux échelles numériques continues indépendantes sans imposer de catégorisation forcée sur l’axe primaire.
La manipulation technique débute par la sélection exclusive des plages de données bidimensionnelles. Dans la feuille de calcul, l’opérateur sélectionne la plage de la colonne Axe_X ainsi que celle de la colonne Axe_Y_Empilement, en incluant ou en excluant les en-têtes de colonne selon la pratique établie (l’inclusion étant préférable si l’on souhaite qu’Excel baptise automatiquement la série de données). L’analyste se dirige ensuite vers le ruban supérieur d’Excel, clique sur l’onglet Insertion, puis localise le groupe fonctionnel intitulé Graphiques.
Au sein de la galerie de sélection, il est impératif d’activer le menu déroulant Insérer un graphique en nuage de points (X, Y) ou un graphique à bulles et de choisir expressément l’option Nuage de points avec marqueurs uniquement (le premier pictogramme représentant des points isolés sans segments de liaison rectilignes ni courbes lissées). Un canevas rectangulaire apparaît alors immédiatement sur la feuille de travail, matérialisant l’esquisse embryonnaire du dot plot.
4.2 Résolution des inversions d’axes fréquentes lors de l’insertion
L’un des comportements les plus déroutants du moteur graphique d’Excel réside dans son interprétation heuristique aléatoire de l’orientation des plages sélectionnées. Il n’est pas rare que le logiciel, croyant anticiper l’intention de l’utilisateur, permute involontairement l’affectation des axes : les fréquences d’empilement se retrouvent ainsi projetées sur l’axe horizontal, tandis que la variable psychométrique observée se voit reléguée sur l’axe vertical, générant un profil visuel couché sans pertinence sémiologique.
Le diagnostic de cette anomalie s’effectue par un simple coup d’œil aux plages de graduation : si l’axe horizontal ne présente que des entiers variant de 1 à 4 alors que l’axe vertical s’étend de 10 à 25, les dimensions ont été inversées. La correction s’opère selon une procédure standardisée rigoureuse :
- Effectuer un clic droit dans la zone du graphique et sélectionner l’élément Sélectionner des données… dans le menu contextuel.
- Dans la boîte de dialogue de gestion des sources de données, cliquer sur la série affichée dans la section gauche (Entrées de légende / séries), puis cliquer sur le bouton Modifier.
- La fenêtre d’édition de série détaille trois champs explicites : Nom de la série, Valeurs de la série X et Valeurs de la série Y. Il convient d’effacer méthodiquement le contenu erroné des champs X et Y.
- Réassigner manuellement le champ Valeurs de la série X en pointant la souris sur la plage de cellules hébergeant les scores de la variable observée (par exemple
$D$2:$D$41). - Réassigner le champ Valeurs de la série Y en sélectionnant la plage correspondant aux entiers séquentiels d’empilement (par exemple
$E$2:$E$41). - Valider les modifications en cliquant deux fois consécutivement sur le bouton OK. Le graphique se réarticule immédiatement dans l’orientation cartésienne canonique prescrite.
5. Étape 3 : Paramétrage technique précis des axes et des échelles
5.1 Calibration millimétrée de l’axe horizontal (variable observée)
La configuration par défaut délivrée par les algorithmes d’auto-ajustement d’Excel est presque systématiquement inadaptée aux normes de publication académique. Le logiciel a tendance à introduire des marges d’extrapolation spatiale périphériques excessives et à choisir des intervalles de graduation arbitraires (tels que des pas de 2,5 ou de 5 unités) qui ne coïncident pas avec la métrique intrinsèque de l’instrument d’évaluation utilisé.
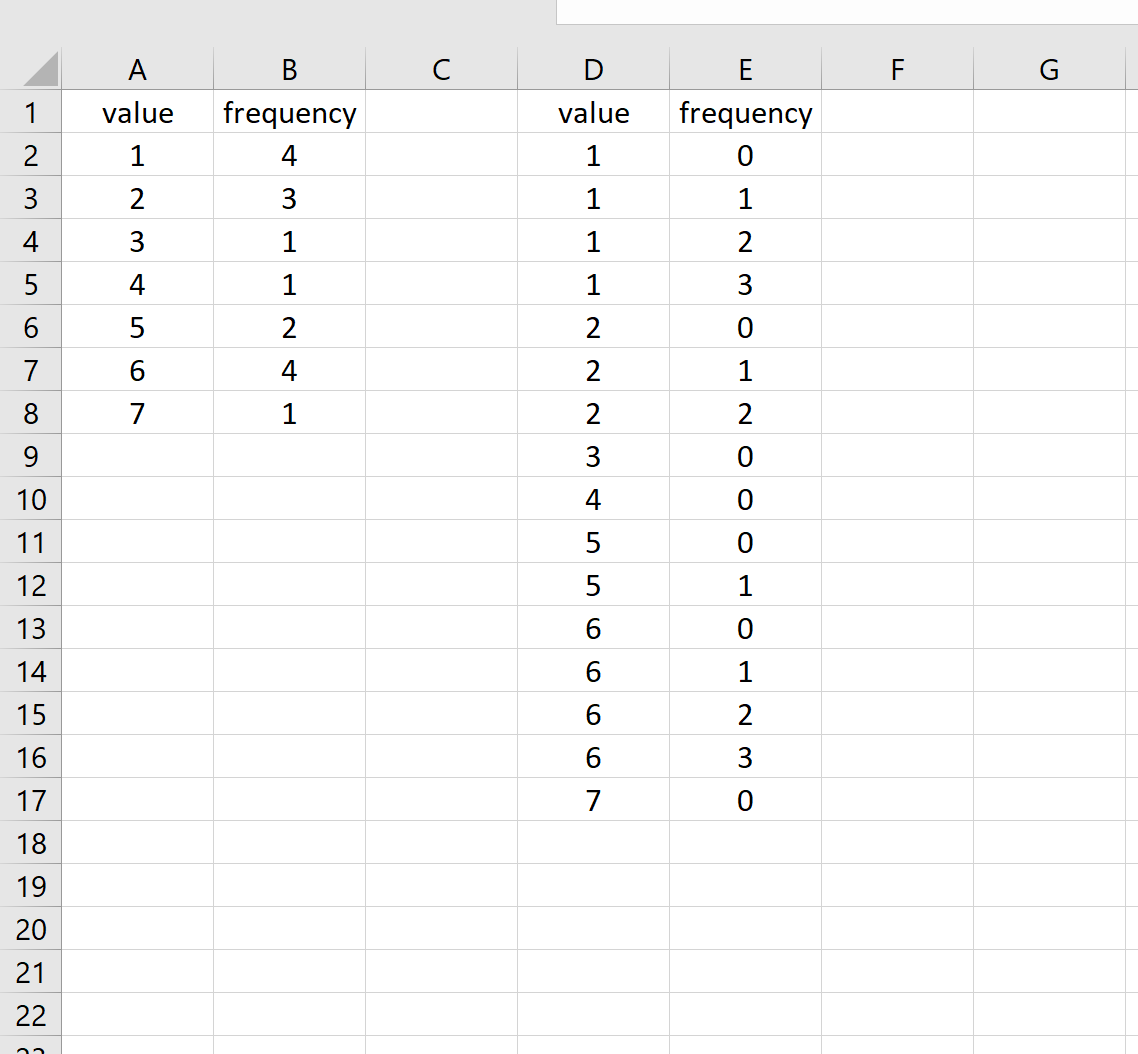
Pour calibrer l’axe horizontal avec une rigueur métrique sans faille, double-cliquer directement sur les chiffres bordant l’axe des abscisses pour déployer le volet latéral intitulé Format de l’axe. Sous l’onglet symbolisé par trois barres verticales (Options d’axe), l’analyste doit impérativement basculer le mode de calcul automatique vers un ancrage fixe délibéré :
- Limites minimale et maximale : Fixer la limite minimale à une unité inférieure au score théorique minimum observable (ou au score plancher de l’échantillon si l’échelle est large), et la borne maximale à une unité supérieure au score maximum observé. Cette respiration géométrique contrôlée évite que les marqueurs situés aux bornes extrêmes ne viennent chevaucher les traits de bordure du cadre graphique.
- Unités principales (Pas de graduation) : Ajuster impérativement l’unité principale sur la valeur entière
1,0lorsque la variable sous-jacente est discrète ou évalue un score psychologique entier. Chaque colonne de points empilés correspondra ainsi exactement à un trait de graduation dédié, éliminant toute ambiguïté sur la valeur quantitative exacte des observations. - Graduations secondaires : Désactiver l’affichage des graduations secondaires, lesquelles ne feraient que surcharger visuellement la ligne de base sans apporter de gain informationnel.
5.2 Neutralisation et gestion de l’axe vertical (axe des fréquences)
L’axe vertical dans un dot plot univarié soulève une question épistémologique cruciale relative à la sémiologie graphique. Contrairement à un tracé bivarié ordinaire où l’ordonnée mesure une variable empirique réelle, l’axe Y n’est ici qu’un artifice spatial traduisant une fréquence de comptage unitaire. L’affichage d’un axe vertical lourdement gradué, assorti de nombres décimaux (comme 1,5 ou 2,5), constitue un contresens méthodologique flagrant qui perturbe l’interprétation du lecteur.
Dans le volet de formatage de l’axe vertical, la limite minimale doit être impérativement ancrée à la valeur 0, et la limite maximale fixée à la valeur entière supérieure à la fréquence la plus élevée observée dans l’échantillon (par exemple, 5,0 si le mode empirique s’élève à 4). Cette marge supérieure garantit que le point culminant de la colonne la plus dense ne touche pas le bord supérieur de la zone de traçage.
Sur le plan stylistique, deux options méthodologiques rigoureuses se présentent à l’analyste : la première consiste à supprimer purement et simplement la ligne de contour de l’axe vertical tout en masquant ses étiquettes numériques (en sélectionnant Aucun sous la rubrique Étiquettes), transformant ainsi la lecture en une appréciation perceptive purement visuelle du décompte des points. La seconde option, plus formelle, consiste à conserver les étiquettes numériques tout en contraignant l’unité principale à 1,0 et en appliquant un format de nombre sans aucune décimale, explicitant ainsi sans équivoque que l’élévation d’un étage correspond strictement à l’ajout d’une unité d’observation.
5.3 Élimination des éléments graphiques distracteurs
Conformément aux principes de minimalisme graphique théorisés par Edward Tufte, tout composant visuel qui consomme de l’encre sans transmettre une information statistique substantielle doit être banni. Les versions modernes d’Excel injectent systématiquement un ensemble d’artéfacts cosmétiques standard qui polluent l’espace perceptif et nuisent à la lisibilité générale du tracé.
La première mesure d’assainissement consiste à sélectionner le quadrillage d’arrière-plan (lignes horizontales et verticales de la grille) et à presser la touche Supprimer du clavier. Ces lignes de guidage segmentent le regard et entrent en compétition cognitive avec l’alignement des disques empilés. De même, le bloc de texte générique pré-généré intitulé Titre du graphique doit être supprimé de l’espace de traçage interne : dans les publications académiques ou les mémoires de recherche, la titraison d’une figure ne s’effectue jamais au sein du conteneur vectoriel, mais dans le corps du texte typographique situé immédiatement au-dessus ou en dessous du visuel, selon les canons stricts des manuels de style.
Enfin, la légende identifiant la série unique (souvent nommée Série1) doit être instantanément neutralisée. Une légende ne possède aucune justification formelle lorsqu’une unique population d’observations est soumise à l’affichage, son maintien ne constituant qu’une redondance spatiale stérile.
6. Étape 4 : Personnalisation esthétique et optimisation visuelle des marqueurs
6.1 Formatage morphologique et dimensionnel des points
La morphologie géométrique des marqueurs constitue le cœur sémiologique du graphique à points. Par défaut, Excel applique fréquemment des disques minuscules d’un diamètre insuffisant ou des marqueurs carrés qui s’agglutinent de façon inesthétique lors des empilements verticaux serrés. Pour conférer au graphique une allure académique impeccable, un paramétrage sur-mesure de la géométrie des points est incontournable.
L’analyste clique directement sur l’un des points de la série affichée pour sélectionner l’intégralité des marqueurs, puis ouvre le volet Mise en forme de la série de données. En cliquant sur l’icône du pot de peinture (Remplissage et trait), sélectionner le sous-onglet Marqueur, puis dérouler la section Options de marqueur :
- Activer la case d’option Intégré pour débrayer les styles pré-paramétrés.
- Dans le catalogue des formes fondamentales, sélectionner exclusivement le disque circulaire. Les triangles, croix, étoiles ou losanges génèrent des interférences perceptives au niveau de leurs arêtes lors de l’empilement vertical et doivent être rigoureusement proscrits dans la construction d’un dot plot univarié classique.
- Ajuster la Taille du marqueur avec minutie. La dimension optimale oscille généralement entre
8 ptet14 pt. Cette métrique ne doit rien au hasard : les disques empilés doivent idéalement présenter une contiguïté spatiale harmonieuse, se touchant presque sans jamais s’écraser ni fusionner en une barre indistincte. Si l’échantillon comprend des empilements élevés, une taille réduite préservera l’individualité de chaque point au sein de la colonne.
6.2 Gestion de la bordure et de la transparence pour éviter la saturation visuelle
L’écueil récurrent lors de la présentation d’observations denses ou de mesures très resserrées réside dans le phénomène de saturation visuelle (overplotting), où l’œil humain peine à distinguer la frontière physique séparant deux marqueurs adjacents. La résolution élégante de ce problème repose sur l’association conjointe d’une bordure contrastée et d’un indice de transparence méticuleusement calibré.
Dans la section Remplissage du marqueur, opter pour un remplissage uni. Dans le cadre d’un manuscrit destiné à l’impression scientifique, l’usage d’une teinte sombre sobre (tel qu’un bleu nuit institutionnel, un gris ardoise profond ou un noir classique) assure une compatibilité parfaite avec les contraintes de reproduction en niveaux de gris. Il est hautement recommandé d’appliquer un pourcentage de Transparence de l’ordre de 10 % à 20 %. Cette légère translucidité confère une profondeur visuelle subtile au graphique et permet de deviner les éventuels chevauchements marginaux.
Simultanément, dérouler la section Bordure située immédiatement sous les options de remplissage. Cocher l’option Trait plein, sélectionner une couleur noire pure ou d’un ton nettement plus sombre que la teinte de remplissage, et fixer la Largeur du contour entre 0,75 pt et 1 pt. Ce cerclage graphique net et délimité détoure chaque disque individuel de manière chirurgicale, garantissant que même lorsque deux points viennent à se frôler verticalement ou latéralement, leur indépendance géométrique demeure parfaitement discernable par le lecteur.
7. Méthodes dynamiques avancées : Automatisation par formules matricielles Excel
7.1 Génération dynamique de l’axe des ordonnées via la fonction NB.SI
Si l’agencement manuel ou l’emploi de Power Query résout la question de la structuration statique, les protocoles de recherche vivants requièrent fréquemment l’adjonction continue de nouvelles données sans avoir à réexécuter manuellement l’intégralité de la chaîne de traitement. La méthode la plus élégante pour concevoir un dot plot auto-actualisable dans Excel repose sur l’exploitation calculée de la fonction statistique NB.SI combinée à une technique de référencement semi-absolu.
Supposons que la liste brute des scores observés soit saisie au kilomètre dans la colonne A, de la cellule A2 à la cellule A100, sans aucun tri préalable indispensable. Dans la colonne B contiguë, à la cellule B2, l’analyste insère la formule canonique suivante :
=NB.SI($A$2:A2; A2)
Le principe mathématique sous-jacent à cette écriture est d’une remarquable puissance logique. En figeant la borne supérieure de la plage de calcul par le dollar ($A$2) tout en laissant la borne inférieure libre (A2), la formule opère un décompte cumulatif conditionnel incrémental lors de son étirement vers le bas :
- Lors de la première occurrence d’une valeur spécifique (par exemple, le score 15 rencontré pour la première fois en ligne 2), la plage inspectée
$A$2:A2ne contient qu’une seule fois cette valeur. La fonction renvoie donc1. - Si le score 15 réapparaît plus bas, par exemple à la cellule
A14, la plage évaluée$A$2:A14comprend désormais deux fois la valeur 15. La fonction renvoie instantanément2. - À chaque nouvelle occurrence du même score le long de la série brute, l’ordonnée d’empilement s’auto-incrémente arithmétiquement d’une unité, construisant organiquement les coordonnées verticales d’élévation sans exiger aucun tri préliminaire des observations.
7.2 Implémentation d’une table d’expansion automatique avec SEQUENCE, LET et REDUCE
Avec l’avènement du moteur de calcul matriciel dynamique introduit dans les versions modernes de Microsoft 365, il est désormais possible de franchir un palier d’abstraction supplémentaire en synthétisant l’intégralité du tableau de coordonnées (X, Y) au moyen d’une formule matricielle unique à propagation automatique (spill), éradiquant définitivement le besoin d’étirer des formules le long des colonnes.
Considérant une table récapitulative où les scores uniques figurent dans la plage Score_Plage et leurs fréquences respectives dans Freq_Plage, l’analyste peut mobiliser la puissance combinée des fonctions LET, REDUCE et LAMBDA pour concevoir une macro-fonctionnelle native. La construction s’articule autour de l’instruction LET qui permet de déclarer des variables de calcul locales optimisant la vitesse d’exécution :
La formule déploie pour chaque modalité i un sous-vecteur vertical de taille Frequence[i] rempli de la valeur scalaire Score[i] pour l’axe horizontal, et parallèlement une suite d’entiers générée par la fonction SEQUENCE(Frequence[i]) pour l’axe vertical. En empilant ces sous-matrices par le biais de la fonction ASSEMB.V (assemblage vertical) récursivement appliquée via REDUCE, une table bidimensionnelle complète se déverse dynamiquement dans la feuille.
L’avantage cardinal de cette architecture matricielle avancée réside dans son insensibilité totale aux modifications en amont : toute modification apportée aux effectifs dans la table source régénère instantanément la table de coordonnées cartésiennes développée, laquelle réajuste automatiquement l’emprise visuelle du graphique associé via des plages nommées dynamiques configurées avec la syntaxe de hachage (par exemple =Feuil1!$D$2#).
8. Extension aux comparaisons intergroupes et protocoles expérimentaux
8.1 Superposition de groupes expérimentaux : condition contrôle versus traitement
La puissance heuristique du dot plot s’exprime pleinement lors de la confrontation visuelle de plusieurs groupes expérimentaux, par exemple dans le cadre d’un essai randomisé contrôlé comparant un groupe recevant une thérapie cognitive numérisée à un groupe témoin sur liste d’attente. L’objectif consiste alors à superposer ou juxtaposer les distributions au sein d’un même repère métrique afin de rendre manifeste tout décalage distributionnel.
Pour implémenter cette visualisation comparative sous Excel, la structure tabulaire doit être scindée de manière à alimenter deux séries graphiques indépendantes. La colonne des abscisses conserve l’ensemble des scores mesurés. En revanche, deux colonnes d’ordonnées distinctes sont créées : Y_Controle et Y_Traitement. Les scores des sujets témoins sont renseignés dans la première série d’ordonnées tandis que les cellules correspondantes de la seconde série demeurent vides, et inversement pour les sujets du groupe expérimental.
Lors de l’injection dans le graphique, l’analyste déclare deux séries distinctes via le gestionnaire de données. Cette dissociation autorise une personnalisation chromatique et morphologique contrastée :
- Groupe Contrôle : Disques pourvus d’un remplissage blanc neutre et d’un contour noir marqué d’une épaisseur de 1 pt, figurant une population de référence non modifiée.
- Groupe Traitement : Disques pleins arborant une teinte soutenue et saturée (tel qu’un bleu cobalt ou un pourpre académique), attirant l’attention cognitive sur l’effet induit par l’intervention.
Afin de prévenir les collisions géométriques frontales lorsque deux sujets issus de groupes opposés partagent un score rigoureusement identique, il est d’usage d’appliquer un décalage horizontal artificiel contrôlé (technique dite de jittering discret ou décalage factoriel). L’opérateur peut ainsi soustraire 0,15 unité aux coordonnées X du groupe contrôle et ajouter 0,15 unité aux coordonnées X du groupe traitement. Les colonnes de points apparaissent dès lors côte à côte au-dessus de chaque graduation de l’axe, permettant une comparaison transversale immédiate de la densité relative des deux cohortes.
8.2 Construction d’un graphique à points appariés (Before-After Dot Plot)
Dans les devis de recherche à mesures répétées, l’évaluation de l’évolution temporelle intra-individuelle (pré-test versus post-test) souffre fréquemment d’une communication visuelle réductrice focalisée sur les seules moyennes de groupe. Ce mode de restitution statistique occulte dramatiquement l’hétérogénéité des trajectoires thérapeutiques, empêchant de discerner si l’amélioration globale découle d’un bénéfice homogène modéré partagé par tous les participants ou de gains spectaculaires concentrés sur une fraction isolée de l’échantillon.
Le graphique à points appariés (également documenté sous l’appellation de slopegraph à points ou diagramme de profils individuels) offre une réponse méthodologique exemplaire à ce problème. L’architecture spatiale s’inverse ici : l’axe horizontal ne figure plus une variable psychologique continue, mais les deux temps de mesure discrets, paramétrés arbitrairement aux positions numériques 1 (Temps 1 : Pré-intervention) et 2 (Temps 2 : Post-intervention). L’axe vertical reçoit désormais la magnitude continue du score clinique évalué.
Pour chaque participant, deux points sont projetés : (1 ; Score_T1) et (2 ; Score_T2). L’innovation décisive consiste à relier ces deux coordonnées par un segment linéaire discret propre à chaque unité expérimentale. Au sein d’Excel, cette liaison peut être réalisée en configurant chaque paire de scores sous forme d’une série distincte au format « Nuage de points avec lignes droites et marqueurs », ou plus efficacement, en construisant une série unique séquencée par l’insertion de lignes vides intercalaires (marquant une rupture de tracé vectoriel) entre chaque participant.
Le clinicien ou le chercheur visualise alors instantanément le faisceau des trajectoires singulières : les segments plongeant vers le bas attestent d’une rémission symptomatique, les lignes horizontales trahissent une inertie thérapeutique, tandis que d’éventuels segments ascendants isolent immédiatement les détériorations cliniques iatrogènes qu’aucun test paramétrique global (comme un test t de Student apparié) ne mettrait en lumière avec une telle acuité sémiotique.
9. Enrichissement statistique : Intégration d’indicateurs de tendance centrale et de dispersion
9.1 Inclusion d’une barre ou d’un marqueur de moyenne arithmétique
Bien que le propos fondamental du dot plot réside dans l’exposition transparente de la granularité empirique, la contextualisation des observations brutes au regard des métriques paramétriques classiques demeure un impératif de la démarche scientifique. L’enrichissement du graphique par l’adjonction d’une mesure de tendance centrale ne doit cependant jamais masquer les données individuelles sous-jacentes.
Pour superposer une moyenne arithmétique rigoureuse sur le graphique sans dénaturer sa géométrie univariée, l’analyste procède au calcul préalable de l’indicateur dans une cellule dédiée via la fonction =MOYENNE(Plage_Scores). Deux démarches techniques sont envisageables au sein de la zone graphique :
- Le marqueur ponctuel flottant : L’analyste intègre une nouvelle série constituée d’un couple cartésien unique : l’abscisse correspond à la moyenne calculée (par exemple
X = 16,35) et l’ordonnée est fixée arbitrairement au niveau du sol (Y = 0) ou en suspension au-dessus de la pile la plus haute. Ce marqueur est formaté sous la forme d’un losange proéminent ou d’une croix d’une couleur d’alerte (rouge carmin ou orange vif), signalant le barycentre de la distribution. - La ligne verticale d’ancrage : Une méthode visuellement plus explicite consiste à ériger un segment vertical coupant la distribution à la valeur exacte de la moyenne. Cela s’opère en créant une série secondaire constituée de deux coordonnées partageant la même abscisse moyenne :
(Moyenne ; 0)et(Moyenne ; Y_Max), reliées par un trait plein ou discontinu d’une épaisseur de 1,5 pt.
Cette confrontation directe entre la réalité spatiale des données et le modèle statistique théorique qu’incarne la moyenne met immédiatement en exergue les situations où la tendance centrale est décalée par la présence d’une asymétrie marquée, rappelant visuellement à l’analyste le danger de s’en remettre aveuglément à la seule moyenne pour résumer des phénomènes asymétriques.
9.2 Représentation de l’intervalle de confiance ou de l’erreur type
Pour satisfaire pleinement aux exigences éditoriales des revues internationales de premier rang, l’affichage de l’incertitude inférentielle entourant l’estimation de la moyenne s’avère indispensable. Dans le formalisme méthodologique contemporain, cet estimateur prend préférentiellement la forme d’un intervalle de confiance à 95 % (IC 95 %) ou, à défaut, de l’erreur type de la moyenne (SEM).
L’opération s’exécute dans Excel en associant des barres d’erreur bidirectionnelles personnalisées au marqueur de la moyenne préalablement positionné. La procédure analytique se déploie comme suit :
- Calculer la marge d’erreur dans le tableau de synthèse. Si l’échantillon comprend 30 observations, la marge pour un intervalle à 95 % s’établit par la formule statistique :
=INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(Plage); NB(Plage)). - Sélectionner le marqueur de moyenne dans le graphique, cliquer sur le bouton « + » (Éléments de graphique) situé dans l’angle supérieur de l’objet graphique, puis cocher la case Barres d’erreur et sélectionner Autres options….
- Dans le volet de configuration des barres d’erreur horizontales (l’axe métrique de notre variable étant horizontal), choisir la direction Les deux et définir le style d’extrémité sur Avec marque de fin (barrette en T) ou Sans marque de fin (pour une ligne épurée).
- Sous la rubrique Marge d’erreur, cocher impérativement l’option Personnalisée et cliquer sur le bouton Spécifier une valeur.
- Dans les champs Valeur d’erreur positive et Valeur d’erreur négative, pointer vers la cellule unique contenant la valeur de la marge d’erreur préalablement calculée. Valider par OK.
- Désactiver expressément toute barre d’erreur verticale parasite qu’Excel aurait pu générer simultanément sur l’axe Y.
L’intégration de cet intervalle de confiance horizontal ancre la lecture empirique dans une perspective inférentielle moderne, telle que préconisée par le mouvement de la « Nouvelle Statistique » (The New Statistics porté par Geoff Cumming), en donnant à voir simultanément les données brutes complètes, le point focal de l’estimation ponctuelle et l’étendue de l’imprécision d’échantillonnage.
10. Diagnostic des anomalies de tracé et résolution des problèmes fréquents
10.1 Résolution des distorsions liées au format des données (texte versus numérique)
L’un des dysfonctionnements les plus déroutants observés lors de la construction de graphiques scientifiques sous Excel réside dans l’altération subreptice de la nature métrique de l’axe des abscisses. Les symptômes en sont manifestes : l’axe horizontal refuse d’ajuster ses bornes minimales et maximales de manière continue, les points semblent distribués à intervalles strictement équidistants quel que soit leur écartement arithmétique réel, et la commande permettant de modifier l’échelle logarithmique ou les unités principales apparaît grisée ou absente dans le panneau de configuration.
Cette anomalie structurelle résulte invariablement d’une contamination des cellules sources par un format textuel. Lorsque des données quantitatives sont importées depuis des logiciels tiers, des plateformes de passation en ligne (comme Qualtrics ou Google Forms) ou des fichiers délimités, les valeurs scalaires sont fréquemment encapsulées avec des caractères invisibles ou formatées sous forme de chaînes de caractères alphanumériques. Le moteur de nuage de points d’Excel, incapable de projeter du texte sur un continuum euclidien, bascule silencieusement dans un mode de secours catégoriel dégradé.
Pour rétablir l’intégrité métrique du système cartésien, plusieurs techniques de remédiation formelles doivent être appliquées :
- Application de la fonction CNUM : Créer une colonne transitoire et appliquer à chaque cellule de score la formule
=CNUM(EPURAGE(SUPPRESPACE(A2)))afin d’éliminer les espaces insécables et d’obliger le processeur à convertir la chaîne en valeur flottante pure. - Technique du collage spécial multiplicatif : Saisir le chiffre
1dans une cellule vierge quelconque, copier cette cellule (Ctrl+C), sélectionner l’ensemble de la plage des scores suspects, effectuer un clic droit et choisir Collage spécial…, puis cocher l’opération Multiplication avant de valider. Cette instruction force une réévaluation arithmétique instantanée de chaque cellule sans en modifier la magnitude scalaire. - Vérification des séparateurs décimaux régionaux : Dans les configurations francophones d’Excel, la présence de points en lieu et place des virgules décimales neutralise la reconnaissance numérique. L’exécution d’une commande globale Rechercher et remplacer (Ctrl+H) transformant le point « . » en virgule « , » restaure immédiatement la reconnaissance des nombres décimaux.
10.2 Correction des points tronqués, invisibles ou anormalement espacés
Une autre catégorie d’anomalies visuelles récurrentes concerne la troncation périphérique des marqueurs circulaires. Il arrive fréquemment que les disques positionnés sur les coordonnées extrêmes (valeurs minimales ou maximales) apparaissent semi-amputés, leur moitié externe étant masquée par le cadre délimitant la zone de traçage. Ce phénomène s’explique par le fait que le moteur graphique calcule les limites d’axe en se basant sur le centre barycentrique infinitésimal du point mathématique, omettant de prendre en compte le rayon physique d’affichage du disque vectoriel en pixels.
La résolution requiert un desserrage chirurgical des bornes de l’axe horizontal. Si la valeur empirique la plus basse observée est 10, il ne faut jamais fixer la limite minimale de l’axe à 10,0, mais obligatoirement introduire une tolérance spatiale d’au moins une demi-unité ou une unité entière (par exemple 9,0 ou 9,5). Le même ajustement symétrique doit être consigné sur la borne maximale supérieure.
Dans les cas où des points demeurent rigoureusement invisibles bien que leurs coordonnées soient validées dans le tableau, le diagnostic doit porter sur les paramètres de visibilité de la série :
- Vérifier que la couleur de remplissage du marqueur ne soit pas configurée sur Aucun remplissage combinée à une bordure paramétrée sur Aucun trait, ce qui rendrait le point structurellement transparent.
- Contrôler l’ordre de superposition des séries dans la boîte de dialogue Sélectionner les données : une série de grande surface (telle qu’une zone de remplissage ou un histogramme superposé) placée au premier plan occulte mécaniquement les nuages de points d’arrière-plan. La série de dot plot doit impérativement figurer au sommet de la pile hiérarchique d’affichage.
- S’assurer que le ratio hauteur/largeur de la zone de traçage ne soit pas compressé au point de générer un écrasement anamorphique des disques. Pour garantir une rotondité parfaite, la zone graphique globale doit respecter une proportion géométrique harmonieuse, idéalement un ratio 4:3 ou 16:9, validé par l’inspection visuelle des propriétés de dimensions absolues (ruban Format de forme, champs Hauteur et Largeur).
11. Exportation académique et mise en conformité avec les normes APA (7e édition)
11.1 Standardisation typographique et stylistique selon l’APA 7
La publication d’une figure au sein d’une revue affiliée à l’American Psychological Association ou respectant ses standards éditoriaux requiert une obéissance absolue à des directives formelles immuables. L’élaboration d’un graphique esthétiquement satisfaisant ne suffit pas ; il doit s’insérer dans un appareil critique codifié régissant la typographie, les contrastes, la numérotation et la contextualisation textuelle.
Sur le plan typographique, la règle d’or réside dans la cohérence trans-documentaire. La police de caractères employée au sein du graphique (étiquettes d’axes, mentions d’unités) doit être strictement de la même famille que celle du manuscrit textuel principal, ou appartenir à une police sans-serif neutre recommandée par l’APA (telles qu’Arial, Calibri en corps 8 à 14 pt). Les effets d’ombrage, de relief tridimensionnel (3D), de dégradés chromatiques complexes ou de contours biseautés sont formellement bannis par l’épistémologie de l’APA, qui les qualifie d’artéfacts de « chartjunk » nuisant à la sobriété démonstrative.
Le dispositif documentaire entourant le dot plot doit être agencé selon l’ordonnancement séquentiel suivant :
- Numéro de la figure : Positionné en exergue au-dessus du graphique, aligné à gauche, composé en caractères gras droits (ex. : Figure 1).
- Titre de la figure : Placé immédiatement sous le numéro de figure, sur une ligne dédiée, aligné à gauche, composé en caractères italiques avec une majuscule au premier mot et aux noms propres (titre descriptif concis, ex. : Distribution des scores d’anxiété pré- et post-intervention chez les patients cliniques).
- Corps du graphique : Le tracé vectoriel proprement dit, dépouillé de tout titre interne, délimité par des axes épurés. Les bordures d’encadrement externes du conteneur global doivent être rendues parfaitement invisibles (Aucun trait pour le contour de forme du graphique dans Excel).
- Note de figure : Située immédiatement sous le graphique, alignée à gauche, débutant par l’étiquette Note. en italique, suivie d’un texte courant détaillant la signification des symboles, les abréviations utilisées, les indices de tendance centrale représentés (ex. : Note. Chaque point circulaire représente le score individuel d’un participant (N = 30). Les losanges rouges pleins figurent les moyennes arithmétiques de groupe et les barres horizontales indiquent l’intervalle de confiance à 95 % bilatéral).
11.2 Procédure d’exportation haute résolution pour manuscrit scientifique
L’une des défaillances techniques les plus fréquemment déplorées par les éditeurs de presse scientifique concerne la dégradation de la résolution graphique consécutive à des méthodes d’exportation inappropriées. La pratique universellement répandue consistant à exécuter une simple capture d’écran ou un copier-coller matriciel direct depuis Excel vers Microsoft Word engendre une rastérisation à basse définition (souvent 72 ou 96 DPI), générant un flou cinématique et une pixellisation désastreuse dès que le document fait l’objet d’une mise en page d’imprimerie professionnelle.
Pour préserver la pureté vectorielle absolue des graphiques à points, deux filières techniques certifiées doivent être privilégiées :
- L’exportation vectorielle via métafichier amélioré (EMF) : Sélectionner le graphique dans Excel, presser Ctrl+C, ouvrir le document de travail sous Word, cliquer sur la flèche déroulante sous le bouton Coller de l’onglet Accueil, sélectionner Collage spécial…, puis opter expressément pour Image (métafichier amélioré). Ce format conserve la structure géométrique vectorielle native du tracé : les disques, les traits d’axes et les polices vectorielles demeurent infiniment scalables, sans aucune perte de netteté quelle que soit l’échelle de grossissement finale lors de l’impression.
- La conversion raster haute définition (TIFF 300 à 600 DPI) : Lorsque les directives de la revue exigent impérativement des fichiers images autonomes non compressés (généralement au format TIFF ou EPS), le graphique Excel doit être isolé dans une feuille dédiée, ajusté aux dimensions finales d’impression (largeur standard de 83 mm pour une publication en colonne simple, ou de 174 mm pour une double colonne), puis imprimé au format PDF vectoriel haute fidélité via l’imprimante virtuelle d’Adobe Acrobat ou le module d’exportation PDF natif d’Excel. Ce fichier PDF intermédiaire est ensuite converti via un logiciel graphique spécialisé (tel que GIMP, Photoshop ou Inkscape) en fichier TIFF calibré rigoureusement à une résolution minimale de 300 DPI pour les images en demi-teintes et de 600 à 1200 DPI pour les tracés au trait noir pur.
12. Étude de cas pratique : Analyse de scores d’un inventaire d’anxiété pré- et post-intervention
12.1 Description du protocole expérimental et des données recueillies
Afin de cristalliser l’ensemble des préceptes théoriques, méthodologiques et techniques exposés au fil de ce traité, nous développons ici une étude de cas pratique intégrale. Soit un protocole d’évaluation clinique mené auprès d’un échantillon d’individus diagnostiqués avec un trouble anxieux généralisé d’intensité modérée à sévère (cohorte de taille N = 30). Le protocole vise à évaluer l’efficacité d’une intervention brève de restructuration cognitive assistée par réalité virtuelle d’une durée de huit semaines.
La sévérité de la symptomatologie est mesurée au moyen d’un inventaire psychométrique standardisé dont le score total varie sur une échelle discrète bornée de 1 à 10, où toute note supérieure ou égale au seuil clinique conventionnel de 7 dénote une anxiété cliniquement pathologique requérant une prise en charge intensive. Les évaluations sont conduites à deux moments charnières : lors du bilan initial pré-interventionnel (Phase T1), puis à l’issue immédiate du programme thérapeutique (Phase T2).
Le tableau de contingence brut récapitulant les fréquences absolues observées pour chacune des modalités s’établit conformément aux décomptes suivants :
- Score 2 : Pré-intervention (T1) = 0 | Post-intervention (T2) = 2
- Score 3 : Pré-intervention (T1) = 0 | Post-intervention (T2) = 5
- Score 4 : Pré-intervention (T1) = 1 | Post-intervention (T2) = 7
- Score 5 : Pré-intervention (T1) = 2 | Post-intervention (T2) = 6
- Score 6 : Pré-intervention (T1) = 3 | Post-intervention (T2) = 4
- Score 7 : Pré-intervention (T1) = 6 | Post-intervention (T2) = 3
- Score 8 : Pré-intervention (T1) = 9 | Post-intervention (T2) = 2
- Score 9 : Pré-intervention (T1) = 7 | Post-intervention (T2) = 1
- Score 10 : Pré-intervention (T1) = 2 | Post-intervention (T2) = 0
L’objectif scientifique assigné à la visualisation réside dans la démonstration immédiate du basculement distributionnel opéré par le traitement, tout en identifiant sans ambiguïté les sujets réfractaires demeurant au-delà du seuil de significativité clinique.
12.2 Déploiement pas à pas de la solution dans Excel
L’implémentation opérationnelle sous Microsoft Excel s’organise au sein d’un nouveau classeur selon les phases directives suivantes :
Étape A : Expansion dynamique des vecteurs cartésiens. Dans la feuille de calcul intitulée Donnees_Cliniques, la liste exhaustive des 30 observations individuelles brutes de la condition Pré-intervention (T1) est saisie dans la colonne A (cellules A2:A31), tandis que les 30 observations de la condition Post-intervention (T2) sont saisies dans la colonne B (cellules B2:B31). Dans la colonne C, étiquetée Y_T1, l’analyste renseigne la formule à décompte conditionnel en C2 : =NB.SI($A$2:A2; A2), étirée jusqu’à la cellule C31. Dans la colonne D, étiquetée Y_T2, il insère en D2 la formule correspondante : =NB.SI($B$2:B2; B2), étirée jusqu’à la cellule D31.
Étape B : Création et assignation des séries graphiques. L’opérateur insère un graphique en nuage de points vierge (Scatter plot sans marqueurs de liaison). Via le menu Sélectionner des données, il initialise deux séries distinctes :
- Série 1 : Nommée
Pré-intervention (T1); Valeurs X de la série pointant sur$A$2:$A$31; Valeurs Y pointant sur$C$2:$C$31. - Série 2 : Nommée
Post-intervention (T2); Valeurs X pointant sur$B$2:$B$31; Valeurs Y pointant sur$D$2:$D$31.
Étape C : Paramétrage métrique de l’environnement cartésien. Sur l’axe horizontal, fixer la limite minimale à 1,0, la limite maximale à 11,0, et l’unité principale à 1,0, garantissant que chaque échelon scalaire de l’inventaire psychométrique soit visualisé. Sur l’axe vertical, définir l’ancrage minimal à 0 et la borne supérieure à 11,0. Désactiver le quadrillage horizontal et vertical. Supprimer les étiquettes et la ligne de trait de l’axe vertical pour épurer la lecture.
Étape D : Différenciation sémiotique des marqueurs et intégration du seuil clinique. Les marqueurs de la série T1 (Pré) sont paramétrés sous forme de cercles de taille 10 pt pourvus d’un contour noir fin (0,75 pt) et d’un remplissage gris perle semi-transparent (transparence 30 %). Les marqueurs de la série T2 (Post) sont stylisés en cercles de taille 10 pt revêtus d’un remplissage bleu de Prusse profond sans transparence, détrempés d’un cerclage blanc immaculé de 1 pt. Pour marquer la frontière nosologique, une ligne de seuil vertical est insérée à l’abscisse X = 6,5 au moyen d’une série additionnelle reliant les points cartésiens (6,5 ; 0) et (6,5 ; 10), formatée sous forme d’un trait discontinu rouge vermillon d’épaisseur 1,25 pt assorti d’une étiquette textuelle indiquant « Seuil de significativité clinique ».
12.3 Interprétation statistique et clinique à partir du graphique à points final
L’inspection du graphique à points finalisé fournit une puissance d’élucidation sémiologique qu’aucune présentation synthétique tabulaire ne saurait égaler. Le déplacement horizontal global de la masse distributionnelle saute immédiatement aux yeux de l’observateur : alors que la cohorte pré-thérapeutique formait un bloc compact et dense concentré entre les scores 7 et 10 (témoignant d’un niveau d’anxiété majeur avec un mode empirique culminant à 8), la distribution post-thérapeutique révèle un affaissement généralisé vers le quadrant gauche inférieur de l’échelle, le barycentre des observations s’établissant désormais dans l’intervalle des scores 3 à 5.
Toutefois, la vertu méthodologique cardinale du dot plot réside dans sa capacité à préserver l’accès immédiat aux observations marginales dissidentes. Un simple test paramétrique (tel qu’un test t de Student apparié rapportant une diminution statistiquement significative de t(29) = 8,42 ; p < 0,001) aurait pu inciter le chercheur à conclure de manière péremptoire à l'efficacité généralisée de la thérapie. Or, le dot plot met en lumière la persistance de trois cas cliniques isolés dont les scores post-intervention s'ancrent invariablement à 7, 8 et 9, demeurant résolument en deçà de la ligne rouge de rémission clinique.
Cette révélation graphique immédiate invite le clinicien à engager une réflexion étiologique complémentaire : ces trois patients non-répondeurs présentent-ils des comorbidités particulières, des profils de personnalité spécifiques ou des résistances au dispositif immersif ? En restituant aux données quantitatives leur épaisseur individuelle et en démasquant les asymétries locales, le graphique à points s’affirme non seulement comme un vecteur de communication esthétique irréprochable sous Excel, mais avant tout comme un instrument d’investigation scientifique de premier ordre.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1984). Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging. The American Statistician, 38(4), 270-280. https://doi.org/10.1080/00031305.1984.10483226
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L. (1999). Dot plots. The American Statistician, 53(3), 276-281. https://doi.org/10.1080/00031305.1999.10474474
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0