
Dans le champ contemporain de la science des données et de l’ingénierie analytique, la réduction de la complexité multidimensionnelle constitue l’un des défis épistémologiques majeurs auxquels sont confrontés les chercheurs et les praticiens. Face à des flux massifs d’informations hétérogènes, identifier avec célérité et rigueur les variables possédant le plus fort pouvoir explicatif ou déterminant représente une nécessité fonctionnelle. C’est précisément à cette intersection entre sémiotique visuelle et diagnostic statistique que se déploie le diagramme de Pareto. Cet instrument de visualisation bivarié, qui conjugue un histogramme catégoriel ordonné et une ogive cumulative des fréquences relatives, ne constitue pas une simple convention graphique descriptive ; il matérialise une théorie formelle de la hiérarchisation causale.
L’adoption de Python comme écosystème de prédilection pour l’instrumentation de ces visualisations découle de la maturité exceptionnelle de ses bibliothèques de calcul scientifique et de manipulation matricielle. En combinant la puissance d’abstraction vectorielle offerte par Pandas et la granularité paramétrique de l’architecture graphique orientée objet de Matplotlib, le développeur et le chercheur disposent d’un contrôle absolu sur chaque élément géométrique, typographique et fonctionnel de la figure. L’implémentation programmatique d’un tel artefact transcende le simple recours à des logiciels fermés ou à des interfaces utilisateur rigides, car elle garantit une reproductibilité expérimentale totale, une auditabilité algorithmique sans faille et une intégration fluide au sein de pipelines de production automatisés.
L’objectif de ce traité exhaustif est de formaliser, de manière didactique et hautement rigoureuse, la construction intégrale d’un diagramme de Pareto sous Python. À travers un cheminement méthodique débutant par l’ancrage théorique des distributions à queue lourde pour aboutir à la modularisation logicielle avancée et à l’optimisation esthétique selon les normes académiques internationales, nous explorerons chaque articulation conceptuelle et algorithmique requise. Destiné aux scientifiques des données, aux analystes organisationnels, ainsi qu’aux chercheurs en psychométrie et sciences comportementales, ce guide dote le lecteur d’une maîtrise technique et réflexive indispensable pour transformer des jeux de données complexes en leviers décisionnels tangibles.
1. Fondements conceptuels et mathématiques du diagramme de Pareto
1.1 Origine empirique et principe de la loi des 80/20
L’assise conceptuelle du diagramme de Pareto prend racine dans les travaux pionniers de l’ingénieur, économiste et sociologue italien Vilfredo Pareto à la fin du dix-neuvième siècle. Dans son traité inaugural Cours d’économie politique publié en 1896, Pareto formalise une observation empirique devenue matricielle pour les sciences sociales et économiques : la répartition de la richesse au sein des nations ne suit nullement une loi uniforme, mais se caractérise par une concentration asymétrique structurelle. À travers l’étude minutieuse des registres fiscaux de plusieurs États européens, il constate qu’approximativement quatre-vingts pour cent des terres et des capitaux sont détenus par vingt pour cent de la population. Cette régularité macroéconomique, bien loin d’être un artéfact statistique transitoire, traduit une propriété fondamentale des systèmes complexes : l’émergence spontanée d’inégalités distributives sous l’effet de processus rétroactifs cumulatifs.
Il faut toutefois attendre le milieu du vingtième siècle pour que cette intuition économique soit transposée au domaine du génie industriel et de l’assurance qualité par l’ingénieur roumano-américain Joseph Juran. Dans son ouvrage de référence Quality Control Handbook paru en 1951, Juran identifie une analogie profonde entre la concentration des richesses observée par Pareto et la distribution des non-conformités dans les chaînes de fabrication industrielle. Il théorise alors le principe universel des « quelques facteurs vitaux et des nombreux facteurs triviaux » (souvent requalifiés ultérieurement de « facteurs utiles » afin de ne point nier leur existence). Juran démontre qu’au sein de tout système productif, la majorité écrasante des défaillances, des coûts de rebuts ou des pertes de rendement est imputable à un nombre extrêmement restreint de causes sources.
D’un point de vue statistique rigoureux, le phénomène sous-jacent renvoie aux distributions de probabilité à queue lourde, et plus spécifiquement aux lois de puissance formalisées mathématiquement par la densité de probabilité où la probabilité qu’une variable aléatoire continue excède une valeur donnée décroît de manière polynomiale plutôt qu’exponentielle. Cette formulation tranche radicalement avec la distribution normale de Gauss-Laplace. Dans un univers gaussien régenté par le théorème central limite, les événements convergent étroitement autour d’une moyenne centrale, et les écarts extrêmes présentent une décroissance exponentielle rapide les rendant virtuellement inexistants aux échelles plurivariées. À l’inverse, l’univers de Pareto se caractérise par une invariance d’échelle où les occurrences extrêmes jouent un rôle disproportionné dans la variance totale du système. Reconnaître cette asymétrie fondamentale constitue l’étape inaugurale de toute analyse causale scientifique.
1.2 Structure sémiotique et graphique de la visualisation
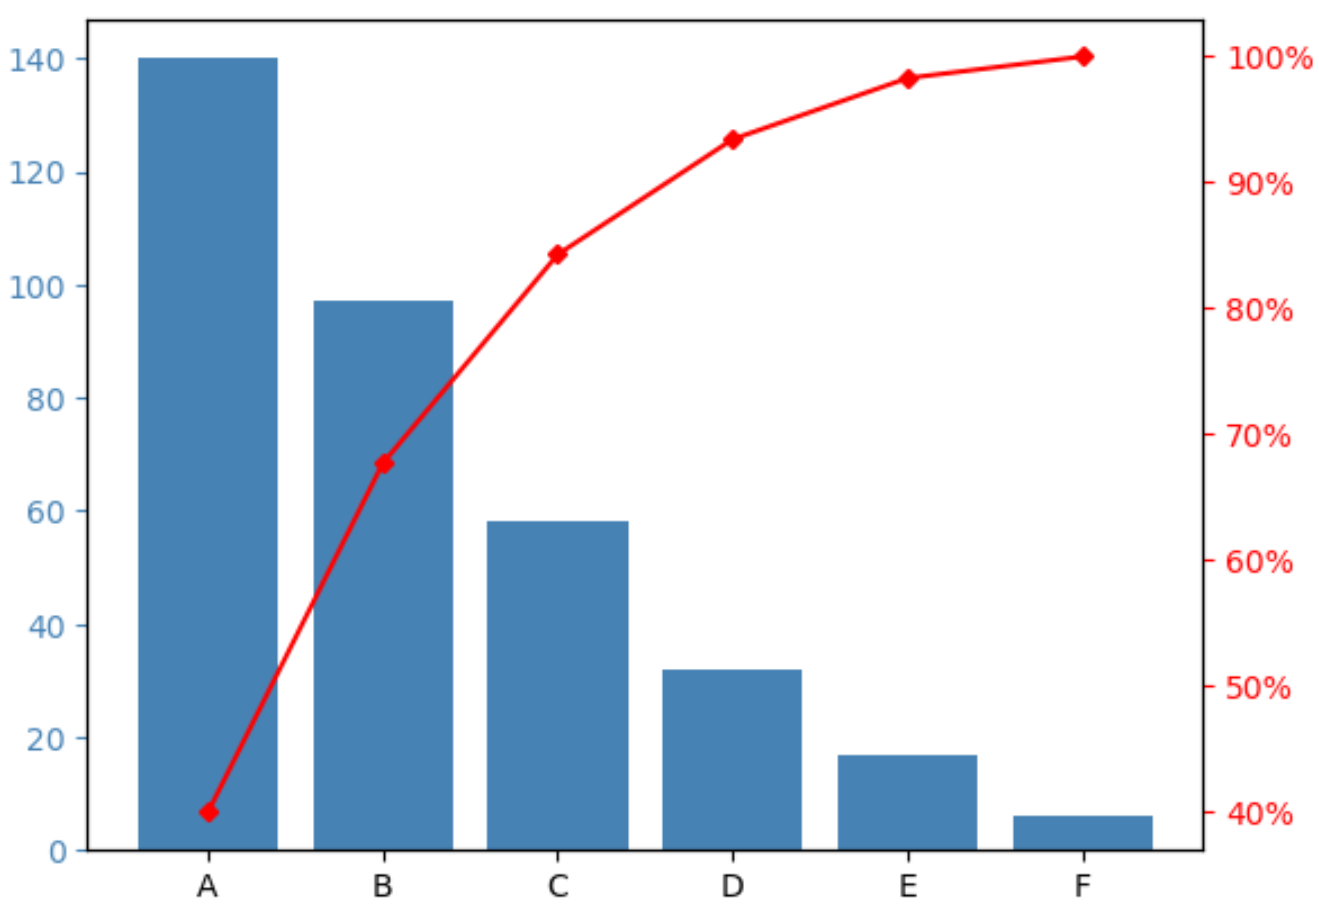
La transcription visuelle de cette réalité probabiliste exige une architecture sémiotique sophistiquée capable d’articuler deux régimes de données fondamentalement distincts : une variable discrète nominale ou ordinale représentant les causes étudiées, et une variable continue mesurant l’amplitude relative et cumulative de leurs impacts respectifs. Le diagramme de Pareto résout cette exigence cognitive par une composition graphique orthogonale synchronisant deux représentations géométriques distinctes sur un même espace planétaire d’affichage.
Le premier composant de cette structure est un histogramme à barres verticales disjointes, ancré sur un axe des ordonnées primaire situé à gauche. Chaque barre représente une catégorie spécifique, dont la hauteur physique traduit fidèlement l’amplitude de sa fréquence absolue ou de son coût unitaire agrégé. La caractéristique déterminante de cet histogramme réside dans son agencement spatial impératif : les modalités sont classées selon un ordre strictement décroissant d’importance, de la gauche vers la droite le long de l’axe des abscisses. Cette disposition contraint l’œil de l’observateur à embrasser immédiatement le gradient de gravité ou d’occurrence des phénomènes, isolant sans ambiguïté les modalités primordiales.
Le second composant, qui parachève l’efficacité sémiotique du dispositif, est une courbe brisée — assimilable à une ogive cumulative ou à une discrétisation empirique de la courbe de Lorenz — superposée à l’histogramme et indexée sur un axe vertical secondaire positionné à droite. Cette ogive relie les sommets cumulés des catégories, cartographiant l’accroissement de la proportion relative cumulée, graduée de zéro à cent pour cent. L’intersection fonctionnelle entre cette courbe ascendante concave et les barres sous-jacentes offre un point de lecture immédiat. Le point d’inflexion visuel, associé au franchissement du seuil critique conventionnel des quatre-vingts pour cent, délimite géométriquement la frontière entre les causes hautement prioritaires et le reliquat distributif dont le traitement immédiat présenterait un rendement marginal décroissant.
1.3 Pertinence méthodologique en analyse comportementale et données psychologiques
Bien que le diagramme de Pareto ait été forgé dans le creuset de l’économétrie et de l’ingénierie industrielle, son utilité épistémologique s’avère tout aussi déterminante dans le champ des sciences comportementales, de la psychologie clinique et de la psychiatrie computationnelle. L’appareil psychique et les dynamiques comportementales humaines sont gouvernés par des interactions biopsychosociales hautement non linéaires, au sein desquelles certains stresseurs environnementaux ou distorsions cognitives agissent comme des catalyseurs disproportionnés de décompensation ou de souffrance subjective.
Dans le cadre de l’investigation épidémiologique en santé mentale, la hiérarchisation des facteurs de stress chez des cohortes vulnérables permet d’échapper à l’écueil du réductionnisme linéaire ou de l’éparpillement diagnostique. L’application du principe de Pareto autorise les équipes cliniques à identifier avec une rigueur chiffrée les deux ou trois composantes étiologiques qui concentrent l’essentiel de la charge allostatique ou de la détresse psychologique mesurée. Qu’il s’agisse de recenser la prévalence de certains biais cognitifs dans l’étiologie des troubles anxieux généralisés ou d’isoler les déterminants comportementaux prédominants dans l’inobservance thérapeutique, l’analytique de Pareto offre une boussole empirique indispensable.
En outre, cette approche offre une justification méthodologique robuste pour l’ingénierie des protocoles d’intervention et l’allocation des ressources cliniques. Dans un contexte organisationnel, hospitalier ou thérapeutique caractérisé par une finitude des moyens temporels, humains et financiers, prétendre neutraliser l’intégralité des variables perturbatrices constitue une illusion managériale. Le diagramme de Pareto légitime une priorisation ciblée, démontrant formellement qu’une intervention ciblée sur les facteurs critiques produit un effet thérapeutique de grande envergure, optimisant l’efficience globale du dispositif de soin.
2. Configuration de l’environnement de programmation Python
2.1 Sélection des bibliothèques scientifiques indispensables
La matérialisation computationnelle d’un diagramme de Pareto aux exigences de la recherche reproductible repose sur une trilogie logicielle éprouvée au sein de l’écosystème scientifique Python. Chacune de ces bibliothèques remplit un rôle fonctionnel spécialisé, s’articulant harmonieusement pour convertir des données brutes en un objet graphique vectoriel de haute précision.
Au cœur de l’infrastructure de traitement tabulaire se situe la bibliothèque Pandas. Conçue pour offrir des structures de données rapides, flexibles et expressives, Pandas fournit l’objet DataFrame, une matrice hétérogène bidimensionnelle dotée d’axes étiquetés. Dans notre architecture, Pandas assure l’ingestion des séries catégorielles, l’exécution des opérations de regroupement par modalités, le tri vectorisé des occurrences et l’implémentation des algorithmes de calcul cumulatif. L’élégance de sa syntaxe permet de s’affranchir de boucles itératives impératives au profit d’opérations vectorisées optimisées en langage C sous-jacent.
Pour la synthèse numérique et les calculs matriciels de bas niveau, la bibliothèque NumPy constitue le socle sur lequel Pandas s’appuie. Même si son invocation directe peut sembler discrète lors de tracés élémentaires, NumPy intervient dès lors qu’il s’agit de gérer l’allocation mémoire des vecteurs d’entiers ou de flottants, d’effectuer des interpolations discrètes ou de manipuler des masques booléens lors du filtrage conditionnel des cohortes expérimentales. Sa compatibilité absolue avec les structures de données natives garantit une intégrité typologique exempte de dérives de précision à virgule flottante.
Enfin, la modélisation graphique vectorielle est intégralement déléguée à Matplotlib, et plus singulièrement à son sous-module procédural et orienté objet pyplot. Matplotlib représente la norme de facto pour la publication scientifique. Contrairement à des surcouches déclaratives de plus haut niveau qui masquent délibérément l’agencement interne du canevas, Matplotlib autorise un contrôle chirurgical sur la hiérarchie des objets constitutifs : la figure, les axes cartésiens, les collections de polygones, les lignes, les graduations et les localisateurs typographiques. La méthode spécifique du double axe, condition sine qua non du diagramme de Pareto, y trouve son implémentation la plus stable et personnalisable.
2.2 Mise en place d’un environnement virtuel isolé
La reproductibilité computationnelle, érigée en dogme par la science ouverte, exige une isolation stricte des environnements d’exécution afin d’annihiler tout conflit de dépendances logicielles entre projets concurrents. L’instanciation d’un environnement virtuel dédié constitue la première démarche opératoire de tout chercheur scrupuleux. Deux vecteurs méthodologiques s’offrent ici : l’utilisation du module standardisé venv ou le recours au gestionnaire binaire multi-plateforme Conda.
Dans un terminal système standard, l’initialisation d’un espace isolé via venv s’opère par la commande invoquant l’interpréteur Python système suivi du module d’isolation et de l’identifiant du répertoire cible. Une fois cet espace activé, le gestionnaire de paquets pip est utilisé pour figer l’arbre des dépendances au sein d’un fichier déclaratif nommé conventionnellement requirements.txt. Ce document répertorie non seulement les trois piliers évoqués (Pandas, Matplotlib, NumPy), mais également leurs sous-dépendances directes avec l’exactitude de leurs numéros de version sémantique. L’enregistrement rigoureux de ces versions neutralise les ruptures d’interfaces de programmation applicative (API) susceptibles de compromettre l’exécution future des scripts.
Pour le prototypage exploratoire et l’expérimentation visuelle itérative, l’adjonction d’un noyau d’exécution Jupyter au sein de l’environnement virtuel s’avère hautement préconisée. La liaison du noyau à l’espace virtuel garantit que les carnets de notes exécuteront scrupuleusement les binaires isolés. Parallèlement, le paramétrage initial du moteur d’affichage (le backend graphique) mérite une attention particulière : l’utilisation de backends vectoriels non-interactifs tels que Agg ou PDF s’avère optimale pour l’automatisation de scripts d’exportation de qualité professionnelle, tandis que les moteurs intégrés conviennent aux phases interactives d’exploration.
3. Étape 1 : Structuration et nettoyage des données brutes avec Pandas
3.1 Création du DataFrame initial représentatif
La genèse algorithmique du diagramme de Pareto requiert une formalisation rigoureuse de la table de contingence sous forme d’un objet DataFrame issu de Pandas. Dans les contextes de recherche empirique, les données se présentent généralement soit sous la forme d’un journal univarié d’événements bruts (où chaque ligne consigne une observation isolée requérant une agrégation préalable), soit sous la forme d’une table pré-agrégée associant directement à chaque modalité catégorielle son effectif empirique observé.
L’instanciation de cette structure implique la définition explicite de deux vecteurs unidimensionnels : un vecteur contenant les étiquettes qualitatives, représentatives des catégories diagnostiques ou fonctionnelles, et un vecteur numérique consignant les occurrences scalaires. L’intégrité typologique des colonnes doit faire l’objet d’une validation computationnelle stricte. La colonne des libellés doit être convertie vers le type abstrait object ou, de préférence, vers le type catégoriel optimisé category qui permet une rationalisation de l’empreinte mémoire, tandis que le vecteur des fréquences doit impérativement adopter un type numérique entier (typiquement int64) ou flottant (float64) si les grandeurs mesurées traduisent des durées, des pourcentages de variance ou des unités monétaires.
Une vigilance particulière doit être accordée au traitement des données aberrantes, incomplètes ou nulles. Les cellules affectées d’une valeur manquante (NaN ou None) au niveau des fréquences doivent être détectées et imputées ou supprimées, car leur propagation au sein des opérations cumulatives ultérieures corromprait l’intégrité de la sommation discrète. De surcroît, les catégories présentant une fréquence strictement nulle méritent un examen analytique préalable : si leur inclusion descriptive peut parfois se justifier dans des bilans exhaustifs, leur maintien au sein d’un diagramme de Pareto dilue la saillance cognitive du tracé et enfreint la rationalité de la recherche des facteurs critiques.
3.2 Tri impératif par ordre décroissant de fréquence
L’étape charnière qui conditionne la validité théorique et la conformité sémiotique de l’analyse repose sur le tri strict de la distribution catégorielle. Contrairement à un histogramme conventionnel dont l’axe des abscisses peut refléter un ordre chronologique, une taxonomie préétablie ou une séquence alphabétique arbitraire, le diagramme de Pareto impose un agencement exclusivement fondé sur la magnitude des occurrences observées.
L’opération est exécutée par l’application méthodique de la fonction sort_values sur l’instance du DataFrame, en ciblant spécifiquement la variable numérique d’effectif et en configurant le paramètre directionnel sur une modalité descendante (paramètre ascending=False). Cette réorganisation matricielle garantit que la modalité dominante occupera sans équivoque la première position vectorielle, indexée à l’origine de l’axe des abscisses, et que chaque modalité subséquente possédera une hauteur géométrique inférieure ou égale à celle qui la précède immédiatement.
Toute dérogation ou omission algorithmique lors de cette phase de tri engendre une rupture de monotonicité désastreuse sur la courbe cumulative calculée en aval. Au lieu de déployer une ogive strictement concave dont la dérivée discrète décroît de façon continue, le tracé cumulatif adopterait une trajectoire sinueuse erratique, alternant accélérations et plateaux. Une telle anomalie géométrique dénature intégralement l’esprit du diagramme, détruit son efficience sémiotique et induit l’analyste en erreur quant à l’identification du véritable point de bascule des causes vitales.
4. Étape 2 : Calcul vectoriel des fréquences cumulées et pourcentages
4.1 Application de la somme cumulative avec cumsum()
Une fois la série catégorielle impeccablement agencée par ordre d’importance décroissante, l’analyste doit procéder à l’intégration discrète de la distribution. En calcul tensoriel et statistique appliquée, cette opération correspond à la construction de la série des sommes partielles, où chaque élément indexé représente l’accumulation séquentielle de la modalité courante et de l’ensemble de ses antécédentes.
Sous la bibliothèque Pandas, cette sommation discrète est opérée nativement par la méthode vectorisée cumsum, invoquée directement sur la colonne des fréquences triées. Contrairement à une boucle algorithmique explicite qui itérerait manuellement sur l’index avec un coût de calcul non négligeable en Python pur, la méthode cumsum délègue le traitement à des routines vectorielles optimisées basées sur la bibliothèque standard C sous-jacente. Cette approche assure une rapidité d’exécution instantanée, même dans l’hypothèse de nomenclatures catégorielles massives comprenant des dizaines de milliers d’entrées.
Le contrôle de validité de cette première étape de calcul impose une vérification rigoureuse de cohérence : l’ultime valeur scalaire obtenue au sein de ce nouveau vecteur d’accumulation cumulative doit obligatoirement coïncider au bit près avec la somme arithmétique totale des fréquences individuelles de l’échantillon, notée conventionnellement N. Toute divergence entre cette dernière valeur cumulée et la sommation globale traduirait la présence insidieuse d’une valeur non numérique non gérée ou un artéfact d’instabilité mémoire au sein du vecteur.
4.2 Normalisation relative et dérivation des pourcentages cumulés
L’intégration géométrique de la courbe de Lorenz discrétisée requiert une normalisation dimensionnelle de l’échelle d’accumulation. Les effectifs bruts cumulés, dépendant étroitement de la taille de l’échantillon ou du volume de transactions analysé, ne permettent point de comparer transversalement des études hétérogènes. La conversion de cette grandeur en un ratio relatif, puis en une graduation en pourcentage s’étendant formellement de zéro à cent pour cent, est indispensable.
L’algorithme de calcul applique une opération d’algèbre vectorielle élémentaire mais cruciale : la série des sommes cumulées est divisée élément par élément par le scalaire représentant la somme totale de l’ensemble des fréquences (obtenue par la méthode sum), puis le vecteur résultant est multiplié par cent. Cette dérivation vectorisée génère une nouvelle variable dans le DataFrame, nommée conventionnellement le pourcentage cumulatif. Chaque coordonnée discrète de cette colonne traduit précisément la fraction de la charge causale globale absorbée par le sous-ensemble des catégories considérées jusqu’à ce rang.
D’un point de vue numérique, l’analyste doit veiller à la préservation de la précision à virgule flottante sous le standard international IEEE 754 à double précision (float64). Il est fortement déconseillé d’arrondir prématurément ces valeurs au stade de la structuration tabulaire, car des arrondis scalaires successifs introduisent des micro-dérives cumulatives qui peuvent décaler artificiellement le point d’inflexion visuel de la courbe sur le canevas graphique. L’arrondi ne doit être envisagé qu’au stade ultime de la restitution textuelle des annotations sur la figure.
5. Étape 3 : Construction de l’axe primaire pour l’histogramme catégoriel
5.1 Initialisation du canevas graphique avec plt.subplots()
L’édification du tracé au sein de Matplotlib abandonne délibérément l’approche procédurale basée sur l’automate à états implicite de pyplot pour adopter de manière inconditionnelle l’architecture orientée objet. Cette rigueur programmatique commence par l’appel formel à la fonction plt.subplots, qui initialise simultanément la structure de premier niveau du canevas, l’objet Figure, et l’instance d’axe primaire dévolue aux effectifs discrets, conventionnellement désignée par la variable ax1.
Cette initialisation paramétrique permet de définir dès l’origine les dimensions spatiales absolues de la zone de dessin par l’argument figsize, exprimé sous forme d’un tuple désignant la largeur et la hauteur en pouces conventionnels. Parallèlement, la densité de pixels par pouce (paramètre dpi) doit être explicitement calibrée : une valeur standard de cent points par pouce convient aux phases interactives d’exploration sur écran, tandis qu’une valeur de trois cents à six cents points par pouce s’avère impérative dès lors que le graphique est destiné à l’impression offset ou à l’inclusion dans une publication scientifique internationale soumise à des protocoles de révision stricts.
Cette étape conditionne également l’allocation spatiale des marges géométriques périphériques. Une mauvaise anticipation de la géométrie globale aboutit inévitablement au rognage des libellés catégoriels le long de l’axe horizontal ou à la superposition inesthétique des titres d’axes verticaux. La sélection précoce d’une palette chromatique sobre, conforme aux chartes graphiques de l’édition scientifique et rejetant les couleurs saturées criardes, assure d’emblée une lisibilité optimale et une sobriété cognitive bienvenue.
5.2 Tracé des barres d’effectifs discrets
Une fois l’espace cartésien ax1 convenablement dimensionné, l’analyste procède au dessin physique de l’histogramme catégoriel en invoquant la méthode bar attachée à l’instance d’axe. Cette méthode requiert deux arguments positionnels primordiaux : les positions discrètes le long de l’axe horizontal (généralement matérialisées par l’index catégoriel du DataFrame ou par une séquence d’entiers contigus) et les hauteurs d’amplitudes correspondantes, extraites de la colonne des fréquences individuelles ordonnées.
Le contrôle morphologique des barres s’avère déterminant pour préserver l’intégrité sémiotique de l’histogramme. Le paramètre de largeur relative (width), fixé conventionnellement autour d’une valeur comprise entre 0,7 et 0,8, préserve un espacement inter-barres équilibré, évitant à la fois la fusion optique des catégories adjacentes et l’effilement excessif des colonnes qui nuirait à l’impact visuel de la distribution. Les propriétés chromatiques de remplissage (color) et de bordure (edgecolor) doivent être sélectionnées avec soin : un bleu acier ardoise, un gris profond ou une teinte sourde dotée d’un contour sombre discret assure une excellente restitution tant à l’écran qu’en reproduction monochrome en niveaux de gris.
La complétion de cette phase implique l’assignation sans équivoque de l’étiquette textuelle de l’axe primaire gauche par la méthode ax1.set_ylabel, accompagnée de la définition de la police typographique et de son corps. Ce libellé doit préciser scrupuleusement la nature de la métrique représentée (par exemple, « Fréquence absolue observée » ou « Nombre de cas d’inobservance clinique »), éliminant ainsi toute ambiguïté interprétative chez le lecteur quant à la nature brute des hauteurs géométriques affichées.
6. Étape 4 : Implémentation du second axe et superposition de la courbe cumulative
6.1 Génération de l’axe jumeau avec la méthode twinx()
La singularité géométrique et conceptuelle du diagramme de Pareto réside dans la cohabitation intime de deux systèmes de coordonnées verticaux partageant rigoureusement la même base d’abscisses catégorielle. Dans l’écosystème Matplotlib, cette prouesse d’agencement spatial s’opère par l’invocation de la méthode hautement spécialisée twinx appliquée sur l’instance de l’axe primaire ax1.
L’exécution de l’instruction ax2 = ax1.twinx() instancie un nouvel objet d’axe cartésien transparent, désigné conventionnellement par ax2. Cet axe jumeau est mécaniquement superposé au canevas préexistant : il hérite sans la moindre altération de l’ensemble des limites géométriques horizontales et de l’indexation discrète de ax1, tout en déportant son propre système de graduation verticale sur le flanc droit de la figure. Cette dissociation topologique permet de tracer des grandeurs continues ou cumulatives dont les unités et les ordres de grandeur différent radicalement de ceux de l’histogramme primaire sans corrompre ce dernier.
Cette double couche géométrique introduit cependant un défi technique lié à l’empilement visuel des éléments graphiques, régi par la propriété zorder. Par défaut, les nouveaux éléments tracés sur l’axe secondaire ax2 viennent recouvrir ceux de l’axe primaire. Si cette hiérarchie par défaut s’avère généralement favorable (la courbe cumulative devant survoler les barres d’histogramme sans être masquée par leur opacité), l’analyste doit s’assurer que les grilles de fond ou les arrière-plans ne viennent point opacifier et occulter les tracés primordiaux. Une configuration explicite des niveaux d’empilement prévient tout écueil d’occultation visuelle intempestive.
6.2 Tracé vectoriel de la courbe de Lorenz discrétisée
Disposant de l’axe secondaire ax2 vierge et aligné, l’analyste y intègre le tracé de la courbe cumulative au moyen de la méthode fondamentale plot. Ce tracé exploite les mêmes positions catégorielles sur l’abscisse mais projette en ordonnée le vecteur des pourcentages cumulés dérivés lors de l’étape de structuration analytique.
Le choix stylistique de cette trajectoire vectorielle obéit à des normes graphiques rigoureuses. La couleur de la ligne doit instaurer une rupture chromatique franche avec celle des barres sous-jacentes afin d’éviter toute confusion cognitive : l’usage d’un cramoisi soutenu, d’un ambre chaud ou d’un vermillon contrastant avec le bleu ou le gris de l’histogramme est traditionnellement plébiscité. L’épaisseur du trait (linewidth) doit être étalonnée pour affirmer la trajectoire sans alourdir le graphe, généralement entre 1,5 et 2,5 points. De plus, l’adjonction de marqueurs géométriques discrets (comme des cercles pleins paramétrés par l’argument marker=’o’) à l’aplomb exact de chaque catégorie catégorielle permet de matérialiser sans ambiguïté les nœuds réels de la discrétisation.
D’un point de vue épistémologique, l’usage d’un tracé continu reliant des catégories purement discrètes suscite parfois un débat théorique au sein des cercles formalistes de la statistique. L’analyste doit garder à l’esprit que cette ligne brisée ne décrit point un phénomène sous-jacent continu, mais matérialise l’interpolation linéaire d’une fonction de répartition empirique discrète. L’inclusion des marqueurs ponctuels sur chaque sommet catégoriel assume précisément ce statut : ils rappellent visuellement au lecteur que seules les coordonnées ponctuelles possèdent une réalité probabiliste, la ligne servant uniquement de guide perceptif à l’appréciation de la pente d’accumulation globale.
7. Étape 5 : Calibration rigoureuse des échelles et formatage de précision
7.1 Normalisation absolue de l’axe des ordonnées secondaire
L’un des écueils les plus pernicieux et les plus fréquents lors de la génération automatisée d’un diagramme de Pareto réside dans le calibrage dynamique par défaut des limites de l’axe secondaire. Par nature, les algorithmes de mise à l’échelle automatique de Matplotlib ajustent l’étendue verticale aux valeurs minimales et maximales présentes dans le vecteur tracé. Ainsi, si la première modalité absorbe quarante-cinq pour cent du total et que la somme atteint cent pour cent, Matplotlib tend à borner l’axe entre quarante et cent, ou à étendre artificiellement la limite supérieure à cent cinq pour cent pour insérer une marge d’espacement.
Cette dérive doit être impérativement proscrite par un verrouillage manuel absolu via l’instruction ax2.set_ylim(0, 100). La justification épistémologique de cette contrainte est indiscutable : un axe de pourcentage cumulé exprime une proportion sur la totalité finie de l’échantillon. Abaisser l’origine à zéro est indispensable pour conférer à la pente de l’ogive une valeur perceptive véridique. Si l’axe démarre à une valeur arbitraire non nulle, la concavité de la courbe est artificiellement aplatie, induisant une distorsion cognitive sévère chez le décideur quant à l’intensité de la concentration causale initiale.
De surcroît, une harmonisation subtile doit être opérée entre l’amplitude maximale de l’axe primaire des effectifs et l’axe secondaire des pourcentages. Si l’effectif maximal d’une modalité est par exemple de quatre-vingts unités pour un total de cent vingt, calibrer le sommet de l’axe primaire de manière proportionnelle à l’effectif global permet aux barres et à la courbe de s’équilibrer harmonieusement dans l’espace visuel. Une coordination mathématique des localisateurs de graduations majeures (Major Ticks) assure par ailleurs un alignement horizontal parfait des repères chiffrés à gauche et à droite, conférant à la planche un équilibre géométrique reposant pour l’œil.
7.2 Formatage syntaxique avec PercentFormatter
La lisibilité académique d’un graphique dépend pour une part substantielle de l’élégance et de la rigueur de sa typographie numérique. Laisser les graduations de l’axe secondaire sous forme de simples entiers bruts (par exemple : 20, 40, 60, 80, 100) sans indication d’unité contraint le lecteur à un effort contextuel inutile et peut susciter une confusion éphémère avec les effectifs scalaires de l’axe opposé.
Pour résoudre ce point avec une propreté logicielle exemplaire, il convient d’importer le sous-module spécialisé matplotlib.ticker et de recourir à la classe PercentFormatter. Contrairement à une concaténation textuelle manuelle de chaînes de caractères qui figerait les étiquettes et interdirait toute mise à l’échelle dynamique ultérieure, le formateur de pourcentage s’intègre au moteur de rendu dynamique de l’axe via l’instruction ax2.yaxis.set_major_formatter(ticker.PercentFormatter(xmax=100, decimals=0)).
Le paramétrage du formateur requiert deux arguments stratégiques : l’argument xmax, qui doit être explicitement fixé à cent pour stipuler que les grandeurs manipulées ont déjà été multipliées par ce facteur (évitant ainsi une multiplication redondante par cent qui afficherait des pourcentages aberrants de dix mille pour cent), et le paramètre decimals, judicieusement positionné à zéro. L’élimination systématique des décimales sur les repères cardinaux allège la charge visuelle de la figure. L’observateur n’a que faire de lire « 80.00 % » sur un axe gradué : la sobriété sémiotique commande d’afficher un « 80 % » net, immédiat et d’une netteté irréprochable.
8. Optimisation esthétique et conformité aux standards de publication
8.1 Signalisation graphique du seuil critique des 80 %
L’apport diagnostique du diagramme de Pareto atteint sa pleine expression sémiotique lorsque le point de décision méthodologique est explicitement signalé sur la composition graphique. Si le lecteur averti est en mesure de localiser mentalement le seuil des quatre-vingts pour cent, la matérialisation physique de cette ligne directrice guide le regard avec une précision chirurgicale vers le point de bascule de la distribution.
Cette insertion géométrique s’effectue par l’appel à la méthode ax2.axhline, en assignant une coordonnée d’ordonnée fixe à quatre-vingts. Pour ne point saturer l’espace visuel ni concurrencer la courbe de données, cette ligne doit adopter un registre graphique discret mais contrasté : un trait discontinu (paramètre linestyle=’–‘), d’une épaisseur modérée d’environ un point, teinté d’un gris neutre ou d’un rouge carmin subtil. Cette horizontale traverse toute la largeur du canevas, intersectant l’ogive cumulative à l’endroit précis où le cumul des causes absorbe la majorité convenue de l’impact global.
Pour parachever la rigueur de l’annotation, le tracé d’un segment vertical tombant de cette intersection vers l’axe des abscisses, ou l’adjonction d’une flèche textuelle vectorielle via ax2.annotate, permet de sceller formellement l’interprétation. Le texte d’annotation, formulé avec concision (par exemple : « Seuil de Pareto : 80 % de la charge causale »), explicite sans détour les catégories prioritaires situées à gauche de la démarcation. Ce dispositif graphique convertit une simple contemplation passive de données en un schéma décisionnel immédiatement actionnable pour les instances d’arbitrage clinique ou managérial.
8.2 Épuration de l’environnement graphique
Conformément aux principes canoniques de la conception graphique théorisés par Edward Tufte, l’efficience d’une visualisation scientifique est directement proportionnelle au ratio données-encre (data-ink ratio). Tout élément graphique non porteur d’information statistique intrinsèque doit être systématiquement épuré ou neutralisé afin d’éviter le « fouillis graphique » (chartjunk).
Dans l’écosystème Matplotlib, cette discipline passe tout d’abord par la suppression méthodique des bordures superflues, dénommées spines. Les segments supérieur et latéral droit de l’axe primaire ax1, ainsi que les segments correspondants de l’axe secondaire ax2, doivent être masqués par l’instruction programmatique modifiant leur visibilité à l’état booléen faux. Cette suppression désenclave le canevas central, offrant une respiration spatiale qui valorise les données tracées au détriment du carcan géométrique périphérique.
Parallèlement, la mise en place d’une trame ou grille cartésienne en arrière-plan (grid) exige une grande délicatesse. Si une grille d’ordonnées facilite l’estimation visuelle des hauteurs de barres, elle doit impérativement être cantonnée à l’axe vertical primaire, tracée sous forme de pointillés très fins, dotée d’une transparence prononcée (paramètre alpha=0.3) et reléguée au niveau d’empilement le plus profond (zorder=0). La superposition anarchique de deux grilles distinctes issues de ax1 et ax2 engendrerait un maillage optique parasite particulièrement éprouvant pour l’observateur. Enfin, la création d’une légende synthétique unifiée, fusionnant les descripteurs des barres discrètes et de la courbe continue au sein d’un cartouche unique, parachève la cohérence architecturale de l’ensemble.
8.3 Ajustement des étiquettes d’abscisse pour les nomenclatures denses
L’un des défis récurrents lors du déploiement de diagrammes de Pareto sur des données réelles réside dans la verbosité ou l’étendue textuelle des étiquettes catégorielles. Lorsque les modalités diagnostiques ou cliniques comportent de longs syntagmes nominaux (tels que « Dysfonctionnement cognitif secondaire » ou « Inadéquation de l’environnement socioprofessionnel »), leur disposition purement horizontale sur l’abscisse conduit inévitablement à des chevauchements typographiques mutuels rendant l’ensemble indéchiffrable.
Pour remédier à cette dégradation sans altérer l’intégrité sémantique des libellés, l’analyste doit paramétrer l’orientation angulaire des graduations horizontales au moyen de la méthode tick_params ou en manipulant les propriétés des étiquettes via ax1.set_xticklabels. Une rotation paramétrique de quarante-cinq degrés, combinée impérativement à un alignement horizontal positionné sur la droite (ha=’right’), garantit que l’extrémité terminale de la chaîne de caractères viendra s’ancrer avec une géométrie parfaite sous le centre de chaque barre d’histogramme correspondante.
Dans les cas extrêmes où la nomenclature présente une densité textuelle encore plus lourde, une routine de troncature logicielle préalable ou l’insertion programmatique de sauts de ligne réguliers (au moyen du caractère d’échappement usuel) au-delà d’un certain seuil de caractères permet de préserver l’équilibre morphologique de la planche. L’ultime instruction de la séquence d’affichage doit systématiquement faire appel à plt.tight_layout(). Cette commande recalcule dynamiquement les boîtes englobantes de chaque élément de texte et réajuste automatiquement les marges de la figure, évitant avec une rigueur absolue tout risque de rognage accidentel des étiquettes inférieures lors de la phase finale d’exportation.
9. Modularisation : Conception d’une fonction réutilisable pour la production
9.1 Architecture logicielle de la fonction de tracé
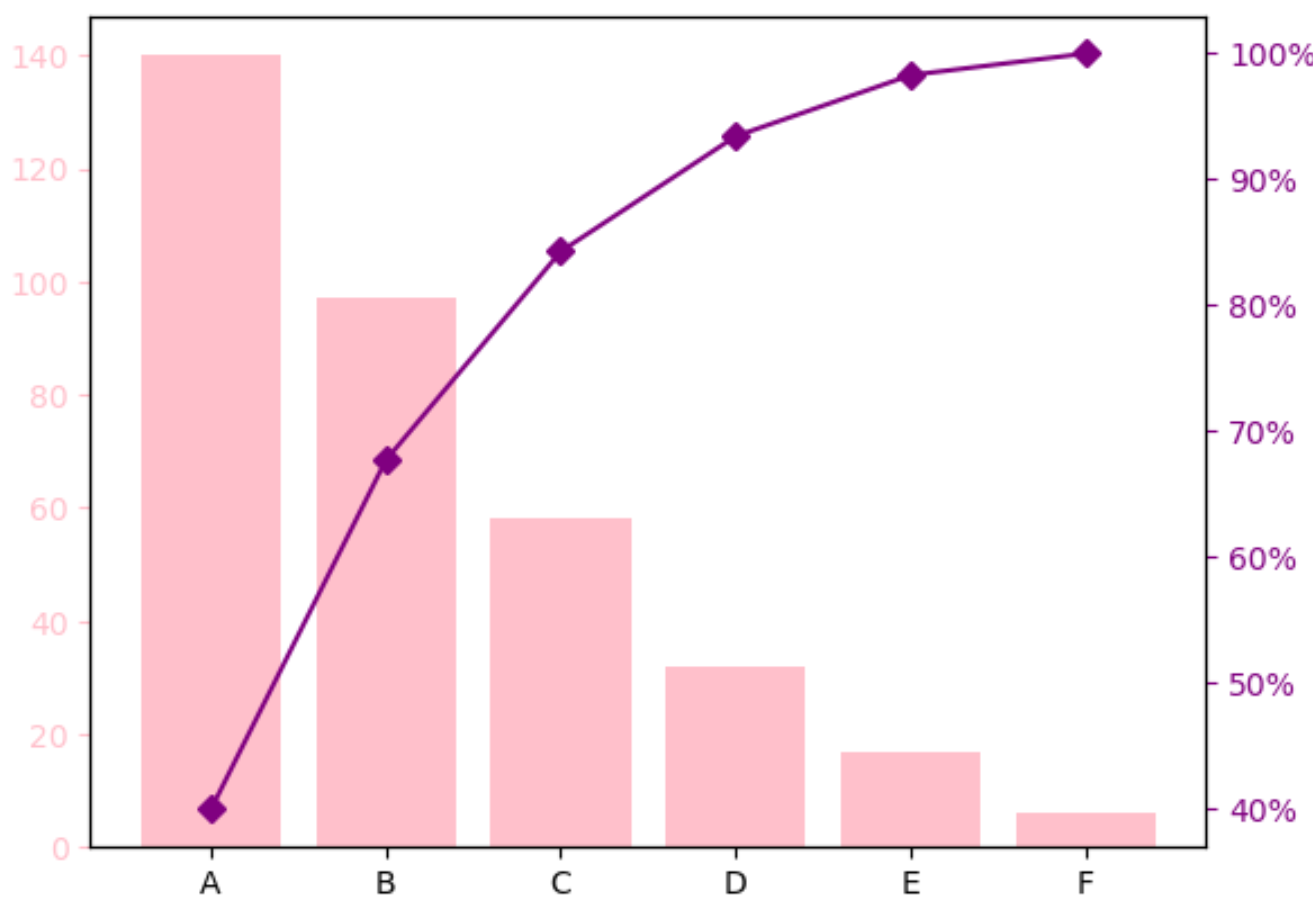
L’industrialisation des méthodes d’analyse de données requiert de dépasser le stade de l’écriture séquentielle de scripts jetables au profit du paradigme de la programmation modulaire et réutilisable. Encapsuler l’ensemble de la logique computationnelle et graphique du diagramme de Pareto au sein d’une fonction Python paramétrique permet de standardiser la production de figures à travers une organisation entière, de simplifier la maintenance du code et d’assurer une homogénéité stylistique totale des publications scientifiques émanant d’un même laboratoire.
La signature de cette fonction doit être conçue avec une grande flexibilité ergonomique. Elle doit accepter en argument principal d’entrée soit une série Pandas univariée indexée par ses catégories, soit un DataFrame bivarié complet, accompagné des chaînes de caractères désignant respectivement la colonne des étiquettes et celle des fréquences d’occurrence. Une collection d’arguments optionnels avec des valeurs par défaut pertinentes permet ensuite de personnaliser l’expérience : titre global de la figure, étiquette sémantique de l’axe primaire, seuil critique de coupure (positionné conventionnellement à 80 mais débrayable à 70 ou 90 selon le paradigme étudié), dimensions de la figure et palette chromatique choisie.
D’un point de vue de l’ingénierie logicielle défensive, le corps de la fonction doit comporter des assertions et des vérifications préalables (preconditions). La fonction doit valider que la série d’entrée n’est point vide, que les valeurs numériques sont strictement positives, et qu’aucune incohérence typologique ne viendra faire échouer l’exécution en aval. Enfin, le code doit être documenté selon les standards académiques internationaux (notamment la norme de documentation NumPy ou Google Docstring), détaillant exhaustivement la nature des arguments, les exceptions levées et les objets renvoyés en sortie.
9.2 Gestion automatisée des retours d’objets Matplotlib
Un défaut récurrent des fonctions de visualisation amateurs réside dans l’appel immédiat et destructeur de la méthode plt.show() au terme de leur exécution interne, ce qui vide le tampon d’affichage et interdit toute modification ultérieure par l’utilisateur. Une architecture logicielle mature doit à l’inverse préserver l’accès à la hiérarchie des objets vectoriels instanciés.
La fonction modulaire doit explicitement renvoyer un tuple structuré comprenant la référence directe vers l’objet Figure, ainsi que les deux instances d’axes cartésiens ax1 et ax2. Cette interface de programmation offre à l’utilisateur final une liberté d’action totale : il conserve la faculté d’adjoindre des annotations supplémentaires, de modifier ponctuellement une police typographique, d’insérer des éléments artistiques complémentaires ou d’imbriquer la figure obtenue au sein d’une composition multi-panneaux complexe sans avoir à réécrire la logique interne du tracé de Pareto.
Parallèlement, la fonction peut utilement intégrer un paramètre d’exportation programmatique direct. Si une chaîne de caractères correspondant à un chemin d’accès disque valide lui est transmise, la fonction déclenche l’exécution de fig.savefig. Ce sous-système doit alors gérer automatiquement les formats de sortie en fonction de l’extension de fichier spécifiée : rendu matriciel compressé non destructif en PNG haute résolution pour les intégrations bureautiques ou web, ou rendu vectoriel infiniment redimensionnable au format standardisé SVG ou PDF pour la soumission directe auprès des comités éditoriaux des revues scientifiques de premier rang.
10. Visualisations alternatives et interactives : Seaborn et Plotly
10.1 Approche combinée Seaborn et Matplotlib
Dans l’écosystème de l’analyse exploratoire sous Python, la bibliothèque Seaborn s’est imposée comme une surcouche statistique de référence au-dessus de Matplotlib, offrant des primitives de haut niveau dotées de thèmes esthétiques sophistiqués et d’une gestion automatisée des inférences de densité ou de régression. Son utilisation pour bâtir un diagramme de Pareto offre des atouts ergonomiques notables, mais révèle également des limites conceptuelles intrinsèques qu’il convient de circonscrire lucidement.
Le principal bénéfice apporté par Seaborn réside dans la stylisation immédiate de l’histogramme primaire via sa fonction barplot. Cette méthode simplifie la liaison avec les données tabulaires et permet de moduler les contextes d’affichage (via sns.set_context) pour adapter automatiquement la graisse des traits et la taille relative des polices selon que la figure est destinée à un article imprimé (paper), à une présentation sur écran (talk) ou à un panneau d’affichage académique de grand format (poster). Les palettes chromatiques continues et catégorielles fournies nativement par Seaborn facilitent également l’élaboration de rendus visuellement très harmonieux sans effort de configuration manuelle.
Néanmoins, Seaborn pèche par l’absence délibérée de prise en charge native des architectures graphiques à deux axes verticaux indépendants. Les concepteurs de Seaborn ont historiquement découragé l’usage des diagrammes à double axe en raison des risques fréquents de manipulation cognitive ou de mauvaise calibration d’échelles décrits dans la littérature de sémiotique graphique. Par conséquent, pour implémenter un diagramme de Pareto sous Seaborn, l’analyste est irrémédiablement contraint de revenir aux primitives d’axe sous-jacentes de Matplotlib pour générer l’axe jumeau avec twinx et tracer la courbe cumulative. Seaborn n’agit donc ici que comme un stylisateur de l’histogramme, sans s’affranchir de la mécanique d’orchestration vectorielle développée précédemment.
10.2 Implémentation interactive avec Plotly Graph Objects
À l’ère du déploiement universel des tableaux de bord analytiques et des carnets de recherche interactifs sur les réseaux informatiques, les visualisations statiques vectorielles rencontrent leurs limites naturelles lorsqu’il s’agit d’offrir une exploration dynamique de nomenclatures catégorielles particulièrement riches. C’est sur ce terrain que la bibliothèque Plotly démontre une pertinence remarquable, convertissant des jeux de données complexes en objets graphiques interactifs basés sur les standards web ouverts (HTML5 et WebGL).
La construction d’un diagramme de Pareto sous Plotly s’articule autour de son module déclaratif de bas niveau plotly.graph_objects et de son sous-module d’agencement make_subplots. L’analyste initialise une canevas matriciel en spécifiant formellement dans le paramètre des spécifications que la sous-figure possède un axe secondaire (specs=[[{« secondary_y »: True}]]). Dès lors, l’injection des éléments visuels s’opère par l’adjonction séquentielle de traces spécialisées : une première trace de type go.Bar pour l’histogramme d’effectifs, suivie d’une seconde trace de type go.Scatter pour l’ogive de cumul, cette dernière étant expressément assignée à l’axe secondaire via le paramètre booléen secondary_y=True.
L’avantage opérationnel déterminant de cette approche réside dans l’enrichissement de l’analyse rendu possible par les infobulles dynamiques (hover data). Alors qu’un tracé statique imprimé contraint l’analyste à restreindre l’affichage sous peine de saturation perceptive, Plotly permet à l’utilisateur de survoler chaque modalité au pointeur pour faire apparaître instantanément une fenêtre d’information contextuelle détaillée. Cette infobulle peut afficher non seulement la fréquence brute et le pourcentage cumulé précis au dixième près, mais également des métadonnées qualitatives complémentaires (descriptifs cliniques complets, intervalles de confiance statistiques, sous-cohortes associées). Cette plasticité fait de Plotly un instrument d’élection pour les plateformes cliniques décisionnelles et les comités d’arbitrage organisationnels.
11. Étude de cas appliquée : Hiérarchisation des facteurs de dysfonctionnement psychologique
11.1 Scénario empirique et modélisation de l’échantillon
Afin d’ancrer notre démonstration théorique dans la réalité pragmatique de la recherche quantitative, déployons une étude de cas appliquée au champ de la psychologie de l’éducation et de la psychopathologie du travail. Considérons une enquête diagnostique multicentrique menée auprès d’une cohorte de douze cents étudiants de premier cycle universitaire signalés pour un risque avéré de décrochage académique ou de rupture psychologique majeure. L’objectif étiologique de l’étude consiste à répertorier et hiérarchiser les motifs prédominants invoqués lors des entretiens cliniques semi-directifs d’évaluation initiale.
À travers un protocole de codage standardisé conforme aux critères nosographiques du DSM-5 et aux modèles dimensionnels de l’épuisement étudiant, les motifs de détresse ont été agrégés en une nomenclature empirique de dix catégories fonctionnelles bien définies :
- Anxiété de performance invalidante : manifestations somatiques aiguës et blocages cognitifs lors des épreuves certificatives formelles.
- Procrastination chronique d’évitement : report compulsif et non régulé des activités d’apprentissage générant un sentiment d’auto-dépréciation critique.
- Précarité matérielle et insécurité financière : charge mentale liée à la survie quotidienne et à l’exercice contraint d’une activité salariée chronophage.
- Isolement social et déliaison relationnelle : absence complète de réseau de soutien proximal, sentiment de déréliction au sein du campus.
- Déficit d’organisation et surcharge allostatique : inaptitude méthodologique à planifier l’effort intellectuel face à un volume d’exigences concurrentes.
- Perturbations chroniques du rythme circadien : insomnies sévères, dysrégulation des cycles veille-sommeil et fatigue diurne invalidante.
- Perfectionnisme clinique inadapté : fixation d’exigences irréalistes induisant une paralysie fonctionnelle dès l’apparition d’un micro-échec.
- Conflits interpersonnels dans la sphère privée : ruptures conjugales, tensions filiales ou pressions familiales délétères interférant avec l’étude.
- Symptomatologie dépressive sous-syndromique : anhédonie diffuse, ralentissement psychomoteur modéré et perte d’intentionnalité d’action.
- Défiance institutionnelle ou inadéquation d’orientation : perte de signification épistémique envers le cursus suivi et aliénation pédagogique.
Le jeu de données brutes synthétique recueilli présente des effectifs très contrastés, allant de plusieurs centaines d’occurrences pour les manifestations les plus banalisées mais envahissantes, jusqu’à quelques dizaines de signalements pour les problématiques périphériques. Ce jeu de données fournit le terrain d’expérimentation parfait pour éprouver notre protocole algorithmique sous Python.
11.2 Exécution intégrale du pipeline analytique
Le déploiement computationnel débute par l’ingestion de ces données catégorielles au sein d’un DataFrame Pandas dédié. Les effectifs sont soumis au tri décroissant immédiat, suivi du calcul de l’intégrale discrète par la méthode cumsum, puis de la dérivation du pourcentage relatif cumulé normalisé sur une base de zéro à cent pour cent. Dès lors, le canevas Matplotlib est instancié avec une résolution de trois cents points par pouce, un formatage de proportions équilibré de dix pouces sur six, et la mise en œuvre de la liaison d’axe jumeau avec twinx.
Le rendu de l’histogramme primaire affiche les barres d’effectifs discrets dans une teinte bleu ardoise sobre, soulignée d’une bordure fine sombre pour assurer un détachement optique irréprochable. L’axe secondaire accueille simultanément l’ogive de cumul tracée d’un trait rouge carmin continu, serti de marqueurs circulaires à chaque nœud d’observation. L’axe des pourcentages est rigidement verrouillé sur l’intervalle fermé [0, 100], son formatage syntaxique étant confié à l’utilitaire PercentFormatter pour afficher une typographie sans décimales. La ligne critique des quatre-vingts pour cent est incrustée de manière discontinue, flanquée d’une annotation textuelle discrète mais explicite pointant vers le seuil de décision.
L’inspection du graphique obtenu révèle avec une force sémiotique éclatante les conclusions de l’investigation empirique. Les trois premières catégories causales — à savoir l’anxiété de performance invalidante, la procrastination chronique et la précarité financière — absorbent à elles seules près de soixante-dix-neuf pour cent de la charge allostatique cumulée au sein de la cohorte étudiée. Les sept autres facteurs de la nomenclature se répartissent sur le quart restant de la distribution, formant le traditionnel palier asymptotique de l’ogive.
Cette mise en évidence graphique produit un impact diagnostique immédiat sur la formulation des préconisations cliniques et l’allocation des budgets universitaires d’intervention psychosociale. L’administration d’ateliers de régulation émotionnelle face aux examens, la mise en place de thérapies cognitivo-comportementales de groupe dédiées à la déconstruction de la procrastination, conjuguées à un renforcement des fonds d’aide d’urgence sociale, constituent les trois leviers stratégiques majeurs capables de neutraliser l’immense majorité des risques de décrochage. Tenter de concevoir simultanément dix programmes transversaux pour juguler chaque micro-cause périphérique aurait fragmenté les moyens d’action pour un rendement curatif dérisoire.
12. Pièges méthodologiques fréquents et critères de validation visuelle
12.1 Erreurs algorithmiques et dérives de représentation
La simplicité apparente de la structure formelle d’un diagramme de Pareto dissimule des pièges méthodologiques et algorithmiques qui, s’ils ne sont point maîtrisés, dégradent l’artefact en un instrument trompeur ou scientifiquement non valide. L’analyste de données se doit d’exercer une vigilance critique constante tout au long de la chaîne de traitement.
Le premier écueil, d’ordre algorithmique, consiste en l’omission pure et simple du tri décroissant des effectifs avant le calcul cumulatif. Cette bévue, souvent imputable à une mauvaise interprétation de l’API Pandas, conduit à un tracé chaotique dépourvu de monotonicité concave. Une telle figure cesse formellement d’être un diagramme de Pareto pour redevenir un simple graphe composite dont la lecture de la courbe cumulative ne véhicule plus aucun sens diagnostique lié à la loi de puissance.
Un deuxième piège pernicieux réside dans la désynchronisation des échelles ou la manipulation intentionnelle ou inconsciente des limites d’axes. Tronquer l’axe secondaire pour ne point le faire démarrer à zéro produit une distorsion cognitive sévère, exagérant visuellement la pente de l’ogive et faisant croire à une concentration causale bien plus vertigineuse qu’elle ne l’est en réalité. De façon symétrique, décaler artificiellement le sommet de l’axe primaire des effectifs peut aplatir indûment les barres d’histogramme, altérant la perception relative de l’amplitude respective des problèmes inventoriés.
Un troisième travers, fréquemment observé dans les rapports organisationnels de piètre qualité, découle d’une agrégation abusive de catégories périphériques au sein d’une catégorie indifférenciée baptisée « Autres ». S’il est méthodologiquement recevable de regrouper les résidus ultra-minoritaires pour éviter d’encombrer inutilement l’axe des abscisses, cette modalité agrégée ne doit en aucun cas afficher une fréquence supérieure aux causes unitaires dominantes. Si la catégorie « Autres » se hisse parmi les premières barres du diagramme, cela trahit une nomenclature de codage déficiente qui masque des variables explicatives critiques, annihilant le pouvoir de discernement sémiotique de l’outil.
12.2 Protocole de contrôle qualité pour publications scientifiques
Avant d’autoriser l’insertion d’un diagramme de Pareto au sein d’un manuscrit soumis à évaluation par les pairs ou d’un rapport décisionnel stratégique, l’analyste doit soumettre son artefact à un protocole systématique de vérification et d’assurance qualité. Ce contrôle s’articule autour d’une grille d’évaluation combinant critères mathématiques, sémiotiques et d’accessibilité visuelle universelle.
En premier lieu, la stricte convexité de l’ogive cumulative doit faire l’objet d’une validation géométrique : la courbe doit impérativement débuter avec sa pente d’élévation la plus abrupte dès la première modalité, pour voir son gradient de progression décroître continuellement au fil de l’intégration des catégories subséquentes, jusqu’à atteindre un plateau tangent horizontal parfait à l’altitude exacte des cent pour cent sur la dernière modalité. Tout fléchissement local trahirait une rupture dans l’ordonnancement préalable des données.
En second lieu, la conformité de la figure aux normes internationales d’accessibilité visuelle — et particulièrement aux standards d’inclusion des personnes atteintes de déficits de perception des couleurs (daltonisme, deutéranopie, protanopie) — constitue une obligation déontologique contemporaine. L’analyste doit impérativement s’assurer que la distinction perceptive entre les barres d’histogramme et la courbe cumulative ne repose point exclusivement sur un contraste chromatique rouge-vert ambigu. L’utilisation conjointe de contrastes de luminance marqués, de contours géométriques francs et de marqueurs de dispersion pleins sur la courbe garantit une lisibilité parfaite même lors d’une restitution en noir et blanc intégrale.
Enfin, l’arbitrage entre granularité catégorielle et lisibilité sémiotique globale doit être pesé au trébuchet statistique. Une planche comportant plus de quinze ou vingt modalités catégorielle sature inévitablement les capacités de mémorisation de travail de l’observateur. L’analyste veillera alors à structurer son analyse selon une approche gigogne (ou en cascade) : un diagramme de Pareto macroscopique identifiant les trois branches causales maîtresses, complété en sous-figure par un diagramme de Pareto microscopique raffinant la décomposition interne de la catégorie dominante identifiée. Cette cascade analytique scelle le triomphe de la méthode scientifique : ordonner le chaos du réel sans jamais dénaturer sa complexité sous-jacente.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions de l’École des Hautes Études en Sciences Sociales.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Juran, J. M. (1951). Quality Control Handbook. McGraw-Hill.
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). https://doi.org/10.25080/Majora-92bf1922-00a
- Pareto, V. (1896). Cours d’économie politique professé à l’Université de Lausanne. F. Rouge.
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021