
Dans le paysage de l’analyse exploratoire des données et du contrôle statistique des processus, la hiérarchisation rigoureuse des facteurs causaux constitue un impératif méthodologique incontournable. Face à des ensembles d’observations complexes où s’enchevêtrent une multiplicité de variables qualitatives et discrètes, le chercheur ou le statisticien praticien se trouve confronté au défi d’isoler les éléments prépondérants dont l’impact s’avère déterminant. Le diagramme de Pareto s’impose alors comme un dispositif visuel et analytique de premier ordre, combinant avec élégance la puissance descriptive de l’histogramme ordonné et la clarté synthétique de la courbe cumulative. Cet outil ne se résume pas à une simple représentation graphique ; il incarne une véritable démarche d’arbitrage scientifique permettant de départager l’essentiel de l’accessoire.
L’environnement de calcul statistique R offre un écosystème d’une richesse exceptionnelle pour concevoir, personnaliser et automatiser la production de tels diagrammes. Grâce à sa double approche — reposant d’une part sur des bibliothèques spécialisées dans le contrôle de la qualité comme le package qcc et, d’autre part, sur la flexibilité expressive de la grammaire des graphiques portée par ggplot2 —, R permet de transformer des tableaux de fréquences bruts en synthèses décisionnelles conformes aux standards académiques et industriels les plus exigeants. La maîtrise de ces flux de travail constitue ainsi un jalon essentiel pour tout analyste désireux de combiner rigueur quantitative et excellence sémiologique.
Le présent guide propose une déconstruction exhaustive, théorique et appliquée, de la genèse d’un diagramme de Pareto au sein du logiciel R. En parcourant chaque étape du processus, de la formalisation mathématique des distributions cumulées à la manipulation des vecteurs nommés, jusqu’à la résolution des pièges typiques de superposition d’échelles secondaires, cet ouvrage détaille pas à pas les protocoles indispensables à une mise en œuvre sans faille. Que votre objectif relève de l’optimisation industrielle, de l’épidémiologie clinique, de la psychométrie différentielle ou de la gestion de la qualité des données, cette méthodologie intégrée vous fournira les clés algorithmiques et visuelles pour convertir vos distributions catégorielles en vecteurs d’action ciblés.
1. Introduction théorique et épistémologique au diagramme de Pareto sous R
1.1 Origine conceptuelle et principe de Pareto (la règle des 80/20)
L’origine intellectuelle du principe de Pareto s’ancre dans les travaux pionniers de l’économiste et sociologue italien Vilfredo Pareto à la fin du dix-neuvième siècle. En étudiant la répartition des revenus et du patrimoine foncier dans plusieurs nations européennes, Pareto formalise en 1896 une régularité empirique remarquable : une fraction restreinte de la population détient systématiquement la majeure partie de la richesse globale. Cette observation mathématique, initialement formalisée sous la forme d’une loi de distribution de probabilité continue à queue lourde, a mis en lumière l’invariance d’échelle caractérisant les phénomènes d’inégalité distributive à travers divers contextes socio-économiques.
Ce n’est toutefois qu’au milieu du vingtième siècle que cette intuition macroéconomique a été transposée au domaine de l’ingénierie et du management de la qualité par le théoricien américain Joseph M. Juran. Observant que la prolifération des non-conformités au sein des chaînes de production industrielle résultait généralement d’un nombre restreint de défaillances fondamentales, Juran universalise le concept sous l’appellation populaire de la « règle des 80/20 ». Dans son acception contemporaine, ce postulat stipule que près de 80 % des effets constatés au sein d’un système complexe découlent de 20 % seulement des causes sous-jacentes. Cette asymétrie fondamentale invite les praticiens à opérer une distinction nette entre ce que Juran désignait par les termes de « vital few » et de « trivial many ».
D’un point de vue épistémologique et heuristique, la loi empirique de Pareto fournit un modèle parcimonieux pour l’étude des variables aléatoires discrètes et des séries statistiques catégorielles. Elle incite l’analyste à ne pas traiter chaque modalité sur un pied d’égalité, mais à rechercher délibérément la concentration du phénomène étudié. Qu’il s’agisse de défaillances techniques, de manifestations cliniques ou de réclamations d’usagers, la distribution parétienne rappelle que la dispersion des occurrences obéit rarement à une distribution uniforme ou symétrique, justifiant une approche méthodologique explicitement orientée vers l’extraction des signaux dominants.
1.2 Utilité de la double visualisation fréquence-cumul
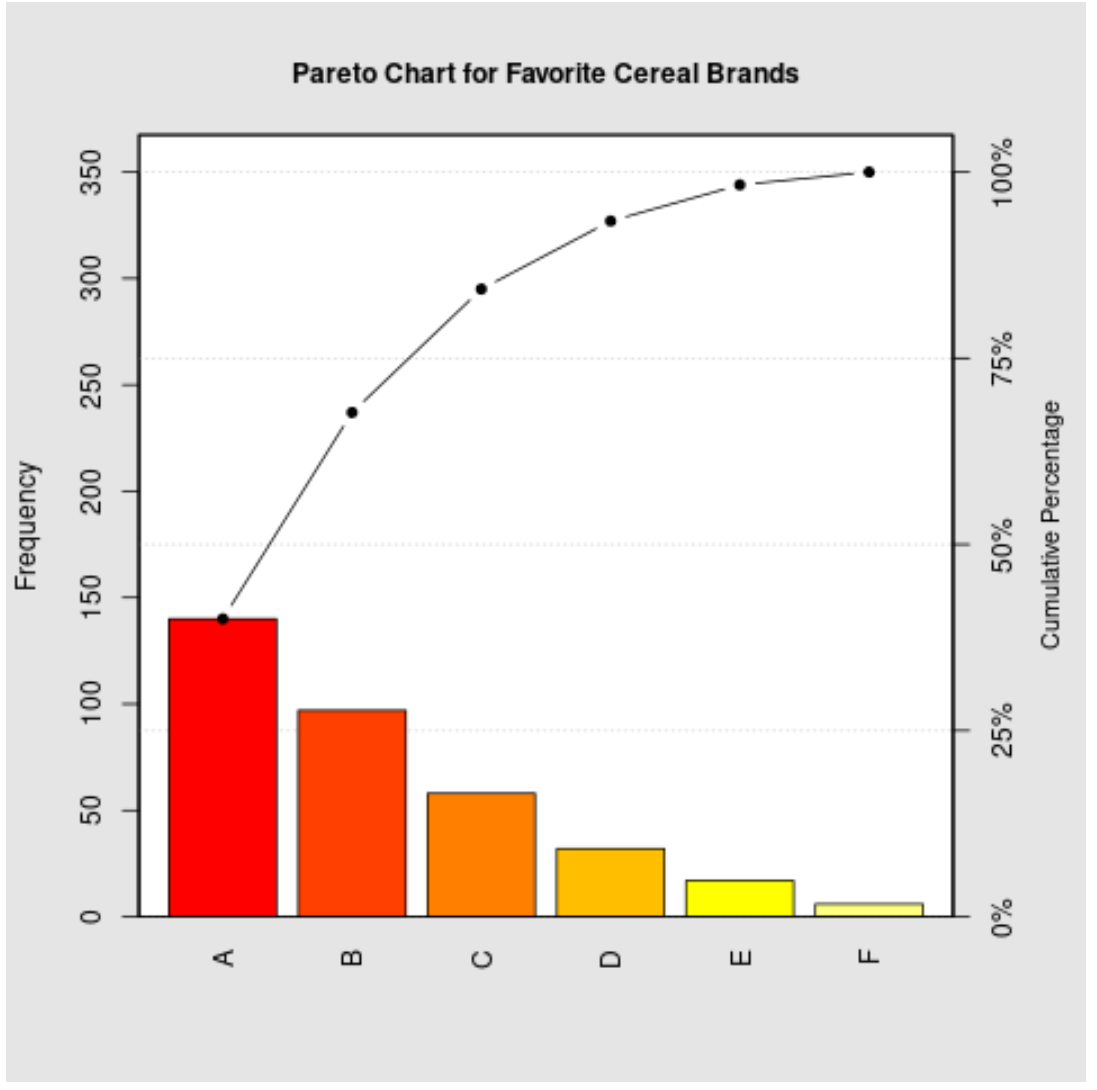
La force opératoire du diagramme de Pareto réside dans son architecture visuelle hybride qui conjugue simultanément deux registres de lecture statistique. D’un côté, un diagramme en colonnes présente les fréquences absolues ou relatives associées à chaque modalité catégorielle, ordonnées de façon strictement décroissante de la gauche vers la droite. De l’autre, une courbe ogivale polygonale matérialise la progression cumulative des proportions, reliant les sommets successifs des barres jusqu’à atteindre l’asymptote conceptuelle des 100 %. Cette juxtaposition d’un tracé discret et d’une cinétique continue enrichit la perception du chercheur en dévoilant la structure sous-jacente de la distribution.
Cette articulation géométrique permet d’identifier sans ambiguïté les seuils de rupture au sein des données. Le regard de l’évaluateur n’est plus dispersé entre des dizaines d’occurrences disparates : il appréhende d’emblée la masse critique représentée par les premières colonnes. L’observation conjointe de la hauteur unitaire d’une barre et de l’inclinaison locale de la courbe ogive informe immédiatement sur le rendement marginal d’une intervention corrective. Tant que la courbe cumulative présente une pente abrupte, chaque modalité additionnelle agrège une fraction substantielle de la variance totale ; dès lors que le profil s’aplatit, l’analyste sait qu’il pénètre dans la zone des facteurs secondaires dont l’impact individuel demeure marginal.
En matière d’arbitrage décisionnel fondé sur les données empiriques, cette double visualisation supprime les conjectures subjectives. Elle fournit un substrat quantitatif incontestable pour arbitrer l’allocation des ressources matérielles, financières ou temporelles. Plutôt que de disperser les efforts de remédiation sur l’intégralité des symptômes répertoriés, les comités de direction ou les équipes de recherche peuvent focaliser leurs investigations sur le sous-ensemble circonscrit qui condense la quasi-totalité des enjeux observés.
1.3 Positionnement du logiciel R pour l’analyse parétienne
Dans l’éventail des environnements de calcul scientifique contemporains, le langage R occupe une position privilégiée pour l’exécution d’analyses parétiennes reproductibles. Contrairement aux tableurs bureautiques traditionnels dont les procédures de tracé reposent souvent sur des manipulations manuelles opaques et sources d’erreurs d’alignement d’axes, R garantit une rigueur algorithmique absolue. Chaque phase de calcul, de l’agrégation des fréquences jusqu’au dimensionnement des échelles cartésiennes, est consignée dans un script textuel transparent, vérifiable et immédiatement redéployable sur de nouvelles données.
L’écosystème R se distingue par la coexistence féconde de deux paradigmes méthodologiques complémentaires. D’une part, le package spécialisé qcc (Quality Control Charts) propose des fonctions prêtes à l’emploi spécifiquement conçues pour le contrôle de la qualité industrielle. Sa commande maîtresse encapsule l’intégralité des calculs statistiques et des conventions graphiques dans une syntaxe d’une concision exemplaire. D’autre part, la bibliothèque ggplot2, adossée aux principes fondateurs de la grammaire des graphiques de Leland Wilkinson, offre une granularité de personnalisation visuelle sans équivalent dans le monde open source.
L’intégration de l’analyse de Pareto au sein de scripts R facilite par ailleurs son incorporation dans des flux de production documentaire automatisés, tels que Quarto ou R Markdown. Cette fluidité permet aux équipes scientifiques de publier des rapports périodiques, des articles évalués par les pairs ou des tableaux de bord interactifs où les graphiques s’actualisent dynamiquement à mesure que de nouveaux relevés empiriques enrichissent les bases de données sources.
2. Composantes mathématiques et structurelles du diagramme de Pareto
2.1 Calculs des métriques fondamentales
La genèse d’un diagramme de Pareto repose sur un socle d’opérations statistiques univariées élémentaires mais dont la rigueur algorithmique conditionne l’exactitude de l’interprétation. Soit une variable qualitative nominale observant un ensemble fini de modalités disjointes notées k allant de 1 à K. La première étape consiste à dénombrer les occurrences absolues associées à chaque modalité au sein de l’échantillon global de taille N. Cette fréquence absolue, conventionnellement désignée par n_k, quantifie le volume brut d’événements attribuables au niveau considéré.
À partir de ces grandeurs discrètes, l’analyste procède au calcul des fréquences relatives, notées f_k, définies par le rapport strict entre le décompte individuel n_k et la taille totale de l’échantillon N. Exprimée sous la forme d’une proportion comprise dans l’intervalle fermé [0, 1] ou convertie en pourcentage par multiplication scalaire par 100, la fréquence relative standardise la mesure et permet la comparaison transversale entre des populations d’effectifs dissemblables. La somme arithmétique de ces fréquences relatives sur l’ensemble des K catégories est par définition rigoureusement égale à l’unité ou à 100 %.
L’étape discriminante réside dans le tri décroissant strict des modalités selon la valeur de leur fréquence absolue, de telle sorte que n_1 soit supérieur ou égal à n_2, lui-même supérieur ou égal à n_3, jusqu’au terme minimal n_K. C’est sur ce vecteur ordonné qu’intervient l’algorithme du cumul additif. La fréquence cumulée d’ordre m correspond à la somme séquentielle des fréquences relatives des modalités ordonnées de 1 à m. Ce calcul génère une suite monotone croissante dont la valeur inaugurale coïncide avec la fréquence relative de la modalité dominante et dont le terme final atteint inéluctablement la totalité de la masse statistique observée.
2.2 Topologie visuelle du graphique à double échelle
La restitution visuelle d’un diagramme de Pareto implique la mise en place d’un système de coordonnées cartésiennes pourvu d’une double graduation verticale orthogonale à l’abscisse. L’axe horizontal héberge les modalités qualitatives discrètes, distribuées à intervalles réguliers sous la forme d’intervalles contigus ou espacés. L’ordonnancement de ces catégories sur l’abscisse n’est pas guidé par un ordre alphabétique ou temporel arbitraire, mais par la magnitude décroissante de leurs fréquences effectives, consacrant ainsi la primauté de l’impact causal.
L’axe vertical primaire, systématiquement positionné sur la bordure gauche du canevas graphique, est dévolu à la métrique brute des effectifs ou des fréquences absolues. Son origine démarre invariablement à la valeur zéro pour éviter tout artéfact de distorsion visuelle, et son étendue s’élève généralement jusqu’à la somme totale des événements N ou jusqu’à une valeur plafond calibrée pour englober la barre la plus élevée tout en maintenant une lisibilité harmonieuse. À l’opposé, l’axe vertical secondaire, disposé sur le flanc droit de la figure, est réservé à l’échelle des pourcentages cumulés, gradué linéairement de 0 % à 100 %.
La complexité géométrique de cette disposition réside dans l’alignement spatial parfait entre les éléments graphiques et leurs graduations respectives. Chaque barre d’histogramme prend appui sur l’axe gauche, tandis que les sommets de la ligne brisée polygonale doivent correspondre à la projection exacte des cumuls partiels sur l’axe droit. Les nœuds de cette courbe ogive se positionnent conventionnellement à l’aplomb du bord droit ou du centre géométrique de chaque colonne correspondante, formalisant visuellement l’intégration progressive des catégories dans le réservoir statistique global.
2.3 Propriétés statistiques de la hiérarchisation des données catégorielles
L’ordonnancement systématique des données catégorielles au sein d’un diagramme de Pareto confère au graphique des propriétés statistiques spécifiques qui méritent une attention méthodologique soutenue. En premier lieu, la stabilité de la hiérarchie observée est fortement tributaire de la taille de l’échantillon d’analyse. Lorsque l’effectif global N est modeste, les fluctuations d’échantillonnage peuvent induire des inversions de rang entre des modalités dont les fréquences théoriques sous-jacentes sont très proches, conférant à la hiérarchie une robustesse apparente qu’il convient de relativiser par des tests d’homogénéité ou des intervalles de confiance multinomiaux.
En second lieu, la morphologie générale de la courbe ogivale constitue un indicateur direct de la dispersion ou de la concentration du phénomène au sein de la population. Une distribution caractérisée par une queue lourde — c’est-à-dire une multiplicité de catégories résiduelles dotées d’effectifs infimes mais non nuls — engendre une décélération prononcée de la progression cumulative après les premières colonnes. L’observation de la concavité de la courbe permet ainsi d’évaluer instantanément le degré d’inégalité du système étudié, à l’instar de la courbe de Lorenz dans l’analyse économique des revenus.
Enfin, la gestion des catégories résiduelles soulève des interrogations structurelles majeures. Dans la pratique empirique, il est fréquent d’observer un éclatement des causes secondaires en une multitude de dénominations anecdotiques. L’analyste se trouve alors confronté à l’opportunité de regrouper ces occurrences mineures sous une étiquette synthétique de type « Divers » ou « Autres ». Si un tel regroupement épure la représentation visuelle, il introduit une distorsion potentielle dans l’ordonnancement : la catégorie composite, bien que rassemblant des facteurs secondaires, peut afficher une fréquence globale supérieure à certaines modalités individuelles significatives. La rigueur impose alors de reléguer systématiquement cette modalité résiduelle à l’extrême droite du graphique, indépendamment de son effectif brut.
3. Préparation de l’environnement de développement statistique dans R
3.1 Installation et chargement du package spécialisé qcc
Pour amorcer la construction d’un diagramme de Pareto dans les règles de l’art statistique, le recours au package qcc constitue la démarche la plus directe et la plus éprouvée. Développé initialement par Luca Scrucca, ce module fournit une infrastructure complète dédiée au contrôle statistique de la qualité industrielle et intègre des algorithmes optimisés pour la réalisation de cartes de contrôle et de graphiques parétiens. Son acquisition s’opère de manière standardisée via le Comprehensive R Archive Network en exécutant la commande d’installation usuelle au sein de la console R.
Une fois l’installation menée à son terme sans message d’anomalie, la bibliothèque doit être explicitement chargée dans la mémoire vive de la session active par l’instruction de bibliothèque idoine. Cette action met à la disposition du praticien l’ensemble des structures de données et des méthodes graphiques du package, et plus particulièrement la fonction maîtresse intitulée pareto.chart(). Cette fonction se charge d’exécuter de façon sous-jacente le tri décroissant, l’estimation des cumuls et le tracé coordonné des axes primaire et secondaire.
Il est recommandé de contrôler périodiquement la version du package qcc déployée dans votre environnement. Les révisions successives de cette bibliothèque ont en effet introduit des raffinements esthétiques et des optimisations algorithmiques notables, notamment dans la gestion des marges du canevas et le retour d’objets structurés de classe spécifique. La vérification de la compatibilité ascendante assure la pérennité de vos chaînes de traitement automatisées au sein des systèmes d’exploitation Linux, macOS ou Windows.
3.2 Configuration optionnelle du tidyverse pour la manipulation avancée
Bien que le package qcc suffise amplement pour une production graphique immédiate et autonome, l’analyste désireux de s’affranchir des limitations du moteur graphique de base de R tirera profit de l’écosystème tidyverse. Cet ensemble cohérent d’outils partagés propose une philosophie de programmation fluide et expressive, particulièrement adaptée aux opérations de nettoyage, de transformation et de visualisation tabulaire. L’installation et l’invocation conjointe des bibliothèques dplyr, tibble et ggplot2 constituent la fondation d’un environnement de travail moderne.
L’apport de dplyr se manifeste principalement lors des phases préliminaires de manipulation matricielle. Grâce à ses verbes intuitifs permettant le regroupement, le dénombrement, le tri dynamique et la création séquentielle de colonnes cumulées, l’ingénierie des données préalables au tracé devient limpide et reproductible. De son côté, la structure enrichie fournie par tibble améliore la lisibilité des impressions en console, prévenant les tronquages intempestifs ou les conversions implicites indésirables de vecteurs de chaînes en facteurs non ordonnés.
Sur le plan du rendu graphique, l’adjonction de ggplot2 offre un contrôle absolu sur chaque pixel et chaque élément vectoriel de l’illustration finale. L’analyste peut ainsi ajuster la typographie institutionnelle, moduler les contrastes chromatiques selon des normes d’accessibilité visuelle universelles et exporter des planches graphiques prêtes pour la photogravure académique. L’initialisation conjointe de ces deux approches — qcc d’une part pour la validation rapide, tidyverse d’autre part pour la personnalisation millimétrée — représente une configuration de référence pour tout projet d’envergure.
3.3 Bonnes pratiques de reproductibilité et initialisation du script
L’assurance d’une reproductibilité totale des calculs et des visualisations constitue un canon fondamental de la science contemporaine. Pour garantir que vos collègues ou les évaluateurs indépendants puissent régénérer rigoureusement les mêmes graphiques de Pareto à partir des données sources, la structuration formelle du script R doit obéir à des standards stricts dès son initialisation. Tout document de travail doit débuter par un en-tête documentaire spécifiant l’objet de l’étude, l’auteur, la date d’exécution et les versions logicielles cibles.
Une bonne pratique élémentaire consiste à initialiser l’espace de travail en purgeant les variables résiduelles qui pourraient subsister en mémoire cache, tout en configurant de manière explicite les options globales de la session. Si votre protocole comporte une composante de simulation ou de rééchantillonnage pour estimer des intervalles de confiance autour des fréquences empiriques, la fixation préalable d’une graine de pseudo-aléatoire via la commande standard de R s’avère impérative afin d’assurer l’invariance mathématique des tirages successifs.
Enfin, la traçabilité de l’environnement informatique doit être matérialisée en consignant en fin de script l’inventaire exhaustif des dépendances logicielles. L’appel à la fonction d’audit système de R renvoie l’architecture matérielle, le numéro de version du noyau R et la liste intégrale des extensions chargées avec leurs numéros de version respectifs. Cette précaution neutralise les risques d’incompatibilité future découlant de mises à jour de packages tiers et garantit l’intégrité pérenne de vos artefacts graphiques.
4. Étape 1 : Création et structuration méthodique du jeu de données
4.1 Construction d’un data frame représentatif sous R
L’élaboration d’un diagramme de Pareto sous R débute systématiquement par l’organisation rigoureuse des données sous la forme d’une structure rectangulaire native de type data frame. Pour illustrer la démarche sur un cas d’école réaliste et pédagogique, nous considérons un audit de contrôle qualité portant sur les dysfonctionnements observés au sein d’une unité de fabrication de dispositifs médicaux de précision. Les observations répertoriées au terme d’une campagne de surveillance industrielle sont classées selon six typologies de défaillances distinctes : défaut d’assemblage micrométrique, rayure de surface, bavure d’usinage, contamination particulaire, non-conformité dimensionnelle et altération thermique.
La déclaration de cette structure sous R s’opère en instanciant un data frame composé de deux vecteurs élémentaires de même dimension. Le premier vecteur, de nature textuelle ou catégorielle, liste nominativement les différentes modalités d’anomalies observées. Le second vecteur, de nature numérique entière, consigne le décompte exact des occurrences comptabilisées pour chaque catégorie correspondante lors de la période d’échantillonnage. Il est essentiel de veiller à ce que les vecteurs sous-jacents ne comportent aucune discordance d’appariement lors de leur assignation conjointe.
Sur le plan typologique, les variables de dénombrement doivent être formalisées sous un typage numérique strict (vecteurs entiers ou doubles) exempt de tout caractère textuel parasite, tel que des symboles de pourcentages ou des délimiteurs de milliers mal interprétés. La nomenclature des modalités gagne à être rédigée de manière concise et explicite, évitant les acronymes abscons qui pénaliseraient la clarté sémiologique du graphique final lors des étapes de restitution éditoriale.
4.2 Vérification de l’intégrité et exploration descriptive des données
Préalablement à tout traitement graphique, une inspection minutieuse de l’intégrité des données s’impose pour prévenir les défaillances silencieuses d’exécution. L’application des fonctions d’exploration structurale permet de vérifier que l’objet créé possède bien la dimension bidimensionnelle escomptée et que les attributs de colonnes respectent les types atomiques requis. Un contrôle formel de la non-vacuité des cellules doit être conduit afin de s’assurer de l’absence totale de valeurs manquantes (notées traditionnellement NA dans l’environnement R), ces dernières étant susceptibles de fausser les calculs cumulatifs ou de provoquer des exclusions silencieuses d’observations.
L’évaluation statistique préliminaire implique également le calcul de l’effectif total d’échantillonnage par sommation arithmétique simple de la colonne des décomptes. Cette grandeur scalaire, désignée par N, sert d’étalon universel pour la calibration ultérieure des proportions relatives et constitue la valeur de référence pour le dimensionnement de l’axe vertical gauche du diagramme de Pareto. Toute anomalie constatée sur cette somme globale révélerait une troncature involontaire des données sources.
L’analyste veillera également à repérer d’éventuelles anomalies d’encodage de caractères, courantes lors du traitement de termes francophones pourvus d’accents ou de cédilles au sein de systèmes d’exploitation hétérogènes. La standardisation en encodage UTF-8 constitue la parade absolue pour garantir que les libellés de catégories apparaîtront sans altération typographique ni caractères de substitution disgracieux lors du rendu visuel de la planche graphique.
4.3 Attribution des noms d’éléments et mise en forme vectorielle
Une spécificité technique fondamentale de la fonction pareto.chart() réside dans son exigence syntaxique vis-à-vis du format des données d’entrée. Contrairement à de nombreuses fonctions du socle graphique moderne qui attendent directement un objet tabulaire complet accompagné de formules d’association de variables, la méthode canonique du package qcc nécessite la transmission d’un vecteur numérique pourvu d’un attribut de noms d’éléments explicite. La transmission brute d’un data frame non conditionné conduirait invariablement à un message d’erreur d’exécution ou à une interprétation erronée des colonnes.
Pour satisfaire à ce prérequis architectural, le statisticien doit extraire le vecteur des effectifs numériques et lui assigner les étiquettes textuelles issues de la colonne catégorielle au moyen de la fonction d’attribution des noms de R. Cette opération fusionne la magnitude quantitative de la fréquence et son identifiant sémantique au sein d’une structure vectorielle unidimensionnelle compacte et élégante. L’inspection en console de cet objet vectoriel nommé confirme que chaque modalité textuelle surplombe désormais sa valeur numérique associée.
Cette distinction entre le format tabulaire relationnel (le data frame) et le vecteur nommé représente une étape d’initiation cruciale pour les utilisateurs abordant les packages traditionnels de R. Une fois cette transformation vectorielle exécutée et validée, l’objet se trouve parfaitement calibré pour être ingéré par l’algorithme sous-jacent de pareto.chart(), garantissant une interprétation sans faille de la hiérarchie des facteurs et de leurs libellés respectifs.
5. Étape 2 : Génération du diagramme de Pareto avec la fonction pareto.chart()
5.1 Exécution de la commande élémentaire
La génération du diagramme de Pareto dans sa forme inaugurale s’effectue par un appel direct et d’une remarquable concision à la fonction pareto.chart(), en lui transmettant pour unique argument obligatoire le vecteur numérique nommé préalablement structuré. Dès la validation de l’instruction, le moteur graphique natif de R initialise un dispositif d’affichage cartésien et procède au rendu visuel immédiat de la figure. En l’espace d’une fraction de seconde, la dispersion anarchique des occurrences catégorielles se trouve métamorphosée en une composition géométrique parfaitement ordonnée.
L’un des atouts majeurs de cette implémentation réside dans son automatisation intrinsèque. L’utilisateur n’est nullement contraint de trier au préalable ses données manuelles selon un ordre décroissant : l’algorithme interne inspecte le vecteur, détecte la grandeur des coefficients scalaires, procède à une permutation ordonnée des catégories et réassigne les étiquettes correspondantes en parfaite cohérence. Les barres verticales sont ensuite tracées séquentiellement depuis le bord gauche du canevas en décroissant fidèlement vers le flanc droit.
Conjointement à la génération de la fenêtre graphique, la fonction exécute une sortie synchrone au sein de la console R. Elle y imprime un tableau synthétique structuré récapitulant les paramètres quantitatifs fondamentaux issus du traitement mathématique. Cette dualité entre production visuelle et reporting tabulaire instantané fait de la commande pareto.chart() l’une des routines les plus efficientes du catalogue analytique de R pour le diagnostic exploratoire immédiat.
5.2 Analyse du comportement algorithmique interne
Pour appréhender pleinement la mécanique opératoire de pareto.chart(), il convient d’en déconstruire le flux d’instructions algorithmiques internes. Dès l’ingestion du vecteur nommé, la fonction calcule la sommation intégrale des valeurs numériques afin de déterminer l’assiette totale d’échantillonnage N. À partir de cette constante fondamentale, chaque modalité se voit attribuer sa fréquence relative individuelle par simple division arithmétique, opération vectorisée d’une célérité optimale sous R.
L’algorithme enchaîne immédiatement sur le calcul des sommes cumulatives en invoquant les routines de cumul additif du noyau R. Cette séquence permet de dériver une trajectoire discrète croissante comprise entre la proportion de la première modalité dominante et la borne supérieure théorique de 100 %. Sur le plan du tracé géométrique, le moteur graphique superpose un système d’axes secondaires étalonné de manière rigoureusement linéaire sur l’intervalle [0, 100]. Les sommets des colonnes d’histogrammes et les points nodaux de la courbe ogivale sont calculés de concert pour garantir leur concordance spatiale.
Un autre raffinement algorithmique notable concerne le positionnement automatique de repères graphiques horizontaux. Par défaut, la fonction projette une ligne en pointillé au niveau conventionnel de 80 % sur l’axe secondaire droit, guidant immédiatement le regard de l’observateur vers le seuil d’inflexion critique postulé par le principe de Juran. Les nœuds polygonaux sont interconnectés par des segments linéaires fermes, matérialisant l’accélération puis la décélération de l’agrégation statistique.
5.3 Paramètres d’ajustement syntaxiques initiaux
Bien que l’exécution brute de la commande pareto.chart() produise un résultat fonctionnel, la conformité aux exigences de communication scientifique impose l’ajustement immédiat de plusieurs arguments syntaxiques optionnels. Le premier niveau d’enrichissement réside dans la précision des métadonnées textuelles. L’argument principal main permet d’attribuer un titre explicite et professionnel à l’illustration, spécifiant le périmètre de l’échantillon investigué et la nature de l’évaluation conduite. Un sous-titre contextualisant peut être adjoint via l’argument sub pour consigner par exemple la période temporelle de collecte.
La dénomination des axes dimensionnels requiert une attention égale. Par défaut, le package peut attribuer des intitulés génériques en langue anglaise. L’adjonction formelle de l’argument ylab permet de substituer à l’étiquette par défaut une mention francophone claire telle que « Fréquence absolue des non-conformités ». L’axe horizontal peut être explicité au moyen du paramètre xlab, identifiant sans équivoque la variable catégorielle sous-jacente (« Typologie des défaillances observées »).
Enfin, l’utilisateur a la possibilité de réguler la prolifération des sorties au sein de sa session de travail. Si le tracé est destiné à être intégré dans une boucle de traitement automatisée générant des dizaines de planches séquentiellement, l’argument logique d’impression tabulaire peut être basculé à faux afin de museler l’affichage textuel en console et de réserver les ressources informatiques au calcul géométrique pur.
6. Analyse rigoureuse et interprétation des sorties tabulaires de pareto.chart()
6.1 Décomposition de la matrice de sortie statistique
L’un des bénéfices majeurs de l’invocation de pareto.chart() réside dans le fait que la fonction ne se borne pas à dessiner un canevas graphique : elle renvoie simultanément un objet mathématique riche que le statisticien peut capturer au sein d’une variable désignée. Cet objet, relevant formellement de la classe qcc, encapsule une matrice de données bidimensionnelle contenant l’ensemble des métriques descriptives ayant présidé au tracé. L’extraction programmatique de cette matrice permet d’automatiser la rédaction de conclusions chiffrées au sein de rapports dynamiques.
La structure matricielle générée s’organise rigoureusement selon quatre colonnes normalisées. La première colonne, intitulée Frequency, reproduit les effectifs absolus de chaque modalité réordonnés selon une hiérarchie strictement descendante. La deuxième colonne, Cum.Freq., présente les effectifs cumulés additifs, illustrant l’accroissement continu de la masse d’événements à mesure que l’on progresse dans l’inventaire des causes. On observe obligatoirement que la dernière valeur de cette série coïncide à l’unité près avec l’effectif global d’échantillonnage N.
Les troisième et quatrième colonnes convertissent ces décomptes bruts en pourcentages normalisés. La colonne Percentage consigne la contribution relative marginale de chaque modalité par rapport à l’ensemble du phénomène. Enfin, la colonne Cum.Percent. consigne la distribution cumulative croissante en pourcentage. C’est précisément l’examen analytique de cette dernière série qui permet de valider formellement la convergence vers le seuil asymptotique des 100,00 %, garantissant la clôture arithmétique de la distribution sans dispersion résiduelle non quantifiée.
6.2 Évaluation du seuil critique d’inflexion
L’exploitation de la matrice de données statistique vise prioritairement à repérer avec une précision mathématique le point de bascule délimitant les catégories prépondérantes des facteurs secondaires. Cette étape ne doit pas être menée de manière dogmatique en recherchant une coïncidence absolue avec le nombre 80 %, car la distribution empirique d’un échantillon fini de variables discrètes ne produit que très rarement un cumul arithmétique tombant rigoureusement sur cette valeur théorique entière. L’évaluation s’appuie donc sur la localisation du premier nœud du cumul dépassant ou s’approchant au plus près de ce palier conventionnel.
D’un point de vue géométrique, ce point de bascule correspond au « coude » d’inflexion visible sur la courbe ogivale. C’est l’emplacement cartésien précis où la dérivée discrète de la courbe marque une décélération notable, signalant une transition d’un régime de forte concentration marginale à un régime de rendements décroissants. En inspectant la colonne des pourcentages cumulés au sein de la matrice R, l’analyste identifie les rangs des modalités dont l’agrégation franchit le seuil des 80 % d’impact global.
La zone résiduelle représentant les quelque 20 % restants de la distribution doit être interprétée pour ce qu’elle est : une dispersion de facteurs multiples à faible occurrence unitaire. Bien que ces éléments ne doivent pas être ignorés dans une perspective de maîtrise totale des procédés à long terme, ils ne justifient pas une allocation immédiate et massive de ressources d’ingénierie, leur éradication individuelle ne produisant qu’une amélioration marginale de la performance globale du système.
6.3 Rapportage scientifique des résultats selon les standards quantitatifs
La restitution textuelle des enseignements tirés d’un diagramme de Pareto au sein d’une publication scientifique évaluée par les pairs ou d’un mémoire technique exige une rigueur de formulation irréprochable. L’analyste doit proscrire les jugements d’évidence vagues et privilégier une narration structurée adossée aux métriques extraites de la matrice de sortie de R. Chaque affirmation quantitative relative à une modalité dominante doit être étayée par la mention conjointe de sa fréquence absolue d’apparition et de sa contribution relative en pourcentage.
Une convention académique solide commande de présenter les effectifs sous la forme n = [valeur], immédiatement assortis de leur proportion relative entre parenthèses, selon la syntaxe standard [valeur] %. Par exemple, une synthèse méthodologiquement robuste énoncera que : « L’analyse de Pareto révèle que deux typologies de défaillances concentrent à elles seules près de 82,3 % des anomalies globales observées (N = 452). Les défauts d’assemblage micrométrique constituent le facteur prépondérant (n = 241, soit 53,3 %), suivis des rayures de surface (n = 131, soit 29,0 %). Les quatre autres catégories répertoriées n’interviennent individuellement que pour des fractions marginales inférieures à 8 % chacune. »
Il est par ailleurs impératif d’alerter le lecteur contre les biais d’extrapolation causale abusive. Le classement issu d’un diagramme de Pareto reflète une préséance empirique basée sur la fréquence d’apparition ; il ne démontre pas en soi une chaîne de causalité déterministe sous-jacente. Il incombe aux chercheurs de contextualiser ces résultats au regard des mécanismes physiques ou comportementaux du système investigué afin de valider si la concentration observée correspond bien à un levier d’action opérationnel pertinent.
7. Personnalisation graphique avancée du diagramme sous qcc
7.1 Harmonisation chromatique et différenciation des composantes
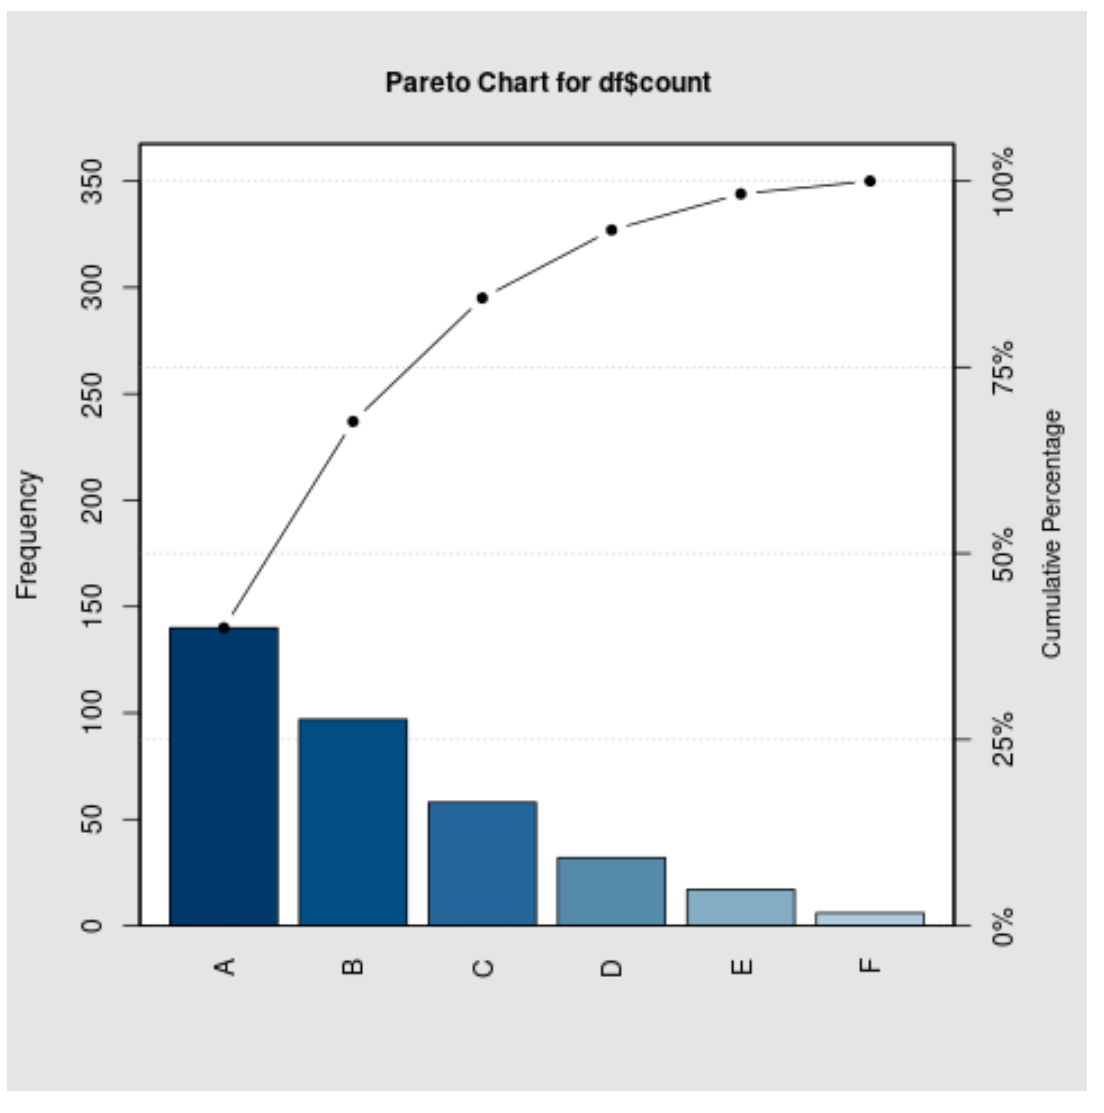
L’affichage par défaut généré par la fonction pareto.chart() présente une esthétique fonctionnelle mais austère, caractérisée par des teintes de gris neutres qui ne favorisent pas toujours une différenciation immédiate des strates d’information. Pour élever le diagramme aux standards de communication visuelle contemporains, l’analyste peut moduler le profil chromatique du tracé en exploitant les arguments vectoriels d’ombrage et de coloration intégrés dans le package qcc.
Le paramètre col permet d’assigner une palette de couleurs spécifique aux rectangles de l’histogramme. Plutôt que d’appliquer une teinte uniforme, il est pertinent d’utiliser des gradients séquentiels continus ou des palettes divergentes issues de référentiels scientifiques certifiés, tels que les palettes de Cynthia Brewer ou celles de l’espace chromatique Viridis. Une approche visuelle particulièrement didactique consiste à attribuer une couleur accentuée vive (comme un bleu profond ou un bordeaux soutenu) aux barres relevant du noyau dur des 80 % de Pareto, et une nuance atténuée (tel qu’un gris ardoise clair) aux catégories secondaires appartenant au résidu marginal.
L’esthétique de la courbe cumulative ogivale peut être pareillement peaufinée. Au travers d’arguments graphiques additionnels transférés aux routines d’affichage de bas niveau de R, l’utilisateur a la faculté de redéfinir la couleur du tracé polygonal, l’épaisseur du trait (via le paramètre standard de largeur de ligne lwd) ainsi que la géométrie des nœuds marquant chaque palier de catégorie (en spécifiant le type de point pch, tel qu’un cercle plein ou un losange contrasté). Cette différenciation nette entre la texture des barres et le fil de la courbe améliore considérablement le confort de lecture lors de la reproduction sur support papier en niveaux de gris.
7.2 Configuration typographique et lisibilité des étiquettes
L’un des défis récurrents dans la construction d’un diagramme de Pareto réside dans la lisibilité des libellés textuels positionnés sous l’axe horizontal. Lorsque les dénominations des modalités qualitatives comportent des intitulés polysyllabiques ou des descriptions techniques étendues, les étiquettes ont tendance à se chevaucher horizontalement, rendant l’axe d’abscisse totalement indéchiffrable. Le moteur graphique sous-jacent de R propose plusieurs mécanismes typographiques pour contourner cet écueil spatial.
Le paramètre d’orientation des étiquettes, conventionnellement désigné par l’argument las au sein des paramètres généraux de l’environnement graphique, constitue le premier levier d’ajustement. En fixant cette valeur à 1 ou à 2, l’analyste force une rotation systématique des libellés de l’axe horizontal, les affichant perpendiculairement à l’axe des abscisses. Cette orientation verticale offre un dégagement spatial optimal pour accueillir de longues chaînes de caractères sans risque de collision mutuelle.
Toutefois, la rotation verticale des textes requiert un redimensionnement proportionné des marges périphériques de la figure. En invoquant la fonction d’ajustement des paramètres graphiques par() en amont du tracé, l’utilisateur peut étendre la marge inférieure (premier élément du vecteur mar) afin d’éviter que les libellés verticaux ne soient tronqués par le cadre extérieur du périphérique d’affichage. De surcroît, le paramètre de mise à l’échelle typographique cex.names permet de réduire subtilement la taille de la police de caractères des modalités pour assurer un rendu aéré et harmonieux.
7.3 Ajout de repères analytiques et seuils personnalisés
Pour parfaire l’efficience heuristique du diagramme de Pareto, l’adjonction de repères graphiques sur mesure permet de matérialiser instantanément les seuils décisionnels adoptés par l’équipe de recherche. Bien que pareto.chart() trace spontanément un trait horizontal discontinu à la hauteur des 80 %, certains contextes industriels ou biomédicaux imposent l’exploration de seuils alternatifs plus sévères, tels que la barre des 90 % pour les défauts critiques de sécurité, ou celle des 70 % pour des interventions préliminaires ciblées.
L’intégration de lignes directrices s’effectue par l’invocation de fonctions de bas niveau du moteur de dessin de R venant enrichir le canevas existant sans en réinitialiser les coordonnées. La fonction standard de tracé de droites abline permet d’insérer des segments horizontaux à n’importe quelle cote spécifique de l’axe secondaire, en modulant la couleur du trait, sa structure discontinue (par le choix du type de ligne lty) et son épaisseur géométrique. Il est également possible d’abaisser une ligne orthogonale verticale depuis l’intersection de la courbe cumulative et du seuil des 80 % jusqu’à l’axe des abscisses, délimitant visuellement la frontière exacte du noyau critique.
L’analyste peut également enrichir la figure au moyen d’annotations textuelles directes en utilisant la primitive text(). Cette fonctionnalité offre l’opportunité de positionner une légende explicative ou d’inscrire le pourcentage exact au-dessus de chaque nœud polygonal de la courbe ogive. Ces annotations ponctuelles éliminent tout effort d’extrapolation oculaire pour le lecteur, qui peut lire instantanément la valeur de saturation statistique associée à chaque modalité sans devoir projeter son regard vers l’axe gradué opposé.
8. Étape alternative : Construction pas à pas d’un diagramme de Pareto avec ggplot2
8.1 Ingénierie des données préalable avec dplyr
Pour les analystes souhaitant intégrer leur production visuelle au sein d’un pipeline de science des données unifié respectant les standards du tidyverse, la construction manuelle d’un diagramme de Pareto sous ggplot2 constitue une démarche méthodologique d’une élégance et d’une puissance incomparables. Contrairement à l’approche encapsulée de qcc, cette voie exige une préparation explicite et transparente de la table de données en amont du tracé en mobilisant les opérateurs de transformation de dplyr.
La première phase de ce pipeline consiste à ordonner sans équivoque le data frame source selon les fréquences observées en appliquant le verbe de tri décroissant arrange(desc(frequence)). Une fois cette hiérarchie matérialisée dans l’agencement des lignes, l’analyste exploite la fonction mutate() pour générer séquentiellement les variables de cumul statistique. Deux colonnes calculées sont ainsi créées : le cumul arithmétique absolu produit par l’opérateur de sommation continue cumsum(), puis la proportion cumulative standardisée exprimée en pourcentage par rapport à la somme totale de l’échantillon.
L’étape charnière de cette préparation réside dans la redéfinition du statut de la variable qualitative de modalité. Si la colonne descriptive demeure encodée sous la forme d’un simple vecteur de chaînes de caractères brutes, ggplot2 procèdera inéluctablement à un reclassement alphabétique lors de la projection sur l’abscisse, détruisant instantanément la logique ordonnée de Pareto. Pour verrouiller spatialement la géométrie du graphique, la colonne catégorielle doit être explicitement transformée en un facteur R dont les niveaux (levels) épousent rigoureusement l’ordre séquentiel décroissant des fréquences.
8.2 Superposition de geom_bar et geom_line sur double échelle
La construction graphique sous ggplot2 repose sur l’assemblage modulaire de couches géométriques successives reliées par l’opérateur d’addition. L’infrastructure de base est initiée en déclarant la table de données transformée et en configurant l’esthétique globale, en assignant la variable factorielle ordonnée à l’axe des abscisses et la fréquence absolue brute à l’ordonnée primaire. La couche inaugurale matérialisant les rectangles d’occurrences est injectée via la commande geom_col(), laquelle préserve la hauteur exacte des décomptes précalculés sans appliquer de transformation statistique masquée.
L’intégration de la courbe cumulative et de ses points nodaux sur le même canevas soulève une problématique de calibrage dimensionnel majeure : l’ordonnée primaire est étalonnée sur une échelle de comptages absolus (pouvant atteindre des centaines ou des milliers d’unités), tandis que la progression cumulative évolue strictement sur un intervalle borné entre 0 et 100 %. Pour résoudre ce hiatus d’amplitude au sein d’un unique repère cartésien, l’analyste doit déterminer un facteur d’échelle multiplicateur défini comme le ratio strict entre la valeur maximale de l’axe des fréquences et la borne supérieure du cumul (100).
En mobilisant ce facteur de conversion scalaire, la couche linéaire geom_line() et la couche nodale geom_point() sont superposées aux colonnes existantes en appliquant une transformation homothétique directe à leur coordonnée verticale. En assignant la valeur calculée du pourcentage cumulé multipliée par ce coefficient scalaire à l’esthétique y de la courbe, les trajectoires polygonales viennent se déployer harmonieusement sur toute l’amplitude visuelle du graphique, s’alignant idéalement avec le sommet des rectangles sans distorsion projective.
8.3 Configuration de l’axe secondaire via sec_axis()
L’ultime opération mathématique et géométrique pour parachever le diagramme sous ggplot2 consiste à restituer visuellement l’axe vertical secondaire droit afin de rendre lisible la graduation de la courbe cumulative. Depuis la version 2.2.0 de ggplot2, cette fonctionnalité est orchestrée de manière rigoureuse au travers de la fonction d’échelle scale_y_continuous(), qui intègre un argument dédié à la construction des axes dérivés nommé sec_axis().
La spécification de sec_axis() exige une formulation mathématique explicite de la fonction inverse de celle appliquée lors de la superposition des couches géométriques. L’argument de transformation formelle attendu au sein de sec_axis() doit neutraliser le facteur d’échelle préalablement injecté en divisant la valeur projetée par ce même ratio multiplicateur, ramenant ainsi la lecture graduée sur l’intervalle canonique de 0 à 100 %. L’omission ou l’inversion de ce facteur de normalisation réciproque constituerait une erreur méthodologique sévère, aboutissant à une graduation fantaisiste sans rapport avec la réalité des données cumulées.
L’analyste configure également au sein de cette fonction les étiquettes textuelles distinctes associées aux deux ordonnées, en inscrivant par exemple « Nombre de non-conformités observées » pour le montant primaire gauche et « Pourcentage cumulé (%) » pour l’axe dérivé droit. De surcroît, les limites de l’échelle globale doivent être fixées de manière concertée pour débuter rigoureusement à zéro et s’achever à la cote maximale de l’échantillon N, tout en appliquant une expansion nulle ou modérée pour garantir que les bases des colonnes reposent sans flottement sur la ligne de référence horizontale.
9. Perfectionnement stylistique du diagramme ggplot2 selon les normes de publication
9.1 Application de thèmes académiques épurés
L’apparence graphique par défaut de ggplot2, reconnaissable à son arrière-plan grisâtre quadrillé de blanc, a été conçue pour l’exploration interactive rapide mais s’avère peu appropriée pour une reproduction formelle dans des périodiques scientifiques internationaux ou des rapports institutionnels de haut niveau. L’élévation de la figure aux critères d’excellence de la communication visuelle exige la purge intégrale du bruit graphique superflu, conformément aux préceptes d’épure visuelle formulés par Edward Tufte sur le ratio données/encre.
La substitution du thème d’origine par un environnement prédéfini minimaliste, tel que theme_classic() ou theme_minimal(), constitue la première étape d’assainissement esthétique. Ces thèmes éliminent d’emblée la trame grise d’arrière-plan au profit d’un canevas blanc pur et rétablissent la netteté des axes cartésiens orthogonaux tracés d’un trait noir franc. L’analyste affine ensuite cette configuration via la fonction polyvalente theme() en supprimant sélectivement les lignes de grille secondaires qui surchargent la composition sans apporter d’information discriminante.
La typographie générale doit faire l’objet d’une uniformisation rigoureuse. Il convient de prescrire des familles de polices à empattements neutres ou sans serif universellement reconnues (telles que Helvetica, Arial ou Latin Modern) et de calibrer hiérarchiquement les corps de caractères. Les intitulés des axes majeurs, les valeurs numériques des graduations et les libellés des catégories doivent adopter des tailles proportionnées garantissant une lisibilité optimale même en cas de réduction dimensionnelle de la figure lors de la mise en page éditoriale.
9.2 Mise en valeur visuelle des catégories critiques
L’un des avantages substantiels de la grammaire ggplot2 réside dans sa flexibilité pour mettre en relief de manière sélective les informations stratégiques. Alors qu’un tracé conventionnel colore l’ensemble des rectangles d’une teinte monotone, il est extrêmement profitable d’introduire une coloration conditionnelle différenciant instantanément les modalités appartenant au segment vital des 80 % de celles relevant de la traîne secondaire. Cette différenciation sémantique guide immédiatement l’attention cognitive du lecteur vers les priorités d’action.
Cette distinction s’opère en amont au sein de la table de données par la création d’un vecteur booléen ou d’un facteur binaire indiquant si la modalité considérée participe ou non au franchissement initial du seuil de Pareto. En associant cette variable indicatrice à l’esthétique de remplissage (fill) de la couche geom_col(), le chercheur peut assigner manuellement une bichromie contrastée via scale_fill_manual(), opposant par exemple une tonalité bleu acier affirmée pour les facteurs prioritaires à une nuance sable ou perle pour les facteurs périphériques.
Pour accentuer davantage la rigueur démonstrative, l’adjonction de lignes de repères segmentées s’avère particulièrement probante. L’utilisation de geom_segment() ou de la combinaison conjointe de geom_hline() et geom_vline() permet de tracer un faisceau discontinu partant de l’ordonnée 80 % sur l’axe droit, progressant horizontalement jusqu’à l’intersection de la trajectoire ogivale, puis s’abaissant verticalement vers l’axe des abscisses. Cet artifice géométrique matérialise sans ambiguïté le périmètre exact des causes racines sur lesquelles doit se focaliser l’arbitrage décisionnel.
9.3 Finalisation des légendes et métadonnées
Le perfectionnement ultime d’un artefact visuel destiné à la publication réside dans le soin méticuleux apporté à l’appareil textuel périphérique et aux métadonnées contextuelles. Un graphique scientifique ne doit jamais être livré de manière isolée ou silencieuse : il doit contenir en son sein toutes les clefs nécessaires à son intelligibilité autonome, selon le principe d’autonomie sémiotique des figures de recherche. L’appel à la fonction labs() permet de structurer cette couche d’information contextuelle.
Le titre principal doit synthétiser le message analytique majeur plutôt que d’énoncer un simple constat passif (« Hiérarchisation des non-conformités : prédominance des défauts d’assemblage »). Un sous-titre dynamique peut être exploité pour préciser la représentativité de l’échantillon, la méthode d’audit et la granulométrie temporelle des relevés. En bas de page, l’argument caption constitue l’emplacement privilégié pour consigner les mentions de sources primaires, la taille globale d’échantillonnage N, ainsi que d’éventuelles indications méthodologiques relatives au traitement des valeurs aberrantes ou résiduelles.
Enfin, la gestion de la légende chromatique mérite un arbitrage réfléchi. Si la coloration conditionnelle des barres a été explicitée par des étiquettes textuelles directes au sein du graphique ou si le contraste visuel est intuitivement décodé via le texte d’accompagnement, il est préférable de désactiver la boîte de légende superflue via l’instruction theme(legend.position = « none »). Cette économie d’encre libère un espace horizontal substantiel, permettant aux colonnes d’histogramme de s’épanouir sur toute la largeur utile sans compression latérale.
10. Applications empiriques du diagramme de Pareto en sciences comportementales et psychologiques
10.1 Hiérarchisation sémiologique des plaintes et symptômes cliniques
Bien que le diagramme de Pareto ait vu le jour dans le giron de l’économie politique et de l’ingénierie manufacturière, sa pertinence épistémologique s’étend avec une acuité particulière aux disciplines des sciences comportementales et de la psychiatrie clinique. Dans le cadre de protocoles d’évaluation diagnostique menés auprès de cohortes de patients souffrant de troubles complexes — tels que le syndrome de stress post-traumatique, les épisodes dépressifs majeurs ou les troubles anxieux généralisés —, les praticiens se heurtent fréquemment à une profusion sémiologique hétéroclite où s’entremêlent des dizaines de plaintes subjectives et de marqueurs comportementaux.
L’application d’une démarche parétienne permet d’agréger les fréquences d’expression de chaque entité symptomatique recensée au moyen d’échelles d’auto-évaluation standardisées ou d’entretiens cliniques structurés. En traçant le diagramme de Pareto des manifestations cliniques, l’équipe de recherche isole immédiatement le sous-ensemble restreint de symptômes qui condense l’essentiel de la charge pathologique rapportée par la cohorte. Cette démarche évite la dispersion des soignants face à des tableaux cliniques touffus.
Sur le versant thérapeutique, cette stratification statistique offre des retombées directes pour la médecine de précision et l’optimisation des thérapies cognitives et comportementales. En ciblant prioritairement les modules de remédiation sur les « facteurs vitaux » qui saturent les premiers 80 % de la souffrance exprimée — par exemple les réveils nocturnes précoces et les ruminations intrusives —, les cliniciens peuvent maximiser l’efficacité de l’intervention à brève échéance avant de traiter de manière individualisée les éléments symptomatiques périphériques.
10.2 Analyse des biais cognitifs et erreurs décisionnelles
Dans les domaines de l’ergonomie cognitive, des facteurs humains et de la psychologie de la sécurité au travail, l’analyse des défaillances opératoires constitue un axe de recherche névralgique. Qu’il s’agisse d’incidents aéronautiques, d’erreurs d’administration médicamenteuse en milieu hospitalier ou d’accidents industriels majeurs, l’investigation post-accidentelle s’attache à classifier les heuristiques défaillantes et les biais cognitifs ayant compromis la conscience de la situation des opérateurs.
Le recours au diagramme de Pareto sous R permet de cartographier la typologie des erreurs humaines répertoriées au sein des bases de données de retour d’expérience institutionnelles. En catégorisant les incidents selon des taxinomies psychologiques reconnues (telles que les erreurs de fixation d’attention, le biais de confirmation, l’excès de confiance ou les défauts de communication d’équipe), l’analyste met en lumière la concentration asymétrique des vulnérabilités cognitives au sein des situations critiques d’exploitation.
Les conclusions d’une telle analyse orientent de façon décisive l’ingénierie pédagogique des programmes de formation continue et la conception des interfaces homme-machine. Plutôt que de saturer les professionnels sous une masse informe de consignes réglementaires impossibles à assimiler dans l’urgence, les concepteurs de simulateurs peuvent focaliser les entraînements de gestion des ressources d’équipe (Crew Resource Management) sur la neutralisation des deux ou trois heuristiques fautives à l’origine de l’écrasante majorité des bifurcations accidentelles.
10.3 Exploitation dans les enquêtes d’opinion et psychométrie différentielle
L’exploitation des données issues d’enquêtes d’opinion, d’études de climat social ou de questionnaires psychométriques représente un autre terrain d’élection pour l’analyse parétienne. Face à des batteries de questions explorant la satisfaction d’usagers, l’engagement professionnel de collaborateurs ou l’adhésion à des mesures de santé publique, les analystes recourent trop systématiquement à des moyennes arithmétiques ou à des médianes d’échelles de Likert, écrasant ainsi la variance et masquant la topologie des mécontentements intenses.
En procédant au dénombrement exclusif des réponses critiques ou des motifs d’insatisfaction déclarés de manière ouverte par les participants, le diagramme de Pareto extrait la structure des griefs dominants. Cette approche met en exergue la non-linéarité des attentes individuelles : une poignée de dysfonctionnements récurrents génère la quasi-totalité du ressentiment perçu, tandis qu’un large catalogue de doléances individuelles ne reflète que des sensibilités idiosyncrasiques isolées.
Dans la perspective de la psychométrie différentielle, cette hiérarchisation ordonnée permet d’épurer les instruments d’évaluation lors des phases pilotes de calibration de tests. En identifiant les items dont la dispersion des réponses obéit à une loi de Pareto marquée, les psychométriciens peuvent discriminer les stimuli hautement discriminants de ceux qui n’apportent qu’un bruit redondant, contribuant ainsi à la mise au point de questionnaires plus courts, plus fidèles et dotés d’une validité incrémentielle supérieure.
11. Pièges méthodologiques, erreurs fréquentes sous R et solutions de débogage
11.1 Anomalies de réordonnancement des niveaux de facteurs
L’écueil le plus fréquemment rencontré par les praticiens lors de la transition des packages de base vers l’environnement ggplot2 réside dans l’altération intempestive de l’ordonnancement horizontal des catégories. Un data frame peut contenir des données parfaitement ordonnées de manière séquentielle dans ses lignes, mais dès lors que la commande d’affichage graphique est lancée, l’axe d’abscisse se réorganise spontanément selon un strict ordre alphabétique. Cet artéfact annihile la forme caractéristique du diagramme de Pareto, transformant les barres descendantes en une série de créneaux erratiques dénuée de sens analytique.
Ce phénomène s’explique par la sémantique interne du langage R : lorsqu’un vecteur de chaînes de caractères brutes (type character) est transmis à une esthétique graphique de ggplot2, la fonction le convertit implicitement en un facteur dont les niveaux sont arbitrairement indexés par ordre lexicographique. Pour contourner définitivement ce comportement par défaut, l’analyste doit impérativement expliciter l’attribut levels de la variable catégorielle en amont du tracé, soit en réassignant manuellement l’ordre via la fonction de base factor(vecteur, levels = vecteur_ordonne), soit en mobilisant l’opérateur hautement efficient fct_reorder() issu de l’extension forcats.
Une vigilance particulière doit être observée lors de l’actualisation dynamique des jeux de données. Si une nouvelle modalité fait son apparition au cours d’un relevé ultérieur et que les niveaux du facteur ont été codés en dur dans le script sous la forme d’une liste textuelle statique, cette nouvelle occurrence sera silencieusement convertie en valeur manquante (NA) lors de l’exécution graphique. L’automatisation du calcul des niveaux par injection directe des identifiants triés issus de la phase d’agrégation numérique constitue le seul gage d’invariance et de robustesse programmatique.
11.2 Erreurs de calcul sur la transformation de l’axe secondaire
La mise en œuvre de la double échelle cartésienne au sein de ggplot2 constitue une source récurrente de déconvenues mathématiques pour les utilisateurs non avertis. L’erreur typique consiste à injecter des pourcentages cumulés directement au sein de la fonction d’échelle sec_axis() sans avoir préalablement appliqué une homothétie sur la couche géométrique de tracé de la courbe. Cette omission se traduit graphiquement par une courbe polygonale écrasée sur la ligne de base du sol, totalement déconnectée visuellement des rectangles qu’elle est censée surmonter.
Pour prévenir cette déformation, l’analyste doit formaliser mathématiquement l’équation de liaison reliant l’espace des effectifs réels [0, Max_Y] à l’espace des pourcentages normés [0, 100]. Le facteur d’échelle multiplicatif k doit être rigoureusement calculé selon le ratio : k = Max_Y / 100. Lors de la déclaration de geom_line(), la variable de pourcentage cumulé doit impérativement être multipliée par ce coefficient k pour être projetée à l’altitude visuelle adéquate sur l’ordonnée primaire.
Symétriquement, au sein de l’instruction de définition de l’axe secondaire dérivé scale_y_continuous(sec.axis = sec_axis(~ . / k, …)), l’argument de transformation attendu est rigoureusement la transformation réciproque, c’est-à-dire une division scalaire par ce même facteur k. Tout écart arithmétique ou confusion entre multiplication et division dans cette clause brise la correspondance géométrique, affichant une graduation de droite totalement mensongère par rapport à la position physique des nœuds de la courbe ogivale.
11.3 Traitement rigoureux des catégories à effectifs nuls ou identiques
La présence de modalités catégorielles caractérisées par des décomptes nuls (effectif égal à zéro) ou par des effectifs rigoureusement identiques (situations d’ex æquo) soulève des arbitrages méthodologiques qui ne doivent pas être laissés au hasard des comportements algorithmiques des bibliothèques logicielles. L’inclusion intempestive de catégories vides dans un diagramme de Pareto encombre inutilement l’axe d’abscisse de barres d’épaisseur nulle et étire artificiellement la courbe cumulative sur un plateau horizontal stérile.
La bonne pratique consiste à appliquer un filtre conditionnel d’exclusion des occurrences nulles en amont de toute phase de calcul cumulatif. À moins qu’une contrainte réglementaire n’impose de tracer exhaustivement l’intégralité d’un répertoire standard de causes pour attester formellement de leur non-apparition lors de la campagne d’audit, les modalités à zéro occurrence doivent être purgées de la matrice d’analyse, leur prise en compte dégradant inutilement le ratio de lisibilité du graphique.
S’agissant des modalités partageant des effectifs rigoureusement équivalents, l’analyste doit prendre conscience que leur ordonnancement respectif au sein du classement parétien relève d’une convention purement arbitraire guidée par l’ordre d’apparition dans le fichier source ou par l’ordre alphabétique sous-jacent. Si deux catégories à fort effectif se trouvent ex æquo au voisinage immédiat du seuil critique des 80 %, l’inclusion de l’une plutôt que de l’autre au sein du cercle des « facteurs vitaux » introduit un biais décisionnel aléatoire. La mention formelle de cette égalité dans le corps du rapport et l’analyse conjointe de ces modalités soeurs évitent toute interprétation spécieuse fondée sur un artefact de classement.
12. Synthèse procédurale et flux de travail exportable pour publications scientifiques
12.1 Écriture d’une fonction R modulaire et automatisée
Pour pérenniser le savoir-faire acquis et garantir une efficience maximale lors du traitement récurrent de bases de données volumineuses, il est hautement recommandé d’encapsuler l’intégralité du pipeline d’ingénierie statistique et de rendu graphique au sein d’une fonction personnalisée robuste et réutilisable. Cette modularisation du code sous R affranchit l’analyste des fastidieuses opérations de copier-coller, réduisant drastiquement le risque d’erreurs de frappe et facilitant la maintenance logicielle au fil des projets.
Une fonction parétienne moderne doit être paramétrée pour accepter en entrée un tableau de données rectangulaire quelconque, les noms symboliques des colonnes d’intérêt (la variable catégorielle et le vecteur des effectifs), ainsi que des arguments optionnels permettant de personnaliser le titre, les seuils critiques et la palette chromatique. Grâce aux mécanismes d’évaluation non standard offerts par l’environnement rlang au sein du tidyverse, les noms de colonnes peuvent être transmis sous forme nue sans nécessiter de guillemets textuels rigides, conférant à la commande une fluidité d’usage remarquable.
Sur le plan de l’architecture logicielle, une fonction accomplie ne doit pas se cantonner à projeter une fenêtre graphique volatile : elle doit retourner une structure composite, conventionnellement matérialisée sous la forme d’une liste R nommée. Cet objet synthétique réunit d’une part la table de données enrichie des calculs statistiques de rangs et de cumuls (au format tibble), et d’autre part l’artefact graphique final de classe ggplot prêt pour l’inspection ou la sérialisation sur disque dur.
12.2 Exportation vectorielle haute définition (TIFF, PDF, EPS)
L’aboutissement d’une recherche scientifique ou d’un rapport technique réside dans la phase d’exportation matérielle des planches graphiques vers des formats de fichiers répondant aux normes draconiennes des éditeurs internationaux. Une erreur classique consiste à capturer le canevas graphique par une simple copie d’écran ou un export raster basse définition (tel qu’un fichier JPEG compressé), aboutissant à des artéfacts de pixellisation rédhibitoires dès lors que la figure est imprimée sur rotative professionnelle ou agrandie sur grand écran.
La commande universelle ggsave(), indissociable de l’environnement ggplot2, offre une interface d’exportation d’une précision millimétrique. L’analyste doit impérativement y spécifier les dimensions physiques absolues de l’illustration (en centimètres ou en pouces) en se calquant fidèlement sur les largeurs de colonnes de la revue cible (généralement 85 millimètres pour une composition sur simple colonne ou 175 millimètres pour une présentation sur double colonne). Le choix de l’extension de sortie dicte la nature du pilote de rendu sous-jacent.
Pour les supports nécessitant une pixellisation finale — tels que les fichiers au format TIFF fréquemment exigés dans les sciences biomédicales —, la résolution spatiale doit être formellement verrouillée à un minimum de 300 points par pouce (DPI), voire 600 DPI pour les dessins au trait. Toutefois, la recommandation ultime pour préserver l’intégrité graphique réside dans l’exportation au format vectoriel pur, tel que le PDF ou l’Encapsulated PostScript (EPS). Dans ces formats, chaque ligne polygonale, chaque caractère typographique et chaque rectangle d’histogramme est codé sous forme d’équations géométriques scalaires, garantissant une netteté absolue et une fidélité d’impression parfaite à n’importe quelle échelle de grossissement.
12.3 Check-list finale de conformité méthodologique
Avant d’apposer le sceau de validation définitive sur un diagramme de Pareto destiné à la diffusion publique ou à l’évaluation académique, il est salutaire de soumettre l’artefact produit à une grille d’audit qualité méthodologique rigoureuse. Cette check-list récapitule les prérequis incontournables garantissant l’exactitude analytique et la probité sémiologique de la représentation.
Le premier point de contrôle porte sur l’intégrité de la sommation d’échantillonnage : l’analyste doit vérifier formellement que l’assiette totale N correspond sans ambiguïté au recensement réel des observations et que le terme ultime de la courbe ogivale atteint très exactement 100,00 % sans dérive d’arrondi. Le second contrôle concerne la topologie des axes : l’axe vertical primaire gauche doit obligatoirement démarrer à l’ordonnée zéro pour prohiber tout écrasement flatteur des hauteurs, et l’axe secondaire droit doit être rigoureusement aligné avec le facteur de proportionnalité de la courbe cumulative.
Le troisième point d’attention audite la sémantique de l’abscisse : l’ordonnancement strictement décroissant doit être confirmé, et la modalité résiduelle composite éventuelle (« Divers » ou « Autres ») doit être reléguée sans exception à l’extrémité droite de l’axe, même si son décompte agrégé dépasse celui de catégories individuelles distinctes. Enfin, la traçabilité intégrale du code R source doit être assurée, permettant à n’importe quel tiers auditeur de reproduire à l’identique la figure finale à partir des données brutes initiales, scellant ainsi l’alignement absolu du protocole sur les standards contemporains de la science ouverte et reproductible.
Références
- Juran, J. M. (1951). Quality Control Handbook. McGraw-Hill. https://www.worldcat.org/title/quality-control-handbook/oclc/559868
- Pareto, V. (1896). Cours d’économie politique. F. Rouge. https://archive.org/details/coursdconomiepo00paregoog
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Scrucca, L. (2004). qcc: an R package for quality control charting and statistical process control. R News, 4(1), 11-17. https://cran.r-project.org/doc/Rnews/Rnews_2004-1.pdf
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag. https://ggplot2-book.org/
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686
- Wilkinson, L. (2005). The Grammar of Graphics (2e éd.). Springer. https://link.springer.com/book/10.1007/0-387-28695-0