
Dans le champ contemporain de la science des données et de la recherche empirique, la communication graphique constitue un vecteur déterminant de transmission de la connaissance scientifique. Loin de se réduire à un simple artifice d’illustration, la sémiologie graphique conceptualisée par Jacques Bertin rappelle que le traitement visuel de l’information participe intimement au processus de découverte et d’inférence statistique. Parmi l’éventail des représentations offertes par l’écosystème analytique contemporain, le diagramme à barres groupées occupe une place prépondérante dès lors qu’il s’agit d’analyser et de présenter des jeux de données structurés selon des plans factoriels complexes. Sa capacité à projeter simultanément une métrique quantitative continue sur un croisement de deux dimensions qualitatives discrètes en fait un outil d’exploration incontournable pour l’évaluation des effets principaux et des dynamiques d’interaction.
L’avènement de l’écosystème scientifique Python, porté par la bibliothèque de haut niveau Seaborn bâtie au-dessus du moteur d’affichage fondamental Matplotlib, a profondément redéfini l’ingénierie visuelle appliquée à la statistique descriptive et inférentielle. Seaborn ne se contente pas de simplifier les procédures de traçage géométrique : la bibliothèque impose une adéquation rigoureuse entre la structure formelle des données et leur transcription géométrique. La fonction dédiée aux diagrammes à barres, nativement synchronisée avec les tableaux de données structurés au format ordonné (dit tidy data), décharge le praticien des calculs fastidieux de décalages spatiaux, d’agrégation d’estimateurs centraux et d’estimation d’intervalles d’incertitude, tout en garantissant une conformité esthétique et ergonomique optimale.
Le présent traité méthodologique propose une exploration exhaustive, progressive et scientifiquement rigoureuse de la conception d’un diagramme à barres groupées au sein de Seaborn. Depuis les fondements théoriques justifiant le choix de cette modalité de représentation visuelle face à des alternatives concurrentes telles que les barres empilées, jusqu’aux procédures avancées de personnalisation typographique, d’étiquetage numérique direct et d’exportation matricielle et vectorielle conforme aux standards éditoriaux les plus stricts de l’American Psychological Association, chaque section vise à doter les chercheurs, statisticiens et ingénieurs de données des compétences pratiques nécessaires à l’élaboration de figures irréprochables sur les plans technique, statistique et sémiotique.
1. Fondements théoriques et pertinence du diagramme à barres groupées dans l’analyse de données
1.1 Définition conceptuelle et comparaison avec les diagrammes simples et empilés
Le diagramme à barres groupées, désigné dans la littérature anglo-saxonne sous l’appellation de grouped bar plot ou clustered bar chart, constitue un dispositif visuel bivarié ou trivarié conçu pour segmenter une variable dépendante continue à travers l’intersection de deux facteurs catégoriels distincts. Contrairement au diagramme à barres simple qui se borne à illustrer la variation d’une mesure à travers les modalités d’un unique facteur primaire, le groupement introduit une dimension d’analyse supplémentaire par l’adjonction d’un facteur secondaire. Ce dernier est spatialisé sous la forme de sous-colonnes juxtaposées au sein de chaque grappe discrète le long de l’abscisse. Cette disposition géométrique crée un regroupement spatial unifié qui invite l’œil du lecteur à opérer des comparaisons multiniveaux : d’une part, les variations intra-grappes qui éclairent l’impact du facteur secondaire à condition constante du facteur primaire, et d’autre part, les modulations inter-grappes qui traduisent l’évolution globale à travers le facteur principal.
L’avantage comparatif du diagramme groupé face au diagramme à barres empilées (stacked bar chart) réside principalement dans la psychophysique de la perception visuelle. Selon les travaux fondateurs de William S. Cleveland et Robert McGill sur la hiérarchie des tâches cognitives graphiques, la comparaison de longueurs alignées sur une ligne de base commune génère un taux d’erreur de jugement considérablement inférieur à celui provoqué par l’évaluation de longueurs non alignées ou de segments flottants. Dans un diagramme empilé, si la première modalité repose effectivement sur l’axe zéro, les modalités subséquentes démarrent à des hauteurs arbitraires dictées par l’amplitude des composantes sous-jacentes. Cette absence d’ancrage commun rend la comparaison quantitative directe des segments supérieurs extrêmement périlleuse et sujette à des illusions perceptives. Le diagramme à barres groupées neutralise ce biais cognitif en réalignant scrupuleusement chaque barre sur la ligne de base d’origine, préservant ainsi la précision absolue de la lecture métrique pour l’ensemble des sous-groupes.
Dans les champs empiriques exigeants tels que les sciences comportementales, la psychométrie, l’économie expérimentale et la biomédecine, cette fidélité d’évaluation visuelle s’avère indispensable. Dans ces disciplines, l’expérimentateur évalue fréquemment des réponses mesurées selon des protocoles à plans factoriels croisés, par exemple un facteur pharmacologique (traitement actif contre placebo) croisé avec un facteur démographique ou chronologique (phases temporelles pré- et post-intervention). L’alignement systématique de l’origine permet aux comités de lecture scientifique d’inspecter sans distorsion les amplitudes brutes, d’estimer instantanément les ampleurs d’effet et de juger de la cohérence interne des observations cliniques ou de laboratoire.
1.2 Conditions statistiques et typologie des variables requises
La mobilisation correcte d’un diagramme à barres groupées requiert une adéquation stricte entre la structure mathématique des données collectées et les primitives géométriques déployées sur le canevas. La variable assignée à l’axe des ordonnées (l’axe vertical dans une configuration classique) doit impérativement posséder une nature quantitative, qu’elle soit continue (comme une masse corporelle, une latence de réaction ou une concentration sérique) ou discrète issue d’un dénombrement ou d’un score agrégé d’items psychométriques. L’application d’une hauteur géométrique à une grandeur purement ordinale ou nominale constitue une aberration formelle qui violerait le principe fondamental selon lequel la surface ou la hauteur d’un rectangle physique est proportionnelle à la magnitude de la valeur numérique qu’elle prétend représenter.
Parallèlement, la projection spatiale horizontale exige la sélection de deux variables qualitatives ou catégorielles mutuellement indépendantes dans leur définition théorique. La première variable, généralement désignée comme le facteur primaire ou variable d’abscisse, structure les grappes principales, tandis que la seconde variable, couramment dénommée facteur de sous-groupement ou nuance chromatique (hue), orchestre la subdivision interne de chaque amas de barres. La cardinalité de ces facteurs, c’est-à-dire le nombre de modalités discrètes qu’ils comportent, exerce une influence critique sur la charge cognitive globale du graphique. Une cardinalité trop élevée sur le facteur d’abscisse (plus de huit à dix catégories) combinée à une cardinalité excessive du facteur de sous-groupement (plus de quatre ou cinq sous-niveaux) produit une surcharge d’informations visuelles. Cette prolifération de barres disjointes détériore la lisibilité globale et désoriente le lecteur face à une forêt de rectangles impossibles à interpréter globalement.
Il importe en outre de formaliser la distinction conceptuelle entre des données agrégées brutes et des jeux de données d’observations répétées. Dans les configurations où chaque ligne d’un tableau synthétise déjà une somme déterministe ou un pourcentage pré-calculé sans dispersion sous-jacente, la barre se borne à matérialiser une hauteur fixe. En revanche, lorsque le jeu de données compile de multiples observations indépendantes par croisement factoriel, la barre ne traduit plus une valeur scalaire brute mais devient l’incarnation d’un estimateur statistique ponctuel (le plus souvent la moyenne arithmétique ou la médiane conditionnelle). Cette dimension inférentielle exige que le traceur graphique associe impérativement à la hauteur de la barre une mesure de dispersion ou d’incertitude d’échantillonnage, sous peine de masquer la variabilité intrinsèque des phénomènes analysés.
1.3 Rôle de la visualisation dans la validation des hypothèses de recherche
Dans la démarche hypothético-déductive propre à la recherche scientifique, le diagramme à barres groupées agit comme une passerelle visuelle décisive entre la statistique exploratoire et la modélisation statistique confirmatoire. Sa fonction première consiste à révéler sans ambiguïté les potentiels effets d’interaction entre les deux facteurs explicatifs. Un effet d’interaction se manifeste statistiquement lorsque l’effet d’un facteur sur la variable dépendante varie en intensité ou en direction selon le niveau occupé par le second facteur. Sur le plan sémiologique, une absence d’interaction se matérialise par des profils de variations parallèles d’une grappe à l’autre : le différentiel de hauteur entre les sous-barres demeure constant à travers l’ensemble des modalités du facteur primaire. Inversement, toute non-parallélisme manifeste, tel qu’une inversion d’inclinaison ou une divergence d’écartement entre les sous-barres le long de l’abscisse, constitue l’indice visuel immédiat d’une interaction factorielle significative.
Cette visualisation préliminaire fournit un diagnostic intuitif indispensable en amont de la conduite formelle d’un modèle d’Analyse de Variance factorielle (ANOVA) à deux voies ou d’une régression linéaire généralisée à effets mixtes. Elle permet au statisticien de valider la pertinence de l’inclusion d’un terme d’interaction dans l’écriture formelle de son modèle linéaire. Au-delà des moyennes, l’inspection visuelle des marques de dispersion superposées aux barres permet d’apprécier sommairement l’hypothèse d’homoscédasticité, c’est-à-dire l’homogénéité de la variance à travers les différents sous-groupes expérimentaux. Si certaines barres présentent des étendues d’incertitude disproportionnellement larges par rapport à d’autres, l’analyste se trouve immédiatement alerté sur une violation potentielle des hypothèses de normalité et de constance de la variance résiduelle.
Néanmoins, la rigueur méthodologique impose de formuler une mise en garde épistémologique quant aux biais potentiels induits par la visualisation par barres. En condensant un ensemble potentiellement étendu d’observations individuelles en une surface opaque unique, le diagramme à barres masque la distribution sous-jacente des points, dissimulant l’éventuelle bimodalité d’un sous-échantillon ou la présence délétère de valeurs aberrantes (outliers). Une moyenne arithmétique visuellement flatteuse peut n’être que le produit artificiel d’une distribution hautement asymétrique polluée par un artefact de mesure. Le chercheur avisé doit donc concevoir le diagramme à barres groupées non pas comme une preuve probabiliste définitive, mais comme une projection synthétique hautement normalisée qui exige d’être validée par un examen rigoureux des résidus statistiques et des distributions de densité.
2. Configuration de l’environnement de travail Python et dépendances scientifiques
2.1 Installation et gestion des versions des bibliothèques clés
L’implémentation robuste d’un flux de travail analytique en Python repose impérativement sur la mise en place d’un environnement d’exécution isolé et déterministe. Dans le contexte de la science des données, l’utilisation anarchique de l’environnement racine du système d’exploitation engendre fréquemment des conflits de versions irréconciliables entre bibliothèques mathématiques compilées en C et moteurs de rendu graphique. L’analyste privilégiera donc l’instanciation d’un environnement virtuel autonome, déployé soit au moyen de l’utilitaire standard venv, soit par l’entremise du gestionnaire multi-plateforme Conda. Cette isolation logicielle garantit que les versions spécifiques de Seaborn, Matplotlib, Pandas et NumPy demeurent figées et reproductibles indépendamment des futures mises à jour du système hôte.
Le déploiement des paquets requis s’effectue au moyen du gestionnaire de paquets officiel de l’écosystème Python en exécutant les instructions de commande suivantes :
pip install –upgrade pip
pip install seaborn matplotlib pandas numpy
Il est crucial de prêter une attention rigoureuse à la matrice de compatibilité des bibliothèques. Les versions de Seaborn supérieures ou égales à la branche v0.12.0 ont introduit des remaniements majeurs d’architecture logicielle, standardisant notamment de nouvelles interfaces de calcul statistique et modifiant en profondeur le comportement de certains arguments de traçage. Par conséquent, il convient de s’assurer que la version conjointe de Matplotlib (idéalement supérieure à v3.6.0) et de Pandas (supérieure à v2.0.0) permette l’interopérabilité sans émission d’avertissements de dépréciation (DeprecationWarnings). L’exécution d’une routine d’assertion programmatique en début de script constitue à ce titre une excellente pratique d’ingénierie logicielle pour vérifier formellement l’intégrité de l’environnement avant tout calcul lourd.
Dans le cadre d’un travail interactif mené au sein de carnets Jupyter Lab ou Jupyter Notebook, la configuration des extensions de rendu graphique conditionne directement la lisibilité de la figure. Pour échapper au rendu pixellisé standard et garantir une restitution vectorielle parfaite des typographies et des traits géométriques, l’activation du format de rendu vectoriel SVG dans le noyau interactif est hautement recommandée. L’incorporation de la directive %config InlineBackend.figure_format = ‘svg’ ou la configuration de l’export rétinien permet d’obtenir un confort de lecture optimal sur les écrans modernes à haute densité de pixels.
2.2 Importation conventionnelle et initialisation du moteur graphique
L’organisation syntaxique du code source obéit à des conventions communautaires strictes établies au sein de la communauté scientifique Python. Les modules fondamentaux sont chargés dès l’en-tête du programme en adoptant les alias canoniques : import seaborn as sns pour la bibliothèque de haut niveau, import matplotlib.pyplot as plt pour l’interface de pilotage graphique de bas niveau, et import pandas as pd pour l’infrastructure matricielle tabulaire. Tout écart par rapport à ces abréviations conventionnelles détériore la lisibilité collaborative du code sans apporter le moindre bénéfice fonctionnel.
Dès l’importation effectuée, l’initialisation du moteur visuel passe par la configuration des thèmes graphiques globaux offerts par Seaborn. La fonction sns.set_theme() offre un point d’entrée centralisé pour contrôler simultanément la palette de couleurs par défaut, les styles de bordures, la présence ou l’absence de grilles d’alignement ainsi que l’échelle typographique des annotations. En spécifiant explicitement des contextes tels que context= »paper » ou context= »notebook », l’utilisateur indique à la bibliothèque l’environnement cible de lecture, ce qui déclenche un recalcul automatique des proportions des fontes, de la largeur des bordures et des espacements relatifs des marges périphériques.
Il s’avère conceptuellement indispensable d’appréhender la relation hiérarchique qui unit Seaborn à Matplotlib. Seaborn ne constitue en aucune manière une entité graphique disjointe ou concurrente de Matplotlib. Elle opère fondamentalement comme une surcouche déclarative de très haut niveau qui délègue l’intégralité du rendu visuel aux primitives de Matplotlib. Chaque appel à une fonction Seaborn instancie ou manipule des objets sous-jacents de type matplotlib.figure.Figure et matplotlib.axes.Axes. Cette synergie structurelle signifie que l’utilisateur peut à tout moment enrichir, corriger ou outrepasser les automatismes de Seaborn en invoquant directement les méthodes natives de bas niveau de Matplotlib sur l’objet d’axe retourné. Cette complémentarité fonctionnelle offre un équilibre remarquable entre la vélocité d’instanciation statistique de Seaborn et la précision d’ajustement géométrique chirurgicale offerte par Matplotlib.
3. Étape 1 – Structuration et préparation rigoureuse du jeu de données avec Pandas
3.1 Création du DataFrame à partir de données expérimentales ou d’observation
L’intégrité de la représentation graphique dépend inexorablement de la précision et de la structure du tableau de données sous-jacent. Afin d’ancrer notre démarche dans un scénario réaliste de recherche expérimentale en psychologie cognitive appliquée, nous allons concevoir un jeu de données simulant les performances attentionnelles d’individus soumis à différents niveaux de stress environnemental à travers plusieurs moments d’une journée de travail. Les colonnes du tableau contiendront le jour d’évaluation (facteur primaire d’abscisse), la condition expérimentale appliquée au sujet (facteur de sous-groupement : « Contrôle », « Bruit modéré », « Bruit intense »), et le score de performance cognitive mesuré sous la forme d’un indice quantitatif continu variant sur une échelle de 0 à 100.
L’instanciation de cette structure au moyen de Pandas s’effectue en veillant méticuleusement à l’attribution explicite des types de données (dtypes). Les scores quantitatifs doivent impérativement être transtypés en formats numériques flottants (float64) ou entiers signés, tandis que les identifiants de conditions et de cycles temporels doivent être convertis en types catégoriels ou textuels explicites. L’omission de cette rigueur de typage peut induire le moteur d’inférence statistique de Seaborn en erreur, le poussant par exemple à interpréter une modalité expérimentale codée numériquement (comme 1, 2 et 3) comme un continuum continu plutôt que comme des catégories distinctes, ce qui anéantirait l’architecture factorielle du diagramme à barres groupées.
Une phase de validation sanitaire des données doit systématiquement précéder tout appel aux fonctions graphiques. Cette étape consiste à inspecter l’exhaustivité dimensionnelle du DataFrame et à repérer la présence de valeurs nulles ou manquantes (représentées par l’indicateur NaN pour Not a Number). Bien que Seaborn gère nativement l’omission des valeurs manquantes lors de la phase d’estimation agrégée, leur présence non documentée peut altérer le calcul des degrés de liberté et fausser l’amplitude des intervalles de confiance calculés par rééchantillonnage. L’utilisation méthodique des fonctions d’inspection tabulaire telles que info() et describe() permet de certifier l’équilibre expérimental du jeu de données avant toute tentative de modélisation visuelle.
3.2 Importance du format long (tidy data) pour Seaborn
L’architecture interne de Seaborn repose intégralement sur le paradigme des données ordonnées formalisé par Hadley Wickham sous l’appellation de tidy data. Les principes cardinaux de ce standard formel s’énoncent avec une limpidité géométrique : chaque variable mesurée doit constituer une colonne distincte, chaque unité observationnelle individuelle doit former une ligne unique, et chaque cellule du tableau doit héberger une valeur scalaire atomique. Dans la terminologie des bases de données et de la manipulation tabulaire, ce formalisme correspond rigoureusement au « format long » (long-form format), qui s’oppose conceptuellement au « format large » (wide-form format).
Dans un format large traditionnel hérité des habitudes d’encodage sur tableur bureautique, les différentes conditions expérimentales sont souvent éparpillées en autant de colonnes distinctes (par exemple, une colonne dédiée aux scores du groupe témoin et une autre colonne aux scores du groupe traité). Bien que cette présentation s’avère confortable pour la saisie manuelle, elle se révèle structurellement incompatible avec la mécanique déclarative de Seaborn. L’argument central hue, qui gouverne la subdivision des grappes de barres, exige de pointer vers le nom d’une unique colonne d’attribut catégoriel qui discrimine l’appartenance factorielle de chaque enregistrement individuel.
Lorsque le statisticien est confronté à une structure tabulaire au format large, il doit impérativement procéder à une restructuration dimensionnelle préalable en déployant la fonction de fusion vectorielle pandas.melt(). Cette opération matricielle a pour effet de pivoter les colonnes désignées vers le bas pour recomposer une colonne de libellés factoriels et une colonne unique de valeurs numériques associées. Cette normalisation préalable constitue le prérequis absolu sans lequel il devient impossible d’exploiter la puissance syntaxique de Seaborn, car toute tentative de forçage sur des formats larges imbriqués aboutit à une complexification ingérable des scripts et à la neutralisation des mécanismes d’automatisation statistique.
3.3 Gestion des facteurs catégoriels ordonnés
Un écueil analytique fréquent réside dans l’ordonnancement par défaut des modalités qualitatives le long des axes du graphique. Par construction algorithmique, lorsqu’une colonne textuelle classique (de type chaîne de caractères object) est passée à Seaborn, le moteur classe automatiquement les niveaux selon l’ordre alphabétique standard ou selon l’ordre d’apparition séquentiel au sein du fichier source. Dans le contexte de variables intrinsèquement ordonnées, telles que les jours d’une semaine de travail chronologique (lundi, mardi, mercredi, jeudi, vendredi) ou des paliers d’intensité expérimentale (faible, moyen, fort), un agencement alphabétique produit une incohérence cognitive majeure en plaçant, par exemple, le jeudi avant le lundi ou le niveau moyen avant le niveau faible.
Pour prévenir cette déstructuration temporelle ou logique, le statisticien doit transformer explicitement la série Pandas correspondante en une variable de type catégoriel ordonné en exploitant la classe spécialisée pd.CategoricalDtype. Cette instanciation requiert la définition exhaustive d’une liste ordonnée des catégories et l’activation du paramètre booléen ordered=True. Lors de la conversion de la colonne, Pandas intègre de manière immuable la hiérarchie relative des modalités au niveau des métadonnées de la structure de données.
L’impact de ce verrouillage sémantique sur la chaîne de traitement graphique est immédiat et systématique. Dès lors que la colonne catégorielle ordonnée est injectée dans les routines de traçage, Seaborn lit directement l’ordre formel encapsulé dans le type de données sans nécessiter d’interventions manuelles répétitives au niveau des arguments de tracé. Cette rigueur garantit la parfaite reproductibilité de la disposition horizontale des grappes de barres à travers tous les sous-panneaux d’analyse, prévenant les erreurs d’interprétation humaine causées par des commutations d’axes intempestives au fil du traitement de multiples sous-échantillons.
4. Étape 2 – Génération du diagramme à barres groupées fondamental avec Seaborn
4.1 Syntaxe essentielle de la fonction sns.barplot
La matérialisation d’un diagramme à barres groupées s’articule autour de l’invocation de la fonction déclarative seaborn.barplot(). L’élégance de l’API de haut niveau réside dans la clarté sémantique de ses arguments directeurs, qui établissent un pont direct entre les colonnes du DataFrame et les dimensions perceptives du repère cartésien. La signature élémentaire de l’instruction mobilise conjointement quatre paramètres cruciaux :
- data : spécifie l’instance du DataFrame Pandas hébergeant les données dans leur format long normalisé ;
- x : désigne formellement le nom de la variable catégorielle primaire dont les modalités formeront les grappes discrètes ordonnées sur l’axe des abscisses ;
- y : pointe vers la variable quantitative continue dont les grandeurs doivent être agrégées pour déterminer la hauteur géométrique de chaque rectangle ;
- hue : désigne la variable catégorielle secondaire qui scinde spatialement chaque grappe en barres individuelles juxtaposées et assigne à chacune une nuance chromatique distincte.
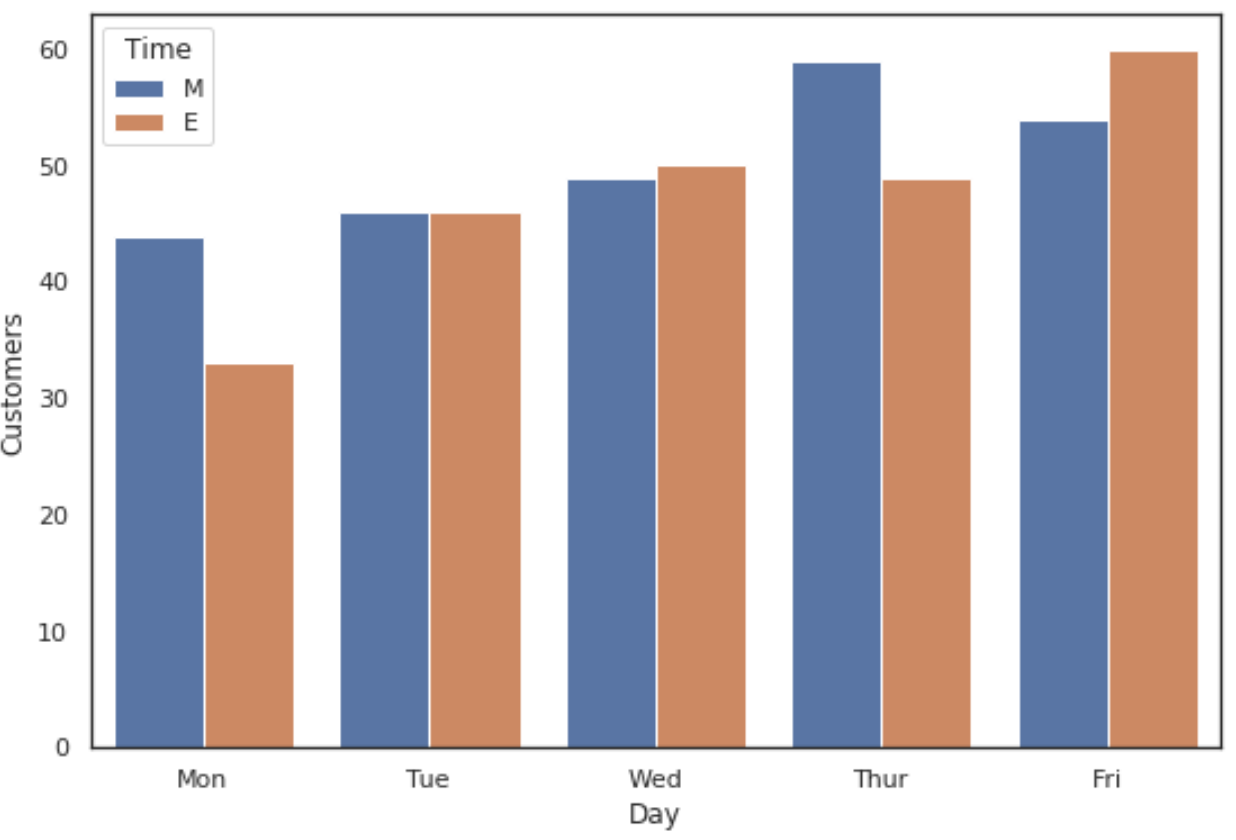
Sur le plan opérationnel, l’appel combiné ax = sns.barplot(data=df, x= »Jour », y= »Score », hue= »Condition ») déclenche une cascade computationnelle automatisée d’une grande complexité. Seaborn segmente le tableau de données selon le produit cartésien formé par les niveaux de la variable x et les niveaux de la variable hue. Pour chaque sous-ensemble d’observations résultant, le moteur calcule l’estimation centrale par défaut (la moyenne arithmétique des scores) ainsi que l’incertitude afférente, puis délègue le dessin physique des rectangles au moteur de rendu graphique de Matplotlib.
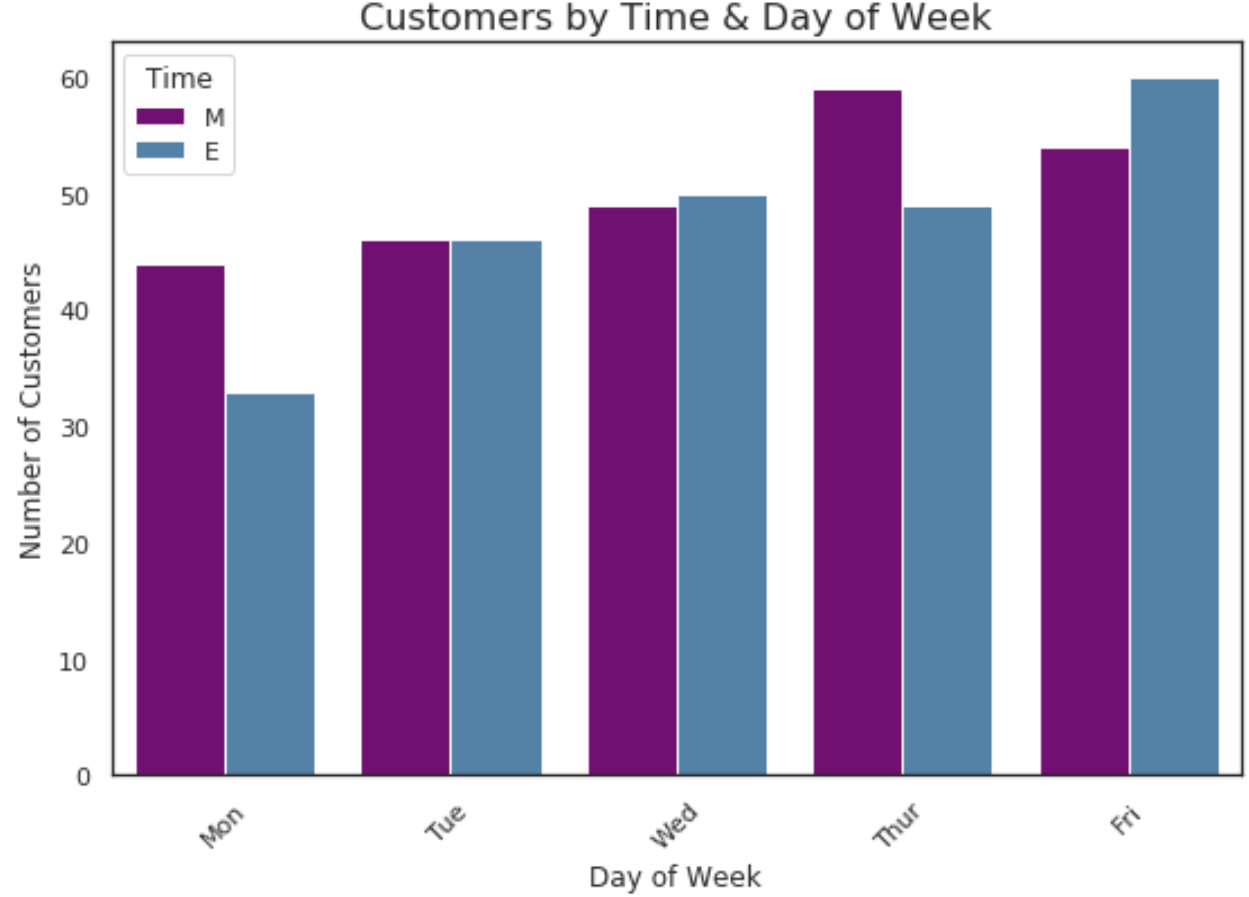
Ce paradigme déclaratif dispense le chercheur de devoir programmer manuellement le partitionnement des données, le calcul des moyennes vectorielles ou le positionnement trigonométrique des décalages sur l’axe horizontal. L’intégralité du processus de structuration visuelle s’exécute en une instruction lisible, hautement expressive et directement maintenable au sein d’une chaîne de traitement automatisée.
4.2 Anatomie de la figure générée et conteneurs d’objets
Pour dépasser le stade de l’utilisation superficielle et exercer une maîtrise absolue sur le résultat graphique, il est indispensable de disséquer l’anatomie de l’objet produit par l’instruction sns.barplot. La fonction retourne une référence directe vers un objet d’axe matplotlib.axes.Axes. Cet objet constitue le réceptacle fondamental contenant l’intégralité des éléments géométriques de la scène visuelle : les lignes d’axes (spines), les graduations majeures et mineures (ticks), les étiquettes textuelles (tick labels), le canevas de fond, ainsi que la collection exhaustive des formes géométriques générées.
Les barres matérielles ne sont pas de simples traits vectoriels flottants ; elles sont organisées et encapsulées au sein de structures appelées BarContainer, accessibles via la propriété ax.containers. Chaque conteneur correspond à un niveau spécifique du facteur assigné à l’argument hue et rassemble les instances individuelles d’objets géométriques matplotlib.patches.Rectangle répartis le long de l’abscisse. Chaque rectangle possède des propriétés physiques intrinsèques modifiables par programme : des coordonnées absolues d’ancrage dans le repère, une largeur (width), une hauteur métrique (height), une couleur de remplissage (facecolor), une couleur de contour (edgecolor) et un degré d’opacité.
La disposition juxtaposée des barres le long de l’axe des abscisses est pilotée par un calcul rigoureux de décalages géométriques (offsets). Plutôt que de centrer toutes les barres sur la coordonnée entière de la graduation (par exemple, x = 0 pour la première journée), Seaborn calcule l’espacement requis pour loger côte à côte les barres correspondant aux différentes modalités de hue, tout en préservant des intervalles d’espacement vides (padding) harmonieux entre les grappes voisines. Cette gestion spatiale automatique garantit que la lecture visuelle distingue spontanément les blocs factoriels indépendants sans risquer de collision de tracé.
5. Paramétrage avancé de la fonction sns.barplot et rôle de l’argument hue
5.1 Comportement du paramètre hue et division des groupes
L’argument hue gouverne la décomposition multidimensionnelle du diagramme en barres groupées, mais son action dépend étroitement de l’argument connexe dodge. Par défaut, la valeur booléenne de dodge est positionnée sur True dans sns.barplot. Ce comportement impose une translation latérale géométrique des barres associées à chaque sous-catégorie afin d’éviter tout chevauchement physique au sein de la même grappe. Si un utilisateur forçait l’affectation dodge=False, Seaborn annulerait les décalages horizontaux et superposerait tous les rectangles d’un même groupe sur la même position centrale d’abscisse, transformant le graphique en un tracé obstrué où les barres les plus hautes masqueraient irrémédiablement les plus petites.
Un défi classique dans l’analyse de données expérimentales réside dans le traitement des plans factoriels incomplets ou déséquilibrés, c’est-à-dire des situations où certaines combinaisons entre les modalités de x et les modalités de hue ne renferment aucune observation empirique. Dans une telle occurrence, Seaborn gère par défaut la vacuité en laissant un vide spatial proportionné au sein de la grappe concernée, afin de préserver l’alignement strict des sous-barres d’une grappe à l’autre. Si cette rigueur spatiale est indispensable pour maintenir la comparaison visuelle, elle peut parfois générer des dissymétries visuelles perturbantes si la largeur des barres restantes n’est pas convenablement harmonisée.
L’utilisateur peut également ajuster la largeur relative des barres au moyen du paramètre width, qui contrôle le pourcentage d’espace total alloué à chaque grappe sur l’intervalle unitaire de l’abscisse. Un paramétrage minutieux de la largeur permet d’ajuster l’équilibre esthétique entre la densité d’information affichée et les zones de respiration visuelle nécessaires à une lecture sereine, évitant ainsi l’impression de compression étouffante ou, au contraire, d’isolement disproportionné des signaux visuels.
5.2 Contrôle de l’ordre des variables explicatives
L’un des prérequis cardinaux de la communication scientifique réside dans la maîtrise absolue de l’ordre d’agencement des éléments d’analyse. La dispersion arbitraire des groupes ou des conditions affaiblit l’impact de la démonstration expérimentale. Pour figer de manière formelle et déterministe la séquence des modalités primaires sur l’axe horizontal, Seaborn met à disposition l’argument direct order. En lui transmettant une liste ordonnée explicite de libellés textuels, le chercheur dicte au compilateur graphique la progression exacte souhaitée de gauche à droite sur l’axe des abscisses, neutralisant tout ordonnancement implicite dépendant du tri d’entrée des données.
De manière rigoureusement analogue, l’ordonnancement interne des sous-groupes au sein de chaque grappe est gouverné par l’argument hue_order. Ce paramètre prend en charge une liste ordonnée désignant la séquence des modalités du facteur secondaire. Ce paramétrage assure que l’agencement interne des rectangles et la succession des entrées dans le bloc de légende suivent une logique scientifique rigoureuse, dictée par les hypothèses de travail plutôt que par les contingences du code source.
Cette maîtrise de l’ordre spatial revêt une importance capitale dans les protocoles biomédicaux et psychométriques standards. Dans de tels dispositifs d’expérimentation, il est méthodologiquement primordial de positionner systématiquement la condition de référence ou le groupe témoin (control group) en première position sur la gauche de chaque grappe, suivi successivement des groupes d’intervention selon un gradient logique d’intensité ou de chronologie. Cette constance structurelle permet au lecteur d’ancrer son regard sur la norme de base avant de balayer horizontalement les effets thérapeutiques ou expérimentaux successifs, minimisant ainsi la charge cognitive superflue.
6. Contrôle des estimateurs statistiques et calcul des intervalles de confiance
6.1 Modification de la fonction d’agrégation centrale
Par défaut, l’architecture computationnelle de sns.barplot agrège les observations multiples de chaque sous-groupe factoriel au moyen de l’estimateur de la moyenne arithmétique classique (équivalent à la fonction numpy.mean). Si la moyenne constitue l’indicateur central par excellence dans le cadre de distributions gaussiennes symétriques idéales, son emploi devient profondément contestable dès lors que la variable mesurée présente une forte asymétrie de distribution (skewness) ou se trouve altérée par des valeurs atypiques extrêmes, comme c’est classiquement le cas pour des variables telles que les temps de réaction mentale, les revenus monétaires ou les concentrations immunitaires.
Pour adapter la géométrie de la barre à la réalité de la distribution sous-jacente, Seaborn permet de substituer à l’estimateur par défaut n’importe quelle fonction d’agrégation statistique par l’entremise du paramètre estimator. En assignant par exemple estimator=numpy.median, la hauteur physique des barres matérialisera désormais la médiane conditionnelle de chaque cellule factorielle. Ce choix confère au graphique une robustesse méthodologique accrue face aux distorsions induites par des queues de distribution prononcées, reflétant plus fidèlement le point de bascule de la moitié centrale de la population étudiée.
Le paramètre estimator ne se cantonne pas aux seules primitives mathématiques de base. L’analyste peut lui transmettre des fonctions personnalisées complexes, définies sous la forme de routines Python ou de fonctions anonymes (lambda). Il devient ainsi possible d’illustrer visuellement des moyennes tronquées (trimmed means), des ratios spécifiques ou des fonctions de pondération empirique élaborées. Cette flexibilité algorithmique garantit que la réduction dimensionnelle opérée par la surface géométrique traduit scrupuleusement la décision théorique formulée par le statisticien.
6.2 Paramétrage des barres d’erreur et intervalles statistiques
Depuis la refonte majeure intervenue dans Seaborn v0.12.0, l’ancien paramètre ci (abréviation de confidence interval) a été formellement déprécié au profit d’un argument à la sémantique unifiée et considérablement plus expressive : errorbar. La transcription visuelle de l’incertitude ne doit jamais être abandonnée au hasard ou à des configurations floues. L’argument errorbar accepte une gamme étendue de spécifications statistiques permettant d’éclairer le lecteur sur la métrique de dispersion représentée :
- Intervalles de confiance par rééchantillonnage (bootstrap) : spécifiés par la chaîne errorbar= »ci » ou sous forme de tuple errorbar=(« ci », 95), ils mettent en œuvre une simulation stochastique par tirages aléatoires avec remise pour estimer les bornes non paramétriques de l’intervalle de confiance entourant la moyenne, généralement fixé au seuil de 95 % ;
- Écart-type empirique : configuré via l’instruction errorbar= »sd », il représente directement la dispersion descriptive brute des observations autour de leur moyenne au sein de l’échantillon, offrant une mesure pure de variabilité biologique ou comportementale ;
- Erreur-type de la moyenne : spécifiée par errorbar= »se », elle modélise l’écart-type de la distribution d’échantillonnage théorique de la moyenne arithmétique, directement calibrée sur l’inverse de la racine carrée de la taille d’échantillon ;
- Intervalles de centiles : déclarés sous la forme errorbar=(« pi », 50), ils projettent des étendues interquartiles ou des plages percentiles spécifiques autour de la médiane estimée.
Dans les configurations méthodologiques où le jeu de données d’origine consiste en une table d’agrégats pré-calculés ne comportant qu’une observation unique par intersection factorielle, ou lorsque l’analyste visualise des comptages exhaustifs dénués de variabilité stochastique, il convient de désactiver délibérément le calcul des barres d’erreur en précisant errorbar=None. Cette désactivation prévient l’émission d’avertissements de calcul computationnel et garantit un canevas graphique net, débarrassé de marqueurs d’incertitude factices de longueur nulle.
6.3 Personnalisation graphique des marques d’incertitude
Au-delà de leur assise mathématique, les marques d’incertitude nécessitent un ajustement de leur rendu géométrique pour optimiser la sémiotique de l’ensemble. L’argument capsize offre la possibilité d’ajouter des segments orthogonaux d’extrémité (familièrement appelés chapeaux ou moustaches d’erreur). En spécifiant une valeur numérique flottante telle que capsize=0.15, Seaborn dessine des ailettes horizontales proportionnées au sommet et à la base de la barre d’erreur, facilitant la lecture précise des bornes numériques supérieures et inférieures le long des repères de l’axe vertical.
Les versions récentes de Seaborn consolident la configuration des attributs de tracé des barres d’erreur à l’aide de l’argument dictionnaire err_kws. Par son entremise, le programmeur contrôle avec précision la largeur des traits de dispersion (linewidth), leur teinte chromatique (color) ainsi que leur degré d’opacité (alpha). Par exemple, l’injection de la directive err_kws={‘linewidth’: 1.5, ‘color’: ‘#2C3E50’} confère aux marques d’erreur une présence visuelle affirmée mais mesurée, évitant les traits filiformes illisibles lors de l’impression sur papier comme les lignes excessivement épaisses susceptibles de masquer le sommet des rectangles.
Une mise en garde sémiologique primordiale doit être formulée quant à l’interprétation des barres d’erreur par le lectorat académique. Une méprise fréquente consiste à déduire une absence de différence statistiquement significative du simple fait que les barres d’erreur de deux groupes adjacents se chevauchent visuellement. Dans le cas d’intervalles de confiance à 95 %, un chevauchement modéré peut parfaitement coexister avec une valeur de p inférieure au seuil conventionnel de 0,05 dans un test de Student. Le chercheur consciencieux se doit d’expliciter sans ambiguïté la nature exacte de l’estimateur déployé dans les légendes textuelles d’accompagnement de ses figures.
7. Personnalisation esthétique et application des palettes chromatiques
7.1 Choix et application de palettes de couleurs scientifiquement fondées
L’attribution de la couleur dans un graphique scientifique ne relève pas d’une préférence artistique subjective, mais d’une convention cognitive régie par des impératifs d’accessibilité universelle et de fidélité perceptive. Le facteur de sous-groupement assigné à hue véhiculant des modalités qualitatives sans graduation ordinale continue inhérente, le recours à une palette de couleurs purement catégorielle s’impose de manière impérative. Seaborn intègre nativement des palettes standard optimisées telles que « tab10 », « muted » ou « deep », activables sans friction au moyen du paramètre dédié palette.
Une responsabilité déontologique majeure incombe à l’analyste : garantir la parfaite perceptibilité de ses figures pour les lecteurs atteints d’anomalies de la vision chromatique, comme le daltonisme (deutéranopie, protanopie ou tritanopie), qui touche environ 8 % de la population masculine mondiale. L’emploi non critique de palettes combinant indistinctement le rouge vif et le vert saturé constitue une faute d’accessibilité qui rend les sous-groupes indiscernables pour ces lecteurs. Seaborn résout élégamment ce défi par l’intégration de la palette spécialisée palette= »colorblind », conçue scientifiquement pour maximiser les contrastes de luminance et de chroma perceptibles par l’ensemble des systèmes visuels humains.
Pour répondre à des chartes éditoriales académiques ou institutionnelles sur mesure, Seaborn autorise le passage direct d’un dictionnaire d’association chromatique personnalisé au paramètre palette. Dans cette structure, chaque niveau catégoriel du facteur de nuance est explicitement couplé à une valeur hexadécimale rigoureusement choisie, comme l’illustre la construction conceptuelle suivante :
- palette={« Contrôle »: « #4A7BB7 », « Bruit modéré »: « #F28E2B », « Bruit intense »: « #E15759 »}
Cette approche manuelle permet d’assurer une parfaite cohérence visuelle à travers l’ensemble des figures d’un mémoire ou d’un manuscrit scientifique, tout en garantissant une neutralité émotionnelle indispensable qui préserve l’esprit critique du lecteur.
7.2 Ajustement de la texture, des contours et de la transparence
L’optimisation graphique d’un tracé factoriel implique également la modulation de la texture géométrique des rectangles. L’argument alpha, qui contrôle l’opacité sur une échelle variant de 0 (transparence totale) à 1 (opacité absolue), permet d’adoucir la présence de masses chromatiques massives sur la page. Un ajustement d’opacité fixé aux alentours de alpha=0.85 ou 0.90 atténue la fatigue visuelle induite par des aplats trop agressifs tout en préservant le contraste nécessaire pour discriminer distinctement chaque sous-condition factorielle.
La précision de lecture des limites des barres est grandement magnifiée par l’application de contours contrastés au moyen des arguments conjoints edgecolor et linewidth. L’affectation d’une bordure discrète, matérialisée par edgecolor= »black » ou une tonalité anthracite foncée associée à une épaisseur fine telle que linewidth=1.0, permet de délimiter rigoureusement les rectangles de chaque grappe sans empâter le tracé. Cette technique s’avère particulièrement salutaire lorsque deux barres adjacentes présentent des tonalités de couleurs proches ou lorsque la figure est susceptible d’être reproduite en niveaux de gris lors d’impressions physiques économiques.
Cette modération esthétique s’aligne fidèlement sur les préceptes universels de minimalisme énoncés par le théoricien de l’information visuelle Edward Tufte. Tufte a théorisé le concept cardinal de ratio « encre-données » (data-ink ratio), postulant que chaque milligramme d’encre imprimé sur une surface graphique doit correspondre à une particule d’information utile, à l’exclusion de tout ornement non fonctionnel. L’élimination des dégradés inutiles, des effets de relief pseudotridimensionnels désuets et des bordures excessives recentre l’attention cognitive sur la géométrie des données statistiques.
8. Optimisation des axes, des étiquettes et de la lisibilité des échelles
8.1 Édition typographique des labels et titres scientifiques
La production d’une figure de calibre académique exige une finition typographique rigoureuse. Les dénominations brutes de variables informatiques héritées des bases de données de travail (telles que « score_att_brut » ou « cond_exp_code ») doivent être proscrites des figures destinées à la diffusion publique. Elles doivent impérativement être substituées par des libellés scientifiques complets, formellement rédigés en français ou en anglais académique, et systématiquement pourvus de leurs unités de mesure internationales formalisées entre parenthèses.
Cette opération d’enrichissement textuel se concrétise en exploitant les méthodes d’accès dédiées de l’objet d’axe retourné par Seaborn. L’invocation de ax.set_xlabel() et ax.set_ylabel() permet d’éditer la teneur textuelle des axes tout en modulant leur police, leur graisse typographique (fontweight= »bold ») ainsi que leur corps typographique exprimé en points typographiques (fontsize=12). L’espacement physique séparant le titre de l’axe des graduations chiffrées peut être finement régulé au moyen de l’argument labelpad, prévenant ainsi toute collision physique inesthétique.
Le couronnement textuel du graphique réside dans la configuration de son titre formel par l’entremise de ax.set_title(). Un titre scientifique de qualité ne se contente pas d’annoncer les dimensions en présence ; il doit synthétiser la condition d’expérience et expliciter les conditions de validité de l’observation. L’ajustement du paramètre d’espacement supérieur pad=15 confère à la figure un équilibre aéré, permettant d’isoler visuellement le titre de la masse des barres géométriques situées en contrebas.
8.2 Configuration fine des graduations et de l’échelle numérique
L’étalonnage de l’axe des ordonnées constitue le siège d’un enjeu d’intégrité scientifique d’une importance capitale. Dans un diagramme à barres, dont la sémiologie repose sur l’hypothèse perceptive que la hauteur physique du rectangle reflète fidèlement la magnitude du phénomène quantitatif, le point d’origine zéro doit impérativement figurer sur le tracé. Le tronquage artificiel de l’axe vertical pour grossir artificiellement d’infimes variations résiduelles constitue une manipulation visuelle trompeuse documentée par Darrell Huff dans son ouvrage classique sur les distorsions statistiques. L’utilisation explicite de l’instruction ax.set_ylim(bottom=0) verrouille l’ancrage au zéro absolu, garantissant la loyauté méthodologique de la représentation.
La gestion des graduations de l’axe horizontal (tick labels) appelle également un traitement géométrique adapté. Lorsque les libellés des modalités du facteur primaire s’avèrent étendus sur le plan lexical, leur disposition horizontale classique risque d’induire des superpositions textuelles désastreuses. Pour contourner cet écueil sans abréger arbitrairement les termes scientifiques, il est recommandé d’incliner légèrement le texte le long de son axe d’ancrage en invoquant ax.tick_params(axis=’x’, rotation=30) ou en ajustant l’alignement horizontal par ha=’right’. Cette rotation angulaire préserve l’intégrité textuelle des mentions tout en garantissant un espacement latéral satisfaisant.
Pour le formatage des valeurs métriques le long de l’axe des ordonnées, la mobilisation du module spécialisé matplotlib.ticker permet d’automatiser l’insertion de symboles monétaires, de séparateurs de milliers ou de pourcentages réguliers. L’application d’un formateur de chaîne de caractères (via StrMethodFormatter ou PercentFormatter) garantit une homogénéité formelle des décimales présentées, bannissant les longueurs numériques flottantes asymétriques le long des graduations majeures de la figure.
8.3 Gestion de la grille structurelle en arrière-plan
L’intégration d’une grille cartésienne en arrière-plan du canevas constitue un outil d’aide à la projection visuelle, facilitant le report mental du sommet des rectangles géométriques vers l’échelle graduée des ordonnées. Néanmoins, une grille omniprésente ou excessivement contrastée contrevient au principe d’économie visuelle en saturent la scène de « bruit graphique » parasite. Le style de fond peut être initialisé par le biais de la fonction globale sns.set_style(« whitegrid »), ou piloté manuellement au moyen de la méthode de bas niveau ax.grid().
Dans le cas d’un diagramme à barres groupées vertical standard, l’activation des lignes de grille doit être strictement circonscrite à l’axe des ordonnées en appliquant la directive ax.grid(axis=’y’, linestyle=’–‘, alpha=0.6, color=’#BDC3C7’). Les lignes de grille verticales traversant les grappes d’abscisse n’apportent aucun bénéfice cognitif et tendent à fragmenter visuellement les sous-barres, brouillant l’intelligibilité des groupes factoriels. L’adoption d’un tracé discontinu en pointillés grisés assure un compromis idéal entre guidance optique et effacement contextuel.
Un raffinement technique supplémentaire réside dans le contrôle de l’ordre d’empilement visuel des plans géométriques (l’indice zorder dans Matplotlib). Par défaut, il arrive que les lignes de grille de fond se superposent disgracieusement par-dessus les surfaces des barres de données, tranchant artificiellement les rectangles de couleur. En affectant formellement une valeur de zorder=3 aux conteneurs de barres tout en calibrant la grille sur un niveau zorder=0 associé à l’instruction ax.set_axisbelow(True), le statisticien s’assure que les rectangles peints viennent se déposer au-dessus des repères métriques, garantissant un rendu impeccable de premier plan.
9. Gestion méticuleuse de la légende et des annotations textuelles directes
9.1 Repositionnement et formatage de la boîte de légende
L’instanciation de l’argument hue dans Seaborn génère automatiquement une boîte de légende qui synthétise l’association entre les nuances chromatiques déployées et les modalités du facteur secondaire. Si cet automatisme s’avère précieux, l’algorithme de placement par défaut dépose fréquemment la légende à l’intérieur du champ de traçage, risquant d’obstruer des barres de données ou de masquer les barres d’erreur d’un sous-groupe élevé. Pour parer à cette interférence visuelle, il devient nécessaire d’extraire le contrôle de l’objet de légende et de repositionner ce dernier de manière stratégique.
La relocalisation de la légende en dehors du cadre effectif des données s’opère en modifiant l’argument bbox_to_anchor de la méthode ax.legend(). En définissant des coordonnées normalisées telles que bbox_to_anchor=(1.02, 1) et en associant le point d’ancrage loc=’upper left’, la légende est élégamment expulsée sur la périphérie droite du graphique sans empiéter sur l’espace d’analyse. Parallèlement, l’utilisateur peut renommer formellement le titre de la légende pour éliminer les abréviations de variables internes en spécifiant l’argument title= »Condition d’expérience » pourvu de sa propre typographie hiérarchisée.
Pour les figures destinées à être intégrées dans des colonnes de texte étroites ou pour des mises en page horizontales panoramiques, il s’avère particulièrement efficace de disposer les entrées de la légende de manière compacte sur plusieurs colonnes en bas ou en haut de figure. L’adjonction du paramètre ncol=3 au sein de l’appel legend contraint le moteur à organiser horizontalement les descripteurs factoriels, offrant ainsi une compacité optimale tout en préservant l’intelligibilité globale de la scène.
9.2 Inclusion d’étiquettes de données précises sur les barres
L’inspection purement optique de la hauteur d’un rectangle géométrique ne permet d’approximer la grandeur statistique qu’avec une précision limitée par l’étalonnage de l’axe vertical. Dans des rapports d’activité analytiques, des bilans de performance ou des synthèses industrielles, les parties prenantes exigent fréquemment la connaissance exacte de la valeur numérique mesurée sans avoir à effectuer une projection mentale fastidieuse sur l’ordonnée. L’introduction de la méthode native ax.bar_label dans les versions modernes de Matplotlib a révolutionné cette opération en rendant caduque l’écriture de boucles manuelles d’annotation fastidieuses.
L’application d’étiquettes directes sur un diagramme à barres groupées s’effectue en itérant systématiquement à travers la liste des conteneurs hébergés dans l’axe, comme l’illustre la logique de code suivante :
- Parcours séquentiel : for container in ax.containers: ax.bar_label(container, fmt=’%.1f’, padding=4, fontsize=9)
Dans cette structure déclarative, le paramètre fmt reçoit une chaîne de formatage Python gouvernant le nombre de décimales affichées (par exemple, ‘%.1f’ pour contraindre à un unique chiffre après la virgule, ou ‘%.0f%%’ pour injecter un suffixe de pourcentage). Le paramètre padding applique un espacement dynamique en points typographiques entre le sommet physique du rectangle et la base du glyphe textuel, éliminant les contacts visuels disgracieux.
La prudence méthodologique s’impose néanmoins dès lors que le diagramme héberge simultanément des étiquettes numériques directes et des barres d’erreur d’échantillonnage volumineuses. Dans cette conjoncture graphique dense, le chiffre textuel risque de rentrer en collision spatiale avec le segment de la barre d’erreur. Deux options s’offrent alors au statisticien : soit utiliser l’argument label_type=’center’ pour loger le libellé chiffré au cœur géométrique du rectangle de couleur (à la condition expresse que le contraste chromatique garantisse une parfaite lisibilité typographique), soit réserver l’étiquetage direct aux figures illustrant des valeurs déterministes dénuées d’intervalles de dispersion.
10. Structuration multidimensionnelle avec FacetGrid et catplot
10.1 Transition de sns.barplot vers l’interface de niveau figure sns.catplot
Dans la taxonomie logicielle de Seaborn, les fonctions de traçage se subdivisent rigoureusement en deux catégories d’architecture distinctes : les fonctions de niveau axe (axes-level functions), dont relève sns.barplot, et les fonctions de niveau figure (figure-level functions), orchestrées par l’interface unifiée seaborn.catplot. Alors que sns.barplot s’installe modestement au sein d’un axe Matplotlib préexistant qui lui est fourni, catplot prend les commandes de la figure dans son entièreté, créant et coordonnant l’ensemble des toiles, des marges et des objets de légende au sein d’un objet gestionnaire de type FacetGrid.
Pour reproduire le diagramme à barres groupées fondamental sous l’interface de niveau figure, la transition syntaxique s’avère particulièrement limpide. L’analyste invoque sns.catplot en conservant scrupuleusement les assignations de variables data, x, y et hue, tout en explicitant l’argument discriminant kind= »bar ». Le dimensionnement géométrique n’est plus confié à l’habituelle instruction plt.subplots mais se configure directement via les arguments dédiés height (qui gouverne la hauteur absolue en pouces de chaque sous-panneau) et aspect (qui détermine le ratio largeur/hauteur de chaque sous-graphe).
L’avantage opérationnel déterminant de cette interface réside dans l’automatisation intégrale des périphériques d’affichage. catplot calcule et applique de manière autonome le placement de la boîte de légende en dehors du champ de traçage, uniformise les espacements inter-panneaux et ajuste dynamiquement les marges périphériques pour prévenir toute coupure de texte. Ce haut degré d’abstraction décharge le chercheur des opérations de bas niveau tout en assurant une structure standardisée immédiatement prête pour l’analyse.
10.2 Introduction d’un quatrième facteur expérimental par le treillis
La véritable puissance analytique de l’interface catplot s’exprime lorsqu’il devient nécessaire d’explorer des plans d’expérimentation complexes imbriquant trois ou quatre dimensions factorielles indépendantes. Le diagramme à barres groupées standard épuise ses capacités d’encodage spatial cartésien en exploitant l’axe x pour le premier facteur et l’attribut hue pour le second. Pour intégrer un troisième facteur catégoriel (par exemple, la distinction démographique « Sexe : Homme / Femme ») ou un quatrième facteur (par exemple, la tranche d’âge), l’analyste fait appel au partitionnement en treillis (technique des small multiples théorisée par Edward Tufte).
L’activation de cette grille de sous-graphiques s’effectue par l’injection élémentaire des arguments col et row au sein de l’instruction catplot. En précisant par exemple col= »Sexe », Seaborn démultiplie instantanément le diagramme à barres groupées en autant de sous-panneaux distincts disposés horizontalement en colonnes, chaque panneau projetant la relation [Jour x Score x Condition] conditionnellement à une modalité spécifique de la variable de facette. Ce dispositif graphique permet d’inspecter visuellement des interactions factorielles de troisième ordre (« Sexe x Jour x Condition »), jusqu’alors invisibles au sein d’un tracé bivarié aplati.
L’interface garantit une rigueur méthodologique sans faille en synchronisant par défaut les échelles des axes verticaux et horizontaux à travers l’ensemble des panneaux générés (sharex=True, sharey=True). Cette homogénéité dimensionnelle absolue est un impératif d’évaluation : elle prévient tout biais cognitif d’interprétation qui résulterait de sous-graphiques aux échelles d’ordonnées flottantes, permettant au lecteur d’évaluer immédiatement les grandeurs d’effet relatives d’un panel à l’autre sans risque de tromperie d’échelle.
11. Exportation en haute résolution et intégration dans les publications scientifiques
11.1 Sélection des formats de sortie et calibrage de la résolution
L’aboutissement de la chaîne de production visuelle réside dans l’exportation physique du fichier image vers le disque dur, destinée à alimenter la composition typographique d’un manuscrit de recherche, d’un rapport technique ou d’un support de communication orale. Cette étape d’enregistrement physique ne doit en aucun cas être réalisée par de vulgaires captures d’écran qui altèrent la résolution et interpolent arbitrairement les pixels. Le flux de travail professionnel requiert l’utilisation formelle de la méthode savefig() de Matplotlib, invoquée sur l’objet de figure racine (accessible via plt.savefig ou fig.savefig).
Le choix du format de fichier conditionne directement la fidélité de restitution du graphique :
- Formats matriciels (raster) : PNG et TIFF : adaptés pour des présentations numériques ou lorsque les revues scientifiques réclament explicitement des images aplaties. L’export matriciel exige impérativement le calibrage du paramètre de densité de pixels par pouce à une valeur minimale de dpi=300 pour des reproductions standard, voire dpi=600 pour des impressions de très haute définition garantissant une netteté cristalline sous loupe typographique ;
- Formats vectoriels : PDF et SVG : constituent le standard d’or incontesté pour la publication académique professionnelle sous LaTeX ou les outils de PAO. Dans un fichier vectoriel, les rectangles, les lignes d’erreur, les axes et les caractères typographiques ne sont pas tramés sous forme de pixels discrets mais codés comme des primitives mathématiques pures. Cette propriété garantit une netteté absolue à n’importe quel coefficient d’agrandissement sans jamais pixelliser.
Deux arguments techniques cruciaux doivent systématiquement être adjoints à l’instruction d’exportation pour certifier l’intégrité de la mise en page. En premier lieu, la directive bbox_inches=’tight’ ordonne au moteur de calcul de recalculer l’emprise physique extérieure de l’image en incluant rigoureusement tous les éléments périphériques (titres, légendes externes, annotations d’abscisses) qui, sans cette option, risqueraient d’être brutalement rognés par le bord géométrique du canevas. En second lieu, l’argument booléen transparent=False permet de figer un fond blanc opaque uniforme, évitant ainsi des artefacts de contraste fâcheux lors de l’insertion dans des documents aux arrière-plans hétérogènes.
11.2 Alignement sur les normes éditoriales académiques (style APA)
Les maisons d’édition académiques et les consortiums scientifiques internationaux, au premier rang desquels figure l’American Psychological Association (APA 7e édition), imposent des directives visuelles extrêmement strictes régissant l’esthétique des figures admises pour publication. L’esthétique par défaut de Seaborn, bien qu’élégante, arbore souvent des toiles de fond grisées (le style darkgrid) incompatibles avec les normes de sobriété formelle des périodiques scientifiques majeurs. Il appartient donc à l’analyste de dépouiller son diagramme de tout artifice superflu pour le conformer aux chartes académiques.
La première exigence de mise en conformité stylistique consiste à éliminer les bordures superflues encadrant la scène visuelle. La fonction sns.despine() offre une commande spécialisée permettant de supprimer instantanément les lignes d’axes supérieure (top) et droite (right), ne conservant que les deux axes directeurs perpendiculaires essentiels (l’ordonnée et l’abscisse). Cette épuration géométrique allège la charge visuelle globale et valorise immédiatement les rectangles de données. Le recours au thème minimaliste épuré sns.set_style(« ticks ») permet également d’ancrer de courtes graduations physiques noires tournées vers l’extérieur des axes, signature esthétique propre aux publications de rang international.
La règle éditoriale académique stipule enfin qu’une figure scientifique doit former une entité autoportante (self-contained), c’est-à-dire être intégralement compréhensible par un pair sans que celui-ci ait besoin de lire le corps du texte principal. Cette autonomie s’articule autour d’une légende textuelle de bas de figure (figure caption) structurée selon les canons de la discipline : un numéro d’ordre en gras (ex. : Figure 3), suivi d’un titre en italique explicitant les variables représentées, et complété par un descriptif textuel exhaustif détaillant la nature exacte de l’estimateur central (moyenne ou médiane), la signification précise des barres d’erreur (erreur-type de la moyenne, intervalle de confiance à 95 % ou écart-type), ainsi que la taille numérique de l’échantillon global ou partitionné (n).
12. Diagnostic des erreurs courantes, optimisation du code et bonnes pratiques méthodologiques
12.1 Résolution des pièges techniques récurrents
Dans la pratique quotidienne du codage statistique sous Seaborn, les ingénieurs et chercheurs se heurtent fréquemment à un panel d’anomalies récurrentes qui entravent la génération du diagramme attendu. Le dysfonctionnement le plus couramment rapporté réside dans l’écrasement ou l’alignement centré non désiré des barres factorielles. Ce comportement anomalique survient presque toujours lorsque l’utilisateur fournit une variable continue codée numériquement comme variable de nuance hue sans l’avoir explicitement déclarée en type catégoriel, poussant Seaborn à tenter une interprétation de couleur continue plutôt qu’une partition spatiale avec décalage géométrique (dodge). La vérification préalable du typage de la variable via df[‘variable’].astype(‘category’) résout instantanément ce conflit d’affichage.
Un deuxième piège technique classique provient de la confusion fréquente entre les types de données numériques et les chaînes de caractères lors du filtrage tabulaire avec Pandas. Si une variable numérique contient des symboles textuels masqués ou des espaces résiduels non nettoyés, Pandas classe l’intégralité de la colonne en type object. Lors de l’invocation de sns.barplot, Seaborn échoue alors à calculer l’agrégation statistique numérique de l’ordonnée, générant des messages d’erreur obscurs de type TypeError: unsupported operand type(s). La conversion systématique via pd.to_numeric(df[‘y’], errors=’coerce’) permet d’assainir la structure en amont de toute commande graphique.
Enfin, l’évolution rapide de la base de code de Seaborn engendre une profusion de messages d’avertissement d’obsolescence (FutureWarning) chez les praticiens qui maintiennent d’anciens scripts. L’utilisation d’arguments historiques tels que ci=68, errcolor ou errwidth déclenche des alertes répétées dans les versions actuelles. L’actualisation méthodique des scripts en migrant vers l’argument unifié errorbar et le dictionnaire de paramétrage err_kws élimine les alertes de dépréciation tout en garantissant la pérennité d’exécution du code au sein des futures versions de l’environnement Python.
12.2 Garantie de reproductibilité et architecture logicielle
La reproductibilité computationnelle représente la pierre angulaire de l’éthique scientifique moderne. Dans la mesure où le diagramme à barres groupées mobilise par défaut une procédure de rééchantillonnage stochastique par bootstrap pour calculer les intervalles de confiance encadrant les moyennes, deux exécutions consécutives d’un même script sur un même jeu de données produiront des bornes d’intervalles d’erreur infinitésimalement divergentes si la source de hasard n’est pas scellée. Pour neutraliser cette variabilité stochastique et obtenir un tracé strictement déterministe au pixel près, il est impératif de fixer la graine du générateur de nombres pseudo-aléatoires de NumPy dès le démarrage du flux de travail au moyen de l’instruction canonique numpy.random.seed(42) ou en assignant l’argument seed dans les méthodes de bootstrap de Seaborn.
Sur le plan de l’architecture logicielle, la bonne pratique de programmation répudie la rédaction de scripts séquentiels monolithiques linéaires. L’analyste rigoureux encapsule la logique de génération du diagramme au sein d’une fonction Python modulaire, propre et réutilisable. Cette fonction doit recevoir en paramètres le DataFrame d’entrée, la désignation formelle des variables directrices (x, y, hue), la palette souhaitée, et renvoyer proprement l’objet d’axe matplotlib.axes.Axes manipulable. Cette approche par composants réutilisables permet de centraliser la maintenance graphique de projets de grande envergure, de standardiser les paramètres au sein d’un laboratoire de recherche et d’interdire la duplication de code redondant.
Pour parachever la rigueur de la démarche, la documentation systématique du pipeline de transformation des données constitue un devoir impérieux. Aucune figure ne devrait être générée sans que l’ensemble des étapes de filtrage, d’imputation des valeurs manquantes, de redimensionnement dimensionnel (melt) et de transtypage des facteurs catégoriels ne soit scrupuleusement consigné dans un script versionné sous Git ou commenté dans un carnet analytique interactif. C’est à ce prix de transparence méthodologique et de rigueur technique que la visualisation de données s’élève au rang d’instrument d’investigation scientifique authentique, apportant une contribution loyale, intelligible et indiscutable à l’avancement de la recherche empirique.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-003
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10