
La visualisation des données quantitatives constitue un pilier fondamental de la démarche scientifique contemporaine, servant à la fois d’outil d’exploration heuristique et de vecteur de communication probatoire. Au sein de l’arsenal méthodologique du chercheur et du statisticien, la représentation des structures catégorielles décomposées pose des défis sémiologiques constants. Lorsqu’il s’agit de cartographier simultanément les variations d’une grandeur globale et la répartition interne de ses composantes élémentaires à travers plusieurs groupes d’observations, le diagramme en barres empilées s’impose comme une modalité graphique privilégiée. Ce dispositif visuel permet d’agréger deux dimensions d’analyse qualitative au sein d’un même repère cartésien, offrant une vue synoptique des compositions proportionnelles ou absolues.
Dans l’écosystème du langage de programmation statistique R, la création de tels graphiques a connu une mutation paradigmatique profonde. Autrefois cantonnée aux primitives graphiques matricielles du moteur de base, la visualisation s’est structurée autour des concepts formels de la grammaire des graphiques théorisée par Leland Wilkinson et opérationnalisée dans l’extension ggplot2 par Hadley Wickham. Cette approche déclarative confère une flexibilité algorithmique sans précédent, permettant d’articuler étroitement le schéma des données tabulaires avec les propriétés géométriques et esthétiques de la figure finale. La manipulation des barres cumulatives exige néanmoins une maîtrise rigoureuse de la typologie des variables, de l’algèbre relationnelle sous-jacente et des mécanismes de perception visuelle humaine.
Le présent article propose une exploration exhaustive, théorique et appliquée, de la conception des barplots empilés sous R. En abordant successivement les fondements sémiotiques, la préparation structurelle des données au format long, l’implémentation par couches successives, les ajustements relatifs à cent pour cent, l’optimisation typographique et l’étiquetage mathématique précis des centroïdes de segments, ce guide fournit aux chercheurs en sciences comportementales et aux analystes de données les compétences nécessaires pour produire des visualisations conformes aux standards académiques les plus stricts.
1. Introduction aux diagrammes en barres empilées sous R
1.1 Définition et morphologie du barplot empilé
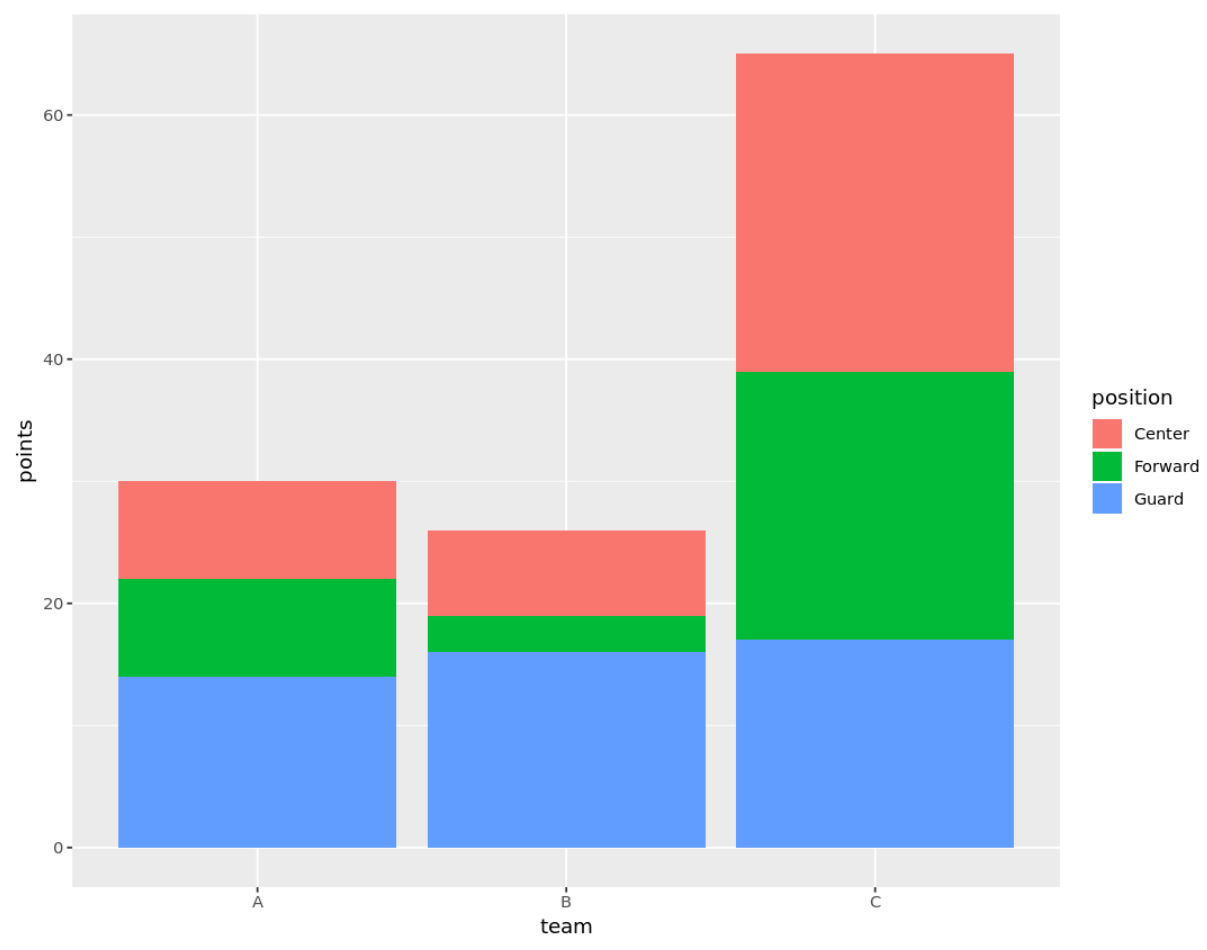
Le diagramme en barres empilées, ou stacked barplot dans la littérature internationale, est une variante structurelle de l’histogramme pour variables discrètes qui repose sur le principe de segmentation cumulative d’une quantité numérique. Contrairement à la barre simple, qui associe la hauteur ou la longueur d’un parallélépipède rectangle unique à la valeur scalaire d’un groupe, la barre empilée partitionne ce continuum géométrique en une série de sous-segments contigus. Chaque sous-segment correspond à une modalité d’une seconde variable catégorielle, superposée à la précédente le long de l’axe de mesure. Cette morphologie implique que l’extrémité supérieure de chaque tranche sert d’origine spatiale à la tranche consécutive, érigeant ainsi une représentation hiérarchique où la somme des parties constitue l’altitude totale de la colonne.
D’un point de vue morphologique, il convient d’opérer une différenciation stricte entre les barres simples, les barres groupées et les barres empilées. Les barres groupées disposent les sous-catégories de manière adjacente le long de l’axe nominal, garantissant que chaque segment repose sur une ligne de base commune fixée à l’ordonnée zéro. En revanche, le barplot empilé sacrifie cet alignement basal universel au profit d’une compacité dimensionnelle accrue. Il fusionne dans une empreinte spatiale unitaire deux niveaux de classification : la variable d’agrégation principale en abscisse et la variable de stratification interne identifiée par le canal perceptif de la couleur de remplissage. Cette bidimensionnalité permet de représenter simultanément la magnitude agrégée du collectif et sa microstructure sociologique, clinique ou expérimentale.
Les objectifs sémiologiques attachés à cette morphologie graphique relèvent de la transmission condensée d’informations multivariées. Dans les contextes où l’espace d’affichage ou la pagination académique est contraint, le diagramme empilé délivre un double message : il communique l’évolution d’un volume total entre différentes conditions tout en esquissant la dynamique de recomposition interne. Il s’agit d’un encodage particulièrement puissant lorsque la question de recherche porte prioritairement sur la conservation, l’expansion ou la contraction de la somme globale, sous réserve que l’interprétation des strates intermédiaires demeure encadrée par des précautions méthodologiques rigoureuses.
1.2 Applications empiriques en recherche psychologique et comportementale
Dans le champ des sciences psychologiques, cognitives et comportementales, la confrontation avec des données multivariées combinant des classifications démographiques et des mesures psychométriques est omniprésente. L’une des applications empiriques les plus documentées concerne le dépouillement des instruments de mesure psychologique fondés sur des échelles de Likert. Face à des batteries d’items évaluant par exemple l’anxiété, la satisfaction au travail ou l’adhésion à des croyances spécifiques, le barplot empilé permet de condenser l’éventail complet des degrés d’accord au sein de cohortes cliniques distinctes, mettant immédiatement en relief l’asymétrie des distributions affectives ou attitudinales.
Une seconde application privilégiée réside dans la décomposition des profils psychopathologiques ou des typologies comportementales à travers différentes strates sociodémographiques. Par exemple, lors de l’étude de la comorbidité au sein d’une population de patients diagnostiqués pour un trouble de l’humeur, la hauteur totale de chaque barre peut correspondre à l’incidence globale dans une classe d’âge spécifique, tandis que l’empilement décline la distribution proportionnelle des troubles associés tels que l’anxiété généralisée, l’abus de substances ou les manifestations somatoformes. Ce procédé favorise une lecture holistique des interdépendances étiologiques sans nécessiter la multiplication de tableaux numériques complexes.
Par ailleurs, la visualisation de l’allocation temporelle au cours de protocoles expérimentaux bénéficie grandement de cette modalité graphique. Qu’il s’agisse de mesurer la durée passée dans différentes zones d’un dispositif de labyrinthe aquatique de Morris chez le rongeur, ou de quantifier les temps de fixation oculaire sur différentes régions d’intérêt en eye-tracking chez l’humain, la barre empilée restitue la finitude de l’enveloppe temporelle globale tout en illustrant la réallocation des ressources attentionnelles selon les conditions expérimentales manipulées par le chercheur. Enfin, l’agrégation des indices de performance cognitive globale et de leurs sous-composantes factorielles trouve ici une transcription visuelle intuitive et immédiatement interprétable.
1.3 Panorama des solutions graphiques dans l’écosystème R
L’histoire computationnelle du logiciel R, issu du langage S développé aux laboratoires Bell, est marquée par une évolution continue des moteurs de rendu graphique. Initialement, la construction de graphiques reposait exclusivement sur le package graphics, intégré au cœur du système. Au sein de ce paradigme historique, la fonction barplot() permet de générer des diagrammes empilés en lui soumettant une structure matricielle bidimensionnelle. Si cette approche offre une rapidité d’exécution incontestable pour des scripts rudimentaires, elle souffre d’un déficit d’abstraction programmatique notable : le contrôle des paramètres de style, l’alignement des légendes et la gestion des échelles colorimétriques requièrent une imbrication complexe de fonctions accessoires de bas niveau.
La rupture épistémologique majeure est survenue avec l’émergence de la grammaire des graphiques, conceptualisée algorithmiquement au sein du package ggplot2. Rejetant l’approche impérative consistant à tracer séquentiellement des formes géométriques sur une toile statique, ggplot2 introduit une méthodologie déclarative où le graphe est conçu comme une association formelle entre des variables de données et des propriétés visuelles ou esthétiques. Dans ce cadre, la production d’un diagramme en barres empilées découle naturellement de la déclaration d’une géométrie spécifique associée à un ajustement de position précis, garantissant une cohérence théorique absolue entre la structure du tableau sous-jacent et l’artéfact graphique produit.
Cette standardisation moderne s’inscrit au cœur de l’écosystème tidyverse, un ensemble cohérent de bibliothèques conçues pour partager une même philosophie de conception et des structures de données harmonisées. Au sein du tidyverse, les modules de manipulation comme dplyr et de restructuration tabulaire comme tidyr alimentent directement le pipeline graphique sans nécessiter de transformations matricielles opaques. Cette intégration garantit une traçabilité intégrale du flux d’analyse statistique, maximise la reproductibilité des résultats scientifiques et facilite l’audit méthodologique des protocoles de visualisation lors des processus d’évaluation par les pairs.
2. Fondements théoriques et sémiotique graphique
2.1 Perception visuelle et charge cognitive de l’empilement
La transcription de grandeurs numériques abstraites en stimuli visuels perceptibles obéit à des mécanismes psychophysiques rigoureusement documentés par la psychologie cognitive et la sémiologie graphique. Selon la théorie des attributs pré-attentifs formalisée par Anne Treisman, le système visuel humain décode certaines propriétés physiques de manière automatique, holistique et quasi instantanée, bien avant l’intervention des processus cognitifs descendants plus lents. Parmi ces propriétés, la position spatiale le long d’une échelle commune, la longueur, la superficie, la saturation et la teinte chromatique n’offrent pas le même niveau de précision métrique lorsqu’elles sont soumises au jugement perceptif de l’observateur.
Dans les travaux fondamentaux de William Cleveland et Robert McGill sur la hiérarchie des jugements graphiques élémentaires, la tâche consistant à estimer la longueur relative de segments partageant une origine commune se classe au sommet de la fidélité perceptive. Or, la morphologie intrinsèque du barplot empilé génère une dissymétrie cognitive majeure : seul le segment reposant directement sur l’axe des abscisses bénéficie d’une ligne de base fixe et universelle. Les segments situés aux niveaux intermédiaires reposent sur des frontières inférieures mobiles, dont l’altitude dépend mécaniquement de la variabilité cumulée des couches sous-jacentes. Dès lors, l’évaluation visuelle de ces tranches intermédiaires repose sur un jugement de longueur sans origine fixe, tâche perceptuelle nettement plus imprécise et sujette à des illusions d’optique induites par la forme des segments voisins.
Cette contrainte sémiotique engendre une charge cognitive accrue pour le lecteur. L’observateur ne peut pas se contenter d’un balayage horizontal uniforme pour comparer les grandeurs relatives d’une modalité donnée à travers plusieurs colonnes ; il doit mentalement soustraire l’ordonnée de départ de l’ordonnée d’arrivée ou procéder à une estimation visuelle de la surface du rectangle coloré. Par conséquent, l’encodage visuel par empilement implique un arbitrage délibéré : il optimise la perception globale de la somme totale et du premier segment basal au détriment de la précision analytique immédiate relative aux strates médianes, un facteur dont l’analyste doit impérativement avoir conscience lors de la conceptualisation de ses figures.
2.2 Critères méthodologiques de sélection du barplot empilé
L’adoption d’un barplot empilé au sein d’une publication scientifique ne doit jamais résulter d’un choix esthétique arbitraire, mais d’une validation scrupuleuse des propriétés mathématiques des données manipulées. Le postulat sine qua non d’une telle représentation réside dans l’additivité stricte des sous-composantes. Les grandeurs affectées aux segments successifs doivent posséder une métrique dimensionnelle homogène permettant une sommation arithmétique rigoureuse. C’est le cas des effectifs absolus d’individus, des durées temporelles fractionnées, des allocations budgétaires ou des fréquences relatives normalisées issues d’une partition exhaustive de l’espace d’échantillonnage.
À l’inverse, l’application d’un empilement à des variables intensives constitue une aberration statistique et sémiologique majeure. Des grandeurs telles que des moyennes arithmétiques, des scores standardisés en scores Z, des médianes, des proportions calculées sur des dénominateurs variables ou des indices d’intensité non cumulatifs ne possèdent aucune réalité mathématique lorsqu’elles sont sommées visuellement. Superposer la moyenne d’un score de dépression de Hamilton et la moyenne d’un score d’anxiété de Beck au sein d’une même barre verticale produit une hauteur cumulée dépourvue de signification clinique et trompe délibérément le lecteur sur la magnitude réelle du statut psychologique observé.
Les recommandations édictées par l’American Psychological Association dans son manuel de publication soulignent l’importance de préserver l’honnêteté intellectuelle des graphiques statistiques. L’auteur doit s’assurer que le dispositif d’empilement ne masque pas des disparités structurelles critiques ou des tailles d’échantillons insuffisantes qui invalideraient les inférences visuelles. La sélection de cette modalité graphique n’est méthodologiquement légitime que si la question de recherche s’intéresse conjointement à l’évolution du tout et aux contributions fractionnelles des parties, tout en garantissant que les variables sous-jacentes satisfont formellement aux exigences de l’algèbre de composition.
3. Préparation de l’environnement R et gestion des dépendances
3.1 Installation et chargement des packages requis
La mise en place d’un environnement computationnel stable et reproductible constitue le préalable incontournable à toute production graphique scientifique sous R. Pour orchestrer la manipulation avancée et la visualisation vectorielle des diagrammes en barres empilées, trois extensions majeures du métapackage tidyverse sont rigoureusement requises : ggplot2 pour l’implémentation de la grammaire visuelle, dplyr pour les opérations matricielles de filtrage, de regroupement et d’agrégation, ainsi que tidyr pour le remodelage dimensionnel des jeux de données. À ce socle fondamental s’ajoute l’extension scales, indispensable pour formater les graduations d’axes et calibrer les notations numériques.
L’installation de ces bibliothèques logicielles s’exécute à l’aide de l’instruction standard d’interaction avec le Comprehensive R Archive Network. Il est recommandé de procéder à une installation unifiée via la commande install.packages("tidyverse") ou de cibler spécifiquement les packages élémentaires si l’on opère sur des serveurs distants ou des conteneurs à ressources computationnelles contraintes. Pour des besoins de publication de haut niveau, l’installation de l’utilitaire ggrepel est vivement conseillée afin de résoudre dynamiquement les problématiques de recouvrement spatial des annotations textuelles dans les segments étroits.
Dans une perspective de science ouverte et de reproductibilité computationnelle stricte, il importe de neutraliser les aléas d’exécution en fixant systématiquement les générateurs de nombres pseudo-aléatoires à l’aide de l’instruction set.seed() dès l’initialisation du script d’analyse. De même, l’inspection documentée des versions des bibliothèques via sessionInfo() prémunit le chercheur contre les modifications comportementales potentielles des futures versions de l’API graphique. Le chargement des dépendances s’effectue au sommet du script par les appels conventionnels library(ggplot2), library(dplyr), library(tidyr) et library(scales).
3.2 Bonnes pratiques de codage selon le style tidyverse
L’architecture syntaxique moderne de l’écosystème R privilégie une écriture linéaire, lisible et hautement déclarative, formalisée par le guide de style du tidyverse. Le cœur opérationnel de cette syntaxe repose sur l’utilisation intensive de l’opérateur de redirection séquentielle. Qu’il s’agisse de l’opérateur historique %>% issu du package magrittr ou de l’opérateur natif |> intégré au moteur de base de R depuis sa version 4.1.0, ce connecteur logique permet d’injecter la sortie d’une fonction directement en tant que premier argument de la fonction consécutive, éliminant l’imbrication désordonnée des appels d’instructions.
Dans la construction des flux graphiques, la structuration modulaire exige une distinction claire entre le pipeline de préparation des données et l’assemblage des couches de rendu graphique. Tandis que les opérations de filtrage, de tri et de mutation relationnelle s’enchaînent au moyen de l’opérateur de redirection, l’empilement des couches géométriques au sein de ggplot2 s’opère exclusivement au moyen de l’opérateur arithmétique +. Cette dualité syntaxique doit être rigoureusement maintenue, chaque nouvelle spécification esthétique ou thématique faisant l’objet d’un retour à la ligne indenté de deux espaces afin de maximiser l’intelligibilité du code pour les réviseurs.
Enfin, la gestion rigoureuse de la portée des variables et la documentation contextualisée des blocs d’instructions participent à la pérennité du code source. L’analyste évitera scrupuleusement l’affectation de sous-objets éphémères dans l’environnement global, privilégiant des transformations fluides au sein du graphe d’exécution. Les noms de colonnes et les modalités de facteurs devront être explicités en minuscules sans caractères accentués ou espaces non conformes, réduisant ainsi les risques de ruptures logicielles lors de l’exécution multi-plateforme des protocoles statistiques.
4. Structuration et manipulation des données pour ggplot2
4.1 Différenciation fondamentale entre formats large et long
L’incompréhension de l’organisation matricielle des données constitue l’écueil le plus fréquent lors de l’apprentissage de ggplot2. Historiquement, les logiciels de tableurs conventionnels et les interfaces de saisie manuelles privilégient une disposition dite « large » (wide format). Dans cette configuration, chaque unité statistique occupe une seule ligne, tandis que les mesures répétées ou les différentes modalités d’un même facteur sont réparties sur plusieurs colonnes adjacentes. Quoique visuellement pratique pour la saisie humaine directe, ce format matriciel hybride mélange la nature sémantique des variables et leurs instanciations mesurées au sein de la même dimension spatiale.
À l’opposé, le paradigme des « données propres » (tidy data) conceptualisé par Hadley Wickham postule trois principes cardinaux : chaque variable doit constituer une colonne distincte, chaque observation élémentaire doit occuper une ligne unique, et chaque type d’unité d’observation doit former une table indépendante. Ce modèle converge vers le format « long » (long format), dans lequel une modalité expérimentale n’est plus dispersée dans les entêtes de colonnes multiples mais encodée sous la forme d’un vecteur de facteurs catégoriels au sein d’une colonne dédiée, juxtaposée à une colonne unique rassemblant l’ensemble des valeurs numériques correspondantes.
Le moteur d’inférence de ggplot2 est intrinsèquement programmé pour interagir avec des structures tabulaires conformes à ce format long. Pour mapper une variable à l’attribut esthétique de remplissage chromatique (fill) d’un barplot empilé, cette variable doit impérativement exister sous forme d’un vecteur catégoriel continu le long des lignes du tableau. Le diagnostic structurel préliminaire d’un jeu de données s’opère systématiquement à l’aide des fonctions d’inspection analytique str() ou de son homologue optimisé dplyr::glimpse(), lesquelles révèlent instantanément le typage atomique des composantes et la conformité dimensionnelle de la matrice avant toute tentative de modélisation visuelle.
4.2 Transformation des données avec tidyr et dplyr
Lorsque les données expérimentales se présentent sous leur format large initial, une conversion structurelle automatisée s’avère incontournable. L’extension tidyr met à disposition la fonction de pivotement dynamique pivot_longer(), conçue pour consolider les colonnes de mesures disparates en un couple unifié d’attributs clé-valeur. En précisant les colonnes sources à agréger via l’argument cols, le nom de la variable catégorielle de destination via names_to, et l’étiquette de la variable numérique de sortie via values_to, le jeu de données subit une reconfiguration géométrique instantanée le rendant compatible avec la grammaire graphique.
Parallèlement, la préparation d’un barplot empilé requiert souvent des opérations de synthèse statistique en amont du rendu géométrique. L’utilisation conjointe des primitives group_by() et summarise() de l’extension dplyr permet d’agréger les micro-données individuelles brutes en effectifs totaux ou en sommes métriques selon les croisements factoriels d’intérêt. Cette phase préparatoire doit comporter un traitement méthodique des données manquantes, qu’elles soient explicites (codées par des sentinelles NA) ou implicites (combinaisons factorielles absentes des relevés expérimentaux), lesquelles peuvent être complétées via l’instruction complete() afin d’éviter l’interruption non sollicitée des barres cumulatives.
Une étape déterminante de cette manipulation réside dans le typage formel des variables catégorielles sous la forme de facteurs stricts. La transformation des vecteurs de chaînes de caractères brutes (character) en facteurs ordonnés ou nominaux à l’aide de l’instruction mutate() associée à factor() ou as_factor() permet d’ancrer définitivement la disposition séquentielle des strates. C’est à ce stade précoce de la chaîne de traitement que l’analyste décide de l’organisation hiérarchique qui gouvernera ultérieurement l’ordre d’empilement au sein du canvas graphique.
4.3 Création du jeu de données expérimental de démonstration
Afin de concrétiser l’ensemble des protocoles méthodologiques détaillés dans cet ouvrage, nous construisons un jeu de données synthétique, robuste et contrôlé, simulant une étude en psychologie comportementale et organisationnelle. Nous postulons une recherche examinant l’incidence de diverses manifestations d’épuisement professionnel ou de stress psychologique au sein de plusieurs départements institutionnels ou équipes opérationnelles d’une grande organisation académique.
Ce jeu de données de démonstration, structuré sous la forme d’un tableau unifié nommé df_stress, comprend trois variables fondamentales : Departement, une variable catégorielle à quatre modalités (Recherche, Enseignement, Administration, Logistique) servant d’axe principal ; Niveau_Stress, un facteur ordinal décliné en quatre strates comportementales rigoureusement hiérarchisées (Faible, Modéré, Élevé, Sévère) ; et Effectif, une variable quantitative discrète renseignant le décompte exact des individus recensés dans chacune des configurations factorielles croisées.
L’intégrité nominale et numérique du tableau de données fait l’objet d’une validation computationnelle directe. Le code instanciant ce tableau garantit l’absence de valeurs nulles ou aberrantes, générant seize lignes d’observations correspondant au produit cartésien parfait des départements et des niveaux de stress. L’impression préliminaire de la structure tabulaire permet de confirmer que la condition fondamentale de « tidy data » est rigoureusement satisfaite : chaque ligne représente une sous-population homogène, caractérisée par son affiliation institutionnelle, son niveau d’atteinte psychologique et le volume métrique associé prêt pour l’intégration graphique.
5. Construction du premier barplot empilé élémentaire avec ggplot2
5.1 Déclaration des couches esthétiques fondamentales
L’initialisation d’un graphique sous ggplot2 repose sur l’appel fondateur à la fonction ggplot(), qui a pour rôle de créer l’objet graphique de base et de configurer l’espace de coordonnées. Cet appel reçoit obligatoirement en premier argument le jeu de données préparé, suivi de la déclaration des correspondances esthétiques par l’intermédiaire de la fonction aes() (abréviation d’aesthetics). Cette étape ne trace aucun pixel sur l’écran, mais établit un contrat mathématique formel reliant les attributs visuels du système de coordonnées cartésiennes aux colonnes du tableau sous-jacent.
Dans l’architecture du barplot empilé, trois spécifications esthétiques élémentaires doivent être déclarées conjointement. L’argument x se voit assigner la variable indépendante catégorielle qui régira la discrétisation spatiale le long de l’axe horizontal, dans notre cas la variable Departement. L’argument y reçoit quant à lui la variable quantitative qui gouvernera la dimension verticale des colonnes, matérialisée par la mesure Effectif. Ces deux premiers paramètres définissent le repère spatial bidimensionnel dans lequel les géométries prendront place.
Le troisième paramètre, critique pour l’instanciation de l’empilement, est l’argument fill, auquel on affecte la variable qualitative secondaire, à savoir Niveau_Stress. Il convient de souligner la distinction conceptuelle majeure opérée par ggplot2 entre l’esthétique colour (qui contrôle la teinte des lignes, des points et des bordures périmétriques externes des polygones) et l’esthétique fill (qui détermine exclusivement la couleur de remplissage de la surface polygonale intérieure). Omettre l’affectation de fill réduirait inexorablement le graphique à une série de barres unicolores plates.
5.2 Instanciation de la géométrie geom_bar
Une fois les liaisons esthétiques initialisées, l’adjonction de la couche géométrique s’effectue au moyen de la fonction geom_bar() reliée par l’opérateur d’addition. Cette fonction encapsule une logique computationnelle interne puissante qui exige une attention méthodique. Par défaut, geom_bar() applique une transformation statistique d’agrégation d’effectifs (stat = "count"). Dans ce mode opératoire automatique, le système s’attend à ne recevoir qu’une seule variable en x et calcule lui-même la fréquence d’apparition de chaque modalité, ce qui génère une exception logicielle bloquante si une variable explicite est déjà déclarée en y.
Pour forcer geom_bar() à utiliser directement les grandeurs numériques pré-calculées contenues dans la colonne associée à y, il est impératif de modifier son algorithme interne en spécifiant explicitement le paramètre stat = "identity". Cette instruction signale au moteur graphique de lire la valeur brute de la cellule sans chercher à lui appliquer un décompte d’occurrences préalable. Concernant l’empilement proprement dit, le paramètre d’ajustement spatial position est configuré par défaut sur position = "stack", ce qui déclenche la sommation géométrique verticale des différents segments associés aux niveaux de la variable de remplissage.
L’esthétique des contours géométriques peut être affinée dès cette étape en intégrant le paramètre colour = "black" et un ajustement d’épaisseur linewidth = 0.2 au sein de geom_bar(). L’analyse du rendu généré par défaut met en lumière le comportement standard du système : les segments se superposent rigoureusement le long d’une échelle absolue d’effectifs, tandis qu’une légende automatique est générée sur le flanc droit du graphique, cartographiant les teintes par défaut du cercle chromatique de base aux modalités de la variable stratificatrice.
5.3 Alternative géométrique via geom_col
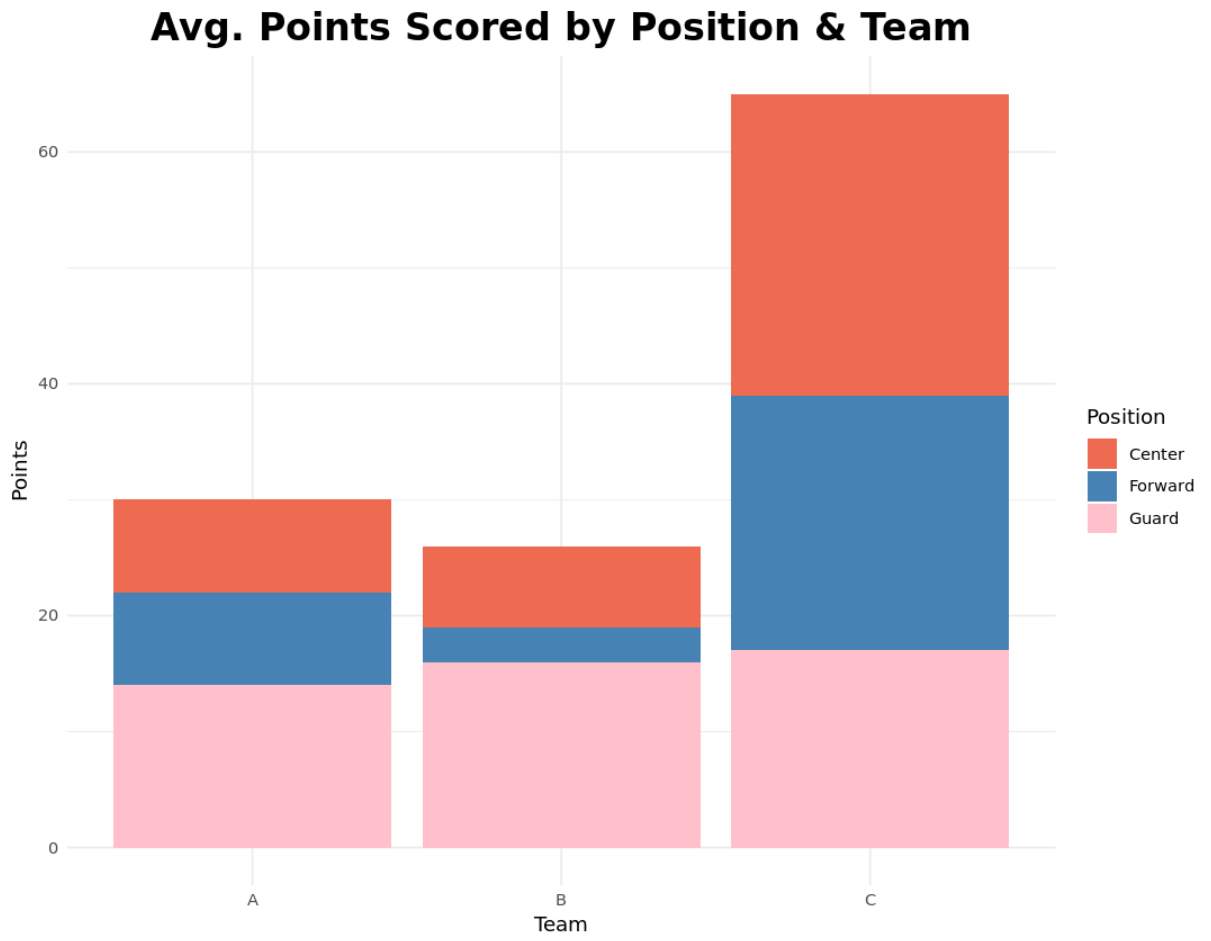
Face à la récurrence des erreurs de programmation générées par l’oubli du paramètre stat = "identity" au sein de geom_bar(), l’équipe de développement de ggplot2 a introduit une fonction spécialisée hautement intuitive : geom_col(). Sur le plan purement fonctionnel et géométrique, geom_col() constitue un alias direct et rigoureusement équivalent à l’instruction geom_bar(stat = "identity"). Sa raison d’être réside dans l’économie syntaxique et la sécurisation conceptuelle des scripts d’analyse.
L’utilisation de geom_col() clarifie l’intention du statisticien : elle stipule sans ambiguïté que les données sources ont déjà franchi l’étape de consolidation statistique et se présentent sous la forme d’un tableau pré-agrégé où chaque ligne dicte la hauteur exacte de son composant. Cette formulation réduit les risques de bugs lors de la maintenance logicielle collaborative et allège la charge cognitive liée à la relecture du code. De plus, les performances de compilation s’avèrent strictement identiques entre les deux formulations, garantissant une efficience d’exécution optimale même sur des volumétries de données considérables.
D’un point de vue didactique et appliqué, l’adoption de geom_col() est aujourd’hui préconisée comme la meilleure pratique au sein de la communauté R contemporaine lorsqu’une ordonnée métrique est déclarée au sein du bloc aes(). La structure du script d’initialisation se simplifie ainsi en ggplot(df_stress, aes(x = Departement, y = Effectif, fill = Niveau_Stress)) + geom_col(), constituant la pierre angulaire minimale sur laquelle viendront se greffer l’ensemble des personnalisations méthodologiques avancées.
6. Barplot empilé absolu contre barplot empilé relatif à 100%
6.1 Mécanique du positionnement position=’fill’
Le diagramme en barres empilées absolu, généré par le positionnement position = "stack", conserve l’échelle arithmétique d’origine des données. Bien que précieux pour comparer les volumes bruts globaux entre différentes catégories principales, ce dispositif s’avère défavorable lorsque la question d’intérêt porte sur la structure interne relative des strates, notamment lorsque les effectifs totaux des groupes d’abscisse présentent des disparités quantitatives massives. Un département comptant mille individus écrasera visuellement un service n’en comptant qu’une cinquantaine, masquant d’éventuelles similitudes ou anomalies dans la proportion de sujets en détresse psychologique.
Pour neutraliser l’effet de distorsion volumique lié à la taille totale des échantillons, l’analyste peut recourir à la variante dite du « barplot empilé relatif à cent pour cent ». Au sein de ggplot2, cette transformation ne requiert aucun recalcul manuel fastidieux des pourcentages au niveau du tableau source ; elle s’exécute de manière algorithmique directe via la modification de l’argument de positionnement dans la géométrie : position = "fill" (ou formellement via la fonction constructrice position_fill()). Cette instruction force le moteur de rendu à calculer dynamiquement la somme locale de chaque barre verticale et à diviser la hauteur de chaque segment unitaire par ce total absolu.
Sous l’effet du positionnement position = "fill", l’ensemble des colonnes verticales acquiert une hauteur uniforme standardisée normalisée sur une échelle continue s’étendant strictement de zéro à un (correspondant aux pourcentages de 0 % à 100 %). L’hétérogénéité des effectifs d’échantillonnage est temporairement élidée du champ visuel, permettant à l’observateur d’isoler parfaitement la composition interne de chaque groupe et de procéder à des comparaisons morphologiques rigoureuses de ratios sans être parasité par les écarts de taille globale des départements analysés.
6.2 Ajustement formel de l’axe des ordonnées en pourcentages
Bien que le positionnement position = "fill" normalise la hauteur des barres à la valeur unitaire, l’axe vertical affiche par défaut les coefficients de proportionnalité sous la forme de fractions décimales allant de 0.00 à 1.00. Pour satisfaire aux standards de clarté requis par les publications à comité de lecture, il est impératif de reconfigurer cet étiquetage métrique afin de convertir ces valeurs décimales brutes en pourcentages lisibles, tout en calibrant précisément les intervalles des graduations majeures et mineures.
Cette personnalisation formelle mobilise l’extension spécialisée scales, intégrée harmonieusement au sein de la fonction de calibrage continue scale_y_continuous(). En assignant la fonction vectorielle scales::percent (ou sa variante contemporaine scales::label_percent()) à l’argument labels, l’utilisateur automatise la multiplication arithmétique par cent et la concaténation du glyphe de pourcentage. Le paramètre breaks permet parallèlement de fixer avec une rigueur absolue l’espacement cartésien des repères, par exemple via la fonction de séquence régulière seq(0, 1, by = 0.2) pour matérialiser des paliers réguliers de 20 %.
Dans un contexte de publication francophone, les exigences de typographie éditoriale imposent l’insertion d’un espace insécable entre la valeur numérique et le symbole typographique du pourcentage, ainsi que l’utilisation éventuelle de la virgule comme séparateur décimal. L’instruction avancée scales::label_percent(decimal.mark = ",", suffix = " %") permet d’atteindre ce degré supérieur de conformité linguistique, garantissant une intégration visuelle parfaite du barplot au sein d’un manuscrit rédigé en langue française respectant les normes de l’imprimerie nationale.
6.3 Comparatif décisionnel entre position stack et position fill
Le choix méthodologique entre un positionnement cumulatif absolu (position = "stack") et un positionnement proportionnel normalisé (position = "fill") procède d’un arbitrage analytique profond dicté par les hypothèses de recherche formulées en amont du protocole statistique. Aucune de ces deux représentations ne surpasse l’autre de manière intrinsèque ; elles répondent à des finalités sémiotiques distinctes qu’il convient d’articuler avec discernement en fonction des objectifs de démonstration.
Le mode position = "stack" doit être systématiquement privilégié lorsque la magnitude globale du phénomène d’intérêt constitue une information scientifique d’importance égale ou supérieure à sa segmentation interne. Par exemple, si l’objectif d’une étude épidémiologique est de dimensionner les infrastructures d’accueil hospitalières en fonction du volume brut de patients attendus, effacer l’information relative à l’effectif total par une normalisation proportionnelle priverait le décideur d’un indicateur logistique capital. L’observateur a besoin de percevoir immédiatement que tel groupe contribue massivement au volume total d’incidents recensés.
À l’inverse, position = "fill" s’impose avec force dès lors que l’investigation clinique ou sociologique postule l’existence d’une altération de la structure intrinsèque d’une condition indépendamment de sa prévalence absolue dans la population générale. Si un groupe d’intervention présente un effectif restreint par rapport à un groupe de contrôle volumineux, la normalisation à 100 % permet de démontrer visuellement si la part relative des sujets en détresse sévère s’est comprimée sous l’effet du traitement. Dans les monographies scientifiques de grande envergure, la complémentarité de ces deux visions est couramment exploitée, soit par une présentation en panneaux juxtaposés, soit par l’annotation explicite de l’effectif global N au sommet de chaque colonne proportionnelle.
7. Personnalisation esthétique : couleurs, thèmes et typographie
7.1 Application des palettes chromatiques adaptées
L’attribution du spectre chromatique au sein d’un barplot empilé conditionne directement l’exactitude de son interprétation et son accessibilité scientifique universelle. Le recours aux palettes par défaut, générées par rotation uniforme autour de l’espace colorimétrique HSL, engendre souvent des distorsions perceptives dues à des variations non linéaires de luminance. Pour pallier ce biais, la mobilisation de palettes perceptuellement uniformes et universellement adaptées aux diverses formes de dyschromatopsies (daltonisme) constitue une obligation éthique et méthodologique fondamentale.
L’extension viridis, désormais intégrée nativement dans le cœur de ggplot2 via la fonction scale_fill_viridis_d(), propose des dégradés spécifiquement calibrés pour préserver une gradation de luminance strictement monotone. Ces palettes, déclinées en options telles que Viridis, Magma, Plasma ou Cividis, garantissent que les données conservent leur hiérarchie visuelle même lorsqu’elles sont imprimées en niveaux de gris purs ou perçues par des lecteurs atteints de protanopie ou de deutéranopie. Pour des données purement catégorielles non hiérarchisées, l’appel à scale_fill_brewer(palette = "Set2") issu des travaux de Cynthia Brewer fournit une séparation colorimétrique optimale sans favoriser indûment une modalité par rapport aux autres.
Dans le cas spécifique des échelles psychométriques ou attitudinales de type Likert, la sémiotique visuelle impose l’usage de palettes dites divergentes ou d’échelles de saturation manuelle ordonnées. Par l’intermédiaire de l’instruction scale_fill_manual(), le chercheur peut déclarer un vecteur explicite de codes hexadécimaux validés, associant par exemple des teintes neutres froides aux degrés de stress modérés et des teintes chaudes plus denses aux manifestations pathologiques sévères. Cette correspondance signifiante entre le signifiant chromatique et le signifié conceptuel renforce l’immédiateté de la communication des résultats scientifiques.
7.2 Épuration typographique et sélection de thèmes préconfigurés
L’adhésion aux principes d’excellence graphique théorisés par Edward Tufte exige l’optimisation systématique du ratio données-encre (data-ink ratio). Tout élément graphique qui ne transmet pas directement de l’information statistique ou ne contribue pas à l’orientation cartésienne de base doit être impitoyablement élidé. L’arrière-plan gris quadrillé par défaut de ggplot2, bien que conçu pour stabiliser la perception des couleurs saturées, constitue souvent un bruit visuel superflue dans le cadre d’un rapport de recherche rigoureux.
Le basculement vers des thèmes préconfigurés de haute précision typographique s’exécute par l’adjonction d’une couche dédiée. L’instruction theme_bw() instaure un cadre orthogonal noir et blanc classique particulièrement apprécié des éditeurs de revues scientifiques. Pour une épuration plus radicale, theme_classic() élimine l’intégralité des quadrillages internes pour ne préserver que les deux axes orthogonaux, tandis que theme_minimal() préserve de discrètes lignes de guidage horizontales tout en supprimant la boîte de délimitation externe, allégeant considérablement l’espace visuel global.
Au-delà du choix de base, la fonction theme() offre une granularité de contrôle micrométrique sur l’ensemble des éléments non géométriques. Elle permet d’ajuster l’alignement des textes d’axes (axis.text.x), d’augmenter l’espacement des marges d’affichage (plot.margin), d’éliminer sélectivement les lignes du quadrillage vertical (panel.grid.major.x = element_blank()) qui n’ont aucune fonction le long d’un axe catégoriel discret, et de positionner la légende en bas de figure (legend.position = "bottom") afin de réallouer la largeur maximale de la page aux barres comparatives.
7.3 Titrage et annotations éditoriales avec labs
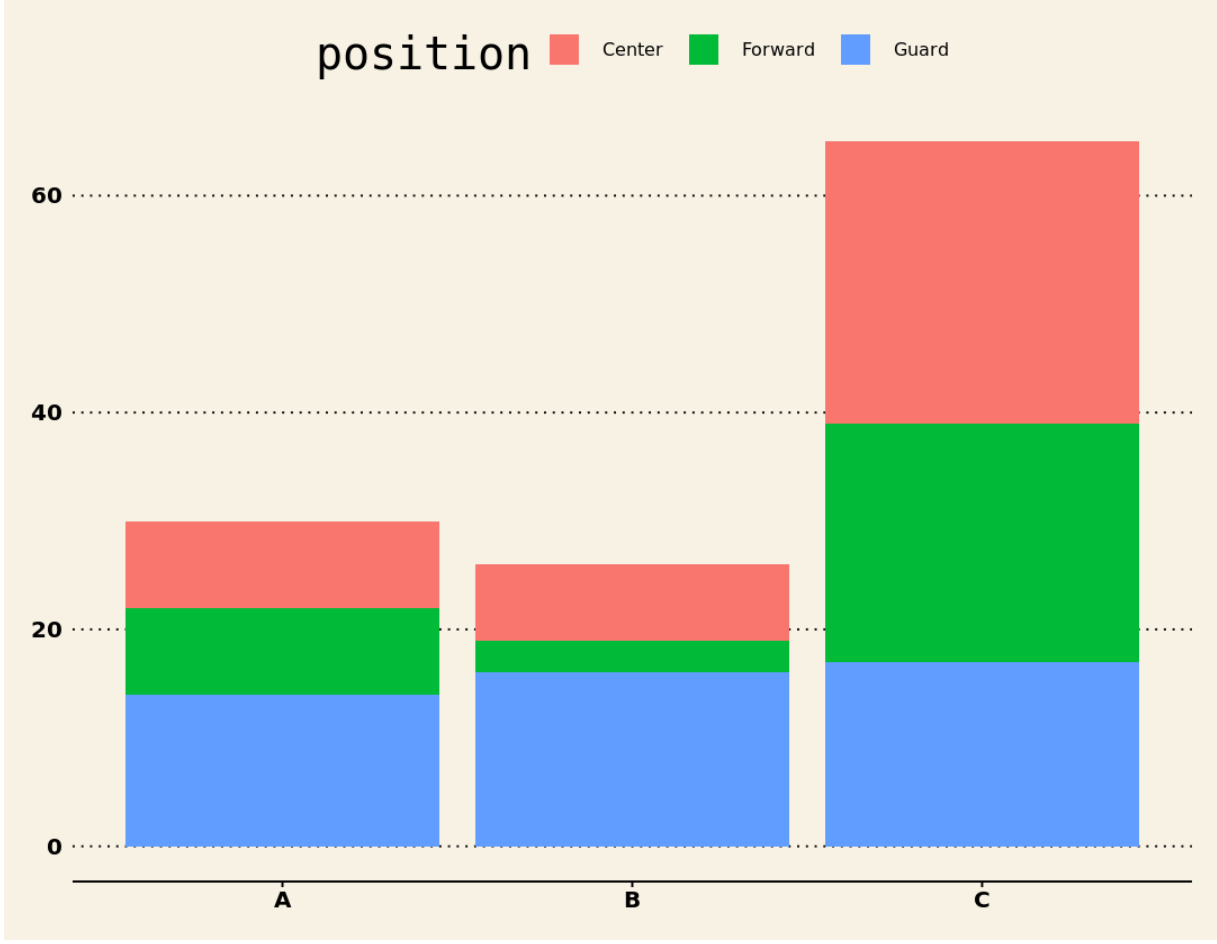
Une figure scientifique ne saurait se suffire à elle-même ; elle doit être rigoureusement contextualisée et documentée par un appareil textuel précis qui élimine toute ambiguïté sur la provenance et la métrique des données représentées. La fonction labs() concentre l’ensemble des déclarations éditoriales associées aux axes, aux légendes et au cadrage conceptuel général du graphique.
Le paramètre title doit énoncer avec clarté la variable dépendante fondamentale et l’objet de l’expérience, complété de manière idoine par un subtitle apportant des précisions sur la taille de l’échantillon global N ou les conditions protocolaires spécifiques. Les arguments x et y doivent impérativement écraser les dénominations techniques brutes issues de la base de données informatique au profit d’intitulés scientifiquement rigoureux incluant les unités de mesure entre parenthèses (par exemple, « Département académique » et « Fréquence relative (%) » ou « Effectif total de participants »).
Le paramètre fill au sein de labs() permet de renommer l’entête de la boîte de légende pour expliciter le concept psychologique sous-jacent, tandis que l’argument caption est réservé aux mentions de bas de page. Cette dernière zone textuelle accueille conventionnellement la référence méthodologique source, les seuils de significativité des tests statistiques éventuellement appliqués, ou les déclarations relatives aux valeurs manquantes imputées. Ce soin éditorial garantit que la figure peut être extraite de son manuscrit et comprise de manière entièrement autonome par la communauté académique.
8. Étiquetage textuel précis des segments empilés
8.1 Calcul analytique des coordonnées médianes de superposition
L’un des défis algorithmiques les plus ardus lors de la conception d’un barplot empilé réside dans l’apposition d’étiquettes textuelles précises (valeurs brutes ou pourcentages) au centre géométrique exact de chaque segment coloré. Contrairement à un barplot simple où l’ordonnée d’ancrage textuel équivaut simplement au sommet de la barre, le segment empilé requiert le calcul d’une coordonnée médiane le long de la pile verticale. Une erreur d’ancrage se traduit instantanément par un chevauchement des étiquettes avec les lignes de partition polygonales, annihilant la lisibilité du document.
Sur le plan mathématique, l’ordonnée médiane d’un segment spécifique $i$ au sein d’une pile ordonnée de $k$ segments correspond à la somme cumulative des hauteurs des segments sous-jacents ($1$ à $i-1$) augmentée de la moitié de la hauteur propre du segment considéré :
$$Y_{centre, i} = \sum_{j=1}^{i-1} H_j + \frac{1}{2} H_i$$
Lorsque cette opération est implémentée en amont dans dplyr, le chercheur doit ordonner rigoureusement ses données via arrange(), appliquer la fonction de sommation progressive cumsum(), et tenir compte scrupuleusement de la direction d’empilement par défaut opérée par le moteur de rendu de ggplot2, laquelle procède souvent dans l’ordre inverse de l’apparition des facteurs dans la structure matricielle.
8.2 Intégration de geom_text et geom_label
Pour s’affranchir de la complexité mathématique du calcul pré-opérationnel des sommes cumulées, ggplot2 offre une solution algorithmique intégrée d’une grande élégance via la fonction de positionnement position_stack() (ou position_fill() pour les versions normalisées). En transmettant l’argument de centrage vertical unitaire vjust = 0.5 au sein de position_stack(), le moteur calcule automatiquement le centroïde cartésien de chaque strate et y positionne l’ancre du glyphe textuel.
L’adjonction de ces indicateurs s’opère couramment au moyen de la géométrie geom_text(). Au sein de son bloc esthétique, l’argument label est alimenté par la variable numérique d’effectif ou par une chaîne formatée exprimant le pourcentage. Afin de préserver un contraste visuel satisfaisant avec les aplats chromatiques de fond, il convient d’assigner une couleur de police neutre constante (telle que le blanc ou le noir profond selon la luminance de la palette) et de calibrer la graisse typographique via fontface = "bold" et l’échelle de taille avec size.
Lorsque la palette de remplissage présente des variations extrêmes de saturation rendant impossible le choix d’une couleur d’écriture universelle, l’alternative geom_label() apporte une réponse robuste. Cette fonction génère un petit cartouche rectangulaire opaque sous le texte, doté d’une bordure subtile et d’un fond clair semi-transparent (alpha = 0.8). Ce dispositif garantit une lisibilité optique absolue de chaque chiffre, préservant la précision numérique directe sans contraindre l’observateur à des allers-retours fastidieux vers l’axe des ordonnées.
8.3 Résolution des chevauchements d’étiquettes complexes
L’apparition de segments de taille infinitésimale constitue l’écueil le plus sévère de l’étiquetage automatique au sein des barplots empilés. Lorsqu’un département ou une cohorte ne compte qu’une proportion marginale d’individus dans une modalité donnée (par exemple 1 % ou 2 %), l’épaisseur géométrique du rectangle polygonale devient inférieure à la hauteur physique des caractères typographiques. L’étiquette déborde alors inévitablement sur les strates contiguës, créant une collision visuelle confuse qui altère l’intégrité esthétique de la figure.
La première stratégie de résolution consiste à appliquer un filtrage conditionnel rigoureux directement dans la déclaration des données de la couche d’étiquetage. En utilisant une fonction conditionnelle ternaire de type ifelse(Effectif > seuil, as.character(Effectif), ""), l’analyste supprime purement et simplement le texte pour les strates dont la magnitude est insuffisante pour accueillir un marquage interne décent. La distribution globale demeure lisible grâce à la légende chromatique, tandis que la figure est expurgée de ses encombrements parasitaires.
Pour les contextes où chaque valeur doit être impérativement matérialisée numériquement pour satisfaire aux exigences d’audit scientifique, la mobilisation de l’extension ggrepel devient impérative. Grâce à sa géométrie geom_text_repel() associée à des lignes de renvoi directionnelles (leader lines), les étiquettes trop volumineuses pour être contenues à l’intérieur des segments sont automatiquement expulsées hors de la pile graphique par un algorithme de répulsion physique simulée. Cette mécanique sophistiquée préserve l’exactitude exhaustive de l’information tout en maintenant un standard de lisibilité irréprochable sur l’ensemble de l’espace cartésien.
9. Gestion avancée des facteurs et contrôle de l’ordre d’empilement
9.1 Ordonnancement des catégories principales sur l’axe des abscisses
Le comportement algorithmique par défaut de ggplot2 face à des variables catégoriel-texte consiste à convertir ces dernières en facteurs dont les niveaux sont ordonnés de manière strictement alphanumérique. Si cette logique séquentielle possède une justification opérationnelle minimale, elle conduit presque invariablement à des visualisations non optimales sur le plan sémiotique. L’ordonnancement alphabétique des départements ou des conditions expérimentales disperse l’attention du lecteur et complique la détection immédiate des gradients de performance ou de détresse psychologique.
Pour instaurer une hiérarchie visuelle signifiante, l’analyste doit remodeler activement les niveaux du facteur sous-jacent à l’aide des outils spécialisés de l’extension forcats. La fonction fct_reorder() offre une solution programmatique puissante pour réorganiser dynamiquement l’axe des abscisses en fonction d’une métrique de synthèse calculée sur une variable numérique associée. L’analyste peut ainsi classer les départements selon l’effectif cumulé total de manière à produire une cascade monotone ascendante ou descendante de barres à travers l’écran.
Dans d’autres configurations d’analyse factorielle, l’organisation spatiale doit refléter une logique protocolaire interne plutôt qu’un gradient de fréquence. L’utilisation de la primitive de base factor(x, levels = c(...)) permet de spécifier manuellement la succession rigoureuse des conditions (par exemple : « Témoin », « Pré-test », « Post-test », « Suivi à long terme »). Ce contrôle pré-graphique scrupuleux garantit que la progression visuelle de gauche à droite sur l’axe horizontal s’aligne fidèlement sur la dynamique chronologique ou l’intensité de manipulation de la variable indépendante.
9.2 Maîtrise de l’ordre d’empilement interne des segments
Une divergence récurrente et hautement déconcertante pour l’analyste débutant réside dans la désynchronisation fréquente entre l’ordre d’apparition des étiquettes dans la boîte de légende et l’ordre d’empilement effectif des strates polygonales le long de la barre verticale. Par construction mathématique, ggplot2 empile les couches de bas en haut selon l’ordre interne des niveaux du facteur, mais génère la légende de haut en bas en suivant le même ordre nominal, produisant un effet miroir déroutant qui impose une gymnastique cognitive inutile à l’observateur.
Pour rétablir une parfaite symétrie topologique entre la figure et sa légende explicative, plusieurs leviers d’action sont mobilisables. La méthode la plus directe consiste à inverser formellement la hiérarchie factorielle de la variable assignée à fill à l’aide de la fonction fct_rev() du package forcats au sein même du pipeline de mutation dplyr. En inversant les niveaux, la strate que le lecteur perçoit au sommet de la colonne graphique se trouve immédiatement indexée en première position au sommet de la légende textuelle associée.
Alternativement, ce contrôle peut être opéré sans modifier la structure des données sous-jacentes en intervenant directement au niveau de la spécification des guides graphiques via l’instruction guides(fill = guide_legend(reverse = TRUE)). Cette commande ordonne au moteur de rendu d’inverser sélectivement la disposition typographique de la boîte de légende. La maîtrise combinée des fonctions fct_rev() et guide_legend() confère au chercheur une autorité géométrique totale sur l’orientation de ses flux visuels, éliminant tout risque d’inversion interprétative lors de la lecture des strates de sévérité clinique.
10. Techniques avancées : facettage et représentations multi-groupes
10.1 Décomposition en matrices graphiques avec facet_wrap
Lorsque la structure du protocole de recherche intègre une troisième variable nominale d’intérêt—telle que le genre des participants, le statut socio-professionnel ou le centre hospitalier d’inclusion—tenter d’incorporer cette dimension au sein d’une unique barre empilée saturée d’encodages esthétiques conduit irrémédiablement à une illisibilité complète. La sémiologie moderne préconise dans cette conjoncture le déploiement du principe des « petits multiples » (small multiples) théorisé par Edward Tufte, lequel postule la répétition modulaire d’un même canevas graphique élémentaire à travers les sous-ensembles de l’échantillon global.
Sous ggplot2, ce mécanisme de partitionnement dynamique est orchestré avec une efficience remarquable par l’instruction facet_wrap(). En lui transmettant une formule conditionnelle du type ~ Genre ou ~ Centre_Hospitalier, l’algorithme segmente le jeu de données unifié en sous-matrices indépendantes et trace une matrice de barplots empilés rigoureusement calibrés sur les mêmes échelles géométriques. L’utilisateur contrôle l’architecture matricielle globale en fixant le nombre de colonnes d’affichage via l’argument ncol ou de rangées via nrow.
Un enjeu analytique majeur lors de l’application de facet_wrap() réside dans la gestion de la liberté des échelles cartésiennes. Si l’argument scales = "fixed" constitue la norme scientifique stricte garantissant la validité des comparaisons inter-panneaux en maintenant des axes d’ordonnées identiques pour toutes les sous-figures, l’option scales = "free_y" ou scales = "free_x" peut s’avérer nécessaire dans des explorations de cohortes aux volumétries excessivement disparates. Ce choix doit néanmoins demeurer rigoureusement explicité en légende afin d’éviter tout diagnostic visuel erroné induit par des bascules d’échelle inaperçues.
10.2 Organisation en grille bidimensionnelle avec facet_grid
Pour les plans expérimentaux hautement factorisés croisant simultanément deux variables de modération catégorielles distinctes (par exemple, le croisement complet d’un groupe d’âge en quatre modalités et d’une cohorte clinique en trois niveaux), l’extension matricielle franchit un palier supérieur avec la fonction facet_grid(). Contrairement à facet_wrap() qui enroule séquentiellement une liste de panneaux le long d’une bande uni-dimensionnelle, facet_grid() structure un échiquier cartésien bidimensionnel explicite régi par la formule Variable_Lignes ~ Variable_Colonnes.
Cette organisation géométrique offre une puissance de comparaison analytique incomparable pour l’identification des interactions d’ordre supérieur en psychologie expérimentale. Les marges marginales globales peuvent être intégrées automatiquement via le paramètre booléen margins = TRUE, insérant des panneaux de synthèse récapitulant les distributions agrégées sur l’ensemble des strates. Cette morphologie d’ensemble condense en un seul coup d’œil des matrices factorielles d’une grande complexité qui nécessiteraient autrement la rédaction de dizaines de pages de tableaux d’analyses de contingence.
L’optimisation esthétique d’une grille factorielle de cette densité exige un réglage minutieux des bandeaux textuels supérieurs et latéraux désignant les sous-groupes (strip labels). Au sein du bloc theme(), les paramètres strip.background et strip.text permettent d’alléger la teinte des cartouches de titrage et d’adapter la taille de la typographie afin que l’encre graphique globale demeure prioritairement allouée aux barres de données, conformément aux préceptes de la visualisation scientifique contemporaine.
11. Étude de cas appliquée : dépouillement d’un questionnaire psychométrique
11.1 Structuration d’une échelle de mesure ordinale de type Likert
Afin de mettre en application la totalité de l’échafaudage méthodologique présenté jusqu’ici, nous développons une étude de cas appliquée et intégrale dédiée au dépouillement graphique d’un inventaire psychométrique de détresse psychologique en milieu professionnel. Nous modélisons une enquête d’évaluation clinique administrée à un échantillon représentatif de cinq cents salariés répartis à travers cinq directions stratégiques d’un consortium industriel international. L’instrument mobilise une échelle de Likert ordinale standardisée à cinq points d’ancrage sémantique : « Fortement en désaccord », « En désaccord », « Neutre », « D’accord » et « Fortement d’accord ».
Le protocole computationnel débute par la génération et l’assainissement de la matrice tabulaire dans l’environnement R. Le script génère les contingences expérimentales, agrège les occurrences individuelles sous forme d’un tibble structuré au format long, et opère la conversion des modalités de réponse en un facteur ordinal rigoureusement typé à l’aide de l’instruction factor() dotée de ses étiquettes ordonnées. Une étape de contrôle algorithmique s’assure que le taux de réponse moyen par direction est conforme aux exigences de représentativité et que la somme intra-groupe des pourcentages converge exactement vers la valeur unitaire de 100 %.
Cette phase préliminaire met également en œuvre une transformation des données visant à isoler les pourcentages relatifs intra-départements via la séquence group_by(Direction) |> mutate(Pourcentage = Frequence / sum(Frequence) * 100). Ce calcul explicite, bien que rendu facultatif par l’utilisation ultérieure de position = "fill", garantit une flexibilité absolue pour le formatage personnalisé des chaînes de caractères destinées aux étiquetages textuels de haute précision qui viendront enrichir la figure de publication.
11.2 Génération et raffinement du graphique de publication
L’aboutissement de ce cas d’école consiste en l’élaboration d’un script de publication complet, élégant et auto-suffisant, conjuguant les géométries avancées, les palettes divergentes et un raffinement typographique irréprochable. Pour maximiser la lisibilité des intitulés descriptifs des directions professionnelles sans recourir à des rotations de texte d’abscisse qui fatiguent la lecture, nous introduisons la bascule orthogonale du repère cartésien par la fonction coord_flip() (ou par l’inversion directe des esthétiques x et y permise dans les versions modernes de ggplot2).
Le script intègre la palette divergente "Spectral" issue de ColorBrewer ou une gamme chromatique personnalisée scale_fill_brewer(palette = "RdYlBu", direction = -1), qui affecte intuitivement des teintes bleutées aux réponses sereines et des teintes ambrées à pourpres aux réponses traduisant une souffrance psychologique prononcée. Les segments proportionnels sont étiquetés en leur centre médian par geom_text() en exploitant l’argument position = position_fill(vjust = 0.5), avec un masque d’effacement automatique des labels correspondant aux strates d’une ampleur relative inférieure à 5 % pour prévenir toute pollution graphique.
Le polissage final est complété par l’application d’un theme_minimal() épuré, le repositionnement horizontal de la légende au sommet du graphique pour favoriser un balayage oculaire naturel, et l’introduction d’un appareil de titrage exhaustif via labs(). Enfin, la pérennisation vectorielle du document fait l’objet d’un appel rigoureux à la fonction ggsave(), qui enregistre le rendu dans des formats de publication haute définition (PDF vectoriel pour les manuscrits LaTeX, TIFF non compressé à 300 DPI pour les éditeurs biomédicaux, et PNG optimisé pour la communication web), scellant une chaîne de traitement allant de la saisie psychométrique brute à la figure de publication d’excellence.
12. Bonnes pratiques, écueils méthodologiques et alternatives
12.1 Erreurs méthodologiques courantes et solutions techniques
L’élaboration d’un barplot empilé n’est pas exempte d’écueils méthodologiques susceptibles d’altérer la validité des conclusions tirées par la communauté scientifique. La première pathologie visuelle réside dans la « saturation dimensionnelle », survenant lorsqu’un chercheur tente d’empiler un nombre excessif de sous-catégories au sein de la même colonne (fréquemment au-delà de cinq ou six strates). Cette fragmentation extrême produit une mosaïque de micro-segments impossible à décoder, exacerbant les biais perceptifs liés à l’absence de ligne de base commune et diluant l’attention de l’observateur dans des détails anecdotiques.
La solution technique à cet écueil consiste à opérer un regroupement sémantique raisonné des modalités minoritaires en amont de la modélisation graphique. La bibliothèque forcats propose à cette fin la fonction fct_lump_n() ou fct_collapse(), permettant d’agréger systématiquement les catégories marginales sous un libellé consolidé unique tel que « Autres » ou « Réponses combinées ». Cette synthèse préalable rétablit la prégnance des gradients fondamentaux tout en préservant l’exhaustivité de l’inventaire statistique sous-jacent.
Un second écueil sévère concerne l’oblitération totale de l’effet d’échantillonnage au sein des représentations relatives à 100 % (position = "fill"). Présenter des barres proportionnelles rigoureusement identiques en hauteur sans indiquer les effectifs sous-jacents n peut conduire le lecteur à accorder la même confiance statistique à une cohorte comportant vingt sujets qu’à un échantillon consolidé de deux mille individus. Pour désamorcer ce risque de méprise méthodologique, le chercheur doit obligatoirement intégrer la taille de chaque sous-groupe directement au sein des libellés de l’axe catégoriel (par exemple : « Enseignement (n = 450) » et « Logistique (n = 35) »), conférant ainsi à la figure une transparence scientifique irréprochable.
12.2 Alternatives graphiques au barplot empilé
La reconnaissance lucide des limites perceptives inhérentes au barplot empilé doit conduire l’analyste à envisager des dispositifs géométriques alternatifs lorsque la question scientifique exige une comparaison directe, précise et sans distorsion des composantes individuelles.
La première alternative directe est le barplot groupé ou côte à côte, instancié dans ggplot2 par l’ajustement position = position_dodge(preserve = "single"). En ramenant l’ensemble des segments sur une ligne de base horizontale commune fixée à l’ordonnée zéro, le diagramme groupé rétablit la tâche perceptive au niveau d’un jugement de longueur sur échelle alignée, garantissant une acuité d’évaluation maximale selon les critères de Cleveland et McGill. Ce format doit être privilégié dès lors que l’interaction univariée entre les niveaux de stratification constitue le foyer exclusif de l’analyse, au détriment de l’appréhension de la somme globale.
Pour le dépouillement spécifique des échelles psychométriques ordinales bipolaires, le diagramme en barres divergentes (popularisé par l’extension likert ou par un calibrage négatif des coordonnées cartésiennes dans ggplot2) représente une modalité visuelle largement supérieure. En alignant les catégories neutres ou d’inflexion directement sur un axe vertical zéro central, les réponses de désaccord se déploient vers la gauche tandis que les approbations progressent vers la droite, offrant une lecture immédiate du tropisme affectif ou axiologique de l’échantillon sans les ambiguïtés induites par l’empilement cumulatif classique.
Enfin, lorsque le croisement catégoriel met en jeu des matrices denses associant un nombre élevé de catégories sur les deux dimensions, le recours à des cartes thermiques catégorielles (heatmaps via geom_tile()) ou à des arbres de proportions hiérarchiques (treemaps) constitue l’alternative de choix. Ces dispositifs mobilisent la luminance chromatique ordonnée ou la tessellation spatiale pour cartographier la complexité sans imposer à l’œil les acrobaties géométriques exigées par le décodage de barres empilées excessivement fragmentées, parachevant ainsi l’éventail des solutions offertes au statisticien contemporain pour donner forme à la rigueur de ses découvertes empiriques.
Références
- Brewer, C. A. (2006). Basic mapping principles for visualizing cancer data using geographic information systems (GIS). American Journal of Preventive Medicine, 30(2), S25-S36. https://doi.org/10.1016/j.amepre.2005.09.007
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Treisman, A. (1985). Preattentive processing in vision. Computer Vision, Graphics, and Image Processing, 31(2), 156-177. https://doi.org/10.1016/S0734-189X(85)80004-9
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2-book.org/
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0