
Dans le champ de la psychométrie contemporaine et de l’analyse statistique appliquée aux sciences humaines, la vérification des postulats distributionnels constitue une exigence méthodologique primordiale. Trop souvent reléguée à une formalité périphérique, l’exploration de la distribution empirique conditionne pourtant la légitimité théorique et la validité statistique de l’ensemble des inférences paramétriques ultérieures. Parmi les instruments diagnostiques disponibles pour le chercheur et le praticien, le tracé de probabilité normale — couramment désigné sous le vocable de diagramme quantile-quantile (Q-Q plot) ou droite de Henry — s’impose comme un standard méthodologique d’une puissance d’évaluation inégalée, transcendant les simplifications réductrices des indices numériques sommaires.
Si des progiciels spécialisés et payants automatisent fréquemment cette construction graphique, l’utilisation de Microsoft Excel offre un environnement d’une valeur pédagogique et méthodologique remarquable. En décomposant chaque étape algébrique au sein d’une feuille de calcul, l’analyste s’émancipe de l’effet d’opacité inhérent aux procédures entièrement automatisées. Il réinvestit la logique mathématique fondamentale qui relie un score psychométrique empirique à son quantile théorique correspondant sous l’hypothèse de la loi de Laplace-Gauss. Cette réappropriation procédurale garantit une traçabilité intégrale des transformations numériques, un contrôle absolu sur le formatage graphique selon les normes académiques internationales et une acuité diagnostique accrue face aux anomalies de distribution.
Ce guide exhaustif a été conçu pour accompagner pas à pas les chercheurs, étudiants de cycles supérieurs et analystes quantitatifs dans la conception d’un tracé de probabilité normale d’une précision exemplaire sous Microsoft Excel. En associant rigueur formelle, développements mathématiques approfondis et mise en situation concrète issue de l’évaluation psychologique, ce document explicite l’intégralité du cycle de traitement : de la structuration matricielle des données brutes jusqu’à l’interprétation morphologique fine des écarts à la droite théorique, dans le strict respect des exigences éditoriales des sciences du comportement.
1. Introduction aux tracés de probabilité normale et pertinence en psychométrie
1.1 Définition et rôle fondamental en analyse quantitative
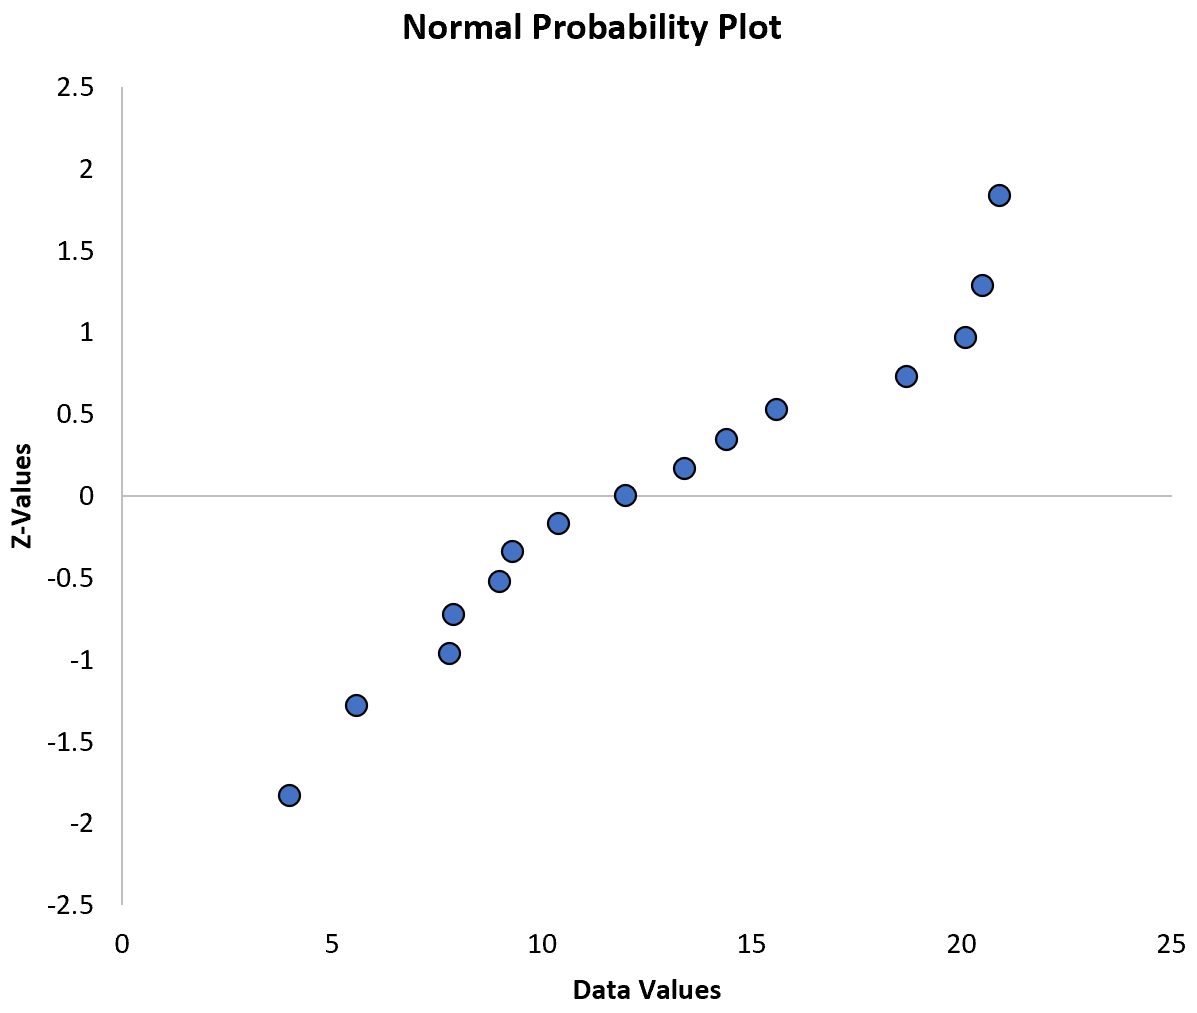
Le tracé de probabilité normale représente un dispositif graphique bidimensionnel d’inférence visuelle destiné à évaluer le degré d’adéquation entre la distribution d’une variable quantitative continue observée et la loi théorique normale standardisée. Sur le plan sémiologique, cette technique statistique se décline sous deux formes complémentaires : le tracé quantile-quantile (Q-Q plot) et le tracé pourcentage-pourcentage (P-P plot). Alors que le diagramme P-P compare directement les fonctions de répartition cumulées empiriques et théoriques, le diagramme Q-Q projette les quantiles observés d’une série statistique contre les quantiles théoriques attendus si l’échantillon était rigoureusement issu d’une population parente distribuée selon la loi normale de Laplace-Gauss.
Dans la pratique analytique moderne, le recours exclusif aux indicateurs synthétiques numériques d’asymétrie (skewness) et d’aplatissement (kurtosis) expose le chercheur à des écueils interprétatifs majeurs. Bien que ces métriques fournissent une quantification globale du troisième et du quatrième moment centré de la distribution, elles agrègent l’information en une valeur scalaire unique susceptible de masquer des anomalies structurelles localisées. Un indice d’aplatissement globalement acceptable peut, par exemple, résulter de la compensation fortuite entre une concentration excessive au centre de la distribution et des queues modérément tronquées. À l’inverse, l’examen optique du tracé de probabilité normale préserve l’intégrité configurationnelle des données en exposant la position exacte de chaque observation par rapport à l’idéal gaussien. Cette granularité visuelle permet de discriminer immédiatement la nature des déviations : décalages d’asymétrie globale, épaississement bilatéral des queues de distribution, présence de points aberrants isolés ou bimodalité sous-jacente.
L’avantage épistémologique de la méthode graphique réside ainsi dans son pouvoir heuristique. Loin de s’opposer aux modélisations quantitatives, elle fournit un contexte topologique indispensable qui permet de valider ou de nuancer les résultats obtenus par les tests d’ajustement formels, offrant une vision granulaire de la dispersion empirique que nulle métrique scalaire ne saurait restituer intégralement.
1.2 Importance du postulat de normalité en sciences psychologiques
L’édifice des statistiques inférentielles paramétriques — comprenant notamment le test t de Student pour échantillons indépendants ou appariés, l’analyse de variance univariée et multivariée (ANOVA/MANOVA), ainsi que la régression linéaire ordinaire — repose de manière consubstantielle sur le respect du postulat de normalité distributionnelle des erreurs résiduelles. En sciences psychologiques et en neurosciences cognitives, où les construits latents sont approchés par des mesures quantitatives indirectes, l’hypothèse de normalité constitue le fondement mathématique garantissant que les statistiques de test calculées suivent rigoureusement les lois théoriques tabulées sous l’hypothèse nulle.
Lorsque cette condition fondamentale est substantiellement transgressée, l’appareil inférentiel subit des dégradations préjudiciables. En premier lieu, le taux d’erreur de première espèce (le risque alpha de rejeter à tort une hypothèse nulle pourtant vraie) se trouve dérégulé, conduisant soit à une inflation incontrôlée des faux positifs, soit à un conservatisme excessif. En second lieu, la puissance statistique du test se trouve compromise, empêchant le chercheur de détecter des effets réels d’amplitude modérée ou faible. L’estimation des intervalles de confiance associés aux paramètres d’intérêt perd alors sa fiabilité nominale, ce qui menace la reproductibilité empirique des conclusions.
Cette problématique revêt une acuité singulière au regard de la typologie des données collectées en psychologie. Les scores composites issus d’échelles de Likert au sein de questionnaires de personnalité ou d’inventaires cliniques présentent fréquemment des effets de seuil (plafonnement ou plancher) induisant une asymétrie marquée. De surcroît, les mesures chronométriques telles que les temps de réaction informatisés lors de tâches de flexibilité cognitive manifestent invariablement une distribution asymétrique positive, caractérisée par une queue droite étirée reflétant les processus d’attention soutenue ou les lapsus attentionnels. Enfin, les batteries neuropsychologiques évaluant des populations atypiques ou pathologiques concentrent souvent les scores sains sur une extrémité de l’échelle, générant des ruptures de normalité structurelles qui proscrivent l’usage aveugle de métriques paramétriques sans examen préalable minutieux.
1.3 Objectifs pédagogiques et méthodologiques du guide
Face à la complexité intrinsèque de ces problématiques distributionnelles, ce guide méthodologique s’assigne une triple mission pédagogique, technique et critique. L’ambition première est d’offrir un protocole opérationnel entièrement reproductible au sein de l’environnement Microsoft Excel. En décomposant la chaîne de traitement en étapes modulaires et séquentielles, ce document ambitionne de démystifier les équations sous-jacentes et de démontrer comment un outil de calcul généraliste peut être configuré pour rivaliser avec la précision analytique de suites statistiques spécialisées.
Le second objectif consiste à déconstruire le modèle de la « boîte noire » logicielle. Dans de nombreux environnements fermés, la génération d’un tracé Q-Q s’opère par simple sélection d’une case à cocher, dissimulant à l’utilisateur les choix critiques d’implémentation algorithmique, tels que la formule d’estimation des positions relatives (plotting positions) ou l’ajustement de l’ordonnée à l’origine de la droite de repérage. En programmant explicitement chaque transformation mathématique au moyen des fonctions natives d’Excel, l’expérimentateur acquiert une compréhension intime des mécanismes de conversion liant l’ordre de grandeur empirique d’un score à sa probabilité cumulée, puis à son quantile théorique correspondant sur l’axe standardisé des cotes z.
Enfin, le troisième objectif vise à doter le lecteur d’un cadre d’interprétation visuelle rigoureux, conforme aux critères éditoriaux de l’American Psychological Association (APA 7th edition). Il ne s’agit pas uniquement de construire un graphique techniquement exact, mais de conférer à cet artefact visuel une lisibilité et une pertinence clinique optimales, permettant d’étayer solidement les décisions méthodologiques qui jalonnent l’évaluation d’un protocole de recherche empirique.
2. Fondements mathématiques du tracé de probabilité normale
2.1 Transformation des scores bruts en quantiles théoriques
L’architecture mathématique du tracé de probabilité normale repose sur la confrontation directe entre deux fonctions de répartition : la fonction de répartition empirique, déduite de l’échantillon observé, et la fonction de répartition cumulative théorique de la loi normale centrée réduite. Soit une variable aléatoire continue quantitative $X$. Si cette variable est distribuée selon une loi normale d’espérance $\mu$ et de variance $\sigma^2$, notée $\mathcal{N}(\mu, \sigma^2)$, sa fonction de densité de probabilité $f(x)$ s’exprime par la formule analytique classique :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right)$$
La fonction de répartition cumulative théorique, notée $Phi(z)$ pour la variable normale standardisée $Z = (X – \mu) / \sigma$, représente l’intégrale de cette densité de probabilité de l’infini négatif jusqu’à la borne $z$ :
$$\Phi(z) = P(Z le z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} \exp\left(-\frac{t^2}{2}\right) dt$$
Dans le cadre de l’élaboration du tracé, l’analyste dispose des scores bruts ordonnés $x_{(1)} le x_{(2)} le dots le x_{(n)}$, désignés sous l’appellation de statistiques d’ordre. Pour chaque observation de rang $i$, on associe une estimation de sa probabilité cumulée théorique $p_i$. La transition fondamentale vers le quantile théorique $z_i$ s’opère par l’application de la fonction quantile, qui est la bijection réciproque (ou inverse) de la fonction de répartition cumulative de la loi normale standardisée, notée $\Phi^{-1}(p)$ :
$$z_i = \Phi^{-1}(p_i)$$
Sur le plan géométrique, lorsque les quantiles théoriques $z_i$ sont mis en relation graphique avec les scores observés standardisés correspondants, les points $(z_i, x_{(i)})$ s’alignent le long d’une droite affine. Si les données brutes ne sont pas standardisées, la relation théorique demeure strictement linéaire, la pente de la trajectoire correspondant à l’écart-type de l’échantillon ($\sigma$) et l’ordonnée à l’origine à sa moyenne arithmétique ($\mu$). Si les deux séries sont préalablement standardisées, la droite de référence théorique se confond avec la première bissectrice cartésienne, formant un angle géométrique exact de quarante-cinq degrés passant par l’origine coordinateuse $(0,0)$.
2.2 Les formules de positionnement plotting positions
L’estimation de la probabilité cumulée $p_i$ associée au $i$-ème élément ordonné d’un échantillon de taille $n$ constitue un problème mathématique d’une subtilité historique déterminante. Une intuition naïve consisterait à poser $p_i = i / n$. Toutefois, cette formulation introduit un biais asymétrique critique : pour l’observation maximale où $i = n$, la probabilité cumulée atteindrait rigoureusement la valeur $1$, ce qui engendrerait une impasse mathématique lors de l’application de la fonction quantile inverse $\Phi^{-1}(1)$, cette dernière divergeant asymptotiquement vers l’infini positif ($+\infty$). De manière symétrique, le choix de $p_i = (i – 1) / n$ conduirait pour $i = 1$ à une probabilité nulle, dont l’inverse quantile tend vers l’infini négatif ($-\infty$).
Afin de circonscrire cette singularité aux bornes et de fournir une estimation non biaisée des fractiles de la population, la théorie statistique a vu émerger une constellation d’approches correctives, regroupées sous l’expression générique d’algorithmes de positionnement (plotting positions). Ces formules s’inscrivent généralement dans la forme paramétrique unifiée :
$$p_i = \frac{i – a}{n + 1 – 2a}$$
Où le paramètre $a$ est une constante de centrage comprise dans l’intervalle $[0, 0.5]$. Diverses formulations canoniques se partagent la littérature :
- La méthode de Weibull ($a = 0$), définie par $p_i = \frac{i}{n + 1}$, souvent préconisée pour son élégance arithmétique et son caractère d’espérance mathématique non biaisée de la probabilité de dépassement dans les distributions non paramétriques.
- La méthode de Hazen ($a = 0.5$), caractérisée par la formulation $p_i = \frac{i – 0.5}{n}$, représentant l’une des corrections de continuité les plus intuitives, attribuant à chaque point le centre exact de son intervalle percentile empirique.
- L’approximation de Blom ($a = 0.375$), formalisée par $p_i = \frac{i – 0.375}{n + 0.25}$, qui a été mathématiquement optimisée pour minimiser l’erreur quadratique moyenne de l’estimation des quantiles d’une loi normale standard, raison pour laquelle elle constitue l’algorithme par défaut de logiciels de référence comme SPSS.
- La formulation de Tukey ($a = 1/3$), formalisée par $p_i = \frac{i – 1/3}{n + 1/3}$, largement reconnue dans l’analyse exploratoire de données.
Dans l’écosystème fonctionnel de Microsoft Excel, la formule standardisée de Hazen $p_i = (i – 0.5) / n$ s’est imposée comme le choix algorithmique par excellence. Elle conjugue une excellente robustesse théorique avec une simplicité d’implémentation arithmétique remarquable, tout en garantissant un partitionnement symétrique parfait des probabilités autour du centile médian $p = 0.5$ pour les séries statistiques finies.
2.3 Comportement asymptotique et distribution d’échantillonnage
L’une des méprises méthodologiques les plus pernicieuses dans l’évaluation visuelle d’un tracé de probabilité normale réside dans l’attente irréaliste d’un alignement rectiligne rigoureusement parfait de tous les points expérimentaux. En vertu de la théorie de l’échantillonnage, la variance de distribution des statistiques d’ordre n’est pas uniforme le long de l’axe réel. Au centre de la distribution, au voisinage de la médiane ($z \approx 0$), la densité de probabilité de la loi normale est maximale ($f(0) \approx 0.3989$), ce qui confère aux quantiles empiriques une faible variabilité d’échantillonnage. En d’autres termes, les points médians sont contraints par une forte densité d’observations et manifestent une stabilité géométrique élevée.
À l’inverse, au fur et à mesure que l’on progresse vers les queues de la distribution (pour des valeurs absolues de $|z| > 1.96$), la densité de probabilité normale décroît exponentiellement vers zéro. En conséquence, la variance d’échantillonnage des statistiques d’ordre extrêmes $x_{(1)}$ et $x_{(n)}$ est considérablement plus substantielle que celle des rangs médians. Cette disparité est modélisée asymptotiquement par la loi limite des quantiles d’échantillonnage : la variance du quantile empirique d’ordre $p$, noté $\hat{x}_p$, est inversement proportionnelle au carré de la densité théorique :
$$operatorname{Var}(\hat{x}_p) \approx \frac{p(1 – p)}{n [f(\Phi^{-1}(p))]^2}$$
Puisque le dénominateur $f(\Phi^{-1}(p))$ tend vers zéro à mesure que $p to 0$ ou $p to 1$, la variance explose aux extrémités. Il est donc mathématiquement attendu et parfaitement naturel que les points terminaux du graphique manifestent une dispersion et des fluctuations résiduelles plus amples autour de la ligne de référence théorique, même si la population mère est rigoureusement gaussienne.
Il incombe dès lors au chercheur de mobiliser le théorème central limite avec circonspection : si la moyenne d’échantillonnage converge en loi vers la normalité pour de larges effectifs, la morphologie locale des queues d’un échantillon fini reste vulnérable aux aléas stochastiques d’échantillonnage. Le diagnostic doit ainsi veiller à ne point confondre des fluctuations aléatoires bénignes, inhérentes à la raréfaction des occurrences aux extrêmes, avec des dérives directionnelles persistantes et systématiques traduisant une inadéquation morphologique fondamentale du modèle théorique.
3. Préparation préalable de l’environnement de travail dans Excel
3.1 Configuration du classeur et structuration tabulaire
La mise en œuvre d’analyses quantitatives exigeantes dans Microsoft Excel requiert une discipline d’organisation architecturale rigoureuse afin d’éviter les erreurs de référence et d’assurer une parfaite traçabilité des données. Dès l’initialisation du classeur, l’analyste évitera l’écueil consistant à disperser les calculs de manière anarchique. Une feuille de calcul dédiée, renommée explicitement « Diagnostic_Normalite », doit être configurée selon une logique colonnaire stricte où chaque colonne héberge une variable spécifique ou un stade déterminé de la transformation mathématique.
L’utilisation des « Tableaux structurés » natifs d’Excel (accessibles via le ruban Insertion > Tableau ou le raccourci clavier standard Ctrl+L sous environnement francophone) offre des avantages opérationnels décisifs. Ce mécanisme convertit une plage matricielle statique en un conteneur relationnel dynamique doté d’en-têtes standardisés. Les formules appliquées au sein d’un tableau structuré adoptent une syntaxe de références structurées extrêmement lisible (par exemple [@Score_Obs] au lieu de références de coordonnées absolues complexes), tout en automatisant la propagation verticale instantanée des formules lors de l’adjonction ultérieure de nouvelles observations cliniques.
Les colonnes de calcul doivent être ordonnées de gauche à droite selon la cinématique computationnelle séquentielle suivante :
- Colonne A (Identifiant_Sujet) : Attribution d’un code alphanumérique unique pour chaque participant garantissant l’anonymat et le contrôle d’intégrité de la saisie.
- Colonne B (Score_Brut) : Réception de la variable psychométrique continue originale issue de la passation de l’instrument d’évaluation.
- Colonne C (Score_Trie) : Réarrangement monotone croissant des observations brutes, étape préalable obligatoire au positionnement des rangs.
- Colonne D (Rang_Statistique) : Calcul de la position ordinale $i$ de chaque observation au sein de la distribution échantillonnale.
- Colonne E (Probabilite_Cumulee) : Détermination du centile empirique associé via l’algorithme de positionnement retenu.
- Colonne F (Quantile_Theorique_Z) : Projection des probabilités cumulées dans l’espace métrique de la loi normale centrée réduite au moyen de la fonction inverse.
3.2 Nettoyage et inspection initiale des observations
Avant d’engager le moindre calcul algorithmique, un audit d’assainissement métrologique du jeu de données brutes s’avère indispensable. Le moteur de calcul matriciel d’Excel présente une sensibilité singulière aux contaminations typographiques. Des erreurs subtiles, telles que l’insertion accidentelle d’une espace insécable avant un chiffre ou l’utilisation inappropriée d’un point décimal anglo-saxon (« . ») au sein d’un système d’exploitation paramétré avec le séparateur décimal virgule francophone (« , »), convertissent silencieusement une valeur numérique en chaîne de caractères typographiques (texte). Ces chaînes de caractères faussent l’ordre de tri et induisent des échecs d’évaluation dans les fonctions quantiles, générant des messages d’erreur d’interruption du type #VALEUR!.
Pour prévenir ces dysfonctionnements, l’expérimentateur appliquera un filtre systématique d’inspection préliminaire. L’instruction logique native =ESTNUM(B2) permet de tester immédiatement la nature arithmétique de chaque cellule de la plage cible. Parallèlement, l’outil Rechercher et remplacer (Ctrl+H) permettra de substituer uniformément d’éventuels points typographiques par des virgules décimales conformes aux réglages régionaux de l’instance logicielle.
Enfin, l’intégrité métrologique propre au construit psychologique doit être rigoureusement interrogée. Des scores hors bornes théoriques — par exemple, un indice d’inventaire d’anxiété enregistré à 85 alors que le protocole de cotation standardisé borne l’amplitude de l’échelle entre 20 et 80 points — révèlent immanquablement des erreurs de saisie dactylographique ou des corruptions de codage numérique. La fonction intégrée de validation des données d’Excel (Données > Validation des données) sera avantageusement paramétrée pour interdire formellement l’introduction de toute valeur s’écartant des bornes d’admissibilité théoriques du test psychologique administré.
4. Étape 1 : Structuration et saisie du jeu de données psychologiques
4.1 Constitution de l’échantillon d’étude illustratif
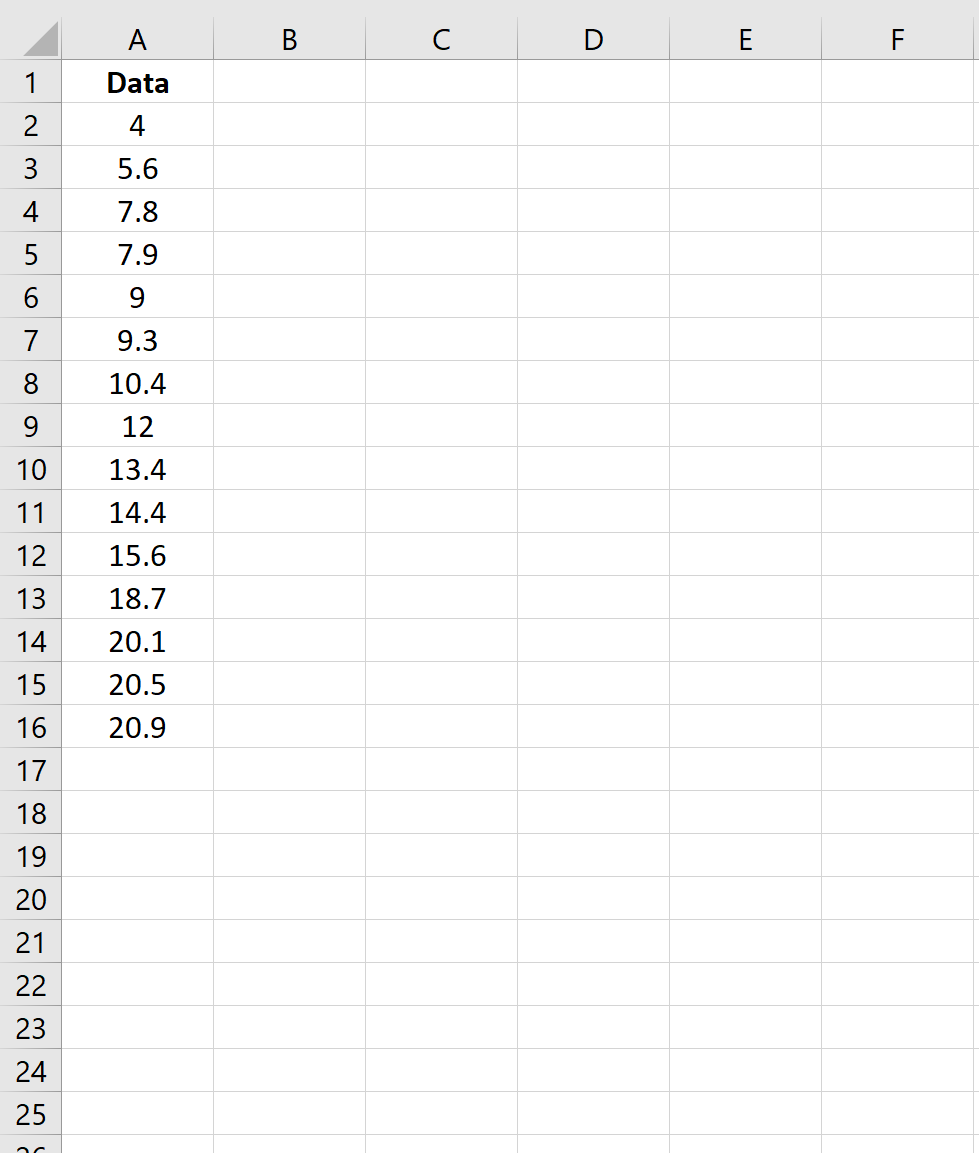
Afin d’ancrer la démonstration dans une perspective écologique propre aux sciences comportementales, nous considérons un protocole expérimental fictif mais réaliste portant sur l’évaluation de l’anxiété cognitive d’anticipation. L’échantillon d’étude se compose de $n = 15$ participants adultes soumis à un inventaire clinique psychométrique standardisé dont les scores bruts sont théoriquement échelonnés sur un continuum continu allant de 10 (sérénité cognitive absolue) à 50 (détresse anxieuse aiguë invalidante).
Les observations quantitatives empiriques recueillies auprès de ces quinze sujets se distribuent comme suit :
- Sujet P01 : 22,4
- Sujet P02 : 31,8
- Sujet P03 : 18,5
- Sujet P04 : 27,2
- Sujet P05 : 34,1
- Sujet P06 : 25,0
- Sujet P07 : 29,6
- Sujet P08 : 39,2
- Sujet P09 : 23,7
- Sujet P10 : 28,1
- Sujet P11 : 33,0
- Sujet P12 : 15,2
- Sujet P13 : 26,5
- Sujet P14 : 36,7
- Sujet P15 : 30,4
Ce jeu de données synthétique présente une étendue empirique de $39,2 – 15,2 = 24,0$ points, avec une moyenne d’échantillonnage de $\bar{x} \approx 27,42$ et un écart-type corrigé de $s \approx 6,43$. L’amplitude modérée de cet effectif ($n = 15$) reproduit fidèlement la réalité des études pilotes en psychologie expérimentale ou des protocoles exploratoires en neuropsychologie clinique, contextes méthodologiques dans lesquels la puissance des tests d’ajustement formels est réduite et où l’inspection du tracé de probabilité normale prend une importance diagnostique capitale.
4.2 Ordonnancement numérique des valeurs observées
Le traitement préparatoire incontournable pour la construction du tracé Q-Q réside dans le tri ordonné des valeurs observées selon une relation d’ordre monotone croissante. Les algorithmes de positionnement probabiliste assignent en effet un fractile théorique à chaque observation en fonction de son rang séquentiel au sein du continuum ordonné des réalisations expérimentales. Dans les versions modernes d’Excel (Microsoft 365, Excel 2021 et versions supérieures), cette opération peut être exécutée de manière dynamique sans altérer la colonne de saisie primaire grâce à la fonction de tableau dynamique matriciel TRIER :
=TRIER(B2:B16; 1; 1)
Cette syntaxe prescrit le tri de la matrice source située de la cellule B2 à B16 selon la première colonne d’argument (1) et selon un vecteur d’ordonnancement strictement ascendant (1). Les valeurs triées s’écoulent automatiquement dans la colonne adjacente.
Pour les utilisateurs de versions patrimoniales d’Excel ne disposant pas du moteur de tableaux dynamiques, l’ordonnancement s’exécute traditionnellement via la sélection de la plage des scores observés, suivie de l’activation de la commande contextuelle Données > Trier du plus petit au plus grand. Une attention particulière doit être portée à l’invite de dialogue du logiciel : il convient de refuser l’extension automatique de la sélection si l’on souhaite dissocier le vecteur trié des identifiants originaux, ou d’inclure les colonnes connexes si l’on souhaite préserver l’appariement sujet-score. La séquence triée résultante forme notre ensemble de statistiques d’ordre $x_{(1)} = 15,2$, $x_{(2)} = 18,5$, $x_{(3)} = 22,4$, jusqu’à $x_{(15)} = 39,2$.
4.3 Dénombrement systématique de la taille d’échantillon
Dans une perspective de modélisation paramétrique pérenne et réutilisable, la taille de l’échantillon $n$ ne doit jamais être inscrite sous forme de constante numérique statique (en dur) au sein des dénominateurs de calcul. Une telle pratique rigidifie le classeur et engendre des erreurs systémiques majeures dès lors que le chercheur incrémente son jeu de données ou tronque l’échantillon pour des analyses en sous-groupes.
Le calcul du cardinal de l’échantillon $n$ doit être systématiquement délégué à la fonction arithmétique NB, qui dénombre exclusivement les cellules hébergeant un contenu numérique valide au sein d’un vecteur spécifié :
=NB($C$2:$C$16)
Cette expression, idéalement isolée dans une cellule de métadonnées réservée (par exemple la cellule $H$2) ou directement imbriquée dans les formules des colonnes probabilistes, garantit une adaptabilité automatique du modèle d’analyse. Si l’expérimentateur insère de nouvelles observations cliniques par expansion de la matrice, l’ensemble des dénominateurs fractionnaires s’ajuste instantanément sans nécessiter d’intervention corrective manuelle sur la grille algorithmique.
5. Étape 2 : Calcul des rangs percentiles et des probabilités cumulées
5.1 Détermination du rang statistique individuel
Une fois les scores bruts disposés en ordre croissant au sein de la colonne C (plage C2:C16), l’assignation du rang statistique ordinal $i$ pour chaque entité observée constitue l’opération suivante. Puisque les observations ont été rigoureusement pré-triées, l’approche la plus directe et la moins consommatrice de ressources informatiques consiste à générer une suite d’entiers consécutifs indexés de $1$ à $n$. Cette indexation peut être générée en saisissant la valeur $1$ en cellule D2, puis en appliquant la relation d’incrément arithmétique =D2+1 sur l’ensemble du vecteur vertical jusqu’à l’observation terminale $15$.
Néanmoins, si l’on souhaite consolider le classeur afin qu’il traite les valeurs sans exiger un pré-tri physique obligatoire des cellules, l’usage des fonctions statistiques spécialisées d’Excel s’impose. La fonction RANG.EQ calcule le rang d’une valeur au sein d’une référence collective :
=RANG.EQ(B2; $B$2:$B$16; 1)
Le troisième argument (1) prescrit explicitement un ordonnancement ascendant, attribuant le rang $1$ à la valeur numérique minimale. Une problématique surgit toutefois en présence d’ex æquo (ties), situation fréquente dans les inventaires psychométriques discrets où plusieurs participants obtiennent un score strictement identique. La fonction RANG.EQ attribue le même rang ordinal supérieur à toutes les occurrences identiques, ce qui crée une rupture de continuité dans la séquence des rangs (par exemple, deux scores ex æquo au rang 4 recevront le rang 4, et le score suivant recevra le rang 6, sautant le rang 5). Pour neutraliser cette distorsion dans les calculs de centiles théoriques, il est souvent préférable d’utiliser RANG.MOYENNE, qui affecte aux ex æquo la moyenne arithmétique des rangs qu’ils auraient occupés, ou d’adjoindre un terme de correction de rupture d’ex æquo basé sur l’occurrence via la fonction NB.SI.
5.2 Formulation de la probabilité cumulée empirique
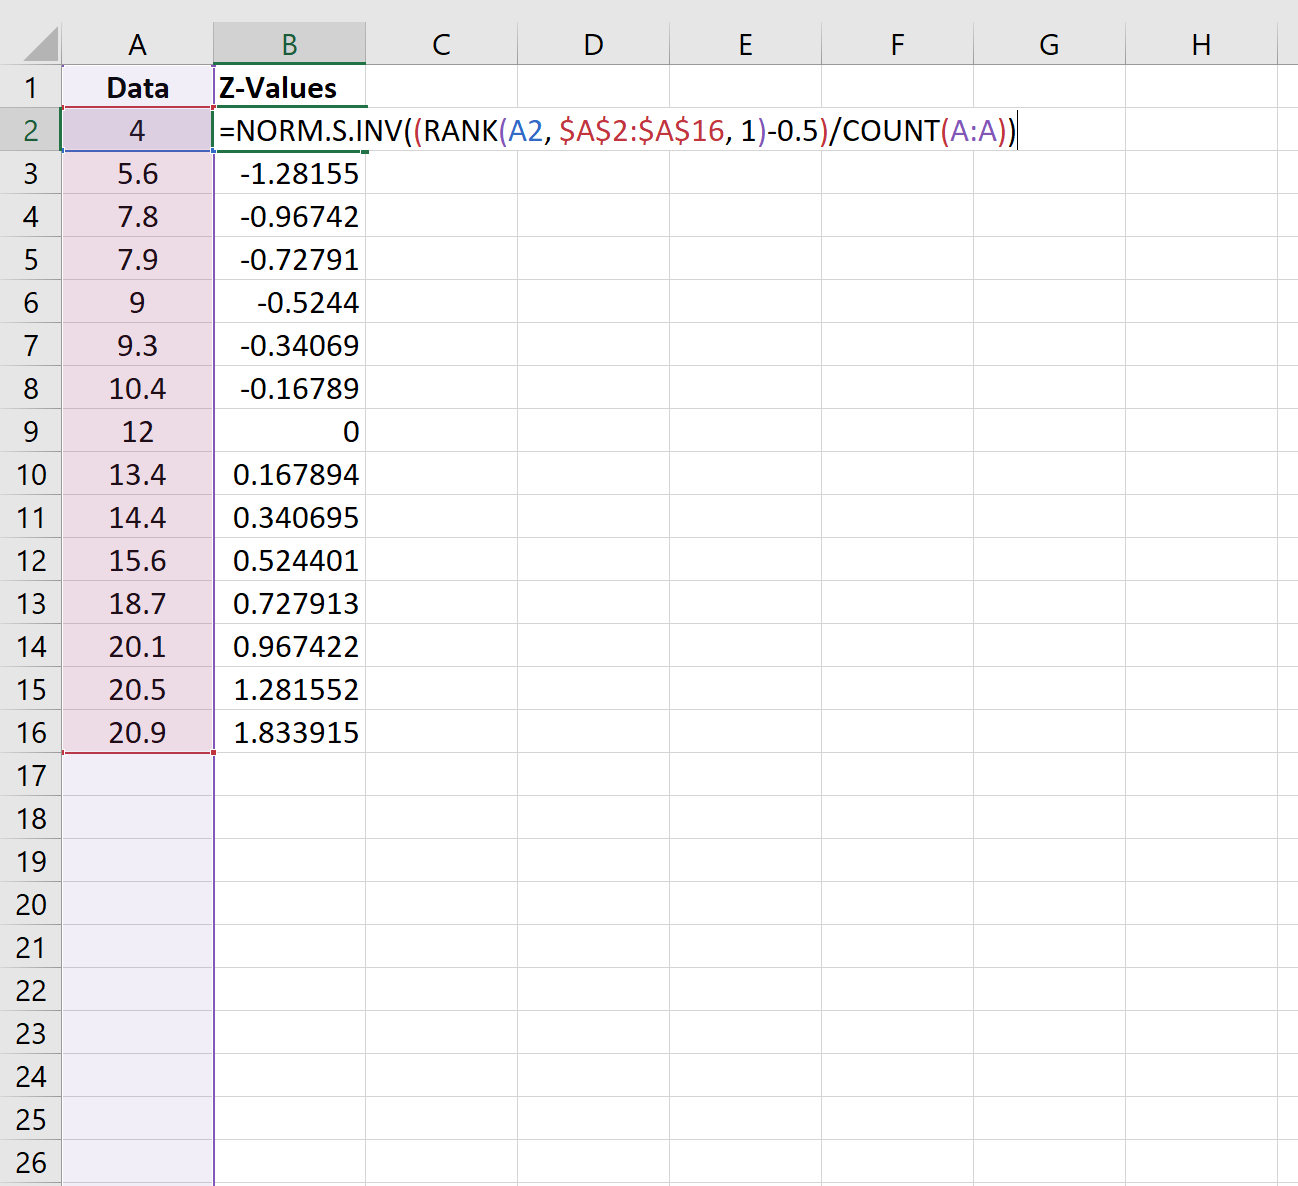
Disposant désormais du rang statistique individuel $i$ (colonne D) et de la taille globale de l’échantillon $n$ (obtenue par la fonction NB), nous procédons au calcul de la probabilité cumulée empirique non biaisée $p_i$ pour chaque ligne de calcul de notre matrice. Conformément aux arbitrages mathématiques détaillés au sein de la sous-section 2.2 de cet ouvrage, nous appliquons l’algorithme standardisé de Hazen, dont la correction de continuité centrale à $-0,5$ garantit un positionnement symétrique et prévient la saturation aux bornes asymptotiques.
Au sein de la cellule E2, la formule opérationnelle s’implémente sous la syntaxe arithmétique suivante :
=(D2 - 0,5) / NB($C$2:$C$16)
Analysons précisément la décomposition structurelle de cette expression :
- Le numérateur
(D2 - 0,5)retranche un demi-point d’intervalle au rang ordinal $i$. Pour le premier score de l’échantillon ($i = 1$), le numérateur s’établit à $1 – 0,5 = 0,5$. Pour l’observation finale ($i = 15$), il s’établit à $15 – 0,5 = 14,5$. - Le dénominateur
NB($C$2:$C$16)évalue dynamiquement le cardinal global $n = 15$. - Le quotient résultant engendre une séquence de probabilités strictement bornée à l’intérieur de l’intervalle ouvert $]0, 1[$. Pour la première observation, nous obtenons $p_1 = 0,5 / 15 \approx 0,0333$ (soit le 3,33e percentile). Pour l’observation médiane ($i = 8$), nous obtenons rigoureusement $p_8 = (8 – 0,5) / 15 = 7,5 / 15 = 0,5000$ (le 50e percentile médian exact). Enfin, pour la valeur sommitale ($i = 15$), nous relevons $p_{15} = 14,5 / 15 \approx 0,9667$ (le 96,67e percentile).
Cette progression géométrique symétrique assure que chaque observation est positionnée au barycentre de sa tranche de probabilité empirique, condition indispensable à l’absence de biais lors de la rétro-projection quantile.
5.3 Propagation et verrouillage des références de cellules
L’intégrité de l’étirement vertical d’une formule sous Microsoft Excel repose sur la maîtrise absolue des mécanismes d’adressage relatif et absolu. Dans la formule =(D2 - 0,5) / NB($C$2:$C$16), l’opérateur de référence D2 est délibérément laissé sous sa forme relative (sans symbole dollar). Lors de la copie incrémentielle vers le bas, cette coordonnée s’adaptera automatiquement pour référencer D3, D4, et ainsi de suite jusqu’à D16, capturant à chaque ligne le rang propre au score évalué.
À l’inverse, l’argument matriciel de la fonction dénombrement doit impérativement être immobilisé au moyen des identificateurs d’ancrage absolu : $C$2:$C$16. L’omission des dollars (qui produirait l’argument relatif C2:C16) déclencherait un glissement de plage vers le bas lors de l’étirement de la formule (devenant C3:C17 à la ligne suivante, puis C4:C18). Ce décalage réduirait artificiellement la taille de l’échantillon dénombré à chaque nouvelle ligne, générant des dénominateurs erronés et corrompant l’ensemble des probabilités cumulées calculées.
Après avoir saisi l’instruction en E2, l’analyste double-cliquera sur le coin inférieur droit de la cellule (poignée de recopie) ou étirera manuellement le cadre jusqu’à la cellule E16. Un contrôle visuel d’audit permettra de valider instantanément la justesse de l’opération : la somme des probabilités symétriques extrêmes ($p_1 + p_n$) doit être rigoureusement égale à $1$ ($0,0333 + 0,9667 = 1,0000$), confirmant la symétrie parfaite du calcul.
6. Étape 3 : Calcul mathématique des valeurs Z avec LOI.NORMALE.STANDARD.INVERSE
6.1 Principes de la fonction LOI.NORMALE.STANDARD.INVERSE
La conversion des probabilités cumulées empiriques $p_i$ en quantiles théoriques standardisés s’effectue au moyen de l’évaluation numérique de la fonction inverse de la loi normale centrée réduite $\Phi^{-1}(p)$. Dans l’environnement moderne de Microsoft Excel, l’opérateur algorithmique dédié à cette transformation se nomme :
LOI.NORMALE.STANDARD.INVERSE(probabilité)
Sur le plan de l’historique logiciel, il convient de souligner que les versions antérieures à la refonte du moteur statistique d’Excel 2010 utilisaient l’instruction NORMSINV (ou LOI.NORMALE.STANDARD.INVERSE dans son ancienne version non optimisée). Les algorithmes antérieurs souffraient d’imprécisions numériques résiduelles, en particulier dans l’estimation des quantiles d’extrémités profondes (pour des probabilités inférieures à $10^{-6}$ ou supérieures à $1 – 10^{-6}$). Depuis Excel 2010, Microsoft a réécrit ces routines en intégrant des approximations rationnelles de haute précision basées sur les travaux mathématiques de Wichura (1988), garantissant une conformité arithmétique jusqu’au seizième chiffre significatif.
Mathématiquement, la fonction prend en argument unique une probabilité $p$ strictement comprise entre 0 et 1, et renvoie la valeur $z$ telle que l’intégrale de la loi normale standard de $-\infty$ à $z$ égale exactement cette probabilité. Ainsi :
- Si $p = 0,5$, la fonction renvoie rigoureusement $z = 0,000$, la médiane théorique d’une distribution gaussienne centrée coïncidant avec son espérance.
- Si $p < 0,5$, la fonction renvoie un score $z$ strictement négatif, traduisant un écart-type positionné sous la moyenne de référence.
- Si $p > 0,5$, la fonction génère un score $z$ strictement positif, indiquant une valeur supérieure à la moyenne.
6.2 Implémentation de la formule globale combinée
Pour matérialiser cette étape au sein de notre architecture tabulaire, nous insérons dans la cellule F2 l’appel fonctionnel pointant vers la probabilité calculée dans la colonne adjacente :
=LOI.NORMALE.STANDARD.INVERSE(E2)
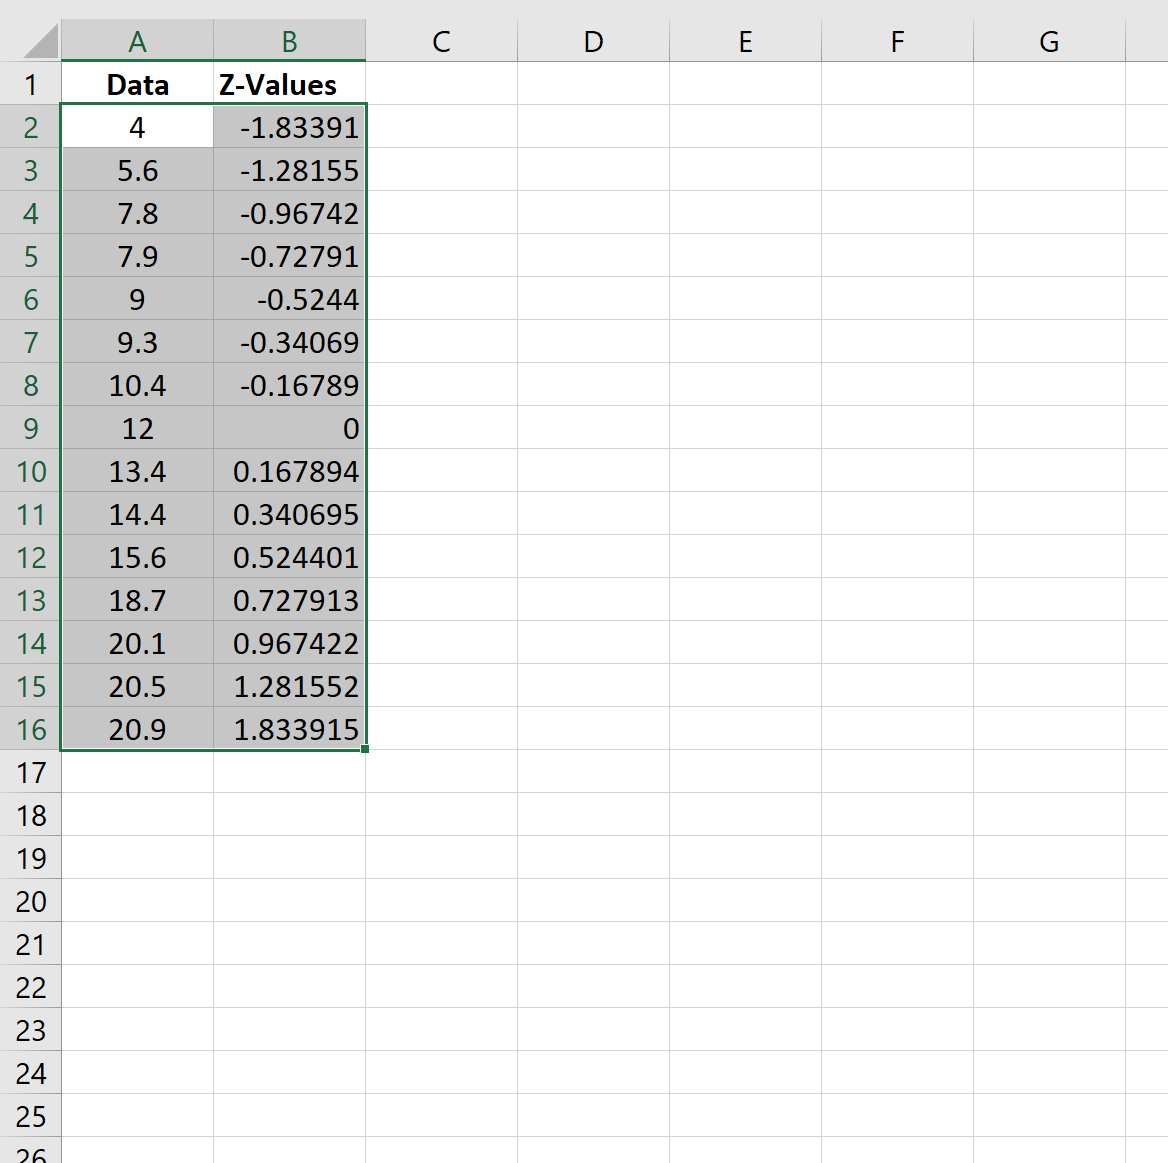
Après étirement vertical de F2 jusqu’à F16, la colonne se remplit des quantiles théoriques exprimés en unités d’écart-type (scores $z$). Pour notre jeu de données expérimental, les valeurs calculées se déploient harmonieusement de $z_1 \approx -1,834$ (pour $p_1 \approx 0,0333$) jusqu’à $z_{15} \approx +1,834$ (pour $p_{15} \approx 0,9667$), le rang médian $z_8$ affichant exactement $0,000$.
Il est envisageable de condenser l’ensemble du cycle de calcul au sein d’une formule unifiée unique, s’affranchissant du recours aux colonnes intermédiaires de rang et de probabilité :
=LOI.NORMALE.STANDARD.INVERSE((RANG.EQ(B2;$B$2:$B$16;1)-0,5)/NB($B$2:$B$16))
Si cette écriture condensée présente une incontestable élégance syntaxique et réduit l’encombrement horizontal de la feuille de calcul, nous la déconseillons formellement dans le cadre d’un protocole d’analyse de recherche ou d’un audit psychométrique. La décomposition granulaire en colonnes discrètes (Scores > Rangs > Probabilités > Quantiles Z) offre une traçabilité analytique supérieure. Elle facilite la détection immédiate d’éventuelles anomalies numériques intermédiaires et permet une appropriation pédagogique intégrale du processus par les étudiants et chercheurs collaborateurs.
6.3 Contrôle qualité des scores z calculés
L’analyste consciencieux procédera, dès la génération de la colonne F terminée, à un contrôle qualité systématique articulé autour de trois règles de cohérence stochastique :
1. Contrôle de symétrie centrale bilatérale : La somme arithmétique de l’ensemble des scores $z$ théoriques calculés sur un échantillon régulier doit être théoriquement nulle :
$$\sum_{i=1}^{n} z_i = 0$$
Dans la pratique informatique sous Excel, en raison des limites inhérentes à la représentation des nombres réels en virgule flottante binaire selon la norme IEEE 754, l’application de la fonction =SOMME(F2:F16) pourra renvoyer un nombre infinitésimal non strictement nul mais extrêmement proche de zéro (par exemple de l’ordre de $10^{-16}$). Une telle valeur confirme la validité formelle de la symétrie.
2. Vérification de la bijection monotone : La série des scores $z$ doit présenter une stricte croissance monotone le long des lignes de calcul ($z_1 < z_2 < z_3 < dots < z_n$). L'apparition d'une stagnation locale ou d'une inversion de pente indique une corruption dans la séquence des rangs ou une erreur de tri dans la colonne source.
3. Absence d’indicateurs d’exception logicielle : L’affichage d’un message d’erreur de type #NOMBRE! révèle immanquablement qu’une probabilité cumulée a atteint ou dépassé les bornes d’admissibilité fonctionnelle ($p le 0$ ou $p ge 1$), traduisant une omission de la correction de continuité dans la formulation de Hazen. L’affichage d’un code d’erreur #VALEUR! indique la présence résiduelle d’un caractère non numérique au sein de la chaîne computationnelle.
7. Étape 4 : Génération graphique du nuage de points dans Excel
7.1 Sélection adéquate des séries de données
La génération du tracé repose sur la mise en relation graphique des deux séries numériques appariées : les observations quantitatives réelles issues du test psychologique (scores observés) et les fractiles théoriques modélisés (scores z normaux). À ce stade, un arbitrage méthodologique de premier ordre s’impose concernant la convention d’affectation des axes cartésiens.
Dans la littérature biomédicale et physique anglo-saxonne issue des travaux pionniers d’Hazelton et de Chambers, il est fréquent de disposer les quantiles théoriques en abscisse ($X$) et les données observées en ordonnée ($Y$). Selon cette convention, la modélisation mathématique exprime les mesures physiques en fonction de la loi théorique de référence. Toutefois, dans la tradition psychométrique continentale francophone et au sein de multiples traités d’évaluation comportementale s’inscrivant dans la filiation de la méthode de Henry, l’attribution inverse est couramment adoptée : la variable mesurée empiriquement constitue le repère d’abscisse ($X$), tandis que la projection des scores z standardisés se déploie sur l’axe vertical des ordonnées ($Y$). Cette seconde approche offre l’avantage pédagogique de lire directement sur l’axe des ordonnées l’écart en écart-type par rapport à la moyenne normative centrée sur zéro.
Quelle que soit la convention retenue par l’expérimentateur, la règle d’or est la constance méthodologique. Dans le cadre de ce tutoriel, nous retiendrons l’architecture suivante :
- Axe des abscisses ($X$) : Les scores observés triés de notre variable d’anxiété cognitive (Plage
C2:C16). - Axe des ordonnées ($Y$) : Les quantiles théoriques de la loi normale standardisée $z_i$ (Plage
F2:F16).
7.2 Insertion du diagramme de dispersion XY
Pour matérialiser graphiquement les couples de coordonnées $(x_{(i)}, z_i)$ au sein du classeur Excel, l’analyste procède selon le cheminement opératoire suivant :
1. Sélectionner simultanément les deux plages de données disjointes. Pour ce faire, surligner la plage des scores observés triés C2:C16, puis, tout en maintenant la touche contrôle Ctrl enfoncée (sur environnement Windows) ou la touche commande Cmd (sous macOS), sélectionner la plage des quantiles théoriques F2:F16.
2. Diriger le pointeur vers le ruban supérieur d’Excel et activer l’onglet Insertion.
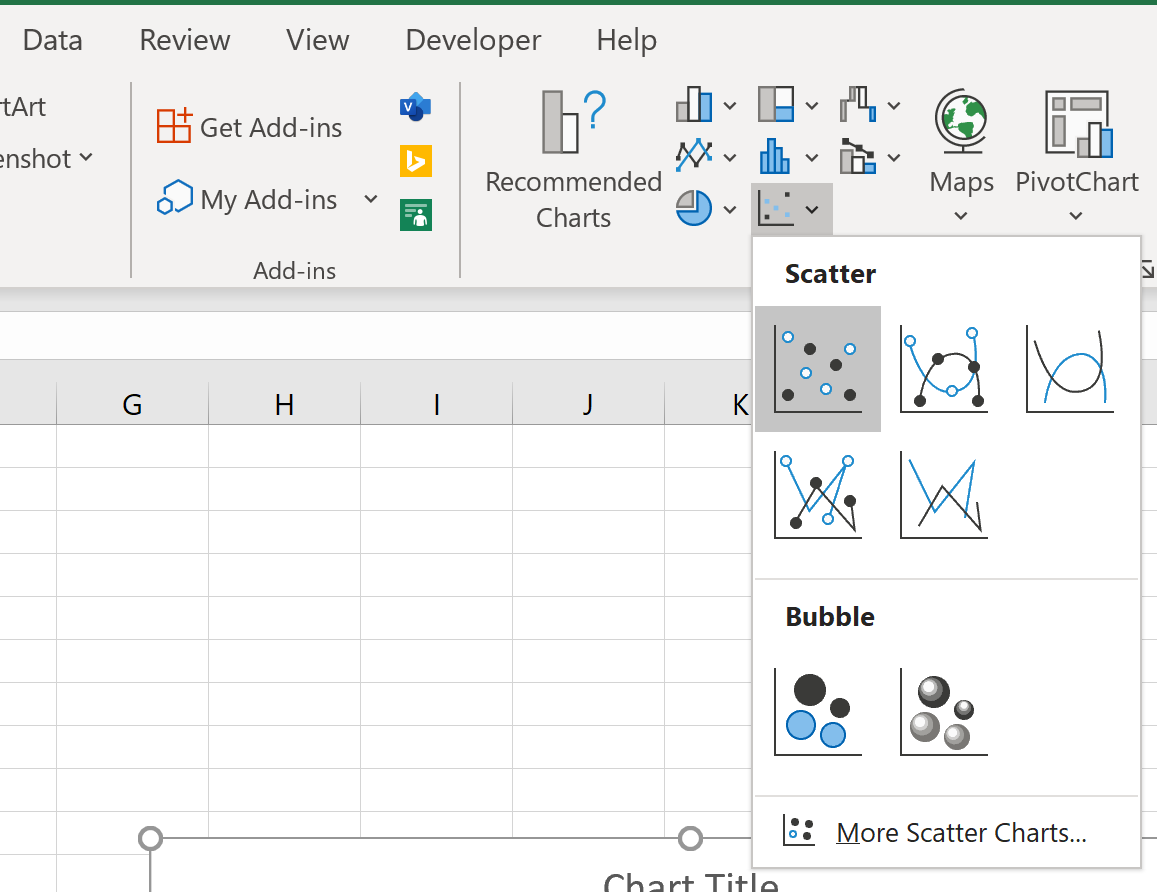
3. Au sein du groupe d’outils labellisé Graphiques, identifier et cliquer sur l’icône Insérer un graphique en nuage de points (X, Y) ou un graphique à bulles.
4. Dans la galerie déroulante des formats de restitution, sélectionner impérativement la modalité élémentaire : Nuage de points (dispersion simple constituée exclusivement de marqueurs géométriques discrets sans aucune ligne de jonction interpolée).
Il convient de formuler ici une mise en garde technique capitale : l’utilisateur ne doit en aucun cas sélectionner un graphique de type « Ligne » ou « Courbe ». Les graphiques en courbes d’Excel traitent la variable affectée à l’axe horizontal non point comme une échelle numérique continue, mais comme une suite arbitraire d’étiquettes qualitatives catégorielles équidistantes. Si l’on utilisait par mégarde un graphique en courbe, les écarts réels séparant les scores observés seraient oblitérés, chaque observation étant arbitrairement espacée d’un intervalle graphique uniforme, ce qui vicierait irrémédiablement l’architecture projective du tracé.
7.3 Diagnostic visuel primaire de la configuration des points
L’insertion du diagramme génère immédiatement un tracé brut au sein de la feuille de calcul active. Avant d’engager les phases de personnalisation esthétique avancée, l’analyste doit opérer une lecture diagnostique de premier niveau afin de confirmer la conformité structurelle de la projection graphique.
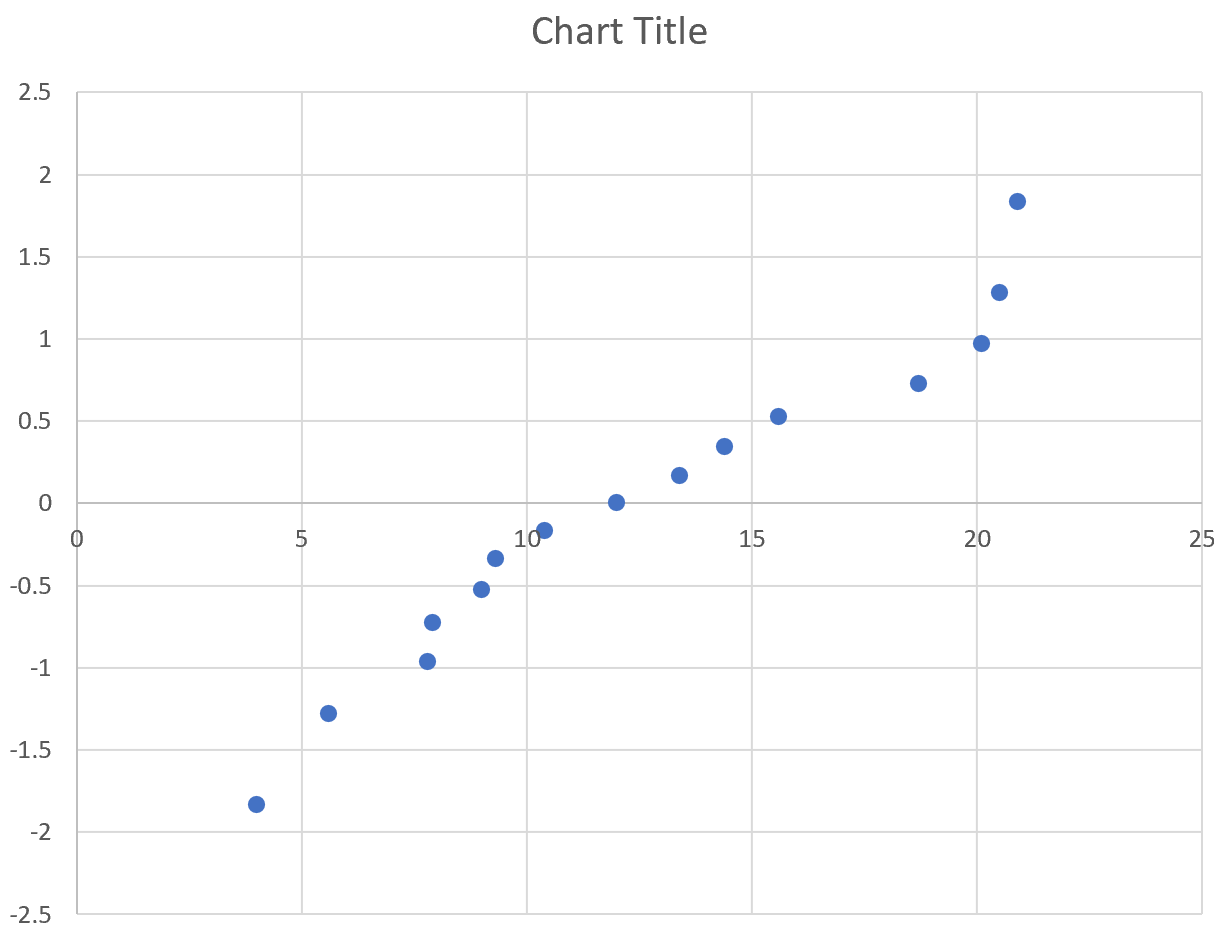
Un premier regard sur le canevas permet de déceler d’éventuelles inversions d’axes involontaires. L’axe horizontal doit afficher les valeurs d’anxiété comprises entre 15 et 40 points, tandis que l’axe vertical doit impérativement être centré autour de 0, s’étendant symétriquement de part et d’autre vers des valeurs positives (+2) et négatives (-2). Si l’on observe l’inverse, un clic droit sur le canevas du graphique, suivi de l’option Sélectionner des données, permettra d’activer la commande Modifier la série pour réaffecter correctement la plage $X$ sur C2:C16 et la plage $Y$ sur F2:F16.
Une fois les axes validés, l’analyste examine l’alignement général du nuage de points. Pour notre échantillon d’anxiété cognitive de 15 sujets, les points doivent dessiner une trajectoire globalement rectiligne ascendante, orientée du quadrant inférieur gauche vers le quadrant supérieur droit. Les scores s’échelonnent sans ruptures majeures le long d’une diagonale virtuelle, suggérant à ce stade préliminaire une concordance empirique honorable avec le modèle théorique gaussien.
8. Étape 5 : Personnalisation technique et mise en forme académique du graphique
8.1 Formatage des axes cartésiens selon les normes APA
La configuration graphique par défaut délivrée par Microsoft Excel privilégie des choix visuels bureautiques (quadrillages denses, polices génériques, marges excessives) incompatibles avec les exigences d’austérité et de précision des revues savantes en psychologie. La mise aux normes académiques — notamment conformes aux prescriptions stylistiques de l’APA (7e édition) — requiert une recalibration métrique des deux axes cartésiens.
Pour ajuster l’axe vertical des ordonnées ($Y$, Quantiles théoriques) :
- Double-cliquer sur l’axe vertical pour déployer le volet latéral Format de l’axe.
- Sous l’onglet Options d’axe, fixer les bornes d’affichage : attribuer la valeur minimale $-2,5$ et la valeur maximale $+2,5$. Cet encadrement symétrique englobe rigoureusement l’amplitude des cotes z attendues pour un échantillon de quinze sujets tout en évitant les zones de vide périphérique.
- Définir l’unité de graduation principale à $1,0$ et l’unité secondaire à $0,5$.
- Dans la section Graduations, sélectionner le type À l’extérieur pour les graduations principales afin de matérialiser des encoches de repérage nettes.
Pour ajuster l’axe horizontal des abscisses ($X$, Scores observés) :
- Double-cliquer sur l’axe horizontal dans le panneau de configuration.
- Paramétrer la valeur minimale à $10,0$ (seuil plancher de notre échelle psychométrique d’anxiété) et la valeur maximale à $45,0$. Cet élargissement contrôlé de l’empan visuel offre une vue contextualisée de l’emplacement des observations par rapport à l’étendue théorique de l’instrument d’évaluation.
- Fixer l’unité principale à $5,0$ points.
- Régler l’intersection de l’axe vertical : cocher impérativement l’option Valeur de l’axe et stipuler la valeur minimale $10,0$. Par défaut, Excel fait couper l’axe vertical à l’abscisse $0$, ce qui déporterait anormalement l’axe des ordonnées loin à gauche de notre nuage de points expérimentaux.
8.2 Typographie et esthétique des éléments graphiques
L’esthétique d’une figure scientifique repose sur le principe de sobriété fonctionnelle d’Edward Tufte : minimiser l’encre superflue afin de maximiser le ratio d’encre utile aux données statistiques (data-ink ratio). L’analyste appliquera méthodiquement les rectifications suivantes :
1. Épuration du fond cartésien : Sélectionner les lignes de quadrillage horizontales et verticales pré-insérées et appuyer sur la touche Suppr du clavier pour les éliminer intégralement. Le fond du graphique doit être d’une blancheur immaculée, exempte de remplissage texturé ou de bordure d’encadrement périphérique parasite.
2. Harmonisation typographique : Uniformiser l’ensemble des textes du graphique au moyen d’une police institutionnelle neutre et lisible (Times New Roman, Arial ou Calibri), en adoptant une taille de 10 à 11 points pour les graduations scalaires et de 12 points avec graisse moyenne pour les intitulés d’axes.
3. Retouche morphologique des marqueurs de dispersion : Cliquer sur la série des points expérimentaux, puis ouvrir la section Remplissage et trait > Marqueur > Options de marqueur. Privilégier des cercles discrets d’une taille calibrée à 5 ou 6 points. Sélectionner un remplissage transparent ou blanc pur cerclé d’un trait noir ou bleu nuit profond d’une épaisseur de 1 point. Cette représentation par anneaux ouverts offre une lisibilité supérieure à celle des disques pleins : si deux sujets présentent des scores extrêmement proches, les cercles se chevauchent visuellement sans se fusionner, permettant à l’œil d’identifier immédiatement les zones de superposition de données.
4. Intitulés formels des axes : Cliquer sur l’icône + verte (Éléments de graphique) et cocher Titres des axes. Formuler des légendes rigoureuses intégrant les unités de mesure :
- Axe horizontal : Score observé d’anxiété cognitive (Points d’échelle)
- Axe vertical : Quantiles théoriques attendus (Scores Z normaux)
8.3 Intégration d’éléments de repérage statistique
Afin de parfaire la valeur heuristique du tracé de probabilité normale, l’adjonction de repères de centrage statistique s’avère hautement profitable. Dans le cadre de notre projection cartésienne, le score théorique $z = 0$ incarne la ligne de partage médiane universelle de la distribution gaussienne de référence.
Pour matérialiser cette ligne médiane d’équipartition :
- Sélectionner l’axe horizontal des abscisses.
- Dans le volet de mise en forme des axes, ajuster le tracé du trait de l’axe horizontal : opter pour une ligne pleine d’une teinte grise neutre (par exemple un gris à 50 %) dotée d’une épaisseur fine de 0,75 point.
- Excel positionnera ce trait continu exactement à l’ordonnée $y = 0$, matérialisant ainsi un niveau de référence visuel neutre sans surcharger la composition graphique globale.
Enfin, pour une publication dans une revue savante ou l’intégration dans un mémoire doctoral, le graphique sera exporté non pas sous la forme d’une simple capture d’écran matricielle comprimée (qui pixeliserait lors du redimensionnement d’imprimerie), mais sous forme d’un objet vectoriel ou d’une image haute résolution (300 à 600 DPI). Le copier-coller de l’objet graphique natif d’Excel directement au sein de Microsoft Word préserve son encapsulation vectorielle, garantissant une netteté de rendu typographique et géométrique absolue à l’impression finale.
9. Étape 6 : Ajout et modélisation de la ligne de référence théorique
9.1 Insertion d’une courbe de tendance linéaire
L’interprétation clinique du tracé de probabilité normale repose sur l’évaluation visuelle des déviations des marqueurs empiriques par rapport à une trajectoire rectiligne idéale. Pour objectiver cette comparaison, il est coutumier d’adjoindre une ligne de référence théorique guidant le regard de l’analyste.
Le procédé le plus immédiat au sein d’Excel consiste à insérer une droite de régression des moindres carrés ordinaires :
1. Sélectionner le graphique, cliquer sur le pictogramme + d’éléments graphiques, positionner le curseur sur Courbe de tendance, puis cocher la variante Linéaire.
2. Double-cliquer sur la droite de tendance ainsi générée pour déployer son panneau de personnalisation.
3. Sous l’onglet Remplissage et trait, paramétrer la couleur du trait sur une nuance contrastante mais sobre (par exemple un carmin sombre ou un gris anthracite soutenu), fixer son épaisseur à 1 point, et sélectionner un type de tiret discontinu (tirets moyens ou pointillés fins).
Sur le plan de la théorie statistique, cette droite de régression linéaire empirique ajuste les données expérimentales par la minimisation des écarts quadratiques verticaux :
$$z = \beta_0 + \beta_1 x + \varepsilon$$
Puisque notre axe horizontal porte les scores bruts $x$ et notre axe vertical les quantiles standardisés $z$, la pente calculée $\beta_1$ converge théoriquement vers l’inverse de l’écart-type de l’échantillon ($1/s$), tandis que l’intersection à l’origine $\beta_0$ correspond au rapport négatif de la moyenne sur l’écart-type ($-\bar{x}/s$).
9.2 Méthode alternative rigoureuse : la droite théorique passant par les quartiles
Bien que l’insertion d’une simple courbe de tendance linéaire des moindres carrés ordinaires représente la pratique la plus répandue, elle présente une vulnérabilité méthodologique majeure : la méthode des moindres carrés est sensible aux valeurs extrêmes. Si l’échantillon comporte des points aberrants sévères dans les queues de distribution, ces derniers exercent un effet de levier sur l’ajustement linéaire, faisant pivoter la droite de tendance. La droite s’incline alors artificiellement vers les données atypiques, masquant ou distordant la perception visuelle de la non-normalité.
Pour pallier ce biais, la statistique orthodoxe (telle qu’implémentée dans des progiciels de référence comme le package stats sous le langage R avec la fonction qqline) préconise de modéliser la ligne théorique non par les moindres carrés globaux, mais en faisant passer strictement une droite par les coordonnées du premier quartile ($Q_1$, correspondant au 25e percentile) et du troisième quartile ($Q_3$, correspondant au 75e percentile). Les quartiles constituant des statistiques d’ordre hautement résistantes aux valeurs aberrantes, la droite de Henry ainsi calibrée reflète fidèlement la dispersion centrale de la population sans subir la contamination des queues de distribution.
Pour implémenter cette ligne théorique de haute rigueur dans Excel :
- Calculer les quartiles empiriques des scores au sein de cellules annexes :
$Q_1 = \text{QUARTILE.EXCLU}(C2:C16; 1)$
$Q_3 = \text{QUARTILE.EXCLU}(C2:C16; 3)$ - Déterminer les quantiles normaux théoriques correspondants aux probabilités 0,25 et 0,75 :
$z_{0,25} = \text{LOI.NORMALE.STANDARD.INVERSE}(0,25) \approx -0,6745$
$z_{0,75} = \text{LOI.NORMALE.STANDARD.INVERSE}(0,75) \approx +0,6745$ - Déduire la pente robuste : $a = (z_{0,75} – z_{0,25}) / (Q_3 – Q_1)$ et l’ordonnée robuste : $b = z_{0,25} – a \times Q_1$.
- Générer une mini-série de deux points aux bornes de l’axe des abscisses (par exemple pour $x = 10$ et $x = 45$) en appliquant l’équation de la droite robuste $y = ax + b$.
- Ajouter cette série auxiliaire sur le graphique existant via la boîte de dialogue Sélectionner les données, et la formater en ligne continue sans marqueurs.
Cette approche méthodologique offre un standard d’exactitude analytique irréprochable qui valorise considérablement les travaux de recherche soumis à l’évaluation par les pairs.
9.3 Évaluation du coefficient de détermination R²
Dans le panneau de configuration de la courbe de tendance d’Excel, l’activation de la case à cocher Afficher le coefficient de détermination (R²) sur le graphique permet de faire apparaître la métrique $R^2$, correspondant au carré du coefficient de corrélation linéaire de Pearson unissant les scores observés et leurs quantiles théoriques.
Ce coefficient quantifie la proportion de variance des quantiles théoriques expliquée linéairement par les statistiques d’ordre empiriques. Dans le cadre de l’évaluation de la normalité (procédure analogue au test d’ajustement de Filliben, 1975) :
- Un coefficient $R^2 ge 0,98$ traduit une adhérence linéaire exceptionnelle, apportant un soutien empirique manifeste à l’hypothèse de normalité distributionnelle univariée.
- Un coefficient compris entre $0,95 le R^2 < 0,98$ signale une adéquation globale acceptable pour les tests paramétriques réputés robustes (tels que l’ANOVA à effectifs équilibrés), tout en alertant sur la présence d’anomalies morphologiques modérées.
- Un coefficient $R^2 < 0,95$ matérialise une déviation substantielle et critique par rapport au modèle gaussien, incitant à récuser formellement les modélisations linéaires classiques sans transformation préalable.
Toutefois, une vigilance épistémologique s’impose : l’analyste ne doit jamais ériger le $R^2$ en critère décisionnel unique et aveugle. Une série de données présentant une courbure non linéaire hautement systématique (asymétrie sévère) peut néanmoins afficher un coefficient $R^2$ faussement rassurant supérieur à 0,96 en raison de la dispersion globale de l’échelle. La quantification linéaire ne saurait se substituer au discernement morphologique visuel fourni par le tracé.
10. Guide complet d’interprétation visuelle des anomalies de distribution
10.1 Détection et analyse des asymétries (Skewness)
L’asymétrie distributionnelle caractérise une rupture d’équiprobabilité de part et d’autre de la tendance centrale de l’échantillon, étirant l’une des queues de la distribution vers des valeurs périphériques. Sur un tracé de probabilité normale où les données observées sont portées sur l’axe des abscisses et les cotes z théoriques sur l’axe des ordonnées, les asymétries se traduisent par des inflexions géométriques caractéristiques :
1. Asymétrie positive (étalement à droite, skewness > 0) : Lorsque les données se concentrent massivement sur les scores bas tout en s’étirant vers les valeurs hautes (morphologie typique des mesures chronométriques de temps de réaction en neuro-ergonomie ou des échelles d’anxiété au sein d’une population non clinique), le nuage de points adopte une morphologie incurvée résolument convexe vers le bas (forme ascendante décélérée). Les observations initiales s’élèvent au-dessus de la droite théorique, tandis que les valeurs extrêmes supérieures s’aplatissent en deçà de la trajectoire idéale, traduisant une raréfaction des scores très élevés par rapport au modèle gaussien.
2. Asymétrie négative (étalement à gauche, skewness < 0) : À l’opposé, lorsque les données s’agglutinent vers les scores supérieurs tout en traînant une queue résiduelle vers les valeurs inférieures (situation classique d’épreuves cognitives simples présentant un effet de plafond marqué où la majorité des sujets frôle le score maximal), le nuage de points dessine une courbure globalement concave vers le bas (forme ascendante accélérée). Les scores bas plongent bien en dessous de la ligne théorique, signalant une dispersion déficitaire dans la queue inférieure.
L’identification immédiate de ces motifs non linéaires permet au psychométricien de diagnostiquer la nature exacte de l’asymétrie structurelle et de statuer sur la légitimité des indices de tendance centrale à mobiliser dans le rapport clinique.
10.2 Diagnostic des anomalies d’aplatissement (Kurtosis)
L’aplatissement caractérise la propension d’une distribution à concentrer sa masse de probabilité simultanément au niveau de son apex central et de ses queues d’extrémité, ou au contraire à disperser sa variance dans les épaulements intermédiaires. L’inspection optique du tracé permet de discriminer nettement ces deux états :
1. Distribution leptokurtique (queues lourdes, kurtosis excessif positif > 0) : Une distribution leptokurtique concentre une forte proportion d’observations à la fois au centre et aux extrêmes distaux, au détriment des zones intermédiaires. Sur le tracé Q-Q, cette configuration engendre une signature visuelle en forme de « S » caractéristique. Aux extrémités, les scores observés s’écartent vers l’extérieur : les points inférieurs sont déportés vers la gauche (valeurs plus négatives qu’attendu sous la loi normale) et les points supérieurs vers la droite (valeurs plus élevées). Cette déviation signale un risque accru d’événements extrêmes, susceptible de biaiser l’estimation des erreurs types dans les modélisations par régressions.
2. Distribution platykurtique (queues légères ou troncature, kurtosis excessif négatif < 0) : À l’inverse, lorsque la distribution est plus plane que la cloche de Gauss ou que ses extrémités ont été mécaniquement bornées par la conception de l’instrument d’évaluation (absence d’observations extrêmes), le tracé prend une forme de « S inversé ». Les valeurs observées convergent vers le centre : les points de la queue inférieure sont trop hauts (décalés vers la droite) et ceux de la queue supérieure sont trop bas (décalés vers la gauche). Cette configuration se rencontre également dans les distributions discrètement bimodales résultant du mélange hétérogène de deux sous-populations cliniques non discriminées au sein de l’échantillon d’étude.
10.3 Discrimination des valeurs aberrantes (Outliers)
L’un des apports majeurs du tracé de probabilité normale réside dans sa capacité à isoler avec netteté les valeurs discordantes ou atypiques (outliers), que les tests d’ajustement globaux diluent souvent dans l’agrégat des variances résiduelles.
Un point aberrant se matérialise sur le graphique par une discontinuité graphique franche : le marqueur se détache de la trajectoire rectiligne générale et fait un bond vers l’extérieur du profil continu tracé par les autres participants. Il importe d’opérer une distinction clinique et méthodologique rigoureuse :
- L’aberrance technique ou typographique : Un point isolé à l’extrême périphérie de l’axe des abscisses (par exemple un score de 39,2 au sein d’une échelle dont la moyenne oscille autour de 20 avec un écart maximal à 25) doit immédiatement susciter une vérification des bordereaux de saisie bruts afin d’exclure une erreur de dactylographie ou un bogue de transcodage de questionnaire informatisé.
- La singularité clinique authentique : Si l’investigation matérielle confirme la validité de la mesure, le point atypique témoigne de la réactivité singulière d’un sujet au protocole expérimental. Dans une cohorte clinique, l’exclusion aveugle et mécanique de ces observations sous le prétexte normatif d’assainir la distribution constitue une faute méthodologique susceptible d’oblérer des manifestations symptomatiques majeures.
En présence d’observations discordantes authentiques, l’expérimentateur privilégiera des modélisations statistiques robustes (régressions robustes fondées sur les M-estimateurs de Huber, tests non paramétriques de rangs de Wilcoxon-Mann-Whitney ou de Kruskal-Wallis) plutôt qu’une censure injustifiée de la variance écologique de l’échantillon.
11. Comparaison avec les tests d’hypothèse de normalité formels dans Excel
11.1 Calcul de l’asymétrie et de l’aplatissement numériques
L’investigation qualitative issue du tracé de probabilité normale gagne à être systématiquement complétée par l’évaluation computationnelle des troisième et quatrième moments centrés standardisés de la distribution. Microsoft Excel propose deux fonctions d’ingénierie statistique dédiées à ces estimations :
Pour le calcul de l’asymétrie d’échantillonnage (Fisher-Pearson standardized skewness coefficient) :
=COEFFICIENT.ASYMETRIE(C2:C16)
Cette fonction implémente l’estimateur corrigé du biais de taille d’échantillon $G_1$, calculé à partir de la somme des écarts cubiques normalisés divisée par le produit factoriel $(n-1)(n-2)$.
Pour le calcul du coefficient d’aplatissement excessif (excess kurtosis) :
=KURTOSIS(C2:C16)
Cette instruction évalue l’aplatissement centré sur zéro (l’indice théorique d’une loi normale univariée équivaut ainsi à $0$, et non à $3$). Elle intègre également une correction d’échantillonnage basée sur le facteur $(n-1) / ((n-2)(n-3))$.
Dans la pratique psychométrique courante, les critères de tolérance pour juger de l’admissibilité d’un échantillon à des modélisations paramétriques s’articulent autour des seuils de référence suivants :
- Des indices de Skewness et de Kurtosis compris dans l’intervalle $[-1,0 ; +1,0]$ attestent d’une excellente proximité avec la normalité mathématique, autorisant l’usage serein de tests paramétriques stricts.
- Des coefficients situés dans l’empan modéré $[-2,0 ; +2,0]$ sont considérés par la majorité des méthodologistes (notamment George & Mallery, 2010) comme acceptables pour les analyses d’invariance ou les régressions univariées sur grands effectifs.
- Des valeurs absolues excédant le seuil critique de $\pm 2,0$ prescrivent l’abandon des méthodes paramétriques classiques ou exigent le recours à des transformations mathématiques correctrices préalables.
11.2 Aperçu des tests statistiques formels : Shapiro-Wilk et Kolmogorov-Smirnov
Dans les rapports de recherche contemporains, l’évaluation de la normalité est souvent adossée à un test d’hypothèse inférentiel formel, au sein duquel l’hypothèse nulle ($H_0$) postule la normalité parfaite de la population parente :
- $H_0 : F(x) = \Phi(x)$
- $H_1 : F(x) \neq \Phi(x)$
Le test de Shapiro-Wilk ($W$), fondé sur le rapport entre le meilleur estimateur linéaire non biaisé de l’écart-type et la variance d’échantillonnage, est universellement reconnu comme le test le plus puissant pour les petits et moyens échantillons ($n < 50$). Le test de Kolmogorov-Smirnov, quant à lui, évalue la déviation maximale verticale séparant la fonction de répartition cumulative empirique de la loi théorique ; sa variante de Lilliefors est requise lorsque la moyenne et l’écart-type sont estimés à partir des données de l’échantillon sans être connus a priori.
Toutefois, ces tests formels souffrent d’un double paradoxe méthodologique pervers qui justifie la supériorité opérationnelle du tracé de probabilité normale :
- Le déficit de puissance sur petits échantillons : Lorsque la cohorte est restreinte ($n < 20$, comme dans notre échantillon de 15 sujets), les tests formels manquent de puissance statistique. Ils échouent fréquemment à rejeter l’hypothèse nulle ($p > 0,05$), conduisant l’expérimentateur à conclure à tort à la normalité en présence de violations pourtant substantielles.
- L’hypersensibilité sur grands échantillons : À l’inverse, dès lors que la taille de l’échantillon devient importante ($n > 300$), le pouvoir de détection des tests formels devient exacerbé. Ils rejettent alors l’hypothèse nulle pour des déviations infimes et triviales qui n’ont aucun impact préjudiciable réel sur la robustesse pratique des tests paramétriques sous-jacents.
Bien que le test de Shapiro-Wilk exige des coefficients polynomiaux complexes non implémentés nativement dans Excel, il demeure possible d’implémenter directement dans la feuille de calcul le test de Jarque-Bera ($JB$), qui évalue simultanément la déviation conjointe du skewness ($S$) et du kurtosis ($K$) au moyen d’une statistique suivant asymptotiquement une loi du chi-carré à deux degrés de liberté :
$$JB = \frac{n}{6} \left( S^2 + \frac{K^2}{4} \right)$$
Dans Excel, la p-valeur associée se calcule aisément via l’expression :
=LOI.KHIDEUX.DROITE(Valeur_JB; 2)
Un résultat statistiquement significatif ($p < 0,05$) corrobore le constat d’une distribution s’écartant du modèle théorique gaussien.
11.3 Arbre de décision pour le chercheur en sciences du comportement
Face à la convergence ou aux discordances manifestes entre le diagnostic visuel issu du tracé de probabilité normale, les indices scalaires de moments et les tests formels d’adéquation, le chercheur en psychométrie opérationnalisera sa décision méthodologique selon la grille décisionnelle suivante :
Cas de figure 1 : Concordance optimale. Le nuage de points du tracé de probabilité normale est rectiligne, sans anomalies marquées aux extrémités ; les indices d’asymétrie et d’aplatissement sont circonscrits dans l’intervalle $[-1, +1]$ ; le coefficient de détermination $R^2$ excède 0,98. Décision : Maintenir sans réserve l’application des procédures paramétriques univariées et multivariées de référence.
Cas de figure 2 : Déviations asymptotiques modérées. Le tracé affiche des fluctuations aux extrémités mais préserve un alignement solide sur son segment central ; le test formel de Jarque-Bera oscille au voisinage du seuil critique de 0,05 ; l’effectif est égal ou supérieur à $n ge 30$. Décision : En vertu du théorème central limite et de la robustesse avérée de l’ANOVA aux violations modérées de normalité, maintenir le protocole paramétrique, tout en intégrant un signalement descriptif exhaustif au sein de la section méthodologique du rapport.
Cas de figure 3 : Rupture morphologique sévère. Le tracé révèle une inflexion systématique en arc prononcé (asymétrie marquée) ou une signature en « S » contrastée ; les indices numériques dépassent l’amplitude de $\pm 2,0$. Décision : L’analyste s’orientera vers l’une des trois voies de remédiation suivantes :
- La transformation non linéaire de variable : L’application d’une transformation logarithmique
=LN(Score)pour corriger une asymétrie positive marquée, d’une fonction racine carrée=RACINE(Score)pour des données de dénombrement discrètes, ou d’une transformation inverse=1/Scorepour stabiliser des dispersions asymétriques très étirées. Une fois la transformation opérée, un nouveau tracé Q-Q doit être généré pour valider visuellement le rétablissement de la normalité. - L’inférence non paramétrique : Abandon des calculs fondés sur la moyenne et l’écart-type au profit d’analyses basées sur les rangs (test U de Mann-Whitney, test des rangs signés de Wilcoxon, analyse de variance de Kruskal-Wallis).
- Les méthodes de rééchantillonnage : Recours aux techniques de bootstrapping (auto-amorçage à 5000 itérations) pour dériver des intervalles de confiance empiriques et des tests d’hypothèse exempts d’hypothèses distributionnelles restrictives.
12. Bonnes pratiques méthodologiques et limites statistiques en recherche comportementale
12.1 Effets pervers de la taille d’échantillon sur la lisibilité du tracé
La puissance diagnostique du tracé de probabilité normale est conditionnée par l’effectif global $n$ de l’échantillon d’étude. Deux écueils interprétatifs opposés menacent la validité des déductions du chercheur selon l’empan volumétrique considéré :
1. L’instabilité stochastique des micro-échantillons ($n < 20$) : Pour de très faibles cohortes (comme notre exemple illustratif à $n = 15$ participants), la variabilité d’échantillonnage propre aux statistiques d’ordre induit une instabilité graphique naturelle. Les données générées à partir d’une population parfaitement gaussienne peuvent, par simple fluctuation d’échantillonnage aléatoire, dessiner des oscillations perceptibles autour de la droite théorique. L’analyste novice encourt le risque de surinterpréter ces variations ponctuelles comme des pathologies de distribution réelles. Une retenue interprétative s’impose : pour ces faibles effectifs, seules les courbures massives, continues et directionnelles méritent d’être considérées comme indicatrices d’une non-normalité substantielle.
2. Le problème de surpopulation visuelle des macro-échantillons ($n > 500$) : À l’autre extrémité du spectre, les études épidémiologiques ou les protocoles de validation d’échelles standardisées sur de vastes cohortes ($n ge 1000$) se heurtent au phénomène de saturation graphique (overplotting). L’agrégation de centaines de marqueurs au centre du repère cartésien produit une masse sombre uniforme qui oblitère la densité locale relative des observations. Pour remédier à cette baisse de lisibilité :
- Réduire la dimension géométrique des marqueurs à des diamètres très fins (2 ou 3 points d’échelle).
- Accroître le niveau de transparence des marqueurs dans le panneau de couleur d’Excel (ajuster la transparence à 60 % ou 75 %), ce qui permet aux zones de forte densité de se matérialiser visuellement par une intensification progressive de la saturation chromatique.
- Compléter systématiquement l’inspection du tracé par un histogramme de densité superposé à la cloche théorique de Gauss.
12.2 Considérations éthiques et reporting dans les publications scientifiques
La transparence méthodologique constitue l’un des piliers déontologiques de la recherche académique contemporaine, singulièrement dans le contexte de la crise de reproductibilité traversée par les sciences comportementales. La politique éditoriale des revues savantes régies par le style APA (7e édition) prescrit désormais d’expliciter sans ambiguïté les procédures d’évaluation de la normalité au sein de la section Méthode > Analyses statistiques des manuscrits.
Une dérive éthique fréquente consiste à céder au « cherry-picking » (sélection opportuniste d’indicateurs) : une pratique blâmable consistant à passer sous silence les résultats d’un test formel qui invaliderait la normalité pour ne s’appuyer que sur une interprétation visuelle complaisante du tracé, ou inversement, à masquer un tracé manifestement non linéaire en arguant d’un skewness situé sous le seuil de tolérance de 1,0. Le chercheur consciencieux se doit de documenter la convergence de ses faisceaux d’indices diagnostiques.
Dans l’esprit du mouvement pour la science ouverte (Open Science Framework), il est désormais recommandé de verser les classeurs Excel ayant servi à la calibration des tracés de normalité et aux calculs statistiques intermédiaires au sein d’entrepôts de données publics et pérennes (Zenodo, OSF, Dataverse). Cette mise à disposition de la matrice analytique permet aux pairs d’inspecter la granularité des étapes computationnelles, garantissant la reproductibilité computationnelle intégrale des conclusions expérimentales rapportées.
12.3 Synthèse procédurale et modèle réutilisable
Pour ancrer durablement les compétences méthodologiques développées au fil de ce traité, nous récapitulons la cinématique globale de construction du tracé de probabilité normale en six étapes clés opérationnelles :
- Étape 1 : Structuration des données — Disposer les scores continus bruts dans une colonne dédiée (colonne B), auditer l’absence de chaînes textuelles ou de valeurs hors limites, et établir un vecteur ordonné croissant (colonne C).
- Étape 2 : Détermination des rangs — Assigner à chaque observation ordonnée son rang ordinal entier $i$ de $1$ à $n$ (colonne D).
- Étape 3 : Calcul des probabilités cumulées — Appliquer la correction de centrage symétrique de Hazen : $p_i = (i – 0,5) / n$ (colonne E).
- Étape 4 : Conversion en quantiles Z — Rétro-projeter les probabilités empiriques sur la loi normale centrée réduite via la fonction
LOI.NORMALE.STANDARD.INVERSE(p_i)(colonne F). - Étape 5 : Traçage du nuage cartésien — Sélectionner les colonnes disjointes et insérer un graphique de dispersion XY (Scores observés en abscisse, Quantiles Z en ordonnée), exempt de toute ligne d’interpolation.
- Étape 6 : Modélisation de référence et mise aux normes APA — Rectifier les empan d’axes, insérer une droite de tendance linéaire théorique (ou une droite quartile robuste), assainir la typographie et inspecter la morphologie du nuage (asymétrie, aplatissement, aberrances).
L’assimilation approfondie de ce cycle procédural confère à l’analyste une indépendance conceptuelle précieuse face aux progiciels commerciaux. Elle constitue le socle cognitif indispensable pour aborder avec maturité le maniement des environnements de programmation statistique avancés (tels que R avec les packages ggplot2 et car, ou le langage Python avec scipy.stats et seaborn), consacrant le passage de l’exécution empirique passive à la pleine maîtrise de l’ingénierie quantitative des données.
Références
Blom, G. (1958). Statistical estimates and transformed variables. John Wiley & Sons.
Chambers, J. M., Cleveland, W. S., Kleiner, B., & Tukey, P. A. (1983). Graphical methods for data analysis. Wadsworth International Group.
D’Agostino, R. B., & Stephens, M. A. (1986). Goodness-of-fit techniques. Marcel Dekker.
Filliben, J. J. (1975). The probability plot correlation coefficient test for normality. Technometrics, 17(1), 111-117. https://doi.org/10.1080/00401706.1975.10489279
George, D., & Mallery, P. (2010). SPSS for Windows step by step: A simple guide and reference, 17.0 update (10th ed.). Allyn & Bacon.
Hazen, A. (1914). Storage to be provided in impounding reservoirs for municipal water supply. Transactions of the American Society of Civil Engineers, 77(1), 1539-1640.
Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163-172. https://doi.org/10.2307/1403192
Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156-166. https://doi.org/10.1037/0033-2909.105.1.156
Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21-33.
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3-4), 591-611. https://doi.org/10.1093/biomet/52.3-4.591
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Wichura, M. J. (1988). Algorithm AS 241: The percentage points of the normal distribution. Applied Statistics, 37(3), 477-484. https://doi.org/10.2307/2347330