
Dans le paysage contemporain de l’ingénierie des données et de la recherche scientifique assistée par ordinateur, la restitution visuelle des résultats constitue l’ultime passerelle entre l’analyse computationnelle brute et l’interprétation cognitive humaine. Bien que l’écosystème Python dispose d’une myriade de bibliothèques dédiées à l’exploration graphique, l’environnement historique Matplotlib demeure la clé de voûte incontournable pour la production de figures à destination de publications académiques de haut niveau. Toutefois, si la plupart des praticiens maîtrisent l’art d’échafauder des nuages de points, des histogrammes gaussiens ou des courbes de régression polynomiales, l’intégration rigoureuse et esthétique de matrices textuelles — communément appelées tableaux — demeure une compétence technique trop souvent négligée ou sous-estimée au sein des pipelines de données scientifiques.
L’acte de juxtaposer une structure tabulaire à une représentation graphique ne relève pas d’une simple coquetterie typographique ; il répond à une exigence épistémologique fondamentale. Les figures scientifiques modernes exigent fréquemment une double grille de lecture, combinant la perception holistique et intuitive procurée par les tracés géométriques à la rigueur indiscutable des métriques numériques exactes. Qu’il s’agisse de documenter la significativité statistique par des valeurs p, d’exposer les coefficients de pondération d’un modèle économétrique ou de récapituler les intervalles de confiance d’un protocole expérimental, la présence d’un tableau directement incorporé dans la figure élimine les ambiguïtés inhérentes à la lecture d’axes continus et évite l’éparpillement documentaire entre figures et tables annexes.
Ce guide encyclopédique se propose de décortiquer, avec une granularité exhaustive et une rigueur algorithmique absolue, l’intégralité du module tabulaire de Matplotlib. En explorant les mécanismes profonds régissant la classe Table, les stratégies d’ancrage spatial via la méthode ax.table(), l’interopérabilité avec les structures pandas, l’optimisation micro-typographique et l’exportation vectorielle conforme aux exigences des plus prestigieuses revues scientifiques, cet ouvrage constitue le manuel de référence exhaustif pour tout chercheur, biostatisticien ou ingénieur en apprentissage automatique désireux d’élever ses visualisations au rang des standards internationaux les plus stricts.
1. Introduction à la génération de tableaux avec Matplotlib en contexte scientifique
1.1 Rôle de la visualisation tabulaire dans la restitution des données quantitatives
Dans la démarche de communication scientifique, la restitution des données quantitatives est soumise à une tension dialectique permanente entre la synthèse visuelle et la fidélité numérique brute. Les représentations géométriques, telles que les courbes de niveau ou les diagrammes de dispersion, excellent à traduire des tendances globales, des ruptures de pente ou des séparations topologiques au sein de grands volumes d’observations. Néanmoins, cette abstraction graphique s’accompagne inévitablement d’une perte de résolution informative : le lecteur est contraint de projeter mentalement un point sur un axe gradué pour estimer une coordonnée, introduisant ainsi une imprécision visuelle inhérente à l’acte de lecture projective.
À l’inverse, la structure tabulaire préserve l’intégrité numérique intégrale des grandeurs mesurées. Dans des domaines critiques tels que l’épidémiologie clinique, l’astrophysique observationnelle ou l’économétrie financière, la connaissance exacte d’une valeur médiane, de son écart multidimensionnel ou d’un seuil de tolérance ne saurait tolérer la moindre approximation perceptive. Le tableau s’impose dès lors comme le garant de la reproductibilité scientifique, offrant une grille d’évaluation formelle où chaque chiffre est contextualisé sans distorsion perspective.
La complémentarité entre tracés continus et données tabulées permet ainsi d’établir un dialogue heuristique optimal au sein d’une publication savante. Les revues à comité de lecture exigent d’ailleurs de plus en plus fréquemment que les figures composites encapsulent simultanément l’illustration visuelle d’un phénomène expérimental et le résumé tabulaire des tests d’hypothèse sous-jacents, consolidant ainsi la crédibilité méthodologique des conclusions formulées.
1.2 Architecture graphique de Matplotlib : Figures, Axes et objets Table
L’architecture interne de Matplotlib repose sur un paradigme de programmation orientée objet hautement hiérarchisé, structuré selon un emboîtement rigoureux de conteneurs graphiques. Au sommet de cette topologie se trouve la classe Figure, qui représente l’espace global de dessin, analogue à une toile vierge dotée de ses propres propriétés d’échelle et de rendu physique. Au sein de cette figure s’inscrivent un ou plusieurs conteneurs de la classe Axes, couramment désignés sous le terme de sous-graphiques, qui définissent le système de coordonnées mathématiques où s’effectuent les tracés.
C’est précisément en tant qu’artiste spécialisé (sous-classe de matplotlib.artist.Artist) que vient s’insérer l’objet Table au sein du conteneur Axes. Contrairement aux tracés de lignes ou de collections de polygones qui opèrent directement dans le repère de données réelles (déterminé par les limites xlim et ylim), l’objet Table interagit de manière polymorphique avec le système de coordonnées de l’axe ou de la figure, exploitant des transformations projectives spécifiques pour garantir sa géométrie propre indépendamment des échelles mathématiques sous-jacentes.
Le cycle de rendu graphique d’un tableau met en jeu un processus d’instanciation en cascade. Lorsque l’instruction de dessin est sollicitée, la table décompose sa structure matricielle en un maillage d’objets élémentaires de la classe Cell, chacun étant lui-même dépositaire d’un objet Text et d’un polygone rectangulaire définissant sa bordure et son fond. Cette modélisation unitaire confère à Matplotlib une flexibilité algorithmique absolue, autorisant des manipulations microscopiques sur chaque cellule lors de la phase finale de pixellisation ou de vectorisation.
1.3 Arbitrage méthodologique : représentations graphiques versus tabulaires
L’arbitrage entre l’emploi d’un graphique vectoriel pur et celui d’un tableau structuré repose sur l’analyse de la charge cognitive imposée à l’observateur. Face à des nuages de points denses ou des séries chronologiques complexes présentant une variance locale élevée, la perception humaine est rapidement saturée par le bruit visuel, peinant à extraire la hiérarchie des signaux statistiques pertinents. De surcroît, les diagrammes en barres ou les histogrammes multipolaires révèlent leurs limites lorsqu’il s’agit de juxtaposer des grandeurs physiques aux dimensions hétérogènes, par exemple des pourcentages, des devises monétaires et des p-valeurs asymptotiques.
Le tableau devient incontestablement supérieur au graphique dès lors que le nombre total d’observations synthétiques est modéré (typiquement inférieur à une cinquantaine d’entrées) et que la valeur numérique exacte prime sur la forme générale de la distribution. Il élimine le risque d’illusions d’optique ou de distorsions d’échelle susceptibles d’induire le lecteur en erreur, notamment lorsque les axes d’ordonnées sont tronqués ou calibrés de manière non linéaire.
Dans la pratique de la recherche de pointe, l’approche optimale consiste souvent à adopter un paradigme hybride. L’utilisation d’une table analytique placée au bas d’un graphique permet de fournir la synthèse descriptive directe (moyenne, écart-type, taille d’échantillon N) tout en laissant au tracé supérieur la charge d’illustrer la dynamique temporelle ou la densité de probabilité continue. Cette division du travail visuel maximise l’efficacité informative globale et répond scrupuleusement aux critères d’évaluation des éditeurs scientifiques.
2. Les fondements de la fonction ax.table() dans Matplotlib
2.1 Anatomie technique et paramètres fondamentaux de la méthode
La passerelle privilégiée pour instancier un tableau au sein de l’environnement orienté objet de Matplotlib réside dans la méthode ax.table(), rattachée directement à l’instance de l’axe hôte. Cette fonction de haut niveau encapsule la complexité de l’instanciation de l’objet Table en acceptant un ensemble rigoureux d’arguments positionnels et nommés, dont le dimensionnement détermine la structure topologique de la grille de données.
Au cœur de cette signature se trouve l’argument fondamental cellText, qui attend une séquence bidimensionnelle (liste de listes ou tableau NumPy de dimension 2) contenant les représentations textuelles de chaque élément matriciel. Ce paramètre peut être complété par colLabels et rowLabels, deux séquences unidimensionnelles dictant respectivement les intitulés des colonnes supérieures et des lignes latérales gauches. L’absence délibérée de l’une de ces séquences entraîne la suppression pure et simple de l’en-tête correspondant, modifiant ainsi le système d’indexation matricielle des cellules périphériques.
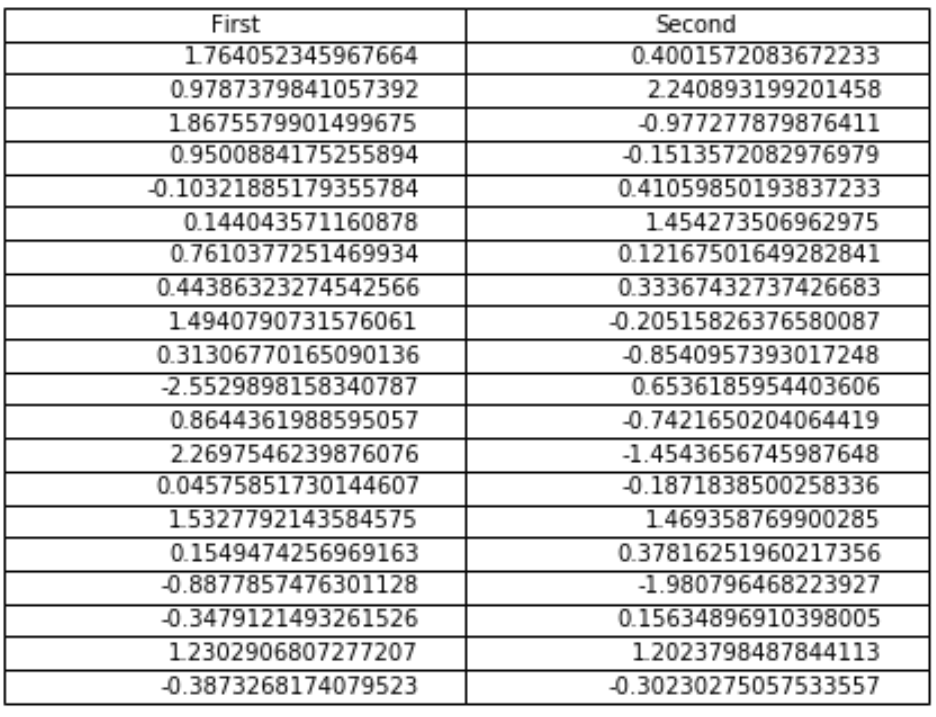
La personnalisation chromatique s’opère dès la signature via les paramètres matriciels cellColours, colColours et rowColours. Ces matrices ou vecteurs doivent impérativement présenter des dimensions rigoureusement identiques à celles de leurs équivalents textuels, sous peine de déclencher des exceptions d’incompatibilité de dimensions (ValueError). Chacun de ces éléments accepte des spécificateurs de couleurs standardisés, allant des chaînes hexadécimales aux tuples RGBA normalisés sur l’intervalle unitaire.
2.2 Gestion de l’ancrage spatial et de l’alignement avec le paramètre loc
Le paramètre textuel loc régit la politique de positionnement de l’entité tabulaire au sein de l’espace de référence de l’axe. Matplotlib implémente une nomenclature cardinale empruntée aux systèmes de mise en page géographiques, comprenant des valeurs standardisées telles que 'center', 'top', 'bottom', 'left', 'right', ainsi que leurs déclinaisons combinées telles que 'upper left', 'lower right' ou 'center right'.
Lorsque le paramètre loc est employé sans spécification conjointe d’une boîte englobante personnalisée, l’objet Table s’arrime automatiquement aux frontières de la zone de traçage matérialisée par l’axe. Par exemple, une table configurée avec loc='bottom' viendra se positionner immédiatement sous l’axe des abscisses, partageant sa largeur horizontale tout en projetant ses cellules vers l’extérieur du graphique. Cette mécanique interactive s’avère particulièrement séduisante pour confectionner des tables de contingence directement associées aux graduations cartésiennes.
Cependant, ce positionnement périphérique impose une vigilance extrême quant à la gestion des marges globales de la figure. Un tableau ancré en position basse ou haute déborde fréquemment des limites standard de découpage de la figure, entraînant un rognage drastique des étiquettes lors de l’affichage interactif ou de l’exportation sur disque. La maîtrise fine des commandes d’ajustement géométrique s’impose donc comme un corollaire indissociable de l’usage de ce paramètre.
2.3 Structure interne de l’objet Table et granularité des cellules
D’un point de vue architectural, l’objet renvoyé par l’exécution de la méthode ax.table() est une instance directe de la classe matplotlib.table.Table. Cette structure n’est point une boîte noire opaque, mais un conteneur matriciel indexé selon un système de coordonnées bidimensionnel associant des coordonnées de lignes (ordonnées i) et de colonnes (abscisses j). Au sein de ce référentiel interne, les cellules régulières de données occupent les indices entiers positifs débutant à (0, 0) pour la cellule supérieure gauche du corps de table.
Les en-têtes de colonnes sont assignés structurellement à la ligne d’index -1 (ou 0 selon la présence ou l’absence d’étiquettes de lignes), tandis que les libellés de lignes adoptent la colonne d’index -1. L’accès programmatique à une cellule spécifique s’effectue au travers du dictionnaire sous-jacent table_instance._cells ou, plus élégamment et conformément à l’API publique, au moyen de la méthode d’indexation matricielle :
Chaque instance de Cell encapsulée dispose d’une suite exhaustive de méthodes modificatrices permettant de contrôler son cycle de vie. On retrouve notamment la gestion de l’épaisseur du trait via set_linewidth(), l’injection de textures hachurées avec set_hatch(), ou encore l’altération directe des propriétés de la chaîne textuelle sous-jacente par l’intermédiaire de cell.get_text().set_text(). Cette granularité microscopique constitue la véritable force de Matplotlib, offrant une liberté créative qu’aucun module automatisé ne saurait égaler.
3. Méthode 1 : Génération d’un tableau à partir d’un DataFrame pandas
3.1 Extraction et conversion des structures de données matricielles
L’ingénierie moderne des données reposant massivement sur la structure bidimensionnelle du DataFrame de pandas, l’interfaçage fluide entre cette structure matricielle et le moteur de rendu de Matplotlib représente un cas d’usage prépondérant. La conversion débute par l’extraction des données numériques et textuelles sous forme de matrices brutes au moyen de l’attribut df.values ou, plus rigoureusement selon les conventions actuelles, via df.to_numpy(). Cette instruction produit un tableau NumPy homogène ou hétérogène de dimension 2, prêt à être consommé par l’argument cellText.
Les métadonnées structurelles du DataFrame requièrent une attention similaire. Les noms des variables de colonnes sont extraits sous la forme d’une liste Python conventionnelle à l’aide de l’expression df.columns.astype(str).tolist(), garantissant que d’éventuels types d’index complexes (tels que des objets de type MultiIndex ou des catégories numériques) soient convertis en chaînes de caractères sans ambiguïté. Si l’index de lignes du DataFrame porte une charge sémantique cruciale — à l’instar d’identifiants de patients ou de dates d’échantillonnage —, il convient de l’extraire symétriquement par df.index.astype(str).tolist() pour alimenter le paramètre rowLabels.
Un piège technique récurrent réside dans le typage des séries à virgule flottante. L’injection directe d’un tableau NumPy de nombres flottants conduit Matplotlib à restituer la totalité des chiffres significatifs machine, produisant des chaînes numériques interminables qui saturent immédiatement l’espace horizontal des cellules. Il est donc hautement recommandé d’appliquer préalablement une fonction de formatage vectorisée sur le DataFrame, par exemple à l’aide de df.round(3).astype(str) ou de compréhensions de listes utilisant le formatage par chaînes littérales interpolées (f-strings).
3.2 Neutralisation des axes cartésiens pour l’affichage exclusif
Lorsqu’une figure Matplotlib est exclusivement dédiée à la restitution d’un tableau de données, la présence résiduelle des composantes visuelles de l’axe cartésien — telles que les graduations (ticks), les lignes d’axes (spines) et la grille d’arrière-plan — constitue une pollution graphique préjudiciable à la clarté informative. La première étape méthodologique consiste donc à neutraliser l’intégralité du repère de coordonnées à l’aide de la directive explicite ax.axis('off').
Cette commande a pour effet immédiat de masquer les axes mathématiques tout en préservant le système de projection spatial interne indispensable au positionnement du tableau. Pour affiner davantage la composition géométrique et s’assurer que l’espace dévolu au tableau occupe l’intégralité du cadre sans distorsion d’échelle disproportionnée, on complétera utilement cette étape par l’instruction ax.axis('tight'), laquelle recalibre dynamiquement les boîtes englobantes des artistes résidents.
En outre, il s’avère souvent pertinent de désactiver le remplissage par défaut de la figure elle-même au moyen de fig.patch.set_visible(False). Cette manipulation garantit l’obtention d’un arrière-plan totalement transparent lors de l’exportation vers des formats vectoriels ou matriciels, facilitant ainsi l’intégration harmonieuse du tableau généré au sein de transparents de présentation ou de documents typographiés via LaTeX.
3.3 Implémentation pas à pas et contrôle de la reproductibilité
Afin de garantir une reproductibilité algorithmique sans faille lors de la génération de données synthétiques, la fixation préalable d’une graine pseudo-aléatoire via numpy.random.seed() s’impose dès l’initialisation du script. Considérons un cas d’étude illustrant la distribution de métriques physico-chimiques au sein d’une cohorte d’échantillons géologiques standardisés. Le DataFrame synthétique regroupe des variables de concentration, de température critique et d’indices de réfraction.
Après instanciation de la figure et de l’axe via l’idiome fig, ax = plt.subplots(), la désactivation cartésienne est opérée. L’appel à ax.table() intègre ensuite la matrice textuelle convertie, la séquence des noms de colonnes et la valeur d’ancrage centralisé loc='center'. La compilation visuelle est régie par l’application de table.scale(1.2, 1.5) afin de dilater harmonieusement l’espacement inter-cellulaire, garantissant qu’aucun glyphe ne vienne empiéter sur les bordures périphériques.
L’exécution finale du pipeline mobilise la commande plt.tight_layout() pour recalculer les marges globales de la figure avant la restitution interactive par plt.show() ou l’écriture sur support physique via plt.savefig(). Cette séquence protocolaire garantit une constance géométrique stricte quel que soit le système d’exploitation ou le pilote d’affichage graphique sous-jacent.
4. Méthode 2 : Conception de tableaux à partir de données brutes et listes personnalisées
4.1 Structuration manuelle des matrices de données bidimensionnelles
Dans un contexte d’ingénierie logicielle allégée, d’environnements embarqués ou de scripts utilitaires autonomes, l’introduction d’une dépendance lourde telle que pandas peut s’avérer disproportionnée ou proscrite par les contraintes d’architecture. Matplotlib permet fort heureusement la construction ex nihilo de structures tabulaires en s’appuyant exclusivement sur les types de données natifs du langage Python, principalement les listes imbriquées de dimension 2.
La conception d’une matrice bidimensionnelle brute exige une discipline structurelle sans faille. Chaque sous-liste doit correspondre rigoureusement à une ligne horizontale de la table, et l’ensemble des sous-listes doit impérativement présenter une parité dimensionnelle absolue (le même nombre cardinal d’éléments). Une hétérogénéité dans la longueur des rangées déclenche inévitablement des corruptions d’affichage lors de la tentative d’indexation spatiale par le moteur de rendu de Matplotlib.
En matière de typage, bien que Python autorise la coexistence d’entiers, de nombres à virgule flottante et de chaînes au sein d’une même liste, il est méthodologiquement impératif de réaliser une conversion explicite préalable de tous les éléments en chaînes de caractères (str). Cette étape permet de maîtriser précisément la représentation alphanumérique des données, en gérant manuellement les arrondis décimaux et l’échappement des caractères spéciaux avant leur transfert au composant graphique.
4.2 Définition explicite des étiquettes structurelles
L’attribution manuelle des descripteurs de variables via la séquence colLabels et des identifiants d’observations via rowLabels requiert une synchronisation dimensionnelle rigoureuse avec la matrice de données sous-jacente. La séquence assignée à colLabels doit comporter un nombre d’éléments textuels strictement égal au nombre de colonnes de la matrice cellText. Réciproquement, la liste fournie à rowLabels doit présenter une longueur parfaitement superposable au nombre de rangées constitutives.
L’omission intentionnelle des en-têtes constitue une option typographique valable lorsque le contexte visuel immédiat permet d’identifier sans ambiguïté la nature des colonnes. Néanmoins, d’un point de vue architectural, l’absence de colLabels reconfigure l’indexation matricielle interne : la ligne d’indice supérieur devient alors la rangée 0, éliminant la ligne spéciale d’indice -1 habituellement réservée aux en-têtes.
Lorsque des étiquettes de lignes sont incorporées, Matplotlib génère une colonne supplémentaire à la gauche immédiate de la structure matricielle. Cette colonne structurelle adopte fréquemment, par défaut, un style visuel similaire à celui des en-têtes de colonnes, instaurant une hiérarchie graphique qui démarque sans ambiguïté les métadonnées de catalogage expérimental du corps numérique des mesures observées.
4.3 Cas pratique d’application : tableau de métriques expérimentales
Considérons la conception d’un module d’évaluation métrologique pour des capteurs thermiques industriels, rédigé en Python standard sans recours à aucune bibliothèque tierce en dehors de Matplotlib. Les données brutes recueillies se composent d’identifiants de sondes, de températures moyennes de fonctionnement, d’erreurs quadratiques moyennes et d’indices de conformité binaire.
La structure de données est formalisée par une liste de listes dans laquelle chaque grandeur flottante est formatée à l’aide de f-strings rigoureuses, tronquant l’incertitude expérimentale à deux décimales significatives. Les colonnes d’en-tête sont explicitement instanciées par la séquence ['Sonde ID', 'Temp. Moyenne (°C)', 'RMSE', 'Statut']. L’appel à ax.table() est orchestré au sein d’un axe dont les composantes graphiques ont été au préalable totalement éteintes.
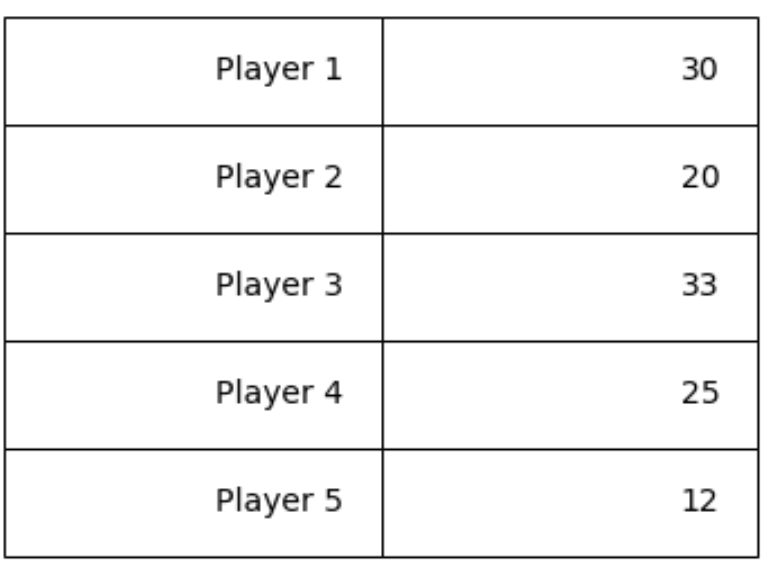
Ce déploiement dépouillé de toute couche logicielle intermédiaire offre des gains substantiels en termes de temps d’exécution et d’empreinte mémoire, une caractéristique particulièrement appréciable lors de la génération massive de rapports en boucle au sein de pipelines d’intégration continue. Le tableau généré démontre qu’une structure brute, lorsqu’elle est maîtrisée sur le plan dimensionnel, offre une qualité de restitution vectorielle strictement identique à celle issue d’outils analytiques de haut niveau.
5. Optimisation géométrique et gestion dimensionnelle des cellules
5.1 Contrôle global des proportions à l’aide de table.scale()
L’un des écueils les plus récurrents rencontrés lors de l’instanciation de tableaux avec les paramètres par défaut de Matplotlib réside dans la compression verticale excessive des cellules. Cette densité géométrique produit souvent des superpositions inélégantes entre le texte et les bordures polygonales supérieures ou inférieures. Pour pallier cette contrainte sans recalculer l’intégralité des coordonnées absolues de la figure, l’API fournit la méthode correctrice fondamentale table.scale(xscale, yscale).
Cette fonction applique une transformation affine multiplicative aux facteurs d’échelle géométrique de chaque cellule individuelle constituant l’objet Table. Le premier argument, xscale, dilate ou contracte la largeur horizontale des colonnes, tandis que le second argument, yscale, module la hauteur verticale des rangées. Dans la majorité des scénarios d’édition scientifique, l’application d’un coefficient vertical compris entre 1.3 et 2.0 combiné à un coefficient horizontal unitaire permet d’aérer magnifiquement la structure tabulaire en octroyant un espace de respiration visuelle suffisant autour des glyphes typographiques.
Toutefois, l’usage inconsidéré de facteurs d’échelle élevés peut entraîner une protrusion du tableau en dehors de la boîte englobante de l’axe hôte. L’ingénieur doit donc trouver un équilibre délicat entre le ratio d’aspect initial de la figure globale (configuré via l’argument figsize lors de l’appel à plt.subplots()) et les multiplicateurs appliqués par la méthode scale(), assurant ainsi une harmonie géométrique globale.
5.2 Définition individualisée des largeurs de colonnes
Par défaut, Matplotlib applique une heuristique de répartition équitable des largeurs de colonnes, divisant l’espace horizontal disponible par le nombre total de variables représentées. Or, les ensembles de données réels présentent une asymétrie textuelle marquée : une colonne dédiée à la désignation descriptive d’une méthode expérimentale peut exiger une largeur substantiellement supérieure à celle requise par une simple colonne d’indices numériques ou de symboles booléens.
Pour imposer une métrique sur mesure, le paramètre colWidths de la fonction ax.table() accepte une liste de nombres flottants dont la somme ne doit pas obligatoirement valoir l’unité, mais dont les valeurs relatives dictent la part proportionnelle dévolue à chaque colonne au sein du repère normalisé de l’axe. Par exemple, une spécification telle que colWidths=[0.4, 0.2, 0.2, 0.2] attribue le double d’espace horizontal à la première colonne comparativement à ses homologues.
Une alternative algorithmique plus avancée consiste à déterminer dynamiquement ce vecteur de largeurs en calculant la longueur maximale de chaîne de caractères présente dans chaque colonne (en incluant l’étiquette d’en-tête), pondérée par la taille de police active. Cette approche programmatique évite tout rognage accidentel et élimine le recours à un ajustement empirique manuel lors du traitement automatisé de données dynamiques.
5.3 Utilisation de la boîte englobante (bbox) pour un positionnement millimétré
Bien que le paramètre loc offre une solution de positionnement cardinale rapide, il se révèle insuffisant dès lors que l’on souhaite intégrer un tableau au sein d’une composition géométrique asymétrique ou d’une zone résiduelle spécifique d’une figure composite. Pour une maîtrise spatiale absolue, Matplotlib met à disposition le paramètre bbox (bounding box).
Le paramètre bbox prend la forme d’un conteneur à quatre éléments sous la structure canonique [x, y, largeur, hauteur], exprimés sous forme de coordonnées relatives normalisées comprises entre 0 et 1 au sein de l’espace de référence de l’axe hôte. Les coordonnées (x, y) définissent l’ancrage du coin inférieur gauche du tableau, tandis que largeur et hauteur gouvernent son extension bidimensionnelle exacte :
x: Position horizontale normalisée du bord gauche du tableau par rapport à l’axe (0.0 correspond au bord gauche, 1.0 au bord droit).y: Position verticale normalisée du bord inférieur du tableau (0.0 correspond à la base de l’axe, 1.0 au sommet).largeur: Extension horizontale absolue du tableau en fraction de la largeur totale de l’axe.hauteur: Extension verticale absolue du tableau en fraction de la hauteur totale de l’axe.
L’utilisation de la boîte englobante supplante et neutralise totalement les directives dictées par le paramètre loc. Elle garantit que le tableau occupera une surface immuable lors des phases ultérieures d’ajustement interactif ou de compilation multi-formats, offrant un niveau de déterminisme spatial indispensable à la publication de prestige.
6. Personnalisation typographique et mise en forme du texte
6.1 Configuration des propriétés de police et hiérarchie visuelle
L’efficacité cognitive d’une structure tabulaire repose sur l’établissement d’une hiérarchie typographique limpide entre les différents niveaux d’information. Par défaut, Matplotlib tente d’ajuster automatiquement la taille de police afin que le texte contenu dans la cellule la plus volumineuse ne déborde pas de ses bordures physiques. Cependant, ce mécanisme d’auto-ajustement génère fréquemment un effet secondaire désastreux : la réduction globale de l’ensemble des textes à une taille microscopique à peine lisible.
Pour reprendre le contrôle absolu de l’ordonnancement typographique, il est impératif de débrayer cet automatisme en appelant l’instruction explicite table.auto_set_font_size(False), immédiatement suivie de la fixation d’un corps de texte standardisé via table.set_fontsize(taille_points). Une fois cette base établie, il devient possible de parcourir algorithmiquement les cellules structurelles pour injecter des variations de graisse ou de style.
L’accès direct aux instances de Text s’opère au moyen de la méthode cell.get_text(). On appliquera alors des spécificateurs de poids tels que set_weight('bold') pour souligner la prééminence des en-têtes de colonnes ou des moyennes générales, tandis que des annotations contextuelles secondaires pourront être inclinées en italique via set_style('italic'). L’harmonisation avec la police globale de la figure s’assure en amont via les paramètres de configuration rcParams de Matplotlib, permettant par exemple l’usage exclusif de familles de polices Serif conformes aux canons des presses universitaires.
6.2 Gestion de l’alignement horizontal et vertical du contenu
L’alignement spatial du texte au sein d’une cellule n’est point un choix arbitraire ; il répond à des conventions sémiologiques strictes établies par les maîtres de la typographie éditoriale. Une restitution rigoureuse exige que les données textuelles qualitatives soient alignées à gauche pour faciliter le balayage visuel occidental, tandis que les valeurs numériques continues doivent impérativement être justifiées à droite afin d’aligner naturellement les ordres de grandeur décimaux. Les identifiants courts, codes d’échantillons ou symboles catégoriels trouvent quant à eux leur place dans un alignement rigoureusement centré.
Au sein de Matplotlib, l’alignement s’ajuste individuellement sur l’artiste textuel sous-jacent de chaque cellule à l’aide des méthodes set_horizontalalignment() (acceptant 'left', 'center', 'right') et set_verticalalignment() (acceptant 'center', 'top', 'bottom', 'baseline'). Il convient de noter que pour préserver un espacement élégant vis-à-vis des parois polygonales de la cellule, un alignement à droite pur peut nécessiter l’ajout manuel d’un espace insécable ou la manipulation des marges internes de la cellule.
Une bonne pratique d’ingénierie consiste à élaborer une fonction itérative qui inspecte la nature sémantique de chaque colonne et applique automatiquement la règle d’alignement appropriée sur l’ensemble des cellules de la rangée verticale correspondante, garantissant une cohérence formelle sur l’ensemble de la table.
6.3 Formatage algorithmique des nombres et expressions scientifiques
La précision numérique affichée au sein d’une figure de recherche doit scrupuleusement refléter la précision réelle de l’instrumentation physique ou de la modélisation statistique employée, proscrivant les résidus d’arrondi machine arbitraires. La troncature et le formatage doivent intervenir en amont de la construction tabulaire, par le recours systématique aux chaînes de formatage avancées de Python (spécificateurs de type {valeur:.2f} pour deux décimales fixes, ou {valeur:.2e} pour une notation exponentielle rigoureuse).
L’un des avantages concurrentiels majeurs de Matplotlib par rapport aux bibliothèques tabulaires purement web réside dans son intégration native de son moteur de rendu mathématique Mathtext, offrant un sous-ensemble robuste de la syntaxe TeX sans requérir l’installation externe d’une distribution LaTeX complète. L’encadrement d’une expression par des symboles de dollar (ex. : r'$\sigma = 0.05 \pm 0.002$') déclenche le parseur typographique interne, permettant de restituer des lettres grecques, des exposants, des indices ou des symboles d’intégrales avec une perfection esthétique absolue.
Ce formalisme mathématique s’étend également à la représentation conventionnelle de la significativité statistique. L’adjonction d’astérisques d’évaluation d’hypothèse (par exemple $p < 0.001^{***}$) au sein des cellules numériques s’effectue sans distorsion d’alignement, offrant une clarté analytique immédiate à l’évaluateur scientifique.
7. Stylisation visuelle avancée : couleurs, bordures et mise en valeur
7.1 Application de palettes chromatiques aux en-têtes et corps de table
L’application judicieuse de la couleur au sein d’une table analytique ne doit jamais répondre à une finalité purement décorative, mais obéir à une stratégie fonctionnelle visant à structurer les strates de lecture. L’accentuation chromatique de la bannière d’en-tête, réalisée par l’injection d’une teinte soutenue via l’argument colColours, crée une rupture visuelle nette avec le corps des données, ancrant immédiatement le rôle de métadonnée descriptive de cette ligne liminaire.
Pour le corps matriciel, la technique typographique classique du lignage zébré (zebra striping), consistant à alterner des fonds de cellules blancs et de teintes pastel extrêmement subtiles (comme des nuances de gris perle ou de bleu pâle), atténue substantiellement la fatigue oculaire lors du parcours de tables dotées de nombreuses colonnes. Cette alternance chromatique guide le regard de l’expérimentateur le long de la coordonnée horizontale sans risque de glissement perceptif vers les rangées adjacentes.
Le choix des palettes chromatiques doit impérativement respecter les recommandations d’accessibilité visuelle universelle. Le recours aux palettes perceptuellement uniformes développées pour la visualisation scientifique, telles que Viridis, Cividis ou des déclinaisons atténuées de la bibliothèque ColorBrewer, garantit que les contrastes demeurent parfaitement identifiables pour les personnes atteintes de déficiences de la vision des couleurs (daltonisme, deutéranopie), tout en assurant une lisibilité exemplaire lors d’une impression monochrome sur support papier.
7.2 Mise en forme conditionnelle et tableaux de type carte thermique
L’introduction d’un gradient de couleur conditionnel au sein d’un tableau permet d’opérer une hybridation remarquable entre la précision textuelle d’une table et le pouvoir de synthèse synoptique d’une carte thermique (heatmap). Cette technique s’avère particulièrement puissante pour les matrices de corrélation de Pearson, les tableaux d’évaluation de métriques de confusion en apprentissage profond, ou les suivis de covariables génomiques.
L’implémentation algorithmique de cette stylisation dynamique s’articule autour de l’utilisation conjointe d’une échelle de normalisation scalaire (matplotlib.colors.Normalize) et d’une carte de couleurs continue (matplotlib.cm.ScalarMappable). Les grandeurs numériques sont tout d’abord projetées sur l’intervalle unitaire [0, 1] en fonction de leurs bornes empiriques minimales et maximales, puis converties en nuances chromatiques précises.
Une exigence fondamentale de lisibilité impose de calculer dynamiquement la luminance relative de chaque fond de cellule ainsi généré. Si l’intensité de la nuance de fond franchit un seuil critique d’obscurcissement, le code doit automatiquement basculer la couleur de la police textuelle du noir vers le blanc pur via cell.get_text().set_color('white'), préservant ainsi un contraste suffisant conforme aux recommandations d’ergonomie cognitive.
7.3 Contrôle précis des bordures et traits de séparation
Dans l’édition scientifique de très haut niveau, l’utilisation outrancière de quadrillages rectangulaires fermés (les bordures complètes autour de chaque cellule) est considérée comme un archaïsme visuel nuisible qui surcharge inutilement l’espace graphique (l’effet de grille étouffant dénoncé par Edward Tufte). Les canons typographiques actuels, incarnés notamment par le célèbre package LaTeX Booktabs, préconisent l’élimination quasi-totale des filets verticaux au profit d’un usage parcimonieux et hiérarchisé de filets horizontaux fins.
La manipulation granulaire des arêtes au sein de Matplotlib est rendue possible grâce à l’attribut spécialisé visible_edges propre à chaque instance de la classe Cell. Cet attribut accepte une chaîne de caractères spécifiant les côtés du polygone qui doivent être matérialisés lors du rendu :
'T': Rendu exclusif de la bordure supérieure (Top).'B': Rendu exclusif de la bordure inférieure (Bottom).'L': Rendu exclusif de la bordure latérale gauche (Left).'R': Rendu exclusif de la bordure latérale droite (Right).- Combinaisons complexes telles que
'TB'pour encadrer horizontalement une ligne sans tracer les cloisons verticales.
En combinant cette suppression sélective des bordures avec l’ajustement de l’épaisseur du trait via cell.set_linewidth() — en allouant un trait plus épais au filet sommital et sous-jacent à l’en-tête, et un trait ultra-fin pour clore le tableau —, l’auteur confère à sa visualisation une distinction éditoriale et une élégance sobre immédiatement perceptibles.
8. Conception de figures hybrides : cohabitation graphiques et tableaux
8.1 Superposition directe d’un tableau sous un tracé cartésien
L’une des configurations graphiques les plus stimulantes sur le plan méthodologique consiste à adosser un tableau de contingence immédiatement sous un tracé cartésien, de telle sorte que les colonnes du tableau s’alignent rigoureusement avec les coordonnées en abscisse de séries discrètes ou continues. Ce schéma est couramment rencontré dans les courbes de survie de Kaplan-Meier en recherche médicale, où le graphique supérieur illustre la probabilité cumulée d’événement au cours du temps, tandis que le tableau inférieur documente précisément la table des effectifs résiduels (nombre de sujets à risque) pour chaque jalon temporel.
Pour réussir cette intégration anatomique sans décalage parallactique, le tableau doit être instancié au sein de l’axe cartésien principal en spécifiant l’ancrage loc='bottom'. La difficulté technique majeure réside dans la synchronisation des limites en abscisse : le tableau calcule la position de ses colonnes sur une échelle normalisée de 0 à 1, ce qui impose d’aligner mathématiquement le nombre de colonnes avec le nombre précis de graduations majeures de l’axe des X.
De plus, il devient impératif de masquer les étiquettes textuelles natives des graduations d’abscisse via ax.set_xticklabels([]) pour éviter toute interférence physique ou collision visuelle entre les graduations numériques et la ligne d’en-tête du tableau qui vient s’y superposer. Le tableau assume ainsi pleinement le rôle de système de graduation enrichi, fusionnant métrique continue et dénombrement discret en un ensemble structurel indissociable.
8.2 Architecture modulaire avec GridSpec et sous-graphiques dédiés
Lorsque la complexité du document de recherche s’accroît, la superposition forcée au sein d’un axe unique atteint ses limites géométriques. L’approche architecturale supérieure consiste à découper la figure globale en sous-zones étanches à l’aide du module spécialisé matplotlib.gridspec.GridSpec. Cette classe confère un contrôle matriciel de niveau professionnel sur la topologie de la figure, autorisant des allocations d’espace asymétriques au travers d’arguments de pondération tels que height_ratios et width_ratios.
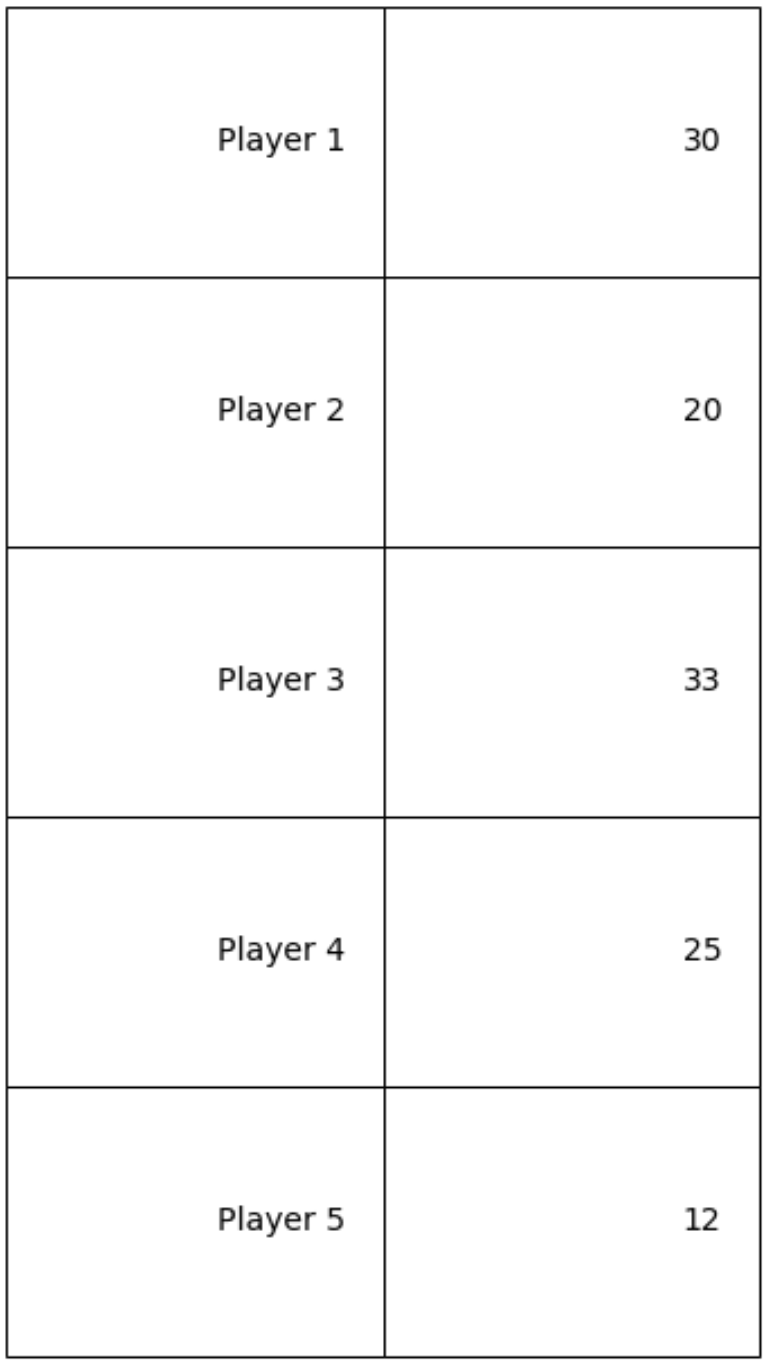
Dans ce paradigme de conception modulaire, un premier sous-graphique est dévolu à la représentation graphique pure (par exemple une distribution multivariée tracée dans l’axe supérieur ax_plot), tandis qu’un second axe dédié (ax_table) est aménagé dans la partie inférieure de la grille. L’axe réservé au tableau est immédiatement délesté de tout affichage cartésien par ax_table.axis('off'), servant exclusivement de réceptacle spatial étalonné pour l’objet Table.
Cette dissociation structurelle offre une robustesse remarquable : la modification des échelles logarithmiques, des limites dimensionnelles ou des marges d’erreur sur le graphique principal n’exerce aucune influence collatérale délétère sur la géométrie ou l’ancrage typographique du tableau situé en dessous. La figure finale se comporte comme une planche éditoriale composite unifiée, parfaitement reproductible et d’une clarté exemplaire.
8.3 Tableaux récapitulatifs de paramètres statistiques en incrustation
Dans de nombreuses disciplines quantitatives, l’espace intérieur d’un tracé graphique présente des zones de vacuité informative — fréquemment dans les quadrants supérieurs droits ou inférieurs gauches d’un diagramme de corrélation linéaire où aucun point expérimental ne réside. Il est alors particulièrement judicieux d’exploiter cet espace libre pour y incruster une table miniature (inset table) résumant les paramètres formels du modèle mathématique ajusté (valeur du coefficient de détermination R², pente, ordonnée à l’origine, statistique F de Fisher, écarts-types résiduels).
Cette incrustation peut être opérée soit par l’appel à la fonction ax.inset_axes([x, y, w, h]), qui génère un axe enfant imbriqué au sein du système de coordonnées de l’axe parent, soit par le recours au paramètre bbox au sein d’un simple appel à ax.table(). La première méthode offre l’avantage d’une isolation totale, tandis que la seconde minimise l’arborescence des objets instanciés.
Une considération esthétique primordiale dans la conception de ces tables d’encadré réside dans la gestion de la transparence. Il est recommandé de doter les cellules d’un léger degré d’opacité via la composante alpha de leur couleur de fond (par exemple un blanc pur avec une valeur alpha de 0.85). Cet artifice garantit que la table demeure parfaitement lisible sans pour autant oblitérer totalement la continuité visuelle d’une ligne de tendance ou d’une composante de grille sous-jacente.
9. Traitement des tableaux denses et gestion des cas complexes
9.1 Stratégies face au débordement textuel et cellules étroites
L’un des défis les plus redoutables de la typographie computationnelle réside dans le traitement des chaînes de caractères volumineuses encapsulées dans des colonnes étroites. Lorsqu’un intitulé de variable ou une description observationnelle excède l’extension physique horizontale de sa cellule hôte, Matplotlib ne tronque point la chaîne par défaut ; il la laisse déborder anarchiquement sur les cellules voisines, générant un enchevêtrement illisible de glyphes superposés.
Pour juguler cette anomalie sans dégrader le corps de la police à des dimensions microscopiques, la solution algorithmique réside dans l’emploi concerté du module standard textwrap de Python. En appliquant la méthode textwrap.fill(texte, width=seuil) à l’ensemble des éléments lexicaux longs en amont de la construction matricielle, les chaînes continues sont automatiquement scindées par des sauts de ligne explicites (n), contraignant le texte à s’épanouir dans la dimension verticale de la cellule.
Il conviendra parallèlement de compenser cet accroissement vertical en appliquant une dilatation correspondante de la hauteur de rangée via table.scale(1.0, facteur_vertical) ou en modifiant sélectivement la hauteur de la cellule incriminée par cell.set_height(nouvelle_hauteur). Cette gestion fine du retour à la ligne garantit la préservation intégrale du capital lexical sans compromettre l’étanchéité géométrique des colonnes.
9.2 Techniques de partitionnement pour les jeux de données étendus
Tenter de restituer une matrice comprenant des centaines de lignes au sein d’une unique figure Matplotlib constitue un contresens méthodologique majeur : le moteur de tracé saturera la résolution spatiale disponible, provoquant l’effondrement des cellules les unes sur les autres et générant un artefact visuel inexploitable. Face à des jeux de données denses mais devant impérativement être restitués sous forme visuelle pour un rapport exhaustif, le partitionnement paginé s’impose comme la seule stratégie viable.
Le protocole technique repose alors sur l’utilisation du gestionnaire de sorties multipages matplotlib.backends.backend_pdf.PdfPages. Le script procède au découpage itératif du jeu de données par blocs de taille constante (par exemple 25 à 30 observations par feuille), instancie une nouvelle Figure à chaque itération, génère la table correspondante avec ses en-têtes préservés au sommet, puis persiste la vue au sein du document PDF global via la méthode pdf.savefig(fig).
D’un point de vue calculatoire, il est fondamental de libérer explicitement la mémoire allouée à chaque figure en invoquant systématiquement plt.close(fig) au sein de la boucle de partitionnement. À défaut, l’accumulation interne des instances d’artistes au sein du moteur d’état global de Matplotlib engendre des fuites de mémoire substantielles (memory leaks) susceptibles de provoquer le crash du processus d’exécution lors du traitement de volumétries massives.
9.3 Gestion des valeurs manquantes et des cas particuliers
Les protocoles de collecte de données empiriques sont inévitablement confrontés à la problématique des valeurs manquantes (valeurs NaN, chaînes vides, pointeurs nuls ou valeurs aberrantes censurées). L’injection brute de valeurs telles que np.nan au sein de cellText produit généralement l’affichage disgracieux de la chaîne textuelle littérale 'nan', signalant un manque d’élégance algorithmique et d’attention éditoriale.
Une pratique rigoureuse impose la transformation préalable de ces anomalies en notations typographiques standardisées reconnues par la communauté académique. La convention dominante préconise le remplacement des données manquantes par un tiret cadratin ou demi-cadratin ('—'), ou par le sigle formel 'N/A' (Non Applicable ou Non Disponible). Ce remplacement doit s’opérer de façon programmatique lors de la phase de préparation matricielle :
Sur le plan visuel, il est également recommandé d’appliquer une stylisation spécifique à ces cellules lacunaires. L’attribution d’un fond texturé d’un hachurage discret au moyen de cell.set_hatch('//') ou d’une teinte grise neutre indique immédiatement au lecteur la nature non informative de la cellule sans attirer indûment son attention, préservant ainsi l’intégrité topologique et la sérénité visuelle de l’ensemble tabulaire.
10. Exportation haute résolution et conformité aux standards de publication
10.1 Formats d’exportation vectoriels et matriciels
L’aboutissement du travail de composition tabulaire réside dans la phase d’exportation physique vers un fichier pérenne. Le choix du format de fichier est conditionné par le support de destination et les spécifications imposées par les comités de rédaction des revues scientifiques. Deux grands paradigmes s’opposent : les formats vectoriels et les formats matriciels rastérisés.
Pour tout travail comportant des éléments textuels et des cloisons géométriques fines, les formats vectoriels — au premier rang desquels figurent le PDF (Portable Document Format), le SVG et l’EPS — doivent impérativement être privilégiés. Ces formats encodent les glyphes typographiques et les tracés polygonaux sous forme d’instructions géométriques pures indépendantes de toute grille de pixels. Il en résulte une netteté absolue et infinie, autorisant l’agrandissement typographique sans aucune pixellisation ni perte de définition lors de l’impression professionnelle.
Lorsque le recours à un format matriciel (tel que PNG ou TIFF non compressé) est incontournable, l’ingénieur doit impérativement calibrer la densité d’échantillonnage spatiale via le paramètre dpi (dots per inch) de la fonction plt.savefig(). Les standards académiques internationaux proscrivent toute résolution inférieure à 300 DPI pour les illustrations couleur ou en niveaux de gris, et préconisent fréquemment une résolution minimale de 600, voire 1200 DPI pour les planches contenant exclusivement des schémas au trait et des matrices de texte fin, garantissant l’absence de crénelage (aliasing) sur les bordures minces.
10.2 Conformité avec les normes éditoriales académiques (style APA et revues scientifiques)
L’intégration d’un tableau au sein d’une publication savante impose une soumission stricte aux normes bibliographiques et stylistiques en vigueur dans la discipline concernée, à l’instar des directives édictées par l’American Psychological Association (APA 7th edition) ou les presses de revues comme Nature ou Science.
Les canons de l’APA proscrivent formellement le quadrillage intégral de style tableur. Un tableau scientifique conforme doit exhiber une épuration géométrique absolue, matérialisée par :
- Un filet horizontal supérieur robuste délimitant le début de la table.
- Un filet horizontal intermédiaire isolant distinctement la rangée d’en-tête du corps des observations.
- Un filet horizontal inférieur scellant la fin des données avant d’éventuelles notes méthodologiques.
- L’absence totale et catégorique de lignes de séparation verticales entre les colonnes.
De surcroît, le tableau doit être accompagné de métadonnées textuelles rigoureusement ordonnées : un numéro d’ordre en gras (ex. : Tableau 1), suivi d’un titre bref et descriptif composé en italique sur une ligne dédiée, et clôturé à sa base par des notes de bas de page explicatives introduites par la mention Note. en italique. Ces éléments textuels périphériques peuvent être programmés avec une précision chirurgicale au sein de Matplotlib à l’aide des commandes ax.set_title() et fig.text(), produisant une planche prête à être imprimée sans intervention manuelle ultérieure dans un logiciel d’édition graphique.
10.3 Automatisation de l’exportation et compilation dans des flux documentaires
Dans un contexte de science ouverte et d’ingénierie logicielle contemporaine, la production de figures ne doit plus résulter de manipulations manuelles dans des cahiers interactifs, mais s’inscrire dans des pipelines d’automatisation intégrés (flux CI/CD, scripts de compilation périodique de rapports décisionnels). L’exécution sans surveillance (headless) exige la configuration explicite d’un backend non interactif en préambule de tout script :
L’utilisation de la directive matplotlib.use('Agg') garantit que le moteur graphique n’essaiera point d’ouvrir une interface de fenêtrage X11 ou Wayland sur un serveur d’intégration dépourvu d’affichage physique, évitant ainsi l’arrêt prématuré du script par des erreurs de type DisplayError.
Enfin, l’instruction de sauvegarde doit systématiquement inclure le paramètre bbox_inches='tight'. Cette option fondamentale ordonne à Matplotlib de recalculer la boîte englobante exacte de tous les artistes résidents — y compris les tableaux ayant débordé des limites formelles de l’axe ou les notes de bas de page incrustées —, éliminant ainsi les marges blanches inutiles et empêchant tout rognage accidentel du texte lors de son inclusion finale dans des documents typographiés par un moteur TeX.
11. Analyse comparative : Matplotlib face aux alternatives spécialisées
11.1 Matplotlib et l’API styler de pandas
La bibliothèque pandas intègre nativement une API de mise en forme très populaire dénommée DataFrame.style (Styler). Cette suite logicielle permet d’appliquer des feuilles de styles CSS, des barres de progression horizontales directement au sein des cellules, ou des gradients thermiques continus. Toutefois, le domaine de validité de l’API Styler demeure fondamentalement confiné aux environnements d’exécution interactifs orientés Web, tels que les carnets Jupyter Notebook, dont la finalité d’affichage repose sur le DOM (Document Object Model) d’un navigateur.
La limite critique de l’API Styler apparaît dès lors que l’on souhaite exporter la figure sous la forme d’une illustration autonome haute résolution ou d’un fichier vectoriel vectorisable pour une revue papier. Le format de sortie natif du Styler est le code HTML/CSS brut ou, plus récemment et de manière encore restreinte, un code source de tableau LaTeX. Pour transformer ce rendu en image autonome, des dépendances tierces complexes (telles que des navigateurs headless comme Playwright ou Selenium) doivent être mobilisées, alourdissant drastiquement l’architecture logicielle.
À l’inverse, Matplotlib génère des objets graphiques vectoriels directs qui s’inscrivent nativement dans le canevas de rendu de bas niveau. Si sa syntaxe de configuration s’avère nettement plus verbeuse et impérative que l’approche déclarative de pandas, Matplotlib demeure le choix incontestable pour toute sortie destinée à l’impression physique directe, aux documents PDF vectoriels et aux intégrations multi-panneaux synchronisées avec des graphiques de données.
11.2 Comparaison avec Great Tables, PrettyTable et Tabulate
L’écosystème Python héberge plusieurs bibliothèques spécialisées dans le formatage textuel tabulaire, parmi lesquelles figurent les packages renommés Tabulate et PrettyTable, ainsi que des solutions d’inspiration moderne comme Great Tables (le pendant Python du célèbre package gt de l’écosystème R). Chacune de ces solutions répond à des exigences d’usage distinctes qu’il convient de cartographier avec rigueur.
Tabulate et PrettyTable ont pour fonction première la génération de tableaux textuels en art ASCII pur ou en chaînes de caractères enrichies pour une restitution lisible au sein d’une console d’émulation de terminal ou de fichiers journaux (logs). Bien qu’extrêmement véloces et dépourvues de dépendances graphiques, ces solutions n’ont aucune prétention typographique ou graphique : elles ignorent la notion de police proportionnelle, de résolution vectorielle, de nuance de couleurs d’arrière-plan ou de synchronisation d’axes géométriques.
Great Tables propose quant à elle une architecture de stylisation déclarative d’une exceptionnelle puissance esthétique, conçue selon une philosophie structurée (en-tête, bandeau, corps, notes de bas de page). Néanmoins, son mode de restitution principal est encore axé sur le Web (HTML) et l’intégration documentaire statique. Aucune de ces bibliothèques ne dispose de la plasticité de Matplotlib pour ancrer, aligner et synchroniser géométriquement une table au millimètre près le long des axes d’un graphique cartésien complexe.
11.3 Bibliothèques interactives : Plotly, Bokeh et alternatives web
L’essor des applications analytiques interactives et des tableaux de bord hébergés a favorisé la démocratisation d’outils basés sur JavaScript tels que Plotly (au travers de sa classe go.Table) ou Bokeh. Ces bibliothèques offrent une expérience utilisateur résolument moderne, permettant à l’observateur de trier dynamiquement les colonnes d’un simple clic sur un en-tête, de faire défiler des milliers de rangées au moyen de curseurs virtuels réactifs, ou de filtrer interactivement des observations en temps réel.
Toutefois, cette interactivité séduisante a un coût substantiel en termes de dépendances techniques, d’empreinte logicielle et de résilience temporelle. Une visualisation Plotly requiert l’injection d’un moteur d’exécution JavaScript volumineux, rendant les fichiers de sortie dépendants de navigateurs modernes et vulnérables aux ruptures de compatibilité logicielle au fil des années. De plus, la rastérisation statique d’une table interactive Web via des convertisseurs headless pour l’impression génère fréquemment des artefacts typographiques, des textes flous ou des bordures irrégulières.
Pour la pérennité archivistique de la communication scientifique formelle — où un document publié doit pouvoir être consulté et reproduit à l’identique dans un siècle sans nécessiter de machine virtuelle ou de navigateur Web —, la rusticité du modèle statique de Matplotlib, adossé aux formats vectoriels universels ouverts (PDF/SVG), constitue un gage de fiabilité et de conformité documentaire qu’aucune technologie dynamique ne saurait évincer.
12. Bonnes pratiques, erreurs fréquentes et guide de dépannage
12.1 Diagnostic des erreurs d’alignement et de troncature géométrique
Le symptôme le plus universellement rapporté par les développeurs utilisant ax.table() se manifeste par la disparition partielle ou le rognage abrupt d’une portion du tableau lors de la visualisation interactive ou de la génération d’images matricielles. Ce dysfonctionnement trouve son origine dans le fait que la méthode positionne souvent la géométrie de la table en périphérie de la boîte englobante standard de l’axe, dans une zone spatiale que le gestionnaire de mise en page par défaut considère comme vide.
La résolution de ce diagnostic repose sur un protocole d’ajustement géométrique strict. En premier lieu, l’appel à plt.tight_layout() doit être systématiquement testé ; ce mécanisme recalcule dynamiquement les espacements internes de la figure en mesurant les étendues réelles des artistes déclarés. Si des collisions persistent, notamment entre le tableau ancré au bas et les titres de l’axe horizontal, une intervention manuelle plus granulaire via plt.subplots_adjust() s’avère indispensable :
bottom=0.25(ou supérieur) : Alloue une marge inférieure substantiellement élargie pour accueillir sans contrainte un tableau volumineux.top=0.90: Réserve un espace suffisant pour les en-têtes et le titre principal de la figure composite.left=0.15etright=0.95: Évitent le débordement latéral des étiquettes d’observations ou des notes méthodologiques.
En cas d’utilisation d’une boîte englobante explicite (bbox), il convient de vérifier scrupuleusement que la coordonnée y additionnée à la hauteur ne dépasse pas la valeur critique de 1.0, sous peine de voir le sommet de la table être projeté au-delà de la frontière physique du canevas de dessin.
12.2 Pièges récurrents liés aux types de données et dimensions
Une incompréhension fréquente des mécanismes d’instanciation de Matplotlib concerne la manipulation dimensionnelle des arguments vectoriels. L’erreur la plus redoutée est la levée de l’exception interne ValueError: The number of columns must match the length of colLabels. Cette anomalie découle généralement d’une omission méthodologique lors de la préparation des données : si cellText est une matrice de dimensions M × N, la séquence colLabels doit impérativement posséder une cardinalité exacte de N, et rowLabels une cardinalité exacte de M.
Un autre piège pernicieux réside dans la transposition matricielle involontaire. Les data scientists habitués à manipuler des séries temporelles ou des matrices NumPy inversent fréquemment les axes de leurs structures (lignes versus colonnes). Dans Matplotlib, le premier indice d’indexation de cellText parcourt inexorablement les rangées (axe vertical descendant), et le second les colonnes (axe horizontal). Une inversion non délibérée produit un tableau difforme dont le nombre de colonnes ne correspond plus aux spécifications de colWidths ou des étiquettes fournies.
Il est dès lors vivement recommandé d’intégrer des assertions défensives de pré-conditionnement au sein de ses fonctions de traçage, sous la forme rigoureuse de tests de conformité dimensionnelle :
De telles validations explicites neutralisent les comportements erratiques dès la phase d’initialisation du pipeline computationnel.
12.3 Protocole de vérification avant soumission ou diffusion
Avant d’intégrer une figure composite comprenant des tableaux dans le manuscrit final d’une thèse, d’un article scientifique ou d’un rapport décisionnel exécutif, le chercheur ou l’ingénieur doit soumettre sa production à un protocole de vérification qualité systématique articulé autour de quatre piliers fondamentaux :
- Vérification de l’intégrité numérique : Opérer un récolement minutieux entre les données tabulées dans la figure finale et les données sources issues des calculs ou des bases de données de référence. S’assurer que les arrondis n’ont pas altéré la cohérence de colonnes totalisatrices ou de proportions normalisées à 100 %.
- Audit de lisibilité typographique multi-échelle : Inspecter le document exporté sous différents facteurs d’échelle (de 50 % pour simuler une lecture globale à 400 % pour traquer d’éventuels artéfacts de vectorisation ou des collisions de contours). Vérifier que la taille de police minimale reste supérieure ou égale à 6 points typographiques réels une fois la figure imprimée à sa largeur d’édition définitive.
- Conformité d’accessibilité et de contraste chromatique : Évaluer les contrastes de teintes entre texte et fond de cellule au regard des critères de succès WCAG (Web Content Accessibility Guidelines), en veillant à maintenir un ratio de contraste minimal de 4.5:1 pour le texte courant. Vérifier la lisibilité des cartes thermiques tabulaires sous simulation de daltonisme.
- Reproductibilité et scellement du code source : S’assurer que le script de génération est scellé, que les versions logicielles de Python, Matplotlib, NumPy et pandas sont rigoureusement documentées (au sein d’un fichier
requirements.txtou d’un environnement Conda explicite), et que la graine pseudo-aléatoire est fixée pour garantir la réplication exacte de la figure par tout évaluateur externe indépendant.
En respectant scrupuleusement ces directives méthodologiques et en exploitant la formidable plasticité offerte par le module tabulaire de Matplotlib, les praticiens de la science des données transforment des données brutes hétérogènes en planches documentaires d’une rigueur mathématique irréprochable et d’une souveraineté esthétique totale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Matplotlib Development Team. (2023). matplotlib.table.Table API Reference Documentation. Matplotlib Project. https://matplotlib.org/stable/api/table_api.html
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-00a
- The pandas development team. (2023). pandas.DataFrame.style Documentation. PyData. https://pandas.pydata.org/docs/user_guide/style.html
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10