
Dans le vaste univers de l’analyse exploratoire de données (communément désignée sous l’acronyme EDA pour Exploratory Data Analysis), la visualisation multidimensionnelle constitue l’une des étapes les plus déterminantes de la démarche scientifique moderne. Face à des jeux de données de plus en plus volumineux et complexes, l’analyste, le chercheur ou le biostatisticien ne peut plus se contenter de simples résumés statistiques agrégés. Les métriques univariées traditionnelles telles que la moyenne empirique, la médiane, la variance ou l’écart-type échouent fréquemment à capturer la subtilité des structures topologiques sous-jacentes, des regroupements de points et des dépendances croisées qui caractérisent les phénomènes réels. C’est précisément pour remédier à cette cécité statistique qu’a été conçue la matrice de nuages de points, universellement reconnue dans l’écosystème informatique contemporain sous le vocable de pairs plot ou scatter plot matrix (SPLOM).
L’environnement de programmation scientifique Python, propulsé par des bibliothèques de haut niveau telles que Seaborn, Matplotlib et Pandas, offre une infrastructure d’une flexibilité remarquable pour matérialiser ces visualisations matricielles. En une seule commande cohérente, le praticien est en mesure d’engendrer un canevas graphique d’une richesse documentaire inouïe. Ce dispositif permet de juxtaposer simultanément les distributions marginales univariées de chaque variable et les relations bivariées formées par chaque couple de descripteurs numériques continus. Dès lors, le pairs plot transcende le simple statut d’illustration graphique pour s’ériger en véritable outil de diagnostic statistique préliminaire, guidant de manière rationnelle les hypothèses de modélisation prédictive, le calibrage d’algorithmes d’apprentissage automatique supervisé ou non supervisé, ainsi que l’évaluation de la colinéarité.
Le présent article se propose de dresser un panorama exhaustif, à la fois théorique, méthodologique et hautement technique, de la création, de la personnalisation et de l’optimisation des pairs plots en Python. Conçu sous une perspective académique rigoureuse, ce traité vous accompagnera depuis les fondements d’algèbre matricielle qui sous-tendent la disposition en grille, jusqu’aux raffinements typographiques les plus sophistiqués de la publication scientifique internationale, en passant par le traitement des grands volumes de données, l’intégration de strates catégorielles et l’usage de la classe modulaire avancée PairGrid.
1. Introduction théorique et fondements conceptuels du pairs plot en Python
1.1 Définition et structure matricielle de la visualisation bivariée
La matrice de nuages de points, désignée formellement sous le vocable de scatter plot matrix et popularisée sous l’appellation de pairs plot au sein des environnements d’informatique statistique, représente une organisation carroyée d’éléments graphiques conçue pour explorer exhaustivement les relations existant au sein d’un espace vectoriel à p dimensions réelles. D’un point de vue structural, si l’on considère une matrice de données quantitatives constituée de n observations et de p variables aléatoires continues, le pairs plot organise la restitution visuelle sous la forme d’un tableau à double entrée de dimension p × p sous-graphiques (ou subplots). Chaque cellule de cette méga-grille est rigoureusement assignée à la confrontation visuelle de deux coordonnées précises, définies par l’intersection d’une ligne i et d’une colonne j du système cartésien sous-jacent.
L’élégance méthodologique du dispositif repose sur une différentiation spatiale fondamentale entre les cellules situées sur la diagonale principale et celles positionnées hors diagonale. Sur la diagonale principale, où l’indice de ligne coïncide parfaitement avec l’indice de colonne (c’est-à-dire où i = j), la comparaison bivariée d’une variable avec elle-même s’avérerait redondante et stérile si elle était matérialisée par une droite de régression triviale de pente unitaire. C’est pourquoi cet espace privilégié est systématiquement alloué à la représentation de la distribution univariée de la variable considérée. Selon les préférences de l’analyste, cette projection marginale s’exprime par le truchement d’un histogramme discrétisé à pas variable ou d’une courbe continue estimée par noyau (Kernel Density Estimation ou KDE). À l’inverse, l’ensemble des cases hors diagonale (où i ≠ j) accueille des nuages de points bivariés traditionnels, chaque observation expérimentale étant projetée dans le plan sous la forme d’un marqueur ponctuel dont les abscisses et les ordonnées correspondent respectivement aux valeurs prises par les deux variables mises en regard.
Cette disposition simultanée procure un gain analytique inestimable face à la dispersion multidimensionnelle. L’observateur n’a plus à scruter isolément des dizaines de graphiques disjoints sans cadre référentiel commun. Le pairs plot tire ses racines mathématiques des travaux fondamentaux de la statistique graphique et de la sémiologie visuelle développée par John Tukey dans les années 1970, lors de l’avènement de l’analyse exploratoire de données. L’intérêt majeur de cette disposition matricielle réside dans sa capacité à exposer immédiatement à l’œil humain la présence de corrélations linéaires, de dépendances non linéaires d’ordre quadratique ou exponentiel, de bifurcations chaotiques ou d’hétéroscédasticité locale, des phénomènes qu’une simple matrice de covariances numériques serait incapable de résumer sans perte d’information préjudiciable.
1.2 Importance exploratoire dans l’analyse de données quantitatives et comportementales
Dans les sciences empiriques, qu’il s’agisse des neurosciences cognitives, de la psychométrie comportementale, de la génomique fonctionnelle ou de la macroéconomie quantitative, l’étape initiale du diagnostic des données brutes conditionne l’ensemble des inférences ultérieures. L’un des mérites cardinaux du pairs plot réside dans son aptitude à détecter instantanément des aberrations d’échantillonnage et des configurations marginales atypiques. Une valeur aberrante (outlier) peut fort bien paraître anodine lorsqu’elle est projetée sur un axe univarié isolé, demeurant dissimulée au sein de l’étendue interquartile globale, tout en constituant une anomalie flagrante et structurante dès lors qu’elle est confrontée à une seconde variable continue avec laquelle elle rompt la dynamique de covariance attendue.
Parallèlement, la matrice de nuages de points s’avère un instrument de premier ordre pour l’évaluation diagnostique de la colinéarité multivariée préalable à l’estimation d’équations de régression linéaire multiple ou à la mise en œuvre d’analyses en composantes principales (ACP). Lorsque deux ou plusieurs covariables explicatives manifestent un alignement quasi parfait le long d’une trajectoire affine étroite, le chercheur est averti du risque imminent de multicolinéarité sévère, susceptible de déstabiliser l’inversion de la matrice d’information de Fisher, de gonfler artificiellement les erreurs-types des coefficients estimés et de dégrader la validité interne du modèle prédictif.
Enfin, sur le plan de la communication scientifique, le pairs plot offre un support pédagogique exceptionnel. Lors de la restitution de protocoles expérimentaux d’envergure devant des auditoires multidisciplinaires ou des comités d’orientation non mathématiciens, cette visualisation globale permet de contextualiser immédiatement la structure factorielle sous-jacente des cohortes étudiées. En exposant la variabilité conjointe sans le truchement d’abstractions algorithmiques opaques, elle instaure un rapport de confiance transparent entre les données empiriques recueillies sur le terrain et les modélisations inférentielles sophistiquées qui en découlent.
1.3 Comparaison méthodologique avec la matrice de corrélation et la heatmap
Il est fréquent de constater, dans la pratique empirique profane, une confusion méthodologique entre l’emploi d’une matrice de corrélation condensée sous la forme d’une carte thermique (heatmap) et le déploiement d’un véritable pairs plot. Bien que ces deux approches partagent une topologie matricielle bidimensionnelle analogue, leurs fondements épistémologiques et leurs apports informationnels divergent substantiellement. La matrice de corrélation synthétise la relation entre deux séries quantitatives par le biais d’un scalaire unique, le plus souvent le coefficient r de Pearson, ou les indices de rang de Spearman et de Kendall. Cette réduction paramétrique extrême postule implicitement la linéarité stricte du lien et l’absence de perturbations structurelles complexes au sein de la distribution conjointe.
La justification la plus éloquente de la supériorité exploratoire du pairs plot sur la simple lecture d’un coefficient synthétique demeure l’illustration historique canonique apportée par le célèbre quartette d’Anscombe, formulé en 1973 par le statisticien Francis Anscombe. Ce jeu de données théorique met en lumière quatre ensembles distincts de points bidimensionnels partageant rigoureusement les mêmes propriétés statistiques élémentaires : moyennes marginales identiques, variances marginales strictement équivalentes, droite de régression des moindres carrés rigoureusement superposable et coefficient de corrélation de Pearson invariable fixé à 0,816. Pourtant, la restitution graphique de ces quatre jeux démontre des réalités morphologiques antinomiques : le premier présente une relation linéaire classique bruitée par une erreur gaussienne, le deuxième dévoile une trajectoire parfaitement parabolique sans bruit aléatoire, le troisième illustre une linéarité parfaite perturbée par un unique point aberrant excentré, tandis que le quatrième exhibe une concentration verticale de points totalement indépendante modulée par un levier extrême. Une lecture aveugle basée sur une heatmap de corrélation conclurait à une équivalence absolue de ces quatre architectures de données, induisant le modélisateur en erreur tragique.
Dès lors, la démarche méthodologique optimale ne consiste pas à opposer ces deux outils, mais bien à les articuler selon une complémentarité séquentielle rigoureuse. L’exécution préalable d’une carte thermique issue de sns.heatmap(df.corr()) permet d’obtenir un balayage macroscopique instantané des macro-tendances et d’identifier rapidement les blocs de variables potentiellement associés. Immédiatement après cette phase de tri, le recours systématique au pairs plot via sns.pairplot(df) offre l’indispensable audit granulaire permettant de vérifier la réalité distributionnelle des corrélations suspectées, de traquer les non-linéarités sous-jacentes et de garantir l’intégrité de la chaîne inférentielle.
2. Environnement technique et prérequis logiciels en Python
2.1 Configuration des bibliothèques fondamentales pour la data science
L’élaboration d’une matrice de nuages de points hautement optimisée requiert la mobilisation coordonnée de l’ensemble de la pile scientifique standard de l’écosystème Python. Au cœur de cette architecture trône la bibliothèque Seaborn, développée originellement par Michael Waskom, qui constitue une surcouche déclarative de très haut niveau adossée aux mécanismes graphiques fondamentaux de Matplotlib. Pour assurer la manipulation vectorielle des matrices sous-jacentes et l’indexation tabulaire des données d’observation, les modules NumPy et Pandas sont rigoureusement indispensables. Il est vivement conseillé de maintenir ces composants dans des versions contemporaines et mutuellement compatibles, idéalement au sein d’un environnement virtuel isolé géré par des gestionnaires de paquets modernes tels que Conda, Pipenv ou Poetry.
Dans le cadre d’un script standardisé destiné à la production ou au sein d’un calepin électronique interactif de type Jupyter Lab, le protocole d’importation canonique répond à des conventions universellement adoptées par la communauté internationale de l’informatique décisionnelle. L’environnement doit être initialisé par l’importation de Pandas sous le pseudonyme canonique pd, de NumPy sous l’alias np, de Matplotlib Pyplot sous l’étiquette plt et de Seaborn sous la désignation sns. Cette rigueur stylistique garantit la parfaite portabilité et l’immédiate lisibilité du code par des pairs réviseurs.
Un aspect souvent négligé mais déterminant concerne la configuration du backend graphique de Matplotlib, qui orchestre la rastérisation ou la vectorisation des primitives géométriques générées. Pour un rendu interactif au sein des calepins électroniques, l’instruction magique %matplotlib inline ou l’intégration d’un moteur de rendu dynamique comme ipympl doit être déclarée dès l’en-tête du fichier. Lorsque l’objectif final s’oriente vers la préparation de manuscrits académiques devant être soumis à des revues à comité de lecture, il est impératif d’orienter le moteur de rendu vers des formats vectoriels haute fidélité tels que le PDF ou le PostScript encapsulé (EPS), préservant ainsi la netteté chirurgicale des polices typographiques et des contours de marqueurs, indépendamment du niveau de grandissement appliqué.
2.2 Structuration et validation préalable des DataFrames Pandas
L’invocation d’un générateur de pairs plot ne saurait être entreprise avec succès sans un travail préalable rigoureux de nettoyage, d’assainissement et de typage structurel au niveau de l’objet pandas.DataFrame sous-jacent. Le moteur algorithmique de Seaborn scrute la structure interne des séries de données pour déterminer la nature des tracés à déployer. Dès lors, il est indispensable de soumettre le tableau à un contrôle de cohérence typologique strict. Les colonnes destinées à figurer sur les axes continus doivent impérativement être transtypées sous des formats scalaires conformes, à savoir float64 ou int64, tandis que les attributs appelés à stratifier l’affichage graphique doivent être formellement catalogués sous le format category ou object.
La problématique des valeurs manquantes, désignées conventionnellement par le symbole NaN (Not a Number), constitue un écueil méthodologique omniprésent dans la gestion des données réelles issues d’enquêtes ou d’expérimentations de laboratoire. Par défaut, la présence de valeurs nulles peut altérer gravement le calcul des estimations de densité univariées par noyau (KDE) et provoquer des discontinuités erratiques dans l’agencement des sous-graphiques, voire déclencher des interruptions d’exécution non interceptées au sein des couches d’interpolation de bas niveau. Deux alternatives stratégiques se présentent à l’expérimentateur : l’élimination par liste (listwise deletion) au moyen de la méthode dropna(), qui restreint l’analyse aux seules observations complètes au risque de biaiser l’échantillon si les données ne sont pas manquantes de façon purement aléatoire (MCAR), ou l’imputation statistique multivariée préalable faisant appel à des estimateurs par chaîne d’équations (MICE) ou par plus proches voisins (KNN).
Enfin, une attention minutieuse doit être portée à la dénomination sémantique des étiquettes d’en-têtes de colonnes du DataFrame. Seaborn extrait automatiquement ces libellés textuels pour annoter les échelles des axes horizontaux et verticaux de chaque facette de la grille. L’usage de dénominations brutes cryptiques héritées de bases de données relationnelles, truffées de caractères spéciaux non standardisés, de barres obliques ou de traits d’union non espacés, nuit lourdement à la lisibilité finale. Il convient donc de renommer systématiquement les séries au moyen de libellés clairs, explicites et harmonisés, incorporant idéalement les unités de mesure physiques standardisées (par exemple en utilisant la notation décimale internationale et les unités du Système International entre crochets) avant d’engager le processus de restitution graphique.
2.3 Optimisation des paramètres d’exécution et de mémoire
L’instanciation d’un pairs plot constitue une opération graphiquement et algorithmiquement dispendieuse. Il convient de garder à l’esprit que la création d’une grille matricielle pour un ensemble de p variables requiert l’initialisation simultanée de p² objets d’axes indépendants au sein de l’architecture Matplotlib. Si ce jeu de données renferme un effectif volumineux de n observations, le moteur de rendu se voit contraint d’allouer en mémoire vive les structures de données nécessaires au tracé de dizaines de milliers d’objets géométriques primitifs distincts, ce qui peut rapidement saturer la mémoire cache et provoquer un effondrement dramatique des performances d’exécution.
Pour prévenir ces ralentissements invalidants lors des sessions de travail exploratoires intensives, plusieurs optimisations de bas niveau peuvent être configurées. Au sein de Matplotlib, la réduction drastique de la résolution temporaire d’affichage par le réglage de la variable de configuration figure.dpi à une valeur intermédiaire (par exemple 72 ou 100 points par pouce lors de la phase de conception interactive) soulage considérablement l’occupation de la mémoire vive graphique, réservant le seuil réglementaire de 300 ou 600 DPI à la seule phase d’exportation définitive des planches éditoriales.
De surcroît, le déclenchement intempestif de messages d’avertissement émis par les bibliothèques sous-jacentes — concernant par exemple la convergence numérique des estimateurs de bande passante dans les contours de densité ou l’obsolescence programmée de certaines méthodes internes de Pandas — peut polluer inutilement la console d’exécution et ralentir l’environnement interactif. La manipulation réfléchie du module standard warnings de Python, à travers l’appel ciblé de la fonction warnings.filterwarnings('ignore') restreinte aux avertissements non critiques de type UserWarning ou FutureWarning, permet de conserver un journal d’exécution irréprochable et lisible tout au long du cycle de développement statistique.
3. Implémentation standard avec Seaborn : La fonction sns.pairplot()
3.1 Syntaxe fondamentale et instanciation immédiate
La concrétisation pratique d’une matrice de nuages de points au sein de l’écosystème Python atteint un degré d’accessibilité remarquable grâce à la fonction wrapper de haut niveau seaborn.pairplot(). Cette routine unifiée encapsule l’ensemble des mécanismes de génération de sous-graphiques, de calcul des estimateurs statistiques marginaux et d’assignation cartésienne des coordonnées dans une interface syntaxique minimaliste. Pour illustrer la démarche canonique, la communauté scientifique recourt quasi universellement au jeu de données biologique historique de l’Iris setosa, collecté par Edgar Anderson et popularisé par Ronald Aylmer Fisher en 1936 pour formaliser les concepts d’analyse discriminante linéaire.
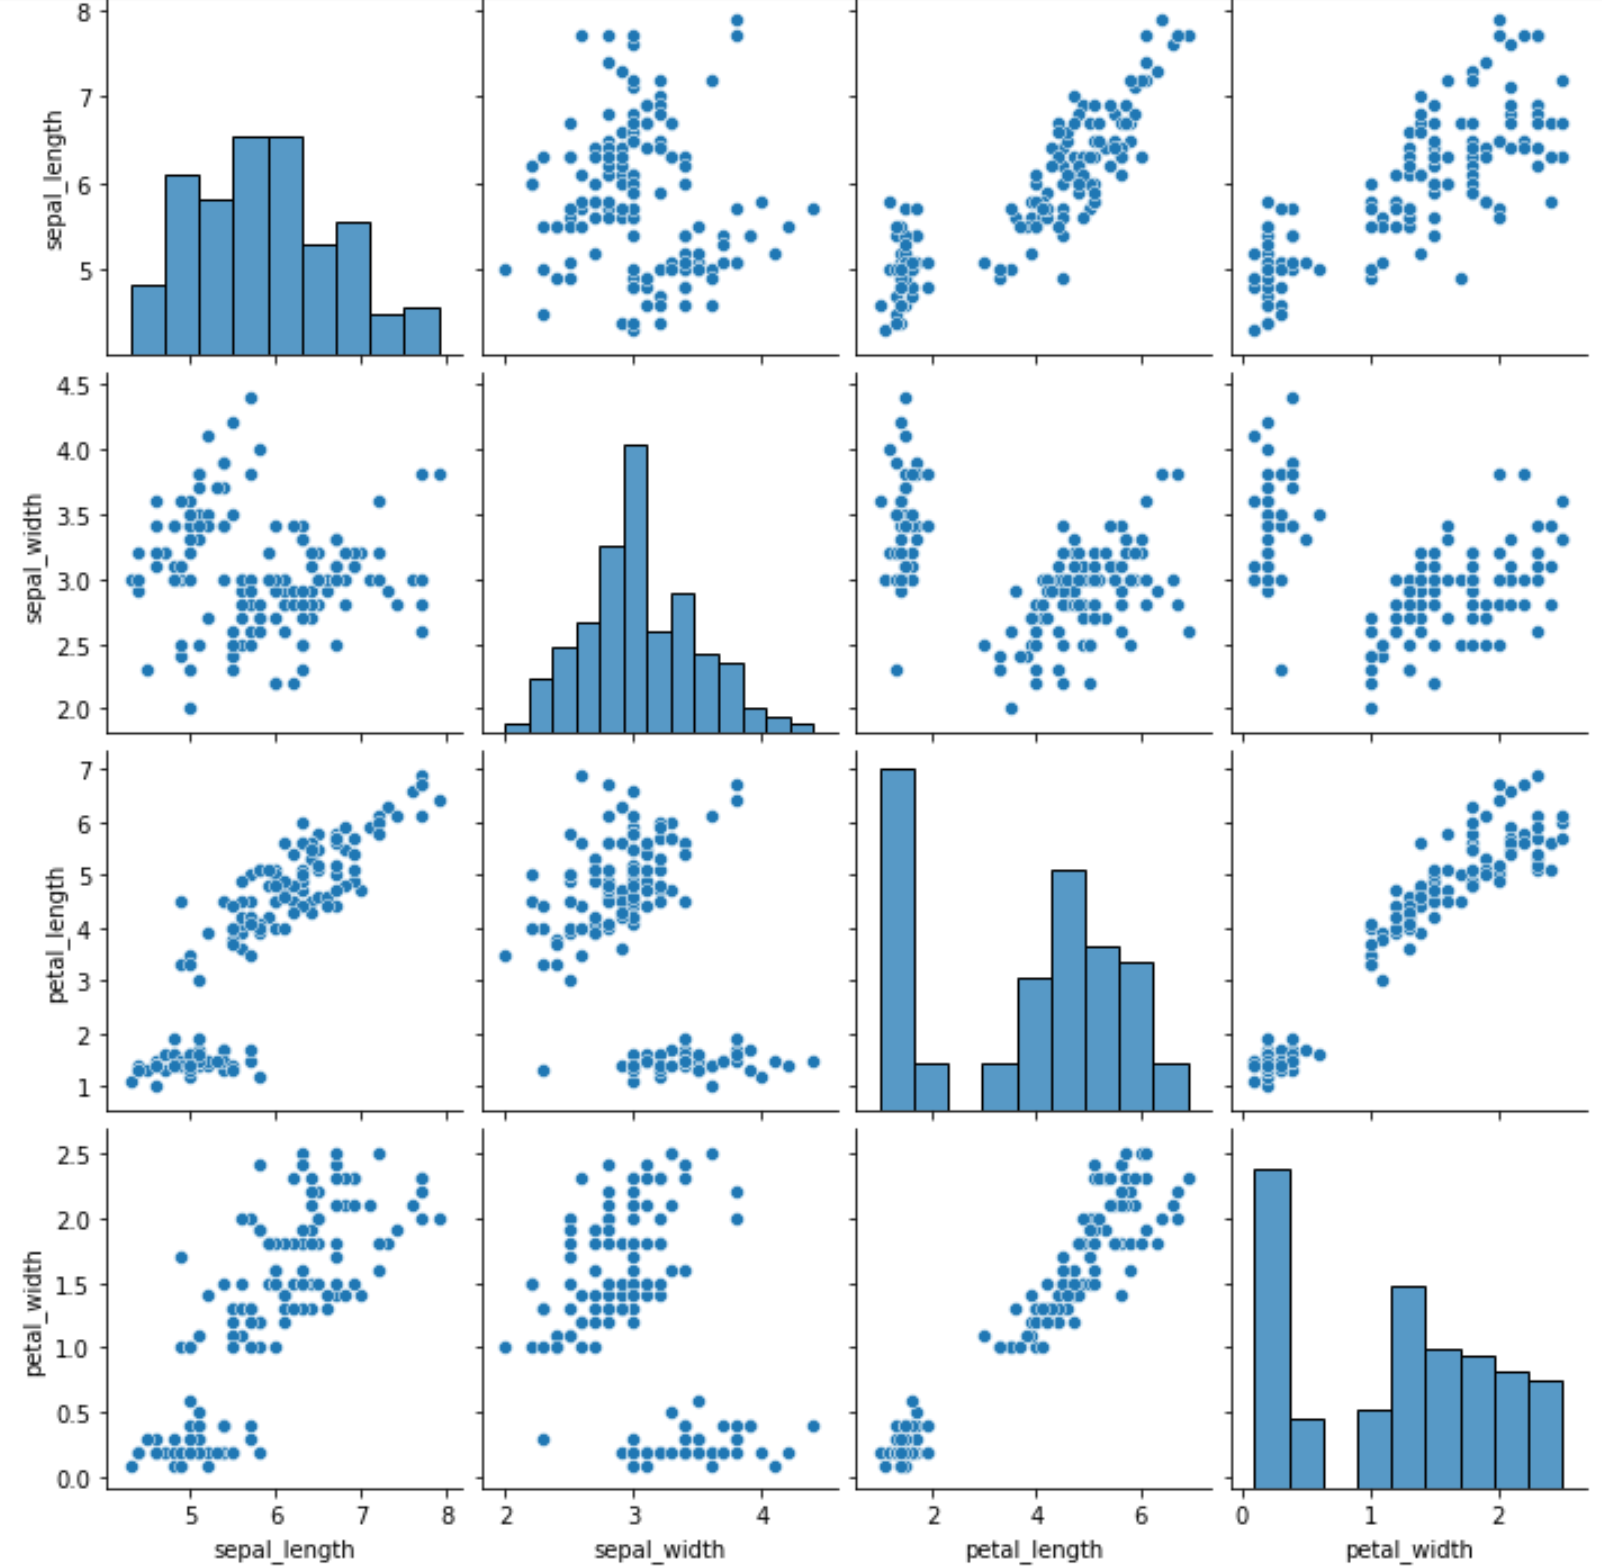
Le chargement de cette matrice canonique peut s’effectuer sans friction grâce aux utilitaires intégrés de Seaborn par l’appel de df = sns.load_dataset('iris'). Ce tableau modèle regroupe 150 spécimens de fleurs pour lesquels quatre mesures morphologiques continues sont répertoriées en centimètres : la longueur du sépale, la largeur du sépale, la longueur du pétale et la largeur du pétale, complétées par une variable catégorielle nominale désignant l’appartenance taxinomique à l’une des trois espèces répertoriées (setosa, versicolor et virginica). Dès cet instant, l’exécution élémentaire de l’instruction sns.pairplot(df) suffit à ordonnancer la construction intégrale de la matrice bivariée.
Par cette unique invocation, Seaborn inspecte le DataFrame, filtre automatiquement les colonnes scalaires répondant aux critères numériques requis, instancie une figure matricielle de 4 lignes par 4 colonnes (soit un total de 16 facettes cartésiennes distinctes), calcule les bornes extrêmes pour harmoniser les étendues scalaires et drape les résultats au sein de l’environnement graphique par défaut. Cette restitution immédiate illustre la puissance du paradigme déclaratif : l’utilisateur spécifie ce qu’il désire visualiser sur le plan conceptuel, laissant au moteur logiciel le soin d’arbitrer les contingences géométriques et algorithmiques d’implémentation sous-jacentes.
3.2 Décomposition anatomique de la sortie graphique
Une analyse scrupuleuse de la figure matricielle engendrée par la configuration par défaut révèle une organisation géométrique d’une rigueur absolue. L’élément central structurant réside dans la diagonale principale qui traverse la grille du sommet supérieur gauche vers le coin inférieur droit. Sur cet axe où chaque variable est confrontée à elle-même, Seaborn remplace le nuage de points par un histogramme de fréquences univarié discrétisé. Cet aménagement permet d’apprécier la forme générale de la loi de distribution empirique régissant chaque descripteur morphologique, révélant d’emblée la présence d’asymétries manifestes ou d’allures multimodales.
De part et d’autre de cette diagonale se déploient les sous-graphiques bivariés, agencés selon une stricte symétrie par réflexion matricielle. Plus précisément, la cellule située à l’intersection de la ligne i et de la colonne j projette le même couple de variables que la cellule positionnée sur la ligne j et la colonne i, à la seule différence fondamentale que les axes d’abscisse et d’ordonnée se trouvent rigoureusement permutés. Cette duplication symétrique, loin de constituer un simple gaspillage d’espace, répond à des impératifs physiologiques de perception visuelle : certains observateurs détectent plus spontanément une corrélation fonctionnelle ascendante lorsque la variable causale ou indépendante suspectée est systématiquement positionnée sur l’axe horizontal, ce que permet l’exploration alternée des deux triangles matriciels.
La lecture des échelles cartésiennes obéit à un ordonnancement partagé conçu pour maximiser l’épure visuelle. Afin d’éviter la prolifération redondante de chiffres d’échelles numériques sur l’intégralité des facettes intérieures, Seaborn procède à un partage automatisé des axes (shared axes). Ainsi, les sous-graphiques appartenant à une même colonne partagent une graduation identique sur leur axe horizontal inférieur, tandis que l’ensemble des panneaux composant une même rangée horizontale s’aligne sur l’échelle commune matérialisée sur la bordure extérieure gauche. Ce verrouillage géométrique garantit que l’œil humain peut effectuer des comparaisons visuelles d’alignement d’un panneau à l’autre sans subir de distorsion de perspective due à des échelles locales discordantes.
3.3 Interprétation empirique des premières observations graphiques
L’observation attentive de la matrice par défaut appliquée aux données d’Anderson permet d’illustrer immédiatement la fécondité empirique de l’approche exploratoire. En examinant les nuages de points confrontant la longueur du pétale à sa largeur, l’œil discerne instantanément une relation quasi linéaire d’une régularité remarquable. L’orientation générale de la dispersion ponctuelle, dirigée fermement du quadrant inférieur gauche vers le quadrant supérieur droit, témoigne d’un coefficient de corrélation de Pearson positif extrêmement vigoureux. Plus une fleur présente des pétales longs, plus ces derniers manifestent une largeur prononcée, soulignant une allométrie morphologique manifeste au sein de la famille végétale.
Néanmoins, la découverte la plus marquante réside dans la discontinuité flagrante qui traverse l’espace bivarié. Loin de dessiner une ellipse gaussienne continue et homogène, la distribution conjointe se scinde en deux agglomérats spatiaux nettement disjoints, séparés par un intervalle de vacuité totale. Un groupe compact et resserré se cantonne aux très faibles valeurs de dimension pétalaire, tandis qu’un second regroupement, plus dispersé et étendu, colonise les valeurs élevées. Cette partition spatiale spontanée alerte sans ambiguïté l’analyste sur l’hétérogénéité de sa population statistique et suggère impérieusement l’existence de sous-populations taxinomiques distinctes que la configuration globale par défaut échoue à discriminer explicitement sur le plan chromatique.
Parallèlement, la configuration non stratifiée montre rapidement ses limites lorsqu’on observe les variables sépalaires. La distribution univariée de la largeur des sépales sur la diagonale arbore une allure en cloche d’apparence symétrique et unimodale, mimant une loi normale canonique. En revanche, l’histogramme de la longueur des pétales exhibe une silhouette profondément bimodale, dotée de deux sommets d’intensité inégale trahissant un mélange sous-jacent de densités. Cette discordance structurelle démontre que le tracé global agrégé aplatit des réalités différentielles complexes, imposant le recours à des fonctionnalités de ciblage et de stratification catégorielle plus avancées.
4. Sélection ciblée et filtrage des variables d’intérêt
4.1 Restriction de la matrice via l’argument vars
Dans le cadre d’études empiriques réelles portant sur des cohortes industrielles, épidémiologiques ou sociologiques, les tableaux de données recensent fréquemment plusieurs dizaines, voire plusieurs centaines de métriques continues simultanées. L’application indiscriminée de la fonction de tracé matriciel à un DataFrame comportant ne serait-ce que 30 variables aboutirait à une grille monstrueuse de 900 sous-graphiques, totalement illisible à l’échelle d’une page de publication ou d’un écran d’ordinateur standard, sans compter l’épuisement prématuré des ressources de calcul du processeur. Il devient par conséquent crucial de savoir circonscrire la projection graphique à un sous-ensemble théoriquement motivé de descripteurs.
L’argument vars répond avec exactitude à cette nécessité méthodologique d’élagage cognitif. En transmettant à ce paramètre une liste sélective de chaînes de caractères correspondant aux libellés exacts des colonnes retenues au sein du DataFrame, l’analyste contraint le moteur logiciel à ne bâtir la matrice qu’autour de ces seuls axes prioritaires. Si, au sein d’une investigation psychométrique ou biomédicale, seules deux ou trois dimensions fonctionnelles retiennent l’attention de l’équipe de recherche, leur isolement via vars=['longeur_petale', 'largeur_petale'] engendre un panneau concentré de dimension 2 × 2, préservant la netteté des détails morphologiques et réduisant drastiquement l’encombrement graphique superflu.
Cette démarche de sélection ciblée favorise une approche hypothético-déductive vertueuse. Au lieu de noyer l’auditoire sous une surabondance d’informations visuelles périphériques souvent non corrélées ou redondantes, l’analyste recentre le discours scientifique sur les interactions fondamentales qui motivent l’interrogation expérimentale. La charge mentale imposée au lecteur s’en trouve allégée, facilitant la détection immédiate des patrons de covariance critiques pour la validation ou l’infirmation des hypothèses de travail.
4.2 Génération de matrices asymétriques avec x_vars et y_vars
Bien que la matrice carrée classique constitue la norme conventionnelle en phase d’exploration globale symétrique, la modélisation statistique avancée impose très fréquemment une distinction épistémologique nette entre deux typologies de données : les variables indépendantes (également désignées comme variables explicatives, prédicteurs ou régresseurs) et les variables dépendantes (qualifiées de variables à expliquer, réponses ou critères de prédiction). Dans ce scénario asymétrique prédictif, confronter visuellement les prédicteurs entre eux ou confronter mutuellement les critères de réponse peut s’avérer hors sujet ou détourner l’attention de l’objectif central de l’étude.
Seaborn résout cette exigence analytique avec une élégance structurelle remarquable en proposant le découplage des axes via l’action conjuguée des deux paramètres indépendants x_vars et y_vars. En alimentant x_vars avec une liste de prédicteurs environnementaux ou expérimentaux et y_vars avec une liste d’indicateurs physiologiques de réponse, la routine abandonne la structure carrée pour forger une grille rectangulaire asymétrique sur mesure de dimension m × k sous-graphiques. Dans cette configuration spécialisée, la diagonale principale univariée disparaît naturellement, cédant l’intégralité du champ cartésien à des représentations bivariées fonctionnelles où chaque variable explicative en abscisse projette son impact directionnel direct sur la variable de réponse assignée en ordonnée.
Cette approche rectangulaire se révèle particulièrement efficiente lors de la préparation de protocoles d’analyse de régression linéaire multiple ou d’estimation par équations structurelles. Elle permet d’examiner d’un seul coup d’œil transversal la pente, la linéarité locale, la présence potentielle d’effets de seuil saturants ou l’instabilité de la dispersion résiduelle reliant une panoplie de facteurs d’influence potentiels à la cible biologique ou économique mesurée, optimisant ainsi l’allocation d’espace au sein des rapports de recherche académique.
4.3 Pratiques d’exclusion des colonnes identifiantes ou non pertinentes
L’une des inadvertances les plus récurrentes lors de l’exécution initiale de visualisations bivariées réside dans la présence subreptice, au sein du DataFrame source, de colonnes numériques dépourvues de toute signification statistique continue réelle. Il s’agit typiquement des clés primaires de bases de données, des numéros d’identification arbitraires de patients ou de participants d’enquêtes (tels que des colonnes intitulées patient_id ou subject_index), ou encore de codes temporels séquentiels incrémentaux.
Si ces variables parasitaires ne sont pas délibérément neutralisées en amont de l’appel graphique, le moteur automatisé les interprète comme des grandeurs scalaires continues légitimes, bâtissant des sous-graphiques absurdes où les mesures morphologiques sont confrontées à une progression arithmétique d’identifiants sans valeur explicative. Cette intrusion induit un gaspillage d’espace graphique préjudiciable et altère la lisibilité de la composition générale.
Pour immuniser les flux de traitement contre ces artefacts indésirables, deux méthodologies programmatiques complémentaires doivent être préconisées dans le cadre de bonnes pratiques logicielles. La première consiste en une exclusion explicite par suppression préventive ou par filtrage sélectif au moyen de la méthode Pandas df.drop(columns=['id', 'index']). La seconde stratégie, plus dynamique et hautement robuste dans les pipelines de reporting automatisé, s’appuie sur l’introspection programmatique via df.select_dtypes(include=[np.number]), couplée à une règle de filtrage par motifs textuels (regex) permettant d’écarter automatiquement toute colonne dont le nom contiendrait des suffixes réservés tels que _id, _num ou _key.
5. Intégration de dimensions catégorielles via l’argument hue
5.1 Principe de stratification par groupes démographiques ou cliniques
L’analyse bivariée purement quantitative révèle son plein potentiel heuristique dès lors qu’elle est mise en perspective avec la structure sous-jacente des populations observées. Dans les sciences de la vie et le domaine biomédical, les participants à un protocole clinique ou les spécimens biologiques ne forment que très rarement un ensemble homogène indifférencié. Ils se subdivisent structurellement selon des facteurs nominaux ou ordinaux fondamentaux : groupes recevant une molécule thérapeutique versus groupe témoin sous placebo, stades d’évolution nosologique d’une pathologie, ou encore typologies génétiques différenciées.
L’introduction du paramètre hue (qui se traduit littéralement par « teinte chromatique ») constitue l’un des apports fonctionnels les plus décisifs de Seaborn. En assignant à cette variable la dénomination d’une colonne catégorielle du DataFrame, l’analyste déclenche une métamorphose complète de la matrice cartésienne. Sur l’ensemble des panneaux bivariés hors diagonale, les marqueurs ponctuels abandonnent leur teinte monochrome unifiée pour arborer des couleurs distinctives rigoureusement calibrées en fonction de la modalité d’appartenance de chaque observation individuelle.
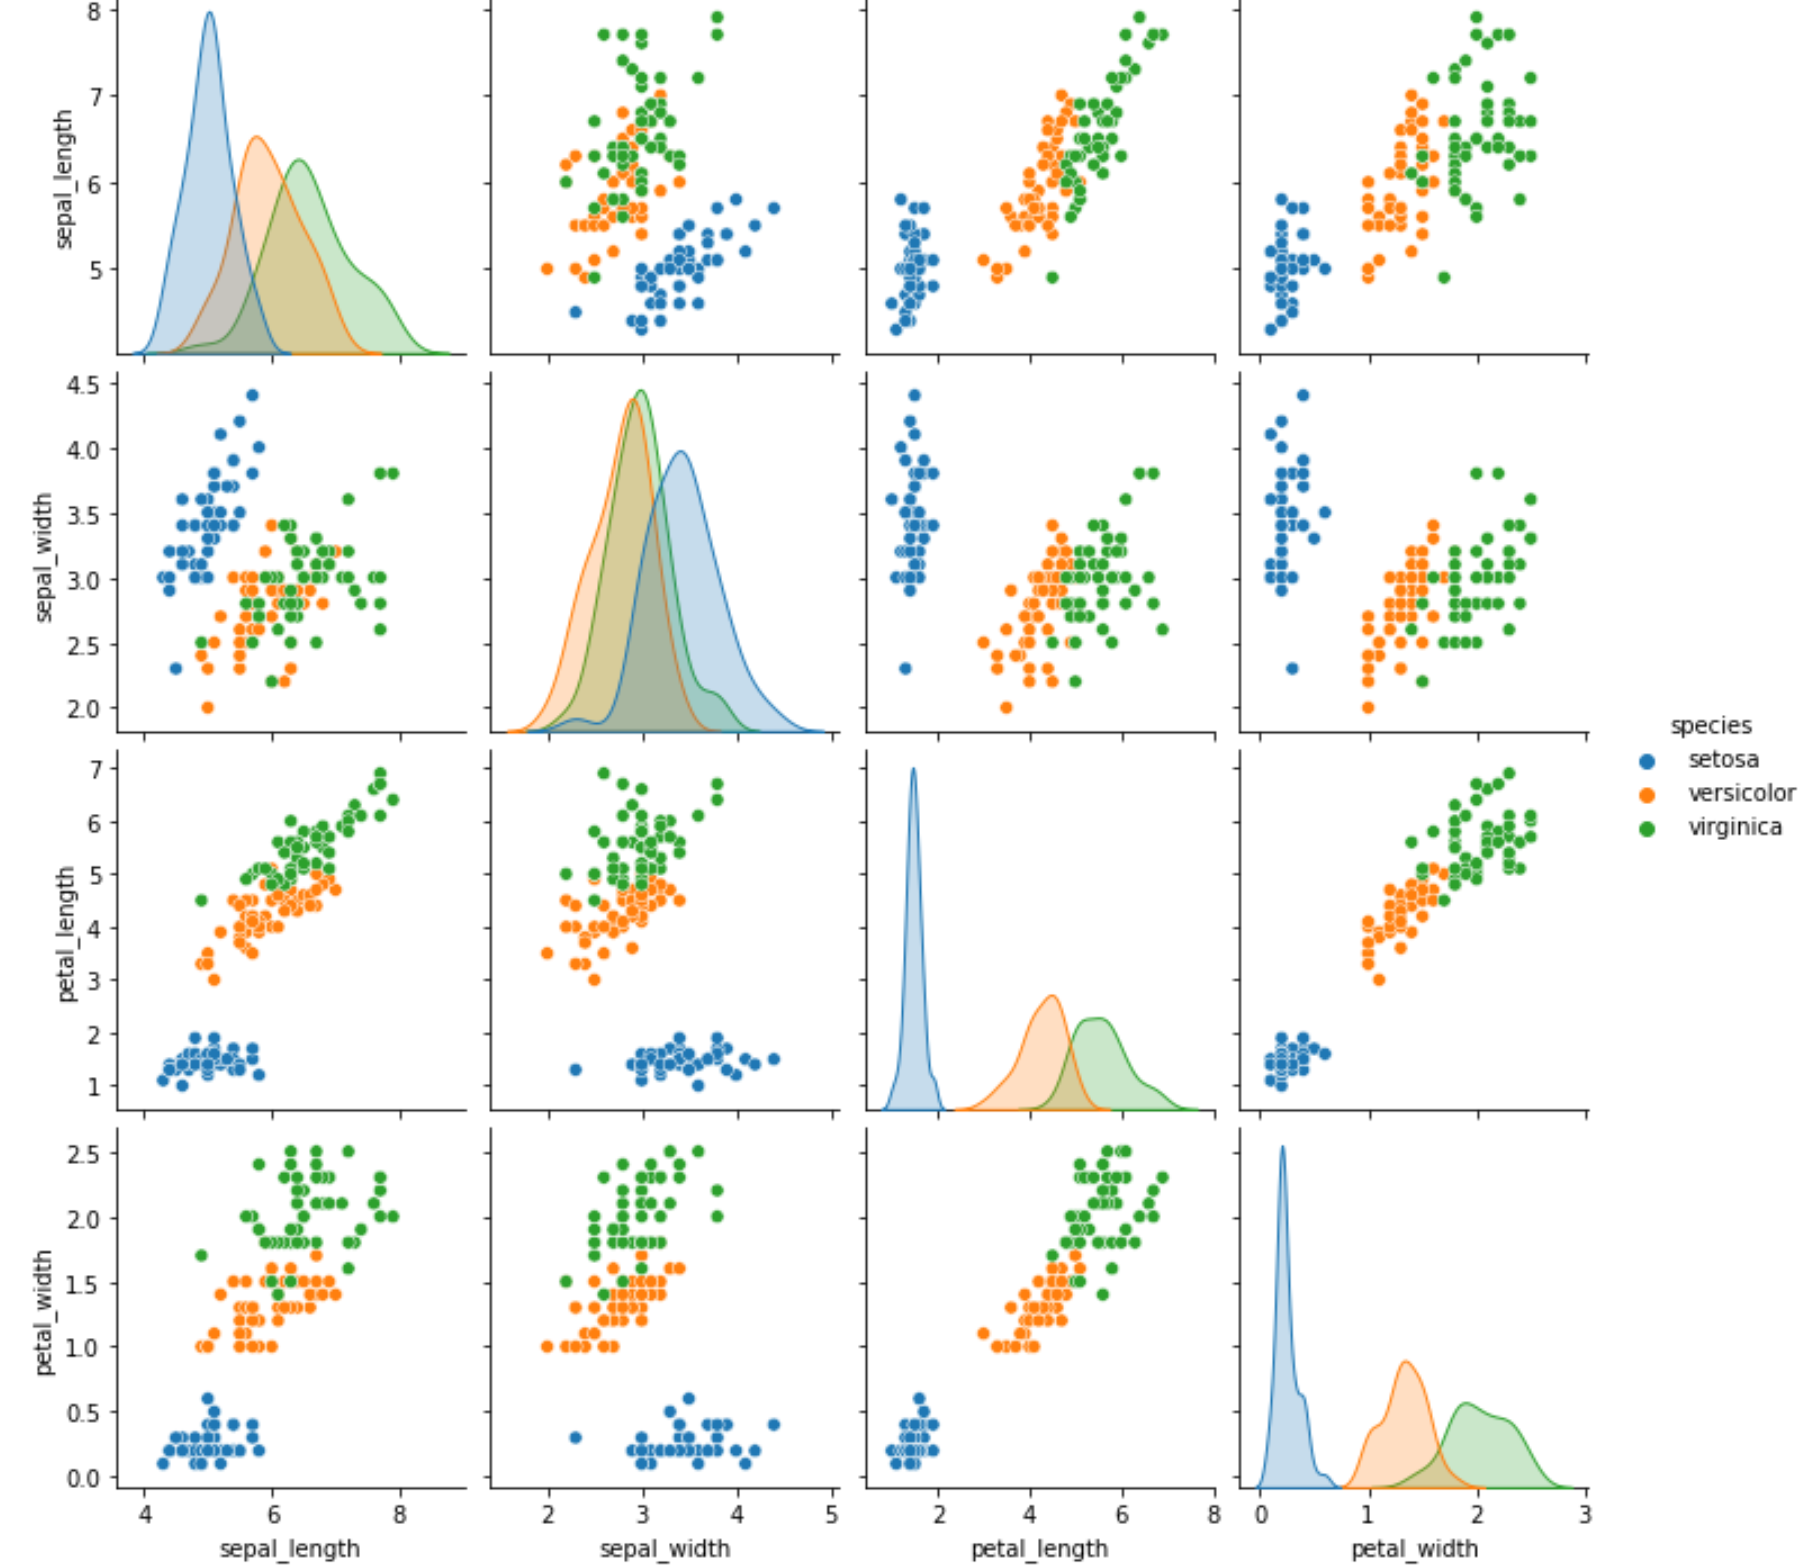
Simultanément, cette modification s’accompagne d’un bouleversement conceptuel majeur sur la diagonale principale. L’histogramme univarié global cède automatiquement la place à des estimations de densité par noyau lissées (KDE), tracées de manière dissociée pour chaque sous-groupe catégoriel et superposées au sein d’une même facette. Dès cet instant, la lecture de la diagonale cesse d’être une simple vérification de normalité globale pour devenir une comparaison multidimensionnelle directe de la séparation des densités de probabilité conditionnelles entre les différentes strates de la population.
5.2 Personnalisation des palettes chromatiques et de l’ordre d’affichage
L’utilisation de la couleur en visualisation scientifique ne saurait être gouvernée par des considérations purement arbitraires ou décoratives. Elle engage la précision de la transmission du message statistique et doit impérativement respecter les règles strictes de l’ergonomie visuelle et de l’accessibilité universelle. Par défaut, Seaborn mobilise une palette contemporaine attrayante, mais qui peut s’avérer inadaptée aux contraintes sévères de la reprographie papier ou à la lecture par des individus présentant des déficiences de la vision des couleurs (dyschromatopsies telles que le daltonisme deutéranope ou protanope).
Pour répondre à ces exigences éditoriales d’excellence, l’argument palette permet de substituer instantanément au jeu de teintes standard des échelles chromatiques scientifiquement éprouvées. Les palettes issues des travaux de Cynthia Brewer (famille ColorBrewer) ou les gradients perceptuellement uniformes développés par la communauté scientifique — tels que viridis, cividis ou plasma — constituent des choix de premier plan hautement recommandés. La palette colorblind intégrée nativement à Seaborn garantit quant à elle une séparabilité optimale des teintes, même sous des conditions d’impression en niveaux de gris dégradés.
En étroite corrélation avec l’harmonisation chromatique, le paramètre hue_order offre la possibilité de contrôler scrupuleusement la hiérarchie séquentielle selon laquelle les catégories sont introduites dans la légende et projetées sur le canevas cartésien. Cette maîtrise de l’ordonnancement évite que des catégories minoritaires ou secondaires ne viennent visuellement écraser ou masquer en avant-plan les strates de référence fondamentales d’un essai randomisé (notamment la catégorie témoin ou contrôle, que l’on positionnera avantageusement en première position structurelle).
5.3 Évaluation de la séparabilité des classes
Sur le plan de l’apprentissage automatique et de la reconnaissance de formes statistiques, l’inspection visuelle d’un pairs plot stratifié par hue opère comme un test de diagnostic empirique préalable exceptionnellement puissant pour juger de la séparabilité intrinsèque des classes. Lorsque l’expérimentateur contemple la dispersion chromatique au fil des différents cadrans, il peut immédiatement évaluer le degré de recouvrement spatial (overlap) séparant les nuages de points associés aux différentes modalités catégorielles.
Si, au sein d’un plan bivarié déterminé, les différentes couleurs forment des grappes hyper-denses, géométriquement compactes et séparées par des zones de clivage franches sans la moindre collision de marqueurs, l’analyste détient la preuve formelle que ces deux variables spécifiques renferment un pouvoir discriminant maximal. Une telle configuration garantit par anticipation qu’un algorithme de classification linéaire, tel qu’une analyse discriminante linéaire de Fisher ou une machine à vecteurs de support (SVM) à noyau linéaire, obtiendra des scores de précision et un rappel proches de la perfection sans risque d’erreur d’affectation.
Inversement, si les points multicolores s’entremêlent de façon confuse et inextricable au sein de toutes les projections factorielles disponibles, cette imbrication visuelle avertit le modélisateur que les variables continues mesurées ne contiennent pas l’information discriminante requise pour ségréguer les groupes cibles. Cette observation précoce réoriente immédiatement la stratégie de modélisation vers l’extraction de nouvelles caractéristiques dimensionnelles non linéaires ou l’acquisition de covariables physiologiques complémentaires, épargnant ainsi des heures de calcul algorithmique stérile autour de modèles prédictifs structurellement condamnés à l’échec.
6. Personnalisation des représentations diagonales (distributions univariées)
6.1 Configuration de l’argument diag_kind : histogrammes vs densités
L’arbitrage méthodologique régissant la nature géométrique des tracés affectés à la diagonale principale constitue une étape charnière dans la construction d’une matrice exploratoire. La fonction unifiée de Seaborn permet de trancher formellement cette orientation par l’intermédiaire de l’argument clé diag_kind, qui accepte traditionnellement les valeurs scalaires 'hist' pour l’érection d’histogrammes discrétisés à barres verticales, ou 'kde' pour le déploiement d’estimations continues de densité par lissage de noyau.
L’option diag_kind='hist' s’impose avec une pertinence incontestable dès lors que l’objectif principal consiste à auditer avec une fidélité absolue les effectifs réels d’échantillonnage et à surveiller d’éventuelles discontinuités de mesure locales. L’histogramme préserve fidèlement la matérialité empirique des données brutes en consignant chaque observation dans des intervalles disjoints (les bins). Cette approche s’avère particulièrement irremplaçable pour détecter des anomalies d’arrondi numérique, des trous de quantification dans les appareils d’acquisition expérimentaux ou des concentrations suspectes de valeurs entières répétées.
À l’opposé, le recours à diag_kind='kde' déploie une approche probabiliste élégante et infinitésimale. En remplaçant chaque valeur discrète observée par une distribution gaussienne élémentaire pondérée et en sommant l’ensemble de ces contributions le long de l’axe réel continu, l’estimateur KDE produit un profil régularisé exempt des aspérités arbitraires inhérentes au découpage des histogrammes. Ce mode d’affichage s’avère infiniment supérieur lorsque l’on souhaite superposer avec clarté plusieurs sous-groupes catégoriels issus de l’argument hue : les courbes de densité lissées peuvent s’entremêler visuellement sans créer l’occlusion opaque inévitable causée par le chevauchement de barres d’histogrammes massives.
6.2 Ajustement des hyperparamètres diagonaux via diag_kws
Bien que les moteurs algorithmiques de Seaborn sélectionnent par défaut des hyperparamètres raisonnables, la rigueur scientifique impose fréquemment une reprise en main fine des paramètres mathématiques gouvernant la construction de ces tracés univariés. Cette personnalisation chirurgicale s’opère par l’intermédiaire du paramètre dictionnaire diag_kws (abréviation conventionnelle de diagonal keyword arguments), lequel transmet directement une collection de directives spécialisées aux fonctions sous-jacentes de bas niveau de Matplotlib ou Seaborn.
Dans l’hypothèse où l’expérimentateur opte pour des histogrammes univariés (diag_kind='hist'), le réglage de la granularité du découpage spatial représente un enjeu critique. Par l’injection de diag_kws={'bins': 25, 'stat': 'density', 'multiple': 'stack'}, il devient aisé de spécifier le nombre exact de compartiments de discrétisation, de normaliser la hauteur des barres pour exprimer une véritable densité de probabilité intégrée à l’unité plutôt qu’un comptage brut dépendant de la taille de l’échantillon, et d’empiler harmonieusement les contributions chromatiques des différentes strates démographiques afin de préserver la visibilité intégrale des effectifs sous-jacents.
Lorsque le choix se porte sur les estimateurs de noyau continu (diag_kind='kde'), l’hyperparamètre central de régulation réside dans la largeur de la fenêtre de lissage, plus communément dénommée bande passante ou bandwidth. Par l’entremise de la commande diag_kws={'bw_adjust': 0.75, 'fill': True, 'alpha': 0.4}, le biostatisticien peut moduler avec finesse le compromis biais-variance de son estimation. Une valeur de bw_adjust inférieure à l’unité permet de révéler des singularités ou des sous-pics d’intensité locale que l’algorithme conventionnel de Silverman aurait indûment gommés par un sur-lissage excessif, tandis que l’application d’une transparence canalisée (alpha) assure la lisibilité immédiate des aires de recoupement situées sous les courbes de densités entremêlées.
6.3 Détection visuelle des anomalies de distribution
La diagonale principale du pairs plot ne remplit pas seulement une mission descriptive passive ; elle agit comme un puissant révélateur sémiologique des déviations par rapport aux postulats de la statistique paramétrique classique. La plupart des protocoles d’inférence ultérieurs, à l’instar de l’analyse de variance univariée ou multivariée (ANOVA/MANOVA) ou de la régression des moindres carrés ordinaires, postulent formellement la normalité résiduelle et la symétrie distributionnelle des grandeurs observées. L’examen attentif de la diagonale permet de tester visuellement ces attendus avec une immédiateté saisissante.
L’asymétrie empirique (ou skewness) saute immédiatement aux yeux dès lors que la masse principale de la distribution se trouve comprimée contre l’un des bords du spectre scalaire, laissant s’étirer vers l’extrémité opposée une longue traîne asymptotique effilée. Une telle silhouette, fréquemment rencontrée dans l’étude des temps de réaction psychomoteurs ou des distributions de revenus économiques, signale impérieusement la nécessité d’appliquer une transformation mathématique non linéaire stabilisatrice — telle qu’une transformation logarithmique népérienne, une racine carrée ou une transformation puissance de type Box-Cox — préalablement à toute tentative de modélisation linéaire.
Parallèlement, la détection des effets de plancher (floor effects) et des effets de plafond (ceiling effects) constitue un enseignement cardinal, singulièrement prégnant dans le dépouillement d’échelles de mesure subjectives en psychométrie ou en sciences de l’éducation. Lorsque la courbe de distribution univariée heurte brutalement la borne minimale ou maximale admissible d’une échelle de notation bornée, provoquant une accumulation artificielle et anormale de fréquences au niveau de la sentinelle extrême, le chercheur sait instantanément que son instrument de mesure a subi une saturation de sensibilité. Cette anomalie compromet gravement la linéarité des covariances associées et impose le recours à des modélisations plus sophistiquées issues de l’économétrie des variables dépendantes censurées, telles que les modèles de régression Tobit.
7. Personnalisation des tracés hors diagonale (relations bivariées)
7.1 Diversification des représentations avec le paramètre kind
Si la diagonale dévoile la topologie marginale des variables isolées, la véritable vocation relationnelle du pairs plot se cristallise dans le traitement exhaustif des cellules hors diagonale. Afin de répondre aux intentions analytiques les plus variées, la routine de Seaborn propose un levier de diversification immédiat via l’argument polyvalent kind, capable de transmuter radicalement la nature géométrique des projections bivariées.
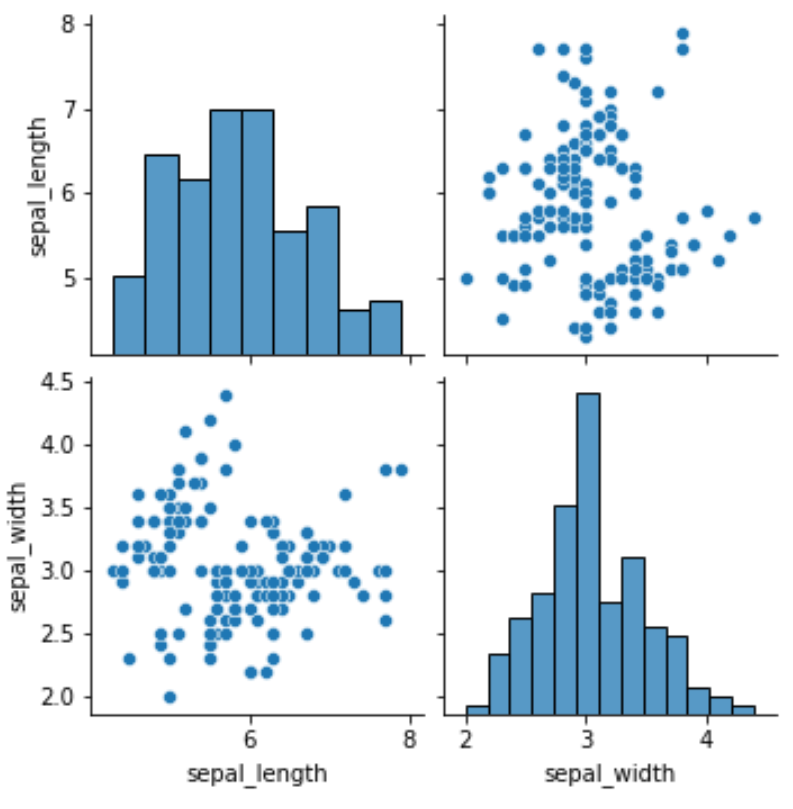
Par défaut, l’instruction active kind='scatter', projetant une cartographie ponctuelle classique sous la forme d’un semis de marqueurs discrets dans l’espace euclidien. Cette configuration offre l’avantage de la simplicité et d’une fidélité totale à l’emplacement individuel de chaque sujet statistique. Néanmoins, lorsque la volumétrie des données s’accroît substantiellement, ce mode d’affichage traditionnel se heurte à des limitations physiques majeures liées à l’empilement indistinct des coordonnées.
Pour dépasser ces restrictions spatiales, Seaborn autorise des alternatives de restitution particulièrement novatrices :
- L’option
kind='kde'substitue aux semis de points des surfaces de niveau isodensité bidimensionnelles générées par estimation conjointe de noyau. Ces représentations topographiques, mimant des courbes de niveau cartographiques concentriques, délimitent avec précision les foyers de plus forte probabilité conjointe au sein de l’espace bivarié. - L’option
kind='hist'convertit l’espace plan en une grille de pavages bivariés rectangulaires ou carrés (binned heatmaps), où l’intensité chromatique locale de chaque facette reflète fidèlement la densité d’échantillons qui y sont capturés, procurant une alternative robuste et dépourvue d’hypothèse de lissage continu. - L’option
kind='reg'enfin, injecte un formalisme statistique explicite en superposant instantanément à chaque semis de points une droite d’ajustement linéaire calculée selon la méthode des moindres carrés ordinaires, complétée par un intervalle de confiance ombré.
7.2 Intégration et interprétation des régressions linéaires bivariées
L’activation de l’ajustement linéaire par le réglage kind='reg' confère au pairs plot une dimension prédictive et inférentielle d’une redoutable efficacité exploratoire. Ce dispositif ne se borne pas à tracer une droite géométrique statique reliant arbitrairement les points extrêmes du nuage ; il calibre un modèle mathématique rigoureux de la forme y = β₀ + β₁x + ε pour chaque cellule de la grille matricielle.
L’un des raffinements statistiques les plus spectaculaires de cette implémentation réside dans le calcul et la projection automatique d’une bande de confiance translucide encadrant la droite de régression centrale. Par défaut, cette enveloppe incertaine est estimée à un niveau de confiance de 95 % par le biais de simulations de rééchantillonnage non paramétrique à l’aveugle, plus connues sous le concept de bootstrap. Cette procédure itérative effectue des centaines de rééchantillonnages aléatoires avec remise au sein des couples de données empiriques pour recalculer la pente à chaque tirage, matérialisant ainsi la stabilité géométrique de la relation. Une bande d’ombrage extrêmement fine et rectiligne atteste d’une relation solide étayée par un effectif robuste, tandis qu’un évasement prononcé vers les bordures met en exergue une fragilité inférentielle induite par l’absence d’observations périphériques.
Cette visualisation immédiate des droites d’ajustement constitue également un analyseur exceptionnel de l’homoscédasticité et du comportement de la variance des résidus. Lorsque l’expérimentateur constate visuellement que la dispersion verticale des points autour de la droite de régression s’accroît de façon spectaculaire et évasée à mesure que l’on progresse vers les valeurs positives de l’abscisse (dessinant une silhouette conique ou en entonnoir caractéristique), il recueille le diagnostic flagrant d’une hétéroscédasticité sévère. Cette distorsion structurelle signale l’invalidation des hypothèses de Gauss-Markov et enjoint l’analyste à renoncer à l’estimateur classique au profit d’erreurs-types robustes à l’hétéroscédasticité (comme les estimateurs de White-Huber) ou à envisager des modèles linéaires généralisés (GLM).
7.3 Paramétrage granulaire via l’argument plot_kws
De même qu’il existe un dictionnaire réservé aux réglages de la diagonale univariée, Seaborn met à la disposition des concepteurs l’argument plot_kws pour moduler au niveau microscopique les propriétés esthétiques et mathématiques des tracés bivariés hors diagonale. Cette modularité chirurgicale permet de résoudre élégamment les frictions ergonomiques les plus communes inhérentes à la sémiologie graphique.
Le premier levier d’action fondamental réside dans le contrôle de la transparence optique des marqueurs, manipulable par le paramètre alpha. En transmettant au sein du dictionnaire l’instruction plot_kws={'alpha': 0.3}, l’expérimentateur dissout l’opacité impénétrable des points individuels. Dès cet instant, chaque point isolé apparaît sous un aspect translucide discret, tandis que la superposition d’une multitude de points en une même région cartésienne engendre par accumulation chromatique une saturation tonale intense, révélant la véritable structure de densité d’un nuage en apparence indistinct.
Parallèlement, la morphologie même des marqueurs peut être remodelée pour enrichir la sémantique de l’affichage. L’argument permet de spécifier le diamètre géométrique des points (via le paramètre s ou size), d’activer ou d’annuler les liserés de contour contrastants (via edgecolor et linewidth), et de choisir des glyphes géométriques différenciés (au moyen du sélecteur marker, autorisant des ronds, carrés, triangles ou croix distinctives). Lorsque le mode régression est sélectionné, plot_kws permet en outre de configurer isolément les attributs de la ligne directrice centrale (en définissant par exemple une couleur rougeoyante d’alerte, une épaisseur de trait amplifiée ou un tracé en pointillé stylisé via line_kws={'color': 'darkred', 'linewidth': 1.5, 'linestyle': '--'}), offrant ainsi une lisibilité éditoriale irréprochable.
8. Contrôle modulaire avancé avec la classe PairGrid de Seaborn
8.1 Différences d’architecture entre sns.pairplot et sns.PairGrid
Bien que la fonction polyvalente sns.pairplot() satisfasse avec brio la très grande majorité des exigences exploratoires de routine, elle demeure structurellement une fonction de haut niveau dite « enveloppante » (ou wrapper function). Par nature, sa conception vise à simplifier drastiquement l’interface applicative en prenant unilatéralement un certain nombre d’arbitrages de mise en page et en masquant la complexité interne des couches géométriques. Dès lors qu’un chercheur souhaite briser la symétrie canonique des représentations, introduire des fonctions de calcul mathématique inédites dans certaines cellules ou concevoir une figure totalement asymétrique, les limites intrinsèques de cette fonction enveloppante sont rapidement atteintes.
C’est à cet instant précis de la démarche scientifique qu’il convient de s’émanciper de la fonction de haut niveau pour solliciter directement l’ossature fondamentale sous-jacente : la classe seaborn.PairGrid. Loin d’être un simple substitut syntaxique, PairGrid incarne un paradigme de programmation modulaire entièrement différent, scindé en un cycle séquentiel rigoureux en trois phases :
- Phase d’instanciation de l’armature géométrique : L’appel de l’objet
g = sns.PairGrid(df)initialise la topologie matricielle et réserve les zones d’axes dans la mémoire graphique sans dessiner le moindre marqueur ni la moindre courbe. - Phase d’assignation fonctionnelle (le mapping) : Le développeur mappe sélectivement des fonctions de traçage arbitraires (qu’elles émanent de Seaborn, des primitives de Matplotlib ou de fonctions Python écrites sur mesure) sur les différentes sections topologiques de la grille.
- Phase de post-traitement et de rendu éditorial : Enfin, les méthodes de la classe permettent d’ajuster globalement la géométrie, les légendes et les échelles avant la finalisation de l’image.
Cette architecture déclarative découplée offre une liberté créative et scientifique totale. Le canevas cartésien n’est plus une boîte noire monolithique fermée sur elle-même ; il devient une grille de calcul programmable où chaque sous-espace bidimensionnel peut recevoir une logique algorithmique et esthétique distincte, répondant avec exactitude aux spécifications éditoriales les plus drastiques.
8.2 Dissociation asymétrique : map_upper, map_lower et map_diag
Le pouvoir d’émancipation le plus spectaculaire conféré par l’objet PairGrid s’exprime dans la possibilité de rompre formellement la redondance symétrique entre les deux moitiés de la matrice cartésienne. Alors qu’un pairs plot conventionnel affiche deux nuages de points rigoureusement équivalents de part et d’autre de la diagonale, PairGrid permet de fragmenter l’espace matriciel en trois compartiments autonomes gouvernés par des méthodes de projection dédiées : map_upper(), map_lower() et map_diag().
Cette dissociation tripartite permet de concevoir des planches de visualisation composites d’une densité analytique hors du commun. Un modèle d’excellence méthodologique fréquemment plébiscité dans les publications à haut facteur d’impact consiste à ordonnancer la matrice selon la typologie fonctionnelle suivante :
- Sur la diagonale principale (administrée souverainement par
g.map_diag(sns.histplot, kde=True)), l’analyste fait figurer des histogrammes détaillés enrichis d’un lissage continu par estimation de noyau, offrant une vue univariée exhaustive de la distribution marginale de chaque grandeur. - Sur l’ensemble du triangle supérieur (affecté via l’instruction
g.map_upper(sns.scatterplot, alpha=0.6)), sont déployés des nuages de points classiques, permettant de surveiller individuellement l’alignement géométrique de chaque mesure d’observation et de détecter l’émergence d’éventuels points atypiques isolés. - Sur l’intégralité du triangle inférieur (gouverné simultanément par
g.map_lower(sns.kdeplot, fill=True, cmap='Blues_d')), le praticien substitue aux points des cartes d’isodensité bivariées fluides et teintées. Ces contours de densité révèlent instantanément le centre de gravité gravitationnel et les foyers probabilistes préférentiels des variables conjointes, éliminant totalement l’encombrement visuel qui affecte la lecture des nuages discrets.
Par cette combinaison structurelle tripartite, aucune cellule de la figure ne fait double emploi avec une autre. Chaque cadran apporte un éclairage statistique singulier et complémentaire, transformant la planche matricielle en un tableau de bord holistique irremplaçable pour l’audit empirique global.
8.3 Injection de fonctions statistiques et graphiques personnalisées
Le degré ultime de sophistication offert par la classe PairGrid réside dans sa capacité intrinsèque à servir de réceptacle à des fonctions d’ordre supérieur programmées sur mesure par l’utilisateur. Rien n’oblige l’expérimentateur à cantonner son affichage aux seules routines graphiques préfabriquées des bibliothèques commerciales. En exploitant le mécanisme d’application séquentielle de PairGrid, il devient possible d’écrire des routines d’annotation analytique qui viendront s’exécuter localement au sein de chaque cellule individuelle de la grille.
L’application la plus féconde de ce procédé consiste à concevoir une fonction Python dédiée qui calcule dynamiquement le coefficient de corrélation linéaire r de Pearson entre les deux vecteurs de données transmis à chaque cellule du triangle supérieur, évalue sa significativité statistique via le calcul de la p-valeur associée (au moyen du module scipy.stats.pearsonr), puis injecte cette information textuelle sous une typographie calibrée au centre exact du cadran correspondant. Dès lors, le triangle supérieur ne se contente plus d’illustrer une dispersion nébuleuse ; il se transmue en une matrice d’inférence quantitative directe affichant formellement des métriques numériques rigoureuses accompagnées de leurs étoiles de significativité conventionnelles.
Le code source sous-jacent à cette customisation repose sur l’extraction dynamique de la référence d’axe Matplotlib active à chaque étape de l’itération. À l’aide de primitives comme ax = plt.gca() et d’appels à ax.annotate(), la routine personnalisée dimensionne la police de caractères proportionnellement à la magnitude absolue de la force du lien statistique, matérialisant ainsi un pont graphique saisissant entre la rigueur paramétrique de la matrice de corrélation chiffrée et la force expressive narrative du pairs plot visuel.
9. Optimisation esthétique, stylisation et mise en page éditoriale
9.1 Configuration des thèmes visuels et du contexte d’affichage
L’intégration d’un pairs plot au sein d’un article scientifique destiné à une revue académique de premier plan ou dans un rapport institutionnel d’aide à la décision requiert un soin typographique et stylistique exemplaire. Les standards d’affichage par défaut des calepins électroniques, souvent saturés de fonds grisâtres et de quadrillages lourds, ne satisfont pas aux exigences graphiques rigoureuses de l’édition scientifique internationale. C’est pourquoi la maîtrise fine du système de thèmes visuels de Seaborn s’avère indispensable.
L’écosystème Seaborn propose un moteur de thématisation globale piloté par la fonction unifiée sns.set_theme(). Pour une production éditoriale sobre, élégante et lisible, le style style='ticks' ou style='whitegrid' doit être résolument privilégié. Le mode ticks élimine l’ombrage inutile de l’arrière-plan cartésien pour déployer une toile de fond blanche immaculée, rehaussée de délicats tirets de graduation externes sur les axes bordiers, ce qui garantit un contraste optique maximal des marqueurs de données et prévient tout gaspillage d’encre lors de l’impression sur support physique.
Concomitamment au style décoratif, la notion de contexte d’échelle représente une innovation ergonomique majeure de Seaborn, manipulable via l’instruction sns.set_context(). Cette directive permet d’ajuster homothétiquement la proportion relative de l’ensemble des éléments textuels et graphiques de la composition (épaisseur des contours, diamètre des marqueurs, dimension des étiquettes de graduation). L’activation du contexte context='paper' recalibre l’ensemble des proportions pour une lecture optimale sur un document imprimé au format standardisé, tandis que le contexte context='talk' ou context='poster' amplifie significativement l’épaisseur des traits et la corpulence des polices de caractères afin de garantir une lisibilité sans faille lors d’une projection sur grand écran en amphithéâtre.
9.2 Gestion géométrique : dimensions, proportions et espacements
En raison de sa nature matricielle carroyée démultipliant le nombre de panneaux cartésiens, le pairs plot est particulièrement vulnérable aux phénomènes de collision géométrique et de distorsion d’échelle spatiale. Si les dimensions globales ne sont pas scrupuleusement paramétrées, les sous-graphiques risquent d’apparaître sous une forme minuscule illisible, ou au contraire de déborder démesurément du cadre d’affichage en provoquant le chevauchement chaotique des libellés d’axes.
Le contrôle de l’envergure spatiale globale s’opère dès l’appel initial de sns.pairplot() à travers le couplage de deux paramètres déterminants : height et aspect. Le paramètre height dicte la hauteur absolue allouée à chaque facette individuelle en pouces typographiques (une valeur oscillant entre 2.2 et 2.8 pouces représente généralement un compromis idéal pour une grille 4 × 4), tandis que le coefficient scalaire aspect définit le rapport largeur sur hauteur de chaque cellule cartésienne. En maintenant aspect=1.0, le chercheur s’assure que chaque cellule préserve une géométrie strictement isométrique carrée, préservant ainsi l’équivalence géométrique visuelle des pentes de régression sur les axes horizontaux et verticaux.
Une friction visuelle classique concerne l’espacement intercalaire séparant les différents panneaux de la grille. Par défaut, Seaborn ménage un espace minimal, mais celui-ci peut s’avérer insuffisant lorsque les valeurs numériques portées sur les échelles d’axes comportent de nombreux chiffres décimaux. L’accès direct à l’objet Figure sous-jacent de Matplotlib, via l’attribut g.fig généré par l’instance de tracé, permet d’invoquer la méthode fondamentale subplots_adjust(wspace=0.15, hspace=0.15). Ce réglage millimétrique des marges internes horizontale (width space) et verticale (height space) garantit une aération élégante de la composition sans fragmenter la continuité visuelle de l’ensemble.
9.3 Attribution de titres globaux et d’annotations académiques
Une figure scientifique ne saurait être considérée comme achevée sans un encadrement textuel rigoureux comprenant un titre directeur intelligible, des légendes explicatives exhaustives et des étiquettes dimensionnelles sans ambiguïté sémantique. L’intégration d’un titre général au sommet d’une matrice complexe générée par Seaborn soulève néanmoins une difficulté technique récurrente : si l’analyste se contente d’invoquer la fonction standard plt.title(), Matplotlib n’assignera ce texte qu’au seul et unique dernier petit sous-graphique tracé en bas à droite de la matrice.
Pour couronner l’intégralité de la composition matricielle d’un titre fédérateur unique et magistral, il est impératif d’interpeller directement le canevas de haut niveau par l’instruction g.fig.suptitle(). De surcroît, afin d’éviter que ce titre directeur ne vienne empiéter et chevaucher les distributions univariées tracées sur la rangée supérieure de la grille, il convient d’associer systématiquement un décalage vertical compensateur au moyen du paramètre géométrique y=1.02, dégageant ainsi une marge de respiration supérieure harmonieuse.
Enfin, l’étape ultime de la chaîne graphique éditoriale réside dans l’exportation sur support pérenne. L’enregistrement ne doit jamais s’effectuer par une simple capture d’écran rasterisée de basse résolution. Il convient de solliciter la fonction de sauvegarde vectorielle de Matplotlib :
plt.savefig('matrice_analytique_haute_resolution.pdf', dpi=300, bbox_inches='tight')
L’adjonction de l’argument bbox_inches='tight' s’avère absolument fondamentale : elle force le moteur d’exportation à calculer la boîte englobante minimale entourant l’intégralité des éléments de la figure, rognant automatiquement les marges blanches superflues et garantissant que ni la légende latérale extérieure, ni les étiquettes extrêmes des axes ne se retrouveront tronquées lors de l’incorporation finale du document dans un système de composition typographique de type LaTeX.
10. Résolution des défis computationnels et grands volumes d’échantillons
10.1 Traitement du problème de superposition dense (overplotting)
Le principal écueil guettant la représentation de nuages de points bivariés traditionnels dès lors que la cohorte d’étude franchit un certain volume d’observations (typiquement au-delà de quelques milliers de sujets) réside dans le phénomène destructeur du recouvrement d’encre ou overplotting. Dans cette conjoncture, des centaines de marqueurs ponctuels viennent s’agréger exactement sur les mêmes pixels de rendu, formant des taches d’encre massives et uniformément saturées. L’observateur se trouve alors dans l’incapacité totale de distinguer si une région compacte abrite une dizaine de cas isolés ou concentre en réalité quatre-vingt pour cent de la masse totale de la population observée.
Pour contrecarrer cette cécité visuelle, la stratégie élémentaire la plus accessible consiste en une réduction drastique de l’opacité individuelle des marqueurs au moyen de faibles valeurs d’alpha (par exemple plot_kws={'alpha': 0.05}). Par ce truchement, un marqueur isolé n’imprime qu’une trace fantomatique quasi imperceptible sur le canevas, tandis que les régions d’agrégation majeure se teintent d’une coloration profonde et dense par sommation cumulative des transparences locales, révélant ainsi les véritables centres d’attraction probabiliste du système.
Une seconde approche, particulièrement salvatrice lorsque les données quantitatives continues dérivent originellement d’échelles d’évaluation discrètes ou de questionnaires de Likert comportant un nombre fini d’échelons (provoquant des superpositions parfaites de coordonnées entières identiques), réside dans l’introduction méthodique d’une perturbation stochastique contrôlée, communément désignée sous le terme de gigue aléatoire ou jittering. En adjoignant un bruit uniforme infime aux coordonnées scalaires brutes préalablement à leur transmission au moteur de tracé, l’analyste déploie spatialement les amas de points superposés en de petits essaims distincts, restituant à l’œil humain la perception instantanée de l’effectif réel confiné sur chaque palier de mesure.
10.2 Gestion de la charge de calcul et de la complexité quadratique
Au-delà des barrières de perception graphique, l’application d’un pairs plot à des méga-bases de données industrielles ou génomiques se heurte à un verrou algorithmique incontournable : la complexité computationnelle quadratique. Si l’on désigne par p le nombre de descripteurs quantitatifs inclus dans l’espace exploratoire, le nombre total de cellules cartésiennes à initialiser et à interpoler évolue selon la fonction polynomiale O(p²). Lorsque cette explosion combinatoire du nombre de facettes vient se conjuguer à un effectif de lignes n se chiffrant en millions d’enregistrements, la machine hôte subit une sollicitation extrême de son processeur et de sa mémoire vive, conduisant inévitablement à des temps de calcul prohibitifs ou au crash brutal du processus par épuisement de la mémoire système (Out Of Memory).
Face à ce défi d’échelle, la démarche la plus rigoureuse et scientifiquement irréprochable consiste à appliquer en amont une procédure d’échantillonnage aléatoire stratifié. En exploitant la méthode Pandas df.sample(n=5000, random_state=42), l’analyste extrait un sous-ensemble hautement représentatif de sa population d’origine. Sur le plan de l’inférence exploratoire, un échantillon aléatoire de cinq mille individus capture avec une fidélité morphologique absolue l’ensemble des structures géométriques, des courbures de covariance et des corrélations sous-jacentes du jeu de données parent de grande envergure, tout en divisant par plusieurs ordres de grandeur le temps requis pour l’ordonnancement graphique de la figure matricielle.
Une optimisation complémentaire de premier ordre au sein de Seaborn réside dans la désactivation méthodique des calculs d’intervalles de confiance par rééchantillonnage non paramétrique. Lorsqu’on sollicite le mode régression bivariée (kind='reg'), Seaborn procède par défaut à 1000 tirages bootstrap consécutifs pour chaque cellule hors diagonale afin de délimiter l’enveloppe de confiance à 95 %. Sur de très grands échantillons, cette procédure de rééchantillonnage réitérée sur des dizaines de facettes génère une charge computationnelle écrasante. En configurant explicitement l’argument ci=None au sein de plot_kws, le calcul stochastique du bootstrap est purement et simplement contourné, ce qui permet à l’algorithme d’ajuster les droites des moindres carrés analytiques en une fraction de seconde, sans sacrifier l’orientation empirique du diagnostic.
10.3 Erreurs fréquentes et stratégies de débogage
La pratique quotidienne de l’analyse exploratoire sous Python confronte régulièrement les utilisateurs à une série de messages d’erreurs et d’exceptions cryptiques émanant des profondeurs de Matplotlib ou de NumPy. Savoir décrypter ces alertes et leur apporter une réponse architecturale immédiate conditionne la fluidité du cycle d’investigation statistique.
L’une des défaillances les plus universellement recensées se matérialise sous la forme de l’exception TypeError: unhashable type: 'numpy.ndarray' ou ValueError: could not convert string to float. Ce dysfonctionnement survient de manière quasi systématique lorsqu’un tableau de données en apparence propre renferme une colonne numérique contaminée par des chaînes de caractères orphelines (telles que des libellés d’absence de données codés sous la forme 'NULL', 'NA' ou de simples tirets '-'). Lors du tracé, le moteur graphique de bas niveau tente de projeter ces descripteurs sur des échelles réelles continues et s’effondre face à l’impossibilité d’effectuer la conversion arithmétique. Le remède consiste à systématiser l’emploi préalable de la fonction de coercition vectorielle pd.to_numeric(df[col], errors='coerce'), convertissant sans compromis tout caractère aberrant en valeur nulle standardisée NaN, susceptible d’être ensuite imputée ou éliminée selon les règles de l’art.
Une seconde distorsion insidieuse concerne l’écrasement complet des échelles graphiques induit par la présence de valeurs aberrantes extrêmes consécutives à des erreurs d’acquisition capteurs. Si une seule observation isolée présente une valeur accidentelle décalée de six ordres de grandeur par rapport au reste de la distribution, le moteur d’harmonisation des axes comprime quatre-vingt-dix-neuf pour cent des données légitimes dans un espace confiné d’un millimètre de large contre la bordure d’axe afin d’inclure l’aberration sur la scène cartésienne. Dès lors, le pairs plot semble paradoxalement vide. Le statisticien avisé veillera donc toujours à soumettre ses séries de données à un filtrage d’intervalle interquartile préalable ou à un écrêtage des percentiles extrêmes (winsorization) afin de garantir que les axes cartésiens exploitent pleinement l’espace visuel disponible pour révéler la dynamique intrinsèque de la cohorte d’étude.
11. Étude de cas empirique : Analyse multidimensionnelle de scores psychométriques
11.1 Présentation du protocole expérimental et du jeu de données
Afin de concrétiser de façon vivante l’ensemble des préceptes théoriques et techniques détaillés jusqu’ici, développons une étude de cas empirique intégrale inspirée des neurosciences cognitives et de la psychométrie clinique contemporaine. Considérons une cohorte de recherche translationnelle colligeant les données de n = 300 participants soumis à un protocole standardisé d’évaluation de la vulnérabilité au stress et de la symptomatologie affective. L’objectif scientifique consiste à élucider les patterns d’interaction croisés unissant l’âge chronologique des sujets à trois dimensions d’évaluation comportementale standardisées : un indice composite d’Anxiété-Trait, un score de Symptomatologie Dépressive, et une échelle standardisée mesurant la Résilience Émotionnelle.
Le protocole expérimental segmente scrupuleusement la cohorte selon un facteur diagnostique tripartite : un premier groupe témoin composé d’individus sains (noté Contrôle), un deuxième groupe intégrant des patients répondant aux critères diagnostiques de Trouble de l’Adaptation (noté Stress_Aigu), et un troisième sous-groupe de patients souffrant d’un Épisode Dépressif Caractérisé (noté Depression_Clinique). Les scores psychométriques bruts ont été soumis à un étalonnage vectoriel et s’expriment sous la forme de scores standardisés réduits (les Z-scores), centrés sur une moyenne nulle avec une variance unitaire.
L’hypothèse expérimentale fondamentale postule que la Résilience Émotionnelle exerce un effet tampon protecteur modulant négativement la corrélation pathologique entre Anxiété et Dépression, mais que cette dynamique homéostatique subit une désactivation sévère au sein du groupe clinique présentant la pathologie dépressive avérée. Notre mission analytique consiste à mobiliser le pairs plot en Python pour auditer visuellement cette hypothèse d’interaction complexe avant d’engager des modélisations par équations structurelles.
11.2 Démarche séquentielle de génération du pairs plot
La transcription programmatique de ce protocole s’opère par une séquence déclarative rigoureuse sous Seaborn, tirant parti des techniques de stratification et de mise en page les plus affinées. Le jeu de données ayant été préalablement validé et nettoyé au format DataFrame sous la variable df_psycho, la configuration du thème institutionnel est initialisée par un fond blanc rigoureux et une typographie formelle de type sans empattement.
La construction de la figure repose sur l’appel orchestré suivant :
- Assignation des variables psychométriques continues au moyen de
vars=['Age', 'Anxiete_Trait', 'Depression_Score', 'Resilience']. - Stratification taxinomique conditionnelle par le groupe clinique via
hue='Diagnostic'. - Attribution d’une palette chromatique hautement discriminante et médicalement sobre, telle que
palette='Set2', en veillant à fixer l’ordre hiérarchique naturel des groupes au travers dehue_order=['Contrôle', 'Stress_Aigu', 'Depression_Clinique']. - Définition d’un mode de régression linéaire bivarié sur l’ensemble des cellules hors diagonale via
kind='reg', associé à une réduction de la taille des marqueurs (s=20) et à une transparence maîtrisée (alpha=0.6) injectées dansplot_kws. - Sélection d’estimations de densité par noyau lissées sur la diagonale (
diag_kind='kde'), avec une translucidité surfacique paramétrée viadiag_kws={'fill': True, 'alpha': 0.3, 'bw_adjust': 0.8}. - Calibrage géométrique spatial de précision imposant
height=2.5etaspect=1.0pour garantir une matrice harmonieuse parfaitement équilibrée.
L’exécution conjointe de ces instructions engendre une planche graphique composite d’une lisibilité immédiate, surmontée d’un titre formel positionné via g.fig.suptitle() et immédiatement prête pour la soutenance ou la soumission éditoriale.
11.3 Interprétation analytique et restitution des résultats psychologiques
L’audit de la planche graphique ainsi matérialisée livre un ensemble d’enseignements cliniques d’une richesse remarquable, confirmant la pertinence heuristique du pairs plot face à des phénomènes psychologiques intriqués. En premier lieu, la lecture transversale de la diagonale principale met en lumière une ségrégation morphologique sans équivoque des distributions de la Résilience Émotionnelle. Tandis que la cohorte témoin affiche une distribution univariée gaussienne décalée vers les valeurs hautement positives du spectre standardisé, le groupe présentant un trouble dépressif caractérisé s’effondre dans les valeurs négatives sévères, manifestant une asymétrie marquée vers la gauche qui trahit un appauvrissement massif des ressources psychologiques d’adaptation.
Toutefois, la découverte la plus spectaculaire se dévoile à la confrontation bivariée croisant le score d’Anxiété-Trait avec la Résilience Émotionnelle. L’observation des droites de régression spécifiques à chaque sous-groupe met en scène une modulation de pente vertigineuse. Chez les sujets du groupe contrôle, la droite de régression arbore une pente négative remarquablement affirmée : face à une recrudescence modérée d’anxiété, le niveau de résilience s’exprime vigoureusement pour compenser l’inconfort émotionnel. En revanche, au fur et à mesure que l’on passe au groupe de stress aigu puis au groupe dépressif clinique, on assiste à un aplatissement drastique de la pente de régression, celle-ci devenant quasiment horizontale et insensible au sein du contingent dépressif. Cette rupture de pente géométrique matérialise sous une forme visuelle éclatante l’hypothèse clinique de découplage homéostatique : chez les patients sévèrement atteints, la dynamique fonctionnelle de la résilience est rompue, ne modulant plus l’anxiété éprouvée.
Enfin, l’examen granulaire des nuages de points permet d’isoler une grappe atypique d’observations hautement singulières : trois patients rattachés au groupe clinique dépressif se détachent du peloton de leur classe d’appartenance pour venir se nicher dans le cadran supérieur droit, associant paradoxalement une forte symptomatologie anxieuse à un score de résilience exceptionnellement préservé. L’identification visuelle immédiate de cette anomalie offre une piste clinique prometteuse, invitant les psychiatres de l’équipe à réexaminer les dossiers individuels de ces trois cas isolés afin d’identifier des facteurs environnementaux protecteurs non répertoriés dans le modèle initial.
12. Alternatives et extensions interactives dans l’écosystème Python
12.1 Génération de matrices interactives avec Plotly Express
Si la bibliothèque Seaborn, épaulée par Matplotlib, demeure la référence académique incontournable pour la production de figures statiques vectorielles haute résolution destinées à la presse universitaire imprimée, l’essor contemporain des applications décisionnelles infonuagiques, des tableaux de bord interactifs et des plateformes d’analyse de données en ligne a impulsé l’émergence d’outils de visualisation dynamiques. Au premier rang de cette révolution ergonomique figure la bibliothèque Plotly Express.
Grâce à sa fonction dédiée plotly.express.scatter_matrix(), cet environnement permet de générer des matrices de nuages de points interactives entièrement matérialisées sous la forme de documents HTML interactifs autonomes propulsés par le standard technologique JavaScript / WebGL. L’analyste bénéficie d’une liberté de navigation exploratoire absolue :
- Le zoom dynamique et le panoramique fluide autorisent l’utilisateur à encadrer à la souris une sous-région spatiale densément peuplée pour l’agrandir instantanément, chaque sous-graphique de la matrice synchronisant automatiquement son échelle sur la sélection courante.
- L’infobulle interactive (hover tooltip) permet d’afficher en surimpression volante, lors du simple survol d’un point par le curseur, l’intégralité des métadonnées du participant (son numéro d’identification, son âge précis, ses antécédents médicaux), déchargeant ainsi l’analyste de l’obligation d’isoler manuellement les cas aberrants dans son calepin électronique.
- La technique de brossage et liaison (brushing and linking) permet, en sélectionnant au lasso un groupe de points dans une cellule déterminée, d’illuminer simultanément ces mêmes individus à travers l’intégralité des autres facettes matricielles, révélant leur trajectoire multidimensionnelle en temps réel.
Cette interactivité prodigieuse s’accompagne néanmoins d’un compromis technique : les figures Plotly exigent des ressources de calcul et un volume mémoire substantiels côté client sur le navigateur web, rendant leur intégration peu commode au sein des flux éditoriaux académiques traditionnels axés sur les formats statiques PDF et LaTeX.
12.2 L’approche historique Pandas : pd.plotting.scatter_matrix
Avant que Seaborn n’érige son hégémonie sur le paysage de la visualisation scientifique en Python, la bibliothèque centrale Pandas intégrait déjà nativement un utilitaire historique de tracé matriciel : la méthode pandas.plotting.scatter_matrix(). Cet outil, qui subsiste au sein de la documentation contemporaine, mérite d’être connu de tout scientifique des données en raison de sa présence omniprésente dans le code patrimonial de nombreux laboratoires et de sa rusticité fonctionnelle appréciable.
L’avantage cardinal de la routine Pandas réside dans son absence de dépendance logicielle vis-à-vis de Seaborn. Si un environnement de calcul restreint ou un serveur de calcul distant ne dispose que de Pandas et de l’armature de base de Matplotlib, une ligne d’instruction élémentaire telle que pd.plotting.scatter_matrix(df, figsize=(10, 10), diagonal='kde') suffit à engendrer instantanément une matrice bivariée fonctionnelle. Cette méthode fait preuve d’une vitesse de compilation brute souvent supérieure sur des architectures matérielles limitées, constituant une solution de secours irremplaçable lors de sessions rapides de débogage de flux de données.
Néanmoins, sur le plan de la sémiologie graphique et de la souplesse méthodologique, l’approche native de Pandas accuse des lacunes flagrantes face aux standards modernes. L’outil ne dispose d’aucune gestion native de la dimension de stratification catégorielle hue : si l’analyste souhaite colorer ses points selon différentes modalités médicales, il est contraint d’écrire manuellement des boucles itératives complexes associant des masques booléens et des listes de couleurs brutes. De surcroît, les mécanismes d’ajustement automatique des espacements et des étiquettes s’avèrent infiniment plus rudimentaires, confinant cet utilitaire au rang d’outil de diagnostic rapide à usage purement personnel.
12.3 Synthèse et arbre de décision pour le choix de la méthode visuelle
Face à la pluralité des approches disponibles au sein du riche écosystème logiciel de Python, le chercheur ou l’ingénieur de données doit savoir opérer un arbitrage méthodologique rigoureux, guidé par les contraintes matérielles de son environnement, le volume de ses observations et la destination finale de ses productions visuelles. Le schéma décisionnel suivant résume de façon synthétique les critères de sélection cardinaux :
- Pour une publication scientifique imprimée (revue à comité de lecture, thèse, livre) : La solution souveraine incontestable est
seaborn.pairplot()ouseaborn.PairGrid. Couplée au thèmestyle='ticks', à des palettes colorblind-friendly et à un export vectoriel direct en format PDF à 300 DPI, elle garantit une élégance graphique chirurgicale et une conformité absolue aux standards typographiques internationaux. - Pour la conception de tableaux de bord interactifs (Dash, Streamlit, rapports d’entreprise) : L’orientation obligatoire doit se porter sur
plotly.express.scatter_matrix(). L’interactivité dynamique, l’inspection instantanée des cas marginaux au survol et le brossage multidimensionnel y surpassent infiniment l’austérité des rendus statiques. - Pour des diagnostics rapides sur des scripts légers sans dépendances : L’invocation sommaire de
pd.plotting.scatter_matrix()demeure une alternative fonctionnelle pragmatique et expéditive. - Pour l’exploration de très grands volumes de données (plus de 100 000 lignes) : Il convient impérativement d’appliquer une stratégie d’échantillonnage aléatoire stratifié en amont ou de basculer vers des alternatives basées sur le tramage matriciel pur, telles que la bibliothèque Datashader, afin d’échapper à l’asphyxie computationnelle.
Enfin, quelle que soit la méthodologie logicielle finalement retenue, l’exigence suprême de la recherche scientifique contemporaine réside dans la reproductibilité computationnelle intégrale. La traçabilité méthodologique impose d’archiver scrupuleusement l’ensemble des scripts de génération, de figer les graines de génération aléatoire (via random_state ou np.random.seed) lors des phases d’échantillonnage ou de bootstrap, et de documenter exhaustivement les numéros de version de chaque bibliothèque logicielle au sein d’environnements virtualisés conteneurisés. L’intégration de ces pipelines graphiques au sein d’outils de publication computationnelle automatisée de nouvelle génération, à l’instar de Quarto, de Jupyter Book ou de Sphinx, assure l’avènement d’une science des données transparente, élégante et rigoureusement vérifiable par la communauté internationale des pairs.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman & Hall/CRC. https://doi.org/10.1201/9781315140919
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0