
L’exploration quantitative des données contemporaines repose fondamentalement sur la compréhension des interdépendances linéaires et non linéaires qui structurent les systèmes multivariés. Qu’il s’agisse de valider un instrument de mesure psychométrique, de calibrer un modèle prédictif d’apprentissage automatique ou d’éprouver des hypothèses théoriques en économétrie, la matrice de corrélation s’érige comme l’un des artefacts analytiques les plus prégnants et universels. Cet instrument mathématique condense, sous une forme géométrique matricielle élégante, l’ensemble des relations bivariées standardisées qui unissent des vecteurs d’observations au sein d’un espace multidimensionnel.
Dans l’écosystème du calcul scientifique moderne, le langage de programmation Python s’est imposé comme le standard de référence pour la modélisation statistique. Porté par des bibliothèques performantes telles que Pandas, NumPy, SciPy et Seaborn, il offre un cadre computationnel d’une grande rigueur méthodologique. Toutefois, la production d’une matrice de corrélation ne saurait se réduire à l’exécution machinale d’une fonction logicielle. Elle exige une maîtrise approfondie des postulats mathématiques sous-jacents, une vigilance constante face aux violations d’hypothèses distributionnelles et une capacité à restituer graphiquement des résultats conformément aux normes de diffusion scientifique les plus strictes.
Le présent traité propose une déconstruction exhaustive des principes, des algorithmes et des protocoles empiriques nécessaires à la construction, à l’analyse et à la visualisation des matrices de corrélation en Python. De la théorie axiomatique de Karl Pearson aux décompositions spectrales, en passant par le contrôle des taux de fausses découvertes et le traitement probabiliste des données manquantes, ce guide offre une référence méthodologique complète destinée aux chercheurs, statisticiens et praticiens de la science des données soucieux d’exactitude analytique.
1. Introduction théorique à la matrice de corrélation et fondements mathématiques
1.1 Définition formelle du coefficient de corrélation de Pearson
Le coefficient de corrélation produit-moment, formalisé par le mathématicien et biostatisticien Karl Pearson à la fin du dix-neuvième siècle, quantifie l’intensité et le sens de l’association linéaire existant entre deux variables aléatoires quantitatives continues. D’un point de vue algébrique, ce paramètre de population, conventionnellement noté par la lettre grecque rhô, est défini comme le rapport strict entre la covariance conjointe des deux variables et le produit de leurs écarts-types respectifs. Cette opération d’adimensionnalisation a pour effet de standardiser la métrique originelle, éliminant ainsi toute dépendance vis-à-vis des unités de mesure physiques ou psychologiques dans lesquelles les variables sont initialement exprimées.
L’estimateur ponctuel d’échantillon, universellement désigné par le symbole r, projette cette relation dans un continuum numérique oscillant rigoureusement entre les bornes finies de -1 et +1. Une valeur de +1 signale une relation linéaire ascendante exacte, signifiant que toute modification incrémentielle standardisée de la première variable se traduit par une augmentation proportionnelle directe et déterministe de la seconde. Réciproquement, une valeur de -1 caractérise une relation linéaire descendante absolue. Une valeur nulle témoigne de l’absence totale d’association linéaire, bien qu’elle n’exclue nullement l’existence de configurations stochastiques non linéaires complexes, telles que des fonctions sinusoïdales ou quadratiques.
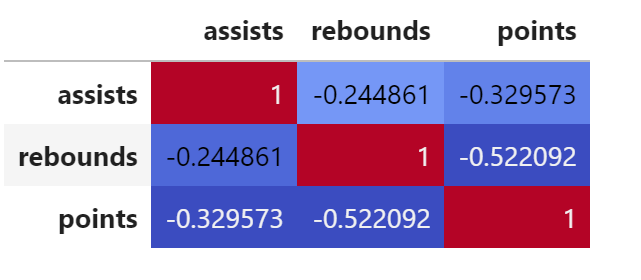
L’inférence statistique valide adossée au coefficient de Pearson repose sur le respect impératif de postulats distributionnels précis. En premier lieu, la relation sous-jacente doit présenter une stricte linéarité, condition vérifiable empiriquement par l’inspection des nuages de points. En second lieu, les couples d’observations doivent idéalement dériver d’une distribution normale bivariée, impliquant que chaque variable soit non seulement univariément gaussienne, mais que leur combinaison conjointe dessine des ellipsoïdes de densité réguliers. Enfin, l’hypothèse d’homoscédasticité des résidus garantit que la dispersion conditionnelle d’une variable demeure invariante sur l’ensemble du domaine de variation de l’autre variable.
1.2 Structure matricielle et propriétés mathématiques
Lorsque le dispositif expérimental s’étend à un ensemble de p variables quantitatives continues, l’analyse bivariée isolée cède la place à un formalisme matriciel unifié. Une matrice de corrélation, généralement désignée par la lettre R, se présente sous la forme d’un tableau carré de dimensions p × p au sein duquel chaque élément rij correspond au coefficient d’association linéaire entre la i-ième et la j-ième variable. Cette structure jouit de propriétés géométriques remarquables découlant directement des axiomes du produit scalaire dans les espaces vectoriels euclidiens de dimension n.
La première propriété cardinale réside dans la symétrie exacte de la matrice par rapport à sa diagonale principale. Puisque la covariance est un opérateur bilinéaire symétrique, l’association entre la variable X et la variable Y est rigoureusement identique à celle liant la variable Y à la variable X, d’où l’égalité rij = rji pour tout couple d’indices. La diagonale principale est exclusivement composée de valeurs unitaires (1,00), traduisant le fait tautologique que la corrélation d’une variable aléatoire avec elle-même, en l’absence d’erreur de mesure expérimentale, est invariablement maximale et parfaite.
D’un point de vue spectral, toute matrice de corrélation valide est une matrice semi-définie positive, ce qui implique que pour tout vecteur colonne non nul v de dimension p, la forme quadratique vTRv est supérieure ou égale à zéro. Cette contrainte mathématique structurelle équivaut à stipuler que l’ensemble des valeurs propres de la matrice sont réelles et non négatives. L’espace vectoriel engendré garantit ainsi la cohérence interne des distances multivariées. Toute déviation par rapport à cette semi-positivité indique la présence de paradoxes mathématiques, souvent provoqués par un traitement inadéquat de données manquantes par paires ou par des erreurs de troncature computationnelle.
1.3 Rôle méthodologique dans l’évaluation psychométrique et statistique
Dans le domaine de la psychométrie et des sciences comportementales, la matrice de corrélation constitue le pivot central de l’évaluation des instruments de mesure standardisés, tels que les inventaires de personnalité ou les échelles attitudinales de type Likert. Son examen rigoureux permet d’effectuer un diagnostic précoce de redondance informationnelle entre items ou sous-dimensions. Deux variables affichant des coefficients d’association excédant 0,85 ou 0,90 partagent une part excessive de variance, révélant une colinéarité conceptuelle préjudiciable à la parcimonie du modèle de mesure.
L’exploration des motifs corrélationnels guide également les phases préparatoires de l’analyse factorielle exploratoire (AFE) et confirmatoire (AFC). Les regroupements systématiques de coefficients élevés au sein de sous-blocs matriciels matérialisent empiriquement l’action de variables latentes inobservées, responsables de la covariance partagée entre les indicateurs manifestes. L’analyse conjointe de ces intercorrélations autorise l’estimation de la consistance interne, traditionnellement appréhendée à travers l’alpha de Cronbach ou l’oméga de McDonald.
Enfin, la matrice de corrélation formalise la vérification de la validité de construit théorisée par Campbell et Fiske à travers la matrice multitrait-multiméthode (MTMM). Elle permet d’opérationnaliser la double exigence de validité convergente et de validité discriminante. La validité convergente postule que des mesures distinctes censées évaluer un même construit théorique doivent exhiber des corrélations substantielles et significatives. À l’opposé, la validité discriminante exige que les corrélations reliant des construits conceptuellement orthogonaux demeurent modestes, attestant ainsi de la spécificité théorique des échelles développées.
2. Configuration de l’environnement de développement Python pour l’analyse statistique
2.1 Sélection et installation des bibliothèques fondamentales
L’exécution pérenne de calculs statistiques exige un environnement informatique rigoureusement instrumenté. Le noyau de l’architecture d’analyse quantitative en Python repose sur la symbiose de modules spécialisés. Le gestionnaire de paquets pip ou l’écosystème de conteneurisation Conda permettent d’ordonnancer l’installation reproductible de ces composants. Pandas constitue la colonne vertébrale du traitement tabulaire, proposant la structure DataFrame qui aligne les vecteurs d’observations selon des index explicites, tandis que NumPy fournit les moteurs vectoriels compilés en C optimisant le calcul matriciel sous-jacent.
Pour le calcul des probabilités critiques et l’évaluation des tests d’hypothèses associés aux matrices, l’intégration des paquets SciPy et statsmodels est incontournable. Le sous-module scipy.stats héberge les fonctions d’estimation paramétrique et non paramétrique, délivrant non seulement les coefficients ponctuels mais également les degrés de liberté et les distributions asymptotiques nécessaires aux tests bilatéraux. De surcroît, la bibliothèque psychométrique pingouin s’avère particulièrement adaptée à l’extraction immédiate de métriques diagnostiques complexes telles que les corrélations partielles et les intervalles de confiance robustes.
La transcription perceptive de ces matrices tabulaires requiert des bibliothèques de restitution graphique de haut niveau. Matplotlib opère comme le moteur de rendu élémentaire, accordant un contrôle micrométrique sur chaque élément géométrique du canevas. Concomitamment, Seaborn surmonte cette couche bas niveau en fournissant des abstractions de haut niveau spécifiquement adaptées à la visualisation des structures corrélationnelles, notamment par l’intermédiaire de fonctions spécialisées dans le traçage de cartes thermiques et de matrices de dispersion multivariées.
2.2 Bonnes pratiques de reproductibilité du code
La reproductibilité computationnelle s’impose comme une obligation épistémologique stricte dans toute démarche de recherche quantitative. La variabilité des versions logicielles constitue une source fréquente de divergence dans les algorithmes d’optimisation ou dans la gestion des cas particuliers d’inversion matricielle. Dès lors, il est indispensable de consigner l’environnement d’exécution via des fichiers de spécification déclaratifs de type requirements.txt ou environment.yml, documentant avec précision le numéro de version de chaque bibliothèque exploitée.
L’initialisation systématique des générateurs de nombres pseudo-aléatoires au moyen de graines déterministes (par exemple via l’instruction numpy.random.seed() ou l’instanciation de générateurs np.random.default_rng()) assure la stabilité absolue des calculs stochastiques. Cette précaution est d’autant plus cruciale lorsqu’il s’agit d’estimer des intervalles de confiance par rééchantillonnage bootstrap ou de simuler des distributions sous l’hypothèse nulle. Sans cette initialisation déterministe, les variations asymptotiques marginales introduites par le bruit aléatoire risquent de modifier imperceptiblement les seuils de significativité des p-values.
Enfin, la modélisation doit être ordonnancée selon une architecture logicielle modulaire. Bien que les calepins interactifs Jupyter Notebook offrent un cadre ergonomique pour l’exploration exploratoire immédiate, la transition vers des scripts Python purs encapsulant le traitement dans des fonctions pures et réutilisables garantit la robustesse du flux de traitement. Les responsabilités logiques doivent être distinctement partitionnées : ingestion et nettoyage des données d’un côté, modélisation matricielle de l’autre, et enfin modules dédiés à la sérialisation des graphiques haute résolution.
3. Préparation et structuration des jeux de données avec Pandas
3.1 Importation et inspection structurelle du DataFrame
L’amorce de tout protocole d’analyse corrélationnelle débute par l’ingestion rigoureuse des corpus de données brutes dans une structure tabulaire standardisée. La fonction pandas.read_csv() ou son homologue read_excel() permet d’importer les fichiers de terrain, tout en requérant une vigilance particulière quant à l’encodage des caractères, aux séparateurs décimaux et à la désignation explicite des délimiteurs de colonnes. Lors de cette étape initiale, il convient de s’assurer que les enregistrements reflètent fidèlement les unités d’échantillonnage indépendantes sur chaque ligne.
Une fois le DataFrame instancié, un diagnostic structurel immédiat s’impose via l’invocation de la méthode df.info(). Cette inspection fondamentale révèle le profil typologique des colonnes (Dtypes). Le calcul d’un coefficient de Pearson exigeant des variables strictement numériques (entiers ou flottants), toute présence anormale du type générique object sur une variable quantitative trahit la contamination de la colonne par des caractères non numériques, tels que des espaces insécables, des chaînes textuelles orphelines ou des conventions erronées d’encodage des valeurs manquantes.
L’exploration se poursuit méthodiquement par l’application de la méthode df.describe() sur les attributs continus. Ce résumé statistique univarié renseigne sur les moyennes, les écarts-types, les quantiles et l’amplitude des observations. Cette étape de salubrité pré-analytique permet de vérifier la plausibilité substantielle des étendues observées : un score psychométrique théoriquement borné entre 1 et 7 qui présenterait une valeur maximale de 99 reflète indiscutablement une coquille de saisie ou un code de non-réponse mal interprété qui fausserait dramatiquement les calculs de variance conjointe.
3.2 Sélection et filtrage des variables d’intérêt
Les tableaux de données bruts intègrent fréquemment une taxonomie hétérogène de variables incluant des métadonnées contextuelles, des identifiants techniques uniques (UID, clefs primaires SQL), des variables d’horodatage et des segments de texte libre non structuré. Tenter d’engager ces vecteurs d’information dans une matrice de corrélation constitue une hérésie méthodologique susceptible d’engendrer des erreurs d’exécution ou de polluer l’espace factoriel avec des corrélations purement fortuites dénuées de sens.
Le chercheur doit donc opérer un filtrage délibéré au moyen de la méthode df.select_dtypes(include=[np.number]) pour restreindre l’analyse aux seules variables quantitatives continues ou de rapport. Néanmoins, ce filtrage purement typologique demeure insuffisant : les identifiants numériques arbitraires (tels que les numéros d’anonymat attribués aux répondants) doivent être explicitement radiés du sous-ensemble sélectionné, car leur corrélation numérique avec des variables psychologiques ne reflète qu’un artefact d’indexation linéaire sans valeur substantielle.
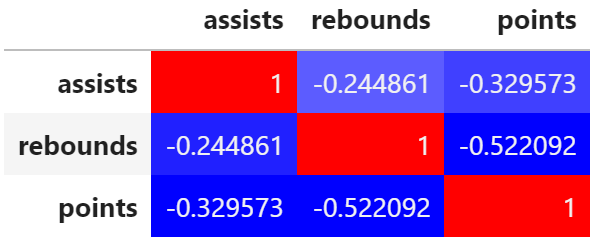
Une attention spécifique doit être portée aux échelles de mesure semi-quantitatives ou ordinales, singulièrement représentées par les échelles de Likert à 5 ou 7 points d’ancrage. Bien que ces variables ne possèdent pas, en toute rigueur théorique, la propriété d’intervalle constant caractéristique des variables continues, la pratique statistique courante tolère fréquemment leur inclusion dans des matrices de corrélation produit-moment sous réserve d’une distribution symétrique et d’un nombre de catégories suffisant. Dans le cas contraire, un réencodage explicite ordonné s’avère indispensable pour orienter les variables selon une valence sémantique cohérente.
3.3 Contrôle de la distribution et prétraitement des échelles
L’estimation non biaisée du coefficient de Pearson repose sur l’hypothèse de normalité univariée et bivariée des distributions marginales. Avant de figer le protocole de calcul, il est donc impératif de mesurer formellement les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) pour chaque variable sélectionnée, au moyen des fonctions spécialisées du module scipy.stats. Une asymétrie absolue supérieure à 2 ou un aplatissement excédant 7 signale une déviation prononcée de la loi normale susceptible d’atténuer artificiellement la magnitude des coefficients de corrélation.
En présence d’asymétries structurelles, l’analyste peut recourir à des transformations mathématiques univariées non linéaires afin de restaurer la symétrie distributionnelle. L’application d’une transformation logarithmique, racine carrée, ou plus formellement d’une transformation de puissance paramétrique de type Box-Cox ou Yeo-Johnson, permet de contraindre les distributions marginales vers une géométrie quasi-gaussienne avant la dérivation matricielle des covariances.
Parallèlement, la mise en œuvre de standardisations centrées-réduites (z-score via StandardScaler) ou de normalisations d’échelle (min-max) peut être conduite à des fins de comparabilité dimensionnelle. Bien que le coefficient de Pearson soit mathématiquement invariant par translation affine (la corrélation entre aX + b et cY + d étant rigoureusement identique à celle liant X et Y), la standardisation préalable stabilise les algorithmes d’optimisation numérique et facilite l’analyse diagnostique immédiate des résidus de modélisation linéaire.
4. Calcul de la matrice de corrélation avec la méthode Pandas corr()
4.1 Syntaxe de base et paramétrage standard
Au sein de l’écosystème Pandas, le calcul matriciel des associations bivariées s’effectue nativement par l’invocation de la méthode corr() appliquée directement sur une instance de DataFrame. Par défaut, l’instruction df.corr() exécute l’algorithme de Pearson en évaluant de manière itérative chaque combinaison bivariée possible au sein de l’ensemble des colonnes numériques. Le code résultant renvoie un nouveau DataFrame carré, dont les index de ligne et de colonne reprennent rigoureusement les étiquettes des variables sélectionnées.
Le comportement algorithmique sous-jacent est entièrement vectorisé, tirant parti des optimisations de bas niveau de NumPy pour accélérer les opérations de produit scalaire sur les matrices de variance-covariance. L’analyste se doit de vérifier immédiatement les dimensions du tableau renvoyé au moyen de l’attribut .shape : pour un jeu de données comportant p variables candidates, la matrice résultante doit strictement présenter une dimension dimensionnelle de p × p. Toute discordance dans cette volumétrie trahit l’omission inopinée de certaines colonnes lors de la phase de typage.
L’examen direct de l’objet tabulaire généré permet une vérification instantanée des propriétés formelles évoquées précédemment. Les éléments diagonaux se matérialisent invariablement par des valeurs flottantes strictement égales à 1.0, tandis que l’égalité parfaite des triangles supérieur et inférieur confirme la symétrie de l’opérateur. Ce tableau sert de réceptacle exhaustif pour l’ensemble des procédures d’analyse quantitative subséquentes.
4.2 Ajustement du paramètre min_periods
L’un des leviers d’ajustement algorithmique les plus cruciaux de la méthode pandas.DataFrame.corr() réside dans le paramètre optionnel min_periods. Par défaut fixé à 1, ce paramètre stipule le nombre minimal absolu d’observations conjointes et non manquantes nécessaires pour déclarer valide le calcul d’un coefficient entre deux colonnes données. Dans les cohortes épidémiologiques ou psychométriques massives présentant des structures d’omission complexes, ce réglage par défaut recèle un danger statistique considérable.
Si deux variables ne partagent accidentellement que deux ou trois unités statistiques communes au sein d’un jeu de données englobant par ailleurs des milliers d’individus, l’exécution standard de corr() calculera sans avertissement un coefficient de Pearson sur ce micro-échantillon d’appariement. Ce coefficient souffrira d’une variance d’échantillonnage astronomique et sera potentiellement affecté par une marge d’erreur inacceptable, tout en se présentant visuellement sur le même plan que des coefficients estimés sur plusieurs centaines de sujets.
Pour prévenir cette dérive méthodologique, le paramètre min_periods doit être délibérément ajusté à un seuil statistique conservateur (par exemple min_periods=30 ou min_periods=100). Dès lors que le nombre d’observations conjointes valides entre deux colonnes chute en deçà de ce quantum empirique prédéterminé, Pandas assigne automatiquement la valeur manquante NaN (Not a Number) à la cellule matricielle correspondante, alertant ainsi le chercheur sur l’indigence observationnelle de cette association bivariée spécifique.
4.3 Filtrage et extraction de sous-matrices d’intérêt
Dans les contextes d’investigation impliquant de vastes questionnaires d’évaluation comprenant des dizaines ou des centaines de variables, la matrice globale résultante devient cognitivement intraitable dans son exhaustivité. L’analyste doit dès lors déployer des techniques d’indexation booléenne pour isoler sélectivement les segments d’intérêt théorique. L’application d’un masque logique d’amplitude, tel que (matrice_corr.abs() > 0.5) & (matrice_corr != 1.0), permet d’extraire instantanément l’ensemble des associations d’intensité substantielle tout en occultant la trivialité unitaire de la diagonale.
Une configuration récurrente dans les protocoles de modélisation prédictive consiste à isoler l’association unilatérale liant un critère d’intérêt unique (la variable dépendante ou cible) à l’ensemble des régresseurs candidats. Cette projection unidimensionnelle s’obtient élégamment par l’extraction vectorielle matrice_corr[['variable_cible']], suivie d’une instruction de tri décroissant au moyen de la méthode .sort_values(by='variable_cible', ascending=False). Cette démarche ordonnance hiérarchiquement les facteurs de prédiction selon leur magnitude d’association bivariée brute.
Enfin, pour transformer la matrice bidimensionnelle en une structure relationnelle linéaire compatible avec les pipelines de modélisation modernes ou les bases de données relationnelles, les fonctions de restructuration s’avèrent indispensables. L’appel à la méthode .unstack() déploie la grille carrée en une série indexée hiérarchiquement par couples de variables, autorisant des opérations immédiates de filtrage, de suppression des doublons symétriques et de classement global des relations les plus déterminantes du système.
5. Exploration des coefficients alternatifs : Spearman, Kendall et corrélations partielles
5.1 Corrélation des rangs de Spearman pour les relations non linéaires
Lorsque la structure empirique des données contrevient manifestement à l’hypothèse de normalité multivariée ou que la relation entre deux variables s’avère non linéaire mais strictement monotone (c’est-à-dire qu’une augmentation de l’une s’accompagne continuellement d’une progression de l’autre sans que cette progression ne soit proportionnelle), l’application du coefficient de Pearson sous-estime systématiquement la force de l’association. Dans ce cas de figure, le coefficient de corrélation des rangs de Charles Spearman, noté rhô de Spearman, fournit une alternative non paramétrique d’une robuste validité.
L’implémentation informatique de cette métrique s’effectue sans aucune difficulté conceptuelle au sein de l’environnement Pandas en modifiant simplement le paramètre dédié de la fonction mère : df.corr(method='spearman'). Sur le plan algorithmique, cette méthode commence par substituer à chaque valeur quantitative son rang séquentiel au sein du vecteur ordonné d’observations. Le calcul du coefficient de Pearson standard est ensuite exécuté non pas sur les grandeurs brutes primitives, mais directement sur ces rangs ordinaux transformés.
Cette méthodologie confère au coefficient de Spearman une insensibilité remarquable face à la présence de valeurs aberrantes extrêmes situées sur les queues de distribution. Dès lors qu’un point atypique préserve sa position séquentielle relative d’ordre maximal ou minimal, son éloignement numérique absolu n’exerce aucune influence distordante sur la magnitude de l’indice calculé, garantissant ainsi une mesure fidèle et résiliente des associations monotones globales au sein d’échantillons hétérogènes.
5.2 Tau de Kendall pour les échantillons réduits et les rangs ex æquo
Le coefficient tau de Maurice Kendall représente une seconde alternative non paramétrique d’une remarquable élégance mathématique, accessible via l’instruction df.corr(method='kendall'). Contrairement à l’approche de Spearman qui repose sur les écarts quadratiques des rangs, le tau de Kendall s’enracine dans une approche probabiliste pure, articulée autour de la concordance et de la discordance relatives observées au sein de l’ensemble des paires de points d’échantillonnage.
Pour chaque paire d’observations bivariées (Xi, Yi) et (Xj, Yj), la paire est classifiée comme concordante si l’ordre relatif des deux sujets est identique sur les deux dimensions (soit Xi > Xj et Yi > Yj, ou inversement). À l’inverse, si l’ordre s’inverse d’une variable à l’autre, la paire est jugée discordante. Le tau de Kendall normalise la différence arithmétique entre le nombre total de paires concordantes et le nombre de paires discordantes par rapport au nombre total de combinaisons possibles n(n – 1) / 2.
En contexte psychométrique, la littérature statistique privilégie très largement l’emploi du tau-b de Kendall face au rhô de Spearman lorsque la taille d’échantillon est restreinte (n < 30) et que le protocole de recueil engendre une proportion substantielle de rangs ex æquo (ce qui est intrinsèquement le cas des échelles d’évaluation ordinales à nombre de modalités discret). Le tau de Kendall converge plus rapidement vers la distribution normale asymptotique et propose un paramètre d’estimation non biaisé de la probabilité de concordance au sein de la population cible.
5.3 Calcul des corrélations partielles et semi-partielles avec Pingouin
L’un des écueils épistémologiques majeurs de la corrélation bivariée réside dans son incapacité structurelle à discerner les liaisons causales directes des relations fallacieuses induites par l’action conjointe d’un tiers facteur confondant. Deux variables X et Y peuvent exhiber un coefficient d’association très substantiel non pas en raison d’un lien d’influence réciproque, mais parce qu’elles constituent toutes deux les manifestations directes d’une variable sous-jacente commune Z. La corrélation partielle résout cette ambiguïté en quantifiant le degré d’association linéaire résiduelle entre X et Y une fois l’effet linéaire de Z entièrement soustrait des deux membres de l’équation.
La bibliothèque statistique spécialisée pingouin offre un cadre algorithmique particulièrement abouti pour exécuter ces décompositions. Par le biais de sa fonction native pingouin.pcorr(), l’analyste peut générer de manière totalement automatisée la matrice intégrale des corrélations partielles pour un ensemble multivarié donné, chaque cellule rxy.z reflétant l’association résiduelle conditionnelle à l’ensemble des autres prédicteurs du modèle. La relation mathématique sous-jacente s’exprime par le biais de l’inversion de la matrice de covariance standardisée.
De façon complémentaire, la corrélation semi-partielle (ou corrélation de partie) neutralise l’impact de la variable confondante sur un seul des deux indicateurs étudiés. Cette approche s’avère particulièrement féconde dans le cadre des équations de régression linéaire hiérarchique, car le carré de la corrélation semi-partielle matérialise avec une précision mathématique rigoureuse l’incrément de variance expliqué (ΔR²) attribuable à l’adjonction spécifique d’une nouvelle variable au sein du modèle prédictif.
6. Évaluation de la significativité statistique et construction des p-values
6.1 Calcul vectoriel des degrés de liberté et de la valeur p avec Scipy
Un écueil fréquent inhérent à l’utilisation brute de la méthode pandas.DataFrame.corr() tient au fait qu’elle retourne exclusivement les grandeurs d’effet ponctuelles des coefficients, en omettant par défaut les indices de significativité statistique inférentielle. Or, dans toute démarche de recherche empirique rigoureuse, l’interprétation d’un coefficient de corrélation ne peut être dissociée du test d’hypothèse statistique visant à rejeter l’hypothèse nulle (H0 : ρ = 0), stipulant l’absence totale d’association au sein de la population parente.
Pour combler cette lacune, le chercheur doit recourir aux fonctions d’inférence probabiliste hébergées au sein de scipy.stats, et tout particulièrement aux routines pearsonr() et spearmanr(). Ces algorithmes calculent la statistique de Student t associée au coefficient estimé r selon l’expression canonique t = r × √((n – 2) / (1 – r²)), suivant une loi de Student à n – 2 degrés de liberté. La fonction en déduit la probabilité critique bilatérale (p-value), quantifiant le risque de commettre une erreur de première espèce en rejetant H0 à tort.
La formulation d’une fonction Python personnalisée et vectorisée permet d’itérer systématiquement sur l’ensemble des paires de variables du DataFrame pour synthétiser conjointement une matrice de corrélation et une matrice symétrique homologue hébergeant les p-values correspondantes. L’assemblage de ces deux matrices constitue le socle indispensable à tout rapport analytique formel, permettant d’identifier immédiatement les coefficients qui atteignent le seuil critique conventionnel de significativité statistique (typiquement α = 0,05, α = 0,01 ou α = 0,001).
6.2 Ajustement pour les comparaisons multiples
L’estimation conjointe d’un nombre élevé de coefficients de corrélation au sein d’une même matrice confronte l’analyste au redoutable paradoxe méthodologique des comparaisons multiples. Lors du calcul d’une matrice englobant p variables, le nombre total d’hypothèses nulles bilatérales évaluées simultanément s’élève précisément à p(p – 1) / 2. Si l’on considère une matrice relativement modeste de 20 variables, ce ne sont pas moins de 190 tests d’hypothèses indépendants qui sont exécutés de concert.
À un seuil de significativité nominal de 5%, le risque d’erreur de type I global (l’inflation du risque de déclarer faussement significative au moins une association purement aléatoire) croît de manière exponentielle selon la loi αglobal = 1 – (1 – α)k, où k représente le nombre de comparaisons. Pour 190 tests, la probabilité d’enregistrer des faux positifs avoisine les 99,99%. Maintenir les seuils de décision sans ajustement relève dès lors d’une méconnaissance grave des lois du calcul probabiliste.
Pour contrecarrer cette dérive, l’emploi du module statsmodels.stats.multitest.multipletests s’impose. Il offre la possibilité d’appliquer des corrections de contrôle de l’erreur par famille telles que la méthode stricte de Bonferroni ou la procédure séquentielle plus puissante de Holm-Bonferroni. Dans les cadres exploratoires impliquant des centaines de dimensions, la maîtrise du taux de fausse découverte (False Discovery Rate ou FDR), orchestrée via la célèbre méthodologie de Benjamini-Hochberg, assure un équilibre optimal entre le rejet des bruits stochastiques et la préservation de la puissance statistique requise pour détecter les effets réels.
6.3 Estimation des intervalles de confiance par rééchantillonnage bootstrap
La publication exclusive d’une valeur ponctuelle de corrélation adossée à une p-value binaire souffre d’un appauvrissement épistémique largement décrié par les autorités méthodologiques internationales. L’estimation précise de la taille d’effet requiert impérativement la construction d’un intervalle de confiance délimitant l’étendue des valeurs plausibles du paramètre au sein de la population à un niveau de certitude prescrit (généralement 95%).
Lorsque les conditions de normalité bivariée sont incontestablement remplies, l’intervalle peut être modélisé analytiquement en recourant à la transformation asymptotique en z de Ronald Fisher (argument tangente hyperbolique réciproque : z = arctanh(r)), qui convertit la distribution asymétrique bornée des coefficients de corrélation en une distribution strictement gaussienne d’erreur standard 1 / √(n – 3). Une fois les bornes établies dans l’espace z, l’application de la fonction réciproque (tangente hyperbolique standard) rétablit les bornes finales dans la métrique originelle [-1, 1].
Néanmoins, en présence d’incertitudes distributionnelles marquées, la méthodologie non paramétrique du bootstrapping (rééchantillonnage itératif avec remise) offre une flexibilité de calibrage inégalée. En programmant sous Python une boucle de rééchantillonnage itérant typiquement de 2 000 à 10 000 tirages au moyen de NumPy, il est aisé d’enregistrer la distribution empirique des coefficients estimés et d’en dériver les percentiles 2,5% et 97,5%. Ces intervalles de confiance bootstrap corrigés des biais offrent une fidélité d’inférence exceptionnelle, affranchie de tout postulat paramétrique préalable.
7. Visualisation avancée : Conception de cartes thermiques avec Seaborn
7.1 Création d’une heatmap de corrélation fondamentale
La restitution tabulaire textuelle d’une matrice de corrélation volumineuse sature rapidement les facultés d’analyse visuelle de l’observateur. La transposition graphique sous forme de carte thermique (heatmap) résout cette surcharge cognitive en substituant aux grandeurs décimales continues une projection chromatique immédiatement décryptable. La bibliothèque Seaborn formalise cette transformation par l’intermédiaire de sa fonction dédiée sns.heatmap(), qui prend en argument direct l’objet DataFrame produit par la méthode de corrélation.
L’optimisation ergonomique du rendu requiert l’activation judicieuse de plusieurs arguments fonctionnels fondamentaux. L’argument annot=True impose l’affichage en surimpression textuelle des coefficients numériques au cœur de chaque pavé coloré, permettant une double lecture quantitative et qualitative. Simultanément, la commande fmt='.2f' prescrit un arrondi strict à deux décimales, garantissant une uniformité esthétique et évitant le débordement typographique des décimales flottantes non tronquées.
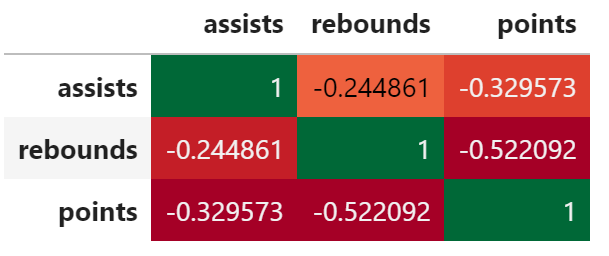
La spatialisation du canevas graphique doit être calibrée à proportion du nombre de variables analysées. L’appel préalable à la méthode plt.figure(figsize=(largeur, hauteur)) sous Matplotlib s’avère essentiel : pour une matrice comportant 10 à 15 variables, une échelle minimale de 12 × 10 pouces assure une aération typographique adéquate, prévenant ainsi les chevauchements illisibles entre les annotations numériques et les bordures de cellules.
7.2 Sélection rigoureuse des palettes divergentes
Le choix de la charte chromatique pour une carte thermique de corrélation ne relève aucunement d’une préférence cosmétique arbitraire ; il répond à des règles strictes de sémiologie graphique. La distribution des coefficients de corrélation étant intrinsèquement bipolaire et symétrique autour d’un point central neutre (zéro), l’emploi d’une palette de couleurs continue unilatérale (telle que des dégradés de gris ou de bleus simples) constitue une faute d’interprétation visuelle majeure, car elle suggérerait une continuité scalaire entre l’association négative maximale et l’association positive maximale.
Il est donc méthodologiquement impératif de sélectionner une palette résolument divergente, matérialisée par des nuanciers canoniques tels que vlag, coolwarm ou icefire. Ces palettes assignent une teinte vive distinctive aux valeurs positives prononcées, une teinte diamétralement opposée aux valeurs négatives profondes, et transitent imperceptiblement par une couleur strictement neutre (souvent un blanc cassé ou un gris très pâle) pour marquer l’absence de relation autour de zéro.
De surcroît, le calibrage mathématique des bornes d’ancrage dynamique constitue une exigence absolue : les paramètres vmin=-1.0, vmax=1.0 et center=0.0 doivent être impérativement spécifiés au sein de l’instruction sns.heatmap(). Sans cette explicitation formelle, Seaborn bornera arbitrairement l’échelle chromatique sur le minimum et le maximum empiriques des données transmises, introduisant un biais perceptif dramatique en conférant par exemple la couleur de saturation maximale à une corrélation modeste de 0,40 si celle-ci s’avère être la plus élevée du jeu de données.
Enfin, les critères d’accessibilité visuelle universelle méritent une attention déontologique systématique. Une proportion notable de la population masculine présentant diverses formes de dyschromatopsies (notamment la deutéranopie et la protanopie), les palettes divergentes rouge-vert conventionnelles doivent être formellement proscrites au profit d’associations chromatiques inclusives préservant la différenciation perceptive des gradients de contraste, telles que les nuances bleu-orange ou le schéma perceptuellement uniforme viridis ajusté.
7.3 Masquage de la redondance : Triangle supérieur vs inférieur
En vertu de la propriété mathématique de symétrie axiale démontrée précédemment, une matrice de corrélation conventionnelle contient exactement 50% d’informations dupliquées hors diagonale. Présenter l’intégralité du carré matriciel au sein d’une publication impose au lecteur un effort d’abstraction inutile en l’obligeant à balayer visuellement deux fois le même espace relationnel. L’occultation méthodique de l’un des deux triangles géométriques constitue ainsi un standard académique établi.
Cette épuration géométrique s’orchestre avec une grande concision algorithmique sous Python en combinant NumPy et Seaborn. L’instruction np.triu(np.ones_like(matrice_corr, dtype=bool)) génère un masque booléen triangulaire supérieur de même dimension que la matrice étudiée. Ce tableau logique assigne la valeur True à l’ensemble des coordonnées du triangle supérieur ainsi qu’à la diagonale principale, tout en attribuant False au triangle inférieur.
La transmission directe de ce masque à l’argument mask=masque au sein de sns.heatmap() neutralise automatiquement le tracé des cellules ciblées, laissant subsister exclusivement le triangle inférieur gauche. Cette mise en page aérée désencombre visuellement le graphique, focalise immédiatement l’attention sur les interrelations empiriques uniques et s’aligne rigoureusement sur les canons de restitution stylistique préconisés par l’American Psychological Association (APA).
8. Personnalisation graphique et mise en page pour publication scientifique
8.1 Contrôle précis de l’environnement Matplotlib
L’élévation d’un tracé graphique préliminaire au rang de figure publiable au sein de revues scientifiques internationales exige une reprise en main granulaire des objets d’axes sous-jacents. La manipulation exclusive des commandes d’abstraction Seaborn atteignant rapidement ses limites d’ajustement, l’analyste doit explicitement instancier le couple hiérarchique figure-axe via l’instruction fig, ax = plt.subplots(figsize=(...)) afin d’interagir directement avec les méthodes typographiques de bas niveau de Matplotlib.
La lisibilité des étiquettes dimensionnelles (tick labels) représentant le nom des variables sur les bordures abscisses et ordonnées conditionne la recevabilité de la figure. Il convient d’ajuster formellement leur orientation angulaire ainsi que leur point d’ancrage textuel au moyen de ax.set_xticklabels(ax.get_xticklabels(), rotation=45, horizontalalignment='right', fontsize=10). Cette disposition angulaire prévient toute collision visuelle tout en conservant une fluidité de lecture horizontale pour le réviseur.
L’annotation contextuelle globale doit être parachevée par la formulation d’un titre scientifique informatif, positionné au sommet de la composition via ax.set_title(). Ce titre ne doit pas se borner à une mention tautologique telle que « Matrice de corrélation », mais consigner rigoureusement la taille globale de l’échantillon analysé (N), la méthodologie de corrélation retenue (Pearson, Spearman) ainsi que les mentions relatives à l’exclusion éventuelle de données aberrantes ou de filtres temporels spécifiques.
8.2 Superposition des annotations de significativité statistique
La restitution conjointe de la magnitude de l’association et de son degré d’inférence probabiliste représente le standard analytique le plus accompli. Plutôt que de contraindre le lecteur à alterner laborieusement entre un graphique chromatique et un tableau séparé de p-values, la meilleure pratique consiste à incruster directement le niveau de rejet de l’hypothèse nulle au sein des cellules de la carte thermique, sous la forme d’astérisques conventionnels.
Pour concrétiser cette intégration, il est nécessaire de construire une matrice textuelle bidimensionnelle personnalisée en Python. Au terme du calcul des coefficients et de leurs probabilités critiques associées, une boucle itérative ou une compréhension de liste vectorisée formule pour chaque intersection un libellé textuel combinant la valeur tronquée du coefficient et le symbole d’inférence calibré selon les seuils épistémiques usuels : * p < 0,05, ** p < 0,01, et *** p < 0,001.
Cette matrice de chaînes de caractères ainsi forgée est ensuite injectée directement dans l’argument annot=matrice_labels de la fonction sns.heatmap(), conjointement avec la désactivation du formatage automatique (fmt=''). Le résultat délivre une synthèse visuelle d’une densité informationnelle optimale, où l’intensité chromatique guide immédiatement le regard vers les structures d’association les plus prononcées, tandis que l’annotation textuelle atteste instantanément de leur validité inférentielle face aux fluctuations d’échantillonnage.
8.3 Exportation vectorielle haute résolution
L’intégration de figures analytiques dans des manuscrits destinés à l’édition universitaire ou à la composition typographique sous LaTeX proscrit catégoriquement l’emploi d’enregistrements d’écran ou de formats matriciels compressés destructifs de type JPEG. Ces formats souffrent d’une pixellisation rédhibitoire lors des opérations de mise à l’échelle ou de photocomposition professionnelle.
Le chercheur doit exclusivement privilégier l’exportation vers des formats vectoriels encapsulés, tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics), voire le format EPS (Encapsulated PostScript). Ces formats préservent la nature mathématique des primitives géométriques : chaque texte, chaque ligne de grille et chaque pavé coloré demeure un polygone vectoriel parfaitement restituable à n’importe quel facteur de grossissement sans la moindre perte de définition.
L’exécution de cette sérialisation s’opère par la méthode plt.savefig('matrice_correlation.pdf', dpi=300, bbox_inches='tight'). Le paramètre dpi=300 garantit une résolution nominale ultra-haute pour les couches matricielles résiduelles, tandis que l’argument bbox_inches='tight' active un algorithme de rognage adaptatif qui élimine les marges blanches périphériques superflues et prévient la troncation malencontreuse des étiquettes de variables inclinées situées aux limites extrêmes du canevas.
9. Gestion des données manquantes et traitement des valeurs aberrantes
9.1 Suppression par paire (Pairwise) vs suppression par liste (Listwise)
Les investigations empiriques en sciences humaines et sociales sont invariablement confrontées à la problématique des valeurs manquantes résultant d’abandons de protocole, d’omissions de réponse ou de défaillances techniques de capteurs. Face à cette incomplétude, deux paradigmes d’élision s’opposent fondamentalement au sein des logiciels statistiques : la suppression globale par liste (listwise deletion) et la suppression locale par paire (pairwise deletion).
La suppression par liste, déclenchée par l’application préalable de la méthode df.dropna(), élimine l’intégralité d’une observation dès lors qu’une seule valeur fait défaut sur l’ensemble du vecteur de variables analysé. Cette approche garantit que l’ensemble des coefficients de la matrice seront rigoureusement estimés sur la même sous-population d’individus et préserve ainsi la nature semi-définie positive de la matrice de corrélation finale. En revanche, si les données manquantes sont disséminées sur de nombreux indicateurs distincts, elle peut provoquer une amputation catastrophique de la puissance statistique globale par attrition massive de la taille d’échantillon utile.
À l’inverse, l’implémentation algorithmique native de la méthode pandas.DataFrame.corr() adopte par défaut le mécanisme de suppression par paire. Pour chaque cellule bivariée rij, le calcul mobilise la totalité des observations présentant simultanément des valeurs valides sur Xi et Xj, indépendamment de leurs statuts de complétude sur les autres colonnes. Bien que cette méthode maximise la quantité totale de données exploitées, elle introduit une asymétrie redoutable : chaque coefficient de la matrice repose potentiellement sur un effectif différent et sur une sous-population non identique. Sur le plan mathématique, cette hétérogénéité d’échantillonnage peut détruire la cohérence géométrique interne de l’espace métrique, aboutissant fréquemment à des matrices non semi-définies positives possédant des valeurs propres négatives absurdes, rendant impossible leur inversion dans des contextes d’analyses multivariées avancées.
9.2 Impact et identification des observations extrêmes
Le coefficient de corrélation produit-moment de Pearson présente une sensibilité extrême (un point de rupture asymptotique théorique de 1 / n) face aux observations aberrantes univariées et multivariées. Un point unique doté d’un fort effet de levier géométrique peut, à lui seul, transmuer une corrélation populationnelle rigoureusement nulle en un coefficient d’échantillon hautement significatif, ou inversement, masquer complètement une association linéaire éclatante partagée par la quasi-totalité de la cohorte.
Le diagnostic de ces anomalies ne saurait se borner à l’inspection d’écarts-types univariés. Il nécessite le calcul d’indices de distance multidimensionnels, au premier rang desquels figure la distance de Mahalanobis. Contrairement à la distance euclidienne standard, la distance de Mahalanobis pondère les déviations multidimensionnelles par la matrice inverse de variance-covariance des prédicteurs, identifiant avec acuité les unités statistiques dont la configuration conjointe viole l’organisation géométrique multivariée globale du système, même si leurs scores pris isolément paraissent conventionnels.
Face à la détection de telles aberrations, l’analyste dispose de plusieurs options méthodologiques robustes. Outre l’expulsion motivée des observations résultant d’erreurs matérielles manifestes, il est recommandé de substituer au coefficient classique des estimateurs de corrélation robustes, tels que les M-estimateurs bivariés ou le coefficient de corrélation à minimum de covariance déterminante (MCD) implémenté dans sklearn.covariance.MinCovDet. Ces algorithmes alternatifs pondèrent dynamiquement l’influence de chaque observation en fonction de son éloignement par rapport au centroïde des données régulières.
9.3 Imputation multiple appliquée aux matrices corrélationnelles
Lorsque les données manquantes se conforment au mécanisme stochastique MAR (Missing at Random — manquantes de manière aléatoire conditionnellement aux variables observées), la suppression pure et simple introduit des biais systématiques dans l’estimation des coefficients. Le paradigme moderne préconisé par la statistique contemporaine réside dans le déploiement de protocoles d’imputation multiple par équations chaînées (MICE), accessible via l’estimateur IterativeImputer de Scikit-Learn ou par des paquets spécialisés.
Le protocole ne consiste pas à générer un tableau unique complété artificiellement (ce qui sous-estimerait gravement l’incertitude épistémique de la mesure), mais à engendrer m jeux de données complets distincts (par exemple m = 20 ou m = 50). Au sein de chaque itération, les valeurs manquantes sont imputées par tirage stochastique à partir de modèles prédictifs conditionnels incorporant une composante d’erreur aléatoire modélisant l’incertitude distributionnelle.
Une matrice de corrélation indépendante est ensuite calculée sur chacun des m jeux de données imputés. La phase finale repose sur la mise en œuvre des célèbres règles d’agrégation de Donald Rubin (Rubin’s Rules). Les coefficients de corrélation sont préalablement stabilisés via la transformation en z de Fisher, moyennés pour former l’estimateur combiné final, tandis que la variance totale de chaque cellule est décomposée en variance intra-imputation et variance inter-imputations. Ce procédé rigoureux garantit une estimation non biaisée des paramètres d’association tout en reflétant fidèlement l’incertitude inhérente aux données non observées.
10. Techniques interactives et dynamiques avec Plotly
10.1 Développement d’une matrice de corrélation interactive
Bien que les visualisations statiques générées par Matplotlib et Seaborn demeurent l’étalon d’or pour la publication sur support papier ou dans les documents au format PDF, l’exploration de données contemporaine bénéficie puissamment de l’interactivité dynamique. La bibliothèque graphique moderne Plotly permet de transcender les limitations des figures figées en conférant à l’utilisateur des capacités d’exploration tactile et analytique en temps réel.
Le module plotly.express propose l’abstraction px.imshow(), capable d’ingérer immédiatement une matrice de corrélation issue de Pandas pour construire une carte thermique vectorielle interactive exécutée directement dans le navigateur client via la technologie WebGL. La palette chromatique s’initialise au moyen d’échelles continues divergentes rigoureusement calibrées (telles que color_continuous_scale='RdBu_r') avec un verrouillage impératif des bornes extrêmes sur le domaine d’amplitude [-1, 1].
L’avantage fonctionnel premier de cette approche réside dans la personnalisation avancée des modèles d’infobulles (hover templates). Par un simple passage du curseur de la souris sur une cellule matricielle, l’utilisateur déclenche l’apparition dynamique d’une fenêtre contextuelle détaillant avec une grande richesse informative l’intitulé complet des deux variables en relation, la grandeur décimale précise du coefficient de corrélation, la taille exacte de l’échantillon apparié sous-jacent ainsi que la p-value ajustée associée.
10.2 Intégration au sein de tableaux de bord analytiques
La portabilité technique des composants graphiques Plotly facilite leur dissémination au-delà des environnements de recherche restreints. Une figure interactive peut être sérialisée en une seule instruction sous la forme d’un fichier HTML totalement autonome et autosuffisant via la méthode fig.write_html('rapport_correlation.html'). Ce livrable intègre l’ensemble des données, les moteurs de rendu JavaScript et les mécanismes de zoom interactif, autorisant une transmission directe aux équipes de direction ou aux partenaires industriels sans nécessiter la moindre installation logicielle préalable.
Dans une perspective de déploiement plus intégrée, ces visualisations matricielles interactives constituent les modules centraux d’applications web analytiques développées sous les cadriciels réactifs contemporains que sont Streamlit ou Dash de Plotly. L’analyste peut ainsi concevoir des tableaux de bord sophistiqués dotés de sélecteurs de commandes dynamiques (barres de défilement, menus déroulants, cases à cocher contextuelles).
Cette réactivité computationnelle permet aux utilisateurs finaux de recalculer et de redessiner instantanément la matrice de corrélation en fonction de filtres démographiques granulaires (par exemple en comparant dynamiquement la structure des intercorrélations chez les cohortes féminines vs masculines), de modifier à la volée les seuils d’exclusion statistique ou de basculer interactivement d’un algorithme paramétrique de Pearson vers une estimation non paramétrique de Spearman sans avoir à manipuler la moindre ligne de code source sous-jacent.
11. Applications méthodologiques avancées : Diagnostic de multicolinéarité et réduction de dimension
11.1 Détection de la multicolinéarité sévère en régression linéaire
Dans le paradigme des modèles linéaires généraux (régression linéaire multiple, modèles de Cox, modèles mixtes), la matrice de corrélation des variables explicatives remplit une fonction diagnostique préventive fondamentale. La présence d’une interdépendance linéaire excessive entre plusieurs prédicteurs — désignée sous le concept statistique de multicolinéarité — constitue l’une des pathologies les plus pernicieuses menaçant la stabilité des estimations économétriques.
Lorsque deux régresseurs exhibent une corrélation bivariée absolue excédant les seuils critiques empiriques de 0,80 ou 0,90, ils introduisent une redondance informationnelle quasi-totale au sein de la matrice de conception X. Cette colinéarité entraîne une inflation exponentielle de l’erreur standard associée aux coefficients de régression partiels. Dès lors, bien que le modèle global puisse afficher un coefficient de détermination global (R²) très élevé et hautement significatif, les tests de Student univariés individuels s’effondrent, rendant impossible l’identification formelle des contributions explicatives spécifiques de chaque facteur.
Au-delà de l’inspection visuelle des fortes valeurs de la matrice R, le diagnostic formel s’opère par l’inversion de la matrice de corrélation standardisée. Les éléments situés sur la diagonale principale de la matrice inverse R-1 correspondent mathématiquement aux Facteurs d’Inflation de la Variance (VIF — Variance Inflation Factor) de chaque variable. Un VIF excédant une valeur seuil de 5 (ou de 10 selon les disciplines scientifiques) matérialise une multicolinéarité sévère imposant impérativement l’expulsion méthodique du prédicteur redondant ou le recours à des techniques de régression pénalisée de type Ridge ou Lasso.
11.2 Regroupement hiérarchique et réordonnancement des variables
L’ordonnancement conventionnel des colonnes et des lignes au sein d’une matrice de corrélation brute dérive généralement de la nomenclature administrative du questionnaire d’origine ou de l’ordre accidentel des champs au sein de la base de données. Cet ordonnancement non raisonné disperse spatialement les relations substantielles, rendant difficile la perception des macro-structures organisationnelles unissant les indicateurs empiriques.
La fonction sns.clustermap() de Seaborn résout magistralement cette difficulté d’interprétation en opérant un réordonnancement algorithmique fondé sur la classification ascendante hiérarchique (CAH). Plutôt que de conserver l’ordre initial des variables, l’algorithme calcule une métrique de distance mathématique entre chaque vecteur corrélationnel (par exemple la distance euclidienne des profils d’association ou la distance de corrélation d = 1 – r) et applique un critère d’agrégation d’arborescence tel que la méthode de Ward ou la liaison moyenne (Average Linkage).
Le résultat graphique se matérialise par une matrice réorganisée flanquée de dendrogrammes hiérarchiques sur ses marges supérieures et latérales. Les variables présentant des profils de covariance homologues sont automatiquement permutées pour se juxtaposer le long des axes, révélant avec une clarté remarquable des blocs thématiques homogènes et des structures modulaires au sein de volumineux questionnaires psychologiques. Cette modularité visuelle constitue souvent le préambule empirique à la formalisation d’échelles de mesure composites unifiées.
11.3 Transition vers l’Analyse en Composantes Principales (ACP)
Sur le plan fondamental de l’algèbre linéaire, la matrice de corrélation standardisée constitue le matériau computationnel exact à partir duquel s’érige l’Analyse en Composantes Principales (ACP). Cette technique de réduction dimensionnelle non supervisée vise à condenser l’information contenue dans p variables corrélées en un nombre restreint k < p de dimensions orthogonales non corrélées, baptisées composantes principales, capturant le maximum de variance partagée.
Avant d’engager cette transition dimensionnelle, deux tests de faisabilité statistique doivent être systématiquement appliqués à la matrice de corrélation. Le test de sphéricité de Bartlett évalue l’hypothèse nulle stipulant que la matrice observée ne diffère pas d’une matrice identité unitaire (dans laquelle toutes les corrélations hors diagonale seraient nulles) ; son rejet franc est une condition absolue préalable. Simultanément, l’indice d’adéquation de l’échantillonnage de Kaiser-Meyer-Olkin (KMO) évalue le ratio entre les corrélations bivariées et les corrélations partielles. Un indice KMO global supérieur à 0,70 certifie que le système relationnel présente une cohésion suffisante pour autoriser une factorisation légitime.
L’extraction factorielle s’exécute ensuite mathématiquement par la décomposition spectrale de la matrice de corrélation R au moyen de l’algorithme des valeurs propres et vecteurs propres (np.linalg.eig(R)). Les valeurs propres résultantes λi quantifient la part exacte de variance totale absorbée par chaque composante successive, tandis que les vecteurs propres normalisés associés définissent les coefficients de projection linéaire géométrique permettant d’interpoler les individus au sein du nouvel espace factoriel orthogonal réduit.
12. Étude de cas complète et protocole de restitution empirique
12.1 Mise en œuvre intégrale sur un jeu de données quantitatives
Afin de formaliser de manière synthétique et pragmatique l’ensemble des préceptes théoriques exposés tout au long de cet ouvrage, nous déployons ici un protocole complet d’ingénierie statistique appliqué à un échantillon empirique représentatif. Le scénario investigue les interdépendances reliant divers indicateurs psychométriques et physiologiques au sein d’une cohorte clinique standardisée (N = 250). Le pipeline d’exécution est orchestré de manière continue, allant de l’ingestion brute jusqu’à la restitution du tracé final.
Le flux computationnel commence par la sélection stricte des vecteurs quantitatifs d’intérêt au moyen de Pandas, suivie d’un diagnostic d’incomplétude confirmant la compatibilité avec un traitement par suppression par liste pour éliminer toute ambiguïté de semi-positivité matricielle. L’estimation des coefficients de corrélation s’opère ensuite via la méthode df.corr(method='pearson'). Concomitamment, un sous-programme itératif exploite scipy.stats.pearsonr pour instancier la matrice des p-values associées, laquelle subit immédiatement une correction pour comparaisons multiples selon la procédure de contrôle du taux de fausse découverte de Benjamini-Hochberg implémentée via statsmodels.
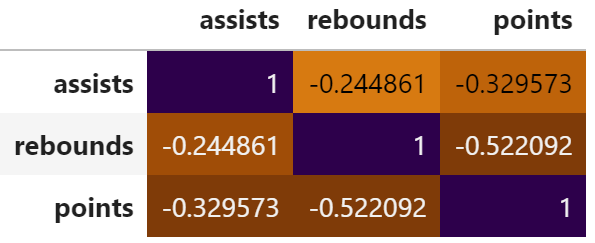
La phase d’orchestration graphique mobilise conjointement Matplotlib et Seaborn au sein d’une structure hiérarchique contrôlée. Un masque booléen triangulaire supérieur dérive de np.triu() pour désencombrer la figure. Les cellules du triangle inférieur sont annotées de manière personnalisée par une matrice textuelle agrégeant les coefficients tronqués et les astérisques de significativité corrigés. La cartographie chromatique déploie la palette divergente accessible vlag, centrée rigoureusement sur le zéro et bornée sur l’intervalle canonique [-1, 1]. La figure résultante est enfin exportée au format vectoriel haute fidélité PDF avec rognage strict des marges périphériques.
12.2 Rédaction et interprétation académique des résultats
La consignation rédactionnelle des résultats corrélationnels au sein d’un manuscrit soumis pour évaluation par les pairs (peer review) répond à des canons stylistiques rigides qu’il convient d’honorer scrupuleusement. Chaque association commentée au sein du corps du texte doit faire l’objet d’une déclaration formelle standardisée spécifiant le type de coefficient, les degrés de liberté de l’estimation, la valeur numérique tronquée du paramètre ponctuel, l’intervalle de confiance estimé ainsi que la valeur critique exacte de probabilité.
Une formulation exemplaire s’énonce selon le gabarit méthodologique suivant : « L’analyse corrélationnelle produit-moment de Pearson révèle une association positive, d’intensité modérée à forte et statistiquement significative entre le niveau d’anxiété préopératoire et la réactivité cardiovasculaire systolique (r(248) = 0,48, IC à 95% [0,38 ; 0,57], p < 0,001 après ajustement de Benjamini-Hochberg). » Cette formalisation exclut toute ambiguïté d’interprétation et livre au lecteur l’ensemble des éléments requis pour apprécier la robustesse de l’estimation.
Il est de surcroît un devoir épistémologique absolu de réaffirmer, au sein de la section Discussion du rapport, l’infranchissable frontière conceptuelle séparant la mise en évidence d’une corrélation bivariée et l’inférence d’un lien de causalité déterministe. Une covariation empirique, aussi intense et hautement significative soit-elle, ne démontre en aucune manière qu’une variable produit l’autre. Elle peut invariablement résulter de relations causales inverses, de boucles de rétroaction bidirectionnelles ou de l’influence masquée de variables médiatrices exogènes non mesurées.
12.3 Synthèse des pièges fréquents et recommandations finales
Au terme de cette exploration exhaustive, il convient de récapituler les anomalies analytiques récurrentes dont l’analyste doit impérativement se prémunir dans sa pratique quotidienne du calcul de matrices de corrélation en Python. Le premier piège réside dans le redoutable paradoxe de Simpson, dans lequel l’agrégation globale de données issues de sous-populations hétérogènes fait émerger une corrélation globale d’un signe donné, alors même que l’analyse désagrégée au sein de chaque sous-groupe révèle une relation d’un signe rigoureusement inverse. L’inspection préalable de sous-groupes démographiques constitue l’unique parade face à cette illusion d’optique statistique.
Le second danger tient à l’aveuglement face aux relations curvilignes induit par l’emploi non critique du coefficient de Pearson. Deux variables unies par une relation quadratique exacte de type parabolique (Y = X²) centré sur zéro afficheront une corrélation de Pearson rigoureusement égale à zéro, masquant une dépendance pourtant totale et déterministe. Le recours systématique aux tracés exploratoires de nuages de points univariés (au moyen de sns.pairplot()) demeure le garant incontournable de la conformité du modèle aux hypothèses de linéarité requises.
Enfin, nous suggérons d’adopter le protocole de vérification formelle suivant préalablement à toute dissémination finale de résultats corrélationnels calculés sous Python :
- Vérification formelle du format numérique continu strict des colonnes ingérées (exclusion systématique des identifiants et des codes textuels).
- Contrôle distributionnel de l’asymétrie et de l’aplatissement, avec choix justifié d’une alternative non paramétrique (Spearman ou Kendall) le cas échéant.
- Détection multidimensionnelle et traitement documenté des valeurs aberrantes univariées et multivariées.
- Explicitation méthodique du traitement des données manquantes (par liste ou par paire avec verrouillage strict du paramètre
min_periods). - Calcul des probabilités critiques associées et application obligatoire d’une correction pour comparaisons multiples (Bonferroni ou Benjamini-Hochberg).
- Rendu visuel reposant exclusivement sur une palette chromatique divergente, centrée sur 0 et bornée strictement de -1 à +1, avec occultation de la redondance triangulaire.
- Consignation des résultats respectant rigoureusement les normes de publication internationales, incluant degrés de liberté, intervalles de confiance et mise en garde explicite contre toute extrapolation causale indue.
Références
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-003
- Pearson, K. (1895). VII. Mathematical contributions to the theory of evolution.—III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. John Wiley & Sons. https://doi.org/10.1002/9780470316696
- Vallat, R. (2018). Pingouin: statistics in Python. Journal of Open Source Software, 3(31), 1026. https://doi.org/10.21105/joss.01026
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021